
تمثل إدارة البيانات وتحليلها في جداول البيانات ركيزة محورية في البحث العلمي التطبيقي، والتحليل الإحصائي، وإدارة الأعمال المعاصرة. ومن بين الأدوات المتعددة التي يقدمها برنامج مايكروسوفت إكسيل (Microsoft Excel)، تبرز أداة “التصفية المتقدمة” (Advanced Filter) بوصفها واحدة من أقوى الآليات الهندسية وأكثرها مرونة لمعالجة البيانات المعقدة واستخلاص المعلومات الدقيقة. ورغم بساطة واجهة الاستخدام الظاهرة، فإن البنية التحتية لهذه الأداة ترتكز على مبادئ الجبر البولياني ونظرية المجموعات، مما يمنح المحلل قدرة فائقة على تفكيك مصفوفات البيانات الكبيرة وفق شروط منطقية صارمة ودقيقة للغاية.
تكمن إحدى أبرز المعضلات التحليلية في تصفية البيانات استناداً إلى معايير متعددة متزامنة أو متبادلة ضمن بُعد تصنيفي أو عمود واحد. ففي حين توفر التصفية التلقائية القياسية (AutoFilter) حلولاً سريعة وبديهية، فإنها غالباً ما تقف عاجزة عند الحاجة إلى تطبيق بنى شرطية مركبة تجمع بين المجالات العددية المغلقة، والمطابقات النصية الجزئية المعقدة، والفئات غير المتصلة في آن واحد. وهنا تظهر التصفية المتقدمة كحل منهجي يعتمد على عزل نطاق الشروط، مما يحول كراسة العمل من مجرد جدول إلكتروني إلى محرك استعلام شبه علائقي يتمتع بقدرات استثنائية على تكرار العمليات البرمجية وضمان اتساقها العلمي.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك منهجي وتطبيقي معمق لآليات عمل التصفية المتقدمة بمعايير متعددة في عمود واحد داخل بيئة إكسيل. سنستعرض الأسس النظرية والهندسية للأداة منذ نشأتها الأولى، والنمذجة الرياضية لعلاقات المنطق الجمعي (AND) والمنطق البديل (OR)، مع تفصيل الإجراءات العملية الدقيقة، وتوظيف المحارف البديلة، واستخراج التسجيلات الفريدة، وصولاً إلى الأتمتة الكاملة باستخدام لغة الفيجوال بيسك للتطبيقات (VBA). كما سنناقش التطبيقات الواقعية في مجالات قياس العلوم السلوكية والإحصاء الحيوي، مع تسليط الضوء على أبرز الأخطاء الشائعة وسبل تلافيها وفق أعلى معايير الجودة المنهجية المتبعة في بحوث معالجة البيانات.
1. الأسس النظرية لأداة التصفية المتقدمة في برنامج إكسيل وتمايزها عن التصفية التلقائية
1.1 المفهوم البنيوي للتصفية المتقدمة (Advanced Filter)
تعود الجذور التاريخية لأداة التصفية المتقدمة في برنامج إكسيل إلى إصدار Microsoft Excel 5.0 الذي أُطلق في عام 1993 بواسطة شركة مايكروسوفت؛ حيث قُدمت هذه الخاصية لتتيح للمستخدمين استخراج مجموعات فرعية من قواعد البيانات المسطحة (Flat Databases) وفق معايير شرطية معقدة تتجاوز قيود الواجهات القائمة على القوائم المنسدلة. من الناحية الهندسية، تعتمد أداة التصفية القياسية (AutoFilter) على فحص مرئي مباشر يقوم فيه المستخدم بتحديد القيم يدوياً أو بناء جمل شرطية محدودة عبر مربعات الحوار البسيطة. في المقابل، تقوم التصفية المتقدمة على مبدأ المعمارية المنفصلة؛ إذ تفصل فصلاً تاماً بين ثلاثة مكونات هيكلية رئيسية: نطاق القائمة الأساسية (List Range)، ونطاق المعايير المنفصل (Criteria Range)، ونطاق استخراج المخرجات المستهدفة (Copy To Range).
يتيح هذا الفصل البنيوي للمحلل الرياضي أو الإحصائي بناء نماذج استعلام مستدامة يمكن إعادة استخدامها والرجوع إليها دون التأثير المباشر على هيكلية الجدول الأصلي. كما تدعم الأداة طبيعتين مختلفتين من المخرجات: إما الفلترة في نفس الموقع (In-Place) عن طريق إخفاء الصفوف غير المطابقة للشروط برمجياً، أو النسخ الفيزيائي التام للسجلات المطابقة إلى موضع مستقل تماماً (Copy to another location). تتميز هذه المعمارية بقدرة استيعابية فائقة لمعالجة مجموعات البيانات الضخمة التي قد تتضمن مئات الآلاف من الصفوف، متفوقة على المعالجات اليدوية وموفرة بيئة عمل خالية من الأخطاء التكرارية التي تصاحب عادة التعديل المباشر على البيانات الأولية.
1.2 متطلبات إعداد مصفوفة البيانات الأولية
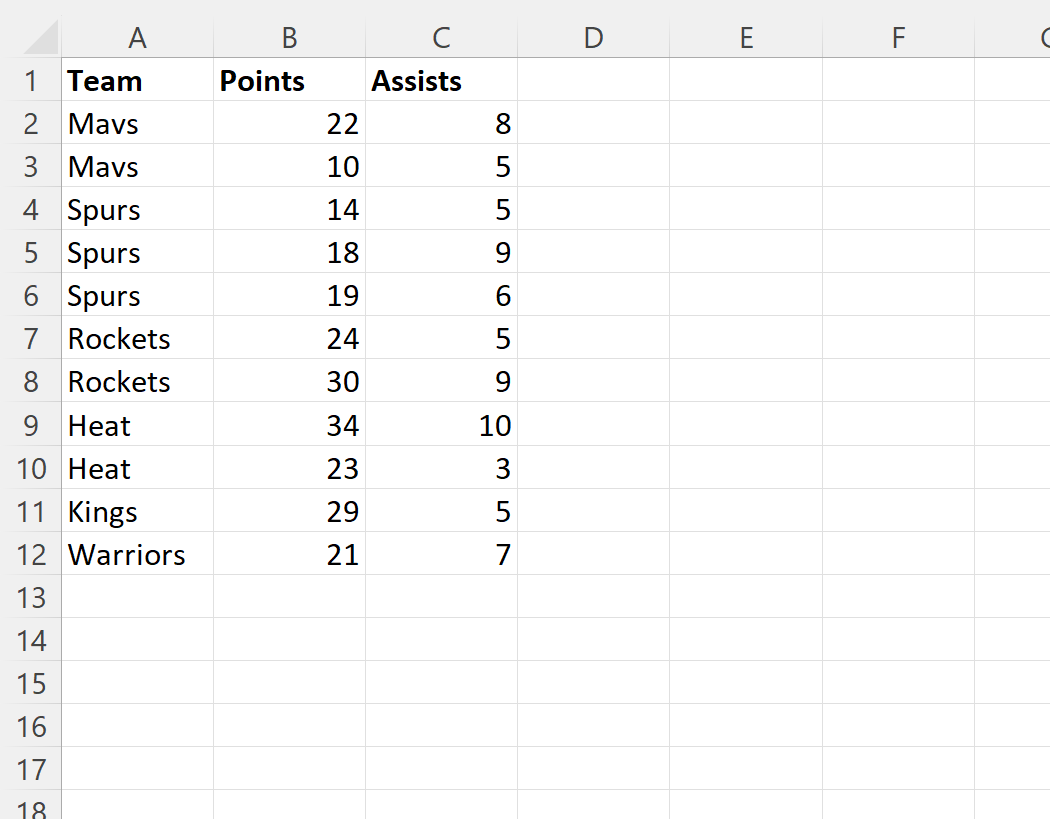
تتطلب التصفية المتقدمة انضباطاً منهجياً صارماً في إعداد وتجهيز مصفوفة البيانات الأولية لضمان عمل محرك التصفية بكفاءة مطلقة ودون أخطاء خفية. أولى هذه القواعد الحتمية هي التطابق الحرفي التام بين ترويسات الأعمدة (Headers) في نطاق القائمة الأصلي وترويسات نطاق المعايير. يجب أن تتطابق التسميات حتى على مستوى البايت والمحارف غير المرئية، إذ إن وجود مسافة إضافية غير مقصودة في نهاية اسم العمود في أحد النطاقين سيؤدي حتماً إلى إخفاق المحرك في الربط المنطقي بين المعيار والعمود المستهدف، مما يسفر عن مخرجات فارغة أو استرجاع كامل السجلات دون تصفية.
علاوة على ذلك، يستوجب التصميم الهندسي السليم تجنب دمج الخلايا (Merged Cells) نهائياً داخل نطاق البيانات أو نطاق المعايير؛ فالخلايا المدمجة تؤدي إلى تكسير البنية الفهرسية المرجعية للخلايا، مما يربك خوارزمية البحث المضمنة. كما ينبغي تجنب وجود صفوف أو أعمدة فارغة تتخلل البيانات؛ لأن البرنامج قد يفسر الفراغ المفاجئ كحد نهائي لمصفوفة البيانات (Table Boundary). وأخيراً، يجب توحيد النوع النمطي للبيانات في العمود الواحد؛ بحيث لا تختلط القيم الرقمية المخزنة كنصوص بالأرقام الصافية، ولا تتباين صياغات التواريخ بين الأنماط المحلية المختلفة، لضمان استجابة رياضية دقيقة لمعاملات الفرز والمقارنة.
1.3 القيمة المنهجية لتطبيق معايير متعددة في عمود واحد
تتجلى القيمة المنهجية للتصفية المتقدمة عند الحاجة إلى استكشاف أبعاد ظاهرة معينة تتطلب عزل فئات محددة متعددة ضمن نفس المتغير التصنيفي أو العددي. في العديد من الدراسات التحليلية، لا يبحث الباحث عن قيمة منفردة، بل يسعى إلى استخلاص مستويات متعددة متباينة، كعزل مجموعتين تجريبيتين من بين خمس مجموعات دراسية، أو تحديد المشاركين الذين تقع درجاتهم ضمن مجالين منفصلين من مقياس مستمر. توفر التصفية المتقدمة في عمود واحد حلاً رياضياً أنيقاً يغني عن اللجوء إلى أعمدة المساعدة المرهقة (Helper Columns) أو كتابة معادلات منطقية شديدة التعقيد والتداخل.
إن تقليل الاعتماد على الدوال الحسابية الثقيلة يسهم بصورة مباشرة في رفع كفاءة الحوسبة وسرعة استجابة الملفات، لا سيما في البيئات البحثية التي تتعامل مع بيانات مكثفة. يدعم هذا النهج اتخاذ القرارات القائمة على الأدلة؛ إذ يتيح للباحث عزل المتغيرات المحددة بدقة متناهية وفحصها بصورة معزولة عن المتغيرات المشوشة (Confounding Variables). يسمح هذا التجريد المنهجي بالتحقق من الفرضيات العلمية ومراجعة عينات البيانات وتوثيق معايير الاستخراج بخطوات مقننة وقابلة للتكرار العلمي، وهو معيار جوهري في رصانة البحوث التجريبية والوصفية المعاصرة.
2. البنية الرياضية والمنطقية لصياغة المعايير: التمييز بين المنطقين البوليانيين (AND و OR)
2.1 التمثيل الرياضي للمنطق البديل (OR Logic)
يرتكز المنطق البديل (Disjunction / OR Logic) في نظرية المجموعات على مفهوم الاتحاد (Union)؛ حيث تكون النتيجة صحيحة (True) إذا تحقق على الأقل أحد الشروط المطروحة. في سياق تصفية عمود واحد في إكسيل، يعني هذا رغبة المحلل في استرجاع كافة السجلات التي تحتوي على القيمة الأولى، أو القيمة الثانية، أو أية قيم إضافية مدرجة ضمن المعايير. تُترجم هذه العلاقة الرياضية داخل أداة التصفية المتقدمة من خلال التوزيع الرأسي للمعايير؛ أي كتابة ترويسة العمود المستهدف مرة واحدة، ثم رص القيم والشروط المطلوبة في صفوف متتالية ومستقلة تقع رأسياً أسفل تلك الترويسة مباشرة.
عند تنفيذ هذه الهيكلية، يقرأ محرك التصفية في إكسيل نطاق المعايير كدالة منطقية تسير عمودياً وفق الصياغة الجبرية التالية: الشرط في الصف الأول $lor$ الشرط في الصف الثاني $lor$ الشرط في الصف الثالث. يقوم المحرك بفحص كل سجل في جدول البيانات على حدة، فإذا تطابقت قيمة العمود مع أي صف من صفوف المعايير الرأسية، يتم تمرير السجل إلى مصفوفة المخرجات المقبولة فوراً، ويتم تجاهل باقي الشروط لهذا السجل تجنباً لإهدار الطاقة المعالجة. يمثل هذا التوزيع الرأسي حجر الزاوية في استخراج التصنيفات النوعية المتعددة دون إجهاد بنية البيانات.
2.2 التمثيل الرياضي للمنطق الجمعي (AND Logic)
في المقابل، يستند المنطق الجمعي (Conjunction / AND Logic) إلى مفهوم التقاطع الرياضي (Intersection) بين المجموعات؛ حيث يشترط لإقرار صحة السجل (Record Validity) أن يستوفي كافة القيود المفروضة في آن واحد ودون أي استثناء. عند الرغبة في تطبيق هذا المنطق الصارم على عمود واحد، كأن نرغب في تحديد الأرقام المحصورة بين حد أدنى وحد أقصى (مثلاً: الدرجة أكبر من 50 وأقل من 80)، تنشأ ضرورة هندسية لتكرار ترويسة العمود أفقياً في أعمدة متجاورة وملاصقة ضمن صف العناوين في نطاق المعايير.
تتم كتابة الشروط المتزامنة على نفس الصف أفقياً أسفل الترويسات المكررة. يفسر محرك إكسيل وجود شرطين في نفس الصف الأفقي بأنهما مرتبطان برابطة منطقية جمعية تتطلب التحقق المتزامن وفق الصيغة: الشرط في العمود الأول $land$ الشرط في العمود الثاني. فإذا أخفق السجل في تحقيق أحد المعيارين، يتم استبعاده كلياً من المخرجات حتى لو كان محققاً للمعيار الآخر بنجاح فائق. تتيح هذه الآلية حصر المجالات المغلقة وتقييد النطاقات المستهدفة بكفاءة برمجية متقدمة تضمن استبعاد أي قيمة تشذ عن النطاق المحدد سلفاً.
2.3 النمذجة التخطيطية لتفادي أخطاء التقاطع المنطقي
إن التطبيق العملي للجبر البولياني في جداول البيانات يتطلب حذراً شديداً من الوقوع في فخاخ التعارض المنطقي التي تقود إلى نتائج صفرية أو مخرجات مشوهة. من أبرز هذه الأخطاء الفادحة هو تضمين صف فارغ عرضي داخل نطاق المعايير؛ إذ يعتبر محرك إكسيل أي خلية فارغة بمثابة محرف بدل شامل (Wildcard) يقبل أي قيمة مهما كانت. وبناءً على منطق الفصل البديل (OR)، فإن وجود صف فارغ تماماً ضمن نطاق المعايير يؤدي إلى تفسير رياضي مفاده: “تحقق من الشروط المحددة أو اقبل أي شيء”، مما ينتج عنه استرجاع كامل مصفوفة البيانات وإلغاء فاعلية التصفية بالكامل.
كما يجب الحذر من الوقوع في التناقض الصريح عند صياغة المنطق الجمعي (AND) لنفس العمود؛ فكتابة ترويستين متجاورتين لنفس العمود النصي ووضع قيمتين نصيتين مختلفتين في نفس الصف الأفقي (مثل: المجموعة تساوي “أ” والمجموعة تساوي “ب”) سيجعل المحرك يبحث عن خلية واحدة تحمل في ذات الوقت قيمتين مختلفتين، وهو مستحيل منطقياً، مما يسفر حتماً عن جدول نتائج فارغ تماماً. يستلزم التخطيط الرشيد توثيق جدول المعايير والتأكد من توافق العلاقات المنطقية مع طبيعة المتغيرات لضمان سلامة الإجراءات الإحصائية اللاحقة كما هو موضح في الأدبيات المنهجية لتحليل النظم والبيانات (Christensen et al., 2018).
3. تطبيق المنطق البديل (OR) لتصفية القيم النصية المتعددة في عمود واحد
3.1 إعداد وتصميم نطاق المعايير الرأسي
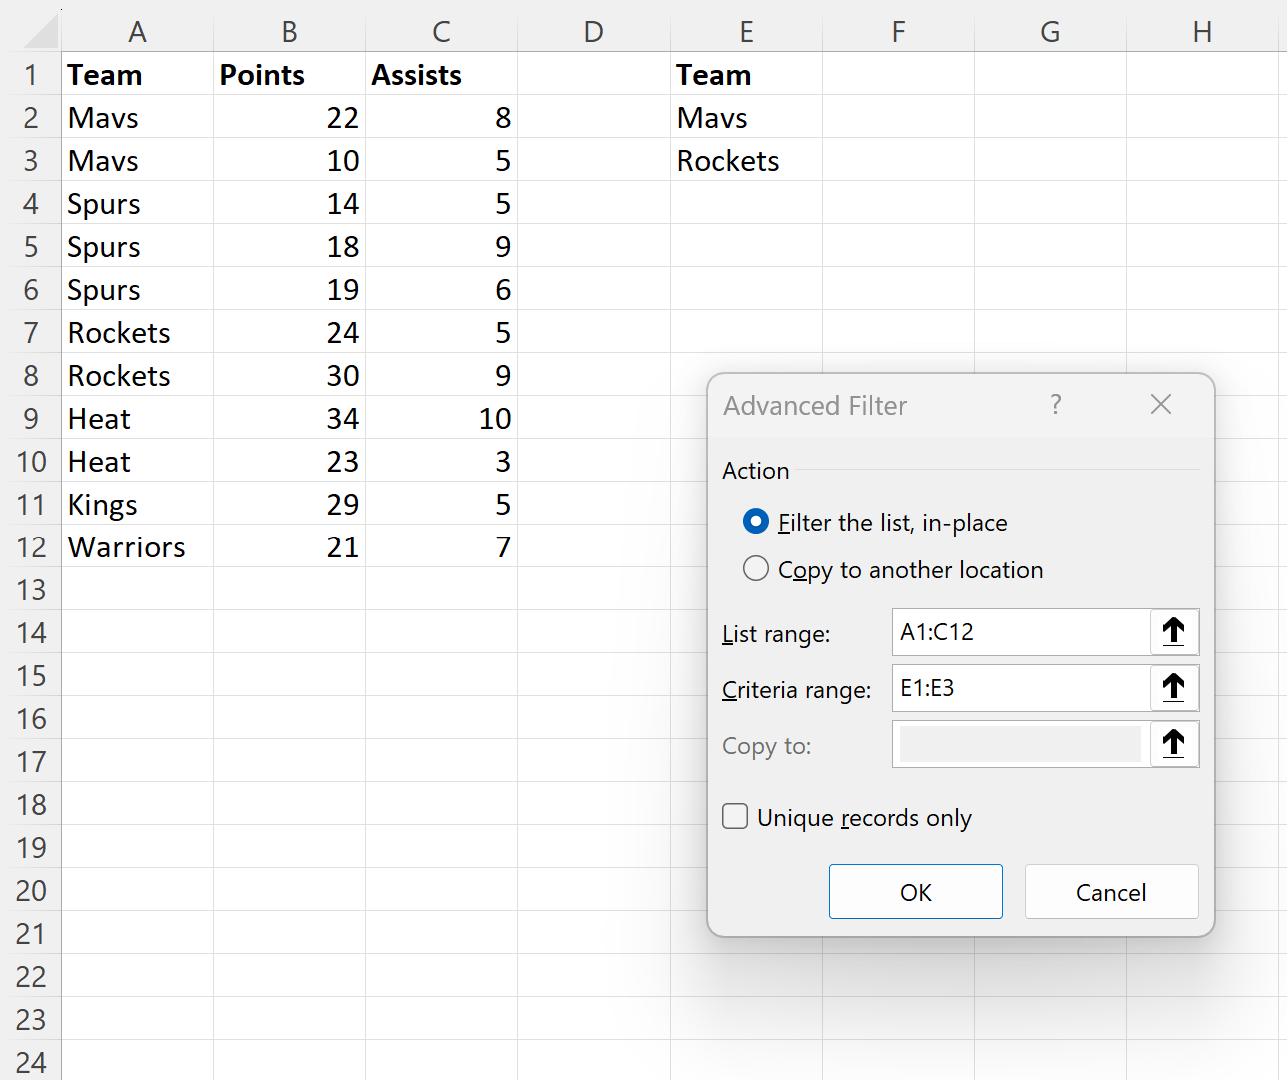
يبدأ التطبيق العملي للمنطق البديل (OR) باختيار موضع معزول ومناسب لإنشاء نطاق المعايير (Criteria Range) داخل ورقة العمل. يفضل دائماً وضع هذا النطاق في أعمدة تقع إلى يمين أو يسار الجدول الأصلي ويفصل بينهما عمود فارغ على الأقل، أو الأفضل من ذلك، وضعه في صفوف علوية تعلو الجدول الأساسي مع ترك صفوف فاصلة، وذلك لتجنب إخفاء نطاق المعايير نفسه عند اختيار الفلترة في نفس الموقع (In-Place). نقوم أولاً بنسخ ترويسة العمود المستهدف ولصقها بدقة حرفية في الخلية العليا من نطاق المعايير، ولتكن الخلية G1 على سبيل المثال.
عقب تحديد الترويسة، يتم إدراج القيم النصية المراد استخلاصها في الخلايا التي تليها مباشرة في نفس العمود، خلية تلو الأخرى (مثل G2 و G3). إذا أردنا تصفية سجلات المرضى لاستخراج المقبولين في عيادتي “الطب الباطني” و”طب الأعصاب”، نكتب هاتين الكلمتين في الخلايا الرأسية المتتابعة. ويجب هنا فحص النصوص بعناية فائقة للتأكد من خلوها من أية مسافات زائدة في البداية أو النهاية، والتأكد من مطابقة الرموز النحوية (مثل الهمزات والتاء المربوطة)؛ لأن عدم التطابق سيؤدي إلى تجاهل السجلات المقابلة وإسقاطها من العينة المفلترة.
3.2 خطوات التنفيذ الإجرائية عبر واجهة المستخدم
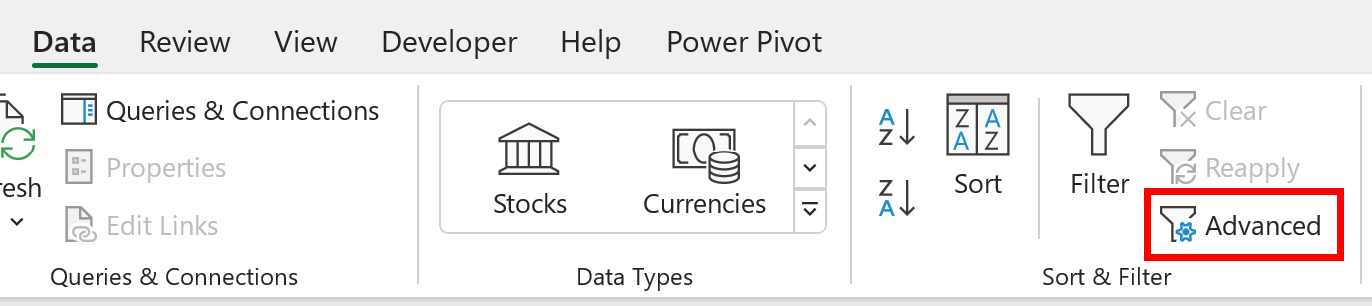
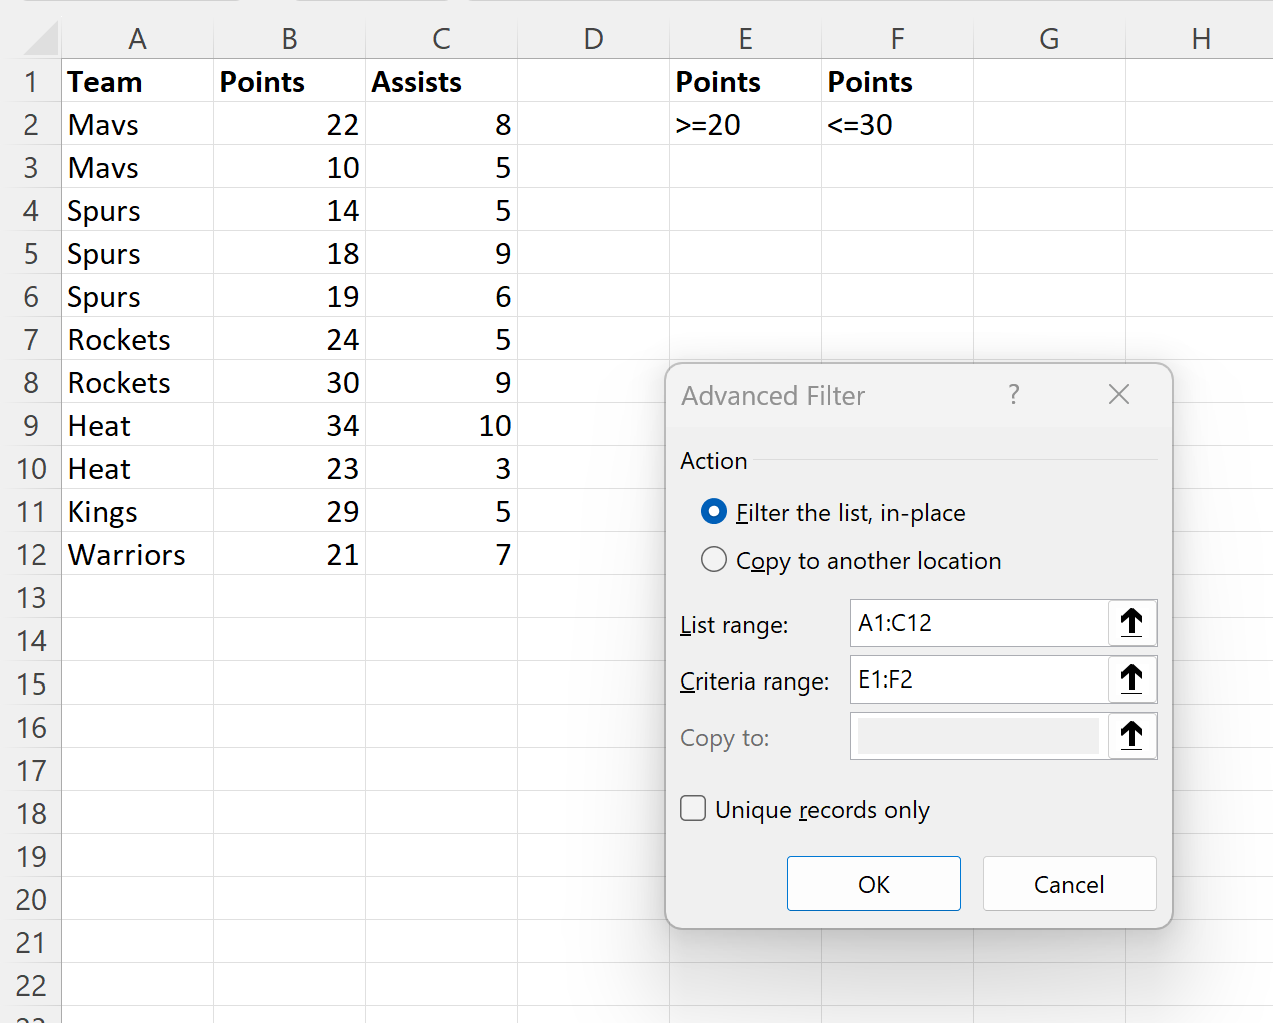
بعد إتمام بناء نطاق المعايير بدقة، ينتقل المستخدم إلى الواجهة التنفيذية لتطبيق الفلترة عبر اتباع الخطوات التقنية القياسية. يتم النقر أولاً داخل أي خلية ضمن نطاق البيانات الأصلي، ثم التوجه إلى شريط الأدوات العلوي واختيار تبويب “بيانات” (Data). ومن مجموعة “فرز وتصفية” (Sort & Filter)، يتم النقر على أيقونة “خيارات متقدمة” (Advanced) لفتح مربع الحوار المخصص للأداة. يحدد المستخدم في مربع الحوار الإجراء المطلوب، وليكن “تصفية القائمة في نفس الموقع” (Filter the list, in-place).
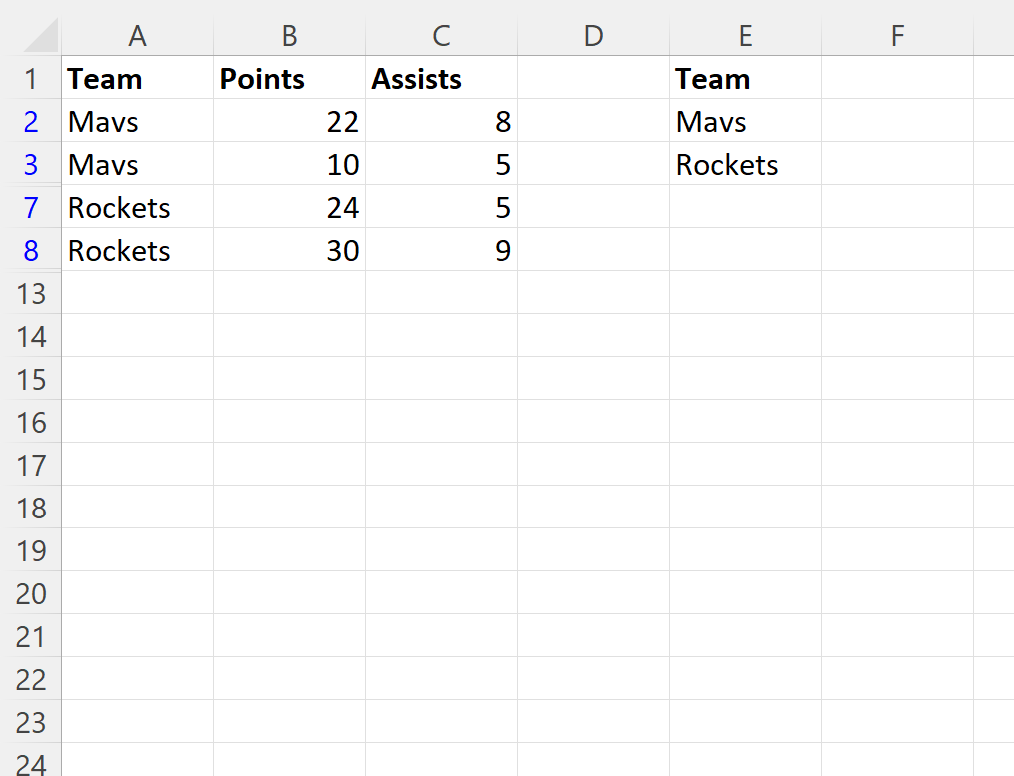
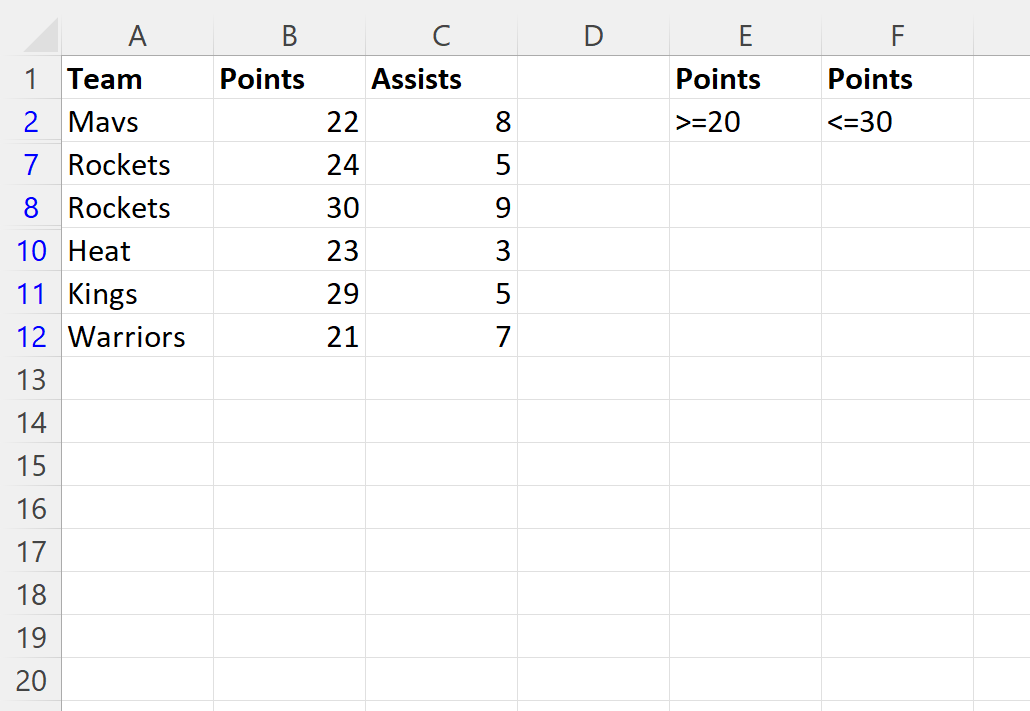
يقوم البرنامج غالباً بالتعرف التلقائي على “نطاق القائمة” (List Range)، ولكن يجب مراجعته للتأكد من شموله لكامل المصفوفة بدءاً من صف الترويسات وحتى آخر صف يحتوي على بيانات (مثل A1:D500). بعد ذلك، يوجه المؤشر إلى حقل “نطاق المعايير” (Criteria Range) ويتم تحديد النطاق الرأسي الذي تم إنشاؤه مسبقاً (مثل G1:G3). يُنصح بالتحقق التام من عدم تضمين أية خلايا إضافية فارغة أسفل النطاق. بالضغط على زر “موافق” (OK)، يقوم محرك إكسيل فوراً بإخفاء كافة الصفوف التي لا تنتمي تصنيفياً إلى إحدى الفئتين المذكورتين، مع إبراز أرقام الصفوف المطابقة باللون الأزرق كدلالة بصرية على تفعيل حالة التصفية النشطة.
3.3 دراسة تطبيقية: استخلاص فئات تصنيفية متعددة
لتجسيد هذا الإجراء في دراسة تطبيقية، نفترض وجود مصفوفة بيانات ضخمة ترصد استجابات دراسة مسحية متعددة المراكز تضم آلاف المفحوصين موزعين على مناطق جغرافية مختلفة، ونرغب في عزل عينة محددة تنتمي إلى فئتين جغرافيتين هما: “المنطقة الشمالية” و”المنطقة الجنوبية” حصراً ضمن عمود “المنطقة”. يتم تصميم نطاق المعايير برسم ترويسة “المنطقة” وتحتها القيمتان بشكل رأسي. بعد تشغيل التصفية المتقدمة، يُلاحظ أن خوارزمية البرنامج تعمل بسرعة فائقة تقاس بأجزاء من الثانية، حتى مع قواعد البيانات التي تقترب من الحدود القصوى للأداء التقليدي.
عند مقارنة النتائج المستخرجة بالقوائم المتوقعة إحصائياً، يتبين أن التطابق يصل إلى نسبة 100% دون تسجيل أي انحراف نوعي أو فقدان للبيانات الوصفية المصاحبة لكل مفحوص. إن كفاءة الاستجابة للبيانات الفئوية تمنح الباحثين في الدراسات الإنسانية واللغوية موثوقية عالية تماثل ما تؤكده المنهجيات المتقدمة في معالجة المدونات وتحليل المتغيرات الفئوية (Lozano, 2021)، حيث يغني هذا الأسلوب المنهجي عن التدخل اليدوي المعرض للخطأ البشري، مما يرسي قاعدة صلبة للتحليلات البارامترية واللابارامترية اللاحقة.
4. تطبيق المنطق الجمعي (AND) لتصفية المجالات الرقمية والفترات في عمود واحد
4.1 صياغة المعايير الأفقية باستخدام ترويسات مكررة
يستدعي حصر المتغيرات المستمرة ضمن فترات عددية محددة اعتماد بنية المنطق الجمعي المتزامن (AND). ولتحقيق ذلك في أداة التصفية المتقدمة لعمود واحد، يتم اللجوء إلى تقنية هندسية ذكية تتمثل في تكرار اسم العمود المستهدف في خليتين متجاورتين أفقياً ضمن صف الترويسة في نطاق المعايير. إذا كان العمود المستهدف يحمل عنوان “العمر”، نقوم بكتابة كلمة “العمر” في الخلية I1 ونكرر نفس الكلمة تماماً في الخلية J1. هذه الازدواجية الأفقية هي الشفرة البنيوية التي يفهم من خلالها إكسيل أن الشروط المكتوبة أدناهما يجب أن تطبق معاً وبالتزامن على نفس الخلية في كل سجل.
تتم بعد ذلك صياغة القيود الرقمية باستخدام معاملات المقارنة الرياضية القياسية المتاحة في برمجيات الجداول الحسابية: أكبر من (>)، أكبر من أو يساوي (>=)، أصغر من (<)، وأصغر من أو يساوي (<=). إذا كانت العينة المستهدفة تقتصر على الأفراد الذين تتراوح أعمارهم بين 20 و 30 عاماً ضمناً، نكتب في الخلية I2 المعيار الرياضي >=20، ونكتب في الخلية المجاورة J2 المعيار الرياضي <=30. يضمن هذا الترتيب الأفقي فحص القيمة العددية لكل مفحوص وإلزامها بالوقوع داخل المجال الرياضي المغلق الممتد بين النقطتين المرجعيتين.
4.2 التنفيذ التقني للتصفية المحصورة ضمن نطاق عددي
لإتمام التنفيذ التقني لهذه العملية، يتم استدعاء نافذة التصفية المتقدمة من تبويب “بيانات”، ثم تحديد نطاق القائمة الأصلي بدقة متناهية. في حقل “نطاق المعايير”، نقوم هذه المرة بتحديد النطاق الأفقي المكون من صفين وعمودين، وهو في مثالنا السابق يمثل النطاق المرجعي I1:J2. عند تأكيد العملية بالضغط على زر “موافق”، يقوم محرك التصفية بإخضاع كل قيمة عددية في عمود “العمر” للاختبار المنطقي المزدوج؛ حيث تفحص الخوارزمية تحقق الشرطين معاً عبر دالة تقييم داخلية تماثل عمل الدالة المنطقية =AND(Age >= 20, Age <= 30).
تستجيب السجلات التي تقع قيمتها بدقة داخل المجال بالظهور الفوري، بينما يتم حجب كافة السجلات الأخرى التي تنخفض عن القيمة 20 أو تزيد عن القيمة 30. ومن الضروري هنا فحص السجلات الواقعة على الحدود الحدية (Boundary Values)؛ فالمعامل >= يضمن اشتمال الرقم 20 ضمن النتائج، بينما استخدام المعامل الصارم > كان سيؤدي حتماً إلى استبعاد الأفراد البالغين من العمر عشرين عاماً بالتمام والكمال. يتطلب التدقيق العلمي وعياً تاماً بمدى تأثير هذه المعاملات على حجم العينة النهائية ودقة التحليل الإحصائي المترتب عليها.
4.3 تطبيقات القياس على متغيرات التشتت والنزعة المركزية
يمتد توظيف هذه الآلية الأفقية بفاعلية فائقة إلى التطبيقات المتقدمة في فحص جودة البيانات وحساب مقاييس النزعة المركزية والتشتت. ففي دراسات مراقبة الاستجابات الفسيولوجية والبيولوجية المعقدة، مثل قياسات تقلب معدل ضربات القلب أو مستويات اليقظة والانتباه (da Freitas et al., 2024)، يواجه الباحثون تحدي عزل القراءات الطبيعية عن التشويش البيئي والارتجاف العضلي. يمكن توظيف التصفية الجمعية لحصر المشاهدات الواقعة بدقة ضمن انحراف معياري واحد أو انحرافين حول المتوسط الحسابي ($\mu \pm 2\sigma$).
يتم ذلك بحساب الحدود الدنيا والقصوى المسموح بها رياضياً، وإدراجها ضمن نطاق المعايير الأفقي المزدوج لعزل السجلات التي تقع خارج هذا النطاق باعتبارها قيماً متطرفة (Outliers) أو أخطاء قياس ناتجة عن انزلاق المستشعرات. كما يفيد هذا الفحص في دراسة شكل التوزيع التكراري ومقارنة الخصائص الإحصائية للعينة المفلترة قبل وبعد استبعاد الأطراف المتطرفة. يسهم هذا الحصر العددي المنضبط في حماية النماذج الإحصائية التنبؤية من الانحياز، ويوفر أرضية متينة لإجراء اختبارات التباين والانحدار المتعدد بموثوقية علمية رفيعة المستوى.
5. توظيف المحارف البديلة (Wildcards) لتصفية النصوص المتعددة غير المتطابقة حرفياً
5.1 الخصائص الإجرائية للمحارف البديلة في إكسيل
توفر بيئة إكسيل مجموعة من الرموز الخاصة المعروفة بالمحارف البديلة (Wildcards)، والتي تمنح أداة التصفية المتقدمة مرونة استثنائية في التعامل مع البيانات النصية غير المتجانسة كلياً أو التي تشوبها اختلافات إملائية طفيفة. المحرف الأول والأكثر استخداماً هو علامة النجمة (*)، والتي تستخدم لتمثيل سلسلة نصية من المحارف ذات طول غير محدد، بما في ذلك الحالة التي لا يوجد فيها أي محرف (صفر من المحارف). على سبيل المثال، كتابة المعيار *أحمد* تعني استرجاع أية خلية تتضمن هذا الاسم في أي موقع، سواء كان في البداية، الوسط، أو النهاية.
المحرف الثاني هو علامة الاستفهام (?)، وهي مخصصة لمطابقة محرف فردي واحد فقط في موضع دقيق ومحدد داخل السلسلة النصية؛ فالمعيار س?د يطابق كلمات مثل “سعد” و”سيد”، ولكنه يستبعد قطعاً كلمة “سعيد” لتجاوزها عدد المحارف المحدد. أما المحرف الثالث فهو علامة التلدة (~)، ووظيفتها حيوية للغاية؛ إذ تستخدم لتحييد الخصائص الوظيفية للمحارف السابقة في حال كانت البيانات الأصلية تحتوي بالفعل على علامة نجمة أو استفهام حقيقية يراد البحث عنها حرفياً، حيث تُكتب العلامة مسبوقة بالتلدة (مثل ~*) لتوجيه المحرك للتعامل معها كنص مجرد.
5.2 دمج المحارف البديلة مع شروط المنطق البديل (OR)
تكتسب المحارف البديلة قوة مضاعفة عند دمجها في مصفوفة شروط رأسية لتطبيق المنطق البديل (OR) على عمود نصي واحد. يبرز هذا الاحتياج بوضوح عند التعامل مع قواعد البيانات الضخمة التي تحتوي على تباينات في إدخال المصطلحات، مثل تباين رسم الهمزات أو أخطاء الياء المهملة والألف المقصورة. يمكن للمحلل بناء نطاق معايير رأسي تحت ترويسة عمود “المسمى الوظيفي” يتضمن عدة صفوف مثل: *مدير* في الصف الأول، و*مشرف* في الصف الثاني، و*منسق* في الصف الثالث.
تتيح هذه المصفوفة الرأسية استخلاص كافة الكوادر الإشرافية والإدارية بصرف النظر عن السوابق أو اللواحق الملحقة بالمسمى (مثل “مساعد مدير عام”، “مدير تنفيذي”، “مشرف إقليمي”). يقرأ محرك التصفية المتقدمة هذه الشروط كعلاقة فصل منطقية مرنة، مسترجعاً كافة السجلات التي تلبي أياً من هذه الأنماط النصية. تسهم هذه المنهجية في تلافي فجوات إدخال البيانات الميدانية، وتوفر ساعات طويلة من أعمال التدقيق اليدوي وإعادة الترميز، مما يضمن معالجة متسقة للبيانات دون الإخلال بالمحتوى الدلالي للعينات المفحوصة.
5.3 الاستخدام المتقدم للمحارف في تصفية النصوص ذات البنية المركبة
في العديد من البيئات البحثية والمؤسسية، يتم تخزين البيانات في صيغة أكواد مشفرة ذات بنية هيكلية محددة مسبقاً، كما هو الحال في ترميز عينات الأبحاث الجينية أو المعرفية أو أرقام الاستبيانات الطولية المعقدة. يمكن هنا توظيف علامات الاستفهام المتتالية لإجراء تصفية فائقة الدقة تستند إلى طول الكود ومواقع مقاطعه الرمزية. إذا كانت الأكواد المسجلة في عمود “رمز المشارك” تتكون من حرفين متبوعين بثلاثة أرقام يعبر الرقم الأوسط فيها عن تصنيف الحالة العيادية، فإن كتابة معيار مثل ??-1?-* سيعزل حصرياً المشاركين المصنفين برقم 1 في ذلك الموضع المحدد.
وعلاوة على ذلك، يجب الانتباه إلى الفارق المنهجي الجوهري بين البحث عن نص عادي والمطابقة التامة. في إكسيل، كتابة القيمة أحمد دون علامات مساواة تُعامل افتراضياً وكأنها تبدأ بهذه الكلمة (Begins with). ولإلزام محرك التصفية المتقدمة بالمطابقة الحرفية الصارمة للخلية بأكملها دون السماح بوجود زوائد نصية، يتعين إدخال المعيار بصيغة نصية تعتمد إشارة المساواة، كأن يُكتب المعيار بالشكل: ="=أحمد". يمنع هذا التمييز إدراج سجلات غير مقصودة في المخرجات، ويعد ركيزة أساسية لضمان سلامة النماذج اللغوية والتصنيفية الدقيقة في الدراسات التطبيقية (Wesche & Paribakht, 2000).
6. إدارة المعايير المعقدة: الجمع بين المنطق المتزامن (AND) والبديل (OR) في نفس العمود
6.1 هندسة المصفوفات الشَرطية متعددة الأبعاد
تمثل المعايير المعقدة التي تدمج بين المنطق الجمعي (AND) والمنطق البديل (OR) في عمود واحد الذروة الهندسية لأداة التصفية المتقدمة. تنشأ هذه الحاجة التحليلية عندما يتعين على المحلل استخلاص فترات رقمية متقطعة أو غير متجاورة؛ كأن يُطلب استخراج كافة المشاهدات التي تتراوح درجاتها بين 10 و 20، أو تقع بين 80 و 90 في نفس الاختبار السيكومتري. إن محاولة تنفيذ هذا الإجراء عبر أدوات التصفية التقليدية تتطلب خطوات يدوية متكررة ومعقدة، في حين تقدم التصفية المتقدمة حلاً موحداً عبر هندسة مصفوفة شرطية ثنائية الأبعاد (2D Matrix Grid).
ترتكز هذه المصفوفة على الجمع بين التوسيع الأفقي والتوسيع الرأسي لنطاق المعايير في آن واحد. يقوم المحرك بمعالجة كل صف أفقي مستقل كوحدة منطقية جمعية (AND)، ثم يربط بين الصفوف المختلفة برابطة فصل منطقية بديلة (OR). تفكك الخوارزمية الداخلية لإكسيل هذه الشبكة وفق أولوية منطقية بوليانية صارمة: حيث تحسب قيمة الصواب لكل صف على حدة، وإذا حقق السجل شروط أي صف من الصفوف المتاحة بالكامل، يتم اعتماده فوراً ضمن النتائج. يتيح هذا التصميم للمحللين بناء استعلامات بالغة التطور تضاهي لغات الاستعلام البنيوية المتقدمة مثل SQL.
6.2 الخطوات التطبيقية لضبط المجالات العددية المتقطعة
لتطبيق استخلاص المجالات المتقطعة لعمود الدرجات، نقوم أولاً بإنشاء ترويستين متطابقتين أفقياً باسم “الدرجة” في الخليتين L1 و M1. في الصف الثاني مباشرة، نحدد الفترة الأولى عبر كتابة >=10 في الخلية L2 و <=20 في الخلية M2؛ وبذلك يكتمل تمثيل الفترة الصغرى كمنطق جمعي متزامن. ننتقل بعد ذلك إلى الصف الثالث، ونقوم بتحديد الفترة الثانية عبر كتابة >=80 في الخلية L3 و <=90 في الخلية M3 أسفل نفس الترويستين المكررتين تماماً.
يصبح نطاق المعايير الكلي هو الكتلة المستطيلة L1:M3. عند تشغيل التصفية المتقدمة وإدخال هذا النطاق، يقوم إكسيل بفحص كل سجل: هل الدرجة محصورة بين 10 و 20؟ إذا كانت الإجابة نعم، يُقبل السجل. وإذا كانت الإجابة لا، ينتقل المحرك فوراً لفحص الفرضية البديلة: هل الدرجة محصورة بين 80 و 90؟ إذا صحت، يُقبل السجل ويظهر في النتائج النهائية. تضمن هذه الآلية استيعاب كافة الفئات المتناثرة بدقة حسابية متناهية ودون أي تداخل أو إغفال للبيانات الهامشية، مما يمنح الباحثين كفاءة مطلقة في إدارة العينات متعددة المستويات.
6.3 اختبار اتساق البيانات والتحقق من صحة النتائج المنطقية
إن بناء مصفوفات شرطية معقدة يفرض على المحلل التحقق المنهجي المستمر من اتساق المخرجات وتوافقها مع محددات النظرية الإحصائية. بعد إتمام الفلترة، يجب استخدام دوال المراجعة مثل SUBTOTAL (باستخدام المعامل 102 لحساب التكرارات المرئية فقط أو 109 لحساب المجموع الصافي) للتأكد من أن حجم العينة المستخرجة يطابق رياضياً مجموع العينات المحسوبة عبر الصيغ المنفصلة مثل COUNTIFS. يقدم هذا التحقق المزدوج برهاناً رياضياً على عدم تسرب سجلات غير مستوفية للشروط إلى التحليل النهائي.
علاوة على ذلك، ينبغي مراجعة نسب التمثيل؛ حيث يساعد حساب نسبة العينة المفلترة إلى مجمل المجتمع الأصلي في رصد أي شذوذ منهجي غير متوقع قد ينجم عن أخطاء في كتابة معاملات المقارنة (مثل الخلط بين > و <). إن التوثيق المنهجي لشبكة الشروط ومعايير الفرز يسهم في تعزيز موثوقية الأبحاث العلمية، مما يتيح للفرق البحثية المستقلة إعادة إنتاج نفس النتائج بدقة مطلقة وفق مبادئ الشفافية والنزاهة الأكاديمية الراسخة في مناهج البحث العلمي المعاصر (Wyse & Bradbury, 2022).
7. تصفية السجلات الفريدة واستخراج البيانات دون المساس بالبيانات الأصلية
7.1 استخراج السجلات الفريدة فقط (Unique Records Only)
تحتوي نافذة التصفية المتقدمة في إكسيل على خيار تقني بالغ الأهمية يتمثل في مربع الاختيار “السجلات الفريدة فقط” (Unique records only). يتيح هذا الخيار تصفية البيانات واستبعاد السجلات المتكررة تماماً أثناء تطبيق المعايير المتعددة على العمود المستهدف. ومن الضروري هنا التمييز المنهجي الدقيق بين مفهوم إزالة القيم المكررة من عمود المعيار بحد ذاته، ومفهوم فحص السجل الكامل (Entire Row Record). فالأداة لا تنظر إلى تكرار القيمة في عمود الفلترة بمعزل عن باقي الأعمدة؛ بل تفحص الصف بأكمله عبر كافة حقوله لتقرير ما إذا كان السجل يمثل تكراراً متطابقاً لسجل سابق أم لا.
تكتسب هذه الميزة أهمية استثنائية عند تجميع البيانات من مصادر متعددة أو من أنظمة استجابة إلكترونية قد تسجل نقرات متعددة لنفس المشارك أو الحدث. من خلال تفعيل خيار السجلات الفريدة بالتزامن مع تطبيق المعايير المتعددة في عمود واحد، يحصل المحلل على مصفوفة بيانات نهائية مطهرة تماماً من الشوائب والتكرارات غير المقصودة. يضمن هذا الإجراء بناء أطر إحصائية صافية، ويحمي التحليلات المتقدمة من تضخم حجم العينة الزائف (Sample Inflation) الذي يقود إلى تشويه مستويات الدلالة الإحصائية وقيم الارتباط.
7.2 النسخ إلى موقع بديل (Copy to Another Location)
يوفر خيار “النسخ إلى موقع آخر” (Copy to another location) داخل أداة التصفية المتقدمة حماية جوهرية لأمن وتكامل البيانات الأصلية (Data Integrity). عند اختيار هذا النمط، تظل مصفوفة البيانات الخام ثابتة ومكتملة دون إخفاء أي صف من صفوفها، ويقوم إكسيل بإنشاء نسخة فيزيائية جديدة تتضمن حصرياً السجلات المطابقة للشروط المحددة، مما يقلل احتمالات الحذف العرضي أو التعديل الخاطئ أثناء التحليل.
ومع ذلك، تفرض بيئة إكسيل شرطاً برمجياً حازماً لتنفيذ هذا الإجراء بنجاح: يجب أن تبدأ عملية استدعاء وتشغيل أداة التصفية المتقدمة من داخل ورقة العمل المستهدفة كوجهة للمخرجات (Destination Sheet). إذا رغب المحلل في نسخ النتائج إلى “ورقة 2” انطلاقاً من بيانات موجودة في “ورقة 1″، فإن محاولة تشغيل الأداة أثناء تنشيط “ورقة 1” ستصطدم برسالة الخطأ الشهيرة: “لا يمكن نسخ البيانات إلا إلى الورقة النشطة”. لذا، يتعين فتح “ورقة 2” أولاً، ثم استدعاء نافذة التصفية المتقدمة منها، وتوجيه “نطاق القائمة” إلى “ورقة 1″، مما يسمح بالنسخ السلس والآمن إلى الموقع الجديد دون أي عوائق برمجية.
7.3 الاستخراج الانتقائي لحقول محددة مسبقاً
من الميزات الخفية شديدة القوة في أداة التصفية المتقدمة إمكانية استخراج مخرجات انتقائية لا تشمل كافة أعمدة الجدول الأصلي، بل تقتصر على حقول محددة مسبقاً تلبي متطلبات تقرير نوعي معين. لتحقيق ذلك، يقوم المحلل بنسخ الترويسات الخاصة بالأعمدة المطلوبة فقط (مثلاً: “الاسم” و”النتيجة النهائية”) ولصقها جنباً إلى جنب في الموضع المستهدف لاستقبال البيانات المستخرجة في ورقة العمل.
عند فتح نافذة التصفية المتقدمة وتحديد خيار النسخ إلى موقع آخر، يوجه المستخدم حقل “النسخ إلى” (Copy to) ليشمل نطاق ترويسات الأعمدة المنتقاة تحديداً (مثل P1:Q1). يقرأ محرك إكسيل هذه الترويسات كأمر هندسي يقضي بنقل البيانات التابعة لهذه الحقول فقط وتجاهل باقي الأعمدة الموجودة في الجدول الأصلي بالكامل. يسهم هذا التقليص البُعدي الانتقائي في تبسيط العرض النهائي، وحماية البيانات السرية أو غير ذات الصلة من الظهور في التقارير المرفوعة، مع تحسين كفاءة استهلاك الذاكرة وتسهيل قراءة النتائج الإحصائية وتفسيرها.
8. أتمتة التصفية المتقدمة لعمود واحد عبر وحدات الماكرو ولغة VBA
8.1 تسجيل الماكرو التلقائي وتحليل الكود الناتج
تمثل أتمتة الإجراءات المتكررة خطوة حيوية لرفع كفاءة العمليات التحليلية وضمان خلوها من الأخطاء التشغيلية. يتيح برنامج إكسيل تسجيل خطوات التصفية المتقدمة تلقائياً عبر مسجل الماكرو (Macro Recorder) للوقوف على التكوين البرمجي الذي يحكم الأداة. عند فحص الكود المتولد داخل بيئة التطوير (Visual Basic Editor – VBA)، نجد أن العملية بأكملها تتمحور حول استدعاء الدالة الكائنية AdvancedFilter التابعة لفئة النطاق (Range).
تستند هذه الدالة البرمجية إلى أربعة معاملات أساسية تحدد مسار المعالجة بدقة متناهية: المعامل Action (والذي يأخذ القيمة الثابتة xlFilterInPlace للفلترة في نفس الموضع أو xlFilterCopy للنسخ إلى موضع مستقل)، والمعامل CriteriaRange (وهو كائن نطاق يحدد موضع جدول الشروط)، والمعامل CopyToRange (الذي يحدد الوجهة في حال النسخ)، وأخيراً المعامل المنطقي Unique (الذي يأخذ القيمة True لتصفية السجلات الفريدة أو False للاحتفاظ بكافة السجلات). يوضح المقتطف البرمجي التالي الهيكل الأساسي للأمر التلقائي دون تعقيد:
Range("A1:D500").AdvancedFilter Action:=xlFilterInPlace, CriteriaRange:=Range("G1:G3"), Unique:=False
8.2 كتابة تعليمات برمجية ديناميكية لتعديل المعايير آلياً
على الرغم من فائدة التسجيل التلقائي، إلا أن الأكواد المسجلة تعاني من الجمود ومحدودية النطاقات الثابتة (Hardcoded Ranges). لتحويل هذه العملية إلى نظام ديناميكي متطور يتكيف تلقائياً مع تمدد أو انكماش البيانات، يتم كتابة تعليمات برمجية مخصصة تستخدم خاصية CurrentRegion لتحديد نطاق البيانات الأصلي ونطاق المعايير برمجياً وبشكل مرن للغاية، مما يضمن استيعاب أية صفوف مضافة دون الحاجة لإعادة ضبط الكود يدوياً في كل مرة.
علاوة على ذلك، يمكن ربط تنفيذ هذا الإجراء بالأحداث التلقائية لورقة العمل عبر حدث Worksheet_Change؛ بحيث يراقب الماكرو نطاق خلايا المعايير، وبمجرد قيام المستخدم بتعديل أي معيار أو كتابة قيمة تصنيفية جديدة في عمود الشروط، يتم إطلاق دالة التصفية فوراً وبشكل لحظي. يحول هذا الربط التفاعلي جداول إكسيل التقليدية إلى لوحات تحكم متقدمة وديناميكية (Interactive Dashboards) تلبي متطلبات التحليل الاستكشافي السريع وتمكن صناع القرار من رؤية استجابة البيانات الفورية للسيناريوهات المختلفة.
8.3 بناء واجهات تفاعلية لتشغيل التصفية بضغطة زر
لتعزيز تجربة المستخدم وتمكين غير المتخصصين في البرمجة من تشغيل الاستعلامات المعقدة، يتم تصميم واجهات تفاعلية مبسطة داخل ورقة العمل. يمكن تحقيق ذلك من خلال إدراج أزرار التحكم بالنماذج (Form Controls) أو أشكال رسومية مخصصة، وتسميتها بوضوح مثل “تطبيق الفلترة المتقدمة” وتعيين ماكرو التصفية البرمجي إليها بحيث تُنفذ العملية بضغطة زر واحدة.
وبالمثل، تقتضي قواعد التصميم البرمجي الرصين إضافة زر ملازم يخصص لإلغاء التصفية وإعادة إظهار كافة السجلات المجدولة؛ ويتم ذلك برمجياً من خلال استدعاء الإجراء البسيط ActiveSheet.ShowAllData. ولمنع توقف النظام البرمجي وإظهار رسائل خطأ للمستخدم في حال الضغط على زر الإلغاء بينما البيانات غير مفلترة أصلاً، يتم تضمين معالجات الأخطاء المسبقة عبر التعليمة البرمجية On Error Resume Next أو التحقق الشرطي باستخدام If ActiveSheet.FilterMode Then ActiveSheet.ShowAllData. يضمن هذا البناء المحكم تشغيلاً انسيابياً ومستقراً للنظام التحليلي تحت مختلف ظروف الاستخدام اليومي.
9. الأخطاء الشائعة واستكشاف المشكلات وإصلاحها في التصفية المتقدمة
9.1 أخطاء نطاق المعايير والمسافات غير المرئية
تعد المسافات البادئة أو اللاحقة غير المرئية من أكثر الأسباب شيوعاً لإخفاق التصفية المتقدمة في إكسيل بصورة صامتة (Silent Failures)؛ حيث لا تظهر أية رسائل تحذيرية ولكن النتائج تأتي فارغة تماماً. يحدث هذا عندما تتضمن خلية الترويسة أو القيم المدخلة في نطاق المعايير مسافة فارغة إضافية ناتجة عن الطباعة السريعة (مثل "المجموعة " بدلاً من "المجموعة"). يرى محرك إكسيل هاتين القيمتين كنصوص متباينة تماماً على المستوى الثنائي، مما يؤدي إلى فشل مطابقة المعيار مع العمود المقابل في مصفوفة البيانات.
ولمعالجة هذه المعضلة المنهجية، ينبغي إخضاع البيانات الأولية ونطاقات الشروط لعمليات التنظيف الآلي باستخدام الدالتين TRIM لحذف المسافات الزائدة و CLEAN لإزالة أية محارف غير قابلة للطباعة ناتجة عن التصدير من قواعد بيانات خارجية. كما تجب مراجعة النطاق المرجعي المحدد في مربع الحوار بعناية فائقة لتفادي إدراج صف فارغ في نهاية نطاق المعايير بطريق الخطأ، وهو الخطأ الذي أشرنا سابقاً إلى أنه يعطل وظيفة الفرز المنطقي تماماً ويجعل الأداة تعيد إظهار كامل البيانات دون تصفية.
9.2 مشاكل تنسيق وتصنيف البيانات في العمود المستهدف
تبرز إشكالية تقنية كبرى أخرى تتعلق بتعارض التنسيقات الداخلية للبيانات (Data Types Conflict)؛ لا سيما عند تخزين الأرقام كنصوص أو العكس داخل عمود المعيار المستهدف. إذا كانت أرقام الاستبيان مسجلة كنصوص في الجدول الأصلي بينما تمت صياغة المعايير العددية كقيم رقمية صريحة (مثل >100)، فإن محرك المقارنة الرياضي سيعجز عن إجراء العملية الترتيبية بصورة سليمة، مما يؤدي إلى استبعاد غير مبرر لسجلات مؤهلة رياضياً.
تتفاقم هذه المشكلة بصورة خاصة في حقول التواريخ نتيجة الاختلاف الشائع بين تنسيقات التواريخ المحلية؛ كالتضارب بين النسق الأمريكي (شهر/يوم/سنة) والنسق البريطاني المتبع غالباً (يوم/شهر/سنة). لعلاج هذه التشوهات، يُنصح باستخدام أداة “النص إلى أعمدة” (Text to Columns) لإعادة توحيد النسق وتعيين التنسيق الحقيقي للعمود، أو صياغة معايير الفترات الزمنية عبر الدالة الصريحة DATE(YYYY, MM, DD) لضمان استجابة محرك الفرز الداخلي بدقة رياضية تتجاوز الإعدادات الإقليمية لنظام التشغيل.
9.3 مشكلات مسار النسخ ونطاق المخرجات المتقاطع
يواجه العديد من المحللين رسالة الخطأ المتكررة: “لا يمكن نسخ البيانات إلا إلى الورقة النشطة”، وهي معضلة برمجية يرجع أصلها إلى القيود الهيكلية التي فرضتها مايكروسوفت على واجهة الأداة منذ إصداراتها الأولى. وكما تم تفصيله في القسم السابع، فإن حل هذه المشكلة يكمن حصرياً في الانطلاق المنهجي الصحيح: فتح وتنشيط الورقة المستهدفة أولاً، ثم استدعاء أمر التصفية من داخلها وتوجيه مسارات النطاقات نحو الورقة المصدرية الحاضنة للبيانات.
وعلاوة على ذلك، يجب توخي الحذر الشديد لمنع حدوث أي تقاطع مكاني أو تداخل بين نطاق البيانات المصدر، ونطاق المعايير، ونطاق استخراج المخرجات. إذا تم توجيه نطاق النسخ إلى موضع يتقاطع مع صفوف أو أعمدة الجدول الأصلي، فإن العملية قد تتسبب في الكتابة الفوقية على البيانات الأولية وتدميرها، أو الدخول في حلقة استدعاء مرجعية تمنع اكتمال الإجراء البرمجي. يقتضي التخطيط التحليلي السليم حجز مساحات جغرافية واضحة ومستقلة لكل نطاق لضمان انسيابية تدفق البيانات وسلامتها الفيزيائية.
10. دراسات حالة تطبيقية: معالجة بيانات القياس النفسي والسلوكي باستخدام التصفية المتقدمة
10.1 تصفية عينات الاستجابة السلوكية بناءً على مقاييس ليكرت المتعددة
في بحوث القياس النفسي والسلوكي، يمثل تحليل البيانات المستخلصة من مقاييس ليكرت (Likert Scales) المتدرجة تحدياً منهجياً متكرراً؛ خاصة عند الرغبة في عزل وتحليل الفئات التي تتبنى مواقف استجابية حدية أو متطرفة. لنفترض أن باحثاً يعكف على دراسة أنماط الضغوط النفسية لدى عينة عيادية باستخدام مقياس سباعي التدريج، ويرغب في عزل المستجيبين الذين يقعون في أقصى أطراف التوزيع؛ أي الذين اختاروا استجابة “أوافق بشدة” أو استجابة “أرفض بشدة” حصراً في عمود الاستجابة الخاص بأحد الأسئلة الجوهرية، وذلك لفحص سماتهم الشخصية بشكل مستقل.
يتم تحقيق هذا الهدف المنهجي عبر بناء نطاق معايير يعتمد المنطق البديل (OR) في عمود واحد؛ حيث توضع ترويسة المتغير السلوكي، وتُسرد الفئتان المستهدفتان رأسياً في صفين متتابعين. بعد تشغيل التصفية المتقدمة، يتم استخلاص الأفراد المنتمين لهذه الاستجابات المتطرفة بكفاءة متناهية، مما يتيح حساب مقاييس التشتت وعزل التباين الحقيقي عن التباين العشوائي. يسهم هذا الإجراء في تسريع عمليات الفرز العيادي ومقارنة سمات المجموعات الحدية بالمجتمع الكلي للعينة، مما يوفر أرضية تجريبية متينة لدراسة ديناميكيات السمات والحالات النفسية المعقدة في سياقات العلاج والتقييم السلوكي (Schöller et al., 2018).
10.2 حصر درجات القلق والاكتئاب ضمن مجالات معيارية في مقياس واحد
تتطلب العديد من البروتوكولات التجريبية في أبحاث الصحة النفسية والطب السلوكي اختيار مشاركين يظهرون مستويات معتدلة أو متوسطة من سمة نفسية مقاسة، مع استبعاد الحالات السوية تماماً أو الحالات شديدة التأثر لتفادي التأثيرات السقفية والأرضية (Ceiling and Floor Effects). في هذه الحالة، يتم الاعتماد على الدرجات المعيارية المحولة (Z-scores أو T-scores) لدرجات مقياس القلق أو الاكتئاب المسجلة في عمود رقمي مستمر.
يقوم الباحث بتطبيق المنطق الجمعي (AND) عبر تكرار ترويسة عمود الدرجة المعيارية أفقياً في نطاق المعايير، وتحديد المجال المستهدف؛ كأن تُحصر الدرجات بين $+1.0$ و $+2.0$ انحراف معياري فوق المتوسط (صياغة الشروط: >=1.0 و <=2.0). تضمن التصفية المتقدمة هنا عزل الشريحة العيادية المطلوبة بدقة متناهية وإدراجهم في قوائم الترشيح للمرحلة التجريبية التالية. تمثل هذه التصفية المنهجية خطوة بالغة الحساسية في إدارة سلاسل البيانات المكثفة وتصميم التجارب السريرية الرصينة، بما يتوافق مع المعايير المعاصرة لإعداد البيانات الطولية والمعرفية في البحوث النفسية (Ariens et al., 2020).
10.3 تحليل الأداء الوظيفي والأنماط المعرفية وفق تصنيفات متعددة
تمتد التطبيقات الميدانية للتصفية المتقدمة إلى مجالات علم النفس التنظيمي والمهني وإدارة الموارد البشرية التحليلية؛ حيث يتم تقييم الأداء الوظيفي والأنماط المعرفية للعاملين عبر مؤشرات أداء نوعية مجمعة في عمود تصنيفي موحد. عند الرغبة في رصد الموظفين الذين يتطابق تصنيفهم مع أكثر من معيار كفاءة حرج (مثل مستويات الكفاءة “متقدم نوعي” أو “خبير استراتيجي”) مع استبعاد سجلات جلسات التقييم المكررة لنفس الفرد عبر الزمن، تظهر القوة المشتركة للتصفية المتقدمة في عمود واحد عند تفعيل خيار “السجلات الفريدة فقط”.
تتيح هذه العملية المتزامنة فرز الفئات المستهدفة نوعياً عبر المنطق البديل الرأسي، وفي نفس الوقت تنقية القائمة المستخرجة من الجلسات التقييمية الزائدة عن الحاجة، مما ينتج عنه مصفوفة نهائية دقيقة ترصد الأفراد المؤهلين للترقية أو برامج القيادة بدقة مطلقة. يسهم هذا النهج الممنهج في إعداد تقارير التحليل الإحصائي النهائي بموثوقية عالية تدعم اتخاذ القرارات الإدارية والتطويرية، تماماً كما هو متبع في المراجعات المنهجية التي تدرس محددات الضغوط النفسية والرفاهية التنظيمية في بيئات الأداء العالي (Simpson et al., 2021).
خاتمة
استعرض هذا المقال الأكاديمي الشامل الأبعاد النظرية والهندسية والتطبيقية لأداة التصفية المتقدمة (Advanced Filter) في برنامج إكسيل، مع التركيز المكثف على منهجيات تطبيق معايير متعددة في عمود واحد. وقد اتضح جلياً أن هذه الأداة تتجاوز بخصائصها حدود التصفية التلقائية البسيطة؛ إذ ترتكز على مبادئ الجبر البولياني ونظرية المجموعات، مما يتيح للمحللين والباحثين تمثيل المنطقين المنفصلين: المنطق البديل (OR) عبر التوزيع الرأسي للمعايير، والمنطق الجمعي (AND) عبر التكرار الأفقي للترويسات، فضلاً عن دمج هذين المنطقين في شبكات شرطية متعددة الأبعاد تستوعب أعقد الفترات العددية المتقطعة والتصنيفات النوعية المركبة.
كما بينت المراجعة التفصيلية أهمية الانضباط في إعداد مصفوفات البيانات الأولية ونطاقات الشروط؛ حيث تبرز الحاجة الدائمة للتطابق الحرفي للترويسات، وتجنب المسافات الخفية عبر أدوات التنظيف الآلي، وتفادي الفراغات العرضية التي تعطل محرك الفرز المنطقي. وتكاملت هذه الإجراءات التقنية مع استعراض توظيف المحارف البديلة، واستخراج السجلات الفريدة، وحماية أمن البيانات عبر النسخ إلى مواقع مستقلة، وصولاً إلى بناء حلول أتمتة برمجية متطورة باستخدام لغة VBA تمنح الجداول الحسابية مرونة ديناميكية متقدمة.
ختاماً، تجدر الإشارة إلى أنه على الرغم من ظهور دوال حديثة في النسخ المعاصرة من حزمة مايكروسوفت 365 (مثل الدالة الديناميكية =FILTER() التي تعتمد الحساب البولياني عبر المعاملين + للمنطق البديل و * للمنطق الجمعي دون الحاجة إلى نطاق معايير خارجي)، فإن التصفية المتقدمة الكلاسيكية تظل الأداة المرجعية الأكثر استقراراً، وتوافقاً مع الإصدارات التاريخية، وقدرة على معالجة قواعد البيانات الضخمة دون استهلاك الذاكرة التشغيلية للدوال التكرارية. إن التمكن المعرفي والتقني من هذه الأداة يعد مهارة أساسية لا غنى عنها لكل مشتغل في حقول تحليل البيانات، والقياس النفسي، والبحث العلمي التجريبي، مما يرتقي بجودة المخرجات ويضمن دقة النتائج وسلامتها المنهجية.
المراجع
- Ariens, S., Ceulemans, E., & Adolf, J. (2020). Time series analysis of intensive longitudinal data in psychosomatic research: A methodological overview. Journal of Psychosomatic Research, 137, 110191. https://doi.org/10.1016/j.jpsychores.2020.110191
- Christensen, A. P., Kenett, Y. N., Aste, T., Silvia, P. J., & Kwapil, T. R. (2018). Network structure of the Wisconsin Schizotypy Scales–Short Forms: Examining psychometric network filtering approaches. Behavior Research Methods, 50(5), 2031–2050. https://doi.org/10.3758/s13428-018-1032-9
- da Freitas, A. W. Q., Almeida, R., Gonçalves, H. M. S. L. M., Conceição, G., & Freitas, A. (2024). Monitoring fatigue and drowsiness in motor vehicle occupants using electrocardiogram and heart rate − A systematic review. Transportation Research Part F: Traffic Psychology and Behaviour, 104, 280–306. https://doi.org/10.1016/j.trf.2024.05.008
- Lozano, C. (2021). CEDEL2: Design, compilation and web interface of an online corpus for L2 Spanish acquisition research. Second Language Research, 37(4), 705–719. https://doi.org/10.1177/02676583211050522
- Schöller, H. J., Viol, K., Aichhorn, W., Hütt, M.-T., & Schiepek, G. K. (2018). Personality development in psychotherapy: a synergetic model of state-trait dynamics. Cognitive Neurodynamics, 12(5), 441–459. https://doi.org/10.1007/s11571-018-9488-y
- Simpson, R. A. C., Didymus, F. F., & Williams, T. L. (2021). Organizational stress and well-being in competitive sport: a systematic review. International Review of Sport and Exercise Psychology, 17(1), 474–506. https://doi.org/10.1080/1750984x.2021.1975305
- Wesche, M. B., & Paribakht, T. S. (2000). Reading‐Based Exercises in Second Language Vocabulary Learning: An Introspective Study. Modern Language Journal, 84(2), 196–213. https://doi.org/10.1111/0026-7902.00062
- Wyse, D., & Bradbury, A. (2022). Reading wars or reading reconciliation? A critical examination of robust research evidence, curriculum policy and teachers’ practices for teaching phonics and reading. Review of Education, 10(1), e3314. https://doi.org/10.1002/rev3.3314