
تُمثّل إدارة البيانات النصية ومعالجتها إحدى الركائز الأساسية في أبحاث العلوم الاجتماعية، والإحصاء التطبيقي، وعلوم البيانات المعاصرة. فعند التعامل مع مصفوفات البيانات الضخمة التي يتم جمعها عبر الاستبيانات الرقمية، أو المقابلات المفرغة، أو السجلات الإدارية والمؤسسية، يواجه الباحث والمحلل سيلاً من التباينات الأسلوبية، والأخطاء الإملائية، والزوائد الرمزية التي تعيق عمليات النمذجة والتحليل الإحصائي الدقيق. وفي هذا المضمار، لا تقتصر وظيفة برمجيات الجداول الحسابية، وفي مقدمتها مايكروسوفت إكسل (Microsoft Excel)، على إجراء العمليات الحسابية والمعادلات الرياضية المعقدة فحسب، بل تمتد لتشكل بيئة عمل متكاملة لتنقية وتطهير البيانات (Data Cleansing) وإعدادها للتحليل المتقدم.
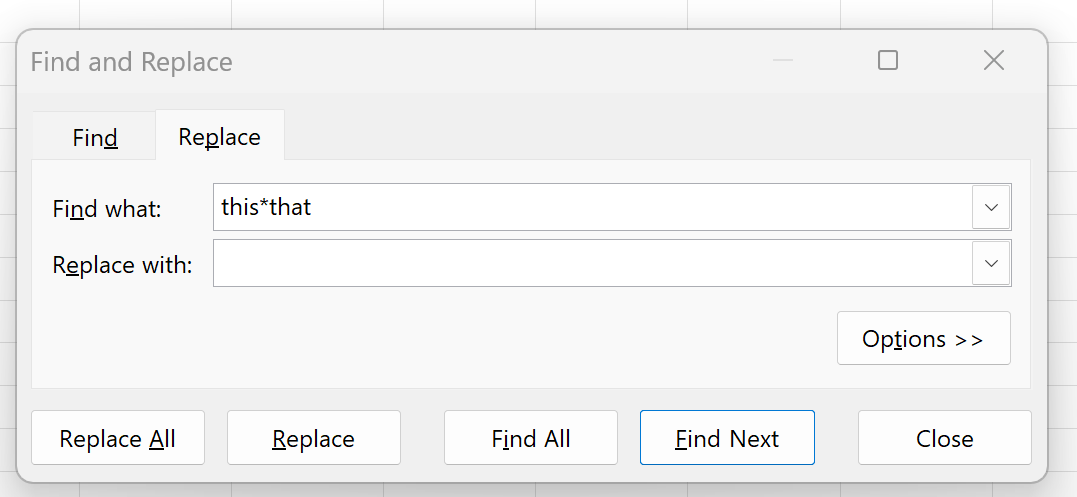
تُعد أداة البحث والاستبدال (Find and Replace) المزودة بأحرف البدل (Wildcards) من أقوى التقنيات التحويلية المتاحة داخل بيئة إكسل، إذ تنقل المستخدم من حدود المطابقة الحرفية الساكنة إلى آفاق المطابقة النمطية الديناميكية المتقدمة. يتيح هذا النهج معالجة آلاف الخلايا التي تشترك في بنية بنيوية معينة بضغطة زر واحدة، مما يوفر مئات الساعات من الجهد اليدوي المضني الذي يرافقه دائماً هامش خطأ بشري مرتفع. إن إتقان هذه الأداة لا يُعد مجرد مهارة تقنية تشغيلية، بل هو كفاية منهجية تعزز من موثوقية وجودة المدخلات في الدراسات الأكاديمية والتطبيقية على حد سواء.
يهدف هذا الدليل المرجعي الشامل إلى تقديم تفكيك نظري وتطبيقي دقيق لآليات البحث والاستبدال باستخدام أحرف البدل في إكسل. سيتناول المقال الأسس البنيوية والتاريخية التي استندت إليها هذه المحارف، والخصائص الوظيفية لكل رمز، وكيفية صياغة الأنماط النصية للتعامل مع الحواصر، والسوابق، واللواحق، والرموز المحجوزة برمجياً. كما يُبرز الأخطاء الشائعة واستراتيجيات الإنقاذ المنهجية، متخذاً من الرصانة العلمية والعمق الإجرائي مساراً لتزويد الباحثين والمهنيين بأعلى مستويات الاحترافية في إدارة ومعالجة الجداول الإلكترونية.
1. مدخل نظري إلى أداة البحث والاستبدال وأهميتها في إدارة جداول البيانات
1.1 التطور الوظيفي لأداة البحث والاستبدال في مايكروسوفت إكسل
شهدت برمجيات الجداول الإلكترونية تحولات جذرية منذ إطلاق النسخة الأولى لبرنامج إكسل المخصصة لأجهزة ماكنتوش في عام 1985، وتلتها نسخة نظام ويندوز في عام 1987 تحت قيادة المطور دوغ كلوندر (Doug Klunder) وفريقه في شركة مايكروسوفت. في المراحل الأولى لتطوير البرمجية، كانت وظيفة البحث والاستبدال تقتصر على محرك مطابقة خطي بدائي يعتمد على التماثل الحرفي التام بين السلسلة المستهدفة والمحتوى المخزن في الذاكرة المؤقتة للخلية. ومع تزايد التعقيد في مجموعات البيانات الأكاديمية والمؤسسية، برزت الحاجة الماسة إلى ترقية المحرك الداخلي ليتحول إلى نظام متقدم لمعالجة اللغات والنصوص، قادر على تفسير الأنماط المعقدة وتخطي عوائق الإدخال البشري غير المنضبط.
أصبح تقليص الوقت المستغرق في تنقية البيانات أحد أبرز مؤشرات الكفاءة التشغيلية للأداة؛ إذ أثبتت الدراسات التطبيقية في علم البيانات أن مرحلة المعالجة المسبقة والتطهير النصي تستنزف ما يقارب 60% إلى 80% من إجمالي زمن مشاريع التحليل. ومن ثم، وفّرت نافذة البحث والاستبدال التفاعلية، المدعومة بخيارات التخصيص الدقيقة، نقلة نوعية عبر إتاحة التحكم في نطاق البحث، سواء ضمن ورقة العمل الحالية أو كامل المصنف، وتحديد ما إذا كان الاستهداف يشمل القيم الناتجة أم الصيغ البرمجية المضمنة في البنية التحتية للخلايا.
1.2 أهمية أتمتة المعالجة النصية في بيئات العمل الاحترافية والأكاديمية
في الأبحاث الأكاديمية والدراسات الميدانية واسعة النطاق، تمثل المعالجة اليدوية للسجلات النصية خطراً منهجياً يهدد صدق وثبات النتائج. إن التدخل البشري لتعديل آلاف النصوص، مثل أسماء المفحوصين، أو الأكواد التشخيصية، أو الترميزات الجغرافية، ينطوي حتماً على هفوات ناتجة عن التشتت البصري والإجهاد المعرفي، مما يؤدي إلى تشويه البيانات الميدانية. تسهم الأتمتة الإجرائية عبر البحث والاستبدال النمطي في تحييد هذا العامل البشري، مما يضمن خضوع جميع السجلات لنفس المعيار الحسابي والمنطقي بصرامة متناهية ودون تحيز لا واعٍ.
علاوة على ذلك، يُعد تحقيق الاتساق المعياري للمصطلحات والمفردات في قواعد البيانات الإحصائية متطلباً جوهرياً لضمان دقة دمج الجداول (Table Joining) وتفعيل عمليات المطابقة المتقاطعة (Cross-matching). فعندما تتعدد المصادر المجمعة منها العينات، كأن تأتي من نماذج استبيانية متعددة أو منصات إلكترونية غير متجانسة، تصبح الأنماط البديلة الأداة الأساسية لتوحيد التهجئات، وإزالة اللواحق الطفيلية، وضبط الفواصل، مما يجعل البيانات مهيأة فورياً للانتقال إلى حزم التحليل الرياضي والنمذجة اللاحقة مثل البرمجيات الإحصائية المتقدمة (SPSS أو R أو Python).
1.3 المحددات الأساسية والفرق بين الاستبدال القياسي والاستبدال النمطي
يكمن الفارق التقني الجوهري بين الاستبدال القياسي والاستبدال النمطي في فلسفة تعريف السلسلة النصية المستهدفة. يعتمد الاستبدال القياسي على “المطابقة المتطابقة الساكنة” (Literal Static Matching)؛ حيث يلزم تطابق كل رمز، ومسافة، وحرف في المدخل مع محتوى الخلية بشكل مطلق. هذا الأسلوب ينهار تماماً عند التعامل مع نصوص ذات أطوال متباينة أو تراكيب تحتوي على قيم وسيطة مجهولة أو متغيرة، كأن يرغب الباحث في حذف أرقام المعرفات الوظيفية المدمجة في نهايات الأسماء والتي تختلف قيمتها من موظف لآخر ومن سجل لآخر.
في المقابل، يؤسس الاستبدال النمطي المدعوم بمحارف البدل لمفهوم “المطابقة الديناميكية التكيفية” (Dynamic Adaptive Matching). هنا لا يبحث إكسل عن سلسلة محددة بعينها، بل يبحث عن “قالب تجريدي” أو بنية شكلية محددة المعالم؛ مثل: “أي نص يبدأ بقوس وينتهي بقوس”، أو “أي تسلسل رقمي يبدأ بالحرف A ويليه رقمان مجهولان”. يمثل هذا التحول الجسر الإجرائي بين المعالجة المكتبية البسيطة والأساليب الحوسبية المتقدمة للتنقيب داخل النصوص غير المهيكلة، مما يمنح المحلل مرونة فائقة لمعالجة البيانات المعقدة بيسر وفاعلية مطلقة.
2. المفاهيم البنيوية لأحرف البدل (Wildcards) في بيئة إكسل
2.1 التعريف الأكاديمي والتقني لأحرف البدل
تُعرّف أحرف البدل برمجياً بأنها رموز ومحارف مخصصة داخل لغات الاستعلام ومحركات النصوص تُعامل بوصفها عناصر نائبة (Placeholders) أو بدائل دلالية تنوب عن محرف نصي واحد أو سلسلة غير محددة من المحارف النصية والرقمية داخل المتن المستهدف. تستمد هذه الرموز خلفيتها التاريخية والنظرية من نظرية اللغات الصورية والآلات الذاتية الحوسبية، وتحديداً من إسهامات عالم الرياضيات الأمريكي ستيفن كول كلين (Stephen Cole Kleene) الذي قدم في عام 1951 مفهوم “نجمة كلين” (Kleene Star) بوصفها عملية رياضية تدل على التكرار الحر للمحارف في سلاسل التعبيرات النمطية.
وقد انتقلت هذه المفاهيم الرياضية إلى بيئات الحوسبة وأنظمة التشغيل، وتحديداً مع ظهور ميزة مطابقة الأنماط (Globbing) التي أدخلها كين تومسون (Ken Thompson) في نظام التشغيل يونكس (Unix) عام 1971 لتسهيل التعامل مع مسارات الملفات عبر سطر الأوامر. وعند تطوير برنامج إكسل، استعارت مايكروسوفت هذه القواعد اللغوية لتوفير محرك خفيف الوزن وسريع الاستجابة داخل الواجهة الرسومية؛ حيث يقوم مترجم النصوص الداخلي للبرنامج باعتراض أحرف البدل فور إدخالها في حقل البحث، وتفسيرها كأوامر منطقية للتحكم في طول ونطاق التطابق بدلاً من التعامل معها كمحارف نصية جامدة.
2.2 الأهمية المنهجية لاستخدام الرموز البديلة في تنقية البيانات
تنبع الأهمية المنهجية لاعتماد الرموز البديلة في بيئات العمل البحثية والتجريبية من قدرتها الفائقة على احتواء التباين العشوائي غير المنضبط في النصوص المجمعة من بيئات متعددة. ففي بحوث العلوم النفسية والاجتماعية على سبيل المثال، قد يُدخل المشاركون بياناتهم الديموغرافية بطرق متعددة ومتباينة؛ فيكتب أحدهم الدرجة العلمية “ماجستير (علم نفس)” ويكتب آخر “ماجستير (إحصاء)”، ويصبح الهدف المنهجي هو تجريد المصطلح ليصل إلى الكلمة المفتاحية الموحدة “ماجستير”. يتيح استخدام الرموز البديلة تنفيذ عمليات الحذف، والاستبدال، والتوحيد في خطوة إجرائية أحادية ومباشرة.
يغني هذا المسار عن الحاجة الملحة لبناء معادلات نصية مركبة وطويلة باستخدام دوال الاستقطاع المعقدة، مثل دوال البحث والقطع (MID, LEFT, RIGHT, SEARCH)، والتي قد تثقل كاهل الذاكرة العشوائية وتؤدي إلى بطء ملحوظ في تحديث مصنفات البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف. فضلاً عن ذلك، فإن اختزال خطوات التنقية إلى إجراءات معيارية مقننة يقلل من احتمالات حدوث أخطاء النسخ واللصق، ويرفع من مستوى الموثوقية التكرارية (Reproducibility) في إعداد وتجهيز البيانات الأولية للدراسات التجريبية والإحصائية.
3. تصنيف أحرف البدل المعتمدة في إكسل وخصائصها الوظيفية
3.1 رمز النجمة (*): الخصائص والاستخدامات الدلالية
يُعد رمز النجمة (*) أكثر أحرف البدل استخداماً وأوسعها قدرة تعبيرية في محرك إكسل. يتحدد المعنى الدلالي للنجمة في تمثيل “أي تسلسل نصي، بغض النظر عن نوع المحارف المتضمنة، وبطول يتراوح من صفر إلى ما لا نهاية من الرموز”. إن تضمين حالة “الصفر محرف” يعني بالضرورة أن النجمة تنوب عن عدم وجود أي شيء على الإطلاق، كما تنوب في الوقت عينه عن حرف واحد، أو كلمة كاملة، أو جمل وسياقات نصية مركبة ذات فواصل ومساحات متعددة تمتد إلى أقصى حدود سعة الخلية.
يتسم سلوك النجمة بالبحث الموسع أو ما يُعرف في الأدبيات البرمجية بالسلوك “الجشع” (Greedy Behavior)؛ حيث يسعى المحرك إلى التوسع في تحديد أكبر نطاق نصي ممكن يقع بين نقطة البداية ونقطة النهاية المحددة في نمط البحث. وتُستخدم النجمة بكفاءة متناهية لاستهداف الكلمات ذات النهايات المتباينة؛ فالبحث عن النمط “تقييم*” سيطابق حتماً مفردات: “تقييم”، و”تقييمات”، و”تقييميين”، بل وحتى “تقييم الأداء المؤسسي”، مما يجعلها سلاحاً فائق المرونة يتطلب وعياً تاماً بحدود التحديد لتجنب التعديلات العشوائية غير المرغوبة.
3.2 رمز علامة الاستفهام (?): التمثيل الفردي الدقيق
على النقيض من السلوك المفتوح وغير المقيد لرمز النجمة، تُمثل علامة الاستفهام (?) في إكسل عنصراً نائباً عن محرف فردي واحد ووحيد فقط؛ سواء أكان ذلك المحرف حرفاً أبجدياً، أو رقماً حسابياً، أو علامة ترقيم، أو حتى مسافة فارغة واحدة. تتميز علامة الاستفهام بالصرامة الرياضية والتطابق الموضعي الدقيق؛ مما يعني أن كل علامة استفهام توضع في حقل البحث تحجز خانة واحدة حصرية لا تقبل الزيادة أو النقصان إطلاقاً ضمن السلسلة المستهدفة بالمعالجة.
تكتسب هذه الأداة أهمية بالغة في ضبط الفروق الهجائية الفردية والتحكم في التهجئات البديلة؛ فالبحث عن النمط “Sm?th” يتيح للباحث التقاط الاسمين “Smith” و”Smyth” مع استبعاد الأسماء التي تخرج عن هذا الطول مثل “Smooth”. كما يمكن تكرار علامات الاستفهام تسلسلياً للتحكم الصارم في أطوال النصوص؛ فوضع ثلاثة رموز متتالية “???” في حقل البحث سيطابق بدقة الكلمات والمحددات الثلاثية فقط، مما يمنع التداخل مع الكلمات الرباعية أو الثنائية ويوفر تحكماً دقيقاً للغاية عند توحيد المفاتيح والرموز الكودية للأفراد والعينات البحثية.
3.3 رمز التلدة (~): وظيفة الإلغاء والهروب الأبجدي
نظراً لأن النجمة (*) وعلامة الاستفهام (?) محجوزتان وظيفياً في بيئة إكسل وتفسران دوماً بوصفهما محارف بدل تنوب عن نصوص أخرى، تنشأ إشكالية بنيوية عندما يحتاج المستخدم إلى البحث الفعلي عن علامة النجمة ذاتها، أو علامة الاستفهام الحقيقية المضمنة في السجلات (كأن تكون علامة استفهام في نهاية سؤال مسحي، أو نجمة تدل على الدلالة الإحصائية $p < .05$). هنا يتدخل رمز التلدة (~)، المعروف تقنياً باسم "محرف الهروب" (Escape Character)، ليقوم بتحييد الصفة البرمجية الرمزية للمحرف التالي له مباشرة.
تتمثل الوظيفة الحصرية لمحرف التلدة في إجبار محرك البحث على قراءة الرمز الذي يعقبه كقيمة نصية خام خالية من أي توجيه برمجي. وبناءً على هذا التركيب النحوي الصارم، فإن إدخال النمط “~*” يوجه البرنامج للبحث عن النجمة كرمز شكلي مجرد وتجاهل معناها التوسعي البديل، والأمر ذاته ينطبق على النمط “~?” لمطابقة علامة الاستفهام الفعلية. وعند الرغبة في البحث عن رمز التلدة نفسه متى ما ورد في البيانات، يتطلب المنطق البرمجي مضاعفة الرمز وإدخال “~~”، حيث تقوم التلدة الأولى بإلغاء الصفة البرمجية للتلدة الثانية وتحويلها إلى حرف نصي تقليدي قابل للاستبدال.
4. الآليات التقنية لاستبدال النصوص المحصورة بين رمزين محددين
4.1 البنية التركيبية للبحث عن محتويات الأقواس والحواصر
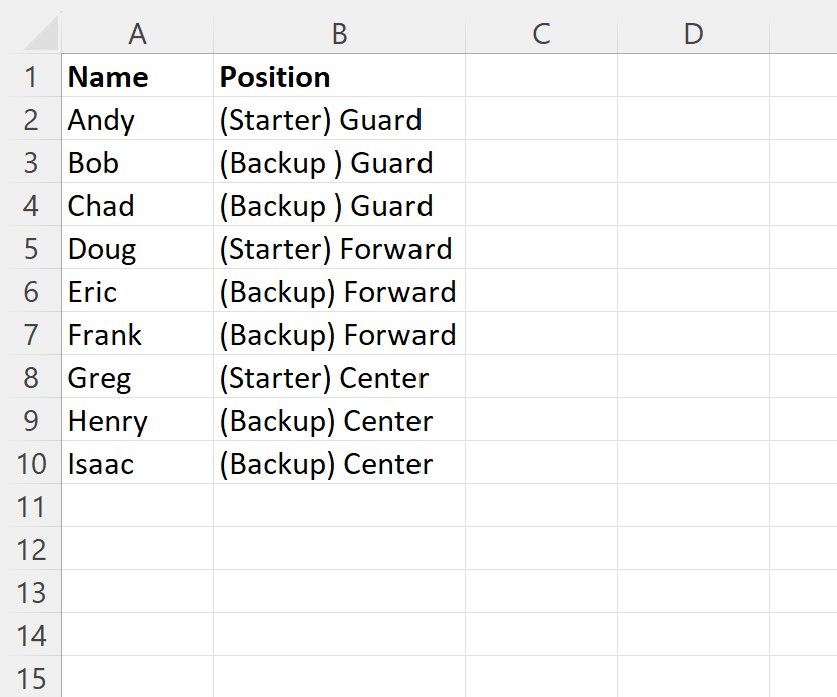
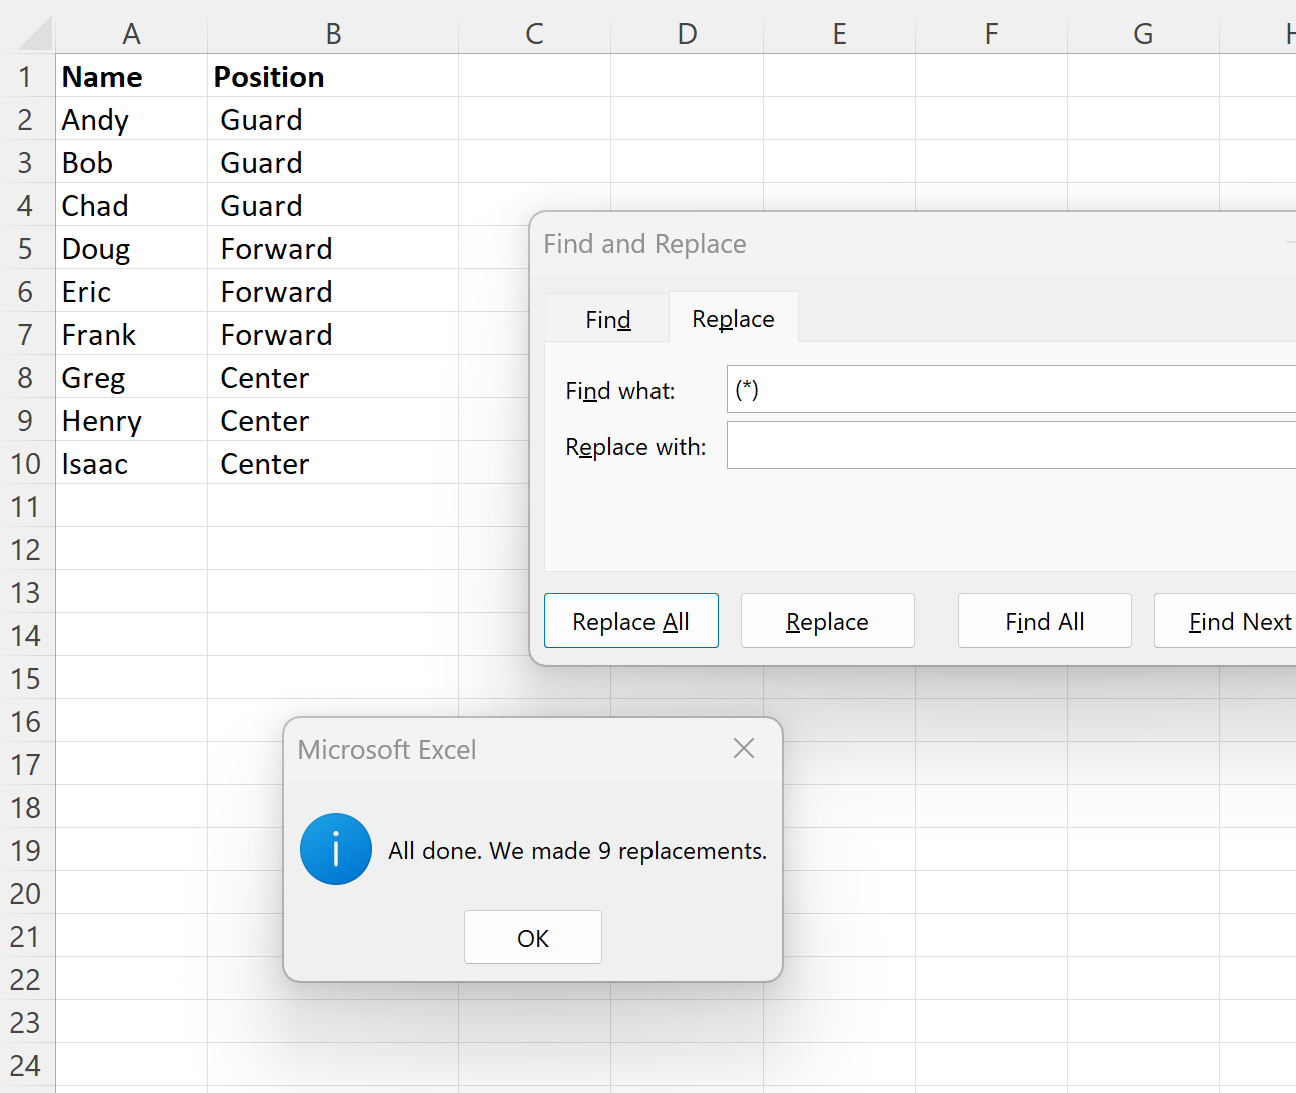
تعد مسألة التخلص من النصوص المحصورة بين الأقواس التوضيحية أو الحواصر التكميلية من أكثر الإجراءات شيوعاً في إعداد البيانات الميدانية والمسحية. تتكون البنية التركيبية لهذا النمط من دمج الرموز الحاصرة مع رمز النجمة البديل؛ حيث يُصاغ النمط بالشكل المعياري “(*)” لاستهداف الأقواس الدائرية وما بداخلها، أو “[*]” للأقواس المربعة، أو “{*}” للحواصر المزخرفة. يعتمد المنطق الرياضي لهذا النمط على تثبيت نقطة ابتداء المطابقة عند القوس المفتوح، وتثبيت نقطة الانتهاء عند القوس المغلق، بينما تتولى النجمة استيعاب وابتلاع كل المحارف الواقعة بينهما مهما كان نوعها أو حجمها.
يبرز هذا التطبيق العملي بقوة عند معالجة الجداول المهنية والوظيفية التي تتضمن مسميات وظيفية متبوعة بإضافات إدارية، مثل: “مدير مشروع (فرع الرياض)” و”باحث إحصائي (دوام جزئي)”. إن استبدال النمط “(*)” بسلسلة فارغة يؤدي إلى حذف تلك الإضافات بضربة واحدة، مع الإبقاء على اللقب المجرد “مدير مشروع” و”باحث إحصائي”. كما يضمن إدراج الأقواس في الصيغة عدم المساس بالنصوص الحرة الخارجية التي لا تحتوي على تلك الحواصر المحددة، مما يؤمن قدراً عالياً من الانتقائية الإجرائية.
4.2 خطوات التنفيذ العملي خطوة بخطوة عبر لوحة التحكم
لضمان التنفيذ الدقيق والخالي من الأخطاء العرضية، يجب اتباع بروتوكول تنفيذي صارم يتألف من خطوات إجرائية محكمة:
- أولاً: حصر النطاق المستهدف: تجنب تفعيل الأمر والمصنف بأكمله متاح دون تحديد؛ يجب أولاً تحديد عمود البيانات المعني حصرياً أو مجموعة الخلايا المستهدفة لتفادي انتقال التعديل إلى أعمدة أخرى تتضمن أقواساً تشكل جزءاً بنيوياً أصيلاً من معادلات أو ملاحظات لا يجوز المساس بها.
- ثانياً: استدعاء نافذة الاستبدال وتدقيق الخيارات: يتم الضغط على الاختصار السريع لوحة المفاتيح (Ctrl + H) لفتح نافذة البحث والاستبدال، والضغط فوراً على زر “خيارات” (Options) للتأكد من حالة مربعات الاختيار؛ حيث يجب مبدئياً إلغاء تحديد خيار “مطابقة كافّة محتويات الخلية” (Match entire cell contents) لتمكين الأداة من العمل كقاطع جزئي داخل النص.
- ثانياً: ضبط حقول الإدخال والتعويض: في حقل “البحث عن” (Find what)، يُكتب النمط ” (*)” (مع ملاحظة إدراج مسافة فارغة قبل القوس المفتوح لضمان حذف المسافة التي كانت تفصل بين الكلمة والقوس تجنباً لتخلف مسافات مزدوجة). وفي حقل “استبدال بـ” (Replace with)، يُترك الحقل فارغاً تماماً دون أي مسافات.
- رابعاً: التحقق الإحصائي النهائي: الضغط على زر “استبدال الكل” (Replace All). يعرض إكسل رسالة تأكيدية تتضمن عدد الاستبدالات التي تمت (مثل: “تم إجراء 1,450 عملية استبدال”)؛ وتُعد هذه القيمة مؤشراً أولياً للتحقق من تطابق عدد التعديلات مع التوقعات المنطقية للبيانات الخاضعة للمعالجة.
4.3 معالجة التداخل والتكرار للأقواس في الخلية الواحدة
تنشأ معضلة كبرى عندما تحتوي الخلية الواحدة على أكثر من زوج من الأقواس؛ كأن تشتمل الخلية على النص التالي: “أحمد (مشرف) حاصل على جائزة التميز (2023)”. إذا طبق المستخدم النمط التقليدي “(*)” بحسن نية بهدف حذف الأوصاف الوظيفية فقط، فإن السلوك “الجشع” (Greedy Matching) للنجمة سيؤدي إلى كارثة في البيانات؛ حيث سيبدأ المحرك بالتطابق من أول قوس مفتوح بعد كلمة “أحمد” ويستمر متجاوزاً القوس المغلق الأول وكل الكلمات البينية وصولاً إلى آخر قوس مغلق يقع بعد “2023”. ونتيجة لذلك، سيتم استبدال كامل النص البيني، ليتبقى في الخلية كلمة “أحمد” فقط وفقدان عبارة “حاصل على جائزة التميز” تماماً.
للتعامل مع هذه المعضلة وتفادي الابتلاع المفرط للبيانات في بيئة إكسل الأساسية، تتعدد الممارسات المنهجية المتبعة:
- إذا كانت محتويات أحد القوسين تتميز بعدد أحرف ثابت، كأن تكون سنوات مؤلفة من أربعة أرقام دائمًا، يمكن استبدال النجمة بعدد مقنن من علامات الاستفهام مثل “(????)” لاستهداف التواريخ فقط دون الأوصاف.
- اللجوء إلى إبدال الأقواس غير المستهدفة مؤقتاً برمز بديل فريد (مثل استخدام الأقواس المعقوفة مؤقتاً عبر استبدال بسيط) قبل تشغيل الاستبدال النجمي الموسع.
- في الحالات بالغة التعقيد، يُنصح بالانتقال إلى صيغ الدوال النصية المركبة مثل دوال
SUBSTITUTEالمكررة أو برمجة دالة خاصة عبر فيجوال بيسك للتطبيقات (VBA) تدمج خوارزميات التعبيرات العادية غير الجشعة (Non-greedy Regular Expressions) لضمان عزل وتفكيك كل قوس على حدة بدقة متناهية.
5. منهجية استبدال كافة المحارف السابقة لنص أو رمز محدد
5.1 المنطق البرمجي لحذف السوابق النصية (Prefixes)
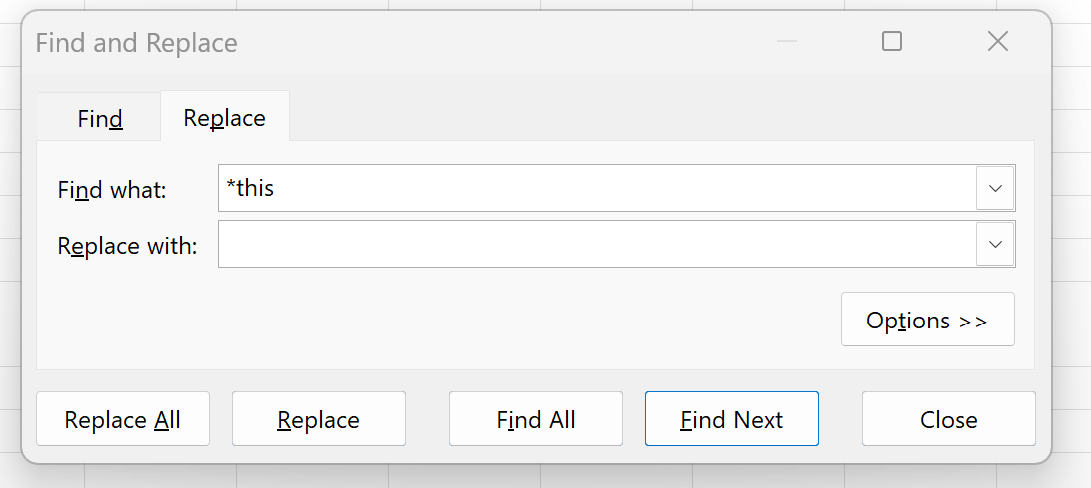
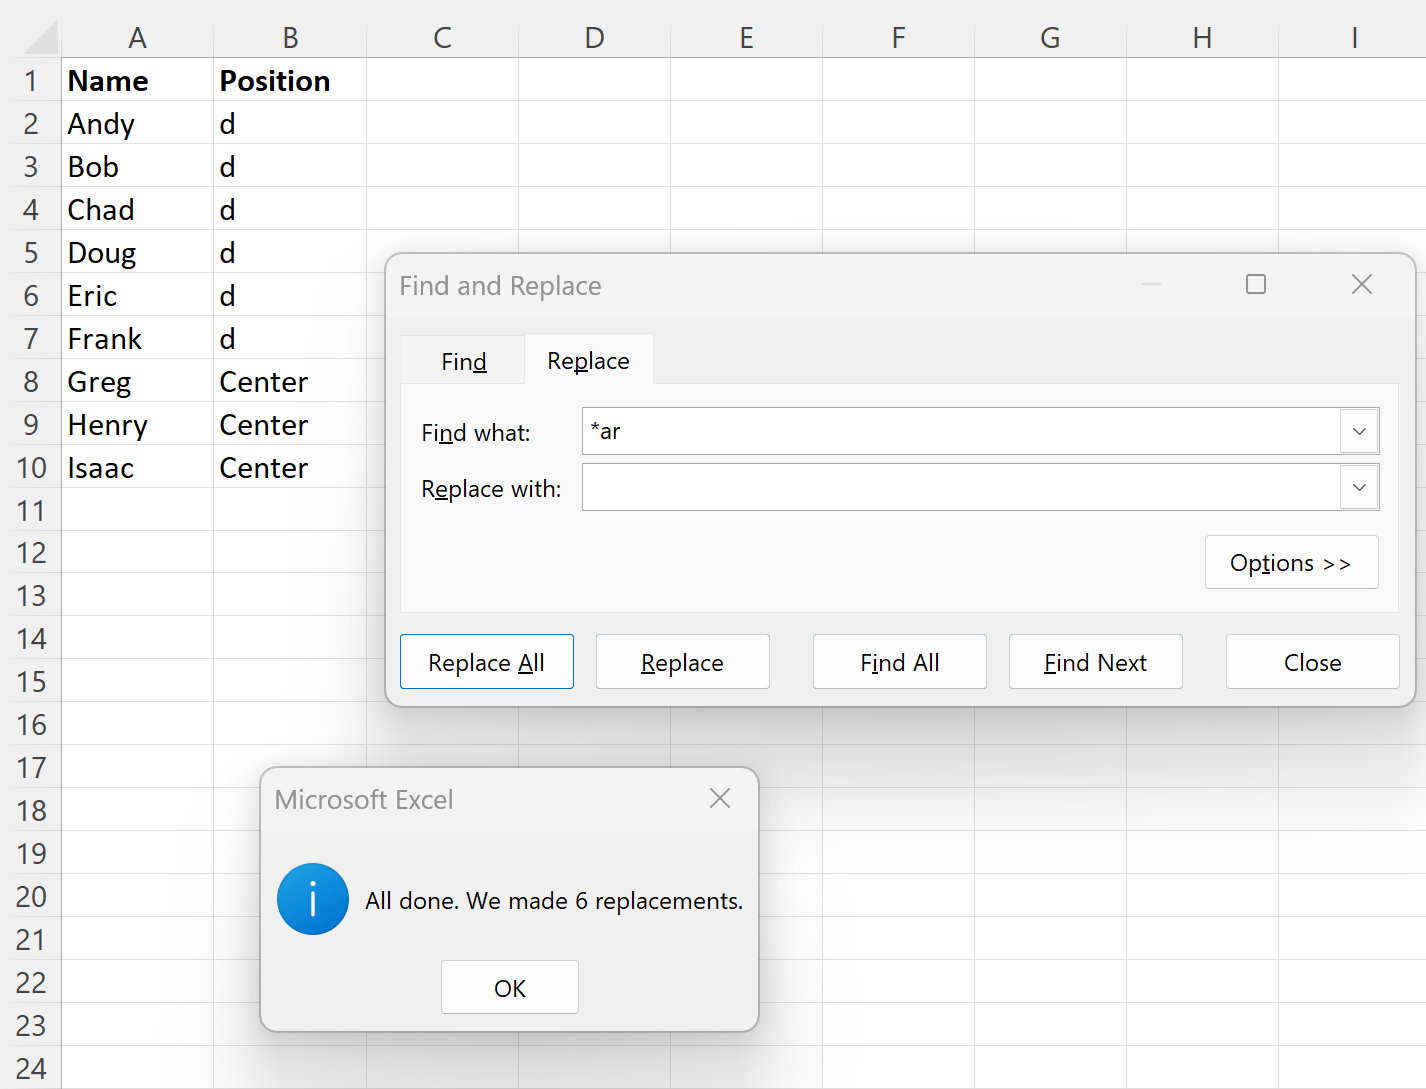
يعتمد الحذف المنطقي للسوابق النصية (Prefix Stripping) على بناء نمط استبدال يتتبع الخلية من بدايتها المطلقة وصولاً إلى نقطة الارتكاز المتمثلة في رمز فاصل أو كلمة دالة. ويتم ذلك برمجياً من خلال وضع رمز النجمة في مقدمة النمط متبوعاً فورياً بالرمز المستهدف، وتأخذ الصيغة العامة الشكل “*X” (حيث يمثل X المحرف الفاصل مثل النقطة، أو الفاصلة، أو الشارطة، أو المسافة). بموجب هذا المنطق، يمسح محرك البحث محتوى الخلية باحثاً عن الرمز الفاصل، ويقوم بابتلاع كل ما سبقه من أحرف وأرقام ومسافات، متضمناً الرمز الفاصل ذاته عند إدراجه ضمن التحديد.
يكتسب هذا الإجراء أهمية استراتيجية في توحيد الأكواد الوظيفية وقواعد البيانات التاريخية؛ حيث تقوم بعض المؤسسات بإدراج بادئات كودية تشير إلى القسم أو النظام القديم متبوعة بعلامة شارطة مثل “DEP1-8842″، في حين تستخدم أقسام أخرى صيغاً مثل “FINANCE-8842”. إن تطبيق النمط “*-” واستبداله بسلسلة فارغة يتخلص فورياً من كل البوادئ المتنوعة مهما اختلف طولها، ويبقي على المعرف العددي الموحد “8842” جاهزاً لإعادة الهيكلة وعمليات التحليل القياسية.
5.2 حالات تطبيقية: عزل أسماء العائلات وتنقية المعرفات
في سجلات البحوث النفسية والتربوية، غالباً ما تُسجل أسماء المشاركين مقرونة بألقابهم الأكاديمية والمهنية السابقة، مثل: “د. عبد الله الصالح”، “أ. د. منى العمري”، “م. سارة القحطاني”. تمثل هذه الألقاب عائقاً كبيراً أمام خوارزميات الترتيب الهجائي الدقيق وعمليات الربط السجلي بين قواعد البيانات المختلفة. ومن خلال صياغة نمط استبدال ذكي يراعي وجود النقطة والمسافة اللاحقة، مثل النمط “*. “، يمكن للباحث التخلص من كل ما يسبق النقطة والمسافة بضغطة زر واحدة، مما يؤدي إلى تنقية الأسماء وتجريدها في قائمة موحدة تخضع للمعايير الاسمية المجردة.
وينطبق الأمر ذاته على تنقية الأرقام التسلسلية ومعرفات العينات التجريبية المستوردة من أجهزة القياس المخبرية المعقدة، والتي غالباً ما تلحق بالأكواد بادئات زمنية أو تقنية تشير إلى رقم الحاضنة أو تاريخ القياس المفصول بنقطتين رأسيتين مثل “EXP_01:DATA_992”. إن كتابة النمط “*:” والاستبدال بلا شيء يعزل المعرف الحيوي للعينة “DATA_992” بشكل مستقل وتام. وتضمن هذه الخطوة سلامة البنية المتبقية للنص وتوافقها الكامل مع متطلبات المتغيرات المستقلة والتابعة في مصفوفات التحليل الإحصائي الإجرائي.
5.3 التعامل مع الحالات التي لا تحتوي على الرمز المستهدف
تُعد دراسة استجابة إكسل للخلايا الشاذة التي تخلو من المعيار الفاصل المحدد في حقل البحث مسألة محورية لضمان تكامل البيانات. فعند تنفيذ أمر استبدال يحتوي على النمط “*:”، يتجاهل إكسل تلقائياً وبشكل كامل أي خلية لا تشتمل على علامة النقطتين الرأسيتين (:). وتبقى تلك الخلايا كما هي تماماً دون أي حذف أو تشويه، وهو سلوك آمن افتراضياً يحول دون التدمير الكلي للسجلات، ولكنه قد يخلق حالة من عدم التجانس المنهجي إذا بقيت تلك السجلات الشاذة دون معالجة موازية.
لمنع حدوث تشوهات غير ملحوظة في البيانات البحثية الناتجة عن هذه الفجوة الإجرائية، يُوصى بتطبيق بروتوكول فحص وفرز استباقي:
- استخدام خاصية التصفية التلقائية (AutoFilter) وتطبيق تصفية نصية مسبقة عبر اختيار “يحتوي على” للتأكد من حصر كافة الخلايا التي تتضمن الرمز الفاصل قبل تفعيل نافذة الاستبدال.
- أو بناء عمود تدقيق مؤقت يعتمد على دوال التحقق المنطقي، مثل دالة
ISNUMBER(SEARCH(":", A2))، لفرز البيانات وتحديد الخلايا التي تفتقر للرمز المستهدف تمهيداً لمعالجتها استثنائياً بشكل مستقل يضمن شمولية التوحيد لجميع أفراد العينة.
6. منهجية استبدال كافة المحارف اللاحقة لنص أو رمز محدد
6.1 المنطق البرمجي لاقتطاع اللواحق النصية (Suffixes)
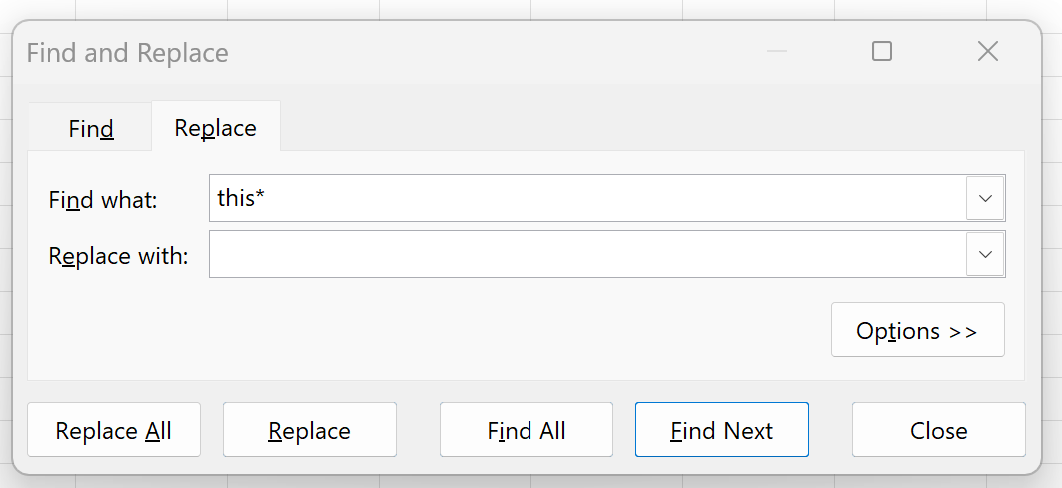
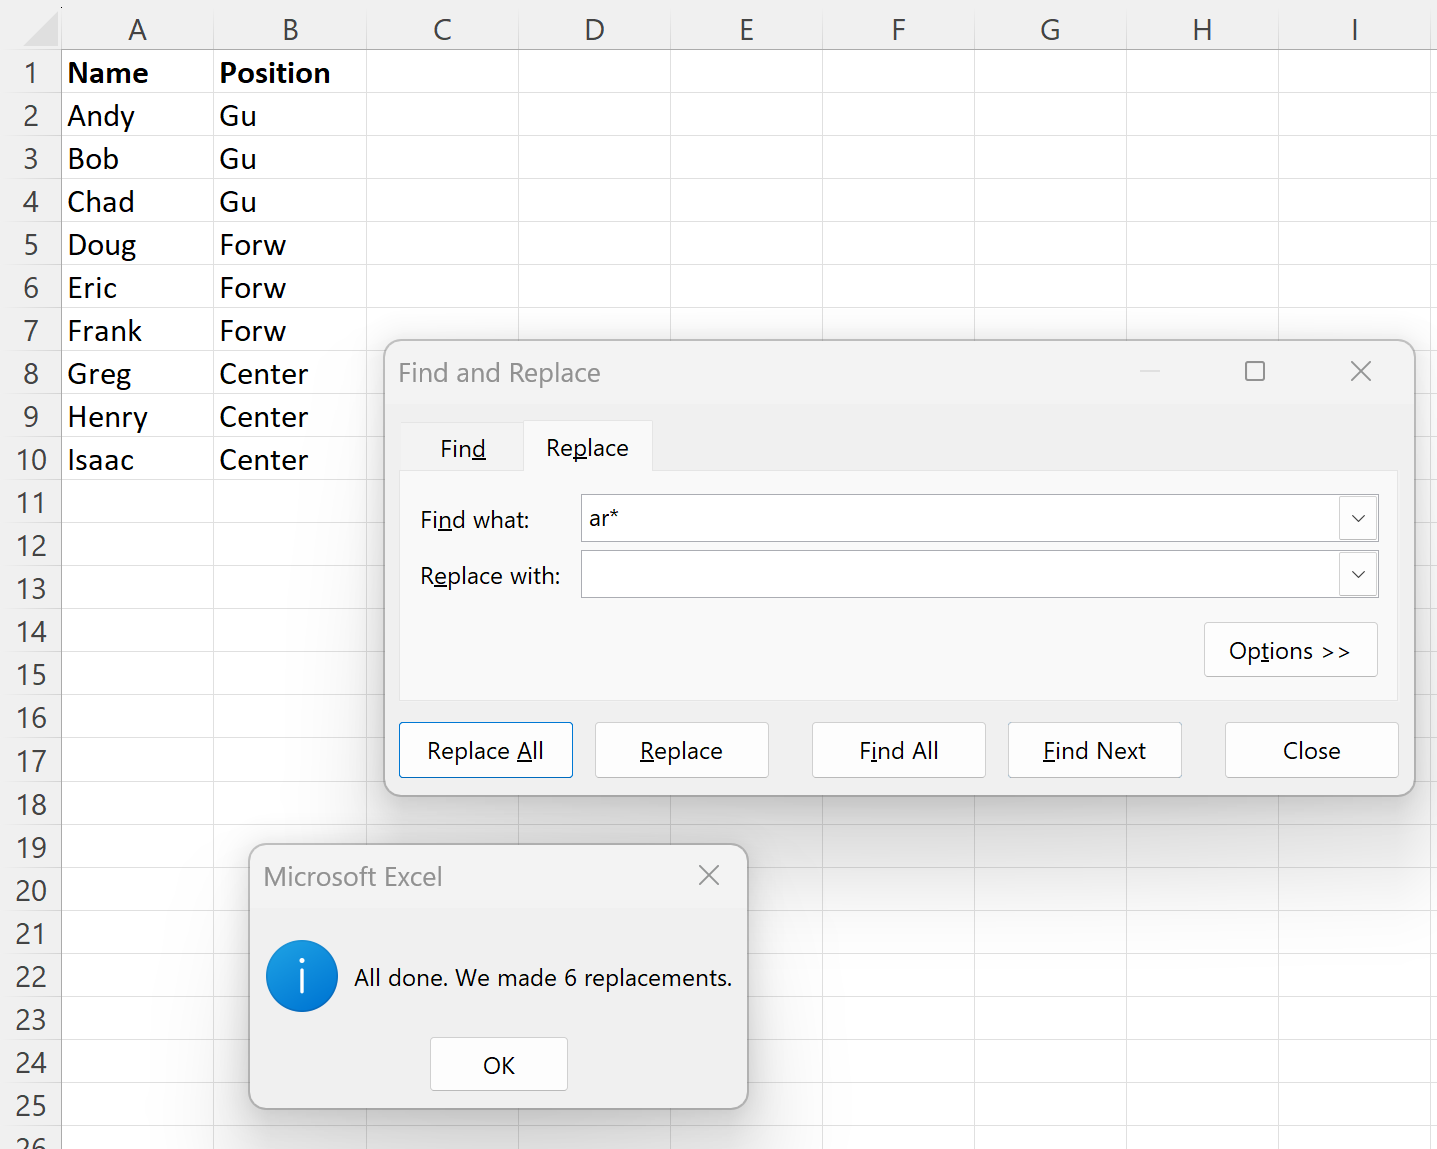
يمثل اقتطاع اللواحق النصية (Suffix Truncation) الوجه المقابل لحذف السوابق، ويستهدف التخلص من كافة الذيول، والتعليقات، والامتدادات التي تعقب محرفاً فاصلاً معيناً داخل الخلية. يقوم البناء البرمجي لهذا النمط على تثبيت الرمز الفاصل في مستهل عبارة البحث ثم إلحاقه برمز النجمة البديل، لتصبح الصيغة المعيارية “X*” (حيث يمثل X الرمز الفاصل مثل الفاصلة، أو النجمة، أو أي علامة ترقيم أخرى). هنا يبحث المحرك عن الموقع الفيزيائي للرمز، وفور العثور عليه، يقوم بمسح الرمز ذاته وكل المحارف النصية والرقمية والمسافات الممتدة من بعده حتى نهاية الخلية بصورة كاملة.
يساعد هذا النهج الاقتطاعي في تقليص أحجام السلاسل النصية وتوحيدها على نحو جذري. وتتجلى أهميته في تنقية القيود المحاسبية، وسجلات التكاليف الإدارية، ومدخلات الاستبيانات الرقمية التي غالباً ما يرفق بها المستخدمون ملاحظات تذييلية تبدأ بفاصلة أو نقطة مثل: “15000 (غير شامل الضريبة)” أو “موافق بشدة، تم التعديل لاحقاً”. إن استبدال النمط “،*” أو ” (*” بسلسلة فارغة يجرد القيد المحاسبي أو الاستجابة المقياسية من كل الشوائب التفسيرية، ليعيدها إلى صيغة إحصائية قابلة للتجميع والحساب الرياضي الفوري.
6.2 تطبيقات واقعية: فصل البيانات المركبة وتنظيف الملاحظات
تبرز التطبيقات الواقعية لاقتطاع اللواحق في مجالات إدارة البيانات الحضرية والجغرافية، وسجلات المشاركين في التجارب الميدانية. ففي السجلات الديموغرافية التي تتضمن العناوين بصيغة مدمجة تضم اسم المدينة متبوعاً بالرمز البريدي أو الحي مثل: “الرياض – 11564” أو “جدة / حي الصفا”، يؤدي تطبيق نمط البحث ” -*” أو ” /*” إلى بتر كافة التذييلات المكانية بدقة فائقة، مما يوفر قائمة ناصعة بأسماء المدن الرئيسية ويسهل عمليات التصنيف والتوزيع التكراري لمناطق إقامة أفراد العينات البحثية.
كما يُستخدم هذا الإجراء بكفاءة استثنائية في تنقية عناوين البريد الإلكتروني لاستخراج أسماء المستخدمين (Usernames) وحذف النطاقات بالكامل؛ حيث يؤدي البحث عن النمط “@*” واستبداله بحقل فارغ إلى شطب رمز (@) وما يليه من اسم النطاق وخوادم الاستضافة، مبقياً فقط على المعرف الفردي للمشارك. ويُطبق المسار نفسه في معالجة سجلات الدخول والخروج التي تتضمن قيود التواريخ مقترنة بالطوابع الزمنية للساعات والدقائق مفصولة بمسافة؛ إذ يتيح استبدال النمط ” *” التخلص من التذييل الزمني والإبقاء على التاريخ المجرد بصيغة متسقة تخلو من التشويش التركيبي.
6.3 الضبط الدقيق للمسافات وعلامات الترقيم بعد عملية الاقتطاع
تتمثل إحدى العواقب غير المقصودة لاقتطاع اللواحق النصية في تخلف مسافات بيضاء غير مرئية (Trailing Spaces) في نهاية النص المتبقي إذا لم يراعِ المستخدم إدراج المسافة داخل نمط البحث الاستبدالي. فعلى سبيل المثال، إذا كان النص هو “جامعة الملك سعود – الرياض” واستخدم الباحث نمط الاستبدال “-*”، ستكون النتيجة المتبقية في الخلية هي “جامعة الملك سعود ” متضمنة مسافة إضافية في نهايتها. تبدو هذه المسافة غير مرئية للعين المجردة، لكنها برمجياً تمنع نجاح دوال المطابقة الصارمة مثل دالة VLOOKUP ودالة XLOOKUP وتؤدي إلى تصنيف النص كسلسلة مختلفة كلياً.
لتلافي هذه الفجوة وضمان التطهير النهائي للبيانات، يُنصح بتطبيق تدبيرين متكاملين:
- الضبط الاستباقي لنمط البحث عبر تضمين المسافة الفارغة قبل الرمز الفاصل مباشرة في حقل “البحث عن” (مثل كتابة مسافة ثم الشارطة والنجمة ” -*”) ليتم حذف المسافة ضمناً مع الرمز واللاحقة المقتطعة.
- التطهير البعدي الإجباري للعمود المعالج باستخدام دالة التشذيب المعيارية
TRIMفي عمود ملاصق، والتي تعمل بصورة حاسمة على استئصال كافة المسافات الزائدة في البدايات والنهايات والمسافات المتكررة بين الكلمات، مما يحيل البيانات إلى نسق نهائي منضبط ومعياري صالح للتعامل الرقمي الموثوق.
7. التعامل المتقدم مع الرموز الخاصة وتوظيف علامة التلدة (~)
7.1 معضلة البحث عن الرموز المحجوزة برمجياً
تنشأ أزمة معالجة البيانات النصية الأكثر حرجاً داخل إكسل عندما تشتمل جداول الباحث أو المحلل على رموز النجمة أو علامات الاستفهام كجزء أساسي ومقصود من متون البيانات ذاتها. فعلى سبيل المثال، تُستخدم النجمة في الجداول الإحصائية للإشارة إلى مستويات المعنوية الإحصائية (مثل دلالة الفروق عند $p < .05^{*}$ أو $p < .01^{**}$)، كما ترد علامات الاستفهام في استبيانات تقييم الآراء لقياس الحيرة أو الأسئلة المفتوحة، أو كرمز للتعبير عن البيانات المفقودة (Missing Data Code) في بعض المسوح الميدانية القديمة.
إذا جهل المستخدم المنطق البرمجي الداخلي للأداة وقام بإدخال رمز النجمة (*) بمفرده في حقل “البحث عن” رغبةً منه في حذف علامات النجوم التي تشير للدلالة الإحصائية، فإن مترجم إكسل سيفسر النجمة وفق وظيفتها كبديل عن “أي شيء وكل شيء”. وبناءً عليه، وعند النقر على أمر “استبدال الكل”، سيقوم البرنامج بمسح شامل وتام لكافة المحتويات النصية والرقمية في النطاق المحدد واستبدالها بالقيمة الجديدة، مما يترتب عليه تفريغ محتوى الخلايا بالكامل والتسبب في تدمير كارثي للبيانات يستحيل تداركه إذا أُغلق المصنف أو تعذر التراجع الفوري.
7.2 التطبيق التقني لتحييد الرموز باستخدام التلدة
لتجاوز هذه المعضلة الحوسبية، يوفر محرك إكسل أداة التحييد المعيارية عبر إقحام رمز التلدة (~) قبل الرمز المحجوز مباشرة، مما يجرد الرمز من صفته الوظيفية ويعيده إلى حالته الحرفية الأولية الخام. وتتحقق هذه المعالجة وفق صياغات محددة بدقة:
- استبدال النجمة الفعلية: يجب كتابة النمط “~*” في حقل “البحث عن”. في هذه الحالة، يتجاهل البرنامج وظيفة النجمة كبديل شمولي ويستهدف النجوم المطبوعة نصياً في الخلايا فقط لحذفها أو استبدالها برمز آخر مثل كتابة “دال إحصائياً”.
- استبدال علامة الاستفهام الفعلية: يتطلب الأمر كتابة النمط “~?” في حقل البحث. هذا التحديد الدقيق يمنع الأداة من اعتبار علامة الاستفهام بديلاً عن حرف فردي، ويحصر الاستهداف في علامات الاستفهام الحقيقية المنتهية بها الجمل الاستفهامية في استطلاعات الرأي.
- استبدال رمز التلدة نفسه: في حال احتوت البيانات على رمز التلدة (المستخدم أحياناً في النصوص اللاتينية للإشارة للقيم التقريبية مثل ~50)، يُلزم النظام المستخدم بكتابة الرمز بصيغة مزدوجة “~~”؛ حيث تقوم التلدة الأولى بإلغاء الخاصية الوظيفية للتلدة الثانية، ليتم استبدال الرمز الحرفي بنجاح تام وبلا أدنى التباس برمجياتي.
7.3 دراسة مقارنة بين استبدال الرموز الخاصة والتعبيرات العادية
على الرغم من النجاح الإجرائي الفائق لأداة البحث والاستبدال المدمجة في إكسل عند توظيف التلدة، فإن لها حدوداً وظيفية حتمية عند مقارنتها بمحركات التعبيرات العادية الشاملة (Regular Expressions – RegEx) المدعومة في بيئات التطوير البرمجي ولغة VBA. تقتصر أحرف البدل في واجهة إكسل التقليدية على ثلاثة محارف فقط (*، ?، ~)، وهي غير قادرة بذاتها على التعبير عن منطق التناوب الشرطي (مثل البحث عن كلمة “أحمد” OR “محمد”)، أو استهداف فئات محددة من المحارف دون غيرها (كالبحث عن الأرقام فقط دون الأحرف، أو استهداف الحروف الكبيرة فقط).
ومع ذلك، تتفوق أداة إكسل الأصيلة على لغات البرمجة وحلول الأكواد في سرعة التنفيذ وسهولة الوصول، وانعدام متطلبات التهيئة البرمجية المسبقة، وخاصة عند معالجة الجداول الكبيرة التي تتضمن عشرات الآلاف من السجلات؛ حيث صُمم محرك الاستبدال المكتبي الداخلي بلغة C++ عالية التحسين ليعمل مباشرة في ذاكرة المعالجة اللحظية للبرنامج. ويوضح الجدول التالي الفروق الجوهرية بين الأنماط القياسية لأحرف البدل في إكسل وما يقابلها من مفاهيم في التعبيرات النمطية المتقدمة:
- رمز النجمة في إكسل (*): يقابله في RegEx التعبير
.*، ولكنه يختلف عنه بكونه جشعاً دائماً في إكسل ولا يمكن إيقاف جشعه محلياً إلا عبر التقييد المحيطي للرموز. - علامة الاستفهام في إكسل (?): يقابلها في RegEx النقطة الفردية
.التي تدل على أي محرف فردي، في حين تدل علامة الاستفهام في RegEx على تكرار المحرف السابق لمرة واحدة أو صفر. - رمز التلدة في إكسل (~): يقابله في RegEx وفي معظم لغات البرمجة محرف الشرطة المائلة العكسية
(Backslash) المستخدم لأداء وظيفة الهروب ذاتها قبل الرموز المحجوزة.
8. تطبيقات وحالات عملية في تنظيف وتنسيق مجموعات البيانات الكبيرة
8.1 تنظيف السجلات الرياضية والإحصائية المأخوذة من المصادر الخارجية
عند تنزيل واستيراد مجموعات البيانات الإحصائية وسجلات أداء الأنشطة الرياضية أو المؤسسية من قواعد بيانات الويب، غالباً ما تحتوي الجداول على حواشٍ رقمية ووسوم شفرات لغة ترميز النص الفائق (HTML Tags) ملتصقة بالنصوص والأسماء، مثل: “فريق الأمل<td>” أو “اللاعب: طارق سالم [1]”. تعيق هذه اللواحق عمليات حساب متوسطات الأداء وتمنع تنفيذ دوال الربط والمزامنة بين الجداول المختلفة، كما تزيد من حجم المصنف وتحدث تشويشاً بصرياً ودلالياً أثناء عرض النتائج.
باستخدام أداة البحث والاستبدال بأحرف البدل، يمكن تنقية آلاف هذه القيود بدقة متناهية عبر مراحل متعاقبة:
- للتخلص من وسوم البرمجة التنسيقية، يُوضع النمط “<*>” في حقل البحث، وتُترك خانة الاستبدال فارغة؛ فيقوم إكسل بمسح كافة وسوم الفتح والإغلاق النصية دفعة واحدة.
- لتجريد أسماء الفرق واللاعبين من أرقام المراجع والاقتباسات، يُطبق النمط “[*]” لحذف الأقواس المربعة بما تحويه من أرقام وهوامش توثيقية.
- تسمح هذه التصفية المعيارية للبيانات بالعودة إلى صيغتها النقية المتجانسة، مما يمهد لربط الجداول بسلاسة بواسطة دوال التجميع والمطابقة المتقدمة دون تعثر ناجم عن التباينات الرمزية.
8.2 إعادة هيكلة العناوين البريدية وسجلات الاتصال
تشكل أرقام الاتصال الهاتفية وسجلات العناوين الميدانية تحدياً مستمراً في إدارة البيانات بسبب تباين أنماط الإدخال وتعدد صيغ التدوين. فقد تتضمن أرقام الهواتف فتح خط الدولة محصوراً بين أقواس دائرية، أو مفصولاً بشرطات وفواصل عشوائية متباينة مثل: “(+966) 50-123-4567” أو “00966-501234567”. لعزل الأرقام وتحويلها إلى تسلسل رقمي قياسي موحد يصلح للتحليل الإحصائي أو الربط بأنظمة الرسائل الآلية، يتبع المحلل استراتيجيات استبدال متتالية لتطهير البيانات من الشوائب غير الرقمية.
يتم في المرحلة الأولى استهداف الأقواس الدائرية برمتها عبر النمط “(+*)” واستبدالها بالقيمة البديلة الموحدة “0” لتحويل بادئة الدولة إلى البادئة المحلية المعيارية. تلي ذلك مرحلة استئصال الفواصل والشرطات التنسيقية عبر البحث عن الشارطة “-” واستبدالها بسلسلة فارغة، ثم تكرار الأمر للمسافات الفارغة. كما يمتد هذا الإجراء إلى توحيد العناوين الديموغرافية متعددة المستويات عبر فصل المقاطعات والمدن؛ حيث يُستخدم النمط “,*” لحذف أسماء المقاطعات اللصيقة بالمدن، مما يسرع عمليات الفرز الجغرافي وحساب أحجام العينات وفق التوزيع المكاني بدقة تامة.
8.3 إعداد النصوص للتحليل الحاسوبي واللسانيات التطبيقية
في مشاريع اللسانيات الحاسوبية (Computational Linguistics) وتحليل المضمون في العلوم الاجتماعية، يتطلب استقراء النصوص وفرز المتون اللغوية تنظيفاً حذراً يسبق استخراج تكرارات المفردات وبناء مصفوفات المصطلحات والوثائق (Term-Document Matrices). تحتوي المتون المستخلصة عادةً على تعليقات المحققين، وعلامات التنقيص، وهوامش التوثيق المدرجة بين أقواس معقوفة، مما يؤدي إلى تضخيم غير حقيقي لقوائم الترددات المعجمية وتشويش مؤشرات التماسك الأسلوبي.
يُسهم الاستبدال النمطي في تحضير هذه النصوص عبر مسارات محددة:
- حذف كافة التعليقات الهامشية المحصورة بين معقوفتين باستخدام النمط “[*]”.
- معالجة علامات الحذف والاقتطاع المتكررة (مثل النقاط المتتابعة ….) عبر البحث عن النمط “???” أو الأنماط المكررة لتوحيدها أو استئصالها لضبط الحدود الإعرابية للجمل.
- توحيد المساحات والفراغات البيضاء المتباينة بين الفقرات والكلمات، والتي تتسبب في ظهور فراغات كاذبة ككلمات مستقلة في محركات التحليل الحاسوبي؛ مما يمنح المتن اللغوي نقاءً تركيبياً يؤهل برمجيات التحليل المعجمي لتوليد مؤشرات دقيقة وصادقة علمياً.
9. الأخطاء الشائعة أثناء استخدام أحرف البدل واستراتيجيات تفاديها
9.1 خطأ التوسيع المفرط (Over-matching) والشمول غير المقصود
يُعد خطأ التوسيع المفرط أو الشمول غير المقصود (Over-matching) الخطر الأكثر فتكاً بسجلات البيانات عند استخدام أحرف البدل. ينشأ هذا الخطأ من الطبيعة الجشعة لرمز النجمة (*)، والتي تدفعه لابتلاع أقصى مساحة نصية متاحة تتوافق مع الشرطين المحددين في بداية ونهاية النمط. فعندما يرغب المحلل في حذف كلمة محصورة بين فاصلتين مثل: “محمد، باحث، الرياض”، ويكتب النمط “،*،” ظناً منه أنه سيحذف كلمة “باحث” فقط ويفصل بين الاسمين، فإن المحرك سيبحث عن أول فاصلة وآخر فاصلة في السجل مقتطعاً كل ما بينهما حتى وإن تضمن ذلك عشرات الكلمات والحقول المفصولة بفواصل مكررة.
تتمثل الاستراتيجية الوقائية الحاسمة لتفادي هذا الفخ في تفضيل استخدام أسلوب “الحصر العددي المقنن” بالاعتماد على علامة الاستفهام (?) متى ما كانت الأطوال البينية معروفة أو متقاربة، كاستخدام “،????،” بدلاً من النجمة المفتوحة. كما يجب مراجعة البيانات بعناية استكشافية للتأكد من عدم احتواء الخلايا على فواصل ثنائية غير مقصودة، مع ضرورة تفكيك النصوص المركبة عبر أداة “نص إلى أعمدة” (Text to Columns) أولاً إذا تعذر ضبط السلوك الجشع للنجمة، مما يتيح عزل النطاقات وتفادي الشمول المدمر لمحتويات الخلايا.
9.2 إغفال حالة تحسس الأحرف وتحديد نطاق البحث داخل المصنف
يقع كثير من المستخدمين في فخ إغفال ضبط محددات النطاق وحساسية الحروف في نافذة خيارات البحث المتقدمة. فمن الناحية المعيارية، تتسم أحرف البدل في إكسل بأنها غير حساسة لحالة الأحرف (Case-insensitive) افتراضياً عند التعامل مع اللغات اللاتينية؛ مما يعني أن النمط “*test*” سيلتقط الكلمات بالصيغتين: “TEST” و”test”. إذا كان التصنيف البحثي يستلزم تمييز الأكواد الإنجليزية الكبيرة (Uppercase) عن الصغيرة (Lowercase) في سجلات العينات، فإن عدم تفعيل خيار “مطابقة حالة الأحرف” (Match case) سيؤدي إلى استبدال جائر يشوه ترميز العينات دون تمييز نوعي.
الأمر الأكثر خطورة يتجلى في ترك خيار “ضمن” (Within) مضبوطاً على “المصنف” (Workbook) بدلاً من “ورقة العمل” (Sheet)، مع ترك خيار “مطابقة كافّة محتويات الخلية” (Match entire cell contents) معطلاً. في هذه الحالة، وإذا أجرى المستخدم استبدالاً نمطياً متسرعاً، فلن يقتصر التعديل على الجدول الحالي المعروض أمامه، بل سيمتد ليعبث بجميع الأوراق المخزنة في المصنف بالكامل؛ بما في ذلك أوراق التوثيق، وجداول المعادلات التراكمية، ومفاتيح فك الرموز، مما يحدث دماراً شاملاً في بنية المصنف قد لا يكتشفه الباحث إلا بعد فوات الأوان.
9.3 استراتيجيات الإنقاذ والاسترجاع عند حدوث أخطاء استبدال كارثية
عند وقوع استبدال نمطي خاطئ، يمثل الفهم المسبق لآليات الإنقاذ التقنية الفارق بين استعادة البيانات بأمان أو خسارتها بصورة دائمة. إن أول خط دفاع هو استخدام أمر التراجع اللحظي من لوحة المفاتيح (Ctrl + Z). ولكن تجب الإشارة الصارمة إلى أن أمر التراجع في إكسل يرتبط بحالة بقاء المصنف قيد التشغيل؛ فإذا قام المستخدم بحفظ المصنف (Save) بعد عملية الاستبدال الكارثية، تفرغ ذاكرة التراجع فوراً ويصبح من المتعذر كلياً العودة للحالة السابقة عبر هذا الأمر.
لمواجهة أسوأ السيناريوهات، يجب اعتماد استراتيجيات الإنقاذ المؤسسية التالية:
- الاعتماد على تاريخ الإصدارات (Version History) المتاح في منصات التخزين السحابي مثل OneDrive أو SharePoint؛ حيث يتيح استرجاع النسخة المحفوظة قبل ثوانٍ من تنفيذ أمر الاستبدال الخاطئ.
- التحقق من ملفات الاسترداد التلقائي (AutoRecover) المحفوظة في مسارات النظام المؤقتة المحلية في حال انقطاع التيار أو إغلاق البرنامج المفاجئ.
- تبني “القاعدة الذهبية المنهجية”: إنشاء نسخة احتياطية مستقلة ومؤرخة من ملف البيانات الأساسي (Raw Data Backup) قبل فتح نافذة الاستبدال النمطي، وحفظها بصيغة “للقراءة فقط” لتظل مرجعاً ثابتاً لا يمكن تشويهه.
10. أفضل الممارسات المنهجية لضمان سلامة وموثوقية البيانات أثناء الاستبدال
10.1 بروتوكول الفحص المسبق واستخدام أمر البحث عن الكل
يقتضي المنهج العلمي الصارم عدم القفز مباشرة إلى الضغط على زر “استبدال الكل” (Replace All) فور صياغة النمط في حقل البحث. يتطلب بروتوكول الفحص المسبق تفعيل خيار “البحث عن الكل” (Find All) أولاً كخطوة إلزامية أولى. يقوم هذا الإجراء بفحص مصفوفة البيانات وتوليد جدول سفلي متكامل يعرض قائمة تفصيلية بجميع الخلايا الفردية التي تنطبق عليها شروط النمط المصاغ، متضمناً اسم الورقة، وعنوان الخلية، والقيمة النصية الحالية المعروضة بداخلها.
يتيح هذا الكشف البصري للباحث إجراء مسح استكشافي سريع للنتائج؛ فيتحقق من سلامة العينات، ويتأكد من أن النمط لم يمتد ليلتقط خلايا مجاورة لا ينبغي المساس بها. كما يسمح الضغط على أي سطر في نافذة النتائج بالانتقال اللحظي المباشر إلى الخلية المعنية في ورقة العمل لمعاينتها في سياقها الطبيعي. ويُعد توثيق الأنماط والمعايير المستخدمة في هذه المرحلة جزءاً لا يتجزأ من سجل التعديلات المنهجية (Audit Trail) المطلوب في البحوث العلمية لضمان الشفافية وقابلية التدقيق الأكاديمي للبيانات.
10.2 عزل المعالجة في أعمدة وسيطة مساعدة لتجنب التعديل المباشر
يتمثل أحد أهم المبادئ في الإدارة الآمنة للبيانات (Defensive Data Management) في تجنب إجراء التعديلات الهيكلية المباشرة على الأعمدة الأصلية التي تحتضن البيانات الخام. يُوصى منهجياً بإنشاء “عمود وسيط تجريبي” بجانب العمود الأصلي ونسخ البيانات بالكامل إليه، وتطبيق عمليات البحث والاستبدال النمطية على هذا العمود المستنسخ حصراً. يضمن هذا الإجراء بقاء المرجع الأصلي للبيانات سليماً طوال مراحل التجريب والمعالجة المرحلية.
بعد إتمام عملية الاستبدال في العمود الوسيط، يُطبق بروتوكول المقارنة المنطقية عبر بناء صيغ رياضية فاحصة مثل صيغة المقارنة =EXACT(A2, B2) لمعرفة الخلايا التي طالها التغيير بالتحديد، واستعراض مقدار الاختلاف وحجم النص المحذوف عبر صيغ الأطوال النصية =LEN(A2)-LEN(B2). وفور التأكد التام من استيفاء المخرجات لكافة معايير السلامة والتنقية المنشودة، يتم نسخ العمود المعدل ولصقه كـ “قيم” (Values) مكان العمود الأصلي، ثم حذف العمود الوسيط ليعود الجدول إلى هيكله النظيف والمتسق.
10.3 التكامل بين أحرف البدل والدوال النصية المتقدمة
لا تنتهي حدود الكفاءة في إكسل عند حدود نافذة البحث والاستبدال التفاعلية، بل تتضاعف قوتها التحليلية عند التكامل المنهجي بين أحرف البدل والدوال الحسابية والنصية المدمجة. ففي حين توفر نافذة البحث والاستبدال حلاً سريعاً وناجعاً للتعديل الشامل لمرة واحدة، تتفوق الصيغ البرمجية التلقائية في توفير سجلات معالجة ديناميكية تتكيف ذاتياً مع أي بيانات جديدة تُضاف لاحقاً للمصنف دون الحاجة للتدخل اليدوي المتكرر للمستخدم.
تدعم دوال البحث والإحصاء المعيارية أحرف البدل بكفاءة مطلقة؛ فدوال مثل COUNTIF، وSUMIF، وXLOOKUP تقبل النجمة وعلامة الاستفهام داخل وسائط شروطها؛ مما يتيح على سبيل المثال حساب عدد الطلاب الذين تبدأ معرفاتهم بالحرف “A” عبر الصيغة =COUNTIF(A2:A100, "A*"). كما يمكن الدمج بين الأداة التفاعلية والدوال النصية مثل دالتي REPLACE وSUBSTITUTE للوصول إلى بيئة عمل فائقة التوازن، تجمع بين الخفة الإجرائية للبحث السريع والدقة الرياضية الصارمة لإدارة وتحليل البيانات المعقدة بأعلى المستويات الاحترافية المعترف بها أكاديمياً.
خاتمة
تُشكل أداة البحث والاستبدال باستخدام أحرف البدل في مايكروسوفت إكسل ركيزة جوهرية لا غنى عنها لأي باحث أو محلل بيانات يسعى إلى تحقيق أعلى درجات الدقة والفاعلية في معالجة السجلات النصية وتنقيتها. فمن خلال الانتقال الواعي من المطابقة الحرفية الساكنة إلى التوظيف المنهجي المرن لأحرف البدل الثلاثة—النجمة (*) لسلاسل المحارف غير المحدودة، وعلامة الاستفهام (?) للمحارف الفردية المنضبطة، والتلدة (~) لتحييد الرموز المحجوزة واستعادة صفتها النصية الخام—يتحول إكسل من مجرد دفتر جداول حسابية بسيط إلى محرك قوي لمعالجة النصوص وإدارتها بمهارة حوسبية فائقة.
إن إتقان هذا المسار التقني يستلزم الموازنة المستمرة بين قوة الأتمتة السريعة ومتطلبات الحذر المنهجي الصارم؛ إذ إن الطبيعة التوسعية الجشعة لأحرف البدل قد تنقلب إلى مصدر لتدمير السجلات إذا أُهملت بروتوكولات الفحص المسبق، كاستعراض النتائج بأمر “البحث عن الكل”، أو عزل البيانات في أعمدة تجريبية وسيطة، والاحتفاظ الدائم بنسخ احتياطية أولية للبيانات الخام. ومن ثم، فإن اعتماد أفضل الممارسات الموثقة في هذا الدليل لا يضمن كفاءة إعداد البيانات فحسب، بل يرسخ الأمانة العلمية ويدعم موثوقية التحليلات والنتائج الإحصائية اللاحقة في شتى حقول البحث والمعرفة التطبيقية.
المراجع
- Kleene, S. C. (1951). Representation of events in nerve nets and finite automata (Research Memorandum RM-704). RAND Corporation. https://www.rand.org/pubs/research_memorations/RM704.html
- Kleene, S. C. (1952). Introduction to metamathematics. D. Van Nostrand Company.
- Kleene, S. C. (1956). Representation of events in nerve nets and finite automata. In C. E. Shannon & J. McCarthy (Eds.), Automata studies (Annals of Mathematics Studies, No. 34, pp. 3–41). Princeton University Press.
- Microsoft Corporation. (2024). Look up values with VLOOKUP, INDEX, or MATCH. Microsoft Support. https://support.microsoft.com/en-us/office/look-up-values-with-vlookup-index-or-match-680a6dd6-6021-40d3-a438-86e0f40447fa
- Microsoft Corporation. (2024). Find or replace text and numbers on a worksheet. Microsoft Support. https://support.microsoft.com/en-us/office/find-or-replace-text-and-numbers-on-a-worksheet-0e304ca5-ecef-4808-b90f-f44aca714dda
- Thompson, K. (1971). The UNIX time-sharing system (First edition manual). Bell Telephone Laboratories.