
تعد معالجة السلاسل النصية واستخراج البيانات النوعية والكمية منها إحدى أهم الركائز الأساسية في هندسة البيانات وإدارة نظم المعلومات الحديثة. في بيئات الأعمال الأكاديمية والمهنية، تتراكم البيانات غير المهيكلة بمعدلات متسارعة، وغالبًا ما تصل السجلات مدخلة بنسق هجين يجمع بين الرموز النصية والأرقام الحسابية داخل حقل بياني واحد، مثل معرفات الموظفين المركبة، ورموز المنتجات المخزنية، وأرقام المعاملات المحاسبية المقترنة ببادئات الحسابات. يتطلب التعامل الرشيد مع هذه السجلات تفكيك هذا النسيج المختلط لتحويله إلى مصفوفات قابلة للتحليل الإحصائي، والربط العلائقي، والنمذجة التنبؤية، مما يستوجب أدوات دقيقة في نمذجة المعادلات الحسابية داخل برمجيات الجداول الممتدة.
تمثل حزمة برمجيات مايكروسوفت إكسيل بيئة معالجة مركزية لملايين المحللين حول العالم منذ إطلاقها التاريخي، حيث تتيح محركًا حسابيًا متطورًا قادرًا على إجراء الحسابات المصفوفية المعقدة دون الحاجة الفورية إلى كتابة نصوص برمجية مخصصة. ومع ذلك، تقف البرمجية التقليدية عاجزة في بعض الأحيان أمام معالجة النصوص غير المتجانسة ذات الأطوال المتغيرة عبر الدوال النصية الأساسية البسيطة. تبرز هنا الحاجة الملحة إلى صياغة خوارزمية ذكية وقابلة للتكرار تعمل داخل الخلية المفردة، وتعتمد على مبادئ الحساب المصفوفي لتحديد الموضع النسبي لأول رقم يظهر داخل السلسلة النصية، ومن ثم تمكين المحلل من فصل هذا الرقم أو اقتطاع الجزء الرقمي بالكامل لدعم اتخاذ القرار وتأكيد موثوقية السجلات المؤسسية.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة معمقة وتفكيك تحليلي متكامل لصيغة العثور على أول رقم في سلسلة نصية داخل إكسيل. سنستعرض الأسس المنطقية والهيكلية التي تبنى عليها الصيغة الكلاسيكية القائمة على دمج مصفوفات البحث مع الدوال الدائرية، مع التركيز على التحصين المنطقي ضد أخطاء المعالجة، والتعامل مع السجلات الاستثنائية والمعقدة. كما سنتناول التطورات الحديثة التي طرأت على بيئة إكسيل المتقدمة عبر إدخال دوال التعابير النمطية، فضلًا عن تحليل كفاءة الأداء الحسابي في قواعد البيانات الضخمة وحوكمة عمليات تدقيق البيانات لضمان أعلى معايير الجودة والاستدامة الحسابية.
1. مدخل نظري لمعالجة السلاسل النصية واستخراج البيانات في إكسيل
1.1 أهمية فصل البيانات النصية عن العددية في بيئات العمل التحليلية
تمثل جودة البيانات حجر الزاوية في بناء أي نموذج تحليلي موثوق، حيث تعتمد المؤسسات الحديثة على التدفق المستمر للسجلات القادمة من نظم تخطيط موارد المؤسسات، وبوابات التجارة الإلكترونية، وتطبيقات إدارة علاقات العملاء. في كثير من هذه الأنظمة، تُسجل البيانات في صيغ مدمجة أو غير مهيكلة لأسباب تشغيلية تتعلق بضمان تفرد المعرفات، كأن يُدمج كود القسم مع الرقم التسلسلي للموظف داخل خانة واحدة. هذا المزج بين الحروف الأبجدية والأرقام الحسابية يعرقل عمل خوارزميات التجميع الرياضي، مثل حساب المتوسطات، والانحرافات المعيارية، وعمليات الفرز والتصنيف، لأن محركات قواعد البيانات والجداول الحسابية تعامل السلاسل المركبة كقيم نصية غير قابلة للقياس المباشر، مما يؤدي إلى تشويه التحليلات الإحصائية وتضليل نماذج التنبؤ المؤسسية.
يرتبط هذا التحدي بصورة مباشرة بما أشار إليه الباحثون في سياق معالجة قواعد البيانات المعجمية الضخمة من ضرورة تنقية المدخلات وضمان اتساقها الهيكلي لتجنب التحيزات الحسابية، كما بين كوليرز وزملاؤه (Keuleers et al., 2011) في مشروع المعجم البريطاني، حيث تطلبت معالجة عشرات الآلاف من المفردات النصية عزل الرموز المشوهة بدقة صارمة لضمان موثوقية النتائج السلوكية. على الصعيد التقني داخل إكسيل، يؤدي عزل القيمة العددية عن سياقها الحرفي إلى تصحيح الفروق الهيكلية الجوهرية بين نوعي البيانات؛ فالقيم النصية تُحاذى افتراضيًا إلى اليسار (أو اليمين بحسب اتجاه اللغة) وتُعامل كمصفوفات محارف جامدة، بينما تُحاذى القيم الرقمية إلى الاتجاه المعاكس وتخضع لقواعد الجبر الحسابي. إن هذا الفصل الدقيق يرفع من كفاءة عمليات الفهرسة المتقاطعة، ويسهل مطابقة السجلات عبر جداول متعددة دون اللجوء إلى معالجات يدوية مكلفة ومحفوفة بالخطأ البشري.
1.2 التحديات التقنية المرتبطة بالبحث عن الأرقام داخل النصوص غير المتجانسة
تتسم السلاسل النصية الحقيقية بدرجة عالية من عدم التجانس، حيث لا تتخذ الأرقام فيها مواضع ثابتة يمكن استخلاصها عبر دوال الاقتطاع البسيطة ذات الإحداثيات الجامدة. ففي بعض السجلات، قد يظهر الرقم في الخانة الرابعة بعد بادئة نصية ثلاثية، بينما يتأخر في سجلات أخرى إلى الخانة العاشرة نتيجة لاختلاف تصنيف البيانات أو وجود أسماء أقسام متباينة الطول. هذا التباين يلغي فعالية الاعتماد الأعمى على دوال الإزاحة الثابتة، ويفرض البحث عن خوارزمية مرنة قادرة على مسح السلسلة المحرفية ذاتيًا وتحديد نقطة الانعطاف التي يتحول فيها النص من الحقل الحرفي إلى الحقل الرقمي بصرف النظر عن حجم البادئة.
تتفاقم هذه الصعوبة التقنية عند التعامل مع معارف رقمية قد تبدأ بأصفار غير ظاهرة تفقد قيمتها إذا عوملت كرقم حسابي بصورة مبكرة، أو عند احتواء النص على فواصل، وعلامات ترقيم، ورموز خاصة تسبق الجزء العددي أو تتخلله. إن الدوال النصية التقليدية في برمجيات الجداول الحسابية صُممت أساسًا للتعامل مع محددات نصية معروفة مسبقًا، مثل البحث عن مسافة أو فاصلة منقوطة، وتفتقر بنيتها الكلاسيكية إلى التعرف التلقائي على الفئات المجردة كفئة الأرقام. لذلك، تصبح صياغة حلول مرنة تعتمد على المعادلات الحسابية المركبة أمرًا لا غنى عنه، لتمكين المحلل من إنجاز مهام المعالجة المعقدة بمرونة تشغيلية تامة وموثوقية رياضية محكمة تتفادى الحاجة إلى تشغيل بيئات برمجية خارجية.
2. الأساس المنطقي لصيغة تحديد موضع أول رقم في السلسلة النصية
2.1 الصياغة العامة للمعادلة الحسابية المعتمدة
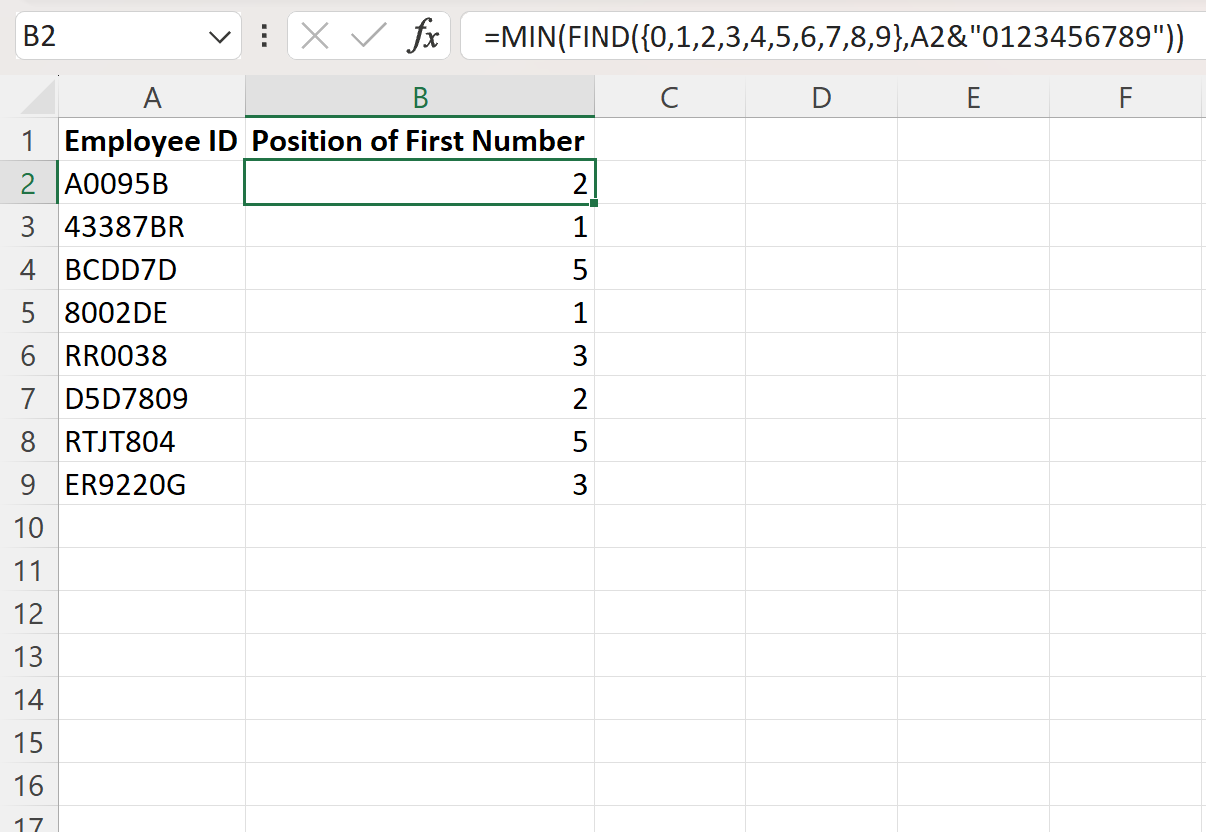
تعتمد الصيغة القياسية الأكثر استقرارًا وكفاءة في بيئة إكسيل لتحديد فهرس أول رقم داخل سلسلة نصية تقع في الخلية A1 على التركيب الرياضي التالي:
=MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”))
يقوم المنطق الهيكلي لهذه الصيغة على مبدأ المسح المتزامن متعدد المسارات؛ حيث يتم إجبار دالة البحث النصي على فحص وجود كامل فئة الأرقام العشرية الأساسية من الصفر إلى التسعة دفعة واحدة داخل النص المستهدف، بدلاً من إجراء عشر عمليات بحث متتالية ومنفصلة عبر خلايا مساعدة.
تعمل الصيغة من خلال توليد مصفوفة داخلية افتراضية تخزن المواضع النسبية لكل رقم من الأرقام العشرة داخل النص المعالج. بمجرد اكتمال عملية البحث عن كل عنصر في مصفوفة الأرقام، يتم تمرير هذه المصفوفة المكونة من عشرة إحداثيات رقمية إلى دالة التقليص الرياضي الصغرى، والتي تستخلص أصغر قيمة عددية من بين هذه الإحداثيات. تعبر هذه القيمة الصغرى بدقة متناهية عن الفهرس النصي لأول خانة يظهر فيها أي رقم من الأرقام العشرة، معتمدة على نظام الإحداثيات القياسي في إكسيل الذي يبدأ فيه ترقيم المحارف في السلسلة النصية من الموقع واحد، مما يوفر مؤشرًا حسابيًا دقيقًا يصلح كمدخل رئيسي للمراحل التحليلية التالية.
2.2 دور تقنية دمج النص بالأرقام الافتراضية لمنع أخطاء البحث
يمثل الجزء & “0123456789” الملحق بنهاية النص الأصلي داخل وسيط البحث حيلة هندسية بالغة الذكاء في بناء المعادلات الرياضية المعقدة، والهدف منها هو ضمان الحصانة المنطقية للمعادلة. فمن الخصائص المتأصلة في دالة البحث النصي أنها مصممة لإرجاع خطأ فادح في القيمة عندما تفشل في العثور على الرمز المطلوب داخل السلسلة المستهدفة. وفي سياق البحث المصفوفي، إذا كان النص الأصلي يحتوي على أرقام معينة مثل “3” و “7” فقط، فإن دالة البحث ستفشل في العثور على باقي الأرقام الثمانية، مما يؤدي إلى إنتاج مصفوفة نتائج تحتوي على ثمانية أخطاء حسابية، وهو ما يتسبب تلقائيًا في إفشال الدالة الخارجية التي لا تستطيع معالجة المصفوفات المشوبة بالأخطاء.
من خلال إلحاق السلسلة النصية المكونة من الأرقام العشرة المتتالية في نهاية محتوى الخلية، نضمن بصورة قطعية أن كل رقم من الصفر إلى التسعة موجود مرة واحدة على الأقل داخل السلسلة الممتدة الناتجة عن الدمج. هذا الإجراء الرياضي يمنع دالة البحث من إرجاع أي خطأ حسابي على الإطلاق، ويجعل مصفوفة المخرجات تحتوي دائمًا على عشر قيم عددية موجبة صالحة بالكامل للمعالجة اللاحقة. وإذا كان الرقم موجودًا بالفعل في النص الأصلي، فإن دالة البحث ستسجل موقعه الأسبق في النص الأصلي وتتجاهل ظهوره المتأخر في السلسلة الملحقة، مما يمنح الصيغة ثباتًا تشغيليًا مطلقًا بغض النظر عن محتوى الخلية المستهدفة.
3. التفكيك المنهجي لمكونات الصيغة: دالتا FIND وMIN والمصفوفة الثابتة
3.1 تحليل عمل مصفوفة الثوابت {0,1,2,3,4,5,6,7,8,9}
تُعرّف مصفوفة الثوابت في بيئة إكسيل بأنها مجموعة مغلقة من القيم المحاطة بأقواس مجعدة، وتُمرر ككتلة واحدة إلى وسائط الدوال دون الحاجة إلى حجز نطاق خلايا فعلي على ورقة العمل. في سياق هذه الصيغة، تفرض المصفوفة الثابتة {0,1,2,3,4,5,6,7,8,9} نمط الحساب المتجهي، حيث تعامل دالة البحث كل عنصر في المصفوفة كمدخل مستقل ومكتمل. يقلل هذا التقييم المتزامن من العبء المعرفي والحسابي اللازم لتصميم النماذج، ويحاكي مبادئ معالجة المعلومات المعقدة بكفاءة عالية وفق ما وضحه بولوك وتشاندلر وسويلر (Pollock, Chandler, & Sweller, 2002)، حيث يؤدي تنظيم المعالجة الحسابية في نسق مدمج ومترابط إلى تقليل تشتت الموارد الحسابية والذهنية على السواء.
تتميز مصفوفة الثوابت باستقرار استهلاكها للذاكرة العشوائية مقارنة بالاستدعاءات المستمرة لنطاقات الخلايا المرجعية. فعند تطبيق الصيغة على عشرات الآلاف من الصفوف في قواعد البيانات المؤسسية، يؤدي استخدام المصفوفة الثابتة إلى عزل محرك الحساب عن عمليات الوصول المتكرر إلى خلايا الشبكة، مما يمنع انخفاض سرعة المعالجة ويقلل من الاعتمادية التبادلية بين الخلايا. هذا الفصل المنطقي يجعل الصيغة مستقلة بذاتها ومحصنة ضد أي تغييرات قد تطرأ على هيكلية ورقة العمل المحيطة، مثل حذف الأعمدة المرجعية أو تعديل مواضعها، مما يحافظ على استدامة النموذج الحسابي وصحته البنيوية.
3.2 الخصائص المحددة لدالة FIND وسلوكها عند تلقي وسائط مصفوفية
تختص دالة FIND بالبحث عن موضع بداية نص معين داخل نص آخر، وتتميز بكونها حساسة لحالة الأحرف ولا تدعم الرموز البديلة الجامحة، على النقيض من دالة SEARCH التي تتجاهل حالة الأحرف وتدعم المحارف البديلة. على الرغم من أن حساسية الأحرف لا تنطبق مباشرة على الأرقام المجردة، فإن اختيار دالة FIND يُعد المعيار الأفضل هندسيًا هنا بسبب سرعتها الحسابية المتفوقة نسبيًا وخلوها من التعقيدات المرتبطة بتفسير علامات الاستفهام والنجوم كمحارف جامحة، مما يضمن تقييم الأرقام كرموز حرفية صريحة.
عندما تتلقى دالة FIND مصفوفة الثوابت كوسيط أول، فإنها لا تُرجع قيمة عددية مفردة كما تفعل في الاستخدام التقليدي، بل تُنتج مصفوفة مخرجات أحادية البعد تتكون من عشرة عناصر عددية، يمثل كل عنصر فيها الفهرس الحسابي للظهور الأول للرقم المقابل له في المصفوفة الأصلية. إذا تكرر نفس الرقم عدة مرات داخل السلسلة النصية، تلتزم الدالة بنيويًا بإرجاع موضع الظهور الأول فقط من جهة اليسار، وهو السلوك المطلوب تمامًا لعزل نقطة بداية الجزء العددي دون الالتفات إلى أي أرقام لاحقة قد تتكرر داخل النص، مما يحفظ الدقة الإحداثية لعملية المسح النصي.
3.3 دور دالة MIN في استخلاص نقطة البداية الرقمية
تأتي دالة MIN في المستوى الخارجي للصيغة لتؤدي وظيفة التلخيص والاختزال الرياضي للمصفوفة المتولدة عن دالة البحث. تحتوي المصفوفة المكونة من عشرة مواضع على أرقام تمثل مواقع الأرقام التي ظهرت في النص الأصلي، بالإضافة إلى مواقع الأرقام الافتراضية التي أُلحقت بنهاية النص في السلسلة الممتدة. تتولى دالة MIN تصفية هذه القيم الحسابية لاستخلاص أدنى قيمة عددية مطلقة، والتي تمثل حتمًا أول رقم واجهته الدالة أثناء قراءة السلسلة النصية من بدايتها.
تتجلى عبقرية التفاعل بين الدوال في قدرة دالة MIN على استبعاد المواضع الناتجة عن السلسلة الملحقة تلقائيًا طالما وجد رقم واحد على الأقل في النص الأصلي؛ وذلك لأن فهرس أي رقم في النص الأصلي سيكون دائمًا أقل من فهرس الأرقام الافتراضية التي تبدأ بعد نهاية النص مباشرة. وبذلك، تحول الدالة المصفوفة المعقدة إلى مؤشر أحادي بسيط وصالح للاستخدام المباشر كمعامل إزاحة في دوال الاقتطاع النصي المتقدمة، سواء كان هذا الرقم واقعًا في الخانة الأولى من النص أو متأخرًا في نهايته، مما ينهي مرحلة تحديد الموضع بنجاح رياضي محكم.
4. استخراج القيمة الفعلية لأول رقم عبر دمج دالتي MID وMIN
4.1 البنية التركيبية لمعادلة استخراج القيمة العددية
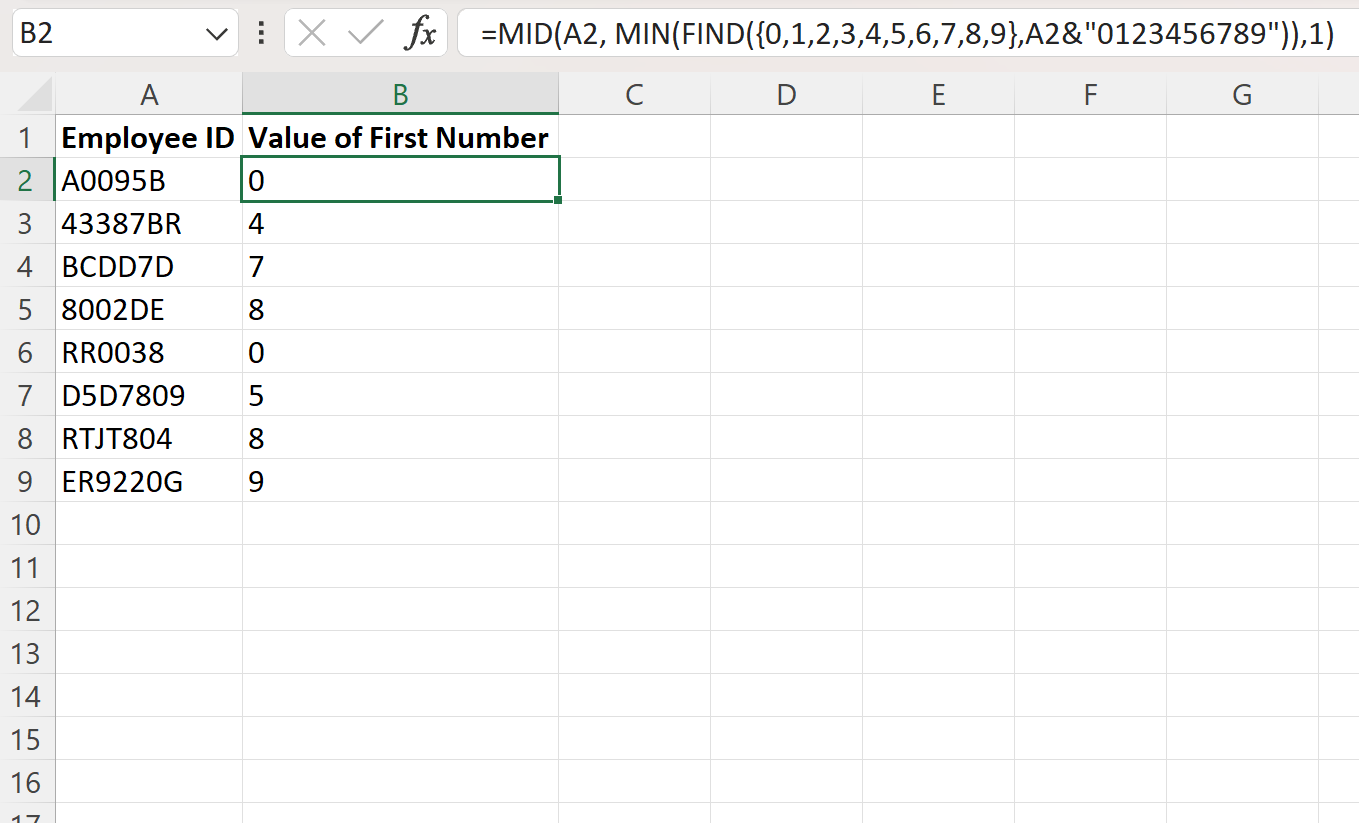
بعد النجاح في تحديد الفهرس العددي لموضع أول رقم، يتطلب التحليل العملي في كثير من السيناريوهات استخلاص الرمز الرقمي الفعلي ذاته وليس مجرد معرفة موقعه المجرد. لتحقيق هذه الغاية، تُدمج صيغة الموضع السابقة كمعامل وسيط لبداية الاقتطاع داخل دالة الاستقطاع النصي MID، لتصبح الصيغة التركيبية على النحو التالي:
=MID(A1, MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”)), 1)
تستقبل دالة MID ثلاثة وسائط: النص الأصلي في الخلية A1، ونقطة بداية الاقتطاع التي تولدها صيغة MIN(FIND(…))، وطول الجزء المقتطع والذي يُحدد هنا بالقيمة الثابتة 1 لضمان استخلاص خانة رقمية مفردة تعبر عن أول رقم في السلسلة.
يوضح هذا الدمج التركيبي الفارق المعرفي بين استخراج الإحداثي المكاني واستخراج المحتوى الدلالي للبيانات. إن استخراج الرقم المنفرد يتيح للمحلل إجراء عمليات تصنيف سريعة تعتمد على بادئات الترقيم، مثل فرز السجلات التي تبدأ أرقامها بالرقم 1 عن تلك التي تبدأ بالرقم 2، مما يوفر مرونة تحليلية لا تتيحها معرفة موضع الرقم بمفرده. كما تتيح هذه القيمة المستخرجة إجراء عمليات تحقق منطقية متقدمة لمطابقة المعرفات الوظيفية والتشغيلية مع جداول الصلاحيات والترميز المعتمدة داخل المنظمة.
4.2 معالجة نوع البيانات المستخرجة: النص مقابل الرقم
تتعامل دالة MID بحكم تعريفها التقني كمولد لسلاسل نصية، مما يعني أن المخرجات الناتجة عنها، حتى وإن كانت تتكون من أشكال رقمية مثل “5”، تُعامل داخل بيئة إكسيل كنصوص محرفية وليست كقيم حسابية فعلية. هذا التمايز التقني يترتب عليه نتائج حاسمة في تصميم النماذج؛ فالأرقام المعاملة كنصوص تفشل في التفاعل مع دوال الجمع والضرب، وتؤدي إلى مقارنات منطقية مضللة عند فحص علاقات التباين الرياضي، حيث يعتبر إكسيل أي قيمة نصية أكبر رياضيًا من أي قيمة عددية بغض النظر عن المقدار الحسابي الظاهري.
لتحويل هذه السلسلة النصية المقتطعة إلى قيمة رقمية حسابية أصيلة، يجب إخضاع الناتج لعملية تحويل نمطي صريحة. يمكن للمحلل استخدام الدالة النظامية VALUE، أو اللجوء إلى التقنية الأكثر شيوعًا وسرعة في الحساب المصفوفي والمتمثلة في استخدام العامل الحسابي المزدوج — قبل استدعاء دالة الاقتطاع، كالتالي:
=–MID(A1, MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”)), 1)
يجبر هذا المعامل محرك إكسيل على إجراء عمليتي نفي حسابيتين متتاليتين، مما يحول الرمز النصي قسرًا إلى رقم دون تغيير مقداره الحسابي. ومع ذلك، ينبغي توخي الحذر الشديد عند التعامل مع الأرقام التعريفية التي تحتوي على أصفار بادئة، مثل الأكواد التي تبدأ بالقيمة “05”، حيث يؤدي التحويل الحسابي إلى إسقاط الصفر البادئ وتحويله إلى الرقم المجرد 5، مما يستوجب الإبقاء على النسق النصي في الحالات التي تتطلب الحفاظ على البنية الشكلية الكاملة للمعرفات.
5. نماذج تطبيقية وسيناريوهات عملية في تحليل معرفات العمل
5.1 تطبيق الصيغة على معرفات الموظفين والأكواد الوظيفية
تتضمن بيئات الموارد البشرية والرواتب غالبًا أنظمة ترقيم وظيفي تطورت عبر عقود متباينة، مما ينتج عنه سجلات تجمع بين بادئات تاريخية وأرقام متسلسلة غير موحدة. على سبيل المثال، قد تجد في سجل الموظفين أكوادًا مثل EMP0095 للموظفين القدامى، و A0095B للمتعاقدين، و HR4892 لموظفي الموارد البشرية. عند إدراج صيغة تحديد موضع أول رقم في العمود المقابل وسحبها لكامل السجلات، تُرجع الصيغة القيمة 4 للسجل الأول، والقيمة 2 للسجل الثاني، والقيمة 3 للسجل الثالث بدقة متناهية، متجاوزة تباين أطوال المقاطع الحرفية.
يمكن استثمار هذه الإحداثيات المستخرجة في تصنيف السجلات وفصل رموز الأقسام الحرفية عن الأرقام التسلسلية للموظفين. فمن خلال دمج موضع أول رقم مع دالة LEFT، يمكن اقتطاع الجزء الحرفي الخالص وتجميعه في حقل مستقل لفرز الأقسام، بينما تُستخدم دالة MID بالتكامل مع طول السلسلة الإجمالي لاستخلاص المعرف الرقمي الصافي. يتيح هذا الإجراء أتمتة تصنيف القوى العاملة، وتتبع التسلسل التاريخي للتوظيف، وتحسين عمليات التحقق والمطابقة مع سجلات التأمينات الاجتماعية والأنظمة الحكومية ذات الصلة.
5.2 معالجة أرقام التشغيل ورموز المنتجات في المستودعات والمخازن
تواجه سلاسل الإمداد وإدارة المستودعات تحديات معقدة ناتجة عن التباين الكبير في ترميز السلع والقطع المصنعية، حيث تُنشأ وحدات حفظ المخزون بدمج معايير التصنيع والموديل وسنة الإنتاج، كالأكواد SKU-482-X و PRD987 و BOX-L-014. إن أتمتة قراءة وفصل هذه الأكواد تعد خطوة أساسية لضمان سرعة الجرد وتجنب أخطاء الإدخال اليدوي التي تكلف المؤسسات خسائر مالية فادحة نتيجة تأخر تلبية الطلبات أو ازدواجية التسجيل في برمجيات المخازن.
يوفر استخدام صيغة الفهرس الرقمي آلية سريعة لفرز السلع وعزل البادئات المصنعية الخاصة بالموردين عن أرقام التشغيل التسلسلية التي تعبر عن خطوط الإنتاج الفعلية. يسهم هذا الفصل في تمكين موظفي المستودعات من إجراء استعلامات بحث متقاطعة عالية السرعة باستخدام الأرقام فقط، ومطابقة الشحنات الواردة مع فواتير الشحن الدولية التي قد تختلف في صياغة البادئات النصية لكنها تتطابق في التسلسل الرقمي المحوري، مما يعزز الكفاءة اللوجستية ويقلل زمن دورة إدارة المخزون بنسب ملحوظة.
5.3 تتبع الفواتير والقيود المحاسبية غير المتجانسة
في الإدارات المالية والمحاسبية، تتراكم قيود اليومية وأرقام المعاملات الصادرة عن بوابات دفع إلكترونية متعددة، مثل فواتير تبدأ بالرمز INV/2024/9841 أو قيود مصرفية مثل TRX-REF-55421. إن تباين صياغة هذه القيود يمنع المحاسبين القانونيين من تنفيذ عمليات المطابقة البنكية الآلية دون إجراء عمليات معالجة نصية مسبقة لعزل الأرقام المرجعية المستقلة، والتي تُعد الرابط الفعلي بين سجلات البنوك والدفاتر المحاسبية العامة داخل المنشأة.
يتيح تطبيق صيغة البحث عن أول رقم عزل المعرفات المالية الممتدة بعد البادئات الدفترية، مما يمهد لبناء أدوات تدقيق مالي مؤتمتة تقارن الفواتير الصادرة بأوامر الصرف المسجلة في الحسابات الدائنة والمدينة. كما يسهم ذلك في إنشاء لوحات تحكم مالية ذكية ترصد التدفقات النقدية بناءً على الأرقام التشغيلية الصافية، وتمنع تكرار تسجيل العمليات المالية التي قد تُقيد بطريق الخطأ تحت بادئات مختلفة نتيجة أخطاء أنظمة الترحيل المالي المتعددة.
6. معالجة الحالات الخاصة والاستثناءات الهيكلية في البيانات
6.1 التعامل مع السلاسل النصية الخالية تماماً من الأرقام
من الضروري للمصمم المحترف للجداول الممتدة فهم السلوك الحسابي الدقيق للصيغة عند مواجهة سلاسل نصية خالية تمامًا من أي عنصر رقمي، مثل الخلية التي تحتوي على الكلمة النصية الصافية “General”. في هذه الحالة، تفشل دالة البحث في العثور على أي رقم داخل النص الأصلي، وتتجه مباشرة نحو السلسلة الملحقة في النهاية “0123456789” لتسجل أول رقم فيها وهو الصفر، والذي يقع حتمًا في الفهرس الذي يلي آخر حرف من النص الأصلي مباشرة.
نتيجة لهذا السلوك الهندسي، تُرجع الصيغة قيمة عددية تساوي بدقة طول النص الأصلي مضافًا إليه واحد:
LEN(A1) + 1
لتحصين النموذج وتجنب اعتبار هذا الموقع الافتراضي كفهرس لرقم حقيقي داخل الخلية، يجب دمج الصيغة بشرط منطقي يفحص ما إذا كان المؤشر المستخرج يتجاوز الطول الفعلي للنص الأصلي، وذلك باستخدام التركيب التالي:
=IF(MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”)) > LEN(A1), “لا يوجد رقم”, MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”)))
يضمن هذا التحقق الشرطي استبعاد السجلات التي لا تحتوي على معارف رقمية وتوجيهها إلى مسارات معالجة استثنائية دون تلويث مصفوفة النتائج التحليلية بقيم وهمية.
6.2 تحصين المعادلة ضد الخلايا الفارغة والأخطاء المتوقعة
تتطلب البيئات الإنتاجية التعامل الوقائي مع احتمالات وجود خلايا فارغة بالكامل أو خلايا تحتوي على مسافات بيضاء غير مرئية نتجت عن عمليات استيراد وتصدير خاطئة لقواعد البيانات. عند تطبيق الصيغة على خلية فارغة تمامًا، يكون طول النص مساويًا للصفر، وتُرجع الصيغة القيمة 1 لأن الرقم صفر في السلسلة الملحقة يصبح في الموضع الأول، وهو ما قد يفسره النموذج كوجود رقم في أول الخلية الفارغة.
لتفادي هذا الخلل وحماية جداول التقارير، يُنصح بتغليف الصيغة بدالتي التحقق النصي والتأمين ضد الأخطاء، مستعينين بدالتي IF و TRIM لتطهير المدخلات قبل معالجتها:
=IF(OR(ISBLANK(A1), TRIM(A1)=””), “”, IF(MIN(FIND({0,1,2,3,4,5,6,7,8,9}, A1 & “0123456789”)) > LEN(TRIM(A1)), “لا يوجد رقم”, MIN(FIND({0,1,2,3,4,5,6,7,8,9}, TRIM(A1) & “0123456789”))))
كما يمكن استخدام دالة IFERROR كطبقة حماية خارجية شاملة لاعتراض أي أعطال حسابية غير متوقعة، مما يضمن الحفاظ على المظهر الاحترافي لتقارير الأعمال ومنع تفشي أخطاء واجهات الجداول عبر الأقسام الإدارية والتحليلية.
6.3 تأثير الرموز الخاصة وعلامات الترقيم على دقة الاكتشاف
كثيرًا ما تتضمن السجلات الحقيقية علامات ترقيم ورموزًا غير أبجدية، مثل الشرطات، والنقاط، والشرطات المائلة، والأقواس، كالسلسلة #REF-(99)-B. لا تتأثر دالة FIND بهذه الرموز طالما أنها لا تتطابق مع المحارف الرقمية المحددة في مصفوفة الثوابت، حيث تتجاهل الدالة أي رمز لا ينتمي إلى المجموعة المحددة بدقة بين الصفر والتسعة وتواصل مسح السلسلة المحرفية حتى تصطدم بأول رقم حقيقي.
يبرز التحدي الحقيقي فقط عندما تتضمن النصوص لغات متعددة أو علامات تشكيلية قد تغير من تسلسل البايتات داخل الذاكرة إذا كانت النصوص مستوردة من أنظمة تشفير عتيقة لا تدعم اليونيكود الحديث بصورة معيارية كاملة. ومع ذلك، وبفضل الطبيعة الصريحة لمصفوفة الثوابت، تظل الصيغة محصنة ضد التداخل مع الحروف الخاصة أو الحروف المركبة، وتضمن استبعاد الرموز التعبيرية وعلامات الترقيم، واستهداف الأرقام حصريًا بأعلى مستويات الدقة القياسية الممكنة في معالجة السجلات المؤسسية.
7. مقارنة الحلول التقليدية بالدوال الحديثة وتقنيات التعبير النمطي (RegEx)
7.1 البدائل الحديثة في الإصدارات المتقدمة (Excel 365)
شهدت الإصدارات الحديثة من مايكروسوفت إكسيل، لا سيما الاشتراكات السحابية في إكسيل 365 التي تم تحديثها مؤخرًا، ثورة بنيوية في معالجة النصوص عبر إدخال دوال التعابير النمطية المباشرة والمدمجة بصورة أصلية في بيئة الجداول الحسابية. بات بإمكان المحللين تجاوز التركيبات المصفوفية الكلاسيكية المعقدة واستبدالها بدوال صريحة مثل REGEXEXTRACT التي تستخدم محركات التعبير النمطي المتوافقة مع معايير الحوسبة العالمية، حيث يمكن استخلاص أول رقم في السلسلة باستخدام صيغة مباشرة وأنيقة:
=REGEXEXTRACT(A1, “d”)
حيث يشير الرمز المحرفي d إلى نمط أي خانة عددية مفردة.
علاوة على ذلك، إذا كان الهدف هو استخلاص كامل العدد المتصل الذي يبدأ عند ذلك الموضع (مثل استخراج 450 كاملة من السلسلة “Trial450B”)، تتيح التعابير النمطية إضافة علامة التكرار + لتصبح الصيغة:
=REGEXEXTRACT(A1, “d+”)
أما إذا أردنا تحديد الموضع الدقيق للفهرس الرقمي عبر الدوال الحديثة، فيمكن دمج دالة الاستخلاص النمطي مع دالة البحث المباشر كالتالي:
=FIND(REGEXEXTRACT(A1, “d”), A1)
ورغم هذه الكفاءة الفائقة والمقروئية العالية للدوال الحديثة، تظل الصيغة الكلاسيكية المعتمدة على MIN و FIND هي المعيار الأوسع انتشارًا والأكثر موثوقية في بيئات المؤسسات المتعددة؛ نظرًا لمتطلبات التوافق العكسي مع الإصدارات القديمة من إكسيل التي تفتقر إلى محرك التعابير النمطية المحدث، مما يجعل إتقان الصيغ التقليدية ضرورة حتمية لأي مهندس بيانات يحرص على قابلية تشغيل مصنفاته لدى جميع الأطراف دون قيود تقنية.
7.2 الحلول البرمجية المخصصة عبر Visual Basic for Applications (VBA)
يُمثل بناء الدوال المخصصة والمعرفة من قبل المستخدم عبر لغة البرمجة المدمجة في إكسيل خيارًا هندسيًا بالغ القوة في سيناريوهات المعالجة المتقدمة. يمكن للمطور كتابة دالة برمجية تقوم بالمرور التكراري على كل محرف في السلسلة النصية واختباره لمعرفة ما إذا كان يمثل رقمًا باستخدام دوال الفحص الحسابية، أو تفعيل كائن التعابير النمطية VBScript.RegExp لتنفيذ البحث النمطي عبر الشيفرة المصدرية في خلفية التطبيق.
يوضح هذا النموذج البرمجي البسيط كيفية تحقيق ذلك عبر حلقة تكرارية تفحص المحارف واحدًا تلو الآخر:
Function FindFirstDigitIndex(Target As Range) As Long
Dim i As Long
Dim txt As String
txt = Target.Value
For i = 1 To Len(txt)
If Mid(txt, i, 1) Like “[0-9]” Then
FindFirstDigitIndex = i
Exit Function
End If
Next i
FindFirstDigitIndex = 0
End Function
على الرغم من الأناقة الشكلية للحلول البرمجية المخصصة، إلا أنها تنطوي على محاذير تشغيلية وأمنية جسيمة داخل بيئات العمل المؤسسية. فالملفات التي تحتوي على أكواد ماكرو تتطلب حفظ المصنف بتنسيقات خاصة وغالبًا ما تُحظر عبر جدران الحماية المؤسسية وسياسات أمان مراكز تكنولوجيا المعلومات خشية البرمجيات الخبيثة. بالإضافة إلى ذلك، فإن استدعاء دوال المستخدم عبر آلاف الصفوف يؤدي إلى بطء ملحوظ في الأداء مقارنة بالدوال الحسابية الأصلية المكتوبة بلغات منخفضة المستوى والمحسنة داخليًا بواسطة مايكروسوفت، مما يجعل الاعتماد على الصيغ المباشرة في ورقة العمل هو الخيار الأفضل تشغيليًا وأمنيًا.
8. تحسين الأداء الحسابي وكفاءة المعالجة في قواعد البيانات الضخمة
8.1 أثر العمليات المصفوفية على استهلاك موارد المعالج والذاكرة
تتطلب معالجة السجلات المليونية في بيئات الأعمال المعاصرة وعيًا كاملًا بسلوك محرك الحساب وتكلفة استهلاك موارد وحدة المعالجة المركزية. فعلى الرغم من أن صيغة MIN(FIND(…)) صيغة موجزة، فإن تطبيقها على مئات الآلاف من الخلايا يجبر المحرك على تنفيذ عشر عمليات بحث نصي مستقلة لكل صف على حدة، مما يعني إجراء ملايين العمليات الرياضية التقييمية عند كل إعادة حساب كاملة لورقة العمل. هذا العبء يظهر بوضوح في النماذج الكبيرة ويثير تساؤلات حول الكفاءة المعرفية والتقنية لتصميم الأنظمة وفق الأطر التي تناولها شوارتز وبرانسفورد (Schwartz & Bransford, 1998)، حيث يجب مواءمة الهياكل التفسيرية المعقدة مع قدرات المعالجة لتحقيق أعلى كفاءة عملية دون استنزاف للموارد.
لإدارة هذا الاستهلاك بكفاءة، يُنصح بتعطيل وضع الحساب التلقائي وتحويله إلى وضع الحساب اليدوي أثناء فترات إدخال وتعديل البيانات الضخمة، لضمان عدم تجميد واجهة المستخدم بسبب عمليات إعادة الحساب المستمرة مع كل ضغطة مفتاح. كما يجب الحرص على حصر نطاق تطبيق الصيغ المصفوفية بدقة على الخلايا التي تحتوي على بيانات فعلية دون سحب الصيغ إلى آلاف الصفوف الفارغة في قاع ورقة العمل، مما يحافظ على سرعة استجابة المصنف ويقلل من استهلاك الذاكرة العشوائية إلى أدنى حد ممكن.
8.2 استراتيجيات الأعمدة المساعدة مقابل الصيغ المركبة ذات الخطوة الواحدة
يطفو دائمًا جدل هندسي حول المفاضلة بين الاعتماد على الصيغ المركبة الطويلة أحادية الخلية وبين تقسيم منطق الحل على أعمدة مساعدة مرحلية. تمتاز الصيغة المركبة أحادية الخلية بالحفاظ على نظافة الهيكل البصري للجدول وتجنب تشتيت المستخدم النهائي بتفاصيل تقنية وسيطة، لكنها في الوقت ذاته تصبح صعبة التدقيق عند حدوث أخطاء غير متوقعة، وتتطلب فهمًا عميقًا من قبل أي محلل آخر قد يتولى صيانة النموذج لاحقًا.
في المقابل، يتيح استخدام الأعمدة المساعدة (مثل تخصيص عمود لحساب طول النص، وعمود ثانٍ لتنظيف المسافات، وعمود ثالث لحساب موضع الرقم، وعمود رابع لاقتطاع القيمة) مزايا استثنائية في تتبع الأخطاء وفحص سير البيانات بدقة في كل مرحلة. وعلى الرغم من أن هذا النهج يزيد نسبيًا من حجم ملف العمل على القرص الصلب، إلا أنه غالبًا ما يكون أكثر كفاءة في سرعة المعالجة الحسابية؛ لأن المحرك يتفادى تكرار العمليات الحسابية المتطابقة داخل الصيغ المركبة الطويلة، ويستفيد من نتائج الخلايا الوسيطة المخزنة مؤقتًا، مما يجعل اختيار النهج الأمثل رهنًا بحجم البيانات ومتطلبات سهولة الصيانة والتدقيق داخل المنظمة.
9. دليل استكشاف الأخطاء وتصحيحها في صيغ تحديد الأرقام
9.1 الأخطاء المنطقية الشائعة وطرق فحصها وتجاوزها
تعتبر الإعدادات الإقليمية لنظام التشغيل وبرنامج إكسيل المصدر الأول للأخطاء الشائعة التي تواجه المحللين عند كتابة الصيغ الحسابية. ففي الأنظمة التي تعتمد التنسيقات الإقليمية للولايات المتحدة والمملكة المتحدة، تُستخدم الفاصلة العادية للفصل بين وسائط الدوال، بينما تفرض التنسيقات الإقليمية للعديد من الدول الأوروبية والشرق أوسطية استخدام الفاصلة المنقوطة للفصل بين الوسائط لتجنب التداخل مع الفاصلة العشرية. عدم مراعاة هذا التمايز الإقليمي يؤدي فورًا إلى ظهور رسائل اعتراضية تمنع إدخال الصيغة بالكامل، مما يستوجب ضبط الصياغة لتتوافق مع إعدادات الجهاز المحلي:
=MIN(FIND({0;1;2;3;4;5;6;7;8;9}; A1 & “0123456789”))
تنشأ أخطاء منطقية أخرى بسبب وجود مسافات بادئة خفية أو محارف بيضاء غير مرئية تسبق النص الأصلي، مما يؤدي إلى انحراف مؤشر الموضع المحسوب وزيادته بمقدار تلك المسافات عن الموضع الظاهري للرقم. لتشخيص وفحص هذه الأخطاء المعقدة، يوفر إكسيل أداة تقييم الصيغة خطوة بخطوة، والتي تتيح للمحلل متابعة تفكيك مصفوفة الثوابت ومراقبة القيم المؤقتة التي تنتجها دالة البحث لكل رقم على انفراد، مما يكشف بدقة عن منبع الخلل ويسمح بمعالجته عبر دمج دوال التنقية المسبقة قبل إقرار النتائج النهائية للنموذج.
9.2 مشكلات ترميز النصوص وتأثير صيغ الأرقام الإقليمية
يواجه المحللون في المنطقة العربية والشرق الأوسط تحديًا تقنيًا فريدًا يتمثل في الاختلاف بين الأرقام المستخدمة دوليًا (المعروفة تقنيًا بالأرقام العربية الغربية 0-9) والأرقام العربية المشرقية (المعروفة بالأرقام الهندية ٠-٩). إن الصيغة الكلاسيكية المعتمدة على مصفوفة الثوابت اللاتينية {0,1,2,3,4,5,6,7,8,9} تفشل تمامًا في التعرف على الأرقام العربية المشرقية؛ لأن المحارف “٠” و “١” تمتلك نقاط ترميز يونيكود مختلفة كليًا عن الأرقام “0” و “1”، مما يجعل دالة البحث تعتبرها نصوصًا حرفية عادية وتتجاهلها.
لحساب مواضع الأرقام المشرقية في قواعد البيانات التي تفرض هذا الترميز، يجب تكييف مصفوفة الثوابت والسلسلة الملحقة لتشمل هذه المحارف بصورة صريحة:
=MIN(FIND({“٠”,”١”,”٢”,”٣”,”٤”,”٥”,”٦”,”٧”,”٨”,”٩”}, A1 & “٠١٢٣٤٥٦٧٨٩”))
أو بناء مصفوفة بحث ثنائية موسعة تدمج النمطين معًا لضمان اكتشاف أول رقم بغض النظر عن نسق الترقيم المستخدم داخل السجل. إن توحيد ترميز الخطوط والبيانات قبل الشروع في عمليات الاستخراج والمعالجة يظل هو الممارسة الاحترافية الفضلى لضمان اتساق قواعد البيانات الرقمية الدولية، كما بينت الدراسات التحليلية في حوسبة اللغات الطبيعية التي تناولت بناء قواعد البيانات المعجمية الدقيقة مثل مشروع مانولكس لبيانات القراءة الابتدائية الذي قاده ليتيه وزملاؤه (Lété, Sprenger-Charolles, & Colé, 2004)، ومشروع المعجم الفرنسي الذي طوره فيران وزملاؤه (Ferrand et al., 2010)، حيث يمثل الضبط الصارم لترميز المحارف شرطًا أوليًا لا يقبل التهاون لضمان موثوقية استرجاع البيانات وتحليلها الإحصائي.
10. أفضل الممارسات وحوكمة البيانات لتصميم نماذج عمل مستدامة
10.1 توثيق الصيغ المعقدة وضمان قابلية الصيانة المستمرة
تعتمد استدامة النماذج الحسابية في المؤسسات على سهولة قراءتها وقابليتها للصيانة والتطوير من قبل فرق العمل المتعاقبة. إن إدراج صيغ مصفوفية متقدمة دون توثيق كافٍ يرفع من خطر الأخطاء التشغيلية عند قيام موظفين جدد بتعديل أوراق العمل دون إدراك المنطق الداخلي للمصفوفات الثابتة. هذا الخلل في تقييم الذات والمهارات التقنية ناقشه بعمق دانينغ وهيث وسولز (Dunning, Heath, & Suls, 2004)، حيث أثبتوا أن غياب الفهم الواضح والتوثيق المعياري يقود الأفراد في كثير من الأحيان إلى قرارات خاطئة وثقة مفرطة في نماذج مشوبة بالعيوب، مما يؤكد الأهمية القصوى للتوثيق الصريح في البيئات التحليلية الحساسة.
تشمل أفضل الممارسات في هذا السياق كتابة تعليقات توضيحية مفصلة ملحقة برؤوس الأعمدة تشرح الغرض من الصيغة المصفوفية وكيفية عملها. علاوة على ذلك، يُنصح بتعريف مصفوفة الثوابت كنطاق مسمى داخل إدارة الأسماء في إكسيل، كأن يُطلق على المصفوفة اسم DigitsList، مما يحول الصيغة إلى نسق مقروء وشديد الوضوح:
=MIN(FIND(DigitsList, A1 & “0123456789”))
يسهم هذا التبسيط الدلالي في رفع كفاءة التدقيق الداخلي، ويسهل نقل المعرفة بين المحللين، ويحمي الاستثمارات المؤسسية في بناء مصنفات ونماذج التحليل المالي والإداري المستدام.
10.2 دمج الصيغة ضمن مسارات عمل التحقق من صحة البيانات (Data Validation)
تتجاوز فائدة صيغة تحديد موضع الرقم مجرد استخراج البيانات وتنظيفها بأثر رجعي، لتصل إلى لعب دور محوري في حوكمة تدفق البيانات منذ لحظة إدخالها الأولى عبر أدوات التحقق من صحة البيانات المدمجة في إكسيل. يمكن لمديري النظم فرض قيود صارمة على الخلايا التي يُشترط فيها التزام المستخدم بنسق ترقيم قياسي، كاشتراط أن يبدأ الرقم التعريفي دائمًا برمز حرفي لا يتجاوز ثلاثة أحرف يليه رقم مباشر، مما يمنع إدخال السجلات المشوهة في مهدها.
يتم هذا التكامل عبر إدخال صيغة التحقق المنطقي المخصصة داخل نافذة التحقق من صحة البيانات، لرفض أي إدخال لا يطابق الشروط الهيكلية المعيارية وتنبيه المستخدم برسالة خطأ توضيحية توجهه نحو النسق الصحيح. إن بناء أنظمة إنذار مبكر تكتشف الشذوذ في تراكيب البيانات قبل ترحيلها إلى المستودعات المركزية وقواعد البيانات السحابية يمثل قمة النضج المؤسسي في إدارة البيانات، ويقلل من التكاليف الباهظة والجهود المضنية المرتبطة بعمليات التنقية اللاحقة، مما يرسخ بيئة معلوماتية رصينة تتسم بأعلى درجات الدقة والنزاهة الإحصائية.
خاتمة
يمثل التمكن من تحديد موضع أول رقم واستخلاصه من السلاسل النصية غير المتجانسة مهارة محورية في هندسة الجداول الممتدة ومعالجة البيانات المتقدمة. لقد كشف هذا التحليل الأكاديمي الشامل عن البنية المنطقية العميقة التي تجعل من الصيغة الكلاسيكية القائمة على دمج دالتي FIND و MIN مع مصفوفة الثوابت الرقمية والسلسلة الاحترازية الملحقة نموذجًا هندسيًا عبقريًا في الاستقرار والثبات، قادرًا على معالجة ملايين السجلات دون الوقوع في شراك الأخطاء الرياضية التقليدية أو التضحية بالأداء الحسابي.
ومع تطور محركات الحساب وظهور إكسيل 365 المزود بالدوال الحديثة والتعابير النمطية المباشرة، يشهد مجال معالجة البيانات نقلة نوعية تتيح صياغة حلول فائقة الأناقة والسرعة. ومع ذلك، يظل الفهم العميق للأسس الحسابية والرياضية التي بنيت عليها الدوال التقليدية هو الدرع المعرفي الحقيقي للمحلل، وضمانته الكبرى لتصميم نماذج عمل مرنة ومستدامة وقابلة للتشغيل عبر مختلف البيئات البرمجية والإقليمية، مما يرسخ ثقافة حوكمة البيانات ويضمن دقة اتخاذ القرارات في المنظمات الحديثة.
المراجع
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Ferrand, L., New, B., Brysbaert, M., Keuleers, E., Bonin, P., Méot, A., et al. (2010). The French Lexicon Project: Lexical decision data for 38,840 French words and 38,840 pseudowords. Behavior Research Methods, 42(2), 488–496. https://doi.org/10.3758/brm.42.2.488
- Keuleers, E., Lacey, P., Rastle, K., & Brysbaert, M. (2011). The British Lexicon Project: Lexical decision data for 28,730 monosyllabic and disyllabic English words. Behavior Research Methods, 44(1), 287–304. https://doi.org/10.3758/s13428-011-0118-4
- Lété, B., Sprenger-Charolles, L., & Colé, P. (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers, 36(1), 156–166. https://doi.org/10.3758/bf03195560
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction, 12(1), 61–86. https://doi.org/10.1016/s0959-4752(01)00016-0
- Schwartz, D. L., & Bransford, J. D. (1998). A Time For Telling. Cognition and Instruction, 16(4), 475–522. https://doi.org/10.1207/s1532690xci1604_4