
تُعد معالجة السلاسل النصية وتنقيتها في برمجيات جداول البيانات، وعلى رأسها مايكروسوفت إكسل (Microsoft Excel)، ركيزة محورية في تحضير البيانات وإعدادها للتحليل الإحصائي والنمذجة الرياضية. إن تدفق البيانات من مصادر متعددة، مثل قواعد البيانات المركزية، أو الاستبيانات الإلكترونية، أو مستودعات القياس النفسي والاجتماعي، غالباً ما ينتج عنه مدخلات نصية مركبة تدمج عدة حقول معلوماتية داخل خلية واحدة باستخدام فواصل رمزية شائعة، مثل علامة الشرطة (-). هذه الكيانات المدمجة، وإن كانت مفيدة في مراحل الأرشفة والترميز الأولي، تتحول إلى عائق منهجي حين تقتضي متطلبات التحليل عزل المتغيرات وتجريد المفاهيم المستقلة لدراستها على حدة.
تتطلب عملية استخلاص النصوص الواقعة قبل رمز الفاصل، وإزالة كافة الأحرف والزوائد التي تليه، إدراكاً عميقاً للبنية الخوارزمية التي تتعامل بها بيئة إكسل مع البيانات الحرفية (String Data). فعلى مدار العقود الماضية، تطورت هذه الآليات من مجرد صيغ رياضية ومركبة تعتمد على تضافر دوال الاقتطاع الموضعي والبحث المرجعي، وصولاً إلى الثورة البرمجية التي أطلقتها شركة مايكروسوفت عبر محرك المصفوفات الديناميكية والدوال المتخصصة الحديثة. يمثل هذا التحول نقلة نوعية تهدف إلى تقليص الأخطاء البشرية، وتحسين كفاءة استهلاك الذاكرة الحاسوبية، وتوفير مسارات عمل قابلة لإعادة التكرار والتدقيق الأكاديمي الرصين.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك إشكالية “إزالة الأحرف بعد الشرطة” في إكسل عبر دراسة بنيوية مفصلة تغطي كافة الأبعاد المنهجية والتقنية. سنستعرض الأسس النظرية لمعالجة النصوص وتحديات الفواصل الرمزية، ونحلل الدالة الحديثة TEXTBEFORE بتفصيل رياضي وإجرائي، قبل أن ننتقل إلى تفكيك البدائل الكلاسيكية المركبة لضمان التوافق مع الإصدارات التاريخية. كما سيتناول الدليل الحلول غير البرمجية، وآليات التنقية الذكية، وتقنيات المعالجة الضخمة عبر محرك باور كويري (Power Query)، مدعوماً بضوابط التحقق المنهجي لضمان تكامل وموثوقية البيانات المستخلصة وفق أعلى المعايير المعرفية والتطبيقية.
1. مدخل نظري إلى معالجة النصوص وتجزئة السلاسل النصية في مايكروسوفت إكسل
1.1 أهمية تنقية السلاسل النصية في التحليل الإحصائي للبيانات
تمثل جودة البيانات المدخلة المحدد الأساسي لمصداقية المخرجات الإحصائية في أي دراسة علمية أو تطبيق مهني. عند التعامل مع حزم البيانات النصية المجمعة، يُلاحظ تكرار وجود شوائب رمزية وتراكمات نصية غير متجانسة تؤدي إلى تشويه التوزيع التكراري للمتغيرات، مما يعرقل خوارزميات الاسترجاع الآلي للمعلومات ويحد من دقة نماذج القياس. في بحوث العلوم السلوكية واللغوية الحاسوبية، كما أشار Keuleers et al. (2010) في سياق دراسة التعرف البصري على المفردات، فإن تباين المعايير النصية والزوائد التوصيفية داخل الوحدات اللغوية يؤدي إلى تشويش في تصنيف المثيرات واستجابات القياس، مما يبرز الحاجة الماسة إلى تقنيات تطهير حازمة تعيد توحيد البنية الصرفية والرمزية للمتغيرات قيد الفحص.
إن توحيد معايير إدخال النصوص وتجريدها من اللواحق غير الضرورية يضمن توافق جداول البيانات مع حزم التحليل المتقدمة مثل SPSS وR وبايثون. فعندما يحتوي حقل تعريفي على معرف المبحوث متبوعاً بشرطة تليها شفرة المجموعة التجريبية (مثل “ID409-GroupA”)، فإن النظم الحاسوبية تتعامل مع هذا المزيج كقيمة فريدة جديدة بدلاً من اعتباره متغيراً تصنيفياً قابلاً للتجزئة. هذا الخلط الهيكلي يمنع البرمجيات من إجراء عمليات المطابقة الرأسية والربط بين الجداول المختلفة، فضلاً عن تأثيره السلبي على اختبارات الفروق وتحليلات التباين التي تشترط نقاءً مطلقاً في تعريف المجموعات المستقلة.
علاوة على ذلك، يظهر التباين الجوهري بين إدارة النصوص الثابتة والمتغيرات الديناميكية داخل قواعد البيانات الضخمة؛ فالنص الثابت يمثل كتلة بيانات لا تتغير طبيعتها بمرور الوقت، في حين أن السلاسل النصية المجمعة من مصادر متغيرة تخضع لتغيرات دورية تتطلب حلولاً مؤتمتة تمتاز بالمرونة والقدرة على التحديث الفوري. إن إقحام المعالجات النصية الديناميكية يقلل من التدخل البشري اليدوي، وهو ما يحد من أخطاء الرقن والتحريف، ويعزز إمكانية تكرار مسارات التحليل العلمي (Reproducibility) في شتى مجالات البحث والتطبيق المؤسسي.
1.2 التحديات الهيكلية المرتبطة بوجود الرموز الفاصلة مثل الشرطة (-)
تحتل علامة الشرطة مكانة مزدوجة ومربكة في بنية البيانات؛ فهي تُستخدم حيناً كرمز للفصل الدلالي والتصنيفي بين فئات المعلومات المختلفة، وتُستخدم حيناً آخر كأداة للترميز اللغوي في الكلمات المركبة، فضلاً عن دلالتها الحسابية الأصيلة للإشارة إلى الأرقام السالبة أو عمليات الطرح. هذا التعدد الوظيفي يولد إشكاليات برمجية معقدة داخل إكسل، إذ يجد المحرك الحسابي صعوبة في تفسير مقصد المستخدم عند غياب التحديد الدقيق، خصوصاً إذا تداخلت الشرطات مع قيم رقمية تؤدي إلى تحويل النص التلقائي وغير المرغوب فيه إلى صيغ تاريخ أو قيم نقدية سالبة تطيح بتماسك البنية الأصلية للبيانات.
وتتفاقم هذه المعضلة الهيكلية مع التباين الحاد في أطوال النصوص الواقعة قبل الشرطة وبعدها عبر سجلات الملف الواحد. ففي جدول بيانات يضم آلاف المدخلات، قد تقع الشرطة بعد ثلاثة أحرف في صف معين، بينما تفصل بين ثلاثين حرفاً في صف آخر، كما في دراسات استخلاص السمات النصية وتطوير المثيرات الدلالية التي حللها Cardillo et al. (2010). هذا التفاوت الطولي يحرم المحلل من استخدام أدوات الاقتطاع ذات العرض الثابت (Fixed Width)، ويجعل من البحث الديناميكي عن موضع الفاصل الرمزي ضرورة تقنية لا مناص منها لعزل المتغيرات بطريقة تضمن سلامة المعنى ودقة التصنيف.
ينعكس عدم اتساق تنسيق النصوص ووجود الفواصل العشوائية بشكل مباشر على عمليات الفرز الأبجدي والتصفية المتقدمة والتحليل التجميعي؛ إذ يؤدي احتفاظ السلسلة النصية باللواحق التالية للشرطة إلى بعثرة النتائج ومنع تجميع الكيانات المتماثلة في جداول محورية (Pivot Tables) موحدة. فعوضاً عن ظهور الصنف ككتلة إحصائية واحدة متكاملة، يتشظى إلى مصفوفة من الفئات الفرعية المتباعدة، الأمر الذي يقود المحلل إلى استنتاجات مضللة ناتجة عن التكرار المشوه وليس عن التوزيع الحقيقي للظاهرة الخاضعة للدراسة.
2. الأساس الوظيفي والرياضي لدالة TEXTBEFORE في الإصدارات الحديثة
2.1 بنية دالة TEXTBEFORE ووسائطها الأساسية والاختيارية
أحدثت شركة مايكروسوفت نقلة نوعية في بيئة إكسل عام 2022 بإطلاق مجموعة من دوال معالجة النصوص للمصفوفات الديناميكية ضمن اشتراكات Microsoft 365 وإصدار Excel 2021 وما يليه، وتأتي دالة TEXTBEFORE في طليعة هذه الابتكارات. تهدف الدالة وظيفياً إلى استخلاص كافة النصوص الواقعة قبل محدد رمزي معين دون الحاجة إلى دمج دوال متعددة. تتكون البنية التركيبية القياسية للدالة من وسائط محددة رياضياً بالصيغة التالية: =TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])، مما يمنحها مرونة برمجية فائقة للتعامل مع أكثر الحالات التركيبية تعقيداً.
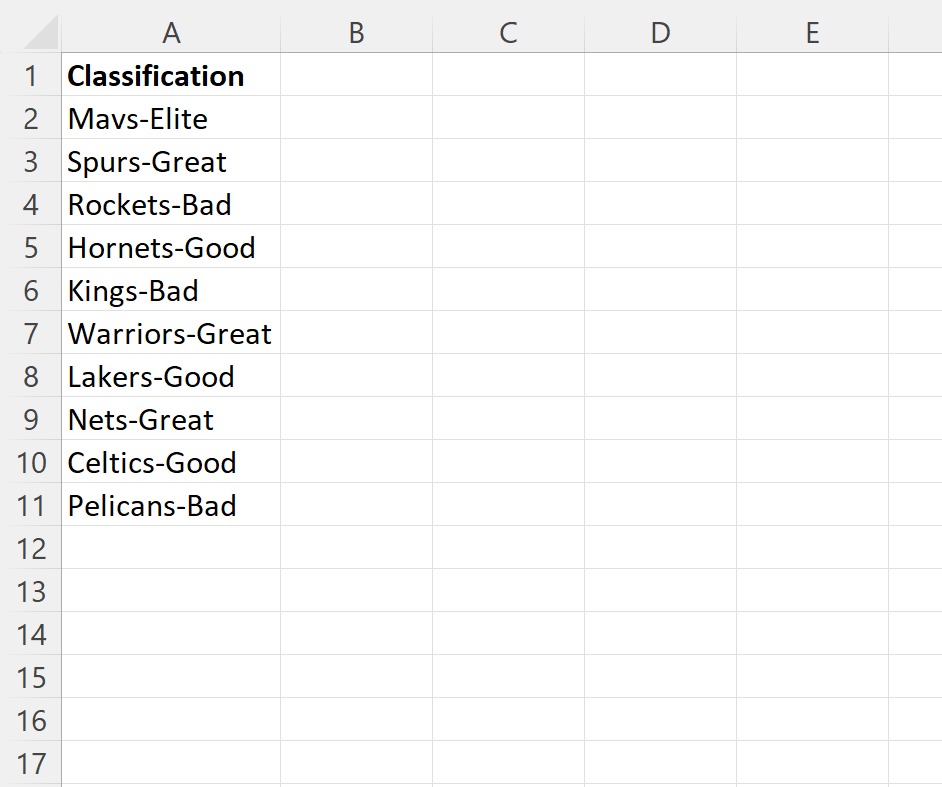
تتمثل الوسيطة الإلزامية الأولى (text) في تحديد الخلية المصدرية أو السلسلة النصية المستهدفة بالمعالجة، وهي تمثل الأساس المرجعي الذي تنطلق منه خوارزمية الفحص. أما الوسيطة الإلزامية الثانية (delimiter)، فهي الرمز الفاصل المعتمد، والذي يتم تعريفه في سياقنا هذا بعلامة الشرطة (“-“). تبرز الوسائط الاختيارية كأدوات ضبط دقيقة؛ حيث تتيح الوسيطة الثالثة (instance_num) تعيين رقم التكرار المستهدف للشرطة، مما يمكن المستخدم من تحديد ما إذا كان الاقتطاع يجب أن يتم عند الشرطة الأولى أو الثانية أو الأخيرة، كما سنتناول لاحقاً.
تختص الوسائط الاختيارية المتبقية بإدارة سلوك البحث وحالات الاستثناء؛ فالوسيطة الرابعة (match_mode) تحدد حساسية حالة الأحرف، والوسيطة الخامسة (match_end) تعامل نهاية النص كمحدد افتراضي، في حين تكتسب الوسيطة السادسة (if_not_found) أهمية بالغة في هندسة البيانات، حيث تسمح بتحديد القيمة البديلة المرتجعة في حال غياب علامة الشرطة عن الخلية المستهدفة، مثل إعادة النص الأصلي كاملاً بدلاً من إظهار رسائل الخطأ الحسابي. تتميز الدالة خوارزمياً بقدرتها على عزل السلسلة الفرعية بدقة واستبعاد المحدد الرمزي نفسه تلقائياً دون الحاجة إلى طرح قيم إزاحة يدوية، مما يضمن خروج النص المستهدف نقياً وخالياً من أي بقايا فاصلة.
2.2 المزايا الخوارزمية لدالة TEXTBEFORE مقارنة بالدوال المركبة التقليدية
تتفوق دالة TEXTBEFORE خوارزمياً على الدوال المركبة الكلاسيكية بانخفاض مستوى التعقيد الحسابي الموجه لوحدة المعالجة المركزية، لاسيما عند تطبيقها على مصفوفات البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف. في النماذج القديمة، كان إكسل يضطر إلى استدعاء دالة البحث الموضعي لحساب الفهرس الرقمي لموقع الشرطة، ثم تمرير هذا الرقم إلى دالة الاقتطاع، مما يضاعف عدد العمليات الداخلية لكل خلية. في المقابل، تقوم الدالة الحديثة بمسح خطي أحادي (Single-Pass Linear Scan) للمصفوفة النصية، مستخلصة المحتوى المطلوب ومحررة الذاكرة التشغيلية بكفاءة برمجية ملحوظة.
إلى جانب الكفاءة الحسابية، تساهم هذه الدالة في تقليص احتمالية الوقوع في الأخطاء البشرية المعرفية المصاحبة لكتابة صيغ متداخلة ومعقدة، وهو الجانب الذي يتلاقى مع أبحاث الضغط الإدراكي وهندسة التفاعل بين الإنسان والحاسوب التي تناولها Beres et al. (2021)، حيث تؤدي واجهات البرمجة المبسطة إلى خفض معدلات الأخطاء الذهنية وتحسين إنتاجية المستخدم. فالصيغ الطويلة التي تجمع دوالاً مثل LEFT وSEARCH وLEN وIFERROR تخلق فوضى بصرية داخل شريط المعادلات، مما يزيد من صعوبة تدقيقها وصيانتها عند انتقال الملف بين أعضاء الفريق البحثي، في حين تقدم TEXTBEFORE صياغة موجزة، واضحة المعالم، ومباشرة في دلالتها الوظيفية.
وتكتمل هذه المزايا بالاستفادة الكاملة من محرك المصفوفات الديناميكية (Dynamic Arrays Engine)، حيث يمكن للدالة أن تقبل نطاقاً كاملاً من الخلايا في وسيطة النص الأولى وتنسكب تلقائياً (Spill) لتغطي كافة الصفوف دون الحاجة إلى سحب المعادلة يدوياً. هذا الارتباط التفاعلي يضمن التحديث التلقائي الفوري لنتائج التصفية بمجرد تعديل المدخلات الأصلية، مما يجعلها بيئة مثالية لإنشاء لوحات التحكم والتقارير الإحصائية التي تعتمد على مصادر بيانات متجددة باستمرار.
3. التطبيق الإجرائي خطوة بخطوة: إزالة ما بعد الشرطة الأولى
3.1 إعداد بيئة البيانات وصياغة المعادلة القياسية
تبدأ الممارسة الإجرائية السليمة في مايكروسوفت إكسل بهيكلة جدول البيانات وتأطير الأعمدة المستهدفة بشكل منهجي يمنع تداخل المتغيرات. يُخصص العمود الأساسي وليكن العمود A لاحتواء السلاسل النصية الخام المشوبة بالفواصل وما يتلوها، في حين يُفرد عمود جديد مجاور وليكن العمود B لاستقبال البيانات النقية المستخلصة بعد إزالة الشرطة وما بعدها. يضمن هذا الفصل الصارم عدم الكتابة فوق البيانات المصدرية، ويتيح مساحة للمقارنة الإحصائية ومراجعة اتساق المخرجات قبل اعتمادها بصورة نهائية.
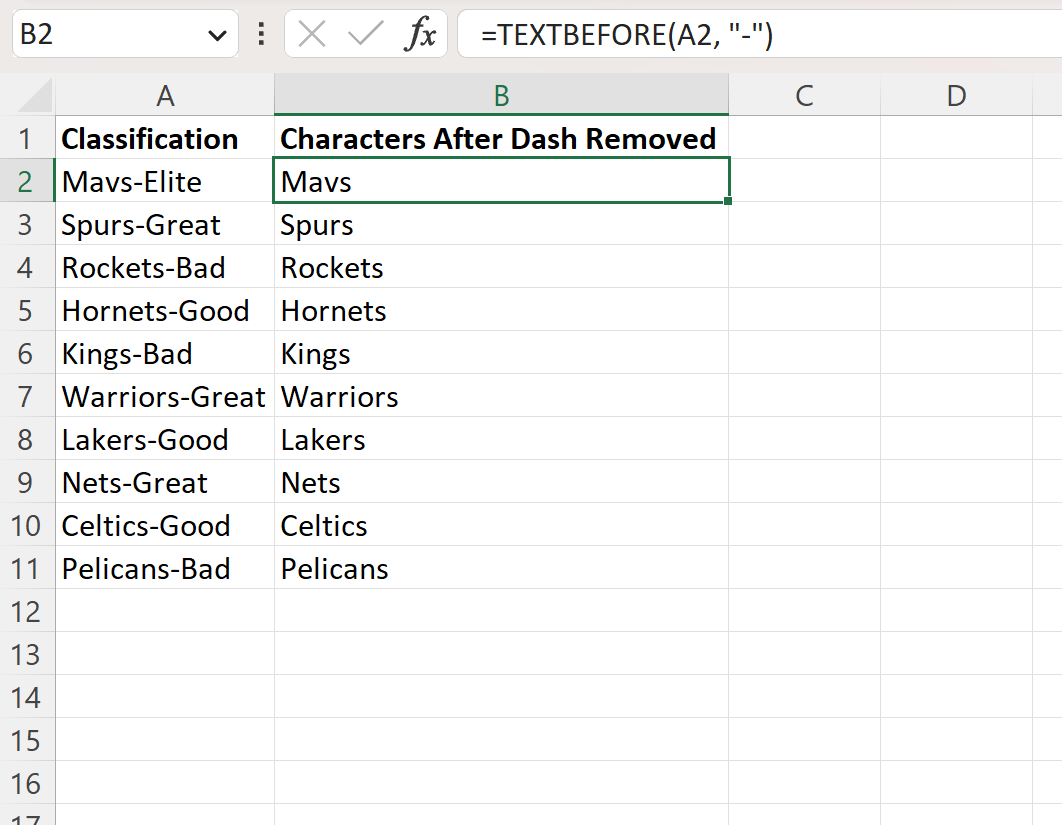
لكتابة الصيغة الرياضية القياسية، يقف المستخدم في الخلية العلوية للنطاق المفرغ (مثل B2)، ويشرع في إدخال المعادلة بالصيغة البرمجية الدقيقة: =TEXTBEFORE(A2, "-"). يتم ضبط المرجع A2 كمرجع نسبي حر دون استخدام علامات التثبيت ($) لتمكين المعادلة من التفاعل مع الحركة الرأسية عبر الصفوف. يجب إحاطة رمز الشرطة بعلامتي تنصيص مزدوجتين (“-“) لتعريفه صراحة كسلسلة نصية حرفية داخل المحرك البرمجي لإكسل، وبخلاف ذلك سيتعامل البرنامج مع العلامة كمعامل طرح حسابي، مما يسفر عن رسائل خطأ فورية تعطل تنفيذ الأمر.
فور الضغط على مفتاح الإدخال، تقوم الخوارزمية بمسح محتوى الخلية A2 من اليسار إلى اليمين (أو حسب اتجاه النص البرمجي)، حتى تصطدم بالظهور الأول لعلامة الشرطة. عند تلك النقطة الحسابية المحددة، تقتطع الدالة كافة المحارف الواقعة على يسار الفاصل متجاهلة الشرطة ذاتها وما يليها من محتوى بالكامل، وتُلقي بالنتيجة المستخلصة داخل الخلية المستهدفة B2، محققة عزلاً نصياً دقيقاً يتطابق مع المتطلبات المنهجية المحددة مسبقاً.
3.2 تعميم المعادلة وضمان مرونة السحب والتعبئة التلقائية
بعد نجاح التطبيق الفردي في الخلية الأولى، تأتي مرحلة تعميم الإجراء عبر مصفوفة السجلات التي قد تمتد إلى آلاف الصفوف داخل المصنف. يتم ذلك عبر توظيف مقبض التعبئة (Fill Handle) المتموضع في الزاوية السفلية اليسرى (أو اليمنى حسب لغة الواجهة) لإطار الخلية النشطة، إما من خلال النقر المزدوج السريع الذي يؤدي إلى تعميم الصيغة آلياً على امتداد النطاق الموازي في العمود A، أو عبر سحب المقبض يدوياً نحو الأسفل حتى نهاية البيانات قيد المعالجة.
تتجلى كفاءة المراجع النسبية أثناء هذه التعبئة التلقائية؛ حيث يتحول المرجع تلقائياً من A2 إلى A3 ثم A4 وهكذا دواليك، مما يضمن معالجة كل سجل باستقلالية تامة دون حدوث انزياح في نطاق المقارنة. في الإصدارات الحديثة الداعمة لانسكاب المصفوفات، يمكن تحقيق ذلك بصيغة واحدة شاملة تكتب في الخلية B2 على النحو التالي: =TEXTBEFORE(A2:A5000, "-")، حيث تتكفل الدالة بتعبئة النطاق بأكمله بضربة زر واحدة دون أي سحب يدوي، مع كفاءة تشغيلية فائقة توفر موارد المعالجة.
تتطلب هذه المرحلة مراجعة دقيقة ومراقبة منهجية لسلوك المخرجات المستخرجة للتأكد من استبعاد الرمز الفاصل بصورة قطعية مع كافة الأحرف الملحقة به. ينبغي إجراء مسح بصري لعينة عشوائية وفحص مؤشرات التنسيق للتأكد من عدم تسرب أي شوائب فراغية أو رمزية، والتأكد من ثبات نوع البيانات كقيم نصية غير ملوثة بأكواد خطأ، مما يؤكد سلامة النطاق البرمجي وجهوزيته للتحليلات الإحصائية اللاحقة.
3.3 تحليل تطبيقي على عينات واقعية لتصنيفات الفرق الرياضية والبيانات الوصفية
لتجسيد التطبيق العملي، نفترض وجود جدول بيانات يحتوي على سجلات مدمجة لتصنيفات الفرق الرياضية المدرسية، حيث دونت المدخلات في العمود A على النمط: “Al-Ahli Club – First Tier”، و”Zamalek SC – Division Two”، و”Esperance – Semi-Pro”. تمثل هذه البيانات الوصفية الملحقة بعد الشرطة عائقاً أمام حساب الترددات الصافية لأسماء الأندية، إذ يعتبر إكسل كل سلسلة مدمجة كياناً رياضياً مستقلاً بذاته يمنع المقارنات المباشرة.
بتطبيق الصيغة القياسية =TEXTBEFORE(A2, "-")، يُلاحظ أن الدالة تقتطع الجزء الأول لتصبح المخرجات: “Al”، وهو خطأ تحليلي شائع ينجم عن احتواء اسم النادي نفسه على شرطة أصلية تفصل بين مقاطعه، كما في “Al-Ahli”. هنا تبرز أهمية الفحص النوعي لبنية البيانات؛ فإذا كان الفاصل المستهدف يتضمن مسافات محيطة مثل (” – “)، فيجب تضمين هذه المسافات داخل وسيطة المحدد بالصيغة: =TEXTBEFORE(A2, " - "). هذا التعديل البسيط يوجه الخوارزمية لتجاهل الشرطات اللغوية الداخلية المركبة واستهداف الشرطة الفاصلة بين الاسم والتصنيف حصراً.
يقود هذا الإجراء المخصص إلى عزل أسماء الأندية الحقيقية بدقة تامة: “Al-Ahli Club” و”Zamalek SC” و”Esperance”، مجردة من تصنيفاتها الملحقة. إن تقييم هذه المخرجات ومطابقتها للمعايير الصارمة لضبط جودة البيانات يثبت أن دمج الفهم السياقي للمحدد الرمزي مع الخيارات الوظيفية المتاحة في إكسل يمنع الأخطاء التصنيفية الجسيمة، ويحول السجلات الخام الفوضوية إلى هياكل بيانات مهيأة للتحليل العلمي والنمذجة الرياضية الموثوقة.
4. التعامل المتقدم مع تكرار الفواصل: إزالة الأحرف بعد الشرطة النونية
4.1 آلية تحديد وسيطة رقم التكرار (Instance Number) داخل الدالة
تزداد التحديات التركيبية في السلاسل النصية عندما تحتوي السلسلة الواحدة على أكثر من رمز فاصل متطابق، كأن يتضمن السجل تركيبة معقدة تجمع بين رمز المنطقة، والكود التعريفي، ومستوى الأداء (مثل: “MED-042-Experimental”). في مثل هذه الهياكل المتشابكة، يفشل الاقتطاع الافتراضي المستند إلى الشرطة الأولى؛ لأنه سيبقي فقط على رمز المنطقة (“MED”)، مقتطعاً الكود التعريفي الأساسي الذي يمثل وحدة التحليل الفعلية للدراسة.
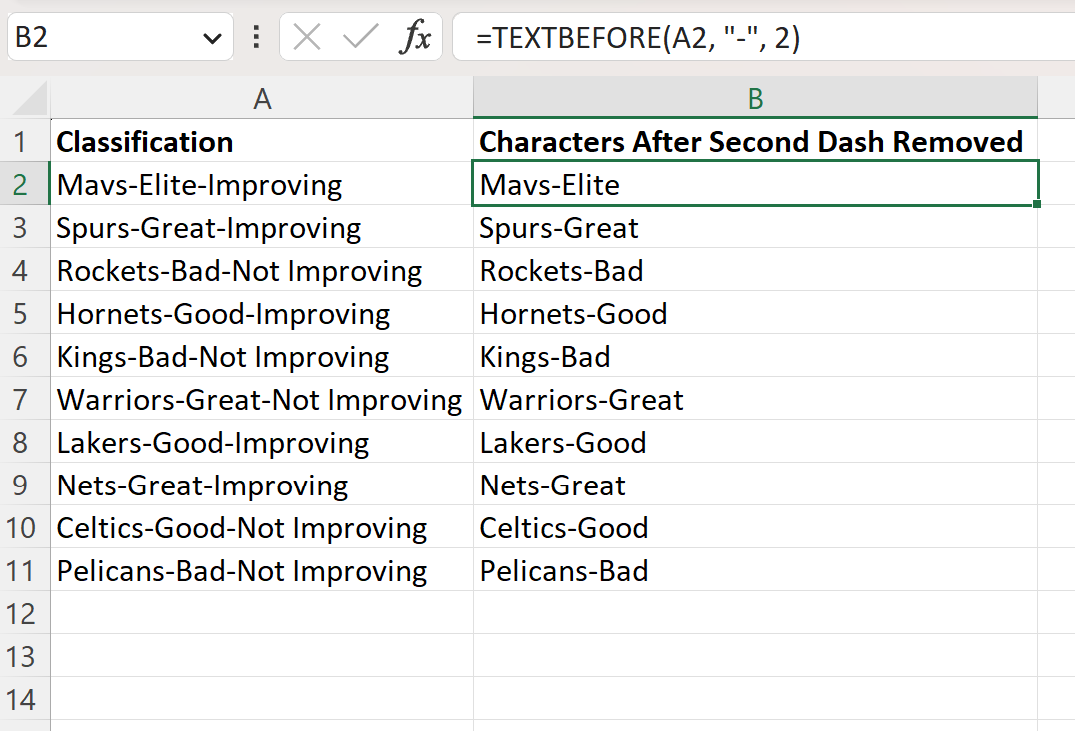
تتيح دالة TEXTBEFORE حلاً خوارزمياً أنيقاً من خلال وسيطتها الاختيارية الثالثة: instance_num. تمكن هذه الوسيطة المحلل من تحديد رقم التكرار المستهدف بدقة متناهية؛ فإذا أردنا إزالة ما بعد الشرطة الثانية مع الحفاظ على الشرطة الأولى ومحتواها النصي كاملاً، نصيغ المعادلة كالتالي: =TEXTBEFORE(A2, "-", 2). تقوم هذه الصيغة بتوجيه محرك البحث لتجاوز الشرطة الأولى ومحتواها، ومواصلة القراءة حتى الوصول إلى الشرطة الثانية لتقوم بالقص عندها مباشرة، معيدة السلسلة: “MED-042”.
يحمل اختيار تكرار محدد أبعاداً دلالية وهيكلية بالغة الأهمية على بنية البيانات المتبقية؛ إذ يسمح بالحفاظ على التراكيب الرمزية المعقدة دون الإخلال بهوية المفردة. هذا الأسلوب يخدم الدراسات المعجمية وتصنيف الشخصية المعتمدة على الرموز المركبة، كما في منهجيات التحليل اللغوي التي ناقشها Thalmayer et al. (2019)، حيث تتطلب الأكواد المركبة تجزئة انتقائية تحافظ على الأبعاد المفهومية الأولى وتعزل الإضافات الهامشية التي تزيد من تشتت مصفوفات البيانات والتحليل الإحصائي.
4.2 المعالجة العكسية باستخدام الأرقام السالبة لتحديد الفواصل من النهاية
في كثير من الحالات الميدانية غير المنمطة، تتباين السجلات في عدد الشرطات الموجودة بداخلها؛ فقد يحتوي صف على شرطتين، بينما يحتوي صف آخر على أربع شرطات، غير أن السمة المشتركة تكمن في الرغبة الدائمة في إزالة اللاحقة الأخيرة فقط وما يرتبط بها من نصوص متبقية. في هذا السياق، يصبح تحديد رقم تكرار موجب أمراً غير مجدٍ ويقود إلى نتائج خاطئة، نظراً لتغير الموضع الترتيبي للشرطة المستهدفة من اليسار.
لمعالجة هذه المعضلة الهندسية، يدعم محرك دالة TEXTBEFORE مفهوم “الفهرسة العكسية” (Reverse Indexing) من خلال قبول قيم عددية سالبة في وسيطة instance_num. عند إدخال القيمة الحسابية (-1) في الوسيطة الثالثة بالصيغة: =TEXTBEFORE(A2, "-", -1)، تعكس الخوارزمية اتجاه المسح البرمجي؛ فتبدأ بقراءة الخلية من أقصى اليمين (نهاية السلسلة) متجهة نحو اليسار حتى تلتقي بالشرطة الأولى من جهة النهاية، وتقوم بالاقتطاع عندها مع إعادة كل ما يسبقها من بداية النص.
تتجلى قوة هذه المعالجة العكسية في إدارة الأكواد المركبة التي تحتوي على أقسام فرعية متباينة الطول والعدد؛ فهي تضمن تجريد السلسلة من ملحقها النهائي بصرف النظر عما تحتويه من تعقيدات داخلية في أجزائها الأولى. من الناحية الحسابية، تظهر مقارنة الكفاءة تفوق المسح العكسي في تقليص خطوات التحقق المنطقي، متجاوزة الحاجة إلى حساب الطول الكلي للسلسلة وطرح مواضع الرموز، مما يوفر صياغة رياضية محكمة وقوية تصمد أمام التباينات البنيوية لملفات البيانات الحقيقية.
5. البدائل الكلاسيكية للإصدارات السابقة: دمج الدوال LEFT و FIND و SEARCH
5.1 التحليل المنطقي لمعادلة الجمع بين LEFT و FIND
قبل إطلاق الدوال الحديثة للمصفوفات الديناميكية، اعتمد محللو البيانات لعقود على الجمع المنطقي والرياضي بين دالتي الاقتطاع الموضعي والبحث الفهرسي لتحقيق إزالة الأحرف الواقعة بعد الشرطة. تقوم هذه المنهجية الكلاسيكية على معادلة تركيبية قياسية تستخدم دالة البحث FIND لحساب الموضع الرقمي للفاصل، ثم تمرر هذا الفهرس إلى دالة الاقتطاع LEFT لاقتطاع السلسلة الواقعة على يساره. تتمثل الصياغة الرياضية المألوفة لهذا الإجراء في المعادلة: =LEFT(A2, FIND("-", A2) - 1).
يعمل هذا التركيب الرياضي وفق تسلسل خطي محكم؛ حيث تبدأ دالة FIND("-", A2) بمسح النص حرفاً فحرفاً حتى تجد علامة الشرطة، لتعيد رقماً صحيحاً يمثل فهرسها العددي داخل السلسلة (مثلاً، الرقم 8 إذا كانت الشرطة هي الحرف الثامن). بعد ذلك، تأتي الخطوة الحسابية الجوهرية المتمثلة في طرح القيمة العددية واحد ( – 1 ) من الناتج. يهدف هذا الطرح إلى تصحيح حدود الاقتطاع لتتوقف عند الحرف السابع الذي يسبق الشرطة مباشرة، متفادياً بذلك تضمين علامة الشرطة نفسها ضمن النص المقتطع.
أخيراً، تتسلم دالة LEFT(A2, 7) المدخلات؛ حيث تشير الوسيطة الأولى إلى الخلية المصدرية، وتشير الوسيطة الثانية إلى العدد الإجمالي للأحرف الواجب اقتطاعها بدءاً من الحرف الأول في أقصى اليسار. تعيد هذه المعادلة النص السابق للشرطة بنجاح تام، مما شكل حجر الزاوية في معالجة النصوص عبر مختلف إصدارات إكسل التاريخية منذ أواخر ثمانينيات القرن الماضي وحتى يومنا هذا، محافظة على استقرار قواعد البيانات القديمة.
5.2 الفروق الجوهرية بين دالتي FIND و SEARCH في هذا السياق
عند صياغة البدائل الكلاسيكية، يواجه المستخدم خياراً تقنياً بين استخدام دالة FIND أو دالة SEARCH كأداة لتحديد موضع الفاصل الرمزي. يكمن الفارق الجوهري الأول بين الأداتين في مسألة حساسية حالة الأحرف (Case Sensitivity)؛ فبينما تتسم دالة FIND بحساسية مطلقة لحالة الأحرف اللاتينية، تتجاهل دالة SEARCH هذه الفروق، وهي ميزة قد لا تبدو مؤثرة عند البحث عن رمز الشرطة البسيط، لكنها تصبح محورية إذا كان المحدد يتكون من مقطع نصي مركب يجمع بين أحرف وشرطة (مثل “-Code-“).
أما الفارق الجوهري الثاني فيتجلى في دعم الرموز البديلة وعلامات التطابق (Wildcards)؛ حيث تدعم دالة SEARCH علامة الاستفهام (?) للدلالة على حرف فردي مجهول، وعلامة النجمة (*) للدلالة على أي عدد من المحارف غير المعرفة. هذا الدعم يمنح SEARCH مرونة استثنائية عند محاولة استهداف شرطات تحيط بها أنماط غير منتظمة من الحروف، في حين تكتفي FIND بالبحث المطابق الحرفي الدقيق دون أي تأويل للرموز البديلة.
تستند معايير المفاضلة المنهجية بين الأداتين إلى طبيعة المتغيرات الخاضعة للدراسة؛ ففي النصوص اللغوية البسيطة والأرقام القياسية التي تتضمن شرطات واضحة، يُفضل استخدام FIND نظراً لسرعتها الخوارزمية الهامشية لكونها تتجاوز محرك مطابقة الأنماط المعقد. في المقابل، تُرجح كفة SEARCH عند استكشاف هياكل بيانات شائبة تحتوي على متغيرات لغوية متباينة، لتفادي إخفاقات البحث الناتجة عن عدم تطابق حالات الأحرف أو الأنماط الحرفية المتغيرة المحيطة بالفواصل.
5.3 التعامل مع النصوص الخالية من الشرطة لتفادي رسائل الخطأ الحسابي
يتمثل الخلل الهيكلي الأكبر في معادلة الجمع الكلاسيكية بين LEFT و FIND في سلوكها العنيف عند مواجهة خلايا تفتقر إلى المحدد الرمزي؛ فإذا خلت الخلية المستهدفة من علامة الشرطة، تفشل دالة FIND في تحديد الفهرس العددي، مما يؤدي فوراً إلى انهيار المعادلة وتوليد رسالة الخطأ الشهيرة #VALUE!. لا يقتصر ضرر هذا الخطأ على الخلية المعنية فحسب، بل يمتد ليعطل أي معادلات تجميعية أو إحصائية لاحقة تعتمد على العمود المستخرج.
لتطويق هذه الفجوة الحسابية، يجب تغليف الصيغة الكلاسيكية بدالة معالجة الأخطاء الاستباقية IFERROR، لتصبح المعادلة بالصيغة الدفاعية التالية: =IFERROR(LEFT(A2, SEARCH("-", A2) - 1), A2). في هذا البناء البرمجي المتكامل، يقوم إكسل بتنفيذ عملية الاقتطاع إذا عُثر على الشرطة؛ أما إذا فشلت العملية وولدت خطأ القيمة، تتدخل IFERROR لتعيد محتوى الخلية A2 كاملاً دون تغيير، محافظة على انسيابية البيانات وسلامة السلسلة من الانقطاع.
كبديل منهجي متقدم، يمكن توظيف دالة الفحص المنطقي ISNUMBER جنباً إلى جنب مع الدالة الشرطية IF، في بناء تركيبي يتحقق من وجود الفاصل قبل الإقدام على عملية الاقتطاع: =IF(ISNUMBER(SEARCH("-", A2)), LEFT(A2, SEARCH("-", A2) - 1), A2). يتميز هذا المدخل الاستباقي بأنه يتحقق من الحالة المنطقية للخلية مسبقاً بدلاً من انتظار حدوث الخطأ ومعالجته لاحقاً، مما يجعله أكثر انضباطاً من الناحية البرمجية ويقلل من استهلاك الموارد الموجهة لإدارة الاستثناءات في المعالجات الكبيرة.
6. المعالجة التكميلية: تطهير المسافات والرموز المخفية باستخدام TRIM و CLEAN
6.1 معالجة المسافات الهامشية المحيطة بالشرطة النصية
نادراً ما تأتي السلاسل النصية في بيئات العمل الواقعية محددة بشرطة مجردة؛ إذ يغلب في الكتابة والتوثيق إحاطة الشرطة بمسافات بيضاء لتسهيل القراءة البشرية (مثل: “Item 401 – Active”). عند تطبيق خوارزمية إزالة ما بعد الشرطة، سواء باستخدام TEXTBEFORE أو الصيغ المركبة، يقتطع النظام النص الواقع قبل الشرطة مباشرة، تاركاً مسافة هامشية لاحقة ملتصقة بنهاية النص المتبقي (“Item 401 “) دون أن يلاحظها المستخدم بالعين المجردة.
تعتبر هذه المسافات الخفية عائقاً مدمراً في قواعد البيانات وعمليات المطابقة الإحصائية؛ إذ إن وجود مسافة واحدة في نهاية السلسلة يجعل إكسل ينظر إليها كمدخل مختلف كلياً عن السلسلة النقية المطابقة لها حرفياً، مما يسفر عن فشل ذريع في دوال البحث والربط مثل VLOOKUP وXLOOKUP ومطابقات الاختبارات السلوكية التي ناقشها Shull et al. (2001) حول دقة التصنيف ومعدلات المطابقة. لحل هذه المعضلة جذرياً، يجب دمج دالة التطهير TRIM ضمن الصيغة المستعملة لإزالة كافة المسافات البادئة واللاحقة، واختزال المسافات المتعددة بين الكلمات إلى مسافة قياسية واحدة.
تتم صياغة هذا الدمج المتداخل في بيئة الإصدارات الحديثة على النحو التالي: =TRIM(TEXTBEFORE(A2, "-"))، أو في الإصدارات الكلاسيكية عبر: =TRIM(IFERROR(LEFT(A2, SEARCH("-", A2) - 1), A2)). إن اختزال مراحل المعالجة في صيغة برمجية واحدة مطهرة يضمن تدفق مخرجات نصية صافية تماماً من الحواف الفراغية، مما يرفع من جودة البيانات ويؤمن موثوقيتها الرياضية للاستخدامات التحليلية اللاحقة دون الحاجة إلى أعمدة مساعدة إضافية.
6.2 التفرقة بين أنواع الشرطات المختلفة والترميزات الخاصة
تخفي لوحات المفاتيح والترميزات الرقمية فخاً تقنياً معقداً يتمثل في وجود أشكال متعددة ومتمايزة لعلامة الشرطة لا يستطيع المستخدم العادي تمييزها بصرياً. فالشرطة العادية أو واصلة لوحة المفاتيح القياسية (Hyphen-Minus) الممثلة بالرمز البرمجي (Unicode U+002D) تختلف كلياً من المنظور الثنائي للنظم الحاسوبية عن الشرطة المتوسطة (En-Dash: U+2013) والشرطة الطويلة (Em-Dash: U+2014) الشائعتين في ملفات النصوص المستوردة من معالجات النصوص المتقدمة أو صفحات الويب والمواقع البحثية.
إذا كانت الدالة مصممة للبحث عن الشرطة العادية (“-“)، وكانت البيانات المصدرية تحتوي على شرطة متوسطة (“–”)، فإن الدالة ستفشل حتماً في رصد المحدد وتعيد رسالة خطأ أو النص الأصلي بالكامل، معتبرة أن الفاصل غير موجود إطلاقاً. لمواجهة هذا التباين المشوش، كما يصف Nechvatal (2011) تداخل الضوضاء والرموز غير المرئية في تشويه الأنظمة المعلوماتية، يتعين على المحلل توحيد أشكال الشرطات قبل الشروع في التجزئة، وذلك بتوظيف دالة الاستبدال SUBSTITUTE المتداخلة لتوحيد كافة الرموز في شرطة قياسية واحدة.
تُصاغ هذه العملية التطهيرية عبر المعادلة المركبة التالية التي تستهدف استبدال الشرطات الطويلة والمتوسطة بالشرطة القياسية، مدمجة مع دالة CLEAN للتخلص من الأحرف غير القابلة للطباعة (Non-printable Characters) ورموز التحكم المستوردة من خوادم خارجية:
=TEXTBEFORE(CLEAN(SUBSTITUTE(SUBSTITUTE(A2, "–", "-"), "—", "-")), "-"). يمثل هذا التأسيس الهندسي للمعادلة خط دفاع برمجي متين يحصن قاعدة البيانات ضد الشوائب الرقمية ويوحد الأنماط النصية تحت معيار رقمي موحد وقابل للمعالجة الخوارزمية دون إخفاق.
7. الحلول غير البرمجية: استغلال ميزة ‘النص إلى أعمدة’ (Text to Columns)
7.1 تفكيك السلاسل النصية عبر معالج تحويل النص إلى أعمدة
تقدم ميزة “النص إلى أعمدة” (Text to Columns) في مايكروسوفت إكسل حلاً هندسياً مباشراً وتطبيقياً للمستخدمين الذين يفضلون الإجراءات التفاعلية السريعة عبر واجهة المستخدم الرسومية دون كتابة صيغ رياضية معقدة. تعتمد هذه الأداة على معالج خطوات متسلسل يتيح تفكيك السلاسل النصية المدمجة وإعادة توزيع مكوناتها على أعمدة مستقلة استناداً إلى محددات موضعية أو رمزية محددة بدقة.
لتنفيذ هذا الإجراء، يُحدد نطاق الخلايا المستهدف في العمود A، ثم يُنتقل إلى شريط الأدوات العلوي تحت تبويب “بيانات” (Data) والنقر على أيقونة “النص إلى أعمدة”. في الخطوة الأولى من المعالج التفاعلي، يُختار خيار “محدد” (Delimited) بدلاً من “عرض ثابت” (Fixed Width)، مما يمنح النظام مرونة في التعامل مع التباينات الطولية للنصوص. في الخطوة الثانية، يُلغى تحديد كافة المحددات الافتراضية مثل المسافة أو الفاصلة، ويُفعل خيار “غير ذلك” (Other) مع إدخال رمز الشرطة (-) في الحقل المخصص، مع إمكانية متابعة المعاينة الحية للتقسيم في النافذة السفلية.
تكمن الخطوة الجوهرية والمهنية في المرحلة الثالثة من المعالج؛ حيث يُحدد العمود الثاني الناتج (الذي يضم النصوص والأحرف غير المرغوب فيها الواقعة بعد الشرطة)، وتُفعل خانة الاختيار “عدم استيراد العمود (تخطي)” (Do not import column – Skip). كما يُحدد عمود الوجهة (Destination) ليكون عموداً مجاوراً لضمان عدم استبدال البيانات الأصلية. وبمجرد الضغط على “إنهاء” (Finish)، يقوم إكسل بتفكيك السلاسل وعزل الجزء المطلوب وحذف ما بعد الشرطة بصورة فورية ومطلقة.
7.2 التقييم المقارن بين ميزة النص إلى أعمدة والمعادلات الحسابية
يقدم التحليل المقارن بين أداة “النص إلى أعمدة” والمعادلات الرياضية (مثل TEXTBEFORE أو LEFT & FIND) صورة واضحة عن المفاضلات الفنية الواجب مراعاتها عند تصميم مسارات تنقية البيانات. تتميز أداة تحويل النص إلى أعمدة بسرعة الإنجاز الفائقة في معالجة العمليات الثابتة ولمرة واحدة (One-off Tasks)، حيث لا تتطلب حفظ صيغ أو استهلاك قدرات المعالجة في إعادة الحساب الدوري، مما يجعلها مثالية للفرز الأولي للملفات التاريخية المغلقة.
في المقابل، يتمثل العيب الهيكلي القاتل لهذه الأداة في فقدانها للديناميكية (Static Behavior)؛ فالنتائج المترتبة على استخدامها تمثل قيماً جامدة لا تستجيب لأي تعديل أو تحديث يطرأ على البيانات المصدرية في العمود الأصلي. وإذا أضيفت سجلات جديدة في أسفل الجدول، يجب تكرار الإجراء اليدوي بالكامل بكل مراحله وخطواته، مع ما يحمله ذلك من احتمالية التناسي والخطأ، فضلاً عن صعوبة التراجع التلقائي والتدقيق البرمجي الممنهج.
من الناحية المنهجية، يوصى بالاعتماد على التفكيك الثابت عبر ميزة “النص إلى أعمدة” فقط في سياق الأرشفة واستخراج العينات العاجلة المعزولة. أما في البيئات البحثية، وقواعد البيانات المتنامية، والنماذج الإحصائية التي تُبنى على تدفقات مستمرة للمعلومات، فإن الربط الديناميكي عبر المعادلات الحسابية المحدثة ذاتياً يظل الخيار الأكاديمي والمهني الرصين الذي يحمي تكامل البيانات ويضمن اتساقها الزمني دون الحاجة لتدخل بشري متكرر.
8. التنقية الآلية الذكية: ميزة التعبئة السريعة (Flash Fill)
8.1 الأسس الخوارزمية للتعرف على الأنماط في التعبئة السريعة
تمثل ميزة التعبئة السريعة (Flash Fill)، التي أدرجتها مايكروسوفت منذ إصدار Excel 2013، تطبيقاً مبتكراً لخوارزميات التعلم الآلي والاستقراء الذكي داخل بيئة جداول البيانات. تعتمد هذه الأداة على نظرية “البرمجة بالأمثلة” (Programming by Example – PBE)؛ حيث تقوم برصد وتحليل المدخلات النصية اليدوية التي يكتبها المستخدم في خلية مجاورة، لتستنتج النمط الرياضي أو التحويلي الكامن خلف عملية التعديل وتقوم بتعميمه آلياً على بقية السجلات دون الحاجة لكتابة كود برمجي أو صياغة رياضية.
لتفعيل هذه الآلية الذكية في مسألة إزالة ما بعد الشرطة، يكتفي المستخدم بالوقوف في الخلية المجاورة لأول سجل مشوب وليكن B2، وكتابة النص المستهدف يدوياً بعد تجريده من الشرطة وما يليها، ثم الضغط على مفتاح الإدخال والانتقال للخلية B3 والبدء في كتابة النموذج الثاني. عند هذه النقطة، يقوم إكسل بالتعرف على النمط التجريدي (حذف كل ما يلي الشرطة)، ويعرض معاينة رمادية شفافة للنتائج المستقراة عبر العمود بالكامل. يكفي الضغط على مفتاح الإدخال للموافقة، أو تفعيل الأمر مباشرة عبر اختصار لوحة المفاتيح الفائق Ctrl + E.
تثبت هذه التقنية كفاءة باهرة وسرعة استثنائية في إنجاز المهام داخل الملفات ذات الحجم المحدود والأنماط الواضحة غير المعقدة؛ إذ تتيح للمستخدم غير المتخصص في الدوال استخراج نصوص نقية في ثوانٍ معدودة. توفر التعبئة السريعة مرونة ذهنية عالية في استبعاد الفواصل المتنوعة في آن واحد دون الدخول في تفاصيل وسائط الدوال أو إدارة أخطاء التركيب، مما يجعلها أداة مساعدة لا غنى عنها في المعاينات الاستكشافية الأولية للبيانات.
8.2 حدود ومخاطر الاعتماد على التعبئة السريعة في البيئات الأكاديمية والمهنية
على الرغم من الجاذبية التشغيلية للتعبئة السريعة، إلا أن الاعتماد المطلق عليها في البيئات الأكاديمية والمؤسسية الحساسة ينطوي على مخاطر هيكلية لا يستهان بها. تعود هذه المخاطر إلى الطبيعة الاحتمالية للخوارزمية الاستقرائية؛ فالنظام يحاول “تخمين” القصد البشري، وقد يقع في استنتاجات خاطئة تماماً إذا صادف أنماطاً شاذة (Outliers) أو خلايا تختلف بنيتها التركيبية عن نموذج العينة الأولى (مثل الخلايا التي تحتوي على عدة شرطات متباعدة أو التي تفتقر للفاصل كلياً).
تتضاعف هذه الخطورة بسبب غياب مسار التدقيق الحسابي (Audit Trail)؛ فالمخرجات الناتجة عن التعبئة السريعة تُطبع في الخلايا كقيم نصية ثابتة ومستقلة، لا توفر أي صيغة مرجعية توضح للمدقق المستقل كيف تم اشتقاق هذه النتيجة، على خلاف ما يقتضيه المنهج العلمي الصارم والتوثيق المفتوح. ففي مجموعات البيانات الكبيرة التي تضم عشرات الآلاف من السجلات، يصبح من المستحيل تقريباً اكتشاف الانحرافات الناتجة عن أخطاء التخمين الذكي من خلال الفحص البصري المجرد، مما قد يسفر عن تسرب نصوص مشوهة وغير مكتملة إلى داخل النماذج الإحصائية دون أن يشعر الباحث.
وبناءً على ذلك، تقتضي المعايير المنهجية الرصينة حصر استخدام التعبئة السريعة في مرحلة الفرز التجريبي السريع، وتجنب اتخاذها أساساً نهائياً لإعداد البيانات في البحوث والتقارير المعتمدة. وفي حال استخدامها اضطرارياً، يجب إلزام الفريق البحثي بإجراء مراجعة إحصائية لعينة عشوائية ممثلة (Representative Random Sample)، وإجراء اختبارات مطابقة صارمة للتأكد من أن الخوارزمية لم تحرف المعاني الدلالية أو تسقط حقولاً جوهرية من السجلات الخاضعة للتطهير.
9. معالجة البيانات الضخمة وأتمتة التطهير عبر أداة باور كويري (Power Query)
9.1 استيراد البيانات وإجراء تقسيم الأعمدة استناداً إلى الشرطة
عندما تتجاوز البيانات حدود الجداول التقليدية وتتحول إلى قواعد بيانات ضخمة ومستمرة التدفق، تبرز أداة “باور كويري” (Power Query) كأقوى محرك لتحويل وهيكلة البيانات داخل بيئة مايكروسوفت إكسل. تتيح هذه المنصة المتطورة إجراء تحويلات معقدة على السلاسل النصية على مستوى خط أنابيب البيانات (Data Pipeline) وقبل تحميلها إلى ورقة العمل، مما يجنب المصنفات البرمجية البطء والانهيار المصاحبين لاستهلاك الذاكرة في الدوال التقليدية الحسابية.
تبدأ الخطوات الإجرائية بتحويل نطاق البيانات إلى جدول رسمي (Excel Table) ثم استيراده إلى محرر باور كويري عبر خيار “من جدول/نطاق” (From Sheet/Table) في تبويب “بيانات”. داخل واجهة المحرر التفاعلية، يُحدد العمود المشوب بالنقر على رأسه، ثم يُنتقل إلى تبويب “تحويل” (Transform) واختيار أمر “تقسيم العمود” (Split Column) استناداً إلى “المحدد” (By Delimiter). في النافذة المنبثقة، يختار المستخدم الشرطة (-) كمحدد رئيسي، مع ضبط خيار الانقسام عند “المحدد في أقصى اليسار” (Left-most delimiter) لإزالة ما بعد الشرطة الأولى بدقة بالغة.
يسفر هذا التقسيم عن ولادة عمودين جديدين؛ يحتوي الأول على النص النقي المراد الاحتفاظ به، بينما يحتوي الثاني على الشرطة وما بعدها. يقوم المستخدم ببساطة بحذف العمود الثاني الزائد بنقرة زر واحدة (Remove Column)، ثم يعيد تسمية العمود المستخلص ليتطابق مع المعايير التصنيفية المطلوبة. تختتم العملية بضبط نوع البيانات (Data Type) الصريح ليكون نصاً (Text)، مما يحمي المخرجات من أي تفسير حسابي خاطئ قد يفرضه محرك إكسل التلقائي على الأكواد المشابهة للأرقام والتواريخ.
9.2 بناء مسارات تدفق عمل قابلة للتكرار والتحديث الآلي
يكمن السر في قوة أداة باور كويري في قدرتها على تسجيل وتدوين كافة الخطوات الإجرائية التي يقوم بها المستخدم تلقائياً وتحويلها إلى كود برمجي موثق بلغة “إم” (M Code). هذا التسجيل الآلي يبني مسار عمل متكاملاً ومحمياً ضد التغييرات (ETL Pipeline: Extract, Transform, Load)، يمكن استدعاؤه وإعادة تنفيذه ملايين المرات بدقة متناهية وبنفس الكفاءة دون أي تدخل إجرائي إضافي من الباحث أو محلل النظم.
بعد الانتهاء من ضبط معايير العزل والتطهير داخل المحرر، يضغط المستخدم على “إغلاق وتحميل” (Close & Load)، ليتم تصدير الجدول المطهر حديثاً إلى ورقة عمل نظيفة ومستقلة داخل المصنف. إذا أضيفت في المستقبل آلاف السجلات الجديدة أو تم تعديل البيانات المصدرية الخام، لا يحتاج المستخدم إلى إعادة التقسيم أو صياغة دوال جديدة؛ إذ يكفي النقر بزر الفأرة الأيمن واختيار “تحديث” (Refresh) ليتولى مسار باور كويري قراءة البيانات الجديدة وتطهيرها وتحديث الجدول المصفى في أجزاء من الثانية.
يتيح هذا الفصل المعماري المتقدم بين طبقة تخزين البيانات وطبقة المعالجة خارج واجهة إكسل التقليدية أعلى درجات الأداء الحاسوبي، ويمنع تجمد الشاشة وبطء معالجة الملفات العملاقة التي تعاني عادة من ثقل الدوال المتشابكة. كما يفتح هذا النهج آفاقاً واسعة لمشاريع الرعاية الصحية والتدخلات النفسية والاجتماعية الرقمية، كالتي استعرضها O’Dea et al. (2020) في تجارب التطبيقات الهاتفية الميدانية، حيث تتدفق مصفوفات البيانات باستمرار وتتطلب بنية تحتية مؤتمتة لتنظيف وتقسيم السجلات الرقمية وضمان جهوزيتها الفورية للتقييم والتحليل.
10. دليل استكشاف الأخطاء وتأمين سلامة البيانات (Troubleshooting & Validation)
10.1 تشخيص الأخطاء الشائعة وحلولها الجذرية
إن مواجهة الأخطاء البرمجية أثناء عمليات تطهير النصوص في إكسل أمر شائع الحدوث، ويتطلب فهماً تشخيصياً لجذور المشكلة لمعالجتها بصورة حاسمة تضمن سلامة المعطيات. يمثل ظهور خطأ #N/A في دالة TEXTBEFORE أحد أبرز هذه المعضلات، وهو ينتج مباشرة عن عدم تمكن الدالة من العثور على المحدد الرمزي المذكور (الشرطة) داخل الخلية المصدرية المستهدفة. يُعالج هذا الإخفاق جذرياً عبر توظيف الوسيطة الاختيارية السادسة [if_not_found] وضبطها لتعيد النص الأصلي، مثل: =TEXTBEFORE(A2, "-", , , , A2)، مما يمنع انقطاع الحسابات ويؤمن عودة البيانات بصورة طبيعية.
أما في الصيغ الكلاسيكية المركبة، فيبرز خطأ القيمة #VALUE! عند فشل دالتي FIND أو SEARCH في رصد موضع الشرطة، وكما أسلفنا، فإن الحل الجذري يكمن في تغليف المعادلة بدالة IFERROR الدفاعية. علاوة على ذلك، يواجه المحللون مشكلة التحول التلقائي للنصوص المقتطعة إلى تواريخ مشوهة أو أرقام علمية؛ فعلى سبيل المثال، إذا كان النص المستخلص هو “10-2023” وأزيل ما بعد الشرطة، قد يفسر إكسل المتبقي “10” على أنه رقم حسابي، أو يفسر الكود المتبقي كتاريخ وشهور تقويمية. للتغلب على هذه المعضلة، يجب فرض التنسيق النصي الصريح عبر دالة TEXT أو بادئة الفاصلة العليا (‘): =TEXT(TEXTBEFORE(A2, "-"), "@") لضمان الحفاظ على الهوية النصية للمدخلات.
كما يجب الانتباه إلى حالات التكرار الخاطئ للفواصل والمسافات غير المرئية (Non-breaking Spaces: ASCII 160) التي تفشل دالة TRIM القياسية في إزالتها. يتم تشخيص هذا الخلل عندما تبدو الخلية نقية بصرياً ولكنها تفشل في اختبارات التطابق الحسابي. يُحل هذا العائق بتوظيف الدالة البرمجية المزدوجة التي تستبدل المسافة المستعصية بمسافة فارغة قبل الاقتطاع: =SUBSTITUTE(A2, CHAR(160), " ")، مما يحصن مخرجات التنقية ضد أي تشوهات مخفية قد تعطل خطط التحليل الإحصائي اللاحقة.
10.2 أفضل الممارسات الأكاديمية لتوثيق وتأكيد موثوقية السلاسل النصية المستخرجة
تفرض الأمانة العلمية والمنهجية الأكاديمية الرصينة في معالجة البيانات النصية اتباع بروتوكول توثيق وتحقق صارم يضمن موثوقية النتائج وإمكانية إعادة إنتاجها من قبل باحثين مستقلين. تبدأ هذه الممارسات بالقاعدة الذهبية الثابتة: “عدم المساس بالبيانات الخام الأصلية” (Raw Data Immutability). يجب الاحتفاظ دائماً بنسخة أصلية محمية ومقفلة من ملف البيانات في ورقة عمل مستقلة أو مستودع رقمي محايد، وإجراء كافة التحويلات والاقتطاعات في أعمدة أو مصنفات مشتقة مخصصة للمعالجة والتحليل.
وللتأكد البرمجي من سلامة عمليات التطهير وخلو النصوص المستخرجة تماماً من علامة الشرطة والزوائد غير المرغوب فيها، يتعين إجراء اختبارات تطابق كمية باستخدام دوال العد المشروط والمنطق المتقدم. يمكن إنشاء عمود فحص تدقيقي (Audit Column) يطبق المعادلة التالية على كافة النتائج: =IF(ISNUMBER(SEARCH("-", B2)), "Warning: Delimiter Exists", "Valid"). يضمن هذا الإجراء رصد أي تسرب للفاصل في المخرجات تلقائياً وبشكل فوري، ويسمح بتصفية الحالات الشاذة ومراجعتها يدوياً لتبيان أسباب الخلل المنهجي فيها.
ويكتمل بروتوكول التوثيق بكتابة حواشي وصفية مفصلة (Metadata Annotations) داخل المصنف البرمجي، تتضمن شرحاً وافياً للأساس المنطقي والمعادلات المستخدمة، وإصدار إكسل الذي تم البناء عليه، وطبيعة التعديلات المطبقة على المحددات والفواصل، وتاريخ تنفيذ عملية التنقية. تتماشى هذه الدقة التوثيقية مع المعايير المهنية الصارمة المتبعة في دراسات الضغوط والمتغيرات السريرية، كما ناقشها Wakeman & Mestayer (1985) حول ضرورة الضبط المنهجي الصارم للبروتوكولات التداخلية لضمان مصداقية البيانات وقابليتها للتعميم والتطبيق في الميادين البحثية والمهنية المختلفة.
يلخص الجدول التالي مقارنة منهجية شاملة بين مختلف التقنيات المشروحة في هذا المقال لتسهيل الاختيار التقني الأمثل وفقاً لظروف العمل البحثي ومتطلبات النظام المستخدم:
| المنهجية التقنية | الإصدار المتوافق | طبيعة المعالجة (ديناميكية / جامدة) | التعقيد البرمجي | أفضل سيناريو للاستخدام |
|---|---|---|---|---|
| دالة TEXTBEFORE | Microsoft 365 / Excel 2021+ | ديناميكية (تحديث فوري ومصفوفات) | منخفض للغاية | البيئات الحديثة والتحليلات المتكررة المستمرة |
| مركب LEFT + SEARCH / FIND | كافة إصدارات إكسل التاريخية | ديناميكية (عبر سحب المعادلة) | متوسط إلى مرتفع | ضمان التوافق مع الأنظمة والمصنفات القديمة |
| أداة النص إلى أعمدة (Text to Columns) | كافة إصدارات إكسل | جامدة (تتطلب إعادة التطبيق اليدوي) | معدوم (واجهة رسومية) | المعالجات الفردية السريعة والملفات المؤرشفة لمرة واحدة |
| التعبئة السريعة (Flash Fill) | Excel 2013 فما بعده | جامدة (استنتاج تخميني) | معدوم (تعلم آلي بالأنماط) | المعاينات الاستكشافية والنماذج الصغيرة البسيطة |
| محرك باور كويري (Power Query) | Excel 2010 فما بعده (إضافات أو مدمج) | ديناميكية مؤتمتة (بنقرة تحديث) | متوسط (خطوات مسجلة بلغة M) | مشاريع البيانات الضخمة ومسارات التدفق المعقدة |
خاتمة شاملة
إن عملية إزالة الأحرف والزوائد النصية الواقعة بعد الشرطة في مايكروسوفت إكسل تتجاوز كونها مجرد خدعة برمجية أو مهارة إجرائية عابرة؛ إنها خطوة منهجية مركزية في بناء نظم البيانات الرصينة وضمان جودة المدخلات الإحصائية والتحليلية. وقد أظهر العرض المقارن في هذا المقال تنوع الخيارات المتاحة للمحلل والباحث، وتفاوتها الملموس بين الحلول البرمجية فائقة التطور مثل دالة TEXTBEFORE، والحلول الكلاسيكية الراسخة المعتمدة على الجمع المنطقي بين دوال LEFT وFIND وSEARCH مع حمايتها عبر دوال إدارة الأخطاء، وصولاً إلى الأدوات التفاعلية المباشرة كمعالج النص إلى أعمدة، والتعبئة السريعة، ومنصة باور كويري لأتمتة تحويل البيانات العملاقة.
يتطلب اتخاذ القرار التقني السليم موازنة واعية بين أربعة معايير حاسمة: بيئة العمل والإصدار البرمجي المستخدم، وحجم مصفوفة البيانات وتكرارها الزمني، والحاجة إلى التحديث التلقائي الديناميكي للمخرجات، والضوابط الصارمة لتوثيق مسار التدقيق الحسابي. إن تبني أساليب التطهير التكميلية كمعالجة المسافات الهامشية وتوحيد شفرات الفواصل المختلفة، يضمن حماية قواعد البيانات من الشوائب والتشوهات الخفية، ويؤسس لنتائج إحصائية وموضوعية تتطابق مع أعلى المتطلبات المنهجية والأكاديمية المعاصرة في إدارة وتحليل البيانات الرقمية.
المراجع
- Beres, N. A., Klarkowski, M., & Mandryk, R. L. (2021). Under Pressure. Proceedings of the ACM on Human-Computer Interaction. https://doi.org/10.1145/3474666
- Cardillo, E. R., Schmidt, G. L., Kranjec, A., & Chatterjee, A. K. (2010). Stimulus design is an obstacle course: 560 matched literal and metaphorical sentences for testing neural hypotheses about metaphor. Behavior Research Methods. https://doi.org/10.3758/brm.42.3.651
- Keuleers, E., Diependaele, K., & Brysbaert, M. (2010). Practice Effects in Large-Scale Visual Word Recognition Studies: A Lexical Decision Study on 14,000 Dutch Mono- and Disyllabic Words and Nonwords. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2010.00174
- Nechvatal, J. (2011). Immersion Into Noise. Open Humanities Press eBooks. https://doi.org/10.3998/ohp.9618970.0001.001
- O’Dea, B., Han, J., Batterham, P. J., Achilles, M. R., Calear, A. L., Werner‐Seidler, A., et al. (2020). A randomised controlled trial of a relationship‐focussed mobile phone application for improving adolescents’ mental health. Journal of Child Psychology and Psychiatry. https://doi.org/10.1111/jcpp.13294
- Shull, R. L., Gaynor, S. T., & Grimes, J. A. (2001). RESPONSE RATE VIEWED AS ENGAGEMENT BOUTS: EFFECTS OF RELATIVE REINFORCEMENT AND SCHEDULE TYPE. Journal of the Experimental Analysis of Behavior. https://doi.org/10.1901/jeab.2001.75-247
- Thalmayer, A. G., Saucier, G., Ole‐Kotikash, L., & Payne, D. L. (2019). Personality structure in east and west Africa: Lexical studies of personality in Maa and Supyire-Senufo. Journal of Personality and Social Psychology. https://doi.org/10.1037/pspp0000264
- Wakeman, R. J., & Mestayer, R. (1985). Stress-related disorders. Postgraduate Medicine. https://doi.org/10.1080/00325481.1985.11698991