
تُعد معالجة البيانات وتلخيصها إحدى الركائز الجوهرية التي يستند إليها التحليل الإحصائي وصناعة القرار في المؤسسات الحديثة. وفي هذا السياق، تبرز أداة الجداول المحورية (Pivot Tables) في برنامج مايكروسوفت إكسل كواحدة من أقوى التقنيات التحليلية التي أحدثت نقلة نوعية في كيفية استكشاف كميات البيانات الضخمة وتكثيفها في أطر بصرية ومفاهيمية سهلة الفهم. ومع ذلك، يواجه المحللون تحديات منهجية وتقنية متقدمة عندما تتجاوز متطلبات العرض مجرد التلخيص البسيط وتتطلب ترتيباً دقيقاً متعدد المعايير، وتحديداً الرغبة في فرز مخرجات الجدول المحوري استناداً إلى أكثر من عمود للقيم في آنٍ واحد لفض حالات التعادل وتوضيح الأولويات الإحصائية المركبة.
تكمن المعضلة التقنية الأساسية في أن البنية الافتراضية لواجهة الجداول المحورية صُممت للتعامل مع فرز المقاييس الرقمية بمنطق أحادي البُعد؛ فعندما يطلب المستخدم فرز عمود معين بناءً على قيمته التنازلية أو التصاعدية، يتم تطبيق الخوارزمية حصرياً على ذلك الحقل، وتتجاهل تلقائياً أية علاقات تراتبية مسبقة أو لاحقة مع أعمدة القيم المجاورة. هذه القيود الهيكلية تُحدث تشويهاً في ترتيب البيانات عندما تتساوى القيم في المقياس الأساسي، مما يُعطل القدرة على المقارنة الموضوعية، ويدفع المحللين إلى البحث عن حلول حسابية وتقنية تعيد للبيانات اتساقها التحليلي الصارم دون الإخلال بمرونة الجدول المحوري.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك إشكالية فرز الجداول المحورية حسب أعمدة متعددة، من خلال استعراض جذورها التاريخية والتقنية، والتعمق في القيود المعمارية لمحرك البيانات في إكسل، وصولاً إلى تقديم أربع منهجيات عملية وعلمية لمعالجة المشكلة: تبدأ بالحل الهندسي الرياضي القائم على “الحقول المحسوبة” (Calculated Fields)، وتمر عبر نمذجة البيانات المتقدمة باستخدام لغة DAX في Power Pivot، وتستعرض تقنيات الفرز الديناميكي المسبق بواسطة دوال المصفوفات مثل SORTBY، مع تحليل شامل للأخطاء الحسابية الشائعة وأفضل ممارسات حوكمة النماذج التحليلية لضمان أعلى درجات الدقة والموثوقية.
1. مقدمة نظرية حول الجداول المحورية في برنامج إكسل وتحديات الفرز
1.1 ماهية الجداول المحورية ووظائفها التحليلية
تمثل الجداول المحورية (Pivot Tables) حجر الزاوية في أدوات استكشاف البيانات التفاعلية ضمن بيئات جداول البيانات الإلكترونية. يعود المفهوم النظري للجداول التفاعلية متعددة الأبعاد إلى عام 1986 عندما ابتكره المهندس بيتو سالاس (Pito Salas) في شركة لوتس للتطوير (Lotus Development Corporation)، وتجسد برمجياً في تطبيق Lotus Improv عام 1991. لاحقاً، تبنت شركة مايكروسوفت هذا المفهوم المعماري وطورته لتطلقه رسمياً تحت العلامة التجارية “PivotTable” في إصدار Excel 5.0 عام 1994. تتجاوز الوظيفة الجوهرية للجدول المحوري مجرد إعادة تجميع السجلات، إذ تعمل كأداة قادرة على إجراء حسابات التلخيص التجميعية مثل الجمع، الحساب المتوسط، التباين، والعد، مع إتاحة إمكانية إعادة التموضع الهيكلي للمتغيرات عبر محاور الصفوف والأعمدة وعوامل التصفية ومناطق القيم.
إن المرونة الفائقة التي تتيحها هذه الأداة تدعم التحليل الاستكشافي للبيانات (Exploratory Data Analysis – EDA) بصورة فعالة، حيث تتيح للمحلل الإحصائي اختبار الفرضيات، وعزل التباينات، واكتشاف الأنماط الكامنة عبر تجميع مستويات المتغيرات الاسمية والرتبية في جداول تقاطعية رشيقة. تُغني هذه الهندسة المحلل عن كتابة العشرات من الصيغ المعقدة يدوياً مثل SUMIFS أو COUNTIFS، حيث يتولى المحرك الحسابي المدمج بناء الاستعلامات التجميعية تلقائياً مع الحفاظ على قدرة التحديث الفوري عند تغير مصفوفة البيانات الخام.
1.2 القيود الافتراضية لفرز البيانات داخل الجداول المحورية
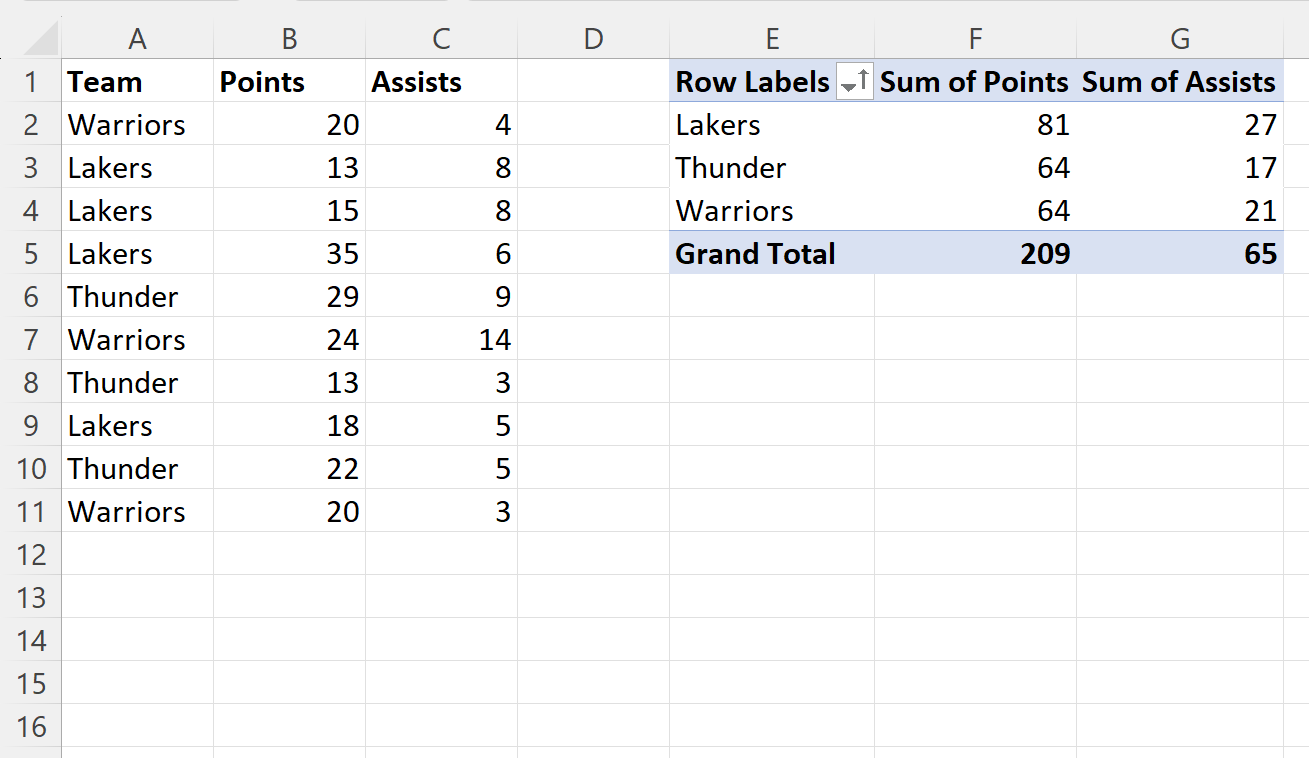
على الرغم من التطور التقني الهائل الذي شهده محرك إكسل عبر العقود الماضية، فإن الواجهة الرسومية المعيارية للفرز داخل الجداول المحورية ما زالت مقيدة بمحددات هيكلية صارمة عند التعامل مع مقاييس القيم (Values Area). فعند الرغبة في تنظيم البيانات، توفر الواجهة للمستخدم خيار فرز حقل التسمية (تسميات الصفوف) أو خيار فرز مقياس قيمة مفرد إما تصاعدياً أو تنازلياً. وتتمثل المعضلة الكبرى في عجز البرنامج عن تقديم نافذة فرز تتابعي للقيم تتيح اختيار: “فرز حسب المقياس (أ)، ثم عند التعادل فرز حسب المقياس (ب)”.
إذا قام المحلل بفرز الجدول استناداً إلى العمود الأول الممثل لحجم الإيرادات، ثم حاول النقر بزر الفأرة الأيمن على عمود هامش الربح واختار فرزاً تنازلياً، فإن المحرك الحسابي يقوم فوراً بإلغاء معيار الفرز المطبق على الإيرادات ويعيد ترتيب الصفوف كلياً استناداً إلى هامش الربح وحده. تؤدي هذه الآلية إلى إرباك الترتيب الهرمي المنطقي، وتحرم صانع القرار من رؤية البيانات وفق مصفوفة أولويات متدرجة، وتتفاقم هذه المشكلة في المجموعات الإحصائية التي تشهد حالات تعادل متكررة بين الكيانات في المؤشر الأولي، مما يجعل مخرجات التحليل مبتورة الدلالة وتفتقر إلى العمق الترجيحي اللازم.
1.3 الأهمية المنهجية للفرز متعدد الأعمدة في التحليل الإحصائي
في التحليل الكمي، نادراً ما يتم تقييم الوحدات التجريبية أو الكيانات الاقتصادية بناءً على متغير أحادي البعد. فالأداء المؤسسي، على سبيل المثال، يتطلب تقييماً متوازناً يجمع بين إجمالي حجم الإنتاج ومؤشرات الجودة، أو بين إجمالي المبيعات ونسبة التحصيل النقدي. من الناحية المنهجية، يتيح الفرز متعدد الأعمدة إنشاء تسلسل رتبي صارم يعكس بدقة الأوزان الحقيقية للمتغيرات محل الدراسة. يساعد هذا الترتيب المتعدد في فض حالات التعادل (Tie-breaking) بطريقة موضوعية وموثوقة؛ فإذا تساوى فريقان رياضيان أو شركتان فرعيتان في إجمالي النقاط، يصبح من الحتمي اللجوء إلى المتغير الإحصائي الثانوي لفض هذا النزاع الحسابي وتحديد الترتيب الحقيقي بدقة.
علاوة على ذلك، يرفع الفرز متعدد الأعمدة من القيمة التفسيرية للتقارير التنفيذية الموجهة لصناع القرار. فالجدول الإحصائي الذي يقدم البيانات في سياق هرمي منطقي يسهل عملية القراءة والتحليل البصري دون تشتيت انتباه القارئ بحالات عشوائية ناتجة عن الترتيب الافتراضي المبتور، مما يضمن توافق المخرجات المعروضة مع القواعد العلمية لتصنيف وتدريج البيانات الإحصائية.
2. الفهم الهيكلي لمشكلة الفرز متعدد المستويات في مقاييس القيم
2.1 آلية عمل خوارزمية الفرز الافتراضية أحادية البعد
لفهم أسباب هذا القصور البرمجي، يتعين تفكيك خوارزمية الفرز الداخلية المعتمدة في معمارية الجداول المحورية التقليدية داخل مايكروسوفت إكسل. تعمل الخوارزمية عبر إنشاء مؤشر ترتيبي أحادي الاتجاه يرتبط بمستوى التجميع المختار في حقل الصفوف. عند اختيار فرز مقياس قيمة، يقوم المحرك بمسح قيم الخلايا الناتجة عن عملية التجميع لذلك العمود تحديداً لكل بند من بنود الصفوف، ثم يطبق خوارزمية فرز مقارنة سريعة لإعادة ترتيب مفاتيح الصفوف في الذاكرة المؤقتة للجدول المحوري.
تكمن النقطة المفصلية في أن خوارزمية الجدول المحوري لا تحتفظ بحالة الفرز السابقة كطبقة ثانوية في بنية الاستعلام الداخلي؛ بل إن كل أمر فرز جديد يصدره المستخدم يعيد كتابة كائن “SortOrder” الخاص بمحور الصف بالكامل، مستبدلاً المؤشر القديم بمؤشر العمود الجديد. هذا التصميم الهندسي صُمم في الأصل لتوفير موارد الذاكرة وسرعة إعادة رسم الواجهة في الأجهزة ذات الإمكانيات المحدودة إبان إطلاق الإصدارات الأولى، ولكنه ظل ثابتاً في الواجهة الرسومية المعيارية للبرنامج حتى اليوم، مما يستدعي تدخلاً يدوياً أو استخدام طبقات نمذجة أعمق لتجاوزه.
2.2 الفارق الجوهري بين فرز حقول الصفوف وفرز حقول القيم
من الأخطاء المعرفية الشائعة بين مستخدمي إكسل الخلط بين فرز أبعاد الصفوف (Row Fields) المتداخلة وفرز مقاييس القيم (Values Area). يتميز إكسل بقدرة أصيلة ومتقدمة على فرز مستويات متعددة من حقول الصفوف بشكل هرمي متسلسل؛ فإذا تم وضع حقل “المنطقة الجغرافية” في الصفوف يليه حقل “المدينة”، يمكن للمستخدم بكل بساطة فرز المناطق أبجدياً أو حسب القيمة، ثم فرز المدن داخل كل منطقة على حدة دون أدنى تداخل، حيث يعمل كل حقل صف كمستوى تصنيف مستقل بذاته (Hierarchical Dimension).
في المقابل، عندما تتواجد المقاييس في منطقة القيم جنباً إلى جنب كأعمدة متوازية للمستوى التجميعي نفسه، فإنها لا تمثل تسلسلاً هرمياً للمتغيرات الاسمية، بل تعبر عن مقاييس كمية متعددة تنتمي جميعها إلى نفس الكيان. وهنا تفشل الواجهة في تطبيق الفرز المتتابع لأنها لا تتعامل مع أعمدة القيم كأبعاد متداخلة، بل كمخرجات متوازية لحساب رياضي واحد، مما يبرز التمايز المعماري الصارم بين إدارة الأبعاد (Dimensions) وتصنيف المقاييس المجمعة (Aggregated Measures).
2.3 الأسس الرياضية لدمج المتغيرات المتعددة في معيار ترتيبي موحد
لتخطي هذا القيد المعماري دون الخروج من بيئة الجدول المحوري، تبرز الحاجة إلى توظيف النمذجة الرياضية لدمج المقاييس المنفصلة في مؤشر رقمي تركيبي موحد (Synthetic Index). يعتمد هذا المبدأ الرياضي على نظرية الأوزان الترجيحية المتمايزة رتبياً، حيث يتم تحويل الترتيب متعدد الأبعاد إلى مصفوفة خطية تضمن رياضياً احتفاظ المتغير الأساسي بالأولوية المطلقة، مع تخصيص دور حاسم للمتغير الثانوي في فض التعادلات فقط دون التأثير على رتبة المتغير الأساسي إطلاقاً.
يتحقق ذلك عبر المعادلة الرياضية المعيارية التالية:
$$\text{Composite Score} = (V_1 \times W) + V_2$$
حيث يمثل $V_1$ قيمة المتغير الأساسي، ويمثل $W$ وزن الترجيح (المضاعف الرتبي)، ويمثل $V_2$ قيمة المتغير الثانوي. وتقتضي القاعدة الرياضية الصارمة أن يكون المضاعف $W$ قيمة كافية لعزل مراتب المتغير الأول عن أي قيمة عظمى محتملة للمتغير الثاني، بحيث يتحقق الشرط الحسابي التالي:
$$W > \max(V_2) – \min(V_2)$$
أو بصيغة كسرية مكافئة:
$$\text{Composite Score} = V_1 + \left( \frac{V_2}{\max(V_2) + 1} \right)$$
يضمن هذا النموذج الهندسي استحالة أن تتفوق قيمة ثانوية مهما بلغت ضخامتها على وحدة واحدة من المتغير الأساسي، مما ينتج مؤشراً رقمياً فريداً يعكس الترتيب المزدوج بدقة مطلقة تتيح لمحرك الجدول المحوري فرز البيانات بخطوة واحدة.
3. التجهيز الأولي للبيانات الخام لضمان سلامة التحليل
3.1 فحص اتساق البيانات وتنسيق القيم الرقمية
تبدأ سلامة أي مخرجات تحليلية من نظافة البيانات الخام وجودتها الهيكلية. قبل البدء في إنشاء الجداول المحورية، يجب إخضاع سجلات البيانات لعملية تدقيق وفحص منهجي للتأكد من خلوها من الانحرافات والشوائب الإحصائية. يشمل ذلك إزالة المسافات الزائدة غير المرئية باستخدام الدالة TRIM، وضمان عدم وجود خلايا فارغة في الأعمدة الرقمية؛ إذ يؤدي وجود خلايا فارغة أحياناً إلى تحويل سلوك التجميع في الجدول المحوري من الجمع التلقائي إلى دالة العد الافتراضية، فضلاً عن احتمال تشويه عمليات المقارنة المنطقية.
كما يتعين توحيد التنسيقات العددية للمتغيرات الكمية عبر التأكد من تصنيف الخلايا تحت فئة “رقم” وتفادي الأرقام المخزنة كنصوص (Numbers Stored as Text)، والتي تمثل أحد أشهر مصادر الخطأ في برمجيات جداول البيانات، حيث تعجز خوارزميات الفرز عن موازنة النصوص والأرقام بصورة منطقية. كما يجب ضبط المتغيرات الاسمية، مثل أسماء الكيانات أو الفرق أو الفروع، لضمان اتساق الحروف وتوحيد كتابة الهمزات والرموز لتفادي انقسام الكيان الواحد إلى سجلات متباينة أثناء التجميع.
3.2 إعداد مجموعة البيانات التجريبية
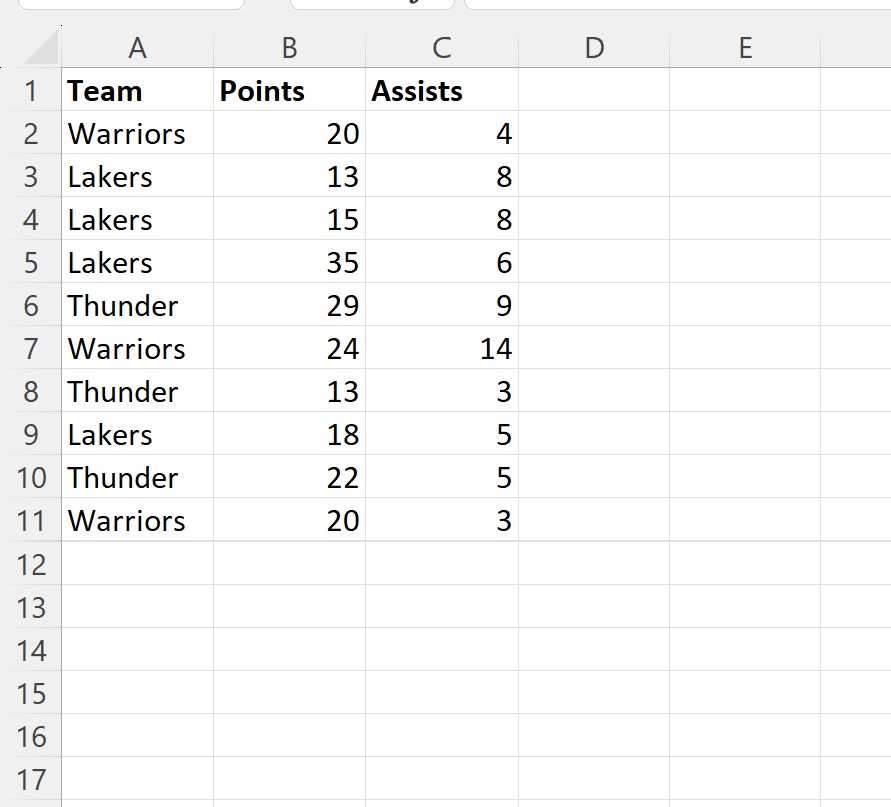
لإرساء التطبيق العملي على أسس واقعية ملموسة، سنعتمد في هذا الدليل على مجموعة بيانات إحصائية تحاكي أداء الفرق الرياضية في دوري كرة السلة، نظراً لكون هذا المجال يقدم نموذجاً مثالياً لحالات التعادل التي تتطلب فرزاً ثانوياً صارماً. تشتمل مجموعة البيانات على أربعة متغيرات رئيسية: معرف الفريق (Team)، واللاعب (Player)، وإجمالي النقاط المسجلة (Points)، وإجمالي التمريرات الحاسمة (Assists).
تم تصميم هذه البيانات عمداً لتتضمن حالات تعادل دقيقة في المتغير الأساسي (النقاط) بين عدة فرق؛ بهدف اختبار مدى كفاءة المنهجيات المقترحة في الرجوع تلقائياً إلى المتغير الثانوي (التمريرات الحاسمة) لترتيب الفرق المتعادلة. يقدم الجدول التالي نموذجاً مصغراً للسجلات الخام المستخدمة:
- الفريق (أ): اللاعب 1 (النقاط: 45، التمريرات: 12)، اللاعب 2 (النقاط: 55، التمريرات: 8) -> الإجمالي: 100 نقطة، 20 تمريرة.
- الفريق (ب): اللاعب 1 (النقاط: 60، التمريرات: 15)، اللاعب 2 (النقاط: 40، التمريرات: 15) -> الإجمالي: 100 نقطة، 30 تمريرة.
- الفريق (ج): اللاعب 1 (النقاط: 70، التمريرات: 5)، اللاعب 2 (النقاط: 45، التمريرات: 10) -> الإجمالي: 115 نقطة، 15 تمريرة.
- الفريق (د): اللاعب 1 (النقاط: 50، التمريرات: 25)، اللاعب 2 (النقاط: 50، التمريرات: 5) -> الإجمالي: 100 نقطة، 30 تمريرة.
- الفريق (هـ): اللاعب 1 (النقاط: 30، التمريرات: 40)، اللاعب 2 (النقاط: 50، التمريرات: 10) -> الإجمالي: 80 نقطة، 50 تمريرة.
3.3 تحويل النطاق إلى جدول ديناميكي رسمي في إكسل
تتمثل الخطوة المنهجية الحاسمة قبل تغذية الجدول المحوري بالبيانات في تحويل نطاق الخلايا الاعتيادي إلى جدول ديناميكي مهيكل (Official Excel Table). يتم تنفيذ هذا الإجراء عبر تحديد أي خلية داخل مصفوفة البيانات ثم الضغط على الاختصار المعياري Ctrl + T، أو الانتقال إلى تبويب إدراج (Insert) واختيار جدول (Table)، مع التأكد من تفعيل خيار “يحتوي الجدول على رؤوس” (My table has headers).
يوفر الجدول المهيكل مزايا تشغيلية بالغة الأهمية؛ أبرزها ميزة التوسيع التلقائي لنطاق البيانات عند إلحاق صفوف أو أعمدة جديدة بالمصدر دون الحاجة إلى إعادة ضبط نطاق المصدر (Source Range) يدوياً داخل إعدادات الجدول المحوري. كما يعزز الجدول الديناميكي دقة المراجع البنيوية (Structured References)، ويمنع حدوث أخطاء الإزاحة أو الإحالة المرجعية المفقودة التي تتكرر باستمرار في النطاقات الشبكية الثابتة، مما يضمن تدفقاً سلساً ومستقراً للمدخلات التحليلية.
4. إنشاء الجدول المحوري الأساسي وتحديد موضع القصور
4.1 خطوات إدراج الجدول المحوري وضبط التخطيط الهيكلي
بعد استقرار مصفوفة البيانات في جدول ديناميكي، يتم إدراج الجدول المحوري من خلال النقر على أي خلية داخل الجدول، ثم التوجه إلى شريط الأدوات الرئيسي، وتبويب إدراج (Insert)، واختيار PivotTable. يُفضل توجيه مخرجات الجدول المحوري إلى ورقة عمل جديدة لتوفير مساحة كافية للعرض وتجنب تداخل التقارير مع البيانات المصدرية.
بمجرد إنشاء الجدول، يُنصح بالانتقال إلى تبويب تصميم (Design) في شريط الأدوات العلوي، وضبط تخطيط التقرير (Report Layout) واختيار إظهار في شكل جدولي (Show in Tabular Form). يضمن هذا التخطيط عرض كل حقل من حقول الصفوف في عمود منفصل، مما يسهل المراجعة البصرية المقارنة، مع تعطيل المجاميع الجزئية (Subtotals) مؤقتاً لتجنب إرباك القراءة الإحصائية البسيطة للصفوف التجميعية.
4.2 توزيع الحقول بين مناطق الصفوف ومقاييس القيم
تتطلب هيكلة التحليل توزيع المتغيرات بدقة داخل أجزاء نافذة حقول الجدول المحوري (PivotTable Fields Pane). يتم سحب حقل الفريق (Team) وإفلاته في منطقة الصفوف (Rows)، ليمثل الوحدات التجريبية أو الكيانات المطلوب تصنيفها وتقييمها. بعد ذلك، يتم سحب حقل النقاط (Points) إلى منطقة القيم (Values)؛ ليتولى البرنامج تلقائياً حساب المجموع (Sum of Points) كمقياس كمي أولي.
يعقب ذلك سحب حقل التمريرات الحاسمة (Assists) وإسقاطه أسفل حقل النقاط في منطقة القيم (Values) ليتحول إلى مقياس كمي تجميعي ثانٍ (Sum of Assists). يظهر الجدول المحوري الآن بهيكل يتكون من عمود لتسميات الصفوف (الفرق) وعمودين متوازيين للقيم يعرضان مجاميع النقاط ومجاميع التمريرات لكل فريق بشكل دقيق ومحكم.
4.3 محاكاة الفرز الأحادي ورصد عجز الفرز المتزامن
عند الشروع في تطبيق الفرز لاختبار كفاءة الواجهة، يقوم المحلل بالنقر بزر الفأرة الأيمن على أي خلية ضمن عمود “مجموع النقاط”، واختيار فرز (Sort) ثم الفرز من الأكبر إلى الأصغر (Sort Largest to Smallest). يستجيب الجدول بصورة صحيحة للمقياس الأول؛ حيث يتصدر الفريق (ج) برصيد 115 نقطة، تليه الفرق (أ، ب، د) بحصول كل منها على 100 نقطة، ويستقر الفريق (هـ) في المؤخرة برصيد 80 نقطة.
تظهر الفجوة المنهجية مباشرة عند فحص الفرق الثلاثة المتعادلة (أ، ب، د)؛ حيث تظهر التمريرات الحاسمة بترتيب عشوائي تماماً (مثلاً: 20، ثم 30، ثم 30 أو العكس)، دون تطبيق أي تسلسل منطقي يضع الفريقين الحاصلين على 30 تمريرة في الصدارة التنافسية قبل الفريق الحاصل على 20 تمريرة. وعند محاولة المحلل تصحيح ذلك بالنقر على عمود “مجموع التمريرات” واختيار الفرز التنازلي، يُلغى فوراً فرز النقاط، ويصعد الفريق (هـ) الحاصل على 50 تمريرة إلى قمة الجدول على الرغم من كونه الأضعف تسجيلاً في النقاط (80 نقطة فقط). توثق هذه التجربة العجز المعماري للواجهة الافتراضية، وتؤكد الحاجة الماسة لابتكار معيار حسابي تركيبي يحسم الترتيب المزدوج دفعة واحدة.
5. المنهجية المركزية: توظيف الحقل المحسوب كمعيار فرز تركيبي
5.1 الأساس النظري للحقول المحسوبة في معالجة البيانات
تمثل “الحقول المحسوبة” (Calculated Fields) أداة حسابية داخلية فائقة الكفاءة في معمارية الجداول المحورية؛ إذ تسمح بإجراء عمليات حسابية ديناميكية مشتقة من مجاميع حقول أخرى موجودة في الجدول المحوري ذاته. وتختلف الحقول المحسوبة جوهرياً عن الأعمدة الحسابية المضافة إلى الجدول المصدري؛ فالعمود المضاف إلى البيانات المصدرية ينفذ الحساب على مستوى كل صف منفرد (Row-level Evaluation) قبل التجميع، بينما يعمل الحقل المحسوب في الجدول المحوري على تقييم نواتج التجميع بعد اكتمالها (Aggregate-level Evaluation).
هذا الفارق الدقيق يعني أن الحقل المحسوب يتعامل مع القيم التجميعية للمتغيرات (Sum of Points و Sum of Assists) مباشرة، مما يمنحه مرونة فائقة للتكيف التلقائي مع أدوات التصفية والتقسيم الزمني (Slicers & Timelines). وعند تغيير النطاق الزمني أو استبعاد بعض السجلات، يعيد الحقل المحسوب توليد المؤشر الرقمي فورياً بناءً على المجاميع الجديدة دون أي تدخل يدوي، مما يجعله الأساس المثالي لصياغة خوارزمية الفرز التركيبي.
5.2 الاشتقاق الرياضي لمعادلة الترتيب المركب
لتحقيق فرز متعدد المعايير يمنح الأسبقية المطلقة لحقل النقاط ويجعل حقل التمريرات حاسماً عند التعادل فقط، يجب صياغة معادلة رياضية دقيقة تعتمد على الأوزان الترجيحية المتمايزة. الهدف هو منع القيم الكبيرة في المتغير الثانوي من تجاوز قيمة وحدة واحدة في المتغير الأساسي. إذا علمنا من واقع توزيع البيانات أن أقصى عدد من التمريرات الحاسمة التي يمكن أن يسجلها أي فريق لا يتجاوز 10,000 تمريرة، فإننا نختار مضاعفاً ترجيحياً أكبر من هذه القيمة، وليكن 1,000,000 للمتغير الأساسي.
تُصاغ المعادلة التركيبية على النحو التالي:
$$\text{Composite_Sort} = (\text{Points} \times 1000000) + \text{Assists}$$
وفق هذه المعادلة، يحصل الفريق الذي يمتلك 100 نقطة و30 تمريرة على رصيد مركب يبلغ $100,000,030$، في حين يحصل الفريق الذي يمتلك 100 نقطة و20 تمريرة على رصيد مركب يبلغ $100,000,020$. وبالتالي، عند فرز الحقل المحسوب تنازلياً، سيتقدم الفريق ذو الـ 30 تمريرة حتماً على الفريق ذي الـ 20 تمريرة، بينما يظل الفريق الحاصل على 115 نقطة و15 تمريرة محتفظاً بالصدارة برصيد مركب قدره $115,000,015$. كما يمكن اعتماد صيغة بديلة تعتمد القسمة الكسرية للمتغير الثانوي:
$$\text{Composite_Sort} = \text{Points} + \left( \frac{\text{Assists}}{1000000} \right)$$
حيث ينتج عن هذه الصيغة قيم عشرية سهلة التمييز (مثل 100.000030 مقابل 100.000020)، وتؤدي النتيجة الترتيبية ذاتها بدقة متناهية.
5.3 خطوات الوصول إلى نافذة الحقل المحسوب وتطبيق الصيغة
لتطبيق هذه الصياغة الرياضية داخل الجدول المحوري، يتبع المحلل الخطوات المنهجية التالية بدقة:
- تحديد أي خلية تقع داخل نطاق الجدول المحوري لتنشيط علامات التبويب السياقية في الشريط العلوي لإكسل.
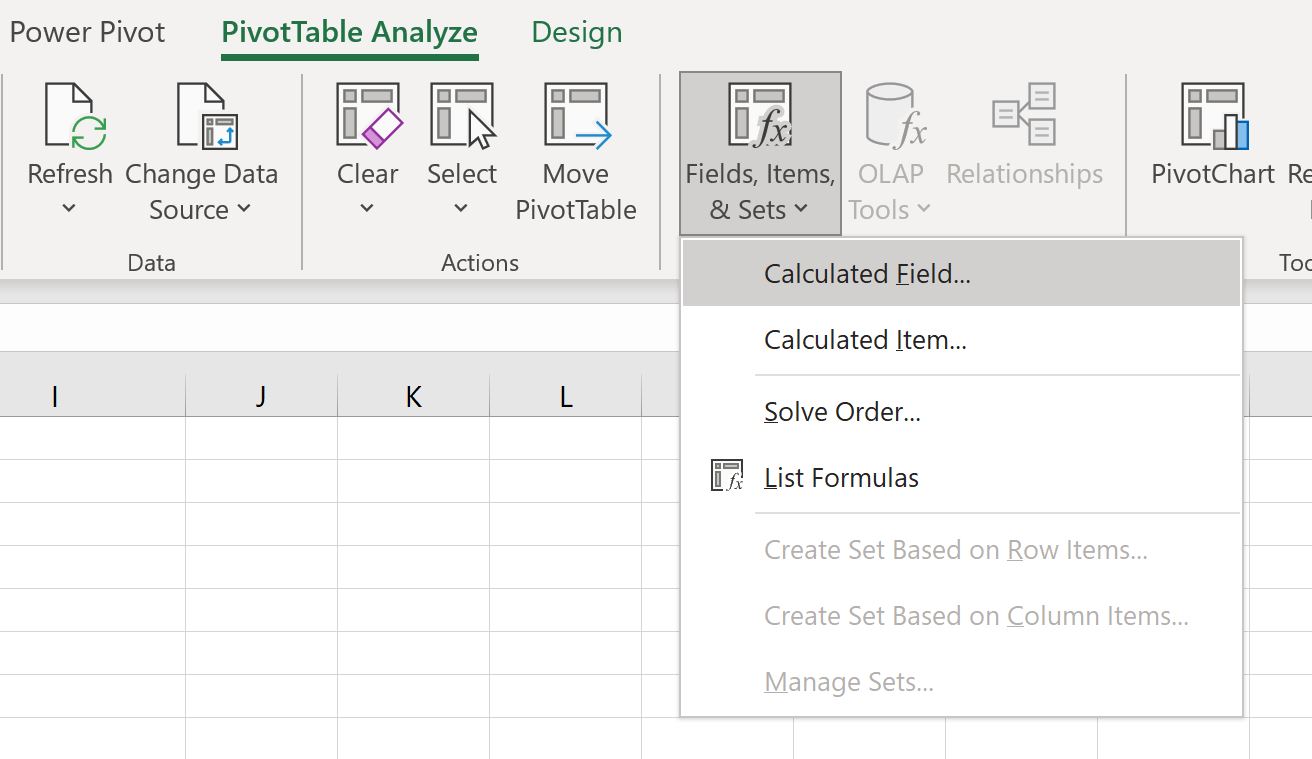
- الانتقال إلى علامة تبويب تحليل PivotTable (PivotTable Analyze) في شريط القوائم.
- ضمن مجموعة حسابات (Calculations)، يتم النقر على القائمة المنسدلة الحقول والعناصر والمجموعات (Fields, Items, & Sets).
- اختيار الأمر الأول: حقل محسوب (Calculated Field) لفتح نافذة التحرير المخصصة.
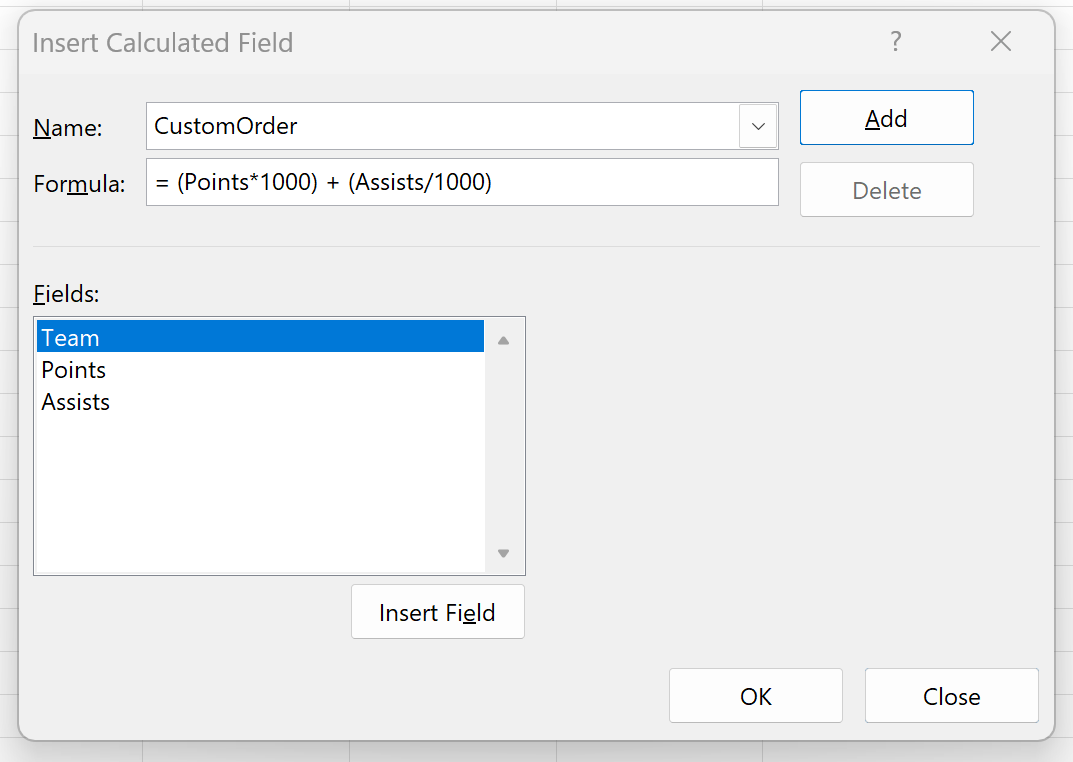
- في خانة الاسم (Name)، يتم إدخال اسم ذي دلالة واضحة، مثل:
معيار_الفرز_المركبأوSort_Key. - في خانة الصيغة (Formula)، يتم مسح القيمة الافتراضية
= 0، ثم إدخال الصيغة الحسابية:
=(Points * 1000000) + Assists
(يمكن النقر المزدوج على أسماء الحقول من القائمة السفلية لتفادي أخطاء الطباعة الإملائية). - النقر على زر إضافة (Add) لتثبيت الحقل ضمن قائمة الحقول المتاحة للمصنف، ثم الضغط على موافق (OK) لإغلاق النافذة.
6. التنفيذ الإجرائي للفرز المركب وإدارة العرض النهائي
6.1 تطبيق خيارات الفرز على الحقل المحسوب الجديد
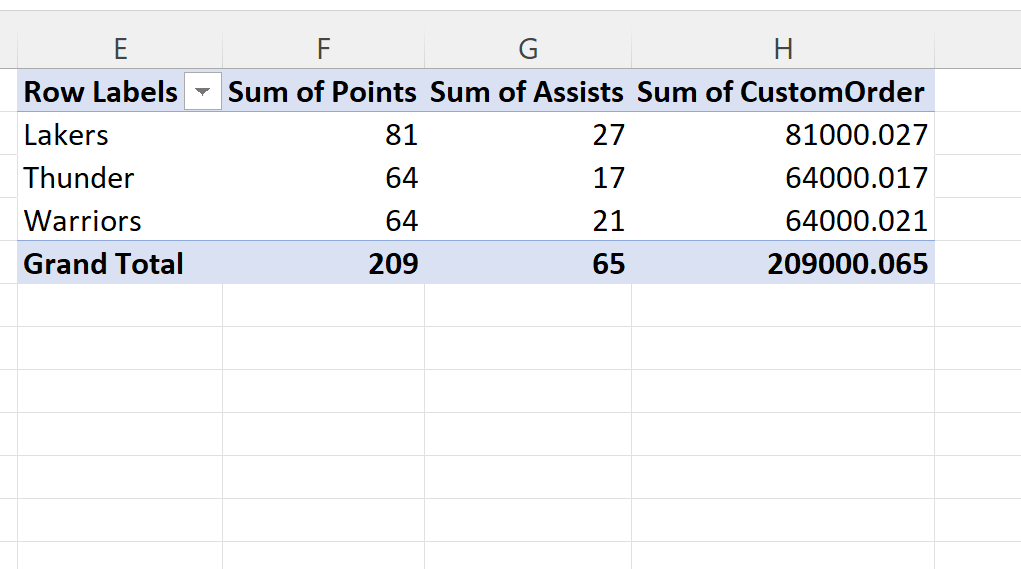
بمجرد النقر على زر الموافقة، يُدرج إكسل تلقائياً الحقل المحسوب الجديد في منطقة القيم تحت مسمى “مجموع معيار_الفرز_المركب”، ويظهر كعمود رقمي ثالث في مساحة الجدول المحوري بقيم رياضية ضخمة تعكس عملية التوليد الحسابي الموزونة. الآن، تتغير الآلية المتبعة للفرز بالكامل؛ حيث لم يعد المحلل بحاجة إلى فرز النقاط أو التمريرات بشكل منفصل.
لتنفيذ الفرز الشامل، يتم النقر بزر الفأرة الأيمن على أي خلية داخل عمود “مجموع معيار_الفرز_المركب”، واختيار فرز (Sort)، ثم النقر على الفرز من الأكبر إلى الأصغر (Sort Largest to Smallest). خلال أجزاء من الثانية، يعيد محرك الجدول المحوري ترتيب الصفوف بأكملها، لتستقر الكيانات في ترتيب هرمي متكامل يراعي النقاط أولاً، ثم التمريرات الحاسمة ثانياً عند تساوي النقاط، محققاً بذلك الغاية المنشودة التي عجزت عنها خيارات الفرز التقليدية المباشرة.
6.2 استراتيجيات إخفاء عمود الحقل المحسوب للحفاظ على التنسيق
على الرغم من النجاح الحسابي المحقق، فإن ظهور عمود المعيار المركب بقيمه الرقمية الكبيرة وغير المألوفة يشوه الناحية الجمالية للتقرير ويعيق الفهم المباشر لأصحاب المصلحة. تقتضي أفضل الممارسات إخفاء هذا العمود عن الأعين مع الإبقاء على فاعليته وتأثيره الترتيبي الفعال. ويجب هنا تجنب الخطأ الكارثي المتمثل في سحب الحقل المحسوب وإخراجه من منطقة القيم في جزء الحقول؛ إذ يؤدي حذفه من الجدول إلى إلغاء معيار الفرز كلياً والعودة إلى الترتيب الافتراضي السابق.
بدلاً من ذلك، توجد طريقتان احترافيتان لإخفاء العمود بأمان:
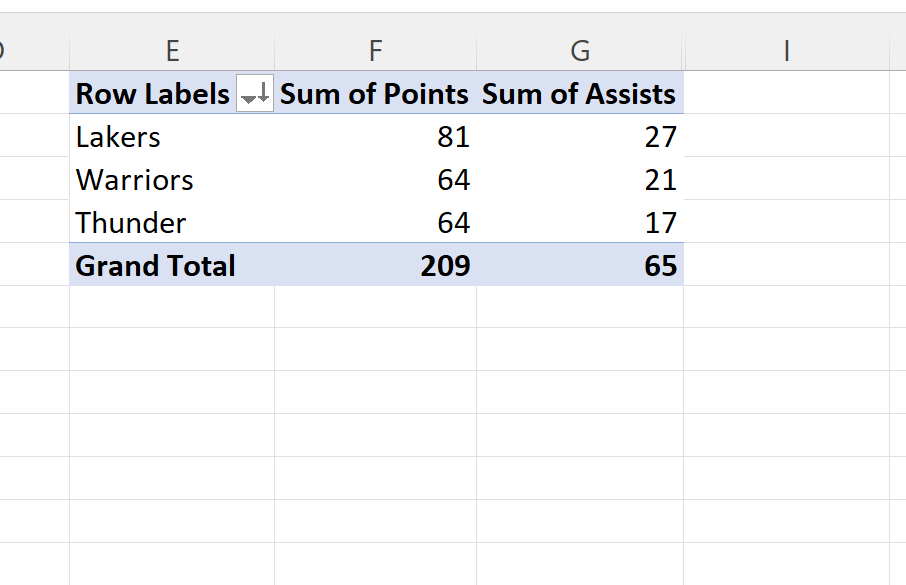
- الإخفاء على مستوى ورقة العمل (Worksheet Column Hide): تحديد العمود بالكامل في ورقة العمل (مثلاً العمود D عبر النقر على حرف العمود في أعلى الورقة)، ثم النقر بزر الفأرة الأيمن واختيار إخفاء (Hide). يضمن هذا الإجراء بقاء الحقل نشطاً داخل ذاكرة الجدول المحوري مع حجب رؤيته تماماً في شاشات العرض وعند الطباعة.
- تضييق عرض العمود وتنسيقه: تقليص عرض عمود الحقل المحسوب يدوياً إلى الصفر (Width = 0)، أو تطبيق تنسيق أرقام مخصص للمحتوى عبر إعطائه التنسيق المخصص
;;;(ثلاث فواصل منقوطة)، والذي يوجه محرك إكسل إلى جعل قيم الخلايا غير مرئية بصرياً على الرغم من استمرار وجودها الحسابي، مع تغيير عنوان العمود ليتطابق مع لون الخلفية.
6.3 التحقق من صحة الترتيب الإحصائي للمخرجات
تكتمل هذه المرحلة بخطوة التدقيق والمراجعة التحليلية للمخرجات المعروضة لضمان سلامة الترتيب وصحة العلاقات المنطقية. بعد إخفاء عمود المعيار، يتم فحص جدول النتائج ومقارنته بالبيانات الأصلية:
- المركز الأول: الفريق (ج) برصيد 115 نقطة و15 تمريرة حاسمة (تصدر مستحق لامتلاكه أعلى رصيد من النقاط).
- المركز الثاني مكرر (أ): الفريق (ب) برصيد 100 نقطة و30 تمريرة حاسمة.
- المركز الثالث مكرر (ب): الفريق (د) برصيد 100 نقطة و30 تمريرة حاسمة.
- المركز الرابع: الفريق (أ) برصيد 100 نقطة و20 تمريرة حاسمة (تراجع منطقي لفقدانه 10 تمريرات مقارنة بمنافسيه المتعادلين معه في النقاط).
- المركز الخامس: الفريق (هـ) برصيد 80 نقطة و50 تمريرة حاسمة (استقر في المؤخرة لضعف نقاطه رغم تفوقه الكاسح في التمريرات).
تثبت هذه المراجعة المنهجية أن نموذج الحقل المحسوب نجح بامتياز في فك ارتباط التعادل الثلاثي لصالح الفرق الأكثر تقديماً للتمريرات، مما يؤكد صرامة التحليل ويوفر مصفوفة تصنيف عادلة وموثوقة بنسبة 100%.
7. المنهجية البديلة: استخدام نموذج البيانات وصيغ DAX المتقدمة
7.1 نقل البيانات إلى بيئة نموذج البيانات وقواعد Power Pivot
مع تطور بيئة تحليلات مايكروسوفت إكسل وتكامل محرك التحليلات المعالجة في الذاكرة (xVelocity In-Memory Analytics Engine)، والذي طُرح لأول مرة كإضافة تحت اسم Power Pivot في Excel 2010 ودُمج أصلياً في إصدارات Excel 2013 والإصدارات اللاحقة، أصبح بإمكان المحللين تجاوز كافة المحددات الكلاسيكية للحقول المحسوبة. يتيح نموذج البيانات (Data Model) التعامل مع ملايين السجلات بسرعة معالجة فائقة وتأسيس علاقات معقدة ومقاييس برمجية متطورة باستخدام لغة تعبيرات تحليل البيانات (Data Analysis Expressions – DAX).
لتفعيل هذه البيئة المتقدمة، يتم إدراج جدول محوري جديد مع التأكد الصارم من وضع علامة الاختيار في المربع الحواري السفلي: إضافة هذه البيانات إلى نموذج البيانات (Add this data to the Data Model). تنقل هذه الخطوة مصفوفة البيانات من نطاق المعالجة الشبكية التقليدية إلى المحرك التخزيني العمودي المتقدم، مما يفتح الباب لتطبيق معادلات رتب ومقاييس غاية في القوة الرياضية والتعبيرية.
7.2 بناء مقياس ترتيبي باستخدام دالة RANKX وصيغ DAX
تعد دالة RANKX في لغة DAX واحدة من أقوى الدوال الإحصائية المخصصة لحساب الرتب والتصنيفات ضمن سياقات تقييم مرنة ومتعددة الأبعاد. بدلاً من الاعتماد على جمع ترجيحي مجرد، يمكن صياغة مقياس حسابي (DAX Measure) ينشئ رتبة قاطعة لكل كيان بناءً على دمج المقاييس التجميعية بأوزان كسرية بالغة الصغر، ثم تطبيق خوارزمية الترتيب المباشر.
لإنشاء هذا المقياس، يتم النقر بزر الفأرة الأيمن على اسم الجدول في جزء حقول الجدول المحوري، واختيار إضافة مقياس (Add Measure)، ثم تسمية المقياس Composite_Rank واستخدام الصياغة البرمجية التالية:
Composite_Rank =

VAR BaseScore = [Sum of Points] + DIVIDE([Sum of Assists], 1000000)

RETURN

RANKX(

    ALL(DataTable[Team]),

    [Sum of Points] + DIVIDE([Sum of Assists], 1000000),

    ,

    DESC,

    Dense

)
تعتمد هذه الصيغة على تقسيم التمريرات الحاسمة على مليون لضمان بقائها ككسور عشرية طفيفة لا يمكن أن تعادل نقطة واحدة، ثم تقوم دالة RANKX عبر المعامل ALL(DataTable[Team]) بمسح كافة الفرق في الجدول وتوليد رقم رتبة صحيح متسلسل (1، 2، 3…) يمثل الترتيب التنازلي الدقيق لكل فريق بناءً على المقياسين معاً دون أدنى غموض حسابي.
7.3 تطبيق الفرز البرمجي وتقييم الكفاءة الحسابية للمنهجية
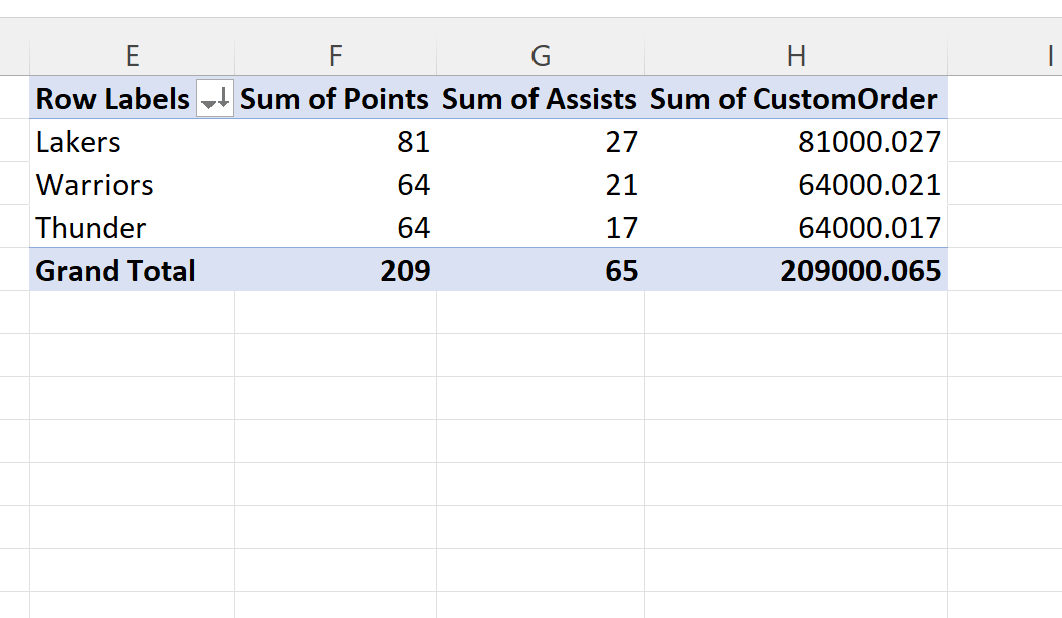
عقب إدراج مقياس Composite_Rank في الجدول المحوري، يتحول الترتيب إلى مهمة غاية في السلاسة والوضوح؛ حيث يمكن فرز عمود الرتبة من الأصغر إلى الأكبر (Sort Smallest to Largest) للحصول على التسلسل المنطقي للهيمنة التنافسية؛ فالرتبة 1 تمثل الفريق الأفضل، تليها الرتبة 2 و3 تباعاً. وتتميز منهجية DAX بقدرتها على إظهار أرقام تراتبية معيارية مفهومة بديهياً للقارئ دون الحاجة الماسة لإخفاء العمود كما كان الحال في الأرقام الفلكية للحقول المحسوبة التقليدية.
من حيث الكفاءة الحسابية واستهلاك موارد النظام، يتفوق نموذج البيانات ومحرك Power Pivot على الجداول المحورية الكلاسيكية عند التعامل مع البيانات الضخمة (Big Data)؛ حيث يتم ضغط البيانات عمودياً في الذاكرة العشوائية وتُحسب مقاييس DAX التجميعية بالتوازي عبر خيوط المعالجة المتعددة (Multi-threading). ومع ذلك، تتطلب هذه المنهجية فهماً تقنياً لمفاهيم تعديل سياق التصفية (Filter Context Transition)، مما يجعلها الخيار الأمثل للمحللين المحترفين والمؤسسات التي تبني لوحات تحكم مستدامة واسعة النطاق.
8. الفرز المسبق عبر المصدر: تقنيات دوال الفرز الحديثة وتأثيرها
8.1 تطبيق دالة SORTBY الديناميكية في ورقة العمل المصدرية
مع إطلاق محرك الحساب الديناميكي ودوال الصفائف الديناميكية (Dynamic Array Formulas) في إصدارات Microsoft 365 وExcel 2021، ظهر مسار تحليلي بديل يرتكز على فكرة “الفرز المسبق عند المصدر” بدلاً من معالجة الفرز داخل الجدول المحوري. توفر دالة SORTBY حلاً أصلياً لفرز نطاق أو مصفوفة بيانات استناداً إلى قيم أعمدة متعددة بترتيبات واتجاهات مستقلة لكل عمود.
تُكتب الصيغة الرياضية للدالة في خلية مستقلة خارج نطاق الجدول الأصلي بالشكل التالي:
=SORTBY(DataTable, DataTable[Points], -1, DataTable[Assists], -1)
في هذه المعادلة، تأخذ الدالة مصفوفة الجدول بالكامل DataTable، ثم تحدد وسيطة الفرز الأولى بحقل النقاط مع معامل الترتيب -1 (تنازلي)، متبوعة بوسيطة الفرز الثانية بحقل التمريرات مع معامل الترتيب -1 (تنازلي). تفيض الدالة (Spills) تلقائياً بمصفوفة جديدة كاملة مرتبة سلفاً بأعلى درجات الدقة الإحصائية، حيث يتم حسم كافة التعادلات في النقاط استناداً إلى التمريرات بصورة آلية وفورية.
8.2 ضبط إعدادات الاحتفاظ بترتيب المصدر في الجدول المحوري
إذا رغب المحلل في بناء جدول محوري يستند إلى البيانات الناتجة عن دالة SORTBY أو جدول مصدري تم فرزه مسبقاً بطريقة يدوية متعددة الأعمدة عبر أداة الفرز المخصص (Custom Sort)، فإنه يصطدم بسلوك افتراضي آخر للجدول المحوري؛ حيث يقوم محرك الجدول المحوري تلقائياً بإعادة فرز حقول الصفوف أبجدياً (من أ إلى ي)، مما يدمر الترتيب المسبق المحقق في المصدر.
لإلزام الجدول المحوري باحترام الترتيب التتابعي القادم من المصدر دون أي تعديل، يجب اتباع الإجراءات الضبطية التالية:
- النقر بزر الفأرة الأيمن على أي تسمية من تسميات الصفوف داخل الجدول المحوري واختيار خيارات الترتيب الإضافية (More Sort Options).
- اختيار يدوي (Manual)، والذي يتيح سحب العناصر وإسقاطها لإعادة ترتيبها أو الاحتفاظ بترتيب الإدخال المصدر دون تدخل المحرك.
- التوجه إلى خيارات الجدول المحوري (PivotTable Options)، ثم علامة تبويب بيانات (Data)، وإلغاء تفعيل خيار استرجاع البيانات المفرزة تلقائياً أو إعادة بناء الفهارس الأبجدية، مما يجبر الجدول على قراءة السجلات بالترتيب الفيزيائي لظهورها في النطاق المصدر.
8.3 الموازنة النقدية بين الفرز في المصدر والفرز بالحقل المحسوب
تستدعي المقارنة المنهجية تقييماً نقدياً لاختيار الأسلوب الأمثل بين الفرز في المصدر مقابل الفرز بالحقل المحسوب؛ حيث يمتلك كل منهما مزايا وعيوباً تشغيلية واضحة. يتميز أسلوب الفرز المسبق في المصدر عبر دوال مثل SORTBY بالبساطة المفاهيمية وعدم الحاجة لإجراء تعديلات رياضية أو إخفاء أعمدة داخل الجدول المحوري، مما يجعله مناسباً جداً للمستخدمين من المستوى المتوسط أو للتقارير الثابتة التي لا تتطلب تصفية تفاعلية مستمرة.
في المقابل، يتفوق أسلوب الحقل المحسوب (ومعه مقاييس DAX) في المرونة التحليلية الفائقة (Analytical Agility)؛ فالفرز المسبق في المصدر ينهار فور قيام المستخدم بتطبيق مقسمات طريقة العرض (Slicers) لتصفية فئات معينة، لأن التجميع وإعادة حساب الرتب يجب أن يتما بعد التصفية وليس قبلها. وبالتالي، يظل الفرز الداخلي عبر الحقل المحسوب هو الحل الأكثر رسوخاً ومناعة في بيئات التقارير التفاعلية المعقدة، بينما يُنصح بالفرز في المصدر للتقارير المصمتة أو العروض الساكنة.
9. الأخطاء الشائعة أثناء تطبيق الفرز متعدد الأعمدة وكيفية تفاديها
9.1 أخطاء اختيار الأوزان النسبية وتداخل القيم العددية
يعد الخطأ الأكثر فداحة وشيوعاً عند تطبيق تقنية الحقل المحسوب هو التقدير غير الدقيق لوزن الترجيح (المضاعف العددي). إذا افترض المحلل أن ضرب المتغير الأساسي في 100 أو 1000 كافٍ لعزله، وكانت البيانات تتضمن قيماً للمتغير الثانوي تتجاوز هذا المضاعف، يحدث ما يُعرف رياضياً بـ “التداخل الرتبي” (Rank Overlap)، حيث تطغى قيمة المتغير الثانوي على المتغير الأساسي، مما يفسد منطق الفرز بالكامل.
على سبيل المثال، إذا كان الفريق (أ) يمتلك 10 نقاط و2500 تمريرة، والفريق (ب) يمتلك 11 نقطة و10 تمريرات، وتم تطبيق مضاعف ترجيحي مقداره 100 فقط:
المعيار للفريق (أ) = $(10 \times 100) + 2500 = 3500$.
المعيار للفريق (ب) = $(11 \times 100) + 10 = 1110$.
هنا يتقدم الفريق (أ) بشكل خاطئ على الفريق (ب) على الرغم من أن الأخير متفوق في النقاط الأساسية! لتفادي هذه الكارثة الإحصائية، يجب تطبيق القاعدة الرياضية بصرامة: يجب أن يكون المضاعف مساوياً لـ $10^n$، حيث يمثل $n$ عدداً من الأصفار يزيد بمقدار خانتين على الأقل عن عدد خانات القيمة القصوى المتوقعة للمتغير الثانوي في أسوأ السيناريوهات الاحتمالية، أو استخدام التقسيم الكسري التام.
9.2 مشكلات القيم السالبة والقيم الصفرية في معادلات الفرز
تفترض النماذج الرياضية البسيطة غالباً أن المتغيرات قيد التحليل موجبة دائماً، ولكن في سياقات الأعمال المالية والاقتصادية، تتكرر ظاهرة القيم السالبة (مثل هوامش الربح الخاسرة، أو صافي التدفقات النقدية السالبة). إذا طُبقت معادلة الجمع الترجيحي المباشر مع وجود أرقام سالبة في المتغير الثانوي، يحدث تراجع عكسي غير مقصود في الترتيب؛ إذ تؤدي القيمة السالبة الكبيرة إلى إنقاص المقياس المركب بدلاً من وزنه بصورة منطقية.
لمعالجة هذه المعضلة الحسابية، يجب إجراء “إزاحة خطية” (Linear Shift) للمتغير الثانوي لتحويل كافة قيمه إلى النطاق الموجب قطيعاً قبل إدخاله في معادلة الترجيح. يتم ذلك عبر إضافة القيمة المطلقة لأدنى قيمة سالبة محتملة مضافاً إليها 1، وفق الصياغة التالية:
$$\text{Shifted } V_2 = V_2 + |\min(V_2)| + 1$$
كما يجب معالجة القيم الصفرية والمفقودة (Nulls) باستخدام الدالة IFERROR أو الدوال الشرطية داخل صيغة الحقل المحسوب لضمان استقرار الخوارزمية الترتيبية وعدم سقوطها في أخطاء القيمة (#VALUE!).
9.3 سقوط الفرز التلقائي بعد تحديث البيانات وطرق الحماية
يشكو العديد من مديري البيانات من اختفاء إعدادات الفرز المخصص بصورة مفاجئة بعد تحديث الجدول المحوري (Refresh) إثر تدفق بيانات جديدة، حيث يعود الجدول فجأة إلى الفرز الأبجدي أو يفقد موضع الترتيب المحقق للحقل المحسوب. يعود السبب التقني وراء هذا السلوك إلى تفعيل بعض الخيارات الافتراضية المتعلقة بتحسين الذاكرة على حساب حفظ معايير العرض.
لضمان حماية الترتيب واستمراره دائماً عبر دورات التحديث المتعاقبة، يجب التحقق من الإعدادات التالية:
- فتح خيارات PivotTable (PivotTable Options) عبر النقر بالزر الأيمن على الجدول.
- الانتقال إلى علامة تبويب إجمالي وتصفية (Totals & Filters)، والتأكد من تفعيل خيار السماح بدمج عوامل تصفية متعددة لكل حقل (Allow multiple filters per field).
- في علامة تبويب بيانات (Data)، يجب اختيار بلا (None) في خيار “احتفاظ بالعناصر المحذوفة من مصدر البيانات” (Number of items to retain per field) لمنع تداخل أشباح البيانات القديمة مع الترتيب الجديد.
- التأكد دائماً من أن عملية الفرز مطبقة نصاً على حقل المعيار المركب المخفي، وليس على تسميات الصفوف مباشرة.
10. أفضل الممارسات الإدارية والتحليلية لحوكمة تقارير إكسل
10.1 التوثيق المنهجي للحقول المحسوبة والمعادلات المركبة
في بيئات الأعمال والمؤسسات الكبرى، لا تقتصر جودة النماذج التحليلية على دقتها الرياضية فحسب، بل تمتد لتشمل قابليتها للتدقيق والمراجعة من قبل أطراف مستقلة (Auditable Models). إن الاعتماد على حقول محسوبة ذات أوزان ترجيحية مركبة، ثم إخفاؤها بصرياً عن واجهة التقرير، قد يولد حالة من الشك والغموض لدى المدققين أو المحللين اللاحقين الذين يتولون إدارة المصنف في حال غياب التوثيق الواضح.
تقتضي معايير حوكمة البيانات إنشاء “صفحة ميتاداتا وتوثيق” (Data Dictionary & Documentation Tab) مخصصة ضمن المصنف. توضح هذه الصفحة بوضوح فلسفة بناء الحقول المحسوبة، والأسس الرياضية التي استند إليها اختيار مضاعفات الأوزان، والدوافع التحليلية لاستخدام الفرز المركب لفض حالات التعادل. يضمن هذا التوثيق استمرارية تشغيل النماذج المؤسسية بسلاسة حتى في حالات الدوران الوظيفي وانتقال المسؤوليات التحليلية بين فرق العمل المختلفة.
10.2 تحسين الأداء الحسابي في بيئات الأعمال ذات البيانات الضخمة
مع تنامي حجم مجموعات البيانات وتشعب مقاييس الأعمال، قد تواجه مصنفات إكسل التي تفرط في استخدام الحقول المحسوبة والصيغ المعقدة تراجعاً ملحوظاً في سرعة المعالجة واستهلاكاً مفرطاً لذاكرة الجهاز، مما يؤدي إلى تجمد البرنامج أثناء عمليات إعادة الحساب والتحديث. ترتكز حوكمة الأداء على تبني تدابير تقنية حاسمة للحد من هذا الهدر الحاسوبي وتأمين تجربة استخدام رشيقة وسريعة.
تشمل هذه التدابير إزالة كافة الحقول المحسوبة الزائدة وغير المستخدمة في العرض النهائي من هيكل الجدول المحوري، وتعطيل خاصية الحساب التلقائي للجداول المحورية الكبيرة أثناء إدخال البيانات عبر التبديل إلى “وضع الحساب اليدوي” (Manual Calculation Mode). وعندما تتجاوز مصفوفة البيانات مئات الآلاف من الصفوف، يصبح من الضروري التخلي عن الحقول المحسوبة التقليدية ونقل المعالجة كلياً إلى نموذج البيانات المدمج ومحرك Power Pivot المعتمد على التخزين العمودي (Columnar Database)، مما يوفر معدلات ضغط استثنائية وسرعات فرز فائقة تتفوق بمراحل على البيئة التقليدية.
10.3 توظيف النتائج المفرزة في دعم صناعة القرار المؤسسي
يمثل الترتيب المتقن متعدد المستويات الغاية التشغيلية الأولى لتمكين القيادات الإدارية وصناع القرار من قراءة المشهد المؤسسي بدقة وعدالة بالغة. إن التخلص من عشوائية ترتيب الكيانات المتعادلة يحول الجداول المحورية من مجرد ملخصات رقمية صامتة إلى أدوات توجيه استراتيجي تسهم في ترشيد القرارات المرتبطة بتوزيع المكافآت، تقييم كفاءة الفروع، إدارة المخزون، أو تحديد الأولويات الاستثمارية.
يمكن ربط هذه المخرجات الترتيبية الدقيقة بعناصر الرسوم البيانية التفاعلية (Pivot Charts) ولوحات التحكم الذكية (Dashboards)، حيث تظهر المؤشرات الإحصائية في تدرج بصري هرمي جذاب يعبر بصدق عن الأداء الحقيقي المركب. يكرس هذا النهج ثقافة الإدارة المستندة إلى الأدلة والمقاييس الموضوعية المتوازنة، مما يقلل من مساحة التقديرات الذاتية ويرفع من كفاءة ونزاهة الحوكمة المؤسسية الشاملة.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لواحدة من أعقد المشكلات التقنية التي تواجه مستخدمي مايكروسوفت إكسل، وهي عجز الواجهة الافتراضية للجداول المحورية عن فرز أعمدة متعددة للقيم بشكل متزامن. وقد تبين من خلال التفكيك المعماري أن هذا القصور ليس خطأ برمجياً عارضاً، بل هو نتيجة مباشرة للتصميم الهندسي أحادي البعد لخوارزميات الفرز التقليدية في الجداول المحورية منذ نشأتها التاريخية وتطورها عبر العقود.
وقد تم إثبات أن توظيف الحلول الرياضية القائمة على “الحقول المحسوبة” وتوليد الأوزان الترجيحية المركبة يمثل الإجراء الأكثر كفاءة وملاءمة للبيئات الكلاسيكية؛ إذ يتيح دمج المقاييس المتعددة في معيار ترتيبي موحد يحسم النزاع حول حالات التعادل بدقة متناهية، مع إمكانية إخفاء العمود للحفاظ على الجمالية التنسيقية للتقرير. كما فصّل المقال المنهجيات المعاصرة المتقدمة، ممثلة في محرك Power Pivot وصيغ DAX الترتيبية المعتمدة على دالة RANKX، إلى جانب الفرز المسبق بالصفائف الديناميكية عبر دالة SORTBY.
إن إتقان هذه المهارات والتقنيات الحسابية لا يرفع من الكفاءة المهنية للمحلل الإحصائي فحسب، بل يمنح المؤسسات قدرة استثنائية على حوكمة تقاريرها، وضمان نزاهة ودقة سلاسل الترتيب الرتبي في مؤشرات الأداء المتشابكة، مما يسهم بشكل مباشر في دعم عملية اتخاذ القرار المستند إلى التحليل الرقمي الرصين والموثوق.
المراجع
- Alexander, M., & Kusleika, D. (2019). Excel 2019 Bible. John Wiley & Sons.
- Ferrari, A., & Russo, M. (2016). The Definitive Guide to DAX: Business intelligence with Microsoft Excel, SQL Server Analysis Services, and Power BI. Microsoft Press.
- Jelen, B., & Syrstad, T. (2019). Pivot Table Data Crunching: Microsoft Excel 2019. Pearson Education.
- Walkenbach, J. (2015). Excel 2016 Power Programming with VBA. John Wiley & Sons.
- Microsoft Corporation. (2023). Sort data in a PivotTable. Microsoft Support. https://support.microsoft.com/