
تُمثّل المقارنة الإحصائية بين مجموعات البيانات إحدى الركائز الجوهرية التي يقوم عليها البحث العلمي الحديث والتحليل الاستدلالي في مختلف الحقول المعرفية. فسواء كان الباحث يسعى لتقييم فاعلية برنامج علاجي جديد في علم النفس السريري، أو يهدف إلى فحص الفروق الأكاديمية بين بيئات تعليمية تقليدية ورقمية، فإن البيانات الخام تظل صامتة وعاجزة عن تقديم إجابات قاطعة ما لم تُخضع لمنهجيات مقارنة إحصائية رصينة تُميط اللثام عن الفروق الدلالية والأنماط الكامنة خلف الأرقام. ومن هذا المنطلق، لا تقتصر المقارنة على مجرد تباين بصري للأرقام، بل تمتد لتشمل استنطاق التوزيعات الاحتمالية واختبار الفرضيات الصفرية والبديلة بدقة بالغة.
وعلى الرغم من توافر العديد من البرمجيات الإحصائية المتخصصة والمغلقة، يظل برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشاراً ومرونة وقدرة على المزاوجة بين سهولة الاستخدام وقوة المعالجة الحسابية والبيانية. إن بناء نموذج مقارنة إحصائي متكامل داخل بيئة إكسيل يمنح الباحثين والمحللين سيطرة استثنائية على كل مرحلة من مراحل التحليل؛ بدءاً من تدقيق البيانات وتنظيفها وهيكلتها، مروراً بحساب المقاييس الوصفية والبارامترية واللابارامترية، وانتهاءً بالاختبارات الاستدلالية المتقدمة والتمثيل البياني الاحترافي الذي يتوافق مع المعايير الأكاديمية العالمية.
يهدف هذا الدليل المنهجي الموسع إلى تقديم إطار تطبيقي شامل ومفصل خطوة بخطوة لكيفية إنشاء مقارنة إحصائية احترافية بين مجموعتي بيانات باستخدام مايكروسوفت إكسيل. سنستعرض بعمق الطريقتين الأساسيتين لتحليل البيانات المقارنة: ملخص الأرقام الخمسة والتوزيع الربيعي عبر المخططات الصندوقية، ومقارنة المتوسطات الحسابية ومقاييس التشتت المعيارية، وصولاً إلى الاختبارات الاستدلالية مثل اختبارات الفروق (t-Test) مع تقديم صياغات أكاديمية رصينة للنتائج تدعم مسارات اتخاذ القرار المبني على الدليل الإحصائي المحكم.
1. مدخل نظري وأكاديمي إلى المقارنة الإحصائية بين مجموعات البيانات في إكسيل
1.1 أهمية المقارنة الإحصائية في الأبحاث والبيانات النفسية والسلوكية
تكتسب المقارنة الإحصائية أهمية استثنائية في مجالات العلوم النفسية والاجتماعية والتربوية، حيث لا يمكن استيعاب الظواهر السلوكية المعقدة إلا من خلال مقارنة مستويات الاستجابة بين بيئات متباينة أو ظروف تجريبية مدروسة بعناية. إن جوهر المنهج التجريبي وشبه التجريبي يتأسس على مقارنة عينة ضابطة (Control Group) بأخرى تجريبية (Experimental Group) للتحقق مما إذا كان التدخل العلاجي، أو المثير النفسي، قد أحدث فارقاً حقيقياً يتجاوز مجرد الصدفة العشوائية، وهو ما وثقته الأدبيات السلوكية في دراسات مثل دراسة Carey et al. (2018) التي أكدت على ضرورة الربط الدقيق بين تقنيات تغيير السلوك وآليات التأثير المقاسة كمياً.
تتيح المقارنة المنهجية استكشاف تباين التوزيعات الاحتمالية للمتغيرات الخاضعة للقياس؛ إذ نادراً ما تتطابق استجابات الأفراد نتيجة للفروق الفردية الكامنة والتباين المنهجي والخطأ العشوائي. يساعد التحليل المقارن على تحويل هذه البيانات الأولية من أرقام خام مشتتة إلى مؤشرات كمية قابلة للتفسير الموضوعي، مما يتيح للباحث اختبار فرضياته حول الفاعلية النفسية أو التحصيل المعرفي، كما يظهر بجلاء في قياس مستويات الضغوط النفسية التي تتطلب مقارنة دقيقة بين مستويات خط الأساس ومستويات ما بعد التدخل، كالنماذج المطبقة في أبحاث Browning et al. (2021) حول استجابة العينات الجامعية للمتغيرات الضاغطة.
وهنا يبرز دور مايكروسوفت إكسيل كبيئة عمل استقرائية وتطبيقية متميزة تمزج بين إمكانية الوصول الشاملة والقدرة العالية على محاكاة النماذج الرياضية والإحصائية. يتيح البرنامج للباحثين تصميم مسارات تحليلية مخصصة لا تعتمد على مخرجات الصندوق الأسود (Black-box) الشائعة في البرمجيات المعقدة، بل تسمح بالاطلاع المباشر على بنية المعادلات الإحصائية، واختبار سلوك البيانات في الوقت الفعلي، ومراقبة كيفية تأثير التعديلات الطفيفة في العينات على المؤشرات الكلية، مما يرفع من جودة التفسير العلمي ويدعم النزاهة الأكاديمية للنتائج.
1.2 الركائز المنهجية للمقارنة بين توزيعين إحصائيين
ترتكز المقارنة الإحصائية الرصينة بين توزيعين على التمييز الواعي والمنهجي بين نوعين من المقاييس الأساسية: مقاييس النزعة المركزية (Measures of Central Tendency) التي تحدد النقطة المركزية أو القيمة التي تميل البيانات للتجمع حولها، ومقاييس التشتت (Measures of Dispersion) التي تكشف عن مدى انتشار هذه الدرجات أو تقاربها بالنسبة لتلك النقطة المركزية. إن الاكتفاء بمتوسط الدرجات وحده دون معرفة درجة التشتت قد يقود إلى استنتاجات مضللة؛ فقد تتساوى مجموعتان في المتوسط الحسابي بينما تظهر إحداهما تبايناً شديداً والأخرى تجانساً مرتفعاً، وهو ما يغير المعنى السيكومتري للنتيجة كلياً كما أشارت دراسات فحص أدوات التقييم مثل Vilagut et al. (2016).
علاوة على ذلك، تلعب القيم المتطرفة والشاذة (Outliers) دوراً حاسماً في تشويه المؤشرات الإحصائية التقليدية؛ حيث يؤدي وجود درجة واحدة شديدة الارتفاع أو الانخفاض إلى سحب المتوسط الحسابي باتجاهها بصورة مصطنعة، وزيادة قيمة التباين والانحراف المعياري بدرجة تبالغ في تصوير عدم تجانس المجموعة. يتطلب هذا التحدي تحليلاً دقيقاً لشكل التوزيع التكراري، والمفاضلة الرصينة بين المقاييس البارامترية (المعلمية) التي تفترض التوزيع الطبيعي والاعتدالية، والمقاييس اللابارامترية (اللامعلمية) مثل الوسيط والمدى الربيعي، والتي تتسم بالاستقرار ومقاومة الانحياز في ظل العينات الصغيرة أو التوزيعات الملتوية التي تحفل بها بيئات القياس التربوي والمقارنات التعليمية كالتي تناولها Delgado et al. (2018).
2. إعداد وتنظيم مجموعتي البيانات في بيئة عمل إكسيل
2.1 هيكلة الأعمدة وتنظيم المتغيرات للتحليل
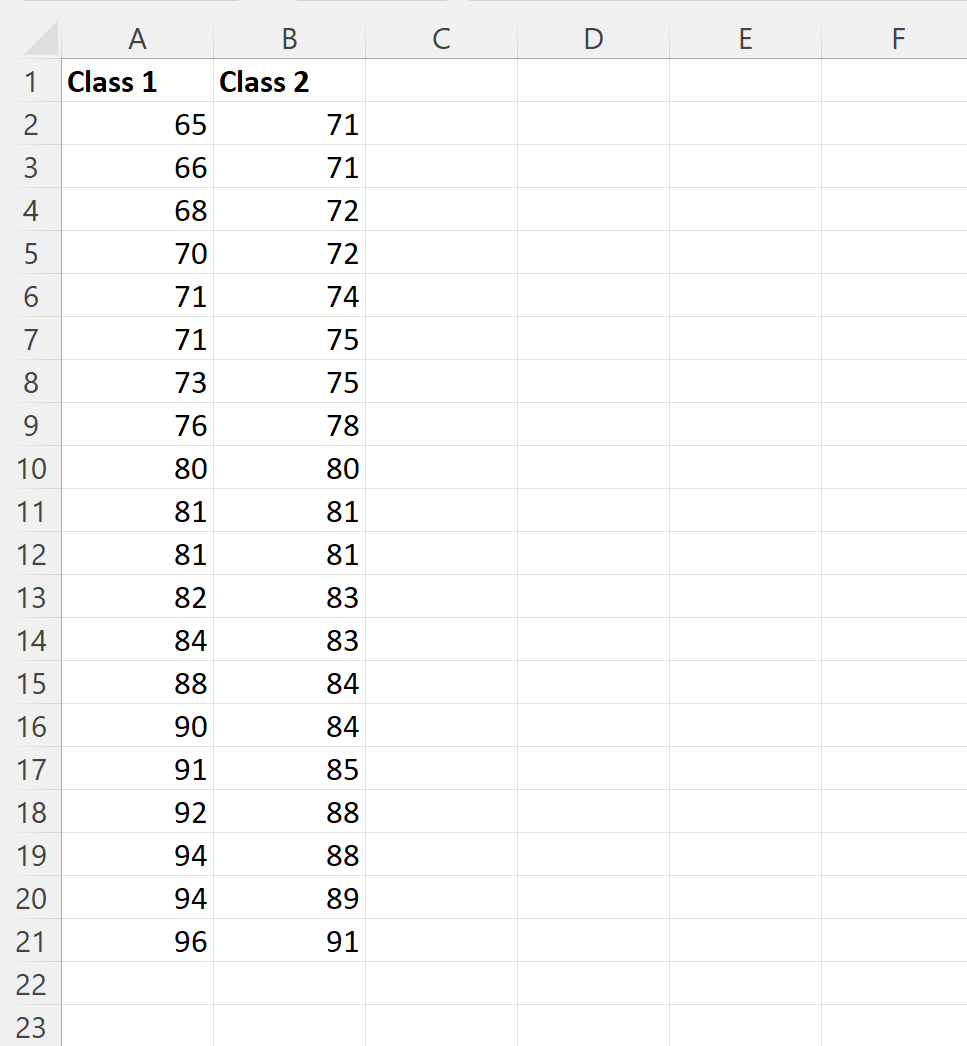
تبدأ دقة المعالجة الإحصائية في مايكروسوفت إكسيل من التصميم الهيكلي السليم لأوراق العمل؛ حيث يُوصى بتنسيق مجموعتي البيانات المقارنة في أعمدة متجاورة ومستقلة، مثل تخصيص العمود A لدرجات المجموعة الضابطة والعمود B لدرجات المجموعة التجريبية، أو تخصيص أعمدة متسلسلة للمتغيرات التابعة المستقلة. يتيح هذا الترتيب المتجاور سهولة تطبيق الصيغ الحسابية والنسخ التلقائي للمعادلات، كما يسهل عملية المقارنة البصرية وتحديد مجالات كل متغير بدقة متناهية ودون تداخل إجرائي أثناء كتابة الصيغ المتقدمة.
من الضروري أيضاً إيلاء اهتمام فائق لصف العناوين (Headers)، حيث يجب أن تحتوي الخلية الرأسية على تسمية وصفية دقيقة وموجزة تعبر عن طبيعة المتغير (مثل: درجات_الاختبار_القبلي، ودرجات_الاختبار_البعدي)، مع تجنب استخدام المسافات المعقدة أو الرموز الخاصة التي قد تسبب أخطاء في كتابة المعادلات البرمجية لاحقاً. كما يتعين توحيد نوع البيانات الرقمية لجميع الخلايا التابعة للمتغير من خلال شريط التنسيق، والتأكد من تحديد نوع الخلية كـ “رقم” (Number) مع تحديد عدد المنازل العشرية بوضوح، لمنع إكسيل من تفسير الأرقام كسلاسل نصية (Text) مما يعطل عمل الدوال الإحصائية.
لتحقيق أقصى درجات الكفاءة البرمجية وتقليل احتمالات الخطأ الإنساني عند كتابة النطاقات اليدوية (مثل A2:A101)، يُنصح بتسمية النطاقات (Defined Names) في إكسيل. يمكن تحديد نطاق كل مجموعة وتسميته من خلال مربع الاسم (Name Box) إلى أسماء ذات دلالة مثل “Control_Group” و”Experimental_Group”. لا تُسهم هذه الخطوة في تسهيل كتابة الصيغ مثل AVERAGE(Control_Group) فحسب، بل تجعل أوراق العمل البحثية وثيقة أكاديمية قابلة للقراءة والتدقيق والمراجعة من قبل باحثين آخرين دون لبس.
2.2 فحص سلامة البيانات ومعالجة القيم المفقودة
يعد فحص سلامة البيانات (Data Hygiene) مرحلة تحضيرية لا غنى عنها قبل إجراء أي مقارنة إحصائية؛ فالأخطاء غير المكتشفة في الإدخال قد تؤدي إلى تشويه التحليل وتوليد استنتاجات خاطئة تماماً. يوفر إكسيل ميزة التنسيق الشرطي (Conditional Formatting) كأداة بصرية بالغة الفاعلية لتحديد الشذوذ في البيانات؛ إذ يمكن تطبيق قواعد لتلوين الخلايا الفارغة تلقائياً، أو تمييز القيم التي تتجاوز الحدود المنطقية لدرجات القياس (كأن تزيد درجة اختبار مقنن على 100، أو تكون سالبة)، مما يسهم في التدقيق السريع وتصحيح أخطاء الطباعة والإدخال فوراً.
يمثل التعامل مع البيانات المفقودة (Missing Data) تحدياً منهجياً حرجاً في التحليل المشترك؛ فالخلايا الفارغة قد تؤثر بصورة جذرية على المقارنات الثنائية، لا سيما في الاختبارات المرتبطة التي تتطلب أزواجاً متطابقة من البيانات لكل مشارك. إذا تم احتساب الخلية المفقودة كصفر عن طريق الخطأ، فإن ذلك سيؤدي إلى انخفاض غير حقيقي للمتوسط الحسابي وتضخم زائف للانحراف المعياري، بينما يؤدي حذف الحالة بالكامل إلى تقليل حجم العينة وقوتها الإحصائية، مما يستدعي توثيق طبيعة الفقد واتخاذ قرار منهجي مبرر سواء بالحذف أو بالتعويض المعتمد على المتوسطات أو الوسيط.
لضمان جاهزية البيانات، تُوظف دوال التدقيق المنطقي والتنظيف الأولي؛ حيث يمكن استخدام دالة ISBLANK لاكتشاف الفراغات، ودالة ISNUMBER للتأكد من خلو العمود من محارف غير مرئية أو نصوص تعطل الحساب. كما تسهم دالة COUNT في التحقق من الحجم الفعلي للعينة المتاحة، ودالة TRIM في إزالة المسافات الزائدة التي قد تلتصق بالبيانات عند استيرادها من استبانات إلكترونية أو برمجيات أخرى، مما يضمن خضوع البيانات لمعالجة قياسية متجانسة تؤهلها لمرحلة الحساب الإحصائي الفعلي.
3. الطريقة الأولى: ملخص الأرقام الخمسة لفهم التوزيع التكراري
3.1 مفهوم ملخص الأرقام الخمسة ودلالاته الإحصائية
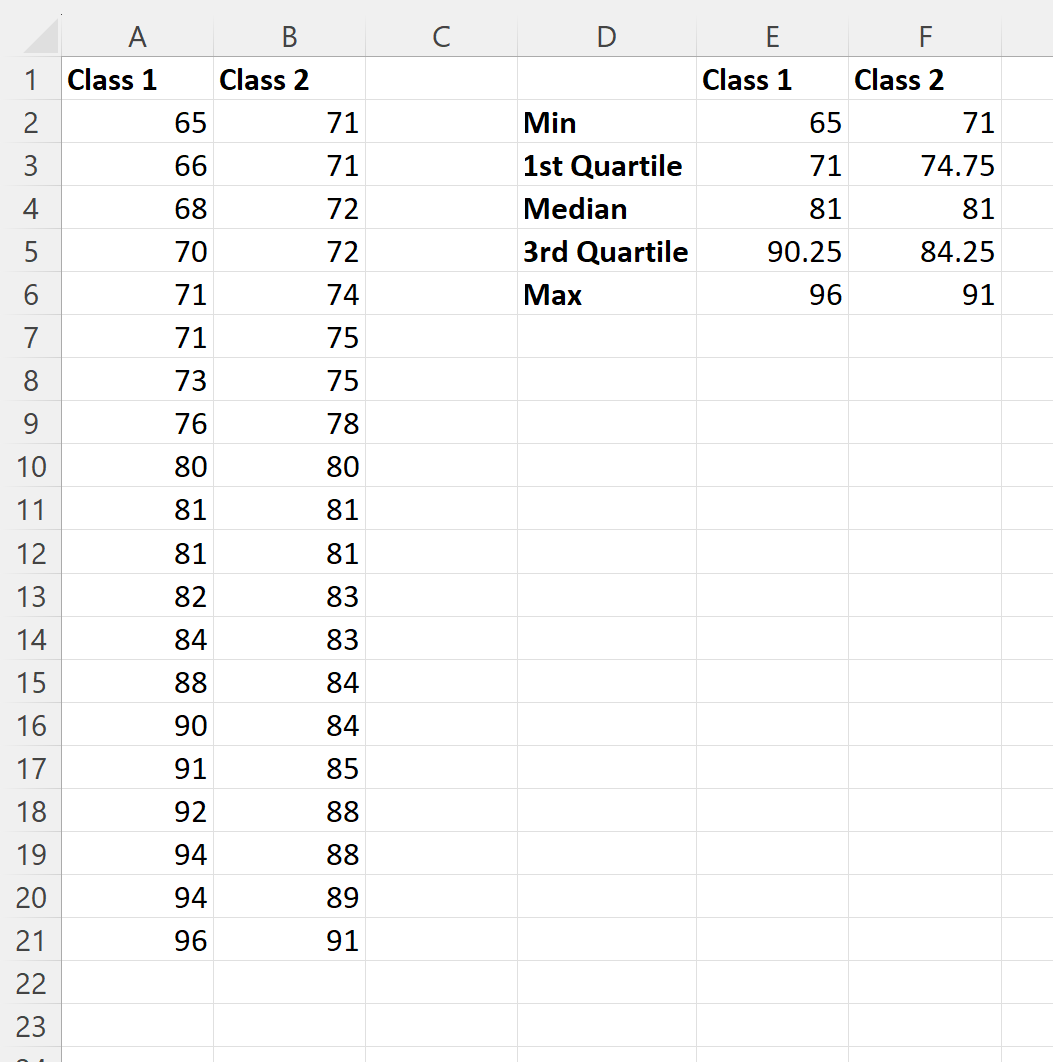
يُعد ملخص الأرقام الخمسة (Five-Number Summary) أحد أهم أدوات التحليل الاستكشافي للبيانات (Exploratory Data Analysis) التي طورها عالم الإحصاء الشهير جون توكي؛ حيث يهدف إلى اختصار توزيع البيانات الكمية في خمس قيم جوهرية تعكس معالم التوزيع دون الحاجة إلى وضع افتراضات مسبقة حول شكله الاحتمالي. تتألف هذه المنظومة الإحصائية من: الحد الأدنى (Minimum)، والربيع الأول (First Quartile – Q1)، والوسيط (Median – Q2)، والربيع الثالث (Third Quartile – Q3)، والحد الأقصى (Maximum). يوفر هذا الملخص صورة متكاملة عن المدى الكلي، ومناطق تركز الكثافة الحسابية، ودرجة التجانس النسبي للمتغير المقاس.
يحدد الحد الأدنى والأقصى النطاق الإجمالي (Range) الذي تتراوح ضمنه الدرجات المقاسة، وهو ما يلقي الضوء على أقصى اتساع للفروق الفردية داخل كل مجموعة. في المقابل، يمثل الربيع الأول نقطة القطع المئوية التي تقع دونها 25% من الدرجات، في حين يمثل الربيع الثالث النقطة التي تقع دونها 75% من البيانات؛ وبذلك يحدد الفرق بينهما، المعروف بالمدى الربيعي (Interquartile Range – IQR)، النطاق الذي يضم النصف الأوسط (50%) من أفراد العينة، مما يوفر مقياساً لتشتت البيانات بمنأى تام عن التأثيرات المشوهة للقيم الطرفية الشديدة.
يقع الوسيط في قلب هذا الملخص بوصفه مقياس النزعة المركزية الأكثر حصانة واستقراراً؛ فهو يقسم البيانات المرتبة إلى نصفين متساويين، متجاهلاً المسافات الرقمية المطلقة بين القيم لصالح رتبها النسبية. وتكتسب هذه الخاصية قيمة سيكومترية استثنائية عند تفسير درجات الاختبارات النفسية والسلوكية والمقارنة بين أداء المجموعات المعرضة لظروف غير اعتيادية، كما يُلاحظ في دراسات تحليل المؤشرات الوجدانية والرفاه النفسي كدراسة Lyubomirsky et al. (2005)، حيث تضمن هذه الطريقة عدم انحياز النتائج بفعل الاستجابات القصوى للمشاركين غير المتفاعلين أو المبالغين في التقييم.
3.2 مقارنة التماثل والالتواء عبر الأرقام الخمسة
يتجاوز ملخص الأرقام الخمسة مجرد كونه وصفاً كمياً جامداً ليعمل كأداة استدلالية بصرية وحسابية بالغة الدقة لفحص تماثل التوزيعات الإحصائية والتواءاتها دون الحاجة لمعادلات معقدة. يتم ذلك من خلال فحص موقع الوسيط الحسابي بالنسبة للربيعين الأول والثالث؛ فإذا كان الوسيط يقف تماماً في منتصف المسافة بين الربيعين الأول والثالث (أي أن الفرق بين الوسيط والربيع الأول يساوي تقريباً الفرق بين الربيع الثالث والوسيط)، فإن التوزيع يتمتع بدرجة عالية من التماثل (Symmetry) حول مركزه.
على النقيض من ذلك، إذا كانت المسافة بين الوسيط والربيع الأول أصغر بكثير من المسافة بين الوسيط والربيع الثالث، فإن ذلك يشير إلى أن درجات النصف الأدنى متكتلة بكثافة بينما تمتد درجات النصف الأعلى على نطاق أوسع، مما يبرهن على وجود التواء إيجابي (Positive Skewness) في درجات المجموعة نحو اليمين. وبالعكس، فإن قرب الوسيط من الربيع الثالث واتساع المسافة بينه وبين الربيع الأول يؤكد وجود التواء سلبي (Negative Skewness) نحو اليسار، وهو ما ينبئ بأن غالبية الأفراد قد حققوا درجات مرتفعة بينما انفردت قلة قليلة بدرجات شديدة الانخفاض تسببت في سحب الذيل الأيسر للتوزيع.
تكتسب هذه المقارنة أهمية منهجية مضاعفة عند وضع مجموعتين وجهاً لوجه؛ إذ يمكن للباحث مقارنة شكل توزيع المجموعة التجريبية بنظيرتها الضابطة. فإذا أظهرت المجموعة الأولى التواءً إيجابياً فيما أظهرت الثانية توزيعاً متماثلاً أو التواءً سلبياً، فإن هذا الاختلاف في مورفولوجيا التوزيع يكشف عن التباين في طبيعة تأثير المتغير المستقل على فئات الأداء المختلفة، ويوضح ما إذا كان التأثير السلوكي أو التحصيلي ينحصر في رفع مستويات فئة معينة من العينة أو يسري بانتظام على جميع الرتب دون تمييز.
4. التطبيق العملي لدوال ملخص الأرقام الخمسة في إكسيل
4.1 استخدام دوال الحد الأدنى والأقصى والوسيط
يقدم برنامج إكسيل ترسانة من الدوال الحسابية المباشرة التي تتيح استخراج قيم ملخص الأرقام الخمسة بسرعة فائقة ودقة متناهية. يبدأ التطبيق العملي باستخراج الحدود الدنيا والقصوى لكلتا المجموعتين؛ حيث تُستخدم دالة MIN لتحديد القيمة الأصغر ضمن النطاق، وتُكتب الصيغة الرياضية للمجموعة الأولى في خلية مخصصة على النحو التالي: MIN(A2:A101) لحساب أدنى قيمة مسجلة في المجموعة، وتُكرر الصيغة في العمود المجاور للمجموعة الثانية باستخدام MIN(B2:B101).
في المقابل، تُستخدم دالة MAX لتحديد السقف الأعلى للدرجات المحققة في كل مجموعة؛ وتُكتب الصيغة: MAX(A2:A101) للمجموعة الضابطة، وMAX(B2:B101) للمجموعة التجريبية. يتيح طرح ناتج دالة MIN من ناتج دالة MAX في خلية مستقلة حساب المدى المطلق (Range) لكل مجموعة، مما يوفر مؤشراً مبدئياً على اتساع رقعة الدرجات وفحص ما إذا كانت إحدى المجموعتين قد أظهرت تبايناً كلياً أكبر في حدودهما القصوى.
لحساب القيمة الوسطى للتوزيع، يتم توظيف دالة MEDIAN، وتُكتب الصيغة على النحو: MEDIAN(A2:A101). تقوم هذه الدالة بترتيب القيم داخلياً واختيار الرقم الأوسط (أو المتوسط الحسابي للرقمين الأوسطين في حال كان حجم العينة زوجياً)، مما يقدم قراءة متزنة للمركز الإحصائي. ومن خلال تنظيم هذه الدوال في جدول موحد، يستطيع المحلل مقارنة وسيط المجموعة الأولى بوسيط المجموعة الثانية، واستنتاج الفارق الجوهري بين مركز ثقل المجموعتين بمنأى عن تأثير أي قيم متطرفة قد تكون تسللت إلى البيانات.
4.2 حساب الربيعات باستخدام دوال QUARTILE المتخصصة
عند الشروع في حساب الربيعات في الإصدارات الحديثة من إكسيل، يواجه الباحث خيارين رئيسيين من الدوال: دالة QUARTILE.INC ودالة QUARTILE.EXC، ويكمن الفارق المنهجي بينهما في كيفية التعامل مع حدود النسب المئوية. تعتمد دالة QUARTILE.INC مبدأ الاحتواء أو الشمول (Inclusive)، حيث تعتبر أن النسب المئوية تتدرج من الصفر إلى الواحد الصحيح [0, 1] شاملاً القيم الدنيا والقصوى للبيانات، مما يجعلها متوافقة مع الأساليب الكلاسيكية لحساب الربيعات. في حين تعتمد دالة QUARTILE.EXC مبدأ الاستبعاد (Exclusive)، وتعتبر أن النسب تقع بدقة داخل المجال المفتوح (0, 1)، مما يعطي نتائج أكثر ملاءمة للعينات الأكبر حجماً المسحوبة من مجتمعات متصلة.
لحساب الربيع الأول (Q1) الذي يمثل النسبة المئوية 25%، يتم استخدام دالة QUARTILE.INC مع إسناد الرقم 1 كمعامل للربيع، وفق الصيغة الرياضية التالية: QUARTILE.INC(A2:A101, 1). يوفر هذا الرقم خط الأساس الذي يفصل بين الربع الأدنى من المشاركين وبقية أفراد العينة؛ وتسمح مقارنة هذا الرقم بين المجموعتين بمعرفة ما إذا كان التدخل قد نجح في رفع مستوى الفئة الأضعف أداءً في المجموعة التجريبية مقارنة بنظيرتها في المجموعة الضابطة.
أما لحساب الربيع الثالث (Q3) الذي يمثل النسبة المئوية 75%، فيتم استخدام الصيغة: QUARTILE.INC(A2:A101, 3). يمثل هذا المؤشر سقف الأداء العام، ويتيح للباحث مقارنة فئات التفوق والتميز بين المجموعتين. وبناءً على هذه المعطيات، يتم إنشاء جدول ملخص إحصائي ديناميكي في إكسيل يضم صفوفاً مستقلة للحد الأدنى، والربيع الأول، والوسيط، والربيع الثالث، والحد الأقصى، يجاورهما عمود لحساب المدى الربيعي (Q3 – Q1) لكل مجموعة، مما يشكل قاعدة بيانات وصفية متكاملة تصف البنية التوزيعية للمتغيرين المقارنين بأعلى درجات الموثوقية الأكاديمية.
5. التمثيل البصري للمقارنة: المخطط الصندوقي (Box and Whisker)
5.1 إنشاء المخطط الصندوقي المزدوج في إكسيل
يمثل المخطط الصندوقي المزدوج (Box and Whisker Plot) الترجمة البصرية المباشرة لملخص الأرقام الخمسة، ويعد من أقوى الأدوات الاستكشافية للمقارنة بين توزيعين إحصائيين في بيئة عمل متزامنة. لبناء هذا المخطط في مايكروسوفت إكسيل، يقوم المحلل بتحديد بيانات المجموعتين معاً عبر تظليل نطاقي العمودين (بما في ذلك صفي العناوين)، ثم الانتقال إلى شريط الأدوات العلوي واختيار تبويب “إدراج” (Insert)، والتوجه إلى قسم “المخططات الإحصائية” (Statistical Charts)، واختيار “صندوق وشاربان” (Box and Whisker).
بمجرد إدراج المخطط، تظهر سلسلتان بصريتان متجاورتان؛ تمثل كل واحدة منهما إحدى المجموعتين الخاضعتين للدراسة. ولتحقيق أقصى درجات الوضوح الأكاديمي، يتم النقر المزدوج على عناصر المخطط لفتح لوحة “تنسيق سلسلة البيانات” (Format Data Series)، ومن خلالها يمكن التحكم في خيارات العرض المتقدمة، مثل تحديد تباعد الفئات لتقريب أو إبعاد الصندوقين لتسهيل الموازنة البصرية، وضبط ألوان التعبئة والحدود لتمييز كل مجموعة بلون متباين ومريح بصرياً يتوافق مع معايير النشر في الدوريات العلمية الرصينة.
يتيح إكسيل أيضاً مرونة فائقة في تخصيص التفاصيل الإحصائية الدقيقة داخل المخطط الصندوقي؛ حيث يمكن للمحلل من خلال خيارات السلسلة تفعيل أو تعطيل خيار “إظهار نقاط البيانات الداخلية” (Show inner points) لعرض التوزيع النقطي الفعلي لكل قيمة مسجلة، وتفعيل خيار “إظهار علامة المتوسط الحسابي” (Show mean marker) التي تظهر على شكل علامة تقاطع (X) داخل الصندوق، فضلاً عن رسم خط يصل بين المتوسطات لمراقبة التغير بين المجموعات بصرياً، مما يوفر رؤية مزدوجة تجمع بين المقاييس الوسيطية اللابارامترية والمقاييس المركزية البارامترية في آن واحد.
5.2 قراءة وتفسير المخطط البياني في السياق المقارن
تبدأ قراءة المخطط الصندوقي المقارن بفحص ارتفاع الصندوقين اللذين يمثلان المدى الربيعي (IQR)؛ فالصندوق ذو الارتفاع الأكبر يعكس تبايناً وتشتتاً أوسع في الـ 50% الوسطى من البيانات، بينما يشير الصندوق المضغوط إلى تركز عالٍ وتجانس ملحوظ في درجات أفراد تلك المجموعة. وتتيح مقارنة ارتفاع الصندوق للمجموعة التجريبية بالضابطة تقييم أثر المتغير المستقل على تجانس الاستجابات؛ فإذا أدى التدخل إلى تقليص حجم الصندوق، فإن ذلك يبرهن على أن التدخل قاد العينة نحو تقارب سلوكي أو معرفي متجانس.
تتمثل الميزة الاستثنائية للمخطط الصندوقي في إكسيل في قدرته الآلية على اكتشاف القيم المتطرفة وعزلها بصرياً؛ إذ يقوم البرنامج باحتساب الأسوار الداخلية بناءً على المسافة الحسابية (1.5 × المدى الربيعي) انطلاقاً من أطراف الصندوق. تُرسم أي قيمة تتجاوز هذه الحدود كنقطة منفصلة ومعزولة تقع خارج نطاق الشاربين (Whiskers). إن رصد هذه النقاط وظهورها في إحدى المجموعتين دون الأخرى يوفر معطيات إكلينيكية وبحثية بالغة الأهمية حول وجود حالات خاصة أو استجابات غير نمطية تستلزم عزلاً أو فحصاً معمقاً لمعرفة أسباب هذا الانحراف، وهو إجراء محوري في الدراسات الوبائية والنفسية المعقدة كالتي حللها Prati & Mancini (2021) أثناء قياس الآثار الطولية للأزمات الممتدة.
وأخيراً، يوفر فحص درجة التداخل (Overlap) بين الصندوقين مؤشراً بصرياً أولياً حول الدلالة الإحصائية للفروق. فإذا كان هناك تداخل ضئيل أو انعدام تام للتداخل بين جسمي الصندوقين (أي أن الربيع الثالث لأدنى مجموعة يقع دون الربيع الأول للمجموعة الأعلى)، فإن ذلك يشير بقوة إلى وجود فرق حقيقي وجوهري بين التوزيعين يُرجح أن يتأكد إحصائياً عند إجراء اختبارات الفرضيات. أما إذا تداخلت الصناديق بصورة شبه تامة مع تقارب الشوارب، فإن الفروق الظاهرة تكون في الغالب ناتجة عن التباين العشوائي ولا تعكس تبايناً أصيلاً بين المجموعتين.
6. الطريقة الثانية: المقارنة عبر المتوسط الحسابي والانحراف المعياري
6.1 الأسس الرياضية للنزعة المركزية البارامترية
يعد المتوسط الحسابي (Arithmetic Mean) المؤشر الأكثر شيوعاً ورسوخاً في التحليلات الإحصائية البارامترية، حيث يمثل مركز الثقل الرياضي لمجموعة البيانات، ويُحسب بجمع كافة قيم المشاهدات وقسمتها على العدد الكلي للأفراد الخاضعين للقياس. يتميز المتوسط الحسابي بخصائص جبرية فريدة تجعله أساساً لا غنى عنه في النماذج الإحصائية الاستدلالية المتقدمة مثل تحليل التباين والتحليل الانحداري؛ إذ يعتمد على الاستفادة من القيمة العددية الدقيقة لكل مفردة من مفردات العينة دون استثناء، مما يرفع من كفاءته التقديرية للبارامترات المجهولة في المجتمع الأصلي شريطة اعتدالية التوزيع.
ومع ذلك، تقترن هذه القوة الرياضية بنقطة ضعف جوهرية تتمثل في الحساسية الشديدة للقيم المتطرفة والانحرافات التوزيعية؛ فبما أن المتوسط الحسابي يدمج جميع القيم في ناتج الجمع، فإن درجة واحدة شاذة ومتطرفة الارتفاع كفيلة بسحبه نحو اليمين وتضخيمه بما لا يعبر عن المستوى الفعلي لغالبية أفراد العينة، والأمر ذاته ينطبق على القيم المتطرفة الانخفاض. تبرز هذه المشكلة بوضوح في قياس المتغيرات النفسية الحركية والسلوكية التي تخضع لمثيرات سريعة ودقيقة كتلك التي رصدها Davison et al. (2016) في تحليل حركات الوجه الدقيقة، حيث تتطلب دقة القياس الانتباه الشديد لأي انزياح مصطنع في المتوسطات ناجم عن استجابات غير منضبطة.
لذلك، يتطلب الاعتماد على المتوسط الحسابي كمعيار للمقارنة التحقق الصارم من استيفاء افتراضات التوزيع الطبيعي وتماثل البيانات حول نقطة الارتكاز المركزية. وعند ثبوت هذا التماثل، يصبح المتوسط الحسابي الأداة المثلى لتقييم مقدار الفارق المطلق بين المجموعات المقارنة، والركيزة الأساسية لحساب حجوم التأثير (Effect Sizes) مثل مؤشر كوهين (Cohen’s d)، الذي يترجم الفرق بين المتوسطين إلى وحدات معيارية قابلة للمقارنة والتعميم عبر مختلف الدراسات والمجالات العلمية.
6.2 الانحراف المعياري ومفهوم التشتت الإحصائي
لا يكتمل التوصيف البارامتري لأي مجموعة بيانات بالاعتماد على المتوسط الحسابي بمفرده؛ بل يتطلب بالضرورة إقرانه بمقياس دقيق للتشتت يمثله الانحراف المعياري (Standard Deviation). يُعرّف الانحراف المعياري رياضياً بأنه الجذر التربيعي لمتوسط مربعات انحرافات الدرجات عن متوسطها الحسابي؛ وهو يحدد مقدار التباعد أو الانتشار النموذجي للبيانات حول مركز ثقلها. كلما صغرت قيمة الانحراف المعياري، دل ذلك على تجانس أفراد العينة وتقارب أدائهم وتمركزهم الحثيث حول المتوسط، بينما تشير القيمة الكبيرة إلى تباين واسع وفروق فردية شاسعة بين أفراد المجموعة ذاتها.
تكتسب دراسة الانحراف المعياري أهمية تطبيقية حاسمة في الأبحاث المقارنة، وتحديداً في تقييم مخرجات التدخلات السلوكية أو البرامج التعليمية في المدارس والمؤسسات؛ فالمقارنة بين مجموعتين قد تسفر عن تطابق في المتوسط الحسابي، ولكن المجموعة الأولى تمتلك انحرافاً معيارياً صغيراً يعكس نجاح التدخل في إيصال كافة المشاركين إلى مستوى متقارب من التحصيل أو الاستقرار النفسي، بينما تمتلك المجموعة الثانية انحرافاً معيارياً مضاعفاً، مما يكشف عن عدم اتساق نتائج التدخل وتسببه في تباين حاد بين مستفيدي المجموعة الواحدة، وهو بعد تفسيري يغفله التحليل المقتصر على النزعة المركزية وحدها.
وعندما يواجه الباحث موقفاً يتطلب مقارنة مجموعتين تم قياسهما بأدوات أو مقاييس مختلفة تماماً من حيث المدى ووحدات القياس (كأن تتم مقارنة درجات اختبار تحصيلي مقاس من 100 مع مقياس زمني مقاس بالثواني)، فإن المقارنة المباشرة للانحرافات المعيارية تصبح غير دقيقة رياضياً. في هذه الحالة، يتم اللجوء إلى معامل الاختلاف النسبي (Coefficient of Variation – CV)، والذي يُحسب بقسمة الانحراف المعياري على المتوسط الحسابي وضربه في مئة للتعبير عن التشتت كنسبة مئوية، مما يمنح الباحث مؤشراً معيارياً موحداً للمفاضلة بين مستويات التجانس للمجموعتين بمعزل عن وحدات القياس الأصلية.
7. التنفيذ الإجرائي لحساب المتوسط والانحراف المعياري في إكسيل
7.1 تطبيق صيغ المتوسط الإحصائي
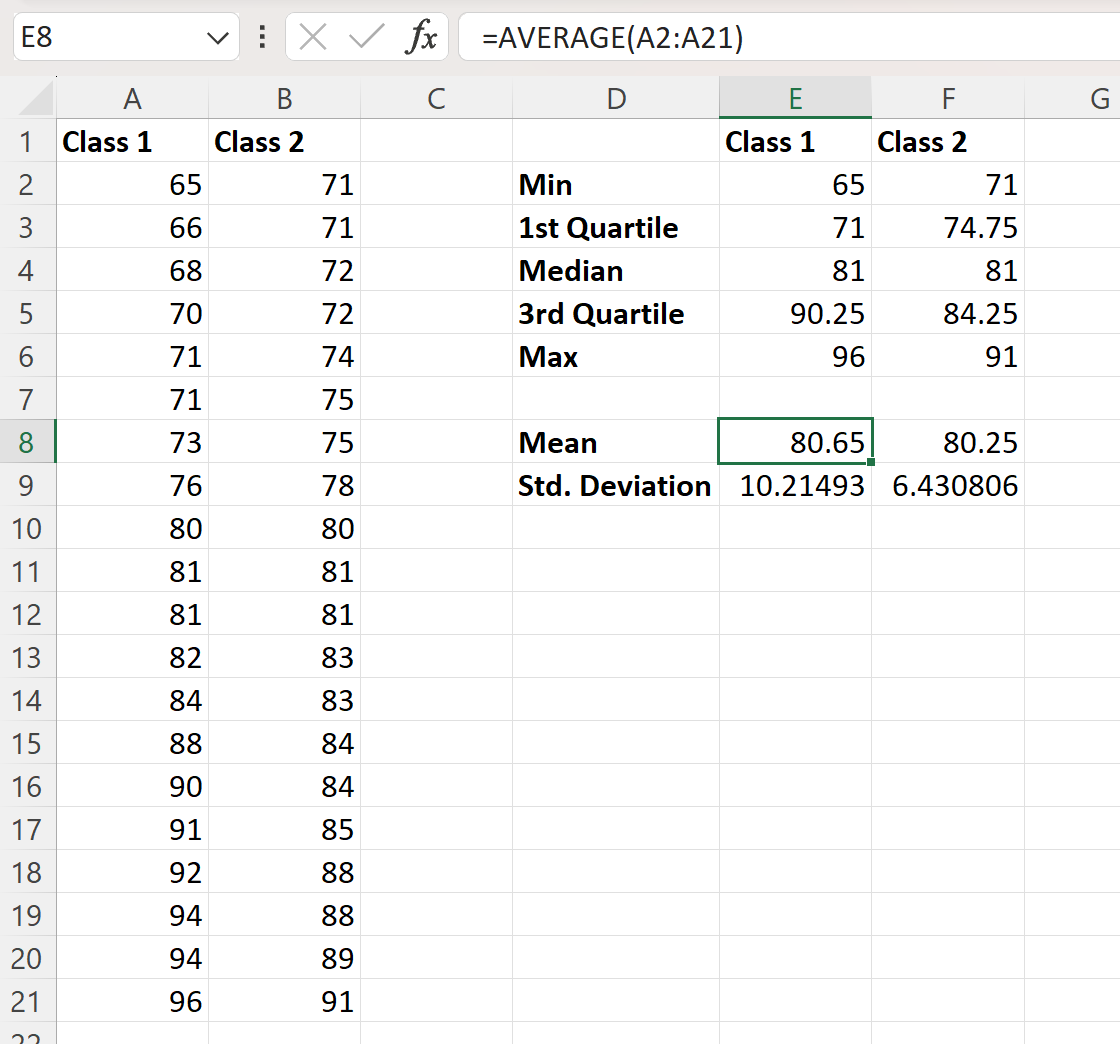
يوفر مايكروسوفت إكسيل مجموعة متقدمة من الصيغ البرمجية المدمجة لحساب المتوسطات الحسابية بدقة متناهية. لحساب الوسط الحسابي البسيط للمجموعة الأولى، يكتب المحلل في الخلية المخصصة للنتائج الصيغة الأساسية: AVERAGE(A2:A101)، ويكرر الإجراء في عمود المجموعة الثانية بكتابة: AVERAGE(B2:B101). تتولى هذه الدالة آلياً جمع كافة القيم الرقمية المتضمنة في النطاق وقسمتها على عدد الخلايا المحتوية على أرقام فعلية، متجاهلة الخلايا النصية أو تلك التي تُركت فارغة بصورة كلية.
في الحالات التي تتطلب معالجات إحصائية أكثر تعقيداً ترتبط بفرز البيانات وتطبيق شروط تقييم محددة (مثل استبعاد درجات معينة لا تنطبق عليها معايير الاختبار أو تصفية البيانات وفق متغير وسيط كالجنس أو الفئة العمرية)، تُستخدم دالة المتوسط الشرطي AVERAGEIF. تتيح هذه الدالة كتابة صيغة تحدد نطاق الفحص، والشرط الرياضي المطلوب، ونطاق المتوسط الفعلي؛ على سبيل المثال: AVERAGEIF(A2:A101, “>0”) لحساب متوسط الدرجات التي تزيد عن الصفر حصراً، مما يمنح مرونة عالية في تنقية القياسات وتجنب إدراج درجات الغياب أو الحالات الخاصة ضمن حساب المتوسط المقارن.
عقب استخراج المتوسط الحسابي لكلتا المجموعتين، يتم بناء خلايا فرعية لحساب الفوارق الرياضية؛ حيث يُحسب الفارق المطلق بطرح متوسط المجموعة الضابطة من متوسط المجموعة التجريبية عبر الصيغة المباشرة: (AVERAGE(B2:B101) – AVERAGE(A2:A101)). كما يُحسب الفارق النسبي المئوي بقسمة هذا الفارق المطلق على متوسط المجموعة الأساسية وضرب الناتج في مئة، مما يوفر مقياساً دقيقاً لنسبة التحسن أو التراجع التي أحدثها المتغير المستقل، ويُثري القسم الوصفي في التقرير الإحصائي بمؤشرات قابلة للفهم المباشر من قبل غير المتخصصين.
7.2 اختيار وتطبيق دوال الانحراف المعياري الصحيحة
يتطلب حساب مقاييس التشتت في إكسيل وعياً أكاديمياً بالفارق الجوهري بين دالتي الانحراف المعياري: STDEV.S وSTDEV.P. صُممت دالة STDEV.S (Sample) لحساب الانحراف المعياري لـ “عينة” مسحوبة من مجتمع، وتعتمد في معادلتها الجبرية على قسمة مجموع مربعات الانحرافات على درجات الحرية (n – 1) بدلاً من الحجم الكلي للعينة (n). يُعرف هذا التعديل الرياضي المنهجي بتصحيح بيسل (Bessel’s Correction)، وهو ضروري لإزالة الانحياز الإحصائي وتقديم تقدير غير متحيز لتشتت المجتمع الأصلي غير المتاح بالكامل للباحث.
في المقابل، صُممت دالة STDEV.P (Population) للاستخدام في الحالات النادرة التي يتمكن فيها المحلل من حصر وقياس “مجتمع الدراسة بالكامل” دون أخذ عينات، حيث تقسم المعادلة على العدد الإجمالي (N) دون أي تصحيح. وبما أن الغالبية الساحقة من الدراسات النفسية والسلوكية والميدانية تعتمد على عينات تجريبية محدودة الحجم، فإن الاستخدام المنهجي الصحيح يفرض تطبيق دالة STDEV.S حصراً؛ وتُكتب الصيغة للمجموعة الأولى على النحو: STDEV.S(A2:A101)، وللمجموعة الثانية: STDEV.S(B2:B101).
لتتويج هذا العمل الإجرائي، يُبنى جدول إحصائي مقارن ومصفوفة تلخيصية في مساحة مخصصة من ورقة العمل تضع المؤشرات البارامترية للمجموعتين جنباً إلى جنب. يتضمن هذا الجدول صفاً لحجم العينة المحسوب بدالة COUNT، وصفاً للمتوسط الحسابي، وصفاً للانحراف المعياري، وصفاً للخطأ المعياري للمتوسط (Standard Error of the Mean – SEM) الذي يُحسب بالمعادلة: (STDEV.S(A2:A101) / SQRT(COUNT(A2:A101)))، مما يهيئ مصفوفة شاملة وواضحة ترصد معالم النزعة والتشتت ودرجة الوثوق الإحصائي لكلتا المجموعتين بصورة متوازية ودقيقة.
8. التوسع المتقدم: اختبار الفرضيات الإحصائية (t-Test) في إكسيل
8.1 استخدام حزمة أدوات التحليل الإحصائي (Analysis ToolPak)
للانتقال من مرحلة الإحصاء الوصفي إلى آفاق الإحصاء الاستدلالي واختبار الفرضيات، يوفر مايكروسوفت إكسيل حزمة متكاملة تُعرف باسم “أدوات تحليل البيانات” (Analysis ToolPak). إذا لم تكن هذه الحزمة مفعلة في شريط الأدوات العلوي، يمكن للباحث تنشيطها بالذهاب إلى تبويب “ملف” (File)، ثم “خيارات” (Options)، واختيار “الوظائف الإضافية” (Add-ins). من القائمة السفلية، يتم تحديد “وظائف Excel الإضافية” والنقر على زر الانتقال (Go)، ثم وضع علامة الاختيار أمام “Analysis ToolPak” والتأكيد، ليظهر زر “تحليل البيانات” (Data Analysis) فوراً ضمن تبويب “بيانات” (Data).
يوفر هذا الملحق ثلاثة نماذج أساسية لاختبار ت (t-Test) تخدم التصاميم البحثية المختلفة:
- اختبار ت لعينتين مرتبطتين (t-Test: Paired Two Sample for Means): يُستخدم في تصاميم القياس المتكرر على نفس الأفراد (قبل/بعد التدخل) أو العينات المتطابقة سيكومترياً، حيث يفترض أن درجات الفروق الفردية بين القياسين موزعة توزيعاً طبيعياً.
- اختبار ت لعينتين مستقلتين متساويتي التباين (t-Test: Two-Sample Assuming Equal Variances): يُعرف باختبار ستيودنت الكلاسيكي (Student’s t-Test)، ويفترض أن المتغير التابع متصل، والمشاهدات مستقلة، والتوزيعات اعتدالية، مع وجود تجانس تام في التباين بين المجموعتين (Homoscedasticity).
- اختبار ت لعينتين مستقلتين غير متساويتي التباين (t-Test: Two-Sample Assuming Unequal Variances): يُعرف عالمياً باختبار ويلش (Welch’s t-Test)، وهو تعديل منهجي صارم يسقط افتراض تجانس التباين بين المجموعتين ويحسب درجات الحرية عبر معادلة ويلش-ساترثويت (Welch–Satterthwaite equation)، مما ينتج غالباً درجات حرية كسرية ويحمي التحليل من الأخطاء من النوع الأول (Type I Error).
عند اختيار الاختبار المناسب من نافذة التحليل، يحدد الباحث نطاق الإدخال للمتغير الأول والثاني، ويفعل خيار العناوين (Labels) إذا تضمن التحديد صفي الأسماء، ويحدد قيمة الفرق الفرضي بين المتوسطات (Hypothesized Mean Difference) والتي توضع كـ (0) لاختبار الفرضية الصفرية بعدم وجود فروق. أخيراً، يتم تحديد مستوى الدلالة المعنوية ألفا (Alpha) والذي يُضبط قياسياً عند 0.05، ثم اختيار نطاق الإخراج لطباعة جدول إحصائي متكامل يتضمن المتوسطات الحسابية، والتباينات الفعلية، وحجم المجموعات، وقيمة إحصاء ت المحسوب، ودرجات الحرية، والقيم الاحتمالية المصاحبة للاختبار بنوعيه الأحادي والثنائي.
8.2 تطبيق دالة T.TEST البرمجية المباشرة
إلى جانب الحزمة الإحصائية الثابتة، يوفر إكسيل ميزة ديناميكية مذهلة من خلال دالة T.TEST المدمجة، والتي تُحسب قيمتها في الوقت الفعلي وتتحدث تلقائياً بمجرد تعديل أو إضافة أي بيانات إلى المجموعتين. تتطلب كتابة صيغة T.TEST أربعة معاملات أساسية بالشكل التالي: T.TEST(array1, array2, tails, type)، حيث يمثل المعاملان الأول والثاني النطاقين الرقميين لمجموعتي البيانات المقارنة (مثل: A2:A101 و B2:B101).
يحدد المعامل الثالث “نوع الذيل” (Tails)؛ حيث يُكتب الرقم (1) للاختبار أحادي الاتجاه (One-tailed test) عندما يكون لدى الباحث فرضية موجهة مسبقاً تؤكد تفوق إحدى المجموعتين على الأخرى، في حين يُكتب الرقم (2) للاختبار ثنائي الاتجاه (Two-tailed test) وهو الأكثر تحفظاً وشيوعاً في الأبحاث الاستكشافية، حيث يفترض وجود فروق مطلقة دون الجزم باتجاهها لصالح أي من الطرفين. أما المعامل الرابع “نوع الاختبار” (Type)، فيحدد الطبيعة المنهجية للعينات؛ حيث يُرمز للعينات المرتبطة بالرقم (1)، وللعينات المستقلة متساوية التباين بالرقم (2)، وللعينات المستقلة غير متساوية التباين (اختبار ويلش) بالرقم (3).
تُنتج هذه الدالة مباشرة القيمة الاحتمالية الدقيقة (p-value). تُفسر هذه القيمة بمقارنتها بمستوى ألفا المحدد سلفاً (غالباً 0.05): فإذا كانت قيمة p الناتجة أصغر من 0.05، يتم رفض الفرضية الصفرية وقبول الفرضية البديلة، مما يؤكد أن الفارق الملاحظ بين متوسطي المجموعتين ذو دلالة إحصائية حقيقية ولا يُعزى لعوامل الصدفة العشوائية، وهو المنهج الاستدلالي المتبع في دراسات الصحة العامة وعلم الأوبئة السلوكي كدراسات Blakely et al. (2003) والتحليلات الوبائية العالمية لعبء الاضطرابات النفسية التي قدمها Ferrari et al. (2014). أما إذا كانت القيمة أكبر من 0.05، فيتعين الإبقاء على الفرضية الصفرية لعدم كفاية الدليل الإحصائي لإثبات وجود فرق حقيقي.
9. التفسير الأكاديمي للنتائج والمفاضلة بين أساليب المقارنة
9.1 معايير الاختيار بين ملخص الأرقام الخمسة والمتوسط والانحراف المعياري
يتطلب التحليل الإحصائي المحكم وعياً نقدياً بمعايير المفاضلة بين ملخص الأرقام الخمسة كمنهج لابارامتري رتيب، وبين المتوسط الحسابي والانحراف المعياري كمنهج بارامتري معلمي. ترتكز هذه المفاضلة بصورة جوهرية على فحص اعتدالية التوزيع الإحصائي للبيانات؛ ويتم ذلك داخل إكسيل عبر حساب معاملي الالتواء (Skewness) باستخدام دالة SKEW والتفرطح (Kurtosis) باستخدام دالة KURT. كقاعدة أكاديمية عامة، إذا كانت قيمة معامل الالتواء تقع بين (-1 و +1)، فإن البيانات تعتبر قريبة من التوزيع الطبيعي بما يبرر استخدام المقاييس البارامترية بثقة تامة.
في الحالات التي يتجاوز فيها الالتواء هذه الحدود، أو عند وجود قيم متطرفة حادة لا يمكن تبرير استبعادها علمياً، أو عندما تكون البيانات التابعة مستقاة من مقاييس رتبية غير متصلة كالمقاييس الليكرتية المحدودة في العينات الصغيرة، يصبح استخدام ملخص الأرقام الخمسة والوسيط والمدى الربيعي هو الخيار المنهجي الأكثر أماناً واستقراراً؛ لكونه يقدم توصيفاً موضوعياً للتمركز والتشتت لا يتأثر بأطراف التوزيع المشوهة ولا يفترض تجانساً مصطنعاً لا تعكسه التجربة الواقعية.
مع ذلك، لا تعني المفاضلة استبعاد أحدهما بصورة مطلقة، بل يكمن الإتقان الأكاديمي في التكامل بين المنهجين؛ حيث يتيح تقديم كلا الملخصين معاً في التقارير البحثية الموسعة فحصاً شاملاً متعدّد المستويات للمتغير التابع. يتيح هذا التكامل للمحلل ملاحظة الفجوة بين المتوسط والوسيط كمؤشر كمي بديهي على درجة التواء البيانات، مما يمنح القارئ والباحث رؤية استكشافية متعمقة تدمج دقة التحليل الرياضي الشامل للمتوسطات مع استقرار ومناعة المؤشرات الربيعية.
9.2 صياغة التقارير الإحصائية وفق التنسيقات العلمية المعيارية
إن إتقان العمليات الحسابية داخل إكسيل يفقد جزءاً كبيراً من قيمته العلمية إذا لم يُتوّج بصياغة أكاديمية منسقة للنتائج تتبع المعايير القياسية العالمية، وفي مقدمتها معايير جمعية علم النفس الأمريكية (APA Style – الإصدار السابع). يتطلب هذا النمط الأكاديمي توثيق الفروق الإحصائية بدقة، وتضمين المؤشرات الوصفية بجانب المخرجات الاستدلالية بصورة متسلسلة تشمل: المتوسطات الحسابية (M)، الانحرافات المعيارية (SD)، قيمة اختبار ت (t)، درجات الحرية (df)، والقيمة الاحتمالية الدقيقة (p).
تتم الصياغة النصية للأبحاث المقارنة بأسلوب أكاديمي رصين ومحكم، على النحو النموذجي التالي: “أظهرت نتائج اختبار (ت) للعينات المستقلة وجود فروق ذات دلالة إحصائية بين درجات المجموعة التجريبية (M = 78.45, SD = 9.12) والمجموعة الضابطة (M = 65.20, SD = 11.34) لصالح المجموعة التجريبية؛ حيث بلغت قيمة t(98) = 6.42، بمستوى دلالة p < 0.001، مما يبرهن على الأثر الإيجابي الكبير للتدخل”. وفي حال كان الاختبار المستخدم هو اختبار ويلش نظراً لعدم تجانس التباين، يتعين توثيق درجات الحرية الكسرية بدقة (مثل df = 87.35) والإشارة الصريحة للاختبار في متن المنهجية.
كما يُوصى بتضمين جداول أكاديمية منسقة ومبسطة داخل التقرير تدمج المقاييس الوصية لكلا المجموعتين؛ تتضمن أعمدة للمجموعات، وأحجام العينات، والمتوسطات، والانحرافات المعيارية، وفترات الثقة (Confidence Intervals – 95% CI) لفروق المتوسطات. يرتبط هذا العرض الرقمي بالربط النظري والسلوكي المحكم؛ إذ لا تنتهي مهمة التقرير عند إثبات الدلالة الإحصائية، بل يجب الانتقال مباشرة لمناقشة المعنى المعرفي أو الإكلينيكي للفارق ومدى اتساقه مع الإطار النظري والدراسات السابقة في حقل التخصص.
10. أفضل الممارسات والأخطاء الشائعة عند مقارنة البيانات في إكسيل
10.1 الأخطاء الحسابية والمنهجية المتكررة
يقع العديد من مستخدمي مايكروسوفت إكسيل في مجموعة من المنزلقات والأخطاء الشائعة التي تقوض موثوقية المقارنة الإحصائية. يأتي في مقدمة هذه الأخطاء الخلط المنهجي الفادح بين دوال العينة ودوال المجتمع؛ كأن يستخدم المحلل دالة STDEV.P بدلاً من STDEV.S عند دراسة عينات تجريبية، أو تطبيق اختبار ت للعينات المستقلة متساوية التباين دون إجراء اختبار أولي لتجانس التباين (مثل اختبار ليفين أو اختبار ف للتباينين الفرضيين)، مما يؤدي إلى التقليل المصطنع من قيمة الخطأ المعياري وزيادة احتمالية ارتكاب الخطأ من النوع الأول وادعاء دلالة غير حقيقية.
من الأخطاء الحسابية البالغة الخطورة أيضاً إغفال الفرق الإجرائي الجوهري بين الخلايا الفارغة وتلك التي تتضمن الرقم صفر (0)؛ فبينما تتجاهل دالة AVERAGE الخلية الفارغة تلقائياً وتخفض مقام القسمة تبعاً لذلك، فإنها تدرج الخلية المحتوية على الرقم صفر كقيمة عددية فعلية ضمن الجمع والقسمة، مما يسحب المتوسط الحسابي بصورة دراماتيكية نحو الأسفل ويشوه الانحراف المعياري للمجموعة دون قصد من الباحث، وهو ما يفرض تنظيف حقول البيانات والتأكد من تحويل الغياب إلى خلايا فارغة أو صيغ خاصة تعزلها عن الحساب.
علاوة على ذلك، يغفل باحثون كثر مقارنة مجموعات غير متكافئة إحصائياً أو تجاهل أثر الارتباط في البيانات المتكررة؛ كأن يطبق الباحث اختبار ت للعينات المستقلة على درجات قياس قبلي وبعدي لنفس المشاركين متجاهلاً استخدام اختبار ت للعينات المرتبطة (Paired t-Test)، وهو خطأ منهجي جسيم يهدر التباين الداخلي للأفراد ويقلل من القوة الإحصائية للاختبار بصورة تعيق رصد الفروق الواقعية للتدخل.
10.2 إرشادات الأتمتة وضمان جودة التحليل الإحصائي
لضمان أعلى معايير الجودة والاستدامة في بيئة العمل، يُوصى بتحويل النطاقات العادية إلى “جداول إكسيل الديناميكية” (Excel Tables) عبر الأمر (Ctrl + T). تمنح هذه الجداول ميزة الأتمتة الكاملة للتحليل؛ حيث تتوسع تلقائياً عند إضافة حالات جديدة في أسفل الجدول، وتقوم بتحديث كافة الصيغ الإحصائية والمخططات الصندوقية المرتبطة بها في الوقت الفعلي ودون الحاجة لإعادة كتابة نطاقات المعادلات يدوياً، مما يلغي تماماً احتمالات نسيان إدراج الصفوف الجديدة في التحليل.
يتعين أيضاً حماية المصنفات البحثية وتوثيقها بصورة منهجية؛ وذلك بقفل الخلايا الحسابية الحساسة التي تتضمن المعادلات المتقدمة وحمايتها بكلمة مرور لمنع التعديل العرضي أو المسح غير المقصود أثناء إدخال البيانات أو تنقيحها. كما يُستحسن تخصيص ألوان موحدة للخلايا المخصصة للإدخال المباشر وتلك الخاصة بالمخرجات الحسابية لتبسيط بيئة العمل، وتدوين ملاحظات توضيحية (Notes / Comments) تشرح طبيعة الصيغ المستخدمة وتبرير اختيار الاختبارات الإحصائية المحددة.
أخيراً، ينبغي دائماً تطبيق تقنيات التحقق المتبادل (Cross-Validation) من النتائج لضمان سلامة الأرقام قبل الاعتماد النهائي؛ كأن يُحسب الانحراف المعياري بالصيغة المباشرة ثم يُعاد حسابه عبر الجذر التربيعي لناتج دالة التباين VAR.S(A2:A101) للتأكد من التطابق التام، واستخراج الدلالة الاحتمالية عبر دالة T.TEST ومطابقتها بمخرجات حزمة التحليل Analysis ToolPak. إن هذه الرقابة المزدوجة تمنح الباحث ثقة مطلقة في رصانة نتائجه وتمنع أي مفاجآت أو أخطاء حسابية أثناء مناقشة ونشر المخرجات العلمية.
خاتمة
إن إنشاء مقارنة إحصائية رصينة بين مجموعتي بيانات في مايكروسوفت إكسيل يتجاوز مجرد سرد الأرقام واستخراج المتوسطات السطحية؛ إنه مسار منهجي متكامل يربط بين الفهم العميق لخصائص التوزيعات، وحصانة المقاييس الوصفية، والتمثيل البصري البليغ عبر المخططات الصندوقية، والقوة الاستدلالية لاختبارات الفروض. لقد أثبت إكسيل جدارته كمنصة متكاملة تمكن الباحثين في حقول علم النفس والعلوم السلوكية والتربوية من السيطرة التامة على بياناتهم، وفحص استجابات العينات بدقة فائقة، واستخلاص الفروق ذات الدلالة وفق أرقى معايير النزاهة العلمية وصياغتها بنسق أكاديمي رصين يدعم تقدم المعرفة الإنسانية والممارسة القائمة على الدليل.
المراجع
- Blakely, T. A., Collings, S. C., & Atkinson, J. (2003). Unemployment and suicide. Evidence for a causal association?. Journal of Epidemiology & Community Health, 57(8), 594–600. https://doi.org/10.1136/jech.57.8.594
- Browning, M. H. E. M., Larson, L. R., Sharaievska, I., Rigolon, A., McAnirlin, O., Mullenbach, L. E., Cloutier, S., Vu, T. M., Thomsen, J., Reigner, N., Metcalf, E. C., D’Antonio, A., Helbich, M., Bratman, G. N., & Alvarez, H. O. (2021). Psychological impacts from COVID-19 among university students: Risk factors across seven states in the United States. PLoS ONE, 16(1), e0245327. https://doi.org/10.1371/journal.pone.0245327
- Carey, R., Connell Bohlen, L., Johnston, M., Rothman, A. J., de Bruin, M., Kelly, M. P., & Michie, S. (2018). Behavior Change Techniques and Their Mechanisms of Action: A Synthesis of Links Described in Published Intervention Literature. Annals of Behavioral Medicine, 53(8), 693–707. https://doi.org/10.1093/abm/kay078
- Davison, A. K., Lansley, C., Costen, N. P., Tan, K., & Yap, M. H. (2016). SAMM: A Spontaneous Micro-Facial Movement Dataset. IEEE Transactions on Affective Computing, 9(1), 116–129. https://doi.org/10.1109/taffc.2016.2573832
- Delgado, P., Vargas, C., Ackerman, R., & Salmerón, L. (2018). Don’t throw away your printed books: A meta-analysis on the effects of reading media on reading comprehension. Educational Research Review, 25, 23–38. https://doi.org/10.1016/j.edurev.2018.09.003
- Ferrari, A. J., Norman, R. E., Freedman, G., Baxter, A. J., Pirkis, J., Harris, M. G., Page, A., Carnahan, E., Degenhardt, L., Vos, T., & Whiteford, H. A. (2014). The Burden Attributable to Mental and Substance Use Disorders as Risk Factors for Suicide: Findings from the Global Burden of Disease Study 2010. PLoS ONE, 9(4), e0091936. https://doi.org/10.1371/journal.pone.0091936
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin, 131(6), 803–855. https://doi.org/10.1037/0033-2909.131.6.803
- Prati, G., & Mancini, A. D. (2021). The psychological impact of COVID-19 pandemic lockdowns: a review and meta-analysis of longitudinal studies and natural experiments. Psychological Medicine, 51(2), 201–211. https://doi.org/10.1017/s0033291721000015
- Vilagut, G., Forero, C. G., Barbaglia, G., & Alonso, J. (2016). Screening for Depression in the General Population with the Center for Epidemiologic Studies Depression (CES-D): A Systematic Review with Meta-Analysis. PLoS ONE, 11(5), e0155431. https://doi.org/10.1371/journal.pone.0155431