
تُعدّ معالجة النصوص وتجزئتها داخل بيئات الجداول الحسابية أحد الركائز الجوهرية في علم إدارة البيانات وهندسة المعلومات الحديثة. فعند التعامل مع قواعد بيانات ضخمة تحتوي على سجلات غير مهيكلة بالكامل، يبرز التحدي التقني المتمثل في استخلاص المقاطع الدلالية المفيدة لتحويل النصوص الخام إلى مؤشرات قابلة للفرز والتحليل والمقارنة. إن استخراج أول ثلاث كلمات من خلية نصية يمثل نموذجاً تطبيقياً معيارياً تتطلبه العديد من سيناريوهات العمل، بدءاً من استخلاص الأسماء الثلاثية، مروراً بفصل العناوين الفرعية والمصطلحات التمهيدية، ووصولاً إلى بناء ملخصات قياسية تمكّن محللي البيانات من توحيد المفاهيم الببليوغرافية والرقمية داخل منصة مايكروسوفت إكسيل.
لم يعد التعامل مع النصوص محصوراً في العمليات الميكانيكية البسيطة مثل الاقتطاع المعتمد على عدد المحارف الثابت، بل تطور ليصبح منهجية حوسبة لغوية دقيقة تعتمد على إدراك الحدود المعجمية والفواصل الفراغية بين الكلمات. هذا التحول استدعى تطوير خوارزميات ودوال متقدمة تتيح للمستخدم الانتقال من المعادلات المعقدة والمركبة إلى صيغ مدمجة وشديدة المرونة. تتناول هذه المقالة بالتفصيل المعمق كافة المسارات التقنية والحسابية المتبعة لتحقيق هذا الهدف، مع التركيز على دالة TEXTBEFORE الثورية، ومقارنتها بالبدائل الكلاسيكية، والأدوات الديناميكية المساعدة في إصدارات البرنامج المختلفة.
يهدف هذا البحث الإجرائي الموسع إلى تزويد الباحث ومحلل البيانات بفهم متكامل للبنية الرياضية والمنطقية المتحكمة في السلاسل النصية، وكيفية التعامل مع الحالات الشاذة، والمسافات غير المنتظمة، والأخطاء البرمجية الناتجة عن تباين أطوال النصوص، فضلاً عن تقديم استراتيجيات الأتمتة الشاملة باستخدام لغة الاستعلامات Power Query ولغة الفيجوال بيسك للتطبيقات (VBA).
1. مقدمة منهجية لمعالجة النصوص واستخراج الكلمات في برنامج إكسيل
1.1 مفهوم استخراج النصوص الجزئية في إدارة وتنظيم البيانات
يمثل استخراج النصوص الجزئية (Substring Extraction) ركناً أساسياً في عمليات تنقية وتجهيز البيانات (Data Wrangling). في البيئات المهنية والأكاديمية، غالباً ما يتم استيراد البيانات من مصادر متعددة كاستمارات الاستبيان الإلكترونية، أو واجهات برمجة التطبيقات (APIs)، أو ملفات النصوص المنسدلة، مما ينتج عنه حقول نصية طويلة تتضمن معلومات متباينة في خلية واحدة. إن القدرة على تجزئة هذه السلاسل النصية وإعادة توظيفها تتيح إعادة هيكلة الجداول لتصبح متوافقة مع متطلبات النمذجة الإحصائية وقواعد البيانات العلاقية.
يكمن الفارق الجوهري في معالجة السلاسل الرمزية بين نمطين رئيسيين: الأول هو المعالجة المعتمدة على طول المحارف المادي (Character-based Processing)، والثاني هو المعالجة المعجمية المعتمدة على الوحدات الصرفية أو الكلمات (Word-based Processing). في النمط الأول، تفترض المعادلات اقتطاع عدد ثابت من الحروف، وهو أسلوب يثبت فشله التام عند التعامل مع نصوص متغيرة الطول؛ حيث يؤدي اقتطاع 15 حرفاً مثلاً إلى بتر الكلمة الأخيرة في منتصفها، مما يشوه المعنى الدلالي للمفردة. في المقابل، ترتكز المعالجة المعجمية على رصد الفواصل الطبيعية بين المفردات، وهو ما يحافظ على سلامة الكلمات كمفاهيم مكتملة البناء.
تتجلى الأهمية البالغة لعزل الكلمات الافتتاحية في تسريع عمليات الفهرسة والتصنيف الرقمي؛ حيث أثبتت الممارسات الإدارية أن الكلمات الثلاث الأولى في أي عنوان مهني أو وصف وظيفي أو مصطلح تجاري غالباً ما تختزن الكتلة الدلالية الأثقل (Semantic Weight). وبناءً على ذلك، فإن عزل هذه التراكيب يسهم بصورة مباشرة في خفض زمن البحث والاستعلام، وتسهيل تجميع البيانات المتجانسة وتصنيفها في فئات معيارية متماسكة داخل لوحات البيانات التفاعلية.
1.2 التحديات التقنية الشائعة عند التعامل مع السلاسل النصية المركبة
تواجه معالجة النصوص في بيئة إكسيل مجموعة من العقبات التقنية، تأتي في مقدمتها إشكالية التباين الحاد في أطوال الكلمات داخل النصوص الطويلة. فاللغات الطبيعية، وخاصة اللغة العربية، تتسم بمرونة اشتقاقية تجعل بعض الكلمات تتألف من حرفين أو ثلاثة، بينما تمتد كلمات أخرى لتصل إلى أكثر من عشرة أحرف نتيجة اتصال الضمائر وأدوات التعريف وحروف الجر. هذا التباين يجعل من المستحيل تطبيق معادلات الاقتطاع البسيطة المعتمدة على الدوال الموضعية دون إقرانها بخوارزميات ذكية ترصد الفواصل الفراغية بدقة متناهية.
بالإضافة إلى تباين الأطوال، تمثل الفواصل والمسافات غير المنتظمة معضلة برمجية كبرى؛ إذ غالباً ما تحتوي السجلات النصية المدخلة يدوياً على مسافات بادئة (Leading Spaces)، أو مسافات ختامية (Trailing Spaces)، أو مسافات مزدوجة متكررة بين المفردات. يُعامل المحرك الحسابي في إكسيل كل مسافة فارغة بوصفها محرفاً مستقلاً يحمل رمزاً برمجياً في جدول الترميز، مما يؤدي إلى تشويه معايير العد عند توجيه البرمجية للبحث عن المسافة رقم ثلاثة، حيث قد تكون هذه المسافة مجرد فراغ عشوائي مكرر بعد الكلمة الأولى، مما ينتج عنه مخرجات خاطئة تماماً.
تاريخياً، عانت الدوال الكلاسيكية مثل LEFT و MID و RIGHT من حدود هيكلية واضحة في معالجة هذه الديناميكيات؛ إذ تطلبت صياغة معادلات بالغة التعقيد والتداخل لتحديد مواقع الفواصل النصية بصورة غير مباشرة. هذا التعقيد لم يكن يثقل كاهل المحلل في كتابة وتتبع المعادلة فحسب، بل كان يرفع كذلك من احتمالية حدوث أخطاء حسابية غير مرئية عند تطبيق النماذج على مئات الآلاف من الصفوف، الأمر الذي استوجب تحديث المنظومة الحسابية بظهور أجيال جديدة من الدوال النصية المتطورة.
1.3 الأهمية المنهجية والعملية لعزل أول ثلاث كلمات بدقة
يحظى الاستخلاص المنضبط لأول ثلاث كلمات باهتمام منهجي واسع في مختلف حقول تحليل البيانات وإدارة النظم. ففي قطاع الموارد البشرية وإدارة السجلات المدنية، تمثل أول ثلاث كلمات في الغالب التركيب المعياري للاسم الكامل (الاسم الأول، واسم الأب، واسم العائلة)، وعزل هذا المقطع بدقة متناهية يضمن فصل الاسم المعياري عن الألقاب الإضافية أو الرتب الوظيفية أو التوضيحات الملحقة التي قد ترد لاحقاً في حقل السجل المدون.
كما يلعب هذا الإجراء دوراً محورياً في تنقية البيانات المجمعة من خوادم الويب وقواعد البيانات الخارجية، والتي غالباً ما تتضمن لواحق غير منتظمة. فعلى سبيل المثال، عند التعامل مع أسماء المنتجات أو العناوين الأكاديمية المفهرسة، تكون الكلمات الافتتاحية هي المحدد الفعلي لفئة المنتج أو موضوع الدراسة الرئيس، في حين تشير بقية السلسلة إلى مواصفات تفصيلية ثانوية يمكن إرجاؤها إلى مراحل تحليلية لاحقة. إن توحيد الصياغة البحثية عبر اعتماد المقاطع الثلاثية يسهم في إنشاء معرفات فريدة (Keys) تسهل عمليات الربط الجدولي (Lookups) بين الجداول المختلفة.
علاوة على ذلك، تبرز الأهمية العملية في تحسين التصميم الهندسي لواجهات المستخدم ولوحات المؤشرات (Dashboards)؛ إذ يؤدي عرض السلاسل النصية الطويلة كما هي إلى تشتيت الانتباه البصري، واستهلاك مساحات واسعة من الشاشة، وتشويه التنسيق العام للجداول. إن توفير ملخصات قياسية تقتصر على أول ثلاث كلمات يوفر مساحة تخزين بصرية مثالية، ويمنح القارئ انطباعاً أولياً كافياً عن طبيعة السجل، مع إمكانية الاحتفاظ بالنص الأصلي الكامل في خلفية النظام للرجوع إليه عند الحاجة التحليلية المعمقة.
2. التشريح التركيبي لدالة TEXTBEFORE وآلية عملها الحسابية
2.1 بنية الصيغة الرياضية والوسائط الإلزامية والاختيارية
مع إطلاق النسخ الحديثة من تطبيق إكسيل ضمن بيئة Microsoft 365، أحدثت دالة TEXTBEFORE نقلة نوعية في التعامل مع السلاسل النصية، متجاوزة التعقيدات التراكمية للدوال التقليدية. تتأسس هذه الدالة على منطق استخلاص كافة المحارف الواقعة قبل محدد نصي معين (Delimiter)، وتتألف بنيتها القياسية من وسائط إلزامية وأخرى اختيارية تمنح المستخدم تحكماً فائقاً في آلية الاقتطاع والمعالجة البرمجية.
تتمثل المعلمة الأولى الإلزامية في الوسيطة (text)، وهي التي تحدد النطاق أو الخلية المصدرية الحاوية للنص الخام المراد معالجته؛ حيث يقوم المحرك الحسابي بتحميل هذه السلسلة في الذاكرة المؤقتة لتحليلها محرفاً تلو الآخر. أما المعلمة الثانية الإلزامية فهي الوسيطة (delimiter)، والتي تمثل الحرف أو الكلمة أو الرمز الذي يشكل الحد الفاصل المراد الاقتطاع عنده، وفي حالة استخراج الكلمات، يتم تعيين المسافة الفارغة بين علامتي تنصيص كمحدد قياسي يرمز لانفصال المفردات المعجمية داخل الجملة.
أما المعلمة الثالثة، وهي الوسيطة (instance_num)، فتكتسب أهمية حاسمة في سياق هذا البحث؛ إذ تحدد رقم التكرار المستهدف للمحدد النصي. وبإسناد القيمة 3 إلى هذه الوسيطة، يصدر أمر رياضي للدالة بتجاوز الفاصل الأول (الذي يلي الكلمة الأولى) والفاصل الثاني (الذي يلي الكلمة الثانية)، والتوقف بشكل صارم عند الفاصل الثالث (الذي يلي الكلمة الثالثة)، ومن ثم استخلاص كل ما يسبق هذه النقطة، مما يضمن عزل الكلمات الثلاث الأولى مجتمعة دون نقصان أو زيادة.
2.2 دور المحدد النصي (Delimiter) وتعيين المسافة كفاصل قياسي
يُعد المحدد النصي العنصر التوجيهي لخوارزمية البحث الداخلي في برنامج إكسيل. برمجياً، يتم التعبير عن المسافة الفارغة بكتابة فراغ أحادي محصور بين علامتي تنصيص مزدوجتين، وتتعامل نواة المعالجة مع هذه المسافة كرمز مستقل له وزنه وموقعه في السلسلة النصية. عندما تشرع الدالة في مسح النص من بدايته، فإنها ترصد هذا الرمز لتعيد ضبط مؤشر القراءة الداخلي وترقية عداد التكرارات الفاصلة بين المفردات اللغوية.
تكمن الصعوبة أحياناً في سلوك خوارزمية البحث عند مواجهة فراغات متتالية غير معالجة؛ إذ إن الدالة في صيغتها المجردة لا تفرق بين مسافة تفصل بين كلمتين حقيقيتين وبين مسافتين متجاورتين نتجتا عن خطأ مطبعي. هذا التعيين الحرفي يعني أن وجود مسافة مزدوجة سيُحتسب بوصفه ظهورين للمحدد النصي، مما يؤدي إلى توقف الدالة قبل الوصول إلى الكلمة الثالثة الفعلية. لذلك، فإن الفهم العميق لكيفية إدراك إكسيل للمحدد النصي يُعد شرطاً أولياً لضمان سلامة العمليات اللاحقة وتفادي الانحرافات الدلالية.
علاوة على ذلك، يرتبط ترميز المحدد النصي بطبيعة النظام ولغة الإدخال. فالمسافة المعيارية الناتجة عن زر الفراغ في لوحة المفاتيح تحمل ترميزاً مختلفاً عن مسافات الفصل الأخرى المستخدمة أحياناً في التنسيقات البرمجية والطباعية. إن ضبط المحدد النصي ليكون المسافة الفارغة القياسية يضمن أعلى درجات التوافق، ويتيح للدالة إجراء مقارنات بايتية (Byte-level Comparisons) سريعة للغاية لا تستهلك موارد المعالجة حتى في السجلات الضخمة المليئة بالبيانات النصية.
2.3 مبدأ العد وتكرار المحدد النصي (Instance Number)
ترتكز آلية عمل وسيطة التكرار (instance_num) على المسح المتسلسل؛ حيث تبدأ الخوارزمية من المحرف الأول في السلسلة النصية (من أقصى اليمين في النصوص العربية، أو من أقصى اليسار في النصوص اللاتينية)، وتتقدم في مسار خطي أفقي. يتم تتبع كل ظهور للمحدد النصي وربطه بعداد تراتبي تصاعدي (1، ثم 2، ثم 3)، وفور وصول العداد إلى القيمة المستهدفة، يتم تجميد عملية المسح وتحديد الإحداثي الموضعي لتلك النقطة داخل الخلية.
من المزايا الاستثنائية لهذه الآلية أنها تدعم الإسناد المتجهي المزدوج؛ فالقيم الموجبة تعني البدء من نقطة الانطلاق الطبيعية للنص، وهو ما نحتاجه حصراً لاستخراج أول ثلاث كلمات عبر إسناد القيمة (+3). في المقابل، فإن إسناد قيم سالبة (مثل -3) يوجه الدالة للبدء بالعد العكسي من نهاية النص لاستخراج المقاطع الأخيرة، مما يبرز المرونة الرياضية الفائقة للهندسة البرمجية التي بنيت عليها دالة TEXTBEFORE مقارنة بأدوات البرمجة التقليدية التي كانت تتطلب حساب طول النص كاملاً قبل تحديد موقع الاقتطاع.
بمجرد تحديد موقع الظهور الثالث للمسافة، تدرك الدالة رياضياً النطاق الحصري المطلوب: وهو الجزء الممتد من بداية السلسلة النصية وحتى الموقع الذي يسبق هذا الفاصل بمقدار محرف واحد تماماً. يتم إهمال واستبعاد كل ما يلي ذلك المحدد الثالث تلقائياً، دون المساس بالبيانات الأصلية في الخلية المصدر، مما يولد ناتجاً نقياً ومستقلاً يمثل التركيب الثلاثي الافتتاحي للنص الأصلي.
3. الدليل الإجرائي التطبيقي لاستخراج أول ثلاث كلمات خطوة بخطوة
3.1 إعداد بيئة العمل وهيكلة جدول البيانات المصدرية
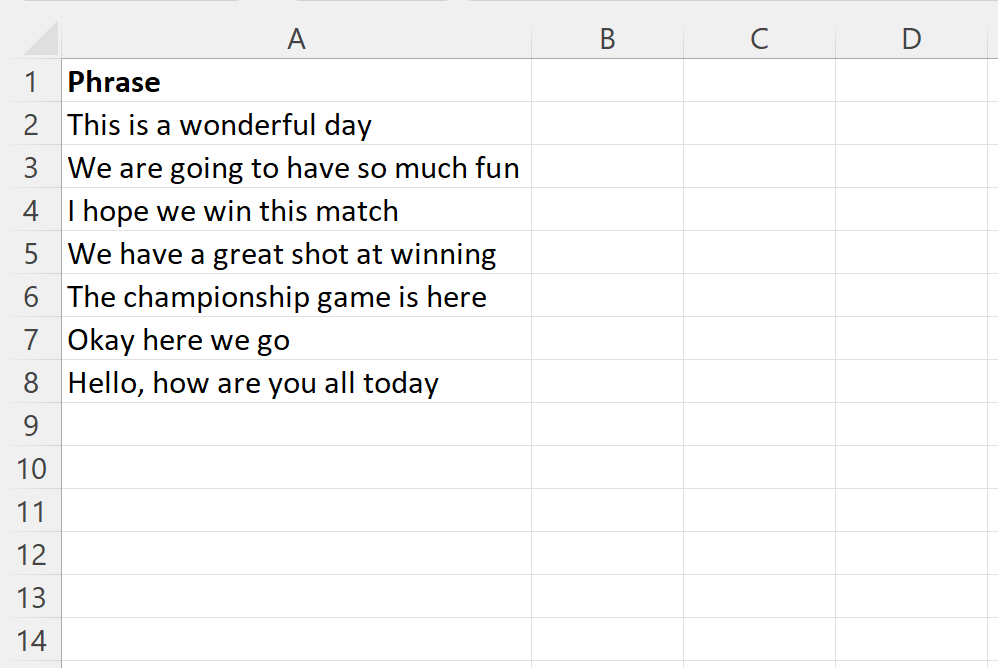
تتطلب الإدارة الاحترافية لبيانات إكسيل إعداداً منهجياً لبيئة العمل قبل الشروع في كتابة الصيغ الرياضية؛ لضمان عدم حدوث تعارضات في التنسيق وتسهيل صيانة ورقة العمل لاحقاً. تبدأ هذه الخطوة بتنظيم البيانات النصية الأصلية داخل عمود موحد ومحدد، وليكن العمود (A)، مع تسمية رأس العمود بعنوان وصفي واضح مثل “النص الأصلي الكامل”. يجب التأكد التام من أن تنسيق خلايا هذا العمود مضبوط على تنسيق “عام” (General) أو “نص” (Text) لتجنب قيام إكسيل بتفسير بعض الكلمات ذات الأشكال الرقمية على أنها قيم حسابية.
في الخطوة التالية، يتعين إنشاء عمود إخراج مخصص ومجاور للعمود المصدري، وليكن العمود (B)، ويُمنح اسماً إرشادياً مثل “الكلمات الثلاث الأولى المستخرجة”. يُحظر منهجياً محاولة تطبيق التعديلات أو العمليات الحسابية فوق البيانات الأصلية مباشرة؛ لأن الحفاظ على سلامة العمود المصدر يتيح للمحلل مراجعة النتائج، وتدقيق العمليات، والرجوع إلى الأصل في حال اكتشاف استثناءات لاحقة تتطلب تعديل معلمات الدوال المستخدمة.
أخيراً، يجب التحقق التقني من إصدار إكسيل المستخدم؛ حيث إن دالة TEXTBEFORE ليست متاحة في الإصدارات القديمة مثل Excel 2016 أو Excel 2019. يتطلب تشغيل هذه الدالة توفر إصدار Microsoft 365 المحدث، أو إصدار Office 2024، أو استخدام تطبيق Excel للويب المجاني عبر المتصفح. يضمن هذا التحقق الأولي عدم ظهور خطأ التعريف الشائع (#NAME?) الذي يطرأ عند محاولة استدعاء دوال غير معرفة في الإصدار المكتبي المثبت على الجهاز.
3.2 صياغة المعادلة القياسية وتطبيقها المباشر في الخلية
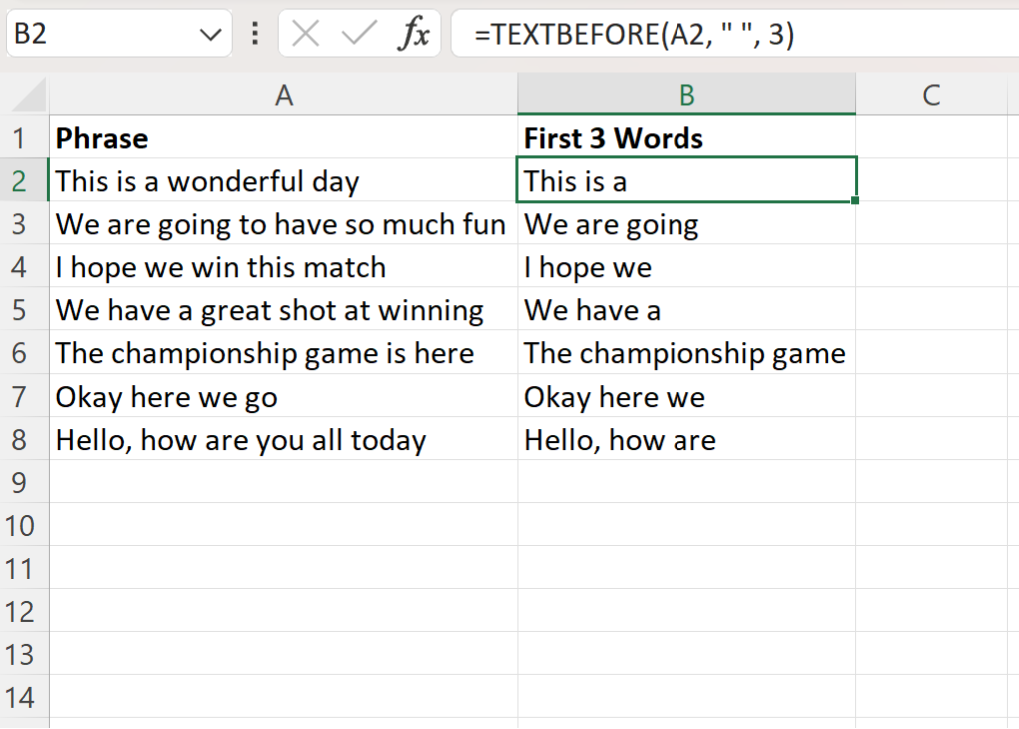
عقب تهيئة البيئة وتجهيز الأعمدة، يتم الانتقال إلى الخلية الأولى في عمود الإخراج، ولتكن الخلية (B2) المقابلة للبيانات المصدرية الأولى في الخلية (A2). يبدأ المستخدم بكتابة علامة التساوي (=) لإعلام محرك الحسابات بالشروع في معالجة رياضية، تليها تسمية الدالة بالأحرف اللاتينية، ثم فتح قوس المعلمات لتمرير المدخلات الثلاثة الأساسية بدقة بالغة.
تتم كتابة الصيغة على النحو التالي تماماً: يُشار أولاً إلى الخلية المصدرية A2، ثم توضع الفاصلة أو الفاصلة المنقوطة (وفقاً لإعدادات اللغة الإقليمية للجهاز)، تليها علامتا تنصيص تحصران مسافة فارغة واحدة واحدة بينهما ” ” لتمثيل المحدد النصي، ثم توضع الفاصلة التالية، ويُختتم الإدخال بالرقم 3 لتحديد تكرار الفاصل المستهدف، لتكون المعادلة المكتملة بصيغتها الصريحة: =TEXTBEFORE(A2, ” “, 3). يتم بعد ذلك إغلاق القوس والضغط على مفتاح الإدخال (Enter).
بمجرد الضغط على زر الإدخال، يقوم إكسيل بتنفيذ عملية التحليل النصي الفورية، ويظهر في الخلية B2 المقطع المتضمن الكلمات الثلاث الأولى فقط. يتعين على المحلل في هذه اللحظة مراجعة النتيجة بصرياً لمقارنتها بالنص الأصلي؛ والتأكد من أن الكلمة الثالثة مكتملة ولم يتم بتر أي من أحرفها، وعدم وجود أي مسافات زائدة ملتصقة بنهاية المقطع المستخرج، مما يؤكد صحة الإعداد الأولي للمعادلة وجاهزيتها للتطبيق الموسع.
3.3 تقنيات سحب وتعميم المعادلة الرياضية على النطاقات الكبيرة
بعد نجاح التطبيق الفردي في الخلية الأولى، تأتي مرحلة تعميم المعادلة على كامل النطاق البياني الذي قد يمتد لعشرات الآلاف من الصفوف. تُعد الطريقة الكلاسيكية الأكثر شيوعاً هي استخدام مقبض التعبئة التلقائية (AutoFill Handle)، وذلك بالنقر على المربع الصغير الكائن في الزاوية السفلى من إطار الخلية B2 النشطة، وسحبه يدوياً إلى الأسفل حتى الوصول إلى الصف الأخير من جدول البيانات المراد معالجته.
لتجاوز مشقة السحب اليدوي في الملفات العملاقة، يوفر إكسيل تقنية النقر المزدوج السريع على مقبض التعبئة. عند النقر المزدوج، يقوم البرنامج تلقائياً بمسح العمود المجاور (A)، واستشعار حدود نهاية البيانات النصية، ومن ثم نسخ الصيغة الحسابية وتعديل المراجع النسبية من (A2) إلى (A3) وحتى آخر صف مأهول بالبيانات، مما يوفر وقداً زمنياً هائلاً ويمنع حدوث أخطاء التجاوز أو التوقف غير المكتمل قبل نهاية السجلات.
فضلاً عن ذلك، يتيح محرك الحسابات الحديث في إكسيل استخدام مصفوفات الانسكاب الديناميكي (Dynamic Spill Arrays). فبدلاً من تطبيق الدالة على خلية مفردة ونسخها، يمكن كتابة المعادلة في الخلية العلوية وتمرير النطاق العمودي كاملاً كمعلمة نصية واحدة، كأن يُكتب: =TEXTBEFORE(A2:A1000, ” “, 3). بمجرد الضغط على Enter، ستنسكب النتائج تلقائياً في الخلايا التابعة إلى الأسفل في حركة رياضية واحدة بالغة الكفاءة، مما يلغي الحاجة لتكرار المعادلات ويقلل بصورة ملموسة من الحجم الكلي للمصنف على القرص الصلب.
4. معالجة الحالات الاستثنائية وتفادي أخطاء الاحتساب النصي
4.1 إدارة النصوص التي تحتوي على أقل من ثلاث كلمات
من أهم العقبات التي تواجه المحلل عند تطبيق الدالة القياسية ظهور خطأ عدم التوفر (#N/A!). يرجع السبب البرمجي المباشر لهذا الخطأ إلى أن خوارزمية دالة TEXTBEFORE مبرمجة على البحث الحصري عن ثلاث مسافات فارغة؛ فإذا كانت الخلية المصدرية تحتوي على نص يتألف من كلمة واحدة فقط أو كلمتين (مثل أسماء الشركات القصيرة أو المصطلحات المفردة)، فإن الخوارزمية تفشل في العثور على المسافة الثالثة المطلوبة، مما يدفع المحرك لإرجاع الخطأ كدلالة على تعذر استيفاء شرط الحساب.
لمعالجة هذه المشكلة بصورة أصلية دون إثقال المصنف بدوال إضافية، وفرت شركة مايكروسوفت وسائط متقدمة داخل بنية دالة TEXTBEFORE ذاتها. من بين هذه الوسائط وسيطة (match_end)؛ حيث تتيح هذه الوسيطة إبلاغ الدالة باعتبار نهاية السلسلة النصية بمثابة محدد نصي شرعي، وذلك بإسناد القيمة الرقمية (1) إليها. عند تفعيل هذا الخيار، إذا لم تعثر الدالة على ثلاث مسافات، فإنها تتوقف عند نهاية النص الموجود وتعيده كاملاً للمستخدم دون توليد أخطاء.
تتم كتابة المعادلة المصححة لتشمل هذه الوسيطة بتخطي وسيطة نمط المطابقة وتركها فارغة، ثم تفعيل وسيطة نهاية المطابقة كالتالي: =TEXTBEFORE(A2, ” “, 3, , 1). كما يمكن استخدام وسيطة أخرى بديلة وهي (if_not_found) التي تتيح إدخال نص مخصص أو إرجاع قيمة الخلية الأصلية ذاتها في حال عدم العثور على الفواصل المطلوبة، بصيغة مثل: =TEXTBEFORE(A2, ” “, 3, , , A2)، مما يجعل النموذج مرناً ومحصناً ضد التوقف المفاجئ.
4.2 دمج دالة IFERROR لحماية واجهة النتائج وضمان الاتساق الأكاديمي
على الرغم من فاعلية الوسائط المدمجة في دالة TEXTBEFORE، إلا أن الممارسات الاحترافية في حوكمة النماذج الحسابية تفضل غالباً بناء طبقات حماية خارجية باستخدام دالة IFERROR. تضمن هذه الدالة التقاط كافة أنواع الأخطاء الحسابية غير المتوقعة (سواء كانت #N/A أو #VALUE! الناشئة عن وجود قيم غير متوافقة في الخلايا المصدرية)، وتوجيه البرنامج نحو مخرجات بديلة تحافظ على الاتساق العام للتقرير.
يتم دمج الدالتين عبر وضع دالة TEXTBEFORE كمعلمة أولى (القيمة المختبرة) داخل دالة IFERROR، ثم تعيين المعلمة الثانية التي تمثل الإجراء التصحيحي الواجب تنفيذه. تتجلى القوة الحسابية لهذه الصيغة المركبة في إمكانية توجيه الدالة لإرجاع النص الأصلي بالكامل إذا تعذر استخراج الكلمات الثلاث، وتتم صياغة هذه المعادلة المعيارية بالشكل التالي: =IFERROR(TEXTBEFORE(A2, ” “, 3), A2).
يسهم هذا الأسلوب الوقائي في تحسين المظهر المهني لملفات العمل وجداول النشر الأكاديمي؛ حيث إن ظهور رموز الأخطاء في التقارير يعطي انطباعاً بضعف جودة البيانات وخلل النماذج الرياضية المستخدمة. علاوة على ذلك، يتيح خيار استبدال الخطأ بقيمة فارغة (“”) من خلال كتابة الصيغة: =IFERROR(TEXTBEFORE(A2, ” “, 3), “”) عزل السجلات المكتملة بصرياً عن السجلات القصيرة، مما يسهل عمليات التدقيق اللاحقة وعزل الحالات الشاذة لمعالجتها بصورة مستقلة.
4.3 التحكم في وسائط مطابقة النصوص وتجاهل الحالات الخاصة
تتضمن دالة TEXTBEFORE وسائط متقدمة أخرى تتحكم في سلوك المطابقة بدقة؛ مثل الوسيطة (match_mode) التي تحدد مدى حساسية الدالة لحالة الأحرف في اللغات اللاتينية (Case Sensitivity)، أو التمييز بين المحددات الدقيقة. وعلى الرغم من أن المسافة الفارغة رمز متطابق في كافة الحالات، إلا أن التحكم في هذه الوسائط يصبح ضرورياً للغاية عندما تتضمن الجمل محددات نصية بديلة أو إضافية تفصل بين المفردات اللغوية.
من الإشكاليات البارزة في المعالجة النصية مسألة التصاق علامات الترقيم (كالفواصل، أو النقط، أو علامات التنصيص، أو الشرطات) بالكلمة الثالثة. في هذه الحالة، إذا كانت الكلمة الثالثة متبوعة بفاصلة مباشرة تليها مسافة، فإن الدالة ستستخرج الكلمة الثالثة مقرونة بتلك الفاصلة؛ لأن عملية الاقتطاع تتوقف عند الفراغ وليس عند علامة الترقيم. يتطلب هذا السلوك أحياناً إجراء معالجة مسبقة لتفكيك الرموز غير المعجمية وضمان استخلاص الكلمات بحروفها الصافية فقط.
يمكن التغلب على ذلك بتمرير مصفوفة من المحددات النصية داخل وسيطة (delimiter)، كأن يتم توجيه الدالة للبحث عن المسافات والفواصل في آن واحد باستخدام الأقواس المعقوفة: {” “, “،”, “-“}. تتيح هذه المرونة العالية للدالة التكيف مع السلاسل النصية التي كُتبت بتنسيقات غير منضبطة، مما يرفع من دقة التحليل ويحول دون اختلاط علامات الترقيم ببنية الكلمات المستخلصة داخل قاعدة البيانات النهائية.
5. تطهير وتنقية النصوص المصدرية لضمان دقة الاستخراج
5.1 أثر المسافات الزائدة وغير المنتظمة على معايير العد النصي
تُعد المسافات الزائدة وغير المرئية العدو الخفي الأكبر لخوارزميات معالجة النصوص في إكسيل. تنشأ هذه المسافات عادةً عند نسخ البيانات من صفحات الإنترنت، أو نتيجة أخطاء الإدخال اليدوي وسهو مدخلي البيانات بالنقر المتكرر على زر المسافة. تشمل هذه الظاهرة ثلاثة أنماط رئيسية: المسافات البادئة التي تسبق أول حرف في النص، والمسافات الختامية التي تأتي بعد آخر حرف، والمسافات البينية المزدوجة أو المتعددة المحصورة بين الكلمات.
تتجلى خطورة هذه المسافات في إرباك معيار العد الرياضي للدالة؛ فإذا بدأت الخلية بمسافة بادئة واحدة، فإن هذه المسافة ستُحتسب كأول محدد نصي فوري، وبالتالي فإن الكلمة الأولى الواقعية في النص ستُعامل كأنها واقعة بين الفاصل الأول والثاني، مما يزيح مؤشر العد بمقدار درجة كاملة. ينتج عن ذلك قيام الدالة باستخراج كلمتين فقط بدلاً من ثلاث؛ لأن الفاصل الثالث المستهدف سيأتي مبكراً قبل الوصول إلى الكلمة الثالثة الحقيقية، وهو ما يمثل انحرافاً حسابياً فادحاً في المخرجات.
أما المسافات المزدوجة بين الكلمات، فإنها تخلق فواصل فارغة وهمية؛ حيث يرى محرك البرنامج مسافة أولى تليها مسافة ثانية مباشرة، فيعتبر كل مسافة منهما حداً فاصلاً قائماً بذاته. وبذلك، تستنفد المعادلة تكراراتها العددية في فراغات لا معنى لها بدلاً من القفز بين المفردات الفعلية. ولذلك، فإن تطبيق أي معادلة استخراج على بيانات خام دون تطهير مسبق يُعد خطأً منهجياً يهدد سلامة وموثوقية التحليلات بأسرها.
5.2 التكامل الوظيفي بين دالتي TRIM وTEXTBEFORE
لتحصين عملية الاستخراج ضد مشكلات الفراغات العشوائية، تبرز دالة TRIM بوصفها الأداة الحيوية التي لا غنى عنها في هندسة البيانات. تقوم هذه الدالة بتطبيق معيار خوارزمي صارم: حذف كافة المسافات البادئة في مستهل السلسلة، ومحو كافة المسافات الختامية في نهايتها، وتقليص أي فجوات فراغية متكررة بين الكلمات لتتحول قسراً إلى مسافة مفردة واحدة فقط، مما يعيد النص إلى بنيته المعجمية السليمة.
يتحقق التكامل التقني الأمثل من خلال تداخل الدوال (Function Nesting)؛ حيث يتم إدراج دالة TRIM داخل دالة TEXTBEFORE لتعمل كطبقة فلترة ومعالجة وسيطة قبل تمرير السلسلة إلى خوارزمية التجزئة. في هذا النموذج، يتلقى محرك إكسيل الخلية A2، ويقوم بتعقيمها وتطهيرها لحظياً في الذاكرة العشوائية بواسطة TRIM، ومن ثم يُسلّم النص المطهر إلى دالة TEXTBEFORE لتقوم بالبحث عن المسافة الثالثة واقتطاع ما قبلها بأمان مطلق.
تُصاغ المعادلة القياسية المتكاملة الأكثر أماناً واعتماداً في بيئات العمل المهنية على النحو الآتي: =TEXTBEFORE(TRIM(A2), ” “, 3). يضمن هذا الدمج الحسابي استقراراً تاماً للمخرجات؛ فمهما كانت درجة الفوضى في المسافات داخل الخلية المصدرية، سيتم اختزالها أولاً إلى هيكل موحد، مما يجعل مؤشر العد المخصص للرقم (3) يقابل حتماً نهاية الكلمة الثالثة الحقيقية دون أي انزياح أو أخطاء ناتجة عن الفراغات المتكررة.
5.3 معالجة المسافات غير القابلة للكسر والرموز الخفية
في كثير من الحالات المتقدمة، تفشل دالة TRIM الكلاسيكية في حل مشكلة الفراغات، خاصة عند استيراد البيانات من صفحات الإنترنت أو وثائق HTML و PDF. يرجع هذا الفشل إلى احتواء النصوص على ما يُعرف برمجياً باسم “المسافة غير القابلة للكسر” (Non-breaking Space)، والتي تحمل الرمز القياسي CHAR(160) في جداول ASCII، مقارنة بالمسافة العادية التي تحمل الرمز CHAR(32). صُممت دالة TRIM للتعامل حصرياً مع الرمز 32، وتتجاهل كلياً الرمز 160، مما يترك الفواصل الشاذة مفسدة للعمليات الحسابية.
لمواجهة هذا التعقيد، يتوجب توظيف دالة SUBSTITUTE لاستبدال المسافات غير القابلة للكسر بمسافات عادية قابلة للمعالجة والتنظيف. يتم ذلك عبر صياغة تعبير برمجي يستهدف استبدال كل ظهور للرمز CHAR(160) بالرمز CHAR(32) أو بمسافة عادية ” “، وذلك قبل تمرير النص إلى دالة التنظيف TRIM، مما يقضي على كافة العوائق الخفية الكامنة في البنية التحتية للنصوص الرقمية المستوردة.
تكتمل منظومة التطهير المتقدمة بدمج دالة CLEAN للتخلص من المحارف والرموز غير القابلة للطباعة (المرمزة من 0 إلى 31 في جداول المحارف)، والتي قد تتسرب أثناء عمليات النسخ أو التصدير وتتسبب في إتلاف تسلسل الكلمات. تصبح الصيغة الاحترافية الاستباقية لتطهير النصوص المعقدة مركبة كالتالي: =TEXTBEFORE(TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), ” “))), ” “, 3)، وهو ما يوفر بيئة استخراج معقمة بنسبة مئة بالمئة تحمي النماذج من أي سلوك غير متوقع.
6. الحلول البديلة في إصدارات إكسيل الكلاسيكية والقديمة
6.1 الاستخراج التجميعي باستخدام دوال LEFT وFIND وSUBSTITUTE
في الإصدارات الكلاسيكية من برنامج إكسيل (مثل 2010 و 2013 و 2016 و 2019)، لا تتوفر دالة TEXTBEFORE، مما يستدعي اللجوء إلى حل رياضي عبقري غير مباشر يعتمد على هندسة الدوال التجميعية المركبة، وتحديداً من خلال الجمع بين دوال: LEFT و FIND و SUBSTITUTE. تعتمد الفكرة الجوهرية لهذا الأسلوب على تحويل المشكلة المعجمية (عد الكلمات) إلى مشكلة موضعية حسابية (تحديد رقم محرف القطع داخل السلسلة).
تبدأ الخوارزمية باستخدام دالة SUBSTITUTE بذكاء نادر؛ حيث يتم توجيهها للبحث عن المسافة الفارغة ” ” في النص المطهر، وتكليفها باستبدال “الظهور الثالث تحديداً” برمز مؤقت وفريد وغير مألوف في النصوص العادية (مثل علامة @ أو الحرف ^ أو الرمز ~). يتم ذلك بتحديد وسيطة التكرار داخل دالة الاستبدال بالقيمة 3، لينتج نص جديد يطابق النص الأصلي في كل شيء، باستثناء أن المسافة التي تلي الكلمة الثالثة قد تم وسمها بهذا الرمز المؤقت الاستثنائي.
في الخطوة التالية، تتدخل دالة FIND لتحديد الموقع الحسابي الدقيق (رقم المحرف) لهذا الرمز الفريد الذي تم زرعه للتو. وفور الحصول على هذا الرقم، يُطرح منه الرقم (1) لاستبعاد موقع الرمز نفسه، ثم يُمرر الرقم الناتج كمعلمة ثانية لدالة LEFT، والتي تقوم باقتطاع كل ما يقع على يسار (أو يمين في النصوص العربية) هذا الموقع انطلاقاً من بداية النص. تتجسد هذه المعادلة الكلاسيكية المعقدة بالشكل التالي: =LEFT(TRIM(A2), FIND(“^”, SUBSTITUTE(TRIM(A2), ” “, “^”, 3)) – 1)، محققة النتيجة ذاتها بدقة تامة.
6.2 مقارنة منهجية في الكفاءة والتعقيد بين الأسلوب القديم والحديث
عند إجراء تقييم مقارن بين الأسلوب القديم المركب ودالة TEXTBEFORE الحديثة، يظهر بوضوح مدى القفزة النوعية التي حققتها النظم الحسابية الحديثة في معايير كفاءة التطوير والصيانة البرمجية. فالصيغة الكلاسيكية تتسم بدرجة عالية من التعقيد الهيكلي وصعوبة القراءة (Readability)، مما يجعل مراجعتها أو تعديلها من قبل مستخدمين آخرين أمراً عرضة للأخطاء والتفسيرات الخاطئة، في حين تتميز الصيغة الحديثة بوضوح دلالي مباشر يكشف عن وظيفته فور قراءته.
من زاوية الأداء الحاسوبي واستهلاك الذاكرة، فإن التركيبة الكلاسيكية (LEFT/FIND/SUBSTITUTE) تجبر معالج إكسيل على إجراء ثلاث عمليات متتالية لكل خلية: استبدال محرف في الذاكرة، ثم مسح السلسلة للعثور على موقع المحرف الجديد، ثم تنفيذ عملية الاقتطاع المادي للمحارف. هذا التسلسل المتعدد يرفع من زمن المعالجة (Execution Time) بشكل ملحوظ عند تطبيق المعادلة على مصنفات ضخمة تتجاوز مئات الآلاف من السجلات، مقارنة بدالة TEXTBEFORE التي تنفذ العملية عبر خوارزمية مسح مباشرة وموحدة مكتوبة في لغة النواة الأساسية للبرنامج.
بالإضافة إلى ذلك، فإن قدرة الدالة الحديثة على التعامل الذاتي مع الاستثناءات (كنقص عدد الكلمات) عبر وسائطها الاختيارية يتفوق بمراحل على الأسلوب القديم؛ إذ يتطلب الأسلوب القديم لفَّ المعادلة المركبة بأكملها داخل دالة IFERROR لتجنب ظهور الخطأ عند غياب المسافة الثالثة، مما يزيد من طول المعادلة لتتجاوز أحياناً مئة محرف، مسببة ترهلاً برمجياً في بنية ورقة العمل يصعب توثيقه وحوكمته.
6.3 استخدام المصفوفات التقليدية في استخلاص مقاطع الكلمات
قبل ظهور مصفوفات الانسكاب الديناميكي، لجأ الخبراء أحياناً إلى صياغة حلول مصفوفية بديلة تعتمد على دوال التكرار والصفوف الحسابية (مثل استخدام ROW و INDIRECT و MID) لاحتساب مواقع الفواصل تلقائياً. كانت هذه الطرق تهدف إلى تفكيك النص كاملاً إلى مصفوفة افتراضية من المحارف الفردية، وفحص كل محرف للتحقق مما إذا كان مسافة، ثم تحديد المواقع التراكمية لتلك المسافات لاستخلاص الكلمات المستهدفة دون الحاجة لزرع رموز استبدال فريدة.
كانت المشكلة الهيكلية الكبرى لهذه الحلول المصفوفية القديمة تكمن في متطلبات تنفيذها الصارمة؛ إذ كانت تتطلب الضغط الإلزامي على مفاتيح لوحة المفاتيح الثلاثية Ctrl + Shift + Enter (المعروفة اصطلاحاً بمعادلات CSE) لتطويق المعادلة بالأقواس المعقوفة { } وإعلام المحرك بضرورة تفعيل معالجة المصفوفات في الذاكرة. أي تعديل طفيف على الخلية دون إعادة الضغط على هذا الاختصار كان يؤدي فوراً إلى انهيار المعادلة وتوليد أخطاء حسابية شائعة.
علاوة على ذلك، اتسمت معادلات الصفيف التقليدية باستهلاك هائل لموارد وحدة المعالجة المركزية (CPU Throttle)، مما كان يتسبب في تجميد البرنامج وإبطاء حركة التنقل بين أوراق العمل في المصنفات الضخمة. ومع الانتقال إلى البنى الحسابية المعاصرة، أصبحت هذه الحلول جزءاً من تاريخ البرمجة في إكسيل، وحلت محلها تقنيات الانسكاب التلقائي المتطورة مثل TEXTSPLIT و TAKE التي جعلت من استخلاص مقاطع الكلمات عملية بديهية وسريعة وخالية من التعقيد اليدوي.
7. بناء نماذج استخراج ديناميكية مرنة لعدد متغير من الكلمات
7.1 تحويل الثابت العددي (3) إلى مرجع بارامتري متغير
في العديد من البيئات التحليلية المتقدمة، قد لا يكون متطلب استخراج أول “ثلاث كلمات” ثابتاً على الدوام؛ إذ قد يطرأ تغير في قواعد العمل يستلزم استخراج كلمتين فقط، أو أربع كلمات، أو تخصيص العدد وفقاً لكل حالة على حدة. إن الإبقاء على الرقم (3) كقيمة ثابتة مشفرة داخل صلب المعادلة (Hardcoded Value) يمثل ممارسة تصميمية غير محبذة؛ لأنها تجبر المستخدم على تعديل نص المعادلة وإعادة تعميمها يدوياً عند كل تغيير في متطلبات التحليل.
يكمن الحل المنهجي في تحويل هذا الثابت العددي إلى مرجع بارامتري ديناميكي؛ وذلك بتخصيص خلية تحكم مستقلة في ورقة العمل (ولتكن الخلية C1 مثلاً)، وتسميتها “عدد الكلمات المستهدفة”، وإسناد القيمة 3 إليها. بعد ذلك، يتم تعديل المعادلة في عمود الإخراج ليتم ربط وسيطة التكرار بالخلية C1 مع تثبيتها بالمراجع المطلقة لضمان ثباتها أثناء السحب، لتصبح المعادلة: =TEXTBEFORE(TRIM(A2), ” “, $C$1).
يمنح هذا البناء البارامتري مرونة تشغيلية فائقة لورقة العمل؛ حيث تتيح للمستخدم تغيير عدد الكلمات المستخلصة لكامل الجدول الممتد عبر آلاف الصفوف بمجرد تعديل الرقم المكتوب في الخلية C1 إلى 2 أو 4 أو 5، ليقوم إكسيل بإعادة احتساب الجدول كاملاً بصورة فورية وتفاعلية، دون الحاجة للتدخل في بناء المعادلات أو المساس بالبنية البرمجية المستقرة للمصنف.
7.2 التحقق الشرطي من طول الجملة قبل الاستخراج الديناميكي
لضمان أعلى درجات الرصانة الرياضية في النماذج الديناميكية، يفضل تضمين خوارزمية فحص شرطي استباقية تتحقق من إجمالي عدد الكلمات الموجودة فعلياً في الجملة قبل إصدار أمر الاقتطاع. يمكن تحقيق ذلك بالاعتماد على التكتيك الرياضي الشهير لحساب عدد الكلمات في الخلية عبر مقارنة طول النص الإجمالي بطول النص بعد تفريغه من المسافات، وذلك باستخدام دالتي LEN و SUBSTITUTE وفق المعادلة: LEN(TRIM(A2)) – LEN(SUBSTITUTE(TRIM(A2), ” “, “”)) + 1.
يُمثل ناتج هذه المعادلة العدد الدقيق للمفردات المعجمية داخل الخلية A2. وبناءً على ذلك، يتم دمج هذا المعيار داخل دالة IF الشرطية؛ لمقارنة عدد الكلمات الفعلي بالقيمة المرجعية المحددة في خلية التحكم C1. فإذا كان عدد كلمات الجملة أكبر من أو يساوي الرقم المستهدف، تمضي الدالة في تنفيذ عملية استخراج المقاطع الجزئية عبر TEXTBEFORE؛ أما إذا كان عدد الكلمات أقل، يتولى الفرع الشرطي توجيه البرنامج للتعامل الاستباقي مع الحالة.
تتم كتابة هذه الصيغة المتقدمة لحماية التدفق الحسابي على النحو التالي: =IF((LEN(TRIM(A2))-LEN(SUBSTITUTE(TRIM(A2),” “,””))+1) >= $C$1, TEXTBEFORE(TRIM(A2), ” “, $C$1), TRIM(A2)). يضمن هذا النهج الدفاعي عدم حدوث أي انكسار برمجي، ويقدم للمحلل مخرجات نظيفة تلبي الشروط الرياضية المحددة، مما يجعل النموذج مؤهلاً للاستخدام في تقارير الأعمال المعقدة دون خوف من حدوث انزياحات غير مرصودة.
7.3 تصميم قوائم منسدلة لتحديد حجم المقطع المستخلص
للارتقاء بتجربة المستخدم (User Experience) وتحويل جدول البيانات إلى أداة تحليل تفاعلية تشبه التطبيقات البرمجية، يمكن ربط خلية التحكم البارامترية (C1) بأدوات التحقق من صحة البيانات (Data Validation). يتيح هذا الدمج منع المستخدم من إدخال قيم عشوائية أو سالبة أو نصوص لا تصلح كمعايير عددية، وحصر خياراته في نطاق منطقي محدد سلفاً.
يتم ذلك عبر تحديد الخلية C1، والتوجه إلى علامة التبويب “بيانات” (Data)، واختيار “التحقق من صحة البيانات”، وتعيين نمط الإدخال ليكون “قائمة” (List)، ثم كتابة القيم المسموح بها مفصولة بفاصلة، مثل: 1, 2, 3, 4, 5. ينتج عن هذا الإجراء ظهور سهم قائمة منسدلة أنيق داخل الخلية، يتيح للمحلل بنقرة زر واحدة التبديل السلس بين استخراج الكلمة الأولى، أو أول كلمتين، أو أول ثلاث كلمات وهكذا دواليك.
يعمل هذا التكامل بين أدوات التحكم البصري والصيغ النصية الديناميكية على تحسين بيئة صنع القرار المؤسسي؛ حيث يمكن لمديري المشاريع والمحللين استعراض سيناريوهات متعددة لتجزئة العناوين أو تصنيف العملاء وتحديث الرسوم البيانية التابعة لها بشكل فوري ولحظي، مما يرفع من القيمة الوظيفية للمصنف ويجعله نموذجاً عالي الاحترافية يجمع بين دقة الحساب وسهولة الاستخدام المكتبي.
8. الوسائل التفاعلية والأدوات غير البرمجية لاستخراج الكلمات
8.1 تطبيق ميزة التعبئة السريعة (Flash Fill) لاستنتاج النمط
إلى جانب الحلول القائمة على المعادلات الحسابية، يتضمن إكسيل أدوات ذكاء اصطناعي تفاعلية مدمجة قادرة على استنتاج الأنماط النصية بصورة مستقلة، وتأتي أداة التعبئة السريعة (Flash Fill) في طليعة هذه الوسائل. ترتكز هذه الأداة على خوارزميات الاستقراء النمطي والتعلم القائم على الأمثلة؛ حيث تراقب تصرفات المستخدم وتستنبط القاعدة التحويلية التي يرغب في تطبيقها على بقية السجلات دون الحاجة لكتابة معادلة واحدة.
لتطبيق هذه الميزة لاستخراج أول ثلاث كلمات، يقوم المستخدم بكتابة الكلمات الثلاث الأولى يدوياً وبدقة تامة في الخلية الأولى من عمود الإخراج (B2)، مقتطعة من الخلية المجاورة (A2). بعد الضغط على مفتاح الإدخال، ينتقل إلى الخلية (B3) ويبدأ في كتابة الكلمات الثلاث المقابلة، وهنا سيتعرف محرك التعبئة السريعة على النمط الرياضي فوراً، ويعرض تلميحاً ظلياً باللون الرمادي لكامل العمود متضمناً أول ثلاث كلمات من كل صف. يكفي حينها الضغط على مفتاح Enter لاعتماد المخرجات فوراً، أو يمكن تشغيلها مباشرة عبر اختصار لوحة المفاتيح الشهير Ctrl + E.
على الرغم من السرعة المذهلة والبساطة الظاهرة لهذه التقنية، إلا أنها تنطوي على محدودية جوهرية تجعلها غير صالحة للنماذج الديناميكية الدائمة؛ فالمخرجات الناتجة عن التعبئة السريعة هي نصوص صامتة وثابتة (Static Text) وليست صيغاً حية. هذا يعني أن أي تعديل أو تصحيح يطرأ لاحقاً على النص الأصلي في العمود (A) لن ينعكس إطلاقاً على العمود المستخلص (B)، مما يقطع الرابط التفاعلي بين البيانات ويستوجب إعادة تشغيل الأداة يدوياً مع كل تحديث بياني.
8.2 استخدام أداة تحويل النص إلى أعمدة (Text to Columns)
تُمثل أداة تحويل النص إلى أعمدة (Text to Columns) واحدة من أقدم وأقوى الأدوات الإجرائية المدمجة في بيئة إكسيل المخصصة لتفكيك السلاسل المركبة. تعتمد هذه الأداة على تجزئة محتويات الخلية المصدرية وتوزيعها أفقياً على عدة أعمدة متتالية بالاعتماد على فاصل محدد، وهو المسافة الفارغة في سياق معالجة المفردات اللغوية.
يتم تفعيل الأداة بتحديد العمود المصدر كاملاً، ثم التوجه إلى شريط الأدوات واختيار “النص إلى أعمدة” من تبويب “بيانات”، وتحديد خيار “محدد” (Delimited)، ثم تفعيل خانة “المسافة” (Space) كمحدد وحيد للتجزئة. عند المتابعة، سيقوم البرنامج بنشر كل كلمة في عمود منفصل؛ لتستقر الكلمة الأولى في العمود (B)، والكلمة الثانية في العمود (C)، والكلمة الثالثة في العمود (D)، بينما تتوزع بقية الكلمات على الأعمدة اللاحقة.
لإعادة تجميع هذه الكلمات الثلاث الأولى في حقل نهائي موحد، يتطلب الأمر خطوة متممة عبر استخدام دالة الدمج الحديثة TEXTJOIN، وذلك بكتابة الصيغة: =TEXTJOIN(” “, TRUE, B2:D2) داخل العمود المستهدف، والتي تقوم بإعادة ضم الكلمات الثلاث مفصولة بمسافة واحدة مع إهمال الخلايا الفارغة. ورغم فاعلية هذا النهج في المشروعات التحويلية الشاملة، إلا أنه يتطلب تنظيفاً يدوياً للأعمدة الزائدة المستحدثة، مما يجعله خياراً معقداً نسبياً مقارنة بالدوال المباشرة المنجزة للمهمة في خطوة واحدة.
8.3 تقييم مخاطر الحلول اليدوية على نزاهة واتساق البيانات
ينطوي الاعتماد على الأدوات الإجرائية اليدوية كالتعبئة السريعة وتقسيم الأعمدة على مخاطر حقيقية تمس حوكمة ونزاهة قواعد البيانات داخل المؤسسات؛ فالطبيعة غير الديناميكية لهذه الأدوات تجعلها عرضة لفقدان المزامنة فور قيام فرق العمل بإضافة صفوف جديدة في أسفل المصنف، حيث تبقى الصفوف الجديدة فارغة تماماً دون أي استخلاص، مما يولد ثغرات خطيرة في اتساق التقارير التحليلية.
علاوة على ذلك، ترتفع احتمالية الخطأ البشري بصورة ملحوظة عند استخدام ميزة التعبئة السريعة تحديداً؛ إذ قد تفشل الخوارزمية في إدراك الحالات الاستثنائية كالجمل التي تحتوي على علامات ترقيم خاصة أو أرقام، فتولد مخرجات خاطئة دون أن ينتبه المستخدم لوجود هذا الانحراف ما لم يقم بمراجعة بصرية مضنية لمئات الصفوف. هذا القصور يجعل من المستحيل استخدام هذه الوسائل في البيئات الأكاديمية أو الأنظمة الحسابية الحساسة التي تتطلب تدقيقاً حسابياً مؤتمتاً وموثوقاً.
وبناءً على هذه التحديات، يجمع خبراء هندسة البيانات على ضرورة حصر استخدام الأدوات السريعة وغير البرمجية في مهام المعالجة السريعة العارضة (Ad-hoc Tasks) التي تُنفذ لمرة واحدة فقط لغايات الاستكشاف الأولي. أما في بناء النماذج التشغيلية المعتمدة ومصنفات الإنتاج المؤسسي، فيظل الاعتماد الصارم على المعادلات الرياضية الديناميكية هو الخيار الوحيد الذي يضمن السلامة والاتساق الكامل لقواعد البيانات عبر الزمن.
9. الأتمتة المتقدمة للمعالجة النصية عبر Power Query ولغة VBA
9.1 استخلاص الكلمات الثلاث الأولى باستخدام محرر Power Query
يُمثل محرر الاستعلامات المتقدم Power Query الأداة المعيارية لهندسة استخراج وتحويل وتحميل البيانات (ETL) داخل منظومة إكسيل الحديثة. يوفر هذا المحرك بيئة معالجة استثنائية تنفصل عن واجهة ورقة العمل المباشرة، مما يجعله قادراً على التعامل مع ملايين السجلات النصية دون التأثير على استقرار وسرعة المصنف، مع ميزة التحديث التلقائي لكافة مسارات المعالجة بمجرد النقر على زر “تحديث” (Refresh).
لتنفيذ عملية استخلاص أول ثلاث كلمات في بيئة Power Query، يتم أولاً تحويل نطاق البيانات إلى جدول رسمي ثم استيراده إلى المحرر عبر خيار “من جدول/نطاق” (From Table/Range). داخل نافذة المحرر، يتم تحديد عمود النص، والتوجه إلى تبويب “إضافة عمود” (Add Column)، ثم النقر على أداة “استخراج” (Extract) واختيار “النص قبل المحدد” (Text Before Delimiter). في النافذة المنبثقة، يتم تعيين المحدد ليكون مسافة فارغة واحدة، ومن خيارات الفحص المتقدمة يتم ضبط تكرار المحدد على القيمة (3)، مع توجيه المحرك للبحث انطلاقاً من بداية النص.
كما يمكن للمحترفين كتابة هذه العملية مباشرة عبر لغة الصيغ المتقدمة (M Code) لضمان أقصى درجات التحكم في التعامل مع الأخطاء؛ حيث تُصاغ الخطوة باستخدام دالة Text.BeforeDelimiter البرمجية بالشكل التالي: Text.BeforeDelimiter([TextColumn], ” “, 2) مع مراعاة أن مؤشر الفهرسة في لغة M يبدأ من الصفر (Zero-based Indexing)، ولذلك يمثل الرقم 2 الظهور الثالث الفعلي للمسافة. تُعد هذه الطريقة الخيار الأمثل على الإطلاق عند بناء مسارات تحويل بيانات مؤتمتة تُسحب دورياً من قواعد بيانات خارجية.
9.2 برمجة دالة مخصصة (UDF) بواسطة Visual Basic for Applications
في بيئات العمل التي تتطلب توافقاً تاماً مع إصدارات إكسيل القديمة جنباً إلى جنب مع الرغبة في البساطة الدلالية للدوال الحديثة، تبرز لغة البرمجة النصية فيجوال بيسك للتطبيقات (VBA) كحل جذري عبر إنشاء “دالة معرفة من قِبل المستخدم” (User Defined Function – UDF). تتيح هذه الدالة صياغة خوارزمية مستقلة في محرر الأكواد واستدعائها داخل أي خلية في ورقة العمل بنفس طريقة استدعاء الدوال الجاهزة.
يتم فتح محرر الأكواد بالضغط على مفاتيح Alt + F11، وإدراج وحدة نمطية جديدة (Standard Module)، ثم كتابة الكود البرمجي الذي يستقبل النص كمعلمة إدخال، ويقوم بتطهيره وتفكيكه داخلياً. تعتمد الخوارزمية البرمجية على استخدام دالة Application.Trim لتنقية النص من المسافات الزائدة، تليها دالة Split البرمجية التي تقوم فوراً بتقسيم السلسلة عند كل مسافة وتخزين الكلمات في مصفوفة أحادية البعد مفهرسة تبدأ من الصفر.
يقوم الكود بعد ذلك بفحص حجم المصفوفة الناتجة بحذر ودفاعية برمجية؛ فإذا كان حجم المصفوفة يحتوي على ثلاثة عناصر على الأقل، يتم تجميع العناصر الثلاثة الأولى (ذات الفهارس 0 و 1 و 2) وإعادة دمجها بمسافات عبر دالة Join أو التجميع المتسلسل، أما إذا كانت الجملة أقصر من ذلك، فيقوم الكود بإرجاع النص كاملاً دون توليد أخطاء. وبمجرد حفظ المصنف بصيغة تدعم وحدات الماكرو (.xlsm)، يصبح بمقدور أي مستخدم كتابة الصيغة البسيطة: =ExtractFirst3Words(A2) لتعمل بكفاءة مطلقة في أي إصدار من إكسيل.
9.3 مقارنة الأداء الحسابي في بيئات قواعد البيانات الضخمة
تتفاوت التقنيات البرمجية والحسابية في استهلاك موارد الجهاز وإدارة الذاكرة العشوائية (RAM) وسرعة استجابة المعالج، خاصة عند التعامل مع جداول البيانات الضخمة المليونية (Big Data Sheets). إن إجراء مقارنة أداء دقيقة يسهم في تمكين مهندسي البيانات من اختيار الأداة المناسبة وفقاً لحجم السجلات وطبيعة البيئة التشغيلية للمصنف المؤسسي.
تتفوق بيئة Power Query تفوقاً كاسحاً في الملفات المليونية؛ حيث تعتمد على محرك معالجة داخلي شديد التطور يعمل بتقنية الضغط العمودي للبيانات (VertiPaq Engine) ويستغل كافة خيوط المعالجة المتوازية (Multi-threading). هذا يعني أن تجزئة مليون صف نصي عبر Power Query تستهلك ثوانٍ معدودة ولا تؤدي إلى تجميد البرنامج، في حين أن كتابة صيغ مصفوفية أو دوال نصية حية في مليون خلية داخل ورقة العمل مباشرة سيؤدي حتماً إلى استهلاك الذاكرة كلياً وشلل تام في استجابة المصنف أثناء عمليات إعادة الاحتساب (Recalculation).
من ناحية أخرى، تقع الدوال المخصصة بلغة VBA في مرتبة متوسطة من حيث السرعة؛ إذ تُنفذ في بيئة أحادية الخيط (Single-threaded Execution)، مما يجعلها أبطأ نسبياً من محرك Power Query وأبطأ من دوال C++ الأصلية المدمجة في إكسيل مثل TEXTBEFORE. وبناءً على ذلك، تنص المعايير الهندسية على حصر استخدام الصيغ والدوال المباشرة في الجداول التي لا تتجاوز بضع عشرات الآلاف من الصفوف لضمان السلاسة، والانتقال الإلزامي نحو Power Query بمجرد الدخول في نطاق البيانات المؤسسية الضخمة المتدفقة باستمرار.
10. معايير الجودة والحوكمة في إدارة ومعالجة السلاسل النصية
10.1 بروتوكولات التحقق الأكاديمي من صحة وسلامة النصوص المستخرجة
تقتضي معايير الحوكمة وضمان الجودة في إدارة البيانات إخضاع كافة عمليات الاستخراج النصي لبروتوكولات تحقق صارمة وموثقة؛ للتأكد من خلو المخرجات من أي انزياحات دلالية أو تشوهات معجمية ناتجة عن استثناءات غير مرئية. لا يجوز في العمل الأكاديمي أو المالي الركون إلى الفحص النظري العابر، بل يتعين تطبيق منهجيات تدقيق إحصائي واستدلالي على امتداد دورة حياة البيانات داخل النظام.
يشمل البروتوكول الأول تصميم عينات فحص عشوائية طبقية (Stratified Random Sampling) من مختلف أجزاء الجدول؛ حيث يتم اختيار نسب مئوية محددة من السجلات وإخضاعها للمراجعة الدقيقة. كما يتم توظيف دوال المطابقة المنطقية الصارمة، مثل دالة EXACT لمقارنة عينات الاستخراج مع نصوص معيارية مُعالجة مسبقاً، للتأكد من تطابق الأحرف والمسافات بنسبة مئة بالمئة وعدم سقوط أي أحرف أو علامات خاصة أثناء المعالجة الحسابية.
يتكامل هذا الإجراء مع تفعيل قواعد التنسيق الشرطي (Conditional Formatting) الاستباقية؛ حيث يتم إنشاء قواعد شرطية تقوم بتمييز وتلوين أي خلية في عمود الإخراج تنتج نصاً فارغاً، أو تحتوي على محارف غير متوقعة، أو تظهر فيها رموز الأخطاء، أو يقل طولها النصي عن حد معين. تمنح هذه التنبيهات البصرية محلل البيانات القدرة على التدخل الفوري وتعديل مسار الدوال قبل اعتماد التقارير النهائية وتصديرها إلى الجهات المستفيدة.
10.2 توثيق النماذج الحسابية وصيانة أوراق العمل المؤسسية
يُمثل التوثيق الهندسي عنصراً حاسماً في استدامة وصيانة نماذج إكسيل داخل المؤسسات؛ إذ غالباً ما تؤدي مغادرة المحلل الذي صمم المعادلة إلى عجز بقية أعضاء الفريق عن فهم الصيغ المعقدة أو تعديلها بأمان. إن توثيق كل خطوة إجرائية يضمن استمرارية الأعمال وحماية الملكية الفكرية والتشغيلية للمؤسسة.
يتعين على المحلل كتابة تعليقات وملاحظات توضيحية داخل الخلايا ذاتها (Cell Notes / Comments) لشرح الغرض الوظيفي من استخدام دالة TEXTBEFORE أو دمج دالة TRIM، مع توضيح الدلالة الرياضية للرقم (3) كمعيار لاقتطاع المسافة الثالثة. كما يفضل تخصيص ورقة عمل مستقلة في مقدمة المصنف تسمى “دليل البيانات” (Data Dictionary / ReadMe)، تتضمن بياناً شاملاً لكافة الأعمدة، ومصادر البيانات الخام، والإصدار الأدنى المطلوب لتشغيل البرنامج بكفاءة.
علاوة على ذلك، يجب التحقق المستمر من التوافقية العكسية (Backward Compatibility)؛ فإذا كان المصنف سيُتداول بين فروع أو أجهزة تستخدم إصدارات متنوعة من إكسيل، يتوجب توثيق مسار العمل البديل بشكل واضح، وتوضيح أن الدالة المدمجة قد تتحول إلى صيغ غير معرفة في الإصدارات القديمة، وتضمين الحل الكلاسيكي البديل أو كود VBA الجاهز لضمان استمرار عمل النماذج في كافة البيئات التقنية المشغلة دون انقطاع.
10.3 إرشادات التحسين المستمر لمعالجة وتحليل البيانات الضخمة
للحفاظ على أعلى درجات الكفاءة التشغيلية، يجب أن تخضع نماذج معالجة البيانات لمراجعات دورية تهدف إلى التحسين والتطوير المستمر. تبدأ هذه الإرشادات بضرورة تحويل النطاقات النصية العادية إلى جداول إكسيل رسمية (Excel Tables) باستخدام الاختصار Ctrl + T؛ حيث توفر الجداول الرسمية خاصية مراجع الأعمدة الهيكلية (Structured References) والتمدد التلقائي للمعادلات بمجرد إدخال صفوف جديدة، مما يلغي تماماً الحاجة لسحب المعادلات يدوياً.
كما يُنصح بالحد من استخدام الدوال المتقلبة (Volatile Functions) داخل نفس أوراق العمل التي تتضمن معالجة نصوص مكثفة؛ حيث تجبر هذه الدوال محرك البرنامج على إعادة احتساب كامل الورقة مع أي حركة أو نقرة يقوم بها المستخدم، مما يثقل الجهاز بلا طائل. إن التركيز على الدوال المستقرة والموجهة حصرياً للمحددات المطلوبة يحافظ على سلاسة المعالجة ويقلل من استهلاك موارد النظام.
أخيراً، فور الانتهاء من مراجعة وتدقيق عمليات الاستخراج واعتماد صحة الكلمات الثلاث المستخلصة في المشروعات غير المتغيرة دورياً، يُفضل تطبيق استراتيجية تجميد النتائج عبر “نسخ عمود المخرجات ولصقه كقيم” (Paste as Values). يؤدي هذا الإجراء التطهيري إلى استبدال الصيغ الحسابية بنصوص قطعية ثابتة، مما يزيل عبء المعالجة عن المصنف نهائياً، ويقلص حجم الملف، ويمنع حدوث أي أخطاء مستقبلية قد تنتج عن تعديل أو حذف البيانات في العمود المصدر، مع الاحتفاظ بنسخة احتياطية من المصنف الحسابي الأصلي للأغراض التوثيقية.
خاتمة
استعرضت هذه الدراسة الإجرائية المتكاملة الأبعاد النظرية والتطبيقية لعملية استخراج أول ثلاث كلمات من خلية في برنامج مايكروسوفت إكسيل، مبرزةً التحول النوعي من المعالجة الصامتة المعتمدة على عدد الحروف إلى المعالجة المعجمية الذكية المرتكزة على الحدود الفاصلة للمفردات اللغوية. إن ظهور دالة TEXTBEFORE ضمن إصدارات Microsoft 365 الحديثة قد وفر حلاً رياضياً وهندسياً متقدماً يتسم بالأناقة البرمجية والسرعة الفائقة، مستبعداً التعقيدات الكلاسيكية التي عانت منها أجيال المحللين لعقود طويلة عند صياغة الدوال التجميعية المتداخلة.
وقد تبين بوضوح أن النجاح المطلق لعمليات الاقتطاع النصي لا يتوقف على كتابة الصيغة المجردة فحسب، بل يرتكز بالأساس على جودة بروتوكولات التطهير المسبق باستخدام دوال التنقية مثل TRIM و CLEAN واستبدال الرموز غير المرئية، وإقران المعادلات بطبقات الحماية الدفاعية كدالة IFERROR والوسائط المعيارية للتعامل مع النصوص القصيرة. كما وفرت البدائل المتقدمة عبر محرر Power Query ولغة البرمجة VBA مسارات أتمتة فائقة القوة تتيح للمؤسسات حوكمة ومعالجة قواعد البيانات الضخمة بدقة واتساق دون استنزاف موارد الأنظمة الحسابية.
إن إتقان هذه المهارات والتقنيات المتكاملة يمثل إضافة نوعية لا غنى عنها لأي محلل بيانات أو باحث يسعى لإدارة وتجهيز السجلات النصية باحترافية عالية. وباتباع المنهجيات والضوابط الموثقة في هذا الدليل، يصبح بمقدور المستخدمين تحويل البيانات النصية الخام إلى مخرجات مهيكلة وموحدة تسهم بصورة فاعلة في تحسين التقارير التحليلية ودعم اتخاذ القرار المؤسسي الرشيد.
المراجع
- Microsoft Corporation. (2024). TEXTBEFORE function. Microsoft Support. https://support.microsoft.com/en-us/office/textbefore-function-d099c2e7-113f-4f70-ace2-4e0ad8627031
- Microsoft Corporation. (2024). TRIM function. Microsoft Support. https://support.microsoft.com/en-us/office/trim-function-410388fa-c5df-49c6-b16c-9e5630b479f9
- Microsoft Corporation. (2024). Split text into different columns with functions. Microsoft Support. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-functions-49ec97f9-b570-4bc2-86ee-11d2fc50e104
- Microsoft Corporation. (2024). Power Query Text functions reference. Microsoft Learn. https://learn.microsoft.com/en-us/powerquery-m/text-functions
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.
- Alexander, M., & Kusleika, R. (2019). Excel 2019 Power Programming with VBA. John Wiley & Sons.