
تُعد جداول البيانات الإلكترونية، وفي طليعتها منصة جداول بيانات جوجل (Google Sheets)، من الركائز التقنية الأساسية التي يعتمد عليها الباحثون ومحللو البيانات في مختلف الحقول المعرفية والتطبيقية. وتكتسب هذه الأدوات أهميتها من قدرتها الفائقة على تجميع وتصنيف واستقراء المتغيرات المتعددة عبر معادلات خوارزمية مرنة؛ إلا أن التعامل مع البيانات النوعية والنصية غالباً ما يفرض تحديات منهجية تتجاوز الحسابات العددية البسيطة. ومن أبرز هذه التحديات مسألة التمييز بين الحالات المختلفة للأحرف اللاتينية (الحروف الكبيرة والصغيرة)، وهي السمة المعروفة برمجياً بحساسية حالة الأحرف (Case Sensitivity). يمثل إغفال هذا التمايز مدخلاً للانحرافات الإحصائية والأخطاء التحليلية الجسيمة، لا سيما في البيئات البحثية الصارمة كترميز السلوكيات النفسية، والأبحاث الجينية، وتوليد المعرفات الفريدة لقواعد البيانات الميدانية.
تعتمد النظم البرمجية التقليدية في حزم الجداول الحسابية، افتراضياً، على منطق التوحيد القياسي للنصوص بهدف تيسير استرجاع المعلومات والحد من التشتت الناتج عن تباين أساليب الإدخال اليدوي. تبرز دالة العد الشرطي القياسية COUNTIF كنموذج صريح لهذه الفلسفة؛ إذ تقوم بمعاملة النصوص ذات التركيب الهجائي المتشابه كمتطابقات كلية بغض النظر عن نسق التحرير. يترتب على هذا التسامح الخوارزمي دمج فئات متباينة جوهرياً تحت مظلة تصنيفية واحدة، مما يؤدي إلى تضخيم غير واقعي لبعض المؤشرات الإحصائية وتشويه العلاقات الارتباطية بين المتغيرات المستقلة والتابعة. ومن هنا، تنشأ الحاجة البحثية الملحة إلى تجاوز القيود البنيوية للدوال الجاهزة وتطوير استراتيجيات برمجية مركبة تكفل استرداد الدقة الوصفية للمصفوفات النصية دون الإخلال بسلامة البناء الرياضي للجداول الحسابية.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك وتحليل آليات العد الشرطي الحساس لحالة الأحرف داخل بيئة جداول بيانات جوجل. سنستعرض الأسس النظرية للمطابقة النصية الصارمة، ونناقش المحدوديات الفنية التي تكتنف الدوال الكلاسيكية، ثم ننتقل إلى تأسيس الحل الرياضي المتقدم القائم على المزج التكاملي بين مصفوفات دالة SUMPRODUCT والتعبيرات النمطية لدالة REGEXMATCH، إضافة إلى المناهج التنافسية مثل EXACT وARRAYFORMULA وFILTER. وسيتطرق التحليل أيضاً إلى مناهج تصحيح الأخطاء، وحوكمة تدفق البيانات، وإدارة كفاءة الذاكرة الحسابية في المشاريع الضخمة، بما يضمن للممارس الأكاديمي والمحلل المتخصص امتلاك رؤية منهجية متكاملة تضمن أعلى مستويات الصدق والموثوقية في استخراج المؤشرات الكمية من البيانات النوعية المعقدة.
1. الأسس النظرية لعمل الدوال الإحصائية والشرطية في جداول بيانات جوجل
1.1 بنية الدوال الشرطية ودورها في إدارة البيانات الحسابية والنصية
تمثل الدوال الشرطية في الحوسبة الجدولية العمود الفقري لعمليات الفرز والتصفية والتلخيص الآلي، حيث تقوم بإخضاع كل عنصر ضمن نطاق بياني معين لتقييم ثنائي يعتمد على مخرجات جبر المنطق البولياني (Boolean logic). في سياق معالجة البيانات، تتحدد وظيفة هذه الدوال في فرز المتغيرات إلى فئات متمايزة بالاعتماد على محددات معيارية محددة سلفاً. لا تقتصر هذه الآلية على البيانات الكمية التي يسهل إخضاعها للمتباينات الرياضية (مثل أكبر من، أصغر من، أو يساوي)، بل تمتد لتشمل البنى النصية المعقدة التي تتطلب مضاهاة متسلسلة للمحارف الأبجدية، مما يفرض على المنصة الحسابية تفسير السلاسل الرمزية عبر قوالب منطقية دقيقة.
تنطلق الفلسفة التصميمية لمنصة جداول بيانات جوجل من تسهيل تجربة المستخدم العادي، وهو ما دفع مطوري المنصة إلى تفضيل المرونة الاسترجاعية على الصرامة المعجمية في الدوال الشائعة. فعند تمرير نص معين كشرط للاحتساب، تُجري المنصة معالجة تمهيدية تقوم على تجريد السلسلة النصية من خصائصها الشكلية المتقدمة لضمان شمولية المخرجات. هذا التوجه، رغم فائدته في منع إغفال المدخلات العفوية في الاستبانات المفتوحة، يشكل معضلة منهجية كبرى في أبحاث العلوم الاجتماعية والطبية التي تعتمد على نظم ترميزية بالغة الدقة؛ حيث يؤدي خفض معايير المطابقة إلى فقدان القدرة على رصد التمايزات الدقيقة بين المتغيرات النصية المستقلة، ويقود بالتالي إلى أخطاء في التوصيف الإحصائي الكلي.
1.2 مفهوم حساسية حالة الأحرف (Case Sensitivity) في النظم الرقمية
يرتكز التمييز بين الحروف اللاتينية الكبيرة (Uppercase) والصغيرة (Lowercase) على أصول معمارية تعود إلى فجر ترميز البيانات الرقمية، وتحديداً معيار الشفرة القياسية الأمريكية لتبادل المعلومات (ASCII). في هذا النظام، يُخصص لكل حرف رقم ثنائي فريد؛ فعلى سبيل المثال، يُمثل الحرف الكبير A بالقيمة العشرية 65، بينما يُمثل الحرف الصغير a بالقيمة 97. هذا الاختلاف الرقمي الجذري يعني أن الأنظمة الحاسوبية في مستواها المادي المنخفض لا ترى تشابهاً عضوياً بين الحرفين، بل تتعامل معهما ككيانين منفصلين تماماً، ولا يتم إقرار التماثل بينهما إلا عبر خوارزميات برمجية عليا تعمل على تحويل النصوص قسرياً إلى نسق موحد قبل إجراء عمليات المقارنة المنطقية.
تكتسب هذه الحساسية النصية أهمية محورية في سياقات البحث العلمي والتطبيقات الميدانية. ففي البحوث النفسية والمسوح السلوكية، غالباً ما تُستخدم اختصارات نصية متباينة الحالات لترميز استجابات نوعية مختلفة؛ كأن يُخصص الرمز Pos للدلالة على السلوك الإيجابي التلقائي بينما يُشير الرمز POS إلى استجابة تنظيمية مقننة. إن غياب الحساسية لحالة الأحرف في أداة التحليل يُسقط هذا الحاجز الدلالي، مما يدمج النمطين في فئة واحدة ويفرغ عملية الترميز من قيمتها التشخيصية. يمتد هذا التأثير إلى ترميز السلاسل الوراثية وتصنيف المركبات الكيميائية، حيث يُحدث التغيير في حالة حرف واحد تحولاً جذرياً في طبيعة العنصر المدروس، مما يبرز التناقض الصريح بين المعالجة التلقائية الساذجة والتطلعات الأكاديمية الصارمة.
1.3 موقع دالة COUNTIF ضمن حزمة الدوال الإحصائية الموجهة
تتموضع دالة COUNTIF ضمن عائلة الدوال الإحصائية الوصفية ذات الاستدعاء الشرطي المفرد، حيث صُممت لحساب تكرار الخلايا التي تستوفي معياراً واحداً ومحدداً ضمن نطاق جدولي مغلق. تتميز الدالة بصيغة استدعاء مباشرة تختزل العمليات الخوارزمية المعقدة في وسيطين أساسيين: النطاق المستهدف (Range) والمعيار الرياضي أو النصي (Criterion). وبفضل بساطتها التركيبية، غدت الدالة الأداة الأكثر شيوعاً في تقييم معدلات الحدوث والتحقق من الترددات البسيطة للمتغيرات التجريبية، متفوقة على عمليات العد اليدوي المعرضة للخطأ البشري.
ومع ذلك، تقف دالة COUNTIF عند حدود كفاءة واضحة عندما تواجه تركيبات نصية تتطلب تحليلاً دلالياً عميقاً. فالمحرك الحسابي للدالة مبرمج لتفسير المعايير النصية عبر آليات التجريد الشكلي، متجاهلاً التمايزات الفرعية المرتبطة بحالة الأحرف، فضلاً عن ارتباكه في معالجة الرموز الخاصة المتشابهة جزئياً إلا إذا استُخدمت معه محارف الهروب البرمجية. هذا القصور يحد من فاعلية الدالة في دراسات التتبع الميداني المتقدمة، ويجعل من استدعائها المباشر دون تعديل مجازفة منهجية تقوض سلامة الاستدلال الإحصائي، وتدفع الباحثين قسراً نحو ابتكار صياغات مصفوفية أكثر نضجاً وقدرة على محاكاة المنطق البحثي الصارم.
2. التحليل الفني لمحدودية دالة COUNTIF القياسية تجاه حالة الأحرف
2.1 السلوك الافتراضي لدالة COUNTIF وتجاهل التباين النصي
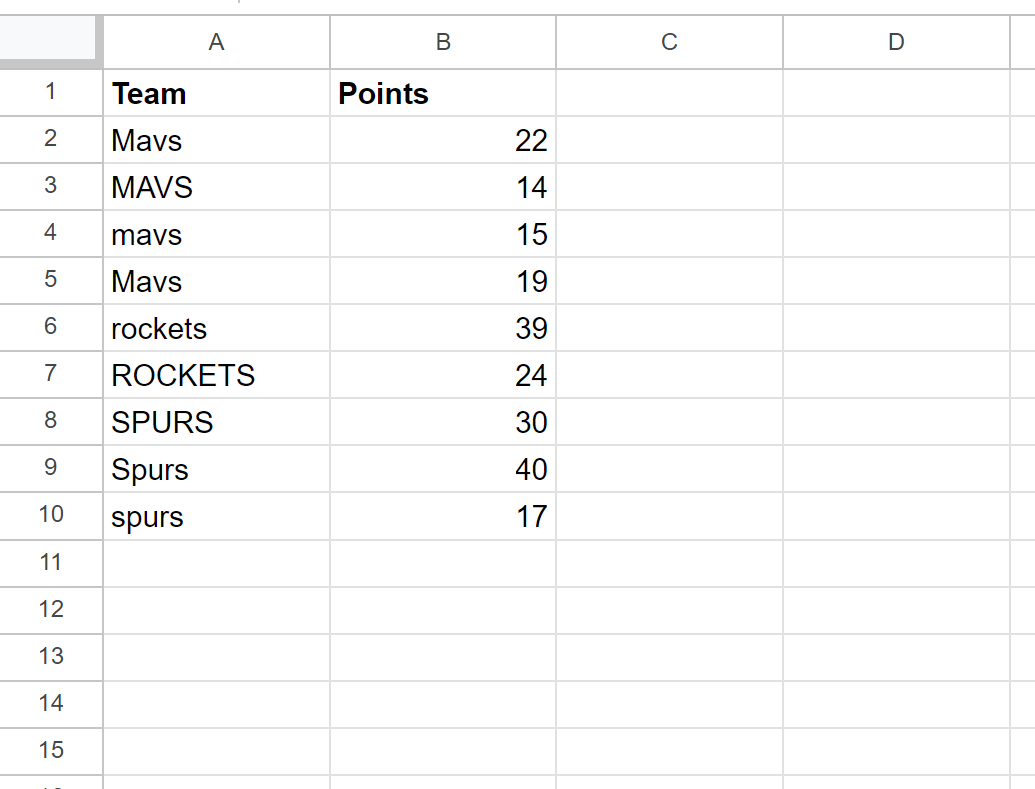
يعتمد السلوك الافتراضي لمحرك دالة COUNTIF في منصة جداول بيانات جوجل على مقارنة النصوص بطريقة غير حساسة لحالة الأحرف (Case-Insensitive Matching). برمجياً، يقوم هذا السلوك على مساواة السلاسل النصية بعد تمريرها ضمنياً على خوارزمية تطابق تُماثل دالة التوحيد الصغير (LOWERCASE)، حيث يتم إسقاط الفروق بين الرموز ذات الترميز العالي والمنخفض. ونتيجة لذلك، إذا اشتمل النطاق البياني على كلمات مثل MAVS وMavs وmavs، فإن تمرير أي منها كمعيار داخل الدالة سينتج عنه احتساب كل هذه الحالات على أنها متطابقة ومحققة للشرط بصورة تامة وبلا تمييز.
تتجلى التبعات المنهجية لهذا التسوية الجبرية في إلغاء التنوع داخل عينات البيانات البحثية. فعندما يرغب الباحث في دراسة توزع استجابات معينة تتباين في شدتها بناءً على اصطلاح رمزي يتخذ من حالة الحرف مؤشراً كمياً أو نوعياً، فإن دالة COUNTIF تطمس هذه الظاهرة كلياً. يتولد عن ذلك قراءات تكرارية مضللة تعطي انطباعاً زائفاً بارتفاع وتيرة ظهور المتغير، في حين أن التكرار الفعلي للنمط المطلوب قد لا يتجاوز جزءاً يسيراً من الحصيلة الإجمالية المعلنة، وهو ما يستدعي تفكيك هذا القصور وتشييد بدائل خوارزمية تتجاوز هذه التسوية المفروضة قسراً على المحلل.
2.2 مخاطر الاعتماد على COUNTIF القياسية في التصنيفات الحساسة
ينطوي الاعتماد غير المنضبط على دالة COUNTIF القياسية في التصنيفات الحساسة على مخاطر جسيمة تمس مصداقية التحليلات الوصفية والاستدلالية. في الأبحاث القائمة على الملاحظة المقننة، يُعد التفريق بين الرموز المتقاربة شكلياً عاملاً حاسماً في ضبط قياسات الصدق التمييزي (Discriminant validity). إن احتساب عناصر خارجة عن التعريف الإجرائي للمتغير المستهدف يؤدي بالضرورة إلى تضخيم الخطأ المعياري من النوع الأول (Type I Error)، حيث يقود التقدير الكمي المنتفخ إلى قبول فرضيات زائفة حول تركز نمط سلوكي معين بين أفراد العينة.
علاوة على ذلك، يمتد هذا التشوه إلى عمليات بناء المعاير وإدارة المستودعات الرقمية، حيث تُستخدم الرموز النصية كأكواد وصول فريدة ترتبط بوحدات قياس ومحددات تفصيلية. فعندما يُخلط بين الكود ID_A والكود id_a، تفقد نظم التحقق الداخلي موثوقيتها، مما يُنتج فوضى في توزيع المؤشرات ويُفرز تقارير تقييمية تتضمن معلومات متناقضة. إن إدراك هذه التحديات يشكل دافعاً أساسياً للباحثين للامتناع عن استخدام الدوال الشائعة دون إخضاعها المسبق لاختبارات التحقق المنهجي من مطابقة الشروط الدقيقة.
2.3 مقارنة مقاربة Google Sheets مع برمجيات الجداول الحسابية الأخرى
لا تنفرد منصة جداول بيانات جوجل بهذا السلوك غير الحساس في دالتها القياسية؛ إذ تتقاسم هذا التوجه مع معظم حزم البرمجيات المكتبية العالمية، وعلى رأسها مايكروسوفت إكسل (Microsoft Excel). يعود هذا التطابق السلوكي التاريخي إلى محاكاة المنصات الحديثة للمعايير التي أرستها برمجيات الجداول المبكرة مثل Lotus 1-2-3، حيث كان الهدف الأسمى آنذاك هو التغلب على تباين كتابة المستخدمين للكلمات وتوحيد النتائج المالية والجدولية الأساسية دون إرهاق ذاكرة المعالجة الحاسوبية المحدودة بمطابقات محرفية معقدة.
ومع ذلك، تبرز جداول بيانات جوجل بميزة معمارية استثنائية مقارنة بالعديد من البرمجيات المنافسة، وتتمثل في مرونتها العالية في معالجة العمليات المصفوفية وتكاملها الطبيعي مع محركات التعبيرات النمطية دون الحاجة إلى تثبيت إضافات خارجية أو كتابة نصوص برمجية معقدة بلغة برمجة التطبيقات (Google Apps Script). هذا الانفتاح الخوارزمي يسمح للمستخدم بابتكار مسارات تدمج دوال معالجة النصوص المنطقية مع أدوات الجمع الحسابي بسلاسة فائقة، متجاوزاً بذلك أوجه القصور الهيكلية للدوال التقليدية دون المساس بسرعة تدفق العمليات الحسابية داخل البيئة السحابية التشاركية.
3. أهمية المطابقة النصية الدقيقة في تحليل البيانات التجريبية والتطبيقية
3.1 ترميز المتغيرات المعقدة في قواعد البيانات الميدانية
في التجارب الميدانية متعددة المراحل، يلجأ الباحثون بصورة مكثفة إلى استراتيجيات الترميز النصي المكثف لتضمين عدة طبقات من المعلومات داخل سلسلة نصية واحدة موجزة. ففي علم النفس التجريبي والبحوث السريرية، يمكن للباحث أن يُشفر مجموعة المتغيرات عبر صيغ مركبة: حيث يُشير الحرف الكبير C إلى المجموعة الضابطة (Control Group) والحرف الصغير c إلى فئة ثانوية خاضعة لتدخل علاجي جزئي. يتيح هذا الترميز إدارة فضاء الجداول الحسابية بكفاءة وتوفير مساحات العرض، ولكنه يتطلب في المقابل آليات حسابية متطورة تمتلك القدرة على قراءة الفروق الطفيفة وتصنيف الحالات بدقة متناهية.
كما تُعد المطابقة الصارمة ضرورة لا غنى عنها عند التعامل مع المعرفات المتسلسلة الفريدة (Unique Identifiers) وأكواد المستجيبين المشفرة بتقنيات الهاش، والتي تُصمم بنيوياً لتكون حساسة لحالة الأحرف لتوسيع فضاء العناوين الممكنة. في هذه النظم، يمثل أي تسامح في قراءة الحالات خرقاً لسلامة الربط العلائقي بين الجداول، وقد يسفر عن تجميع بيانات مستجيبين مختلفين داخل ملف واحد. إن الضبط الرياضي الدقيق لعمليات العد الشرطي يوفر صمام أمان حاسم يمنع التداخل البياني، ويضمن إسناد القياسات الرقمية إلى مصادرها الأصلية الصحيحة دون انزلاق نحو التعميم الخاطئ.
3.2 التدقيق الرياضي المتقدم ومراقبة الجودة الإحصائية
تتطلب عمليات مراقبة الجودة الإحصائية وتنقية البيانات (Data Cleansing) قبل الانخراط في النمذجة المتقدمة تتبعاً دقيقاً لشوائب الإدخال والشذوذ التكراري. غالباً ما تشهد قواعد البيانات المجمعة من مصادر متعددة تشتتاً ناتجاً عن غياب التوحيد الصارم لسلوكيات التدوين؛ كأن يكتب باحث Pending ويكتب آخر pending. في مثل هذه البيئات، تتيح أدوات العد الحساسة للحالة تحديد التردد الدقيق لكل أسلوب إدخال، مما يسهل تشخيص جودة العمل الميداني وقياس نسب الخطأ البشري في توثيق الحالات التجريبية.
فضلاً عن ذلك، يرتبط التحقق من الاتساق الداخلي للبيانات برصد التكرارات الوهمية التي قد تُخفي وراءها ازدواجية في الحساب أو تزييفاً للمدخلات. إذا كانت الأداة الإحصائية غير قادرة على الفصل بين الحالات، فإن مؤشرات موثوقية المقاييس وثباتها الداخلي (مثل معامل ألفا كرونباخ) ستتأثر سلباً بالضجيج الحسابي الناتج عن إدراج قيم غير متكافئة وظيفياً. وعليه، فإن ترقية آليات المضاهاة النصية إلى المستوى الحساس يمثل خطوة منهجية وقائية ترفع من موثوقية نتائج الاختبارات المعلمية واللامعلمية التي تُبنى لاحقاً على هذه المؤشرات الوصفية الأولية.
3.3 إدارة البيانات اللغوية والنصية ذات الطبيعة الحساسة
تفرض حقول معالجة اللغات الطبيعية (NLP) واللسانيات الحاسوبية تحديات فريدة عند تطبيق عمليات الإحصاء الوصفي على المتون النصية داخل جداول البيانات. فالعديد من اللغات التي تستخدم الأبجدية اللاتينية تفرق دلالياً بين الكلمات اعتماداً على حالة الحرف الأول؛ فالكلمة التي تبدأ بحرف كبير قد تدل على اسم علم أو موقع جغرافي (Proper Noun)، في حين تدل نفس الكلمة المكتوبة بحروف صغيرة على اسم جنس عام أو فعل مجرد (مثل May كشهر أو اسم علم مقابل may كفعل مساعد يفيد الاحتمال).
إن تجاهل هذه الفروق عند إحصاء الترددات اللفظية يقود إلى نتائج بحثية مشوهة تماماً تخل بالدراسات الدلالية واستكشاف الأنماط اللغوية. وبالمثل، في القياسات الفيزيائية والحسابية الميدانية، يُحدث الفرق بين السوابق المتفق عليها دولياً تغيراً في رتبة المقدار بمليارات الأضعاف، حيث يُشير الحرف الكبير M إلى الميجا (عشرة أس ستة) بينما يُشير الحرف الصغير m إلى الميلي (عشرة أس سالب ثلاثة). تقتضي إدارة هذه البيانات اعتماد صياغات منطقية لا تقبل المساومة على نمط الحرف، لضمان استقرار التحليلات وصونها من الأخطاء التفسيرية الجسيمة.
4. الهيكلية الرياضية لحل المسألة: دمج دالتي SUMPRODUCT و REGEXMATCH
4.1 الأساس النظري لدالة SUMPRODUCT في التعامل مع المصفوفات
تُعد دالة SUMPRODUCT من أقوى الدوال الحسابية متعددة الاستخدامات في جداول بيانات جوجل، إذ يرتكز أساسها النظري على نظرية المصفوفات والجبر الخطي. صُممت الدالة أساساً لتلقي مصفوفات متناظرة الأبعاد، وإجراء عملية ضرب متناظر بين العناصر المتطابقة في المواقع، ثم جمع حواصل الضرب تلك لإنتاج قيمة عددية مفردة (Scalar). تكمن القوة الاستثنائية لهذه الدالة في قدرتها الذاتية على معالجة النطاقات كمصفوفات دون الحاجة إلى تشغيل بروتوكولات الإدخال المصفوفي الخاصة أو المعقدة، مما يمنحها استقراراً تنفيذياً عالياً في البيئة الحسابية.
في سياق المشكلات الشرطية المتقدمة، لا تقتصر مدخلات SUMPRODUCT على الأرقام الصرفة، بل تمتد لتستوعب المصفوفات المنطقية الناتجة عن عمليات التقييم الشرطي. عند تغذية الدالة بمصفوفة تحتوي على قيم منطقية ثنائية (TRUE وFALSE)، يتم تحويل هذه القيم عبر العمليات الحسابية الضمنية إلى تمثيل رقمي قياسي؛ حيث تُعامل القيمة TRUE كواحد صحيح (1)، في حين تُعامل القيمة FALSE كصفر (0). تتيح هذه الميزة البنيوية استخدام الدالة كجامع تراكمي دقيق للأحداث التي تحقق الشروط المعقدة، متجاوزة القصور الذاتي لدوال الجمع والعد الشرطي الكلاسيكية.
4.2 الآلية الوظيفية لدالة REGEXMATCH في تعقب الأنماط النصية
تستند دالة REGEXMATCH إلى محرك التعبيرات النمطية القياسي، وهو نظام خوارزمي متطور مخصص لمسح السلاسل النصية ومطابقتها وفق قواعد اصطلاحية بالغة الدقة. تتميز هذه الدالة بخاصية محورية تميزها عن غالبية الدوال النصية الأخرى في جداول جوجل، وهي الحساسية الصارمة لحالة الأحرف افتراضياً. فعند استدعاء الدالة وتزويدها بنص هدف ونمط بحثي محدد، فإنها لا تقر بالوجود إلا إذا تطابقت أحرف النمط مع النص المستهدف في ذات الترتيب وذات التنسيق المحرفي (كبيراً كان أم صغيراً).
تتمثل مخرجات REGEXMATCH في قيمة منطقية بسيطة: فإذا عثرت الدالة على النمط داخل الخلية الهدف تُرجع القيمة TRUE، وفي حال عدم المطابقة التامة تُرجع القيمة FALSE. وبما أن الدالة تمتلك القدرة على قراءة النطاقات الممتدة وتطبيق المقارنة النمطية على كل خلية على حدة، فإنها تقوم بتوليد مصفوفة أحادية أو ثنائية الأبعاد من القيم المنطقية الصافية، مما يجعلها الأداة المثالية لتشريح النصوص وتحديد المواقع الدقيقة للبيانات التي تستجيب للمعايير الحساسة لحالة الحرف دون أي مساومة خوارزمية.
4.3 ميكانيكية الربط بين الدالتين لتحقيق العد الحساس لحالة الأحرف
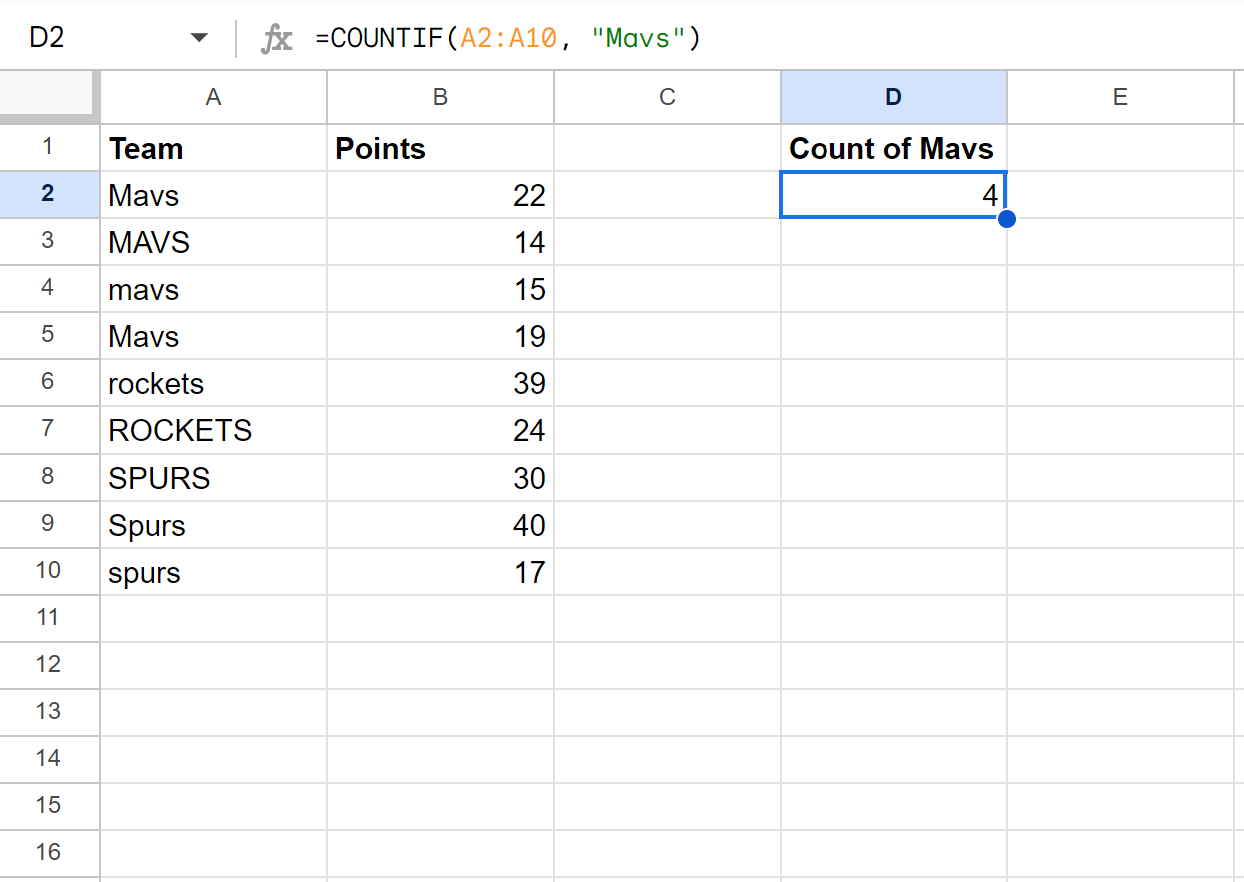
ينشأ الحل المتكامل لمشكلة العد الحساس لحالة الأحرف من التزاوج المنطقي والرياضي بين الخصائص الاستكشافية لدالة REGEXMATCH والقدرات التجميعية لدالة SUMPRODUCT. تعمل هذه المنظومة المركبة عبر مرحلتين تنفيذيتين متتابعتين داخل دورة معالجة حسابية واحدة: تتولى دالة REGEXMATCH مسح النطاق المستهدف بحثاً عن النص المعياري، مُنتجة مصفوفة من الإشارات المنطقية التي تمثل حالة المطابقة الدقيقة في كل خلية على حدة.
في المرحلة التالية، تتدخل دالة SUMPRODUCT لتستقبل هذه المصفوفة المنطقية. ومن خلال التحويل الرياضي، تتحول القيم المنطقية المعبرة عن المطابقة (TRUE) إلى قيم عددية متكافئة (1)، بينما تتحول الإخفاقات (FALSE) إلى قيم منعدمة (0). تقوم الدالة بعد ذلك بجمع هذه الأعداد الناتجة جمعاً تراكمياً، مما يفرز النتيجة الإحصائية النهائية التي تمثل التكرار الحقيقي والمطلق للكلمة المعيارية بحالتها النصية المحددة. تتخذ هذه المعادلة النموذجية الصياغة الرياضية التالية:
=SUMPRODUCT(REGEXMATCH(النطاق, “النص”))
يضمن هذا الهيكل البرمجي حصر العد بدقة متناهية دون أدنى تداخل من التنسيقات الأخرى لنفس الكلمة، محققاً بذلك الغاية التي تعجز عنها دالة COUNTIF القياسية.
5. التطبيق العملي المنهجي خطوة بخطوة للمعادلة المركبة
5.1 إعداد بيئة البيانات ونطاق التجربة الحسابية
لتطبيق هذه المنهجية بصورة علمية منضبطة، يتعين أولاً تهيئة بيئة تجريبية واضحة داخل جداول بيانات جوجل تسمح بإجراء المقارنة المباشرة وتفادي التأثيرات المشوشة للمتغيرات الدخيلة. نقوم بإنشاء جدول اختباري يتضمن عموداً مخصصاً للمدخلات النصية، ولتكن الخلايا من A1 إلى A10، حيث ندرج داخل هذا النطاق عينة من السلاسل النصية التي تحاكي بيئة ترميزية حقيقية، مع تعمد التنويع الشكلي لنفس اللفظ لاختبار استجابة الخوارزميات.
يمكن توزيع المدخلات التجريبية كالتالي: كتابة النمط Mavs في خليتين (مثل A1 وA5)، وكتابة النمط mavs بالأحرف الصغيرة في خليتين أُخريين (مثل A2 وA6)، وكتابة النمط MAVS بالأحرف الكبيرة بالكامل في خليتين (مثل A3 وA7)، ثم استكمال بقية النطاق بكلمات متباينة تماماً مثل Celtics وWarriors. كما يجب التأكد التام من خلو الخلايا المجاورة من أي مدخلات عشوائية، وضبط تنسيق العمود ليكون نصاً عادياً (Plain Text) لضمان عدم قيام المنصة بأي تحويلات تلقائية قد تشوش على مخرجات التجربة.
5.2 تنفيذ الصيغة القياسية لـ COUNTIF ورصد انحراف النتائج
في الخطوة التالية من التجربة، نقوم برصد السلوك التقليدي للدوال القياسية للتدليل عملياً على وجود الانحراف المعياري. نحدد خلية مستقلة (ولتكن C2) ونكتب داخلها صيغة العد الكلاسيكية الموجهة للبحث عن النمط المختلط: =COUNTIF(A1:A10, "Mavs"). عند الضغط على زر الإدخال، سنلحظ أن المنصة تُرجع على الفور القيمة الرقمية (6). يعكس هذا الرقم تجميعاً لكافة الخلايا التي تحتوي على حروف الكلمة بغض النظر عن نسقها الشكلي؛ حيث شملت النتيجة كلاً من Mavs وmavs وMAVS بالتساوي.
يكشف هذا المخرج العملي الهوة الواسعة بين القصد البحثي للمحلل والنتيجة الرقمية المستخرجة؛ فالباحث الذي يسعى لقياس معدل ظهور النمط الهجين Mavs تحديداً سيحصل على بيانات مضخمة بنسبة 200% عن الواقع الميداني الفعلي للعينة. يوثق هذا الإجراء الإخفاق الوظيفي للدالة التقليدية في الاستجابة للمتطلبات الدقيقة، ويثبت بالدليل الإمبريالي المباشر ضرورة العزوف عنها في هذا السياق واستدعاء الصياغات البديلة القادرة على احترام الضوابط البنيوية للنصوص.
5.3 تطبيق صيغة SUMPRODUCT مع REGEXMATCH وتدقيق المخرجات
لمعالجة هذا الانحراف، ننتقل الآن إلى تطبيق الصيغة المركبة المتقدمة. نختار الخلية المجاورة (ولتكن C3) ونقوم بإدخال المعادلة المتطورة بالشكل التالي: =SUMPRODUCT(REGEXMATCH(A1:A10, "Mavs")). بمجرد تنفيذ الأمر، يظهر المخرج الرقمي الصارم مسجلاً القيمة (2). يُمثل هذا الرقم عدد الخلايا التي احتوت حرفياً على الكلمة بالبادئة الكبيرة واللواحق الصغيرة، مستبعداً بصورة قاطعة كلاً من mavs وMAVS.
ولإجراء تدقيق متقاطع (Cross-Validation)، يمكن كتابة معادلة إضافية في الخلية C4 تستهدف النمط الصغير بالكامل: =SUMPRODUCT(REGEXMATCH(A1:A10, "mavs")) لتُرجع النتيجة (2)، وأخرى للنمط الكبير: =SUMPRODUCT(REGEXMATCH(A1:A10, "MAVS")) لتُرجع (2) أيضاً. وبجمع هذه المخرجات الفرعية (2 + 2 + 2 = 6)، تتضح أمامنا الخارطة التوزيعية التكرارية الصادقة للعينة، مما يؤكد الفاعلية التشغيلية للتركيبة البرمجية الجديدة وقدرتها على استعادة السيطرة المنهجية الكاملة على معالجة البيانات النصية الحساسة داخل بيئة العمل.
6. التطابق التام مقابل التطابق الجزئي: ضبط التعبيرات النمطية
6.1 معالجة مشكلة المطابقة الجزئية للنصوص داخل الخلايا
على الرغم من النجاح الحاسم لدالة REGEXMATCH في عزل التباينات الناتجة عن حالة الأحرف، إلا أن طبيعتها الوظيفية المستندة إلى محرك التعبيرات النمطية تفتح الباب أمام تحدٍ منهجي آخر يتعلق بنطاق التطابق داخل السلسلة النصية؛ إذ تعمل الدالة افتراضياً وفق مبدأ البحث عن الاحتواء الجزئي (Substring Matching). هذا يعني أنها إذا وجدت الكلمة المعيارية كجزء من نص أطول أو كبادئة لكلمة مركبة داخل الخلية، فإنها ستعتبر الشرط محققاً وتُرجع القيمة المنطقية TRUE.
يتضح هذا المأزق إذا تضمن نطاق البحث الميداني خلايا تحتوي على عبارات مثل Mavs_Team أو GoMavs؛ ففي هذه الحالة ستقوم المعادلة البسيطة =SUMPRODUCT(REGEXMATCH(A1:A10, "Mavs")) باحتساب هذه الخلايا ضمن التكرارات، على الرغم من أنها قد تمثل متغيرات مختلفة تماماً في دلالتها الوصفية عن الكلمة المستقلة Mavs. إن ترك هذا الأمر دون معالجة يعيدنا إلى دائرة التضخيم الإحصائي والخطأ القياسي، مما يفرض على الباحث تحصين الصيغة البرمجية بضوابط نمطية تحصر المقارنة في حدود التطابق التام والشامل لكامل محتوى الخلية.
6.2 استخدام محددات البداية والنهاية في السلاسل النصية (^ و $)
للخروج من مأزق المطابقة الجزئية وفرض التطابق الحرفي الكامل، تمنحنا لغة التعبيرات النمطية أداتين برمجيتين هائلتي الأثر تُعرفان بمحددات التثبيت الركيزية (Anchors): وهما علامة الإقحام (Caret: ^) وعلامة الدولار (Dollar Sign: $). تُستخدم علامة الإقحام ^ لإلزام محرك البحث بالبدء حصراً من الحرف الأول الفعلي للسلسلة النصية داخل الخلية، بينما تُوضع علامة الدولار $ في نهاية النمط لإلزام المحرك بالتحقق من أن الحرف الأخير في المعيار يتطابق تماماً مع المحرف الختامي في الخلية دون أي إضافات تالية.
من خلال دمج هذين الرمزين حول الكلمة المستهدفة، تصبح الصيغة الرياضية المتطورة كالتالي:
=SUMPRODUCT(REGEXMATCH(A1:A10, “^Mavs$”))
بموجب هذا التعديل البنيوي الصارم، ترفض الدالة احتساب أي خلية تحتوي على حروف تسبق كلمة Mavs أو تعقبها، كالفراغات أو الشرطات أو السوابق واللواحق اللفظية، وتقصر الاحتساب الإحصائي فقط على الخلايا التي تطابق بنيتها النصية الكلمة المحددة من أول محرف إلى آخره، مما يرتقي بالمعادلة إلى مستوى التطابق المعياري التام والمغلق.
6.3 التعامل مع الرموز الخاصة وعلامات الترقيم في الأنماط
تواجه التعبيرات النمطية تعقيداً إضافياً عندما تحتوي النصوص المعيارية المراد إحصاؤها على رموز تنتمي في الأصل إلى منظومة أوامر لغة التعبيرات النمطية ذاتها (Metacharacters)، مثل الأقواس الهلالية ()، أو علامة النجمة *، أو علامة الجمع +، أو علامة الاستفهام ?، أو النقطة .. إذا حاول الباحث البحث عن كود معملي حساس للحالة كالصيغة (A1)، فإن محرك البحث سيفسر الأقواس كأمر لتجميع الخانات الفرعية بدلاً من قراءتها كمحارف نصية جامدة، مما يقود إلى تعطل الصيغة وظهور أخطاء تركيبية غير متوقعة.
لتجاوز هذا اللبس الدلالي، يجب تطبيق آلية الهروب البرمجي (Escaping) عبر إدراج الشرطة المائلة العكسية (Backslash: ) قبل أي رمز خاص مراد إدراجه ضمن معيار البحث النصي. على سبيل المثال، إذا أردنا عد التكرارات الدقيقة للشفرة [Mavs] بتطابق تام وحساسية للحالة، يتعين كتابة المعادلة على النسق التالي: =SUMPRODUCT(REGEXMATCH(A1:A10, "^[Mavs]$")). إن تحييد الوظائف البرمجية للمحارف الخاصة يضمن بقاء التحليل ضمن حدوده الوصفية الصحيحة، ويقي الباحث من أخطاء القراءة الخوارزمية التي تتسبب في إفساد قواعد البيانات الميدانية الضخمة.
7. المنهجيات البديلة: استخدام دوال EXACT و FILTER و ARRAYFORMULA
7.1 توظيف دالة EXACT للمطابقة الحرفية الصارمة
إلى جانب مسار التعبيرات النمطية، توفر منصة جداول بيانات جوجل دالة تخصصية مدمجة صُممت خصيصاً للمقارنة النصية الحساسة لحالة الأحرف وهي دالة EXACT. تتلخص وظيفة هذه الدالة الكلاسيكية في مقارنة سلسلتين نصيتين وإرجاع القيمة المنطقية TRUE إذا وفقط إذا تطابقت السلسلتان تطابقاً حرفياً تاماً في كل شيء، بما في ذلك المسافات وحالة الأحرف الصغير منها والكبير. وبخلاف REGEXMATCH، فإن EXACT لا تتطلب فهماً لقواعد التعبيرات النمطية المعقدة، وتوفر بطبيعتها حماية ذاتية من مشاكل التطابق الجزئي دون الحاجة لمحددات إضافية.
لكي نوظف هذه الدالة في عمليات العد الشاملة للنطاقات، ندمجها مع دالة SUMPRODUCT مع إدخال معامل التحييد الحسابي المزدوج السلبي (Double Unary: --) أو المعالجة المباشرة لتحويل القيم المنطقية إلى قيم عددية، وذلك وفق الصيغة التالية:
=SUMPRODUCT(–EXACT(“Mavs”, A1:A10))
يعمل المعامل السالب المزدوج على إجبار النظام على تحويل TRUE إلى 1 وFALSE إلى 0 بسرعة معالجة فائقة. تتميز هذه الطريقة بالبساطة المنهجية، والموثوقية العالية، وتفوقها الطفيف في سرعة التنفيذ الحسابي على دالة REGEXMATCH، خاصة عند التعامل مع مصفوفات ضخمة لا تتطلب تطبيق أنماط تعبيرية متقدمة.
7.2 استخدام دالة ARRAYFORMULA مع دالة SUM ودالة EXACT
تمثل دالة ARRAYFORMULA في جداول بيانات جوجل المحرك المركزي لإطلاق القدرات المصفوفية للدوال المنطقية البسيطة التي لا تدعم النطاقات الممتدة تلقائياً. فنظراً لأن دالة EXACT مصممة أصلاً لمقارنة خليتين مفردتين فقط، فإن تمرير نطاق كامل مثل A1:A10 بداخلها سيتسبب في تعطلها، إلا إذا أُحيطت بالغطاء المصفوفي ARRAYFORMULA الذي يجبرها على تكرار فحص المقارنة عبر كل خلية من خلايا النطاق المستهدف على حدة وبصورة متزامنة.
عند الربط بين هذه المنظومة ودالة التجميع الحسابي SUM والدالة الشرطية IF، نحصل على صيغة مصفوفية متماسكة للغاية تأخذ الهيكل التالي:
=ARRAYFORMULA(SUM(IF(EXACT(A1:A10, “Mavs”), 1, 0)))
تقوم هذه المعادلة بفحص النطاق خلية بخلية؛ فإذا تطابقت الخلية شكلياً مع القيمة “Mavs” تُرجع دالة IF الرقم 1، وإلا تُرجع الرقم 0، ثم تتولى دالة SUM تجميع هذه الآحاد داخل فضاء الذاكرة الحسابية. ورغم متانة هذا الأسلوب وقدرته الفائقة على التوسع، إلا أن بعض المحللين المبتدئين قد يجدون صعوبة في قراءة وفهم تركيبه المتشعب وصيانته على المدى الطويل مقارنة بصيغة SUMPRODUCT البسيطة.
7.3 تطبيق دالتي FILTER و COUNTCOUNTA للتصفية النصية الدقيقة
ثمة مدخل تحليلي بديل يعتمد على الاستخراج التصفوي للبيانات بدلاً من التجميع الجبري الصرف، ويتمثل في الاستعانة بدالة التصفية FILTER متبوعة بدالة عد القيم COUNTA (أو كما يُشار إليها أحياناً وظيفياً بدمج الدالتين لحساب الحجم الكلي للمصفوفة المفلترة). يقوم هذا المسار على فكرة استخلاص النطاق الجزئي الذي يحقق شرط المطابقة الحساسة لحالة الأحرف أولاً، ثم قياس حجم المصفوفة الناتجة لمعرفة عدد التكرارات المتحققة في الواقع الميداني.
تُصاغ هذه المنهجية عبر المعادلة المركبة التالية:
=COUNTA(IFERROR(FILTER(A1:A10, EXACT(A1:A10, “Mavs”)), “”))
تتجلى ميزة هذا الأسلوب في قدرته على عزل الكيانات المتطابقة وتسهيل استعراضها البصري المستقل، وهو أمر بالغ الفائدة في سياقات التدقيق الأكاديمي للعينات المشبوهة. ومع ذلك، يعيب هذا المسار استهلاكه المرتفع لموارد المعالجة السحابية مقارنة بالحلول المصفوفية الخالصة، إضافة إلى ضرورة إدراج دالة حماية من الأخطاء مثل IFERROR لتجنب انهيار المعادلة وظهور خطأ مرجعي في حال كانت التكرارات مساوية للصفر (أي عدم وجود أي خلية تطابق المعيار المطلوب)، وهو ما يرفع من درجة تعقيد بنائها الرياضي.
8. استكشاف الأخطاء البرمجية الشائعة وطرق تصحيحها
8.1 معالجة أخطاء عدم تطابق النطاقات والمصفوفات الفارغة
أثناء تطبيق المعادلات المصفوفية الحساسة لحالة الأحرف، كثيراً ما يواجه الباحثون ظهور رسائل خطأ مفاجئة مثل #N/A أو #VALUE!. تعود هذه الأخطاء في معظم الأحيان إلى عدم التناسق الهندسي بين النطاقات المستدعاة في العمليات متعددة الشروط، أو إلى وجود خلايا تحتوي على فراغات غير مرئية تفصل بين الحروف أو تلحق بنهايات الكلمات (Trailing Spaces). هذه المسافات الخفية تُعد في المنطق الحاسوبي محارف مستقلة لها ترميزها الخاص، مما يجعل الخلية المحتوية على “Mavs “ غير مطابقة مطلقاً للمعيار “Mavs”، وبالتالي تسقط من نتائج العد دون تنبيه صريح للباحث.
لمعالجة هذا التشوه النصي الخفي، يُنصح بتطبيق دالة التنظيف المدمجة TRIM على النطاق المستهدف لتجريد الكلمات من الفراغات الزائدة قبل إخضاعها للمطابقة الحساسة. كما يجب تأمين المعادلات ضد النطاقات الفارغة بالكامل؛ إذ إن تمرير نطاق فارغ لبعض الدوال المتقدمة قد ينتج عنه مصفوفة غير معرفة. يساعد إدراج الشروط التحوطية واستخدام النطاقات المقيدة مسبقاً في توفير بيئة معالجة آمنة تضمن استقرار المخرجات الرقمية وتمنع تعطل لوحات التحكم الإحصائية المرتبطة بها.
8.2 الأخطاء الناجمة عن سوء استخدام علامات الاقتباس والمحارف
يقع العديد من مستخدمي جداول بيانات جوجل في فخ أخطاء الصياغة التركيبية (Syntax Errors) نتيجة الخلط الشائع بين علامات الاقتباس الفردية والمزدوجة، أو بسبب الإسناد غير الصحيح لمعايير البحث عند محاولة ربطها بخلية خارجية متغيرة بدلاً من كتابة الكلمة بصورة نصية ثابتة داخل جسم المعادلة. فعند الرغبة في جعل المعيار النصي ديناميكياً مستمداً من محتوى الخلية D1 مثلاً، يفشل الكثير من المبتدئين في فهم آلية ربط النصوص البرمجية عبر معامل الربط الأبجدي الرقمي (Ampersand: &).
لتطبيق المطابقة التامة الحساسة لحالة الأحرف بالاعتماد على مرجع خلية ديناميكي، يجب كتابة المعادلة بدقة على النحو التالي:
=SUMPRODUCT(REGEXMATCH(A1:A10, “^” & D1 & “$”))
يضمن هذا التركيب دمج محدد البداية ^ مع محتوى الخلية D1 ومحدد النهاية $ في سلسلة نصية موحدة يقرؤها محرك التعبيرات النمطية بسلاسة. إن إهمال علامات الربط أو إسقاط الأقواس المزدوجة يؤدي حتماً إلى فشل الدالة في الترجمة وتوقف التدفق المنطقي للحساب، مما يعطل التحديث التلقائي للنتائج عند تعديل معطيات البحث في الخلية المرجعية.
8.3 فحص توافق أنواع البيانات المدخلة في النطاق المستهدف
من المزالق الفنية البارزة التي تواجه التحليلات الحسابية احتواء النطاق المستهدف على أنواع بيانات متباينة، كأن يتضمن العمود مزيجاً من النصوص الصريحة والأرقام الخالصة والتواريخ والقيم المنطقية. تواجه دالة REGEXMATCH إشكالاً جوهرياً في التعامل مع الأرقام المحضة؛ حيث صُمم محركها لاستقبال السلاسل النصية فقط (Strings)، وعند اصطدامها برقم عشري أو صحيح داخل النطاق دون تمهيد مسبق، قد تتوقف الدالة عن العمل وتُصدر خطأ مفاده أن المدخل ليس نصاً متوافقاً، مما يُبطل حساب النطاق كاملاً.
لتفادي هذا العطل وتأمين سلامة التدفق التحليلي، يجب اتخاذ أحد إجراءين منهجيين: إما تحويل العمود بالكامل إلى نسق نصي صريح من خلال قائمة التنسيق المالي والنصي المتاحة في المنصة، أو إعادة صياغة المعادلة عبر دمج دالة التحويل النصي القسري TO_TEXT ضمن مسار المعالجة، كأن يُكتب النطاق بالشكل TO_TEXT(A1:A10) داخل المعادلة المصفوفية. كما يُعد استخدام دالة احتواء الأخطاء IFERROR حزام أمان أساسياً لامتصاص أي شذوذ نوعي في البيانات ومنع انقطاع المؤشرات الإحصائية في لوحات العرض النهائية.
9. تحسين الأداء الحاسوبي والكفاءة في المجموعات البيانية الضخمة
9.1 أثر استخدام دوال التعبيرات النمطية على سرعة معالجة الملفات
على الرغم من القوة والشمول اللذين تتمتع بهما دالة REGEXMATCH، إلا أن استدعاء محرك التعبيرات النمطية في خلفية بيئة جداول بيانات جوجل يفرض تكلفة حسابية ليست بالهينة على الذاكرة الآنية للبرمجية. تتطلب محركات الرموز النمطية دورات معالجة معقدة نسبياً لمسح كل حرف، وتحديد موقعه، ومطابقته مع قواعد النمط المعطى، وهو ما يختلف جذرياً عن عمليات المقارنة المباشرة البسيطة بين البايتات الرقمية التي تقوم بها دوال المضاهاة الثنائية.
عندما تُطبق هذه المعادلات على ملفات بيانات ضخمة تحتوي على عشرات الآلاف من الصفوف السحابية المتفاعلة، قد يلحظ الباحث بطئاً ملموساً في تحديث الشيت وتأخراً في إعادة الحساب التلقائي مع كل عملية تعديل أو فرز ميداني. وفي مثل هذه السيناريوهات المكثفة، تبرز دالة EXACT المدمجة مع SUMPRODUCT كبديل تقني أكثر كفاءة وأقل استهلاكاً لموارد وحدة المعالجة المركزية، نظراً لبساطة بنيتها المادية وتفوقها في إجراء المقارنات المعجمية المباشرة دون الحاجة إلى تشغيل مفسر التعبيرات النمطية المعقد.
9.2 تقييد النطاقات وتفادي استخدام الأعمدة المفتوحة غير المحددة
من العادات البرمجية الشائعة والخاطئة بين متعاملي الجداول الحسابية استخدام النطاقات المفتوحة اللانهائية، مثل الإشارة إلى العمود بأكمله عبر الصيغة A:A بدلاً من تحديد المجال الفعلي للبيانات. في الحسابات القياسية البسيطة قد لا يبدو هذا التأثير كارثياً، ولكن عند التعامل مع الدوال المصفوفية الحساسة لحالة الأحرف مثل SUMPRODUCT وREGEXMATCH، فإن استدعاء العمود بالكامل يجبر الخادم السحابي على فحص كافة الخلايا المتاحة في الجدول حتى لو كانت فارغة، وهو ما قد يصل إلى مئات الآلاف من الخلايا عديمة الفائدة.
يؤدي هذا السلوك غير الرشيد إلى استنزاف الذاكرة المخصصة للجلسة وتباطؤ مزامنة التعديلات بين فرق العمل البحثية. تقتضي أفضل الممارسات المنهجية حصر النطاقات في حدودها التشغيلية الدنيا مثل A2:A500، أو الاستعانة بالدوال الديناميكية غير المتطايرة لحساب نهاية النطاق الفعلي بصورة آلية. يضمن هذا الإجراء تسريع استجابة الجداول الحسابية، وتخفيف الضغط على خوادم المعالجة، والحفاظ على كفاءة ملف التحليل عند تشغيله عبر الأجهزة اللوحية أو الاتصالات الميدانية الضعيفة.
9.3 الموازنة بين التعقيد البرمجي وسهولة الصيانة المنهجية
يواجه الباحثون المتخصصون دائماً معضلة الموازنة بين اختزال العمليات الحسابية داخل صيغ برمجية بالغة التعقيد تشغل خلية واحدة، وبين تجزئة المشكلة عبر مراحل وسيطة باستخدام ما يُعرف بالأعمدة المساعدة (Helper Columns). تمنح الصيغ المفردة فائقة التعقيد مظهراً احترافياً ونظيفاً لواجهة البيانات، ولكنها في المقابل قد تتحول إلى كابوس صيانة في حال رغبة زميل باحث آخر في تدقيق المعادلات أو تعديل شروطها، نظراً لتراكم الدوال وتشابك منطق عملها.
يمثل إنشاء عمود مساعد يجري فيه فحص المطابقة عبر دالة EXACT أو REGEXMATCH لكل سطر على حدة، ثم تطبيق دالة جمع بسيطة SUM في النهاية، حلاً منهجياً بديلاً يتسم بالوضوح المطلق وقابلية التتبع والمراجعة. علاوة على ذلك، يجب على الفرق البحثية الحرص على توثيق المعادلات المعقدة من خلال ميزة إدراج الملاحظات والتعليقات المدمجة في جداول جوجل، لشرح المنطق المتبع في استدعاء الرموز وتأصيل المحددات، بما يحقق مبدأ الشفافية المنهجية المعمول به في الدراسات العلمية الرصينة.
10. أفضل الممارسات المعيارية المتقدمة لتدقيق البيانات النصية في جداول بيانات جوجل
10.1 تأسيس قواعد التحقق من صحة البيانات (Data Validation) لمنع التباين
تتمثل القاعدة الذهبية في هندسة البيانات وإدارتها في أن الوقاية من التباين والتشوه في المصدر أفضل بكثير من استنزاف الوقت والجهد في معالجته حسابياً بعد وقوعه. ومن هنا، يبرز تأسيس قواعد التحقق من صحة البيانات (Data Validation) كإجراء وقائي واستباقي حاسم في المسوح الميدانية؛ إذ يمكن لمدير قاعدة البيانات فرض قوائم إسقاط منسدلة صارمة تُجبر جامعي البيانات على اختيار التسميات المعتمدة بحالتها الصحيحة دون السماح بالإدخال الحر العشوائي من لوحة المفاتيح.
علاوة على ذلك، تتيح جداول بيانات جوجل كتابة صيغ مخصصة (Custom Formulas) داخل قواعد التحقق لمنع حفظ الخلية إذا لم تلتزم بالحالة المطلوبة للأحرف. يمكن على سبيل المثال استخدام قاعدة تعتمد على دالة EXACT لرفض أي إدخال لا يطابق تماماً النسق المعياري المقبول للكود البحثي. يُسهم هذا الحصار التقني الصارم للأخطاء في تجفيف منابع التباين غير المقصود، ويرفع من مستوى التجانس البنيوي لقواعد البيانات، مما يقلل لاحقاً من الحاجة لتطوير معادلات مصفوفية معقدة لفرز وتصحيح التكرارات الزائفة.
10.2 بناء نماذج لوحات التحكم والتقارير الأكاديمية الحساسة للحالة
عند الشروع في بناء لوحات التحكم التفاعلية (Dashboards) والتقارير العلمية التلخيصية، يجب ربط الدوال الحساسة لحالة الأحرف بخلايا معيارية تتيح للمستخدم النهائي استعراض المؤشرات بمرونة تامة. بدلاً من تثبيت الكلمات المفتاحية بصفة جامدة داخل الصياغات الحسابية، يتم توجيه المعادلات لقراءة معايير البحث من واجهات تفاعلية مخصصة، مما يُمكن صانع القرار من المقارنة الفورية بين فئات البيانات النصية المختلفة بمجرد تغيير حالة الحرف في خلية المعيار المرجعي.
يمتد هذا التكامل الوظيفي إلى استخدام التنسيق الشرطي الحساس للحالة (Case-Sensitive Conditional Formatting) لتمييز الشواذ والانحرافات التدوينية بصرياً داخل النطاقات الكبيرة. بتسخير نفس القواعد البرمجية القائمة على EXACT داخل محرك التنسيق، يمكن تلوين الخلايا التي استجابت للشرط الحساس بألوان مميزة فور إدخالها، مما يمنح مدققي الجودة إنذاراً بصرياً مبكراً يرصد وجود أي تناقض أو خلط تصنيفي في العينات المدخلة، ويُسهم في الحفاظ على التناسق الهيكلي للمشروع البحثي برمته.
10.3 الدليل الإرشادي المنهجي لاختيار الدالة المثالية وفق الحالة التحليلية
لتسهيل اتخاذ القرار المنهجي والتقني من قبل المحللين والباحثين، يستعرض الجدول الإرشادي التالي مصفوفة مفاضلة دقيقة توضح متى يتعين تفضيل تركيبة برمجية معينة على غيرها بناءً على طبيعة البيانات المطروحة والأهداف التحليلية المتوخاة وحجم الملف قيد المعالجة:
- حالة البحث عن تطابق نصي تام ومستقل مع أفضل كفاءة حاسوبية: يُنصح باستخدام تركيبة
SUMPRODUCTمع دالةEXACTبصيغة:=SUMPRODUCT(--EXACT("Criterion", Range))؛ نظراً لبساطتها وسرعتها العالية وعدم تأثرها بأخطاء الرموز الخاصة. - حالة البحث المتقدم الذي يتضمن أنماطاً وبادئات أو أجزاء داخلية مشروطة: يُعد دمج
SUMPRODUCTمع دالةREGEXMATCHالحل الأمثل بصيغة:=SUMPRODUCT(REGEXMATCH(Range, "^Criterion$"))، حيث يتيح استخدام القوة الكاملة للتعبيرات النمطية والتحكم في حدود الكلمات. - حالة الرغبة في معاينة وتصفية البيانات واستخراجها بصرياً بجانب الحساب: يُفضل مسار الاستخلاص عبر
COUNTAودالةFILTERبصيغة:=COUNTA(IFERROR(FILTER(Range, EXACT(Range, "Criterion")), ""))، والتي تخدم أهداف الفحص النوعي المعمق للعينات المتطابقة. - حالة التحليلات البسيطة جداً التي لا تكترث بالحساسية النصية: يبقى الخيار الكلاسيكي
COUNTIF(Range, "Criterion")كافياً وفعالاً شريطة غياب أي تداخل دلالي ناتج عن التباين في كتابة الحروف الكبيرة والصغيرة.
إن تبني هذا الدليل المعياري يُرشد الممارسة الأكاديمية نحو الاستخدام الأمثل لموارد البرمجيات الجدولية، ويؤسس لتقاليد تحليلية تتسم بالرصانة العلمية، والاتساق الخوارزمي، والمناعة التامة ضد المزالق الإحصائية التي قد تنجم عن الركون الساذج للدوال الافتراضية المجهزة مسبقاً.
الخاتمة
تُبرز المعالجة المتقدمة للبيانات داخل جداول بيانات جوجل أن النجاح التحليلي في البيئات الأكاديمية والتطبيقية لا يتوقف فحسب على معرفة الدوال الأساسية الشائعة، بل يرتبط ارتباطاً وثيقاً بفهم البنية الهيكلية والقيود الخوارزمية الكامنة وراء تلك الدوال. لقد أثبت التحليل الفني المفصل في هذا المقال أن دالة COUNTIF التقليدية، رغم ما تتمتع به من سهولة انتشار واسعة، تظل قاصرة وعاجزة عن تلبية متطلبات التصنيف الدقيق عندما تتقاطع المتغيرات المستهدفة مع مبدأ حساسية حالة الأحرف، مما يحتم على الباحث الرصين البحث عن صيغ برمجية بديلة تسد هذه الفجوة التحليلية الخطيرة وتضمن مصداقية النتائج الإحصائية.
إن التوليفة الرياضية الناتجة عن دمج دالتي SUMPRODUCT وREGEXMATCH، المعززة بالمحددات الركيزية للتطابق التام (^ و$)، تمثل معياراً تقنياً ذهبياً يمنح المحلل سلطة كاملة على فضاء البيانات النوعية، مما يكفل استخلاص التكرارات الحقيقية للأكواد السلوكية، والمتغيرات الطبية، والمعرفات الرقمية دون أدنى تزييف إحصائي أو تداخل تصنيفي. وبالمثل، تظل البدائل المتمثلة في دالة EXACT مع الحساب المصفوفي أدوات ذات قيمة بالغة تضمن تعظيم الكفاءة الحاسوبية وسلامة الإجراءات الميدانية للمشاريع البحثية المعقدة.
ختاماً، يتعين على المؤسسات الأكاديمية والباحثين المتخصصين النظر إلى أدوات جداول البيانات كفضاءات حوسبة علمية تتطلب تطبيق أرقى معايير الحوكمة وضبط الجودة. إن ضبط المدخلات عبر قواعد التحقق الصارمة، والتنظيف الاستباقي للنطاقات، وحسن الموازنة بين التعقيد البرمجي وكفاءة الأداء، كلها ممارسات متكاملة تصب في غاية واحدة: الارتقاء بموثوقية البحث العلمي وصيانة البيانات من التحريف العفوي، بما يحقق استنتاجات قائمة على أرضية تجريبية وإحصائية بالغة الصلابة والدقة.
المراجع
- Google. (n.d.). COUNTIF function. Google Docs Editors Help. Retrieved from https://support.google.com/docs/answer/3093480
- Google. (n.d.). SUMPRODUCT function. Google Docs Editors Help. Retrieved from https://support.google.com/docs/answer/3094294
- Google. (n.d.). REGEXMATCH function. Google Docs Editors Help. Retrieved from https://support.google.com/docs/answer/3098292
- Google. (n.d.). EXACT function. Google Docs Editors Help. Retrieved from https://support.google.com/docs/answer/3094123
- Friedl, J. E. (2006). Mastering regular expressions (3rd ed.). O’Reilly Media.
- Walkenbach, J. (2015). Excel 2016 formulas. John Wiley & Sons.
- American National Standards Institute. (1986). Information systems – coded character sets – 7-bit American national standard code for information interchange (7-bit ASCII) (ANSI X3.4-1986). American National Standards Institute.