
تُعد إدارة البيانات ومعالجتها ركيزة أساسية في عصر الحوسبة السحابية وتحليل النظم المعلوماتية. ومع التنامي المتسارع لحجم البيانات الرقمية في شتى المجالات الأكاديمية والمهنية، باتت الحاجة ملحة لتطوير آليات أوتوماتيكية دقيقة تُمكّن الباحثين والمحللين من تصفية واستخلاص مجموعات فرعية من السجلات وفق معايير منطقية صارمة ودون تدخل يدوي مستمر. تقدم بيئة جداول بيانات جوجل نموذجاً حوسبياً متقدماً يتيح للمستخدمين بناء هياكل بيانات ديناميكية عالية المرونة تعتمد على منطق المصفوفات الموجهة.
تاريخياً، تعود جذور منصة جداول بيانات جوجل إلى تطبيق الحوسبة السحابية “XL2Web” الذي ابتكره كل من جوناثان روشيل وفرزاد خوسروشاهي ضمن شركة “2Web Technologies”، قبل أن تستحوذ عليها شركة جوجل في عام 2005، لتطلق لاحقاً الإصدار التجريبي الأول لجداول البيانات عبر مختبراتها في السادس من يونيو عام 2006. ومنذ ذلك الحين، تطورت المنصة من مجرد أداة بسيطة لتدوين الأرقام إلى بيئة برمجية تحليلية متكاملة تدعم التصفية الخوارزمية، والتعامل مع الدوال الرياضية المتداخلة، وتوليد مخرجات منسابة تتبدل ذاتياً بمجرد تعديل المدخلات الأساسية في جداول المصدر.
يهدف هذا الدليل المنهجي الشامل إلى تفكيك وتحليل كيفية استخراج قائمة فرعية من البيانات استناداً إلى معيار واحد أو معايير متعددة متزامنة وبديلة. سنستعرض فيه التشريح الهندسي للصيغ المركبة الكلاسيكية التي طالما شكلت الأساس النظري لمعالجة المصفوفات المتقدمة، وصولاً إلى الحلول الحديثة السريعة التي توفرها الدوال المدمجة، مع التركيز على ضبط جودة البيانات، وتحسين الكفاءة الحسابية، وتطبيق أفضل الممارسات المتبعة في إعداد النماذج البحثية والتقنية الرصينة.
1. مقدمة منهجية لإدارة البيانات الشرطية في جداول بيانات جوجل
1.1 أهمية استخراج القوائم البرمجية المؤتمتة في تحليل البيانات
يمثل استخراج البيانات المشروطة بصورة آلية حجر الزاوية في منظومة التحليل الإحصائي الحديث. فعند معالجة قواعد البيانات الواسعة، يُشكل الاعتماد على التدخل البشري لنقل السجلات أو فرزها يدوياً خطراً بنيوياً داهماً يتسبب في وقوع أخطاء النسخ واللصق، وحذف الملاحظات الهامة، وتشوه البنية التحتية للمعلومات. إن أتمتة هذه العمليات تسهم بشكل حاسم في تقويض هذا الاحتمال، وتؤسس لمنهجية قائمة على الوضوح الرياضي القابل للتدقيق وإعادة الإنتاج.
إلى جانب الحد من الأخطاء العرضية، تضمن القوائم البرمجية المؤتمتة الحفاظ على الاتساق الديناميكي المتزامن؛ إذ إن أي تحديث أو إدخال جديد يطرأ على البيانات المصدرية ينعكس فوراً ولحظياً في جدول المخرجات دون أي تدخل يدوي إضافي. هذا الترابط الوظيفي يعد أمراً جوهرياً في الدراسات العلمية والبحوث الكمية، وتحديداً في مجالات العلوم الاجتماعية والسلوكية حيث يتطلب الأمر تنقية مجموعات المشاركين واستبعاد الحالات الشاذة أو غير المستوفية لمعايير الشمول والاستبعاد (Inclusion and Exclusion Criteria) وفق محددات رقمية صارمة.
علاوة على ذلك، فإن بناء هياكل تقارير مؤتمتة يرفع بشكل استثنائي من كفاءة تدفق الأعمال الإحصائية. فالقدرة على استدعاء عينات عشوائية أو فئوية بناءً على محددات معيارية محددة مسبقاً، تمكّن المحلل من بناء لوحات تحكم ديناميكية وقوالب معالجة جاهزة تخدم غايات التحليل الوصفي والاستدلالي، موفرة بذلك الوقت والموارد الحسابية والذهنية التي كانت تُهدر في العمليات الروتينية غير المنتجة.
1.2 المقارنة بين التصفية اليدوية والتصفية الديناميكية المعتمدة على الصيغ
تنطوي التصفية اليدوية التقليدية (Manual Filtering) على استخدام أدوات الواجهة الرسومية البسيطة لعرض صفوف معينة وإخفاء أخرى داخل نطاق البيانات نفسه. ورغم سهولة هذه العملية وسرعتها للمستخدم المبتدئ، إلا أنها تعاني من قصور جوهري يتمثل في عدم قدرتها على تقديم مخرجات معزولة ضمن نطاقات أو أوراق عمل مستقلة دون اللجوء إلى النسخ اليدوي للمخرجات الظاهرة، مما يكسر حلقة الاتصال الحي بين السجل الأصلي والنتيجة المستخلصة.
في المقابل، تتميز التصفية الديناميكية المعتمدة على الصيغ الحسابية (Formula-based Dynamic Subsetting) بقدرتها على قراءة النطاق المرجعي ككيان إحصائي غير قابل للتشويه، واستخراج النتائج المطابقة للشروط إلى حيز مستقل تماماً، مع ترك البيانات الخام سليمة ومحمية من التعديلات العرضية. وتتجلى الميزة الكبرى في التحديث الفوري التلقائي؛ فبمجرد تعديل إحدى قيم المدخلات أو إلحاق سجلات جديدة، يعيد المحرك الحسابي تقييم المعادلات ليُحدّث القائمة المستخرجة تلقائياً.
تمنح الصيغ الرياضية المحلل ميزة الاندماج والربط الخوارزمي، حيث لا تتوقف مخرجات الصيغة عند مجرد عرض الأسماء أو الأرقام، بل يمكن توجيهها بصورة مباشرة لتكون مدخلات لدوال حسابية وإحصائية أخرى متراكبة. يتيح ذلك صياغة نماذج نمذجة تحليلية معقدة ومترابطة يصعب تحقيقها بأدوات التصفية الساكنة التي تجمد حركة البيانات داخل مسار مغلق.
1.3 المتطلبات الهيكلية لتجهيز جداول البيانات للمعالجة المتقدمة
يتطلب الشروع في كتابة صيغ مصفوفية متقدمة إعداداً هيكلياً صارماً لقاعدة البيانات الأصلية لضمان استقرار العمليات التحليلية وموثوقيتها. ترتكز النماذج القياسية على مفهوم “البيانات المرتبة” (Tidy Data)، حيث يُمثل كل صف ملاحظة مستقلة وفريدة (Record)، ويُخصص كل عمود لمتغير وصفي أو كمي محدد (Variable). إن الإخلال بهذا التوزيع يربك منطق البحث المصفوفي ويقود إلى تعطل الصيغ الحسابية.
يعد توحيد أنماط البيانات داخل العمود الواحد شرطاً حاسماً لتفادي التناقضات المنطقية. فمن الأخطاء الجسيمة الشائعة مزج النصوص مع الأرقام، كإدخال أرقام استجابات الاستبيانات جنباً إلى جنب مع ملاحظات نصية مثل “غير متوفر” في الحقل نفسه. يؤدي هذا الخلط إلى خلل في تقييم المعايير المنطقية واستجابات الدوال؛ لذا يجب الحفاظ على التجانس النوعي الصارم واستخدام ترميزات عددية موحدة للحالات المفقودة.
يتعين كذلك ضبط النطاقات المرجعية وتحديد مساحاتها بدقة، وتفادي دمج الخلايا (Merged Cells) نهائياً داخل الجداول المخصصة للمعالجة؛ إذ إن دمج الخلايا يشوه إحداثيات الصفوف والأعمدة ويمنع الصيغ المصفوفية من التعرف على المواقع النسبية للبيانات. إن ضمان نقاء الهيكل التنظيمي للجدول يُعد الضمانة الأولى لاستقرار النماذج المعقدة واستدامتها.
2. التشريح التركيبي للصيغة الأساسية (INDEX و SMALL و IF و ROW)
2.1 آلية عمل دالة INDEX في تعيين المواضع واسترجاع القيم
تُعد دالة INDEX إحدى أهم ركائز استرجاع البيانات المتقدمة في برمجيات الجداول الإلكترونية، نظراً لقدرتها العالية على التعامل مع المصفوفات وإرجاع محتوى خلية معينة استناداً إلى تقاطع إحداثيات محددة. تأخذ الدالة صيغتها الرياضية القياسية من خلال تمرير النطاق المرجعي كمصفوفة أساسية، تليها معطيات رقم الصف ثم رقم العمود المراد استخلاص القيمة منه، مما يحولها إلى أداة بحث إحداثية فائقة الدقة.
في إطار بناء القوائم الشرطية، تُستخدم INDEX كطبقة نهائية لعرض النتائج؛ حيث يتم تزويدها بنطاق البيانات المستهدف، في حين يُترك رقم الصف ليتحدد بصورة ديناميكية متغيرة عبر دوال وسيطة. تتيح هذه الهندسة المرنة استدعاء أي قيمة في العمود المستهدف بمجرد معرفة ترتيبها النسبي، متجاوزة بذلك القيود الصارمة التي تفرضها دوال البحث العمودي التقليدية مثل VLOOKUP التي تلزم أن يكون مفتاح البحث في العمود الأول دائماً.
لضمان سلامة الاستدعاء، يُعد التثبيت المطلق للنطاق المرجعي داخل دالة INDEX باستخدام علامات الدولار ضرورة حسابية حتمية عند التعامل مع الصيغ القابلة للسحب والنسخ؛ إذ يضمن هذا التثبيت بقاء إطار البيانات ثابتاً في مواضعه بينما تتحرك مؤشرات الصفوف التابعة للصيغ الداخلية بسلاسة وتوافق تام.
2.2 التقييم المنطقي عبر دالة IF وبناء مصفوفة المواقع الافتراضية
تمثل دالة IF النواة المنطقية لتوليد القائمة المشروطة ضمن التركيبة الكلاسيكية، وتتمثل وظيفتها المحورية في إجراء فحص تقابلي لكل عنصر داخل نطاق المعيار ومقارنته بالقيمة المستهدفة. لا يتم هذا الفحص على مستوى خلية منفردة فحسب، بل يمتد عبر معالجة مصفوفية متزامنة تقارن متجهاً كاملاً بقيمة معيارية معينة، منتجة سلسلة من الاستجابات الثنائية القائمة على الصواب والخطأ.
يكمن الابتكار في هذه التقنية في تحويل نتيجة الاختبار المنطقي إلى أرقام مواقع فعلية؛ فعندما يكون الشرط محققاً (TRUE)، تُوجّه دالة IF النظام لحساب رقم الصف المقابل لهذا السجل، بينما تُرجع قيمة منطقية سالبة أو قيمة منطقية مجردة (مثل FALSE) في حال عدم تحقق الشرط. وبذلك، يتم توليد مصفوفة داخلية خفية في ذاكرة البرنامج المؤقتة تحتوي على أرقام الصفوف الصالحة متباعدة بفواصل من القيم المهملة.
تتم هذه المعالجة الافتراضية دون الحاجة إلى إنشاء أعمدة مساعدة مرئية في ورقة العمل، مما يحافظ على نظافة التصميم الخارجي للنموذج وسريته. تتكفل الذاكرة الحسابية باستيعاب هذا المتجه الرقمي وتمريره بصورة آنية إلى المرحلة التالية من الصيغة لترتيب المواقع وانتقائها تباعاً.
2.3 التسلسل الديناميكي باستخدام دالتي SMALL و ROW
بعد توليد المصفوفة الافتراضية المحملة بأرقام الصفوف المطابقة والقيم الفارغة أو المنطقية، تبرز معضلة استخراج هذه الأرقام واحداً تلو الآخر بنسق منتظم ومستمر دون ترك فراغات. هنا يأتي دور دالة SMALL التي تختص بالتقاط أصغر قيمة في مصفوفة ما بناءً على رتبة ترتيبية محددة تُعرف بالمعامل (k)، مما يجعلها الأداة المثالية لفرز أرقام الصفوف تصاعدياً.
لتوليد العداد الترتيبي (k) بشكل ديناميكي تلقائي، يتم توظيف الدالة ROW بمحدد نسبي مثل ROW(1:1)؛ حيث تُرجع هذه الصيغة القيمة الرقمية (1) في أول صف كُتبت فيه. وعند سحب المعادلة رأسياً نحو الأسفل، يتغير المرجع تلقائياً ليصبح ROW(2:2) معطياً القيمة (2)، ثم ROW(3:3) معطياً القيمة (3)، وهكذا دواليك. يعمل هذا التغيير الطردي كعداد ميكانيكي يستدعي أصغر صف محقق للشرط، ثم ثاني أصغر صف، وصولاً إلى استيفاء جميع العناصر.
يتطلب هذا التسلسل الحسابي معايرة دقيقة لإزاحة مؤشر البداية؛ فالنطاق المرجعي قد لا يبدأ من الصف الأول للورقة، بل قد يتواجد في صفوف متأخرة تبدأ بعد ترويسات الجداول. تتطلب هذه الحالة طرح رقم صف البداية لضمان أن الرقم المسترجع بواسطة SMALL يتطابق بنيوياً مع الفهرس النسبي للبيانات داخل دالة INDEX.
2.4 إدارة الأخطاء الحسابية وتطويقها باستخدام IFERROR
عند استخدام تقنية السحب الرأسي لمعادلة تعتمد على دالة SMALL، سيصل العداد التكراري حتماً إلى مرحلة تتجاوز فيها قيمة المعامل (k) إجمالي عدد الصفوف التي حققت الشرط المنطقي في مصفوفة البيانات. وفي هذه اللحظة، يعجز المحرك الحسابي عن إيجاد القيمة الترتيبية المطلوبة، مما يؤدي تلقائياً إلى إرجاع الخطأ الحسابي الشهير #NUM!.
إن ترك هذه الأخطاء ظاهرة يشوه المظهر العام للجداول، ويولد انطباعاً بوجود عيب برمجي في بناء النموذج، فضلاً عن أنه يتسبب في تعطل العمليات الحسابية والإحصائية التابعة التي قد تعتمد على هذا النطاق المستخرج كمدخل لها. ومن هنا، يبرز الدور الحيوي لتطويق المعادلة الرياضية بأكملها بواسطة دالة IFERROR، والتي تعمل كصمام أمان حسابي يعترض رسائل الأخطاء قبل وصولها للواجهة.
تسمح دالة IFERROR للمحلل بتحديد استجابة بديلة في حال تعثر الصيغة، والتي غالباً ما تكون نصاً فارغاً يُعبر عنه بعلامتي اقتباس متتاليتين "". يؤدي ذلك إلى بقاء الخلايا الزائدة فارغة وأنيقة بصرياً، مع المحافظة على سلامة النموذج التحليلي وقابليته للاندماج ضمن تقارير نهائية رفيعة المستوى.
3. التطبيق الإجرائي لإنشاء قائمة بناءً على معيار أحادي
3.1 إعداد بيئة العمل وتحديد المتغيرات المرجعية
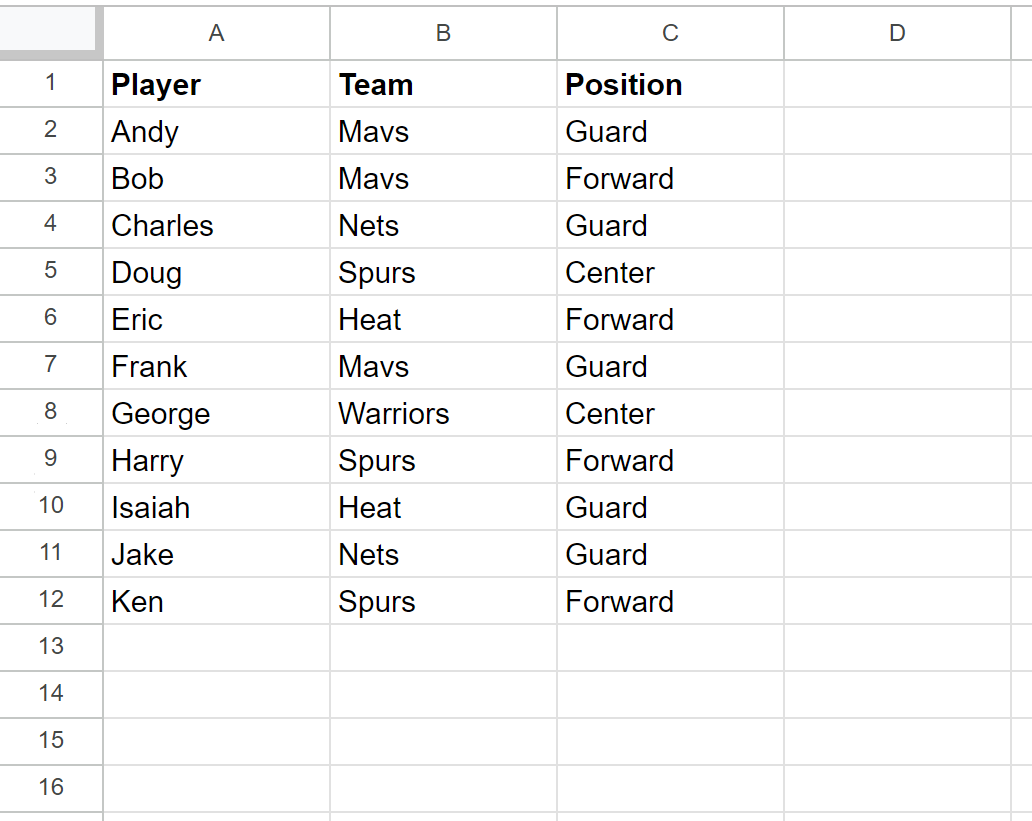
يبدأ التطبيق العملي بتأسيس بيئة عمل منضبطة داخل ورقة الحساب؛ فلنفترض وجود جدول بيانات تجريبي يمتد عبر النطاق A2:B100، حيث يحتوي العمود A على أسماء المشاركين في دراسة بحثية، بينما يشتمل العمود B على التصنيف الفئوي للمشارك (مثل: “مؤهل” أو “غير مؤهل”). الهدف الإجرائي هو عزل كافة الأسماء التي تحمل صفة “مؤهل” ونقلها إلى جدول مستقل يبدأ من العمود D.
يتم تعيين خلية منفصلة لتكون حاضنة للمعيار المرجعي المستهدف، ولتكن الخلية F1، حيث يُكتب بداخلها النص المطلوب (“مؤهل”). يُعد عزل المعيار في خلية خارجية ممارسة منهجية فضلى بدلاً من كتابته بصورة ثابتة ومباشرة داخل الصيغة؛ إذ يسمح هذا الفصل بتغيير معيار التصفية في أي وقت من خلال تعديل محتوى الخلية F1 فقط، دون المساس بالبنية البرمجية للمعادلات المطبقة.
عقب تجهيز المعيار ومصفوفة البيانات المصدرية، يتم إعداد نطاق الإخراج المخصص لعرض النتائج (العمود D)، مع إضافة ترويسة واضحة تعكس طبيعة البيانات المستخلصة. يُراعى تفريغ النطاق المقابل لأسفل الترويسة لضمان عدم وجود بيانات سابقة قد تتداخل مع المخرجات المسترجعة.
3.2 صياغة المعادلة المركبة وتطبيق التثبيت المرجعي المطلق
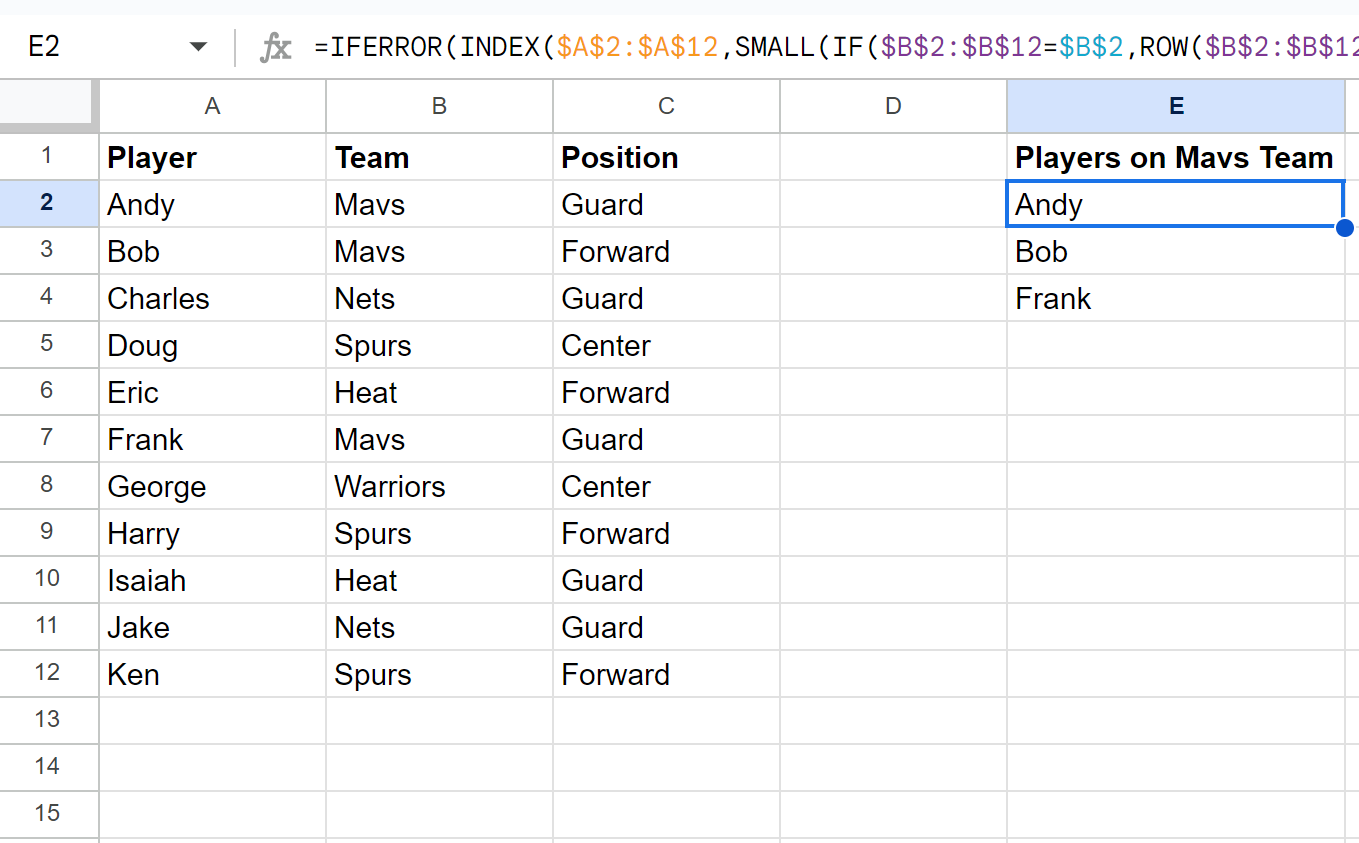
لكتابة الصيغة المركبة في الخلية D2، نقوم بدمج العناصر التي تم تفكيكها نظرياً في قالب رياضي واحد. في بيئة جداول بيانات جوجل، تُصاغ المعادلة المعيارية التقليدية على النحو التالي:
=IFERROR(INDEX($A$2:$A$100, SMALL(IF($B$2:$B$100=$F$1, ROW($B$2:$B$100)-ROW($B$2)+1), ROW(1:1))), "")
يتطلب إدخال هذه الصيغة المصفوفية في جداول بيانات جوجل ضغط المفاتيح Ctrl + Shift + Enter في حال كانت البيئة لا تدعم المصفوفات التلقائية المباشرة، مما يغلف المعادلة بدالة ARRAYFORMULA لتمكينها من معالجة نطاقات الخلايا كمتجهات موحدة.
يظهر في هذه الصيغة التطبيق الدقيق للتثبيت المرجعي المطلق؛ حيث تم تجميد نطاق الاسترجاع $A$2:$A$100 ونطاق الشرط $B$2:$B$100 وخلية المعيار $F$1 باستخدام علامات الدولار. يضمن هذا التجميد بقاء الحدود ثابتة تماماً عند تعميم الصيغة. في المقابل، تُرك المعامل ROW(1:1) حراً دون تثبيت ليتدرج رأسياً ويولد الترقيم المتصاعد اللازم لدالة SMALL دون انحراف.
3.3 تنفيذ السحب التلقائي وتدقيق اتساق النتائج
بعد تثبيت المعادلة في الخلية الأولى D2، يتم النقر على مقبض التعبئة في الزاوية السفلية للخلية وسحبه رأسياً إلى الأسفل عبر النطاق الموازي للعمود D بما يغطي أقصى عدد متوقع من النتائج المحققة للمعيار. ومع السحب، تتولى المعادلة استخلاص الأسماء المطابقة واحداً تلو الآخر، بينما تتحول الخلايا الإضافية إلى خلايا فارغة بفعل دالة IFERROR بمجرد استنفاد كافة السجلات الصالحة.
تأتي بعد ذلك مرحلة التدقيق المنهجي للتأكد من مطابقة النتائج المسترجعة للبيانات الأصلية. يتم التحقق بحساب عدد السجلات التي حققت الشرط في الجدول المصدر عبر دالة الإحصاء COUNTIF($B$2:$B$100, $F$1) ومقارنة هذا الناتج بعدد الصفوف الفعلية الممتلئة في عمود المخرجات D. إن تطابق الرقمين يبرهن على سلامة البناء الرياضي ودقة الاستدعاء.
تُختتم هذه الخطوة باختبار المرونة الديناميكية للنموذج؛ حيث يتم تعديل محتوى الخلية F1 من “مؤهل” إلى “غير مؤهل”، ومراقبة سرعة استجابة عمود المخرجات. يجب أن تتبدل القائمة بصورة فورية ولحظية لتعكس الأسماء المنتمية للفئة الجديدة، وهو ما يؤكد نجاح النموذج في تحقيق الأتمتة الكاملة للفرز المشروط.
4. توسيع النموذج الرياضي لدعم المعايير المتعددة (منطق الضرب الجبري)
4.1 الأسس الرياضية لمحاكاة المعامل المنطقي AND في المصفوفات
في كثير من الحالات التحليلية المعقدة، لا يكفي استخراج البيانات بناءً على معيار أحادي، بل تبرز الحاجة لتصفية السجلات بناءً على تحقق شرطين متزامنين أو أكثر. في بيئة معالجة المصفوفات الرياضية، لا يمكن استخدام الدالة المنطقية التقليدية AND مباشرة داخل مصفوفات الدوال الكلاسيكية، لأن دالة AND تقوم بدمج كافة القيم المنطقية في المصفوفة وإرجاع قيمة مفردة واحدة، بدلاً من إرجاع مصفوفة من القيم المنطقية المقابلة لكل صف.
للتغلب على هذا القيد البنيوي، يتم اللجوء إلى الجبر البولياني (Boolean Algebra) واستخدام عملية “الضرب الحسابي” كبديل رياضي للمعامل المنطقي AND. في هذا النظام، تُترجم القيمة المنطقية TRUE إلى الرقم (1)، بينما تُترجم القيمة FALSE إلى الرقم (0). وعند ضرب مصفوفتين منطقيتين في بعضهما، ينتج متجه رقمي جديد يحمل القيمة (1) فقط للصفوف التي حققت كلا الشرطين معاً (1 × 1 = 1).
في المقابل، إذا فشل السجل في تحقيق أحد المعايير المفروضة أو كلاهما، فإن عملية الضرب ستتضمن صفراً واحداً على الأقل (1 × 0 = 0 أو 0 × 0 = 0)، مما يُسقط هذا الصف حسابياً من مصفوفة الاسترجاع. يتيح هذا المنطق الجبري البديع فحص شروط متراكبة غير محدودة عبر سلاسل ضرب متتابعة تتسم بالدقة الرياضية والسرعة الحسابية الفائقة.
4.2 دمج الشروط المتعددة ضمن صيغة IF المركبة
لتطبيق منطق الضرب الجبري عملياً، يتم تغليف كل اختبار منطقي مستقل بين قوسين منفصلين ومغلقين، ثم الربط بينهما بعلامة الضرب النجمية (*). يُعد استخدام الأقواس الصارمة أمراً لا يقبل التهاون في بيئة الجداول الحسابية؛ إذ يضمن إعطاء أولوية التقييم للعمليات المنطقية الداخلية قبل إجراء عملية الضرب المصفوفي الشاملة بين المتجهات.
تأخذ مصفوفة الاختبار المنطقي داخل دالة IF الشكل الرياضي التالي: ((نطاق_الشرط_الأول = المعيار_الأول) * (نطاق_الشرط_الثاني = المعيار_الثاني)). يتم تقييم هذا التعبير كلياً داخل الذاكرة المؤقتة، ليتحول إلى متجه من الآحاد والأصفار. بعد ذلك، تتعامل دالة IF مع الرقم (1) بوصفه مكافئاً منطقياً للقيمة TRUE، فتقوم بإرجاع رقم الصف المقابل، بينما تتجاهل الأصفار وتتعامل معها بوصفها FALSE مستبعدة إياها من الترقيم.
يحافظ هذا التعديل البنيوي على مرونة الصيغة الأصلية بالكامل؛ إذ تظل دالتا SMALL و INDEX تعملان بنفس الآلية التتابعية دون تغيير في أدوارهما الفهرسية، مما يبرهن على قوة هذا النموذج وقابليته للتوسع التراكمي لدعم ثلاثة أو أربعة شروط متزامنة دون الحاجة لإعادة هندسة الهيكل الحسابي كلياً.
4.3 دراسة حالة عملية: استخراج السجلات وفق معيارين متزامنين
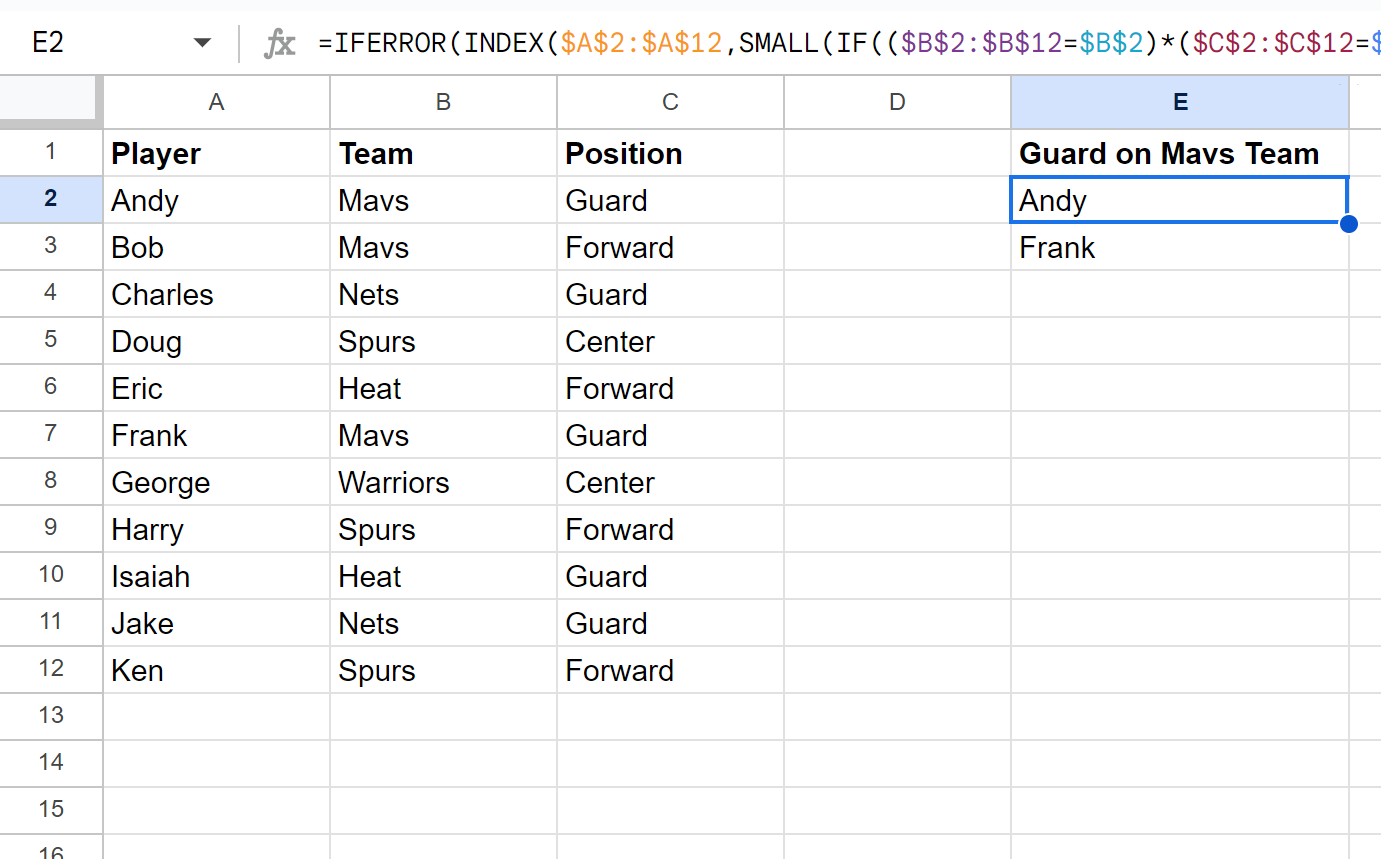
لتجسيد هذا الطرح في دراسة حالة ميدانية، نفترض قاعدة بيانات لقسم الموارد البشرية تضم أعمدة للموظفين تشمل: الاسم في النطاق A2:A100، والقسم الإداري في النطاق B2:B100، والموقع الجغرافي للعمل في النطاق C2:C100. المطلوب هو استخراج قائمة حصرية بأسماء الموظفين التابعين لقسم “التقنية” (المحدد في الخلية F1) والذين يعملون حصراً في موقع “المقر الرئيسي” (المحدد في الخلية F2).
تتم صياغة المعادلة المركبة المتقدمة في الخلية D2 على النحو التالي:
=IFERROR(INDEX($A$2:$A$100, SMALL(IF(($B$2:$B$100=$F$1) * ($C$2:$C$100=$F$2), ROW($A$2:$A$100)-ROW($A$2)+1), ROW(1:1))), "")
بتتبع مسار التقييم الحسابي لهذه المعادلة، نجد أن النظام يبدأ بفحص العمود B؛ فإذا كان السجل تابعاً للتقنية يُعطى 1 وإلا 0. بالتوازي مع ذلك، يُفحص العمود C؛ فإذا كان الموقع هو المقر الرئيسي يُعطى 1 وإلا 0. تتولى عملية الضرب دمج المتجهين، ولا يتبقى سوى الموظفين الذين حققوا الشرطين معاً ليتم التقاط أرقام صفوفهم عبر دالة SMALL ثم استدعاء أسمائهم بدقة بواسطة INDEX.
تُسحب الصيغة إلى أسفل لتوليد كامل القائمة المشروطة. وعند مراجعة المخرجات مقارنة بالبيانات الخام، يتضح العزل التام للمستهدفين بدقة متناهية، مع استبعاد تام لمن يحقق أحد الشرطين دون الآخر، مما يثبت الكفاءة العالية لمنطق الضرب الجبري في حل المعضلات التصنيفية المركبة.
5. صياغة الشروط البديلة والمعايير المعقدة (منطق الجمع الجبري OR)
5.1 توظيف عملية الجمع لمحاكاة المعامل المنطقي OR
على النقيض من اشتراط التحقق المتزامن لكافة المعايير (AND)، تفرض بعض المتطلبات التحليلية استخراج السجلات التي تستوفي واحداً على الأقل من بين مجموعة معايير مطروحة، وهو ما يمثل منطق الاختبار البديل OR. وكما هو الحال مع المعامل السابق، فإن الدالة OR التقليدية تعجز عن إرجاع مصفوفة من النتائج الفردية، وتكتفي بإرجاع قيمة واحدة، مما يستلزم اللجوء إلى الجمع الحسابي كأداة للمحاكاة الرياضية في بيئة المصفوفات.
تقوم هذه الآلية على جمع مصفوفات الاختبارات المنطقية بدلاً من ضربها. فعند فحص شرطين بديلين، تُحول القيم إلى أرقام، ويتم جمع المتجهين معاً. إذا تحقق الشرط الأول فقط، يكون الناتج (1 + 0 = 1). وإذا تحقق الشرط الثاني فقط، يكون الناتج (0 + 1 = 1). أما إذا تحقق كلا الشرطين في السجل نفسه، فإن ناتج الجمع يصبح (1 + 1 = 2). في حين أن السجل الذي يفشل في الشرطين معاً يعطي ناتجاً صفرياً حتمياً (0 + 0 = 0).
تتعامل بيئات الحوسبة في الجداول مع أي قيمة رقمية موجبة أكبر من الصفر بوصفها دلالة قطعية على الصواب المنطقي (TRUE). وعليه، فإن كلاً من القيمتين (1) و(2) تُعدان شرطاً كافياً لتحفيز دالة IF على إرجاع رقم الصف المقابل، بينما يتم إسقاط الصفوف الصفرية فقط، مما يحقق بنجاح المحاكاة التامة لمنطق الشروط البديلة.
5.2 معالجة أسبقية العمليات الحسابية في المصفوفات المعقدة
عند بناء نماذج استخلاص متقدمة تجمع بين الشروط الإلزامية (AND) والشروط البديلة (OR) في معادلة واحدة، تنشأ إشكالية بنيوية تتعلق بترتيب وأسبقية العمليات الحسابية (Operator Precedence). فالقواعد الرياضية القياسية تمنح عملية الضرب أولوية التنفيذ على عملية الجمع، الأمر الذي قد يقود إلى تشويه المنطق الشرطي المستهدف إذا لم يتم ضبط التعبير بدقة بالغة.
لتفادي هذا الخلل، يجب استخدام الأقواس التجميعية لفرض الترتيب المنطقي المراد تنفيذه. على سبيل المثال، إذا كان المطلوب هو استخراج الموظفين الذين ينتمون إلى فرع معين، وبشرط أن يكونوا إما في قسم التسويق أو المبيعات، فإن الجزء البديل الخاص بالأقسام ((القسم="تسويق") + (القسم="مبيعات")) يجب أن يُحاط بقوسين خارجيين جامعين قبل ضربه في مصفوفة شرط الفرع * (الفرع="الشمال").
يضمن هذا الإجراء الحسابي إتمام عملية الجمع البديل أولاً لتحديد المنتمين لأي من القسمين، قبل تطبيق عملية الفلترة الإلزامية الخاصة بالموقع الجغرافي. إن الإغفال عن وضع هذه الأقواس سيوجه النظام لضرب شرط المبيعات بالفرع أولاً ثم إضافة التسويق إليه دون قيد جغرافي، مما يسفر عن مخرجات خاطئة تماماً تشوبها التشوهات الإحصائية.
5.3 دمج معايير النصوص والأرقام والتواريخ ضمن نموذج استخراج موحد
تتضمن قواعد البيانات الميدانية مزيجاً متنوعاً من أنواع المتغيرات التي تتطلب فهماً عميقاً لطبيعة المعالجة الحاسوبية الخاصة بكل نوع. فعند مقارنة النصوص، يجب الانتباه إلى حساسية حالة الأحرف في بعض البيئات البرمجية والتأكد من مطابقة السلاسل الحرفية بدقة دون مسافات زائدة قد تفشل عملية التطابق المتساوي.
أما بالنسبة للمتغيرات الرقمية، فإنها تتيح استخدام عوامل المقارنة الرياضية النسبية، مثل الأكبر من >، أو الأصغر من <، أو عدم التساوي <>. يمكن بسهولة دمج هذه المعاملات ضمن مصفوفات الفحص المنطقي، كاشتراط أن تتجاوز مبيعات الموظف حداً رقمياً معيناً كشرط إضافي بجانب المعايير التصنيفية النصية، مما يمنح النموذج قدرة تصفية دقيقة ومعمقة.
فيما يتعلق بالتواريخ الزمنية، تتعامل جداول بيانات جوجل مع التاريخ داخلياً كرقم تسلسلي متصل يمثل عدد الأيام المنقضية منذ نقطة زمنية مرجعية محددة (30 ديسمبر 1899). لذا، عند وضع شروط تاريخية، يُفضل دائماً استخدام دالة DATE(السنة, الشهر, اليوم) لمقارنة القيم الزمنية بدلاً من كتابة التاريخ كنص، لضمان توافقه الرياضي التام مع النظام التسلسلي وتفادي أخطاء التفسير المحلي للصيغ الزمنية.
6. التحكم في المراجع النسبية والمطلقة وإزاحة المؤشرات
6.1 الأهمية المنهجية لتثبيت النطاقات لمنع الانزياح المرجعي
يمثل التمييز الدقيق بين المراجع المطلقة (Absolute References) والمراجع النسبية (Relative References) فارقاً جوهرياً بين نموذج برمجي رصين وآخر معرض للانهيار الفوري بمجرد التوسع. عند سحب أي صيغة حسابية رأسياً أو أفقياً، تقوم البرمجية تلقائياً بإزاحة عناوين الخلايا الواردة في المعادلة بمقدار خطوة واحدة لكل صف أو عمود، وهي ميزة مصممة للعمليات الحسابية المتتابعة لكنها تشكل خطراً بالغاً على مصفوفات البحث الثابتة.
في معادلات الاستخراج الشرطي، يؤدي نسيان تثبيت نطاق البيانات المصدرية، مثل كتابة A2:A100 بدلاً من $A$2:$A$100، إلى انزياح حدود البحث مع كل خلية يتم تعبئتها نحو الأسفل. فالخلية الثانية ستبحث في A3:A101، والثالثة في A4:A102، مما يؤدي بالضرورة إلى إسقاط الصفوف الأولى تدريجياً من مجال الفحص واحتمالية التقاط خلايا فارغة أو غير ذات صلة في نهاية الجدول، الأمر الذي يفسد النتائج دون إظهار رسالة خطأ واضحة.
تقتضي المنهجية الصارمة تطبيق التثبيت الكامل لجميع النطاقات المصدرية وخلايا المعايير عبر تضمين علامة $ قبل حرف العمود ورقم الصف، مع ترك مراجع العدادات التسلسلية حرة الحركة. ولتسهيل سير العمل، يمكن للمحلل استخدام المفتاح الوظيفي F4 فور تظليل النطاق للتنقل السريع والدقيق بين خيارات التثبيت المختلفة المتاحة في بيئة العمل.
6.2 دور الدالة ROW(1:1) كأداة ترقيم تصاعدية ذاتية
تُعد صياغة المعامل الترتيبي في دالة SMALL من أكثر النقاط التي يقع فيها المبتدئون في أخطاء منهجية شائعة، حيث يلجأ البعض إلى كتابة أرقام ثابتة صريحة مثل الرقم (1) في الخلية الأولى، ثم تعديله يدوياً إلى (2) في الخلية التالية، وهكذا. تفتقر هذه الطريقة تماماً إلى الأتمتة وتلغي ميزة التوليد التلقائي للقوائم الممتدة لمئات السجلات.
يمثل توظيف التعبير ROW(1:1) الحل الحسابي الأمثل لهذه المعضلة؛ فالدالة ROW تعيد رقم الصف للنطاق الممرر لها، وبما أن النطاق 1:1 يمثل الصف الأول في الورقة ككل، فإن الناتج الحسابي المباشر سيكون الرقم (1). الميزة الجوهرية هنا هي المرجعية النسبية المجردة؛ فعند نسخ المعادلة إلى الخلية التي بالأسفل، يتحول المرجع تلقائياً إلى ROW(2:2) منتجاً الرقم (2)، وتالياً ROW(3:3) منتجاً (3)، مما يؤسس لعداد ترقيمي ذاتي لا ينقطع.
يحافظ هذا التكنيك الذاتي على استمرارية التدفق الحسابي بصرف النظر عن الموقع الفيزيائي الفعلي للجدول داخل ورقة العمل؛ فسواء بدأت كتابة القائمة المستخرجة في الصف الخامس أو الصف الخمسين، فإن استخدام ROW(1:1) سيضمن بدء الترتيب دائماً من الرقم القياسي (1)، مستدعياً أولى النتائج الصالحة دون أي تشويه ناجم عن موقع جدول الإخراج في الصفحة.
6.3 معايرة مؤشر الطرح لحساب فروق صفوف العناوين
تنشأ إحدى أكثر المشكلات الحسابية دقة عند حساب أرقام الصفوف المسترجعة من داخل دالة IF. فعند استخدام التعبير ROW($A$2:$A$100) بمفرده، ستقوم الدالة بإرجاع الأرقام الفعلية للصفوف في ورقة العمل العامة، حيث يبدأ أول سجل محتمل بالرقم (2) نظراً لأن الصف الأول مخصص لعناوين وأسماء الأعمدة.
هنا تظهر فجوة إزاحة خطيرة تؤدي إلى تعطل دالة INDEX؛ فالدالة INDEX تنظر إلى النطاق الممرر لها $A$2:$A$100 بوصفه مصفوفة نسبية مستقلة تبدأ من العنصر رقم (1)، وهو السجل الفعلي المقابل للخلية A2. فإذا أعادت دالة IF الرقم الحسابي العام (2) كأول صف مطابق، ستوجه INDEX لاستدعاء العنصر الثاني في مصفوفتها، وهو القابع في الخلية A3، مما يتسبب في إزاحة النتائج بمقدار صف كامل للأسفل واستدعاء قيم غير صحيحة.
تتم تسوية هذه الفجوة الرياضية وتصحيح مؤشر البداية عبر تطبيق تقنية الطرح المعياري: ROW($A$2:$A$100) - ROW($A$2) + 1. يقوم هذا التعبير بحساب رقم الصف العام وطرح رقم صف البداية منه مع إضافة الرقم (1)، مما يؤدي إلى إعادة ترقيم متسلسلة السجلات لتبدأ من 1، 2، 3 إلى نهاية المصفوفة، بغض النظر عن موقع النطاق داخل الورقة، مما يضمن التوجيه الحسابي الدقيق لدالة INDEX.
7. تحليل مقارن: تركيبة (INDEX/SMALL) في مواجهة دالة FILTER
7.1 الخصائص المعمارية لدالة FILTER وسهولة الاستخدام
مع التحديثات المتقدمة في محركات جداول البيانات، قدمت شركة جوجل دالة متطورة تُعرف باسم FILTER، والتي صُممت خصيصاً لإلغاء التعقيد الهندسي المصاحب للتركيبات القديمة. تتميز دالة FILTER ببنائها النحوي البسيط والمباشر المتمثل في الصيغة: =FILTER(range, condition1, [condition2, ...])، مما يتيح للمحلل إنجاز عمليات الاستخراج المتقدمة بعبارة برمجية واحدة شديدة الوضوح.
تعتمد دالة FILTER على معمارية “المصفوفات الديناميكية المنسابة” (Dynamic Spill Arrays)؛ حيث يكفي كتابة الصيغة مرة واحدة في الخلية العلوية الأولى فقط، ليتولى المحرك الحسابي مهمة تفريغ وانسكاب كامل المخرجات المطابقة عبر الخلايا المجاورة لأسفل ولليسار تلقائياً، دون أي حاجة لسحب مقبض التعبئة يدوياً أو استخدام عدادات ترقيم متزايدة مثلما تتطلب تركيبة SMALL التقليدية.
تتعامل دالة FILTER مع الشروط المتعددة الإلزامية بسلاسة تامة بمجرد سردها كمحددات متتالية تفصل بينها الفواصل، مما يعني تطبيق منطق AND تلقائياً. في المقابل، يمكن تطبيق منطق OR البديل ضمنها باستخدام عملية الجمع الجبري للأقواس تماماً كما في الصيغ السابقة، مما يجعلها الخيار المعاصر الأكثر انتشاراً بين مستخدمي جداول بيانات جوجل.
7.2 مرونة وقوة التحكم في تركيبة INDEX و SMALL التقليدية
على الرغم من البساطة الملحوظة لدالة FILTER، إلا أن تركيبة الدوال الكلاسيكية المتمثلة في INDEX و SMALL و IF تحتفظ بمكانة استثنائية وأهمية منهجية كبرى في تطبيقات إدارة البيانات المتقدمة. تعود هذه الأهمية في المقام الأول إلى التوافق البرمجي الشامل؛ فهذه التركيبة تعمل بكفاءة مطلقة عبر مختلف المنصات وبرمجيات الجداول، بما في ذلك الإصدارات القديمة جداً من برنامج مايكروسوفت إكسل التي تفتقر للمحركات الحسابية الداعمة لانسكاب الدوال.
تمنح الصيغة الكلاسيكية المستخدم سيطرة ميكانيكية دقيقة وفردية على كل خلية على حدة ضمن عمود الإخراج؛ فالمخرجات ليست كتلة مصفوفية واحدة لا تقبل التجزئة، بل هي معادلات مستقلة في كل صف، مما يتيح إمكانية دمج شروط استثنائية وتخصيصات فردية في صفوف محددة، أو تشتيت النتائج وربطها بخلايا غير متصلة عبر واجهات العرض، وهو أمر يصعب تنفيذه بالمصفوفات المنسابة المقيدة بنطاقات صلبة.
من الناحية المعرفية والتعليمية، يوفر دراسة وفهم تركيبة INDEX و SMALL أساساً بنيوياً عميقاً لفهم هندسة المتجهات والتحويلات المنطقية والجبر البولياني داخل بيئات الجداول، مما يثري الحصيلة البرمجية للمحلل ويجعله قادراً على ابتكار حلول حسابية خارج الصندوق للمشكلات المعقدة التي تتجاوز قدرات الدوال المسبقة الإعداد.
7.3 تقييم الكفاءة واستهلاك الموارد الحسابية بين الطريقتين
عند تقييم الأداء في قواعد البيانات الضخمة التي تشتمل على عشرات الآلاف من الصفوف، تتباين الكفاءة الحاسوبية واستهلاك موارد المعالجة بشكل ملحوظ بين النموذجين. فتركيبة INDEX و SMALL المعتمدة على السحب الفردي تفرض عبئاً حسابياً هائلاً؛ نظراً لأن كل خلية في عمود المخرجات تقوم بإعادة تقييم المصفوفة بالكامل من جديد لحساب أصغر قيمة ترتيبية خاصة بها، مما يؤدي إلى تكرار العمليات الحسابية لملايين المرات واستنزاف ذاكرة المتصفح.
في المقابل، تتمتع دالة FILTER بكفاءة معمارية عالية؛ حيث يقوم محرك الحسابات بقراءة مصفوفة البيانات ومصفوفات الشروط في دورة معالجة موحدة، ويستخلص السجلات المؤهلة ويسكبها في خطوة حسابية متكاملة واحدة، مما يقلل بشكل ملموس من زمن الاستجابة، ويحافظ على سلاسة الواجهة الرسومية وسرعة تحديث البيانات عبر بيئة الويب السحابية.
تتجه المعايير المنهجية الأكاديمية والعملية إلى تفضيل استخدام دالة FILTER في المشروعات الحية السحابية التي تتعامل مع تدفقات بيانات كبيرة ومتجددة، في حين يُحتفظ بتركيبة INDEX و SMALL للحالات التوافقية المتطلبة للنقل بين منصات متباينة أو المشروعات التي تشترط تحكماً جزئياً في بنية الخلايا وتصميماتها الفردية.
8. استراتيجيات استكشاف الأخطاء وإصلاحها وتحسين الأداء
8.1 تشخيص الأخطاء الشائعة وحلها (#NUM!، #REF!، #VALUE!)
تتطلب إدارة النماذج الحسابية المتقدمة معرفة دقيقة بالتشخيص الدلالي لرسائل الأخطاء الشائعة التي قد تطرأ على ورقة العمل لتصحيحها منهجياً. يظهر الخطأ #NUM! بصورة رئيسية عند استخدام دالة SMALL عندما تتلقى طلباً لاستخراج رتبة ترتيبية (k) تتجاوز النطاق الرقمي للقيم المتاحة، وهو مؤشر قياسي على انتهاء قائمة العناصر المطابقة، ويُعالج مباشرة بالتغليف الوقائي عبر دالة IFERROR.
أما الخطأ الإحداثي #REF!، فيرتبط بانكسار في المراجع الهيكلية؛ وله سببان شائعان: الأول هو تجاوز دالة INDEX لنطاق أبعاد المصفوفة الأصلية عند تزويدها برقم صف يتجاوز الحدود القصوى للجدول المرجعي. والسبب الثاني، الشائع جداً مع دالة FILTER والدوال المنسابة، هو وجود عائق في مسار الانسكاب المكتبي (Spill Collision)، حيث تعترض خلية غير فارغة طريق تمدد النتائج، مما يفرض تفريغ كافة الخلايا المجاورة لأسفل الصيغة لتصحيح الخطأ فوراً.
ينشأ الخطأ المنطقي #VALUE! عند وجود تباين وتناقض في أبعاد النطاقات المتقاطعة؛ كأن يتم محاولة فحص شرط لمصفوفة تمتد على النطاق B2:B100 بينما نطاق البحث الأصلي يمتد على A2:A50. يتسبب عدم التماثل في أعداد الصفوف في شلل مصفوفي تام يعجز فيه المحرك عن تطبيق الضرب أو الفرز، ويتطلب حله إعادة توحيد بدايات ونهايات النطاقات المستخدمة في الصيغة الرياضية بدقة مطلقة.
8.2 تحسين سرعة الحساب وتقليل العبء على المعالج
لضمان استقرار وسرعة أوراق العمل المعقدة، يجب تبني استراتيجيات تقنية ترشد استهلاك موارد المعالجة وتحد من زمن التحميل. تتمثل إحدى أهم هذه الممارسات في تجنب الإشارة إلى الأعمدة اللانهائية المفتوحة بالكامل، مثل كتابة A:A أو B:B في الصيغ المصفوفية؛ حيث يفرض هذا التعيين على المحرك فحص ومعالجة ما يزيد عن مليون خلية افتراضية في الورقة، معظمها خلايا فارغة وغير مفيدة.
بدلاً من ذلك، يُنصح دائماً بتأطير النطاقات وحصرها على مساحة البيانات الفعلية المأهولة فقط، كاستخدام A2:A1000، أو بناء نطاقات مرجعية ديناميكية مرنة تتسع ذاتياً بحسب حجم البيانات دون الإفراط في هدر المساحات. يساهم هذا التحديد الموجه في تقليص مصفوفات الذاكرة بنسبة تزيد عن 90%، مما ينعكس إيجابياً على سلاسة حركة الملف وسرعة الحساب.
ينبغي كذلك الابتعاد التام عن إدراج الدوال المتقلبة (Volatile Functions) مثل NOW() أو TODAY() أو RAND() داخل المعايير المنطقية المباشرة للصيغ المصفوفية؛ لأن هذه الدوال تفرض إعادة احتساب النموذج بأكمله بصورة قسرية مع كل حركة نقر أو تعديل هامشي يجريه المستخدم على الورقة، مما يثقل كاهل المعالج السحابي ويتسبب في بطء الاستجابة.
8.3 ضمان جودة البيانات ومدخلات المعايير الشرطية
تعتمد سلامة المخرجات الحسابية المشروطة اعتماداً كلياً على نقاء وجودة المدخلات الأولية؛ فالصيغ المصفوفية تتعامل مع النصوص بمنطق المطابقة الصارمة. لذا، فإن وجود مسافة فارغة إضافية غير مرئية في نهاية الكلمة داخل الخلية المصدرية أو خلية المعيار كفيل بإفشال المقارنة المنطقية كلياً واعتبار العنصرين غير متطابقين، مما يحرم سجلاً صحيحاً من الظهور في النتائج.
لإرساء حوكمة جودة البيانات، يُوصى باستخدام دالة تنظيف المسافات TRIM ودالة إزالة الرموز غير الطباعية CLEAN على البيانات النصية الواردة من مصادر خارجية قبل إدراجها في منظومة التصفية، لضمان تجانس وتطابق البنية النصية لكافة السجلات.
من الضروري كذلك ربط خلايا المعايير الخارجية بأداة “التحقق من صحة البيانات” (Data Validation) عبر إنشاء قوائم منسدلة مستمدة مباشرة من عناصر البيانات الأصلية. يمنع هذا الإجراء الوقائي وقوع أخطاء الإدخال الإملائية الشائعة من قِبل المستخدمين، ويضمن بقاء المعيار المستهدف متوافقاً دوماً مع التسميات الفعلية المسجلة في قاعدة البيانات الأساسية.
9. التطبيقات المتقدمة: الفرز، والفرادة، والتفاعل الديناميكي
9.1 دمج دالة SORT لترتيب القوائم المستخرجة تلقائياً
في إطار بناء التقارير التحليلية التنفيذية، لا يقتصر المطلب على مجرد تصفية السجلات واستخراجها، بل يمتد ليشمل ترتيب هذه المخرجات نسقياً لتسهيل قراءتها واستيعاب أنماطها. يتميز محرك جداول بيانات جوجل بالقدرة على دمج الدوال المنسابة مع بعضها البعض في صيغ مركبة انسيابية، مما يتيح إدماج دالة SORT الرياضية مباشرة فوق مخرجات التصفية.
تأخذ المعادلة المركبة للفرز والتصفية النمط التطبيقي التالي: =SORT(FILTER(A2:B100, B2:B100="مؤهل"), 1, TRUE). في هذا السياق، تقوم دالة FILTER أولاً باستخلاص مجموعة السجلات المحققة للمعيار، ثم تتلقى دالة SORT هذا الناتج كمصفوفة فورية، وتقوم بإعادة ترتيبه تصاعدياً بناءً على العمود الأول (عمود الأسماء)، دون المساس بترتيب السجلات الأصلي في قاعدة البيانات الخام.
يسمح هذا التكامل بالتحكم الكامل في اتجاهات الفرز (تصاعدي أو تنازلي) وفق معايير نصية أو رقمية متزامنة، مما يسهل بناء مصفوفات مخرجات مجهزة إحصائياً تُستخدم بصورة مباشرة لتوليد المخططات البيانية والرسمية الجاهزة للعرض الأكاديمي والمهني.
9.2 إزالة التكرارات واستخراج القيم الفريدة المشروطة
تتضمن العديد من قواعد البيانات التشغيلية تكراراً طبيعياً لبعض العناصر والمعرفات؛ كأن يسجل الموظف مبيعات متعددة في أيام مختلفة، أو يسجل المشارك عدة محاولات في اختبار بحثي. وعند استخراج قائمة بالمشاركين المؤهلين، تقتضي المنهجية حصر الأفراد كقيم متفردة دون إظهار الاسم نفسه مرات متعددة تعكس عدد مرات نشاطه المسجل في الجدول الأصلي.
لتحقيق هذا الغرض، يتم استدعاء الدالة القوية UNIQUE وتغليفها حول دالة التصفية على النحو التالي: =UNIQUE(FILTER(A2:A100, B2:B100="مؤهل")). تقوم التركيبة بعملية فحص مزدوجة ومترابطة؛ حيث تقوم FILTER بعزل الأسماء المشروطة، بينما تتولى UNIQUE فحص المتجه المسترجع واستئصال كافة الإدخالات المتكررة بدقة متناهية، مبقية على ظهور فردي ووحيد لكل عنصر مستوفٍ للشروط.
يمثل هذا المزيج الوظيفي أداة محورية لإنتاج ملخصات تنفيذية سريعة وموجزة لمجموعات البيانات، تفيد في إحصاء أعداد المستهدفين الحقيقيين وتساعد في استخراج عينات بحثية نقية تفي بالمعايير دون تضخيم زائف في أحجام العينات ناجم عن تكرار السجلات الفردية.
9.3 تأسيس لوحات معلومات تفاعلية بالاعتماد على القوائم المنسدلة
يصل التحليل الشرطي إلى أقصى درجات النضج المؤسسي والتقني عندما يتم تحويل النطاقات الجامدة إلى لوحات معلومات تفاعلية (Interactive Dashboards) تلبي احتياجات المستخدم النهائي بمرونة وسهولة. يرتكز هذا التصميم على ربط مدخلات المعايير بخلايا تحكم تفاعلية تستند إلى القوائم المنسدلة للتحقق من صحة البيانات.
يتم ذلك عبر تخصيص خلية تحكم علوية، ولتكن الخلية C1، وتهيئتها كقائمة منسدلة تحتوي على التصنيفات الرئيسية للبحث. في المقابل، تُبنى معادلة الاستخراج الرئيسية بحيث تقرأ معيارها حركياً من هذه الخلية. وبمجرد أن يقوم المستخدم بالنقر على السهم واختيار فئة جديدة بنقرة زر واحدة، يعاد تقييم المعادلات المصفوفية تلقائياً، وتتبدل مخرجات القوائم والمخططات المرافقة بصورة بصرية لحظية فائقة السلاسة.
يمكن تصعيد هذا النموذج لبناء قوائم منسدلة تابعة ومتتالية (Dependent Drop-down Lists)؛ حيث تُستخدم القائمة المستخرجة بالمعادلة الأولى كمدخل لتغذية القائمة المنسدلة الثانية، مما يسمح بتصفية البيانات تدريجياً عبر طبقات تصنيفية متدرجة، وصولاً إلى استخلاص أدق التفاصيل من قواعد البيانات الضخمة دون تعقيد إجرائي.
10. أفضل الممارسات الأكاديمية والتوثيق المنهجي للنماذج
10.1 معايير التوثيق الأكاديمي للصيغ المعقدة في بيئات العمل المشتركة
تتسم بيئات العمل التعاونية والسحابية بمشاركة ملفات البيانات بين باحثين وفرق تحليل متعددة، الأمر الذي يفرض الالتزام بأعلى معايير التوثيق المنهجي لمنع الغموض والارتباك الحسابي. إن الصيغ المصفوفية المتداخلة الطويلة، ورغم براعتها الرياضية، تظل صعبة القراءة والتفسير للمستخدم الخارجي إذا لم تُعزز بتوثيق توضيحي يفكك آليات عملها ومنطق بنائها الداخلي.
تتمثل الخطوة الأولى في إدراج التعليقات الوصفية داخل بيئة العمل، سواء عبر أدوات التعليقات الحوارية للخلايا أو استخدام الدالة التوثيقية LET التي توفرها البيئات المعاصرة لتعريف المتغيرات وتسمية الخطوات الحسابية داخل المعادلة نفسها، مما يحول الرموز المجردة إلى مقاطع دلالية واضحة ومفهومة لأي مراجع أكاديمي أو تقني يطالع النموذج.
إلى جانب التعليقات، يُعد إنشاء صفحة مستقلة لـ “البيانات الوصفية” (Metadata Sheet) ممارسة بحثية لازمة في المشاريع الكبرى. تشمل هذه الصفحة دليلاً شاملاً لكافة المتغيرات، والنطاقات المسماة (Named Ranges)، وأرقام الإصدارات، والشروط المنطقية المطبقة في كل ورقة، والهدف البحثي المحدد لكل جدول مستخرج، مما يضمن قابلية النموذج للتدقيق والمراجعة ومطابقة معايير النزاهة العلمية.
10.2 الفصل الهيكلي بين طبقات البيانات والمعالجة والعرض
تستلزم هندسة نظم المعلومات والبيانات الفصل الصارم بين الطبقات الوظيفية المكونة للنموذج المحوسب، وهو المبدأ المنهجي المعروف بفصل الاهتمامات (Separation of Concerns). يُحظر في النماذج الاحترافية دمج إدخال البيانات وتدوين الملاحظات الخام في نفس الصفحة التي تُجرى فيها العمليات الحسابية المصفوفية أو تُعرض فيها الرسوم البيانية التلخيصية.
يتم تطبيق هذا الفصل عبر تخصيص ورقة عمل مستقلة تُخصص بالكامل للبيانات الخام غير المعالجة (Raw Data)، حيث تُحفظ كسجل تاريخي نقي لا تمتد إليه أي صيغ تعديلية. وتُخصص ورقة عمل تالية لـ “المعالجة الوسيطة” (Processing Layer)، وتضم مصفوفات الدوال، والتصفيات الشرطية، والتحويلات الهيكلية، وأعمدة المقارنة الرياضية المتقدمة.
أما الطبقة الثالثة والأخيرة، فتتمثل في “واجهة العرض للمستخدم” (Presentation Layer)، وتقتصر على استدعاء النتائج النهائية، والجداول المنقحة، والمؤشرات الرقمية، والمخططات المرئية. يتيح هذا الفصل المعماري حماية الخلايا الحاوية على الصيغ من التعديل العرضي أو التلف غير المقصود عبر إقفال وحماية أوراق المعالجة والبيانات الخام، مانحاً المستخدم النهائي مساحة تفاعل آمنة ومنضبطة.
10.3 إجراءات التدقيق والتحقق الدوري من سلامة المخرجات الشرطية
لا يكتمل بناء أي نموذج تحليلي دون وضع منظومة صارمة للتدقيق الدوري والتأكد من مطابقة المخرجات للواقع الإحصائي للبيانات المصدرية. فمع استمرار تدفق البيانات، قد تنشأ استثناءات غير متوقعة تؤدي إلى انحراف النتائج دون أن تُطلق البرمجية رسائل تحذير واضحة، مما يتطلب تأسيس آليات فحص ذاتية مؤتمتة ومدمجة في النظام.
يتم تطبيق هذه الآليات عبر تصميم “معادلات توازن ومطابقة” في زوايا معزولة من أوراق العمل؛ فعلى سبيل المثال، يتم احتساب المجموع الإجمالي للسجلات المستخرجة والمصنفة ومقارنته بالمجموع الكلي للبيانات في الورقة الخام عبر معادلة فحص شرطية: =IF(SUM(Filtered_Data) = SUM(Raw_Data), "مطابق وموثوق", "تنبيه: يوجد خلل في التصفية"). يؤدي هذا التنبيه البصري الفوري إلى لفت انتباه المحلل لأي تناقض حسابي في اللحظة التي يقع فيها.
يُختتم البروتوكول بوضع جدول زمني للمراجعة والتدقيق الميداني، يشمل اختبار النموذج بحالات حدية وافتراضية (Stress Testing)، وإجراء عمليات تدقيق يدوي لعينات عشوائية مسترجعة للتأكد من انطباق المعايير عليها، لضمان استدامة موثوقية النماذج البحثية والمحاسبية وقدرتها الدائمة على تقديم قرارات وإحصاءات دقيقة لا يتطرق إليها الشك.
خاتمة
استعرضنا في هذا الدليل الموسع الأطر النظرية والتطبيقية لإنشاء القوائم المشروطة في جداول بيانات جوجل، مبيّنين أهمية الأتمتة البرمجية في رفع كفاءة التحليل الإحصائي وتفادي الأخطاء البشرية الشائعة. وقد تناولنا بالتشريح الدقيق البناء الهندسي للمصفوفات الكلاسيكية (INDEX و SMALL و IF و ROW) وكيفية محاكاتها لمنطق الجبر البولياني بشقيه المتزامن (AND) والبديل (OR)، وصولاً إلى استعراض الحلول الحديثة السلسة التي توفرها دالة FILTER المنسابة وما يرتبط بها من دوال مساعدة كـ SORT و UNIQUE.
إن إتقان هذه المهارات المتقدمة في إدارة البيانات يمثل جسراً تحويلياً ينقل الباحث والمحلل من مجرد مستخدم تقليدي للجداول الإلكترونية إلى مصمم نظم بيانات قادر على بناء لوحات تفاعلية ونماذج بحثية رصينة تتسم بالدقة، والقابلية للتوسع، والتوثيق الأكاديمي المنهجي المتكامل.
المراجع
- Google. (n.d.). FILTER function. Google Docs Editors Help. https://support.google.com/docs/answer/3093197
- Google. (n.d.). INDEX function. Google Docs Editors Help. https://support.google.com/docs/answer/3098242
- Google. (n.d.). QUERY function. Google Docs Editors Help. https://support.google.com/docs/answer/3093304
- Google. (n.d.). SORT function. Google Docs Editors Help. https://support.google.com/docs/answer/3093150
- Google. (n.d.). UNIQUE function. Google Docs Editors Help. https://support.google.com/docs/answer/3093198
- Rochelle, J. (2021). About Jonathan Rochelle. Jonathan Rochelle Personal Site. https://www.jonathanrochelle.com