
تُعدّ هندسة البيانات ومعالجة النصوص المدخل الأساسي لأي مسار تحليلي رصين في بيئات العمل الرقمية المعاصرة. فعند استيراد البيانات من واجهات برمجة التطبيقات (APIs)، أو ملفات السجلات التقنية (Log Files)، أو قواعد البيانات العلائقية وغير العلائقية، نادراً ما تظهر المدخلات بصيغ مهيكلة بالكامل وجاهزة للاستخدام التحليلي الفوري. تبرز جداول بيانات Google (Google Sheets) كمنصة حوسبة سحابية متقدمة تتيح للمحللين والمهندسين تنفيذ عمليات استخلاص وتطهير النصوص بدقة متناهية، متجاوزةً بذلك القيود التقليدية التي فرضتها البرمجيات المكتبية السابقة عبر بنيتها السحابية المرنة ومحركاتها البرمجية المدمجة.
تتمحور إحدى أكثر المعضلات التقنية تكراراً في تحضير البيانات حول الحاجة الحتمية إلى عزل واستخراج أجزاء محددة من السلاسل النصية استناداً إلى مواقع محارف أو فواصل مفتاحية، وتحديداً اقتطاع ما يلي محرفاً معيناً مثل الشرطات، أو النقطتين الرأسيتين، أو علامات البريد الإلكتروني، أو الرموز الخاصة. يتطلب هذا الإجراء فهماً عميقاً للمنطق الحسابي الذي يحكم السلاسل الرمزية، وكيفية التعامل مع المتجهات النصية، سواء عبر الدوال الكلاسيكية الموروثة من تاريخ جداول البيانات الحسابية الممتد، أو من خلال محركات التعبيرات النمطية المتقدمة مثل محرك RE2 المدمج في بيئة Google السحابية. كما يشير بولتون وفياتكينا (Boulton & Vyatkina, 2021) في دراستهما حول تحليل الأنماط اللغوية المعتمدة على البيانات، فإن القدرة على استخلاص الأنماط النصية بكفاءة تمثل الركيزة الأساسية لأي نظام استدلالي يتعامل مع المدخلات غير المهيكلة.
يهدف هذا المرجع الأكاديمي الشامل إلى تفكيك كافة المناهج الرياضية والبرمجية المعنية باستخراج النصوص الواقعة بعد حرف أو رمز محدد داخل جداول بيانات Google. سنستعرض الآليات الدقيقة التي تبتدئ من التحليل النظري لبنية النصوص كمتجهات أحادية البعد، مروراً بالتشريح الصارم لدالة REGEXEXTRACT واستراتيجيات المطابقة الحتمية، وصولاً إلى دمج الدوال الكلاسيكية (RIGHT, LEN, FIND) وتقنيات المصفوفات الممتدة عبر ARRAYFORMULA، مع تقديم معالجات معمقة لإدارة الأخطاء وحالات الشذوذ في بيئات الأعمال الواقعية.
1. مدخل نظري لمعالجة النصوص وهندسة البيانات في جداول بيانات Google
1.1 أهمية استخلاص السلاسل النصية في تنظيف البيانات وتحليلها
تلعب تنقية البيانات النصية دوراً جوهرياً في الارتقاء بمستويات الموثوقية داخل النماذج التحليلية وقواعد البيانات المركزية. في البيئات التشغيلية، تأتي البيانات الأولية مشبعة بالشوائب التنسيقية والمحددات التركيبية التي تحجب المعنى الدلالي للأرقام أو المعرفات. على سبيل المثال، قد تحتوي حقول المنتجات على معرفات تسلسلية مدمجة مع أسماء الفئات داخل سلسلة نصية واحدة مفصولة بشرطة، مما يجعل عمليات التجميع (Aggregation) والربط العلائقي (Relational Joining) مستحيلة دون عزل تلك المكونات واستخراج المتغيرات الفرعية بدقة تامة.
يسهم تحويل البيانات غير المهيكلة وشبه المهيكلة إلى حقول رقمية ونصية مستقلة في بناء فهارس استعلامات عالية الكفاءة ويسهل عمليات التصنيف الرياضي. وقد أوضح الذيابي وآخرون (Aldhyani et al., 2022) أن مرحلة المعالجة المسبقة للنصوص واستخلاص الميزات المحددة تمثل الخطوة الأهم لضمان استقرار الخوارزميات وصحة النتائج المستخلصة. من دون عزل محكم للنصوص استناداً إلى الفواصل الحاكمة، تتعرض مسارات البيانات لأخطاء المطابقة الجزئية وتشوهات التحليل الدلالي، مما يرفع كلفة معالجة الأخطاء في المراحل التحليلية المتقدمة.
تتفاقم التحديات المنهجية في إدارة هذه العمليات بفعل التنوع الهائل في أشكال النصوص الواردة؛ حيث لا تلتزم النظم المصدرية دوماً باتساق موحد للفواصل. تتباين محددات الفصل داخل الخلية الواحدة ما بين مسافات بيضاء غير مرئية، ورموز ترقيم دولية، ومحارف تحكم برمجية. هذا التباين يستوجب صياغة قواعد تطهير نصية لا تكتفي بالحلول الظرفية، بل تؤسس لمعمارية رياضية صارمة تستوعب الحالات الشاذة وتضمن نقاء المخرجات التحليلية النهائية.
1.2 المفاهيم الرياضية والمنطقية الكامنة خلف معالجة السلاسل النصية
تُعامل السلاسل النصية في علوم الحاسوب ونظم الجداول الممتدة كمتجهات رياضية أحادية البعد (One-Dimensional Arrays/Vectors) تتألف من خانات محرفية متسلسلة (Character Sequences). في هذا النموذج الرياضي، يحتل كل رمز أو مسافة أو محرف موقعاً رقمياً محدداً ضمن فضاء المتجه، ويبدأ هذا الترتيب في جداول بيانات Google بالفهرس 1 (1-based Indexing)، على خلاف بعض لغات البرمجة العامة كبايثون وسي التي تعتمد الفهرسة الصفرية (0-based Indexing). هذا الفارق المفاهيمي يعد محورياً عند إجراء عمليات الإزاحة الحسابية.
يعتمد منطق استخراج النصوص بعد رمز محدد على حساب إزاحة المؤشر (Pointer Offset) وتحديد الفهارس النسبية للمحارف المستهدفة. تتمثل العملية الرياضية الأساسية في إيجاد الدالة الرياضية لموقع المحرف الفاصل، ثم حساب طول المتجه الكلي، لتحديد متجه فرعي (Substring Vector) يبتدئ من نقطة الإزاحة وينتهي عند الطرف الأخير للمتجه الأصلي. يتطلب هذا التحليل فهماً دقيقاً للمسافة الإقليدية الفاصلة بين الفهرس المكتشف ونهاية السلسلة، مع الأخذ بالاعتبار طبيعة التمثيل الثنائي للمحارف الممتدة ضمن معايير UTF-8.
يقودنا هذا التأطير الرياضي إلى التحليل المقارن بين أسلوبين معرفيين: المطابقة التامة للمحارف (Deterministic Character Matching) والمطابقة المعتمدة على الأنماط البرمجية (Pattern-Based Matching). تعتمد المطابقة التامة على البحث الخطي المباشر عن رمز ثنائي محدد، وتتميز بانخفاض التعقيد الحسابي وخفة استهلاك الذاكرة. في المقابل، توفر مطابقة الأنماط، القائمة على نظرية اللغات الصورية والآلات المحدودة الذاتية (Finite State Automata)، مرونة فائقة تسمح بالتعامل مع التغيرات الاحتمالية لمواقع الرموز وبنيتها الشكلية دون الحاجة إلى إعادة صياغة الشيفرة الحسابية عند كل تغير في المدخلات.
1.3 نظرة عامة على أدوات جداول بيانات Google في المعالجة النصية
شهدت جداول بيانات Google تطوراً متسارعاً منذ انطلاقها في يونيو 2006؛ حيث اعتمدت في بداياتها على الدوال النصية التقليدية المشتقة من الحزم المكتبية التاريخية مثل Lotus 1-2-3 وميكروسوفت إكسيل. شملت هذه الأدوات الكلاسيكية دوال التقطيع الثابت كـ MID وRIGHT وLEFT مقترنة بدوال التعيين المكاني FIND وSEARCH. ومع تزايد حجم البيانات السحابية المعقدة، أضافت المنصة دعماً أصيلاً لدوال التعبيرات النمطية المتقدمة مثل REGEXEXTRACT وREGEXREPLACE وREGEXMATCH، مما أحدث نقلة نوعية في قدرات المعالجة السحابية.
تعمل جداول بيانات Google ضمن بيئة حوسبة سحابية موزعة تؤثر بصورة مباشرة على سرعة وكفاءة العمليات الحسابية النصية. على النقيض من البرمجيات المثبتة محلياً، تُنفذ الصيغ الرياضية داخل مراكز بيانات Google السحابية، حيث تُرسل البيانات وتُعالج ضمن خيوط حوسبة متوازية، ثم تُعاد النتائج للمتصفح. تمنح هذه البنية ميزة هائلة عند تشغيل دوال التعبيرات النمطية المكتوبة بلغة C++ والمدمجة في محرك RE2 فائق السرعة، بينما تفرض في الوقت ذاته قيوداً متعلقة بزمن الاستجابة (Latency) وحدود استخدام المعالج عند تكرار الحسابات على مصفوفات ضخمة.
تتكامل هذه الصيغ الخلوية بصورة مدمجة مع منصة البرمجة النصية عبر Google Apps Script المبنية على معايير ECMAScript. يتيح هذا التكامل للمطورين سد الثغرات التي تعجز الدوال المباشرة عن معالجتها؛ حيث يمكن استدعاء دوال مخصصة (Custom Functions) تدمج خوارزميات الذكاء الاصطناعي ومعالجة اللغات الطبيعية لمعالجة الحالات المستعصية، مع الحفاظ على مرونة التفاعل اللحظي التي تتيحها خلايا ورقة العمل العادية دون الحاجة إلى تشغيل برمجيات خلفية منفصلة.
2. بنية دالة REGEXEXTRACT والتشريح الدقيق لصيغتها البرمجية
2.1 التعريف المعياري للدالة ووسائط الإدخال الأساسية
تُعد دالة REGEXEXTRACT الأداة الأكثر أناقة وقوة في جداول بيانات Google لاستخراج النصوص استناداً إلى قواعد نمطية محددة. تعمل هذه الدالة بمثابة واجهة مستخدم مباشرة لمحرك التعبيرات النمطية الخطي RE2 المطور من قِبل Google، والذي يتميز بضمان تنفيذ العمليات في زمن خطي يتناسب مع حجم النص المُدخل O(n)، مما يمنع حدوث ظاهرة التراجع الكارثي (Catastrophic Backtracking) الشائعة في محركات التعبيرات النمطية التقليدية الأخرى.
تتكون الصيغة المعيارية للدالة من وسيطين أساسيين غير اختياريين وفق التركيب الرياضي التالي:
=REGEXEXTRACT(text, regular_expression)
يمثل الوسيط الأول (text) النص المصدري أو المرجع الخلوي المستهدف (مثل A2). يقبل هذا الوسيط أي سلسلة نصية مجردة أو مخرجات دالة نصية أخرى، ويشترط المحرك أن يكون المدخل قابلاً للتحويل إلى تمثيل محرفي متصل؛ فإذا تم تمرير قيمة فارغة أو رقم خالص دون تحويل مسبق، يُجري المحرك تحويلاً ضمنياً إلى نص قبل تطبيق النمط.
يمثل الوسيط الثاني (regular_expression) التعبير النمطي الحاكم لقواعد الاستخراج، ويُكتب وجوباً كسلسلة نصية محاطة بعلامات اقتباس مزدوجة. يحتوي هذا الوسيط على القواعد الرمزية ومجموعات الالتقاط (Capturing Groups) التي تملي على المحرك الأجزاء الدقيقة المراد عزلها. أما بالنسبة لقيم الإخراج، ففي حال نجاح المطابقة ووجود مجموعة التقاط، تعيد الدالة المحتوى المحصور داخل تلك المجموعة كنص نقي. وفي حال فشل المطابقة أو عدم العثور على النمط المستهدف، تُرجع الدالة خطأ عدم التوفر الرياضي الكلاسيكي (#N/A).
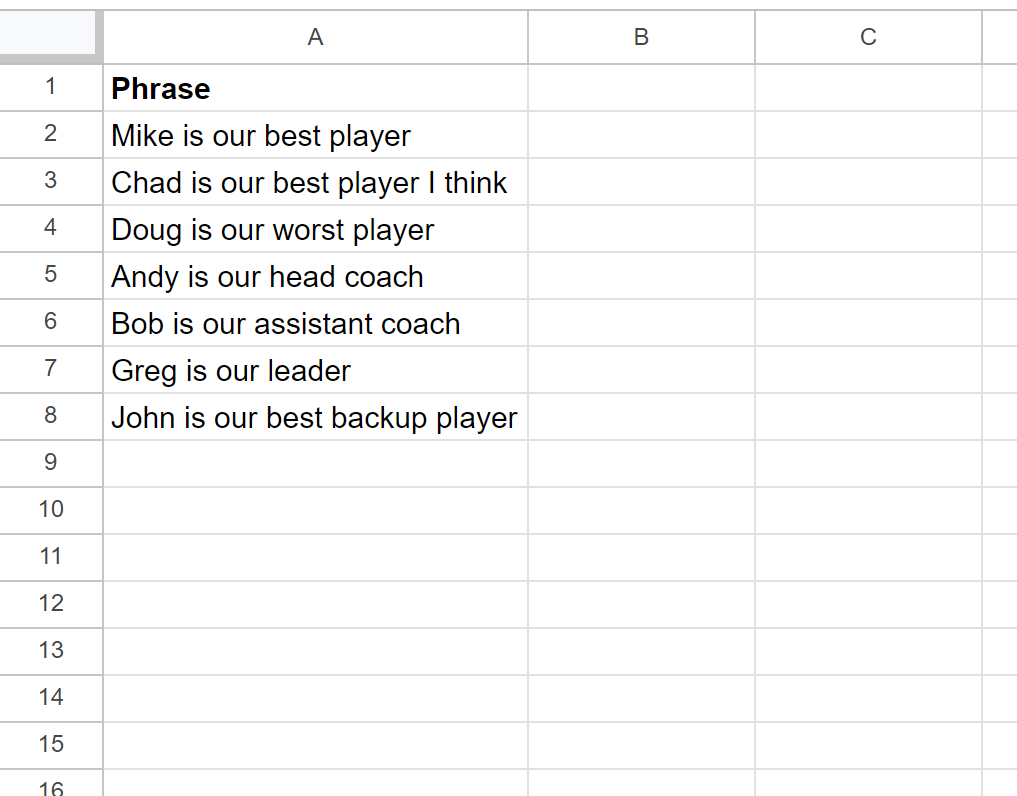
2.2 الرموز الأساسية للتعبيرات النمطية المستخدمة في الدالة
لفهم آلية استخراج النصوص بعد حرف معين، يجب تفكيك القواعد النحوية للرموز الأساسية في محرك التعبيرات النمطية. يأتي في مقدمة هذه الرموز الرمز النقطي (.)، والذي يمثل علامة مطابقة كونية (Wildcard) تتطابق مع أي محرف مفرد أياً كان نوعه، سواء كان حرفاً أبجدياً، أو رقماً، أو رمزاً خاصاً، أو حتى مسافة فارغة، باستثناء محارف نهاية السطر في التهيئات القياسية للمحرك ما لم تُفعل الأنماط الشاملة.
يتكامل الرمز النقطي بصورة مباشرة مع المعامل النجمي (*)، والمعروف رياضياً بنجمة كلين (Kleene Star). يحدد هذا المعامل خاصية التكرار الصفري أو اللانهائي للمحرف الذي يسبقه مباشرة؛ أي أن النمط .* يعني لغوياً: “طابق أي عدد من المحارف المتتالية من الصفر وحتى نهاية السلسلة”. يتيح هذا المعامل مسح أجزاء كاملة من السلسلة النصية دون الحاجة إلى معرفة عدد المحارف الفعلية المكونة لها مسبقاً، مما يوفر مرونة استثنائية في التعامل مع النصوص متباينة الأطوال.
تُعد الأقواس الهلالية () الأداة المحورية التي تحدد مخرجات دالة REGEXEXTRACT. في علوم اللغات الصورية، تُعرف هذه الأقواس بمجموعات الالتقاط (Capturing Groups). حين يُطبق التعبير النمطي على نص الخلية، يعامل المحرك كافة الأجزاء الواقعة خارج الأقواس كشروط تطابق واجبة الإثبات ولكنها مستبعدة من الإخراج النهائي، بينما يتم التقاط السلسلة المحصورة داخل القوسين فقط وإرسالها إلى الخلية كناتج نهائي للدالة، وهو ما يتيح تجاوز الرمز الفاصل وعزل ما بعده بحرفية هندسية كاملة.
2.3 آلية عمل الصيغة المحورية: =REGEXEXTRACT(A2, “.*our(.*)”)
لفهم كيفية استخراج النص بعد حرف أو كلمة معينة، دعنا نشرح الصيغة النموذجية:
=REGEXEXTRACT(A2, ".*our(.*)")
(مع استبدال “our” بأي حرف أو كلمة مفتاحية مستهدفة). يبدأ محرك RE2 بتنفيذ الشق الأولي للنمط .*، وبما أن المعامل النجمي يعمل افتراضياً وفق السلوك الطماع (Greedy Evaluation)، فإنه يلتهم السلسلة النصية بأكملها من اليسار إلى اليمين حتى نهايتها، ثم يتراجع إلى الوراء محرفاً تلو الآخر (Backtracking خطي منضبط) حتى يلتقي بالمحارف الدقيقة المكونة للكلمة المفتاحية أو الرمز المستهدف.
بمجرد وصول المحرك إلى الرمز أو السلسلة المستهدفة (وليكن الحرف المفتاحي)، يتحقق من مطابقتها التامة مع النص المصدري. يقوم المحرك هنا بخطوة منطقية حاسمة: عزل الرمز المستهدف واعتباره حداً فاصلاً يجب تجاوزه؛ حيث إنه يقع خارج الأقواس الهلالية، مما يعني استبعاده قطعياً من مصفوفة الإخراج. يضمن هذا الترتيب المنطقي تنقية النتيجة النهائية من الفاصل نفسه، وتجنب الحاجة إلى إجراء عمليات اقتطاع تالية لحذفه.
في المرحلة الختامية، يدخل المحرك في نطاق مجموعة الالتقاط المحددة بالقوسين (.*). يقوم هذا الجزء باستهلاك السلسلة المتبقية بالكامل من موقع ما بعد الرمز مباشرة وحتى الحد الأقصى لنهاية السلسلة النصية داخل الخلية. تُحزم هذه السلسلة الفرعية الملتقطة وتُرجع كنص مستقل داخل الخلية الوجهة، محققةً بذلك الاستخلاص النقي للنص الذي يلي الحرف المستهدف بأعلى كفاءة حوسبية وبأقصر صياغة ممكنة.
3. التطبيق العملي الأساسي: استخراج النصوص بعد كلمات ورموز محددة
3.1 خطوات التنفيذ المنهجي لعزل النصوص بعد كلمة معينة
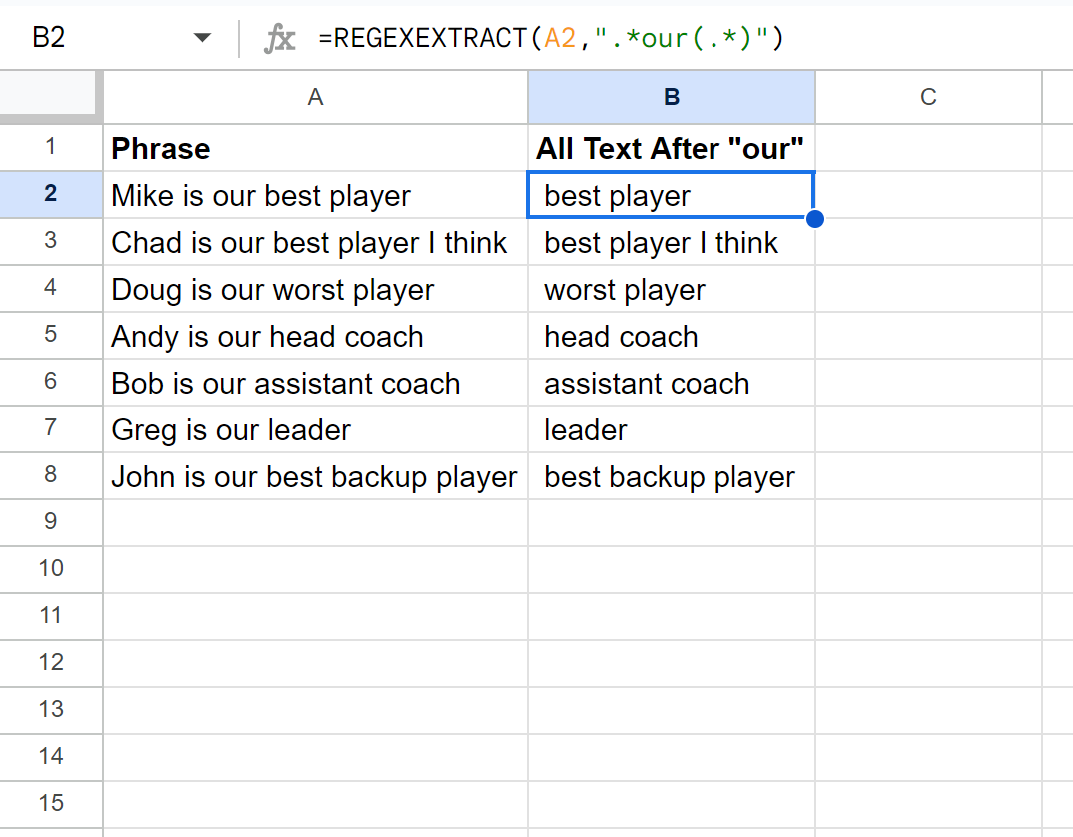
يتطلب التطبيق العملي لاستخراج النصوص بعد كلمة معينة داخل جداول بيانات Google اتباع تسلسل منهجي يضمن استقرار الورقة وتفادي أخطاء التحديث التلقائي. تبدأ الخطوة الأولى بتحديد الخلية المصدرية (ولنفرض أنها A2) وفحص بنيتها النصية للتأكد من وجود الكلمة المفتاحية المراد التجزئة بناءً عليها. تُكتب الصيغة الرياضية في الخلية المقابلة (B2) بصيغة دقيقة تأخذ الشكل التالي:
=REGEXEXTRACT(A2, "Words*(.*)")
حيث يضمن الرمز s* ابتلاع أي مسافات بيضاء تلي الكلمة المفتاحية مباشرة لعزل المحتوى النقي دون فراغات غير مرغوبة.
بمجرد اعتماد الصيغة وظهور الناتج الأولي بصورة صحيحة، تأتي مرحلة التعميم عبر العمود. بدلاً من إعادة كتابة الصيغة يدوياً، يتم سحب مقبض التعبئة التلقائية (Fill Handle) في الركن الأيسر السفلي للخلية B2 وتمريره رأسياً على الخلايا المقابلة، أو النقر المزدوج عليه لنشر المعادلة تلقائياً حتى آخر صف يحتوي على بيانات في العمود المجاور. خلال هذه العملية، تُحدث جداول بيانات Google المراجع النسبية للخلايا تلقائياً لتتحول من A2 إلى A3 وA4 بالتتابع المنطقي الدقيق.
تتمثل الخطوة الرقابية الحاسمة في التحقق من صحة النتائج المرجعة ومطابقتها للمعايير التحليلية المطلوبة. يتضمن ذلك تدقيق العينات العشوائية للتأكد من عدم ابتلاع أجزاء من النصوص بفعل تشابه الكلمات المفتاحية، وضمان عدم تأثر النصوص المستخرجة بالمسافات الفارغة المجاورة التي قد تتسلل في حال غياب محددات الفراغ الصريحة، مما يحافظ على تكامل البيانات عند تصديرها إلى منصات التقارير وقواعد البيانات المتقدمة.
3.2 استخراج النصوص بعد الرموز الشائعة وعلامات الترقيم
تحتوي حقول البيانات اليومية على طيف واسع من علامات الترقيم الشائعة التي تُستخدم كمحددات هيكلية لعزل المعلومات. للتعامل مع الفواصل البسيطة مثل النقطتين الرأسيتين (:) أو الفاصلة العادية (,) أو الشرطة القياسية (-)، يمكن تطبيق تعبيرات نمطية مباشرة دون تعقيد إضافي. على سبيل المثال، لاستخراج تفاصيل الحالة الواقعة بعد النقطتين الرأسيتين في سلسلة نصية مثل “Status: Completed”، تُصاغ المعادلة بالشكل التالي:
=TRIM(REGEXEXTRACT(A2, ":(.*)"))
حيث تقوم الدالة TRIM بتنظيف الفراغ المتبقي بعد النقطتين الرأسيتين لضمان نضج المخرج النهائي.
يبرز استخراج أسماء النطاقات (Domain Names) من عناوين البريد الإلكتروني كأحد أشهر التطبيقات الهندسية في قواعد بيانات العملاء. لعزل اسم النطاق الواقع بعد رمز البريد الإلكتروني (@)، نستخدم الصيغة الحتمية:
=REGEXEXTRACT(A2, "@(.*)")
تتجاوز هذه المعادلة الاسم التعريفي للمستخدم وتلتقط كافة المحارف الواقعة على يمين الرمز، مما يوفر تصنيفاً فورياً للمنظمات والمؤسسات التي ينتمي إليها أصحاب تلك العناوين دون الحاجة إلى تشغيل خوارزميات برمجية معقدة عبر واجهات خارجية.
وبالمثل، يمثل استخلاص المسارات الرقمية والفرعية الواقعة بعد الشرطة المائلة (/) ركيزة أساسية في تحليل بيانات تدفق الويب (Web Traffic). عند التعامل مع روابط أو مسارات أدلة مثل “category/electronics”، تتيح كتابة النمط /(.*) عزل الفئات الفرعية المتبقية بالكامل. تُعد هذه الطريقة استراتيجية في تقييم مسارات تصفح المستخدمين وتفكيك البنى التركيبية للملفات الرقمية المخزنة سحابياً عبر جداول العمل التعاونية.
3.3 الهروب البرمجي للمحارف الخاصة في التعبيرات النمطية
تواجه عمليات استخراج النصوص عقبة برمجية دقيقة عندما يكون الحرف المفتاحي المستهدف بحد ذاته أحد المحارف المحجوزة وظيفياً داخل محرك التعبيرات النمطية (Metacharacters). تشمل هذه المحارف النقطة (.)، وعلامة الاستفهام (?)، وعلامة الجمع (+)، والنجمة (*)، والأقواس بكافة أنواعها () و[] و{}، وعلامة الدولار ($)، وعلامة البداية (^)، والشرطة المائلة العكسية (). إذا كُتبت هذه الرموز مجردة داخل وسيط الدالة، فإن المحرك سيفسرها كوظائف برمجية بدلاً من اعتبارها رموزاً حرفية مجردة، مما يؤدي إلى فشل الصيغة وظهور أخطاء جسيمة.
لتحييد المعنى الوظيفي لهذه المحارف الخاصة وإجبار المحرك على معاملتها كرموز نصية جامدة، يجب استخدام آلية “الهروب البرمجي” (Character Escaping) عن طريق إسباق الرمز المحجوز بشرطة مائلة عكسية (). تعمل هذه الشرطة المائلة العكسية كأمر تحذيري للمفسر النمطي لإلغاء الميزة البرمجية للحرف التالي مباشرة وتفسيره كبايت نصي تقليدي مطابق لشكل الرمز في الخلية المصدرية.
تتضح هذه الآلية عبر التطبيقات الواقعية المتكررة؛ فعلى سبيل المثال، إذا أردنا استخراج النص الواقع بعد علامة الدولار ($) في سلسلة تشير إلى أسعار المنتجات مثل “Cost$150.00″، تُصاغ الدالة على النحو:
=REGEXEXTRACT(A2, "$(.*)")
وفي حال استخراج المحتوى الواقع بعد النقطة الفاصلة في أسماء الملفات الرقمية:
=REGEXEXTRACT(A2, ".(.*)")
كما تُستخدم الصيغة:
=REGEXEXTRACT(A2, "((.*)")
لاستخراج ما يلي قوس الفتح، مما يحقق استقراراً حسابياً تاماً للصيغة ويتجنب توقف المحرك عن العمل.
4. معالجة التكرارات المتعددة للرمز الواحد داخل الخلية
4.1 الفرق بين السلوك الطماع والسلوك الكسول في المطابقة النمطية
يمثل التباين بين السلوك الطماع (Greedy Matching) والسلوك الكسول (Lazy / Reluctant Matching) جوهر التحكم المنطقي عند معالجة الخلايا التي تشتمل على تكرارات متعددة لنفس الحرف أو الرمز الفاصل. بطبيعته الافتراضية، يعمل المعامل النجمي * ومعامل الجمع + بنمط طماع جارف؛ حيث يحاول المحرك استهلاك أكبر قدر ممكن من السلسلة النصية ومطابقة الرمز المستهدف عند أبعد نقطة ممكنة جهة اليمين، متجاهلاً كافة التكرارات السابقة لنفس الرمز داخل المتجه النصي.
في المقابل، يهدف السلوك الكسول إلى إيقاف عملية التهام المحارف عند أقرب نقطة يتحقق فيها الشرط الأدنى للمطابقة. يتم تفعيل هذا النمط بإلحاق علامة الاستفهام ? بالمعامل التكراري لتصبح الصيغة .*?. في هذه الحالة، يتوقف المحرك فور مصادفة أول ظهور للرمز المستهدف من جهة اليسار، ويعامل ما بعد هذا الظهور الأول كمحتوى خاضع لمجموعة الالتقاط، مما يوفر سيطرة تفصيلية على اتجاهات البحث الاقتطاعي.
تتجلى الأهمية العملية لهذه المفاضلة في سلسلة نصية تحوي عدة فواصل مثل “Alpha – Beta – Gamma”. إذا طُبق النمط الطماع .*-(.*)، فإن النتيجة المستخرجة ستكون “Gamma” فقط؛ لأن النمط مسح السلسلة حتى آخر شرطة. أما إذا طُبق نمط مخصص يعتمد استراتيجية الوقوف عند المحرف الأول، فإن المخرج سيكون “Beta – Gamma”. يحدد هذا التمييز الرياضي الدقيق شكل البيانات المسترجعة وفقاً للغايات التحليلية للمشروع.
4.2 استخراج النصوص بعد الظهور الأول لمحرف متكرر
عندما تكون الغاية الهندسية هي استخراج كامل النص الذي يلي التكرار الأول لرمز متكرر داخل الخلية مع استبعاد هذا الرمز بدقة، فإن الاعتماد على التعبير .*? داخل مجموعة التقاط قد يسفر أحياناً عن سلوكيات غير متوقعة بسبب قيود محرك RE2 في تفسير مجموعات الالتقاط المسبوقة بمطابقات صفرية. يكمن الحل الرياضي الأكثر قوة واستقراراً في توظيف مفهوم “الفئات المحرفية المنفية” (Negated Character Classes).
تُبنى الفئة المنفية باستخدام القوسين المعقوفين مسبوقين بعلامة الإقحام [^x]، والتي تعني برمجياً: “طابق أي محرف مهما كان نوعه بشرط ألا يكون هو المحرف x”. لبناء صيغة تستخرج النص بعد أول ظهور للشرطة (-) مثلاً، نكتب التعبير التالي:
=REGEXEXTRACT(A2, "^[^-]*-(.*)")
يقوم الشق الأولي ^[^-]*- باستهلاك كافة المحارف الواقعة من بداية السلسلة النصية وحتى مصادفة أول شرطة فقط، ويتوقف عندها حتماً لعدم قدرته على تخطي أي شرطة أخرى وفق تعريف الفئة المنفية.
تُطبق هذه الاستراتيجية المنهجية بكثافة في عمليات تجزئة العناوين الجغرافية والمعرفات المركبة؛ فعند التعامل مع مدخلات مثل “ID992-ZoneA-Node4″، تضمن هذه الصيغة إرجاع السلسلة “ZoneA-Node4” كاملة دون بتر للأجزاء اللاحقة التي قد تشتمل على شرطات إضافية. تمنح الفئات المنفية المعادلة مناعة فائقة ضد التغيرات غير المنضبطة في أعداد الفواصل داخل السجلات المتسلسلة.
4.3 استخراج النصوص بعد الظهور الأخير لمحرف متكرر
في الاتجاه المعاكس تماماً، تقتضي العديد من السيناريوهات التحليلية استخلاص البيانات الواقعة حصرياً بعد الظهور الأخير للمحرف الفاصل، متجاهلين كافة التكرارات البدائية. يتجلى هذا المطلب بوضوح عند تفكيك مسارات الملفات وأنظمة المجلدات السحابية، حيث يتكرر رمز الشرطة المائلة (/) عشرات المرات، وتكون الغاية هي عزل اسم الملف النهائي الواقع بعد آخر شرطة مائلة في أقصى اليمين.
لتحقيق هذا الاستخراج، يمكن استغلال السلوك الطماع الافتراضي لمحرك REGEXEXTRACT بصورة مباشرة عبر الصيغة:
=REGEXEXTRACT(A2, ".*-(.*)")
حيث يلتهم المقطع .* كافة المحارف والشرطات حتى يصل إلى الشرطة الأخيرة في السلسلة النصية قبل التوقف، ثم تلتقط الأقواس الهلالية (.*) النص الأخير. كما يمكن صياغتها بأسلوب رياضي بديل يعتمد على الربط بنهاية السلسلة النصية عبر علامة الدولار ($):
=REGEXEXTRACT(A2, "[^-]+$")
حيث يطابق هذا النمط كافة المحارف غير المتضمنة للشرطة الممتدة حتى حافة السطر الأخيرة.
يضمن هذا الأسلوب استقراراً هيكلياً استثنائياً للصيغة البرمجية، بغض النظر عما إذا كان المسار يحتوي على شرطة واحدة، أو عشر شرطات، أو مائة شرطة. تظل المعادلة الحسابية محصنة ضد التغيرات في عمق الأدلة أو التسلسلات، مؤكدةً على مرونة المحركات النمطية مقارنة بالحسابات الإزاحية اليدوية التي تتطلب معادلات متداخلة لا نهائية لتحقيق نفس الغرض.
5. التقنيات البديلة: الدمج بين الدوال النصية الكلاسيكية
5.1 توظيف الدوال RIGHT و LEN و FIND في صيغة موحدة
على الرغم من القوة المطلقة لدوال التعبيرات النمطية، تظل منظومة الدوال الكلاسيكية الموروثة (RIGHT وLEN وFIND) تشكل حجر الزاوية في المعالجة النصية داخل جداول البيانات، وتحديداً في البيئات التي تتطلب توافقية تامة مع برمجيات الجداول الأخرى أو عند الرغبة في تحسين زمن الحساب البسيط. تعتمد هذه المنظومة على التوليف الجبري بين قياس طول المتجه وتحديد إحداثيات الموقع النسبي للمحرف المستهدف.
تبدأ العملية باستخدام دالة FIND لتحديد الموقع الرقمي (الفهرس المستند إلى الرقم 1) للمحرف الفاصل؛ حيث تعيد هذه الدالة رقماً يمثل إحداثي الرمز محسوباً من الطرف الأيسر للسلسلة النصية. بالتوازي مع ذلك، تقوم الدالة LEN بحساب الطول الإجمالي للمتجه النصي داخل الخلية المستهدفة. من خلال طرح قيمة موقع المحرف من الطول الإجمالي، نحصل رياضياً على العدد الدقيق للمحارف المتبقية على يمين الفاصل:
=RIGHT(A2, LEN(A2) - FIND("-", A2))
في المرحلة النهائية، تستقبل الدالة RIGHT هذا الناتج الرقمي كاقتطاع كمي محدد، وتقوم بسحب هذا العدد المعين من المحارف انطلاقاً من أقصى يمين السلسلة النصية. تُعد هذه الصيغة الحسابية نموذجاً للأناقة الحسابية المجردة؛ حيث تعمل كدالة محددة حتمياً ومغلقة رياضياً، مما يجعلها خياراً ممتازاً للمحللين الذين يفضلون الصيغ الرياضية الواضحة دون الخوض في القواعد اللغوية للتعبيرات النمطية.
5.2 استخدام الدالة SEARCH للمطابقة غير الحساسة لحالة الأحرف
تبرز فروق جوهرية في الدقة الرياضية بين الدالتين SEARCH وFIND داخل جداول بيانات Google؛ فبينما تتسم دالة FIND بحساسيتها الصارمة لحالة الأحرف (Case-Sensitive)، مما يعني تمييزها المطلق بين الحرف الكبير “A” والحرف الصغير “a”، تعمل دالة SEARCH كبديل متسامح يتجاهل حالة الأحرف بالكامل (Case-Insensitive)، فضلاً عن دعمها المدمج لعلامات المطابقة العامة الكونية كعلامة الاستفهام والنجمة.
تتجلى الأهمية التطبيقية لاستخدام الدالة SEARCH عند محاولة استخراج النصوص الواقعة بعد كلمات مفتاحية في نصوص إنجليزية أو لاتينية غير منضبطة التنسيق؛ حيث قد يُدخل المستخدمون كلمة “ref:” تارة بحروف صغيرة، وتارة أخرى كـ “REF:” أو “Ref:”. في هذه الحالة، يؤدي استخدام الدالة FIND إلى انهيار المعادلة وظهور خطأ #VALUE! لعدم المطابقة الدقيقة، بينما تضمن صياغة المعادلة كالتالي نجاح الاستخراج في كافة الحالات:
=RIGHT(A2, LEN(A2) - SEARCH("ref:", A2) - LEN("ref:") + 1)
يضمن هذا التبديل الاستراتيجي بين الأدوات تحقيق اتساق إحصائي فائق في النتائج المرجعة ومطابقتها للمعايير التحليلية الموضوعة مسبقاً. كما يقضي على الحاجة إلى توحيد حالة الأحرف مسبقاً عبر دوال إضافية مثل LOWER أو UPPER، مما يقلل من حجم العمليات الحسابية المتداخلة ويبسط التركيب العام للخلية التحليلية.
5.3 مقارنة الكفاءة والأداء بين دالة REGEXEXTRACT والدوال الكلاسيكية
تخضع المفاضلة الهندسية بين دالة REGEXEXTRACT والتركيب الكلاسيكي (RIGHT + LEN + FIND) لمعايير الأداء الحسابي، وسهولة القراءة البرمجية، وتكاليف الصيانة طويلة الأجل. من منظور التعقيد الحسابي البسيط، تتفوق الدوال الكلاسيكية بشكل طفيف عند معالجة السجلات الفردية البسيطة؛ نظراً لأن محرك البحث الخطي الداخلي للدالة FIND خفيف للغاية ولا يتطلب تهيئة آلة حالات محددة مسبقة كالتي يبنيها محرك RE2.
مع ذلك، عندما يتسع نطاق البيانات ليشمل مصفوفات ضخمة تتجاوز مئات الآلاف من الصفوف، تنقلب المعادلة لصالح REGEXEXTRACT؛ حيث تستطيع دمج عمليات التحقق والقفز والاقتطاع في تمريرة حسابية واحدة (Single Pass) فوق النص، بينما تجبر الدوال الكلاسيكية المركبة النظام على مسح المتجه النصي ثلاث مرات منفصلة: مرة لحساب الطول عبر LEN، ومرة لتحديد الموقع عبر FIND، ومرة ثالثة لتنفيذ الاقتطاع عبر RIGHT، مما يضاعف من استهلاك الذاكرة المؤقتة لبيئة السحابة.
أما من زاوية الصيانة وسهولة القراءة (Code Maintainability)، فتتفوق REGEXEXTRACT بوضوح من خلال اختصار الصيغ الطويلة والمعقدة في سطر نمطي واحد ومكثف. يسهل هذا الاختصار من اكتشاف الأخطاء وتعديل الفواصل مستقبلاً، بخلاف الصيغ الكلاسيكية المتداخلة التي تصبح شديدة الهشاشة وعرضة للانهيار عند إضافة شروط إزاحة جديدة أو التعامل مع فواصل ذات أطوال متغيرة.
6. استراتيجية التجزئة والاسترجاع عبر دالتي SPLIT و INDEX
6.1 مبادئ عمل الدالة SPLIT في تقسيم النصوص المجدولة
تمثل دالة SPLIT مقاربة بنيوية مختلفة تماماً لمعالجة النصوص في جداول بيانات Google؛ فبدلاً من التركيز على القياس الإزاحي أو الاقتطاع النمطي، تتعامل هذه الدالة مع النص كوحدة تركيبية متكاملة يتم تفكيكها ونشرها في مصفوفة أفقية متجاورة من الخلايا، استناداً إلى محرف أو مجموعة محارف فاصلة محددة وفق الصيغة:
=SPLIT(text, delimiter, [split_by_each], [remove_empty_text])
توفر دالة SPLIT وسائط تحكم متقدمة بالغة الأهمية؛ فالوسيط الثالث split_by_each يتيح تحديد ما إذا كان كل حرف مفرد في نص الفاصل سيعامل كقاسم مستقل (القيمة الافتراضية TRUE)، أم أن السلسلة الممررة يجب مطابقتها ككتلة نصية موحدة غير قابلة للتجزئة (FALSE). كما يتيح الوسيط الرابع remove_empty_text تنظيف الخلايا الناتجة تلقائياً من الفراغات الصفرية الناجمة عن تجاور الفواصل المتكررة داخل السلسلة الواحدة.
تنطوي دالة SPLIT المنفردة على أثر جانبي خطير يتمثل في “فيض المصفوفة” (Array Spill)؛ حيث إن ناتجها لا ينحصر في الخلية التي تحوي الصيغة، بل يفيض أفقياً على الخلايا المجاورة جهة اليسار أو اليمين بحسب اتجاه الورقة. إذا كانت تلك الخلايا تحتوي على بيانات مسبقة، ستفشل العملية وتُرجع الخلية خطأ التمدد الشهير #REF!، مما يفرض احتواء هذه المصفوفة عبر دوال عزل تكميلية قبل استخدامها في النماذج التحليلية.
6.2 دمج الدالة INDEX لعزل العنصر النصي المستهدف بدقة
لتحييد ظاهرة فيض المصفوفة والاستفادة من سرعة تقسيم دالة SPLIT، تُدمج الدالة INDEX لتلعب دور المرشح الانتقائي النهائي. تقوم دالة INDEX باستقبال المصفوفة الأفقية المتولدة داخل الذاكرة المؤقتة للدالة SPLIT دون السماح لها بالانتشار فوق ورقة العمل، ثم تقوم باسترجاع عنصر محدد من هذه المصفوفة بدلالة إحداثيات الصف والعمود المحددة رياضياً.
إذا كانت الغاية هي استخراج النص الواقع مباشرة بعد أول ظهور للرمز الفاصل، فإننا نستهدف العمود الثاني من المصفوفة المفردة عبر كتابة الصيغة النموذجية التالية:
=INDEX(SPLIT(A2, "-"), 1, 2)
حيث يمثل الرقم 1 الصف الأول الوحيد للمصفوفة، ويمثل الرقم 2 الجزء النصي الثاني الواقع بعد الفاصل المستهدف، مما يُرجع قيمة نصية نقية ومستقرة تماماً داخل نفس الخلية دون المساس بالمساحات المجاورة.
تصل هذه المنهجية إلى ذروة مرونتها عند الرغبة في استخراج الجزء الأخير من السلسلة بغض النظر عن عدد الفواصل الداخلية؛ حيث يمكن استبدال رقم العمود الثابت بتركيب ديناميكي يعتمد على الدالة COUNTA لحساب عدد عناصر المصفوفة المتولدة لحظياً:
=INDEX(SPLIT(A2, "-"), 1, COUNTA(SPLIT(A2, "-")))
تضمن هذه المعادلة النفاذ التلقائي إلى الشق الأخير بدقة برمجية متناهية تتكيف مع تباين أطوال النصوص وتشعباتها المختلفة.
6.3 المفاضلة المعيارية بين أسلوب SPLIT وأسلوب REGEXEXTRACT
تخضع عملية الاختيار بين استراتيجية (SPLIT + INDEX) واستراتيجية REGEXEXTRACT لمجموعة من المعايير التشغيلية المحددة بطبيعة البيانات المعالجة. تتفوق طريقة SPLIT بصورة واضحة في المواقف التي تكون فيها الفواصل بسيطة وواضحة (مثل الشرطات العادية أو الفواصل الإنجليزية) ويكون الهدف هو التوزيع الهيكلي متعدد الأجزاء؛ حيث تتسم هذه الصيغة بسهولة الفهم والقراءة لدى المستخدمين المبتدئين ولا تتطلب دراية مسبقة بعلوم التعبيرات النمطية المعقدة.
في المقابل، تظهر القيود الجوهرية لدالة SPLIT عند مواجهة الفواصل المركبة أو المتغيرة أو المشروطة؛ حيث تعجز عن التمييز الدلالي بين الرموز المتطابقة شكلاً والمتباينة سياقاً. كما أن تطبيق SPLIT على خلايا قد تفتقر إلى وجود الفاصل المستهدف يؤدي إلى استرجاع القيمة الأصلية كاملة في العمود الأول وفشل استرجاع العمود الثاني بظهور خطأ الإزاحة المرجعية، مما يتطلب إحاطتها بدوال معالجة استثناءات إضافية.
وعليه، يُعد أسلوب REGEXEXTRACT هو الخيار المعياري الأمثل والأكثر متانة عند التعامل مع مشاريع البيانات الكبيرة ذات المحددات النصية غير المتسقة؛ نظراً لقدرته على فرض شروط تحقق صارمة، ودمج الاستخراج مع التطهير في صياغة رياضية موحدة ومدمجة تحافظ على استقرار تدفق البيانات داخل منصات ذكاء الأعمال المترابطة.
7. معالجة المسافات البيضاء والمحارف غير المرئية بعد الاستخراج
7.1 تطهير النصوص المقتطعة باستخدام الدالة TRIM
نادراً ما تسفر عمليات استخراج النصوص بعد المحارف عن مخرجات نصية نقية وجاهزة للربط فوراً؛ إذ غالباً ما تترك الفواصل وراءها مسافات بيضاء غير مرئية تفصل بين الرمز والنص الفعلي (مثل: “Category : Electronics”). عند تطبيق صيغ الاقتطاع التقليدية، تنتقل هذه المسافة البادئة (Leading Space) تلقائياً إلى ناتج الخلية، مما يؤدي إلى فشل عمليات المطابقة العلائقية اللاحقة كدوال VLOOKUP أو XLOOKUP لعدم تطابق ” Electronics” مع “Electronics”.
تتدخل دالة TRIM البرمجية كخط دفاع محوري لتطهير هذه المخرجات وتوحيد بنيتها النصية. تقوم الدالة TRIM بإزالة كافة المسافات البادئة والمسافات اللاحقة (Trailing Spaces) من السلسلة النصية المستخرجة، كما تقوم باختزال أي مسافات بينية مكررة تفصل بين الكلمات لتقتصر على مسافة فردية قياسية واحدة، محققةً الاتساق التام للشروط القياسية لقواعد البيانات.
لدمج هذه الدالة بكفاءة، يتم تغليف صيغ الاستخراج السابقة بداخلها بصورة متكاملة:
=TRIM(REGEXEXTRACT(A2, "-(.*)"))
أو مع الصيغ الكلاسيكية:
=TRIM(RIGHT(A2, LEN(A2) - FIND("-", A2)))
يضمن هذا التغليف الوقائي تطهير الناتج لحظة استخراجه، مما يحمي النماذج الإحصائية النهائية من التباينات الناتجة عن أخطاء الإدخال البشري العشوائية للمسافات.
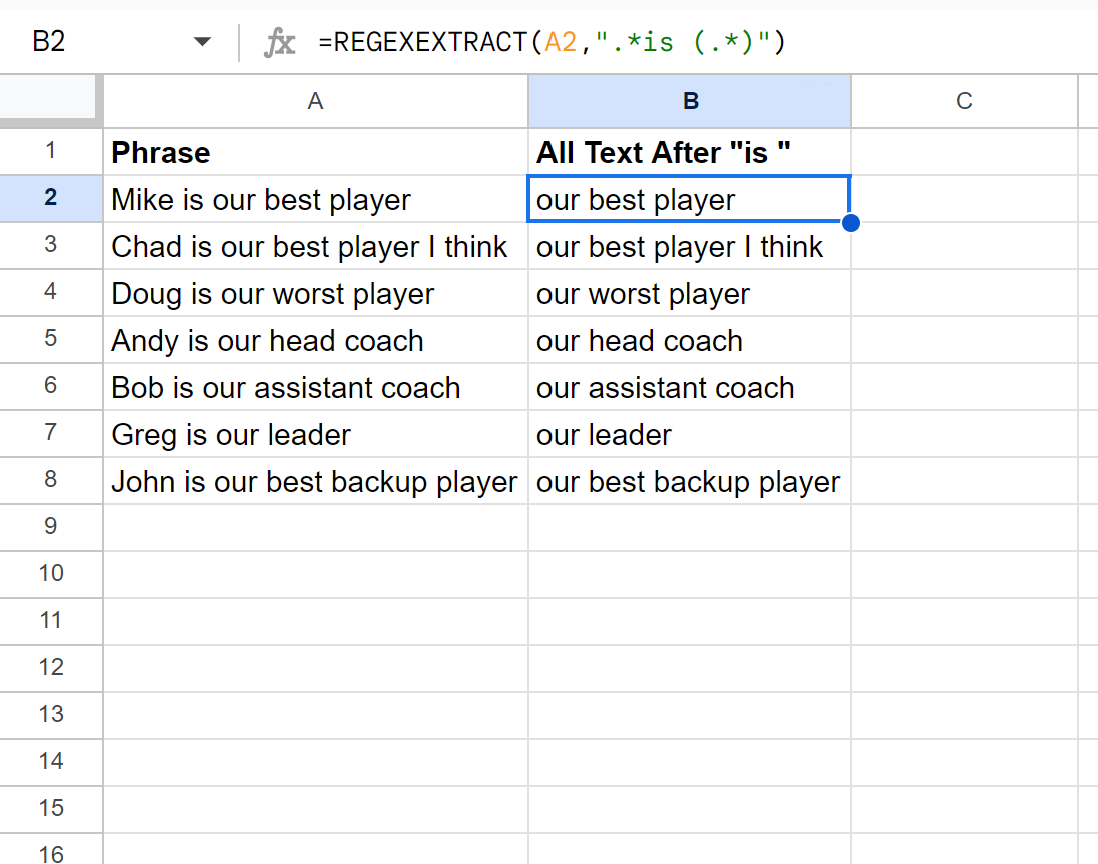
7.2 التعامل مع الفواصل السطرية والمحارف غير القابلة للطباعة
تشكل محارف الانتقال السطري (Line Breaks) ورموز التحكم البرمجية غير القابلة للطباعة (Non-Printable ASCII Control Characters) تحدياً خفياً في السجلات النصية المستوردة من خوادم الويب وتطبيقات الهواتف. تشتمل هذه المحارف على محرف إرجاع التغذية (Carriage Return – r) ومحرف السطر الجديد (Line Feed – n)، والتي تقع غالباً ضمن مجال الرموز من 0 إلى 31 في جدول معايير ASCII القياسي، ولا تنجح الدالة TRIM وحدها في القضاء عليها.
لمعالجة هذه المعضلة، توفر جداول بيانات Google الدالة التطهيرية CLEAN، والتي تتخصص في مسح واستئصال المحارف غير المطبوعة من المتجه النصي دون الإخلال بالمحتوى الهجائي. يتم تطبيقها بتوسيع نطاق التغليف البرمجي:
=CLEAN(TRIM(REGEXEXTRACT(A2, "-(.*)")))
مما يضمن تفريغ النص من أي شفرات تحكم متبقية قد تتسبب في تشويه تصدير الملفات لاحقاً بصيغ CSV الموجهة لنظم الإنتاج الكبرى.
عندما تكون الغاية الهندسية ذاتها هي استخراج النصوص الواقعة حصرياً بعد سطر جديد داخل خلية متعددة الأسطر، يمكن توظيف دالة REGEXEXTRACT باستهداف الرمز المحرفي n مباشرة في التعبير النمطي:
=REGEXEXTRACT(A2, "n(.*)")
يتيح هذا النمط اقتناص الأسطر التالية بدقة عالية وعزل الملاحظات التوضيحية أو التذييلات البرمجية التي يدرجها المستخدمون أسفل السجلات الأساسية داخل الخلية الواحدة.
7.3 توحيد المعايير التنسيقية للمخرجات النصية المستخرجة
تكتمل دورة معالجة البيانات النصية المستخرجة بإخضاعها لعمليات التوحيد التنسيقي (Format Normalization) لضمان اتساقها الشامل مع المعايير المعرفية المعتمدة في التقارير الإدارية والتحليلية. في سياق النصوص الأبجدية، يُفضل دائماً تحديد نمط أحرف موحد لتلافي تشوهات العرض المرئي عبر دوال التحويل التلقائي لحالة الأحرف: UPPER لتحويل كافة الأحرف إلى الصيغة الكبيرة، وLOWER للأحرف الصغيرة، وPROPER لتحويل الحرف الأول من كل كلمة إلى حرف كبير بما يتوافق مع الأسماء المعيارية.
أما في الحالات التي يكون فيها النص المستخرج بعد الرمز الفاصل عبارة عن قيمة رقمية مجردة (مثل استخراج القيمة المالية الواقعة بعد رمز العملة أو استخراج المعرف العددي بعد النقطتين)، فإن محرك جداول بيانات Google يواصل التعامل مع هذا المخرج كسلسلة نصية (String Text) ما لم يُنص صراحة على غير ذلك، مما يحول دون إدخال هذه الأرقام في العمليات الحسابية أو الجمع التراكمي عبر دالة SUM.
لتحويل هذه السلاسل النصية إلى مقادير حسابية حقيقية، تُدمج الدالة التحويلية VALUE حول صيغة الاستخراج:
=VALUE(TRIM(REGEXEXTRACT(A2, ":(.*)")))
تقوم هذه الدالة بإعادة فحص المتجه النصي وتحويله إلى قيمة كمية قابلة للتجميع والإحصاء، مما يضمن الجاهزية التشغيلية الكاملة للبيانات وربطها المباشر بلوحات التحكم التفاعلية ومنصات ذكاء الأعمال المتقدمة.
8. توسيع النطاق والأتمتة الديناميكية باستخدام ARRAYFORMULA
8.1 تحويل الصيغ الفردية إلى معادلات مصفوفية شاملة للأعمدة
في بيئات البيانات الواقعية الضخمة، تفقد منهجية سحب الصيغ الخلوية يدوياً عبر مقبض التعبئة التلقائية جدواها التشغيلية؛ إذ تصبح عرضة للإهمال البشري، وتستهلك موارد الحوسبة المحلية بصورة مفرطة، فضلاً عن انهيارها التام عند تدفق صفوف بيانات جديدة عبر نماذج الويب الآلية. هنا تبرز دالة ARRAYFORMULA كأداة أتمتة ثورية تتيح كتابة صيغة استخراج وحيدة في رأس العمود لتتولى معالجة النطاق الرأسي بأكمله ديناميكياً.
تتمتع دالة REGEXEXTRACT بتوافقية مدمجة واستثنائية مع ARRAYFORMULA؛ حيث تتقبل النطاقات متعددة الصفوف كبدائل للمراجع الفردية وتنفذ نمط المطابقة على كل صف بشكل منفصل ومتزامن داخل بيئة المعالجة الموزعة لـ Google. تُصاغ المعادلة المصفوفية الشاملة على النحو التالي:
=ARRAYFORMULA(REGEXEXTRACT(A2:A, "-(.*)"))
تقوم هذه المعادلة المفردة بالعمل كخيط حوسبي مستقل يغطي آلاف الصفوف الممتدة من الصف الثاني وحتى حافة الجدول السفلى في جزء من الثانية.
يسهم هذا الأسلوب المصفوفي في تخفيف العبء الحسابي لملف العمل بشكل ملحوظ؛ حيث تنخفض مساحة التخزين المخصصة لتعريف الصيغ داخل بنية XML التحتية لملف Google Sheets، ويتم تفادي أخطاء تعديل الصيغ بالخطأ في الصفوف الوسطى من قِبل المستخدمين المشاركين، مما يمنح الورقة حصانة هيكلية واستقراراً مطلقاً في بيئات العمل التعاونية النشطة.
8.2 التحكم في الصفوف الفارغة ومنع امتداد الأخطاء عبر النطاق
عند تطبيق ARRAYFORMULA على نطاقات رأسية مفتوحة النهاية (مثل A2:A)، تواجه المنظومة مشكلة تقنية كبرى؛ إذ ستحاول الدالة استخراج النصوص من كافة الصفوف الفارغة الممتدة أسفل الجدول حتى الحد الأقصى للصفوف المتاحة (والتي قد تتجاوز عشرات الآلاف)، مما يسفر عن ملء آلاف الخلايا برسائل الخطأ #N/A وتوقف الورقة عن العمل بسلاسة نتيجة الهدر الحسابي غير المبرر في معالجة خلايا لا تحوي أي مدخلات.
للتحكم في هذا التمدد العشوائي ومنع انتشار الأخطاء، يُدمج الشرط المنطقي IF مع دالة التحقق من الفراغ ISBLANK لإنشاء بوابة تحقق أمنية توقف الحسابات فور وصول النطاق إلى صفوف غير مأهولة. يتم ضبط هذا الحارس المنطقي بالصيغة المصفوفية التالية:
=ARRAYFORMULA(IF(ISBLANK(A2:A), , REGEXEXTRACT(A2:A, "-(.*)")))
حيث يوجه الوسيط الثاني الفارغ في دالة IF النظام لترك الخلية المقابلة فارغة تماماً دون تنفيذ أي معالجة نمطية إذا كان المرجع الخلوي في العمود A خالياً من البيانات.
كما يمكن توظيف صيغة منطقية بديلة ومكافئة بالاعتماد على التحقق من وجود نصوص غير صفرية عبر العامل الرياضي A2:A<>"":
=ARRAYFORMULA(IF(A2:A<>"", REGEXEXTRACT(A2:A, "-(.*)"), ""))
تضمن هذه المعمارية المزدوجة احتواء الصيغ بدقة متناهية وظهور البيانات بسلاسة وجمالية داخل لوحات العرض، مع توفير أقصى درجات الكفاءة التشغيلية لموارد السحابة.
8.3 تحسين كفاءة الملفات الضخمة وتجنب بطء الحساب السحابي
على الرغم من القوة الرياضية الهائلة للصيغ المصفوفية، فإن الاستخدام غير المنضبط للنطاقات المفتوحة اللانهائية (Unbounded Ranges) قد يؤدي إلى استنزاف حاد لذاكرة التخزين المؤقت للمتصفح وتراجع سرعة استجابة ورقة العمل؛ حيث تضطر خوادم Google إلى التحقق المستمر من حالة التغيير الحسابي في كافة خلايا العمود المليون عند كل عملية تعديل طفيفة يجريها أي مستخدم على الورقة.
تقتضي أفضل الممارسات الهندسية تحديد حدود النطاقات المكانية بدقة كلما كان ذلك متاحاً؛ كاستخدام النطاق المقنن A2:A5000 بدلاً من النطاق المفتوح A2:A إذا كانت التقديرات التشغيلية لحجم البيانات لا تتجاوز هذا السقف خلال دورة حياة التقرير. يسهم هذا التقنين في حصر فضاء العمليات الحسابية داخل حدود مصفوفية معروفة مسبقاً، مما يسرع من أوقات التقديم البصري وتحديث الرسوم البيانية التفاعلية المعتمدة على النتائج المستخرجة.
إضافة إلى ذلك، يُنصح بتجنب تكديس الدوال النصية المعقدة والمتداخلة داخل مصفوفة ARRAYFORMULA واحدة ممتدة. ففي حال تطلب مسار العمل استخراجاً وتطهيراً وتنسيقاً شرطياً متعدد المستويات، يُفضل فصل العمليات عبر أعمدة وسيطة (Staging Columns) أو استخدام البرمجة النصية عبر Google Apps Script لمعالجة الدفعات التراكمية في الخلفية وتثبيت النتائج كقيم جامدة، مما يضمن الحفاظ على خفة وسرعة النماذج التحليلية الموجهة للإدارة العليا.
9. معالجة الاستثناءات واستكشاف الأخطاء البرمجية وإصلاحها
9.1 إدارة الخطأ الكلاسيكي #N/A الناتج عن غياب المحرف المستهدف
يعد الخطأ #N/A (غير متاح – Not Available) أكثر المشاكل التقنية شيوعاً عند التعامل مع دوال استخراج النصوص القائمة على التعبيرات النمطية في جداول بيانات Google. يظهر هذا الخطأ الحتمي عندما يفشل محرك REGEXEXTRACT في العثور على أي مطابقة للنمط المشروط داخل السلسلة النصية؛ كأن تخلو الخلية المصدرية من الرمز الفاصل المستهدف تماماً، أو أن تختلف بنية السجل عن النمط الرياضي المبرمج في الصيغة.
لإدارة هذا الاستثناء بطريقة احترافية، يُلجأ إلى تغليف الصيغة بدوال اعتراض الأخطاء. تُعد الدالة IFERROR الأداة الأشمل للتعامل مع كافة أشكال الانهيار الحسابي؛ حيث تستقبل القيمة المحسوبة وتوفر مخرجاً بديلاً محدداً في حال وقوع أي خطأ:
=IFERROR(REGEXEXTRACT(A2, "-(.*)"), "غير متوفر")
أو ترك الخلية فارغة تماماً عبر تمرير علامتي اقتباس فارغتين "" في وسيط القيمة البديلة، مما يمنع تشويه الواجهة التحليلية برسائل التنبيه الحمراء.
مع ذلك، تقتضي الدقة المنهجية تفضيل الدالة التخصصية IFNA على الدالة العامة IFERROR؛ حيث تختص IFNA باعتراض أخطاء عدم المطابقة النصية (#N/A) دون حجب أو إخفاء الأخطاء الحسابية أو التركيبية الأخرى الأكثر خطورة (مثل أخطاء المراجع #REF! أو أخطاء التسمية البرمجية #NAME?). يضمن هذا التمييز للمحلل اكتشاف العيوب البنيوية في ورقة العمل بسرعة مع استمرار توفير تجربة استخدام ناعمة ومحصنة ضد غياب الفواصل النصية العارضة.
9.2 معالجة أخطاء الصياغة البرمجية وأخطاء الاقتباس والتجميع
تنشأ أخطاء الصياغة البرمجية (Syntax Errors) في معادلات استخراج النصوص نتيجة عدم الانضباط في تطبيق القواعد الهيكلية للغة التعبيرات النمطية أو وسائط البرنامج الأساسية. يبرز الخطأ #VALUE! عادة عند نسيان إغلاق علامات الاقتباس المزدوجة المحيطة بالنمط النمطي، أو عند إسقاط الأقواس الهلالية الخاصة بمجموعات الالتقاط، أو عند تمرير قيم رقمية غير متوافقة حسابياً مع وسائط الدوال النصية الكلاسيكية.
كما تمثل مشكلة تعارض المحددات اللغوية والإقليمية (Locale Settings) أحد أكبر مصادر الارتباك للمطورين متعددي الثقافات؛ ففي النطاقات الإقليمية التي تستخدم الفاصلة العشرية بدلاً من النقطة (مثل بعض الدول الأوروبية ودول أمريكا اللاتينية)، تُستبدل الفاصلة العادية (,) المستخدمة لفصل وسائط الدوال بفاصلة منقوطة (;). إذا نُسخت صيغة مكتوبة بتهيئة الولايات المتحدة إلى ورقة عمل ذات تهيئة إقليمية مختلفة، تنهار الصيغة مباشرة وتُرجع خطأ صياغة عام دون توضيح السبب الحقيقي.
لتشخيص هذه الاختلالات البنيوية وعلاجها جذرياً، يجب التحقق من تكافؤ الأقواس المفتوحة والمغلقة، والتأكد من تحييد المحارف الخاصة عبر الهروب البرمجي، ومراجعة إعدادات ورقة العمل الإقليمية عبر قائمة (ملف -> الإعدادات -> الإعدادات الإقليمية). يضمن هذا التدقيق المنهجي استقرار الصيغ عبر البيئات المختلفة وتوافقها التام مع متطلبات المستخدمين الدوليين دون انقطاع.
9.3 بناء سيناريوهات احتياطية متعددة المراحل لاستخراج النصوص
تفرض السجلات النصية شديدة الفوضى—والتي تنشأ عادة عن جمع بيانات عبر استبيانات مفتوحة أو مصادر خارجية متعددة لا تلتزم بمعيار موحد—بناء خطط استخراج احتياطية متعددة المراحل قادرة على التكيف مع التنوع الهيكلي للفواصل. إذا لم يتوفر الفاصل الأساسي (كالشرطة مثلاً)، يجب أن تنتقل الدالة ذاتياً للبحث عن فواصل بديلة (كالنقطتين الرأسيتين أو الفاصلة المنقوطة) قبل إعلان فشل المطابقة.
تتيح التعبيرات النمطية تحقيق هذا التكيف المتشعب بسلاسة منقطعة النظير عبر توظيف معامل التخيير المنطقي (|) داخل التعبير النمطي، والذي يعادل وظيفياً المعامل “أو” (OR). يمكن صياغة نمط يستخرج ما بعد أول ظهور للشرطة أو النقطتين الرأسيتين في معادلة واحدة أنيقة:
=REGEXEXTRACT(A2, "(?:-|:)s*(.*)")
حيث يمثل التركيب (?:...) مجموعة مطابقة غير ملتقطة (Non-Capturing Group) تتحقق من وجود أي من الرمزين البديلين، لتتولى المجموعة الثانية (.*) التقاط المحتوى اللاحق مباشرة.
أما في المنظومات التحليلية الكلاسيكية، فيمكن تحقيق نفس الغاية بالدمج المتسلسل لدوال التقاط الأخطاء؛ حيث تُعشّش دالة IFNA داخل دالة IFNA أخرى لاختبار الفواصل بالتتابع:
=IFNA(REGEXEXTRACT(A2, "-(.*)"), IFNA(REGEXEXTRACT(A2, ":(.*)"), A2))
تضمن هذه التركيبة المتسلسلة عدم توقف التدفق التحليلي؛ حيث تستخرج النص بناءً على الأولويات المحددة، وتعيد النص الأصلي كاملاً كحل أخير في حال غياب كافة المحددات الافتراضية، مما يوفر أماناً مطلقاً للمسارات البيانية المؤتمتة.
10. دراسات حالة متقدمة ونماذج تطبيقية في بيئات الأعمال الواقعية
10.1 تطهير واستخراج المعرفات والرموز التسلسلية للمنتجات (SKU)
تشكل إدارة وحدات حفظ المخزون (Stock Keeping Units – SKU) في منصات التجارة الإلكترونية الكبرى تحدياً لوجستياً يتطلب استخلاصاً نصياً دقيقاً وموثوقاً. غالباً ما تصاغ هذه الرموز التسلسلية بدمج رمز الفئة الرئيسية، متبوعاً بشرطة فاصلة، ثم الكود التسلسلي التعريفي للمنتج، ثم رمز الحجم أو اللون في نهاية السلسلة النصية (مثل: “ELEC-98432-BLK”). تعتمد أنظمة الفوترة وإدارة المستودعات على عزل الرقم التسلسلي النقي لمعالجة الطلبات.
لاستخراج المعرف التسلسلي الأوسط الواقع بعد الشرطة الأولى، نطبق استراتيجية الفئات المنفية:
=REGEXEXTRACT(A2, "^[^-]*-([^-]+)")
حيث تلتقط هذه الصيغة الرقم “98432” بمفرده دون رمز الفئة السابق ودون الخصائص اللاحقة. أما في حال رغبة قسم المخزون في استخراج كافة المواصفات والبيانات الواقعة بعد كود المنتج الرئيسي المتمركز بعد الشرطة الأولى بالكامل، فإن الصيغة القياسية:
=REGEXEXTRACT(A2, "^[^-]*-(.*)")
تُرجع القيمة “98432-BLK” جاهزة للإدراج في بطاقات التوزيع الداخلي للمستودع.
تسهم هذه الأتمتة المباشرة في توحيد تقارير الجرد السنوية والشهرية، واستبعاد الأخطاء البشرية الناجمة عن النسخ واللصق اليدوي لأكواد المنتجات المعقدة. كما تُمكّن مسؤولي سلاسل الإمداد من بناء نماذج محاكاة رقمية تتبع حركة المنتجات ومطابقتها اللحظية مع قواعد بيانات الموردين العالمية دون الحاجة إلى استيراد برمجيات تخطيط موارد المؤسسات (ERP) المكلفة والمغلقة.
10.2 معالجة الروابط التشعبية وتحليل معاملات التتبع الرقمي (UTM)
في قطاع التسويق الرقمي وتتبع الحملات الإعلانية المدفوعة، تُضاف سلاسل تتبع متقدمة تُعرف بمعاملات UTM إلى الروابط التشعبية لرصد مصادر الزيارات وسلوكيات المستخدمين. تتصل هذه المعاملات بنهاية الرابط الأصلي بعد علامة الاستفهام (?)، وتتضمن وسائط تفصيلية مثل مصدر الحملة، ونوع الوسيط الإعلاني، والمسمى التسويقي (مثل: “https://example.com/landing?utm_source=google&utm_campaign=spring_sale”).
يواجه مسؤولو التحليلات التسويقية مهمة عزل واستخراج كامل معمارية البيانات التسويقية الواقعة بعد علامة الاستفهام للقيام بعمليات التصنيف والتوزيع المالي. نظراً لكون علامة الاستفهام محرفاً برمجياً محجوزاً في محرك التعبيرات النمطية، يُطبق مبدأ الهروب البرمجي المنهجي عبر المعادلة:
=REGEXEXTRACT(A2, "?(.*)")
تسترجع هذه الصيغة كامل السلسلة البارامترية الممتدة على يمين الرابط النظيف، محيدةً البنية التحتية لاسم النطاق والمسار الداخلي لصفحة الهبوط.
للانتقال إلى مستوى أعلى من التخصيص، يمكن عزل قيمة مصدر الحملة حصراً، والمتموضعة بعد المتغير utm_source= مباشرة، عبر النمط الدقيق التالي:
=REGEXEXTRACT(A2, "utm_source=([^&]+)")
يقوم هذا التعبير بامتصاص النص الواقع بعد المعامل وحتى مصادفة علامة العطف (&) الفاصلة بين المعاملات، مما يُرجع القيمة “google” نقية تماماً، ويوفر مادة خاماً عالية القيمة لبناء لوحات مؤشرات الأداء الرقمي ومراقبة عائد الإنفاق الإعلاني بصورة فورية ومؤتمتة بالكامل.
10.3 تجزئة الأسماء المركبة والمعلومات الديموغرافية والوظيفية
تحتوي قواعد بيانات الموارد البشرية وإدارات علاقات العملاء (CRM) عادة على حقول مدمجة تضم الاسم الكامل واللقب، أو المسمى الوظيفي مقترناً بالإدارة المسؤولة ضمن حقل نصي واحد (مثل: “د. عبد الله الشمري – مستشار أول نظم معلومات” أو “Smith, John”). يتطلب إرسال المراسلات الرسمية وتخصيص تجارب المستخدمين تجزئة هذه البيانات وعزل الألقاب والصفات المهنية عن الهوية الاسمية المجردة.
في حالة قواعد البيانات الغربية أو المنسقة بنمط الفاصلة والاسم الأخير أولاً (“Lastname, Firstname”)، يقتضي استخراج الاسم الأول الواقع بعد الفاصلة تطبيق صيغة التطهير المدمجة:
=TRIM(REGEXEXTRACT(A2, ",(.*)"))
تتخلص هذه الصيغة من الفاصلة التقديمية والمسافة البادئة وتسترجع الاسم الشخصي للمستخدم، مما يتيح استخدامه في أدوات التخصيص التلقائي لرسائل البريد الإلكتروني ونماذج التواصل التفاعلي.
أما على صعيد الهياكل الإدارية والمسميات الوظيفية، فإن استخراج اسم الإدارة أو القسم الواقع بعد الشرطة الفاصلة في سلسلة مثل “مهندس بيانات – إدارة البنية التحتية والذكاء الاصطناعي” يتم عبر الصياغة الهندسية:
=TRIM(REGEXEXTRACT(A2, "-(.*)"))
تتيح هذه التجزئة الدقيقة لمديري الموارد البشرية إجراء تصنيفات ديموغرافية متعددة المستويات، ومراقبة توزيع الكفاءات البشرية عبر الأقسام، واستخراج إحصائيات الأداء الوظيفي دون الحاجة لإعادة كتابة وتفكيك سجلات الموظفين الضخمة يدوياً.
خاتمة
يمثل استخراج النصوص بعد حرف أو محرف محدد في جداول بيانات Google عملية هندسية محورية تمزج بين المنطق الرياضي الصارم للنظم الحسابية والتطبيقات المرنة للغات الصورية ومحركات التعبيرات النمطية. من خلال استعراض المناهج المتعددة—بدءاً من الصياغات الدقيقة لدالة REGEXEXTRACT ومحرك RE2 السحابي، مروراً بالتوليف الجبري الكلاسيكي لدوال RIGHT وLEN وFIND، ووصولاً إلى أساليب المصفوفات الديناميكية عبر SPLIT وINDEX ومصفوفات ARRAYFORMULA الموسعة—يتضح أن النجاح التحليلي لا يرتبط بمجرد حفظ الصيغ، بل بفهم البنية التركيبية للبيانات وتحديد القيود الحوسبية المحيطة بها.
إن إتقان آليات الهروب البرمجي، والتمييز الواعي بين السلوكيات الطماعة والكسولة، ومعالجة الاستثناءات ومحارف الفراغ والتحكم، يشكل الفارق بين ورقة عمل هشة ومعرضة للانهيار المستمر، ومنظومة بيانات سحابية متقدمة ومرنة تخدم صانعي القرار بأعلى مستويات الموثوقية والدقة. تظل جداول بيانات Google منصة حيوية ومتطورة تتيح للمحللين والمهندسين أدوات حاسوبية فائقة؛ شريطة تطبيقها بوعي منهجي، وتجريد رياضي، وانضباط برمجي يحقق الاستثمار الأمثل في معالجة وإدارة البيانات الرقمية المعاصرة.
المراجع
- Aldhyani, T. H. H., Alsubari, S. N., Alshebami, A. S., Alkahtani, H. S., & Ahmed, Z. A. T. (2022). Detecting and Analyzing Suicidal Ideation on Social Media Using Deep Learning and Machine Learning Models. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph191912635
- Boulton, A., & Vyatkina, N. (2021). Thirty years of data-driven learning: Taking stock and charting new directions over time. Language learning & technology. https://doi.org/10.64152/10125/73450