
تُعد معالجة السلاسل النصية واستخلاص الأنماط المحددة منها إحدى الركائز الجوهرية في هندسة البيانات الحديثة والتحليل الإحصائي المحوسب؛ إذ إن البيانات المجمعة من الحقول التطبيقية—سواء كانت مستقاة من استبيانات بحثية، أو سجلات نظم خادمة، أو استجابات نصية غير منتظمة—نادراً ما تتطابق مع المعايير التركيبية اللازمة للتحليل المباشر. وفي هذا السياق، تبرز بيئة جداول بيانات جوجل (Google Sheets) كواحدة من أكثر المنصات السحابية مرونة وفاعلية في إدارة البيانات وتنقيتها، حيث توفر ترسانة متقدمة من الأدوات الخوارزمية والدوال الرياضية والنصية التي تتيح للباحثين والمحللين عزل المتغيرات بدقة متناهية. إن الحاجة إلى استخراج نص يقع بدقة بين حرفين أو محرفين محددين تمثل عملية كلاسيكية متكررة في دورة حياة تطهير البيانات، وتحظى باهتمام منهجي بالغ لكونها تحول الكتل النصية الصامتة إلى وحدات تحليلية قابلة للقياس والتصنيف الرياضي.
تاريخياً، تعود جذور منصة جداول بيانات جوجل إلى الاستحواذ الذي أجرته شركة جوجل في عام 2006 على التقنية التي طورتها شركة “2Web Technologies” بقيادة جوناثان روشيل (Jonathan Rochelle) وفرزاد خسروشاهي (Farzad Khosrowshahi)، مما أرسى دعائم بيئة سحابية تشاركية قادرة على إجراء العمليات الحسابية والمعالجات النصية بكفاءة عالية عبر المتصفح مباشرة دون الحاجة إلى بنية تحتية محلية معقدة. ومع تطور المنصة، دُمجت بها محركات مطابقة الأنماط النصية المستندة إلى أسس رياضية متينة، ولا سيما نظرية اللغات الصورية والتعبيرات النمطية التي وضع لبنتها الأولى عالم الرياضيات الأمريكي ستيفن كول كلين (Stephen Cole Kleene) في خمسينيات القرن العشرين، وتحديداً في ورقته التأسيسية الصادرة عام 1956 حول تمثيل الأحداث في الشبكات العصبية والآلات الذاتية المحدودة. هذا التزاوج بين الحوسبة السحابية والنظرية الرياضية للأنماط أتاح للمستخدمين أدوات متطورة للغاية، تتجاوز حدود الاقتطاع الميكانيكي البسيط للمحارف لتصل إلى إدراك السياقات الهيكلية المعقدة للنصوص.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك كافة الأبعاد النظرية والتطبيقية لعملية استخراج النصوص المحصورة بين حرفين أو سلسلتين نصيتين في بيئة جداول بيانات جوجل. وسيتناول التحليل المقارن التشريح البنيوي للدوال الحديثة المعتمدة على محرك التعبيرات النمطية مثل REGEXEXTRACT، جنباً إلى جنب مع الدوال الإحداثية الكلاسيكية مثل MID وFIND وSEARCH، مع تسليط الضوء على الإشكاليات الخوارزمية الدقيقة المتعلقة بسلوك الجشع والكسل في المطابقة، وكيفية ترويض الرموز الوظيفية المحجوزة، وصولاً إلى بناء مصفوفات أوتوماتيكية متكاملة عبر ARRAYFORMULA تضمن تدفقاً تحليلياً خالياً من الأخطاء القياسية.
1. الأسس النظرية لمعالجة النصوص في جداول بيانات جوجل
1.1 أهمية التنقيب عن النصوص وتطهير البيانات المجدولة
يمثل التنقيب عن النصوص (Text Mining) وتطهير البيانات المجدولة خطوة تحضيرية حتمية تسبق أي عملية استدلال إحصائي أو نمذجة تنبؤية متقدمة. ففي البيئات البحثية والأكاديمية، غالباً ما تُجمع البيانات الأولية في قوالب غير منظمة أو شبه منظمة، مثل المعرفات المركبة للمشاركين، أو الأكواد الرقمية المدمجة داخل نصوص وصفية، أو الطوابع الزمنية المقترنة بتعليقات سردية. وتتجلى الإشكالية الإبستمولوجية في أن الأنظمة الإحصائية الحديثة تعجز عن قراءة هذه الكيانات المركبة كوحدات دلالية ما لم تُفكك روابطها وتُعزل متغيراتها المستقلة في أعمدة منفصلة تعكس بدقة البعد المقاس دون تشويش خارجي، وهو ما تدعمه دراسات استرجاع البيانات ومعالجة المدونات اللغوية (Boulton & Vyatkina, 2021).
إن خفض معدلات الخطأ في الدراسات المسحية والتحليلات الكمية يرتبط ارتباطاً وثيقاً بمدى صرامة عمليات التنقية المطبقة على السجلات النصية؛ إذ إن وجود فراغ زائد، أو محرف غير مرئي، أو عدم اتساق في حدود استخلاص النص، يترتب عليه بالضرورة تشوه في مصفوفات التغاير والارتباط، ويقود إلى انحيازات تقديرية تقلل من الموثوقية العلمية للنتائج. ولذلك، فإن استخلاص الأجزاء الحيوية من النصوص ليس مجرد مسألة تنسيقية، بل هو عملية ترشيح منهجي تهدف إلى إزالة الضجيج المحيط بالمعلومات وتثبيت بنية المفردات المبحوثة تمهيداً لترميزها رقمياً، سواء كان ذلك في أبحاث الصحة الرقمية وتتبع سلوك المستخدمين (Sardi et al., 2017) أو في النظم التحليلية متعددة الوسائط المعقدة (Safa et al., 2021).
1.2 نظرة عامة على محرك التعبيرات النمطية (RE2) في جوجل
تعتمد منظومة جداول بيانات جوجل في معالجة التعبيرات النمطية على مكتبة برمجية متقدمة طورتها شركة جوجل مفتوحة المصدر وتُعرف باسم محرك RE2. يتميز هذا المحرك باختلافه الجذري عن المحركات التقليدية المعتمدة على خوارزميات التراجع الخلفي التعسفي (Backtracking) مثل محركات PCRE؛ إذ صُمم RE2 من الأساس ليعمل وفق مبادئ آلات الحالات المحدودة الحتمية (Deterministic Finite Automata – DFA) وغير الحتمية (NFA)، مما يوفر ضمانات أمان زمني صارمة تحول دون وقوع ما يُعرف بـ “التراجع الكارثي” (Catastrophic Backtracking) الذي يتسبب في تجميد الخوادم واستهلاك الذاكرة الحسابية بشكل أسي عند مواجهة نصوص شديدة التعقيد أو غير متطابقة.
تضمن هذه الخلفية الرياضية لمحرك RE2 تنفيذاً خطياً للوقت يتناسب طردياً مع طول السلسلة النصية المراد معالجتها ($O(n)$)، بغض النظر عن مدى تعقيد النمط المنطقي المطبق. ينعكس هذا الأداء الاستثنائي بصورة مباشرة على استقرار منصة جداول بيانات جوجل السحابية، حيث يتمكن المحرك من فحص مئات الآلاف من الخلايا النصية الموزعة في وقت متزامن ومطابقتها مع محددات الحصر بدقة حاسوبية مطلقة ودون التأثير سلباً على زمن الاستجابة التفاعلي، مما يمنح الباحثين أداة موثوقة رياضياً وقادرة على الصمود أمام أضخم قواعد البيانات النصية شبه المنظمة.
2. البنية التركيبية والدلالية لدالة REGEXEXTRACT
2.1 التشريح اللغوي لصيغة الدالة ومعاملاتها الأساسية
تحتل دالة REGEXEXTRACT موقع الصدارة في قائمة الدوال المخصصة لمعالجة النصوص في جداول بيانات جوجل، وتُصاغ دلالياً لاستقبال معاملين إجباريين وفق البنية العامة: =REGEXEXTRACT(text, regular_expression). يمثل المعامل الأول (text) المرجع الإحداثي للخلية المستهدفة أو السلسلة النصية الأولية الخاضعة للفحص، في حين يشكل المعامل الثاني (regular_expression) المتغير التوجيهي الخوارزمي الذي يحدد القواعد النحوية الصارمة التي يجب على المحرك تتبعها لمسح الحروف واقتناص المقطع المطلوب.
تتسم الدالة بسلوك إرجاعي بالغ الدقة؛ فحينما ينجح المحرك في مطابقة النمط المحدد داخل النص الأصلي، تقوم الدالة بإرجاع أول تطابق تقع عليه خوارزمية المسح، شريطة أن يُحدد حيز الاستخلاص عبر أقواس العزل المنطقية. وفي المقابل، إذا أخفقت الخوارزمية في إيجاد تطابق يحقق شروط النمط بالكامل، أو إذا كانت الخلية المصدر فارغة تماماً، فإن الدالة تسقط في حالة الخطأ القياسي #N/A، مما يشير إلى انقطاع الرابط الدلالي بين محددات البحث المعطاة والبنية الفعلية للخلية، وهو ما يستلزم إحاطتها بتدابير استثنائية لمنع انتشار الخطأ في الحسابات المعتمدة عليها.
2.2 مجموعات الالتقاط وتحديد نطاق العزل النصي
يكمن السر الجوهري في استخلاص النص الواقع “بين” حرفين دون تضمين هذين الحرفين أنفسهما ضمن الناتج في توظيف ما يُعرف اصطلاحاً بـ “مجموعات الالتقاط” (Capturing Groups)، والتي يتم الإعلان عنها برمجياً عبر إحاطة التعبير الفرعي المستهدف بزوج من الأقواس الهلالية الدائرية (...). فبدون هذه الأقواس، يعيد المحرك كامل السلسلة النصية التي حققت التطابق الإجمالي بما في ذلك الأحرف الحدودية، مما يُفسد الغاية المنهجية المتمثلة في عزل النواة الدلالية الحرة المجردة من المحددات الخارجية.
عندما تلتقي خوارزمية REGEXEXTRACT بزوج من الأقواس الهلالية ضمن صياغة النمط، فإنها تدرك على الفور أن دور المحارف الواقعة خارج هذه الأقواس ينحصر فقط في دور “المثبتات السياقية” (Contextual Anchors) التي ترشد المسار الحسابي إلى نقطة البداية ونقطة النهاية، بينما يتم تحويل الذاكرة الإخراجية للدالة لتقتصر حصرياً على ما تم التقاطه وتجميعه داخل حيز القوسين. هذا الفصل الدلالي بين شروط المطابقة الهيكلية ومحتوى الإرجاع الفعلي هو الأساس التقني الذي تبتني عليه عمليات الاستخلاص النظيف لكافة المتغيرات النصية في البيئات المجدولة.
3. الرموز الوصفية وقواعد التعبيرات النمطية المستخدمة في الحصر
3.1 دلالة الرمز النقطي والمطابق الشامل للمحارف
يُعد الرمز النقطي . (Dot Metacharacter) أحد أقوى الرموز الوصفية وأكثرها استخداماً في منظومة التعبيرات النمطية داخل محرك RE2؛ إذ يحمل دلالة برمجية صريحة تعني مطابقة أي محرف مفرد أياً كانت طبيعته، سواء كان حرفاً أبجدياً، أو رقماً حسابياً، أو رمزاً خاصاً، أو مسافة بيضاء اعتيادية. ويشكل هذا الرمز حجر الزاوية عند بناء محددات الحصر، لكون المحلل لا يعلم بالضرورة مسبقاً ماهية المحارف التي تتألف منها الكلمة أو العبارة المحصورة بين المحددات، مما يوجب اعتماد مطابق شامل يستوعب التنوع اللغوي والرمزي المحتمل للمدخلات دون تقييد مسبق.
ومع ذلك، يجب الانتباه بعناية إبستمولوجية إلى الحدود الصارمة لعمل هذا الرمز؛ فالرمز النقطي الافتراضي في RE2 لا يطابق محارف فواصل الأسطر غير المرئية مثل رمز السطر الجديد (n) أو الإرجاع للبداية (r). وبالتالي، إذا كان النص المحصور يمتد عبر فقرات متعددة مفصولة بأوامر نزول للسطر داخل الخلية نفسها، فإن النقطة المفردة تفشل في ردم الفجوة المكانية بين الحرفين المحددين ما لم تُفعّل مؤشرات النمط المتعدد الأسطر، أو يُستبدل الرمز النقطي بتعبير فئوي شامل يعالج فواصل الأسطر مثل [sS] لضمان استيعاب الكتلة النصية بكافة أبعادها الطبوغرافية دون انقطاع.
3.2 محددات التكرار والكمية: دراسة الرمز النجمي
إذا كان الرمز النقطي يمثل هوية المحرف المطابق، فإن محددات الكمية (Quantifiers) هي التي تحكم مداه العددي وامتداده الأفقي على طول السلسلة. ويبرز الرمز النجمي *، المعروف تاريخياً بنجمة كلين (Kleene Star)، كمعامل رياضي يُفيد تكرار العنصر السابق له بمقدار يبدأ من الصفر ويمتد نظرياً إلى ما لا نهاية ($[0, \infty)$). وعند دمج النقطة بالنجمة في التعبير الشهير .*، ينشأ كيان تعبيري بالغ المرونة يمتلك القدرة على ابتلاع أي تتابع عشوائي من المحارف، حتى وإن كانت المسافة بين الحرف المحدد الأول والحرف المحدد الثاني خالية تماماً من أي محتوى (أي مطابقة بطول صفر محرف).
تتجلى الأهمية المنهجية للنجمة في قدرتها على استيعاب الحالات الحدية التي قد ترد في قواعد البيانات المسحية؛ ففي حال ظهور الحرف المبدئي متبوعاً مباشرة بالحرف الختامي (مثل وجود قوسين متجاورين فارغين ())، فإن النمط القائم على النجمة لا يتوقف أو يُصدر خطأ حسابياً، بل يعيد سلسلة نصية فارغة مطابقة تماماً للواقع الإحصائي للخلية. وعلى النقيض من ذلك، فإن استخدام رمز الزائد + يفرض وجود محرف واحد على الأقل بين المحددات ($[1, \infty)$)، مما يجعل الاختيار بين النجمة والزائد قراراً منهجياً مرتبطاً بتحديد ما إذا كان الفراغ بين الحرفين يُعد قيمة مفقودة صالحة للاستخلاص أم حالة شاذة يجب تجاهلها.
4. استخراج النصوص المحصورة بين سلسلتين نصيتين محددتين
4.1 صياغة الأنماط النصية الثابتة كحدود استخراج
عندما تكون المحددات عبارة عن أحرف أبجدية اعتيادية أو سلاسل نصية مكونة من كلمات مفتاحية واضحة، يُبنى النمط التعبيري بطريقة مباشرة تخلو من التعقيد الترميزي؛ فإذا افترضنا وجود سجل نصي يحتوي على بيانات مفصولة بكلمات دالة مثل “البداية:” و”النهاية:”، يتم تركيب معادلة الاستخلاص كالتالي:
=REGEXEXTRACT(A2, "البداية:(.*?)النهاية:")
يقوم المحرك هنا بالبحث عن التسلسل الحرفي “البداية:” أولاً لتثبيت نقطة الانطلاق، ثم يشرع عبر مجموعة الالتقاط (.*?) في تجميع كافة المحارف المتتالية في ذاكرة عازلة، حتى يصل إلى أول تتابع يطابق السلسلة “النهاية:”، فيتوقف فورياً عن التجميع ويُغلق عملية الالتقاط مقتصراً على إخراج ما تم جمعه بين هذين القطبين الدلاليين.
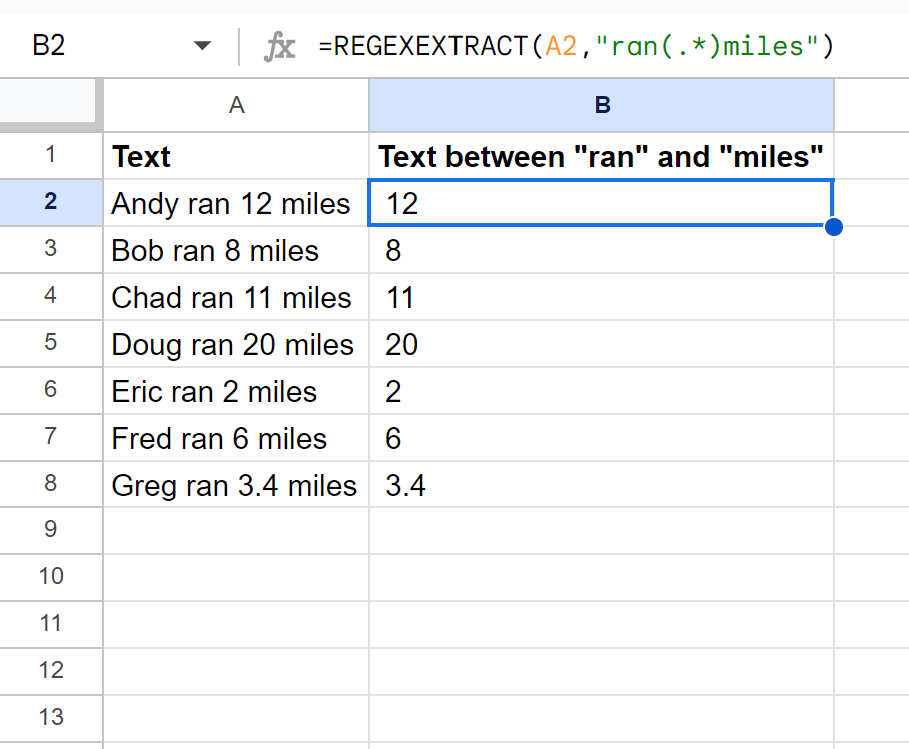
يجب التنبيه الصارم إلى أن محرك RE2 يتعامل بحساسية تامة لحالة الأحرف (Case Sensitivity) في اللغات التي تتمايز فيها المحارف (كاللاتينية والإنجليزية)، فضلاً عن حساسيته الفائقة لعلامات التشكيل والتطويل والهمزات في اللغة العربية؛ فالمحدد “البداية” يختلف كلياً في بنيته المعجمية الصورية عن “البدايه” بالتاء المربوطة أو الهاء. وبالتالي، فإن أي تباين طفيف بين الصياغة الحرفية للنص الموجود داخل الخلية ونمط الاستخراج المدون في المعادلة سيؤدي حتماً إلى إخفاق عملية المطابقة وظهور خطأ القيمة غير المتوفرة، مما يستوجب توحيد الهياكل الإملائية للمدخلات كإجراء قبلي لازم.
4.2 التعميم الرأسي وسحب الصيغة عبر السجلات المتعددة
يمثل الانتقال بالصيغة من مستوى الخلية الفردية إلى مستوى العمود الإحصائي الكامل اختباراً حقيقياً لمتانة النمط المصاغ. عند تطبيق المعادلة وسحبها رأسياً عبر آلاف الصفوف، تتجلى إشكالية تباين أطوال السلاسل النصية ومواضع المحددات عبر السجلات؛ إذ قد يقع النص المطلوب في بداية السجل في الصف الأول، بينما يقع في ذيل السجل في الصف العاشر. تكمن القوة البنيوية لدالة REGEXEXTRACT في قدرتها على التكيف الذاتي مع هذا التموضع المتغير للمحددات دون الحاجة إلى تعديل معاملات الإزاحة أو إعادة ضبط الحسابات الموضعية.
لضمان سلامة التعميم الرأسي، يتعين على الباحث التحقق المنهجي من اتساق النتائج عبر عينة اختبار عشوائية تمثل كافة أشكال السجلات (القصيرة، الطويلة، والمركبة)؛ حيث يُساعد هذا الفحص الاستكشافي في كشف ما إذا كانت هناك صفوف تفتقر إلى أحد المحددات أو تحتوي على فراغات غير مرئية تفصل بين المحدد ومحتوى الاستخراج، مما يتيح ضبط النمط لاستيعاب الفراغات البيضاء تلقائياً عبر إضافة محددات المسافات مثل s* حول المحددات لتجنب التقاط المسافات الهامشية غير المرغوبة ضمن النص النهائي المستخلص.
5. تقنيات تجاوز الرموز الخاصة واستخراج المحتوى بين الأقواس
5.1 مفهوم رمز الهروب ودوره الوظيفي في البرمجة النصية
في لغات التعبيرات النمطية، تحظى مجموعة معينة من الرموز بمكانة نحوية خاصة وتُعرف بالرموز الوظيفية أو المحجوزة (Reserved Metacharacters)، وتشمل: ( ) [ ] { } ^ $ . * + ? | . هذه الرموز لا تُعامل كمحارف أبجدية عادية، بل تُفسر بواسطة المحرك كأوامر تشغيلية لبناء مجموعات، أو تحديد كميات، أو الإشارة إلى بدايات ونهايات السلاسل. وهنا يبرز مفهوم “رمز الهروب” (Escape Character) المتمثل في الخط المائل العكسي (Backslash) كأداة لا غنى عنها لتعطيل القوة الوظيفية لتلك الرموز وإعادتها إلى حالتها الصامتة كمحارف نصية بحتة يُراد البحث عنها بذاتها داخل النص.
إذا حاول المستخدم استخراج نص محصور بين قوسين هلاليين دون استخدام رمز الهروب، وكتب الصيغة على النحو الآتي: "((.*?))"، فإن محرك RE2 سيفسر ذلك كأقواس التقاط متداخلة غير صالحة ولن يبحث عن رمز القوس الفيزيائي المكتوب في النص، مما يؤدي إلى فشل الصيغة هيكلياً وتوليد أخطاء تفسيرية مبهمة. إن وضع الخط المائل العكسي قبل القوس يجرده من وظيفته التركيبية، معلناً للمحرك أن الهدف هو مطابقة محرف القوس كما هو مرسوم في النص الأصلي، وهو مبدأ حاسم في البرمجة النصية يضمن التمييز الدقيق بين لغة التحكم والبيانات الخاضعة للتحليل.
5.2 التطبيق الإجرائي على الأقواس بمختلف أشكالها الهندسية
تتعدد أشكال الأقواس المستخدمة في حصر المعطيات الإحصائية والتوضيحية داخل قواعد البيانات؛ وتعتمد صياغة أنماط استخراج ما بينها على الاستخدام الصارم لرمز الهروب تبعاً للشكل الهندسي للقوس المستهدف. لاستخراج النص المحصور بين قوسين هلاليين دائريين (...)، تُكتب المعادلة بدقة على النحو الآتي:
=REGEXEXTRACT(A2, "((.*?))")
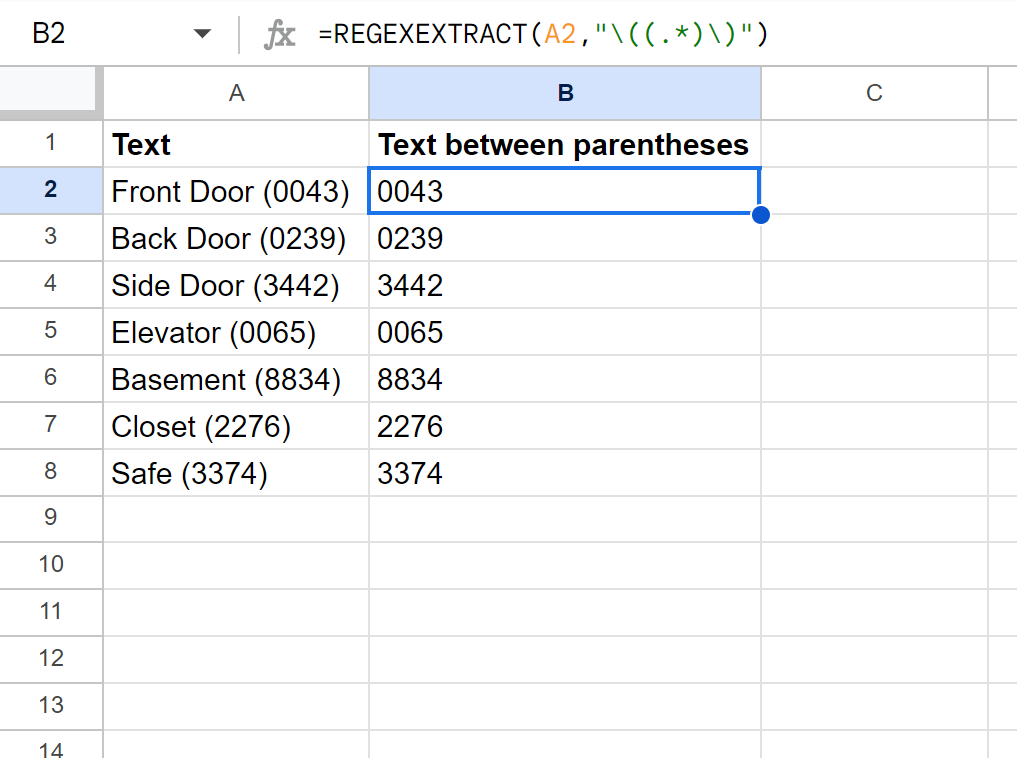
في هذه الصيغة المنسوجة بعناية، يمثل ( مطابقة حرفية لقوس الفتح، بينما يمثل ) مطابقة حرفية لقوس الإغلاق، وتقوم مجموعة الالتقاط الداخلية (.*?) باقتناص كل ما يقع بينهما وتجاهل القوسين من مصفوفة الإخراج. وبالمثل، إذا كانت البيانات محصورة بين قوسين مربعين [...]، وهي صيغة شائعة لترميز المتغيرات التابعة والاستشهادات الرقمية، يتم تكييف الصيغة بوضع رموز الهروب المناسبة:
=REGEXEXTRACT(A2, "[(.*?)]")
أما في حالة الأقواس المعقوفة {...} أو علامات التنصيص المزدوجة "..."، فيتم تطبيق نفس المنطق المنهجي؛ مع ملاحظة أن علامات التنصيص داخل جداول بيانات جوجل تتطلب معالجة خاصة تتمثل في مضاعفتها (أي كتابة """" لتمثيل علامة تنصيص مفردة داخل نص المعادلة) أو استدعاء محرفها اللاتيني الخاص لتفادي انقطاع السلسلة التوجيهية الكبرى للدالة، مما يضمن تدفقاً سلساً لبيانات التقارير الإحصائية وحصر الأرقام المضمنة بين حواصر بأعلى معايير الدقة الهندسية.
6. التحكم في جشع المطابقة: المقارنة بين السلوك النهم والسلوك الكسول
6.1 طبيعة الخوارزميات النهمة في ابتلاع النصوص المتكررة
تتميز محددات الكمية القياسية في التعبيرات النمطية، مثل * و+، بسلوك خوارزمي متأصل يُعرف تقنياً بـ “المطابقة النهمة” أو “الجشعة” (Greedy Matching). في هذا النمط من التشغيل، يسعى المحرك إلى ابتلاع أكبر قدر ممكن من المحارف النصية المتاحة أمامه، مفضلاً التوسع الأفقي الأقصى على التوقف المبكر؛ فهو يستمر في المسح عبر السجل حتى يصطدم بآخر تطابق محتمل لمحدد الإغلاق في نهاية الخلية بأكملها، متجاهلاً كافة المحددات الوسيطة التي صادفها في مساره.
لتوضيح التبعات السلبية لهذا السلوك في التطبيقات العملية، لنفترض وجود سجل نصي يحتوي على التعبير الآتي: [العينة 1] ضابطة و [العينة 2] تجريبية. إذا استخدم الباحث الصيغة النهمة الكلاسيكية:
=REGEXEXTRACT(A2, "[(.*)]")
فإن النتيجة المستخرجة لن تكون العينة 1 كما قد يتوقع المبتدئ، بل ستكون: العينة 1] ضابطة و [العينة 2! لقد تجاوز المحرك الجشع قوس الإغلاق الأول وابتلع كل ما يليه وصولاً إلى القوس المربع الأخير في أقصى يسار أو يمين السجل، مما يمثل خطأ منهجياً فادحاً يخل بتركيبة المتغيرات المستخلصة ويدمج سجلات متباينة في كيان نصي هجين غير صالح للاستخدام الإحصائي.
6.2 تقييد البحث وتفعيل المطابقة الكسولة لحصر أقصر مجال
للتعامل مع قصور الخوارزميات النهمة وضمان عزل المقطع الأول بصورة مستقلة، يلجأ مهندسو البيانات إلى تقييد سلوك الكمية عبر تفعيل ما يُعرف بـ “المطابقة الكسولة” أو “غير الجشعة” (Lazy / Reluctant Matching). ويتحقق ذلك رياضياً عن طريق إلحاق علامة الاستفهام ? مباشرة بعد محدد الكمية لتصبح الصيغة .*? بدلاً من .*. هذه الإضافة التحويرية البسيطة تُغير الاستراتيجية التشغيلية للمحرك تغييراً جذرياً؛ إذ تجبره على استهلاك أقل عدد ممكن من المحارف والتوقف الفوري عن المسح بمجرد العثور على أول ظهور للمحدد الختامي المستهدف.
إذا أعدنا تطبيق المعادلة السابقة بالصيغة المقيدة:
=REGEXEXTRACT(A2, "[(.*?)]")
فإن المحرك سيتوقف بمجرد اصطدامه بقوس الإغلاق الأول المجاور لـ العينة 1، ليعيد بدقة الكيان النصي النقي دون أي زيادات تشويهية. تُعد هذه المطابقة الكسولة ضرورة حتمية في معالجة استجابات الاستبيانات المفتوحة، وتغريدات وسائل التواصل الاجتماعي، والرسائل التفاعلية حيث تتكرر علامات الترقيم والأقواس بكثافة، مما يضمن سلامة المعطيات الأولية واستخراج المعرفات والوسوم بدقة ميكانيكية مطلقة تساند تحليلات المحتوى المتقدمة، كالتي تطرق لها الباحثون في فحص الخطاب والتعبيرات النفسية على شبكات التواصل (Aldhyani et al., 2022).
7. البدائل التقليدية: توظيف الدوال المدمجة لاستخراج النصوص
7.1 تكامل دالة MID مع دوال التحديد الموضعي FIND و SEARCH
قبل إدماج دوال التعبيرات النمطية في برمجيات الجداول السحابية، كان استخراج النصوص المحصورة بين حرفين يعتمد كلياً على الحساب الإحداثي الهندسي للمواقع والمحارف عبر الدمج المتداخل بين دالة الاقتطاع المركزي MID ودوال التحديد الموضعي التراكمي مثل FIND أو SEARCH. تقوم دالة MID باقتطاع جزء من سلسلة نصية انطلاقاً من رقم محرف البدء وبطول عدد محدد من الحروف، استناداً إلى الصياغة الرياضية العامة:
=MID(text, start_num, num_chars)
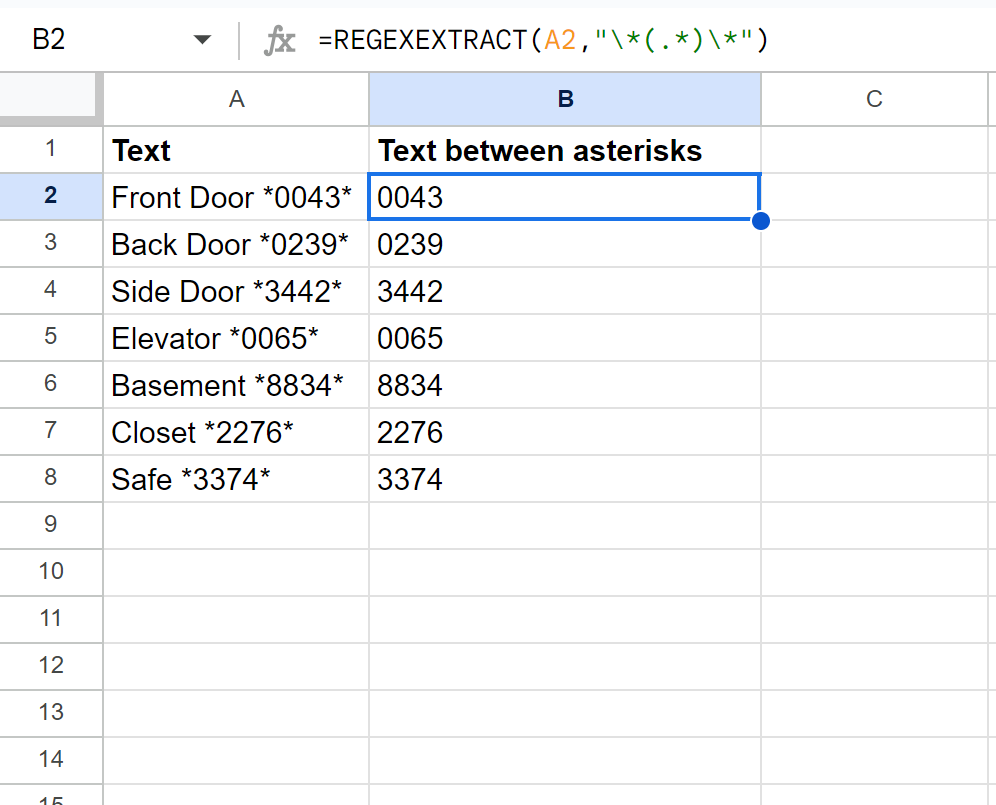
ولبناء معادلة استخراج نقي لنص يقع بين القوس المربع المفتوح [ والقوس المغلق ] داخل الخلية A2، تتكامل الدوال في البنية التوليدية الآتية:
=MID(A2, FIND("[", A2) + 1, FIND("]", A2) - FIND("[", A2) - 1)
يعتمد هذا النموذج الحسابي على حساب نقطة الانطلاق عبر FIND("[", A2) + 1 لتجاوز القوس المبدئي نفسه والدخول مباشرة إلى الحرف الأول من المحتوى المستهدف. أما المعامل الثالث الذي يمثل طول السلسلة المراد اقتطاعها، فيُحسب بطرح الموضع الإحداثي للقوس الأول من الموضع الإحداثي للقوس الثاني، مع طرح الرقم واحد لتعويض الفارق الموضعي للقوس المستهدف. وتجدر الإشارة المنهجية هنا إلى أن دالة FIND تتسم بحساسيتها الصارمة لحالة الأحرف ولا تقبل الرموز البديلة، بينما دالة SEARCH غير حساسة لحالة الأحرف وتدعم الرموز العامة كالنجمة وعلامة الاستفهام، مما يجعل اختيار إحداهما مرتبطاً بخصائص السلاسل النصية المفحوصة بدقة.
إذا كانت المحددات عبارة عن سلاسل نصية متعددة المحارف بدلاً من أحرف مفردة (مثل استخراج ما بين كلمتين)، فإن المعادلة تتطلب تعويض أطوال السلاسل المحددة باستخدام دالة LEN لتجاوز طول الكلمة المبدئية بدقة:
=MID(A2, FIND("start", A2) + LEN("start"), FIND("end", A2, FIND("start", A2) + LEN("start")) - (FIND("start", A2) + LEN("start")))
7.2 الموازنة التقنية بين دالة التعبيرات النمطية والحلول المركبة
عند إجراء مقارنة أداء وتحليل بنيوي بين دالة REGEXEXTRACT والحلول المركبة القائمة على MID وFIND، تبرز فروق تشغيلية وهندسية عميقة ترتبط بقابلية الصيانة واستهلاك الموارد الحسابية. من زاوية قابلية القراءة (Readability)، تتفوق REGEXEXTRACT تفوقاً ساحقاً؛ إذ تختزل عمليات الحساب الهندسي المعقدة وتكرار استدعاء دوال البحث في نمط وصفي مدمج لا يتجاوز بضعة محارف، مما يقلل من احتمالات الخطأ البشري أثناء صياغة المعادلات الطويلة في المشاريع البحثية المشتركة.
أما من منظور الكفاءة الحاسوبية واستنزاف الذاكرة، فإن صيغ MID المتداخلة قد تفرض إجهاداً إضافياً على معالج الحسابات السحابي نظراً لأنها تجبر الخوارزمية على فحص السلسلة النصية نفسها ثلاث مرات متتالية (مرة لتحديد بداية الاقتطاع، ومرتين إضافيتين لحساب طول السلسلة)، في حين ينفذ محرك RE2 في REGEXEXTRACT مسحاً خطياً موحداً يحدد من خلاله نقطة البداية والنهاية ومحتوى الالتقاط في دورة مرور واحدة. علاوة على ذلك، تتميز دوال التعبيرات النمطية بمرونة فائقة في التعامل مع البنى غير المنتظمة، حيث تعجز الصيغ الكلاسيكية تماماً عن مواجهة التباينات الهيكلية أو المحددات الشرطية البديلة دون تضخيم المعادلة بعشرات الدوال الشرطية المتداخلة.
8. إدارة الأخطاء وحالات الاستثناء الناتجة عن غياب المحددات
8.1 التعامل مع خطأ القيمة غير المتوفرة النمطي (#N/A)
من أكثر التحديات التشغيلية شيوعاً عند تطبيق عمليات الاستخلاص على نطاقات واسعة من البيانات هو ظهور خطأ القيمة غير المتوفرة #N/A. ينشأ هذا الخطأ كنتيجة حتمية لفشل محرك التعبيرات النمطية في العثور على أحد الحرفين المحددين أو كليهما داخل النص المفحوص، أو عندما تكون الخلية المستهدفة فارغة في الأصل. إن بقاء هذه الأخطاء متناثرة داخل الأعمدة المستخرجة لا يؤدي إلى تشويه المظهر الاحترافي لورقة العمل فحسب، بل يتسبب في تعطيل وحجب كافة الدوال الإحصائية اللاحقة التي تعتمد على هذه الأعمدة كمدخلات (مثل دوال AVERAGE أو COUNT أو مصفوفات الارتباط).
لتحصين النموذج الحسابي ضد هذه الانهيارات التسلسلية، يتعين دمج دالة التحصين الاستثنائي IFERROR كغلاف وقائي خارجي يحيط بدالة الاستخلاص. وتأخذ الصيغة المحصنة الهيكل الآتي:
=IFERROR(REGEXEXTRACT(A2, "((.*?))"), "")
يقوم هذا التركيب باختبار مخرجات الاستخلاص أولاً؛ فإذا تحقق التطابق بسلاسة يُعرض النص المستخرج مباشرة، أما إذا سقطت الدالة في أي خطأ، فإن IFERROR تعترض الانهيار وتعيد بدلاً منه سلسلة نصية فارغة (ممثلة بالرمزين "") أو أي قيمة تعويضية منطقية يحددها المحلل (مثل تدوين “غير متوفر” أو “بيانات مفقودة”)، مما يحفظ اتساق التقارير النهائية ويسمح بتدفق التحليلات دون عوائق برمجية مفاجئة، وهي ممارسة منهجية راسخة في معالجة وتدقيق بيانات التجارب التعليمية والملاحظات الميدانية (Veldkamp et al., 2020).
ويجدر بالباحث الالتفات إلى طبيعة البيانات المستخرجة؛ فكلا الدالتين REGEXEXTRACT وMID تُعيدان المخرجات دائماً بصيغة نصية (Text Data Type) حتى وإن كانت المحارف المستخلصة أرقاماً حسابية مجردة. ولتمكين النظام من إجراء العمليات الرياضية وحساب المتوسطات والانحرافات المعيارية على الأرقام المستخرجة من بين الحرفين، يجب تحويل المخرجات قسراً إلى قيم رقمية عبر دمج دالة VALUE أو استخدام المعامل الحسابي المزدوج --، وفق الصياغة الآتية:
=IFERROR(VALUE(REGEXEXTRACT(A2, "((.*?))")), "")
8.2 معالجة المدخلات المركبة والأقواس المتداخلة
تتعقد المسألة المنهجية بصورة ملحوظة عندما تحتوي السجلات النصية على أقواس متداخلة هندسياً أو تكرارات عميقة داخل نفس العبارة، كأن تتضمن الخلية نصاً من قبيل: تم رصد (الاستجابة الأولى مع (ملاحظة إضافية) ملحقة) بنجاح. في هذا السيناريو المعقد، يطرح المحلل تساؤلاً جوهرياً: هل الهدف هو عزل المستوى الخارجي الأوسع للأقواس، أم اقتناص المستوى الداخلي الأدق؟ إن التعبيرات النمطية الكسولة البسيطة ((.*?)) ستلتقط فورياً المقطع الاستجابة الأولى مع (ملاحظة إضافية لأنها تتوقف عند أول قوس إغلاق تصادفه، مما ينتج عنه نص مشوه يحتوي على قوس فتح غير مغلق داخلياً.
للتغلب على هذه المعضلة واقتناص النطاق الداخلي بدقة متناهية (أي استخراج المحتوى بين القوسين الداخليين الصرفين دون احتوائهما على أي أقواس أخرى)، يتم تطوير النمط عبر استبدال المطابق الشامل بفئة الحروف المستبعدة (Negated Character Class):
=REGEXEXTRACT(A2, "(([^()]*))")
يقوم التعبير [^()]* بمطابقة أي تتابع من المحارف بشرط صارم ألا يحتوي على أي قوس فتح أو قوس إغلاق آخر، مما يجبر المحرك رياضياً على الانزلاق إلى أعمق مستوى من التداخل واقتناص الملاحظة الداخلية النقية حصراً (ملاحظة إضافية). يمثل هذا المستوى المتقدم من التحكم في شروط التطابق ضرورة حتمية للتعامل مع النصوص الاصطلاحية والطبية المعقدة وبروتوكولات التفاعل بين الإنسان والآلة التي تحوي مستويات تراتبية من الرموز الحاصرة، كما تُبين دراسات التفاعل البشري مع الأنظمة المؤتمتة (Tezza & Andujar, 2019; Oertel et al., 2020).
9. الأتمتة المتقدمة والمعالجة المجمعة عبر دالة ARRAYFORMULA
9.1 تحويل الصيغة الفردية إلى مصفوفة إجرائية تلقائية
في بيئات العمل المتقدمة وسلاسل معالجة البيانات الضخمة، يُعد السحب اليدوي للمعادلات عبر آلاف الصفوف ممارسة بالية تنطوي على مخاطر جمة؛ إذ إنها تهدر الوقت وتزيد من حجم ملف جدول البيانات وتتعرض لخطر الانقطاع عند إدخال صفوف جديدة بواسطة استمارات الاستبيان المتدفقة تلقائياً. وهنا يأتي الدور التحويلي الرائد لدالة المصفوفات ARRAYFORMULA، التي تتيح إدراج معادلة استخراج واحدة في الخلية الرأسية العلوية لتتكفل تلقائياً بمعالجة وتوليد النتائج على امتداد العمود الإحصائي بالكامل دفعة واحدة.
لتحويل دالة استخراج النصوص بين حرفين إلى مصفوفة إجرائية ممتدة في نطاق غير محدد النهاية (مثلاً من الخلية A2 وحتى نهاية العمود A)، تتم صياغة المعادلة المركبة على النحو التالي:
=ARRAYFORMULA(IFERROR(REGEXEXTRACT(A2:A, "((.*?))")))
بمجرد كتابة هذه الصيغة الفريدة في أول صف من عمود الإخراج، يقوم المحرك الداخلي لجداول بيانات جوجل بإرسال نطاق السجلات A2:A ككتلة مصفوفية إلى دالة REGEXEXTRACT، حيث يتم تنفيذ نمط المطابقة وعزل النصوص بين القوسين بالتوازي عبر كافة الصفوف، وتسكين القيم المستخرجة في الخلايا المقابلة دون الحاجة لنسخ الصيغة أو التدخل البشري المستمر.
9.2 تقييد التنفيذ الشرطي لتجنب معالجة الصفوف الفارغة
على الرغم من القوة الاستثنائية لدالة ARRAYFORMULA، إلا أن تطبيقها على نطاقات مفتوحة النهاية مثل A2:A ينطوي على ثغرة حاسوبية خطيرة إذا لم يتم ترشيدها؛ فالمصفوفة ستستمر في فحص وتطبيق المعادلة على آلاف الصفوف الفارغة الممتدة حتى الحد الأقصى لورقة العمل، مما يستهلك موارد الذاكرة السحابية المؤقتة المخصصة للمستخدم ويؤدي إلى تباطؤ ملحوظ في سرعة التمرير والتحديث. ولتفادي هذا العبء التشغيلي غير المبرر، يتعين تضمين اختبار شرطي صارم يقصر التنفيذ على الصفوف التي تحتوي على نصوص حقيقية فقط.
تتم هذه الحماية المنهجية عبر دمج دالة IF المنطقية كحاجز قبلي يختبر فراغ الخلية قبل إطلاق خوارزمية الاستخراج، وفق التنسيق البرمجي الموصى به:
=ARRAYFORMULA(IF(ISBLANK(A2:A), "", IFERROR(REGEXEXTRACT(A2:A, "((.*?))"), "")))
أو بصياغة أخرى متكافئة رياضياً وأكثر إيجازاً:
=ARRAYFORMULA(IF(A2:A="", "", IFERROR(REGEXEXTRACT(A2:A, "((.*?))"), "")))
تحقق هذه المعادلة التوازن الأمثل بين الأتمتة الكاملة والاستهلاك الرشيد للموارد؛ إذ تُبقي الصفوف غير المشغولة فارغة ومحايدة برمجياً، بينما تنطلق خوارزمية الاستخلاص فور كتابة أي سجل نصي جديد في العمود A، مما يجعل تدفق البيانات سلساً وديناميكياً ومتوافقاً مع أفضل ممارسات هندسة البيانات المجدولة.
10. المعايير المنهجية وأفضل الممارسات لضبط جودة استخلاص البيانات
10.1 التوثيق الصارم للأنماط النصية والتحقق المعياري
تتطلب الأمانة العلمية وجودة العمل المؤسسي توثيقاً صارماً ودقيقاً لكافة المعادلات والأنماط النصية المستخدمة في أوراق العمل، ولا سيما في المشاريع البحثية المشتركة التي تتعدد فيها الأيدي المحللة للبيانات؛ إذ غالباً ما تبدو التعبيرات النمطية لمن لم يكتبها كرموز طلاسمية مبهمة يصعب فهم غايتها أو التدقيق في مدى صحتها المنهجية. لذلك، يُعد تضمين تعليقات توضيحية داخل الخلايا أو إنشاء ورقة عمل ملحقة بمثابة “قاموس بيانات” لشرح وظيفة كل محدد ونمط ومبررات استخدام المطابقة الكسولة دليلاً إجرائياً ضرورياً لضمان استدامة المشروع وقابلية نتائجه للتكرار والتحقق المستقل.
علاوة على ذلك، ينبغي على الباحث بناء ورقة فحص مرجعية (Validation Sheet) تحتوي على حالات الحافة المتطرفة (Edge Cases)، مثل السجلات ذات الأطوال الاستثنائية، أو السجلات التي تنعدم فيها الفراغات، أو تلك التي تكررت فيها محددات الحصر عدة مرات في سياقات متناقضة. يتيح تعريض الصيغ لهذه العينات التجريبية اختبار متانة الأنماط واستجابتها قبل تعميمها النهائي على مئات الآلاف من السجلات الأصلية، والتأكد من مطابقتها للمعايير التحليلية المتبعة في مراقبة وتنقية مدخلات النظم المعقدة كالتي تُناقش في مراقبة وتحليل سلوكيات القيادة الآمنة وتدفقاتها المعطياتية (Alkinani et al., 2020).
10.2 تحسين الأداء التشغيلي في قواعد البيانات النصية الواسعة
مع تضخم أوراق العمل وبلوغها عشرات أو مئات الآلاف من السجلات النصية، يصبح الحفاظ على سرعة الاستجابة التشغيلية لجداول بيانات جوجل أولوية قصوى؛ فبقاء التعبيرات النمطية المعقدة في حالة “حساب نشط ومستمر” في كل مرة يُعاد فيها فتح الملف أو تعديل أي مدخل جانبي يستنزف المعالجات المتاحة. لذلك، تنص البروتوكولات المتقدمة لإدارة البيانات على تجميد نتائج الاستخلاص فور الانتهاء من تدقيقها واعتماد صحتها المنهجية، عبر نسخ عمود النتائج المستخلصة وإعادة لصقه في نفس الموضع كقيم ثابتة (Paste Special > Values Only).
يؤدي هذا الإجراء التطهيري إلى استئصال العبء الحسابي المتكرر وتخليص قاعدة البيانات من مئات الآلاف من استدعاءات الدوال الآنية، مما يعيد للواجهة خفتها وسرعتها الفائقة أثناء التصفية والفرز والتحليل الإحصائي الإجمالي. وتتكامل هذه الخطوة مع تطبيق بروتوكولات حماية الخصوصية ومحو البيانات التعريفية الزائدة من النصوص المصدرية، لضمان بقاء المتغيرات البحثية المستخلصة خاضعة لمعايير الأمان والشفافية العلمية الصارمة المتعارف عليها دولياً في إدارة وتحليل قواعد البيانات المجدولة المعاصرة، وخاصة عند التعامل مع معطيات حساسة وتطبيقات رعاية وتدخلات سلوكية رقمية تستوجب أعلى درجات الدقة والتحوط (Lehtimaki et al., 2021).
خاتمة
استعرضت هذه الدراسة المنهجية الموسعة المبادئ النظرية والمسارات التطبيقية المتنوعة لاستخراج النصوص المحصورة بين حرفين أو سلسلتين محددتين في بيئة جداول بيانات جوجل السحابية. ولقد أثبت التحليل المقارن أن الاعتماد على دالة التعبيرات النمطية REGEXEXTRACT المدعومة بمحرك RE2 السريع يمثل الحل الأكثر مرونة وكفاءة وأناقة برمجية، مقارنة بالصيغ الكلاسيكية المتداخلة المعتمدة على MID وFIND، نظراً لقدرة التعبيرات النمطية على استيعاب الفروق الهيكلية والتعامل الدقيق مع استثناءات الحصر والتكرار.
كما تم إبراز الأهمية الفاصلة للتحكم في سلوك المطابقة والانتقال الصارم من النمط النهم الجشع .* إلى النمط الكسول المقيد .*? لضمان عدم ابتلاع المحددات النصية اللاحقة وعزل النواة الدلالية الحقيقية للمتغيرات، جنباً إلى جنب مع التطبيق العملي لرموز الهروب المائلة لتحييد الأقواس بكافة أشكالها الهندسية. وتوج البحث ببيان كيفية دمج هذه الحلول ضمن مصفوفات أوتوماتيكية ممتدة ومحمية شرطياً عبر دالتي ARRAYFORMULA وIFERROR، مما يؤسس لمنظومة معالجة بيانات قوية وعالية الأداء ترتقي بجودة البحوث الإحصائية وتوفر قاعدة رصينة لكافة عمليات التنقيب والتحليل النصي المتقدم في البيئات السحابية الحديثة.
المراجع
- Aldhyani, T. H. H., Alsubari, S. N., Alshebami, A. S., Alkahtani, H. S., & Ahmed, Z. A. T. (2022). Detecting and Analyzing Suicidal Ideation on Social Media Using Deep Learning and Machine Learning Models. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph191912635
- Alkinani, M. H., Khan, W. Z., & Arshad, Q. (2020). Detecting Human Driver Inattentive and Aggressive Driving Behavior Using Deep Learning: Recent Advances, Requirements and Open Challenges. IEEE Access. https://doi.org/10.1109/access.2020.2999829
- Boulton, A., & Vyatkina, N. (2021). Thirty years of data-driven learning: Taking stock and charting new directions over time. Language learning & technology. https://doi.org/10.64152/10125/73450
- Lehtimaki, S., Martic, J., Wahl, B., Foster, K. T., & Schwalbe, N. (2021). Evidence on Digital Mental Health Interventions for Adolescents and Young People: Systematic Overview. JMIR Mental Health. https://doi.org/10.2196/25847
- Oertel, C., Castellano, G., Chétouani, M., Nasir, J., Obaid, M., Pélachaud, C., et al. (2020). Engagement in Human-Agent Interaction: An Overview. Frontiers in Robotics and AI. https://doi.org/10.3389/frobt.2020.00092
- Safa, R., Bayat, P., & Moghtader, L. (2021). Automatic detection of depression symptoms in twitter using multimodal analysis. The Journal of Supercomputing. https://doi.org/10.1007/s11227-021-04040-8
- Sardi, L., Idri, A., & Fernández‐Alemán, J. L. (2017). A systematic review of gamification in e-Health. Journal of Biomedical Informatics. https://doi.org/10.1016/j.jbi.2017.05.011
- Tezza, D., & Andujar, M. (2019). The State-of-the-Art of Human–Drone Interaction: A Survey. IEEE Access. https://doi.org/10.1109/access.2019.2953900
- Veldkamp, A., van de Grint, L., Knippels, M. P. J., & van Joolingen, W. (2020). Escape education: A systematic review on escape rooms in education. Educational Research Review. https://doi.org/10.1016/j.edurev.2020.100364