
تُعد جداول بيانات جوجل (Google Sheets) واحدة من أكثر الأدوات البرمجية السحابية انتشاراً وتأثيراً في إدارة وتحليل البيانات المجدولة منذ إطلاقها الأولي عبر مختبرات جوجل عام 2006 في أعقاب الاستحواذ التقني على تقنية 2Web Technologies عام 2005. ومع تطور متطلبات معالجة البيانات الضخمة والمعقدة، برزت الحاجة الماسة إلى أتمتة عمليات التدقيق الداخلي ومطابقة السجلات عبر خوارزميات وقواعد بصرية مرنة تضمن اتساق المدخلات وتقلل من احتمالية الخطأ البشري. ومن بين أبرز هذه العمليات التحليلية، تبرز مسألة فحص وجود عنصر بياني محدد يقع ضمن نطاق فرعي واختباره مقابل قائمة مرجعية معيارية أوسع، مع تمييز الخلايا المطابقة تلقائياً من خلال تقنية التنسيق الشرطي (Conditional Formatting).
يتناول هذا المقال التأسيسي والشامل المبادئ الهيكلية والتطبيقات الحسابية المتقدمة لخاصية تمييز الخلية في جداول بيانات جوجل إذا كانت قيمتها متواجدة داخل قائمة مرجعية معينة. وسنستعرض في هذا السياق الأبعاد النظرية المنظمة للمقارنات البولية بين المجموعات المنفصلة، والتشريح الدقيق لدالة العد المشروط COUNTIF وكيفية تطويعها كأداة اختبار منطقي، بالإضافة إلى استكشاف البدائل الهندسية الأخرى مثل تراكيب MATCH وISNUMBER والدوال المصفوفية المتقدمة لمعالجة النصوص الحساسة لحالة الأحرف ومطابقة البيانات عبر أوراق العمل المتعددة. ويستهدف هذا الطرح تمكين الباحثين ومحللي البيانات ومديري النظم المؤسسية من بناء بيئات عمل رقمية عالية الموثوقية والدقة.
إن إتقان آليات المطابقة المتقاطعة بين النطاقات في بيئة العمل السحابية لا يقتصر على مجرد إضفاء لمسات جمالية أو بصرية على أوراق العمل، بل يتعداه إلى تشكيل نظام دفاعي أولي لمراقبة جودة البيانات (Data Quality Control). فعندما تتضخم المصفوفات الرقمية وتتداخل المعطيات عبر مسارات متفرعة، يتحول الفحص اليدوي إلى عبء معرفي غير قابل للإدارة ومصدر دائم للتباين المنهجي، الأمر الذي يجعل من القواعد التلقائية ركيزة لا غنى عنها في الحوكمة البيانية المعاصرة وضبط الاتساق التجريبي في بيئات المعالجة الحديثة.
1. مقدمة نظرية حول التنسيق الشرطي والتحقق من اتساق البيانات
1.1 مفهوم التنسيق الشرطي وأهميته في النظم البيئية للبيانات
يُعرَّف التنسيق الشرطي في بيئات الجداول الإلكترونية بأنه آلية برمجية ديناميكية تتيح تطبيق سمات بصرية محددة—مثل تغيير لون خلفية الخلية، أو نمط الخط، أو إضافة حدود لونية—بصورة آلية بناءً على تحقق شرط رياضي أو منطقي مسبق. وفي النظم البيئية للبيانات، يتجاوز التنسيق الشرطي كونه أداة تجميلية ليصبح واجهة حيوية للتمثيل البصري الفوري (Data Visualization) للمتغيرات الكمية والنوعية أثناء تدفقها الإدخالي. إن هذه الأتمتة البصرية تحول المصفوفات الرقمية الصامتة إلى لوحات معلومات تفاعلية تسهم في لفت انتباه المحلل إلى الأنماط الشاذة أو المتطابقة دون الحاجة إلى تشغيل استعلامات تصفية متكررة تستهلك وقتاً تشغيلياً ثميناً.
من منظور هندسة المعرفة وعلم الإدراك البشري، يلعب الإبراز اللوني دوراً محورياً في خفض العبء المعرفي الواقع على كاهل مدققي ومحللي البيانات. فعند التعامل مع قواعد بيانات تمتد لآلاف الصفوف والأعمدة، تتعرض الذاكرة العاملة للإرهاق السريع نتيجة التدقيق النصي التكراري، مما يرفع احتمالية تفويت الأخطاء المطبعية أو التكرارات غير المرغوبة. ويساعد التباين البصري المنسق في تفعيل المعالجة المعرفية التلقائية قبل الانتباهية (Pre-attentive visual processing)، مما يتيح للعين البشرية رصد التشابهات والتناقضات الإحصائية في أجزاء من الثانية، وهو ما يعزز سرعة استخلاص النتائج الإحصائية وتفسيرها بدقة منهجية رصينة.
تكتسب هذه التقنية أهمية مضاعفة في الأوساط الأكاديمية والمؤسسية التي تتطلب مستويات صارمة من موثوقية قواعد البيانات. ففي سياقات جمع البيانات الميدانية أو إدارة قواعد البيانات السريرية، يعد التحقق من اتساق المدخلات ومطابقتها مع المعايير الموضوعة سلفاً خط الدفاع الأول لتفادي ما يُعرف بتلوث البيانات (Data Contamination). إن فحص تطابق المدخلات مع القوائم المعيارية يحفظ سلامة النماذج القياسية من التحيزات التي قد تنجم عن أخطاء الترميز، وهو ما ينعكس بصورة مباشرة على مصداقية التحليلات الاستدلالية اللاحقة وصحة القرارات المؤسسية المتخذة بناءً عليها.
1.2 المبادئ التحليلية لمقارنة النطاقات البيانية المنفصلة
ترتكز عملية مقارنة النطاقات البيانية في جوهرها على التمييز الرياضي الصارم بين ما يُعرف بالقائمة المرجعية (Reference List) والقائمة المستهدفة بالفحص (Target List). تمثل القائمة المرجعية، في لغة النماذج الرياضية، مجموعة معيارية ثابتة تحتوي على القيم المصادق عليها، أو العناصر المسموح بها، أو مفاتيح الفهرسة المعتمدة مسبقاً. في المقابل، تشكل القائمة المستهدفة مجموعة من المتغيرات الديناميكية الخاضعة للتدقيق والمراقبة، والتي قد تشهد إضافات مستمرة أو تعديلات دورية تتطلب تقييماً متواصلاً لبيان مدى انتمائها للمجموعة المرجعية الأم.
يستند المنطق البرمجي الموجه لاختبار العلاقات المتبادلة بين هذه المجموعات إلى مبادئ نظرية المجموعات (Set Theory)، وتحديداً مفهوم التقاطع (Intersection) والاحتواء (Inclusion). عندما نسعى لمعرفة ما إذا كانت الخلية المفحوصة موجودة في قائمة ما، فإننا نقوم بعملية إسقاط منطقي لاختبار ما إذا كان العنصر ينتمي إلى مجموعة التقاطع الرياضي بين القائمتين. يتم ترجمة هذا الاختبار الحسابي عبر محركات جداول البيانات إلى تقييم بولياني ثنائي القيمة؛ حيث تُمثل النتيجة إما بالإيجاب، ما يعني تحقق شرط الانتماء، أو بالسلب الذي يشير إلى الانفصال المطلق بين العنصر والقائمة المرجعية المقابلة.
تتكامل هذه المبادئ التحليلية مع الأثر المعرفي للتغذية البصرية الراجعة (Visual Feedback Loops). فعندما يربط الباحث أو المشغل نظام إدخال البيانات بآلية إبراز فوري للمطابقات، يتشكل مسار تدقيق تفاعلي مغلق؛ حيث يؤدي كل إدخال يتطابق مع القائمة المعيارية إلى إضاءة بصرية آنية تؤكد صحة العملية أو تحذر من تكرارها غير المسوغ. هذه التغذية الراجعة السريعة تعيد صياغة أساليب التدقيق من عمليات لاحقة مؤجلة تتم بعد انتهاء الإدخال، إلى إجراءات وقائية استباقية تتزامن مع لحظة تدفق البيانات الأولية في النظام.
2. البنية المرجعية لدالة COUNTIF وآلية استخدامها المنطقي
2.1 التشريح التركيبي لدالة العد الشرطي COUNTIF
تحتل دالة COUNTIF موقع الصدارة كأكثر الأدوات البرمجية استخداماً في جداول بيانات جوجل لتنفيذ التنسيق الشرطي القائم على مقارنة القوائم. يتكون التشريح البنائي لهذه الدالة من معاملين أساسيين لا غنى لأحدهما عن الآخر: المعامل الأول هو النطاق المرجعي (Range)، والمعامل الثاني هو المعيار الرياضي أو النصي (Criterion). في الصيغة النموذجية العامة، تُصاغ الدالة على النحو التالي: COUNTIF(range, criterion)، حيث يُحدد النطاق حدود الخلايا التي سيجري التفتيش بداخلها، بينما يحدد المعيار القيمة التي نبحث عن تكرارها داخل هذا النطاق المحدد سلفاً.
عند تفكيك المعامل الأول، نجد أنه يتطلب تحديداً دقيقاً لحدود القائمة المرجعية التي تحوي البيانات المعتمدة؛ كأن نحدد النطاق الممتد من الخلية الأولى إلى الأخيرة في عمود ما. أما المعامل الثاني، فهو يمثل الخلية المستهدفة بالفحص، والتي يُراد التحقق من وجودها داخل ذلك النطاق المرجعي. تكمن القوة التحليلية لهذه الدالة في قدرتها على إجراء مسح خطي أو مفهرس داخل المحرك الحسابي لجداول جوجل لمقارنة محتوى معيار البحث مع كل خلية على حدة ضمن النطاق المرجعي، ورصد إجمالي التكرارات المطابقة لذلك المعيار بدقة متناهية.
تتعامل الخوارزمية الداخلية لدالة COUNTIF مع القيم بنمط حسابي تراكمي، حيث تعيد الدالة عدداً صحيحاً يمثل التكرار الدقيق لظهور القيمة. فإذا كان العنصر المراد فحصه غير موجود مطلقاً في القائمة المرجعية، تعيد الدالة القيمة الصفرية، أما إذا كان موجوداً مرة واحدة فإنها تعيد الرقم واحد، وفي حال تكرار العنصر عدة مرات في القائمة المرجعية، ستعيد الدالة الرقم الدال على مجموع تلك التكرارات. هذا السلوك العددي هو الأساس الصلب الذي يُبنى عليه المنطق البولياني المطلوب لتفعيل قواعد التنسيق التلقائي في الخطوات التالية.
2.2 تحويل المخرجات الحسابية إلى قيم منطقية بوليانية
لا تتطلب بيئة التنسيق الشرطي في جداول بيانات جوجل بالضرورة دالة تعيد نصوصاً أو قيماً رقمية مركبة، بل تعتمد في جوهرها على تقييم ناتج الصيغة كاستجابة منطقية ثنائية: صواب (TRUE) لتطبيق التنسيق، أو خطأ (FALSE) لحجبه. وهنا يأتي دور الربط المنطقي بتحويل المخرجات العددية لدالة العد الشرطي إلى قيم بوليانية حاسمة عبر إضافة المعامل الرياضي للمقارنة، كأن تتم صياغة المعادلة لتصبح: COUNTIF($B$2:$B$100, A2) > 0، مما يضمن تقييم أي تكرار مساوٍ أو أكبر من واحد كقيمة صحيحة تؤدي فوراً إلى تلوين الخلية.
تتميز جداول بيانات جوجل بميزة هندسية بالغة الأهمية تتعلق بطريقة تفسير القيم الرقمية داخل محرك التنسيق الشرطي؛ إذ يعتبر المحرك أي قيمة عددية موجبة لا تساوي الصفر بمثابة قيمة صواب منطقية حقيقية (Truthy value)، في حين تُعامل القيمة صفر دوماً كقيمة خطأ (Falsy value). وبناءً على هذا السلوك البرمجي المدمج، فإن كتابة الصيغة بصورة مبسطة مثل COUNTIF($B$2:$B$100, A2) دون كتابة معامل الأكبر من صفر بصورة صريحة ستؤدي إلى نفس النتيجة الوظيفية تماماً، حيث يقرأ المحرك الناتج العددي الموجب كأمر نافذ لتطبيق السمة اللونية المختارة على الخلية المفحوصة.
ورغم أن التقييم المباشر دون معاملات مقارنة يُعد صيغة مقبولة وموجزة، إلا أن إضافة التقييم المنطقي الصريح عبر المقارنة مع الصفر يُعد الممارسة الأكثر موثوقية ورصانة من الناحية البرمجية والتحليلية. يرجع ذلك إلى أن التقييم المشروط يمنع حدوث أي لبس دلالي أثناء قراءة المعادلات المعقدة، ويضمن توافق الصيغة إذا ما جرى نقلها أو تعديلها لتقوم بمهام استعلامية خارج نافذة التنسيق الشرطي؛ مثل تضمينها داخل دوال شرطية مركبة كدالة IF أو الدوال المنطقية AND وOR لتنفيذ مستويات فحص متعددة الطبقات.
2.3 الأهمية البالغة لتثبيت المراجع المطلقة والنسبية
يمثل الاستخدام الواعي للمراجع المطلقة (Absolute References) والمراجع النسبية (Relative References) الحد الفاصل بين نجاح قاعدة التنسيق الشرطي وفشلها الذريع. يتمثل جوهر هذه الآلية في استخدام علامة الدولار ($) لتجميد إحداثيات الخلايا وتثبيتها؛ حيث إن إدراج هذه العلامة قبل رمز العمود ورقم الصف، مثل $B$2:$B$100، يجبر المحرك الحسابي لجداول جوجل على الحفاظ على حدود هذا النطاق المرجعي ثابتة تماماً دون أي تغيير مهما تغير موقع الخلية التي يجري فحصها في المصفوفة البيانية.
في المقابل، يجب أن يُترك مرجع الخلية المفحوصة كمرجع نسبي تام، مثل كتابة A2 دون أي علامات دولار ملحقة بها. يتيح هذا التنسيق النسبي للمحرك الحسابي إزاحة نقطة الفحص بشكل ديناميكي ومتسق متزامن مع حركة التقييم عبر الخلايا المستهدفة؛ فعندما ينتقل المحرك لتقييم الخلية A3، تتحول الصيغة داخلياً وبصورة تلقائية لتفحص الخلية A3 في مواجهة نفس النطاق المرجعي الثابت $B$2:$B$100، وهكذا دواليك عبر كامل أرجاء النطاق المطلوب دون انحراف موضعي.
إن إغفال التثبيت المطلق لحدود القائمة المرجعية—كأن تُكتب الصيغة على النحو COUNTIF(B2:B100, A2)—يؤدي إلى ما يُعرف برمجياً بانزياح النطاق (Range Drift). ففي هذه الحالة الكارثية من منظور التحليل، عندما يقوم النظام بتقييم الخلية A3، سينزاح النطاق المرجعي بمقدار صف واحد ليصبح B3:B101، وعند تقييم الخلية A4 سينزاح إلى B4:B102. هذا الانزلاق الميكانيكي يؤدي إلى إخراج العناصر الأولى من دائرة المقارنة تدريجياً وإدخال خلايا فارغة أو بيانات غير ذات صلة، مما يترتب عليه إخفاق تام في تمييز القيم المتطابقة التي تقع في الصفوف العليا من القائمة المرجعية الأصلية.
3. التطبيق العملي خطوة بخطوة لصيغة المطابقة المخصصة
3.1 هيكلة البيانات وتهيئة نطاقات العمل التجريبية
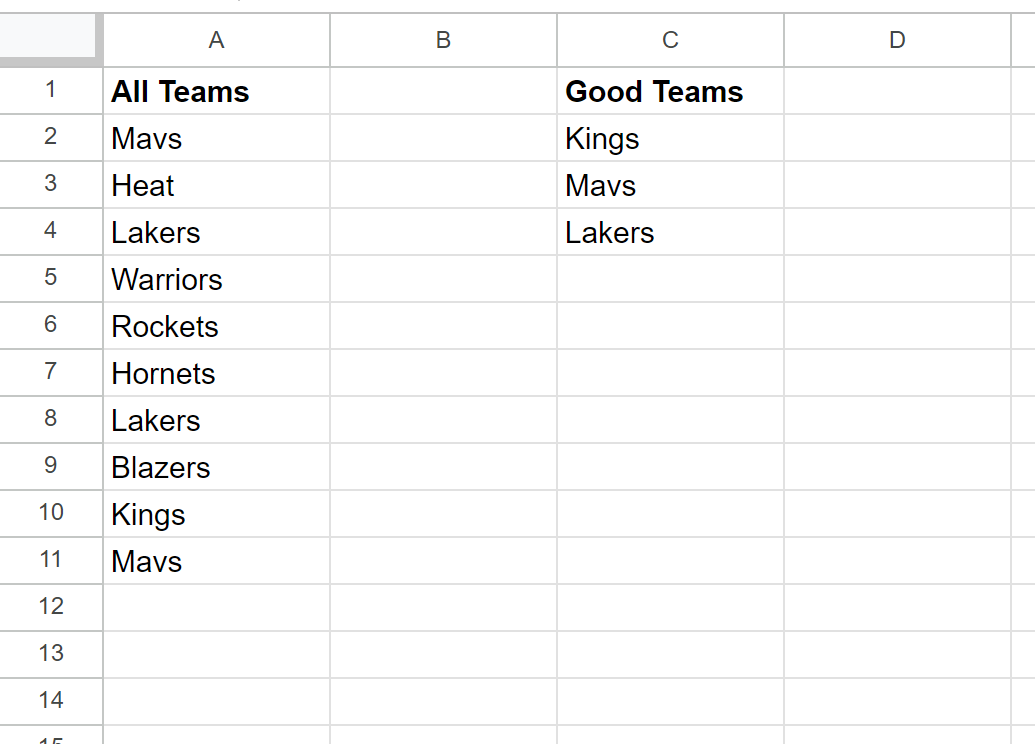
تبدأ الممارسة العملية المتقنة بتنظيم بيئة البيانات وتنظيفها الهيكلي لضمان دقة العمليات المنطقية اللاحقة. نفترض في هذا السياق وجود جدول بيانات يحتوي على عمودين رئيسيين: العمود A ويمثل القائمة الشاملة أو المتغير التابع الذي يحتوي على المدخلات الميدانية الحديثة المراد التحقق منها، والعمود B الذي يضم القائمة المرجعية المعيارية المعتمدة التي تتضمن القيم المفتاحية المستقلة التي تمثل معايير المقارنة الصارمة للتحليل البياني.
قبل الشروع في كتابة أي معادلة، يتعين على المحلل التأكد من استيفاء شروط جودة البيانات، والتي يأتي في مقدمتها إزالة المسافات الزائدة والتأكد من خلو الخلايا من التنسيقات المتضاربة أو الرموز الإدخالية المشوهة التي قد تعيق عمليات التحقق الخوارزمي. تتطلب هذه المرحلة تحويل كافة البيانات ذات الصلة إلى نسق نصي أو عددي موحد لتجنب الفروق الدقيقة التي تحول دون تطابق المتغيرات، مثل تباين إدخال الأرقام التسلسلية بصيغ نصية في عمود ومطابقتها مع أرقام حسابية بحتة في العمود المقابل.
ينبغي أيضاً وضع تصور تنظيمي واضح لحدود النطاقات التشغيلية وتسمية الترويسات (Headers) بوضوح في الصف الأول، مع إدراك أن الفحص الفعلي يجب أن يبدأ من صف البيانات الأول، والذي يكون عادة الصف الثاني لتفادي شمول الترويسات النصية في عمليات المقارنة والمطابقة. إن التحديد المسبق لنطاقات العمل يقي المصمم من الوقوع في أخطاء تداخل النطاقات التي قد تشوه الواجهة التفاعلية لجداول البيانات وتحد من كفاءتها البصرية.
3.2 الولوج إلى واجهة التنسيق الشرطي وضبط النطاق المستهدف
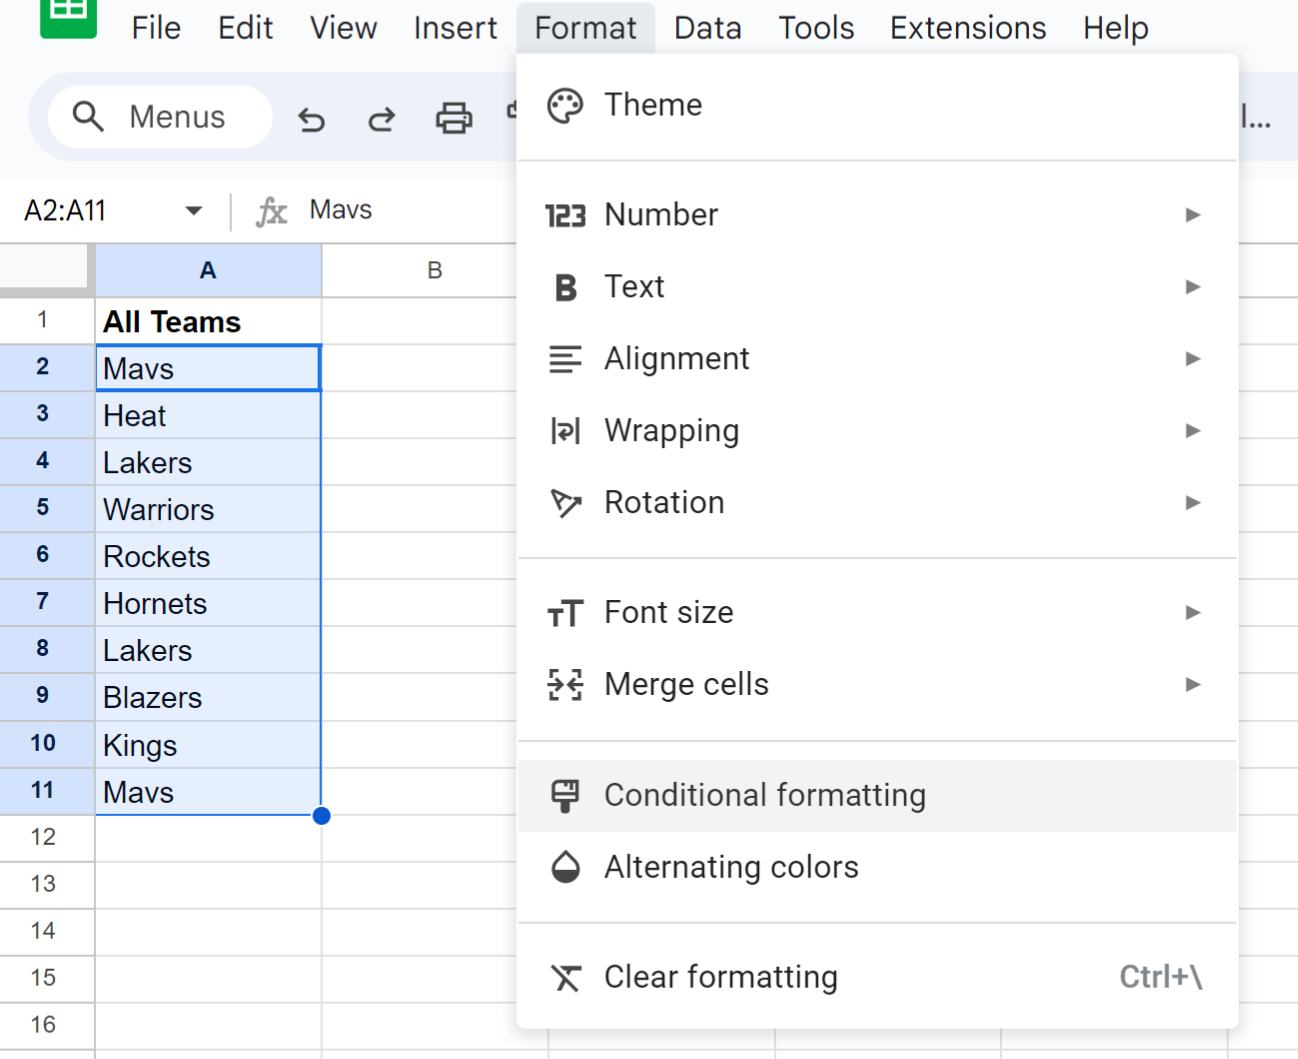
لتطبيق القاعدة عملياً، يقوم المستخدم بتحديد النطاق المستهدف بالفحص بدقة عبر واجهة جداول بيانات جوجل، وليكن على سبيل المثال النطاق الممتد من A2 إلى A100. بعد تظليل الخلايا المطلوبة، يتم التوجه إلى شريط القوائم العلوي واختيار تبويب تنسيق (Format)، ثم النقر على خيار التنسيق الشرطي (Conditional formatting). يؤدي هذا الإجراء إلى انبثاق اللوحة الجانبية لقواعد التنسيق الشرطي على الجانب الأيسر أو الأيمن من الشاشة وفق لغة الواجهة المستخدمة.
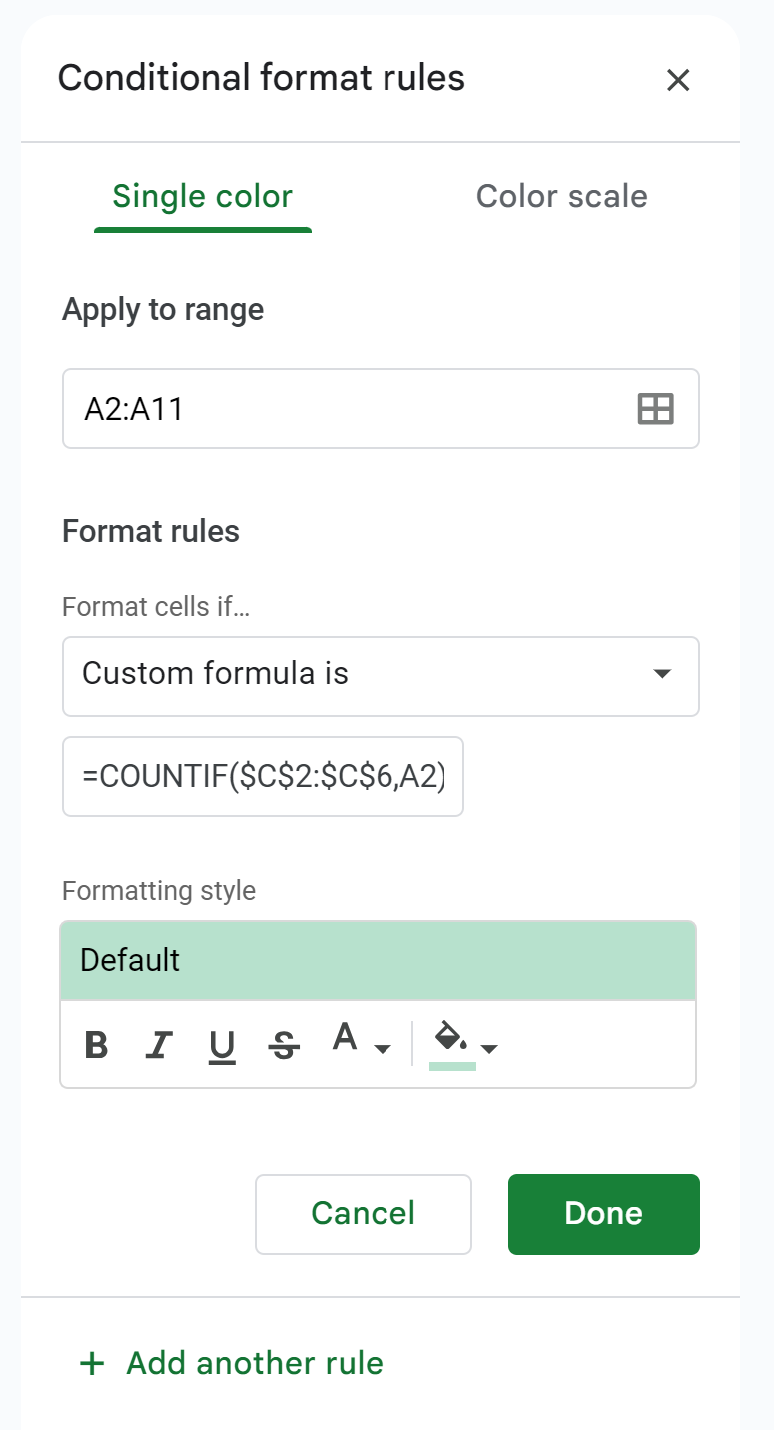
تتضمن اللوحة الجانبية خانة حاسمة تسمى التطبيق على النطاق (Apply to range)؛ ويجب التحقق بعناية من أن القيمة المدونة في هذه الخانة تطابق تماماً النطاق الفعلي المراد تمييزه، مثل A2:A100. إن ضبط هذا النطاق يحدد بدقة المساحة الجغرافية داخل جدول البيانات التي ستخضع لتقييم المحرك الحسابي، وأي خطأ في كتابة هذه الحدود سينعكس مباشرة على سلوك التطبيق أو يؤدي إلى تمييز خلايا غير مقصودة خارج إطار الدراسة البيانية.
تتمثل الخطوة التالية في الانتقال إلى قسم قواعد التنسيق (Format rules) وفتح القائمة المنسدلة لاختيار معيار التقييم. تتضمن هذه القائمة خيارات نمطية مسبقة الصنع مثل التحقق من النصوص أو الأرقام الأكبر من قيمة محددة، إلا أن معالجة مسألة المطابقة بين القوائم تتطلب تجاوز القوالب الجاهزة والتمرير لأسفل القائمة المنسدلة حتى الوصول إلى خيار الصيغة المخصصة هي (Custom formula is). يفتح هذا الخيار حقل إدخال يتيح كتابة الشيفرات والمعادلات الحسابية الحرة التي تمثل قلب العملية التحليلية النابض.
3.3 كتابة الصيغة واختيار التنسيق البصري المناسب
في الحقل المخصص للصيغة المخصصة، يتم إدراج المعادلة الحسابية المنطقية بدقة متناهية، مع مراعاة الربط المحكم بين النطاق المرجعي والخلية الأولى في النطاق المستهدف: =COUNTIF($B$2:$B$100, A2) > 0. تجدر الإشارة هنا إلى ضرورة بدء الصيغة بعلامة المساواة (=)، لتعريف المحرك البرمجي بأن المدخل يمثل تعبيراً رياضياً يحتاج إلى تقييم حسابي وليس نصاً مجرداً، مع التأكيد التام على أن الخلية المذكورة كمعيار وهي الخلية A2 في مثالنا تمثل الرأس النسبي للنطاق المحدد في خانة التطبيق على النطاق.
بمجرد كتابة الصيغة بصورة صحيحة، ينتقل المستخدم إلى ضبط نمط التنسيق (Formatting style). توفر هذه اللوحة خيارات مرنة لتحديد لون التعبئة (Fill Color)، ولون الخط، والأنماط التوكيدية كالخط العريض (Bold) أو المائل (Italic). يوصى من الناحية المنهجية باختيار ألوان ذات دلالات وظيفية متناسقة ومستويات تباين بصري كافية تحقق سهولة القراءة وتراعي متطلبات إمكانية الوصول، مثل استخدام درجات الباستيل الهادئة كاللون الأخضر الخفيف للإشارة إلى المطابقة الإيجابية، أو درجات البرتقالي الفاتح للتحذير من التكرارات المفحوصة.
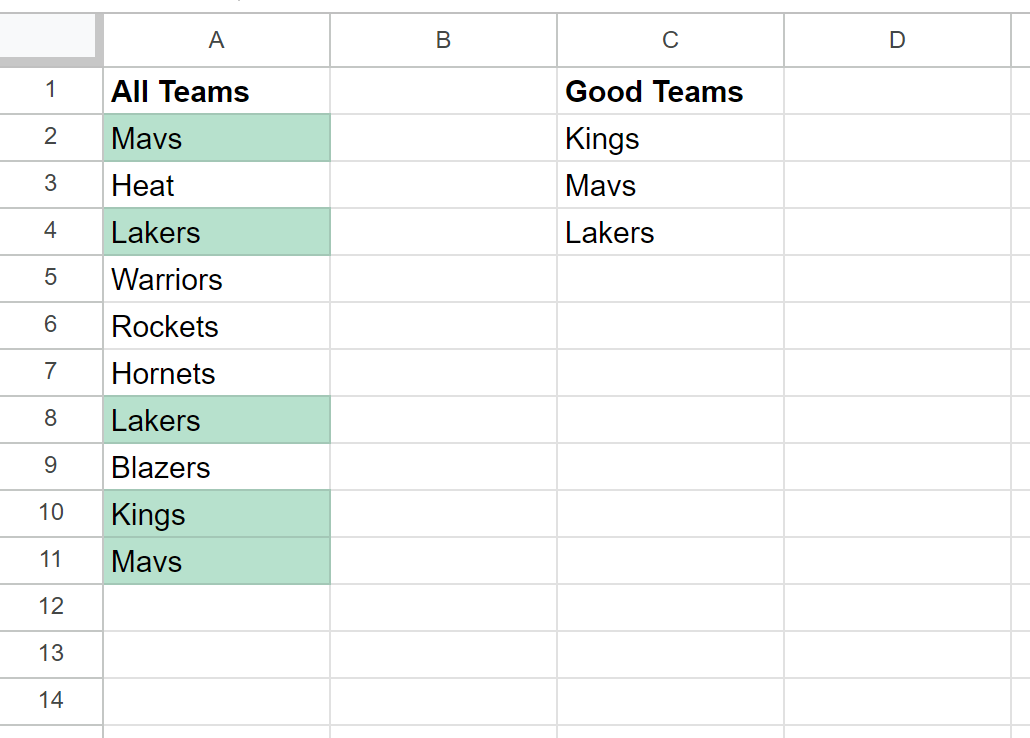
بعد الاستقرار على التنسيق المفضل، يتم الضغط على زر تم (Done) لحفظ القاعدة وتفعيلها فوراً. يقوم المحرك البرمجي لجداول جوجل في هذه اللحظة بتقييم فوري وشامل لكافة خلايا النطاق المستهدف، وتطبيق السمة اللونية المختارة في أجزاء من الثانية على كل خلية في العمود A تظهر قيمتها بالفعل داخل العمود B. تصبح بعد ذلك هذه القاعدة نشطة ديناميكياً؛ فإذا عُدلت أي قيمة لاحقاً في أي من العمودين، تتكيف التنسيقات البصرية فوراً وبصورة آلية لتعكس التغيرات الطارئة على المنظومة البيانية.
4. الصيغ والبدائل التقنية المتقدمة للتحقق من المطابقة
4.1 توظيف تركيبة دالتي MATCH و ISNUMBER كبديل قياسي
رغم الانتشار الواسع لدالة COUNTIF، إلا أن هناك تركيباً تقنياً متقدماً يعتمد على دمج دالتي MATCH وISNUMBER، والذي يمثل المعيار الذهبي المفضل لدى مطوري النظم ومحللي البيانات المتمرسين. تعمل دالة MATCH على البحث عن قيمة محددة داخل مصفوفة أحادية البعد وإرجاع الفهرس الموضعي النسبي لتلك القيمة كرقم صحيح يمثل رقم الصف أو العمود الذي احتضن التطابق، وتُصاغ بالنمط التالي: MATCH(lookup_value, lookup_array, [search_type]).
عندما نقوم بتعيين معامل نوع البحث إلى القيمة الصفرية 0، نلزم دالة MATCH بإجراء تطابق تام لا لبس فيه. فإذا وجدت الدالة القيمة المستهدفة في النطاق المرجعي، فإنها تعيد رقماً موجباً يعبر عن ترتيب الخلية المطابقة، أما في حال عدم وجودها، فإنها تنتج الخطأ القياسي الشهير (#N/A). وهنا يبرز دور الدالة الغلافية المنطقية ISNUMBER، والتي تأخذ مخرجات MATCH كمدخل لها؛ فإذا كان الناتج رقماً حولته إلى صواب (TRUE)، وإذا كان ناتجها خطأ حولته بسلاسة إلى خطأ (FALSE).
تتم صياغة هذه القاعدة المجمعة داخل نافذة الصيغة المخصصة بالشكل التالي: =ISNUMBER(MATCH(A2, $B$2:$B$100, 0)). تتجلى الميزة الوظيفية الكبرى لهذا التركيب في مجموعات البيانات الكبيرة؛ حيث يتفوق هذا الأسلوب على دالة العد الشرطي من خلال توفير استهلاك الذاكرة وتفادي المسح الكامل للنطاق؛ إذ تتوقف دالة MATCH بمجرد العثور على أول تطابق صحيح، في حين تواصل دالة COUNTIF مسح كامل النطاق المرجعي لاحتساب المجموع الإجمالي لكافة التكرارات المحتملة، مما يجعل تركيبة البحث أكثر خفة وكفاءة حاسوبية.
4.2 استخدام دالتي VLOOKUP و ISERROR في المطابقة العكسية
يمثل الاستخدام المشترك لدوال البحث الرأسي VLOOKUP والدوال المنطقية النافية للأخطاء مقاربة هندسية أخرى تستحق التحليل المعمق. تبحث دالة VLOOKUP عن مفتاح الفحص في العمود الأول من النطاق المرجعي المحدد، وتسترجع القيمة المماثلة عند العثور عليها، وتفشل بإرجاع الخطأ #N/A في حال غياب المفتاح. وفي سياق التنسيق الشرطي، يمكن تحويل هذه الآلية إلى أداة اختبار دقيقة عبر تغليفها بدالة رصد الأخطاء المرجعية ISERROR أو ISNA، ودمجها مع أداة النفي المنطقي NOT.
تُصاغ معادلة التحقق عبر البحث الرأسي على النحو التالي: =NOT(ISNA(VLOOKUP(A2, $B$2:$B$100, 1, FALSE))). تقوم الدالة هنا بمحاولة مطابقة محتوى الخلية A2 مع محتويات النطاق B2:B100؛ فإن تحقق التطابق تجاوزت الدالة حالة الخطأ، لتقوم دالة NOT بعكس التقييم وتحويله إلى صواب منطقي يؤدي إلى تمييز الخلية المنسقة. يُعد هذا النمط مفيداً بصفة خاصة للمحللين المعتادين على التعامل مع هياكل VLOOKUP والراغبين في الاستفادة من بنيتها المألوفة في التدقيق البياني التلقائي.
ومع ذلك، من الضروري تقييم كفاءة الذاكرة عند تطبيق دوال البحث داخل قواعد التنسيق؛ فدالة VLOOKUP مصممة في الأصل لاسترجاع قيم متعددة عبر أعمدة متجاورة، واستخدامها لمجرد استرجاع العمود ذاته لغرض التحقق يُشكل حمولة حسابية إضافية على المعالج مقارنة بدالة MATCH. تبرز الفائدة الحقيقية لأسلوب المطابقة العكسية عبر الخطأ عندما نرغب في إبراز الخلايا غير الموجودة (Missing Values)؛ حيث تصبح المعادلة البسيطة =ISNA(VLOOKUP(A2, $B$2:$B$100, 1, FALSE)) وسيلة مباشرة وفعالة لإضاءة القيم الشاذة أو الغائبة عن القائمة المعيارية المعتمدة.
4.3 المقارنة الأدائية بين تقنيات المطابقة المختلفة
يتطلب اتخاذ قرار هندسي حول اختيار الصيغة المثلى للمطابقة إجراء موازنة تقنية دقيقة بين سرعة التنفيذ الحسابي (Computational Speed) ومعدلات استهلاك الذاكرة العشوائية لمتصفح الويب. ففي بيئة جداول بيانات جوجل السحابية، تُجرى كافة حسابات التنسيق الشرطي محلياً داخل متصفح المستخدم عبر لغة جافا سكريبت، مما يعني أن أي زيادة في تعقيد الخوارزميات المضمنة ستؤثر بصورة مباشرة ولحظية على سلاسة التمرير واستجابة المصنف المكتبي ككل.
تتميز دالة COUNTIF بسهولة كتابتها وبديهية تركيبها للمستخدم المبتدئ والمتوسط، وتؤدي مهامها بكفاءة مذهلة في المصفوفات الصغيرة والمتوسطة التي لا تتعدى بضعة آلاف من الصفوف. ولكن عند توسيع نطاق التحليل ليشمل مصفوفات عملاقة تحتوي على عشرات الآلاف من السجلات المتداخلة، تصبح كلفة الخوارزمية التي تتبعها COUNTIF—والتي تتطلب مسحاً شاملاً O(N)—أكثر إرهاقاً للنظام مقارنة بدالة MATCH ذات البحث المحسن التي تقف عند حد التطابق الأول O(1 إلى N)، الأمر الذي يمنح تركيبة MATCH وISNUMBER تفوقاً ملحوظاً في اختبارات السرعة الزمنية.
يوضح الجدول التحليلي التالي مقارنة شاملة بين الصيغ الرياضية الأكثر شيوعاً لتنفيذ المطابقة في التنسيق الشرطي، موضحاً المتغيرات البرمجية والأدائية لكل تقنية على حدة:
- الصيغة الأولى: COUNTIF — الصيغة: =COUNTIF($B$2:$B$100, A2) > 0 — التعقيد الحسابي: مسح كامل للنطاق المرجعي — الاستهلاك الذاكري: متوسط — أفضل استخدام: القوائم الصغيرة والمتوسطة حتى 5000 صف لسهولة صيانتها.
- الصيغة الثانية: MATCH مع ISNUMBER — الصيغة: =ISNUMBER(MATCH(A2, $B$2:$B$100, 0)) — التعقيد الحسابي: مسح ينتهي عند أول تطابق — الاستهلاك الذاكري: منخفض ومحسن — أفضل استخدام: مجموعات البيانات الضخمة التي تتطلب استجابة سريعة وتمرير سلس.
- الصيغة الثالثة: VLOOKUP مع NOT وISNA — الصيغة: =NOT(ISNA(VLOOKUP(A2, $B$2:$B$100, 1, FALSE))) — التعقيد الحسابي: تحميل جدول استعلام كامل — الاستهلاك الذاكري: مرتفع نسبياً — أفضل استخدام: سيناريوهات التحقق العكسي لاستخراج السجلات الغائبة وتطبيقات مطابقة المفاتيح المعقدة.
5. التعامل مع النصوص الدقيقة والمطابقة الحساسة لحالة الأحرف
5.1 معالجة قيود عدم حساسية دالة COUNTIF لحالة الأحرف اللاتينية
من القيود الجوهرية التي يغفل عنها الكثير من المستخدمين في جداول بيانات جوجل أن دوال العد والبحث النمطية، بما فيها COUNTIF وMATCH العادية، تتجاهل بصورة افتراضية تامة الفروق بين الأحرف الكبيرة والصغيرة في اللغات التي تعتمد الأبجدية اللاتينية (Case-Insensitive). على سبيل المثال، إذا كانت القائمة المرجعية تحتوي على الرمز المخبري “EX-100″، فإن دالة COUNTIF ستتعامل مع المدخل “ex-100” في القائمة المستهدفة كتطابق صحيح تماماً وتقوم بتمييزه، وهو ما قد يشكل خطأً منهجياً جسيماً في قواعد البيانات البيولوجية أو البرمجية أو الكيميائية التي تفرق بنيوياً بين هذه المحارف.
للتغلب على هذا القيد البنائي وتجاوز فجوة الحساسية الحرفية، يتعين الاستعانة بدالة المقارنة النصية الصارمة EXACT. تقوم هذه الدالة بإجراء فحص ومقارنة حرفية متناهية الدقة بين قيمتين نصيتين، ولا تعيد القيمة صواب (TRUE) إلا إذا كانت النصوص متطابقة تماماً في كل محرف، بما في ذلك حالة كل حرف على حدة. ولكن نظراً لأن دالة EXACT تقبل عادة مدخلات مفردة بدلاً من نطاقات كاملة في صيغتها القياسية، يتطلب استخدامها في التنسيق الشرطي حيلة مصفوفية متطورة تدمجها مع الدالة الرياضية SUMPRODUCT.
تتمثل الصيغة المتطورة للمطابقة الحساسة لحالة الأحرف في التعبير الرياضي التالي: =SUMPRODUCT(–EXACT(A2, $B$2:$B$100)) > 0. تعمل علامة السالب المزدوجة (–) كمعامل تحويل قسري (Unary Operator) لتحويل النتائج المنطقية البوليانية الناتجة عن مصفوفة مقارنات EXACT إلى أصفار وآحاد رقمية، ثم تقوم دالة SUMPRODUCT بجمع هذه الآحاد عبر المصفوفة المرجعية برمتها؛ فإذا كان المجموع أكبر من صفر، دلّ ذلك بشكل قطعي على وجود تطابق حرفي حساس ومكتمل الأركان، مما يؤدي إلى تفعيل التنسيق اللوني المستحق دون أي التباس شكلي.
5.2 تطهير النصوص البرمجية والمسافات البيضاء المخفية
تشكل المسافات البيضاء المخفية (Trailing and Leading Spaces) أحد أكثر الأسباب شيوعاً لإخفاق خوارزميات المطابقة والتنسيق الشرطي في بيئات الأعمال الفعلية. تتولد هذه المسافات غير المرئية عادة أثناء النسخ واللصق من مصادر خارجية مثل رسائل البريد الإلكتروني أو ملفات PDF أو استعلامات قواعد بيانات SQL المنقولة، حيث تحتوي الخلية ظاهرياً على النص “Sample”، ولكنها في الواقع تتضمن مسافة لاحقة تجعلها مخزنة برمجياً كـ “Sample “، مما يفشل أي محاولة للتطابق مع القائمة المعيارية التي تحتوي على “Sample” النظيفة.
لمعالجة هذا التباين المدمر للمطابقات، يجب تدعيم صيغة الفحص بدوال التطهير النصي المسبق؛ وعلى رأسها دالتا TRIM وCLEAN. تقوم دالة TRIM بإزالة كافة المسافات البادئة واللاحقة مع تقليص المسافات المتعددة بين الكلمات إلى مسافة واحدة فقط، في حين تعمل دالة CLEAN على استئصال كافة المحارف غير القابلة للطباعة (Non-printable characters) وأكواد التبديل الرأسي التي قد تندس داخل النصوص أثناء التصدير الآلي للبيانات الميدانية.
يمكن صياغة قاعدة تنسيق شرطي محصنة ضد عيوب المسافات البيضاء من خلال تنظيف نص الخلية المفحوصة آنياً ضمن صيغة التحقق؛ على النحو الآتي: =COUNTIF($B$2:$B$100, TRIM(CLEAN(A2))) > 0. تضمن هذه الصيغة المتقدمة تنقية القيمة المستهدفة برمجياً داخل المعالج قبل الشروع في مطابقتها مع النطاق المرجعي، مما ينقذ المحلل من فخاخ التطابق الكاذب ويضمن عدم إفلات أي قيمة صالحة من التمييز اللوني لمجرد وجود فراغ عشوائي غير مقصود ناتج عن سرعة الإدخال البشري.
6. مقارنة القوائم عبر أوراق عمل متعددة ضمن نفس الملف
6.1 استدعاء النطاقات الخارجية باستخدام دالة INDIRECT
تفرض جداول بيانات جوجل قيداً معمارياً صارماً على واجهة التنسيق الشرطي؛ إذ تمنع القواعد البرمجية المدمجة الإحالة المباشرة إلى أوراق عمل أخرى (Cross-sheet reference) إذا كُتبت بالصيغة التقليدية المعتادة، مثل محاولة كتابة =COUNTIF(ReferenceSheet!$A$2:$A$100, A2) > 0. يؤدي إدخال هذه الصيغة المباشرة إلى ظهور رسالة خطأ فورية تنص على عدم صلاحية الصيغة التنسيقية (“Invalid formula”)، وهو ما يشكل عقبة تقنية رئيسية للمستخدمين الراغبين في عزل القوائم المرجعية في أوراق عمل منفصلة مخصصة للإعدادات والمعايير.
يتمثل المخرج التقني الأنيق والوحيد لكسر هذا القيد المعماري في توظيف دالة الإحالة غير المباشرة INDIRECT. تقوم هذه الدالة باستقبال مسار النطاق المرجعي كسلسلة نصية مجردة محاطة بعلامات اقتباس، وتقوم بعد ذلك بترجمتها برمجياً أثناء وقت التشغيل إلى مرجع خلية حقيقي وفعال يستطيع المحرك الحسابي التعامل معه دون الاصطدام بحواجز واجهة التنسيق الشرطي الرقابية.
تُصاغ معادلة المطابقة عبر أوراق العمل باستخدام INDIRECT على النحو التالي: =COUNTIF(INDIRECT(“ReferenceSheet!$A$2:$A$100″), A2) > 0. يتم هنا تمرير عنوان الورقة الخارجية واسم النطاق بصيغة نصية محكمة، مما يسمح للتنسيق الشرطي في ورقة العمل الحالية بالوصول السلس إلى القائمة المعيارية المحفوظة في ورقة أخرى تماماً؛ ومع ذلك، تجدر الإشارة إلى أن دالة INDIRECT تندرج تحت فئة الدوال المتطايرة (Volatile Functions) التي يُعاد تقييمها مع كل نقرة أو تعديل في أي مكان بالملف، مما يستوجب استخدامها بتعقل تجنباً لأي هبوط غير مرغوب في أداء المعالجة عند اتساع المصنف.
6.2 استخدام النطاقات المسماة لتسهيل الإحالة المرجعية
تعد النطاقات المسماة (Named Ranges) من أرقى الممارسات الهندسية لإدارة أوراق العمل المعقدة، حيث تسمح للمحلل بتعيين اسم وصفي دال ودائم لنطاق معين من الخلايا، مثل إطلاق اسم MasterList على النطاق الجغرافي B2:B100 الواقع في ورقة عمل فرعية. يتم هذا الإجراء بسهولة عبر تحديد النطاق واختيار تبويب البيانات (Data) ثم النقر على النطاقات المسماة وتعيين الاسم المعياري المطلوب وفق معايير التسمية المتبعة.
بالإضافة إلى إضفاء وضوح دلالي فائق على بنية الملف، توفر النطاقات المسماة وسيلة بديلة وموثوقة لاستدعاء البيانات المرجعية في التنسيق الشرطي. فبدلاً من كتابة إحداثيات الخلايا وعلامات الدولار والوقوع المستمر في أخطاء الانزياح، يمكن تضمين النطاق المسمى مباشرة عبر دالة INDIRECT ليصبح نص المعادلة: =COUNTIF(INDIRECT(“MasterList”), A2) > 0، مما يحرر الصيغة من الارتباط الصلب بالمواقع المكانية ويعزز استقلاليتها البرمجية.
تتجلى الفائدة التشغيلية القصوى للنطاقات المسماة عند تحديث أو توسيع القوائم المرجعية في النماذج التحليلية المؤسسية الكبرى؛ فإذا أضيفت عناصر جديدة للقائمة المعيارية، يكفي تحديث إحداثيات النطاق المسمى من نافذة الإدارة المركزية مرة واحدة فقط، لتنعكس التوسعة آلياً على كافة قواعد التنسيق الشرطي والصيغ الاستعلامية المرتبطة به عبر مختلف أوراق الملف دون الحاجة لفتح كل قاعدة وتحرير صيغتها المخصصة بشكل يدوي مجهد وعرضة للأخطاء.
7. تمييز الصف بأكمله استناداً إلى مطابقة الخلية الفردية
7.1 تعديل المراجع وتجميد الأعمدة لأغراض التمييز الأفقي
في كثير من التطبيقات العملية المتقدمة، لا يكتفي الباحث أو متخذ القرار بتمييز الخلية الفردية التي تحتوي على القيمة المطابقة في عمود الفحص، بل تقتضي الضرورة المنهجية تلوين الصف بأكمله (Entire Row Highlighting) عبر كامل أعمدة السجل البياني لجلب الانتباه الشامل للحالة التي استوفت المعيار. ولتحقيق هذه القفزة الوظيفية، يتحول التركيز من المراجع المطلقة والنسبية التامة إلى ما يُعرف في هندسة البرمجيات بالمراجع المختلطة (Mixed References).
تعتمد آلية تلوين الصف بالكامل على تثبيت حرف العمود المستهدف وتجميده، مع ترك رقم الصف حراً ونسبياً ليتحرك رأسياً مع كل صف جديد. ويتحقق هذا التثبيت الجزئي بوضع علامة الدولار ($) حصرياً أمام حرف العمود، مع تجريد رقم الصف منها؛ لتصبح الصيغة المخصصة على النحو التالي: =COUNTIF($B$2:$B$100, $A2) > 0. يؤدي وضع علامة $ قبل الحرف A إلى إجبار المحرك الحسابي على الرجوع دوماً إلى العمود A لتقييم الشرط، حتى عندما ينتقل لتنسيق الخلايا الواقعة في الأعمدة المجاورة مثل C وD وE لنفس الصف.
إن إغفال تجميد العمود في هذه الحالة—كأن تُكتب الصيغة باستخدام A2 بدون علامة الدولار أثناء تطبيق القاعدة على نطاق عريض كـ A2:E100—سيتسبب في تفكك منطق التنسيق بصورة دراماتيكية. ففي هذا الوضع الخاطئ، ستقوم خلايا العمود C بمقارنة محتويات العمود C نفسه مع القائمة المرجعية بدلاً من الرجوع للعمود المستهدف A، مما ينتج عنه تشوهات بصرية عشوائية وتضارب تام في مخرجات التلوين لا يمت بصلة للهدف التحليلي المطلوب تحقيقه.
7.2 إعادة ضبط نطاق التطبيق الشامل للمصفوفة
لاستكمال عملية التمييز الأفقي الشامل، يجب المواءمة التامة بين خانة التطبيق على النطاق وصيغة المرجع المختلط. فإذا كان الجدول البياني المعني بالتحليل يمتد من العمود A حتى العمود F ويشمل البيانات من الصف الثاني حتى المائة، يتعين تعيين نطاق التطبيق في اللوحة الجانبية بصورة مصفوفية موسعة ليصبح: A2:F100، مما يضمن خضوع كافة هذه الخلايا المستعرضة لنفس القاعدة الحسابية המوحدة.
تكمن النقطة المفصلية التي يرتكب فيها أغلب المستخدمين أخطاء الإزاحة القاتلة في التزامن الشاقولي بين بداية نطاق التطبيق وبداية صيغة الفحص. يجب أن يتطابق رقم الصف الأول في خانة “التطبيق على النطاق” تطابقاً حرفياً مع رقم الصف المذكور في الصيغة المخصصة؛ فبما أن النطاق يبدأ من الصف 2 (A2:F100)، يجب حتماً أن تبدأ الصيغة بالإشارة إلى الصف 2 أي $A2. إن أي اختلاف في هذه المزامنة—كأن يحدد النطاق من A2:F100 وتُكتب الصيغة مستندة إلى $A1 أو$A3—سيؤدي إلى إزاحة رأسية بمقدار صف كامل للأعلى أو للأسفل عبر كامل الجدول، مما يلون صفوفاً بريئة ويعزل الصفوف المطابقة الحقيقية.
عندما تكتمل هذه المزامنة الإحداثية بدقة، يعمل محرك جداول جوجل بكفاءة متناهية: فعند مسح الصف الخامس مثلاً، يقوم النظام بتقييم محتوى الخلية $A5 ومقارنتها بالقائمة المرجعية؛ فإذا تحقق الشرط، يُطبق التنسيق المختار بصورة متزامنة على الخلايا A5 وB5 وC5 وD5 وE5 وF5 على حد سواء وبنفس الدرجة اللونية، مما يقدم عرضاً بصرياً فائق الوضوح يعزز كفاءة المراقبة والتدقيق الشامل للسجلات المؤسسية.
8. تحسين الأداء وإدارة قواعد البيانات الضخمة
8.1 قياس العبء الحاسوبي للتنسيق الشرطي على المتصفح
تعمل جداول بيانات جوجل وفق نموذج حوسبي هجين؛ حيث تُخزن البيانات وتُعالج الاستعلامات الكبرى على الخوادم المركزية لجوجل، في حين تُعهد مهام التنسيق الشرطي وعرض الواجهات إلى وحدة المعالجة المركزية (CPU) والذاكرة العشوائية (RAM) الخاصة بجهاز المستخدم عبر المتصفح (Client-side execution). ويعني هذا البناء التقني أن كل معادلة تنسيق شرطي تُترجم إلى دورات معالجة برمجية تتكرر باستمرار داخل محرك جافا سكريبت بالمتصفح مع كل حركة تمرير أو تعديل تطرأ على المصنف المكتبي.
عندما تتسع مصفوفات البيانات لتضم عشرات الآلاف من السجلات، وتُطبق عليها قواعد تنسيق شرطي متباينة تستخدم صيغاً معقدة أو دوال متطايرة، تتضاعف العمليات الحسابية المطلوبة في الثانية الواحدة بصورة أسية. فإذا طبقنا معادلة COUNTIF على 10,000 خلية مستهدفة في مواجهة قائمة مرجعية تتألف من 5,000 عنصر، فإن المتصفح سيضطر إلى إجراء ما يصل إلى 50 مليون عملية مقارنة منطقية لتحديث حالة الألوان، وهو ما يستهلك موارد الجهاز بسرعة فائقة ويؤدي إلى هبوط حاد في معدل الإطارات أثناء التصفح وتأخير واضح في استجابة لوحة المفاتيح والواجهة التفاعلية.
تتمثل أبرز مؤشرات الإجهاد الحسابي على جداول البيانات في ظهور مؤشر التحميل الأخضر الدائري باستمرار في الزاوية العلوية، وبطء التمرير العمودي، وتجمد الشاشة لثوانٍ معدودة عند إدخال بيانات جديدة، بالإضافة إلى إشعارات المتصفح التي تحذر من أن “الصفحة أصبحت غير مستجيبة”. وتتطلب هذه الأعراض التدخل الفوري من جانب مهندس البيانات لإعادة هيكلة القواعد التنسيقية واعتماد استراتيجيات التخفيف الحاسوبي لضمان استدامة تشغيل المصنف وسلاسته.
8.2 استراتيجيات تقليل الجهد الحسابي وتسريع المعالجة
لإبقاء استهلاك الموارد في الحدود الدنيا وضمان أعلى كفاءة تشغيلية، يتعين تطبيق حزمة من الإجراءات الوقائية الهندسية في تصميم جداول البيانات. تأتي في مقدمة هذه الإجراءات تجنب ما يُعرف بالنطاقات المفتوحة اللانهائية في قواعد التنسيق؛ كأن يُكتب نطاق التطبيق بالشكل A:A أو A2:A، حيث يجبر هذا التوصيف المتصفح على تقييم كافة صفوف الورقة حتى آخر صف فارغ متاح (والذي قد يصل إلى عشرات الآلاف من الصفوف غير المأهولة)، والصواب هو حصر نطاق التطبيق بدقة على الخلايا المشغولة فعلياً بالبيانات مثل A2:A2500.
تتمثل الاستراتيجية الذهبية الثانية في الاستعانة بـ أعمدة المساعدة (Helper Columns) المحسوبة مسبقاً لعزل العمليات المنطقية الثقيلة عن محرك التنسيق الشرطي. فبدلاً من إلزام التنسيق الشرطي بحساب صيغة COUNTIF المعقدة لكل خلية على حدة، يمكن إنشاء عمود تقني إضافي—يمكن إخفاؤه لاحقاً—يحتوي على دالة مصفوفية واحدة مجمعة مثل MAP أو ARRAYFORMULA تقوم بحساب حالة المطابقة لكل صف مسبقاً وتخزين القيمة المنطقية TRUE أو FALSE كبيانات خام في الذاكرة. بعد ذلك، يُربط التنسيق الشرطي بفحص مباشر وبسيط للغاية لمحتوى خلية عمود المساعدة عبر صيغة متناهية الخفة مثل =$Z2=TRUE، مما يقلص الجهد الحاسوبي الواقع على المتصفح بنسبة تزيد على 90%.
علاوة على ذلك، يجب مراجعة لوحة التنسيق الشرطي بانتظام لحذف القواعد المتراكمة والفائضة؛ حيث يميل المستخدمون أثناء العمل اليومي وتكرار عمليات النسخ واللصق إلى استنساخ قواعد تنسيقية مكررة أو مقسمة إلى أجزاء ونطاقات مجزأة، مما يثقل كاهل المحرك بقواعد متعددة تقوم بذات الدور الوظيفي. إن دمج هذه القواعد المشتتة في قاعدة واحدة شاملة، وحذف القواعد المعطلة، يعد ركيزة أساسية لصيانة جداول البيانات وحفظ رشاقتها الأدائية في بيئات الإنتاج المكثفة.
9. استكشاف الأخطاء الشائعة ومعالجتها منهجياً
9.1 معالجة عدم تطابق أنماط البيانات بين النصوص والأرقام
يعد تباين الأنماط النوعية للبيانات (Data Type Mismatch) من أكثر مصادر الإحباط البرمجي شيوعاً عند بناء قواعد المطابقة والتنسيق الشرطي؛ حيث يبدو العنصران للعين البشرية متطابقين تماماً على الشاشة، ومع ذلك ترفض الخلية أن تتلون وفق الشرط المحدد. يعود السبب الجوهري لهذه الظاهرة إلى التباين في البنية التخزينية داخل محرك الجداول؛ فالرقم 12345 المخزن كقيمة عددية يختلف برمجياً وداخلياً عن السلسلة النصية “12345” حتى لو كان مظهرهما الخارجي متماثلاً تماماً.
تنشأ هذه المشكلة بصورة مكثفة عند استيراد البيانات من ملفات CSV أو تصديرها من بوابات الدفع وقواعد بيانات المؤسسات؛ حيث تُسبق الأرقام أحياناً بفاصلة عليا خفية تحولها لنص، أو تُخزن الأرقام كأكواد نصية صريحة. لحل هذه المعضلة وتوحيد النسق البرمجي داخل صيغة التنسيق، يمكن استخدام دوال التحويل النوعي المباشرة؛ مثل دالة VALUE لتحويل النصوص ذات المظهر العددي إلى أرقام صريحة، أو دالة TO_TEXT لتحويل الأرقام إلى نصوص برمجية مكافئة قبل إجراء عملية المقارنة.
تزداد هذه الإشكالية تعقيداً عند التعامل مع التواريخ؛ فالجداول الإلكترونية تتعامل داخلياً مع التواريخ كأرقام تسلسلية صحيحة (Serial Numbers) تمثل عدد الأيام المنقضية منذ تاريخ الأساس المرجعي التاريخي. فإذا قورن تاريخ مخزن بصيغة تسلسلية مع تاريخ تم إدخاله نصياً بنمط “2023/10/15” فلن يتحقق التطابق مطلقاً؛ ويتطلب تصحيح ذلك استخدام دالة DATEVALUE لتوحيد المدخلات وضمان مقارنة الأرقام التسلسلية الحقيقية لتواريخ الأحداث وليس واجهاتها النصية الظاهرة للمستخدم.
9.2 إدارة تضارب القواعد الشرطية وتحديد أولويات التنفيذ
عندما تتعدد متطلبات التدقيق في مصنف معقد، تزداد احتمالية تطبيق قواعد تنسيق شرطي متعددة على نفس النطاق من الخلايا، مما يفتح الباب أمام ظاهرة تضارب القواعد (Rule Conflict) وتنافس التنسيقات اللونية. تعمل واجهة التنسيق الشرطي في جداول بيانات جوجل وفق نظام تسلسل هرمي صارم للأولويات (Hierarchy of Precedence)؛ حيث تحتل القاعدة الواقعة في أعلى قائمة القواعد باللوحة الجانبية الأسبقية التنفيذية المطلقة وتلغي تأثير أي قاعدة تقع أسفلها إذا تضاربت معها في نفس السمة التنسيقية كـ لون الخلفية.
إذا كانت هناك قاعدة عليا تقضي بتلوين الخلايا التي تزيد قيمتها عن 100 باللون الأصفر، وقاعدة أدنى منها تطابق وجود الخلية في قائمة معينة باللون الأخضر، فإن أي خلية تستوفي كلا الشرطين ستتلون حتماً بالأصفر لأن قاعدتها تتصدر الترتيب التنازلي. يمكن للمحلل إعادة ضبط هذه الأولويات البصرية بسهولة من خلال النقر المطول على المقابض الجانبية ذات النقاط الثلاث المجاورة لبطاقة القاعدة في اللوحة الجانبية وسحبها للأعلى أو للأسفل لتعديل أسبقية التنفيذ بما يتماشى مع الأهمية التحليلية المطلوبة لكل معيار تدقيق.
يوصى باتباع منهجية الفحص التدريجي لعزل أسباب التشوه البصري؛ والتي تبدأ بتعطيل أو إخفاء القواعد التنسيقية مؤقتاً عبر تفريغ نطاقاتها، ومراقبة سلوك القاعدة الفردية بمعزل عن غيرها. كما يُفضل توحيد القواعد المعقدة داخل صيغة منطقية واحدة متعددة الشروط باستخدام الدوال الجامعة كـ AND أو OR لضبط التداخل في صيغة مخصصة موحدة وواضحة المعالم بدلاً من بناء قواعد منفصلة تتنافس على المورد اللوني نفسه وتخلق تشويشاً إدراكياً لمستخدم النظام البياني.
10. تطبيقات منهجية في إدارة البيانات والبحوث الميدانية
10.1 التحقق من القوائم المعيارية وضبط جودة العينات البحثية
في سياق الدراسات الاستقصائية الميدانية والأبحاث الأكاديمية متعددة المراحل، تشكل مطابقة العينات المقبولة مع السجلات الأولية ركيزة منهجية لا غنى عنها لضبط الجودة ومنع الانحراف المعياري لبيانات الدراسة (Hora & Oleson, 2017). فعند تنفيذ دراسات تتبعية تتطلب استجابات متسلسلة عبر نقاط زمنية متباعدة، يتعين على الباحث التحقق الفوري من أن كل مستجيب في الموجة الثانية ينتمي بالفعل إلى القائمة المرجعية المعتمدة للمشاركين الذين استوفوا الشروط الصارمة في الموجة الأولى، وهو ما يوفره التنسيق الشرطي عبر تقديم تنبيه بصري فوري يؤكد انتماء المفحوص للمجتمع الإحصائي المستهدف.
يسهم هذا الفحص المؤتمت في عزل الحالات الشاذة أو السجلات غير المسجلة بصورة استباقية قبل دمجها في التحليلات الإحصائية الوصفية أو الاستدلالية؛ حيث يؤدي تمييز العناصر غير المتطابقة إلى سرعة استبعاد المدخلات الدخيلة، وتفادي تزييف النتائج النهائية بما يضمن نزاهة المخرجات التجريبية. وتكتسب هذه التقنية أهمية خاصة عند إدارة البيانات المعقدة في البيئات البحثية الطبية والإكلينيكية التي تفرض التزاماً متناهياً ببروتوكولات الأمانة المنهجية وصحة بيانات الخاضعين للتجارب السريرية (Ragno et al., 2023).
بالإضافة إلى ذلك، يتيح التنسيق الشرطي تتبع حضور ومتابعة التزام المفحوصين عبر مراحل التجارب المعملية المتتالية؛ فمن خلال ربط أعمدة الحضور الأسبوعية بالقائمة المرجعية الأصلية، تتشكل مصفوفة متابعة ديناميكية تمكن الباحث من رصد معدلات التسرب من التجربة (Attrition Rates) بدقة فائقة وبشكل يومي، مما يعزز الرقابة الميدانية ويدعم دقة التقارير المنهجية التي تُنشر في المجلات الأكاديمية المرموقة.
10.2 إدارة القوائم البيضاء والسوداء في تصفية السجلات الإدارية
تمتد التطبيقات الوظيفية لتقنيات المطابقة التلقائية إلى القطاعات الإدارية وإدارة العمليات المؤسسية، وتحديداً في حوكمة القوائم البيضاء (Whitelists) المسموح لها بالحصول على صلاحيات أو امتيازات محددة، والقوائم السوداء (Blacklists) المحظورة أو المعلقة لدواعي الرقابة والامتثال الداخلي. إن تطبيق التنسيق الشرطي لمقارنة سجلات العمليات اليومية مع هذه القوائم يحصن النظم الإدارية من الأخطاء التشغيلية الجسيمة الناتجة عن الإدخال العشوائي للموظفين.
على سبيل المثال، عند إدراج أسماء الموردين في سجلات الصرف المالي، يكفل تمييز الخلية فوراً باللون الأحمر تنبيه المحاسب إلى أن هذا الكيان مدرج ضمن قائمة الموردين الموقوفين أو غير المعتمدين، مما يوقف صرف المبالغ بصورة استباقية ويوفر حماية مالية حازمة للأصول المؤسسية. وتتجلى أهمية هذه النظم الرقابية في تعزيز استقلالية اتخاذ القرار الميداني ودعم الحوكمة الإدارية الرشيدة عبر توفير مؤشرات تشغيلية موضوعية تمنع الاجتهادات الفردية الخاطئة (Slemp et al., 2018).
يختزل هذا التكامل البرمجي مفهوم الامتثال الإجرائي للحوكمة الرقمية الحديثة؛ حيث تتحول اللوائح والسياسات الورقية الصامتة إلى كود برمجي نشط يفرض نفسه مباشرة في صلب واجهة العمل اليومية. إن المراقبة التفاعلية لحركات الإدخال ومطابقتها الآلية مع الأهداف والموجهات المؤسسية لا ترفع كفاءة التدقيق الداخلي فحسب، بل تبني ثقافة تشغيلية قائمة على جودة البيانات والالتزام المنهجي الصارم الذي يشكل العمود الفقري للتحول الرقمي المستدام.
الخاتمة
يمثل التنسيق الشرطي المعتمد على مطابقة القيم مع القوائم المرجعية في جداول بيانات جوجل واحداً من أقوى الحلول التقنية المتاحة للمحللين والمؤسسات لأتمتة عمليات التحقق البياني وتحقيق أعلى مستويات الاتساق المنهجي. ومن خلال التشريح الدقيق لدالة COUNTIF وفهم أسرار المراجع المطلقة والنسبية، يتضح أن هذه الإجراءات ليست مجرد لمسات شكلية، بل هي بنيان رياضي بولياني رصين يحصن قواعد البيانات من التشوهات والانزياحات الخاطئة. كما يتيح الاستيعاب المتعمق للبدائل التقنية المتقدمة—بدءاً من تركيبة دالتي MATCH وISNUMBER، مروراً بالمعادلات المصفوفية الصارمة لحساسية الأحرف عبر EXACT وSUMPRODUCT، وصولاً إلى استدعاء النطاقات الخارجية والمسماة عبر INDIRECT—مرونة تشغيلية لا متناهية لتطويع بيئة العمل السحابية لتلائم أعقد السيناريوهات الإدارية والبحثية.
إن بناء هذه القواعد بوعي هندسي يراعي متطلبات تحسين الأداء وتخفيف العبء الحسابي على متصفح المستخدم يضمن استدامة المصنفات البيانية حتى عند تضخمها لعشرات الآلاف من الصفوف. كما أن الالتزام باستراتيجيات تنظيف النصوص المسبقة والتعامل المنهجي مع أنماط البيانات المتضاربة وتحديد أولويات التنفيذ التنسيقي يحمي المنظومة من الإخفاقات الخفية التي قد تعصف بدقة النتائج. وفي نهاية المطاف، يشكل التطبيق الصارم لهذه الأدوات جسراً متيناً يصل بين المبادئ الأكاديمية المجردة في التحقق وضبط الجودة وبين الإجراءات التنفيذية اليومية، مما يرتقي بكفاءة الحوكمة الرقمية ويؤسس لبيئات عمل موثوقة تستند إلى حقائق بيانية دقيقة وراسخة.
المراجع
- Hora, M. T., & Oleson, A. K. (2017). Examining study habits in undergraduate STEM courses from a situative perspective. International Journal of STEM Education. https://doi.org/10.1186/s40594-017-0055-6
- Ragno, L., Borboni, A., Vannetti, F., Amici, C., & Cusano, N. (2023). Application of Social Robots in Healthcare: Review on Characteristics, Requirements, Technical Solutions. Sensors. https://doi.org/10.3390/s23156820
- Slemp, G. R., Kern, M. L., Patrick, K., & Ryan, R. M. (2018). Leader autonomy support in the workplace: A meta-analytic review. Motivation and Emotion. https://doi.org/10.1007/s11031-018-9698-y