
تعد جداول بيانات جوجل (Google Sheets) واحدة من أكثر المنصات السحابية انتشاراً واعتماداً في بيئات العمل الحديثة، حيث تتقاطع فيها متطلبات إدارة الأعمال اليومية مع التحليلات الإحصائية وهندسة البيانات الخفيفة. وفي خضم التدفق المستمر للبيانات من مصادر متباينة—بدءاً من استمارات الاستبيان الرقمية وتطبيقات الطرف الثالث، مروراً بسجلات قواعد البيانات العلائقية، ووصولاً إلى الملفات النصية المجمعة يدوياً—تظهر إشكالية هيكلة النصوص كأحد أبرز التحديات التي تواجه محللي البيانات والباحثين. فنادراً ما تأتي البيانات النصية بصورة معيارية نظيفة وجاهزة للتحليل الفوري، بل غالباً ما تتسم بدرجة عالية من العشوائية، والتداخل، وعدم الانتظام في استخدام الفواصل والمحددات، مما يتطلب تدخلاً منهجياً لإعادة قولبتها وتطبيعها في هيئة جداول قابلة للقراءة والمعالجة الآلية.
تعتبر عملية تجزئة النصوص (Text Splitting) حجر الزاوية في خطوط أنابيب تنظيف البيانات (Data Cleaning Pipelines)، إذ تمثل الجسر الرابط بين النصوص غير المنظمة (Unstructured Text) والكيانات البيانية المصنفة والموزعة على أعمدة محددة بدقة. وعلى الرغم من أن منصة جداول بيانات جوجل توفر دالة مدمجة ومخصصة لهذا الغرض، وهي الدالة الشهيرة SPLIT، إلا أن الاستخدام العملي لهذه الدالة في معالجة سيناريوهات العالم الحقيقي سرعان ما يصطدم بتعقيدات ناشئة عن تنوع المحددات (Delimiters) داخل السلسلة النصية الواحدة. فالنصوص الواقعية لا تنفصل دائماً بفاصلة مفردة أو مسافة منتظمة؛ بل تتشابك فيها الفواصل المنقوطة، والشرطات، والشرطات المائلة، والمسافات المتعددة، أو حتى الكلمات المفتاحية المركبة، الأمر الذي يشل قدرة الدالة المنفردة إذا ما استُخدمت دون استيعاب دقيق لآليات تشغيلها وخيارات دمجها مع دوال متقدمة أخرى.
يتناول هذا البحث الشامل والمنهجي كيفية تطويع دالة SPLIT للتعامل مع المحددات المتعددة بكفاءة تشغيلية وحسابية فائقة. سننطلق من الأسس النظرية لمعالجة النصوص في البيئات السحابية ومحددات محرك جداول جوجل، مروراً بالتشريح الدقيق للبنية التركيبية للدالة ومعاملاتها المنطقية. وسنستعرض بالتفصيل استراتيجيات توظيف التعبيرات النمطية (Regular Expressions) عبر دالة REGEXREPLACE كأداة لتطبيع البيانات قبل التقسيم، وصولاً إلى بناء الصيغ المصفوفية الديناميكية المتقدمة، وإدارة الحالات الشاذة، وتطبيق أفضل ممارسات الحوكمة الرقمية، بهدف تزويد المحلل والباحث بمرجع متكامل يضمن دقة النمذجة واستدامة التدفقات البيانية المعقدة.
1. مدخل نظري لمعالجة النصوص وهندسة البيانات في جداول بيانات جوجل
1.1 أهمية تقسيم النصوص وتوحيد معاييرها في تحليلات البيانات
في الفضاء المعرفي لعلم البيانات، تُعزى كفاءة النماذج الإحصائية وقواعد البيانات التحليلية بدرجة رئيسية إلى جودة وتناسق المدخلات الأولية، وهو ما تعبر عنه القاعدة الهندسية الشهيرة “المدخلات غير المنظمة تؤدي حتماً إلى مخرجات مشوهة”. في بيئات العمل التشاركية التي تتيحها الحوسبة السحابية، تتفاقم ظاهرة تباين المدخلات نتيجة غياب القيود الصارمة على واجهات إدخال النصوص؛ حيث يقوم المستخدمون بتسجيل المعلومات بطرق شخصية متباينة، مما يخلق تراكيب نصية هجينة تشتمل على فواصل اعتباطية كالفاصلة العشرية واللاتينية، والشرطات الأفقية، والمسافات الزائدة.
إن غياب الاتساق في المحددات النصية يولد انحرافات جوهرية عند بناء النماذج الإحصائية وتغذية لوحات المعلومات الرقمية. فعندما تُترك السجلات المتعددة القيم ضمن خلية واحدة دون تجزئة قياسية، تعجز محركات الاستعلام التجميعية مثل دالة QUERY في جداول جوجل أو جداول المحاور (Pivot Tables) عن التعرف على العناصر المستقلة وإجراء العمليات الحسابية من عد وتصنيف وترتيب. هذا التداخل يقود إلى حسابات مزدوجة، وتوزيعات احتمالية مضللة، واختلال في مستويات القياس، فضلاً عن انتهاك المعيار البنائي للشكل الطبيعي الأول (First Normal Form – 1NF) المتعارف عليه في نظريات قواعد البيانات العلائقية، والذي يفرض أن تكون قيم الأعمدة قيمًا أولية غير قابلة للتجزئة (Atomic Values).
من هنا، تبرز عملية تنظيف وتطبيع النصوص كضرورة بنيوية تسعى إلى تحويل السلاسل النصية الفوضوية إلى هياكل بيانات جدولية متسقة وموزعة بدقة. يتضمن هذا التحول عزل العناصر المعنوية المستقلة، وفرز المعرفات الرقمية والأسماء والتواريخ إلى مسارات عمودية مخصصة، مما يرفع من موثوقية التحليلات اللاحقة، ويسهل عمليات الربط عبر مفاتيح فريدة مع جداول أخرى، ويؤسس لبيئة بيانات صلبة وقابلة للتوسع البرمجي المستمر.
1.2 الخصائص الحسابية لمحرك جداول بيانات جوجل في التعامل مع السلاسل النصية
يعمل محرك الحسابات في جداول بيانات جوجل استناداً إلى بنية تحتية سحابية موزعة تدير استهلاك الموارد المخصصة للذاكرة الحية (RAM) والمعالجة الدقيقة لكل مستند بشكل مشترك وديناميكي. عند التعامل مع السلاسل النصية، يقوم المحرك بتخزين النصوص كمتتاليات من المحارف المشفرة بترميز اليونيكود (UTF-8)، مما يمنحه مرونة واسعة في استيعاب شتى اللغات البشرية بما فيها اللغة العربية. ومع ذلك، فإن هذه المرونة تخضع لمحددات أداء صارمة ترتبط بالحد الأقصى لطول النصوص داخل الخلية الواحدة (حيث يبلغ الحد الأقصى 50,000 حرف لكل خلية) وحجم المستند الإجمالي الذي لا يمكن أن يتجاوز عشرة ملايين خلية حالياً.
تختلف معالجة النصوص وحيدة الخلية (Single-Cell Processing) جذرياً عن المعالجة التدفقية للمصفوفات (Array-Streaming Processing). فعند تنفيذ دالة نصية على خلية منفردة، يخصص المحرك مساحة مؤقتة لتقييم السلسلة وإرجاع الناتج، وهي عملية سريعة لا تثقل الذاكرة. أما في حالة المعالجة المصفوفية المتدفقة، يُنشئ المحرك شجرة تقييم مصفوفية (Matrix Evaluation Tree) تبقي كافة عناصر النطاق في الذاكرة النشطة بالتوازي، مما يتيح توزيع السلاسل النصية عبر خلايا مجاورة دفعة واحدة دون الحاجة إلى تكرار كتابة المعادلات يدوياً في كل صف على حدة.
تلعب الدوال المنطقية والتحويلية دور المنسق الحسابي الذي يعيد تشكيل مسار تدفق البيانات داخل هذا المحرك؛ إذ تتيح تحويل النصوص ذات البنية التراكمية إلى كائنات مصفوفية متجهة (Vectors) أو جداول فرعية. يعتمد استقرار هذا المحرك على قدرة المصمم الرياضي للصيغة على تجنب التكرارات الحسابية غير الضرورية، واختيار الخوارزميات النصية التي تحقق تعقيداً زمنياً منخفضاً (Low Time Complexity)، لتفادي استنزاف موارد الخادم وحدوث أخطاء المهلة الزمنية (Execution Timeout Errors) أثناء معالجة آلاف السجلات النصية بصورة متزامنة.
2. البنية التشغيلية لدالة SPLIT ومحدداتها الافتراضية
2.1 الصيغة التركيبية لدالة SPLIT ووسائطها الأساسية
تعتبر الدالة SPLIT الأداة القياسية المدمجة في جداول بيانات جوجل لتفتيت النصوص وتوزيع محتوياتها عبر صفوف أفقية ممتدة على أعمدة متجاورة. تأتي الصيغة التركيبية العامة للدالة على النحو التالي:
SPLIT(text, delimiter, [split_by_each], [remove_empty_text])
يمثل الوسيط الأول text السلسلة النصية المراد تقسيمها، ويمكن أن يكون هذا الوسيط قيمة نصية ثابتة محاطة بعلامات تنصيص، أو مرجعاً لخلية مفردة تحتوي على النص المطلوب معالجته. ويشكل هذا الوسيط المدخل الخام الذي يطبق عليه المحرك الحسابي خوارزمية البحث والتقسيم.
أما الوسيط الثاني delimiter، فهو الحرف أو مجموعة المحارف التي يعتمدها النظام كمعيار قطعي لانفصال السلسلة النصية؛ حيث يتم بتر النص عند كل موضع يطابق هذا المحدد ونقل النص اللاحق إلى الخلية المجاورة جهة اليسار أو اليمين بحسب اتجاه الصفحة. والجدير بالبيان هنا هو السلوك التشغيلي للوسيط الثالث الاختياري split_by_each، والذي يأخذ قيمة منطقية افتراضية هي TRUE. عند ضبط هذا الوسيط على TRUE، يتعامل محرك جداول جوجل مع كل حرف مفرد موجود داخل وسيط المحدد كفاصل مستقل تماماً ومكافئ لغيره. على سبيل المثال، إذا تم تمرير القيمة “,;/” كمحدد، فإن الدالة ستقوم بالتقسيم عند العثور على الفاصلة، أو الفاصلة المنقوطة، أو الشرطة المائلة بشكل منفرد ومستقل دون اشتراط تتابعها معاً.
أما الوسيط الرابع والأخير remove_empty_text، فيتحكم بالسلوك الإجرائي تجاه الحقول الفارغة التي قد تنتج عن توالي الفواصل في النص الأصلي، وتكون قيمته الافتراضية هي TRUE أيضاً. عند بقاء هذا الوسيط مفعلاً، يقوم المحرك بدمج الفواصل المتجاورة واعتبارها فاصلاً واحداً، متجاهلاً إنتاج أي خلايا نصية فارغة في المصفوفة الناتجة. أما إذا حُددت قيمته بـ FALSE، فإن الدالة ستحتفظ بالفجوات الناتجة عن توالي الفواصل، وتفرغها في صورة خلايا فارغة متتالية، وهو خيار بالغ الأهمية عند التعامل مع ملفات البيانات المجدولة (مثل ملفات CSV) التي تشير فيها الفواصل المتتالية إلى قيم مفقودة (Null Values) يجب الحفاظ على موقعها البنيوي لضمان عدم إزاحة الأعمدة اللاحقة.
2.2 القيود المنهجية عند محاولة استخراج النصوص بفواصل غير متجانسة
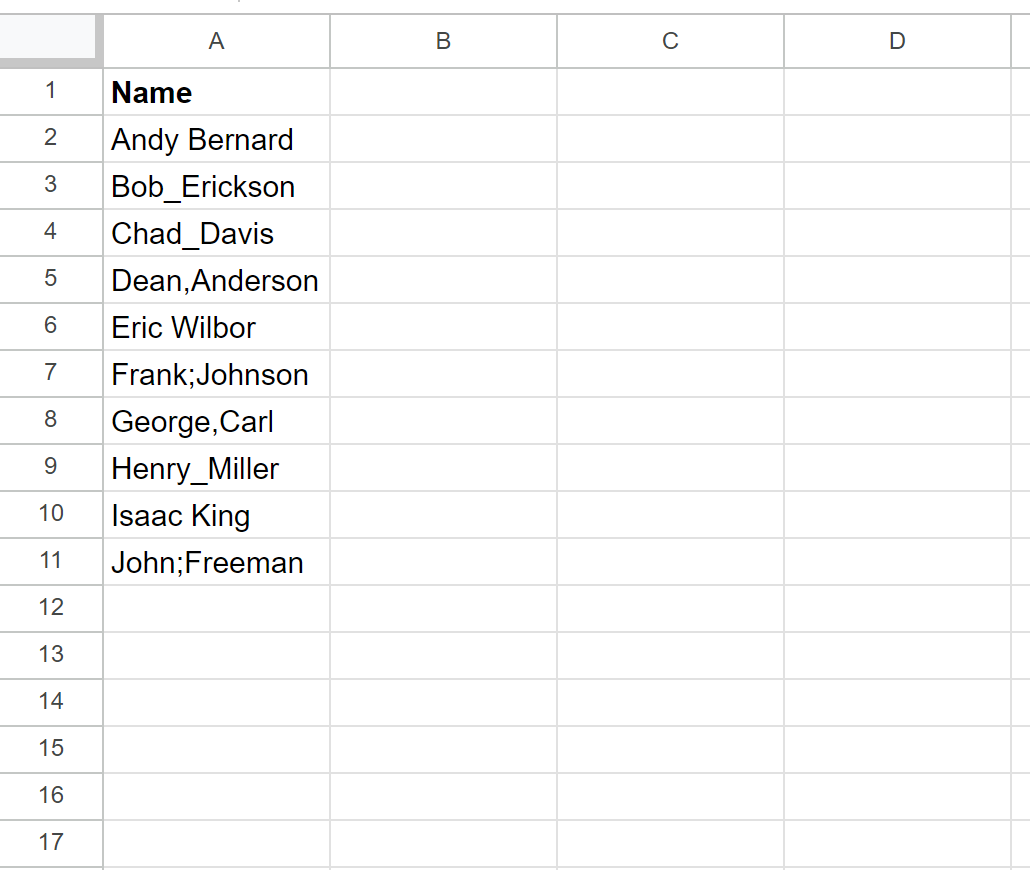
على الرغم من المرونة التي يقدمها وسيط split_by_each عند تفعيله للتعامل مع رموز فردية متعددة، إلا أن الدالة SPLIT تعاني من قيود منهجية بنيوية تجعلها عاجزة بمفردها عن مواجهة تحديات التنظيف المتقدمة. يكمن القصور الأكبر في عدم قدرة الدالة على التعامل مع المحددات المركبة المكونة من عدة أحرف بالتوازي مع محددات مفردة؛ فإذا أردت تقسيم نص يتضمن الفاصلة “,” كفاصل من جهة، والعبارة النصية ” AND ” كفاصل آخر من جهة ثانية، فإن تفعيل split_by_each سيؤدي إلى تفكيك كلمة “AND” إلى أحرفها المكونة لها (A و N و D) والتقسيم عند كل حرف منها، مما يدمر سلامة الكلمات داخل النص الأصلي. أما إذا تم تعطيل الوسيط ليصبح FALSE، فإن الدالة ستشترط وجود السلسلة الكاملة بدقة ولن تعترف بالفواصل الأخرى.
يضاف إلى ذلك ظاهرة توليد الأعمدة غير المرغوب فيها والناشئة عن تباين الفواصل وتداخل المسافات البيضاء. فعندما يدخل المستخدمون فواصل متباينة يتبع بعضها مسافات بيضاء والبعض الآخر لا يتبعه شيء (مثل: “بيانات1, بيانات2;بيانات3 / بيانات4”)، فإن ضبط الدالة المباشر قد يؤدي إما إلى تضمين مسافات بيضاء غير مرئية في بدايات ونهايات الخلايا المقسمة تؤثر على دوال البحث اللاحقة مثل VLOOKUP أو XLOOKUP، أو إنتاج تشوهات عمودية تفقد الجدول تناسقه.
تفرض هذه المحددات التقنية حاجة ملحة إلى وجود طبقة معالجة وسيطة تسبق استدعاء دالة SPLIT؛ حيث تكمن المنهجية الاحترافية في تطبيع البيانات الخام (Data Normalization) وتوحيد كافة الفواصل المتباينة والمتناثرة وتحويلها برمجياً إلى رمز اصطلاحي موحد ومعياري، ليتم بعد ذلك تسليمه للدالة SPLIT لإتمام التوزيع الأفقي باستقرار ودقة متناهية.
3. توظيف التعبيرات النمطية عبر دالة REGEXREPLACE كأداة معيارية
3.1 مفهوم التعبيرات النمطية (Regular Expressions) في بيئة جداول جوجل
تمثل التعبيرات النمطية، والمعروفة اختصاراً بـ Regex، لغة تركيبية ومنطقية فائقة القوة مخصصة للتعرف على الأنماط داخل السلاسل النصية ومطابقتها والتلاعب بها استناداً إلى قواعد رياضية صارمة مستمدة من نظرية اللغات الصورية وحسابات الأوتوماتا (Automata Theory). في بيئة جداول بيانات جوجل، يعتمد النظام على محرك التعبيرات النمطية RE2 المطور من قبل شركة جوجل، وهو محرك برمجي مفتوح المصدر مصمم للعمل بسرعة خطية وموثوقية عالية، متفادياً مشاكل التراجع الكارثي (Catastrophic Backtracking) التي تصيب محركات مطابقة النصوص التقليدية عند التعامل مع أنماط شديدة التعقيد.
تتيح التعبيرات النمطية للمحلل صياغة نماذج وصفية للمحددات بدلاً من الاعتماد على قيم نصية جامدة. ومن أبرز الأدوات المنطقية التي توفرها هذه الأنماط عامل الاختيار المنطقي العمودي، أو ما يعرف برمز الأنبوب (|)، والذي يعمل كمعامل “أو” (OR Operator). يسمح هذا الرمز بربط مجموعة متسلسلة من المحددات المفردة أو المركبة؛ فعلى سبيل المثال، يمثل النمط التعبيري ",|;|/|s+" تعبيراً دقيقاً يعني مطابقة الفاصلة، أو الفاصلة المنقوطة، أو الشرطة المائلة، أو تتابع مسافة بيضاء واحدة أو أكثر. كما تتيح الأقواس المربعة الفئوية مثل [;,/] اختزال المحارف المفردة المستهدفة ضمن تصنيف نمطي موحد يعالجه المحرك كخيار محتمل للمطابقة الحسابية.
يتطلب توظيف هذه التعبيرات النمطية فهماً شاملاً لرموز الإفلات والتحييد البرمجي (Escaping Characters). فبعض الرموز المستخدمة في النصوص العادية—كالشرطة المائلة العكسية ()، والنقطة (.)، وإشارة الجمع (+)، وعلامة الاستفهام (؟)، والأقواس المتنوعة—تعتبر محارف محجوزة برمجياً داخل محرك RE2 تؤدي وظائف نمطية محددة. وبالتالي، فإن استخدام أي من هذه الرموز كمحدد حقيقي داخل النص يتطلب إلغاء تفعيله النمطي عبر وضع شرطة مائلة عكسية تسبقه فوراً (مثل . أو |) لإجبار المحرك على معاملته كرمز نصي مجرد.
3.2 التحليل الوظيفي لدالة REGEXREPLACE لتطبيع المحددات
تعد الدالة REGEXREPLACE الأداة التحويلية المثالية لتنفيذ هندسة تطبيع المحددات في جداول بيانات جوجل. تمتاز هذه الدالة بقدرتها على مسح النص الأصلي بالكامل، والتعرف على كافة المحارف أو الأنماط التي تطابق التعبير النمطي المحدد، واستبدالها بسلسلة نصية جديدة بديلة بشكل شامل عبر عملية مسح واحدة (Single Pass Execution). وتأتي بنية الدالة على الهيئة التالية:
REGEXREPLACE(text, regular_expression, replacement)
تكمن الكفاءة المعيارية لهذه الدالة في معالجة إشكالية الفواصل المتعددة؛ فبدلاً من تطبيق دوال الاستبدال التقليدية المتسلسلة والمملة مثل دالة SUBSTITUTE التي تتطلب تداخل عدة صيغ حسابية داخل بعضها لمعالجة كل رمز على حدة (Nested SUBSTITUTE Functions)، تتيح REGEXREPLACE استهداف مصفوفة غير محدودة من الفواصل المتنوعة في خطوة برمجية واحدة وأنيقة. يمكن للمحلل تمرير كافة الفواصل المرصودة في البيانات الخام ضمن تعبير نمطي واحد واستبدالها برمز قياسي موحد، كالرمز الشريطي (“|”) أو الرمز المربع (“#”) أو المسافة المفردة (” “).
تتعامل الدالة مع الرموز المحجوزة بكفاءة تشغيلية ملحوظة، مما يتيح التخلص الفوري من المحددات المركبة وحالات التكرار العشوائي للفواصل الناتجة عن أخطاء الإدخال البشري. هذا الأسلوب يقلل من حجم العبء الحسابي الملقى على خوادم المعالجة، ويختصر عدد دورات التقييم الرياضي في المستند، كما يحافظ على مقروئية الصيغ الحسابية وسهولة صيانتها وتدقيقها لاحقاً من قبل مهندسي البيانات وفرق العمل المشتركة.
4. المعادلة الهجينة: دمج SPLIT مع REGEXREPLACE لتجاوز الفواصل المتعددة
4.1 الصيغة الرياضية والتركيبية للمعادلة المركبة
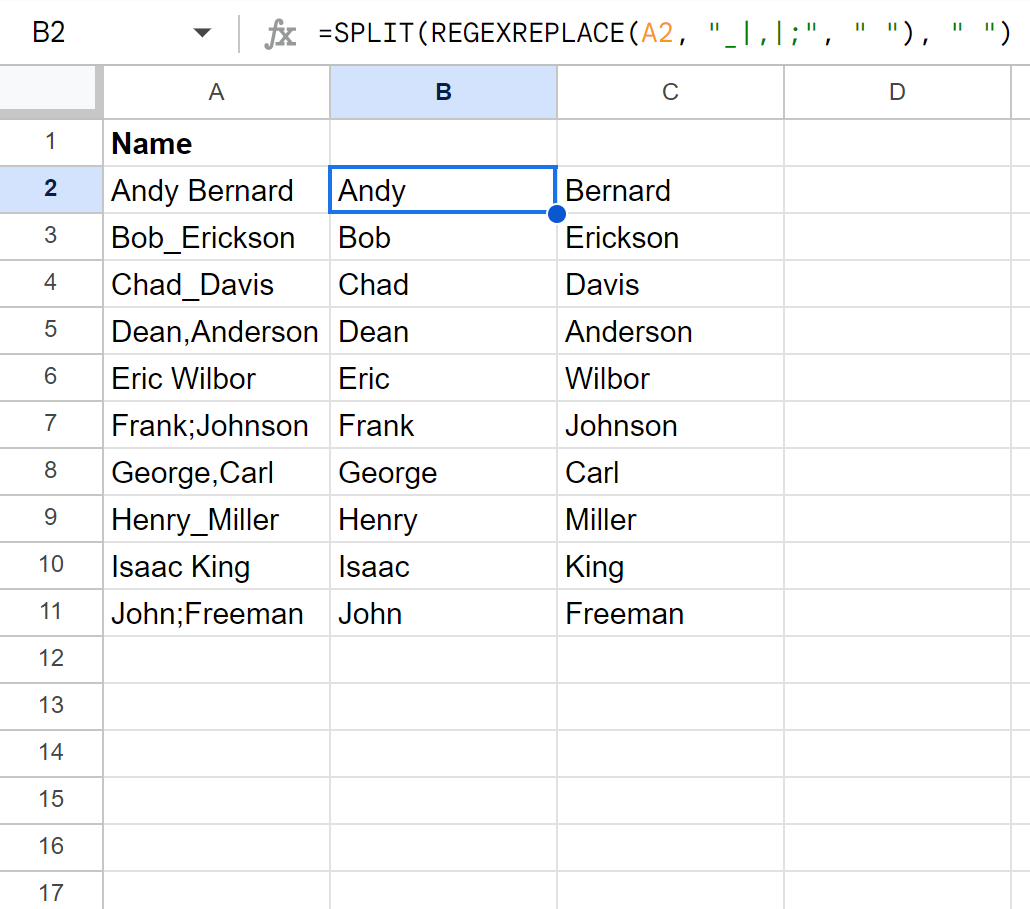
ينشأ التكامل البرمجي الأقوى في معالجة النصوص داخل جداول بيانات جوجل عبر صياغة معادلة هجينة تدمج القوة التعبيرية لدالة REGEXREPLACE مع القدرة التوزيعية المكانية لدالة SPLIT. تقوم هذه الفلسفة على تفكيك العملية المعقدة إلى مرحلتين متعاقبتين: مرحلة التطبيع النمطي، تليها مرحلة التجزئة والتوزيع العمودي. وتتخذ الصيغة الهيكلية العامة لهذا النموذج الشكل التالي:
=SPLIT(REGEXREPLACE(A2, “[_;/,]”, “|”), “|”)
أو بصيغتها الأكثر مرونة وتوسعاً للتعامل مع العبارات النصية المتعددة المحارف:
=SPLIT(REGEXREPLACE(A2, “(?i)s*(AND|OR|;|/|,)s*”, “|”), “|”)
يعمل التقييم الحسابي لهذه المعادلة وفق ترتيب تدفقي منطقي دقيق يبدأ من الداخل إلى الخارج. في الخطوة الأولى، تتلقى دالة REGEXREPLACE النص الخام من الخلية المصدرية (A2)، وتقوم عبر محرك التعبيرات النمطية بتمشيط محتوى الخلية لمطابقة أي من المحددات المستهدفة—سواء كانت شرطات سفلية، فواصل منقوطة، شرطات مائلة، فواصل تقليدية، أو حتى كلمات منطقية كـ AND و OR مع المسافات المحيطة بها دون تحسس لحالة الأحرف بفضل المعدل (?i). عند العثور على أي من هذه الأنماط، تستبدله فوراً بالفاصل المعياري المختار، وهو الرمز الشريطي “|” في هذا النموذج.
في الخطوة الثانية، يتم تسليم السلسلة النصية المطبعة والموحدة إلى دالة SPLIT الخارجية كمدخل رئيسي. وبما أن كافة المحددات الأصلية قد تحولت إلى رمز موحد وحيد، تصبح مهمة SPLIT حتمية وبسيطة ومجردة من أي غموض تركيبي؛ حيث تقوم بتقطيع السلسلة حول الرمز “|” وتوزيع الأجزاء المستخرجة على خلايا النطاق الأفقي المقابلة للخلية الأصلية بدقة متناهية ودون إنتاج خلايا وسيطة شاذة.
يعد اختيار الفاصل الموحد المؤقت عنصراً حاسماً لضمان سلامة العملية برمتها؛ إذ يجب أن يقع الاختيار على رمز غير موجود قطعاً ضمن النصوص الأصلية ولا يحتمل وروده كقيمة بيانية حقيقية. يعتبر الرمز الشريطي (|)، أو علامة التلدة (~)، أو بعض رموز اليونيكود الخاصة من الخيارات النموذجية التي تمنع التداخل البرمجي الخاطئ بين الفاصل المؤقت ومحتوى النصوص الفعلية.
4.2 تحليل الأداء الحسابي للمعادلة المركبة
عند تقييم كفاءة هذه المعادلة الهجينة عبر مجموعات البيانات الضخمة التي تحتوي على عشرات الآلاف من السجلات، يتبين أن الأداء الحسابي يظل مرتفعاً ومستقراً مقارنة بالبدائل البرمجية الأخرى. تعتمد دالتا SPLIT و REGEXREPLACE على دوال أصلية مكتوبة بلغات برمجية منخفضة المستوى (Native C++) ومترجمة ومحسنة داخل البنية التحتية لمحرك جوجل، مما يجعل استهلاكها للذاكرة وسرعة معالجتها للأوامر متفوقة بمراحل على النصوص البرمجية المخصصة المكتوبة عبر واجهة تطبيقات جداول جوجل (Google Apps Script).
إن تشغيل كود Apps Script مخصص لمعالجة النصوص على نطاق واسع يتطلب نقل البيانات عبر طبقة وسيطة واستدعاء واجهات البرمجة التابعة لمحرك V8، مما يولد تأخيراً زمنياً ملحوظاً (Latency) واستهلاكاً لحصص التنفيذ المحددة سحابياً لكل حساب. على النقيض من ذلك، فإن المعادلات الهجينة المدمجة تُنفذ مباشرة ضمن حلقة الحسابات الأساسية لورقة البيانات، مما يضمن تقليل زمن التأخير لأجزاء من الثانية ويسمح بالتحديث الفوري واللحظي للنتائج (Instant Recalculation) بمجرد تعديل أو إضافة أي قيمة في الخلايا المصدرية دون الحاجة إلى تشغيل يدوي للبرمجيات.
علاوة على ذلك، تتميز هذه المعادلة بكفاءة توزيع الموارد أثناء مرحلة الرسم والتمدد الشبكي؛ فالبيانات المقسمة تُنقل مباشرة إلى مصفوفات العرض دون إبقاء مصفوفات وسيطة ضخمة محجوزة في الذاكرة الحية بعد اكتمال التقييم الحسابي، مما يحمي جداول البيانات من الانهيار المفاجئ أو بطء الاستجابة الحركية عند التمرير والفرز وتطبيق المرشحات.
5. تطبيق عملي خطوة بخطوة: معالجة سجلات ونصوص متباينة الفواصل
5.1 إعداد بيئة البيانات وتحليل العينات المعقدة
لتجسيد التطبيق العملي لهذه المنهجية، سنفترض وجود بيئة بيانات واقعية لشركة استشارات تدير قائمة بمشاريع متعددة التخصصات، حيث تم تسجيل أسماء الاستشاريين المشرفين على كل مشروع داخل خلية واحدة بصيغة نصية حرة دون تقييد مسبق لقواعد الإدخال. يتضمن العمود A أسماء المشاريع، بينما يتضمن العمود B سجلات الاستشاريين بالشكل الموضح في الحالات النمطية التالية:
- الحالة الأولى (خلية B2): “أحمد محمود, د. سمير عبد الله; المهندس خالد توفيق / منى صابر” (تتداخل فيها الفاصلة اللاتينية، والفاصلة المنقوطة، والشرطة المائلة مع مسافات متفاوتة).
- الحالة الثانية (خلية B3): “طارق إبراهيم – سارة خليل_ياسين زاهر” (استخدام الشرطة الأفقية والشرطة السفلية بدون مسافات تارة ومع مسافات تارة أخرى).
- الحالة الثانية (خلية B4): “محمود عز الدين AND كمال شكري OR زياد فهمي” (استخدام فواصل لفظية مركبة تفصل بين الكيانات).
- الحالة الرابعة (خلية B5): “هدى فؤاد,, ريم قاسم;; لمياء شريف” (تكرار الفواصل بشكل غير مقصود ناتج عن سرعة الإدخال البشري).
يكشف الفحص الميداني لهذه السجلات عن استحالة استخدام دالة SPLIT القياسية وحدها؛ حيث يؤدي تمرير المحددات إليها مباشرة إما إلى عزل جزء من الأسماء واحتجاز أجزاء أخرى، أو تقطيع الكلمات المركبة، أو تشتيت الأسماء عبر أعمدة غير متناسقة مما يستحيل معه إجراء أي تصنيف وظيفي موحد.
يتحدد الهدف النهائي في هذه المسألة ببناء معادلة معيارية مرنة تُدرج في العمود C، وتتكفل بفرز كل استشاري في عمود مستقل بالترتيب (الاستشاري الأول في العمود C، والاستشاري الثاني في D، والثالث في E، وهكذا)، مع تنقية الأسماء من أي شوائب رمزية أو مسافات فارغة محيطة، وضمان اتساق البنية التحتية للجدول بالكامل.
5.2 التنفيذ الإجرائي للمعادلة وسحبها عبر النطاق المستهدف
لتحقيق الهدف المحدد، نبدأ بصياغة المعادلة المعيارية الموسعة في الخلية C2 لمعالجة الحالة الأولى، وتتخذ المعادلة الشكل التنفيذي التالي:
=SPLIT(REGEXREPLACE(B2, “(?i)s*(,|;|/|-|_|s+(AND|OR)s+)s*”, “|”), “|”, TRUE, TRUE)
بمجرد إدخال هذه الصيغة في الخلية C2 والضغط على مفتاح الإدخال، نلاحظ السلوك الفوري للنظام: يقوم محرك التعبيرات النمطية بمطابقة الفاصلة والفاصلة المنقوطة والشرطة المائلة مع المسافات التي تحيط بها، ويحولها جميعاً إلى الرمز “|”. ثم تتدخل دالة SPLIT لتقرأ النص المطهر، وتوزع الأسماء على أربعة أعمدة متجاورة كالتالي: الخلية C2 تحتوي “أحمد محمود”، والخلية D2 تحتوي “د. سمير عبد الله”، والخلية E2 تحتوي “المهندس خالد توفيق”، والخلية F2 تحتوي “منى صابر”. نلاحظ هنا أن جميع الأسماء استقرت في خلاياها نظيفة تماماً دون أي مسافة زائدة في البداية أو النهاية، ودون بقاء أي أثر للفواصل القديمة.
الخطوة التالية تتمثل في تعميم هذه المعادلة عبر سحب مقبض التعبئة التلقائية (Fill Handle) أو نسخ الصيغة ولصقها في الخلايا C3 و C4 و C5. عند التطبيق على الخلية B3، تنجح المعادلة في تجاوز الشرطة الأفقية والشرطة السفلية وتوزيع الأسماء الثلاثة بدقة. وعند التطبيق على الخلية B4، يتعرف النمط بذكاء على الكلمتين “AND” و “OR” كفواصل مستقلة بفضل التعبير النمطي، ويوزع الأشخاص الثلاثة في الأعمدة C و D و E دون المساس بالأحرف الداخلية للأسماء.
وأخيراً، عند تطبيقها على الخلية B5 التي تحتوي على فواصل مكررة (“,,” و “;;”)، فإن تفعيل الوسيط الرابع في دالة SPLIT بالقيمة TRUE (أو الاعتماد على ضبط النمط التعبيري لابتلاع الفواصل المتعددة) يمنع ظهور أي أعمدة فارغة بين الأسماء، ويضمن أن يستقر اسم “هدى فؤاد” في العمود C، و”ريم قاسم” في العمود D، و”لمياء شريف” في العمود E، محققاً بذلك استقراراً هيكلياً ومحاذاة تامة للأعمدة عبر كافة الصفوف.
6. مقارنة منهجية بين الحلول المتاحة لتقسيم الفواصل المتعددة
6.1 المقارنة بين تقنية REGEXREPLACE والوسيط split_by_each
قد يتبادر إلى ذهن الممارس تساؤل جوهري: ما هي الدواعي المنهجية التي تبرر اللجوء إلى التعبيرات النمطية المعقدة عبر REGEXREPLACE ما دامت الدالة SPLIT تحتوي بالفعل على الوسيط المدمج split_by_each الذي يقبل سلسلة من الرموز؟ للإجابة عن ذلك، لا بد من إجراء موازنة تقنية معمقة توضح الفروق الجوهرية ومجالات التطبيق المناسبة لكل منهما.
إن استخدام الدالة المباشرة بصيغة =SPLIT(A1, ",;/-_") مع الاعتماد على القيمة الافتراضية للوسيط (TRUE) يُعد حلاً ممتازاً وسريعاً ومنخفض التكلفة الحسابية في سيناريو واحد محدد: عندما تكون جميع المحددات المستهدفة عبارة عن رموز مفردة تتألف من حرف واحد فقط، ولا تشترط أي سياق نصي يحيط بها. ففي هذه الحالة، يؤدي الوسيط وظيفته بكفاءة قصوى دون الحاجة إلى دوال إضافية.
ومع ذلك، تتهاوى كفاءة هذا الحل البسيط بمجرد ظهور متطلبات معقدة تتجاوز الرموز الفردية. فالوسيط split_by_each عاجز تماماً عن معالجة المحددات اللفظية متعددة الأحرف مثل الفواصل التي تتضمن كلمات كـ “أو” أو “ثم” أو التعبيرات الإنجليزية مثل “AND”؛ حيث يؤدي دمج هذه الكلمات في وسيط التقسيم المباشر إلى تدمير النص وتقسيمه عند كل حرف يرد في تلك الكلمات. فضلاً عن ذلك، تفتقر SPLIT المباشرة إلى القدرة على التحكم بالمسافات البيضاء المتغيرة حول المحددات، مما يترك أطراف النصوص المقسمة مليئة بالفراغات المشوهة. في المقابل، تمنح تقنية REGEXREPLACE المحلل سيطرة رياضية مطلقة على البنية النصية، وتتيح له تحديد التوافقات الشرطية، واستخدام فئات المحارف، وتجاهل حالة الأحرف، وابتلاع المسافات المحيطة ضمن عملية تحويل واحدة لا تضاهى من حيث الدقة والمرونة.
6.2 المقارنة مع ميزة ‘تقسيم النص إلى أعمدة’ المدمجة
توفر واجهة جداول بيانات جوجل أداة يدوية مدمجة ضمن شريط القوائم تعرف بـ “تقسيم النص إلى أعمدة” (Split text to columns)، وهي أداة يلجأ إليها العديد من المستخدمين المبتدئين لتنفيذ المهام السريعة. إلا أن إجراء مقارنة علمية بين هذه الأداة اليدوية والمعادلات الرياضية المركبة يظهر فروقاً جذرية تؤثر على موثوقية الأنظمة البيانية.
تتسم الأداة اليدوية بجمود إجرائي هدام؛ فهي تعد عملية تدميرية للبيانات الأصلية في مسارها؛ إذ تقوم بالكتابة فوق الخلايا الأصلية أو استبدالها بشكل دائم، مما يفقد المستخدم القدرة على تتبع السجل الأولي ما لم يحتفظ بنسخة احتياطية مسبقة. أضف إلى ذلك أن الأداة اليدوية مصممة في الأصل للتعامل مع فاصل وحيد في كل تشغيل (مثل اختيار الفاصلة فقط، أو علامة التبويب فقط)، مما يجبر المستخدم على إعادة تكرار الإجراء اليدوي عدة مرات وبشكل تسلسلي مرهق إذا احتوت بياناته على فواصل متباينة، مع احتمالية ارتكاب أخطاء بشرية لا يمكن تداركها بسهولة.
لكن العيب الأكبر للأداة اليدوية يتمثل في غياب الديناميكية والتحديث التلقائي. فعند إضافة صفوف جديدة أو استيراد دفعات بيانية لاحقة إلى الجدول، تظل البيانات الجديدة على حالتها الخام دون تقسيم، مما يفرض إعادة تنفيذ العملية اليدوية مراراً وتكراراً. في المقابل، توفر المعادلات الهجينة تدفقاً بيانياً مستداماً ذاتي التحديث (Real-time Reactive Pipeline)؛ حيث يتم تطبيق القواعد الحسابية فورياً على أي سجل جديد يدخل النظام دون أي تدخل يدوي، مما يجعلها الخيار المهني الحصري لبناء لوحات المعلومات الاحترافية والأنظمة المؤسسية المستقرة.
7. معالجة الحالات المعقدة والبيانات الشاذة (Edge Cases)
7.1 إدارة المحددات المتكررة والمتتالية ومنع الفجوات
في تدفقات البيانات الحقيقية، تنشأ الحالات الشاذة والبيانات المشوهة بصورة متكررة نتيجة إدخال فواصل متتالية دون نصوص بينية، كأن يكتب المستخدم “,,, ” أو “; ; / “. وإذا لم تتم إدارة هذه الحالات بحذر شديد، فإنها تؤدي إما إلى ظهور أعمدة فارغة تسمى “الأعمدة الشبحية” (Ghost Columns) التي تزيح البيانات اللاحقة عن موضعها الصحيح، أو إلى ضياع بنية الجدول الإحصائية بالكامل.
تتمثل الاستراتيجية المثلى للتعامل مع هذا التحدي في استخدام المكممات النمطية (Regex Quantifiers) داخل دالة REGEXREPLACE. وبشكل محدد، فإن استخدام علامة الجمع (+) في نهاية فئة المحددات مثل "[,;/_]+" يخبر محرك البحث النمطي بضرورة مطابقة حرف واحد أو أكثر من تلك المحددات المتجاورة ودمجها برمجياً ليتم استبدال كامل التكتل المتتابع بفاصل معياري واحد فقط. وبذلك، يتم إغلاق الثغرة من المنبع قبل وصول النص إلى دالة التقسيم.
علاوة على ذلك، يجب ضبط الوسيط الرابع في دالة SPLIT وهو remove_empty_text بعناية فائقة. ففي السيناريوهات التي يكون فيها الهدف هو استخلاص النصوص فقط وتجاهل الفراغات الناتجة عن أخطاء الإدخال، يجب ضبط هذا الوسيط بشكل صريح على القيمة TRUE (أو تركه لقيمته الافتراضية). أما في السيناريوهات الصارمة المتعلقة بالمسوح الميدانية أو استمارات الاستبيان المجدولة التي يُراد فيها إثبات غياب القيمة في حقل معين عبر ترك عموده فارغاً ليعبر عن قيمة مفقودة (Missing Data)، فيجب حينها ضبط الوسيط على FALSE مع ضبط التعبير النمطي ليميز بدقة بين تكرار الفواصل المقصود وغير المقصود لضمان اتساق التمثيل الإحصائي للبيانات.
7.2 تنظيف النصوص من المسافات الزائدة باستخدام دالتي TRIM وCLEAN
لا تتوقف شوائب النصوص عند حدود الفواصل المرئية؛ بل تمتد في كثير من الأحيان إلى محارف غير مرئية تتسلل إلى السجلات عبر عمليات النسخ واللصق من مستندات الويب أو ملفات PDF القديمة. من أبرز هذه الشوائب المسافات البيضاء الطرفية (التي تسبق الكلمة الأولى أو تلي الكلمة الأخيرة)، والمسافات المزدوجة المتتالية، والمحارف غير القابلة للطباعة (Non-printable Control Characters) مثل محارف بداية ونهاية السطر (ASCII 0 إلى 31).
ولتحقيق أقصى درجات النقاء البياني، يجب تطويق دالة التقسيم بحزام وقائي يتألف من دالتي TRIM و CLEAN. تتولى دالة CLEAN مهمة إزالة كافة المحارف غير القابلة للطباعة ورموز التبديل السطري العشوائية من النص، في حين تقوم دالة TRIM بإزالة المسافات البيضاء الزائدة من طرفي النص واختزال المسافات المتعددة الداخلية إلى مسافة مفردة منتظمة. ينتج عن هذا التداخل صياغة مصفوفة معيارية شاملة تجمع بين التنقية، والاستبدال النمطي، والتقسيم في صيغة ثلاثية محكمة:
=SPLIT(TRIM(REGEXREPLACE(CLEAN(A2), “s*([,;/_]|s+(AND|OR)s+)s*”, “|”)), “|”, TRUE, TRUE)
تضمن هذه الصيغة المتكاملة معالجة البيانات الخام على ثلاث طبقات فيزيائية وحسابية متتالية: نزع الرموز الخفية المشوهة أولاً بواسطة CLEAN، تلاها استبدال المحددات وتوحيد المسافات بواسطة REGEXREPLACE، ثم تشذيب الأطراف الهامشية بواسطة TRIM، وأخيراً تفكيك النص النظيف بدقة مطلقة عبر SPLIT، مما ينتج عنه حقول بيانية نقية تلبي متطلبات التحليل المتقدم وعلوم البيانات الحديثة.
8. أتمتة العملية على النطاقات الديناميكية باستخدام ARRAYFORMULA
8.1 التحديات التقنية لدمج دالة SPLIT داخل مصفوفات ARRAYFORMULA
عند بناء حلول برمجية واسعة النطاق في جداول بيانات جوجل، يسعى مهندسو البيانات عادة إلى تحويل الصيغ الرياضية من صيغ تعتمد على صف مفرد إلى صيغ مصفوفية شاملة تغطي العمود بالكامل وتستجيب تلقائياً للبيانات الجديدة دون الحاجة إلى سحب المعادلة يدوياً. والأداة الكلاسيكية لتحقيق ذلك هي الدالة الشهيرة ARRAYFORMULA.
ومع ذلك، يصطدم المستخدمون بحقيقة تقنية صادمة ومعروفة في هندسة برمجيات جداول جوجل: دالة SPLIT غير متوافقة بنيوياً مع الدالة ARRAYFORMULA لتوليد تمدد عمودي تلقائي. يعود السبب في هذا التضارب الهندسي إلى أن دالة SPLIT في أصل تصميمها الحسابي هي دالة متعدية أفقياً (Horizontally Expanding Function)؛ حيث تُرجع صفاً مصفوفياً من الخلايا لكل خلية مدخلة. عندما توضع SPLIT داخل ARRAYFORMULA مع تمرير نطاق عمودي كامل (مثل A2:A)، يدخل المحرك الحسابي في حالة تصادم في الأبعاد (Dimension Collision)؛ إذ لا يستطيع تحديد كيفية توزيع مصفوفة ثنائية الأبعاد تتمدد أفقياً وعمودياً في آن واحد دون تصادم مع حدود النطاق، مما يجعل ARRAYFORMULA تطبق الدالة على الخلية الأولى فقط في النطاق متجاهلة بقية الصفوف بالكامل.
ظل هذا القيد الهندسي لسنوات يمثل معضلة كبرى للمطورين، ويدفعهم إما إلى اللجوء لمعادلات نصية معقدة ومجهدة تعتمد على دوال REGEXEXTRACT المتداخلة مع SEQUENCE، أو كتابة نصوص برمجية خاصة عبر Apps Script، وهو ما ينطوي على هبوط حاد في كفاءة النظام البياني وسرعة استجابته.
8.2 النماذج المتقدمة للحلول المصفوفية المستدامة
لحسن الحظ، أحدث إطلاق دوال دوال لامبدا (LAMBDA Helper Functions) في التحديثات الحديثة لجداول بيانات جوجل ثورة جذرية أنهت هذا القيد التاريخي بصورة نهائية. وفرت هذه الدوال الجديدة—وبالأخص الدالة BYROW والدالة MAP—القدرة على تكرار تطبيق دالة معينة على كل صف أو عنصر في النطاق بشكل برمجي ذكي، مع الحفاظ على التدفق المصفوفي الديناميكي بالكامل ودون الحاجة إلى كتابة سطر برمجي واحد في Apps Script.
يتجسد الحل المصفوفي الحديث والمستدام في تطبيق دالة BYROW مقترنة مع LAMBDA لصياغة معادلة مصفوفية متطورة توضع في رأس العمود مرة واحدة فقط، لتتولى قراءة ومعالجة العمود بالكامل. وتتخذ الصيغة التنفيذية النموذجية الهيئة التالية:
=BYROW(A2:A, LAMBDA(row, IF(row=””,, SPLIT(REGEXREPLACE(row, “[,;/_]”, “|”), “|”))))
يقوم منطق هذه المعادلة على الآلية التالية: تتلقى الدالة BYROW النطاق العمودي كاملاً من A2 إلى آخر خلية في الورقة (A2:A)، وتقوم بتمرير كل صف على حدة إلى دالة LAMBDA التابعة تحت المتغير المسمى “row”. تبدأ الدالة بفحص شرطي ذكي عبر IF(row=””,,) للتحقق مما إذا كان الصف فارغاً؛ فإذا كان فارغاً يتم تركه دون معالجة لتجنب امتلاء الورقة بأخطاء الحسابات في الصفوف التي لم تُسجل فيها بيانات بعد وتفادي استهلاك موارد الخادم بلا طائل.
أما إذا احتوى الصف على بيانات نصية، يتم تنفيذ المعادلة الهجينة (SPLIT مع REGEXREPLACE) على ذلك الصف بشكل معزول ومستقل، وتسكب النتيجة أفقياً في الخلايا المجاورة لذلك الصف مباشرة. ومع استمرار عمل BYROW، يتم توليد مصفوفة المخرجات لكافة الصفوف بمرونة متناهية، وبمجرد إدراج أي مستخدم لصف جديد في أسفل الجدول، تقوم الصيغة بالتقاطه فورياً، وتطهيره، وتقسيمه إلى أعمدة متناسقة في لمح البصر وبكفاءة حسابية مذهلة.
9. الأخطاء البرمجية الشائعة واستراتيجيات استكشاف الأخطاء وإصلاحها
9.1 تحليل أخطاء المراجع والقيم الشائعة (#REF! و #VALUE!)
أثناء تطبيق المعادلات المركبة لمعالجة النصوص وتقسيمها، يواجه المحللون طيفاً من رسائل الخطأ البرمجية التي قد تعطل تدفق العمل إذا لم يتم تشخيص أسبابها الجذرية وفهم دلالاتها التقنية. من أكثر هذه الأخطاء شيوعاً هو خطأ تضارب المراجع الحسابية الشهير #REF! والمصحوب برسالة تحذيرية تفيد بأن “المصفوفة الناتجة لم يتم توسيعها لأنها ستكتب فوق البيانات الموجودة” (Array result was not expanded because it would overwrite data).
ينشأ هذا الخطأ الحرج لأن دالة SPLIT تتطلب بطبيعتها مساحة أفقية فارغة تماماً لتسكب فيها مخرجاتها المجزأة. فإذا وجد المحرك الحسابي أن إحدى الخلايا الواقعة في مسار التمدد الأفقي تحتوي على قيمة مسجلة مسبقاً—سواء كانت نصاً، أو رقماً، أو حتى مسافة بيضاء غير مرئية—يتوقف النظام قسرياً عن التمدد حمايةً لبيانات المستخدم من التلف، ويطلق خطأ #REF!. يتطلب حل هذه المشكلة فحص المسار الأفقي المقابل للصيغة وتفريغ كافة الأعمدة المجاورة من أي مدخلات مسبقة لإفساح المجال لتدفق المصفوفة بحرية.
أما الخطأ الثاني واسع الانتشار فهو خطأ القيمة #VALUE!، والذي يظهر عادة في سياقين مختلفين: الأول، عند تمرير قيمة فارغة تماماً إلى دالة SPLIT دون وجود نص ليتم تقسيمه، أو عند فشل دالة REGEXREPLACE في إرجاع مدخل نصي سليم. والثاني، عند وقوع خطأ تركيبي داخل التعبير النمطي نفسه (Syntax Error in Regular Expression) كأن ينسى المحلل إغلاق قوس فئوي، أو يترك شرطة مائلة عكسية غير مكتملة، مما يربك محرك RE2 ويعجزه عن تفسير النمط. يتم تصحيح هذا الخطأ بالتحقق الدقيق من سلامة بناء النمط التعبيري وإلغاء تثبيت الرموز المحجوزة، وتطويق المعادلة بفحوصات منطقية تتأكد من احتواء الخلية على قيمة قبل الشروع في التقييم.
9.2 آليات الفحص والتحقق من صحة المخرجات المقسمة
لضمان الحفاظ على سلامة ونزاهة قواعد البيانات، لا ينبغي للمحلل الاكتفاء بمجرد ظهور البيانات في الأعمدة المقسمة، بل يجب عليه تأسيس آليات فحص وتدقيق آلية (Auditing and Quality Control) للتحقق من تطابق المخرجات مع التوقعات المعيارية واكتشاف أي انزياح أو تشوه في السجلات مبكراً.
تتمثل إحدى أقوى استراتيجيات التدقيق في إنشاء “أعمدة تحقق” (Verification Columns) مخصصة لمراقبة الجودة. يمكن على سبيل المثال استخدام دالة التعداد الإحصائي COUNTA أو دالة قياس أبعاد المصفوفة COLUMNS لمعرفة عدد العناصر التي نتجت عن تقسيم كل خلية ومقارنتها بالحدود المنطقية المتوقعة. فإذا كان من المعروف أن السجلات يجب أن تتكون دوماً من أربعة حقول (مثل: الاسم، التخصص، المدينة، البريد الإلكتروني)، فإن ظهور صف يحتوي على ثلاثة حقول فقط أو خمسة حقول يشير فوراً إلى وجود خلل بنيوي في الفواصل داخل السجل المصدر يتطلب تدخلاً ومعالجة خاصة.
يضاف إلى ذلك أهمية توظيف دالة الحماية والاحتواء IFERROR لتوفير واجهات مستقرة ومنيعة ضد الانهيار البصري؛ حيث يمكن صياغة المعادلة بحيث تُرجع نصاً توضيحياً أو تترك الخلية فارغة عند مواجهة أي سجل شاذ بدلاً من إظهار رسائل الخطأ الحسابية المشوهة:
=IFERROR(SPLIT(REGEXREPLACE(A2, “[,;/_]”, “|”), “|”), “سجل غير متوافق”)
وأخيراً، يجب إيلاء عناية فائقة لقضايا التشفير واتجاه النصوص (Bi-directional Text Direction) عند التعامل مع اللغة العربية. فدخول بعض المحددات اللاتينية مثل الشرطات المائلة (/) أو الشرطات الأفقية (-) بين الكلمات العربية قد يربك محرك العرض البصري (BiDi Engine) داخل المتصفح، مما يوحي للمستخدم خطأً بأن ترتيب الكلمات قد تغير، في حين أن الترتيب التخزيني الداخلي سليم. ويساعد توحيد الفواصل إلى الرمز “|” على تجنب هذا اللبس البصري بفضل حياديته الاتجاهية داخل نصوص اليونيكود.
10. أفضل الممارسات المنهجية لإدارة وتنظيف قواعد البيانات النصية
10.1 حوكمة جمع البيانات وتقليل التباين عند نقطة الإدخال
على الرغم من القوة والبراعة الرياضية التي تتيحها المعادلات الهجينة لمعالجة النصوص وتطبيعها، إلا أن المبدأ الهندسي الأسمى في إدارة البيانات يؤكد دائماً على أن الوقاية خير من التنظيف اللاحق. إن الاعتماد المستمر والمفرط على خوارزميات التنظيف المعقدة يمثل هدراً لموارد المؤسسة الحسابية والبشرية، ويزيد من احتمالية تسلل البيانات الفاسدة إلى مسارات اتخاذ القرار.
تتجلى الحوكمة الرشيدة للبيانات في فرض قيود ومعايير صارمة عند نقطة الإدخال الأولى (Point of Data Entry) لتقليل التباين البشري إلى أدنى مستوياته الممكنة. في بيئة جداول بيانات جوجل، يمكن تحقيق ذلك بكفاءة عالية عبر تفعيل أدوات “التحقق من صحة البيانات” (Data Validation). فعوضاً عن ترك الخلايا مفتوحة للمستخدمين لكتابة نصوص حرة تحتوي على فواصل عشوائية، ينبغي توجيه المستخدمين للاختيار من قوائم منسدلة محددة مسبقاً (Dropdown Menus)، أو إلزامهم بإدخال البيانات عبر نماذج جوجل الرقمية (Google Forms) التي تعزل كل حقل بياني في خانة إدخال مستقلة ومفردة منذ البداية.
وفي الحالات التي يتحتم فيها جمع البيانات كنصوص مركبة عبر مستندات مشتركة، يجب على الفرق والمؤسسات صياغة وثيقة واضحة لسياسات إدخال البيانات ومعاييرها القياسية (Standard Operating Procedures – SOPs). توضح هذه الوثيقة بصرامة الفاصل المعتمد رسمياً للتدوين (كالالتزام التام بالفاصلة المنقوطة وحدها دون غيرها)، وتوضح للمدخلين التبعات السلبية لعدم الامتثال، مما يقلل فجوات التباين النصي ويؤسس لثقافة مؤسسية تقدر دقة البيانات ونزاهتها.
10.2 بناء خطوط أنابيب لمعالجة البيانات (Data Pipelines) داخل جداول جوجل
في المشروعات التحليلية المتقدمة التي تتطلب قدراً عالياً من الاستدامة وقابلية التوسع، يجب التخلي عن النهج العشوائي القائم على نثر المعادلات داخل نفس مساحة العمل التي يتم فيها استعراض التقارير. البديل الهندسي الصحيح هو تبني معمارية خطوط أنابيب البيانات متعددة الطبقات (Multi-Layer Data Architecture) داخل مصنف جداول جوجل، والتي تقوم على عزل مراحل المعالجة إلى ثلاث أوراق عمل متمايزة:
- طبقة البيانات الخام (Raw Data Layer): ورقة عمل مخصصة لاستقبال السجلات الأصلية كما هي دون تعديل، وتكون مغلقة ومحمية الصلاحيات لمنع أي عبث بمحتواها، وتعمل كمصدر حقيقة وحيد (Single Source of Truth).
- طبقة المعالجة والتطبيع (Staging / Processing Layer): ورقة عمل يتم فيها تطبيق المعادلات الهجينة المتقدمة (BYROW و SPLIT و REGEXREPLACE) لتطهير النصوص وتجزئتها وتنظيف الحقول الشاذة، لتتحول البيانات فيها إلى جداول معيارية نقية وموثوقة.
- طبقة التحليل والعرض (Analytical / Presentation Layer): ورقة عمل نهائية ترتبط بطبقة المعالجة عبر دوال الاستعلام والربط المتقدمة، وتُخصص لبناء لوحات المعلومات التفاعلية، والرسوم البيانية، والجداول المحورية التي تخدم متخذي القرار.
ولضمان استدامة هذه الأنابيب البرمجية وسهولة صيانتها مستقبلاً، يُنصح بشدة بتحويل الصيغ المركبة المعقدة إلى دوال مسماة (Named Functions) عبر الميزة المتقدمة التي توفرها جداول بيانات جوجل. تتيح هذه الميزة للمحلل encapsulating المعادلة الهجينة الطويلة تحت اسم مخصص وواضح مثل CUSTOM_MULTI_SPLIT(text, regex_delimiters)، مع توثيق وسائطها وشرح وظيفتها. هذا التجريد البرمجي يرفع من مقروئية الصيغ الحسابية عبر المنظمة، ويمنع أخطاء التكرار والنسخ اليدوي، ويتيح لفرق العمل إعادة استخدام الخوارزمية المركزية بمرونة فائقة وكفاءة مهنية ترقى لأعلى المعايير الهندسية المعاصرة.
خاتمة
لقد استعرض هذا المقال الشامل البنية المنهجية المتقدمة لاستخدام الدالة SPLIT مع محددات متعددة داخل جداول بيانات جوجل، مبيناً أن التحديات الناشئة عن فوضى المدخلات النصية لا تمثل عائقاً مستعصياً أمام المحلل المحترف الذي يمتلك فهماً عميقاً للخصائص الحسابية للنظام. إن الانتقال من التطبيق المباشر الساذج للدوال المنفردة إلى صياغة الحلول الهجينة التي تدمج التعبيرات النمطية عبر REGEXREPLACE مع دوال التقسيم والتنظيف (TRIM و CLEAN) يؤسس لقفزة نوعية في كفاءة ودقة خطوط أنابيب معالجة البيانات.
كما أظهر التحليل التفصيلي أن التطورات الأخيرة في محرك جداول جوجل—ولاسيما إدخال دوال لامبدا المساعدة مثل BYROW و MAP—قد أزالت العوائق التاريخية التي كانت تحول دون تنفيذ التجزئة المتدفقة على النطاقات المصفوفية المفتوحة، مما جعل من الممكن أتمتة هذه العمليات بالكامل ضمن بيئة عمل سحابية مستقرة وسريعة ودون الحاجة للاعتماد على نصوص برمجية خارجية. وباتباع أفضل ممارسات الحوكمة الرقمية، وضبط معايير الإدخال، وعزل طبقات المعالجة، يضمن مهندسو ومحللو البيانات تحويل التدفقات النصية الخام إلى أصول بيانية استراتيجية تتمتع بأعلى درجات الموثوقية وتدعم بكفاءة متطلبات اتخاذ القرار في مختلف القطاعات المعرفية والعملية.
المراجع
- Google. (n.d.). SPLIT function. Google Docs Editors Help. https://support.google.com/docs/answer/3094136
- Google. (n.d.). REGEXREPLACE function. Google Docs Editors Help. https://support.google.com/docs/answer/3098245
- Google. (n.d.). BYROW function. Google Docs Editors Help. https://support.google.com/docs/answer/12570930
- Google. (n.d.). LAMBDA function. Google Docs Editors Help. https://support.google.com/docs/answer/12508718
- Google. (n.d.). Create and use named functions. Google Docs Editors Help. https://support.google.com/docs/answer/12504534
- Google. (n.d.). RE2: A fast, safe, thread-friendly regular expression engine. GitHub Repository. https://github.com/google/re2