
تمثل معالجة البيانات النصية وتطهيرها حجر الزاوية في بناء الأنظمة المعلوماتية الحديثة، حيث تشير التقديرات الإحصائية في علوم البيانات إلى أن المتخصصين يقضون ما يربو على ثمانين بالمئة من وقتهم في مراحل تنقية السجلات وهيكلتها قبل الشروع في أي تحليل استدلالي أو استكشافي متقدم. وفي بيئات الأعمال المعاصرة التي تعتمد على جداول بيانات جوجل (Google Sheets)، تبرز الحاجة الملحة إلى أدوات خوارزمية مرنة قادرة على تفكيك النصوص المركبة والمصفوفات الحرفية غير المهيكلة بدقة متناهية ودون المساس بسلامة البيانات الأصلية.
تتنوع التحديات التي تواجه محللي البيانات عند التعامل مع مدخلات نصية مركبة داخل خلية مفردة؛ إذ تتداخل الأسماء الشخصية مع الألقاب، وتندمج الرموز الوظيفية مع التوصيفات الإدارية، وتختلط الأرقام التعريفية بالفئات المكانية. في ظل هذا التداخل، يفقد التحليل الحاسوبي قدرته على الفرز والتصنيف والتجميع بكفاءة، مما يستدعي اعتماد استراتيجيات تحويلية تفصل هذه العناصر عبر محددات نصية قياسية. وتُعد المسافة البيضاء الفاصلة الأكثر شيوعاً في اللغات الطبيعية ومنظومات التوثيق، ما يجعل استخراج النص الواقع قبل المسافة الأولى عملية تأسيسية لا غنى عنها في هندسة البيانات اليومية.
يقدم هذا البحث الأكاديمي الموسع تشريحاً تقنياً وبنيوياً متكاملاً لمنهجية استخراج النصوص الواقعة على يسار المسافة الفارغة، مع التركيز على الدمج الخوارزمي بين دالتي الاقتطاع الموضعي LEFT والمسح الفهرسي FIND. وسيتناول المقال الأسس النظرية والميكانيكية الرياضية التي تحكم عمل هذه الدوال، وصولاً إلى استراتيجيات التحصين البرمجي ضد الأخطاء الحسابية، والمعالجة المتجهة واسعة النطاق باستخدام صيغ المصفوفات، والمقارنة النقدية مع التقنيات البديلة لضمان حوكمة البيانات وأعلى معايير الجودة في البيئات التشغيلية المتقدمة.
1. الأسس النظرية لمعالجة النصوص في جداول بيانات جوجل
1.1 أهمية استخلاص النصوص وتنقيتها في إدارة البيانات
تعتمد النماذج الإحصائية والمحاسبية المتقدمة على مبدأ تجانس وتفرد المتغيرات داخل مستودعات البيانات؛ إذ إن الخلية التي تحتوي على قيم متعددة تعامل رياضياً كقيمة غير نمطية تعيق إجراءات التجميع والمقارنة المعيارية. يؤدي تدني جودة البيانات النصية، الناجم عن الجمع العشوائي بين المقاطع الحرفية، إلى تشويه نتائج التوزيع التكراري وتوليد مخرجات مضللة في لوحات المؤشرات التشغيلية. لذا، يمثل استخلاص النصوص إجراءً تصحيحياً جوهرياً يهدف إلى تفكيك السلاسل المركبة إلى مكوناتها الذرية المستقلة، بما يضمن تطابق السجلات مع متطلبات النمذجة الرياضية الصارمة ويسهل الربط الجدولي بين الجداول العلائقية المختلفة.
تنشأ التحديات الهيكلية في قواعد البيانات المؤسسية عندما يتم تجميع مدخلات غير خاضعة لضوابط الإدخال الصارمة، مثل استيراد ملفات نصية مسطحة تفصل بين الحقول بفواصل غير متسقة أو إدراج أسماء العملاء كاملة ضمن حقل نصي أحادي. يؤدي غياب العزل الدقيق للمقاطع النصية إلى شلل كامل في استخدام دوال المطابقة المرجعية، مثل دوال البحث الرأسي أو الأفقي، مما ينعكس سلباً على موثوقية القرارات المستندة إلى تلك السجلات. ومن ثم، فإن عمليات التطهير النصي المنهجية لا تقتصر على تحسين الجوانب البصرية لورقة العمل، بل تمتد لتكون خط الدفاع الأول لحماية النماذج التنبؤية من الانحياز والخطأ الحسابي المنتظم.
علاوة على ذلك، ترتبط سلامة قواعد البيانات ونزاهتها التنظيمية بمدى القدرة على حوكمة البيانات المخزنة وتوحيد هياكلها. فعندما يتم عزل الكلمة التأسيسية الأولى، كالاسم الأول أو الرمز الإداري، تكتسب السجلات مرونة عالية تتيح لمهندسي البيانات تطبيق خوارزميات الاستدلال الآلي والتحقق المعياري عبر مختلف قواعد البيانات المؤسسية. إن عملية تنقية البيانات هذه ليست مجرد خطوة تمهيدية في خط أنابيب المعالجة، بل هي عملية محورية ترفع كفاءة المعالجة الخوارزمية وتضمن استدامة التحليلات الإحصائية وقابليتها للتكرار والمراجعة المنهجية الصارمة.
1.2 المفاهيم البنيوية للسلاسل الحرفية في جداول البيانات
تُعرف السلسلة النصية في علوم الحوسبة وجداول البيانات على أنها تسلسل خطي منتظم من الرموز والمحارف المخزنة وفق ترميز محدد، حيث يحتل كل محرف موضعاً رقمياً ثابتاً وفريداً يسمى الفهرس أو المؤشر الحرفي. تبدأ جداول بيانات جوجل في تعيين هذه المؤشرات اعتماداً على نظام العد الأحادي القائم على الأساس واحد (1-based indexing)، مما يعني أن الحرف الأول في أي خلية يحمل الرقم المفهرس واحد، يليه المحرف الثاني بالرقم اثنين، وهكذا دواليك حتى نهاية السلسلة. وتعد معرفة هذا الترتيب الخطي للمحارف أمراً حاسماً لفهم كيفية تطبيق دوال الاقتطاع والتجزئة المكانية بدقة فائقة.
تحظى الفواصل البيضاء بطبيعة بنيوية خاصة في معمارية السلاسل الحرفية؛ إذ إنها ليست فراغاً رياضياً معدوماً، بل هي رموز فعلية تشغل مساحة تخزينية وموقعاً مؤشرياً محدداً بدقة. يتم تمثيل المسافة القياسية في الحواسيب المعاصرة برمز تشفيري محدد في جدول يونيكود (Unicode) تحت الرمز الثابت U+0020، المقابل للنظام العشري 32. وبناءً على ذلك، يتعامل محرك جداول البيانات مع المسافة الفارغة كأي محرف أبجدي أو رقمي آخر، فتخضع لقوانين الإحصاء الحرفي والحساب الموقعي، مما يجعلها علامة حدودية بالغة الكفاءة في تحديد نهايات الكلمات وبدايات المقاطع النصية اللاحقة.
تتفرع السلاسل الحرفية من حيث طبيعتها الإحصائية إلى سلاسل ذات أطوال ثابتة وسلاسل ذات أطوال ديناميكية متغيرة، وهو ما يفرض تبايناً جذرياً في أساليب المعالجة البرمجية. فبينما يمكن تفكيك السلاسل الثابتة كأرقام الهويات الوطنية عبر التقطيع الميكانيكي بعدد محدد سلفاً من الرموز، تتطلب النصوص الحرة المتغيرة، مثل أسماء الأعلام أو العناوين الوصفية، أدوات خوارزمية ذكية تتكيف تلقائياً مع تباين أطوال الكلمات دون تدخل يدوي مستمر. هذا التمايز يبرز الضرورة الرياضية للتكامل بين دوال الرصد المكاني ودوال الاقتطاع الموجه لضمان مرونة الحلول المحوسبة.
1.3 نظرة تمهيدية على التكامل الرياضي بين دالتي LEFT وFIND
يقوم المفهوم التكاملي لمعالجة النصوص في جداول البيانات على دمج دالة قياس ديناميكية مع دالة قطع موضعي لتشكيل وحدة خوارزمية موحدة ومرنة. فإذا كانت دالة الاقتطاع مسؤولة عن استخلاص عدد معين من المحارف بدءاً من طرف السلسلة، فإنها تظل عاجزة عن العمل بكفاءة في البيئات غير المتجانسة دون تزويدها بمتغير عددي يعكس الطول الدقيق للجزء المراد عزله. هنا يبرز التكامل الرياضي الرصين، حيث تتولى دالة القياس مسح النص واكتشاف الموقع العددي للفواصل الهيكلية، لتقوم بتمرير هذا الناتج تلقائياً كوسيطة دخل رياضية لدالة القطع، محققة بذلك عملية فصل ذاتي بالغة التعقيد والدقة.
يمثل هذا التكامل نقلة نوعية من المعالجة الساكنة التي تفترض ثبات أطوال النصوص إلى المعالجة التفاعلية المستمرة القادرة على التكيف مع التباينات البنيوية لكل سجل على حدة. إن التحول من التقطيع الثابت للأحرف إلى التقطيع الديناميكي يلغي الحاجة إلى التدخل البشري اليدوي لإعادة ضبط معاملات الدوال الحسابية لكل صف، مما يقلص احتمالات الخطأ البشري إلى أدنى مستوياتها الممكنة. هذا النمط من التركيب الوظيفي يجسد مبادئ الهندسة البرمجية المصغرة داخل بيئة الحوسبة السحابية للجداول، موفراً حلولاً مرنة تتجاوز قيود الصيغ التقليدية الجامدة.
تتجلى كفاءة هذه الخوارزمية المركبة عند معالجة البيانات الضخمة التي تحتوي على عشرات الآلاف من السجلات المتغيرة زمنياً. فبدلاً من استهلاك الموارد الحاسوبية في عمليات التكرار اليدوي أو الاعتماد على نصوص برمجية معقدة عبر منصات خارجية، يتيح التكامل المباشر بين دالتي LEFT وFIND تنفيذ العمليات الحسابية داخل الذاكرة العشوائية لمتصفح الويب بسرعة استجابة فائقة. تضمن هذه الآلية تقليص الحمل الحاسوبي وتفادي استهلاك موارد المعالجة الفائضة، مما يحافظ على استقرار ورقة العمل وسرعة تحديث نتائجها بصورة فورية ولحظية تخدم متطلبات التحليل الاستراتيجي السريع.
2. التشريح المعماري لدالة LEFT في جداول بيانات جوجل
2.1 البنية التركيبية ومعايير الدخل لدالة LEFT
تعد دالة LEFT إحدى الدوال النصية التأسيسية في بيئات جداول البيانات، وتستند في تركيبها الرياضي والبرمجي إلى صيغة قياسية محددة بدقة. تأخذ الدالة الشكل الهيكلي التالي: LEFT(string, [number_of_characters])، حيث تعبر وسيطة string عن السلسلة النصية المراد معالجتها أو المرجع الخلوي الذي يحتوي على القيمة المستهدفة، بينما تمثل وسيطة number_of_characters الاختيارية عدداً صحيحاً يحدد كمية المحارف المراد استخلاصها انطلاقاً من أقصى الطرف الأيسر للنص الأصلي المدخل.
تشترط الدالة في وسيطتها الأولى أن تكون نصاً صريحاً موضوعاً بين علامتي تنصيص مزدوجتين، أو مرجعاً لخلية تحتوي على قيمة نصية أو رقمية يمكن تحويلها برمجياً إلى صيغة حرفية. أما الوسيطة الثانية، فتخضع لقيود جبرية صارمة؛ إذ يجب أن تكون قيمة عددية حقيقية موجبة، أو يتم تحويلها تلقائياً إلى عدد صحيح عبر اقتطاع الكسور العشرية إن وجدت. وفي حال تمرير قيمة سالبة كعدد للأحرف، يرفض محرك الجداول تنفيذ العملية ويطلق خطأ حسابياً منهجياً يمنع استكمال الدالة لوظيفتها، مما يعكس صرامة المعايير المنطقية الحاكمة لبنيتها التركيبية.
يتميز محرك جداول بيانات جوجل بالمرونة في استقبال نواتج الدوال الحسابية الأخرى كوسيطة دخل ثانية لدالة LEFT، شريطة أن تعيد تلك الدوال قيماً رقمية صالحة تقع ضمن النطاق المقبول. يتيح هذا التصميم البنيوي بناء صيغ متداخلة معقدة، حيث تذوب الحدود بين النصوص والأرقام لخدمة منطق الاقتطاع الرياضي. ويشكل الاستيعاب الدقيق لقواعد بناء هذه الوسائط الأساس المنهجي الموجه لأي محلل يسعى إلى تجنب الانهيارات البرمجية في نماذج البيانات الكبيرة، وضمان التدفق السليم للبيانات بين الطبقات الحسابية المتتالية.
2.2 آلية العد والمسح الحرفي من الجهة اليسرى
تعتمد دالة LEFT مساراً مسحياً خطياً ينطلق حصرياً من أقصى الجانب الأيسر للسلسلة النصية، وتحديداً من المحرف الأول ذي الفهرس رقم واحد، ثم يتقدم المسح تدريجياً وبانتظام باتجاه اليمين وفق المقدار العددي المحدد في الوسيطة الثانية. يعمل هذا المسار البرمجي على تكوين سلسلة فرعية جديدة عبر جمع المحارف المتتالية تباعاً حتى استيفاء العدد المطلوب تماماً، ليتم بعد ذلك إنهاء المعالجة وإرجاع القيمة الجزئية المعزولة إلى الخلية المستهدفة، تاركاً بقية السلسلة الأصلية دون تغيير أو تعديل هيكلي.
في الحالات التي يقوم فيها المحلل بإغفال وسيطة عدد الأحرف وإهمال تدوينها داخل الصيغة، تتبع الدالة سلوكاً افتراضياً مبرمجاً مسبقاً يقضي باعتبار القيمة المطلوبة مساوية للرقم واحد (1). وبناءً عليه، فإن كتابة الدالة بصيغة =LEFT(A2) تكتفي بإرجاع الحرف الأول فقط من السلسلة الواقعة في الخلية المحددة. أما إذا كان عدد الأحرف المطلوب استخلاصه مساوياً لطول السلسلة النصية الكاملة أو متجاوزاً إياه، فإن الدالة تتصرف بمرونة عالية، حيث تتوقف عند نهاية النص القائم وتعيد السلسلة بأكملها دون أن تسجل أي أخطاء حسابية في بيئة التنفيذ.
يتعامل منطق المسح الداخلي لدالة LEFT مع كافة الرموز والمحارف بحيادية بنيوية تامة؛ فلا يميز المحرك بين الأحرف الهجائية والأرقام والرموز الرياضية والفواصل البيضاء. فإذا صادف المسار المسحي مسافة فارغة أو علامة ترقيم ضمن النطاق العددي المحدد، فإنه يقوم بإدراجها فوراً ضمن مصفوفة الأحرف المستخرجة باحتسابها وحدة رمزية كاملة. يفرض هذا السلوك المحايد دقة بالغة في تحديد معاملات القطع، حيث إن أي إزاحة عددية طفيفة قد تؤدي إلى إدراج فراغات غير مرئية أو اقتطاع حروف أصيلة من صلب الكلمة المستهدفة.
2.3 القيود المنهجية للدالة عند الاستخدام الفردي
تتجلى القيود الجوهرية لدالة LEFT بوضوح تام عند محاولة استخدامها كأداة وحيدة ومنفردة لتجزئة السجلات غير المتجانسة؛ إذ إن تثبيت وسيطة عدد الأحرف يدوياً يولد جموداً حسابياً يمنع الدالة من التكيف مع التباينات الطبيعية في أطوال الكلمات. فعلى سبيل المثال، إذا تم تعيين وسيطة القطع على خمسة أحرف لاستخراج اسم علم قصير، فإن الدالة ستخفق بنيوياً عند تطبيقها على اسم ذي أربعة أحرف باحتوائها على مسافة لاحقة، بينما ستقتطع أجزاء مشوهة من الأسماء التي تتجاوز حروفها هذا الحاجز الثابت، مما يفقد المعالجة قيمتها الإحصائية.
يتعارض هذا التجميد اليدوي لعدد الأحرف مع المبادئ التأسيسية لأتمتة معالجة البيانات، حيث يؤدي إلى استنزاف هائل في الوقت والجهد للتحقق اليدوي من صحة استخراج كل سجل بمفرده عبر آلاف الصفوف. إن غياب المرونة الاستجابية في الدالة المفردة يجعلها غير صالحة للتعامل مع المتغيرات النصية التراكمية، مما يستوجب الاستعانة بنظام رصد خارجي قادر على استشعار النهايات المتغيرة للمقاطع النصية وتزويد الدالة بالإحداثيات الموضعية الصحيحة لحظة بلحظة وبصورة تفاعلية آلية.
ومن هذا المنطلق، تصبح الحاجة إلى كسر الجمود الحسابي ضرورة ملحة لتحقيق الكفاءة التشغيلية المرجوة داخل ورقة العمل. لا يمكن تحويل دالة LEFT إلى أداة استخراج ذكية إلا عبر إقرانها بدوال فحص قادرة على تحليل تضاريس النص الداخلي، واستكشاف مواقع الفواصل والحدود البنيوية بصورة مستقلة عن التدخل البشري. إن فهم هذه المحدودية المنهجية هو ما يقود المتخصصين نحو بناء تركيبات دالية متعددة المستويات تدمج وظائف الاستكشاف الهندسي بميكانيكا الاقتطاع المباشر.
3. التحليل الوظيفي لدالة البحث FIND وتحديد مواقع الرموز
3.1 ميكانيكية عمل دالة FIND في فحص المحتوى
تعمل دالة FIND في جداول بيانات جوجل كأداة مسح طوبولوجي تفحص الترتيب الداخلي للمحارف، وتستهدف تحديد الموقع الهندسي الدقيق لبداية ظهور سلسلة نصية فرعية داخل نص مستهدف أكبر. تأخذ الدالة صيغتها الرسمية كالتالي: FIND(search_for, text_to_search, [starting_at])، حيث تعيد قيمة رقمية صحيحة تمثل الفهرس الموقعي الأول الذي يبدأ عنده الرمز المطلوب. ويعتمد هذا التحديد الفهرسي على النظام الموقعي القياسي للجدول الذي ينطلق من الرقم واحد لأول محرف في الخلية المستهدفة بالبحث.
تتميز دالة FIND بصرامتها الحسابية الفائقة وحساسيتها التامة لحالة الأحرف ونوع الرموز، مما يعني أنها تفرق تفريقاً قاطعاً بين الحروف اللاتينية الكبيرة والصغيرة، ولا تتسامح مع أي تباين في التشكيل أو المحارف الخاصة. يوفر هذا التدقيق العالي ميزة منهجية كبرى عند الرغبة في تعقب رموز بعينها دون أدنى تشويش ناتج عن تشابهات شكلية عارضة. وتتيح الوسيطة الثالثة الاختيارية للمحلل تحديد موضع انطلاق المسح لتجاوز مقاطع محددة، لكن إغفالها يوجه محرك البحث الداخلي لبدء الفحص الافتراضي من أول رمز يقع في أقصى يسار السلسلة.
إذا نجحت دالة FIND في العثور على الرمز المستهدف، فإنها تنهي مسار البحث فورياً وتعيد الإحداثي العددي الدقيق لأول مطابقة تصادفها، متجاهلة أي تكرارات لاحقة للرمز ذاته داخل السلسلة. في المقابل، إذا أخفقت الدالة في مطابقة الرمز المطلوب لعدم وجوده أصلاً في النص المفحوص، فإنها تسجل اعتراضاً برمجياً وتطلق الخطأ الشهير #VALUE!، مما يعكس فشل العملية الحسابية في تحديد موقع صالح. هذا الرد الإخفاقي يستوجب دراسة أثره بعناية وبناء سواتر برمجية تضمن استقرار ورقة البيانات وتمنع توقف العمليات الحسابية المرتبطة بها.
3.2 رصد المسافة البيضاء كرمز فاصل
لتحقيق الغرض الخوارزمي في استخراج النص الأول، يتم استخدام دالة FIND لرصد أول مسافة بيضاء بوصفها الحد الفاصل المنهجي بين الكلمة التأسيسية وبقية مكونات السلسلة المركبة. يتم تمثيل هذا المحدد الفاصل برمجياً داخل وسيطة البحث عبر وضع فراغ قياسي مفرد محصور بين علامتي تنصيص مزدوجتين، هكذا: " ". عند استلام هذه المعاملة، ينطلق محرك الفحص في تمشيط السلسلة الحرفية رمزاً تلو الآخر، حتى يصطدم بأول محرف يطابق الشفرة الثنائية للمسافة القياسية ليعلن فوراً عن إحداثيه الرقمي المكتشف.
يعد العثور على موقع أول مسافة تعترض مسار الفحص النقطة المرجعية الحاسمة التي تفصل بين الجزء المستهدف استخلاصه وسائر مكونات النص. فإذا كانت السلسلة في الخلية هي “محمد عبدالله”، فإن دالة FIND الموجهة للبحث عن المسافة ستفحص الحروف الأربعة الأولى من الاسم الأول لتجد المسافة في الموقع الخامس مباشرة، فتعيد الرقم خمسة (5) كنتيجة للعملية. يمثل هذا الرقم الموضع الهندسي للفاصل الهيكلي، وهو الأساس الذي ستُبنى عليه كافة العمليات اللاحقة لتحديد عمق الاقتطاع المطلوب بدقة مطلقة تضمن عزل الاسم الأول بصورة نقية.
تستلزم هذه الميكانيكية انتباهاً خاصاً من محلل البيانات للتمييز بين المسافة القياسية المنتظمة وغيرها من المحارف الفراغية الخفية غير القابلة للطباعة التي قد تتسرب إلى البيانات عند استيرادها من صفحات الويب أو منصات المؤسسات المتعددة. إن دالة FIND المبرمجة لرصد المسافة القياسية ستتجاوز أي فراغات أخرى ذات ترميز رقمي مختلف، مما يؤدي إلى نتائج خاطئة أو إطلاق أخطاء تشغيلية غير متوقعة. لذا، يظل إدراك طبيعة المحدد الفاصل وموقعه الرياضي في مصفوفة المحارف الركيزة الأساسية لضمان نجاح عملية الفحص الحسابي بكافة مراحلها.
3.3 المقارنة التحليلية بين دالتي FIND وSEARCH
يوفر محرك جداول بيانات جوجل دالتين متماثلتين في الهدف الظاهري ومتباينتين في الخصائص المنهجية لتحديد مواقع النصوص؛ وهما دالتا FIND وSEARCH. يكمن الفارق الجوهري والتأسيسي بينهما في حساسية حالة الأحرف؛ فبينما تتسم دالة FIND بحساسية قطعية وصارمة لحالة الأحرف والأشكال التشكيلية، تتجاهل دالة SEARCH هذه الفروق اللغوية تماماً وتعتبر الحروف الكبيرة والصغيرة متطابقة هيكلياً، فضلاً عن دعمها لمحارف البدل الخاصة كعلامة الاستفهام والنجمة في استعلامات التطابق المعقدة.
عندما يتعلق الأمر بالبحث عن المسافات البيضاء القياسية، تتلاشى الفروق العملية المباشرة بين الدالتين من حيث النتيجة الرقمية المستخرجة؛ إذ إن المسافة الفارغة رمز محايد لا يمتلك حالة كبيرة أو صغيرة ولا يرتبط بخصائص لغوية خاصة بالأحرف الأبجدية. وبالتالي، فإن استخدام الصيغة FIND(" ", A2) يعطي نتائج عددية مطابقة تماماً للصيغة SEARCH(" ", A2) عند تطبيقهما على نفس السلسلة النصية ونفس محدد المسافة القياسي، ما يجعل استبدال إحداهما بالأخرى أمراً ممكناً دون المساس بالجوهر الرياضي لعملية التحديد.
ومع ذلك، تظهر الدراسات البرمجية والأكاديمية لأداء محركات المعالجة أن دالة FIND تتميز بسرعة معالجة أعلى واستهلاك أدنى لموارد الذاكرة المؤقتة مقارنة بدالة SEARCH. يعود هذا التفوق الأدائي إلى تجنب دالة FIND لعمليات المقارنة الموسعة وتخطيها لمرحلة مطابقة محارف البدل التناظرية، مما يجعلها الخيار المثالي والأكثر انضباطاً في المشروعات التحليلية الكبرى التي تتعامل مع مئات الآلاف من الصفوف المترابطة. هذا الانضباط الأدائي والمنهجي يمنح FIND الأفضلية المطلقة في التصاميم الهندسية الرصينة لجداول البيانات المؤسسية.
4. الدمج الخوارزمي: بناء صيغة الاستخراج الديناميكية
4.1 تفكيك العلاقة الرياضية بين الدالتين
يتحقق البناء الخوارزمي المتكامل لاستخراج النصوص عبر تضمين ناتج دالة FIND في موضع وسيطة عدد الأحرف داخل دالة LEFT، مما يولد صيغة مركبة موحدة ذات تدفق بيانات متعدد المستويات. يخضع هذا التركيب الهيكلي لقواعد الأسبقية الحسابية المنظمة لعمل محرك الجداول، حيث يبدأ المحرك أولاً بتقييم الدالة الداخلية الأكثر عمقاً (وهي دالة FIND) لاستخراج الإحداثي الموقعي للمسافة كقيمة عددية مجردة، ثم يقوم فوراً بتمرير هذه القيمة المصقولة إلى الدالة المحيطة الخارجية (وهي دالة LEFT) لتحديد حدود الاقتطاع المنفذ.
يمثل تدفق البيانات هذا تحويلاً وظيفياً للبيانات النصية؛ إذ يبدأ كمسار فحص نوعي يستهدف رصد الفاصل الأبيض، وينتهي كأمر اقتطاع كمي يستخلص شريحة حرفية محددة. لا تحتاج دالة LEFT في هذا السياق إلى معرفة أي تفاصيل لغوية أو بنيوية عن النص المفحوص؛ فكل ما تطلبه هو رقم صحيح يوجه مسار شفرتها البرمجية لقطع عدد متطابق من الأحرف انطلاقاً من جهة اليسار. إن هذا التجريد الرياضي الرائع هو ما يمنح الصيغة المركبة قوتها الخارقة وقدرتها على استيعاب تباين النصوص وتغير أطوالها تلقائياً ودون أي ارتباك في منطق المعالجة.
تتم هذه المعالجة التكاملية داخل دورة حسابية واحدة، مما يمنع التكرار ويوفر بيئة عمل فائقة السرعة والاستقرار. وبدلاً من تشتيت مساحة ورقة البيانات بإنشاء أعمدة مساعدة مخصصة لاحتساب مواقع الفواصل ثم بناء أعمدة تالية لتنفيذ عمليات الاقتطاع، يسمح هذا الدمج الرياضي المباشر بحصر العملية برمتها في تعبير برمجي مفرد وموجز وأنيق هندسياً، يعزز من كفاءة التصميم العام للجدول ويرفع من مستوى أمان تدفقات البيانات الحسابية وسرعة تحديثها التلقائي.
4.2 الدلالة الرياضية للعملية الحسابية طرح واحد (-1)
تشكل العملية الحسابية القائمة على طرح الرقم واحد (-1) من ناتج دالة البحث عنصراً جوهرياً لا غنى عنه في بناء الصيغة الرياضية الصحيحة؛ وترجع أهميتها إلى الفهم الدقيق لطبيعة المؤشر الرقمي الذي تعيده دالة FIND. فعندما تحدد الدالة موقع المسافة، فإنها تعيد موضع المسافة ذاتها كجزء من الإحصاء التراكمي لمحارف النص. فلو افترضنا نصاً يبدأ بكلمة طولها أربعة محارف (مثل “سالم أحمد”)، فإن دالة البحث ستعيد الرقم خمسة (5) دلالة على موقع المسافة الأولى الواقعة مباشرة بعد الحرف الرابع.
إذا تم تمرير هذا الناتج الرقمي (5) مباشرة إلى دالة LEFT دون تعديل رياضي، فإن دالة الاقتطاع ستستخلص أول خمسة محارف من السلسلة انطلاقاً من اليسار، مما يؤدي إلى استخراج الكلمة الأولى متبوعة بالمسافة البيضاء في نهايتها لتصبح القيمة المستخرجة "سالم " بدلاً من "سالم". ورغم أن هذا الفرق قد يبدو غير مرئي للعين المجردة داخل الخلية المعروضة، إلا أنه يحمل آثاراً تدميرية على سلامة العمليات اللاحقة؛ فالنص المحتوي على مسافة متطرفة يفشل حتماً في اختبارات التطابق التام، ويقود إلى انهيار دوال المطابقة المرجعية، مثل VLOOKUP وXLOOKUP، التي تطلب تطابقاً رقمياً وحرفياً تاماً.
ومن هنا، تكتسب عملية الطرح (-1) دلالتها الهندسية العميقة بوصفها خطوة تصحيحية تهدف إلى إزاحة مؤشر الاقتطاع خطوة واحدة إلى الوراء، مستبعدة بذلك رمز المسافة الأبيض تماماً من المخرجات المعزولة. وبإجراء العملية الحسابية (5 - 1 = 4)، يُطلب من دالة LEFT اقتطاع أربعة محارف فقط، مما يضمن خروج الكلمة الأولى مجردة، نقية، ومطابقة لقيمتها المعجمية والرياضية المطلوبة. إن إهمال هذه الإزاحة الرياضية يمثل أحد أكثر الأخطاء شيوعاً بين الممارسين، وتصحيحها هو المعيار الفاصل بين النمذجة الاحترافية والتطبيقات العشوائية العاجزة.
4.3 صياغة التعبير البرمجي النهائي وتوثيقه
بتركيب الأجزاء الخوارزمية التي تم تشريحها، يتبلور التعبير البرمجي النموذجي والأصيل لاستخراج النص الواقع قبل أول مسافة في جداول بيانات جوجل بالصيغة القياسية التالية:
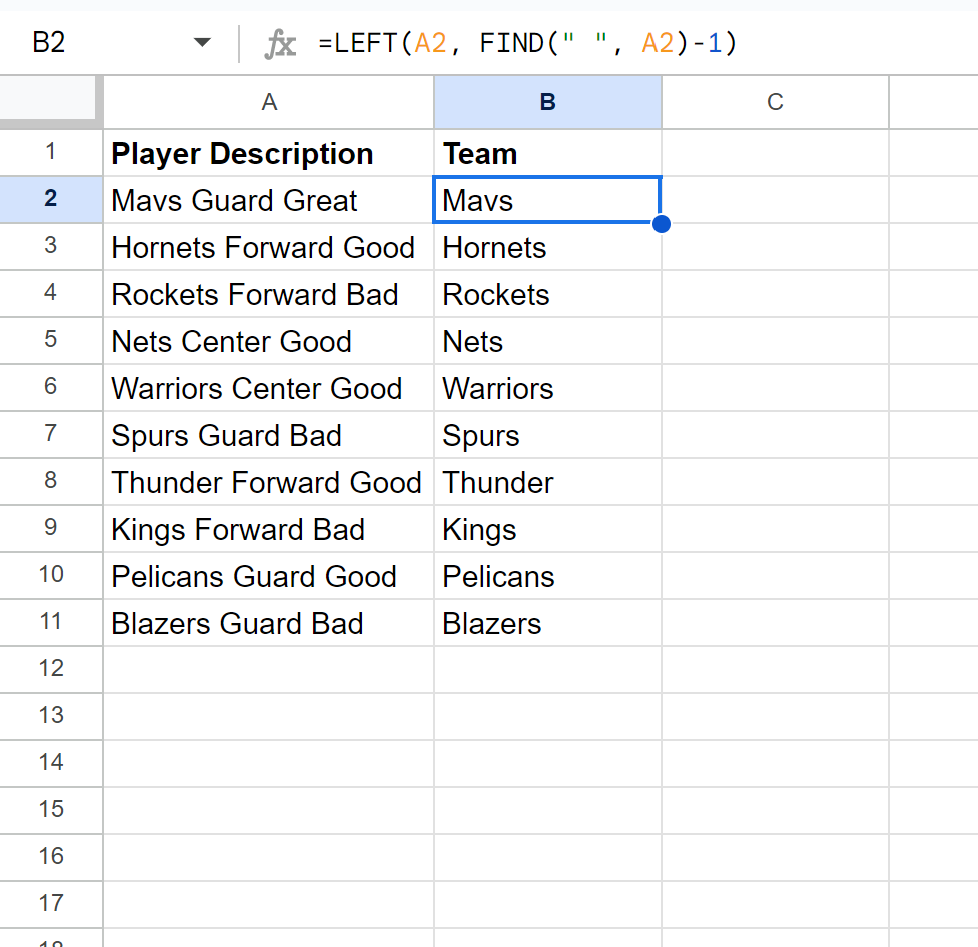
=LEFT(A2, FIND(" ", A2) - 1)
يفترض هذا التعبير أن السلسلة النصية المركبة المستهدفة بالمعالجة تقع داخل الخلية A2؛ حيث تشرع الصيغة في فحص الخلية A2 لتحديد موقع المسافة البيضاء بواسطة FIND(" ", A2)، ثم تطرح واحداً من هذا الموقع لتحديد الحد الأخير للكلمة الأولى، ثم تأمر LEFT باقتطاع المحارف المحددة بدءاً من الحرف الأول في يسار الخلية المعنية.
تقتضي معايير التوثيق الهندسي للمعادلات الحسابية في المؤسسات التحليلية مراجعة القواعد الشكلية والرمزية لكتابة الصيغ؛ ويشمل ذلك التأكد التام من مطابقة الأقواس الرياضية المفتوحة والمغلقة، وضمان استخدام علامات التنصيص المزدوجة القياسية لإحاطة رمز المسافة البيضاء دون استخدام علامات التنصيص المفردة أو الرموز الطباعية الملتوية التي قد يولدها محرر النصوص أثناء النسخ واللصق. إن عدم الالتزام بتلك المعايير الدقيقة يقود إلى أخطاء في تركيب الجملة البرمجية (Syntax Error) تمنع تنفيذ الصيغة من الأساس.
علاوة على ذلك، ينبغي على محللي النظم توثيق الغرض التشغيلي للصيغة داخل توصيفات رؤوس الأعمدة أو من خلال إدراج تعليقات برمجية داخل ورقة العمل توضح المنهجية المتبعة وتبعيات الدوال المستخدمة. يتيح هذا التوثيق الأكاديمي الصارم لفرق التدقيق والمراجعة التحليلية فهم المنطق الرياضي الكامن خلف الصيغة، وتسهيل مهام الصيانة والتطوير المستمر لنماذج البيانات المؤسسية دون الحاجة إلى تفكيك المعادلات المعقدة من الصفر عند كل تحديث إداري أو تقني طارئ.
5. التطبيق الإجرائي العملي: تجزئة السجلات خطوة بخطوة
5.1 تهيئة مصفوفة البيانات الأولية
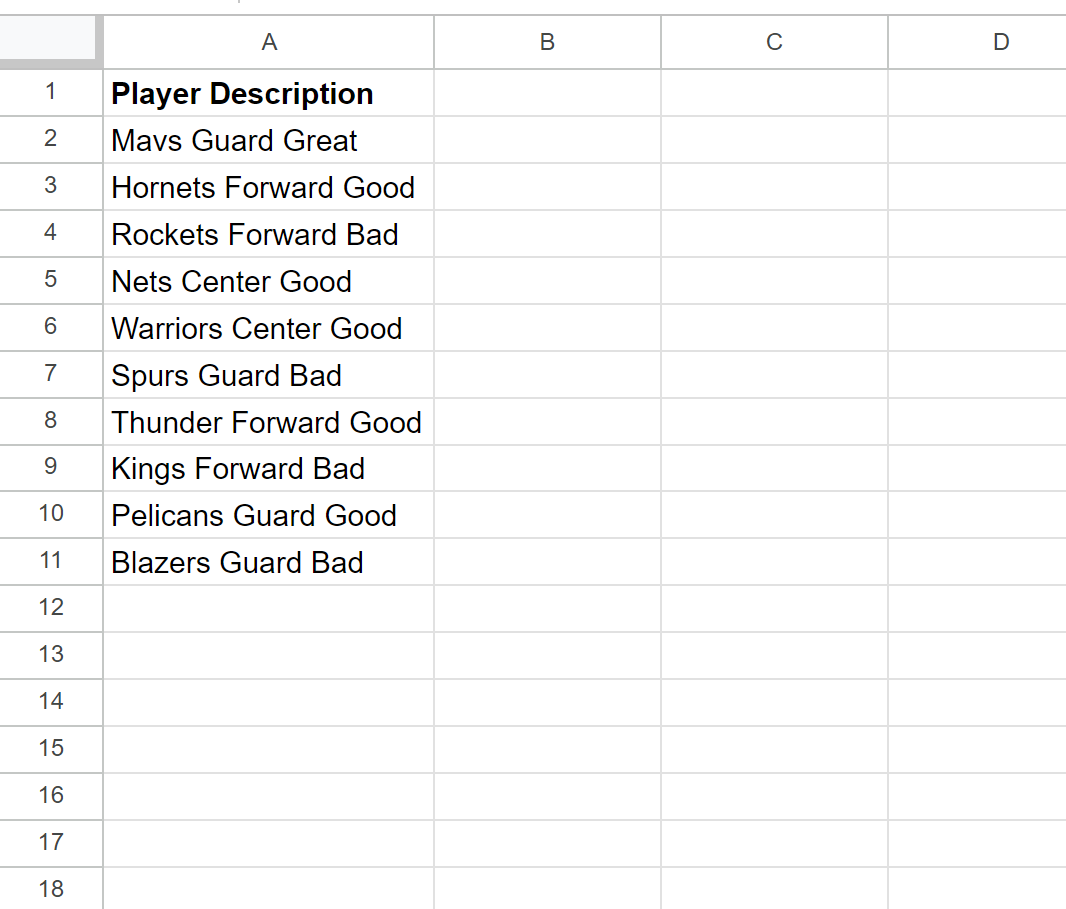
تبدأ الخطوات الإجرائية لتطبيق تقنية استخراج النصوص بمرحلة الإعداد المنهجي للبيئة الجدولية التي ستحتضن العمليات الحسابية. يتعين على المحلل في المقام الأول فحص طبيعة العمود المصدري المشتمل على البيانات غير المهيكلة، والتأكد من تحديد النطاق الخلوي المستهدف بدقة، والتحقق البصري الأولي من نمط الفواصل المستخدمة في إدخال السجلات. تتطلب هذه المرحلة عزل البيانات الأصلية وتجنب الكتابة المباشرة فوقها لضمان إمكانية الرجوع إليها في حال الرغبة بمراجعة التناقضات أو استعادة المدخلات الأولية.
يعقب ذلك إنشاء عمود تشغيلي جديد مخصص لاستقبال النتائج المستخرجة، ويستحسن وضعه بجوار العمود المصدري مباشرة لسهولة التحقق والمقارنة الميدانية. يجب تزويد هذا العمود برأس وصفي واضح وموحد يراعي القواعد القياسية لتسمية الحقول، مثل تسميته “الاسم_الأول” أو “رمز_التصنيف_المستخرج”، مع تجنب استخدام المسافات العشوائية في مسميات الأعمدة التابعة لتسهيل التعامل معها لاحقاً في استعلامات النطاق المتقدمة وأكواد تطبيقات جوجل سكريبت (Google Apps Script) عند الحاجة للأتمتة البرمجية.
تتضمن تهيئة المصفوفة كذلك مراجعة التنسيقات الخلوية العامة للنطاق المستهدف؛ حيث يجب التأكد من ضبط تنسيق الخلايا على الوضع “تلقائي” أو “نص عادي”، وتفادي تطبيق أي تنسيقات مسبقة مخصصة للأرقام أو التواريخ قد تتداخل مع نواتج الدوال النصية وتسبب ارتباكاً في طريقة عرض المخرجات النهائية. هذا الإعداد التأسيسي المحكم يضمن تدفق العمليات الحسابية في بيئة تقنية مستقرة وخالية من العوائق المظهرية أو البرمجية الخفية التي قد تعطل مسار الاستخراج المستهدف.
5.2 إدخال الصيغة وضبط مراجع الخلايا
يتم الانتقال بعد مرحلة التهيئة إلى كتابة الصيغة الحسابية في أول خلية نشطة مخصصة للمخرجات تقع في الصف التابع للبيانات، ولتكن الخلية B2 على سبيل المثال المقابلة للبيانات المصدرية في الخلية A2. يبدأ المستخدم بإدراج إشارة التساوي = متبوعة بالدالة الرئيسية LEFT، وتفتح الأقواس لإدراج المرجع الخلوي النسبي A2، يعقبه الفاصلة القياسية المعتمدة في إعدادات الورقة الجغرافية، ثم استدعاء دالة المسح FIND(" ", A2) مع تطبيق عملية الطرح الحسابي - 1 قبل إغلاق القوس النهائي للدالة الكبرى.
أثناء عملية الكتابة اليدوية، يقدم محرك جداول بيانات جوجل نافذة تلميحات ذكية تعرض الهيكل المعماري للدالة ونموذجاً توضيحياً لوسائطها، بالإضافة إلى معاينة حية وفورية للمخرج النصي المتوقع إنتاجه من الخلية المحددة. تمثل هذه المعاينة المباشرة أداة تحقق تشغيلية بالغة الأهمية تتيح للمحلل التحقق من صحة تركيبه للصيغة الرياضية ومطابقة النتيجة المبدئية لما هو متوقع منطقياً، وذلك قبل الاعتماد النهائي للصيغة بالضغط على زر الإدخال في لوحة المفاتيح.
يجب التركيز التام في هذه الخطوة على نسبية المراجع الخلوية المستخدمة؛ إذ يتعين تمرير المرجع A2 دون تثبيته بعلامات الدولار (أي تجنب كتابته بصيغة $A$2 أو $A2 ما لم تقتض الضرورة المنهجية ذلك). تضمن نسبية المرجع الخلوي استجابة الصيغة لعمليات النسخ والتمرير اللاحقة، حيث يتحول المرجع تلقائياً ليعبر عن الخلية A3 عند الانتقال إلى الصف الثالث، وهكذا على طول المصفوفة، مما يحقق الأتمتة الحسابية المطلوبة ويعفي المحلل من عناء كتابة المعادلات بصورة فردية منفصلة.
5.3 تعميم المعادلة وتعبئة النطاق التشغيلي
بمجرد استقرار المخرج المستخرج في الخلية التجريبية الأولى بنجاح، يتم الشروع في تعميم الصيغة عبر النطاق الرأسي لورقة العمل بالكامل لاستخراج النصوص المقابلة لكافة السجلات المدرجة. توفر بيئة جداول بيانات جوجل عدة آليات تقنية لتنفيذ هذه التعبئة؛ أبرزها النقر المزدوج على “مقبض التعبئة” (Fill Handle) الصغير المتمركز في الزاوية اليسرى أو اليمنى السفلية لمحدد الخلية النشطة، مما يدفع المحرك لمسح النطاق المحاذي في العمود المصدري وتعميم الصيغة تلقائياً حتى آخر صف يحتوي على بيانات متصلة.
كما يمكن الاعتماد على اختصارات لوحة المفاتيح لتسريع وتيرة العمل التشغيلي في المجموعات الضخمة؛ وذلك بتحديد الخلية المحتوية على الصيغة مع النطاق المطلوب تعبئته هبوطاً، ثم تطبيق الأمر الحسابي القياسي Ctrl + D (أو Cmd + D في أنظمة ماك) لتكرار الصيغة رأسياً في جزء من الثانية. تضمن هذه الطرق التقليدية مرونة التنفيذ واستجابة مراجع الصفوف النسخية بصورة متزامنة تعكس نتائج استخراج النصوص بدقة متناهية عبر مختلف مستويات الجدول التشغيلي المؤسسي.
يعقب التعميم إجراء فحص بصري وميداني سريع للتحقق من سلامة المخرجات المعزولة عبر عينات متفرقة في مصفوفة النتائج، مع إيلاء اهتمام استثنائي للصفوف التي تحتوي على كلمات طويلة أو مركبة للتحقق من عدم حدوث اقتطاعات شاذة أو تشوهات نصية غير مقصودة. وتعد هذه الخطوة الختامية في مرحلة التطبيق الإجرائي جسر العبور الأساسي نحو مرحلة فحص الحالات الحدية، حيث تبدأ مواجهة الاستثناءات غير النمطية ومعالجتها وفق أسس الحماية والتحصين البرمجي المتقدم.
6. معالجة الحالات الحدية واستكشاف الأخطاء البرمجية وإصلاحها
6.1 تشخيص أسباب ظهور الخطأ الحسابي #VALUE!
يعد الخطأ الحسابي الشهير #VALUE! أكثر الإخفاقات التشغيلية شيوعاً عند تطبيق صيغة الاستخراج الكلاسيكية =LEFT(A2, FIND(" ", A2)-1)؛ وينشأ هذا الخطأ كنتيجة حتمية لفشل دالة FIND في استيفاء شرط البحث الأساسي عندما تواجه خلية نصية لا تحتوي على أي مسافة بيضاء على الإطلاق. يحدث هذا السيناريو الشائع عند إدراج أسماء أحادية مفردة، أو رموز وظيفية غير مقترنة بتوصيفات، أو أرقام هويات متصلة تخلو بنيوياً من المحدد الفاصل المستهدف برمجياً.
تكمن العلة المنهجية في أن دالة FIND مصممة معمارياً لتعيد خطأ رفض صريح عندما تفشل في مطابقة محدد البحث داخل السلسلة المستهدفة، بدلاً من إرجاع القيمة صفر أو تجاهل الخلية. وعندما يولد المستوى الداخلي للصيغة هذا الخطأ، فإنه يتسرب فوراً وبصورة ارتدادية إلى المستوى الخارجي المتمثل في دالة LEFT، مما يعطل مسار الحوسبة بأكمله ويؤدي إلى انهيار الخلية المستهدفة وعرض رسالة الخطأ الصريحة التي تعلن عجز المحرك عن معالجة المدخلات.
يحمل ظهور أخطاء #VALUE! تبعات سلبية جسيمة على لوحات التحكم والتقارير الإحصائية المعقدة؛ إذ إن وجود خطأ حسابي مفرد ضمن عمود بياني كافٍ لإفشال كافة الدوال التجميعية اللاحقة التي تحاول قراءة هذا العمود، مثل دوال العد النصي أو المقارنة الشرطية. هذا التأثير المتسلسل يفرض على مهندس البيانات ضرورة التدخل لتشخيص مكامن الخلل، والتمييز بين أخطاء المراجع المفقودة الناجمة عن خلايا تالفة وأخطاء الغياب الطبيعي للفاصل النصي، والعمل على بناء سواتر برمجية توفر معالجة مرنة تستوعب هذه الحالات الشاذة.
6.2 التحصين البرمجي عبر دمج دالة IFERROR
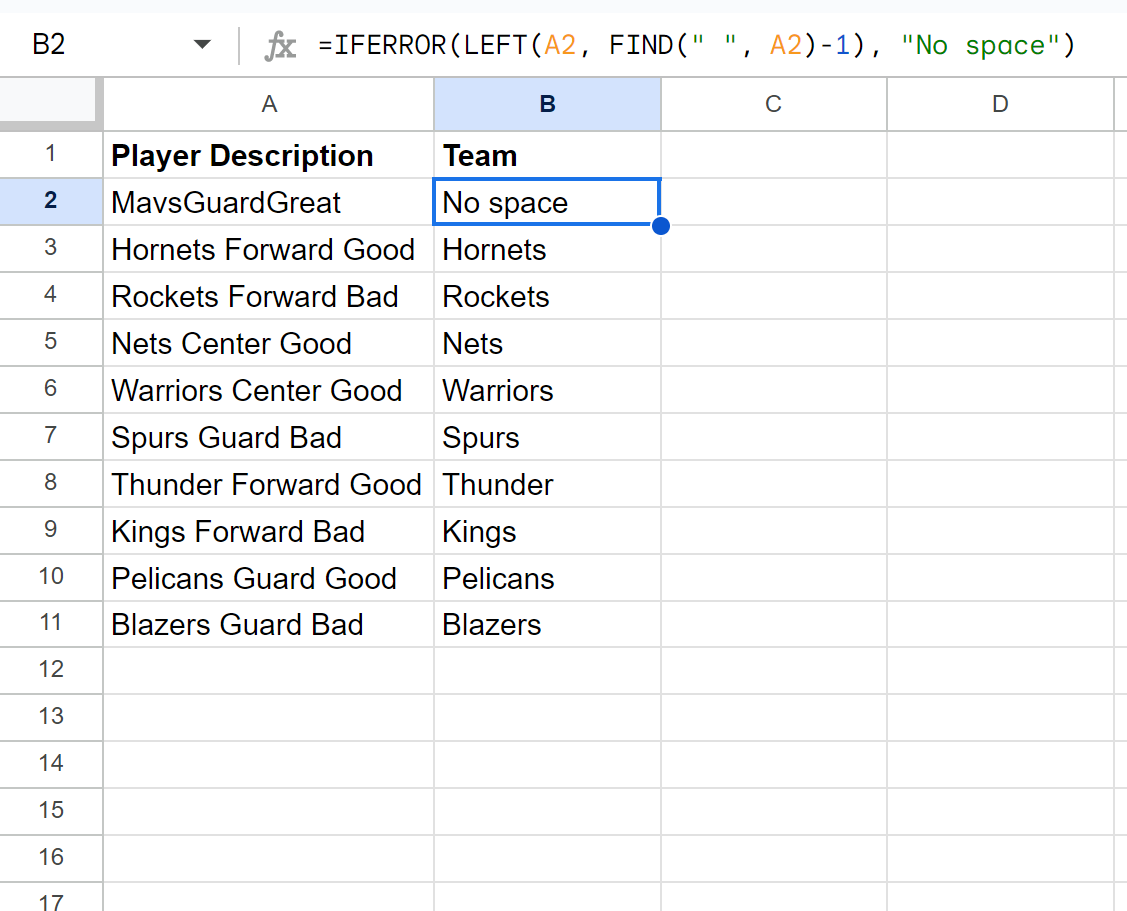
لتفادي الانهيارات التشغيلية الناتجة عن غياب المسافات البيضاء في بعض السجلات، يتم اللجوء إلى تقنية “التحصين البرمجي” عبر تطويق الصيغة التأسيسية بدالة إدارة الاستثناءات الشهيرة IFERROR. تتولى هذه الدالة مراقبة المسار التنفيذي للصيغة المحتواة داخلها، فإذا اكتملت العملية بنجاح تم إرجاع ناتج الاقتطاع الطبيعي، أما إذا أطلقت العمليات الداخلية أي شكل من أشكال الخطأ الحسابي، فإنها تتدخل تلقائياً لتحييد رسالة العطل وتقديم قيمة بديلة ومحددة سلفاً من قبل المحلل.
تتم الصياغة المطورة والآمنة للتعبير البرمجي بإدراج المرجع الخلوي الأصلي كقيمة تعويضية في حال الإخفاق، ليصبح التركيب الهندسي للصيغة كالتالي:
=IFERROR(LEFT(A2, FIND(" ", A2) - 1), A2)
في هذا النموذج المحصن، إذا واجهت دالة FIND كلمة أحادية مجردة من المسافات (مثل “أحمد”)، فإن خطأ #VALUE! المتولد يتم التقاطه فوراً بواسطة دالة IFERROR، والتي تستجيب بتنفيذ الخيار الاحتياطي المتمثل في إرجاع محتوى الخلية A2 كاملاً دون اقتطاع، مما يحافظ على الكلمة الأحادية سليمة ويعبر بدقة عن الغرض التحليلي من معالجة البيانات.
تسمح دالة IFERROR كذلك بتوسيع سيناريوهات الحماية البديلة وفق متطلبات دراسات الحالة المتخصصة؛ حيث يمكن للمحلل توجيه الدالة لإظهار خلية فارغة تماماً عند تعذر العثور على المسافة عبر استخدام علامتي التنصيص الفارغتين ""، أو إدراج تنبيه نصي إداري مخصص مثل "بيان غير مطابق" لتنبيه فرق التدقيق لوجود شذوذ هيكلي في المدخلات. يمنح هذا التحصين المرن ورقة البيانات مناعة تشغيلية فائقة تجعلها قادرة على الصمود أمام تباين أنماط الإدخال وتغيرها دون أي تعثر في العمليات التحليلية الكبرى.
6.3 معالجة الخلايا الفارغة والبيانات المفقودة
تمثل الخلايا الفارغة وغير المكتملة تحدياً منهجياً آخر يواجه خوارزميات الاقتطاع النصي؛ فعندما يمتد نطاق تطبيق الصيغة ليشمل صفوفاً مهجورة أو خلايا لم يتم تسجيل قيم بداخلها بعد، تشرع دوال البحث والاقتطاع في محاولة معالجة تلك الفراغات، مما قد يولد نتائج صفرية غير متوقعة أو رسائل أخطاء حسابية تشوه المظهر العام لورقة العمل وتزيد من حجم الملف التشغيلي على الذاكرة السحابية دون جدوى حقيقية.
ولمعالجة هذه المعضلة الحسابية بكفاءة عالية، يتم تطويق الصيغة بشرط منطقي أولي يعتمد على دالة IF للتحقق من احتواء الخلية المستهدفة على بيانات حقيقية قبل توجيهها لمحركات الاقتطاع. يتجسد هذا الفحص الوقائي في بناء تعبير يختبر ما إذا كانت الخلية المصدرية مساوية للفراغ، فإذا ثبت خلوها، تعيد الصيغة فراغاً فورياً وتوقف مسار المعالجة، أما إذا ثبت احتواؤها على نصوص، فيتم تفعيل الخوارزمية المستهدفة، وذلك على النحو التالي:
=IF(A2="", "", IFERROR(LEFT(A2, FIND(" ", A2)-1), A2))
يسهم هذا الأسلوب الوقائي في تحسين الكفاءة الجمالية والوظيفية لجداول البيانات بشكل جذري؛ إذ يمنع تراكم المخرجات الصفرية العشوائية على امتداد الصفوف الفارغة، ويمنح ورقة العمل مظهراً احترافياً متقناً يسهل قراءته وفحصه من قبل متخذي القرار. كما تضمن هذه الخطوة ترشيد استخدام طاقة المعالجة الداخلية للنظام عبر استبعاد الخلايا الميتة من خطوط المعالجة الدالية، مما يحافظ على مرونة وتجاوب المنظومة الحاسوبية ويمنع بطء التحديث عند التعامل مع مجموعات البيانات المؤسسية الضخمة والمتنامية باستمرار.
7. إدارة المسافات الزائدة وتنقية السلاسل الحرفية
7.1 تأثير المسافات البادئة والمسافات المتعددة
تشكل المسافات البيضاء الزائدة والطفيلية أحد أكثر العوامل تشويهاً لمخرجات المعالجة النصية، وتنتج عادة عن أخطاء الإدخال البشري غير المنضبط أو عمليات استيراد البيانات من مصادر خارجية غير مهيكلة. يتجسد الخطر الأكبر في هذا السياق في “المسافات البادئة” (Leading Whitespaces) التي تستقر في مستهل السلسلة الحرفية قبل الكلمة الأولى؛ فعندما تبدأ السلسلة النصية بفراغ غير مقصود، تقع خوارزمية الاستخراج في مأزق تقني معقد يفسد النتائج برمتها.
تتمثل المشكلة في أن دالة FIND تبدأ مسحها الفهرسي من أقصى اليسار، وتصطدم مباشرة بتلك المسافة البادئة عند الموقع الهندسي الأول (1)، فتقوم بإرجاع هذا الإحداثي كأول تطابق للمحدد المستهدف. وعند إجراء العملية الحسابية للطرح (1 - 1 = 0)، تصبح وسيطة طول الاقتطاع الموجهة لدالة LEFT مساوية للصفر تماماً، مما يدفع الدالة لإرجاع مخرج نصي فارغ لا يحتوي على أي حرف، متجاهلة بذلك الكلمة المستهدفة بالكامل رغم وجودها الفعلي داخل الخلية، وهو ما يشكل خطأ منطقياً صامتاً يصعب رصده بمجرد النظر السطحي.
كما تؤدي المسافات المتعددة والمتتالية المستقرة بين الكلمات إلى اضطرابات حادة في حساب المسافات الإزاحية وتعيين الحدود النصية الدقيقة. فعند وجود مسافتين متتاليتين تفصلان بين الكلمة الأولى والثانية، فإن تطبيق تقنيات استخراج النصوص اللاحقة التي تعتمد على هذه المحددات قد يؤدي إلى التقاط فراغات إضافية غير مرغوبة، مما يشوه جودة البيانات المجمعة. تفرض هذه الظواهر المشوهة ضرورة اعتماد مراحل تطهير مسبقة تنقي النص وتضبط تضاريسه الداخلية قبل الدفع به إلى مسارات الاقتطاع البرمجية المعتمدة.
7.2 التكامل التقني مع دالة التطهير TRIM
تعتبر دالة TRIM الأداة الخوارزمية القياسية المخصصة لإزالة كافة المسافات الزائدة من السلاسل النصية في جداول بيانات جوجل؛ وتعمل هذه الدالة وفق منطق برمجي صارم يقضي بحذف جميع المسافات البادئة التي تسبق أول حرف، وإزالة جميع المسافات اللاحقة المتطرفة التي تستقر بعد آخر حرف، فضلاً عن تقليص أي مسافات بيضاء متعددة تفصل بين الكلمات إلى مسافة قياسية مفردة واحدة تضمن سلامة التركيب المعجمي للسلسلة.
لتحقيق أعلى درجات الدقة والتحصين ضد أخطاء الفراغات البادئة، يتم إدراج دالة TRIM كطبقة تصفية داخلية تطوق المرجع الخلوي المستهدف قبل تمريره لكل من دالتي LEFT وFIND. وتصاغ هذه التركيبة الهندسية المصقولة على النحو التالي:
=IFERROR(LEFT(TRIM(A2), FIND(" ", TRIM(A2)) - 1), TRIM(A2))
تضمن هذه الصيغة المدمجة تطهير السلسلة النصية في الذاكرة المؤقتة اللحظية للمعالجة، مما يضمن انطلاق الفحص من أول حرف حقيقي، ويقضي نهائياً على احتمالية اصطدام دالة FIND بمسافة بادئة زائفة تفرغ الناتج من قيمته.
يوفر هذا التطهير الضمني داخل الصيغة مرونة استثنائية تعفي مهندس البيانات من الحاجة لإنشاء أعمدة تطهير وسيطة لتنظيف النصوص المصدرية، مع الحفاظ الكامل على سلامة البيانات الخام في موقعها الأصلي. إن الاعتماد المنهجي على دمج دالة TRIM في معادلات الاقتطاع النصي يمثل ممارسة قياسية متقدمة تحصن تدفقات المعالجة ضد عيوب الإدخال الشائعة، وترفع من موثوقية السجلات الناتجة وجاهزيتها المباشرة للاستخدام في التحليلات الإحصائية الدقيقة والمستودعات الرقمية الموحدة.
7.3 التعامل مع المسافات غير القابلة للكسر والرموز الخفية
تواجه عمليات معالجة البيانات النصية في بيئات المؤسسات عائقاً بنيوياً خفياً يتمثل في “المسافات غير القابلة للكسر” (Non-Breaking Spaces)، والمعروفة برمجياً بالرمز الكودي أو المحرف التشفيري CHAR(160) في بيئات الحوسبة اللاتينية والويب، والمقابلة للترميز U+00A0 في أنظمة يونيكود. تتسلل هذه المسافات الشاذة بكثافة عند نسخ السجلات من واجهات الويب الرقمية، أو أنظمة إدارة علاقات العملاء (CRM)، أو مستندات PDF المستوردة، وتبدو للمستخدم العادي متطابقة كلياً مع المسافات القياسية المنتظمة.
تكمن المعضلة التقنية في أن محرك جداول بيانات جوجل يتعامل مع محرف المسافة غير القابلة للكسر كرمز مغاير تماماً للمسافة العادية (CHAR(32)). ولذا، فإن دالتي FIND وTRIM تعجزان كلياً عن التعرف على هذا الفراغ أو إزالته بالوسائل التقليدية؛ حيث تتخطى دالة FIND(" ", A2) محرف المسافة CHAR(160) دون رصده، مما يؤدي إلى فشل الاقتطاع وظهور رسائل الأخطاء أو قفز البحث إلى مسافات أخرى لاحقة، مشوهاً البنية المنطقية للكلمة المستهدفة بالاستخلاص.
ولكسر هذا العائق التشفيري، يتم استخدام تقنية الاستبدال التحويلي المسبق عبر دالة SUBSTITUTE لتبديل كافة المسافات غير القابلة للكسر بمسافات قياسية قابلة للرصد والفحص. ويتحقق هذا الإجراء الرياضي المتقدم بصياغة تعبير برمجي يقوم بتحويل محرف CHAR(160) إلى مسافة عادية " " قبل بدء دورة الاقتطاع، على النحو التالي:
=SUBSTITUTE(A2, CHAR(160), " ")
يؤدي هذا الاستبدال إلى توحيد الشفرة البنيوية لكافة الفواصل الفراغية، مما يمهد الطريق أمام دالتي TRIM وFIND للعمل بأعلى مستويات الكفاءة والجاهزية، قاطعة الطريق أمام أي تداعيات خفية قد تنتج عن المحارف الشبكية المشوهة.
8. المعالجة الحسابية واسعة النطاق باستخدام مصفوفات ARRAYFORMULA
8.1 مفهوم المعالجة الاتجاهية للسجلات في جداول جوجل
يمثل الانتقال من الحوسبة الخلوية المنفردة إلى المعالجة الاتجاهية للمصفوفات نقلة نوعية في كفاءة إدارة مستودعات البيانات الضخمة داخل بيئة جداول بيانات جوجل؛ إذ تعتمد المعالجة التقليدية على نسخ الصيغ الحسابية وتكرارها المستقل داخل كل خلية على امتداد آلاف الصفوف، مما يولد عبئاً ثقيلاً على الذاكرة التشغيلية لمتصفح الويب، ويزيد من مخاطر التعديل العارض أو التخريب غير المقصود لبعض الصيغ في الصفوف المتفرقة، مهدداً اتساق العمليات الحسابية الشاملة.
تتيح دالة المصفوفات الشهيرة ARRAYFORMULA تجاوز هذه القيود الجذرية عبر تطبيق منطق حسابي متكامل على نطاق متجهي كامل (Vectorized Range) انطلاقاً من خلية مفردة وحيدة مستقرة في أعلى العمود. وبدلاً من تكرار الأوامر، يتولى محرك الجداول معالجة مصفوفة البيانات في خطوة حسابية داخلية مجمعة، ثم يقوم بنشر النتائج وتوزيعها ديناميكياً على امتداد الخلايا التابعة رأسياً دون الحاجة لتكرار إدراج الصيغة يدوياً في كل صف على حدة.
تكتسب هذه التقنية الاتجاهية أهمية قصوى في بيئات العمل الحيوية التي تستقبل بيانات جديدة ومستمرة عبر منصات الربط البرمجي أو نماذج جوجل المتصلة (Google Forms)؛ حيث تضمن معالجة المصفوفات تطبيق خوارزمية الاستخراج تلقائياً وبصورة لحظية فور هبوط أي سجل جديد في الجدول، دون أي حاجة لتدخل بشري لتمرير الصيغ أو تحديث النطاقات. يعزز هذا النهج من مستوى الأتمتة الإدارية ويوفر بنية حوسبية متينة تتكيف بسلاسة مع التوسع المستمر في حجم البيانات المؤسسية المدخلة.
8.2 صياغة معادلة ARRAYFORMULA واستخراج النصوص تلقائيًا
لبناء صيغة مصفوفية متكاملة تقوم باستخراج الكلمة الأولى من كامل العمود تلقائياً، يتم تحويل المراجع الخلوية الأحادية (مثل A2) إلى مراجع قطاعية ممتدة (مثل A2:A)، مع تطويق المنظومة الدالية بأكملها داخل إطار دالة ARRAYFORMULA. وتتطلب السلامة التشغيلية دمج الفحص الشرطي للمحتوى لضمان عدم امتداد المعالجة الحسابية إلى الخلايا المهجورة في قاع ورقة العمل، مما يحافظ على التوازن الأدائي للنظام ككل.
يتبلور النموذج التطبيقي الشامل للصيغة المصفوفية المتقدمة والمحصنة ضد الأخطاء الحسابية على النحو التالي:
=ARRAYFORMULA(IF(A2:A="", "", IFERROR(LEFT(TRIM(A2:A), FIND(" ", TRIM(A2:A))-1), TRIM(A2:A))))
تستقر هذه الصيغة الرياضية المركزية في الخلية B2 فقط؛ حيث تتولى فحص المتجه المصدري A2:A، وإذا صادفت خلية فارغة تركت الخلية المقابلة لها فارغة فوراً، أما في الخلايا الممتلئة، فإنها تقوم بتطهير المسافات عبر TRIM، واكتشاف موقع الفاصل عبر FIND، وتطبيق الاقتطاع النظيف عبر LEFT، مع تحييد الأخطاء النصية عبر IFERROR في دورة حوسبية اتجاهية مجمعة وفائقة السرعة.
تتميز هذه الصياغة المصفوفية بالحصانة التامة ضد التدخلات اليدوية العشوائية؛ إذ لا يمكن للمستخدمين العاديين تعديل النواتج المستخرجة في الصفوف السفلية عن طريق الخطأ، حيث إن أي محاولة للكتابة المباشرة في مسار تمدد المصفوفة ستؤدي فوراً إلى حجب النتائج وظهور خطأ التمدد التوسعي المعروف برمز #REF!، منبهاً الجميع إلى الطبيعة المصفوفية المركزية للصيغة الأم الحاكمة للنطاق، مما يعزز انضباط وحوكمة البيانات في بيئات العمل التشاركية المتعددة.
8.3 محاذير استخدام المصفوفات وأفضل ممارسات إدارة الموارد
على الرغم من القوة الخارقة للصيغ المصفوفية، إلا أن الاستخدام غير المنضبط لمعادلات ARRAYFORMULA قد يقود إلى استنزاف هائل للموارد الحاسوبية وبطء حاد في استجابة ورقة البيانات؛ وينبع هذا التراجع الأدائي عادة من استخدام المراجع المفتوحة حتى نهاية الورقة (مثل A2:A) في ملفات تحتوي على آلاف الصفوف الفارغة، مما يجبر المحرك السحابي على تخصيص دورات معالجة لفحص وتتبع تلك الخلايا الميتة في كل مرة يتم فيها تحديث أي جزء من ورقة العمل.
تقتضي أفضل الممارسات الهندسية لتجنب هذا الاستنزاف الحسابي تحديد النطاقات بدقة كلما أمكن ذلك، أو تقييد أبعاد الورقة بحذف الصفوف الزائدة غير المستغلة في قاع الجدول. فإذا كانت البيانات الفعلية للمشروع لا تتجاوز بضعة آلاف من الصفوف، فإن تقليص حدود ورقة العمل لتتوقف عند هذا الحد يمنع محرك المصفوفات من الدخول في حلقات مسح لا نهائية تستهلك الذاكرة المخصصة لجلسة العمل، وتضمن بقاء سرعة الاستجابة اللحظية ضمن أعلى معدلاتها القياسية المقبولة.
كما ينبغي توخي الحذر الشديد من تداخل الصيغ المصفوفية المتعددة داخل نفس ورقة العمل، وتجنب بناء مصفوفات مركبة تقوم باستدعاء دوال فحص نصي ثقيلة فوق مصفوفات أخرى معقدة بصورة متسلسلة؛ إذ يفضل دائماً تسوية النتائج المستقرة وتحويلها إلى قيم نصية ثابتة عند انتهاء مراحل المعالجة الأولية. إن الموازنة الرصينة بين قوة الأتمتة الاتجاهية ورشاقة استهلاك الموارد السحابية هي الضمان الحقيقي لاستدامة النماذج التحليلية وقدرتها على العمل بكفاءة تحت الضغوط التشغيلية المؤسسية الكبرى.
9. مقارنة منهجية مع الأدوات والدوال النصية البديلة
9.1 المقارنة مع ميزة تقسيم النص إلى أعمدة في الواجهة
توفر واجهة الاستخدام الرسومية في جداول بيانات جوجل أداة مدمجة سريعة تعرف بميزة “تقسيم النص إلى أعمدة” (Split text to columns)، والتي تتيح للمستخدمين تفكيك النصوص المركبة يدوياً عبر اختيار المسافة البيضاء كرمز فاصل مخصص. ورغم أن هذه الأداة توفر حلاً فورياً وسهلاً لا يتطلب كتابة أي صيغ أو معادلات برمجية، إلا أنها تخضع لقيود هيكلية تجعلها قاصرة عن تلبية متطلبات الأنظمة المعلوماتية الديناميكية المتقدمة.
يكمن العيب الجوهري في أداة الواجهة الرسومية في كونها عملية تدميرية ساكنة (Static Destructive Process)؛ حيث تقوم بتعديل البيانات الأصلية مباشرة أو الكتابة القسرية فوق الأعمدة المجاورة دون الاحتفاظ بأصل السلسلة ما لم يتم نسخها مسبقاً، كما أنها تتطلب تدخلاً بشرياً يدوياً متكرراً في كل مرة يتم فيها استيراد بيانات جديدة أو تحديث السجلات الحالية. هذا القصور يجعلها غير ملائمة على الإطلاق لخطوط أنابيب البيانات المؤتمتة التي تتطلب تحديثات مستمرة ولحظية للنتائج دون انتظار المشغل البشري.
في المقابل، توفر الصيغ الحسابية التكاملية، مثل تركيبة LEFT وFIND، معالجة غير تدميرية تحافظ على كينونة البيانات الأصلية في موضعها دون مساس، وتضمن تدفق التحديثات بطريقة برمجية مرنة ومستمرة. تتفوق المعادلات الرياضية بقدرتها على العمل ضمن هياكل النمذجة الآلية؛ حيث ترتبط النتائج بعلاقات تبعية منطقية تتغير ذاتياً بمجرد تعديل السجلات المصدرية، مما يمنحها الأفضلية المطلقة في المشروعات التحليلية والأنظمة المؤسسية التي تشترط الدقة والاستدامة وقابلية التدقيق والمراجعة المستمرة.
9.2 مقارنة الأداء مع دالتي SPLIT وINDEX
تبرز تركيبة دالتي SPLIT وINDEX كأحد أبرز الحلول البديلة في جداول بيانات جوجل لاستخراج النص الأول الواقع قبل المسافة، وتعتمد في بنيتها على تقسيم النص بأكمله إلى مصفوفة أفقية من الكلمات ثم استخلاص العنصر الأول منها. وتصاغ هذه المعادلة البديلة كالتالي:
=INDEX(SPLIT(A2, " "), 1)
حيث تتولى دالة SPLIT تفكيك السلسلة عند كل مسافة فارغة لتولد مجموعة من المقاطع الحرفية المستقلة، بينما تتدخل دالة INDEX لالتقاط المقيم الأول في هذه المجموعة والذي يمثل الكلمة الأولى المطلوبة بدقة.
تتميز تركيبة SPLIT وINDEX بالأناقة البرمجية وسهولة القراءة والفهم؛ إذ إنها تتجنب العمليات الحسابية المرتبطة بقياس المواقع وطرح الإزاحات العددية (-1) التي تشترطها دوال القطع الكلاسيكية. ومع ذلك، فإن هذه البساطة الظاهرية تخفي استهلاكاً حاسوبياً أعلى في كفاءة المعالجة؛ حيث تضطر دالة SPLIT إلى تفكيك السلسلة النصية بأكملها وتقطيع جميع كلماتها اللاحقة واحتجاز مساحات ذاكرية مؤقتة لها، حتى وإن كان المحلل لا يستهدف سوى الكلمة الأولى فقط، مما يمثل هدراً برمجياً غير مبرر للطاقة الحوسبية.
على النقيض من ذلك، تعمل تركيبة LEFT وFIND بمبدأ الاقتطاع الموجه والموضعي، حيث تتوقف دالة FIND بمجرد اكتشاف أول مسافة بيضاء، وتقوم دالة LEFT بسحب الجزء المستهدف فقط دون الاكتراث ببقية السلسلة أو استهلاك الذاكرة في تفكيكها وتخزين أجزائها الفائضة. وبناءً على ذلك، تظهر المقارنات التقنية تفوقاً ملموساً لتركيبة LEFT الكلاسيكية في سرعة التنفيذ وخفة استهلاك موارد المتصفح عند معالجة آلاف الصفوف مقارنة بنظيرتها القائمة على تقطيع المصفوفات الكاملة بواسطة SPLIT.
9.3 المقارنة مع التعابير النمطية REGEXEXTRACT
تمثل التعابير النمطية (Regular Expressions) عبر دالة REGEXEXTRACT الأداة الأكثر تقدماً ومرونة في معالجة واقتطاع النصوص المعقدة داخل جداول بيانات جوجل. تتيح هذه الدالة للمحللين استخراج المقاطع الحرفية عبر مطابقة الأنماط النصية المجردة بدلاً من الاعتماد على المواقع العددية الثابتة. ولعزل النص الأول الواقع قبل أول مسافة، يمكن استخدام الصيغة النمطية المباشرة التالية:
=REGEXEXTRACT(A2, "^[^ ]+")
أو بصياغة نمطية أخرى تستهدف كافة المحارف غير الفراغية: =REGEXEXTRACT(A2, "^S+").
يعمل هذا التعبير النمطي المعجز بطريقة فائقة الدقة؛ حيث تشير علامة الإقحام ^ إلى بداية السلسلة النصية، وتحدد الأقواس المعقوفة [^ ] استخراج أي محرف بشرط ألا يكون مسافة بيضاء، بينما تدل علامة الجمع + على استمرار المطابقة واستخلاص كافة المحارف المتتالية حتى الاصطدام بأول فراغ. تتميز هذه الطريقة بحصانتها الذاتية؛ فهي لا تتأثر بطول الكلمة، ولا تطلق أخطاء حسابية في حال كانت الخلية مكونة من كلمة واحدة فقط دون مسافات، مما يعفي المحلل من استخدام دوال الحماية المعقدة كـ IFERROR.
ورغم هذه المزايا الهائلة، تواجه التعابير النمطية عقبة رئيسية تتمثل في منحنى التعلم الحاد؛ إذ تتطلب إتقاناً عميقاً لقواعد الصياغة الرمزية الخاصة بالأنماط، مما يجعل صيانتها ومراجعتها أمراً عسيراً على غير المتخصصين في البرمجة. كما أن محرك تحليل التعابير النمطية يستهلك جهداً معالجياً أكبر مقارنة بالعمليات الحسابية البسيطة لدالتي LEFT وFIND. ولذا، تظل تركيبة LEFT الكلاسيكية هي الخيار الأكثر توازناً، واعتمادية، وانتشاراً في بيئات الأعمال العامة بفضل وضوحها المنطقي وكفاءتها التشغيلية العالية وسهولة تدقيقها من قبل مختلف الكوادر التحليلية.
10. تطبيقات متقدمة وضوابط الحوكمة في بيئات العمل التحليلية
10.1 سيناريوهات مهنية وتطبيقية لاستخراج النصوص
تتعدد التطبيقات المهنية الميدانية لتقنية استخراج النصوص قبل المسافة لتشمل طيفاً واسعاً من المتطلبات المؤسسية والتحليلية في مختلف القطاعات الاقتصادية. يبرز التطبيق الأكثر شهرة في إدارة الموارد البشرية ومنظومات التسويق الرقمي، حيث يتطلب تخصيص الرسائل الموجهة للعملاء عزل “الاسم الأول” بدقة تامة عن الأسماء العائلية المركبة؛ إذ إن إرسال بريد إلكتروني تحفيزي يبدأ بالاسم الشخصي المجرد يرفع معدلات التفاعل والتحويل مقارنة بالرسائل التي تدرج الاسم الكامل بصورة جافة تفتقر إلى التخصيص الاحترافي.
وفي قطاعات الإمداد والخدمات اللوجستية وإدارة المخازن، تُستخدم هذه التقنية لتفكيك السجلات المدمجة لرموز المنتجات وتوصيفاتها؛ حيث تتكون رموز الجرد غالباً من مقطع كودي رقمي متبوع بمسافة ثم التوصيف اللفظي للسلعة، مثل السجل "SKU-98214 قطع_غيار_محركات". ويتيح تطبيق صيغة LEFT وFIND عزل كود المنتج الوظيفي في عمود مستقل يسهل استخدامه كمعرف رئيسي (Primary Key) في جداول البحث والمطابقة، وربط حركات المخزون بملفات المبيعات بسرعة ودقة تامة تلغي احتمالات التكرار والازدواجية.
كما تمتد هذه السيناريوهات الحيوية لتشمل معالجة البيانات الجغرافية والزمنية المعقدة المستخرجة من أجهزة التتبع أو سجلات الخوادم الشبكية غير المهيكلة؛ حيث يتم تسجيل التواريخ والأوقات في حقل نصي حر واحد يفصل بينهما فراغ قياسي، مثل "2026-03-30 14:22:10". يتيح الاقتطاع النظيف للنص الواقع قبل المسافة عزل التاريخ المجرد بصيغة نصية قياسية تمهد لتحويله لاحقاً إلى مصفوفات زمنية تخضع لحسابات التباين الإحصائي، مما يعكس الأهمية الاستراتيجية لهذه الأداة في تحويل الفوضى النصية إلى بيانات منظمة تخدم أهداف اتخاذ القرار المؤسسي المتقدم.
10.2 معايير التوثيق وحوكمة النماذج الحسابية في المؤسسات
تقتضي معايير حوكمة البيانات المؤسسية إخضاع كافة عمليات التنقية والاقتطاع النصي لضوابط توثيق صارمة تضمن استمرارية الأعمال وقابلية النماذج للمراجعة والتدقيق الخارجي. يتطلب ذلك في المقام الأول وضع مسميات واضحة وموحدة للأعمدة المحسوبة تعبر بدقة عن طبيعة العملية المطبقة وتاريخ إجرائها، مع تجنب الاختصارات المضللة. كما يوصى بإرفاق ورقة توثيق فرعية (Data Dictionary) داخل مصنف البيانات تشرح المنهجية المتبعة، وتحدد مصادر السجلات الأصلية بدقة تامة لتسهيل تتبع مسار تدفق البيانات (Data Lineage).
يشمل الإطار الحاكم كذلك تسجيل الصيغ والمعادلات المعتمدة ضمن أدلة العمل القياسية للمؤسسة؛ حيث يتم توثيق البدائل المستخدمة لعلاج الحالات الشاذة ومبررات اختيار دوال معينة (مثل تفضيل IFERROR وTRIM لضبط الأخطاء والمسافات الزائدة). يضمن هذا التوثيق التقني عدم ارتباك الفرق التحليلية الجديدة في فهم العلاقات البنيوية للمصنف في حال غياب مطوري النماذج الأصليين، ويوفر مرجعية تشغيلية تدعم الامتثال لمتطلبات الجودة والشفافية المفروضة في القطاعات المالية والصحية التي لا تتسامح مع أي غموض في مسارات المعالجة الحسابية.
علاوة على ذلك، يجب على المؤسسات الاستثمار في تدريب الكوادر البشرية ورفع جاهزيتهم الفنية في التعامل مع تحديات تنظيف النصوص وضبط هياكلها؛ إذ إن بناء الوعي بالآثار السلبية للأخطاء الحسابية الخفية والمسافات غير المرئية يمثل الركيزة الأساسية لضمان سلامة النظم المعلوماتية. إن حوكمة النماذج الحسابية لا تقتصر على فرض السياسات المكتوبة، بل تتكامل مع الممارسة العملية المستمرة التي تضمن تطبيق أفضل المعايير التقنية في صياغة المعادلات وتأمين مخرجاتها ضد أي انحرافات تشغيلية محتملة.
10.3 قائمة التحقق النهائية لضمان موثوقية النتائج المستخرجة
قبل اعتماد المخرجات المستخرجة ودمجها بصورة نهائية في خطوط أنابيب التقارير التنفيذية أو قواعد البيانات الإنتاجية، يتعين على محلل النظم إخضاع النتائج لقائمة تدقيق منهجية صارمة تتألف من عدة مراحل فحص متعاقبة:
- فحص العينات العشوائية المتناظرة: يتم سحب عينات طبقية عشوائية تمثل نصوصاً ذات أطوال متباينة (كلمات قصيرة جداً، كلمات بالغة الطول، سجلات أحادية تخلو من المسافات)، ومقارنة المخرجات المعزولة بالمصادر الأصلية للتحقق البصري والمنطقي من مطابقتها التامة لمعايير الاستخراج.
- التأكد من التطهير التام من المسافات الطفيلية: يتم تطبيق دالة الفحص الحسابي لطول النصوص
LENعلى عينة من النتائج للتأكد من خلو نهايات الكلمات من أي مسافات بيضاء غير مرئية نتجت عن إهمال معامل الإزاحة(-1)، وضمان أن عدد المحارف المعزولة مطابق تماماً للعدد الحقيقي لحروف الكلمة المستهدفة. - رصد وتحليل الاستثناءات وأخطاء التحويل: تصفية عمود النتائج بالكامل للبحث عن أي رسائل خطأ باقية (مثل
#VALUE!أو#REF!)، والتحقق من أن كافة السجلات الاستثنائية تم احتواؤها بنجاح عبر مسارات المعالجة البديلة المبرمجة داخل دالة IFERROR. - تأمين وتجميد النتائج التشغيلية: عند الرغبة في أرشفة المستودعات النهائية للبيانات وقطع ارتباطها الحي بالصيغ لتقليل استهلاك الذاكرة، يتم نسخ عمود النتائج بالكامل وإعادة لصقه في موضعه بصيغة “قيم فقط” (Paste Special > Values only عبر الاختصار
Ctrl + Shift + V). يضمن هذا الإجراء تجميد المخرجات كنصوص استاتيكية دائمة ومحصنة تماماً ضد أي تغيرات مستقبلية في الخلايا المصدرية، ومؤهلة للتصدير الآمن نحو منصات التحليل المؤسسية الكبرى.
خاتمة
استعرض هذا المقال المعمق الأبعاد النظرية والتطبيقية لاستخدام دالة LEFT بالاقتران مع دالة FIND لاستخراج النصوص الواقعة قبل أول مسافة في جداول بيانات جوجل. وقد تبين من خلال التشريح الرياضي أن هذا التكامل الخوارزمي يمثل الحل الأكثر توازناً وكفاءة لتفكيك السجلات المتغيرة وتجاوز قيود المعالجة الساكنة للأطوال الثابتة؛ حيث تتولى دالة FIND دور المرشد الفهرسي الراصد لمواقع الفواصل، بينما تنفذ دالة LEFT الاقتطاع الموجه بدقة فائقة وبمساعدة معامل الإزاحة الرياضي الحاسم (-1) لتطهير المخرجات من أي فراغات طفيلية لاحقة.
كما أثبتت المعالجة التقنية ضرورة تطويق هذه الصيغة الكلاسيكية بسواتر برمجية احترافية، تتقدمها دالة إدارة الاستثناءات IFERROR لحماية ورقة العمل من أخطاء الانهيار الحسابي عند غياب المحددات، ودالة التطهير المسبق TRIM لضبط المسافات البادئة والزائدة، علاوة على استبدال المحارف التشفيرية الخفية مثل مسافات الويب غير القابلة للكسر CHAR(160). إن فهم هذه التفاصيل الدقيقة هو ما يفصل بين الحلول العشوائية الهشة والتطبيقات الهندسية المنيعة القادرة على العمل بثبات في البيئات الإنتاجية والمؤسسية الحساسة.
ختاماً، يؤكد المقال أن الاتجاه الحديث في إدارة البيانات السحابية يميل بقوة نحو المعالجة الاتجاهية واسعة النطاق عبر دالة ARRAYFORMULA التي تضمن التحديث التلقائي اللحظي للسجلات المتنامية دون هدر الموارد التشغيلية. إن تبني هذه التقنيات المتكاملة، والانضباط بمعايير الحوكمة والتوثيق والتحقق النهائي من سلامة السجلات، يظل الركيزة التأسيسية التي تمكن محللي النظم والبيانات من تحويل المدخلات النصية غير المهيكلة إلى أصول رقمية عالية القيمة والاعتمادية، تدعم النماذج الإحصائية وتدفع مسارات اتخاذ القرار المبني على الحقائق نحو أعلى درجات النضج المؤسسي.
المراجع
- Google. (n.d.). LEFT function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3094079
- Google. (n.d.). FIND function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3094126
- Google. (n.d.). SEARCH function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3094154
- Google. (n.d.). IFERROR function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093304
- Google. (n.d.). TRIM function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3094140
- Google. (n.d.). ARRAYFORMULA function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093275
- Google. (n.d.). REGEXEXTRACT function: Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3098244
- Unicode Consortium. (2024). The Unicode Standard, Version 15.1 – Core Specification. Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/