
تعد معالجة البيانات النصية وتطهيرها إحدى الركائز الأساسية التي يقوم عليها التحليل الإحصائي الحديث وإدارة قواعد البيانات المتقدمة. وفي ظل التدفق المستمر للبيانات الرقمية غير المهيكلة وشبه المهيكلة الناتجة عن التفاعلات المؤسسية، واستجابات الاستبيانات الميدانية، وسجلات النظم البرمجية، يواجه المحللون تحدياً متكرراً يتمثل في الحاجة إلى استخلاص أجزاء محددة وذات دلالة من سلاسل نصية مركبة. ولا تتوقف هذه العملية عند مجرد تنظيم شكلي، بل تمثل خطوة تحضيرية حاسمة تضمن دقة النماذج الرياضية وسلامة المؤشرات المستخرجة.
وتبرز جداول بيانات جوجل (Google Sheets) كواحدة من أكثر البيئات السحابية مرونة وقوة للتعامل مع هذا النوع من التحديات التحليلية، نظراً لتكاملها الوظيفي وقدرتها على معالجة البيانات التعاونية الضخمة في الوقت الفعلي. ورغم أن عمليات الاقتطاع النصي قد تبدو بديهية للوهلة الأولى، إلا أن التباين الشديد في أطوال المدخلات ومواقع الرموز الفاصلة يفرض على الباحثين ومحللي البيانات تجاوز الأساليب اليدوية أو الدوال البسيطة ذات الطول الثابت، والاتجاه نحو بناء صيغ رياضية مركبة وديناميكية قادرة على التكيف اللحظي مع بنية كل سلسلة نصية على حدة.
يتناول هذا الدليل الشامل والمفصل تفكيك وتحليل الصيغة المعيارية لاقتطاع النصوص من جهة اليسار حتى الوصول إلى رمز فاصل محدد، بالاعتماد على التوليف المتكامل بين دالتي الاقتطاع والفهرسة. وسنستعرض في هذا السياق الأبعاد المنطقية، والميكانيكا الرياضية، وإدارة الاستثناءات والأخطاء، وتوسيع الصيغ مصفوفياً، مع إجراء مقارنات تقنية معمقة مع البدائل الحديثة، لتزويد المتخصصين بمرجع منهجي متين لمعالجة وتطهير السلاسل النصية بكفاءة عالية واحترافية متقدمة.
1. المدخل المنهجي لمعالجة السلاسل النصية في جداول بيانات جوجل
1.1 أهمية تجزئة النصوص وتطهير البيانات في التحليل الإحصائي
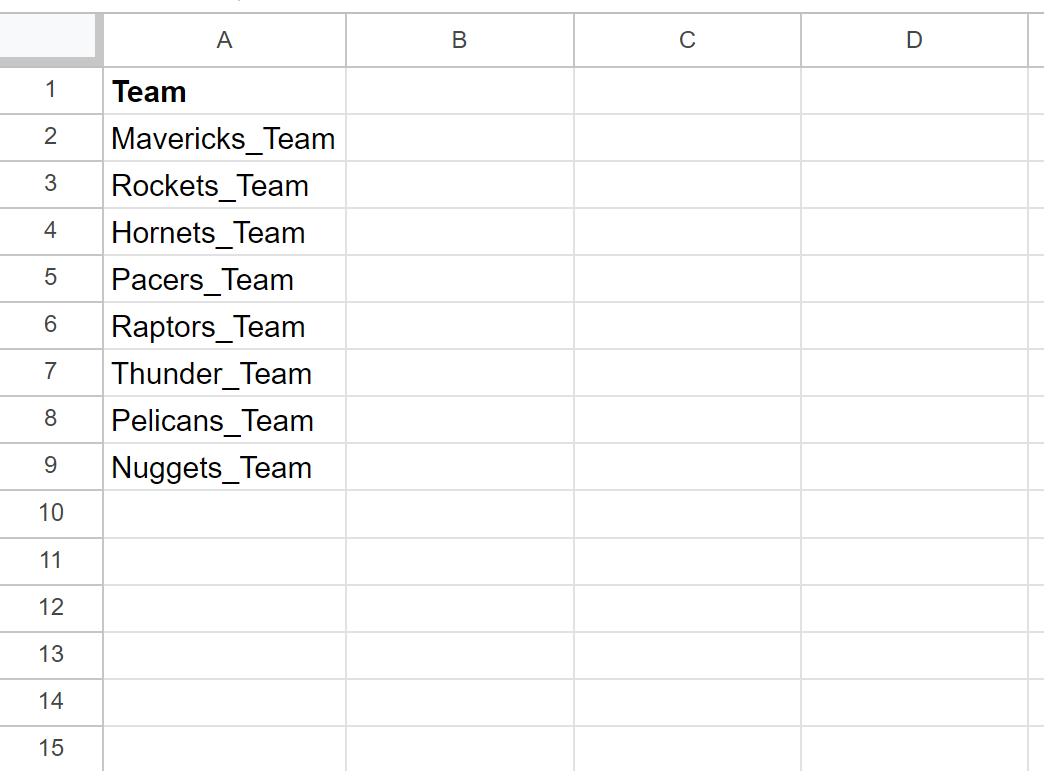
تمثل جودة البيانات النصية المدخل الأول والحاسم لأي نموذج استدلالي أو تحليلي يسعى لإنتاج مخرجات موثوقة. ففي سياق جمع البيانات الرقمية، غالباً ما تتجمع النصوص في صورة كتل مركبة تضم معرفات، وتصنيفات فرعية، وأرقاماً تسلسلية مفصولة برموز اصطلاحية مثل الواصلات أو الشرطات السفلية. وإذا لم تخضع هذه السلاسل لعمليات فرز وتجزئة صارمة، فإن النظم التحليلية تعجز عن إجراء المقارنات المعيارية، مما يقود إلى تشتت المتغيرات وتوليد فئات اسمية غير دقيقة تشوه نتائج التحليل التكراري أو العاملي.
وتفرض الاستجابات الواردة من الاستبانات الرقمية والنظم السلوكية تحديات استثنائية ترتبط بعدم تجانس الهياكل المدخلة. فعلى سبيل المثال، قد يُطلب من المستجيب كتابة رمز المؤسسة متبوعاً بمعرفه الشخصي، فينتج عن ذلك تباين واسع في عدد الأحرف التي تسبق الرمز الفاصل. ويتطلب هذا التباين إخضاع البيانات لمرحلة تسمى “تطهير البيانات” (Data Cleansing)، والتي تهدف إلى تفكيك النصوص وإلغاء الشوائب النصية والزوائد التنسيقية، لضمان اتساق القياس ومطابقة المدخلات للشروط الرياضية المعتمدة في قواعد البيانات العلاقية.
من ناحية أخرى، يؤدي الاعتماد على التجزئة الآلية عبر الصيغ الديناميكية إلى القضاء على التدخل البشري اليدوي، وهو المصدر الأكبر للتحيز والخطأ في تنميط البيانات. فالتحرير اليدوي للسجلات التي تعد بالآلاف لا يستنزف الوقت والجهد المؤسسي فحسب، بل يرفع معدلات الخطأ المطبعي ويسقط محارف حاسمة دون قصد. ومن ثم، فإن بناء معادلات رياضية مؤتمتة لمعالجة السلاسل يعزز من قابلية إعادة إنتاج البحث العلمي ويوفر مسار تدقيق صارم وموثوق لجميع مراحل معالجة المتغيرات.
1.2 المحددات الفنية للتعامل مع السلاسل النصية غير المتجانسة
تعتمد معالجة النصوص البرمجية في جداول البيانات على مفهوم “الفواصل الرمزية” (Delimiters)، وهي محارف خاصة كالمسافات البيضاء، والفواصل المنقوطة، والشرطات، والرموز الحسابية التي توضع كعلامات إرشادية للفصل بين دلالتين مختلفتين داخل الخلية الواحدة. وتعمل هذه الفواصل بمثابة نقاط استدلال حاسمة توجه الدوال لمعرفة الحدود المكانية التي ينتهي عندها المقطع الأول ويبدأ المقطع اللاحق، مما يحول السلسلة غير المهيكلة إلى حقول مفهرسة دقيقة.
وتنشأ المشكلة الفنية الكبرى عندما تكون أطوال النصوص الواقعة قبل هذه الفواصل متغيرة وغير متماثلة بين الصفوف المختلفة. ففي عمود يحتوي على مئات السجلات، قد يتكون الاسم الأول للكيان في الصف الأول من ثلاثة أحرف، بينما يمتد في الصف الثاني إلى اثني عشر حرفاً قبل الوصول إلى الشرطة السفلية الفاصلة. وفي هذه الحالة، تصبح أدوات الاقتطاع الثابتة عديمة الفائدة تماماً؛ إذ إن فرض رقم اقتطاع محدد مسبقاً سيؤدي إما إلى بتر نصوص طويلة أو جلب الرمز الفاصل وما بعده في النصوص القصيرة، مما يفسد البنية الهيكلية لقاعدة البيانات بأكملها.
لذلك، تبرز الحاجة الحسابية الماسة إلى ابتكار معادلات ديناميكية تجمع بين بعدين: الأول هو “الرصد الفهرسي” لتحديد الموقع الجغرافي الدقيق للرمز الفاصل بصورة فردية لكل خلية على حدة، والبعد الثاني هو “الاقتطاع الحسابي” الذي يستقبل ذلك الموقع النسبي ويطوعه ليقتطع الحروف الواقعة حصراً على يساره. هذا التكامل بين البحث والموقع والاقتطاع هو الذي يمنح جداول بيانات جوجل المرونة والقدرة على استيعاب مجموعات البيانات غير المتجانسة وتحويلها إلى بيانات نقية ومنظمة.
2. البنية التركيبية والخصائص الوظيفية لدالة LEFT
2.1 التعريف الرياضي والمعاملات الأساسية لدالة LEFT
تعد دالة LEFT واحدة من أهم دوال معالجة النصوص الكلاسيكية الموروثة في برمجيات الجداول الحسابية، وتختص وظيفياً باستخلاص عدد محدد من المحارف النصية انطلاقاً من أقصى الطرف الأيسر لسلسلة نصية معينة. وتستند الدالة في جوهرها الحسابي إلى فهرسة موضعية ترقيمية تبدأ من الرمز الأول الواقع في الخانة اليسرى الأولى للسلسلة وتتقدم تتابعياً نحو اليمين حتى تستوفي العدد المطلوب استقطاعه بدقة تامة وبصورة خطية.
تتكون البنية العامة لصيغة دالة LEFT من معاملين اثنين، يكتبان وفق النحو الرياضي الآتي:
=LEFT(string, [number_of_characters])
المعامل الأول string هو معامل إلزامي يمثل السلسلة النصية المراد الاقتطاع منها، ويمكن تمريره في صورة نص مباشر محاط بعلامات تنصيص مزدوجة، أو كمرجع خلوي يوجه الدالة إلى موقع القيمة المخزنة في ورقة العمل (مثل الخلية A2). أما المعامل الثاني number_of_characters فهو معامل اختياري يحدد عدد المحارف التي يجب على الدالة سحبها وتضمينها في المخرج النصي النهائي، ويشترط أن يكون هذا المعامل عدداً صحيحاً موجباً أو صفراً.
وفي حال قام المستخدم بإغفال المعامل الثاني ولم يحدده داخل الصيغة الحسابية، فإن دالة LEFT تطبق سلوكها الافتراضي الصارم، والذي يفترض أن القيمة المطلوبة للاقتطاع هي (1). ونتيجة لذلك، فإن كتابة الصيغة بدون المعامل العددي ستؤدي حصرياً إلى إرجاع الحرف الأول فقط من السلسلة النصية، وهو ما يفسر ضرورة ضبط المعامل الثاني وتغذيته بحسابات دقيقة كلما كان الهدف استخلاص كلمات أو مقاطع أطول من مجرد محرف وحيد.
2.2 القيود التشغيلية للاستخدام المنفرد لدالة LEFT
على الرغم من سهولة ومباشرة دالة LEFT، إلا أن استخدامها المنفرد يواجه قيوداً تشغيلية قاهرة عند التعامل مع نصوص واقعية متنوعة. يعود هذا القصور إلى طبيعة الدالة “العمياء” تجاه المعاني والدلالات الرمزية؛ فالدالة لا تمتلك أي ميكانيزم داخلي يمكنها من استشعار وجود رموز تعبيرية، أو فواصل نقطية، أو شرطات أفقية، ولا تستطيع أن “تقرر” التوقف عن الاقتطاع تلقائياً بمجرد اصطدامها برمز معين ما لم يتم تزويدها بالرقم العددي النهائي للمسافة الفاصلة بدقة مطلقة.
وعندما يطبق المحلل الاقتطاع المنفرد ذو الطول الثابت على عمود يحتوي على أسماء مدن متبوعة برموز بريدية مفصولة بشرطة، كأن يعين المعامل الثاني بالقيمة 6 لجميع الصفوف، تظهر الكوارث البيانية فوراً. فالمدن التي تقل أسماؤها عن ستة أحرف ستجلب معها الشرطة الفاصلة وأول محرفين من الرمز البريدي، بينما ستتعرض المدن التي تزيد أسماؤها عن ستة أحرف للبتر التشويهي، مما يخلق متجهات نصية متباينة وغير قابلة للاستخدام في التصنيف الإحصائي أو التحليل اللاحق.
ومن هذا المنطلق، تصبح محاولة تطهير البيانات النصية المتغيرة بالاعتماد على دالة LEFT وحدها نهجاً غير عملي ومحكوماً بالفشل في البيئات المؤسسية. وتتجلى الحتمية المنهجية في ضرورة البحث عن وسيلة مساعدة تحسب موقع النهاية لكل صف بصورة مستقلة ومرنة، وتمرر ناتج هذا الحساب كمدخل رقمي ديناميكي إلى المعامل الثاني لدالة LEFT، وهو ما ينقلنا مباشرة إلى استدعاء دوال الفهرسة والرصد النصي المتقدمة.
3. التحليل الفني لدالة FIND وآلية الرصد الفهرسي للمحارف
3.1 ميكانيكية عمل دالة FIND والتعرف على مواقع الرموز
تمثل دالة FIND المسبار الفهرسي الذي يتيح لجداول بيانات جوجل استكشاف المحتويات النصية بدقة متناهية. تكمن الوظيفة الجوهرية لهذه الدالة في تحديد الموضع الرقمي للظهور الأول لمحرف معين أو سلسلة نصية جزئية داخل نص مستهدف، حيث تعتمد الدالة نظام الترقيم القائم على الأساس واحد (1-based index)، مما يعني أن أول محرف في أقصى الطرف الأيسر للسلسلة يحمل الرقم الفهرسي 1، ويزداد هذا الرقم بمقدار واحد لكل محرف تالٍ وصولاً إلى نهاية السلسلة.
وتُصاغ دالة FIND برمجياً من خلال ثلاثة معاملات محددة تتبع النمط الآتي:
=FIND(search_for, text_to_search, [starting_at])
حيث يمثل المعامل الأول search_for الرمز أو النص المراد تعقبه، في حين يشير text_to_search إلى النص الكامل أو المرجع الخلوي المراد فحصه، بينما يمثل starting_at معاملاً اختيارياً يحدد موضع البداية الذي تنطلق منه عملية البحث، ويفيد بصورة بالغة في تجاوز التكرارات المبكرة للرمز في حال رغب المحلل في تجاهل الظهور الأول والتركيز على ظهور متقدم داخل السلسلة النصية.
ومن الخصائص المحورية التي ينبغي التنبه لها بصرامة أن دالة FIND تتميز بحساسيتها المطلقة لحالة الأحرف (Case-Sensitive) عند التعامل مع النصوص المكتوبة بالأبجدية اللاتينية. فالأحرف الكبيرة تُعامل كمحارف مستقلة تماماً ومختلفة عن الأحرف الصغيرة المقابلة لها؛ فالبحث عن الرمز “a” لن يطابق أبداً الحرف “A”. كما تطبق الدالة مبدأ التطابق الحرفي التام دون أي استثناء للرموز الخاصة وعلامات الترقيم والمسافات البيضاء، مما يجعلها أداة رصد هندسية دقيقة للغاية.
3.2 المقارنة الفنية بين دالتي FIND وSEARCH في جداول البيانات
توفر جداول بيانات جوجل دالة فهرسية أخرى تتقاطع ظاهرياً مع دالة FIND وهي دالة SEARCH، مما يولد ارتباكاً منهجياً متكرراً لدى المشتغلين بتحليل البيانات حول أيهما أفضل للاعتماد في عمليات الاقتطاع النصي. ورغم أن كلتا الدالتين تعيدان الفهرس الرقمي لموضع الرمز المبحوث عنه، إلا أن الفروق التشغيلية العميقة بينهما تؤثر بشكل مباشر على استقرار النماذج وقابليتها للتكيف.
يكمن الفارق الجوهري الأول في أن دالة SEARCH تتجاهل تماماً حالة الأحرف (Case-Insensitive)، مما يعني أنها لا تفرق بين الأحرف الكبيرة والصغيرة في اللغات الأجنبية. أما الفارق الثاني، وهو الأكثر خطورة، فيتمثل في دعم دالة SEARCH للمحارف البديلة أو علامات التطابق الشاملة (Wildcard Characters)، مثل علامة الاستفهام (?) لمطابقة أي محرف منفرد، وعلامة النجمة (*) لمطابقة أي تسلسل من المحارف. هذا الدعم يمنح دالة SEARCH مرونة استثنائية عند البحث عن أنماط نصية مبهمة، ولكنه يمثل نقطة ضعف إذا كان الرمز الفاصل المطلوب هو بذاته علامة استفهام أو نجمة؛ إذ سيتطلب ذلك استخدام محرف الإلغاء التتابعي مسبقاً (Tilde ~) لتجنب تفسيرها كعلامة مطابقة.
بناءً على ذلك، يتم تحديد معيار الاختيار المنهجي وفقاً لطبيعة البيانات النصية المراد معالجتها. فإذا كان الرمز الفاصل المستهدف ثابتاً ومحدداً بدقة لا تحتمل التأويل، مثل الشرطة السفلية (_) أو الفاصلة المائلة (/) أو علامة البريد (@)، فإن دالة FIND تصبح الخيار الأكثر أماناً وأعلى كفاءة لكونها تتفادى المعالجات التفسيرية الإضافية التي تجريها دالة SEARCH للمحارف البديلة. أما في الحالات التي تتسم بعشوائية إدخال حالة الأحرف أو الحاجة إلى مطابقة أنماط متغيرة، فإن دالة SEARCH تحتل الصدارة التشغيلية.
4. الصيغة المركبة: دمج دالتي LEFT وFIND للاقتطاع الديناميكي
4.1 التشريح الرياضي للصيغة المركبة وتكامل المتغيرات
يتشكل الاقتطاع الديناميكي الحقيقي من خلال التكامل المنطقي بين قدرة دالة FIND على التوطين الفهرسي، وقدرة دالة LEFT على الاستقطاع الخطي. وتتخذ الصيغة المعيارية المركبة لهذا الغرض الهيكل الرياضي الآتي:
=LEFT(A2, FIND(“character”, A2) – 1)
يعمل هذا التركيب من خلال مسار تغذية راجعة داخلي، حيث تتولى الدالة المتداخلة أولاً فحص محتوى الخلية A2 واستخراج الموقع الترتيبي للرمز الفاصل، لتقوم بعد ذلك بتمرير هذا الرقم كناتج مباشر يغذي المعامل الثاني للدالة الخارجية LEFT، فتتحول العملية من اقتطاع جامد إلى عملية حيوية قابلة للتكيف مع كل صف على حدة بصرف النظر عن طول النص المستهدف.
ويكتسب الجزء الحسابي – 1 أهمية محورية لا تقل عن أهمية الدوال ذاتها؛ إذ إنه يحل مسألة رياضية كلاسيكية تعرف في علوم الحوسبة بـ “خطأ تجاوز الحافة بواحد” (Off-by-one Error). فعندما ترصد دالة FIND رمزاً معيناً، فإنها تعيد موضع الرمز نفسه في السلسلة. فإذا كان الرمز يقع في الخانة الخامسة، فإن تمرير الرقم 5 مباشرة لدالة LEFT سيجعلها تقتطع خمسة محارف، مما يعني ظهور الرمز الفاصل غير المرغوب فيه في نهاية المخرج النهائي. ومن هنا، يضمن طرح القيمة 1 توقف عملية الاقتطاع عند المحرف الأخير الواقع مباشرة قبل الرمز الفاصل، مما يسفر عن نص نقي ومجرد تماماً من أي محارف زائدة.
تتم المعالجة الداخلية في محرك جداول جوجل بتسلسل خطي صارم يمر بثلاث مراحل مجهرية متتالية: أولاً، استدعاء محتوى الخلية وتثبيته في الذاكرة التخزينية المؤقتة؛ ثانياً، إجراء مسح ليزري لمصفوفة البايتات المكونة للنص لتحديد موقع الرمز الفاصل وحساب قيمته المنطقية بعد خصم الواحد الحسابي؛ وثالثاً، استدعاء دالة LEFT وتطبيق عملية البتر من أقصى اليسار وحتى الحد الرقمي المحسوب، ثم إرجاع النتيجة وتصييرها على واجهة المستخدم في الخلية المستهدفة.
4.2 دراسة حالة تطبيقية: استخراج الأسماء قبل الرموز الفاصلة
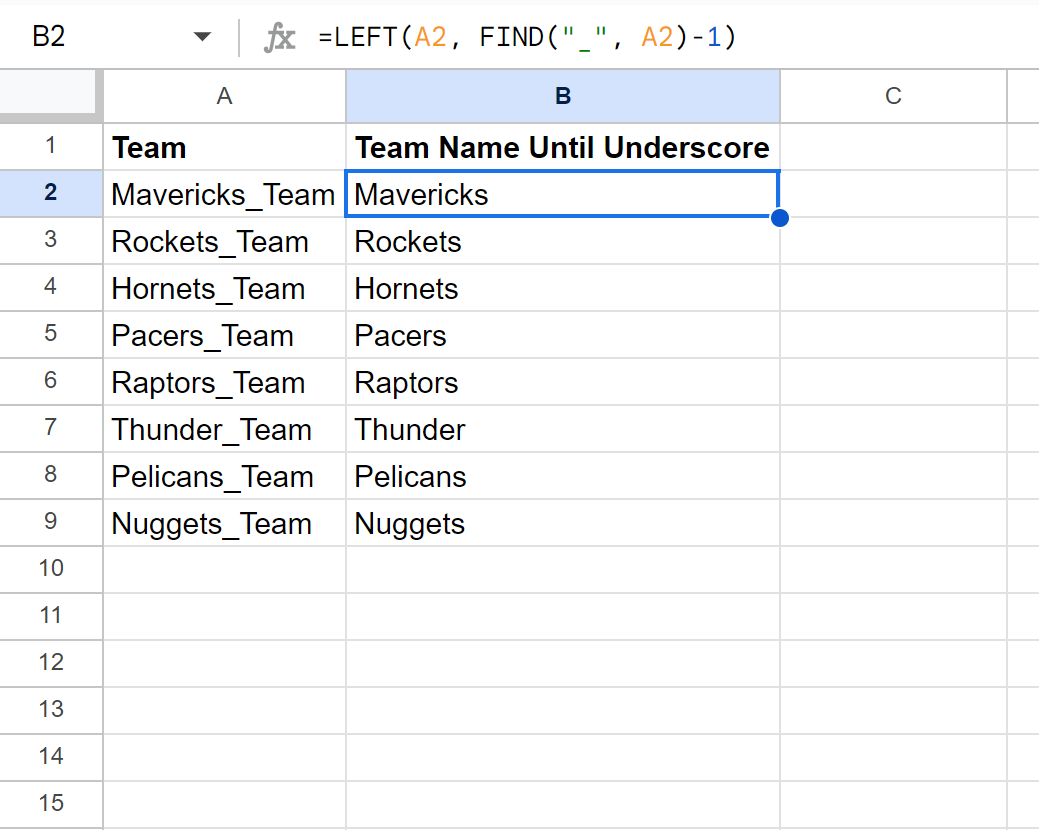
لتجسيد التطبيق العملي لهذه الصيغة، نفترض وجود جدول بيانات يتضمن سجلات لأندية رياضية ورموزها التصنيفية في العمود A، حيث تدون البيانات على النحو التالي: “Hawks_East” في الخلية A2، و”Lions_West” في الخلية A3، و”Warriors_Central” في الخلية A4. والهدف التحليلي هنا هو عزل أسماء الأندية فقط في العمود B، والتخلص التام من لواحق المناطق والشرطة السفلية الفاصلة بينهما.
لتحقيق ذلك بدقة منهجية، ندرج الصيغة التالية في الخلية B2:
=LEFT(A2, FIND(“_”, A2) – 1)
عند تنفيذ الصيغة، تفحص دالة FIND النص “Hawks_East” فتجد أن الشرطة السفلية تقع في الموقع رقم 6. وتطرح المعادلة واحداً من الناتج ليصبح العدد 5. تتلقى دالة LEFT هذا الإيعاز فتقتطع المحارف الخمسة الأولى بدءاً من أقصى اليسار، لينتج لدينا اللفظ النقي “Hawks”. وبالمثل، عند سحب مقبض التعبئة التلقائي لتطبيق الصيغة على الخلية A3، ترصد الدالة الشرطة السفلية في الموقع 6 لتستخرج “Lions”، بينما ترصدها في الخلية A4 في الموقع 9 لتستخرج الكلمة الطويلة “Warriors” بدقة مطلقة دون تدخل يدوي.
تخضع المخرجات بعد ذلك لاختبارات التحقق المعياري للتأكد من خلوها من الشرطات العالقة أو الفراغات الطرفية. ويمكن إتمام ذلك عبر اقتران الصيغة بدالة الطول النصي LEN للتأكد من أن عدد الأحرف المستخرجة يطابق رياضياً عدد أحرف الاسم الأصلي للنادي قبل الفاصل، مما يثبت نجاح الصيغة في تلبية متطلبات التحليل دون الإخلال بسلامة البنية النصية للبيانات المستهدفة.
5. إدارة الأخطاء والاستثناءات النصية في البيئات التطبيقية
5.1 تحليل أسباب ظهور خطأ القيمة الشهير #VALUE!
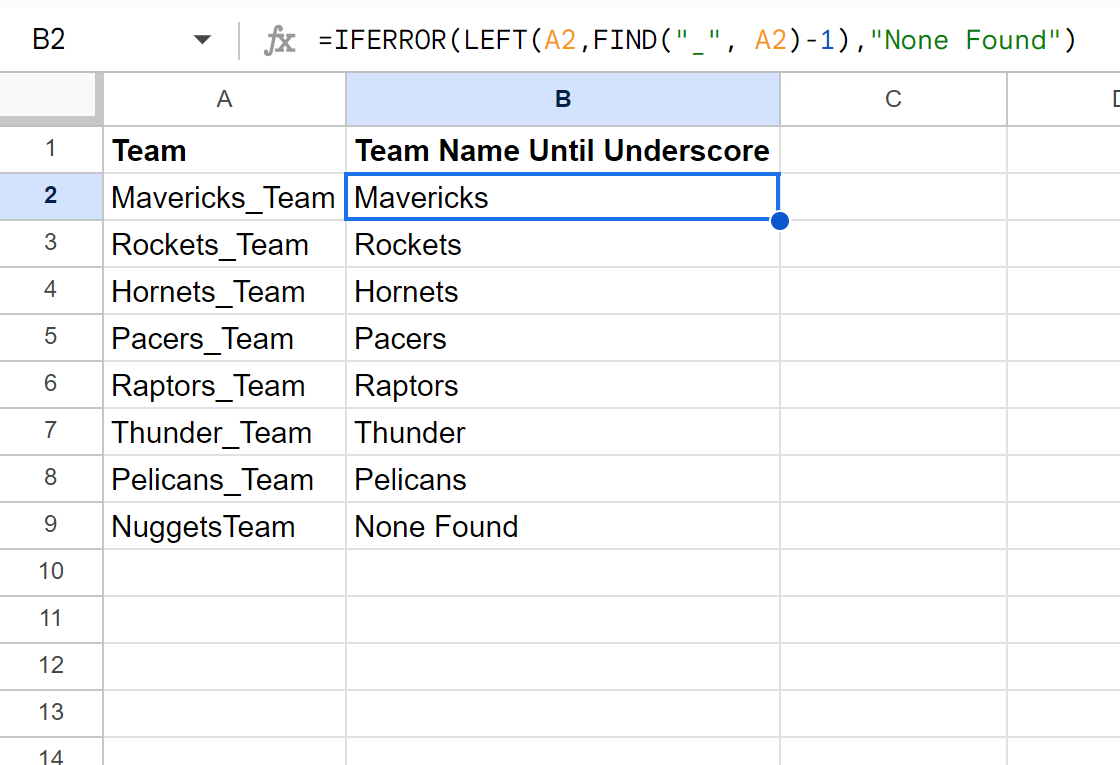
يعد الخطأ الفهرسي الشهير #VALUE! الهاجس الأكبر الذي يواجه مطوري ومحللي النماذج في جداول بيانات جوجل. يظهر هذا الخطأ التشغيلي الصريح عندما تعجز الدالة عن العثور على القيمة المبحوث عنها في السلسلة النصية المستهدفة. وفي سياق صيغتنا المركبة، إذا كانت الخلية A2 تحتوي على نص مصمت لا يحتوي إطلاقاً على الرمز الفاصل المحدد، مثل “HawksEast” بدون شرطة، فإن دالة FIND تتوقف عن العمل وترسل إشارة استثناء فوري مفادها أن الرمز المستهدف غير موجود، مما يؤدي إلى انهيار العملية الحسابية برمتها وظهور رسالة الخطأ المزعجة في الخلية.
وثمة أسباب خفية أخرى تقود إلى ذات النتيجة الكارثية، أبرزها وجود المحارف غير المرئية أو المسافات البيضاء المشفرة بأنماط غير قياسية، مثل المسافات غير القابلة للكسر (Non-breaking spaces) التي تنتقل غالباً عند نسخ البيانات من صفحات الويب أو البرمجيات الخارجية. فإذا كان المحلل يبحث عن مسافة اعتيادية بينما يحتوي النص على مسافة برمجية خاصة، فإن الدالة ستفشل حتماً في المطابقة وتطلق الخطأ الرقمي، رغم أن النص يبدو للعين المجردة وكأنه يحتوي على فواصل صحيحة.
علاوة على ذلك، تلعب الخلايا الفارغة تماماً داخل نطاق البيانات دوراً جوهرياً في إفساد استقرار النماذج الحسابية. فحينما تُمرر خلية فارغة إلى الصيغة المركبة، تحاول الدالة استقراء قيمة فارغة داخل مصفوفة معدومة، فتتولد حالة من عدم التوافق المنطقي تفضي إلى سلسلة من أخطاء القيمة التي تشوه الجداول النهائية وتمنع الدوال الإحصائية التجميعية اللاحقة (مثل دوال العد والتلخيص) من العمل بصورة طبيعية، ما لم يتم تحصين الصيغة بدروع وقائية متقدمة.
5.2 بناء دروع الحماية المتقدمة باستخدام دالة IFERROR
لتلافي الانهيارات البيانية الناتجة عن أخطاء القيمة، يتم اللجوء إلى التغليف الوقائي للصيغ عبر دمج دالة IFERROR. تعمل هذه الدالة بمثابة صمام أمان يعترض الأخطاء البرمجية قبل تصييرها على واجهة الشاشة، ويوفر مساراً حسابياً بديلاً ومخصصاً يضمن الحفاظ على نظافة الجدول واستمرار العمليات التحليلية دون انقطاع.
تتم كتابة الصيغة المحصنة وفق الصياغة المنهجية الآتية:
=IFERROR(LEFT(A2, FIND(“_”, A2) – 1), A2)
في هذا البناء الدفاعي المتين، تقيم الدالة الجزء الداخلي المركب أولاً؛ فإذا تمكنت دالة FIND من رصد الرمز، يُنفذ الاقتطاع بصورة طبيعية ويُعرض الناتج النقي. أما إذا غاب الرمز تماماً وتولد خطأ القيمة، فإن دالة IFERROR تلتقط الخطأ وتتجاهله بصمت، وتمرر القيمة البديلة المحددة في معاملها الثاني، وهي في هذه الحالة الخلية الأصلية A2 بكامل نصها غير المنقوص، مما يحمي محتوى البيانات من الضياع أو التشوه برموز الأعطال.
كما يمكن للمحلل تخصيص المخرجات البديلة بما يخدم التوثيق المؤسسي للبيانات. فبدلاً من إرجاع النص كاملاً، يمكن ضبط الصيغة لترجع خلية فارغة تماماً باستخدام علامتي تنصيص متتاليتين “” لتنظيف التقارير التقديمية، أو إرجاع رسالة تنبيهية مثل “الرمز غير موجود” لتوجيه جامعي البيانات نحو مراجعة وتدقيق السجلات الشاذة التي تفتقر للبنية التركيبية القياسية.
5.3 التحقق المسبق من وجود الرمز عبر دمج دالتي IF وISNUMBER
رغم كفاءة دالة IFERROR، إلا أنها تتعامل مع الأخطاء بعد وقوعها بالفعل وتستهلك موارد معالجة لمحاصرة الاستثناءات. لذا، يفضل المهندسون الحسابيون استخدام منهج “التحقق المسبق” القائم على التحليل المنطقي الاستباقي للبيانات، وذلك بالدمج التكاملي بين دالتي IF وISNUMBER للتحقق من وجود الرمز الفاصل قبل الشروع في عملية الاقتطاع.
وتُبنى هذه الصيغة المتقدمة على النحو الرياضي الآتي:
=IF(ISNUMBER(FIND(“_”, A2)), LEFT(A2, FIND(“_”, A2) – 1), A2)
تعتمد الميكانيكا المنهجية هنا على خاصية رياضية أصيلة في دالة FIND؛ فهي عند نجاحها في الرصد تعيد رقماً فهرسياً، بينما تولد خطأ عند الفشل. وبناءً عليه، تفحص دالة ISNUMBER المخرج؛ فإذا كان ناتج الفحص قيمة رقمية (True)، يتحقق الشرط المنطقي لدالة IF ويُؤذن للمحرك الحسابي بإجراء عملية الاقتطاع النصي بأمان تام. أما إذا كان الناتج غير رقمي (False)، فإن الصيغة تنحرف تلقائياً إلى المسار البديل دون أن تستدعي ميكانيزمات الأخطاء البرمجية أصلاً.
يوفر هذا النهج الاستباقي ميزتين هيكليتين؛ الأولى تتمثل في خفض العبء الحسابي المفروض على المتصفح ومحركات جداول البيانات عند معالجة عشرات الآلاف من الصفوف المتزامنة، حيث تجري معالجة الشروط المنطقية الخفيفة بدلاً من تتبع مكدس الأخطاء البرمجية الثقيلة. والميزة الثانية هي إمكانية تفريع الشروط وتوسيعها لتبني مسارات معالجة متعددة تتيح البحث عن رموز فاصلة بديلة في حال غياب الرمز الأول وفق تسلسل هرمي محدد.
6. التعامل مع الرموز المتعددة والحالات النصية الخاصة
6.1 استخراج النصوص عند تكرار الرمز الفاصل داخل الخلية الواحدة
تواجه عمليات معالجة النصوص تعقيداً إضافياً عندما تتضمن الخلية الواحدة تكراراً متعدداً لذات الرمز الفاصل. لنفترض وجود سلسلة نصية من قبيل: “Data_Analysis_Section_2023” في الخلية A2؛ إن تطبيق الصيغة التقليدية =LEFT(A2, FIND(“_”, A2) – 1) سيؤدي حتماً إلى اقتطاع المقطع الأول فقط وهو “Data”، لأن دالة FIND تتوقف برمجياً عند نقطة التقائها الأولى بالرمز من جهة اليسار وتتجاهل كافة التكرارات اللاحقة له في بقية السلسلة.
إذا كان الهدف التحليلي هو اقتطاع النص وصولاً إلى الظهور الثاني أو الأخير للرمز، فإن الصيغ الكلاسيكية تصبح عاجزة دون الاستعانة بالدوال الإحلالية. وهنا تبرز دالة SUBSTITUTE كأداة عبقرية لاستهداف تكرار محدد للرمز الفاصل، حيث تتيح هذه الدالة استبدال تكرار معين بحرف فريد لا يتواجد في السلسلة مطلقاً (مثل الرمز # أو ~)، ليتم بعد ذلك توجيه دالة FIND للبحث عن هذا المحرف الفريد حصراً وتحديد موقعه بدقة تامة لتمريره لدالة LEFT.
وللوصول إلى الظهور الأخير لرمز متكرر، تُدمج دالة الطول LEN مع دالة SUBSTITUTE لحساب إجمالي عدد مرات ظهور الرمز عبر المعادلة الرياضية:
=LEN(A2) – LEN(SUBSTITUTE(A2, “_”, “”))
ومن ثم يُمرر هذا الرقم المحسوب كمعامل تكرار داخل دالة الاستبدال لتحديد موقع الشرطة الأخيرة، مما يتيح استخلاص الجملة المركبة كاملة “Data_Analysis_Section” حتى آخر فاصل، وهو ما يوفر حلاً متيناً للمشكلات المعقدة التي تطرأ عند التعامل مع مسارات المجلدات أو عناوين الروابط الإلكترونية في أوراق العمل.
6.2 معالجة النصوص ثنائية اللغة وتداخل الحروف والرموز الخاصة
تفرض اللغة العربية بخصوصيتها الصرفية واتجاه كتابتها من اليمين إلى اليسار (RTL) تحديات مفاهيمية وتشغيلية بالغة الحساسية عند معالجة السلاسل النصية في جداول بيانات جوجل. ورغم أن النص العربي يكتب بصرياً من اليمين، إلا أن الدوال البرمجية في جداول البيانات تستند برمجياً إلى الترتيب المنطقي للتدفق الثنائي (Logical Stream Order) المخزن في ذاكرة الحاسوب؛ حيث يعتبر أول حرف منطقي يكتبه المستخدم في الخلية هو الحرف رقم 1، بغض النظر عن اتجاه المحاذاة على الشاشة.
ومع ذلك، ينشأ التداخل والتشوه عند خلط النصوص العربية برموز لاتينية أو أرقام ورموز خاصة مثل الواصلات والشرطات. فعندما تجاور الحروف العربية محارف لاتينية أو فواصل قياسية، قد يبدو مظهر النص على الشاشة معكوساً بسبب خوارزمية الاتجاه ثنائي الاتجاه التابعة لنظام يونيكود (Unicode Bidirectional Algorithm). ولتجنب الأخطاء في حساب المواقع، يجب على المحلل أن يستند دائماً إلى الترتيب الفهرسي الرقمي المجرد الذي ترصده دالة FIND دون الاعتماد على المعاينة البصرية للموقع الظاهر على الشاشة.
إضافة إلى ذلك، تعد الشوائب الفراغية من أكبر مهددات دقة الاقتطاع في النصوص العربية، نظراً للتباين الكبير في استخدام المسطرة وتكرار المسافات العشوائية بين الكلمات أو قبل علامات الترقيم. ومن هنا، يبرز التوجيه المنهجي بضرورة تطهير السلاسل مسبقاً وتمرير الخلية المستهدفة داخل دالة TRIM لتجريدها من أي مسافات زائدة في البداية أو النهاية، فضلاً عن تقليص المسافات البينية المتعددة إلى مسافة مفردة واحدة، قبل إخضاع النص لصيغة الدمج بين LEFT وFIND لضمان استقرار الفهارس المستخرجة.
7. أتمتة المعالجة على نطاقات ضخمة باستخدام مصفوفات ARRAYFORMULA
7.1 التحول من التكرار اليدوي إلى المعالجة المصفوفية الشاملة
في بيئات العمل الاحترافية وقواعد البيانات الضخمة، يفقد سحب الصيغ الحسابية يدوياً أو تكرارها عبر مئات الآلاف من الصفوف جدواه التشغيلية، بل ويصبح مصدراً رئيساً للأخطاء وعدم الكفاءة. ويتجلى الحل التقني الأمثل في جداول بيانات جوجل عبر استدعاء دالة المصفوفات الشاملة ARRAYFORMULA، والتي تسمح بتطبيق المعادلة المركبة على عمود كامل بنقرة واحدة ومن خلال خلية مفردة توضع في رأس العمود.
تتم إعادة صياغة المعادلة المركبة لتتحول إلى صيغة مصفوفية على النحو التالي:
=ARRAYFORMULA(LEFT(A2:A, FIND(“_”, A2:A) – 1))
عند إدخال هذه الصيغة في الخلية B2، يتولى المحرك الحسابي تحويل المتغيرات الفردية إلى متجهات مصفوفية متصلة؛ حيث يقرأ النطاق A2:A كمتجه عمودي متكامل، وتجري دالة FIND عمليات المسح الفهرسي المتزامن لجميع صفوف العمود، بينما تطبق دالة LEFT الاقتطاع الآلي في الذاكرة لتنسكب النتائج تلقائياً في الخلايا المقابلة دون الحاجة لكتابة أي معادلة في الخلايا الواقعة بالأسفل.
وتحقق هذه المنهجية فوائد إدارية وحوكمية لا تقدر بثمن لفرق العمل المشتركة؛ إذ يؤدي حصر الصيغة في الخلية العلوية الأولى إلى حماية سلامة المنظومة الحسابية من عبث المستخدمين الآخرين. فلو حاول أي مستخدم حذف أو تعديل ناتج الاقتطاع في أحد الصفوف السفلية، فإن التغيير يُلغى تلقائياً بفعل تدفق المصفوفة، كما أن إضافة أي صفوف جديدة في قاع الجدول ستخضع تلقائياً وفورياً لعملية التطهير والاقتطاع دون أدنى تدخل يدوي متكرر.
7.2 التحكم في امتداد المصفوفة وتفادي معالجة الصفوف الفارغة
رغم القوة الهائلة لدوال المصفوفات، إلا أن كتابة الصيغة المصفوفية بالشكل المجرد السابق يفتح ثغرة تشغيلية خطيرة تتمثل في استمرار تدفق المصفوفة إلى أقصى حدود الورقة، مما يؤدي إلى محاولة فحص آلاف الصفوف الفارغة في قاع الجدول. وينتج عن ذلك ظهور آلاف من أخطاء #VALUE! في الخلايا الخالية، فضلاً عن استنزاف الذاكرة العشوائية للمتصفح وإبطاء زمن استجابة الورقة السحابية بصورة ملحوظة.
وللتحكم في هذا الامتداد غير المرغوب فيه وضبط أطراف المصفوفة، يتعين دمج شرط منطقي مسبق باستخدام دالة IF لفرز الصفوف المشغولة عن الفارغة، مدعوماً بدروع حماية الأخطاء، وفق الهيكل البرمجي الاحترافي التالي:
=ARRAYFORMULA(IF(A2:A=””, “”, IFERROR(LEFT(A2:A, FIND(“_”, A2:A) – 1), A2:A)))
يقوم هذا التكوين المتقن بفحص كل صف في النطاق؛ فإذا كانت الخلية المقابلة في العمود A فارغة تماماً (ممثلة بالشرط A2:A=””)، تعيد المصفوفة فوراً قيمة فارغة “” وتوقف المعالجة لهذا الصف دون استهلاك للموارد. أما إذا كانت الخلية تحتوي على مدخلات حقيقية، فتمرر السلسلة عبر الدرع الوقائي لدالة IFERROR لاستخلاص النص قبل الرمز الفاصل أو إرجاع النص كاملاً في حال غياب الرمز.
يسهم هذا الأسلوب المنضبط في تحسين زمن المعالجة وتقليل الحمل الحسابي السحابي بنسب كبيرة، ويحافظ على المظهر الاحترافي لورقة العمل بخلوها التام من الأخطاء العشوائية في المساحات غير المستغلة، مما يضمن كفاءة استثنائية وسرعة فائقة للجداول حتى مع تجاوز حجم البيانات عشرات الآلاف من السجلات.
8. المقارنة المنهجية: الصيغة المركبة مقابل البدائل التقنية الحديثة
8.1 مقارنة دالة LEFT المركبة مع دالة REGEXEXTRACT المبنية على التعابير النمطية
توفر جداول بيانات جوجل بيئة متقدمة لدعم “التعابير النمطية” (Regular Expressions) عبر دالة REGEXEXTRACT، مما يضع المحلل أمام خيارين تقنيين لإنجاز ذات المهمة التطهيرية. وتتيح دالة التعابير النمطية استخراج النصوص الواقعة قبل محرف معين باستخدام صياغة تعبيرية مقتضبة، كأن يُكتب:
=REGEXEXTRACT(A2, “^([^character]+)”)
حيث يرمز الرمز ^ إلى بداية السلسلة، وتحدد الأقواس المعقوفة مع علامة النفي اقتطاع كافة المحارف المتتالية التي تسبق الرمز الفاصل المحدد، دون الحاجة لحساب أي مؤشرات فهرسية أو إجراء عمليات طرح رقمية.
وتتفوق دالة REGEXEXTRACT بمرونتها الفائقة في التعامل مع الأنماط غير المنتظمة والمعقدة، مثل استخراج النصوص حتى أول رقم يظهر، أو حتى أول رمز غير أبجدي، وهي سيناريوهات تعجز الدوال الرياضية التقليدية كـ LEFT وFIND عن معالجتها إلا بصيغ متداخلة بالغة التعقيد. إلا أن هذا التميز يقابله منحنى تعلم حاد وتراجع ملحوظ في قابلية قراءة وتفسير النماذج الحسابية من قبل فرق العمل العادية التي لا تمتلك خلفية برمجية معمقة في قواعد التعابير النمطية، مما يرفع من تكلفة صيانة الجداول وتدقيقها لاحقاً.
أما من منظور الأداء الحسابي وسرعة المعالجة في السحب البياني الضخم، فإن الصيغة المركبة من LEFT وFIND تظل في كثير من الأحيان أسرع استجابة وأقل استهلاكاً لدورات المعالجة السحابية مقارنة بمحرك التعابير النمطية الذي يتطلب إجراء تحليل نحوي معجمي (Parsing) لكل بايت في السلسلة النصية للتحقق من تطابق النمط، بينما تنفذ دوال الاقتطاع عمليات فهرسة وإزاحة ذاكرية مباشرة بالغة البساطة والسرعة.
علاوة على ذلك، دعمت جوجل في التحديثات الأخيرة دالة حديثة مخصصة كلياً لهذا الغرض وهي دالة TEXTBEFORE، والتي تبسط العملية للغاية من خلال كتابة:
=TEXTBEFORE(A2, “character”)
ورغم القوة والأناقة التعبيرية لهذه الدالة الجديدة، إلا أن الصيغة الكلاسيكية المعتمدة على LEFT وFIND تظل المعيار العالمي الأكثر موثوقية والأوسع توافقية، لكونها مدعومة بلا استثناء في كافة إصدارات برمجيات الجداول السحابية والمحلية، والتطبيقات القديمة والحديثة، مما يضمن صمود النماذج عند تصديرها بين منصات الحوسبة المختلفة دون حدوث أعطال توافقية.
8.2 تقييم أداة تقسيم النص إلى أعمدة ودالة SPLIT التلقائية
يلجأ بعض المحللين في كثير من الأحيان إلى خيار تفكيك النصوص باستخدام الأداة المدمجة في واجهة المستخدم “تقسيم النص إلى أعمدة” (Split text to columns)، أو نظيرتها البرمجية التلقائية دالة SPLIT. وتعتمد هذه التقنية على تفتيت السلسلة النصية بأكملها عند كل ظهور للرمز الفاصل، وتوزيع الأجزاء الناتجة على خلايا متجاورة أفقياً في نفس الصف، مما يتيح عزل الجزء الأول في العمود الأول والاحتفاظ بالمتبقي في الأعمدة المجاورة.
ويمكن توظيف دالة SPLIT برمجياً لاقتطاع الجزء الأول فقط دون المساس بالأعمدة المجاورة عبر دمجها مع دالة INDEX لاستخلاص العنصر الأول من المصفوفة المفتتة وفق الصيغة:
=INDEX(SPLIT(A2, “_”), 1)
ورغم جاذبية وبساطة هذا التركيب، إلا أنه ينطوي على قيود هيكلية جوهرية؛ فدالة SPLIT تتعامل افتراضياً مع كل محرف في المعامل الفاصل بشكل فردي إذا كان الرمز مؤلفاً من أكثر من حرف، ما لم يتم تعطيل خيار التقسيم الفرعي بدقة، في حين تحافظ دالة FIND على فحص السلسلة ككتلة واحدة مترابطة.
كذلك تفرض الأداة اليدوية لتقسيم النصوص أثراً ثابتاً غير رجعي في بنية الجدول، حيث تقوم بالكتابة فوق البيانات الموجودة في الأعمدة المجاورة إلى اليمين مالم تكن تلك الأعمدة فارغة ومعدة مسبقاً، مما يعرض الجداول المزدحمة للتلف. في المقابل، توفر صيغة LEFT المحسوبة استقلالاً تاماً للمخرجات داخل عمود مخصص دون التعدي على المساحات المجاورة، وتتميز بكونها صيغة حيوية تتحدث ذاتياً ومباشرة بمجرد تعديل النص الأصلي، دون الحاجة لإعادة تنفيذ أمر التقسيم اليدوي بصورة دورية.
9. تطبيقات ونماذج عملية في مجالات تحليل البيانات والبحوث
9.1 فصل البيانات التعريفية واستخلاص أسماء المستخدمين من البريد الإلكتروني
يمثل التعامل مع سجلات التواصل الرقمي وتطهير قوائم العناوين الإلكترونية واحداً من أشهر التطبيقات الميدانية التي تتطلب توظيف صيغة الاقتطاع حتى رمز محدد. ففي المؤسسات البحثية والجامعية، تتكدس في قواعد البيانات آلاف العناوين البريدية للطلاب والمشاركين في الدراسات، وتبرز الحاجة المتكررة إلى عزل “اسم المستخدم” (Username) الشخصي عن النطاق المؤسسي العام (Domain) لأغراض تخصيص الرسائل أو بناء المعرفات الفريدة في النماذج الإحصائية.
في هذا السياق، يلعب الرمز @ دور المحدد الفاصل القياسي الذي تتكئ عليه دالة FIND. وتُصاغ المعادلة لاستخلاص اسم المستخدم بدقة متناهية من الخلية A2 كما يلي:
=IFERROR(LEFT(A2, FIND(“@”, A2) – 1), A2)
تقوم الصيغة بمسح العنوان والتقاط موقع علامة @، ومن ثم يطرح المحرك الرقم 1 لعزل كافة الأحرف الواقعة قبلها مباشرة. وتتميز هذه المعالجة بالقدرة على التعامل مع تباين أطوال الأسماء التي قد تتراوح بين أحرف معدودة وصولاً إلى تركيبات طويلة تحتوي على نقاط أو أرقام، مما ينتج عموداً نظيفاً يحوي فقط الأسماء المعرفة الجاهزة للاقتران بدوال التخصيص والمراسلة الآلية.
كما تسهم إضافة دالة IFERROR في هذا التطبيق في حماية قواعد البيانات من العناوين الشاذة أو المشوهة التي قد يدخلها بعض المشاركين خطأ دون احتواء علامة البريد، مما يتيح لفرق المتابعة عزل وتدقيق الحالات غير المتوافقة بسهولة، وضمان بقاء القوائم البريدية الموجهة للدراسات والمسوح الميدانية نقية ومطابقة لأعلى معايير جودة البيانات.
9.2 تطهير المعرفات الأكاديمية والرموز المشفرة في قواعد البيانات
في البحوث التجريبية والدراسات النفسية والاجتماعية والسريرية، تُمنح العينات البحثية عادة معرفات كودية مركبة ومقننة تدمج بين تصنيف المجموعة، والموقع الجغرافي، والرقم التسلسلي للمفحوص، وتفصل بينها علامات معيارية مثل الشرطات الأفقية؛ كأن يُسجل الكود على النحو التالي: “EXP-NYC-0842″ للمجموعة التجريبية، و”CTRL-LON-0119” للمجموعة الضابطة. ويحتاج الباحث لتحليل الفروق إلى تجريد البادئة التصنيفية الأولى لعزل متغير المجموعة المستقل دون الارتباك بالمتغيرات الفرعية الأخرى.
يتم تطبيق الصيغة المركبة في هذا الإطار لعزل بادئة التصنيف من خلال استهداف الشرطة الأولى (-):
=LEFT(A2, FIND(“-“, A2) – 1)
يؤدي هذا الاستخلاص الرياضي إلى عزل الأكواد “EXP” و”CTRL” في عمود تصنيفي مستقل وموحد، يمكن استخدامه مباشرة كمتغير تجميعي (Grouping Variable) في اختبارات الفروق الإحصائية مثل تحليل التباين (ANOVA) أو اختبارات “ت” (t-tests)، فضلاً عن تمكين دوال البحث والمطابقة مثل VLOOKUP أو XLOOKUP من ربط هذا الكود المجرد بجداول التوصيفات والمتغيرات التابعة دون أخطاء ناتجة عن تباين الأطوال التسلسلية للعينات.
ويسهم هذا التطهير المنهجي في تقليص أزمنة إعداد وتنظيف ملفات البيانات قبل تصديرها إلى الحزم البرمجية الإحصائية المتقدمة (مثل R وPython وSPSS)، حيث يُشترط أن تكون المعرفات الفئوية مفصولة تماماً عن المحددات الرقمية والفردية للمفحوصين، وهو ما يجسد الدور الحيوي لدوال جداول بيانات جوجل البسيطة في تأمين المدخلات الأولية للبحوث العلمية الرصينة.
10. المعايير المتقدمة لتحسين الأداء والكفاءة الحاسوبية في الجداول المعقدة
10.1 تحسين استهلاك الذاكرة وتفادي الحسابات التكرارية غير الضرورية
عندما تتسع قواعد البيانات في جداول جوجل لتشمل مئات الآلاف من الصفوف في بيئة حوسبة سحابية مشتركة، تصبح كفاءة استهلاك الذاكرة وإدارة دورات وحدة المعالجة المركزية (CPU Cycles) أمراً بالغ الأهمية لضمان سرعة واستقرار الورقة. فالاستخدام المفرط وغير المدروس للصيغ المركبة التي تتضمن دوال فهرسية متداخلة قد يقود إلى بطء شديد في إعادة الحساب (Recalculation Latency)، خاصة إذا كانت السلاسل النصية طويلة وتتكرر فيها عمليات البحث الحرفي بشكل مكثف ومتزامن عبر الخلايا.
تتمثل إحدى أهم استراتيجيات التحسين الحاسوبي في تقليل “الحسابات التكرارية المتطابقة” (Redundant Calculations). ففي الصيغ التي تكرر استدعاء دالة FIND عدة مرات داخل نفس الخلية — كما هو الحال عند كتابة معادلات منطقية استباقية مثل:
=IF(ISNUMBER(FIND(“_”, A2)), LEFT(A2, FIND(“_”, A2) – 1), A2)
يقوم المحرك الحسابي بمسح نفس النص وتحديد موقع نفس الرمز مرتين متتاليتين لكل صف على حدة، مما يضاعف العبء الحسابي المفروض على المتصفح والسحابة دون أي قيمة مضافة.
ولمعالجة هذا الهدر في النماذج العملاقة، يوصي مهندسو البيانات بالاعتماد على منهجية “الأعمدة المساعدة” (Helper Columns)، أو الاستعانة بدالة LET الحديثة في جداول بيانات جوجل التي تتيح تخزين ناتج العملية الحسابية في متغير اسمي ليعاد استخدامه عدة مرات دون إعادة حسابه:
=LET(pos, FIND(“_”, A2), IFERROR(LEFT(A2, pos – 1), A2))
من خلال هذا التأسيس البرمجي الراقي، تُنفذ عملية البحث الفهرسي مرة واحدة فقط وتُخزن قيمتها مؤقتاً في المتغير pos، مما يوفر نصف زمن المعالجة المطلوب ويحقق التوازن المثالي بين الأداء الرياضي الفائق وسلاسة التعامل مع مجموعات البيانات الضخمة.
10.2 دليل الصيانة الدورية وتوثيق الصيغ الحسابية لفرق العمل
تعتمد استدامة النماذج التحليلية وسلامتها في البيئات المؤسسية المشتركة على جودة توثيق الصيغ ووضع بروتوكولات صارمة لصيانتها وحمايتها من التشويه. فالصيغ المركبة التي تبدو بديهية للمحلل الذي بناها قد تتحول إلى لغز برمجي مبهم لأعضاء الفريق الآخرين، مما قد يغري بعضهم بتعديلها أو حذف معامل الطرح الحاسم – 1 دون إدراك لآثاره التراكمية على سلامة قاعدة البيانات بأكملها.
يبدأ التوثيق المؤسسي الفعال بإدراج تعليقات نصية شارحة (Notes / Comments) مباشرة فوق رؤوس الأعمدة التي تحتضن المعادلات المصفوفية الكبرى، مع بيان دقيق للغاية للرمز الفاصل المستهدف والغرض التحليلي من عملية الاقتطاع. علاوة على ذلك، يجب تفعيل أدوات “التحقق من صحة البيانات” (Data Validation) في أعمدة الإدخال الأصلية لتقييد المستخدمين وتنبيههم في حال إدخال سلاسل نصية تفتقر للرمز الفاصل المعياري، مما يقضي على المشكلات من منبعها الأولي قبل وصولها لمرحلة الاقتطاع.
وأخيراً، ينبغي لفرق التحليل وضع جدول زمني دوري لإجراء اختبارات الجودة البيانية (Data Quality Audits)، تتضمن فحص عينات عشوائية من مخرجات الاقتطاع، والتحقق من عدم وجود مسافات بيضاء غير مرئية قد تؤدي إلى تباعد المعرفات عن أصولها، والتأكد من صمود النماذج الحسابية أمام أي تغييرات طارئة في هياكل المدخلات الصادرة عن الأنظمة الرقمية المصدرية، مما يرسخ بيئة عمل احترافية ومستدامة قائمة على الدقة والشفافية التقنية العالية.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد المنهجية والفنية لاقتطاع السلاسل النصية حتى رمز محدد في جداول بيانات جوجل عبر الدمج التكاملي بين دالتي LEFT وFIND. وقد بيّن التحليل أن تحقيق هذا الهدف لا يقتصر على مجرد استدعاء دالتين مدمجتين، بل يتطلب فهماً رياضياً دقيقاً لميكانيكا الفهرسة الموضعية، ومعالجة حتمية لخطأ تجاوز الحافة عبر طرح القيمة واحد، فضلاً عن بناء تحصينات دفاعية متقدمة عبر دوال إدارة الأخطاء لضمان صمود النماذج أمام المدخلات الشاذة أو غير المتجانسة.
كما أبرزت المقارنات الفنية أن الصيغة المركبة تظل الركيزة الأكثر استقراراً وعالمية لمعالجة النصوص، مع إمكانية تعزيزها بالحلول المصفوفية الشاملة عبر ARRAYFORMULA أو الاستفادة من التطورات الحديثة مثل دوال TEXTBEFORE وLET لتحسين الأداء الحاسوبي وتبسيط الصيانة في قواعد البيانات الضخمة. إن تبني هذه الأسس المنضبطة في تطهير السلاسل النصية يسهم بصورة جوهرية في تقليص الأخطاء البشرية، ورفع جودة ونقاء البيانات، وتمهيد الطريق أمام تحليلات إحصائية استدلالية رصينة تبنى على أسس معيارية محكمة.
المراجع
- Google Workspace Support. (n.d.). LEFT function – Google Docs Editors Help. Google. https://support.google.com/docs/answer/3094079
- Google Workspace Support. (n.d.). FIND function – Google Docs Editors Help. Google. https://support.google.com/docs/answer/3094126
- Google Workspace Support. (n.d.). ARRAYFORMULA function – Google Docs Editors Help. Google. https://support.google.com/docs/answer/3093275
- Google Workspace Support. (n.d.). TEXTBEFORE function – Google Docs Editors Help. Google. https://support.google.com/docs/answer/12479907
- Bobbitt, Z. (2023). Google Sheets: A formula for LEFT until specific character. Statology. https://www.statology.org/google-sheets-left-until-character/