
تُعد معالجة البيانات النصية وتنقيتها حجر الزاوية في منظومة التحليلات الرقمية الحديثة، حيث تشير التقديرات الإحصائية إلى أن ما يتجاوز ثمانين بالمئة من البيانات التي تجمعها المؤسسات تكون في صورة بيانات غير مهيكلة أو شبه مهيكلة تتطلب تدخلاً تقنياً مكثفاً لضبطها وتوحيدها. وفي بيئات الأعمال المعاصرة، تبرز جداول بيانات جوجل (Google Sheets) كواحدة من أكثر المنصات السحابية استخداماً ومرونة للتعامل مع البيانات الضخمة والنماذج الحسابية التعاونية. ومع ذلك، يواجه المحللون ومديرو قواعد البيانات تحدياً متكرراً يتمثل في وجود زوائد نصية أو رموز تصنيفية بادئة غير مرغوب فيها، تم إقحامها في السجلات إما نتيجة لتصدير آلي من أنظمة قديمة، أو لاحتواء المدخلات على معرفات بادئة اصطلاحية لا تتطابق مع المعايير التحليلية المطلوبة.
تكتسب مسألة إزالة عدد ثابت من المحارف من مستهل السلسلة النصية—وتحديداً إزالة أول ثلاثة أحرف—أهمية بالغة في مسارات تنظيف البيانات (Data Cleansing Pipelines). فهذه الثلاثية غالباً ما تمثل رموزاً فئوية (مثل الرموز التعريفية للدول، أو فئات المنتجات، أو بادئات المعاملات المالية)، التي يعوق بقاؤها إجراء المقارنات المعيارية، أو تنفيذ عمليات البحث والمطابقة، أو استخدام الدوال المتقدمة مثل VLOOKUP أو XLOOKUP. من هنا، يصبح استيعاب الهندسة المنطقية للدوال النصية في جداول بيانات جوجل وسيلة لا غنى عنها لتحويل الجداول الفوضوية إلى مستودعات بيانات موثوقة ذات اتساق منهجي عالٍ.
يسعى هذا البحث الشامل إلى تفكيك كافة الأبعاد النظرية والتطبيقية لعملية استئصال أول ثلاثة محارف من أي سلسلة نصية داخل بيئة جداول بيانات جوجل. وسنستعرض في هذا السياق مجموعة متكاملة من التقنيات، بدءاً من المعادلة الكلاسيكية المركبة التي تجمع بين دالتي RIGHT وLEN، مروراً بالحلول المباشرة كدالة MID ودالة REPLACE، ووصولاً إلى الأدوات الحسابية المتقدمة مثل التعابير النمطية (Regular Expressions) عبر دالة REGEXREPLACE، والحوسبة المصفوفية الشاملة بواسطة ARRAYFORMULA. كما سيتناول المقال معالجة الأخطاء الشائعة وحالات الاستثناء اللغوية والترميزية، بما يضمن للممارس الأكاديمي والمهني فهماً بنيوياً متيناً وممارسة لا تشوبها شائبة.
1. مقدمة منهجية لمعالجة النصوص في جداول بيانات جوجل
1.1 أهمية تنظيف البيانات النصية في بيئات العمل التحليلية
إن نزاهة التحليل الإحصائي ترتبط ارتباطاً وثيقاً بمدى نقاء البيانات الأولية؛ فالمدخلات المشوبة بعناصر نصية غير مفيدة أو بادئات عشوائية تولد تشويشاً منهجياً يؤدي بالضرورة إلى انحيازات كارثية في مخرجات التحليل التنبؤي أو الوصفي. في الأنظمة المؤسسية، تستقبل جداول البيانات سيلاً مستمراً من السجلات القادمة من مصادر متباينة، مثل بوابات الدفع الإلكتروني، وأنظمة تخطيط موارد المؤسسات (ERP)، وبرمجيات إدارة علاقات العملاء (CRM). هذا التعدد يفرز بطبيعته تبايناً في التنسيق، حيث تعمد بعض الأنظمة إلى إلحاق رموز ثلاثية تمهيدية لتمييز الفرع أو العملة أو القسم.
يتطلب تحقيق التوافق المعياري إزالة هذه البادئات عبر بروتوكولات حاسوبية صارمة وموحدة. فعندما تتضمن السلسلة النصية زوائد في بدايتها، فإن الفرز الأبجدي يعتمد خطأً على هذه الرموز المضافة بدلاً من الاعتماد على المعرف الحقيقي للنص، مما يحول دون التجميع الموضوعي الدقيق للسجلات المتشابهة. بالإضافة إلى ذلك، فإن تقنيات التجميع الفئوي وتصنيف المتغيرات تصبح مشلولة جزئياً، حيث يُعامل السجل ذو البادئة ككيان منفصل تماماً عن السجل الخالي منها، على الرغم من تطابقهما المفاهيمي والعملي في جوهر البيانات.
1.2 مفهوم السلاسل النصية وبنيتها الهيكلية في جداول البيانات
تُعرّف السلسلة النصية (String) رياضياً وبرمجياً في بيئات معالجة البيانات على أنها تسلسل مرتب من المحارف المنفصلة التي تحتل فهارس رقمية متتالية تعكس مواضعها الفيزيائية داخل الذاكرة المخصصة للخلية. في جداول بيانات جوجل، تبدأ فهرسة النصوص من الرقم واحد (1-based indexing) وليس من الصفر كما هو شائع في لغات البرمجة الحديثة مثل بايثون أو سي بلس بلس. هذا يعني أن أول محرف في الخلية يقع بالضرورة عند الفهرس رقم 1، والمحرف الثاني عند الفهرس 2، وهكذا دواليك. ولقد ناقشت الدراسات المعنية بالهياكل الرمزية في المعالجة الآلية، مثل دراسة Tse et al. (2016)، كيف تشكل الترتيبات المحرفية وتكوينات المقاطع الثنائية والثلاثية المحدد الجوهري للتعرف على الرموز في الأطر الحاسوبية.
من الأهمية بمكان إدراك أن مفهوم “المحرف” في جداول بيانات جوجل لا يقتصر على الحروف الأبجدية المجردة؛ بل يشمل كل ما يشغل حيزاً ترميزياً في السلسلة، كالمسافات البيضاء، وعلامات الترقيم، والأرقام، وحتى الرموز الخاصة غير المطبوعة. وتتميز القيم النصية هيكلياً عن القيم الرقمية البحتة بكون الأولى تُعامل ككتل رمزية ثابتة لا تخضع للعمليات الحسابية المباشرة بصورة افتراضية، مما يجعل التعامل معها يتطلب دوال معالجة مخصصة تستند إلى قياس الطول واقتطاع الأجزاء وفقاً لإحداثيات الفهارس المحددة سلفاً.
1.3 إشكالية المقاطع البادئة غير الضرورية وأثرها على المعالجة
تنشأ أزمة البادئات النصية في جداول البيانات غالباً نتيجة الترحيل اليدوي أو التلقائي من قواعد البيانات العتيقة التي كانت تشترط وجود رموز ثلاثية دالة على التاريخ، أو نوع القيد، أو معرف الخادم. وتتحول هذه المحارف الثلاثة الأولى إلى عقبة تقنية كبرى عند الرغبة في دمج الجداول المتعددة من خلال المفاتيح الأساسية (Primary Keys). فإذا احتوى الجدول المصدري على المعرف “ID_98765” واحتوى الجدول الفرعي على الرقم الصافي “98765”، فإن دوال الربط التلقائي تفشل فشلاً ذريعاً في إيجاد أي تطابق، وتصدر مخرجات خطأ تمنع تدفق البيانات التحليلية.
تتجلى ضرورة استئصال البادئات الثابتة في كونها الخطوة التأسيسية لأتمتة ربط البيانات. إن عدم تنقية هذه المعرفات يدوياً أو آلياً يفرض على المحلل عبئاً تشغيلياً هائلاً يتمثل في التدخل اليدوي المتكرر لتصحيح الروابط، وهو أمر يفتح الباب واسعاً للأخطاء البشرية القاتلة. وعليه، فإن استخدام الدوال الحسابية المتخصصة لتجريد السلسلة من أحرفها الثلاثة الأولى يمثل حلاً هندسياً قاطعاً يضمن تكامل السجلات، ويعيد النص إلى بنيته الصافية المؤهلة للتحليل الخوارزمي الدقيق.
2. التشريح النظري للصيغة المركبة: دمج دالتي RIGHT وLEN
2.1 الدور الوظيفي لدالة RIGHT ومعايير مدخلاتها الحسابية
تُعد دالة RIGHT إحدى الأدوات القياسية العريقة في تاريخ برمجيات الجداول الممتدة، وتعود أصولها الهندسية إلى مواصفات برمجيات الجداول الأولى مثل لوتس 1-2-3 وميكروسوفت إكسل، وصولاً إلى نسختها الحديثة في جداول بيانات جوجل التي انطلقت عام 2006. تقوم هذه الدالة باستخلاص عدد محدد من المحارف من الطرف النهائي (الأيمن) لسلسلة نصية معينة، استناداً إلى بنيتها الخوارزمية التي تبدأ العد التنازلي من آخر محرف نحو بداية النص.
تتطلب الدالة وسيطتين أساسيتين: الوسيطة الأولى هي السلسلة النصية المصدر (أو مرجع الخلية المحتوية عليها مثل A2)، بينما الوسيطة الثانية تمثل عدداً صحيحاً موجباً يحدد كمية المحارف التي يجب الإبقاء عليها واستخراجها. وإذا كان العدد المحدد في الوسيطة الثانية مساوياً لطول السلسلة أو متجاوزاً له، فإن السلوك الافتراضي الخوارزمي للدالة يقضي بإعادة السلسلة النصية الأصلية كاملة دون حذف، ودون إطلاق أي تحذير برمجي، وهو سلوك يضمن استمرارية تدفق العمليات الحسابية داخل أوراق العمل.
2.2 آليات عمل دالة LEN في حساب الأطوال النصية
تختص دالة LEN (المشتقة من المصطلح الإنجليزي Length) بإجراء قياس دقيق للمحتوى الحسابي الداخلي للخلية، حيث تقوم بإرجاع القيمة العددية الصحيحة التي تمثل الطول الإجمالي لكافة المحارف المكونة للسلسلة النصية المستهدفة. تعمل الدالة على مسح السلسلة من بدايتها إلى نهايتها، وتقوم بعد كل رمز فردي، بما في ذلك المسافات الفارغة المتقدمة أو المتأخرة، وعلامات الترقيم، والرموز الهجائية، والأرقام.
تكمن قوة دالة LEN في حساسيتها الفائقة لجميع الرموز المشغولة داخل الخلية، حتى تلك التي قد لا تظهر بوضوح للعين المجردة مثل المسافات المزدوجة غير المرئية أو الحروف التنسيقية. وبفضل هذه الطبيعة القياسية الصارمة، يُنظر إلى مخرجات دالة LEN كقيمة مرجعية ديناميكية بالغة الأهمية؛ حيث تتيح للمحلل تحويل الخصائص الهيكلية للنص غير المرئي إلى أرقام صريحة يمكن إقحامها في العمليات الرياضية التكميلية، مما يمهد الطريق لبناء صيغ تفاعلية تتكيف مع تباين أطوال النصوص المختلفة في ذات العمود.
2.3 التحليل الرياضي لعملية الطرح الحسابي (LEN – 3)
يقوم المنطق الجبري لاستئصال البادئات على معادلة تمايزية بسيطة ولكنها شديدة الفاعلية: إذا كانت السلسلة النصية تتكون من عدد إجمالي من المحارف يُرمز له بالرمز (L)، وكان المطلوب التخلص نهائياً من أول ثلاثة محارف مستقرة في الطرف الأيسر (الفهارس 1، و2، و3)، فإن الجزء المراد استبقاؤه يمثل المحارف الواقعة في نهاية السلسلة، وعددها الرياضي الحتمي هو (L – 3).
عندما نقوم بتغذية دالة RIGHT بهذا الفارق الرياضي الناتج عن طرح الرقم 3 من المخرج الإجمالي لدالة LEN، فإننا نوجه المؤشر الخوارزمي ليتحرك من أقصى يمين السلسلة نحو اليسار بعدد خطوات يساوي تماماً (الطول الإجمالي – 3). هذا يضمن حسابياً بقاء كافة المحارف الأصلية على قيد الوجود في النص المسترجع، باستثناء الثلاثة الأولى التي يقع التوقف قبل بلوغها؛ مما يحقق هدف التطهير النصي بنسبة خطأ صفرية دون الحاجة إلى معرفة مسبقة بمدى طول السلسلة الإجمالي في كل سطر على حدة.
3. الدليل الإجرائي لتطبيق صيغة اقتطاع أول 3 أحرف عملياً
3.1 إعداد بيئة العمل وفحص الخلية المصدر
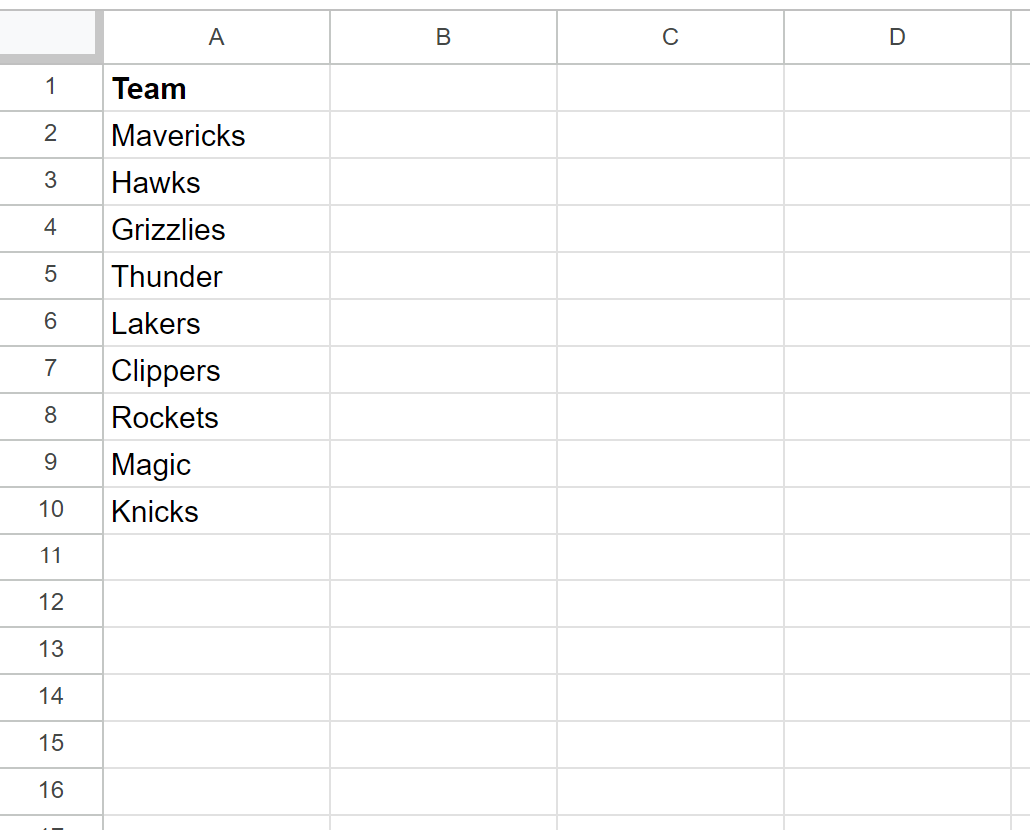
تبدأ العملية التنفيذية المنهجية بفحص أولي لجودة البيانات المتمركزة في العمود المصدري (وليكن العمود A). يتعين على المحلل التأكد من أن السجلات لا تخضع لتنسيقات عرض اصطناعية تخفي الحقائق المحرفية للخلية؛ فعلى سبيل المثال، قد تحتوي الخلية على تنسيق مخصص يظهر رمزاً بادئاً ظاهرياً بينما القيمة الحقيقية للخلية خالية منه، أو العكس بالعكس. وتكتسب المنهجية التطبيقية الدقيقة أهمية قصوى لضمان عدم تلف البيانات أثناء المعالجة، وهو ما تشير إليه الأدبيات التقنية كدراسة Fulcini et al. (2023) حول أهمية أدوات التحقق والاختبار في البرمجيات لضمان اتساق النتائج ومنع الأخطاء الوظيفية.
يُنصح دائماً بإدراج عمود إضافي فارغ بجوار العمود الأصلي المستهدف مباشرة، وتسميته باسم وصفي مناسب مثل “البيانات_المنقاة” (Cleansed_Data) ليكون مستودعاً آمناً لاستقبال المخرجات المعالجة، مع الاحتفاظ الصارم بالبيانات الأصلية الخام في العمود المجاور لضمان إمكانية التراجع والتدقيق المقارن في أي وقت لاحق. كما يجب التأكد من ضبط تنسيق العمود الجديد كـ “نص عادي” (Plain Text) من قائمة “تنسيق” لتجنب التحويل التلقائي للأرقام المستخلصة إلى تواريخ أو أشكال رقمية تشوه سلامة السجل النصي.
3.2 كتابة الصيغة المركبة داخل المحرر المرجعي
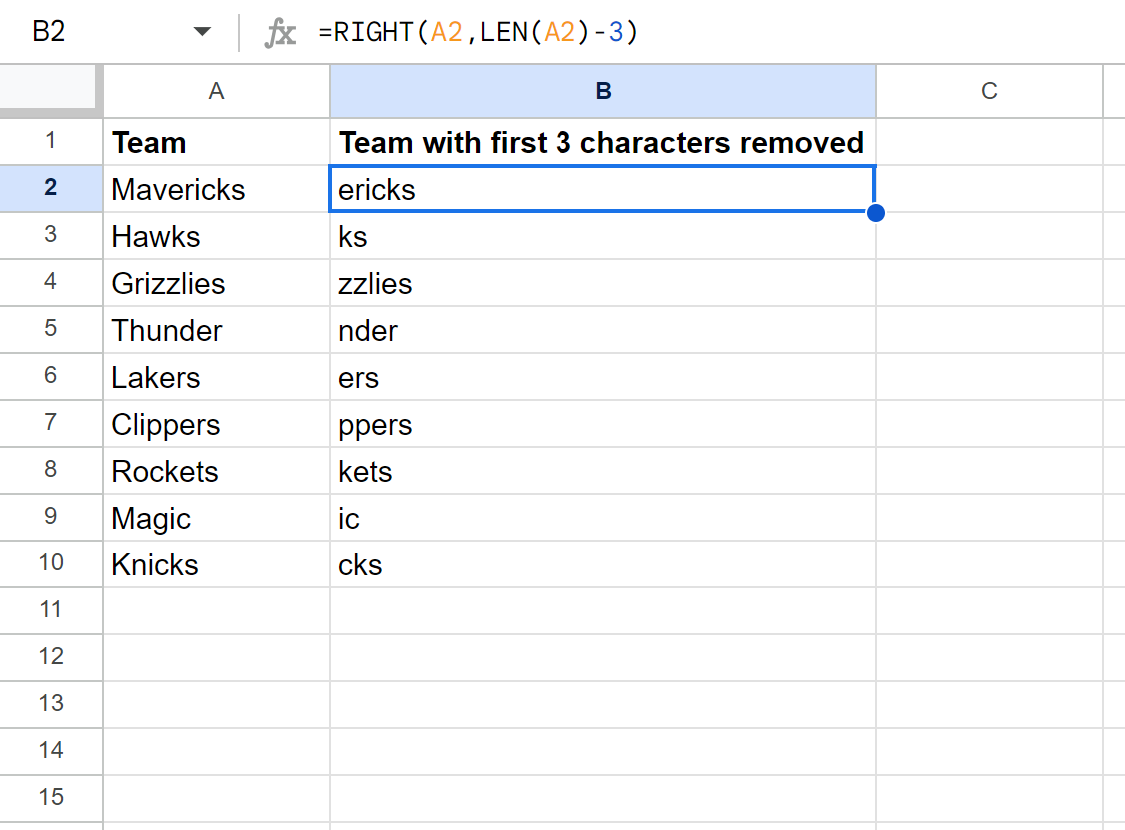
يتم النقر على الخلية الأولى المقابلة للسجل المصدري المستهدف في العمود الجديد (ولنفرض أنها الخلية B2 المقابلة للمصدر A2). بعد وضع المؤشر في شريط الصيغ بالأعلى، يتم إدخال التعبير الرياضي بصيغته الدقيقة كالتالي:
=RIGHT(A2, LEN(A2) - 3)
يتطلب هذا الإدخال عناية تامة بتركيبة الأقواس لضمان عدم وقوع تداخل منطقي؛ فالقوس الأول يفتح وسيطات دالة RIGHT، يليه اسم الخلية A2 وفاصلة (أو فاصلة منقوطة بناءً على الإعدادات الإقليمية لجدول البيانات)، ثم يُستدعى التعبير الرياضي الداخلي LEN(A2) مطروحاً منه العدد 3، ثم يُغلق القوس النهائي. بمجرد الضغط على مفتاح الإدخال (Enter)، يقوم محرك الحوسبة في جداول بيانات جوجل بتقييم الطول الكلي، وإجراء عملية الطرح، واستخلاص المقطع المتبقي، لتظهر النتيجة النقية في الخلية فوراً.
3.3 التعميم الآلي للصيغة عبر تقنيات السحب والملء التلقائي
بمجرد التحقق البصري من صحة المخرج في الخلية B2، تأتي خطوة تعميم المعالجة على بقية السجلات في العمود والتي قد تمتد لآلاف الصفوف. توفر منصة جداول بيانات جوجل خيار “مقبض التعبئة” (Fill Handle)، وهو المربع الأزرق الصغير الكائن في الزاوية السفلى اليسرى (أو اليمنى حسب لغة الواجهة) من الخلية النشطة. يمكن النقر المزدوج السريع على هذا المقبض، لتقوم المنصة تلقائياً بقراءة النطاق الرأسي المجاور واستنساخ الصيغة حتى نهاية آخر صف يتضمن بيانات في العمود A.
تتكيف المراجع النسبية أثناء عملية التمدد الرأسي بذكاء تام، فتتحول الصيغة تلقائياً في الصف الثالث لتصبح =RIGHT(A3, LEN(A3) - 3)، وفي الصف الرابع =RIGHT(A4, LEN(A4) - 3)، وهكذا إلى نهاية النطاق. كما يمكن الاستعانة بميزة الإكمال التلقائي الذكي (Smart Fill) التي تقترح ملء العمود كاملاً بمجرد استشعار النمط التكراري، وهو ما يقلص زمن المعالجة اليدوية ويوفر حماية تامة ضد أخطاء التخطي أو عدم اتساق المراجع الحسابية.
4. دراسة حالات تطبيقية واقعية: من السجلات الخام إلى البيانات المنقاة
4.1 تطهير معرفات الفرق والرموز الرياضية التمهيدية
من الأمثلة التوضيحية البارزة في تطبيقات معالجة النصوص، ما يظهر في سجلات البطولات الرياضية المنظمة؛ حيث تعمد الجهات الإحصائية إلى تصدير أسماء الفرق مقرونة ببادئات رقمية أو كودية تشير إلى المجموعة أو التصنيف. لنتأمل جدولاً يضم الفرق في العمود A على النحو التالي:
- الخلية A2:
001ريال مدريد - الخلية A3:
002برشلونة - الخلية A4:
003بايرن ميونخ - الخلية A5:
004مانشستر سيتي
عند كتابة الصيغة =RIGHT(A2, LEN(A2) - 3) في الخلية B2 وسحبها للأسفل، تحسب دالة LEN طول النص في A2 البالغ 13 محرفاً (بما فيها المسافة)، ثم تطرح 3 ليصبح الناتج 10 محارف. بعد ذلك، تستخرج دالة RIGHT المحارف العشرة من اليمين، مما يعزل السلسلة “ريال مدريد” بدقة مطلقة، مع زوال الكود البادئ “001”. وبالمثل، يتحول السجل في A3 إلى “برشلونة” الصافية، مما يتيح للباحث الرياضي تصنيف الأندية وإجراء تحليلات إحصائية دقيقة دون تشويه نصي.
4.2 معالجة الأكواد التعريفية وأرقام الشحنات والمنتجات
في قطاع التجارة الإلكترونية وإدارة سلاسل الإمداد، غالباً ما تحتوي أرقام تتبع الشحنات وأكواد السلع (SKUs) على معرفات مستودعية سابقة. لنفترض أن شركة شحن تستخدم النظام البادئ “EXP” للإشارة إلى الشحنات السريعة متبوعة برقم التتبع الفعلي، فتكون القيود مثل EXP88392019 أو EXP77410294. إن وجود هذا الكود النصي “EXP” يحول دون استخدام أرقام التتبع كأرقام تسلسلية فريدة قابلة للفرز العددي أو التصدير التلقائي لأنظمة الجمارك.
بتطبيق معادلة الاقتطاع، يتم التخلص الجراحي من محارف “EXP” الثلاثة الأولى في لمح البصر، تاركاً الأرقام التسلسلية الصافية 88392019 و77410294 في العمود المستهدف. وعندها، يمكن للمحلل تحويل هذه الأرقام المستخلصة إلى قيم رقمية صحيحة أو تركها كنصوص فريدة مؤهلة لعمليات الربط المباشر مع قواعد بيانات العملاء، مما يرفع كفاءة تتبع الشحنات ويزيل التكرارات الناتجة عن اختلاف تنسيقات البادئات بين شركات النقل المتعاونة.
4.3 إدارة الأخطاء في السجلات النصية القصيرة والمتباينة
تبرز إشكالية تقنية حرجة عندما يشتمل عمود البيانات على سجلات تتألف من ثلاثة محارف فقط أو أقل. لنفترض أن الخلية A10 تحتوي على الكود “USA” بينما الخلية A11 تحتوي على الحرفين “UK”. إذا طُبقت الصيغة المركبة =RIGHT(A10, LEN(A10) - 3)، فإن دالة LEN ستحسب الطول مساوياً لـ 3، وتكون نتيجة الطرح (3 – 3 = 0). تستجيب دالة RIGHT لإلزامها باستخراج صفر محارف بإرجاع سلسلة نصية فارغة تماماً (Empty String)، وهو سلوك منطقي ومقبول.
أما في حالة الخلية A11 المحتوية على حرفين فقط، فإن المعادلة ستنتج قيمة سالبة: (2 – 3 = -1). وهنا يفشل المنطق الحسابي لدالة RIGHT، إذ لا يمكن خوارزمياً استخراج عدد سالب من المحارف، مما يؤدي فوراً إلى انفجار خطأ القيمة البرمجي الشهير #VALUE!. يتطلب التعامل المنهجي مع هذه السجلات المتباينة بناء آليات احترازية تمنع وصول العمليات السالبة إلى وسيطة الاستقطاع، لضمان عدم توقف تدفق الحسابات في الجداول الضخمة التي قد تضم ملايين الخلايا.
5. البدائل المنهجية المكافئة: استخدام دالة MID كخيار مباشر
5.1 الأساس المنطقي لعمل دالة MID في استقطاع النصوص
توفر جداول بيانات جوجل دالة MID كأداة تشريحية متقدمة تهدف إلى اقتطاع جزء محدد من السلسلة النصية بدءاً من أي موضع عشوائي يختاره المستخدم، وحتى استيفاء عدد معين من المحارف. وخلافاً لدالة RIGHT التي تبدأ عملها دائماً من الطرف النهائي للنص، تمنح دالة MID للمحلل تحكماً كاملاً في تعيين نقطة الارتكاز الابتدائية التي ينطلق منها الاستقطاع.
تعتمد فلسفة إزالة أول ثلاثة محارف باستخدام دالة MID على تجاوز تلك المحارف بالكامل منذ اللحظة الأولى. فبما أن النظام المتبع في فهرسة الجداول هو الفهرسة القائمة على الرقم 1، فإن المحارف الثلاثة الأولى تحتل المواضع 1، و2، و3 على التوالي. بناءً على ذلك، إذا أردنا إسقاطها جميعاً، فما علينا سوى توجيه دالة MID للبدء مباشرة من المحرف الرابع (Position 4). هذا المدخل المباشر يلغي الحاجة الذهنية إلى احتساب الفروق العكسية المعقدة في بعض الأحيان، مما يجعله خياراً جذاباً للكثير من خبراء البيانات.
5.2 صياغة معادلة التجاوز النصي البدء من الموضع الرابع
لبناء الصيغة المباشرة بواسطة دالة MID، يتم استدعاء الدالة بثلاث وسيطات رئيسية: النص المصدري، وفهرس البداية، والعدد الأقصى للمحارف المراد اقتطاعها. تأخذ الصيغة النموذجية الشكل التالي:
=MID(A2, 4, LEN(A2))
في هذه المعادلة، تشير الوسيطة الثانية (الرقم 4) إلى أن القراءة ستبدأ حتماً من الحرف الرابع، متجاهلة تماماً الأحرف الثلاثة السابقة. أما الوسيطة الثالثة، فإننا نمرر لها دالة LEN(A2) كقيمة عددية عليا تكفي حتماً لاستيعاب كل ما تبقى من النص مهما بلغ طوله. ومن الخصائص التشغيلية البديعة لدالة MID أنها لا تطلق أي خطأ إذا تجاوز عدد المحارف المطلوب طول النص المتبقي في الخلية، بل تكتفي بقراءة النص حتى آخره ثم تتوقف بسلام، مما يجعل استخدام الطول الكلي كحد أقصى وسيلة برمجية بالغة الذكاء والبساطة.
5.3 مقارنة معيارية بين تقنية RIGHT/LEN وتقنية دالة MID
عند إجراء تقييم مقارن بين الصيغة المزدوجة =RIGHT(A2, LEN(A2) - 3) والصيغة المباشرة =MID(A2, 4, LEN(A2))، تبرز فروق بنيوية تتعلق بالسهولة الإدراكية وسلوك معالجة الأخطاء. من حيث سهولة القراءة البرمجية، تعتبر دالة MID أكثر وضوحاً وتعبيراً عن المقصد الوظيفي، حيث تنص صراحة على أن الاستخراج يبدأ من الموضع الرابع، دون إقحام عمليات طرح جبرية داخل وسائط الدالة.
من زاوية أخرى، تتفوق دالة MID تفوقاً ساحقاً في بيئات البيانات التي قد تحتوي على نصوص قصيرة تقل عن ثلاثة أحرف؛ فبدلاً من توليد خطأ #VALUE! الحسابي الذي تسببه دالة RIGHT نتيجة الطرح السالب، تتعامل دالة MID مع النصوص القصيرة بهدوء خوارزمي، فإذا بدأت من الموضع 4 في نص لا يتجاوز حرفين، تُرجع فوراً سلسلة فارغة دون أن تعطل الجدول بأكمله. أما من ناحية استهلاك الذاكرة، فكلا الأسلوبين يعملان بتعقيد زمني متماثل، وإن كانت دالة MID تحظى بتفضيل واسع لدى مهندسي الحلول التحليلية الضخمة لقدرتها الفائقة على احتواء الاستثناءات دون دوال إضافية.
6. المعالجة المتقدمة باستخدام التعابير النمطية ودالة REGEXREPLACE
6.1 مدخل إلى التعابير النمطية (Regex) في جداول بيانات جوجل
تمثل التعابير النمطية (Regular Expressions) إحدى أذكى وأقوى التقنيات الحاسوبية التي ابتكرت لمطابقة النصوص والتعرف على الأنماط المجردة في السلاسل المحرفية. وتدعم جداول بيانات جوجل محرك التعابير النمطية القائم على معيار RE2 الذي طورته شركة جوجل، متيحة للمستخدمين دوال قوية مثل REGEXEXTRACT، وREGEXMATCH، وREGEXREPLACE. هذه الأدوات تنقل المحلل من مرحلة التعامل الحسابي البسيط مع أطوال النصوص إلى مرحلة المعالجة المنطقية والشرطية المتقدمة.
تختص دالة REGEXREPLACE بالبحث عن نمط رمزي محدد داخل الخلية، واستبداله بسلسلة نصية بديلة يحددها المستخدم. وتتميز هذه الأداة بقدرتها على استيعاب المحددات المكانية، مثل إشارة بداية النص أو نهايته، فضلاً عن تحديد فئات المحارف المستهدفة، مما يفتح آفاقاً غير محدودة لتنظيف البيانات التي تعجز عنها الدوال النصية التقليدية المشلولة بالقياسات الحسابية الثابتة للأطوال.
6.2 بناء النمط البرمجي لحذف أول ثلاثة محارف بدقة
لإنجاز عملية استئصال أول ثلاثة محارف باستخدام التعابير النمطية، نصيغ المعادلة البرمجية التالية:
=REGEXREPLACE(A2, "^.{3}", "")
يعتمد هذا التعبير على تفكيك دقيق للرموز النمطية القياسية:
- رمز الإقحام (Caret)
^: يمثل محدداً مكانياً يثبت نطاق البحث عند “بداية السلسلة النصية” حصراً، مما يمنع الدالة من المساس بأي محارف في منتصف النص أو نهايته. - النقطة
.: رمز بديل شمولي (Wildcard) يطابق أي محرف مفرد أياً كان نوعه، سواء أكان حرفاً، أو رقماً، أو مسافة، أو رمزاً خاصاً. - المحدد الكمي
{3}: يحصر نطاق المطابقة في تكرار النمط لثلاث مرات متتالية بالضبط. - الوسيطة الأخيرة
"": تمثل السلسلة المستهدفة للاستبدال، وكونها فارغة يعني إزالة المحارف الثلاثة الأولى المستهدفة دون ترك أي أثر في الناتج النهائي.
6.3 حالات تفوق التعابير النمطية على الدوال النصية التقليدية
تتجلى العبقرية البرمجية لدالة REGEXREPLACE عند التعامل مع شروط عمل متباينة وحالات استثنائية معقدة. فعلى سبيل المثال، إذا كان المطلوب هو إزالة أول ثلاثة محارف بشرط أن تكون حتماً حروفاً أبجدية وليس أرقاماً، فإن الدوال التقليدية (RIGHT وMID) تعجز تماماً عن التمييز، بينما يمكن لتعبير نمطي مثل ^[A-Za-z]{3} أن ينجز المهمة ببراعة منقطعة النظير، حيث يقوم بالحذف إن تحقق الشرط، ويترك النص على حاله الأصلي إن كانت البداية رقمية.
كذلك، فإن دالة REGEXREPLACE تتميز بحصانة تامة ضد أخطاء السلاسل القصيرة؛ فإذا صادفت الدالة خلية تحتوي على حرفين فقط، فإن النمط ^.{3} لن يجد تطابقاً كاملاً من ثلاثة محارف، وبالتالي لن ينفذ أي استبدال ويعيد النص المكون من حرفين كما هو دون أن يتسبب في إيقاف المعالجة بخطأ برمجيات. هذه المرونة تجعل التعابير النمطية الخيار المفضل لتطهير البيانات غير المتجانسة والتي يُخشى فيها من وجود شوائب متعددة الأطوال والأنواع.
7. التطبيق الشامل عبر دالة ARRAYFORMULA للمعالجة المجمعة
7.1 فلسفة الحوسبة المصفوفية وأثرها على أداء جداول البيانات
في بيئات العمل الحديثة التي تتعامل مع تدفقات بيانات ضخمة (Big Data Streams)، يصبح النسخ اليدوي للصيغ وسحبها عبر آلاف الصفوف ممارسة تقنية بالية ومحفوفة بالمخاطر؛ فهي تؤدي إلى تضخم حجم الملف وزيادة العبء على ذاكرة التخزين السحابية للمتصفح، فضلاً عن تعرض الصيغ المنفردة لخطر التعديل أو الحذف العرضي من قِبل المستخدمين المشاركين في الورقة.
هنا تبرز دالة ARRAYFORMULA كأداة ثورية تتبنى مفهوم “العمليات المصفوفية”؛ حيث تتيح كتابة صيغة واحدة في قمة العمود تقوم تلقائياً بمعالجة النطاق الرأسي بأكمله وتوزيع النتائج على كافة الصفوف المتتابعة. إن هذه الحوسبة المركزية تضمن توحيد المنطق الحسابي لجميع السجلات، وتقلص استهلاك موارد المعالجة السحابية، فضلاً عن ميزتها الجوهرية في التفاعل اللحظي؛ إذ تطبق المعالجة فورياً على أي سجل جديد يتم إدراجه في ذيل الجدول دون أي تدخل بشري لاحق.
7.2 دمج صيغة الحذف النصي داخل مصفوفة ديناميكية
لدمج خوارزمية اقتطاع أول ثلاثة محارف داخل منظومة مصفوفية، نقوم بإحلال نطاق عمودي كامل (Range) بدلاً من مراجع الخلايا المفردة داخل الصيغة الأصلية، وتغليفها بدالة المصفوفات على النحو التالي:
=ARRAYFORMULA(RIGHT(A2:A, LEN(A2:A) - 3))
بمجرد إدخال هذه الصيغة الفريدة في الخلية B2، يقوم محرك جداول بيانات جوجل بتوسيع نطاق التقييم، فيمرر كل عنصر من عناصر المتجه الرأسي A2:A إلى دالة LEN التي تحسب أطوال النصوص بالتوازي، ثم تقوم دالة RIGHT باستخلاص المحارف المستهدفة لكل سطر وتنزيلها تلقائياً في العمود B. يضمن هذا النمط المصفوفي تحديثاً فورياً ومستمراً للسجلات بمجرد تدفق البيانات من استمارات جوجل (Google Forms) أو عبر واجهات برمجة التطبيقات (APIs) الخارجية.
7.3 التحكم في النطاقات الفارغة لمنع ظهور الأخطاء المتكررة
تنشأ معضلة كبرى عند استخدام الصيغة المصفوفية السابقة بدون قيود؛ حيث يمتد النطاق A2:A إلى قاع ورقة العمل متضمناً مئات الصفوف الفارغة. وتتعامل دالتا LEN وRIGHT مع الخلية الفارغة كقيمة نصية طولها صفر، مما ينتج العملية الحسابية (0 – 3 = -3)، وهو ما يؤدي إلى إغراق جميع الصفوف غير المشغولة في أسفل الجدول بأخطاء #VALUE! البشعة التي تشوه المظهر العام وتعيق التحليلات الإحصائية.
لحل هذه المعضلة حلاً جذرياً، يتم تطويع دالة IF الشرطية لفحص وجود البيانات وطولها قبل الشروع في عملية الاقتطاع، فتتحول الصيغة إلى نسختها الاحترافية المكتملة:
=ARRAYFORMULA(IF(LEN(A2:A) > 3, RIGHT(A2:A, LEN(A2:A) - 3), ""))
بهذا الشرط المحكم، تفحص الدالة كل خلية في النطاق؛ فإن كان طول محتواها يتجاوز ثلاثة محارف، نفذت عملية الاقتطاع فورا، أما إذا كانت الخلية فارغة أو كان طولها لا يتعدى الثلاثة محارف، فإنها تودع في الخلية المقابلة سلسلة فارغة تماماً "". يمنح هذا الأسلوب جدول البيانات مظهراً احترافياً فائق النقاء، ويمنع ظهور الأخطاء في الصفوف السفلية نهائياً.
8. إدارة الأخطاء واستكشاف الأعطال الشائعة ومعالجتها
8.1 التعامل مع خطأ القيمة (#VALUE!) وأسباب ظهوره
يُعد خطأ القيمة #VALUE! العَرَض الأكثر شيوعاً وإرباكاً عند التعامل مع صيغ المعالجة النصية المعتمدة على الدوال الحسابية. والسبب الجذري لظهور هذا الخطأ في صيغة RIGHT(A2, LEN(A2) - 3) هو خرق المبدأ الخوارزمي الذي يقضي بأن وسيطة عدد المحارف في دالة RIGHT يجب أن تكون قيمة صحيحة غير سالبة (Non-negative Integer). فعندما يصادف المحرك نصاً يتألف من حرف أو حرفين، تنتج الدالة وسيطة عددية سالبة ترفضها بيئة الحوسبة فورياً.
لتطويق هذه الظاهرة وعزل الأخطاء، يُستحسن تغليف الصيغة بدالة الحماية المنطقية IFERROR، لتصبح المعادلة كالتالي:
=IFERROR(RIGHT(A2, LEN(A2) - 3), "")
يتيح هذا التغليف للدالة محاولة تنفيذ الاقتطاع الطبيعي، فإذا واجهت قيمة سالبة أطلقت خطأ القيمة، تتدخل دالة IFERROR فوراً وتكتم رسالة الخطأ مستبدلة إياها بسلسلة فارغة، أو بنص تنبيهي منظم مثل “قيمة غير صالحة” يتيح لمدقق البيانات اكتشاف الشواذ السلوكية في السجلات وفحصها منفصلة.
8.2 تأثير المسافات البادئة المخفية ورموز التنسيق غير المرئية
تتمثل إحدى الخدع البصرية الأكثر تكراراً في وجود مسافات بيضاء غير مرئية تفصل بين حافة الخلية والنص الفعلي. فإذا كانت الخلية A2 تحتوي على النص ” ABCDEF” (مسافتان في البداية متبوعتان بالنص)، ورغب المستخدم في حذف الرموز الثلاثة “ABC”، فإن صيغة RIGHT(A2, LEN(A2) - 3) ستقوم بحذف المسافتين والحرف “A” فقط! والسبب أن دالة LEN تحتسب المسافات كأي محارف عادية أخرى، مما ينتج نصاً مشوهاً يبدأ بالحرف “B”.
ولتحصين العمليات الحسابية ضد هذه الانحرافات، يجب دمج دالة التطهير TRIM التي تقوم باستئصال كافة المسافات البادئة والمتأخرة وتكثيف المسافات البينية لتصبح مسافة واحدة. وبدمج الدوال تنتج صيغة منيعة بالغة القوة:
=RIGHT(TRIM(A2), LEN(TRIM(A2)) - 3)
تضمن هذه الصيغة تنظيف النص من المسافات الطفيلية أولاً، ثم قياس طوله الصافي ثانياً، وتنفيذ الاقتطاع على أساس سليم لا يتأثر بأخطاء الإدخال اليدوي أو مشكلات النسخ العشوائي للمعلومات.
8.3 الحفاظ على الأنماط الخاصة بالنصوص الرقمية والتواريخ
عندما تكون البيانات الأصلية تحتوي على أرقام أو تواريخ تم تخزينها ببادئة نصية (مثل TXT100250)، فإن استئصال أول ثلاثة محارف سينتج السلسلة "100250". ورغم أن هذا الناتج يبدو رقماً مجرداً للعين، إلا أن جداول بيانات جوجل تظل تعامله داخلياً كقيمة نصية محاذاة لليسار، مما يمنع إدراجه في دوال الجمع مثل SUM أو المتوسط AVERAGE.
إذا كانت الغاية التحليلية تتطلب إعادة تحويل هذا المخرج إلى رقم حسابي صريح، يجب تغليف المعادلة بدالة VALUE على النحو التالي:
=VALUE(RIGHT(A2, LEN(A2) - 3))
أما في حالات التواريخ، فيجب الانتباه الشديد؛ لأن التواريخ في جداول البيانات تخزن أساساً كأرقام تسلسلية داخلية تبدأ من 30 ديسمبر 1899. فاقتطاع أجزاء من نصوص التاريخ الخام قد يقود إلى تشويه هذا الرقم التسلسلي، مما يستلزم استخدام دالة DATEVALUE أو معالجة التاريخ بدوال اليوم والشهر والسنة بدلاً من الاقتطاع النصي الأعمى.
9. الاعتبارات المعيارية للمحارف الخاصة واللغات متعددة البايت
9.1 خصائص معالجة النصوص متعددة البايت والأبجدية العربية
تتبنى جداول بيانات جوجل معيار الترميز العالمي الموحد (UTF-8)، وهو نظام ترميز متطور يخصص لكل محرف عدداً متفاوتاً من البايتات يتراوح بين بايت واحد (كما في الحروف اللاتينية الأساسية) إلى بايتين أو أكثر للحروف العربية والحروف الآسيوية المعقدة. ومع ذلك، فإن الدوال النصية القياسية في جداول بيانات جوجل (LEN، وRIGHT، وMID) مصممة لتتعامل مع المحارف بالمعنى البصري/المنطقي (Characters) وليس بعدد البايتات الفيزيائية، مما يجنب المستخدم الأخطاء الشائعة في لغات البرمجة منخفضة المستوى.
ومع ذلك، تظهر خصوصية كبرى عند التعامل مع اللغة العربية في وجود علامات التشكيل والحركات الإعرابية (كالضمة، والفتحة، والكسرة، والشدة). تُعامل الحركات التشكيلية في ترميز اليونيكود كمحارف ربط مستقلة (Combining Characters)؛ فإذا كانت الكلمة تحتوي على حركة، فإن دالة LEN ستحتسب الحرف كوحدة والحركة كوحدة ثانية منفصلة تماماً. وبالتالي، فإن محاولة إزالة ثلاثة أحرف من كلمة مشكولة قد يؤدي إلى حذف حرف وحركته وحرف تالٍ، تاركاً بنية الكلمة ممزقة لغوياً، وهو ما يفرض إزالة التشكيل أولاً قبل الشروع في عمليات الاقتطاع البنيوي.
9.2 التعامل مع الرموز التعبيرية (Emojis) والمسافات الصفرية
في عصر التحليلات الرقمية المعاصرة لشبكات التواصل الاجتماعي، تتضمن البيانات النصية المستخرجة أعداداً هائلة من الرموز التعبيرية (Emojis) والمحارف الخفية مثل “المسافة الصفرية غير القابلة للكسر” (Zero-Width Non-Joiner – ZWNJ). وتكمن المفارقة التقنية في أن بعض الرموز التعبيرية لا تتكون من محرف واحد في بنية اليونيكود، بل تتركب من زوجين بديلين (Surrogate Pairs) أو تسلسلات مركبة ترتبط بمحرف ربط صفري.
إذا كانت البادئة الثلاثية المستهدفة تتضمن رموزاً تعبيرية، فإن دالة LEN قد تقرأ الرمز التعبيري الواحد كحرفين، مما يؤدي إلى انزلاق خطأ غير مقصود في موضع القطع. كذلك فإن المسافات الصفرية، التي لا تظهر في الخلية نهائياً، تُحتسب كمحارف صحيحة في الطول؛ مما يستدعي من المحلل فحص البيانات مسبقاً وتطهيرها من هذه الرموز التنسيقية الشبحية لضمان تطابق الاقتطاع مع التوقعات البصرية الصريحة للمحتوى.
9.3 توحيد المعايير اللغوية قبل تطبيق معادلات الاستقطاع
لضمان عدم تشوه السجلات متعددة اللغات، يُلزم البروتوكول المنهجي بتمرير النصوص عبر دالة CLEAN أولاً، والتي تختص بكنس كافة محارف التحكم غير القابلة للطباعة (ASCII characters from 0 to 31) التي تتسلل من ملفات التصدير النصية القديمة أو لغات البرمجة الخارجية. إن توحيد بنية الترميز وضمان خلو النصوص من المحارف الشبحية يعد ركيزة أساسية قبل تفعيل أي استقطاع محرفي.
علاوة على ذلك، يجب على المحلل التحقق من عينات عشوائية ممثلة لكافة اللغات الموجودة في ورقة البيانات للتأكد من أن السلوك الاستقطاعي لم يترك مقاطع محرفية مبتورة في النصوص المكتوبة من اليمين إلى اليسار (RTL) كالغة العربية والفارسية، مقارنة بالنصوص اللاتينية المكتوبة من اليسار إلى اليمين (LTR)، والاطمئنان التام إلى أن موضع الانطلاق في دوال RIGHT وMID يحقق الاتساق المنطقي المقصود في كلا الاتجاهين.
10. أفضل الممارسات المنهجية لتثبيت وتحويل البيانات المنقاة
10.1 تحويل الصيغ الحسابية إلى قيم نصية ثابتة
بمجرد الانتهاء من ضبط الصيغ والتأكد من نجاح عملية اقتطاع المحارف الثلاثة الأولى عبر كافة الصفوف، تصبح الخطوة الحيوية التالية هي “تجميد” البيانات. إن إبقاء الأعمدة معتمدة على صيغ تفاعلية حية (Dynamic Formulas) يفرض استهلاكاً مستمراً لذاكرة المتصفح وطاقة الخوادم المركزية عند كل إعادة تحميل للورقة، فضلاً عن أنه يشكل خطراً بنيوياً داهماً؛ إذ إن أي تعديل أو حذف غير مقصود في العمود المصدري A سيؤدي حتماً إلى دمار البيانات في العمود B.
تتم عملية التثبيت المنهجية باتباع تسلسل إجرائي دقيق:
- تحديد العمود المعالج حديثاً بالكامل (العمود B).
- نسخ النطاق عبر الضغط على
Ctrl + C(أوCmd + Cفي أنظمة ماك). - النقر بزر الفأرة الأيمن على رأس العمود، واختيار “لصق خاص” (Paste special)، ثم تحديد “القيم فقط” (Values only)، أو استخدام الاختصار المباشر
Ctrl + Shift + V.
يحول هذا الإجراء الصيغ الرياضية فورياً إلى قيم نصية نهائية وثابتة، مما يسمح بحذف العمود المصدري الأصلي A بأمان مطلق دون مواجهة خطأ المرجع المفقود الشهير #REF!.
10.2 توثيق منطق التحويل لضمان الموثوقية وقابلية التدقيق
تقتضي معايير الحوكمة وإدارة جودة البيانات توثيق كافة المعالجات التحويلية التي خضعت لها السجلات داخل المؤسسة. لا ينبغي للمحلل الاكتفاء بحذف المحارف وترك الأعمدة صامتة دون بيان؛ بل يتعين إضافة تعليق أو ملاحظة توثيقية في رأس العمود (Header Note) يشرح بالتفصيل التاريخ، والهدف، والصيغة الرياضية المحددة التي استُخدمت لإنتاج هذه البيانات المنقاة.
كما يُنصح بتسجيل هذه الخطوات في ملف “قاموس البيانات” (Data Dictionary) المرافق للمشروع، متضمناً الإشارة إلى أن العمود قد خضع لاستئصال البادئة الثلاثية بغرض مواءمته مع معايير الأنظمة الإدارية أو تحضيره للربط مع جداول أخرى. هذا التوثيق الشفاف يسهل على مدققي الحسابات، وفرق التحليل اللاحقة، فهم مسار تحول البيانات وتتبع أي انحرافات مفترضة قد تطرأ مستقبلاً دون الحاجة إلى تفكيك عكسي للخطوات التاريخية.
10.3 بناء مسار تنظيف بيانات نصي متكامل وقابل للتكرار
لا تتوقف المهمة التحليلية عند معالجة ملف لمرة واحدة، بل تتسع لتشمل بناء نماذج عمل قابلة للتكرار الدوري (Repeatable Workflows). يُمكن للمحلل المتمرس تصميم ورقة عمل مخصصة كـ “طبقة تنظيف وسيطة” (Staging Layer) تستقبل البيانات الخام في عمود، وتمررها عبر دالة ARRAYFORMULA الشرطية المركبة مع TRIM وCLEAN، لتقوم بتطهير النصوص دورياً ومزامنتها تلقائياً.
يمكن تصدير هذه المخرجات المنقاة لاحقاً بصورة مؤتمتة إلى قواعد البيانات العلائقية مثل PostgreSQL أو BigQuery عبر الموصلات السحابية. إن تضمين خوارزميات إزالة البادئات النصية كحلقة متكاملة داخل منظومة جمع البيانات الدورية يرفع الكفاءة التشغيلية للمؤسسة، ويوفر مئات الساعات المهدرة في التصحيحات اليدوية، ويجعل المنظومة التحليلية برمتها تعمل بتناغم ودقة متناهية.
خاتمة شاملة
استعرضنا في هذا الدليل التخصصي الموسع التشريح الهندسي والتطبيقي الدقيق لعملية استئصال أول ثلاثة محارف من السلاسل النصية في بيئة جداول بيانات جوجل. وقد تبين لنا بوضوح أن هذه المهمة—التي قد تبدو بسيطة في ظاهرها—تستند إلى منظومة برمجية ورياضية غنية تتطلب فهماً عميقاً لفهارس النصوص وطبيعة الفهارس القائمة على الرقم 1 وسلوكيات الترميز المحرفي وميكانيكا التقييم الداخلي للخلايا.
إن إتقان الصيغة الكلاسيكية المعتمدة على دمج دالتي RIGHT وLEN، واستيعاب بديلها المباشر والأنيق عبر دالة MID، والتسلح بالقوة المطلقة للتعابير النمطية عبر REGEXREPLACE، ثم تعميم هذه الأدوات مصفوفياً بواسطة ARRAYFORMULA مع إحكام السيطرة على الاستثناءات عبر IFERROR وTRIM، يمنح المحلل ترسانة برمجية لا غنى عنها للتعامل مع أكثر مجموعات البيانات فوضوية وتحويلها إلى أصول معلوماتية نقية وعالية الجودة. إن جودة التحليل الإحصائي النهائي ما هي إلا انعكاس مباشر لنقاء البيانات الأولية، وتظل هذه المهارات النصية الأساس المتين الذي تُبنى عليه كافة التحليلات التنبؤية وقرارات الأعمال الرشيدة في عصر البيانات الضخمة.
المراجع
- Fulcini, T., Coppola, R., Ardito, L., & Torchiano, M. (2023). A Review on Tools, Mechanics, Benefits, and Challenges of Gamified Software Testing. ACM Computing Surveys. https://doi.org/10.1145/3582273
- Tse, C.-S., Yap, M. J.-M., Chan, Y.-L., Sze, W. P., Shaoul, C., & Lin, D. (2016). The Chinese Lexicon Project: A megastudy of lexical decision performance for 25,000+ traditional Chinese two-character compound words. Behavior Research Methods. https://doi.org/10.3758/s13428-016-0810-5