
تُعد معالجة السلاسل النصية وضبط اتساقها من الركائز البنيوية الجوهرية في هندسة البيانات وتحليلها، لا سيما في عصر تهيمن فيه المنصات السحابية كأدوات معيارية لإدارة وتدقيق وتداول البيانات المؤسسية والبحثية. وفي إطار العمل ضمن بيئة جداول بيانات جوجل (Google Sheets)، التي تعود أصولها التقنية الأولى إلى استحواذ شركة جوجل عام 2005 على شركة “2Web Technologies” التي أسسها كل من جوناثان روشيل (Jonathan Rochelle) وفرزاد خسروشاهي (Farzad “Fuzzy” Khosrowshahi) مطوري نظام “XL2Web” ثم إطلاقها رسمياً كبرنامج تجريبي في يونيو 2006، برزت الحاجة الملحة إلى أدوات مرنة لتحرير ومعالجة البيانات المتدفقة من شتى المصادر. تلتزم دوال التلاعب بالنصوص المعيارية في جداول بيانات جوجل بمواصفات “OpenDocument” والأنظمة الحسابية التاريخية كـ Lotus 1-2-3 وميكروسوفت إكسل، مما يجعل فهم آلياتها متطلباً حاسماً لكل باحث ومحلل يسعى لبناء نماذج خالية من التشويه.
إن ظاهرة وجود رموز أو محارف طرفية غير مرغوب فيها في نهاية السلاسل النصية ليست مجرد عيب بصري عابر، بل هي خلل هيكلي يؤثر على سلامة العمليات التحليلية وعمليات الربط بين الجداول (Data Joins) وعمليات البحث والتطابق (Lookup Operations). قد تتمثل هذه المحارف الزائدة في فواصل متبقية من ملفات CSV، أو شرطات إضافية، أو أصفار مقطوعة، أو مسافات بيضاء غير مرئية نتجت عن مدخلات بشرية غير منضبطة أو عمليات تصدير غير مهيأة برمجياً من قواعد بيانات قديمة. ويترتب على ذلك فشل الدوال المرجعية، وانهيار النماذج الإحصائية، وظهور أخطاء عدم التطابق، مما يُلزم محلل البيانات بامتلاك أدوات دقيقة ومتنوعة لتنقية النصوص بكفاءة ودون المساس بالبنية الأساسية للبيانات.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك وتحليل كافة التقنيات المتاحة داخل بيئة جداول بيانات جوجل لإزالة الحرف الأخير من سلسلة نصية، بدءاً من البنية الرياضية التقليدية القائمة على دمج دالتي LEFT و LEN، مروراً بالحلول المتقدمة التي توظف التعابير النمطية (Regular Expressions) عبر دالة REGEXREPLACE، والبدائل القائمة على دالتي MID و LEN، وصولاً إلى الأتمتة الشاملة باستخدام الحوسبة المصفوفية (ARRAYFORMULA) والنصوص البرمجية التوسعية عبر Google Apps Script. سيتطرق التحليل أيضاً إلى مناقشة معمقة لأبرز المنزلقات البرمجية والحالات الحافية الشاذة (Edge Cases) وإدارة الأخطاء لضمان تماسك النظم المعلوماتية وقابليتها للتوسع والتدقيق الأكاديمي.
1. مقدمة عامة حول معالجة السلاسل النصية في جداول بيانات جوجل
1.1 أهمية تنظيف وتدقيق البيانات النصية في الحوسبة السحابية
تمثل جودة البيانات النصية حجر الزاوية في بناء النماذج التحليلية الموثوقة والأنظمة الإحصائية المتقدمة. في بيئات الحوسبة السحابية الحديثة، حيث تتكامل جداول البيانات مع منصات ذكاء الأعمال ومستودعات البيانات الضخمة عبر واجهات برمجة التطبيقات (APIs)، يصبح اتساق السلاسل النصية شرطاً أساسياً لضمان سلامة العمليات الترابطية. إن وجود حرف طرفي زائد، سواء كان نقطة أو فاصلة أو رمزاً خاصاً، يؤدي إلى كسر علاقات الربط الأحادية والمتعددة (One-to-Many Relationships) بين الجداول، حيث تتعامل محركات قواعد البيانات ومحركات الاستعلام النصي مع الكلمات المتطابقة حرفياً والتي تختلف في محرف طرفي واحد ككيانات مستقلة تماماً لا رابط بينها.
يمتد أثر التشويه النصي إلى النماذج الإحصائية الاستدلالية؛ حيث يؤدي تكرار الفئات الاسمية بتهجئات مشوهة بفعل الأحرف الزائدة إلى تفتيت المتغيرات النوعية، مما ينتج عنه انخفاض في القوة الإحصائية للاختبارات وتقديرات غير دقيقة لحجم العينات وتشتت التكرارات. علاوة على ذلك، فإن الاعتماد على التدخل البشري والتحرير اليدوي لمعالجة هذه الشوائب في قواعد البيانات الضخمة ينطوي على مخاطر جمة، أبرزها الخطأ البشري غير المنهجي، واستهلاك الوقت والجهد، وافتقار العملية لقابلية التكرار وإعادة الإنتاج (Reproducibility)، وهو ما يفرض تبني منهجيات مؤتمتة وقائمة على معادلات صلبة لتنظيف البيانات فور ورودها.
1.2 التحديات التقنية الشائعة المرتبطة بالأحرف الطرفية الزائدة
تتعدد الأسباب التي تؤدي إلى تراكم الأحرف الزائدة في نهايات السلاسل النصية داخل بيئات العمل الواقعية. ومن أبرز هذه السيناريوهات تصدير البيانات من أنظمة إدارة تخطيط الموارد (ERP) أو منصات التجارة الإلكترونية، حيث تُلحق بعض الأنظمة فواصل محددة مثل الفاصلة المنقوطة أو الشُرط المائلة في أواخر السجلات النصية كأدوات حشو تلقائية. وفي سياقات أخرى، تتسلل محارف التحكم غير المرئية أو الرموز الفاصلة الناتجة عن محارف السطر الجديد (Line Feeds) ومحارف الإرجاع (Carriage Returns) أثناء عمليات النسخ واللصق المتعددة بين محررات النصوص المختلفة وجداول البيانات.
تتفاقم صعوبة التعامل مع هذه المشكلات عند مواجهة مجموعات بيانات مليونية أو واسعة النطاق؛ فالطرق اليدوية لا تنهار فقط بسبب بطئها، بل لأنها غير قادرة على التمييز البصري بين الرموز المتشابهة أو اكتشاف المسافات البيضاء المخفية في نهاية النص. يتطلب هذا التحدي التقني فهماً عميقاً لسلوك المعالجات النصية في الحوسبة السحابية، والقدرة على تطبيق عمليات اقتطاع ديناميكية تراعي التباين في أطوال النصوص داخل العمود الواحد، دون التأثير على النصوص السليمة أو إنتاج خلايا تالفة برمجياً.
1.3 نظرة عامة على المنهجيات والدوال المتاحة للمعالجة
توفر جداول بيانات جوجل منظومة متكاملة من الدوال الرياضية والنصية لمعالجة هذه الإشكاليات بكفاءة متناهية. تتركز المقاربة الأولى والأكثر استخداماً في الجمع التركيبي بين الدوال النصية القياسية، وتحديداً استخدام دالة استقطاع النصوص من اليسار مع دالة قياس الطول الإجمالي للسلسلة النصية؛ حيث تشكل هذه التركيبة معياراً موحداً معتمداً عبر مختلف منصات الجداول الإلكترونية نظراً لبساطتها وسرعة معالجتها الحسابية وانخفاض استهلاكها لموارد المعالج السحابي.
أما المقاربة الثانية، فتعتمد على القوة التعبيرية الهائلة للتعابير النمطية (Regular Expressions) عبر دوال متخصصة مدمجة مثل REGEXREPLACE، وهي تقنية توفر مرونة فائقة لمعالجة الأنماط المعقدة وتجاوز قيود الدوال التقليدية. وتتكامل هذه الحلول مع إمكانية استخدام دوال الاقتطاع البديلة مثل MID، أو الارتقاء بالعملية الحسابية بأكملها نحو الحوسبة المصفوفية الشاملة بواسطة ARRAYFORMULA، فضلاً عن الحلول المبرمجة كلياً باستخدام نصوص تطبيقات جوجل (Google Apps Script) للتعامل مع السيناريوهات المعقدة التي تتطلب تعديل البيانات في مكانها الأصلي دون إنشاء أعمدة مساعدة.
2. البنية التركيبية للمعادلة الأساسية: دمج دالتي LEFT و LEN
2.1 التحليل المفهومي والوظيفي لدالة LEFT
تُصنف دالة LEFT ضمن عائلة دوال النصوص الكلاسيكية الموروثة من مواصفات الجداول الإلكترونية الأصلية، وتتمثل وظيفتها الأساسية في استخلاص عدد محدد من المحارف ابتداءً من أقصى الطرف الأيسر للسلسلة النصية المحددة. تتطلب الدالة بنيوياً وسيطين أساسيين: الوسيط الأول الإلزامي هو “النص” (text)، والذي يمثل القيمة النصية المراد معالجتها أو المرجع المباشر للخلية التي تحتوي على تلك القيمة. أما الوسيط الثاني فهو “عدد المحارف” (number_of_characters)، وهو معامل عددي يحدد بدقة متناهية كمية المحارف المستهدفة للاستقطاع بدءاً من المحرف رقم واحد في السلسلة.
في حال إغفال تحديد الوسيط الثاني، فإن الدالة تلجأ إلى سلوك افتراضي معياري يتمثل في استخراج محرف واحد فقط من بداية النص. تتطابق دالة LEFT مع المعايير القياسية لترميز اليونيكود (Unicode)، حيث تتعامل مع المحارف متعددة البايتات بصورة صحيحة في أغلب السيناريوهات، بيد أن قوتها الوظيفية تظل مقيدة بحقيقة أنها تتطلب معرفة مسبقة ومحددة بعدد المحارف المراد استخراجها، وهو ما يمثل عائقاً أمام معالجة النصوص ذات الأطوال المتفاوتة في حال استخدامها بمفردها كقيمة رقمية مصمتة.
2.2 آلية قياس أطوال النصوص بدقة عبر دالة LEN
تختص دالة LEN بحساب القياس العددي الدقيق للطول الإجمالي للسلسلة النصية، معيدة قيمة عددية صحيحة تمثل عدد الوحدات النصية المكونة للبيان المدخل. لا تقتصر الدالة على عد الحروف الأبجدية الظاهرة فقط، بل تمتد آليتها القياسية لتشمل المسافات البيضاء الفاصلة، والمسافات البادئة والختامية، وعلامات الترقيم، وكافة الرموز الخاصة ومحارف التحكم غير المرئية. تُشتق تسمية الدالة من الكلمة الإنجليزية “Length”، وتعتمد على خوارزمية قياس عددية مباشرة تتفاعل مع طول مصفوفة المحارف المخزنة في الذاكرة.
تتأثر القيمة المرجعة من دالة LEN بتنسيق البيانات ونوع القيمة المخزنة داخل الخلية؛ فالأرقام المجردة تعامل معاملة النصوص عند تمريرها داخل الدالة، في حين أن التنسيقات البصرية للأرقام والعملات والتواريخ لا يتم احتساب محارفها التنسيقية ما لم تكن مخزنة كنصوص صريحة. يشكل هذا القياس الإحصائي الدقيق لنواة السلسلة النصية الأساس الرياضي المتغير الذي يُبنى عليه تحديد مواضع الاقتطاع في كافة العمليات البرمجية المعقدة لتنظيف النصوص المتفاوتة الأطوال.
2.3 التكامل الرياضي والمنطقي في صيغة LEFT مع LEN
ينشأ التكامل الرياضي والمنطقي عند دمج الدالتين في صيغة تركيبية موحدة تتخذ الشكل الرياضي التالي:
=LEFT(A1, LEN(A1) – 1)
يقوم هذا التركيب على مبدأ الطرح الحسابي التراجعي؛ حيث تتولى الدالة الداخلية LEN(A1) مهمة حساب الطول الإجمالي للنص وتعيينه كقيمة عددية نرمز لها بالرمز $n$. وبمجرد تحديد هذا الطول، تُخضع المعادلة هذه القيمة لطرح جبري بمقدار وحدة واحدة ($n – 1$)، لتمرر النتيجة الحسابية الجديدة فوراً كمعامل عددي يمثل وسيط “عدد المحارف” لدالة الاقتطاع الخارجية LEFT.
يتبع محرك الحوسبة في جداول بيانات جوجل تسلسل تنفيذ برمجي يبدأ بحل الدوال الفرعية المتداخلة من الداخل إلى الخارج؛ حيث يتم تقييم محتوى الخلية المرجعية A1 أولاً، ثم قياس طولها، ثم إجراء العملية الحسابية، وأخيراً استقطاع السلسلة النصية بدءاً من اليسار وحتى المحرف الذي يسبق المحرف الأخير مباشرة. تكمن المرونة الهيكلية لهذه الصيغة في قدرتها التكيفية التلقائية مع أي طول نصي في كل سجل على حدة؛ فإذا احتوت خلية على عشرة أحرف، فإن الصيغة تقتطع تسعة، وإذا احتوت على مائة، تقتطع تسعة وتسعين، مما يضمن حذف المحرف النهائي بدقة بغض النظر عن تفاوت أحجام المدخلات عبر الصفوف المختلفة.
3. دليل تطبيقي تدريجي لحذف الحرف الأخير
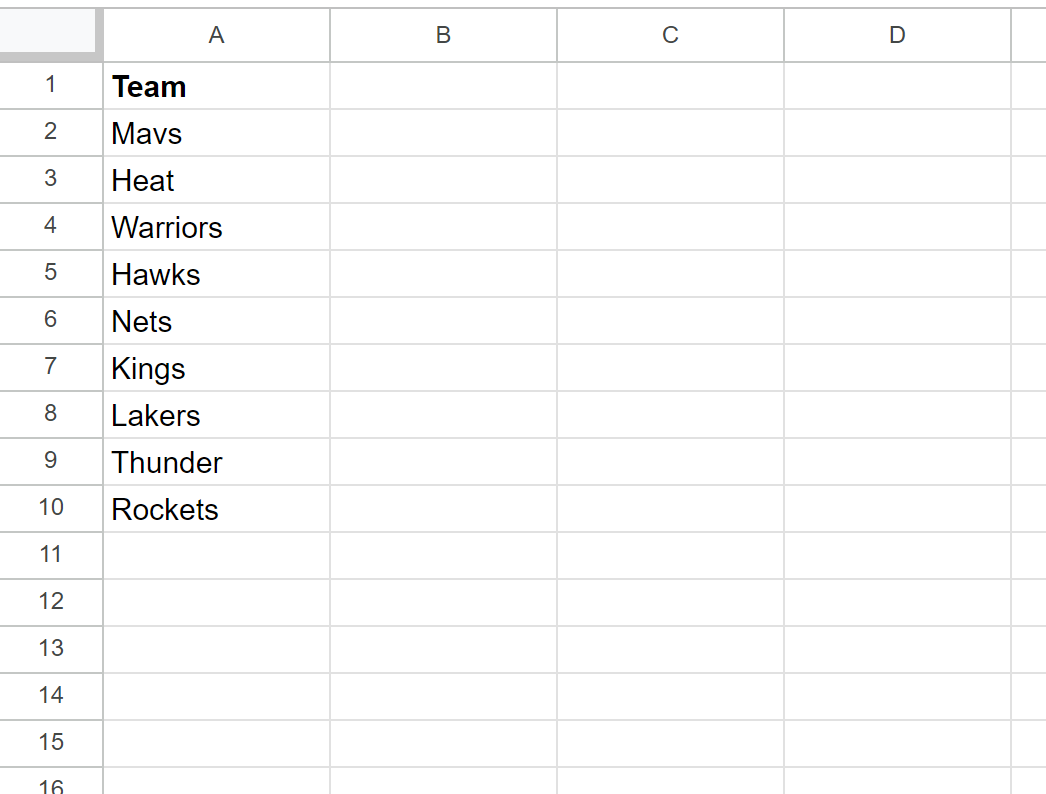
3.1 إعداد بيئة العمل وهيكلة جدول البيانات التجريبي
يتطلب التنفيذ الاحترافي لأي عملية تنظيف بيانات إعداداً منهجياً لبيئة العمل داخل جدول البيانات لضمان الحفاظ على سلامة البيانات الخام (Raw Data) وتفادي التعديلات غير القابلة للاسترداد. تبدأ الخطوة الأولى بتحديد العمود أو النطاق المستهدف الذي يحتوي على السلاسل النصية المشوبة بالمحارف الطرفية الزائدة. يُفضل دائماً تجميد الصفوف الرأسية (Freeze Header Rows) لتثبيت عناوين الحقول، والتأكد من وضوح تصنيف كل متغير.
ينبغي عزل البيانات الأصلية في عمود مرجعي مستقل، وليكن العمود A، مع تجنب تطبيق أي معادلات مباشرة تؤدي إلى استبدال المحتوى في نفس موقعه في هذه المرحلة. يتم إنشاء عمود جديد مجاور ومخصص حصراً لاستقبال النتائج المستخرجة، ويُمنح اسماً وصفياً دقيقاً مثل “النص_المعالج” أو “Cleaned_Data”. قبل البدء في كتابة المعادلات، يجب فحص عينة عشوائية من الخلايا للتأكد من نوع البيانات المخزنة والتثبت مما إذا كانت تحتوي على أرقام ذات تنسيقات خاصة أو قيم تاريخية، حيث إن هذا التدقيق الأولي يمنع حدوث تشوهات غير متوقعة في المخرجات لاحقاً.
3.2 بناء الصيغة وتطبيقها على الخلية المرجعية الأولى
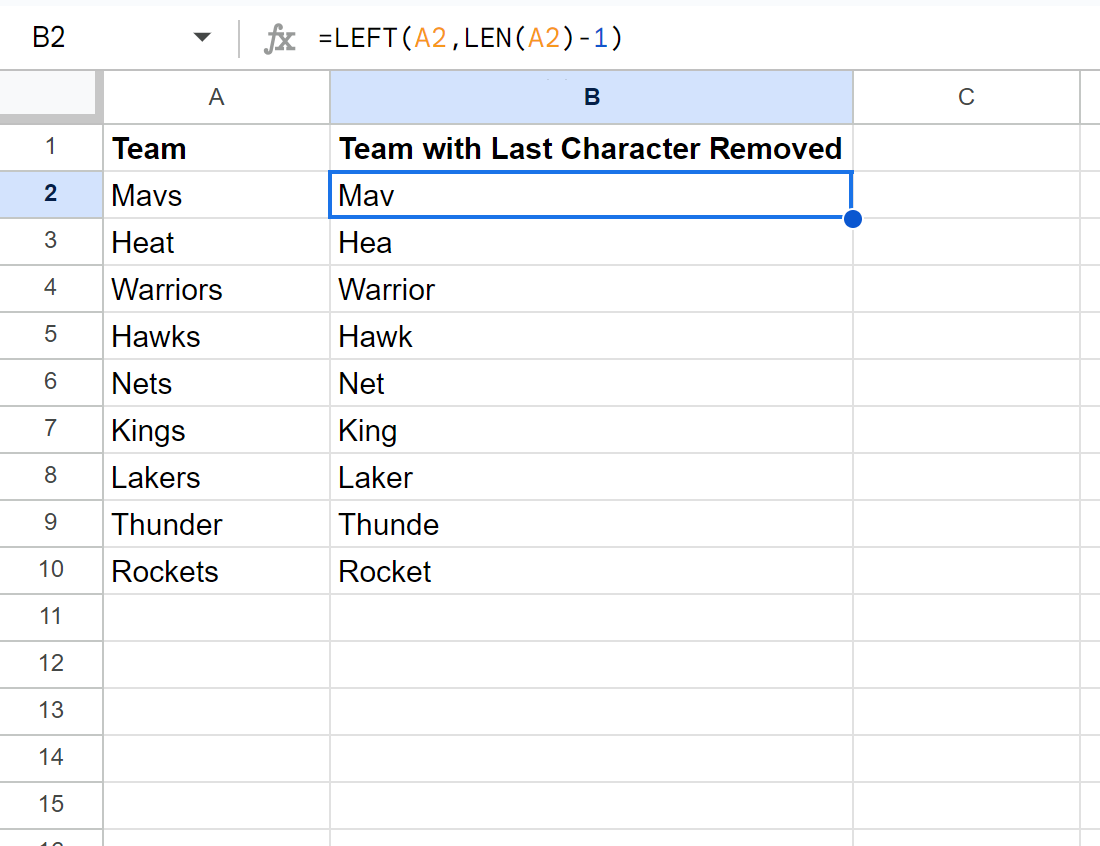
بعد إتمام التهيئة الهيكلية للجدول، ننتقل إلى الخلية المقابلة لأول سجل بياني يحتوي على قيمة مشوهة، ولتكن الخلية B2 على افتراض أن B1 يمثل رأس العمود وأن البيانات الفعلية تبدأ من الخلية A2. يقوم المستخدم بإدخال الصيغة الحسابية المركبة بدقة تامة:
=LEFT(A2, LEN(A2) – 1)
تعتمد هذه الصياغة على “المراجع النسبية” (Relative References)، مما يعني أن الإشارة إلى الخلية A2 ستتغير تلقائياً بالتوازي عند تعميم الصيغة رأسياً لاحقاً.
بمجرد الضغط على زر الإدخال (Enter)، يقوم محرك البرنامج بمعالجة النص فورياً. يتعين على المحلل في هذه اللحظة فحص القيمة الناتجة في الخلية B2 بعناية فائقة، والتحقق بصرياً وتقنياً من أن المحرف الأخير المستهدف قد أُزيل بالفعل، وأن بقية أجزاء النص ومحارفه الوسطية والبادئة قد ظلت سليمة دون أي بتر غير مقصود. يجب مراعاة اختبار هذه الخطوة مع نصوص تحتوي على محارف عربية وأخرى لاتينية ورموز خاصة للتأكد من أن اتجاه الكتابة وتعدد لغات الإدخال لا يؤثران على سلامة التقييم الحسابي لدالتي LEFT و LEN.
3.3 تعميم المعادلة على السجلات عبر السحب والتعبئة التلقائية
عقب التحقق من صحة المخرجات في الخلية الفردية الأولى، يتم تعميم الصيغة الحسابية على امتداد النطاق الرأسي لكافة السجلات المطلوب معالجتها. تتيح واجهة جداول بيانات جوجل وسيلة بصرية قياسية تُعرف بـ “مقبض التعبئة” (Fill Handle)، وهو المربع الصغير الأزرق الكائن في الزاوية اليسرى أو اليمنى السفلية من إطار الخلية النشطة تبعاً لاتجاه واجهة البرنامج. يمكن للمستخدم النقر مع الاستمرار على هذا المقبض وسحبه رأسياً إلى أسفل العمود حتى آخر صف من البيانات.
كبديل أكثر سرعة وموثوقية في الجداول التي تحتوي على آلاف الصفوف، يمكن للمستخدم النقر المزدوج (Double-click) مباشرة على مقبض التعبئة في الخلية B2، لتقوم المنصة تلقائياً بتكرار الصيغة وتطبيقها رأسياً بما يتطابق تماماً مع المدى المشغول في العمود المجاور A. خلال هذه العملية، يقوم النظام بتعديل المرجع النسبي بصورة متسلسلة؛ فتتحول الصيغة في الصف الثالث إلى =LEFT(A3, LEN(A3) - 1)، وفي الصف الرابع إلى =LEFT(A4, LEN(A4) - 1)، وهكذا دواليك. ومع أن هذه الطريقة تؤدي الغرض بكفاءة في المجموعات المتوسطة، إلا أن تقييم الأداء عند بلوغ مئات الآلاف من الصفوف قد يشير إلى بطء في الاستجابة واستهلاك مفرط للذاكرة، وهو ما يستدعي لاحقاً التفكير في الحلول المصفوفية الأكثر تقدماً.
4. البدائل المتقدمة: استخدام التعبيرات النمطية عبر REGEXREPLACE
4.1 مدخل نظري إلى التعابير النمطية في معالجة البيانات النصية
تمثل التعابير النمطية (Regular Expressions) لغة صورية فائقة القوة مخصصة لمطابقة وتوصيف واستبدال الأنماط النصية ضمن مجموعات البيانات. يتميز محرك جداول بيانات جوجل بدمجه لمحرك تعابير نمطية متطور متوافق مع معايير “RE2” التي طورتها شركة جوجل، مما يتيح للمحللين والباحثين تجاوز القيود الحسابية الصارمة للدوال التقليدية. تكمن القوة الجوهرية للتعابير النمطية في قدرتها على وصف المحارف بناءً على خصائصها وسياقها المكاني والتركيبي، بدلاً من الاعتماد فقط على إحصاء مواقعها الرقمية المجردة.
تتطلب معالجة نهايات النصوص فهماً دقيقاً لمفهوم “المثبتات” (Anchors) في هندسة الأنماط. فبينما تتطلب الدوال الكلاسيكية حساب الطول أولاً ثم تنفيذ الاقتطاع في خطوتين حسابيتين متتاليتين، توفر التعابير النمطية إمكانية استهداف وتحديد “المحرف الأخير أياً كانت هويته” مباشرة في خطوة معالجة واحدة من خلال الإشارة إلى المحرف الواقع مباشرة قبل علامة نهاية السلسلة النصية، وهو ما يفتح آفاقاً جديدة لمعالجة النصوص الديناميكية التي قد تفشل معها التراكيب الحسابية البسيطة.
4.2 صياغة واستخدام دالة REGEXREPLACE لإزالة الحرف الختامي
توفر جداول بيانات جوجل دالة متخصصة في الاستبدال النمطي وهي REGEXREPLACE، وتتطلب ثلاثة وسائط: النص الأصلي، والنمط البرمجي للبحث، والنص البديل. لحذف الحرف الأخير من السلسلة النصية في الخلية A1، تُكتب المعادلة بالهيئة المعيارية التالية:
=REGEXREPLACE(A1, “.$”, “”)
يقوم النمط البرمجي .$ على مفردتين دلاليتين في علم التعابير النمطية: تمثل النقطة (.) رمزاً شمولياً (Wildcard) يطابق أي محرف مفرد أياً كان نوعه (حرف، رقم، مسافة، رمز)، بينما يمثل الرمز ($) مثبت نهاية النص (End of String Anchor)، الذي يجبر محرك البحث على تقييد المطابقة بالمحرف الذي يسبق ختام السلسلة فوراً.
يمثل المعامل الثالث سلسلة نصية فارغة ""، وتتمثل نتيجته في استبدال ذلك المحرف الأخير المطابق بلا شيء، مما يؤدي وظيفياً إلى حذفه التام. ومن الأخطاء الشائعة والجسيمة التي يقع فيها الممارسون المبتدئون إغفال رمز التثبيت وكتابة النمط كـ "." بمفرده، مما يترتب عليه استبدال المحرف الأول فقط من النص أو استبدال كافة محارف السلسلة النصية وتحويلها إلى فراغ كامل بدلاً من عزل الحرف الأخير، وهو ما يؤكد على إلزامية رمز $ لضمان استهداف الطرف الختامي حصراً. وتجدر الإشارة إلى أن رمز النقطة القياسي في محرك RE2 لا يطابق محارف فواصل الأسطر، مما يجعل هذا النمط يعمل بدقة داخل الخلايا أحادية السطر.
4.3 مقارنة معيارية بين التركيب التقليدي والتعابير النمطية
عند إجراء مقارنة معيارية بين الصيغة القياسية LEFT(LEN-1) وصيغة التعابير النمطية REGEXREPLACE، يبرز تباين واضح في معايير الأداء البرمجي وسهولة الصيانة. من منظور استهلاك موارد المعالجة الحسابية (Computational Overhead)، تمتاز الدالة التقليدية LEFT مع LEN بسرعة تنفيذ أعلى واستهلاك أقل للذاكرة، نظراً لأن عملياتها تعتمد على عمليات رياضية بدائية (طرح عددي وقراءة متسلسلة للذاكرة) تدعمها كافة معالجات الجداول الحسابية التاريخية والحديثة بكفاءة تشغيلية دنيا.
في المقابل، تتطلب دالة REGEXREPLACE استدعاء محرك مطابقة الأنماط النصية، مما يفرض جهداً حسابياً إضافياً لتفسير النمط وتطبيقه، وهو فارق قد لا يظهر في الجداول متواضعة الحجم، لكنه يغدو ملموساً عند تطبيقه على جداول تتجاوز عشرات الآلاف من الصفوف الحسابية النشطة. ومن زاوية قابلية القراءة والتوثيق، تعتبر الصيغة التقليدية أكثر وضوحاً لفرق العمل الإدارية والتحليلية غير المتخصصة في البرمجة، في حين تمتاز صيغة REGEXREPLACE بالمرونة الفائقة والقدرة على التوسع، كأن يُطلب مثلاً إزالة الحرف الأخير “بشرط أن يكون رقماً أو علامة ترقيم محددة”، وهو ما تعجز عنه الدوال الكلاسيكية إلا بتركيبات شديدة التعقيد والتداخل.
5. استخدام دالتي MID و LEN كنهج بديل لتقطيع النصوص
5.1 المعاملات البنيوية لدالة MID وطريقة تشغيلها
تمثل دالة MID أداة اقتطاع نصية متقدمة تمنح المستخدم تحكماً فائقاً في تحديد موقع ونطاق الاستخراج داخل السلاسل النصية. وخلافاً لدالتي LEFT و RIGHT اللتين تلتزمان بجوانب محددة مسبقاً، تمتلك دالة MID بنية ثلاثية الوسائط تتضمن: “النص” المستهدف، وموضع “البداية” (starting_at)، و”طول الاستخراج” (extract_length). يسمح هذا التكوين بالانطلاق من أي نقطة داخل السلسلة النصية واستخراج عدد محدد بدقة من المحارف المتتالية.
يعتبر موضع البداية في دالة MID فهرساً قائماً على الترقيم الأحادي (1-based index)، حيث يشير الرقم 1 دوماً إلى المحرف الأول أقصى اليمين أو اليسار تبعاً لاتجاه السلسلة. وتتكامل هذه الدالة بسلاسة مع دالة LEN عندما يتم حساب طول الاستخراج كمعامل ديناميكي مشتق من البنية العامة للنص، مما يجعلها مساوية وظيفياً لدالة LEFT في استخراج النصوص الطرفية، مع تميزها بالقدرة على التحول الفوري لتجاوز محارف البداية دون الحاجة لتغيير البنية المنطقية للدالة.
5.2 تطبيق التركيب البرمجي =MID(A2, 1, LEN(A2)-1)
يمكن توظيف دالة MID كبديل مباشر ومحكم لدالة LEFT لإزالة المحرف الأخير عبر تطبيق التركيب البرمجي التالي:
=MID(A2, 1, LEN(A2) – 1)
يعتمد المنطق الحسابي في هذه الصيغة على تحديد الرقم الثابت 1 كوسيط لبداية الاستخراج، مما يوجه الدالة لعدم تفويت أي محرف من مقدمة السلسلة والبدء الصارم من أول وحدة نصية.
أما بالنسبة للوسيط الثالث، فيتم استخدام التعبير الديناميكي ذاته LEN(A2) - 1 لتحديد عدد المحارف المطلوب اقتطاعها. إذا احتوت الخلية A2 على سلسلة نصية مكونة من ثمانية محارف، تُعلم دالة LEN المحرك بأن الطول الكلي هو 8، وتُجري عملية الطرح ليصبح الطول المطلوب 7 محارف. تبدأ دالة MID من المحرف الأول وتستمر في استخراج سبعة محارف متتالية، لتتوقف جبرياً قبل الوصول إلى المحرف الثامن والأخير، مؤدية بذلك وظيفة حذف المحرف النهائي بدقة تطابق المخرجات الناتجة عن دالة LEFT.
5.3 الحالات الأكاديمية والتطبيقية المفضلة لاستخدام MID
على الرغم من التطابق الوظيفي الظاهري بين الدالتين في هذا السياق، إلا أن تفضيل استخدام دالة MID يتجلى في الأبحاث والتطبيقات التي تتطلب قابلية التوسع نحو أنماط تنظيف نصية مزدوجة أو متداخلة. فعلى سبيل المثال، إذا طرأ تغيير على متطلبات تنظيف البيانات استدعى حذف المحرف الأول والمحرف الأخير في آنٍ واحد (كما في حالات النصوص المحاطة بأقواس معقوفة أو علامات اقتباس غير مرغوبة)، تصبح دالة MID الخيار الأمثل والوحيد ببنية أنيقة تتخذ الشكل:
=MID(A2, 2, LEN(A2) – 2)
يعكس هذا التركيب تفوق دالة MID الهيكلي مقارنة بالدوال الطرفية الأخرى؛ إذ إن إنجاز هذه المهمة باستخدام دالة LEFT سيتطلب دمجها قسرياً مع دالة RIGHT في معادلة شديدة التعقيد. فضلاً عن ذلك، يُسهم استخدام MID في الحفاظ على توافقية برمجية قياسية عند تصدير القواعد الحسابية والترجمات الآلية للمعادلات بين تطبيقات الجداول الإلكترونية المتنوعة وقواعد البيانات العلائقية مثل SQL التي تعتمد دوالاً استخراجية مشابهة (مثل الدالة SUBSTRING)، مما يجعلها الخيار المفضل للمهندسين الساعين لتوحيد منطق المعالجة عبر منصات متعددة.
6. أتمتة النطاقات الموسعة باستخدام الصيغ المصفوفية ARRAYFORMULA
6.1 مفهوم الحوسبة المصفوفية ودور دالة ARRAYFORMULA
تُمثل الحوسبة المصفوفية نقلة نوعية في منهجيات إدارة البيانات السحابية، حيث تحول طريقة المعالجة من التعامل مع الخلايا ككيانات معزولة تتطلب تكرار المعادلات في كل صف على حدة، إلى معالجة نطاقات كاملة من البيانات ككتلة حسابية متصلة أو “متجه بيانات” (Data Vector). تلعب دالة ARRAYFORMULA في جداول بيانات جوجل دور المحفز البرمجي الذي يُمكّن الدوال القياسية غير المصفوفية من قبول مصفوفات ونطاقات ممتدة كوسائط دخل، ثم إرجاع مصفوفة مخرجات تطابق في أبعادها أبعاد النطاق الأصلي وتنسكب تلقائياً في الخلايا المستهدفة.
يترتب على تطبيق هذا المفهوم فوائد تقنية جمة، أبرزها التخفيض الجذري في حجم الملف البرمجي وتخفيف الضغط على خوادم المعالجة، فضلاً عن القضاء التام على الحاجة لسحب مقبض التعبئة يدوياً كلما أُضيفت سجلات جديدة. بمجرد وجود صيغة مصفوفية في الخلية الأولى من العمود، تصبح الورقة قادرة على الاستجابة الفورية والديناميكية لتدفق البيانات الجديد، وتطبيق قواعد التنظيف النصي تلقائياً دون أي تدخل بشري إضافي.
6.2 صياغة التركيب التكاملي لحذف الحرف الأخير مصفوفياً
لإسقاط الحرف الأخير مصفوفياً من عمود بيانات كامل، يتم دمج دالة ARRAYFORMULA مع صيغة LEFT و LEN الأساسية عبر تمرير نطاق متعدد الخلايا بدلاً من المرجع الفردي. تُصاغ المعادلة في الخلية الأولى من عمود المخرجات على النحو التالي:
=ARRAYFORMULA(LEFT(A2:A, LEN(A2:A) – 1))
في هذا التركيب، يمثل النطاق A2:A مرجعاً غير مقيد النهاية (Open-ended Range) ينطلق من الخلية الثانية ويستمر حتى آخر صف متاح في ورقة العمل. يقوم محرك جوجل الداخلي بتحويل عمليتي الحساب والاستقطاع إلى معالجة دفعية (Batch Processing)، حيث يُحسب طول كل خلية في النطاق بصورة متوازية، ويُطرح منه واحد، لتستقطع دالة LEFT السلاسل المعالجة وتسكبها في العمود المخصص. ومع ذلك، فإن تطبيق هذه الصيغة الخام بهذا الشكل دون شروط حماية يؤدي إلى مشكلات تشغيلية معقدة عند مواجهة الخلايا الفارغة، وهو ما يتطلب تدخلاً بنيوياً إضافياً لضبط السلوك الحسابي.
6.3 عزل الخلايا الفارغة لمنع توليد الأخطاء البرمجية المزعجة
تكمن العلة الأساسية في تطبيق الصيغ المصفوفية غير المقيدة في سلوكها تجاه الصفوف غير المشغولة في أسفل الجدول؛ فعندما تصل الصيغة إلى خلية فارغة يكون طولها النصي صفراً ($LEN = 0$)، يؤدي إجراء الطرح الرياضي ($0 – 1$) إلى توليد قيمة سالبة ($-1$) كمعامل لدالة LEFT، مما يتسبب في انهيار المعالجة وظهور خطأ القيمة الحسابية #VALUE! عبر آلاف الصفوف الشاغرة. لحل هذا الإشكال البنيوي وتطهير التقرير من المخرجات المشوهة، يتم إدراج دالة الشرط المنطقي IF لعزل الخلايا الفارغة واختبار امتلاء السجلات قبل تمريرها للاقتطاع، وفق الصيغة المتكاملة التالية:
=ARRAYFORMULA(IF(LEN(A2:A) > 1, LEFT(A2:A, LEN(A2:A) – 1), “”))
يختبر هذا التعبير المنطقي كل خلية ضمن النطاق؛ فإذا كان طول النص يتجاوز محرفاً واحداً، يقوم المحرك بتنفيذ أمر الحذف بأمان واقتطاع الحرف الأخير. أما إذا كانت الخلية فارغة أو طولها النصي صفراً، فإن الشرط يتحول إلى القيمة الخاطئة، فتُرجع الدالة سلسلة نصية فارغة "" تضمن بقاء الخلية بيضاء ونقية. لا يقتصر أثر هذا الضبط المنطقي على تحسين المظهر الجمالي للتقارير فحسب، بل يمتد لتحرير ذاكرة المتصفح ومنع استهلاك دورات المعالجة السحابية في محاولات اقتطاع غير مجدية على نطاقات فارغة.
7. إدارة الأخطاء ومعالجة الحالات الاستثنائية للبيانات
7.1 التعامل المنهجي مع الخلايا التي تحتوي على حرف واحد فقط
تُعد السلاسل النصية أحادية المحرف من أبرز الحالات الحافية (Edge Cases) التي تختبر مرونة وقوة الصيغ الرياضية في جداول البيانات. عندما تطبق الصيغة التقليدية =LEFT(A1, LEN(A1)-1) على خلية تحتوي على حرف واحد فقط (مثل حرف “A” أو رمز كودي مفرد)، فإن دالة LEN تُرجع القيمة 1. وعند إنقاص هذه القيمة بمقدار 1، يصبح ناتج الطرح صفراً ($1 – 1 = 0$). وفي هذه الحالة المحددة، لا ينهار البرنامج، بل تستقبل دالة LEFT القيمة صفر كعدد للمحارف المطلوب اقتطاعها، مما يؤدي إلى إرجاع سلسلة نصية فارغة (Empty String).
على الرغم من أن إرجاع سلسلة فارغة قد يكون مقبولاً في بعض المعالجات، إلا أنه قد يؤدي إلى فقدان تام للبيانات في حقول تتطلب الحفاظ على الرموز الأساسية. وفي حال كانت الخلية فارغة تماماً منذ البداية، فإن النتيجة تكون $-1$ كما سلف الذكر، وتطلق المنصة خطأ تقييم صريحاً (Evaluation Error). يتطلب التعامل المنهجي مع هذا السيناريو تقييد الصيغة بشرط تحوطي يحدد المخرجات المتوقعة بدقة؛ فإما أن يُفرغ الحقل بالكامل عن قصد، أو تُرجع القيمة الأصلية ذاتها كما هي إذا كان طولها مساوياً للواحد، وذلك بحسب ما تقتضيه المعايير المنهجية المعتمدة لتدقيق البيانات وتصنيفها.
7.2 معالجة أخطاء عدم تطابق النوع والقيم الرقمية الصرفة
من المفاهيم الخاطئة الشائعة الاعتقاد بأن دوال النصوص تحافظ دائماً على التنسيقات البصرية للأرقام والتواريخ عند إخضاعها لعمليات الاقتطاع. في بيئة جداول بيانات جوجل، تُخزن التواريخ والأوقات كقيم رقمية متسلسلة (Serial Dates)؛ حيث يمثل كل تاريخ عدداً حقيقياً يمثل الأيام المنقضية منذ تاريخ الأساس المرجعي (30 ديسمبر 1899). عندما تُمرر خلية تاريخ منسقة ظاهرياً كـ “2023/12/31” داخل دالة LEFT، فإن الدالة لا تتعامل مع هذا التمثيل النصي المرئي، بل تقتطع المحارف من الرقم التسلسلي الخام غير المنسق والمخزن في ذاكرة النظام، مما يولد نتائج مشوهة وغير مفهومة.
ينطبق الأمر ذاته على الأرقام المالية المنسقة بفواصل الآلاف وعلامات العملات أو الأرقام التي تبدأ بأصفار غير ظاهرة. لتلافي هذا التشوه البنيوي، يجب إجراء تحويل قسري للأنواع البرمجية (Explicit Type Casting) عبر توظيف دالة TO_TEXT أو دالة TEXT الموجهة قبل الشروع في عمليات الاقتطاع، وفق البنية التالية:
=LEFT(TO_TEXT(A1), LEN(TO_TEXT(A1)) – 1)
تضمن هذه الخطوة تحويل القيمة الرقمية أو التاريخية إلى تمثيلها النصي الصريح المتطابق مع العرض المرئي، مما يسمح بحذف الحرف أو الرقم الأخير بدقة تامة دون العبث بالبنية التحتية للنظام الرقمي للملف.
7.3 بناء صيغ مرنة وحصينة بالاستعانة بدالتي IFERROR و IF
يقتضي التحليل الأكاديمي الحصين تصميم نماذج بيانات منيعة ضد الانهيار البرمجي تحت شتى سيناريوهات الإدخال الشاذة أو غير المتوقعة. يُعد تغليف الصيغ الحسابية الأساسية بدوال التحوط والوقاية المعيارية، وتحديداً دالتي IF و IFERROR، خطوة إلزامية لبناء جداول بيانات قابلة للاستخدام المشترك والإنتاج الموسع دون انقطاع، وفق التركيب الوقائي التالي:
=IFERROR(IF(LEN(A1) > 1, LEFT(A1, LEN(A1) – 1), A1), “خطأ في الإدخال”)
تتعدد طبقات الحماية المنطقية في هذه الصيغة المركبة؛ حيث تختبر دالة IF الداخلية طول النص أولاً: فإذا كان النص يحتوي على أكثر من محرف، يُنفذ أمر الاقتطاع بحذف الحرف الأخير. وإذا كان النص مؤلفاً من محرف واحد فقط، تُرجع الصيغة القيمة الأصلية للخلية A1 ذاتها للحيلولة دون تفريغها أو ضياع الرمز المفرد. وتختص الطبقة الخارجية، ممثلة في دالة IFERROR، باعتراض أي أخطاء حسابية أو شذوذ بنيوي لا يمكن التنبؤ به (كالقيم المرجعية التالفة #REF! أو أخطاء القسمة أو أخطاء النوع الشديدة)، مستبدلة رمز العطل البرمجي بنص توجيهي مخصص يشرح للمستخدم بوضوح وجود خلل في الإدخال الأصلي، مما يحافظ على استقرار وتماسك لوحات التحكم والتقارير التنفيذية.
8. التعامل مع المسافات البيضاء والرموز الخفية وغير المرئية
8.1 التأثير الخفي للمسافات الزائدة (Trailing Spaces) على دقة الحذف
تُمثل المسافات البيضاء الطرفية غير المرئية (Trailing Whitespace) أحد أكثر الأفخاخ البرمجية شيوعاً وإرباكاً لمحللي البيانات ومستخدمي الجداول الإلكترونية. يكمن الخطر في حقيقة أن المسافة البيضاء، على الرغم من كونها غير مرئية للعين البشرية على الشاشة، تُعامل من قِبل معالج جداول بيانات جوجل كمحرف كامل ومستقل يحمل قيمة ترميزية محددة في معيار ASCII واليونيكود. بناءً على ذلك، تحتسب دالة LEN تلك المسافة الطرفية كجزء من الطول الإجمالي للسلسلة النصية.
يترتب على هذا الواقع الفني نتيجة غير مرغوبة إطلاقاً عند محاولة حذف المحرف الأخير الظاهر؛ فعندما تحتوي الخلية على النص "Data " متبوعاً بمسافة طرفية، فإن تطبيق المعادلة =LEFT(A1, LEN(A1)-1) سيؤدي إلى اقتطاع المسافة البيضاء فقط، ليبقى الحرف الأخير الفعلي "a" دون أي حذف، مما يعطي انطباعاً خادعاً بأن الصيغة قد تعطلت أو لم تقم بمهمتها الحسابية. يكشف هذا التشخيص عن ضرورة استخدام أدوات تقنية لفحص وجود المسافات، مثل مقارنة طول النص قبل وبعد تطبيق دوال التطهير، أو النقر المزدوج داخل شريط الصيغ لرؤية موضع مؤشر الكتابة الفعلي بعد نهاية الكلمة.
8.2 التوظيف الاستباقي لدالة TRIM لتطهير أطراف النصوص
تُعد دالة TRIM الأداة القياسية الأهم لتطهير ومعالجة المسافات البيضاء غير المنضبطة في جداول البيانات. تختص هذه الدالة بوظيفة ثلاثية الأبعاد: إزالة كافة المسافات البادئة في مطلع النص، وإزالة كافة المسافات الختامية في نهاية النص، وتقليص أي مسافات مضاعفة متتالية بين الكلمات إلى مسافة قياسية واحدة فقط. بناءً على ذلك، فإن التطبيق الاستباقي لدالة TRIM يمثل مرحلة تأسيسية إلزامية قبل تطبيق أي قياس حسابي للأطوال، لضمان استهداف المحارف الحقيقية حصراً.
يتم التوظيف التكاملي للدالة من خلال دمجها داخل مصفوفة المعادلة الأصلية، بحيث تُمرر السلسلة المطهرة داخل دالة قياس الطول ودالة الاقتطاع في آنٍ واحد، وفق الصيغة المحكمة التالية:
=LEFT(TRIM(A1), LEN(TRIM(A1)) – 1)
يكفل هذا التنسيق التتابعي ضمان تنقية أطراف السلسلة من أي شوائب فضائية غير مرئية أولاً، ليقيس محرك LEN الطول الفعلي للكتلة النصية الظاهرة بدقة مطلقة، مما يمكن دالة LEFT من استئصال الحرف الأخير الحقيقي دون الوقوع في شرك اقتطاع الفراغات الهوائية.
8.3 إزالة الرموز غير القابلة للطباعة وفواصل الأسطر
تتعدى الشوائب النصية المسافات البيضاء الكلاسيكية لتشمل طيفاً واسعاً من محارف التحكم غير القابلة للطباعة (Non-printable Control Characters)، وفواصل الأسطر الناشئة عن عمليات الاستيراد من صفحات الويب أو محررات الأكواد البرمجية. تتجسد هذه الرموز في محارف مثل فاصل الأسطر (Line Feed – محرف ASCII رقم 10) أو محرف الإرجاع (Carriage Return – محرف ASCII رقم 13)، وهي رموز تختبئ غالباً في نهايات النصوص المستوردة وتتسبب في إرباك حسابات الطول تماماً كالمسافات الزائدة.
تختص دالة CLEAN بمهمة تنقية السلاسل النصية من أول 32 محرف تحكم في جدول ASCII القياسي القديم ذي الـ 7 بتات، مما يجعلها خط الدفاع الأساسي ضد التشويه الناتج عن فواصل الأسطر العالقة. ولتحقيق أعلى درجات الدقة والنزاهة في تنظيف البيانات الحساسة، يُنصح ببناء مصفوفة تنقية مزدوجة تدمج دالتي CLEAN و TRIM معاً قبل الشروع في حساب الأطوال والاقتطاع، وفق الصيغة المتطورة:
=LEFT(TRIM(CLEAN(A1)), LEN(TRIM(CLEAN(A1))) – 1)
توفر هذه المعادلة المركبة درعاً وقائياً متكاملاً يزيل الشوائب غير المرئية وفواصل الأسطر، ويطهر المسافات الهامشية، ومن ثم يقص الحرف النهائي المستهدف بدقة جراحية لا تشوبها أخطاء البيانات الخفية.
9. الأتمتة المتقدمة باستخدام نصوص برمجة تطبيقات جوجل (Google Apps Script)
9.1 مبررات الانتقال من الدوال الحسابية إلى المعالجة البرمجية
مع تنامي الاعتماد على جداول بيانات جوجل في إدارة قواعد البيانات المؤسسية الضخمة التي تضم مئات الآلاف من السجلات الموزعة عبر أوراق عمل تفاعلية متعددة، قد تصل الدوال الحسابية التقليدية والصيغ المصفوفية المركبة إلى حدودها القصوى من حيث استهلاك الذاكرة وتأخير تحميل الواجهات. يكمن القصور البنيوي في الدوال القياسية في أنها بطبيعتها صيغ اشتقاقية؛ أي أنها تتطلب دوماً إنشاء عمود جديد مخصص لاستقبال النتائج، وهو ما قد لا يتوافق مع التصاميم المعمارية لقواعد البيانات التي تشترط إجراء التعديل في نفس موضع الخلية الأصلية (In-place modification).
يمثل الانتقال إلى المعالجة البرمجية عبر منصة Google Apps Script، المبنية على لغة جافا سكريبت الموجهة للسحابة، حلاً جذرياً لهذه التحديات التقنية. تتيح هذه البيئة التفاعلية للمطورين بناء خوارزميات مخصصة تنفذ عمليات التعديل والتنظيف مباشرة على مصفوفات الذاكرة الداخلية دون الحاجة لأعمدة وسيطة، وتوفر واجهات استخدام مبسطة ومؤتمتة للمستخدمين غير التقنيين، فضلاً عن تحرير موارد الحساب السحابي التفاعلية عبر جدولة المهام الكثيفة لتعمل في الخلفية بصورة مستقلة.
9.2 كتابة دالة مخصصة (Custom Function) بلغة جافا سكريبت
يمكن استبدال الصيغ المعقدة في جداول البيانات بدالة برمجية مخصصة ومبسطة يتم بناؤها عبر محرر البرمجة النصية في جوجل (المتاح عبر تبويب: ملحقات ثم Apps Script). تعتمد هذه الدالة على الأساليب الحديثة لتقطيع النصوص في لغة جافا سكريبت، مثل دالتي slice و substring، حيث يدعم تابع slice الفهارس السالبة بمرونة فائقة تمكنه من استبعاد المحرف الأخير مباشرة دون الحاجة لقياس طول النص صراحة.
تُصاغ الدالة المخصصة داخل بيئة المحرر وفق الشفرة البرمجية التالية:
function REMOVE_LAST_CHAR(input) {
if (Array.isArray(input)) {
return input.map(function(row) {
return row.map(function(cell) {
return (typeof cell === ‘string’ && cell.length > 0) ? cell.slice(0, -1) : cell;
});
});
}
if (typeof input !== ‘string’ || input.length === 0) return input;
return input.slice(0, -1);
}
بمجرد حفظ هذه الشفرة وتوثيقها، تصبح الدالة REMOVE_LAST_CHAR متاحة للاستخدام المباشر داخل خلايا جدول البيانات تماماً كأي دالة قياسية مدمجة (مثل كتابة =REMOVE_LAST_CHAR(A1) أو تمرير نطاق كامل =REMOVE_LAST_CHAR(A1:A100)). يراعي هذا التصميم البرمجي معالجة المدخلات سواء كانت قيماً فردية أو مصفوفات بيانات ثنائية الأبعاد، مما يضمن كفاءة أداء فائقة ومرونة تشغيلية عالية وسهولة لا مثيل لها في قراءة وصيانة المستند البرمجي.
9.3 تصميم مشغل حدثي (Trigger) للتعديل الآلي عند الإدخال
للراغبين في تحقيق أعلى درجات الأتمتة وإجراء التعديل الفوري على البيانات في موضعها الأصلي دون تدخل يدوي، يمكن برمجة “مشغل حدثي بسيط” (Simple Trigger) يستجيب تلقائياً لحدث التحرير onEdit. تعترض هذه الدالة الحدثية تدفق الإدخال في اللحظة التي يقوم فيها المستخدم بتعديل أي خلية داخل نطاق أو عمود مستهدف، وتقوم بفحص القيمة المدخلة وتجريدها من الحرف الأخير فوراً ثم كتابة القيمة النظيفة في نفس الخلية بصورة غير مرئية وسلسة.
تُكتب الدالة الحدثية في محرر البرمجة على النحو التالي:
function onEdit(e) {
var range = e.range;
var sheet = range.getSheet();
var col = range.getColumn();
if (sheet.getName() === “Sheet1” && col === 1) {
var val = range.getValue();
if (typeof val === ‘string’ && val.length > 1) {
range.setValue(val.slice(0, -1));
}
}
}
تختبر هذه الشفرة اسم ورقة العمل ورقم العمود المستهدف (العمود الأول في هذا المثال)؛ وعند تحقق الشرط، تتأكد من أن القيمة نصية وتتجاوز المحرف الواحد، لتستبدل القيمة الأصلية بالقيمة المقتطعة تلقائياً. يتعين عند تطبيق هذه المشغلات مراعاة أذونات الأمان والصلاحيات السحابية لحسابات المستخدمين المشتركين في الملف، والتأكد من إحاطة الإجراءات البرمجية بضوابط دقيقة لمنع استهلاك حدود الحصص اليومية (Quotas) لتنفيذ نصوص جوجل السحابية، وضمان عدم دخول المشغل في حلقات تكرارية مغلقة ومستمرة أثناء التعديل الآلي.
10. أفضل الممارسات الأكاديمية لتحقيق جودة واستقرار البيانات
10.1 تحويل الصيغ الحسابية إلى قيم ثابتة (Static Values)
تُعد مرحلة تثبيت البيانات (Data Freezing) خطوة إلزامية في بروتوكولات إدارة البيانات الاحترافية بعد الانتهاء من تطبيق عمليات التنظيف والتحوير النصي. تعتمد الصيغ الحسابية في جداول البيانات على مراجع ديناميكية متقلبة تظل نشطة وقابلة للتغيير التلقائي كلما تم تعديل الخلايا المصدرية أو حذفها أو نقلها من موضعها، مما يجعل التقارير النهائية عرضة للأعطال والتشوه عند إزالة الأعمدة الأصلية التي كانت تحتوي على البيانات المشوبة.
يتحقق تحويل الصيغ إلى قيم ثابتة ومستقرة عبر تحديد النطاق الناتج بالكامل، ونسخه إلى الحافظة (Ctrl + C)، ثم تطبيق أمر “لصق خاص كقيم فقط” (Paste Special > Values only) في نفس الموقع أو في موضع الحفظ النهائي. يترتب على هذا الإجراء إزالة الأنوية البرمجية التابعة لمحرك الجداول وتحويل النتائج إلى نصوص ثابتة ومجردة. تكمن الفائدة الجوهرية لهذه الخطوة في تحرير الذاكرة المؤقتة للمستند، وتخفيض حجم الملف، وإيقاف عمليات إعادة الحساب المستمرة، فضلاً عن تثبيت البيانات كمرجعية تاريخية مستقرة غير قابلة للتغيير الطارئ لأغراض التدقيق والمراجعة الإحصائية.
10.2 تحسين الكفاءة الحسابية في جداول البيانات العملاقة
تتطلب إدارة جداول البيانات العملاقة التي تتضمن مئات الآلاف من العمليات الحسابية المتزامنة التزاماً صارماً بمعايير التحسين البرمجي لتحقيق أقصى استجابة تشغيلية. يجب على المحلل تجنب الاعتماد على ما يُعرف بـ “الدوال المتقلبة” (Volatile Functions) داخل نفس أوراق العمل التي تجري فيها عمليات تنظيف نصي موسعة، حيث تُجبر تلك الدوال المحرك السحابي على إعادة احتساب كافة معادلات الورقة عند كل حركة تفاعلية أو تعديل يطرأ على أي خلية، مما يتسبب في بطء استجابة الملف وتجميد واجهة المستخدم.
من المعايير المعمارية الحاسمة أيضاً في هذا السياق: الموازنة الدقيقة بين استخدام الصيغ التفاعلية الحية والمعالجة الدفعية المجدولة، وتجنب استخدام النطاقات المصفوفية غير المحدودة إذا كانت الورقة تحتوي على آلاف الصفوف الشاغرة التي لم تُحذف يدوياً؛ إذ يفضل دوماً تقييد النطاقات لتشمل الصفوف الفعلية فقط (مثل A2:A50000 بدلاً من A2:A) متى كانت حدود البيانات معروفة مسبقاً. يسهم هذا الانضباط الهيكلي في تسريع عمليات التحميل، وتحسين زمن الاستجابة لواجهات برمجة التطبيقات المتصلة، وتوفير استهلاك الطاقة الحاسوبية المخصصة للمستند السحابي.
10.3 توثيق عمليات معالجة البيانات وضمان النزاهة الإحصائية
تقتضي المنهجية العلمية والنزاهة الإحصائية في الأبحاث والمشاريع المؤسسية إنشاء سجل توثيقي شامل (Audit Trail) يوضح كافة المراحل والعمليات التعديلية التي طرأت على المتغيرات والسلاسل النصية منذ لحظة استيرادها الأولى وحتى إعدادها النهائي. إن إخضاع البيانات للتعديل والحذف دون توثيق مسبق يُعد خرقاً لمبادئ النزاهة وقابلية إعادة الإنتاج، وقد يؤدي إلى إشكاليات منهجية معقدة عند محاولة تتبع مصادر الشذوذ في التوزيعات التكرارية للعينات.
يشمل التوثيق المنهجي الاحتفاظ الإلزامي بنسخة احتياطية نقية وغير معدلة من “البيانات الخام” (Raw Data) في ورقة عمل مستقلة ومحمية من التعديل (Protected Sheet) للرجوع إليها كمرجع أصلي عند الحاجة. علاوة على ذلك، يتعين تدوين القواعد البرمجية والصيغ المستخدمة في عمود مخصص للملاحظات أو في مستند توثيق خارجي (Data Dictionary)، مع تطبيق بروتوكولات الفحص والتحقق الصارم من النتائج عبر سحب عينات عشوائية منتظمة ومقارنتها بالمدخلات للتأكد التام من أن عمليات الاقتطاع قد أصابت المحارف المشوهة حصراً، دون المساس بالمحتوى الجوهري للهويات والرموز والبيانات قيد الدراسة.
خاتمة
استعرض هذا الدليل المتكامل المنهجيات والتقنيات المتنوعة المتاحة في جداول بيانات جوجل لإزالة الحرف الأخير من سلسلة نصية، مبرزاً الأبعاد الوظيفية والرياضية التي تحكم كل مقاربة. تظل الصيغة الكلاسيكية القائمة على دمج دالتي LEFT و LEN المعيار المفضل لمعظم حالات الاستخدام اليومية نظراً لبساطتها وسرعتها التشغيلية. وفي الوقت ذاته، تبرز التعبيرات النمطية عبر REGEXREPLACE كأداة لا غنى عنها في المعالجات المشروطة والمتقدمة، في حين تقدم دالة MID مرونة استثنائية عند الحاجة لاقتطاع متزامن للأطراف.
إن إدراك الفروق الدقيقة في معالجة المسافات البيضاء والرموز الخفية باستخدام دالتي TRIM و CLEAN، والتحوط المنطقي ضد الخلايا الفارغة والأحادية عبر دالتي IF و IFERROR، يشكل الفارق الحقيقي بين المعالجة العشوائية والمنهجية الأكاديمية الرصينة لإدارة البيانات. وسواء اعتمد المحلل على الصيغ المصفوفية الشاملة عبر ARRAYFORMULA أو ارتقى بالعملية نحو الحلول البرمجية الكاملة بواسطة Google Apps Script، فإن الالتزام بأفضل ممارسات التحويل إلى قيم ثابتة، وتحسين استهلاك الموارد، والتوثيق المنهجي الصارم، يظل الضمانة الأساسية لحفظ نزاهة البيانات وسلامة مخرجاتها التحليلية والإحصائية.
المراجع
- Google. (2023). Google Sheets function list. Google Docs Editors Help. https://support.google.com/docs/table/25273
- Google Developers. (2023). Google Apps Script: Spreadsheet service (SpreadsheetApp). Google for Developers. https://developers.google.com/apps-script/reference/spreadsheet
- OASIS. (2021). Open Document Format for Office Applications (OpenDocument) Version 1.3. Part 4: Recalculated Formula (OpenFormula) Format. OASIS Standard.
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.