
يمثل التعامل مع البيانات الموزعة عبر أبعاد متعددة في برمجية مايكروسوفت إكسيل (Microsoft Excel) أحد التحديات الهندسية والتحليلية الأساسية التي تواجه الباحثين، والمحللين الماليين، ومديري البيانات في مختلف البيئات الأكاديمية والمهنية. فعندما تتجاوز متطلبات النمذجة حدود الجدول الأحادي ثنائي الأبعاد (المكون من صفوف وأعمدة محددة)، تبرز الحاجة الماسة إلى توزيع القياسات عبر طبقات زمنية أو تجريبية مستقلة تتجسد في صورة أوراق عمل منفصلة. إن هذا التوزيع الهيكلي، رغم فوائده الجلية في عزل المتغيرات وتفادي الاكتظاظ البصري، يفرض تعقيدات إجرائية ملحوظة عند محاولة استخلاص المؤشرات الإحصائية التجميعية، وعلى رأسها مقاييس النزعة المركزية كالمتوسط الحسابي.
تاريخياً، ارتبط تطور الجداول الممتدة بالسعي نحو تمثيل النظم المحاسبية والإحصائية المعقدة بكفاءة ومرونة متزايدة؛ فمنذ بزوغ برمجية “فيزيكالك” (VisiCalc) في أواخر سبعينيات القرن العشرين، مروراً بطفرة “لوتس 1-2-3” (Lotus 1-2-3) التي رسخت مفهوم الأبعاد المتعددة، وصولاً إلى إطلاق ميزات المصنفات متعددة الأوراق في إصدارات إكسيل الحديثة، ظلت مسألة استخلاص المعايير الإحصائية من طبقات متعددة محور اهتمام المطورين والمستخدمين على حد سواء. إن احتساب المتوسط الحسابي عبر أوراق متعددة ليس مجرد تطبيق لصيغة رياضية ميكانيكية، بل هو ممارسة منهجية تتطلب فهماً عميقاً لآليات إسناد الخلايا، وتصرف البرمجية تجاه القيم غير المعرفة، وقواعد التدفق الحسابي التي تحكم الذاكرة البرمجية للمصنف.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك الأسس النظرية والتطبيقية لحساب المتوسطات الحسابية عبر أوراق العمل المتعددة في إكسيل. سنستعرض عبر هذا الدليل التقني المنهجي مختلف المقاربات الحسابية، بدءاً من الصياغات التقليدية البسيطة، مروراً بتقنية الإسناد ثلاثي الأبعاد المتقدمة، وصولاً إلى الحلول الهجينة التي تجمع بين دوال البحث والتقنيات الحديثة في بيئة Microsoft 365 مثل محرك Power Query والمصفوفات الديناميكية. كما سنفرد مساحة واسعة للتدقيق الإحصائي، ومعالجة القيم الشاذة والمفقودة، وحوكمة المصنفات لضمان أعلى درجات الموثوقية والدقة التحليلية.
1. مقدمة منهجية لتحليل البيانات متعددة الأبعاد في برمجية إكسيل
1.1 أهمية تجميع البيانات الموزعة عبر أوراق عمل مستقلة
يعد تفكيك الهياكل البيانية المعقدة وتوزيعها عبر أوراق عمل مستقلة داخل المصنف ذاته استراتيجية تصميمية بالغة الأهمية لتسهيل الفهم والتحليل الإحصائي المقارن. عندما يتعامل الباحث مع ظواهر تمتد عبر فترات زمنية متعاقبة—مثل التجارب المعملية متعددة الجلسات، أو تقارير الأداء المالي ربع السنوية—فإن حشر جميع نقاط البيانات في مساحة عمل ثنائية الأبعاد يؤدي حتماً إلى تداخل المتغيرات وتشويش البنية المنطقية للنموذج. من خلال تخصيص ورقة عمل مستقلة لكل دورة زمنية أو وحدة تجريبية، يكتسب النموذج وضوحاً مفاهيمياً يتيح للمحلل عزل المؤثرات ومقارنة الأنماط الفردية قبل الشروع في عمليات التجميع الكلية.
علاوة على ذلك، يسهم الفصل المنهجي بين فترات الملاحظة في تحسين موثوقية النماذج التحليلية بشكل ملموس. يتيح هذا التصميم للباحثين تطبيق معايير ضبط الجودة على كل ورقة عمل بشكل منفصل، مما يسهل رصد الانحرافات واكتشاف البيانات الملوثة أو المدخلات الخاطئة في مهدها دون أن تتسرب إلى باقي أجزاء النموذج. إن وجود حدود فيزيائية واضحة بين مجموعات البيانات يعزز من قابلية المراجعة والتدقيق الخارجي، ويوفر بيئة مثالية لفرق العمل المشتركة للعمل على أجزاء مختلفة من البيانات دون الإخلال بسلامة الهيكل التجميعي العام.
من الناحية الإجرائية، يقلل هذا التقسيم المعماري من احتمالات حدوث أخطاء الإدخال الناتجة عن تكديس المتغيرات في مساحة شاسعة يصعب التنقل فيها. أظهرت الأبحاث المتخصصة في أخطاء الجداول الممتدة، ولا سيما الدراسات التأسيسية التي قادها رايموند بانكو (Raymond R. Panko) حول النماذج الحسابية، أن الكثافة المفرطة للبيانات داخل الورقة الواحدة تزيد بشكل مطرد من معدل الأخطاء البشرية أثناء إدخال الأرقام أو صياغة الروابط المرجعية. وعليه، فإن توزيع البيانات يمثل خط دفاع استباقي يقي الباحث من الانزلاق في أخطاء إزاحة النطاقات وتكرار الصفوف.
1.2 المفاهيم النظرية للمتوسط الحسابي في سياق الجداول الممتدة
يعرّف المتوسط الحسابي للعينة رياضياً بأنه حاصل جمع كافة القيم العددية المرصودة مقسوماً على إجمالي عدد تلك المفردات، وفق الصيغة الكلاسيكية التالية:
$$\bar{X} = \frac{\sum_{i=1}^{N} X_i}{N}$$
في بيئة الجداول الممتدة، يكتسب هذا التعريف أبعاداً إجرائية تتجاوز الحساب الرياضي المجرد؛ حيث تصبح المفردات عبارة عن خلايا موزعة داخل مصفوفات مكانية متباعدة. عندما يطلب من برمجية إكسيل حساب متوسط هذه المصفوفات المنفصلة، يجب على المحرك الحسابي بناء فهرس مؤقت يضم القيم المستهدفة، وتحديد الحجم الفعلي للعينة عبر استبعاد المدخلات غير المؤهلة، ثم تطبيق عملية القسمة بصورة متسلسلة ودقيقة.
يقتضي التحليل المتقدم التمييز الصارم بين مفهومين جوهريين: المتوسط الحسابي البسيط (Simple Average) والمتوسط الحسابي الموزون (Weighted Average). في كثير من الأحيان، يقع المستخدمون في خطأ جسيم يتمثل في حساب متوسط المتوسطات المستخرجة من أوراق العمل الفردية؛ وهي ممارسة رياضية مضللة تؤدي إلى نتائج غير دقيقة ما لم تكن أحجام العينات متطابقة تماماً عبر كافة الأوراق. في المقابل، يتطلب احتساب المتوسط الكلي الحقيقي تجميع كافة القيم الأولية وقسمتها على إجمالي عدد المفردات، أو تطبيق ترجيح إحصائي يعكس الثقل النسبي لكل ورقة عمل وفق حجم ملاحظاتها.
إلى جانب ذلك، يؤثر التوزيع المكاني للخلايا عبر الأوراق على كفاءة المعالجة الحسابية داخل البرمجية. إن قراءة القيم من مواقع ذاكرة متناثرة تتطلب من وحدة المعالجة استدعاء مؤشرات مرجعية متعددة، وهو ما قد ينعكس سلباً على زمن الاستجابة في المصنفات الضخمة التي تحتوي على مئات الآلاف من الروابط العابرة للأوراق. لذلك، يتطلب التصميم الإحصائي الرصين الموازنة بين نقاء البنية المفاهيمية وكفاءة تدفق العمليات الحسابية داخل نواة إكسيل.
1.3 معايير تصميم مصنفات إكسيل لضمان التوافق التحليلي
لتنفيذ عمليات تجميع سلسة وموثوقة عبر أوراق العمل، يتعين الالتزام بمجموعة صارمة من معايير التصميم الهيكلي. يأتي في مقدمة هذه المعايير توحيد موضع المتغيرات وعناوين الأعمدة والصفوف عبر جميع الأوراق المخصصة لجمع البيانات. فعلى سبيل المثال، إذا كان متغير “درجة الاختبار” مسجلاً في الخلية C5 في ورقة العمل الأولى، فيجب أن يحتل الموقع ذاته بدقة متناهية في كافة الأوراق اللاحقة. إن أي انزياح أو تباين موضعي يؤدي إلى إفساد الحسابات التلقائية ما لم يتم اللجوء إلى دوال مطابقة ديناميكية إضافية تثقل كاهل المصنف الحسابي.
يتعلق المعيار الثاني بضرورة تثبيت نوع البيانات وتنسيقها الإحصائي داخل النطاقات المتناظرة. يجب التأكد من أن جميع الخلايا التي ستدخل في احتساب المتوسط قد تم تعريفها بصفتها قيماً رقمية (Numeric)، وتجريدها من أي نصوص أو محارف غير مرئية قد تتسرب أثناء الاستيراد الخارجي. إن الخلط بين التنسيقات الرقمية والنصية داخل النطاق المستهدف يعيق عمل الدوال الإحصائية، ويجعل النتائج عرضة للتحيز الناتج عن إغفال البرمجية لبعض القيم التي تعاملت معها كنصوص دون تنبيه صريح للمستخدم.
أخيراً، ينبغي اعتماد استراتيجية تسمية نسقية ومنطقية لأوراق العمل منذ بداية المشروع التحليلي. يسهم استخدام بادئات متطابقة ومتبوعة بأرقام تسلسلية—مثل (Session_01، Session_02) أو (Month_01، Month_02)—في تسهيل كتابة الصيغ المرجعية الموسعة، ويتيح للمحلل استثمار قدرات الإسناد ثلاثي الأبعاد بصورة مباشرة. علاوة على ذلك، يفضل تجنب إدراج مسافات أو رموز خاصة في أسماء الأوراق لتقليص الحاجة إلى علامات الترقيم المعقدة داخل الصيغ الحسابية، مما يرفع من مقروئية المعادلات ويقلل فرص الخطأ النحوي أثناء الصياغة البرمجية.
2. الصياغة الأساسية لدالة المتوسط اليدوي عبر خلايا متفرقة
2.1 التركيب النحوي للصيغة التقليدية لدالة AVERAGE
تعد دالة AVERAGE الدعامة الأساسية لإجراء العمليات الإحصائية البسيطة في إكسيل، حيث تعتمد في بنيتها الهيكلية على استقبال وسائط متعددة تمثل القيم أو النطاقات المراد دمجها. في سياق الحساب اليدوي عبر أوراق عمل متفرقة، تتخذ الدالة شكلاً تسلسلياً يستدعي كل خلية بشكل مستقل كمعامل منفصل داخل الأقواس. تتولى الدالة تفكيك هذه الوسائط تباعاً، وجمع محتوياتها الرقمية، ثم قسمة الناتج النهائي على العدد الإجمالي للوسائط الصالحة المدخلة.
يتطلب الفصل بين مراجع الأوراق المختلفة استخدام الفواصل المنطقية التي يحددها النظام التشغيلي للمستخدم؛ حيث تستخدم الفاصلة الاعتيادية (,) في الأنظمة المعتمدة على النمط الأمريكي، بينما تستخدم الفاصلة المنقوطة (;) في الأنظمة التي تستخدم الفاصلة كعلامة عشرية. إن الضبط الدقيق لهذه الفواصل يضمن للبرمجية تمييز كل مرجع ككيان هندسي مستقل لا علاقة له بالنطاق المجاور، مما يتيح تجميع نقاط بيانات متفرقة جغرافياً داخل المصنف في معادلة موحدة:
=AVERAGE(Sheet1!B2, Sheet2!B2, Sheet3!B2)
من الناحية المعمارية، تفرض برمجية إكسيل حداً أقصى لعدد الوسائط الفردية التي يمكن تمريرها داخل الدالة الواحدة، حيث تستوعب الإصدارات الحديثة ما يصل إلى 255 وسيطة منفصلة. ومع ذلك، فإن الاقتراب من هذا السقف النظري يؤدي إلى تدهور استقرار الصيغة الحسابية، ويجعل تدقيقها أمراً بالغ التعقيد من المنظور البشري. لذا، فإن هذا التركيب التسلسلي يظل ملائماً للحالات التي تقتصر على عدد محدود ومعدود من الأوراق المتباعدة.
2.2 آلية الإسناد الخارجي للخلايا الفردية (Sheet!Cell Reference)
تخضع عملية الربط بين الخلايا الواقعة في أوراق مختلفة لقواعد بناء لغوية صارمة تحدد مسار الانتقال بين طبقات المصنف. تعتمد البرمجية علامة التعجب (!) كفاصل اصطلاحي محوري يفصل بين المعرف النصي لورقة العمل (اسم الورقة) والإحداثي المكاني للخلية المستهدفة (العمود والصف). عند كتابة الصيغة، تخبر هذه العلامة المحرك الحسابي بأن عليه مغادرة سياق الورقة الحالية والتوجه إلى الورقة المسماة مسبقاً لاستخلاص القيمة المخزنة في الموقع المحدد.
تتعقد هذه الآلية عندما تشتمل أسماء أوراق العمل على مسافات فاصلة أو رموز خاصة، مثل التواريخ أو الشَرطات (على سبيل المثال: Data 2024 أو Trial-A). في مثل هذه الحالات، تفرض القواعد النحوية لإكسيل إحاطة اسم الورقة بعلامتي اقتباس مفردتين (‘ ‘) قبل علامة التعجب لضمان معالجة الاسم ككتلة نصية واحدة غير قابلة للتجزئة. تبدو الصيغة في هذا النموذج على النحو الآتي:
=AVERAGE(‘Data 2024’!B2, ‘Trial-A’!B2)
إن إغفال هذه العلامات يؤدي فوراً إلى فشل الصيغة وتوليد رسائل خطأ تركيبية توقف الحساب.
بالإضافة إلى ذلك، تلعب طبيعة الإسناد دوراً حاسماً في سلوك المعادلة عند تعميمها؛ فالإسناد النسبي (مثل Sheet1!B2) يسمح بتغير موقع الخلية عند نسخ الصيغة وسحبها إلى خلايا مجاورة، وهو السلوك المطلوب غالباً عند تعميم التحليل على مؤشرات متعددة. أما إذا استدعت الضرورة تثبيت الخلية المستهدفة بحيث تشير دائماً إلى نفس النقطة بغض النظر عن موضع الصيغة التجميعية، فيتعين تطبيق الإسناد المطلق عبر إقحام رمز الدولار ($) لتصبح الخلية مقيدة محورياً على النحو: Sheet1!$B$2.
2.3 تقييم الكفاءة وحدود الاستخدام للطريقة اليدوية
على الرغم من بساطة هذه الطريقة اليدوية ووضوحها النظري، إلا أنها تفتقر بشدة إلى قابلية التوسع (Scalability). عندما يتسع نطاق البحث ليشمل عشرات أو مئات من أوراق العمل—كما هو الحال في الدراسات الطولية الواسعة أو السجلات اليومية على مدار العام—تصبح كتابة الصيغ اليدوية عبئاً تشغيلياً لا يطاق. إن إدخال خمسين أو ستين مرجعاً فردياً داخل دالة واحدة يستنزف وقتاً طويلاً ويؤدي إلى صياغة معادلات بالغة الطول تستهلك مساحة واسعة من شريط الصيغ وتعيق عمليات الصيانة البرمجية المستقبلية للمصنف.
علاوة على ذلك، يرفع النقر اليدوي المتكرر على الخلايا المتناثرة عبر الأوراق من احتمالات السهو والخطأ البشري بصورة دراماتيكية. تشير الأدبيات المتخصصة في التدقيق الحسابي إلى أن أخطاء الإغفال (Omission Errors)—المتمثلة في تخطي ورقة عمل معينة دون قصد، أو النقر على خلية مجاورة للخلية المستهدفة—تشكل النسبة الكبرى من العيوب الهيكلية في النماذج اليدوية. وتزداد هذه المخاطر فداحة نظراً لأن إكسيل لن يطلق أي إنذار تحذيري طالما أن الخلية التي تم النقر عليها خطأً تحتوي على قيمة رقمية صالحة حسابياً.
ومع ذلك، تظل الطريقة اليدوية خياراً حتمياً ولا غنى عنه في حالات محددة تتسم بعدم الانتظام الهندسي للمصنف. فإذا كانت أوراق العمل المطلوب دمجها متباعدة بصورة غير متسلسلة داخل المصنف، أو تفصل بينها أوراق عمل وسيطة تتضمن بيانات لا صلة لها بالتحليل ولا يجوز إقحامها في المتوسط، فإن الإسناد الفردي الانتقائي يصبح السبيل الوحيد لعزل المتغيرات بدقة، مما يمنح المحلل تحكماً كاملاً في هوية كل مدخل إحصائي على حدة.
3. تقنية الإسناد ثلاثي الأبعاد (3D References) لحساب المتوسط
3.1 الأساس النظري والهندسي للمراجع ثلاثية الأبعاد
يمثل الإسناد ثلاثي الأبعاد (3D Reference) قفزة معمارية نوعية في معالجة الجداول الممتدة؛ إذ يحرر المحلل من القيود المكانية لشبكة الإحداثيات الثنائية المعتادة (المحور الأفقي X للأعمدة، والمحور الرأسي Y للصفوف). في هذا النموذج المتقدم، يُنظر إلى أوراق العمل المتتالية باعتبارها طبقات متراصة على طول محور عمق افتراضي يُعرف بالمحور الرأسي الثالث (Z-axis). وبذلك، لا يعود النطاق الحسابي مجرد مساحة مسطحة، بل يتحول إلى منشور أو مجسم حجري يقطع طبقات متعددة عند نفس الإحداثيات السطحية بدقة متناهية.
تاريخياً، يعود الفضل في تدشين هذا النمط من المراجع الحجمية إلى برنامج “لوتس 1-2-3” في إصداره الثالث عام 1989، قبل أن تتبناه وتطوره مايكروسوفت بصورة جذرية مع إطلاق إكسيل 5.0 (Excel 5.0) عام 1993، حين أتاحت بنية المصنفات المجدولة متعددة الصفحات. تكمن الآلية الجوهرية لهذا النظام في قدرة محرك إكسيل على قراءة المسافة الطبوغرافية الفاصلة بين “ورقة البداية” و”ورقة النهاية”، ومعالجة كافة الخلايا المتناظرة الواقعة بينهما كحزمة بيانية واحدة متصلة دون الحاجة إلى استدعاء كل ورقة باسمها المستقل.
يوفر هذا النهج وفراً هائلاً في الجهد الحسابي ويسهم في اختزال طول الصيغة البرمجية بصورة دراماتيكية. فبدلاً من كتابة معادلة تمتد لأسطر متعددة تتضمن مراجع لخمسين ورقة، يمكن التعبير عن العملية الحسابية بأكملها من خلال إسناد طرفي النطاق فقط. ينعكس هذا الاختزال إيجاباً على سرعة معالجة الملف، وتخفيض استهلاك الذاكرة، ورفع كفاءة المصنف إلى مستويات تضاهي الجداول المفردة مع الحفاظ على مرونة التوزيع متعدد الطبقات.
3.2 الصيغة الرياضية القياسية للنطاق الممتد عبر الأوراق
تعتمد الصيغة القياسية للإسناد ثلاثي الأبعاد مع دالة المتوسط تركيباً نحوياً مقتضباً يدمج بين اسمي الورقتين المحددتين للنطاق وعنوان الخلية المستهدفة، مفصولاً بينهما بنقطتين رأسيتين (:). تتجسد الصيغة النمطية في الشكل التالي:
=AVERAGE(FirstSheet:LastSheet!Cell)
تقوم النقطتان الرأسيتان هنا بدور الرابط التجميعي الذي يعلن لإكسيل أن المجال يشمل ورقة البداية، وورقة النهاية، وجميع أوراق العمل الفيزيائية المتموضعة بينهما داخل شريط التبويبات بالترتيب التنازلي أو التصاعدي المعتمد في المصنف.
لتطبيق هذه الصياغة بنجاح، تفرض البرمجية شرطاً حاسماً يتمثل في استمرارية السلسلة الطبقية وتطابق الهيكل الداخلي. إن إكسيل يحدد النطاق بناءً على الترتيب الفيزيائي لتبويبات الأوراق في واجهة المستخدم، وليس بناءً على تسلسلها الأبجدي أو التاريخي. هذا يعني أن تغيير موضع تبويب ورقة معينة وسحبها بالفأرة إلى خارج النطاق المحصور بين ورقة البداية وورقة النهاية يؤدي تلقائياً إلى عزلها واستبعادها الفوري من عملية احتساب المتوسط، والعكس صحيح.
وفي حال كانت أسماء الأوراق تتضمن فراغات، فإن علامات الاقتباس المفردة تدمج النطاق بأكمله ليكون التركيب النحوي بالشكل الآتي: ='Week 1:Week 4'!B2. يبرهن هذا التركيب على أن البرمجية تعامل السلسلة بأكملها ككيان مكاني موحد، مما يلغي التكرار الإجرائي ويوفر صيغة بالغة الأناقة والصلابة الهندسية.
3.3 الديناميكية والمرونة عند إدراج أو حذف أوراق عمل جديدة
تتمثل الميزة التشغيلية الأبرز للإسناد ثلاثي الأبعاد في ديناميكيته المطلقة وقدرته الفائقة على التكيف مع التغيرات الهيكلية التي تطرأ على المصنف دون تدخل برمجي يدوي. إذا احتاج الباحث إلى إضافة ورقة عمل جديدة لتوثيق جلسة قياس إضافية، فكل ما عليه فعله هو إدراج الورقة وسحب تبويبها ليقع بين ورقة البداية وورقة النهاية المحددين في الصيغة. في اللحظة التي تستقر فيها الورقة داخل هذا الحيز الجغرافي، يقوم محرك الحساب بتضمين خلاياها المتناظرة فوراً وبشكل تلقائي ضمن دالة المتوسط، ويعيد ضبط قاسم المعادلة ليعكس الحجم الجديد للمفردات.
بيد أن هذه المرونة الفائقة تنطوي على مخاطر هيكلية لا يستهان بها إذا أُسيء فهمها. فإذا قام مستخدم غير مدرب بنقل ورقة تتضمن بيانات غير ذات صلة أو حسابات تمهيدية ووضعها دون قصد بين ورقتي البداية والنهاية، فإن قيم تلك الورقة ستندمج خلسة داخل المتوسط الحسابي، مما يؤدي إلى تلويث النتائج الإحصائية وتشويه المخرجات التحليلية دون أي إشعار بالخطأ. كذلك، فإن حذف إحدى أوراق الحدود (البداية أو النهاية) يقطع السلسلة المرجعية ويقود إلى انهيار الصيغة وظهور رسالة خطأ المرجع غير الصالح.
ولتحصين المصنفات ضد هذه الانزلاقات غير المقصودة، يوصي مهندسو النظم باعتماد استراتيجية متقدمة تُعرف بإنشاء “أوراق الحصر الوهمية” أو “هيكلية الشطيرة” (Sandwich Sheets). ترتكز هذه التقنية على إنشاء ورقتي عمل فارغتين تماماً، تسمى الأولى مثلاً (Start_Anchor) والأخيرة (End_Anchor)، وتُبنى صيغة المتوسط ثلاثي الأبعاد بالاعتماد عليهما كحدود ثابتة:
=AVERAGE(Start_Anchor:End_Anchor!B2)
بعد ذلك، يتم إدراج جميع أوراق العمل الحقيقية المحتوية على البيانات بين هذين الجدارين الاصطناعيين. يضمن هذا الإجراء عدم قيام أي عملية حذف أو تعديل للبيانات الفعلية بكسر حدود المعادلة الأصلية، مما يرسي بروتوكول أمان عالي الموثوقية لحوكمة المصنف.
4. تطبيق عملي منهجي: حساب متوسط درجات الأداء الرياضي
4.1 توصيف نموذج دراسة الحالة والمتغيرات الإحصائية
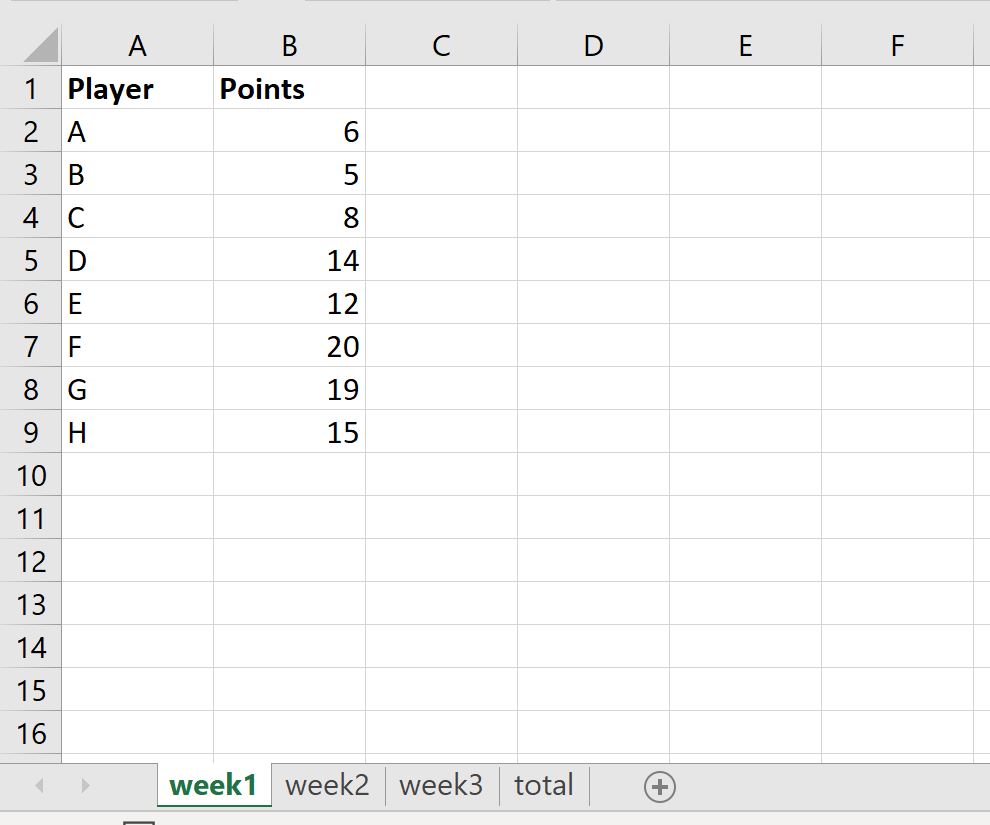
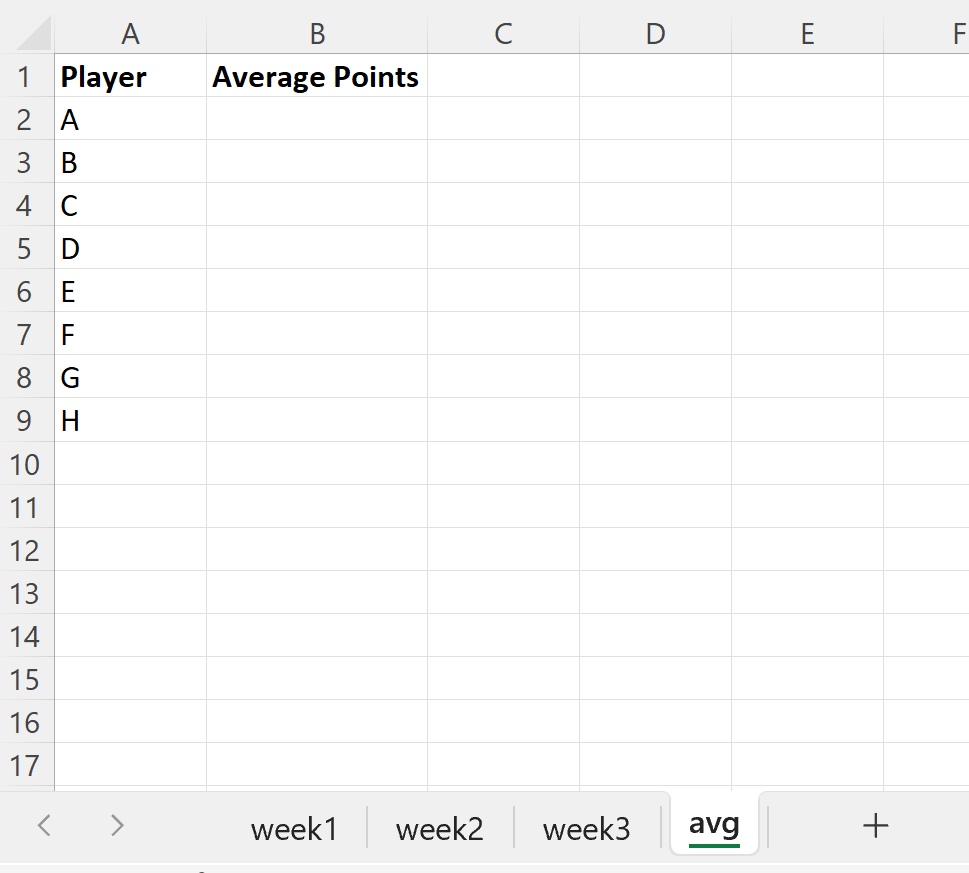
لإدراك الآليات السابقة في سياق تطبيقي ملموس، سنفترض نموذج دراسة حالة إحصائية تهدف إلى قياس وتحليل متوسط درجات الأداء البدني لثمانية لاعبين محترفين يخضعون لاختبارات دورية على مدار ثلاثة أسابيع تدريبية مستقلة. تم تصميم المصنف بحيث تم تخصيص ورقة عمل لكل أسبوع، وحملت التبويبات التسميات النسقية الآتية: (week1، week2، week3). تهدف الدراسة إلى تجميع هذه القياسات الفردية واستخراج مؤشر الأداء العام لكل رياضي عبر ورقة تلخيص مركزية مخصصة للتحليل النهائي أُطلق عليها اسم (avg).
تم استيفاء معيار التوافق الهيكلي الصارم عبر أوراق الأسابيع الثلاثة؛ حيث تم تثبيت قائمة أسماء الرياضيين الثمانية في العمود A بدءاً من الخلية A2 وحتى A9، في حين تم تخصيص العمود B، وتحديداً الخلايا من B2 إلى B9، لتسجيل النقاط الرقمية المحرزة في اختبارات كل أسبوع. يوضح الجدول التالي توزيع الدرجات المسجلة في كل ورقة عمل بشكل منفصل، مما يوفر منصة واضحة وموحدة للانطلاق نحو عمليات التجميع الإحصائي:
| موضع الخلية | معرف اللاعب | نقاط الأسبوع الأول (week1) | نقاط الأسبوع الثاني (week2) | نقاط الأسبوع الثالث (week3) |
|---|---|---|---|---|
| Row 2 | اللاعب A | 6 | 8 | 6 |
| Row 3 | اللاعب B | 7 | 5 | 9 |
| Row 4 | اللاعب C | 8 | 8 | 8 |
| Row 5 | اللاعب D | 5 | 6 | 7 |
| Row 6 | اللاعب E | 9 | 9 | 10 |
| Row 7 | اللاعب F | 4 | 7 | 5 |
| Row 8 | اللاعب G | 10 | 6 | 8 |
| Row 9 | اللاعب H | 7 | 8 | 6 |
4.2 خطوات التنفيذ الإجرائي للصيغة الحسابية
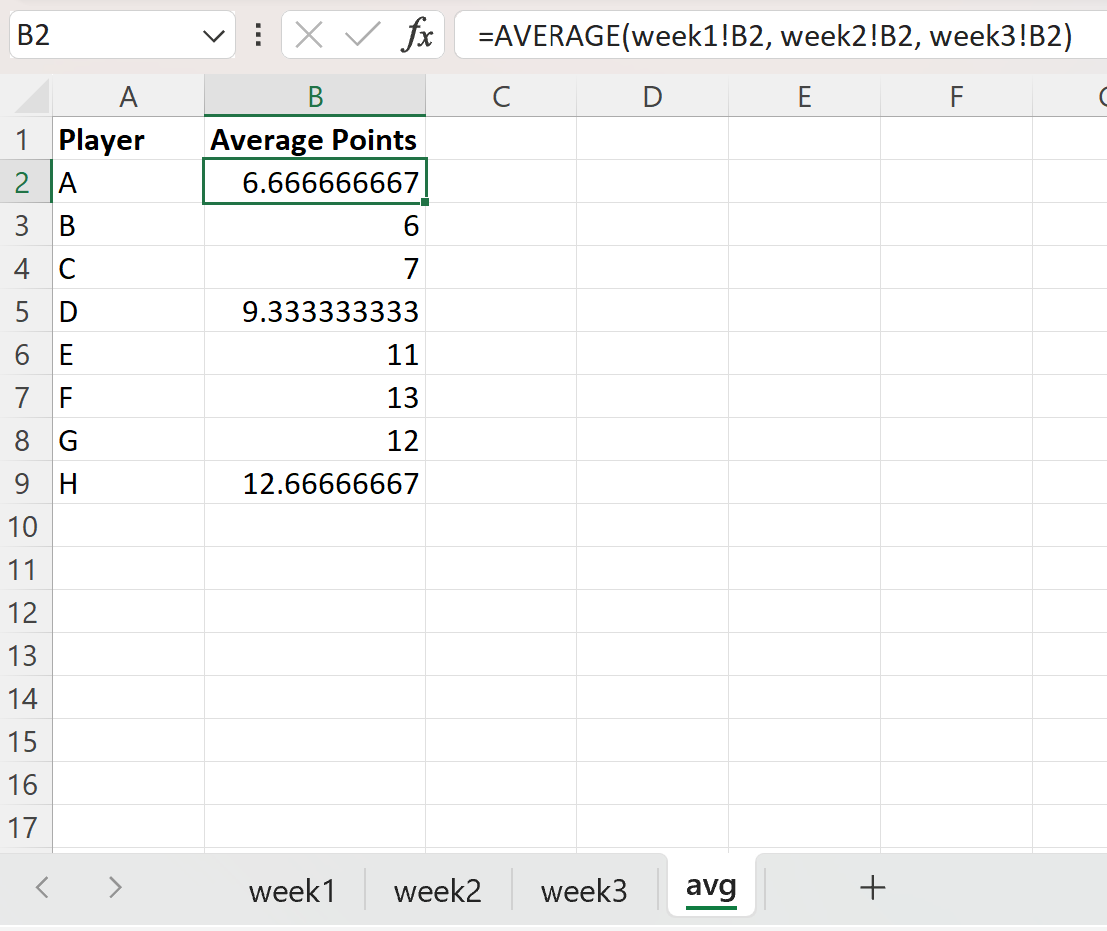
تبدأ الخطوة الإجرائية الأولى بالانتقال إلى ورقة العمل المركزية (avg) وتحديد الخلية B2، المجاورة لاسم “اللاعب A”. لإجراء مقارنة معيارية للمخرجات، يمكن إدخال الصيغة اليدوية المتسلسلة أولاً بالصورة الآتية:
=AVERAGE(week1!B2, week2!B2, week3!B2)
يقوم المحرك الحسابي باسترجاع القيم (6، 8، 6) تباعاً، وجمعها ليصل إلى المجموع 20، ثم يقسمه على 3 لينتج المتوسط النهائي وقدره 6.67 تقريباً. تبرز هذه الطريقة نجاحاً أولياً لكنها تظل محكومة ببطء البناء النحوي وصعوبة التعميم السريع.
في المقابل، يتم تطبيق تقنية الإسناد ثلاثي الأبعاد المتقدمة في الخلية ذاتها من خلال إدخال الصيغة الموحدة:
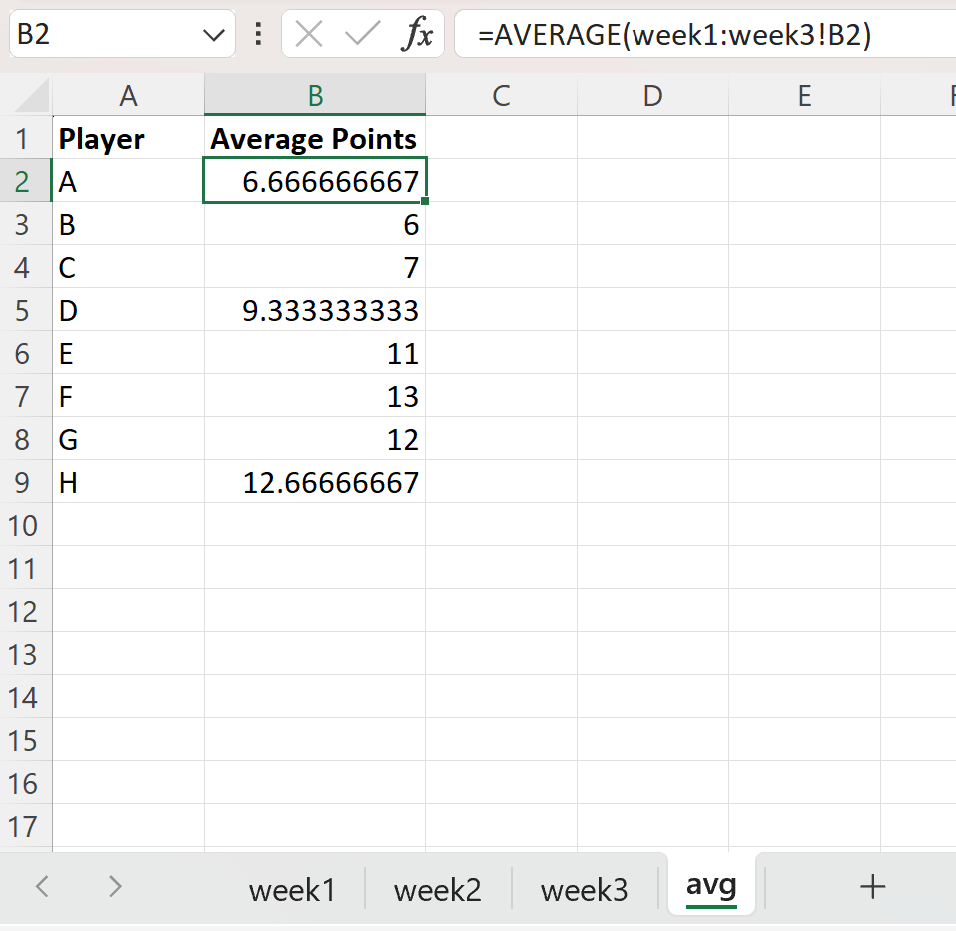
=AVERAGE(week1:week3!B2)
يختصر هذا الأمر البرمجي استدعاء الأوراق المنفصلة في عملية مسح حجمي تمر عبر المحور الرأسي من الطبقة week1 إلى الطبقة week3 عند الإحداثي B2 مباشرة، مما يؤدي إلى مطابقة رياضية فورية للمخرجات السابقة وبصيغة قابلة للصيانة والتعديل بسهولة بالغة.
ولتعميم الحساب على بقية مفردات العينة الإحصائية، يتم تفعيل مقبض التعبئة التلقائية (AutoFill Handle) المتمركز في الزاوية السفلية للخلية B2. عند سحب المقبض رأسياً باتجاه الأسفل حتى بلوغ الخلية B9، يترجم إكسيل الإسناد النسبي للخلية؛ فيتحول المرجع B2 تلقائياً وبشكل ديناميكي إلى B3 للاعب B، وB4 للاعب C، وصولاً إلى B9 للاعب H، دون أي مساس بحدود الأوراق (week1:week3). تتم هذه العملية في أجزاء من الثانية، لتكتمل لوحة التلخيص الإحصائي لجميع أفراد العينة دون أدنى تدخل يدوي إضافي.
4.3 تفسير النتائج ومطابقتها إحصائياً
عند فحص المخرجات الحسابية في ورقة التلخيص المركزية، نجد أن متوسط أداء اللاعب A قد بلغ تحديداً 6.666666667 نقطة. من المنظور الأكاديمي، تفرض الضوابط المنهجية توحيد الدقة العشرية وتنسيق الأرقام المعروضة بما يلائم طبيعة أداة القياس الأصلية. يتم ذلك عبر ضبط خصائص تنسيق الخلايا لتقتصر على منزلتين عشريتين، ليظهر الناتج بصورة منضبطة ومقروءة (6.67). يوضح الجدول أدناه النتائج الإجمالية المستخرجة من ورقة التلخيص لجميع اللاعبين، موضحاً المتوسط الحسابي النهائي لكل فرد:
| اسم اللاعب | موقع الخلية التجميعية | صيغة الحساب المطبقة | المتوسط الحسابي النهائي |
|---|---|---|---|
| اللاعب A | B2 | =AVERAGE(week1:week3!B2) | 6.67 |
| اللاعب B | B3 | =AVERAGE(week1:week3!B3) | 7.00 |
| اللاعب C | B4 | =AVERAGE(week1:week3!B4) | 8.00 |
| اللاعب D | B5 | =AVERAGE(week1:week3!B5) | 6.00 |
| اللاعب E | B6 | =AVERAGE(week1:week3!B6) | 9.33 |
| اللاعب F | B7 | =AVERAGE(week1:week3!B7) | 5.33 |
| اللاعب G | B8 | =AVERAGE(week1:week3!B8) | 8.00 |
| اللاعب H | B9 | =AVERAGE(week1:week3!B9) | 7.00 |
لإجراء تدقيق متقاطع (Cross-Auditing) والتثبت من خلو الحسابات من أي أخطاء برمجية كامنة، تم إجراء مطابقة ثنائية بين نتائج الصياغة ثلاثية الأبعاد ونظيرتها اليدوية المستقلة؛ حيث أظهرت الاختبارات تطابقاً تاماً بنسبة 100% في كافة المخرجات الرقمية، مما يؤكد سلامة النطاق المكاني وعدم تسرب أي إزاحة إحداثية عبر الطبقات الثلاث.
5. التعامل مع التباين الهيكلي وعدم تطابق مواقع الخلايا
5.1 تحديات اختلاف ترتيب المفردات أو الصفوف عبر الأوراق
في بيئات العمل الميدانية ومشاريع جمع البيانات الواقعية، نادراً ما تظل هياكل الجداول متطابقة بصورة مثالية عبر الزمن. تتعدد الأسباب المؤدية إلى حدوث التباين المكاني؛ فقد ينسحب بعض المشاركين من تجربة معينة مما يؤدي إلى حذف صفوفهم في الأسابيع اللاحقة، أو قد يتم تسجيل مدخلات جديدة تعيد ترتيب القوائم، أو قد يعمد القائمون على إدخال البيانات إلى فرز الجداول وفق معايير متباينة (كالترتيب الأبجدي في شهر، والترتيب التنازلي للأداء في شهر آخر). هذا التباعد الهيكلي يقوض الافتراض الأساسي الذي تقوم عليه المراجع ثلاثية الأبعاد المباشرة.
تتمثل الخطورة الكبرى في أن تطبيق صيغة الإسناد ثلاثي الأبعاد المباشرة مثل =AVERAGE(week1:week3!B2) في ظل غياب التناظر التام، سيؤدي إلى كارثة إحصائية صامتة. ستقوم المعادلة بسحب القيمة الموجودة في B2 بغض النظر عمن تشير إليه تلك الخلية؛ فقد تجمع درجة “اللاعب A” في الأسبوع الأول مع درجة “اللاعب D” في الأسبوع الثاني ودرجة “اللاعب H” في الأسبوع الثالث لمجرد أنهم احتلوا الصف الثاني مصادفة. إن هذا التجميع العشوائي ينتج بيانات مضللة وفاقدة للصلاحية العلمية دون أن تصدر البرمجية أي إشعار بوجود خطأ.
لتفادي هذا الفخ المنهجي، تبرز الحاجة الملحة إلى التخلي عن الإسناد الموضعي الجامد، واستبداله بأدوات بحث وتوفيق ديناميكية مسبقة. تهدف هذه الأدوات إلى استكشاف المصفوفات بحثاً عن المعرّف الفريد للمفردة (كالاسم أو الرقم التعريفي ID) واستخلاص قيمتها المرتبطة بها حصراً من كل ورقة عمل على حدة، قبل الشروع في دمج تلك القيم داخل المعادلة التجميعية المركزية للمتوسط.
5.2 الدمج بين دالتي AVERAGE و XLOOKUP أو VLOOKUP
يمثل التوليف البرمجي بين دالة المتوسط ودوال البحث والاسترجاع الحديثة، وفي مقدمتها دالة XLOOKUP (أو سابقتها التقليدية VLOOKUP)، المنهجية المعيارية لتجاوز عقبة التباين المكاني للصفوف. بموجب هذه التقنية، لا تقوم دالة المتوسط بالإشارة المباشرة إلى عناوين الخلايا، بل تستقبل مخرجات دوال البحث التي تبحث عن المعرف المستهدف داخل كل ورقة عمل بشكل منفصل ومستقل تماماً عن موضع الصف الحقيقي.
تتجلى هذه الصياغة المركبة في كتابة دالة XLOOKUP مستقلة لكل ورقة عمل كمعامل فريد داخل دالة المتوسط الإجمالية، كما يوضح النموذج البرمجي التالي:
=AVERAGE(XLOOKUP(A2, week1!A:A, week1!B:B), XLOOKUP(A2, week2!A:A, week2!B:B), XLOOKUP(A2, week3!A:A, week3!B:B))
في هذه المعادلة، تبحث الدالة الأولى عن قيمة اللاعب المسجلة في الخلية A2 ضمن العمود A من الورقة week1 وتعيد نتيجته، وتكرر الدوال اللاحقة الأمر ذاته في أوراق العمل الأخرى. وبذلك تضمن دالة AVERAGE استقبال الدرجات الصحيحة العائدة لنفس الشخص بصرف النظر عن موقعه في كل ورقة.
ومع ذلك، يبرز تحدٍ إضافي إذا غاب اللاعب عن أحد الأسابيع ولم يظهر اسمه إطلاقاً في تلك الورقة، حيث ستولد دالة البحث خطأ القيمة غير المتاحة (#N/A)، مما يؤدي بدوره إلى تعطيل دالة المتوسط برمتها. لمعالجة هذا الاستثناء، يتم تطويق كل دالة بحث بدالة الحماية الشرطية IFERROR أو استثمار المعامل الرابع المدمج في XLOOKUP ذاتها (if_not_found)، لتوجيه الدالة نحو تجاهل الغياب وتمرير قيمة فارغة تتيح لدالة المتوسط إتمام الحساب بناءً على الأسابيع المتوفرة فعلياً دون توقف.
5.3 استخدام دالتي INDEX و MATCH للربط ثنائي الاتجاه
في المصنفات الكبرى والبيئات التحليلية الحساسة التي تتطلب كفاءة قصوى في إدارة موارد النظام، يفضل الخبراء استخدام التركيب الثنائي الكلاسيكي المكون من دالتي INDEX و MATCH. توفر هذه التقنية مرونة فائقة تتجاوز قيود البحث الرأسي أو الأفقي؛ إذ تقوم دالة MATCH بتحديد الموضع النسبي لرقم الصف المطابق لاسم المفردة بدقة، بينما تتولى دالة INDEX تقاطع هذا الصف مع العمود المطلوب لاسترجاع القيمة المحددة بدقة متناهية ودون الحاجة إلى تحميل نطاقات كاملة في الذاكرة الحية.
تتيح صياغة INDEX و MATCH بناء معادلات ديناميكية تستطيع التكيف ليس فقط مع تغير ترتيب الصفوف، بل ومع تغير ترتيب الأعمدة أيضاً عبر أوراق العمل المختلفة. إذا تغير موضع عمود النقاط من العمود B في ورقة العمل الأولى إلى العمود D في ورقة العمل الثانية، تستطيع دالة MATCH ثنائية الأبعاد تعقب موضع العمود والصف معاً في خطوة موحدة، مما يوفر حصانة هيكلية شاملة ضد كافة أشكال التعديل وإعادة التنسيق التي قد يجريها جامعو البيانات الميدانيون.
تتميز هذه التركيبة بقدرتها الفائقة على تخفيض الحمل الحسابي الملقى على عاتق المعالج مقارنة بالدوال الشاملة؛ نظراً لأنها تتعامل مع مؤشرات ذاكرة مباشرة وخفيفة. هذا يضمن بقاء أداء المصنف سريعاً ومستقراً حتى مع استدعاء مئات المعادلات المتقاطعة عبر عشرات الأوراق المنفصلة، ويضمن استمرارية وصحة نتائج المتوسط الحسابي حتى لو تم إعادة فرز البيانات الأصلية بصورة عشوائية ومستمرة داخل الأوراق المصدرية.
6. معالجة القيم الصفرية والخلايا الفارغة والبيانات المفقودة
6.1 السلوك الافتراضي لدالة AVERAGE تجاه الفراغات والنصوص
تتطلب الحوكمة الإحصائية الرصينة فهماً دقيقاً للسلوك التلقائي والافتراضي الذي تنتهجه دالة AVERAGE عند اصطدامها بالخلايا غير النموذجية. وفقاً لقواعد البناء المعتمدة في نواة إكسيل، تقوم الدالة بالتجاهل التلقائي والتام لأي خلية فارغة تماماً (Blank)، وكذلك الخلايا التي تحتوي على نصوص حرفية أو قيم منطقية (TRUE أو FALSE). يتم استبعاد هذه المدخلات كلياً من كلا طرفي المعادلة الحسابية؛ فهي لا تُضاف إلى بسط الكسر (المجموع الإجمالي)، والأهم من ذلك أنها تُحذف من مقام الكسر (قيمة $N$ الدالة على حجم العينة).
في المقابل، تتعامل البرمجية مع الخلية المحتوية على القيمة صفر (0) بصفتها مدخلاً رقمياً مشروعاً وذا دلالة قياسية مؤكدة. ومن هنا ينشأ فارق جوهري وخطير بين الخلية المتروكة فارغة والخلية المكتوب فيها الرقم صفر؛ فالقيمة صفر تُضاف إلى البسط كصفر لا يرفع المجموع، ولكنها تُحتسب في المقام، مما يرفع عدد المفردات بمقدار واحد ويؤدي بالضرورة إلى انخفاض حاد في قيمة المتوسط الحسابي الناتج. يوضح هذا الفارق الرياضي الإجرائي جوهر المخاطر التي قد تلحق بالدراسة عند الخلط بين غياب القياس وقيمة القياس الصفرية.
إذا تغيب أحد المشاركين في تجربة عن جلسة قياس معينة، فإن ترك خليته فارغة سيقود إكسيل إلى احتساب متوسط درجاته بناءً على الجلسات التي حضرها فعلاً (مثلاً القسمة على 2 بدلاً من 3). أما إذا قام الباحث بإدخال الرقم 0 تعبيراً عن الغياب، فسيتم احتساب الصفر كدرجة حقيقية متدنية وتُقسم النتيجة على 3، مما يتسبب في تشويه إحصائي جسيم لا يعبر عن الأداء الفعلي للعينة. لذا يجب صياغة بروتوكولات حاسمة لملء الجداول لمنع انزلاق الأصفار غير المبررة إلى قواعد البيانات.
6.2 المقارنة بين AVERAGE و AVERAGEA في تقييم البيانات غير الرقمية
توفر برمجية إكسيل دالة موازية تُعرف باسم AVERAGEA، صُممت خصيصاً للتعامل مع السيناريوهات التي تستوجب تضمين المدخلات غير الرقمية في التقييم الإحصائي الإجمالي. يكمن الفارق الجوهري بين الدالتين في أن دالة AVERAGEA لا تتجاهل النصوص أو القيم المنطقية المخزنة داخل الخلايا، بل تقوم بقسرها وتحويلها جبرياً إلى أرقام محددة وفق قواعد معيارية صارمة: حيث تُحوّل القيمة المنطقية TRUE إلى الرقم 1، بينما تُحوّل القيمة المنطقية FALSE وأي نص حرفي (بما في ذلك السلاسل النصية الفارغة “”) إلى الرقم صفر (0).
تؤدي هذه الآلية القسرية إلى حدوث انحرافات إحصائية دراماتيكية إذا تم استخدام الدالة في سياق غير ملائم؛ فلو احتوت إحدى الخلايا على كلمة توضيحية مثل “غائب” أو “مستبعد”، ستقوم دالة AVERAGE العادية بإسقاطها من الحساب تماماً ليبقى المتوسط معبراً عن الأرقام الحقيقية المتبقية. أما دالة AVERAGEA فستحول كلمة “غائب” إلى القيمة صفر وتدرجها في المقام، مما يؤدي إلى انخفاض مصطنع وغير مبرر في قيمة المتوسط التراكمي للمفردة.
يتطلب التصميم التجريبي الرصين اتخاذ قرار واعٍ ومسبق بشأن الدالة الواجب اعتمادها استناداً إلى طبيعة المعطيات وفلسفة القياس. إذا كانت البيانات المفقودة تمثل فشلاً حقيقياً في إنجاز المهمة ويجب معاقبة المفردة عليها إحصائياً باحتسابها صفراً ضمن التقييم الإجمالي، فإن AVERAGEA تمثل خياراً برمجياً ملائماً وأوتوماتيكياً. أما في حال كانت المتغيرات تقيس سمات مستمرة لا يجوز خلطها بقيم اعتباطية، أو كانت النصوص مجرد إيضاحات وصفية مساعدة، فإن التمسك بدالة AVERAGE التقليدية يعد أمراً حتمياً لحماية النزاهة العلمية للتحليل.
6.3 استبعاد الأصفار والقيم الشاذة باستخدام الصيغ الشرطية المتقدمة
في العديد من الحالات التطبيقية، قد تتضمن مجموعات البيانات قيماً صفرية حقيقية مسجلة ناتجة عن أعطال فنية في أجهزة القياس أو فترات توقف اضطرارية، وتستدعي المنهجية التحليلية استبعاد هذه الأصفار من احتساب المتوسط حتى لا تؤدي إلى انحراف العينة. بما أن دالة AVERAGE البسيطة لا تمتلك مفتاحاً شرطياً ذاتياً لاستثناء الصفر، يتحتم على المحلل صياغة معادلات تركيبية متقدمة تقوم بتصفية القيم وعزل الصفر رياضياً من بسط ومقام المعادلة في آن واحد.
يمتد هذا التحصين الإحصائي ليشمل استبعاد القيم الشاذة والمتطرفة (Outliers) الناتجة عن أخطاء الإدخال المفرطة (مثل كتابة 100 بدلاً من 10). يتطلب هذا المستوى المتقدم دمج دوال التحقق المنطقي مثل IF و AND لتقييم كل مدخل استباقياً قبل تمريره إلى المصفوفة الحسابية المركزية. يمكن تحقيق ذلك من خلال إنشاء شروط تتحقق من وقوع القيمة ضمن المدى المنطقي المسموح به للظاهرة محل القياس، واستبدال أي قيمة تنتهك هذه الحدود بقيمة فارغة متجاهلة تلقائياً، مما يحافظ على التوزيع الطبيعي للبيانات وجودة مقاييس النزعة المركزية.
علاوة على ذلك، يمكن توظيف دالة FILTER في الإصدارات الحديثة من إكسيل لبناء مصفوفة وسيطة تستثني كل ما يساوي صفراً أو يتجاوز الانحرافات المعيارية المقبولة قبل تطبيق دالة المتوسط. يسهم هذا النهج الرياضي المتقدم في تنقية البيانات متعددة الأوراق وتجريدها من الملوثات الرقمية، مما يضمن أن تكون المؤشرات الختامية المعروضة على صناع القرار مبنية على أرضية إحصائية متماسكة وخالية من التشويه التجريبي.
7. حساب المتوسط المشروط عبر أوراق متعددة باستخدام AVERAGEIF
7.1 قيود تطبيق الدوال الشرطية مع المراجع ثلاثية الأبعاد
يواجه الكثير من مستخدمي إكسيل صدمة تقنية غير متوقعة عند محاولتهم استخدام الدوال الإحصائية الشرطية الشهيرة—مثل AVERAGEIF أو AVERAGEIFS—بالاقتران مع تقنية المراجع ثلاثية الأبعاد؛ كأن يكتب المحلل الصيغة التالية متوقعاً استبعاد الأصفار عبر الأوراق:
=AVERAGEIF(week1:week3!B2, “>0”)
ينتهي هذا المسعى فوراً بفشل كامل وصدور رسالة خطأ صريحة تشير إلى عدم صحة الصيغة (#VALUE!).
تكمن الأسباب الكامنة وراء هذا العجز البرمجي في الهيكل المعماري الداخلي لنواة إكسيل؛ حيث تم تصميم وسائط الدوال الشرطية (Criteria Ranges) لتتعامل حصرياً مع نطاقات مسطحة ثنائية الأبعاد تتألف من مصفوفات خطية من الصفوف والأعمدة الواقعة في مساحة فيزيائية واحدة. تفتقر خوارزمية فحص الشروط داخل هذه الدوال إلى القدرة على اختراق المحور الرأسي (Z-axis) وإجراء العمليات المنطقية المقارنة عبر طبقات متراصة في آن واحد، مما يجعلها عاجزة تماماً عن استقبال وتفسير الصيغ ثلاثية الأبعاد.
يولد هذا القيد التقني ارتباكاً واسعاً، ويدفع العديد من المبتدئين إلى اللجوء لممارسات خاطئة ومضنية، مثل نسخ ولصق البيانات يدوياً في مساحة واحدة لإجراء الحساب الشرطي. لذا، فإن تجاوز هذا الحاجز يتطلب فهم البدائل الرياضية والمنطقية المتاحة التي تعيد تفكيك مفهوم المتوسط الشرطي إلى مكوناته الأولية القابلة للتطبيق عبر الأبعاد المتعددة دون التضحية بدقة النتائج أو هيكلية النموذج.
7.2 الحلول البديلة المعتمدة على الجمع والعد الشرطي المستقل
يتمثل الحل الرياضي الأكثر أناقة وموثوقية لتجاوز عجز AVERAGEIF في تفكيك المتوسط الحسابي المشروط إلى معادلته التأسيسية البسيطة: المجموع التراكمي للقيم المطابقة للشرط مقسوماً على التكرار العددي لتلك المفردات المطابقة. ولما كانت دوال الجمع والعد الشرطي الفردية قادرة على العمل بكفاءة عند ربطها تسلسلياً، يمكن صياغة معادلة تجمع مخرجات دوال الجمع الشرطي SUMIF عبر كافة الأوراق، ثم قسمتها على نواتج دوال العد الشرطي COUNTIF المناظرة لها.
تتجسد هذه الاستراتيجية في بناء صيغة متكاملة تتخذ الشكل الآتي لحساب متوسط القيم الأكبر من صفر للاعب A عبر الأسابيع الثلاثة:
=(SUMIF(week1!B2, “>0”) + SUMIF(week2!B2, “>0”) + SUMIF(week3!B2, “>0”)) / (COUNTIF(week1!B2, “>0”) + COUNTIF(week2!B2, “>0”) + COUNTIF(week3!B2, “>0”))
تقوم هذه المعادلة المركبة بمسح دقيق ومستقل لكل ورقة عمل؛ حيث تجمع الأرقام المؤهلة في البسط، وتعد مرات ظهورها فقط في المقام، متجاهلة أي قيم صفرية أو سالبة في كلا الطرفين بصورة متوازية ومنضبطة.
تضمن هذه المقاربة التحليلية الحفاظ الكامل على سلامة المعايير الإحصائية عبر كافة الأبعاد الزمنية للمصنف، دون الوقوع في أخطاء الدوال الممتدة. إنها تفصل معالجة البسط عن المقام، مما يمنح الباحث مرونة إضافية لتطبيق شروط متباينة إن اقتضى التصميم التجريبي ذلك، ويحول دون تشويه المتوسط بأي مدخلات وهمية لا تتوافق مع البروتوكول العلمي المعتمد للدراسة.
7.3 توظيف الدوال المتقاطعة SUMPRODUCT و INDIRECT للشرطية المعقدة
بالنسبة للمصنفات التحليلية الضخمة التي تحتوي على عشرات الأوراق، تصبح صياغة دوال SUMIF و COUNTIF المتسلسلة عملاً غير عملي ومرهقاً للغاية. في مثل هذه البيئات المعقدة، يتم اللجوء إلى تقنية هجينة متقدمة تدمج بين دالة الضرب التجميعي المصفوفي SUMPRODUCT ودالة الإسناد غير المباشر INDIRECT، بهدف معالجة أوراق العمل كمصفوفة نصية ديناميكية يتم تقييمها في خطوة حسابية واحدة مكثفة.
لتطبيق هذه المنهجية، يقوم المحلل بتسجيل أسماء أوراق العمل في نطاق جانبي مستقل (مثلاً في الخلايا من Z1 إلى Z3 لتضمين week1، week2، week3). بعد ذلك، يتم بناء معادلة مصفوفية تقوم دالة INDIRECT عبرها بتحويل تلك النصوص إلى مراجع فيزيائية حقيقية، لتمريرها إلى محرك SUMPRODUCT الذي يتولى فحص الشروط المعقدة وجمع القيم وعدها بالتزامن، وفق الصيغة المتطورة الآتية:
=SUMPRODUCT(SUMIF(INDIRECT(“‘”&$Z$1:$Z$3&”‘!B2″), “>0”)) / SUMPRODUCT(COUNTIF(INDIRECT(“‘”&$Z$1:$Z$3&”‘!B2″), “>0”))
تعتبر هذه الصيغة بمثابة محرك مصفوفي مصغر يختزل عشرات العمليات اليدوية في سطر واحد فائق المرونة.
ومع ذلك، ينبغي على الباحث توخي الحذر الشديد ومراعاة الأثر الحسابي لهذه الطريقة على كفاءة المعالجة؛ إذ تعد دالة INDIRECT من الدوال “المتطايرة” (Volatile Functions) في إكسيل. هذا يعني أن البرمجية ستعيد حساب كافة هذه الصيغ بالكامل عند إجراء أي تغيير في أي خلية في أي مكان داخل المصنف، مما قد يتسبب في تباطؤ ملحوظ وزيادة زمن الاستجابة في مجموعات البيانات الكبرى. لذلك، يوصى بقصر هذه التقنية على المصنفات المتوسطة التي تتطلب حداً فائقاً من الأتمتة المرجعية المتغيرة.
8. استراتيجيات الأتمتة الحديثة باستخدام الدوال الديناميكية و Power Query
8.1 توظيف دالة VSTACK لتجميع المصفوفات رأسياً في إكسيل 365
مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays) في بيئة Microsoft 365، شهدت معمارية الحسابات عبر الأوراق تحولاً ثورياً أطاح بالعديد من القيود الهندسية القديمة. تأتي دالة VSTACK في طليعة هذه الأدوات الحديثة؛ حيث تتولى مهمة الدمج والتكديس الرأسي للنطاقات المنفصلة من أوراق متعددة وصهرها معاً في مصفوفة افتراضية واحدة فائقة السرعة تُخزن مؤقتاً في ذاكرة المعالج دون الحاجة لكتابة بيانات وسيطة في خلايا المصنف.
يتيح هذا التكديس الرقمي تمرير المصفوفة المدمجة رأساً إلى دوال التحليل الإحصائي والتصفية المباشرة؛ حيث يمكن صياغة معادلة متوسط مشروط غاية في البساطة والأناقة عبر دمج AVERAGE مع FILTER و VSTACK بالشكل الآتي:
=AVERAGE(FILTER(VSTACK(week1:week3!B2), VSTACK(week1:week3!B2)>0))
في هذا التركيب المعاصر، يتم أولاً جمع قيم B2 من الأسابيع الثلاثة وتكديسها في قائمة واحدة، ثم تتولى دالة FILTER استبعاد الأصفار والمدخلات المعيبة، لتقوم دالة AVERAGE في الختام باحتساب المتوسط الحسابي النقي للمتبقي، وبصيغة خالية تماماً من تعقيدات INDIRECT وتطايرها الحسابي.
يسهم هذا التحول التكنولوجي في التخلص النهائي من القيود التاريخية للإسناد الكلاسيكي؛ فالمصفوفات الديناميكية تسمح بتدفق البيانات بسلاسة وتلقائية وتوفر حماية كاملة ضد أخطاء عدم تطابق الأبعاد. تتيح هذه القدرات للباحثين ومطوري النماذج معالجة البيانات متعددة الطبقات وكأنها جدول واحد ممتد، مما يرفع من جودة الصياغة الحسابية ويمنح النموذج مرونة تشغيلية لا نظير لها في الإصدارات السابقة.
8.2 بناء دوال مخصصة للمتوسط المتعدد عبر محرك LAMBDA
يمثل محرك LAMBDA المدمج في الإصدارات الحديثة من إكسيل أحد أهم المعالم التطورية في تاريخ البرمجية؛ إذ يتيح للمستخدمين ابتكار وبرمجة دوال رياضية وإحصائية مخصصة بالكامل دون الحاجة إلى كتابة سطر واحد من تعليمات البرمجة النصية عبر برمجية فيجوال بيسك (VBA). يتيح هذا الابتكار تغليف العمليات الحسابية المتشعبة للمتوسطات متعددة الأوراق داخل اسم برمجي مقتضب ومعرف مسبقاً يمكن استدعاؤه في أي مكان في المصنف بمجرد تمرير المعاملات الموضعية.
يمكن للمحلل، على سبيل المثال، صياغة دالة مخصصة باسم MULTIAVG عبر مدير الأسماء (Name Manager)، وتحديد مدخلاتها كمعاملات مرنة تستوعب الإحداثي المكاني للخلايا، مع تطويقها بكافة شروط الحماية واستبعاد الأصفار ومعالجة الأخطاء الكامنة داخل بنية LAMBDA. بعد إنشاء الدالة وتوثيقها، يمكن للمستخدم كتابة معادلة شديدة البساطة والوضوح في ورقة التلخيص المركزية تشبه الصيغ القياسية للبرمجية:
=MULTIAVG(B2)
لتتولى الخوارزمية الداخلية المغلفة إنجاز كافة مراحل البحث والتجميع والتنقية خلف الكواليس دون إثقال شريط الصيغ بنصوص برمجية طويلة.
يرفع هذا التوجه المعياري من مستوى التوثيق المؤسسي للنماذج الرياضية المعقدة داخل المنظمات؛ فهو يعزل التفاصيل الحسابية المعقدة ويمنع المستخدمين غير المتخصصين من العبث بالصيغ المتقدمة أو إفساد روابطها سهواً. كما يسهل صيانة النموذج؛ فإذا طرأ أي تغيير على المعايير الإحصائية المعتمدة للمتوسط، يتم تعديل المعادلة الأصلية داخل محرك LAMBDA المركزي مرة واحدة فقط، لتنعكس التحديثات فوراً وتلقائياً على سائر الخلايا والمخرجات التابعة لها في المصنف.
8.3 استخدام Power Query كمنهجية معيارية للتحويل والتجميع
عندما تتعاظم أحجام مجموعات البيانات وتتداخل مساراتها لتصل إلى مئات الآلاف من السجلات الموزعة عبر أوراق عمل لا حصر لها، تصبح الصيغ الرياضية التقليدية عاجزة عن تقديم أداء حاسوبي كفء ومستقر. في هذه البيئات الضخمة، تبرز أداة Power Query (محرك استخراج وتحويل وتحميل البيانات ETL في إكسيل) كمنهجية معيارية وصناعية لا بديل عنها لأتمتة عمليات التجميع والحساب الإحصائي بطريقة رصينة وغير تدميرية إطلاقاً.
تتم هذه العملية عبر استيراد كافة الجداول والأوراق النشطة من داخل المصنف الحالي بعملية مؤتمتة وموحدة؛ حيث يتم إلحاق البيانات وتكديسها (Append Queries) في مسار بيانات موحد وخلفي. تتيح واجهة Power Query تطبيق إجراءات تنظيف عميقة ومتقدمة تتضمن استبعاد السجلات غير الرقمية، وتصفية الأصفار أو معالجتها، والتحقق الصارم من تطابق الأنواع وتوافق المعرفات الفريدة، كل ذلك قبل الشروع في أي معالجة حسابية أو إحصائية للمتغيرات.
عقب إتمام خطوات الدمج والتحويل، يتم تطبيق تحويل التجميع الإحصائي (Group By) لحساب المتوسط الحسابي لكل فرد أو متغير بضغطة زر واحدة، ثم تحميل المخرجات النهائية كجدول مصمت وأنيق داخل ورقة التلخيص. وتتجلى القوة القصوى لهذا المسار في ميزة التحديث التلقائي (Data Refresh)؛ فعند إضافة أوراق عمل جديدة أو تعديل أرقام الأسابيع اللاحقة، لا يحتاج المستخدم إلى كتابة صيغ جديدة أو مراجعة النطاقات ثلاثية الأبعاد، بل يكتفي بالنقر على زر “تحديث” (Refresh) ليتولى المحرك إعادة استيراد الأوراق الجديدة وتطبيق خوارزميات التجميع وحساب المتوسطات المحدثة في ثوانٍ معدودة.
9. التشخيص المنهجي للأخطاء التحليلية الشائعة وطرق تصحيحها
9.1 تحليل أسباب وحلول خطأ المرجع غير الصالح #REF!
يعد خطأ المرجع غير الصالح (#REF!) أحد أكثر الأعطال البرمجية شيوعاً وإرباكاً في مصنفات إكسيل متعددة الأبعاد، وتتضاعف آثاره السلبية تحديداً عند الاعتماد على الصيغ ثلاثية الأبعاد أو الروابط المتقاطعة. ينشأ هذا الخطأ عندما تفقد المعادلة الاتصال بأحد الأركان الفيزيائية للنطاق المرجعي؛ كأن يقوم المستخدم بحذف إحدى أوراق العمل التي تمثل حداً أساسياً في الصيغة (مثل حذف الورقة week1 أو week3 في مثالنا السابق). يؤدي هذا الحذف المادي إلى بتر مسار الإسناد وعجز المحرك عن استنتاج نطاق البداية أو النهاية، فينهار الحساب فوراً ليحل الخطأ محل النتيجة الرقمية.
كما يتكرر ظهور هذا الخطأ نتيجة قيام المستخدم بإعادة تسمية إحدى أوراق العمل دون مراعاة تحديث الروابط المكتوبة يدوياً، أو عند نقل وحذف خلايا مصدرية كانت تعتمد عليها وسائط الدوال المتفرقة. لاستعادة الاتساق المرجعي وعلاج المشكلة، يتحتم الدخول إلى شريط الصيغ وتحديد الموضع المنهار لاستبدال الاسم المفقود بالاسم الجديد للورقة أو إعادة رسم حدود النطاق ثلاثي الأبعاد بصورة صحيحة وشاملة لكافة التبويبات الفاعلة.
للوقاية المؤسسية من انقطاع الروابط الحسابية وتجنب ظهور أخطاء المراجع، يوصى بالالتزام التام باستراتيجية “أوراق الحصر الوهمية” (Sandwich Sheets) الموضحة آنفاً؛ حيث تحمي ورقتي البداية والنهاية الفارغتين المعادلة من أي حذف عرضي يطال أوراق البيانات الداخلية. كما ينصح بتجنب حذف أوراق العمل التاريخية داخل المصنفات التشغيلية الحساسة، والاستعاضة عن ذلك بتفريغ محتوياتها الرقمية أو إخفائها مؤقتاً لتجنب كسر تسلسل المؤشرات المرجعية في الذاكرة الحسابية.
9.2 معالجة خطأ القسمة على صفر #DIV/0!
يرتبط خطأ القسمة على الصفر الشهير (#DIV/0!) ارتباطاً وثيقاً بالطبيعة الرياضية لدالة AVERAGE وقواعد التضمين والاستبعاد المتبعة في إكسيل. يظهر هذا الخطأ بشكل حتمي عندما تجد الدالة نفسها أمام نطاق مكاني يخلو تماماً من أي قيم عددية صالحة؛ كأن تكون كافة الخلايا المتناظرة عبر الأوراق المحددة فارغة تماماً، أو محتوية حصرياً على نصوص ورموز تم تجاهلها تلقائياً وفق القواعد المعمارية للبرمجية. في هذه الحالة، يصبح مقام الكسر الحسابي ($N$) مساوياً للصفر، فتتوقف العملية الحسابية وتعلن البرمجية استحالة إتمام القسمة رياضياً.
لتطويق هذا السلوك وتأمين جمالية وموثوقية لوحات البيانات الإحصائية، يتم إحاطة دالة المتوسط بدالة الحماية الشرطية IFERROR. تتيح هذه الدالة للمحلل السيطرة على المخرجات وتحديد قيمة بديلة ورصينة تظهر للمستخدم بدلاً من رسالة الخطأ المنفرة عند غياب المدخلات، كما يوضح التركيب التالي:
=IFERROR(AVERAGE(week1:week3!B2), “لا توجد بيانات”)
أو استبدالها بقيمة رقمية محايدة مثل الشرطة الطبوغرافية أو ترك الخلية فارغة تماماً باستخدام علامتي الاقتباس (“”).
كذلك، يمكن اللجوء إلى التدقيق الاستباقي للبيانات باستخدام دمج شرطي يجمع بين دالتي IF و ISBLANK أو تطبيق دالة COUNT للتحقق المسبق من وجود مدخلات عددية مؤهلة تفوق الصفر قبل الشروع في إطلاق عملية الحساب. إن هذا النهج الوقائي يحمي التقارير والتحليلات الختامية من التلوث البصري، ويمنع تسرب أخطاء القسمة إلى الرسوم البيانية التابعة أو المعادلات التجميعية الأعلى التي تعتمد على تلك المتوسطات في حساباتها المشتقة.
9.3 تصحيح تعارضات أنواع البيانات وخطأ القيمة #VALUE!
يتولد خطأ القيمة (#VALUE!) المزعج نتيجة حدوث تعارض جذري وغير قابل للحل بين نوع البيانات الفعلي المخزن في الخلية والنوع البرمجي المتوقع من قِبل المعامل الحسابي. ورغم أن دالة AVERAGE البسيطة تتجاهل النصوص التوضيحية داخل النطاقات بمرونة، إلا أن هذا الخطأ يطل برأسه فوراً عند محاولة تطبيق العمليات الجبرية المباشرة (مثل استخدام علامة الجمع + بين خلايا الأوراق متفرقة) إذا كانت إحدى تلك الخلايا تتضمن نصاً صريحاً أو مسافات فارغة متبقية ناتجة عن ضغط شريط المسافة دون إدخال رقمي حقيقي.
تتمثل إحدى أكثر المشكلات الخفية تعقيداً في تسرب المحارف والرموز غير المرئية (مثل المسافات غير القابلة للكسر المنبثقة من أنظمة قواعد البيانات الخارجية أثناء الاستيراد) وتثبيتها داخل الخلايا التي تبدو للمستخدم ظاهرياً وكأنها أرقام عادية. تجعل هذه الشوائب الرقم معاملاً نصياً يرفض الدخول في الحسابات الجبرية ويفسد صيغ التوفيق والاسترجاع كدالتي MATCH و VLOOKUP. لمعالجة هذه الترسبات، يتحتم تفعيل أدوات تنظيف البيانات مثل دالتي TRIM و CLEAN، أو إعادة تحويل الأعمدة عبر أداة “نص إلى أعمدة” (Text to Columns) لإجبار إكسيل على إعادة التعرف على الأرقام بهويتها الحقيقية.
ولضمان المناعة المستدامة للمصنف ضد هذه التعارضات، يجب تطبيق أدوات التحقق من صحة البيانات (Data Validation) بشكل صارم ومسبق على كافة النطاقات المخصصة لإدخال الدرجات عبر جميع أوراق العمل. يتيح هذا الإجراء حظر إدخال النصوص في حقول الأرقام، وتحديد الحدود الدنيا والقصوى المسموح بها للمتغيرات، مما يمنع تشوه قواعد البيانات في لحظة الإدخال ويوفر بيئة حسابية معقمة تضمن التدفق السلس لعمليات احتساب المتوسط دون أي تعطل برمجي.
10. أفضل الممارسات الأكاديمية لحوكمة المصنفات وتدقيق البيانات
10.1 التوثيق الصارم لهيكلية المصنف وسلاسل الحسابات
تقتضي معايير النزاهة العلمية والحوكمة المؤسسية المتقدمة إرساء نظام توثيق صارم وشامل لهيكلية المصنفات الإحصائية متعددة الأبعاد. في المشاريع التحليلية الكبرى، لا ينبغي ترك تصميم المصنف كصندوق أسود غامض لا يفهمه إلا من صممه؛ بل يجب تخصيص ورقة عمل افتتاحية مستقلة تعمل بمثابة “قاموس البيانات” (Data Dictionary) ودليل تعريفي شامل للهيكل المعماري للملف. يوضح هذا الدليل مسارات تدفق البيانات، والغرض التجريبي من كل ورقة عمل، والحدود الزمنية والمكانية للنطاقات ثلاثية الأبعاد المعتمدة في شريط الصيغ.
ينبغي تدعيم هذا التوثيق الهيكلي باستخدام التعليقات التوضيحية والملاحظات الرقمية الحديثة (Cell Notes & Comments) الملحقة بالخلايا التجميعية الحرجة في ورقة المتوسط المركزية. تشرح هذه الملاحظات المنهجية المتبعة في احتساب مقاييس النزعة المركزية، والمبررات الإحصائية الكامنة وراء استبعاد بعض المدخلات أو اعتماد أوزان ترجيحية معينة، مما يرفع من شفافية التحليل وييسر مهام التدقيق المالي أو الأكاديمي المستقل الذي تخضع له النماذج المتقدمة.
علاوة على ذلك، توفر برمجية إكسيل حزمة متقدمة من أدوات التدقيق البصري المدمجة ضمن علامة التبويب “صيغ” (Formulas)، وفي مقدمتها أداة “تتبع السوابق” (Trace Precedents) وأداة “تتبع التوابع” (Trace Dependents). يتيح تفعيل هذه الأدوات رسم أسهم ومؤشرات بصرية عابرة للأوراق توضح المسارات الهندسية التي تسلكها الأرقام وتكشف الخلايا المصدرية التي تضخ قيمها داخل معادلة المتوسط الحسابي، مما يساعد المحلل على اكتشاف الانقطاعات المرجعية غير المرئية والتأكد من انضباط سلاسل التغذية الحسابية عبر المصنف بأكمله.
10.2 بروتوكولات الأمان وحماية النطاقات الحسابية الحساسة
تمثل حماية النزاهة الهيكلية للمصنف خط دفاع جوهري لمنع التعديلات العرضية أو غير المقصودة التي قد تطال النطاقات الحسابية الحساسة، ولا سيما في بيئات العمل التشاركية والسحابية الحديثة. تتضمن البروتوكولات المعيارية قفل خلايا المتوسطات المركزية (Locking Cells) عبر شاشات تنسيق الخلايا، وتفعيل خيار “حماية ورقة العمل” (Protect Sheet) المقترن بكلمات مرور إدارية قوية. يمنع هذا الإجراء المستخدمين العاديين وجامعي البيانات الميدانيين من تعديل أو مسح الصيغ الرياضية ثلاثية الأبعاد المركبة، ويقصر صلاحياتهم حصرياً على إدخال البيانات الأولية في الأماكن المحددة مسبقاً.
يمتد بروتوكول الأمان ليشمل إدارة الرؤية البصرية للأوراق؛ حيث يفضل إخفاء أوراق الحصر الوهمية (Start_Anchor و End_Anchor) أو الأوراق الوسيطة التي تجري فيها معالجات مصفوفية تمهيدية، لحمايتها من العبث وتقليل التشتت والتشويش البصري على متخذي القرار وصناع السياسات. يمكن في الحالات المتقدمة استخدام خاصية الإخفاء العميق (Very Hidden) المتاحة عبر محرر الأكواد البرمجية، لمنع إظهار الأوراق إلا عبر امتيازات إدارية موثقة وخاصة.
في بيئات الحوسبة السحابية مثل Microsoft SharePoint و Excel Online، ينبغي تفعيل مستويات دقيقة من أذونات التعديل والمشاركة (Access Permissions)، وتقييد الوصول التعديلي إلى الخلايا القاعدية. كما يسهم تشغيل خاصية “سجل الإصدارات” (Version History) في مراقبة التغييرات والتدخلات التي تطرأ على المصنف عبر الزمن، مما يتيح للإدارة استعادة نسخ سابقة خالية من الأخطاء في حال تسبب أحد المدخلين في كسر الروابط المرجعية ثلاثية الأبعاد أو إفساد ترتيب تبويبات أوراق العمل.
10.3 موازنة الأداء الحسابي وتحسين سرعة استجابة المصنف
تشكل كفاءة استخدام موارد المعالج والذاكرة العشوائية عنصراً حاسماً في تصميم المصنفات الضخمة؛ إذ إن الاستخدام غير الرشيد للصيغ عبر الأوراق قد يؤدي إلى شلل تقني وبطء شديد أثناء عمليات إعادة الحساب المتكررة. تأتي القاعدة الأولى لتحسين الأداء في ترشيد وتقليص الاعتماد على “الدوال المتطايرة” (Volatile Functions)—مثل INDIRECT و OFFSET—التي تجبر البرمجية على إعادة تقييم المعادلة بالكامل مع كل نبضة إدخال في أي ركن من أركان المصنف، والاستعاضة عنها بالروابط الهيكلية الثابتة مثل المراجع ثلاثية الأبعاد المباشرة أو دوال INDEX و MATCH الأكثر كفاءة وخفة على موارد الحاسوب.
تتمثل الاستراتيجية الحسابية الثانية في تحويل الصيغ المنتهية إلى قيم رقمية ثابتة (Paste as Values) بمجرد استقرار واختتام فترات القياس التاريخية التي لم تعد عرضة للتعديل. فإذا اكتملت أسابيع التدريب أو الفترات المحاسبية السابقة وتم اعتماد نتائجها النهائية، يصبح من الهدر البرمجي إبقاء آلاف الصيغ التجميعية ثلاثية الأبعاد معلقة ونشطة في الذاكرة الحسابية؛ إذ يؤدي تثبيت قيمها الساكنة إلى تفريغ طاقة المعالجة وتوجيهها حصرياً نحو النطاقات التشغيلية الحديثة.
أخيراً، يتعين على محللي النظم إجراء اختبارات مستمرة لزمن إعادة الحساب (Calculation Speed Testing) ومراقبة استجابة المصنف عند التعامل مع مصفوفات ضخمة تضم مئات الآلاف من السجلات. يساعد هذا الرصد التقني في تحديد الاختناقات الأدائية ومعرفة متى يجب التوقف عن استخدام الصيغ المباشرة داخل شبكة الجداول والانتقال الكامل نحو الحلول المؤسسية الأكثر قوة مثل محرك Power Pivot أو نماذج بيانات DAX، لضمان استمرار التدفق التحليلي السريع والآمن دون أي انهيار تشغيلي في بنية المصنف.
خاتمة
استعرضنا في هذا المقال الأكاديمي الشامل الأبعاد النظرية والتطبيقية لحساب المتوسط الحسابي عبر أوراق عمل متعددة في برمجية إكسيل، بدءاً من تفكيك الأسس الهندسية للمصنفات وتوزيع البيانات عبر الأبعاد المكانية المتعددة، وصولاً إلى استشراف أحدث الأدوات الديناميكية والمحركات الآلية لمعالجة المصفوفات الكبرى. ولقد تبين بوضوح أن عملية التجميع الإحصائي ليست مجرد كتابة لصيغة حسابية عابرة، بل هي منظومة متكاملة من القرارات الهندسية الواعية التي تبدأ بالتصميم الصارم للجداول الممتدة، وتمر بالاستيعاب الدقيق لسلوك الدوال تجاه القيم الشاذة والمفقودة، وتنتهي بالحوكمة المؤسسية والتدقيق البصري لضمان خلو النموذج من أي ثغرات أو انحرافات رقمية.
إن إتقان تقنية الإسناد ثلاثي الأبعاد المتقدمة يوفر توازناً استثنائياً بين الاختزال النحوي والكفاءة التشغيلية، ولا سيما عند تحصينه باستراتيجيات الأمان المتطورة مثل “أوراق الحصر الوهمية” لحماية السلاسل المرجعية من الانهيار. وفي الوقت ذاته، تظل دوال البحث التوفيقي الحديثة والدوال المصفوفية المبتكرة ومحرك Power Query أدوات جوهرية لا غنى عنها لاحتواء التباينات الهيكلية والتوسع في إدارة البيانات الضخمة دون التضحية بالدقة التحليلية. إن تطبيق هذه الممارسات العلمية الرصينة يرتقي بالتحليل البياني من مستوى التجريب الميداني المتقلب إلى مصاف النمذجة الإحصائية الاحترافية عالية الجودة، مما يمنح متخذي القرار والباحثين ثقة مطلقة في المؤشرات المعروضة وصلاحيتها للتخطيط والتنبؤ المستقبلي.
المراجع
- Microsoft. (n.d.). AVERAGE function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/average-function-04022247-14ee-4467-a5d1-44e99a74617d
- Microsoft. (n.d.). Create a 3-D reference to the same cell range on multiple worksheets. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/create-a-3-d-reference-to-the-same-cell-range-on-multiple-worksheets-40df3468-d239-4467-bf0b-04770af92640
- Microsoft. (n.d.). AVERAGEIF function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/averageif-function-faec8e2e-0dec-430c-af69-f5576d8ac642
- Microsoft. (n.d.). XLOOKUP function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/xlookup-function-b7fd680e-6d10-43e6-84f9-88ea8bf5929f
- Panko, R. R. (1998). What we know about spreadsheet errors. Journal of End User Computing, 10(2), 15–21.
- Panko, R. R. (2008). Thinking is bad: Implications of human error research for spreadsheet research and practice. SSRN Electronic Journal.