
يحتل تحليل الفروق بين المتغيرات المقترنة مكانة مركزية في صلب منهجيات البحث العلمي والإحصاء التطبيقي، حيث يمثل الأساس الرياضي لتقييم التغيرات الطارئة على الظواهر عبر الزمن، أو قياس التباين الناتج عن إخضاع العينات البحثية لتجارب محددة. في مختلف حقول المعرفة، من العلوم النفسية والسلوكية إلى التحليلات الطبية والاقتصادية، يواجه الباحث والمحلل ضرورة الإجابة عن سؤال جوهري: هل أحدث التدخل التجريبي أو الفارق الزمني تحولاً حقيقياً في قيم المفردات الخاضعة للقياس؟ هنا يبرز مفهوم متوسط الفروق بوصفه مؤشراً وصفياً واستدلالياً لا غنى عنه لتلخيص حجم واتجاه هذا التغير بطريقة رقمية منضبطة تعكس واقع البيانات الخام بدقة بالغة.
ومع تنامي الاعتماد على الحوسبة في معالجة البيانات، أضحى برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشاراً ومرونة للتعامل مع المصفوفات العددية والجداول المتقاطعة، متجاوزاً كونه مجرد تطبيق مكتبي لحفظ السجلات إلى منصة برمجية قادرة على تنفيذ العمليات الحسابية المتشابكة والصيغ المصفوفية المتقدمة بكفاءة عالية. إن حساب متوسط الفرق بين سلسلتين متناظرتين من البيانات يمثل نموذجاً مثالياً لكيفية استغلال إمكانيات إكسيل لتجاوز العمليات اليدوية التكرارية، مما يوفر على الباحثين ساعات طويلة من الحسابات اليدوية المعرضة للخطأ البشري، ويوفر بيئة تدقيق موثوقة تلبي معايير الدقة الرياضية الصارمة.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك كافة الجوانب النظرية والتطبيقية المرتبطة بحساب متوسط الفرق في بيئة إكسيل، بدءاً من التأصيل الرياضي للمفهوم والتمييز بين القياسات الموجهة والمطلقة، مروراً بالبنية التركيبية للصيغ المباشرة والمصفوفات الديناميكية الحديثة، ووصولاً إلى استراتيجيات معالجة الأخطاء البرمجية والبيانات المفقودة، وربط المخرجات بالاختبارات الإحصائية المتقدمة. وسواء كنت باحثاً يسعى لتقييم أثر تدخل علاجي أو تربوي، أو محللاً يرغب في ضبط جودة التقييمات والملاحظات المتعددة، فإن هذا المرجع يقدم لك منهجية رصينة خطوة بخطوة للوصول إلى نتائج موثوقة وقابلة للتعميم وفق أعلى المعايير المنهجية المتعارف عليها في المجتمع العلمي.
1. مدخل مفاهيمي لحساب متوسط الفرق في برنامج إكسيل
1.1 التعريف الرياضي والإحصائي لمتوسط الفروق
يقوم المفهوم الرياضي لمتوسط الفروق (Raw Mean Difference)، والذي يرمز له إحصائياً بالرمز ($\bar{D}$) أو ($\Delta\bar{X}$)، على قياس الفارق الحسابي بين أزواج متناظرة من الملاحظات داخل التصاميم المعتمدة على القياسات المتكررة أو العينات المرتبطة (Paired/Within-Subjects Design). ففي سياق قياس متغيرين على نفس المفردات—مثل قياس مستوى القلق قبل وبعد الخضوع لبرنامج تدريبي—لا نتعامل مع مجموعتين منفصلتين، بل نتعامل مع أزواج مرتبطة يتحدد فيها لكل فرد أو وحدة معاينة زوج من الدرجات ($X_{1i}, X_{2i}$). رياضياً، يُعرّف متوسط الفروق بأنه المتوسط الحسابي لحاصل طرح الدرجات الفردية لكل زوج على حدة، ويُعبر عنه بالمعادلة التالية:
$$\bar{D} = \frac{1}{N}\sum_{i=1}^{N}(X_{1i} – X_{2i}) = \bar{X}_1 – \bar{X}_2$$
حيث يمثل $N$ عدد الأزواج المتناظرة، ويمثل $X_{1i}$ القياس الأول للحالة $i$، بينما يمثل $X_{2i}$ القياس الثاني لنفس الحالة. ومن الناحية الجبرية، تتجلى حقيقة إحصائية بالغة الأهمية مفادها أن متوسط الفروق الفردية يكافئ تماماً فارق المتوسطين الحسابيين للمجموعتين، شريطة اكتمال البيانات وعدم وجود قيم مفقودة في أي من المتغيرين. ورغم هذا التطابق الحسابي التام، فإن البناء الاستدلالي يختلف جذرياً؛ إذ يركز متوسط الفروق على مصفوفة التغير الداخلي التي تزيل التباين الفردي بين المشاركين (Between-subject variability)، مما يعزز القوة الإحصائية عند رصد التغير الحقيقي الطارئ عبر الزمن أو عبر شروط التجربة المختلفة.
1.2 استخدامات متوسط الفرق في التحليل الإحصائي والبحوث
يعد حساب متوسط الفرق حجر الزاوية في البحوث التجريبية وشبه التجريبية التي تستهدف قياس أثر التدخلات العلاجية، النفسية، والتربوية. ففي الدراسات السريرية، يُمكّن هذا المقياس الباحثين من تقييم مدى تراجع الأعراض المرضية بعد إعطاء دواء تجريبي أو تطبيق برنامج علاج سلوكي معرفي، كما أظهرت الدراسات التراكمية في مجال الرعاية التشاركية للاضطرابات النفسية (Archer et al., 2012). كما يُطبق على نطاق واسع في دراسات القياس النفسي لتتبع تطور سمات مثل الرضا عن الحياة، ومستوى التحصيل، والتكيف الاجتماعي، حيث يساعد رصد متوسط الفروق في إدراك المسارات النمائية للمشاركين بمرور الوقت.
علاوة على ذلك، يبرز دور متوسط الفرق في قياس فاعلية البرامج التنموية وتدخلات علم النفس الإيجابي، حيث يسعى الباحثون لتقييم ما إذا كانت استراتيجيات تعزيز المشاعر الإيجابية تفضي إلى تحسينات جوهرية ومستمرة في الأداء الإنساني والمهني، وهو ما أكدته الأبحاث المنشورة في المراجعات النفسية (Lyubomirsky, King, & Diener, 2005). ويمتد هذا الاستخدام إلى دراسات الصدمات النفسية والنمو التالي للصدمات (Prati & Pietrantoni, 2009)، وكذلك تقييم تأثيرات الأزمات الكبرى كالأوبئة والكوارث على الصحة النفسية لطلاب الجامعات (Browning et al., 2021). يتيح التحديد الدقيق لمتوسط الفرق استنباط مؤشرات حجم الأثر (Effect Size) مثل مؤشر كوهين $d$، مما يوفر أساساً كمياً موثوقاً لإجراء المقارنات الميتا-تحليلية وتوجيه صناع القرار في الميادين الإكلينيكية والتعليمية.
1.3 دور إكسيل كأداة لتحليل الفروق الزوجية
يوفر برنامج إكسيل بيئة رقمية فائقة المرونة تُمكّن الباحث من إدارة ومعالجة المصفوفات الرياضية المعقدة دون الحاجة إلى امتلاك مهارات برمجية متقدمة في لغات مثل R أو Python. وتكمن قوة إكسيل في بنيته الشبكية التفاعلية التي تتيح معاينة البيانات الأولية بجانب النتائج التحليلية المستخرجة، مما يعزز الشفافية الإجرائية ويسهل اكتشاف الأخطاء وتصحيحها فورياً. وبدلاً من اللجوء إلى الآلات الحاسبة أو العمليات الورقية التكرارية المجهدة، يستطيع إكسيل معالجة آلاف الصفوف ومئات المتغيرات في أجزاء من الثانية، مما يقضي تماماً على احتمالات السهو الحسابي ويضمن اتساق التحليلات في العينات الكبيرة.
بالإضافة إلى ذلك، يتميز البرنامج بتطوره المستمر، حيث دُمجت فيه محركات حسابية حديثة تدعم الصيغ المصفوفية وتتيح تنفيذ عمليات الطرح والتجميع في خلية واحدة دون تشويه ورقة العمل بأعمدة وسيطة غير ضرورية. هذا التحول من الحسابات التقليدية المجزأة إلى المعالجة الرقمية اللحظية يجعل إكسيل خياراً مثالياً ليس فقط للمهام المكتبية والمحاسبية، بل أيضاً للأبحاث الأكاديمية الصارمة التي تتطلب سرعة في الإنجاز وتوثيقاً منهجياً شفافاً لكافة مراحل التحويل الرياضي للبيانات.
2. الصيغة الأساسية المباشرة لحساب متوسط الفرق بين عمودين
2.1 البنية التركيبية للمعادلة =AVERAGE(B2:B11 – C2:C11)
تمثل المعادلة =AVERAGE(B2:B11 - C2:C11) الحل الرياضي الأكثر أناقة وتكثيفاً لحساب متوسط الفروق الزوجية في بيئة إكسيل؛ حيث تقوم على دمج عملية حسابية ثنائية (طرح نطاقين) كمعامل مباشر داخل دالة التجميع الإحصائي AVERAGE. تتركب هذه الصيغة من علامة المساواة (=) التي تُعرّف إكسيل ببدء إجراء حسابي، تليها الدالة القياسية لمتوسط القيم، ثم القوس المفتوح الذي يتضمن مصفوفة الطرح المتقاطعة بين النطاق المستهدف الأول (وليكن نطاق القياس القبلي $B2:B11$) والنطاق المقابل له (نطاق القياس البعدي $C2:C11$).
يكمن الجوهر الرياضي في تعامل إكسيل مع النطاقين كنواقل عددية متماثلة الأبعاد (Vectors). فعند تنفيذ الطرح داخل القوسين، لا يقوم البرنامج بإجراء عملية طرح تقليدية بين قيمتين فرديتين، بل يطرح كل عنصر في النطاق الأول من العنصر المقابل له هندسياً في نفس الصف بالنطاق الثاني، لينتج عن ذلك ما يُعرف في الأدبيات البرمجية بـ “المصفوفة الوهمية المؤقتة” (Virtual Array). تستقبل دالة AVERAGE هذه المصفوفة المكونة من نواتج الفروق كمدخل وحيد، وتقوم بحساب وسطها الحسابي من خلال جمع تلك الفروق وقسمتها على عددها الإجمالي، لترجع النتيجة النهائية مباشرة في الخلية المحددة.
2.2 آلية عمل الصيغ المصفوفية في إصدارات إكسيل الحديثة
شهدت إصدارات إكسيل الحديثة، وبخاصة التحديثات المدرجة ضمن اشتراكات مايكروسوفت 365 (Microsoft 365) وإصدار إكسيل 2021، ثورة تقنية كبرى بفضل إدخال محرك المصفوفات الديناميكية (Dynamic Array Engine). في هذا النظام المحدث، أصبحت صيغ المصفوفات مدعومة أصلياً وتلقائياً على مستوى بيئة العمل، مما يعني أن كتابة الصيغة =AVERAGE(B2:B11 - C2:C11) تكتفي تماماً بالضغط على مفتاح الإدخال العادي (Enter) دون الحاجة لأي اختصارات إضافية.
يعالج محرك الحساب الداخلي عملية الطرح متعددة الأبعاد داخل الذاكرة العشوائية المخصصة لبرنامج إكسيل بصورة سريعة وغير مرئية، ثم يمرر النتيجة التراكمية إلى الدالة الخارجية. ونظراً لأن دالة AVERAGE هي بطبيعتها دالة تجميعية تُرجع قيمة فردية واحدة (Scalar Value)، فإنها تستوعب المصفوفة المتدفقة داخلياً وتمنع ظاهرة “انسكاب المصفوفة” (Spillover) في الخلايا المجاورة، مما يحافظ على نظافة ورقة العمل ويمنح الباحث مرونة غير مسبوقة في التعامل مع الحسابات المصفوفية المعقدة دون تعقيدات تقنية.
2.3 متطلبات التوافق في الإصدارات القديمة من إكسيل
عند العمل على الإصدارات التقليدية من برنامج إكسيل (مثل إكسيل 2019 وما قبله)، تختلف آلية التعاطي مع الصيغ التي تتضمن عمليات مصفوفية على نطاقات متعددة. في تلك البيئات الحسابية القديمة، لا يتعرف إكسيل تلقائياً على أن الطرح يتم بين مصفوفتين لإنتاج سلسلة فروق، وإذا تم إدخال المعادلة بالضغط على مفتاح Enter العادي، فإن النتيجة ستكون إما خطأ في القيمة (#VALUE!) أو احتساب الفارق بين الخلية الأولى فقط في كل نطاق وتجاهل باقي الصفوف، مما يفضي إلى تشويه علمي كارثي للنتائج.
لضمان التوافق التام والصحة الإحصائية في الإصدارات التراثية، يجب إدخال المعادلة باستخدام التركيبة الثلاثية الشهيرة لمفاتيح لوحة المفاتيح: Ctrl + Shift + Enter، والتي تُعرف في الأوساط البرمجية بصيغ CSE. بمجرد الضغط على هذا المزيج المتزامن، يقوم إكسيل بإحاطة الصيغة تلقائياً بقوسين معقوفين من النمط {=AVERAGE(B2:B11 - C2:C11)}، كدلالة برمجية على أن الصيغة قد تم تسجيلها والتعامل معها كصيغة مصفوفة رسمية. ويجب التنبيه بشدة إلى أن كتابة القوسين المعقوفين يدوياً من لوحة المفاتيح لن تفعل ميزة المصفوفة، بل سيتعامل معها إكسيل كنص عادي، مما يستلزم الالتزام الصارم بالإدخال عبر المفاتيح المحددة لتجنب تعطل التحليلات الإحصائية عند تبادل الملفات بين إصدارات متباينة.
3. تجهيز وتنظيم البيانات في جدول إكسيل قبل التحليل
3.1 قواعد هيكلة الأعمدة والصفوف المتناظرة
تعد النظافة الهيكلية لجدول البيانات الشرط الأول لضمان موثوقية التحليلات في إكسيل، لا سيما في تحليل العينات المرتبطة الذي يتطلب تماثلاً دقيقاً ومتبادلاً بين الملاحظات المقارنة. يجب تخصيص صف مستقل لكل مشارك أو وحدة معاينة تجريبية، بحيث تمثل الصفوف الحالات الفردية، بينما تمثل الأعمدة المتغيرات المقاسة. فإذا كانت الدرجات القبلية مدونة في العمود $B$، والدرجات البعدية مدونة في العمود $C$، فيجب أن تقع درجات الحالة الأولى بدقة في الخليتين $B2$ و $C2$ على التوالي، مما يضمن التناظر التام في قياس الفارق الزوجي.
كما يُشترط رياضياً تساوي أطوال النطاقات المشمولة في المعادلة؛ إذ إن محاولة طرح نطاق يتألف من 10 صفوف (مثلاً $B2:B11$) من نطاق يتألف من 12 صفاً (مثل $C2:C13$) ستؤدي حتماً إلى فشل العملية الرياضية أو ظهور أخطاء عدم تطابق الأبعاد. وينبغي الاهتمام البالغ بصياغة ترويسات الأعمدة (Column Headers) في الصف الأول بعبارات واضحة تدل على البناء العلمي للمتغير، كأن نستخدم “القياس_القبلي” و”القياس_البعدي”، لتمييز القياسات بدقة ومنع وقوع التباس لدى المحلل أثناء كتابة مراجع الخلايا في شريط الصيغ.
3.2 تنقية البيانات من القيم الشاذة والأخطاء الإدخالية
قبل الشروع في كتابة أي معادلة رياضية، يتعين على الباحث إخضاع مصفوفة البيانات لفحص تدقيقي صارم لاستبعاد الشوائب الإدخالية التي تعطل محركات الحساب. تشمل هذه الشوائب وجود مسافات بيضاء غير مرئية نتجت عن أخطاء إدخال يدوي أو عمليات نسخ غير منضبطة من مصادر خارجية، حيث يتعامل إكسيل مع الخلية التي تحوي مسافة بيضاء بوصفها نصاً غير رقمي، مما يؤدي إلى فشل الصيغ المصفوفية وتوقف العمليات الحسابية بصورة غير مبررة.
ولضمان صيانة مصفوفة المدخلات، يُنصح بشدة بتفعيل أدوات التحقق من صحة البيانات (Data Validation) المتاحة في شريط أدوات إكسيل، من خلال وضع قيود تلزم المستخدم بإدخال أرقام عشرية أو صحيحة تقع حصراً ضمن المدى المنطقي المعتمد للمقياس المستخدم (مثلاً، درجات مقياس تقع بين 0 و 100). هذا الإجراء يمنع تسرب القيم الشاذة المتطرفة الناتجة عن أخطاء مطبعية (مثل كتابة 500 بدلاً من 50)، والتي إن تُركت دون معالجة، ستؤدي إلى تحريف جسيم في قيمة متوسط الفروق، وتشوه حجم الأثر المحسوب، وتخرج بالدراسة عن نطاق الدقة العلمية والموضوعية.
3.3 توحيد التنسيقات الرقمية للأعمدة المقارنة
تتطلب موثوقية العمليات الحسابية داخل إكسيل ضبطاً دقيقاً لتنسيق الخلايا (Cell Formatting). في كثير من الأحيان، تؤدي عمليات استيراد البيانات من استبانات إلكترونية أو منصات خارجية كـ Google Forms إلى تخزين الأرقام كنصوص برمجية (Numbers Stored as Text)، وهي حالة خادعة تظهر فيها الأرقام بوضوح للعين المجردة، لكن محرك إكسيل يتجاهلها كلياً أو يولد خطأ فادحاً عند محاولة تطبيق العمليات الجبرية المباشرة عليها كصيغ المصفوفات.
لتصحيح هذا الاختلال، يجب تحديد كافة الخلايا المتضمنة للبيانات، والنقر بزر الفأرة الأيمن لاختيار “تنسيق الخلايا” (Format Cells)، ثم اختيار التنسيق “رقم” (Number) أو “عام” (General). وفي السياق البحثي الأكاديمي، يُستحسن توحيد عدد المنازل العشرية (Decimal Places) لتكون منزلتين أو ثلاث منازل عشرية عبر كامل العمودين، بما يتسق مع معايير جمعية علم النفس الأمريكية (APA Style)، مما يضمن الاتساق البصري للمصفوفة ويمنع أخطاء التقريب البصري التراكمية التي قد تؤثر سلباً على تفسير النتائج لاحقاً.
4. خطوات التطبيق العملي لحساب متوسط الفرق خطوة بخطوة
4.1 إدخال مصفوفة البيانات في ورقة العمل
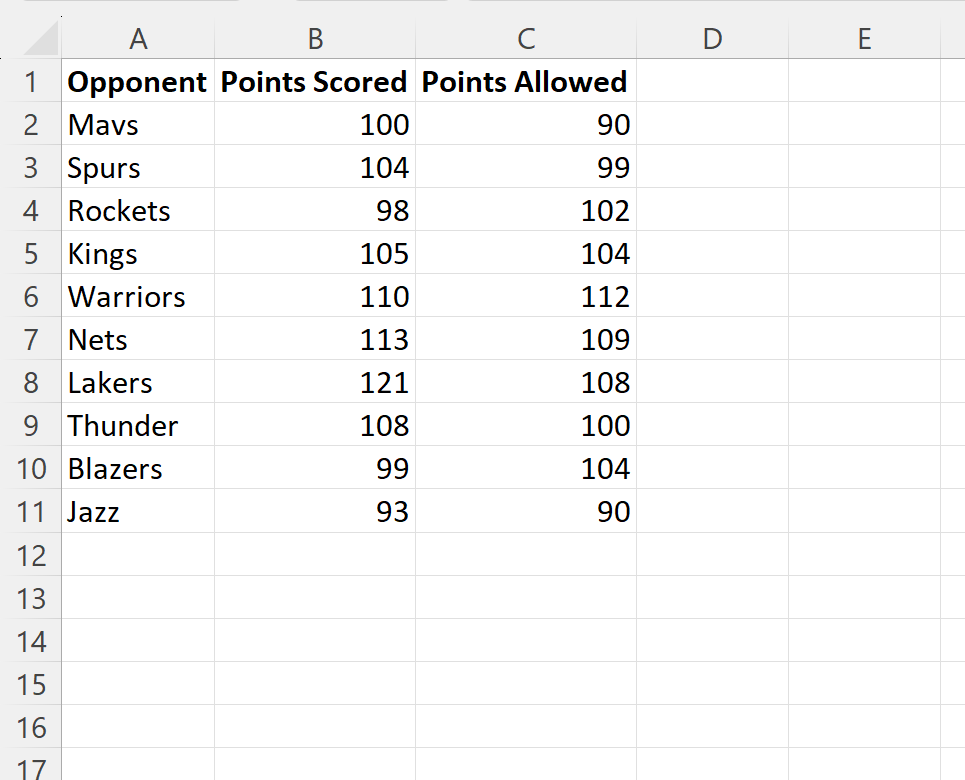
تبدأ الممارسة العملية المباشرة بتهيئة ورقة عمل إكسيل نظيفة، حيث يُخصص العمود $A$ لترميز المشاركين (مثل كود الحالات: ID_01, ID_02… إلخ) لمنع الكشف عن هويات الأفراد والحفاظ على السرية الأخلاقية للبحث. بعد ذلك، يتم إدخال درجات القياس الأول الأساسي في العمود $B$، ابتداءً من الخلية $B2$ وحتى نهاية العينة في الخلية $B11$، لتمثل مصفوفة القياس المرجعي الأساسية (Baseline Measurements).
تُدخل بعد ذلك درجات القياس الثاني المقارن في العمود الموازي مباشرة، أي في النطاق من $C2$ إلى $C11$. وبعد الانتهاء من الإدخال، يجب إجراء مراجعة بصرية ومطابقة مزدوجة مع الاستمارات الورقية أو السجلات الأصلية للتأكد من خلو العمودين من أي انزياح رأسي في البيانات، والتأكد التام من أن كل درجة في العمود المقارن تنتمي قطيعاً لنفس المفحوص المسجل في ذلك الصف، لتفادي إفساد التناظر الزوجي الذي يرتكز عليه التحليل برمته.
4.2 كتابة وتنفيذ صيغة متوسط الفرق
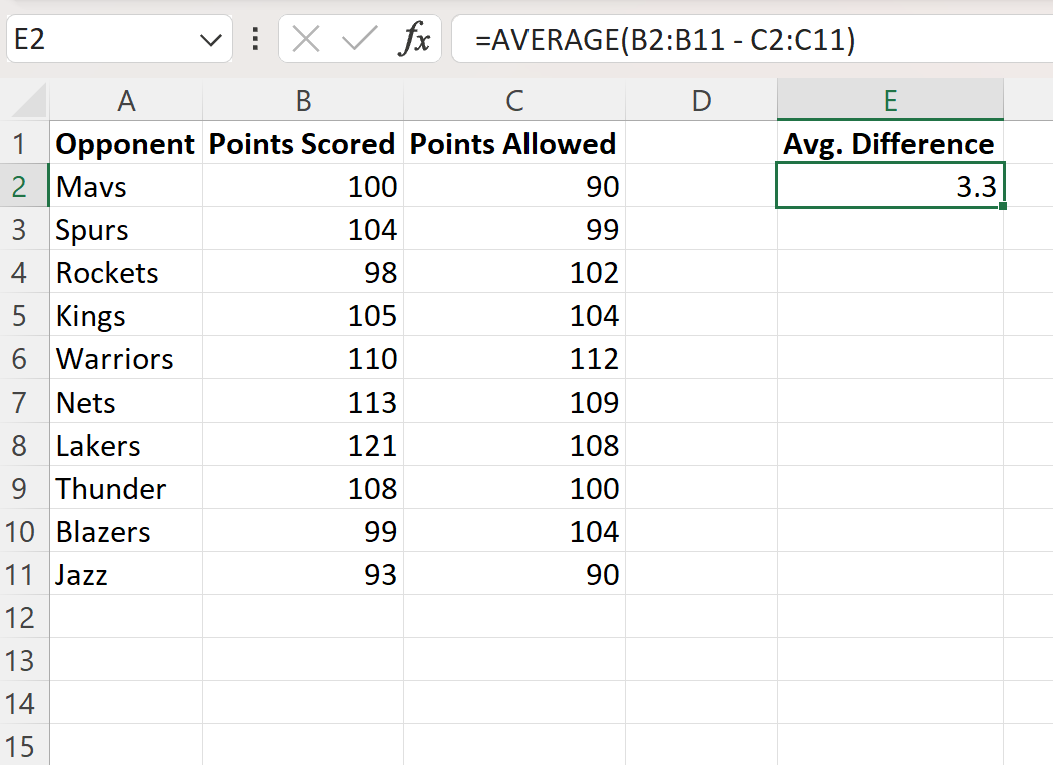
عقب إتمام رصف البيانات، يتم اختيار خلية فارغة ومستقلة لتكون مستودعاً لعرض القيمة الإحصائية المستخرجة، ولتكن الخلية $E2$ على سبيل المثال. يُنصح بكتابة عنوان وصفي في الخلية التي تعلوها مباشرة ($E1$) يحمل اسم “متوسط الفروق” لتحديد مدلول الرقم، ثم النقر على الخلية $E2$ والانتقال إلى شريط الصيغ (Formula Bar) في الجزء العلوي من واجهة البرنامج.
تُكتب الصيغة الرياضية كما هي دون مسافات زائدة:
=AVERAGE(B2:B11 - C2:C11)
وفي حال رغب الباحث في حساب الفارق المتمثل في التغير الحاصل من القياس القبلي إلى البعدي (أي البعدي مطروحاً منه القبلي لرصد النمو أو الزيادة)، يمكن عكس الترتيب الداخلي للصيغة لتصبح:
=AVERAGE(C2:C11 - B2:B11)
يتم بعد ذلك الضغط على مفتاح Enter (أو Ctrl + Shift + Enter في الإصدارات القديمة). وفور التنفيذ، يظهر الرقم النهائي المحسوب بدقة متناهية وبصورة فورية داخل الخلية، مجسداً خلاصة المعالجة الإحصائية للمصفوفة بالكامل.
4.3 التفسير العلمي للرقم الناتج
لا يكتمل التحليل الإحصائي بمجرد استخراج النتيجة الرقمية، بل يتطلب الأمر قراءة علمية واعية لدلالة الإشارة الرياضية المصاحبة للرقم ولحجمه النسبي. إن ظهور قيمة موجبة عند استخدام الصيغة =AVERAGE(C2:C11 - B2:B11) يعكس اتجاهاً إيجابياً عاماً نحو ارتفاع مؤشرات القياس البعدي مقارنة بالقبلي؛ مما يعني في الدراسات التعليمية مثلاً تحسناً في مستوى التحصيل الأكاديمي للطلاب بعد تطبيق استراتيجية تدريس حديثة.
وعلى النقيض من ذلك، إذا كانت القيمة الناتجة سالبة، فإن ذلك يشير إلى هبوط في الدرجات؛ وهو ما يعد نتيجة إيجابية ومرغوبة في الأبحاث الإكلينيكية إذا كان المتغير المقاس هو مقياس لأعراض الاكتئاب، أو مستويات القلق، أو الضغوط النفسية الحادة، حيث تشير الإشارة السالبة حينئذ إلى انخفاض المعاناة النفسية بفضل التدخل العلاجي. ولصياغة هذا المخرج في التقرير العلمي، يجب أن يُكتب بلغة أكاديمية واضحة، كأن يُذكر: “أظهرت النتائج أن متوسط الفرق الزوجي في درجات القلق قبل وبعد البرنامج التدريبي بلغ ($\bar{D} = -4.35$)، مما يشير إلى انخفاض متوسط الأعراض لدى أفراد العينة بمقدار 4.35 درجة على مقياس القياس المعتمد”.
5. التحليل الميكانيكي الداخلي لكيفية عمل الصيغة داخل إكسيل
5.1 مرحلة الطرح الأولي بين عناصر المصفوفة
لفهم البراعة الكامنة وراء أداء إكسيل، لا بد من تشريح الآلية الخوارزمية التي يتبعها البرنامج في كواليس المعالجة عند تنفيذ الصيغة =AVERAGE(B2:B11 - C2:C11). لا يرى المستخدم في واجهة التطبيق سوى الخلية التي تضم النتيجة، ولكن في عمق الذاكرة التنفيذية (RAM)، يبدأ إكسيل بتوليد مؤشر متزامن يمر على عناصر النطاقين سطراً بسطر؛ فيأخذ القيمة المسجلة في الخلية $B2$ ويطرح منها قيمة $C2$، ثم ينتقل بالتزامن إلى $B3$ ليطرح منها $C3$، مكرراً الإجراء نفسه وصولاً إلى الزوج الأخير في $B11$ و $C11$.
تولد هذه العملية التكرارية السريعة متجهاً رياضياً داخلياً غير مرئي (Hidden Internal Vector) يأخذ الشكل:
$${ (B2-C2), (B3-C3), (B4-C4), dots, (B11-C11) }$$
وتُمثل هذه القيم الفروق الفردية الحقيقية لكل حالة مستقلة، مخزنة بصورة عائمة في الذاكرة المؤقتة. وتتميز هذه الآلية بعدم استهلاك مساحة مرئية من أوراق العمل، مما يحافظ على تكامل النماذج الحسابية وتماسكها، لا سيما في المشروعات التحليلية الضخمة التي تحوي مئات المتغيرات وتتطلب إدارة صارمة للموارد الحاسوبية للبرنامج.
5.2 مرحلة تجميع الفروق وحساب المتوسط الحسابي
بمجرد انتهاء مرحلة توليد مصفوفة الفروق الفردية، تنتقل السيطرة الرياضية بصورة فورية إلى دالة التجميع AVERAGE. تعمل هذه الدالة بمثابة مصفاة حسابية (Computational Filter) تستقبل مدخل المصفوفة الداخلية أحادية البعد؛ فتقوم بجمع كافة الأعداد السالبة والموجبة المخزنة داخلها لحساب المجموع الجبري الكلي للفروق:
$$\sum_{i=1}^{N} D_i$$
ثم تتولى الدالة رصد عدد العناصر المعالجة، وهو ما يعادل عدد الصفوف المتناظرة الصالحة للحساب ($N$). وفي الخطوة النهائية، تجري الدالة عملية القسمة الحسابية المعتادة بقسمة المجموع الإجمالي للفروق على العدد الكلي للأزواج، لتنتج القيمة الحسابية النهائية كقيمة مفردة (Scalar). يتم بعد ذلك تفريغ الذاكرة المؤقتة من المصفوفة الوسيطة وعرض الرقم المتبقي حصراً في الخلية المختارة، محققاً بذلك الكفاءة الحسابية المطلوبة دون ترك أي أثر لمعالجات وسيطة في واجهة المستخدم.
5.3 تتبع وتقييم خطوات الحساب عبر أداة تقييم الصيغة
يوفر إكسيل ميزة تشخيصية متقدمة تُعرف بأداة “تقييم الصيغة” (Evaluate Formula)، تتيح للباحث والمدقق مشاهدة هذه المعالجة الداخلية الخفية بالعين المجردة وبشكل تفاعلي. للوصول إلى هذه الأداة، يقوم المستخدم بتحديد الخلية المحتوية على صيغة متوسط الفرق، ثم يتوجه إلى شريط الأدوات العلوي، ويختار تبويب “صيغ” (Formulas)، ومن مجموعة “تدقيق الصيغة” (Formula Auditing) ينقر على زر “تقييم الصيغة”.
تفتح الأداة نافذة حوارية تعرض الصيغة الرياضية مع وضع خط تسطيري تحت الجزء الجاري تقييمه، وعند النقر المتكرر على زر “تقييم” (Evaluate)، يُشاهد المستخدم تحول مراجع الخلايا $B2:B11$ و $C2:C11$ إلى المصفوفات الرقمية الفعلية المخزنة بداخلها، تليها خطوة استبدال عملية الطرح بمصفوفة الأرقام الناتجة بين قوسين معقوفين، مثل {-2; 5; 0; -3; ...}. وأخيراً يظهر ناتج دالة المتوسط الإجمالي. يمثل هذا التدقيق البصري أداة تعليمية وتوثيقية بالغة القوة، تمكن الباحث من التيقن المطلق من الترتيب الرياضي السليم للعمليات ومطابقتها للمنطق الإحصائي المعتمد قبل تضمين الأرقام في الأوراق البحثية.
6. الطرق البديلة لحساب متوسط الفرق ومقارنتها بالصيغة المباشرة
6.1 طريقة العمود المساعد لحساب الفروق الفردية
تتمثل الطريقة التقليدية الأكثر شيوعاً بين مستخدمي إكسيل في إنشاء ما يُعرف بـ “العمود المساعد” (Helper Column). في هذه المنهجية، يضيف الباحث عموداً جديداً محاذياً للبيانات، وليكن العمود $D$، ويمنحه ترويسة مثل “الفرق الفردي”. ثم يُدرج في الخلية $D2$ صيغة الطرح الثنائية البسيطة =B2-C2، ويقوم بسحب مقبض التعبئة التلقائي للأسفل لتكرار المعادلة عبر كافة الصفوف حتى الخلية $D11$. بعد ذلك، يُحسب متوسط هذا العمود الجديد في خلية منفصلة باستخدام الصيغة القياسية =AVERAGE(D2:D11).
تحمل هذه الطريقة ميزة بيداغوجية ملموسة تتمثل في إتاحة الفرصة للمحلل لرؤية مقدار التغير الخاص بكل مشارك على حدة، مما يسهل رصد الحالات الشاذة الفردية بصرياً وإجراء تحليلات إضافية على درجات التغير (مثل رسم المدرج التكراري للفروق). ومع ذلك، فإن عيبها الرئيس يكمن في استهلاكها لمساحات إضافية من ورقة العمل، وزيادة احتمالية تعرض الملف للخلل عند حذف العمود المساعد عن غير قصد، فضلاً عن كونها غير عملية في قواعد البيانات الكبيرة التي تتضمن مئات المتغيرات، مما يجعل الصيغة المصفوفية المباشرة أكثر إحكاماً ومهنية في النمذجة المتقدمة.
6.2 طريقة طرح المتوسطات المستقلة
تعتمد الطريقة البديلة الثانية على استغلال الخاصية الرياضية للخطية في المشغل الإحصائي للمتوسط، وذلك عبر استخدام الصيغة التي تطرح متوسط العمود الثاني من متوسط العمود الأول بصورة مباشرة:
=AVERAGE(B2:B11) - AVERAGE(C2:C11)
هذه المعادلة تتسم بالبساطة وعدم حاجتها للتعامل مع منطق المصفوفات إطلاقاً في أي إصدار من إصدارات البرنامج، وهي تعطي نفس الناتج الرقمي تماماً طالما كانت مصفوفة البيانات كاملة بصورة مثالية ولا تشوبها أي شائبة.
بيد أن هذه الطريقة تنطوي على خطورة منهجية جسيمة ومضللة في سياق العينات المرتبطة؛ ففي حال وجود قيمة مفقودة في إحدى خلايا العمود الأول دون العمود الثاني (مثلاً غياب أحد المشاركين عن الاختبار البعدي مع وجود درجته القبلية)، فإن دالة AVERAGE ستحسب متوسط العمود $B$ استناداً إلى 10 حالات، بينما تحسب متوسط العمود $C$ استناداً إلى 9 حالات فقط. هذا التفاوت يكسر التناظر الزوجي، ويجعل الفارق الناتج فاقداً لمعناه الاستدلالي الصحيح لتحليل العينات المقترنة، في حين أن الصيغة المصفوفية تنبه الباحث وتتعامل مع الحالات غير المتطابقة كوحدة متكاملة، مما يجعل الصيغة المستقلة غير آمنة في الدراسات الواقعية المعرضة لتسرب المشاركين.
6.3 استخدام دالة SUM و COUNT البديلة
للتعمق في المبادئ الرياضية الأولى لحساب المتوسط، يلجأ بعض المحللين إلى تفكيك الدالة إلى مكونيها الأصليين: المجموع الكلي والعدد الإجمالي، وذلك عبر تركيب الصيغة المركبة التالية:
=SUM(B2:B11 - C2:C11) / COUNT(B2:B11)
تعتمد هذه الصيغة في شطرها الأول على استخدام دالة الجمع SUM لجمع عناصر مصفوفة الفروق المتولدة في الذاكرة، ثم قسمة الناتج الصافي على إجمالي عدد الحالات المحسوبة باستخدام دالة العد الإحصائي COUNT المطبقة على النطاق المقارن.
تتجلى فائدة هذه الطريقة في تقديم تحكم تفصيلي للباحث في آلية القسمة، كما تسمح باستبدال المقام بدوال أخرى في حالات التعديل الإحصائي المتقدم (مثل تقليل درجات الحرية). غير أن الجانب السلبي فيها يرتبط بزيادة حجم المعادلة والتعقيد التركيبي غير المبرر في الحالات الروتينية، إلى جانب استهلاك وقت معالجة إضافي طفيف في المصنفات الضخمة التي تضم ملايين القياسات، حيث تضطر البرمجية لاستدعاء دالتين مستقلتين وإجراء معالجة مزدوجة للنطاق بدلاً من توظيف دالة AVERAGE الفردية المحسنة داخلياً لأداء تلك المهمة المزدوجة بأعلى كفاءة في إدارة الذاكرة.
7. حساب متوسط الفرق المطلق في مقابل الفرق الموجه
7.1 الفرق النظري بين الفارق المطلق والفارق الاتجاهي
في التحليل الكمي، يمثل “الفارق الموجه” (Directional Difference) صافي التغير مع الاحتفاظ بالإشارات الجبرية السالبة والموجبة، وهو أمر محوري لمعرفة ما إذا كان المسار العام للمجموعة يتجه نحو التحسن أو التراجع. ومع ذلك، يبرز قصور جوهري في هذا القياس عند تقييم أداء النماذج التنبؤية، أو دقة تقديرات المعايرة الذاتية، أو قياس خطأ التقدير الإنساني، حيث تؤدي الفروق الموجبة الناتجة عن المبالغة في التقدير إلى إلغاء الفروق السالبة الناتجة عن التقليل من التقدير بصورة متبادلة، مما يظهر متوسط الفروق الموجه قريباً من الصفر بشكل خادع يوحي بانعدام الخطأ، في حين أن الواقع يشهد وجود أخطاء فادحة في الاتجاهين، وهي ظاهرة معروفة في أدبيات القصور في التقييم الذاتي (Dunning, Heath, & Suls, 2004).
هنا تبرز الحاجة المنهجية الملحة لما يُعرف بـ “متوسط الفارق المطلق” (Mean Absolute Difference – MAD) أو متوسط الخطأ المطلق (Mean Absolute Error – MAE)، والذي يُلغي تماماً تأثير الإشارات السالبة، ويقيس المقدار المحض للتغير أو الانحراف بغض النظر عن اتجاهه، وفق الصياغة الرياضية الآتية:
$$\text{MAD} = \frac{1}{N}\sum_{i=1}^{N}|X_{1i} – X_{2i}|$$
يعد هذا المقياس مؤشراً دقيقاً على حجم التذبذب الفعلي والاستقرار القياسي بين فترتين أو بين مقيمين مختلفين، مما يجعله مكملاً تحليلياً لا يمكن الاستغناء عنه لقراءة سلوك البيانات فهماً شاملاً دون الوقوع في فخ التحييد الجبري للإشارات المعاكسة.
7.2 دمج دالة ABS مع دالة AVERAGE لحساب متوسط الفرق المطلق
يوفر إكسيل إمكانية حساب متوسط الفارق المطلق في خطوة واحدة وبمنتهى السلاسة البرمجية عبر دمج دالة القيمة المطلقة ABS داخل دالة المتوسط AVERAGE، من خلال صياغة المعادلة الرياضية المتراكبة:
=AVERAGE(ABS(B2:B11 - C2:C11))
تتعامل دالة ABS في هذه المعادلة مع مصفوفة الفروق الناتجة عن عملية الطرح المتبادل بين النطاقين، فتقوم بتحويل كافة الأرقام السالبة الناتجة عن انخفاض درجات بعض المفحوصين إلى أرقام موجبة متطابقة في القيمة المطلقة، بينما تترك الأرقام الموجبة والصفرية كما هي دون أي تغيير.
تتلقى دالة AVERAGE بعد ذلك مصفوفة مكونة بالكامل من أرقام غير سالبة تمثل المسافات الهندسية المحضة بين النقاط المتقابلة، وتستخرج متوسطها الحسابي النقي. في إصدارات Microsoft 365 وإكسيل الحديثة، تعمل هذه الصيغة تلقائياً بمجرد ضغط Enter، بينما تتطلب في الإصدارات الأقدم تطبيق الاختصار الإلزامي Ctrl + Shift + Enter لتعمل بدقة ودون ظهور أخطاء برمجية، مانحةً الباحث مقياساً كمياً منضبطاً لحجم التباين الفعلي المجرد من أثر الاتجاه الجبري.
7.3 أمثلة تطبيقية لمقارنة النتيجتين وتفسيرهما
لتوضيح التباين الجوهري بين المفهومين بمثال رقمي عياني، نفترض أن لدينا عينة من 4 طلاب خضعوا لاختبارين، وكانت فروق الدرجات الفردية بين القياسين كالتالي: الطالب الأول حقق (+10) درجات، والطالب الثاني حقق (-10) درجات، والطالب الثالث حقق (+15) درجة، بينما سجل الطالب الرابع (-15) درجة. إذا قمنا بتطبيق صيغة الفرق الموجه =AVERAGE(B2:B5 - C2:C5)، سنجد أن الناتج هو:
$$\frac{10 + (-10) + 15 + (-15)}{4} = \frac{0}{4} = 0$$
وهذا الرقم يرسل إشارة مضللة توحي بأن درجات الطلاب لم تشهد أي تغير بالمطلق بين الاختبارين.
في المقابل، إذا طبقنا صيغة متوسط الفرق المطلق =AVERAGE(ABS(B2:B5 - C2:C5))، فإن العملية ستجري على النحو التالي:
$$\frac{|10| + |-10| + |15| + |-15|}{4} = \frac{10 + 10 + 15 + 15}{4} = \frac{50}{4} = 12.5$$
يظهر هذا الناتج بوضوح أن درجات الطلاب قد تحركت وتغيرت في المتوسط بمقدار ضخم مقداره 12.5 درجة، وهو ما يكشف اضطراباً ملحوظاً أو تذبذباً حاداً في أداء المفحوصين. ولذلك، تقتضي الأمانة العلمية في التوثيق الإحصائي الجمع بين كلا الرقمين؛ حيث يشير متوسط الفرق الموجه إلى المحصلة الإجمالية للنمو الجمعي، بينما يشير متوسط الفرق المطلق إلى المقدار الفعلي لديناميكية الحركة والتغير الداخلي للأفراد المستهدفين بالدراسة.
8. معالجة الأخطاء الشائعة وحالات البيانات غير المكتملة
8.1 التعامل مع خطأ القيمة #VALUE! وأسبابه
يعد الخطأ البرمجي #VALUE! من أكثر العوائق إحباطاً للباحثين عند التعامل مع الصيغ المصفوفية في إكسيل، وهو ينشأ أساساً عندما يطلب المستخدم من البرنامج إجراء عملية حسابية رياضية—كالطرح—على محتويات لا تتصف بصفات القيم العددية. ويحدث هذا في أغلب الأحيان عند وجود نصوص في ترويسات الأعمدة تم شملها بالخطأ في نطاق الصيغة، أو وجود رموز ترميزية يدوية استخدمها جامع البيانات (مثل كتابة كلمة “غائب” أو “مفقود” أو علامة الشرطة -) داخل أحد النطاقات المستهدفة بالمعادلة.
كما تلعب المسافات المخفية دوراً رئيساً في توليد هذا الخطأ؛ إذ يعتبرها إكسيل سلاسل نصية (String Data) لا يجوز رياضياً طرحها من أرقام حقيقية. لمعالجة هذا الخلل وتطهير المصفوفات، يمكن صياغة دوال شرطية تنقي البيانات قبل الطرح، أو استبدال النصوص بقيم عددية عبر شريط البحث والاستبدال، أو كتابة صيغة متقدمة تستخدم دالتي ISNUMBER و IF لتمرير الخلايا الرقمية فقط، مثل التركيب التالي:
=AVERAGE(IF(ISNUMBER(B2:B11)*ISNUMBER(C2:C11), B2:B11 - C2:C11))
تضمن هذه الصياغة تحييد أي مدخل نصي والحيلولة دون تعطل الصيغة المصفوفية بالخطأ القيمي المزعج.
8.2 معالجة خطأ انعدام القسمة #DIV/0!
ينفجر خطأ القسمة على الصفر #DIV/0! في وجه المحلل عندما تجد دالة AVERAGE نفسها مجبرة على إجراء عملية القسمة على مقام مقداره صفر، وهو ما يقع عندما يكون النطاق المحدد خالياً تماماً من أي قيم عددية صالحة لإجراء الحساب، أو عندما تقوم مرشحات التنقية باستبعاد كافة الصفوف في الجدول لعدم مطابقتها للشروط الموضوعة. هذا يترك مصفوفة الفروق فارغة تماماً من الأعداد، مما يجعل احتساب المتوسط مستحيلاً رياضياً وبرمجياً داخل بنية إكسيل.
لتحصين نماذج العمل ضد هذا الخطأ، ومنع تشويه مظهر التقارير الإحصائية ومخرجات الجداول الجاهزة للطباعة، يُنصح بتغليف معادلة متوسط الفرق بدالة الأمان الشهيرة IFERROR، وذلك بصياغتها وفق النمط التالي:
=IFERROR(AVERAGE(B2:B11 - C2:C11), "")
أو استبدال علامتي التنصيص الفارغتين بعبارة تدل على النقص مثل "بيانات غير كافية" أو الرقم 0 بحسب مقتضى المنهج الإحصائي المتبع. تضمن هذه الإستراتيجية استمرار ورقة العمل في أداء مهامها الحسابية دون أن تتسبب خلية واحدة فارغة في تعطيل سلسلة المعادلات المرتبطة بها في سائر أقسام النموذج الرياضي.
8.3 التعامل المنهجي مع البيانات المفقودة جزئياً
تمثل مشكلة الفقد الجزئي للبيانات (Missing Data Pairs)—حيث تتوافر درجة القياس القبلي للحالة مع غياب درجتها في القياس البعدي أو العكس—تحدياً منهجياً معقداً في تحليل العينات المرتبطة. ففي الصيغة المصفوفية المباشرة =AVERAGE(B2:B11 - C2:C11)، إذا كانت الخلية $C5$ فارغة تماماً مع وجود قيمة في $B5$، فإن إكسيل قد يتعامل مع الخلية الفارغة افتراضياً باعتبارها مساوية للصفر (0)، مما يجعل ناتج الطرح لذلك الصف مساوياً لدرجة $B5$ كاملة، وهو ما يشكل خطأً منهجياً فادحاً يضخم الفروق المصطنعة دون أي سند تجريبي.
لحل هذه المعضلة العلمية وتجاوز أي افتراضات خاطئة للصفر، يجب اعتماد صيغ مركبة متقدمة تقوم على تصفية واستبعاد أي زوج غير مكتمل قبل تمرير البيانات لعملية الطرح. في إصدارات إكسيل الحديثة، يمكن توظيف دالة FILTER الرائعة عبر الصيغة:
=AVERAGE(FILTER(B2:B11 - C2:C11, (B2:B11<>"") * (C2:C11<>"")))
تعمل هذه الصيغة على وضع شرط حازم يتطلب أن تكون الخليتان في الصف معاً غير فارغتين (حيث يمثل رمز الضرب المنطقي * مشغل المعية المنطقية AND). وبذلك، تُستبعد تلقائياً كافة الأزواج المشوهة أو الناقصة من مصفوفة الطرح، وتقتصر الحسابات على الحالات التي استكملت كافة أدوات القياس، حمايةً للمصداقية العلمية للدراسة ونتائجها.
9. التطبيقات المتقدمة لحساب متوسط الفرق في البحوث النفسية والتربوية
9.1 قياس أثر التدخلات العلاجية في الاختبار القبلي والبعدي
يعد التطبيق الأكثر تجلياً لحساب متوسط الفروق هو ذلك المرتبط بتقييم فاعلية البرامج العلاجية والتربوية والتطويرية القائمة على تصميم القياس القبلي والبعدي (Pretest-Posttest Designs). ففي مجال الصحة النفسية، يسعى الباحثون لتقييم برامج التدخل لخفض القلق والاكتئاب أو تحسين الرضا وجودة الحياة، وهو ما يوثق دورياً في الدراسات الإكلينيكية ودراسات المآل الصحي وطول العمر لدى الفئات المعرضة للاضطرابات النفسية (Chang et al., 2011). بعد استخراج متوسط الفروق الزوجية ($\bar{D}$) عبر إكسيل، لا يقف المحلل عند هذا الوصف الرقمي المجرد، بل يوظفه لاستخراج مؤشر حجم الأثر الموحد المعروف بـ “كوهين دي” (Cohen’s $d$) للأزواج المرتبطة عبر المعادلة الإحصائية:
$$d = \frac{\bar{D}}{S_D}$$
حيث تمثل $S_D$ الانحراف المعياري لمصفوفة الفروق الفردية، والتي يمكن حسابها مباشرة في إكسيل بصيغة مصفوفية متطابقة:
=STDEV.S(B2:B11 - C2:C11)
يتيح هذا التكامل داخل ورقة العمل إنتاج مخرجات كمية منسجمة بالكامل مع المعايير الدولية الصارمة لجمعية علم النفس الأمريكية (APA Style)، مما يسهل كتابة الجداول التلخيصية التي تجمع بين متوسط الفرق، والانحراف المعياري للتغير، وحجم الأثر الناتج، بصورة احترافية تدعم ثقة المحكمين والناشرين في القيمة العلمية للبحث ومخرجاته.
9.2 حساب الفروق بين تقييمات الملاحظين المتعددين
في العديد من البحوث السلوكية والتربوية، لا تستند البيانات إلى اختبارات ورقية آلية، بل تُستقى من خلال درجات الملاحظة المباشرة التي يجريها مقيمون مستقلون (Independent Raters) لرصد سلوكيات مستهدفة (مثل التشتت الذهني، التفاعل الاجتماعي، أو النطق اللغوي). في هذه السياقات، يبرز خطر “تحيز المقيم” (Rater Bias)، حيث يميل بعض الملاحظين للتساهل ومنح درجات مرتفعة، بينما يميل آخرون للتشدد، وهو تباين يعالجه الباحثون عبر فحص الفروق القياسية، كالدراسات اللغوية والمعرفية التي تتطلب ضبطاً دقيقاً لتقييمات الخصائص الدلالية والمفردات المعجمية (Brysbaert, Warriner, & Kuperman, 2013; McRae, Cree, Seidenberg, & McNorgan, 2005; van Heuven, Mandera, Keuleers, & Brysbaert, 2013).
يساعد حساب متوسط الفرق بين تقييمات المقيم الأول في العمود $B$ والمقيم الثاني في العمود $C$ باستخدام دالة متوسط الفروق في إكسيل على توفير فحص تشخيصي سريع لمدى وجود انزياح منهجي ثابت (Systematic Bias) بين المقيمين. فإذا كان متوسط الفرق بينهما قريباً من الصفر، دل ذلك على توازن عام في موازين التقدير، أما إذا ابتعد متوسط الفرق بصورة جوهرية عن الصفر، فإن ذلك يعطي الباحث إنذاراً مبكراً بوجود خلل في اتساق الملاحظين يستدعي إعادة تدريبهم وتوحيد المعايير الإجرائية، أو إدخال معاملات ضبط إحصائية لإعادة موازنة الدرجات قبل المضي قدماً في التحليلات التفسيرية المعقدة.
9.3 التكامل مع اختبار t للعينات المرتبطة في إكسيل
على الرغم من الأهمية الوصفية الكبيرة لمتوسط الفروق، إلا أنه يظل عاجزاً بمفرده عن الإجابة على السؤال الاستدلالي الحاسم: هل هذا الفرق المرصود يعكس تغيراً حقيقياً ذا دلالة، أم أنه مجرد نتاج عشوائي لخطأ المعاينة وتقلبات الصدفة؟ للإجابة عن هذا التساؤل المنهجي، يتكامل حساب متوسط الفرق في إكسيل مع دالة اختبار ت للعينات المرتبطة (Paired Samples t-test) المدمجة أصلياً في البرنامج تحت اسم T.TEST.
تُكتب هذه الدالة في خلية مجاورة لمتوسط الفروق بالشكل التالي:
=T.TEST(B2:B11, C2:C11, 2, 1)
حيث يمثل المعامل 2 اختباراً ثنائي الذيل (Two-Tailed Test)، بينما يحدد المعامل 1 نوع الاختبار ليكون فحصاً للعينات المزدوجة المرتبطة (Paired Test). تُرجع هذه الدالة القيمة الاحتمالية الدقيقة ($p\text{-value}$). وإذا كانت هذه القيمة أقل من مستوى الدلالة المعتمد ($\alpha = 0.05$)، يقترن متوسط الفرق المحسوب ببرهان إحصائي يؤكد اختلافه جوهرياً عن الصفر الإحصائي، مما يسمح للباحث برفض الفرضية الصفرية والتأكيد بثقة إحصائية راسخة على فاعلية التدخل المجرب وتجاوزه لحدود التباين العشوائي.
10. أفضل الممارسات المنهجية للتوثيق والتحقق من صحة النتائج في إكسيل
10.1 التدقيق المتقاطع والتحقق اليدوي للعينة العشوائية
تقتضي الرصانة الأكاديمية إخضاع مخرجات البرمجيات الحسابية لمسار تدقيقي متقاطع (Cross-Validation) للتأكد من عدم تسرب أي أخطاء صيغية خفية. من أفضل الممارسات في هذا الصدد قيام الباحث باختيار عينة فرعية عشوائية مؤلفة من 3 إلى 5 حالات من مصفوفة البيانات الكلية، وإجراء العمليات الحسابية عليها بصورة يدوية مجردة باستخدام الورقة والقلم، ثم مقارنة هذا الناتج اليدوي بالمخرجات المقابلة التي ولدتها صيغة إكسيل لنفس تلك الحالات الفرعية.
كما يُوصى، كلما أمكن ذلك، بإجراء مقارنة دورية للمخرجات بين إكسيل وإحدى الحزم الإحصائية التخصصية المكرسة للأبحاث، مثل حزمة SPSS أو منصة Jamovi؛ حيث يُقارن متوسط الفروق المستخرج من إكسيل بالجدول الناتج عن إجراء Paired Samples T-Test في تلك البرامج. ويشمل التدقيق أيضاً تفحص تثبيت مراجع الخلايا باستخدام علامة الدولار ($) لتفادي الانزياح غير المقصود لنطاقات البيانات عند نسخ الصيغ ونقلها بين أوراق العمل المتباينة، مما يعزز مناعة النموذج ضد الأخطاء الهيكلية الشائعة.
10.2 استخدام التسميات المعرفة والنطاقات المسماة لتسهيل القراءة
تعد ميزة “النطاقات المسماة” (Named Ranges) في إكسيل من أرفع الممارسات البرمجية التي ترتقي بورقة العمل من مجرد جدول حسابي غامض مليء بمسميات الخلايا المشفرة إلى مستند إحصائي مقروء يسهل فهمه وتداوله أكاديمياً. تتيح هذه الخاصية للمحلل تحديد العمود $B2:B11$ ومنحه اسماً علمياً معبراً مثل PreTest عبر مربع التسمية (Name Box)، وتحديد النطاق $C2:C11$ وتسميته PostTest.
بناءً على ذلك، تتحول صيغة حساب متوسط الفروق من شكلها المرجعي الجاف إلى صيغة برمجية فائقة الوضوح:
=AVERAGE(PostTest - PreTest)
ولا تقتصر فائدة هذه التسميات على تحسين المظهر البصري لورقة العمل وسهولة قراءتها من قِبل المراجعين والباحثين المشاركين فحسب، بل تمتد لتوفير حماية ديناميكية حاسمة؛ إذ إن إضافة حالات أو صفوف جديدة داخل النطاق المسمى تجعل الصيغة تستوعبها تلقائياً دون الحاجة لتعديل أطراف المعادلات يدوياً، مما يقلص أخطاء عدم تطابق النطاقات إلى الصفر ويضمن استدامة التحليل عبر مراحل المشروع البحثي المختلفة.
10.3 التوثيق المنهجي للبيانات والترميز داخل بيئة العمل
إن التحليل الإحصائي الرصين لا ينفصل عن التوثيق الصارم لمسار تدفق البيانات (Data Provenance). ينبغي على الباحث إدراج تعليقات توضيحية وملاحظات مدمجة (Cell Notes/Comments) في الخلايا المحتوية على صيغ متوسط الفروق، تتضمن شرحاً موجزاً للمنطق الحسابي المستخدم، وتوضيحاً لاتجاه الطرح (من تم طرحه من الآخر وما يترتب على ذلك من تفسير لإشارة الناتج)، وتحديداً دقيقاً لكيفية معالجة القيم المفقودة إن وجدت.
كما تشمل الممارسات المثلى فرض حماية صارمة على الخلايا التي تضم المعادلات الرياضية الحيوية (Locking and Protecting Cells) لمنع التعديل العرضي أو المسح غير المقصود أثناء عمليات إدخال وتنقيح البيانات الروتينية. وتكتمل هذه المنظومة بإلحاق صفحة أو مساحة مخصصة داخل المصنف تُعرف بـ “قاموس البيانات” (Data Dictionary)، يُسجل فيها تاريخ إجراء التحليل، واسم المحلل، وإصدار برنامج إكسيل المستخدم، مما يجعل ورقة العمل سجلاً علمياً متكاملاً يتوافق مع أرقى بروتوكولات الشفافية وقابلية إعادة الإنتاج (Reproducibility) في البحث العلمي المعاصر.
خاتمة
لقد استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لحساب متوسط الفرق في بيئة مايكروسوفت إكسيل، مؤكداً أن هذه العملية ليست مجرد مهارة إجرائية لاحتساب فارق رقمي، بل هي ممارسة إحصائية تتطلب وعياً بالبنية الرياضية للمصفوفات، وفهماً لطبيعة التصاميم الزوجية المرتبطة، ودقة في إعداد وتنقية البيانات من الأخطاء الإدخالية. ومن خلال توظيف الصيغ المباشرة والمصفوفات الحديثة بدلاً من الطرق التقليدية المرهقة، يستطيع الباحثون والمحللون الوصول إلى مؤشرات كمية دقيقة تعكس جوهر التغير الإنساني والتجريبي بكفاءة فائقة وموثوقية متناهية.
إن التمييز الدقيق بين الفروق الموجهة التي ترصد صافي اتجاه التغير، والفروق المطلقة التي تقيس حجم التذبذب المجرد، جنباً إلى جنب مع إتقان التعامل مع رسائل الخطأ وحالات الفقد الجزئي للبيانات، يشكل معياراً فارقاً بين الاستخدام السطحي والاستخدام الاحترافي لبرنامج إكسيل. ومع الاستناد إلى أفضل ممارسات التوثيق والتدقيق المتقاطع والتكامل مع اختبارات الدلالة الإحصائية، يتحول إكسيل إلى مختبر تحليلي فاعل قادر على تلبية متطلبات النشر العلمي الرصين، بما يسهم في ترقية الممارسات البحثية في شتى الميادين الأكاديمية والتطبيقية.
المراجع
- Archer, J., Bower, P., Gilbody, S. M., Lovell, K., Richards, D. A., Gask, L. L., et al. (2012). Collaborative care for depression and anxiety problems. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd006525.pub2
- Browning, M. H. E. M., Larson, L. R., Sharaievska, I., Rigolon, A., McAnirlin, O., Mullenbach, L. E., et al. (2021). Psychological impacts from COVID-19 among university students: Risk factors across seven states in the United States. PLoS ONE. https://doi.org/10.1371/journal.pone.0245327
- Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
- Chang, C.‐K., Hayes, R. D., Perera, G., Broadbent, M., Fernandes, A. C., Lee, W. E., et al. (2011). Life Expectancy at Birth for People with Serious Mental Illness and Other Major Disorders from a Secondary Mental Health Care Case Register in London. PLoS ONE. https://doi.org/10.1371/journal.pone.0019590
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin. https://doi.org/10.1037/0033-2909.131.6.803
- McRae, K., Cree, G. S., Seidenberg, M. S., & McNorgan, C. (2005). Semantic feature production norms for a large set of living and nonliving things. Behavior Research Methods. https://doi.org/10.3758/bf03192726
- Prati, G., & Pietrantoni, L. (2009). Optimism, Social Support, and Coping Strategies As Factors Contributing to Posttraumatic Growth: A Meta-Analysis. Journal of Loss and Trauma. https://doi.org/10.1080/15325020902724271
- van Heuven, W. J. B., Mandera, P., Keuleers, E., & Brysbaert, M. (2013). Subtlex-UK: A New and Improved Word Frequency Database for British English. Quarterly Journal of Experimental Psychology. https://doi.org/10.1080/17470218.2013.850521