
تُعد القيمة الاحتمالية (P-Value) ركيزة بنيوية في صلب المنهجية الإحصائية المعاصرة، حيث تمثل المعيار الرياضي الأكثر شيوعاً واستخداماً للحكم على دلالة النتائج التجريبية والمسحية في شتى حقول المعرفة العلمية، ولا سيما في العلوم السلوكية والنفسية والاجتماعية. إن ممارسة الاستدلال العلمي تتطلب جسراً كمياً متيناً يربط بين الملاحظات المشاهدة في العينات العشوائية والفرضيات التجريدية حول المجتمعات الأصلية. هذا الجسر يُبنى بالأساس على فكرة تقييم الصدفة ومعايرة التشتت العشوائي للبيانات عبر توزيعات نظرية محددة، تتيح للباحث اختبار ما إذا كان النمط الملاحظ يمثل أثراً حقيقياً ذا دلالة، أم أنه لا يعدو كونه تقلباً عشوائياً ناتجاً عن خطأ المعاينة الطبيعي.
ومع التحول التقني الهائل الذي شهدته بيئات التحليل الإحصائي، لم تعد الحسابات اليدوية المعقدة والرجوع المجهد إلى الجداول المطبوعة في ملحقات الكتب المرجعية خياراً عملياً لدى الباحث الرصين. تبرز برمجية مايكروسوفت إكسيل (Microsoft Excel) كواحدة من أكثر البيئات الحاسوبية كفاءة ومرونة في إجراء الحسابات الإحصائية الاستدلالية بدقة بالغة وسرعة فائقة، بما توفره من مكتبة ثرية بالدوال الرياضية المتخصصة وحزم التحليل المتقدمة. يتيح فهم المعمارية الحسابية لهذه الدوال تمكين الباحث من تجاوز التطبيق الآلي الأعمى نحو إدراك تحليلي عميق لكيفية ترجمة المؤشرات الإحصائية إلى قيم احتمالية قابلة للتفسير المنهجي.
يسعى هذا المقال الأكاديمي الشامل إلى تفكيك الأسس النظرية لاختبار الفرضيات الإحصائية، مع تقديم دليل تطبيقي خطوة بخطوة لحساب القيمة الاحتمالية في إكسيل من خلال ثلاثة سيناريوهات عملية مفصلة: الاختبار ثنائي الطرفين، واختبار الطرف الأيسر، واختبار الطرف الأيمن. كما يتناول المقال توظيف حزمة أدوات التحليل، واستعراض أطر التفسير المنهجي الصحيح للنتائج وفق معايير جمعية علم النفس الأمريكية (APA)، متطرقاً إلى المحاذير والأخطاء الشائعة التي تكتنف تفسير القيمة الاحتمالية في الأوساط الأكاديمية.
1. مدخل نظري ومفاهيمي إلى القيمة الاحتمالية واختبار الفرضيات الإحصائية
1.1 مفهوم القيمة الاحتمالية (P-Value) ودورها في الاستدلال العلمي
تُعرّف القيمة الاحتمالية من الناحية الرياضية والإحصائية الصارمة بأنها الاحتمال الشرطي للحصول على إحصائية اختبارية مساوية على الأقل للإحصائية الملاحظة في العينة أو أكثر تطرفاً منها، بافتراض أن الفرضية الصفرية صحيحة في المجتمع الإحصائي الأصلي. رياضياً، تتخذ هذه الصيغة التعبير التالي: (P(T ge t_{text{obs}} mid H_0))، حيث تمثل (T) إحصائية الاختبار كمتغير عشوائي يخضع لتوزيع احتمالي نظري محدد مسبقاً، بينما تمثل (t_{text{obs}}) القيمة المحسوبة الفعلية المستخرجة من بيانات العينة الخاضعة للدراسة. لا تقيس القيمة الاحتمالية احتمالية صحة الفرضية الصفرية في حد ذاتها، بل تعكس درجة التوافق أو التنافر بين البيانات المجمعة والنموذج النظري للعدم المفترض.
يتطلب اتخاذ القرار الاستدلالي السليم تحديداً مسبقاً لمستوى الدلالة الإحصائية (Alpha)، وهو العتبة الحرجة المعتمدة للفصل بين ما يمكن إرجاعه للصدفة البحتة وما يُعتد به كأثر حقيقي يستوجب رفض الفرضية الصفرية. في الممارسات العلمية الراسخة، تتراوح هذه الحدود بين 0.05، و0.01، و0.10 تبعاً لطبيعة التخصص وصرامة العواقب المترتبة على القرار الإحصائي؛ حيث يمثل مستوى 0.05 المعيار الذهبي الأكثر شيوعاً في الدراسات السلوكية والنفسية، ويعني قبول احتمالية قدرها 5% لرفض الفرضية الصفرية خطأً. وقد بينت الأدبيات السيكولوجية الرصينة، مثل مراجعات Dunning et al. (2004)، أن دقة التقييمات المعرفية والسلوكية تتطلب فحصاً كمياً دقيقاً لتفادي الوقوع في تقديرات عشوائية غير منضبطة.
من الأهمية بمكان التأكيد المنهجي على التفريق الدقيق بين الدلالة الإحصائية المجردة (Statistical Significance) والأهمية العملية أو حجم الأثر (Practical Significance / Effect Size). إن تحقيق قيمة احتمالية متناهية الصغر يخبر الباحث بوجود دليل كافٍ يرجح عدم حدوث الفارق بالصدفة، ولكنه لا يضمن بالضرورة أن الفارق كبير أو ذو مغزى تطبيقي في الحياة الواقعية أو في الممارسات الإكلينيكية والسلوكية. في العينات بالغة الضخامة، قد تظهر الفروق التافهة جداً كفروق دالة إحصائياً، وهو ما يبرز ضرورة التكامل بين الدلالة الاحتمالية وحجم الأثر لتجنب التفسيرات المضللة.
تاريخياً، يعود المفهوم التأسيسي لحساب الاحتمالات المرتبطة بالاختبارات إلى دراسات كارل بيرسون عام 1900 عند تقديمه لاختبار كاي تربيع لحسن المطابقة، وتبعه ويليام سيلي جوسيت (تحت الاسم المستعار “Student”) عام 1908 بصياغة توزيع تائي للعينات الصغيرة ذات التباين المجهول. لاحقاً، قام العالم رونالد فيشر خلال عشرينيات وثلاثينيات القرن العشرين بتنظيم اختبارات الدلالة الإحصائية، مقدماً القيمة الاحتمالية كمعيار متصل لتقييم قوة الدليل التجريبي، ومكرساً حد العشرين إلى واحد (أي مستوى 0.05). وفي المقابل، طوّر جيرزي نيومان وإيجون بيرسون إطاراً قرارياً ثنائياً يستند إلى الموازنة بين فرضيتين متنافستين وتحديد أخطاء القرار الإحصائي، ليندمج هذان المدخلان لاحقاً في المنهجية الهجينة السائدة اليوم في الإحصاء الاستدلالي التطبيقي.
1.2 صياغة الفرضية الصفرية (H0) والفرضية البديلة (HA)
تنطلق أي دراسة استدلالية رصينة من الصياغة المنهجية المحكمة للفرضيات، حيث تمثل الفرضية الصفرية ((H_0)) فرضية الوضع الراهن أو الحياد الرياضي، والتي تفترض انعدام الفروق، أو غياب العلاقات الارتباطية، أو انعدام التأثير التدخلي بين المتغيرات المقاسة في المجتمع الأصلي. تُصاغ الفرضية الصفرية بصورة مساواة دقيقة ((mu = mu_0))، وهي الأساس النظري الذي يُبنى عليه التوزيع الاحتمالي لإحصائية الاختبار؛ إذ لا يمكن حساب الاحتمالات التراكمية إلا بافتراض نقطة ارتكاز محددة ومعلومة رياضياً يتم الانطلاق منها لمعايرة الانحرافات التجريبية.
في المقابل، تمثل الفرضية البديلة ((H_A) أو (H_1)) الافتراض البحثي المقابل الذي يتبناه الباحث، وتُصاغ إما بصيغة موجهة أحادية الذيل (One-Tailed) كأن تفترض زيادة ((mu > mu_0)) أو نقصاناً ((mu < mu_0))، أو بصيغة غير موجهة ثنائية الذيل (Two-Tailed) تفترض مجرد وجود اختلاف معنوي دون تحديد اتجاهه مسبقاً ((mu neq mu_0)). يستند الاختيار بين هاتين الصياغتين إلى الأطر النظرية التأسيسية للدراسة؛ فإذا كانت الأدبيات السابقة تؤكد بوضوح اتجاه التأثير، يُسوغ استخدام الاختبار الموجه، في حين يُلزم الباحث بالصيغة ثنائية الطرف عند دراسة ظواهر استكشافية جديدة أو غير محسومة المسار في سياقها النظري.
تؤثر صياغة الفرضية بصورة مباشرة على استراتيجية حساب القيمة الاحتمالية وتوزيع مناطق الرفض الحرجة تحت المنحنى الاحتمالي للتوزيع المعتمد. في الاختبارات ثنائية الطرف، تُقسم المساحة الحرجة لمستوى الدلالة ((alpha)) بالتساوي على طرفي المنحنى النظري ((alpha/2) في الطرف الأيسر و(alpha/2) في الطرف الأيمن)، مما يتطلب دليلاً أكثر قوة في أي من الاتجاهين لتحقيق الدلالة. أما في الاختبارات أحادية الطرف، فتتركز المساحة الحرجة بكاملها في طرف واحد محدد، ما يسهل رفض الفرضية الصفرية في ذلك الاتجاه، ولكنه يجعل التحليل عاجزاً تماماً عن رصد أي أثر ذي دلالة معاكس للاتجاه المفترض.
تتجلى هذه النمذجة الرياضية بدقة في العينات السيكولوجية والعلوم الاجتماعية، حيث تتداخل المتغيرات النفسية المعقدة كالتوافق والدافعية والقلق. فالباحث الذي يصوغ فرضية لا تحتمل التأويل يسعى إلى حصر المتغيرات الدخيلة، معتمداً على أدوات قياس دقيقة تم التحقق من ثباتها وصدقها الإحصائي لتلائم التوزيعات الرياضية المستهدفة، كما هو متبع في دراسات قياس التردد اللفظي وأثر العمليات المعرفية المقارنة المعروضة في أبحاث Brysbaert & New (2009).
1.3 أنواع الأخطاء الإحصائية في اتخاذ القرارات (النوع الأول والنوع الثاني)
ينطوي اتخاذ القرار الاستدلالي على مخاطر احتمالية ترتبط بطبيعة الانتقال من جزء محدود (العينة) إلى الكل التجريدي (المجتمع الأصلي). يتمثل الخطأ من النوع الأول (Type I Error)، والمعروف باحتمالية ألفا ((alpha))، في اتخاذ الباحث لقرار رفض الفرضية الصفرية في حين أنها صحيحة وحقيقية في المجتمع، وهو ما يُعرف اصطلاحاً بالنتيجة “الإيجابية الكاذبة” (False Positive). يمثل هذا الخطأ تهديداً جسيماً للنزاهة العلمية؛ إذ يقود إلى إقرار وجود علاقات أو تأثيرات علاجية أو سلوكية وهمية لا وجود لها في الواقع الخارجي، مما يهدر الموارد البحثية ويشوه المعرفة التراكمية.
أما الخطأ من النوع الثاني (Type II Error)، والذي يُرمز لاحتمالية وقوعه بالرمز بيتا ((beta))، فيحدث عندما يفشل الباحث في رفض الفرضية الصفرية على الرغم من كونها غير صحيحة في المجتمع الأصلي وتستوجب الرفض لوجود أثر تجريبي حقيقي، وهو ما يُسمى بالنتيجة “السلبية الكاذبة” (False Negative). يرتبط هذا الخطأ بمفهوم القوة الإحصائية (Statistical Power)، والتي تُحسب رياضياً بالصيغة ((1 – beta))، وتعبر عن قدرة الاختبار الإحصائي المنهجية على رصد واكتشاف الأثر الحقيقي ذي الحجم المعين متى ما كان موجوداً بالفعل. تتأثر القوة الإحصائية بصورة جوهرية بحجم العينة المختارة، ومستوى ألفا المحدد، وتباين البيانات، وحجم الأثر الفعلي المراد رصده.
تتطلب الإبستمولوجيا الإحصائية إرساء استراتيجيات موازنة حذرة بين تقليل مخاطر خطأ النوع الأول وتفادي الوقوع في خطأ النوع الثاني. إن خفض قيمة ألفا بصورة مفرطة وتصلبها (مثل تثبيتها عند 0.001) يقلل احتمالية الإيجابيات الكاذبة إلى حدود دنيا، لكنه يرفع بالتبعية وبصورة تلقائية مخاطر خطأ النوع الثاني، ما لم يقابله تعويض منهجي من خلال زيادة حجم العينة لرفع القوة الإحصائية. يتعين على الباحث قبل الشروع في جمع البيانات إجراء تحليل قبلي للقوة (A Priori Power Analysis) لتحديد الحجم الأمثل للعينة اللازم لضمان قوة إحصائية متوازنة لا تقل عن 0.80 وفقاً للأعراف الأكاديمية السائدة، محافظاً في الوقت عينه على ألفا عند 0.05.
2. الإحصاء الاستدلالي واختبار (t): الربط بين الإحصاء الاختباري والقيمة الاحتمالية
2.1 البنية الرياضية لحساب إحصائية اختبار ت (t-score)
تمثل إحصائية اختبار ت المقياس المعياري الموجه الذي يعبر عن المسافة النسبية بين الإحصاء الملاحظ في العينة والمعلمة المفترضة في الفرضية الصفرية، مقاساً بوحدات الخطأ المعياري للتقدير. في اختبار ت للعينة الواحدة، تأخذ المعادلة الرياضية التأسيسية الشكل التالي:
$$t = \frac{\bar{x} – \mu_0}{s / \sqrt{n}}$$
حيث تمثل (bar{x}) المتوسط الحسابي الملاحظ للعينة، و(mu_0) المتوسط المجتمعي المفترض بموجب الفرضية الصفرية، و(s) الانحراف المعياري لدرجات العينة، بينما يمثل (n) الحجم الإجمالي للعينة، و(s / sqrt{n}) الخطأ المعياري للمتوسط ((SE)). تعكس هذه المعادلة في بسطها حجم التباين المنظم أو الأثر الظاهر، في حين يجسد مقامها التشتت العشوائي غير المنضبط والتقلب الناتج عن أخطاء المعاينة العشوائية.
يرتبط شكل توزيع ستودنت التائي (Student’s t-distribution) بعدد درجات الحرية (Degrees of Freedom – (df))، والتي تُعرف في حالة العينة الواحدة بالصيغة ((df = n – 1)). تُمثل درجات الحرية عدد القيم المستقلة القابلة للتغير الرياضي الحر في عملية حساب المعلمة الإحصائية بعد فرض قيود حسابية معينة (مثل المتوسط الحسابي). كلما كانت درجات الحرية منخفضة، امتلك منحنى توزيع ت ذيولاً أكثر سماكة وارتفاعاً مقارنة بالمنحنى الطبيعي المعياري، مما يفسر التشتت الإضافي الناجم عن تقدير الانحراف المعياري للمجتمع من عينة محدودة. ومع تزايد درجات الحرية لتقترب من اللانهاية، يتطابق توزيع ت هندسياً ورياضياً تماماً مع التوزيع الطبيعي المعياري ((z)).
تحدد قيمة إحصائية ت المحسوبة الموقع الهندسي الدقيق للنتيجة على المحور الأفقي لمنحنى توزيع ت المتماثل حول نقطة الصفر. إن المسافة بين موقع إحصائية ت والصفر ترتبط رياضياً بالمساحة المتبقية تحت المنحنى في الذيل (أو الذيول) المتطرف؛ فكلما ازدادت القيمة المطلقة لإحصاء ت، اتسعت المسافة المعيارية عن نقطة المركز، وتضاءلت المساحة التراكمية المحصورة فيما وراء هذه النقطة نحو الأطراف، وهو ما يترجم مباشرة إلى انخفاض في القيمة الاحتمالية الناتجة. وعلى العكس من ذلك، فإن تضخم التباين والانحراف المعياري في درجات العينة يؤدي إلى تضخيم المقام في معادلة ت، مما يقلص قيمة إحصائية ت المحسوبة ويقربها من الصفر، منتجاً قيمة احتمالية مرتفعة تحول دون رفض فرضية العدم.
2.2 الانتقال المنهجي من إحصائية (t) إلى القيمة الاحتمالية المقابلة
يمثل الانتقال من إحصائية ت المجردة إلى القيمة الاحتمالية المقابلة تحويلاً رياضياً ينقل القيمة من مقياس الانحرافات المعيارية إلى مقياس الاحتمال التراكمي. تترجم القيمة الاحتمالية هذه المسافة عبر مكاملة دالة كثافة الاحتمال لتوزيع ستودنت التائي على المجال المحصور من القيمة الملاحظة ((t_{text{obs}})) إلى أقصى الطرف ((infty) أو (-infty)). توفر هذه العملية للمجتمع العلمي لغة موحدة ومجردة للمقارنة تتجاوز وحدات القياس الفيزيائية أو السيكولوجية الخام الخاصة بكل اختبار على حدة.
تاريخياً، كان الباحثون يعتمدون على الجداول الإحصائية المطبوعة في ملحقات المراجع المتقدمة، والتي تكتفي بتحديد القيم الحرجة (Critical Values) لعدد محدود من مستويات الدلالة المسبقة (مثل 0.05، 0.01، 0.001) تحت درجات حرية محددة. وكان هذا الإجراء اليدوي يكتفي بإصدار حكم قطعي عما إذا كانت إحصائية ت المحسوبة تتجاوز القيمة الحرجة أم لا (مما يُصاغ عادة كـ (p < .05)) دون القدرة على معرفة القيمة الاحتمالية التراكمية الحقيقية بدقة متناهية. ومع التطور الحسابي المعاصر الذي أتاحته الخوارزميات الرقمية في برمجيات مثل إكسيل، بات بالإمكان استخراج القيمة الاحتمالية بدقة تصل إلى عدة خانات عشرية، مما يوفر تقييماً متصلاً ودقيقاً لقوة الدليل.
تعتمد آلية التحويل على الخصائص الهندسية المتماثلة لتوزيع ت حول الصفر؛ فالإحصاءات السالبة والإحصاءات الموجبة ذات القيمة المطلقة المتساوية تمتلك نفس المساحات الاحتمالية في الذيول المقابلة، مما يتيح التعامل معها بمرونة رياضية كاملة في البرمجيات الإحصائية. ومع ذلك، فإن صحة هذا الانتقال التحويلي واستقامته العلمية تظل مشروطة بتحقق افتراضات توزيع ت الإحصائية، والتي تشمل: اعتدالية التوزيع الأصلي للمتغير في المجتمع المدروس (Normality)، واستقلالية الملاحظات والمشاهدات الفردية داخل العينة (Independence)، واستخدام مستوى قياس كمي فئوي أو نسبي (Interval or Ratio Scale) للبيانات المجمعة.
3. الدوال الإحصائية المتخصصة في إكسيل لحساب القيمة الاحتمالية
3.1 دالة T.DIST: التركيب البرمجي واستخدامات التوزيع التراكمي
تُعد دالة T.DIST إحدى الدوال الأساسية الأكثر مرونة في بيئة إكسيل الحديثة لحساب احتمالات توزيع ستودنت التائي. يتكون التركيب البرمجي العام لهذه الدالة من الصيغة الرياضية التالية:
=T.DIST(x, deg_freedom, cumulative)
حيث تتضمن ثلاثة مدخلات رئيسية يجب إدخالها بدقة متناهية لضمان صحة المخرجات:
- x: القيمة الرقمية لإحصائية ت المحسوبة المراد تقييم الاحتمال المقابل لها.
- deg_freedom: عدد صحيح يمثل درجات الحرية المرتبطة بالعينة والخاضعة للتحليل ((df = n – 1)).
- cumulative: معامل منطقي (Boolean) يأخذ قيمتين إما TRUE لحساب دالة التوزيع التراكمي، أو FALSE لحساب دالة كثافة الاحتمال عند النقطة المحددة.
تتجلى الأهمية الإحصائية لإدخال المعامل التراكمي بصيغة الإيجاب (TRUE) في كونه يوجه إكسيل لحساب إجمالي المساحة المتراكمة تحت المنحنى من أقصى الطرف الأيسر (-(infty)) وصولاً إلى القيمة المحددة ((x)). يُعد هذا الاستخدام المباشر ملائماً لاختبارات الطرف الأيسر (Left-Tailed Tests)، خاصة عندما تكون قيمة إحصائية ت سالبة، حيث تعبر النتيجة مباشرة عن القيمة الاحتمالية لذيل الاختبار دون الحاجة إلى إجراء أي عمليات طرح أو تحويل رياضي إضافي.
من الناحية البرمجية، حلت دالة T.DIST والدوال المتفرعة عنها محل الدالة الكلاسيكية القديمة (TDIST) المعتمدة في إصدارات إكسيل السابقة لعام 2010. كانت الدالة القديمة تعاني من محدوديات بنيوية، من أبرزها عدم قبول قيم ت السالبة واشتراط مدخلات مطلقة وتحديد عدد الذيول يدوياً كمعامل رقمي، مما كان يؤدي إلى أخطاء شائعة في التقدير المنهجي. ومع ذلك، يحافظ إكسيل الحديث على التوافق التراجعي لدعم فتح المصنفات القديمة، مع التوصية الصارمة باستخدام الصيغ المحدثة لاتساقها التام مع المعايير الإحصائية الدولية.
3.2 دالة T.DIST.2T: الحساب الدقيق للاختبارات ثنائية الطرف
خُصصت دالة T.DIST.2T بصورة حصرية لحساب القيمة الاحتمالية المرتبطة بالاختبارات الإحصائية ثنائية الطرف (Two-Tailed Tests). تأخذ هذه الدالة بنية برمجية مدمجة وبسيطة تتضمن مدخلين فقط على النحو التالي:
=T.DIST.2T(x, deg_freedom)
تتميز هذه الدالة بقدرتها على توفير المساحة التراكمية المشتركة في كلا الطرفين تلقائياً (الطرف الأيسر والأيمن مجتمعين)، بما يتطابق منهجياً مع فرضيات العدم التي تفترض وجود فروق مطلقة دون توجه مسبق، كأن يُفترض أثر الفروق الفردية في سرعة استرجاع المفردات أو درجات التجريد المعرفي استناداً إلى أطر كتلك التي ناقشها Brysbaert et al. (2013) في دراسات التقييم الدلالي.
تشترط الدالة من الناحية الخوارزمية الصارمة أن تكون قيمة المعامل ((x)) قيمة عددية موجبة وغير سالبة ((x > 0)). في حال قيام الباحث بإدخال قيمة سالبة لإحصائية ت مباشرة في هذه الدالة، فإن إكسيل سيرد فوراً برسالة خطأ في القيمة الرقمية من نوع (#NUM!). لتلافي هذا العائق البرمجي المعتاد، يوصى دائماً بدمج دالة القيمة المطلقة (ABS) ضمن التركيب الداخلي للدالة، لتصبح الصيغة الاحترافية: =T.DIST.2T(ABS(x), deg_freedom)، مما يضمن معالجة القيمة بصورة صحيحة بغض النظر عن إشارة الناتج الحسابي المبدئي.
تقوم الدالة بحساب المساحة المحصورة في الذيل الأيمن للقيمة الموجبة المعطاة ثم تضاعف الناتج تلقائياً ليمثل مجموع مساحتي الطرفين المتماثلين في التوزيع التائي. يمثل هذا التصميم الآلي بديلاً موثوقاً لعمليات الضرب اليدوي، مما يحمي الباحث من أخطاء السهو البرمجي عند معالجة المصفوفات الكبيرة، ويوفر توافقاً منهجياً مثالياً عند إعداد تقارير اختبار ت لعينتين أو للعينة الواحدة ثنائية الطرف.
3.3 دالة T.DIST.RT: الحساب المتخصص لاختبارات الطرف الأيمن
تمثل دالة T.DIST.RT الأداة البرمجية المخصصة في إكسيل لحساب المساحة الاحتمالية المحصورة في الذيل الأيمن للتوزيع التائي (Right-Tailed Tests)، وتتخذ البنية البرمجية التالية:
=T.DIST.RT(x, deg_freedom)
تُستخدم هذه الدالة بصورة أساسية ومباشرة في اختبار الفرضيات الموجهة التي تتوقع حدوث زيادة إحصائية إيجابية في متوسط العينة مقارنة بالمتوسط المعياري المرجعي للمجتمع، أو في تجارب التحسن البعدي في البرامج التأهيلية والتربوية.
تتعامل الدالة بطبيعتها مع القيم الموجبة لإحصائية ت لتقرأ المساحة الواقعة على يمين النقطة المعطاة باتجاه اللانهاية الإيجابية ((+infty)). يُغني هذا الحساب المباشر الباحث عن اللجوء إلى العمليات الجبرية التكميلية التقليدية، ويوفر قراءة رقمية فورية للمنطقة الحرجة التراكمية في الطرف العلوي من التوزيع. ومع ذلك، فإن إدخال قيم سالبة في هذه الدالة يظل متاحاً حسابياً لحساب المساحة الكاملة الواقعة على يمين تلك القيمة السالبة (والتي ستتجاوز حتماً 0.5)، مما يتطلب يقظة منهجية من الباحث حول اتساق المعامل المدخل مع اتجاه الفرضية المصاغة.
من الناحية الرياضية، تتكافأ مخرجات دالة T.DIST.RT تماماً مع مخرجات الصيغة التكميلية التي توظف دالة التوزيع العام التراكمي: =1 - T.DIST(x, deg_freedom, TRUE). يوضح هذا التكافؤ للمحلل الإحصائي الطبيعة الهندسية للتكامل التراكمي تحت المنحنى؛ فبما أن المساحة الكلية للاحتمال تحت المنحنى بأكمله تساوي الواحد الصحيح (1.000)، فإن طرح المساحة المتجمعة من أقصى اليسار إلى النقطة يترك بالضبط المساحة المتبقية في أقصى اليمين، وهو المنطق ذاته المعتمد في التحليلات الوبائية وتوزيعات انتشار المقاييس النفسية كالتي أوردها Vilagut et al. (2016).
4. المثال التطبيقي الأول: حساب القيمة الاحتمالية لاختبار ثنائي الطرفين (Two-Tailed Test)
4.1 وصف المشكلة وتحديد الفرضيات وحساب إحصائية ت يدوياً
افترض أن باحثاً في القياس النفسي يجري دراسة استكشافية لفحص ما إذا كان متوسط درجات عينة من المتدربين على مقياس الوظائف التنفيذية المعرفية يختلف عن المتوسط المعياري العام السائد في المجتمع والبالغ 15 نقطة. نظراً لعدم وجود اتجاه نظري حاسم يفترض التفوق أو التراجع، صاغ الباحث فرضية ثنائية الطرف. تكونت العينة من 12 مشاركاً ((n = 12))، وأسفرت نتائج القياس القبلي عن تسجيل متوسط حسابي مقداره 14.33 نقطة، بانحراف معياري قدره 1.37 نقطة.
تُصاغ الفرضيات الإحصائية للاختبار بدقة متناهية على النحو التالي:
- الفرضية الصفرية ((H_0)): لا يوجد فرق ذو دلالة إحصائية بين متوسط العينة والمتوسط المجتمعي المرجعي، أي أن: (mu = 15).
- الفرضية البديلة ((H_A)): يوجد فرق ذو دلالة إحصائية بين متوسط العينة والمتوسط المجتمعي المرجعي، أي أن: (mu neq 15).
للانتقال نحو الحساب الكمي، يتم احتساب الخطأ المعياري للمتوسط أولاً: (SE = s / sqrt{n} = 1.37 / sqrt{12} approx 1.37 / 3.4641 approx 0.3955). بعد ذلك، تُحسب إحصائية اختبار ت بتطبيق المعادلة المباشرة:
$$t = \frac{\bar{x} – \mu_0}{SE} = \frac{14.33 – 15}{0.3955} = \frac{-0.67}{0.3955} \approx -1.694$$
تُحسب درجات الحرية المقترنة بهذا الاختبار بالعلاقة: (df = n – 1 = 12 – 1 = 11). تقع هذه القيمة المحسوبة ((t = -1.694)) على مسافة 1.694 خطأ معياري إلى يسار الصفر المركزي، والمطلوب الآن هو حساب مجموع المساحتين المتطرفتين على كلا طرفي التوزيع التائي عند درجات حرية 11.
4.2 خطوات التنفيذ البرمجي في إكسيل باستخدام دالة T.DIST.2T ودالة ABS
لتطبيق الحساب العملي داخل بيئة إكسيل، يقوم المحلل بتنظيم مصفوفة الخلايا في ورقة العمل لتضمين المعطيات الأولية على النحو التالي:
- الخلية B1: يُدخل فيها متوسط العينة (14.33).
- الخلية B2: يُدخل فيها المتوسط المرجعي للمجتمع (15).
- الخلية B3: يُدخل فيها الانحراف المعياري للعينة (1.37).
- الخلية B4: يُدخل فيها حجم العينة (12).
- الخلية B5: يُحسب فيها درجات الحرية عبر الصيغة
=B4-1لتسجل القيمة 11. - الخلية B6: تُخصص لحساب إحصائية ت عبر الصيغة الرياضية المركبة:
=(B1-B2)/(B3/SQRT(B4))، فتظهر النتيجة بدقة: -1.69408.
في الخلية المخصصة للنتيجة النهائية للقيمة الاحتمالية ثنائية الطرف (وليكن الخلية B7)، تُكتب الصيغة المتخصصة بدمج دالة القيمة المطلقة:
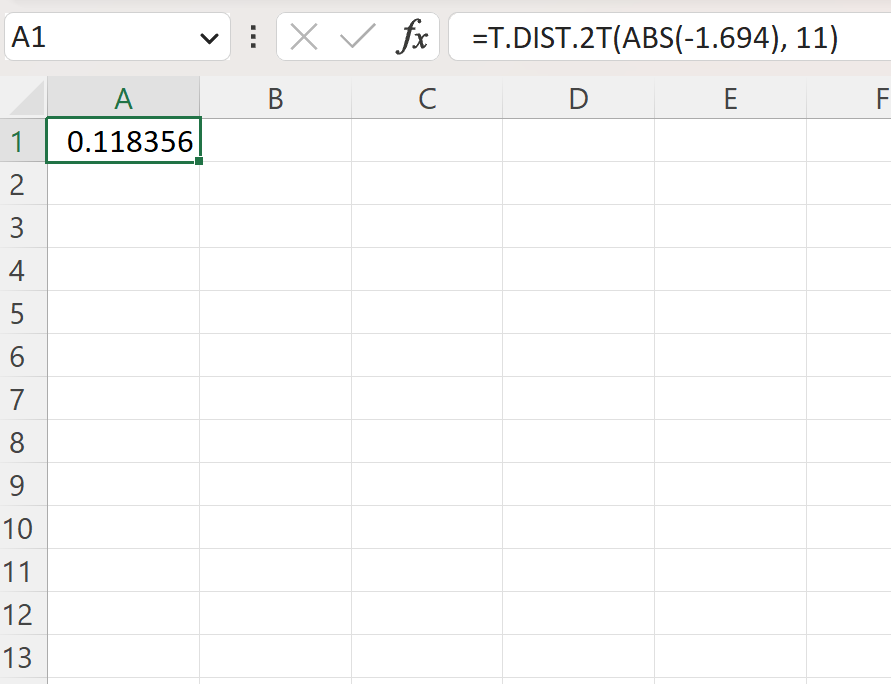
=T.DIST.2T(ABS(B6), B5)
أو كتابة الصيغة مباشرة باستخدام القيم الرقمية: =T.DIST.2T(ABS(-1.694), 11). تعمل دالة ABS على نزع الإشارة السالبة لتمرير القيمة الموجبة 1.694 إلى الدالة، متجنبة بذلك إطلاق رسائل الخطأ الرقمي الحسابية وموفرة مخرجاً مباشراً لاحتمالية كلا الذيول مجتمعة.
تنتج برمجية إكسيل القيمة الرقمية النهائية الدقيقة والتي تبلغ نحو (0.118) (أو 0.1183 بتفصيل الخانات العشرية). تعبر هذه النتيجة عن أن المساحة التراكمية في الطرف الأيسر لما دون النقطة -1.694 مضافاً إليها المساحة المتماثلة في الطرف الأيمن لما فوق النقطة +1.694 تبلغ معاً 11.8% من إجمالي مساحة التوزيع الاحتمالي الكامل.
4.3 تفسير النتيجة الإحصائية واتخاذ القرار العلمي
تخضع القيمة الاحتمالية الناتجة ((p = 0.118)) للمقارنة المعيارية المباشرة مع مستوى الدلالة المحدد مسبقاً في خطة التحليل الإحصائي للدراسة، وهو ((alpha = 0.05)). نلاحظ هنا بوضوح أن:
$$p = 0.118 > \alpha = 0.05$$
بناءً على هذه المقارنة الرقمية الصارمة، يكون القرار الإحصائي المنهجي هو: الفشل في رفض الفرضية الصفرية ((H_0)). ويُعزى هذا القرار إلى عدم توافر أدلة تجريبية قاطعة وكافية للبرهنة على أن الفارق الظاهر بين متوسط العينة الحالي (14.33) والمتوسط المعياري المفترض (15) هو فارق حقيقي يتجاوز نطاق التقلب العشوائي لأخطاء المعاينة الطبيعية.
من الناحية التفسيرية للأبعاد السلوكية والقياسية، فإن الباحث لا يملك مسوغاً إحصائياً للادعاء بوجود تأثير نوعي أو تغير جوهري في الوظائف التنفيذية لعينة المتدربين؛ إذ تظل الفروق المرصودة قابلة للحدوث بفعل الصدفة المحضة بنسبة 11.8% في ظل صحة فرضية العدم. وفي السياق التوثيقي الأكاديمي، ينبغي صياغة القرار بتقرير إحصائية الاختبار ودرجات الحرية والقيمة الاحتمالية المقابلة بدقة متناهية، مع الإشارة إلى فترات الثقة المصاحبة لتعزيز الشفافية التفسيرية للنتائج.
5. المثال التطبيقي الثاني: حساب القيمة الاحتمالية لاختبار أحادي الطرف الأيسر (Left-Tailed Test)
5.1 بناء النموذج الإحصائي وصياغة الفرضية الموجهة نحو النقصان
يتناول هذا السيناريو تقييم فعالية برنامج تدخلي في علم النفس العيادي يهدف إلى خفض حدة أعراض التوتر النفسي لدى عينة من المراجعين، على غرار الأهداف العلاجية المشتركة ونماذج الدعم النفسي التي حللها Archer et al. (2012) في التجارب السريرية للرعاية التعاونية. يُفترض نظرياً أن البرنامج يؤدي بصورة قاطعة إلى تقليص مؤشرات التوتر، ولذلك فإن الفحص يتخذ صيغة الاختبار الموجه أحادي الطرف الأيسر لمقارنة درجات العينة بالمتوسط المرجعي المرتفع المقدر بـ 28 درجة على مقياس التوتر المعترف به.
تتم صياغة الفرضيات الإحصائية الموجهة على النحو التالي:
- الفرضية الصفرية ((H_0)): لا يسهم البرنامج في خفض التوتر؛ أي أن متوسط العينة يظل مساوياً للمتوسط المعياري أو أعلى منه: (mu ge 28).
- الفرضية البديلة ((H_A)): يسهم البرنامج بفاعلية في خفض مستوى التوتر النفسي، ليكون المتوسط أقل من القيمة المرجعية: (mu < 28).
تم تطبيق البرنامج على عينة قوامها 16 مشاركاً ((n = 16))، وأسفرت القياسات البعدية عن متوسط حسابي مقداره 25.40 نقطة، بانحراف معياري قدره 4.20 نقطة. يُحسب الخطأ المعياري للعينة بالصيغة: (SE = 4.20 / sqrt{16} = 4.20 / 4 = 1.05). وبالتالي، تُستخرج إحصائية اختبار ت بالعلاقة الحسابية المباشرة:
$$t = \frac{25.40 – 28}{1.05} = \frac{-2.60}{1.05} \approx -2.476$$
تأخذ درجات الحرية في هذا النموذج القيمة: (df = 16 – 1 = 15). تقع إحصائية ت المحسوبة في عمق الذيل الأيسر للتوزيع، وتتركز منطقة الرفض الحرجة بالكامل في الطرف الأيسر الأقصى لمنحنى التوزيع التائي، بمساحة إجمالية تعادل قيمة ألفا المعتمدة (0.05 أو 0.01).
5.2 التطبيق العملي في إكسيل باستخدام دالة T.DIST ذات التراكم الإيجابي
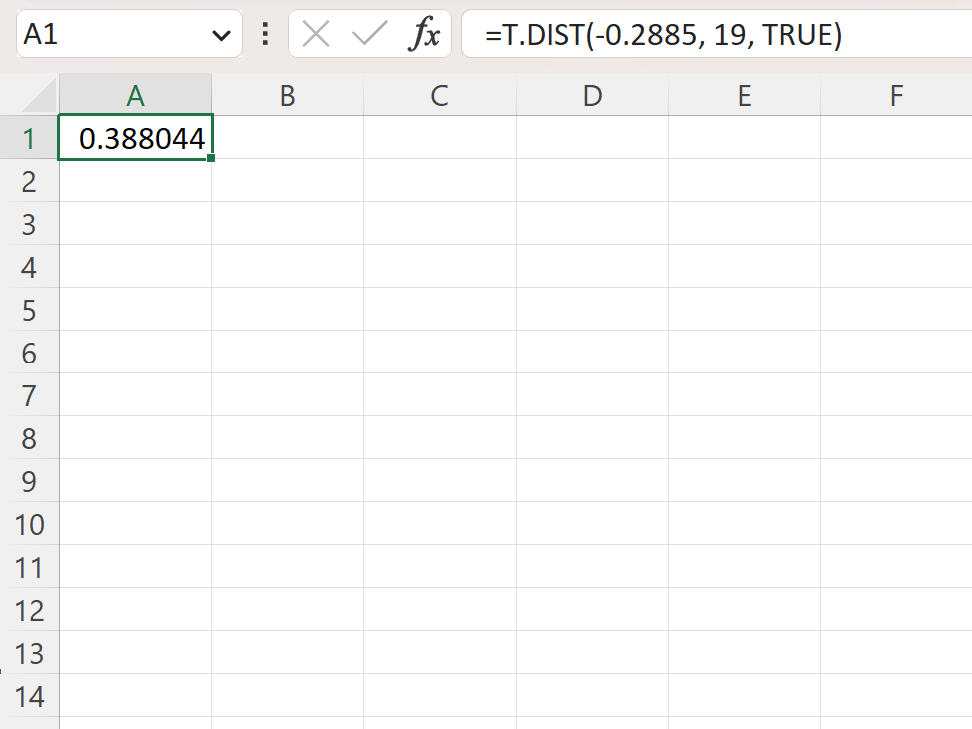
يتميز إكسيل بقدرته على حساب احتمالية الطرف الأيسر بصورة انسيابية ومباشرة عبر دالة التوزيع العام التراكمي دون الحاجة إلى معالجات جبرية معقدة. يتم إدخال الصيغة التالية في الخلية المخصصة لعرض النتيجة:
=T.DIST(-2.476, 15, TRUE)
تقوم الدالة بقراءة المعامل الأول ((-2.476)) مباشرة بإشارته السالبة، واستدعاء درجات الحرية (15)، ثم تطبيق الحساب التراكمي (TRUE). تقوم الخوارزمية بمكاملة دالة التوزيع من اللانهاية السالبة وصولاً إلى نقطة الإحصاء الملاحظ، لتحدد بالدقة الرقمية حجم المساحة المتبقية تحت الذيل الأيسر.
تظهر المخرجات المحسوبة في إكسيل قيمة احتمالية تبلغ بدقة:
$$p \approx 0.0128$$
للتحقق الرياضي من اتساق الدوال داخل إكسيل، يمكن للباحث استخدام دالة الاختبار ثنائي الطرف وقسمة الناتج النهائي على 2، بالصيغة التالية: =T.DIST.2T(ABS(-2.476), 15) / 2. ستسفر هذه المعادلة البديلة عن نفس النتيجة الرقمية تماماً ((0.0256 / 2 = 0.0128))، مما يبرهن على التناغم الداخلي لمنطق الحساب الإحصائي في بيئة إكسيل.
5.3 القراءة المنهجية للنتائج وتحليل أبعاد الفشل أو النجاح في خفض القياس
بمقارنة القيمة الاحتمالية الناتجة ((p = 0.0128)) مع مستوى الدلالة المعياري المعتمد ((alpha = 0.05))، يتضح بجلاء أن:
$$p = 0.0128 < \alpha = 0.05$$
وعليه، يُتخذ القرار العلمي المنهجي بـ رفض الفرضية الصفرية ((H_0)) وقبول الفرضية البديلة الموجهة ((H_A)). تؤكد هذه النتيجة وجود دليل إحصائي كافٍ وذي دلالة يعزز الاستنتاج بأن البرنامج التدخلي خفض درجات التوتر النفسي لدى المشاركين بصورة لا يمكن عزوها لعوامل الصدفة المعايناتية البحتة.
إذا اعتمد الباحث مستوى دلالة أكثر صرامة عند ((alpha = 0.01))، فإن القيمة المستخرجة (0.0128) تظل أكبر قليلاً من العتبة الحرجة، مما يعني الفشل في الرفض عند ذلك المستوى المتشدد، الأمر الذي يوضح أهمية توثيق مستوى الألفا المعتمد سلفاً. علاوة على ذلك، يجب على الباحث التحقق المنهجي الحذر من أن الانخفاض الملاحظ يتوافق فعلياً مع اتجاه الفرضية الموجهة؛ إذ لو كانت إحصائية ت موجبة (أي تشير إلى زيادة في التوتر)، لكان رفض الفرضية الصفرية في هذا الاختبار خطأً منهجياً فادحاً يهدد مصداقية النتائج السريرية للتدخل.
6. المثال التطبيقي الثالث: حساب القيمة الاحتمالية لاختبار أحادي الطرف الأيمن (Right-Tailed Test)
6.1 تأطير فرضية الزيادة وبناء المتغيرات الإحصائية
يركز هذا السيناريو على فحص أثر إدخال تقنية تعزيز الدعم التفاؤلي والاستراتيجيات المعرفية التكيفية على درجات النمو الإيجابي أو الرضا المهني لدى العاملين في المنظمات، استناداً إلى المنطلقات المنهجية لنمو ما بعد الأزمات التي وثقها Prati & Pietrantoni (2009)، والدراسات النفسية التي تبرز مزايا المشاعر الإيجابية في الأداء والنجاح الوظيفي مثل أعمال Lyubomirsky et al. (2005). يفترض الباحث هنا أن التدريب المنهجي يقود إلى زيادة معنوية موجبة في مؤشر الأداء متجاوزاً خط الأساس المستقر في المنظمة عند 70 نقطة.
تتم صياغة الفرضيات الإحصائية أحادية الطرف الأيمن على النحو التالي:
- الفرضية الصفرية ((H_0)): لا يؤدي التدريب إلى أي تحسن في الرضا المهني؛ أي أن المتوسط يظل مساوياً للقيمة المعيارية أو أقل منها: (mu le 70).
- الفرضية البديلة ((H_A)): يؤدي التدريب بصورة مؤكدة إلى زيادة ذات دلالة في متوسط الرضا المهني، ليتجاوز القيمة السابقة: (mu > 70).
شملت التجربة عينة من 20 موظفاً ((n = 20))، وسجلت القياسات متوسطاً حسابياً بعدياً قدره 74.50 نقطة، بانحراف معياري قدره 8.10 نقطة. يُحسب الخطأ المعياري للعينة بالصيغة: (SE = 8.10 / sqrt{20} approx 8.10 / 4.4721 approx 1.8112). وبناءً عليه، تُحسب إحصائية ت بالعلاقة:
$$t = \frac{74.50 – 70}{1.8112} = \frac{4.50}{1.8112} \approx 2.484$$
تُحسب درجات الحرية لهذا النموذج بالعلاقة: (df = 20 – 1 = 19). تأخذ إحصائية ت المحسوبة قيمة موجبة ملحوظة تقع في الجانب الأيمن للتوزيع، وتتمركز المساحة الحرجة للرفض بالكامل في الذيل الأيمن الأقصى، معبرة عن الاحتمال التراكمي لتحقيق تفوق بمقدار 2.484 خطأ معياري أو أكثر عن المتوسط المفترض.
6.2 خطوات الاستخراج في إكسيل باستخدام دالتي T.DIST.RT والمعادلة التكميلية
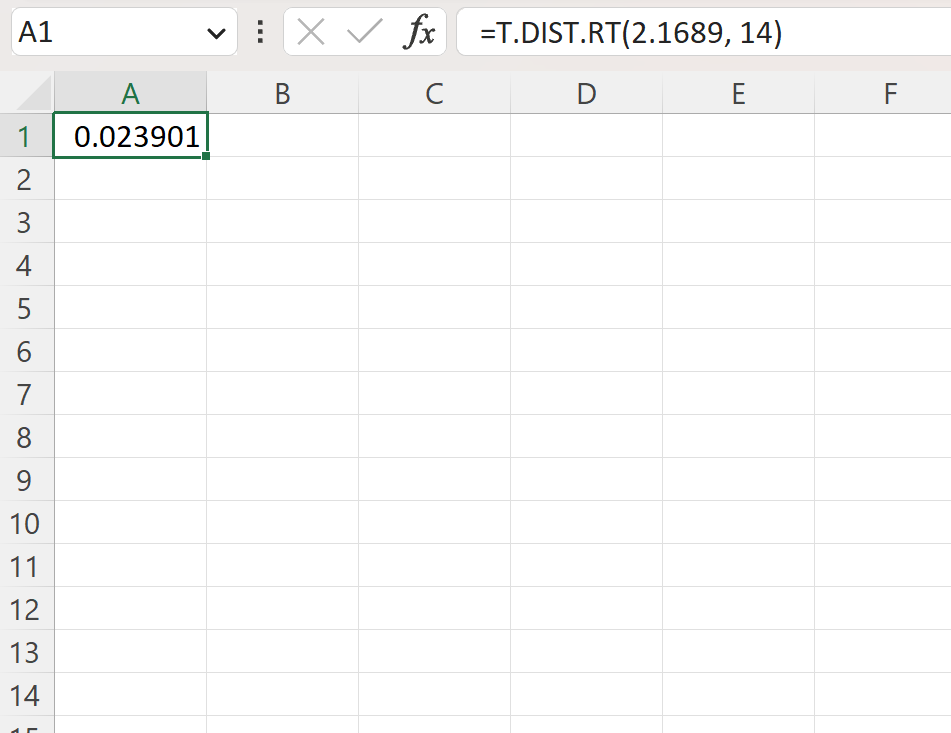
يوفر إكسيل طريقتين رياضيتين لحساب احتمالية الذيل الأيمن، وتؤدي كلتاهما إلى نفس النتيجة بدقة مطلقة. تتمثل الطريقة المباشرة في استخدام دالة الطرف الأيمن المتخصصة:
=T.DIST.RT(2.484, 19)
حيث تُمرر إحصائية ت الموجبة مباشرة إلى جانب درجات الحرية، لتقوم الدالة فوراً باستخلاص المساحة المحصورة بين النقطة المحددة واللانهاية الموجبة في الطرف الأيمن.
أما الطريقة الثانية، فتعتمد على تطبيق المبدأ التكميلي للاحتمال الكلي باستخدام دالة التوزيع العام التراكمي:
=1 - T.DIST(2.484, 19, TRUE)
تقوم دالة T.DIST هنا بحساب كامل المساحة التراكمية الواقعة على يسار النقطة 2.484 (والتي تبلغ في هذا المثال نحو 0.9886)، ثم يؤدي طرحها من القيمة الإجمالية للمنحنى (1.0) إلى استخلاص المساحة الباقية في أقصى اليمين.
تسفر كلتا الصيغتين في إكسيل عن مخرج احتمالي متطابق تماماً:
$$p \approx 0.0114$$
يعزز هذا التطابق البرمجي فهم الممارس الإحصائي للطبيعة التكاملية للمنحنى؛ فإذا كانت قيمة ت المحسوبة سالبة في سيناريو يفترض الزيادة بالطرف الأيمن، فإن دالة T.DIST.RT ستنتج تلقائياً قيمة أكبر من 0.5، مما يعكس فشلاً فورياً في إثبات فرضية التفوق أو الزيادة في الاتجاه المطلوب.
6.3 التحليل الاستدلالي واتخاذ القرار الخاص بفرضيات التحسن والتفوق
بمقارنة القيمة الاحتمالية الناتجة ((p = 0.0114)) مع مستوى الدلالة المعياري المقبول ((alpha = 0.05))، يتبين أن:
$$p = 0.0114 < \alpha = 0.05$$
يقتضي المنهج العلمي هنا اتخاذ قرار حاسم بـ رفض الفرضية الصفرية ((H_0)) وتأييد الفرضية البديلة ((H_A)). يبرهن هذا الاستنتاج على أن الزيادة الملاحظة في معدلات الرضا المهني (74.50 مقابل 70) تمثل تحسناً دالاً إحصائياً، ويعزز الفرضية القائلة بفاعلية برامج التدريب والتطوير في تعزيز المؤشرات الإيجابية لدى الموظفين.
تتميز اختبارات الطرف الواحد بحساسية وقوة إحصائية أعلى لاكتشاف الآثار الحقيقية في الاتجاه المحدد مسبقاً مقارنة باختبارات الطرفين؛ حيث تتركز كامل قيمة ألفا (0.05) في ذيل واحد بدلاً من تقسيمها ((0.025) في كل طرف). ومع ذلك، يتعين على الباحث التحلي بالأمانة الأكاديمية والصرامة النظرية في تبني اختبار الطرف الواحد قبل البدء بجمع البيانات، وتفادي التحول إليه لاحقاً لتبرير نتائج غير دالة في الاختبارات ثنائية الطرف، لما يمثله ذلك من تحيز تأكيدي ينافي معايير البحث العلمي الموضوعي.
7. استخدام أدوات تحليل البيانات (Data Analysis Toolpak) لحساب القيمة الاحتمالية تلقائياً
7.1 تفعيل حزمة أدوات التحليل الإحصائي (Data Analysis Toolpak) في إكسيل
تحتوي برمجية مايكروسوفت إكسيل على حزمة إحصائية برمجية متكاملة تُعرف باسم “أدوات تحليل البيانات” (Data Analysis Toolpak)، والتي تتيح إجراء تحليلات معقدة على مجموعات البيانات الخام دون الحاجة لكتابة الدوال الرياضية يدوياً في كل خلية. على الرغم من أن هذه الحزمة مدمجة تلقائياً ضمن البرنامج، إلا أنها تتطلب تفعيلاً أولياً من جانب المستخدم لتظهر في الواجهة التشغيلية.
لتفعيل الحزمة في بيئة نظام التشغيل ويندوز (Windows)، يتبع المستخدم الخطوات المنهجية التالية:
- النقر على تبويب ملف (File) في الشريط العلوي، ثم الانتقال إلى خيارات (Options).
- اختيار تبويب الوظائف الإضافية (Add-ins) من القائمة الجانبية لنافذة الخيارات.
- التأكد من ضبط مربع الإدارة في أسفل النافذة على وظائف Excel الإضافية (Excel Add-ins)، ثم النقر على زر انتقال (Go).
- وضع علامة الاختيار في المربع المجاور لخيار Analysis ToolPak، ثم النقر على موافق (OK).
بمجرد إتمام هذا الإجراء، يُلاحظ ظهور أيقونة جديدة تحت مسمى تحليل البيانات (Data Analysis) في أقصى الجانب الأيمن من تبويب بيانات (Data) في الشريط الرئيسي. أما في بيئة ماك (macOS)، فيتم التفعيل بصورة مماثلة عبر القائمة الرئيسية: أدوات (Tools) ثم وظائف إكسيل الإضافية (Excel Add-ins)، ثم اختيار نفس الحزمة. توفر هذه الإضافة بيئة ملائمة لمعالجة مصفوفات البيانات الكبيرة واستخراج الجداول التلخيصية بضغطة زر واحدة.
7.2 تطبيق اختبار ت للعينات المستقلة وعينات القياسات المتكررة آلياً
توفر حزمة تحليل البيانات أدوات مخصصة لتطبيق اختبارات ت لمقارنة المتوسطات بحسب التصميم التجريبي للدراسة، وتشمل ثلاثة خيارات رئيسية:
- t-Test: Paired Two Sample for Means: يُستخدم لاختبار العينات المترابطة أو القياسات المتكررة (قبل / بعد) لنفس المجموعة.
- t-Test: Two-Sample Assuming Equal Variances: يُستخدم لمقارنة مجموعتين مستقلتين مع افتراض تجانس التباين بينهما.
- t-Test: Two-Sample Assuming Unequal Variances: يُستخدم لاختبار مجموعتين مستقلتين عند عدم تحقق شرط تجانس التباين (اختبار ويلش Welch’s t-test).
لتشغيل التحليل، يحدد الباحث النطاق المدخل للبيانات (Variable 1 Range و Variable 2 Range)، ويحدد الفارق المفترض بين المتوسطين (Hypothesized Mean Difference، وعادة ما يُضبط على 0 لاختبار فرضية العدم)، مع ضبط قيمة ألفا المطلوبة (افتراضياً 0.05). يُخرج التحليل جدولاً متكاملاً يتضمن المتوسطات والانحرافات لكل مجموعة، ودرجات الحرية، وقيمة إحصائية ت المحسوبة، جنباً إلى جنب مع القيم الاحتمالية للاختبارين: أحادي الطرف P(T<=t) one-tail وثنائي الطرف P(T<=t) two-tail.
تتميز هذه الطريقة بالسرعة والموثوقية العالية في معالجة البيانات الخام الواسعة وتجنب أخطاء الإدخال الحسابي اليدوي للمعادلات. غير أن كتابة الدوال الفردية تظل الطريقة المفضلة عند بناء نماذج ديناميكية ترتبط فيها النتائج آلياً بأي تحديث أو تعديل يطرأ على البيانات في ورقة العمل.
8. تفسير الدلالة الإحصائية واتخاذ القرار الأكاديمي بناءً على القيمة الاحتمالية
8.1 قواعد اتخاذ القرار الإحصائي: معيار مقارنة P-Value بـ Alpha
ترتكز عملية اتخاذ القرار في الاستدلال العلمي على قاعدة معيارية دقيقة تقارن القيمة الاحتمالية المحسوبة ((p)) بمستوى الدلالة المحدد سلفاً ((alpha)). تُصاغ هذه القاعدة على النحو التالي: إذا كانت القيمة الاحتمالية أصغر من أو تساوي مستوى الدلالة ((p le alpha))، يتم اتخاذ قرار قطعي بـ رفض الفرضية الصفرية لصالح الفرضية البديلة، معتبراً أن البيانات تقدم دليلاً كافياً ضد فرضية العدم. أما إذا تجاوزت القيمة الاحتمالية هذا المستوى ((p > alpha))، فإن القرار المنهجي الصارم يتمثل في الفشل في رفض الفرضية الصفرية (Fail to Reject (H_0)).
من الأخطاء المفاهيمية الشائعة التعبير عن الفشل في رفض الفرضية الصفرية بأنه “قبول” لها؛ فالإحصاء الاستدلالي لا يثبت صحة الفرضية الصفرية إطلاقاً، بل يعبر عن عجز البيانات الحالية عن تقديم برهان إحصائي كافٍ لتفنيدها. وكما يُقال في الأعراف المنهجية: “إن غياب الدليل لا يمثل دليلاً على الغياب”. يظل نموذج العدم قائماً كاحتمال غير مدحوض حتى تتوفر معطيات تجريبية مغايرة من دراسات لاحقة.
تثير مسألة “الدلالة الهامشية” (Marginal Significance) جدلاً واسعاً في الأوساط الأكاديمية المعاصرة، وهي التسمية التي يطلقها بعض الباحثين عندما تسفر التحليلات عن قيم احتمالية تتراوح بين 0.05 و0.10. ترفض المدارس الإحصائية الصارمة هذا التوصيف، وتعتبره نوعاً من التبرير الالتفافي على المعايير المعتمدة مسبقاً في خطة البحث. يجب على الباحث الالتزام الكامل بالعتبة الحرجة المحددة قبلياً، وتجنب تعديل الأحكام بناءً على رغبات تأكيدية غير منضبطة.
8.2 فترات الثقة (Confidence Intervals) كدعامة تكميلية للقيمة الاحتمالية
تُعد فترات الثقة (Confidence Intervals)، لاسيما فترات 95% أو 99%، دعامة إحصائية أساسية تكمل أوجه القصور المتأصلة في القيمة الاحتمالية المجردة. تُعرّف فترة الثقة بأنها مدى رقمي يُحسب من بيانات العينة بحيث يُتوقع أن يشمل المعلمة الحقيقية المجهولة للمجتمع بنسبة محددة (مثل 95%) في حال تكرار تجارب المعاينة المستقلة في ظل نفس الظروف. تتكامل فترة الثقة بصورة وثيقة مع اختبارات الفرضيات، وتوفر للمحلل فهماً شاملاً لمدى دقة التقدير الإحصائي.
ترتبط فترة الثقة رياضياً باختبار الفرضيات ثنائي الطرف؛ فإذا كانت فترة ثقة 95% لفرق المتوسطات لا تتضمن قيمة الصفر (أي تقع بالكامل في النطاق الموجب أو النطاق السالب)، فإن هذا يكافئ بالضرورة تحقيق قيمة احتمالية أصغر من 0.05 لنفس البيانات، مما يوجب رفض الفرضية الصفرية. وعلى العكس من ذلك، فإن احتواء فترة الثقة على الصفر يعني أن القيمة الاحتمالية ستكون حتماً أكبر من 0.05، مؤكدة الفشل في رفض فرضية العدم لوجود احتمال معتبر بأن الفارق الفعلي قد ينعدم تماماً.
تتفوق فترات الثقة على القيم الاحتمالية المنفردة بقدرتها على توفير معلومات كمية ملموسة حول حجم الأثر المرجح ومدى التشتت واللاتيقن الإحصائي في البيانات. كما تبرز تطبيقات دمج فترات الثقة مع مقاييس الدلالة في الدراسات المعجمية وتطوير قواعد البيانات المعرفية واللغوية، مثل الأبحاث التي أنجزها van Heuven et al. (2013)، حيث تتطلب نمذجة المتغيرات التحقق من التشتت والمدى المتوقع للمعالم بدقة عالية تتجاوز مجرد إثبات الدلالة الاسمية.
9. الأخطاء الشائعة وسوء التفسير للقيمة الاحتمالية في البحوث النفسية والاجتماعية
9.1 المفاهيم المغلوطة حول القيمة الاحتمالية (P-Value Fallacies)
تشهد الأوساط الأكاديمية والبحثية خلطاً متكرراً في تفسير الدلالة الإحصائية، ومن أبرز هذه المفاهيم المغلوطة الاعتقاد الشائع بأن القيمة الاحتمالية تعبر عن احتمال صحة الفرضية الصفرية في ذاتها، أو احتمالية خطأ الفرضية البديلة؛ أي الخلط بين الاحتمال الشرطي للبيانات بافتراض صحة العدم (P(text{Data} mid H_0)) واحتمال صحة العدم بافتراض البيانات المجمعة (P(H_0 mid text{Data})). إن حساب هذا الاحتمال الأخير غير ممكن رياضياً في إطار الإحصاء التكراري الكلاسيكي، بل يتطلب استدلالاً بايزياً يدمج الاحتمالات القبلية للمتغيرات في التحليل.
يتمثل المفهوم الخاطئ الثاني في “وهم قياس حجم الأثر”؛ حيث يميل بعض الباحثين إلى اعتبار القيمة الاحتمالية بالغة الصغر دليلاً على وجود أثر سريري أو تدخلي قوي. فالقيمة الاحتمالية دالة تتأثر بصورة مباشرة بحجم العينة ((n)) والخطأ المعياري، مما يجعلها قادرة على إبراز فروق ضئيلة جداً ولا قيمة لها تطبيقياً كفروق دالة إحصائياً في العينات الكبيرة. وعلى العكس من ذلك، قد تعجز الدراسات ذات العينات المحدودة عن الوصول للدلالة الإحصائية رغم وجود آثار تجريبية جوهرية وواعدة سريرياً.
يتجسد الخطأ الثالث في الاعتقاد بأن القيمة الاحتمالية المنخفضة تؤكد قابلية تكرار النتيجة ذاتها في دراسة مستقلة مستقبلية بنسبة ((1 – p)). فالقيمة الاحتمالية تعبر عن وضعية العينة الحالية حصراً في ضوء التوزيع النظري، وتتأرجح تكرارياً عبر العينات المتعاقبة تبعاً لتقلبات المعاينة العشوائية، ولا تقدم أي ضمان احتمالي لتطابق نتائج إعادة القياس في أوقات لاحقة.
9.2 ممارسات التنقيب عن الدلالة (P-Hacking) والتحيز في النشر الأكاديمي
أدى الضغط الأكاديمي والمهني المفروض على الباحثين للوصول إلى العتبة الحرجة للدلالة الإحصائية ((p < .05)) كشرط للنشر في الدوريات العلمية إلى انتشار ممارسات منهجية ملتوية تُعرف اصطلاحاً بالتنقيب عن الدلالة أو اختراقها (P-Hacking). تشمل هذه الممارسات تعديل المعطيات تعسفياً عبر اختبار نماذج إحصائية متعددة، واستبعاد ملاحظات متطرفة دون مبرر منهجي سليم، أو إيقاف جمع البيانات لحظة بلوغ مستوى الدلالة، وصولاً إلى صياغة الفرضيات بعد معرفة النتائج وتطابقها بأثر رجعي (HARKing).
ترتبط هذه الممارسات غير الرصينة بأزمة الاستنساخ وقابلية التكرار (Replication Crisis) التي واجهت العلوم النفسية والاجتماعية والطبية في العقدين الأخيرين؛ حيث عجزت فرق بحثية مستقلة عن إعادة إنتاج النتائج المنشورة لدراسات شهيرة ادعت أثرها الإحصائي القوي. تنشأ هذه الإشكالية أيضاً عند إجراء مقارنات إحصائية متعددة داخل نفس الدراسة دون تطبيق تصحيحات رياضية صارمة، مما يضخم احتمالية ارتكاب خطأ النوع الأول التراكمي للأسرة البحثية (Family-Wise Error Rate)، ما يبرز أهمية تطبيق تصحيح بونفيروني (Bonferroni Correction) أو غيره من الأساليب التعديلية لضبط مستويات ألفا.
للحد من هذه المعضلات، تشجع المؤسسات العلمية المعاصرة على تبني مبادئ “العلم المفتوح” (Open Science) والتسجيل المسبق للفرضيات وطرق التحليل (Preregistration) في منصات أكاديمية معتمدة قبل البدء الفعلي في جمع البيانات. يضمن هذا الإجراء التزام الباحث بالمسارات التحليلية المقررة سلفاً، ويحول دون التلاعب بالمعادلات أو انتقاء النتائج، مما يحافظ على نزاهة وموثوقية المعرفة العلمية المتراكمة.
10. أفضل الممارسات المنهجية لإعداد التقارير الإحصائية وفق دليل أسلوب APA
10.1 معايير كتابة نتائج القيمة الاحتمالية واختبارات ت في المتن الأكاديمي
يضع دليل أسلوب النشر العلمي لجمعية علم النفس الأمريكية في نسخته السابعة (APA 7th Edition) معايير موحدة وصارمة لكتابة النتائج الإحصائية في المتن الأكاديمي لضمان وضوحها وتيسير المقارنات التحليلية. تشترط هذه القواعد كتابة جميع الرموز الإحصائية اللاتينية بحروف مائلة في النص (مثل: t, p, M, SD, df)، باستثناء الرموز اليونانية (مثل: (alpha, beta, eta^2)) التي تُكتب بالخط العادي دون إمالة.
فيما يتعلق بتدوين القيمة الاحتمالية، يُلزم الدليل بكتابة القيمة الرقمية الدقيقة مقربة إلى خانتين أو ثلاث خانات عشرية دون وضع صفر قبل الفاصلة العشرية (Leading Zero)؛ نظراً لأن القيمة الاحتمالية لا يمكن أن تتجاوز الواحد الصحيح رياضياً. على سبيل المثال، تُكتب النتيجة بالصيغة: p = .024 أو p = .118. وفي الحالات التي تسفر فيها الحسابات في إكسيل أو البرمجيات الإحصائية عن مخرجات متناهية الصغر تظهر كأصفار مجردة (مثل: 0.000)، يحظر قطعياً تدوين p = .000، ويجب تدوينها بدلاً من ذلك بالصيغة القياسية المعتمدة: p < .001 للدلالة على أن القيمة أصغر من هذا الحد المعياري الأدنى.
تتضمن الصياغة المتكاملة للفقرة الإحصائية إدراج قيمة الاختبار ودرجات الحرية والقيمة الاحتمالية وحجم الأثر داخل النص، وتأخذ الصياغة الأكاديمية النموذجية النمط التالي:
t(15) = -2.48, p = .013, d = 0.62
حيث يوضع عدد درجات الحرية بين قوسين مباشرة بعد رمز إحصائية ت، متبوعاً بقيمة الاختبار، ثم القيمة الاحتمالية الدقيقة، ومؤشر حجم الأثر المعتمد مع متوسطات المجموعات وانحرافاتها المعيارية لتكتمل أركان التقرير المنهجي.
10.2 تكامل القيمة الاحتمالية مع مقاييس حجم الأثر (Cohen’s d) والشفافية العلمية
انطلاقاً من القصور الذاتي للقيمة الاحتمالية في قياس شدة الظواهر السلوكية، تشترط المعايير الأكاديمية إرفاق القيمة الاحتمالية بمقاييس كمية معتمدة لحجم الأثر، وأبرزها معامل كوهين (Cohen’s d) في اختبارات ت، والذي يعبر عن المسافة المعيارية بين المتوسطين مقسومة على الانحراف المعياري المجمع (Pooled Standard Deviation). يُمكّن إدراج حجم الأثر القارئ والباحث من تقييم المغزى الحقيقي للظاهرة وفق التصنيفات الإرشادية المتعارف عليها (0.2 للأثر الصغير، 0.5 للأثر المتوسط، 0.8 للأثر الكبير)، مما يعزز الفهم الموضوعي لطبيعة الفروق المرصودة.
يتكامل هذا النهج الإحصائي مع التمثيل البياني المنضبط للبيانات؛ إذ يوصى دائماً بتدعيم الجداول الإحصائية بالرسوم البيانية المعززة بأشرطة الخطأ (Error Bars)، والتي توضح للمتلقي فترات الثقة 95% أو الخطأ المعياري للمتوسط، وتتيح قراءة بصرية سريعة لمقدار التداخل أو التباين بين المجموعات. إن الاعتماد المشترك على الجداول التلخيصية والتمثيل البصري يوفر عمقاً إيضاحياً يغني عن الاسترسال الإنشائي في وصف البيانات.
تقتضي الشفافية العلمية في البيئات البحثية المعاصرة التزام الباحث بحفظ وتوثيق ملفات العمل الحسابية لجداول إكسيل وتوفيرها ضمن الملاحق الإلكترونية أو المستودعات البحثية المفتوحة. إن مشاركة خطوات التحليل والدوال والمعادلات المستخدمة بدقة يعزز نزاهة الباحث ويسهل عمليات المراجعة والتدقيق، ويسهم في بناء ممارسة أكاديمية قائمة على التوثيق المحكم والدقة المنهجية التي تخدم تقدم العلوم الإنسانية والتطبيقية على حد سواء.
خاتمة
لقد أوضح هذا المقال التحليلي المتكامل أن القيمة الاحتمالية (P-Value) تمثل أداة استدلالية مركزية لا غنى عنها في اتخاذ القرارات الإحصائية واختبار الفرضيات في شتى العلوم، ولاسيما الدراسات السلوكية والنفسية. وقد تبين من خلال الأمثلة الثلاثة المطبقة في إكسيل (الاختبار ثنائي الطرفين، واختبار الطرف الأيسر، واختبار الطرف الأيمن) كيف توفر دوال T.DIST و T.DIST.2T و T.DIST.RT مرونة حسابية ودقة متناهية تحاكي أرقى البرمجيات الإحصائية المتخصصة. ومع ذلك، يظل الحساب الرقمي مجرد خطوة تقنية تستلزم فهماً نظرياً عميقاً لشروط الاختبارات وتوزيعاتها، وتكاملاً منهجياً مع فترات الثقة ومقاييس حجم الأثر (Cohen’s d)، والتزاماً صارماً بأخلاقيات البحث العلمي ومعايير التوثيق الأكاديمي وفق دليل APA، بما يضمن سلامة الاستنتاجات العلمية وموثوقيتها.
المراجع
- Archer, J., Bower, P., Gilbody, S. M., Lovell, K., Richards, D. A., Gask, L. L., et al. (2012). Collaborative care for depression and anxiety problems. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd006525.pub2
- Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods. https://doi.org/10.3758/brm.41.4.977
- Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin. https://doi.org/10.1037/0033-2909.131.6.803
- Prati, G., & Pietrantoni, L. (2009). Optimism, Social Support, and Coping Strategies As Factors Contributing to Posttraumatic Growth: A Meta-Analysis. Journal of Loss and Trauma. https://doi.org/10.1080/15325020902724271
- van Heuven, W. J. B., Mandera, P., Keuleers, E., & Brysbaert, M. (2013). Subtlex-UK: A New and Improved Word Frequency Database for British English. Quarterly Journal of Experimental Psychology. https://doi.org/10.1080/17470218.2013.850521
- Vilagut, G., Forero, C. G., Barbaglia, G., & Alonso, J. (2016). Screening for Depression in the General Population with the Center for Epidemiologic Studies Depression (CES-D): A Systematic Review with Meta-Analysis. PLoS ONE. https://doi.org/10.1371/journal.pone.0155431