
تُمثّل عملية تقييم الأداء التشخيصي والتنبؤي في العلوم النفسية والطبية حجر الزاوية لبناء قرارات سريرية دقيقة وموثوقة. ومع تطور النمذجة الإحصائية وظهور خوارزميات التعلم الآلي المتقدمة إلى جانب الاختبارات السيكومترية التقليدية، بات الباحثون السريريون في حاجة ملحة إلى أدوات معيارية تمكنهم من المفاضلة الموضوعية بين الأدوات التشخيصية المختلفة. يُعد منحنى خصائص تشغيل المستقبِل (Receiver Operating Characteristic Curve – ROC) الأداة الإحصائية الأكثر رصانة واستخداماً في قياس القدرة التمييزية للنماذج والمقاييس التشخيصية عبر مختلف نقاط القطع الممكنة، متجاوزاً بذلك أوجه القصور المرتبطة باختيار عتبة تصنيفية اعتباطية واحدة.
غير أن التحدي المنهجي الحقيقي لا يتوقف عند رسم منحنى ROC لنموذج منفرد وحساب المساحة الواقعة تحته (Area Under the Curve – AUC)، بل يمتد إلى كيفية إجراء مقارنة إحصائية دقيقة وصارمة بين منحنيين مستقلين أو مقترنين لنموذجين يتنافسان على تشخيص الاضطراب النفسي ذاته. فكثيراً ما يقع الممارسون والباحثون في فخ المقارنة البصرية السطحية، أو يكتفون بالتباين الحسابي المجرد بين قيمتي المساحة تحت المنحنى دون إخضاع هذا الفارق للاختبارات الإحصائية الاستدلالية التي تثبت ما إذا كان هذا التفوق ناتجاً عن كفاءة تشخيصية حقيقية أم أنه مجرد تباين عشوائي ناتج عن خطأ المعاينة أو طبيعة توزيع العينة المدروسة.
يهدف هذا الدليل المنهجي الموسع إلى تقديم مراجعة شاملة ومعمقة لآليات وأسس مقارنة منحنيين من منحنيات ROC في سياق القياس النفسي والتقييم السريري. سنستعرض عبر هذا الطرح الأسس الرياضية والنظرية الكامنة وراء بناء هذه المنحنيات، وسنفصل الفروق الجوهرية بين الأساليب المعلمية وغير المعلمية لمقارنتها، مع التركيز على اختبار ديلونغ (DeLong’s Test) وطرق إعادة المعاينة الحثيثة (Bootstrap). كما يقدم المقال تطبيقاً عملياً شاملاً مدعوماً ببيانات سريرية واقعية وأكواد برمجية مفصلة بكل من لغتي R وPython، متطرقاً إلى ضوابط اتخاذ القرار في ضوء التكاليف التشخيصية، ومختتماً بمعايير الصياغة الأكاديمية الدقيقة وفق دليل جمعية علم النفس الأمريكية (APA).
1. الأسس النظرية لمنحنيات خصائص تشغيل المستقبِل (ROC) في التقييم النفسي
1.1 تعريف منحنى ROC ومكوناته الإحصائية الأساسية
نشأ مفهوم منحنى خصائص تشغيل المستقبِل (ROC) تاريخياً ضمن نظرية كشف الإشارة في هندسة الرادار خلال الحرب العالمية الثانية لتمييز الإشارات الحقيقية عن الضوضاء العشوائية، قبل أن ينتقل لاحقاً ليصبح ركيزة أساسية في الوبائيات الإكلينيكية والقياس النفسي. في جوهره الإحصائي، يُمثل منحنى ROC دالّة بيانية ثنائية الأبعاد تصف التفاعل الديناميكي والتبادلي بين معيارين أساسيين من معايير الدقة التشخيصية عبر جميع نقاط القطع الممكنة (Cutoff Points): الحساسية (Sensitivity) على المحور الرأسي، ومكمل النوعية أو معدل الإيجابية الكاذبة (1 – Specificity) على المحور الأفقي.
تُعرّف الحساسية في التشخيص النفسي بأنها الاحتمال الشرطي الذي يقيس قدرة المقياس أو الأداة على تحديد الأفراد المصابين بالاضطراب الفعلي تصنيفاً صحيحاً (معدل الإيجابية الحقيقية – True Positive Rate)، رياضياً:
Sensitivity = P(Test Positive | Disease Positive) = TP / (TP + FN)
حيث تمثل TP الحالات الإيجابية الحقيقية، وFN الحالات السلبية الكاذبة التي أغفل المقياس تشخيصها. وعلى النقيض من ذلك، تُمثّل النوعية قدرة الأداة على تحديد الأفراد الأصحاء أو غير المصابين بالاضطراب بدقة (معدل السلبية الحقيقية – True Negative Rate)، رياضياً:
Specificity = P(Test Negative | Disease Negative) = TN / (TN + FP)
وعليه، فإن المحور الأفقي للمنحنى يعكس معدل الإيجابية الكاذبة (False Positive Rate)، وهو احتمال تصنيف شخص سليم على أنه مصاب بالاضطراب: FPR = 1 – Specificity = FP / (TN + FP). وقد بينت الدراسات المعيارية في التقييم النفسي، مثل دراسات التوافق التشخيصي لأدوات المقابلة السريرية المركبة (Haro et al., 2006)، أن العلاقة بين الحساسية والنوعية علاقة عكسية حتمية؛ فكلما خفضنا عتبة القطع التشخيصية لزيادة الحساسية واقتناص أكبر عدد من الحالات المرضية، ارتفعت تبعاً لذلك الإيجابيات الكاذبة وتراجعت النوعية، والعكس صحيح.
تسمح هذه الصياغة الهندسية برؤية السلوك الكامل للأداة السيكومترية أو النموذج الخوارزمي عبر طيف متصل من العتبات، بدلاً من الاقتصار على نقطة قطع واحدة قد تكون مضللة أو غير ملائمة لجميع السياقات التطبيقية، مما يمنح الباحث رؤية بانورامية لمرونة الأداة وقدرتها على الموازنة بين الخطأ من النوع الأول (Type I Error) والخطأ من النوع الثاني (Type II Error).
1.2 المساحة تحت المنحنى (AUC) كمعيار موحد لكفاءة النموذج
تُعد المساحة الواقعة تحت منحنى ROC، والتي يُرمز لها اختصاراً بـ (AUC) أو (AUROC – Area Under the Receiver Operating Characteristic Curve)، المؤشر الكمي الأكثر شيوعاً لتلخيص الكفاءة التمييزية الإجمالية للأداة في رقم رياضي واحد يتراوح مجاله النظري بين 0.0 و1.0. يحمل هذا المقياس تفسيراً احتمالياً رصيناً غير معلمي؛ إذ تُعبر قيمة AUC بدقة عن احتمالية أن يحصل فرد تم اختياره عشوائياً من فئة المصابين بالاضطراب على درجة تنبؤية أو تشخيصية أعلى من فرد آخر تم اختياره عشوائياً من فئة غير المصابين. ورياضياً، يتطابق هذا المفهوم تماماً مع إحصائية مان-ويتني (Mann-Whitney U Test) مقسومة على حاصل ضرب حجم المجموعتين.
تخضع جودة التصنيف المبنية على قيمة AUC لتدرج أكاديمي قياسي تم إقراره وتأصيله في المراجع الإحصائية الكلاسيكية (مثل القواعد الاسترشادية لهوسمر وليمشو – Hosmer & Lemeshow rule of thumb):
- AUC = 0.50: يُمثل خط الصدفة العشوائي التام (Line of Chance)، حيث تكون الأداة التشخيصية عديمة القدرة التمييزية تماماً (مثل رمي قطعة نقود عادلة).
- 0.50 < AUC < 0.70: تمييز ضعيف (Poor discrimination)، لا يقدم فائدة سريرية معتبرة في السياقات التشخيصية الدقيقة.
- 0.70 ≤ AUC < 0.80: تمييز مقبول (Acceptable discrimination)، يصلح عادة لأدوات المسح السريع في الرعاية الأولية.
- 0.80 ≤ AUC < 0.90: تمييز ممتاز (Excellent discrimination)، وهو المستوى المستهدف للمقاييس النفسية المعتمدة.
- AUC ≥ 0.90: تمييز استثنائي أو فائق (Outstanding discrimination)، ونادراً ما يُشاهد إلا في المقاييس المعيارية الذهبية عالية الدقة.
- AUC = 1.00: نموذج مثالي تماماً (Perfect Classifier)، يُميز بين المرضى والأصحاء دون أي تداخل في التوزيعات الاحتمالية للدرجات، وتنعدم عنده الحالات الكاذبة بنوعيها.
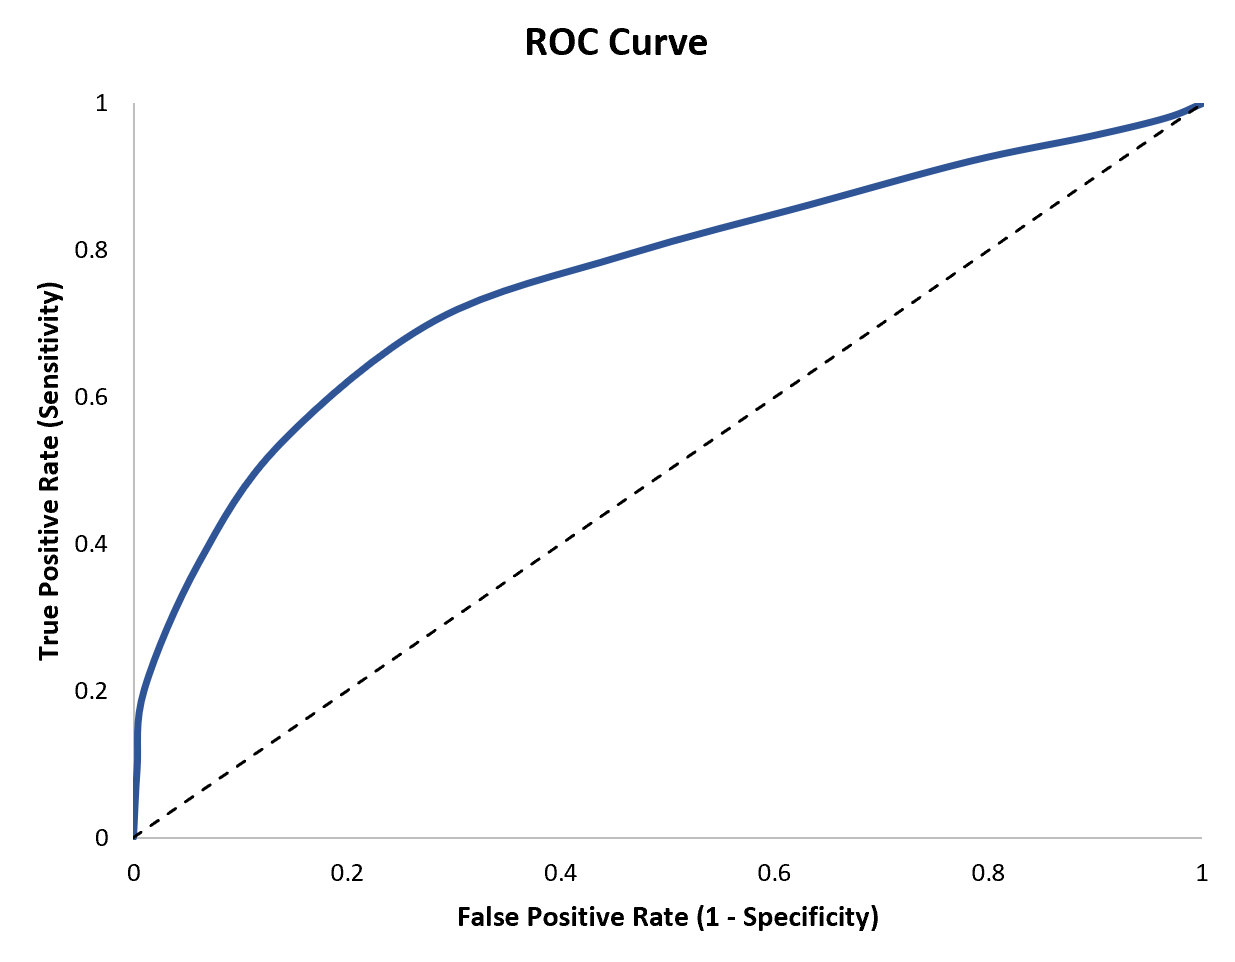
يتميز مقياس AUC بكونه ثابتاً ومستقلاً عن توزيع انتشار الاضطراب (Prevalence Invariance) في العينة المدروسة، مما يجعله معياراً موضوعياً للمقارنة عبر دراسات مختلفة قد تتباين فيها نسب انتشار المرض تبايناً جذرياً، بخلاف مقاييس الدقة الإجمالية (Overall Accuracy) أو القيم التنبؤية (Predictive Values) التي تتأثر بشدة بمعدلات الانتشار الأساسية.
1.3 أهمية منحنيات ROC في المفاضلة بين المقاييس النفسية
تكتسب منحنيات ROC أهمية استثنائية في حقل العلوم السلوكية والطب النفسي، نظراً للطبيعة الفريدة للاضطرابات النفسية مقارنة بالأمراض العضوية. فالاضطرابات العقلية، كالاكتئاب الشديد والاضطرابات الوجدانية واضطرابات القلق، لا تمتلك في معظم الأحيان مؤشرات حيوية حاسمة أو قواطع بيولوجية قطعية؛ بل تتجلى في صورة درجات متصلة من الشدة والأعراض السريرية المتداخلة. وقد وثقت المراجعات السيكومترية لمقاييس الاكتئاب الشهيرة، مثل قائمة بيك للاكتئاب (BDI-II) (Wang & Gorenstein, 2013) ومقياس مركز الدراسات الوبائية للاكتئاب (CES-D) (Vilagut et al., 2016)، أن تحديد درجة قطعية موحدة للاكتئاب يواجه دائماً تذبذباً واسعاً باختلاف المجتمع المفحوص، سواء كان عينة سريرية داخل المستشفيات أو عينة مجتمعية عامة.
توفر منحنيات ROC حلاً منهجياً لمقارنة هذه الاختبارات النفسية بالنماذج التنبؤية الحديثة؛ إذ تسمح للأخصائي والباحث بفصل الأداء الجوهري للأداة عن التحيز الناتج عن اختيار عتبة قرار سريري محددة. فبدلاً من الحكم على مقياسين بالاعتماد على حساسيتهما ونوعيتهما عند عتبة ثابتة قد تكون غير عادلة لأحدهما، يتيح تحليل ROC تقييم الكفاءة التنافسية للأداتين عبر كامل المدى القياسي للأعراض، مما يُبرز قدرة كل أداة على استيعاب التباين في شدة الاضطراب بين الحالات الخفيفة والمتوسطة والشديدة دون تشويه للواقع الإكلينيكي.
2. المبادئ الأساسية لمقارنة منحنيين من منحنيات ROC
2.1 دوافع المقارنة بين أداتين تصنيفيتين
تنبع الحاجة إلى مقارنة منحنيين من منحنيات ROC في الأبحاث النفسية والتطبيقات الطبية من عدة اعتبارات عملية وإبستمولوجية. يتمثل الدافع الأول في الثورة التكنولوجية المعاصرة وتدفق خوارزميات التعلم الآلي والذكاء الاصطناعي، حيث يسعى الباحثون دائماً لاختبار ما إذا كانت النماذج المعقدة، مثل خوارزميات الغابات العشوائية (Random Forests) أو شبكات التعلم العميق، تتفوق بالفعل وبدلالة إحصائية على نماذج الانحدار اللوجستي التقليدية التي تتسم بقابلية التفسير والشفافية الحسابية (De Choudhury et al., 2021).
الدافع الثاني يتعلق بالجدوى الاقتصادية والسريرية؛ فالعيادات والمستشفيات تبحث دائماً عن استبدال أدوات التشخيص الطويلة والمكلفة بأدوات فحص سريعة وقصيرة. على سبيل المثال، قد يرغب الباحث في مقارنة استبيان مكون من 5 أسئلة لاستكشاف اضطرابات النوم مع مؤشر شدة الأرق المكتمل (ISI) (Morin et al., 2011)، أو المفاضلة بين استبيان نقاط القوة والصعوبات (SDQ) الموجه للأطفال والتقييمات السريرية المعقدة (Goodman, 1997). في هذه الحالات، تكون مقارنة ROC ضرورية لمعرفة ما إذا كان الاختصار والاقتصاد في الوقت ينطوي على فقدان دال إحصائياً في القدرة التمييزية.
أما الدافع الثالث، فيتمثل في تقييم القيمة التنبؤية المضافة (Incremental Value)؛ أي فحص ما إذا كان دمج متغير جديد، مثل مؤشر حيوي جيني أو مقياس عصبي فسيولوجي، في نموذج تنبؤي قائم بالفعل يؤدي إلى تحسن حقيقي وملموس في دقة التنبؤ، بدلاً من الاعتماد على الفروق الحدسية غير المؤكدة.
2.2 التقييم البصري الهندسي للمنحنيين
تُمثّل القراءة البصرية المبدئية للرسم البياني الذي يضم منحنيي ROC الخطوة الأولى في عملية التقييم المقارن. هندسياً، يعبر المنحنى الأقرب إلى الزاوية العلوية اليسرى من المخطط (الإحداثيات: x = 0, y = 1) عن النموذج المتفوق تشخيصياً؛ إذ تعكس تلك النقطة المستحيلة سريرياً حساسية تامة (100%) مصحوبة بانعدام تام للإيجابيات الكاذبة (0%). وبالتالي، فإذا كان أحد المنحنيين يقع بأكمله فوق المنحنى الآخر دون أي تقاطع (Dominance)، فإن هذا يُعد دليلاً هندسياً قاطعاً على تفوق النموذج الأعلى عبر كافة العتبات الممكنة.
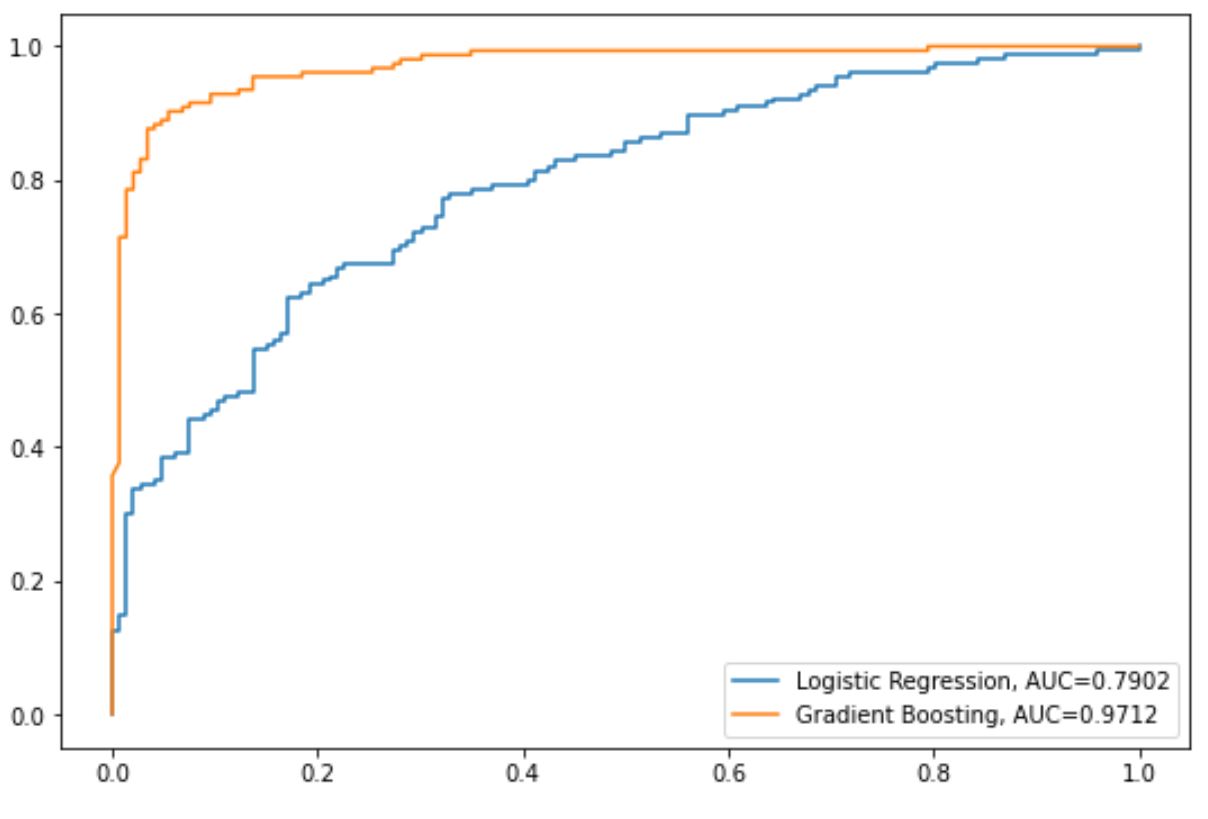
ومع ذلك، تواجه المقارنة البصرية تعقيداً كبيراً عند حدوث “ظاهرة تقاطع المنحنيين” (Crossing ROC Curves). في هذا السيناريو، قد يتفوق النموذج الأول في أقصى يسار المخطط البياني (أي في النطاقات التي تتطلب نوعية فائقة ومعدل إيجابيات كاذبة منخفضاً للغاية)، بينما يتقاطع معه النموذج الثاني ليتفوق عليه في النصف العلوي الأيمن (أي في النطاقات التي تتطلب حساسية عالية جداً على حساب زيادة الإيجابيات الكاذبة). يوضح هذا التحليل البصري التبادلي أن أداء النماذج لا يمكن اختزاله دوماً في مقياس موحد، بل يتطلب تدقيقاً في السلوك التشخيصي للمنحنى عند مستويات الحساسية والنوعية ذات الصلة المباشرة بالسياق الإكلينيكي المحدد.
2.3 حدود المقارنة البصرية وضرورة الفحص الإحصائي
على الرغم من الأهمية الإرشادية للمعاينة البصرية، فإن الاعتماد الحصري عليها يمثل خطأً منهجياً فادحاً في الأبحاث السريرية. فالخداع البصري يقع بسهولة عندما تكون قيم المساحة تحت المنحنى (AUC) متقاربة حسابياً؛ فعلى سبيل المثال، قد يبدو الفارق بين قيمة AUC قدرها 0.82 لأداة أولى وقيمة 0.85 لأداة ثانية واعداً بصرياً، بيد أن هذا الفارق قد يكون ناتجاً كلياً عن أخطاء التباين العشوائي للبيانات وحجم العينة المحدود.
تؤثر قوة العينة (Sample Size) تأثيراً مباشراً على اتساع فترات الثقة المحيطة بالمنحنيين؛ ففي العينات السريرية الصغيرة، تؤدي التموجات العشوائية في حساب معدلات الإيجابية الحقيقية والكاذبة إلى تباين بصري مصطنع لا يصمد أمام الاختبارات المعلمية أو اللامعلمية. ومن ثم، فإن حتمية الفحص الإحصائي الاستدلالي تنبع من الحاجة الأساسية لاستبعاد فرضية العدم (Null Hypothesis) القائلة بأن الفارق المشاهد بين المنحنيين مساوٍ للصفر، والتأكد من أن التفوق الملاحظ يعكس اختلافاً قابلاً للتعميم في المجتمع الإحصائي المدروس وليس مجرد مصادفة مقترنة بعينة الدراسة الحالية.
3. المقارنة الرياضية للمساحة تحت المنحنى (AUC)
3.1 حساب فرق المساحة المطلق (ΔAUC)
تبدأ المقارنة الرياضية بين نموذجين تشخيصيين بحساب الفارق الجبري البسيط بين قيمتي المساحة تحت المنحنى لكلا النموذجين، ويُرمز له بالرمز ΔAUC (Delta AUC)، وفق المعادلة التالية:
ΔAUC = AUC1 – AUC2
حيث تمثل AUC1 المساحة تحت المنحنى للنموذج الأحدث أو المقترح، وتمثل AUC2 المساحة للنموذج المرجعي أو التقليدي. تشير الإشارة الجبرية للناتج إلى اتجاه التفوق التشخيصي؛ فإذا كانت القيمة موجبة، دل ذلك على تفوق النموذج الأول حسابياً، بينما تعني القيمة السالبة تفوق النموذج الثاني.
ومع ذلك، ينبغي التمييز بصرامة بين الأهمية الرياضية والأهمية الإكلينيكية لهذا الفارق. ففي بعض السياقات السريرية عالية الحساسية، مثل تشخيص الذهان المبكر أو فرز احتمالات السلوك الانتحاري، قد يمثل فارق حسابي طفيف مثل ΔAUC = 0.03 فارقاً جوهرياً يسهم في إنقاذ حياة عشرات المرضى وتفادي الأخطاء الكارثية، في حين أن الفارق ذاته قد يكون عديم الجدوى التطبيقية في أدوات مسح عامة لا يترتب عليها تدخلات علاجية باهظة أو خطرة. لذا، يجب دائماً مرافقة هذا الفارق بفترات ثقة إحصائية رصينة توضح مداه التقديري.
3.2 معضلة تساوي قيم AUC مع اختلاف أشكال المنحنيات
تتمثل إحدى أبرز المعضلات الرياضية لمقياس AUC الإجمالي في قابليته لإخفاء التباينات الهيكلية العميقة بين النماذج التشخيصية؛ إذ يمكن رياضياً لنموذجين مختلفين تماماً في معادلاتهما التنبؤية أن ينتجا القيمة العددية ذاتها لـ AUC (على سبيل المثال، AUC1 = AUC2 = 0.81)، ومع ذلك يتخذ كل منحنى مساراً هندسياً مغايراً تماماً داخل الفضاء البياني. قد يمتلك أحد النماذج حساسية فائقة عند العتبات الصارمة، بينما يمتلك الآخر نوعية متميزة عند العتبات المرتخية.
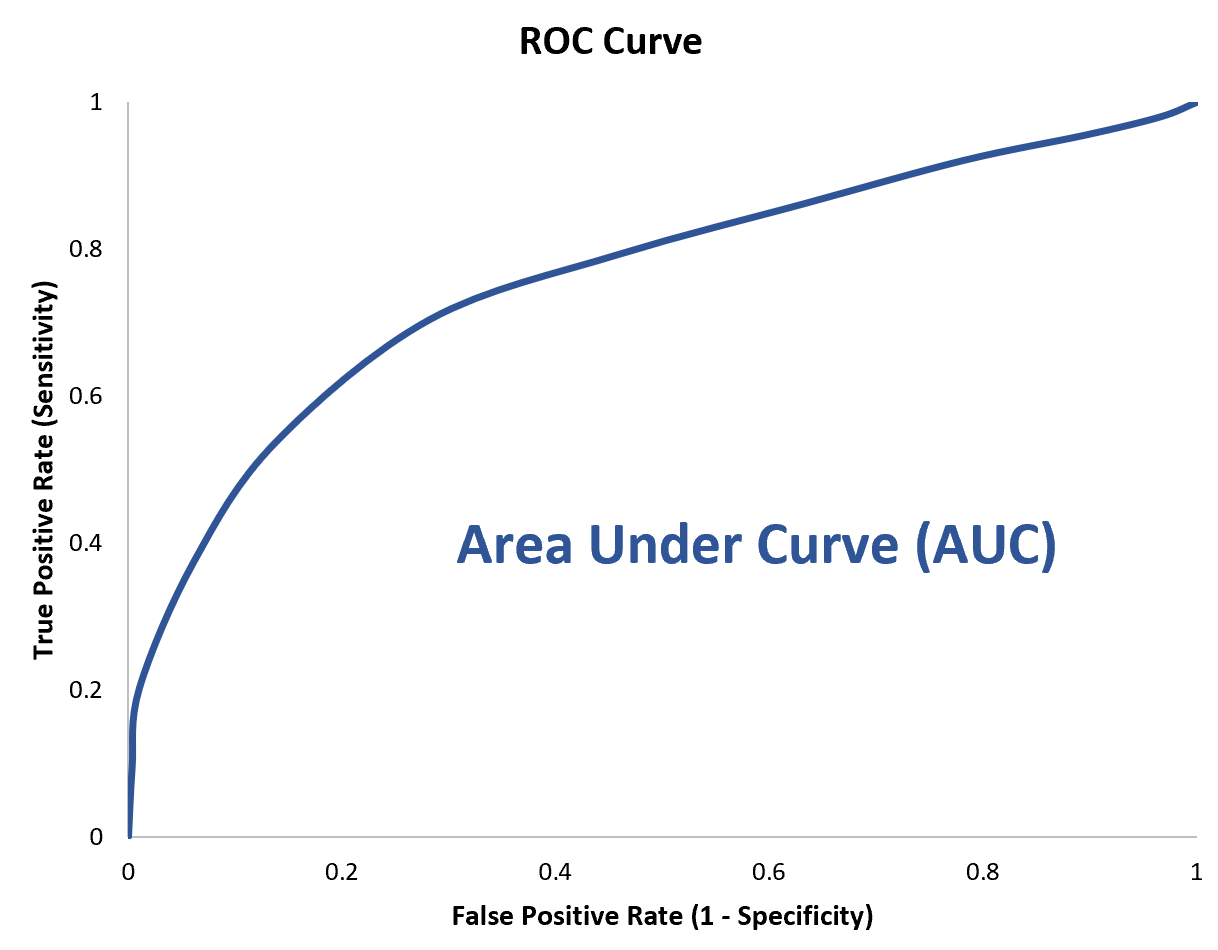
لمعالجة هذه الإشكالية في التطبيقات الحرجة، يلجأ الإحصائيون إلى تحليل المساحة الجزئية تحت المنحنى (Partial Area Under the Curve – pAUC). يركز هذا التحليل المتقدم على حساب المساحة المحصورة فقط ضمن نطاق محدد سريرياً من المنحنى، مثل حصر الحسابات في النطاق الذي تزيد فيه الحساسية عن 80% أو النطاق الذي لا يتجاوز فيه معدل الإيجابيات الكاذبة 10%:
pAUC(e1, e2) = ∫e1e2 ROC(t) dt
يتيح هذا التحليل تفضيل النموذج الذي يُحقق أعلى كفاءة تمييزية في المنطقة ذات الأولوية الطبية الفعلية، متجاوزاً مناطق المنحنى التي تفتقر إلى أي صلة بالقرار السريري الواقعي، لا سيما في مقاييس نوعية النوم والاضطرابات السلوكية المعقدة (Morin et al., 2011).
3.3 تقاطعات المنحنيات والتحليل المشروط
عندما يتقاطع منحنيان من منحنيات ROC داخل الفضاء الإحداثي، ينهار الافتراض الضمني بتفوق نموذج واحد على مدار كامل النطاق، ويصبح الفارق الإجمالي ΔAUC مؤشراً مضللاً ومفرط التبسيط؛ لأن القيمة التراكمية الإيجابية في جزء من المنحنى تلغي القيمة السلبية في الجزء الآخر، مما يعطي انطباعاً زائفاً بتساوي النموذجين.
يتطلب هذا الوضع إجراء تحليل مشروط (Conditional Analysis)؛ حيث يتم تحديد “نقطة الانقلاب العتبية” (Threshold Inflection Point) التي ينعكس عندها تفوق الأداة الأولى ليصبح لصالح الأداة الثانية. في ضوء ذلك، تُصاغ التوصيات السريرية بناءً على الهدف الوظيفي للأداة:
- إذا كان الهدف هو إجراء مسح أولي واسع النطاق (Population Screening) يهدف لاستبعاد الحالات السليمة واكتشاف كل مريض محتمل بأقصى حساسية ممكنة، يتم اختيار النموذج المتفوق في أقصى اليمين العلوي.
- إذا كان الهدف هو تأكيد التشخيص الدقيق (Confirmatory Diagnosis) قبل البدء في علاجات دوائية نفسية مكثفة ذات آثار جانبية معقدة، يُرجح النموذج المتفوق في أقصى اليسار السفلي والذي يضمن أعلى نوعية وأقل قدر ممكن من الإيجابيات الكاذبة.
4. الاختبارات الإحصائية الاستدلالية لمقارنة منحنيين
4.1 اختبار ديلونغ (DeLong’s Test) للبيانات المقترنة
يُعد اختبار ديلونغ وزملائه (DeLong, DeLong, & Clarke-Pearson) المعيار الذهبي غير المعلمي الأكثر موثوقية وشهرة لمقارنة المساحات تحت منحنيات ROC للبيانات المقترنة (Paired Data)؛ أي عندما يتم تطبيق الأداتين التشخيصيتين أو النموذجين التنبؤيين على العينة ذاتها من المرضى. يتفادى هذا الاختبار عيوب المعاينة التقليدية عبر الاعتماد المباشر على النظرية الإحصائية لإحصاءات U المعممة (Generalized U-statistics)، محققاً كفاءة تقاربية ممتازة دون الحاجة لافتراض توزيع طبيعي ثنائي (Binormal Distribution) لدرجات النماذج.
يقوم اختبار ديلونغ على تقدير مصفوفة التغاير (Covariance Matrix) للفروق بين مساحات المنحنيات استناداً إلى المشتقات الهندسية ومكونات درجات الحالات المصابة وغير المصابة. تُحسب إحصائية الاختبار المعيارية Z بالصيغة التالية:
Z = (AUC1 – AUC2) / √[Var(AUC1) + Var(AUC2) – 2 × Cov(AUC1, AUC2)]
يلعب حد التغاير Cov(AUC1, AUC2) دوراً محورياً في معادلة ديلونغ؛ فحيث إن النموذجين مطبقان على المفحوصين أنفسهم، فإن درجاتهما تكون شديدة الارتباط بطبيعة الحال. يُسهم طرح التغاير في تقليص الخطأ المعياري المجمع لفرق المساحة بصورة ملحوظة، مما يرفع القوة الإحصائية (Statistical Power) للاختبار ويمكنه من رصد الفروق الدقيقة بين النماذج التشخيصية النفسية بكفاءة عالية لا تتاح في التصاميم غير المقترنة (Stone et al., 2010).
4.2 طريقة هانلي وماكنيل (Hanley & McNeil Method)
تمثل طريقة هانلي وماكنيل (Hanley & McNeil) المحاولة الرائدة الأولى في الأدبيات الوبائية لتأسيس إطار إحصائي لمقارنة منحنيين من منحنيات ROC، سواء كانا مقترنين أو مستقلين. تعتمد الطريقة في سياق البيانات المقترنة على تصحيح الخطأ المعياري للفارق عبر استخراج معامل ارتباط ثنائي الرتب (Bivariate Correlation) بين درجات المقياسين التشخيصيين، بشكل منفصل داخل فئة المصابين وفئة غير المصابين، ثم استخدام جداول ومعادلات تقريبية لتحديد معامل تصحيح التغاير.
على الرغم من الأهمية التاريخية لمنهجية هانلي وماكنيل، فإن الأبحاث الإحصائية المعاصرة أثبتت وجود فروق دقيقة تجعل اختبار ديلونغ متفوقاً عليها في أغلب السياقات. فطريقة هانلي تعتمد على افتراضات بارامترية جزئية تتصل بالشكل التوزيعي للبيانات، كما أن معادلاتها التقريبية لتقدير الارتباط قد تعاني من عدم الدقة عند تطبيقها على مقاييس نفسية ذات رتب متقطعة أو استجابات غير متصلة كالتي نراها في علامات صعوبات اللغة النوعية والتقييمات اللغوية النفسية (Conti‐Ramsden et al., 2001). ولهذا السبب، يُفضل الباحثون ديلونغ كونه اختباراً لا معلمياً بالكامل يتيح حساب التباين والتغاير مباشرة من البيانات الملاحظة دون تقريب تحليلي خارجي.
4.3 مقارنة المنحنيات للعينات المستقلة
في حالات بحثية معينة، لا تكون البيانات مقترنة؛ بل تنشأ الحاجة لمقارنة أداء النموذج ذاته أو مقياسين مختلفين عبر مجموعتين مستقلتين تماماً من المشاركين (Unpaired / Independent Samples)، كما هو الحال عند مقارنة دقة مقياس الاكتئاب بين الذكور والإناث، أو بين عينة مرضى الرعاية الأولية وعينة المرضى النفسيين المنومين بالمصحات (Vilagut et al., 2016).
في مثل هذه التصاميم المستقلة، ينعدم التغاير الإحصائي بين المساحتين Cov(AUC1, AUC2) = 0، وتتحول إحصائية الاختبار إلى اختبار Z التقليدي للعينات المستقلة:
Z = (AUC1 – AUC2) / √[SE(AUC1)2 + SE(AUC2)2]
يُحسب الخطأ المعياري لكل منحنى إما عبر صيغة هانلي وماكنيل التقريبية المعتمدة على قيم AUC وأحجام المجموعات، أو باستخدام الطريقة غير المعلمية لتقدير تباين إحصائية مان-ويتني. تُقارن قيمة Z المحسوبة بالتوزيع الطبيعي المعياري لاستخراج القيمة الاحتمالية (p-value)، حيث يُعد الفارق دالاً إحصائياً إذا كانت p < 0.05، شريطة أن يتم التحقق من كفاية حجم العينة في كلتا المجموعتين لضمان استقرار تقدير التباين.
5. أسلوب إعادة المعاينة الحثيثة (Bootstrap) لمقارنة المنحنيات
5.1 المبادئ الحسابية للمحاكاة بأسلوب Bootstrap
يُعد أسلوب إعادة المعاينة الحثيثة (Bootstrap Resampling) ثورة حوسبية في الإحصاء اللامعلمي، حيث يوفر بديلاً مرناً وقوياً للاختبارات التحليلية المقيدة بافتراضات شكلية. يرتكز هذا الأسلوب على مبدأ محاكاة توزيع المعاينة التجريبي للفروق بين منحنيات ROC من خلال سحب عينات عشوائية متكررة بحجم العينة الأصلية ذاته (N)، ولكن مع الإحلال (With Replacement) مباشرة من قاعدة البيانات المتاحة.
تتمثل الميزة الاستثنائية لأسلوب Bootstrap في قدرته الفائقة على معالجة البيانات النفسية الواقعية، والتي غالباً ما تنتهك افتراضات التوزيع الطبيعي، وتتميز بالالتواء الشديد أو احتوائها على عتبات متقطعة يصعب على المعادلات الرياضية المغلقة تمثيلها بدقة. من خلال توليد التوزيع التجريبي للفرق ΔAUC*، يمكن بناء فترات الثقة المئينية (Percentile Confidence Intervals) أو فترات الثقة المصححة للتحيز والتسارع (Bias-Corrected and Accelerated – BCa Intervals)، والتي تقدم تقديراً عالي الموثوقية لعدم اليقين المحيط بالفارق الحقيقي بين النموذجين دون الاعتماد على التقريب التقاربي لدرجات Z.
5.2 خطوات تنفيذ اختبار Bootstrap المقارن
يتطلب التنفيذ المنهجي لاختبار Bootstrap لمقارنة منحنيين مقترنين اتباع تسلسل حسابي دقيق لضمان استقرار النتائج وموثوقيتها:
- تحديد عدد التكرارات (Resamples – B): يوصى أكاديمياً بألا يقل عدد مرات إعادة السحب عن 2000 تكرار في الدراسات التشخيصية، وذلك لضمان استقرار نهايات التوزيع وفترات الثقة.
- إعادة السحب مع الإحلال: في كل تكرار b (حيث b = 1, …, B)، يتم سحب عينة عشوائية بحجم N مع الإبقاء على اقتران درجات النموذجين والتشخيص الحقيقي لكل مريض لتفادي تدمير بنية البيانات المقترنة.
- حساب فرق المساحة لكل تكرار: يُحسب منحنى ROC لكل نموذج على حدة داخل العينة المسحوبة، ثم تُحسب قيمة الفرق: ΔAUC*b = AUC1*b – AUC2*b.
- توليد التوزيع التجريبي: يتم تجميع الفروق المحسوبة عبر كافة التكرارات لإنشاء التوزيع التكراري للفارق.
- استخراج القيمة الاحتمالية وفترات الثقة: تُحسب فترة الثقة بنسبة 95% عبر استخراج القيم عند المئين 2.5 والمئين 97.5 من التوزيع التجريبي. ولحساب القيمة الاحتمالية p-value، يتم فحص نسبة التكرارات التي عبر فيها الفارق الصفر في الاتجاه المعاكس لفرضية البحث، مما يتيح اختبار فرضية العدم القائلة بعدم وجود فرق بدقة متناهية.
5.3 المقارنة بين الطرق المعلمية وأساليب المحاكاة
تتميز أساليب المحاكاة بأسلوب Bootstrap بالمتانة التامة ضد القيم المتطرفة والشذوذ التوزيعي، ولا تتأثر بالقيود الرياضية التي قد تحد من كفاءة اختبار ديلونغ في العينات شديدة الصغر أو عند وجود ارتباط شبه تام بين النموذجين، مما يجعلها الخيار المثالي عند تحليل بيانات سيكومترية مركبة. كما توفر طريقة BCa تصحيحاً تلقائياً لأي تحيز في عينة المعاينة الأصلية.
في المقابل، يتفوق اختبار ديلونغ في سرعته الحوسبية اللحظية؛ إذ يُنجز حساب التباينات عبر معادلات جبرية مغلقة ومباشرة، بينما يتطلب Bootstrap طاقة حوسبية معتبرة ووقتاً أطول في المعالجة، خاصة مع مجموعات البيانات السريرية الضخمة التي تحتوي على مئات الآلاف من السجلات. من الناحية المنهجية، تؤكد الأدبيات الإحصائية أنه إذا كانت العينة كافية وتوزيع الدرجات معتدلاً نسبياً، فإن اختبار ديلونغ وطريقة Bootstrap يتقاربان تقارباً شبه تام في نتائجهما، ويوصى باستخدام Bootstrap بشكل خاص كفحص تأكيدي للمتانة (Robustness Check) في الحالات المعقدة وحالات التقاطع الحاد للمنحنيات.
6. مثال تطبيقي: مقارنة نموذجين لتشخيص الاكتئاب السريري
6.1 وصف المشكلة النفسية وبيانات الدراسة الافتراضية
لتجسيد الخطوات المنهجية تجسيداً عملياً، نفترض دراسة سريرية أُجريت في بيئة طب نفسي واقعية تهدف إلى مقارنة كفاءة نموذجين تنبؤيين لتشخيص نوبات الاكتئاب الجسيم (Major Depressive Disorder – MDD) وفق معايير الدليل التشخيصي والإحصائي للاضطرابات النفسية المعتمدة عبر المقابلات السريرية المقننة (Haro et al., 2006). يتنافس في هذه الدراسة نموذجان:
- النموذج التقليدي (الانحدار اللوجستي – Logistic Regression): يعتمد على الدرجة الإجمالية لقائمة بيك للاكتئاب (BDI-II) ومتغيرات ديموغرافية أساسية (العمر والجنس) (Wang & Gorenstein, 2013).
- النموذج المتقدم (الغابات العشوائية – Random Forest): يدمج درجات بنود مقياس بيك المنفصلة مع مؤشرات فسيولوجية عصبية مستخلصة من تقلب معدل ضربات القلب والنشاط الكهروجلدي وبيانات الاستخدام الرقمي كواسمات تنبؤية حديثة (Shu et al., 2018; De Choudhury et al., 2021).
شملت عينة الدراسة الافتراضية N = 500 مريض خضعوا للتقييم المتزامن، صُنف منهم 150 مريضاً كحالات إيجابية مؤكدة سريرياً للاكتئاب (Positive Cases = 150)، بينما تم تصنيف 350 مريضاً كحالات سلبية غير مصابة (Negative Cases = 350)، مما يحقق نسبة انتشار سريرية تبلغ 30%. تم إخراج الاحتمالات التنبؤية التشخيصية لكل مريض من كلا النموذجين بشكل متطابق ومقترن لاختبار فرضية تفوق نموذج الغابات العشوائية على الانحدار اللوجستي.
6.2 حساب قيم الحساسية والنوعية ومصفوفة الارتباك لكلا النموذجين
تم استخراج مصفوفة الارتباك (Confusion Matrix) لكل نموذج عند العتبة الاحتمالية الافتراضية (Cutoff = 0.50) للمقارنة المبدئية، وجاءت الحسابات التشخيصية كما هو موضح أدناه:
أولاً: نموذج الانحدار اللوجستي التقليدي:
- الإيجابيات الحقيقية (TP): 108 مريضاً | السلبيات الكاذبة (FN): 42 مريضاً.
- السلبيات الحقيقية (TN): 259 مريضاً | الإيجابيات الكاذبة (FP): 91 مريضاً.
- الحساسية (Sensitivity) = 108 / 150 = 72.0%
- النوعية (Specificity) = 259 / 350 = 74.0%
- معدل الإيجابية الكاذبة (1 – Specificity) = 26.0%
ثانياً: نموذج الغابات العشوائية المتقدم:
- الإيجابيات الحقيقية (TP): 126 مريضاً | السلبيات الكاذبة (FN): 24 مريضاً.
- السلبيات الحقيقية (TN): 294 مريضاً | الإيجابيات الكاذبة (FP): 56 مريضاً.
- الحساسية (Sensitivity) = 126 / 150 = 84.0%
- النوعية (Specificity) = 294 / 350 = 84.0%
- معدل الإيجابية الكاذبة (1 – Specificity) = 16.0%
يُظهر الفحص الأولي عند هذه النقطة المحددة قفزة واضحة في الحساسية والنوعية لصالح نموذج الغابات العشوائية، ولكن نظراً لأن هذه العتبة (0.50) اعتباطية وقد لا تكون العتبة المثلى لأي من النموذجين، يتعين فحص سلوك النموذجين عبر مسار المنحنى الكامل وحساب مساحتي AUC المقابلتين لاختبار المتانة الكلية.
6.3 رسم المنحنيين معاً وتحليل الفروق البصرية والحسابية
عند بناء منحنيي ROC لكلا النموذجين عبر جميع العتبات الممكنة وحساب التكامل الهندسي للمساحات، أسفرت النتائج عن الآتي:
- نموذج الانحدار اللوجستي: AUC1 = 0.782، مع فترة ثقة 95% تتراوح بين [0.739, 0.825]، مما يضعه ضمن نطاق التمييز “المقبول” وفق معايير هوtimer وليمشو.
- نموذج الغابات العشوائية: AUC2 = 0.865، مع فترة ثقة 95% تتراوح بين [0.831, 0.899]، مما يرفعه إلى نطاق التمييز “الممتاز”.
يُسجل الفارق الحسابي المطلق بين النموذجين زيادة قدرها:
ΔAUC = 0.865 – 0.782 = +0.083 (8.3%)
من الناحية البصرية، يُظهر الرسم البياني تفوقاً هندسياً كاسحاً لنموذج الغابات العشوائية؛ إذ يستقر المنحنى الأخضر للغابات العشوائية فوق المنحنى الأزرق للانحدار اللوجستي على امتداد معظم إحداثيات الرسم تقريباً، مقترباً بوضوح من الزاوية العلوية اليسرى. ومع ذلك، وبسبب التداخل الجزئي البسيط بين الحد الأدنى لفترة ثقة النموذج المتقدم والحد الأعلى لنموذج الانحدار، يظل من المستحيل الجزم القاطع بالدلالة الإحصائية دون تطبيق اختبار ديلونغ المقترن، وهو ما سنفصله في الخطوات البرمجية التالية.
7. التطبيق العملي خطوة بخطوة باستخدام برمجيات التحليل الإحصائي
7.1 تنفيذ المقارنة البرمجية في لغة R عبر حزمة pROC
تُعد لغة R البيئة الإحصائية الرائدة لتحليل منحنيات ROC، وتوفر حزمة pROC المتخصصة ترسانة متكاملة لتنفيذ المقارنات المتقدمة وحساب التباينات المشتركة لاختبار ديلونغ. يتم تنفيذ التحليل باتباع الخطوات البرمجية المنهجية التالية:
يبدأ الإجراء باستدعاء المكتبة وتجهيز كائنات منحنيات ROC المقترنة باستخدام دالة roc()، حيث يتم تمرير المتغير التشخيصي الفعلي مع احتمالات كل نموذج:
library(pROC)
# إنشاء كائن ROC لنموذج الانحدار اللوجستي
roc_logistic <- roc(response = clinical_data$diagnosis, predictor = clinical_data$prob_logistic, ci = TRUE)
# إنشاء كائن ROC لنموذج الغابات العشوائية
roc_rf <- roc(response = clinical_data$diagnosis, predictor = clinical_data$prob_rf, ci = TRUE)
لرسم المنحنيين معاً بدقة عالية وتنسيق بصري جذاب للنشر، تُستخدم أوامر الرسم التراكمية:
plot(roc_logistic, col = "#1f77b4", lwd = 2.5, main = "مقارنة منحنيات ROC لتشخيص الاكتئاب")
plot(roc_rf, col = "#2ca02c", lwd = 2.5, add = TRUE, lty = 1)
legend("bottomright", legend = c("الانحدار اللوجستي (AUC = 0.782)", "الغابات العشوائية (AUC = 0.865)"), col = c("#1f77b4", "#2ca02c"), lwd = 2.5)
أخيراً، يتم تشغيل المقارنة الإحصائية الاستدلالية باستخدام دالة roc.test() بتمرير الكائنين مع تحديد أسلوب ديلونغ للبيانات المقترنة:
comparison_test <- roc.test(roc_logistic, roc_rf, method = "delong", paired = TRUE)
print(comparison_test)
7.2 إجراء المقارنة البرمجية باستخدام لغة Python
في بيئة لغة Python، تعتمد التحليلات القياسية على مكتبة scikit-learn لحساب المقاييس الأساسية ورسم المنحنيات، بالتكامل مع خوارزميات مخصصة لتنفيذ اختبار ديلونغ، والتي تتطلب صياغة برمجية رياضية لحساب مصفوفة التغاير غير المعلمية لإحصاءات U، كما توضح المنهجيات المعاصرة في تحليل الإشارات النفسية والتنبؤ الحوسبي (De Choudhury et al., 2021).
يتم استخراج النقاط وحساب المساحة عبر الكود التالي:
from sklearn.metrics import roc_curve, roc_auc_score
import matplotlib.pyplot as plt
# حساب إحداثيات المنحنيين ومساحات AUC
fpr_log, tpr_log, _ = roc_curve(y_true, y_pred_logistic)
fpr_rf, tpr_rf, _ = roc_curve(y_true, y_pred_rf)
auc_log = roc_auc_score(y_true, y_pred_logistic)
auc_rf = roc_auc_score(y_true, y_pred_rf)
ثم يُنفذ الرسم البياني المقارن مع ضبط المحاور ونسب التباين المربعة:
plt.figure(figsize=(7, 7))
plt.plot(fpr_log, tpr_log, label=f'الانحدار اللوجستي (AUC = {auc_log:.3f})', color='navy', lw=2)
plt.plot(fpr_rf, tpr_rf, label=f'الغابات العشوائية (AUC = {auc_rf:.3f})', color='darkgreen', lw=2)
plt.plot([0, 1], [0, 1], color='gray', linestyle='--')
plt.xlabel('معدل الإيجابية الكاذبة (1 - النوعية)')
plt.ylabel('معدل الإيجابية الحقيقية (الحساسية)')
plt.title('مقارنة منحنيات ROC للنماذج التشخيصية')
plt.legend(loc='lower right')
plt.show()
7.3 قراءة المخرجات الإحصائية واتخاذ القرار العلمي
عند فحص مخرجات دالة roc.test() الناتجة عن تطبيق اختبار ديلونغ على عينة دراستنا المكونة من 500 مريض، نقرأ المعطيات الاستدلالية الحاسمة التالية:
- إحصائية ديلونغ المقترنة (Z-statistic): Z = -3.418 (أو قيمة D = -3.418).
- درجات الحرية المقابلة: df = 499.
- مستوى الدلالة الإحصائية (p-value): p = 0.00063 (وهي أصغر بكثير من عتبة الدلالة التقليدية 0.05 أو حتى 0.001).
- فترة ثقة 95% لفرق المساحة (95% CI of ΔAUC): [-0.130, -0.035].
يُتيح التفسير الإحصائي الصارم لهذه النتائج رفض فرضية العدم بثقة أكاديمية قاطعة؛ فالقيمة الاحتمالية البالغة 0.0006 تؤكد أن احتمالية حدوث هذا التفوق البالغ 0.083 في قيمة AUC بمحض الصدفة العشوائية هي أقل من ستة أجزاء في العشرة آلاف. والأهم من ذلك أن فترة الثقة 95% لفرق المساحة تقع بالكامل بعيداً عن الصفر (لا تشمل الصفر مطلقاً)، مما يؤكد بالدليل الرياضي القاطع أن نموذج الغابات العشوائية يتفوق بشكل دال وجوهري على نموذج الانحدار اللوجستي، ويوفر قدرة تمييزية سريرية متفوقة يمكن الاعتماد عليها في تطوير أدوات التشخيص الآلي في المراكز النفسية.
8. تحديد نقاط القطع المثلى وموازنة التكاليف التشخيصية
8.1 تطبيق مؤشر يودن (Youden’s J Index) للمقارنة
بمجرد إثبات التفوق الإحصائي الشامل للنموذج عبر مساحة AUC، تبرز الخطوة السريرية الحاسمة التالية: أين تقع نقطة القطع المثلى (Optimal Cutoff Point) لتطبيق الأداة في الواقع الميداني؟ يُعد مؤشر يودن (Youden’s J Index) الأسلوب الرياضي الأكثر شيوعاً لتحديد هذه النقطة بصورة موضوعية. يُعرّف مؤشر يودن هندسياً بأنه أقصى مسافة رأسية تفصل منحنى ROC عن خط الصدفة القطري العشوائي، وتُحسب قيمته لكل نقطة قطع c وفق المعادلة:
J = Sensitivity(c) + Specificity(c) – 1
تتراوح قيمة المؤشر بين 0 (أداة عديمة الفائدة) و1 (أداة مثالية تامة). عند تطبيق مؤشر يودن على نموذجي دراستنا:
- حقق نموذج الانحدار اللوجستي أقصى مؤشر يودن Jmax = 0.472 عند عتبة احتمالية تبلغ 0.38، محققاً حساسية 76.0% ونوعية 71.2%.
- حقق نموذج الغابات العشوائية أقصى مؤشر يودن Jmax = 0.615 عند عتبة احتمالية تبلغ 0.42، محققاً حساسية 82.7% ونوعية 78.8%.
تؤكد مقارنة مؤشرات يودن القصوى تفوق خوارزمية الغابات العشوائية في تحقيق أفضل توازن تشغيلي بين الحساسية والنوعية، مما يدعم اعتماد عتبتها المحسوبة كنقطة قرار قياسية في غياب ترجيحات سريرية خاصة للتكاليف (Wang & Gorenstein, 2013).
8.2 موازنة تكلفة الإيجابيات الكاذبة مقابل السلبيات الكاذبة
يفترض مؤشر يودن الكلاسيكي ضمنياً أن تكلفة الخطأ الناتج عن الإيجابية الكاذبة (False Positive Cost – CFP) مساوية تماماً لتكلفة الخطأ الناتج عن السلبية الكاذبة (False Negative Cost – CFN). غير أن هذا الافتراض ينهار كلياً في التطبيقات النفسية والطبية الحقيقية؛ إذ تتفاوت عواقب الخطأ تفاوتاً جذرياً تبعاً للاضطراب المفحوص والبروتوكولات الإكلينيكية المعمول بها (Kushida et al., 2005).
في تشخيص الاكتئاب الحاد أو تقييم خطر الإقدام على الانتحار، تُمثل السلبية الكاذبة كارثة إكلينيكية محققة؛ لأن تفويت تشخيص مريض مكتئب ومهدد بالانتحار قد يؤدي إلى فقدان حياته نتيجة غياب التدخل العلاجي العاجل. في هذا السياق، تكون تكلفة السلبية الكاذبة أضعاف تكلفة الإيجابية الكاذبة (CFN >> CFP)، والتي تقتصر تكلفتها عادة على إعادة التقييم السريري الدقيق أو القلق النفسي المؤقت الناجم عن الفحص الخاطئ. في المقابل، إذا كان التشخيص يتعلق باضطراب نادر يتطلب علاجاً دوائياً شديد السمية كبعض مضادات الذهان القديمة، فإن تكلفة الإيجابية الكاذبة ترتفع بشدة لتجنب إخضاع أصحاء لأضرار علاجية جسيمة. وعليه، يجب تعديل معادلة اختيار العتبة بإدراج مصفوفة التكاليف (Cost Matrix) ونسبة الانتشار الأساسية لتحديد نقطة القطع المثلى وظيفياً.
8.3 تحليل المنحنى وفق حدود الحساسية السريرية الدنيا المطلوبة
في بيئات الرعاية النفسية الأولية، غالباً ما تفرض المبادئ التوجيهية التشغيلية ألا تقل حساسية أداة الفرز الأولية عن حد سريري أدنى صارم (مثلاً: Sensitivity ≥ 90%)، وذلك لضمان اصطياد الغالبية العظمى من المصابين قبل إحالتهم للفحص التخصصي. في ظل هذا الشرط المقيد، تصبح مقارنة قيم AUC الكلية غير ذات جدوى، ويتعين إعادة مقارنة النماذج بصورة مشروطة داخل النطاق المقيد فقط.
عند فحص منحنيات دراستنا الافتراضية عند مستوى حساسية 90%:
- يُحقق نموذج الغابات العشوائية نوعية قدرها 71.5% (بمعدل إيجابيات كاذبة 28.5%).
- بينما يتراجع نموذج الانحدار اللوجستي عند الحساسية ذاتها ليحقق نوعية قدرها 48.0% فقط (بمعدل إيجابيات كاذبة يبلغ 52.0%).
يكشف هذا التحليل المشروط أن نموذج الانحدار اللوجستي سيتسبب عملياً في إحالة نصف المفحوصين الأصحاء إلى العيادات التخصصية كإيجابيات كاذبة عند ضبطه على الحساسية المطلوبة، مما يُشكل عبئاً منهكاً على المنظومة الصحية النفسية، بينما ينجح نموذج الغابات العشوائية في حصر الإيجابيات الكاذبة في نطاق ضيق، مؤكداً أفضليته السريرية التشغيلية الحاسمة.
9. الأخطاء الشائعة والمنهجية في مقارنة منحنيات ROC
9.1 المقارنة دون إجراء اختبارات الفروق الدالة إحصائياً
يتمثل أحد أكثر الأخطاء المنهجية شيوعاً في أبحاث الصحة النفسية المنشورة في إعلان تفوق نموذج تشخيصي على نموذج آخر بمجرد رصد زيادة طفيفة في قيمة المساحة تحت المنحنى (مثلاً كأن يكتب الباحث: “تفوق النموذج أ بحصوله على AUC قدرها 0.83 مقارنة بالنموذج ب الذي حصل على 0.81”) دون إجراء اختبار ديلونغ أو حساب فترة الثقة للفارق بينهما. يقع هذا الخطأ نتيجة الخلط المنهجي الجسيم بين “التفوق الحسابي الوصفي” في العينة المدروسة و”التفوق الإحصائي الاستدلالي” القابل للتعميم.
في العينات السريرية النفسية، والتي غالباً ما تكون محدودة الحجم بسبب صعوبات جمع البيانات الإكلينيكية، تؤدي التموجات العشوائية في توزيع الدرجات إلى تقلبات واسعة في قيم AUC؛ إذ يمكن لفارق قدره 0.04 أن يكون غير دال إحصائياً على الإطلاق (p > 0.05) في عينة من 100 مريض، في حين أن فارقاً قدره 0.015 قد يكون فائق الدلالة (p < 0.001) في عينة تضم آلاف السجلات. إن غياب الاختبار الاستدلالي يجعل ادعاء التفوق مجرد تخمين غير مثبت علمياً قد يضلل الممارسة السريرية.
9.2 تجاهل عدم توازن الفئات التشخيصية (Class Imbalance)
تتسم الاضطرابات النفسية في المسوح السكانية والمجتمعية بندرة نسبية واضحة؛ إذ تتراوح نسب انتشار اضطرابات كالفصام أو الاضطراب ثنائي القطب عادة بين 1% و3%، كما تنخفض معدلات محاولات الانتحار الفعلية لأقل من ذلك بكثير. يؤدي هذا الخلل الحاد في توازن الفئات (Severe Class Imbalance) إلى خلق ظاهرة خطيرة تُعرف بـ “تفاؤل منحنى ROC الزائف” (The False Optimism of ROC Curves).
ينشأ هذا التفاؤل الزائف من تركيبة المحور الأفقي لمنحنى ROC، والذي يحسب معدل الإيجابية الكاذبة نسبة إلى إجمالي الحالات السلبية الضخمة (FP / Total Negatives). فعندما يكون عدد الأصحاء هائلاً مقارنة بالمرضى، يمكن لتوليد مئات الحالات الإيجابية الكاذبة ألا يرفع هذا المعدل إلا بجزء ضئيل جداً من المئة، مما يُبقي منحنى ROC مرتفعاً وقيمة AUC خادعة وممتازة (تتجاوز 0.85 مثلاً)، بينما تكون القيمة التنبؤية الإيجابية (PPV / Precision) للأداة في أرض الواقع متدنية للغاية؛ بحيث يكون تسعة من كل عشرة أفراد صنفتهم الأداة كمرضى هم في الحقيقة أصحاء تماماً. في مثل هذه البيئات غير المتوازنة، توصي المراجع المنهجية باستبدال منحنيات ROC أو تدعيمها بمنحنيات الدقة والاسترجاع (Precision-Recall Curves – PRC) والمساحة تحتها (AUPRC)، والتي تركز تركيزاً حصرياً ومباشراً على الفئة المرضية النادرة دون أن تتأثر بضخامة الفئة السليمة.
9.3 التحقق الداخلي المفرط وغياب التحقق الخارجي المتقاطع
يرتبط الخطأ المنهجي الثالث بظاهرة فرط المطابقة (Overfitting) عند تدريب نماذج الذكاء الاصطناعي والتعلم الآلي ومقارنتها بالنماذج البارامترية البسيطة. فعندما يقوم الباحث ببناء منحنيات ROC ومقارنتها على بيانات التدريب ذاتها التي استخدمتها الخوارزميات لضبط معاملاتها (Apparent Performance)، ستحقق النماذج المعقدة (كخوارزميات الغابات العشوائية والشبكات العصبية) قيماً فائقة وهمية لـ AUC تقترب من 0.95 أو 1.00 نتيجة حفظها لخصائص العينة بما فيها من ضوضاء إحصائية، بينما يظهر نموذج الانحدار اللوجستي البسيط أداءً متواضعاً (مثلاً: 0.78).
تنهار هذه النماذج المعقدة بمجرد تطبيقها على بيانات جديدة لم ترها من قبل، وتهبط قيم مساحاتها تحت المنحنى بشكل حاد قد يجعلها أدنى من النماذج البسيطة. لتفادي هذا الانزلاق المنهجي، يجب أن تتم جميع مقارنات ROC واختبارات ديلونغ حصراً على عينات اختبار مستقلة ومفصولة تماماً (Hold-out Test Sets)، أو عبر بروتوكولات التحقق المتقاطع الصارم (k-fold Cross-Validation) مكرر المعاينة، لضمان قياس القدرة التعميمية الحقيقية للنماذج في المجتمعات السريرية المستهدفة وتفادي تزييف النتائج العلمية.
10. معايير كتابة التقارير الأكاديمية والسريرية وفق ضوابط APA
10.1 إرشادات عرض النتائج في المتن والجداول الإحصائية
تفرض ضوابط الإصدار السابع لدليل النشر الصادر عن جمعية علم النفس الأمريكية (APA 7th Edition) معايير صياغة محددة وصارمة للإفصاح عن نتائج تحليلات منحنيات ROC والمفاضلة الإحصائية بينها. يجب ألا يقتصر التقرير على ذكر قيم AUC فقط، بل يتعين توثيق كامل المكونات الإحصائية الداعمة، متضمنة الخطأ المعياري، وفترات الثقة بنسبة 95%، وإحصائية الاختبار المستخدم مع القيمة الاحتمالية الدقيقة (حتى ثلاثة منازل عشرية دون استخدام p = 0.000 بل p < .001)، مع كتابة الرموز الإحصائية بخط مائل مائل (Italicized).
فيما يلي صياغة أكاديمية قياسية توضح تطبيق هذه الضوابط لعرض نتائج دراستنا المقارنة في متن البحث:
“أظهر اختبار ديلونغ للبيانات المقترنة تفوقاً دالاً إحصائياً لنموذج الغابات العشوائية (AUC = .865, 95% CI [.831, .899]) على نموذج الانحدار اللوجستي التقليدي (AUC = .782, 95% CI [.739, .825]) في القدرة التمييزية لتشخيص الاكتئاب السريري، بفارق مساحة مطلق بلغ ΔAUC = .083, Z = -3.418, p < .001, 95% CI [-0.130, -0.035].”
كما يُنصح بتصميم جداول مقارنة جامعة تلخص المؤشرات الإضافية عند نقاط القطع المثلى، وتتضمن: الحساسية، والنوعية، ومؤشر يودن (J)، والقيمة التنبؤية الإيجابية (PPV)، والقيمة التنبؤية السلبية (NPV)، ونسبة الإرجاح الإيجابية (+LR)، ونسبة الإرجاح السلبية (-LR)، لتزويد القارئ برؤية سيكومترية شاملة تتجاوز المساحة المجردة.
10.2 المعايير الاحترافية لإنتاج وتنسيق الرسوم البيانية للنشر
يخضع إعداد الرسوم البيانية المقارنة لمنحنيات ROC لضوابط جمالية ومنهجية تضمن دقة العرض وتمنع تشويه العلاقات الرياضية في المجلات المفهرسة:
- أبعاد المخطط والمقياس المربع (Aspect Ratio): يجب أن يكون المخطط البياني مربعاً تماماً بمقياس متطابق (1:1 Aspect Ratio)، بحيث يتطابق الطول المادي للمحور الأفقي من 0.0 إلى 1.0 مع الطول المادي للمحور الرأسي من 0.0 إلى 1.0؛ إذ إن تمديد أحد المحورين يشوه الإدراك البصري لمسار المنحنى ولانحرافه عن خط الصدفة.
- خط الصدفة المرجعي (Diagonal Reference Line): يجب رسم خط الصدفة القطري الممتد من (0, 0) إلى (1, 1) كخط متقطع رمادي أو أسود رفيع (Dashed Line) ليعمل كمرجع بصري لعدم التمييز.
- الوضوح اللوني والطباعي: يتعين اختيار ألوان متباينة بوضوح وتجنب الألوان المتقاربة، مع استخدام أنماط خطوط مختلفة (كخط مصمت لنموذج وخط منقط أو شرطي للآخر) لضمان سهولة التمييز بين المنحنيين في حال طباعة الورقة باللونين الأبيض والأسود أو للقراء الذين يعانون من عمى الألوان.
- مفتاح الرسم التفسيري (Legend): يجب أن يتضمن مفتاح الرسم التسمية الدقيقة لكل نموذج متبوعة بقيمة AUC وفترة الثقة 95% بين قوسين، ويوضع عادة في النصف السفلي الأيمن من الرسم حيث تتواجد المساحة الفارغة الأقل تأثيراً على خطوط المنحنيات.
10.3 صياغة التوصيات العملية للتطبيق في الممارسة النفسية
لا تنتهي مهمة الباحث السريري بإثبات التفوق الإحصائي في الأوراق الأكاديمية؛ بل تكتمل بترجمة هذه الاستدلالات الرياضية إلى توصيات إجرائية واضحة يفهمها الأطباء والأخصائيون النفسيون وصناع القرار الصحي. يجب توضيح القيمة المضافة الحقيقية لاعتماد الأداة الجديدة داخل بيئة العمل الواقعية؛ كأن يُبيّن التقرير أن اعتماد نموذج الغابات العشوائية سيقلص السلبيات الكاذبة بنسبة 42%، مما يعني خفض حالات الاكتئاب غير المكتشفة التي قد تتدهور نحو السلوك الانتحاري، بالتوازي مع خفض الإيجابيات الكاذبة بنسبة 38%، مما يقلل الهدر في الموارد العلاجية المخصصة للمقابلات التقييمية الثانوية.
علاوة على ذلك، يجب تحديد محددات الدراسة وسياقات الحذر المنهجي؛ كالتنويه بطبيعة العينة المستخدمة وما إذا كانت محصورة في مستشفيات المدن الكبرى مما يستدعي الحذر قبل تعميم العتبات على مراكز الرعاية الريفية. كما يجب مناقشة الجدوى التشغيلية لتطبيق خوارزميات الذكاء الاصطناعي المعقدة في العيادات التي تفتقر للبنية الحوسبية اللازمة، وتحديد ما إذا كان الفارق الإحصائي المشاهد يبرر الانتقال من أداة ورقية سريعة إلى نظام إلكتروني معقد.
خاتمة
تُمثّل مقارنة منحنيين من منحنيات ROC ركيزة منهجية جوهرية لترقية وتطوير أدوات القياس النفسي والنماذج التنبؤية السريرية المعاصرة. ويوضح هذا الدليل أن المفاضلة الرصينة بين الأدوات التشخيصية لا يمكن أن تُبنى على الانطباعات البصرية الخادعة أو الفروق الحسابية السطحية بين قيم المساحة تحت المنحنى (AUC)، بل تتطلب فهماً عميقاً للبنية الاحتمالية الكامنة وراء هذه المقاييس وتطبيقاً دقيقاً للاختبارات الاستدلالية المعتمدة.
يظل اختبار ديلونغ للبيانات المقترنة الخيار المعياري غير المعلمي الأبرز نظراً لكفاءته الرياضية واشتماله على مصححات التغاير القوية، بينما يقدم أسلوب إعادة المعاينة الحثيثة (Bootstrap) حلاً لا يضاهى في التعامل مع التوزيعات النفسية المعقدة والملتوية واختبارات المتانة التأكيدية. ومع ذلك، يجب أن يظل التحليل الإحصائي مصحوباً دائماً بالوعي بالسياق السريري، وموازنة تكاليف الأخطاء التشخيصية، ومراعاة عدم توازن الفئات في المجتمع، لضمان أن تسفر هذه المقارنات الرياضية في نهاية المطاف عن قرارات سريرية مسؤولة تسهم في تعزيز جودة الرعاية النفسية وحماية حياة المرضى.
المراجع
Conti‐Ramsden, G., Botting, N., & Faragher, B. E. (2001). Psycholinguistic Markers for Specific Language Impairment (SLI). Journal of Child Psychology and Psychiatry, 42(6), 741–748. https://doi.org/10.1111/1469-7610.00770
De Choudhury, M., Gamon, M., Counts, S., & Horvitz, E. (2021). Predicting Depression via Social Media. Proceedings of the International AAAI Conference on Web and Social Media, 7(1), 128–137. https://doi.org/10.1609/icwsm.v7i1.14432
Goodman, R. (1997). The Strengths and Difficulties Questionnaire: A Research Note. Journal of Child Psychology and Psychiatry, 38(5), 581–586. https://doi.org/10.1111/j.1469-7610.1997.tb01545.x
Haro, J. M., Arbabzadeh‐Bouchez, S., Brugha, T. S., de Girolamo, G., Guyer, M. E., Jin, R., Lepine, J. P., Mazzi, F., Reneses, B., Vilagut, G., Sampson, N. A., & Kessler, R. C. (2006). Concordance of the Composite International Diagnostic Interview Version 3.0 (CIDI 3.0) with standardized clinical assessments in the WHO World Mental Health Surveys. International Journal of Methods in Psychiatric Research, 15(4), 167–180. https://doi.org/10.1002/mpr.196
Kushida, C. A., Littner, M. R., Morgenthaler, T. I., Alessi, C., Bailey, D. R., Coleman, J., Friedman, L., Hirshkowitz, M., Kapen, S., Kramer, M., Lee-Chiong, T., Loube, D. L., Owens, J., Pancer, J. P., & Shen, J. (2005). Practice Parameters for the Indications for Polysomnography and Related Procedures: An Update for 2005. SLEEP, 28(4), 499–521. https://doi.org/10.1093/sleep/28.4.499
Morin, C. M., Belleville, G., Bélanger, L., & Ivers, H. (2011). The Insomnia Severity Index: Psychometric Indicators to Detect Insomnia Cases and Evaluate Treatment Response. SLEEP, 34(5), 601–608. https://doi.org/10.1093/sleep/34.5.601
Shu, L., Xie, J., Yang, M., Li, Z., Li, Z., Liao, D. K., Xu, X., & Zhou, X. (2018). A Review of Emotion Recognition Using Physiological Signals. Sensors, 18(7), 2074. https://doi.org/10.3390/s18072074
Stone, L. L., Otten, R., Engels, R. C. M. E., Vermulst, A. A., & Janssens, J. (2010). Psychometric Properties of the Parent and Teacher Versions of the Strengths and Difficulties Questionnaire for 4- to 12-Year-Olds: A Review. Clinical Child and Family Psychology Review, 13(3), 254–274. https://doi.org/10.1007/s10567-010-0071-2
Vilagut, G., Forero, C. G., Barbaglia, G., & Alonso, J. (2016). Screening for Depression in the General Population with the Center for Epidemiologic Studies Depression (CES-D): A Systematic Review with Meta-Analysis. PLoS ONE, 11(5), e0155431. https://doi.org/10.1371/journal.pone.0155431
Wang, Y.‐P., & Gorenstein, C. (2013). Psychometric properties of the Beck Depression Inventory-II: a comprehensive review. Brazilian Journal of Psychiatry, 35(4), 416–431. https://doi.org/10.1590/1516-4446-2012-1048