
يمثل التعامل مع البيانات الاسمية والنصية في بيئات الحوسبة السحابية حجر زاوية في علوم البيانات التطبيقية والإدارة المكتبية والتحليل الإحصائي المتقدم. تتيح جداول بيانات جوجل (Google Sheets) كمنصة مرنة وقوية طيفاً واسعاً من الأدوات الخوارزمية والدوال الرياضية القادرة على استخلاص الرؤى الكمية من سجلات الأسماء غير المتجانسة. إن فرز وحساب الأسماء ليس مجرد عملية روتينية، بل هو مسار منهجي يهدف إلى تحويل المصفوفات النصية الوصفية إلى مؤشرات رقمية قابلة للاستدلال والقياس، سواء كان ذلك في سياق تتبع الحضور، أو إدارة العينات المسحية، أو تصنيف العملاء والباحثين، أو ضبط الجودة داخل قواعد البيانات المؤسسية الضخمة.
تكمن الصعوبة التقنية في معالجة الأسماء داخل الجداول الحسابية في الطبيعة الديناميكية للسلاسل النصية (Strings) مقارنة بالمتغيرات العددية البحتة؛ فالنصوص بطبيعتها عرضة لتباينات الرسم الإملائي، ووجود الفراغات البيضاء غير المرئية، وتعدد التراكيب اللغوية مثل الأسماء المركبة وتنوع الألقاب والكنى. لذلك، فإن الاعتماد على آليات العد اليدوي أو مجرد الاستعراض البصري يؤدي حتماً إلى ارتفاع هامش الخطأ الإدراكي وتشتت البيانات، مما يفرض ضرورة تبني نماذج مؤتمتة تعتمد على محركات الدوال الرياضية والمنطقية، وعلى رأسها الدالة متعددة الاستخدامات COUNTIF ومشتقاتها المتقدمة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك وتحليل كيفية حساب عدد الأسماء في جداول بيانات جوجل من خلال ثلاثة نماذج تطبيقية رئيسية: المطابقة التامة، والمطابقة الجزئية باستخدام محارف البدل، والجمع المنطقي للشروط المتعددة. سنغوص عميقاً في البنية التركيبية لكل معادلة، والآليات الحاسوبية التي يعتمدها محرك جداول جوجل في تقييم الشروط النصية، مع معالجة التحديات التقنية الشائعة مثل معالجة الفراغات الشبحية وتفادي أخطاء التكرار المزدوج، وصولاً إلى بناء بنية تحتية رقمية تضمن موثوقية عالية للتحليلات الإحصائية.
1. المدخل المفاهيمي لإدارة وحساب البيانات الاسمية في جداول بيانات جوجل
1.1 أهمية المعالجة الإحصائية للبيانات النصية والاسمية
تحتل معالجة البيانات النصية مكانة محورية في بحوث العمليات والتحليلات الإدارية والأكاديمية، حيث تشكل الأسماء المتغير التوصيفي الأبرز لتحديد الهويات وتصنيف المجموعات الفردية. إن تحويل القوائم الاسمية غير المعيارية إلى مؤشرات كمية قابلة للقياس المنهجي يعد شرطاً أساسياً للانتقال من مرحلة التجميع السردي الخام إلى مرحلة النمذجة الرياضية. فعندما يتم التعامل مع مصفوفة تحتوي على مئات أو آلاف الأسماء المدخلة عبر استمارات رقمية، فإن معرفة تكرار اسم محدد أو عائلة معينة بدقة متناهية يفرز مؤشرات توزيع تكراري تعتمد عليها القرارات المؤسسية، مثل حساب معدلات التمثيل الديمغرافي، أو قياس تكرار ظهور عناصر معينة في عينات الدراسات الميدانية.
وتتجلى الأهمية الإحصائية في ضرورة عزل التكرارات الاسمية داخل العينات الميدانية؛ إذ إن الخطأ في تقدير ظهور اسم ما قد يترتب عليه انحياز في النتائج وتشويه في حجم العينة الفعلي (Effective Sample Size). إن التكرار غير المنضبط يولد ارتباطات زائفة واختلالاً في مصفوفات التباين المشترك، ولذلك فإن استخدام معادلات رياضية دقيقة لحصر السجلات يضمن النقاء الإحصائي لقاعدة البيانات. يسهم التحليل الرقمي الرصين للنصوص في رفع الموثوقية التكرارية (Replicability) لقواعد البيانات، حيث يمكن لأي باحث أو محلل مستقل تشغيل الخوارزمية ذاتها للوصول إلى النتيجة العددية نفسها بدقة مطلقة تخلو من التخمين.
علاوة على ذلك، يمثل التحول نحو الأتمتة البرمجية داخل جداول البيانات وسيلة حاسمة لتقليص التحيز البشري والخطأ الإدراكي الناجم عن الفرز البصري اليدوي. تظهر الممارسات التجريبية أن المراجعة البشرية للقوائم الطويلة تعاني من معدلات خطأ تتصاعد طردياً مع حجم البيانات، نتيجة للإجهاد الذهني أو الخلط بين الأسماء المتشابهة في رسمها الخطي. تتيح الدوال المنطقية لجداول جوجل إجراء عمليات مسح متزامنة بسرعات فائقة، مع الحفاظ على صرامة المعايير المنطقية المحددة مسبقاً، مما يوفر بيئة تحليلية متسقة تلبي متطلبات النزاهة العلمية وضبط الجودة الإحصائية.
1.2 طبيعة المتغيرات النصية في جداول بيانات جوجل (Google Sheets)
تختلف معالجة السلاسل النصية (String Data) اختلافاً جوهرياً عن إدارة البيانات العددية (Numeric Data) أو المنطقية (Boolean Data) في جداول بيانات جوجل. فالأرقام تخضع لقواعد الحساب الجبري الخطي المباشر حيث تكون القيم متصلة وقابلة للعمليات الرياضية القياسية، في حين أن النصوص تعامل كسلاسل خطية من المحارف المرتبطة بمحددات ترميزية معينة (مثل ترميز Unicode وUTF-8). هذا التمايز يفرض على خوارزميات البرنامج استخدام مقارنات تعتمد على مطابقة محارف السلسلة، حرفاً بحرف، وفق مواقعها الترتيبية ضمن المتجه النصي للخلية المستهدفة.
من أهم الخصائص التقنية التي تحكم السلاسل النصية في بيئة جداول بيانات جوجل هي مسألة حساسية حالة الأحرف (Case Sensitivity). في الدوال القياسية مثل COUNTIF، يعتمد محرك الجداول سلوكاً افتراضياً غير حساس لحالة الأحرف في اللغات اللاتينية؛ ما يعني أن النظام يعامل السلسلة “BOB” والمصفوفة النصية “bob” كقيمتين متطابقتين تماماً. ومع ذلك، فإن هذه المرونة تتطلب حذراً كبيراً عندما يرغب المحلل في تتبع حالات دقيقة تتطلب حساسية مطلقة للحروف. كما تلعب المسافات البيضاء (Whitespace Characters)—سواء كانت مسافات بادئة، أو لاحقة، أو فاصلة بين أجزاء الاسم—دوراً حاسماً؛ فالنظام يعتبر المسافة محرفاً مستقلاً تماماً، وبالتالي فإن وجود مسافة إضافية في نهاية الاسم يجعل السلسلة غير متطابقة منطقياً مع نظيرتها المكتوبة بدون مسافة، وهو ما يشكل أحد أكثر مصادر الأخطاء الصامتة شيوعاً في التحليل النصي.
أما من زاوية التخزين الرقمي، فإن جداول جوجل السحابية تخزن النصوص داخل كائنات خلايا تحمل بيانات وصفية (Metadata) تتضمن نوع المحتوى وتنسيقه الظاهري. هذا الفصل بين القيمة التخزينية الكامنة (Raw Value) والمظهر البصري المعروض يقتضي تدقيقاً عميقاً في بنية الإدخال. الرموز الخاصة مثل الشرطات، والنقاط، وعلامات الترقيم، ومحارف التحكم المخفية تؤثر بصورة مباشرة على الفهرسة والفرز؛ ما يستدعي تهيئة السلاسل النصية وضبط اتساقها الترميزي لضمان خضوعها الدقيق لمعايير المطابقة الرياضية.
1.3 نظرة عامة على التقنيات الثلاث المستخدمة في الحساب
تتنوع متطلبات التحليل الإحصائي للأسماء بحسب أهداف الدراسة وطبيعة البيانات المجمعة، مما استدعى تطوير تقنيات حسابية تلبي حالات الاستخدام المختلفة. التقنية الأولى والأساسية هي تقنية “المطابقة التامة للاسم الفردي” (Exact Match). ترتكز هذه المنهجية على التحقق الحصري من تطابق المحتوى الكلي للخلية مع النص المستهدف، دون زيادة أو نقصان. تُستخدم هذه المقاربة الصارمة عندما تتطلب الدراسة تتبع أفراد بعينهم يمتلكون تركيباً اسمياً ثابتاً، مما يمنع حدوث أي تداخل مع مدخلات أخرى قد تشترك في أحد مقاطع الاسم، كاستخراج تكرار طالب معين في قائمة الحضور الدراسي أو حصر استجابات مبحوث محدد في تجربة متكررة.
التقنية الثانية تتمثل في “المطابقة الجزئية” (Partial Match) باستخدام محارف البدل (Wildcards). تهدف هذه الطريقة إلى تجاوز قيود التطابق الكلي عبر فحص السلاسل النصية الفرعية داخل الخلية. من خلال توظيف الرموز الخاصة مثل النجمة (*) أو علامة الاستفهام (؟)، يتمكن المحرك من رصد اسم مستهدف أينما ورد، سواء كان مسبوقاً باسم أول، أو متبوعاً بلقب عائلي، أو محاطاً ببادئات وظيفية كالألقاب المهنية. تعتبر هذه التقنية شديدة الأهمية في معالجة السجلات الحرة التي لم تلتزم بنمط إدخال موحد، وفي دراسات الأنساب والتوزيع العائلي التي تركز على تكرار الألقاب والكنى بغض النظر عن الأسماء الأولى للأفراد.
أما التقنية الثالثة، فهي “الجمع المنطقي للشروط المتعددة” (Multiple Disjunctive Criteria)، وتعتمد على مبادئ الجبر البولياني لدمج استعلامات حسابية متعددة باستخدام منطق الاختيار (OR Logic). تُستخدم هذه التقنية عندما يسعى الباحث إلى قياس التكرار الإجمالي لمجموعة مختارة من الأسماء التي تنتمي إلى فئة تحليلية موحدة (مثل حساب الظهور المشترك لحاملي لقبي “Johnson” و”Smith” معاً داخل النطاق). تتيح هذه الطريقة دمج استجابات فئات اسمية متنوعة في مخرج إحصائي واحد، مع مراعاة الضوابط الرياضية التي تحول دون الوقوع في معضلة التكرار المزدوج للسجلات التي قد تستوفي أكثر من شرط في آن واحد.
2. الأسس الرياضية والوظيفية لدالة COUNTIF في تحليل النصوص
2.1 البنية المنهجية لصيغة الدالة COUNTIF وسياق عملها
تعتبر الدالة COUNTIF من الدوال الأساسية في بيئة الحوسبة الإحصائية لجداول بيانات جوجل، حيث تصنف وظيفياً كدالة عد شرطي تجمع بين آلية التكرار الحلقي والفحص المنطقي الثنائي. الصيغة الهيكلية العامة للدالة تأخذ الشكل الرياضي التالي: =COUNTIF(range, criterion). تعتمد الدالة على مدخلين إجباريين؛ الأول هو مصفوفة النطاق الجغرافي داخل ورقة العمل (Range)، والذي يمثل مجموعة الخلايا المتصلة أو المنفصلة المراد مسحها، والمعامل الثاني هو معيار الفرز (Criterion) الذي يحدد الشرط الرياضي أو النصي الواجب تحققه لاحتساب الخلية ضمن النتيجة الإجمالية.
يخضع المعامل الأول لضوابط الفهرسة المتجهة الصارمة، حيث يتم تحويل النطاق المحدد (مثل A2:A11) إلى مصفوفة خطية أحادية البعد يتم استعراضها تتابعياً بواسطة محرك المعالجة السحابي لجداول جوجل. يقوم المحرك بفحص كل خلية بصورة مستقلة واستخلاص قيمتها النصية الخام، ليتم مطابقتها مع المعامل الثاني. يتم كتابة المعيار النصي عادة كقيمة محاطة بعلامات اقتباس مزدوجة لتعريف المحرك بطبيعته الحرفية، أو يُمرر كمرجع لخلية أخرى تتضمن القيمة المرجعية.
على المستوى الخوارزمي، تنفذ الدالة دالة تقييم منطقية ثنائية تولد داخلياً متجهاً من القيم البوليانية (TRUE / FALSE). في كل خطوة تكرارية، إذا كانت نتيجة المقارنة بين محتوى الخلية والمعيار تساوي (TRUE)، تتم زيادة العداد التراكمي بمقدار وحدة رياضية واحدة (1)، وإذا كانت النتيجة (FALSE) يتم تجاهل الخلية ويظل العداد ثابتاً. في نهاية المسح الشامل لجميع عناصر النطاق، تُرجع الدالة القيمة النهائية التراكمية كعدد صحيح موجب يمثل التكرار المطلق (Absolute Frequency) لمرات تحقق الشرط.
2.2 استخدام الرموز البديلة (Wildcards) لتعزيز مرونة الاستعلام
تمثل الرموز البديلة أو محارف البدل (Wildcards) أداة تمكينية فائقة الفاعلية في توسيع القدرة الاستعلامية لدالة COUNTIF لتتجاوز المطابقة الحرفية الساكنة. محارف البدل هي رموز اصطلاحية محجوزة يفهمها المحرك الحسابي كنماذج مرنة يمكن أن تحل محل أي محرف أو مجموعة من المحارف ضمن السلسلة النصية. يتصدر هذه الرموز محرف النجمة (*)، والذي يمتلك وزناً رياضياً يعبر عن “صفر أو أكثر من المحارف المتتالية أياً كانت هويتها”. عند وضع النجمة قبل أو بعد الكلمة المفتاحية، يعامل المحرك أي تسلسل نصي متصل بتلك الكلمة كاستيفاء صحيح للمعيار، مما يسهل رصد النصوص المدمجة داخل نصوص أطول.
أما الرمز البديل الثاني فهو علامة الاستفهام (؟)، وتستخدم لتمثيل محرف مفرد محدد بدقة مكانية داخل السلسلة النصية. فإذا كان الباحث يتعامل مع أسماء تشهد تباينات طفيفة في حرف واحد، مثل التمييز بين الأسماء التي تُكتب بنمطين متقاربين، فإن استخدام علامة الاستفهام يتيح فرض تقييد على طول السلسلة وموضع التغيير، بحيث لا يتم احتساب المحارف الإضافية التي قد تخل بالبنية الصوتية للاسم المستهدف. يمثل هذا التمييز الرياضي الدقيق بين النجمة (للتوسع غير المقيد) وعلامة الاستفهام (للتقييد الموضعي الدقيق) ركيزة أساسية في معالجة المدخلات اللغوية المتغيرة.
تتطلب الضوابط المنطقية للحساب معالجة خاصة في حال احتوت الأسماء الأصلية داخل قاعدة البيانات على علامة النجمة أو علامة الاستفهام كرموز فعلية وليست محارف استعلامية (مثل وجود حواشي أو إشارات نجمية مدخلة بالخطأ ضمن الاسم). في مثل هذه الحالات، يوفر محرك جداول جوجل رمز الهروب الرياضي (Tilde: ~)، بحيث يؤدي وضع علامة المدّة قبل محرف البدل (مثل ~* أو ~?) إلى إلغاء وظيفته الاستعلامية وتحويله إلى محرف نصي صريح، وهو ما يمنع حدوث التباس خوارزمي أثناء الفرز ويضمن دقة الحصر الإحصائي.
2.3 الفروق الجوهرية بين COUNTIF والدوال الحسابية البديلة
من الأخطاء المنهجية الشائعة الخلط بين نطاقات الاستخدام المخصصة لكل من الدوال الإحصائية المختلفة في بيئة الجداول الحسابية، خاصة بين الدوال COUNT وCOUNTA وCOUNTIF. إن دالة COUNT مصممة برمجياً للتعامل حصرياً مع البيانات العددية، وعند تطبيق الصيغة =COUNT(A2:A11) على نطاق نصي يحتوي على أسماء، ستكون النتيجة الحسابية الحتمية هي صفر (0)، لأن المحرك يتجاهل الخلايا النصية تماماً في هذه الدالة. في المقابل، تضطلع دالة COUNTA بمهمة حساب عدد الخلايا غير الفارغة بغض النظر عن طبيعة محتواها النصي أو العددي، مما يجعلها أداة لحساب حجم العينة الإجمالي دون القدرة على التمييز النوعي بين الأسماء أو رصد تكرار اسم بذاته.
عندما تتطلب الدراسة فحصاً شرطياً متزامناً يخضع لمصفوفات متعددة، يظهر دور الدالة COUNTIFS، والتي تمثل الامتداد متعدد الأبعاد لدالة COUNTIF القياسية. تتيح هذه الدالة تطبيق شروط اقترانية متعددة ترتكز على منطق المعية (AND Logic)؛ حيث يتم التحقق من تحقق كافة المعايير في السطر نفسه عبر نطاقات مختلفة. ومع ذلك، تعجز COUNTIFS عن إجراء الجمع المنطقي الانفصالي (OR Logic) ضمن النطاق الواحد بصورة مباشرة وبسيطة، وهو ما يجعل استخدام الجمع الخطي لعدة دوال COUNTIF أو اللجوء إلى الدوال المصفوفية خياراً تقنياً أكثر فاعلية عند الرغبة في حساب أسماء متعددة في نطاق واحد.
على مستوى متقدم من البنية التحتية للبيانات، تبرز الدالة QUERY كأداة فائقة القدرة تعتمد على صياغات تشبه لغة الاستعلامات البنيوية (Google Visualization API Query Language). تتميز QUERY بقدرتها على إجراء عمليات الفرز، والتجميع، والعد الشرطي المعقد ضمن استعلام لغوي واحد مدمج. ورغم قوتها، فإن دالة COUNTIF تظل الخيار الأكثر كفاءة وخفة من الناحية الحاسوبية في العمليات البسيطة والمتوسطة، حيث تستهلك قدراً أقل من الذاكرة اللحظية وتوفر سرعة استجابة فورية تتفوق بها على استعلامات QUERY الثقيلة التي تتطلب ترجمة نصية برمجية مسبقة قبل التنفيذ.
3. إعداد بيئة البيانات وهيكلة مصفوفة الأسماء المرجعية
3.1 تجهيز جدول البيانات الأكاديمي للدراسة التطبيقية
يتطلب التحليل التجريبي الرصين بناء مصفوفة بيانات معيارية تحاكي البيئات الميدانية للتحقق من أداء الخوارزميات الحسابية وتوثيق نتائجها. لتحقيق هذا الغرض، يتم إعداد جدول بيانات في جداول جوجل يبدأ بتهيئة النطاق المرجعي للدراسة ضمن المجال الجغرافي المحدد بالخلايا من A2 إلى A11، مع تخصيص الخلية A1 كرأس وصفي للمصفوفة يحمل المعرف المعياري “Full Name” أو “الاسم الكامل”. يعكس تحديد النطاق بعشرة سجلات تمثيلية نموذجاً مختزلاً ودقيقاً يتيح التتبع البصري والمقارنة الحسابية الصارمة للمخرجات الرقمية.
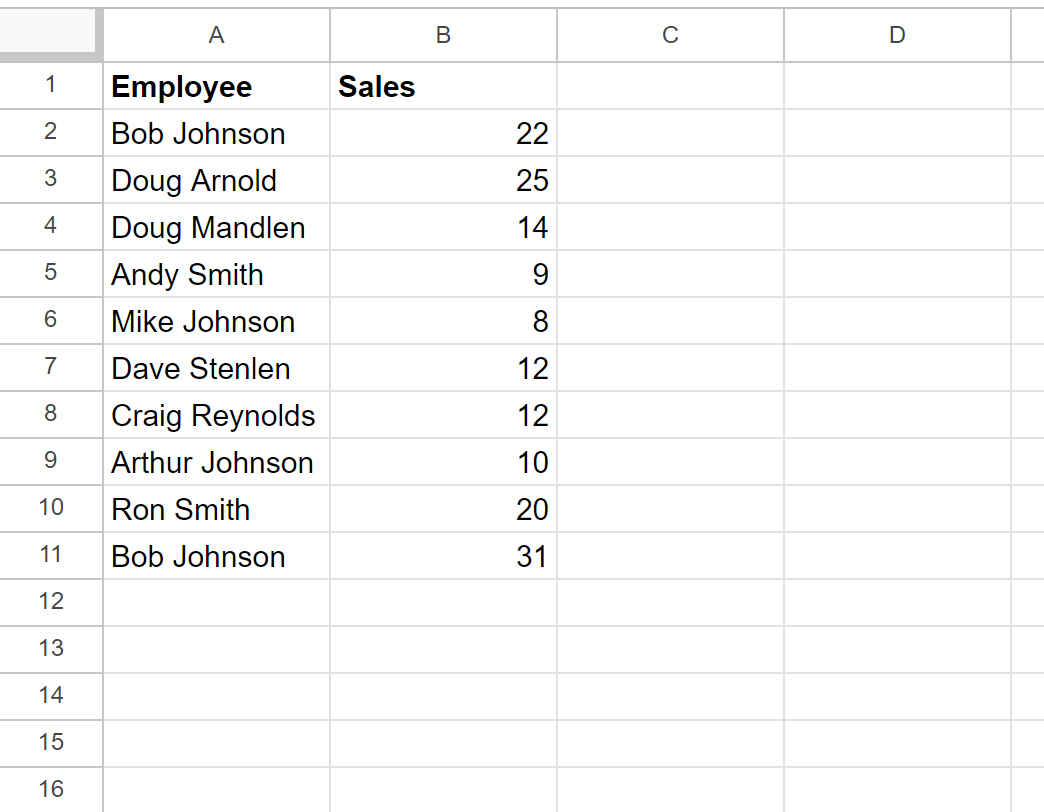
تتضمن مصفوفة الفحص المبدئي مجموعة متنوعة من الأشكال التركيبية للأسماء لضمان اختبار حدود الدوال في حالات المطابقة التامة والجزئية والمتعددة. يتم إدخال الأسماء التمثيلية التي تعكس توزيعاً منتظماً وتكرارات متعمدة، كإدراج الاسم “Bob Johnson” في مواضع محددة، والاسم “John Smith”، و”Alice Johnson”، و”Johnsonville”. هذا التنوع الهندسي في هيكلة النطاق المرجعي يضمن محاكاة السيناريوهات الحقيقية التي يواجهها المحلل عند التعامل مع قواعد البيانات الضخمة التي تختلط فيها الأسماء الفردية بالمركبة وتتداخل فيها الألقاب المشتركة.
قبل الشروع في كتابة أي معادلة رياضية، يتم فحص مصفوفة الإدخال للتأكد من خلوها المبدئي من الخلايا الفارغة أو المعلقة غير المقصودة. إن وجود خلية فارغة محاطة بمسافات قد يربك بعض التحليلات المقارنة أو يؤثر على اتساق النطاق عند تعميم الصيغ. يهدف هذا البروتوكول الإعدادي إلى إرساء بيئة رقمية محكمة، توفر قياساً دقيقاً وموضوعياً لقدرة كل صيغة حسابية على استخراج القيم المطلوبة بدقة حاسوبية خالية من التشوهات الهيكلية.
3.2 بروتوكولات التحقق الأولي من سلامة السلاسل النصية
تعد مرحلة تنقية البيانات (Data Cleansing) شرطاً مسبقاً لا غنى عنه قبل تطبيق معادلات العد الشرطي، إذ تشير الأدبيات الحاسوبية إلى أن غالبية إخفاقات المطابقة النصية لا ترجع إلى عيوب في الصيغ الحسابية ذاتها، بل إلى وجود شوائب نصية داخل السجلات. في مقدمة هذه الشوائب تأتي المسافات البيضاء الإضافية التي قد تلتصق ببداية الأسماء أو نهاياتها نتيجة لأخطاء الطباعة أو النسخ والنقل من استمارات خارجية. تتطلب الممارسة السليمة تشغيل أدوات التطهير الآلي لضمان حذف كافة المسافات غير الضرورية التي تمنع تحقق شروط التطابق التام.
يتضمن بروتوكول التحقق أيضاً توحيد أنماط الترميز اللغوي وعلامات الترقيم في كتابة الأسماء المدخلة؛ فاستخدام فواصل متباينة (مثل الفاصلة اللاتينية المتبوعة بمسافة مقارنة بالفاصلة الملتصقة بالاسم) يولد مدخلات غير متجانسة تؤدي إلى تجزئة غير مقصودة للمطابقات. كذلك ينبغي الانتباه إلى تجانس أشكال الحروف والمحارف وتفادي الخلط بين علامات التنصيص المائلة وعلامات التنصيص البرمجية المستقيمة المستخدمة كمعاملات داخل محرك جداول جوجل.
أخيراً، يتم تأمين النطاق المرجعي برمجياً عبر استخدام أسلوب المراجع المطلقة (Absolute References). فبدلاً من الإشارة إلى النطاق كمرجع نسبي A2:A11، يتم إحاطة عناوين الأعمدة والصفوف برمز الدولار ليصبح $A$2:$A$11. هذه الخطوة المنهجية الحاسمة تمنع انزلاق حدود المصفوفة عند سحب الصيغة الرياضية وتطبيقها عمودياً أو أفقياً في خلايا أخرى ضمن ورقة العمل، مما يضمن ثبات النطاق المرجعي ومطابقة كافة العمليات الإحصائية لمصفوفة الأساس الموحدة.
4. المثال الأول: حساب عدد الخلايا ذات الاسم المطابق تماماً (Exact Name)
4.1 الصيغة الرياضية والمنطق الإجرائي للمطابقة التامة
يرتكز أسلوب المطابقة التامة على مبدأ الحصر الصارم لمحتوى الخلية، حيث يُشترط أن يتطابق النص الكامل للخلية حرفياً وبشكل مطلق مع المعيار المستهدف، دون أي زيادة في عدد المحارف ودون أي نقصان. تأخذ الصيغة المعيارية في جداول بيانات جوجل الشكل التالي: =COUNTIF(A2:A11, "Bob Johnson"). في هذه المعادلة، يتم توجيه محرك البرنامج لإجراء مسح خطي عمودي عبر النطاق A2:A11 لمقارنة محتوى كل خلية بالسلسلة النصية المحددة بدقة بين علامتي التنصيص المزدوجتين.
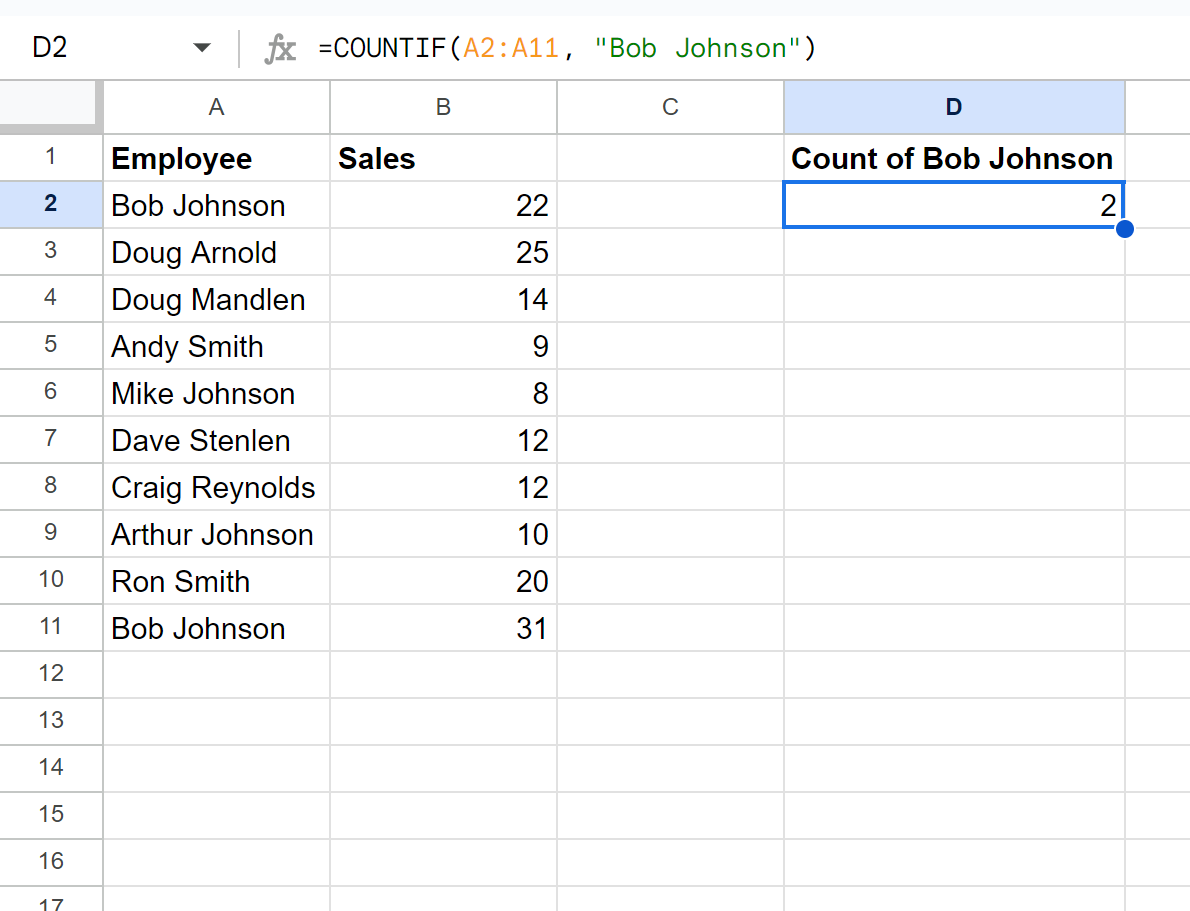
تعتبر علامات التنصيص المزدوجة المحيطة بالاسم "Bob Johnson" عنصراً بنيوياً إجبارياً في لغة الصيغ لجداول بيانات جوجل؛ إذ إن غيابها يدفع المحرك إلى تفسير الكلمات كمعرفات لأسماء نطاقات محجوزة أو متغيرات برمجية غير معرفة، مما يتسبب فوراً في إرجاع خطأ تركيبي. تُعلم علامات التنصيص المفسر الحاسوبي بأن المحتوى الداخلي هو سلسلة نصية حرفية ثابتة (String Literal) يجب مقارنتها كما هي مع محتويات الخلايا المستهدفة.
أثناء التنفيذ، يقوم المحرك بمقارنة المحارف المكونة للسلسلة النصية بالتسلسل؛ فيفحص الحرف الأول “B” ثم الثاني “o” ثم الثالث “b”، ويليه محرف المسافة البيضاء الإلزامية، ثم حروف الكلمة الثانية “J-o-h-n-s-o-n”. إذا تطابقت كافة المحارف بالترتيب نفسه، وكانت الخلية لا تحتوي على أي محارف إضافية قبل أو بعد السلسلة، يُنتج التقييم المنطقي القيمة الثنائية (TRUE)، والتي تترجم رياضياً إلى الرقم واحد (1) في مجمع الدالة، في حين أن أي اختلاف في حرف واحد أو وجود مسافة زائدة يسفر عن القيمة (FALSE) ويستبعد الخلية نهائياً من الحساب.
4.2 التطبيق العملي وتحليل مخرجات الخلية المحددة
عند إدخال الصيغة =COUNTIF(A2:A11, "Bob Johnson") في الخلية المخصصة لعرض النتيجة، وليكن ذلك في الخلية C2، يقوم محرك الحساب بمعالجة المصفوفة بصورة فورية، لتظهر على الشاشة القيمة الرقمية (2). تدل هذه النتيجة الرقمية المباشرة على أن النطاق المرجعي المكون من عشر خلايا يحتوي حصرياً على خليتين تتطابقان بنسبة مائة بالمائة مع المعيار النصي المحدد، وهو ما يتوافق تماماً مع البيانات التجريبية التي تم إدخالها عمداً في المصفوفة لتوليد تكرار ثنائي دقيق.
يكشف التدقيق المنهجي في مخرجات النطاق عن عمق الانضباط الرياضي لأسلوب المطابقة التامة؛ فبالرغم من وجود خلايا أخرى داخل النطاق تشترك في الاسم نفسه جزئياً، مثل الخلية التي تحتوي على الاسم المركب “Bob Johnson Jr.” أو الخلية التي تشتمل على الاسم التابع “Bob Johnsonville”، فإن الدالة استبعدت تلك السجلات تماماً ولم تحتسبها ضمن الناتج الإجمالي. يعود ذلك إلى أن وجود اللواحق النصية “Jr.” أو “ville” يجعل الطول الكلي للسلسلة والمحتوى الحرفي النهائي مغايراً للمعيار المشترط في المعادلة.
يثبت هذا التطبيق العملي فاعلية المطابقة التامة في عزل الكيانات المستقلة وتفادي تداخل الهويات في السجلات الحساسة. إن القدرة على استبعاد الأسماء التي تشتمل على أجزاء مشتركة تمثل صمام أمان إحصائي يضمن عدم تضخيم النتائج برصد حالات لا تحقق الصفة المرجعية المطلوبة، وهو ما يعزز دقة القياس في المسوح الإحصائية والتحليلات الأكاديمية الصارمة.
4.3 استخدام مراجع الخلايا كبديل مرن للنصوص الثابتة
بالرغم من وضوح كتابة الاسم المستهدف بصورة صريحة وثابتة داخل المعادلة، إلا أن الممارسة المهنية والمتقدمة في تصميم جداول البيانات توصي بفصل معايير الحساب عن البنية الهيكلية للصيغ الرياضية. يتحقق ذلك من خلال استبدال النص الثابت بمرجع خلية ديناميكي، بحيث تصبح المعادلة بالصيغة التالية: =COUNTIF(A2:A11, C2)، حيث يتم إدخال الاسم المستهدف البحث عنه داخل الخلية C2 بصورة منفصلة، بينما تقوم الدالة باستدعاء محتوى تلك الخلية كمعيار مرجعي للمقارنة.
يوفر هذا التحول المنهجي مرونة تشغيلية فائقة في بناء لوحات التحكم الديناميكية (Dynamic Dashboards) والتقارير الإحصائية التفاعلية. فبدلاً من الاضطرار إلى تحرير الشفرة المصدرية للمعادلة في كل مرة يرغب فيها الباحث في تغيير الاسم المستهدف، يكفي ببساطة كتابة الاسم الجديد في الخلية المرجعية C2، لتقوم الدالة بإعادة تقييم النطاق وتحديث القيمة الرقمية الناتجة في أجزاء من الثانية دون أي تدخل برمجي إضافي.
علاوة على ذلك، يقلل استخدام مراجع الخلايا من احتمالية حدوث الأخطاء المطبعية التي تتكرر عند كتابة الأسماء المعقدة يدوياً داخل الصيغ الرياضية المتعددة. كما يتيح دمج الخلية المرجعية مع أدوات التحقق من صحة البيانات (Data Validation)، مثل إنشاء قائمة منسدلة (Dropdown List) تحتوي على كافة الأسماء المسجلة، مما يمنح المستخدم تجربة تفاعلية تمتاز بالدقة الإجرائية والاحترافية التقنية وتمنع إدخال أسماء غير موجودة في مصفوفة الأساس.
5. المثال الثاني: حساب عدد الخلايا بالاعتماد على التطابق الجزئي (Partial Name)
5.1 بناء الصيغة باستخدام محارف البدل لتتبع الألقاب والأسماء المشتركة
يقتضي التحليل الإحصائي في كثير من التطبيقات تتبع الأصول العائلية، أو تصنيف المجموعات بناءً على ألقاب مشتركة، أو استخراج سجلات الأفراد الذين تم تسجيل أسمائهم بصيغ مختلفة تتضمن ألقاباً تشريفية أو أسماء أوسط متنوعة. في هذه الحالات، تصبح المطابقة التامة عاجزة عن الوفاء بمتطلبات الحصر، مما يستدعي الترقية المنهجية إلى أسلوب التطابق الجزئي (Partial Match) المعتمد على محارف البدل. تأخذ المعادلة التطبيقية الموسعة لهذا النمط الشكل الرياضي: =COUNTIF(A2:A11, "*Johnson*").
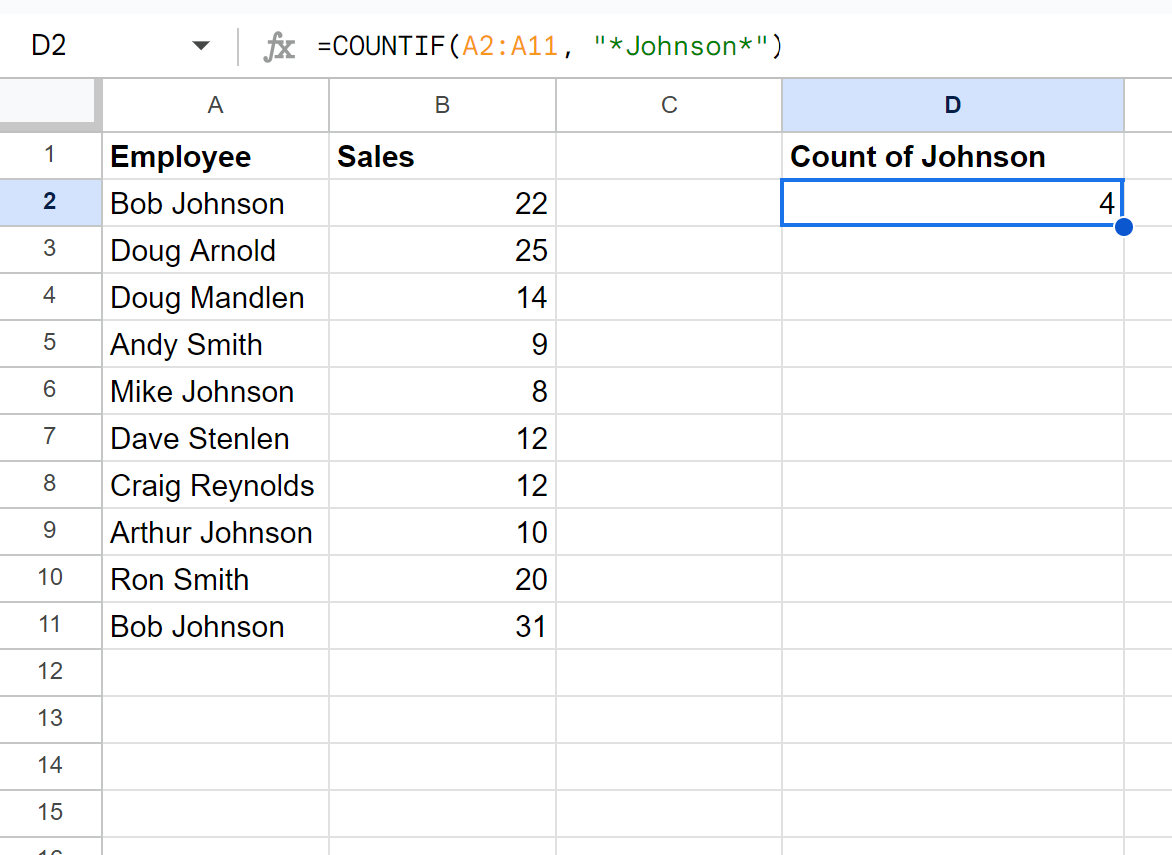
يرتكز البناء المنطقي لهذه المعادلة على إحاطة الكلمة المفتاحية المستهدفة “Johnson” برمز النجمة من الجهتين؛ فالنجمة الأولى * الموضوعة في بداية المعيار تعني إخطار المحرك الحاسوبي بقبول أي عدد من المحارف (بما في ذلك الصفر من المحارف) قبل الحرف “J”. والنجمة اللاحقة * الموضوعة في نهاية المعيار تعني قبول أي تسلسل نصي يأتي بعد الحرف الأخير “n”. وبالتالي، يتحول المعيار من اشتراط التطابق الكلي للمحتوى إلى اشتراط احتواء الخلية على السلسلة النصية المحددة كجزء من تكوينها العام أينما كان موقعها.
تمنح هذه الصياغة الدالة مرونة استثنائية لرصد الاسم المستهدف في شتى المواضع الهيكلية داخل الخلية؛ فسواء ورد الاسم في بداية النص كما في “Johnson, Alice”، أو توسط السلسلة كما في “Mark Johnson Smith”، أو جاء في نهاية النص كما في الصيغة القياسية “Bob Johnson”، فإن محرك جداول جوجل سيقيم الخلية كاستيفاء صحيح وموجب للمعيار، مما يتيح تجميع الحالات النصية المتفرقة تحت مظلة إحصائية واحدة متكاملة دون الحاجة لكتابة معادلات منفصلة لكل موضع محتمل.
5.2 تفسير النتيجة المحتسبة في ضوء مجموعة البيانات المدخلة
عند تنفيذ المعادلة =COUNTIF(A2:A11, "*Johnson*") على النطاق المرجعي للدراسة، يُسفر الحساب التلقائي عن إرجاع القيمة الرقمية (4). يوضح التحليل المقارن بين هذه النتيجة ونتيجة المثال الأول (التي توقفت عند 2 فقط) اتساع النطاق الشمولي للدالة بعد توظيف محارف البدل؛ فالقيمة الجديدة تعكس التقاط كافة التنويعات النصية التي استبعدتها المطابقة التامة في الخطوة السابقة، وتجميعها ضمن مؤشر التكرار الكلي للقب المستهدف.
بتشريح السجلات الأربعة التي استوفت المعيار، نجد أنها تشمل: السجلين التقليديين للاسم المتطابق تاماً “Bob Johnson”، بالإضافة إلى السجل المشتمل على الاسم المركب “Alice Johnson”، والسجل الذي يضم الكيان المشتق “Johnsonville” (أو أي صيغة اسمية مماثلة تتضمن السلسلة المرجعية). يبرز هذا الحصر الشامل قدرة الصيغة على استيعاب تباينات الإدخال الميداني والتغلب على عدم اتساق التنسيقات الفردية التي عادة ما تصاحب عمليات جمع البيانات المفتوحة.
ومع ذلك، ينبغي للمحلل الإحصائي توخي الحذر الشديد وفحص النطاق بدقة؛ إذ إن التطابق الجزئي الشامل قد يترتب عليه في بعض الحالات ضم سجلات غير مرغوبة لا تنتمي حقيقة إلى الفئة المدروسة، مثل احتساب الاسم الجغرافي “Johnsonville” أو أسماء مركبة ذات دلالات مختلفة تماماً لمجرد احتوائها على السلسلة الحرفية ذاتها. يمثل هذا التحدي المفاهيمي الفارق الأساسي بين الكفاءة الاسترجاعية للخوارزمية ودقتها الاصطفائية، وهو ما سنفصله في التحليل المقارن لاحقاً.
5.3 الدمج الديناميكي بين محارف البدل ومراجع الخلايا
لضمان الاستدامة المنهجية لملفات التحليل، تبرز الحاجة إلى الجمع بين مرونة محارف البدل وقوة مراجع الخلايا المتغيرة. تتطلب هذه العملية صياغة تركيبية خاصة تدمج بين الرموز النصية المحجوزة وقيم المتغيرات عبر استخدام مشغل الربط النصي (Ampersand: &). يتم بناء هذه المعادلة بالشكل النموذجي التالي: =COUNTIF(A2:A11, "*" & C2 & "*")، حيث يتم استدعاء القيمة المكتوبة في الخلية C2 وإحاطتها ببادئة ولاحقة نجمية بشكل برمجي ديناميكي.
يعتمد المبدأ التشغيلي لهذه الصيغة على آلية التجميع التسلسلي للسلاسل النصية (String Concatenation)؛ حيث يقوم محرك جداول جوجل أولاً بتقييم التعبير "*" & C2 & "*" قبل تمريره إلى المعامل الثاني لدالة COUNTIF. فإذا كانت الخلية C2 تحتوي على السلسلة “Johnson”، فإن مشغل الربط يقوم بدمج النجمة الأولى مع الكلمة ثم دمج النجمة الثانية، ليتحول المعيار داخلياً وبشكل تلقائي إلى الصيغة المتطابقة تماماً مع المعيار الحرفي "*Johnson*" دون أي تدخل يدوي.
يقضي هذا الأسلوب الرياضي المتقدم على الأخطاء التركيبية الشائعة التي يقع فيها المستخدمون عند محاولة وضع محارف البدل مباشرة داخل مراجع الخلايا دون فواصل ربط صريحة (مثل كتابة "*C2*" والتي يفسرها البرنامج خطأً بالبحث الحرفي عن الكلمة “C2” محاطة بنجوم بدلاً من استدعاء محتوى الخلية). يتيح هذا النموذج الديناميكي بناء أدوات استعلام إحصائية قوية تقبل التحديث اللحظي لأي لقب أو مقطع اسمي بمجرد تعديل المدخل في خلية التحكم المرجعية.
6. المثال الثالث: حساب عدد الخلايا المحتوية على أحد الأسماء المتعددة (Multiple Criteria)
6.1 الأسس الرياضية للجمع المنطقي لدوال COUNTIF المتعددة
تفرض بعض السيناريوهات الإحصائية المتقدمة حساب الحجم التراكمي لعدة فئات اسمية متباينة داخل النطاق نفسه، كأن يستهدف الباحث معرفة إجمالي عدد السجلات التي تحمل لقب “Johnson” أو لقب “Smith”. في بيئات الجداول الحسابية، لا توفر دالة COUNTIF المفردة قدرة ذاتية على معالجة معيارين مستقلين يستندان إلى رابط الانفصال المنطقي (OR Logic) ضمن معامل المعيار الواحد. ولمعالجة هذا القيد الهيكلي، يتم اللجوء إلى مبدأ الإضافة البوليانية (Boolean Addition) عبر بناء معادلة جمع خطية تدمج بين عمليتي عد مستقلتين.
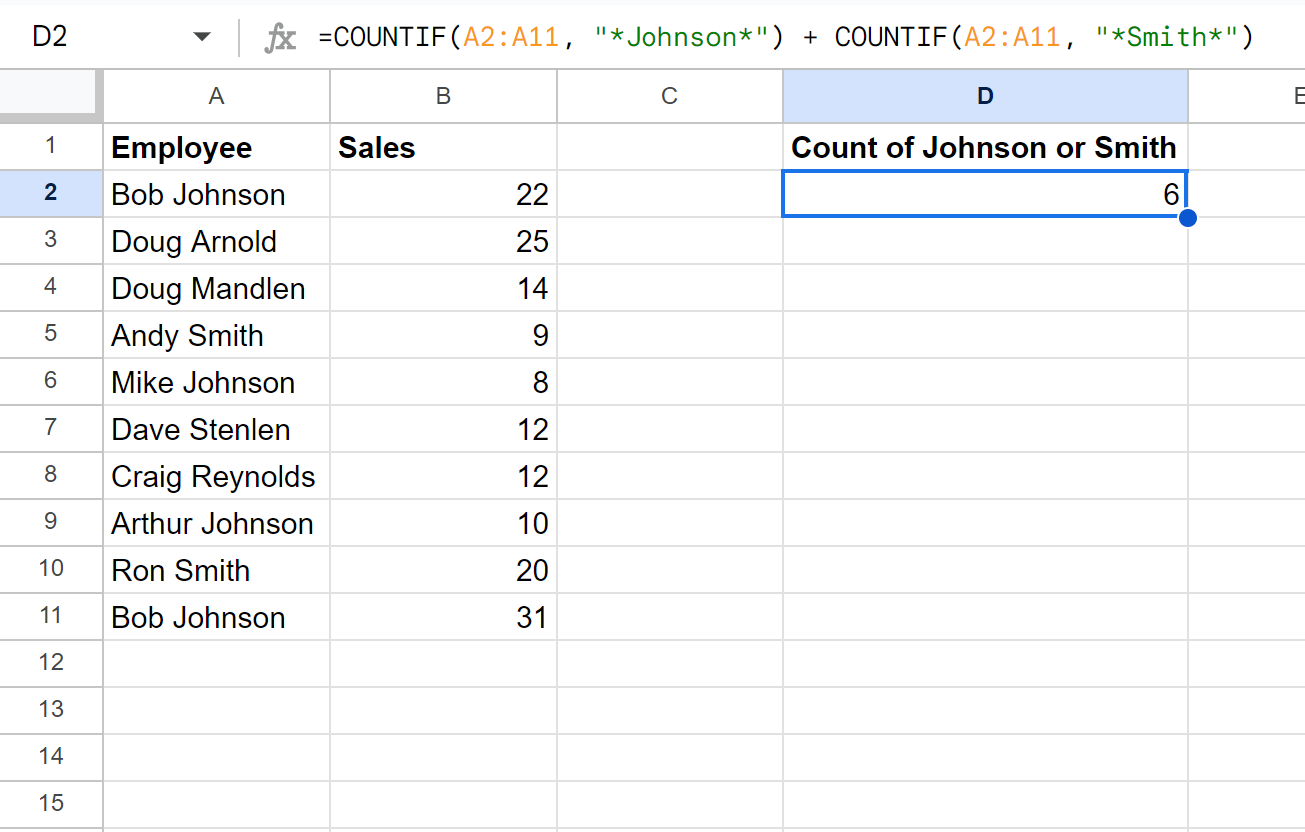
تأخذ المعادلة المركبة الموجهة لهذا الغرض الصيغة الرياضية التالية: =COUNTIF(A2:A11, "*Johnson*") + COUNTIF(A2:A11, "*Smith*"). تعتمد هذه الهندسة الحسابية على تشغيل عمليتي مسح متوازيتين؛ تقوم الدالة الأولى بمسح النطاق A2:A11 واستخراج التكرار المطلق للقب الأول، بينما تقوم الدالة الثانية بمسح النطاق ذاته بصورة مستقلة تماماً لاستخراج التكرار المطلق للقب الثاني، ومن ثم يتولى مشغل الجمع الرياضي (+) دمج الناتجين في قيمة إحصائية نهائية واحدة.
يمتاز الجمع الخطي المباشر لدوال COUNTIF المتعددة بالبساطة المفاهيمية والوضوح الإجرائي، حيث يتجنب التعقيدات التركيبية للدوال المصفوفية الثقيلة التي قد يصعب تصحيحها أو صيانتها من قبل باحثين آخرين. كما يتيح هذا الأسلوب التحكم المنفصل في شروط كل طرف من أطراف المعادلة، كأن يتم تطبيق مطابقة تامة على الاسم الأول مع تطبيق مطابقة جزئية على الاسم الثاني وفق متطلبات التصنيف المحددة في خطة البحث العلمي.
6.2 المعالجة الحسابية لمجموعات الأسماء المنفصلة والمتداخلة
عند تطبيق المعادلة المركبة =COUNTIF(A2:A11, "*Johnson*") + COUNTIF(A2:A11, "*Smith*") على النطاق النموذجي، تُظهر النتيجة الحسابية التراكمية القيمة (7)، بافتراض احتواء النطاق على 4 سجلات للقب الأول و3 سجلات للقب الثاني. تعكس هذه القيمة الإجمالية التوزيع التكراري المشترك للفئتين المستهدفتين، مما يوفر مؤشراً سريعاً لحجم التمثيل النسبي للمجموعتين مجتمعتين مقارنة بالحجم الكلي للعينة المدروسة.
غير أن هذه المنهجية الحسابية تصطدم بمعضلة إحصائية بالغة الخطورة تُعرف بمعضلة “الحساب المزدوج” (Double-Counting) في حال احتواء البيانات على مجموعات متداخلة غير منفصلة (Non-mutually Exclusive Sets). فإذا وُجدت خلية واحدة داخل النطاق تشتمل على كلا الاسمين معاً (مثل احتواء الخلية على الاسم الثنائي “Bob Johnson-Smith” أو ورود شراكة عمل تضم “Alice Johnson and John Smith”)، فإن الدالة الأولى ستقوم باحتساب هذه الخلية كتحقق صحيح لمعيارها، وستقوم الدالة الثانية باحتساب الخلية ذاتها مرة أخرى كتحقق صحيح لمعيارها الثاني، مما يؤدي إلى عد السجل نفسه مرتين وتضخيم النتيجة الإحصائية بصورة وهمية تخل بصدق النتائج.
لتفادي هذا الانحياز الرياضي عند الشك في وجود خلايا مشتركة، يتعين على المحلل اتخاذ إجراءات احترازية، إما عن طريق إضافة حد خصم جبري يطرح الخلايا المشتركة كمعادلة: - COUNTIFS(A2:A11, "*Johnson*", A2:A11, "*Smith*")، أو اللجوء إلى الدوال المتقدمة التي تقيم الشرط المنطقي الانفصالي كفحص مركب لمرة واحدة لكل سطر داخل النطاق، وهو ما يضمن دقة التمثيل الإحصائي ومنع التداخل التكراري غير المبرر.
6.3 بدائل تركيبية متقدمة باستخدام المصفوفات لحساب أسماء متعددة
عندما تتسع دائرة البحث لتشمل قائمة طويلة من الأسماء تتجاوز اسمين أو ثلاثة، تصبح كتابة دوال متكررة وموصولة بعلامات الجمع اليدوية عملية شاقة وعرضة للخطأ وتفتقر إلى الأناقة البرمجية. كبديل معياري متقدم، يمكن توظيف المعالجة المصفوفية المدمجة التي تتيح تمرير قائمة من المعايير داخل دالة COUNTIF وتغليفها بدالة الجمع SUM وفق الصيغة التالية: =SUM(COUNTIF(A2:A11, {"*Johnson*", "*Smith*"})).
تعتمد هذه الصيغة على إنشاء ثابت مصفوفي (Array Constant) محاط بأقواس معقوفة {...} يتضمن كافة المعايير النصية المستهدفة مفصولة بفواصل. يتعامل محرك جداول جوجل مع هذه الصيغة بإجراء تقييم متعدد الأبعاد، حيث يُرجع متجه مصفوفي داخلي يحتوي على نتيجة العد لكل عنصر من عناصر المصفوفة على حدة، ثم تتدخل دالة SUM لجمع عناصر هذا المتجه وإرجاع الرقم الإجمالي التراكمي في خطوة حاسوبية موحدة وذات كفاءة معمارية عالية.
يقدم هذا النمط المصفوفي ميزة توسعية هائلة؛ إذ يمكن للمحلل إضافة عشرات الأسماء أو الألقاب إلى مصفوفة الفحص بكل سلاسة بمجرد إدراج نصوص جديدة بين الأقواس المعقوفة، دون المساس بالبنية الهيكلية للمعادلة أو التوسع الأفقي المفرط في شريط الصيغ. ورغم قوتها، تظل هذه الطريقة أيضاً عرضة لمأزق الحساب المزدوج في حال وجود أسماء مشتركة في الخلية الواحدة، مما يستدعي دوماً التحقق المسبق من طبيعة انفصال الفئات الاسمية داخل مصفوفة التحليل.
7. تحليل مقارن للمنهجيات الثلاث وتقييم حدود تطبيقها
7.1 مقارنة الدقة المنهجية وهامش الخطأ بين الأمثلة الثلاثة
تتباين المنهجيات الثلاث المتبعة في حساب الأسماء تبايناً جوهرياً في مستوى الصرامة الإجرائية، ونوعية هامش الخطأ المحتمل حدوثه أثناء المعالجة الإحصائية. تتميز منهجية المطابقة التامة (Exact Match) بأعلى درجات الصلابة التحليلية؛ حيث ينعدم فيها احتمال تسجيل نتائج إيجابية كاذبة (False Positives)، نظراً لاشتراطها التطابق الحرفي المطلق للمصفوفة النصية. إلا أن هذا التشدد يرفع في المقابل من احتمال الوقوع في أخطاء سلبية كاذبة (False Negatives)، حيث تفشل الصيغة في احتساب السجلات التي تمثل الشخص المستهدف فعلياً لمجرد وجود خطأ مطبعي طفيف، أو مسافة بيضاء غير مقصودة، أو لقب تكميلي لم يتم إدراجه في نص المعيار.
في الاتجاه المقابل، تعكس منهجية التطابق الجزئي (Partial Match) كفاءة استرجاعية مرتفعة تجعلها قادرة على اصطياد كافة التنويعات النصية ذات الصلة، مما يقلل بشكل ملموس من الأخطاء السلبية الكاذبة ويضمن شمولية العينة المرصودة. بيد أن هذه المرونة تمثل في الوقت ذاته نقطة ضعفها المنهجية؛ إذ يرتفع هامش الوقوع في النتائج الإيجابية الكاذبة بشكل كبير نتيجة احتساب سلاسل نصية تتشابه عارضاً مع المعيار ولكنها تنتمي إلى كيانات مختلفة كلياً. يتطلب الاعتماد على التطابق الجزئي تدقيقاً لاحقاً ومراجعة عينية لمخرجات الفرز لضمان عدم تسلل مدخلات غريبة تشوه النقاء الإحصائي لقاعدة البيانات.
أما منهجية الجمع المنطقي للشروط المتعددة (Multiple Criteria)، فإنها تمثل نموذجاً هجيناً تتوقف دقته على طبيعة تركيبة المعايير الفرعية المستخدمة (سواء كانت تامة أو جزئية). تكمن الخطورة المنهجية الأبرز في هذه المقاربة في الأثر التراكمي للانحيازات؛ فالأخطاء الإيجابية في كل طرف تتضاعف بالجمع الرياضي، وتزداد حدة الانحراف الإحصائي كلما تداخلت فئات العينة وحدث حساب مزدوج للسجلات. يتطلب التطبيق الرصين لهذه المنهجية استقلالية إحصائية تامة بين المجموعات المفحوصة لضمان صدق الاستدلال الرياضي.
7.2 جدول معايير الاختيار المنهجي حسب طبيعة البحث والبيانات
يوضح الجدول المقارن التالي محددات الاختيار المنهجي بين التقنيات الثلاث، بناءً على الخصائص الهيكلية للبيانات والأهداف التحليلية للدراسة، لتسهيل عملية اتخاذ القرار التقني السليم من قبل الباحثين ومحللي البيانات:
| المعيار التحليلي | المثال الأول: المطابقة التامة (Exact Match) | المثال الثاني: المطابقة الجزئية (Partial Match) | المثال الثالث: الشروط المتعددة (Multiple Criteria) |
|---|---|---|---|
| صيغة الدالة المعيارية | =COUNTIF(A2:A11, "Bob Johnson") |
=COUNTIF(A2:A11, "*Johnson*") |
=COUNTIF(A2:A11, "*Johnson*") + COUNTIF(A2:A11, "*Smith*") |
| الهدف الإحصائي الأساسي | التحقق الحصري وتحديد التكرار الفردي الدقيق. | رصد الأصول العائلية والأسماء المشتركة والتنويعات. | حساب التوزيع التكراري التراكمي لفئات متعددة. |
| حساسية المسافات واللواحق | مرتفعة جداً (أي اختلاف يؤدي للاستبعاد). | منخفضة (تتجاهل النصوص السابقة واللاحقة). | متغيرة (تتبع طبيعة صياغة كل معيار فرعي). |
| مخاطر التحيز الإحصائي | نتائج سلبية كاذبة (False Negatives). | نتائج إيجابية كاذبة (False Positives). | الحساب المزدوج وتضخم النتائج (Double-Counting). |
| سياق التطبيق الموصى به | سجلات الحضور، المعرفات الأكاديمية، الفحص الأمني. | تحليل الألقاب، السجلات الحرة غير المعيارية. | دمج الفئات المهنية، التوزيعات المسحية المتنوعة. |
يتضح من هذا التأطير المقارن أن الاختيار بين المنهجيات ليس مسألة تفضيل تقني عشوائي، بل هو قرار منهجي ينبغي أن يستند إلى طبيعة البيانات ومستوى النقاء المطلوب في المخرجات؛ فالمطابقة التامة تظل المعيار الذهبي عند غياب المرونة والحاجة للتحقق الفردي القطعي، في حين تمثل المطابقة الجزئية والجمع المنطقي حلولاً لا غنى عنها في معالجة البيانات غير المهيكلة والتصنيفات المركبة.
8. التحديات التقنية الشائعة وأساليب استكشاف الأخطاء وإصلاحها
8.1 معالجة المسافات غير المرئية والمحارف الشبحية (Invisible Characters)
تشكل المسافات غير المرئية والمحارف الشبحية التحدي التقني الأكثر إرباكاً في معالجة البيانات النصية داخل جداول بيانات جوجل. تتمثل هذه الإشكالية في وجود مسافات بادئة (Leading Whitespaces) أو مسافات لاحقة (Trailing Whitespaces) أضيفت سهواً أثناء إدخال الاسم، مما يجعل الخلية تبدو للعين المجردة مطابقة تماماً للمعيار، لكنها في الواقع تحتوي على كود محرفي إضافي يحول دون تحقق المساواة المنطقية في دالة COUNTIF. يؤدي هذا الخلل الخفي إلى انخفاض غير مبرر في القيم المحتسبة وتوليد نتائج سلبية كاذبة يصعب اكتشافها بالفحص السريع.
للتغلب الجذري على هذه العقبة، توفر بيئة جداول جوجل دوالاً متخصصة في تطهير النصوص، في مقدمتها الدالة المعيارية TRIM. تقوم هذه الدالة بإزالة كافة المسافات البادئة واللاحقة، مع تقليص المسافات المتعددة المتتالية بين الكلمات إلى مسافة فاصلة واحدة فقط. يُنصح المحللون بتمرير مصفوفة الأسماء عبر عمود مساعد يطبق الصيغة =TRIM(A2)، أو تطبيق الدالة بشكل مصفوفي شامل لتوليد نطاق مطهر يُعتمد كمرجع رسمي لكافة عمليات العد والحساب اللاحقة.
إلى جانب المسافات العادية، قد تتسلل محارف غير قابلة للطباعة (Non-printable Characters) عند استيراد البيانات من ملفات خارجية مثل ملفات CSV أو قواعد بيانات الويب القديمة. تظهر هذه الرموز كفراغات أو شفرات غير مرئية تفشل معها حتى دالة TRIM. هنا يأتي دور الدالة CLEAN التي تعمل على إزالة المحارف الوظيفية غير المطبوعة ومحارف التحكم في النظام (ASCII 0-31)، مما يضمن تنقية السلاسل النصية واستعادة نقائها الرقمي بصورة تعيد للمطابقة الشرطية دقتها وموثوقيتها.
8.2 إشكاليات التوحيد الإملائي للأسماء وتأثيرها على نتائج الدوال
تفرض الخصائص الصوتية والإملائية للغات تحديات بالغة التعقيد على خوارزميات العد النصي، وتتجلى هذه الصعوبة بوضوح في معالجة الأسماء باللغة العربية، نظراً للتنوع الواسع في رسم الحروف المتقاربة. من أبرز هذه التحديات التباين في كتابة الهمزات؛ فالخلط بين الألف المهموزة (أ، إ، آ) والألف المجردة (ا) يؤدي بالضرورة إلى انقسام الاسم الواحد إلى مدخلات متعددة ومستقلة برمجياً. كذلك يبرز التحدي في استخدام حرف الياء والياء غير المنقوطة (الألف المقصورة: ى)، فضلاً عن التداخل الشائع بين التاء المربوطة (ة) والهاء (ه) في نهايات الأسماء والألقاب.
إن تطبيق دالة COUNTIF البسيطة على نطاق يحتوي على تباينات من قبيل “أحمد” و”احمد”، أو “مصطفى” و”مصطفي”، سيؤدي حتماً إلى إسقاط نصف السجلات تقريباً من مخرجات العد، نظراً لتعامل المحرك مع كل رسم كرمز مستقل في جدول المحارف. لمعالجة هذا القصور، يتعين على المحلل اللجوء إلى استراتيجيات التوحيد المسبق (Normalization)، والتي تتضمن استخدام مصفوفات الاستبدال التلقائي عبر دوال النصوص مثل SUBSTITUTE لتوحيد أشكال الهمزات والياءات قبل الشروع في بناء دوال العد، مما يؤسس لمصفوفة موحدة القياس.
كحل بديل فائق التطور، يمكن تجاوز دوال المطابقة التقليدية والانتقال إلى الدوال المدعومة بالتعبيرات النمطية (Regular Expressions) مثل الدالة REGEXMATCH. تتيح هذه الأدوات المتقدمة بناء فئات محارف مدمجة (Character Classes) داخل معيار الفحص، مثل كتابة نمط يقبل الحرف بأي من أشكاله المتعددة، مما يمكن الدالة من مطابقة كافة التنويعات الإملائية للاسم في خطوة حسابية واحدة دون إخلال ببيانات الإدخال الأصلية أو الحاجة لتعديلها اليدوي.
8.3 تشخيص الأخطاء التركيبية وتصحيح بنية الصيغ الحسابية
أثناء بناء الصيغ المركبة وتوسيع نطاقاتها، قد يواجه المستخدمون رسائل أخطاء حاسوبية تعطل عمل الورقة بالكامل، ويأتي في مقدمتها خطأ تحليل الصيغة الحسابية المشهور (#ERROR!). ينشأ هذا الخطأ التركيبي (Syntax Error) عادة نتيجة عدم اكتمال البنية اللغوية للمعادلة، كنسيان إغلاق أحد الأقواس المزدوجة، أو إسقاط إحدى علامات التنصيص المحيطة بالمعيار النصي، أو كتابة معاملات الربط النصي (&) بشكل ملاصق للمتغيرات دون مراعاة الفواصل التركيبية المعتمدة في مفسر جوجل.
من الأسباب الشائعة أيضاً لهذا الخطأ حدوث خلط بين علامات الفصل المستخدمة بين معاملات الدوال؛ حيث تختلف علامة الفصل الافتراضية تبعاً للإعدادات الإقليمية (Locale Settings) لورقة العمل في جداول جوجل. في الأنظمة التي تستخدم النقطة كفاصلة عشرية (مثل الولايات المتحدة والمملكة المتحدة)، تكون الفاصلة العادية (,) هي الأداة المعتمدة للفصل بين النطاق والمعيار =COUNTIF(A2:A11, "Name")، بينما في الأنظمة التي تستخدم الفاصلة كعلامة عشرية (مثل بعض الدول الأوروبية وأمريكا اللاتينية)، تُعتمد الفاصلة المنقوطة (;) للفصل بين المعاملات =COUNTIF(A2:A11; "Name"). إن محاولة استخدام الفاصلة الخاطئة ستؤدي فوراً إلى فشل التحليل وظهور الخطأ الهيكلي.
يتضمن بروتوكول التصحيح أيضاً التدقيق في مرجعية النطاقات الجغرافية؛ فالسحب غير المنضبط للصيغ عبر خلايا ورقة العمل يؤدي إلى انزلاق النطاق النسبي (مثلاً تحول A2:A11 إلى A3:A12 ثم A4:A13)، وهو ما يتسبب في إسقاط صفوف عليا واحتساب صفوف فارغة سفلى دون أن يصدر البرنامج أي رسالة تحذيرية صريحة. يقتضي تصحيح هذا الخطأ الصامت التثبيت الفوري للمصفوفات المرجعية عبر إدراج علامات الدولار ($A$2:$A$11)، مما يضمن استقرار الحدود الرياضية للنطاق المشمول بالتحليل.
9. التكامل والترقية: الانتقال إلى دوال التعبير النمطي (RegEx)
9.1 تجاوز القيود الوظيفية لدالة COUNTIF التقليدية
على الرغم من المرونة العالية التي تقدمها دالة COUNTIF بالاقتران مع محارف البدل التقليدية، إلا أنها تظل مقيدة بحدود وظيفية واضحة تجعلها غير قادرة على تلبية متطلبات الاستعلام شديدة التعقيد. فعلى سبيل المثال، تعجز محارف البدل البسيطة (النجمة وعلامة الاستفهام) عن التمييز الدقيق لحدود الكلمات المنفصلة (Word Boundaries)؛ فالبحث عن *Dan* بهدف حصر الاسم “Dan” سيؤدي حتماً إلى احتساب الأسماء المشتقة مثل “Daniel” و”Jordan” و”Dana”، وهو ما يولد تداخلاً إحصائياً غير مرغوب فيه يصعب عزله باستخدام المعايير القياسية وحدها.
هنا تتجلى الحاجة العلمية والعملية للترقية نحو التعبيرات النمطية (Regular Expressions – RegEx). تمثل التعبيرات النمطية لغة برمجية قياسية قائمة بذاتها مخصصة لمطابقة الأنماط النصية المعقدة وفحص تراكيبها المجهرية. توفر التعبيرات النمطية أدوات تمكينية متقدمة تشمل فئات المحارف، والمحددات الكمية، ومحددات البداية والنهاية، والروابط المنطقية الموجهة، مما يمنح المحلل سلطة مطلقة في توصيف الاسم المستهدف وتمييزه بدقة متناهية تفوق بمراحل الإمكانات المحدودة للدوال التقليدية.
إن الانتقال إلى محركات التعبير النمطي في جداول جوجل لا يعالج فقط مشكلة حدود الكلمات وتفادي التشابهات العارضة، بل يتيح أيضاً التحكم الحصري في مسألة حساسية حالة الأحرف، والتعامل المرن مع التباينات الإملائية المتزامنة ضمن صياغة استعلامية مكثفة وموجزة. هذا التكامل البرمجي يحول ورقة العمل من مجرد جدول حسابي بسيط إلى بيئة متقدمة لتنقية واستخلاص البيانات النصية الضخمة بكفاءة واقتدار.
9.2 تطبيق الدالة ARRAYFORMULA مع REGEXMATCH لحساب التكرارات المعقدة
لتحقيق قوة التعبيرات النمطية في عمليات العد التكراري، يتم بناء تركيبة دالية متقدمة تدمج بين دالة معالجة المصفوفات ARRAYFORMULA، ودالة الفحص النمطي REGEXMATCH، مع دالة العد COUNTIF. تأخذ الصيغة الرياضية المتكاملة النموذج التالي: =COUNTIF(ARRAYFORMULA(REGEXMATCH(A2:A11, "(?i)bJohnsonb")), TRUE). تمثل هذه الصيغة النسيجية قمة التطور في تقنيات الفرز النصي داخل جداول بيانات جوجل.
لتفكيك المنطق الإجرائي لهذه الصيغة المتقدمة، نجد أن دالة REGEXMATCH تتولى فحص السلسلة النصية ومطابقتها مع النمط المحدد. يشتمل هذا النمط على المعامل (?i) الذي يفرض تجاهل حالة الأحرف اختيارياً، محاطاً بالمحدد البنيوي b من الطرفين، والذي يمثل قيد “حدود الكلمة” (Word Boundary). هذا القيد الصارم يضمن مطابقة الكلمة “Johnson” ككيان مستقل ومكتمل، ويمنع احتسابها إذا وردت كجزء من كلمة أطول مثل “Johnsonville”. وبفضل تغليف العملية بدالة ARRAYFORMULA، يتم تطبيق هذا الفحص تلقائياً على كل خلية في النطاق A2:A11، لينتج داخلياً مصفوفة من القيمتين المنطقيتين (TRUE/FALSE)، ثم تتولى دالة COUNTIF الخارجية حساب عدد الخلايا التي أرجعت القيمة (TRUE).
تفتح هذه المنهجية آفاقاً غير محدودة أمام الباحث الإحصائي؛ حيث يمكن على سبيل المثال استخدام الرمز الرأسي | داخل التعبير النمطي لتحقيق منطق الاختيار (OR Logic) المتقدم: "(?i)b(Johnson|Smith)b". تضمن هذه الصياغة حساب الخلايا التي تحتوي على أي من الاسمين بدقة، مع الحماية المطلقة والتلقائية من مأزق الحساب المزدوج؛ فالخلية التي تحتوي على كلا الاسمين ستقوم دالة REGEXMATCH بتقييمها مرة واحدة فقط بالقيمة (TRUE)، وبالتالي تُحتسب كوحدة إحصائية مفردة، مما يوفر حلاً جذرياً لأعقد الإشكاليات التي تواجه طرق العد التقليدية.
10. بروتوكولات التوثيق العلمي والحفاظ على موثوقية التحليلات الاسمية
10.1 أفضل الممارسات الأكاديمية لتوثيق الصيغ والبيانات الوصفية
تقتضي النزاهة العلمية ومعايير الجودة في البحوث المؤسسية والأكاديمية إرساء نظام توثيقي صارم يحيط بكافة مراحل المعالجة الرياضية للبيانات. في مقدمة هذه الممارسات تأتي ضرورة التوثيق الشفاف للصيغ المستخدمة من خلال إدراج التعليقات والملاحظات الوصفية (Notes and Comments) مباشرة داخل خلايا الجداول. يجب أن تتضمن هذه الملاحظات شرحاً وافياً للمنطق الرياضي الكامن وراء اختيار كل معادلة، وتوضيح أسباب استخدام محارف البدل أو الاستعانة بمصفوفات الجمع، وتحديد التاريخ الزمني لإنشاء الصيغة وهوية المحلل المسؤول عنها لضمان الشفافية الإجرائية.
من المبادئ المعمارية الجوهرية أيضاً في إدارة البيانات هو الفصل التام بين أوراق البيانات الخام (Raw Data) وأوراق المعالجة والتحليل الإحصائي (Analytics/Output Sheets). إن إدخال الصيغ الحسابية والتعديلات المباشرة ضمن مصفوفة الإدخال الأصلية يعرض البيانات لمخاطر التلف العرضي، أو الحذف غير المقصود، أو تشويه السجلات المرجعية. يضمن عزل البيانات الخام في ورقة مستقلة ومحمية برمجياً بقاء المرجع الأصلي سليماً وقابلاً للرجوع إليه في أي مرحلة من مراحل التحقق أو التدقيق المستقل.
علاوة على ذلك، ينبغي للباحث بناء “قاموس بيانات” وصفي (Data Dictionary) ملحق بجدول التحليل. يحدد هذا القاموس التعريفات الإجرائية للمتغيرات، ويوضح معايير المطابقة المعتمدة (سواء كانت تامة أو جزئية)، ويوثق كيفية التعامل مع الأسماء المركبة، والألقاب، والمسافات البيضاء. هذا التأطير المعرفي يرفع من القيمة العلمية لقاعدة البيانات ويتيح للباحثين الآخرين إعادة إنتاج النتائج بالدقة ذاتها والموثوقية المنهجية المطلوبة في النشر الأكاديمي الرصين.
10.2 المراجعة المتبادلة والتدقيق التكراري لضمان دقة الاستدلال
لا تكتمل العملية التحليلية بمجرد ظهور المخرجات الرقمية للدوال، بل يجب إخضاع تلك النتائج لبروتوكولات المعايرة والتحقق المتبادل (Cross-Validation). يتمثل أحد أكثر الأساليب فاعلية في سحب عينات تدقيق عشوائية (Random Audit Samples) من مصفوفة الأسماء وإجراء حساب يدوي مستقل لها ومقارنته بالنتيجة المحتسبة برمجياً عبر الدوال. يتيح هذا الاختبار الكشف المبكر عن أي انحرافات غير متوقعة أو أخطاء صامتة ناجمة عن الشوائب النصية التي قد تكون أفلتت من مرشحات التطهير الأولي.
كأداة مساعدة شديدة الفاعلية، يُوصى بتوظيف ميزة التنسيق الشرطي (Conditional Formatting) داخل جداول بيانات جوجل للتحقق البصري الموازي. من خلال تطبيق قواعد التنسيق الشرطي باستخدام المعايير النصية ذاتها (مثل تظليل الخلايا التي تطابق المعيار بلون مميز)، يستطيع المحلل استعراض الخلايا التي دخلت فعلياً في الحساب بصرياً والتأكد الفوري من مطابقتها للتوقعات المنهجية، واكتشاف أي حالات إيجابية كاذبة تم تظليلها دون مبرر أو حالات سلبية تم استبعادها بالخطأ.
ختاماً، يجب أن تنعكس هذه الإجراءات التوثيقية والتدقيقية في المتن المنهجي للتقارير البحثية والدراسات التطبيقية. إن الإفصاح الصريح عن الخوارزميات المتبعة، ونسب التوافق المحققة، والحدود التقنية للمطابقة، يعكس التزاماً عميقاً بأخلاقيات البحث العلمي والأمانة الأكاديمية، مما يعزز موثوقية النتائج المستخلصة ويجعلها ركيزة صلبة لبناء القرارات الإدارية والسياسات المؤسسية المبنية على الدليل الرقمي القاطع.
خاتمة
استعرض هذا المقال الأكاديمي الموسع الأبعاد المنهجية والتقنية لحساب البيانات الاسمية والنصية في جداول بيانات جوجل من خلال ثلاثة أمثلة تطبيقية رئيسية. لقد تبين بوضوح أن اختيار الصيغة الرياضية الملائمة—سواء كانت المطابقة التامة عبر =COUNTIF(A2:A11, "Bob Johnson")، أو المطابقة الجزئية بالاستعانة بمحارف البدل عبر =COUNTIF(A2:A11, "*Johnson*")، أو الجمع المنطقي للشروط المتعددة عبر =COUNTIF(A2:A11, "*Johnson*") + COUNTIF(A2:A11, "*Smith*")—يرتبط ارتباطاً وثيقاً بطبيعة الأسئلة البحثية وخصائص مصفوفة البيانات المعالجة.
كما أظهر التحليل العميق أن دقة التحليل الإحصائي لا تتوقف عند سلامة الصيغة الرياضية فحسب، بل تتطلب بالأساس بيئة بيانات مطهرة وخالية من المسافات الشبحية، والتباينات الإملائية، والشوائب الترميزية. إن الإلمام بالبدائل المتقدمة، مثل التعبيرات النمطية (Regular Expressions) وتوظيف مراجع الخلايا الديناميكية، يمنح المحلل أدوات فائقة الدقة لتفادي معضلات شائعة مثل الحساب المزدوج أو النتائج الإيجابية الكاذبة، مما يؤسس لممارسات معالجة بيانات تتسم بالرصانة العلمية والموثوقية التشغيلية في شتى الميادين البحثية والمهنية.
المراجع
- Bobbitt, Z. (2023, September 14). How to Count Names in Google Sheets (3 Examples). Statology. https://www.statology.org/google-sheets-count-names/
- Google. (n.d.). COUNTIF function: Count cells matching a specific criterion. Google Docs Editors Help. https://support.google.com/docs/answer/3093480
- Google. (n.d.). Google Visualization API Query Language Reference. Google Developers. https://developers.google.com/chart/interactive/docs/querylanguage
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.