
تُعدّ معالجة البيانات النصية وتكميمها من الركائز الجوهرية في مختلف حقول البحث العلمي المعاصر، والتحليل الإحصائي، وإدارة الأعمال؛ إذ تمثل النصوص غير المهيكلة مصدراً غنياً بالمعلومات التي تتطلب أدوات دقيقة لتحويلها إلى مؤشرات قابلة للقياس والنمذجة. يواجه الباحثون والمحللون يومياً تدفقات هائلة من المدخلات النصية، بدءاً من استجابات الاستبيانات المفتوحة، والمقابلات النوعية، ووصولاً إلى سجلات المعاملات وقواعد البيانات الضخمة، حيث يبرز التحدي التقني والمنهجي في فرز هذه المفردات وتحديد أنماط تكرارها بدقة متناهية.
إن برنامج مايكروسوفت إكسيل (Microsoft Excel)، منذ انطلاقته التاريخية في منتصف ثمانينيات القرن الماضي، لم يعد مجرد دفتر حسابات رقمي يقتصر على العمليات الحسابية البسيطة والعمليات المالية، بل تطور ليغدو بيئة متكاملة لمعالجة وهندسة البيانات النصية. يتطلب استخلاص التكرارات اللفظية وإدارتها فهماً عميقاً للبنية الخوارزمية للدوال، وكيفية توظيف الصيغ الحسابية التقليدية والمصفوفية، والتعامل مع التحديات اللغوية مثل حساسية حالة الأحرف، والمسافات غير المرئية، والتباينات الإملائية التي قد تشوه النتائج الإحصائية إذا لم تُعالج بصورة منهجية رصينة.
تهدف هذه المقالة المرجعية إلى تقديم دليل تحليلي وتطبيقي شامل ومفصل حول كيفية حساب الكلمات المكررة في إكسيل، مستعرضةً الأسس النظرية والمفاهيم الإحصائية للتوزيعات التكرارية، وموضحةً الخطوات الإجرائية الدقيقة لتنظيف البيانات وهيكلتها، وصياغة الدوال الرياضية البسيطة والمركبة، وتوظيف أدوات التحليل المتقدمة كالجداول المحورية وأداة Power Query. كما يتناول الدليل آليات بناء لوحات التحكم التفاعلية للوصول إلى مخرجات دقيقة تتوافق مع أرقى معايير التحليل الأكاديمي والمهني.
1. مقدمة منهجية لتحليل تكرار البيانات النصية في إكسيل
1.1 أهمية التحليل الكمي للبيانات والمفردات النصية
يمثل التحليل الكمي للبيانات النصية نقلة إبستمولوجية ومنهجية تتيح للباحثين سد الفجوة بين الأبعاد النوعية الوصفية والأبعاد الرياضية الصلبة. إن عملية تحويل المتغيرات الوصفية، مثل الإجابات الحرة للمشاركين في الدراسات الاجتماعية أو توصيفات المنتجات في السجلات الصناعية، إلى مؤشرات كمية ترتكز على التوزيع العددي، تمكّن المحلل من إخضاع هذه الظواهر اللغوية لاختبارات الدلالة الإحصائية، وتحليل الانحدار، والنمذجة المتقدمة. يؤدي قياس تكرار الكلمات دوراً محورياً في استكشاف الأنماط اللغوية الكامنة واستنباط المفاهيم المفتاحية التي تكرس ثقل النص الدلالي، مما يكشف عن التوجهات السائدة داخل المتن المحلل بدقة لا تتيحها القراءة الانطباعية السريعة.
تتجلى أهمية الدقة المنهجية في تتبع الكلمات في تفادي تراكم البيانات المغلوطة وتضخيم النتائج؛ إذ إن أي انحراف في احتساب تكرار لفظة معينة قد يؤدي إلى استنتاجات مضللة تؤثر سلباً على جودة القرارات الاستراتيجية أو مصداقية البحوث الأكاديمية. وقد أكدت الدراسات المتقدمة في المعايير اللغوية، مثل أبحاث برايزبيرت ونيو (Brysbaert & New, 2009)، أن قياس التردد اللفظي بصورة دقيقة يمثل متغيراً حاسماً في فهم زمن الاستجابة الإدراكية والمعالجة المعرفية للمفردات. وتعتمد مجالات شتى على هذا التعداد الدقيق، ومنها تحليل المحتوى الإعلامي، والتقييم النفسي اللغوي لبروتوكولات التفكير الصوتي، والتنقيب في البيانات الطبية والبحثية، حيث تصبح التكرارات مؤشرات موضوعية تعكس الواقع العملي قيد الدراسة.
علاوة على ذلك، يتقاطع هذا الإجراء الإحصائي مع مبادئ تصنيف الخصائص الدلالية للمفاهيم المجردة والملموسة، والتي تتطلب حصر تكرار السمات بدقة بالغة لبناء نماذج معيارية موثوقة (McRae et al., 2005). بالتالي، فإن الحساب الدقيق للمفردات في بيئات الجداول الإلكترونية ليس مجرد مهارة مكتبية عابرة، بل هو إجراء علمي تأسيسي ينقل المعطيات الخام من حالتها المشوشة إلى نسق معرفي منظم يدعم الاستدلال المنطقي والاستنباط الموضوعي.
1.2 المفاهيم الإحصائية الأساسية للتكرار والتوزيع التكراري
يرتكز التحليل الإحصائي للنصوص على التمييز الصارم بين التكرار المطلق (Absolute Frequency) والتكرار النسبي (Relative Frequency)؛ حيث يشير الأول إلى العدد الفعلي الصرف لمرات ظهور المفردة داخل النطاق المدروس دون ربطه بحجم العينة، في حين يمثل التكرار النسبي حاصل قسمة هذا التكرار المطلق على إجمالي عدد الكلمات في المتن، وغالباً ما يُعبَّر عنه بنسبة مئوية أو قيمة عشرية تقع بين الصفر والواحد الصحيح. هذا التمييز يمنح المحلل القدرة على المقارنة المنهجية بين نصوص متباينة الطول دون الوقوع في خطأ التحيز لحجم الوثيقة، وهو ما يتوافق مع القوانين اللغوية الراسخة مثل قانون زيبف (Zipf’s Law) الذي يوضح العلاقة العكسية الرياضية بين رتبة الكلمة وتكرارها النسبي.
ينبغي للباحث أيضاً تحديد مفهوم “المفردة الفريدة” (Unique Token) بدقة وفصلها عن “حالات الظهور” (Instances or Tokens)؛ فالمفردة الفريدة تعبر عن الكلمة في صورتها المجردة المستقلة بصرف النظر عن عدد مرات تواردها في النص، في حين تمثل حالات الظهور المجموع التراكمي لكل استخدام لتلك المفردة. يسهم فهم التوزيع التكراري في تشخيص الكثافة البيانية، وتحديد ما إذا كان المتن يعاني من فقر معجمي أو تركز مفرط حول مصطلحات محددة، كما يساعد في كشف القيم الشاذة، مثل التكرارات الطافرة الناتجة عن أخطاء إدخال البيانات المكررة آلياً أو السجلات التالفة.
يتيح بناء جدول التوزيع التكراري المنظم في برمجيات الجداول الإلكترونية ترتيب البيانات في فئات منتظمة تضم الكلمة، وتكرارها المطلق، ونسبتها المئوية، والتكرار التراكمي المقابل لها. ويشكل هذا الجدول قاعدة صلبة لمتخذ القرار، حيث يمكنه من تقييم الأوزان الدلالية للألفاظ، واستبعاد الكلمات الوظيفية الزائدة، والتركيز على المفاهيم الجوهرية ذات الأثر الفعلي في توجيه التفسيرات التحليلية.
1.3 نظرة عامة على أدوات ودوال إكسيل في معالجة النصوص
يوفر برنامج إكسيل ترسانة متكاملة من الدوال الإحصائية والمنطقية المصممة خصيصاً للتعامل مع البيانات النصية، وتتصدر هذه الأدوات دالة COUNTIF وشقيقتها متعددة المعايير COUNTIFS. تتيح هذه الدوال للمستخدم احتساب تكرار نص محدد أو جزء منه بناءً على شروط منطقية محددة، مع مرونة استخدام أحرف البدل (Wildcards) مثل النجمة (*) وعلامة الاستفهام (?)، مما يمنح المحلل مرونة فائقة في التعامل مع النصوص المتنوعة واكتشاف الكلمات المطابقة كلياً أو جزئياً عبر النطاقات الجغرافية أو الأكاديمية المختلفة.
شهدت الإصدارات الحديثة من إكسيل (مثل Microsoft 365 وExcel 2021 وما تلاها) ثورة وظيفية عبر إدخال محرك المصفوفات الديناميكية (Dynamic Arrays)، والذي أفرز دوالاً بالغة القوة مثل دالة UNIQUE ودالة FILTER ودالة SORT. هذه الدوال قلصت الحاجة إلى كتابة الصيغ المعقدة أو البرمجة باستخدام لغة Visual Basic for Applications (VBA)، حيث بات بالإمكان استخراج كافة المفردات الفريدة من عمود نصي ضخم بضغطة زر واحدة ودون تكرار، لتتوسع النتائج تلقائياً في الخلايا المجاورة.
إلى جانب الصيغ والدوال، تحتل الجداول المحورية (Pivot Tables) مكانة مركزية كأداة تلخيصية تفاعلية تمكّن من استيعاب آلاف السجلات النصية وتلخيصها فورياً بأعلى كفاءة تشغيلية ودون استهلاك مفرط لذاكرة الحاسوب. كما تمثل أداة Power Query المحرك الأقوى لمعالجة البيانات الضخمة (ETL)، حيث تتيح تنظيف، واستخراج، وتجميع الكلمات بدقة خوارزمية مؤتمتة وقابلة للتحديث التلقائي بمجرد تدفق سجلات جديدة إلى النظام.
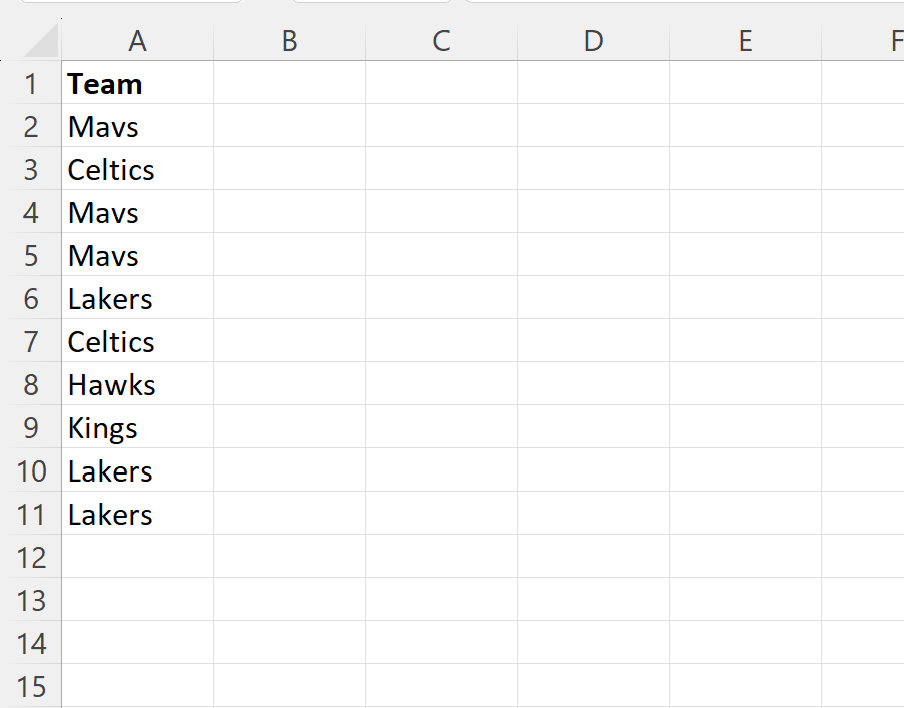
2. إعداد وتنظيم البيانات الأولية قبل المعالجة الإحصائية
2.1 هيكلة جداول البيانات النصية وفق المعايير القياسية
تتطلب المعالجة الإحصائية السليمة للبيانات النصية تصميماً هيكلياً منضبطاً لقواعد البيانات داخل ورقة العمل، حيث يُعد الالتزام بمبدأ “البيانات المرتبة” (Tidy Data) شرطاً لا غنى عنه لتفادي حدوث أخطاء مرجعية أثناء استدعاء الدوال. يقتضي هذا المبدأ وضع كل متغير في عمود مستقل، وتسجيل كل ملاحظة أو مفردة في صف منفرد، مع الابتعاد التام عن ممارسة دمج الخلايا العشوائي (Merged Cells) التي تعد من أكثر الممارسات إضراراً بالبنية الحسابية؛ إذ يتسبب الدمج في تعطيل قراءة النطاقات بواسطة دوال المصفوفات ويؤدي إلى استرجاع قيم فارغة غير متوقعة.
إن تنظيم البيانات النصية يقلل من العبء المعرفي الواقع على الباحث ويسهل إدراك العلاقات البيانية المعقدة، وهو ما تدعمه نظريات معالجة المعلومات والتعلم المعرفي (Pollock et al., 2002)؛ حيث يؤدي التقسيم الهيكلي السليم إلى تفادي الإجهاد الذهني ورفع دقة التدقيق والمراجعة. يجب تسمية رؤوس الأعمدة بأسماء أحادية المعنى وخالية من المسافات الطويلة أو الرموز الخاصة لتسهيل الرجوع إليها في الصيغ المركبة واستخدام مراجع الجداول المنظمة (Structured References).
يُنصح بشدة بتحويل النطاقات التقليدية إلى جداول إكسيل رسمية (Excel Tables) باستخدام الاختصار القياسي Ctrl + T. يضمن هذا الإجراء مرونة فائقة؛ إذ يتمدد الجدول تلقائياً بمجرد إدراج نصوص جديدة في أسفله، مما يعني تحديث كافة الصيغ الرياضية والجداول المحورية المرتبطة به دون الحاجة إلى إعادة ضبط حدود النطاق يدوياً في كل مرحلة من مراحل التحليل.
2.2 تنظيف النصوص وإزالة المسافات الزائدة باستخدام الدوال
تُعد المسافات البيضاء الزائدة من أكثر المشكلات التقنية الخفية المسببة لفشل عمليات التطابق النصي في إكسيل؛ فالبرنامج يتعامل مع السلسلة النصية “علم” متبوعة بمسافة ككيان مستقل تماماً ومختلف عن كلمة “علم” المجردة من المسافات. للتغلب على هذه المعضلة المنهجية، توفر بيئة إكسيل دالة TRIM المتخصصة في إزالة المسافات البادئة واللاحقة، علاوة على تقليص المسافات المتعددة الواقعة بين الكلمات وحصرها في مسافة واحدة قياسية فقط.
عند استيراد النصوص من مصادر خارجية مثل شبكة الإنترنت، أو واجهات برمجة التطبيقات (APIs)، أو ملفات النصوص المصدرية غير المهيكلة، غالباً ما تقترن الكلمات بمحارف غير مرئية وغير قابلة للطباعة (مثل محارف نهاية السطر ASCII 10 أو فاصل الصفحات). هنا تتكامل دالة CLEAN مع دالة TRIM في تركيبة وظيفية مزدوجة تأخذ الصيغة:
=TRIM(CLEAN(A2))
تعمل هذه الصيغة المركبة على تطهير الخلية من كافة الشوائب التشفيرية التي تؤدي إلى انهيار صيغ المطابقة. وبعد الانتهاء من عملية التنظيف عبر عمود مساعد، يُلزم التحليل المنهجي الباحث بنسخ العمود الناتج ولصقه كقيم ثابتة (Paste as Values) عبر الخيار Ctrl + Alt + V، مما يعزل البيانات المطهرة عن ارتباطات الدوال الديناميكية ويوفر أداءً حسابياً أسرع خلال المراحل اللاحقة.
2.3 توحيد صياغة الكلمات ومعالجة الحروف
تتميز اللغة العربية بخصائص صرفية ورسمية تتطلب عناية فائقة أثناء المعالجة الآلية للنصوص؛ إذ يقع العديد من مدخلي البيانات في خطأ الخلط بين أشكال الهمزات المختلفة (أ، إ، آ، ا)، أو التمييز غير المنضبط بين الياء المهملة والألف المقصورة (ي، ى)، وكذا التاء المربوطة والهاء (ة، هـ). يؤدي هذا التباين الإملائي إلى تقسيم الكلمة الواحدة ذات المعنى المتطابق إلى مفردات متعددة في جداول التكرار، مما يشوه النتائج الإحصائية تشويهاً جوهرياً.
يمكن معالجة هذه التحديات عبر استخدام تقنيات البحث والاستبدال المتقدم (Find and Replace)، أو صياغة دوال الاستبدال المتداخلة باستخدام دالة SUBSTITUTE لتوحيد الرسم الإملائي وفق نسق معياري صارم. أما عند التعامل مع مصطلحات أو نصوص باللغات الأجنبية التي تتأثر بحالة الأحرف، فيجب اللجوء إلى دالتي UPPER أو LOWER لتوحيد كافة الكلمات إما بصيغة الحروف الكبيرة أو الصغيرة، وذلك لتفادي ازدواجية النتائج عند تطبيق أدوات حساسة لحالة الخط.
ينبغي أيضاً فحص السجلات للتأكد من تجريد الكلمات من علامات الترقيم الملتصقة بها كالفواصل والنقاط وعلامات التنصيص؛ فوجود كلمة “بيانات،” مقترنة بفاصلة يجعلها تختلف في المنطق الحاسوبي عن كلمة “بيانات” المجردة. يضمن التطهير الإملائي والترقيمي وصول المحلل إلى متن نصي موحد يمثل الواقع الدلالي الفعلي للمفردات محل الدراسة.
3. حساب تكرار كل كلمة منفردة باستخدام دالتي UNIQUE وCOUNTIF
3.1 استخراج قائمة الكلمات الفريدة بواسطة دالة UNIQUE
تمثل دالة UNIQUE حجر الزاوية في المعالجة الحديثة للبيانات داخل إكسيل؛ حيث صُممت خصيصاً لفحص نطاق محدد واستخراج كافة العناصر المختلفة الواردة فيه دون أي تكرار. تعمل هذه الدالة بموجب الصيغة العامة:
=UNIQUE(array, [by_col], [exactly_once])
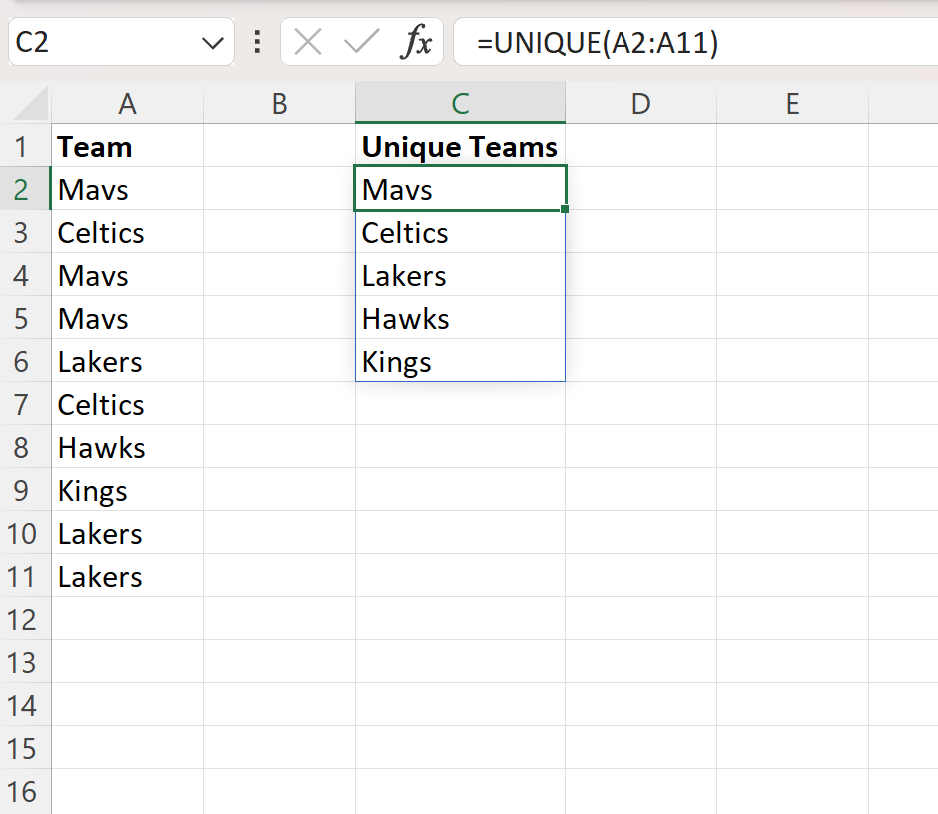
عند تطبيق الصيغة المبسطة =UNIQUE(A2:A11) على نطاق يحتوي على قائمة مفردات نصية، يقوم محرك الحساب باسترجاع كل كلمة وردت لمرة واحدة على الأقل، ويُسقط كافة التكرارات الإضافية بصورة آلية.
تتميز هذه الدالة بسلوك “التمدد التلقائي” (Spill Range)؛ إذ يكفي كتابة المعادلة في خلية عليا واحدة (ولتكن الخلية C2)، ليفيض الناتج في الخلايا الواقعة أسفلها وفقاً لعدد المفردات الفريدة المكتشفة، وتُحاط هذه المخرجات بحد أزرق رفيع يشير إلى ارتباط النطاق بالمصفوفة الأم. هذا السلوك الديناميكي يعني أنه في حال إضافة كلمات جديدة إلى النطاق المصدر، فإن قائمة الكلمات الفريدة ستتحدث فورياً دون أي تدخل يدوي من قبل المحلل.
في المقابل، إذا كان الباحث يعمل على إصدارات تاريخية أو غير محدثة من إكسيل تفتقر إلى محرك المصفوفات الديناميكية، فإن استخراج القيم الفريدة يتطلب مساراً بديلاً يعتمد على أداة “إزالة التكرارات” (Remove Duplicates) الموجودة في تبويب بيانات (Data)، أو استخدام صيغ الفهرسة المعقدة مثل تركيب دالتي INDEX وMATCH مع دالة COUNTIF بصيغة مصفوفية كلاسيكية تستلزم تثبيت الإدخال بالضغط على المفاتيح الثلاثية Ctrl + Shift + Enter.
3.2 الصياغة المنهجية لدالة COUNTIF لحساب التكرار الفردي
عقب استخراج قائمة الكلمات الفريدة وتثبيتها في عمود التحليل (العمود C على سبيل المثال)، تأتي مرحلة حساب تكرار كل مفردة منها في العمود الأصلي باستخدام دالة العد الشرطي الكلاسيكية COUNTIF. تستقبل هذه الدالة معاملين رياضيين رئيسيين وفق الهيكل القياسي:
=COUNTIF(range, criteria)
حيث يمثل المعامل الأول النطاق الجغرافي للبيانات المراد فحصها، بينما يمثل المعامل الثاني الشرط أو القيمة المراد احتساب مرات ظهورها.
تتجلى الدقة المنهجية في هذه الخطوة في تطبيق أسلوب التثبيت المطلق (Absolute Referencing) للنطاق المصدري؛ فإذا كانت البيانات الأصلية موزعة في الخلايا من A2 إلى A11، فإنه يتحتم كتابة النطاق باستخدام علامات الدولار على الصورة $A$2:$A$11. يمنع هذا التثبيت انزلاق النطاق المرجعي إلى أسفل عند سحب الصيغة أو نسخها لتطبيقها على بقية الكلمات، مما يضمن ثبات إطار المعاينة الإحصائية لكل مفردة من المفردات.
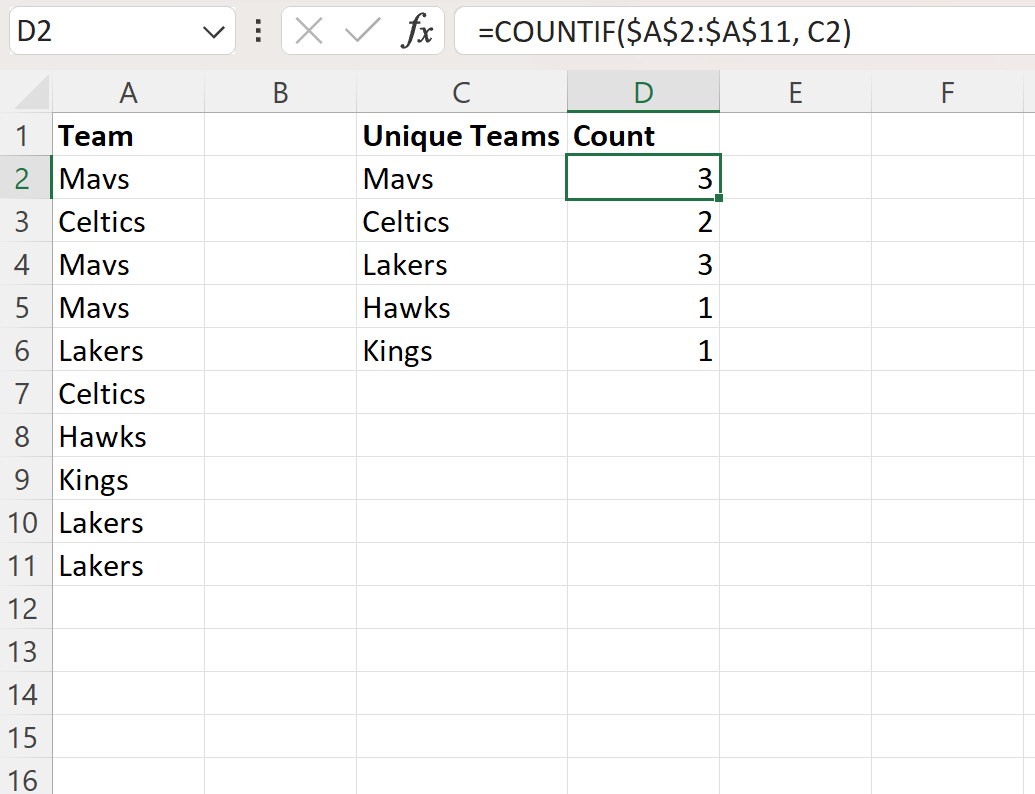
بناءً على ذلك، تأخذ المعادلة التطبيقية المكتوبة في الخلية D2، لحساب تكرار المفردة الأولى المستخرجة في C2، الصيغة النهائية التالية:
=COUNTIF($A$2:$A$11, C2)
عند سحب مقبض التعبئة التلقائية للأسفل المقابل لقائمة الكلمات الفريدة، ستقوم الدالة بحساب التكرار المطلق الدقيق لكل لفظة في العمود المستهدف، مستفيدة من التغير النسبي لمرجع المعيار (C2، C3، C4…) مع ثبات النطاق المرجعي للأصل.
3.3 تحليل مخرجات جدول التكرار ومراجعته إحصائياً
بعد توليد عمود التكرارات، يخضع الجدول الناتج لعملية تدقيق إحصائي صارمة للتأكد من سلامة المعالجة الحسابية وعدم سقوط أي سجل من سجلات المتن. تتمثل الخطوة التحققية الأولى في حساب المجموع التراكمي لكافة التكرارات الفردية المحسوبة عبر دالة SUM ومقارنة هذا الناتج بالعدد الإجمالي لصفوف النطاق الأصلي المحسوب بدالة COUNTA؛ فإذا تطابقت القيمتان تطابقاً تاماً، اعتُبرت البنية الحسابية خالية من التشوهات والانحرافات المرجعية.
يوضح الجدول التطبيقي التالي مثالاً توضيحياً لحساب التكرارات لمجموعة من المفردات النصية المستخلصة من عينة بيانات بحثية:
| النطاق الأصلي (A2:A11) | الكلمات الفريدة (دالة UNIQUE) | التكرار المطلق (دالة COUNTIF) | التكرار النسبي (%) |
|---|---|---|---|
| بيانات | بيانات | 3 | 30% |
| إحصاء | إحصاء | 2 | 20% |
| بحث | بحث | 2 | 20% |
| بيانات | تحليل | 1 | 10% |
| تحليل | نموذج | 1 | 10% |
| بحث | متغير | 1 | 10% |
| إحصاء | – | – | – |
| نموذج | – | – | – |
| متغير | – | – | – |
| بيانات | – | – | – |
| الإجمالي: 10 صفوف | المجموع الفريد: 6 كلمات | المجموع الكلي: 10 | 100% |
يكشف الفحص الدقيق لهذا الجدول عن تمايز إحصائي جوهري؛ حيث تبرز الكلمات ذات التكرار الأحادي (مثل: تحليل، نموذج، متغير) كعناصر تقع في الأطراف التوزيعية، بينما تشكل الكلمات متعددة الظهور (بيانات، إحصاء، بحث) الركائز المركزية للنص. يساعد هذا التوثيق الدقيق للتوزيع التكراري في بناء مؤشرات كمية صلبة تخدم التقارير الأكاديمية والتحليلات الببليومترية بدقة منهجية لا تحتمل اللبس.
4. حساب إجمالي الكلمات المكررة متضمنة الظهور الأول
4.1 التأصيل المنطقي لمفهوم التكرار الشامل
يواجه المحللون في كثير من التطبيقات البحثية حاجة ملحة لقياس حجم “الكتلة التكرارية الشاملة” داخل المتن، وهو ما يُعرف بحساب إجمالي الإدخالات التي تنتمي إلى فئات غير فريدة، مع شمول مرات الظهور الأولى ضمن هذا التعداد. يختلف هذا المفهوم اختلافاً جذرياً عن حساب “فائض التكرار”؛ إذ يهدف التكرار الشامل إلى تحديد النسبة المئوية للبيانات التي تفتقر إلى الفرادة داخل المستودع النصي.
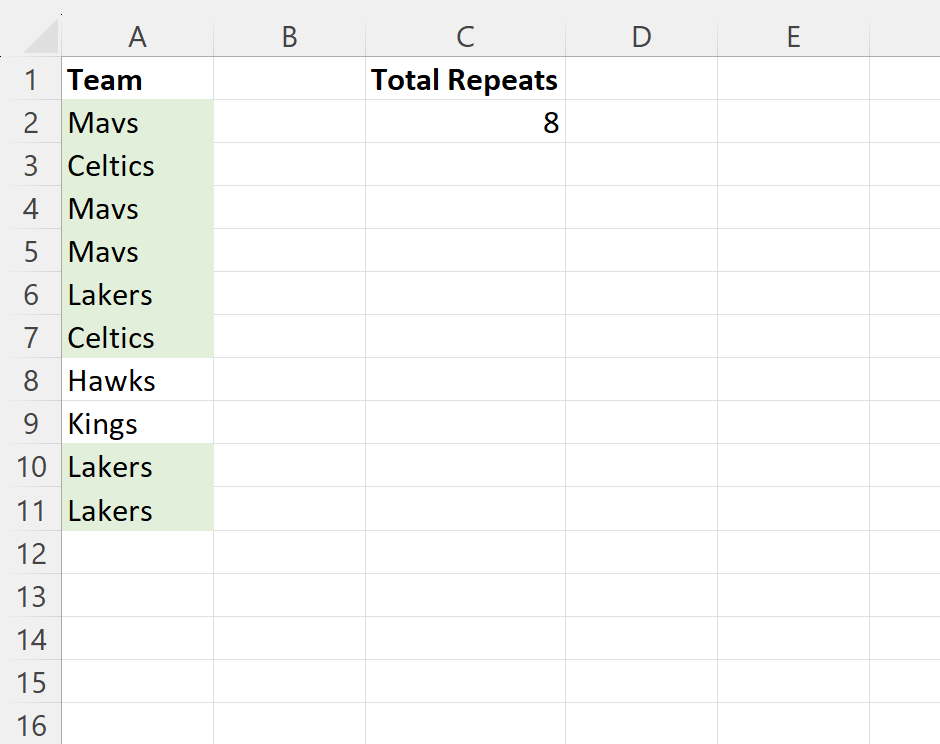
من الناحية الإحصائية، إذا كانت لدينا كلمة مثل “بيانات” تكررت 3 مرات، وكلمة “بحث” تكررت مرتين، وكلمة “متغير” وردت مرة واحدة فقط، فإن حساب التكرار الشامل يعتبر أن كل ظهور لكلمتي “بيانات” و”بحث” هو جزء من منظومة التكرار، وبالتالي يبلغ التعداد الشامل في هذه العينة 5 إدخالات (3 + 2)، في حين يُستبعد فقط ظهور كلمة “متغير” لأنها فريدة مطلقاً ولم يتكرر رسمها داخل العينة.
يستند هذا الأساس الرياضي إلى منطق الاستبعاد الانتقائي؛ فبدلاً من محاولة إحصاء التكرارات المتفرقة بطريقة تصاعدية مشتتة، يقوم التحليل باستبعاد العناصر ذات التردد المساوي للواحد الصحيح (f = 1) من مجمل حجم المتن الإحصائي. يفيد هذا القياس بصورة خاصة في مراجعة الجودة وتحديد مدى تنوع المفردات في النماذج اللغوية، وتقييم حجم التنميط اللفظي في الاستجابات المقروءة.
4.2 تفكيك الصيغة المركبة لحساب التكرار الشامل
لبناء صيغة رياضية موحدة ومحكمة في إكسيل تؤدي وظيفة حساب التكرار الشامل في خطوة واحدة ودون الحاجة لأعمدة مساعدة، يتطلب الأمر دمج عدة دوال مصفوفية بصورة متراكبة. ترتكز هذه الصيغة على أربعة عناصر خوارزمية: دالة ROWS، ودالة COUNTIF، ودالة IF، ودالة SUM.
تعمل دالة ROWS($A$2:$A$11) أولاً على إرجاع العدد الإجمالي لكافة الصفوف المتضمنة في نطاق البيانات (وهو 10 صفوف في مثالنا). بعد ذلك، يُمرر النطاق ذاته كمعامل ومعيار في آن واحد داخل دالة العد الشرطي على الهيئة COUNTIF($A$2:$A$11, $A$2:$A$11)؛ مما يدفع الدالة لتوليد مصفوفة رقمية خفية في الذاكرة تعكس تكرار كل عنصر من عناصر العمود بالترتيب (على سبيل المثال: {3; 2; 2; 3; 1; 2; 2; 1; 1; 3}).
تأتي بعد ذلك دالة الفحص المنطقي IF لتقييم كل قيمة في المصفوفة الرقمية المولدة؛ فإذا كانت القيمة تساوي 1 (أي أن الكلمة فريدة تماماً)، تُرجع الدالة الرقم 1، وما عدا ذلك تُرجع صفراً:
IF(COUNTIF($A$2:$A$11, $A$2:$A$11)=1, 1, 0)
تتكفل دالة الجمع SUM بتجميع الآحاد الناتجة، وهو ما يعبر بدقة عن إجمالي عدد الكلمات التي ظهرت لمرة واحدة فقط دون أي تكرار. وبطرح هذا المجموع من حاصل دالة ROWS الكلية، تنتج لدينا القيمة الصافية لإجمالي الكلمات التكرارية متضمنة مرات ظهورها الأولى.
4.3 التطبيق العملي للصيغة =ROWS()-SUM(IF())
تُصاغ المعادلة الرياضية المتكاملة لحساب التكرار الشامل على النحو التالي:
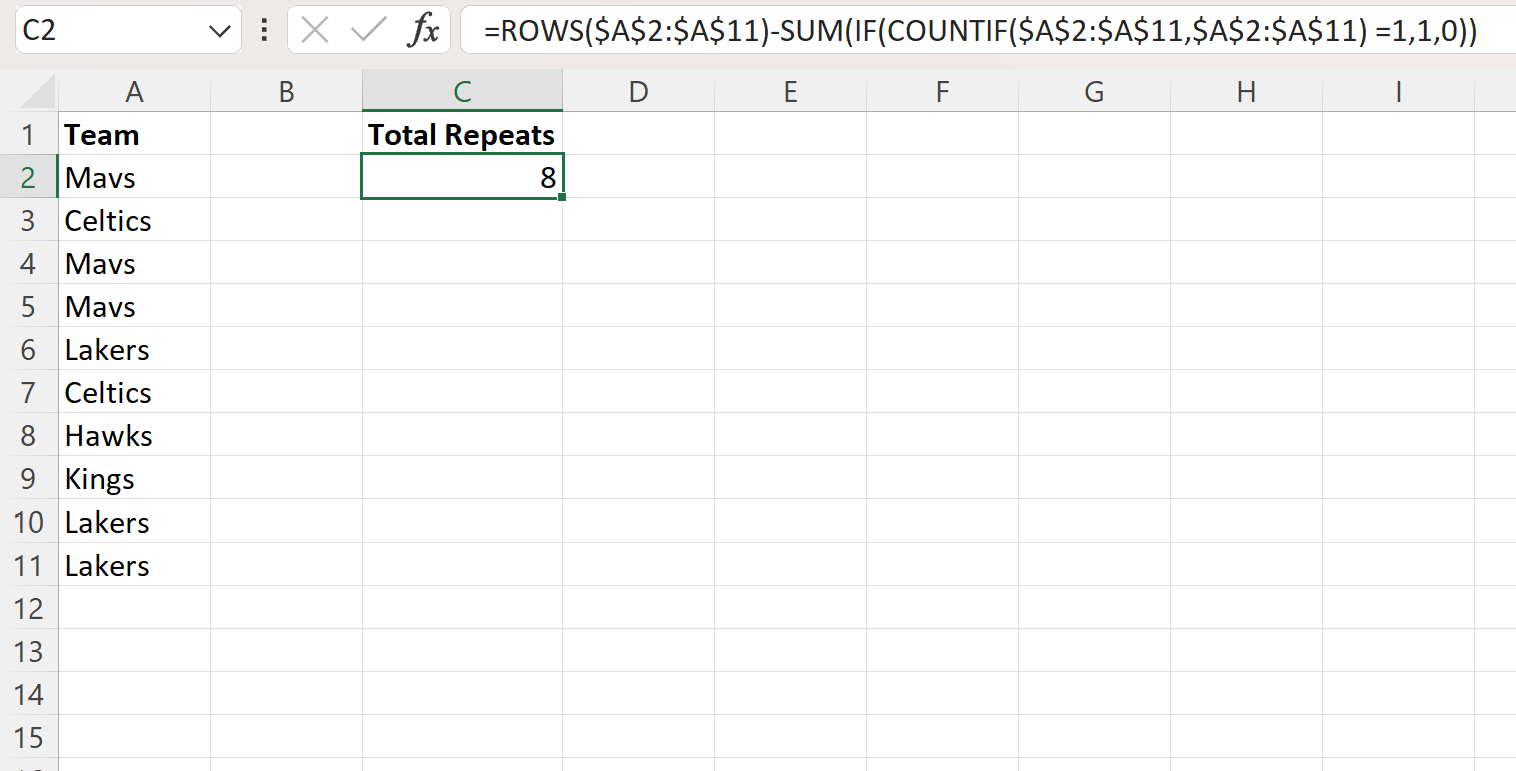
=ROWS($A$2:$A$11) - SUM(IF(COUNTIF($A$2:$A$11, $A$2:$A$11)=1, 1, 0))
في بيئات مايكروسوفت 365 والنسخ الحديثة من إكسيل، يتم إدخال هذه الصيغة مباشرة والضغط على مفتاح Enter؛ حيث يتولى محرك الحساب الديناميكي معالجة المصفوفة بصورة فورية وتلقائية. أما في الإصدارات الأقدم (إكسيل 2019 وما قبله)، فيتحتم على المحلل إدخال هذه الصيغة كمعادلة مصفوفية تقليدية عبر الضغط معاً على Ctrl + Shift + Enter، مما يؤدي إلى ظهور أقواس حاصرة منحنية { } تحيط بالمعادلة في شريط الصيغ دلالةً على تفعيل المعالجة المصفوفية.
بتتبع خطوات التنفيذ الحسابي على بيانات جدولنا السابق خطوة بخطوة:
- إجمالي الصفوف:
ROWS($A$2:$A$11)يعطي 10. - المصفوفة التكرارية: دالة
COUNTIFترجع التكرارات المقابلة لكل صف {3; 2; 2; 3; 1; 2; 2; 1; 1; 3}. - الشرط المنطقي: دالة
IFتحول المصفوفة إلى {0; 0; 0; 0; 1; 0; 0; 1; 1; 0} بتحديد الخلايا التي تكرارها 1 فقط. - الجمع: دالة
SUMتجمع الآحاد ليكون الناتج 3 (وهي كلمات: تحليل، نموذج، متغير). - الناتج النهائي: 10 – 3 = 7.
تفسر هذه النتيجة الرقمية (7) بأن 70% من البيانات النصية في هذه العينة تقع ضمن دائرة المفردات المتكررة المشتركة، وهو مؤشر كمي دقيق يسلط الضوء على الكثافة التكرارية الشاملة للمتن محل البحث.
5. حساب التكرارات الفائضة مع استثناء الظهور الأول
5.1 الأساس الرياضي لحساب عدد التكرارات الزائدة
يحتل مفهوم “فائض التكرار” (Redundancy or Excess Duplicates) أهمية محورية في تدقيق قواعد البيانات وتنظيفها، ويُقصد به حساب عدد النسخ المكررة الإضافية الناتجة عن تكرار الكلمات مع استبعاد وتجاوز الظهور الأول (الأصل) لكل مفردة. فإذا ظهرت كلمة معينة 4 مرات، فإن الأصل هو ظهورها الأول، بينما تمثل المرات الثلاث التالية تكراراً فائضاً يمكن حذفه دون الإخلال بالمحتوى الدلالي العام للقائمة.
تستند هذه العملية إلى معادلة منطقية وبديهية بالغة البساطة والصرامة في آن واحد:
فائض التكرار = إجمالي عدد السجلات غير الفارغة – إجمالي عدد المفردات الفريدة
تُعد هذه القيمة مقياساً حيوياً لتقدير “نسبة تضخم البيانات” (Data Bloat)؛ إذ تكشف بدقة عن الحجم الزائد غير الضروري الذي تشغله السجلات المكررة داخل النظام، وتساعد مسؤولي قواعد البيانات ومحللي المعلومات في تقييم تكلفة التخزين وتحديد المدى الذي يمكن عنده تقليص الجداول دون فقدان التنوع النوعي للمحتوى.
5.2 بناء الصيغة الحسابية باستخدام COUNTA ودالة UNIQUE
مع تدشين الدوال الديناميكية في بيئة إكسيل، بات بالإمكان صياغة هذه العلاقة الرياضية بدقة وسرعة فائقة دون كتابة معادلات مصفوفية معقدة. يتم تحقيق ذلك من خلال دمج دالة عد السجلات الممتلئة COUNTA مع دالتي ROWS وUNIQUE في نسق تركيبي مباشر.
تُكتب المعادلة على النحو الآتي:
=COUNTA(A2:A11) - ROWS(UNIQUE(A2:A11))
تتولى الدالة COUNTA(A2:A11) حساب عدد كافة الخلايا المحتوية على نصوص في النطاق المستهدف، وتتجاهل أي خلايا فارغة، لتعطي القيمة الإجمالية (10). في المقابل، تقوم الدالة UNIQUE(A2:A11) باستخراج مصفوفة الكلمات غير المكررة، وتأتي دالة ROWS لتعد الصفوف الفعلية لتلك المصفوفة الفريدة وتستخرج القيمة (6). ينتج عن عملية الطرح المباشرة بين القيمتين الرقم (4).
يمثل الرقم 4 الفائض التراكمي الدقيق؛ وهو عدد السجلات التي يمكن تنقيحها إذا رغب المحلل في تصفية العمود والإبقاء على نسخة فريدة واحدة فقط لكل كلمة. تبرز كفاءة هذه الصيغة في قلة استهلاكها لموارد المعالجة المركزية، وسهولة تتبع منطقها الحسابي من قِبل المدققين الإحصائيين.
5.3 طريقة بديلة باستخدام دالة COUNTIF التراكمية
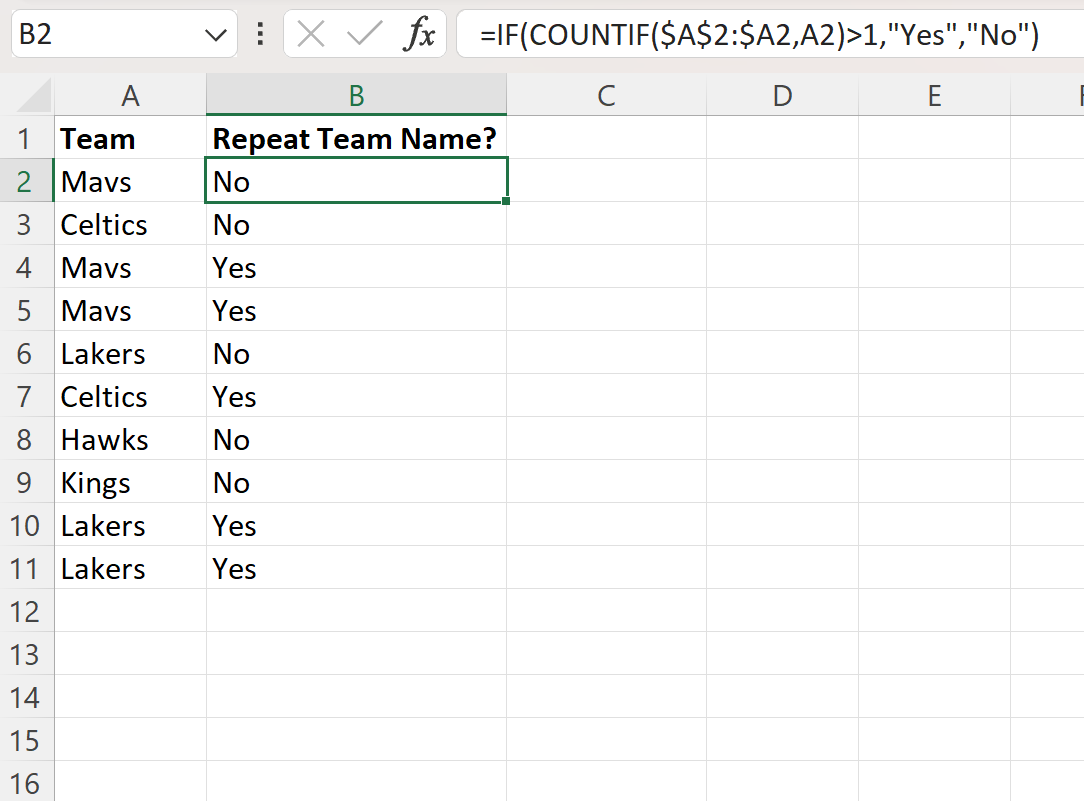
توجد طريقة منهجية أخرى بالغة الأهمية تتيح تتبع موقع كل تكرار فائض وتحديده على مستوى الصف المنفرد بدلاً من استخراج رقم إجمالي مجرد للملف ككل؛ وتعتمد هذه الطريقة على كتابة صيغة عد تراكمي تعتمد على مبدأ “النطاقات التوسعية” أو شبه المطلقة (Expanding Ranges).
يتم إنشاء عمود مساعد بجوار البيانات الأصلية (في الخلية B2 مثلاً)، وتُكتب الصيغة الرياضية التالية:
=COUNTIF($A$2:A2, A2)
يكمن الذكاء البرمجي في هذه الصيغة في تثبيت بداية النطاق بعلامة الدولار $A$2 وترك نهاية النطاق A2 حرة ومتحركة، فعند سحب المعادلة نحو الأسفل إلى الخلايا B3، B4، وما بعدها:
- في الصف 2: تفحص الدالة النطاق
$A$2:A2، لتعطي القيمة 1 للظهور الأول. - في الصف 5 (مثلاً عند تكرار كلمة بيانات): يتوسع النطاق إلى
$A$2:A5، فتكتشف الدالة أن الكلمة قد ظهرت سابقاً، لتعطي القيمة 2. - في الصف 10 (عند تكرار الكلمة للمرة الثالثة): يصبح النطاق
$A$2:A10، فتسجل الدالة القيمة 3.
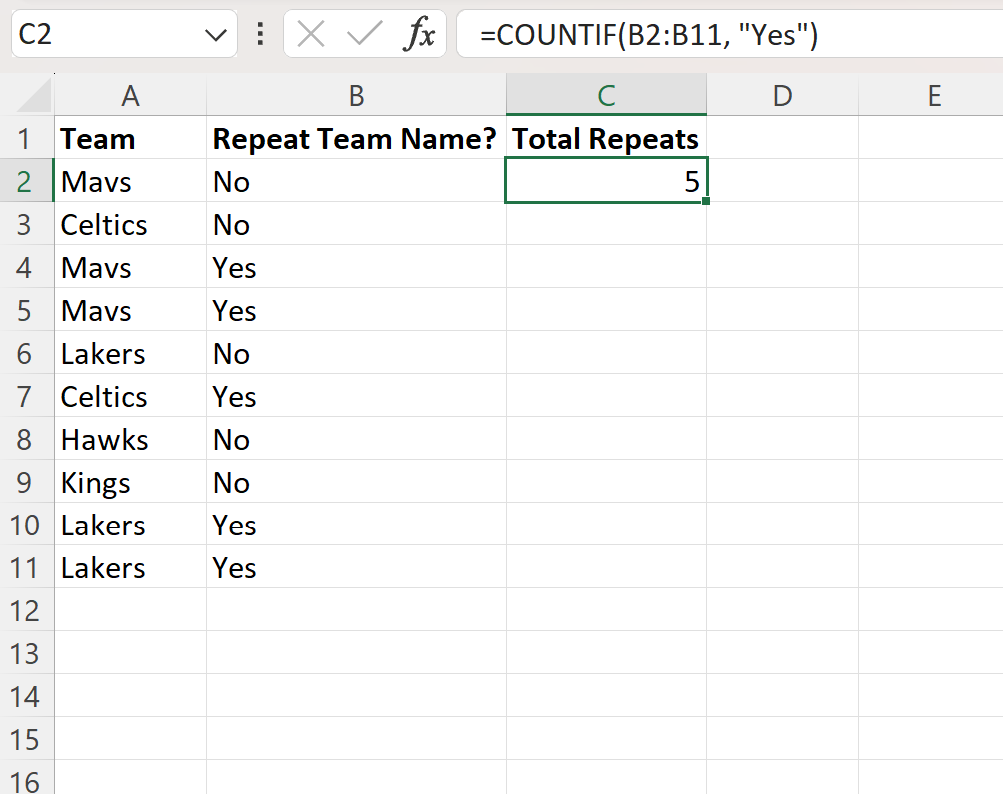
بموجب هذا الترتيب التراكمي، فإن كل سجل يأخذ الرقم 1 يمثل “الظهور الأصلي الأول” للمفردة، بينما كل سجل يحصل على قيمة عددية أكبر من 1 (≥ 2) يمثل حتماً “تكراراً زائداً وفائضاً”. ويمكن بعد ذلك استخدام دالة العد الشرطي لجمع كافة التكرارات الفائضة عبر الخلية التحليلية المستقلة:
=COUNTIF(B2:B11, ">1")
تمنح هذه التقنية الباحث تحكماً رقابياً فائقاً في تصفية الصفوف الزائدة بدقة، وتسهل تحديد أماكن التكرارات داخل التسلسل الزمني لورود البيانات.
6. التعامل مع النصوص الحساسة لحالة الأحرف (Case-Sensitive)
6.1 قصور دالة COUNTIF التقليدية أمام حساسية النصوص
يتمثل أحد القيود المنهجية المتجذرة في خوارزمية دالة COUNTIF القياسية في افتقارها التام للحساسية تجاه حالة الأحرف (Case-Insensitive)؛ فعند توظيفها لتحليل نصوص مكتوبة باللغات اللاتينية (كالإنجليزية أو الفرنسية) أو مصطلحات تقنية تضم رموزاً متباينة، تتعامل الدالة مع الكلمتين “Data” و”DATA” و”data” باعتبارها مدخلات متطابقة تماماً، وتعطي تكراراً جامعاً لها دون تمييز هيكلي.
يشكل هذا القصور عائقاً منهجياً خطيراً في بحوث متقدمة معينة؛ مثل تحليل الشفرات الجينية ومطابقة تسلسلات البروتينات (DNA Sequences)، أو تدقيق لغات البرمجة والرموز المعيارية للمتغيرات العلمية، حيث يؤدي الحرف الصغير وظيفة دلالية أو كيميائية تختلف جذرياً عن الحرف الكبير المقابل له. إن تجاهل هذه الفروق يقود إلى انحرافات تجريبية غير مقبولة تشكك في صدق النتائج ومطابقتها للمتطلبات المعيارية المقننة.
من هنا تنشأ الحاجة المنهجية لتجاوز القيود الحسابية الافتراضية، وبناء مصفوفات مقارنة صارمة تقوم على مبدأ “المطابقة التامة للمصفوفات النصية” (Exact Matching)، حيث يُفحص المحرف ليس فقط من حيث نوعه ورسمه، بل وفق شفرته الرقمية الثنائية وتطابقه الحرفي الدقيق.
6.2 صياغة معادلة دقيقة باستخدام دالتي EXACT وSUMPRODUCT
لتحقيق التعداد الحساس لحالة الأحرف في إكسيل، لا بد من استدعاء دالة المقارنة المنطقية الصارمة EXACT. تتلقى هذه الدالة سلسلتين نصيتين وتقارن بينهما مقارنة حرفية بالغة الدقة؛ فإذا تطابقت الأحرف في الرسم والحالة أرجعت القيمة المنطقية TRUE، وإذا اختلف حرف واحد في حالته أرجعت القيمة FALSE.
عندما ندمج دالة EXACT مع نطاق متعدد، مثل:
EXACT(C2, $A$2:$A$11)
فإنها تولد في ذاكرة البرنامج مصفوفة من القيم المنطقية {TRUE; FALSE; FALSE...} تعبر عن المواقع التي تطابقت فيها الكلمة المستهدفة تطابقاً تاماً وحساساً للحالة. ولكن بما أن دوال الجمع الحسابي تعجز عن جمع الكلمات المنطقية مباشرة، يُستخدم المعامل الرياضي السالب المزدوج (Double Unary Operator --)؛ حيث يعمل هذا المعامل على إجبار محرك إكسيل على تحويل القيم المنطقية إلى قيم رقمية مكافئة، فتتحول القيمة TRUE إلى الرقم 1، وتتحول القيمة FALSE إلى الرقم صفر.
تتكامل هذه التركيبة بإدراج دالة الضرب والتجميع المصفوفي SUMPRODUCT التي تجمع هذه الآحاد والأصفار دون الحاجة إلى تشغيل مصفوفات معقدة. وتكون الصيغة المعتمدة نهائياً هي:
=SUMPRODUCT(--EXACT(C2, $A$2:$A$11))
تقوم هذه الصيغة باحتساب تكرار اللفظة الموجودة في الخلية C2 داخل النطاق المحدد بصورة حرفية صارمة لا تسمح بخلط الحالات المتباينة.
6.3 مقارنة عملية بين الحساب القياسي والحساب الحساس للحالة
لتوضيح التباين الجوهري بين نتائج الحساب القياسي والحساب الحساس لحالة الأحرف، نستعرض الجدول المقارن التالي لبيانات تجريبية تضم مصطلحات بلغة أجنبية:
| المصطلح في الخلية (C2) | النطاق المفحوص (A2:A7) | نتيجة COUNTIF القياسية | نتيجة SUMPRODUCT مع EXACT الحساسة |
|---|---|---|---|
| Excel | Excel | 3 | 2 |
| EXCEL | excel | 3 | 1 |
| excel | EXCEL | 3 | 1 |
| – | Excel | – | – |
| ملاحظة: تعاملت COUNTIF مع المصطلحات الثلاثة كشيء واحد وأرجعت (3) لكل منها، بينما ميزت المعادلة الحساسة الفروق الدقيقة. | |||
يكشف هذا التحليل المقارن عن الأثر العلمي الحاسم للاختيار الرياضي؛ ففي حين توفر دالة COUNTIF حلاً ملائماً وسريعاً للنصوص العامة والاستبيانات غير المقيدة بالرسم الحرفي، فإن توظيف معادلة SUMPRODUCT(--EXACT()) يغدو واجباً منهجياً ملزماً في الدراسات المعجمية الصارمة وتحليلات لغات البرمجة وقواعد البيانات المقننة تفادياً لفقدان الفروق الجوهرية بين المتغيرات.
7. استخراج وتلخيص تكرار الكلمات عبر الجداول المحورية (Pivot Tables)
7.1 مزايا التحليل التكراري التفاعلي بالجداول المحورية
تُعد الجداول المحورية (Pivot Tables) إحدى أكثر أدوات إكسيل كفاءة ورسوخاً في تلخيص وهندسة البيانات الكبيرة، حيث توفر حلاً بديلاً ومتكاملاً يتفوق على الدوال الحسابية المكتوبة في السيناريوهات التي تشمل مئات الآلاف من الصفوف النصية. إن الاعتماد الحصري على كتابة آلاف الصيغ الرياضية المتكررة مثل COUNTIF قد يثقل كاهل المعالج ويتسبب في بطء الاستجابة البرمجية، في حين تعمل الجداول المحورية عبر تقنية ضغط الذاكرة المؤقتة (Pivot Cache)، مما يتيح استخراج النتائج بسرعة فائقة ودون استهلاك مفرط للطاقة الحاسوبية.
تتميز الجداول المحورية بمرونتها التفاعلية العالية؛ إذ يمكن تحديث كافة التكرارات المستخرجة فورياً بمجرد النقر على زر “تحديث” (Refresh) إثر أي تعديل يطرأ على البيانات المصدرية. بالإضافة إلى ذلك، توفر هذه الأداة بيئة تحليلية مرئية تسمح بإعادة ترتيب المفردات، وفرزها تصاعدياً أو تنازلياً، وتطبيق مستويات متقدمة من التصفية والتصنيف المقارن بضغطة زر واحدة، مما يقلص احتمالات الأخطاء البشرية الناتجة عن أخطاء صياغة المعادلات وسحب النطاقات غير المثبتة.
تشكل هذه الأداة جسراً انتقالياً بين المعالجة الإحصائية الأولية وبناء التقارير الإدارية والأكاديمية الرفيعة، حيث تمكن الباحث من استعراض الأبعاد المتعددة للنص وتوزيعاته المعجمية في قوالب بصرية متسقة وقابلة للتطويع الفوري.
7.2 خطوات إنشاء جدول محوري لتعداد الكلمات خطوة بخطوة
يتطلب بناء جدول محوري مخصص لحساب تكرار المفردات اتباع خطوات تقنية متسلسلة ومنضبطة تضمن دقة المخرجات:
- تحديد النطاق المصدري: تظليل عمود الكلمات بالكامل مع التأكد الصارم من اشتماله على رأس وصفي في الخلية الأولى (مثل: “قائمة_المفردات”).
- إدراج الجدول المحوري: الانتقال إلى الشريط العلوي واختيار تبويب إدراج (Insert)، ثم النقر على أيقونة جدول محوري (PivotTable)، وتحديد موضع وضع التقرير (يفضل اختياره في ورقة عمل جديدة New Worksheet).
- ضبط حقول الصفوف (Rows): من نافذة حقول الجدول المحوري الجانبية (PivotTable Fields)، يتم سحب حقل “قائمة_المفردات” وإفلاته داخل منطقة الصفوف (Rows). تؤدي هذه الحركة تلقائياً وظيفة دالة
UNIQUE، حيث تُستعرض كافة الكلمات الفريدة دون أدنى تكرار. - تفعيل آلية التعداد الحسابي: يُسحب نفس الحقل (“قائمة_المفردات”) مرة ثانية، ولكن يُسقط هذه المرة داخل منطقة القيم (Values).
- التحقق من نوع التلخيص: بما أن البيانات المدرجة نصية، فإن إكسيل يقوم افتراضياً بضبط العملية الحسابية على خيار التعداد (Count of قائمة_المفردات). وإذا لم يتم ذلك تلقائياً، ينقر المحلل على سهم الحقل في منطقة القيم، ويختار إعدادات حقل القيمة (Value Field Settings)، ويحدد دالة Count يدوياً لضمان حساب مرات التكرار بدلاً من أي معامل آخر.
7.3 تنسيق مخرجات الجدول المحوري وعرض النسب المئوية
لا تقتصر كفاءة الجداول المحورية على إظهار التكرار المطلق الصرف، بل تمتد لتتيح إمكانات متقدمة لإظهار التكرار النسبي المئوي بالتوازي. يمكن للمحلل سحب حقل المفردات مرة ثالثة إلى منطقة القيم؛ ليظهر عمود مكرر للتعداد، ثم بالدخول إلى “إعدادات حقل القيمة” والنقر على تبويب إظهار القيم كـ (Show Values As)، يتم اختيار نسبة مئوية من الإجمالي الكلي (% of Grand Total).
ينتج عن هذا الإجراء جدول مزدوج يعرض المفردة، وتكرارها العددي، ووزنها النسبي المئوي من حجم العينة الكلية في آن واحد. ولتنظيم هذا الجدول بما يخدم القراءة الأكاديمية السريعة، يتم النقر بزر الفأرة الأيمن على أي رقم داخل عمود التعداد واختيار أمر فرز (Sort) ثم فرز من الأكبر إلى الأصغر (Sort Largest to Smallest)، فتترتب المفردات تنازلياً لتتصدر الكلمات الأكثر تكراراً قمة التقرير متوافقة مع مبادئ المنحنيات التوزيعية.
يتيح الجدول المحوري أيضاً تطبيق عوامل التصفية للقيم (Value Filters)، مثل تصفية العناصر التي يتجاوز تكرارها عتبة معينة (مثلاً: إظهار الكلمات التي تكررت أكثر من 5 مرات فقط)، أو استخراج أهم عشر كلمات مؤثرة في النص عبر ميزة (Top 10). تمثل هذه المخرجات جداول نهائية متكاملة يمكن نسخها ونشرها مباشرة في الأبحاث والمجلات العلمية المحكمة.
8. تقنيات التمييز البصري والتنسيق الشرطي للكلمات المكررة
8.1 تطبيق القواعد الجاهزة لتظليل الكلمات المكررة
يمثل الإدراك البصري عنصراً حاسماً في الفحص الاستكشافي للبيانات؛ حيث يسهم الترميز اللوني في توجيه الانتباه نحو الأنماط الشاذة أو التكتلات المتكررة بسرعة تتجاوز قراءة الأرقام المجردة، وتؤكد الدراسات المعرفية في أساليب المعالجة البصرية المكانية (Kozhevnikov et al., 2005) أن التنسيق اللوني المنظم يعزز قدرة الفرد على استيعاب الفروق الهيكلية وإدراك بنية النظم المعقدة بأقل مجهود ذهني. يوفر إكسيل ميزة التنسيق الشرطي (Conditional Formatting) كأداة بصرية فاعلة لتحقيق هذا الغرض.
لتظليل الكلمات المكررة عبر القواعد الجاهزة:
- يحدد الباحث نطاق الخلايا النصية المستهدفة (من
A2إلىA11). - من علامة التبويب الصفحة الرئيسية (Home)، يتم النقر على التنسيق الشرطي (Conditional Formatting).
- اختيار قواعد تمييز الخلايا (Highlight Cells Rules)، ثم النقر على القيم المكررة (Duplicate Values…).
- تفتح نافذة خيارات تتيح للمستخدم تحديد نمط التلوين المطلوب (مثل: تعبئة بالأحمر الفاتح مع نص أحمر داكن). بمجرد الضغط على زر الموافقة، تضاء كافة الخلايا التي تتكرر كلماتها في أي موقع آخر داخل النطاق المحدد.
يجب الانتباه إلى أن هذه القاعدة الجاهزة تقوم بتظليل كافة حالات التكرار بما في ذلك الظهور الأول لكل كلمة؛ مما يمنح نظرة شمولية سريعة حول مدى كثافة البيانات التكرارية داخل العمود، في حين يتيح الصندوق المنسدل ذاته خياراً معاكساً وهو تمييز “القيم الفريدة” (Unique Values) في حال رغب المحلل في حصر الكلمات التي لم تتكرر مطلقاً.
8.2 بناء قواعد مخصصة باستخدام الصيغ الرياضية
في كثير من الأحيان، يحتاج المحلل إلى تجاوز القواعد العامة الجاهزة لتطبيق معايير بصرية أكثر دقة وانتقائية؛ كأن يقوم بتظليل التكرارات اللاحقة فقط مع ترك الظهور الأول بلونه الطبيعي لتسهيل التدقيق اليدوي، أو تظليل الكلمات التي يتجاوز تكرارها عتبة إحصائية معينة. يتم ذلك عبر خيار “استخدام صيغة لتحديد الخلايا التي سيتم تنسيقها” داخل مدير قواعد التنسيق الشرطي.
لتمييز الكلمات التي يتجاوز تكرارها الإجمالي 3 مرات مثلاً، يدخل المحلل الصيغة الشرطية المنطقية:
=COUNTIF($A$2:$A$11, A2) > 3
حيث يُثبت نطاق الفحص بالكامل $A$2:$A$11 بينما تترك الخلية المقارنة A2 نسبية لتتحرك ديناميكياً مع كل صف داخل النطاق المظلل.
أما لتمييز الظهور الثاني فما بعد وتجاوز الظهور الأول بصرياً لتجنب حذفه عن طريق الخطأ، تُستخدم صيغة النطاق التوسعي التراكمي المشروحة سلفاً:
=COUNTIF($A$2:A2, A2) > 1
عند تطبيق هذه القاعدة وتخصيص لون تعبئة مميز لها، ستظل كل نسخة أصلية من الكلمات محتفظة بخلفيتها العادية غير الملونة، في حين تبرز النسخ المكررة الإضافية بألوان تحذيرية تمكن الباحث من مراجعتها أو حذفها يدوياً دون أي ارتباك.
8.3 إدارة وتعديل قواعد التنسيق الشرطي لتفادي بطء الملف
على الرغم من القيمة الاستكشافية العالية للتنسيق الشرطي، فإن الإفراط في استخدامه أو تركه دون إدارة منضبطة يؤدي إلى تدهور حاد في سرعة استجابة ملف الإكسيل وزيادة ملحوظة في حجمه البرمجي؛ إذ يقوم محرك البرنامج بإعادة حساب وتقييم كافة الصيغ الشرطية المدمجة مع كل حركة تمرير أو تعديل يطرأ على أي خلية داخل ورقة العمل.
لتفادي هذا العبء التقني، يجب الدخول دورياً إلى مدير قواعد التنسيق الشرطي (Conditional Formatting Rules Manager) عبر مسار Home -> Conditional Formatting -> Manage Rules، والتحقق من قائمة القواعد المطبقة على “ورقة العمل الحالية”. تتيح هذه النافذة دمج القواعد المتطابقة وحذف القواعد المتضاربة أو المكررة الناتجة عن عمليات النسخ واللصق المتكررة للنطاقات.
يُنصح بتفعيل خيار إيقاف إذا تحقق الشرط (Stop If True) في الحالات التي تستخدم قواعد شرطية متسلسلة، مما يمنع البرنامج من مواصلة اختبار بقية الشروط للخلية التي تطابقت بالفعل مع القاعدة الأولى ويوفر دورات معالجة ثمينة. كما يفضل تجميد وتنسيق الجداول بملء يدوي للألوان الثابتة بعد انتهاء مرحلة التدقيق الأولي إذا كانت البيانات ضخمة ومعدة للأرشفة أو الطباعة الورقية للتقارير الإحصائية.
9. الأخطاء الشائعة وحلولها التقنية في حساب تكرار النصوص
9.1 أخطاء تثبيت النطاقات وتغيير المراجع النسبية
يُعد إغفال التثبيت المطلق للنطاقات المرجعية أحد أكثر الأخطاء التقنية شيوعاً بين مستخدمي برمجيات الجداول الإلكترونية؛ فعند كتابة الدالة بصيغة المرجع النسبي غير المثبت، مثل:
=COUNTIF(A2:A11, C2)
ثم سحب هذه المعادلة إلى الأسفل لتشمل بقية الكلمات، ينزلق النطاق المصدري بالتوازي مع حركة السحب، فيتحول في الصف التالي إلى A3:A12، ثم في الذي يليه إلى A4:A13، وهكذا دواليك.
ينتج عن هذا الانزلاق خروج السجلات النصية الواقعة في أعلى العمود من دائرة المعاينة الحسابية تدريجياً؛ مما يؤدي إلى ظهور نتائج تكرارية ناقصة ومضللة للمفردات التي تصادف وجودها في الصفوف الأولى للجدول. ويمكن للباحث اكتشاف هذا الخطأ القاتل عبر الاستعانة بأداة تدقيق الصيغ (Formula Auditing) والنقر على أمر تتبع السوابق (Trace Precedents)، حيث تظهر أسهم زرقاء ترسم بيولوجيا الارتباط بين الصيغة ونطاقها وتفضح على الفور أي انحراف في الموضع المرجعي.
يمثل استخدام الأسماء المعرفة للنطاقات (Named Ranges)، كإطلاق اسم رمزي على النطاق مثل TextData عبر مربع الاسم (Name Box)، أو الاعتماد على مراجع جداول إكسيل الرسمية Table1[الكلمات]، الحل الهندسي الأمثل لاستئصال هذه المشكلة من جذورها؛ إذ تظل هذه التسميات ثابتة ثباتاً مطلقاً في كامل بنية المصنف دون الحاجة إلى القلق بشأن وضع علامات الدولار $ في كل مرة.
9.2 معالجة مشكلات المسافات غير المرئية والرموز الخاصة
تتولد إحدى أكثر الإشكالات المستعصية في مطابقة النصوص عند وجود مسافات بيضاء تفشل دالة TRIM التقليدية في التخلص منها؛ والسبب في ذلك يعود إلى أن النصوص المستوردة من صفحات الويب ومحررات HTML غالباً ما تحتوي على مسافة غير قابلة للكسر تعرف تشفيرياً بالرمز وتأخذ المعرف البرمجي CHAR(160) في نظام ترميز ASCII، في حين أن دالة TRIM مبرمجة حصرياً لإزالة مسافة المفتاح المسافي القياسي ذي الرمز CHAR(32).
يقود هذا التباين الشفري إلى ظهور كلمتين متطابقتين ظاهرياً كعنصرين منفصلين ومستقلين في دوال التكرار والفرادة. ولعلاج هذا الخلل الجذري، يجب تطهير المتن عبر استبدال المسافة غير القياسية بمسافة قياسية أولاً ثم تطبيق التقليم، وذلك باستخدام الصيغة المركبة:
=TRIM(SUBSTITUTE(A2, CHAR(160), " "))
من جانب آخر، يجب توخي الحذر الشديد عند البحث عن مفردات تحتوي بداخلها على رموز خاصة مثل النجمة (*) أو علامة الاستفهام (?)؛ إذ يتعامل محرك دالة COUNTIF مع هذه الرموز باعتبارها أحرف بدل للبحث الموسع. فإذا احتوت الخلية على نص “ما هو؟”، فإن الدالة ستعد أي نص يبدأ بكلمة “ما هو” متبوعة بأي حرف عشوائي بدلاً من البحث عن رمز الاستفهام بحد ذاته. ولتحييد هذا السلوك البرمجي وإجبار الدالة على معاملة الرمز كحرف طباعي عادي، يجب وضع علامة التلدة (~) قبله مباشرة، لتصبح الصيغة في معيار الفحص: "ما هو~?".
9.3 حل مشكلات عدم توافق الدوال في إصدارات إكسيل المتنوعة
يصطدم المحللون في كثير من بيئات العمل المشتركة والمؤسسات الأكاديمية بظهور الخطأ التحذيري #NAME? عند فتح مصنفاتهم على أجهزة أخرى؛ وينشأ هذا الخطأ في الغالب عن استخدام الدوال المصفوفية الحديثة مثل UNIQUE أو FILTER أو SORT على إصدارات تاريخية من إكسيل (مثل Excel 2016، 2013، وما قبلهما) التي تفتقر بنيتها البرمجية الأساسية إلى محرك الحساب المصفوفي الديناميكي.
لضمان التوافقية العالية للمصنف في البيئات التقنية المتباينة، يتوجب على المحلل إما تزويد المستلمين ببدائل تعتمد على الجداول المحورية (Pivot Tables) التي تتمتع بتوافق شامل وتاريخي عبر كافة نسخ إكسيل منذ عقود، أو بناء صيغ بديلة كلاسيكية تعتمد على دمج دالتي INDEX وMATCH لاستخراج المفردات الفريدة وفق الصيغة المصفوفية:
{=INDEX($A$2:$A$11, MATCH(0, COUNTIF($C$1:C1, $A$2:$A$11), 0))}
حيث تُدخل هذه الصيغة بالضغط المتزامن على Ctrl + Shift + Enter لتعمل بنجاح في النسخ التراثية. ومع ذلك، يظل الخيار الأفضل مؤسسياً هو التوصية بتحديث بيئة العمل المكتبية إلى Microsoft 365 أو الاعتماد المؤقت على النسخة السحابية المجانية Excel for the Web التي تتضمن أحدث محركات الدوال الرياضية والمصفوفية وتضمن استقرار التحليلات البرمجية وتكاملها السلس.
10. تطبيقات متقدمة وأتمتة تحليل الكلمات المكررة في قواعد البيانات
10.1 حساب التكرار وفق معايير شرطية متعددة باستخدام COUNTIFS
تتطلب الدراسات الإمبيريقية المعقدة في الغالب تفكيك التكرارات اللفظية وفق سياقات تصنيفية أو زمانية متعددة؛ كأن يسعى الباحث إلى قياس تردد مصطلح محدد ليس على مستوى العينة ككل، بل داخل فئة تجريبية معينة، أو ضمن نطاق زمني وتاريخي محدد، أو بحسب جنس المستجيب. في هذه الحالات المتقدمة، يتم استبدال الدالة الأحادية بدالة المعايير الشرطية المتعددة COUNTIFS.
تسمح دالة COUNTIFS بفحص ما يصل إلى 127 زوجاً من النطاقات والشروط وفق الهيكلية الرياضية:
=COUNTIFS(criteria_range1, criteria1, criteria_range2, criteria2, ...)
فإذا كان لدينا عمود النصوص في $A$2:$A$100، وعمود يحدد نوع المستجيب (طالب / معلم) في $B$2:$B$100، وعمود ثالث يحدد تاريخ المقابلة في $C$2:$C$100، ورغبنا في حساب تكرار كلمة “صعوبة” المسجلة في الخلية E2 لدى شريحة “الطلاب” فقط خلال عام 2024، فإن المعادلة تصاغ كالتالي:
=COUNTIFS($A$2:$A$100, E2, $B$2:$B$100, "طالب", $C$2:$C$100, ">=2024-01-01", $C$2:$C$100, "<=2024-12-31")
هذا العمق التحليلي يحول إكسيل من مجرد أداة لتعداد الكلمات الساذج إلى محرك استدلالي قادر على بناء “مصفوفات تقاطعية” (Cross-Tabulation Matrices) تبين كيفية تقاطع الألفاظ الدلالية مع المتغيرات الديموغرافية والزمنية للبحث، وهو ما يدعم الدراسات التقييمية المتقدمة في العلوم السلوكية واللغوية المعاصرة (Kosiński, 2024).
10.2 أتمتة فرز وتعداد التكرارات باستخدام أداة Power Query
تمثل أداة Power Query المدمجة داخل إكسيل الحل الصناعي الرائد لمعالجة خطوط أنابيب البيانات (ETL Pipelines) وأتمتة استخراج وتلخيص تكرارات النصوص الضخمة التي تفوق قدرة الصيغ الحسابية التقليدية، وتصل إلى مئات الآلاف أو ملايين الصفوف؛ حيث يتميز هذا النظام بأداء خوارزمي فائق وقدرة على عزل عمليات المعالجة في بيئة خلفية مستقرة لا تؤثر على سرعة ورقة العمل الرئيسية.
تتلخص خطوات أتمتة تعداد الكلمات في Power Query في الآتي:
- تحديد جدول البيانات، ثم التوجه إلى تبويب بيانات (Data) والنقر على من جدول/نطاق (From Sheet / From Table/Range) ليفتح محرر الباور كويري المستقل.
- تحديد العمود النصي وتطبيق أدوات التنظيف الفورية؛ كالنقر على خيار تحويل (Transform) ثم اختيار تنسيق (Format) وتطبيق أمري Trim وClean وLowercase لإزالة المسافات وتوحيد الحالات برمجياً في أجزاء من الثانية.
- اختيار أمر التجميع حسب (Group By) من الشريط العلوي. في نافذة التجميع، يتم تعيين عمود الكلمات كحقل رئيسي للتجميع، وتعيين العملية الحسابية كـ تعداد الصفوف (Count Rows) مع تسمية العمود الناتج باسم “التكرار_المطلق”.
- النقر على زر إغلاق وتحميل إلى (Close & Load To…) وتفريغ النتائج في جدول جديد داخل ورقة العمل.
تتجلى قوة هذه الأداة في قابليتها الكاملة للأتمتة المستدامة؛ ففي حال تم ربط ورقة الإكسيل بملف خارجي متجدد، أو أضيفت آلاف الكلمات الجديدة إلى قاعدة البيانات، لا يتطلب الأمر سوى الضغط على زر “تحديث الكل” (Refresh All)، ليعيد المحرك تطبيق كافة خطوات التنظيف، والتحويل، والتجميع، وتوليد النتائج النهائية في ثوانٍ معدودة دون الحاجة لإعادة كتابة أي دالة أو تدخل يدوي على الإطلاق.
10.3 دمج نتائج تعداد الكلمات في لوحات المؤشرات (Dashboards)
تتوج مرحلة التحليل الإحصائي بتحويل الجداول التكرارية الرقمية الصامتة إلى لوحات مؤشرات تفاعلية (Interactive Dashboards) تسهم في توصيل الرؤى التحليلية بصرياً لأصحاب القرار وفرق البحث. يمكن ربط الجداول التكرارية المولدة بالجداول المحورية بمجموعة من المخططات البيانية المصممة بعناية؛ حيث يُعد المخطط الشريطي الأفقي (Bar Chart) الأداة المثالية لعرض الكلمات الأكثر تكراراً؛ إذ يوفر مساحة أفقية مريحة لقراءة النصوص العربية الطويلة دون تداخل أو ميل في الحروف.
لتعزيز التفاعلية والتحكم، يتم ربط المخططات بـ مقسمات البيانات (Slicers) وخطوط الزمن (Timelines)، مما يتيح للمستخدم النقر على فئة معينة أو فترة محددة لتتغير الرسوم البيانية وقوائم التكرارات بصورة حية وديناميكية تعكس التوزيع التكراري للفئة المختارة حصراً.
علاوة على ذلك، تُصمم بطاقات قياس رقمية كبرى (KPI Cards) في أعلى اللوحة باستخدام دوال بسيطة وموجهة، مثل استعراض “إجمالي الكلمات المفحوصة”، و”عدد الكلمات الفريدة”، و”نسبة التكرار الفائض”، وتحديد “الكلمة الأكثر استخداماً” عبر دمج دالتي INDEX وMODE.MULT أو ربطها بخلية القمة في الجدول المحوري. يضفي هذا العرض البصري المنظم طابعاً احترافياً رفيعاً يحول البيانات النصية الخام إلى مخرجات استراتيجية تدعم التقييم الدقيق وتوجه المسارات البحثية والتنفيذية بكفاءة واقتدار.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد المنهجية، والرياضية، والتقنية لحساب الكلمات المكررة في برنامج مايكروسوفت إكسيل، مؤكداً أن هذه العملية تتجاوز كونها مجرد إجراء حسابي روتيني لتشكل أساساً جوهرياً في بنية التحليل الكمي للبيانات غير المهيكلة والتنظيم المعجمي للنصوص. إن إتقان التعامل مع المفردات التكرارية يستلزم فهماً متكاملاً يبدأ من مرحلة التطهير والتنقيح الإملائي، ويمر عبر الاختيار الرشيد للدوال الرياضية سواءً كانت بسيطة، مصفوفية، أو حساسة لحالة الأحرف، ولا ينتهي إلا بالتلخيص التفاعلي والعرض البصري في لوحات المؤشرات.
إن التطبيق الواعي للمفاهيم المشروحة—من التمييز بين التكرار الشامل وفائض التكرار، والتحوط ضد أخطاء التشفير والمسافات غير المرئية، والانتقال نحو قوة الجداول المحورية وأتمتة Power Query—يمكّن الباحث والمحلل من بناء خطوط معالجة تتسم بالدقة، والموثوقية، وقابلية التكرار في البيئات العلمية والمهنية المختلفة. يظل التوظيف المتقن لبيئة إكسيل أداة تمكينية بالغة القوة تمنح البيانات النصية أبعاداً قياسية صلبة تسهم في ترشيد التفسير ودعم القرارات المستندة إلى الأدلة الموضوعية.
المراجع
- Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods, 41(4), 977–990. https://doi.org/10.3758/brm.41.4.977
- Kosiński, M. (2024). Evaluating large language models in theory of mind tasks. Proceedings of the National Academy of Sciences, 121(45), e2405460121. https://doi.org/10.1073/pnas.2405460121
- Kozhevnikov, M., Kosslyn, S. M., & Shephard, J. M. (2005). Spatial versus object visualizers: A new characterization of visual cognitive style. Memory & Cognition, 33(4), 710–726. https://doi.org/10.3758/bf03195337
- McRae, K., Cree, G. S., Seidenberg, M. S., & McNorgan, C. (2005). Semantic feature production norms for a large set of living and nonliving things. Behavior Research Methods, 37(4), 547–559. https://doi.org/10.3758/bf03192726
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction, 12(1), 61–86. https://doi.org/10.1016/s0959-4752(01)00016-0