
تُعدّ معالجة البيانات النصية وفرزها ركيزة أساسية في كافة العلوم التطبيقية والتحليلات الإدارية والميدانية؛ إذ تمثل دقة الحسابات الإحصائية المدخل الجوهري لبناء استنتاجات علمية رصينة خالية من التشويه. وفي بيئات الأعمال المعاصرة والبحوث المسحية والاجتماعية، تتكرر مواقف يجد فيها المحلل أو الباحث نفسه أمام سجلات ضخمة تحوي مئات أو آلاف التكرارات الاسمية، كمعرّفات المشاركين في التجارب النفسية والسلوكية، أو أسماء العملاء في المنظومات التسويقية، أو سجلات مسؤولي المبيعات في العمليات التجارية اليومية. إن محاولة عزل الكيانات المستقلة وتحديد الحجم الفعلي للمفردات الفريدة دون احتساب التكرارات غير المبررة تُعدّ الخطوة الأولى نحو تطهير مجموعات البيانات (Data Cleansing) وضمان موثوقية المؤشرات المشتقة منها.
يقدم برنامج مايكروسوفت إكسيل (Microsoft Excel) بنية حوسبية مرنة تدرجت في تعقيدها وإمكاناتها عبر العقود الأربعة الماضية لمواجهة هذه التحديات الإحصائية. فبينما كانت الإصدارات الكلاسيكية السابقة تعتمد على حلول التفافية تستدعي تركيب مصفوفات حسابية معقدة لربط مؤشرات المواضع النسبية بالتوزيعات التكرارية، جاءت التحديثات الأخيرة في محرك الحسابات الديناميكي لتوفر دوالاً ثورية مباشرة تعالج تدفق البيانات بكفاءة استثنائية. ومع ذلك، فإن فهم البنية التحتية الرياضية لكلا المسارين يظل ضرورة منهجية للباحث الرصين، ليس فقط لضمان التوافقية العابرة للإصدارات، ولكن لفهم المنطق الرياضي الكامن خلف تحويل النصوص الوصفية إلى مقادير عددية دقيقة تخضع للتحليل الكمي الصارم.
يتناول هذا الدليل الأكاديمي الشامل المعالجة المعمقة لمسألة حساب الأسماء الفريدة في بيئة إكسيل بمختلف إصداراتها، مفككاً المنطق الحسابي والرياضي للصيغ الكلاسيكية المركبة مثل تفاعل دوال SUMPRODUCT وMATCH وFREQUENCY، ومستعرضاً القفزة النوعية المتمثلة في دالتي UNIQUE وCOUNTA في بيئة Microsoft 365. كما يركز المقال على دراسة تطبيقية مفصلة لحساب أسماء ممثلي المبيعات، ومناقشة المعالجات المسبقة للبيانات النصية لتفادي أخطاء المطابقة الخفية، وتقديم البدائل الحديثة المعتمدة على محرك الجداول المحورية وأداة Power Query، وصولاً إلى وضع موجهات إجرائية توثق خطوات التحليل لضمان شفافية النتائج وقابليتها للتكرار.
1. المقدمة والأسس المنهجية لإحصاء البيانات النصية في إكسيل
1.1 أهمية تكرار وتفرد البيانات في الأبحاث والتحليلات الإحصائية
يمثل ضبط التكرار في المتغيرات الفئوية والنصية صمام الأمان المنهجي لمنع الانحياز الإحصائي وتفادي تشويه العينات في المسوح الميدانية والدراسات السلوكية والاجتماعية. فعند دراسة ظاهرة محددة تتطلب قياسات متكررة عبر الزمن لنفس الأفراد، يؤدي إدراج اسم المشارك كمدخل مستقل في كل جلسة رصد دون عزل هويته الفريدة إلى تضخيم زائف لحجم العينة الحقيقي، مما يرفع خطأ التقدير ويفسد حسابات درجات الحرية وتوزيعات المعنوية الإحصائية. إن معرفة الحجم الفعلي للمفردات المستقلة المشمولة بالدراسة يحدد بدقة القوة الإحصائية (Statistical Power) ومدى قابلية تعميم النتائج على المجتمع الأصلي.
علاوة على ذلك، يواجه المحلل تحديات تقنية جوهرية عند التعامل مع السلاسل النصية (Text Strings) مقارنة بالمتغيرات الرقمية. فالأرقام تخضع لخصائص الترتيب والقياس الفئوي والنسبي التلقائي، في حين تتطلب النصوص آليات مطابقة معقدة تعتمد على الترميز الثنائي لكل حرف على حدة. إن أدنى اختلاف غير مرئي في النص—كمسافة إضافية أو رمز خفي—يؤدي إلى تصنيف الاسم كمفردة جديدة ومستقلة، مما يولد انحيازاً بنيوياً في مؤشرات التفرد ويقود إلى اتخاذ قرارات إدارية وعلمية مبنية على بيانات مضللة تتطلب تدخلاً تطهيرياً حازماً وممنهجاً.
1.2 تطور أدوات المعالجة النصية عبر إصدارات مايكروسوفت إكسيل المتتابعة
شهدت معالجة البيانات النصية في إكسيل تحولاً جذرياً يوازي التحولات في بنية عتاد الحوسبة ونظم التشغيل منذ إطلاق البرنامج لأول مرة لنظام ماكنتوش عام 1985 ونظام ويندوز عام 1987. ففي الإصدارات الكلاسيكية الممتدة حتى إصدار 2019، كان إكسيل يعتمد على نموذج خلية أحادية الإرجاع؛ مما فرض على المستخدمين صياغة معادلات مصفوفية (Array Formulas) بالغة التعقيد، تتطلب في كثير من الأحيان ضغط مفاتيح Ctrl + Shift + Enter لإجبار البرنامج على تقييم سلاسل المقارنات في الذاكرة المؤقتة، مثل صيغة مقلوب التكرار التوزيعي الشهيرة.
ومع إطلاق محرك الحسابات الديناميكي في إصدارات Microsoft 365 وExcel 2021، أزاحت مايكروسوفت هذا العبء الحسابي بتقديم دوال الصفائف الديناميكية (Dynamic Array Functions) وعلى رأسها دالة UNIQUE التي تنسكب مخرجاتها تلقائياً عبر الخلايا المجاورة. وتتوقف المفاضلة بين هذه الأساليب اليوم على معايير بيئة العمل المؤسسية؛ حيث تظل الحلول الكلاسيكية ضرورية لضمان التوافق مع الأنظمة التراثية والملفات المتداولة عبر إصدارات قديمة، بينما تتفوق الحلول الحديثة في السرعة الحسابية، وسهولة القراءة، والقدرة على التعامل مع التدفقات الضخمة من البيانات دون استنزاف الذاكرة العشوائية للجهاز.
2. التأصيل المفاهيمي: الفرق بين القيم الفريدة (Unique) والقيم غير المكررة (Distinct)
2.1 التعريف الرياضي والإحصائي للقيم الفريدة والقيم المتميزة
يقع كثير من ممارسي التحليل في خلط مفاهيمي بين مصطلحي “القيم المتميزة” (Distinct Values) و”القيم الفريدة قطيعاً” (Strictly Unique Values)، على الرغم من التباين الجذري بينهما في دلالة القياس الرياضي وتطبيقاته. تُعرّف القيمة المتميزة في نظرية المجموعات بأنها كل عنصر يظهر داخل المجموعة لمرة واحدة على الأقل، حيث يُختزل التكرار ليمثل العنصر بنسخة مفردة تلغي الفائض، فالمجموعة التي تحوي العناصر {أ، ب، أ، ج، ب} تضم ثلاث قيم متميزة هي {أ، ب، ج}.
في المقابل، يُقصد بالقيمة الفريدة الدقيقة (Strictly Unique) ذلك العنصر الذي يظهر داخل النطاق لمرة واحدة فقط وبصورة حصرية دون أن يرافقه أي تكرار نهائياً في كامل السجل، وهو ما يعني في المثال السابق أن القيمة {ج} هي الوحيدة التي تنطبق عليها صفة الفرادة المطلقة، بينما يُستبعد العنصران {أ} و{ب} نظراً لورودهما المتكرر. إن الخلط بين هذين المفهومين يؤدي إلى انحرافات جسيمة في استخراج المؤشرات الكمية، لا سيما عند محاولة عزل الحالات الشاذة أو حساب الكثافة الحقيقية للعينات قيد التحليل والدراسة.
2.2 السياقات الوظيفية لاستخدام كل تصنيف في إدارة قواعد البيانات
تتطلب الإدارة المنهجية لقواعد البيانات وعمليات التدقيق الداخلي تحديداً دقيقاً للغاية للسياق الوظيفي الذي يُستدعى فيه كل من المؤشرين. فعلى سبيل المثال، يُعتمد مؤشر القيم المتميزة (Distinct Values) عند الرغبة في معرفة عدد العملاء الفريدين الذين أجروا معاملات شراء خلال الشهر، أو لحصر العدد الإجمالي للموظفين المسجلين في كشوف الحضور والانصراف اليومية بغض النظر عن عدد نوبات عملهم، مما يتيح للإدارة تقييم الحجم الحقيقي لقاعدة المتعاملين الفعليين وقياس نسب التغطية السوقية أو التشغيلية بدقة.
وعلى النقيض من ذلك، يبرز الاحتياج التحليلي لمفهوم الفرادة الدقيقة (Strictly Unique) في سيناريوهات الرقابة وضبط الجودة والتحقيق الاستقصائي في البيانات؛ كالبحث عن الطلاب الذين تقدموا لاختبار تقييمي لمرة واحدة فقط وتغيبوا عن الاختبارات الدورية اللاحقة، أو حصر الموردين الذين تم التعامل معهم في صفقة استثنائية واحدة دون تجديد التعاقد، أو الكشف عن المعاملات المصرفية الفردية المنعزلة التي قد تشير إلى أخطاء في ترحيل القيود أو سلوكيات مالية غير نمطية تستوجب الفحص والمراجعة الحثيثة.
3. التفكيك المنطقي والمعماري للمعادلة الكلاسيكية المركبة لحساب الأسماء
3.1 البنية العامة لصيغة SUMPRODUCT المركبة مع دوال الدعم
تمثل صيغة SUMPRODUCT المركبة حجر الزاوية في المعالجة الكلاسيكية لحساب القيم المتميزة في إصدارات إكسيل التي تسبق عهد المصفوفات الديناميكية. تتجاوز هذه الدالة وظيفتها الأساسية المتمثلة في ضرب النطاقات وجمعها لتلعب دور معالج مصفوفات مدمج قادر على تقييم سلاسل الشروط المنطقية دون الحاجة إلى التنشيط الحصري عبر Ctrl + Shift + Enter في معظم السيناريوهات الحسابية المستقرة، مما يمنحها موثوقية عالية واستقراراً برمجياً واسع النطاق عبر مختلف المنصات.
تعتمد البنية الهيكلية لهذه المعادلة على تطويع المعامل المزدوج السالب (Double Unary Operator –) الذي يوضع مباشرة قبل الدوال الداخلية ليعمل كمحول جبري قسري؛ إذ يقوم بتحويل القيم المنطقية الناتجة عن الاختبارات الرياضية (صواب/خطأ أو TRUE/FALSE) إلى قيم رقمية مكافئة (واحد وصفر) على التوالي. هذا التحويل البسيط في مظهره والعميق في أثره الحسابي يسمح لدالة SUMPRODUCT بتجميع مخرجات المصفوفات المنطقية الناتجة عن دمج دوال البحث والتكرار، وإرجاع الناتج التجميعي النهائي في خلية الإخراج بصورة مباشرة ودقيقة.
3.2 التكامل الوظيفي بين الدوال المتداخلة داخل الصيغة
تعتمد القوة الحسابية للمعادلة الكلاسيكية على تناغم هيكلي بديع بين مجموعة من الدوال المتداخلة؛ حيث تبدأ العملية برسم خريطة إحداثية لتموضع الأسماء، يليها إنشاء شبكة مقارنة تكرارية ترتكز على مصفوفات الأرقام التسلسلية. تعمل هذه الدوال المتقاطعة معاً داخل الذاكرة المؤقتة لإكسيل لمعالجة البيانات عبر مصفوفات فرعية مجهولة الهوية لا تستهلك مساحات تخزين دائمة في ورقة العمل، بل يتم إنشاؤها واستدعاؤها وتقييمها وإفراغها لحظياً بمجرد إتمام دورة الحساب التكراري للدالة الحاضنة.
ورغم الرصانة الفائقة لهذا التداخل الوظيفي، فإنه ينطوي على كلفة حوسبية معتبرة يجب أن يدركها الباحث بدقة؛ حيث يتطلب تقييم التكرارات النصية المتداخلة إجراء مقارنات لوغاريتمية وتربيعية تزداد تعقيداً كلما زاد حجم السجلات. فإذا طُبقت المعادلة على نطاق يحوي عشرات الآلاف من الصفوف النصية، فإن محرك إكسيل يُجبر على توليد مصفوفات وسيطة ضخمة تستهلك جزءاً ملحوظاً من دورات المعالجة المركزية (CPU Cycles) ومساحة الذاكرة العشوائية (RAM)، مما يفرض قصر استخدام هذا الأسلوب المركب على مجموعات البيانات المتوسطة أو الاستعانة بمحركات قواعد البيانات الأكثر كفاءة في المشاريع العملاقة.
4. التحليل الإجرائي الدقيق لمكونات الصيغة: MATCH وROW وFREQUENCY
4.1 دور الدالة MATCH في تحديد الإحداثيات النسبية للأسماء
تؤدي دالة MATCH الدور المحوري في تحويل السلاسل النصية غير القابلة للقياس المباشر إلى مؤشرات عددية متسلسلة يمكن إخضاعها للعمليات الإحصائية المتقدمة. عند تمرير نطاق من الأسماء كوسيطة بحث ونطاق بحث في آن واحد مع ضبط معامل نوع التطابق على القيمة التامة (Exact Match = 0)، لا تكتفي الدالة بالبحث التقليدي، بل تقوم بمسح النطاق بالكامل وتوليد مصفوفة عددية تعبر عن الموضع النسبي لأول ظهور لكل اسم داخل ذلك النطاق المحدد.
يكمن السر الإجرائي في هذه الخطوة في السلوك الحسابي لدالة MATCH؛ فهي دائماً ما تُرجع مؤشر الفهرس الرقمي لأول تطابق تعثر عليه في المصفوفة متجاهلةً كافة التكرارات اللاحقة لذلك العنصر. فإذا تكرر اسم “أحمد” في الصفوف الأول والرابع والسابع، فإن الدالة سترجع الرقم 1 في كافة المواضع الثلاثة المقابلة لهذا الاسم، مما يحول البيانات الأبجدية المتناثرة إلى مصفوفة رقمية موحدة تعكس الهوية المرجعية الأساسية لكل كيان، وتمهد لعمليات الفرز الإحصائي اللاحقة بكفاءة هندسية بالغة الدقة.
4.2 توليد مصفوفة الفئات المتصلة باستخدام الدالة ROW
لإتمام عملية التصنيف الرياضي داخل الذاكرة الحسابية، تبرز الحاجة إلى بناء مصفوفة حاويات أو فئات رقمية قياسية متصلة تبدأ حتماً من الرقم واحد وتتصاعد تصاعداً منتظماً حتى نهاية عدد صفوف النطاق المستهدف. هنا تتدخل دالة ROW عبر التركيب الرياضي المعياري: ROW(Range) - ROW(FirstCell) + 1، لتقوم بخصم رقم الصف المطلق لأول خلية في النطاق من أرقام صفوف النطاق بأكمله، ثم إضافة الرقم واحد لمعايرة البداية وجعلها نقطة انطلاق رقمية محايدة تماماً.
تحمل هذه المعايرة النسبية أهمية هندسية فائقة في تصميم النماذج المالية والتحليلية في إكسيل؛ إذ إن الاعتماد المباشر على رقم الصف الفعلي ROW(Range) دون ضبط الإزاحة قد يولد أخطاء منطقية جسيمة إذا كان الجدول يبدأ في موضع متقدم من ورقة العمل (كالخلية A15 مثلاً). إن صيغة الإزاحة المعايرة تضمن استقلالية الحساب عن التموضع المكاني للجدول، وتحمي النتائج من الانهيار التلقائي عند قيام المستخدم بإدراج صفوف جديدة أو ترويسات بيانية أعلى نطاق البيانات الخاضع للدراسة، مما يمنح النموذج الرياضي صلابة واستقراراً دائماً.
4.3 آلية عمل الدالة FREQUENCY في تجميع التكرارات الفردية
تُعدّ دالة FREQUENCY المحرك الإحصائي التنفيذي داخل هذه المنظومة الرياضية المركبة؛ حيث تستقبل مصفوفة الإحداثيات المستخرجة من دالة MATCH بوصفها مصفوفة البيانات (Data Array)، وتستقبل مصفوفة التسلسل القياسي المنشأة بواسطة ROW بوصفها مصفوفة الفئات الحاكمة (Bins Array). تقوم الدالة بمسح كل فئة رقمية وإحصاء عدد المرات التي ورد فيها المؤشر المقابل داخل مصفوفة البيانات، مرجعة مصفوفة عمودية تمثل التوزيع التكراري الدقيق لتلك المؤشرات.
يتجلى الإبداع المنطقي هنا في حقيقة أن الظهور الأول لكل اسم سيرجع دائماً تكراراً يساوي أو يزيد عن القيمة 1 في الفئة التي تطابق موقعه النسبي، بينما ستتلقى التكرارات اللاحقة القيمة صفر حتماً؛ نظراً لأن مؤشراتها أعيد توجيهها سلفاً بواسطة MATCH نحو موقع الظهور الأول. وعندما نقرن مخرجات هذه الدالة بالشرط المنطقي التمييزي (>0)، تتحول كافة الأرقام الموجبة المعبرة عن الظهور الأول إلى القيمة المنطقية TRUE، بينما تصبح التكرارات الصفرية FALSE، ليقوم المعامل السالب المزدوج (--) بتحويلها إلى آحاد وأصفار تتكفل دالة SUMPRODUCT بجمعها لإعطاء العدد الصافي الدقيق للأسماء المتميزة.
5. الدراسة التطبيقية الشاملة: حساب الأسماء الفريدة لموظفي المبيعات (المثال العملي)
5.1 توصيف بنية نموذج البيانات والافتراضات التشغيلية
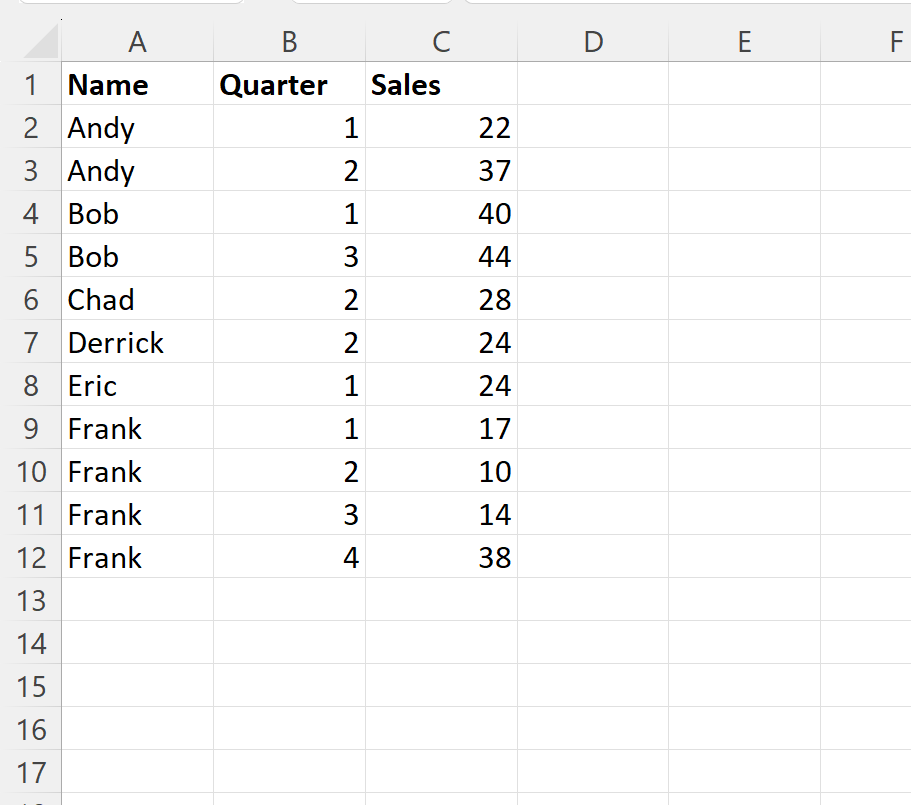
لتجسيد هذه المفاهيم النظرية في إطار عملي واقعي، نفترض وجود سجل مبيعات لإحدى الشركات التجارية يحتوي على قائمة بأسماء ممثلي المبيعات الميدانيين الذين أبرموا صفقات تجارية خلال دورة تشغيلية محددة. يمتد نطاق البيانات النصية في ورقة العمل عبر الخلايا من A2 إلى A12، مشتملاً على إحدى عشرة عملية بيعية مسجلة بأسماء متكررة تعكس طبيعة النشاط المتعدد لنفس المندوبين عبر الأيام المختلفة من الشهر، وتتوزع هذه السجلات على النحو التالي:
- الخلية A2: Andy
- الخلية A3: Bob
- الخلية A4: Chad
- الخلية A5: Chad (تكرار للعملية السابقة لنفس الموظف)
- الخلية A6: Derrick
- الخلية A7: Eric
- الخلية A8: Frank
- الخلية A9: Frank (تكرار لموظف مسجل)
- الخلية A10: Frank (تكرار ثانٍ لنفس الموظف)
- الخلية A11: Derrick (تكرار لموظف مسجل)
- الخلية A12: Andy (تكرار لموظف مسجل)
يتمثل الهدف التحليلي والإجرائي في هذا التطبيق في تجاوز إجمالي عدد العمليات الإحدى عشرة، واستخراج مؤشر عددي دقيق في الخلية E2 يمثل عدد الأفراد المستقلين الفعليين (Distinct Sales Representatives) الذين ساهموا في تحقيق هذه المبيعات، مع ضمان استبعاد كافة المعاملات المتكررة لنفس الموظف بما يضمن التقييم العادل لمؤشرات اتساع الفريق الميداني وفاعليته.
5.2 تنفيذ الصيغة خطوة بخطوة في بيئة إكسيل وتفسير النتائج
لتحقيق هذا الهدف في بيئة إكسيل الكلاسيكية والمستقرة، نقوم بإدخال الصيغة المركبة المتكاملة في الخلية المستهدفة E2 وفق الصياغة البرمجية القياسية الآتية:
=SUMPRODUCT(--(FREQUENCY(MATCH(A2:A12, A2:A12, 0), ROW(A2:A12) - ROW(A2) + 1) > 0))
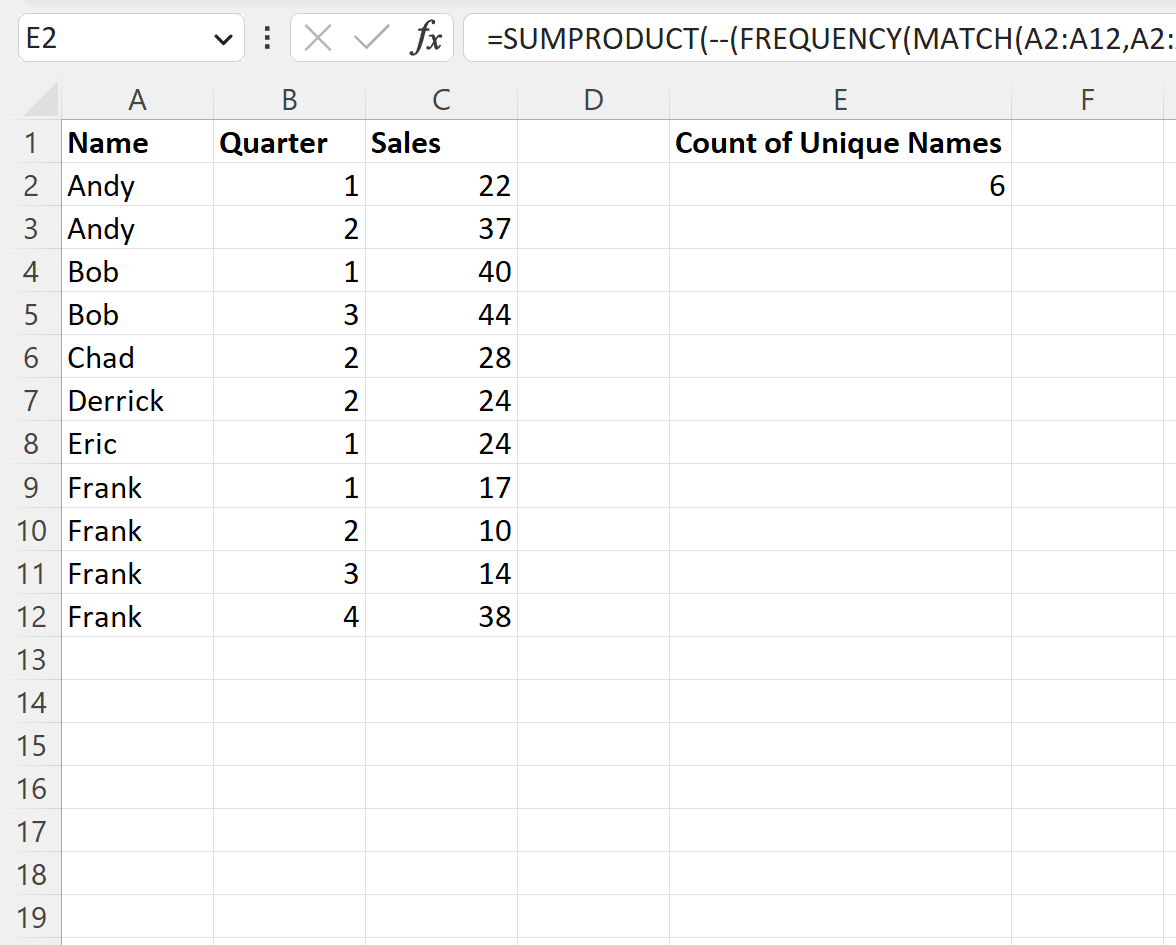
بمجرد تثبيت هذه الصيغة، تظهر النتيجة الحسابية المباشرة وهي الرقم (6)، وهو ما يعكس تماماً الوجود الفعلي لستة ممثلين مستقلين هم: (Andy, Bob, Chad, Derrick, Eric, Frank). ويمكن للباحث والمحلل التحقق الداخلي من سلامة الحسابات ومتابعة السلوك الحسابي للبرنامج عبر استخدام أداة “تدقيق الصيغ” (Evaluate Formula) المتاحة في تبويب “الصيغ” (Formulas) بشريط الأدوات؛ حيث تتيح هذه الأداة تشريح كل خطوة داخلية ورؤية تحول الأسماء إلى مصفوفة مواقع نسبية، ثم متابعة تجميع الفئات التكرارية عبر دالة FREQUENCY، وصولاً إلى التجميع الثنائي النهائي عبر SUMPRODUCT.
5.3 تحليل الأداء والدقة في مختلف سيناريوهات التكرار النصي
تتمتع هذه الصيغة الكلاسيكية بمستوى متقدم من المرونة الرياضية تم اختباره عبر سيناريوهات تجريبية متعددة للتحقق من استقرارها التشغيلي. فعند قيام المستخدم بإدراج اسم جديد كلياً—وليكن “George”—في موضع ما ضمن النطاق، يستجيب محرك الحسابات فوراً بتحديث الإحداثيات النسبية وزيادة الفئات الإحصائية، لترتفع النتيجة التلقائية مباشرة من 6 إلى 7، مما يثبت حساسية النموذج الفورية للمتغيرات الجديدة المضافة للمنظومة.
وعلى النقيض من ذلك، إذا أُضيف صف جديد يحوي اسماً مدرجاً مسبقاً مثل “Bob”، فإن دالة MATCH توجه إحداثيات هذا الإدخال الجديد فوراً نحو الموقع الأصلي الأول للاسم، مما يجعل دالة FREQUENCY ترجع صفراً إضافياً في الفئة الجديدة، ويحافظ المؤشر النهائي على قيمته الثابتة (6) دون أي تأثر بالزيادة السطحية في حجم السجلات. هذا الثبات المنطقي يبرهن على مناعة الصيغة ضد التشوهات الناتجة عن تكرار البيانات، ويؤكد ملاءمتها للاستخدام في النماذج الإدارية التي تشهد توسعاً مستمراً في سجلات الحركة اليومية.
6. الحلول الحديثة: استخراج قائمة الأسماء الفعلية باستخدام دالة UNIQUE
6.1 الخصائص الديناميكية لدالة UNIQUE في برمجية Excel 365
أحدثت دالة UNIQUE التي أُطلقت ضمن حزمة تحديثات Microsoft 365 ثورة حقيقية في منهجية استخراج وتحليل السلاسل النصية؛ حيث استندت إلى فلسفة هندسية جديدة كلياً تُعرف بنطاقات الانسكاب التلقائي (Spill Ranges). بموجب هذه الفلسفة، لم تعد الدالة مقيدة بالخلية التي كُتبت بداخلها، بل بات بإمكانها نشر مخرجاتها عبر نطاق متصل من الخلايا العمودية أو الأفقية وفقاً لحجم البيانات المستخرجة، محاطة بإطار أزرق تفاعلي يشير إلى طبيعة النطاق المنسكب، والذي يمكن الإشارة إليه في الصيغ الأخرى باستخدام مشغل الانسكاب الرمزي (#).
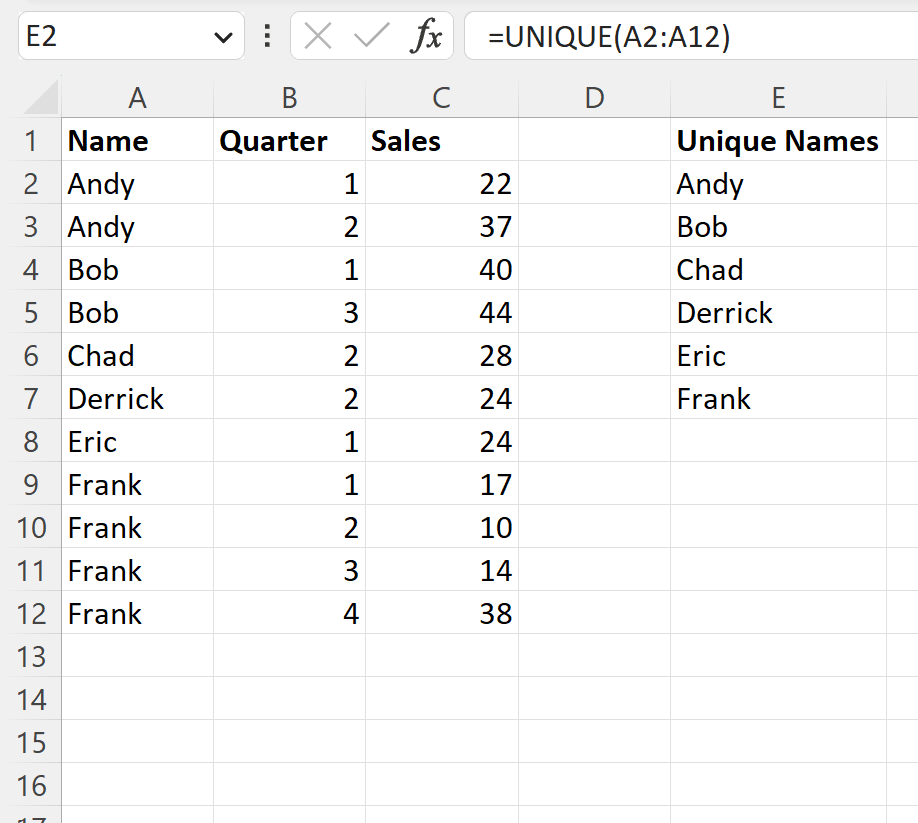
عند بناء الصيغة المبسطة =UNIQUE(A2:A12) في أي خلية شاغرة (ولتكن الخلية C2)، لا يقوم إكسيل بإرجاع رقم مجرد كما كان الحال في الصيغ التجميعية الكلاسيكية، بل يستخرج قائمة نصية حصرية تحتوي على الأسماء المتميزة الستة مسرودة سطراً بسطر. يمثل هذا التمييز نقلة نوعية في أسلوب عرض البيانات؛ حيث يتيح للمحلل الحصول على البنية النصية الصافية للكيانات لاستخدامها في إعداد القوائم المنسدلة للتحقق من صحة البيانات (Data Validation)، أو تغذية الرسوم البيانية التفاعلية ومصفوفات الارتباط دون المرور بتعقيدات برمجية وسيطة.
6.2 المعاملات الاختيارية المتقدمة للدالة UNIQUE
تتميز دالة UNIQUE بمرونة تشغيلية عالية تتجاوز السلوك الافتراضي بفضل وسائطها الاختيارية المصممة بعناية فائقة، حيث تأتي البنية القياسية الكاملة للدالة على النحو الآتي: =UNIQUE(array, [by_col], [exactly_once]). تتيح الوسيطة الثانية (by_col) للمحلل تحديد اتجاه المقارنة؛ حيث تُضبط افتراضياً على القيمة FALSE للفرز المقارن عبر الصفوف المتتالية، بينما يمكن ضبطها على TRUE إذا كانت البيانات النصية مصفوفة أفقياً عبر أعمدة متجاورة، مما يلغي الحاجة إلى إجراء عمليات تدوير مسبقة للنطاقات (Transposition).
أما الوسيطة الثالثة (exactly_once)، فتعد الأداة الرياضية المباشرة لتحقيق الفصل المنهجي بين مفهوم “القيم المتميزة” و”القيم الفريدة قطيعاً” الذي تم تأصيله سابقاً. فإذا تم ضبط هذه الوسيطة على TRUE عبر الصيغة =UNIQUE(A2:A12, FALSE, TRUE)، فإن الدالة ستقوم بفلترة النطاق مستبعدةً أي اسم تكرر أكثر من مرة، لترجع في مثالنا العملي السابق الأسماء التي ظهرت مرة واحدة فقط دون تكرار إطلاقاً وهما: (Bob, Eric). ويمكن تعزيز هذه النتائج بدمج الصيغة مع دالة الترتيب ليصبح التركيب =SORT(UNIQUE(A2:A12))، مما يضمن خروج القائمة المنسكبة مرتبة ترتيباً هجائياً محكماً يعزز وضوح التحليل وسهولة قراءته.
7. الصيغ البديلة السريعة: التكامل بين COUNTA وUNIQUE
7.1 صياغة التعبير المختصر لحساب العدد الإجمالي مباشرة
يمثل التكامل الوظيفي بين دالتي COUNTA وUNIQUE التطور الأكثر كفاءة وأناقة برمجية لحساب عدد الأسماء المتميزة مباشرة في الإصدارات الحديثة من إكسيل دون الحاجة إلى استخراج القوائم المنسكبة في مساحات جانبية من ورقة العمل. يتم هذا الإجراء عبر تداخل مباشر يمرر مخرجات الدالة المصفوفية كوسيطة لدالة العد الإجمالي بالصيغة المختصرة الآتية: =COUNTA(UNIQUE(A2:A12)).
من الناحية الحوسبية، تعمل دالة UNIQUE هنا في الذاكرة اللحظية لمعالجة نطاق الأسماء واختزاله إلى مصفوفة فريدة مجردة، فتتلقف دالة COUNTA هذه المصفوفة الافتراضية وتقوم فوراً بعدّ العناصر غير الفارغة التي تحتوي عليها، مرجعة الرقم (6) في الخلية ذاتها. يتفوق هذا التركيب على المعادلة الكلاسيكية المركبة (SUMPRODUCT-FREQUENCY) بفارق هائل في سهولة الصيانة وقابلية القراءة للباحثين الآخرين، كما يخفض الحمل الحسابي على معالج الحاسوب إلى أدنى المستويات الممكنة، مما يجعله الخيار الأمثل والافتراضي في بيئات العمل التي تعتمد كلياً على بيئة Microsoft 365 المعاصرة.
7.2 المحددات التشغيلية لحل COUNTA المباشر
على الرغم من البساطة والسرعة الفائقة لتركيب COUNTA(UNIQUE(...))، إلا أنه ينطوي على ثغرة تشغيلية ومحدودية منطقية يجب على كل باحث ومحلل الانتباه لها بحذر؛ تتمثل في سلوك دالة COUNTA الصارم في عدّ أي قيمة ترجعها الدالة الداخلية بما في ذلك القيم النصية الصفرية أو الفراغات. فعندما يشتمل نطاق البيانات المستهدف على خلايا فارغة بالكامل، فإن دالة UNIQUE تعتبر تلك الخلية الفارغة عنصراً قائماً بذاته، وترجع إما صفراً عددياً أو نصاً فارغاً ("") لتمثيل تلك الفئة غير المكتملة، مما يدفع دالة COUNTA لاحتسابه ضمن الإجمالي وتوليد تضخيم عددي غير حقيقي بزيادة الناتج بمقدار واحد صحيح.
ولمعالجة هذا القصور المنهجي وتأمين النتائج الرياضية ضد أخطاء السجلات المنقوصة، يتوجب على المحلل تحصين الصيغة بإدماج دالة التصفية FILTER لاستبعاد الخلايا الفارغة قبل وصول البيانات إلى دالة التفرد، وذلك عبر الصياغة الهندسية المتقدمة الآتية: =COUNTA(UNIQUE(FILTER(A2:A12, A2:A12""))). يضمن هذا التعديل خضوع البيانات النصية الممتلئة حصراً للتحليل الحسابي، مانعاً أي تلاعب غير مقصود في مؤشرات التفرد الإحصائية الناجمة عن الفجوات المكانية في جداول الإدخال الميدانية.
8. المعالجة المسبقة للبيانات وتفادي مشكلات التكرار النصي الخفي
8.1 أثر المسافات البيضاء والرموز الخفية على دقة المطابقة النصية
تُعدّ الشوائب النصية والمسافات البيضاء العشوائية العدو الأول لدقة الحسابات الإحصائية في قواعد البيانات وبرمجيات الجداول الممتدة. فعندما يُدخل جامع البيانات اسماً مثل “Andy” مع مسافة لاحقة غير مرئية في الخلية A2، ثم يُدخل الاسم ذاته “Andy” دون مسافات في الخلية A12، فإن المحرك الثنائي لإكسيل يتعامل مع النصين بوصفهما كيانين مستقلين تماماً ومختلفين في الشيفرة الرقمية المقابلة لكل حرف، مما يقود حتماً إلى تكرار زائف وتضخيم وهمي في عدد الأسماء المتميزة المحسوبة.
لتفادي هذا الانحياز التقني الخفي، يتعين تطبيق بروتوكول تطهير مسبق للبيانات يعتمد على دمج الدوال التنظيفية داخل سلاسل المعالجة. تعمل دالة TRIM على بتر كافة المسافات البادئة واللاحقة واختزال المسافات المتعددة بين الكلمات إلى مسافة قياسية واحدة، بينما تنهض دالة CLEAN بمسؤولية حذف المحارف والرموز غير القابلة للطباعة (Non-printable characters) التي تتسرب غالباً عند استيراد البيانات من استبانات الويب أو ملفات النصوص الخارجية (Text/CSV). إن تمرير النطاق عبر الصيغة الوقائية TRIM(CLEAN(Range)) قبل إجراء عمليات العد يمثل ممارسة قياسية لا غنى عنها لضمان التطابق النصي البيني الخالي من التشويه.
8.2 حساسية حالة الأحرف والهمزات والتباين اللغوي
تفرض الطبيعة اللغوية للمدخلات النصية اعتبارات إجرائية تتطلب فهماً عميقاً لمنطق المقارنة المتبع في محرك إكسيل الحسابي؛ حيث تمتاز دوال البحث التقليدية مثل MATCH وCOUNTIF بعدم حساسيتها لحالة الأحرف اللاتينية (Case-Insensitive)، مما يعني أنها تعامل “ANDY” و”Andy” و”andy” كعنصر متطابق تماماً في المعالجة الافتراضية. غير أنه إذا تطلبت المنهجية البحثية تمييزاً صارماً بين الحالات الحرفية، فيجب اللجوء إلى دوال التدقيق المطابق الصارم مثل دالة EXACT المدمجة في مصفوفات الفرز اليدوي.
أما في سياق البيانات المحررة باللغة العربية، فتظهر التحديات في التباين الإملائي الشائع في كتابة الحروف والهمزات؛ كاستخدام الألف المهموزة “أ” والألف المطلقة “ا”، أو الخلط بين الياء المنقوطة “ي” والألف المقصورة “ى”، فضلاً عن التاء المربوطة “ة” والهاء “ه”. يعتبر إكسيل هذه التباينات فروقاً جوهرية تصنع قيماً فريدة جديدة لكل تنويع إملائي. ولذا، تقتضي المنهجية العلمية الرصينة إجراء عمليات استبدال وتوحيد نمطي قياسي عبر دوال التبديل SUBSTITUTE أو أدوات البحث والاستبدال الممنهجة قبل الشروع في بناء مؤشرات الإحصاء النهائي للألقاب والأسماء المتداولة.
8.3 التعامل مع الخلايا الفارغة والأخطاء البرمجية ضمن النطاق
إن وجود الخلايا الفارغة داخل نطاقات التحليل الكلاسيكية يمثل خطراً تشغيلياً داهماً على سلامة الصيغ الحسابية المركبة؛ ففي الصيغ التقليدية المبنية على مقلوب التكرار مثلاً =SUMPRODUCT(1/COUNTIF(range, range))، يؤدي وجود خلية فارغة إلى إرجاع قيمة صفرية في مقام الكسر الرياضي، مما يُسقط المعادلة فوراً في فخ خطأ القسمة على الصفر الشهير (#DIV/0!)، ويوقف التدفق الحسابي لكامل جدول التحليل بصورة تعطل بقية العمليات المرتبطة.
ولتأمين سلامة التقارير الإحصائية الموجهة لصناع القرار، يجب هندسة الصيغ لتكون قادرة على تجاوز الانقطاعات المكانية والفجوات الطارئة في السجلات. يتحقق ذلك إما بتطبيق الصيغة المعيارية المرتكزة على FREQUENCY المشروحة في هذا المقال والتي تتصف بالحصانة الطبيعية المتقدمة ضد أخطاء الفراغات، أو بإحاطة الصيغ المعرضة للانهيار بدالة الحماية البرمجية IFERROR بالصيغة: =IFERROR(Complex_Formula, 0). يضمن هذا النهج الدفاعي عدم توقف لوحات البيانات التفاعلية واستمرار ترحيل النتائج بصورة مستقرة مهما شابت المدخلات من عيوب هيكلية عارضة.
9. البدائل التحليلية المتقدمة: الجداول المحورية وأداة Power Query
9.1 حساب القيم المتميزة عبر الجداول المحورية (Pivot Tables)
تقدم الجداول المحورية (Pivot Tables) بديلاً تحليلياً فائق التفاعلية يتجاوز التعقيدات البرمجية المباشرة للصيغ الحسابية المعقدة، ويوفر بيئة تلخيصية شديدة المرونة لاستكشاف البيانات الضخمة. غير أن الوصول إلى مقياس العد المتميز (Distinct Count) لا يتأتى عبر مسار الجداول المحورية الافتراضي القديم، بل يتطلب تقنية محددة تم دمجها بصورة أصيلة بدءاً من إصدار Excel 2013 فصاعداً عبر محرك التحليل السريع Power Pivot.
لتفعيل هذه الميزة، يقوم المستخدم بتحديد جدول البيانات والتوجه إلى قائمة إدراج جدول محوري (Insert PivotTable)، مع الحرص البالغ على تفعيل المربع الحواري التشغيلي: “إضافة هذه البيانات إلى نموذج البيانات” (Add this data to the Data Model). وبمجرد بناء الجدول المحوري وسحب حقل الأسماء إلى منطقة القيم (Values)، يتم الدخول إلى “إعدادات حقل القيمة” (Value Field Settings)، والتمرير لأسفل قائمة الدوال التجميعية لاختيار دالة “Distinct Count”. تمنح هذه الآلية المحلل قدرة استثنائية على تفكيك الأسماء المتميزة وربطها بشرائح التصفية التفاعلية (Slicers) والخطوط الزمنية بانسيابية متناهية وكفاءة تشغيلية عالية.
9.2 استخدام محرر الاستعلامات Power Query لأتمتة تنقية الأسماء
يمثل محرك استيراد وتجهيز البيانات المتطور المعروف بـ Power Query الحل الأكثر نضجاً ومؤسسية للتعامل مع تدفقات البيانات المتجددة دورياً وعمليات المعالجة الاستخلاصية والتحويلية المعقدة (ETL). فمن خلال استيراد جدول البيانات إلى محرر الاستعلامات عبر التبويب “بيانات” (Data) واختيار “من جدول/نطاق” (From Table/Range)، يدخل المحلل في بيئة معزولة تتيح بناء مسار تدفق تنظيمي مؤتمت وموثق برمجياً خطوة بخطوة بلغة M الدقيقة.
داخل هذه الواجهة، يمكن للمستخدم النقر بزر الفأرة الأيمن على رأس عمود الأسماء واختيار أمر “إزالة التكرارات” (Remove Duplicates) بعد تطبيق خطوات سريعة للتحويل مثل إزالة المسافات الزائدة (Trim) وتوحيد حالة الأحرف اللاتينية إلى أحرف صغيرة (lowercase) أو كبيرة (UPPERCASE). يتميز هذا الأسلوب بأن كافة هذه التحولات تُسجل كخطوات إجرائية محفوظة؛ بحيث لا يتطلب تحديث البيانات المستقبلية سوى النقر على زر “تحديث” (Refresh)، ليقوم المحرك آلياً بإعادة تشغيل المسار بالكامل على السجلات الجديدة واستخراج عدد وقائمة الأسماء الفريدة فوراً دون الحاجة لإعادة كتابة أي معادلات أو التدخل اليدوي المتكرر.
10. التوصيات الإجرائية وأفضل الممارسات لتوثيق ومعالجة البيانات
10.1 معايير اختيار الطريقة الأنسب حسب طبيعة المشروع الأكاديمي أو المهني
يتطلب اتخاذ القرار المنهجي بشأن اختيار الأداة الحسابية المثلى موازنة دقيقة بين مجموعة من المعايير والمحددات التقنية الحاكمة لمحيط العمل، ويمكن بلورة هذه المعايير في مصفوفة القرارات الإجرائية الآتية:
- التوافقية العابرة للنظم: في حال كان الملف التحليلي سيتداول بين باحثين ومؤسسات تستخدم إصدارات برمجية مختلفة أو قديمة (مثل Excel 2010 إلى Excel 2019)، تظل الصيغة الكلاسيكية المركبة
SUMPRODUCT-FREQUENCYهي الخيار الإلزامي الضامن لسلامة فتح الملف وحساب نتائجه دون توليد أخطاء عدم التعرف البرمجي على الدوال الحديثة (#NAME?). - السرعة والبساطة الحسابية: إذا كانت بيئة العمل موحدة تحت مظلة Microsoft 365 أو Excel 2021 وما بعدها، فإن استخدام
COUNTA(UNIQUE(...))المدعومة بـFILTERيمثل المسار الهندسي الأرقى والأكثر سهولة في التدقيق وتوفير موارد المعالجة للجهاز. - حجم السجلات وحيويتها: عند تخطي حجم البيانات حاجز عشرات الآلاف من السجلات، يوصى بالابتعاد التام عن المعادلات المصفوفية والاعتماد الكلي إما على محرك الجداول المحورية (Pivot Tables) المقترن بنموذج البيانات، أو الاعتماد على مسارات
Power Queryالمؤتمتة لحفظ استقرار الأداء وسرعة الاستجابة. - استخدام الجداول الديناميكية الرسمية: أياً كانت الطريقة المختارة، يُنصح دائماً بتحويل النطاقات النصية الثابتة إلى جداول إكسيل رسمية كائنية (Excel Tables – ListObject) عبر ضغط
Ctrl + T؛ حيث يضمن هذا الإجراء تمدد النطاقات وصيغ الحساب ذاتياً مع كل إضافة جديدة لبيانات الموظفين أو المشاركين في الدراسة دون الحاجة لتعديل مجالات الخلايا المكتوبة في وسائط الدوال يدوياً.
10.2 توثيق إجراءات المعالجة لضمان الشفافية وقابلية تكرار النتائج
تفرض التقاليد الأكاديمية الصارمة ومعايير الموثوقية المهنية في إدارة البيانات مستوى متقدماً من التوثيق الشفاف لكافة العمليات الحسابية والتحويلية التي خضعت لها المتغيرات الخام؛ لضمان إمكانية تكرار النتائج والتحقق المستقل منها من قبل مراجعين خارجيين (Replicability and Reproducibility). يجب أن يحرص الباحث على إدراج تعليقات توضيحية وملاحظات نصية مدمجة (Cell Comments/Notes) بجوار الخلايا الحاوية للمعادلات المركبة، تشرح بدقة المنطق الرياضي المتبع ومبررات اختيار التوليفات الدالية المستخدمة.
علاوة على ذلك، ينبغي على فرق العمل تأسيس سجل مراجعة منهجي (Audit Trail) يتضمن مجموعات بيانات اختبارية معيارية محددة النتائج مسبقاً لاختبار متانة الصيغ عند حدوث أي تعديل برمجي أو تحديث لنظم التشغيل، مع تفعيل قواعد التحقق من صحة المدخلات (Data Validation) في مراحل الجمع الأولى عبر فرض قوائم منسدلة أو قيود طولية تحد من الأخطاء الإملائية والمسافات العشوائية عند نقطة الإدخال، مما يقلص بصورة حاسمة الحاجة إلى عمليات التطهير اللاحقة ويوفر أساساً صلباً لبيانات تتميز بالدقة والاتساق المنهجي الرفيع.
خاتمة
استعرض هذا الدليل الأكاديمي الشامل الأبعاد النظرية والتطبيقية لحساب الأسماء المتميزة والفريدة في برنامج مايكروسوفت إكسيل؛ كاشفاً عن التطور الهيكلي لأدوات المعالجة النصية من البنى المصفوفية الكلاسيكية المعقدة المعتمدة على تناغم SUMPRODUCT وMATCH وFREQUENCY، وصولاً إلى الحلول الحديثة الانسيابية التي أتاحها محرك الحسابات الديناميكي عبر دالتي UNIQUE وCOUNTA. إن الإلمام الرصين بهذه الأدوات المتنوعة، وإدراك الفوارق الإحصائية بين القيم المتميزة والقيم المنعزلة الحصرية، واليقظة المنهجية لمعوقات المطابقة كالمسافات البيضاء والهمزات، تمنح الباحث والمحلل القدرة الكاملة على تطهير بياناته واستخلاص مؤشراته الكمية بثقة وموثوقية بالغة تدعم جودة اتخاذ القرار ورصانة البحث العلمي.
المراجع
- Alexander, M., & Kusleika, D. (2019). Excel 2019 Bible. John Wiley & Sons.
- Jelen, B. (2021). Microsoft Excel 2021 and Microsoft 365 from Scratch. Holy Macro! Books.
- Microsoft Support. (n.d.). UNIQUE function. Microsoft Corporation. https://support.microsoft.com/en-us/office/unique-function-c5ab87fd-30a3-4ce9-9d1a-40204fb85e1e
- Microsoft Support. (n.d.). Count unique values among duplicates. Microsoft Corporation. https://support.microsoft.com/en-us/office/count-unique-values-among-duplicates-8d9a69b3-b867-4964-a14a-1e63b8277237
- Statology. (2021). How to Count Unique Names in Excel. Statology Statistics Tutorials. https://www.statology.org/excel-count-unique-names/
- Walkenbach, J. (2015). Excel 2016 Formulas. John Wiley & Sons.