
يمثل التلخيص الإحصائي للبيانات الكمية الركيزة الأساسية التي يستند إليها الباحثون والمحللون لاستقراء الظواهر وفهم البنى الكامنة خلف الأرقام المجردة. فعندما تنمو مجموعات البيانات الخام وتتسع لتشمل مئات أو آلاف المشاهدات، يصبح من المستحيل على العقل البشري استيعاب معالمها أو اكتشاف أنماطها التوزيعية بمجرد استعراض القوائم الرقمية المسردة. هنا تبرز أهمية أساليب التكثيف الإحصائي، وعلى رأسها أسلوب التوزيع التكراري المجمع (Grouped Frequency Distribution)، كأداة منهجية تنقل التحليل من مستوى الوصف الفردي المشتت إلى مستوى التعميم المنظم القائم على فئات ذات حدود رياضية محكمة، مما يمهد الطريق لحساب مقاييس النزعة المركزية والتشتت واستكشاف مدى اعتدالية التوزيع بدقة وموثوقية عالية.
وفي إطار بيئات المعالجة الرقمية المعاصرة، يُعد برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشاراً ومرونة للتعامل مع قواعد البيانات وإجراء التحليلات الإحصائية الوصفية والاستدلالية. ومع ذلك، فإن التحول من مجرد إدخال البيانات إلى بناء توزيعات تكرارية مجمعة يتطلب استيعاباً عميقاً للأدوات المتقدمة التي يوفرها البرنامج، وفي مقدمتها الجداول المحورية (PivotTables) وتطبيقات الدوال المصفوفية. إن إتقان هذه التقنيات يتيح للباحثين اختصار الوقت والجهد، وتقليل احتمالات الخطأ اليدوي إلى الصفر تقريباً، فضلاً عن توفير ديناميكية عالية تسمح بإعادة هيكلة الفئات وضبط اتساعها بما يخدم أهداف البحث العلمي وتطلعات القرار الإداري المستنير.
يتناول هذا الدليل الأكاديمي الشامل كل ما يتعلق بكيفية بناء وتفسير التوزيع التكراري المجمع في إكسيل، بدءاً من الأطر النظرية والمفاهيم الرياضية الحاكمة لتحديد الفئات وحدودها الحقيقية والظاهرية، مروراً بإجراءات تنقية البيانات وتجهيزها، ووصولاً إلى التطبيق العملي المفصل خطوة بخطوة باستخدام الجداول المحورية والدوال المتقدمة. كما يستعرض الدليل كيفية تدقيق المخرجات وحساب التكرارات النسبية والتراكمية، وتمثيل النتائج بيانياً وفق أعلى معايير النشر العلمي المعتمدة، ليكون هذا المرجع دليلاً متكاملاً لكل باحث يسعى للرقي بجودة تحليلاته الإحصائية ورصانتها التوثيقية.
1. الإطار المفاهيمي للتوزيع التكراري المجمع وأهميته في التحليل الإحصائي
1.1 مفهوم التوزيع التكراري والفروق الجوهرية بين البيانات الفردية والمجمعة
يُعرَّف التوزيع التكراري في علم الإحصاء الوصفي بأنه جدول منظم يُلخص طريقة توزيع قيم المتغير المدروس على مختلف المشاهدات، حيث يقرن كل قيمة أو فئة بعدد مرات ظهورها في العينة أو المجتمع، وهو ما يُعرف بالتكرار المطلق. إن الهدف الجوهري من هذا التلخيص هو تكثيف البيانات الضخمة واختزال حجمها المشتت في مصفوفة مدمجة يسهل تفسيرها رياضياً ومنطقياً دون التضحية بالمعالم الأساسية للمتغير الأصلي.
تتجلى المقارنة المنهجية بين الجداول التكرارية البسيطة وتلك المجمعة في طبيعة المتغير الإحصائي الخاضع للدراسة ومدى تباينه. تُستخدم الجداول التكرارية البسيطة بصورة مثالية مع المتغيرات المنفصلة (Discrete Variables) أو المتغيرات النوعية الاسمية والترتيبية التي تتسم بمحدودية قيمها الممكنة، مثل الحالة الاجتماعية، أو الرتب الوظيفية، أو عدد أفراد الأسرة؛ حيث يخصص سطر مستقل لكل قيمة فردية فريدة. أما عندما نتعامل مع متغيرات متصلة (Continuous Variables) تأخذ قيماً لا نهائية داخل مدى معين، مثل درجات الاختبارات، أو الأوزان، أو الدخل السنوي، أو القياسات الزمنية، فإن التوزيع البسيط يصبح عديم الفائدة لأن معظم القيم قد تتكرر مرة واحدة فقط، مما يُبقي الجدول طويلاً ومشتتاً دون أي قيمة تحليلية مضافة.
من هذا المنطلق، تبرز التوزيعات التكرارية المجمعة كضرورة حتمية، حيث يتم تجميع البيانات الخام وتقسيمها إلى فئات أو فترات رقمية متتالية وغير متداخلة تُعرف باسم الفئات أو الحاويات (Bins / Classes). يساهم هذا التجميع المنظم في الكشف السريع عن النمط العام للتوزيع (Distribution Pattern)، وتحديد موقع النزعة المركزية مثل المتوسط والوسيط، واستجلاء طبيعة التشتت، علاوة على فحص استواء البيانات أو تركزها حول المركز. كما يتيح التوزيع المجمع تصنيف الدرجات الخام لمفحوصي العينات ضمن فئات قياسية معيارية، وهو إجراء جوهري في دراسات القياس والتقويم لإصدار أحكام تقييمية دقيقة وموثوقة.
1.2 دور التوزيعات التكرارية المجمعة في معالجة درجات المقاييس النفسية والسلوكية
تحظى التوزيعات التكرارية المجمعة بأهمية استثنائية في مجالات القياس النفسي والتقييم السلوكي، حيث يتعامل الباحثون عادة مع استبيانات ومقاييس متدرجة تتضمن درجات مركبة تجمع استجابات متعددة تعكس سمات شخصية أو أنماطاً معرفية أو حالات انفعالية. وتتطلب دراسات المسح السلوكي، كتلك التي تناولت تقييم الصحة النفسية والضغوط الإدراكية لدى طلاب الجامعات أثناء الأزمات المجتمعية (Wang et al., 2020)، تكثيف الدرجات المتباينة لآلاف المستجيبين في فئات تكرارية منتظمة لاستيعاب المشهد الوبائي والانفعالي للعينة دون الغرق في تفاصيل الدرجات الفردية الخام.
تسهم هذه الجداول التكرارية في فحص مدى ملاءمة درجات العينة للمنحنى الاعتدالي (Normal Distribution)، وهو ما يشكل شرطاً تأسيسياً لتطبيق الاختبارات الإحصائية المعلمية (Parametric Tests). فمن خلال فحص التكرارات المجمعة عبر الفئات، يمكن للباحث التحقق بصرياً وإحصائياً مما إذا كانت الدرجات تتركز في المنتصف وتتناقص تدريجياً نحو الأطراف، أو إذا كانت تعاني من التواء سالب (تكدس في الدرجات المرتفعة) أو التواء موجب (تكدس في الدرجات المنخفضة)، وهو أمر يتكرر في قياسات الأداء الذاتي غير الدقيق، حيث يميل الأفراد أحياناً إلى تقييم كفاءاتهم بمستويات متباينة تعكس تحيزات إدراكية جوهرية (Dunning, Heath, & Suls, 2004).
علاوة على ذلك، يُسهم التوزيع المجمع في تسهيل المقارنة بين المجموعات الفرعية داخل العينة كالمقارنة بين الذكور والإناث، أو بين مستويات وظيفية متباينة تأثرت بالتحولات الرقمية في بيئات العمل (Cascio & Montealegre, 2016). كما يوفر التوزيع الإطار الرياضي الصارم لاشتقاق المعايير التفسيرية (Norms)، حيث تترجم الفئات الرقمية المجمعة إلى مستويات كيفية معيارية كأن تُصنف الدرجات إلى مستويات أداء: “منخفض”، و”متوسط”، و”مرتفع”، مما يعطي الدرجة الفردية معنى ودلالة وظيفية قابلة للتطبيق العملي.
1.3 المعايير الرياضية والإحصائية لتحديد الفئات وحدودها
يرتكز بناء التوزيع التكراري المجمع على أسس رياضية ومفاهيم دقيقة تضمن تمثيل البيانات تمثيلاً أميناً وتمنع أي تشويه قد يلحق بخصائص التوزيع الأصلي. تبدأ العملية الإحصائية بحساب المدى الكلي للبيانات (Total Range)، وهو الفرق الحسابي المطلق بين أعلى قيمة ملاحظة في العينة وأدنى قيمة ملاحظة فيها، وفق العلاقة الرياضية:
$$\text{Range} = X_{\max} – X_{\min}$$
وبعد تعيين المدى، ينبغي تحديد عدد الفئات المناسب، وهو ما يحدد بالتبعية اتساع الفئة (Class Interval or Width). يتطلب اتساع الفئة موازنة دقيقة؛ فالإفراط في تكبير اتساع الفئة يؤدي إلى تصغير عدد الفئات بصورة مفرطة، مما يُخفي التباينات الداخلية ويطمس معالم التوزيع، في حين أن الإفراط في تصغير اتساع الفئة يؤدي إلى تضخيم عدد الفئات وتشتيت النمط الإحصائي العام. وقد أرسى الإحصائي كارل بيرسون منذ عام 1895 الأصول الرياضية للمدرجات التكرارية والمنحنيات التوزيعية المتصلة المشتقة من الفئات المجمعة، مؤكداً على ضرورة الحفاظ على تجانس الفترات الإحصائية.
تقتضي المنهجية الرياضية التمييز الحاسم بين الحدود الظاهرية (Stated Class Limits) والحدود الفعلية أو الحقيقية (Class Boundaries / True Limits). تُعرَّف الحدود الظاهرية بأنها القيم الاسمية المدونة كبداية ونهاية للفئة للبيانات المنفصلة أو المقربة، مثل الفئات (10 – 19) و(20 – 29)، حيث يمثل 10 الحد الأدنى الظاهري (LCL) للفئة الأولى، و19 حدها الأعلى الظاهري (UCL). غير أن هذه الحدود تترك فجوة رقمية بين 19 و20؛ وهنا تتدخل الحدود الفعلية لإلغاء هذه الفجوات لضمان الاتصال الرياضي، وتحسب الحدود الفعلية عبر المعادلة التالية:
$$\text{Lower Boundary} = LCL – \frac{U}{2}, \quad \text{Upper Boundary} = UCL + \frac{U}{2}$$
حيث يمثل $U$ وحدة القياس أو دقة الأداة (Unit of Precision). فإذا كانت الدرجات أعداداً صحيحة ($U = 1$)، فإن الحدود الفعلية للفئة (10 – 19) تصبح (9.5 – 19.5)، وللفئة التالية (19.5 – 29.5). وتتجلى أهمية هذا الضبط الدقيق في تفادي معضلة تداخل الحدود وتكرار المفردات، وضمان أن تقع كل مشاهدة في فئة واحدة فقط بصورة مانعة للبس التفسيري والعددي.
2. تحضير وتنظيم البيانات في إكسيل قبل المعالجة الإحصائية
2.1 قواعد تنظيف البيانات ومعالجة القيم الشاذة والمفقودة
تُمثل مرحلة تنظيف البيانات الخطوة الحاسمة لضمان موثوقية التوزيع التكراري؛ إذ إن إدخال بيانات غير منقحة في أدوات إكسيل يؤدي حتماً إلى نتائج مشوهة أو ظهور أخطاء تقنية أثناء محاولة تجميع الفئات. يجب فحص عمود البيانات والتأكد من خلوه تماماً من أخطاء الإدخال المادية، مثل إدراج حروف أبجدية أو علامات ترقيم شاذة أو مسافات خفية تسبق الأرقام أو تليها، حيث تتسبب المسافات الخفية في تحويل القيمة الرقمية إلى نص (Text Data)، وهو السبب الأكثر شيوعاً لتعطل خيارات التجميع التلقائي في إكسيل.
يتطلب التحليل الإحصائي الرصين استكشاف القيم المتطرفة أو الشاذة (Outliers) التي تبعد بصورة غير منطقية عن النطاق الطبيعي للمتغير؛ إذ إن وجود قيمة شاذة واحدة شديدة الارتفاع أو الانخفاض يؤدي إلى تضخيم المدى الكلي للبيانات تضخيماً زائفاً، مما يقود بالضرورة إلى اتساع مفرط في الفئات وظهور فئات تكرارية فارغة تشوه شكل التوزيع. كما ينبغي التعامل الواعي مع الخلايا الفارغة أو القيم المفقودة (Missing Values)، إما بحذف صفوف الحالات غير المكتملة وفق معايير علمية محددة، أو باستخدام أساليب الإحلال الإحصائي المعتمدة في منهجية البحث.
كذلك يجب توحيد التنسيق الرقمي لجميع خلايا نطاق المتغير. يتم ذلك بتحديد الخلايا المعنية، ثم النقر بزر الفأرة الأيمن واختيار أمر “تنسيق الخلايا” (Format Cells)، ومن تبويب “رقم” (Number) يتم تحديد الخيار كـ “رقم” وتحديد عدد المنازل العشرية الملائم (مثلاً منزلتين عشريتين أو صفر للأعداد الصحيحة). يضمن هذا الإجراء البرمجي تعرف محرك إكسيل على كافة المدخلات كقيم كمية متصلة قابلة لإجراء العمليات الحسابية والمنطقية دون أي تعارض برمجي.
2.2 تنظيم المتغيرات الرقمية في نطاق خلايا قياسي
تعتمد كفاءة أدوات التحليل في إكسيل، لا سيما الجداول المحورية، على البنية الهيكلية لقاعدة البيانات المدخلة في ورقة العمل. ولتحقيق المعالجة الإحصائية المثالية، يجب رصف المتغير الرقمي المستهدف في عمود رأسي موحد ومستقل، مع الحرص التام على عدم دمج الخلايا أفقياً أو رأسياً ضمن نطاق البيانات؛ حيث يُعد دمج الخلايا أحد أكبر العوائق أمام عمل خوارزميات التجميع والفرز.
يجب تخصيص الخلية الأولى العليا في العمود، مثل الخلية A1، لتكون رأس العمود (Header)، وتسميتها بتسمية دلالية واضحة ومحددة تمثل المتغير المقاس، مثل “النقاط”، أو “زمن_الاستجابة”، أو “درجة_المقياس”. يُشترط أن تكون هذه التسمية موجزة وخالية من الرموز الخاصة التي قد تسبب التباساً في صيغ المعادلات. وتبدأ البيانات الرقمية الملاحظة مباشرة من الخلية A2 وصولاً إلى نهاية العينة (مثل الخلية A16 في العينات الصغيرة أو آلاف الخلايا في الدراسات الموسعة).
من الضروري التحقق الصارم من عدم وجود أي صفوف فارغة تماماً أو أعمدة فارغة داخل كتلة البيانات، لأن وجود صف فارغ قد يدفع البرنامج إلى افتراض انتهاء نطاق البيانات عند تلك النقطة، مما يستبعد باقي أفراد العينة من التحليل. أما فيما يتعلق بترتيب البيانات الخام، فلا يُشترط ترتيبها تصاعدياً أو تنازلياً مسبقاً، حيث يمتلك محرك إكسيل الداخلي القدرة على فرز البيانات ومعالجتها حتى لو كانت مدخلة بصورة عشوائية، غير أن الترتيب المسبق قد يفيد الباحث أحياناً في المراجعة البصرية الأولية للمدخلات.
2.3 تحويل نطاق البيانات إلى جدول رسمي (Excel Table)
يُعد تحويل نطاق الخلايا التقليدي إلى جدول رسمي في إكسيل (Excel Table) ممارسة تحليلية رفيعة المستوى توفر مزايا تقنية استثنائية مقارنة بالتعامل مع نطاقات الخلايا الثابتة. يتم هذا الإجراء ببساطة عن طريق النقر داخل أي خلية في نطاق البيانات ثم الضغط على الاختصار القياسي لوحة المفاتيح (Ctrl + T)، أو الانتقال إلى تبويب “إدراج” (Insert) واختيار “جدول” (Table)، مع التأكد من وضع إشارة صح أمام خيار “يحتوي الجدول على رؤوس” (My table has headers).
تتمثل الميزة الكبرى للجداول الرسمية في خاصية التوسع التلقائي الديناميكي؛ فعند إضافة مشاهدات أو درجات جديدة لمرضى أو مفحوصين جدد أسفل العمود، يتوسع الجدول تلقائياً ليستوعب تلك المدخلات ويضمها فوراً إلى نطاقه المرجعي. وبالتالي، لا يضطر الباحث إلى إعادة تعديل صيغ المعادلات أو تحديث النطاق المرجعي للجدول المحوري يدوياً، بل يكفي النقر على زر “تحديث” (Refresh) لينعكس الإدخال الجديد فوراً على الفئات التكرارية القائمة.
علاوة على ذلك، تُتيح الجداول الرسمية الاعتماد على “المراجع المهيكلة” (Structured References)، حيث يُشار إلى المتغير باسم عموده (مثلاً: Table1[النقاط]) بدلاً من استخدام إحداثيات الخلايا الصامتة (مثل $A$2:$A$16)، مما يقلل احتمالات الخطأ عند تكرار التجارب الإحصائية أو تطبيق معادلات فرعية، ويوفر بيئة عمل عالية الاحترافية والشفافية تتماشى مع معايير إدارة البيانات المتقدمة.
3. إنشاء الجدول المحوري (PivotTable) كخطوة أولى لتكوين الفئات
3.1 تحديد مصدر البيانات والوصول إلى معالج الجداول المحورية
يُشكل الجدول المحوري الأداة الأكثر فاعلية ومرونة في بيئة إكسيل لمعالجة البيانات وتلخيصها وتكوين الفئات الإحصائية بدقة بالغة. تبدأ الخطوة الإجرائية الأولى بتحديد مصدر البيانات المراد تجميعه؛ فإذا كانت البيانات قد نُسقت مسبقاً كجدول رسمي، يكفي النقر داخل أي خلية منه، أما إذا كانت نطاقاً عادياً (مثل النطاق A1:A16)، فيجب تظليل النطاق كاملاً بالفأرة مع تضمين رأس العمود التعريفي لضمان التعرف على المتغير بدقة.
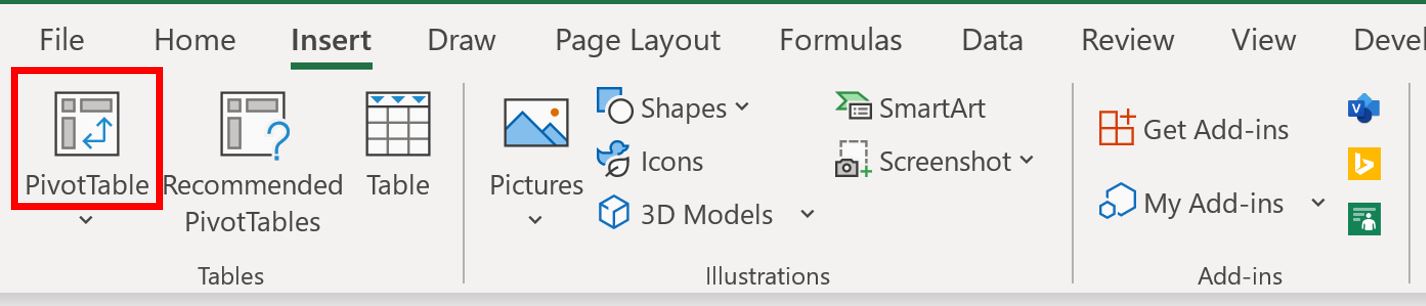
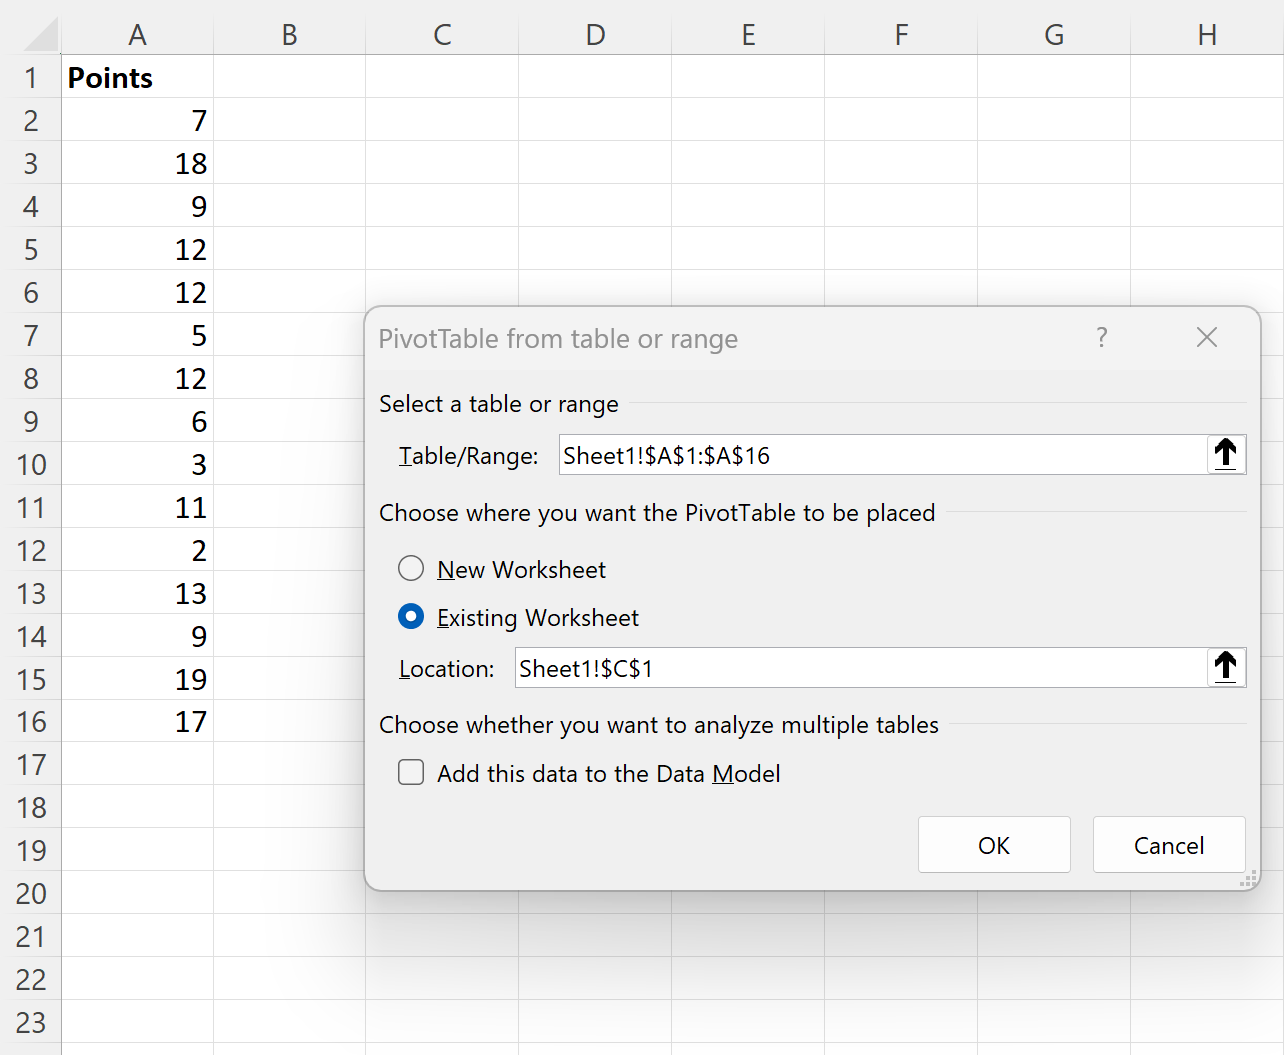
عقب تحديد النطاق، ينتقل المستخدم إلى شريط الأدوات العلوي (Ribbon)، ويختار تبويب “إدراج” (Insert)، ثم ينقر مباشرة على أيقونة “جدول محوري” (PivotTable) الواقعة في أقصى الجانب الأيمن أو الأيسر وفقاً للغة واجهة البرنامج. يُفتح على الفور مربع حوار معالج الجداول المحورية الذي يطلب تأكيد النطاق أو اسم الجدول المختار، ويجب هنا تدقيق مسار النطاق المكتوب والتأكد من مطابقته لحجم البيانات الفعلي لتفادي إسقاط أي من مشاهدات العينة.
يوفر هذا المعالج آلية متكاملة لربط البيانات الخام بمحرك التحليل التجميعي؛ حيث يُنشئ إكسيل في خلفية النظام نموذجاً تحليلياً يُسمى ذاكرة التخزين المؤقت للجدول المحوري (PivotCache)، وهي بنية بيانات محسنة تتيح معالجة العمليات الحسابية وتوليد التكرارات وتقسيم الفئات بسرعة حسابية فائقة دون المساس بسلامة البيانات الأصلية المدخلة أو إجراء أي تعديل مباشر على خلاياها.
3.2 تخصيص موضع إدراج الجدول المحوري في مصنف العمل
يوفر معالج إكسيل للمستخدم خيارين استراتيجيين لتحديد مكان إنشاء وتوليد الجدول المحوري، ويخضع هذا الاختيار لطبيعة الدراسة وحجم البيانات المعالجة:
- ورقة عمل جديدة (New Worksheet): يُعد هذا الخيار هو الأنسب والأكثر رصانة من الناحية الأكاديمية عند معالجة قواعد بيانات بحثية موسعة أو إعداد تقارير متعددة المتغيرات، حيث يُدرج إكسيل ورقة عمل مستقلة نظيفة تُعنى حصرياً بالمخرجات الإحصائية، مما يمنع التداخل البصري بين الأرقام الخام والنتائج الملخصة.
- ورقة العمل الحالية (Existing Worksheet): يُفضل اختيار هذا الخيار في النماذج التحليلية الصغيرة والتطبيقات التعليمية والتدريبية (مثل عينة الـ 15 مفحوصاً الموضحة لاحقاً)، حيث يتم تفعيل هذا الخيار ثم النقر داخل حقل “الموقع” (Location) واختيار خلية فارغة تبعد مسافة كافية عن نطاق البيانات الأصلي (مثل الخلية C1 أو C2)؛ وذلك لتجنب أي تداخل في الحسابات أو استبدال بيانات قائمة بطريق الخطأ.
بمجرد الاستقرار على الموضع المناسب والضغط على زر “موافق” (OK)، يقوم إكسيل بتهيئة منطقة العمل التحليلية؛ حيث تظهر شبكة الجدول المحوري الفارغة في الموقع المحدد، مصحوبة باللوحة الجانبية التفاعلية المخصصة لإدارة وتوزيع حقول البيانات تمهيداً لحساب التكرارات وتوليد الفئات المطلوبة.
3.3 فهم لوحة حقول الجدول المحوري (PivotTable Fields Panel)
تُعد لوحة حقول الجدول المحوري (PivotTable Fields Panel) التي تظهر على يمين أو يسار الشاشة بمثابة غرفة التحكم المركزية لتوليد كافة الحسابات والتصنيفات الإحصائية. تتألف هذه اللوحة بنيوياً من جزأين رئيسيين: الجزء العلوي ويعرض قائمة بجميع المتغيرات ورؤوس الأعمدة المتوفرة في نطاق البيانات المحدد (مثل حقل “النقاط”)، والجزء السفلي ويشتمل على أربع مناطق وظيفية متخصصة تُسحب المتغيرات وتُفلت بداخلها وهي: المرشحات (Filters)، الأعمدة (Columns)، الصفوف (Rows)، والقيم (Values).
يتحدد السلوك الرياضي والتنظيمي للجدول المحوري استناداً إلى المنطقة التي يُسقط فيها الحقل؛ حيث تخصص منطقة “الصفوف” لتصنيف البيانات رأسياً وتكوين العناوين الفئوية، بينما تُعنى منطقة “القيم” بتطبيق الدوال الرياضية والإحصائية كالمجموع والمتوسط والانحراف والتعداد التكراري. وعند إلقاء حقل رقمي في إحدى هذه المناطق، يتعرف إكسيل عليه تلقائياً كمتغير كمي، غير أنه يميل افتراضياً إلى تطبيق دالة المجموع (Sum) في منطقة القيم، وهو ما يستدعي تعديلاً إجرائياً دقيقاً عند بناء الجداول التكرارية.
في حال أُغلقت هذه اللوحة الجانبية عن طريق الخطأ، يمكن استعادتها بيسر عبر تحديد أي خلية داخل نطاق الجدول المحوري، ثم التوجه إلى شريط الأدوات العلوي والنقر على تبويب “تحليل الجدول المحوري” (PivotTable Analyze)، ثم النقر على زر “قائمة الحقول” (Field List) لإعادة تفعيلها ومتابعة بناء النموذج التحليلي دون أي انقطاع إجرائي.
4. ضبط حقول الجدول المحوري لحساب التكرارات الإحصائية
4.1 إدراج المتغير في منطقة الصفوف (Rows Area)
تبدأ المعالجة الإحصائية الفعلية بسحب حقل المتغير الرقمي (مثل حقل “النقاط”) من القائمة العلوية للوحة الحقول باستخدام زر الفأرة الأيسر، وإفلاته داخل مربع “الصفوف” (Rows). بمجرد إتمام هذا الإجراء، يُجري إكسيل مسحاً شاملاً لبيانات المتغير، ويستخرج قائمة فريدة تضم كل قيمة رقمية ظهرت في العينة دون أي تكرار، ويضعها كعناوين في العمود الأول من الجدول المحوري تحت مسمى “تسميات الصفوف” (Row Labels).
تُشكل هذه الخطوة الأساس الرقمي الأولي الذي سيتم بناء الفئات المجمعة عليه لاحقاً؛ فبدلاً من رؤية المشاهدات المكررة مصفوفة وراء بعضها، يظهر كل رقم خام فريد في سطر مستقل. ويتحقق الباحث في هذه اللحظة من عدم وجود قيم شاذة غير متوقعة أو مدخلات نصية تسللت أثناء الإدخال. وتُعد هذه التسميات الصفية هي النوى التي ستتلاحم وتتجمع لاحقاً ضمن مجموعات متسعة تمثل الفئات التكرارية المستهدفة.
ومن المهم إدراك أن وضع المتغير في منطقة الصفوف بمفرده لا يولد جدولاً تكرارياً، بل يقدم فقط قائمة مستخلصة بالقيم الفريدة للبيانات. ولإعطاء هذه القيم صفة التوزيع الإحصائي، لا بد من إقرانها بالمعيار الحسابي الذي يُبين ثقل كل قيمة أو فئة ومدى تكرار حدوثها وظهورها الفعلي في العينة قيد الاختبار.
4.2 إدراج المتغير في منطقة القيم (Values Area)
لتوليد عمود التكرارات، يتطلب الأمر تكرار عملية سحب نفس حقل المتغير الرقمي (“النقاط”) مرة ثانية من الجزء العلوي للوحة الحقول، ولكن يتم إفلاته هذه المرة داخل مربع “القيم” (Values). يمثل تكرار سحب نفس المتغير في منطقتي الصفوف والقيم معاً جوهر المنهجية المتبعة في إكسيل لإنشاء الجداول التكرارية؛ حيث يعمل الحقل الأول في الصفوف كـ “معيار للتصنيف”، بينما يعمل الحقل الثاني في القيم كـ “وعاء للقياس والعد”.
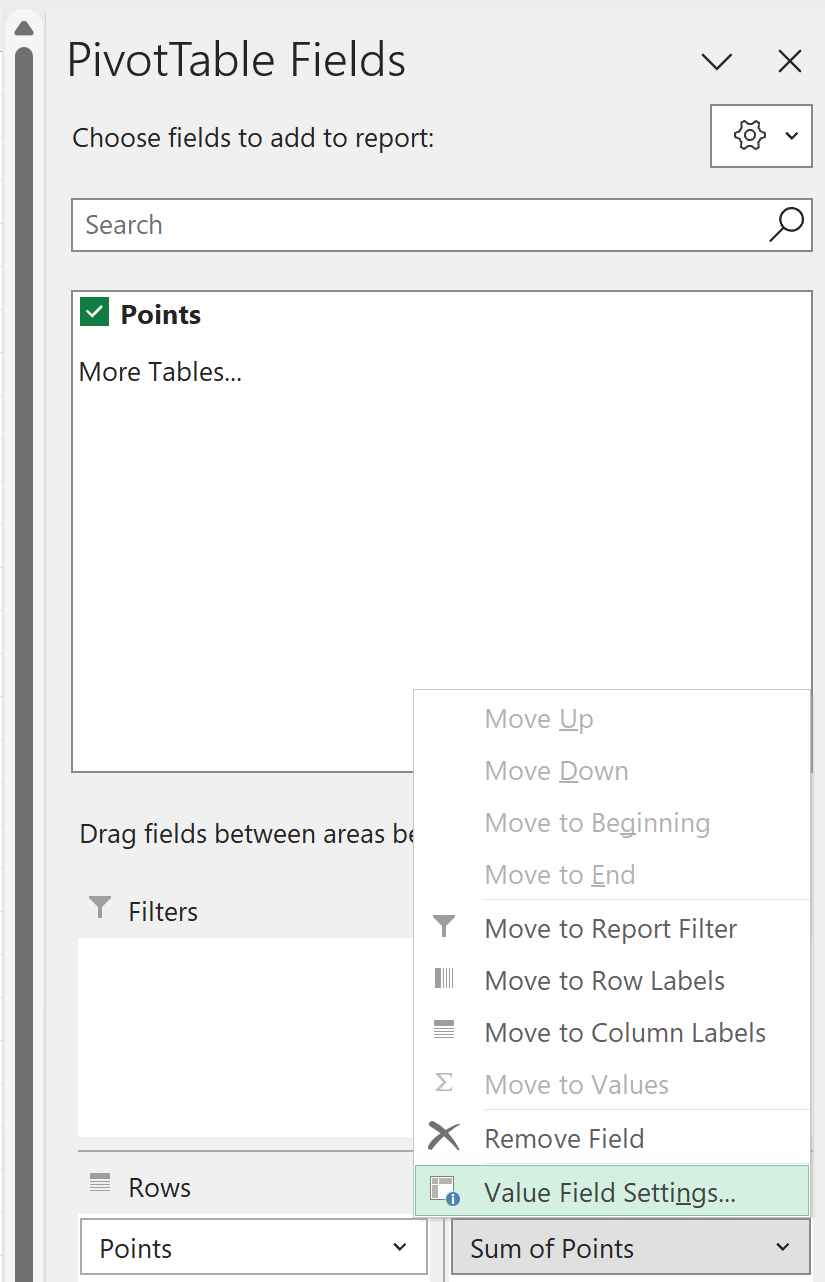
عند إفلات الحقل الرقمي في مربع القيم، يقوم إكسيل وفق برمجته الافتراضية بافتراض أن المستخدم يرغب في جمع الأرقام، فينشئ عموداً موازياً يحمل عنوان “مجموع النقاط” (Sum of Points). ومعنى هذا أن البرنامج يقوم بجمع القيم المتطابقة معاً بدلاً من عدّها، وهو ما يتعارض تماماً مع المفهوم الإحصائي للتكرار (Frequency)، والذي يعني عدد مرات حدوث القيمة وليس حاصل جمعها الجبري.
لذلك، يجب ألا يقف الباحث عند هذه النتيجة الأولية الخاطئة؛ إذ إن بقاء دالة الجمع يؤدي إلى تشويه التحليل وفقدان الدلالة التكرارية بالكامل، مما يفرض ضرورة الدخول إلى خصائص الحقل الحسابية وتعديل نوع الدالة المطبقة لتتحول من دالة تجميع جمعي إلى دالة تجميع تعدائي تمثل التكرار الإحصائي الدقيق.
4.3 تعديل إعدادات حقل القيمة إلى دالة التكرار (Count)
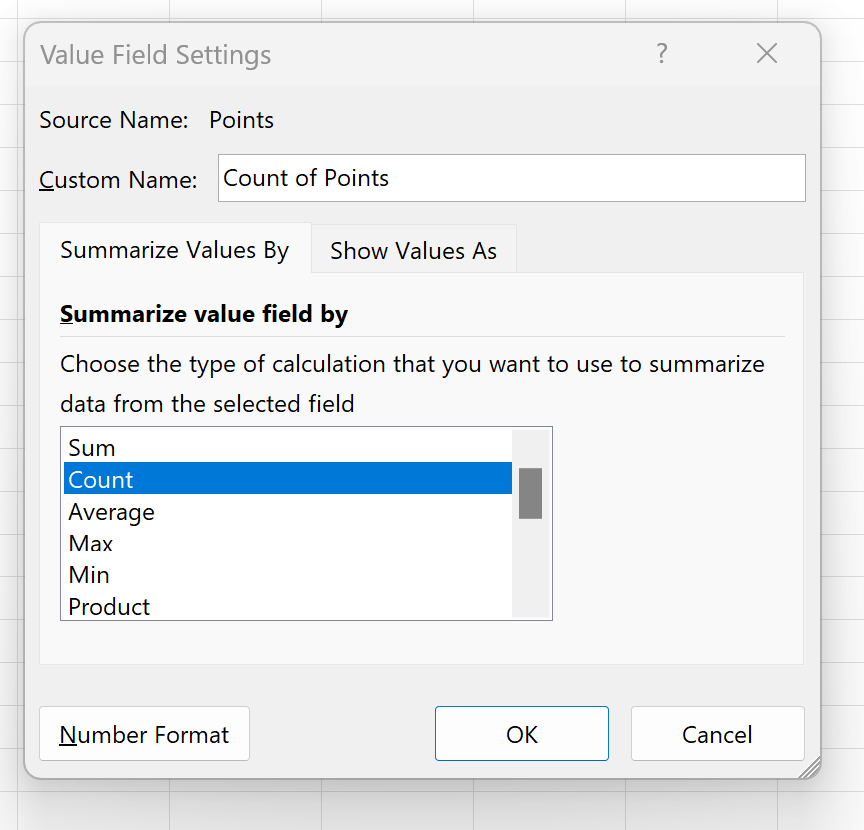
لتحويل الحساب إلى تكرار، يقوم الباحث بالنقر على السهم الصغير المتجه لأسفل بجوار حقل المتغير في مربع القيم (أو النقر بزر الفأرة الأيمن مباشرة على أي رقم داخل عمود القيم في الجدول المحوري)، واختيار أمر “إعدادات حقل القيمة” (Value Field Settings). تفتح هذه العملية نافذة حوارية تحتوي على تبويب “تلخيص القيم حسب” (Summarize Values By)، متضمناً قائمة بجميع الدوال الإحصائية والتلخيصية المتاحة في إكسيل.
من هذه القائمة، يتم النقر على دالة “عدد” (Count) بدلاً من دالة “مجموع” (Sum). تقوم هذه الدالة بتوجيه خوارزمية البرنامج لحساب عدد مرات ظهور كل مفردة داخل العينة بدلاً من جمع قيمها. وبالتزامن مع ذلك، يُستحسن تعديل حقل “الاسم المخصص” (Custom Name) في أعلى النافذة؛ حيث يتم مسح العنوان التلقائي واستبداله بمصطلح إحصائي صريح مثل “التكرار” أو “Frequency” أو الرمز الرياضي المتعارف عليه ($f$).
عقب الضغط على زر “موافق” (OK)، يعيد الجدول المحوري تشكيل نفسه على الفور، حيث يُظهر عموداً يمثل القيم المفردة الفريدة متبوعة بالتكرار الفعلي لكل قيمة في العينة، مع وجود سطر أخير يعرض الإجمالي الكلي (Grand Total) الذي يجب أن يتطابق بدقة مطلقة مع حجم العينة الأصلي ($n$). ويُمثل هذا الجدول المرحلي جدول توزيع تكراري بسيط غير مجمع، ويشكل الانطلاقة المباشرة للمرحلة التالية المتمثلة في تطبيق عملية التجميع الفئوي.
5. تطبيق ميزة التجميع (Group) لإنشاء الفئات المجمعة في إكسيل
5.1 الوصول إلى نافذة التجميع عبر النقر بالزر الأيمن
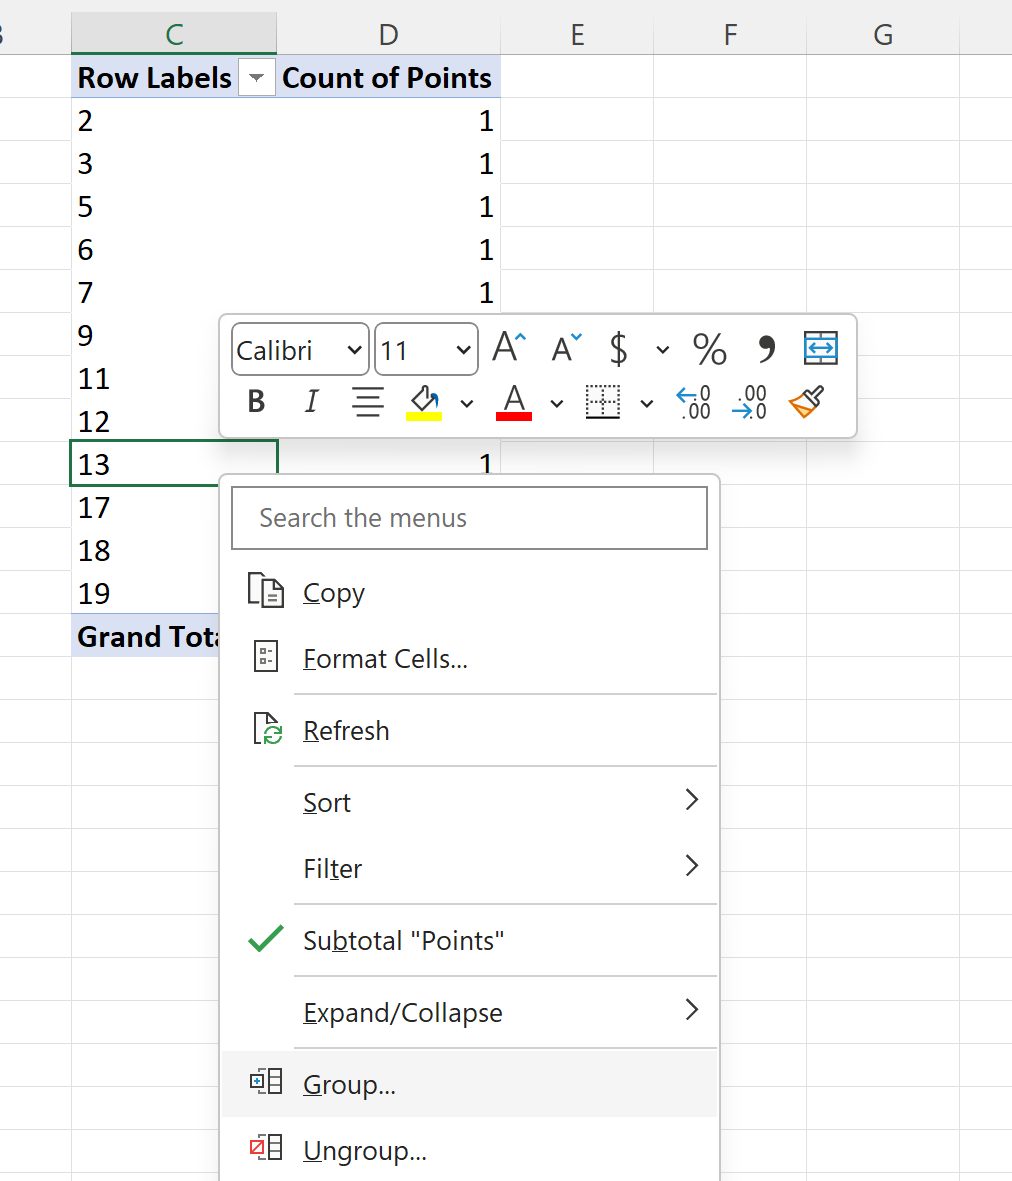
تُمثل خاصية التجميع (Grouping) المضمنة في الجداول المحورية الآلية البرمجية الأرقى التي يتفرد بها إكسيل لتحويل التوزيعات البسيطة إلى توزيعات مجمعة في ثوانٍ معدودة دون الحاجة لكتابة معادلات خوارزمية معقدة. للوصول إلى هذه الخاصية، يوجه الباحث مؤشر الفأرة نحو أي خلية رقمية تقع داخل عمود “تسميات الصفوف” (أي عمود القيم الفريدة)، ثم ينقر بزر الفأرة الأيمن (Right-Click) لتنسدل قائمة الأوامر السياقية.
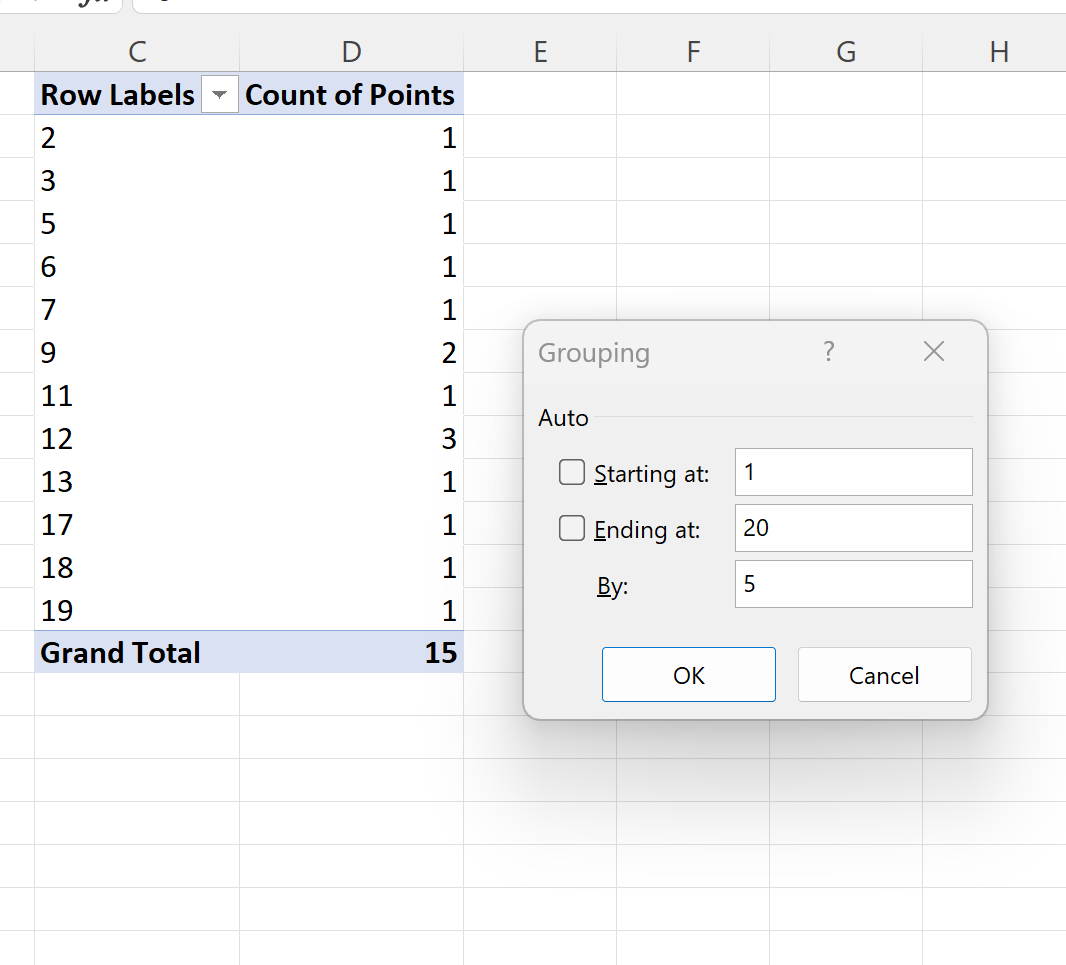
من القائمة المنسدلة، يتم اختيار أمر “تجميع” (Group). يؤدي هذا الإجراء فوراً إلى ظهور مربع حوار متخصص بعنوان “تجميع” (Grouping Dialog Box)، وهو المربع المسؤول عن هندسة الفئات رياضياً وتحديد أبعادها ونطاقاتها العددية. ويحتوي هذا المربع على ثلاثة حقول مدخلات محورية: “البدء من” (Starting at)، و”الانتهاء عند” (Ending at)، و”بمقدار” (By)، وبجوار الحقلين الأولين تظهر مربعات اختيار للتحديد التلقائي.
في بعض الأحيان، قد يُفاجأ المستخدم بتعطل خيار التجميع أو ظهور رسالة الخطأ الشهيرة “لا يمكن تجميع هذا التحديد” (Cannot group that selection). ينشأ هذا العائق في الغالب عن وجود بيانات غير متجانسة داخل النطاق الأصلي، كأن يتضمن عمود الأرقام خلية نصية أو مسافة فارغة أو خلية لا تحتوي على قيمة؛ حيث يمنع محرك إكسيل عمليات التجميع الحسابي التلقائي إلا إذا كانت كافة المدخلات في العمود ذات طبيعة رقمية حقيقية وقابلة للقياس الكمي بنسبة 100%.
5.2 تحديد بداية الفئات ونهايتها (Starting at & Ending at)
عند فتح نافذة التجميع، يقوم إكسيل تلقائياً بملء حقلي “البدء من” و”الانتهاء عند” بأدنى قيمة وأعلى قيمة ملاحظة في العينة الخام على التوالي، وتكون مربعات الاختيار بجوارهما مفعلة بصورة افتراضية. ورغم أن هذا التحديد التلقائي قد يكون مناسباً في النظرات الاستكشافية السريعة، إلا أن التقاليد الإحصائية والأكاديمية تتطلب في أغلب الأحيان تخصيص هذه الحدود بما يتناسب مع طبيعة المقياس النظري والنطاق المنطقي للمتغير المدروس.
لتحديد حدود الفئات بأسلوب منهجي، يقوم الباحث بإلغاء تحديد مربعات الاختيار التلقائية عبر النقر عليها، مما يتيح التعديل اليدوي في الحقول النصية:
- حقل البدء من (Starting at): يتم إدخال الحد الأدنى المختار للفئة الأولى، ويُفضل إحصائياً أن يكون رقماً صحيحاً مريحاً ومستقراً رياضياً يساوي أو يقل قليلاً عن أدنى درجة ملاحظة (مثلاً إدخال القيمة 10 إذا كانت أدنى درجة في العينة هي 10 أو 11)، لضمان احتواء الفئة الأولى على البداية الحقيقية للمتغير.
- حقل الانتهاء عند (Ending at): يتم إدخال الحد الأعلى للفئة الأخيرة، ويجب أن يغطي هذا الرقم أعلى درجة مسجلة في البيانات وربما يتجاوزها قليلاً لإنهاء المدى بنهاية مغلقة ومحكمة (مثلاً إدخال القيمة 30 إذا كانت أعلى درجة هي 29 أو 30).
إن التحقق من اتساع المدى بين نقطتي البدء والانتهاء يضمن استيعاب كافة أفراد العينة دون استثناء أي مشاهدة؛ إذ إن أي قيمة خام تقع خارج النطاق المحدد سوف تُعزل إما في فئة مفتوحة تسبق البداية (مثل: <10) أو فئة تلي النهاية (مثل: >30)، وهو ما يتعارض غالباً مع أسس التوزيع التكراري المغلق المنتظم المعمول به في الدراسات العلمية الرصينة.
5.3 ضبط اتساع الفئة (By / Class Width) وتوليد الفئات
يمثل حقل “بمقدار” (By) المتغير الحاسم في هندسة التوزيع التكراري؛ حيث يُدخل فيه اتساع الفئة المختار ($w$)، وهو الفاصل الرياضي المنتظم الذي يفصل بين بداية كل فئة وبداية الفئة التي تليها مباشرة (مثلاً: 5، أو 10، أو 20 وحدة رقمية). ويتم تحديد هذا الرقم استناداً إلى الصيغ الرياضية المعيارية المعتمدة (مثل قاعدة ستورجس أو المدى الإحصائي المقترح) بما يحقق أفضل توازن بين تكثيف البيانات وتوضيح معالم التوزيع.
تعتمد خوارزمية إكسيل عند بناء مسميات الفئات على مبدأ العد المغلق للأعداد الصحيحة؛ فعند تعيين نقطة البدء عند 10 والاتساع عند 5، يقوم البرنامج بإنشاء الفئة الأولى تحت التسمية “10-14” (والتي تتسع لخمس وحدات رقمية كاملة: 10، 11، 12، 13، 14)، وتكون الفئة التالية “15-19″، ثم “20-24″، وهكذا دواليك. وبمجرد الانتهاء من إدخال قيمة الاتساع، يتم النقر على زر “موافق” (OK).
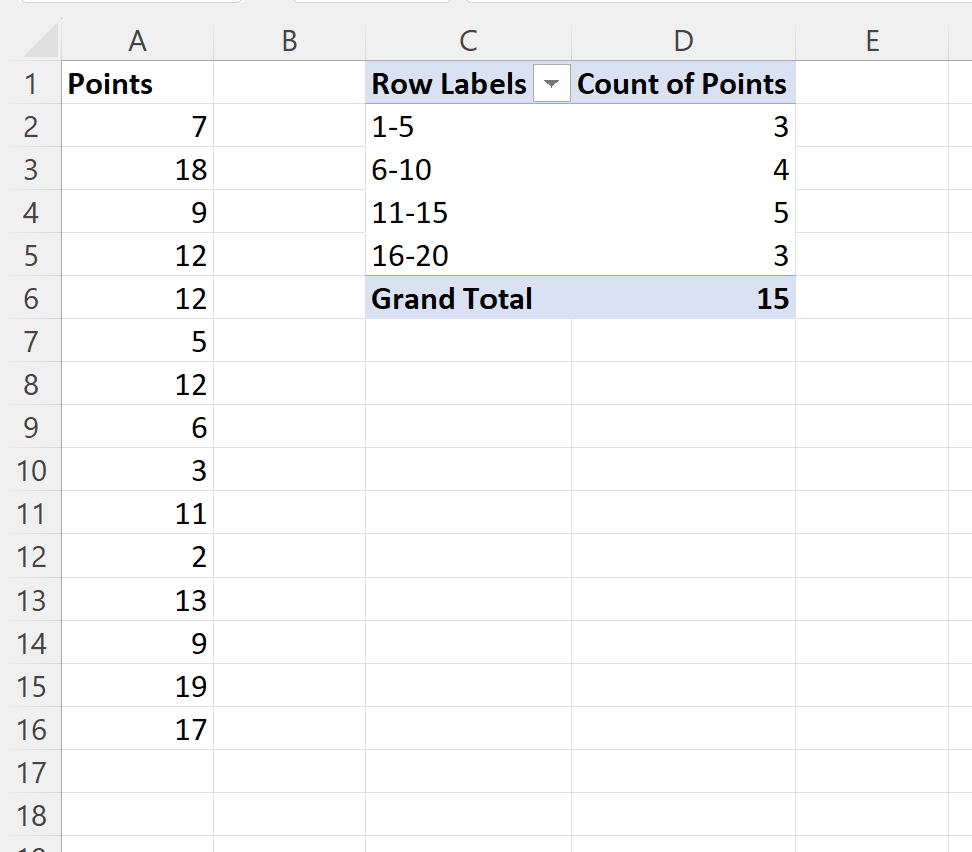
في جزء من الثانية، يقوم الجدول المحوري بإعادة تجميع كافة الصفوف المفردة ودمجها داخل الفئات المصاغة حديثاً، ويُظهر التكرار المطلق التراكمي للقيم الواقعة داخل حدود كل فئة رقمية على حدة. ويجب في هذه الخطوة مراجعة السطر الأخير الخاص بالإجمالي الكلي (Grand Total) والتأكد من مطابقته لحجم العينة الأصلي ($n$)؛ حيث يُعد هذا التطابق دليلاً إجرائياً قاطعاً على أن عملية التجميع تمت بسلامة مطلقة وأن جميع المفردات قد احتُسبت داخل الفئات دون أي فقد أو ازدواجية تصنيفية.
6. تطبيق عملي خطوة بخطوة: بناء توزيع تكراري لدرجات مفحوصين
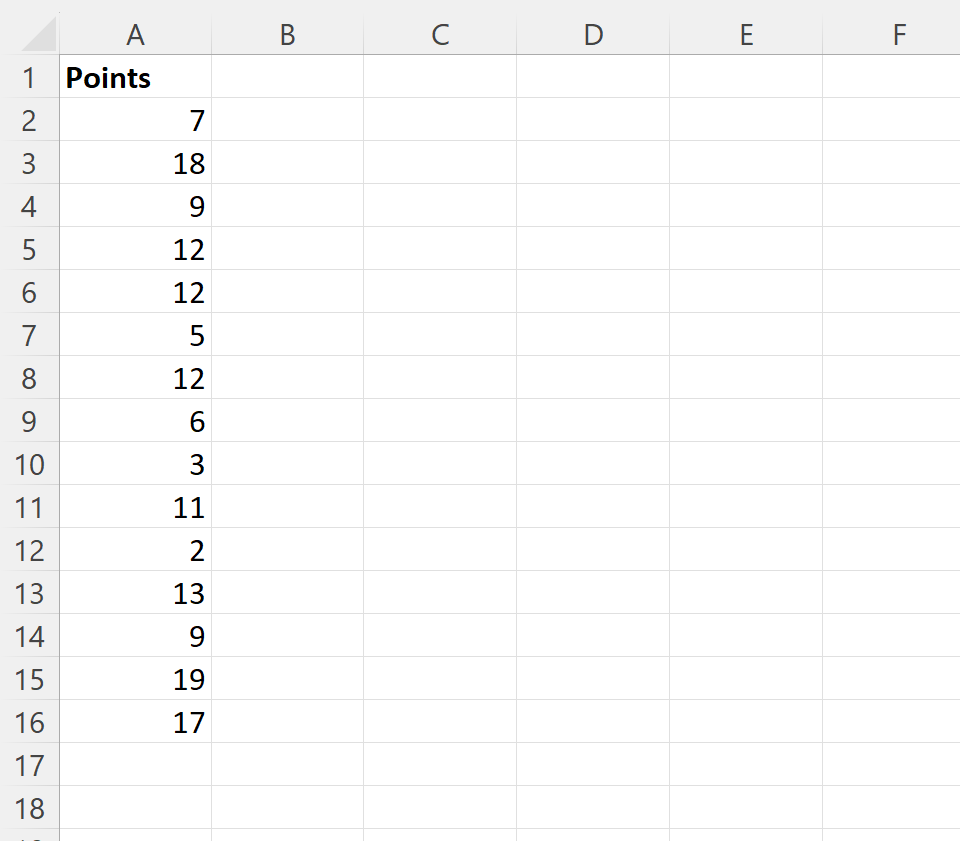
6.1 البيانات المفترضة لدرجات الأداء وإدخالها في النطاق A1:A16
لتجسيد الخطوات السابقة في سياق عملي ملموس، سنعتمد على مجموعة بيانات مفترضة تمثل درجات 15 مفحوصاً خضعوا لاختبار قياس الأداء السلوكي أو الرياضي المقنن، وهو مقياس متدرج يقيس مهارات التوافق والاستجابة تحت ظروف تدريبية محددة تشبه البيئات السلوكية المدروسة في برامج تطوير الأداء (Bergeron et al., 2015). تتيح هذه العينة المكونة من 15 مفردة استيعاب آليات الحساب والمطابقة اليدوية بدقة قبل تعميمها على العينات الكبرى.
تُدخل البيانات في مصنف إكسيل بدءاً من العمود الأول A، حيث نخصص الخلية A1 لتكون رأس العمود تحت اسم “النقاط” (Points)، وتُرصف الدرجات الخام الفردية في الخلايا من A2 إلى A16 كما هو مبين في النطاق التالي:
| إحداثيات الخلية | المتغير: النقاط (Points) |
|---|---|
| A1 | النقاط |
| A2 | 12 |
| A3 | 14 |
| A4 | 15 |
| A5 | 18 |
| A6 | 19 |
| A7 | 20 |
| A8 | 21 |
| A9 | 22 |
| A10 | 23 |
| A11 | 24 |
| A12 | 25 |
| A13 | 26 |
| A14 | 27 |
| A15 | 28 |
| A16 | 29 |
يُلاحظ من استقراء هذه الدرجات الخام أن أدنى قيمة ملاحظة في العينة هي 12، وأعلى قيمة ملاحظة هي 29، وبالتالي فإن المدى الكلي للبيانات هو:
$$\text{Range} = 29 – 12 = 17$$
إن تباين هذه الدرجات وتوزيعها عبر مدى يتجاوز 17 درجة يجعل تجميعها في فئات خطوة جوهرية لتحديد المستويات الأدائية للأفراد ومعرفة النمط التكراري الذي يحكم كفاءة المفحوصين بصورة دقيقة وموجزة.
6.2 التنفيذ الإجرائي الكامل من الإدراج إلى التجميع
نبدأ بتنفيذ الخطوات العملية المنظمة كما يلي:
- تحديد النطاق: نحدد بالفأرة النطاق بالكامل من الخلية A1 إلى الخلية A16.
- إدراج الجدول المحوري: من شريط الأدوات العلوي، ننتقل إلى تبويب “إدراج” (Insert) ثم ننقر على “جدول محوري” (PivotTable). وفي مربع الحوار، نختار “ورقة العمل الحالية” (Existing Worksheet)، ونحدد الخلية C1 كموقع لبدء ظهور الجدول المحوري، ثم ننقر على “موافق” (OK).
- توزيع الحقول: من لوحة حقول الجدول المحوري الجانبية، نسحب حقل “النقاط” ونفلته في مربع “الصفوف” (Rows)، ثم نسحب نفس الحقل “النقاط” مرة ثانية ونفلته في مربع “القيم” (Values).
- ضبط الدالة على التكرار: ننقر على السهم بجوار الحقل في مربع القيم، ونختار “إعدادات حقل القيمة” (Value Field Settings)، ونغير نوع التلخيص من Sum إلى “Count” (عدد)، ونعيد تسمية رأس العمود إلى “التكرار”، ثم نضغط “موافق”.
- تطبيق التجميع الفئوي: ننقر بزر الفأرة الأيمن على أي رقم في عمود تسميات الصفوف (مثل الرقم 12)، ونختار من القائمة أمر “تجميع” (Group).
- تحديد معالم الفئات: في نافذة التجميع، نلغي تفعيل مربعات الاختيار التلقائية، وندخل المعايير التالية بدقة:
- البدء من (Starting at): 10
- الانتهاء عند (Ending at): 30
- بمقدار (By): 5
- اعتماد المخرجات: ننقر على “موافق” (OK) لتوليد الجدول التكراري المجمع النهائي مباشرة داخل ورقة العمل.
6.3 قراءة وتفسير مخرجات جدول التوزيع التكراري الناتج
عقب إتمام الخطوات السابقة بنجاح، يُنتج إكسيل جدول توزيع تكراري مجمع منتظم يتخذ البنية الإحصائية التالية تماماً:
| فئات النقاط (Classes) | التكرار المطلق ($f$) |
|---|---|
| 10-14 | 2 |
| 15-19 | 3 |
| 20-24 | 5 |
| 25-29 | 5 |
| الإجمالي الكلي (Total) | 15 |
يكشف الاستقراء التحليلي الدقيق لهذا الجدول عن دلالات إحصائية بالغة الأهمية؛ حيث يتبين لنا على الفور أن الدرجات تتوزع عبر أربع فئات متساوية الاتساع مقداره 5 وحدات. تتضمن الفئة الأولى (10-14) تكرارين اثنين فقط (وهما القيمتان 12 و14)، بينما تضم الفئة الثانية (15-19) 3 تكرارات (القيم 15، 18، 19).
أما الكتلة الكبرى من أداء المفحوصين، فتتركز في الفئتين العلييين: الفئة (20-24) بواقع 5 أفراد، والفئة (25-29) بواقع 5 أفراد أيضاً. وهذا يُشير إلى وجود “توزيع ثنائي المنوال” (Bimodal Distribution) في الفئات العليا، ويعكس مستوى مرتفعاً من الأداء لدى غالبية أفراد العينة؛ إذ إن ثلثي المفحوصين (10 من أصل 15) حققوا درجات تقع بين 20 و29 نقطة. كما يؤكد سطر الإجمالي الكلي البالغ 15 سلامة الاحتساب واستيعاب كافة الدرجات دون أدنى استبعاد، مما يُبرهن على تفوق هذا التلخيص في توفير قراءة فورية وعميقة لخصائص العينة تفوق بمراحل استعراض القائمة الرقمية الخام غير المنتظمة.
7. الحسابات الإحصائية التكرارية المتقدمة عبر الجدول المحوري
7.1 حساب التكرار النسبي والنسبة المئوية لكل فئة
يُمثل التكرار المطلق ($f$) قيمة كمية تعبر عن عدد المفردات في كل فئة، غير أن فائدته التحليلية تظل قاصرة عندما يرغب الباحث في مقارنة توزيعين لعينتين مختلفتين في الحجم الكلي؛ ومن هنا تنشأ الحاجة الحتمية لحساب التكرار النسبي (Relative Frequency – $rf$) والنسبة المئوية التكرارية لكل فئة. يُعرَّف التكرار النسبي رياضياً بأنه نسبة تكرار الفئة إلى حجم العينة الإجمالي، وفق المعادلة التالية:
$$rf_i = \frac{f_i}{n}, \quad \text{such t\hat } \sum rf_i = 1.0$$
يتيح الجدول المحوري في إكسيل استخراج التكرار النسبي والنسب المئوية بمنتهى السهولة والسرعة الإجرائية دون صياغة معادلات خارجية؛ حيث يقوم الباحث بسحب حقل “النقاط” مرة ثالثة من قائمة الحقول وإفلاته في مربع “القيم” إلى جوار حقل التكرار السابق. يظهر عمود جديد في الجدول باسم تلقائي مثل “Count of Points 2”.
يقوم الباحث بعد ذلك بالنقر بزر الفأرة الأيمن على أي رقم داخل هذا العمود الجديد، ويختار أمر “إظهار القيم كـ” (Show Values As)، ومن القائمة الفرعية المنبثقة يختار “% من إجمالي الصف الكلي” أو “% من الإجمالي الكلي” (% of Grand Total). يتحول العمود فوراً ليعرض النسبة المئوية التي تمثلها كل فئة من إجمالي العينة (مثلاً: الفئة 10-14 تمثل 13.33%، والفئة 20-24 تمثل 33.33%). ويُمكن عبر خيارات تنسيق الخلايا تقريب هذه النسب لأقرب منزلة عشرية وفقاً لمتطلبات النشر العلمي المعمول بها.
7.2 إنشاء التكرار المتجمع الصاعد والتكرار النسبي التراكمي
يُعد التكرار المتجمع الصاعد (Cumulative Frequency – $cf$) أداة تحليلية جوهرية تُستخدم لحساب عدد المشاهدات التي تقل عن أو تساوي الحد الأعلى الحقيقي لفئة معينة. تتجلى أهمية هذا المقياس في حساب المئينات (Percentiles) والرتب المئينية، وتحديد مستويات القطع المعيارية (Cut-off Scores) للمقاييس السلوكية والتشخيصية في دراسات الصحة النفسية والتدخلات العلاجية (Liu et al., 2017). ويُعبر عنه رياضياً بالصيغة التراكمية:
$$cf_k = \sum_{i=1}^k f_i$$
يوفر إكسيل ميزة مدمجة مذهلة لحساب التكرار التراكمي مباشرة عبر الجدول المحوري. يتم ذلك بسحب حقل المتغير إلى مربع القيم مرة إضافية، ثم النقر بزر الفأرة الأيمن داخل خلايا العمود الجديد واختيار أمر “إظهار القيم كـ” (Show Values As)، ثم اختيار “مجموع تراكمي في…” (Running Total In). يفتح البرنامج نافذة صغيرة لتحديد الحقل الأساسي، فيتم اختيار حقل الصفوف (“النقاط”) والنقر على موافق.
يقوم الجدول المحوري في الحال ببناء التكرار المتجمع الصاعد؛ حيث تبدأ الفئة الأولى بقيمتها (2)، وتكون الفئة الثانية (2 + 3 = 5)، وتليها الفئة الثالثة (5 + 5 = 10)، وتصل الفئة الأخيرة إلى إجمالي العينة الكامل (10 + 5 = 15). وإذا رغب الباحث في تحويل هذا التراكم إلى نسبة مئوية تراكمية (Cumulative Percentage)، فيمكنه من نفس القائمة اختيار “النسبة المئوية للمجموع التراكمي في…” (% Running Total In)، ليُظهر الجدول بدقة نسبة الأفراد الذين تقع درجاتهم دون كل فئة، مما يقدم قراءة ارتقائية عميقة لبنية العينة.
7.3 تطبيق التنسيق الشرطي (Conditional Formatting) لتعزيز القراءة البصرية
يُعتبر التنسيق الشرطي (Conditional Formatting) في إكسيل تقنية متقدمة تُضفي عمقاً بصرياً فورياً على جداول التوزيع التكراري، مما يُمكّن العين البشرية من التقاط الفروق الجوهرية والأنماط الكثيفة دون إجهاد تحليلي. ويُستخدم هذا الإجراء لتسليط الضوء على الفئات المنوالية الأكثر تكراراً أو الفئات الهامشية التي تندر فيها الاستجابات داخل التوزيع.
لتطبيق التنسيق الشرطي، يتم تظليل خلايا عمود التكرار الفعلي ($f$) داخل الجدول المحوري، ثم التوجه إلى تبويب “الصفحة الرئيسية” (Home) في شريط الأدوات والنقر على أيقونة “التنسيق الشرطي” (Conditional Formatting). ومن الخيارات المتاحة، تبرز أداتان رئيسيتان تتمتعان برصانة أكاديمية:
- أشرطة البيانات (Data Bars): يؤدي اختيار أشرطة البيانات ذات التدرج اللوني الخفيف إلى رسم شريط أفقي مصغر داخل كل خلية يتناسب طوله مع التكرار المطلق، مما يحاكي رسم بياني شريطي مدمج داخل الجدول مباشرة.
- مقاييس الألوان (Color Scales): تتيح هذه الميزة تطبيق تدرج لوني حراري (مثل تدرج اللون الأخضر من الداكن للأعلى تكراراً إلى الفاتح للأقل تكراراً)، مما يُظهر فوراً مناطق التركز والتشتت في درجات المفحوصين.
تقتضي المعايير الأكاديمية الصارمة عدم الإفراط في استخدام الألوان الصاخبة أو التنسيقات البصرية المتداخلة التي قد تُشتت القارئ؛ إذ يُنصح دوماً باختيار نغمات لونية هادئة متناسقة تُعزز قراءة التوزيع وتُبرز الفئات الشاذة أو المنوالية بوقار علمي يخدم أهداف العرض والتوثيق دون بهرجة إحصائية غير مبررة.
8. التمثيل البياني للتوزيع التكراري المجمع في إكسيل
8.1 إنشاء المدرج التكراري (Histogram) انطلاقاً من الجدول المحوري
يُعد المدرج التكراري (Histogram) التمثيل البياني المعياري والأكثر كفاءة للتعبير عن التوزيعات التكرارية المجمعة للمتغيرات المتصلة؛ حيث تُمثل الفئات على المحور الأفقي، بينما يمثل التكرار المطلق أو النسبي على المحور الرأسي عبر أعمدة مستطيلة. ويتميز المدرج التكراري إحصائياً بأن مساحة كل عمود تتناسب طردياً مع تكرار الفئة الممثلة له، وهو ابتكار منهجي صاغه وطوره الإحصائي كارل بيرسون في نهاية القرن التاسع عشر لدراسة التغيرات التطورية والبيولوجية المعقدة.
لإنشاء مدرج تكراري متصل مباشرة بمخرجات الجدول المحوري، يقوم الباحث بالنقر داخل أي خلية في الجدول المحوري المجمع، ثم الانتقال إلى تبويب “تحليل الجدول المحوري” (PivotTable Analyze) واختيار أمر “مخطط محوري” (PivotChart). في النافذة المنبثقة، يختار نوع المخطط القياسي “عمود” (Column)، وتحديداً خيار “عمود متفاوت المسافات” (Clustered Column)، ثم النقر على “موافق”.
يُدرج إكسيل رسماً بيانياً أولياً يحتوي على فئات الدرجات على المحور الأفقي والتكرارات على المحور الرأسي. وهنا يجب العناية الفائقة بتنسيق عناصر المخطط؛ إذ ينبغي النقر على علامة (+) المجاورة للمخطط لإضافة “عناوين المحاور” (Axis Titles)، حيث يُكتب على المحور الأفقي بدقة: “فئات الدرجات / النقاط”، وعلى المحور الرأسي: “التكرار ($f$)”، مع كتابة عنوان إيضاحي عام وشامل في أعلى الرسم يصف طبيعة المتغير المقاس بصورة لا تدع مجالاً للغموض التفسيري.
8.2 ضبط المسافات البينية (Gap Width) لمحاكاة المدرج الإحصائي القياسي
ينشأ الرسم البياني العمودي التلقائي في إكسيل بمسافات وفجوات بيضاء واضحة تفصل بين كل عمود وآخر؛ ورغم أن هذا الشكل يُعد صحيحاً لتمثيل البيانات الاسمية أو المنفصلة (Bar Chart)، إلا أنه يُعد خطأً إحصائياً وتخطيطياً جسيماً عند تمثيل التوزيعات التكرارية للمتغيرات المتصلة في هيئة مدرج تكراري (Histogram)؛ فالأصل في المدرج التكراري هو تلاصق الأعمدة تلاصقاً تاماً للدلالة الرياضية على اتصال الفئات وتتابع حدودها الحقيقية دون فجوات زمنية أو قيمية.
لتحويل المخطط العمودي إلى مدرج تكراري حقيقي ومقنن في إكسيل، يتم اتباع الإجراءات التالية بدقة:
- النقر المزدوج بزر الفأرة الأيسر على أي عمود من الأعمدة الرأسية داخل المخطط لتُفتح على يمين الشاشة لوحة “تنسيق سلسلة البيانات” (Format Data Series).
- الانتقال إلى أيقونة “خيارات السلسلة” (Series Options) التي تشبه الرسم البياني الشريطي الصغير.
- البحث عن خيار “عرض الفجوة” (Gap Width)، حيث تكون قيمته الافتراضية محددة بحدود 150% أو 219%.
- سحب المؤشر إلى أقصى اليسار أو كتابة الرقم 0% يدوياً داخل الحقل المخصص.
بمجرد ضبط عرض الفجوة على 0%، تتلاشى المسافات البينية فوراً وتتلاصق الأعمدة جنباً إلى جنب تماماً كما تقتضي أصول المدرج التكراري القياسي. ولإضفاء الوضوح البصري ومنع اندماج الأعمدة في كتلة لونية واحدة مصمتة، يُنصح بالانتقال إلى خيار “التعبئة والحدود” (Fill & Line)، واختيار خط حددي (Border) بلون متباين وواضح (كاللون الأبيض أو الرمادي الداكن) بسماكة 1 نقطة، مما يُظهر الحدود الفاصلة بين كل فئة وتالية بصورة أكاديمية غاية في الأناقة والاحترافية.
8.3 إدراج المضلع التكراري وقراءة شكل المنحنى الإحصائي
يُعد المضلع التكراري (Frequency Polygon) رسماً بيانياً مكملاً للمدرج التكراري، ويُبنى عبر توصيل مراكز الفئات (Class Midpoints) بخطوط مستقيمة تمثل التغير في وتيرة التكرار عبر الفئات. ويُحسب مركز الفئة ($m_i$) بالصيغة الرياضية التالية:
$$m_i = \frac{LCL_i + UCL_i}{2} = \frac{\text{Lower Boundary}_i + \text{Upper Boundary}_i}{2}$$
حيث يمثل مركز الفئة النقطة المركزية التي تعبر عن كثافة البيانات ضمن المدى الفئوي المستقل.
في إكسيل، يمكن تراكب المضلع التكراري فوق المدرج من خلال إضافة سلسلة بيانات إضافية للتكرار واختيار نوع المخطط المختلط (Combo Chart) وتحويل السلسلة الثانية إلى خط بياني (Line Chart). يتيح هذا التمثيل للباحث قراءة المنحنى الإحصائي للعينة واستخلاص الخصائص الشكلية التالية:
- التماثل والاعتدالية: إذا كان المنحنى متناظراً حول المركز ويشبه الجرس، فإن البيانات تتبع التوزيع الطبيعي المعياري، مما يدعم استخدام التحليلات المعلمية في الدراسات السلوكية والنفسية (Wang et al., 2020).
- الالتواء (Skewness): إذا كان ذيل المنحنى ممتداً نحو اليمين مع تكدس البيانات يساراً، فإن التوزيع يعاني من التواء موجب؛ أما إذا امتد الذيل نحو اليسار وتكدست الدرجات يميناً، فإنه يُعد التواءً سالباً.
- التفرطح (Kurtosis): يُعبر عن مدى مدببية قمة المنحنى وتفلطح أطرافه؛ حيث يشير المنحنى المدبب (Leptokurtic) إلى تركز شديد للبيانات في نطاق ضيق، بينما يشير المنحنى المفلطح (Platykurtic) إلى تشتت واسع للدرجات عبر الفئات.
تُعد هذه القراءة البصرية المعمقة الأساس الذي يستند إليه الباحث لصياغة الفرضيات الإحصائية وتحديد مدى صلاحية البيانات لتطبيق نماذج الانحدار، واختبارات (t-test)، وتحليل التباين، أو اللجوء للبدائل اللامعلمية في حال الانحراف الشديد عن شروط الاعتدالية.
9. الطرق البديلة لإنشاء التوزيع التكراري المجمع باستخدام دوال إكسيل
9.1 استخدام الدالة المصفوفية FREQUENCY وحساب الفئات يدوياً
على الرغم من المرونة الفائقة والسرعة التي توفرها الجداول المحورية، إلا أن مدرسة الدوال الرياضية المباشرة في إكسيل تظل الملاذ الأفضل في النماذج التحليلية المتقدمة التي تتطلب أتمتة ديناميكية وتكاملاً برمجياً لحظياً مع معادلات رياضية معقدة أخرى. تتصدر دالة التكرار المصفوفية (FREQUENCY) هذه الطرق البديلة؛ إذ صُممت هذه الدالة المعمارية في إكسيل خصيصاً لحساب التكرارات ضمن مصفوفة فئوية محددة وفق الصيغة البرمجية العامة:
=FREQUENCY(Data_Array, Bins_Array)
تتطلب هذه الطريقة من الباحث إنشاء جدول يدوي مستقل في ورقة العمل؛ حيث يُخصص عمود أول لكتابة الحدود العليا للفئات (Bins Array). في مثالنا العملي السابق، تتضمن هذه الحدود الأرقام: (14، 19، 24، 29). ومن الضروري فهم أن دالة FREQUENCY تفحص البيانات وتحسب عدد القيم التي تقل عن أو تساوي الحد الأعلى المعطى وتزيد عن الحد الأعلى للفئة السابقة تلقائياً.
في إصدارات إكسيل الحديثة التي تدعم “المصفوفات الديناميكية” (Dynamic Arrays مثل Microsoft 365 و Excel 2021)، يكفي تحديد خلية واحدة لكتابة الصيغة، مثل:
=FREQUENCY(A2:A16, E2:E5)
ثم الضغط على زر (Enter)، لتفيض النتائج التكرارية تلقائياً عبر الخلايا الرأسية المجاورة (Spill Feature). أما في إصدارات إكسيل الكلاسيكية القديمة، فيجب تحديد نطاق مخرجات التكرار بالكامل مسبقاً، وكتابة الدالة في شريط الصيغ، ثم الضغط على تركيبة المفاتيح الشهيرة (Ctrl + Shift + Enter) لتأكيد الصيغة المصفوفية، والتي يحيطها إكسيل تلقائياً بأقواس معقوفة {}. وتتميز هذه الدالة بدقتها وسرعتها، غير أنها تتطلب جهداً إضافياً في إعادة هيكلة المخططات البيانية المرتبطة بها يدوياً.
9.2 توظيف الدالة الشرطية COUNTIFS لحساب فئات محددة المدى
تُمثل الدالة الشرطية متعددة المعايير (COUNTIFS) أحد أكثر الحلول البرمجية شيوعاً لدى الباحثين الراغبين في بناء جداول تكرارية تتسم بالشفافية المنطقية العالية والقدرة على التحكم في الشروط الفردية لكل فئة على حدة. تقوم هذه الدالة بعدّ الخلايا التي تستوفي شروطاً ومعايير متعددة ومتزامنة ضمن نطاقات محددة.
لبناء توزيع تكراري مجمع باستخدام دالة COUNTIFS، يقوم الباحث بتعريف عمودين مستقلين للحد الأدنى والحد الأعلى لكل فئة رقمية (مثلاً: الفئة الأولى حدها الأدنى 10 في الخلية E2، وحدها الأعلى 14 في الخلية F2). بعد ذلك، تُصاغ المعادلة في عمود التكرار المجاور بالصيغة التالية:
=COUNTIFS($A$2:$A$16, ">=" & E2, $A$2:$A$16, "<=" & F2)
يتحقق في هذا التنسيق معياران شرطيان متزامنان؛ المعيار الأول يحصي المشاهدات التي تتجاوز أو تساوي الحد الأدنى للفئة، بينما المعيار الثاني يحصر القيم التي تقل عن أو تساوي حدها الأعلى. وتوفر هذه الطريقة ميزة فريدة تتمثل في إمكانية تخصيص شروط الفئات المفتوحة عند البداية أو النهاية بكل سهولة، أو التعامل مع معايير ترشيح إضافية كحساب التكرارات لذكور أو إناث فقط بإضافة شرط ثالث للمعادلة. غير أن عيبها الأساسي يكمن في طول الصيغ وحاجتها للتثبيت بالمراجع المطلقة ($) لضمان صحة السحب التلقائي، فضلاً عن بطء أدائها النسبي عند تطبيقها على قواعد بيانات عملاقة تضم مئات الآلاف من الصفوف مقارنة بالجداول المحورية فائقة السرعة.
9.3 مقارنة منهجية شاملة: الجداول المحورية مقابل الدوال الرياضية
تقتضي الرصانة المنهجية إجراء مفاضلة واعية بين استخدام خاصية التجميع في الجداول المحورية واستخدام الدوال الرياضية (كـ FREQUENCY و COUNTIFS)، حيث يمتلك كل مسار نقاط قوة وسياقات تفضيلية تعتمد على بنية المشروع البحثي:
| وجه المقارنة | خاصية التجميع في الجداول المحورية (PivotTables) | الدوال الرياضية (FREQUENCY / COUNTIFS) |
|---|---|---|
| سهولة الإعداد والسرعة | فائقة؛ بنقرات معدودة دون الحاجة لكتابة أي صيغة رياضية. | متوسطة إلى معقدة؛ تتطلب صياغة دقيقة وتحديداً لمصفوفات الفئات. |
| مرونة تعديل اتساع الفئات | مرونة كلية فورية عبر تعديل رقم “بمقدار” (By) في نافذة التجميع. | تتطلب إعادة كتابة وتعديل مصفوفة الحدود العليا والدوال يدوياً. |
| التحديث عند تغير البيانات الأصلية | يتطلب النقر على زر تحديث (Refresh) أو عبر برمجة ماكرو. | تحديث تلقائي فوري ولحظي بمجرد تعديل أو إدخال أي قيمة خام. |
| استخراج التكرار النسبي والتراكمي | مدمج بنقرة زر عبر خيارات “إظهار القيم كـ” دون تعقيد. | يتطلب كتابة أعمدة وصيغ رياضية تكميلية مستقلة لحساب التراكم. |
| الربط البياني التفاعلي | يتكامل تلقائياً مع المخططات المحورية (PivotCharts) ويتزامن معها. | يتطلب بناء الرسوم البيانية وتعديل نطاقات مصدرها بصورة يدوية. |
يتضح من هذا التحليل المقارن أن الجداول المحورية تظل الخيار الأمثل والمهيمن للتحليلات الإحصائية السريعة، والاستكشافات الميدانية، والتقارير الأكاديمية متعددة الأبعاد. في المقابل، تُفضل الدوال الرياضية عند تصميم لوحات القياس المؤتمتة بالكامل (Automated Dashboards) أو عندما تكون متطلبات النمذجة الرياضية تستلزم بقاء الصيغ حية ودائمة التفاعل البرمجي المباشر دون الحاجة لأي تدخل يدوي لتحديث المخرجات.
10. أفضل الممارسات الإحصائية وتجنب الأخطاء الشائعة في التوزيع المجمع
10.1 تحديد عدد الفئات الأمثل وفق الصيغ العلمية المعتمدة
يقع كثير من المبتدئين في التحليل الإحصائي في خطأ اختيار عدد الفئات واتساعها بصورة اعتباطية قائمة على التخمين المجرد؛ وهو ما يقود إلى تشويه التوزيع إما بالإفراط في التكثيف أو التشتيت. لتجنب هذه العشوائية، أرست الأدبيات الإحصائية صيغاً علمية مقننة لتحديد العدد الأمثل للفئات ($k$) استناداً إلى حجم العينة الكلي ($n$).
تُعد قاعدة ستورجس (Sturges’ Rule)، التي صاغها الإحصائي هربرت ستورجس عام 1926، أشهر هذه القواعد المعيارية المطبقة في العينات الصغيرة والمتوسطة المأخوذة من مجتمعات تقترب من الاعتدالية، وتُحسب وفق المعادلة التالية:
$$k = 1 + \log_2(n) \approx 1 + 3.322 \log_{10}(n)$$
حيث يمثل $k$ عدد الفئات الموصى به، ويتم تقريبه عادةً إلى أقرب عدد صحيح. وبمجرد تعيين $k$، يُستخرج اتساع الفئة المقترح ($w$) بقسمة المدى الكلي على عدد الفئات:
$$w \approx \frac{\text{Range}}{k} = \frac{X_{\max} – X_{\min}}{1 + 3.322 \log_{10}(n)}$$
أما في العينات الكبيرة، فتظهر بدائل رياضية أخرى أكثر ملاءمة مثل صيغة رايس (Rice Rule) التي تحدد الفئات بضعف الجذر التكعيبي لحجم العينة ($k = 2 n^{1/3}$)، أو قاعدة سكوت (Scott’s Rule) وقاعدة فريدمان-دياكونيس (Freedman–Diaconis) اللتين تعتمدان على الانحراف المعياري والمدى الربيعي لتقليل الخطأ المتوسط المربع المتكامل (IMSE). ويجب على الباحث دوماً مواءمة المخرجات الرياضية مع المنطق النظري لمجال التخصص؛ بحيث تكون الفئات ذات أطوال متساوية وتتخذ قيماً مريحة وسهلة القراءة في سياق القياس النفسي والسلوكي المتخصص.
10.2 الأخطاء الشائعة في إكسيل أثناء التجميع وكيفية معالجتها
يواجه مستخدمو إكسيل عند بناء التوزيعات التكرارية جملة من العوائق التقنية المتكررة التي يمكن تفاديها باتباع الممارسات الوقائية الصارمة:
- رسالة الخطأ “Cannot group that selection”: تنشأ هذه الرسالة الحتمية عندما تشتمل بيانات العمود الأصلي على أي قيمة غير رقمية. وتتمثل المعالجة في فحص العمود والتأكد من عدم وجود مسافات فارغة غير مرئية نتجت عن النسخ من الويب، أو إدخالات نصية (مثل كتابة “غائب” أو “-” للدلالة على القيمة المفقودة)، ويمكن توظيف دالتي التنظيف الفعالتين
TRIMوCLEANلإزالة كافة الشوائب والمحارف غير المطبوعة من نطاق البيانات. - بقاء الحدود القديمة بعد تحديث البيانات: عند توسيع نطاق البيانات الخام بإضافة مشاهدات تتجاوز الحدود الدنيا أو القصوى القديمة، قد يلاحظ الباحث عدم شمولها داخل الفئات القائمة؛ وتُحل هذه المشكلة بفتح نافذة التجميع (Group) من جديد وتعديل قيمتي “البدء من” و”الانتهاء عند” لتتوافقا مع المدى المستحدث.
- تداخل التواريخ والقيم المنطقية: قد يؤدي وجود تواريخ مختلطة أو قيم منطقية (TRUE/FALSE) محولة بطريق الخطأ في عمود البيانات إلى تحويل نمط التجميع بالكامل إلى تجميع زمني بدلاً من التجميع الرقمي الفئوي؛ لذا يلزم التأكد الحاسم من توحيد نوع البيانات كـ “رقم” عبر ميزة التحقق من صحة البيانات (Data Validation).
إن التحقق الدوري من هذه الضوابط الإجرائية يضمن سيولة التحليل واستقراره البرمجي، ويحول دون توقف المعالجة الإحصائية أو استخراج مخرجات مغلوطة تؤثر سلباً على النتائج البحثية النهائية.
10.3 توثيق التوزيعات التكرارية وفق المعايير الأكاديمية (APA Style)
لا تنتهي مهمة الباحث عند توليد الجداول التكرارية في إكسيل، بل تكتمل بنقل هذه المخرجات وتوثيقها داخل متن الرسائل والأبحاث العلمية وفق الأدلة المنهجية المعيارية، وفي مقدمتها دليل جمعية علم النفس الأمريكية (APA Style الإصدار السابع). يتطلب هذا الأسلوب التوثيقي الالتزام بضوابط صارمة في تخطيط الجداول وصياغة تعليقاتها الإحصائية.
تقتضي معايير APA تجنب الخطوط الرأسية تماماً داخل الجداول الأكاديمية؛ حيث يقتصر التسطير على ثلاثة خطوط أفقية رئيسية فقط: خط أعلى الجدول أسفل العنوان، وخط أسفل ترويسات الأعمدة، وخط أخير أسفل سطر الإجمالي الكلي. كما يجب أن تتضمن ترويسات الأعمدة الرموز الإحصائية المائلة المعيارية، مثل ($n$) لحجم العينة الفرعية، و($N$) للعينة الكلية، والرمز ($f$) للتكرار المطلق، و(%) للنسبة المئوية، مع كتابة جدول التوزيع بخط واضح وحجم متناسق لا يقل عن 10 ولا يزيد عن 12 نقطة.
| فئات الدرجات | f | % | التكرار التراكمي (cf) |
|---|---|---|---|
| 10 – 14 | 2 | 13.33 | 2 |
| 15 – 19 | 3 | 20.00 | 5 |
| 20 – 24 | 5 | 33.33 | 10 |
| 25 – 29 | 5 | 33.33 | 15 |
| الإجمالي | 15 | 100.0 | — |
ملاحظة. البيانات مستمدة من عينة تجريبية مفترضة لقياس كفاءة الأداء السلوكي ($N = 15$).
وفيما يخص الرسوم البيانية والمدرجات التكرارية، يجب إدراجها كـ “أشكال” (Figures) مرقمة ترقيماً متسلسلاً، مع كتابة تسمية وصفية واضحة ومائلة أسفل الشكل، وتوضيح دلالات الأعمدة والمحاور في تعليق هامشي موجز ومحايد. يُسهم هذا التوثيق العلمي الدقيق في منح التحليل الإحصائي مصداقية منهجية عالية تيسر على المحكمين والقراء فهم بنية البيانات واستيعاب مؤشراتها دون أي التباس.
إن بناء التوزيع التكراري المجمع في إكسيل يمثل جسراً منهجياً يربط بين عشوائية البيانات الخام ورصانة التحليل الإحصائي المقنن. ومن خلال الجمع الواعي بين الفهم النظري لاتساع الفئات وحدودها الحقيقية، والتمكن التطبيقي من أدوات الجداول المحورية، يستطيع الباحث الإحاطة بكافة أبعاد المتغير المدروس وتمثيله بيانياً وتوثيقه أكاديمياً بأعلى مستويات الجودة والموثوقية العلمية.
المراجع
- Bergeron, M. F., Mountjoy, M. L., Armstrong, N., Chia, M., Côté, J., Emery, C. A., et al. (2015). International Olympic Committee consensus statement on youth athletic development. British Journal of Sports Medicine. https://doi.org/10.1136/bjsports-2015-094962
- Cascio, W. F., & Montealegre, R. (2016). How Technology Is Changing Work and Organizations. Annual Review of Organizational Psychology and Organizational Behavior. https://doi.org/10.1146/annurev-orgpsych-041015-062352
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Liu, N. H., Daumit, G. L., Dua, T., Aquila, R., Charlson, F., Cuijpers, P. J., et al. (2017). Excess mortality in persons with severe mental disorders: a multilevel intervention framework and priorities for clinical practice, policy and research agendas. World Psychiatry. https://doi.org/10.1002/wps.20384
- Wang, X., Hegde, S., Son, C., Keller, B., Smith, A., & Sasangohar, F. (2020). Investigating Mental Health of US College Students During the COVID-19 Pandemic: Cross-Sectional Survey Study. Journal of Medical Internet Research. https://doi.org/10.2196/22817