
تُعد معالجة السلاسل النصية (String Manipulation) وتفكيكها داخل جداول البيانات الإلكترونية أحد الركائز الجوهرية في هندسة البيانات وتحليلها وإدارتها الحديثة. ففي العديد من البيئات المهنية والأكاديمية، يتلقى المحللون ومسؤولو النظم سجلات ضخمة تشتمل على حقول نصية مركبة، مثل الأسماء الثنائية، أو المسميات الوظيفية المركبة، أو العناوين الأكاديمية، أو المعرفات الرقمية المتبوعة ببيانات وصفية. ويمثل استخراج أجزاء محددة من هذه النصوص—ولا سيما اقتطاع أول كلمتين من الخلية—عملية تحويلية مفصلية لنقل البيانات من حالتها الخام غير المهيكلة إلى حالة منضبطة قابلة للفهرسة والتصنيف الإحصائي والمقارنة المعيارية.
وعلى مدار عقود من تطور حزمة برمجيات مايكروسوفت إكسيل (Microsoft Excel)، خضعت منهجيات اقتطاع الكلمات لتحولات تقنية جذرية؛ حيث انتقلت بيئة العمل من التوليفات الحسابية المعقدة التي تعتمد على تداخل دوال البحث الموضعي عن الفواصل الفراغية، إلى إطلاق دوال التجزئة المباشرة فائقة التطور ضمن تحديثات مايكروسوفت 365. ولا تقتصر أهمية هذه العملية على مجرد التجزئة الشكلية للعبارات، بل تمتد إلى ضمان سلامة البنية الدلالية للمفردات وتفادي التشوهات الحسابية الناتجة عن المسافات غير المرئية أو الحروف الخاصة.
يتناول هذا الدليل التخصصي الشامل دراسة مستفيضة للآليات الإجرائية والنظرية المتبعة لاستخراج أول كلمتين من خلية في إكسيل، بدءاً من التشريح البنيوي للدوال الحديثة مثل دالة استقطاع النصوص المتقدمة، وصولاً إلى الحلول الكلاسيكية المتوافقة مع الإصدارات التاريخية، وتقنيات مصفوفات التجزئة المنسكبة، وحلول الأتمتة الشاملة عبر محرر الاستعلامات المتقدم وكود لغة فيجوال بيسك للتطبيقات، مع التركيز على استراتيجيات التنقية وتحصين النماذج ضد الأخطاء الحسابية الشائعة.
1. مقدمة نظرية لمعالجة النصوص واستخراج الكلمات في مايكروسوفت إكسيل
1.1 مفهوم تجزئة السلاسل النصية والتعامل مع الفواصل
تُعرّف السلسلة النصية (String) في علوم الحاسوب وهندسة الجداول الممتدة بأنها متتالية متتابعة من الرموز والمحارف (Characters) المخزنة في الذاكرة بترميز محدد، تشمل الحروف الأبجدية والأرقام والرموز وعلامات الترقيم، بالإضافة إلى المسافات الفاصلة (Whitespace). وفي بيئة مايكروسوفت إكسيل، لا تتعامل الخلايا مع النصوص بوصفها وحدات لغوية ذات إدراك تركيبي، بل تتعامل معها كمصفوفات من المحارف الخطية المرتبة وفق فهرس موضعي يبدأ من الرمز الأول وصولاً إلى الرمز الأخير. وتلعب الفواصل الفراغية (Space Delimiters) دور الحدود الفاصلة الاصطلاحية التي تفصل بين الكلمات؛ حيث يشير الفاصل الفراغي المنفرد إلى انتهاء وحدة معجمية وبداية وحدة معجمية تالية، وهو ما يتوافق حاسوبياً مع المعايير المعجمية المعترف بها في بناء قواعد البيانات اللغوية (Lété et al., 2004).
إن نمذجة البيانات النصية تتطلب تحويل هذه التتابعات المحرفية غير المنظمة إلى عناصر ذرية (Atomic Elements) يمكن فهرستها وربطها منطقياً. وتكمن الصعوبة التقنية في أن معالجة النصوص داخل الجداول ليست عملية حسابية ثابتة مثل جمع الأرقام، بل تتطلب مسحاً متتابعاً لتعيين مواضع المحارف الفاصلة. وعند استهداف استخراج أول كلمتين من خلية معينة، فإن الهدف الخوارزمي يتمثل في تحديد موضع الفاصل الفراغي الثاني بدقة متناهية، ثم اقتطاع كافة المحارف التي تسبق هذا الموضع وتجاهل ما يليه. ويشكل فهم هذا المبدأ الرياضي الأساس الحاكم لكافة الدوال والمعادلات المستخدمة في هذا السياق.
علاوة على ذلك، فإن عدم انضباط الإدخال اليدوي يولد تحديات إضافية تتمثل في تفاوت عدد المسافات بين الكلمات أو وجود مسافات غير مرئية في مستهل السلسلة النصية أو في ختامها. ومن هذا المنطلق، تصبح دراسة سلوك الفواصل الفراغية والتعامل معها رياضياً متطلباً أولياً لضمان عدم استخراج نصوص مبتورة أو احتساب المسافات الفارغة كأنها كلمات قائمة بذاتها، مما يؤدي إلى انحراف النتائج التحليلية وتشوه النماذج التنبؤية اللاحقة.
1.2 التطور الوظيفي لدوال معالجة النصوص في إكسيل
شهدت معالجة النصوص في مايكروسوفت إكسيل تحولاً بنيوياً ملحوظاً على مدار العقود الأربعة الماضية. فمنذ إطلاق الإصدارات الأولى للبرنامج لنظام ماكنتوش عام 1985 ونظام ويندوز عام 1987، اعتمد المستخدمون على حزمة أساسية من الدوال النصية الكلاسيكية، شملت دوال الاقتطاع الموضعي ودوال البحث النصي الأساسية. وكانت هذه الدوال تتسم بالمحدودية الهيكلية؛ حيث صُممت لتنفيذ عمليات بسيطة مثل استقطاع عدد ثابت من المحارف من الطرف الأيمن أو الأيسر، مما جعل مهمة استخراج الكلمات ذات الأطوال المتغيرة تتطلب صياغة معادلات متداخلة وشديدة التعقيد، تفتقر إلى المرونة وتستهلك وقتاً طويلاً في التدقيق والبناء.
ومع تطور متطلبات تحليل البيانات الضخمة، أطلقت مايكروسوفت في مارس 2022 نقلة نوعية في بيئة إكسيل 365 (وكذلك في إصدار إكسيل 2024 الدائم لاحقاً) تمثلت في تقديم جيل جديد من الدوال الديناميكية المتخصصة في التلاعب بالسلاسل النصية، وفي مقدمتها الدوال المعنية بالتجزئة والاقتطاع المباشر قبل الفواصل وبعدها. وجاءت هذه الدوال لتعالج القصور التاريخي في محرك إكسيل الحسابي، محولة الصيغ المصفوفية المركبة إلى أدوات تنفيذية مباشرة تمتاز بالوضوح الدلالي والكفاءة الحسابية العالية.
هذا التحول المنهجي لم يقتصر على تقليل عدد الرموز البرمجية اللازمة لبناء الصيغة الحسابية فحسب، بل شمل أيضاً تحسين إدارة الذاكرة العشوائية وتفادي أخطاء التدفق (Spill Errors) وانهيار الروابط الحسابية. وبذلك، انتقل مستخدم إكسيل من مرحلة “التحايل الهندسي” على المعادلات عبر استبدال الفواصل برموز نادرة، إلى مرحلة التحديد الوظيفي الصريح للمدخلات والمخرجات، وهو ما جعل استخراج أول كلمتين مسألة تنفيذية مباشرة تتبع خوارزميات محسنة ومبنية داخل نواة البرنامج الأساسية.
1.3 الأهمية الإحصائية والتحليلية لاستخراج الكلمات الأولى
يمثل استخراج أول كلمتين من الحقول النصية خطوة تأسيسية حاسمة في هندسة السمات (Feature Engineering) وتنقية البيانات (Data Cleansing) ضمن مشاريع التحليل الإحصائي والتعلم الآلي. ففي كثير من الأحيان، تحتوي قواعد البيانات الضخمة على نصوص مدمجة غير مقسمة تشتمل على معلومات متعددة المستويات ضمن خلية واحدة؛ ومثال ذلك دمج اسم العميل ولقبه مع مدينته، أو دمج اسم المنتج وتصنيفه الأساسي مع تفاصيل الرقم التسلسلي، أو تضمين أسماء الباحثين المركبة متبوعة ببيانات الانتماء المؤسسي.
ويسهم استخلاص الكلمتين الأوليين في توحيد المعرفات النصية؛ إذ يتيح إنشاء تصنيفات ثنائية موحدة تدمج مثلاً الاسم الأول واسم العائلة، أو تختصر أسماء الشركات التجارية الكبرى إلى كياناتها الأساسية، مما يسهل عمليات الفرز والمطابقة المعيارية وعمليات الربط الرأسي والأفقي عبر الجداول. ويؤدي هذا الإجراء التحويلي إلى تقليص التباين العشوائي في النصوص الطويلة، مما يرفع من دقة خوارزميات التجميع (Clustering) والفرز الإحصائي.
إضافة إلى ذلك، فإن أتمتة هذا الاستخراج عبر معادلات رياضية منضبطة يحد بصورة جذرية من معدلات الخطأ البشري التي تقترن عادة بالمراجعة والتدقيق اليدوي للسجلات الطويلة. فعند التعامل مع قواعد بيانات تشتمل على عشرات أو مئات الآلاف من الصفوف، يصبح التدخل البشري لاستقطاع الكلمات مصدراً مؤكداً للتناقضات الإملائية والنسيان، في حين تضمن الصيغ البرمجية معالجة متسقة تخضع لنفس المعايير الصارمة على امتداد كامل النطاق البياني.
2. التشريح التركيبي والمعايير الرياضية لدالة TEXTBEFORE
2.1 البنية النحوية الأساسية للدالة ومحدداتها
تمثل دالة استخراج النص السابق للفاصل، المعروفة باسمها البرمجي TEXTBEFORE، حلاً جذرياً وهندسياً متقدماً قدمته شركة مايكروسوفت لاقتطاع النصوص بدقة استناداً إلى فواصل محددة. وتتخذ البنية النحوية الرياضية القياسية للدالة الصيغة الهيكلية العامة التالية:
=TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
يرتكز المحور التشغيلي للدالة على وسيطين إجباريين؛ الأول هو وسيط النص المصدر (text)، ويمثل إحداثيات الخلية المستهدفة أو النص المباشر المراد إخضاعه للتحليل والمعالجة. ويقوم المحرك الحسابي بتحويل مدخلات هذا الوسيط إلى متسلسلة محارف نصية بغض النظر عن طبيعة الإدخال الأصلي. أما الوسيط الثاني فهو وسيط الفاصل المعياري (delimiter)، وهو الرمز أو الحرف أو السلسلة الفرعية التي تعمل كعلامة توقف تحدد نهاية الجزء المراد استخراجه وبداية الجزء المستبعد.
وعند توظيف الدالة لاستخراج الكلمات، يُعيّن الفاصل دائماً ليكون مسافة فارغة واحدة موضوعة بين علامتي تنصيص مزدوجتين (” “). وعند تمرير هذه المعطيات إلى المحرك التنفيذي، تبدأ الخوارزمية الداخلية للدالة بمسح السلسلة النصية بدءاً من المحرف الأول في اتجاه القراءة، باحثةً عن المطابقة المحددة للفاصل الفراغي لترسيم حدود الاقتطاع المنطقي وإرجاع النتيجة الفورية للخلية الحاضنة.
2.2 دور وسيط رقم التكرار (instance_num) في تحديد عدد الكلمات
يُعد وسيط رقم التكرار (instance_num) المحدد الرياضي الحاسم للتحكم في عمق الاستخراج وعزل عدد الكلمات المطلوبة بدقة متناهية. وفي الحالة الافتراضية، إذا تم تجاهل هذا الوسيط، تفترض الدالة أن قيمته تساوي الرقم 1، مما يعني استخراج كل ما يسبق المسافة الفراغية الأولى فقط، وهي النتيجة المقابلة لاستخراج “الكلمة الأولى”. ولكن عند تحديد القيمة الحسابية للوسيط لتكون 2، يتغير سلوك الخوارزمية بصورة جذرية لتتجاوز التكرار الأول للفاصل وتستمر في الفحص حتى تقف بدقة عند التكرار الثاني للفاصل الفراغي.
ومن منظور المنطق الرياضي، فإن النص الواقع قبل المسافة الفراغية الثانية يمثل حصراً محتويات الكلمة الأولى متبوعة بالمسافة الفراغية الفاصلة ثم محتويات الكلمة الثانية كاملة. وبذلك، تقتطع الدالة السلسلة النصية بمجرد ملامسة الحد الأيسر للفاصل الثاني، متجاهلة كافة الكلمات والمحارف والرموز التي تعقبه داخل الخلية المصدرية.
وتتجلى القوة الهندسية لهذا الوسيط في مرونته المعيارية؛ إذ لا تقتصر وظيفته على الرقم 2، بل يمكن للمحلل تمرير أي رقم طبيعي نون (n) لاستخراج أول n من الكلمات. كما تتيح الدالة استخدام أرقام سالبة، حيث يؤدي تمرير القيمة -1 أو -2 إلى إجبار الدالة على البحث العكسي بدءاً من نهاية السلسلة النصية نحو بدايتها، مما يوفر قدرات تجزئة ثنائية الاتجاه دون الحاجة إلى إعادة صياغة البنية النحوية للمعادلة.
2.3 الوسائط الاختيارية المتقدمة لضبط سلوك المطابقة
تحتوي دالة TEXTBEFORE على أربعة وسائط اختيارية إضافية تمنحها تفوقاً حاسوبياً مطلقاً مقارنة بكافة الدوال النصية السابقة. وتتمثل هذه الوسائط في وسيط نمط المطابقة (match_mode)، وهو وسيط رقمي منطقي يحدد مدى حساسية الفاصل لحالة الأحرف في اللغات اللاتينية (Case Sensitivity)، حيث تشير القيمة 0 إلى مطابقة تامة حساسة للحالة، بينما تمنح القيمة 1 تجاهلاً لحالة الأحرف، وهو خيار بالغ الأهمية عند استخدام فواصل حرفية مركبة بدلاً من المسافات التقليدية.
ويبرز الوسيط الاختياري الخامس، وهو وسيط مطابقة نهاية السلسلة (match_end)، كأداة تحصين جوهرية؛ إذ يأخذ قيمتين منطقيتين (0 أو 1). وتُمكن القيمة 1 الدالة من اعتبار نهاية السلسلة النصية بمثابة فاصل افتراضي في حال عدم العثور على التكرار المطلوب للفاصل المحدد. وهذا يعني منطقياً أنه إذا احتوت الخلية على كلمتين فقط ولا توجد مسافة تالية، فإن الدالة لن تنهار أو ترجع خطأ حسابياً، بل ستعتبر نهاية النص بمثابة الفاصل الثاني المستهدف وتعيد الكلمتين بالكامل.
أما الوسيط الأخير فهو وسيط القيمة المفقودة (if_not_found)، وهو مخصص لتعيين ناتج احتياطي مسبق في حال تعذر العثور على الفاصل أو في حال عدم اكتمال شروط الاستخراج. ويوفر هذا الوسيط معالجة داخلية مباشرة تغني المحلل عن تضمين دوال الفحص والتحقق الخارجية، مما يحافظ على بساطة التركيب الرياضي للمعادلة ويقلل من استهلاك موارد المعالج أثناء تنفيذ الحسابات المعقدة عبر ملايين السجلات.
3. التطبيق الإجرائي المباشر لاستخراج أول كلمتين باستخدام صيغة TEXTBEFORE
3.1 إعداد بيئة البيانات وهيكلة الخلية المصدرية
قبل الشروع في كتابة الصيغ الحسابية داخل مصنف إكسيل، يجب التأكد من سلامة البنية التحتية للبيانات ومطابقتها للمتطلبات التشغيلية لمحرك الحساب. وتتطلب هذه الخطوة التحقق من التنسيق العام للعمود المحتوي على النصوص المصدرية؛ حيث يجب أن تكون الخلايا مضبوطة على تنسيق “عام” (General) أو “نص” (Text)، وتفادي أي تنسيقات رقمية مخصصة أو تنسيقات تواريخ قد تفسر النصوص المدخلة بطرق شاذة تؤدي إلى تشويه نتائج التجزئة.
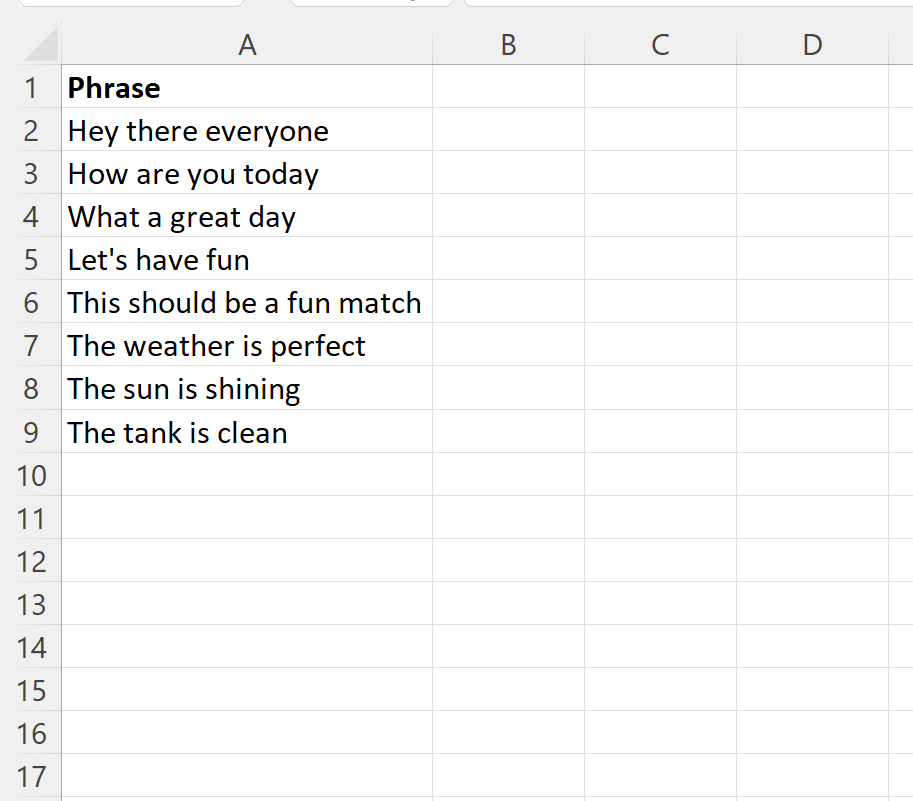
لنفترض في هذا السياق العملي أن البيانات المصدرية تبدأ من الخلية A2 نزولاً على امتداد العمود A، حيث تحتوي كل خلية على نصوص مركبة تمثل أسماء ثلاثية أو رباعية، أو عناوين مقالات، أو أوصافاً فنية للمعدات. ويتم تخصيص العمود المجاور B، وبشكل محدد الخلية B2، لتكون خلية الاستقبال الأولى التي سيتم فيها احتساب وإظهار أول كلمتين من النص المقابل في A2.
من الضروري أيضاً التأكد من خلو الخلية المصدرية A2 من الرموز المضللة التي قد تحول النص إلى صيغة غير مرئية؛ مثل علامات الاقتباس الفردية البادئة التي تُجبر إكسيل على التعامل مع القيم كمدخلات نصية حتى لو احتوت على أرقام، والتأكد من إمكانية قراءة النص بوضوح داخل شريط الصيغة (Formula Bar) للتأكد من استقلالية المدخلات النصية قبل بدء المعالجة.
3.2 صياغة المعادلة وتطبيقها بدقة رياضية
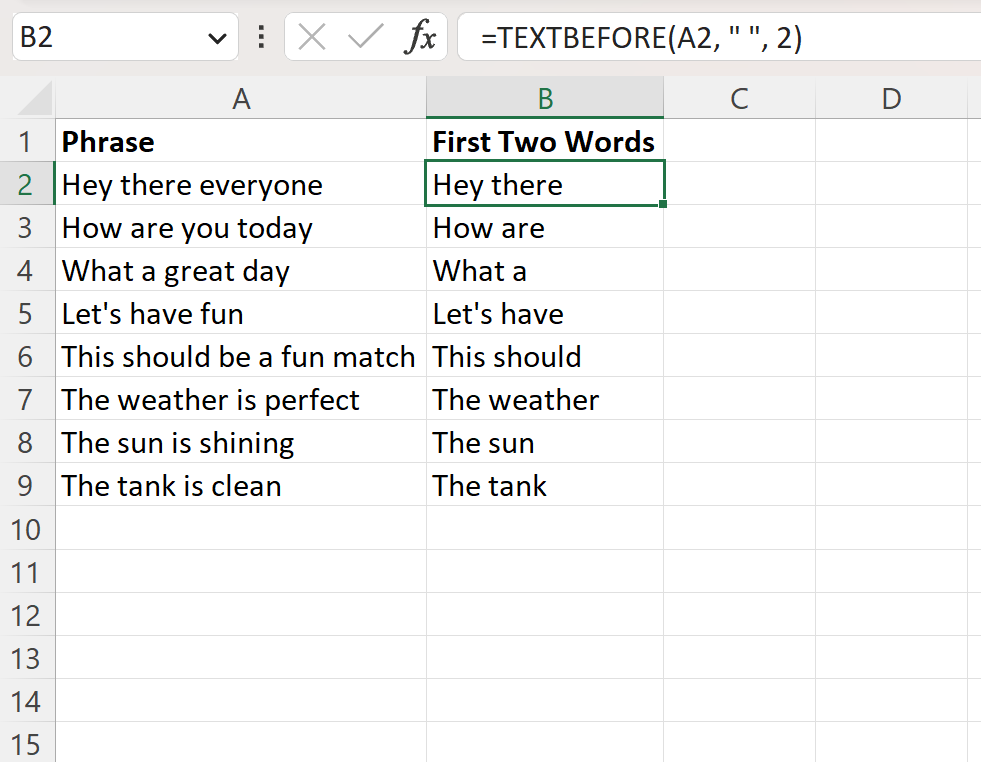
لتنفيذ عملية الاستخراج في صورتها المعيارية الخالية من الأخطاء، يتم النقر فوق الخلية المستهدفة B2، ثم كتابة الصيغة الرياضية بالهيئة التالية:
=TEXTBEFORE(A2, ” “, 2)
تتضمن هذه الصيغة استدعاءً لدالة TEXTBEFORE وتوجيهها لمعالجة محتوى الخلية A2. ويتم تمرير مسافة بيضاء واحدة محاطة بعلامتي تنصيص مزدوجتين (” “) كوسيط ثانٍ لتمثيل الفاصل الفراغي. ويعقب ذلك تمرير الرقم 2 كوسيط ثالث للإشارة إلى رقم التكرار المستهدف. وعند الضغط على مفتاح الإدخال (Enter)، يقوم محرك إكسيل فوراً بمسح السلسلة النصية في A2 والتعرف على المسافة الأولى، ثم مواصلة القراءة حتى الوصول إلى المسافة الثانية، واقتطاع كافة المحارف السابقة لها.
تُظهر الخلية B2 في هذه الحالة أول كلمتين فقط مفصولتين بمسافة واحدة دون تضمين المسافة الثانية في الناتج المسترجع. ويمكن تدقيق هذا الناتج عبر فحص عدد محارف النص المستخرج ومقارنته بالمصدر للتأكد من عدم حدوث انزياح أو اقتطاع جزئي للحروف الأخيرة من الكلمة الثانية، وهو السلوك المعياري الذي تضمنه خوارزمية الدالة عند اكتمال وجود فاصلين على الأقل في السلسلة المدخلة.
3.3 تعميم المعادلة وتوسيع نطاق التطبيق على السجلات
عقب التحقق من صحة الصيغة في الخلية المفردة B2، تأتي مرحلة التعميم الأفقي والرأسي لتطبيق المعالجة على كامل السجلات المدرجة في جدول البيانات. ويتم ذلك تقليدياً عن طريق توجيه مؤشر الفأرة نحو الزاوية اليسرى السفلى (أو اليمنى حسب اتجاه ورقة العمل) للخلية B2 حتى يتحول المؤشر إلى رمز علامة الجمع السوداء المعروفة باسم “مقبض التعبئة التلقائية” (AutoFill Handle)، ثم النقر المزدوج للسحب التلقائي لكافة الصفوف النشطة.
وتعتمد هذه الآلية على مبدأ “المراجع النسبية” (Relative Referencing) المدمج في بنية إكسيل؛ حيث تتغير الإحداثيات تلقائياً أثناء النزول الرأسي لتصبح الصيغة في الصف الثالث =TEXTBEFORE(A3, ” “, 2)، وفي الصف الرابع =TEXTBEFORE(A4, ” “, 2)، وهكذا دواليك على امتداد النطاق دون أدنى تدخل يدوي، مما يضمن تدفق البيانات بسلاسة متناهية.
ولتحقيق أقصى درجات الكفاءة التشغيلية والديناميكية، يُنصح بتحويل النطاق النصي بالكامل إلى “جدول إكسيل رسمي” (Excel Table) عبر تحديد البيانات والضغط على الاختصار المعياري Ctrl + T. وفي هذه البيئة، يتم كتابة الصيغة باستخدام التسميات الهيكلية المنظمة (Structured References) مثل =TEXTBEFORE([@FullName], ” “, 2)؛ حيث يتكفل الجدول بنشر الصيغة تلقائياً عبر العمود المحسوب بالكامل، وتحديث النتائج لحظياً بمجرد إدراج أي صفوف جديدة في قاع الجدول.
4. المعالجة المتقدمة للأخطاء والاستثناءات في السلاسل النصية
4.1 التعامل مع خطأ القيمة #N/A عند نقص عدد الكلمات
على الرغم من البساطة الهيكلية للصيغة السابقة، إلا أن التطبيق العملي على بيانات حقيقية غير منقحة يؤدي حتماً إلى مواجهة استثناءات حاسوبية. وتنشأ المشكلة الأكثر شيوعاً عندما تحتوي الخلية المصدرية على كلمة واحدة فقط، أو على كلمتين دون وجود مسافة ثانية في نهاية النص. وفي هذه الحالات، تبحث دالة TEXTBEFORE عن التكرار الثاني للفاصل الفراغي فلا تعثر عليه داخل السلسلة المحرفية، مما يدفع المحرك الحسابي لإرجاع خطأ القيمة المفقودة (#N/A)، دلالةً على فشل الدالة في استيفاء شرط التكرار المحدد.
ولمعالجة هذا القصور دون اللجوء إلى دوال تطويق إضافية، تقدم دالة TEXTBEFORE حلاً هندسياً أنيقاً مدمجاً في وسيطها الخامس المسمى match_end. فعند ضبط هذا الوسيط على القيمة 1، تُوجّه الدالة لمعاملة نهاية النص الفعلي كما لو كانت مسافة افتراضية إضافية. ويمكن صياغة المعادلة المحصنة على النحو التالي:
=TEXTBEFORE(A2, ” “, 2, , 1)
عند تنفيذ هذه الصيغة المعدلة، إذا واجهت الخلية المصدرية نصاً يتألف من كلمتين فقط دون أي محارف لاحقة، فإنها لن ترجع الخطأ #N/A، بل ستقوم باسترجاع النص كاملاً بوصفه أول كلمتين تم استيفاؤهما بنجاح حتى نهاية السلسلة. وتُعد هذه الميزة التكوينية أحد أهم الفروق الهندسية التي تجعل TEXTBEFORE خياراً فائق المرونة مقارنة بأساليب التجزئة التقليدية القديمة.
4.2 تحصين الصيغة النصية باستخدام دالة IFERROR
في بعض السيناريوهات الإجرائية، قد تشتمل السجلات المصدرية على خلايا تحتوي على كلمة يتيمة مفردة (مثل الأسماء التي لم يُدرج اسم العائلة فيها)، أو قد تحتوي على مدخلات غير متوقعة تؤدي إلى انهيار المعالجة بالرغم من ضبط وسائط الدالة. وهنا تتجلى أهمية تحصين الصيغة عبر بناء هيكل تعشيش برمجي يحيط بدالة TEXTBEFORE باستخدام دالة تصيد الأخطاء المعيارية IFERROR.
تُصاغ هذه المعادلة المتقدمة لتوفر خيار استرجاع بديلاً يحافظ على استمرارية تدفق البيانات دون تشويه بصري لورقة العمل، وذلك بالشكل التالي:
=IFERROR(TEXTBEFORE(A2, ” “, 2, , 1), A2)
تقوم هذه التركيبة بمحاولة تنفيذ استخراج أول كلمتين بالاعتماد على الفواصل ونهاية النص. فإذا نجحت العملية، يتم عرض الكلمتين بصورة طبيعية. أما إذا واجهت الخلية أي خطأ غير متوقع—كأن تحتوي الخلية على كلمة واحدة فقط ويُراد إرجاعها بدلاً من عرض الخطأ—فإن دالة IFERROR تعترض الخطأ فوراً وتُرجع محتوى الخلية المصدرية A2 كما هو.
كما يمكن توظيف وسيط القيمة البديلة لعرض نصوص مخصصة توضح طبيعة الاستثناء للمدقق الإحصائي، مثل استبدال A2 بعبارة “بيانات غير مكتملة” أو ترك الخلية فارغة عبر تمرير سلسلتين نصيتين فارغتين (“”)، مما يتيح تصفية هذه السجلات ومعالجتها لاحقاً في مرحلة مراجعة الجودة وتدقيق البيانات.
4.3 التعامل مع الخلايا الفارغة والبيانات غير المكتملة
يمثل التعامل مع الخلايا الفارغة (Blank Cells) تحدياً مزمناً في هندسة المعادلات داخل إكسيل؛ حيث يؤدي تطبيق الدوال النصية مباشرة على خلايا لا تحتوي على أي قيمة إلى إرجاع قيم فارغة مشوهة أو ظهور علامات خطأ تعيق عمليات التجميع والعد الإحصائي. ولتفادي ذلك، يتعين دمج الشروط المنطقية الاستباقية للتحقق من امتلاء الخلية قبل إخضاعها لعمليات المعالجة والاقتطاع النصي.
ويتم تحقيق هذا الضبط المنهجي من خلال دمج الدالة الشرطية IF مع دالة فحص الفراغ ISBLANK، أو استخدام مقارنة السلسلة الفارغة (“”)، وذلك بصياغة المعادلة المركبة التالية:
=IF(OR(ISBLANK(A2), A2=””), “”, IFERROR(TEXTBEFORE(A2, ” “, 2, , 1), A2))
تقوم هذه المعادلة بإجراء تقييم منطقي أولي؛ فإذا كانت الخلية المصدرية فارغة تماماً من الناحية التخزينية أو تحتوي على فراغ نصي صفري، يتم إيقاف المعالجة اللحظية وتعيين مخرج الخلية المستهدفة كسلسلة فارغة نقية. ولا يتم تشغيل الدالة النصية TEXTBEFORE إلا في حال اجتياز الخلية لاختبار التحقق من وجود نصوص حقيقية قابلة للمعالجة.
يسهم هذا الأسلوب الوقائي في منع التضخم غير المبرر لحجم مصنف إكسيل، ويحول دون استهلاك الذاكرة في تقييم آلاف الخلايا الفارغة الواقعة في أسفل الجداول، وهو ما يعد ركيزة أساسية في بناء النماذج الحسابية المستقرة الموجهة للاستخدام المؤسسي طويل الأمد.
5. تنقية البيانات النصية وضمان اتساق المسافات بين الكلمات
5.1 إزالة المسافات الزائدة والمتعددة عبر دالة TRIM
إن أكبر مهدد لدقة استخراج الكلمات عبر الفواصل الفراغية هو “فوضى المسافات” الناتجة عن أخطاء الإدخال البشري أو تصدير البيانات من أنظمة عتيقة. فإذا احتوت السلسلة النصية على مسافات بادئة في مستهل الخلية (Leading Spaces)، فإن المسافة الأولى التي ترصدها الدالة لن تكون الفاصل الحقيقي بين الكلمتين، بل ستكون المسافة التي تسبق الكلمة الأولى ذاتها. وإذا احتوت السلسلة على مسافات مزدوجة أو متعددة بين الكلمتين، فإن المسافة الثانية ستكون مسافة فارغة تفصل بين المسافة الأولى والكلمة الثانية، مما يؤدي إلى استخراج الكلمة الأولى فقط مع جزء فارغ، وفشل استخراج الكلمة الثانية بالكامل.
للتغلب على هذا التحدي البنيوي، يجب دمج دالة التهذيب النصي TRIM داخل الصيغة الأساسية. وتتلخص الوظيفة الخوارزمية لدالة TRIM في مسح النص وإزالة كافة المسافات البادئة والختامية تماماً، واختزال أي تتابع لمسافات متعددة متتالية داخل النص إلى مسافة بيضاء نظامية واحدة فقط. وتتكامل الدالتان بصورة محكمة في الصيغة الرياضية التالية:
=TEXTBEFORE(TRIM(A2), ” “, 2, , 1)
في هذه التركيبة، يتولى التابع الداخلي TRIM(A2) تطهير السلسلة النصية وتوحيد بنيتها المكانية، ثم يمرر النص المنقح بدقة متناهية إلى الدالة الخارجية TEXTBEFORE. وتضمن هذه الهندسة التركيبية استهداف الفواصل الدلالية الحقيقية التي تفصل بين الكلمات الفعلية حصراً، مما يرفع دقة الاستخراج إلى درجة الكمال الرياضي حتى لو كان النص الأصلي مشوهاً بمسافات عشوائية غير منضبطة.
5.2 تنظيف الحروف غير القابلة للطباعة باستخدام دالة CLEAN
عند استيراد السجلات من قواعد بيانات خارجية أو ملفات نصية بتنسيقات متباينة (مثل ملفات CSV أو مخرجات أنظمة الويب)، غالباً ما تقترن البيانات بمحارف تحكم غير قابلة للطباعة (Non-printable Characters)، وتحديداً الرموز ذات القيم المنخفضة في جدول ترميز أسكي (ASCII) من الرقم 0 إلى 31. وتتمثل أبرز هذه الرموز في الفواصل السطرية الإجبارية (Line Breaks / Line Feeds) وعلامات الرجوع إلى أول السطر (Carriage Returns) التي تفصل بين النصوص رأسياً داخل الخلية الواحدة.
تتسبب هذه المحارف الخفية في إرباك دوال الاقتطاع؛ حيث قد تتصرف بعض الدوال مع فواصل الأسطر كأنها محارف غير معرّفة أو تتجاهلها تماماً، مما يخل بالعد الموضعي للمسافات. وهنا يأتي دور دالة CLEAN المصممة خصيصاً لمسح هذه المحارف الشاذة وإزالتها من الذاكرة اللحظية للنص. ويمكن تعزيز الصيغة النصية بدمج CLEAN جنباً إلى جنب مع TRIM في نسق متسلسل:
=TEXTBEFORE(TRIM(CLEAN(A2)), ” “, 2, , 1)
تضمن هذه المعالجة ثلاثية المراحل (تنظيف المحارف، تهذيب المسافات، ثم الاستخراج النصي) تنقية السلسلة من أي تشوهات إلكترونية قد تعيق قراءة النصوص أو تفسد تنسيق ورقة العمل، مما يجعل المخرجات متوافقة مع معايير الأرشفة الرقمية والتحليل الإحصائي المتقدم دون الحاجة لأدوات تنقية برمجية خارجية.
5.3 التعامل مع المسافات غير القابلة للكسر الناتجة عن الويب
من أكثر المشاكل التقنية تعقيداً وخفاءً على مستخدمي إكسيل مشكلة “المسافة غير القابلة للكسر” (Non-Breaking Space)، والتي تحمل الرمز الرقمي CHAR(160) في جداول الترميز اللاتينية (أو كيان في نصوص لغة HTML). وتنشأ هذه المشكلة بشكل خاص عند نسخ الجداول والنصوص مباشرة من صفحات الإنترنت أو وثائق الويب وتنسيقات PDF المنسوخة ولصقها في خلايا إكسيل.
وتكمن خطورة هذا المحرف في أنه يتطابق بصرياً بنسبة 100% مع المسافة العادية CHAR(32)، لكنه يختلف عنها تماماً من حيث القيمة الرقمية في جدول المحارف الحاسوبية. والمفاجأة الهندسية الصادمة لمعظم المحللين هي أن دالة TRIM القياسية في إكسيل لا تستطيع إزالة أو التعرف على الرمز CHAR(160)؛ لأن تصميم الدالة التاريخي يستهدف حصراً إزالة المسافة النظامية CHAR(32). ونتيجة لذلك، تفشل دالة TEXTBEFORE في رصد الفاصل وتنهار الصيغة معتبرة الكلمتين المتجاورتين كلمة واحدة طويلة لعدم وجود مسافة نظامية بينهما.
لحل هذه المعضلة بدقة قطعية، يجب تطبيق تقنية الاستبدال التحويلي باستخدام دالة SUBSTITUTE؛ حيث يتم استبدال الرمز CHAR(160) بمسافة نظامية CHAR(32) قبل تمرير السلسلة إلى دالتي التهذيب والاستخراج، وتصاغ هذه المعادلة المتقدمة كما يلي:
=TEXTBEFORE(TRIM(SUBSTITUTE(A2, CHAR(160), ” “)), ” “, 2, , 1)
تمثل هذه الصيغة الدرع الواقي الأقصى ضد التناقضات النصية؛ إذ تقوم أولاً بتحويل أي مسافة ويب شاذة إلى مسافة قياسية، ثم تتكفل TRIM بضبط المسافات الزائدة، وأخيراً تقتطع TEXTBEFORE الكلمتين الأوليين بثبات مطلق، لتشكل هذه المعادلة المعيار الذهبي لتنقية ومعالجة النصوص المنسوخة من الشبكة العنكبوتية.
6. البدائل الكلاسيكية في الإصدارات القديمة من إكسيل (ما قبل إكسيل 365)
6.1 التوليف الهندسي بين دالتي LEFT و FIND
في بيئات العمل التي تعتمد على إصدارات مايكروسوفت إكسيل التاريخية (مثل Excel 2010 و 2013 و 2016 و 2019)، لا تتوفر دالة TEXTBEFORE لكونها لم تكن مبرمجة في نواة تلك النسخ. وتطلب هذا الواقع من خبراء الجداول ابتكار حلول تعتمد على التوليف الهندسي بين الدوال الكلاسيكية المتاحة منذ إصدارات البرنامج الأولى في أواخر الثمانينيات، وأبرزها دالة الاقتطاع من اليسار LEFT ودالة البحث عن موضع المحرف FIND.
تعتمد الفكرة الخوارزمية لهذا النموذج على خطوتين متتاليتين؛ الخطوة الأولى هي تحديد الموضع الرقمي للمسافة الفراغية الأولى عبر التعبير FIND(” “, A2). أما الخطوة الثانية، فهي البحث عن موضع المسافة الفراغية الثانية عن طريق إعادة استدعاء دالة FIND مرة أخرى ولكن مع إجبارها على بدء مسار الفحص من المحرف الذي يلي موضع المسافة الأولى مباشرة، وهو ما يُصاغ رياضياً بالشكل:
FIND(” “, A2, FIND(” “, A2) + 1)
بمجرد الحصول على هذا الرقم الذي يمثل الإحداثي الموضعي للمسافة الثانية، يتم طرح الرقم 1 منه لتحديد عدد المحارف الفعلي للكلمتين دون تضمين المسافة نفسها، ثم يُمرر هذا الناتج إلى دالة LEFT التي تقوم باقتطاع هذا العدد من بداية النص. وتتجسد هذه الصيغة التاريخية الكلاسيكية في التركيبة التالية:
=LEFT(A2, FIND(” “, A2, FIND(” “, A2) + 1) – 1)
ورغم دقة هذا التوليف الموضعي، إلا أنه يتسم بخلل رئيسي؛ إذ إنه ينهار فوراً ويعيد خطأ القيمة (#VALUE!) إذا احتوت الخلية المصدرية على أقل من مسافتين، مما يتطلب تطويقه بدوال إضافية كما سيتم بيانه لاحقاً.
6.2 توظيف الدالة SUBSTITUTE لتحديد المسافة بدقة مطلقة
لتجنب التعقيد الحسابي الناتج عن تداخل دوال FIND المتكررة—خاصة في حال الرغبة في التوسع لاستخراج الكلمة الثالثة أو الرابعة—طور المحللون منهجية ذكية بديلة تعتمد على دالة الاستبدال الموضعي SUBSTITUTE. وتمتاز هذه الدالة بوجود وسيط اختياري يتيح تحديد رقم التكرار المراد استبداله دون المساس ببقية التكرارات المتطابقة داخل النص.
تتلخص هذه الاستراتيجية في استبدال المسافة الفراغية الثانية تحديداً برمز فريد وشديد الندرة يستحيل وجوده في النصوص الطبيعية، مثل علامة (@) أو رمز غير قابل للطباعة مثل CHAR(1). وبذلك يتم تحويل النص من صيغة تحتوي على مسافات متطابقة إلى نص يحتوي على مسافة أولى ثم علامة مميزة تحدد نهاية الكلمة الثانية بدقة. وتُنفذ هذه العملية التمهيدية عبر التعبير:
SUBSTITUTE(A2, ” “, “@”, 2)
عقب إتمام هذا الاستبدال الافتراضي داخل ذاكرة المعادلة، تصبح مهمة العثور على موضع نهاية الكلمتين غاية في السهولة؛ إذ تكتفي الدالة بالبحث عن موضع الرمز الفريد (@) باستخدام دالة FIND بسيطة وغير متداخلة، مما يقلل من عبء التداخل الهيكلي للصيغ ويوفر نمطاً برمجياً أكثر استقراراً وقابلية للقراءة والتعديل.
6.3 بناء الصيغة المركبة النهائية للمصنفات القديمة
بدمج أسلوب الاستبدال الفريد مع دالة الاقتطاع LEFT وتحصين النموذج ضد الأخطاء عبر دالة IFERROR لضمان عمل الصيغة بنجاح في حال وجود كلمات أقل من اثنتين، تتبلور الصيغة المركبة النهائية الموجهة للإصدارات القديمة من إكسيل وفق النحو التالي:
=IFERROR(LEFT(A2, FIND(“@”, SUBSTITUTE(A2, ” “, “@”, 2)) – 1), A2)
كما توجد طريقة كلاسيكية أخرى شهيرة تُعرف بـ “طريقة حشو المسافات” (Space Padding Method)، وتعتمد على تضخيم المسافات بين الكلمات لتبلغ طول النص كاملاً باستخدام دالتي REPT و LEN، ثم اقتطاع ضعف طول النص بالدالة LEFT، وأخيراً اختزال المسافات الزائدة بدالة TRIM، وتتخذ الصيغة الهيئة التالية:
=TRIM(LEFT(SUBSTITUTE(A2, ” “, REPT(” “, LEN(A2))), 2 * LEN(A2)))
تتمتع هذه الصيغ الكلاسيكية بميزة جوهرية فريدة تتمثل في التوافقية الشاملة والعكسية المطلقة (Backward Compatibility)؛ حيث يمكن فتح المصنف وتشغيله بسلاسة تامة عبر أي إصدار من إصدارات إكسيل منذ إطلاق البرنامج وحتى أحدث النسخ السحابية دون أي مخاوف من تعطل الروابط الحسابية. ومع ذلك، فإن العيب المقابل لهذه التوليفات يكمن في طولها المفرط، وصعوبة قراءتها وفهمها من قبل المستخدمين غير المتخصصين، وزيادة الحمل الحسابي على محرك المعالجة عند تطبيقها عبر ملايين الصفوف.
7. الحلول البديلة عبر دوال المصفوفات الديناميكية (TEXTSPLIT و TAKE)
7.1 تجزئة النصوص إلى مصفوفة افتراضية عبر دالة TEXTSPLIT
مع تدشين محرك المصفوفات الديناميكية (Dynamic Arrays) في إكسيل، قدمت مايكروسوفت أداة أخرى فائقة القوة لمعالجة النصوص تتمثل في دالة تجزئة النصوص المتقدمة TEXTSPLIT. وعلى النقيض من دالة TEXTBEFORE التي ترجع جزءاً مقتطعاً كقيمة نصية مفردة، تقوم دالة TEXTSPLIT بتفكيك النص بالكامل إلى مصفوفة افتراضية منسكبة من الكلمات المستقلة استناداً إلى فاصل معطى.
وتُصاغ دالة التجزئة الأفقية عبر تمرير الخلية المصدرية وتحديد الفاصل الفراغي على النحو التالي:
=TEXTSPLIT(A2, ” “)
عند تنفيذ هذه الدالة في خلية مجردة، تنبثق مصفوفة منسكبة (Spilled Array) تمتد أفقياً عبر الخلايا المجاورة؛ بحيث تأخذ كل كلمة من كلمات النص خلية منفصلة ومستقلة. وتقوم الخوارزمية الداخلية للدالة بحجز مساحة مؤقتة في ذاكرة الوصول العشوائي للبرنامج لتخزين عناصر هذا المتجه النصي، مما يتيح التعامل مع النص كقائمة مرتبة من المفردات المعزولة كلياً عن بعضها البعض.
تفتح هذه الآلية آفاقاً جديدة في تحليل النصوص؛ حيث لم يعد المحلل بحاجة لحساب أطوال المحارف أو تتبع مواقع الفواصل الفراغية، بل أصبحت الكلمات نفسها كيانات برمجية مفهرسة برقم تسلسلي داخلي يبدأ من العنصر رقم 1 وحتى العنصر رقم نون، مما يجعلها مدخلاً مثالياً لدوال المعالجة المصفوفية المتقدمة.
7.2 اقتطاع العناصر المحددة باستخدام دالة TAKE
للاقتصار على استخراج أول كلمتين فقط من المصفوفة الشاملة التي تنتجها دالة التجزئة، يتم توظيف دالة الاقتطاع المصفوفي الحديثة TAKE. وتتخصص هذه الدالة في استخلاص عدد محدد من الصفوف أو الأعمدة من مصفوفة معينة بدءاً من طرفها الأول أو الأخير دون الإخلال بترتيب العناصر المتبقية.
وتتخذ الدالة TAKE صيغتها العامة عبر تحديد المصفوفة المصدرية وتمرير عدد الصفوف والأعمدة المطلوبة. وفي حالتنا النصية التي تم فيها تقسيم النص أفقياً عبر الأعمدة، يتم توجيه الدالة لاقتطاع أول عنصرين عموديين عبر تمرير الرقم 2 كوسيط للأعمدة، أو تمرير الرقم 2 مباشرة للمصفوفات الأحادية بالشكل التالي:
=TAKE(TEXTSPLIT(A2, ” “), , 2)
تقوم هذه المعادلة المركبة بتجزئة النص أولاً، ثم التدخل الفوري لعزل أول خانتين فقط من المصفوفة وتجاهل كافة الكلمات اللاحقة. وتكمن الميزة التشغيلية لدالة TAKE في قدرتها الفائقة على الحفاظ على مرونة البناء المصفوفي، وتجنب انهيار المعادلات عند تفاوت أطوال النصوص؛ إذ تتعامل مع الكلمات بوصفها “كتلاً” كاملة بصرف النظر عن عدد الحروف المكونة لكل كلمة.
7.3 إعادة تجميع الكلمتين في نص واحد باستخدام دالة TEXTJOIN
إن تطبيق التركيبة السابقة =TAKE(TEXTSPLIT(A2, ” “), , 2) يؤدي هندسياً إلى انسكاب الكلمتين عبر خليتين متجاورتين؛ حيث تسكن الكلمة الأولى في الخلية النشطة وتسكن الكلمة الثانية في الخلية المجاورة لها مباشرة. ولإعادة دمج هاتين الكلمتين في خلية واحدة موحدة تمثل الناتج النهائي المطلوب، تأتي مرحلة التجميع المعياري باستخدام دالة TEXTJOIN.
تختص دالة TEXTJOIN بدمج المصفوفات النصية مع إدراج فاصل محدد بين عناصرها وتوفير خيار لتجاهل أي عناصر فارغة لضمان عدم توليد فراغات شاذة، وتكتمل الصيغة التكاملية الكلية بالصورة الإجرائية التالية:
=TEXTJOIN(” “, TRUE, TAKE(TEXTSPLIT(A2, ” “), , 2))
تنفذ هذه الصيغة خطة عمل محكمة ثلاثية الأبعاد؛ فدالة TEXTSPLIT تفكك النص إلى كلمات، ودالة TAKE تقتطع أول كلمتين، ثم تعيد TEXTJOIN لحام الكلمتين بفاصل مسافة واحدة منتظمة داخل حدود نفس الخلية. ورغم أن دالة TEXTBEFORE تعد أسرع وأبسط وأكثر مباشرة في التنفيذ، إلا أن منهجية TEXTJOIN مع TAKE و TEXTSPLIT تمنح المحلل قوة حوسبية فائقة عندما تتطلب المهام تعديل أو معالجة الكلمات المنفردة كتحويلها إلى أحرف كبيرة أو إضافة لاحقات قبل إعادة التجميع النهائي.
8. الأتمتة الشاملة لاستخراج الكلمات للمجموعات الضخمة عبر Power Query
8.1 استيراد البيانات وتهيئة محرر Power Query
عندما تتجاوز متطلبات المعالجة نطاق مئات السجلات إلى مئات الآلاف أو ملايين الصفوف من البيانات التاريخية غير النمطية، قد تصبح معادلات ورقة العمل عبئاً ثقيلاً يؤدي إلى بطء إعادة الحساب واستهلاك الذاكرة الحية للجهاز. وفي هذه السيناريوهات الضخمة، تبرز أداة استعلامات الطاقة (Power Query) بوصفها محرك الاستخراج والتحويل والتحميل (ETL) الأمثل لأداء هذه المهمة خارج بيئة الشبكة الحسابية للورقة.
تبدأ العملية الإجرائية بتحديد النطاق المشتمل على السلاسل النصية والانتقال إلى تبويب “بيانات” (Data) في الشريط العلوي لإكسيل، ثم النقر على أداة “من ورقة/نطاق” (From Sheet/Range). يؤدي هذا الإجراء إلى فتح محرر الاستعلامات في نافذة معزولة ومستقلة، وتحويل العمود النصي إلى تدفق بياني يخضع لمعالجات موجهة عبر الذاكرة، دون التأثير على استقرار مصنف العمل الرئيسي أثناء مراحل التجهيز.
داخل محرر الاستعلام، يتم فحص نوع البيانات للعمود المصدر والتأكد من ضبطه كنوع “نص” (Text)، مع إمكانية استعراض عينات من البيانات للتأكد من انتظام أنماط الإدخال وملاحظة أي فواصل خاصة أو تكرارات غير متجانسة قد تتطلب تطبيق خطوات تنقية مسبقة قبل الشروع في التجزئة.
8.2 استخدام ميزة تقسيم الأعمدة بحسب الفاصل (Split Column)
يوفر محرر Power Query واجهة رسومية فائقة المرونة لتنفيذ التجزئة بضغطة زر واحدة ودون الحاجة لكتابة معادلات معقدة. ويتم ذلك بتحديد العمود المستهدف ثم اختيار أداة “تقسيم العمود” (Split Column) من تبويب الصفحة الرئيسية، واختيار معيار “بواسطة الفاصل” (By Delimiter).
في نافذة الخيارات المنبثقة، يتم تعيين الفاصل ليكون مسافة (Space)، ثم يُحدد موضع التقسيم الحاسم؛ حيث يتيح المحرر خيار “تقسيم عند كل ظهور للفاصل”، أو “عند الظهور الأيسر”، أو إدخال عدد مخصص من التكرارات المحددة. ولاقتطاع أول كلمتين في عمود موحد أو في أعمدة مستقلة، يمكن إجبار المحرر على التقسيم الموضعي المحدد، مما يؤدي إلى توليد أعمدة فرعية تشتمل على الكلمات المطلوبة بدقة تامة.
كما تتيح الخيارات المتقدمة في الواجهة التحكم في عدد الأعمدة الناتجة وتفادي توليد عشرات الأعمدة الإضافية لبقية الكلمات غير المرغوبة، وذلك بضبط خيار التجزئة ليتوقف بمجرد استخراج العدد المستهدف، مما يحافظ على خفة وبساطة بنية الجدول النهائي المسترجع.
8.3 كتابة دوال مخصصة بلغة Power Query M لاستخراج الكلمات
للمحترفين الساعين إلى تحقيق أقصى درجات الأتمتة والانضباط البرمجي، توفر لغة إم (Power Query M Formula Language) قدرات تحويلية خارقة تتيح دمج استخراج وتجميع الكلمتين في خطوة واحدة داخل نفس العمود دون توليد أي أعمدة فرعية مؤقتة. ويتم ذلك عبر إضافة عمود مخصص (Custom Column) وكتابة صيغة لغة M التالية:
Text.Combine(List.FirstN(Text.Split(Text.Trim([SourceColumn]), ” “), 2), ” “)
تقوم هذه الدالة البرمجية بتهذيب النص أولاً بواسطة Text.Trim، ثم تفكيك السلسلة إلى قائمة من الكلمات المستقلة عبر التابع Text.Split. ويعقب ذلك استخدام التابع اللائحي List.FirstN الذي يقتطع بدقة أول عنصرين (2) فقط من القائمة، ثم تتولى دالة Text.Combine إعادة دمج العنصرين بفاصل مسافة واحدة لإنتاج عمود نهائي جاهز.
عقب إتمام هذا التحويل، يضغط المستخدم على زر “إغلاق وتحميل” (Close & Load) ليتم إرجاع النتائج المعالجة إلى ورقة عمل إكسيل كجدول منظم وفائق السرعة. وتكمن الميزة الاستراتيجية العظمى لهذه المنهجية في قابليتها للتحديث التلقائي الشامل؛ فبمجرد إضافة آلاف الصفوف الجديدة إلى الجدول المصدر في المستقبل، يكتفي المستخدم بالضغط على زر “تحديث الكل” (Refresh All) لتُعاد المعالجة بالكامل في أجزاء من الثانية دون أي تدخل بشري.
9. الحلول البرمجية المخصصة عبر لغة فيجوال بيسك للتطبيقات (VBA)
9.1 برمجة دالة معرفة من قبل المستخدم (UDF) لاستخراج أول كلمتين
في بيئات المؤسسات والشركات التي تعتمد على نماذج عمل تتكرر فيها الحاجة إلى استخراج الكلمات عبر مصنفات متعددة، يوفر تطوير دوال مخصصة عبر لغة البرمجة المدمجة فيجوال بيسك للتطبيقات (Visual Basic for Applications – VBA) حلاً برمجياً متقدماً يعزز من قابلية إعادة الاستخدام ويختزل الصيغ المعقدة في كلمة برمجية واحدة واضحة الدلالة.
تُعرف هذه الدوال البرمجية بالدوال المعرفة من قبل المستخدم (User-Defined Functions – UDFs). ولإنشاء هذه الدالة، يقوم المستخدم بفتح محرر الأكواد عبر الضغط على الاختصار Alt + F11، ثم إدراج وحدة نمطية قياسية جديدة (Standard Module)، والشروع في كتابة الكود البرمجي الذي يحدد اسم الدالة ومدخلاتها ومخرجاتها بدقة متناهية.
تتحول هذه الدالة بمجرد حفظها داخل المصنف إلى دالة قياسية يتعرف عليها شريط الصيغ التلقائي في إكسيل، مما يسمح لأي مستخدم باستدعائها بالاسم وكتابة تعبير بسيط مثل =GetFirstTwoWords(A2) ليحصل على النتيجة فوراً دون الحاجة لمعرفة التعقيدات الداخلية لعمليات الاقتطاع والتجزئة.
9.2 توظيف دالة Split البرمجية والتحكم في المصفوفات
يرتكز المنطق البرمجي لكود VBA المخصص على استخدام التابع البرمجي الداخلي السريع Split، والمخصص لتفكيك السلاسل النصية إلى مصفوفة صفرية الفهرس (Zero-based Array) استناداً إلى الفاصل الفراغي. ويوضح الكود التالي البنية المعمارية للدالة البرمجية المخصصة:
Function GetFirstTwoWords(CellText As String) As String
Dim CleanText As String
Dim Words() As String
CleanText = Trim(CellText)
If Len(CleanText) = 0 Then
GetFirstTwoWords = “”
Exit Function
End If
Words = Split(CleanText, ” “)
If UBound(Words) >= 1 Then
GetFirstTwoWords = Words(0) & ” ” & Words(1)
Else
GetFirstTwoWords = Words(0)
End If
End Function
يتميز هذا الكود بالمتانة التشغيلية؛ إذ يقوم أولاً بتهذيب النص عبر دالة Trim البرمجية لضمان إزالة الفراغات الشاذة، ثم يفحص طول النص لمنع معالجة الخلايا الفارغة. وعقب تقسيم النص بواسطة التابع Split، يتم فحص الحد الأعلى لفهرس المصفوفة باستخدام الدالة UBound. فإذا كان الفهرس أكبر من أو يساوي 1 (مما يعني وجود كلمتين أو أكثر)، تُعيد الدالة دمج العنصر الأول Words(0) مع العنصر الثاني Words(1) بفاصل مسافة. أما إذا كان الفهرس 0 فقط (خلية تشتمل على كلمة واحدة)، فإنها تعيد الكلمة الوحيدة بأمان ودون إرجاع أخطاء انزياح المؤشر البرمجي.
9.3 تقييم الكفاءة والأمان بين حلول VBA والدوال المدمجة
على الرغم من الأناقة البرمجية لحلول VBA، إلا أن اعتمادها يتطلب دراسة دقيقة لموازين الكفاءة وبيئات الأمان التقنية داخل المؤسسة. فأول القيود يتمثل في متطلبات الأمان؛ حيث يتطلب تشغيل الأكواد حفظ المصنف بصيغة تدعم الماكرو بامتداد (.xlsm) أو (.xlsb)، وهو ما قد يؤدي إلى حظر الملف أو تعطيل تشغيله بواسطة برامج الحماية وسياسات أمان تكنولوجيا المعلومات الصارمة التي تمنع تشغيل الماكرو لتفادي البرمجيات الخبيثة.
أما من منظور السرعة والأداء الحسابي، فإن الدوال المدمجة في نواة إكسيل المكتوبة بلغة C++ عالية المستوى (مثل TEXTBEFORE) تتفوق بمراحل شاسعة على أكواد VBA؛ حيث تنفذ دوال النواة العمليات الحسابية عبر خيوط معالجة متعددة (Multi-threading) وتستفيد من التسريع العتادي، في حين تعمل أكواد VBA غالباً عبر خيط معالجة منفرد يمر بطبقات تفسير إضافية، مما يجعلها أبطأ نسبياً عند التعامل مع مئات الآلاف من الصفوف في وقت متزامن.
وبناءً على ذلك، يُعد استخدام حلول VBA خياراً مثالياً عند بناء أدوات مخصصة للاستخدام الفردي الموجه، أو عند الرغبة في توزيع نماذج ذات واجهات تفاعلية موحدة على مستخدمين تنقصهم الدراية بصياغة معادلات إكسيل المعقدة، بينما تظل الدوال المدمجة وتقنيات Power Query الخيار المفضل لتطبيقات الإنتاج الضخمة وقواعد البيانات المفتوحة للمشاركة المؤسسية.
10. أفضل الممارسات المنهجية وإدارة وتوثيق البيانات المستخرجة
10.1 تجميد النتائج وتحويل الصيغ إلى قيم ثابتة
في المشاريع التطبيقية لإدارة البيانات، لا تنتهي مهمة استخراج النصوص عند مجرد ظهور النتائج الصحيحة في الخلايا، بل تمتد إلى مرحلة تأمين استقرار البيانات وضمان عدم تأثرها بالمتغيرات اللاحقة. وتتمثل أولى هذه الممارسات المنهجية في تجميد النتائج عبر تحويل الصيغ الحسابية الديناميكية إلى قيم نصية ثابتة ومستقلة (Values).
إن بقاء المعادلات النصية نشطة بصورة دائمة داخل مصنفات العمل الضخمة يفرض حملاً حسابياً مستمراً على معالج الحاسوب؛ حيث يُجبر إكسيل على إعادة حساب وتدقيق هذه المعادلات في كل مرة يتم فيها تعديل أي خلية في ورقة العمل أو إعادة فتح المصنف. ولتخفيف هذا الحمل الحسابي، يتم نسخ العمود المحتوي على النتائج المستخرجة، ثم استخدام ميزة “لصق كقيم” (Paste as Values) إما من خلال القائمة المنسدلة للماوس أو عبر الاختصار المباشر Ctrl + Alt + V ثم الضغط على V.
يقوم هذا الإجراء بقطع الارتباط التام والنهائي بين البيانات المستخرجة والخلايا المصدرية الأصلية؛ مما يتيح إمكانية حذف أو أرشفة العمود المصدر دون التسبب في أخطاء مراجع (#REF!)، فضلاً عن تأمين سلامة المخرجات عند تصدير البيانات بصيغ خارجية مثل ملفات النصوص المسطحة أو قواعد بيانات SQL دون حدوث تشوهات في بنيتها التركيبية.
10.2 التحقق المنهجي من دقة المخرجات والتدقيق الإحصائي
تقتضي معايير الحوكمة والتدقيق الإحصائي للبيانات بناء أدوات تحقق منطقية للتأكد من أن عملية الاستخراج تمت على النحو المطلوب وخلو العمود المستخرج من أي انحرافات أو أخطاء حسابية مستترة. ومن أفضل التقنيات المتبعة في هذا المجال إنشاء عمود مخصص للفحص والتدقيق الرياضي يعتمد على عد الفواصل الفراغية الموجودة في النص المستخرج ومطابقتها للمعايير المتوقعة.
يمكن التحقق من أن الخلية الناتجة تحتوي على كلمتين بالفعل عبر احتساب عدد المسافات الموجودة في النص المستخرج باستخدام المعادلة الرياضية الشهيرة:
=LEN(TRIM(B2)) – LEN(SUBSTITUTE(B2, ” “, “”))
تقوم هذه المعادلة بقياس الطول الكلي للنص في الخلية B2، ثم طرح طول النص ذاته بعد تجريده من كافة المسافات بواسطة الدالة SUBSTITUTE. وإذا كان الناتج الحسابي مساوياً للرقم 1، فإن هذا يؤكد بصورة قطعية احتواء الخلية على كلمتين تفصل بينهما مسافة واحدة. أما إذا كان الناتج صفراً، فهذا يشير إلى استخراج كلمة واحدة يتيمة، في حين يشير أي رقم يتجاوز الواحد إلى تسرب مسافات إضافية غير مرغوبة، مما يسمح للمحلل بتصفية وعزل هذه السجلات المتباينة ومراجعتها إجرائياً.
ويكتسي هذا الضبط الإجرائي أهمية قصوى للحد من الأعباء المعرفية الواقعة على فرق المراجعة وتلافي أخطاء المعالجة اليدوية المعقدة التي قد تتداخل مع الفهم البشري لمنظومات الجداول (Kirschner & van Merriënboer, 2013). كما تسهم أتمتة هذه التحققات في دعم التفاعل الإيجابي للمستخدمين مع النظم الرقمية والحد من المعوقات التقنية التي تشوب سير العمليات البيانية (Borghouts et al., 2021)، مع إيلاء عناية خاصة للمصطلحات المركبة مثل “عبد الله” أو “أبو بكر” أو الأسماء اللاتينية ذات السوابق المتعددة التي قد تتطلب قواعد مطابقة متقدمة تعتمد على جداول تعويض مسبقة.
10.3 بناء نماذج قابلة للتوسع لاستخراج أي عدد من الكلمات (n Words)
تتمثل قمة النضج الهندسي في تصميم الجداول الممتدة في الانتقال من الحلول الجامدة (Hardcoded Solutions) التي تقتصر على قيمة ثابتة محددة مسبقاً، إلى بناء نماذج ديناميكية قابلة للتوسع والتكيف الفوري لاستخراج أي عدد من الكلمات (n Words) يحدده المستخدم وفقاً لمتغيرات العمل المتجددة.
ويتم تنفيذ هذه المنهجية عن طريق تخصيص خلية إدخال معيارية مستقلة في ورقة العمل—ولتكن الخلية $C$1 على سبيل المثال—لتكون وحدة تحكم ديناميكية يُدخل فيها المستخدم عدد الكلمات المستهدف استخراجها. وتُصاغ المعادلة في العمود التنفيذي بالصورة المرنة التالية:
=TEXTBEFORE(TRIM(A2), ” “, $C$1, , 1)
في هذا النموذج الهندسي المتطور، تم استبدال القيمة الرقمية الثابتة 2 بمرجع مطلق ($C$1) يقرأ القيمة المحددة لحظياً. فإذا رغب المستخدم في استخراج أول 3 كلمات أو أول 5 كلمات من كامل السجلات، فإنه لا يحتاج إلى تعديل أي صيغة في آلاف الصفوف، بل يكتفي بتغيير الرقم في الخلية $C$1 ليعاد احتساب كامل الجدول وتكييف عمق الاستخراج تلقائياً ومباشرة.
ويجب توثيق هذه النماذج بصورة احترافية من خلال تضمين تعليقات توضيحية داخل ورقة العمل (Excel Notes / Comments)، وتأمين خلايا المعادلات ضد التعديل العرضي عبر ميزات حماية الورقة (Protect Sheet)، مما يضمن استمرارية النماذج التشغيلية واستدامتها لعقود طويلة متوافقة مع أرقى معايير الحوكمة البرمجية المؤسسية.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لعملية استخراج أول كلمتين من خلية في مايكروسوفت إكسيل، مبيناً الفروق الجوهرية بين الحلول الحديثة المدعومة بمحرك إكسيل 365—وعلى رأسها دالة TEXTBEFORE المتطورة ودوال المصفوفات الديناميكية مثل TEXTSPLIT و TAKE—وبين التوليفات الكلاسيكية المعتمدة على دمج دوال LEFT و FIND و SUBSTITUTE لتحقيق التوافقية العكسية مع الإصدارات التاريخية.
وقد أظهر التحليل التقني أن نجاح عمليات المعالجة النصية لا يتوقف فقط على صياغة معادلة التجزئة، بل يتطلب بالدرجة الأولى تأسيس بيئة بيانات منقاة عبر التطبيق الاستباقي لدوال TRIM و CLEAN وتقنيات استبدال المسافات غير القابلة للكسر CHAR(160) الناتجة عن الويب. كما تم إبراز البدائل المؤتمتة واسعة النطاق المتاحة عبر أداة Power Query ولغة M، والدوال البرمجية المخصصة عبر VBA لمعالجة السجلات المؤسسية فائقة الضخامة.
إن الاختيار الرشيد بين هذه المنهجيات يعتمد أساساً على طبيعة الإصدار المستخدم وحجم البيانات ومتطلبات الأمان والتوافق المؤسسي؛ حيث تظل الحلول المدمجة الحديثة الخيار الأكثر كفاءة وأناقة برمجية، في حين توفر تقنيات التحويل الثابت والتحقق الإحصائي صمام الأمان النهائي لضمان سلامة النماذج والتقارير الإحصائية وموثوقية مخرجاتها عبر الزمن.
المراجع
- Borghouts, J. W., Eikey, E. V., Mark, G. J., De Leon, C., Schueller, S. M., Schneider, M. L., et al. (2021). Barriers to and Facilitators of User Engagement With Digital Mental Health Interventions: Systematic Review. Journal of Medical Internet Research. https://doi.org/10.2196/24387
- Kirschner, P. A., & van Merriënboer, J. J. G. (2013). Do Learners Really Know Best? Urban Legends in Education. Educational Psychologist. https://doi.org/10.1080/00461520.2013.804395
- Lété, B., Sprenger-Charolles, L., & Colé, P. (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560