
تحظى معالجة السلاسل النصية وتنظيم البيانات باهتمام محوري في علوم البيانات، والبحث العلمي التجريبي، والإدارة المكتبية المتقدمة؛ حيث تمثل الجداول الإلكترونية حجر الزاوية في تجميع وتصنيف المتغيرات قبل إخضاعها للتحليل الإحصائي الدقيق. ويعد برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشاراً واعتماداً في هذا المضمار، نظراً لمرونته وقدرته الفائقة على التعامل مع مصفوفات البيانات الضخمة التي تحتوي على مئات الآلاف من السجلات النصية والرقمية المتنوعة.
في كثير من الأحيان، يواجه الباحث أو محلل البيانات متطلبات إجرائية تقتضي تفكيك المعرفات المركبة، أو استخلاص الرموز الأولية للأسماء، أو عزل المتغيرات التصنيفية من خلال قراءة الحرف البادئ في الخلية. ورغم بساطة هذه العملية ظاهرياً، إلا أن تطبيقها وفق منهجية علمية منضبطة يستوجب فهماً عميقاً للبنية التحتية لتخزين النصوص داخل جداول البيانات، والتعرف على خوارزميات الاقتطاع النصي المدمجة في النظام، وضبط المتغيرات المحيطة كالمسافات غير المرئية واختلافات التكويد اللغوي لتفادي أي تحيز أو خطأ في القياس والتبويب.
يتناول هذا الدليل الأكاديمي الشامل كافة المسارات التقنية والمعرفية المتعلقة بمسألة استخراج الحرف الأول من السلسلة النصية في بيئة إكسيل؛ حيث نستعرض الأدوات التقليدية كدالتي LEFT وMID، والحلول الذكية القائمة على خوارزميات التعرف على الأنماط مثل التعبئة السريعة (Flash Fill)، مروراً بأتمتة التنقية عبر محرك Power Query، والبرمجة النصية عبر لغة Visual Basic for Applications (VBA). كما يضع الدليل أطراً إجرائية لحل المشكلات المعقدة كالتعامل مع النصوص ثنائية الاتجاه والرموز الخاصة، وصولاً إلى ترسيخ أفضل الممارسات المنهجية في توثيق وتنظيف البيانات العلمية.
1. مقدمة عامة حول معالجة السلاسل النصية واستخراج الحرف الأول في إكسيل
1.1 أهمية تفكيك النصوص في التحليل الإحصائي والبيانات الأكاديمية
تمثل مرحلة إعداد البيانات وتنظيفها (Data Cleaning and Preparation) الخطوة الحاسمة التي يتوقف عليها نجاح واستقرار النماذج الإحصائية والتحليلية في البحوث الميدانية والأكاديمية. إن البيانات الخام المستخرجة من منصات الاستبيانات الإلكترونية، أو المقاييس النفسية، أو قواعد البيانات المؤسسية نادراً ما تأتي في صيغة متجانسة جاهزة للإدخال المباشر في حزم التحليل مثل SPSS أو R أو Python. ومن هنا تبرز أهمية تفكيك النصوص وإعادة هيكلتها، حيث يعد استخراج الحرف الأول من المعرفات النصية إحدى آليات الترميز الاختزالي الأكثر استخداماً لتصنيف المجموعات البحثية وفرز المستجيبين وتوحيد أشكال المتغيرات النوعية المعقدة.
على سبيل المثال، عند التعامل مع استجابات تشتمل على معرفات مركبة مثل “G1_P102” لتمييز أفراد المجموعة التجريبية الأولى عن المجموعة الضابطة، يوفر استخراج الحرف الأول “G” مساراً إجرائياً سريعاً لتوليد متغير تصنيفي ثنائي أو متعدد يحدد فئة الفرد المستجيب تلقائياً. علاوة على ذلك، يسهم تقليص الأسماء المطولة أو المعرفات الوظيفية إلى حروف استهلالية في حماية سرية بيانات المشاركين (Anonymization)، وهو ما يمثل شرطاً أخلاقياً صارماً في الأبحاث الاجتماعية والطبية النفسية. إن الدقة المنهجية في هذه المرحلة تضمن تقليل أخطاء الإدخال والقياس، مما يرفع من مستوى صدق وثبات المؤشرات الإحصائية المستخلصة لاحقاً.
وفي إطار تبويب المتغيرات الفئوية (Categorical Variables)، يتيح الاقتطاع النصي المنهجي اختزال سلاسل الحروف المعقدة في مجموعات كودية قابلة للجدولة المتقاطعة (Cross-tabulation). إذ إن تحويل سلاسل نصية طويلة مثل “Excellent” و”Good” و”Poor” إلى الأحرف الاستهلالية يسهل رسم مصفوفات التوزيع التكراري، ويقلل من استهلاك الذاكرة الحاسوبية المخصصة لمعالجة النصوص، مما يضفي مرونة وسلاسة فائقة على سير العمل البحثي داخل بيئة إكسيل.
1.2 البنية التركيبية للنصوص الرقمية وجداول بيانات إكسيل
تتعامل جداول بيانات مايكروسوفت إكسيل مع البيانات المدخلة استناداً إلى تصنيفات نوعية محددة تشمل القيم الرقمية، والقيم المنطقية (Boolean)، والسلاسل النصية (Strings)، وقيم الأخطاء. وتُخزن السلاسل النصية في ذاكرة البرنامج كمصفوفات متتابعة من المحارف (Character Arrays)، حيث يرتبط كل محرف بموقع فهرسي محدد يبدأ من الرقم 1 وينتهي عند الطول الإجمالي للنص. هذا النظام الفهرسي الموضعي (1-based indexing) يختلف عن لغات البرمجة الشائعة مثل Python أو C++ التي تتبنى الفهرسة الصفرية (0-based indexing)، وهو فارق جوهري يجب أن يدركه الباحث بدقة عند ترجمة الخوارزميات والمعادلات إلى ورقة العمل.
من الناحية التركيبية، يفرق إكسيل بصرامة بين السلاسل النصية الصريحة والأرقام المخزنة كنصوص؛ فالمدخل “123” الذي يُنسق كنص يتم التعامل معه كمتتالية من ثلاثة محارف مستقلة لها خصائص سلاسل الحروف ولا تخضع للعمليات الحسابية المباشرة دون تحويل صريح. كما يعتمد إكسيل في معالجته للمحارف على معيار الترميز الموحد (Unicode)، وتحديداً ترميز UTF-16 لتخزين النصوص داخلياً. هذا التكويد يمنحه القدرة على قراءة النصوص متعددة اللغات، بما في ذلك الأحرف العربية، واللاتينية، والرموز المشتقة، بدقة متناهية.
ومع ذلك، فإن هذا التكويد يفرض تحديات تقنية دقيقة؛ إذ تُخزن الحروف العربية كأكواد مستقلة تتأثر باتجاه النص وعلامات التشكيل، في حين قد تتكون بعض المحارف الخاصة والرموز التعبيرية من أزواج بديلة (Surrogate Pairs) تحتل أكثر من موقع تخزيني واحد في الذاكرة. وعليه، فإن تحديد موقع المحرف الأول في السجلات النصية الضخمة يتطلب فهماً لكيفية تعامل محرك إكسيل الحسابي مع تلك المواقع الفهرسية، وضمان عدم حدوث تضارب بين التمثيل الرسومي للنص على الشاشة والتمثيل البايتي المخزن فعلياً في بنية الملف.
1.3 نظرة عامة على الأدوات والوظائف المتاحة للاقتطاع النصي
يوفر نظام مايكروسوفت إكسيل ترسانة متكاملة من الأدوات المصممة لمعالجة وتجزئة النصوص، وتتدرج هذه الأدوات من الوظائف الحسابية القياسية المدمجة في ورقة العمل إلى البيئات البرمجية المتقدمة. وتأتي دالة الاقتطاع الطرفي LEFT في مقدمة هذه الدوال بوصفها الخيار الرياضي المباشر والأكثر استخداماً لاسترجاع المحارف من بداية النص. وإلى جانبها، تبرز دالة MID التي توفر مرونة أكبر بتمكين المستخدم من تحديد نقطة بداية الاقتطاع ومقداره بدقة، فضلاً عن دالة TEXTBEFORE المتوفرة في الإصدارات الحديثة لمنظومة Microsoft 365 والتي تفصل النصوص بناءً على محددات معينة.
على الجانب الآخر، توجد آليات المعالجة التلقائية غير المعتمدة على المعادلات، وأبرزها ميزة الإكمال السريع (Flash Fill)، التي أُدخلت في إصدار عام 2013 لتعمل بالاعتماد على خوارزميات التنبؤ واستنباط الأنماط المتكررة دون الحاجة إلى كتابة صياغات رياضية معقدة. ورغم سرعة هذه الأداة وفاعليتها في إنجاز المهام المكتبية السريعة، إلا أنها تفتقر إلى ديناميكية التحديث التلقائي التي تميز الدوال الرياضية، مما يستوجب الحذر عند استخدامها في معالجة البيانات القابلة للتغير الدوري.
أما على مستوى المعالجة الحجمية وهندسة البيانات الضخمة (Big Data Pipelines)، فإن بيئة استعلامات Power Query تمثل المعيار الذهبي المفضل للباحثين؛ إذ تتيح إنشاء مسارات تنقية مؤتمتة وموثقة تستخرج الحرف الأول وتطبق سلاسل من المعالجات التحويلية على ملايين السجلات النصية قبل تحميلها في بيئة التحليل. وفي الحالات الاستثنائية التي تتطلب شروطاً منطقية شديدة التخصيص، يظل محرر Visual Basic for Applications (VBA) الخيار البرمجي الأقوى لبناء دوال مستخدم مخصصة (UDF) تنفذ خوارزميات اقتطاع فائقة الدقة والسرعة.
2. الدالة الأساسية: التركيب الرياضي والنحوي لدالة LEFT
2.1 المحددات النحوية والمدخلات الخاصة بدالة LEFT
تعد دالة LEFT التعبير القياسي الأصيل في إكسيل لاقتطاع المحارف من الجانب البادئ لأي سلسلة نصية. وتاريخياً، تعود جذور هذه الدالة إلى لغات البرمجة المبكرة مثل Dartmouth BASIC في منتصف الستينيات من القرن العشرين، حيث كانت تُعرف بصيغة LEFT$()، ثم انتقلت إلى البرمجيات الجدولية الرائدة مثل VisiCalc وLotus 1-2-3 وصولاً إلى إطلاق إكسيل عام 1985 على أجهزة ماكنتوش وعام 1987 على نظام ويندوز. ويمتاز التركيب النحوي (Syntax) لهذه الدالة بالبساطة والإحكام الصارم، حيث تُعرف الصيغة العامة لها كما يلي:
=LEFT(text, [num_chars])
تشتمل الدالة على وسيطتين رئيسيتين: الوسيطة الأولى الإلزامية هي text، والتي تمثل السلسلة النصية المراد معالجتها، ويمكن أن تأتي هذه الوسيطة في صورة مرجع مباشر لخلية داخل ورقة العمل (مثل A2)، أو نص صريح موضوع بين علامتي تنصيص مزدوجتين، أو ناتج مرجع لدالة نصية أو رياضية أخرى. أما الوسيطة الثانية فهي num_chars، وهي وسيطة اختيارية تحدد عدد المحارف المطلوب استخراجها انطلاقاً من الموضع الأول. وإذا كانت قيمة هذه الوسيطة أكبر من إجمالي عدد محارف النص المعني، فإن الدالة تُرجع النص كاملاً دون إحداث أخطاء تشغيلية.
من أهم المحددات البرمجية التي يجب الانتباه إليها أن الوسيطة num_chars تفترض القيمة الافتراضية (Default Value) وهي الرقم 1 في حال تم إغفال كتابتها تماماً من قِبل المستخدم. كما يشترط في هذه الوسيطة أن تكون قيمة عددية صحيحة موجبة أو مساوية للصفر؛ فإذا أُدخلت قيمة سالبة، فإن الدالة تُخفق رياضياً وتُرجع خطأ القيمة الشهير #VALUE!. وتُرجع الدالة ناتجها دائماً في صيغة بيانات نصية صريحة (Text Data Type)، حتى وإن كانت المحارف المستخرجة عبارة عن أرقام صرفة، وهو ما يرتب متطلبات إجرائية إضافية إذا كانت الغاية إدراج الناتج في عمليات حسابية لاحقة.
2.2 التطبيق المباشر للصيغة لاستخراج المحرف الأول
لتحقيق الهدف الإجرائي المتمثل في استخراج الحرف الأول من سلسلة نصية مودعة في الخلية A2، يمكن للباحث استخدام إحدى صياغتين متطابقتين رياضياً ووظيفياً. الصياغة الأولى هي الصياغة المفصلة الكاملة التي تنص على تعيين عدد المحارف بشكل صريح:
=LEFT(A2, 1)
في هذه الحالة، يوجه الأمر محرك إكسيل بالذهاب إلى الخلية A2، وقراءة المحرف المتمركز في الموضع الفهرسي رقم 1 فقط، وإهمال باقي المصفوفة النصية. أما الصياغة الثانية، فهي الصياغة المختصرة والمفضلة لدى المحترفين في هندسة الجداول الإلكترونية، وتعتمد على السلوك الافتراضي للدالة عند حذف الوسيطة الثانية:
=LEFT(A2)
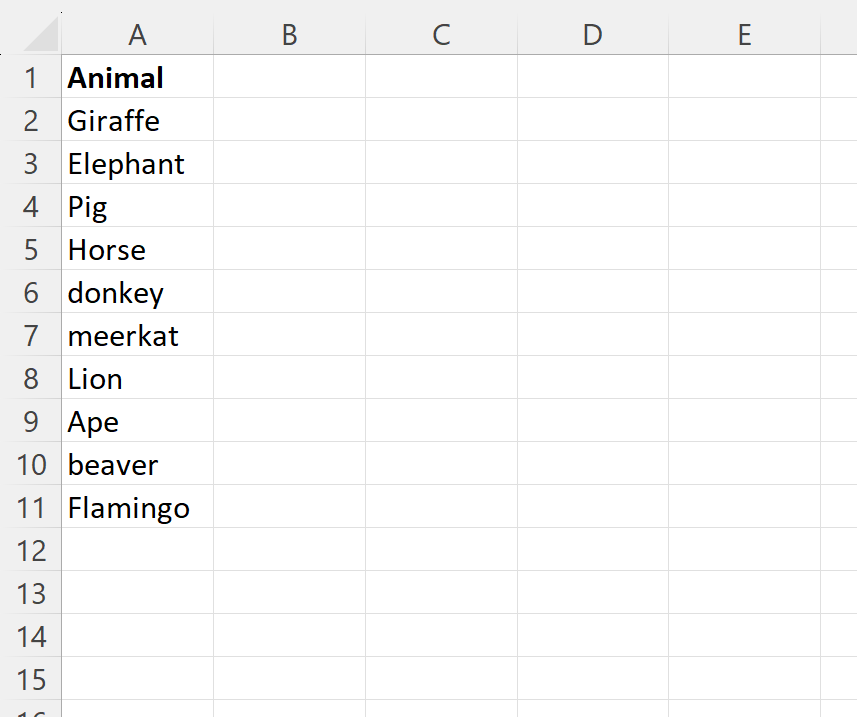
يعمل هذا التركيب المختصر بذات الكفاءة والسرعة الحسابية للصيغة المفصلة، حيث يقوم مترجم المعادلات فوراً بإسناد القيمة 1 للوسيطة المحذوفة. ويُسهم هذا التبسيط في تقليل حجم التعقيد البصري لمعادلات ورقة العمل، لا سيما عند إدراج دالة الاستخراج ضمن صيغ مركبة متداخلة كالدوال الشرطية (Nested IF) أو دوال البحث المتطابق (XLOOKUP / INDEX-MATCH).
عند تنفيذ هذه الصيغة، تُفحص القيمة المرجعة للتأكد من مطابقتها للمحرف المستهدف. ومن الخصائص الجوهرية لدالة LEFT أنها دالة غير حساسة لحالة الأحرف في بنيتها الاسترجاعية؛ بمعنى أنها تعيد الحرف اللاتيني تماماً كما هو مسجل في الخلية المصدر (سواء كان بحالة كبيرة Uppercase مثل “A” أو بحالة صغيرة Lowercase مثل “a”)، دون إجراء أي تحويل آلي لحالته، مما يحافظ على الأمانة الوصفية للمدخلات الأصلية.
2.3 ميكانيكية استجابة إكسيل للمدخلات الفردية والمتغيرات
تتنوع طبيعة المدخلات داخل جداول البيانات تِبعاً لمصادر التجميع، مما يفرض دراسة سلوك دالة LEFT تحت ظروف استثنائية مختلفة. فعند توجيه الدالة إلى خلية تحتوي على حرف واحد فقط، تُرجع الدالة ذلك الحرف بذاته دون إشكالية. أما إذا كان المرجع موجهاً إلى خلية فارغة تماماً (Empty Cell)، فإن الدالة تُرجع نصاً فارغاً (Empty Text String: "")، ولا تُرجع صفراً رقمياً أو رسالة خطأ، وهو سلوك تنظيمي بالغ الأهمية يحول دون تشويه التقارير النهائية بالرموز غير المرغوب فيها.
تنشأ الصعوبات التقنية عندما تحتوي الخلية المصدر على نصوص مسبوقة بمسافات فارغة غير ملحوظة بصرياً (Leading Whitespaces)، أو ما يُعرف بالمحارف البيضاء الناتجة عن أخطاء المفاتيح أو تصدير قواعد البيانات. في هذا السياق، تطبق دالة LEFT مبدأ المعالجة الحرفية الصارمة؛ فالمسافة في منطق إكسيل هي محرف مستقل له كود أسكي خاص (ASCII 32). وبناءً عليه، إذا احتوت الخلية على القيمة ” Ahmed”، فإن تطبيق الدالة =LEFT(A2) سيؤدي حتماً إلى إرجاع المحرف الفراغي ” “، مما يعطي انطباعاً زائفاً بأن الخلية فارغة، ويؤدي إلى انهيار عمليات الفرز الإحصائي اللاحقة.
علاوة على ذلك، يتأثر سلوك الدالة بنوع التنسيق المطبق على الخلية المرجعية؛ فإذا كانت الخلية المصدر تحتوي على تاريخ ميلاد منسق مثل “15/04/1990″، فإن إكسيل يخزن هذا التاريخ داخلياً كرقم تسلسلي (Serial Number) يعبر عن عدد الأيام المنقضية منذ عام 1900 (وهو في هذا المثال الرقم 32978). وإذا طُبقت الدالة =LEFT(A2) على هذه الخلية مباشرة، فإنها ستقتطع الحرف الأول من الرقم التسلسلي التخزيني (أي ستُرجع الرقم “3”) وليس الرقم “1” الظاهر على شاشة العرض. لذا يتوجب على الباحث دوماً التمييز الدقيق بين القيمة الجوهرية للبيانات المودعة وتنسيق العرض الخارجي المطبق عليها.
3. الدليل العملي خطوة بخطوة لتطبيق الصيغة وسحبها عبر الأعمدة
3.1 إعداد وتجهيز مصفوفة البيانات المصدر
يتطلب التحليل العلمي الرصين إرساء بنية تحتية سليمة للبيانات قبل الشروع في كتابة الدوال الحسابية. وتبدأ هذه المرحلة بفحص العمود المصدر الذي يحوي السلاسل النصية المراد تجزئتها، والتأكد من خلوه من أي دمج للخلايا (Merged Cells)؛ إذ يمثل الدمج عائقاً هيكلياً يمنع استقرار الصيغ النسبية ويتسبب في تشويه مصفوفات الحساب. ويجب التأكد من أن رأس العمود يحمل اسماً وصفياً يعبر عن المتغير بدقة وفق معايير التوثيق الأكاديمي، كأن يُسمى “Participant_ID” أو “Raw_Response”.
يتم بعد ذلك إدراج عمود جديد مجاور للعمود المصدر مباشرة، وتسميته باسم منهجي واضح، مثل “First_Initial” أو “Condition_Code”. هذه المجاورة تضمن بقاء البيانات الأصلية في حالة أمان معزولة تماماً عن أي تعديل تخريبي، مما يحقق مبدأ قابلية تتبع البيانات (Data Traceability). كما يُنصح بفحص نوع البيانات العام للعمود الجديد وضبطه على التنسيق “العام” (General) أو “النصي” (Text) لضمان عدم حدوث تداخل بين الصيغ التلقائية وخوارزميات المعالجة التلقائية لإكسيل.
تتضمن عملية الفحص الأولي أيضاً مسحاً سريعاً لاكتشاف الخلايا المفقودة (Missing Values) أو السجلات الشاذة داخل العمود المصدر. ويمكن الاستعانة بأدوات التصفية التلقائية (AutoFilter) لتحديد الخلايا الفارغة أو القيم غير المتجانسة، وتحديد استراتيجية واضحة للتعامل معها، سواء بالاستبعاد أو بتضمين دوال للتحقق المنطقي المسبق، وهو ما يضمن نقاء مصفوفة المخرجات واستقرارها الإحصائي عبر كامل السجلات.
3.2 إدخال المعادلة وتنفيذها في الخلية الأولى
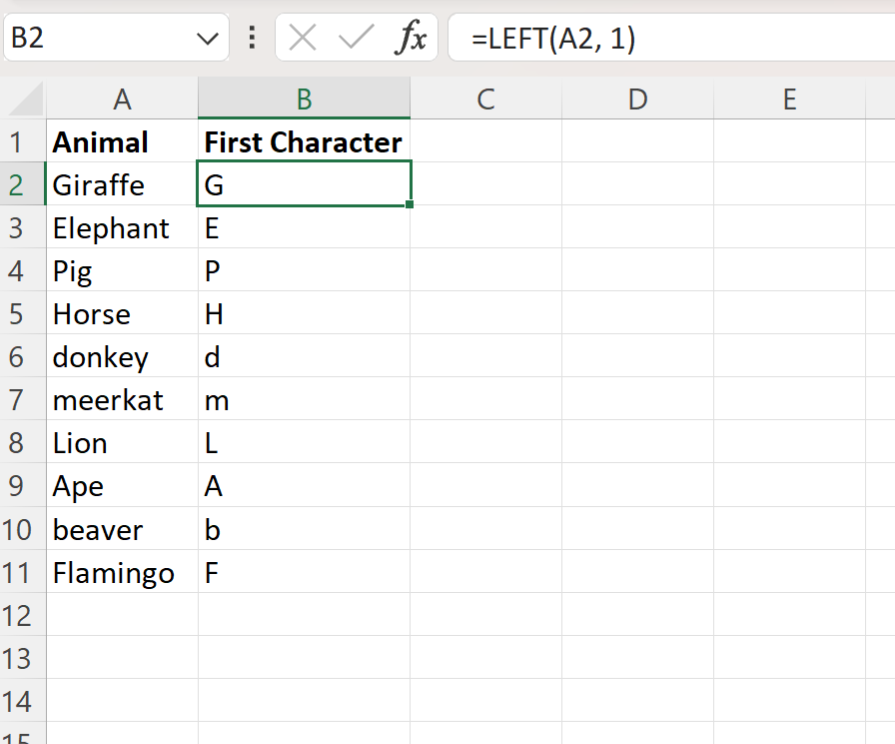
بعد تجهيز مساحة العمل الهيكلية، ينتقل الباحث إلى الخلية العلوية المقابلة لأول سجل بياني فعلي (ولتكن الخلية B2 المقابلة للبيان في A2). تبدأ عملية الإدخال بكتابة علامة التساوي =، وهي الإشارة التشغيلية التي تخطر محرك إكسيل بالتحول من وضع إدخال النصوص الثابتة إلى وضع الحساب الديناميكي. يتبع ذلك كتابة اسم الدالة بحروف واضحة، يليها فتح القوس الرياضي لاحتواء المدخلات:
=LEFT(A2, 1)
أثناء عملية الكتابة، يُفضل استخدام الفأرة أو مفاتيح الأسهم لتحديد الخلية المرجعية A2 بدلاً من كتابتها يدوياً، وذلك لتفادي أخطاء الطباعة التي قد تحيل المعادلة إلى خلية خاطئة. بمجرد الانتهاء من إغلاق القوس، يتم الضغط على مفتاح الإدخال (Enter). في هذه اللحظة، يعالج النظام الدالة فورياً ويُعرض الحرف المستخرج داخل الخلية B2، في حين يظل شريط الصيغة (Formula Bar) في الجزء العلوي محتفظاً بالتركيب الجبري الأصلي للمعادلة.
يجب إجراء فحص بصري سريع للمخرجات المتحصل عليها في هذه الخلية؛ فإذا ظهر الحرف الأول المتوقع، يتم التحقق من عدم وجود مسافات مصاحبة أو مخرجات شاذة. أما إذا ظهرت رسالة خطأ، مثل #NAME?، فهذا يشير حتماً إلى خطأ إملائي في كتابة اسم الدالة (كأن تُكتب LEFFT). وإن ظهر خطأ #VALUE!، فهذا يعني أن الوسيطة العددية قد أُسندت إليها قيمة غير متوافقة رياضياً، مما يستوجب التصحيح المباشر للصيغة قبل الانتقال لتعميمها.
3.3 تعميم الصيغة باستخدام مقبض التعبئة والتكرار التلقائي
بعد التحقق من سلامة الصيغة في الخلية الأولى، تأتي مرحلة التعميم الإجرائي لتشمل كامل العينة البحثية أو السجلات الإدارية التي قد تمتد لعشرات الآلاف من الصفوف. يوفر إكسيل ميزة “مقبض التعبئة” (Fill Handle)، وهو المربع الأسود الصغير المتمركز في الزاوية السفلية اليسرى (أو اليمنى بحسب اتجاه واجهة البرنامج) للخلية النشطة B2. يمكن النقر والسحب يدوياً على هذا المقبض لنسخ المعادلة إلى الصفوف التالية.
ومع ذلك، في السجلات الميدانية الكبيرة التي تتجاوز آلاف الصفوف، يصبح السحب اليدوي غير عملي وعرضة للخطأ. والبديل الاحترافي الأسرع يتمثل في توجيه مؤشر الفأرة نحو مقبض التعبئة حتى يتحول إلى علامة التقاطع السوداء الدقيقة +، ثم النقر المزدوج السريع (Double-click) بزر الفأرة الأيسر. يترتب على هذا الإجراء إرسال نبضة حسابية متتالية تقوم بنسخ المعادلة عمودياً إلى أسفل العمود، متوقفة تلقائياً عند آخر صف يحتوي على بيانات في العمود المجاور A، وهي آلية تضمن التغطية الشاملة دون أي تجاوز.
تعتمد هذه الآلية الرياضية على مفهوم المراجع النسبية (Relative References)؛ فعند نزول المعادلة من الصف 2 إلى الصف 3، يتحول المرجع A2 تلقائياً إلى A3، ثم إلى A4 وهكذا دواليك. وبعد اكتمال التعميم والتحقق من صحة النتائج، يوصى في العمل الأكاديمي بنسخ العمود الجديد بالكامل وإعادة لصقه في نفس موضعه باستخدام خيار “لصق كقيم” (Paste Values). يؤدي هذا الإجراء الحاسم إلى تثبيت الحروف المستخرجة كنصوص جامدة، وحذف الارتباط الديناميكي بالمعادلات، مما يحمي البيانات من التبدل العرضي ويسرع عمليات الحفظ والمعالجة الإحصائية اللاحقة.
4. استخدام دالة MID كبديل تركيبي متقدم لاستخراج الحرف الأول
4.1 المقارنة المفاهيمية بين دالتي LEFT و MID
تم تصميم دالة LEFT بالأساس للتعامل مع نهايات السلاسل النصية وتحديداً الطرف البادئ، وهي بذلك تمثل أداة اقتطاع طرفية محددة الغاية. في المقابل، تُصنف دالة MID كأداة استقطاع داخلي عامة وشاملة، تمتلك القدرة على النفاذ إلى أي موقع موضعي داخل المصفوفة النصية واقتطاع عدد معين من المحارف انطلاقاً من ذلك الموقع. تنبع المقارنة المفاهيمية بين الدالتين من زاوية المرونة الوظيفية في مقابل البساطة الإنشائية.
ففي حين تتطلب دالة LEFT وسيطة أو وسيطتين على الأكثر لتنفيذ مهمتها، تتطلب دالة MID دائماً ثلاث وسائط إجبارية لا يمكن إغفال أي منها. ورغم أن استخدام دالة LEFT يظل هو الخيار الطبيعي والأكثر شيوعاً لاستخراج الحرف الأول نظراً لخفته الإجرائية، إلا أن دالة MID تقدم بديلاً متقدماً يتفوق عندما تتغير متطلبات التحليل لتشمل فحص محارف متعددة في مواقع ديناميكية، أو عند الرغبة في توحيد البنية الرياضية للمعادلات عبر مراحل تنظيف البيانات المختلفة دون التبديل بين دوال متعددة.
من حيث كفاءة المعالجة الحسابية واستهلاك الذاكرة (Algorithmic Complexity)، تتماثل الدالتان تقريباً في الأداء عند التعامل مع السجلات المتوسطة، إلا أن دالة LEFT تمتاز بمسار استدعاء حوسبي أقصر في شفرة البرنامج الثنائية. ورغم ذلك، فإن تبني دالة MID في الأبحاث المعقدة يمنح المحلل ميزة البناء البارامتري؛ حيث يمكن تحويل نقطة البداية إلى متغير رياضي يخضع لمعادلات أخرى، مما يجعلها أداة مرنة تتجاوز مجرد الاقتطاع الثابت.
4.2 صياغة وتطبيق دالة MID للاقتطاع من الموضع الأول
تُعرّف البنية الرياضية والنحوية لدالة MID عبر التركيب الجبري التالي:
=MID(text, start_num, num_chars)
تتمثل الوسيطة الأولى text في السلسلة النصية المراد معالجتها، والوسيطة الثانية start_num هي الرقم الصحيح الذي يحدد موقع أول محرف يراد اقتطاعه، بينما تمثل الوسيطة الثالثة num_chars عدد المحارف المراد استخراجها. ولاستخدام هذه الدالة كأداة مطابقة تماماً لوظيفة استخراج الحرف الأول من الخلية A2، تُصاغ المعادلة على النحو الآتي:
=MID(A2, 1, 1)
في هذه الصياغة النموذجية، تشير القيمة 1 في الوسيطة الثانية إلى ضرورة انطلاق مؤشر الاقتطاع من المحرف الأول في بداية النص، بينما تحدد القيمة 1 في الوسيطة الثالثة قصر عملية الاستخراج على محرف واحد فقط. وبذلك يكون الناتج المسترجع مطابقاً بصورة مطلقة لمخرجات الدالة =LEFT(A2, 1). من الضروري التأكيد هنا على أن محاولة تعيين start_num بالقيمة صفر (0) استناداً إلى المنطق البرمجي السائد في بعض بيئات التطوير سيؤدي فوراً إلى توقف الدالة وإصدار خطأ #VALUE!، نظراً لالتزام إكسيل الصارم بالفهرسة التي تبدأ بالرقم واحد.
يمكن تضمين هذا التركيب في صيغ شرطية اختبارية لضمان جودة البيانات، كأن يتم اختبار مدى مطابقة الحرف الأول لشرط تصنيفي معين باستخدام دالة التماثل المنطقي:
=IF(MID(A2, 1, 1)="T", "Experimental Group", "Control Group")
يوفر هذا التطبيق المركب دليلاً على كيفية توظيف دالة MID في توليد متغيرات بحثية جديدة فورية مستندة إلى استخلاص المحرف الاستهلالي بدقة منهجية تامة.
4.3 سيناريوهات تفضيل دالة MID في المعالجات الأكاديمية المعقدة
تتجلى الأهمية التطبيقية لدالة MID في سيناريوهات التحليل السيكومتري والاستبيانات متعددة المقاييس، حيث تأتي سلاسل البيانات أحياناً في هيئة كتل متصلة تدمج الإجابات معاً (مثل “A3B2C5”)، وتتطلب تفكيكاً تدريجياً منظماً. في هذه البيئات، يفضل الباحثون اعتماد نمط بنائي موحد؛ فبدلاً من استخدام LEFT للحرف الأول، ثم MID للحرف الثاني، وRIGHT للحرف الأخير، يتم استخدام دالة MID عبر كامل المصفوفة مع تغيير وسيطة موضع البداية فقط:
=MID(A2, 1, 1) للحرف الأول، و=MID(A2, 2, 1) للمحرف الثاني، و=MID(A2, 3, 1) للمحرف الثالث. يضفي هذا التناسق البرمجي وضوحاً مطلقاً على كود ورقة العمل ويسهل مراجعته وتدقيقه من قِبل لجان التحكيم العلمي أو الباحثين المشاركين في المشروع.
كذلك تبرز قوة دالة MID عند الرغبة في ربط نقطة البداية بدالة بحث ديناميكية مثل SEARCH أو FIND. فلو افترضنا أن البيانات تحتوي على سوابق متغيرة الطول تفصل بينها شرطة سفلية (مثل “Sub1_ID402″ و”Subject12_ID505”) والمطلوب هو استخراج أول حرف من المعرف الحقيقي الذي يلي الشرطة، فإن دالة LEFT تصبح عاجزة بمفردها، بينما تحقق دالة MID ذلك بسهولة عبر التركيب الديناميكي:
=MID(A2, SEARCH("_", A2) + 1, 1)
إن القدرة على تحويل موضع الانطلاق إلى قيمة مرنة قابلة للحساب الرياضي تجعل من MID حلاً منهجياً متقدماً يتجاوز قيود الاقتطاع الطرفي الجامد.
5. معالجة إشكاليات المسافات البيضاء والرموز الخفية باستخدام دالة TRIM
5.1 تأثير المسافات البادئة على دقة نتائج الاستخراج
تعد المسافات البيضاء الزائدة (Extraneous Whitespaces) واحدة من أكثر مصادر التلوث البياناتي شيوعاً في الدراسات التجريبية والميدانية. وتنشأ هذه المشكلة عادةً نتيجة أخطاء الإدخال اليدوي غير المنضبط من قِبل جامعي البيانات، أو بسبب عدم مواءمة التكويد أثناء تصدير السجلات من نماذج استطلاعات الرأي عبر الويب (مثل Google Forms أو Qualtrics) إلى ملفات إكسيل. وتكمن خطورة المسافة البادئة (Leading Space) في كونها عنصراً غير مرئي للملاحظ العادي عند النظر إلى الخلية المجردة، إلا أنها تحتل وزناً حوسبياً كاملاً في هيكل السلسلة النصية.
عندما يُطلب من دالة =LEFT(A2) اقتطاع الحرف الأول من خلية تحوي القيمة ” Result”، فإن المؤشر الحسابي يلتقط المحرف رقم 1، والذي هو في هذا السياق رمز المسافة الفارغة. يترتب على هذا الخطأ عواقب منهجية وخيمة في التحليل؛ حيث تُصنف الخلية المعالجة كخانة فارغة أو مسافة نصية، مما يعطل دوال العد المشروط مثل COUNTIF، ويفسد عمليات الفرز والترتيب الأبجدي، ويؤدي إلى تصنيف الأفراد في فئات مجهولة أو مفقودة داخل برامج التحليل المتقدمة.
لتشخيص هذه الظاهرة بدقة داخل مجموعات البيانات المشكوك فيها، يمكن للباحث استخدام دالة القياس الطولي LEN بالتوازي مع دالة التحقق من المحارف. فإذا كان طول النص الظاهري يبدو مكوناً من 5 أحرف بينما تعطي الدالة =LEN(A2) القيمة 6، فإن ذلك يمثل دليلاً قطعياً على تسرب محرف غير مرئي في مقدمة أو مؤخرة السلسلة، مما يفرض التدخل المنهجي لتطهير النص قبل الشروع في الاقتطاع.
5.2 دمج دالتي LEFT و TRIM في صيغة تداخلية موحدة
لتحصين عملية استخراج الحرف الأول من السقوط في فخ المسافات البادئة، يُلجأ إلى تقنية تركيب الدوال (Function Nesting) من خلال دمج دالة التطهير النصي TRIM مع دالة الاقتطاع LEFT. تقوم وظيفة TRIM المتخصصة بفحص السلسلة النصية وحذف كافة المسافات البادئة والمسافات اللاحقة (Trailing Spaces) تماماً، فضلاً عن تقليص أي مسافات متتالية متعددة تفصل بين الكلمات إلى مسافة واحدة منتظمة. وتُصاغ المعادلة التداخلية القياسية لحل هذه المعضلة وفق الشكل التالي:
=LEFT(TRIM(A2), 1)
تعتمد أسبقية التنفيذ الرياضي في هذه الصيغة على قاعدة تقييم الأقواس الداخلية أولاً؛ حيث يتلقى محرك الحساب الخلية A2، ويقوم بتسليمها إلى دالة TRIM التي تنزع عنها أية مسافات بادئة مشوهة، منتجة نسخة نصية نظيفة ومنضبطة داخلياً في ذاكرة العمل المؤقتة. فور إتمام عملية التنقية، تتلقى دالة LEFT هذا النص النقي لتستخرج منه المحرف الأول الحقيقي وتضعه في الخلية الهدف.
يوفر هذا التركيب التداخلي حماية فائقة للبيانات تضمن الحصول على الحرف المطلوب أياً كان عدد المسافات غير المقصودة التي تسبقه في الخلية الأصلية. إن اعتماد هذه المعادلة المركبة كإجراء قياسي يقلل من التحيز في استجابات العينات البحثية، ويغني الباحث عن قضاء ساعات طويلة في فحص السجلات يدوياً وتصحيحها خلية تلو الأخرى.
5.3 إزالة المحارف غير القابلة للطباعة باستخدام دالة CLEAN
في كثير من الحالات المتقدمة التي تنطوي على استيراد البيانات من قواعد بيانات علائقية قديمة (Legacy Systems)، أو عبر عمليات القشط الشبكي (Web Scraping)، لا تقتصر المشكلة على المسافات العادية (ASCII 32)، بل تمتد لتشمل محارف تحكم غير قابلة للطباعة (Non-printable Control Characters)، كأكواد فواصل الأسطر (Line Breaks: ASCII 10) والرجوع للبداية (Carriage Returns: ASCII 13)، وأكواد التبويب الأفقي (Tabs). هذه الرموز تقف حائلاً دون عمل دالة TRIM بمفردها، إذ إن TRIM لا تتعامل إلا مع مسافات لوحة المفاتيح القياسية.
هنا تبرز الحاجة المنهجية لإقحام دالة التطهير المتطورة CLEAN، المصممة خصيصاً لإزالة المحارف الـ 32 الأولى غير القابلة للطباعة في نظام ترميز ASCII (من الكود 0 إلى 31). ولتحقيق أعلى درجات الموثوقية وتطهير البيانات المتطرفة، يتم صياغة معادلة استخراج متكاملة ثلاثية المستويات:
=LEFT(TRIM(CLEAN(A2)), 1)
تتبع هذه الصيغة المعيارية نسقاً تنظيفياً صارماً: تقوم CLEAN بحذف الرموز الخفية وأكواد التحكم التالفة، تليها TRIM لمسح المسافات المتطرفة البادئة واللاحقة، لتنتهي العملية بـ LEFT التي تقتطع الحرف الأول الصافي بدقة رياضية متناهية. كما تجدر الإشارة إلى وجود نوع خاص من المسافات يُعرف بـ “المسافة غير المنكسرة” (Non-breaking Space: ASCII 160 أو Unicode U+00A0) والشائع عند النسخ من صفحات الإنترنت؛ وهذا الرمز لا تستطيع TRIM أو CLEAN حذفه تلقائياً، ويتطلب استخدام دالة الاستبدال:
=LEFT(TRIM(SUBSTITUTE(A2, CHAR(160), " ")), 1)
إن تبني هذه المعالجات الاستباقية يعزز من مناعة البحث العلمي وجودة المواد الإحصائية المستخرجة من أوراق العمل الرقمية.
6. تقنيات الاستخراج الذكي بدون معادلات: ميزة الإكمال السريع (Flash Fill)
6.1 آلية التعرف على الأنماط في ميزة التعبئة السريعة
تمثل ميزة الإكمال السريع (Flash Fill)، التي ظهرت أول مرة في إصدار مايكروسوفت إكسيل 2013، تحولاً جذرياً في فلسفة التعامل مع الجداول الإلكترونية، حيث انتقلت بالبرنامج من نموذج الحساب الرياضي البحت المبني على الأوامر الصريحة إلى نموذج الحوسبة القائمة على التنبؤ والتعرف الآلي على الأنماط (Pattern Recognition). وتستند هذه التقنية في جوهرها إلى خوارزميات الاستقراء البرمجي (Program Synthesis) والذكاء الاصطناعي الرمزي؛ حيث يقوم المحرك بمراقبة التغييرات التي يدخلها المستخدم، ومقارنة المدخل اليدوي بمحتويات الخلايا المجاورة لاستنتاج القاعدة التحويلية الضمنية.
عندما يبدأ المستخدم بكتابة الحرف الأول من الكلمة في عمود محاذٍ، يفحص إكسيل التركيب المورفولوجي لعمود المصدر فوراً. ويبحث النظام عما إذا كان هذا الحرف يمثل الحرف البادئ، أو رمزاً يقع بعد محدد معين، أو جزءاً من اختصار معروف. وإذا استشعر النظام وجود اتساق منطقي متكرر يمكن تعميمه على باقي الصفوف، فإنه يبني خوارزمية افتراضية لحظية لتطبيق هذا النمط على امتداد الجدول كاملاً.
يتطلب نجاح هذا التعرف الذكي توفر بيئة سياقية ملائمة، أهمها الالتزام بشرط المجاورة المباشرة؛ إذ يجب أن يكون العمود المخصص للاستخراج ملاصقاً تماماً لعمود البيانات المصدر دون وجود أعمدة فارغة تفصل بينهما قد تعيق عمل محرك الاستقراء. كما يتعزز أداء الخوارزمية كلما كانت البيانات المصدر متسقة في بنائها التركيبي وخالية من التباينات الهيكلية الحادة.
6.2 الخطوات المنهجية لتطبيق Flash Fill لاستخراج الحرف الأول
لتطبيق هذه الميزة بأسلوب عملي سليم ومنهجي لاستخراج الحرف الأول، يتبع المحلل الخطوات الإجرائية التالية بدقة:
- الوقوف في الخلية الأولى من العمود المفرغ الجديد (مثلاً B2)، والمحاذية مباشرة لأول خلية تحتوي على النص الأصلي في العمود المصدر (A2).
- كتابة الحرف الأول يدوياً كما يظهر تماماً في الخلية A2 (مع مراعاة التوافق في حالة الأحرف اللاتينية، أو الحركات وعلامات التشكيل إن وجدت)، ثم الضغط على مفتاح
Enterللانتقال إلى الخلية B3. - تفعيل أداة التعبئة السريعة عبر أحد المسارات التقنية الثلاثة المتاحة:
- استخدام الاختصار المباشر من لوحة المفاتيح بالضغط المتزامن على مفتاحي
Ctrl + E، وهو الخيار الأسرع على الإطلاق. - الانتقال إلى شريط الأدوات العلوي، واختيار تبويب بيانات (Data)، ثم النقر على أيونة التعبئة السريعة (Flash Fill) ضمن مجموعة أدوات البيانات (Data Tools).
- البدء في كتابة الحرف الأول للخلية التالية B3 يدوياً؛ حيث سيعرض إكسيل في الغالب قائمة رمادية شفافة تتنبأ بباقي الحروف لكامل العمود، وحينها يكفي الضغط على مفتاح
Enterلاعتماد التعبئة التلقائية فوراً.
- استخدام الاختصار المباشر من لوحة المفاتيح بالضغط المتزامن على مفتاحي
عقب إتمام التعبئة السريعة، يظهر رمز خيارات التعبئة السريعة الصغير بجانب البيانات المستخرجة. ويتعين على الباحث النقر على هذا الرمز والتأكد من تحديد خيار “قبول الاقتراحات”. كما ينبغي إجراء مراجعة بصرية لعينة عشوائية من الصفوف للتأكد من أن الخوارزمية لم تخطئ في قراءة بعض الأنماط غير المتجانسة، وتصحيح أي خلل يدوياً إن وُجد، حيث يتعلم محرك التعبئة فورياً من التعديلات اليدوية اللاحقة ويعيد مواءمة باقي السجلات تِبعاً لذلك.
6.3 مقارنة تقييمية: التعبئة السريعة مقابل الدوال الديناميكية
على الرغم من الانسيابية والسرعة الاستثنائية التي توفرها ميزة Flash Fill للمستخدمين في المهام العاجلة، إلا أن الفحص المنهجي الدقيق يكشف عن فروق جوهرية بينها وبين استخدام الدوال الديناميكية مثل LEFT وMID. ويوضح الجدول التحليلي التالي الفروق الهيكلية الفاصلة بين الطريقتين:
| وجه المقارنة | الدوال الديناميكية (LEFT / MID) | التعبئة السريعة (Flash Fill) |
|---|---|---|
| الديناميكية وتحديث البيانات | تلقائية ولحظية؛ أي تغيير في العمود المصدر يتبعه تعديل فوري في المخرجات. | ستاتيكية وثابتة؛ البيانات المستخرجة تصبح قيماً نصية جامدة لا تستجيب لأي تعديل لاحق في المصدر. |
| استهلاك ذاكرة المصنف | تستهلك موارد المعالجة الحسابية (CPU) بصورة مستمرة لإعادة تقييم المعادلات. | صفر استهلاك للمعالجة المستمرة؛ تسجل النصوص كقيم ولا ترهق ذاكرة البرنامج في الملفات العملاقة. |
| الموثوقية وقابلية التدقيق | عالية ومطلقة؛ البنية الرياضية محددة بوضوح في شريط الصيغة ويمكن فحصها ومراجعتها أكاديمياً. | عرضة للخطأ التنبؤي؛ الخوارزمية تخمن النمط وقد تخطئ في تفسير الاستثناءات دون تنبيه الباحث. |
| المتطلبات المسبقة | معرفة بصيغ التركيب النحوي للمعادلات وإتقان التعامل مع الدوال التداخلية. | لا تتطلب أي معرفة مسبقة بالمعادلات؛ تعتمد كلياً على تقديم نماذج بصرية للمدخلات. |
تأسيساً على ما سبق، يوصى في الأبحاث العلمية ذات الطابع التكراري، أو قواعد البيانات التي تتلقى مدخلات يومية جديدة، بالاعتماد الكلي على الدوال الديناميكية للحفاظ على الاتساق البرمجي للبيانات. في المقابل، يقتصر استخدام Flash Fill كخيار منهجي سليم على قواعد البيانات الساكنة المكتملة لمرة واحدة، أو عندما يكون الهدف هو التخلص المتعمد من أعباء المعادلات قبل تصدير البيانات إلى حزم البرمجيات الإحصائية المتخصصة.
7. التعامل مع الحالات المعقدة: النصوص متعددة اللغات والأرقام والرموز
7.1 خصوصية النصوص ثنائية الاتجاه واستخراج الحرف الأول العربي
تطرح معالجة اللغات التي تُكتب من اليمين إلى اليسار (Right-to-Left: RTL) مثل اللغة العربية تحديات مفاهيمية وتقنية فريدة داخل بيئة إكسيل. وتتمثل أبرز الإشكاليات في الخلط الشائع بين مفهوم “البداية المنطقية” (Logical Start) للنص ومفهوم “البداية المرئية” (Visual Start) المعروضة على واجهة الاستخدام. تعتمد دالة LEFT في تصميمها النواتي على قراءة السلسلة النصية وفق بدايتها اللغوية المنطقية الصرفة بصرف النظر عن اتجاه ورقة العمل أو محاذاة النص داخل الخلية.
بناءً على ذلك، عند تطبيق دالة =LEFT(A2, 1) على كلمة عربية مثل “جامعة”، فإن الدالة تستخرج الحرف “ج” بصورة صحيحة وطبيعية تماماً؛ لأن الحرف “ج” يمثل الموضع الفهرسي الأول في السلسلة العربية المنطقية. لا تنظر الدالة إلى كون الحرف يظهر في أقصى اليمين بصرياً، بل تتعامل معه كنقطة انطلاق السلسلة. وتتأكد سلامة هذه العملية بصرف النظر عما إذا كانت واجهة ورقة العمل موجهة من اليمين لليسار أو من اليسار لليمين.
تتعقد المشكلة عند التعامل مع النصوص المختلطة (Bi-directional Mixed Text)؛ كأن تبدأ الخلية بمعرف لاتيني يليه نص عربي (مثل “ID_102_طالب”)، أو العكس. في هذه البيئة المركبة، قد يتشوه الترتيب البصري الظاهر على الشاشة بسبب خوارزمية يونيكود ثنائية الاتجاه (Unicode Bidi Algorithm). ولتفادي استخراج محارف غير مقصودة، يجب على الباحث فحص الكود الحقيقي للمحرف الأول منطقياً باستخدام دالة UNICODE أو CODE؛ للتأكد من أن الاقتطاع يصيب المحرف المستهدف وفق الترتيب الإنشائي للنص، وليس وفق الانعكاس الرسومي المؤقت على الشاشة.
7.2 استخراج المحرف الأول من الأرقام والرموز الرياضية المعقدة
في العديد من الدراسات المسحية والتقارير المالية، تتضمن مصفوفات البيانات حقولاً رقمية صرفة كالأرقام الوطنية، وأكواد المتغيرات المسلسلة، أو المؤشرات الحسابية، ويكون الهدف هو استخراج الرقم الأول لتحديد المنطقة الجغرافية أو نوع الحساب. وعند تطبيق دالة LEFT مباشرة على حقل رقمي خالص في الخلية A2 تحوي الرقم 98765، فإن الصيغة =LEFT(A2, 1) تنجح في إرجاع الرمز "9"، ولكن يجب الانتباه الشديد إلى أن المخرج هنا هو “محرف نصي” وليس “قيمة رقمية”.
إذا حاول الباحث استخدام هذا الحرف المستخرج في عمليات رياضية لاحقة أو في مقارنات حسابية صريحة (مثل اختبار ما إذا كان الناتج أكبر من الرقم 5)، فإن النتائج ستكون مشوهة أو خاطئة، لأن إكسيل يقيم النصوص دائماً بأنها أكبر قيمة من أي رقم مجرد في المقارنات المنطقية. ولإعادة تحويل المخرج النصي إلى قيمة رقمية صالحة للتحليل، يجب تطبيق المعامل الأحادي المزدوج (Double Unary --) أو دالة VALUE كما يلي:
=--LEFT(A2, 1) أو =VALUE(LEFT(A2, 1))
أما في الحالات التي تحتوي فيها الأرقام على أصفار بادئة (Leading Zeros) كالمعرفات المقننة (مثل “00432”) والتي تم تنسيقها مسبقاً عبر تنسيقات العرض المخصصة دون تحويلها الفعلي لنص، فإن تطبيق دالة LEFT سيتجاهل الصفر الظاهري ويستخرج الرقم الفعلي المخزن داخلياً في الخلية. ولمعالجة هذه المعضلة وضمان التقاط الصفر البادئ، يجب دمج دالة التحويل النصي المنسق TEXT لتوحيد التمثيل الرقمي قبل الاقتطاع:
=LEFT(TEXT(A2, "00000"), 1)
تضمن هذه الصيغة إجبار إكسيل على تحويل الرقم إلى متتالية نصية تشتمل على الأصفار التنسيقية بدقة، مما يتيح استخراج الصفر الأول كحرف حقيقي دون أي فقد للبيانات.
7.3 التعامل مع الرموز التعبيرية والرموز الرسومية الخاصة (Unicode)
مع تنامي الدراسات السلوكية المعتمدة على استطلاعات الرأي عبر شبكات التواصل الاجتماعي، باتت مجموعات البيانات تحتوي بكثافة على الرموز التعبيرية (Emojis) والرموز الرسومية التعبيرية الخاصة. وتخضع هذه الرموز لتكويد دقيق ضمن معيار اليونيكود في مستويات التشفير التكميلية (Supplementary Planes). وتتميز هذه المحارف بكونها تتطلب أربعة بايتات لتمثيلها، مما يعني أنها تُخزن في نظام UTF-16 المعتمد في إكسيل في صورة “أزواج بديلة” (Surrogate Pairs)، أي أنها تحتل مساحة رمزين برمجيين متتاليين (High Surrogate and Low Surrogate).
إذا كانت الخلية تبدأ برمز تعبيري (مثل وجه مبتسم) متبوع بنص، فإن تطبيق الدالة القياسية =LEFT(A2, 1) لن يستخرج الرمز التعبير كاملاً؛ بل سيقوم باقتطاع النصف الأول فقط من الزوج البديل المشفر. يترتب على هذا الخلل التقني ظهور محرف تالف يتبدى في هيئة علامة استفهام غير مفهومة أو مربع أسود مشوه (Mojibake)، مما يشير إلى انكسار التكويد وتلف القيمة المستخرجة.
ولمعالجة هذه الإشكالية في الإصدارات الحديثة، يجب على الباحث استخدام دوال متقدمة تدرك الفروق بين البايتات والمحارف الصريحة، أو اللجوء إلى معادلات شرطية تفحص المدى الرقمي ليونيكود الحرف البادئ عبر دالة UNICODE. فإذا وقع الكود ضمن نطاق الأزواج البديلة (بين القيمة 55296 و 57343)، يوجه الأمر للدالة باقتطاع محرفين اثنين معاً بدلاً من محرف واحد لعزل الرمز التعبيري بسلامة تامة:
=IF(AND(UNICODE(LEFT(A2, 1))>=55296, UNICODE(LEFT(A2, 1))<=57343), LEFT(A2, 2), LEFT(A2, 1))
إن إدراك هذه الفروق الدقيقة في بنية المحارف الحديثة يمثل خط الدفاع الأول للباحث في العصر الرقمي لمنع تسرب البيانات الفاسدة إلى مصفوفات التحليل النهائي.
8. الأتمتة المتقدمة وتنقية البيانات عبر بيئة Power Query
8.1 استيراد البيانات وفتح محرر Power Query
يمثل محرك Power Query (المعروف بمحرر الاستعلامات المتقدم في إكسيل) بيئة العمل المعيارية الموجهة لهندسة واستخراج وتحويل وتحميل البيانات (ETL: Extract, Transform, Load). وتتجلى القوة المنهجية لاستخدام هذه الأداة في قدرتها على عزل عمليات المعالجة تماماً عن البيانات المصدر، وتسجيل كافة خطوات التنظيف في صورة تدفق عمل مؤتمت وقابل لإعادة التشغيل بضغطة زر واحدة كلما تم تحديث ملف البيانات الأصلي.
للبدء في هذا المسار الأكاديمي المتقدم، يفضل أولاً تحويل النطاق النصي داخل ورقة العمل إلى “جدول إكسيل مهيكل” (Excel Table) عبر تظليل البيانات والضغط على الاختصار Ctrl + T. يمنح هذا الإجراء النطاق اسماً معرفاً ديناميكياً يسهل استدعاءه تلقائياً. بعد ذلك، يتوجه الباحث إلى شريط الأدوات الرئيسي، ويختار تبويب بيانات (Data)، ثم ينقر على أداة من ورقة/جدول (From Sheet / From Table/Range) ضمن مجموعة أدوات “إحضار البيانات وتحويلها” (Get & Transform Data).
عند النقر على هذا الخيار، تنبثق نافذة محرر Power Query المستقلة، حاملة معها نسخة استعراضية حية من البيانات. يتميز هذا المحرر بذاكرة معالجة متقدمة تقرأ عينات السجلات دون تحميل المصنف عبء العمليات الحسابية المتكررة، مما يجعله الحل الأمثل للتعامل مع قواعد البيانات الضخمة التي قد تؤدي صيغ الجداول التقليدية فيها إلى تجميد البرنامج أو بطء استجابته.
8.2 استخراج المحرف الأول باستخدام أدوات واجهة المستخدم الرسومية
يوفر محرر Power Query واجهة مستخدم رسومية تفاعلية تمكن الباحث من إجراء عمليات الاقتطاع النصي المتقدمة دون الحاجة لكتابة أي كود برمجي يدوي. وبعد فتح المحرر واستعراض الجدول، يتم تحديد العمود النصي المستهدف بالنقر على ترويسة العمود. وهنا يتوفر أمام الباحث مساران إجرائيان يعتمد اختيارهما على الغاية البحثية:
- مسار التحويل المباشر (Transform): يُستخدم إذا كانت الرغبة قائمة في استبدال النصوص الأصلية في نفس العمود بالحرف المستخرج والتخلص من السلسلة الكاملة. ويتم ذلك بالانتقال إلى تبويب تحويل (Transform) في الشريط العلوي للمحرر.
- مسار إضافة عمود جديد (Add Column): وهو المسار المفضل أكاديمياً للحفاظ على سلامة المتغير الأصلي إلى جانب الحرف المستخرج. ويتم ذلك بالتوجه إلى تبويب إضافة عمود (Add Column).
في كلا المسارين، يبحث المستخدم عن مجموعة أدوات “العمود النصي” (Text Column)، وينقر على القائمة المنسدلة لأداة استخراج (Extract). ومن بين الخيارات المتاحة، يتم النقر على خيار الأحرف الأولى (First Characters). تنبثق على إثر ذلك نافذة حوارية صغيرة تطلب تحديد عدد المحارف المطلوب استخراجها من بداية السلسلة؛ فيتم إدخال الرقم 1 في الحقل المخصص والضغط على زر الموافقة (OK).
في جزء من الثانية، يقوم المحرك بتطبيق العملية على كامل السجلات، وتظهر النتائج المستخرجة متضمنة الحرف الأول فقط لكل صف. وتسجل هذه العملية فورياً في اللوحة الجانبية اليمنى تحت مسمى الخطوات المطبقة (Applied Steps) تحت عنوان يوضح نوع الإجراء (مثل “Extracted First Characters”). هذا التوثيق التلقائي يضمن الشفافية المنهجية الكاملة لسير معالجة البيانات.
8.3 الصياغة المباشرة للوظيفة باستخدام لغة البرمجة M Code
للمحترفين وعلماء البيانات الذين يفضلون التحكم البرمجي الدقيق، يوفر محرك Power Query لغة برمجة نصية وظيفية متقدمة تُعرف بلغة “M” (Data Mashup Language). وتتميز هذه اللغة بصرامتها الرياضية وحساسيتها لحالة الأحرف (Case-sensitive)، فضلاً عن قدرتها الفائقة على التعامل مع الاستثناءات والقيم الفارغة (Null Handling) التي قد تسبب انهيار المعادلات التقليدية.
الدالة المكافئة لاستخراج الحرف البادئ في لغة M هي الدالة الوظيفية Text.Start. ويمكن للباحث كتابة هذه الصيغة يدوياً من خلال النقر على أداة عمود مخصص (Custom Column) من تبويب إضافة عمود، ثم كتابة الصيغة البرمجية داخل نافذة التحرير كما يلي:
= Text.Start([ColumnName], 1)
حيث يمثل [ColumnName] اسم العمود المصدر في الجدول. ولضمان تحصين الكود ضد الأخطاء الناتجة عن مصادفة خلايا فارغة تحوي القيمة null، يمكن كتابة صياغة متقدمة تجمع بين التحقق المنطقي والتنظيف الاستباقي للبيانات قبل الاقتطاع:
= if [ColumnName] null then Text.Start(Text.Trim([ColumnName]), 1) else null
تقوم هذه العبارة المنطقية بفحص الخلية أولاً؛ فإن احتوت على نص، تم استدعاء دالة Text.Trim لتنظيف المسافات ثم اقتطاع الحرف الأول عبر Text.Start، وإن كانت الخلية فارغة يتم تمرير القيمة null بأمان دون توقف الاستعلام. وبمجرد اعتماد الكود، يتوجه الباحث إلى تبويب الصفحة الرئيسية (Home) وينقر على زر إغلاق وتحميل (Close & Load)، ليعود الجدول المطهر حديثاً إلى ورقة عمل إكسيل نظيفاً وموثقاً بصورة احترافية كاملة.
9. الحلول البرمجية المطورة: استخراج الحرف الأول عبر ماكرو VBA ودوال UDF
9.1 برمجة دالة مخصصة (User-Defined Function) لاستخراج الحرف الأول
عندما تزداد متطلبات التحليل وتتكرر الحاجة لتطبيق خوارزميات اقتطاع مخصصة عبر مصنفات عمل متعددة، تبرز بيئة البرمجة النصية فيجوال بيسك للتطبيقات (VBA) بوصفها الحل الأمثل لأتمتة هذه المهام وبناء أدوات برمجية تحاكي الدوال القياسية. تتيح هذه البيئة إنشاء ما يُعرف بـ “الدوال المعرفة من قِبل المستخدم” (User-Defined Functions: UDFs)، وهي دوال برمجية يبتكرها الباحث لتؤدي وظيفة محددة تحت اسم خاص يسهل استدعاؤه في ورقة العمل.
لتطوير دالة مخصصة لاستخراج الحرف الأول، يقوم الباحث بالضغط على مفتاحي Alt + F11 من لوحة المفاتيح لفتح نافذة محرر الأكواد (VBA Editor). من القائمة العلوية للمحرر، يتم النقر على Insert ثم اختيار Module لإدراج وحدة نمطية جديدة لكتابة الكود البرمجي التالي:
Function GetFirstChar(CellRef As Variant) As String
Dim CleanText As String
If IsNull(CellRef) Or IsEmpty(CellRef) Then
GetFirstChar = ""
Exit Function
End If
CleanText = Trim(CStr(CellRef))
If Len(CleanText) > 0 Then
GetFirstChar = Left(CleanText, 1)
Else
GetFirstChar = ""
End If
End Function
عقب إدراج الكود وحفظه، يغلق المحرر ويعود الباحث إلى ورقة العمل العادية. وتصبح الدالة الجديدة GetFirstChar متاحة فوراً للاستخدام تماماً مثل أي دالة قياسية؛ حيث يكتب في الخلية المستهدفة: =GetFirstChar(A2). تتفوق هذه الدالة البرمجية المخصصة في كونها تدمج بداخلها معالجة المسافات وفحص الخلايا الفارغة تلقائياً دون الحاجة لكتابة دوال مركبة طويلة داخل الخلية، مما يقلل من احتمالات الخطأ الإملائي لدى المستخدمين الأقل خبرة.
9.2 تطوير ماكرو شامل لمعالجة وتعديل نطاقات بيانات ضخمة دفعة واحدة
في الحالات التي تتطلب معالجة مصفوفات بحثية عملاقة تحتوي على مئات الآلاف من الصفوف في زمن قياسي، قد تصبح الدوال التكرارية سبباً في إبطاء استجابة الحاسوب نظراً لحاجتها المستمرة لحساب المعادلات. والحل البديل الأكثر كفاءة يتمثل في تطوير إجراء فرعي (Subroutine Macro) يمر على النطاق المحدد، وينفذ الاقتطاع في الذاكرة الحسابية مباشرة، ويودع النتائج الثابتة في الأعمدة المستهدفة دفعة واحدة.
يتم إدراج الكود التالي داخل وحدة برمجية (Standard Module) في محرر الفيجوال بيسك:
Sub ExtractFirstCharacterRange()
Dim SourceRange As Range, TargetCell As Range
Dim CellData As Variant
On Error GoTo ErrorHandler
Application.ScreenUpdating = False
Application.Calculation = xlCalculationManual
Set SourceRange = Selection
For Each TargetCell In SourceRange
CellData = Trim(TargetCell.Value)
If VarType(CellData) = vbString And Len(CellData) > 0 Then
TargetCell.Offset(0, 1).Value = Left(CellData, 1)
ElseIf IsNumeric(CellData) And Len(CStr(CellData)) > 0 Then
TargetCell.Offset(0, 1).Value = Left(CStr(CellData), 1)
Else
TargetCell.Offset(0, 1).Value = ""
End If
Next TargetCell
Application.ScreenUpdating = True
Application.Calculation = xlCalculationAutomatic
MsgBox "تمت معالجة النطاق واستخراج المحارف الأولى بنجاح.", vbInformation, "توثيق الإجراء"
Exit Sub
ErrorHandler:
Application.ScreenUpdating = True
Application.Calculation = xlCalculationAutomatic
MsgBox "حدث خطأ غير متوقع أثناء المعالجة: " & Err.Description, vbCritical, "خطأ تنفيذي"
End Sub
يمتاز هذا الإجراء بتعطيل تحديث الشاشة المؤقت (ScreenUpdating = False) وإيقاف الحساب التلقائي، وهي تقنية برمجية معيارية تمنع وميض الشاشة وتختصر زمن المعالجة من دقائق إلى أجزاء من الثانية. ويقوم الماكرو بقراءة النطاق المحدد بالفأرة بواسطة الباحث، وتصدير الحرف الأول إلى الخلية المجاورة فورياً، مما يوفر أداة أتمتة فائقة القوة للتعامل مع البيانات المعقدة.
9.3 إدارة الأخطاء والاستثناءات البرمجية داخل الكود
لا يكتمل البناء البرمجي الرصين في بيئة VBA دون إرساء بروتوكول محكم لإدارة الأخطاء وتتبع الاستثناءات (Error Handling). فالجداول الواقعية تحتوي غالباً على قيم أخطاء متوارثة (مثل #DIV/0! أو #N/A) ناتجة عن حسابات سابقة. وإذا اصطدم كود برمجي غير محمي بخلية تحوي خطأ صريحاً، فإن الكود سيتوقف فجأة ويصدر رسالة تعطل النظام (Type Mismatch Error – Error 13)، مما يفسد تجربة المعالجة وربما يؤدي إلى تجميد الملف دون حفظ.
لتجنب هذا الانهيار، يجب تضمين شروط التحقق من الأخطاء في مقدمة الدورة التكرارية باستخدام دالة IsError البرمجية؛ فإذا ثبت أن الخلية تحتوي على كود خطأ، يتجاوزها البرنامج بأمان أو يطبع مكافئا نصيا توثيقيا (مثل “Error_Source”). كما يتضمن البروتوكول استعادة الإعدادات الأصلية للبرنامج (مثل إعادة تفعيل تحديث الشاشة والحساب التلقائي) حتى في حال وقوع استثناءات حرجة، عبر توجيه مسار التنفيذ إلى كتلة معالجة الأخطاء ErrorHandler.
علاوة على ذلك، يقتضي التوثيق العلمي الرصين تذييل الأكواد البرمجية بتعليقات توضيحية شاملة (Comments) تشرح الغرض الإجرائي لكل متغير ودالة. هذا النهج يضمن استدامة البحث العلمي ويسمح للباحثين الآخرين بمراجعة الكود، والتحقق من سلامة العمليات التحويلية المطبقة على البيانات الأصلية، وتكرار التجربة بذات الشروط العلمية (Reproducibility).
10. المعايير المنهجية، استكشاف الأخطاء وإصلاحها، وأفضل الممارسات الأكاديمية
10.1 تشخيص الأخطاء الشائعة وحلولها العملية
يتعرض المحللون أثناء التعامل مع دوال الاقتطاع النصي لمجموعة من رسائل الخطأ الحسابية والمنطقية. ويعد التشخيص المنهجي السليم لهذه المشكلات مفتاح الوصول إلى نتائج موثوقة. ويستعرض هذا القسم أبرز الأخطاء الشائعة ومسبباتها وآليات حلها الميدانية:
- خطأ القيمة
#VALUE!: يظهر هذا الخطأ عادة عند استخدام دالةLEFTأوMIDمع تمرير قيمة عددية غير صالحة للوسيطات الرياضية؛ كأن تكون قيمةnum_charsسالبة (مثل=LEFT(A2, -1))، أو أن تكون قيمةstart_numفي دالةMIDمساوية للصفر. ويكمن الحل في التدقيق الصارم لمعاملات الدوال وضمان كونها أعداداً صحيحة موجبة تبدأ من 1 فما فوق. - خطأ الاسم
#NAME?: ينشأ هذا الخطأ بصورة شبه حتمية عن خطأ إملائي في كتابة اسم الدالة في شريط الصيغة (مثل كتابة=LEET(A2)بدلاً من=LEFT(A2))، أو بسبب استخدام اسم دالة إنجليزية في إصدار إكسيل ذي واجهة عربية تتطلب تسميات الدوال المعربة في حال عدم تفعيل التوافق التلقائي. ويتطلب الحل تصحيح الهجاء والاعتماد على قائمة الإكمال التلقائي للدوال. - خطأ المرجع
#REF!: يتبدى هذا الخطأ الحرج عندما يتم حذف العمود أو الصف الذي يحتوي على الخلية المرجعية المصدر (A2) بعد كتابة المعادلة. ولتجنب هذا الخلل، يجب الاعتماد على خاصية نقل البيانات وتجنب حذف الأعمدة المصدر قبل تحويل نتائج الاستخراج إلى قيم نصية ثابتة عبر خاصية “لصق كقيم”. - المخرجات الفراغية الخادعة: وتتمثل في ظهور الخلية فارغة تماماً رغم عدم وجود أخطاء في الصيغة؛ وتعود أسبابها كما فُصل سابقاً إلى وجود مسافة فارغة بادئة في النص الأصلي. ويكون علاجها الفوري إقحام دالة
TRIMضمن التركيب الرياضي.
لضمان استقرار التقارير النهائية وحمايتها من التشوهات البصرية الناتجة عن الأخطاء الطارئة، يُنصح بإحاطة الصيغ بدالة الحماية المنطقية IFERROR، والتي تتيح للمحلل تحديد مخرج بديل منضبط في حال وقوع أي خطأ غير متوقع:
=IFERROR(LEFT(TRIM(A2), 1), "N/A")
10.2 الحفاظ على ديناميكية ومرونة البيانات عند التحديث
تتطلب الإدارة الاحترافية لقواعد البيانات الأكاديمية الحفاظ على التوازن الدقيق بين ديناميكية التحديث وتماسك الأداء الحاسوبي. إن إحدى أفضل الممارسات المنهجية المعاصرة تتمثل في الابتعاد عن استخدام النطاقات التقليدية الثابتة (مثل A2:A1000) والاعتماد بدلاً من ذلك على “جداول إكسيل الرسمية” (Excel Structured Tables). فعند تحويل نطاق البيانات إلى جدول رسمي، تتحول مراجع الخلايا تلقائياً إلى “المراجع المهيكلة” (Structured References)، وتصبح صيغة استخراج الحرف الأول بالشكل التالي:
=LEFT(TRIM([@ParticipantName]), 1)
يمتاز هذا التركيب بميزة التمدد التلقائي للصيغ الحسابية (Calculated Columns)؛ فعند قيام الباحث بإدخال استجابات جديدة أو استيراد دفعة إضافية من السجلات أسفل الجدول، يقوم إكسيل بمد الصيغة تلقائياً إلى الصفوف الجديدة دون أدنى تدخل يدوي، مما يقضي على احتمالات نسيان تطبيق المعادلة على البيانات المضافة حديثاً.
ومع ذلك، ينبغي ممارسة الحذر المنهجي عند تقرير متى يجب “تجميد” الصيغ وتحويلها لقيم ثابتة. إن أفضل النماذج المعمارية لمصنفات العمل الإحصائي تقضي بالفصل التام بين ثلاث طبقات للبيانات: طبقة البيانات الخام (Raw Data Layer) وتُحفظ دون أي تعديل أو كتابة صيغ لحمايتها كمرجع تاريخي، وطبقة المعالجة والتحويل (Staging/Processing Layer) وتوضع فيها الدوال الرياضية ودوال الاستخراج، وطبقة المخرجات والتحليل (Reporting Layer) وتُنقل إليها القيم المصفاة كقيم نصية نهائية جاهزة للتصدير المباشر نحو حزم التحليل مثل SPSS، مما يحول دون تداخل الصيغ أو فقدان البيانات الأصلية.
10.3 أفضل الممارسات لتوثيق معالجة البيانات في البحوث والتقارير
تمثل النزاهة الأكاديمية وقابلية التكرار (Reproducibility) المبدأ الحاكم في أي نشاط علمي يعتمد على استخراج وتنظيف البيانات. لا يكفي في الأبحاث المحكمة أن يُذكر أن “المتغير تم ترميزه بالحرف الأول”، بل يجب إعداد “كتيب ترميز” مفصل (Codebook) يوثق كافة القواعد والخطوات التقنية التي تم اتباعها لتحويل المتغيرات النصية الأصلية إلى حروف تصنيفية.
يجب أن يوضح هذا التوثيق بدقة الغرض الإجرائي من عملية الاقتطاع؛ كأن يُذكر: “تم تطبيق الدالة =LEFT(TRIM(A2), 1) لعزل الرمز التعريفي للمجموعة التجريبية مع استبعاد أثر المسافات البيضاء الناتجة عن أجهزة الإدخال”. كما ينبغي تضمين بيان تفصيلي بالاستثناءات التي تمت مواجهتها وكيفية معالجتها؛ كحالات السجلات التي بدأت بأرقام أو رموز خاصة، والقرارات المنهجية التي اتُخذت بشأنها سواء بالتصحيح أو الاستبعاد المبرر.
إن الالتزام بهذه الضوابط التوثيقية يعزز من شفافية البحث العلمي، ويبرهن للجان التحكيم والأقران على أن التحويلات الرقمية للبيانات قد تمت وفق معايير برمجية وإحصائية صارمة، بعيداً عن العشوائية أو التحيزات غير الموثقة، مما يرفع من جودة النتائج العلمية ويعطيها موثوقية عالية في الأوساط الأكاديمية.
خاتمة شاملة
استعرض هذا الدليل المتعمق الأبعاد المنهجية والتقنية لعملية استخراج الحرف الأول من السلسلة النصية في بيئة مايكروسوفت إكسيل، مبيناً أن هذه العملية، رغم مظهرها الإجرائي البسيط، تمثل ركيزة جوهرية في مراحل تنظيف البيانات وتصنيف المتغيرات للتحليل العلمي والإداري. ولقد تبين بوضوح أن اختيار الأداة المناسبة يظل محكوماً بطبيعة البيانات، وحجم السجلات، ومتطلبات التحديث الدوري للمشروع.
تمثل دالة LEFT، وتحديداً بصيغتها المدمجة مع أدوات التطهير TRIM وCLEAN، المعيار الرياضي الأصيل والأكثر اتساقاً للمعالجات اللحظية داخل أوراق العمل، في حين تمنح دالة MID مرونة استثنائية عند الحاجة لبناء أنماط اقتطاع متعددة وديناميكية. ومن جهة أخرى، توفر تقنية التعبئة السريعة Flash Fill حلاً ذكياً للمهام السريعة لمرة واحدة، بينما تفرض بيئة Power Query وبرمجيات VBA نفسها كأدوات معيارية لا غنى عنها في إدارة التدفقات الضخمة وتطوير الدوال المخصصة المنيعة ضد الأخطاء.
إن إتقان هذه الأدوات والجمع بينها بوعي منهجي رصين يُمكّن الباحثين ومحللي البيانات من الارتقاء بجودة مصفوفاتهم، وتفادي الأخطاء التراكمية في القياس والتصنيف، وضمان انتقال سلس وموثوق للبيانات من مرحلة الجمع الخام إلى مراحل النمذجة والاستدلال الإحصائي المتقدم.
المراجع
Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 bible. John Wiley & Sons.
Frye, C. (2015). Microsoft Excel 2016 step by step. Microsoft Press.
Jelen, B., & Syrstad, T. (2019). VBA and macros: Microsoft Excel 2019 and Office 365. Pearson Education.
Microsoft Corporation. (2024). LEFT, LEFTB functions. Microsoft Support. https://support.microsoft.com/en-us/office/left-leftb-functions-9203d2d2-7960-479b-84c6-1ea52b99640c
Microsoft Corporation. (2024). MID, MIDB functions. Microsoft Support. https://support.microsoft.com/en-us/office/mid-midb-functions-d5f9e25c-d7d6-472e-b568-4ecb12433028
Microsoft Corporation. (2024). Using Flash Fill in Excel. Microsoft Support. https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-4767-94a6-77884d852109
Puls, K., & Escobar, M. (2016). M is for (Data) Monkey: A guide to the M language in Excel Power Query. Holy Macro! Books.
Walkenbach, J. (2015). Excel VBA programming for dummies (4th ed.). John Wiley & Sons.