
تعد مسألة استخراج القيمة الأكثر تكراراً، أو ما يُعرف في علم الإحصاء بالمنوال (Mode)، إحدى الركائز الأساسية في التحليل الاستكشافي للبيانات وتلخيص المؤشرات الوصفية للعينات والمجتمعات الإحصائية. فعلى الرغم من الانتشار الواسع لمقاييس النزعة المركزية الأخرى مثل المتوسط الحسابي والوسيط، يظل المنوال المقياس الرياضي الفريد القادر على تمثيل القيمة النموذجية التي تفرض هيمنتها العددية أو الفئوية على بنية التوزيع، مما يجعله ذا أهمية بالغة في بحوث العلوم السلوكية، والاقتصاد القياسي، وأبحاث السوق، وتحليل البيانات الضخمة عبر بيئات العمل المكتبية.
يمثل برنامج مايكروسوفت إكسل (Microsoft Excel) البيئة التطبيقية الأكثر شيوعاً لمعالجة وتحليل مجموعات البيانات الرقمية والنصية؛ ومع ذلك، يواجه العديد من الباحثين والمحللين تحديات منهجية وتقنية حقيقية عندما يتعلق الأمر بتحديد المنوال بدقة. تتراوح هذه التحديات بين التعامل مع التوزيعات متعددة القمم (Multimodal Distributions)، ومعالجة النصوص والسلاسل المحرفية التي تعجز الدوال التقليدية عن تحليلها مباشرة، والتغلب على أخطاء الذاكرة وحسابات المصفوفات المعقدة في مجموعات البيانات الكبيرة التي تتطلب حلولاً حسابية وخوارزميات متقدمة.
تهدف هذه الدراسة التطبيقية الشاملة إلى تفكيك كافة الجوانب النظرية والحسابية والبرمجية المرتبطة بإيجاد القيمة الأكثر تكراراً في إكسل. سننطلق من الجذور الإبستمولوجية للمنوال وتطوره في تاريخ التحليل الرياضي، وصولاً إلى بناء الصيغ الديناميكية المركبة الأكثر تقدماً للتعامل مع البيانات النصية والعددية، مع التركيز على تشخيص الأخطاء، وتحسين كفاءة المعالجة، والالتزام بالمعايير الأكاديمية الصارمة لعرض وتوثيق النتائج الإحصائية.
1. الأسس النظرية للمنوال الإحصائي وأهميته في برنامج إكسل
### 1.1 مفهوم المنوال ودوره في مقاييس النزعة المركزية
يعرّف المنوال في الإحصاء الرياضي بأنه القيمة أو الفئة أو المشاهدة التي تمتلك أعلى كثافة تكرارية داخل التوزيع الاحتمالي أو مجموعة البيانات المرصودة. وتعود الصياغة المفاهيمية الاصطلاحية للمنوال إلى عالم الإحصاء البريطاني كارل بيرسون (Karl Pearson) في أواخر القرن التاسع عشر، وتحديداً في أطروحته التاريخية حول التباين والانحراف في المواد المتجانسة المنشورة عام 1895، حيث استعار المصطلح من الكلمة الفرنسية (*la mode*) التي تدل على الشيء الدارج أو السائد أو الشائع بين العموم، ليحدد رياضياً الإحداثي السيني المقابل لأعلى نقطة على منحنى التوزيع التكراري. رياضياً، يمكن التعبير عن المنوال كدالة تبحث عن النقطة الحرجة العليا لكثافة التكرار:
$$Mo = arg\max_x f(x)$$
وفي إطار تصنيف مستويات القياس التي صاغها عالم النفس ستانلي سميث ستيفنز (Stanley Smith Stevens) عام 1946، تتجلى الأهمية الفريدة للمنوال مقارنة بالمتوسط الحسابي (Mean) والوسيط (Median). فبينما يعتمد المتوسط على العمليات الحسابية من جمع وقسمة لجميع المشاهدات مما يجعله محصوراً بالبيانات الفترية والنسبية وشديد التأثر بالقيم المتطرفة، ويعتمد الوسيط على علاقات الترتيب التفضيلي الرتبي، يُعد المنوال مقياس النزعة المركزية الوحيد المسموح به رياضياً لتوصيف البيانات الاسمية (Nominal Data) والنوعية غير القابلة للترتيب، مثل أسماء المدن، والأنماط السلوكية، والتصنيفات المهنية.
تزداد أهمية تحديد التكرارات الشائعة في الأبحاث الميدانية؛ فعلى سبيل المثال، يركز تحليل تكرار الاستجابات في دراسات التقييم الذاتي والسلوك الاجتماعي على رصد الأنماط الجمعية الأكثر انتشاراً (Dunning et al., 2004). كما تكشف دراسة التوزيعات التكرارية عن الطبيعة الهيكلية للبيانات؛ فالتوزيعات وحيدة المنوال (Unimodal) تشير إلى تجانس نسبي حول قيمة مركزية واحدة، بينما تكشف التوزيعات ثنائية المنوال (Bimodal) أو متعددة المنوال (Multimodal) عن وجود مجتمعات فرعية كامنة أو آليات إدراكية وتفضيلية متمايزة تعمل بالتوازي، في حين يؤدي التساوي التام لجميع التكرارات إلى حالة انعدام المنوال (Uniform Distribution). وتساعد مقارنة المنوال بالمتوسط والوسيط في رصد اتجاه التواء التوزيع (Skewness)؛ فإذا كان المنوال أقل من الوسيط وأقل من المتوسط دل ذلك على التواء موجب لليمين، بينما يدل العكس على التواء سالب لليسار.
### 1.2 تطور دوال حساب المنوال عبر إصدارات برنامج إكسل
شهد برنامج مايكروسوفت إكسل تحولاً جذرياً في بنيته الحسابية المخصصة للتحليل الإحصائي على مدار العقود الماضية. في الإصدارات المبكرة، كانت الدالة القياسية المتاحة هي دالة `MODE` البسيطة. ومع أن هذه الدالة أدت دوراً كبيراً في التحليلات الأساسية، إلا أنها عانت من قيود تقنية هيكلية حالت دون تلبية المتطلبات الأكاديمية والمهنية الصارمة؛ إذ كانت الدالة مبرمجة لترجع أول قيمة تكرارية تصادفها في مسار الفحص من الأعلى إلى الأسفل عند وجود قيم متعددة متساوية في أعلى تكرار، متجاهلة تماماً وجود مناول أخرى في البيانات، الأمر الذي يؤدي إلى تضليل تحليلي وقصور في التوصيف الإحصائي.
ولمعالجة هذا القصور، قامت شركة مايكروسوفت ابتداءً من إصدار Excel 2010 بإعادة هيكلة شاملة للدوال الإحصائية؛ فتم إدراج الدالة القديمة `MODE` ضمن فئة دوال التوافق القديمة (Compatibility Functions)، واستحدثت دالتان متخصصتان هما: دالة المنوال المفرد `MODE.SNGL`، ودالة المنوال المتعدد `MODE.MULT`. جاء هذا الانقسام البرمجي ليوفر للمحلل قدرة اختيارية واضحة بين الاكتفاء بقيمة واحدة أو استرجاع البنية المتعددة الكاملة للتوزيع التكراري.
ومع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays) في إصدارات Microsoft 365 وExcel 2021، قفزت إمكانيات حساب التكرارات إلى آفاق جديدة تماماً؛ حيث باتت النتائج المتعددة تتدفق تلقائياً عبر الخلايا المحيطة دون الحاجة إلى التنسيق المعقد لمصفوفات الإصدارات السابقة. ومع ذلك، بقيت هناك فجوة برمجية رئيسية في جميع هذه الدوال المدمجة: عجزها التام عن معالجة البيانات غير الرقمية. فعند تمرير سلاسل نصية إلى دوال المنوال المدمجة، تعيد إكسل خطأ القيمة غير المتاحة، مما فرض على الباحثين تطوير تركيبات رياضية مبتكرة لدمج دوال الفهرسة والبحث لحساب المنوال النصي.
## 2. المقارنة التحليلية بين دوال المنوال المدمجة في إكسل
### 2.1 الخصائص التقنية لدالة MODE.SNGL وسياقات استخدامها
تمثل دالة `MODE.SNGL` التحديث المباشر والمعياري لدالة المنوال الكلاسيكية، وتعتمد في بنيتها التركيبية على الصيغة التالية:
`=MODE.SNGL(number1, [number2], …)`
حيث تستقبل الدالة ما بين مدخل رقمي إلزامي واحد وحتى 255 وسيطة اختيارية، أو ما يعادلها من النطاقات المرجعية والمصفوفات الرياضية المستمرة مثل `(A2:A100)`. من الناحية الحسابية، تفحص الدالة كافة الأرقام المدخلة، وتتجاهل تلقائياً الخلايا الفارغة والقيم المنطقية (TRUE و FALSE) والنصوص الواردة ضمن النطاقات المرجعية، إلا إذا تم إدخال القيم المنطقية كنصوص مدخلة مباشرة داخل وسائط الدالة.
تكمن حدود دقة الدالة في سلوكها عند مواجهة التوزيعات متعددة المنوال؛ فإذا تساوت قيمتان أو أكثر في الحصول على أعلى تردد تكراري، فإن `MODE.SNGL` تتوقف فوراً عند رصد أول قيمة تظهر في ترتيب البيانات الأصلي داخل النطاق، ملقية بظلال من عدم اليقين حول الشمول الإحصائي للتحليل. وعلى الرغم من هذا القيد، تظل الدالة كافية ومناسبة تماماً في السياقات التحليلية التي يُعرف فيها مسبقاً أن التوزيع أحادي المنوال (Unimodal)، أو في الحالات التي لا يتطلب فيها القرار الإداري أو الاستكشافي سوى عينة نموذجية من التكرارات القصوى دون الحاجة لرسم خريطة التكرار التفصيلية.
### 2.2 الميزات المتقدمة لدالة MODE.MULT وكيفية التعامل مع المصفوفات
تمثل دالة `MODE.MULT` الأداة الأكثر رصانة من الوجهة الإحصائية المتقدمة، حيث تتميز بقدرتها الرياضية على إرجاع كافة القيم التي تتشارك في تحقيق أعلى تكرار إحصائي داخل النطاق المستهدف، وتتخذ الصيغة التكوينية نفسها:
`=MODE.MULT(number1, [number2], …)`
ومع ذلك، يختلف المخرج الحسابي لدالة `MODE.MULT` جذرياً؛ إذ تُرجع الدالة مصفوفة عمودية (Vertical Array) تحتوي على قائمة كاملة بجميع المناول دون إغفال أي قيمة، مما يمنع التحيز الناجم عن اختيار قيمة وحيدة اعتباطياً في التوزيعات الثنائية والمتعددة.
في بيئات العمل الحديثة التي تدعم ميزات المصفوفات الديناميكية، يظهر سلوك الدالة من خلال آلية “الانسكاب التلقائي” (Dynamic Spill)؛ حيث يكتفي المحلل بكتابة الصيغة في خلية مفردة لتتولى إكسل تلقائياً حجز الخلايا العمودية الواقعة تحتها ونشر كافة القيم الناتجة فيها محاطة بحدود زرقاء تفاعلية تدل على مصفوفة الانسكاب. أما في إصدارات إكسل التقليدية (Excel 2019 وما قبله)، تتطلب الدالة نهجاً يدوياً صارماً: يجب على المستخدم تحديد نطاق عمودي من عدة خلايا مسبقاً، وكتابة الصيغة، ثم تثبيتها بالضغط على مفاتيح الاختصار `Ctrl + Shift + Enter` لإنشاء صيغة مصفوفية كلاسيكية محاطة بأقواس معقوفة `{}`. إن هذه الخصائص تجعل من `MODE.MULT` المعيار الأكاديمي المفضل للباحثين لضمان الشفافية الإحصائية الكاملة.
## 3. الطريقة الأولى: استخراج القيمة العددية الأكثر تكراراً عملياً
### 3.1 خطوات تطبيق صيغة MODE.MULT على البيانات الرقمية
يتطلب التطبيق العملي السليم لصيغة `MODE.MULT` على مجموعات البيانات الرقمية إعداداً منهجياً لضمان سلامة المخرجات وصحتها الإحصائية. تبدأ المرحلة الأولى بمراجعة جودة البيانات وتنظيفها من القيم المتطرفة الشاذة التي قد تنجم عن أخطاء الإدخال الميداني، بالإضافة إلى استبعاد أو توحيد الخلايا الصفرية إذا كانت تعبر عن غياب البيانات بدلاً من قيم حقيقية. بعد فحص البيانات والتأكد من استقرار النطاق الرقمي، يتم إدخال الصيغة الحسابية باختيار خلية خالية تتوافر أسفلها مساحة كافية لاستيعاب النتائج دون عوائق:
`=MODE.MULT(A2:A11)`
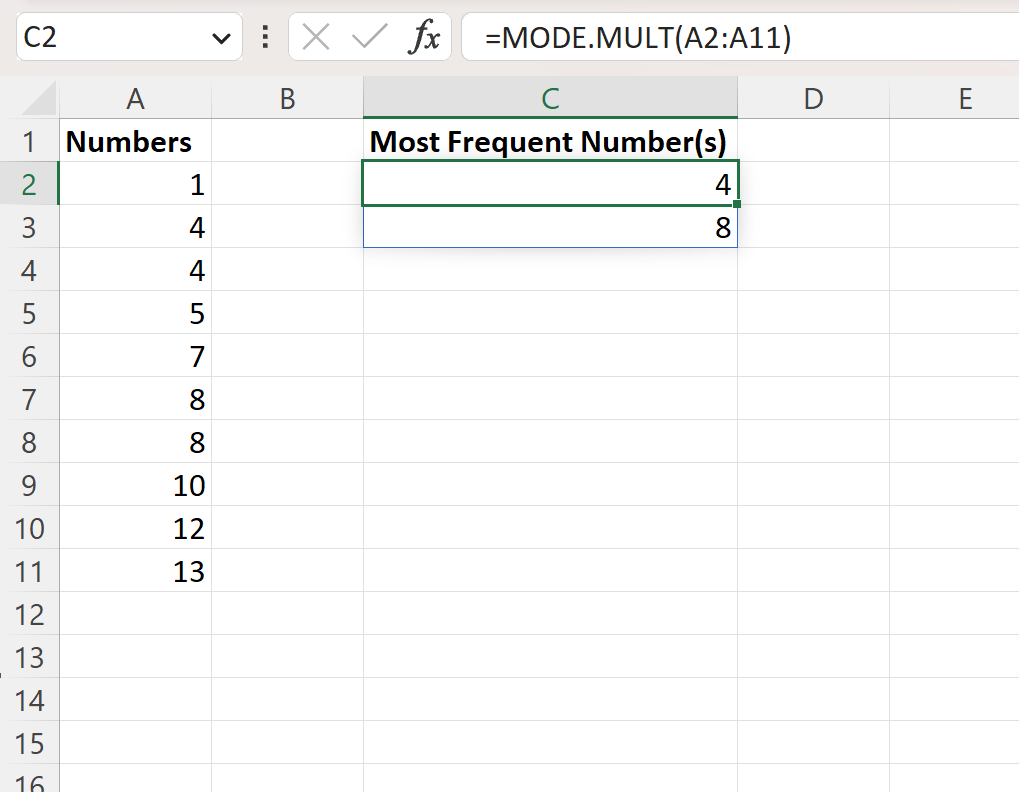
بمجرد الضغط على مفتاح الإدخال، تنشط خوارزمية إكسل لفحص التكرارات ومقارنة أوزان المشاهدات. إذا كان التوزيع أحادي المنوال، تظهر قيمة واحدة في الخلية المحددة؛ أما إذا رصدت الخوارزمية تعدداً في المناول، تنسكب القيم فوراً في الخلايا المجاورة رأسياً. وللتحقق من صحة النتائج المستخرجة، ينبغي للمحلل إجراء مطابقة تقاطعية سريعة باستخدام جدول التوزيع التكراري البسيط أو فحص تكرارات القيم المرجعة للتأكد من أنها متساوية تماماً وتتجاوز ترددات كافة الأرقام الأخرى في العينة المدروسة.
### 3.2 تحليل نموذج عملي رقمي: حالة البيانات متعددة المنوال
لتوضيح الآلية التشغيلية بصورة تطبيقية لا تحتمل اللبس، نفترض وجود مصفوفة بيانات رقمية تمثل درجات تقييم الأداء لعينة من عشرة موظفين في أحد أقسام الأبحاث، موزعة في النطاق من `A2` إلى `A11` وفق القيم الآتية:
- الخلية A2: 85
- الخلية A3: 90
- الخلية A4: 75
- الخلية A5: 85
- الخلية A6: 92
- الخلية A7: 90
- الخلية A8: 88
- الخلية A9: 75
- الخلية A10: 85
- الخلية A11: 90
عند استعراض الترددات نجد أن الدرجة 85 تكررت ثلاث مرات (في الخلايا A2، A5، A10)، وكذلك الدرجة 90 تكررت ثلاث مرات (في الخلايا A3، A7، A11)، بينما ظهرت بقية القيم بترددات أقل. عند تطبيق الدالة الكلاسيكية `=MODE(A2:A11)` أو `=MODE.SNGL(A2:A11)`، ستقتصر النتيجة على إرجاع الرقم 85 فقط، لكونه ظهر أولاً في مسار البحث الرأسي. أما عند كتابة الصيغة المعيارية:
`=MODE.MULT(A2:A11)`
يُنشئ محرك إكسل مصفوفة ثنائية القيمة، حيث تظهر القيمة الأولى (85) في الخلية التي كُتبت بها المعادلة، بينما تنسكب القيمة الثانية (90) تلقائياً في الخلية التي تليها مباشرة. يمثل هذا التوليد المتسلسل برهاناً حسابياً على أن التوزيع ثنائي المنوال، مما يوجه التفسير الإحصائي نحو دراسة خصائص هاتين الفئتين بدلاً من حصر التقييم في قمة وهمية أحادية.
## 4. إدارة التوزيعات متعددة المنوال ومعالجة النتائج المعقدة
### 4.1 التعامل مع خطأ الانسكاب (Spill Error) والمساحات المجاورة
على الرغم من القوة الرياضية لميزة الانسكاب الديناميكي في إصدارات إكسل الحديثة، إلا أنها قد تواجه معوقات لوجستية داخل ورقة العمل تقود إلى ظهور خطأ الانسكاب الشهير `#SPILL!`. يظهر هذا الخطأ الحسابي عندما تعجز دالة `MODE.MULT` عن وضع مصفوفتها المرجعة في الخلايا المستهدفة بسبب وجود بيانات سابقة، أو خلايا مدمجة (Merged Cells)، أو جداول إكسل رسمية (Excel Tables) في المسار الرأسي المطلوب لنشر البيانات.
ولمعالجة هذا الخطأ وضمان انسيابية البيانات، يتوجب على المحلل تفريغ كافة الخلايا الواقعة ضمن نطاق الانسكاب المتوقع؛ حيث يوفر إكسل مؤشراً بصرياً يوضح مساحة النطاق المخصص للانسكاب عند النقر على أيقونة الخطأ. بالإضافة إلى ذلك، قد يفضل المحلل عرض المناول المتعددة في اتجاه أفقي بدلاً من الاتجاه الرأسي لخدمة تصميم التقرير المالي أو الأكاديمي، وهنا يتم تضمين دالة التبديل المصفوفي `TRANSPOSE` لتعديل زاوية التدفق الحسابي:
`=TRANSPOSE(MODE.MULT(A2:A100))`
تضمن هذه المعالجة تحويل المصفوفة المرجعة إلى صف أفقي متناسق، مما يمنع التداخل مع الصفوف السفلية ويحافظ على استقلالية البنى الجدولية المجاورة.
### 4.2 فهرسة وتنسيق مصفوفة النتائج الناتجة عن المنوال المتعدد
عند تحليل مجموعات بيانات ضخمة تسفر عن عدد كبير من القيم ذات التردد المتساوي، تبرز الحاجة إلى ضبط مخرجات المنوال وفهرستها لتقديمها في قوالب إحصائية محكمة وقابلة للقراءة المتخصصة. يمكن تحقيق ذلك بدمج دالة `MODE.MULT` مع دوال الترتيب والتصفية المتقدمة في إكسل. على سبيل المثال، لترتيب القيم الأكثر تكراراً تصاعدياً أو تنازلياً لتحديد الأولويات، يتم إدماج دالة `SORT`:
`=SORT(MODE.MULT(A2:A500), 1, -1)`
ترتب هذه الصيغة المناول الناتجة ترتيباً تنازلياً (-1) بصورة تلقائية فور استخراجها. وعلاوة على ذلك، يقتضي التوثيق الإحصائي الأكاديمي التحقق المتقاطع من قوة المنوال من خلال إظهار التردد الفعلي لكل قيمة متكررة؛ ولتحقيق ذلك، يمكن ربط مصفوفة المنوال المنسكبة مع دالة العد المشروط `COUNTIF` في عمود ملاصق:
`=COUNTIF(A2:A500, C2#)`
حيث يمثل الرمز `#` الملحق بالمرجع `C2#` مشغل نطاق الانسكاب (Spill Range Operator) الذي يوجه دالة العد إلى معالجة كافة القيم المنسكبة من صيغة المنوال تباعاً، مما ينتج جدولاً تحليلياً متكاملاً يوضح القيمة المنوالية وعدد مرات تكرارها الفعلي بدقة متناهية.
## 5. الطريقة الثانية: استخراج النصوص الأكثر تكراراً باستخدام الصيغ المركبة
### 5.1 التحدي الهيكلي لمعالجة البيانات النصية في دوال المنوال
يتمثل أحد أكبر التحديات في بيئة إكسل في العجز البنيوي لجميع دوال فئة `MODE` عن فحص أو استيعاب المتغيرات النوعية غير الرقمية؛ فعند محاولة تطبيق الدالة مباشرة على قائمة تحوي متغيرات اسمية مثل الألوان، أو أسماء المنتجات، أو فئات التشخيص العيادي، تكون النتيجة الفورية هي إرجاع خطأ عدم توفر القيمة `#N/A`. يرجع هذا التقييد البرمجي إلى أن محرك إكسل الداخلي صُمم لإجراء العمليات الحسابية التفاضلية ومقارنات الأوزان الرقمية فقط ضمن هذه الدوال، متجاهلاً مؤشرات الفهارس النصية.
وللتغلب على هذه الفجوة المنهجية، يبتكر خبراء تحليل البيانات حلاً يقوم على فكرة “التحويل التناظري المؤقت” (Analogous Transformation)؛ حيث يتم تحويل كل سلسلة نصية بصورة افتراضية إلى كود رقمي تسلسلي يمثل موضع ظهورها الأول، ثم إخضاع هذه الأرقام البديلة لحسابات المنوال المتقدمة، وأخيراً إعادة تحويل الأرقام الناتجة إلى النصوص المقابلة لها في النطاق الأصلي. يتم هذا المسار المعقد بسلاسة فائقة عبر دمج ثلاث دوال محورية في معادلة مصفوفية واحدة:
`=INDEX(Range, MODE.MULT(MATCH(Range, Range, 0)))`
تمثل هذه الصيغة المركبة إحدى أرقى وأقوى استراتيجيات المعالجة في إكسل، حيث تدمج بين إمكانيات البحث والفهرسة وحساب المنوال الرياضي لإنتاج دالة منوال نصية متكاملة قادرة على استيعاب حتى النصوص المتعددة المتساوية في التكرار.
### 5.2 دراسة حالة تطبيقية: العثور على اسم المدينة الأكثر تكراراً
لتوضيح هذا البناء الحسابي في سياق واقعي، نفترض أن لدينا استبياناً ميدانياً يوثق المدن الأصلية لعينة بحثية، حيث دُوّنت أسماء المدن في النطاق من الخلية `B2` إلى `B11` على النحو التالي:
- B2: الرياض
- B3: دبي
- B4: القاهرة
- B5: الرياض
- B6: بيروت
- B7: دبي
- B8: مسقط
- B9: القاهرة
- B10: الرياض
- B11: دبي
في هذه العينة، تكررت مدينة “الرياض” ثلاث مرات (B2، B5، B10)، وتكررت مدينة “دبي” ثلاث مرات أيضاً (B3، B7، B11)، في حين تكررت “القاهرة” مرتين، وبقية المدن مرة واحدة. لاستخراج المدينة أو المدن الأكثر تكراراً بدقة، نكتب الصيغة المركبة التالية في الخلية `D2`:
`=INDEX(B2:B11, MODE.MULT(MATCH(B2:B11, B2:B11, 0)))`
عند تنفيذ المعادلة، تظهر مدينة “الرياض” في الخلية D2، وتنسكب مدينة “دبي” تلقائياً في الخلية D3. يعكس هذا التدفق كفاءة البناء المصفوفي في التقاط المنوالين النصيين المتكافئين وإرجاع الأسماء الحقيقية المستهدفة بدقة تامة وبلا أي تدخل يدوي، مما يثبت نجاح التحويل التناظري في محاكاة المنوال النصي.
## 6. التشريح الدقيق لمكونات الصيغة المركبة للنصوص
### 6.1 دور دالة MATCH في التحويل التناظري للأرقام
تؤدي دالة `MATCH` الوظيفة الجوهرية الأولى في البناء المصفوفي المركب؛ وتتخذ صيغتها الجزئية الشكل التالي:
`MATCH(B2:B11, B2:B11, 0)`
تعمل الدالة بآلية بحث متجهة نحو النطاق ذاته كمرجع مستهدف؛ فبدلاً من البحث عن قيمة نصية واحدة، يتم تمرير مصفوفة النطاق بالكامل كوسيطة بحث أولى (`lookup_value`) وكسجل مرجعي ثانٍ (`lookup_array`). ويعد المعامل الأخير `0` حاسماً وإلزامياً، إذ يفرض على إكسل البحث عن التطابق التام الدقيق (Exact Match)، مع تجاهل أي محاولة للتقريب.
إن الآلية العبقرية لدالة `MATCH` هنا تكمن في سلوكها الافتراضي عند وجود تكرارات؛ حيث إنها عند مطابقة أي عنصر، تُرجع دائماً رقم الموضع النسبي لأول ظهور له فقط في النطاق المرجعي. وبالتالي، عندما تصادف الدالة كلمة “الرياض” في الخلية B2 تُرجع الرقم 1؛ وعندما تصادف “دبي” في B3 تُرجع الرقم 2؛ وعندما تعود وتصادف “الرياض” مرة أخرى في الخلية B5، فإنها لا تُرجع الرقم 4، بل ترجع الرقم 1 مجدداً، لأن الظهور الأول لهذه الكلمة كان في الموضع الأول. ونتيجة لذلك، تتحول مصفوفة النصوص تلقائياً في ذاكرة إكسل إلى مصفوفة رقمية:
`{1; 2; 3; 1; 5; 2; 7; 3; 1; 2}`
وهكذا ينجز هذا الجزء من المعادلة مهمة استبدال السلاسل النصية بأرقام صحيحة قابلة للتحليل الإحصائي، حيث يتطابق تكرار كل رقم بدقة مع تكرار النص الأصلي الممثل له. وتعتبر هذه الآلية من الآليات المنهجية التي يعتمد عليها اللغويون في معالجة التكرارات المعجمية في المدونات النصية الضخمة (Brysbaert & New, 2009).
### 6.2 وظيفة دالة MODE.MULT في معالجة مصفوفة المواقع
بمجرد قيام دالة `MATCH` بتوليد المصفوفة الرقمية البديلة في ذاكرة التخزين المؤقت، يأتي دور دالة `MODE.MULT` لتستقبل هذه المصفوفة وتجري عليها العمليات الإحصائية البحتة:
`MODE.MULT({1; 2; 3; 1; 5; 2; 7; 3; 1; 2})`
تفحص دالة المنوال هذه الأرقام التسلسلية بالطريقة ذاتها التي تفحص بها أي بيانات كمية. وفي النموذج الموضح أعلاه، ترصد الخوارزمية أن الرقم 1 تكرر ثلاث مرات، وكذلك الرقم 2 تكرر ثلاث مرات، بينما ظهرت الأرقام الأخرى بترددات أقل.
بناءً على ذلك، تلتقط دالة `MODE.MULT` الفهارس المتصدرة وترجع مصفوفة تضم القيمتين الأكثر تكراراً:
`{1; 2}`
تتجاوز هذه المرحلة عقبة عدم قدرة دوال المنوال على التعامل مع الحروف والنصوص؛ فالدالة لم تتعامل مع أسماء المدن إطلاقاً، بل تعاملت مع الأرقام التناظرية الناتجة عن مواقع الظهور الأول، وحافظت في الوقت ذاته على خاصية المصفوفة الديناميكية الجاهزة للانتقال إلى المرحلة الأخيرة من التركيب.
### 6.3 استرجاع النصوص الأصلية عبر دالة INDEX
تتولى دالة الفهرسة `INDEX` إتمام الحلقة التحليلية؛ حيث تستقبل نطاق النصوص الأصلي كمرجع للمصفوفة (`array`)، بينما تستقبل المخرجات الرقمية القادمة من دالة `MODE.MULT` كأرقام للصفوف المستهدفة (`row_num`):
`=INDEX(B2:B11, {1; 2})`
تقرأ دالة `INDEX` الرقم 1، فتتجه إلى الخلية الأولى في النطاق المحدد وتستخرج قيمتها النصية (“الرياض”)، ثم تقرأ الرقم 2، فتتجه إلى الخلية الثانية في النطاق وتستخرج قيمتها النصية (“دبي”). وبما أن النتيجة عبارة عن مصفوفة، فإن إكسل ينشر النتائج رأسياً في خلايا منفصلة.
تمتاز دالة `INDEX` عن غيرها من دوال البحث مثل دالة `VLOOKUP` الكلاسيكية أو حتى `XLOOKUP` الحديثة بمرونتها الفائقة في التعامل مع المصفوفات ثنائية وثلاثية الأبعاد وسرعة استجابتها لنداءات الفهرسة المصفوفية المعقدة دون استهلاك موارد المعالجة؛ حيث تتعامل مع أرقام المواقع المطلقة بكفاءة برمجية لا تتطلب عمليات مسح متكررة لكامل النطاق، مما يجعلها الخيار المثالي في إغلاق دورة المنوال النصي المركب.
## 7. تشخيص الأخطاء الشائعة وحلولها البرمجية والإحصائية
### 7.1 معالجة خطأ القيمة غير المتاحة (#N/A)
يعد الخطأ الإحصائي `#N/A` (القيمة غير متاحة) أكثر الأخطاء شيوعاً عند التعامل مع دوال المنوال؛ وتنشأ هذه الاستجابة البرمجية من سببين متباينين تماماً من الوجهة المنهجية. السبب الأول هو انعدام المنوال الإحصائي (No Mode)؛ حيث يحدث ذلك عندما تكون كافة القيم أو النصوص في النطاق المفحوص فريدة ولا تتكرر مطلقاً، أو عندما تظهر جميع القيم بالتردد المتساوي نفسه تماماً، مثل ظهور كل مشاهدة مرة واحدة فقط. في هذه الحالة، لا تجد الخوارزمية قيمة تفوق غيرها في التردد، فينتج خطأ `#N/A` كتعبير رياضي عن غياب المنوال.
أما السبب الثاني، فيتعلق بالأخطاء الإجرائية في الصياغة، مثل عدم تطابق أبعاد النطاقات المرجعية داخل دالة `MATCH`. ولمعالجة هذا الخطأ وتطوير مخرجات برمجية احترافية، يُنصح بتغليف الصيغ الحسابية بدالة معالجة الأخطاء `IFERROR`، مما يتيح إظهار رسائل نصية إيضاحية تحدد المعنى الدقيق للنتيجة وتمنع تشويه التقارير الإحصائية:
`=IFERROR(INDEX(B2:B100, MODE.MULT(MATCH(B2:B100, B2:B100, 0))), “لا توجد قيم مكررة في البيانات”)`
تحافظ هذه الصياغة الوقائية على المظهر الجمالي للتقارير الرقمية، وتتيح للباحثين الآخرين التمييز الفوري بين أخطاء الإدخال الرياضي وغياب الظاهرة التكرارية داخل العينة المدروسة.
### 7.2 التعامل مع الخلايا الفارغة والبيانات غير المتجانسة
يؤدي وجود الخلايا الفارغة أو المسافات البيضاء غير المرئية والبيانات النصية غير المتجانسة إلى تشوهات جسيمة في حسابات المنوال النصي. فعند احتواء نطاق البحث على خلايا فارغة، ترجع دالة `MATCH` قيماً فارغة تقود إلى فشل دالة `MODE.MULT` وتعطل الصيغة بالكامل. علاوة على ذلك، فإن وجود مسافات بادئة أو لاحقة في السلاسل النصية (مثل: “الرياض” مقابل “الرياض “) يجعل إكسل يعاملهما كمدخلين مختلفين تماماً، مما يفتت التردد التكراري ويخفي المنوال الحقيقي.
للتغلب على تشوهات المسافات، يتعين دمج دالة التنظيف `TRIM` لتنقية البيانات قبل مطابقتها:
`=INDEX(B2:B100, MODE.MULT(MATCH(TRIM(B2:B100), TRIM(B2:B100), 0)))`
أما بالنسبة لاستبعاد الخلايا الفارغة بصرامة برمجية، فيمكن الاستعانة بدالة التصفية `FILTER` المتاحة في الإصدارات الحديثة لعزل الفراغات قبل تمرير النطاق إلى دالتي `MATCH` و`MODE.MULT`. كما يوصى بتوحيد صيغ الحروف والرموز الخاصة لضمان تطابق البيانات النوعية تطابقاً مطلقاً، وهو معيار لا غنى عنه في الدراسات النفسية والسلوكية التي تعتمد على التصنيفات النوعية للأداء (Wolf, 1978).
## 8. المنهجيات البديلة لإيجاد القيمة الأكثر تكراراً
### 8.1 استخدام الجداول المحورية (Pivot Tables) لتحليل التكرارات
تُعد الجداول المحورية (Pivot Tables) الأداة التحليلية الأكثر مرونة وقوة لتلخيص وتحليل التكرارات في مجموعات البيانات الكبيرة والمتنوعة دون الحاجة إلى كتابة صيغ رياضية مركبة ومعقدة. وتتيح هذه الأداة للمحلل إنشاء تقرير تكراري متكامل في ثوانٍ معدودة من خلال سحب المتغير المستهدف ووضعه في منطقة الصفوف (Rows)، ثم سحب المتغير ذاته وإفلاته في منطقة القيم (Values) مع التأكد من ضبط حقل التلخيص على خيار “العدد” (Count).
بعد توليد التقرير الأولي، يقوم الباحث بفرز عمود العدد من الأكبر إلى الأصغر (Sort Largest to Smallest)؛ وبذلك تظهر القيم الأكثر تكراراً في قمة الجدول، مما يتيح الرؤية الفورية للمنوال، سواء كان وحيداً أو متعدداً، بالإضافة إلى معرفة التردد الحسابي الدقيق والنسبة المئوية لكل تكرار من إجمالي العينة. وتتميز الجداول المحورية بقدرتها الفائقة على التفاعل مع المقسمات الديناميكية (Slicers)، والتي تمكن متخذ القرار من تصفية المنوال وتجزئته عبر متغيرات تصنيفية ثانوية مثل الفئات العمرية أو المناطق الجغرافية، وهي ميزة تفوق بمراحل الإمكانيات الثابتة للصيغ الرياضية المباشرة.
### 8.2 استخراج المنوال باستخدام أداة التصفية المتقدمة وPower Query
تمثل أداة تحويل وتنقية البيانات المتقدمة في إكسل (Power Query) الخيار الأفضل عند التعامل مع مجموعات البيانات الضخمة التي يتم تحديثها دورياً من مصادر خارجية متعددة. فبدلاً من تطبيق صيغ المصفوفات المرهقة للذاكرة، يتم استيراد البيانات إلى محرر Power Query وإجراء عملية التجميع (Group By) على العمود المستهدف، مع تحديد عملية العد لكل مجموعة لإنشاء عمود تكراري مخصص.
بعد خطوة التجميع، يتم فرز العمود التكراري تنازلياً، ثم تطبيق تصفية الصفوف العليا (Keep Top Rows) للاحتفاظ بالصف الأول أو الصفوف المتساوية في التردد الأقصى. تكمن الميزة الاستراتيجية لمنهجية Power Query في “أتمتة خط المعالجة” (Data Pipeline)؛ فعند إضافة آلاف السجلات الجديدة إلى ملف البيانات الخام، لا يحتاج المحلل سوى للنقر على زر تحديث البيانات (Refresh)، ليعيد المحرر تشغيل خوارزميات التجميع والفرز تلقائياً وعرض المنوال الجديد دون أي تدخل بشري ودون أي استهلاك إضافي لموارد صيانة الصيغ. وتبرز هذه الأداة كركيزة أساسية عند تحليل تكرارات النصوص الضخمة والبيانات الملموسة في البحوث المعجمية التجريبية (Brysbaert et al., 2013).
### 8.3 التمييز البصري للقيمة الأكثر تكراراً عبر التنسيق الشرطي
يؤدي التمييز البصري دوراً جوهرياً في التحليل الاستكشافي السريع للبيانات، حيث يساعد الباحثين على التقاط الأنماط المتكررة ومواقع تركزها في جداول البيانات الكبيرة دون الحاجة إلى عزلها في أعمدة منفصلة. يتيح برنامج إكسل تحقيق ذلك من خلال قواعد “التنسيق الشرطي” (Conditional Formatting) المستندة إلى المعادلات الحسابية الديناميكية.
لتطبيق هذه القاعدة وتمييز كافة الخلايا التي تتطابق قيمها مع المنوال الإحصائي للبيانات، يتم تحديد نطاق البيانات كاملاً (وليكن من الخلية `A2` إلى الخلية `A100`)، ثم إنشاء قاعدة تنسيق جديدة تعتمد على صيغة مخصصة. إذا كانت البيانات رقمية، تُكتب الصيغة على النحو الآتي:
`=A2=MODE.SNGL($A$2:$A$100)`
أما إذا كانت البيانات نصية أو كان الباحث يرغب في استخدام آلية عامة تصلح لكافة أنواع المدخلات، فيمكن بناء قاعدة تنسيقية تعتمد على مقارنة تردد الخلية الحالية بالتردد الأقصى لكامل النطاق باستخدام دالتي `COUNTIF` و`MAX`:
`=COUNTIF($A$2:$A$100, A2)=MAX(COUNTIF($A$2:$A$100, $A$2:$A$100))`
يتم بعد ذلك اختيار لون تعبئة مميز للخلايا المحققة للشرط. وبمجرد تفعيل القاعدة، تضيء كافة الخلايا التي تحوي القيمة الأكثر تكراراً تلقائياً، مما يمنح المحلل نظرة بصرية مباشرة على مسار توزيع المنوال وانتشاره الجغرافي أو الهيكلي داخل أوراق العمل البحثية.
## 9. اعتبارات الأداء وتحسين كفاءة الصيغ في قواعد البيانات الكبيرة
### 9.1 العبء الحسابي للصيغ المركبة ومصفوفات الذاكرة
على الرغم من الأناقة البرمجية للصيغ المركبة التي تدمج دوال `INDEX` و`MODE.MULT` و`MATCH`، إلا أن تطبيقها على مجموعات البيانات الكبيرة التي تتجاوز عشرات الآلاف من الصفوف يفرض عبئاً حسابياً كبيراً على ذاكرة الوصول العشوائي (RAM) ووحدة المعالجة المركزية (CPU). يرجع هذا التباطؤ إلى التعقيد الخوارزمي التربيعي المتضمن في مطابقة النطاق مع نفسه في دالة `MATCH`، حيث تقوم الخوارزمية بإجراء مقارنات متقاطعة تتصاعد أسياً بمقدار $O(n^2)$ مع تزايد عدد الصفوف.
تتجلى هذه المشكلة بصورة كارثية عند ارتكاب خطأ شائع يتمثل في الإشارة إلى الأعمدة الكاملة في الصيغ المصفوفية، مثل كتابة `=MATCH(A:A, A:A, 0)`. يؤدي هذا التحديد غير المحسوب إلى إجبار معالج إكسل على فحص أكثر من مليون وأربعة وثمانين ألف خلية لكل نداء مصفوفي، مما قد يتسبب في تجميد البرنامج بالكامل أو انهياره المفاجئ. ولتحسين كفاءة المعالجة، يتعين تقليص نطاقات الفحص لتقتصر بدقة على الحجم الفعلي للمشاهدات المكتظة بالبيانات، أو استخدام النطاقات الديناميكية المسماة لتفادي إهدار موارد الذاكرة.
### 9.2 استخدام الأعمدة المساعدة (Helper Columns) كحل بديل للأداء
عندما تتوسع قواعد البيانات لتصل إلى مئات الآلاف من المشاهدات وتصبح سرعة إعادة الحساب (Calculation Latency) عاملاً حاسماً، يتحول الاعتماد على الصيغ المصفوفية المركبة إلى ممارسة غير فعالة من الناحية الهندسية. في مثل هذه البيئات المعقدة، يُعد استخدام “الأعمدة المساعدة” (Helper Columns) الخيار التقني الأفضل والأكثر موثوقية لضمان سرعة واستقرار الأداء الحسابي.
يقوم هذا الحل على إنشاء عمود إضافي بجانب عمود البيانات الأصلي، يُخصص لحساب التردد التكراري لكل صف على حدة باستخدام دالة العد المشروط البسيطة:
`=COUNTIF($A$2:$A$100000, A2)`
وعلى الرغم من أن هذه الخطوة تزيد من حجم الملف بشكل محدود نتيجة إضافة عمود جديد، إلا أن تعقيدها الحسابي يظل خطياً وأقل وطأة على الذاكرة مقارنة بصيغ المصفوفات النصية. بعد ملء هذا العمود، يمكن استخراج المنوال بأقصى سرعة ممكنة عبر البحث عن القيمة المقابلة للحد الأقصى في عمود التكرارات باستخدام تركيبة `INDEX` و`MATCH` التقليدية أو الدالة الحديثة `XLOOKUP`:
`=XLOOKUP(MAX(B2:B100000), B2:B100000, A2:A100000)`
يحقق هذا الأسلوب توازناً عملياً بين بساطة الصيانة وسرعة التنفيذ البرمجي، ويسهل مراجعته وتدقيقه من قِبل الباحثين والمدققين الخارجيين دون الحاجة لفك تشفير تركيبات المصفوفات العميقة.
## 10. المعايير المنهجية لتوثيق وعرض نتائج التكرار في الأبحاث
### 10.1 التفسير العلمي لقيم المنوال المستخرجة من إكسل
لا ينتهي عمل الباحث باستخراج القيمة الأكثر تكراراً من برنامج إكسل، بل تبدأ مرحلة التفسير العلمي المنهجي لتلك النتيجة وربطها بسياق البحث. في التقارير الإحصائية المعتمدة وفق معايير جمعية علم النفس الأمريكية (APA)، يتطلب توثيق المنوال إظهار التردد المطلق للمشاهدة ونسبتها المئوية من مجمل عينة الدراسة، مع الإشارة الصريحة إلى ما إذا كان التوزيع وحيد المنوال أو متعدد المناول؛ إذ يمثل المنوال المتعدد في العادة مؤشراً على انقسام العينة إلى أنماط سلوكية أو فئات مجتمعية فرعية متمايزة تستوجب دراسة مستقلة لكل منها.
ويحذر المنهجيون من الاعتماد المنفرد على المنوال كمقياس مركزي وحيد دون إرفاقه بمقاييس التشتت الملائمة (مثل نسبة التغير النوعي في البيانات الاسمية أو المدى الربيعي والانحراف المعياري في البيانات الكمية). وتتأكد هذه الرؤية المنهجية في البحوث التي تتناول المشاعر الإيجابية وجودة الحياة وتكرارات التفاعل العاطفي والاجتماعي؛ حيث يشير ارتفاع التكرار إلى نماذج تكيفية مستقرة تتجاوز مجرد الصدفة الإحصائية (Lyubomirsky et al., 2005; Algoe & Haidt, 2009). كما تجدر التفرقة الدقيقة بين البيانات المتقطعة (Discrete) التي يسهل رصد منوالها المباشر، والبيانات المستمرة (Continuous) التي تتطلب تقسيماً فئوياً مسبقاً لاستخراج الفئة المنوالية، لضمان دقة الاستنتاجات العلمية في مجالات كالصحة النفسية والطب الرياضي (Reardon et al., 2019).
### 10.2 أفضل الممارسات لإنشاء أوراق عمل قابلة للتدقيق والتكرار
تقتضي قواعد الحوكمة المؤسسية والنزاهة الأكاديمية تصميم نماذج العمل في إكسل وفق معايير هندسية تتيح للباحثين والمراجعين إعادة تطبيق التحليل والتحقق من صحته بسهولة (Replicability). تتطلب الممارسة الأولى في هذا الصدد استخدام “النطاقات المسماة” (Named Ranges)؛ فبدلاً من استخدام المراجع المبهمة مثل `$A$2:$A$500`، يتم إعطاء النطاق اسماً دلالياً مثل `City_Data`، مما يحول الصيغ المركبة إلى عبارات واضحة ومقروءة:
`=INDEX(City_Data, MODE.MULT(MATCH(City_Data, City_Data, 0)))`
كما يُعد الفصل الطبقي الصارم في هيكلة المصنف من أهم الممارسات التنظيمية؛ حيث يُنصح بتخصيص ورقة عمل للبيانات الخام (Raw Data) تظل محمية وغير قابلة للتعديل، وورقة ثانية لعمليات المعالجة والحسابات المساعدة (Processing Layer)، وورقة ثالثة نهائية مخصصة لعرض التقارير والجداول والمؤشرات المنوالية (Presentation Layer).
وأخيراً، ينبغي تدوين تعليقات توضيحية موثقة (Cell Notes) بجانب الصيغ المتقدمة تشرح المنطق الرياضي المتبع وتوضح أسباب اللجوء إلى صيغ المصفوفات، مع حفظ المصنف بالامتدادات الحديثة مثل `.xlsx` أو `.xlsb` لضمان الاستقرار البرمجي لمحرك المصفوفات وتفادي فقدان الدوال المنسكبة عند فتح الملف عبر إصدارات مختلفة من البرنامج.
—
## خاتمة
تناول هذا الدليل المتكامل التشريح التقني والمفاهيمي لآليات استخراج القيمة الأكثر تكراراً في برنامج مايكروسوفت إكسل، رابطاً بين الأسس الإحصائية التي أرساها رواد التحليل الرياضي عبر العصور الحديثة وأحدث التقنيات البرمجية التي يوفرها محرك الحوسبة السحابية والمصفوفات الديناميكية. اتضح من خلال التحليل أن إتقان العمل على المنوال يتجاوز مجرد استدعاء دالة بسيطة؛ فهو يتطلب رؤية تحليلية ناقدة تدرك الفروق الجوهرية بين البيانات الرقمية والنصية، وتتعامل باحترافية مع التوزيعات متعددة القمم وحالات انعدام المنوال، وتعي التكلفة الحسابية لكل تركيبة مصفوفية في قواعد البيانات الضخمة.
إن استخدام الباحث أو المحلل لأدوات مثل `MODE.MULT` المدعومة بالتحويل التناظري عبر `MATCH` و`INDEX`، أو اللجوء إلى أساليب التجميع المرنة عبر الجداول المحورية ومحرر `Power Query`، يضمن تحقيق أعلى درجات الدقة والشفافية في التوصيف الإحصائي. ومن خلال تبني المعايير المنهجية الصارمة في توثيق النطاقات وفصل طبقات المعالجة وتغليف الصيغ بالأدوات الوقائية لمعالجة الأخطاء، تتحول أوراق العمل من مجرد مساحات لتسجيل البيانات إلى وثائق تحليلية رصينة قادرة على دعم اتخاذ القرارات وتقديم قيمة حقيقية للبحث العلمي والممارسة المهنية التطبيقية.
—
المراجع
- Algoe, S. B., & Haidt, J. (2009). Witnessing excellence in action: the ‘other-praising’ emotions of elevation, gratitude, and admiration. The Journal of Positive Psychology. https://doi.org/10.1080/17439760802650519
- Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods. https://doi.org/10.3758/brm.41.4.977
- Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed Self-Assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin. https://doi.org/10.1037/0033-2909.131.6.803
- Newport, E. L. (1990). Maturational Constraints on Language Learning. Cognitive Science. https://doi.org/10.1016/0364-0213(90)90024-q
- Reardon, C. L., Gouttebarge, V., Kroshus, E., Baron, D. A., Bahr, R., Blauwet, C. A., et al. (2019). Mental health in elite athletes: International Olympic Committee consensus statement (2019). British Journal of Sports Medicine. https://doi.org/10.1136/bjsports-2019-100715
- Wolf, M. M. (1978). SOCIAL VALIDITY: THE CASE FOR SUBJECTIVE MEASUREMENT or HOW APPLIED BEHAVIOR ANALYSIS IS FINDING ITS HEART 1. Journal of Applied Behavior Analysis. https://doi.org/10.1901/jaba.1978.11-203