
يمثل استخراج البيانات ومعالجتها داخل جداول البيانات الإلكترونية حجر الزاوية في التحليل الكمي المعاصر، حيث تتطلب النماذج التحليلية المتقدمة فرز المتغيرات واستخلاص عناصر محددة دون تكرار لبناء مؤشرات دقيقة واتخاذ قرارات مبنية على شواهد رقمية موثوقة. وفي بيئات الأعمال والبحوث الأكاديمية التي تعتمد على برمجية مايكروسوفت إكسيل (Microsoft Excel)، تبرز الحاجة المتكررة إلى التعامل مع السجلات المتضخمة التي تعاني من فائض في البيانات المكررة، مما يستدعي توظيف استراتيجيات حسابية محكمة قادرة على عزل المدخلات الفريدة وفرزها وفق نسق ترتيبي منضبط يلبي المتطلبات الإحصائية الدقيقة.
تكتسب مسألة تحديد “القيمة الفريدة رقم N” (Nth Unique Value) أهمية محورية تتجاوز مجرد التصفية الروتينية؛ فهي تعبر عن عملية خوارزمية تهدف إلى استدعاء مفردة بيانية محددة تحتل رتبة موضعية معينة ضمن تسلسل القيم غير المتكررة، وذلك بناءً على أسبقية ظهورها في مصفوفة الإدخال الأصلية أو استناداً إلى معايير فرز مسبقة. وعلى الرغم من أن الإصدارات الحديثة من البرنامج قد وفرت حلولاً ديناميكية مبسّطة، إلا أن استيعاب البنية التركيبية الكلاسيكية يظل ضرورة معرفية وتقنية لفهم السلوك الحسابي الداخلي لمحرك إكسيل، وضمان توافق النماذج التحليلية عبر بيئات العمل التشغيلية المختلفة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك تحليلي متعمق لكيفية إيجاد القيمة الفريدة ذات الرتبة N في إكسيل، موازناً بين الصيغ المصفوفية الكلاسيكية القائمة على دمج دوال الفهرسة والمطابقة والمنطق الشرطي، وبين الدوال الديناميكية الحديثة. سنستعرض الآليات الرياضية الكامنة وراء كل صياغة، مع تقديم دراسة حالة تطبيقية خطوة بخطوة، ومناقشة تفصيلية للأداء الحاسوبي وإدارة الأخطاء وحالات المعالجة المتقدمة، بما يضمن تزويد المحلل بأدوات رصينة لتحسين كفاءة وجودة المعالجة البيانية.
1. مقدمة نظرية حول استخراج القيم الفريدة في برنامج إكسيل
1.1 مفهوم القيم الفريدة وأهميتها في تحليل البيانات الإحصائية
في نظرية المجموعات والمعالجة الإحصائية، يُعرّف العنصر الفريد رياضياً بأنه ذلك الكيان الذي يتميز بخصائص محددة تجعله قابلاً للتمييز التام عن سائر العناصر في فضاء العينة. وعند إسقاط هذا المفهوم على قواعد بيانات جداول إكسيل، يجب التمييز اصطلاحياً بين مفهومين متقاربين: “القيم المتمايزة” (Distinct Values) التي تعبر عن ظهور كل قيمة مختلفة مرة واحدة على الأقل بصرف النظر عن عدد مرات تكرارها الأصلي، و”القيم الفريدة قطيعة التكرار” (Strictly Unique Values) التي تعبر حصراً عن القيم التي لم ترد في السجل بأكمله سوى مرة واحدة مفردة. وفي سياق هذا الدليل التحليلي، فإننا نركز على استخراج القيم المتمايزة وفق أسبقية ورودها، وهو ما يشار إليه اصطلاحاً وشيوعاً في بيئات إكسيل بـ “القيم الفريدة”.
إن عزل العينات غير المكررة يكتسب أهمية بالغة في ضمان دقة التحليلات الإحصائية الوصفية والاستدلالية؛ حيث يؤدي وجود التكرار غير المنضبط إلى إحداث انحياز في مقاييس النزعة المركزية والتشتت، وتشوهات في حساب التكرارات النسبية والنسب المئوية. يساعد تنظيف البيانات واستخلاص مفرداتها الحصرية على تقليص التباين الداخلي غير المفسر، وتصفية المجموعات البيانية من الضجيج الإحصائي الناتج عن أخطاء التسجيل المتعدد، مما يوفر منصة مستقرة لتقدير المعلمات وبناء النماذج القياسية بدرجة عالية من الموثوقية العلمية.
1.2 الفرق بين استخراج القيم المنفردة وتحديد الرتبة الترتيبية N
يقتصر الهدف في عمليات التصفية التقليدية على إنشاء قائمة مسطحة تتضمن العناصر الفريدة دون اعتبار لترتيب تموضعها؛ بيد أن تحديد الرتبة الترتيبية N ينقل المعالجة إلى فضاء الفهرسة الموضعية المستهدفة. فالرتبة N تعني استرجاع العنصر الذي يقع في الترتيب الرقمي المحدد (كالعنصر الأول، أو الثالث، أو العاشر) ضمن متتالية العناصر الفريدة المستخلصة. هذا التمايز يفرض متطلبات برمجية إضافية، إذ لا يكفي مجرد التحقق من فرادة العنصر، بل يجب تخزين موضعه النسبي وربطه بعداد ترتيبي تصاعدي أو تنازلي.
تظهر القيمة التطبيقية للرتبة N بوضوح في النماذج التنبؤية، ونظم المحاكاة، ونماذج التقييم متعددة المستويات؛ حيث يحتاج المحلل المالي مثلاً إلى استخراج “ثالث فرع مصرفي يحقق أعلى أداء متميز”، أو يحتاج الباحث السلوكي إلى استدعاء “المعرف التجريبي للمشارك رقم N” في دراسة تعتمد على قياسات متكررة. تكمن الصعوبة التقنية هنا في غياب فهرسة فيزيائية مسبقة للبيانات غير المتجانسة، مما يحتم صياغة معادلات مركبة تستطيع فرز الطبقات المكررة ديناميكياً وتحديد العنصر المستهدف بالرتبة N بدقة متناهية دون تشويه لبنية السجل الأصلي.
1.3 التحديات الحسابية المرتبطة بالتعامل مع مصفوفات البيانات غير المرتبة
تتسم مجموعات البيانات الواقعية في الغالب بالعشوائية وعدم الترتيب المسبق، مما يفرض تعقيداً حسابياً كبيراً على محركات الجداول الإلكترونية. لمطابقة كل عنصر والتأكد من كونه يمثل الظهور الأول، يضطر النظام إلى إجراء مقارنات تقاطعية متعددة الأبعاد عبر النطاق المتاح بالكامل. هذا الفحص الدوري يستلزم المرور على الخلايا ومقارنة قيمتها بجميع الخلايا السابقة لها للتأكد من عدم سابقة الورود، وهو ما يرفع العبء الحسابي بشكل ملحوظ مع تنامي حجم المصفوفة.
علاوة على ذلك، تعجز الدوال المباشرة والبسيطة في محركات الجداول القديمة (مثل دالة VLOOKUP أو دالة COUNTIF المفردة) عن استخلاص موضع نسبي مشروط لعنصر مجهول القيمة دون الاستعانة بأعمدة مساعدة. ولتجاوز هذه المحدودية البنيوية، تتجه المعايير الحسابية المتقدمة إلى دمج دوال المنطق والبحث والفهرسة ضمن صيغ مصفوفية متكاملة تقوم بإنشاء مؤشرات رقمية مؤقتة في الذاكرة العشوائية للحاسوب، لتوليد مسار حسابي يتيح الوصول المباشر إلى القيمة المستهدفة دون حاجة لإعادة هيكلة الجدول يدوياً.
2. التشريح الهيكلي للصيغة الكلاسيكية المركبة لاستخراج القيمة الفريدة
2.1 تحليل دالة الفهرسة المرجعية INDEX ووظيفتها في الاستدعاء
تشكل دالة الفهرسة INDEX الركيزة الأساسية لواجهة الاسترجاع في صيغ المصفوفات المعقدة داخل إكسيل؛ حيث تقوم هذه الدالة بقبول نطاق جغرافي محدد من الخلايا كمعامل أول (Array)، ثم تتلقى رقم الصف النسبي (Row_num) كمعامل ثانٍ لتقوم بإرجاع القيمة الفعلية القاطنة في ذلك التقاطع الإحداثي. تكمن القوة الهندسية لدالة INDEX في قدرتها على عزل عملية البحث عن عملية الاسترجاع، حيث لا تهتم الدالة بماهية المحتوى بقدر اهتمامها الدقيق بالإحداثي الرقمي المطلوب استدعاؤه.
لضمان عدم انزياح البيانات أثناء تعميم الصيغ وسحبها عبر خلايا التقرير، يتعين تثبيت نطاق الإدخال تثبيتاً مطلقاً باستخدام علامات الدولار (Absolute References مثل $A$2:$A$11). إن ترجمة رقم الصف النسبي المستخرج بواسطة الدوال المساعدة المدمجة إلى قيمة نصية أو رقمية يمثل المرحلة النهائية لعملية الفهرسة، حيث تعمل دالة INDEX كوعاء تنفيذي يترجم المخرجات المنطقية الترتيبية إلى مخرجات بيانية واقعية قابلة للقراءة والتحليل الإحصائي.
2.2 دور دالة المطابقة MATCH في تتبع الظهور الأولي للبيانات
تؤدي دالة المطابقة MATCH الدور المحوري في تقنية تتبع الظهور الأولي للعناصر عبر استغلال ميزتها التشغيلية القياسية: البحث عن المطابقة التامة الأولى وتجاهل ما يليها. عند تمرير نطاق البيانات كاملاً في موضعي البحث (Lookup_value و Lookup_array) مع ضبط وسيط المطابقة على الصفر للمطابقة الدقيقة، مثل MATCH(range, range, 0)، تقوم الدالة بمقارنة كل عنصر من النطاق بالنطاق ذاته ككل، وترجع رقم الفهرس لأول موضع يظهر فيه هذا العنصر حصراً.
ينتج عن هذه العملية مصفوفة رقمية تمثل مواقع الظهور الأول لكل عنصر؛ فإذا تكررت القيمة في الصف الخامس وكانت قد ظهرت مسبقاً في الصف الأول، فإن دالة MATCH ستسجل الرقم 1 لكلا الموضعين. يتيح هذا السلوك الرياضي فرز العناصر؛ حيث يتميز الظهور الأول الحقيقي للعنصر بأن مؤشر مطابقته المسترجع يتطابق تماماً مع رقمه الترتيبي الفعلي داخل النطاق، في حين تشير أي مغايرة في الأرقام إلى أن السجل الحالي يمثل تكراراً لاحقاً لعنصر سبق ظهوره في موقع أعلى ضمن الجدول.
2.3 وظيفة دالتي ROW والحد الحسابي النسبي في بناء متجهات الفهرسة
لتفعيل المقارنة المنطقية مع مخرجات دالة المطابقة، تبرز الحاجة إلى توليد متجه حسابي يمثل التسلسل الطبيعي المتصل لأرقام الأسطر. يتم بناء هذا المتجه باستخدام دالة ROW مدمجة مع حد تصحيحي رياضي، وفق الصيغة المتجهية: ROW(range) - ROW(first_cell) + 1. تعمل دالة ROW المستقلة على استخراج أرقام الصفوف المطلقة لورقة العمل (مثلاً من 2 إلى 11)، وهي أرقام لا تصلح للمطابقة المباشرة مع فهارس المصفوفات التي تبدأ نسبياً من الرقم 1.
لذا، فإن طرح مرجع الصف الأول للبيانات (المثبت كقيمة أحادية) ثم إضافة الرقم 1 يؤدي إلى تطبيع (Normalization) الترقيم ليتحول إلى تسلسل طبيعي متصاعد يبدأ حتماً من الواحد الصحيح {1; 2; 3; ...; k} بصرف النظر عن الموضع الجغرافي للجدول داخل ورقة العمل. هذا التناغم الديناميكي للمتجهات الرياضية يضمن تطابقاً طولياً دقيقاً وموازاة هندسية كاملة بين مصفوفة مواضع الظهور الأولي ومصفوفة الترقيم النسبي للأرقام، مما يمهد للخطوة اللاحقة في التصفية المنطقية.
3. منطق الفلترة والترتيب باستخدام دالتي IF و SMALL
3.1 صياغة الشرط المنطقي لعزل المواضع الحصرية
يتحقق الفصل الحاسوبي بين القيم الفريدة والمكررة من خلال بناء مقارنة تكافؤية داخل دالة الشرط المنطقي IF. يتم التحقق من صحة المعادلة: هل يتطابق موضع الظهور الأول المستخرج بواسطة دالة MATCH مع الترقيم النسبي للصف المولد بواسطة دالتي ROW؟ إذا تطابقت القيمتان، فإن هذا السجل يمثل الظهور الأول قطيع التكرار للعنصر، وبالتالي تصدر الدالة قيمة صائبة (TRUE). أما إذا اختلفت القيمتان، فإن هذا يقطع بأن العنصر مكرر، فتصدر الدالة قيمة خاطئة (FALSE).
تتمثل براعة الصياغة في المعامل المرتجع عند تحقق الشرط: حيث يتم تكليف دالة IF بإرجاع الرقم النسبي للصف ذاته في حال الصحة (TRUE)، في حين يُترك المعامل البديل فارغاً أو يُعيّن كقيمة منطقية خاطئة (FALSE) عند عدم التحقق. ينتج عن هذه العملية مصفوفة هجينة تضم أرقام الصفوف النسبية الخاصة بالمواقع الفريدة فقط، بينما تُستبدل مواضع التكرار بقيم خاطئة، كالشكل التوضيحي التالي: {1; FALSE; 3; FALSE; 5; ...}، مما يؤدي إلى حجب كلي للقيم الفائضة وعزل الإحداثيات المستهدفة.
3.2 آلية عمل دالة SMALL في اختيار الرتبة المستهدفة
تمتلك دالة SMALL خاصية بنيوية فريدة في بيئة إكسيل الحسابية؛ إذ إنها تتجاهل تلقائياً كافة القيم المنطقية (TRUE و FALSE) والنصوص داخل المصفوفات العددية، وتقصر معالجتها حصراً على الأرقام الفعلية. عند تمرير المصفوفة المفلترة الناتجة عن دالة IF إلى دالة SMALL، تقوم الأخيرة بضغط المصفوفة وتجاوز الفجوات الناتجة عن القيم المنطقية الخاطئة، مما يحول مصفوفة المواضع غير الخطية إلى ترتيب تصاعدي محكم.
يأتي هنا دور المتغير N، الذي يتم تمريره كمعامل ثانٍ لدالة SMALL لتحديد الترتيب الموضعي المطلوب بدقة. فإذا حددنا $N=3$، فإن الدالة تفحص الأرقام المتبقية في المصفوفة (والتي تمثل حصراً أرقام صفوف العناصر الفريدة)، وتستخلص ثالث أصغر رقم صف نسبي منها. تحل هذه الآلية مشكلة الترتيب التلقائي، إذ تضمن أن المسترجع هو الإحداثي الحقيقي لثالث قيمة متمايزة ظهرت في الجدول الزمني لإدخال البيانات، محققة بذلك الترتيب الدقيق المطلوب لعملية الاسترجاع النهائية عبر دالة INDEX.
3.3 سلوك المصفوفات في الذاكرة الحسابية لبرنامج إكسيل
تتم هذه العمليات المتشابكة عبر تخصيص مساحات معالجة متجهة داخل الذاكرة المؤقتة (RAM) للخلية الحسابية. في محركات إكسيل التقليدية (الإصدارات السابقة لعام 2020 وتحديثات Office 365 الديناميكية)، كانت هذه العمليات تتطلب إدخالاً استثنائياً يعرف بصيغ المصفوفات المجمعة Control + Shift + Enter (CSE)، والتي تفرض على محرك الحسابات إحاطة المعادلة بقوسي مصفوفة متعرجين {...} لتمكين المعالج من تنفيذ العمليات المتكررة على مستوى المتجهات متعددة الخلايا دفعة واحدة.
يمتاز هذا السلوك بتعقيد حسابي متصاعد يتطلب موارد معالجة مكثفة، حيث يحتفظ البرنامج بمتجهات متعددة مؤقتة في الذاكرة لتنفيذ عمليات المقارنة، والفلترة، والاستخلاص الترتيبي بصورة متزامنة. وقد صُممت هذه الهندسة المعمارية لتعمل داخل حدود مساحة تكديس الذاكرة المخصصة للبرنامج، مما يجعل فهم السلوك الداخلي لهذه الصيغ أمراً جوهرياً لتقييم الأداء الحسابي، لا سيما عند الرغبة في تعميم النماذج على قواعد بيانات ضخمة تحتوي على عشرات الآلاف من السجلات غير المتجانسة.
4. التطبيق العملي خطوة بخطوة: استخراج القيمة الفريدة الثالثة
4.1 إعداد وتجهيز جدول البيانات الأولي للتحليل
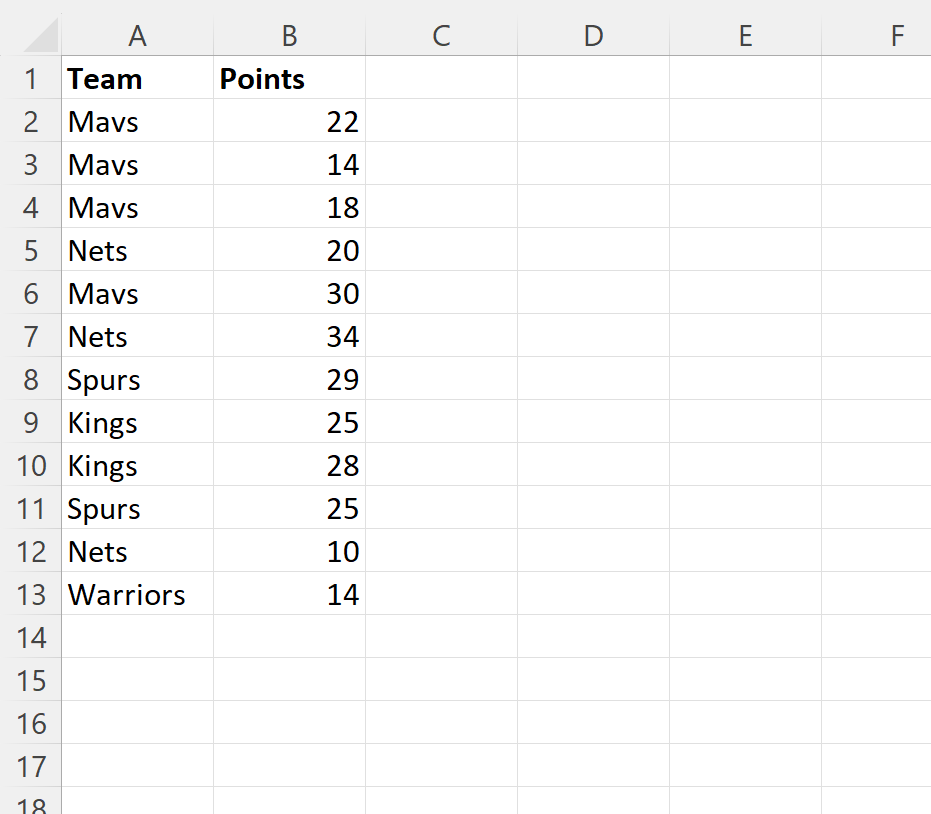
لتجسيد الجوانب النظرية في سياق عملي تطبيقي مستوحى من الممارسات الشائعة في إدارة المسابقات الرياضية، سنقوم بإعداد جدول بيانات يضم قائمة بأسماء فرق كرة السلة المسجلة في إحدى البطولات الإقليمية، حيث تكررت بعض الأسماء نتيجة تعدد المباريات المسجلة لكل فريق. يمتد نطاق البيانات المستهدف عبر العمود A في الخلايا من A2 إلى A11 على النحو الآتي:
- الخلية A2: Celtics
- الخلية A3: Celtics
- الخلية A4: Lakers
- الخلية A5: Warriors
- الخلية A6: Lakers
- الخلية A7: Warriors
- الخلية A8: Warriors
- الخلية A9: Nets
- الخلية A10: Celtics
- الخلية A11: Pacers
قبل الشروع في كتابة الصيغة، يجب التحقق من نظافة البيانات وخلو النصوص من المسافات البادئة أو اللاحقة غير المرئية باستخدام دوال الفحص والتشذيب مثل TRIM، حيث إن اختلاف المسافات النصية يجعل البرنامج يتعامل مع الكلمات المتطابقة ظاهرياً كقيم فريدة ومستقلة، مما يؤدي إلى نتائج إحصائية مضللة. نقوم بتخصيص الخلية C2 كخلية مخصصة لعرض النتيجة الترتيبية المستهدفة لقيمتنا الفريدة الثالثة.
4.2 كتابة وتنفيذ الصيغة الرياضية المركبة
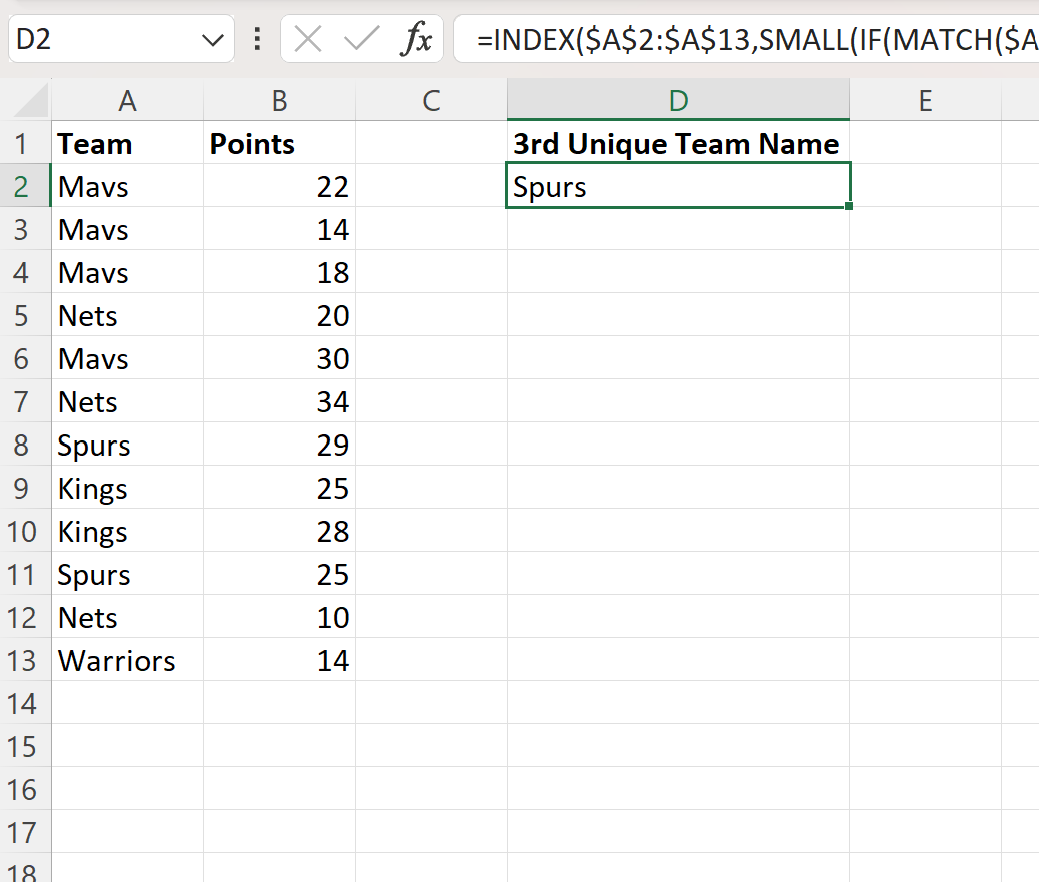
لاستخراج القيمة الفريدة الثالثة ($N=3$)، نتوجه إلى الخلية C2 ونقوم بإدخال الصيغة المركبة الكاملة التي تجمع الركائز الهيكلية التي قمنا بتشريحها سابقاً. تتم كتابة الصيغة بدقة مع تثبيت المراجع كما يلي:
=INDEX($A$2:$A$11, SMALL(IF(MATCH($A$2:$A$11, $A$2:$A$11, 0) = ROW($A$2:$A$11) - ROW($A$2) + 1, ROW($A$2:$A$11) - ROW($A$2) + 1), 3))
إذا كنت تستخدم إصداراً قديماً من إكسيل (Excel 2019 أو ما قبله)، يجب الضغط على مفاتيح Ctrl + Shift + Enter معاً لتأكيد إدخال الصيغة، وحينها ستلاحظ ظهور القوسين المتعرجين تلقائياً حول الصيغة في شريط المعادلات. أما إذا كنت تعمل على الإصدارات الحديثة الداعمة لبيئة المصفوفات الديناميكية (مثل Microsoft 365 أو Excel 2021 وما يليهما)، فيكفي الضغط على مفتاح Enter المعتاد، حيث يقوم المحرك الداخلي بتولي معالجة المتجهات ذاتياً وبكفاءة وسلاسة تامة.
4.3 تفسير النتيجة المستخرجة وتحليل تدفق العمليات
بمجرد إتمام الإدخال، ستعرض الخلية C2 النتيجة المباشرة: Warriors. للتأكد من صحة هذا الاسترجاع ومطابقته لمنطق التحليل البياني، نقوم بتتبع تسلسل الظهور الأصلي للفرق في العمود A:
- الظهور الفريد الأول (N=1): Celtics (في الخلية A2).
- الظهور الفريد الثاني (N=2): Lakers (في الخلية A4، بعد تجاهل تكرار Celtics في A3).
- الظهور الفريد الثالث (N=3): Warriors (في الخلية A5).
- الظهور الفريد الرابع (N=4): Nets (في الخلية A9، بعد تجاهل تكرارات Lakers وWarriors في A6 وA7 وA8).
- الظهور الفريد الخامس (N=5): Pacers (في الخلية A11).
يمكن للمحلل التحقق من هذا التدفق التفصيلي عملياً من خلال أداة “تقييم الصيغة” (Evaluate Formula) المتوفرة في تبويب “صيغ” (Formulas) في إكسيل. تُظهر هذه النافذة خطوة بخطوة كيف قامت دالة MATCH بإنتاج المصفوفة المرجعية {1; 1; 3; 4; 3; 4; 4; 8; 1; 10}، وكيف قام المتجه ROW - ROW + 1 بتوليد المتتالية الطبيعية من 1 إلى 10، مما سمح لدالة IF بإسقاط الأرقام المكررة وحفظ الأرقام {1; FALSE; 3; 4; FALSE; FALSE; FALSE; 8; FALSE; 10}، لتقوم دالة SMALL باختيار الرقم 4 (الذي يمثل ثالث أصغر قيمة رقمية فعلية في هذا المتجه)، لتوجه دالة INDEX مباشرة نحو الصف الرابع النسبي داخل النطاق، وهو ما يقود بدقة لا لبس فيها إلى اسم الفريق المستهدف: Warriors.
5. التحقق من صحة النتائج عبر الدوال الديناميكية الحديثة
5.1 استخدام دالة UNIQUE الحديثة لاستعراض القائمة المنفردة
في سبتمبر من عام 2018، أحدث الفريق المعماري المسؤول عن تطوير محرك حسابات إكسيل بقيادة المهندس جو مكديد (Joe McDaid) ثورة حقيقية في بنية البرنامج بإطلاق نظام “المصفوفات الديناميكية” (Dynamic Arrays)، والذي تم دعمه رسمياً في إصدارات دالة UNIQUE المتقدمة. تتيح هذه الدالة إلغاء الحاجة تماماً للتركيبات الطويلة والمعقدة لعزل القيم غير المكررة.
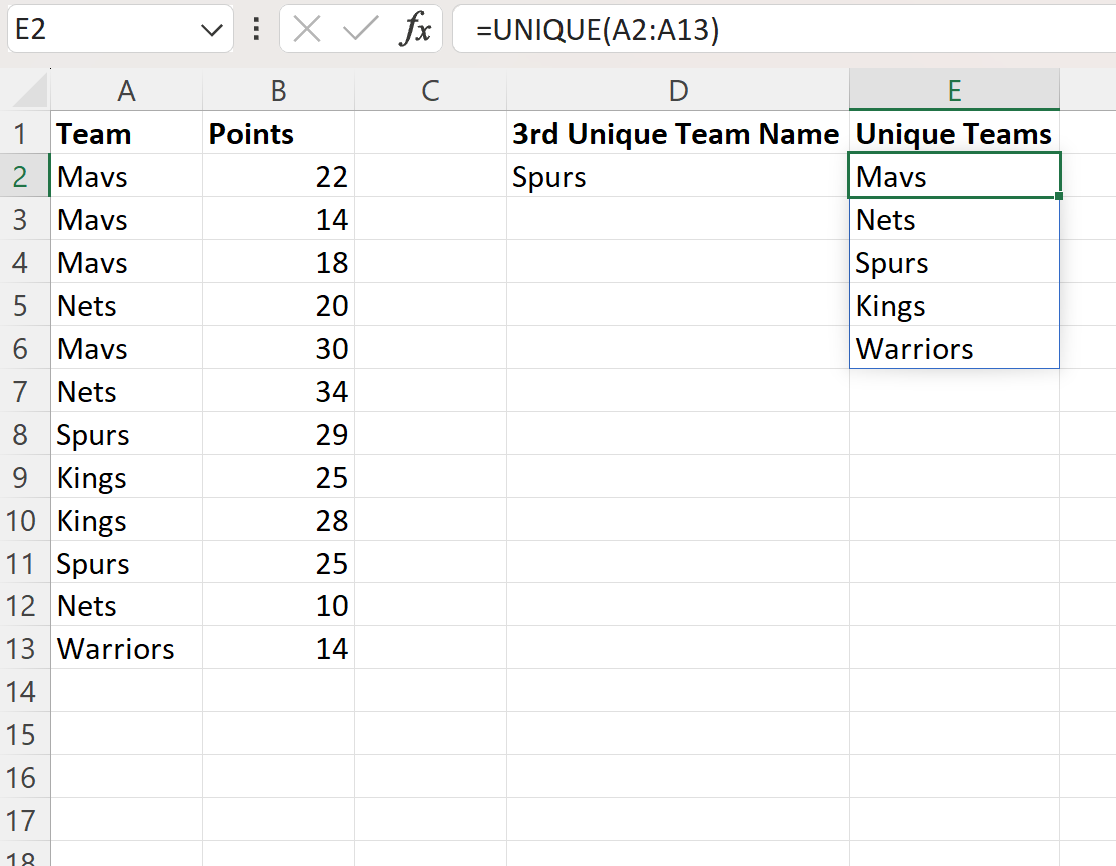
عند كتابة الصيغة البسيطة =UNIQUE(A2:A11) في خلية فارغة مثل E2، يقوم إكسيل تلقائياً بإنشاء قائمة منسكبة (Spilled Array) تضم العناصر الفريدة فقط وفق أسبقية ظهورها الدقيق: Celtics، ثم Lakers، ثم Warriors، ثم Nets، ثم Pacers. تتيح هذه الميزة الحديثة للمحلل إجراء تدقيق بصري وإحصائي فوري للتحقق من سلامة المخرجات التي تولدها الصيغ المصفوفية الكلاسيكية، وتؤكد تطابق النتائج عبر بيئات العمل التقنية المختلفة.
5.2 دمج دالتي INDEX و UNIQUE كحل متقدم ومبسط
يوفر التكامل بين دالتي INDEX و UNIQUE البديل العصري الأكثر أناقة واختصاراً لاستخراج القيمة الفريدة ذات الرتبة N دون الخوض في تعقيدات دوال MATCH و ROW و SMALL. يتم تطبيق هذا الحل المتقدم عبر صياغة تعبيرية موجزة ومباشرة تأخذ الشكل الآتي:
=INDEX(UNIQUE(A2:A11), 3)
وفي التحديثات البرمجية الأكثر حداثة لإكسيل، يمكن أيضاً استخدام دالة CHOOSEROWS لتحقيق الغرض ذاته عبر التعبير: =CHOOSEROWS(UNIQUE(A2:A11), 3). تعمل هذه الصيغ الحديثة بطريقة سلسة للغاية؛ حيث تقوم دالة UNIQUE في الذاكرة بتوليد مصفوفة أحادية البعد مقلصة تحتوي حصراً على الكيانات غير المكررة، ثم تتولى دالة INDEX (أو CHOOSEROWS) استرجاع القيمة المقابلة للرقم N مباشرة. يقلص هذا النمط البرمجي زمن كتابة الصيغ، ويحد بصورة ملموسة من احتمالات الخطأ البشري، فضلاً عن تعزيز وضوح النماذج وسهولة مراجعتها وصيانتها لاحقاً من قبل فرق العمل المختلفة.
5.3 مقارنة دقة المخرجات وثبات البيانات المرجعية
عند إجراء مقارنة فنية بين الطريقة الكلاسيكية المركبة والأسلوب الديناميكي الحديث، نجد تطابقاً تاماً في دقة المخرجات الرقمية؛ إلا أن الفروق التشغيلية تظهر بوضوح عند تعديل بنية البيانات. فعند إدراج صفوف جديدة أو تغيير ترتيب السجلات، يتفاعل كلا النموذجين بمرونة، شريطة أن تكون النطاقات المرجعية تشمل المدخلات المعدلة.
ومع ذلك، تتفوق الصياغة الحديثة =INDEX(UNIQUE(...), n) في ثبات الأداء الحسابي ومقاومة التشوهات البنيوية؛ فالصيغة الكلاسيكية قد تتعرض لأخطاء مرجعية خفية في حال قيام المستخدم بنسخ الخلايا أو حذف أول صف مرجعي يعتمد عليه تصحيح الدالة ROW($A$2). في المقابل، تحافظ الدوال الديناميكية على مرونتها واستقلاليتها المفاهيمية، مما يجعلها الخيار المفضل للمؤسسات التي تستخدم أحدث إصدارات برمجيات الحوسبة المكتبية السحابية.
6. تطوير الصيغة للتعامل مع المتغيرات الديناميكية للموقع N
6.1 ربط الرتبة N بخلية تحكم خارجية تفاعلية
لرفع كفاءة النماذج التحليلية وتطويرها لتصبح لوحات تحكم تفاعلية (Interactive Dashboards)، يجب الابتعاد عن تثبيت الأرقام الثابتة (Hardcoded Values) داخل نص الصيغ البرمجية. يمكن تحقيق ذلك بربط المعامل N بمرجع خلية خارجية منفصلة، مثل الخلية D2. يتم تعديل الصيغة الكلاسيكية لتصبح:
=INDEX($A$2:$A$11, SMALL(IF(MATCH($A$2:$A$11, $A$2:$A$11, 0) = ROW($A$2:$A$11) - ROW($A$2) + 1, ROW($A$2:$A$11) - ROW($A$2) + 1), $D$2))
وكذلك تعديل الصيغة الحديثة لتصبح: =INDEX(UNIQUE($A$2:$A$11), $D$2). يتيح هذا التصميم للمستخدم تغيير الرتبة المستهدفة بمجرد كتابة الرقم المطلوب في الخلية D2 (مثلاً 1، أو 2، أو 4)، لتتحدث النتيجة آنياً دون الحاجة للدخول إلى محرر الصيغ وتعديل مكوناته البرمجية. ولدعم تجربة المستخدم، يمكن دمج هذه الخلية مع أدوات “التحقق من صحة البيانات” (Data Validation) لإنشاء قائمة منسدلة تحدد الخيارات المتاحة بدقة، مما يقلل احتمالات إدخال رتب غير منطقية تخرج عن حدود المصفوفة البيانية.
6.2 استخراج القيمة الفريدة الأولى والأخيرة كحالات خاصة
يمثل استدعاء الطرفين الحديين لمجموعة البيانات (القيمة الأولى والقيمة الأخيرة) حالة استخدام متكررة في التقارير الإدارية والإحصائية. للحصول على القيمة الفريدة الأولى، يتم تعيين المتغير $N=1$ بصورة مباشرة. أما لاستخراج القيمة الفريدة الأخيرة ضمن تسلسل الظهور، فإن الأمر يتطلب معالجة حسابية لحساب إجمالي عدد العناصر الفريدة المتاحة في النطاق واستخدام هذا الإجمالي كمعامل للرتبة N.
في البيئة الحديثة، يتم استدعاء القيمة الفريدة الأخيرة عبر دمج دالتي ROWS و COUNTA مع دالة UNIQUE على النحو الآتي: =INDEX(UNIQUE(A2:A11), ROWS(UNIQUE(A2:A11))). تقوم الدالة الداخلية بحساب عدد صفوف المصفوفة الفريدة، ثم تمرير هذا الرقم تلقائياً إلى دالة الفهرسة. أما في النظم الكلاسيكية، فيتم استخدام دالة MAX بدلاً من دالة SMALL لاستخراج أعلى رقم صف نسبي فريد مسجل، مما يؤدي تلقائياً إلى توجيه دالة INDEX لاسترجاع آخر عنصر متميز تم إدخاله في الجدول بأمان وموثوقية.
6.3 تطبيق النطاقات الديناميكية المتوسعة تلقائياً
تواجه الصيغ المبنية على نطاقات ثابتة (مثل A2:A11) قصوراً واضحاً عند استيراد بيانات جديدة بصورة دورية، مما يفرض تعديل النطاقات يدوياً لتشمل الصفوف المضافة. لتجاوز هذه المحدودية، يُوصى بتحويل النطاق الميداني إلى جدول بيانات رسمي عبر إكسيل من خلال تحديد الخلايا والضغط على اختصار لوحة المفاتيح Ctrl + T، وتسمية الجدول مثلاً باسم DataTable وتسمية العمود Teams.
تتيح الجداول الرسمية استخدام “المراجع المهيكلة” (Structured References) داخل المعادلات، فتتحول الصيغة الحديثة إلى الصيغة المرنة التالية: =INDEX(UNIQUE(DataTable[Teams]), D2). وبالمثل، يمكن صياغة المعادلة الكلاسيكية بالاعتماد على أسماء أعمدة الجدول بدلاً من مراجع الخلايا الإحداثية. تتميز المراجع المهيكلة بقدرتها الذاتية على التوسع والانكماش التلقائي بمجرد لصق صفوف إضافية في أسفل الجدول أو حذف سجلات قائمة، مما يمنع انكسار الروابط المرجعية ويجعل خطوط المعالجة البيانية مستقرة ومؤتمتة بالكامل.
7. إدارة الأخطاء ومعالجة الاستثناءات في مصفوفات البيانات
7.1 معالجة خطأ تجاوز السعة العددية #NUM!
يعد الخطأ الحسابي #NUM! أكثر الأعطال البرمجية شيوعاً عند التعامل مع صيغ استخراج القيمة الفريدة رقم N. ينشأ هذا الخطأ في المقام الأول عند تحديد قيمة للمعامل N تكون سالبة أو مساوية للصفر، أو عندما تتجاوز القيمة المعطاة إجمالي عدد العناصر الفريدة المتوفرة فعلياً داخل فضاء الإدخال (كأن يطلب المستخدم استخراج القيمة الفريدة العاشرة في جدول لا يحتوي في حقيقته إلا على خمسة عناصر فريدة فقط).
لتفادي هذا العطل غير المرغوب فيه، ينبغي تطبيق استراتيجية التحقق الاستباقي من صحة الرتبة عبر دمج دالة IF شرطية قبل تشغيل معادلة الفهرسة. يتم ذلك بمقارنة قيمة N المحفوظة في الخلية D2 بإجمالي العناصر المتاحة المحسوبة عبر دالة الفرز؛ فإذا كانت $D2 > ROWS(UNIQUE(Range))$، يُعرض تنبيه مخصص يوضح أن الرتبة تقع خارج حدود النطاق المسموح به. يضمن هذا الإجراء الوقائي بقاء لوحات القياس التحليلية محمية من الرموز الحسابية المشوشة، ويعزز من متانة النظم المالية والإدارية التي تبنى على هذه المخرجات.
7.2 التعامل مع الخلايا الفارغة والسجلات غير المكتملة
تؤدي وجود خلايا فارغة متفرقة ضمن نطاق الإدخال إلى تشوهات حسابية جسيمة في عمل الصيغ المصفوفية الكلاسيكية والحديثة على حد سواء. فدالة MATCH التقليدية ستعامل الخلايا الفارغة كمدخلات مفقودة وتصدر خطأ عدم المطابقة #N/A إذا لم يتم ضبط معاييرها بعناية، كما أن دالة UNIQUE الحديثة ستعتبر الخلية الفارغة عنصراً فريداً قائماً بذاته، وترجعه في المصفوفة على هيئة الرقم صفر (0)، مما يؤدي إلى تلويث التقارير المستخرجة بمعلومات غير دقيقة.
لتحصين الصيغة ضد ثغرة الفراغات، يجب إدخال شرط إضافي يستبعد الخلايا غير المكتملة؛ ففي البيئة الحديثة ندمج دالة FILTER مع دالة UNIQUE على النحو التالي: =INDEX(UNIQUE(FILTER(A2:A20, A2:A20"")), D2). أما في الصيغة الكلاسيكية، فيتم تعديل الشرط المنطقي الداخلي ليتضمن اختبار التحقق ($A$2:$A$20"") مدمجاً بعملية ضرب منطقية مع شرط الفهارس المتطابقة، مما يضمن إسقاط وتجاوز السجلات الفارغة وكأنها غير موجودة، وحفظ اتساق التسلسل الترتيبي للبيانات المكتملة فقط.
7.3 تحصين الصيغة باستخدام دالتي IFERROR و ISBLANK
يقتضي التطوير الاحترافي للجداول الحسابية بناء طبقة دفاعية نهائية تحيط بالمعادلات المركبة للتعامل مع أي سلوك تشغيلي استثنائي غير متوقع، وذلك بتوظيف دالة الأمان الإدارية IFERROR. تتيح هذه الدالة التقاط كافة أنواع الأخطاء (سواء كانت #NUM!، أو #N/A، أو #VALUE!) واستبدالها بنصوص واضحة وإرشادية تسهل على المدخلين معالجة الخلل، كما في الصيغة الآتية:
=IFERROR(INDEX(UNIQUE(FILTER(A2:A11, A2:A11"")), D2), "الرتبة المحددة غير متوفرة")
بالتوازي مع ذلك، يمكن توظيف دالة ISBLANK لفحص خلية التحكم D2 قبل الشروع في العمليات؛ فإذا كانت الخلية المرجعية فارغة، تمنع الصيغة استمرار دورة الحسابات وتعرض فراغاً أنيقاً "" بدلاً من محاولة تقييم الفراغ كرقم صف صفري يتسبب في تعطل السجل بأكمله. إن هذه الإضافات الدفاعية لا تؤثر إطلاقاً على دقة العمليات الرياضية الكامنة، ولكنها تضفي على ورقة التحليل طابعاً مؤسسياً منضبطاً يتوافق مع أفضل ممارسات تصميم البرمجيات والتقارير الإحصائية المتقدمة.
8. تحليل الكفاءة الحاسوبية والأداء في قواعد البيانات الضخمة
8.1 الأثر الحسابي لصيغ المصفوفات على زمن معالجة المصنف
عند تقييم كفاءة المعالجة الخوارزمية للصيغة الكلاسيكية لاستخراج القيمة الفريدة رقم N، يلاحظ المتخصصون في علوم الحاسوب أنها تتبع نمط التعقيد الزمني التربيعي $O(N^2)$، حيث يستلزم تقييم دالة MATCH(range, range, 0) إجراء مسح دوري شامل للنطاق بأكمله لكل عنصر من عناصره بصورة منفصلة. في الجداول الصغيرة التي لا تتعدى بضع مئات من الأسطر، يكون الزمن المستغرق غير محسوس؛ غير أن تطبيق هذه الصيغة على جداول تحوي ما يزيد على 50,000 أو 100,000 صف يؤدي إلى اختناق حاد في مسارات المعالجة المركزية (CPU Bottleneck).
يتجلى هذا الأثر السلبي بوضوح إذا ما تكرر تطبيق الصيغة المصفوفية الكلاسيكية ذاتها في عدة أعمدة أو خلايا متجاورة داخل نفس المصنف؛ إذ يتضاعف عدد العمليات الحسابية بصورة متسارعة، الأمر الذي يؤدي في كثير من الأحيان إلى تجميد واجهة إكسيل مؤقتاً، وتأخر زمن إعادة الحساب التلقائي (Recalculation Time) بشكل يعيق تدفق الأعمال والتحليلات الفورية بصورة ملموسة.
8.2 أفضل الممارسات لتحسين سرعة إعادة الحساب الدوري
للتخفيف من الأعباء التشغيلية والحفاظ على استجابة المصنف، يتعين اتباع بروتوكولات تحسين الأداء عند كتابة الصيغ الحسابية المعقدة. أولى هذه القواعد وأكثرها أهمية هي الامتناع التام عن الإشارة إلى الأعمدة الكاملة دون قيد (مثل كتابة A:A)، حيث يجبر هذا النمط محرك البرنامج على مسح ما يزيد على مليون خلية في الذاكرة حتى لو كانت الغالبية العظمى منها فارغة؛ وبدلاً من ذلك يجب تحديد نطاق البيانات الفعلية بصرامة (مثل A2:A5000) أو استخدام الجداول الرسمية المهيكلة.
كما يُوصى، عند الضرورة الحتمية لاستخدام الصيغ الكلاسيكية في مجموعات البيانات الكبيرة، باللجوء إلى “الأعمدة المساعدة” (Helper Columns)؛ حيث يتم تقسيم العملية الحسابية إلى مرحلتين: يخصص عمود خفيف لحساب مؤشر التكرار الفردي، بينما تتولى الخلية المستهدفة استخراج القيمة بالاعتماد على مخرجات العمود المساعد. هذا الإجراء يفكك التعقيد التربيعي ويحوله إلى تعقيد خطي نسبي يخفف الضغط على المعالج، فضلاً عن إمكانية تحويل وضع إعادة الحساب داخل خيارات إكسيل إلى الوضع “اليدوي” (Manual Calculation) لتجنب انطلاق الحسابات الشاملة عند كل تعديل طفيف يطرأ على البيانات.
8.3 الفروق المعمارية بين محركات إكسيل التقليدية والحديثة
ترجع الفجوة الشاسعة في سرعة التنفيذ بين الصيغ القديمة والدوال الحديثة إلى الاختلاف الجذري في المعمارية البرمجية لمحركات الحسابات في إكسيل. تعتمد دالة UNIQUE الحديثة في جوهرها على خوارزميات “جداول التجزئة” (Hash Sets)، والتي تتيح فرز القيم المكررة واستخراج الكيانات المتميزة بتعقيد زمني يقترب من التعقيد الخطي الشبه مثالي $O(N)$.
يقوم محرك المصفوفات الديناميكية بحساب متجهات التجزئة مسبقاً وتخزينها بكفاءة عالية في الذاكرة العشوائية السريعة، متجاوزاً عمليات المقارنة المتقاطعة المرهقة التي كانت تفرضها دالتا MATCH و ROW في الصيغ الكلاسيكية. ولذلك، تُعد البيئات الحديثة التي تدعم دالة UNIQUE خياراً حاسوبياً متفوقاً لإجراء التحليلات الإحصائية المتقدمة على قواعد البيانات المؤسسية الضخمة دون التعرض لمخاطر بطء الأداء أو استهلاك الموارد المفرط الذي كانت تعاني منه النماذج الرياضية القديمة.
9. حالات متقدمة: الاستخراج المشروط والفرز المسبق للقيم
9.1 استخراج القيمة الفريدة رقم N وفقاً لمعايير وشروط متعددة
في كثير من السيناريوهات التحليلية، لا يكون المطلوب استخراج القيمة الفريدة من السجل بأكمله، بل استخراج تلك التي تحقق شروطاً قطاعية محددة؛ كأن نرغب في استخراج القيمة الفريدة رقم N للفرق التابعة لمنطقة جغرافية معينة، أو المبيعات المحققة خلال شهر محدد. يتطلب هذا السيناريو تطويع الصياغة لتشمل عوامل تصفية منطقية متزامنة.
في البيئة الحديثة، يتم تحقيق ذلك بمنتهى الأناقة بدمج دالة FILTER مع دالة UNIQUE؛ فإذا كان نوع التصنيف مدوناً في العمود B والمطلوب هو قصر البحث على فئة “East”، تصاغ المعادلة على النحو الآتي:
=INDEX(UNIQUE(FILTER(A2:A11, B2:B11="East")), D2)
أما في المنظومة الكلاسيكية، فيتم تطبيق هذا الشرط عبر ضرب المصفوفات المنطقية داخل دالة IF، بحيث يتم اشتراط تحقق معيار التطابق الفهرسي ومعيار القسم المتزامن معاً ((MATCH(...) = ROW(...)) * (B2:B11="East"))، مما يؤدي إلى استبعاد كافة السجلات غير المطابقة للشرط مسبقاً وتمرير المواقع المؤهلة فقط لدالة SMALL لاختيار الرتبة المطلوبة.
9.2 مراعاة حساسية حالة الأحرف في البيانات النصية اللاتينية
تتسم دوال البحث القياسية في إكسيل (بما فيها دالتا MATCH و UNIQUE افتراضياً) بعدم حساسيتها لحالة الأحرف (Case-Insensitive)؛ حيث تعامل الكلمات المكتوبة بحروف كبيرة وتلك المكتوبة بحروف صغيرة (مثل “EXCEL” و “Excel”) كمدخلات متطابقة تماماً. وإذا كانت طبيعة التحليل العلمي أو اللغوي تفرض التمييز الصارم بين هذه المتغيرات، فإن الصيغ الافتراضية ستخفق في تلبية المتطلب.
لحل هذه المعضلة الدقيقة، يتم دمج دالة المطابقة الحرفية الصارمة EXACT. تقوم هذه الدالة بإجراء مقارنة ثنائية تدقيقية لكل بايت من أحرف النصوص. يتم بناء مصفوفة منطقية تعتمد على EXACT لمقارنة كل خلية بالخلايا السابقة لها في النطاق؛ فإذا لم يسبق ظهور النص بنفس تطابق حالة الأحرف الحرفي الدقيق، يُسمح له بالمرور كعنصر فريد مستقل. يتيح هذا الدمج المتقدم استخراج الرتب الفريدة بدقة فائقة حتى في قواعد البيانات التقنية الحساسة التي تتضمن رموزاً برمجية أو جزيئية متمايزة بناءً على حالة الأحرف اللاتينية.
9.3 فرز القيم الفريدة أبجدياً أو رقمياً قبل استدعاء الرتبة N
يتمثل القيد التشغيلي الأبرز في الصيغ التي استعرضناها سابقاً في استنادها الحصري إلى “ترتيب الظهور الزمني” داخل السجل الأصلي. بيد أن الاحتياجات الإدارية كثيراً ما تتطلب استدعاء القيمة الفريدة التي تحتل المرتبة الثالثة وفقاً لتسلسلها “الهجائي أو الرقمي الذاتي” وليس وفق ترتيب ورودها بالجدول، كمعرفة ثالث اسم عميل فريد بحسب الترتيب الأبجدي لتوزيع المهام على فرق العمل.
في إكسيل الحديث، يمكن تحقيق هذا التعديل المعقد بسهولة فائقة عن طريق إقحام دالة الترتيب SORT ضمن السلسلة الحسابية، بحيث تصبح المعادلة كالآتي:
=INDEX(SORT(UNIQUE(A2:A11)), D2)
تقوم هذه المعادلة المركبة باستخلاص الكيانات الفريدة أولاً، ثم إعادة ترتيبها أوتوماتيكياً من الألف إلى الياء (أو تصاعدياً في الأرقام)، ثم تسليم المصفوفة المرتبة والمرقمة إلى دالة INDEX لجلب العنصر المستهدف بالرتبة N. أما في الإصدارات القديمة، فإن تحقيق الفرز الأبجدي بدون دوال المصفوفات الحديثة يتطلب صياغة معادلات تفوق في تعقيدها كل ما سبق باستخدام دوال الفرز الإحصائي المعتمدة على COUNTIF الموسعة، مما يؤكد الميزة التحويلية الكبرى التي أحدثتها تحديثات البرنامج المتأخرة في تيسير التحليلات المعقدة.
10. المفاضلة المنهجية بين الصيغ المركبة والحلول البرمجية البديلة
10.1 استخدام أداة تجميع وتحويل البيانات Power Query كبديل مستدام
عندما تتعاظم أحجام مجموعات البيانات وتتجاوز مئات الآلاف من السجلات، يصبح الاعتماد على المعادلات الحسابية المضمنة في الخلايا عبئاً تشغيلياً على النظام. هنا تبرز أداة Power Query المدمجة في إكسيل كأحد الحلول المؤسسية الأكثر قوة واستدامة؛ حيث توفر واجهة متقدمة لاستيراد البيانات، وتطهيرها، وإجراء عمليات الفرز المتقدم دون استهلاك الذاكرة الحية لورقة العمل.
يمكن استخراج القيمة الفريدة رقم N عبر Power Query باتباع خطوات بسيطة وموثقة تشمل: استيراد العمود المستهدف، وتطبيق أمر “إزالة التكرارات” (Remove Duplicates) بنقرة واحدة، ثم فرز العمود إذا لزم الأمر، وإضافة “عمود فهرس تسلسلي” (Index Column) يبدأ من الرقم 1، وأخيراً تصفية هذا العمود لاختيار السجل ذي المؤشر N. يمتاز هذا النهج بأنه يتم بمعزل عن طبقة الخلايا، مما يتيح معالجة مجموعات بيانية هائلة الحجم بكفاءة فائقة وسرعة قياسية، مع إمكانية تحديث البيانات بنقرة زر واحدة (Refresh) متى ما وردت تحديثات للمصدر الأصلي.
10.2 برمجة دوال مخصصة عبر Visual Basic for Applications (VBA)
بالنسبة للمستخدمين الذين يتعين عليهم العمل ضمن إصدارات إكسيل قديمة ولكنهم يرغبون في تجنب تعقيدات صيغ المصفوفات الكلاسيكية المرهقة، تبرز بيئة البرمجة الداخلية VBA كخيار هندسي فائق المرونة. يمكن للمبرمج كتابة دالة مخصصة ومعرفة من قبل المستخدم (UDF) تؤدي المهمة باقتدار، بالاعتماد على كائن المعجم البرمجي Scripting.Dictionary الذي صُمم خصيصاً في هندسة البرمجيات لتخزين المفاتيح الحصرية واستبعاد التكرارات تلقائياً.
تتيح كتابة دالة برمجية مثل GetNthUnique(rng As Range, N As Long) As Variant استقبال النطاق الميداني والرتبة كمعاملات مباشرة، حيث تقوم الخوارزمية الداخلية بالمرور على الخلايا وإيداع العناصر غير المكررة في المعجم حتى استيفاء العدد، ثم ترجع مباشرة العنصر الذي يحتل الترتيب N. ورغم مرونة هذه الطريقة، إلا أن عيبها يكمن في ضرورة حفظ المصنف بصيغة تدعم وحدات الماكرو (مثل XLSM)، وهو ما قد يثير تحذيرات أمنية أو قيوداً تنظيمية صارمة في شبكات العمل المشتركة لدى المؤسسات المالية والجهات الحكومية الحساسة.
10.3 مصفوفة اتخاذ القرار لاختيار الأداة المثلى في معالجة البيانات
لضمان اختيار المقاربة التقنية المثلى من بين الخيارات المتاحة، تم تطوير مصفوفة القرار المنهجية الموضحة في الجدول الإحصائي المقارن التالي، والتي تقيّم كل طريقة وفق معايير الأداء التشغيلي وسهولة الصيانة ومستوى التعقيد والبيئة الداعمة:
| المنهجية المتبعة | البيئة التشغيلية المتوافقة | الكفاءة الحاسوبية والسرعة | سهولة التطبيق والصيانة | الاستخدام الأنسب والموصى به |
|---|---|---|---|---|
| صيغة المصفوفات الكلاسيكية (INDEX/SMALL/IF/MATCH) | كافة إصدارات إكسيل (قديمة وحديثة) | منخفضة في النطاقات الكبيرة $O(N^2)$ | معقدة وتتطلب تركيزاً رياضياً دقيقاً | المصنفات المشتركة مع جهات تستخدم إصدارات قديمة ومجموعات بيانات صغيرة. |
| صيغ المصفوفات الديناميكية (INDEX/UNIQUE) | Microsoft 365 و Excel 2021 فما أحدث | عالية جداً وخوارزمية سريعة $O(N)$ | بسيطة جداً ومباشرة وسهلة القراءة | بيئات العمل الحديثة ولوحات التحكم التفاعلية اليومية والسريعة. |
| أداة استعلام البيانات (Power Query) | Excel 2010 فما أحدث (مضمن تلقائياً) | فائقة ومصممة لقواعد البيانات المتضخمة | متوسطة وتعتمد على واجهة مرئية | خطوط المعالجة المؤسسية، والبيانات المجمعة دورياً، والجداول المليونية. |
| البرمجة النصية المخصصة (VBA Macros) | بيئات الحواسيب المكتبية الداعمة لماكرو | عالية جداً عند توظيف كائن المعجم | تتطلب معرفة متقدمة بالأكواد البرمجية | الأتمتة التخصصية المغلقة والتطبيقات الداخلية التي تتطلب معالجات استثنائية. |
تثبت هذه المقارنة أن الخيار المثالي يرتكز في نهاية المطاف على بيئة العمل المؤسسية؛ فبينما يظل الجمع الحديث بين دالتي INDEX و UNIQUE هو التوصية الفنية الأولى للمصنفات التحليلية اليومية المعاصرة لسرعته ومرونته، تظل معرفة البنية الكلاسيكية رصيداً تقنياً لا غنى عنه للمحلل لضمان حل المشكلات البرمجية والتأكد من صمود النماذج الحسابية في مختلف بيئات التشغيل دون انقطاع.
الخلاصة
استعرضنا في هذا الدليل التحليلي المعمق الآليات الرياضية والتقنية المتبعة لإيجاد واستخراج القيمة الفريدة رقم N داخل جداول بيانات مايكروسوفت إكسيل، مبرزين التمايز بين البنى المصفوفية الكلاسيكية القائمة على منظومة التفاعل المنطقي بين دوال INDEX و SMALL و IF و MATCH، والتحولات الجوهرية التي أحدثتها محركات المصفوفات الديناميكية الحديثة عبر دالة UNIQUE والدوال الداعمة لها.
وقد أظهر التحليل أن فهم المنطق الداخلي لمعادلات المصفوفات القديمة لا يمثل فقط تدريباً تقنياً على تفكيك بنية البيانات المعقدة، بل يشكل صمام أمان مهنياً يتيح للمحلل الإحصائي والمالي بناء نماذج مرنة، ومقاومة للأخطاء، وقابلة للتوافق الشامل مع مختلف إصدارات البرمجيات المكتبية دون انكسار في مسارات الحساب التلقائي. ومع تطور متطلبات المعالجة والاتجاه المتسارع نحو قواعد البيانات الضخمة، يتعين على المتخصصين موازنة الأداء الحسابي للأدوات المختارة، والتوجه نحو الحلول الحديثة أو الأدوات التحويلية المستدامة مثل Power Query لضمان كفاءة التحليل وسرعة استخلاص المؤشرات المعرفية بدقة متناهية.
المراجع
- Bobbitt, Z. (2023, June 20). How to Find the Nth Unique Value in Excel (With Example). Statology. https://www.statology.org/excel-find-nth-unique-value/
- Microsoft Corporation. (n.d.). UNIQUE function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/unique-function-c5ab87fd-30a3-4ce9-9d1a-40204fb85e1e
- Microsoft Corporation. (n.d.). INDEX function. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/index-function-a5dcf0dd-996d-40a4-a822-b56b061328bd
- Microsoft Corporation. (n.d.). Guidelines and examples of array formulas. Microsoft Support. Retrieved from https://support.microsoft.com/en-us/office/guidelines-and-examples-of-array-formulas-7d94a64e-3ff3-4686-9372-ecfd5caa57c7