
يحتل الاستدلال الإحصائي مكانة محورية في بنية البحث العلمي المعاصر، لاسيما في حقول العلوم النفسية والسلوكية والتربوية التي تتعامل مع ظواهر إنسانية تتسم بالتعقيد وتعدد المتغيرات. إن الانتقال المنهجي من الملاحظة التجريبية الخام إلى صياغة استنتاجات علمية قابلة للتعميم يتطلب أدوات رياضية تمتاز بالدقة والموثوقية، ويقف اختبار تائي (Student’s t-test) وتوزيعه الاحتمالي كأحد أبرز هذه الأعمدة المنهجية منذ بدايات القرن العشرين. يتيح هذا الاختبار للباحثين تقييم الفروق الجوهرية بين المتوسطات الحسابية، واختبار مدى اتساق البيانات المرصودة مع الفرضيات النظرية المطروحة، متجاوزاً بذلك عوائق التباينات العشوائية وأخطاء المعاينة المتأصلة في جمع البيانات الإكلينيكية والميدانية.
مع ذلك، فإن استخراج قيمة درجة تائية (t-score) المحسوبة يمثل نصف الطريق نحو الحسم الإحصائي؛ إذ تظل هذه القيمة مجرد مقياس نسبي للمسافة المعيارية ما لم تُترجم إلى كمية احتمالية صريحة تُعرف بالقيمة الاحتمالية (p-value). تعبر هذه القيمة بدقة متناهية عن مدى احتمالية رصد هذه الفروق في حال كانت فرضية العدم صحيحة تماماً في المجتمع الأصلي. وهنا تتجلى قوة البرمجيات الحاسوبية، وعلى رأسها برنامج مايكروسوفت إكسيل (Microsoft Excel)، كأداة تحليلية ميسرة لكنها فائقة الدقة والصرامة الرياضية، قادرة على تحويل الدرجات الإحصائية المعقدة إلى قيم احتمالية فورية تسترشد بها القرارات التشخيصية والأكاديمية، شريطة فهم المنطق البرمجي والرياضي الكامن وراء دوالها المتخصصة.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تفكيك نظري وتطبيقي شامل لكيفية إيجاد وتفسير القيمة الاحتمالية المستندة إلى درجة t داخل بيئة إكسيل. سنستعرض الرحلة المنهجية ابتداءً من الأسس الإبستمولوجية لاختبار الفروض والخصائص التوزيعية لمنحنى ستيودنت التكراري، مروراً بالمعادلات الرياضية والمحددات التي تحكم سلوك دوال إكسيل التراكمية، ووصولاً إلى التطبيقات الإكلينيكية المعمقة وتوثيق المخرجات وفق أحدث معايير جمعية علم النفس الأمريكية (APA). ومن خلال التركيز على المعالجات الإحصائية الرصينة، يُقدم هذا النص مرجعاً متكاملاً للباحثين والمحللين الساعين لتوظيف البيانات النفسية باحترافية وتجنب المزالق الإحصائية الشائعة.
1. مدخل نظري لاختبار الفروض الإحصائية في القياس النفسي
1.1 أهمية اختبار الفروض في أبحاث العلوم النفسية والسلوكية
تنطلق الأبحاث السلوكية والعيادية من الحاجة الماسة للتمييز بين الأنماط السلوكية الحقيقية والتقلبات الصدفية الناتجة عن تباين العينات. في القياس النفسي، لا تمثل الدرجة الخام التي يحصل عليها المستجيب حقيقة مطلقة، بل هي مزيج من السمة الكامنة وخطأ القياس العشوائي، وهو مفهوم أصله كلاسيكيات القياس السيكومتري وأكده مونتروز وولف (Wolf, 1978) عند تناول الصدق الاجتماعي وقياس السلوك الإنساني. ولتقييم ما إذا كان برنامج إرشادي جديد يخفف حقاً من حدة أعراض التوتر أو يحسن من جودة الحياة، لا يكفي مجرد مقارنة المتوسطات حسابياً، بل يتعين إخضاع تلك الفروق لاختبار الفروض الإحصائية الصارم لتحديد احتمالية حدوث تلك الفروق بمحض الصدفة البحتة.
تقوم صياغة الفرضيات على تقابل منهجي دقيق بين فرضية العدم الصفرية ($H_0$)، التي تفترض انعدام الفروق الحقيقية بين المجتمعات أو استقرار السمة النفسية دون تغيير، والفرضية البديلة ($H_1$)، التي تتبنى وجود أثر تدخلي أو فارق دال بين المجموعات. إن الصياغة المحكمة لهذه الفرضيات تمنع الوقوع في الانحياز التأكيدي لدى المعالج النفسي أو المجرب السلوكي. يعتمد اتخاذ القرار النهائي برفض الفرضية الصفرية أو الإخفاق في رفضها على قواعد الاستدلال الإحصائي، التي تضع أطراً احتمالية تقنن الشك وتقلل من احتمالية تبني تدخلات علاجية غير مجدية، أو رفض علاجات واعدة بدعوى عدم ثبوت أثرها.
في التطبيقات الإكلينيكية، تكتسب هذه المقاربة أهمية مضاعفة؛ إذ يرتبط اتخاذ القرار السريري بإجراءات تشخيصية ومسارات علاجية مكلفة ومؤثرة في حياة الأفراد، كما يظهر جلياً في بروتوكولات الرعاية التشاركية للاكتئاب والقلق (Archer et al., 2012). إن تقييم فاعلية العقاقير النفسية أو جلسات العلاج المعرفي السلوكي يتطلب استدلالاً إحصائياً يحمي المريض من الوقوع ضحية الخطأ من النوع الأول (رفض فرضية العدم الصائبة)، ويحمي العلم من تفويت اكتشاف علاجات فعالة نتيجة الخطأ من النوع الثاني (الإبقاء على فرضية العدم الخاطئة). من هنا، يمثل الاستدلال الإحصائي الركيزة الأخلاقية والمنهجية التي تضمن سلامة الممارسة النفسية وصرامتها العلمية.
1.2 التعريف الرياضي لدرجة t ودلالتها الإحصائية
تُعرف درجة t الإحصائية رياضياً بأنها نسبة انحراف المعلمة المقدرة (متوسط العينة) عن قيمتها المفترضة في المجتمع الأصلي مقسوماً على الخطأ المعياري لهذا التقدير. في حالة العينة الواحدة، تأخذ المعادلة الشكل الكلاسيكي التالي:
$$t = \frac{\bar{x} – \mu_0}{s / \sqrt{n}}$$
حيث يمثل $\bar{x}$ المتوسط الحسابي الملاحظ في العينة، و$\mu_0$ المتوسط المفترض للمجتمع، و$s$ الانحراف المعياري للعينة، و$n$ حجم العينة الإجمالي. يوضح هذا البناء الرياضي أن قيمة t المحسوبة هي ترجمة للفرق الخام إلى وحدات معيارية تسمى بالخطأ المعياري للمتوسط ($SE = s / \sqrt{n}$). فكلما كان التباين الداخلي داخل العينة صغيراً وحجم العينة كبيراً، تقلص الخطأ المعياري، مما يؤدي بالضرورة إلى تضخيم قيمة t الناتجة حتى لو كان الفارق المطلق بين المتوسطين متواضعاً نسبياً.
يرجع الفضل في تأسيس هذا التوزيع إلى العالم الإحصائي ويليام سيلي جوسيت (William Sealy Gosset)، الذي نشر ورقته التأسيسية عام 1908 تحت الاسم المستعار “ستيودنت” (Student) لأسباب تتعلق بسياسات سرية العمل لدى مصانع غينيس في دبلن. لاحقاً، قام العالم الفذ رونالد أيلمر فيشر (Ronald A. Fisher) عام 1925 بإعادة صياغة هذا التوزيع بربطه المباشر بمفهوم درجات الحرية ($n-1$) وتعميمه على التحليلات الانحدارية والمقارنات الثنائية. يختلف توزيع t عن التوزيع الاعتدالي المعياري ($Z$) في كونه يمتلك ذيولاً أكثر اتساعاً وسمكاً (leptokurtic)، وذلك لتعويض حالة عدم اليقين الناتجة عن تقدير الانحراف المعياري للمجتمع ($\sigma$) المجهول باستخدام الانحراف المعياري للعينة ($s$). وكلما زاد حجم العينة واقتربت درجات الحرية من اللانهاية، يقترب توزيع t تدريجياً ليتطابق بنيوياً مع التوزيع الطبيعي المعياري.
1.3 مفهوم القيمة الاحتمالية ومستويات الدلالة المعتمدة
تُعرف القيمة الاحتمالية ($p\text{-value}$) بأنها الاحتمال الرياضي الممتد تحت منحنى التوزيع التكراري، الذي يقيس فرصة الحصول على إحصاء اختباري (مثل قيمة t) مساوٍ للقيمة الملاحظة بالفعل أو أكثر تطرفاً منها، بافتراض أن الفرضية الصفرية ($H_0$) تمثل الحقيقة المطلقة للمجتمع المستهدف. لا تعبر القيمة الاحتمالية إطلاقاً عن احتمالية صحة الفرضية البديلة أو خطأ الفرضية الصفرية، بل هي مقياس مشروط ببيانات العينة يصف مدى التناقض أو التباعد بين البيانات المرصودة وفرضية العدم المفترضة مقدماً.
في الأبحاث النفسية والسلوكية، يتم مقارنة هذه القيمة الاحتمالية بسقف احتمالي يتم تحديده مسبقاً يُعرف بمستوى الدلالة المعياري ألفا ($\alpha$). جرى العرف الإحصائي المستند إلى إسهامات رونالد فيشر على تبني مستويات دلالة شائعة هي (0.05، و0.01، و0.001). يشير اختيار $\alpha = 0.05$ إلى أن الباحث يقبل المخاطرة باحتمال أقصاه 5% في رفض الفرضية الصفرية بالخطأ، أي الوقوع في الخطأ من النوع الأول. فإذا كانت القيمة الاحتمالية المستخرجة من الحسابات أصغر من أو تساوي ألفا ($p le \alpha$)، يُعلن الباحث رفض الفرضية الصفرية والاعتراف بوجود دلالة إحصائية تستحق التفسير السيكولوجي؛ بينما إذا تجاوزت قيمة p هذا الحد، يُعتبر الفارق عاجزاً عن بلوغ الأهمية الإحصائية.
يرتبط تحديد القيمة الاحتمالية ارتباطاً بنيوياً باتجاهية الفرضية المصوغة مسبقاً. فإذا كان الباحث يمتلك سنداً نظرياً صلباً يوجه التوقع السلوكي نحو الزيادة فقط أو النقصان فقط، فإنه يعتمد اختباراً أحادي الطرف (one-tailed test)، حيث تتجمع منطقة الرفض البالغة $\alpha$ بالكامل في أحد ذيلي التوزيع التكراري. أما إذا كانت الفرضية استكشافية أو غير محددة الاتجاه (افتراض وجود اختلاف دون تحديد جهته)، فإن الاختبار يكون ثنائي الأطراف (two-tailed test)، مما يقتضي تقسيم مساحة الخطأ المسموح به بالتساوي بين طرفي المنحنى الأيمن والأيسر ($\alpha / 2$). يؤثر هذا الاختيار المنهجي تأثيراً مباشراً على حساب القيمة الاحتمالية وتفسيرها الرياضي، إذ يتطلب الاختبار ثنائي الأطراف درجة تائية أكثر تطرفاً لتحقيق المستوى ذاته من الدلالة مقارنة بالاختبار أحادي الطرف.
2. المحددات الرياضية لحساب القيمة الاحتمالية من درجة t
2.1 حساب درجات الحرية وتأثيرها على شكل التوزيع
تمثل درجات الحرية (Degrees of Freedom – df) مفهوماً تأسيسياً في الإحصاء الرياضي، وتشير جوهرياً إلى عدد القيم أو الملاحظات المستقلة التي تمتلك حرية التغير العشوائي أثناء حساب الإحصاء بعد استيفاء الشروط والمعلمات الإحصائية المقدرة من العينة. تختلف صيغة حساب درجات الحرية باختلاف التصميم التجريبي المستخدم في البحث السيكولوجي:
- اختبار t للعينة الواحدة (One-Sample t-test): يُفقد قيد واحد بسبب حساب المتوسط الحسابي للعينة، وبالتالي تكون الصيغة: $df = n – 1$.
- اختبار t للعينات المترابطة أو القياسات المتكررة (Paired-Samples t-test): يُعامل الفرق بين كل زوج من الملاحظات كدرجة مستقلة، مما يجعل الصيغة مساوية لعدد أزواج الدرجات منقوصاً منها واحد: $df = n_{\text{pairs}} – 1$.
- اختبار t لعينتين مستقلتين مع تجانس التباين (Two-Sample Pooled t-test): تُقدر معلمان هما متوسّطا المجموعتين، مما يستنزف درجتين من الحرية وتصبح المعادلة: $df = n_1 + n_2 – 2$.
- اختبار ويلش في حال عدم تجانس التباين (Welch’s t-test): يتم اللجوء إلى معادلة ويلش-ساترثوايت (Welch–Satterthwaite) المعقدة، والتي تنتج غالباً درجات حرية كسرية وليست أعداداً صحيحة، لتعويض عدم تكافؤ التباين بين المجموعتين.
تؤدي درجات الحرية دور المعلمة البنيوية التي تحدد الهيكل الهندسي الدقيق لمنحنى توزيع t. عندما تكون درجات الحرية صغيرة جداً (كما في الدراسات السريرية الاستكشافية ذات الأحجام العينية المحدودة، كأن تكون $df 30$)، يبدأ توزيع t بالتقارب الشديد نحو التوزيع الاعتدالي، حتى يتطابق معه عملياً عند العينات الكبيرة، حيث يصبح الفارق بين القيم الحرجة المستخرجة من جدول t وجدول Z ضئيلاً للغاية.
2.2 التمييز بين الاختبارات أحادية الذيل وثنائية الذيل
إن التمييز الدقيق بين الاختبارات أحادية وثنائية الذيل لا يمثل مجرد خيار حسابي بل هو قرار منهجي إبستمولوجي يرتبط بنوع الفرضية المصوغة قبل البدء بجمع البيانات التجريبية. تُصاغ الفرضيات الموجهة عندما يكون لدى الباحث النفسي سند تجريبي قوي يدعم اتجاه التغير؛ فعلى سبيل المثال، عند اختبار تقنية لتقليل قلق الاختبار، يُتوقع منطقياً أن ينخفض القلق وليس العكس، مما يبرر استخدام اختبار الطرف الأيسر ($H_1: \mu \mu_0$). في المقابل، تُستخدم الفرضيات غير الموجهة ($H_1: \mu \neq \mu_0$) في الدراسات المقارنة المحايدة التي تبحث في وجود تباين أو أثر دون افتراض اتجاه محدد سلفاً.
من الناحية الهندسية والتكاملية تحت منحنى التوزيع، يحدد نوع الطرف كيفية توزيع المساحة الحرجة، وهي المنطقة التي إذا وقعت فيها قيمة t تُرفض الفرضية الصفرية. في الاختبار ثنائي الطرف، تُقسم المساحة الحرجة الكلية ($\alpha$) إلى شطرين متساويين، حيث يُخصص نصفها ($\alpha / 2$) للطرف الأيسر الأدنى ونصفها الآخر للطرف الأيمن الأعلى. هذا التقسيم يفرض حداً فاصلاً أكثر صرامة لقيمة t المحسوبة، حيث يلزم أن تكون القيمة أبعد في التطرف لبلوغ الدلالة. أما في الاختبار أحادي الطرف، فإن المساحة الحرجة تتركز بالكامل في أحد الذيول، مما يخفض من العتبة المطلوبة لتحقيق الدلالة في الاتجاه المحدد، غير أنه في الوقت ذاته يجعل الباحث غير قادر منهجياً وإحصائياً على رصد أي تغييرات تحدث في الاتجاه المعاكس مهما كانت دراماتيكية، إذ تُعامل جميع القيم الواقعة في الاتجاه المعاكس كفشل في رفض فرضية العدم.
3. دوال برنامج إكسيل المخصصة لحساب القيمة الاحتمالية من درجة t
3.1 الدالة الأساسية T.DIST وصيغتها المعيارية
تُعد الدالة T.DIST في برنامج مايكروسوفت إكسيل، والتي طُرحت بدءاً من إصدار إكسيل 2010، الدالة الجوهرية لحساب التوزيع التراكمي للطرف الأيسر أو دالة الكثافة الاحتمالية لمنحنى ستيودنت التكراري. تتخذ البنية النحوية البرمجية لهذه الدالة الهيئة التالية:
=T.DIST(x, deg_freedom, cumulative)
تتضمن الدالة ثلاثة مدخلات أساسية إلزامية:
x: ويمثل القيمة الرقمية لدرجة t المحسوبة المراد تقييمها. وتقبل الدالة قيماً موجبة وسالبة وصفرية دون أي قيود رياضية.deg_freedom: عدد درجات الحرية الخاص بالنموذج الإحصائي، ويجب أن يكون قيمة عددية أكبر من أو تساوي 1. (يقوم إكسيل بحذف الكسور تلقائياً في الإصدارات القديمة وتثبيت العدد الصحيح الأدنى، بينما تقبل الإصدارات الحديثة القيم الكسرية الناتجة عن اختبار ويلش).cumulative: وسيط منطقي يقبل قيمتين فقط؛ إماTRUEلحساب دالة التوزيع التراكمي ($CDF$) التي تمثل المساحة الواقعة على يسار القيمة $x$ تحت المنحنى (أي الاحتمال $P(T le x)$)، أوFALSEلحساب دالة الكثافة الاحتمالية ($PDF$) عند النقطة المحددة.
في سياق استخراج القيمة الاحتمالية لاختبار الفروض، يجب ضبط الوسيط cumulative دائماً على القيمة TRUE. عندما يتم تمرير قيمة t سالبة في الدالة (مثل $t = -2.15$ مع $df = 25$)، فإن ناتج الدالة يعكس مباشرة القيمة الاحتمالية أحادية الطرف للذيل الأيسر ($p = P(T le -2.15)$). أما في حالة تمرير قيمة موجبة مع الرغبة في حساب احتمال الذيل الأيسر، فإن الدالة تُعيد المساحة التراكمية الكلية من أقصى اليسار وحتى تلك القيمة الموجبة، وهي قيمة تتجاوز حتماً 0.50، وهو ما يقتضي انتباه الباحث لكيفية توظيف الناتج وفق الفرضية المطروحة.
3.2 الدالة التراكمية للطرف الأيمن T.DIST.RT
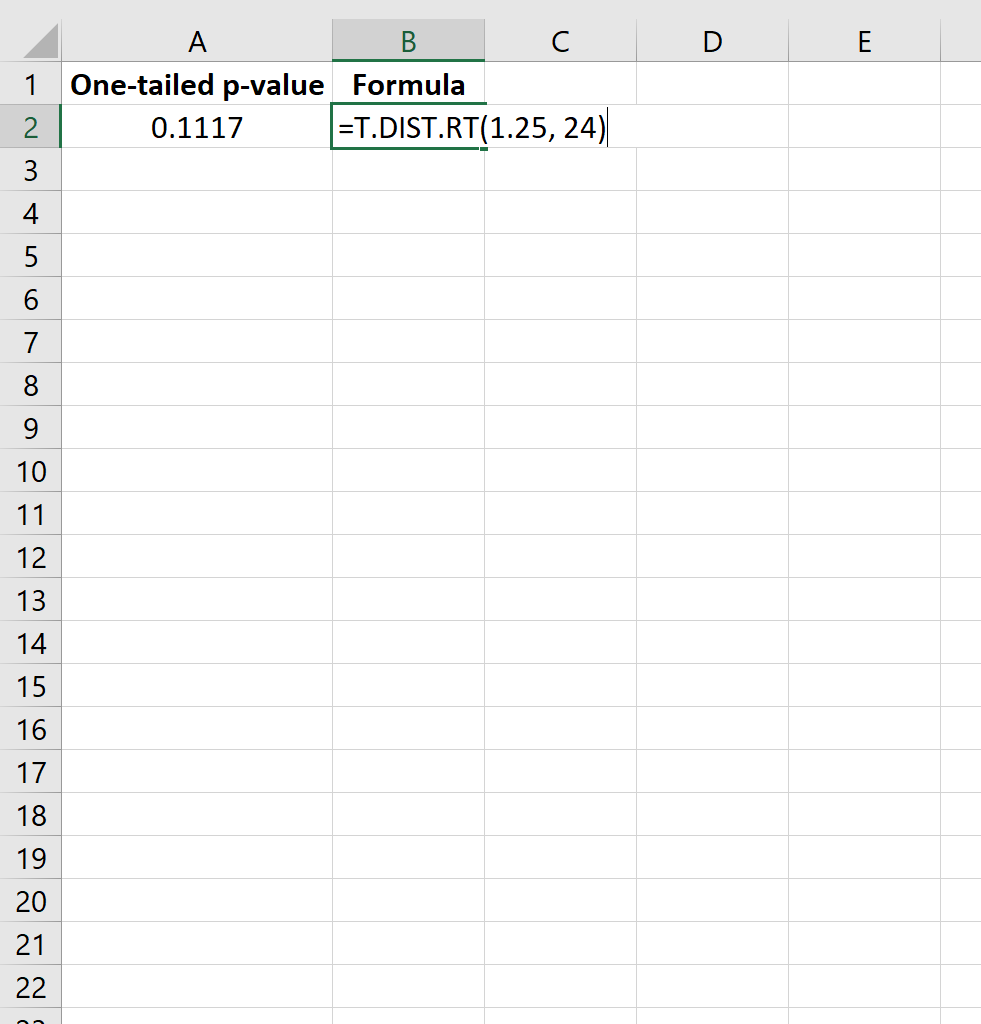
صُممت الدالة T.DIST.RT خصيصاً لاحتساب المساحة التراكمية الواقعة في الطرف الأيمن الأعلى من توزيع ستيودنت، أي أنها تحسب الاحتمال الرياضي $P(T ge x)$. وتتخذ الصيغة العامة للشفرة الهيئة التالية:
=T.DIST.RT(x, deg_freedom)
تمتلك هذه الدالة خصائص تشغيلية محددة يجب مراعاتها بدقة ميكانيكية متناهية لتفادي الأخطاء البرمجية. فالشرط الجوهري لعمل هذه الدالة بنجاح هو أن يكون المدخل x (درجة t) عدداً حقيقياً موجباً أو مساوياً للصفر ($x ge 0$). إذا تم تمرير قيمة t سالبة إلى الدالة، كأن يُكتب =T.DIST.RT(-1.96, 20)، فإن برنامج إكسيل لن يقوم بحساب المساحة، بل سيعيد رسالة الخطأ الشهيرة #NUM!، لأن الدالة برمجياً لا تقبل قيم إحداثيات سالبة في محدداتها الداخلية.
تُطبق هذه الدالة بكفاءة استثنائية عند التعامل مع الفرضيات النفسية الموجهة إيجابياً؛ حيث يُتوقع أن يؤدي المتغير المستقل إلى زيادة معنوية في درجات المتغير التابع (كالتحسن المعرفي أو الدافعية السلوكية). إذا كانت درجة t المحسوبة سالبة ولكن الاتجاه النظري المفترض يقتضي دراسة الطرف الأيمن المعاكس، أو إذا أراد الباحث حساب المساحة المكملة، فيتعين عليه استخدام التحويل المنهجي عن طريق دالة القيمة المطلقة ABS، أو اللجوء إلى الدالة الأساسية عبر الصيغة المكملة للواحد الصحيح:
=1 - T.DIST(t_score, deg_freedom, TRUE)
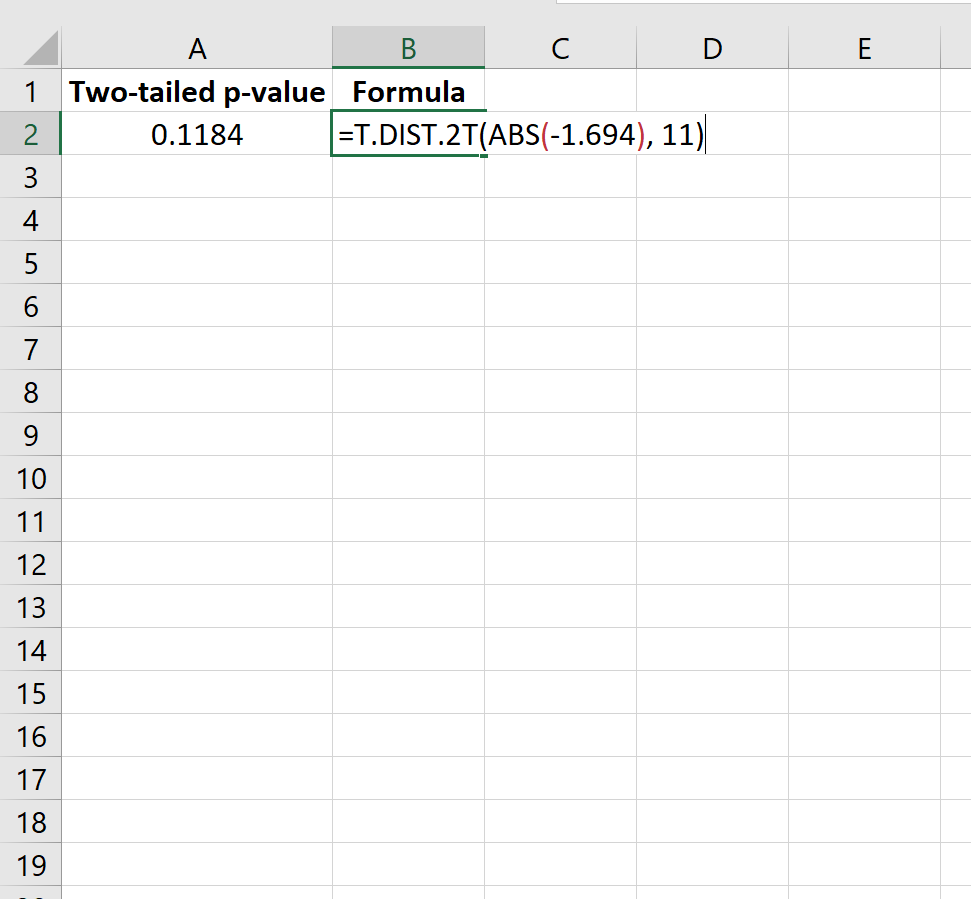
3.3 دالة الطرفين التناظرية T.DIST.2T
تمثل الدالة T.DIST.2T الخيار الأكثر ملاءمة وشيوعاً لدى الباحثين في العلوم النفسية والاجتماعية، حيث تتولى حساب القيمة الاحتمالية التناظرية لكلا الطرفين مجتمعين ($P(|T| ge x)$)، وهو الإجراء المطلوب في كافة الاختبارات ثنائية الذيل غير الموجهة. تظهر بنية الدالة في إكسيل كما يلي:
=T.DIST.2T(x, deg_freedom)
تفرض هذه الدالة شرطاً برمجياً صارماً لا يقبل التجاوز: يجب أن تكون القيمة المدخلة في وسيط x موجبة تماماً وغير سالبة ($x > 0$). إذا تم إدخال درجة t سالبة مباشرة، فإن الدالة ستتوقف فوراً عن التنفيذ وتظهر خطأ القيمة الرياضية #NUM!. والسبب في هذا التصميم البرمجي هو أن الدالة تفترض تلقائياً أن القيمة المدخلة تمثل الحد الإحصائي المطلق $|t|$، لتقوم بحساب مساحة الذيل الأيمن ثم تضاعف الناتج تلقائياً ليعكس مساحة الذيل الأيسر المناظرة بفضل الخاصية التماثلية لمنحنى ستيودنت حول الصفر.
لتجنب هذا الخطأ التقني وضمان مرونة ورقة العمل في التعامل مع شتى المخرجات سواء كانت الفروق التجريبية موجبة أو سالبة، تُكتب الدالة دائماً مقرونة بدالة القيمة المطلقة بالشكل القياسي التالي:
=T.DIST.2T(ABS(x), deg_freedom)
رياضياً، لا يختلف ناتج الدالة =T.DIST.2T(x, df) إطلاقاً عن ناتج مضاعفة احتمال الطرف الواحد، حيث يتطابق بنيوياً مع الصيغة البديلة:
=2 * T.DIST.RT(ABS(x), df)
أو الصيغة التراكمية المعتمدة على الذيل الأيسر للقيمة المطلقة السالبة:
=2 * T.DIST(-ABS(x), df, TRUE)
وهذا التناظر الهندسي التام يبرهن على أن مساحة الرفض في الفرضيات ثنائية الأطراف تنقسم حسابياً إلى نسختين متطابقتين على جانبي التوزيع التكراري.
4. إعداد ورقة عمل إكسيل وتجهيز المدخلات الحسابية
4.1 تنظيم خلايا الإدخال للبيانات الإحصائية الوصفية
يتطلب البناء التحليلي الاحترافي داخل برنامج إكسيل تنظيماً منطقياً للخلايا يمنع التداخل الرياضي ويسهل المراجعة والتدقيق والتوثيق المنهجي. لتجهيز بيئة عمل قابلة للتكرار لحساب قيمة درجة t وقيمتها الاحتمالية لاختبار عينة واحدة أو عينتين، يُنصح بتخصيص خلايا مستقلة للبيانات الوصفية الأساسية كما في النموذج الإرشادي التالي:
- الخلية
B1: حجم العينة ($n$) ويُعبر عنه بعدد المشاركين الفعليين الخاضعين للدراسة. - الخلية
B2: المتوسط الحسابي للعينة ($\bar{x}$) ويُستخرج عبر دالة=AVERAGE(data_range)إذا كانت البيانات الخام متوفرة. - الخلية
B3: الانحراف المعياري للعينة ($s$) ويُحسب باستدعاء دالة العينة القياسية=STDEV.S(data_range). - الخلية
B4: المتوسط النظري أو المعياري للمجتمع ($\mu_0$) المفترض في الفرضية الصفرية.
بناءً على هذه المدخلات، يتم إنشاء خلية تابعة مخصصة لحساب الخطأ المعياري للمتوسط في الخلية B5، باستخدام الصيغة الرياضية المباشرة:
=B3 / SQRT(B1)
إن الفصل بين المكونات التأسيسية للمتغيرات يُضفي وضوحاً هندسياً على النموذج الإحصائي؛ ويُستحسن استخدام خاصية “تسمية النطاقات” (Name Manager) في إكسيل، بتعيين أسماء ذات معنى للمتغيرات (مثل SampleSize للخلية B1، وSampleMean للخلية B2)، مما يجعل المعادلات الرياضية اللاحقة مقروءة وذات دلالة بحثية بدلاً من الاكتفاء بالرموز المجردة للخلايا، وهو أسلوب يقلل من احتمالات الخطأ أثناء تعديل البيانات الحسابية وتطوير النماذج.
4.2 أتمتة حساب درجة t ودرجات الحرية داخل ورقة العمل
عقب تجهيز المعلمات الوصفية الأساسية، تأتي خطوة أتمتة الحسابات الاستدلالية لتوليد قيمة t ودرجات الحرية تلقائياً بمجرد إدخال أو تغيير أي رقم من بيانات العينة. في الخلية B6، تُكتب صيغة استخراج درجات الحرية لاختبار العينة الواحدة:
=B1 - 1
ثم يُشرع في برمجة الخلية B7 لاحتساب قيمة درجة t المحسوبة بالاعتماد على الفارق بين متوسط العينة والمتوسط المفترض مقسوماً على الخطأ المعياري الموجود في الخلية B5، وفق الصيغة:
=(B2 - B4) / B5
أو بدمج المعادلة بالكامل في صيغة واحدة متكاملة تجنباً للأخطاء الوسيطة:
=(B2 - B4) / (B3 / SQRT(B1))
لضمان صلابة النموذج الإحصائي ومنع ظهور أخطاء البرمجة الشائعة مثل القسمة على صفر (#DIV/0!)، التي قد تظهر إذا تُرِك حجم العينة فارغاً أو كان الانحراف المعياري مساوياً للصفر بسبب تشابه درجات جميع المستجيبين، يُفضل تغليف المعادلة الحسابية بدالة التحقق من الأخطاء IFERROR بالشكل التالي:
=IFERROR((B2 - B4) / (B3 / SQRT(B1)), "خطأ في المدخلات")
يضمن هذا الإجراء البرمجي استقرار النموذج الإحصائي وسلامة العمليات عند معالجة عينات سيكولوجية ضخمة واستدعاء النتائج في جداول التقرير النهائي.
5. خطوات استخراج القيمة الاحتمالية للاختبار ثنائي الذيل خطوة بخطوة
5.1 صياغة فرضيات البحث النفسي ثنائي الطرف
تبدأ المعالجة المنهجية للاختبار ثنائي الذيل بالبناء الفرضي المحايد. لنفترض أن باحثاً في علم النفس العصبي يفحص أثر برنامج جديد للتنظيم الانفعالي على تشتت الانتباه، حيث لا تتوفر أدلة قاطعة تحسم ما إذا كان التدخل سيحدث تحسناً (تقليل التشتت) أم إرباكاً إدراكياً مؤقتاً يؤدي لزيادة التشتت. في هذه الحالة، تُصاغ الفرضيات بصيغة غير موجهة بدقة متناهية:
- الفرضية الصفرية ($H_0$): لا توجد فروق ذات دلالة إحصائية بين متوسط درجات تشتت الانتباه لدى المشاركين بعد التدخل ومتوسط درجات المجتمع العام المعياري ($\mu = \mu_0$). أي أن الفارق الإحصائي ناتج عن الصدفة وعوامل المعاينة العشوائية.
- الفرضية البديلة ($H_1$): توجد فروق ذات دلالة إحصائية بين متوسط المشاركين بعد التدخل ومتوسط المجتمع المعياري ($\mu \neq \mu_0$).
يقوم الباحث بتحديد مستوى الدلالة المقبول مسبقاً قبل جمع البيانات، وعادة ما يتم اعتماده عند $\alpha = 0.05$. ويعني هذا الاختيار المنهجي أن الباحث مستعد لتحمل احتمالية قدرها 5% لارتكاب الخطأ من النوع الأول. بما أن الاختبار ثنائي الطرف، فإن منطقة الرفض مقسمة إلى طرفين، بحيث يحتوي كل ذيل متطرف على مساحة قدرها 0.025 من إجمالي مساحة المنحنى الإحصائي. هذا التحديد القبلي المسبق يُلزم الباحث بالتقيد بالقواعد المنهجية ويمنعه من تغيير منطق الفرضية بعد رؤية النتائج التجريبية.
5.2 التطبيق العملي باستخدام الدالة T.DIST.2T
بمجرد اكتمال حساب درجة t ودرجات الحرية في ورقة العمل، يشرع الباحث في استدعاء الدالة المخصصة لحساب الطرفين. بافتراض أن الخلية B7 تحتوي على قيمة درجة t المحسوبة (ولتكن مثلاً $t = -2.48$)، والخلية B6 تتضمن درجات الحرية ($df = 28$)، فإن الانتقال إلى الخلية المخصصة للقيمة الاحتمالية يقتضي كتابة الشفرة البرمجية التالية:
=T.DIST.2T(ABS(B7), B6)
يؤدي استدعاء دالة القيمة المطلقة ABS(B7) إلى تجريد الدرجة التائية من إشارتها الجبرية السالبة، محولاً إياها من $-2.48$ إلى $+2.48$ بصورة مسبقة قبل أن تُعالج عبر دالة التوزيع. بدون هذا التحويل الصريح، سيفشل إكسيل في تقييم المعادلة ويعيد للمستخدم رمز الخطأ الحسابي #NUM!، لأن المحرك الرياضي للدالة T.DIST.2T مبرمج حصرياً لتقبل الحدود الموجبة.
عند الضغط على مفتاح الإدخال (Enter)، يقوم إكسيل بحساب التكامل العددي للمساحة المحصورة خلف النقطة $2.48$ في الذيل الأيمن ثم يضاعف تلك المساحة ليشمل الذيل الأيسر عند $-2.48$. في هذا المثال، يُظهر البرنامج النتيجة الاحتمالية الدقيقة: $p = 0.0194$. تُقرأ هذه النتيجة بأن احتمالية الحصول على فارق بهذه الدرجة من التطرف أو أشد، بمحض الصدفة البحتة وفي ظل افتراض صحة الفرضية الصفرية، تبلغ تقريباً 1.94%. ونظراً لأن هذه القيمة أقل بوضوح من مستوى الدلالة المعتمد ($0.0194 < 0.05$)، يتخذ الباحث قراره الإحصائي الصريح برفض فرضية العدم وقبول الفرضية البديلة، معلناً وجود أثر دال إحصائياً للتدخل.
5.3 الطريقة البديلة باستخدام دالة T.DIST الأساسية ومضاعفة الناتج
على الرغم من سهولة استخدام الدالة المخصصة T.DIST.2T، يفضل العديد من الإحصائيين والمبرمجين استخدام الدالة التراكمية العامة T.DIST لما توفره من فهم عميق للتراكيب الرياضية لمنحنى التوزيع، فضلاً عن توافقها مع مختلف لغات البرمجة والأنظمة الإحصائية الأخرى. في هذه الطريقة، يتم حساب احتمال الذيل الأيسر الواقع خلف القيمة التائية السالبة بصورة مباشرة، ومن ثم يُضرب الناتج في اثنين لمطابقة نتيجة اختبار الطرفين، وذلك بالصيغة التالية:
=2 * T.DIST(-ABS(B7), B6, TRUE)
يعتمد هذا المسار البديل على البناء الهندسي التناظري التام لمنحنى ستيودنت حول نقطة الأصل (المتوسط = صفر). فالمساحة الاحتمالية التراكمية الواقعة على يسار القيمة السالبة $-|t|$ تتطابق رياضياً وبنيوياً مع المساحة الواقعة على يمين القيمة الموجبة $+|t|$. لذا فإن مضاعفة مساحة الذيل الأيسر عبر ضربها في المعامل (2) تنتج بدقة المساحة الكلية لكلا الطرفين مجتمعين.
إذا أردنا التحقق من ذات المثال السابق ($t = -2.48$ مع $df = 28$)، فإن الدالة T.DIST(-2.48, 28, TRUE) تُعطي مساحة الذيل الأيسر وقدرها $0.00971$. وبضرب هذه القيمة في 2 نحصل على $0.01942$، وهي النتيجة ذاتها المتطابقة رقمياً مع ناتج الدالة T.DIST.2T. إن استيعاب هذا التكافؤ يمنح الباحث ثقة إحصائية في فهم ما يجري خلف كواليس البرمجيات، مما يمنعه من التعامل مع دوال إكسيل كصناديق سوداء مجهولة الآليات الرياضية.
6. خطوات استخراج القيمة الاحتمالية للاختبار أحادي الذيل
6.1 حساب القيمة الاحتمالية للطرف الأيسر (الفرضيات السالبة)
في العديد من الدراسات النفسية والعلاجية، يُفترض أن يؤدي التدخل إلى خفض مؤشرات نفسية سلبية كأعراض الاكتئاب، أو مستويات الاحتراق النفسي، أو زمن الرجع في المهام المعرفية. في هذه السياقات، تصاغ الفرضية البديلة بصورة موجهة نحو النقصان أو الطرف الأيسر ($H_1: \mu < \mu_0$)، بينما تفترض فرضية العدم أن المتوسط بعد التدخل أعلى من أو يساوي المتوسط الأصلي المرتفع ($H_0: \mu ge \mu_0$). هذا الاتجاه المنهجي يعني أن الاهتمام الاحتمالي ينصب بالكامل على رصد ما إذا كانت درجة t المحسوبة تقع في أقصى الطرف الأيسر السالب للمنحنى.
لحساب القيمة الاحتمالية للطرف الأيسر في إكسيل، يتم استخدام الدالة التراكمية العامة T.DIST بضبط الوسيط التراكمي على TRUE، وذلك بإدخال الصيغة التالية في الخلية المخصصة للنتيجة:
=T.DIST(t_score, deg_freedom, TRUE)
لنفترض أن باحثاً يفحص فاعلية تقنية استرخاء في تخفيض هرمون الكورتيزول، وحصل على درجة تائية سالبة قدرها $t = -1.85$ مع درجات حرية $df = 22$. عند كتابة الصيغة =T.DIST(-1.85, 22, TRUE)، يقوم إكسيل بحساب التكامل التراكمي من اللانهاية السالبة ($-\infty$) وصولاً إلى النقطة $-1.85$. سيظهر الناتج الرياضي مساوياً $0.0389$. يُفسر هذا الاحتمال بأن هناك فرصة تبلغ 3.89% فقط لرصد هذا الانخفاض بمحض الصدفة؛ ونظراً لأن هذه القيمة أصغر من مستوى الدلالة المعياري الألفي المتفق عليه ($\alpha = 0.05$)، يتخذ الباحث قراره الموثوق برفض فرضية العدم وتأييد فرضية الانخفاض الإحصائي الدال لدرجات الكورتيزول.
6.2 حساب القيمة الاحتمالية للطرف الأيمن (الفرضيات الموجبة)
على النقيض من الحالات السابقة، تتناول فرضيات الطرف الأيمن التدخلات التي تستهدف تعزيز السمات النفسية الإيجابية أو رفع القدرات المعرفية والسلوكية، مثل تعزيز الرضا عن الحياة، والذاكرة العاملة، أو تعزيز تقدير الذات والتوافق النفسي كما بينت دراسات جيفري كوهين وديفيد شيرمان (Cohen & Sherman, 2014) في استعراضهما لتدخلات توكيد الذات والتغير النفسي. هنا تُصاغ الفرضية البديلة بافتراض زيادة إيجابية دالة ($H_1: \mu > \mu_0$)، في حين تفترض الفرضية الصفرية عدم وجود زيادة أو حدوث تراجع ($H_0: \mu le \mu_0$).
يتيح برنامج إكسيل خيارين حسابيين لاستخراج قيمة p للطرف الأيمن بدقة متناهية:
- الخيار الأول (باستخدام الدالة المباشرة للطرف الأيمن):
إذا كانت درجة t المحسوبة موجبة (كأن تكون $t = +2.05$ مع $df = 18$)، يتم إدخال المعادلة المباشرة:
=T.DIST.RT(B7, B6)ستحسب الدالة فوراً المساحة الواقعة في الذيل الأيمن الأعلى متجاوزة النقطة $2.05$، لتعيد قيمة احتمالية قدرها $0.0276$.
- الخيار الثاني (باستخدام مبدأ المكمل الرياضي مع دالة التوزيع العام):
استناداً إلى البديهية الرياضية القائلة بأن إجمالي المساحة تحت المنحنى التكراري يساوي الواحد الصحيح (1.000)، فإن مساحة الذيل الأيمن تكافئ تماماً طرح مساحة الذيل الأيسر التراكمية من الواحد. تُكتب الصيغة كالتالي:
=1 - T.DIST(B7, B6, TRUE)
تتميز الصيغة المكملة بمرونتها الرياضية الفائقة، حيث تحافظ على استقرار الحسابات ولا تُصدر خطأ #NUM! حتى لو كانت درجة t المدخلة سالبة، بل ستعطي مساحة تراكمية تزيد عن 0.50، مما يعكس بوضوح عدم تحقق فرضية الارتفاع الإيجابي ويؤدي فوراً إلى الإخفاق في رفض الفرضية الصفرية، وهو ما ينسجم تماماً مع المنطق الاستدلالي الصارم للاختبارات أحادية الطرف.
7. دراسات حالة وتطبيقات عملية في بحوث علم النفس التجريبي
7.1 دراسة أثر التدخل العلاجي المعرفي السلوكي على القلق (عينة واحدة)
في دراسة سريرية تهدف لتقييم بروتوكول علاجي معرفي سلوكي قصير المدى لدى مرضى القلق العام، جرى تطبيق مقياس مقنن للقلق النفسي يمتلك متوسطاً معيارياً مستقراً في المجتمع العام عند ($\mu_0 = 50$). طُبق التدخل العلاجي على عينة سريرية قوامها 25 مريضاً ($n = 25$). بعد انتهاء الجلسات العلاجية، أظهرت المعالجة الوصفية للدرجات الخام ما يلي:
- متوسط درجات القلق في العينة بعد العلاج ($\bar{x}$) = 45.8
- الانحراف المعياري لدرجات العينة ($s$) = 8.5
- درجات الحرية ($df = n – 1$) = $25 – 1 = 24$
قام الباحث بإعداد ورقة عمل إكسيل لحساب الخطأ المعياري، حيث أدخل في الخلية B5 الصيغة =8.5 / SQRT(25) لينتج الخطأ المعياري بقيمة قدرها $1.70$. بعد ذلك، احتسبت درجة t في الخلية B7 عبر المعادلة =(45.8 - 50) / 1.70، فكانت النتيجة $t = -2.4706$.
نظراً لأن الباحث يريد تقييم أي تغير نوعي سواء بالنقصان أو الزيادة كإجراء استكشافي تحفظي، اختار تطبيق الاختبار ثنائي الذيل. استدعى الباحث الدالة المخصصة في الخلية B8 بالصيغة القياسية:
=T.DIST.2T(ABS(-2.4706), 24)
أظهرت الدالة قيمة احتمالية دقيقة بلغت $p = 0.0210$. بمقارنة هذا الناتج بمستوى الدلالة المعتمد ($\alpha = 0.05$)، وجد الباحث أن $p < 0.05$. سريرياً وعلاجياً، تُفسر هذه النتيجة بوجود انخفاض جوهري ذي دلالة إحصائية في متوسط أعراض القلق لدى المرضى لا يُعزى للمصادفة البحتة، مما يقدم دليلاً إمبريقياً يدعم جدوى التدخل العلاجي المعرفي السلوكي في ضبط وتخفيف حدة الأعراض لدى المرضى النفسيين.
7.2 مقارنة أداء مجموعتين تجريبية وضابطة في اختبار للذاكرة (عينتان مستقلتان)
في تجربة تبحث دور التدريب الذهني القائم على الألعاب المعرفية الرقمية على كفاءة الذاكرة العاملة، استعان الباحث بمجموعتين من المشاركين: مجموعة تجريبية خضعت للتدريب ($n_1 = 20$)، ومجموعة ضابطة لم تتلق أي تدريب خاص ($n_2 = 20$). بعد فترة التجربة، جرى اختبار المجموعتين وكانت النتائج الوصفية كالتالي:
- المجموعة التجريبية: المتوسط $\bar{x}_1 = 78.4$، والانحراف المعياري $s_1 = 6.2$.
- المجموعة الضابطة: المتوسط $\bar{x}_2 = 72.1$، والانحراف المعياري $s_2 = 5.8$.
تطلب التحليل استخراج الانحراف المعياري المجمع (Pooled Standard Deviation – $s_p$) في ورقة إكسيل، استناداً إلى فرضية تكافؤ التباين، عبر الصيغة الحسابية المجمعة:
$$s_p = \sqrt{\frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}}$$
كُتبت المعادلة في خلية إكسيل المستقلة كما يلي:
=SQRT(( (19 * (6.2^2)) + (19 * (5.8^2)) ) / (20 + 20 - 2))
أنتجت الخلية انحرافاً مجمعاً مقداره $s_p = 6.003$. ثم احتسب الباحث الخطأ المعياري للفرق بين المتوسطين عبر المعادلة:
=6.003 * SQRT((1/20) + (1/20))
فكان الناتج $SE = 1.898$. ومن ثم استُخرجت قيمة t للفروق في خلية تالية بالصيغة:
=(78.4 - 72.1) / 1.898
فكانت $t = 3.319$، مع درجات حرية كلية $df = 20 + 20 – 2 = 38$.
نظراً لأن الفرضية الأساسية موجهة وتفترض تفوق المجموعة التجريبية بوضوح ($H_1: \mu_1 > \mu_2$)، طبق الباحث دالة الطرف الأيمن لاستخراج القيمة الاحتمالية بالصيغة:
=T.DIST.RT(3.319, 38)
جاءت القيمة الاحتمالية متناهية في الصغر مساوية لـ $p = 0.0010$. تدل هذه القيمة على وجود فروق جوهرية قاطعة لصالح المجموعة التجريبية عند مستوى دلالة صارم ($\alpha = 0.01$). يُشير التفسير السيكولوجي إلى أن التدريب الذهني الرقمي ساهم فعلياً في تعزيز أداء الذاكرة العاملة بما يتجاوز عوامل التباين العشوائي وفروق الصدفة الفردية بين المشاركين، وتنسجم هذه النتيجة مع أطر التدخلات الرقمية الحديثة (Borghouts et al., 2021).
7.3 قياس أثر الضغط النفسي قبل وبعد المهام المعقدة (عينتان مرتبطتان)
في دراسة تفحص التغير في الأداء الحركي الدقيق والتركيز تحت تأثير الضغط العصبي في بيئات الضغوط النفسية العالية، جرى قياس معدل ارتكاب الأخطاء لدى عينة مكونة من 16 رياضياً من النخبة ($n = 16$)، في مرتين: القياس القبلي في ظروف هادئة، والقياس البعدي أثناء التعرض لمحفزات سمعية وبصرية ضاغطة ومشتتة، وهو سياق يرتبط ارتباطاً وثيقاً بسلامة الأداء والصحة النفسية في الرياضات التنافسية (Reardon et al., 2019). تم إدراج البيانات في عمودين متجاورين في إكسيل؛ العمود A للدرجات القبلية، والعمود B للدرجات البعدية.
في العمود C، تم استخراج فروق الدرجات الفردية لكل رياضي عبر الصيغة =B2 - A2 وصولاً لآخر مشارك في الصف 17. ثم تم استدعاء الدوال الوصفية على عمود الفروق (النطاق C2:C17):
- متوسط الفروق:
=AVERAGE(C2:C17)لينتج $\bar{D} = 4.25$ أخطاء إضافية. - الانحراف المعياري للفروق:
=STDEV.S(C2:C17)لينتج $s_D = 3.10$. - درجات الحرية: $df = 16 – 1 = 15$.
احتسب الباحث الخطأ المعياري لمتوسط الفروق بالصيغة:
=3.10 / SQRT(16)
ليكون الناتج $SE_D = 0.775$. وبقسمة متوسط الفروق على الخطأ المعياري، تم التوصل لدرجة t المحسوبة:
=4.25 / 0.775
فكانت $t = 5.484$. ولاختبار الفرضية ثنائية الطرف التي تبحث في إحداث أي خلل في معدل الأخطاء، كُتبت المعادلة الاحتمالية:
=T.DIST.2T(ABS(5.484), 15)
أعادت الخلية قيمة احتمالية متناهية الصغر بلغت $p = 0.000065$ (أي $p < 0.001$). تثبت هذه النتيجة القاطعة إحصائياً أن الضغط النفسي التجريبي المفروض أدى إلى زيادة جوهرية في ارتكاب الأخطاء الحركية، مؤكداً وجود أثر نفسي ضار للمشتتات على دقة الأداء التنفيذي لدى الأفراد، مما يستدعي برامج دعم نفسي نوعية لتعزيز الصمود والتنظيم السلوكي في المواقف الضاغطة.
8. المشكلات التقنية والأخطاء الشائعة في إكسيل وكيفية معالجتها
8.1 خطأ القيمة السالبة في دوال الطرف الواحد والطرفين (#NUM!)
يواجه الباحثون خطأ الإدخال الرياضي #NUM! بصورة متكررة عند حساب القيم الاحتمالية في إكسيل. ينشأ هذا الخطأ البرمجي بصورة رئيسية عند تمرير قيمة t سالبة في دالة الطرفين T.DIST.2T أو دالة الطرف الأيمن T.DIST.RT. فالخوارزمية الحسابية المضمنة في إكسيل لهاتين الدالتين صُممت لتقبل فقط أعداداً تقع في النطاق غير السالب ($x ge 0$). وعندما يظهر الفارق بين المتوسطات بإشارة سالبة، كأن يكون متوسط العينة أقل من متوسط المجتمع، تظهر قيمة t سالبة، مما يؤدي لتعطل الحساب وظهور هذا الخطأ الذي يعطل ورقة العمل الإحصائية بالكامل.
يتم تصحيح هذا الخطأ جذرياً بطريقتين منهجيتين:
- الحل البرمجي الأول: إدراج دالة القيمة المطلقة
ABSحول مدخل درجة t، لتصبح الصيغة القياسية:=T.DIST.2T(ABS(t_val), df). تعمل هذه الدالة على إزالة الإشارة السالبة تلقائياً وتحويل الرقم إلى نظيره الموجب قبل أن تبدأ دالة التوزيع باحتساب المساحة، مما يضمن تدفق الحسابات بسلاسة وأمان. - الحل الرياضي الثاني: استخدام الدالة الأساسية التراكمية
T.DISTالتي تقبل القيم السالبة دون قيد، ثم مضاعفة ناتجها لاختبار الطرفين عبر المعادلة:=2 * T.DIST(-ABS(t_val), df, TRUE). تمنح هذه الصياغة مناعة كاملة ضد أخطاء القيم غير المقبولة، وتضمن اتساق الحسابات عبر شتى السيناريوهات المعقدة.
8.2 الخلط بين الدوال التراكمية وغير التراكمية في إكسيل
من الأخطاء الكارثية التي يقع فيها بعض الدارسين والباحثين في القياس النفسي هو ضبط وسيط التراكم cumulative على القيمة المنطقية FALSE داخل الدالة T.DIST، كأن يُكتب:
=T.DIST(B7, B6, FALSE)
يؤدي هذا الخطأ إلى إخراج قيمة دالة الكثافة الاحتمالية (Probability Density Function – PDF) عند تلك النقطة التائية المحددة، أي الارتفاع الرأسي للإحداثي على منحنى التوزيع، بدلاً من حساب المساحة السطحية التراكمية المحصورة تحت المنحنى. تمثل القيمة الاحتمالية في المنطق الإحصائي مساحة نسبية (احتمالاً محصوراً بين 0 و 1)، في حين أن قيمة الكثافة الاحتمالية تمثل معدل التغير الرأسي ولا تمتلك أي دلالة احتمالية لاختبار الفروض بمفردها، مما يجعل القرارات المترتبة عليها مضللة علمياً وعارية تماماً عن الصحة الإحصائية.
لضمان الحصول على مساحات الاحتمال التراكمية المعتمدة، يجب تثبيت الوسيط الثالث في دالة T.DIST دائماً بالرمز TRUE أو بالرقم 1. ويجب على الباحث التحقق من أن القيمة الناتجة تقع بالضرورة داخل النطاق الرياضي الطبيعي للاحتمالات $[0, 1]$. فإذا ظهرت قيمة شاذة تتجاوز الواحد الصحيح، أو قريبة من الصفر في مواقف يُتوقع فيها تقارب المتوسطات، فإن ذلك يستوجب فحص بنية الدالة فوراً والتأكد من عدم استدعاء دالة الكثافة دون وعي.
8.3 معالجة أخطاء عدم توافق الإصدارات (الدوال القديمة مقابل الحديثة)
تحتوي الإصدارات القديمة من برنامج إكسيل (إكسيل 2007 وما قبله) على دالة وحيدة موحدة لحساب احتمالات ستيودنت هي الدالة الموروثة TDIST. تختلف هذه الدالة القديمة اختلافاً جوهرياً عن حزمة الدوال الحديثة في ترتيب المدخلات وقواعد المعالجة، حيث تتخذ الهيئة التالية:
=TDIST(x, deg_freedom, tails)
تتطلب هذه الدالة القديمة إدخال درجة t موجبة حصراً في وسيط x، مع إجبار الباحث على تحديد عدد الأطراف في الوسيط الثالث tails بإدخال القيمة 1 للاختبار أحادي الطرف، أو 2 للاختبار ثنائي الطرف. يؤدي عدم إدراك هذه الفوارق عند تبادل ملفات العمل الإحصائية بين باحثين يستخدمون إصدارات برمجية متباينة إلى حدوث أخطاء عدم توافق برمجية وظهور الرمز #NAME? عند فتح ورقة عمل تضم دوال حديثة مثل T.DIST.2T على أجهزة تعمل بإصدارات عتيقة.
لضمان تشغيل الملفات الإحصائية بأمان مطلق عبر شتى الإصدارات الأكاديمية والمؤسسية، يُوصى بتحديث أوراق العمل القديمة واعتماد الدوال الحديثة المتخصصة ذات الصياغة الدقيقة T.DIST.2T وT.DIST.RT. أما في البيئات التي تتطلب التوافقية الرجعية الإلزامية مع الحواسيب القديمة، فيتعين كتابة دالة TDIST القديمة مع تقييد مدخلها الأول بالقيمة المطلقة دائماً:
=TDIST(ABS(x), df, 2)
وهذا الإجراء الوقائي يضمن موثوقية العمليات وتطابق النتائج عبر المنصات المتنوعة.
9. تفسير القيمة الاحتمالية واتخاذ القرار الإحصائي والأكاديمي
9.1 معايير رفض أو قبول الفرضية الصفرية
يرتكز القرار الإحصائي الأكاديمي على مقارنة صارمة ومباشرة بين القيمة الاحتمالية المستخرجة من برنامج إكسيل ($p$) ومستوى المعنوية المحدد سلفاً ($\alpha$). تنص القاعدة الرياضية الحاسمة على أنه إذا كانت القيمة الاحتمالية أصغر من أو تساوي مستوى الدلالة ($p le \alpha$)، فإن القرار المنهجي يقضي برفض الفرضية الصفرية ($H_0$) صراحة، والقبول بوجود دلالة إحصائية تسند الفرضية البديلة ($H_1$). في هذه الحالة، يمتلك الباحث مبرراً إمبريقياً للاستنتاج بأن الفروق الملاحظة بين المجموعات التجريبية أو القياسات النفسية من غير المرجح أن تكون قد نشأت بمحض التباين العشوائي أو الصدفة المعاينية، مما يفسح المجال لبناء الاستنتاجات النظرية السيكولوجية.
في المقابل، إذا جاءت القيمة الاحتمالية أكبر من مستوى الدلالة ($p > \alpha$)، فإن القرار الأكاديمي الدقيق يُصاغ تحت عنوان: “الفشل في رفض الفرضية الصفرية” (Fail to reject the null hypothesis)، ويجب تجنب التعبير الشائع الخاطئ بـ “قبول الفرضية الصفرية أو إثبات صحتها”. يرجع هذا التحفظ الإبستمولوجي الدقيق إلى أن عدم كفاية الأدلة الإحصائية لرفض فرضية العدم لا يعني بحال من الأحوال إثبات عدم وجود أثر في الواقع؛ فقد يكون الأثر السلوكي موجوداً بالفعل لكن قدرة الاختبار الإحصائية كانت قاصرة عن التقاطه نتيجة لصغر حجم العينة، أو الارتفاع المفرط في أخطاء القياس السيكومتري، أو ضعف حساسية الأداة المستخدمة.
9.2 الربط بين القيمة الاحتمالية وحجم الأثر وقوة الاختبار
من أكبر المزالق المنهجية التي تعرضت لنقد لاذع في الأوساط الأكاديمية هو الاعتماد المنفرد على القيمة الاحتمالية كمؤشر على “حجم” أو “أهمية” الظاهرة المكتشفة. إن القيمة الاحتمالية تُخبر الباحث فقط باحتمالية وقوع النتيجة تحت فرضية العدم، لكنها لا تُقدم أي معلومة عن المقدار العملي أو السريري لهذا الفارق. وكما أظهرت أدبيات علم النفس التجريبي ودراسات ديفيد دانينغ وزملائه (Dunning, Heath, & Suls, 2004) في تقييم التقدير الذاتي والأخطاء الإدراكية، فإن الخداع الإحصائي قد يقود لقرارات غير دقيقة ما لم تُسند الدلالة الإحصائية بقياسات كمية لحجم الظاهرة الفعلية.
تتأثر القيمة الاحتمالية تأثراً فائقاً بحجم العينة ($n$). فعندما تكون العينة ضخمة للغاية (مئات أو آلاف المشاركين)، فإن أبسط الفروق الهامشية التافهة سريرياً قد تنتج قيمة $p < 0.001$، مما يوقع الباحث في فخ "الدلالة الإحصائية الزائفة عملياً". لذا تُلزم التوجهات الحديثة الباحثين بربط القيمة الاحتمالية بحجم الأثر (Effect Size)، ويُعد معامل كوهين د (Cohen’s d) المعيار الذهبي المعتمد مع اختبارات t. يمكن أتمتة حساب معامل كوهين د داخل إكسيل بالاعتماد المباشر على قيمة t المستخرجة ودرجات الحرية عبر الصيغة الحسابية السريعة لاختبار العينات المستقلة المتساوية:
= (2 * B7) / SQRT(B1 + B1 - 2)
تُفسر قيم كوهين د وفق محددات كوهين الكلاسيكية: فالقيمة حول $d = 0.20$ تعكس أثراً صغيراً، و$d = 0.50$ تعكس أثراً متوسطاً، بينما تُعبر $d = 0.80$ فما فوق عن أثر سيكولوجي وتطبيقي كبير يستحق التركيز العلاجي والتربوي، وهو ما يثري التفسير العلمي ويفك الارتهان المضلل بالقيمة الاحتمالية المجردة.
10. توثيق النتائج الإحصائية وفق دليل النشر لجمعية علم النفس الأمريكية (APA)
10.1 القواعد القياسية لكتابة رموز t والقيمة الاحتمالية في التقارير
يفرض الدليل الأكاديمي الصادر عن جمعية علم النفس الأمريكية في نسخته السابعة (APA 7th Edition) معايير تحريرية ورياضية بالغة الصرامة لتوثيق نتائج الاختبارات الإحصائية في الأبحاث المنشورة. عند كتابة نتائج اختبار t، يتعين على الباحث تدوين الإحصاء الاختباري متضمناً درجات الحرية بين قوسين، متبوعاً بقيمة t الدقيقة، ومستوى القيمة الاحتمالية $p$، وحجم الأثر المرتبط بها. تتجسد الصياغة النموذجية وفق المعايير التالية:
t(28) = 2.48, p = .019, d = 0.91
تتطلب كتابة هذه الرموز استيفاء شروط مطبعية ومنهجية محددة:
- تُكتب الأحرف اللاتينية التي تمثل إحصاءات أو معلمات رياضية بخط مائل (Italics)، مثل حرف t، وحرف p، وحرف d، في حين تظل الأرقام والأقواس بالخط العادي دون إمالة.
- تُقرب قيمة t وحجم الأثر إلى منزلتين أو ثلاث منازل عشرية بعد الفاصلة، مع إبقاء الصفر الأولي قبل الفاصلة للقيم التي يمكن نظرياً أن تتجاوز الواحد الصحيح (مثل درجات t وكوهين d).
- قاعدة الصفر الأولي للقيمة الاحتمالية: نظراً لأن القيمة الاحتمالية هي احتمال رياضي محصور بالضرورة بين الصفر والواحد الصحيح ولا يمكنها بلوغ الرقم واحد أو تجاوزه بأي حال، تمنع معايير APA كتابة الصفر الأولي قبل الفاصلة العشرية. فيُكتب مثلاً (p = .019) بدلاً من (p = 0.019).
- إذا أنتج برنامج إكسيل قيمة احتمالية متناهية الصغر تظهر في صورة شفرة أرقام عشرية مجهرية (مثل $0.000034$ أو ترميز علمي مثل
3.4E-05)، يُحظر تماماً كتابة (p = .000) في التقرير الأكاديمي، لأن الاحتمال في التوزيعات المستمرة لا يساوي صفراً مطلقاً، بل تُكتب الصيغة التوثيقية الدقيقة كالتالي: (p < .001).
10.2 بناء جداول إحصائية مهنية داخل إكسيل وتصديرها للأبحاث
يمثل إعداد وتنسيق الجداول الإحصائية داخل إكسيل خطوة حاسمة تمهد لنقل المخرجات إلى بيئات معالجة النصوص العلمية مثل مايكروسوفت وورد (Microsoft Word) أو محررات لاتيك (LaTeX). يفرض أسلوب الجمعية الأمريكية لعلم النفس (APA) تصميماً جدولياً نظيفاً يعتمد حصرياً على ثلاثة خطوط أفقية رئيسية: خط أعلى الترويسة، وخط أسفل الترويسة يفصل بين أسماء المتغيرات والبيانات الرقمية، وخط أخير يغلق قاعدة الجدول. يُحظر تماماً استخدام الخطوط العمودية الداخلية أو الخطوط الأفقية الفاصلة بين صفوف المتغيرات، للحفاظ على الانسيابية البصرية والوضوح العلمي.
لإنشاء جدول احترافي لمقارنات اختبار t داخل إكسيل، يتم تنسيق الأعمدة بالترتيب المنهجي التالي:
- العمود الأول: أسماء المجموعات أو المتغيرات المستقلة والتابعة (Variable / Group).
- الأعمدة التالية: البيانات الوصفية لكل مجموعة؛ المتوسط الحسابي M، والانحراف المعياري SD.
- الأعمدة الاستدلالية: درجة t المحسوبة، درجات الحرية df، القيمة الاحتمالية p، وحجم الأثر d.
تُربط القيم الاحتمالية المعروضة بنجوم الدلالة الإحصائية التقليدية في حواشي الجدول الإيضاحية السفلية، حيث يُدرج سطر توضيحي أسفل الجدول يعتمد الترميزات القياسية المعترف بها دولياً:
ملاحظة: * p < .05. ** p < .01. *** p < .001.
لتصدير هذا الجدول بكفاءة ودون فقدان التنسيقات، يُنسخ النطاق المحدد من إكسيل، ثم يُلصق في برنامج معالجة النصوص باستخدام خيار “الاحتفاظ بتنسيق المصدر” أو يُدمج كجدول وورد حر مع تطبيق نمط حدود APA الافتراضية، مما يضمن خروج التقرير الإحصائي بمظهر أكاديمي رصين يفي بمتطلبات التحكيم الصارمة في المجلات العلمية المحكمة عالمياً.
خاتمة
يُمثل استخراج القيمة الاحتمالية من درجة t داخل برنامج مايكروسوفت إكسيل جسراً منهجياً يربط بين البناء النظري للفرضيات العلمية واتخاذ القرارات الإمبريقية الرصينة في بحوث العلوم النفسية والسلوكية. لقد استعرضنا في هذا الدليل التأسيسي والشامل كيف يُترجم الاستدلال الإحصائي التباينات الفردية إلى مقادير كمية مقننة تعكس واقع المجتمعات الأصلية بدقة، بدءاً من المعالجة الرياضية التي صاغها جوسيت وتطويرات فيشر لتوزيع ستيودنت، وصولاً إلى الفروق الدقيقة التي تفصل بين التوزيعات أحادية الطرف وثنائية الطرف وعلاقتها بشكل الذيول ومساحات الرفض الحرجة.
أظهر التحليل العملي أن البرنامج يوفر ترسانة قوية من الدوال الحديثة مثل T.DIST وT.DIST.2T وT.DIST.RT، القادرة على معالجة مختلف التصاميم التجريبية لعينة واحدة أو عينتين مستقلتين أو مترابطتين. إلا أن استثمار هذه الأدوات يتطلب من الباحث وعياً تقنياً دقيقاً لتلافي أخطاء المعالجة الشائعة، مثل خطأ القيمة السالبة #NUM!، والخلط بين دوال التوزيع التراكمي ودوال الكثافة الاحتمالية. وفوق كل ذلك، يبقى التفسير العلمي المشروط والربط الواعي بين القيمة الاحتمالية وحجم الأثر (كوهين د)، والالتزام الصارم بتوثيق النتائج وفق ضوابط النشر لجمعية علم النفس الأمريكية (APA)، هو المعيار الحقيقي الذي يرتقي بالبيانات الرقمية المجردة إلى مستوى المعرفة العلمية الموثوقة.
المراجع
- Archer, J., Bower, P., Gilbody, S. M., Lovell, K., Richards, D. A., Gask, L. L., Dickens, C., & Coventry, P. (2012). Collaborative care for depression and anxiety problems. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd006525.pub2
- Borghouts, J. W., Eikey, E. V., Mark, G. J., De Leon, C., Schueller, S. M., Schneider, M. L., Stadnick, N., Zheng, K., Mukamel, D., & Sorkin, D. H. (2021). Barriers to and facilitators of user engagement with digital mental health interventions: Systematic review. Journal of Medical Internet Research. https://doi.org/10.2196/24387
- Cohen, G. L., & Sherman, D. K. (2014). The psychology of change: Self-affirmation and social psychological intervention. Annual Review of Psychology. https://doi.org/10.1146/annurev-psych-010213-115137
- Dunning, D. A., Heath, C., & Suls, J. M. (2004). Flawed self-assessment. Gothic.net. https://doi.org/10.1111/j.1529-1006.2004.00018.x
- Reardon, C. L., Gouttebarge, V., Kroshus, E., Baron, D. A., Bahr, R., Blauwet, C. A., Budgett, R., Campriani, N., Currie, A., Giel, K. E., McDuff, D., Mountjoy, M., Nieder, T. O., Simon, P. B., Stull, T., Hainline, B., & Engebretsen, L. (2019). Mental health in elite athletes: International Olympic Committee consensus statement (2019). British Journal of Sports Medicine. https://doi.org/10.1136/bjsports-2019-100715
- Wolf, M. M. (1978). Social validity: The case for subjective measurement or how applied behavior analysis is finding its heart 1. Journal of Applied Behavior Analysis. https://doi.org/10.1901/jaba.1978.11-203