
تمثل معالجة البيانات وتجهيزها (Data Wrangling) إحدى الركائز الجوهرية في هندسة البيانات والتحليل الإحصائي المتقدم عبر الجداول الممتدة. وفي صلب هذه المعالجة، تبرز الحاجة المتكررة إلى تصنيف السجلات وفهرستها وفق بنيات هرمية ومجموعات منطقية محددة، بدلاً من الاكتفاء بالترقيم الخطي المسطح لكامل ورقة العمل. إن الانتقال من نمط العد المطلق إلى نمط العد الشرطي الفئوي يعد نقلة نوعية تتيح للباحثين ومحللي النظم تفكيك الأنماط المركبة، وتوليد معرفات هجينة، وتتبع المسارات الزمنية أو التجريبية لكل وحدة تحليل بشكل مستقل.
تكمن المعضلة التقنية التي يواجهها مستخدمو برنامج مايكروسوفت إكسيل (Microsoft Excel) في كيفية بناء عدادات رقمية تراكمية تبدأ قيمتها بالرقم واحد عند كل تصنيف، وتتزايد باطراد مع تكرار عناصر ذلك التصنيف، ثم تعود للتصفير وإعادة البدء بصورة آلية وفورية فور مصادفة تصنيف جديد أو عند الانتقال بين الكتل البيانية. إن تحقيق هذه المهمة بدقة متناهية يتطلب فهماً عميقاً لمنطق عنونة الخلايا، وهندسة النطاقات المتوسعة، والتحليل الخوارزمي لأداء الدوال الإحصائية والمنطقية، بدءاً من الدوال الكلاسيكية وصولاً إلى دوال المحركات الحديثة ومحررات الاستعلام المتقدمة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك وتحليل كافة التقنيات المتاحة لإنشاء أرقام تسلسلية مبوبة حسب المجموعة داخل برنامج إكسيل. سنستعرض الأسس النظرية والرياضية المنظمة لهذه العمليات، ونتناول بالتفصيل خطوات التنفيذ العملي باستخدام الصيغ التقليدية، والتقنيات المبنية على المنطق الشرطي، والدوال المصفوفية الديناميكية المتقدمة، وصولاً إلى أتمتة الإجراء عبر بيئة تحويل البيانات “باور كويري” (Power Query). كما يقدم المقال تقييماً حوسبياً مقارناً للتعقيد الخوارزمي واستهلاك الذاكرة، لضمان أعلى درجات الكفاءة عند التعامل مع مجموعات البيانات البحثية والعملية الضخمة.
1. المدخل النظري والمفاهيمي للترقيم التسلسلي حسب المجموعات في إكسيل
1.1 مفهوم الترقيم الشرطي وأهميته الإحصائية
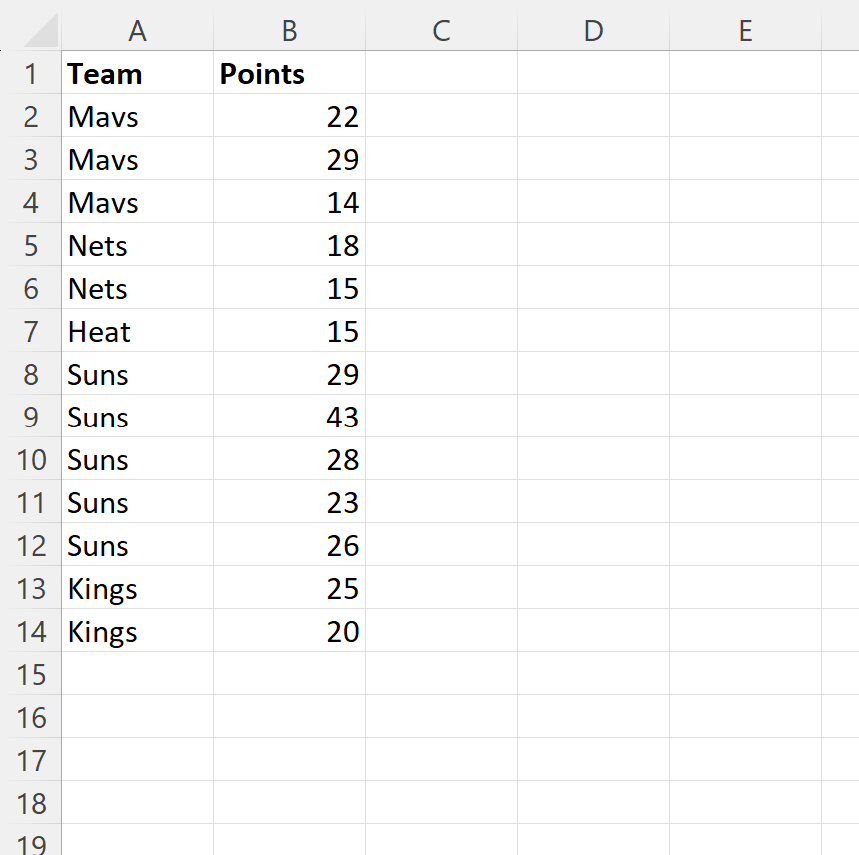
يُعرَّف الترقيم التسلسلي الشرطي (Conditional Sequence Numbering) في حوسبة الجداول الممتدة بأنه إجراء خوارزمي يهدف إلى إسناد قيمة رقمية صحيحة ومتصاعدة لكل صف أو سجل بيانات، بحيث ترتبط تلك القيمة بسياق فئوي معين وتتحدد رتبتها استناداً إلى تكرار الفئة داخل حدود نطاق البحث المعتمد. وخلافاً للترقيم التناظري الخطي البسيط، فإن الترقيم الشرطي لا يتعامل مع جدول البيانات بوصفه فضاءً أحادي البعد، بل ينظر إليه كبنية عنقودية تتألف من مجاميع فرعية متمايزة تستوجب عزلاً برمجياً أثناء الترقيم.
تتجلى الأهمية الإحصائية لهذا الترقيم في تعزيز جودة النمذجة الرياضية؛ حيث يتيح فرز وتصنيف العينات المنظمة هرمياً (Hierarchical Data Structure) مثل القياسات المتكررة على الأفراد، أو مستويات التحصيل للطلاب الموزعين داخل فصول دراسية، أو مبيعات الفروع الموزعة جغرافياً. الفارق الهيكلي بين الترقيم المطلق والترقيم التراكمي الفئوي يتمثل في أن الأول يشير إلى موضع السجل الفيزيائي داخل مصفوفة التخزين، بينما يعكس الترقيم التراكمي رتبة المشاهدة داخل فئتها المرجعية، مما يحول السجل من مجرد صف مجرد إلى نقطة ارتكاز تحليلية قابلة للقياس والمقارنة المستقلة.
يسهم هذا الأسلوب بشكل فعال في تحسين المقروئية المعرفية لمجموعات البيانات الضخمة (Big Data Sets). فعندما تتضمن الورقة عشرات الآلاف من السجلات، يتيح الفهرس الفئوي للمحلل استخلاص حجم كل عينة فرعية بصرياً وحسابياً بمجرد قراءة القيمة القصوى للمؤشر التسلسلي ضمن المجموعة، فضلاً عن تسهيل عمليات الفرز والتصفية اللاحقة دون المساس بالتماسك المنطقي الداخلي لبيانات الفئات المستقلة.
1.2 المجالات البحثية والتطبيقية لحاجة الترقيم المبوب
تتعدد التطبيقات العلمية والعملية التي تشترط وجود ترقيم تسلسلي مبوب. ففي إدارة قواعد البيانات الإحصائية والمسوح الميدانية، يُستخدم هذا الترقيم لترتيب الاستجابات المتعددة المستلمة من المنطقة الجغرافية ذاتها، أو لتسلسل أفراد الأسرة الواحدة في المسوح الديموغرافية، مما يسمح ببناء معرفات مركبة وفريدة (Composite Primary Keys) تجمع بين رمز الأسرة والترتيب النسبي للفرد داخلها.
أما في سياق الأبحاث التجريبية والعلوم السلوكية والقياس الكمي، فإن الترقيم المبوب يمثل أداة بالغة الأهمية أثناء مرحلة تجهيز البيانات وتنظيفها (Data Preparation). على سبيل المثال، عند إجراء اختبارات الاستجابة المتكررة (Repeated Measures Trials) أو دراسة أزمنة رد الفعل عبر مجموعات ضابطة وتجريبية، يحتاج الباحث إلى ترقيم محاولات كل مفحوص على حدة (من المحاولة رقم 1 إلى المحاولة رقم $k$)، لضمان إدراج أثر الترتيب الزمني للمحاولات كمتغير مساعد (Covariate) داخل نماذج تحليل التباين للقياسات المتكررة (RM-ANOVA) أو النماذج الخطية المختلطة (Linear Mixed Models).
يمتد التطبيق ليشمل تنظيم سجلات الإدخال الدوري وتحديد رتبة كل عنصر داخل كيانه الرئيسي في البيئات التشغيلية، مثل ترقيم الفواتير الموجهة لعميل معين، أو تسلسل الحركات المالية داخل الحساب البنكي الواحد، أو مراحل تصنيع القطع داخل خط الإنتاج. علاوة على ذلك، يسهل هذا الترقيم عمليات الربط والاستعلام المرجعي اللاحق (Lookup Operations)، حيث يمكن دمج معرّف الفئة مع الرقم التسلسلي لإنشاء كود مطابق فريد يُستخدم في دوال البحث والتقاطع مثل XLOOKUP أو INDEX/MATCH للوصول المباشر إلى المحاولة رقم $N$ لأي فئة دون الحاجة إلى عمليات بحث مركبة وبطيئة حوسبياً.
2. التحليل الرياضي والمنطقي لدالة COUNTIF في إنشاء السلاسل التراكمية
2.1 البنية التركيبية لدالة العد الشرطي COUNTIF
تُعد دالة COUNTIF من الأدوات الإحصائية الكلاسيكية الأكثر استخداماً في إكسيل، وتعتمد في بنيتها التركيبية على وسيطين إلزاميين: الوسيط الأول هو نطاق البحث (Range)، والوسيط الثاني هو معيار التطابق (Criteria). رياضياً، تعمل الدالة كدالة جمع مؤشرية (Indicator Function) تطبق المنطق البولياني؛ حيث تختبر كل خلية في النطاق المحدد، وتُرجع القيمة 1 إذا تطابقت القيمة مع المعيار، والقيمة 0 إذا لم تتطابق، ثم تحسب المجموع الجبري لهذه القيم البوليانية وفق المعادلة:
$$\text{COUNTIF}(R, c) = \sum_{x in R} \mathbb{I}(x = c)$$
يقوم المحرك الرياضي لبرنامج إكسيل بمعالجة المعامل الأول من خلال تحديد مساحة الذاكرة التي تشغلها مصفوفة الخلايا، بينما يقوم المعامل الثاني بإنشاء نمط الفحص المنطقي. تتميز الدالة بخصائص استجابة ديناميكية تدعم مطابقة النصوص الحرفية، والقيم العددية، والتعبيرات الشرطية الرياضية، فضلاً عن رموز البدل (Wildcards) مثل النجمة (*) وعلامة الاستفهام (?). وتتم هذه العمليات بمعزل عن حالة الأحرف في النصوص الإنجليزية، ولكن مع مراعاة التطابق الحرفي الدقيق في النصوص العربية والمحارف الخاصة، وهو ما يجعلها نموذجاً استثنائياً لتوليد العدادات الشرطية عندما يُعاد تشكيل أفق المراقبة في الوسيط الأول بصورة متغيرة.
2.2 المفهوم المتقدم للنطاق المتوسع تدريجياً
يكمن الابتكار التقني في استخدام دالة COUNTIF لتوليد الأرقام التسلسلية في تطويع مفهوم “النطاق المتوسع تدريجياً” (Expanding Range). يتمثل هذا المفهوم في تشييد نطاق خلوي يتسم بوجود طرف ثابت غير قابل للتحرك (Anchored Boundary) وطرف حر منزلق (Dynamic Boundary) يتغير موقعه بالتوازي مع موضع كتابة أو سحب الصيغة الحسابية.
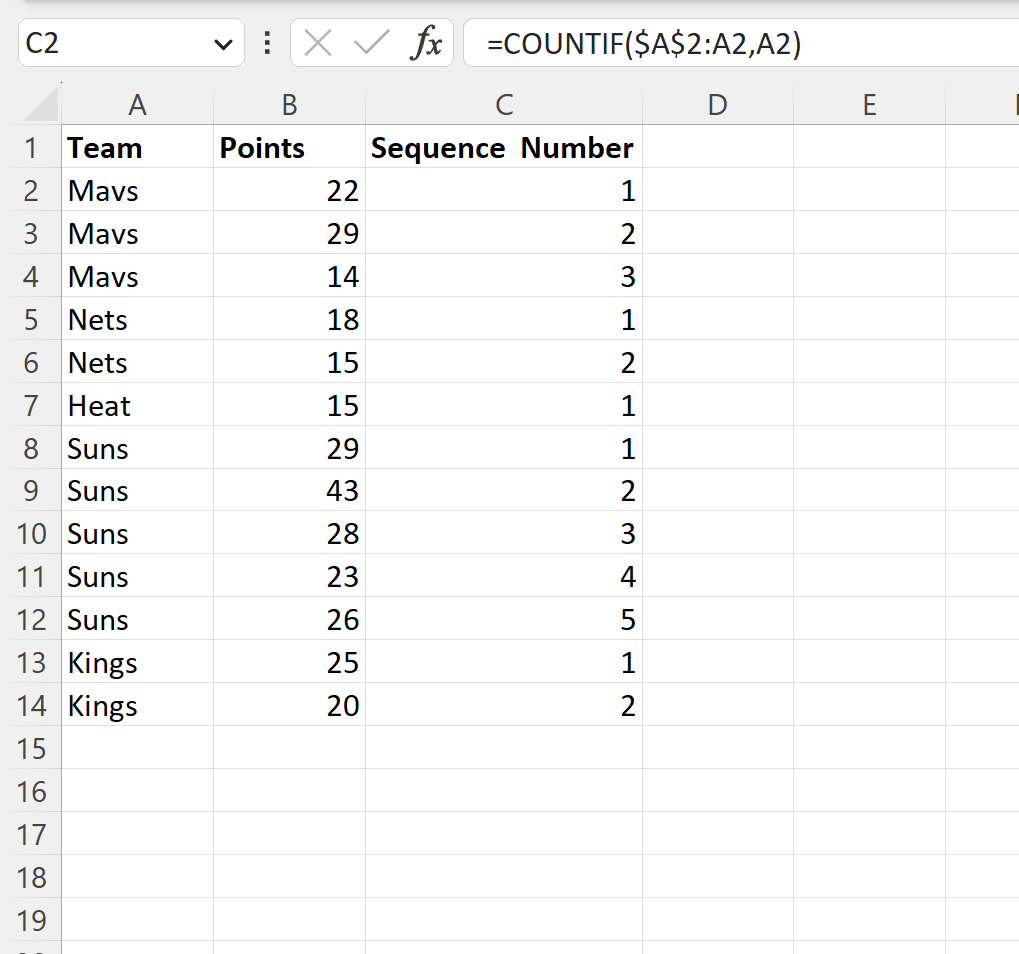
عندما تُكتب الصيغة بالصيغة: =COUNTIF($A$2:A2, A2) في الصف الثاني، فإن نطاق البحث ينحصر في الخلية $A2$ وحدها، ويقارن محتواها بمحتوى $A2$، فتكون النتيجة حتماً 1 كأول ظهور. وعند نسخ الصيغة تلقائياً إلى الصف الثالث، ينزلق الطرف الحر ليصبح النطاق: $A$2:A3، ويتم تقييم محتوى الخلية $A3$ قياساً بمحتويات النطاق التراكمي المكون من خليتين. إذا كانت الخلية $A3$ متطابقة مع $A2$، يعيد المحرك الرياضي القيمة 2؛ أما إذا كانت قيمة جديدة، فإنها لن تجد نظيراً لها في الخلايا السابقة، وبالتالي ستُرجع الدالة القيمة 1 مجدداً.
يؤدي هذا الانزلاق المتدرج لطرف النطاق إلى إعادة ضبط منطقية مستمرة لمصفوفة التقييم عند كل سطر جديد. رياضياً، تتسع المصفوفة خطياً بمقدار خلية واحدة في كل خطوة، مما يولد محاكاة منطقية فائقة الدقة لإعادة تصفير العداد لكل متغير فئوي جديد دون الحاجة إلى استخدام شروط برمجية متداخلة أو وسائط فحص مسبقة لمعرفة ما إذا كانت القيمة مساوية للسطر السابق أم لا.
3. الفارق الجوهري بين المراجع المطلقة والمراجع النسبية في تثبيت النطاقات
3.1 دور علامة الدولار ($) في تثبيت نقاط البداية
تشكل المراجع الخلوية العمود الفقري لتنفيذ الخوارزميات الحسابية داخل إكسيل. تُستخدم علامة الدولار ($) في محرك إكسيل كأداة تثبيت قطعية تمنع نظام الإحداثيات النسبي من تعديل موقع الخلية أو النطاق عند نسخ الصيغ عبر الصفوف أو الأعمدة. في صيغة الترقيم الفئوي، نلجأ إلى تطبيق مفهوم المرجع الهجين أو شبه المطلق (Semi-Absolute Reference)، حيث تُثبت نقطة البداية تثبيتاً مطلقاً على مستوى العمود والصف معاً مثل $A$2، في حين يُترك الطرف المقابل A2 كمرجع نسبي بالكامل.
التبعات الهندسية لإغفال علامة الدولار وتدوين الصيغة كمرجع نسبي بحت =COUNTIF(A2:A2, A2) تكون كارثية على بنية الترقيم؛ فعند السحب الرأسي، ستتحول الصيغة في الصف العاشر إلى =COUNTIF(A10:A10, A10)، مما يعني أن نطاق البحث يتحرك بالتوازي مع الصف ويبقى حجمه خلية واحدة دائماً. يؤدي هذا السلوك إلى ظهور الرقم (1) في كافة خلايا العمود بلا استثناء، حيث لا تفحص الدالة سوى الخلية الحالية مقارنة بنفسها، فاقدةً بذلك صفة التراكمية التاريخية للبيانات السابقة.
أما من منظور السلوك الخلوي الرياضي، فإن الانتقال الرأسي للأسفل يُترجم داخل بيئة إكسيل بإضافة ثابت إزاحة $+k$ إلى مؤشر الصفوف للأطراف النسبية فقط. ومن ثم، فإن المرجع الهجين يضمن ثبات جذر النطاق الحسابي في الخلية الأولى للجدول، مما يُجبر الخوارزمية على استيعاب كافة المشاهدات التاريخية السابقة التي تمت معالجتها وصولاً إلى اللحظة الراهنة.
3.2 مقارنة منهجية بين أنواع المراجع الخلوية
لتوضيح الآثار الرياضية المترتبة على اختيار نمط العنونة، يستعرض الجدول المنهجي التالي مقارنة تقنية توضح سلوك وأنماط المراجع الخلوية داخل محرك العمليات الرياضية في إكسيل وأثر كل منها على عمليات الفهرسة والترقيم الشرطي:
- المراجع المطلقة بالكامل (Absolute References – مثل
$A$2:$A$100): تفرز تجميداً تاماً لأبعاد النطاق وموقعه الجغرافي. إذا طُبقت داخل صيغة العد الفئوي، فإنها تُرجع التكرار الإجمالي للمجموعة عبر كامل الجدول كقيمة ثابتة لا تتغير بتغير الصفوف، مما يفقدها خاصية التسلسل الرتبي. - المراجع النسبية بالكامل (Relative References – مثل
A2:A2): تُنشئ نوافذ انزلاقية ذات مساحة ثابتة تتحرك خطوة بخطوة مع كل صف، مما يجعل الدالة عمياء عن السجلات السابقة وتنتج قيمة أحادية مستمرة تساوي 1 دائماً. - المراجع شبه المطلقة (Semi-Absolute / Expanding References – مثل
$A$2:A2): تمثل الأسلوب الأوحد القادر رياضياً على توليد المصفوفات التراكمية التصاعدية؛ حيث تثبت نواة البداية وتسمح للأفق التقييمي بالتمدد مع تدفق السجلات. - المراجع النسبية المقيدة بالأعمدة (Mixed Column References – مثل
$A2:A2): تسمح بمرونة التمدد الرأسي مع ضمان ثبات عمود التصنيف عند الرغبة في تعميم الصيغة أفقياً عبر عدة أعمدة تحليلية تالية.
يتضح من هذا التوصيف أن الضبط الصارم للمراجع يعد الشرط الحاسم لتفادي انزياح البيانات (Data Drifting) أثناء عمليات النسخ، ولضمان تطابق الأفق المرجعي مع البنية المنطقية للجدول المراد فهرسته.
4. خطوات التطبيق العملي لبناء صيغة الترقيم الفئوي التلقائي
4.1 إعداد وتجهيز بنية جدول البيانات
قبل الشروع في كتابة أي معادلة رياضية داخل بيئة العمل، يتعين على المحلل اتخاذ جملة من التدابير التنظيمية الصارمة لضمان سلامة البنية البيانية. تبدأ هذه الخطوات بالتأكد من خلو مصفوفة الفئات من أي خلايا مدمجة (Merged Cells)؛ فالخلايا المدمجة تمثل خللاً بنيوياً يعطل مرونة المراجع النسبية ويؤدي إلى قراءة قيم فارغة في الصفوف الثانوية المدمجة.
تتضمن مرحلة التهيئة تنظيف السجلات النصية من المسافات البادئة واللاحقة غير المرئية (Leading and Trailing Spaces) التي تنشأ عادة عند استيراد البيانات من خوادم قواعد البيانات أو منصات جمع المسوح. وجود مسافة واحدة غير مرئية في نهاية نص الفئة كفيل بجعل إكسيل يعتبره عنصراً مستقلاً، مما يؤدي إلى انكسار التسلسل وبدء عداد جديد بصورة غير مرغوبة. يمكن اللجوء المسبق إلى دالة TRIM لمعالجة عمود الفئات لضمان التطهير النصي الشامل.
كذلك يجب توحيد أنماط الترميز وحروف النصوص العربية (كالهمزات والتاء المربوطة والياء)، والتحقق من أن الصف الأول يمثل الرؤوس المنطقية للأعمدة (Headers)، وأن أول خلية بيانات فعلية تنطلق بدقة من الصف الثاني (مثل A2 لعمود المجموعات وB2 لعمود الترقيم المستهدف) لتلافي إدراج تسميات الحقول النصية داخل مصفوفات العد الحسابي.
4.2 كتابة الصيغة وتعميمها عبر السحب التلقائي
عقب إتمام مرحلة التنظيف والتهيئة البنيوية، يتم الانتقال إلى الخلية الأولى المخصصة للترقيم التسلسلي، ولتكن الخلية B2 في الجدول، ثم تُدرج الصيغة التالية بصورة دقيقة:
=COUNTIF($A$2:A2, A2)
فور الضغط على زر الإدخال (Enter)، سيقوم البرنامج بتقييم الخلية الأولى ويُرجع الرقم (1). لنشر هذه الصيغة عبر كامل العمود، يتم وضع مؤشر الفأرة على الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) لخلية الإدخال حتى يتحول المؤشر إلى علامة التقاطع السوداء المعروفة بـ “مقبض التعبئة” (Fill Handle). يُنقر نقراً مزدوجاً بالزر الأيسر للفأرة أو يتم السحب يدوياً لأسفل الجدول حتى آخر سجل مأهول بالبيانات.
تتم مراجعة المخرجات عبر فحص أول ظهور لكل مجموعة، والتأكد عيانياً وبرمجياً من أن الأرقام تتصاعد متتالية (1، 2، 3…) ضمن الفئة ذاتها، مع التحقق من أن الانتقال إلى فئة جديدة يُحدث تصفيعاً فورياً للعداد ويعود به إلى الرقم 1 دون أدنى تدخل يدوي، مما يؤكد سلامة تنفيذ النطاق التراكمي وتطابق مخرجاته مع التصميم النظري المستهدف.
5. التعامل مع البيانات غير المرتبة والفئات المتفرقة مكانياً
5.1 سلوك الصيغة في حال عدم فرز البيانات مسبقاً
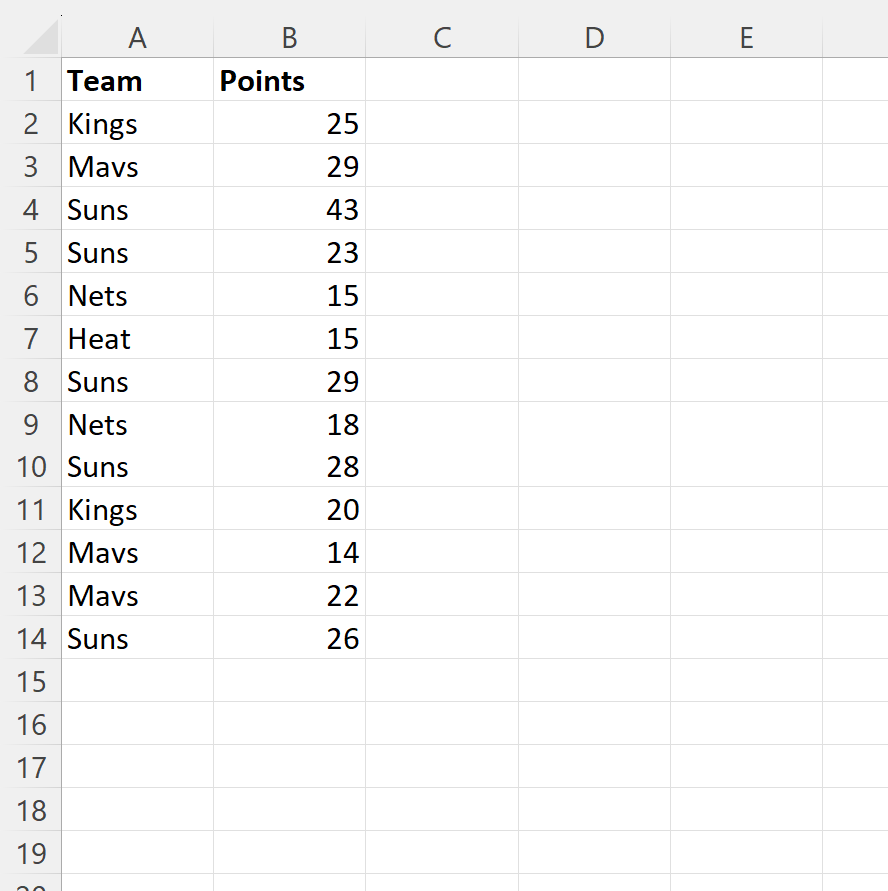
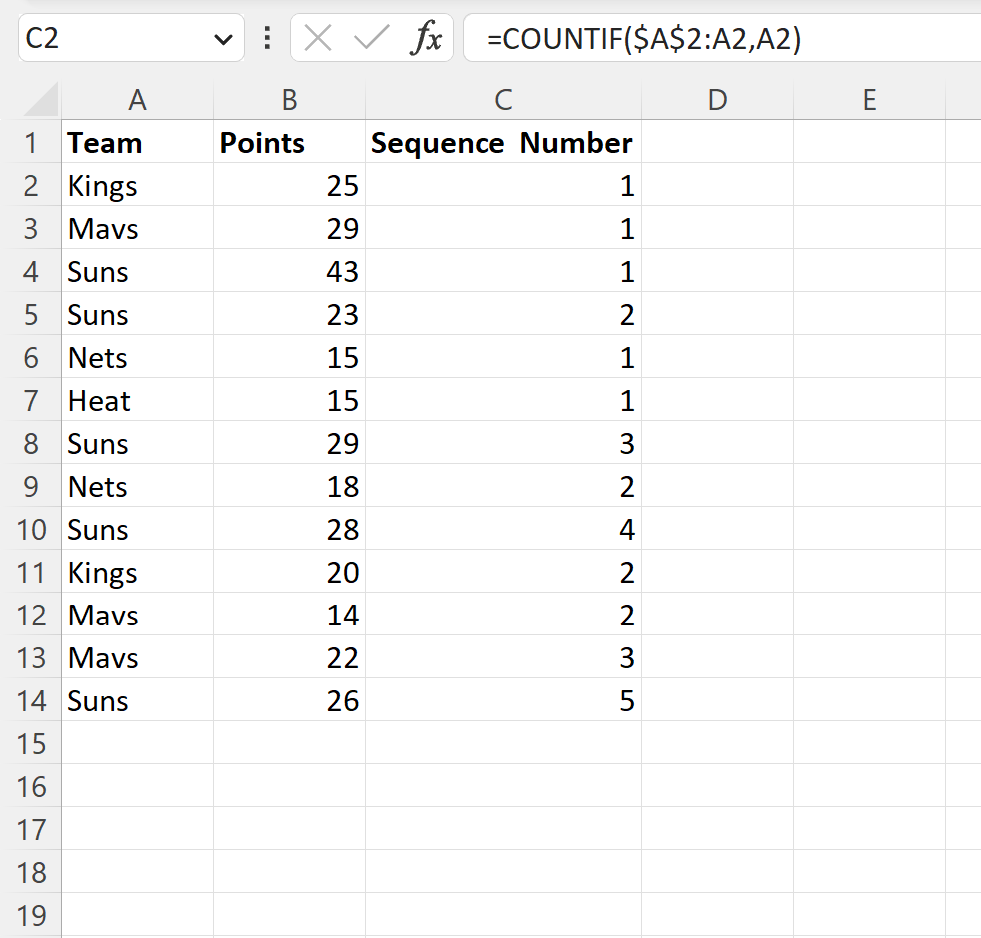
من أهم السمات الحسابية لصيغة النطاق المتوسع باستخدام COUNTIF قدرتها الفائقة على معالجة البيانات غير المرتبة أو المتفرقة جغرافياً ومكانياً داخل الورقة. إذا كانت عناصر المجموعة (أ) تظهر في السطرين 2 و3، ثم تظهر عناصر المجموعة (ب) في الأسطر 4 و5، لتعود المجموعة (أ) للظهور مجدداً في السطر 6، فإن الصيغة تتكيف تلقائياً مع هذا التشتت دون أي خلل رياضي.
عند وصول الصيغة إلى السطر 6، يقوم النطاق المتوسع $A$2:A6 بمسح شامل لكافة الخلايا السابقة، فيكتشف وجود ظهورين سابقين للمجموعة (أ) في السطرين 2 و3؛ وبناءً عليه، يقوم تلقائياً بإسناد الرقم (3) للظهور الجديد في السطر 6، متجاوزاً صفوف المجموعة (ب) المتخللة بينهما. هذا السلوك يعني أن الدالة توفر تتبعاً تاريخياً تراكمياً شاملاً لكل فئة، وهو أمر لا غنى عنه في الدراسات الإحصائية التي ترصد مسارات التكرار الزمني العشوائي للظواهر المعقدة.
بيد أن هذا التشتت المكاني قد يسبب إرباكاً في القراءة البصرية للباحثين غير المتخصصين، حيث تبدو الأرقام في عمود التسلسل وكأنها تقفز عشوائياً (مثال: 1، 2، 1، 2، 3، 1…)، على الرغم من دقتها الحسابية المطلقة بالنسبة لكل فئة بمفردها.
5.2 أهمية الفرز المسبق لتحقيق التسلسل التتابعي المنظم
لتحقيق أعلى درجات الاتساق البصري والهيكلي في الجداول والتقارير الإحصائية، يُفضل أكاديمياً وعملياً إجراء عملية فرز مسبق (Pre-sorting) للبيانات قبل توليد أرقام التسلسل. يتم تنفيذ فرز تصاعدي أو تنازلي متعدد المستويات (Multi-level Sort)؛ بحيث يكون المستوى الأول هو “عمود المجموعة”، والمستوى الثاني هو أي متغير فرعي زمني أو رتبي (مثل تاريخ المشاهدة أو درجة الاختبار).
يؤدي الفرز المسبق إلى تجميع كافة سجلات الفئة الواحدة في كتل بيانية متصلة غير منقطعة (Contiguous Blocks). في هذه الحالة، يتحول عمود الترقيم التسلسلي إلى مظهر ترتيبي مثالي، حيث تتتابع الأرقام بدقة (1، 2، 3… $N$) لكل كتلة، مما يحد تماماً من التشويش الذهني أثناء استعراض البيانات المجمعة، ويجعل مراجعة الجداول وتدقيقها عملاً بالغ السلاسة.
علاوة على ذلك، يفتح الفرز المسبق الباب أمام استخدام بدائل حسابية أكثر سرعة في التنفيذ وأقل استهلاكاً لموارد المعالجة مقارنة بدالة COUNTIF، وتحديداً صيغة المقارنة المنطقية الشرطية IF المباشرة التي تعتمد على مطابقة السطر الحالي بالسطر السابق فقط، وهو ما سيتم تحليله بدقة عند مناقشة التعقيد الحسابي للأداء.
6. الترقيم متعدد المعايير والمجموعات المتداخلة باستخدام COUNTIFS
6.1 توسيع النطاق الشرطي ليشمل فئات فرعية مركبة
تتطلب العديد من التصاميم البحثية المتقدمة تصنيف البيانات وفق أكثر من متغير فئوي في آن واحد، وهو ما يُعرف بالفهرسة متعددة المستويات أو الهياكل المتقاطعة (Cross-classified Designs). ففي دراسات العلوم الطبية والبيولوجية والسلوكية، قد يحتاج الباحث إلى ترقيم السجلات وفق معيار “المجموعة التجريبية” مقترناً بـ “الجنس”، أو تتبع محاولات الأفراد المستقلة بحيث يكون الترقيم خاصاً بكل “مشارك” ضمن كل “جلسة اختبار”.
في مثل هذه البيئات المعقدة، تعجز دالة COUNTIF الأحادية عن الإيفاء بالغرض نظراً لاقتصارها على معيار واحد. هنا يتم توظيف شقيقتها الموسعة دالة COUNTIFS، التي تسمح باختبار حزم متعددة من النطاقات والمعايير المقترنة منطقياً عبر عملية الضرب المنطقي (Logical AND)، بحيث لا تزداد قيمة العداد إلا إذا تحققت كافة الشروط المفروضة بصورة متزامنة داخل الصف نفسه.
التحليل المنطقي لهذه البنية يفترض أن كل قيد إضافي يعمل كمصفاة تضيق أفق العد التراكمي، مما يولد متتالية عددية فريدة تخدم بوصفها رتبة دقيقة للحدث ضمن التقاطع المحدد لكافة الأبعاد الفئوية المعنية بالدراسة.
6.2 صياغة الترقيم المتداخل بدقة واحترافية
لصياغة الترقيم الشرطي متعدد المستويات، نستخدم التركيب النحوي التالي في أول صف للبيانات، بافتراض أن الفئة الأساسية تقع في العمود $A$ والفئة الثانوية في العمود $B$:
=COUNTIFS($A$2:A2, A2, $B$2:B2, B2)
تعتمد هذه الصيغة على تزامن انزلاق نطاقين متوسعين مختلفين $A$2:A2 و $B$2:B2، والتحقق الحسابي من التطابق المزدوج لقيم A2 و B2 في كل حركة. عند تطبيق هذه المعادلة وتعميمها، سيتصاعد الترقيم للمشاركين الذين يشتركون في نفس المجموعة ونفس الفئة الثانوية، وسيعاد ضبط الترقيم ليبدأ من 1 بمجرد تغير أي من المتغيرين في السجلات اللاحقة.
تجدر الإشارة إلى أن إدراج أكثر من نطاق متوسع يفرض عبئاً حسابياً إضافياً على المعالج المركزي عند التعامل مع مصفوفات ضخمة، نظراً لأن المحرك يقوم بعمليات مطابقة تقاطعية تتسع مساحتها مع كل صف جديد. لتفادي تضارب الأولويات وانهيار الأداء، يجب التأكد من تطابق أطوال النطاقات المتوسعة وتماثل إحداثيات البداية والنهاية عبر كافة الوسائط بدقة مطلقة، مع ضمان تجانس أنماط البيانات (نصوص مع نصوص وتواريخ مع تواريخ) لتجنب أخطاء الإسناد المنطقي الخفي.
7. أتمتة الترقيم باستخدام جداول إكسيل الديناميكية (Excel Tables)
7.1 تحويل النطاق التقليدي إلى جدول رسمي منظم
يوفر تحويل النطاقات البيانية المسطحة إلى “جداول إكسيل الرسمية” عبر تحديد البيانات والضغط على مفتاحي الاختصار Ctrl + T ميزات استثنائية لأتمتة معالجة البيانات وضمان استدامتها. يتحول النطاق العادي في هذه البيئة إلى كائن برمجي منظم (ListObject) يتمتع بخصائص ديناميكية متقدمة تحافظ على تماسك المعادلات وسلامة أطرافها الهيكلية.
من أهم تلك الخصائص ميزة “الأعمدة المحسوبة التلقائية” (Calculated Columns)؛ حيث يكفي كتابة المعادلة في الخلية الأولى من عمود الجدول ليقوم إكسيل بملء العمود بأكمله تلقائياً دون الحاجة إلى السحب اليدوي. والأهم من ذلك أنه عند إضافة صفوف جديدة في أسفل الجدول، تتمدد حدود الجدول رأسياً وتُطبق صيغة الترقيم التسلسلي فورياً على السجلات المستحدثة، مما يجعل التدخل اليدوي معدوماً ويوفر بيئة مثالية لجمع البيانات المتدفقة بصورة متواصلة دون المساس بسلامة التسلسل الرقمي المعتمد.
7.2 صياغة المراجع الهيكلية للترقيم الفئوي داخل الجداول
عند التعامل مع جداول إكسيل، تتغير آلية عنونة الخلايا من نظام الإحداثيات الأبجدية-الرقمية ($A2$) إلى نظام “المراجع الهيكلية” (Structured References) الذي يعتمد على أسماء الأعمدة الموضوعة داخل أقواس معقوفة. لبناء نطاق متوسع بصيغة هيكلية لترقيم فئات عمود يحمل اسم [Category]، يمكن كتابة الصيغة التالية:
=COUNTIF(INDEX([Category], 1):[@Category], [@Category])
في هذا التركيب المتقدم، نستخدم دالة INDEX مع المؤشر 1 للإشارة الدائمة والثابتة إلى الخلية الأولى في عمود الفئات كبداية للنطاق التراكمي، بينما يمثل الجزء [@Category] موقع السجل الحالي لنفس الصف كطرف حر منزلق. يوفر هذا الأسلوب حماية هيكلية بالغة القوة ضد أخطاء الحذف العرضي للصفوف العلوية؛ فالإحداثيات التقليدية مثل $A$2 قد تصاب بخطأ المرجع المشهور #REF! إذا حُذف الصف الثاني يدوياً، بينما يضمن استخدام المراجع الهيكلية مع دالة INDEX إعادة توجيه نقطة البداية إلى الصف الأول المتبقي تلقائياً دون أي انهيار برمجي في ورقة العمل.
8. الحلول المتقدمة عبر دوال المصفوفات الحديثة (Dynamic Arrays)
8.1 الترقيم التلقائي الشامل بصيغة خلية واحدة دون سحب
مع إطلاق محرك الحساب الديناميكي للمصفوفات (Dynamic Array Engine) في إصدارات Microsoft 365 وما تلاها، أصبح بالإمكان الاستغناء تماماً عن كتابة الصيغ وسحبها عبر آلاف الصفوف، واستبدال ذلك بـ “صيغة الخلية الواحدة المتدفقة” (Single-cell Spill Formula). تتكفل هذه الصيغ المتقدمة بحساب السلسلة بأكملها وإلقاء نتائجها (Spilling) رأسياً لتغطي كامل أبعاد البيانات تلقائياً.
يتم ذلك عبر توظيف الدوال المتقدمة مثل MAP مقترنة بالدالة البرمجية التجريدية LAMBDA، حيث تُمرر مصفوفة الفئات كمدخل للدالة وتقوم بتنفيذ العد الشرطي التراكمي على كل عنصر من عناصرها بالتتابع عبر استدعاء خوارزمي مستقل. يضمن هذا النهج عدم انقطاع السلسلة التسلسلية نتيجة خطأ بشري أثناء السحب، كما يمنع العبث العرضي بصيغ الخلايا الفردية؛ إذ تكون الصيغة محصورة ومحمية في الخلية العلوية الأولى، وتكون باقي الخلايا مجرد انعكاسات ناتجة عن التدفق الرياضي للمحرك المحدث.
8.2 دمج دالتي SCAN و LET لرفع كفاءة المعالجة
يمثل الدمج الخوارزمي بين دالتي SCAN و LET ذروة الكفاءة البرمجية في معالجة السلاسل التراكمية على البيانات المرتبة مسبقاً. تعمل دالة SCAN على مبدأ المجمّع التكراري (Accumulator Loop)، حيث تفحص عناصر المصفوفة عنصراً تلو الآخر، محتفظة بحالة العداد ومقارنة القيمة الحالية بالقيمة السابقة مباشرة، وهو ما يخفض التعقيد الحسابي جذرياً من $O(N^2)$ التابع لـ COUNTIF إلى $O(N)$ الخطي الخالص.
تُكتب هذه الصيغة المتقدمة في الخلية الأولى على النحو التالي (بافتراض أن مصفوفة الفئات ممتدة من A2:A100):
=DROP(REDUCE(0, A2:A100, LAMBDA(acc, val, VSTACK(acc, IF(val=OFFSET(val,-1,0), TAKE(acc,-1)+1, 1)))), 1)
أو بصورة أكثر حداثة وتجريداً باستخدام تقنيات المتغيرات المعرفة عبر دالة LET لمنع تكرار تقييم النطاقات في الذاكرة المؤقتة. إن هذا الأسلوب لا يسهم فقط في خفض زمن المعالجة من دقائق إلى أجزاء من الثانية في الجداول المليونية، بل يقلل بدرجة هائلة من استهلاك ذاكرة الوصول العشوائي (RAM)، مما يحول دون تجمد برنامج إكسيل أو تعطل المعالجات متعددة الأنوية أثناء إجراء العمليات الإحصائية المكثفة.
9. تشخيص الأخطاء الشائعة وحلول استكشاف الأعطال وإصلاحها
9.1 أخطاء المسافات وتطابق النصوص غير المرئي
تُعد العيوب الخفية في النصوص السبب الأول لانهيار منطق الترقيم التراكمي وظهور تكرارات غير مبررة للرقم (1). يتمثل هذا الخطأ في وجود مسافات بيضاء غير مرئية (Spaces) قبل النص أو بعده، أو وجود مسافات صلبة غير قابلة للكسر (Non-breaking Spaces ذات الترميز CHAR(160)) الشائعة في البيانات المنسوخة من صفحات الويب ومخرجات الأنظمة السحابية.
من الناحية المنطقية، يعتبر المحرك النص "المجموعة أ " كياناً مختلفاً كلياً عن النص "المجموعة أ"؛ مما يدفع دالة العد إلى معاملته كفئة جديدة تماماً، فيتم تصفير العداد لتبدأ السلسلة من 1 عشوائياً وسط سجلات يفترض أنها متصلة. لمعالجة هذا الخلل البنيوي، يُنصح بتغليف عمود التصنيف بالدوال المطهرة قبل تطبيق الفهرسة عبر دمج دالتي TRIM و CLEAN:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
كما يُستحسن فرض قيود صارمة على الإدخال اليدوي للبيانات لاحقاً عبر تفعيل أدوات “التحقق من صحة البيانات” (Data Validation) واستخدام القوائم المنسدلة (Dropdown Lists)، مما يضمن التوحيد الإملائي الصارم ومنع المشغلين من إدخال تباينات نصية تقوض دقة الترقيم التسلسلي المبوب.
9.2 أخطاء المراجع وتلف النطاقات الحسابية
تحدث أخطاء المراجع الخلوية عادة نتيجة التعديلات الهيكلية اليدوية غير المنضبطة على أوراق العمل. ومن أبرز تلك الأخطاء ظهور التنبيه الحسابي الشهير #REF!، والذي ينشأ حتماً إذا قام المستخدم بحذف الصف المصدري الذي يحتوي على المرجع المطلق الأول $A$2؛ حيث يفقد إكسيل الإحداثي الجذري لنواة النطاق، مما يؤدي إلى تلف فوري لكافة الصيغ التابعة في كامل العمود.
الخطأ الشائع الآخر هو “التثبيت الزائد للنطاق”، حيث يقوم بعض المستخدمين بتثبيت طرفي المعادلة بالكامل =COUNTIF($A$2:$A$2, A2)، مما يجمد النطاق ويمنعه من التمدد أثناء السحب، فتنتهي النتيجة بإنتاج الرقم 1 في كل الصفوف. وعلى النقيض من ذلك، فإن حذف علامات التثبيت نهائياً ينتج عنه نوافذ عائمة تحجب الرؤية التراكمية عن السجلات السابقة.
كذلك تبرز معضلة تراجع الأداء وتجمد الملف (Performance Freeze) عند تطبيق دالة COUNTIF ذات النطاق المتوسع على جداول تتجاوز خمسين ألف صف ($N > 50,000$). فالتعقيد الحسابي المربع لهذه الدالة ($O(N^2)$) يجبر الحاسوب على إجراء مئات الملايين من عمليات المقارنة النصية المتكررة مع كل إعادة حساب للورقة. لتجاوز هذه المعضلة التشغيلية، يُنصح بشدة إما بفرز البيانات وتطبيق صيغة الشرط المباشر IF ذات التعقيد الخطي ($O(N)$)، أو نسخ عمود التسلسل بعد اكتمال حسابه ولصقه في نفس الموضع كـ “قيم ثابتة” (Paste as Values)، مما يعزل الملف عن استهلاك الذاكرة ويمنع إعادة الحساب التلقائي المنهك.
10. المقارنة المنهجية: الصيغ الخلوية مقابل Power Query في ترقيم المجموعات
10.1 ترقيم المجموعات عبر محرر Power Query
يوفر محرر استعلامات إكسيل Power Query بيئة معالجة تحويلية فائقة التطور تتبع نموذج الاستخراج والتحويل والتحميل (ETL)، متفوقة على الصيغ الخلوية التقليدية في إدارة وتجهيز مجموعات البيانات الكبرى. تعتمد آلية ترقيم المجموعات داخل Power Query على استخدام لغة M عبر تسلسل منطقي محكم يبدأ بفرز البيانات ثم استخدام أداة “التجميع حسب” (Group By).
يتم اختيار عمود المجموعة كمفتاح للتجميع، مع تحديد العملية بإنشاء جدول متداخل يحتوي على “كافة الصفوف” (All Rows). ينتج عن هذا عمود متداخل يتضمن جداول فرعية منفصلة لكل فئة مستقلة. يتم بعد ذلك استدعاء دالة إضافة عمود الفهرس المخصصة داخل كل جدول فرعي باستخدام الدالة البرمجية Table.AddIndexColumn في لغة M، مع تحديد نقطة البداية بالرقم 1 ومقدار الزيادة بالرقم 1:
Table.AddIndexColumn([Custom], "Index", 1, 1, Int64.Type)
بمجرد توسيع (Expand) هذه الجداول الفرعية واستعادة الأعمدة الأصلية، يُعاد بناء الجدول بالكامل مع إدراج عمود الفهرس التسلسلي لكل مجموعة بدقة متناهية ودون كتابة صيغة خلوية واحدة داخل ورقة العمل. تتميز هذه الطريقة بأنها غير متطايرة (Non-volatile)؛ فالأرقام الناتجة تكون قيماً ثابتة مخزنة داخل نموذج البيانات، ولا تستهلك أي قدر من طاقة المعالج أثناء تصفح الورقة، مع إمكانية تحديثها بنقرة زر واحدة عبر خيار “تحديث” (Refresh) فور ورود بيانات جديدة.
10.2 معايير الاختيار بين صيغ إكسيل ومحرر الاستعلامات
للمفاضلة بين الصيغ الخلوية الحية وبيئة Power Query، يقدم التحليل المقارن التالي معايير دقيقة ترشد الباحثين والمحللين لاختيار الأداة المثلى وفق متطلبات المشروع:
- حجم مصفوفة البيانات (Data Volume): تتفوق صيغة
COUNTIFفي المشاريع الصغيرة والمتوسطة (أقل من 20,000 صف). أما في المشاريع الضخمة التي تضم مئات الآلاف أو الملايين من السجلات، فإن Power Query يمثل الخيار الأوحد المقبول تقنياً لتجنب الاختناق الحسابي الحتمي لمحرك الصيغ المباشرة. - طبيعة الاستجابة والتحديث (Reactivity): تمنح الصيغ الخلوية (مثل
COUNTIFوIF) استجابة ديناميكية لحظية؛ حيث يتغير الترقيم فورياً بمجرد تعديل أي خلية في الجدول. في المقابل، يتطلب Power Query تشغيل عملية التحديث اليدوي أو المجدول لإعادة تنفيذ مراحل لغة M. - سرعة تحميل وحجم الملف (File Overhead): تؤدي كثرة الصيغ المعقدة والمتوسعة إلى تضخم حجم مصنف إكسيل وبطء شديد أثناء عمليات الحفظ والفتح، بينما يحافظ Power Query على خفة ورشاقة الملف نظراً لتخزين النتائج كبيانات مادية مسطحة دون معادلات حية مستمرة المراقبة.
- مستوى تعقيد البنية الفئوية: تعد الصيغ الخلوية أكثر مرونة في بناء النماذج التجريبية المؤقتة السريعة التي تتطلب فهماً بصرياً مباشراً لنتائج الفرز، في حين يعد Power Query الأداة المثالية لبناء خطوط معالجة البيانات الإنتاجية والمستدامة (Production Data Pipelines) التي تتكرر دورياً وفق معايير صارمة.
خاتمة
يمثل الترقيم التسلسلي حسب المجموعة داخل برنامج مايكروسوفت إكسيل كفاءة تقنية ومنهجية لا غنى عنها في الترسانة المعرفية لأي باحث إحصائي أو محلل بيانات. من خلال التفكيك المنهجي المستفيض لمختلف مسارات التنفيذ، اتضح أن النجاح في تطبيق هذه الآلية لا يرتبط بمجرد حفظ دوال جاهزة، بل يستند أساساً إلى استيعاب فلسفة عنونة الخلايا، وهندسة النطاقات المتوسعة، والإدراك العميق للتعقيد الخوارزمي وسلوك استهلاك الذاكرة في كل أسلوب متبع.
توفر دالة COUNTIF بنطاقها شبه المطلق حلاً كلاسيكياً مرناً يمتاز بقدرته الذاتية على التكيف مع مختلف بنيات البيانات، سواء كانت مرتبة أو مبعثرة جغرافياً داخل الورقة، في حين تؤمن الدالة الموسعة COUNTIFS أفقاً ممتداً للتعامل مع الفئات المتقاطعة والمتعددة. ومع ذلك، فإن الباحث الحصيف يدرك تماماً حدود الأداء الحسابي لهذه الدوال؛ فلا يتردد في توظيف الفرز المسبق مع الشرط المنطقي المباشر IF، أو استثمار القوة التحويلية الهادئة لأداة Power Query عندما تتجاوز السجلات عتبات الكفاءة المسموحة في الجداول الضخمة.
في الختام، يُنصح دائماً بالانتقال التدريجي نحو استخدام “جداول إكسيل الرسمية” لضمان أتمتة تمدد الصيغ وسلامة مراجعها ضد أخطاء الحذف والتعديل، والتطلع بثقة نحو دوال المصفوفات الحديثة لمحرك Microsoft 365 التي تعيد صياغة قواعد المعالجة عبر تقديم حلول الخلية الواحدة المتدفقة، بما يجمع بين الدقة الرياضية، والجمال الهيكلي، والكفاءة التشغيلية الفائقة.
المراجع
- Alexander, M., & Kusleika, D. (2022). Excel 2021 All-in-One For Dummies. John Wiley & Sons. https://www.wiley.com/en-us/Excel+2021+All+in+One+For+Dummies-p-9781119830504
- Exceljet. (n.d.). Number groups of rows with COUNTIF. Retrieved October 24, 2023, from https://exceljet.net/formulas/number-groups-of-rows-with-countif
- Microsoft Support. (n.d.). COUNTIF function. Microsoft Corporation. Retrieved October 24, 2023, from https://support.microsoft.com/en-us/office/countif-function-e0de10c6-f885-4e71-abb4-1f464816df34
- Microsoft Support. (n.d.). COUNTIFS function. Microsoft Corporation. Retrieved October 24, 2023, from https://support.microsoft.com/en-us/office/countifs-function-dda3dc6e-f74e-4aee-88bc-aa8c2a866842
- Microsoft Support. (n.d.). SCAN function. Microsoft Corporation. Retrieved October 24, 2023, from https://support.microsoft.com/en-us/office/scan-function-d58dfd11-9969-4439-b2dc-e7062724de29
- Puls, K. (2020). Master Your Data with Power Query in Excel and Power BI. Holy Macro! Books. https://www.apress.com/gp/book/9781615470587
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible: The Comprehensive Tutorial Resource. John Wiley & Sons. https://www.wiley.com/en-us/Microsoft+Excel+2016+Bible-p-9781119077015