
تمثل إدارة البيانات الرقمية الركيزة الجوهرية التي تستند إليها كافة العلوم الإحصائية والتحليلات الحاسوبية الحديثة؛ إذ لا يمكن لأي نظام تحليلي أو تجربة بحثية أن تحقق درجة موثوقية عالية ما لم تكن البيانات المصدرية مبنية على هيكلية معيارية محكمة. وفي بيئة برمجيات الجداول الإلكترونية، وعلى رأسها برنامج مايكروسوفت إكسيل (Microsoft Excel)، يشكل التمييز القاطع بين السجلات والكيانات المختلفة تحدياً منهجياً متواصلاً، خصوصاً عند التعامل مع مجموعات بيانات ضخمة ومعقدة تتشابه فيها الأسماء، وتتكرر داخلها الخصائص الديموغرافية والوظيفية. من هنا، تبرز مسألة إنشاء “المعرفات الفريدة” (Unique Identifiers) بوصفها حجر الزاوية الذي يضمن الفصل المطلق بين الكيانات، ويوفر المفاتيح الأساسية اللازمة للربط بين الجداول، والتتبع الطولي للظواهر عبر الزمن.
إن غياب استراتيجية واضحة لتوليد وتعيين المعرفات الفريدة داخل جداول البيانات يفضي حتماً إلى سلسلة متفاقمة من الأخطاء التحليلية؛ بدءاً من التكرار الخفي للبيانات وتضخيم العينات الإحصائية دون مبرر، وصولاً إلى تعطل آليات الفهرسة، والفرز، والربط العلائقي عبر النماذج المتقدمة. علاوة على ذلك، يفرض تطور أطر حوكمة البيانات ولوائح الخصوصية الدولية متطلبات صارمة تستدعي عزل الهويات الحقيقية للمفحوصين والمشاركين، والاستعاضة عنها برموز تعريفية اصطناعية أو مستعارة تكفل سرية المعلومات الحساسة وتفي بالشروط التنظيمية دون الإخلال بسلامة المنظومة الحسابية وقابليتها للتدقيق والمطابقة.
يتناول هذا الدليل الشامل والمفصل منهجيات إنشاء المعرفات الفريدة وتطبيقها داخل بيئة إكسيل بمختلف إصداراتها، متدرجاً من المنطق الرياضي الكلاسيكي القائم على دمج الصيغ الشرطية ومصفوفات البحث، وصولاً إلى أحدث الدوال الديناميكية المنسكبة، وأدوات نمذجة البيانات المتطورة مثل “باور كويري” (Power Query). سنستعرض في هذه الدراسة المنهجية التطبيقات الرياضية، والاعتبارات النظرية، والضوابط العملية الكفيلة ببناء معرفات فريدة صلبة ومستدامة، تعزز من دقة المعالجة الآلية وتضمن سلامة الاستدلال الإحصائي في الأبحاث والمشاريع الاحترافية.
1. المفاهيم التأسيسية للمعرفات الفريدة وأهميتها في معالجة البيانات
1.1 تعريف المعرف الفريد ودوره في النمذجة الإحصائية
يُعرَّف المعرف الفريد (Unique Identifier) في علوم البيانات وهندسة النظم الإحصائية بأنه خاصية أو متغير نوعي أو رمزي يُخصص لكل مفردة أو كيان أو سجل ضمن مجتمع البيانات، بحيث لا يشترك فيه عنصران على الإطلاق داخل النطاق المرجعي المحدد. يكمن الدور الجوهري لهذا المعرف في عزل الكيانات إحصائياً، وتثبيت مرجعيتها الحسابية؛ مما يحول دون حدوث أي التباس بين السجلات التي قد تتشابه في سماتها الظاهرة كالأسماء، أو التواريخ، أو التوزيعات الجغرافية. وفي إطار النمذجة الإحصائية المتقدمة، يُعد المعرف بمثابة الإحداثي الثابت الذي يسمح للباحث برصد التغيرات الطولية (Longitudinal Changes)، وحساب التباينات بين المفردات، وتطبيق اختبارات القياسات المتكررة (Repeated Measures) بدرجة عالية من الموثوقية والدقة الرياضية.
من الناحية المنهجية، ينبغي التمييز الدقيق بين نوعين أساسيين من المعرفات: المعرفات الطبيعية (Natural Identifiers) والمعرفات الاصطناعية أو البديلة (Surrogate Identifiers). تستند المعرفات الطبيعية إلى خصائص متأصلة في الكيان نفسه وموجودة في العالم الواقعي، مثل رقم الهوية الوطنية، أو الرقم التعريفي الأكاديمي، أو الرقم التسلسلي لجهاز تصنيعي. ورغم بديهية استخدام هذه المعرفات، إلا أنها تنطوي على مخاطر تتعلق بتغير القوانين، أو أخطاء الإدخال البشري، فضلاً عن حساسيتها الأمنية. في المقابل، تُصمم المعرفات الاصطناعية البديلة خصيصاً داخل بيئة النظام المعلوماتي دون أن تحمل في ذاتها أي معنى دلالي أو ارتباط مباشر بالخصائص الشخصية للكيان، كأن تكون متتالية عددية أو كوداً مشفراً يتم توليده آلياً؛ وهو ما يمنحها استقراراً بنيوياً مطلقاً يحمي النماذج من التفكك عند تغير البيانات الوصفية للمفردات.
تتكامل هذه المنهجية بصورة وثيقة مع التشريعات المنظمة لخصوصية البيانات، وفي مقدمتها اللائحة العامة لحماية البيانات (GDPR). فوفقاً للمادة 4(5) من اللائحة، يُعرّف “الترميز المستعار” (Pseudonymization) بأنه معالجة البيانات الشخصية بطريقة تجعل من المستحيل نسبتها إلى صاحب بيانات محدد دون الاستعانة بمعلومات إضافية مستقلة، مع اشتراط حفظ تلك المعلومات الإضافية بشكل منفصل وتطبيق تدابير تقنية وتنظيمية تضمن عدم ربطها بالهوية الأصلية. ويؤكد البند 26 من ديباجة اللائحة (Recital 26) أن البيانات المرمزة مستعاراً تظل قانونياً بيانات شخصية طالما أمكن إعادة التعرف على أصحابها عبر مفاتيح الربط، بخلاف “إخفاء الهوية الكامل” (Anonymization) الذي يلغي إمكانية استرجاع الهوية بشكل لا رجعة فيه ويخرج البيانات تماماً من نطاق سريان التشريعات الشخصية. لذا، يمثل بناء معرفات رقمية بديلة داخل إكسيل وسيلة تقنية بالغة الأهمية لتنفيذ الترميز المستعار بصورة دقيقة تسهم في الحد من مخاطر اختراق الخصوصية أثناء التحليل الإحصائي المشترك.
1.2 تصنيفات المعرفات الفريدة وخصائصها البنيوية
تتنوع المعرفات الفريدة في بنيتها التكوينية استناداً إلى الغرض التشغيلي والتحليلي المستهدف، وتصنف عموماً إلى ثلاثة أنماط رئيسية. النمط الأول يتمثل في المعرفات الرقمية المتسلسلة (Sequential Numeric Identifiers)، وهي متواليات عددية منتظمة تبدأ عادة من الرقم 1 وتزداد بمقدار وحدة رياضية ثابتة لكل سجل جديد. يحظى هذا النمط بأفضلية تقنية واسعة نظراً لانخفاض استهلاكه لذاكرة التخزين وسرعته الفائقة في المعالجة الحسابية والفرز المنطقي؛ غير أنه قد يكشف ضمناً عن الترتيب الزمني لإدخال البيانات، وهو ما قد لا يكون مرغوباً في الدراسات الحساسة أو التجارب ذات العينات العشوائية المحجوبة.
النمط الثاني هو المعرفات النصية المشفرة أو العشوائية (Alphanumeric/Random Identifiers)، وهي سلاسل تتألف من توليفات محددة من الأحرف الهجائية والأرقام الرياضية، مثل رموز التجزئة (Hash Codes) أو المعرفات العشوائية. يهدف هذا النمط إلى تعتيم الترتيب الزمني وإلغاء أي دلالة فئوية يمكن أن تقود للكشف عن هوية المفحوص أو الكيان المسجل. أما النمط الثالث فهو المعرفات المركبة (Composite Identifiers)، وهي معرفات تدمج بين سمات تصنيفية دلالية محددة (مثل كود الدولة، أو رمز الفرع، أو السنة المالية) ومتوالية رقمية متسلسلة، مما يوفر معرفاً غنياً بالمعلومات الهيكلية يسهل على المحللين قراءته وتفسيره بصرياً دون الحاجة إلى الرجوع المستمر إلى المتغيرات التفصيلية الأخرى داخل قاعدة البيانات.
تخضع عملية اختيار بنية المعرف المناسبة لمعايير منهجية دقيقة توازن بين حجم البيانات المتوقع، ونوعية العمليات الرياضية المنفذة، ومتطلبات الأمان والتكامل. ففي مجموعات البيانات الصغيرة والمتوسطة التي لا تحتوي على قيود تنظيمية معقدة، تُعد المعرفات الرقمية المتسلسلة الخيار الأمثل لبساطتها وسرعة إنجازها. بينما تفرض مجموعات البيانات المتشعبة والبيئات المؤسسية التي تتشارك الملفات البحثية عبر قنوات متعددة استخدام معرفات عشوائية أو عالمية تمنع تداخل الأرقام، وتضمن تفرد كل سجل بصورة قاطعة حتى عند دمج جداول مستخرجة من مصادر متنوعة ومتباعدة زمنياً أو جغرافياً.
1.3 مخاطر غياب المعرفات المستقلة في برمجيات الجداول الإلكترونية
إن الاعتماد على المتغيرات الوصفية الطبيعية كبديل عن المعرفات المستقلة داخل برمجيات الجداول الإلكترونية، مثل إكسيل، يوقع المحللين في فخ “الخلط الدلالي” بين الكيانات المتطابقة اسمياً. فمن الشائع جداً في بحوث العلوم الاجتماعية والسجلات الإدارية وجود أفراد يشتركون في الاسم الرباعي نفسه، أو مستودعات ومتاجر تتطابق في المسميات التجارية بحسب التوزيع المناطقي. وعند غياب معرف رقمي فريد يعزل كل مفردة عن نظيرتها، تعجز خوارزميات البرنامج عن إدراك هذا التمايز، مما يقود إلى تجميع بيانات وسلوكيات كيانين مختلفين كأنهما كيان واحد، وهو ما يمثل خطأً منهجياً فادحاً يهدد صحة النتائج برمتها.
يمتد هذا الخطر ليصيب عمليات الربط المتقاطع (Data Merging) بين الجداول المختلفة بالشلل؛ حيث تستند الدوال الشهيرة مثل البحث المرجعي واسترجاع البيانات إلى التطابق الدقيق بين القيم في عمود الربط. فإذا تم استخدام حقل غير فريد كمفتاح للربط، ستقوم البرمجية بالتقاط القيمة الأولى التي تصادفها وإسقاط باقي الحالات المتطابقة، مما يؤدي إلى ضياع بيانات جوهرية، وتوليد أخطاء صامتة (Silent Errors) لا تظهر على هيئة رسائل تحذيرية بل تستقر داخل النتائج الحسابية المشوهة. يترتب على ذلك تضخيم أو تقليص مصطنع في حجم العينة الفعلي، وتشويه التقديرات الإحصائية مثل المتوسطات الحسابية والانحرافات المعيارية واختبارات الفروق.
علاوة على ذلك، تتعطل آليات التصفية والاسترجاع الفوري داخل قواعد البيانات عند غياب المعرفات؛ إذ تصبح عمليات التتبع التاريخي وتدقيق مسار التعديلات شبه مستحيلة. فإذا رغب الباحث في تصحيح قيمة خاطئة لأحد الأفراد، لن يجد وسيلة انتقائية دقيقة تضمن تحديث سجل ذلك الفرد حصراً دون المساس بسجلات الآخرين المتشابهين في الخصائص السطحية، مما يجعل قواعد البيانات عرضة للتلف التدريجي وفقدان الاتساق المنطقي مع تزايد وتيرة التعديلات والمدخلات اللاحقة.
2. المنهجية الكلاسيكية لربط المعرفات بالفئات المتكررة عبر الصيغ المركبة
2.1 التشريح المنطقي للمعادلة المدمجة المعتمدة على MATCH و VLOOKUP
تعد المنهجية الكلاسيكية التي تعتمد على تضافر دوال الفحص والبحث من أرسخ الطرق المستخدمة في إكسيل لتعيين معرفات فريدة للمجموعات أو الفئات المتكررة؛ حيث تتلخص متطلبات هذه التقنية في منح كل قيمة فئوية تظهر لأول مرة معرفاً جديداً، مع الاحتفاظ بنفس المعرف وإعادة توليده كلما تكررت تلك القيمة لاحقاً في الصفوف السفلية. ولتحقيق هذا التوازن المنطقي، يتم بناء هيكل تركيبي يبدأ بالدالة الشرطية الأساسية IF، والتي تقود دفة اتخاذ القرار بناءً على اختبار مسبق لمدى حداثة المدخل في النطاق السابق للخلية النشطة.
يتحقق هذا الاختبار المسبق عن طريق دمج دالة MATCH مع الدالة المنطقية ISNA؛ حيث تعمل الدالة MATCH على مسح النطاق الخلوي الواقع أعلى الصف النشط بدقة بحث تامة (Match Type = 0) للتحقق مما إذا كانت القيمة الحالية قد سبق إدراجها أم لا. فإذا كانت القيمة تظهر للمرة الأولى، تعجز MATCH عن العثور عليها وتُرجع خطأ عدم العثور (#N/A). وهنا يأتي دور الدالة ISNA التي ترصد هذا الخطأ وتحوله إلى قيمة منطقية موجبة (TRUE)، مما يعطي إشارة للدالة IF بأن هذا السجل هو مفردة جديدة تستحق توليد معرف متسلسل جديد باستخدام دالة القيمة العظمى، كما سيتم بيانه لاحقاً.
في المقابل، إذا كانت القيمة قد وردت مسبقاً في السجلات العلوية، فإن دالة MATCH ستعثر على موقعها بنجاح وترجع رقماً ترتيبياً، مما يجعل نتيجة ISNA قيمة سالبة (FALSE). عند هذه النقطة، ينتقل مسار التنفيذ داخل الدالة الشرطية IF إلى وسيط التحقق في حالة الخطأ، وهو الشق المخصص لاسترجاع المعرف القديم. ويتم هذا الاسترجاع عن طريق دالة VLOOKUP التي تبحث عن القيمة في الجدول التراكمي السابق، مستخرجةً المعرف الأصلي الذي خُصص لها عند ظهورها الأول، مما يضمن ثبات المعرف المرتبط بكل فئة عبر كامل امتداد الجدول الإلكتروني بدقة تامة وبلا ازدواجية.
2.2 ديناميكية دالة MAX في إنشاء تسلسل تراكمي تصاعدي
تمثل دالة MAX المحرك الحسابي المسؤول عن رفع قيمة المتوالية العددية للمعرفات بمقدار وحدة واحدة كلما تم رصد فئة جديدة غير مسبوقة. وتعتمد هذه الآلية الرياضية على فحص عمود المعرفات المشيد تدريجياً، وحساب القيمة العظمى المسجلة فيه حتى اللحظة السابقة للصف الحالي، ثم إضافة الرقم واحد (+1) إلى تلك القيمة. هذا التكامل المنطقي يضمن توليد متتالية حسابية تصاعدية تبدأ من الصفر أو الواحد، وتتدرج بثبات دون حدوث فجوات رقمية غير مبررة أو تكرار للمعطيات الحسابية السابقة.
يكمن السر التقني لنجاح هذه الديناميكية في توظيف ما يُعرف بـ “النطاقات المتوسعة” (Expanding Ranges) عبر تقنية المراجع المختلقة داخل إكسيل. فعند كتابة الدالة MAX في الخلية التي تنتظر المعرف، يتم تحديد النطاق المرجعي بحيث يتم تثبيت الخلية الأولى باستخدام علامة الدولار ($)، بينما تُترك الخلية الختامية كمرجع نسبي حر التغير (على سبيل المثال:$C$1:C2). وبفضل هذا الترتيب، عندما يقوم المستخدم بسحب الصيغة إلى الأسفل، يتسع النطاق الخاضع للفحص تلقائياً ليشمل كافة المعرفات التي تم توليدها في الصفوف العلوية، مما يتيح للدالة MAX استخراج أحدث وأكبر رقم تسلسلي تم الوصول إليه بدقة رياضية متناهية.
تتطلب هذه المنهجية معالجة دقيقة لحالة “المعرف الأول” الذي يمثل حجر الأساس للمتوالية؛ ففي الصف الافتتاحي للبيانات، لا يوجد نطاق علوي سابق يحتوي على قيم عددية. ولتفادي أخطاء عدم تطابق الأنواع الرياضية عند جمع الرقم واحد مع نصوص رؤوس الأعمدة، يتم ترويس نطاق البحث بحيث يقتصر إما على خلايا عددية فقط، أو يتم استخدام دوال وقائية تضمن تحويل القيمة الصفرية إلى نقطة انطلاق معيارية للمصفوفة. يضمن ذلك عدم انهيار المعادلة في مستهل تشغيلها، ويجعل النموذج قادراً على العمل الذاتي الموثوق من السجل الأول وحتى آخر سجل في ورقة العمل.
2.3 التحليل المقارن بين البحث التقريبي والبحث المطابق في استرجاع المعرف
عند استخدام دالة البحث VLOOKUP ضمن معادلة توليد المعرفات الكلاسيكية، يمثل تحديد وسيط التطابق (Range Lookup) فارقاً جوهرياً بين دقة البيانات وانهيار النموذج التحليلي بالكامل. تقبل الدالة قيمتين لهذا الوسيط: القيمة التقريبية (TRUE أو 1)، والتطابق التام الحرفي (FALSE أو 0). وتعد القاعدة الأكاديمية الصارمة هنا هي الامتناع التام عن استخدام البحث التقريبي في سياق بناء المعرفات الفريدة، واشتراط القيمة FALSE كخيار إلزامي لضمان عدم استرجاع معرفات فئات مجاورة بالخطأ.
ينبع هذا الإلزام من طبيعة خوارزمية البحث التقريبي في إكسيل، والتي تشترط أن تكون مصفوفة البيانات مرتبة ترتيباً تصاعدياً وأبجدياً صارماً حتى تعمل بصورة صحيحة. فإذا كانت البيانات غير مرتبة — وهو الحال الغالب في تدفقات البيانات الميدانية والواقعية — فإن البحث التقريبي سيُرجع نتائج غير دقيقة وغير متوقعة؛ إذ يقفز المؤشر الحسابي عند أقرب قيمة مطابقة جزئياً، مما يترتب عليه منح فئة جديدة معرفاً يخص فئة أخرى تماماً. وتكمن خطورة هذا النوع من الأخطاء في كونها “أخطاء صامتة”، لا تولد رسائل خطأ برمجية، بل تندس داخل منظومة الأرقام مفسدةً العلاقات المنطقية دون أن يلحظ المحلل ذلك بصرياً.
إلى جانب مسألة التطابق، يجب على المحلل إدراك سلوك إكسيل حيال حساسية حالة الأحرف؛ فدالة VLOOKUP ودالة MATCH لا تميزان افتراضياً بين الحروف الكبيرة (Uppercase) والصغيرة (Lowercase) في اللغات اللاتينية، كما أنهما تعاملان الهمزات والياءات في اللغة العربية وفقاً لتطابق الحروف الحرفي الدقيق. فإذا احتوت البيانات على فروق هجائية طفيفة ناتجة عن أخطاء إملائية (مثل الفرق بين “أحمد” و”احمد”)، ستتعامل الدالة معهما ككيانين منفصلين، وتمنح كل منهما معرفاً مستقلاً تماماً. يضاف إلى ذلك أن الأداء الحسابي لهذه المعادلات المركبة يتباطأ تدريجياً كلما تضخم حجم السجلات ليشمل عشرات الآلاف من الصفوف، نظراً لأن كل صف يتطلب إجراء مسح تكراري للنطاق المتوسع بالكامل، مما يرفع التعقيد الحسابي للمعالجة إلى حدود تقنية قد تؤثر على سرعة استجابة البرنامج.
3. خطوات التطبيق العملي لبناء معرفات المجموعات في إكسيل
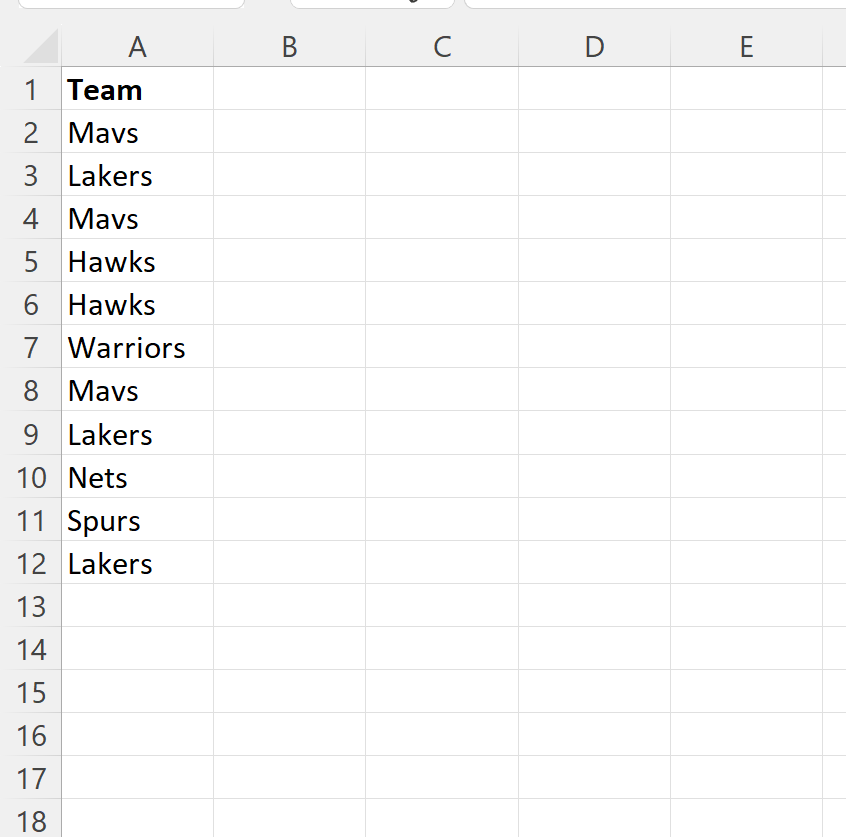
3.1 إعداد ورقة العمل وضبط مصفوفة البيانات الأولية
تبدأ الخطوة الأولى نحو بناء معرفات فريدة موثوقة بتأسيس بيئة عمل منضبطة، وتنظيف حقول البيانات المصدرية من كافة الشوائب الإدخالية التي قد تعرقل عمل الصيغ المنطقية. ومن أهم هذه الإجراءات إزالة المسافات البيضاء البادئة والختامية والمزدوجة، والتي تتسلل عادةً إلى السجلات عبر عمليات النسخ من واجهات الأنظمة الخارجية أو نتيجة التباين في دقة الطباعة البشرية. ولهذا الغرض، يتم تطبيق دالة TRIM في عمود مساعد لضمان تطابق النصوص حرفياً، جنباً إلى جنب مع دالة CLEAN للتخلص من الرموز الخفية وحركات التحويل الطباعي غير القابلة للطباعة.
عقب عملية التنقية، يُنصح بتوحيد التنسيق العام لعمود البيانات المستهدفة، والتأكد من اتساق الأنماط النصية للأسماء والمجموعات؛ فإذا كانت البيانات تشتمل على حروف لاتينية، يُفضل توحيد حالتها باستخدام دوال مثل UPPER لتفادي أي ثغرات تطابق مستقبلية عند التصدير لبرمجيات أخرى. بعد ذلك، يتم تخصيص عمود مستقل ومجاور للبيانات المصدرية ليحتضن “المعرف الفريد للمجموعة”، وتسمية رأس هذا العمود بعنوان دلالي واضح وموجز، مثل Group_ID أو Unique_Key، مع الحرص التام على عدم وجود فراغات أو رموز خاصة في التسمية البرمجية للرأس لضمان سهولة الإسناد المرجعي اللاحق.
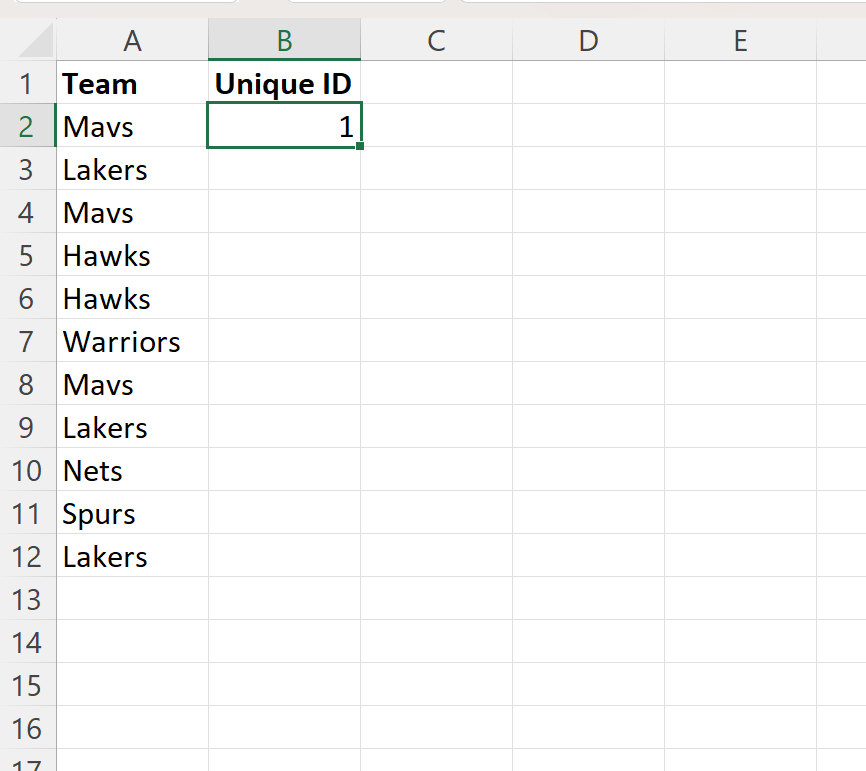
تكتمل مرحلة الإعداد بوضع القيمة المرجعية الأولى التي ستنطلق منها المتتالية الحسابية برمتها. ففي حال كان الصف الأول أسفل العناوين يحتوي على أول ظهور لأول فئة، يمكن كتابة الرقم التعريفي الأول يدوياً (ليكن الرقم 1 على سبيل المثال) لتأسيس نواة الترقيم، أو ضبط المعادلة بحيث تتولى التعامل مع السطر الأول ذاتياً عبر اختبارات دالية مرنة. يتيح هذا التجهيز المسبق تحويل فوضى المدخلات الخام إلى مصفوفة بيانات معيارية ومهيأة رياضياً لاستقبال المعادلات المركبة دون التعرض لأخطاء التشغيل الشائعة.
3.2 كتابة المعادلة المركبة وضبط تثبيت المراجع الخلوية
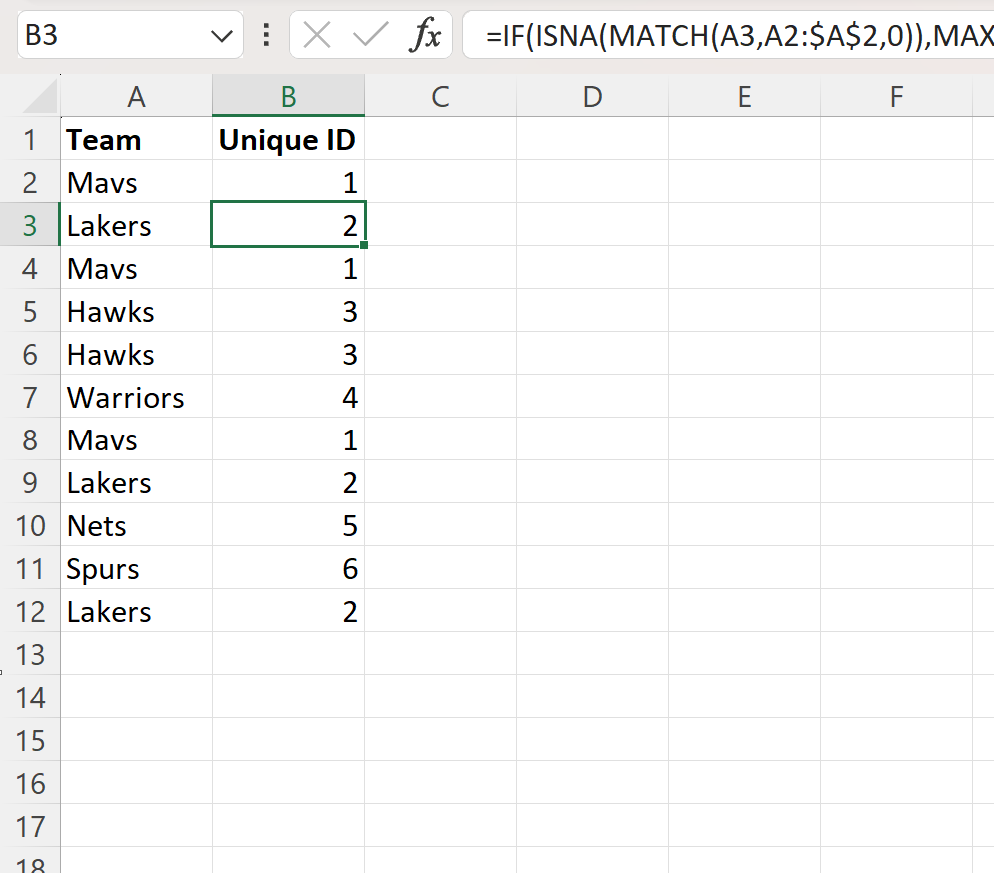
لصياغة المعادلة المركبة بصورة دقيقة داخل الخلية الثانية من عمود المعرفات (لتكن الخلية B3 على افتراض أن البيانات تبدأ من الصف الثاني والرأس في الصف الأول)، نقوم بدمج الدوال السابقة في بنية محكمة رياضياً. تبدأ المعادلة بالشرط التالي:
=IF(ISNA(MATCH(A3, $A$2:A2, 0)), MAX($B$2:B2) + 1, VLOOKUP(A3, $A$2:B2, 2, FALSE))
حيث يمثل الرمز A3 الفئة الحالية المراد فحصها، بينما يمثل النطاق $A$2:A2 الفئات السابقة التي تمت معالجتها في الصفوف الأعلى، ويمثل النطاق $B$2:B2 المعرفات المسندة لتلك الفئات سلفاً.
يعد التحكم في تثبيت المراجع الخلوية عبر علامة الدولار ($) المحور التقني الحرج في هذه الصيغة؛ حيث نلاحظ أن الطرف الأيمن للنطاق المرجعي تم تثبيته بالكامل ($A$2 و$B$2)، بينما تُرك الطرف الأيسر (A2 و B2) دون تثبيت ليعمل كمرجع نسبي. هذا التناقض المقصود في بنية المرجع هو ما ينشئ “النطاق المتوسع”؛ فعندما تنتقل المعادلة من الصف الثالث إلى الصف الرابع، سيتحول النطاق تلقائياً إلى$A$2:A3 و$B$2:B3، مما يوسع دائرة الفحص لتشمل مدخلات الصف الثالث التي أصبحت الآن جزءاً من الماضي الأرشيفي للجدول.
قبل تعميم المعادلة وسحبها، ينبغي التحقق المجهري من مخرجات الخلية المكتوبة يدوياً ومقارنتها بالخلية التالية؛ فإذا كانت الفئة في A3 مطابقة لما في A2، يجب أن تُرجع VLOOKUP الرقم نفسه المكتوب في B2، أما إذا كانت فئة جديدة، فيجب أن تضيف الدالة MAX الرقم واحد إلى أعلى رقم مسجل. إن فهم هذا السلوك وتأكيده بالتجربة على عينة مصغرة يمنع انتشار الأخطاء التنسيقية ويوفر قدراً عالياً من الطمأنينة الرياضية لسلامة النمذجة المطبقة.
3.3 تعميم المعادلة ومراجعة دقة توزيع المعرفات
بعد التحقق من سلامة البناء الهيكلي للصيغة في الخلية التجريبية الأولى، يتم تعميم المعادلة على سائر صفوف البيانات المتبقية في ورقة العمل. ويتحقق ذلك من خلال النقر المزدوج على “مقبض التعبئة التلقائية” (AutoFill Handle) الواقع في الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) لخلية الصيغة، أو بسحب المقبض يدوياً نحو الأسفل حتى آخر سجل مسجل في العمود المصدري. يؤدي هذا الإجراء إلى تدفق الحسابات آلياً وتحديث مراجع النطاقات المتوسعة صفاً تلو الآخر وفقاً لقواعد الإزاحة النسبية المنضبطة.
بمجرد اكتمال التدفق الحسابي، تأتي مرحلة المراجعة الرقابية لضمان تفرد التوزيع وتناسقه المنطقي؛ حيث يقوم المحلل بإجراء مسح عيني وفحص إحصائي لتكرار المعرفات الممنوحة للفئات المتماثلة في مواقع متباعدة من الجدول، والتأكد القطعي من أن كل فئة قد حافظت على رقمها التعريفي الأصلي في كافة إحداثيات ظهورها. كما يجب التحقق من عمود المعرفات للتأكد من عدم وجود أي قفزات رقمية غير مبررة في المتتالية، أو ظهور متكرر لنفس المعرف لفئتين متباينتين في المسمى، وهو ما يشير إن وُجد إلى خطأ في تثبيت مراجع دالتي MATCH أو VLOOKUP.
وأخيراً، تفرض الأمانة العلمية والاحترافية المؤسسية توثيق هذا الإجراء المنطقي بالتفصيل؛ إذ ينبغي إدراج تعليق برمجي (Cell Note) يوضح منطق عمل الصيغة، أو تدوين الخطوات المنهجية داخل ورقة مستقلة لقاموس البيانات. يضمن هذا التوثيق إمكانية إعادة إنتاج التجربة التحليلية بواسطة باحثين ومراجعين آخرين، مما يرفع من القيمة الأكاديمية للمشروع ويسهل عمليات الصيانة اللاحقة لملفات البيانات دون التعرض لمخاطر فقدان السياق المنطقي للتعديلات.
4. إنشاء معرفات فريدة متعددة المستويات لتمييز العناصر ضمن المجموعات
4.1 البنية الهرمية للمعرفات المركبة في البحوث التطبيقية
في كثير من الدراسات الميدانية والأبحاث التطبيقية، لا يقتصر التحليل على تمييز الفئات الكبرى فقط، بل يمتد ليتطلب عزل كل مفردة أو عنصر داخل تلك الفئات بدقة متناهية؛ كأن تضم الدراسة عدة مستشفيات أو جامعات، وتحتوي كل منشأة على مجموعة من المرضى أو الطلاب. وفي مثل هذه البيئات المعقدة، تبرز الحاجة المنهجية لتصميم “معرفات هرمية متعددة المستويات” (Hierarchical Multi-Level Identifiers)، وهي رموز مركبة تدمج بين هوية المستوى الأعلى (المجموعة) وهوية المستوى الأدنى (الفرد داخل المجموعة).
يوفر هذا النظام الترقيمي الثنائي فائدة بحثية مزدوجة؛ فهو من جهة يحافظ على الهوية السياقية للعنصر ويوضح تبعيته الإدارية أو التصنيفية دون الحاجة لإجراء استعلامات إضافية، ومن جهة أخرى يمنع بصورة حاسمة تداخل البيانات الناتجة عن تشابه الترقيم الفرعي الداخلي بين المجموعات المختلفة (كوجود “المريض رقم 1″ في المستشفى الأول، و”المريض رقم 1” في المستشفى الثاني). من خلال دمج المستويين، يتحول الكود التعريفي إلى مفتاح مركب مستقل بذاته يمثل كياناً وحيداً لا يمكن تكراره عبر كامل المشروع البحثي.
تخضع صياغة هذه المعرفات لمعايير صارمة في اختيار الفواصل الرمزية (Delimiters) التي تفصل بين مقاطع الكود (مثل الواصلة “-” أو الشرطة السفلية “_”)؛ حيث يجب تجنب استخدام الرموز التي قد تفسرها البرمجيات الإحصائية كعمليات رياضية سالبة أو فواصل حقول نصية عند التصدير (مثل الفاصلة العادية أو علامة الجمع). يضمن هذا التنسيق البصري الدقيق انسيابية قراءة المعرفات من قِبل الباحثين البشريين وسهولة تجزئتها حاسوبياً عند استدعاء تقنيات النصوص لاحقاً.
4.2 توظيف دالة COUNTIF لحساب التكرار التراكمي الداخلي
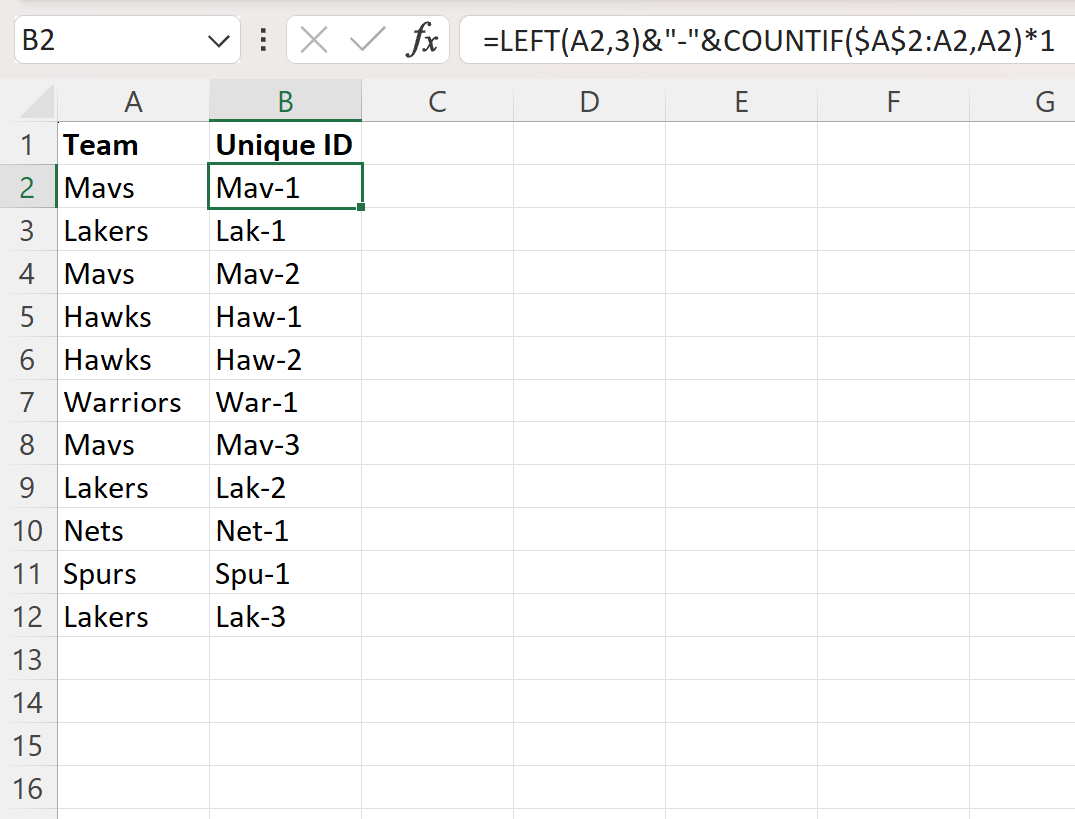
يمثل الترقيم التسلسلي للأفراد التابعين لكل فئة جوهر البنية الهرمية؛ ولتحقيق هذا الهدف داخل إكسيل دون الحاجة إلى الفرز اليدوي المستمر، يتم توظيف دالة العد الشرطي COUNTIF بنطاق متوسع مرجعي يبدأ من رأس عمود الفئات ويتدرج متسعاً مع كل صف إضافي. تختلف هذه الصيغة عن الاستخدام النمطي لدالة العد التي تحسب الإجمالي الكلي، حيث تقتصر هنا على حساب التكرار التراكمي حتى اللحظة الحالية فقط.
تتم كتابة الدالة المسؤولة عن حساب الرتبة الفرعية للعنصر على النحو التالي:
=COUNTIF($A$2:A2, A2)
حيث يمثل $A$2 الخلية الأولى الثابتة لعمود المجموعات، بينما يمثل A2 المرجع المتحرك للفئة في الصف الحالي. فعندما تظهر المجموعة “أ” للمرة الأولى، تجد الدالة أن تكرارها داخل النطاق $A$2:A2 هو 1، فتمنح الفرد الرقم 1. وعندما تظهر المجموعة “أ” مرة ثانية في صف لاحق (وليكن الصف العاشر)، يمتد النطاق ليصبح $A$2:A10، وتحسب الدالة عدد مرات ظهور “أ” في هذا النطاق الموسع، فترجع الرقم 2، وهكذا دواليك لكل مفردة جديدة تنضم إلى نفس المجموعة.
عقب استخراج هذا الرقم الترتيبي الداخلي، يتم استخدام عامل الربط النصي للأمبيرساند (&) لدمج كود المجموعة الأساسي المستخرج بالطريقة الكلاسيكية مع الترتيب التراكمي الناتج عن COUNTIF. على سبيل المثال، إذا كان كود المجموعة المستخرج هو “GRP-01” والرتبة الداخلية هي “1”، تنتج الصيغة معرفاً هرمياً متكاملاً يتخذ الشكل “GRP-01-1”. هذا الأسلوب يتيح للباحث تصنيفاً ديناميكياً مرناً يتكيف فورياً مع أي ترتيب عشوائي لبيانات الإدخال في الجدول.
4.3 صياغة الأكواد التعريفية المتقدمة عبر دمج النصوص والأرقام
لإضفاء طابع احترافي معاييري على المعرفات المركبة، يُفضل دائماً توحيد أطوال المقاطع الرقمية عبر إضافة “أصفار سابقة” (Leading Zeros)؛ فظهور أرقام فردية مثل “1” بجوار أرقام مزدوجة مثل “10” قد يربك عمليات الترتيب الأبجدي للنصوص في الحواسيب، حيث يأتي الترتيب “GRP-10” قبل “GRP-2” في الفرز النصي الخطي. وللتغلب على هذه المشكلة الشائعة، يتم استدعاء دالة التنسيق النصي TEXT للتحكم الصارم في عدد الخانات المخصصة للأرقام الفرعية.
تُطبق دالة TEXT على مخرجات دالة COUNTIF لتوليد صيغة تنسيقية متجانسة كالتالي:
=B2 & “-” & TEXT(COUNTIF($A$2:A2, A2), “000”)
حيث يقوم النموذج “000” بإجبار الرقم الناتج على الظهور في صيغة ثلاثية الخانات حتماً، فيتحول الرقم 1 إلى “001”، والرقم 25 إلى “025”، والرقم 100 يبقى “100”. يؤدي هذا التوحيد إلى حماية البنية الهيكلية للمعرفات من التفكك، ويجعل كافة المفاتيح المركبة ذات طول نصي متطابق تماماً يسهل تصديره وقراءته من قِبل محركات قواعد البيانات العلائقية.
إلى جانب ذلك، يمكن دمج اختصارات نصية تدل على الخصائص النوعية للبيانات المجمعة، مثل الحروف الأولى من اسم المؤسسة أو سنة التسجيل (مثلاً: “MED-2023-001”)، وذلك عبر إدخال دوال النصوص المركبة في بداية الصيغة. تضمن هذه المرونة العالية بناء كود تعريفي هجين وشامل، يعمل كمفتاح رئيسي متفرد (Primary Key) في النماذج الإحصائية دون الاعتماد على أي أعمدة مساعدة إضافية، مما يقلل من حجم الملفات ويزيد من كفاءة المعالجة العامة للبيانات.
5. الاستفادة من دوال المصفوفات الديناميكية في الإصدارات الحديثة من إكسيل
5.1 توليد قوائم فريدة فورية عبر دالة UNIQUE الحديثة
أحدثت مايكروسوفت نقلة نوعية في محرك الحساب الخاص ببرنامج إكسيل في إصداراته الحديثة (ضمن حزمة Microsoft 365 وإكسيل 2021 والإصدارات الأحدث) من خلال إدخال ما يُعرف بـ “المصفوفات الديناميكية” (Dynamic Arrays) وسلوك “الانسكاب التلقائي” (Spill Behavior). وقد ألغت هذه التقنيات الحديثة الحاجة إلى الصيغ المركبة المعقدة واستخدام المراجع المتوسعة المرهقة حاسوبياً؛ إذ بات بإمكان المحللين استخلاص قائمة حصرية بالقيم الفريدة بنقرة واحدة ودالة مباشرة ومبسطة هي الدالة UNIQUE.
تُكتب هذه الدالة بصيغة أولية سلسة تفحص كامل العمود المصدري للفئات:
=UNIQUE(A2:A100)
حيث تقوم الدالة تلقائياً بفحص النطاق واستخراج الكيانات المتميزة فقط دون أي تكرار، لتنسكب النتائج رأسياً في عمود جديد عبر الخلايا المجاورة دون الحاجة لسحب الصيغة يدوياً. وإذا رغب الباحث في تنظيم هذه الفئات أبجدياً لتسهيل الرجوع إليها واستخراج معرفات مرتبة منطقياً، يمكن تطويق الدالة بدالة الترتيب SORT على النحو التالي: =SORT(UNIQUE(A2:A100))، مما ينتج جدولاً مرجعياً مصفى ونقياً ومنظماً في خطوة حسابية واحدة وفائقة السرعة.
تتميز هذه الدوال المنسكبة بخصائص أدائية تفوق بمراحل الصيغ الكلاسيكية؛ فالصيغ القديمة تتطلب معالجة كل صف بصورة منعزلة وتكرار الفحص عبر النطاق الصاعد، مما يستهلك طاقة المعالجة المركزية (CPU) في الجداول الكبيرة ويقود إلى تجمد البرنامج. في حين تعمل دوال المصفوفات الديناميكية على معالجة النطاق المستهدف ككتلة واحدة في ذاكرة الوصول العشوائي (RAM)، مما يوفر استجابة فورية ويقلل إلى أدنى حد من استهلاك موارد النظام.
5.2 الربط الآلي بين دالتي SEQUENCE و COUNTA لتوليد تسلسل تلقائي
بمجرد إنشاء القائمة المرجعية للفئات الفريدة باستخدام الدالة المنسكبة، تظهر الحاجة إلى تعيين معرف تسلسلي تصاعدي لكل فئة من هذه الفئات بصورة آلية تتكيف مع أي تحديثات لاحقة. وهنا يأتي دور دالة توليد المتتاليات العددية SEQUENCE، والتي تمت برمجتها لإنشاء مصفوفة من الأرقام المتتالية بناءً على عدد الصفوف المطلوب تعبئتها.
لجعل هذا التسلسل الرقمي متطابقاً تماماً وذاتياً مع طول قائمة الفئات الفريدة المستخرجة، يتم دمج SEQUENCE مع دالة العد الشامل COUNTA عبر استخدام عامل تشغيل الانسكاب (#). فإذا كانت الفئات الفريدة قد انسكبت انطلاقاً من الخلية D2، يتم توليد الأرقام التسلسلية الموازية لها في العمود المجاور بكتابة الصيغة الآتية:
=SEQUENCE(COUNTA(D2#))
حيث يرمز الرمز (#) بعد D2 إلى الإشارة لكامل مصفوفة الانسكاب الناتجة عن دالة UNIQUE، أياً كان عدد عناصرها المتغيرة.
تضمن هذه الصياغة الذكية مرونة مطلقة للنموذج المرجعي؛ فإذا تمت إضافة سجلات جديدة في الجدول المصدري تحتوي على فئات جديدة لم تكن موجودة من قبل، ستتسع مصفوفة الدالة UNIQUE آلياً لتستوعب الفئات المستحدثة، وسيتحسس عامل الانسكاب (D2#) هذا التغير، مما يؤدي بدوره إلى تمدد دالة SEQUENCE تلقائياً لتوليد أرقام تسلسلية جديدة ومطابقة لعدد الفئات الجديد. ينهي هذا الربط الآلي ظاهرة أخطاء الامتداد اليدوي، ويؤسس لجدول بحث مرجعي مستدام يعمل كمحرك داخلي لتغذية كافة أجزاء ورقة العمل بالمعرفات الحديثة.
5.3 استبدال VLOOKUP بدالة XLOOKUP لربط المعرفات بسرعة وكفاءة
بعد اكتمال بناء جدول المعرفات المرجعي الديناميكي، تأتي الخطوة النهائية المتمثلة في إعادة ربط هذه المعرفات التسلسلية بسجلات البيانات الخام في الجدول الأساسي. ولتحقيق ذلك بأعلى معايير الكفاءة، يتم التخلي عن دالة VLOOKUP التقليدية والاستعاضة عنها بالدالة المتطورة XLOOKUP، التي تمثل جيلاً جديداً من دوال البحث في إكسيل صُمم ليتجاوز كافة القيود الهيكلية التي عانت منها الدوال السابقة طوال العقود الماضية.
تمتاز دالة XLOOKUP بكونها تعتمد التطابق التام (Exact Match) كإعداد افتراضي أصيل، مما يعني أن المحلل لم يعد بحاجة لتذكر كتابة المعامل FALSE أو 0 لتفادي أخطاء البحث الكارثية. كما تتميز الدالة بمرونة مطلقة في تحديد مصفوفة البحث ومصفوفة الإرجاع بصورة منفصلة، مما يلغي القيد الكلاسيكي الذي كان يفرض وجود عمود البحث في أقصى يمين أو يسار النطاق؛ حيث يمكن للدالة البحث في أي اتجاه بحرية كاملة سواء كان ذلك للأمام أو للخلف أو حتى رأسياً وأفقياً.
تُكتب دالة XLOOKUP لربط المعرف في السجل المصدري كالتالي:
=XLOOKUP(A2, D2#, E2#, “غير محدد”)
حيث تمثل A2 الفئة المبحوث عنها، وتمثل D2# مصفوفة الفئات الفريدة المستخرجة، بينما تمثل E2# مصفوفة الأرقام التسلسلية المقابلة، مع إضافة وسيط الأمان النصي (“غير محدد”) في حال عدم العثور على القيمة (if_not_found). تمنح هذه البنية سرعة استرجاع حسابية تضاهي أضعاف سرعة VLOOKUP في قواعد البيانات الكبيرة، فضلاً عن حمايتها للنظام من الانهيار عند إضافة أو حذف أعمدة داخل ورقة العمل.
6. توليد المعرفات العشوائية والمعرفات العالمية الموحدة (GUID/UUID)
6.1 استخدام دوال التوزيع العشوائي RAND و RANDBETWEEN في الترقيم
في العديد من البيئات التجريبية والبحوث الطبية والسلوكية، يمثل استخدام المعرفات المتسلسلة خطراً منهجياً قد يؤدي إلى تحيز الباحثين أو المشاركين؛ نظراً لأن التسلسل الرقمي الصاعد يكشف بوضوح عن الترتيب الزمني للانضمام إلى التجربة أو التوزيع الفئوي للمجموعات. ومن أجل ضمان الحيادية المطلقة وحجب الهويات في الدراسات ذات “التعمية المزدوجة” (Double-Blind Studies)، يتم اللجوء إلى توليد معرفات رقمية عشوائية غير مترابطة منطقياً.
يوفر إكسيل دالتين رئيسيتين للتعامل مع العشوائية الرياضية: دالة RAND التي تولد أرقاماً حقيقية كسرية تقع بين الصفر والواحد وفق توزيع منتظم، ودالة RANDBETWEEN التي تتيح للمستخدم تحديد نطاق رقمي صحيح عبر قيمتين دنيا وعليا. ولتوليد معرف رقمي عشوائي يقلل إلى أدنى حد من فرص التكرار، يتم اختيار نطاق رقمي واسع كأن يتألف من سبع أو ثماني خانات رياضية، على النحو التالي:
=RANDBETWEEN(10000000, 99999999)
حيث تضمن هذه الصيغة إنتاج أكواد رقمية متساوية في الطول النصي ومتباعدة في التوزيع الاحتمالي.
ومع ذلك، ينطوي استخدام هذه الدوال على خاصية تقنية بالغة الخطورة يجب الانتباه إليها بحذر؛ إذ تُصنف دوال العشوائية ضمن “الدوال المتقلبة” (Volatile Functions) التي يُعاد حسابها وتوليد قيم جديدة لها في كل مرة يقوم فيها المستخدم بأي تعديل داخل ورقة العمل أو فتحها من جديد. وإذا تُركت هذه الدوال نشطة في عمود المعرفات، فإنها ستغير قيم الأكواد المخصصة للمشاركين باستمرار، مما يؤدي إلى تدمير ترابط البيانات عبر الزمن. ولتفادي ذلك، يُلزم الباحث بالقيام فورياً بعملية “نسخ ولصق كقيم ثابتة” (Copy and Paste as Values) لتجميد الأرقام العشوائية وتحويلها إلى ثوابت نصية أو رقمية نهائية لا تقبل التبديل التلقائي.
6.2 محاكاة المعرف العالمي الموحد (GUID) عبر الصيغ النصية
عندما تقتضي متطلبات العمل تبادل مجموعات البيانات بين نظم متعددة، أو دمج سجلات يتم إنشاؤها وتجميعها في مراكز بحثية جغرافية متباعدة بلا اتصال شبكي متزامن، تفقد المعرفات التسلسلية العادية والعشوائية البسيطة فعاليتها وتزداد مخاطر تداخل الأرقام بين الفروع. في هذه الحالات، يُعد “المعرف العالمي الموحد” (Globally Unique Identifier – GUID)، والمعروف أيضاً باسم UUID، المعيار الهندسي الأرقى عالمياً لضمان الفرادة المطلقة للسجلات دون الحاجة لوجود منسق مركزي يراقب توليد الأرقام.
يتألف المعرف العالمي الموحد القياسي (وفق النسخة الرابعة UUIDv4) من سلسلة نصية بطول 32 حرفاً ست عشرياً (Hexadecimal) مقسمة عبر واصلات إلى خمس مجموعات متميزة تتخذ الهيكل البنيوي المعياري: 8-4-4-4-12 خانة (على سبيل المثال: E4B2C891-3F1A-4B9C-8A7D-6E5F8C1D2A3B). ورغم أن إكسيل لا يحتوي افتراضياً على دالة مدمجة ومباشرة تحمل اسم GUID، إلا أنه يمكن محاكاة هذا التكوين الرياضي الست عشري بدقة تامة باستخدام مزيج من دالتي DEC2HEX و RANDBETWEEN لتوليد كل مقطع على حدة ثم ربطها نصياً.
تتم كتابة الصيغة المركبة لتوليد المعرف العالمي عبر السلسلة التالية:
=DEC2HEX(RANDBETWEEN(0, 4294967295), 8) & “-” & DEC2HEX(RANDBETWEEN(0, 65535), 4) & “-” & DEC2HEX(RANDBETWEEN(16384, 20479), 4) & “-” & DEC2HEX(RANDBETWEEN(32768, 49151), 4) & “-” & DEC2HEX(RANDBETWEEN(0, 65535), 4) & DEC2HEX(RANDBETWEEN(0, 4294967295), 8)
حيث يتم تثبيت أطوال الخانات لكل مقطع باستخدام وسيط عدد المنازل في دالة التحويل الست عشري. إن الكود الناتج عن هذه العملية يمتلك درجة موثوقية رياضية هائلة تجعل من احتمال تصادف تشابه رمزين بين مركزين بحثيين أمرين مستحيلين عملياً وفق النظريات الاحتمالية المعتمدة دولياً في معايير IETF RFC 4122 الخاصة بهندسة البروتوكولات والإنترنت.
6.3 تقييم مخاطر تصادم المعرفات العشوائية وطرق رصدها
على الرغم من الانطباع السائد بأن الأرقام العشوائية الكبيرة تضمن التفرد التلقائي، إلا أن النظريات الإحصائية تثبت وجود خطر دائم لحدوث ما يُعرف بـ “تصادم المعرفات” (Identifier Collision)، وهو تزامن توليد الكود التعريفي نفسه لعنصرين مختلفين. ويفسر علم الاحتمالات هذه الظاهرة من خلال المفهوم الرياضي الشهير “مفارقة أعياد الميلاد” (Birthday Paradox)؛ والذي يوضح أن احتمالية حدوث تصادم تتزايد بوتيرة تفوق بكثير التقدير الذهني البشري، حتى عندما يكون فضاء الأرقام المتاحة ضخماً جداً، وذلك بمجرد ارتفاع عدد العينات أو السجلات المدرجة في قاعدة البيانات.
لتأمين سلامة البيانات ضد هذا الخطر الكامن، يجب على المحلل إرساء إجراءات رصد صارمة داخل ورقة العمل فور توليد المعرفات العشوائية. وأولى هذه الخطوات التقنية تطبيق “التنسيق الشرطي” (Conditional Formatting) على عمود المعرفات العشوائية بالكامل لتمييز القيم المكررة (Highlight Duplicates) بصرياً بلون تحذيري بارز؛ مما يسمح بالكشف اللحظي عن أي تصادم حسابي حدث أثناء المعالجة وتنبيه الباحث بضرورة التدخل.
كما يُوصى بإنشاء خلية فحص رقابية في أعلى الجدول تستخدم الدالة المنطقية الآتية:
=IF(MAX(COUNTIF(A2:A1000, A2:A1000))>1, “تنبيه: يوجد تكرار”, “البيانات فريدة بالكامل”)
والتي يتم إدخالها كصيغة مصفوفة، حيث تفحص ما إذا كان الحد الأقصى لتكرار أي قيمة يتجاوز الرقم واحد. فإذا تم رصد أي تكرار، يُعاد توليد القيمة المكررة حصراً حتى يستقر النموذج على فرادة مطلقة لكافة السجلات، مما يضمن اتساق التحليلات وتجنب الخلط بين الحالات البحثية المختلفة.
7. صياغة المعرفات الفريدة بالاعتماد على الطوابع الزمنية ودوال النصوص
7.1 توظيف الطابع الزمني والتواريخ في بناء معرفات زمنية فريدة
تكتسب المعرفات الزمنية (Time-Based Identifiers) أهمية استثنائية في عمليات تتبع المعاملات الإدارية، ورصد الاستجابات في الاستبيانات الميدانية، وتوثيق سجلات التجارب المعملية؛ إذ تقدم هذه المعرفات بعداً توثيقياً مزدوجاً يعزل السجل من جهة، ويوفر سجلاً تاريخياً دقيقاً للحظة تسجيله أو وقوع الحدث من جهة أخرى. ويستند هذا النمط إلى الاستفادة من دوال الوقت والتاريخ المدمجة في إكسيل لبناء كود تعريفي غير قابل للتكرار الزمني.
تتم الاستفادة من دالة الوقت الحالية NOW لتوليد أختام زمنية متطورة تشمل أجزاء الثانية؛ ولتحويل هذا الوقت الحركي إلى معرف نصي منضبط وخالٍ من الفواصل والمسافات وعلامات التنصيص التي قد تعرقل قواعد البيانات، يتم إخضاع المخرجات لدالة التنسيق النصي TEXT وفق نمط مخصص وصارم كالتالي:
=TEXT(NOW(), “yyyymmddhhmmss”)
حيث تنتج هذه الصيغة كوداً رقمياً متسلسلاً يتخذ الشكل “20231024143045”، مشيراً بدقة فائقة إلى السنة، والشهر، واليوم، والساعة، والدقيقة، والثانية التي تم فيها التوليد.
غير أن التحدي العملي الذي يواجه المعرفات الزمنية يكمن في إشكالية “الإدخال المتزامن”؛ فإذا حدث وقام النظام بتسجيل معطيات سجلين مختلفين في نفس الثانية بالضبط، ستنتج الصيغة كودين متطابقين تماماً، مما يكسر شرط الفرادة. ولتطويق هذه الثغرة، يعمد الخبراء إلى دمج الختم الزمني بمكون ترقيمي تسلسلي أو برمز فريد يمثل محطة الإدخال أو المحلل الميداني (مثلاً: “20231024143045-A-01”)، مما يضمن التفرد المطلق للكود حتى لو تزامنت لحظة الإنشاء إلى حدود أجزاء الثانية الواحدة.
7.2 تشفير واقتطاع النصوص باستخدام دوال LEFT و MID و RIGHT
تسهم المعرفات التي تتضمن أجزاءً دلالية مقتطعة من البيانات الوصفية في رفع قابلية النظام للفهم والمراجعة السريعة دون الإخلال بفرادة السجلات؛ حيث يلجأ مطورو البيانات إلى اقتطاع الأحرف الأولى من أسماء المدن، أو الفروع، أو التصنيفات الوظيفية لتكون بمثابة بادئات معيارية (Prefixes) للمعرفات الفريدة. ويتم تحقيق ذلك باحترافية عالية عبر توظيف دوال النصوص الأساسية: LEFT لاقتطاع الرموز من بداية السلسلة، و RIGHT لاقتطاعها من النهاية، و MID للاستخلاص من أي موضع داخلي محدد.
على سبيل المثال، إذا كانت ورقة العمل تحتوي على اسم المدينة في الخلية A2 واسم الإدارة في الخلية B2، يمكن صياغة بادئة كودية تتكون من أول حرفين من المدينة وآخر حرفين من الإدارة عبر كتابة التركيبة التالية:
=UPPER(CONCATENATE(LEFT(A2, 2), RIGHT(B2, 2)))
حيث تم استدعاء دالة UPPER لضمان تحويل كافة الأحرف المستخلصة إلى حروف كبيرة باللغات اللاتينية، مما يوحد الهيكل المظهري للمعرفات ويمنع حدوث أي فجوات تطابق ناتجة عن الاختلافات الطباعية.
تكتسي هذه المعالجة النصية أهمية إضافية عند التعامل مع الأسماء والمفردات العربية؛ حيث تبرز مشكلات تشوه النصوص الناتجة عن تباين رسم الهمزات (أ، إ، آ، ا) أو الخلط بين الياء المنقوطة والألف المقصورة (ي، ى). ويستوجب ذلك دمج دوال الاستبدال مثل SUBSTITUTE لمعالجة وتجريد الحروف من علاماتها الخاصة قبل تطبيق عمليات الاقتطاع، مما يضمن أن ينتج المقطع النصي رمزاً تعريفياً قياسياً وثابتاً يعبر عن الكيان بأقصى درجة ممكنة من الاتساق البرمجي والحاسوبي.
7.3 استخدام دالة CONCATENATE و TEXTJOIN لتركيب معرفات متعددة المتغيرات
يمثل تجميع المتغيرات المتعددة لتشكيل معرف هجين خطوة متقدمة في أساليب هندسة البيانات داخل إكسيل؛ حيث يتم الجمع بين المتغيرات الفئوية (كالسنة، والفرع، والجنس، والدرجة العلمية) لإنتاج معرف مركب يلخص سياق السجل بالكامل. وفي الإصدارات السابقة، كانت دالة CONCATENATE أو معامل الربط (&) هي الوسيلة الوحيدة لإنجاز هذا الدمج، غير أنها كانت تتسم بالجمود وتتطلب كتابة الفواصل الرمزية يدوياً بين كل حقل وآخر بشكل متكرر ومضنٍ.
أما في الإصدارات الحديثة، فقد وفرت مايكروسوفت دالة TEXTJOIN التي أحدثت ثورة حقيقية في إدارة التجميع النصي؛ إذ تتيح هذه الدالة للمحلل تحديد فاصل رمزي موحد يتم إدراجه تلقائياً بين كافة العناصر المحددة، مع ميزة استثنائية تتمثل في قدرتها على التجاهل التلقائي للخلايا الفارغة (Ignore Empty Cells)، مما يحمي بنية المعرف من التفكك أو احتواء فواصل مزدوجة غير مبررة عند غياب بعض الخصائص الوصفية لأحد السجلات.
تتم كتابة الدالة لربط مصفوفة من الخصائص المتفرقة في النطاق A2:D2 مع وضع واصلة فاصلة وتجاهل الفراغات على النحو التالي:
=TEXTJOIN(“-“, TRUE, A2:D2)
ورغم القوة الكبيرة لهذه المعرفات المركبة وقابليتها السريعة للتفسير البشري، إلا أنه يجب مراعاة تأثير طول السلسلة النصية الناتجة على كفاءة استهلاك الذاكرة في قواعد البيانات الضخمة؛ حيث تستهلك النصوص الطويلة مساحات تخزين وموارد معالجة تفوق بمراحل الأكواد الرقمية المدمجة، وهو ما يحتم على المحلل الموازنة الدقيقة بين الحاجة إلى تضمين السمات الوصفية والرغبة في الحفاظ على سرعة ورشاقة النموذج التحليلي النهائي.
8. أتمتة توليد المعرفات الفريدة عبر جداول إكسيل وأداة Power Query
8.1 الاستفادة من جداول إكسيل الرسمية (ListObjects) في استدامة الصيغ
يعد الخطأ الأكثر شيوعاً بين مستخدمي إكسيل هو الاعتماد على “النطاقات العادية” (Standard Ranges) غير المهيكلة لإجراء التحليلات الإحصائية وصياغة المعرفات؛ فالنطاقات العادية تتطلب من المحلل نسخ وسحب المعادلات يدوياً في كل مرة يتم فيها إدراج صفوف جديدة، وهو ما ينتج عنه حتماً نسيان تحديث بعض السجلات وظهور أخطاء الامتداد البشري. ولمعالجة هذه الثغرة الهيكلية، تبرز الممارسة الأكاديمية والمؤسسية الفضلى المتمثلة في تحويل النطاق المرجعي فوراً إلى “جدول بيانات رسمي” (Excel Table / ListObject) عبر اختصار لوحة المفاتيح الشهير (Ctrl + T).
يوفر تحويل البيانات إلى جدول رسمي حزمة متكاملة من المزايا التقنية التي تضمن استدامة صياغة المعرفات؛ وأبرزها خاصية “الأعمدة المحسوبة التلقائية” (Calculated Columns). فعند كتابة معادلة توليد المعرف في الخلية الأولى من عمود الجدول، يقوم إكسيل بنشر الصيغة تلقائياً في كافة خلايا العمود حتى نهايته بلمح البصر دون أي تدخل يدوي. علاوة على ذلك، عند إضافة أي بيانات أو لصق صفوف إضافية في أسفل الجدول، يتمدد الجدول ذاتياً ويستوعب السجلات الجديدة، مع تطبيق معادلة المعرف الفريد عليها وتوليد الأكواد المقابلة فوراً وبشكل دقيق.
إلى جانب التوسع التلقائي، تُمكن الجداول الرسمية المحلل من الاستفادة من “المراجع الهيكلية” (Structured References) بدلاً من عناوين الخلايا الجامدة التقليدية؛ حيث تُكتب الصيغ بأسماء الأعمدة المفهومة مثل [@Category] أو [#Data]، مما يجعل صياغة المعادلات أكثر وضوحاً وتوثيقاً ويقلل من احتمالات الخطأ أثناء تعديل هيكل ورقة العمل أو إعادة ترتيب مواقع الأعمدة.
8.2 إضافة أعمدة الفهرسة التلقائية عبر محرر Power Query
عندما تتعامل المشروعات البحثية مع مجموعات بيانات بالغة الضخامة تتجاوز مئات الآلاف من الصفوف، فإن استخدام الصيغ الحسابية المباشرة داخل ورقة العمل — مهما بلغت دقتها — يؤدي إلى ثقل الملف وبطء استجابته. وفي مثل هذا المستوى التحليلي، تبرز أداة “باور كويري” (Power Query) بوصفها الحل الأمثل والمهندس الحقيقي لعمليات استخراج وتحويل وتحميل البيانات (ETL)، متيحة إنشاء معرفات رقمية فريدة خارج بيئة الحسابات التقليدية لورقة العمل.
تبدأ هذه العملية باستيراد البيانات من ورقة العمل أو من مصادر خارجية متعددة إلى واجهة محرر Power Query؛ ولتوليد معرف رقمي متسلسل وفائق السرعة، يتجه المحلل إلى تبويب “إضافة عمود” (Add Column) ويختار أداة “عمود الفهرس” (Index Column). توفر الأداة خيارات فورية لإنشاء المتتالية الرقمية إما بدءاً من الرقم 0 (النمط الحاسوبي القياسي)، أو بدءاً من الرقم 1 (النمط الإحصائي الشائع)، أو تخصيص نقطة بداية وقيمة قفزة تزايدية محددة بما يلائم متطلبات النموذج المعتمد.
يتميز توليد المعرفات داخل Power Query بفصل المعالجة الحسابية عن واجهة العرض؛ حيث يتم تخزين البيانات المفهرسة كقيم مصفوفية مدمجة وثابتة، مما يرفع سرعة معالجة الملفات الضخمة بمستويات قياسية ويتخلص نهائياً من أي عبء حسابي متكرر على المعالج المركزي. وعقب اكتمال تشييد المعرفات، يتم تحميل الجدول المفهرس بنقرة زر واحدة (Close & Load) إلى ورقة العمل النهائية، مع احتفاظ خط الأنابيب البرمجي بقدرته على تحديث المعرفات وإعادة تنظيمها ذاتياً بمجرد النقر على زر “تحديث البيانات” (Refresh).
8.3 إنشاء معرفات المجموعات المجمعة باستخدام Group By في Power Query
توفر أداة Power Query إمكانية معمارية متقدمة لتوليد المعرفات الهرمية ومعرفات المجموعات الفرعية المنضبطة دون كتابة معادلات برمجية معقدة، وذلك بالاعتماد على خوارزمية “التجميع حسب” (Group By). يتيح هذا الإجراء تجميع كافة السجلات التابعة لكل فئة داخل جدول فرعي مصغر وخاص بها، مما يمهد الطريق لترقيم الأفراد أو العناصر ترقيماً تسلسلياً ومستقلاً يبدأ من الرقم 1 داخل كل مجموعة على حدة.
تتحقق هذه الخطوة التقنية المتقدمة من خلال تطبيق تجميع البيانات استناداً إلى عمود الفئة المستهدفة، مع اختيار العملية الرياضية “كافة الصفوف” (All Rows). ينتج عن هذا الإجراء إنشاء عمود وسيط يضم كائنات جدولية مضمنة، يتم عبرها فتح لغة الاستعلامات المصدرية المدمجة (M Code) وتطبيق دالة الفهرسة الجدولية Table.AddIndexColumn على كل جدول فرعي على انفراد، مما يؤدي إلى إنشاء تسلسل رقمي يبدأ من 1 لكل فئة ويتجدد ذاتياً عند الانتقال إلى الفئة التالية.
عقب إتمام إضافة الفهرس الداخلي للمجموعات، يقوم المحلل بنقرة واحدة بتفكيك الجداول الفرعية وتوسيعها (Expand) لاستعادة كافة الحقول والمتغيرات الأصلية جنباً إلى جنب مع عمود الفهرس الفرعي الجديد. يضمن هذا النهج ثباتاً منطقياً مطلقاً للترقيم الداخلي للمجموعات حتى لو خضعت البيانات لعمليات فرز لاحقة داخل ورقة العمل، كما يضمن قابلية تدفق التحديثات المستقبلية عبر خط التحويل البرمجي بمجرد إضافة بيانات جديدة للمصدر بمرونة برمجية فائقة.
9. إجراءات التحقق من صحة المعرفات وضمان سلامتها الرياضية
9.1 تطبيق قواعد التحقق من صحة البيانات لمنع التكرار المسبق
تمثل الوقاية الاستباقية خط الدفاع الأول لضمان نزاهة قواعد البيانات؛ فالجهد المبذول في منع تسجيل معرفات مكررة أثناء مرحلة الإدخال الميداني يقلل إلى حد كبير من الوقت والتكلفة اللازمين لتنظيف البيانات وتصحيحها لاحقاً. ولهذا الغرض، يوفر إكسيل أداة رقابية فعالة تُعرف بـ “التحقق من صحة البيانات” (Data Validation)، والتي تتيح للمحلل صياغة شروط منطقية صارمة تمنع إدراج أي قيمة مكررة في عمود المعرفات بصورة فورية ونهائية.
يتم ضبط هذه الحماية الفنية عن طريق تحديد كامل عمود المعرفات، واختيار نمط التحقق المخصص (Custom)، ثم كتابة الصيغة المنطقية الحاكمة باستخدام دالة العد الشرطي كالتالي:
=COUNTIF($A:$A, A1) <= 1
حيث تجبر هذه الصيغة محرك إكسيل على فحص كامل العمود قبل قبول القيمة المدخلة في الخلية، فإذا تبين أن القيمة موجودة مسبقاً وسيكون تكرارها مساوياً للرقم 2، يسقط الشرط المنطقي فوراً ويرفض البرنامج إتمام عملية الإدخال.
تكتمل هذه المنظومة الوقائية بتصميم وتخصيص “تنبيهات الخطأ” (Error Alerts) التي تنبثق لمدخلي البيانات؛ حيث يتم إعداد رسالة توجيهية حاسمة تمنع التجاوز (بنمط Stop)، لتشرح للمستخدم بلغة عربية صريحة أن المعرف المدخل مستخدم بالفعل لسجل آخر، مع توجيهه إلى الرقم التالي الواجب اعتماده. كما ينبغي تقييد صلاحيات تعديل عمود المعرفات وتجميده لمنع التلاعب بالسجلات التاريخية، مما يحافظ على التماسك البنيوي لقاعدة البيانات وحمايتها من العبث البشري العرضي.
9.2 معالجة القيم الشاذة والأخطاء الحسابية الناتجة عن الصيغ
عند الاعتماد على الصيغ الرياضية والمركبة لتوليد المعرفات واسترجاعها، يتعرض النموذج التحليلي أحياناً لظهور رموز أخطاء مزعجة، مثل خطأ عدم العثور (#N/A)، أو خطأ المرجع المفقود (#REF!)، أو خطأ القيمة غير المتطابقة (#VALUE!). تقود هذه الرموز الحسابية المشوهة إلى انهيار العمليات التحليلية التابعة وتعطل الجداول المحورية؛ مما يستلزم تطويق الصيغ بحواجز وقائية منيعة تعالج هذه الاستثناءات بصورة سلسة ومنطقية.
تمثل دالة المعالجة الوقائية IFERROR الأداة القياسية لتطويق المعادلات الكلاسيكية؛ حيث تتولى الدالة فحص مخرجات الصيغة، فإذا كانت سليمة تمررها كما هي، وإذا احتوت على أي خطأ حسابي، تستبدله بقيمة بديلة يحددها المحلل (مثل ترك الخلية فارغة عبر وضع علامتي تنصيص متتاليتين ""، أو كتابة رسالة تنبيهية مثل “معرف غير صالح”). وتُكتب الصيغة المطوقة على النحو الآتي:
=IFERROR( المعادلة الأصلية , “قيمة بديلة”)
مما يضمن بقاء المظهر الجمالي والوظيفي للجدول متماسكاً وخالياً من رسائل الأعطال البرمجية المربكة.
إلى جانب ذلك، تنشأ أخطاء شائعة جداً نتيجة “تعارض أنواع البيانات” (Data Type Mismatch)؛ كأن يُسجل المعرف في أحد الجداول كنص مخزن (Text) بينما يُسجل في الجدول المقابل كرقم صحيح (Integer). يؤدي هذا التباين الشكلي إلى فشل دوال البحث في مطابقة القيمتين رغم تطابقهما الظاهري للعين البشرية. ولمعالجة ذلك، يتم استخدام دوال التحويل الصارم مثل VALUE لإجبار النصوص على التحول لأرقام، أو دالة TRIM ودوال النصوص لتحويل الأرقام إلى متتاليات نصية متجانسة، مما يزيل الفجوات التنسيقية الخفية ويعيد للنموذج اتساقه وموثوقيته الحسابية التامة.
9.3 المراجعة الدورية وتدقيق الفرادة باستخدام أدوات الفرز والتحليل
لا يكتمل أي بروتوكول أكاديمي لإدارة البيانات دون إرساء آليات تدقيق دورية مستمرة للتأكد من استدامة فرادة المعرفات وصحة بنائها الهيكلي؛ فالأنظمة الحية عرضة لتسرب الأخطاء أثناء عمليات التحرير، والحذف، والدمج المتكرر للبيانات عبر مسار المشروع البحثي. ويعد “التدقيق الجنائي للبيانات” (Data Forensic Auditing) خطوة جوهرية تسبق البدء الفعلي في النمذجة الإحصائية النهائية واختبار الفرضيات.
تتصدر “الجداول المحورية” (Pivot Tables) قائمة الأدوات التحليلية السريعة والفعالة لتنفيذ هذا التدقيق؛ حيث يمكن للمحلل إنشاء جدول محوري سريع يضع فيه عمود المعرفات الفريدة في حقل الصفوف (Rows)، ويضع الحقل نفسه في خانة القيم (Values) مع ضبط عملية التلخيص الحسابي على دالة العد (Count). وفي حال كانت المنظومة تعمل بفرادة مطلقة، يجب أن تُظهر كافة خلايا التلخيص الرقم 1 حصراً؛ فإذا ظهر أي رقم يتجاوز الواحد (مثل 2 أو 3)، ينكشف التكرار فوراً ويتم تحديد المعرف المكرر وتتبعه بدقة متناهية.
كما تشتمل عمليات التدقيق المتقدمة على فحص “سلامة التسلسل الرقمي” لكشف أي قفزات مفقودة في الترقيم ناتجة عن الحذف العشوائي لبعض الصفوف؛ ويتم ذلك بحساب الفرق الرياضي بين كل معرف والمعرف الذي يعلوه، للتأكد من أن الفارق يساوي دوماً وحدة واحدة صحيحة. وتُختتم هذه الإجراءات الرقابية بتدوين نتائج الفحص ضمن “تقرير جودة البيانات” الخاص بالمشروع، مما يوفر توثيقاً منهجياً يعزز من موثوقية الاستنتاجات العلمية ويمنح المحكمين والمشرفين الأكاديميين دليلاً قاطعاً على سلامة البيانات وخلوها من التشوهات الحسابية.
10. أفضل الممارسات الأكاديمية لحوكمة المعرفات وحماية سرية البيانات
10.1 إدارة قواميس البيانات وتوثيق معايير بناء الرموز التعريفية
تشكل حوكمة البيانات المظلة المنهجية التي تضمن استمرارية المشروعات البحثية والمؤسسية وقابليتها للتوسع والتدقيق المستقبلي؛ إذ لا يجوز في العرف العلمي الرصين أن تظل معايير توليد المعرفات مجرد إجراءات ضمنية يستحضرها المحلل بمفرده دون توثيق مدون ومفصل. ومن هنا، يبرز إنشاء “قاموس البيانات” (Data Dictionary) بوصفه واجباً أولياً وملحقاً إلزامياً يُخصص له صفحة مستقلة داخل ملف الإكسيل أو وثيقة مرجعية خارجية ترفق بالدراسة.
يتضمن قاموس البيانات توصيفاً دقيقاً لكل مقطع ومكون يدخل في تشكيل المعرف الفريد؛ موضحاً دلالة الأكواد النصية، والأنماط المتبعة في صياغة التواريخ، والمدى الرقمي المسموح به للمتواليات التسلسلية. كما ينبغي أن يشرح القاموس بوضوح مسار تدفق الصيغ المنطقية المعتمدة لتوليد الأرقام، وتوثيق استراتيجية التوسع المستقبلي في حال استنفاد فضاء الترقيم المتاح (كالانتقال من الترقيم ثلاثي الخانات “001” إلى الترقيم رباعي الخانات “0001” عند تجاوز العينة لعدد 999 مفردة).
وعلاوة على التوثيق الهيكلي للرموز، يُلزم الفريق البحثي بحفظ وأرشفة “النسخ المصدرية الخام” للبيانات في بيئة تخزينية آمنة ومستقلة، قبل إخضاعها لأي عمليات توليد للمعرفات أو تعديل بنيوي. تضمن هذه الممارسة المنهجية إمكانية الرجوع إلى النقطة الصفرية للبيانات عند اكتشاف أي خلل في منطق الصيغ، وتتيح للمراجعين الخارجيين التحقق من أن عملية الترميز الاصطناعي لم تتدخل في تشويه المتغيرات الميدانية الأصلية أو تبديل خصائصها الطبيعية بأي شكل من الأشكال.
10.2 قفل الخلايا وتأمين الحماية التقنية لصيغ المعرفات
بعد الانتهاء من ضبط المعادلات المعقدة وبناء المعرفات الفريدة، تصبح ورقة العمل عرضة لمخاطر التعديل غير المقصود أو الكتابة الفوقية العرضية (Accidental Overwriting) من قِبل مدخلي البيانات أو الباحثين الميدانيين؛ مما قد يكسر الروابط المنطقية ويدمر النطاقات المتوسعة الحساسة. وتفادياً لهذا التهديد التشغيلي، يتيح إكسيل منظومة متكاملة لحماية وتأمين خلايا المعادلات الحسابية عبر تقنيات القفل والإخفاء.
تتم هذه الإجراءات التقنية عبر تحديد عمود المعرفات الفريدة بالكامل، والولوج إلى قائمة تنسيق الخلايا (Format Cells)، ثم تفعيل خياري “مغلقة” (Locked) و”مخفية” (Hidden) في تبويب الحماية (Protection). يؤدي هذا الضبط إلى منع التعديل على محتوى الخلايا وحجب نص المعادلة البرمجية عن شريط الصيغ العلوي؛ ثم يتم استكمال الحماية بتفعيل خيار “حماية ورقة العمل” (Protect Sheet) وتعيين كلمة مرور مشفرة، مع السماح للمستخدمين فقط بتحديد وتعديل الخلايا المخصصة لإدخال البيانات الخام دون المساس بأعمدة المعرفات المحمية.
كما ينبغي ضبط إعدادات الحماية لمنع حذف الصفوف أو الأعمدة التي تتضمن مراجع محورية تتغذى عليها دوال البحث التراكمية، مع أهمية تدريب أفراد الفريق المعاون على كيفية إدخال البيانات ضمن المساحات المسموحة حصراً. يضمن هذا الإغلاق الأمني المحكم استقرار البنية التحتية لملف البيانات، ويمنع الانهيارات المفاجئة في النماذج التحليلية عند تداول الملفات بين أيدي متعددة أثناء العمل الميداني الجماعي.
10.3 التوافق مع برمجيات التحليل المتقدم وقواعد البيانات الخارجية
لا يمثل برنامج إكسيل — في أغلب الدراسات الرصينة — المحطة النهائية لتحليل البيانات، بل يُستخدم كأداة مرنة للتجميع المبدئي، والتدقيق، وهندسة المعرفات قبل تصدير الملفات إلى البرمجيات الإحصائية المتخصصة مثل SPSS و R و SAS أو ترحيلها إلى نظم إدارة قواعد البيانات العلائقية مثل SQL Server و PostgreSQL. ومن هذا المنطلق، تفرض المعايير الاحترافية تهيئة المعرفات الفريدة لتكون متوافقة تماماً مع متطلبات وبيئات تلك البرمجيات المتقدمة.
تقتضي شروط التوافق البرمجي الامتناع الصارم عن استخدام المسافات، أو الرموز الخاصة المعقدة، أو الكلمات المحجوزة برمجياً داخل أسماء أعمدة المعرفات وقيمها؛ حيث يفضل دائماً استخدام الأكواد التي تبدأ بحروف نصية لاتينية تليها أرقام تفصل بينها شرطة سفلية (“_”) حصراً، وهي البنية المعيارية المقبولة في كافة لغات البرمجة الإحصائية. كما يجب تثبيت المعرف ليعمل كـ “مفتاح أساسي” (Primary Key) مستقر وثابت لا يتغير مطلقاً بتغير صفات الكيان، مما يسهل كتابة استعلامات الربط المتقاطع (Joins) ودمج البيانات بأقصى درجات الانسيابية والأمان.
وأخيراً، كخطوة إجرائية حاسمة تسبق عمليات التصدير، يجب تحويل عمود المعرفات بالكامل من صيغ نشطة حركية إلى قيم نصية أو رقمية نهائية صلبة عبر خيار “لصق كقيم” (Paste as Values). إن تصدير الجداول وهي تحتوي على صيغ ديناميكية أو مراجع متوسعة غير ثابتة قد يؤدي إلى قراءتها كأخطاء برمجية أو قيم فارغة في بيئات التحليل الخارجي؛ لذا يضمن تثبيتها المسبق استقرار البيانات واستمرار عمل المعرفات بكفاءتها المطلوبة عبر مختلف المنصات التحليلية المتطورة.
خاتمة
في الختام، يتبين بجلاء أن مسألة توليد المعرفات الفريدة في برمجيات الجداول الإلكترونية، وعلى رأسها مايكروسوفت إكسيل، تتجاوز مجرد كونها مهارة تقنية تشغيلية لتصبح منهجية متكاملة ترتبط مباشرة بسلامة التحليلات الإحصائية ورصانة النتائج البحثية. فمن خلال الفهم العميق للبنية المنطقية للبيانات والتمييز الواعي بين المعرفات الطبيعية والاصطناعية، يستطيع المحلل بناء نماذج رياضية صلبة تقي أبحاثه من مخاطر الخلط الدلالي، والتكرار الخفي، والانهيار الحسابي الذي يهدد قواعد البيانات غير المهيكلة.
وقد أظهر هذا الدليل المنهجي التنوع الواسع في الأدوات والخيارات المتاحة أمام الباحثين؛ بدءاً من الصيغ الكلاسيكية المركبة التي تجمع بين دقة MATCH و VLOOKUP ومرونة MAX في ضبط التراكم العددي، مروراً ببناء المعرفات الهرمية متعددة المستويات عبر COUNTIF و TEXT، وصولاً إلى استثمار الطفرة النوعية التي قدمتها مصفوفات إكسيل الديناميكية المنسكبة مثل UNIQUE و SEQUENCE و XLOOKUP. كما وفرت أدوات النمذجة المتقدمة مثل Power Query ومحاكاة المعرفات العالمية الموحدة (GUID) مسارات احترافية للتعامل مع البيانات الضخمة وحماية الخصوصية الشخصية وفق المتطلبات التشريعية المعاصرة كاللائحة العامة لحماية البيانات (GDPR).
إن تبني أفضل الممارسات في حوكمة المعرفات، وتأمين صيغها عبر تقنيات القفل والحماية، وضبط شروط التحقق الاستباقي من صحة البيانات، وإدارة قواميس التوثيق الشاملة، يمثل الضمانة الأكاديمية الأكيدة لإنتاج معرفات مستقرة ومتوافقة مع حزم التحليل المتقدمة وقواعد البيانات الخارجية. وباتباع هذه الضوابط والمعايير العلمية الصارمة، يرتقي الباحث بجودة بياناته من مجرد أرقام مبعثرة داخل ورقة عمل إلى منظومة معرفية متماسكة ومستدامة، قادرة على تلبية متطلبات الاستدلال العلمي الدقيق وتطبيقات اتخاذ القرار الاحترافي بثقة وموثوقية مطلقة.
المراجع
- European Parliament and Council of the European Union. (2016). Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016 on the protection of natural persons with regard to the processing of personal data and on the free movement of such data (General Data Protection Regulation). Official Journal of the European Union, L 119, 1–88. https://gdpr-info.eu/
- Leach, P., Mealling, M., & Salz, R. (2005). A Universally Unique IDentifier (UUID) URN Namespace (RFC 4122). Internet Engineering Task Force (IETF). https://datatracker.ietf.org/doc/html/rfc4122
- Microsoft Corporation. (2023). Excel functions (alphabetical). Microsoft Support. https://support.microsoft.com/en-us/office/excel-functions-alphabetical-b3944572-255d-4efb-bb96-c6d90033e188
- Microsoft Corporation. (2023). Power Query documentation. Microsoft Learn. https://learn.microsoft.com/en-us/power-query/
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10