
تُعد عملية إدخال البيانات الأولية إلى البيئات البرمجية المتخصصة الركيزة الأساسية التي تقوم عليها دقة وموثوقية كافة التحليلات الإحصائية ونماذج استخراج المعرفة اللاحقة. وفي منظومة تحليل البيانات، يبرز نظام التحليل الإحصائي SAS بوصفه أحد أقوى الحلول البرمجية وأكثرها رسوخاً في الأوساط الأكاديمية والمؤسسات البحثية والقطاعات الطبية والمالية، حيث طُوِّر في بداياته داخل جامعة ولاية كارولاينا الشمالية على يد أنتوني بار وجيمس غودنايت وجون سال وجين هيلويغ، قبل تأسيس معهد SAS رسمياً عام 1976. وتأتي قوة هذه المنظومة من قدرتها الاستثنائية على إدارة ومعالجة البيانات الضخمة وفائقة التعقيد، غير أن كفاءة هذه المعالجة ترتبط ارتباطاً وثيقاً بمدى جودة ودقة مرحلة القراءة والاستيراد الأولي من المصادر الخارجية.
تمثل الملفات النصية المسطحة، بمختلف امتداداتها مثل TXT وDAT والملفات المجدولة، التنسيق الأكثر شيوعاً وعالمية لتبادل السجلات وتخزين المخرجات الصادرة عن النظم الرقمية، ومعدات القياس المختبرية، واستطلاعات الرأي، والمنصات السحابية. يعود هذا الانتشار الواسع إلى بساطة بنيتها، وخلوها من التعقيدات البرمجية أو القيود الاحتكارية، وخفة حجمها عند النقل والتخزين. ومع ذلك، فإن هذه البساطة الظاهرية للملفات النصية تنطوي على تحديات برمجية معتبرة عند نقلها إلى جداول SAS المهيكلة، لا سيما عندما يتعلق الأمر باختلاف المحددات الفاصلة بين الأعمدة، وتباين ترميز الأحرف، والتعامل مع السجلات المفقودة، واقتطاع النصوص الطويلة.
يهدف هذا الدليل المنهجي الموسع إلى تقديم تشريح تحليلي وشامل لآليات استيراد الملفات النصية إلى نظام SAS، متناولاً بالتفصيل الإجراء الآلي السريع المعروف باسم PROC IMPORT وخطوة البيانات البرمجية المخصصة DATA Step مع عبارتي INFILE وINPUT. سنستعرض من خلال هذا البحث الرصين المبادئ النظرية الحاكمة لكل طريقة، ونحلل الخيارات الدقيقة المتاحة للمستخدم، وندعم الشرح بأمثلة تطبيقية واقعية، واستراتيجيات عملية لفحص جودة البيانات المستوردة ومعالجة المشكلات الشائعة، فضلاً عن إرساء أفضل الممارسات التي تضمن التكرارية العلمية والنزاهة المنهجية لإدارة البيانات الحسابية.
1. مقدمة عامة حول استيراد البيانات النصية إلى بيئة SAS
1.1 أهمية الملفات النصية في التحليل الإحصائي وإدارة البيانات
تحظى الملفات النصية الخام من صيغة TXT بمكانة مركزية وريادية في مجالات تخزين ونقل البيانات الرقمية عبر شتى المنصات الحاسوبية والتطبيقات الإحصائية. يعود هذا الشيوع التاريخي والمستمر إلى افتقار هذه الملفات إلى أي طبقات تشفير برمجية معقدة أو تنسيقات احتكارية مغلقة ترتبط ببرمجيات مكتبية محددة. وتوفر هذه الصيغة وعاءً آمناً ومرناً لتدوين الملاحظات الكمية والتصنيفية المتسلسلة، مما يجعلها الخيار المفضل لتصدير السجلات الضخمة من قواعد البيانات المركزية، ونظم إدارة المؤسسات، ومستودعات المعطيات الجينومية والمالية. تتيح الملفات النصية للمحللين والباحثين نقل ملايين السجلات باستهلاك متواضع لمساحات التخزين وحزم شبكات الاتصال، مع الاحتفاظ ببنية مصفوفية شفافة يسهل فحصها بمحررات النصوص الأساسية.
تتجلى الأهمية التطبيقية للملفات النصية في سياقات جمع المعطيات الميدانية والبيانات المسحية والنفسية، حيث تعتمد أجهزة جمع القياسات وأجهزة الرصد السلوكي والحواسيب اللوحية الموزعة في الميادين على إخراج نتائجها في هيئة تدفقات نصية متسلسلة تفصل بين أركانها فواصل موحدة. وتبرز هنا الحاجة المنهجية الماسة لتحويل هذه التدفقات غير المهيكلة أو شبه المهيكلة إلى جداول بيانات رسمية داخل بيئة SAS، المعروفة باسم SAS Data Sets. إذ لا يمكن تطبيق أي من الاختبارات البارامترية، أو النماذج الخطية العامة، أو خوارزميات التنبؤ المتقدمة ما لم تكن البيانات متموضعة في أعمدة ذات خصائص معرفية حاسوبية صارمة، تشمل تحديد النوع والمتغيرات والأطوال والتسميات القياسية التي تعتمدها محركات معالجة الجداول في SAS.
1.2 مقارنة بين طرق استيراد البيانات المختلفة داخل نظام SAS
يوفر نظام SAS مسارين رئيسيين لقراءة البيانات من الملفات النصية الخام، يتمثل الأول في إجراء الاستيراد السريع PROC IMPORT، بينما يتمثل المسار الثاني في استخدام خطوة البيانات الموجهة DATA Step مع تعليمات INFILE وINPUT. صُمم إجراء PROC IMPORT ليكون أداة مؤتمتة عالية السرعة تتولى مسح الأسطر الأولى من الملف النصي، وتخمين نوع المتغيرات سواء كانت رقمية أو نصية، واكتشاف المحددات الفاصلة وتحديد أسماء الأعمدة بصورة ذاتية، مما يوفر وقتاً كبيراً للمحلل عند التعامل مع ملفات قياسية ومنتظمة الهيكل ولا تحتوي على شذوذ شكلي أو عدم انتظام في السجلات.
في المقابل، تمنح خطوة البيانات DATA Step المطور أو الإحصائي تحكماً حتمياً ودقيقاً ومطلقاً في كل بايت يُقرأ من الملف المصدري، متيحة تخصيص أطوال السلاسل النصية حرفاً بحرف، وتطبيق أدوات الإدخال المتخصصة Informats، وإدارة القيم المفقودة، ومعالجة الحقول المتباينة في الأطوال بمرونة لا تضاهى. تتحدد المفاضلة المنهجية بين المسارين بالنظر إلى درجة تعقيد الملف وحجمه؛ فالملفات القياسية المفصولة بفواصل واضحة تُعالج بيسر عبر PROC IMPORT، بينما تتطلب الملفات التي تشتمل على أخطاء هيكلية، أو نصوص مقتبسة معقدة، أو سجلات متداخلة غير منتظمة الاعتماد الكلي على خطوة البيانات. كما تمنح كتابة التعليمات البرمجية الصريحة مزايا أتمتة فائقة مقارنة بالواجهات الرسومية، إذ تضمن الحفاظ على سجل تدقيق قابل لإعادة التنفيذ المنهجي الكامل ضمن خطوط الإنتاج والتحليل المعتمدة.
1.3 المتطلبات المسبقة والتهيئة البرمجية لعملية الاستيراد
تتطلب الإدارة الناجحة لعملية استيراد الملفات النصية في بيئة SAS استيفاء شروط تقنية وبنية تحتية محددة قبل البدء في كتابة أوامر القراءة. ينبغي في المقام الأول التحقق بدقة من المسار الفيزيائي لتخزين الملف النصي المصدر، مع إدراك الفروق الهيكلية الحاكمة لنظم التشغيل التي تعمل عليها خوادم SAS. تختلف صياغة مسارات الملفات في بيئات Windows المحلية التي تستخدم الفواصل المائلة الخلفية Backslashes وتعيين الأحرف للأقراص، اختلافاً جذرياً عن بيئات الخوادم السحابية أو خوادم Unix وLinux (مثل بيئة SAS OnDemand for Academics أو SAS Viya)، حيث تُستخدم الفواصل المائلة للأمام Forward Slashes وتعتمد حساسية حالة الأحرف في أسماء المجلدات والملفات.
يتعين كذلك التأكد من امتلاك جلسة العمل الحالية لأذونات القراءة الضرورية للوصول إلى المجلد الهدف، إذ يؤدي تعارض الصلاحيات الأمنية إلى إخفاق فوري في فتح قناة الإدخال. ومن الأهمية بمكان فحص وتحديد ترميز الأحرف Encoding المعتمد داخل الملف النصي، مثل UTF-8 أو ASCII أو Latin1 أو الترميزات الخاصة بنظام Windows. إذ إن عدم تطابق ترميز الملف المصدري مع ترميز جلسة SAS يؤدي حتماً إلى تشوه السلاسل النصية وظهور علامات غير مفهومة بدلاً من النصوص الصحيحة، لا سيما عند معالجة ملفات تحتوي على أحرف غير لاتينية كاللغة العربية أو الرموز الدلالية المتخصصة في الدراسات والتقارير الدولية.
2. الصيغة الأساسية لإجراء الاستيراد السريع PROC IMPORT
2.1 الهيكل النحوي البرمجي لإجراء PROC IMPORT
يقوم الهيكل النحوي لإجراء الاستيراد السريع PROC IMPORT على مجموعة من العبارات المحورية المترابطة التي تنظم نقل البيانات من البيئة الخارجية إلى الذاكرة التخزينية في SAS. يبدأ الإجراء بالكلمة المفتاحية PROC IMPORT، متبوعة بعدد من المعلمات الأساسية التي تحدد مسار الملف ونوع المنظومة المعالجة للبيانات، ثم تتلوها تعليمات فرعية تفصل آليات التعامل مع الصفوف والأعمدة، وتُختتم الكتلة البرمجية دائماً بعبارة RUN الإلزامية التي تُصدر الأمر المباشر لمحرك المعالجة ببدء القراءة والتحويل وتخزين النتائج.
يرتبط ترتيب الوسائط والتعليمات داخل أمر الاستيراد بقواعد صارمة تضمن اتساق التنفيذ البرمجي. لا يعمل هذا الإجراء كمعالج سياقي مفتوح، بل يتبع منطقاً إجرائياً متسلسلاً يقوم بفتح الملف المصرح عنه، وتحليله وفق النمط المختار، وتوليد شيفرة خطوة بيانات ضمنية في الخلفية لإتمام المعالجة. يُظهر سجل التشغيل SAS Log هذه العمليات الوسيطة بتفصيل كامل، مما يسمح للمحلل بفهم المسار الذي سلكه البرنامج في قراءة كل عنصر، ويبرز أهمية إنهاء الكتلة بعبارة RUN لتفادي تعليق الجلسة البرمجية بانتظار تعليمات أخرى غير مكتملة.
2.2 دور عبارة OUT في تسمية وتخزين مجموعة البيانات الناتجة
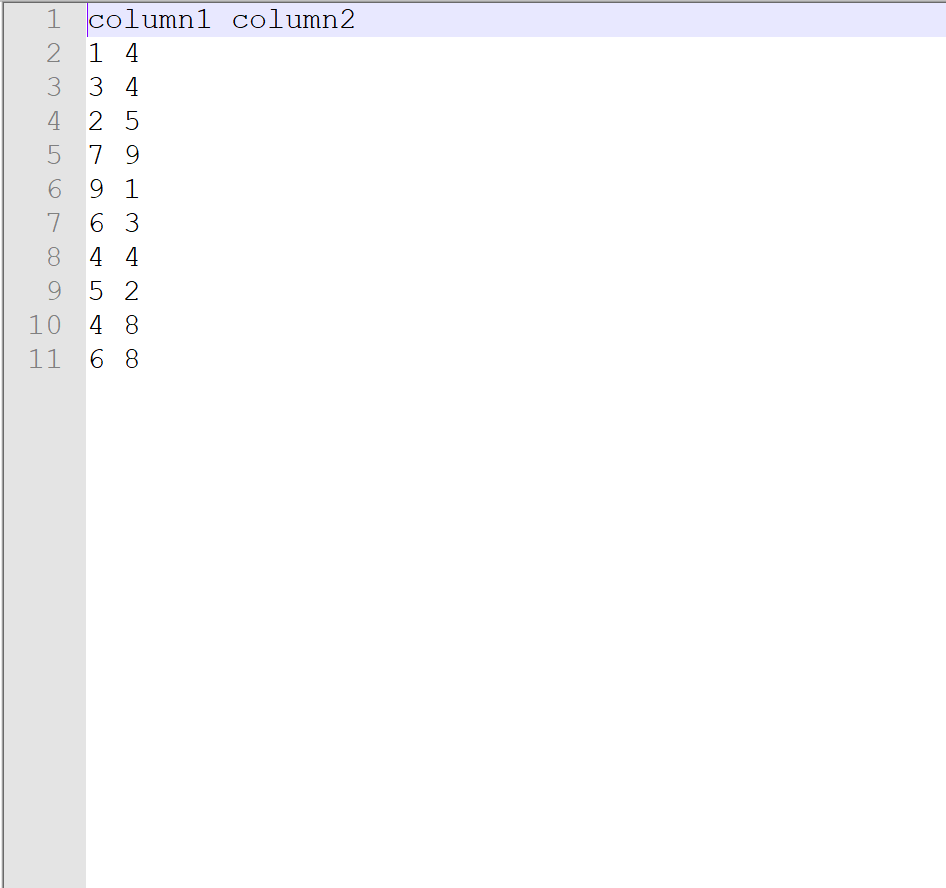
تُعد عبارة OUT في إجراء PROC IMPORT الوسيلة المحددة للوجهة التي ستستقر فيها البيانات المعالجة داخل بيئة SAS. تتيح هذه العبارة للمحلل تحديد اسم مجموعة البيانات الناتجة وتحديد المكتبة التخزينية التي ستستضيفها. فإذا حُدد الاسم بمفردة واحدة مجردة، مثل OUT=survey_data، فإن SAS يوجه المخرجات تلقائياً وبشكل افتراضي إلى المكتبة المؤقتة WORK، وهي مكتبة متطايرة تُمحى محتوياتها بالكامل بمجرد إغلاق جلسة العمل البرمجية، مما يجعلها مثالية للتحليلات اللحظية والاختبارات المبدئية التي لا تتطلب تخزيناً طويل الأجل.
أما في المشروعات التحليلية المستدامة، فيتعين توجيه المخرجات إلى مكتبات دائمة ومخصصة تُنشأ عبر عبارة LIBNAME، ويتم التعبير عنها باستخدام الاسم الثنائي ذي النقطة، مثل OUT=project.survey_data. يضمن هذا التعيين حفظ البيانات المستوردة على القرص الصلب أو وسائط التخزين السحابية كملف دائم بامتداد sas7bdat. ويجب هنا التقيد الدقيق بقواعد تسمية الكائنات في SAS؛ حيث يشترط ألا يتجاوز طول الاسم 32 حرفاً، وأن يبدأ بحرف أبجدي غير رقمي أو بشرطة سفلية، وألا يحتوي على مسافات فارغة أو علامات خاصة أو رموز ترقيم، مما يحفظ تكامل منظومة المعالجة ويمنع حدوث أخطاء الإسناد.
2.3 تحديد مسار الملف المصدري باستخدام عبارة DATAFILE
تتولى عبارة DATAFILE في صيغة الاستيراد وظيفة الإشارة المباشرة إلى موقع الملف النصي على وسائط التخزين المحلية أو الشبكية. يُكتب المسار عادة داخل علامات تنصيص مفردة أو مزدوجة، متضمناً اسم الملف وامتداده الدقيق بصيغة صريحة، مثل DATAFILE=’/home/user/data/sample.txt’. يتطلب العمل المؤسسي الدقة في التمييز بين استخدام المسارات المطلقة التي تبدأ من جذر نظام الملفات، والمسارات النسبية التي ترتبط بالمجلد الحالي أو مسار العمل الافتراضي للجلسة، حيث توفر المسارات المطلقة ثباتاً يمنع أخطاء الانحراف الموقعي للملفات عند تشغيل السكربتات المجمعة.
تبرز الفروق الجوهرية لأنظمة التشغيل عند صياغة هذه المسارات؛ إذ إن خوادم لينكس يونكس المستخدمة بكثرة في بيئات الحوسبة الإحصائية المتقدمة تعامل الأحرف الكبيرة والصغيرة بوصفها مسارات مختلفة تماماً، فالمسار الذي يشير إلى Data.txt يختلف برمجياً عن مسار data.txt. كما تتطلب المسارات التي تتضمن مسافات فارغة أو حروفاً خاصة في أسماء المجلدات أو الملفات إحاطتها بعلامات تنصيص محكمة لمنع تجزئة النص البرمجي إلى معلمات منفصلة غير مفهومة لمحرك الاستيراد، وهو ما يضمن استقرار مؤشر القراءة الحوسبي وتدفقه السلس إلى الملف المستهدف.
3. التحليل التفصيلي لخيارات ومعلمات أمر PROC IMPORT
3.1 تحديد نمط الملف ونوع المحدد بواسطة عبارة DBMS
تتحكم المعلمة DBMS (اختصاراً لنظام إدارة قواعد البيانات DataBase Management System) في تحديد نوع المحرك البرمجي الداخلي الذي سيستخدمه SAS لتفسير بنية الملف المصدري. عند التعامل مع الملفات النصية العامة، تُعد القيمة DBMS=DLM الخيار الأساسي والافتراضي لقراءة الملفات النصية ذات المحددات المتنوعة Delimiter-Separated Values، حيث يوجه هذا الخيار معالج الاستيراد للتعامل مع محددات الحقول العامة، ويفترض النظام بصورة قياسية وجود مسافات كفواصل بين المتغيرات ما لم يُنص على خلاف ذلك عبر عبارات إضافية.
تتكامل خيارات DBMS لتغطي أنماطاً متعددة؛ فالخيار DBMS=CSV مخصص للملفات ذات القيم المفصولة بفواصل قياسية Comma-Separated Values، حيث يطبق هذا المعالج خوارزميات مسبقة الإعداد للتعامل مع النصوص الإنجليزية أو الحقول المحاطة بعلامات اقتباس، بينما يوفر الخيار DBMS=TAB محركاً مهيأً خصيصاً لقراءة الملفات المفصولة بعلامات الجدولة التبادلية. يتيح الفهم العميق للاختلافات الدقيقة بين هذه الأنماط للمحلل ضبط دقة الاستيراد بدقة متناهية، وتجنب التفسير الخاطئ لمحتويات الحقول، لا سيما في البيئات التي تتداخل فيها الفواصل التقليدية مع الأرقام أو الفواصل العشرية المستخدمة في بعض التنسيقات الإقليمية والدولية.
3.2 إدارة استبدال الملفات القائمة عبر خيار REPLACE
تؤدي إضافة خيار REPLACE إلى رأس تعليمة PROC IMPORT دوراً محورياً في تمكين انسيابية العمل البرمجي التكراري. عندما يُنفذ كود الاستيراد لأول مرة، ينشئ SAS الجدول في المكتبة المعنية، ولكن عند إعادة تنفيذ الكود بعد تعديل الملف المصدري أو تحديث المعلمات، سيتوقف المحرك فوراً عن التنفيذ ويرسل خطأً صريحاً في السجل إذا لم يكن خيار REPLACE موجوداً، محذراً من أن مجموعة البيانات موجودة بالفعل وتتعذر الكتابة فوقها حفاظاً على أمان الملفات القائمة ومنع التلف العرضي.
ومع ذلك، ينطوي الإفراط في استخدام REPLACE على مخاطر تشغيلية لا يُستهان بها داخل بيئات الإنتاج الفعلية وقواعد البيانات الضخمة. فالكتابة فوق جدول قائم تعني محو كافة المتغيرات والتعديلات والحقول المحسوبة التي أُضيفت إلى ذلك الجدول في مراحل تحليلية سابقة. لذا يُنصح في الممارسات البرمجية الصارمة بحذف هذا الخيار أو إيقافه عند الانتهاء من تطوير الكود واختباره، أو توجيه المخرجات المستوردة إلى مجموعات بيانات مرحلية متدرجة، لتجنب فقدان البيانات الأصلية أو تدمير الجداول المرجعية الحساسة في حال طرأ خطأ غير متوقع على محتويات الملف المصدري أثناء التشغيل المؤتمت.
3.3 معالجة رؤوس الأعمدة باستخدام معلمة GETNAMES
تحدد المعلمة المنطقية GETNAMES ما إذا كان السطر الأول من الملف النصي سيُعامل بوصفه متضمناً للأسماء الحقيقية للمتغيرات أم أنه يمثل السجل الأول من البيانات الفعلية. عند ضبط الخيار على النمط GETNAMES=YES، يقرأ SAS الصف الأول ويحول القيم النصية الواردة فيه إلى أسماء أعمدة للجدول الناتج. وفي هذه الحالة، يطبق النظام خوارزمية تطهير ذاتية لأسماء الأعمدة؛ فإذا تضمنت الأسماء مسافات أو رموزاً غير مقبولة نحواً، يستبدلها النظام تلقائياً بشرطات سفلية لضمان توافقها مع قواعد التسمية المعيارية المعتمدة في البيئة.
على النقيض من ذلك، فإن تعيين GETNAMES=NO يوجه المحرك إلى اعتبار السطر الأول من الملف سطراً رقمياً أو بيانياً عادياً ينبغي استيراده كأول ملاحظة فعلية داخل مجموعة البيانات المستهدفة. وفي هذا السياق، يقوم SAS بإنشاء أسماء اصطلاحية افتراضية للأعمدة وفق نمط ترقيمي موحد يبدأ بـ VAR1 وVAR2 وVAR3 ويتدرج تصاعدياً تبعاً لعدد الأعمدة المستكشفة. يُمكّن هذا الخيار المحلل من السيطرة التامة على الملفات التي تفتقر تاريخياً للترويسات، ممهداً الطريق لخطوات لاحقة لإعادة تسمية المتغيرات بمسميات دقيقة عبر إجراءات التعديل والتخصيص البعدية.
4. التعامل مع أنواع المحددات المختلفة في الملفات النصية
4.1 استيراد الملفات المفصولة بمسافات قياسية (Space-Delimited)
تمثل الملفات المفصولة بمسافات قياسية التنسيق الأقدم والأكثر تواتراً في مخرجات المحاكاة الحاسوبية والبرمجيات الإحصائية القديمة مثل النظم المكتوبة بلغة Fortran. تتميز هذه الملفات بوجود مسافة بيضاء واحدة أو أكثر تفصل بين القيم المتتالية في السطر الواحد. وعند توظيف أمر PROC IMPORT مع المعلمة DBMS=DLM، يتعامل SAS مع المسافات المتعددة المتتالية على أنها محدد واحد افتراضي، مما يتيح له تجاوز التباعد البصري الذي يضعه بعض مصممي الأنظمة لمحاذاة الأعمدة بشكل عمودي مرتب.
تظهر الصعوبة التشغيلية الأساسية في هذا النمط عند وجود بيانات مفقودة Missing Values ممثلة بفراغات غير معنونة، فبدلاً من قراءة الحقل المفقود كقيمة فارغة، قد يمتص محرك الاستيراد القيمة التالية في السطر لتعبئة الحقل الحالي، مما يُحدث إزاحة كارثية في مصفوفة البيانات بالكامل. للتغلب على هذه المشكلة، يتعين التأكد من أن القيم المفقودة في الملف النصي المتباعد بمسافات قد تم ترميزها بنقطة مفردة (.) للأرقام أو بحرف رمزي متفق عليه، لضمان استقرار قراءة الأعمدة ومواقع المتغيرات بدقة تامة دون تداخل.
4.2 استيراد الملفات المفصولة بعلامة الجدولة (Tab-Delimited)
يُعد التنسيق المفصول بعلامات الجدولة، أو ما يعرف بتنسيق Tab-Delimited Text، من أفضل وأوثق الأنماط النصية لتخزين ونقل المعطيات الجدولية المعقدة، نظراً لأن رمز الجدولة الأفقي لا يتداخل عادة مع الكلمات أو الأرقام أو الفواصل العشرية. يتم استيراد هذه الملفات في SAS باستخدام المعلمة المباشرة DBMS=TAB. يقوم هذا الخيار بتهيئة المحرك البرمجي لتعريف علامة الجدولة (التي تقابل القيمة الست عشرية ’09’x في جداول الترميز) كمحدد حصري للفصل بين المتغيرات في السجلات المقروءة.
وفي بعض الحالات البرمجية الخاصة التي يُراد فيها استخدام DBMS=DLM لقراءة ملفات الجدولة، يمكن التصريح بوضوح عن المحدد داخل كتلة الإجراء باستخدام تعليمة التحديد DELIMITER=’09’x. تتفوق ملفات الجدولة على نظيراتها المفصولة بمسافات في قدرتها على استيعاب السلاسل النصية التي تحتوي على مسافات داخلية بين الكلمات (مثل الأسماء الثنائية أو العناوين الجغرافية) دون الحاجة لإحاطتها بعلامات اقتباس، حيث تحافظ الجدولة على استقلال كل عمود وتضمن عدم تقطيع النصوص إلى متغيرات عشوائية زائفة.
4.3 استيراد الملفات ذات المحددات المخصصة (Custom Delimiters)
تلجأ العديد من المؤسسات المتخصصة في إدارة البيانات إلى استخدام محددات مخصصة ونادرة الشيوع عند تصدير نصوصها الحساسة، وذلك تجنباً لأي تضارب محتمل مع محتويات النصوص الميدانية. ومن أشهر هذه المحددات استخدام الشريط العمودي Pipe (|)، أو النقطتين الرأسيتين (:)، أو علامة التلدة المتموجة (~). لقراءة هذه الأنماط الفريدة عبر إجراء الاستيراد السريع، يتم إسناد المعلمة DBMS=DLM إلى رأس الإجراء، ثم إلحاق تعليمة المحدد المخصص صراحة في السطر التالي عبر الصيغة: DELIMITER=’|’ أو الرمز المستهدف المحدد بعينه.
تمنح هذه الخاصية مرونة بنيوية هائلة لمعالجة التراكيب غير النمطية، حيث تستطيع التعامل مع السجلات التي تتضمن في ثناياها فواصل إنجليزية أو علامات جدولة كجزء أصيل من المتغيرات الوصفية، دون أن يختل اتساق الجدول الرقمي. ويضمن هذا التخصيص الدقيق استقرار قراءة السجلات السلوكية والطبية الموسعة التي تحوي ملاحظات سريرية أو جمل استجابة طويلة، مانعاً أي انقسام غير مرغوب فيه للحقول، مما يحفظ تكامل البيانات المستوردة ويطابقها حرفياً مع مصادرها الأصلية المعتمدة في الميدان التحليلي.
5. تطبيق عملي: استيراد ملف نصي مفصول بمسافات خطوة بخطوة
5.1 إعداد ملف البيانات النصي النموذجي وفحصه
لتطبيق هذه المفاهيم بصورة تجريبية وملموسة، نفترض وجود ملف نصي خام يحمل الاسم research_data.txt محفوظاً في المسار المحلي للخادم، ويحتوي على سجلات لمجموعة من المبحوثين في دراسة قياس سلوكي كمي. يشتمل الملف في سطره الأول على ترويسات الأعمدة، متبوعة بصفوف الملاحظات المفصولة بمسافات قياسية على النحو التالي:
ID Gender Age Score ReactionTime
101 M 23 88.5 450
102 F 29 92.0 412
103 F 31 79.5 520
104 M 22 84.0 488
105 F 35 95.5 390
قبل الشروع في كتابة الكود البرمجي، يتعين على المحلل فحص الملف بمحرر نصوص بسيط للتأكد من خلوه من الأسطر الفارغة الشاذة في النهاية، وضمان عدم وجود أسطر تعليقية غير منسقة. كذلك يتم التحقق من أن المتغيرات النصية (مثل Gender) خالية من الفراغات المدمجة، وأن الأرقام العشرية تستخدم النقطة كفاصل عشري معتمد وليس الفاصلة اللاتينية، لضمان عدم حدوث تضارب أثناء عملية الترجمة الرقمية التي سينفذها محرك الاستيراد فور تشغيله.
5.2 كتابة الشفرة البرمجية لاستيراد البيانات وتسميتها new_data
بمجرد التأكد من سلامة البنية الهيكلية للملف المصدري وتحديد موقعه الفيزيائي، نقوم بصياغة الشفرة البرمجية لإجراء PROC IMPORT لاستيراد هذه البيانات وإنشاء جدول جديد يحمل الاسم new_data في مكتبة العمل المؤقتة WORK. تُكتب الأوامر على النحو التالي:
PROC IMPORT DATAFILE=”/folders/myshortcuts/data/research_data.txt”
OUT=work.new_data
DBMS=DLM
REPLACE;
DELIMITER=’ ‘;
GETNAMES=YES;
RUN;
عند تنفيذ هذه الكتلة البرمجية، يرسل المحرك سلسلة من الأوامر الداخلية لقراءة الملف وتحليله سطر بسطر. يتوجب على المحلل هنا توجيه نظره فوراً إلى نافذة سجل التشغيل SAS Log؛ حيث يمثل هذا السجل وثيقة التحقق الجنائية الرقمية للعملية بأكملها. يُظهر السجل عدد السجلات التي تمت قراءتها، وعدد المتغيرات التي تم استخلاصها، ويؤكد إنشاء مجموعة البيانات WORK.NEW_DATA بنجاح، محذراً في حال ظهور أي رسائل باللون الأزرق (ملاحظات) أو الأصفر (تحذيرات) أو الأحمر (أخطاء صريحة) تسترعي التدخل البرمجي الفوري.
5.3 عرض وتحليل نتائج الاستيراد ومقارنتها بالملف المصدري
تتمثل الخطوة التقييمية الحيوية في مراجعة مخرجات الاستيراد ومطابقتها حرفياً مع الأصل النصي. بعد اكتمال التنفيذ دون أخطاء، يُفترض أن يضم جدول new_data خمس ملاحظات (ممثلة بالصفوف من 101 إلى 105) موزعة على خمسة متغيرات متمايزة. يجب التأكد من أن SAS قد صنف المتغيرين ID وGender تصنيفاً نصياً ملائماً إذا كانت الأرقام في الهوية لا تخضع لعمليات حسابية، أو أن ID قد تم التعرف عليه كمتغير رقمي تماشياً مع قيمه الظاهرة.
كذلك يُفحص المتغيران Score وReactionTime للتأكد من تحويلهما إلى متغيرات رقمية مستمرة يمكن استخدامها لاحقاً في إجراءات حساب المتوسطات الحسابية والانحرافات المعيارية ونماذج الانحدار. إذا لوحظ تحول المتغير Score إلى متغير نصي في مجموعة البيانات، فإن هذا يشير إلى احتواء السطر الأول أو أحد الصفوف على محرف نصي شاذ منع النظام من إدراك الطبيعة الرقمية للعمود، مما يبرز الأهمية البالغة للفحص اليدوي والمقارنة البصرية بين الملف الأصلي والجدول المستخرج قبل الانخراط في التحليلات الإحصائية المتقدمة.
6. استيراد ملفات نصية تفتقر لعناوين المتغيرات أو ذات هياكل خاصة
6.1 تطبيق GETNAMES=NO وإعادة تسمية المتغيرات لاحقاً
تواجه البيئات الأكاديمية والعملية بصورة متكررة ملفات نصية لا تشتمل على صف يمثل عناوين المتغيرات في مطلعها، بل تشرع في سرد السجلات الميدانية مباشرة من السطر الأول. يؤدي استخدام القيمة الافتراضية GETNAMES=YES في هذا السياق إلى كارثة منهجية؛ حيث سيقوم SAS باقتطاع السطر الأول من البيانات الحقيقية وتسمية الأعمدة بالقيم الملاحظة في ذلك السطر، مما يفقد المحلل جزءاً من عينة الدراسة ويشوه أسماء الأعمدة في آن واحد.
يتم تصحيح هذا السلوك بإسناد GETNAMES=NO في أمر الاستيراد، مما يجعل النظام يولد أسماء منهجية بديلة تبدأ من VAR1 وصولاً إلى المتغير الأخير. ولإعادة إكساب هذه المتغيرات دلالاتها العلمية، يُعقب إجراء الاستيراد بخطوة بيانات لاحقة أو استخدام إجراء PROC DATASETS لإعادة التسمية عبر تعليمة RENAME المباشرة:
DATA work.clean_data;
SET work.new_data;
RENAME VAR1=Participant_ID
VAR2=Intervention_Type
VAR3=Pre_Test_Score
VAR4=Post_Test_Score;
RUN;
تضمن هذه الاستراتيجية المزدوجة عدم ضياع أي ملاحظة من السجل الأول، مع استعادة الوضوح الدلالي والتوثيقي الكامل للبيانات تمهيداً لعرضها ومشاركتها في التقارير الرسمية.
6.2 تحديد نطاق الأسطر المستوردة وتخطي البيانات الوصفية
تحتوي الملفات النصية الناتجة عن الأجهزة المخبرية والمحطات المناخية غالباً على مقدمات ديباجية موسعة تسبق البيانات الفعلية، وتشتمل هذه المقدمات على معلومات وصفية Metadata مثل تاريخ المعايرة، واسم المهندس المسؤول، ومعلمات الأجهزة، وإصدارات البرمجيات التشغيلية. لا يمكن استيراد هذه الملفات من سطرها الأول لأن هذه الديباجة تكسر البنية المصفوفية الموحدة وتتسبب في إخفاق محرك الاستيراد فوراً.
يوفر SAS المعلمة المتقدمة DATAROW لحل هذه الإشكالية ببراعة؛ حيث تُحدد هذه المعلمة رقم السطر الفعلي الذي يجب على المحرك الانطلاق منه لقراءة الملاحظات. فإذا كانت الترويسات الوصفية تشغل الأسطر الأربعة الأولى وكانت أسماء الأعمدة تقع في السطر الخامس وتبدأ البيانات الفعلية في السطر السادس، يتم توظيف الخيارات التالية بدقة: GETNAMES=YES مع تعيين DATAROW=6. يتيح هذا الضبط لمحرك الاستيراد قفز وتجاوز النصوص الديباجية بالكامل، والتركيز الحصري على المصفوفة الإحصائية المراد تحليلها دون أدنى تشويش.
6.3 التعامل مع النصوص الطويلة والمتغيرات التي تحتوي على فواصل
من العيوب البنيوية الشائعة التي تواجه المحللين عند الاعتماد الكلي على استيراد PROC IMPORT للملفات النصية هو اقتطاع السلاسل النصية الطويلة. يعتمد محرك الاستيراد التلقائي افتراضياً على فحص عدد محدود من الأسطر الأولى (المحدد افتراضياً بعشرين سطراً في الإصدارات القياسية عبر المعلمة GUESSINGROWS) لتقدير الطول المناسب لكل عمود نصي. فإذا صادف النظام في الأسطر اللاحقة نصاً يتجاوز الطول المقدر، فإنه يقوم باقتطاعه دون هوادة، مما يترتب عليه ضياع نصوص حيوية كالإجابات المفتوحة في الاستبيانات النفسية أو أسماء التشخيصات الطبية المركبة.
تُعالج هذه الإشكالية بزيادة قيمة المعلمة GUESSINGROWS لتشمل مسح كافة أسطر الملف أو عينة ضخمة منه، بصياغة صريحة: GUESSINGROWS=MAX أو تحديد رقم ضخم مثل GUESSINGROWS=5000. علاوة على ذلك، في الحالات التي تتضمن فيها المتغيرات النصية فواصل داخلية شبيهة بمحدد الحقول المستخدم (كأن تحتوي الجملة على فواصل إنجليزية)، يجب التأكد من أن تلك النصوص محاطة بعلامات اقتباس مزدوجة في الملف المصدري، مع التأكد من أن محرك الاستيراد مفعل لقراءة الرموز المقتبسة ككتلة بيانات موحدة لحماية السجل من التمزق الأفقي وتشتت الأعمدة.
7. التحقق من جودة وصحة البيانات المستوردة ومعاينتها
7.1 معاينة السجلات المستوردة باستخدام إجراء PROC PRINT
لا تنتهي مهمة استيراد البيانات بمجرد خلو سجل التشغيل من رسائل الخطأ، بل تبدأ مرحلة جديدة من التدقيق النوعي عبر المعاينة البصرية للسجلات المستوردة. يمثل إجراء PROC PRINT الأداة القياسية الأبسط والأكثر فعالية لعرض محتويات مجموعة البيانات داخل نافذة المخرجات في SAS. ومع ذلك، في قواعد البيانات الكبيرة التي تضم مئات الآلاف من السجلات، يؤدي تشغيل هذا الإجراء دون قيود إلى استنزاف الذاكرة وجمود واجهة المستخدم أثناء توليد آلاف الصفحات غير الضرورية.
تقتضي الممارسة المهنية الرصينة استخدام خيار تقييد الملاحظات (OBS=n) لحصر المخرجات في عينة استطلاعية أولية محكومة. على سبيل المثال، يُمكّن الكود التالي المحلل من فحص أول عشر ملاحظات فقط للتحقق من انتظام القيم في مواضعها الصحيحة ومواءمتها مع أعمدتها المستهدفة:
PROC PRINT DATA=work.new_data (OBS=10);
VAR Participant_ID Intervention_Type Pre_Test_Score Post_Test_Score;
RUN;
تسمح هذه المعاينة الموجهة بالتأكد التام من عدم وجود إزاحة أفقية طالت البيانات، ومن بقاء المتغيرات المعنية ضمن نطاقاتها المنطقية المتوقعة.
7.2 فحص بنية الجدول والسمات عبر إجراء PROC CONTENTS
يُعد إجراء PROC CONTENTS الأداة المحورية المتخصصة في كشف القاموس الوصفي والميتا داتا الداخلية لمجموعات البيانات في SAS. يوفر هذا الإجراء تقريراً تفصيلياً يوضح الخصائص الهيكلية الكاملة للمصفوفة المستوردة، بما في ذلك إجمالي عدد الملاحظات، وإجمالي عدد المتغيرات، وتاريخ الإنشاء، ونظام الترميز المستخدم، والأهم من ذلك: تحديد نوع كل متغير (سواء كان Numeric أو Character) وطوله التخزيني بالبايت.
تكمن الأهمية التحليلية لهذا الإجراء في رصد الأخطاء الدقيقة في تصنيف المتغيرات؛ فكثيراً ما يتسبب وجود رمز نصي غريب في حقل رقمي في تحويل المتغير بأكمله من رقمي إلى نصي بواسطة محرك الاستيراد التلقائي. يُظهر PROC CONTENTS هذا الخلل فوراً، مما يمنع الباحث من المضي قدماً في محاولات فاشلة لإجراء عمليات رياضية على أعمدة يقرؤها النظام كنصوص، متيحاً له التدخل المسبق لتصحيح التنسيقات وتعيين أدوات الإدخال والعرض الملائمة.
7.3 الكشف عن القيم المفقودة والشاذة الناتجة عن عملية الاستيراد
تتضمن المرحلة الثالثة من تقييم جودة الاستيراد الاستعانة بالإجراءات الإحصائية الوصفية للكشف عن مواضع الخلل الناتجة عن عمليات القراءة المشوهة. يبرز هنا استخدام إجراء PROC MEANS للمتغيرات الكمية؛ حيث يُظهر مؤشرات النزعة المركزية والقيم الصغرى والعظمى وعدد الملاحظات الصالحة وعدد القيم المفقودة. إذا ظهرت القيمة الصغرى لمتغير العمر رقماً سالباً، أو جاءت القيمة العظمى لمعدل النبض بالآلاف، فإن هذا يمثل مؤشراً قاطعاً على انزياح الأعمدة وتداخل المتغيرات أثناء الاستيراد.
وبالمثل، يتيح استخدام إجراء PROC FREQ للمتغيرات النوعية والتصنيفية فحص جداول التكرارات ونسب الشيوع. يسهم هذا الفحص في الكشف عن القيم الشاذة، مثل ظهور تصنيف غير معروف للمتغير الجنس (كأن يظهر رقم بدلاً من الحرف)، أو ظهور فئات فارغة متعددة، مما يُمكّن المحلل من التمييز الدقيق بين القيم المفقودة نظامياً في الملف الأصلي، وتلك التي تولدت نتيجة عجز معالج الاستيراد عن قراءة بعض الأنماط المحرفية غير القياسية.
8. البديل المتقدم: استيراد الملفات النصية عبر خطوة البيانات DATA STEP
8.1 استخدام عبارة INFILE للتحكم الكامل في قراءة الملفات
تمثل خطوة البيانات الموجهة عبر تعليمات INFILE وINPUT المعيار الذهبي المطلق للتعامل مع البيانات المعقدة والتي تتطلب درجة فائقة من التكرارية العلمية والتحكم البرمجي الحتمي الصارم. يعود تاريخ هذه الآلية إلى بدايات تطوير نظام SAS في سبعينيات القرن العشرين، وهي تتفوق على إجراء PROC IMPORT في كونها لا تعتمد على التخمين، بل تنفذ الأوامر الهيكلية المكتوبة بدقة متناهية. تبدأ هذه الخطوة بفتح تدفق القراءة عبر عبارة INFILE التي تحدد المسار الفيزيائي للملف وخيارات المعالجة المتقدمة المرتبطة به.
من الخيارات البنيوية الجوهرية في عبارة INFILE نجد الخيار DSD (المعروف بـ Delimiter Sensitive Data)؛ وتكمن عبقرية هذا الخيار في ثلاثة أدوار رئيسية: أولاً، تعيين الفاصلة كمحدد افتراضي ما لم يُحدد غيرها. ثانياً، التعامل مع المحددين المتتاليين على أن بينهما قيمة مفقودة بدلاً من دمجهما، وهو ما يقضي على مشكلة إزاحة البيانات نهائياً. ثالثاً، التجريد التلقائي لعلامات الاقتباس المحيطة بالنصوص دون تخزينها ضمن البيانات. ويتكامل هذا الخيار مع تعليمة TRUNCOVER الحيوية، والتي تمنع مؤشر القراءة من القفز التلقائي إلى السطر التالي عندما يكون السجل الحالي أقصر من عدد المتغيرات المطلوبة، مما يحمي الملفات غير المتجانسة من الانهيار التتابعي.
8.2 تحديد خصائص الأعمدة بدقة بواسطة عبارة INPUT
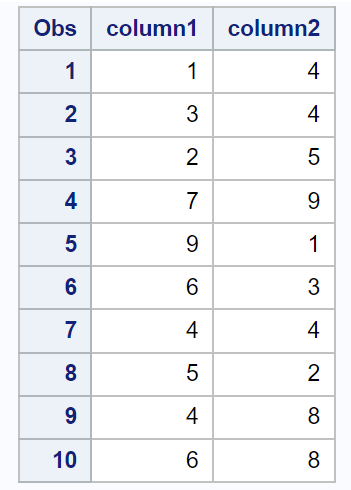
تتولى عبارة INPUT الوظيفة التشغيلية لتوزيع التدفقات النصية القادمة من السطر المفتوح عبر INFILE على المتغيرات المستهدفة وفق الترتيب والأنواع المصرح عنها برمجياً. يوفر نظام SAS ثلاثة أنماط رئيسية للإدخال عبر هذه العبارة: الإدخال الحر المعتمد على القوائم List Input، والإدخال المعتمد على الأعمدة الثابتة Column Input، والإدخال المنسق Formatted Input.
يعد الإدخال المنسق الأقوى والأشمل؛ حيث يتيح للمحلل تطبيق أدوات الإدخال المتخصصة Informats لقراءة التواريخ المعقدة، والعملات المحتوية على رموز خاصة، والأرقام ذات الفواصل العشرية المتغيرة، والنصوص الطويلة ذات الأبعاد الثابتة، كما يظهر في النموذج البرمجي التالي:
DATA work.master_survey;
INFILE ‘/data/survey_raw.txt’ DLM=’,’ DSD TRUNCOVER LRECL=32767 FIRSTOBS=2;
LENGTH Subject_Code $12 Full_Name$40 Clinical_Group $15;
INPUT Subject_Code $
Full_Name $
Enrollment_Date : MMDDYY10.
Clinical_Group $
Baseline_Score : COMMA8.2
Followup_Score : COMMA8.2;
RUN;
يوفر استخدام تعليمة LENGTH استقراراً حاسوبياً يمنع الاقتطاع الافتراضي للسلاسل النصية، بينما يضمن استخدام النقطتين الرأسيتين (:) في الإدخال المنسق تطبيق التنسيق المتخصص مع الحفاظ على مرونة القراءة المعتمدة على المحددات دون التقيد الحرفي بعرض الحقل.
8.3 مقارنة منهجية: متى نستخدم PROC IMPORT ومتى نلجأ إلى DATA STEP؟
تقوم المفاضلة العلمية والمنهجية بين الخيارين على موازنة دقيقة بين اقتصاديات الوقت ومتطلبات الدقة الحاسوبية. يناسب إجراء PROC IMPORT الملفات النصية المرجعية النظيفة ذات البنية المتناغمة والترويسات المنظمة، حيث يحقق توفيراً ملموساً في زمن الكتابة البرمجية والتطوير السريع للاستعلامات المبدئية. إنه الأداة المثلى في مراحل الاستكشاف الأولي والتنقيب السريع عن المعطيات العامة ذات التنسيقات الموثوقة.
في المقابل، تمثل خطوة البيانات DATA Step الخيار الإلزامي والوحيد في البيئات الأكاديمية والطبية الصارمة والتعاملات البنكية الكبرى، حيث لا مجال لهوامش الخطأ الناتجة عن تخمين البرمجيات. تُظهر خطوة البيانات تفوقاً كاسحاً عند التعامل مع ملفات ضخمة تتجاوز ملايين الأسطر، إذ تتيح تخصيص حجوم المتغيرات بدقة، مما يوفر غيغابايتات من مساحة الذاكرة التخزينية. كما أنها لا غنى عنها في معالجة الملفات الهجينة التي تحتوي على أسطر ذات هياكل متباينة، أو تلك التي تدمج تواريخ وتنسيقات غير نمطية تعجز الخوارزميات الآلية عن معالجتها بنجاح.
9. استكشاف الأخطاء الشائعة ومعالجتها أثناء استيراد الملفات النصية
9.1 معالجة خطأ فشل العثور على الملف (File Does Not Exist)
يعد الخطأ “ERROR: Physical file does not exist” أكثر الأخطاء تواتراً عند المبتدئين والمحترفين على حد سواء في بيئة SAS. يعود هذا الخطأ في جوهره إلى إخفاق النظام في الاستدلال على المسار الفيزيائي المحدد في عبارة DATAFILE أو INFILE. وتتمثل الخطوة التحليلية الأولى لعلاجه في فحص كتابة المسار بالكامل، والتأكد من عدم وجود مسافات خفية أو إزاحة في كتابة أسماء المجلدات، مع التذكير الصارم بحساسية حالة الأحرف في أنظمة Linux وخوادم الحوسبة السحابية.
سبب آخر بالغ الشهرة هو الامتداد المزدوج أو المخفي للملفات في بيئات Windows؛ حيث قد يقوم نظام التشغيل بإخفاء الامتداد الافتراضي للملفات المعروفة، فيظهر الملف للمستخدم باسم data.txt بينما اسمه الحقيقي والفيزيائي المسجل في النظام هو data.txt.txt. يؤدي استدعاء المسار الظاهري حينها إلى خطأ مباشر. يُعالج هذا بمراجعة خصائص الملف الحقيقية أو إظهار الامتدادات في خيارات النظام، والتأكد من مطابقة أذونات الوصول وقراءة المجلد المشترك عبر صلاحيات المستخدم التشغيلية.
9.2 حل مشكلات إزاحة الأعمدة واختلاط البيانات (Column Shifting)
تحدث ظاهرة إزاحة الأعمدة Column Shifting عندما يتطابق جزء من البيانات النصية في سطر معين مع المحدد الفاصل المعتمد، أو عند وجود حقول مفقودة دون ترميز دقيق في ملف مفصول بمسافات. في هذه الحالة، ينزاح محتوى العمود الثالث إلى الرابع، والرابع إلى الخامس، مما يخلق تلوثاً شاملاً في قاعدة البيانات. يُكشف هذا الخلل عبر ظهور قيم نصية داخل أعمدة رقمية، مما يجعل SAS يُطلق تحذيرات صريحة في سجل التشغيل مفادها: “NOTE: Invalid data for variable…”.
يكمن الحل المنهجي لهذه المعضلة في الانتقال من القراءة البسيطة إلى استخدام خطوة البيانات المزودة بخياري DSD وTRUNCOVER، أو استخدام الفواصل النادرة (كالأنبوب |) في مرحلة التصدير الأصلية. كما يتعين فحص النصوص الوصفية للتأكد من أنها محاطة بأقواس اقتباس مزدوجة، والتحقق من عدم وجود نهايات أسطر مخفية (مثل Carriage Return المستخدم في دوس) مدمجة في منتصف النصوص، والتي تؤدي إلى كسر السجل إلى سطرين منفصلين وتشويه المحاذاة المصفوفية.
9.3 معالجة أخطاء تعيين أنواع البيانات واقتطاع النصوص (Truncation)
تبرز أزمة اقتطاع النصوص Truncation وأخطاء تعيين الأنواع عندما يعتمد PROC IMPORT على عينة صغيرة لتخمين البنية. إذا كانت أول عشرين ملاحظة لعمود الملاحظات السريرية قصيرة (مثلاً 15 حرفاً)، فسيقوم الإجراء بحجز متغير نصي بطول 15 بايت فقط ($15). وعندما يواجه في السطر الحادي والعشرين ملاحظة طولها 100 حرف، فإنه يقتطع الحروف الزائدة بلا رجعة، مسقطاً بيانات تشخيصية ثمينة دون تنبيه صريح.
تُعالج هذه الإشكالية داخل PROC IMPORT بزيادة عمق التخمين عبر الأمر GUESSINGROWS=MAX؛ حيث يُجبر النظام على قراءة وفحص كل أسطر الملف قبل البت في تحديد أطوال الأعمدة، على الرغم من أن هذا قد يستغرق وقتاً أطول في الملفات المليونية. أو يتم اللجوء إلى خطوة البيانات DATA Step وتحديد الطول المسبق للمتغير صراحة عبر تعليمة LENGTH (مثلاً LENGTH Clinical_Notes $500;)، مما ينهي المشكلة جذرياً ويمنح المتغير الحجم التخزيني الكافي لاستيعاب كافة السجلات مهما بلغت أطوالها.
10. أفضل الممارسات الأكاديمية والمهنية لإدارة استيراد البيانات في SAS
10.1 توثيق عمليات الاستيراد وضمان قابلية إعادة الإنتاج البحثي
تشترط النزاهة المنهجية والأمانة العلمية في المؤسسات الأكاديمية والمراكز البحثية والدوائية خضوع كافة عمليات استيراد البيانات لقواعد توثيق مشددة تضمن قابلية إعادة الإنتاج Reproducibility. يتطلب هذا عدم الاكتفاء بالاستيراد التفاعلي عبر الواجهات البصرية المؤقتة، بل صياغة سكربتات برمجية واضحة ومكتملة، وتضمين تعليقات توضيحية Comments تشرح بالتفصيل مصدر الملف النصي، والترميز المعتمد، والغرض من استخدام خيارات معينة كـ DSD أو TRUNCOVER.
تقتضي الإدارة الرشيدة للبيانات الاحتفاظ بالملفات النصية الخام في مجلدات للقراءة فقط Read-Only وتجميدها كنسخ أرشيفية غير قابلة للتعديل أو الكتابة، وتوثيق بصمة التجزئة الرقمية Hash Checksum لهذه الملفات للتأكد من عدم العبث بها عبر الزمن. كما يُنصح بتسجيل تاريخ وساعة وتفاصيل بيئة التشغيل كجزء من الميتا داتا المضمنة داخل مكتبات SAS، مما يتيح لأي باحث أو مراجع تدقيق خارجي إعادة تشغيل خط الإنتاج البرمجي والحصول على نتائج مطابقة بنسبة مائة بالمائة.
10.2 تحسين الأداء البرمجي عند التعامل مع ملفات نصية ضخمة
يفرض التعامل مع البيانات الضخمة Big Data في الملفات النصية، والتي قد تصل أحجامها لعشرات الغيغابايتات، تطبيق استراتيجيات متقدمة لإدارة موارد الذاكرة والمعالجات. عند استيراد هذه الملفات عبر خطوة البيانات، يُنصح بتفعيل خيارات الضغط المناسبة على جداول SAS الناتجة عبر تعليمة COMPRESS=YES أو COMPRESS=CHAR، مما يقلص حجم الملفات المخزنة على القرص الصلب بنسب تتجاوز أحياناً 70%، ويسرع عمليات القراءة اللاحقة بتقليل الإدخال والإخراج المادي I/O.
يتعين كذلك تجنب إهدار الذاكرة بتخصيص أطوال مفرطة للمتغيرات، بل ضبط المتغيرات الرقمية والنصية بأقصر طول كافٍ لأداء الغرض. وتقتضي الحكمة البرمجية تنظيف مكتبة العمل المؤقتة WORK بصورة دورية، واستخدام تعليمة PROC DATASETS وحذف الجداول المرحلية والمؤقتة فور الانتهاء من استخدامها لتفريغ مساحات التخزين العشوائي للجلسة. كما يتيح إنشاء الفهارس Indexes على المتغيرات المفتاحية المستوردة تسريع الاستعلامات وعمليات الدمج والربط المستقبلية بشكل استثنائي.
10.3 بناء سيناريوهات أتمتة لاستيراد ملفات نصية متعددة دورياً
تتطلب البيئات الإنتاجية والمختبرات الحيوية استيراد تدفقات يومية أو شهرية من عشرات الملفات النصية المتشابهة في البنية والموزعة عبر مجلدات مختلفة. لا يمكن هنا الاعتماد على كتابة كود مكرر لكل ملف على حدة، بل يتم بناء سيناريوهات أتمتة متطورة تعتمد على لغة ماكرو ساس SAS Macro Language؛ حيث يتم تصميم دالة ماكرو تأخذ اسم الملف أو مساره كمعامل متغير، وتنفذ إجراء الاستيراد بصورة ديناميكية متسلسلة.
يمكن دمج هذا السيناريو مع أدوات قراءة أدلة المجلدات عبر محرك الأنابيب المتقدم FILENAME PIPE لقراءة أسماء كافة الملفات النصية الموجودة في مجلد معين، وتشغيل حلقة تكرارية آلية تستورد كل ملف وتدمجه تلقائياً مع الجدول المجمع النهائي باستخدام عبارة SET. ويُختتم هذا التدفق بإنشاء تقارير تدقيق آلية Audit Reports تقارن عدد السجلات المجمعة بإجمالي السجلات المكتوبة في الملفات النصية، مما يؤسس لمنظومة متكاملة لإدارة البيانات تعمل بأعلى درجات الكفاءة والموثوقية المؤسسية.
خاتمة
يُمثل استيراد الملفات النصية إلى بيئة SAS جسر العبور الإلزامي بين عالم البيانات الأولية المشتتة ومجال التحليل الإحصائي والاستكشاف المعرفي الدقيق. وقد أوضح هذا الدليل الشامل الفروق الهيكلية والوظيفية بين المسار المؤتمت السريع المتمثل في PROC IMPORT والمسار الحتمي المتحكم به المتمثل في خطوة البيانات DATA Step مع عبارتي INFILE وINPUT. إن الاختيار الرصين بين هذين المسارين لا ينبغي أن يخضع للصدفة أو الاستسهال البرمجي، بل يقوم على قراءة واعية لخصائص البيانات، وأحجام الملفات، وطبيعة المحددات، ومدى الحاجة إلى المعالجة المعقدة للقيم المفقودة والتنسيقات الزمنية والنصية الخاصة.
تتكامل قوة الأدوات البرمجية داخل نظام SAS مع التزام المحلل بأفضل الممارسات المنهجية، بدءاً من المعاينة البصرية والتحقق من الميتا داتا عبر إجراءي PROC PRINT وPROC CONTENTS، وصولاً إلى ضبط خيارات القراءة المتقدمة كـ DSD وTRUNCOVER وGUESSINGROWS لمنع أخطاء الإزاحة والاقتطاع. إن إتقان هذه المهارات البرمجية لا يضمن فقط سلامة الجداول الإحصائية ونقاء نتائجها من الانحرافات التشغيلية، بل يُرسخ المعايير الأكاديمية والمهنية الصارمة لقابلية إعادة الإنتاج والنزاهة العلمية في كافة المشروعات التحليلية والبحثية المتقدمة.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A user’s guide to SAS 76. SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 statements: Reference. SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). Base SAS 9.4 procedures guide (7th ed.). SAS Institute Inc. https://documentation.sas.com