
تُعد معالجة البيانات وتنقيحها إحدى الركائز الجوهرية في علوم البيانات، والتحليل المالي، والبحوث الإحصائية الميدانية. وفي بيئة الأعمال المعاصرة والبحث الأكاديمي، تمثل الجداول الممتدة عبر برنامج مايكروسوفت إكسيل (Microsoft Excel) الوسيط الأكثر شيوعاً لإدخال السجلات وتخزينها بصورة أولية. ومع تنامي حجم مجموعات البيانات الرقمية وتعدد مصادر الجمع، تتزايد احتمالية تسلل الشوائب والمدخلات المتماثلة، مما يجعل إدارة التكرارات مسألة منهجية حرجة ترتبط ارتباطاً وثيقاً بموثوقية النتائج المستخلصة وسلامة القرارات المؤسسية.
وعلى النقيض من النظرة التقليدية السائدة التي تحصر التعامل مع البيانات المكررة في “الحذف المباشر” بهدف تنظيف الجداول، فإن هناك مسارات تحليلية ورقابية بالغة الأهمية تستوجب عكس هذا الإجراء تماماً، بحيث يكون الهدف هو “الاحتفاظ الحصري بالقيم المكررة” واستبعاد السجلات الفريدة. تنبع هذه الحاجة من ضرورات التدقيق المالي الجنائي لكشف تكرار الفواتير، وفحص قواعد البيانات السلوكية والمسحية للتعرف على تكرار تسجيل المستجيبين، ومطابقة الأرصدة المخزنية، ومراقبة الجودة التشغيلية. إن السجل المتكرر في مثل هذه السياقات لا يمثل مجرد خطأ تقني، بل يشكل مؤشراً تحليلياً يحمل دلالات ينبغي عزلها ودراستها باستفاضة منهجية مستقلة.
يتناول هذا الدليل الشامل الأبعاد النظرية والتطبيقية المتقدمة لعملية استخلاص السجلات المكررة وحفظها فقط في مايكروسوفت إكسيل. وسنستعرض بالتفصيل المنطق الرياضي الكامن خلف دوال العد الشرطي، والتحول التقني الحديث نحو استخدام المصفوفات الديناميكية ودالة التصفية الحسابية، مروراً بأدوات الفرز البصري والتنسيق الشرطي، وانتهاءً بأتمتة الاستخراج عبر محرر الاستعلامات المتقدم (Power Query). ويهدف هذا الطرح الأكاديمي إلى تسليح الباحث والمحلل بالآليات الدقيقة التي تضمن استخراج التكرارات دون المساس بسلامة البيانات الأصلية، مع الحفاظ على المعايير الصارمة لحوكمة ونزاهة المعلومات المجدولة.
1. المفاهيم النظرية لإدارة البيانات المكررة في بيئة مايكروسوفت إكسيل
1.1 تعريف القيم المكررة في النماذج الإحصائية والجداول المجدولة
في فضاء المعالجة الجدولية والنماذج الإحصائية، يُعرَّف التكرار بأنه حدوث تطابق في الخصائص أو القيم المدخلة عبر سجلين أو أكثر ضمن النطاق المرجعي ذاته. وينقسم هذا المفهوم بنيوياً إلى تكرار مطلق (Absolute Duplicate) وتكرار نسبي أو جزئي (Relative/Partial Duplicate). يشير التكرار المطلق إلى تطابق جميع الحقول والمتغيرات في الصف عبر أعمدة الجدول كافة، وهو ما يمثل ازدواجاً كاملاً للكيان الموصوف. أما التكرار النسبي، فيعبر عن تشابه البيانات في سمة محددة أو مجموعة محددة من الأعمدة—مثل رقم الهوية الوطنية، أو الرقم التعريفي للعميل، أو الرمز الشريطي للمنتج—مع اختلاف محتمل في سائر الحقول الأخرى، كالطابع الزمني أو القيمة المالية المقترنة بالسجل.
من الناحية الإحصائية، يؤدي وجود التكرار غير المنضبط إلى إحداث تشوهات جوهرية في مؤشرات النزعة المركزية والتشتت؛ إذ يؤدي إلى تضخيم غير حقيقي لحجم العينة، وتزييف دلالة التوزيعات التكرارية، وتقليص التباين الظاهري، مما يترتب عليه انحياز منهجي في تقديرات الانحدار واختبارات الفروق. غير أن الأبحاث المعاصرة المتخصصة في ضبط جودة البيانات تؤكد أن التكرار بحد ذاته لا يُعد عيباً بنيوياً في جميع السياقات، بل قد يكون الظاهرة المستهدفة بالدراسة والتحليل الإحصائي، مثل قياس معدل تكرار الشراء، أو رصد تكرار الأخطاء التشغيلية في خطوط الإنتاج، مما يستدعي الاحتفاظ الحصري بتلك القيم المكررة لفهم أسباب تكرارها.
وتتجلى دواعي الاحتفاظ الحصري بالقيم المكررة في الدراسات المسحية والأكاديمية، لا سيما في علوم السلوك والمسوح النفسية والاجتماعية الرقمية؛ إذ تتطلب بروتوكولات الفحص المنهجي (Data Screening and Hygiene) تنقية السجلات لعزل المشاركات المتعددة القادمة من ذات المستجيب، والتي يمكن الاستدلال عليها عبر تطابق معرّفات المشاركة الرقمية أو العناوين البريدية أو البصمات الإلكترونية. ويعد عزل هذه السجلات المكررة خطوة منهجية أولية ملزمة قبل الشروع في حساب معاملات الاتساق الداخلي والموثوقية القياسية، لضمان عدم تكرار استجابات العينة الواحدة كما يناقش ذلك المتخصصون في منهجيات القياس والتقييم التشخيصي (Youngstrom, 2013).
1.2 الفرق بين تنقية البيانات لحذف التكرار واستخلاصه لأغراض التدقيق
تعتمد النظم التقليدية لإدارة البيانات خوارزميات صُممت في الأصل لتقليص حجم الملفات والتخلص من الفائض البياني، ومن أمثلة ذلك أداة “إزالة التكرارات” (Remove Duplicates) الراسخة في شريط أدوات مايكروسوفت إكسيل. وتستند هذه الأداة إلى آلية تدميرية تقوم على الإبقاء على الظهور الأول للسجل وتدمير كافة مرات الظهور اللاحقة بشكل نهائي من ورقة العمل. وبالرغم من كفاءة هذه الطريقة في تنظيف القوائم البريدية أو بناء القوائم المرجعية الفريدة، إلا أنها تشكل عائقاً جسيماً في سياقات التدقيق الداخلي والفحص الجنائي والتحليل المتقدم؛ لأنها تطمس أدلة الازدواجية وتمنع المحلل من فحص السياق الكامل للظهور المتكرر.
وعلى النقيض من ذلك، تركز استراتيجيات التدقيق الداخلي على استخلاص التكرارات وعزلها في مصفوفة مستقلة دون الإضرار بالنطاق الأصلي؛ إذ إن تكرار قيمة مالية معينة مقترنة بذات رقم المورد وتاريخ الفاتورة قد يشير إلى صرف مالي مزدوج غير مشروع أو خطأ جسيم في نظام المدفوعات. وبدلاً من إخفاء هذه الواقعة عبر الحذف، يتطلب مسار التدقيق استخلاص كافة الصفوف المتماثلة لدراستها ومقارنتها عبر الزمن. يتيح هذا النهج التحليلي تتبع الأنماط السلوكية الشاذة واكتشاف الثغرات الإجرائية داخل المؤسسات.
وبناءً عليه، يكمن التباين الجوهري بين التصفية التدميرية والتصفية التحليلية في المقصد والمنهجية؛ فالأولى تهدف إلى تحسين المظهر الخارجي لقاعدة البيانات وتوحيد مفاتيحها، في حين تسعى الثانية إلى تفكيك البنية التكرارية للبيانات لاستكشاف التشابهات، وقياس الارتباطات الخفية بين المدخلات، وتوفير سجل تدقيق موثق (Audit Trail) يبرهن على سلامة النتائج وموثوقية مخرجات المعالجة.
2. الأساس الرياضي والمنطقي لدالة العد الشرطي COUNTIF
2.1 التركيب البنائي لمعادلة COUNTIF وآلية عملها
تستند عملية عزل القيم المكررة في برمجية إكسيل بصورة جوهرية إلى النمذجة الرياضية للعد التكراري؛ حيث تبرز دالة العد الشرطي البسيطة COUNTIF كأداة مركزية لا غنى عنها في تحديد وتيرة ظهور المفردة ضمن فضاء عيني محدد. تتألف هذه الدالة رياضياً وبرمجياً من معاملين إجباريين: النطاق المرجعي (Range)، والمعيار المنطقي (Criteria). ويُكتب تركيبها البنائي القياسي بالصيغة الآتية: =COUNTIF(range, criteria)، حيث يمثل النطاق مصفوفة الخلايا المفحوصة، بينما يمثل المعيار القيمة أو التعبير الشرطي المراد احتساب وتيرة ظهوره داخل هذا النطاق.
تعتمد سلامة تطبيق هذه الدالة في استخراج التكرارات على الفهم الدقيق لآلية المراجع الخلوية؛ فلكي يتم مسح الجدول بأكمله بصورة متوازنة دون تشويه لنطاق التقييم، يتحتم على المحلل استخدام المراجع المطلقة (Absolute References) بتثبيت إحداثيات النطاق باستخدام علامة الدولار ($)، كأن يُكتب النطاق بالشكل $A$2:$A$100، بينما يُترك المعيار في صيغة مرجع نسبي (Relative Reference) مثل A2. تتيح هذه الصياغة سحب المعادلة عبر الصفوف المتتالية، مما يضمن ثبات النطاق المرجعي الشامل ومقارنة كل صف على حدة في مواجهة النطاق بأكمله بالتساوي.
من الناحية المنطقية، تتعامل الدالة مع السلاسل النصية والأرقام والتواريخ بنمط مرن؛ غير أن إحدى الخصائص البنيوية الحاكمة في بيئة إكسيل هي أن دالة COUNTIF لا تميز بين الحروف الكبيرة والحروف الصغيرة في النصوص اللاتينية (Case-Insensitive). وبالتالي، فإن القيمة “Test” والقيمة “test” ستعدان متطابقتين تماماً وسينتج عن عدهما تراكم عددي مشترك. يتعين استيعاب هذا السلوك الرياضي لضمان عدم إطلاق أحكام مضللة على التماثل النصي دون تدقيق مسبق لحالة البيانات.
2.2 بناء العبارة المنطقية لتوليد القيم البولينية (TRUE/FALSE)
لتحويل مخرجات العد العددي البحت إلى قرارات آلية تقبل الفرز والتحليل، يلزم إلحاق دالة العد بمشغل مقارنة منطقي يختبر فرضية التكرار. رياضياً، يُعد أي عنصر متكرراً إذا تجاوزت وتيرة ظهوره ضمن المجموعة المرجعية الحد الأدنى المتمثل في المرة الواحدة؛ وعليه، فإن الشرط المنطقي الفاصل هو: أن يكون التكرار أكبر قطيعاً من واحد ($f > 1$). وتُصاغ العبارة الرياضية المنطقية في إكسيل على النحو التالي: =COUNTIF($A$2:$A$100, A2) > 1.
ينقل هذا التعبير الحسابي المخرجات من النمط العددي الصحيح (1، 2، 3…) إلى الفضاء البوليني الثنائي؛ حيث تُنتج الخلية القيمة الصوابية (TRUE) إذا كان العنصر المقابل متكرراً في النطاق مرتين أو أكثر، في حين تُنتج القيمة الخاطئة (FALSE) إذا كان العنصر يمثل قيمة فريدة ظهرت مرة واحدة فقط. يوفر هذا التحويل المنطقي أساساً صارماً يمكن ربطه مباشرة بأدوات التصفية والدوال المصفوفية التي لا تقبل إلا الوسائط البولينية لإجراء عمليات العزل والتضمين.
تتميز هذه المقارنة المنطقية بالكفاءة الحسابية العالية عند التعامل مع مجموعات البيانات المتناسقة؛ إذ يقوم المعالج الرياضي لبرنامج إكسيل بتقييم التعبير اللوجستي بسرعة فائقة داخل الذاكرة العشوائية. ومع ذلك، ينبغي الانتباه إلى أن تعقيد وقت التشغيل لهذه الصيغة عندما تُسحب على مصفوفة كاملة يتبع النمط التربيعي $O(n^2)$، نظراً لأن كل عنصر يخضع لعملية مسح كاملة للنطاق المرجعي بأكمله، وهو ما يستدعي الحذر عند تطبيقها على جداول ضخمة تحوي مئات الآلاف من السجلات.
3. التطبيق الإجرائي للخطوة الأولى: تحديد السجلات المتكررة
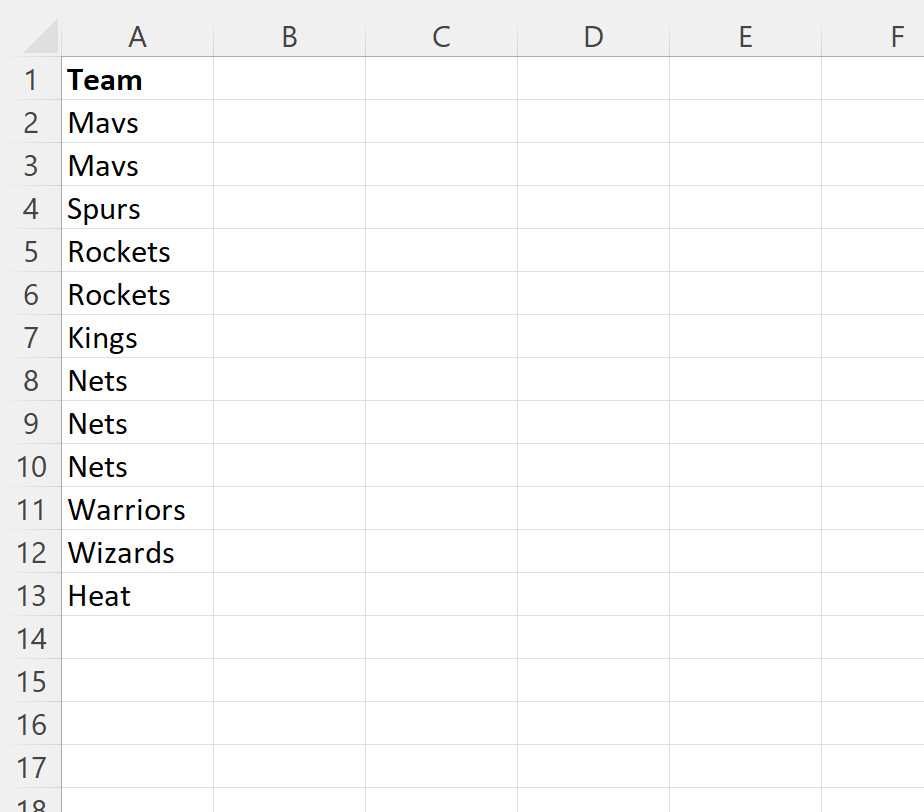
3.1 إعداد جدول البيانات وتجهيز العمود المساعد للاختبار
تبدأ الممارسة الميدانية لعزل البيانات المكررة بتنظيم وتجهيز فضاء العمل لضمان الدقة التحليلية ومنع المخرجات المضللة الناتجة عن عيوب الإدخال. تشمل مرحلة التهيئة تنظيف البيانات من المسافات الزائدة الخفية التي قد تكون ملحقة ببدايات النصوص أو نهاياتها، وضبط التنسيق العام للأعمدة للتأكد من معاملة الحقول العددية ذات الصلة بالشفرات التعريفية (مثل أرقام الحسابات) بنمط موحد لا يقبل التداخل الشكلي بين التخزين الرقمي والنصي.
عقب إتمام الفحص الأولي للجدول، يُدرج عمود جديد ملاصق لنطاق البيانات ويُطلق عليه مسمى منهجي واضح، مثل “حالة_التكرار” أو “مؤشر_التكرار_البوليني” (Duplicate_Flag). يُعد إنشاء العمود المساعد خطوة توثيقية كلاسيكية فائقة الأهمية في هندسة النماذج التحليلية؛ إذ يتيح تفكيك العمليات الحسابية المعقدة إلى مراحل جزئية قابلة للمراجعة والتدقيق والتحقق المستقل من قِبل أي مراجع خارجي دون المساس بهيكل البيانات الخام الأصلية.
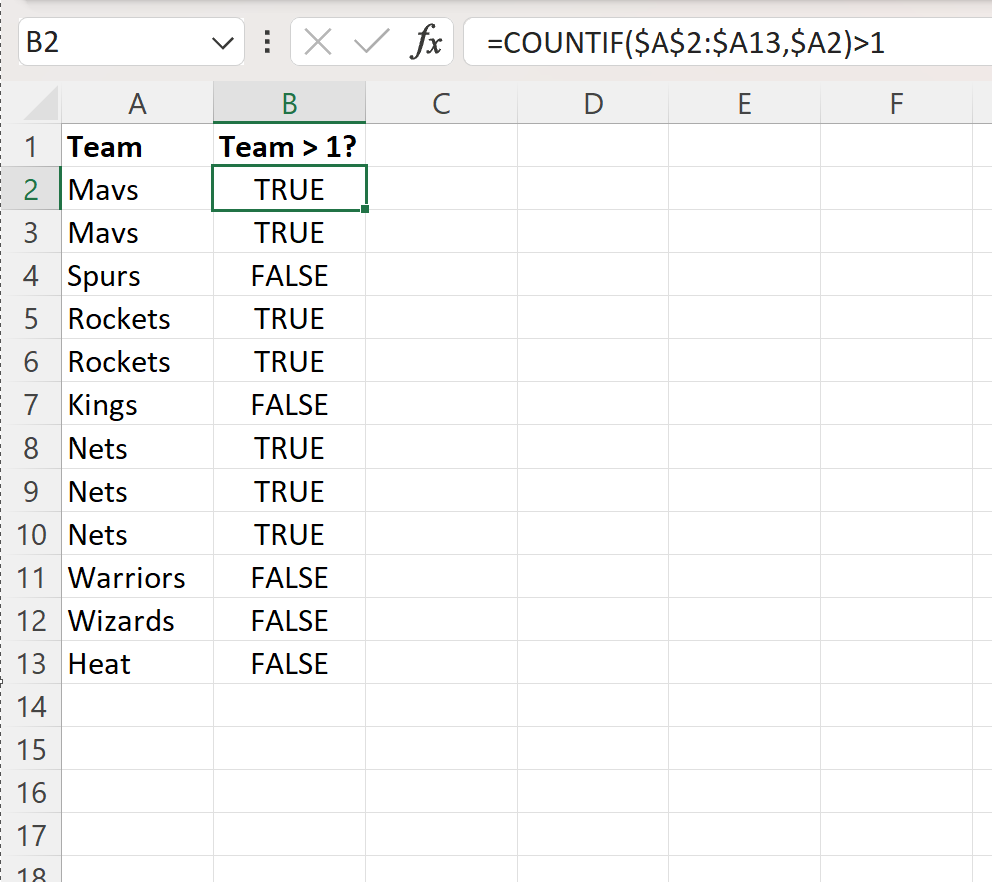
يُطبق في الخلية الأولى من هذا العمود المساعد التعبير المنطقي المتفق عليه، مع العناية الفائقة بتثبيت حدود النطاق الرأسي لضمان اتساق المقارنة لكافة الصفوف. فإذا كانت البيانات المبحوثة تقع في العمود A ابتداءً من الصف 2 وحتى الصف 50، فإن المعادلة الواجب إدخالها في الخلية B2 تكون:
=COUNTIF($A$2:$A$50, A2) > 1
ثم تُعمم هذه الصيغة على امتداد الجدول عبر السحب أو النقر المزدوج على مقبض التعبئة، ليتم ملء العمود المساعد بمخرجات الفحص المنطقي.
3.2 تحليل ومراجعة المخرجات البولينية الناتجة
بمجرد انتشار الصيغة عبر كافة صفوف العمود المساعد، تتشكل مصفوفة ثنائية القيمة تتطلب القراءة النقدية والفحص البصري للتأكد من سلامة منطق التطبيق. تدل القيمة (TRUE) على أن الإدخال الموجود في هذا الصف يشترك مع صف آخر أو أكثر في القيمة ذاتها؛ مما يجعله ينتمي تلقائياً إلى مجتمع السجلات المكررة المستهدفة. وفي المقابل، تؤكد القيمة (FALSE) أن هذا الصف يمثل مدخلاً فريداً لم يتكرر مطلقاً داخل النطاق المحدد، وهو ما يستوجب استبعاده عند الرغبة في الاحتفاظ بالتكرارات فقط.
لإجراء تدقيق سريع للتحقق من عدم حدوث أخطاء في المخرجات، يُوصى باختيار عينة عشوائية من الصفوف التي أفرزت القيمة (TRUE)، واستخدام ميزة البحث السريع (Ctrl + F) للتأكد يدوياً من وجود ظهور آخر لنفس القيمة داخل العمود. كما يمكن استخدام معادلة جمع شرطي فرعية في خلية مستقلة لحساب إجمالي عدد الخلايا المحققة لشرط التكرار عبر الصيغة =COUNTIF(B2:B50, TRUE)، والتأكد من منطقية هذا العدد وملاءمته للتوقعات التشغيلية لبيئة العمل المفحوصة.
يساعد هذا التحليل الممنهج على كشف أخطاء التثبيت المرجعي؛ فإذا تبيّن للمحلل وجود سجل يظهر عدة مرات بالعين المجردة لكن ناتجه المنطقي يظهر (FALSE)، فإن هذا يعد مؤشراً قاطعاً على حدوث انزياح نسبي في النطاق المرجعي نتيجة إغفال علامات التثبيت المالي ($)، أو نتيجة لوجود مسافات بيضاء غير مرئية تفصل بين القيمتين وتمنع دالة العد من إدراكهما ككيان متطابق.
4. استخلاص التكرارات ديناميكياً باستخدام دالة التصفية FILTER
4.1 آلية عمل المصفوفات الديناميكية ودالة FILTER في الإصدارات الحديثة
شهد محرك الحسابات في مايكروسوفت إكسيل تحولاً جذرياً مع إطلاق إصدارات Microsoft 365 وإكسيل 2021 وما تلاها، حيث تم إدراج مفهوم “المصفوفات الديناميكية” (Dynamic Arrays). ألغى هذا التطور الحاجة التقليدية للضغط على مجموعات المفاتيح المعقدة (Ctrl + Shift + Enter) لإدخال صيغ المصفوفات القديمة، وأصبح بإمكان معادلة واحدة مكتوبة في خلية مفردة أن تُرجع مصفوفة كاملة تتمدد تلقائياً وتنسكب (Spill) عبر الخلايا المجاورة رأسياً وأفقياً دون الحاجة لتكرار كتابة الصيغة.
تُعد دالة التصفية FILTER حجر الزاوية في منظومة المصفوفات الديناميكية؛ إذ تم تصميمها خصيصاً لاستخراج مجموعة فرعية من السجلات من مصفوفة أصلية استناداً إلى معايير منطقية دون إحداث أي تعديل تدميري في البيانات المصدرية. يتكون التركيب البنائي لدالة التصفية من ثلاثة وسائط رئيسية:
=FILTER(array, include, [if_empty])
حيث يمثل الوسيط الأول (array) نطاق البيانات المصدرية المراد استخلاص الصفوف منها، ويمثل الوسيط الثاني (include) مصفوفة القيم البولينية التي تحدد أي الصفوف يتم تضمينها (TRUE) وأيها يتم استبعادها (FALSE)، في حين يمثل الوسيط الثالث الاختياري ([if_empty]) الرسالة أو القيمة البديلة التي تُعرض إذا لم يتحقق الشرط المنطقي لأي سجل من السجلات المفحوصة.
4.2 التكامل بين دالة FILTER والمؤشر المنطقي المشتق
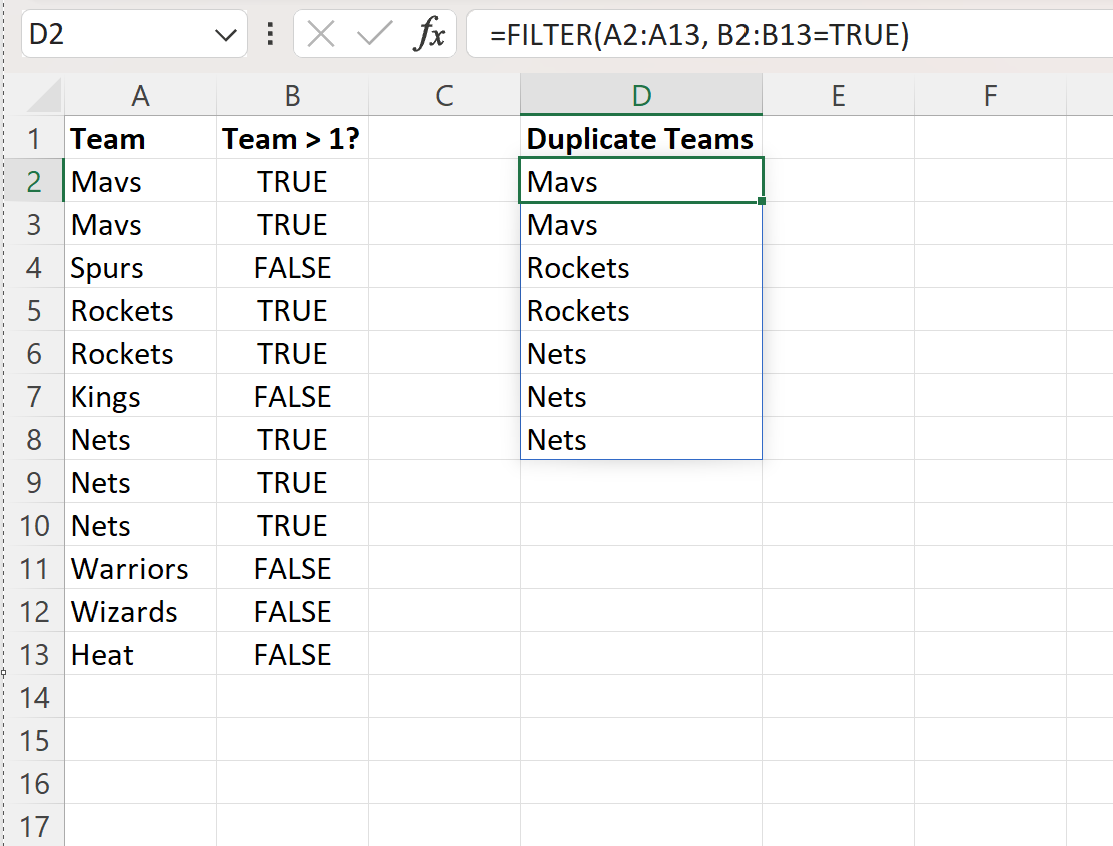
يتحقق الاستخلاص الديناميكي النقي للقيم المكررة من خلال الربط المباشر بين نطاق البيانات الأساسي وعمود الفحص البوليني المساعد الذي تم إنشاؤه مسبقاً. إذا افترضنا أن جدول البيانات المصدري يشغل النطاق A2:C50، وأن العمود المساعد المحتوي على القيم المنطقية (TRUE/FALSE) الناتجة عن فحص العمود A يقع في النطاق D2:D50، فيمكن استخراج جدول التكرارات في موضع مستقل من ورقة العمل بكتابة الصيغة التالية في الخلية F2:
=FILTER(A2:C50, D2:D50 = TRUE, "لا توجد قيم مكررة")
تقوم هذه المعادلة بفحص كل صف في المصفوفة المرجعية A2:C50؛ فإذا كانت الخلية المقابلة له في العمود المساعد D تحتوي على القيمة المنطقية TRUE، يُمرر الصف بالكامل وينسكب تلقائياً داخل جدول المخرجات الجديد في النطاق F2 وما يليه. أما إذا كانت القيمة المقابلة FALSE، فيتم حجبه تماماً من الظهور. وفي حال خلو مجموعة البيانات من أي تطابقات مكررة، تقوم الدالة تلقائياً بتفعيل وسيطها الثالث وإرجاع النص التوضيحي المخصص.
تتمثل الميزة الاستثنائية لهذا الأسلوب في التفاعلية المطلقة؛ فالجدول الناتج ليس لقطة ثابتة، بل هو كائن برمجي ديناميكي مرتبط ارتباطاً حياً بالأصل. فبمجرد تعديل أي مدخل في الجدول المصدري، أو إدخال سجل جديد يتطابق مع سجل قائم، يعيد محرك إكسيل تقييم التعبير الحسابي فوراً، مما يؤدي إلى اتساع نطاق الانسكاب وتحديث السجلات المكررة لحظياً، دون الحاجة لأي تدخل يدوي من قِبل المستخدم.
5. دمج العمليتين في صيغة حسابية مصفوفية أحادية
5.1 الاستغناء عن الأعمدة المساعدة عبر التعشيش الرياضي المباشر
بالرغم من القيمة الإيضاحية للأعمدة المساعدة، إلا أنها قد تشكل عبئاً تنظيمياً وتصميمياً في النماذج المالية والتقارير المتقدمة ذات الهياكل البيانية المتشعبة؛ إذ تزيد من عدد الأعمدة غير الضرورية بصرياً، وتتطلب حماية إضافية لمنع الحذف العرضي لصيغها. لذلك، يتيح محرك إكسيل الحديث دمج المنطقين الحسابيين معاً في معادلة مصفوفية تعشيشية (Nested Formula) واحدة، تستغني كلياً عن أي مساحات مساعدة.
يتم هذا الدمج البنيوي عبر إحلال دالة العد الشرطي الموسعة محل وسيط التضمين (include) داخل دالة التصفية. وفي هذه الحالة، لا يُمرر إلى المعيار في دالة COUNTIF مرجع لخلية مفردة، بل يتم تمرير مصفوفة النطاق بأكملها في طرفي المعادلة. ويُكتب هذا النمط الرياضي المدمج بالصيغة القياسية الآتية:
=FILTER(A2:C50, COUNTIF(A2:A50, A2:A50) > 1, "لا توجد قيم مكررة")
عند تقييم هذا التعبير، يقوم إكسيل بتوليد مصفوفة بولينية افتراضية داخل الذاكرة المؤقتة، دون الحاجة لكتابتها في خلايا ورقة العمل. حيث تقوم دالة COUNTIF(A2:A50, A2:A50) باحتساب عدد مرات ظهور كل عنصر في النطاق مقابل النطاق ذاته، وتُنتج سلسلة من القيم العددية، ثم تُقارن هذه السلسلة بالمعامل (> 1) لتتحول في الذاكرة إلى مصفوفة منطقية ثنائية من قِيَم TRUE وFALSE، والتي تتلقفها دالة FILTER فوراً لتقوم بتمرير الصفوف المتوافقة مع شرط التكرار فقط.
5.2 التطبيق العملي خطوة بخطوة للمعادلة المدمجة
لتطبيق هذه المعادلة بصورة منهجية تضمن سلامة التدفق البياني، يتبع المحلل الخطوات التنفيذية التالية:
- تحديد موقع خلية الهدف التي ستمثل الركن العلوي الأيمن (أو الأيسر تبعاً لاتجاه ورقة العمل) لجدول النتائج المكررة الجديد، مع التأكد من وجود مساحة خالية تحيط بالخلية لتفادي إعاقة انسكاب النتائج.
- كتابة رمز المساواة (=) لبدء الصيغة، متبوعاً بدالة
FILTER، ثم فتح القوس واختيار النطاق البياني الكامل الذي يُراد استخلاص بياناته (على سبيل المثال:A2:C100). - وضع الفاصلة، ثم استدعاء دالة
COUNTIFلتشكيل وسيط التضمين، وتحديد عمود المقارنة المستهدف بالتكرار كنطاق مرجعي، وتكراره ذاته كمعيار للبحث:COUNTIF(A2:A100, A2:A100). - إغلاق قوس دالة العد الشرطي، وإتباعه بمشغل المقارنة المنطقية الأكبر من واحد (
> 1). - إضافة الفاصلة الثانية، وكتابة النص البديل المحصور بين علامتي تنصيص للتعامل مع حالات خلو النطاق من التكرار، ثم إغلاق قوس دالة التصفية النهائي والضغط على مفتاح الإدخال (Enter).
بمجرد إتمام هذه الخطوات، ستظهر كافة الصفوف المتكررة مجتمعة في جدول مستقل، محتفظة بكامل بياناتها عبر الأعمدة المتعددة. ولضمان حوكمة التحليل، يُستحسن توثيق الصيغة في الخلية العلوية أو عبر تعليق برمجي مخصص لتمكين المحللين الآخرين من فهم البنية المدمجة وسهولة صيانتها لاحقاً.
6. عزل القيم المكررة يدويًا باستخدام التنسيق الشرطي وأدوات الفرز
6.1 استخدام التنسيق الشرطي لتمييز المدخلات المتكررة بصريًا
في العديد من سيناريوهات التدقيق الاستكشافي، يحتاج المحلل إلى معاينة التكرارات بصرياً داخل موضعها الأصلي في سياق الجدول بدلاً من استخراجها فوراً عبر المعادلات؛ وهنا يبرز “التنسيق الشرطي” (Conditional Formatting) كأداة قوية للتحليل البصري الاستكشافي. يعتمد التنسيق الشرطي على تطبيق خوارزميات مدمجة تقوم بفحص قيم الخلايا وتلوينها آلياً استناداً إلى قواعد منطقية محددة سلفاً دون تعديل محتواها النصي أو الرقمي.
لتطبيق هذه الآلية، يقوم المستخدم بتحديد عمود البيانات المبحوث، ثم الانتقال إلى تبويب “الصفحة الرئيسية” (Home)، واختيار “التنسيق الشرطي”، والتوجه إلى “قواعد تمييز الخلايا” (Highlight Cells Rules)، ثم النقر على “القيم المتكررة” (Duplicate Values). يتيح هذا الإجراء للمستخدم اختيار نمط تعبئة محدد—مثل التعبئة باللون الأحمر الفاتح مع نص أحمر داكن—ليقوم إكسيل فوراً بمسح العمود وتلوين كل خلية تتطابق مع خلية أخرى داخل التحديد ذاته.
ورغم الفاعلية البصرية الفائقة لهذه الأداة في تحديد كثافة التكرار ومواضعه العشوائية، إلا أنها تظل مقيدة بحدود منهجية جوهرية؛ فالتنسيق الشرطي أداة إيضاح وتنسيق بصري بحت ولا تملك بذاتها القدرة على عزل أو نقل البيانات إلى جدول مستقل، كما أن الاعتماد عليها المنفرد دون خطوات فرز لا يفي بمتطلبات التحليل الإحصائي الدقيق أو تصدير البيانات إلى بيئات برمجية أخرى.
6.2 التصفية المتقدمة وفق خصائص اللون والخلية
لتحويل التمييز البصري الناتج عن التنسيق الشرطي إلى عزل إجرائي ملموس للسجلات المكررة، يلزم استدعاء أداة التصفية التلقائية (AutoFilter). يتم ذلك بتحديد صف العناوين والانتقال إلى تبويب “بيانات” (Data) والنقر على أيقونة “تصفية” (Filter). تُظهر هذه الخطوة أزرار التصفية المنسدلة في رأس كل عمود، والتي تتضمن خيارات فرز وتصفية متقدمة تتجاوز القيم النصية إلى الخصائص التنسيقية.
بالضغط على سهم التصفية الخاص بالعمود المنسق شرطياً، يتم اختيار خيار “التصفية حسب اللون” (Filter by Color)، ومن ثم تحديد لون التعبئة المستخدم لتمييز التكرارات. سيؤدي هذا الإجراء فوراً إلى حجب كافة الصفوف الفريدة التي لم تكتسب التنسيق الملون، والإبقاء فقط على الصفوف التي تطابقت مع قاعدة التكرار، مما يتيح للمحلل عرض السجلات المكررة وحدها داخل الشاشة بصورة حصرية ومباشرة.
وعقب إتمام التصفية، يمكن تحديد الصفوف الظاهرة ونسخها بالكامل عبر الاختصار المعتاد (Ctrl + C)، ثم الانتقال إلى ورقة عمل جديدة ولصقها لاستخراج جدول مستقل للتكرارات. ومع ذلك، ينطوي هذا الأسلوب اليدوي على مخاطر تشغيلية؛ إذ إنه يفتقر إلى الديناميكية، ويتطلب إعادة التصفية والنسخ اليدوي في كل مرة تتغير فيها البيانات، فضلاً عن احتمالية الخطأ البشري أثناء تحديد الخلايا المرئية فقط دون المخفية، مما يجعله خياراً مرحلياً يُفضل الاستعاضة عنه بالدوال المؤتمتة في المعالجات الحساسة.
7. معالجة التكرارات المعقدة المعتمدة على معايير وأعمدة متعددة
7.1 استخدام دالة COUNTIFS لرصد التكرار المركب
في قواعد البيانات المهنية المعقدة، نادراً ما يكون التكرار محصوراً في سمة فردية واحدة؛ ففي سجلات الموظفين أو المسوح الاجتماعية الواسعة، لا يُعد تشابه الاسم الأول تكراراً للسجل، كما لا يُعد تشابه تاريخ الميلاد أو المسمى الوظيفي مؤشراً على الازدواجية. التكرار الحقيقي في مثل هذه السياقات هو التكرار المركب متعدد الأبعاد، والذي يتطلب تطابق مجموعة من الحقول معاً عبر الصفوف—كأن يتطابق “الاسم الكامل” و”تاريخ الميلاد” و”رقم الهاتف” في آن واحد لتأكيد أن السجل يعود إلى الكيان ذاته.
لمعالجة هذه العلاقات المتقاطعة، تُستخدم دالة العد الشرطي المتعدد COUNTIFS، والتي تتميز بقدرتها على فحص نطاقات متعددة بإخضاعها لشروط متزامنة تعمل وفق المنطق العطفي (AND Logic). ويُصاغ التركيب البنائي لهذه الدالة لفحص تكرار صف يمتد عبر عمودين (على سبيل المثال: الاسم في العمود A، ورقم الهوية في العمود B) على النحو التالي:
=COUNTIFS($A$2:$A$100, A2, $B$2:$B$100, B2) > 1
تختبر هذه الصيغة ما إذا كان هناك صف آخر يجمع بين ذات القيمة الموجودة في A2 وذات القيمة الموجودة في B2 معاً. إذا تحقق هذا الشرط المركب مرتين أو أكثر عبر النطاق الإجمالي، تُرجع الدالة القيمة الصوابية (TRUE)، مما يحقق نقاءً تحليلياً استثنائياً يمنع عزل السجلات المتشابهة في بُعد واحد بصورة خاطئة، ويرتقي بدقة الفحص المنهجي للبيانات.
7.2 تصفية السجلات متعددة الأعمدة عبر دالة FILTER المركبة
عند الرغبة في استخلاص الصفوف المكررة استناداً إلى معايير متعددة بصيغة ديناميكية ومباشرة دون أعمدة مساعدة، يتم تعشيش دالة COUNTIFS داخل وسيط التضمين لدالة FILTER. وتُصاغ المعادلة المعقدة في ورقة العمل بالشكل التالي:
=FILTER(A2:C100, COUNTIFS(A2:A100, A2:A100, B2:B100, B2:B100) > 1, "لا توجد تكرارات مركبة")
يعمل هذا التعبير الحسابي المتقدم على مقارنة كل زوج من القيم في المصفوفة الثنائية (A و B) في مواجهة كافة الأزواج الأخرى في الجدول. فإذا تطابق الزوج بالكامل في أكثر من موضع، يُدرج الصف بالكامل (بأعمدته A و B و C) ضمن جدول المخرجات الديناميكي المنسكب.
من الناحية الرياضية، يمكن أيضاً صياغة مصفوفة التصفية المتعددة دون استخدام دالة العد الشرطي عبر الاستفادة من الجبر البوليني المباشر ومفهوم “ضرب المصفوفات المنطقية”. حيث يؤدي ضرب شرط منطقي أول في شرط منطقي ثانٍ (Condition1) * (Condition2) إلى إنتاج القيمة الرقمية 1 فقط عندما يتحقق كلا الشرطين معاً (TRUE * TRUE = 1)، بينما يُنتج 0 في حال اختلال أيٍّ منهما. تتيح هذه المرونة الرياضية لمحللي البيانات بناء نماذج ترشيح مخصصة وشديدة التعقيد تفي بمتطلبات التحقيقات البيانية الأكثر دقة وحساسية.
8. استخراج التكرارات باستخدام أداة محرر الاستعلامات Power Query
8.1 استيراد البيانات وإجراء التجميع الإحصائي عبر لغة M
تُعد أداة Power Query (المعروفة ببيئة Get & Transform Data) التقنية الأقوى والأكثر رسوخاً في بيئة إكسيل لإدارة وتجهيز البيانات الضخمة وأتمتة مسارات استخراج وتحويل وتحميل البيانات (ETL). تقدم هذه الأداة حلاً حاسماً ومستقلاً لعزل التكرارات دون كتابة صيغ خلوية معقدة، وبما يتفادى إرهاق معالج الجدول بالصيغ المصفوفية الثقيلة، بالاعتماد على لغة الاستعلام الوظيفية المتقدمة المعروفة بلغة M.
يبدأ المسار الإجرائي بتحويل نطاق البيانات إلى جدول رسمي عبر الاختصار (Ctrl + T)، ثم الانتقال إلى تبويب “بيانات” والنقر على أمر “من ورقة/نطاق” (From Sheet/Table/Range)، ليفتح محرر Power Query في نافذة مستقلة. تتلخص آلية عزل التكرارات عبر واجهة المستخدم في مسار صريح وسريع؛ حيث يقوم المحلل بتحديد العمود أو الأعمدة المستهدفة بالتكرار، ثم التوجه إلى تبويب “الصفحة الرئيسية” (Home)، والضغط على القائمة المنسدلة “الاحتفاظ بالصفوف” (Keep Rows)، ثم اختيار الأمر المباشر “الاحتفاظ بالتكرارات” (Keep Duplicates).
تعتمد خوارزمية لغة M في خلفية هذا الأمر على خطوتين متكاملتين؛ الأولى هي احتساب التوزيع التكراري لكل مفردة من مفردات العمود المختار وتجميع السجلات المتطابقة، ثم تصفية الجدول الناتج للإبقاء الحصري على السجلات التي تمتلك عدداً تكرارياً يتجاوز الواحد الصحيح. ويتم تدوين هذه العملية كخطوة معيارية في لوحة “خطوات مطبقة” (Applied Steps)، مما يضمن قابلية تتبع المسار التحليلي وإعادة تطبيقه التلقائي على أي تدفقات بيانية مستقبلية.
8.2 دمج الاستعلامات واسترجاع السجلات الأصلية الكاملة
في الحالات التي تتطلب استعادة كافة الحقول الأصلية المصاحبة للتكرارات بعد إجراء تجميع مخصص، يُتيح محرر Power Query تقنية “دمج الاستعلامات” (Merge Queries). تتيح هذه التقنية إجراء ربط داخلي (Inner Join) بين الاستعلام المصدري الأصلي واستعلام التكرارات الملخص المستخلص منه، باستخدام العمود المشترك كمفتاح ربط (Primary/Foreign Key).
يضمن الربط الداخلي تصفية الجدول الأصلي كلياً وإسقاط أي صف لا يتطابق مفتاحه مع المفاتيح المتكررة المتبقية في جدول التلخيص. وعقب إتمام عملية الدمج، يضغط المحلل على أيقونة التوسيع في رأس العمود المدمج لاستعادة كافة الحقول الأصلية المحفوظة، محققاً استخلاصاً شاملاً لكافة السجلات المكررة مع تفاصيلها الأصلية الدقيقة دون أي نقص بياني.
عقب الانتهاء من ضبط التحويلات داخل المحرر، يتم النقر على أمر “إغلاق وتحميل إلى” (Close & Load To…)، واختيار تحميل النتائج إلى جدول في ورقة عمل جديدة. تتميز هذه الطريقة باستقلاليتها التامة عن بنية الجدول الأصلي؛ إذ لا تؤثر التعديلات على البيانات المصدرية، ومع تدفق بيانات جديدة في المستقبل، يكتفي المستخدم بالنقر بزر الفأرة الأيمن على جدول المخرجات واختيار “تحديث” (Refresh) لتُعاد المعالجة بالكامل في أجزاء من الثانية.
9. استكشاف الأخطاء الشائعة وحلولها التقنية أثناء الفرز
9.1 معالجة المسافات الخفية واختلاف حالة الأحرف والترميز
تتعرض عمليات استخراج التكرارات لاختلالات تقنية متكررة تنبع من طبيعة الإدخال البشري للبيانات أو التصدير غير المنقح من البرمجيات الخارجية؛ ولعل أبرز هذه العيوب يتمثل في وجود المسافات البادئة أو اللاحقة (Leading and Trailing Spaces). فعلى سبيل المثال، إذا احتوت الخلية الأولى على النص "ClientA" بينما احتوت الخلية الثانية على "ClientA " (مع مسافة فارغة في النهاية)، فإن محرك الحسابات في دالة COUNTIF أو التنسيق الشرطي سيتعامل معهما كمدخلين مختلفين تماماً، مما يؤدي إلى فشل رصد التكرار وتصنيفهما خطأً كقيم فريدة.
يُعالج هذا القصور الجوهري بتمرير البيانات المصدرية عبر دالة التطهير النصي TRIM، والتي تعمل على إزالة كافة المسافات الزائدة من أطراف النصوص وتوحيد المسافات البينية لتكون مسافة مفردة فقط. وتُدمج هذه المعالجة مسبقاً في مرحلة تنقية البيانات، أو تُدمج داخل الصيغ المصفوفية عبر استبدال وسيط النطاق بالدالة المنقحة لضمان مطابقة الرموز بدقة متناهية.
وعلاوة على ذلك، يبرز التحدي المرتبط بحساسية حالة الأحرف في السجلات اللاتينية (Case Sensitivity)؛ فكما أُسلف، دالة COUNTIF تتجاهل حالة الأحرف حكماً. فإذا كان المسار المنهجي يتطلب تمييز الأحرف الكبيرة عن الصغيرة واعتبار النص “DATA” مستقلاً عن “data”، فإن استخدام COUNTIF يُعد خطأً حسابياً. يُحل هذا الإشكال برمجياً بالاستعانة بدالة التطابق الحرفي الصارم EXACT المدمجة مع دالة التصفية FILTER عبر معادلة مصفوفية تقوم بالمقارنة الثنائية للرموز بدقة الأسكود والترميز القياسي، كما يجب التأكد من تطابق ترميز الحروف والأرقام المخزنة كنصوص لتجنب التناقض بين 100 كرقم و "100" كنص.
9.2 حل أخطاء المراجع وتداخل مسارات المصفوفات الديناميكية
مع اعتماد الدوال المصفوفية الحديثة مثل FILTER، يظهر نمط جديد من الأخطاء التشغيلية، وأكثرها شيوعاً هو خطأ الانسكاب الشهير #SPILL!. يحدث هذا الخطأ الحسابي عندما تجد دالة المصفوفة الديناميكية عائقاً مادياً يمنعها من ملء الخلايا المطلوبة لعرض النتائج؛ كأن تكون هناك خلية واحدة غير فارغة تقع ضمن مسار التمدد المتوقع للمصفوفة، حتى وإن كانت تلك الخلية تحوي مسافة غير مرئية أو تعليقاً نصياً مهملاً. يُحل هذا الخطأ ببساطة بتفريغ النطاق المحيط بخلية المعادلة لتمكين مصفوفة النتائج من التمدد بحرية وتوليد الجدول المستخلص بالكامل.
ومن الأخطاء الكلاسيكية الشائعة أيضاً الوقوع في فخ “المرجع الدائري” (Circular Reference)، والذي يحدث غالباً عند استخدام الأعمدة المساعدة إذا تم تضمين الخلية التي تحوي المعادلة ذاتها ضمن النطاق المرجعي المفحوص لدالة العد (مثل كتابة COUNTIF(A:A, A2) داخل الخلية A2). يؤدي هذا التداخل إلى تعليق محرك الحسابات في حلقة مفرغة، ويتطلب حله تقييد النطاق بدقة ليقتصر على خلايا البيانات المدخلة الفعلية دون تمديده بصورة عشوائية عبر كامل العمود.
وأخيراً، يواجه المحللون ظهور خطأ القيمة الحسابية #CALC! عند استخدام دالة التصفية المدمجة في بيئة تخلو تماماً من أي قيم مكررة، وذلك نتيجة لمحاولة الدالة إرجاع مصفوفة فارغة الحجم. ولتلافي هذا التعطل الظاهري للتقرير المالي أو الإحصائي، يتعين دائماً تضمين الوسيط الثالث الاختياري في دالة FILTER وتزويده بقيمة نصية افتراضية واضحة (مثل: “لا توجد سجلات مكررة”)، ليعمل كصمام أمان برمجي يحافظ على أناقة النموذج واتساقه التشغيلي.
10. أفضل الممارسات لتوثيق وحوكمة البيانات المكررة المستخرجة
10.1 معايير النزاهة وحفظ البيانات الأصلية أثناء عمليات المعالجة
تفرض حوكمة البيانات في المؤسسات المالية والأكاديمية المعاصرة التزاماً صارماً بمبدأ “التصفية غير التدميرية” (Non-Destructive Processing)؛ حيث يُحظر قطعياً إجراء أي تعديلات دائمة، أو عمليات حذف، أو كتابة فوقية (Overwriting) على مجموعات البيانات الخام الأصلية. يجب أن تظل البيانات الأساسية محفوظة في حالتها البكر الأصلية داخل ورقة عمل محمية ومغلقة برمجياً، بينما تُجرى كافة عمليات الفرز، والعزل، والاحتفاظ بالتكرارات في مساحات مخرجات مستقلة تماماً.
يتطلب المسار المنهجي السليم إنشاء سجل تدقيق إجرائي (Audit Trail Log) يُرفق بالنموذج المكتمل، يوضح بالتفصيل أسماء المحللين، وتاريخ وتوقيت استخراج البيانات، والصيغ المنطقية المعتمدة في الفرز (سواء كانت COUNTIF أحادية أو COUNTIFS متعددة الشروط)، وحجم السجلات المستخلصة ونسبتها إلى المجتمع الإجمالي للعينة. يوفر هذا التوثيق الدقيق سنداً للموثوقية يتيح للمدققين الخارجيين والباحثين المستقلين تكرار نفس المعالجة والوصول إلى ذات النتائج بصورة قابلة لإعادة الإنتاج (Reproducibility).
وعلاوة على ذلك، ينبغي حفظ النسخ التاريخية للجداول في مستودعات آمنة تتوافق مع بروتوكولات الأرشفة المعتمدة؛ فإذا تطلبت دراسة مسحية عزل التكرارات لدراسة سلوك الاستجابة غير الجادة أو الازدواجية المسحية، فإن إبراز مسار العزل والتأصيل الرياضي للقرارات المتخذة يُعد المعيار الحاسم لاعتماد نتائج البحث وقبولها للنشر العلمي في المجلات المحكمة ذات التأثير المرتفع.
10.2 تطوير نماذج تقارير دورية لمراقبة التكرار في بيئات العمل
لا تتوقف الإدارة الاحترافية للبيانات المكررة عند مجرد العزل المقطعي اللحظي، بل تتجاوز ذلك نحو بناء نظم رقابة استباقية دورية داخل المؤسسة؛ ويتحقق ذلك بتطوير لوحات معلومات (Dashboards) تفاعلية تعكس مؤشرات جودة البيانات ومعدلات التكرار الطارئة بصورة آلية ومستمرة. يمكن تصميم هذه اللوحات بالاعتماد على مخرجات Power Query المحدثة أوتوماتيكياً والمربوطة بالنماذج الرسومية البيانية لبرنامج إكسيل.
تسهم هذه النماذج الدورية في تقليص التكاليف التشغيلية الناتجة عن تكرار أوامر التوريد أو صرف الرواتب أو تسجيل المعاملات في القطاع المصرفي؛ حيث تتيح لمسؤولي الامتثال الداخلي رصد الطفرات المفاجئة في معدلات الازدواجية فور حدوثها، مما يقود إلى التشخيص السريع للخلل—سواء كان ناتجاً عن عيب برمجي في واجهات الإدخال (UI)، أو ناجماً عن ضعف في تدريب الكوادر البشرية القائمة على إدخال البيانات.
وتختتم هذه الممارسات بصياغة توصيات حاسمة لتصميم نماذج الإدخال المستقبلية؛ حيث يُوصى بتطبيق قيود “التحقق من صحة البيانات” (Data Validation) في مراحل الإدخال المبكرة لمنع كتابة القيم المكررة ابتداءً عبر استخدام دوال العد الشرطي في شروط التحقق المسبق، مما يقلص من العبء التحليلي اللاحق ويوجه الجهد المؤسسي نحو التطوير والابتكار بدلاً من الاستنزاف في مهام التنقية والتنظيف المتكررة.
خاتمة
في الختام، يتبين بجلاء أن مهمة “الاحتفاظ بالقيم المكررة فقط في إكسيل” تمثل إجراءً تحليلياً متقدماً يقع في قلب عمليات الفحص الجنائي المالي، والتدقيق الداخلي، والتنقية المنهجية لبيانات البحوث السلوكية والكمية. إن التخلي عن النمط التدميري المتمثل في الإزالة التلقائية للتكرار والانتقال نحو استراتيجيات العزل المنطقي يفتح آفاقاً رحبة لفهم الظواهر الشاذة، ورصد الأنماط البيانية المتكررة، وضمان سلامة ومصداقية التقارير المرفوعة لأصحاب القرار.
لقد استعرض هذا الدليل منظومة متكاملة من الأدوات التي تلبي كافة الاحتياجات التحليلية بحسب طبيعة البيئة التقنية؛ بدءاً من التأسيس المنطقي لدوال العد الشرطي COUNTIF و COUNTIFS عبر الأعمدة المساعدة، ووصولاً إلى المرونة الفائقة والسرعة التفاعلية لمعادلات المصفوفات الديناميكية ممثلة في دالة FILTER المدمجة. كما وفّر استعراض التنسيق الشرطي أداة مسح بصري أولية للمستخدم، في حين توجت أداة Power Query هذا المسار بتوفير منصة أتمتة مؤسسية مستدامة وقابلة للتكرار الدوري للتعامل مع التدفقات البيانية الهائلة.
إن تبني هذه المنهجيات والتقيد الصارم بمعايير النزاهة وحفظ البيانات الأصلية يمنح الباحثين والمحللين الثقة المطلقة في مخرجاتهم الرقمية، ويحول البيانات المجدولة من مجرد أرقام صامتة إلى أدلة رقابية وإحصائية قاطعة تدعم الشفافية، وترتقي بجودة الممارسة العلمية والمهنية في بيئات العمل المعاصرة.
المراجع
Youngstrom, E. A. (2013). A Primer on Receiver Operating Characteristic Analysis and Diagnostic Efficiency Statistics for Pediatric Psychology: We Are Ready to ROC. Journal of Pediatric Psychology, 38(7), 704–717. https://doi.org/10.1093/jpepsy/jst062