
يمثل التعامل مع البيانات الكمية في برمجيات الجداول الحسابية، وعلى رأسها برنامج مايكروسوفت إكسيل (Microsoft Excel)، ركيزة محورية في إعداد البيانات وتنقيتها لأغراض التحليل الإحصائي وبناء النماذج التنبؤية. وتعد مسألة تنسيق النسب المئوية واحدة من الإشكاليات المنهجية الأكثر شيوعاً التي تواجه الباحثين ومحللي البيانات على حد سواء؛ حيث يختلط في كثير من الأحيان المظهر البصري المعروض على الشاشة بالبنية البرمجية والرياضية الحقيقية المخزنة في الذاكرة الحاسوبية. إن وجود رمز النسبة المئوية (%) قد يبدو للوهلة الأولى مجرد تفصيل شكلي، غير أنه في الواقع يحدد الكيفية التي يفسر بها البرنامج القيمة العددية، ويؤثر بصورة مباشرة على قابلية هذه القيم للخضوع للعمليات الحسابية المتتالية أو التصدير نحو بيئات البرمجة الإحصائية المتقدمة.
تنشأ الحاجة إلى إزالة رمز النسبة المئوية في سياقات متعددة، تتراوح بين تنظيف مخرجات الاستبانات الرقمية المنبثقة من منصات جمع البيانات، وتجهيز المتغيرات المستقلة والتابعة للتحليلات القياسية في حزم إحصائية مثل SPSS أو برمجيات لغة R وبايثون (Python). وفي هذا الإطار الأكاديمي، تبرز أهمية التمييز بين القيمة الكسرية البحتة والتمثيل النسبي المئوي؛ فالرقم المعروض بصيغة 25% يمثل في جوهره الرياضي القيمة العشرية 0.25، ولكن عند استيراد البيانات من ملفات نصية غير منضبطة (مثل CSV أو TXT)، قد يُسجل الرقم كنص صريح يتضمن المحرف الطباعي للرمز المئوي، مما يحرم المحلل من القدرة على إجراء الحسابات الرياضية الأساسية كالمتوسط والانحراف المعياري، ويولد أخطاء برمجية متتالية تعيق سير المعالجة البيانية.
يهدف هذا الدليل المنهجي المتكامل إلى تفكيك الأسس النظرية والتقنية لتمثيل النسب المئوية في بيئة إكسيل، وتقديم استعراض شامل للطرائق المعيارية والبديلة المتبعة للتخلص من هذا الرمز وتحويل القيم إلى أرقام صحيحة أو عشرية صالحة للتحليل الكمي. وسيتناول المقال تفصيلاً دقيقاً للاستخدام الوظيفي لدوال معالجة النصوص، وتوظيف الأدوات التلقائية المدمجة، فضلاً عن تقديم تدقيق إحصائي وتقني متعمق يضمن الحفاظ على الدقة الرياضية ومنع حدوث أي تشوهات في المقاييس الرقمية للبيانات الأصلية.
1. المقدمة والأسس النظرية لتمثيل النسب المئوية في برنامج إكسيل
1.1 التمييز البنيوي بين البيانات الرقمية والنصية
يعتمد النموذج البنيوي لتخزين البيانات في برنامج مايكروسوفت إكسيل على تصنيف صارم يفرق بين الأنواع المختلفة للمدخلات داخل خلايا المصنف. في المستوى القاعدي لمحرك الحسابات، يتم تخزين الأرقام كأعداد حقيقية ذات دقة مضاعفة وفق معيار الفاصلة العائمة (IEEE 754 Floating-Point Standard)، في حين تُعامل السلاسل النصية بوصفها مصفوفات من المحارف المشفرة (String Literals). عندما يقوم المستخدم بإدخال رقم متبوع برمز النسبة المئوية أو يطبق تنسيق النسبة المئوية، يتعامل البرنامج مع هذا الإجراء عبر مسارين متباينين جوهرياً تفرضه طبيعة الإدخال ذاته.
في المسار الأول، إذا تم إدخال القيمة كرقم وتم تطبيق “تنسيق النسبة المئوية” (Percentage Format) من خلال واجهة المستخدم، فإن إكسيل يخزن في الذاكرة كسراً عشرياً مجرداً (مثلاً 0.15)، ولكنه يعرض للمستخدم القيمة مضروبة برمجياً في 100 وملحقة بالرمز البصري (15%). أما في المسار الثاني، وهو الأكثر تعقيداً وإثارة للأخطاء، إذا تم استيراد البيانات من مصادر خارجية كنص مدمج به الرمز “%” كحرف طباعي (Literal Character)، فإن إكسيل يعطل فوراً طبيعته الرقمية ويعامل محتوى الخلية كسلسلة نصية بحتة. هذا التمييز ليس مجرد تفصيل برمجي عابر، بل هو محدد جوهري لقابلية المعالجة الحسابية اللاحقة؛ حيث تفشل الدوال الإحصائية الرياضية القياسية مثل SUM وAVERAGE في قراءة النصوص، مما يؤدي إما إلى تجاهل الخلايا كلياً وإفساد العينة، أو إرجاع رموز الأخطاء التشغيلية مثل #VALUE! التي توقف تدفق سلاسل التحليل المؤتمتة.
إن اتساق تمثيل البيانات يمثل ركيزة النزاهة الإحصائية، حيث يترتب على غياب الضبط الدقيق لنوع البيانات مخاطر تشويه العينات وتشتت القياس، وهو ما يتطابق مع المبادئ العامة لإدارة عبء معالجة المعلومات المعقدة في البيئات الحاسوبية المعرفية (Pollock et al., 2002). لذلك، يستوجب الفحص المنهجي للبيانات التأكد المستمر من طبيعة المحاذاة الافتراضية؛ فالأرقام الحقيقية تُحاذى تلقائياً إلى اليمين (في الواجهات التي تدعم اللغات من اليسار لليمين أو العكس وفق الإعدادات الإقليمية)، بينما تركن النصوص إلى جانب الخلية المقابل، مما يعطي إشارة أولية حول التكوين البنيوي للقيم قبل الشروع في تنقيتها.
1.2 الأساس الرياضي لحساب النسبة المئوية وعرضها
يرتكز المفهوم الرياضي للنسبة المئوية على التعبير عن أي كمية ككسر من العدد مئة، حيث تُعرّف النسبة بأنها العلاقة النسبية $P = (X / Y) \times 100$، أو رياضياً في صورتها الكسرية المجردة $D = X / Y$. في البيئة البرمجية لبرنامج إكسيل، يشكل الكسر العشري $D$ الحقيقة الرياضية الوحيدة المعترف بها داخلياً. فعندما يدخل الباحث القيمة 0.05، ويوجه البرنامج لعرضها كنسبة مئوية، يُجري المحرك الحسابي تحويلاً هندسياً للمظهر يضاعف القيمة بعامل قدره $10^2$ لأغراض الإدراك البصري الآدمي فقط، مع إلحاق الرمز “%” كقناع تنسيقي خارجي.
تكمن المعضلة المنهجية حين يقع الخلط بين “القناع التنسيقي” (Formatting Mask) و”المحرف النصي المادي” (String Character). إذا كان الرمز ناتجاً عن قناع تنسيقي، فإن إزالة الرمز لا تتطلب سوى إعادة تعيين فئة الخلية إلى “عام” (General) أو “رقم” (Number). غير أن هذا الإجراء البسيط سيُظهر فوراً الأساس العشري الكامن، فتحول القيمة المعروضة 75% إلى 0.75. وإذا كان الباحث يهدف إلى استخراج الرقم الصحيح 75 كقيمة مستقلة خالية من الرمز لاستخدامها في نماذج رياضية محددة لا تقبل الكسور العشرية الصغرى، فإن الاكتفاء بإلغاء التنسيق يولد انحرافاً في القياس مقداره مئة ضعف ($100\times$)، مما ينسف التوزيع الاحتمالي للبيانات بالكامل.
أما في الحالات التي يكون فيها الرمز محرفاً نصياً ملحقاً بالرقم داخل سلسلة أحادية، فإن النظام الرياضي للبرنامج يتعطل، ويصبح التحويل عملية مركبة تتطلب أولاً تجريد السلسلة من الرمز الأبجدي، ثم إعادة توزين القيمة الناتجة لضمان توافقها مع المقياس الإحصائي المنشود. إن الإخفاق في فهم هذه الديناميكية التحويلية يؤدي إلى تشوهات فادحة في مصفوفات الارتباط وتحليلات الانحدار المتعدد، حيث يتم الخلط بصورة كارثية بين أوزان المتغيرات المقاسة بالكسور وتلك المقاسة بالقيم الصحيحة.
1.3 دواعي الحاجة المنهجية لإزالة رمز النسبة المئوية
تتعدد الدواعي الأكاديمية والمهنية التي تفرض على الباحثين ومحللي البيانات تجريد القيم من رمز النسبة المئوية. يبرز في مقدمة هذه الدواعي متطلبات التوافق التقني عند تصدير مجموعات البيانات إلى حزم البرمجيات الإحصائية المتقدمة وقواعد البيانات العلائقية (Relational Databases) مثل SQL Server وPostgreSQL، أو لغات البرمجة المخصصة لعلوم البيانات كبايثون وR. غالبية هذه النظم تتطلب جداول بيانات نظيفة تماماً (Tidy Data) تكون فيها كل خلية ممثلة لقيمة ذرية (Atomic Value) وحيدة ذات نوع بيانات متجانس وصارم، وحيث يُنظر إلى وجود الرمز “%” كخطأ تركيبي يمنع استيراد الجدول أو يحول العمود كاملاً إلى متغير فئوي (Categorical/Factor) بدلاً من متغير كمي متصل (Continuous Numeric).
كذلك تفرض متطلبات تنظيف البيانات الضخمة (Big Data Wrangling) المستخرجة عبر تقنيات الكشط الشبكي (Web Scraping) أو المفرغة آلياً من ملفات الـ PDF فحصاً دقيقاً؛ إذ غالباً ما ترد هذه البيانات في قوالب غير معيارية تختلط فيها الأرقام بالرموز الحسابية. ولا يمكن إخضاع هذه البيانات لعمليات التعلم الآلي أو النمذجة الإحصائية دون مرحلة ما قبل المعالجة (Preprocessing) الدقيقة، وهو ما وثقته الدراسات المعاصرة في هندسة الميزات ومعالجة النصوص الرقمية الكبرى (Nijhawan et al., 2022).
بالإضافة إلى ذلك، تبرز الحاجة إلى إزالة الرمز لتفادي الأخطاء التراكمية في سلاسل الحسابات المتقاطعة؛ فحين يُدرج رقم بنسبته المئوية في معادلة تتضمن ضرباً أو قسمة مسبقة، قد يتكرر تطبيق مقياس المئة دون قصد من المستخدم، مما يقزم القيمة الحسابية النهائية بمقدار عشرة آلاف ضعف ($10^4$). وأخيراً، تتطلب برمجيات بناء المخططات البيانية ولوحات القياس (Dashboards) في كثير من الأحيان مقاييس محاور كمية صريحة غير مقيدة بوحدات قياس نصية داخلية، لتمكين تخصيص التسميات وتدرجات المحاور بدقة رياضية متناهية.
2. المنهجية القياسية: استخدام دالة SUBSTITUTE لإزالة رمز النسبة المئوية
2.1 التشريح الفني لدالة SUBSTITUTE ومعاملاتها
تعد دالة SUBSTITUTE إحدى الأدوات النصية الأكثر فاعلية ورصانة في بيئة إكسيل للتعامل مع النصوص المشوهة والمحارف الدخيلة. يرتكز البناء القواعدي لهذه الدالة على استبدال نص قديم بنص جديد داخل سلسلة محددة، وتتألف بنيتها الصورية القياسية من أربعة معاملات رئيسية وفق الصيغة التالية: SUBSTITUTE(text, old_text, new_text, [instance_num]).
يتناول المعامل الأول، text، المرجع المصدري للخلية المراد معالجتها (مثل A2)، والتي تحتوي على القيمة النصية المتضمنة لرمز النسبة المئوية. أما المعامل الثاني، old_text، فيحدد بصورة حرفية المحرف المستهدف بالاستئصال، وهو هنا رمز النسبة المئوية محاطاً بعلامتي تنصيص متماثلتين ("%")؛ إذ تشترط بيئة إكسيل إدراج أي محرف غير رقمي داخل علامات التنصيص لتعريفه كسلسلة نصية صريحة. ويأتي المعامل الثالث، new_text، ليعرف البديل المستهدف، وحيث إن الغاية المنهجية هي التخلص التام من الرمز دون ترك أي فراغ مكانه، يتم تمرير سلسلة نصية فارغة تماماً يعبر عنها بكتابة علامتي تنصيص متتاليتين دون أي مسافة بينهما ("").
أما المعامل الرابع والأخير، [instance_num]، فهو معامل اختياري يحدد أي تكرار للمحرف القديم يجب استبداله في حال تكراره داخل الخلية. وفي سياق إزالة رمز النسبة المئوية، يُترك هذا المعامل فارغاً في العادة، مما يوجه الدالة تلقائياً لتطبيق سلوكها الافتراضي المتمثل في استبدال جميع تكرارات الرمز “%” داخل السلسلة المستهدفة، وهو ما يضمن معالجة الأخطاء الطباعية الشاذة مثل وجود نسب مكررة الرمز كـ “50%%”.
2.2 صياغة المعادلة التكاملية المتقدمة
على الرغم من أن تطبيق دالة SUBSTITUTE المفردة ينجح في إزالة الرمز بصرياً، إلا أن الناتج يظل سجيناً لنوع البيانات النصي، وهو ما يعطل استخدامه كمتغير إحصائي. للتغلب على هذه العقبة البنيوية، يتم بناء معادلة تكاملية متقدمة توظف العمليات الجبرية لإحداث تحول نوعي فوري في بنية المخرجات. تأخذ الصيغة الرياضية الشاملة إحدى الصورتين التاليتين:
الصيغة الأولى المعتمدة على دالة القيمة الصريحة:
=VALUE(SUBSTITUTE(A2, "%", ""))
والصيغة الثانية المتكافئة رياضياً والمعتمدة على المشغلات الحسابية الإجبارية (Unary Operator أو العمليات الحسابية المباشرة):
=SUBSTITUTE(A2, "%", "") * 1
أو بصيغة المعامل الأحادي المزدوج السالب (Double Unary):
=--SUBSTITUTE(A2, "%", "")
في هذه الصيغ المتكاملة، تقوم الدالة الداخلية أولاً بنزع المحرف النصي للنسبة المئوية، محولة القيمة مثل “45.5%” إلى النص الصافي “45.5”. يعقب ذلك مباشرة تدخل المعامل الحسابي الخارجي—سواء عبر الضرب في 1، أو استخدام المشغل الأحادي المزدوج، أو تغليف الناتج بدالة VALUE—مما يجبر المترجم البرمجي لإكسيل على فحص المحتوى الداخلي للسلسلة، والتحقق من صلاحيتها الرياضية، ثم تحويلها قسرياً من نص أبجدي إلى رقم كمي صريح ذي دقة عائمة يوضع فوراً في الذاكرة الحسابية للمصنف.
تتميز هذه المعادلة التكاملية بتوافقيتها المطلقة عبر كافة أجيال وتحديثات برنامج مايكروسوفت إكسيل، بدءاً من الإصدارات القديمة مثل Excel 2003 وصولاً إلى أحدث اشتراكات Microsoft 365، فضلاً عن توافقها الكامل مع برمجيات الجداول البديلة كـ Google Sheets وLibreOffice Calc، مما يجعلها المنهجية الأكاديمية الأكثر اعتمادية وثباتاً في بروتوكولات معالجة البيانات.
2.3 أسباب الجمع بين الاستبدال النصي والعملية الحسابية
إن إدراك الفارق الدقيق بين الاستبدال السطحي والتحويل البنيوي يمثل جوهر الكفاءة التقنية لمحلل البيانات. عندما تقوم دالة SUBSTITUTE بمحو الرمز “%”، فإنها وفق تصميمها الوظيفي المبرمج تُرجع مخرجات تنتمي حصراً لفئة النصوص (Text DataType). إذا ترك المحلل الناتج على هذه الحالة، فإن المصنف سيعامل الخلية معاملة الكلمات والحروف، مما ينطوي على عواقب وخيمة؛ حيث تُعامل هذه الخلايا كقيم صفرية أو يتم تجاهلها تماماً عند تمريرها إلى دوال النمذجة الرياضية.
أضف إلى ذلك ما يمكن تسميته بـ “معضلة الانكماش الرياضي” المقترنة بطريقة إدخال البيانات الأصلية. إذا كانت الخلية الأصلية تخضع لتنسيق النسبة المئوية المدمج (Formatted Number)، وتم تطبيق الدالة النصية عليها دون وعي، فإن استخراج النص قد يسفر أحياناً عن قراءة التمثيل العشري الأساسي للرقم، أو قراءة النص المعروض بحسب لغة واجهة النظام وتفاصيل تكوين المصنف. إن الجمع المنهجي بين الاستبدال والتحويل الحسابي يضمن تثبيت مقياس القيمة بدقة.
علاوة على ذلك، فإن تحويل السلسلة النصية إلى قيمة رقمية عبر العمليات الرياضية المباشرة يعيد تفعيل الخصائص الإحصائية للرقم، بما يسمح بتطبيق خوارزميات الترتيب التلقائي، واختبارات الفرضيات المقارنة (مثل اختبارات $t$ وتحليل التباين ANOVA)، وبناء فترات الثقة الإحصائية دون مواجهة أخطاء عدم تطابق المتغيرات، مما يرفع من جودة البيانات وفق أعلى المعايير المعمول بها في بحوث اللغويات التطبيقية والعلوم الاجتماعية القائمة على التحليل البياني المكثف (Boulton & Vyatkina, 2021).
3. دراسة حالة تطبيقية: خطوات إزالة الرمز خطوة بخطوة بالصيغة المقترحة
3.1 إعداد بيئة العمل والجدول التجريبي
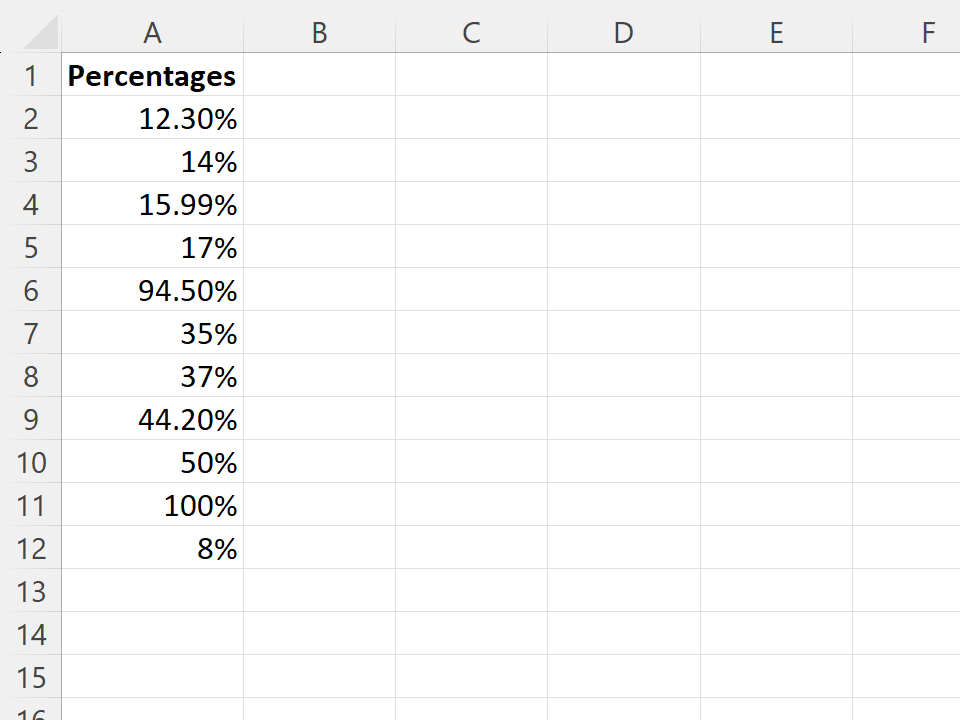
لتطبيق هذه المنهجية بصورة علمية منضبطة، نفترض وجود مصفوفة بيانات تجريبية مستخلصة من مسح ميداني، حيث يمثل العمود A معدلات إنجاز المهام المسجلة بصيغ نصية غير معيارية تدمج الأرقام برموز النسب المئوية. يوضح الجدول التالي تركيبة العينة التجريبية التي تغطي حالات الحافة المتنوعة، بما في ذلك القيم الموجبة، والأرقام ذات الفواصل العشرية، والقيم السالبة، والقيم الصفرية:
| الصف | العمود A: البيانات الخام الواردة | التصنيف النوعي للحالة | الهدف التحليلي |
|---|---|---|---|
| 2 | “45%” | نسبة مئوية صحيحة موجبة | استخراج القيمة الرقمية 45 |
| 3 | “12.75%” | نسبة مئوية كسرية موجبة | استخراج القيمة العشرية 12.75 بدقة |
| 4 | “-5.5%” | نسبة مئوية سالبة (تراجع) | الحفاظ على الإشارة السالبة -5.5 |
| 5 | “0%” | قيمة انعدام (صفرية) | التحويل إلى الصفر الرياضي المطلق 0 |
| 6 | “100%” | قيمة حدية عليا | استخراج القيمة 100 كعدد صحيح |
يبدأ الإجراء المنهجي بإدراج عمود تشغيلي جديد بجوار العمود المستهدف مباشرة، ونخصص له التسمية العمود B: القيم المعالجة كمياً. قبل تطبيق أي معادلة، يُنصح بإجراء فحص تشخيصي لنوع البيانات الأصلي عبر كتابة الدالة الفاحصة =ISNUMBER(A2) في عمود اختباري؛ حيث ستكون النتيجة FALSE لكافة خلايا العينة أعلاه، مما يثبت بالدليل الرقمي القاطع أن المدخلات هي سلاسل نصية مشوبة بعوائق حسابية تستلزم التدخل التطهيري.
3.2 تطبيق الصيغة وسحبها لتغطية النطاق
تبدأ المعالجة التنفيذية بالانتقال إلى الخلية الأولى الموازية لبيانات العينة، وهي الخلية B2، ثم إدخال المعادلة التكاملية المعتمدة بعناية تامة لضمان عدم حدوث أخطاء طباعية:
=VALUE(SUBSTITUTE(A2, "%", ""))
بمجرد الضغط على مفتاح الإدخال (Enter)، يلاحظ المحلل الفوري تحول القيمة المعروضة إلى الرقم الصافي 45، مع محاذاته التلقائية لليمين مشيراً إلى اكتسابه الصفة العددية. ولتعميم هذا التحويل عبر المصفوفة البيانية، يُستخدم مقبض التعبئة التلقائية (Auto-Fill Handle) المتموضع في الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) لخلية B2، حيث يتم النقر عليه نقراً مزدوجاً أو سحبه لأسفل حتى الخلية B6.
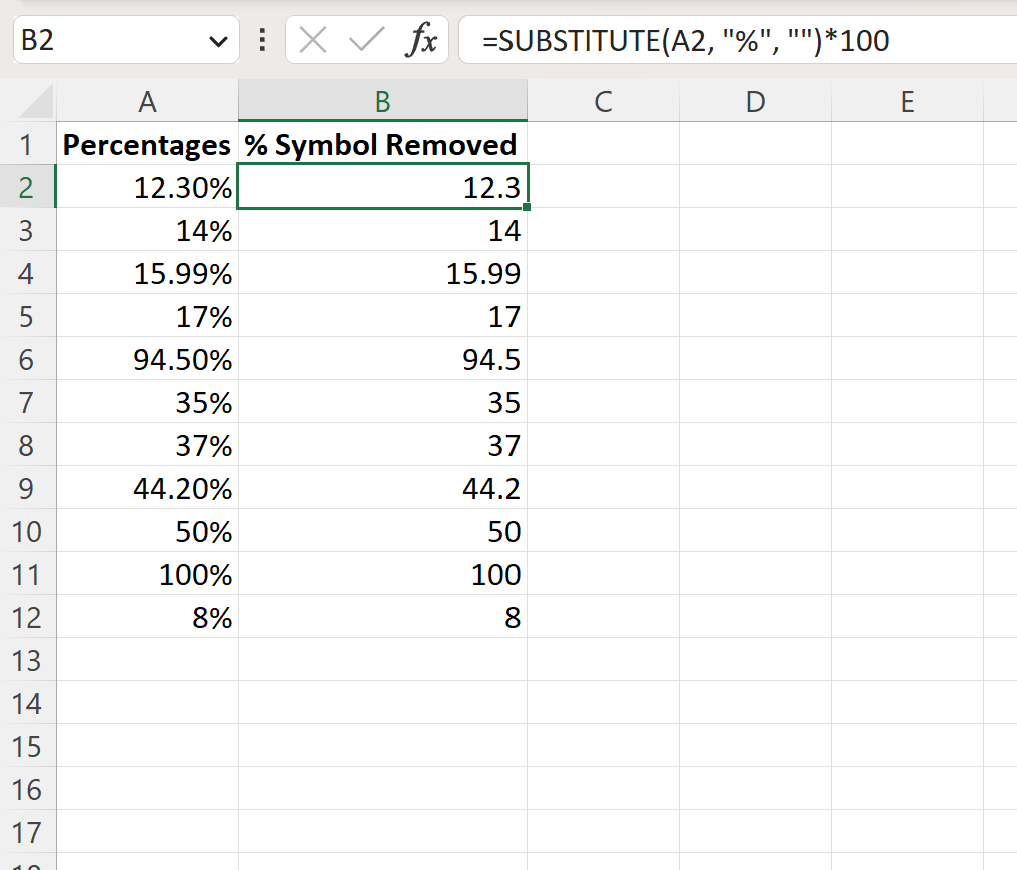
يرتكز هذا الإجراء على نظام “مراجع الخلايا النسبية” (Relative Cell References) المعتمد في إكسيل، حيث يقوم البرنامج تلقائياً بتكييف مرجع الإدخال ليتطابق مع كل صف مستهدف؛ فتتحول الصيغة في B3 إلى =VALUE(SUBSTITUTE(A3, "%", ""))، وفي B4 إلى معالجة الخلية A4، وهكذا دواليك عبر كامل المصفوفة. يتطلب الرصد المنهجي خلال هذه الخطوة مراقبة عدم ظهور أي من مؤشرات الأخطاء المتقاطعة مثل #VALUE!، والتأكد من انطباق المعادلة بسلاسة عبر جميع الحالات المتطرفة، لاسيما النسب السالبة التي يجب أن تحتفظ بإشارتها الجبرية بدقة متناهية.
3.3 التحقق والتدقيق الإحصائي للنتائج المستخرجة
لا يكتمل بروتوكول معالجة البيانات دون مرحلة التدقيق والتحقق الإحصائي (Data Auditing). يتمثل الإجراء الرقابي الأول في فحص سلامة نوع البيانات المستخرجة في العمود B باستخدام الدالة المنطقية =ISNUMBER(B2)، والتي يجب أن تسفر حتماً عن النتيجة TRUE لجميع الخلايا دون استثناء. يعقب ذلك التحقق من ثبات المقاييس الحسابية؛ حيث يتم إنشاء صف إحصائي في نهاية الجدول لحساب المؤشرات المركزية.
عند تطبيق دالة المجموع =SUM(B2:B6)، نحصل على الناتج الحسابي الدقيق 152.25، بينما يؤدي تطبيق دالة المتوسط =AVERAGE(B2:B6) إلى القيمة 30.45. وفي المقابل، لو حاول المحلل تطبيق الدوال ذاتها على النطاق الأصلي A2:A6، لكانت النتيجة صفراً مطلقاً أو خطأً برمجياً، نظراً لتعامي تلك الدوال عن السلاسل النصية. كما يتعين فحص المنازل العشرية للقيمة الناتجة في الخلية B3 للتأكد من عدم حدوث أي اقتطاع أو تقريب غير مقصود للمنزلتين .75، مما يؤكد سلامة التمثيل الرياضي الكامل ومطابقته الصارمة لمعايير جودة البيانات المعتمدة في البحوث الكمية المعيارية (Brysbaert et al., 2013).
4. التحليل التقني المتعمق لآلية تفاعل إكسيل مع المعادلة
4.1 مفهوم التحويل الضمني لنوع البيانات
تستند الكفاءة البرمجية لمعادلة الاستبدال المقترنة بالعمليات الحسابية إلى خاصية متجذرة في محرك إكسيل تُعرف تقنياً بـ “التحويل الضمني للنوع” (Implicit Type Coercion). في لغات البرمجة والأنظمة الحسابية، عندما يواجه المترجم (Compiler) عملية جبرية تجمع بين نوعين غير متجانسين من البيانات (مثل ضرب سلسلة نصية تتألف من رموز رقمية في عدد صحيح صريح)، فإنه يضطر إلى اتخاذ قرار إجرائي محدد بدلاً من إيقاف المعالجة فوراً.
في بيئة إكسيل، تم تصميم خوارزمية الترجمة الداخلية لتقييم النصوص الخاضعة للعمليات الحسابية الأساسية (+، -، *، /)؛ فإذا استوفت السلسلة النصية المعايير الرياضية الدقيقة للرقم الحقيقي (بأن كانت تحتوي حصراً على أرقام وفاصلة عشرية معترف بها نظامياً وإشارة سالبة اختيارية)، فإن البرنامج يعمد خلف الكواليس إلى تفكيك الغلاف النصي المشفر، ويولد في الذاكرة كائناً رقمياً جديداً بنظام الفاصلة العائمة المزدوجة. إن علامات التنصيص الفارغة "" التي تمررها دالة SUBSTITUTE تحذف الرمز النصي % نهائياً من الوجود الفيزيائي للسلسلة، تاركة المحتوى العددي النقي معزولاً، وهو ما يتيح لعملية الضرب اللاحقة إطلاق التحويل الضمني بنجاح ساحق.
من الناحية الأدائية، تستهلك هذه العمليات دورات معالجة بالغة الضآلة في وحدة المعالجة المركزية (CPU)، مما يجعل تطبيق هذه الصيغة آمناً حتى في مجموعات البيانات الضخمة التي تتجاوز مئات الآلاف من الصفوف، دون التسبب في تجميد المصنف أو استهلاك مفرط للذاكرة العشوائية، شريطة تفادي استخدام المراجع الحلقية أو التنسيقات الشرطية المفرطة المتداخلة مع تلك المعادلات.
4.2 معالجة التباين بين النصوص الصريحة والتنسيقات الظاهرية
من الضروري إدراك الكيفية التي يتفاعل بها البرنامج حين تُطبق دالة SUBSTITUTE على خلايا تحتوي بالفعل على “أرقام منسقة بنسبة مئوية” بدلاً من “نصوص تتضمن الرمز”. إذا كانت الخلية A2 تحتوي على الرقم 0.45 ولكنها معروضة بصيغة 45% بناءً على تنسيق إكسيل الداخلي، فإن استدعاء SUBSTITUTE(A2, "%", "") قد يولد سلوكاً غير متوقع يعتمد على بنية النظام.
عندما تُمرر خلية رقمية إلى دالة نصية، يقوم إكسيل بتحويل الرقم داخلياً إلى نص بصورة تلقائية قبل تطبيق التجريد. غير أن هذا التحويل التلقائي يقرأ في كثير من الحالات القيمة المخزنة الأصلية (أي 0.45) وليس القيمة المعروضة. وبما أن النص المولد داخلياً “0.45” لا يحتوي أصلاً على المحرف "%"، فإن الدالة تفشل في العثور على ما تستبدله، وتُرجع السلسلة “0.45” كما هي دون أي تغيير. هنا تتجلى المعضلة: إذا كان هدف الباحث هو الحصول على الرقم 45 كقيمة صحيحة، فإن استخدام دالة الاستبدال على خلية منسقة رقمياً لن يحقق الغاية، بل سيبقيها عند المقياس العشري المنكمش.
تستوجب المعايير المنهجية قيام المحلل بالتدقيق في شريط الصيغ (Formula Bar) أولاً؛ فإذا ظهر الرمز “%” داخل شريط الصيغ عند النقر على الخلية، فإن الخلية نصية وتصلح لها تماماً دالة SUBSTITUTE. أما إذا اختفى الرمز من شريط الصيغ وظهر الرقم العشري المجرد، فإن الخلية تخضع لتنسيق رقمي، وتتطلب مساراً تقنياً مغايراً تماماً يعتمد على التعديل التنسيقي والضرب الحسابي لتعويض الانكماش العشري.
5. البدائل التقنية: إزالة الرمز عبر تعديل تنسيق الخلايا
5.1 استخدام لوحة تنسيق الأرقام القياسية
في الحالات التي يتم التحقق فيها من أن رمز النسبة المئوية هو نتاج تنسيق رقمي ظاهري وليس نصاً مدمجاً، يصبح استخدام الدوال النصية جهداً غير ذي جدوى. يكمن الحل القياسي المباشر في إعادة توجيه الخلية نحو فئات التنسيق العددية الأساسية عبر لوحة تنسيق الخلايا (Format Cells Dialog).
يتم هذا الإجراء عبر تحديد النطاق المستهدف، ثم استدعاء لوحة التحكم التنسيقية عبر الضغط على مفتاحي Ctrl + 1 (في بيئة ويندوز) أو Cmd + 1 (في أنظمة ماك)، أو من خلال النقر بزر الفأرة الأيمن واختيار “تنسيق الخلايا”. من تبويب “رقم” (Number)، يتم تحويل الفئة من “نسبة مئوية” (Percentage) إلى فئة “عام” (General) أو “رقم” (Number) مع تحديد عدد المنازل العشرية المرغوبة. غير أن تطبيق هذه الخطوة بمفردها يولد الأثر الحسابي الجوهري المتمثل في تحول القيمة المعروضة 50% إلى الكسر العشري 0.5، حيث يزول الرمز التنسيقي ولكن القيمة تعود إلى تمثيلها الحقيقي غير المضروب في مئة.
إذا كان الهدف الإحصائي النهائي يقتضي الاحتفاظ بالرقم 50 كعدد صحيح بدلاً من 0.5، يجب اللجوء إلى تقنية التعديل التعويضي باستخدام ميزة “اللصق الخاص” (Paste Special). تتلخص هذه التقنية في الخطوات الإجرائية التالية:
- كتابة الرقم
100في أي خلية فارغة ومستقلة خارج نطاق العمل، ثم نسخها بالضغط علىCtrl + C. - تحديد كامل نطاق الخلايا المراد تعديلها والتي أصبحت تعرض كسوراً عشرية (مثل 0.5 و0.25).
- استدعاء نافذة اللصق الخاص عبر الاختصار
Ctrl + Alt + V، ثم تحديد الخيار “ضرب” (Multiply) من قسم العمليات، والنقر على “موافق”. - إعادة ضبط تنسيق النطاق فوراً إلى “عام” أو “رقم” لضمان مسح أي مخلفات تنسيقية سابقة.
تؤدي هذه العملية إلى مضاعفة الأساس الرياضي لجميع الخلايا في خطوة واحدة دون الحاجة إلى إنشاء أعمدة إضافية أو كتابة معادلات جديدة، مما يعيد ضبط المقاييس الرقمية بدقة فائقة وسرعة تنفيذية عالية.
5.2 الاعتماد على التنسيقات المخصصة المتقدمة
توفر بيئة إكسيل أداة قوية للغاية تتيح للمحللين التحكم المطلق في المظهر البصري للأرقام دون المساس بتركيبتها الجوهرية، وذلك عبر شفرات التنسيق المخصص (Custom Number Formats). يمكن توظيف هذه الشفرات لإلغاء المظهر البصري لرمز النسبة المئوية مع الإبقاء على الخلية في حالتها الرقمية، بل وحتى محاكاة ضرب الرقم بصرياً دون تغيير قيمته الحقيقية.
للوصول إلى هذه الوظيفة، يفتح المحلل نافذة “تنسيق الخلايا” عبر الاختصار Ctrl + 1، ويتجه إلى خيار “مخصص” (Custom) في أسفل قائمة الفئات. في حقل “النوع” (Type)، يمكن للمستخدم كتابة شفرات تحكم محددة تلغي القناع المئوي. غير أن هذه الطريقة تفرض قيوداً تقنية منهجية بالغة الأهمية يجب التحذير منها:
إن التنسيق المخصص يغير فقط الصورة المنعكسة على الشاشة، بينما يظل محتوى الخلية الأساسي المخزن في الذاكرة دون تغيير. فإذا كان الرقم المخزن هو 0.45 وتم إخفاء الرمز مخصصاً ليظهر كـ 0.45 أو كـ 45 بقناع تضخيمي، فإن تصدير المصنف لاحقاً إلى ملف نصي مفصول بفواصل (CSV) أو نقله إلى بيئات تحليلية مثل R أو بايثون سيكشف القيمة الحقيقية المخزنة 0.45، مما يسقط كافة التنسيقات المخصصة فوراً. وبالتالي، لا يُعتد بهذه الوسيلة في مشاريع حوكمة وتجهيز البيانات المعيارية المعدة للتحليل الخارجي، وتقتصر فائدتها الأكاديمية على إعداد التقارير المطبوعة والمستندات المصرفية ذات الاستخدام الداخلي الحصري.
6. تطبيق تقنية البحث والاستبدال المدمجة للمعالجة الجماعية
6.1 تنفيذ إجراء الاستبدال الشامل للرموز النصية
عندما تكون البيانات المستوردة ضخمة وتحتوي ملايين المحارف النصية الملوثة برمز النسبة المئوية المادي، تمثل أداة “البحث والاستبدال” (Find and Replace) حلاً فائق السرعة للمعالجة في نفس المكان (In-Place Transformation) دون الحاجة لإنشاء أعمدة حسابية وسيطة. تعتمد هذه الأداة على فحص مصفوفات الخلايا واستبدال المقاطع المحرفية المتطابقة فورياً.
لتطبيق هذا الإجراء بانضباط منهجي، يجب اتباع التسلسل التالي:
- تحديد نطاق الخلايا المعنية بدقة تامة لتفادي تطبيق الاستبدال غير المقصود على أجزاء أخرى من المصنف تحتوي على رموز مئوية ضرورية.
- استدعاء واجهة الاستبدال عبر الاختصار العالمي
Ctrl + H. - في حقل “البحث عن” (Find what)، يتم إدخال رمز النسبة المئوية الصريح
%دون أي مسافات إضافية. - في حقل “استبدال بـ” (Replace with)، يُترك الحقل فارغاً تماماً ومجرداً من أي محارف أو مسافات.
- النقر على زر “استبدال الكل” (Replace All). يعرض البرنامج فوراً رسالة إحصائية توضح عدد التغييرات التي تم إنجازها عبر النطاق المحدد.
تتسم هذه العملية بطبيعتها “التدميرية” (Destructive Action)؛ حيث إنها تعدل البيانات الأصلية وتلغي حالتها المصدرية بصورة نهائية داخل ملف العمل. وعليه، فإن الممارسات المنهجية الصارمة تحتم على الباحث اتخاذ نسخة احتياطية (Backup Copy) غير معدلة من المصنف قبل إطلاق الاستبدال الشامل، لحماية مسار التدقيق العلمي في حال حدوث أي تشوه غير مقصود في بنية الجداول.
6.2 معالجة العجز الحسابي بعد الاستبدال المباشر
غالباً ما يلاحظ المحللون ظاهرة غريبة عند تطبيق البحث والاستبدال على خلايا كانت خاضعة لتنسيقات متباينة؛ إذ تتحول بعض الأرقام فور استئصال الرمز المئوي إلى كسور عشرية بالغة الصغر، أو تبقى معلقة في هيئة نصوص محايدة ترفض الخضوع للعمليات الرياضية. تسمى هذه المشكلة بـ “العجز الحسابي بعد الاستبدال”.
تنشأ هذه المشكلة عندما يفسر إكسيل الرمز المستبدل كإشارة للتراجع عن التنسيق المئوي دون إعادة ترفيع الأساس الرياضي للرقم، فيتحول الرقم “25%” إلى “0.25” بدلاً من “25”. لتدارك هذا الخلل وتوحيد مقاييس المتغيرات المعالجة، يتم تطبيق إجراء “اللصق الخاص المضاعف” الذي تم تفصيله سابقاً، بضرب كامل النطاق المتضرر بالرقم 100 لتصحيح الانحراف القياسي.
أما بالنسبة للخلايا المستعصية التي تظل محتفظة بصفة السلسلة النصية بعد تفريغ الرمز منها، فيمكن إجبار إكسيل على إعادة قراءتها عبر إعادة تقييم محتوى الخلايا. يتم ذلك إما بالنقر المزدوج داخل كل خلية ثم الضغط على Enter (وهو حل غير عملي في البيانات الضخمة)، أو عبر تحديد العمود واستخدام أداة “تحويل النص إلى أعمدة” دون تغيير أي إعدادات، والنقر المباشر على “إنهاء” (Finish)، مما يطلق فحصاً تلقائياً للمحرك الحسابي يجبر كافة النصوص الرقمية على الاستقرار كأرقام قياسية صحيحة وموحدة.
7. إزالة الرمز باستخدام أداة تحويل النص إلى أعمدة
7.1 تفكيك النصوص استناداً إلى المحددات الفاصلة
تمثل ميزة “تحويل النص إلى أعمدة” (Text to Columns) إحدى أقوى أدوات هندسة البيانات المدمجة في إكسيل لمعالجة السلاسل النصية المشوبة بملحقات اصطلاحية. تقوم الفلسفة التشغيلية لهذه الأداة على شطر محتوى الخلية إلى وحدات مستقلة اعتماداً على وجود محرف فاصل محدد (Delimiter)، أو استناداً إلى عرض ثابت للحقول النصية.
عند التعامل مع رمز النسبة المئوية الملتصق بالقيم، يمكن اعتبار الرمز نفسه “محرفاً فاصلاً استثنائياً”. يتم تنفيذ هذه المعالجة وفق الخطوات التحليلية التالية:
- تحديد العمود الحاوي على النسب المئوية النصية، ثم التوجه إلى شريط الأدوات العلوي واختيار تبويب “بيانات” (Data)، ثم النقر على أيقونة “النص إلى أعمدة” (Text to Columns).
- في الخطوة الأولى من معالج التحويل المكون من ثلاث مراحل، يتم اختيار خيار “محدد” (Delimited) ثم الضغط على زر “التالي” (Next).
- في الخطوة الثانية المخصصة لتعيين الفواصل، يتم إلغاء تحديد كافة الفواصل القياسية (مثل علامة الجدولة والفاصلة والمسافة)، ثم تفعيل خيار “مخصص” أو “غير ذلك” (Other). في المربع النصي الصغير الموازي له، يتم إدخال رمز النسبة المئوية
%يدوياً. - يلاحظ المحلل فوراً في نافذة المعاينة السفلية انشطار النص إلى قسمين؛ حيث تم عزل القيمة العددية في عمود مستقل، بينما تم ترحيل رمز النسبة المئوية المستأصل إلى عمود جديد موازٍ.
- في الخطوة الثالثة، يتم تحديد وجهة الإخراج (Destination)؛ إما بالكتابة فوق البيانات الأصلية أو باختيار نطاق خلايا مجاور للاحتفاظ بالأصل. بعد النقر على “إنهاء”، يتم بكل بساطة حذف العمود الإضافي الذي استقبل الرموز المعزولة، للاحتفاظ بالعمود الرقمي الصافي فقط.
7.2 ضبط التنسيقات أثناء المعالجة بالمعالج
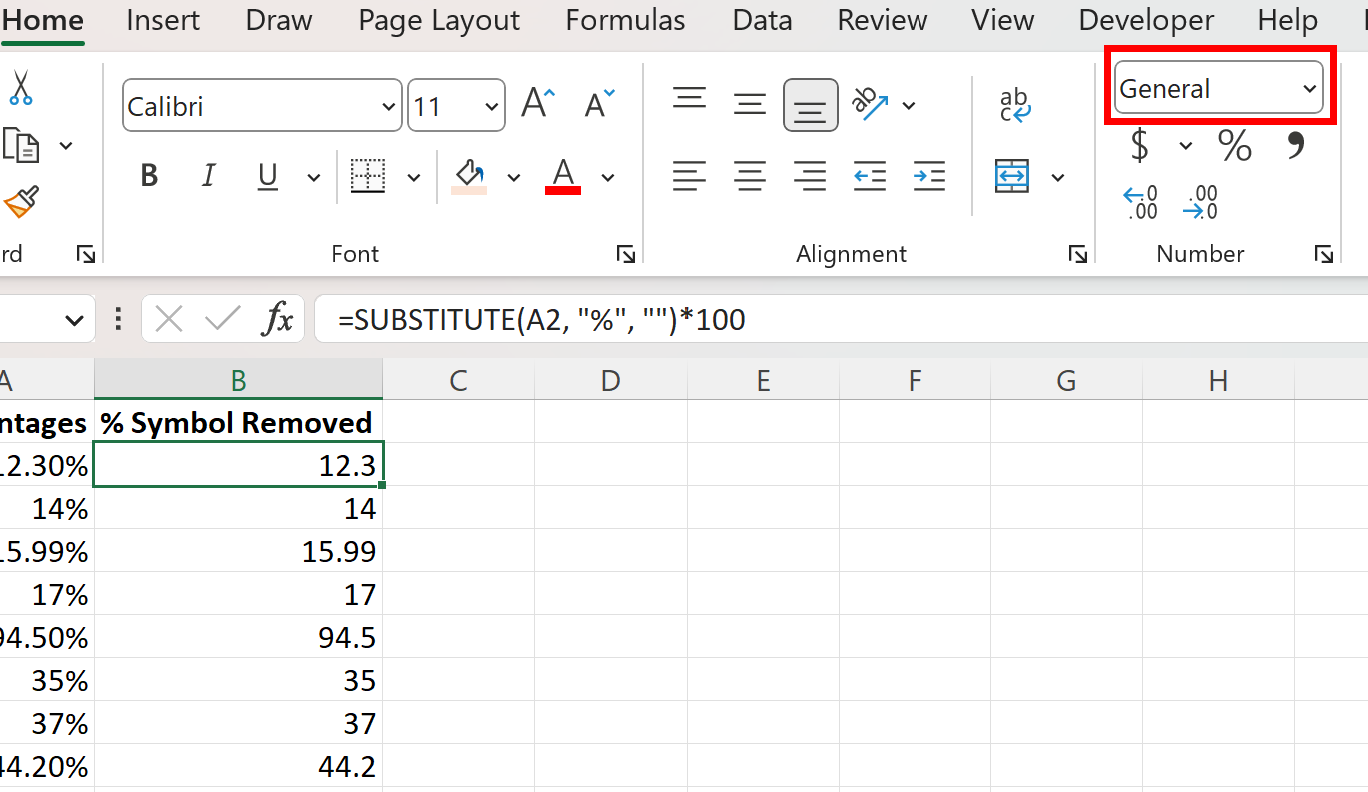
يوفر معالج “تحويل النص إلى أعمدة” ميزة تقنية فريدة تتفوق بها على الاستبدال المباشر، وتتمثل في إمكانية تعيين “تنسيق بيانات العمود” (Column data format) أثناء مرحلة التفكيك ذاتها. في الخطوة الثالثة من المعالج، يمكن للمحلل تحديد نوع العمود الناتج باختيار “عام” (General)؛ حيث يقوم إكسيل تلقائياً بتحويل القيم الرقمية المستخلصة إلى أرقام حقيقية صريحة، والتعامل مع الأرقام السالبة والكسرية بمرونة كاملة.
بالإضافة إلى ذلك، يتيح المعالج معالجة مشكلة شائعة جداً في البيانات المستوردة من خوادم عالمية، وهي مسألة تعارض الإعدادات الإقليمية للفواصل؛ فمن خلال زر “خيارات متقدمة” (Advanced) الموجود في المرحلة الثالثة، يستطيع المستخدم تحديد المحرف المستخدم للفاصلة العشرية (Decimal separator) والمحرف المستخدم لفاصل الآلاف (Thousands separator). فإذا كانت البيانات واردة بنظام أوروبي يستخدم الفاصلة العادية كعلامة عشرية، يمكن إعادة ضبطها هنا لتتوافق مع بيئة العمل المحلية للمحلل دون الحاجة لإجراء عمليات استبدال نصية إضافية معقدة.
تعد هذه الأداة خياراً مفضلاً عند تنظيف البيانات المستوردة الثابتة، غير أن عيبها المنهجي الوحيد يكمن في كونها أداة “غير ديناميكية” (Non-Dynamic)، بمعنى أنها لا تتحدث تلقائياً عند إضافة بيانات جديدة إلى الجدول، بخلاف المعادلات والصيغ الرياضية التي تعيد حساب النتائج لحظياً بمجرد تعديل المدخلات.
8. الحلول المتقدمة عبر دوال معالجة النصوص المركبة والحديثة
8.1 توظيف الدوال الاقتطاعية الرياضية
في بعض السيناريوهات المتقدمة، قد تترافق النسبة المئوية مع مسافات بيضاء غير مرئية أو محارف اصطلاحية متغيرة الموضع تمنع دالة SUBSTITUTE من العمل بدقة مطلقة، أو قد يرغب الباحث في استخدام دوال اقتطاع السلاسل النصية للتعامل مع البيانات وفق نماذج رياضية موجهة. هنا يبرز دور الدمج البنيوي بين دوال الاستقطاع الكلاسيكية: LEFT وLEN وTRIM.
إذا كان الرمز “%” يتموضع دائماً كآخر محرف في السلسلة النصية، يمكن صياغة معادلة رياضية تستقطع كامل طول النص مع استبعاد المحرف الأخير تحديداً، وفق التركيب البرمجي التالي:
=VALUE(TRIM(LEFT(A2, LEN(A2) - 1)))
يقوم هذا البناء المركب بعدة وظائف متتالية في دورة حسابية موحدة:
- تحسب دالة
LEN(A2)الطول الإجمالي للمحارف المكونة للسلسلة النصية داخل الخلية. - تطرح العملية الحسابية
- 1وحدة واحدة من الطول الكلي، وهو ما يمثل الاستغناء عن المحرف النهائي (الذي هو الرمز%). - تستقطع دالة
LEFTعدد المحارف المحدد ابتداءً من أقصى طرف السلسلة، تاركة الرمز الأخير خارج نطاق الاقتطاع تماماً. - تقوم دالة
TRIMبتنقية النص المتبقي من أي مسافات فارغة بادئة أو لاحقة قد تكون تسربت أثناء إدخال البيانات يدوياً. - وأخيراً، تتدخل دالة
VALUEلتحويل السلسلة المطهرة إلى قيمتها العددية القابلة للحساب الرياضي.
تتميز هذه المنهجية الاقتطاعية بصلابتها في مواجهة الرموز المكررة أو المتشابهة، وتمنح المحلل تحكماً صارماً في البنية التكوينية للنصوص، مما يجعلها أداة لا غنى عنها في مستودعات البيانات النصية ذات الطبيعة الحساسة والمتغيرة.
8.2 استخدام الدوال الحديثة ودوال المصفوفات الديناميكية
مع التحديثات الجوهرية التي أدخلتها مايكروسوفت على محرك إكسيل في بيئة Microsoft 365 وإصدارات Excel 2021 وما بعدها، أصبحت معالجة النصوص والبيانات تعتمد على جيل متطور من الدوال التي تدعم “المصفوفات الديناميكية” (Dynamic Arrays)، مما ألغى الحاجة لسحب المعادلات يدوياً عبر آلاف الصفوف، ووفر أدوات نصية فائقة المرونة مثل دالة TEXTBEFORE ودالة NUMBERVALUE.
يمكن استئصال رمز النسبة المئوية بكفاءة متناهية عبر استخدام دالة TEXTBEFORE، التي تقوم باستخلاص كامل النص الواقع قبل محرف معين، وفق الصيغة المتقدمة التالية:
=NUMBERVALUE(TEXTBEFORE(A2:A100, "%"))
يتميز هذا التركيب الحديث بخصائص بنيوية متطورة تعيد تعريف كفاءة المعالجة البيانية:
- الانسكاب التلقائي (Spill Feature): عند كتابة هذه الصيغة في خلية البداية (مثل
B2)، تتدفق النتائج تلقائياً إلى الأسفل لتغطي النطاق المحدد كاملاً (حتىB100) بضغطة زر واحدة، دون الحاجة لمقبض التعبئة التلقائية. - تجاوز التعارض الإقليمي عبر NUMBERVALUE: بخلاف دالة
VALUEالتقليدية، تسمح دالةNUMBERVALUEبتحديد المحارف المستخدمة للفواصل العشرية وفواصل الآلاف مباشرة داخل وسائط الدالة، مما يوفر حماية مطلقة ضد أخطاء عدم تطابق النظم الحسابية بين الأجهزة والدول. - المعالجة الشرطية المدمجة: يمكن دمج هذه الدوال مع دالة
IFودالةISNUMBERلبناء معادلة دفاعية ذكية تفحص حالة الخلية أولاً؛ فإذا كانت الخلية رقماً صريحاً احتفظت به، وإذا كانت نصاً يحمل رمز النسبة المئوية قامت باستئصاله وتحويله، وفق الصيغة المتطورة التالية:
=IF(ISNUMBER(A2), A2, NUMBERVALUE(TEXTBEFORE(A2, "%")))
يوفر هذا المستوى من النمذجة المتقدمة أقصى درجات الأمان المنهجي لخطوط أنابيب البيانات (Data Pipelines)، ويقلل التدخل اليدوي إلى الصفر تقريباً، بما يتسق مع أحدث أساليب إدارة التغيير والتحول الرقمي في الفرق البحثية والمؤسسية المعاصرة (Bagga et al., 2022).
9. الأخطاء الشائعة واستراتيجيات استكشاف المشكلات وتصحيحها
9.1 معالجة أخطاء الصيغ والتوافق الرقمي
أثناء تنفيذ عمليات إزالة رمز النسبة المئوية، كثيراً ما يصطدم المحللون بظهور رموز أخطاء مفاجئة، يقف في مقدمتها الخطأ الشهير #VALUE!. ينشأ هذا الخطأ في أغلب الأحيان نتيجة إجبار دالة التحويل (سواء كانت VALUE أو معامل الضرب الحسابي) على معالجة خلية تحتوي على نصوص أصلية غير قابلة للتحويل، كأن تحتوي الخلية المستهدفة على نصوص مثل “N/A%” أو “غ/م%”، أو وجود مسافات نصية مستعصية لا يراها المستخدم بالعين المجردة.
لتشخيص هذا الخطأ واستئصاله، يُنصح بتغليف معادلة التحويل بدالة الحماية والأمان IFERROR، والتي تتيح للمحلل تحديد سلوك بديل مدروس عند مواجهة أي خلية تالفة، بدلاً من انهيار العمود الحسابي بأكمله:
=IFERROR(VALUE(SUBSTITUTE(A2, "%", "")), "")
أما الإشكالية المنهجية الثانية فتتعلق بتعارض الفواصل العشرية (Decimal Separators) بين النمط الأمريكي (الذي يعتمد النقطة . كفاصل عشري) والنمط الأوروبي واللاتيني (الذي يعتمد الفاصلة ,). فإذا كانت البيانات مستوردة من نظام يستخدم النقطة (مثل “12.5%”) بينما تم ضبط نظام التشغيل المحلي للمحلل على استخدام الفاصلة، فإن تحويل النص المستخلص سيفشل حتماً ويولد خطأ #VALUE!. يتمثل العلاج المنهجي الجذري في توظيف دالة SUBSTITUTE المتداخلة لاستبدال النقطة بفاصلة قبل إتمام التحويل الحسابي:
=VALUE(SUBSTITUTE(SUBSTITUTE(A2, "%", ""), ".", ","))
كما يجب إيلاء عناية فائقة للنسب المئوية المحاطة بأقواس محاسبية دلالة على الإشارة السالبة، مثل (15%)؛ حيث يتطلب تحويلها بنية مركبة تتعرف على الأقواس وتستبدلها بعلامة السالب الرياضية الصريحة لمنع تشويه الاتجاه الإحصائي للمتغير.
9.2 تنظيف البيانات غير المنتظمة والمسافات الخفية
من أكثر العوائق الخفية التي تؤدي إلى فشل دوال الاستبدال الكلاسيكية وجود محارف غير مرئية مرافقة لرمز النسبة المئوية، لاسيما المسافة غير القابلة للكسر (Non-Breaking Space) المعروفة برمجياً بالشفرة CHAR(160) في ترميزات ANSI أو في صفحات الويب. عند نسخ البيانات من مصادر الإنترنت أو مخرجات أدوات جمع البيانات الإلكترونية، تلتصق هذه المسافة برمز %، مما يجعل دالة TRIM العادية عاجزة عن إزالتها؛ إذ إن TRIM مبرمجة فقط للتخلص من المسافة القياسية CHAR(32).
للتغلب على هذا التعقيد الخفي، يجب بناء صيغة تطهير متعددة الطبقات تدمج دالة CLEAN مع استبدال صريح للمحرف CHAR(160) قبل مباشرة استئصال رمز النسبة المئوية، وفق الترتيب البرمجي التالي:
=VALUE(SUBSTITUTE(SUBSTITUTE(CLEAN(A2), CHAR(160), ""), "%", ""))
تتولى دالة CLEAN في هذه الصيغة إزالة كافة المحارف غير المطبوعة (التي تحمل الشفرات من 0 إلى 31 في جدول ASCII)، بينما تتكفل دالة SUBSTITUTE الداخلية بحذف المسافات غير القابلة للكسر، وتتفرغ الدالة الخارجية لمحو الرمز المئوي، مما يتيح لدالة VALUE العمل في بيئة نصية نقية تماماً.
ولضمان جودة هذا المسار، يوصى بتطبيق “التنسيق الشرطي” (Conditional Formatting) على نطاق المخرجات لتمييز أي خلية تفشل في التحول إلى رقم (باستخدام الصيغة الشرطية =NOT(ISNUMBER(B2)))، مما يوفر تنبيهاً بصرياً فورياً للمحلل يحدد موقع الخلايا الشاذة بدقة لإخضاعها للفحص الفردي قبل المضي قدماً في التحليل الإحصائي النهائي.
10. أفضل الممارسات الأكاديمية لحوكمة البيانات وإدارة جداول إكسيل
10.1 حماية النزاهة المنهجية للبيانات الأصلية
تشدد البروتوكولات الأكاديمية الصارمة لإدارة وحوكمة البيانات (Data Governance) على مبدأ أساسي لا يقبل التهاون، وهو “مبدأ عدم التدمير للبيانات المصدرية” (Non-Destructive Data Processing). يقضي هذا المبدأ بوجوب بقاء البيانات الخام (Raw Data) كما وردت من أدوات القياس أو الاستبانات الميدانية في حالتها الأصلية دون أدنى تعديل مادي مباشر على خلاياها.
بناءً على ذلك، يعد تفضيل إنشاء “الأعمدة المشتقة” (Derived Columns) المعالجة عبر الصيغ الحسابية المنهج المعياري الأمثل، مقارنة بإجراءات الاستبدال المباشر في نفس المكان. يتيح هذا النهج مراجعة مسارات التحويل وتدقيقها في أي مرحلة من مراحل البحث، ويوفر القدرة على تصحيح أي انحراف منهجي قد يكتشف لاحقاً دون فقدان البيانات الأصلية.
كما يُلزم الباحثون بإنشاء “صحيفة بيانات وصفية” (Metadata Sheet) أو ما يعرف بـ “قاموس البيانات” (Data Dictionary) ضمن المصنف ذاته، يتم فيها توثيق الخطوات الإجرائية المتبعة لإزالة رمز النسبة المئوية، وتوضيح الصيغ الرياضية المستخدمة، وتبرير اختيار مقياس التمثيل الرقمي النهائي (هل تم التحويل إلى أرقام صحيحة $0-100$ أم كسور عشرية $0-1$). إن هذا التوثيق الدقيق يضمن إمكانية تكرار التجربة وإعادة إنتاج النتائج (Reproducibility)، وهو جوهر المصداقية والنزاهة العلمية المعترف بها في المجتمعات الأكاديمية الدولية.
10.2 التجهيز الأمثل للتصدير والتحليل الإحصائي المتقدم
تتوج مرحلة تنظيف البيانات بتجهيز مصفوفات النتائج لتكون صالحة للاستخدام المشترك عبر المنصات البرمجية المتخصصة. عند اعتماد استخدام الصيغ الرياضية لإزالة رمز النسبة المئوية، تظل الخلايا المعالجة محكومة بالارتباط الديناميكي بتلك الصيغ؛ وإذا ما قام المحلل بتصدير الملف أو حذف الأعمدة المصدرية، فإن جميع النتائج ستتحول فوراً إلى خطأ المرجع الشهير #REF!.
لتفادي هذا الانقطاع المرجعي، تتلخص الممارسة الأكاديمية القياسية في خطوة “تثبيت القيم” (Freezing Values) عبر التسلسل التالي:
- تحديد العمود المعالج بالكامل ونسخه بواسطة الاختصار
Ctrl + C. - النقر في نفس الموضع أو في عمود جديد مخصص للتصدير، واختيار “لصق كقيم” (Paste as Values) عبر الاختصار
Ctrl + Alt + Vثم اختيارV. - يؤدي هذا الإجراء إلى قطع الرابط الديناميكي بالمعادلات وتحويل النتائج إلى أرقام مادية مصمتة وثابتة في خلاياها.
عقب تثبيت القيم، تصبح مصفوفة البيانات مهيأة تماماً للتصدير بتنسيقات النصوص المسطحة مثل القيم المفصولة بفواصل (CSV) أو المفصولة بعلامات جدولة (TSV). ويجب في هذا السياق اختبار التوافق التبادلي للملف المصدر بفتحه في بيئات التحليل المستهدفة مثل R أو SPSS أو لغات معالجة اللغات الطبيعية وهندسة الميزات الحاسوبية (Nijhawan et al., 2022)، والتحقق من أن المتغير المقاس قد صُنّف تلقائياً كمتغير كمي مستمر (Continuous/Numeric Vector)، مما يمهد الطريق لإجراء نمذجة إحصائية متقدمة تستند إلى ركائز بنيوية بالغة النقاء والدقة.
خاتمة
في الختام، يتبين أن عملية إزالة رمز النسبة المئوية في برنامج مايكروسوفت إكسيل تتجاوز كونها مجرد مهارة تقنية روتينية لتلامس جوهر حوكمة البيانات ودقة النمذجة الرياضية. لقد أظهر التحليل التفصيلي أن التعامل الواعي مع البيانات يستلزم فهماً عميقاً للفارق البنيوي بين المظهر التنسيقي البصري والمحتوى الرقمي الحقيقي المخزن في ذاكرة الحاسوب. وتظل المنهجية المعتمدة على دمج دالة SUBSTITUTE مع العمليات الحسابية التحويلية المباشرة (أو دالة VALUE) هي المسار المنهجي الأكثر أماناً وقابلية للتعميم، نظراً لقدرتها على تجريد الرمز وإعادة إكساب القيمة صفتها العددية الصريحة في خطوة واحدة دون الإضرار بسلامة البيانات الأصلية.
إن تبني أفضل الممارسات الموثقة، بدءاً من فحص طبيعة المدخلات عبر الدوال التشخيصية، مروراً بتنقية المحارف الخفية، ووصولاً إلى تجميد القيم وتوثيق الإجراءات في قواميس البيانات، يضمن للمحلل والباحث إنتاج مخرجات رقمية عالية الجودة تلبي المعايير الصارمة لبيئات التحليل الإحصائي المتقدمة والتعلم الآلي. ومن خلال استيعاب هذه الآليات وتطويعها، يتحول جدول البيانات من مجرد وعاء لتكديس الأرقام إلى قاعدة رصينة وموثوقة تدعم اتخاذ القرارات القائمة على الأدلة الكمية الدقيقة وتخدم البحث العلمي بأعلى مستويات النزاهة والموثوقية.
المراجع
Bagga, S. K., Gera, S., & Haque, S. N. (2022). The mediating role of organizational culture: Transformational leadership and change management in virtual teams. Asia Pacific Management Review. https://doi.org/10.1016/j.apmrv.2022.07.003
Boulton, A., & Vyatkina, N. (2021). Thirty years of data-driven learning: Taking stock and charting new directions over time. Language learning & technology. https://doi.org/10.64152/10125/73450
Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
Nijhawan, T., Attigeri, G. V., & Thalengala, A. (2022). Stress detection using natural language processing and machine learning over social interactions. Journal Of Big Data. https://doi.org/10.1186/s40537-022-00575-6
Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0