
تمثل إدارة البيانات الرقمية وتنقيتها حجر الزاوية في بناء المنظومات التحليلية المعاصرة؛ إذ تشير الدراسات المعنية بكفاءة الأعمال وإنتاجية بيئات العمل إلى أن جودة تدفق البيانات تنعكس مباشرة على تقليص الجهد الإدراكي المبذول في تصحيح الأخطاء التشغيلية وزيادة الفاعلية المؤسسية (Oswald et al., 2015). وفي هذا السياق، يُعد برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشاراً واستخداماً لمعالجة الجداول الحسابية والبيانات المجدولة منذ إطلاقه في منتصف ثمانينيات القرن الماضي، حيث طُوّرت بيئته الحسابية استناداً إلى المفاهيم الأولية للجداول الإلكترونية التي أرساها دان بريكلن وبوب فرانكستون في برمجية VisiCalc عام 1979. ومع ذلك، يواجه المحللون والباحثون تحدياً متكرراً يتمثل في تسلل محارف وزوائد نصية غير مرغوب فيها، تأتي في مقدمتها علامات الاقتباس المفردة والمزدوجة، والتي تؤدي إلى عرقلة العمليات الحسابية وإفساد اتساق قواعد البيانات الموجهة للتحليل الإحصائي أو النماذج اللغوية (Kosiński, 2024).
تكمن إشكالية علامات الاقتباس في طبيعتها المزدوجة داخل بيئة إكسيل؛ فهي تارةً تُستخدم كأداة برمجية تنظيمية لتحديد بدايات النصوص ونهاياتها، وتارةً أخرى تظهر كرمز نصي أصيل داخل السلسلة المحرفية ذاتها. هذا الالتباس البنيوي لا يؤدي فقط إلى تشويه الجانب الجمالي والعرض المرئي للجداول والتقارير التنفيذية، بل يمتد ليعطل عمل الدوال المرجعية المتقدمة، ويتسبب في فشل مطابقات السجلات عبر الجداول المتقاطعة، ويخلق اختلالات نوعية أثناء تصدير البيانات إلى بيئات برمجية وقواعد بيانات خارجية. ومن هنا، يغدو اكتساب فهم منهجي دقيق لآليات تطهير السلاسل النصية متطلباً أساسياً لكل من يتعامل مع البيانات على مستوى أكاديمي أو مهني محترف.
يركز هذا الدليل المرجعي الشامل على معالجة هذه المعضلة عبر تفكيك الأسباب الجذرية الكامنة وراء ظهور علامات الاقتباس، وتقديم استعراض تحليلي وتطبيقي مفصل لطريقتين قياسيتين للتخلص منها نهائياً: الطريقة التفاعلية اليدوية القائمة على أداة “البحث والاستبدال” (Find and Replace)، والطريقة الديناميكية الصيغية المعتمدة على دالة الاستبدال النصي (SUBSTITUTE) المعززة برموز المحارف القياسية. وسيتناول المقال الجوانب الفنية لكلتا الطريقتين، بدءاً من المعالجة الإتلافية المباشرة وحتى الحلول غير الإتلافية القابلة للأتمتة في نماذج البيانات الكبيرة والمعقدة، مع بيان أفضل ممارسات الحوكمة لضمان سلامة الأصول الرقمية للمؤسسات والباحثين.
1. مقدمة منهجية حول معالجة النصوص وعلامات الاقتباس في برنامج إكسيل
1.1 طبيعة علامات الاقتباس وتأثيرها على بنية البيانات النصية
تُعد علامات الاقتباس المزدوجة (") وعلامات الاقتباس المفردة (') من الرموز الأساسية التي تُستخدم في علوم الحاسوب كـ “محددات نصية” (Text Delimiters). تتمثل وظيفة هذه المحددات في إبلاغ المحركات الحسابية ومفسرات الأكواد بأن المحتوى المحصور بينها يجب معاملته ككتلة نصية حرفية (String Literal) وليس كأمر برمجي، أو مرجع خلية، أو قيمة رقمية قابلة للحساب الرياضي. في برنامج إكسيل، تتخذ هذه المحارف دوراً محورياً في بناء المعادلات؛ حيث تُحاط المعاملات النصية داخل الصيغ الحسابية بعلامات اقتباس مزدوجة، كأن يُكتب الشرط في الدالة الشرطية بصيغة تفصل بين النص المنطقي والعملية الرياضية.
ومع ذلك، ينشأ التداخل الإشكالي عندما تصبح علامة الاقتباس جزءاً أصيلاً ومخزناً في الذاكرة المخصصة لمحتوى الخلية النصي، وليست مجرد غلاف خارجي ينتهي دوره بمجرد إدخال البيانات. إن وجود علامة اقتباس كرمز محرفي داخل الخلية يغير بصورة جذرية تصنيف نوع البيانات (Data Type) من قيمة رقمية أو تاريخية إلى سلسلة نصية غير متجانسة. على سبيل المثال، تؤدي إحاطة القيمة الرقمية “150” بعلامات اقتباس إلى تحويلها تلقائياً إلى نص مجرد، مما يمنع محرك إكسيل من إدراجها ضمن العمليات التجميعية التلقائية مثل دوال الجمع وحساب المتوسطات الحسابية دون تدخل يدوي إضافي لإعادة تحويلها.
يمتد التأثير البنيوي لعلامات الاقتباس الزائدة إلى اضطراب محاذاة البيانات وتنسيقها الظاهري؛ إذ يُجري إكسيل محاذاة افتراضية للأرقام جهة اليمين وللنصوص جهة اليسار (في الواجهات اللاتينية والعكس في الواجهات العربية المعربة). هذا التباين الشكلي يربك القارئ ويوحي بوجود خلل في اتساق الإدخال، فضلاً عن أن وجود علامات الاقتباس يُربك محركات الفرز (Sorting) والترتيب الأبجدي، حيث تُعطى الأولوية للرموز والمحارف الخاصة على حساب الأحرف الأبجدية، مما يؤدي إلى بعثرة الصفوف وانفصال السجلات المتشابهة داخل قواعد البيانات الضخمة (Lété et al., 2004).
1.2 الدوافع التحليلية لإزالة علامات الاقتباس من جداول البيانات
تتجاوز الحاجة إلى تنظيف البيانات الرغبة في تحسين التنسيق الشكلي؛ إذ ترتبط بدوافع تحليلية وتقنية تمس صلب العمليات الحسابية المتقدمة. يُعد إخفاق الدوال المرجعية، مثل دالة البحث العمودي VLOOKUP والدالة الحديثة XLOOKUP ودالتي INDEX وMATCH، من أبرز التداعيات المباشرة لوجود علامات الاقتباس غير المعالجة. تعتمد هذه الدوال على التطابق الثنائي الصارم (Exact Match) بين مفتاح البحث والمصفوفة المستهدفة؛ وإذا كانت القيمة المراد البحث عنها مخزنة بصيغة A101 بينما السجل المقابل في الجدول المرجعي يحتوي على “A101”، فإن الخوارزمية تعتبرهما قيمتين مختلفتين كلياً، وينتج عن ذلك خطأ عدم العثور على القيمة المألوف (#N/A).
إضافة إلى ذلك، تفرض بروتوكولات تكامل النظم وتصدير البيانات إلى قواعد البيانات العلائقية (Relational Databases) مثل SQL Server وOracle متطلبات صارمة تتعلق باتساق الحقول. فوجود علامات اقتباس غير منضبطة داخل الحقول النصية قد يؤدي إلى كسر تعليمات لغة الاستعلام المهيكلة (SQL Injection vulnerabilities or Syntax Errors)؛ حيث تُفسر قواعد البيانات علامة الاقتباس المفاجئة على أنها نهاية غير متوقعة للحقل النصي، مما يتسبب في فشل عملية الاستيراد التراكمي (Bulk Insert) بالكامل وتوقف خطوط معالجة البيانات المؤتمتة (Data Pipelines).
وعلى صعيد التقارير الإدارية والأكاديمية، يتطلب الإخراج النهائي عرضاً بصرياً خالياً من الشوائب التقنية. إن ظهور علامات الاقتباس حول أسماء الكيانات، أو المدن، أو المنتجات، يعكس ضعفاً في ممارسات ضبط جودة البيانات، ويشتت انتباه متخذي القرار عن المعطيات التحليلية الجوهرية. ومن شأن إزالة هذه العوالق الرمزية توحيد المظهر العام للجداول وجعلها مؤهلة للعرض المباشر في لوحات المؤشرات (Dashboards) والمنشورات العلمية المحكمة دون الحاجة إلى معالجات يدوية لاحقة ومستهلكة للوقت.
1.3 نظرة عامة مقارنة بين الطريقتين الأساسيتين للحل
يوفر برنامج إكسيل منهجين رئيسيين لمعالجة وإزالة علامات الاقتباس، يختلفان في الفلسفة البرمجية وطبيعة الأثر المترتب على بنية الملف. يتمثل المنهج الأول في استخدام أداة البحث والاستبدال (Find and Replace)، وهي أداة تفاعلية مدمجة تتيح للمستخدم استبدال المحارف المستهدفة مباشرة داخل الخلايا المحددة. تتميز هذه الأداة بالسرعة الفائقة والقدرة على إجراء تعديلات شاملة وفورية دون الحاجة إلى إنشاء أعمدة وسيطة أو كتابة صيغ رياضية معقدة، مما يجعلها الخيار المثالي للمعالجات السريعة لمرة واحدة (Ad-hoc Cleaning).
في المقابل، يتمثل المنهج الثاني في توظيف الحلول الصيغية الديناميكية عبر دالة الاستبدال (SUBSTITUTE). تعمل هذه الدالة على قراءة محتوى الخلية المصدري ومعالجته برمجياً لإنتاج سلسلة نصية مطهرة داخل خلية جديدة مستقلة، مما يحافظ على سلامة البيانات الأصلية من التعديل المباشر. وتبرز القوة الاستثنائية لهذه الطريقة عند الرغبة في بناء نماذج عمل مستمرة تستقبل بيانات خاماً متجددة بانتظام؛ حيث تضمن الصيغة تنظيف المدخلات الجديدة تلقائياً بمجرد إدراجها دون تدخل بشري يدوي متكرر.
يتوقف الاختيار المنهجي بين هاتين الأداتين على طبيعة المهمة وحجم مجموعة البيانات ودرجة الحساسية المطلوبة. فالأداة التفاعلية تمثل تدخلاً إتلافياً (Destructive Edit) يُلغي الحالة الأصلية للخلية نهائياً بمجرد حفظ المصنف، بينما توفر الصيغة الحسابية طبقة أمان غير إتلافية (Non-destructive) تتيح المراجعة والتدقيق والمقارنة المتوازية، وهو ما يتوافق مع المعايير الصارمة لبروتوكولات إدارة البيانات في الأبحاث والمشاريع التقنية الدقيقة.
2. أسباب ظهور علامات الاقتباس غير المرغوب فيها في مصنفات إكسيل
2.1 استيراد ملفات CSV والنصوص المحددة بفواصل ومحددات
تنشأ الغالبية العظمى من مشكلات علامات الاقتباس عند تصدير البيانات واستيرادها عبر ملفات القيم المفصولة بفواصل (Comma-Separated Values – CSV). تتبع هذه الملفات معايير محددة (مثل المعيار RFC 4180)، تفرض تغليف أي حقل نصي يحتوي داخله على فاصلة جغرافية أو لغوية بعلامات اقتباس مزدوجة، لضمان عدم قيام البرمجيات بتقسيم الحقل الواحد إلى عمودين منفصلين. فعلى سبيل المثال، إذا تضمن حقل العنوان نصاً مثل “Riyadh, Saudi Arabia”، يقوم برنامج التصدير بتغليفه بعلامات اقتباس لتمييز الفاصلة الداخلية عن الفاصلة الفاصلة بين الأعمدة.
تحدث الأزمة الحقيقية عندما تتداخل معايير البرمجيات المختلفة أثناء التصدير والاستيراد. ففي حالات عديدة، تقوم بعض الأنظمة القديمة أو أدوات جمع البيانات عبر الإنترنت بتطبيق تغليف قسري مزدوج (Double Escaping)؛ حيث يُضاف زوج جديد من علامات الاقتباس حول النصوص التي تحتوي أصلاً على اقتباسات داخلية. وعند فتح هذا الملف داخل إكسيل دون استخدام معالج استيراد النصوص المتقدم، يعجز البرنامج عن التمييز بين المحددات الهيكلية للملف والنصوص الحقيقية، فتظهر السجلات محاطة بعلامات اقتباس ظاهرة داخل الخلايا لا يمكن التخلص منها بمجرد تغيير تنسيق الخلية المعتاد.
كما يؤدي غياب التوافق بين الإعدادات الإقليمية لنظام التشغيل (Regional Settings) إلى تفاقم هذه الظاهرة. ففي بعض البلدان الأوروبية، تُستخدم الفاصلة المنقوطة (;) كمحدد للأعمدة بدلاً من الفاصلة العادية (,) لأن الفاصلة تُستخدم فاصلاً عشرياً للأرقام. وعند فتح ملف مُصدَّر بترميز أمريكي داخل بيئة نظام ذات إعدادات أوروبية، يفشل إكسيل في معالجة المحددات تلقائياً، مما يُبقي علامات الاقتباس عالقة كنصوص صلبة داخل حقول ورقة العمل.
2.2 أخطاء النسخ واللصق من مصادر الويب والمستندات الخارجية
يُعد النقل المباشر للبيانات عبر أوامر النسخ واللصق من صفحات الويب ومستندات معالجة الكلمات المتقدمة مصدراً رئيساً لتلوث السلاسل النصية بمحارف غير متوافقة. فعند نسخ جدول منشور على صفحة إنترنت أو واجهة برمجية، تنتقل في كثير من الأحيان نصوص محمية بعلامات اقتباس غير مرئية أو محارف تحكم خاصة بلغة ترميز النص الفائق (HTML)، مثل الكيانات الرمزية الخاصة باقتباس النصوص (كـ ")، والتي يترجمها إكسيل إلى رموز اقتباس نصية داخل خلايا الجدول.
علاوة على ذلك، تستخدم محررات النصوص المتقدمة، مثل Microsoft Word ومحررات النشر المكتبي، ما يُعرف بـ “علامات الاقتباس الذكية” أو المنحنية (Smart/Curly Quotes: “ ” و ‘ ’) بدلاً من علامات الاقتباس المستقيمة القياسية المعتمدة في البرمجة والأنظمة الحاسوبية (Straight Quotes: ” و ‘). تتميز علامات الاقتباس المنحنية برموز كودية مختلفة تماماً في جدول المحارف، وعند نسخها ولصقها داخل إكسيل، لا يتعامل معها البرنامج كمحددات نصية عادية، بل يعتبرها نصوصاً طباعية أصيلة، مما يجعل إزالتها بالطرق التقليدية المقتصرة على الاقتباس المستقيم أمراً غير مجدٍ ويتطلب إجراءات متخصصة.
يتفاقم هذا التباين التنسيقي عند استيراد نصوص تتضمن علامات ترقيم لغوية متداخلة مع أسماء الكيانات أو الاقتباسات التوثيقية، حيث تختلط علامات التنصيص اللغوية بالرموز البرمجية، مؤدية إلى تباين شكلي صارخ يخل بوحدة النسق البصري للبيانات الأكاديمية والمهنية ويزيد من احتمالات الخطأ أثناء معالجة المتون المعجمية (Lété et al., 2004).
2.3 التنسيقات التلقائية والتحويل القسري للأرقام إلى نصوص
يتضمن تصميم إكسيل ميزة مبيتة تسعى للحفاظ على تنسيق البيانات الرقمية الحساسة، مثل أرقام الهواتف، والرموز البريدية، والأرقام الوطنية، وأكواد المنتجات التسلسلية. تتمثل هذه الميزة في إمكانية وضع علامة اقتباس مفردة (') في أقصى يسار الخلية كبادئة إجبارية. تعمل هذه البادئة على إلزام محرك إكسيل بالتعامل مع المحتوى اللاحق كنص صريح، مما يحول دون الحذف التلقائي للأصفار البادئة (Leading Zeros) أو تحويل الأرقام الضخمة تلقائياً إلى الترميز العلمي الإحصائي المقتضب (Scientific Notation: e.g., 1.23E+11).
تكمن المفارقة في أن علامة الاقتباس المفردة البادئة لا تظهر عادة داخل الخلية عند استعراضها بالعين المجردة، بل تقتصر على الظهور في “شريط الصيغة” (Formula Bar) في الجزء العلوي من البرنامج. بيد أنه في سيناريوهات برمجية معينة—مثل استخراج البيانات عبر استعلامات مخصصة أو دمج النصوص باستخدام صيغ الدمج اليدوي القديمة—تتحول هذه العلامة المفردة أو المزدوجة من بادئة تحكم تنسيقية خفية إلى محرف حقيقي مرئي داخل الخلية نفسها، مما يسبب تشويهاً غير متوقع في محتوى السجلات.
هذا التحويل القسري للأرقام إلى سلاسل نصية مقتبسة يحرم المحلل من القدرة على استخدام هذه المعرفات في المخططات البيانية (Charts) والجداول المحورية (Pivot Tables)؛ إذ لا تستجيب هذه الأرقام المقتبسة لعمليات التجميع العددي والفرز التصاعدي الرياضي، بل تعامل معاملة الكلمات والحروف، مما ينجم عنه وضع الرقم “100” قبل الرقم “2” في الترتيب الأبجدي، وهو ما يفسد المخرجات الإحصائية ويشوه مصداقية النماذج التحليلية المعتمدة على هذه المصنفات.
3. الطريقة الأولى: إزالة علامات الاقتباس باستخدام أداة البحث والاستبدال
3.1 الأساس النظري والوظيفي لنافذة البحث والاستبدال
تستند أداة البحث والاستبدال في مايكروسوفت إكسيل إلى خوارزمية بحث نصي نمطية مصممة لمسح مصفوفة الخلايا المحددة بايت بعد بايت، والبحث عن تطابق محرفي متسلسل بين القيمة المستهدفة ومحتويات الخلايا المخزنة في الذاكرة الحية (RAM). وتتميز هذه الأداة بأنها تُجري تعديلاً هيكلياً “إتلافياً” في موقع البيانات نفسه (In-Place Editing)؛ أي أنها تعيد كتابة محتوى الخلية مباشرة دون استبقاء القيمة السابقة في سجل مؤقت، ما لم يقم المستخدم بإلغاء العملية فورياً عبر أمر التراجع المتسلسل (Undo).
يقوم المفهوم الأساسي لإزالة المحارف عبر هذه الأداة على فكرة “الاستبدال بالسلسلة النصية الفارغة” (Replacement with a Null String). في المنطق الحاسوبي، السلسلة الفارغة ليست مسافة بيضاء، بل هي انعدام مطلق لأي محرف أو كود ثنائي في الموضع المحدد. وبالتالي، عندما يوجه المستخدم البرنامج للبحث عن علامة الاقتباس وترك حقل الاستبدال فارغاً كلياً، يقوم المحرك بمسح رمز علامة الاقتباس وإغلاق الفجوة المحرفية داخل النص الأصلي دون إدخال أي أثر فراغي جديد.
تتمتع هذه الآلية بميزة حاسمة تكمن في قدرتها على معالجة مئات الآلاف من الخلايا في أجزاء من الثانية دون إثقال كاهل المعالج المركزي بالمعادلات المتكررة، مما يجعلها الأداة المفضلة لدى خبراء قواعد البيانات عند تنقية ملفات السجلات الكبيرة غير المرتبطة بصيغ حسابية ديناميكية، وبخاصة قبل تصديرها النهائي نحو أدوات ذكاء الأعمال مثل Power BI أو قواعد بيانات المنظمات الإحصائية.
3.2 الخطوات الإجرائية التفصيلية لتنفيذ الأمر عبر اختصار Ctrl + H
لتطبيق الطريقة الأولى بصورة منهجية تضمن تفادي الأخطاء، يتعين اتباع الخطوات التقنية المتسلسلة بدقة وحذر:
- أولاً: حصر النطاق الجغرافي للبيانات: قبل استدعاء أمر البحث، يجب تحديد نطاق الخلايا التي يراد تنظيفها باستخدام الفأرة أو عبر اختصارات لوحة المفاتيح المتقدمة (مثل
Ctrl + Shift + Down Arrow). هذا الحصر يحمي بقية ورقة العمل من أي استبدال عشوائي غير مقصود. - ثانياً: استدعاء نافذة الاستبدال: اضغط بشكل متزامن على مفتاحي
Ctrl + Hفي نظام التشغيل ويندوز (أوCmd + Hفي بيئة ماك)، ليتم استدعاء مربع الحوار المعنون “بحث واستبدال” (Find and Replace) مع فتح تبويب “استبدال” مباشرة في صدارة الواجهة. - ثالثاً: تعيين محرف الاقتباس المستهدف: ضع مؤشر الكتابة داخل حقل البحث عن (Find what)، ثم قم بطباعة علامة الاقتباس المراد حذفها بدقة؛ فإذا كانت العلامة المستهدفة هي علامة الاقتباس المزدوجة، أدخل الرمز (
")، وتأكد من أن لغة لوحة المفاتيح مضبوطة لتوليد الرمز القياسي. - رابعاً: ضبط حقل الاستبدال بالمحو التام: انتقل إلى حقل استبدال بـ (Replace with)، وتأكد من كونه فارغاً تماماً. يُحظر بشدة إدخال مسافة عبر مسطرة المفاتيح؛ حيث إن إدخال مسافة سيؤدي إلى استبدال علامة الاقتباس بفراغ نصي، وهو ما يولد مشكلات محاذاة وفرز لاحقة.
- خاسماً: التنفيذ الإجمالي للعملية: انقر فوق زر استبدال الكل (Replace All). سيباشر المحرك الحسابي مسح النطاق وإجراء التعديل في موقعه الأصلي بصورة فورية لا تستغرق سوى لحظات وجيزة.
3.3 التحكم في خيارات البحث المتقدمة وتفادي التعديلات العشوائية
يحتوي مربع حوار البحث والاستبدال على زر خيارات متقدمة (Options) يُنصح بالضغط عليه قبل الشروع في الاستبدال الإجمالي، للتأكد من انضباط إعدادات المطابقة الحسابية. من أهم هذه الخيارات التحقق من تعطيل خيار “مطابقة محتوى الخلية بالكامل” (Match entire cell contents)؛ لأن تفعيل هذا الخيار سيجعل البرنامج يبحث حصرياً عن الخلايا التي لا تحتوي إلا على علامة اقتباس وحيدة ومعزولة تماماً، متجاهلاً بذلك أي علامات اقتباس محاطة بكلمات أو نصوص أخرى.
كما يجب الانتباه إلى خيار “مطابقة حالة الأحرف” (Match case) في حال كانت عملية البحث تشمل محارف لغوية مرتبطة بالاقتباسات، على الرغم من أن علامات الاقتباس القياسية لا تخضع لتصنيف الحروف الكبيرة والصغيرة (Upper/Lower Case). والأهم من ذلك هو فحص نطاق البحث المحدد في القائمة المنسدلة “ضمن” (Within)، حيث يتيح إكسيل الاختيار بين البحث داخل “ورقة العمل الحالية” (Sheet) أو مسح “المصنف بأكمله” (Workbook). ويجب التمسك بخيار ورقة العمل وضمن النطاق المظلل حصراً لتجنب إتلاف الصيغ الرياضية أو النصوص التوثيقية في أوراق العمل الأخرى.
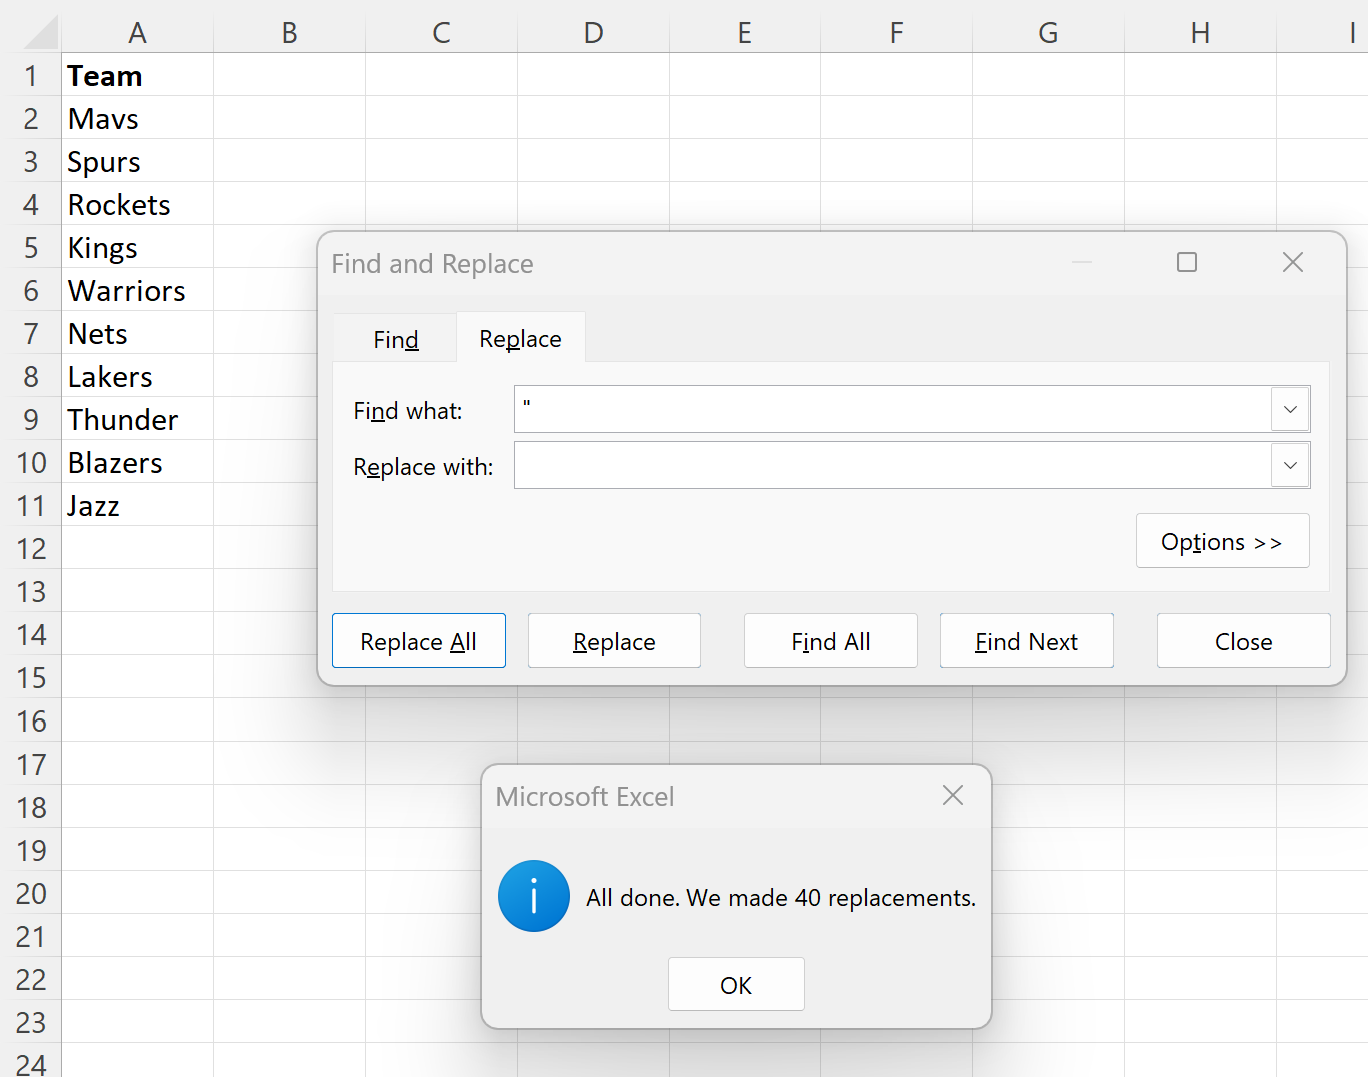
عند اكتمال العملية بنجاح، يُصدر إكسيل رسالة إشعار إحصائية تفيد بإجراء التعديلات، على غرار: “تم الأمر. قمنا بإجراء [X] من الاستبدالات” (All done. We made [X] replacements). تمثل هذه الإحصائية معياراً للتحقق والتدقيق؛ فإذا كان عدد الاستبدالات مساوياً لضعف عدد الصفوف في عمود مغلف بالاقتباسات من الجانبين، فإن هذا يؤكد مبدئياً اكتمال تنقية البيانات بصورة منضبطة ومطابقة للتوقعات الإحصائية للمحلل.
4. دراسة حالة تطبيقية للطريقة الأولى: تنظيف قائمة أسماء الفرق الرياضية
4.1 إعداد وتجهيز مجموعة البيانات التجريبية
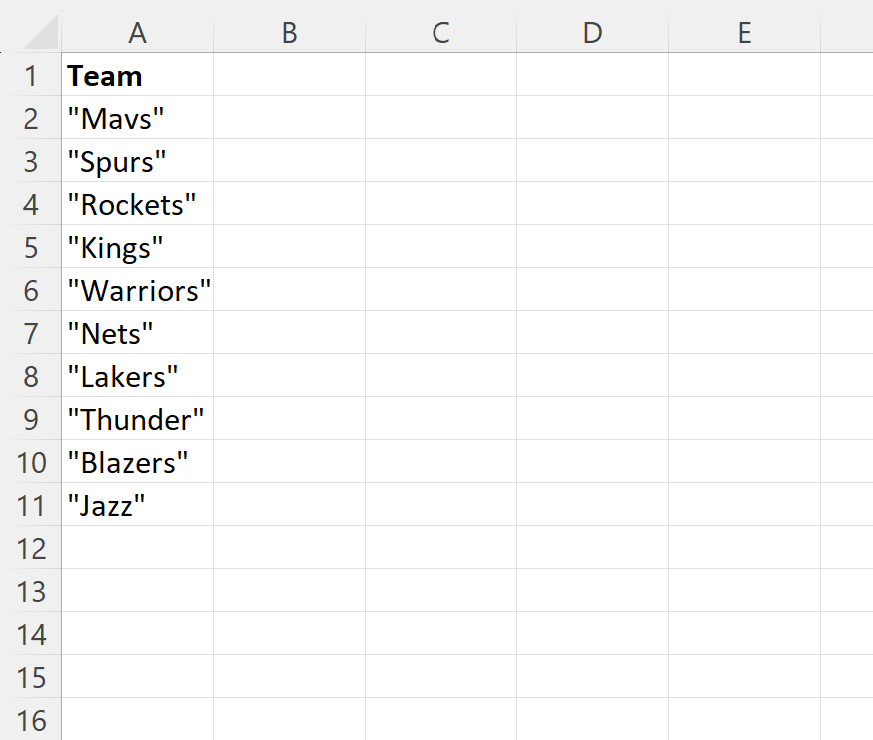
لتجسيد التطبيق العملي للطريقة الأولى، نستعرض سيناريو واقعياً مأخوذاً من سجلات الدوريات الرياضية المحترفة، حيث تم استيراد جدول بيانات يحتوي على أسماء الفرق المشاركة عبر ملف نصي خام. يمتد نطاق البيانات المستهدف عبر الخلايا من A2 إلى A11، وقد تلوثت سجلات الأسماء بعلامات اقتباس مزدوجة ناتجة عن خلل في برنامج التصدير المصدر، كما هو موضح في التمثيل البنيوي التالي للحالة القبلية للبيانات:
- الخلية A2:
"Lakers" - الخلية A3:
"Celtics" - الخلية A4:
"Warriors" - الخلية A5:
"Bulls" - الخلية A6:
"Heat" - الخلية A7:
"Spurs" - الخلية A8:
"Nets" - الخلية A9:
"Knicks" - الخلية A10:
"Rockets" - الخلية A11:
"Clippers"
تُظهر المراجعة الأولية للنطاق المذكور أن كل اسم محاط بزوج من علامات الاقتباس المزدوجة (واحدة في البداية وأخرى في النهاية). هذا التلوث الرمزي يجعل دالة العد الشرطي COUNTIF تفشل في احتساب هذه الفرق إذا تم استخدام الاسم النظيف كمعيار للبحث، فضلاً عن أن عمليات الترتيب الأبجدي ستتأثر بوجود الرمز كبادئة في كل خلية.
4.2 تطبيق إجراءات البحث والاستبدال خطوة بخطوة
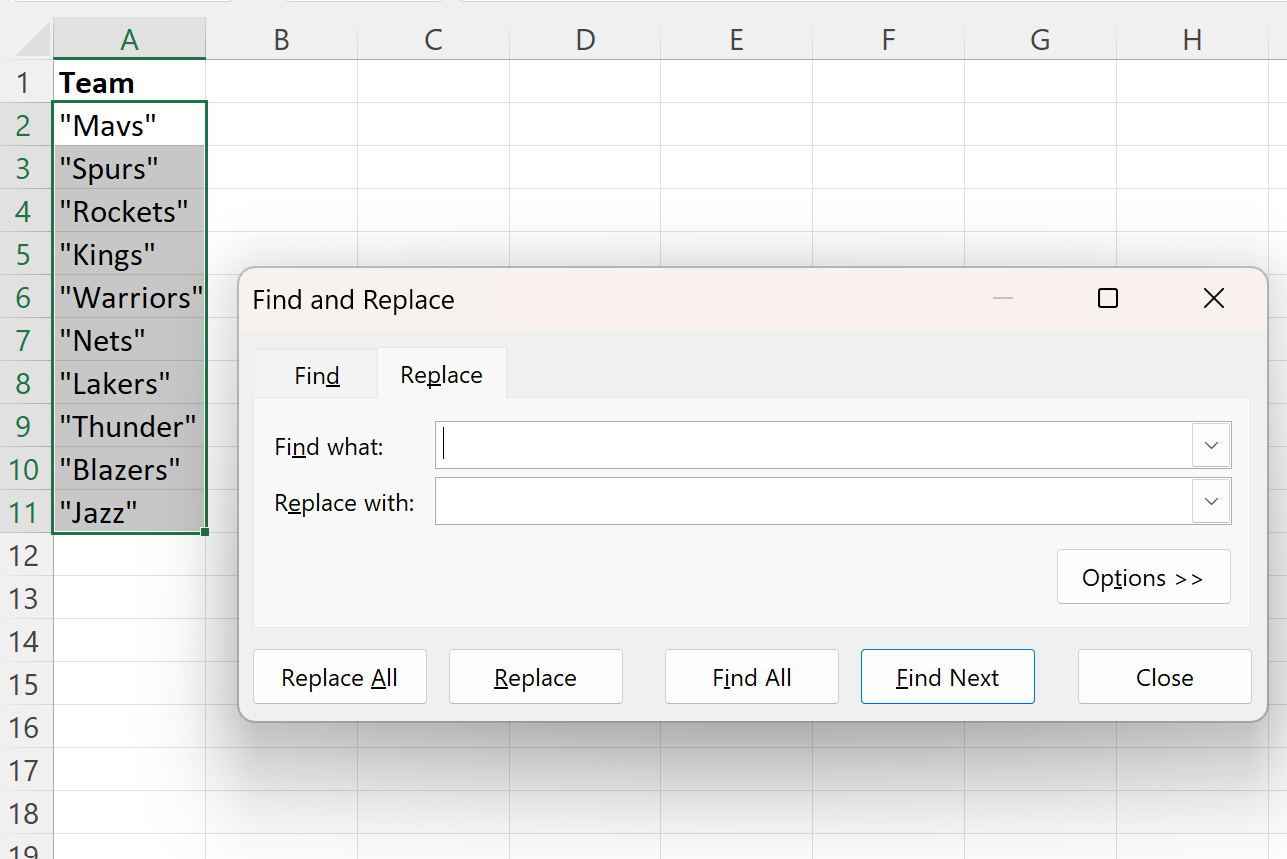
لتطهير هذه القائمة بصورة فعلية، يقوم المحلل بتظليل النطاق A2:A11 بدقة، متفادياً إدراج الخلية الرأسية A1 التي تحتوي على عنوان العمود “اسم الفريق” (Team Name) تجنباً لأي تعديل قد يطال العنوان إذا تضمن علامات ترقيم. بعد اكتمال التظليل، يتم الضغط على الاختصار Ctrl + H لإظهار نافذة المعالجة.
في حقل “البحث عن”، يُدخل المستخدم علامة الاقتباس المزدوجة (")، بينما يُترك حقل “استبدال بـ” فارغاً بصورة مطلقة. عند النقر على زر “استبدال الكل”، يقوم محرك إكسيل بمسح النطاق؛ فيبدأ بالخلية A2 ليعثر على علامة الاقتباس الأولى ويمحوها، ثم يعثر على علامة الاقتباس الختامية ويمحوها، ليتحول النص المخزن إلى Lakers فقط. تتكرر هذه الخوارزمية المتسلسلة على سائر خلايا النطاق حتى الخلية A11، وتكتمل العملية في بضع ملي ثوانٍ دون أي تأخير معالجة ملحوظ.
عقب إتمام الأمر، تظهر نافذة التأكيد موثقة تنفيذ 20 عملية استبدال بالتمام والكمال، وهو رقم يتوافق هندسياً مع وجود علامتي اقتباس في كل سجل من السجلات العشرة المكونة للقائمة التجريبية. يُغلق مربع الحوار بالنقر على “موافق” ثم “إغلاق”، لتظهر قائمة الأسماء وقد استعادت شكلها الطبيعي النظيف داخل العمود نفسه.
4.3 تقييم نتائج الاستبدال وتأكيد سلامة المحتوى
تتطلب منهجية ضبط الجودة إجراء فحص تقييمي لاحق للتأكد من عدم حدوث أي تشوهات جانبية في السجلات المعالجة. يتمثل الاختبار الأول في التحقق البصري المباشر من اختفاء الرموز في جميع الخلايا من A2 إلى A11، وملاحظة أن أطوال النصوص قد تناقصت بمقدار حرفين لكل خلية بصورة متسقة.
أما الاختبار الفني فيتضمن اختبار صلاحية السلاسل النصية للاستخدام في دوال المطابقة؛ حيث يمكن تجربة كتابة صيغة تحقق بسيطة في خلية مجاورة مثل: =A2="Lakers". إذا كانت النتيجة المنطقية المعادة هي TRUE، فإن هذا يقدم برهاناً حسابياً قاطعاً على أن محتوى الخلية أصبح نصاً خالصاً مطابقاً تماماً للنص المدخل دون أي عوالق رمزية أو مسافات خفية متبقية.
كذلك تتيح هذه الخطوة دمج النطاق المطهر مباشرة في خوارزميات التصفية والفرز (Sort & Filter) دون القلق من انزياح الترتيب أو فقدان السجلات أثناء تقاطع البيانات مع جداول الإحصاءات العامة للنقاط والأهداف، وهو ما يثبت فاعلية الطريقة الأولى في سيناريوهات المعالجة المباشرة والنهائية للبيانات.
5. الطريقة الثانية: إزالة علامات الاقتباس ديناميكياً باستخدام دالة SUBSTITUTE
5.1 البنية التركيبية والدلالية لدالة SUBSTITUTE في إكسيل
تنتمي دالة SUBSTITUTE إلى فئة معالجات النصوص المتقدمة (Text Manipulation Functions) في إكسيل، وهي دالة قياسية متوافرة منذ الإصدارات الأولى للبرنامج وتخضع لمعايير حسابية صارمة وموحدة عبر مختلف المنصات البرمجية. تعمل هذه الدالة على استبدال نص قديم بنص جديد داخل سلسلة نصية معطاة، وتتميز بأنها حساسة لحالة الأحرف والمحارف (Case-Sensitive)، مما يمنحها دقة مطلقة في التمييز بين الرموز المتشابهة في الترميز الرقمي.
تتألف البنية النحوية والتركيبية للدالة من أربعة وسائط أساسية، تُكتب وفق الترتيب القياسي التالي:
=SUBSTITUTE(text, old_text, new_text, [instance_num])
حيث يمثل الوسيط الأول (text) المرجع المصدري للخلية التي تحتوي على النص المراد تنقيته، ويمثل الوسيط الثاني (old_text) الرمز أو السلسلة النصية المراد التخلص منها واستبدالها، بينما يحدد الوسيط الثالث (new_text) القيمة البديلة المراد إحلالها في النص. أما الوسيط الرابع الاختياري (instance_num)، فيتيح تحديد رقم التكرار المراد استبداله دون المساس ببقية التكرارات؛ وفي حال حذفه كما في سياق تنظيف البيانات، تقوم الدالة تلقائياً باستبدال كافة تكرارات الرمز القديم داخل الخلية المستهدفة أينما وُجدت.
تتفوق دالة SUBSTITUTE على الأدوات التفاعلية بكونها وسيلة “غير إتلافية”؛ فهي لا تعدل القيمة المخزنة في الخلية المصدرية، بل تنشئ تمثيلاً نصياً جديداً ومستقلاً في الخلية التي تستضيف المعادلة، مما يمنح المحلل القدرة على تتبع مسار التحول البياني وإجراء عمليات المقارنة المزدوجة بين المدخلات والمخرجات بصورة موثقة وشفافة (Schwartz & Bransford, 1998).
5.2 توظيف الدالة CHAR والرمز CHAR(34) لتمثيل علامة الاقتباس المزدوجة
تنشأ عقبة برمجية شهيرة عند محاولة كتابة علامة الاقتباس المزدوجة داخل معادلات إكسيل؛ حيث يعتبر البرنامج علامة الاقتباس أداة تحديد نصية وليست نصاً في حد ذاتها. فإذا حاول المستخدم كتابة علامة اقتباس كمعامل نصي بصيغة """، فإن مفسر الصيغ يتعرض لخلل تركيبي ويعرض رسالة خطأ في الصياغة (Formula Syntax Error) بسبب عدم إغلاق الأقواس أو المحددات بصورة صحيحة.
لحل هذا التعارض البنيوي بأعلى درجات الاستقرار البرمجي، يتم اللجوء إلى جدول رموز أسكي القياسي (ASCII – American Standard Code for Information Interchange)، وهو المعيار الدولي الذي يمنح كل محرف وحرف رقماً ثنائياً ثابتاً في أنظمة الحاسوب. واستناداً إلى هذا المعيار، يمتلك رمز علامة الاقتباس المزدوجة القياسي القيمة الكودية 34. ومن خلال توظيف دالة المحارف CHAR المبيتة في إكسيل، يمكن استدعاء هذا الرمز حاسوبياً عبر كتابة التعبير الصيغي التالي:
CHAR(34)
يوفر استخدام CHAR(34) حلاً قطيعاً وأنيقاً يمنع أي غموض دلالي لدى محرك الحسابات؛ إذ يفهم البرنامج فوراً أن المطلوب هو معالجة المحرف ذي الكود 34 (علامة الاقتباس المزدوجة) دون الحاجة للجوء إلى تقنيات “تجاوز الرموز” المعقدة وغير المقروءة التي تتطلب وضع أربع علامات اقتباس متتالية ("""")، والتي غالباً ما تربك المستخدمين وتزيد من معدلات الخطأ البشري أثناء صياغة المعادلات الموسعة.
5.3 صياغة المعادلة القياسية المعتمدة لمعالجة النصوص
من خلال دمج المفاهيم الوظيفية السابقة، تتبلور المعادلة القياسية الأكثر كفاءة وأماناً لإزالة علامات الاقتباس المزدوجة من الخلايا، وتأخذ الشكل التركيبي المعتمد التالي (بافتراض أن النص المراد تطهيره يقع في الخلية A2):
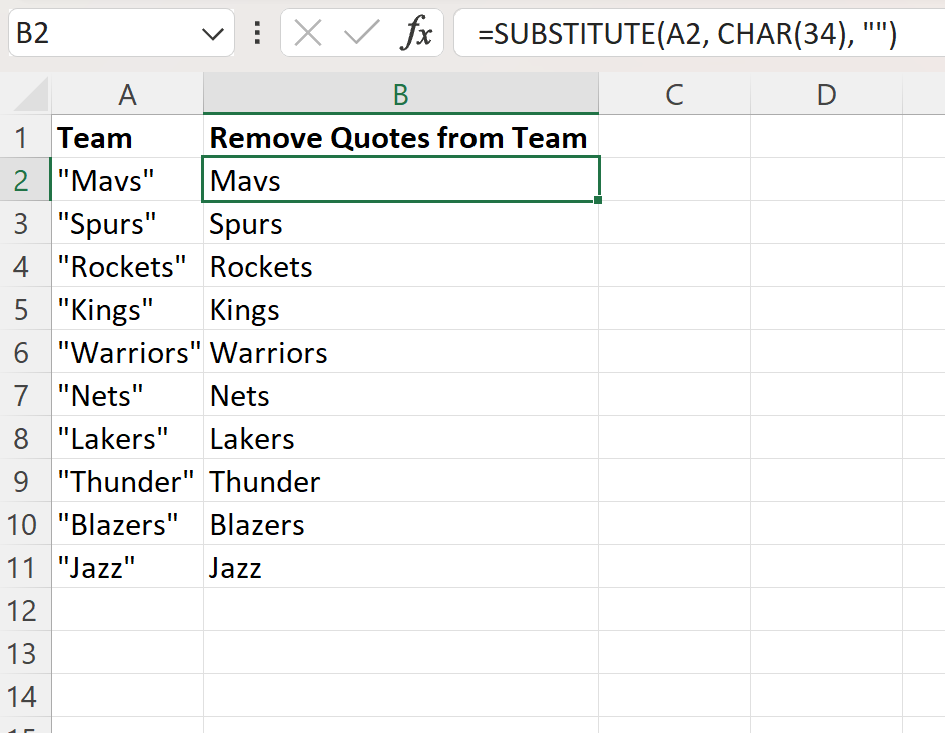
=SUBSTITUTE(A2, CHAR(34), "")
بتفكيك هذه الصيغة منهجياً، نجد أن الخلية المستهدفة بالمعالجة هي A2. ويشير المعامل الثاني CHAR(34) بدقة متناهية إلى علامة الاقتباس المزدوجة كقيمة مستهدفة للإزالة. أما المعامل الثالث ""، فيتألف من علامتي اقتباس متتاليتين تماماً دون وجود أي مسافة بينهما، وهو التعبير البرمجي القياسي في إكسيل عن “السلسلة النصية الفارغة” (Empty String). ونظراً لعدم إدراج الوسيط الرابع الاختياري، فإن الدالة تفهم وجوب مسح كافة علامات الاقتباس الموجودة في الخلية، سواء كانت في أول النص، أو وسطه، أو نهايته.
وعلى الرغم من إمكانية صياغة المعادلة المكافئة عبر أسلوب الاقتباس الرباعي: =SUBSTITUTE(A2, """", "")، إلا أن الإجماع التقني يفضل استخدام صيغة CHAR(34) لأنها توفر وضوحاً بنيوياً فائقاً للقراءة والمراجعة (Readability)، وتتكامل بسلاسة أكبر عند بناء دوال متداخلة ومعقدة لمعالجة السلاسل النصية على نطاقات مؤسسية واسعة.
6. التطبيق الإجرائي الموسع لدالة SUBSTITUTE على البيانات
6.1 كتابة وتعميم الصيغة الحسابية على النطاق المستهدف
يتطلب التطبيق العملي لطريقة SUBSTITUTE تخصيص عمود إضافي مجاور للبيانات الأصلية ليعمل كـ “عمود معالجة وتطهير”. فإذا كانت قائمة أسماء الفرق الرياضية موضوعة في النطاق A2:A11، يتم إدراج عمود جديد فارغ بجوارها يُمنح الرمز B، مع تسمية الخلية الرأسية B1 باسم وصفي ملائم مثل “الاسم المطهر” (Cleaned Name).
تبدأ الخطوة التنفيذية بإدخال الصيغة القياسية داخل الخلية B2 على النحو الآتي:
=SUBSTITUTE(A2, CHAR(34), "")
بمجرد الضغط على مفتاح Enter، تُجري الدالة معالجتها الفورية لتظهر القيمة Lakers داخل الخلية B2 خالية تماماً من علامات الاقتباس، مع بقاء القيمة الأصلية “Lakers” محفوظة كما هي داخل الخلية A2 دون أي مساس بها.
لتعميم هذه المعادلة على كامل عناصر القائمة الرياضية، يتم النقر على الخلية B2 ثم التوجه نحو الزاوية اليسرى السفلية لإطار الخلية النشط (أو اليمنى وفقاً لاتجاه واجهة البرنامج) حتى يتحول مؤشر الفأرة إلى علامة الجمع السوداء الصغيرة المعروفة بـ “مقبض التعبئة التلقائية” (AutoFill Handle). يتم النقر المزدوج السريع على المقبض، أو سحبه يدوياً إلى الأسفل حتى الخلية B11. يقوم إكسيل بتوليد الصيغ التكيفية تلقائياً عبر تعديل مراجع الخلايا النسبية (Relative References)؛ لتتحول الصيغة في B3 إلى =SUBSTITUTE(A3, CHAR(34), "")، وهكذا دواليك حتى استيفاء معالجة السجلات العشرة بنجاح واستقرار.
6.2 معالجة الارتباط التفاعلي وتجميد القيم المستخرجة
على الرغم من اكتمال ظهور الأسماء المطهرة داخل العمود B، إلا أن هذه القيم ليست نصوصاً ثابتة بالمعنى البرمجي، بل هي “مخرجات ديناميكية لصيغ حسابية نشطة”. وهذا يعني أن العمود B يظل مقيداً بوجود العمود A ومرتبطاً به ارتباطاً شرطياً؛ فإذا قام المستخدم بحذف العمود A مباشرة في هذه المرحلة، فستتعطل جميع معادلات العمود B فوراً وتتحول مخرجاتها إلى خطأ المرجع الشهير (#REF!) نظراً لغياب الخلايا المصدرية التي تعتمد عليها الصيغ.
لإنهاء هذا الاعتماد التفاعلي وتحويل المخرجات إلى نصوص مستقلة ودائمة، يجب تطبيق تقنية “التثبيت الحسابي” أو “اللصق كقيم” (Paste Special as Values) عبر الإجراءات التالية:
- تحديد النطاق المطهر كاملاً من
B2إلىB11. - نسخ المحتوى المحدد إلى الحافظة بالضغط على مفتاحي
Ctrl + C(يظهر إطار متقطع ومتحرك يحيط بالنطاق المنسوخ). - الإبقاء على تحديد النطاق نفسه دون تغيير، ثم النقر بزر الفأرة الأيمن في أي موضع داخله لاستدعاء القائمة السياقية، واختيار أيقونة قيم (Values – V) من خيارات اللصق، أو الضغط على الاختصار المتسلسل
Ctrl + Alt + Vثم اختيار “القيم” والضغط على موافق.
بإتمام هذه الخطوة، يتم مسح الصيغ الرياضية الكامنة في خلفية الخلايا ويحل محلها النص النقي الثابت، بحيث تصبح الخلية B2 تحتوي على السلسلة النصية Lakers المجردة تماماً، وكأنها كُتبت يدوياً للمرة الأولى دون وساطة أي دالة برمجية.
6.3 إزالة العمود المصدري وترتيب بنية جدول البيانات النهائي
بعد التحقق من تثبيت القيم في العمود B بنجاح وتأكيد استقلاليتها التامة عن مصادرها السابقة، يصبح من الآمن هيكلياً التخلص من العمود المصدري الملوث لتنظيم بنية المصنف وتقليص حجم الذاكرة المستخدمة. يتم النقر على رأس العمود A لاختياره بالكامل، ثم يُضغط بزر الفأرة الأيمن ويُختار أمر حذف (Delete).
بمجرد حذف العمود القديم، يزحف العمود B تلقائياً ليأخذ الموضع A في ورقة العمل. ولإتمام عملية التهيئة النهائية، يُعاد تدقيق رأس العمود لضمان بقائه مسمى بـ “اسم الفريق” (Team Name)، مع إجراء تعديل ملائم لعرض العمود عبر النقر المزدوج على الحد الفاصل بين رؤوس الأعمدة، ليتسع العمود بدقة لأطول اسم موجود في القائمة، وبذلك يصبح جدول البيانات نقياً، ومتسقاً، وجاهزاً للدمج في نظم التحليل المؤسسي والإحصائي المتقدمة.
7. مقارنة معيارية وتقنية بين أداة البحث والاستبدال ودالة SUBSTITUTE
7.1 معيار الحفاظ على البيانات: التعديل الإتلافي مقابل المعالجة غير الإتلافية
تمثل سلامة البيانات الأولية خط الدفاع الأول في التحليلات الإحصائية وتنقيب البيانات؛ إذ تفرض البروتوكولات الأكاديمية الصارمة الاحتفاظ بالبيانات الخام (Raw Data) كما هي لتمكين المراجعة وتأكيد مصداقية النتائج (Browning et al., 2021). يوضح الجدول المقارن التالي الفروق الجوهرية بين الأسلوبين:
| وجه المقارنة | أداة البحث والاستبدال (Find and Replace) | دالة الاستبدال (SUBSTITUTE) |
|---|---|---|
| طبيعة التأثير على البيانات | تعديل إتلافي مباشر (Overwrites in-place) | معالجة غير إتلافية (Preserves source data) |
| درجة الأمان والاسترجاع | منخفضة (تتطلب التراجع الفوري قبل الحفظ) | عالية جداً (البيانات الأصلية تبقى في عمودها) |
| الكفاءة مع الملفات المليونية | فائقة السرعة واستخدام منخفض للذاكرة | تستهلك موارد المعالجة عند إعادة الحساب |
| القابلية للأتمتة والتحديث | تتطلب تدخلاً يدوياً في كل مرة | ديناميكية وتتحدث تلقائياً مع تدفق البيانات |
| التعقيد الإجرائي | بسيطة للغاية ولا تتطلب معرفة بالصيغ | تتطلب كتابة صيغ وإجراء تثبيت القيم |
تُظهر القراءة التحليلية للجدول أن أداة البحث والاستبدال تحمل مخاطرة تشغيلية ملحوظة؛ ففي حال ارتكاب خطأ أثناء تحديد المحارف أو حقول الاستبدال، يُستبدل النص مباشرة دون وجود عمود مقارنة. وإذا تم حفظ الملف وإغلاقه، يفقد المحلل القدرة على التراجع (Undo)، مما قد يؤدي إلى تلف غير قابل للإصلاح في مجموعات البيانات الحساسة. في المقابل، تضمن دالة SUBSTITUTE توفير بيئة عمل آمنة، تتيح فحص النتائج جنباً إلى جنب مع المدخلات قبل اتخاذ قرار الاستغناء عن البيانات الخام.
7.2 معيار الكفاءة والسرعة الحسابية في مجموعات البيانات الضخمة
عند التعامل مع جداول بيانات عملاقة تقترب من الحدود القصوى لسعة إكسيل (أكثر من مليون صف)، يبرز معيار استهلاك الموارد الحاسوبية كعنصر حاسم في المفاضلة. تعمل أداة البحث والاستبدال بكفاءة استثنائية في هذه السيناريوهات؛ حيث تقوم الخوارزمية المكتوبة بلغة C++ والمدمجة في نواة إكسيل بمسح الخلايا وتبديل مصفوفات الرموز داخل الذاكرة بصورة مباشرة وخاطفة دون خلق بنى إضافية داخل شجرة التبعيات الحسابية للمصنف.
على العكس من ذلك، فإن تطبيق دالة SUBSTITUTE على مليون صف يؤدي إلى إنشاء مليون صيغة حسابية مستقلة يجب تقييمها والاحتفاظ بها ضمن مصفوفة شجرة الحسابات النشطة (Calculation Dependency Tree). هذا الأمر يتسبب في استهلاك مكثف للذاكرة العشوائية (RAM) وبطء ملحوظ أثناء فتح الملف أو حفظه أو إجراء أي تعديل يتطلب إعادة حساب المصنف (Workbook Recalculation). لذلك، يُوصى من منظور الأداء بتفضيل البحث والاستبدال عند معالجة الملفات المليونية الضخمة لمرة واحدة، شريطة اتخاذ تدابير النسخ الاحتياطي المحكمة، في حين تُفضل الصيغ عند بناء النماذج التحليلية المحدودة أو المتوسطة الحجم.
7.3 معيار القابلية للأتمتة والتكامل ضمن نماذج العمل المكررة
في بيئات الأعمال الحديثة التي تعتمد على استخراج تقارير دورية متكررة (يومية أو أسبوعية)، تنعدم كفاءة الحلول اليدوية التفاعلية؛ إذ يؤدي الاضطرار إلى الضغط على Ctrl + H في كل مرة يتم فيها استيراد ملف جديد إلى إهدار وقت المحللين ورفع احتمالات الخطأ والنسيان البشري. هنا تبرز الأفضلية التامة لدالة SUBSTITUTE بفضل طبيعتها الديناميكية الجاهزة للتكامل المؤتمت.
تتجلى هذه الأفضلية بوضوح عند دمج الدالة داخل “جداول إكسيل الذكية” (Excel Tables – المنسقة عبر Ctrl + T)؛ ففي هذه الجداول، يتمتع عمود الصيغة بخاصية التوسع الحسابي التلقائي (Calculated Column Formula). هذا يعني أنه بمجرد لصق صفوف بيانات خام جديدة في قاع الجدول، يقوم إكسيل تلقائياً بتطبيق صيغة SUBSTITUTE على المدخلات الجديدة وتطهيرها في الحال دون أن يضطر المستخدم لسحب مقبض التعبئة أو كتابة أي أمر، مما يوفر منصة معالجة ذاتية مستدامة وقابلة للتكامل مع استعلامات Power Query البرمجية المتقدمة.
8. معالجة الحالات الخاصة والتحديات المتقدمة لعلامات الاقتباس
8.1 التعامل مع علامات الاقتباس المفردة (‘) المخفية والظاهرة
تُمثل علامات الاقتباس المفردة تحدياً تقنياً مزدوجاً نظراً لاختلاف وظيفتها باختلاف موضعها وسلوكها البرمجي. تنقسم هذه العلامات إلى نوعين: علامات اقتباس مفردة ظاهرة تُعد جزءاً من النص الحرفي (مثل أسماء العائلات الأجنبية كـ O’Connor أو علامات الاختصار)، وعلامات اقتباس مفردة بادئة تعمل كعلامة تحكم تنسيقية لإجبار الخلية على معاملة المحتوى كنص.
في حالة علامات الاقتباس المفردة الظاهرة داخل النص، يمكن تطويع دالة SUBSTITUTE لإزالتها بنجاح عبر استدعاء كود أسكي المخصص لعلامة الاقتباس المفردة وهو 39، لتكون المعادلة المعتمدة كالآتي:
=SUBSTITUTE(A2, CHAR(39), "")
تعمل هذه الصيغة على مسح كافة علامات الاقتباس المفردة الظاهرة بدقة وكفاءة دون التأثير على بقية الأحرف المجاورة لها.
أما إذا كانت علامة الاقتباس المفردة بادئة خفية تظهر في شريط الصيغ فقط، فإن كلاً من أداة البحث والاستبدال العادية ودالة SUBSTITUTE تعجزان تماماً عن رصدها أو إزالتها؛ لأنها لا تُعد محرفاً نصياً مسجلاً ضمن طول الخلية المقاس بدالة LEN. ولإزالة هذه البادئات التنسيقية وتفريغها، يجب استخدام ميزة نص إلى أعمدة (Text to Columns) عبر تحديد العمود المستهدف، والتوجه إلى تبويب “بيانات” (Data)، ثم الضغط على “نص إلى أعمدة”، والضغط فوراً على زر “إنهاء” (Finish) دون تحديد أي فواصل، مما يجبر إكسيل على إعادة تقييم محتوى الخلايا وإسقاط علامات الاقتباس البادئة التنسيقية وتحويل القيم إلى أرقام أو نصوص نقية فوراً.
8.2 معالجة علامات الاقتباس المنحنية والذكية (Smart/Curly Quotes)
كما أشرنا سابقاً، تفرز محررات النصوص وأنظمة إدارة المحتوى علامات اقتباس ذكية منحنية لأسباب جمالية وطباعية؛ وتتضمن هذه العلامات اقتباساً مزدوجاً مفتوحاً مائلاً لليسار (“) واقتباساً مزدوجاً مغلقاً مائلاً لليمين (”). تمتلك هذه المحارف قيماً كودية خاصة تختلف كلياً عن الرمز 34 القياسي؛ حيث تحتل علامة الاقتباس المزدوجة المفتوحة الكود CHAR(147)، بينما تحتل العلامة المغلقة الكود CHAR(148) في جدول ترميز ويندوز الغربي القياسي (Windows-1252)، أو ما يقابلها في ترميزات اليونيكود (Unicode: U+201C و U+201D).
إذا احتوت البيانات على هذا النوع من الاقتباسات، فإن تطبيق صيغة CHAR(34) لن يؤدي إلى أي نتيجة إيجابية لعدم وجود تطابق كودي. ولمعالجة هذه المعضلة في خطوة حسابية موحدة، يتم بناء معادلة استبدال متداخلة ومزدوجة (Nested SUBSTITUTE)، تستهدف محو كلا الرمزين بالتتابع في صيغة واحدة متكاملة:
=SUBSTITUTE(SUBSTITUTE(A2, CHAR(147), ""), CHAR(148), "")
تعمل الدالة الداخلية أولاً على تصفية النص من علامة الاقتباس المنحنية الأولى CHAR(147) وتمرير الناتج المطهر للدالة الخارجية، والتي تتولى بدورها البحث عن علامة الاقتباس المنحنية المعاكسة CHAR(148) وإزالتها تماماً. ويمكن التوسع في هذا النمط المتداخل لإضافة الاقتباس المفرد المنحني (CHAR(145) وCHAR(146)) إذا لزم الأمر لضمان التنقية التامة والشاملة لكافة المتحورات الطباعية للرمز.
8.3 دمج دوال التطهير النصي الإضافية (TRIM و CLEAN)
في سياقات التنقيب المتقدم ومعالجة البيانات الواقعية، نادراً ما تأتي مشكلة علامات الاقتباس معزولة؛ إذ غالباً ما تقترن بوجود مسافات بيضاء طفيلية (Spurious White Spaces) أو محارف تحكم غير قابلة للطباعة ناتجة عن انقطاع تسلسل البايتات أثناء الاستيراد. يؤدي حذف علامات الاقتباس وحدها إلى كشف هذه المسافات التي كانت مخبأة داخل الإطار الرمزي، مما يتطلب تطهيراً هيكلياً شاملاً.
لتحقيق ذلك، يتم دمج دالة SUBSTITUTE مع دالتين قياسيتين للتطهير النصي: دالة TRIM التي تتولى مسح كافة المسافات البادئة والختامية للنص مع تقليص المسافات البينية المتعددة لتصبح مسافة واحدة فاصلة، ودالة CLEAN المصممة لإزالة أول 32 محرفاً غير مطبوع في جدول أسكي (ASCII 0 to 31) والتي تشمل فواصل الأسطر غير المرئية ومحارف الرجوع للبداية (Line Breaks & Carriage Returns).
تأخذ هذه المنظومة الثلاثية المتطورة التركيب الصيغي المتسق التالي:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(34), "")))
تضمن هذه المعادلة المركبة إخضاع الخلية لسلسلة تنقية ثلاثية المراحل: إزالة علامات الاقتباس أولاً، ثم مسح الرموز البرمجية غير المرئية ثانياً، ثم اقتطاع المسافات الزائدة ثالثاً؛ لينتج عن ذلك نص فائق النقاء يلبي أعلى معايير الجودة التحليلية والأكاديمية المعتمدة في دراسات النماذج الحسابية المتقدمة (Hoffman et al., 2015).
9. الأخطاء الشائعة أثناء إزالة علامات الاقتباس واستراتيجيات تلافيها
9.1 الاستبدال غير المقصود لعلامات القياس والاختصارات اللغوية
يقع كثير من المحللين في فخ التعميم غير المنضبط عند استخدام أداة البحث والاستبدال، حيث يتم تنفيذ أمر الاستبدال الشامل على أعمدة تحتوي على نصوص ذات طبيعة تقنية أو هندسية أو لغوية خاصة. وتبرز أشهر هذه الأخطاء في الجداول الفنية التي تتضمن قياسات الأبعاد؛ حيث تُستخدم علامة الاقتباس المزدوجة (“) دولياً كرمز قياسي لوحدة البوصة (Inches)، بينما تُستخدم علامة الاقتباس المفردة (‘) لتمثيل وحدة القدم (Feet).
عند تنفيذ استبدال عشوائي لإزالة علامات الاقتباس في جدول يحتوي على قياس مثل Screen 15″ LED، فإن العملية ستؤدي إلى تحويله قسرياً إلى Screen 15 LED، مما يفقده دلالته القياسية ويفسد الوصف التقني للمنتج. كذلك الحال في النصوص الإنجليزية التي تستخدم الفاصلة العليا (Apostrophe) في اختصارات الملكية والنفي، مثل تحويل كلمة Don’t إلى Dont، مما يشوه الصياغة اللغوية الأصلية للمتون النصية المجمعة (Lété et al., 2004).
ولتلافي هذه الأضرار التشغيلية، يتعين تطبيق استراتيجية الفحص المسبق للبيانات؛ وذلك من خلال الامتناع عن استخدام أمر “استبدال الكل” على الفور، واستبداله بالنقر المتكرر على زر “بحث عن التالي” (Find Next) لمراجعة عينة متنوعة من الخلايا والتأكد من عدم وجود استخدامات وظيفية مشروعة للرمز المستهدف، أو اللجوء إلى تقييد الاستبدال بالبحث عن أنماط محددة (مثل إزالة علامة الاقتباس الواقعة في بداية الكلمة فقط عبر الصيغ البرمجية الموجهة).
9.2 أخطاء التنسيق الناتجة عن ترك فراغات غير مرئية في حقل الاستبدال
يُعد الخطأ غير المرئي في حقل “استبدال بـ” (Replace with) من أكثر العيوب الشائعة خفاءً وأشدها ضرراً على العمليات الحسابية. يحدث هذا الخطأ عندما يقوم المستخدم بالضغط سهواً على مسطرة المسافات داخل مربع الاستبدال ظناً منه أن هذا الإجراء يقوم بتفريغ الحقل، في حين أنه يُدخل في واقع الأمر رمز “مسافة بيضاء” (Space Character – ASCII 32).
يترتب على هذا الخطأ استبدال كل علامة اقتباس تم مسحها بمسافة نصية فارغة؛ فإذا كان النص الأصلي محاطاً باقتباسين مثل “Cairo”، يتحول بعد الاستبدال الخاطئ إلى Cairo (محاطاً بمسافة بادئة ومسافة لاحقة). هذه المسافات لا تظهر دائماً للملاحظة العادية، لكنها تُعطل فوراً عمليات الفرز والبحث والمطابقة؛ إذ يعتبر إكسيل الكلمة المصحوبة بمسافة كلمة مختلفة تماماً عن نظيرتها المجردة.
وللوقاية من هذا التهديد، يجب التحقق دائماً من تفريغ حقل “استبدال بـ” عبر النقر المتكرر على مفتاح الحذف للخلف (Backspace) ومفتاح الحذف الأمامي (Delete) داخل الحقل للتأكد المطلق من خلوه من أي فراغات. وفي حال الشك في وقوع هذا الخطأ، يمكن كشفه بتطبيق دالة حساب طول النص: =LEN(A2)؛ فإذا أظهرت الدالة طولاً يزيد عن عدد أحرف الكلمة المرئية، فإن هذا يشير إلى وجود مسافات متخلفة يجب إزالتها فوراً عبر دالة TRIM.
9.3 فقدان البادئات الصفرية عند إزالة الاقتباس من الأكواد الرقمية
تُمثل الأكواد التعريفية المفتتحة برقم الصفر، مثل أرقام الحسابات البنكية الدولية، وأرقام الهواتف، والرموز البريدية، نقطة ضعف حرجة عند تنقية السلاسل النصية. في كثير من الأحيان، تُحاط هذه الأرقام بعلامات اقتباس مزدوجة لضمان استقرارها كنصوص صلبة تمنع إكسيل من إخفاء الصفر البادئ. فعلى سبيل المثال، يُخزن الرمز البريدي لصيغة “01234” بهذه الكيفية لحمايته من التحول إلى الرقم 1234.
عندما يقوم المحلل بإزالة علامات الاقتباس باستخدام أداة البحث والاستبدال المباشرة دون اتخاذ تدابير استباقية، يقوم محرك إكسيل بإعادة تقييم القيمة الناتجة؛ ونظراً لأن النص الباقي يتكون من أرقام فقط، فإن البرنامج يتعامل معه تلقائياً كقيمة رقمية مجردة، مما يؤدي إلى إسقاط الصفر البادئ فوراً وفقدان بنية الكود البريدي أو التعريفي، وهو ما يشكل خطأً جسيماً يهدد صحة سجلات المنظومة الإدارية.
تتمثل الاستراتيجية المثلى لتفادي هذا السقوط في تحديد عمود الأكواد المستهدف مسبقاً، وتغيير تنسيق الخلايا من “عام” (General) إلى نص (Text) صريح عبر شريط الأدوات الرئيسي، وذلك قبل الشروع في إجراء الاستبدال. أو البديل الأكثر أماناً، وهو استخدام دالة SUBSTITUTE؛ لأن مخرجات الدالة تظل دائماً ذات تصنيف نصي (String Output) افتراضياً، مما يضمن بقاء الصفر البادئ في موضعه دون خطر التحول الرقمي التلقائي.
10. أفضل الممارسات المنهجية لحوكمة البيانات وضمان جودتها في إكسيل
10.1 إنشاء نسخ احتياطية وتأمين نقاط الاسترجاع قبل معالجة البيانات
تفرض المبادئ الأكاديمية والمؤسسية لإدارة دورة حياة البيانات تطبيق استراتيجيات احترازية صارمة قبل الشروع في أي عمليات تنقية إتلافية داخل المصنفات الحسابية. ويأتي في طليعة هذه الممارسات إنشاء نقطة استرجاع آمنة عبر أخذ نسخة احتياطية طبق الأصل من ملف العمل وحفظها في مسار مستقل، أو تكرار ورقة العمل المستهدفة داخل المصنف ذاته عبر أمر “نقل أو نسخ” (Move or Copy) مع وضع تسمية واضحة للورقة التاريخية مثل Raw_Data_Archive.
كما يُنصح بالاعتماد على التسمية المنهجية للملفات باستخدام محددات الإصدار والزمن (Version Control)، كأن يُسمى الملف بصيغة Project_Data_V1.0_PreCleaning، ثم يُحفظ الملف المعالج بصيغة Project_Data_V1.1_Cleaned. هذا التوثيق الدقيق يحد من المخاطر التشغيلية، ويتيح لفريق العمل أو المشرف الأكاديمي الرجوع للبيانات الأصلية غير المشوبة في حال اكتشاف أي خطأ منهجي حدث أثناء خطوات التنقية والتطهير، مما يعزز الموثوقية العلمية للنتائج (van Ginneken et al., 2013).
وعلاوة على ذلك، توفر ميزات الحفظ السحابي وإصدارات الملفات في برمجيات Microsoft 365 حماية إضافية من خلال ميزة “سجل الإصدارات” (Version History)، والتي تسمح للمحلل باستعادة الحالات السابقة للمصنف قبل إجراء التعديلات الشاملة إذا دعت الحاجة إلى إلغاء تأثيرات الاستبدال التراكمية.
10.2 التدقيق الإحصائي والتحقق من سلامة الأنماط بعد التطهير
لا تنتهي عملية تنظيف البيانات بمجرد إغلاق مربع حوار الاستبدال أو كتابة المعادلة، بل يجب أن تعقبها مرحلة مراجعة وتدقيق إحصائي تؤكد انضباط التغييرات المتوقعة ومطابقتها للمعايير الرياضية. من أبرز أدوات هذا التدقيق بناء عمود اختبار مؤقت يستخدم دالة حساب الطول: =LEN(Cell)؛ حيث يتيح طرح طول السلسلة المطهرة من طول السلسلة الأصلية التحقق من أن عدد المحارف المفقودة يساوي بدقة عدد علامات الاقتباس التي كان يُفترض حذفها في كل سجل على حدة.
إضافة إلى ذلك، يُعد تطبيق قواعد التنسيق الشرطي (Conditional Formatting) أداة استكشافية متقدمة وفعالة لرصد أي شواهد متبقية. يمكن إنشاء قاعدة تنسيق شرطي مخصصة تستخدم صيغة البحث النمطي:
=ISNUMBER(SEARCH(CHAR(34), A2))
تقوم هذه الصيغة بتمييز وتلوين أي خلية لا تزال تحتفظ بعلامة اقتباس مزدوجة داخل النطاق باللون الأحمر تلقائياً، مما يوفر مسحاً بصرياً فورياً يتيح للمحلل اكتشاف الخلايا الشاذة أو الحالات المعقدة التي استعصت على خوارزميات الاستبدال الأولى ومعالجتها بصورة استثنائية.
كذلك تكتمل مصفوفة التحقق عبر استخراج عينة عشوائية بسيطة (Simple Random Sample) من السجلات المفروزة، وإخضاعها للمراجعة البشرية المباشرة والمطابقة مع الوثائق المرجعية للتأكد من خلوها من أي تشوهات تركيبية في أحرف الهجاء أو علامات الترقيم اللغوية المشروعة (Green & Bavelier, 2012).
10.3 توثيق بروتوكولات تنظيف البيانات لضمان تكرار العمليات المؤسسية
تمثل قابلية التكرار (Reproducibility) المعيار الذهبي لجودة المنهجيات البحثية والتطبيقات المؤسسية. ومن هذا المنطلق، يتعين على محلل البيانات توثيق كافة الخطوات الإجرائية التي طُبقت أثناء تنقية علامات الاقتباس في “مذكرة بروتوكول البيانات” (Data Cleaning Log). يجب أن تتضمن هذه المذكرة نوع الأداة المستخدمة (بحث واستبدال تفاعلي أو دالة صيغية)، وتاريخ المعالجة، والرموز الكودية المحددة التي جرى استهدافها (مثل CHAR(34) أو CHAR(39))، مع بيان عدد السجلات الإجمالية وحجم السجلات المعدلة بدقة.
يسهم هذا التوثيق الصارم في تسهيل تدريب فرق العمل ونقل المعرفة المؤسسية، كما يُمهد الطريق لتحويل هذه الإجراءات إلى كود برمجي دائم بلغة Visual Basic for Applications (VBA) أو نصوص Power Query البرمجية (M Language) لإدراجها ضمن بروتوكولات الاستيراد التلقائي المستقبلي للمؤسسة، مما يقلل احتمالات ظهور هذه الشوائب الرمزية مجدداً في دورات جمع البيانات اللاحقة (Schwartz & Bransford, 1998; Visser et al., 2006).
إن بناء قوالب إكسيل مؤسسية قياسية (Excel Templates – .xltx) مجهزة مسبقاً بالأعمدة الحسابية ودوال التطهير المبيتة يضمن تدفق البيانات الخام عبر مسارات معالجة تلقائية موحدة، مما يقضي على الاجتهادات الفردية العشوائية ويرفع الكفاءة الإنتاجية الإجمالية للمنظومة المعرفية والإدارية.
خاتمة
تناول هذا الدليل المتعمق الأبعاد التقنية والمنهجية لمعالجة وإزالة علامات الاقتباس غير المرغوب فيها في برنامج مايكروسوفت إكسيل؛ تلك المشكلة الشائعة التي تتجاوز التشويه الظاهري إلى تهديد البنية النوعية للبيانات وتعطيل الدوال المرجعية الحسابية كـ VLOOKUP وXLOOKUP. ومن خلال الاستعراض التفصيلي للطريقتين القياسيتين المعتمدتين، تبين أن أداة البحث والاستبدال (Ctrl + H) تقدم كفاءة وسرعة استثنائية في المعالجات المباشرة لمرة واحدة داخل مجموعات البيانات الضخمة عبر التعديل الإتلافي المباشر في موضع الخلايا، في حين تمثل دالة الاستبدال (SUBSTITUTE) الحل المنهجي الأمثل للبيئات المؤسسية التي تتطلب معالجة غير إتلافية تحافظ على سلامة البيانات المصدرية الخام وقابلة للأتمتة التفاعلية المستدامة، لا سيما عند اقترانها بكود أسكي القياسي CHAR(34).
كما فكك الدليل الحالات الخاصة المتقدمة، بما في ذلك علامات الاقتباس المفردة البادئة التنسيقية وتصفيتها عبر ميزة “نص إلى أعمدة”، والتعامل مع الاقتباسات الذكية المنحنية عبر الصيغ المتداخلة، ودمج أدوات التطهير الشامل عبر دالتي TRIM وCLEAN لمسح المسافات والمحارف غير القابلة للطباعة. ويظل الالتزام بأفضل ممارسات الحوكمة—المتمثلة في النسخ الاحتياطي الدوري، والتدقيق الإحصائي المتسلسل عبر دوال الطول والتنسيق الشرطي، وتوثيق بروتوكولات المعالجة المتبعة—الضمانة الحقيقية لحماية جودة البيانات وضمان جاهزيتها التامة لدعم القرارات الإدارية والنماذج الإحصائية الأكاديمية بدقة وموثوقية عالية.
المراجع
- Browning, M. H. E. M., Larson, L. R., Sharaievska, I., Rigolon, A., McAnirlin, O., Mullenbach, L. E., et al. (2021). Psychological impacts from COVID-19 among university students: Risk factors across seven states in the United States. PLoS ONE. https://doi.org/10.1371/journal.pone.0245327
- Green, C. S., & Bavelier, D. (2012). Learning, Attentional Control, and Action Video Games. Current Biology. https://doi.org/10.1016/j.cub.2012.02.012
- Hoffman, D. D., Singh, M., & Prakash, C. (2015). The Interface Theory of Perception. Psychonomic Bulletin & Review. https://doi.org/10.3758/s13423-015-0890-8
- Kosiński, M. (2024). Evaluating large language models in theory of mind tasks. Proceedings of the National Academy of Sciences. https://doi.org/10.1073/pnas.2405460121
- Lété, B., Sprenger-Charolles, L., & Colé, P. (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560
- Oswald, A. J., Proto, E., & Sgroi, D. (2015). Happiness and Productivity. Journal of Labor Economics. https://doi.org/10.1086/681096
- Schwartz, D. L., & Bransford, J. D. (1998). A Time For Telling. Cognition and Instruction. https://doi.org/10.1207/s1532690xci1604_4
- van Ginneken, N., Tharyan, P., Lewin, S. A., Rao, G. N., Meera, S. M., Pian, J., et al. (2013). Non-specialist health worker interventions for the care of mental, neurological and substance-abuse disorders in low- and middle-income countries. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd009149.pub2
- Visser, B. A., Ashton, M. C., & Vernon, P. A. (2006). Beyond g: Putting multiple intelligences theory to the test. Intelligence. https://doi.org/10.1016/j.intell.2006.02.004