
تُعد معالجة البيانات النصية وتصنيفها في برمجيات الجداول الحسابية، وفي مقدمتها برنامج ميكروسوفت إكسيل (Microsoft Excel)، من الركائز الأساسية التي يعتمد عليها الباحثون، ومديرو قواعد البيانات، والإداريون في مختلف المؤسسات الأكاديمية والمهنية. فعند التعامل مع قواعد بيانات تضم مئات أو آلاف المدخلات الاسمية، تبرز مسألة التنظيم وفق معايير قياسية صارمة كشرط جوهري لضمان انسيابية العمل واسترجاع المعلومات بكفاءة. وتواجه هذه العمليات تحدياً تقنياً شائعاً يكمن في إدخال الأسماء الكاملة ضمن حقل واحد، مما يعيق محركات الترتيب التلقائي عن تطبيق المعايير المتعارف عليها عالمياً، والتي تتطلب في معظم الأحيان فرز السجلات بالاعتماد على الاسم الأخير (اسم العائلة أو اللقب) بدلاً من الاسم الأول.
يتناول هذا الدليل الشامل والمعمق تفكيك الأبعاد البنيوية والتقنية لعملية فرز الأسماء حسب اللقب العائلي عند وجود الاسم كاملاً في خلية واحدة. سنستعرض الآليات الحسابية والبرمجية المعقدة التي تتيح عزل المقاطع النصية دون المساس ببنية البيانات الأصلية، مع مقارنة مستفيضة بين الأساليب الكلاسيكية المعتمدة على الدوال التركيبية المتداخلة، والتقنيات الحديثة التي وفرتها الإصدارات المتقدمة، وصولاً إلى الأدوات الذكية المدمجة مثل التعبئة السريعة وتقسيم النصوص. ويستهدف هذا الطرح تقديم مرجع منهجي متكامل يراعي الدقة والامتثال لأعلى معايير إدارة البيانات وسلامتها.
إن الانتقال من بنية البيانات العشوائية إلى مصفوفة مرتبة ومفروزة بدقة ليس مجرد إجراء جمالي أو تنظيمي عابر، بل هو عملية تحول جوهرية تسهم في رفع الموثوقية الإحصائية، والحد من ازدواجية السجلات، وتيسير المطابقة مع المعايير الببليوغرافية والتنظيمية الدولية. ومن خلال الأمثلة العملية المفصلة، سنمضي خطوة بخطوة نحو بناء حلول جذرية للتحديات التي تفرضها الأسماء المتفاوتة في عدد المقاطع والأسماء المركبة، مع توفير آليات تحقق تضمن عدم فقدان الترابط الأفقي لسجلات البيانات الحساسة.
1. مقدمة منهجية حول إدارة وتنظيم البيانات الاسمية في إكسيل
1.1 أهمية الترتيب الأبجدي وفق الاسم العائلي في التوثيق والبحوث
يحتل الترتيب الهجائي المستند إلى اللقب أو الاسم الأخير مكانة مركزية في التقاليد الأكاديمية والتوثيقية عبر مختلف الحقول المعرفية. ففي التوثيق المرجعي المعتمد وفق الجمعية الأمريكية لعلم النفس (APA Style) أو غيرها من الأدلة المنهجية العالمية، يُعد اللقب العائلي المعيار الأساسي لفهرسة الأعمال والمؤلفين؛ مما يمنح الباحثين لغة موحدة للوصول إلى الإنتاج العلمي. ويتجاوز هذا المبدأ حدود قوائم المراجع ليمتد إلى سجلات المشاركين في التجارب العلمية والدراسات الميدانية، حيث يُسهم الترتيب وفق الاسم الأخير في تسريع عمليات الاستدعاء والتدقيق المتبادل، وتفادي الالتباس الناتج عن شيوع وتشابه الأسماء الأولى بين أفراد العينات.
إلى جانب ذلك، يسهم الاعتماد على الاسم الأخير في تنظيم قواعد البيانات الكبرى في تقليل احتمالات التكرار وتيسير دمج المجموعات البيانية المتعددة. فعند توحيد حقل الفرز ليصبح اللقب العائلي، يسهل على المحللين الإحصائيين اكتشاف القيود المكررة أو المتطابقة، وضمان تمثيل دقيق للأسر أو العائلات المستهدفة في المسوح الديموغرافية والاجتماعية. إن هذا التوافق مع المعايير الدولية لا يعزز فقط موثوقية المستودعات الرقمية، بل يضمن أيضاً جاهزية البيانات للتكامل مع نظم إدارة التعلم، وقواعد البيانات العلائقية، وبرمجيات التحليل الإحصائي دون الحاجة إلى عمليات تنقية مجهدة لاحقاً.
1.2 المشكلة البنيوية للأسماء الكاملة المدمجة في خلية واحدة
تنشأ الأزمة التقنية في معالجة الأسماء داخل برمجية إكسيل نتيجة ممارسة شائعة في تصميم استمارات جمع البيانات، حيث يُطلب من المستخدم إدخال “الاسم الكامل” في حقل نصي واحد دون تجزئة. وعند استيراد هذه البيانات إلى ورقة العمل، يُعامل إكسيل السلسلة النصية كوحدة بنائية متصلة تبدأ من اليسار إلى اليمين في النصوص اللاتينية، أو من اليمين إلى اليسار في النصوص العربية، مقيماً الترتيب الافتراضي استناداً إلى الحرف الأول من بداية السلسلة، والذي يمثل بطبيعة الحال الاسم الأول للشخص.
يؤدي هذا القصور البنيوي إلى استحالة إجراء فرز مباشر وفق الاسم الأخير باستخدام أدوات الفرز القياسية المتاحة بنقرة زر واحدة؛ إذ يفتقر البرنامج في واجهته الافتراضية إلى التمييز الدلالي بين مسميات المقاطع النصية كاسم الشخص واسم والده ولقبه العائلي. ومن ثم، فإن أي محاولة لتنفيذ ترتيب أبجدي ستسفر عن تجميع الأسماء بناءً على حروفها الأولى، مما يعطل متطلبات الفهرسة الاحترافية، ويفرض حاجة تقنية ملحة لاستحداث آليات تقوم بتفكيك تلك السلاسل النصية المعقدة، واستخلاص المقطع الختامي بدقة تامة وبطريقة منهجية لا تمس السلامة الهيكلية للبيانات المرافقة.
1.3 نظرة عامة على الاستراتيجية الثنائية للفرز الفعال
للتعامل مع هذه المعضلة الرياضية-النصية، يُعتمد في هندسة البيانات على استراتيجية تقنية ثنائية المراحل تضمن أعلى درجات الدقة والتحكم. تتمثل المرحلة الأولى في إنشاء حقل إضافي يسمى “العمود المساعد” (Helper Column)، يوضع بمحاذاة البيانات الأصلية، ويُخصص له غرض وظيفي محدد يتمثل في استخراج الاسم الأخير وعزله بشكل مستقل باستخدام خوارزميات نصية ديناميكية أو أدوات التعرف على الأنماط. يتيح هذا الإجراء المحافظة على النص الأصلي كاملاً كما هو، مجنباً المحلل مخاطر فقدان البيانات أثناء عمليات التعديل أو الاقتطاع.
أما المرحلة الثانية فتتضمن توظيف خوارزميات الفرز متعددة المستويات المدمجة في البرنامج، بحيث يتم اعتماد العمود المساعد كمعيار فرز رئيسي (مستوى أول)، مع إمكانية إضافة العمود الأصلي أو معرّف الهوية كمعيار ثانوي لفض حالات التعادل في الألقاب المشتركة. والأهم في هذه الاستراتيجية هو الحفاظ الصارم على الارتباط الأفقي بين خلايا الصف الواحد، بحيث تنتقل كافة المتغيرات المرافقة لكل شخص، مثل الرقم التسلسلي، أو البريد الإلكتروني، أو الدرجات المعيارية، بانسجام تام مع موقع الاسم الجديد، محققة فرزاً آمناً ومنهجياً لقاعدة البيانات بأكملها.
2. التحديات التقنية المرتبطة بفرز الأسماء في قواعد بيانات إكسيل
2.1 تفاوت عدد الكلمات المكونة للاسم الكامل
يمثل التباين في عدد المقاطع النصية المكونة للأسماء الكاملة التحدي الرياضي الأكبر عند بناء خوارزميات الاستخراج. ففي قواعد البيانات الواقعية، لا تتبع الأسماء نمطاً موحداً؛ إذ تتجاور الأسماء الثنائية (الاسم الأول واسم العائلة) مع الأسماء الثلاثية (الاسم الأول، واسم الأب، واللقب)، والرباعية، وصولاً إلى الأسماء الخماسية التي قد تتضمن أسماء الأجداد أو ألقاباً إضافية. وبالتالي، فإن محاولات عزل الاسم بالاعتماد على عدّ المسافات من بداية النص تسفر حتماً عن أخطاء فادحة عند تطبيقها على سجلات ذات أطوال مختلفة.
إذا اعتمدت الدالة البرمجية على استهداف الكلمة الثانية بافتراض أن الاسم ثنائي دائماً، فإنها ستستخرج اسم الأب في الأسماء الثلاثية، أو الاسم الأوسط في الأسماء الغربية متجاهلة اللقب الفعلي. ومن هنا تبرز الحاجة التقنية إلى عكس اتجاه البحث والتقييم، بحيث تركز الخوارزمية على الطرف النهائي للسلسلة النصية عبر حساب المسافات الفاصلة الإجمالية واستبدال المسافة الأخيرة بحد ذاتها، مما يضمن اقتطاع المقطع الأخير حصراً، بغض النظر عما إذا كان الاسم يتكون من كلمتين أو عشر كلمات.
2.2 إشكالية الأسماء المركبة والسابقة للألقاب
يتضاعف التعقيد عند الانتقال إلى الأسماء المركبة وأدوات الوصل والبادئات النسبية التي تتداخل مع البنية التقليدية للفواصل. في اللغات اللاتينية، تظهر ألقاب عائلية متعددة الكلمات تتضمن أدوات مثل “van der” أو “de la” أو “Von”، بينما تظهر في الأسماء العربية ألقاب مسبوقة بكلمات مثل “آل” أو “أبو” أو “ابن” أو “عبد” مفصولة بمسافة عن بقية المقطع (مثل “عبد الرحمن” أو “ابن خلدون”). وإذا عوملت المسافة البيئية بين هذه الأجزاء كفاصل اعتيادي بين اسم وآخر، فإن دالة الاقتطاع ستعزل الجزء الأخير فقط (مثل “الرحمن” أو “خلدون”)، مما يشوه اللقب ويؤثر سلباً على الترتيب الأبجدي الدقيق.
يتطلب هذا التحدي صياغة تدابير استباقية تتضمن توحيد معايير الإدخال أو إجراء تنقية نصية مسبقة، يتم فيها استبدال المسافة الفاصلة داخل الاسم المركب برمز غير مرئي مؤقت أو وصلة ثابتة تمنع الخوارزمية من تجزئته. إن فهم الطبيعة اللغوية للمجتمع الذي اشتُقت منه عينة البيانات يُعد جزءاً لا يتجزأ من الممارسة المنهجية لمحلل البيانات، حيث لا يمكن فصل القواعد التقنية المجردة عن الخصوصيات التركيبية للأسماء قيد المعالجة.
2.3 مخاطر فقدان تزامن السجلات أثناء عمليات الترتيب
من أخطر الأخطاء الإجرائية التي يقع فيها مستخدمو الجداول الحسابية هي محاولة فرز عمود واحد بمعزل عن بقية المصفوفة. في بيئة إكسيل، إذا حُدد العمود المحتوي على الأسماء فقط دون تضمين باقي أعمدة الصف (كالبيانات الديموغرافية، وأرقام الهواتف، والنتائج المخبرية)، ثم طُبق أمر الفرز مع تجاهل التنبيه التحذيري الذي يطلقه البرنامج لتوسيع التحديد، فسيتم إعادة ترتيب الأسماء عشوائياً، بينما تظل البيانات المقابلة ثابتة في مواقعها القديمة؛ مما ينتج عنه ما يُعرف تقنياً بـ “انهيار التزامن الهيكلي للسجلات” (Record Disalignment).
يؤدي هذا الخطأ إلى إفساد مصداقية قاعدة البيانات بالكامل وتدمير الارتباط بين المعرّفات والمتغيرات، وهي خسارة قد تكون كارثية في البحوث السريرية أو السجلات المالية. لذلك، تقتضي المنهجية الأكاديمية الصارمة تأمين التحديد الكامل لكافة أعمدة الجدول قبل الشروع في الترتيب، والاعتماد على الجداول الهيكلية المنظمة (Excel Tables)، والتي تفرض التزامن التلقائي لكامل عناصر الصف وتمنع حدوث التفكك العرضي للبيانات تحت أي ظرف.
3. الخطوة الأولى: إعداد وهيكلة جدول البيانات التجريبي
3.1 بناء جدول المدخلات وإدخال الأسماء النموذجية
تبدأ العملية المنهجية بإنشاء ورقة عمل جديدة وتأسيس نطاق إدخال نموذجي يعكس التنوع الحقيقي المتوقع في البيئات البحثية والعملية. يُخصص العمود الأول، وليكن العمود A، لاستقبال الأسماء الكاملة، مع وضع ترويسة واضحة في الخلية الأولى A1 تحمل عنوان “الاسم الكامل”. ولضمان اختبار متانة الإجراءات اللاحقة، ينبغي إدراج عينة متوازنة تتألف من أسماء ثنائية، وأسماء ثلاثية تتضمن اسماً أوسطاً، وأسماء ذات ألقاب متنوعة تمثل حالات اختبار قياسية.
يُراعى عند إدخال البيانات ضبط تنسيق الخلايا ليكون “نصياً” (Text) أو “عاماً” (General)، مع توحيد نوع الخط وحجمه لتسهيل الفحص البصري وتفادي الاختلالات التنسيقية. على سبيل المثال، يمكن تضمين سجلات مثل: “Alan Turing”، و”Ada Lovelace”، و”Grace Brewster Hopper”، و”Tim Berners-Lee” كعينة لاختبار كفاءة القواعد على نماذج متنوعة الأطوال والأنماط الهجائية، مما يوفر بيئة تجريبية منضبطة وقابلة للقياس والتعميم.
3.2 إنشاء وتخصيص العمود المساعد للاسم الأخير
في الخطوة التالية، يتم إدراج عمود إضافي ملاصق لعمود البيانات الأصلية مباشرة، وهو العمود B، ويُمنح ترويسة مميزة في الخلية B1 باسم “الاسم الأخير” أو “اللقب”. يمثل هذا العمود الحقل الاشتقاقي الإجرائي الذي ستُسند إليه مهمة احتواء مخرجات العمليات البرمجية اللاحقة. إن تخصيص عمود مستقل يُعد قاعدة ذهبية في علم البيانات، لأنه يفصل بين المدخلات الخام (Raw Data) والمخرجات التحويلية (Processed Data)، مما يتيح التراجع السريع عند وقوع أخطاء برمجية دون الإضرار بالمدخلات الأساسية.
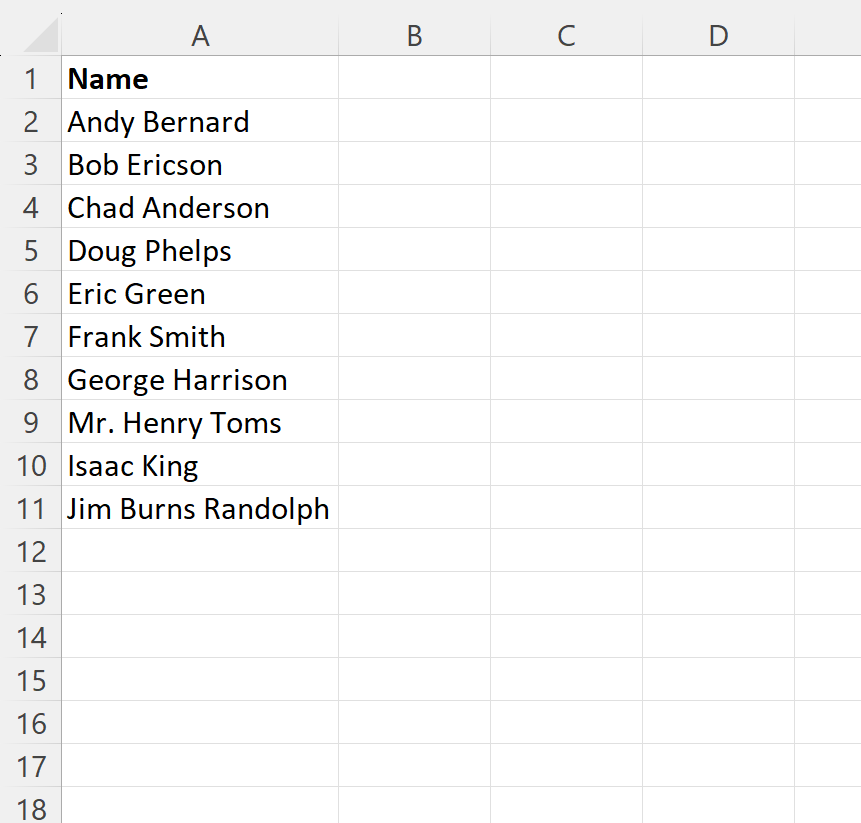
يجب التأكد من أن العمود المساعد فارغ تماماً وخالٍ من أي قيم سابقة أو تنسيقات شرطية قد تتداخل مع عمل الصيغ. كما ينبغي توسيع عرضه ليماثل على الأقل عرض العمود الأصلي لتوفير رؤية واضحة للنتائج. يتيح هذا الإعداد المنظم تهيئة البيئة البرمجية لاستقبال المعادلات النصية المعقدة دون خطر التداخل مع أعمدة مجاورة تحتوي على متغيرات دراسية أخرى.
3.3 فحص البيانات والتأكد من خلوها من المسافات الزائدة
قبل الشروع في كتابة معادلات الاقتطاع، لا بد من إخضاع عمود الأسماء الكاملة لعملية تنقية وتدقيق إملائي وتقني صارمة، تركز على كشف المسافات البيئية الخفية. تتسبب المسافات البادئة (Leading Spaces) أو المسافات اللاحقة (Trailing Spaces) المتولدة عن أخطاء الإدخال البشري في إرباك دوال النصوص، حيث تحسب دالة الطول تلك المسافات كحروف قائمة بذاتها، مما يؤدي إلى استخراج نصوص فارغة أو ألقاب غير مكتملة عند استخدام آليات الاقتطاع العكسي.
لتنفيذ هذه المعالجة الوقائية، يمكن تطبيق دالة التهيئة المسبقة TRIM (المقابلة لدالة تهيئة النص بالعربية)، والتي تعمل على حذف كافة المسافات من بدايات ونهايات السلاسل النصية وتقليص المسافات البينية المتعددة لتصبح مسافة واحدة فقط. يمكن تنفيذ ذلك عبر إحلال صيغة مؤقتة أو تطبيقها مباشرة ضمن المعادلة النهائية، لضمان أن كل اسم داخل النطاق التجريبي يتمتع ببنية معيارية تخلو من أي شوائب رقمية غير مرئية تعرقل دقة العمليات الحسابية اللاحقة.
4. الخطوة الثانية: استخراج الاسم الأخير عبر المعادلة المتقدمة
4.1 عرض الصيغة البرمجية الكاملة الخاصة بالاقتطاع
لتحقيق استخراج آلي وموثوق للاسم الأخير يضمن التعامل الصحيح مع مختلف أطوال الأسماء وتجاوز مشكلة الأسماء الوسطى، نلجأ إلى استخدام صيغة تركيبية متقدمة تعتمد على دمج عدة دوال نصية كلاسيكية في إكسيل. تُكتب هذه الصيغة في الخلية الأولى من العمود المساعد، أي في الخلية B2 المقابلة للاسم الأول الموجود في A2، وتأخذ الشكل التركيبي التالي:
=RIGHT(A2, LEN(A2) – FIND(“@”, SUBSTITUTE(A2, ” “, “@”, LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”)))))
تعتمد هذه الصيغة البرمجية على استراتيجية الاستبدال الموجه للمسافة الأخيرة؛ حيث تعجز الدوال البسيطة مثل FIND بمفردها عن البحث من نهاية النص، وتقتصر على رصد المسافة الأولى من جهة اليسار، وهو ما يؤدي في الأسماء ذات الكلمات الثلاث إلى اقتطاع الاسم الأوسط مع اللقب معاً بدلاً من استخراج اللقب منفرداً. أما هذه المعادلة المتطورة فتتغلب على هذا القيد من خلال ديناميكية ذكية تحدد الموقع الحسابي الدقيق للمسافة الفاصلة الأخيرة، محولة إياها إلى رمز فريد يسهل اقتطاع ما بعده مباشرة.
4.2 تعميم المعادلة وتطبيقها على كامل عناصر العينة
بمجرد إدخال الصيغة الرياضية في الخلية B2 والضغط على زر الإدخال (Enter)، يظهر الاسم الأخير الخاص بالسجل الأول في الخلية بنجاح. ولتعميم هذه العملية على كافة مفردات قاعدة البيانات دون الحاجة لإعادة كتابة المعادلة، يُستخدم “مقبض التعبئة التلقائية” (AutoFill Handle)، وهو المربع الصغير الكائن في الركن السفلي الأيسر (أو الأيمن بحسب لغة الواجهة) للخلية النشطة.
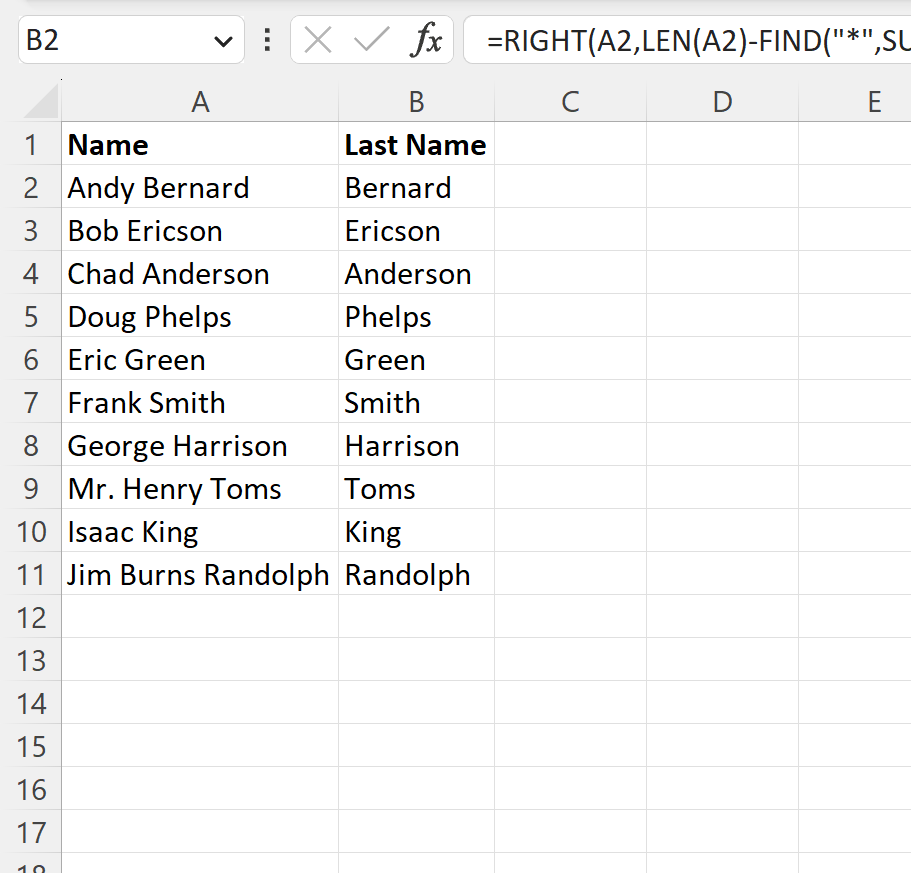
يتم سحب مقبض التعبئة يدوياً إلى الأسفل ليمتد على طول السجلات، أو النقر المزدوج فوقه ليقوم إكسيل بالاستقراء الآلي لطول عمود البيانات ومطابقته. وخلال هذه العملية، يقوم النظام بتعديل المرجع النسبي A2 تلقائياً ليتحول في السطر التالي إلى A3 ثم A4، وهكذا دواليك. ينتج عن ذلك تفعيل متزامن للقدرة التحليلية للمعادلة عبر كامل العمود، مستخرجة اللقب العائلي لكل فرد في الجدول بصورة آلية وفورية.
4.3 المعاينة البصرية للنتائج المستخرجة للتحقق من الاتساق
عقب تعميم الصيغة، تأتي مرحلة المعاينة الميدانية للتحقق من مدى اتساق النتائج ومطابقتها للمتوقع. تقتضي هذه الخطوة قيام المحلل بإجراء مسح بصري لعينة عشوائية من العمود المساعد B، ومقارنة القيم المستخرجة مع النصوص الأصلية في العمود A. ويكمن الهدف الأساسي في التثبت من أن النظام نجح بالفعل في تخطي الأسماء الوسطى والأحرف الأولى المجردة، واقتصاره بدقة على اللقب النهائي.
في المثال العملي المدرج، سيُلاحظ على الفور أن الاسم “Grace Brewster Hopper” قد تمخض عن استخراج “Hopper” وحدها في الخلية المقابلة، في حين لو استخدمت الدوال الابتدائية البسيطة لكانت النتيجة الخاطئة “Brewster Hopper”. هذا التحقق البصري يعزز ثقة الباحث في سلامة الخوارزمية، ويمكّنه من رصد أي حالات شاذة أو غير متوقعة في بنية البيانات تمهيداً لمعالجتها قبل اتخاذ قرار الفرز النهائي.
5. التفكيك التحليلي لمكونات معادلة استخراج الاسم الأخير
5.1 دور دالة الاستبدال في استهداف المسافة الأخيرة
لفهم الآلية الداخلية المعقدة لمعادلة الاقتطاع، لا بد من تفكيك طبقاتها الرياضية بدءاً من القلب المشغل لها والمتمثل في الدالة SUBSTITUTE. تكمن المشكلة التقنية الأساسية في غياب محدد إحداثي يشير إلى المسافة الأخيرة ضمن السلسلة النصية؛ ولذلك تقوم المعادلة أولاً بحساب إجمالي عدد المسافات في الخلية عبر مقارنة طولين:
LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”))
يقوم الجزء الأول بحساب الطول الإجمالي لحروف الخلية LEN(A2)، ثم يطرح منه طول السلسلة ذاتها بعد إفراغها تماماً من المسافات بواسطة الدالة SUBSTITUTE(A2, " ", ""). والفرق الحسابي بين الرقمين يمثل بصورة قطعية ورياضية عدد المسافات الإجمالي الموجودة في الاسم. فإذا احتوى الاسم على مسافتين (كما في الأسماء الثلاثية)، يكون الناتج 2، وهو ما يشكل المؤشر العددي للمسافة الأخيرة المطلوبة.
عقب تحديد هذا المعامل، يُعاد توظيف الدالة SUBSTITUTE الخارجية بصيغتها الكاملة:
SUBSTITUTE(A2, ” “, “@”, LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”)))
حيث تأخذ الدالة النص الأصلي، وتستهدف المسافة كعنصر للتغيير، وتضع مكانها رمزاً نادراً وفريداً لا يتكرر في الأسماء البشرية كعلامة (@)، وتمرر ناتج الطرح السابق كوسيط أخير يحدد “رقم التكرار المستهدف” (Instance Number). وبذلك، يتم الإبقاء على كافة المسافات الأولى دون تغيير، وتُستبدل حصراً المسافة الأخيرة بالعلامة المرجعية لتصبح بمثابة منارة رقمية ترشد بقية الدوال إلى نقطة الفصل الدقيقة.
5.2 وظيفة دالة البحث في رصد موقع الرمز المرجعي
بمجرد زرع الرمز المميز (@) في موضع المسافة الختامية، تتدخل دالة البحث النصي FIND لأداء وظيفتها المتخصصة المتمثلة في تحديد الترتيب الرقمي لموقع هذا الرمز ضمن السلسلة النصية الناتجة. تأخذ الدالة البنية التركيبية التالية:
FIND(“@”, SUBSTITUTE(…))
تعمل الدالة على مسح السلسلة المحورة حرفاً بحرف من البداية وصولاً إلى الرمز المحدد، ثم تُرجع رقماً صحيحاً يمثل ترتيبه المطلق. فإذا كان الاسم الإجمالي يتكون من 20 حرفاً ورمز المسافة الأخيرة يقع في الترتيب 14، فإن مخرجات دالة البحث ستكون القيمة العددية 14 بدقة مطلقة، مما يوفر مؤشراً حسابياً محورياً يربط بين طول النص الإجمالي وموقع بداية مقطع اللقب الأخير.
تتجلى أهمية هذا التكامل في قدرة الدالة على التكيف اللحظي والديناميكي مع أي نص يُسند إليها دون الحاجة لتحديد مواقع ثابتة أو إجراء حسابات تقديرية. ويشكل هذا الرقم الأساس الذي ستعتمد عليه دالة الاقتطاع النهائية لحساب عدد المحارف التي يجب سحبها من الطرف الأيمن، مجسداً التكامل التبادلي بين دوال البحث والتعويض الرياضي في بيئة إكسيل البرمجية.
5.3 آلية عمل دالة الاقتطاع من اليمين وحساب طول المقطع
تتولى دالة الاقتطاع الطرفي RIGHT إتمام المرحلة الأخيرة من العملية واستخلاص الاسم الصافي. تطلب هذه الدالة وسيطين أساسيين: النص المصدري المراد الاقتطاع منه، وعدد الأحرف المراد استخراجها بدءاً من أقصى الطرف الأيمن للنص اللاتيني (أو الطرف النهائي للسلسلة). ولمعرفة عدد أحرف الاسم الأخير بدقة متناهية، تُجري المعادلة عملية طرح بسيطة ولكنها بالغة الدقة:
LEN(A2) – FIND(“@”, …)
من خلال طرح القيمة العددية لموقع الرمز الأخير (التي استخرجتها دالة FIND) من الطول الإجمالي للنص الأصلي LEN(A2)، ينتج لدينا عدد الأحرف الصافي المتبقي بعد الرمز، والذي يمثل حصراً طول الاسم الأخير. وإذا طبقنا هذا حسابياً، فإن طرح الترتيب 14 من إجمالي طول السلسلة البالغ 20 ينتج عنه الرقم 6، وهو عدد أحرف اللقب بدقة.
تقوم الدالة RIGHT بسحب هذه الأحرف الستة مباشرة من النهاية، ليكون الناتج النهائي اسماً عائلياً نقياً تماماً، لا تشوبه أي مسافات فراغية بادئة أو لاحقة، ولا يتأثر على الإطلاق بوجود اسم أوسط أو عدمه. تبرهن هذه المنظومة الرياضية الثلاثية على قوة الدوال التركيبية وقدرتها على محاكاة خوارزميات معالجة اللغات الطبيعية المعقدة بأدوات إكسيل الكلاسيكية والمتاحة في كافة إصداراته.
6. الخطوة الثالثة: تنفيذ الفرز الأبجدي الممنهج لقاعدة البيانات
6.1 تحديد النطاق وتفعيل أداة الترتيب في شريط البيانات
عقب إتمام استخراج الألقاب في العمود المساعد بنجاح والتأكد من صحتها، تبدأ المرحلة الميدانية لترتيب المصفوفة البيانات برمتها. تتطلب هذه العملية المنهجية تظليل وتحديد كامل نطاق البيانات الفعلي، والذي يشمل في مثالنا النطاق من A1 إلى B4 (أو ما يقابل نهاية السجلات)، متضمناً عمود الأسماء الأصلية والعمود المساعد مع صف الترويسات العلوية.
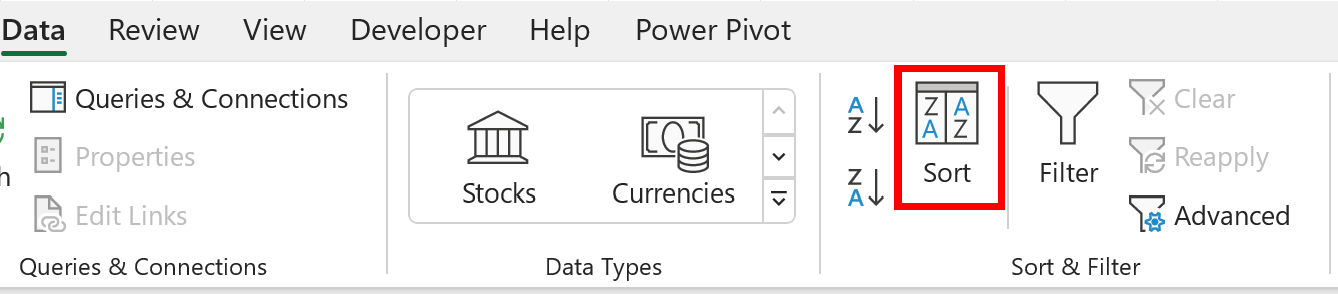
بعد إتمام التحديد الدقيق، يتوجه المستخدم إلى شريط الأدوات الرئيسي في أعلى البرنامج، ثم ينقر على تبويب بيانات (Data)، ومنه يختار أداة فرز (Sort) المتقدمة الممثلة بأيقونة الترتيب ذات المستويات المتعددة. بمجرد النقر، تفتح نافذة الحوار المتخصصة لضبط معايير الفرز. ومن الأمور المنهجية بالغة الأهمية هنا التأكد من تفعيل مربع الاختيار المكتوب بجانبه “تحتوي بياناتي على رؤوس” (My data has headers)؛ إذ يضمن هذا الخيار استبعاد الصف الأول الترويسي من عملية التدوير الأبجدي والحفاظ على مواقعه القيادية في رأس الجدول.
6.2 ضبط معايير الفرز وتحديد ترتيب الحروف
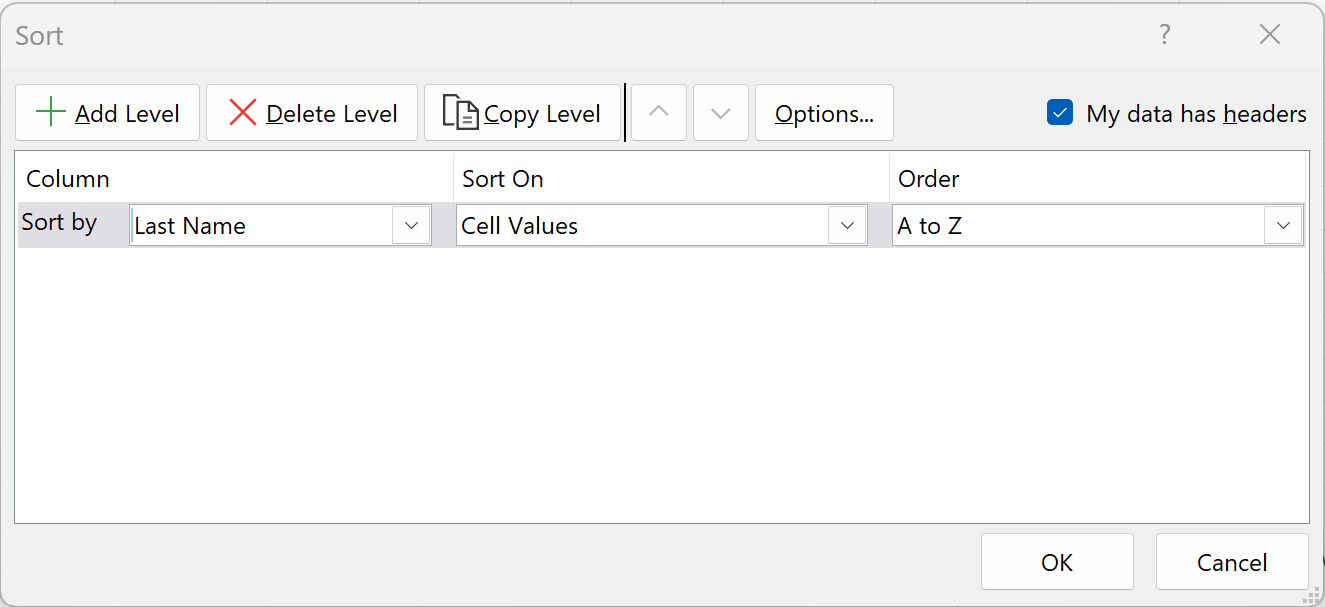
داخل نافذة الفرز التفاعلية، يبدأ تخصيص المعايير المنهجية التي ستحكم إعادة توزيع الأسطر. في القائمة المنسدلة المخصصة لخيار “الفرز حسب” (Sort by)، يُستبعد عمود “الاسم الكامل” ويُختار بدلاً منه العمود المساعد “الاسم الأخير” ليكون هو المرتكز التوجيهي للخوارزمية. وفي خانة “الفرز بناءً على” (Sort On)، يُبقى الخيار الافتراضي على “قيم الخلايا” (Cell Values) لضمان فحص المحتوى النصي المباشر.
تأتي بعد ذلك خطوة تحديد جهة الترتيب الأبجدي من خلال حقل “الترتيب” (Order)؛ حيث يُحدد الاتجاه التصاعدي “من الألف إلى الياء” (A to Z) وفق النهج المتبع في الفهارس الرسمية، أو “من الياء إلى الألف” (Z to A) في حال تطلبت طبيعة التحليل الإحصائي ذلك. علاوة على ذلك، يتيح إكسيل ميزة أكاديمية متقدمة تتمثل في زر “إضافة مستوى” (Add Level)؛ حيث يمكن للمحلل إضافة مستوى فرز ثانوي يستند إلى عمود “الاسم الكامل” كخيار تالٍ، ليعمل البرنامج على فض التعادل تلقائياً بين الأفراد الذين يحملون نفس اللقب العائلي بالاعتماد على أسمائهم الأولى بطريقة هجائية منضبطة.
6.3 تنفيذ الفرز ومراجعة محاذاة البيانات المرافقة
بمجرد النقر على زر “موافق” (OK)، ينفذ محرك إكسيل خوارزمية الفرز الموجه على الفور، حيث يُعاد تموضع الأسطر رأسياً على الفور وبصورة متزامنة وفق المعايير المدخلة. في مثالنا التطبيقي، ينتقل سجل “Ada Lovelace” ليحتل المرتبة الأولى نظراً لبدء لقبها بحرف L، يليه سجل “Grace Brewster Hopper” الذي يتصدر بحرف H (وفق الترتيب الهجائي الدقيق)، ثم سجل “Alan Turing” بحرف T في النهاية.
تتمثل الخطوة المنهجية الختامية في هذا الإجراء بمراجعة مصفوفة البيانات المعروضة بعناية، والتأكد من أن الأسطر قد انتقلت بكتلتها الكاملة؛ بحيث ظل الاسم الأول والأوسط واللقب وأي بيانات وصفية أخرى تابعة للشخص الواحد في نفس الصف الأفقي دون أي تشوه أو انفصال. يمثل الوصول إلى هذا التناسق الأبجدي الكامل تتويجاً ناجحاً للاستراتيجية، محولاً قاعدة البيانات إلى مصفوفة أكاديمية جاهزة للتداول المرجعي أو المعالجة الإحصائية المتقدمة.
7. طرق تقنية بديلة لفرز الأسماء حسب الاسم الأخير
7.1 استخدام ميزة النص إلى أعمدة
تُمثل ميزة “النص إلى أعمدة” (Text to Columns) إحدى الأدوات اليدوية الكلاسيكية التي يمكن اللجوء إليها كبديل للمعادلات الحسابية في بيئات العمل التي لا تتطلب تحديثاً ديناميكياً مستمراً. تتيح هذه الميزة تفكيك محتويات الخلية الواحدة وتوزيع مقاطعها النصية على عدة أعمدة متجاورة بالاعتماد على فاصل محدد، يتم تعريفه في هذه الحالة بـ “المسافة” (Space). وبعد تقسيم أجزاء الاسم، يمكن الانتقال إلى العمود الأخير واستخدامه كمعيار لتنفيذ الفرز الأبجدي المطلوب للجدول.
غير أن هذه الطريقة تنطوي على عيب هيكلي جوهري يجعلها محفوفة بالمخاطر في العينات غير المتجانسة؛ إذ يؤدي التباين في عدد مقاطع الأسماء إلى توزيع الألقاب على أعمدة متباينة في الموقع الأفقي. فالاسم الثنائي سيقع لقبه في العمود الثاني، بينما يقع لقب الاسم الثلاثي في العمود الثالث، والرباعي في العمود الرابع؛ مما يجعل عزل اللقب في عمود موحد أمراً مستحيلاً دون تدخل بشري يدوي مكثف لإعادة توحيد الأعمدة، فضلاً عن كونها عملية ثابتة (Static) تتطلب إعادة التطبيق يدوياً عند إضافة أي سجل جديد.
7.2 الاعتماد على ميزة التعبئة السريعة الذكية
مع إطلاق إصدار إكسيل 2013، أدمجت ميكروسوفت ميزة تقنية ثورية تعتمد على خوارزميات الاستدلال النمطي تُعرف بـ “التعبئة السريعة” (Flash Fill). تتيح هذه الأداة للمستخدم إدخال اللقب العائلي للسجل الأول يدوياً في الخلية المقابلة B2، ثم البدء بكتابة اللقب للسجل الثاني، أو الضغط مباشرة على مفتاحي الاختصار Ctrl + E. يقوم النظام بقراءة النمط النصي ومقارنته بالمدخل الأصلي، ثم يستنتج تلقائياً أن المطلوب هو اقتطاع الكلمة الأخيرة، فيملأ العمود بأكمله في أجزاء من الثانية دون الحاجة لكتابة أي صيغة معقدة.
ورغم السلاسة والسرعة الفائقة التي توفرها التعبئة السريعة، إلا أن لها محددات أكاديمية وتقنية يجب أخذها بالحسبان؛ فهي تولد قيماً نصية ثابتة وليست ديناميكية، مما يعني أن أي تعديل لاحق على الأسماء في العمود A لن ينعكس تلقائياً على عمود الألقاب B. وعلاوة على ذلك، قد تخطئ خوارزميات الاستدلال في تفسير الأنماط المعقدة أو الشاذة كالألقاب المسبوقة بلواحق، مما يتطلب مراجعة بشرية مستمرة لنتائجها وعدم الاعتماد المطلق عليها في قواعد البيانات الكبيرة الحساسة.
7.3 التوظيف المتقدم لدوال النصوص الحديثة في النسخ الجديدة
في إصدارات مايكروسوفت 365 (Microsoft 365) وإصدارات إكسيل الحديثة الصادرة من عام 2022 فصاعداً، أحدثت التحديثات البرمجية نقلة نوعية عبر إدخال مجموعة دوال نصية حديثة، أبرزها دالة الاقتطاع اللاحق TEXTAFTER. تتيح هذه الدالة الاستغناء الكامل عن المعادلات التركيبية الطويلة، حيث يمكن عزل الاسم الأخير مباشرة وبكل بساطة من خلال كتابة الصيغة التالية:
=TEXTAFTER(A2, ” “, -1)
تتجلى العبقرية الهندسية في هذه الصيغة من خلال تمرير المعامل العددي -1 في وسيط التكرار، والذي يوجه محرك إكسيل للبحث العكسي من نهاية السلسلة النصية نحو بدايتها، متجاوزاً كافة المسافات الأولى، ومقتطعاً النص الذي يلي المسافة الختامية مباشرة بمرونة لا مثيل لها وبأداء حوسبي فائق السرعة. غير أن التحدي المنهجي الوحيد لهذا النهج يتمثل في عدم توافقه مع الإصدارات القديمة (Legacy Versions) من البرنامج التي ما زالت مستخدمة على نطاق واسع في المعامل والمؤسسات الأكاديمية حول العالم، مما يوجب الإلمام بالصيغ الكلاسيكية لضمان قابلية تشغيل الملفات المشتركة عبر بيئات حوسبية مختلفة.
8. معالجة الحالات الخاصة والاستثناءات اللغوية المعقدة
8.1 إدارة الأسماء العائلية المركبة متضمنة أدوات الوصل
تفرض الأسماء العائلية المكونة من كلمتين أو المشتملة على أدوات تعريف ونسب تحدياً يتطلب تكييف المعالجة التقنية لضمان عدم شطر اللقب إلى نصفين. في اللغة العربية، تبرز الألقاب المركبة مثل “آل مكتوم” أو “ابن سينا” أو “أبو بكر”، وفي اللغات اللاتينية مثل “De La Rosa”؛ حيث يؤدي تطبيق دالة عزل الكلمة الأخيرة بصيغتها المجردة إلى اقتصار النتيجة على “مكتوم” أو “سينا” أو “Rosa”، فاقدة هويتها التركيبية الصحيحة ومعرقلة الترتيب الهجائي السليم للأسر.
للتعامل مع هذه الحالات المتقدمة، يُوصى باتباع تقنية “الدمج المعياري المؤقت”؛ والتي تقوم على استخدام خاصية الاستبدال (Find and Replace) لاستبدال المسافة الفاصلة بين جزأي اللقب المركب بشرطة وصل غير مسافية (مثل تحويل “آل مكتوم” إلى “آل_مكتوم” أو استخدام المسافة غير القابلة للكسر Non-breaking space). هذا التعديل يجعل الخوارزمية الحسابية تتعامل مع المقطع المركب ككتلة نصية مصمتة واحدة، مما يتيح اقتطاع اللقب بشكله الصحيح والكامل أثناء تطبيق دالة RIGHT أو TEXTAFTER دون أن يتشوه تركيبه المعجمي.
8.2 التعامل مع اللواحق الشرفية والدرجات الأكاديمية
من الأخطاء التحليلية الشائعة التي تفسد عملية الفرز إدراج لواحق تدل على درجات وظيفية أو رتب أو ألقاب تكريمية وجيلية في نهاية الاسم (مثل: Jr.، أو III، أو Ph.D.، أو دكتور، أو مهندس). فعندما تتواجد هذه اللواحق في نهاية السلسلة النصية، تفترض معادلات الاقتطاع الرياضي أن هذه الإضافات هي الاسم الأخير للمشارك؛ مما يؤدي إلى استخراج “Jr.” أو “Ph.D.” كألقاب عائلية، مسبباً تجميع أسماء مختلفة في مواضع هجائية غير ذات صلة.
تقتضي السلامة الأكاديمية تنقية البيانات (Data Cleansing) المسبقة وتجريدها من هذه اللواحق، إما بعزل الرتب والدرجات الأكاديمية في أعمدة مستقلة مخصصة لها قبل المعالجة، أو استخدام دالة الدمج والتنظيف لاستبعاد الكلمات التابعة لقاموس محدد مسبقاً من اللواحق الشائعة. يضمن هذا الإجراء وصول خوارزمية الفرز إلى اللقب الفعلي للمشارك، متجنباً التداخل بين المتغيرات الديموغرافية والوصفية والاسم الذاتي للشخص.
8.3 ضبط الترتيب مع تباين أشكال الأحرف والهمزات
تتميز بعض اللغات، ولا سيما اللغة العربية، بتعدد الأشكال الهجائية للحرف الواحد، وخاصة حرف الألف الذي قد يظهر مهموزاً من الأعلى (أ)، أو من الأسفل (إ)، أو ممدوداً (آ)، أو مجرداً من الهمزة تماماً (ا). في بيئة إكسيل، يُعامل الترتيب الأبجدي هذه التشكيلات بدرجات تفاوت معينة بحسب إعدادات النظام الإقليمية، مما قد يؤدي إلى تبعثر الأسماء التي تنتمي لنفس اللقب الجذري (كأن يوضع “أحمد” في ترتيب مختلف عن “احمد”).
لضمان أعلى معايير الضبط التوثيقي، يُفضّل تطبيق مرحلة مسبقة لتوحيد أنماط الحروف المتشابهة عبر صيغ الاستبدال المبرمج، وتوحيد الهمزات والتاءات المربوطة والياءات المتطرفة وفق نسق معياري محدد. يؤدي هذا التوحيد الصارم إلى منع تشتت الأسماء العائلية المتطابقة جذرياً في قوائم الترتيب، مما يكفل اتساق المخرجات ومواءمتها مع متطلبات النشر العلمي والفهرسة المعيارية في المؤسسات الرائدة.
9. أفضل الممارسات الأكاديمية لضمان سلامة البيانات بعد الفرز
9.1 تحويل الصيغ إلى قيم ثابتة لتثبيت النتائج
عقب إتمام استخراج الألقاب وتطبيق الترتيب الأبجدي المنشود، تظل الخلايا في العمود المساعد مرتبطة بالصيغ الرياضية النشطة والمعقدة التي وُضعت في البداية. إن الإبقاء على هذه الصيغ يجعل قاعدة البيانات عرضة للاختلال في حال إجراء أي تعديل مستقبلي أو عند تصدير البيانات إلى برمجيات إحصائية مثل SPSS أو R، حيث قد تظهر رسائل خطأ مرجعي (مثل #REF!) عند تحريك الأعمدة أو إزاحتها.
لذلك، تقتضي قواعد السلامة المنهجية تحديد خلايا العمود المساعد بالكامل، ثم نسخها باستخدام Ctrl + C، وإعادة لصقها في نفس المكان بصيغة “لصق كقيم” (Paste as Values). يؤدي هذا الإجراء الحاسم إلى تثبيت النتائج النصية المجردة وإلغاء تبعيتها البرمجية للمعادلات، مما يحمي ورقة العمل من التعديلات غير المقصودة ويسمح بالتخلص من العمود المساعد بأمان لاحقاً في حال رغب الباحث في الاحتفاظ بالاسم الأصلي مفرزاً دون أعمدة إضافية.
9.2 الاحتفاظ بنسخ احتياطية وتتبع التغييرات التوثيقية
إن تطبيق عمليات التعديل وإعادة الترتيب على مجموعات البيانات البحثية يفرض التزاماً بتدابير الحفظ والأرشفة المنهجية. يجب على الباحث، كإجراء أولي إلزامي، الاحتفاظ بنسخة طبق الأصل من ورقة البيانات الخام في تبويب مستقل داخل المصنف ذاته، مع وضع توثيق كتابي يبين المعايير والخطوات البرمجية التي طُبقت لتحويل البيانات وفرزها.
من التدابير الفنية الموصى بها في هذا السياق إضافة عمود دائم في أقصى يمين أو يسار الجدول يحمل اسم “المعرف الأصلي” أو “الترقيم التسلسلي الإدخالي” (Original ID)، وتعبئته بأرقام متسلسلة (1، 2، 3…) قبل تنفيذ أي خطوة فرز. يوفر هذا الحقل شبكة أمان لا تقدر بثمن؛ إذ يتيح للباحث في أي وقت العودة إلى الترتيب الزمني أو الإدخالي الأصلي للبيانات ببساطة عن طريق إعادة فرز الجدول بناءً على هذا الرقم التعريفي، متفادياً أي فقدان دائم للتسلسل الأولي.
9.3 التدقيق اليدوي للعينة وفق المعايير المنهجية
رغم الكفاءة الحسابية للأدوات الرقمية المتقدمة، لا يمكن للباحث الأكاديمي الاستغناء عن التحقق الميداني والتدقيق البشري للتأكد من خلو النتائج من الأخطاء العارضة. يُوصى بسحب عينة عشوائية ممثلة تعادل ما نسبته 5% إلى 10% من إجمالي السجلات بعد عملية الفرز، وإخضاعها لفحص دقيق ومطابقة شاملة بين الأعمدة المتقابلة للتحقق من سلامة الارتباط.
يتضمن التدقيق التأكد من أن الدرجات المعيارية، أو الأرقام القومية، أو المتغيرات الحساسة الخاصة بكل مشارك في العينة ما زالت تقع في نفس السطر المقابل لاسمه بعد انتقال الأسطر جراء الترتيب. وتوفر هذه المصادقة الإحصائية واليدوية المزدوجة أعلى درجات الثقة في نقاء مصفوفة البيانات النهائية، مما يؤهلها للاستخدام الأكاديمي الرصين والنشر في الدوريات المحكمة بأعلى معايير المصداقية.
10. الأخطاء الشائعة أثناء فرز الأسماء في إكسيل وسبل معالجتها
10.1 خطأ انهيار الربط بين البيانات الأفقية في السجل
يعد فقدان التزامن الأفقي بين مكونات السجل الواحد الكابوس الأكبر لمحللي قواعد البيانات، ويحدث هذا الخلل عندما يحدد المستخدم عمود “الاسم الأخير” وحده دون باقي الجدول ويضغط على خيار الفرز، ثم يختار خيار “المتابعة مع التحديد الحالي” (Continue with the current selection) متجاهلاً تحذير النظام التلقائي الذي يطالب بـ “توسيع التحديد” (Expand the selection).
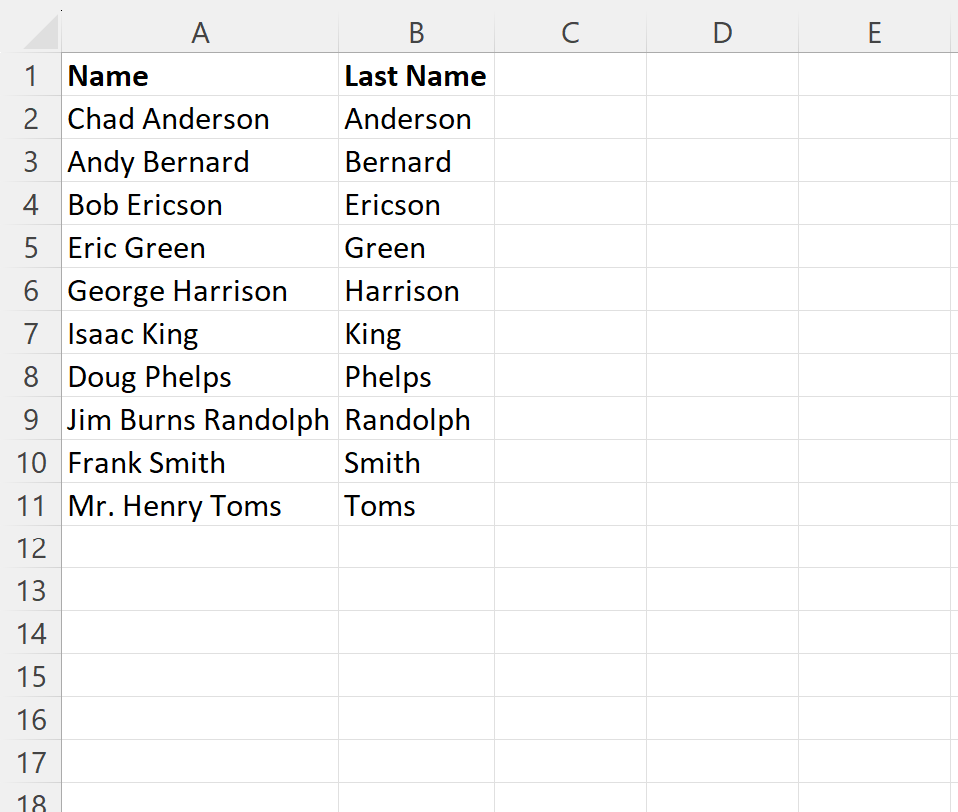
ينجم عن هذا التصرف إعادة ترتيب عمود اللقب بشكل منفصل، بينما تظل الأسماء الأولى وبقية البيانات المرافقة ثابتة في مواضعها، مما يدمر سلامة السجلات تماماً. وفي حال عدم الانتباه للخطأ على الفور عبر التراجع الفوري بالضغط على Ctrl + Z، فإن استعادة البنية الأصلية يصبح أمراً شبه مستحيل بدون النسخ الاحتياطية. ولتلافي هذا الخطر نهائياً، يُنصح دائماً بتحويل نطاق البيانات إلى “جدول إكسيل رسمي” (Excel Table) عبر الاختصار Ctrl + T، حيث يفرض هذا النمط ترابطاً ميكانيكياً متماسكاً يمنع فرز أي عمود دون بقية أعمدة الجدول تلقائياً.
10.2 ظهور أخطاء القيمة والرمز البرمجي في العمود المساعد
عند تعميم الصيغ الرياضية الطويلة عبر كامل عمود البيانات، قد يتفاجأ المستخدم بظهور رسائل خطأ مزعجة في بعض الخلايا مثل #VALUE! أو #N/A. ينشأ هذا العطل عادة في الحالات التي يحتوي فيها السجل على “اسم أحادي” لا يضم أي مسافات فاصلة على الإطلاق (كإدخال الاسم الأول مجرداً)، أو عند مواجهة خلايا فارغة بين صفوف البيانات؛ مما يجعل دالة البحث تعجز عن إيجاد الرمز المرجعي أو المسافة المطلوبة.
لمعالجة هذه الثغرة وتأمين استقرار الورقة الحسابية، يجب تغليف صيغة الاقتطاع البرمجية بدالة معالجة الأخطاء IFERROR، لتصبح المعادلة محمية على النحو التالي:
=IFERROR(RIGHT(A2, LEN(A2) – FIND(“@”, SUBSTITUTE(A2, ” “, “@”, LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”))))), A2)
تضمن هذه الإضافة البرمجية التحقق من صحة المخرجات؛ ففي حال نجاح الاستخراج يُعرض اللقب الصافي، أما إذا واجهت الدالة اسماً أحادياً خالياً من المسافات، فإنها تتفادى رسالة الخطأ وتعرض الاسم الأصلي نفسه المدخل في A2 كلقب افتراضي، مما يضمن استمرار عملية الفرز الأبجدي بسلاسة ودون أدنى انقطاع تقني.
10.3 فشل الفرز الأبجدي بسبب التباين في تنسيق الحقول
من الملاحظات التقنية المربكة التي تواجه العاملين على إكسيل تعطل التسلسل الأبجدي المنطقي في عمود الألقاب، كأن تظهر بعض الأسماء التي تبدأ بحرف محدد في نهاية القائمة بالكامل بدلاً من موقعها الطبيعي. يعود السبب الجوهري وراء هذا السلوك غير المتوقع إلى وجود مسافات بادئة خفية قبل الاسم، أو التباين في تنسيق الخلايا بين التنسيق النصي (Text) والتنسيق العام (General) وتنسيقات الأرقام في السجلات التي تتضمن أرقاماً مركبة مع الألقاب.
ولمعالجة هذه الإشكالية، يجب توحيد خصائص الخلايا في العمود عبر تحديد النطاق بالكامل وتطبيق تنسيق “نص” موحد عبر نافذة تنسيق الخلايا (Format Cells). كما يُنصح بإعادة تطبيق دالة TRIM للتخلص من المسافات الطفيلية، مع إزالة أي تنسيقات شرطية (Conditional Formatting) متضاربة قد تطبق قواعد فرز مخصصة على الخلايا بناءً على ألوانها أو أنماط خطوطها، مما يعيد للبرنامج قدرته على إجراء مقارنة محرفية نقية تحترم الترتيب الأبجدي الطبيعي للأحرف.
خاتمة شاملة
تمثل عملية فرز البيانات الاسمية بالاعتماد على الاسم الأخير في إكسيل مهارة جوهرية تتجاوز مجرد التعامل السطحي مع الجداول الحسابية إلى إدراك عميق لهندسة البيانات وإدارتها المنهجية. لقد أثبت التحليل المستفيض أن الحل الجذري والآمن للمشكلات الناجمة عن دمج الأسماء الكاملة في حقل واحد يعتمد على اتباع نهج مرحلي مدروس؛ يبدأ من تنقية البيانات الأولية وضبط بنيتها، مروراً بتأسيس العمود المساعد واستخدام الدوال التركيبية المتداخلة أو الحديثة لاقتطاع اللقب بدقة، وصولاً إلى تنفيذ الفرز متعدد المستويات وتثبيت القيم كأصول بيانات دائمة ومستقرة.
إن تبني هذه المعايير والتدابير الوقائية يحمي قواعد البيانات الأكاديمية والمهنية من مخاطر انهيار التزامن الهيكلي، ويوفر للباحثين والمحللين مصفوفات معلوماتية رصينة تتوافق مع أعلى المقاييس العالمية في التوثيق والإحصاء. ومع التطور المستمر لبرمجيات الجداول الحسابية، يظل الفهم المنطقي لكيفية عمل الخوارزميات النصية هو الضمان الحقيقي لقدرة المتخصص على تطويع التكنولوجيا ومعالجة الاستثناءات اللغوية والتقنية المعقدة بثقة وكفاءة واقتدار.
المراجع
- Microsoft Support. (n.d.). Split text into different columns with the Convert Text to Columns Wizard. Microsoft. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-the-convert-text-to-columns-wizard-30b14923-346d-4e99-b5f9-f6984a4e1728
- Microsoft Support. (n.d.). Using Flash Fill in Excel. Microsoft. https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-4761-a058-23e5a64a7797
- Microsoft Support. (n.d.). TEXTAFTER function. Microsoft. https://support.microsoft.com/en-us/office/textafter-function-c8db23ae-bb96-49b3-ac61-497d513a13f7
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.