
تُعد معالجة البيانات النصية وهيكلتها الركيزة الأساسية التي تقوم عليها نظم المعلومات والتحليلات الإحصائية المعاصرة. وفي بيئات العمل الرقمية التي تعتمد على المنصات السحابية، يبرز تطبيق جداول بيانات جوجل (Google Sheets) كأحد أكثر الحلول البرمجية مرونة وانتشاراً لإدارة مجموعات البيانات الديناميكية وتنقيتها. ترجع أصول هذه البيئة الحسابية المتطورة إلى استحواذ شركة جوجل في عام 2005 على شركة “2Web Technologies” التي أسسها جوناثان روشيل وفارزاد خوسروشاهي، لتبصر المنصة النور رسمياً كخدمة متكاملة تحت اسم “جداول بيانات جوجل” في يونيو 2006. ومنذ ذلك الحين، تطورت بنيتها الرياضية لتتيح للمستخدمين تنفيذ تحويلات مصفوفية وهيكلية معقدة كانت تقتصر في السابق على بيئات قواعد البيانات المتقدمة.
تعتبر مسألة تفكيك النصوص المتسلسلة والمحتواة داخل حقل بياني واحد إلى عناصر متفرقة ومستقلة من أبرز العمليات المتكررة في علوم البيانات وتطبيقات الإدارة اليومية. ومع ذلك، تصطدم الممارسات التقليدية بحاجز الهيكلية الأفقية التي تفرضها الأدوات الافتراضية؛ إذ تتيح واجهة المستخدم المدمجة تقسيم النصوص عبر الأعمدة المتجاورة فقط، مما يؤدي إلى تشويه التناسق العلائقي للجداول وتشتيت التدفق المنطقي للمتغيرات. ومن هنا، يكتسب التحويل الرأسي أو ما يُعرف بـ “التقسيم الرأسي للخلايا” أهمية بالغة، بوصفه الوسيلة التقنية المثلى لإعادة توزيع السلاسل النصية على نسق صفوف متعاقبة بدلاً من تفريغها أفقياً.
يقدم هذا المقال دليلاً شاملاً وتأصيلاً تقنياً عميقاً لكيفية إخضاع مصفوفات جداول بيانات جوجل لإعادة التوجيه الرأسي عبر الجمع الرياضي والتركيبي بين الدوال المتخصصة، مثل دالتي التفكيك النصي والتدوير المصفوفي، فضلاً عن استعراض التقنيات الحديثة والبدائل البرمجية المؤتمتة. سنناقش بالتفصيل الأبعاد النظرية والتطبيقية، مسلطين الضوء على ميكانيكا الحساب، والتعامل مع المحددات المعقدة، وحل مشكلات التضارب الهندسي في شبكة الخلايا، مما يمنح المحللين والباحثين القدرة على تصميم نماذج بيانات متسقة، وقابلة للتطوير السلس، ومتوافقة تماماً مع المعايير الإحصائية المتقدمة.
1. مقدمة عامة حول معالجة البيانات النصية وتقسيم الخلايا في جداول بيانات جوجل
1.1 مفهوم التقسيم الرأسي للخلايا ومقارنته بالتقسيم الأفقي التقليدي
يُعرَّف التحويل الهيكلي للبيانات في إطار الحوسبة الشبكية بأنه عملية إعادة تشكيل الكتل النصية غير المنظمة أو شبه المنظمة من نسق اتصالي أحادي إلى مصفوفات رياضية ذات اتجاه محدد داخل فضاء الجدول. في بنية جداول بيانات جوجل، تخضع شبكة العمل لمبدأ فيزيائي ثابت يُعرف بـ “ثبات البنية الشبكية الذرية” (Grid Invariance Principle)، والذي يقضي باستحالة شطر الخلية الفردية الواحدة داخلياً إلى خلايا فرعية صغرى دون التأثير على إحداثيات الصفوف والأعمدة الحاكمة لكامل المصنف. وبناءً على هذا المبدأ، فإن مصطلح “التقسيم الرأسي” لا يعني شق الخلية جغرافياً كما يحدث في معالجات الكلمات التقليدية مثل مستندات جوجل، بل يشير إلى عملية برمجية يتم من خلالها استخراج وتفكيك السلسلة النصية المشتركة في خلية المصدر وتوزيع مفرداتها رأسياً على امتداد صفوف متتالية ومستقلة تقع ضمن نفس العمود أو في عمود جديد مجاور.
يختلف هذا المسار اختلافاً جوهرياً عن التقسيم الأفقي التقليدي الذي توفره أدوات الواجهة الرسومية البسيطة. عند اللجوء إلى التوسع الأفقي، فإن البيانات تتدفق عبر محاور الأعمدة المتزايدة (من اليمين إلى اليسار أو العكس بحسب اتجاه الورقة)، مما يتسبب في تضخم اتساع الجدول وإرباك التصميم الهيكلي عبر خلق أعمدة متغيرة الطول تكسر تجانس الحقول البيانية. في المقابل، يُحاكي التوسع الرأسي المعايير القياسية لنمذجة البيانات؛ حيث يمثل كل صف سجلاً بياناتياً منفرداً (Tuple)، في حين يعبر العمود عن سمة أو متغير واحد مستمر. هذا التحول الرأسي يُعيد التوافق مع قواعد الشكل الطبيعي الأول (First Normal Form) في قواعد البيانات، مانعاً حدوث التكرار الشاذ ومحافظاً على التماسك الموضعي للمدخلات.
إن الأثر المعياري للتقسيم الرأسي يتجاوز مجرد التحسين الجمالي أو الترتيب الشكلي؛ فهو يضع الأسس الهندسية الصحيحة لبناء مجموعات بيانات قابلة للنمو المستمر. فعندما تُفرد السلاسل النصية على هيئة سجلات عمودية، تصبح المعالجات الحسابية اللاحقة، مثل التجميع الرياضي والفرز الآلي والمطابقة الإحصائية، عمليات نمطية تتطلب قدراً أقل من استهلاك الذاكرة وتتفادى التعقيد الخوارزمي الناجم عن تتبع أعمدة ممتدة بلا نهاية محددة مسبقاً.
1.2 أهمية التنظيم الرأسي للبيانات في الدراسات والتحليلات الإحصائية
تعتمد النمذجة الإحصائية المتقدمة والتحليلات الاستكشافية على مبدأ تجانس المفردات؛ حيث يتطلب كل مقياس أو مؤشر تجريبياً أن تكون المتغيرات مرصوفة ضمن متجهات رأسية واضحة. يتيح التنظيم الرأسي للمحلل إمكانية تطبيق آليات التصفية والفلترة الديناميكية لكل عنصر بياني بوصفه كياناً مستقلاً بذاته، مما يسهل استخراج المقاييس الوصفية كالتكرارات، والنسب المئوية، والمتوسطات الحسابية دون الحاجة إلى تفكيك البيانات يدوياً في كل مرحلة من مراحل التحليل. وتتجلى هذه الأهمية بوضوح في الأبحاث السلوكية والاجتماعية التي تدرس الأنماط المعقدة، حيث تشير دراسات التصميم والتحليل الهيكلي للمعلومات إلى أن تبسيط البنى البصرية والبيانات يقلل من العبء الإدراكي الواقع على الباحثين ويزيد من دقة رصد المتغيرات المتداخلة (Thoring, 2019).
وعلاوة على ذلك، يمثل الاتساق الرأسي شرطاً تقنياً حتمياً لضمان توافق الجداول مع دوال الاستعلام والبحث المتقدمة، مثل دوال البحث العمودي والاستعلام المنطقي المدمج. فعندما تكون الكلمات المفتاحية أو التصنيفات المجمعة محشورة في خلية مفردة، تصبح خوارزميات الفهرسة عاجزة عن مطابقتها بدقة مع الجداول المرجعية، بينما يمنح التوزيع الرأسي كل قيمة مقسمة معرفاً سياقياً يُمكّن محركات الجداول من ربطها بجداول أبعاد أخرى ضمن بيئات التحليل العلائقية أو مستودعات البيانات الكبرى.
من الناحية العملية، يُترجم هذا التنظيم الرأسي إلى تعزيز مقروئية التقارير الأكاديمية والمهنية، حيث تتحول مجموعات البيانات المكتظة بالنصوص الغامضة إلى هياكل شفافة يمكن قراءتها وتدقيقها بسلاسة من قبل اللجان المتخصصة والأنظمة المؤتمتة على حد سواء. إن قابلية التطوير السلس التي يكتسبها الجدول تجعل من السهل إضافة آلاف السجلات الجديدة دون المساس باستقرار الصيغ الحسابية أو بنية المخططات البيانية المعتمدة على تلك الأعمدة.
1.3 التحديات التقنية الشائعة عند التعامل مع السلاسل النصية المدمجة
تواجه بيئات العمل المكتبية تحدياً متكرراً يتمثل في “ظاهرة تكدس المتغيرات المتعددة”، حيث تُسجل ردود الاستبيانات، أو تفاصيل المشاريع، أو الكلمات المفتاحية المتعددة داخل حقل بيانات فردي دون فصل هيكلي. تنشأ هذه الظاهرة غالباً من آليات الإدخال الحر للبيانات أو التصدير التلقائي من استمارات الويب، مما يحول الخلية الواحدة إلى كتلة غير متجانسة تحتوي على أعداد غير متوقعة من المفردات. تتسبب هذه الهيكلية المشوهة في شل قدرات التحليل الإحصائي الآلي، إذ يستحيل إجراء عمليات العد المنطقي أو المقارنة المعيارية طالما بقيت الكيانات المستقلة محبوسة ضمن سلسلة نصية واحدة.
يتمثل التحدي التقني الثاني في عزل المحددات النصية وتوحيدها؛ ففي المجموعات النصية الكبيرة نادراً ما تلتزم المدخلات بفاصل موحد ومثالي. قد تتداخل الفواصل العادية مع الفواصل المنقوطة، أو تتخللها مسافات بيضاء متفاوتة الأطوال، أو حتى فواصل أسطر برمجية خفية. إن غياب التناسق في هذه الرموز الفاصلة يجعل خوارزميات التفكيك عرضة لإنتاج بيانات مشوهة أو شظايا نصية تحتوي على فراغات غير مرئية تؤدي إلى إخفاق عمليات المطابقة التامة في مراحل المعالجة اللاحقة.
تفرض هذه البيانات المدمجة قيوداً حاسمة على العمليات الرياضية؛ إذ تُعامل برمجيات الجداول تلك الخلايا كقيم نصية مصمتة، مما يمنع إجراء العمليات الحسابية أو المنطقية على الأرقام الواردة في متنها ما لم يتم فصلها تماماً وعزلها في صفوف مخصصة. تتطلب معالجة هذه الأنماط المركبة فهماً معمقاً للتفاعل بين المنطق المصفوفي والدوال النصية، لتفكيك الشفرات المدمجة بأقل قدر ممكن من التدخل اليدوي المعرض للخطأ البشري.
2. الأسس النظرية للصيغة الأساسية: التفاعل الرياضي بين دالتي SPLIT وTRANSPOSE
2.1 التشريح الوظيفي لدالة SPLIT وآلية عمل المحددات الفاصلة
تُمثل دالة التفكيك النصي الأداة المركزية لاستخراج وتجزئة السلاسل النصية في بيئة جداول بيانات جوجل. تعتمد هذه الدالة في بنيتها الرياضية على مسح السلسلة النصية المستهدفة من بدايتها إلى نهايتها لرصد أي تطابق مع محرف محدد يتم تمريره كمعامل للفصل. تأخذ الدالة وسائط متعددة تبدأ بالنص المراد تحليله، يليه الرمز الفاصل، ثم وسائط منطقية اختيارية تتحكم في سلوك المعالجة، وتحديداً وسيط تحديد ما إذا كان الفصل يتم بكل حرف على حدة، ووسيط إزالة النصوص الفارغة الناجمة عن تتابع المحددات الفاصلة في الموضع ذاته.
عندما تعثر الدالة على المحدد المذكور، تقوم بقطع الاتصال بين السلسلة السابقة واللاحقة، وتحويل المفردات المستخلصة إلى عناصر مستقلة داخل متجه بيانات أفقي. يتمثل السلوك الافتراضي الجوهري لهذه الدالة في توليد مصفوفة صفية تمتد أفقياً عبر الأعمدة المتجاورة للخلية التي تستضيف الصيغة؛ حيث يستقر العنصر الأول في نفس عمود الصيغة، بينما ينسكب العنصر الثاني في العمود التالي جهة اليسار أو اليمين، وهكذا دواليك حتى استنفاد كافة العناصر المعزولة.
تتميز الدالة بمرونة فائقة في التعامل مع مختلف الرموز التعبيرية وعلامات الترقيم، إلا أن سلوكها الطبيعي في إفراغ النتائج عبر المحور الأفقي يجعلها غير ملائمة بمفردها لإنشاء جداول قياسية رأسية. فإذا تُركت المخرجات على نسقها الأفقي، فإنها ستلتهم مساحات الأعمدة المخصصة لمتغيرات أخرى، مما يفرض ضرورة إيجاد وسيط رياضي قادر على اعتراض هذا المتجه الصفي وإعادة توجيهه نحو الأسفل.
2.2 دور دالة TRANSPOSE في التدوير المصفوفي من الصفوف إلى الأعمدة
ترتكز دالة التدوير المصفوفي على مفهوم جبري عريق مستمد من الجبر الخطي، حيث يتم تحويل أبعاد المصفوفة الرياضية عبر تبديل المحاور الإحداثية؛ فتتحول الصفوف إلى أعمدة، وتتحول الأعمدة بالتناظر إلى صفوف. في السياق الحسابي لجداول بيانات جوجل، تعمل الدالة على استقبال أي نطاق أو مصفوفة ثنائية أو أحادية الأبعاد، وتدوير فضاء الإحداثيات بزاوية تسعين درجة، مع الحفاظ الكامل على الترتيب التسلسلي الداخلي للعناصر المكونة للمصفوفة.
عند دمج هذه الدالة مع مخرجات المعالجة النصية، فإنها تعترض المتجه الأفقي الناتج عن التفكيك النصي قبل كتابته على واجهة الجدول، وتعيد ترتيب عناصره رياضياً ليصبح متجهاً عمودياً صرفاً. هذا التدوير المتعامد لا يمس بأي شكل من الأشكال السلامة الهيكلية للبيانات النصية؛ فالنصوص المشفرة بتنسيقات اليونيكود، والرموز الخاصة، وحتى المسافات المترابطة، تنتقل بكامل سلامتها الدلالية والترميزية من محور الأفق إلى مدار السجلات الرأسية المتعاقبة.
يعد هذا التبديل المحوري عملية افتراضية فائقة السرعة تُنفذ في الذاكرة الحية (RAM) للبرنامج قبل عملية الرسم النهائي للخلايا؛ مما يضمن عدم حدوث أي تأخير ملحوظ في الأداء عند التعامل مع المتجهات النصية المفردة، ويوفر بيئة خصبة لربط الدوال وتمرير المخرجات من دالة إلى أخرى بمرونة رياضية متناهية النظير.
2.3 الجمع التركيبي بين الدالتين في معادلة تجميعية موحدة
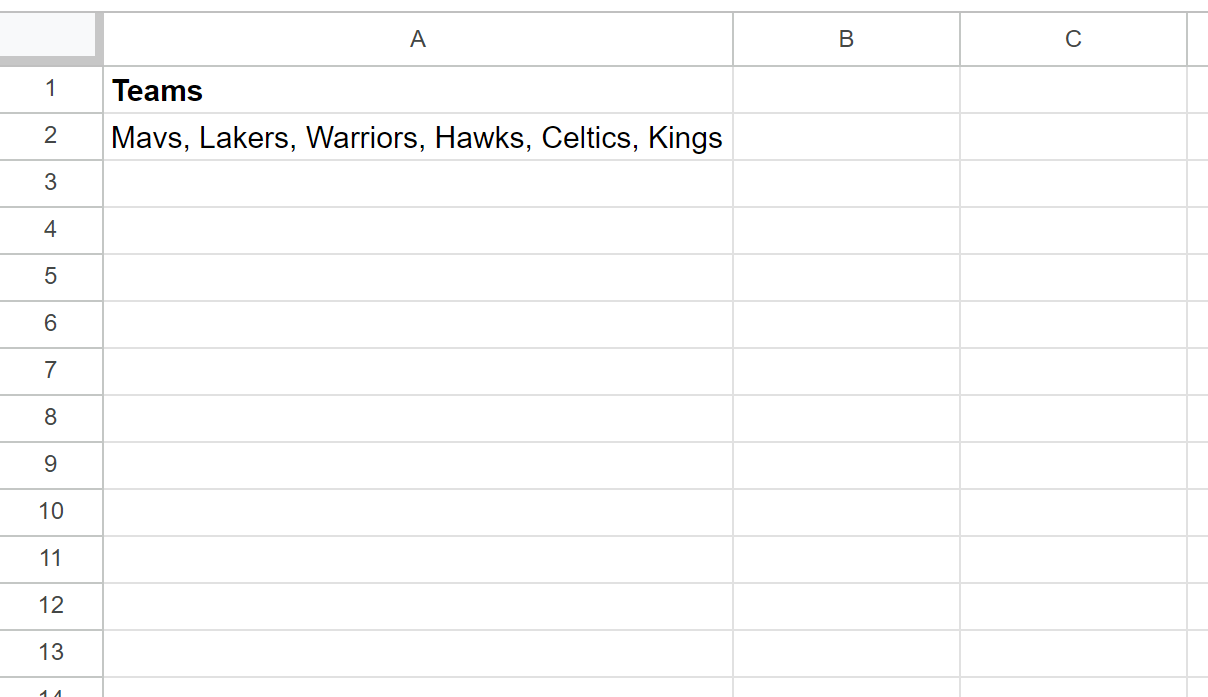
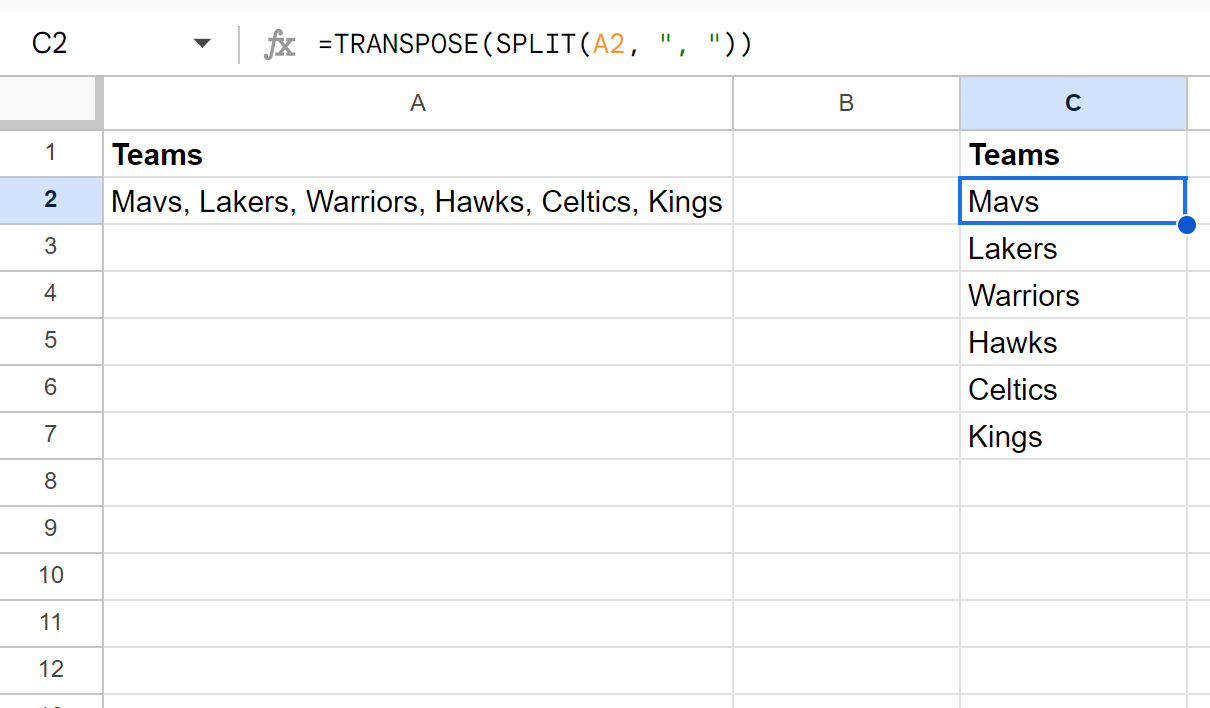
يتحقق الإنجاز التقني للتقسيم الرأسي للخلية المفردة من خلال الصياغة التركيبية التي تجمع بين الإمكانيات النصية لدالة التفكيك والقدرات الجبرية لدالة التدوير، وذلك عبر الصيغة الرياضية النموذجية الموضحة أدناه:
=TRANSPOSE(SPLIT(A2, “, “))
تخضع هذه الصيغة التجميعية لقواعد أسبقية التنفيذ الرياضي الصارمة المعمول بها في لغات البرمجة وبرمجيات الجداول. يبدأ المحرك أولاً بتنفيذ الدالة الداخلية المتضمنة؛ حيث تُرسل محتويات الخلية المصدرية مع الرمز الفاصل (وهو الفاصلة متبوعة بمسافة في هذا النموذج) إلى خوارزمية التجزئة. تقوم هذه الخوارزمية بإنتاج مصفوفة أفقية مؤقتة تحتوي على كافة الكلمات المفردة المجتزأة كعناصر منفصلة في الذاكرة المؤقتة للبرنامج.
بمجرد اكتمال بناء هذا المتجه الصفي في الذاكرة وقبل أن يُتاح له الانسكاب عبر أعمدة الجدول، تتلقى الدالة الخارجية المخرجات لتباشر عملية التدوير الهندسي الفوري لأبعاد المصفوفة، محولة المتجه من فضاء الأفق إلى مسار عمودي أحادي البعد. تسقط المخرجات النهائية في الخلية التي تحتضن المعادلة لتمتد بسلاسة رأسياً إلى الأسفل عبر الصفوف المتعاقبة. وتتجلى مرونة هذه الصيغة الحركية في قدرتها التلقائية على التكيف مع التغير في حجم البيانات المصدرية؛ فإذا احتوت الخلية على ثلاثة عناصر، شغلت المعادلة ثلاثة صفوف، وإذا زيدت إلى مئة عنصر، امتدت المعادلة عمودياً دون الحاجة لتعديل يدوي في شفرة الصيغة.
3. التطبيق العملي خطوة بخطوة لتقسيم خلية رأسياً
3.1 تهيئة بيئة العمل وإعداد البيانات النصية المستهدفة
تبدأ الخطوة الأولى في أي معالجة ناجحة للبيانات بفحص الطبيعة التركيبية للخلية الأصلية التي تحتوي على السلسلة النصية المراد تفكيكها. يجب على المحلل التحقق من نسق النصوص المحتواة—سواء كانت أسماء لفرق عمل، أو كلمات مفتاحية لمقالات أكاديمية، أو تصنيفات جغرافية متعددة—للتأكد من طبيعة الفواصل الفاصلة بينها. يقتضي الإجراء المعياري فحص ما إذا كانت الفواصل المستخدمة منتظمة وموحدة عبر كامل النص، كأن تكون جميعها فواصل عادية متبوعة بمسافة واحدة، أو شرطات أفقية تفصل بين الرموز.
يتعين في هذه المرحلة التثبت من نقاء النص من المحددات الشاذة أو الأخطاء الطباعية التي قد تسللت أثناء الإدخال اليدوي، مثل وجود فاصلتين متتاليتين بالخطأ أو استخدام فاصلة عربية في موضع وفاصلة لاتينية في موضع آخر. يؤدي عدم توحيد هذه المعطيات الأولية إلى تجزئة غير متوازنة تترك بعض العناصر ملتصقة ببعضها دون انفصال سليم.
علاوة على ذلك، يجب تحديد موقع الخلية المستهدفة التي ستستقبل انسكاب النتائج الرأسية. ينبغي أن يقع هذا الحقل في عمود فارغ تماماً أسفل خلية البداية، مع ضمان خلو المسار الرأسي من أي بيانات نصية أو رقمية مسبقة. تكمن أهمية هذا الإجراء في منع حدوث أي مقاطعة مكانية تعيق التمدد الحر للمصفوفة وتؤدي إلى توقف الصيغة عن العمل كما سنوضح لاحقاً في قسم استكشاف الأخطاء.
3.2 إدخال الصيغة الرياضية والتحقق من دقة المعاملات
عقب إعداد بيئة الخلية وتحديد الإحداثيات، ينتقل المستخدم إلى مرحلة التحرير الفعلي؛ حيث يحدد الخلية التي سيبدأ منها ظهور العنصر الأول ويدرج علامة التساوي البرمجية لبدء بناء المعادلة. تُكتب الصيغة التجميعية بدقة فائقة مع إسناد المرجع الصحيح للخلية المصدر، كما في الشكل التالي:
=TRANSPOSE(SPLIT(A2, “, “))
يجب إيلاء عناية قصوى لعلامات التنصيص المزدوجة المحيطة بالرمز الفاصل؛ إذ يُعتبر أي رمز يُدرج بين هاتين العلامتين هو المحدد الحصري الذي ستعتمده الخوارزمية لقص السلسلة النصية. إذا كان النص يحتوي على فاصلة متبوعة بمسافة، فإن إهمال تضمين المسافة داخل علامات التنصيص سيؤدي إلى بقاء المسافات ملتصقة ببداية الكلمات المستخرجة في الصفوف السفلية، مما يفسد دقة العمليات النصية المقارنة لاحقاً.
كما يُراعى في هذه الخطوة تثبيت نوع المرجع المستخدم؛ فإذا كان القصد هو تعميم الفكرة وسحب الصيغة للتعامل مع سجلات متوازية بطرق معينة، يتم استخدام المراجع النسبية البسيطة. أما إذا كان الهدف هو استخراج البيانات من خلية ثابتة لملء جدول جانبي محدد بدقة، فيُفضل تثبيت مرجع الخلية المصدر باستخدام علامة الدولار لتحويله إلى مرجع مطلق يمنع انحراف نطاق القراءة عند تحريك الخلايا في الجدول.
3.3 معاينة المخرجات وتقييم اكتمال التوزيع الرأسي
فور الضغط على زر الإدخال، تشرع بيئة جداول بيانات جوجل في حساب الصيغة وتوزيع المخرجات لحظياً. يقتضي التدقيق المنهجي معاينة العمود المخرَج للتحقق من أن كل عنصر أو مفردة نصية قد استقرت في صف منفصل بمفردها أسفل الخلية الأولى، مع التأكد من أن الترتيب الرأسي الناتج يطابق تماماً الترتيب الأصلي للكلمات كما وردت أفقياً في السلسلة النصية المصدرية دون أدنى تشويه أو بعثرة في تسلسل المعاني.
يجب التحقق بدقة من عدم حدوث اقتطاع للنصوص الطويلة ذات الأحرف المركبة، والتأكد من خلو الخلايا الناتجة من المسافات البادئة أو الشوائب الطباعية غير المرئية التي قد تتسبب في أخطاء بصرية أو تقنية عند الربط. يُجرى هذا الفحص عادة بالنقر المزدوج على بعض الخلايا العشوائية في العمود المقسم للتأكد من نظافة النص من الفراغات الهامشية.
أخيراً، يتم اختبار الاستجابة الديناميكية للصيغة من خلال إحداث تعديل تجريبي طفيف في الخلية المصدر، مثل إضافة عنصر جديد في نهاية السلسلة أو تعديل أحد المفردات القائمة. إذا كانت المعادلة تعمل وفق المعايير المصممة لها، فستنعكس التعديلات بصورة فورية على العمود المقسم رأسياً؛ حيث يظهر العنصر الجديد متدلياً في الصف الموالي مباشرة، مما يبرهن على نجاح وحيوية الرابط المصفوفي المؤسس بين الخلية المصدر وعمود النتائج.
4. معالجة أنواع المحددات المختلفة والفواصل المعقدة
4.1 التعامل مع الفواصل التقليدية: الفواصل المنقوطة والشرطات والمسافات
في الممارسات الواقعية لمعالجة الجداول، تتنوع الرموز المستخدمة للفصل بين الكلمات والبيانات تنوعاً كبيراً بناءً على نظام التصدير المتبع أو طبيعة المصطلحات المدخلة. تبرز الفاصلة المنقوطة كأحد المحددات الشائعة عند تصدير البيانات من الأنظمة الأوروبية أو برمجيات إدارة المراجع، في حين تُستخدم الشرطات الأفقية والمائلة لتسجيل الرموز التعريفية والأكواد التسلسلية. لتكييف دالة التفكيك مع هذه المحددات، يُعدل المعامل الثاني للصيغة بصورة مباشرة؛ فعلى سبيل المثال، للتعامل مع نصوص مفصولة بشرطة، تُصاغ المعادلة على النحو التالي:
=TRANSPOSE(SPLIT(A2, “-“))
عند الرغبة في تفكيك جمل كاملة إلى مفردات لغوية مستقلة، يتم اعتماد المسافة المفردة كمحدد أساسي بين علامتي التنصيص. في هذا السياق، تكتسب الوسائط الإضافية لدالة التفكيك أهمية حاسمة، وتحديداً الوسيط الثالث المعروف بـ “split_by_each”. يحدد هذا الوسيط ما إذا كان محرك الحساب سيتعامل مع كل محرف داخل نص الفاصل بشكل منفصل أم سيتعامل مع السلسلة ككتلة واحدة مدمجة. ضبط هذا الوسيط على القيمة الرياضية المناسبة يمنح المحلل تحكماً مطلقاً في تفسير رموز الفصل بدقة ومنع التفكيك الخاطئ للأحرف المركبة.
تتطلب الإدارة الدقيقة للمحددات التقليدية مراقبة وثيقة لكيفية تعامل الدالة مع تكرار الفواصل العرضي؛ ففي حال وجود مسافات بيضاء غير متساوية بين الكلمات، فإن الاعتماد على المسافة المجردة دون ضبط إضافي قد يولد صفوفاً فارغة عديدة، مما يستوجب توظيف الخيارات المتقدمة لتصفية النصوص الفارغة كما سيتم بيانه لاحقاً لضمان الحصول على عمود منظم ومستمر.
4.2 تقسيم النصوص المستندة إلى فواصل الأسطر البرمجية (Line Breaks)
تُمثل النصوص التي تم إدخالها داخل الخلية الواحدة باستخدام فواصل الأسطر البرمجية أو ما يُعرف بالإرجاع السلس للسطر (Soft Return / Alt+Enter) تحدياً خاصاً؛ إذ لا يظهر الرمز الفاصل هنا كحرف مرئي يمكن إحاطته بعلامات تنصيص اعتيادية. تعتمد أنظمة الحوسبة على شفرات محرفية غير مرئية لتمثيل الانتقال إلى سطر جديد، وفي بيئات الجداول الرقمية وجداول بيانات جوجل، يُشار إلى فاصل السطر البرمجي المعتمد بالرمز المحرفي ذي القيمة 10 وفق جداول الترميز القياسية للأسكي (ASCII) واليونيكود.
لاستحضار هذا المحرف الخفي برمجياً، توظف بيئة الحساب دالة الرموز المحرفية التي تحول القيمة الرقمية إلى المحرف المقابل لها. وبناءً على ذلك، تتم صياغة المعادلة المركبة لتقسيم الخلية رأسياً بالاعتماد على فواصل الأسطر كما يلي:
=TRANSPOSE(SPLIT(A2, CHAR(10)))
تكتسب هذه التقنية أهمية استثنائية عند التعامل مع البيانات المنسوخة من محررات النصوص الخارجية، أو جداول البريد الإلكتروني، أو قواعد البيانات المركزية التي تخزن العناوين البريدية والملاحظات الإدارية الطويلة في خلية واحدة تفصل بين أسطرها محارف التغذية السطرية. تنجح هذه المعادلة في قراءة الشفرة الخفية وتحويل كل سطر مكتوب إلى صف مستقل تماماً في الجدول الجديد دون فقدان أي جزء من النص.
تجدر الإشارة إلى أنه في بعض الحالات المتقدمة للملفات المستوردة من بيئات تشغيل قديمة، قد يترافق فاصل السطر مع محرف إرجاع الحامل (Carriage Return) الممثل بالرمز 13. وفي مثل هذه البيئات المعقدة، يتم الجمع بين الرمزين أو تنظيف النص مسبقاً لضمان عدم بقاء أي بقايا محرفية غير مرئية تؤثر على تنسيق الخلايا ومحاذاتها الرأسية.
4.3 إدارة المحددات المتعددة أو المركبة داخل الخلية الواحدة
في سيناريوهات معالجة البيانات المعقدة، قد تحتوي الخلية الواحدة على خليط غير متجانس من المحددات؛ كأن يفصل الكاتب بين المفردات تارة بفاصلة، وتارة أخرى بفاصلة منقوطة أو شرطة مائلة ضمن نفس السجل. للتعامل مع هذا التباين دون اللجوء إلى مراحل معالجة وسيطة، تتيح دالة التفكيك ميزة الفرز المتعدد من خلال تضمين كافة الرموز المرشحة داخل معامل الفاصل النصي مع تفعيل خاصية الفصل بكل محرف على حدة، كما يظهر في التركيب التالي:
=TRANSPOSE(SPLIT(A2, “,;/|”, TRUE, TRUE))
يلعب الوسيط الرابع في هذا التركيب، وهو وسيط إزالة النصوص الفارغة (remove_empty_text)، دوراً حاسماً في الحفاظ على النقاء الهيكلي للعمود الناتج. فعندما تتجاور محددات مختلفة في الخلية الأصلية—مثل وجود فاصلة متبوعة بمسافة متبوعة بشرطة—فإن خوارزمية التفكيك التقليدية قد تفسر المسافة بين هذه الرموز كمدخل فارغ، مما يؤدي إلى توليد صفوف بيضاء خالية من المعنى بين الكلمات الحقيقية. بضبط هذا الوسيط على الحالة الإيجابية، تتجاهل الدالة أي نواتج فارغة ناجمة عن التكرار المتعاقب للرموز الفاصلة.
تمنح هذه المعالجة الشاملة مرونة استثنائية للباحثين والمحللين في تنقية مجموعات البيانات الضخمة التي جمعت من مصادر متعددة غير منضبطة القواعد. إن إدراك الكيفية التي تتفاعل بها وسائط الفصل المتعددة مع التدوير الرأسي يقلل بشكل ملموس من الوقت الضائع في عمليات التنظيف اليدوي المرهقة، ويوفر مخرجات نقية وجاهزة مباشرة للدمج في خطوط معالجة البيانات المتقدمة.
5. تقنيات التقسيم الرأسي لمجموعات وخلايا متعددة بالتزامن
5.1 قصور السحب التلقائي للصيغة البسيطة وقيود التداخل المصفوفي
عند الانتقال من معالجة خلية فردية منعزلة إلى معالجة عمود كامل يضم مئات السجلات المدمجة، تظهر معضلة تقنية جوهرية تتمثل في فشل آلية “مقبض التعبئة” أو السحب التلقائي الكلاسيكي للصيغة البسيطة. فعندما يقوم المستخدم بكتابة معادلة التدوير والتفكيك في صف معين ثم يسحبها رأسياً إلى الأسفل لتطبيقها على بقية الصفوف، يحدث تصادم رياضي حتمي بين المصفوفات المنسكبة عبر شبكة الخلايا المتجاورة.
ينبع هذا القصور من حقيقة أن كل خلية مصدر تحتوي على عدد متغير من العناصر؛ فإذا احتوت الخلية الأولى على خمس كلمات، فإن صيغتها ستتمدد لتشغل خمسة صفوف رأسية نحو الأسفل. وعند محاولة الخلية الثانية—التي تبعد صفاً واحداً فقط عن الأولى—تفريغ نتائجها المتمددة رأسياً، فإنها تصطدم مباشرة بالخلايا المشغولة بمخرجات الخلية السابقة، مما يؤدي فوراً إلى انهيار العملية البرمجية وظهور خطأ الانسكاب المرجعي الشهير عبر كافة الخلايا، وشل قدرة الجدول على إظهار البيانات بطريقة مجمعة ومتصلة.
تفرض هذه الظاهرة الرياضية ضرورة التخلي عن أساليب المعالجة الفردية الموضعية والارتقاء إلى مستوى “معادلات المصفوفات المتصلة” (Dynamic Array Pipelines). يتطلب الحل المنهجي صياغة دوال تجميعية تمتلك القدرة الإدراكية على قراءة نطاق كامل من الخلايا، وتفكيك محتوياتها بالكامل في بيئة المعالجة الخلفية، ثم تسطيح النتائج المجمعة ورصها في مسار رأسي أحادي التدفق لا يعرف الانقطاع أو الاصطدام المتبادل.
5.2 استخدام دالة FLATTEN لإعادة تشكيل النطاقات المعقدة رأسياً
تُمثل دالة التسطيح المكتبي إحدى أقوى الإضافات الهندسية وأكثرها تميزاً في بيئة جداول بيانات جوجل؛ حيث تكمن مهمتها الحصرية في تفكيك المصفوفات متعددة الأبعاد وتحويلها إلى مصفوفة خطية عمودية وحيدة البعد. بخلاف دوال التدوير التقليدية التي تعيد توجيه المصفوفة ككتلة صلبة واحدة، تقوم هذه الدالة بمسح النطاق الشبكي المعطى صَفاً صَفاً، واستخراج محتوياته بدقة متناهية لصفها رأسياً في عمود واحد متصل من الأعلى إلى الأسفل.
عند دمج قدرات هذه الدالة مع دالة التفكيك النصي المطبقة على نطاق كامل، نحصل على صيغة مصفوفية متطورة قادرة على معالجة أعمدة بأكملها دفعة واحدة دون التعرض لأخطاء التداخل المكاني، كما يتضح في الصيغة المجمعة التالية:
=FLATTEN(SPLIT(A2:A, “, “))
بالإضافة إلى ذلك، توفر التحديثات الحديثة لجداول بيانات جوجل دالة موجهة صراحة لتحويل النطاقات إلى أعمدة رأسية، وهي دالة المتجه العمودي (TOCOL)، والتي يمكن استخدامها كبديل حديث ومباشر لصيغ التدوير والتسطيح المركبة، عبر الصيغة الرياضية:
=TOCOL(SPLIT(A2:A, “, “), 1)
تعمل كلتا الطريقتين على استيعاب المئات من الخلايا المدمجة بالتزامن، حيث تُفكك النصوص أفقياً في فضاء الذاكرة الافتراضية، ثم يُعاد تسطيحها فوراً ودفعها رأسياً في عمود الخرج دون أي تدخل يدوي، مما يوفر حلاً جذرياً لمشكلة معالجة البيانات المتدفقة من استمارات العمل الميدانية ومجموعات الرصد المستمر.
5.3 تنقية الفراغات الناتجة عن التسطيح عبر دالة QUERY
على الرغم من القوة الاستثنائية لصيغ التسطيح المجمعة، إلا أن تطبيقها على نطاقات مفتوحة النهاية (مثل الإسناد إلى كامل مساحة العمود A2:A) يسفر حتماً عن مشكلة ثانوية تتمثل في توليد آلاف الخلايا الفارغة في قاع عمود المخرجات. ينجم هذا السلوك عن محاولة محرك الجداول معالجة الخلايا الفارغة المتواجدة أسفل الجدول الأصلي وتسطيحها كمدخلات نصية معدومة القيمة، مما يتسبب في تضخم غير مبرر في حجم ملف العمل وهبوط كفاءة الأداء البرمجي للمتصفح.
لحل هذه المعضلة وتطهير عمود البيانات النهائي، يتم تطويق الصيغة السابقة بمحرك الاستعلام المتطور الخاص بجداول جوجل، والذي يحاكي لغة الاستعلام البنيوية (SQL). تُبنى الصيغة الثلاثية المركبة عبر إدخال شرط استبعاد القيم الفارغة كما في النموذج التالي:
=QUERY(FLATTEN(SPLIT(A2:A, “, “)), “WHERE Col1 IS NOT NULL AND Col1 ””)
يقوم محرك الاستعلام الداخلي بفحص المتجه العمودي الناتج عن التسطيح، مستبعداً بصورة قاطعة كل صف لا يحتوي على قيمة نصية حقيقية. يضمن هذا الإجراء أن تكون المخرجات المعروضة للمستخدم مصمتة ومتصلة ومحصورة بدقة في النطاق الفعلي للمفردات المفككة، مما يحسن من استقرار الوثيقة الرقمية ويسرع عمليات التمرير والمعالجة الحسابية الإضافية التي تعتمد على عمود النتائج النظيف.
إن تطبيق هذا المعيار المتقدم في ضبط تدفق البيانات يتماشى مع أفضل الممارسات البرمجية المتبعة في هندسة البيانات؛ حيث يتم عزل طبقة استخراج البيانات وتنقيتها ضمن صيغة واحدة مكتفية بذاتها تمنع تسرب الشوائب الهيكلية إلى واجهات العرض والتحليل الإحصائي اللاحقة (Almagro, 2011).
6. استكشاف الأخطاء الشائعة وحلولها البرمجية أثناء التقسيم الرأسي
6.1 معالجة خطأ التوسع والانسكاب المرجعي (#REF!)
يُعد خطأ التوسع المرجعي (#REF!) العائق التقني الأكثر شيوعاً وإحباطاً للمستخدمين أثناء محاولة تقسيم الخلايا رأسياً. ينص التوصيف الدقيق لهذا الخطأ في بيئة جداول بيانات جوجل على تعذر توسيع نتيجة المصفوفة نظراً لأنها ستؤدي إلى الكتابة فوق بيانات موجودة مسبقاً في مسار التوسع. ونظراً لأن التقسيم الرأسي يتطلب بطبيعته حجز عدد من الصفوف يماثل تماماً عدد الكلمات المفردة المجتزأة، فإن وجود ولو قيمة واحدة متبقية—سواء كانت نصاً قديماً أو رقماً أو حتى مسافة فارغة—في أي خلية تقع ضمن المسار العمودي المحدد سيؤدي فوراً إلى تجميد الدالة ورفع راية الخطأ المرجعي.
تتمثل الاستراتيجية العلاجية الأولى في فحص المسار الرأسي الواقع مباشرة أسفل خلية المعادلة وإخلائه تماماً. يمكن للمستخدم النقر على رسالة الخطأ لمعرفة الإحداثيات الدقيقة للخلية المعيقة لحركة المصفوفة، ومن ثم التوجه إليها ومسح محتواها لتمكين المخرجات من الانسكاب التلقائي. ومع ذلك، في النماذج المؤسسية المتطورة، لا يُعتمد على الحلول اليدوية؛ بل يتم تصميم بنية الجداول بحيث تخصص أعمدة معزولة تماماً تسمى “أعمدة التفريغ الديناميكي” التي يُحظر الكتابة اليدوية فيها لضمان عدم حدوث أي اصطدام مصفوفي مفاجئ.
ينبغي أيضاً مراعاة البعد التوسعي المتوقع للبيانات؛ فإذا كانت الخلية المصدرية مرشحة لاستقبال عشرات الكلمات الجديدة في المستقبل، يجب ضمان توفر صفوف كافية في أسفل الجدول تكفي لاستيعاب هذا التمدد، حيث إن بلوغ قاع الورقة الأخير دون وجود صفوف إضافية فارغة سيولد أيضاً نفس الخطأ المرجعي نتيجة نفاد الحيز الشبكي للمصنف.
6.2 تفادي أخطاء عدم توفر القيمة (#N/A) والخلايا الفارغة
تظهر مشكلة تقنية أخرى عند ربط صيغ التقسيم الرأسي بخلايا مصدرية قد تكون فارغة مؤقتاً أو تخلو من المحدد الفاصل المشروط في المعادلة. في هذه الحالة، تفشل دالة التفكيك النصي في العثور على أي نصوص مطابقة، مما يقودها إلى إرجاع خطأ عدم توفر القيمة المشهور (#N/A)، والذي يشير إلى أن المعامل المطلوب غير قابل للمعالجة بالمعايير المحددة. ينتشر هذا الخطأ كالنار في الهشيم عبر كافة الحسابات والجداول المعتمدة على عمود النتائج، متسبباً في تعطل لوحات التحكم التفاعلية.
لتحصين النموذج الرياضي وتأمين استقراره في مواجهة المدخلات الفارغة، يتم إحاطة التركيب بالكامل بدالة اعتراض الأخطاء الوقائية (IFERROR). تعترض هذه الدالة أي رسالة خطأ صادرة وتستبدلها بقيمة بديلة آمنة يحددها المبرمج، وتكون غالباً سلسلة نصية فارغة تماماً، كما هو موضح في البناء النموذجي التالي:
=IFERROR(TRANSPOSE(SPLIT(A2, “, “)), “”)
يتيح هذا التضمين الوقائي للمصممين بناء نماذج تفاعلية مرنة تظل فيها الخلايا هادئة ونظيفة بصرياً بانتظار إدخال البيانات في الخلية المصدر، دون تشويه واجهة الاستخدام برسائل التنبيه والتحذيرات التحليلية المزعجة. كما يضمن بقاء النطاق الحسابي آمناً لعمليات العد الإحصائي التي قد ترتبك بفعل وجود قيم الخطأ النصية.
تعتبر إدارة الأخطاء الصامتة ركيزة لا غنى عنها في هندسة النظم البرمجية وجداول البيانات الاحترافية؛ إذ تمنع تحول الخطأ المحلي الصغير إلى عطل شامل يعرقل مسارات التقارير التجميعية في المصنفات الضخمة.
6.3 إزالة المسافات الزائدة والشوائب النصية بواسطة دالة TRIM
من المشاكل الخفية والمؤرقة في معالجة البيانات النصية وجود المسافات البادئة واللاحقة المحيطة بالمفردات المفككة. فعندما تنقسم سلسلة نصية مثل “تسويق، إدارة، تمويل” بالاعتماد على الفاصلة فقط دون المسافة، يستقر العنصر الثاني في صفه الجديد وهو مسبوق بمسافة غير مرئية للعين المجردة (” إدارة”). على الرغم من أن النص يبدو صحيحاً للمستخدم العادي، إلا أن خوارزميات المطابقة الحاسوبية تفشل تماماً في التعرف عليه؛ فلن تتطابق كلمة ” إدارة” ذات المسافة البادئة مع كلمة “إدارة” القياسية عند إجراء عمليات البحث أو التجميع.
لضمان النقاء المطلق للبيانات المستخرجة والتخلص من هذه العيوب الطباعية، يجب دمج دالة التشذيب النصي (TRIM) ضمن الصيغة الحسابية. تعمل هذه الدالة على مسح النصوص وإزالة كافة المسافات البادئة واللاحقة، فضلاً عن تقليص أي مسافات متكررة في وسط النص إلى مسافة مفردة واحدة. يظهر هذا التكامل المتقدم في التركيب التالي:
=TRANSPOSE(SPLIT(TRIM(A2), “, “))
وفي الحالات التي يُخشى فيها من وجود مسافات عشوائية ناتجة بعد عملية التفكيك، يمكن استخدام دالة المصفوفات لتطبيق التشذيب على عناصر المصفوفة الناتجة برمتها، لضمان أن كل مدخل يستقر في صفه الرأسي يتمتع بتجانس تام وتطابق قطعي مع القواميس والمعاجم المرجعية المعتمدة في النظام الإحصائي.
يعد هذا الإجراء الوقائي حجر الزاوية في بناء مستودعات البيانات المتكاملة؛ حيث إن نظافة المدخلات في مرحلة التقسيم الأولى تعفي المحللين من قضاء ساعات طويلة في استكشاف أسباب فشل صيغ البحث والمطابقة في المراحل المتقدمة من العمل.
7. الحلول البرمجية المتقدمة: استخدام Google Apps Script للتقسيم الرأسي
7.1 دواعي الانتقال من الصيغ الحسابية إلى الأتمتة البرمجية
على الرغم من الأناقة الرياضية التي تتمتع بها الصيغ المركبة السابقة، إلا أن الاعتماد الحصري على الدوال الحسابية الديناميكية يواجه حدوداً تقنية قاسية عندما تتضخم مجموعات البيانات لتشمل عشرات الآلاف من السجلات المعقدة. في مثل هذه البيئات الحسابية الضخمة، يؤدي وجود مئات الصيغ التدويرية المتشابكة إلى استنزاف مفرط للذاكرة العشوائية للمتصفح، مسبباً بطئاً شديداً وتأخيراً ملحوظاً في إعادة حساب الأوراق المالية والإحصائية عند كل نقرة يقوم بها المستخدم.
تبرز الحاجة الحتمية للانتقال إلى الأتمتة البرمجية المعتمدة على بيئة “برمجيات تطبيقات جوجل” (Google Apps Script) عندما تتطلب العمليات المؤسسية تثبيت البيانات وتحويلها إلى قيم مادية دائمة فور تفكيكها، دون إبقاء الورقة رهينة للحسابات اللحظية المستمرة. كما تفرض المعالجات المشروطة المعقدة—كالتي تتطلب دمج محددات سياقية مختلفة بناءً على محتوى السطر، أو إجراء مطابقة خارجية أثناء عملية التقسيم—استخدام لغات برمجة كاملة تدعم الهياكل الشرطية وحلقات التكرار المتقدمة.
توفر الأتمتة البرمجية للمطورين القدرة على النفاذ المباشر إلى واجهة برمجة التطبيقات (API) لجداول البيانات؛ مما يتيح التعديل المادي على بنية الأسطر، كإدراج صفوف جديدة فعلياً تحت الخلية المصدرية وحقن البيانات المجزأة فيها، وهو ما تعجز الصيغ الرياضية العادية عن تحقيقه بشكل مباشر بحكم تقيدها بطبيعة الخلايا المتاحة مسبقاً في الورقة.
7.2 بناء دالة برمجية مخصصة (Custom Function) بلغة جافا سكريبت
تتيح منصة جداول بيانات جوجل للمستخدمين كتابة دوال خاصة بهم باستخدام لغة جافا سكريبت الحديثة لتعمل جنباً إلى جنب مع الدوال القياسية المدمجة في البرنامج. لتنفيذ عملية التقسيم الرأسي برمجياً بطريقة سلسة، يتم الولوج إلى محرر البرامج النصية وتشييد دالة مخصصة تستقبل النص والمحدد الفاصل كمدخلات، ثم تعيد تشكيل المخرجات على هيئة مصفوفة ثنائية الأبعاد تتناسب مع المتطلبات الرأسية للشبكة.
تعتمد خوارزمية الدالة البرمجية على استدعاء التابع النصي القياسي للتجزئة بلغة جافا سكريبت، والذي يفكك السلسلة النصية إلى مصفوفة خطية. بعد ذلك، وباستخدام دوال التحويل المصفوفي المتقدمة، يتم تدوير هذه المصفوفة ليصبح كل عنصر فيها محاطاً بمصفوفة فردية مستقلة تمثل صفاً مخصصاً، مما يُشعر محرك الجداول بوجوب تفريغ هذه البيانات رأسياً عند استدعاء الدالة المخصصة في الخلية، كما يُوضح المنطق التالي المكتوب بلغة جافا سكريبت والمدرج في محرر المنصة:
function SPLIT_VERTICAL(text, delimiter) { if (!text) return “”; var tokens = text.toString().split(delimiter); return tokens.map(function(item) { return [item.trim()]; }); }
بمجرد حفظ هذا النص البرمجي في محرر المشروع، يستطيع أي مستخدم للمصنف كتابة المعادلة المخصصة الجديدة مباشرة في أي خلية وكأنها دالة مدمجة طورتها شركة جوجل ذاتها. تتميز هذه الدالة البرمجية بقدرتها الفائقة على تنظيف البيانات ذاتياً والتأكد من استقرار المخرجات بأعلى كفاءة معالجة ممكنة.
7.3 إنشاء ماكرو تشغيلي لتقسيم الخلية واستبدالها في موضعها
في العديد من سيناريوهات التدقيق الميداني، يُفضل المراجعون تفكيك الخلية النشطة في موضعها الفعلي مع إدراج صفوف حقيقية جديدة تحتها لحمل العناصر الزائدة، بدلاً من نقل المخرجات إلى عمود منفصل بعيد عن السياق الأصلي للمصنف. لتحقيق هذه الغاية، يتم برمجة سيناريو تشغيلي كامل (Macro) يتفاعل بصورة حية مع إحداثيات المؤشر والخلية المحددة حالياً من قبل المستخدم.
يقوم البرنامج النصي المتقدم بقراءة القيمة المخزنة في الخلية النشطة وفصل محتواها بناءً على المحدد المعين، ثم يستخرج عدد العناصر الإجمالية. بعد ذلك، يستدعي البرنامج واجهة الجدول لإدراج عدد من الصفوف الجديدة يماثل عدد العناصر الإضافية مباشرة أسفل الصف النشط، متبوعاً بكتابة كل قيمة في مكانها الصحيح، مع إمكانية نسخ البيانات الوصفية المجاورة (كالرقم التعريفي أو تاريخ السجل) وتكرارها في الصفوف المستحدثة لضمان اكتمال السجلات.
يتم في النهاية ربط هذا الإجراء البرمجي الشامل بزر تفاعلي يُرسم على واجهة الجدول، أو تخصيص اختصار سريع له عبر لوحة المفاتيح. بمجرد قيام المستخدم بالوقوف على أي خلية مدمجة والنقر على الزر المخصص، تنفجر الخلية رأسياً وتتوزع مفرداتها على صفوف نظامية مهيكلة بدقة خلال أجزاء من الثانية، مما يُحدث نقلة نوعية في كفاءة إدارة العمليات المكتبية اليومية.
8. البدائل التحليلية المتقدمة: استخدام التعابير النمطية (REGEX)
8.1 توظيف REGEXEXTRACT لاستخراج العناصر المعقدة رأسياً
تُمثل التعابير النمطية (Regular Expressions) إحدى أذكى وأقوى التقنيات الرياضية لتحليل ومعالجة النصوص في البيئات الحاسوبية المتقدمة. تصبح هذه التعابير ضرورة حتمية لا غنى عنها عندما تكون البيانات النصية المراد تقسيمها رأسياً تفتقر إلى محددات فصل واضحة أو مستقرة، وتتبع بدلاً من ذلك أنماطاً شكلية وسياقية معقدة؛ كأن تحتوي الخلية على مزيج متداخل من الكلمات والتواريخ والأرقام المشفرة دون فواصل قياسية تفصل بينها.
تتيح دالة الاستخراج النمطي في جداول بيانات جوجل مطابقة واستخلاص الأجزاء النصية التي تلائم تعبيراً منطقياً محدداً بدقة. لاستخراج عناصر متعددة وتوجيهها رأسياً، يتم الجمع بين الصيغ النمطية والدوال التكرارية لتوليد مصفوفة تتطابق مع كافة التواجدات للنمط المعني داخل الخلية. على سبيل المثال، لاستخراج كافة الأرقام التسلسلية أو الكلمات المكونة من أحرف محددة فقط وإسقاطها في عمود مستقل، تتم صياغة نمط رياضي يبحث عن التكتلات النصية المستهدفة ويتجاهل الحشوات العشوائية المحيطة بها.
تتجلى عبقرية هذا النهج في قدرته على عزل المدخلات المطلوبة دون الارتهان لوجود الفواصل التقليدية؛ فالنظام لا يبحث عن علامة ترقيم لتقطيع النص، بل يمسح الفضاء النصي لرصد التركيب المورفولوجي للكلمة ذاتها، مما يمنحه دقة متناهية تفوق بكثير قدرات دوال التفكيك النصي البسيطة في بيئات البيانات غير المنظمة.
8.2 إعادة هيكلة النصوص بواسطة REGEXREPLACE قبل التقسيم
في كثير من الحالات العملية، تكون السلسلة النصية مشوهة بفعل وجود فواصل غير متجانسة وشديدة العشوائية، مثل استخدام فواصل تارة، ونقاط تارة أخرى، ومسافات متعددة أو أقواس تحيط بالكلمات. في هذا السياق، تبرز دالة الاستبدال النمطي كأداة هندسية عبقرية لتنظيف وإعادة هيكلة وتوحيد السلسلة النصية قبل دفعها إلى مرحلة التقسيم والتدوير الرأسي.
تعتمد المنهجية على صياغة معادلة تستبدل كافة الأنماط المتفاوتة بمحدد فاصل موحد ومثالي (كالفاصلة القياسية). بعد ذلك، تُمرر السلسلة المطهرة إلى دالة التفكيك والتدوير، كما يتضح في البناء النموذجي التالي:
=TRANSPOSE(SPLIT(REGEXREPLACE(A2, “[s.;/-]+”, “,”), “,”))
تقوم هذه المعادلة المركبة بمسح النص المستهدف واستبدال أي تتابع للمسافات البيضاء أو النقاط أو الفواصل المنقوطة أو الشرطات بفاصلة مفردة قياسية واحدة فقط. فور إتمام هذه المعالجة التحضيرية في الذاكرة اللحظية، تتولى دالة التفكيك شطر النص بسهولة فائقة بالاعتماد على الفاصلة الموحدة، لتتولى دالة التدوير مهمتها الأخيرة في إرسال الكلمات رأسياً على امتداد الصفوف.
إن تبني هذه الاستراتيجية ذات المرحلتين المدمجتين في صيغة واحدة يحل أعقد مشكلات تنظيف البيانات الواردة من مصادر خارجية متعددة، محولاً النصوص الأكثر فوضوية وتداخلاً إلى جداول عمودية بالغة الدقة والانضباط الهيكلي.
8.3 مقارنة الكفاءة والدقة بين الدوال النمطية والصيغ القياسية
عند المفاضلة التقنية بين استخدام دوال التعابير النمطية وبين الاعتماد على دوال التفكيك والتدوير القياسية، يجب على مهندس البيانات الموازنة بين عاملي المرونة الدلالية واستهلاك موارد المعالجة الحسابية. تتميز الدوال النمطية بمرونة فائقة وقدرة مطلقة على التكيف مع النصوص المشوهة وغير المتجانسة، إلا أنها تفرض حملاً حسابياً مضاعفاً على وحدة المعالجة المركزية، نظراً لطبيعة خوارزميات مطابقة الأنماط التي تفحص السلسلة النصية محرفاً بمحرف بصورة تكرارية مجهدة.
في المقابل، تتمتع دوال التفكيك القياسية المدمجة مع التدوير الرأسي بسرعة تنفيذ استثنائية وخفة متناهية في استهلاك الذاكرة المؤقتة للمصنف؛ إذ تعتمد على خوارزميات البحث الخطي البسيط عن رمز محدد ومعلوم مسبقاً. ومع ذلك، فإن نقطة ضعفها تكمن في هشاشتها الشديدة أمام أي تباين غير متوقع في المحددات الفاصلة، مما يؤدي إلى تشوه المخرجات إذا لم تكن البيانات المصدرية نقية وموحدة.
يقودنا هذا التحليل المقارن إلى قاعدة هندسية واضحة: إذا كانت البيانات المصدرية خاضعة لرقابة إدخال جيدة وتمتلك محددات موحدة ومنتظمة، فإن الصيغ القياسية تعد الخيار الأمثل والأنقى للحفاظ على سرعة واستقرار الجداول الضخمة. أما إذا كانت البيانات مستخلصة من مصادر نصية حرة وغير منضبطة، فإن التضحية ببعض موارد المعالجة لصالح استخدام الدوال النمطية المركبة تصبح ضرورة لا غنى عنها لضمان دقة وسلامة الهيكلية الرأسية الناتجة ومنع تسرب الأخطاء إلى مستويات التحليل العليا.
9. أفضل الممارسات لتحسين أداء الجداول وتكامل البيانات المقسمة
9.1 تحويل مخرجات التقسيم الديناميكية إلى قيم نصية ثابتة
على الرغم من الفوائد التحليلية الكبرى للصيغ الديناميكية التي تستجيب تلقائياً للتغييرات، فإن الإبقاء على مئات أو آلاف الصيغ النشطة التي تقوم بالتفكيك والتدوير والتسطيح المستمر داخل المصنف يمثل خطراً حقيقياً على استقرار النظام الحسابي وسرعة استجابة الملف للتعديل والحفظ، خصوصاً في بيئات العمل السحابية المشتركة التي تتطلب تزامناً لحظياً بين عدة مستخدمين.
يتمثل الإجراء المعياري الاحترافي—بمجرد اكتمال عملية تقسيم البيانات وتأكيد صحتها—في عزل هذه المخرجات وتجميدها عبر تحويلها من صيغ برمجية مرنة إلى قيم نصية صلبة وثابتة. يتحقق ذلك من خلال تحديد عمود النتائج المنسكبة بالكامل، ونسخه إلى الحافظة، ثم استخدام أمر اللصق الخاص المخصص لقيم البيانات المجردة (Paste Special -> Values only)، مما يزيل الأعباء الحسابية من كاهل محرك الجداول ويحول البيانات إلى سجلات نصية تقليدية خفيفة الوزن وسريعة المعالجة.
يحقق هذا التحويل فائدة استراتيجية أخرى تتمثل في أرشفة البيانات وحمايتها من التلف العرضي؛ إذ إن بقاء النتائج مرتبطة بصيغ ديناميكية يجعلها عرضة للانهيار أو الاختفاء الكامل في حال تم تعديل الخلية المصدرية الأصلية أو حذفها عن طريق الخطأ في مرحلة لاحقة من دورة حياة المشروع.
9.2 التكامل مع دوال التحليل والمطابقة: VLOOKUP وINDEX/MATCH
لا تتوقف فائدة التقسيم الرأسي عند مجرد ترتيب النصوص في مصفوفة بصرية منظمة، بل تمتد لتشكل المحرك الرئيسي لعمليات التكامل والربط البيني لقواعد البيانات داخل المنظمة. فعندما تتفكك السلاسل المدمجة وتستقر كل مفردة في صف مستقل، تتحول هذه المفردات المستخرجة إلى “مفاتيح بحث أولية” (Primary Search Keys) صالحة للاستخدام المباشر في دوال المطابقة والاسترجاع المتقدمة مثل دوال البحث الرأسي والتقاطع الفهرسي.
يتيح هذا الترتيب للمحللين تمرير القيم المقسمة مباشرة إلى دوال البحث لمطابقتها مع جداول خارجية موازية؛ لاستدعاء السمات الإضافية المرتبطة بكل عنصر، مثل جلب الرقم الوظيفي لموظف تم استخراج اسمه من خلية فريق العمل، أو استدعاء السعر الفردي لقطعة غيار تم فك رمزها من سجل طلبيات مجمع. يؤدي هذا التكامل إلى ترقية الجدول من مجرد مستند نصي ساكن إلى شبكة بيانات علائقية متكاملة تحقق مبدأ “تكامل الكيانات” وتضمن إثراء البيانات دون الحاجة للتدخل البشري المستمر.
تسهم هذه الآلية الهيكلية في تسريع وتيرة تدفق الأعمال وتدقيق المعلومات المعقدة، موفرة بنية تحتية رقمية تدعم خطوط الإمداد التحليلي وتمكن صانعي القرار من الحصول على رؤى تفصيلية مستخلصة من أعمق السجلات المدمجة وأكثرها تعقيداً.
9.3 تنسيق البيانات المقسمة والتحقق من صحة المدخلات (Data Validation)
يقتضي التدبير الهندسي السليم للجداول حماية أعمدة المخرجات والمدخلات عبر حزمة من القواعد الإجرائية والتنسيقية التي تضمن استدامة النظام الرقمي. يبدأ هذا المسار بتطبيق أدوات التحقق من صحة البيانات على مستوى الخلايا المصدرية لفرض معايير صارمة على آليات الإدخال المستقبلي؛ كإلزام المستخدمين باستخدام فواصل محددة، أو استخدام القوائم المنسدلة المقيدة التي تمنع كتابة محددات شاذة تشوش على عمل دوال التقسيم المستقرة في النظام.
علاوة على ذلك، يُنصح بتطبيق آليات التنسيق الشرطي على العمود المقسم رأسياً لتمييز القيم المكررة بصرياً بصورة آلية. ففي كثير من الأحيان، يسفر تفكيك السلاسل الكبيرة عن تكرار بعض المفردات في صفوف مختلفة، مما يستوجب تسليط الضوء عليها عبر ألوان تنبيهية مخصصة لتمكين المحلل من اتخاذ قرار بإبقائها أو إخضاعها لدوال التصفية الحصرية مثل دالة القيم الفريدة (UNIQUE).
يختتم هذا المحور بضرورة توثيق المنهجية المتبعة؛ حيث يتم إدراج تعليقات برمجية وملاحظات توضيحية في ترويسة الأعمدة لشرح طبيعة الصيغ المصفوفية المستخدمة وآلية عملها، مما يضمن فهم المستخدمين الآخرين للمنظومة الهيكلية ويمنع التعديل غير الواعي الذي قد يفسد تناسق الجدول ويدمر الروابط المصفوفية الحساسة القائمة في المستند.
10. نماذج وتطبيقات عملية للتقسيم الرأسي في مختلف المجالات
10.1 تنظيم بيانات فرق العمل والمشاريع في البيئات المؤسسية
في البيئات المؤسسية وإدارات الموارد البشرية، تبرز معضلة متكررة عند تسجيل بيانات المشاريع؛ حيث يُسجل في الغالب أسماء كافة الموظفين المشاركين في مبادرة معينة داخل خلية واحدة تحت حقل “فريق العمل”، مفصولين بفواصل تقليدية. تتسبب هذه الهيكلية المشوهة في حرمان الإدارة من معرفة الأعباء الحقيقية الواقعة على كل موظف، ويستحيل معها إجراء تصفية دقيقة لمعرفة كافة المشاريع التي يشارك فيها شخص بعينه طالما بقي اسمه محاصراً داخل الخلايا المدمجة.
من خلال توظيف تقنية التقسيم والتسطيح الرأسي المدمجة مع معرفات المشاريع، يتم تحويل كل سطر مشروع مدمج إلى سجلات عمل فردية متعاقبة؛ بحيث ينفرد كل موظف بصف مستقل يحمل اسمه مقروناً باسم المشروع التابع له. يتيح هذا التوزيع الرأسي للمديرين بناء لوحات تحكم تفاعلية متطورة تحصي بدقة عدد المهام الموكلة لكل فرد، وتحدد أصحاب الكفاءات المفرطة في الانشغال لضمان التوزيع العادل للمسؤوليات والحد من الإنهاك المهني داخل المنظمة.
تسهل هذه البنية أيضاً تصدير البيانات إلى أنظمة الرواتب وتتبع الأداء المركزية بسلاسة متناهية؛ حيث تلبي السجلات الرأسية المفككة المتطلبات الدقيقة لقواعد البيانات المهنية دون الحاجة إلى إعادة صياغة المستندات يدوياً من الصفر في كل دورة تقييم ربع سنوية.
10.2 معالجة وتحليل الردود متعددة الخيارات الواردة من Google Forms
تُمثل الاستمارات الإلكترونية المدارة عبر منصة نماذج جوجل (Google Forms) أحد أهم مصادر جمع البيانات الميدانية، إلا أنها تفرض إشكالاً هيكلياً مزمناً عند التعامل مع أسئلة “مربعات الاختيار” (Checkboxes) التي تتيح للمستجيب اختيار أكثر من إجابة في آن واحد. يقوم النظام آلياً بتجميع كافة خيارات المستجيب وتفريغها في الخلية المقابلة له في جدول البيانات كسلسلة نصية واحدة تفصل بين خياراتها فاصلة متبوعة بمسافة.
عند محاولة استخراج النسب المئوية أو رسم المخططات البيانية لهذه الردود، تفشل أدوات التحليل الرسومية الافتراضية في فرز الخيارات؛ حيث تُعامل توليفة الإجابات المزدوجة كخيار جديد تماماً ومستقل عن الخيارات الفردية المكونة له. هنا يبرز التقسيم الرأسي عبر دالتي التدوير والتفكيك—المطوق بدوال التسطيح—كأداة إنقاذ حتمية لتحليل المحتوى؛ حيث يتم عزل كل إجابة اختارها المستجيب ورصفها رأسياً في عمود تصنيفي مستقل متسق مع الدراسات الإحصائية المعتمدة (Pryjmachuk et al., 2024).
يُمكّن هذا الإجراء الباحثين من استدعاء دوال الحساب التكراري لإحصاء العدد الفعلي لمرات اختيار كل بند على حدة، وحساب النسب المئوية الحقيقية المنسوبة إلى إجمالي العينة المستهدفة بدقة رياضية مطلقة، فضلاً عن تغذية المخططات البيانية بالمعطيات المنقاة لتمثيل النتائج الميدانية بشفافية واحترافية لا تشوبها شائبة.
10.3 هيكلة البيانات الببليوغرافية والمصادر في البحوث الأكاديمية
في مجال التوثيق الأكاديمي والتحليل الببليومتري للإنتاج العلمي، تتطلب دراسة اتجاهات الأبحاث تفكيك السجلات التوثيقية المعقدة التي تتكدس فيها أسماء المؤلفين المتعددين، أو الكلمات المفتاحية للمقالات، أو الرموز التصنيفية داخل حقل ببليوغرافي واحد في قواعد البيانات المستوردة. يؤدي بقاء هذه المدخلات مدمجة إلى حجب الرؤية عن الروابط التشاركية بين العلماء، ويعيق تتبع تطور المفاهيم العلمية عبر الفترات الزمنية المدروسة.
يسمح تطبيق خوارزميات التقسيم الرأسي للباحثين بتفكيك أسماء المؤلفين في كل ورقة بحثية وإسقاطها رأسياً في صفوف منتظمة تعكس الهيكل المفاهيمي للمعلومات المعقدة، على نحو ما ترصده دراسات التوثيق والتحليل الأدبي والأنثروبولوجي المتقدمة (Wilkes et al., 2016). تتيح هذه الهيكلة الرأسية بناء شبكات التحليل الببليومتري، واستخراج مصفوفات التعاون العلمي، وتحديد الباحثين الأكثر نشاطاً في التخصص بصورة مؤتمتة وموثوقة.
يمتد هذا الإجراء المنهجي ليشمل فهارس الكلمات المفتاحية، حيث يتم فرز المصطلحات المركزية رأسياً لقياس مدى تكرارها واستخدامها في دراسات تحليل المضمون وتطوير الأطر المعرفية المتخصصة في التعليم واكتساب المهارات والتحليل اللغوي (Jiang, 2014; Gorman, 2018). كما يساعد ذلك في تجهيز القوائم المرجعية الكبرى وتنسيقها بما يتوافق مع أدلة النشر العالمية التابعة للمؤسسات الأكاديمية العريقة دون إغفال أي مؤلف أو مصطلح بحثي جوهري.
خاتمة
استعرضنا في هذا الدليل المتعمق الأبعاد العلمية والتطبيقية لكيفية تقسيم خلية رأسياً في جداول بيانات جوجل، مبرهنين على أن هذه العملية تتجاوز مجرد التنسيق المظهري لتشكل ركيزة هيكلية أساسية في إدارة البيانات المعاصرة وهندستها. وضحنا من خلال الفحص الدقيق أن المنصة، بحكم خضوعها لمبدأ ثبات البنية الشبكية الذرية، ترفض تقسيم الخلية الواحدة إلى خلايا داخلية صغرى، وتعتمد بدلاً من ذلك على استخلاص السلاسل النصية وتوزيعها عبر المتجهات المصفوفية الرأسية المتعاقبة.
إن الجمع التناغمي والرياضي بين دالة التفكيك النصي ودالة التدوير المصفوفي—إلى جانب البدائل الحديثة والمتقدمة المتمثلة في دوال التسطيح المكتبي والمتجهات العمودية، وصولاً إلى الحلول البرمجية المؤتمتة عبر برمجيات تطبيقات جوجل والتعابير النمطية—يمنح المستخدمين ترسانة تقنية قادرة على ترويض أعقد مجموعات البيانات غير المنظمة. إن الالتزام بالقواعد الوقائية لمعالجة الأخطاء الشائعة، وتشذيب الشوائب النصية، وتجميد الصيغ المؤقتة وتحويلها إلى قيم مادية مستقرة يضمن سلامة المصنفات وحمايتها من الانهيار الحسابي مع تزايد وتيرة التوسع والتدفق البياني المستمر.
في المحصلة، يظل التمكن من هذه التقنيات الهندسية المعيار الفاصل بين الاستخدام الهامشي العفوي للجداول الرقمية، وبين التوظيف التحليلي الاحترافي القادر على تحويل الكتل النصية الصامتة إلى نماذج بيانات ديناميكية ذات كفاءة تشغيلية وتوافق كامل مع المعايير الإحصائية والمؤسسية المتقدمة.
المراجع
- Almagro, L. M. (2011). Statistical methods in Kansei engineering studies. https://doi.org/10.5821/dissertation-2117-94644
- Gorman, B. M. (2018). A Framework for Speechreading Acquisition Tools. arXiv (Cornell University). https://doi.org/10.48550/arxiv.1806.00812
- Jiang, X. (2014). Vocabulary Learning through Use of the Picture-Word Inductive Model for Young English Learners in China: A Mixed Methods Examination Using Cognitive Load Theory. https://doi.org/10.25148/etd.fi14071150
- Pryjmachuk, S., Kirk, S. A., Fraser, C., Evans, N., Lane, R., & Neill, L., et al. (2024). Service design for children and young people with common mental health problems: literature review, service mapping and collective case study. Health and Social Care Delivery Research. https://doi.org/10.3310/dkrt6293
- Thoring, K. (2019). Designing creative space. Research Repository (Delft University of Technology). https://doi.org/10.4233/uuid:77070b57-9493-4aa6-a9a5-7fed52e45973
- Wilkes, J., Staines, K., & Callard, F. J. (2016). The Restless Compendium. Springer eBooks. https://doi.org/10.1007/978-3-319-45264-7