
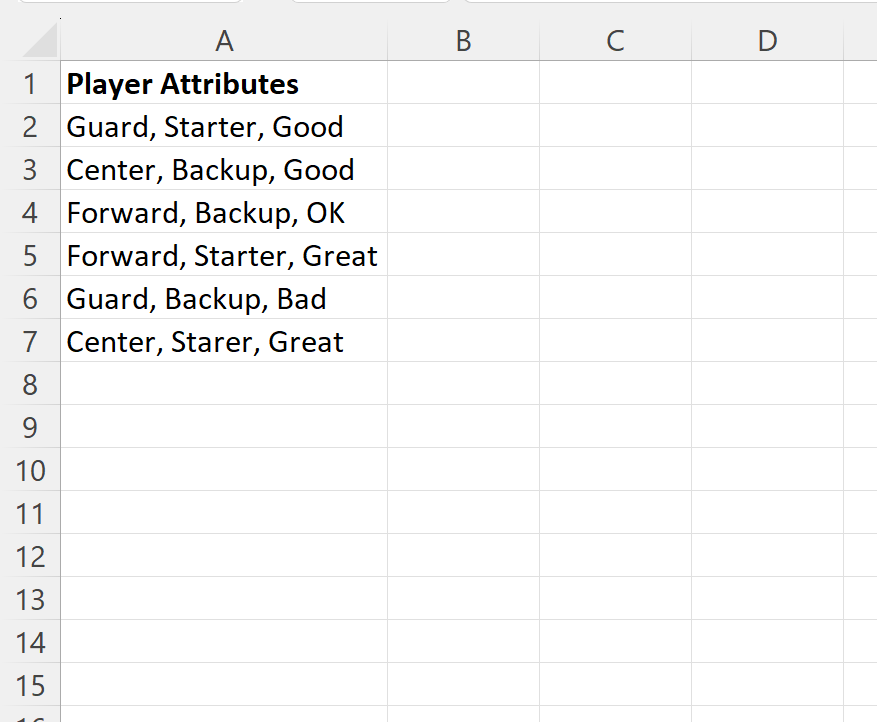
تشكّل معالجة النصوص والسلاسل النصية داخل جداول البيانات ركيزة محورية في ميدان إدارة البيانات التطبيقية والبحث الكمي. فعند تصدير البيانات من الأنظمة الإلكترونية، أو استخراج مخرجات الاستبانات الرقمية متعددة الخيارات، أو سحب السجلات من قواعد البيانات الموزعة، تظهر مشكلة تكديس حقول معلوماتية متعددة داخل خلية واحدة، يفصل بينها رمز محدد يكون في الغالب “الفاصلة”. إن بقاء هذه العناصر مدمجة في كيان نصي واحد يعوق العمليات الإحصائية، ويمنع التطبيق السليم لخوارزميات الفرز والتصفية والنمذجة الرياضية، مما يستدعي تفكيك هذه السلاسل النصية وإعادة توزيعها عبر هياكل جدولية مستقلة وقابلة للتحليل المقارن.
يتناول هذا الدليل الشامل الأبعاد النظرية والإجرائية لعملية تقسيم السلاسل النصية بفاصلة في برنامج مايكروسوفت إكسيل (Microsoft Excel). وسنستعرض عبره المنهجيات اليدوية والأوتوماتيكية والبرمجية المتاحة لتفكيك السجلات، بدءاً من المعالجات الرسومية المدمجة مثل أداة “تحويل النص إلى أعمدة” (Text to Columns)، مروراً بالدوال المصفوفية الحديثة مثل دالة TEXTSPLIT، والدوال التركيبية التقليدية للإصدارات القديمة، وصولاً إلى بيئة محرر الاستعلامات المتقدمة (Power Query) وأداة التعبئة السريعة (Flash Fill). كما يركز التحليل على التحديات المصاحبة لسلامة البيانات وتطهير الفراغات الشاردة والتعامل مع الإشكاليات الإقليمية لترميز الفواصل والرموز.
إن إتقان هذه التقنيات لا يمثل مجرد مهارة مكتبية عابرة، بل هو إجراء منهجي صارم يضمن موثوقية قواعد البيانات وتطبيعها (Data Normalization)، مما يحفظ أمان السجلات ويحول دون فقدان المعلومات الحيوية، خاصة في الدراسات المسحية الكبيرة والأبحاث الإمبريقية التي تعتمد على تحويل البيانات الخام المجمعة إلى مصفوفات رقمية ونوعية مهيأة للتحليل الإحصائي الدقيق عبر الحزم البرمجية المتخصصة.
1. مقدمة منهجية حول معالجة السلاسل النصية وأهمية تقسيم البيانات في إكسيل
1.1 أهمية هيكلة البيانات غير المنتظمة في البيئات البحثية والعملية
تمثل البيانات غير المهيكلة أو شبه المهيكلة عائقاً جوهرياً أمام الباحثين والمحللين في مختلف التخصصات العلمية والتطبيقية. فعندما تُسجل استجابات متعددة داخل متغير بحثي واحد—كما هو الحال في الأسئلة ذات الاختيارات المتعددة المنبثقة من منصات جمع البيانات الرقمية—فإن حصر المتغيرات المستقلة والتابعة في كتلة نصية متصلة يفقد البيانات خصائصها القياسية. إن تحويل البيانات المجمعة في حقل نصي واحد إلى مصفوفات منظمة يسهم في تمكين القياس الكمي لكل سمة على حدة، مما يتيح للباحث ترميز الإجابات، وحساب التكرارات، وبناء جداول التقاطع التكراري بدقة لا يمكن بلوغها في ظل وجود نصوص متشابكة.
علاوة على ذلك، تلعب هيكلة النصوص وتجزئتها دوراً رئيسياً في تحسين جودة البيانات الأولية عبر القضاء على التكرارات النصية المتداخلة وغير المتجانسة. إن تراكم الألفاظ المتلاصقة بداخل السجلات يؤدي إلى تشويه المعالم الإحصائية للعينة ويزيد من تباين المفردات اللغوية لنفس المعطى نتيجة أخطاء الإدخال. ومن خلال تقسيم السلسلة النصية وعزل كل مفردة داخل عمود منفصل، تصبح عملية معايرة المفردات وتوحيد تسمياتها أمراً ممكناً، وهو ما يمهد السبيل لإجراء عمليات التنظيف الآلي والفرز الممنهج.
تتجلى هذه الأهمية بوضوح عند التعامل مع جداول البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف؛ حيث تغدو أدوات الفرز والتصفية والمقارنة المعيارية غير قادرة على استهداف جزء من النص الداخلي للخلية بكفاءة حسابية وسرعة معالجة مقبولة دون التجزئة المسبقة. كما أن الاعتماد على التدخل البشري لتفكيك هذه السجلات يدوياً يرفع معدلات الخطأ البشري إلى مستويات تقوض الثقة في النتائج النهائية، مما يجعل اللجوء إلى الآليات الخوارزمية لتقسيم السلاسل النصية ضرورة حتمية لضمان سلامة البحث وتطبيقات الأعمال على حد سواء.
1.2 طبيعة الفواصل النصية كعلامات فصل قياسية
نشأت الفاصلة الإنجليزية (Comma) كمعيار تاريخي لترميز وتبادل البيانات المهيكلة منذ بزوغ صيغة الملفات المفصولة بفواصل (Comma-Separated Values – CSV). وقد حظيت هذه العلامة بانتشار واسع عبر منصات الحوسبة بفضل بساطتها وقابليتها للقراءة بواسطة الأنظمة البرمجية المختلفة ومحررات النصوص البسيطة، مما جعلها حجر الزاوية في عمليات تصدير واستيراد البيانات بين قواعد البيانات المختلفة وتطبيقات التحليل الإحصائي المتطورة.
ومع ذلك، تبرز العديد من التحديات الدلالية والتطبيقية الناتجة عن تداخل الاستخدام اللغوي للفاصلة مع دورها التقني كمحدد بيانات. ففي السلاسل النصية التي تشتمل على جمل وصفية، أو عناوين بريدية، أو أسماء مؤلفين تتبع النمط الأكاديمي القياسي الذي يفصل اللقب عن الاسم الأول بفاصلة، يُحدث برنامج التحليل خلطاً بين الفاصلة الدلالية اللغوية والفاصلة الهيكلية الفاصلة بين الحقول، مما يؤدي إلى تفكيك البيانات في مواضع غير صحيحة وإتلاف الاتساق العام للسجل المجدول.
تتفاقم هذه الإشكالية بفعل الفروق الهيكلية بين البيئات الإقليمية المختلفة لبرنامج إكسيل؛ حيث تستخدم النسخ الموجهة للمملكة المتحدة والولايات المتحدة الفاصلة كعلامة فصل قياسية بين وسائط الدوال وحقول البيانات، في حين تعتمد النسخ الأوروبية وبعض النسخ المترجمة على الفاصلة المنقوطة (Semicolon) كفاصل بين الحقول، محتفظة بالفاصلة العادية كعلامة عشرية للأرقام. هذا الاختلاف الإقليمي يتطلب فهماً عميقاً لبيئة النظام التشغيلي وإعدادات التوطين، حتى لا تؤول محاولات تجزئة النصوص المعتمدة على الفاصلة إلى أخطاء في التعرف على البنية التركيبية للجدول.
2. الأسس المفاهيمية لأداة تحويل النص إلى أعمدة (Text to Columns)
2.1 آلية عمل الأداة في التعرف على المحددات النصية
تعتمد أداة “تحويل النص إلى أعمدة” المدمجة في بيئة إكسيل على محرك مسح تسلسلي للمحتوى النصي يقوم بفحص مواقع البايتات والرموز داخل الخلية المستهدفة. عندما يواجه المحرك الرمز المحدد—وهو الفاصلة في حالتنا—يقوم بحساب موقعه النسبي في السلسلة النصية ثم يقتطع الجزء الذي يسبق هذا الرمز ويسنده إلى ذاكرة تخزين مؤقتة، ثم يكرر العملية عبر القفز فوق الرمز المحدد لمعالجة السلسلة الفرعية التالية. تتيح هذه الآلية التعامل مع السجلات ذات الأطوال المتفاوتة التي تفتقر إلى الثبات الهندسي في عدد الحروف.
ويختلف هذا المنهج القائم على “المحددات” (Delimited Parsing) جذرياً عن منهج “العرض الثابت” (Fixed Width)؛ إذ يفترض الأخير أن كل حقل معلوماتي يشغل عدداً محدداً وصارماً من الخانات والحروف عبر كافة صفوف الجدول، وهو افتراض يندر تحققه في البيانات النصية الطبيعية المكتوبة بلغات بشرية أو المدخلة عبر نماذج حرة. فالأسماء، وقوائم المهارات، والتصنيفات تتباين بطبيعتها في عدد الحروف، مما يجعل التقسيم المعتمد على المحددات هو الخيار الأكثر موثوقية ومرونة لضمان عدم اقتطاع أجزاء من الكلمات أو دمجها عشوائياً.
إضافة إلى ذلك، تضمن الأداة الحفاظ على الترتيب الطوبولوجي والتسلسل المنطقي للسجلات؛ حيث يتم تفريغ السلاسل المجزأة في الأعمدة الأفقية الجديدة بنفس الترتيب الذي ظهرت به داخل الخلية الأصلية من اليمين إلى اليسار (في الواجهات العربية) أو من اليسار إلى اليمين (في الواجهات اللاتينية). هذا التوافق الإنشائي يضمن احتفاظ البيانات بهيكليتها الدلالية الأساسية عبر كامل الامتداد الرأسي لصفوف جدول البيانات.
2.2 متطلبات تهيئة مساحة العمل قبل بدء عملية الفصل
يتطلب التنفيذ الآمن لتقسيم النصوص عبر أداة تحويل النص إلى أعمدة تخطيطاً مسبقاً لمساحة العمل المحيطة بالنطاق المستهدف. نظراً لأن الأداة تتسم بسلوك “إتلافي” (Destructive Behavior) يقوم بالكتابة فوق الخلايا الموجودة على يمين (أو يسار) العمود المصدر دون طلب تأكيد فردي لكل خلية، فإنه يتحتم على المستخدم تقييم سعة الأعمدة المجاورة، والتأكد التام من خلوها من أية بيانات حيوية، أو إدراج عدد كافٍ من الأعمدة الفارغة الجديدة يعادل أقصى عدد متوقع من المقاطع المجزأة.
كما تشمل التهيئة التحقق الاستكشافي من توحيد نسق الفواصل داخل النطاق؛ إذ تحتوي بعض السجلات المستوردة على مزيج هجين من الفواصل الإنجليزية، والفواصل المنقوطة، أو الفواصل العربية المقلوبة الناتجة عن اختلاف لوحات المفاتيح أثناء التحرير اليدوي. إن إجراء عمليات بحث واستبدال استباقية لتوحيد جميع المحددات إلى الفاصلة القياسية يقي من تشوه المخرجات وظهور صفوف غير مكتملة التجزئة.
وأخيراً، تفرض الأمانة البحثية والمنهجية العلمية إنشاء نسخة احتياطية كاملة للمصفوفة الخام قبل مباشرة التعديلات. إن الاحتفاظ بورقة عمل مستقلة تحتوي على البيانات في صورتها غير المعالجة لا يوفر فقط شبكة أمان ضد أخطاء التخصيص أو الحذف غير المقصود، بل يتيح مراجعة مسار التحولات التدريجي (Audit Trail) للبيانات لضمان قابلية التحقق وإعادة الإنتاج للنتائج المنشورة.
3. الدليل الإجرائي المباشر لتقسيم السلاسل النصية بالفاصلة خطوة بخطوة
3.1 تحديد النطاق المستهدف وتشغيل المعالج المدمج
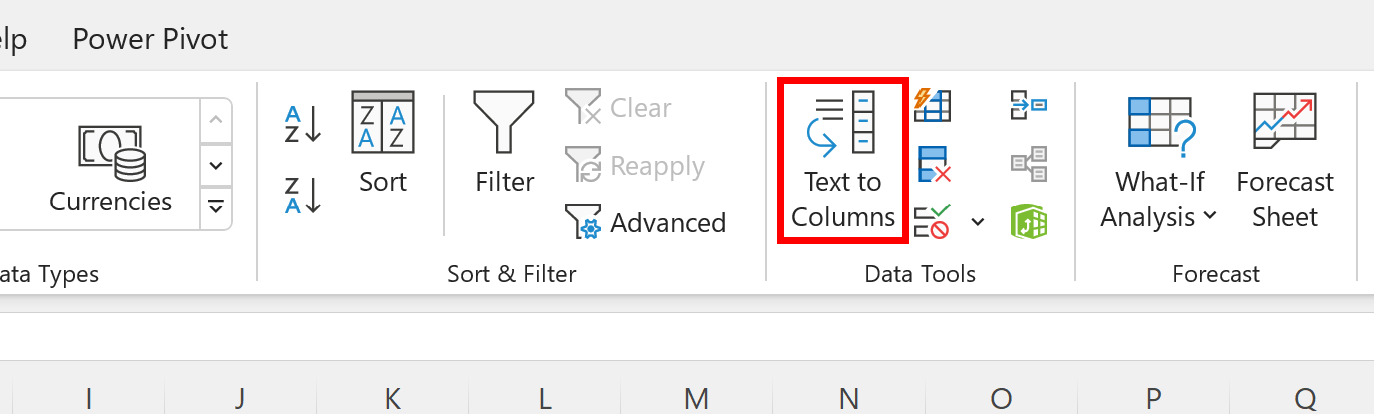
تبدأ العملية الإجرائية بتحديد النطاق العمودي المتضمن للسلاسل النصية المراد تفكيكها. يجب التركيز الصارم على تحديد عمود رأسي واحد في المرة الواحدة؛ إذ إن معالج النصوص في إكسيل لا يقبل تجزئة نطاقات تمتد عبر أعمدة متعددة متزامنة. يتم التحديد إما عبر النقر على رأس العمود كاملاً، أو بتظليل الخلايا المستهدفة بدءاً من الخلية الأولى وحتى نهاية السجلات باستخدام الاختصارات اللوحية القياسية لضمان شمول كافة الصفوف دون إسقاط أية حقول متطرفة.
بعد استكمال التحديد، ينتقل المستخدم إلى شريط الأدوات الرئيسي، وتحديداً إلى علامة تبويب “بيانات” (Data). ومن خلال مجموعة أدوات البيانات (Data Tools)، يتم النقر على أيقونة النص إلى أعمدة (Text to Columns)، ليفتح النظام على الفور نافذة المعالج التفاعلية المكونة من ثلاث خطوات منطقية متعاقبة تتيح ضبط أدق تفاصيل التقسيم قبل تنفيذه الفعلي على قاعدة البيانات.
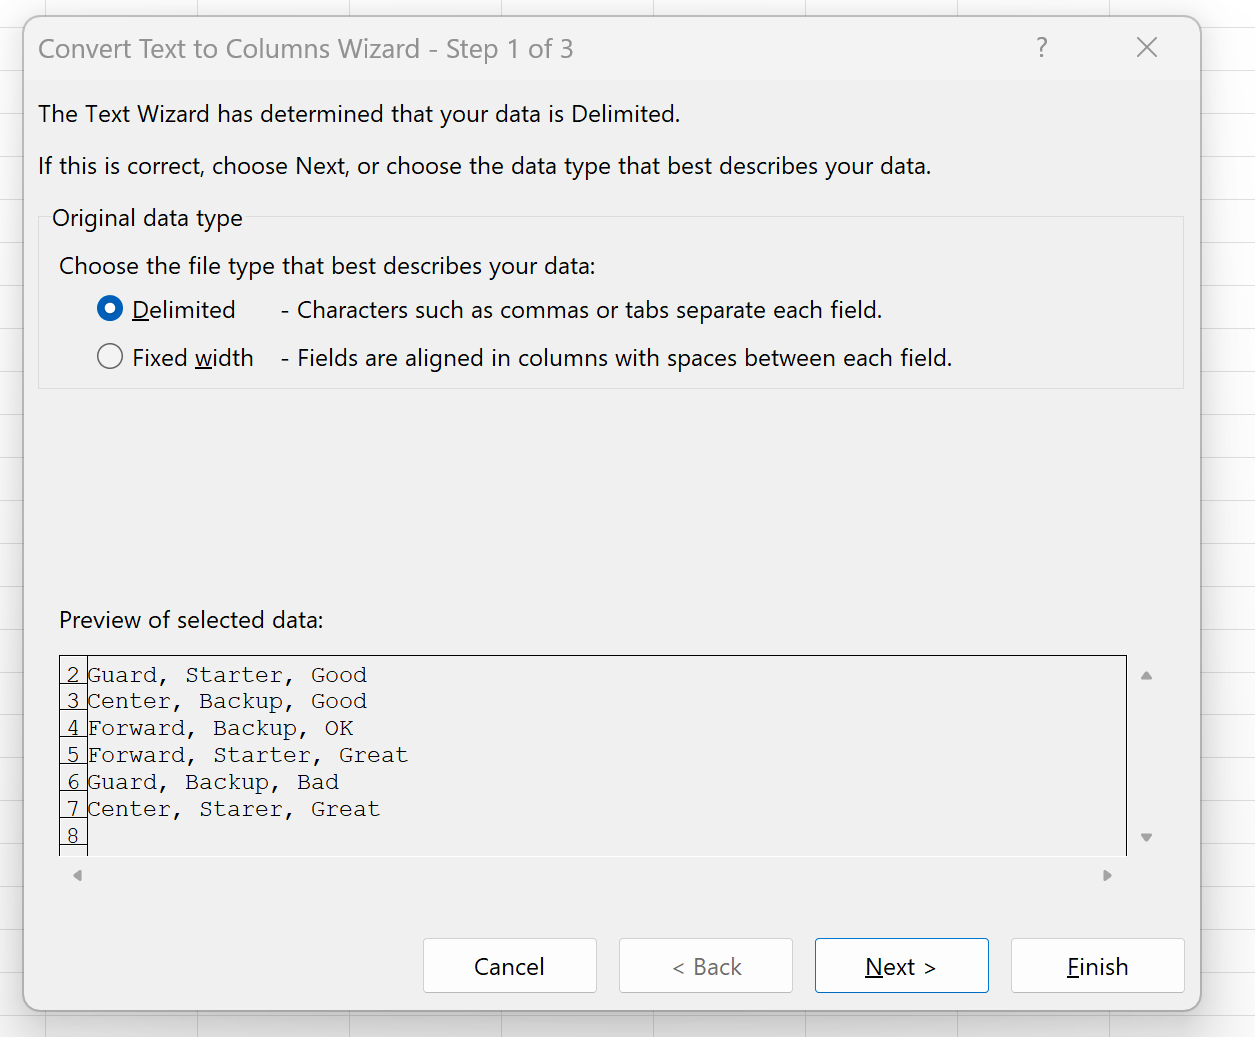
في الشاشة الأولى من المعالج، يُعرض خياران رئيسيان لتوصيف طبيعة السلاسل النصية: خيار “محدد” (Delimited)، وخيار “عرض ثابت” (Fixed width). يتعين هنا اختيار خيار “محدد” بصورة مؤكدة؛ حيث يشير هذا التحديد إلى أن السلسلة النصية تشتمل على حروف معينة—كالفاصلة أو المسافة أو علامة الجدولة—تفصل بين الكيانات المعرفية المستقلة، ثم يتم النقر على زر “التالي” (Next) للانتقال إلى مرحلة توصيف علامات الفصل.
3.2 ضبط خيارات الفواصل والمحددات النصية
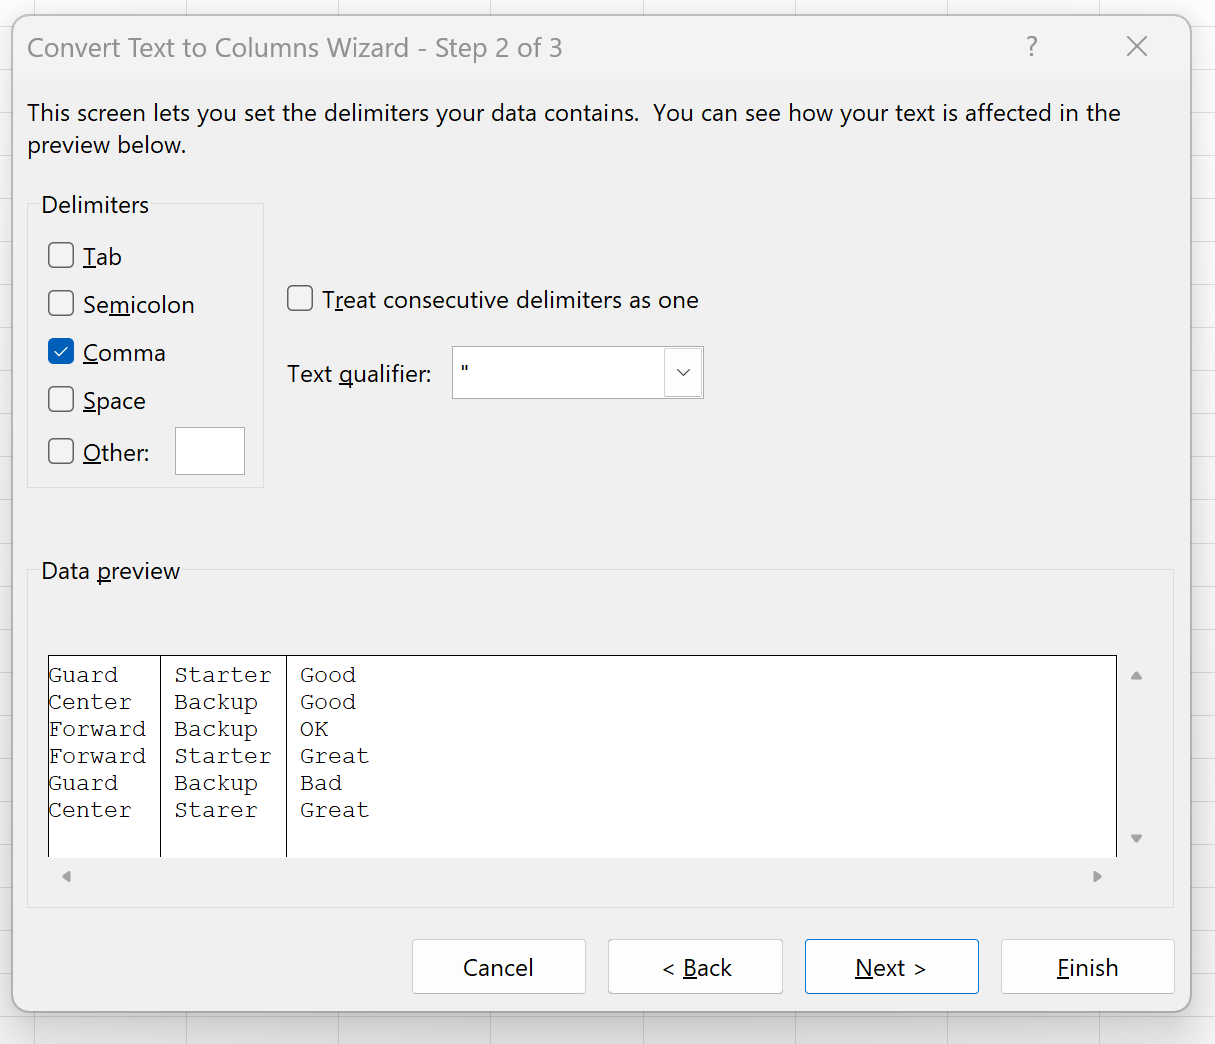
تتيح الخطوة الثانية من المعالج تحديد نوع المحدد النصي الذي تعتمد عليه عملية الفصل. يجب على المستخدم تفعيل مربع الاختيار المقابل لعلامة “الفاصلة” (Comma)، وإلغاء تحديد كافة المربعات الأخرى مثل “علامة الجدولة” (Tab) أو “الفاصلة المنقوطة” (Semicolon) أو “المسافة” (Space)، ما لم تكن هنالك رغبة واعية في الجمع بين محددات متعددة في سياق تقني مدروس. ويجب الانتباه إلى أن تفعيل محددات غير موجودة فعلياً في النص الأصلي قد لا يضر بالعملية ظاهرياً، ولكنه يرفع من مخاطر التقسيم العشوائي إذا ما تواجدت تلك الرموز عرضاً داخل بعض السجلات الفرعية.
توفر النافذة في جزئها السفلي شاشة للمعاينة المباشرة (Data Preview)، حيث يستجيب هذا القسم لحظياً للخيارات المحددة في الأعلى، فيعرض خطوطاً عمودية سوداء تفصل بين البيانات لتوضيح الكيفية التي سيتم بها تشريح السلسلة النصية إلى أعمدة مستقلة. تُعد هذه المعاينة أداة فحص بالغة الأهمية لتقييم صحة الافتراضات؛ إذ تتيح للمستخدم اكتشاف أية انحرافات غير متوقعة في توزع الحقول قبل إتمام الإجراء بشكل نهائي على نطاق العمل الفعلي.
كذلك تشتمل هذه الواجهة على خيار تقني دقيق يتمثل في “معاملة المحددات المتتالية كمحدد واحد” (Treat consecutive delimiters as one). يُنصح بتفعيل هذا الخيار في الحالات التي تحتوي فيها البيانات الخام على فواصل مكررة ناتجة عن أخطاء مطبعية غير مقصودة، لمنع توليد أعمدة وسيطة فارغة تفتقر إلى المعنى الرياضي. وعلى النقيض من ذلك، يجب إلغاء تفعيله إذا كانت الفواصل المتتالية تمثل عمداً خلايا فارغة أو قيماً مفقودة ذات دلالة إحصائية ينبغي الحفاظ على موقعها النسبي داخل الجدول.
3.3 تحديد وجهة الإخراج وتطبيق التحويل النهائي
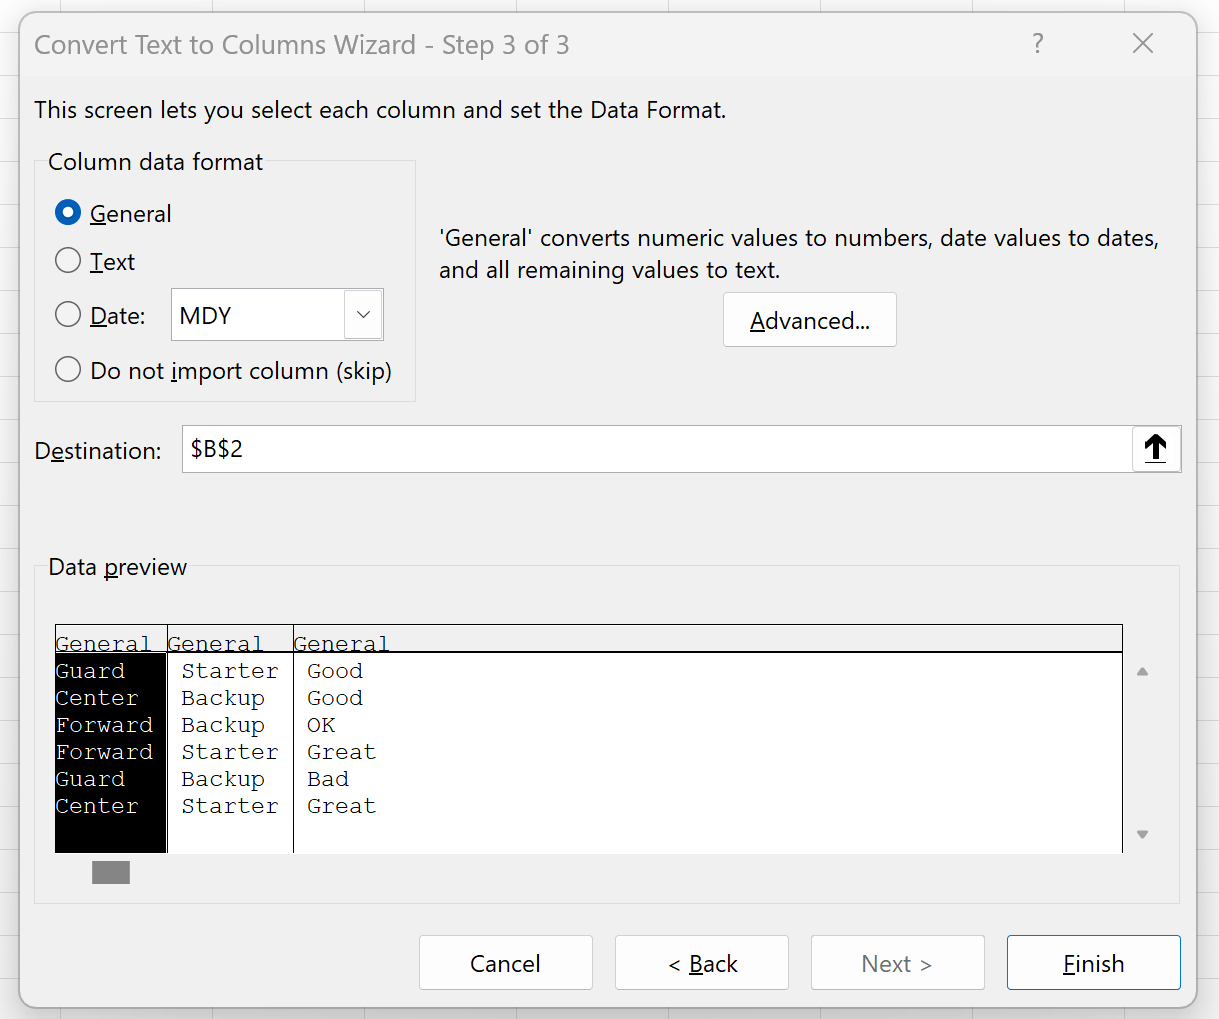
تنقل الخطوة الثالثة والأخيرة المستخدم إلى مرحلة التحكم في وجهة البيانات وتنسيق الأعمدة المفرزة. تحتوي هذه النافذة على حقل “الوجهة” (Destination)، والذي يحمل افتراضياً إحداثيات الخلية الأولى من النطاق المصدر المختار. إذا تُرك هذا الحقل دون تعديل، ستقوم الأداة بوضع أول مقطع نصي مجزأ داخل الخلية الأصلية نفسها، مع تمديد بقية المقاطع إلى الأعمدة المجاورة، مما يؤدي إلى الكتابة فوق السجلات الأصلية ومحوها نهائياً.
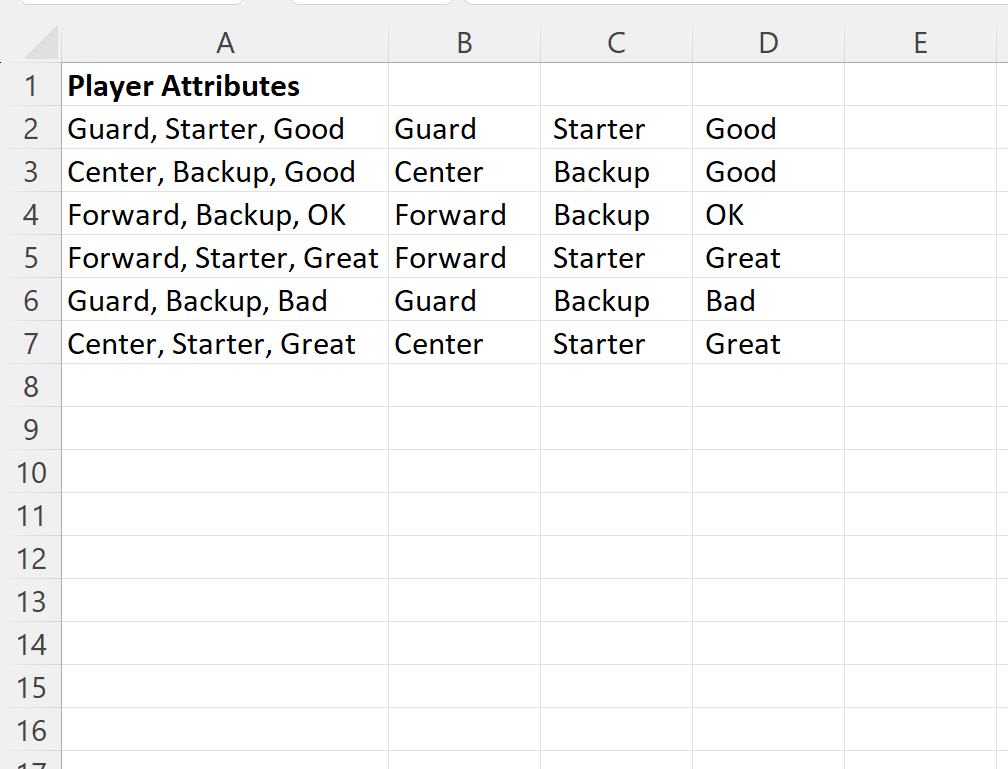
لتجنب هذا السلوك وحماية البيانات الخام، يجب تغيير مرجع الوجهة إلى خلية تبدأ في عمود فارغ تماماً، مثل إسناد الإخراج إلى عمود مجاور يبعد مسافة كافية تضمن استيعاب كافة التفرعات النصية. يُدخل المرجع يدوياً أو عبر النقر على زر اختيار النطاق وتظليل الخلية العليا للعمود المستهدف، مما يمنح المحلل القدرة على المقارنة البصرية اللاحقة بين السلسلة المصدرية الكاملة ومخرجاتها المجزأة.
وعند اكتمال ضبط كافة المعلمات، يتم النقر على زر “إنهاء” (Finish). يُجري البرنامج فوراً العملية الحسابية لتوزيع النصوص عبر الخلايا، متبعاً التكوين المحدد. وإذا تصادف وجود بيانات سابقة في مسار وجهة الإخراج، سيعرض إكسيل رسالة تحذيرية تسأل عما إذا كان المستخدم يرغب في استبدال محتويات الخلايا الوجهة، وهي إشارة تنبيهية تلزم الباحث بإعادة التحقق قبل المصادقة على الإجراء لضمان عدم إتلاف مدخلات أخرى.
4. إدارة تنسيق البيانات المتقدمة وتحديد خصائص الأعمدة الناتجة
4.1 التحكم في أنواع البيانات الناتجة أثناء عملية التقسيم
يتيح المعالج المدمج في خطوته الثالثة تحديد نوع البيانات الحسابي لكل عمود من الأعمدة المفروزة على حدة، وهو ما يمثل ركيزة هامة لمنع التفسير الخاطئ للمعلومات من قبل محرك إكسيل. ففي الوضع الافتراضي، يتم تعيين كافة الأعمدة تحت تصنيف “عام” (General)، وهو تصنيف يقوم بتحويل السلاسل النصية الرقمية تلقائياً إلى أرقام حسابية مجردة، والتعبيرات المتوافقة مع التواريخ إلى صيغ تقويم قياسية، مما قد يؤدي أحياناً إلى تحريف بنية البيانات الأصلية.
يتجلى الخطر الأكبر لهذا التحويل التلقائي عند معالجة السجلات التي تتضمن معرفات رقمية أو أكواد تعريفية تبدأ بالصفر، مثل أرقام الهواتف أو الرموز البريدية المفصولة بفواصل. فعند تعيينها كبيانات عامة، يقوم إكسيل بحذف الأصفار البادئة باعتبارها قيماً رياضية لا وزن لها، مما يشوه صحة المعرف الرقمي بالكامل. لتفادي ذلك، يمكن النقر على العمود المستهدف داخل شاشة المعاينة وتحويل نوع البيانات إلى “نص” (Text)، مما يجبر البرنامج على التعامل مع الأرقام كرموز محرفية تحافظ على نسقها وطولها الدقيق دون نقصان.
كذلك تتيح هذه الواجهة استبعاد حقول ومقاطع معينة من الاستيراد نهائياً، عبر تحديد العمود غير المرغوب وتفعيل خيار “عدم استيراد العمود (تخطي)” (Do not import column – skip). تُعد هذه الخاصية بالغة النفع في تنقية البيانات أثناء مرحلة التجزئة؛ إذ تتيح التخلص الفوري من الفواصل الزائدة، أو المقاطع الحشوية، أو التسميات التوضيحية المتكررة التي لا حاجة للباحث بها في المراحل اللاحقة، مما يقلل من حجم الملف النهائي ويوفر الجهد المبذول في الحذف اليدوي للأعمدة الإضافية.
4.2 الحفاظ على سلامة العمود الأصلي مقابل استبداله
يثير قرار استبدال العمود الأصلي أو الإبقاء عليه تساؤلات منهجية تتعلق ببروتوكولات إدارة البيانات وسلامة المسارات التحليلية. إن استبدال السلسلة النصية المصدرية عبر ترك خيار الوجهة الافتراضي يؤدي إلى تدمير بنية البيانات الخام، مما يحرم الباحث من إمكانية الرجوع إلى التنسيق الأصلي للتحقق من دقة التجزئة أو استدراك أي خطأ منهجي قد يقع أثناء ضبط المحددات أو تعيين أنواع البيانات.
لذلك، تقتضي أفضل الممارسات في البحث العلمي والعمل المؤسسي توجيه المخرجات إلى أعمدة مستقلة تماماً، والاحتفاظ بالسلسلة النصية الأصلية كما هي في موضعها دون مساس. تتيح هذه الاستراتيجية بناء نماذج تدقيق متقاطعة (Cross-Validation Models) يمكن من خلالها تطبيق معادلات برمجية تقارن أطوال السلاسل النصية الأولية بمجموع مخرجات الأعمدة المجزأة للتأكد من عدم سقوط أي مقطع جراء وجود أخطاء في الرموز الفاصلة.
وفضلاً عن ذلك، يمثل توثيق هذه التعديلات التزاماً بالمبادئ الأكاديمية لحوكمة البيانات؛ حيث يتعين على المحلل في تقاريره الوصفية شرح الخطوات الإجرائية التي طُبقت على البيانات الخام، وبيان ما إذا كانت التجزئة قد نتج عنها تعديل في عدد المتغيرات الأصلية للدراسة. إن عزل البيانات المصدرية عن البيانات المعالجة يمنح العمل مصداقية إضافية ويتيح للمراجعين الخارجيين تتبع سلسلة التحولات التي مرت بها المصفوفة من صورتها الأولى إلى النموذج التحليلي النهائي.
5. معالجة المسافات البيضاء والرموز الزائدة المصاحبة للفواصل
5.1 مشكلة المسافات البادئة واللاحقة بعد التجزئة
من أكثر العيوب الشائعة التي تعقب عملية تقسيم النصوص بفاصلة هي مشكلة ظهور “المسافات البيضاء البادئة” (Leading Whitespaces). تنشأ هذه المشكلة لأن القواعد الإملائية القياسية في النصوص الطبيعية تقضي بإدراج مسافة بعد الفاصلة مباشرة، مثل كتابة “تفاح، برتقال، موز”. فعندما يقوم المحلل بفصل السلسلة بالاعتماد على رمز الفاصلة وحده دون تضمين المسافة كمحدد شريك، فإن المقطع الأول (“تفاح”) يستخرج نقياً، بينما تستخرج المقاطع اللاحقة مسبوقة بمسافة بيضاء غير مرئية للعين المجردة (” برتقال”، ” موز”).
تترتب على هذه المسافات الخفية عواقب وخيمة في المراحل التحليلية اللاحقة؛ إذ يعامل إكسيل الكلمات التي تحتوي على مسافات بادئة كمدخلات نصية مغايرة تماماً للكلمات المطابقة الخالية من المسافات. هذا التباين يؤدي إلى فشل دوال البحث والمطابقة الشهيرة مثل VLOOKUP أو XLOOKUP أو MATCH في العثور على التطابقات، كما يؤدي إلى تشتيت مخرجات الجداول المحورية (Pivot Tables) التي ستدرج “برتقال” كفئة مستقلة عن ” برتقال”، مما يعطي انطباعاً زائفاً بوجود تكرارات وتصنيفات إضافية في العينة.
يمكن التغلب على هذا التحدي أثناء استخدام أداة “النص إلى أعمدة” عبر تفعيل محدد “المسافة” جنباً إلى جنب مع محدد “الفاصلة”، شريطة تفعيل خيار “معاملة المحددات المتتالية كمحدد واحد”. ومع ذلك، قد تؤدي هذه الخطوة إلى مخاطر تجزئة غير مقصودة إذا كانت السلاسل الفرعية تشتمل بذاتها على كلمات مركبة يفصل بينها فراغ (مثل الأسماء المركبة أو العناوين)، مما يستدعي التمييز الحذر بين المسافات الفاصلة بين الحقول والمسافات البنيوية داخل الحقل الواحد.
5.2 التطهير اللاحق باستخدام دالة TRIM الرياضية
عندما تفرض طبيعة البيانات تجنب فصل المسافات أثناء استخدام المعالج المدمج تفادياً لتشتيت المصطلحات المركبة، يصبح من الضروري تطبيق استراتيجية تطهير لاحقة تعتمد على الدوال المتخصصة. تأتي في مقدمة هذه الحلول دالة TRIM، وهي دالة مصممة هندسياً لإزالة كافة المسافات البادئة واللاحقة من السلاسل النصية، مع الإبقاء الحصري على مسافة واحدة مفردة بين الكلمات داخل النص، مما يعيد الكلمات المجزأة إلى صورتها الطبيعية الخالية من الشوائب التنسيقية.
ولتحقيق أقصى درجات النقاء في قواعد البيانات المستوردة من خوادم قديمة أو منصات ويب متعددة الترميز، يُنصح بدمج دالة TRIM مع دالة CLEAN في تركيبة موحدة تأخذ الصيغة التالية: =TRIM(CLEAN(Cell_Reference)). تعمل دالة CLEAN على مسح الرموز النصية غير القابلة للطباعة (أول 32 رمزاً في جدول ASCII القياسي)، والتي تتسلل غالباً إلى السلاسل النصية أثناء التصدير الرقمي، مما يضمن خلو الحقول الناتجة من أية أحرف تحكم أو نهايات أسطر مخفية تشوه التحليل الرياضي.
وبمجرد تطبيق صيغة التطهير على امتداد الأعمدة المجزأة وتوليد القيم المُنقاة، يجب تحويل هذه المعادلات إلى قيم رقمية ونصية ثابتة. يتم ذلك عبر نسخ الأعمدة المطهرة ثم استخدام خيار “لصق كقيم” (Paste as Values) فوق النطاق نفسه. إن هذا الإجراء يفك الارتباط الحسابي بالصيغ المرجعية، ويزيل العبء التشغيلي عن معالج إكسيل، ويمنع حدوث أخطاء مراجع دائرية إذا ما تقرر حذف الأعمدة الوسيطة لاحقاً.
6. التقسيم الديناميكي باستخدام دوال إكسيل الحديثة (دالة TEXTSPLIT)
6.1 مفهوم المصفوفات الديناميكية ودور دالة TEXTSPLIT
أحدثت مايكروسوفت نقلة نوعية في معمارية الحوسبة داخل إكسيل عبر تقديم محرك “المصفوفات الديناميكية” (Dynamic Arrays) في إصدارات Microsoft 365 وإكسيل 2024 وإكسيل للويب. يرتكز هذا المفهوم على قدرة المعادلة الواحدة المكتوبة في خلية مفردة على إرجاع مصفوفة متعددة القيم تتمدد وتفيض (Spill) تلقائياً لتغطي الخلايا المجاورة أفقياً ورأسياً بحسب حجم المخرجات، دون الحاجة إلى تطبيق الصيغة التقليدي باستخدام مفاتيح Ctrl+Shift+Enter.
وفي هذا السياق، تم تقديم دالة TEXTSPLIT كحل برمجي مباشر لمشكلة السلاسل النصية المفصولة برموز. تتميز هذه الدالة ببنيتها التركيبية المباشرة التي تتيح تقسيم النص عبر وسائط مرنة. والصيغة الأساسية للدالة هي: =TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])؛ حيث يمثل text مرجع الخلية المحتوية على السلسلة النصية، وcol_delimiter الرمز المحدد الذي يتم التقسيم على أساسه أفقياً عبر الأعمدة.
تتمثل الميزة الاستثنائية لدالة TEXTSPLIT في طبيعتها الديناميكية غير التدميرية؛ فعلى العكس من أداة “تحويل النص إلى أعمدة” التي تتطلب إعادة تشغيل يدوية متكررة عند كل تحديث للسجلات، تقوم TEXTSPLIT بتحديث مخرجاتها فوراً بمجرد تعديل الخلية المصدرية. فإذا أضيفت عناصر جديدة مفصولة بفواصل في الخلية A1، تتمدد الدالة فوراً لتشغل الأعمدة الإضافية دون أي تدخل يدوي، مع اشتراط خلو مسار التمدد من أية بيانات أخرى لتجنب ظهور خطأ التدفق الشائع (#SPILL!).
6.2 معالجة الحالات المعقدة عبر الوسائط الإضافية للدالة
تتجاوز قدرات دالة TEXTSPLIT مجرد التقسيم البسيط؛ إذ تمكن المحلل من التغلب على معضلات التنسيق الأكثر تعقيداً عبر وسائطها الاختيارية المتقدمة. فعلى سبيل المثال، يتيح الوسيط الرابع [ignore_empty]—عند ضبطه على القيمة المنطقية TRUE—تجاهل الخلايا الفارغة الناتجة عن تتابع الفواصل المتتالية (مثل “قيمة1,,قيمة2”). وبذلك تمنع الدالة ظهور خلايا نصية فارغة في المصفوفة الناتجة، وهو ما يعزز اتساق قواعد البيانات دون الحاجة لخطوات تطهير لاحقة.
علاوة على ذلك، توفر الدالة حلولاً ذكية لمعضلة الفواصل المتبوعة بمسافات؛ حيث يمكن للمستخدم ببساطة تمرير محدد يتألف من رمزين معاً في الوسيط الثاني، مثل كتابة: =TEXTSPLIT(A1, “, “). يؤدي هذا التحديد الدقيق إلى إزالة الفاصلة والمسافة المصاحبة لها في خطوة رياضية واحدة، مما ينتج عناصر نقية تماماً دون الحاجة إلى دمج دوال التطهير اللاحقة كدالة TRIM، وهو ما يوفر كفاءة حوسبية هائلة داخل نماذج البيانات الكبيرة.
أما الوسيط السادس [pad_with]، فيوفر حلاً استثنائياً لمشكلة تباين أبعاد البيانات عند تقسيم سلاسل نصية متعددة ضمن مصفوفة ثنائية الأبعاد تتوزع عبر الأعمدة والصفوف معاً. ففي حال احتوت بعض السجلات على ثلاثة عناصر بينما احتوت أخرى على أربعة، تتيح الدالة تعيين قيمة بديلة محددة (مثل “غير متوفر” أو #N/A) لملء الفجوات الهيكلية في المصفوفة المستخرجة، مما يضمن انتظام حواف الجدول التحليلي وتوافقه الكامل مع المعايير الرياضية للمصفوفات المستوية.
7. الحلول البديلة عبر المعادلات التقليدية للإصدارات القديمة
7.1 تفكيك النصوص باستخدام مجموعة الدوال التركيبية
في بيئات العمل التي تعتمد على الإصدارات التقليدية من إكسيل (مثل Excel 2016 أو Excel 2019 المستقلة) والتي تفتقر إلى محرك المصفوفات الديناميكية ودالة TEXTSPLIT، يتعين على المحلل بناء صيغ تركيبية معقدة تعتمد على دوال النصوص الكلاسيكية لعزل السلاسل النصية واستخراجها بدقة متناهية. تعتمد هذه الطريقة على رصد الموقع الفهرسي للفاصلة داخل الخلية، ثم توجيه دوال الاقتطاع لاستخلاص المقاطع المحددة بناءً على هذا الموقع.
لاستخراج الجزء الأول الواقع قبل الفاصلة الأولى، يتم الجمع بين دالة LEFT ودالة FIND وفق الصيغة التالية: =LEFT(A1, FIND(“,”, A1) – 1). تقوم دالة FIND هنا بتحديد الموقع الترتيبي لحرف الفاصلة كقيمة عددية، ثم يتم طرح الرقم 1 لاستثناء الفاصلة نفسها من النتيجة، لتقوم دالة LEFT باقتطاع الحروف الواقعة في بداية النص وصولاً إلى ذلك المؤشر بدقة متناهية ودون شوائب.
أما لاستخراج النص المتبقي بعد الفاصلة، أو للتعامل مع المقاطع المتوسطة في السلاسل متعددة الفواصل، فتُستخدم دالة MID بالاقتران مع FIND و LEN. فعلى سبيل المثال، لاستخراج المقطع الثاني الواقع بعد الفاصلة في سلسلة بسيطة تتكون من عنصرين، تُستخدم المعادلة: =TRIM(MID(A1, FIND(“,”, A1) + 1, LEN(A1)))؛ حيث تبدأ دالة MID الاقتطاع من الخانة التي تلي موضع الفاصلة مباشرة، وتستخرج عدداً من الحروف يساوي الطول الإجمالي للنص كما تحدده دالة LEN، مما يضمن استيعاب المتبقي كاملاً، مع تطبيق TRIM للتخلص من المسافة البادئة المحتملة.
7.2 تقييم كفاءة الصيغ التقليدية مقارنة بالأدوات الرسومية
تتميز الصيغ التركيبية التقليدية بقدرتها على التحديث التلقائي؛ فهي تعيد حساب قيمها بمجرد تعديل محتوى الخلية المصدرية، متفوقة في ذلك على أداة “تحويل النص إلى أعمدة” اليدوية. ومع ذلك، فإن هذه الصيغ تعاني من قصور شديد في الكفاءة عندما يزداد عدد الفواصل داخل السلسلة الواحدة ليتجاوز ثلاثة أو أربعة عناصر؛ إذ تصبح المعادلات المطلوبة لاستخراج المقاطع المتوسطة الثالثة والرابعة شديدة التعقيد والتداخل، وتتطلب توظيف دالة SUBSTITUTE مكررة لتحديد مواضع الفواصل الفرعية بدقة.
يفرض هذا التعقيد الحسابي المتزايد عبئاً ثقيلاً على ذاكرة الجهاز ووحدة المعالجة المركزية، لاسيما عند تطبيق هذه المصفوفات من المعادلات المتقاطعة على عشرات الآلاف من الصفوف. كما تصبح هذه الصيغ عرضة للانهيار التام وظهور أخطاء القيمة (#VALUE!) في حال صادفت خلايا تحتوي على عدد فواصل أقل من المتوقع، مما يستدعي إحاطة كافة المعادلات بدوال تصيد الأخطاء مثل IFERROR، وهو ما يزيد من طول الصيغ ويجعلها عصية على الفهم والصيانة المباشرة.
لذلك، تقتضي الممارسة الرشيدة توثيق هذه الدوال المركبة بدقة شديدة عند الاضطرار لاستخدامها، والحرص على تضمين شروح تفسيرية لمنطق الحساب داخل أوراق العمل أو التوثيق المصاحب للمشروع. ويظل من الأفضل عملياً للمحللين العاملين على إصدارات قديمة تفضيل استخدام أداة “تحويل النص إلى أعمدة” أو محرر “Power Query” للتعامل مع السلاسل النصية الطويلة ذات الفواصل المتعددة، مع قصر استخدام صيغ LEFT وMID المركبة على الحالات الثنائية البسيطة التي تتطلب تحديثاً ديناميكياً محصوراً.
8. الأتمتة المتقدمة لتقسيم النصوص عبر أداة التعبئة السريعة (Flash Fill)
8.1 التعلم الآلي النمطي الكامن وراء التعبئة السريعة
تمثل أداة التعبئة السريعة (Flash Fill)، التي أُدرجت في برنامج إكسيل بدءاً من إصدار 2013، تطبيقاً عملياً متقدماً لخوارزميات الاستقراء النمطي والتعلم الآلي المبسط المصمم للمهام المكتبية. تعتمد الأداة على مراقبة الإجراءات التحريرية التي يقوم بها المستخدم بجوار عمود البيانات الأصلي، ثم محاولة استنتاج “القاعدة التحويلية” الكامنة وراء تلك الإجراءات وتطبيقها التلقائي على بقية السجلات دون الحاجة لكتابة معادلة رياضية واحدة.
لتشغيل هذه التقنية في تفكيك السلاسل المفصولة بفواصل، يقوم المحلل بإنشاء عمود فارغ ملاصق للعمود المستهدف، ثم يكتب يدوياً الجزء الأول المستخرج من الخلية الأولى تماماً كما يظهر قبل الفاصلة. وعند الانتقال إلى الخلية الثانية والبدء في كتابة الحروف الأولى من الجزء المقابل، يستشعر المحرك النمطي في إكسيل الرابطة المنطقية ويعرض مقترحات رمادية باهتة تمثل استخراجاً تلقائياً للأجزاء المناظرة لكافة الصفوف التالية. كما يمكن تحفيز هذه الأتمتة قسراً عبر تظليل النطاق والضغط على الاختصار اللوحي القياسي (Ctrl + E) لتعبئة كامل العمود فوراً.
تكمن القوة الاستثنائية لأداة Flash Fill في قدرتها الفائقة على إجراء عمليات تنظيف موازية أثناء التجزئة؛ فإذا تعمد المستخدم إهمال المسافات البيضاء أو تصحيح حالة الأحرف في النموذج التدريبي الأول الذي كتبه بيده، فإن الخوارزمية تلتقط هذا التفضيل وتطبقه على كامل النطاق المستخرج، مما يوفر خطوة إضافية لتطهير البيانات كانت ستتطلب استخدام دوال تركيبية مستقلة.
8.2 حدود ومخاطر الاعتماد الحصري على Flash Fill
على الرغم من السرعة والسهولة الفائقة التي تميز أداة Flash Fill، إلا أنها تنطوي على مخاطر هيكلية تحد من صلاحيتها كأداة اعتماد رئيسية في التحليلات البحثية والبيئات الصارمة لمراجعة الحسابات. يكمن الخطر الأكبر في افتقار مخرجاتها التام لأي ترابط ديناميكي بالبيانات الأصلية؛ إذ إن النتائج المولدة هي قيم نصية ثابتة ومجردة لا تستجيب لأي تعديل أو تصحيح يطرأ لاحقاً على محتوى السلسلة النصية المصدرية في الخلية الأصلية.
بالإضافة إلى ذلك، فإن خوارزمية الاستقراء النمطي قد تفشل فشلاً ذريعاً في التعرف على النمط الصحيح عند مواجهة استثناءات في بنية البيانات. فعلى سبيل المثال، إذا كانت بعض السجلات تحتوي على فواصل إضافية، أو إذا تباين عدد الكلمات المفصولة بين الصفوف، قد تفترض الخوارزمية قاعدة استخراج خاطئة وتطبقها على مئات السجلات دون إصدار أية رسالة خطأ أو تحذير تنبيهي للمستخدم، مما يؤدي إلى تسلل بيانات مشوهة وغير مكتملة إلى التحليل النهائي.
وبناءً على ذلك، لا ينبغي أبداً اعتبار مخرجات Flash Fill بيانات جاهزة للتحليل دون إخضاعها لتدابير فحص وتدقيق صارمة. يتعين على الباحث فحص عينات عشوائية من مختلف مواضع الجدول—خاصة السجلات الطويلة وتلك التي تحتوي على علامات ترقيم معقدة—للتأكد من أن الأداة لم تقم باقتطاع بيانات خاطئة أو إسقاط أجزاء حيوية من السلسلة نتيجة سوء تفسير النمط الدلالي المتبع.
9. تحويل وتطهير السلاسل النصية باستخدام أداة محرر الاستعلام (Power Query)
9.1 استيراد البيانات وبدء تجزئة الأعمدة وفق الفواصل
يعد محرر الاستعلامات المتقدم Power Query—المتاح أصيلاً في إصدارات إكسيل الحديثة وتحت ملحق إضافي للإصدارات الأقدم—الأداة الأكثر تطوراً ورصانة لمعالجة البيانات المعقدة وتنفيذ خطوط أنابيب تحويل البيانات (ETL Pipelines). يتميز Power Query بقدرته على تسجيل كل خطوة تحويلية في صورة كود برمجي بلغة M، مما يتيح إعادة تكرار وتطبيق نفس المعالجة بضغطة زر واحدة على أي بيانات جديدة تُضاف إلى النظام مستقبلاً.
لبدء تجزئة النصوص، يتم أولاً تحويل نطاق البيانات إلى جدول رسمي (Excel Table)، ثم الانتقال إلى علامة تبويب “بيانات” والنقر على أمر “من ورقة/نطاق” (From Sheet/Table) لتحميل البيانات داخل واجهة محرر Power Query المنفصلة. من داخل الواجهة، يتم النقر بالزر الأيمن للفأرة على رأس العمود المراد تفكيكه، أو الانتقال إلى علامة تبويب “تحويل” (Transform)، ثم اختيار أمر “تقسيم العمود” (Split Column) يليه “حسب المحدد” (By Delimiter).
تفتح هذه الخطوة نافذة ضبط متقدمة يتعرف فيها المحرر تلقائياً على “الفاصلة” كمحدد مقترح. وهنا تتاح للمحلل خيارات دقيقة للتحكم في سلوك التجزئة تشمل: التقسيم عند المحدد الموجود في أقصى اليسار فقط، أو التقسيم عند المحدد الموجود في أقصى اليمين، أو التفكيك الشامل عند كل تكرار للمحدد (At each occurrence of the delimiter). يتيح هذا التنوع التحكم الكامل في كيفية التعامل مع السلاسل النصية المركبة واستخراج المقاطع الحيوية دون تشتيت البيانات المتبقية.
9.2 التقسيم المتقدم إلى صفوف بدلاً من أعمدة
من أروع المزايا المنهجية التي ينفرد بها Power Query مقارنة بأداة تحويل النص إلى أعمدة التقليدية هي إمكانية تقسيم السلسلة النصية بفاصلة إلى “صفوف” (Rows) بدلاً من “أعمدة” (Columns). تكتسب هذه الميزة أهمية استثنائية في سياق “تطبيع البيانات” (Data Normalization) ومبادئ الجداول المنظمة (Tidy Data)؛ حيث تفضل التحليلات الإحصائية ونماذج قواعد البيانات العلائقية احتواء كل رصد أو مشاهدة على صف مستقل بدلاً من استطالة الجدول أفقياً بعدد غير متوقع من الأعمدة.
لتفعيل هذا الخيار، يتم فتح القائمة المنسدلة للخيارات المتقدمة (Advanced options) داخل نافذة تقسيم العمود، واختيار “صفوف” (Rows). يقوم المحرك عندئذ بتكرار كافة البيانات الوصفية المرتبطة بالسجل في الأعمدة الأخرى لكل عنصر من العناصر المفصولة بفاصلة، محولاً السلسلة الأفقية المكتظة إلى تسلسل رأسي نقي ومنظم، مما يسهل عمليات الربط، وبناء مقاييس DAX، وتصميم النماذج التحليلية المتقدمة عبر لوحات المعلومات التفاعلية.
وبالإضافة إلى ذلك، يوفر المحرر أدوات مدمجة للتطهير التلقائي؛ حيث يمكن بنقرة واحدة إزالة المسافات الزائدة عبر أمر Format -> Trim، وتغيير أنواع البيانات لتصبح نصوصاً صريحة أو أرقاماً صحيحة. وعند استكمال المعالجة، يتم الضغط على أمر “إغلاق وتحميل” (Close & Load) لإعادة تفريغ المصفوفة المطهرة بالكامل داخل ورقة عمل جديدة في إكسيل، محتفظة برابط ديناميكي كامل يتحدث تلقائياً بمجرد النقر على أمر “تحديث” (Refresh) عند تغير البيانات المصدرية.
10. أفضل الممارسات والبروتوكولات الأكاديمية لإدارة البيانات المفصولة
10.1 استراتيجيات استكشاف الأخطاء ومعالجة استثناءات البيانات
تواجه عمليات معالجة البيانات النصية تحديات تقنية ناجمة عن التباين في هياكل الإدخال الخام؛ ويأتي في طليعة هذه المشكلات ما يُعرف بالسلاسل النصية المؤطرة بعلامات تنصيص والتي تشتمل في بنيتها الداخلية على فواصل لغوية. ففي السجلات المصدرية بصيغة CSV، تُحاط العبارات التي تحتوي على فواصل بعلامات اقتباس مزدوجة (مثل: “القاهرة، جمهورية مصر العربية”) للدلالة على أنها تمثل حقلاً واحداً لا يتجزأ. إن استخدام أدوات تقسيم سطحية تتجاهل علامات الاقتباس يؤدي إلى كسر الكيان الجغرافي الواحد وتوزيعه عبر أعمدة غير صحيحة.
تتمثل استراتيجية حل هذه المعضلة في استخدام محددات نصوص ذكية أو الاعتماد على معالج النصوص في Power Query، والذي يحتوي على خيار “التعرف على محددات النصوص” (Quote Character)، مما يضمن قراءة الكتلة المحاطة بالتنصيص كقيمة موحدة وتجاهل الفاصلة الداخلية كعلامة فصل هيكلية. كما تشمل الإشكاليات التقنية الشائعة مشكلة ترميز الحروف، لاسيما عند استيراد نصوص باللغة العربية؛ حيث يؤدي عدم التوافق مع معيار الترميز العالمي الموحد (UTF-8) إلى تحول الكلمات والرموز إلى محارف غير مفهومة تُعرف بظاهرة (Mojibake)، مما يستدعي فرض ترميز UTF-8 صراحة أثناء عمليات الاستيراد لتفادي تلف المفردات اللغوية.
وثمة استثناء جوهري آخر يتمثل في “انزياح الأعمدة” (Column Shifting) الناتج عن اختلاف عدد الفواصل من صف لآخر؛ حيث يؤدي وجود فاصلة إضافية في أحد السجلات إلى دفع البيانات المتبقية في ذلك الصف خطوة نحو اليمين، مما يُخل بالاصطفاف الرأسي للمتغيرات ويدمج تصنيفات متباينة في عمود واحد. تتطلب معالجة هذا الخلل تطبيق تقنيات استكشاف الشذوذ المعتمدة على حساب عدد الفواصل في كل صف باستخدام صيغ رياضية مثل: =LEN(A1)-LEN(SUBSTITUTE(A1,”,”,””))؛ حيث يكشف هذا الحساب أي تفاوت غير مبرر في التكرار النسبي للمحددات بين السجلات المختلفة قبل مباشرة التجزئة الشاملة.
10.2 بروتوكول التحقق والاعتماد النهائي للبيانات المفروزة
لا تنتهي مهمة تقسيم البيانات بمجرد ظهور الأعمدة الجديدة، بل تخضع لبروتوكول تدقيق صارم يهدف إلى توثيق وضمان سلامة البيانات قبل إدماجها في نماذج التحليل النهائي. يتضمن هذا البروتوكول تطبيق اختبارات التماسك الإحصائي للتحقق من عدم حدوث فقد في المحتوى المعلوماتي. وتستخدم في ذلك دوال العد الشرطي مثل COUNTA و COUNTBLANK لمقارنة عدد السجلات المعالجة بالعدد المتوقع للمشاهدات، والتأكد من عدم تولد قيم فارغة بصورة غير مبررة.
كما يُنصح بإجراء عمليات المطابقة المنطقية عبر معادلات تحقق تقارن بين المحتوى التجميعي للأعمدة المجزأة والمحتوى الأصلي للسلسلة؛ حيث يمكن استخدام دالة TEXTJOIN لإعادة دمج المقاطع الجديدة ومقارنتها نصياً بالخلية الأم عبر شرط منطقي بسيط مثل: =EXACT(TRIM(A1), TEXTJOIN(“, “, TRUE, B1:D1)). إن الحصول على نتيجة مطابقة صحيحة (TRUE) عبر كامل سجلات العينة يوفر إثباتاً دامغاً على أن خوارزمية التجزئة لم تؤدِ إلى بتر أي حرف أو إدخال تشويه بنيوي على المتغيرات المفحوصة.
وأخيراً، يتطلب الالتزام بالأمانة المنهجية إعداد مذكرة وصفية (Data Codebook) توثق بوضوح الخطوات المتبعة في تقسيم وتطهير السلاسل النصية. يجب أن تتضمن هذه الوثيقة تفاصيل حول المحددات المستخدمة، وكيفية التعامل مع الفراغات الزائدة، والقرارات المتخذة بشأن القيم المفقودة، والصيغة التقنية للأداة الموظفة (سواء كانت Text to Columns أو دوال برمجية أو استعلامات Power Query). إن هذا التوثيق الدقيق لا يحمي الباحث من التشكيك في موثوقية إجراءاته فحسب، بل يتيح للباحثين والمحللين الآخرين إمكانية تكرار التجربة ومراجعة مسارات المعالجة بالدقة العلمية المطلوبة.
خاتمة
استعرضنا في هذا الدليل التخصصي المتكامل مختلف الأبعاد المنهجية والتطبيقية المرتبطة بكيفية تقسيم السلسلة النصية بفاصلة في بيئة برنامج مايكروسوفت إكسيل. وقد تبين لنا بجلاء أن اختيار الأداة الملائمة يتوقف بالأساس على طبيعة البنية التحتية لبرنامج إكسيل المستخدم، وحجم مصفوفة البيانات، ومستوى الديناميكية المطلوب في تحديث النتائج. فبينما تقدم أداة “تحويل النص إلى أعمدة” (Text to Columns) حلاً سريعاً ومباشراً للمهام الثابتة الفردية، تبرز دالة TEXTSPLIT الحديثة كأداة ديناميكية متفوقة للمستخدمين المشتركين في منظومة Microsoft 365 بفضل تكاملها التام مع محرك المصفوفات الحركية والتحديث التلقائي.
من جانب آخر، أظهر التحليل المكانة المحورية لمحرك الاستعلامات المتقدم (Power Query) كأقوى خيار متاح لمعالجة خطوط أنابيب البيانات المعقدة والتحليلية؛ حيث يمنح المحللين القدرة ليس فقط على فصل النصوص بأعلى معايير الدقة، بل وإعادة هيكلتها رأسياً في صورة صفوف مطبعة تخدم أهداف قواعد البيانات ونماذج ذكاء الأعمال بكفاءة لا مثيل لها. وبالتوازي مع ذلك، تظل الدوال التقليدية المركبة وأداة التعبئة السريعة حلولاً رديفة تسد احتياجات معينة وفق قيود البيئة الحاسوبية المتاحة.
ختاماً، تجدر الإشارة إلى أن الجانب التقني البحت لتفكيك النصوص يجب أن يظل دائماً مشروطاً بالالتزام الصارم ببروتوكولات التحقق ومبادئ حوكمة البيانات؛ فالمعالجة غير الواعية للمحددات والمسافات البيضاء والترميزات قد تقود إلى أخطاء فادحة في النتائج الإحصائية. إن التطبيق المتأني للخطوات المنهجية التي تم تفصيلها في هذه المقالة يضمن نقاء البيانات وسلامتها الهيكلية، مما يحول السجلات النصية المتشابكة إلى أصول معرفية رصينة وجاهزة لخدمة أهداف البحث والتحليل بدقة متناهية.
المراجع
- Alexander, M., & Kusleika, R. (2019). Excel 2019 Bible. John Wiley & Sons.
- Harvey, G. (2021). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
- Microsoft Corporation. (n.d.). Split text into different columns with the Convert Text to Columns Wizard. Microsoft Support. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-the-convert-text-to-columns-wizard-30b14946-0fac-41c8-a477-980b129e6396
- Microsoft Corporation. (n.d.). TEXTSPLIT function. Microsoft Support. https://support.microsoft.com/en-us/office/textsplit-function-b144e722-09bc-4812-9292-ba7df51597dc
- Microsoft Corporation. (n.d.). Using Flash Fill in Excel. Microsoft Support. https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-476a-9390-bc9714e3e4ea
- Microsoft Corporation. (n.d.). About Power Query in Excel. Microsoft Support. https://support.microsoft.com/en-us/office/about-power-query-in-excel-7104f32e-cc66-4578-8672-7acb2fc13710
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.