
تعد معالجة البيانات النصية وتطهيرها من الركائز الأساسية في إدارة وتنظيم قواعد البيانات المعاصرة، لا سيما في البيئات البحثية والأكاديمية التي تعتمد على التحليل الإحصائي الكمي والنوعي. غالبًا ما يواجه الباحثون والمحللون تحدي تدفق البيانات في صيغ غير مهيكلة؛ حيث تتراكم المتغيرات والمعلومات المتعددة داخل خلية واحدة، مثل الأسماء المركبة، أو الأرقام المقترنة بوحدات القياس، أو الاستجابات المفتوحة للمشاركين في الدراسات الميدانية. يمثل برنامج مايكروسوفت إكسيل (Microsoft Excel) الأداة الأكثر انتشارًا للتعامل الأولي مع هذه الجداول، وتعتبر عملية “تفكيك النصوص وتقسيمها استنادًا إلى المسافة” خطوة تمهيدية حيوية (Data Wrangling and Preprocessing) لا غنى عنها لتحويل السجلات المعقدة إلى حقول ذرية مستقلة تمهيدًا لتصديرها إلى برمجيات التحليل الإحصائي المتقدمة مثل IBM SPSS أو لغة R أو بايثون.
إن التعامل مع السلاسل النصية المفصولة بمسافات بيضاء ليس مجرد إجراء روتيني عشوائي، بل هو عملية هندسية للبيانات تخضع لمنطق برمجي وتتطلب فهمًا عميقًا لطبيعة المحددات النصية والخواص المصفوفية لبرنامج إكسيل. فعلى مدار عقود، اعتمد المستخدمون على أدوات ثابتة مثل معالج تحويل النص إلى أعمدة، أو معادلات رياضية بالغة التعقيد تدمج دوال البحث والاقتطاع الحرفي. ومع إطلاق التحديثات البرمجية الحديثة، ولا سيما دالة `TEXTSPLIT` الديناميكية عبر حزمة Microsoft 365، شهدت هندسة الجداول ثورة نوعية مكنت المستخدمين من إنجاز هذه العمليات بكفاءة فائقة ومرونة برمجية غير مسبوقة تضمن اتساق البيانات وقابليتها للنمذجة والتحليل الدقيق.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة تحليلية معمقة وشرح تطبيقي مستفيض لجميع المنهجيات والتقنيات المتاحة لتفكيك وتقسيم النصوص المعتمدة على المسافات في برنامج إكسيل. سيتم استعراض الأسس النظرية والمفاهيم الخوارزمية للدوال المصفوفية، وتفكيك بنية دالة `TEXTSPLIT` ومقارنتها بالبدائل التقليدية وأدوات الاستعلام المتطورة مثل Power Query، فضلًا عن تقديم حلول تقنية رصينة للمشكلات الشائعة مثل المسافات غير المنتظمة، وتداخل الأحرف غير القابلة للطباعة، وأخطاء الانسكاب، مع رفد الطرح بدراسات حالة واقعية من صميم جمع البيانات الميدانية والبحث العلمي.
1. مقدمة عامة حول معالجة السلاسل النصية وتفكيك البيانات في إكسيل
1.1 أهمية تقسيم النصوص في إدارة وتنظيم قواعد البيانات الأكاديمية
تمثل جودة البيانات (Data Quality) حجر الزاوية في مصداقية المخرجات البحثية، حيث تفرض قواعد البيانات المعيارية مبدأ “الذرية” (Atomicity)، وهو المفهوم القائل بأن كل خلية أو حقل يجب ألا يحتوي إلا على قيمة أحادية واحدة لا يمكن تجزئتها منطقيًا. إن وجود نصوص مدمجة تحتوي على الاسم واللقب، أو التاريخ والتوقيت، أو الاستجابات المتعددة في خلية واحدة يعوق التحليل الإحصائي المقارن، إذ تعجز المحركات التحليلية عن تصنيف المتغيرات وفرزها فرزًا مستقلًا دون تفكيك مسبق. من هذا المنطلق، يبرز تقسيم النصوص كخطوة منهجية لتطهير البيانات (Data Cleaning)، مما يتيح للباحثين استخراج المتغيرات الاسمية والترتيبية والكمية ووضعها في مصفوفات منفصلة تسهل فحص التوزيعات واختبار الفرضيات.
علاوة على ذلك، يحد التفكيك المنهجي للبيانات من احتمالية الوقوع في أخطاء التحيز القياسي الناتجة عن المعالجة اليدوية المرهقة. فعندما تُجمع البيانات الميدانية عبر استبانات أو استمارات تسجيل إلكترونية، كثيرًا ما يؤدي الإدخال البشري إلى تكديس معلومات متباينة داخل حقل نصي واحد. إن الاعتماد على خوارزميات التقسيم المؤتمتة داخل إكسيل يضمن الحفاظ على السلامة الهيكلية لقواعد البيانات، ويسهل مطابقة السجلات وتوحيدها عبر المعرفات الفريدة للمشاركين، مما يرفع الكفاءة التشغيلية ويختصر الوقت اللازم للتحضير الحسابي والنمذجة الإحصائية اللاحقة في برامج التحليل المتقدمة.
كما يسهم التقسيم الدقيق للنصوص في تسهيل بناء الجداول المحورية (Pivot Tables) والمخططات البيانية التفاعلية. فالمتغيرات المحشورة داخل سلاسل نصية طويلة تظل “خرساء” رقميًا وغير قابلة للتقاطع مع المتغيرات المستقلة والتابعة، في حين يؤدي تفكيكها إلى تحرير المعلومات الكامنة، وتمكين الباحث من رصد العلاقات الارتباطية الدقيقة بين المفردات والسمات المدروسة، وتفادي الالتباس الناتج عن تراكم المتغيرات في مساحات تخزين نصية مختلطة داخل السجلات الرقمية.
1.2 إشكالية المسافة الفاصلة بوصفها محدداً بنيوياً للبيانات
تعد المسافة البيضاء (Space Delimiter) الفاصل اللغوي والبنيوي الأكثر شيوعًا وتكرارًا في الكتابة الإنسانية وفي مخرجات الأنظمة الرقمية؛ إذ تُستخدم تلقائيًا للتفريق بين الكلمات، والأسماء، والمصطلحات. ومع ذلك، فإن هذه المسافة الشائعة تفرض تحديات تقنية معقدة في بيئة معالجة البيانات المجدولة. فالخوارزميات البرمجية تتعامل مع الفراغ بوصفه رمزًا محرفيًا دقيقًا له ترميزه الرقمي الخاص، وليس مجرد “فراغ بصري”. وعليه، فإن أي اختلاف طفيف في عدد المسافات، مثل وجود مسافة مزدوجة غير مقصودة الناتجة عن خطأ مطبعي، قد يُعامل من قِبل الدالة البرمجية كفاصلين متتاليين يولد بينهما عنصرًا نصيًا فارغًا ذي طول صفري، مما يفسد بنية المصفوفة الناتجة.
تختلف المسافات البينية أيضًا عن الفواصل الحرفية الصريحة مثل الفاصلة (Comma) أو الفاصلة المنقوطة (Semicolon) أو علامة الجدولة (Tab)؛ فهذه الفواصل الصريحة غالبًا ما تُدخل عن عمد لأغراض برمجية محددة، مما يقلل من احتمالية تكرارها العشوائي داخل النص. أما المسافة، فقد تتواجد في بداية الجملة (Leading Space)، أو في نهايتها (Trailing Space)، أو تتضاعف في وسطها، فضلاً عن وجود أنواع متباينة من المسافات على المستوى الثنائي مثل مسافة عدم الكسر (Non-breaking space) ذات الرمز البرمجي 160 في جدول ASCII، والتي تختلف جوهريًا عن المسافة التقليدية ذات الرمز 32، مما يؤدي إلى فشل الدوال المعتادة في التعرف عليها إذا لم تُعالج مسبقًا.
تنعكس هذه الإشكاليات على دقة الفرز والتصنيف؛ فإذا احتوت إحدى الخلايا على مسافة زائدة غير مرئية للمستخدم البشري، فإن محرك إكسيل سيعتبرها قيمة فريدة ومستقلة، مما يؤدي إلى تضخم فئات المتغيرات الاسمية وتشتت البيانات أثناء محاولة تجميعها إحصائيًا. لذلك، يتطلب التعامل مع المسافة كمحدد بنيوي فحصًا واعيًا لنقاء السلسلة النصية وفهمًا للآليات التي تستخدمها خوارزميات التجزئة في رصد المسافات ومطابقتها.
1.3 استعراض منهجي لأبرز التقنيات المتاحة في بيئة ميكروسوفت إكسيل
توفر بيئة عمل برنامج إكسيل ترسانة متكاملة من الأدوات والوظائف المصممة لتفكيك السلاسل النصية، وتتنوع هذه الأدوات من حيث الحداثة، والديناميكية، ومستوى الأتمتة، والقدرة على التكيف مع التحديثات اللحظية للبيانات. في طليعة هذه التقنيات تأتي الدوال المصفوفية الحديثة المتاحة في إصدارات Microsoft 365، وعلى رأسها دالة `TEXTSPLIT` التي أطلقتها شركة مايكروسوفت في عام 2022. تمثل هذه الدالة قفزة هندسية نوعية بقدرتها على تحويل النص إلى مصفوفة أفقية أو رأسية متدفقة تلقائيًا دون الحاجة لتكرار إدخال الصيغ يدويًا، مما وفر بديلاً فائق المرونة للبنى البرمجية المعقدة.
من جانب آخر، تحتفظ الواجهة التفاعلية لإكسيل بأداة “تحويل النص إلى أعمدة” (Text to Columns)، وهي ميزة كلاسيكية مدمجة أثبتت كفاءتها التاريخية في المعالجة السريعة للسجلات الكبيرة. تتميز هذه الأداة ببساطتها التشغيلية عبر معالج إرشادي متعدد الخطوات يتيح للمستخدم تقسيم النصوص مباشرة في موقعها، إلا أنها تفتقر إلى الخاصية الديناميكية؛ فالنتائج تظل ثابتة ولا تتعدل تلقائيًا إذا ما طرأ تغيير على السجلات المصدرية في الخلايا الأصلية، مما يجعلها ملائمة للمشروعات ذات البيانات المستقرة التي لا تشهد إضافات مستمرة.
أما بالنسبة للمستخدمين الذين يعملون على إصدارات أقدم من إكسيل (مثل Excel 2016 أو Excel 2019)، فإن الحل الرياضي المتاح يتمثل في صياغة معادلات تركيبية متداخلة تجمع بين دالتي الاقتطاع `LEFT` و`RIGHT` ودوال البحث المكاني مثل `FIND` و`SEARCH` مقرونة بحساب الأطوال الحرفية عبر دالة `LEN`. وتكتمل هذه المنظومة بأداة استعلامات الطاقة الاستثنائية “Power Query”، التي تقدم نموذجًا متقدمًا لاستخراج وتحويل وتحميل البيانات (ETL)، متيحة تقسيم النصوص وفق المسافات بخطوات مسجلة ومؤتمتة بالكامل يمكن تحديثها بضغطة زر واحدة مهما بلغ حجم البيانات المدخلة.
2. دالة TEXTSPLIT: المفهوم البرمجي، الخصائص، والبنية التركيبية
2.1 التعريف التقني لدالة TEXTSPLIT وموقعها بين الدوال المصفوفية الحديثة
تُصنف دالة `TEXTSPLIT` كإحدى أهم الإضافات التي أدخلتها مايكروسوفت على محرك الحسابات الخاص ببرنامج إكسيل ضمن حزمة تحديثات عام 2022 الخاصة ببرنامج Excel for Microsoft 365 وExcel for the Web. تندرج هذه الدالة وظيفيًا تحت فئة “دوال المصفوفات الديناميكية” (Dynamic Array Functions)، وهي فئة تتميز بقدرتها الذاتية على إرجاع مصفوفة من القيم تمتد تلقائيًا وتنسكب (Spill) عبر الخلايا المجاورة في ورقة العمل دون الحاجة إلى اللجوء إلى التوليفات القديمة لمعادلات الصفيف مثل ضغط المفاتيح المزدوج (Ctrl + Shift + Enter).
لقد جاءت هذه الدالة لسد فجوة برمجية طالما عانى منها مستخدمو إكسيل؛ حيث كانت معالجة النصوص متعددة المقاطع تتطلب سابقًا كتابة معادلات بالغة الطول والتعقيد يصعب فهمها أو مراجعتها أو صيانتها لاحقًا من قِبل باحثين آخرين. ومن خلال توحيد خوارزميات التجزئة في دالة قياسية واحدة، وفرت `TEXTSPLIT` بيئة عمل متسقة ومباشرة تضمن للمستخدمين إمكانية التعامل مع النصوص المركبة بكفاءة مكافئة للغات البرمجة المتقدمة مثل بايثون وسكربتات R، مع الاحتفاظ بمرونة وبساطة الواجهة الجدولية.
ومع ذلك، ينبغي التأكيد المنهجي على أن دالة `TEXTSPLIT` غير مدعومة في الإصدارات التاريخية ذات التراخيص الدائمة مثل Excel 2013 أو Excel 2016 أو Excel 2019 أو حتى الإصدار القياسي المستقل من Excel 2021؛ إذ سيؤدي استدعاؤها في تلك الإصدارات إلى ظهور خطأ التسمية الشهير (`#NAME?`). وعليه، يجب التحقق من بيئة التشغيل وتحديث إصدار البرنامج قبل التخطيط للاعتماد الكلي على هذه الأداة في المشاريع البحثية المشتركة التي قد تتداولها فرق عمل ذات بنى برمجية غير متطابقة.
2.2 الصيغة الرياضية العامة والمعاملات الإلزامية والاختيارية
تستند دالة `TEXTSPLIT` إلى بنية تركيبية مرنة تتكون من معاملين إلزاميّين يتبعهما أربعة معاملات اختيارية تمنح المحلل تحكمًا دقيقًا ومخصصًا في تدفق ومخرجات عملية التجزئة. وتأخذ الصيغة العامة للدالة الشكل التالي في بيئة إكسيل:
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
المعامل الإلزامي الأول هو `text`، ويمثل السلسلة النصية المستهدفة أو المرجع المباشر للخلية الحاوية على النص المراد تفكيكه (مثل الخلية A2). أما المعامل الإلزامي الثاني فهو `col_delimiter`، وهو الرمز أو السلسلة المحرفية المحددة التي يتم استخدامها كفاصل لتوزيع النص عبر الأعمدة المجاورة أفقياً. في سياق هذا الدليل، يتم تمرير علامة المسافة بين علامتي تنصيص متتاليتين (” “) لتوجيه الدالة نحو تفكيك النص عند كل فراغ أفقي.
تتضمن المعاملات الاختيارية إمكانات برمجية فائقة الأهمية؛ فالمعامل الثالث `row_delimiter` يسمح بتجاوز التقسيم الأفقي ونقل النتائج رأسياً عبر الصفوف عند تمرير الفاصل ضمنه. أما المعامل الرابع `ignore_empty`، فيأخذ قيمة منطقية (TRUE أو FALSE)، ويحدد ما إذا كان ينبغي للدالة تجاهل الخلايا الفارغة الناتجة عن المسافات المتتالية أم توليد عناصر فارغة في المصفوفة. ويحدد المعامل الخامس `match_mode` حساسية البحث لحالة الأحرف (وهو غير ذي صلة بالمسافات غالبًا)، في حين يتيح المعامل السادس `pad_with` تحديد قيمة بديلة (مثل نصوص معينة أو شرطات) لملء الخلايا الشاغرة عند التقسيم الثنائي ثنائي الأبعاد في حال عدم تكافؤ أطوال المقاطع المفصولة.
2.3 آلية عمل ظاهرة الانسكاب (Spill Behavior) وإدارة نطاق النتائج
تتميز دالة `TEXTSPLIT` بقدرتها على توليد مصفوفة ديناميكية من خلال ما يُعرف في الأدبيات التقنية لإكسيل بـ “سلوك الانسكاب” (Spill Behavior). عند إدخال المعادلة في خلية واحدة محددة، يتكفل محرك الحسابات بتقدير عدد الكلمات الناتجة عن التقسيم، ويقوم تلقائيًا بملء الخلايا المجاورة (على امتداد الصف أو العمود) بالقيم المجزأة، محاطة بإطار أزرق رفيع يشير إلى أن نطاق النتائج هذا يرتبط بصيغة جذرية واحدة موجودة فقط في الخلية الأولى الأساسية، في حين تظل الخلايا المنسكب إليها معتمدة حسابيًا على تلك الخلية الأم دون إمكانية تحرير محتواها بشكل منفصل.
يولد هذا السلوك أحيانًا ما يُعرف بخطأ الانسكاب الشهير (`#SPILL! Error`). ينشأ هذا الخطأ عندما يتعرض مسار التمدد المحسوب لعائق مادي؛ كأن تكون هناك خلية مجاورة تحتوي مسبقًا على نص، أو رقم، أو معادلة أخرى، أو حتى مسافة خفية. بمجرد وجود أي محتوى يعترض طريق المصفوفة، يتوقف محرك إكسيل عن نشر النتائج فورًا ويعرض رمز الخطأ حمايةً للبيانات القائمة من أن تُستبدل أو تُمحى تلقائيًا. وتقتضي معالجة هذا الخطأ إفراغ المسار الجغرافي للانسكاب أو نقل معادلة التقسيم إلى فضاء جدولي فارغ يتسع لعدد الكلمات المتوقعة.
وعلاوة على ذلك، يتيح إكسيل إمكانية الإشارة المرجعية للنطاق المنسكب بالكامل في المعادلات اللاحقة باستخدام رمز الهاشتاج (#) المعروف بمعامل نطاق الانسكاب (Spilled Range Operator). فعلى سبيل المثال، إذا طُبقت الدالة في الخلية `B2` وتمددت النتائج إلى الخلايا المجاورة، يمكن الإشارة إلى كامل السلسلة المجزأة في معادلة أخرى عبر كتابة `=COUNTA(B2#)`، مما يوفر ربطًا حسابيًا ديناميكيًا يتكيف تلقائيًا مع أي زيادة أو نقصان في عدد الكلمات الناتجة عن السلسلة النصية المصدرية دون الحاجة لإعادة ضبط النطاقات يدويًا في كل مرة.
3. الدليل التطبيقي خطوة بخطوة لتقسيم النص حسب المسافة باستخدام دالة TEXTSPLIT
3.1 تهيئة فضاء البيانات وتحديد المتغيرات المستهدفة
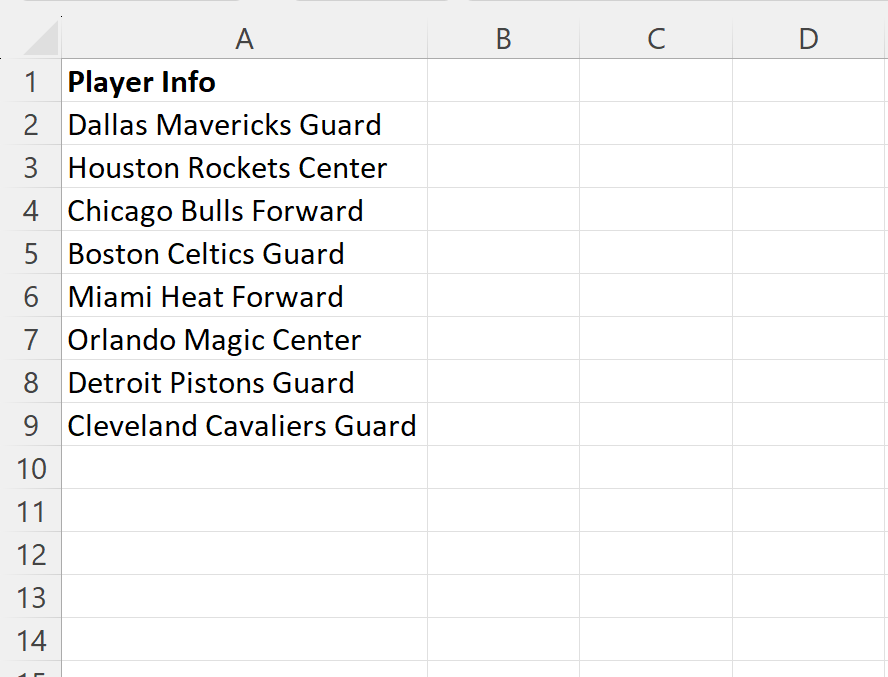
تبدأ الخطوة الأولى لتطبيق التقسيم المنهجي في إعداد بيئة العمل داخل ورقة البيانات لضمان دقة العمليات الحسابية وتفادي أخطاء التنفيذ. يتعين على الباحث أولاً فحص العمود المصدر الحاوي على النصوص المدمجة، والتأكد من أن البيانات مخزنة بصيغة نصية قياسية (General أو Text) وليست منسقة كتواريخ أو أرقام حسابية خاصة قد تتدخل في قراءة المحتوى المحرفي. فإذا افترضنا أن العمود `A` يحتوي على قائمة بأسماء المشاركين الثلاثية المسجلة في حقل واحد، مثل “أحمد محمد علي” في الخلية `A2`، فإن هذا يمثل نقطة الانطلاق الأساسية للمعالجة.
تقتضي الخطوة التالية فحص المساحة الجغرافية المجاورة للعمود `A` جهة اليسار (في واجهات العرض من اليمين إلى اليسار) أو جهة اليمين (في واجهات العرض من اليسار إلى اليمين). يجب التأكد من خلو الأعمدة `B` و`C` و`D` من أي بيانات تاريخية أو ملحوظات مسجلة؛ لأن دالة `TEXTSPLIT` ستحتاج إلى تفريغ الكلمات المجزأة داخل هذه الأعمدة المتتابعة. إن إغفال هذه الخطوة يمثل السبب الجذري لظهور أخطاء الانسكاب المانعة لظهور المخرجات.
كما يُنصح بشدة بعدم تطبيق الدالة داخل “جداول إكسيل الرسمية المهيكلة” (Excel Tables التي يتم إنشاؤها عبر ضغط Ctrl + T)، إذ تمنع البنية البرمجية للجداول المهيكلة الرسمية ظاهرة الانسكاب التلقائي للمصفوفات الديناميكية داخل صفوفها. يجب أن تتم المعالجة ضمن نطاق قياسي حر (Normal Range)، وفي حال كانت البيانات موجودة داخل جدول مهيكل، يجب أولاً تحويله إلى نطاق عادي عبر النقر بزر الفأرة الأيمن واختيار Convert to Range، أو كتابة معادلة التقسيم في نطاق خارجي خارج حدود الجدول الرسمي تجنبًا لتعطيل محرك الحسابات.
3.2 صياغة المعادلة وتطبيقها على الخلية النموذجية الأولى
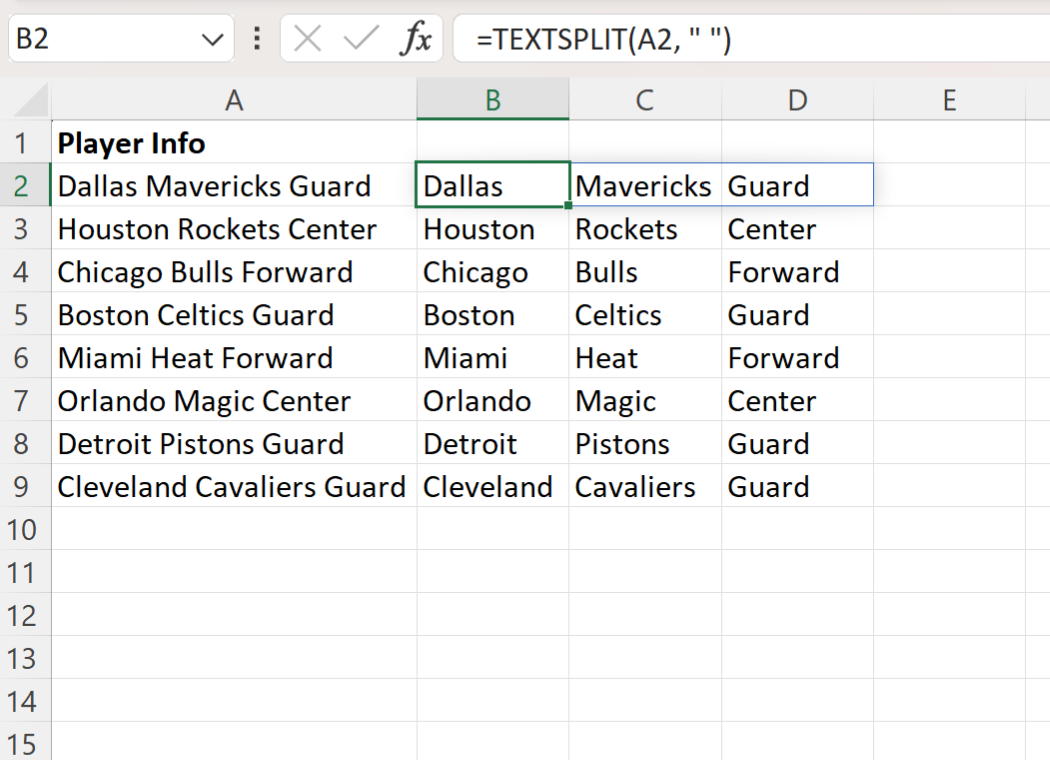
بعد إعداد فضاء العمل وتفريغ الأعمدة المجاورة، يتم الانتقال إلى الخلية المستهدفة لاستقبال الجزء الأول من النص المقسم، ولتكن الخلية `B2`. في هذه الخلية، يشرع المستخدم في كتابة المعادلة الرياضية بصيغتها القياسية الدقيقة والموجزة على النحو التالي:
=TEXTSPLIT(A2, ” “)
تحتوي هذه المعادلة على معطيين واضحين؛ المعطى الأول يوجه المحرك لقراءة السلسلة النصية القابعة في الخلية `A2`، بينما يحدد المعطى الثاني، والموضوع بعناية بين علامتي تنصيص إنجليزيتين مزدوجتين تفصل بينهما مسافة فارغة واحدة (” “)، الفاصل المنطقي المطلوب اعتماده كحد قطعي لتقسيم النص. إن وضع المسافة داخل علامتي التنصيص أمر إلزامي لا يقبل الإغفال؛ فالبرنامج يعتبر أي رمز غير محاط بعلامات تنصيص بمثابة اسم لدالة أو متغير غير معرف، مما يفضي إلى حدوث خطأ برمجي يوقف المعالجة.
بمجرد الضغط على مفتاح الإدخال (Enter)، يقوم محرك الحسابات بقراءة السلسلة الحرفية فورياً؛ حيث يبحث عن كل موضع تتواجد فيه المسافة، ثم يقتطع الكلمة الواقعة قبلها ويضعها في الخلية `B2` (الاسم الأول: “أحمد”)، ثم ينسكب الكود تلقائيًا ليضع الكلمة الثانية في الخلية `C2` (اسم الأب: “محمد”)، وينتهي بتسكين الكلمة الثالثة في الخلية `D2` (اللقب: “علي”). لا يقتصر هذا الإجراء على تقسيم الأسماء فحسب، بل يمتد لأي نص مركب، محققًا توزيعًا بنيويًا مطابقًا لترتيب النص الأصلي بنقرة واحدة ودون الحاجة لأي مهارات برمجية مسبقة في لغات الأتمتة الخارجية.
3.3 تعميم الصيغة على السجلات اللاحقة والتحقق من اتساق المخرجات
بعد نجاح العملية في الخلية الأولى `B2` وتأكد الباحث من انسكاب الكلمات وتوزيعها المنطقي السليم، تأتي مرحلة تعميم الصيغة الحسابية على امتداد بقية سجلات العينة المدروسة في العمود. يتم ذلك عن طريق تحديد الخلية الأصلية `B2` فقط (وليس الخلايا التي انسكبت إليها النتائج)، ثم وضع مؤشر الفأرة على الزاوية السفلية من الخلية حتى يتحول المؤشر إلى علامة الجمع السوداء الصغيرة المعروفة بـ “مقبض التعبئة التلقائية” (AutoFill Handle)، ومن ثم الضغط المزدوج بزر الفأرة الأيسر أو سحب المقبض لأسفل ليغطي كامل عمود البيانات.
تتميز دالة `TEXTSPLIT` بمرونة استثنائية عند نسخها؛ فكل صف سيعمل بصفة مستقلة متكيفة مع عدد الكلمات الموجودة في خليته المقابلة من العمود `A`. فإذا كان السجل في الخلية `A3` يحتوي على كلمتين فقط (مثل: “خالد سعيد”)، فإن النطاق سينسكب فقط عبر خليتين (`B3` و`C3`) تاركًا الخلية `D3` فارغة دون إثارة أي أخطاء. أما إذا احتوى السجل في الخلية `A4` على أربع كلمات، فإن المصفوفة ستتمدد ديناميكيًا لتغطي أربعة أعمدة مستقلة تنتهي في العمود `E4`.
عقب إتمام التعميم، تقتضي قواعد التوثيق الأكاديمي إجراء فحص ومراجعة سريعة لأطراف الأعمدة الناتجة. يتيح هذا التدقيق التأكد من عدم حدوث أي انزياح في الأعمدة (Column Misalignment) في السجلات ذات التراكيب الشاذة، والتحقق من أن الأسماء والمسميات قد استقرت في حقولها الوظيفية المخصصة بما يضمن نقاء المصفوفة البحثية قبل اعتمادها في مراحل النمذجة والاستدلال الإحصائي التالية.
4. التعامل مع المسافات غير المنتظمة وإشكالية الفراغات الزائدة
4.1 تشخيص عيوب المسافات المزدوجة وتأثيرها على توليد خلايا فارغة
تمثل مشكلة المسافات غير المنتظمة أحد أكثر العيوب شيوعًا في معالجة البيانات النصية غير المنقحة. تنشأ هذه المشكلة نتيجة الضغط المتكرر غير المقصود على شريط المسافة أثناء إدخال البيانات يدويًا، مما يؤدي إلى توليد مسافات مزدوجة أو ثلاثية متتالية بين الكلمات، أو وجود مسافات غير مرئية في مستهل النص أو في نهايته. عند تطبيق دالة `TEXTSPLIT` بصيغتها الأساسية المباشرة `=TEXTSPLIT(A2, ” “)` على نص يحوي مسافة مزدوجة، يتعامل محرك إكسيل مع كل مسافة بصفتها فاصلًا مستقلاً تمامًا.
نتيجة لهذه المعاملة الحرفية، يجد المحرك نفسه أمام فاصل أول يتبعه فاصل ثانٍ دون وجود أي محارف بينهما، فيستنتج منطقيًا وجود نص خالي الطول (Empty String / Zero-length text) محصور بين الفاصلين، فيقوم بتخصيص خلية مستقلة فارغة لهذا المقطع المتوهم. يترتب على ذلك ظهور خلايا بيضاء فارغة غير مرغوب فيها في منتصف الأعمدة المقسمة، مما يزيح الكلمات اللاحقة إلى أعمدة خاطئة جهة اليسار ويدمر تجانس المتغيرات عبر السجلات، الأمر الذي يفضي إلى أخطاء فادحة في التحليلات الإحصائية وتصنيف الفئات.
ولا يقل خطر المسافات البادئة والناهية عن المسافات المزدوجة؛ فالمسافة البادئة في بداية الخلية ستؤدي إلى انسكاب خلية فارغة كأول عنصر في مصفوفة النتائج، مما يجعل حقل الاسم الأول فارغًا ويدفع الاسم الفعلي إلى حقل اسم الأب. هذا التباين العشوائي في مواضع الكلمات يفرض على الباحثين ضرورة تشخيص نقاء البيانات مسبقًا وعدم الاكتفاء بالصيغ المباشرة دون تحصينها بآليات المعالجة والتنقية المسبقة.
4.2 المعالجة التوافقية عبر دمج دالتي TRIM و TEXTSPLIT
للتعامل المنهجي مع إشكالية المسافات الزائدة وغير المنتظمة، يمكن الاعتماد على واحدة من أعرق دوال التنظيف في إكسيل وهي دالة `TRIM`. تتمثل الوظيفة الخوارزمية لدالة `TRIM` في فحص السلسلة النصية واستئصال كافة المسافات البادئة الموجودة في بداية النص، وكافة المسافات اللاحقة في نهايته، مع تقليص المسافات البينية المزدوجة أو المتعددة إلى مسافة مفردة واحدة فقط تفصل بين كل كلمة وأخرى وفق قواعد الصياغة اللغوية السليمة.
من خلال دمج الدالتين في بنية برمجية تركيبية واحدة، يتم تمرير مخرجات دالة `TRIM` لتكون هي المدخل المباشر لدالة `TEXTSPLIT`، وذلك عبر كتابة الصيغة التالية:
=TEXTSPLIT(TRIM(A2), ” “)
تعمل هذه المعادلة من الداخل إلى الخارج؛ حيث يتولى الجزء الداخلي `TRIM(A2)` أولاً قراءة النص الأصلي في الخلية `A2` وتطهيره بالكامل من أي فراغات شاذة أو متكررة، وتوليد نص نظيف وموحد هيكليًا تتباعد كلماته بمسافة قياسية مفردة حصرًا. بعد ذلك، يتسلم الجزء الخارجي `TEXTSPLIT` هذا النص المنقى، ويجري عملية التفكيك بدقة متناهية دون أدنى احتمال لتوليد خلايا فارغة أو التسبب في انزياح البيانات عن مساراتها الطبيعية.
تعتبر هذه الصيغة المركبة المعيار الذهبي الموصى به للمحللين والباحثين عند التعامل مع قواعد البيانات المستوردة من مصادر خارجية أو استبانات مفتوحة لم تخضع لرقابة حاسوبية صارمة أثناء الإدخال؛ فهي تجمع بين حماية البيانات وضمان التدفق المصفوفي السلس في آن واحد دون فرض أي عبء إضافي على المستخدم.
4.3 تفعيل معامل تجاهل الفراغات (ignore_empty) المدمج في الدالة
في خطوة تعكس النضج المعماري للدوال الحديثة، ضمنت مايكروسوفت دالة `TEXTSPLIT` حلاً داخليًا أصيلاً لإشكالية المسافات المتكررة دون الحاجة الإلزامية لاستدعاء دوال مساعدة كدالة `TRIM`. يتحقق ذلك من خلال المعامل الاختياري الرابع للدالة، والذي يحمل الاسم البرمجي `ignore_empty`. يتيح هذا المعامل للمستخدم توجيه محرك الحسابات صراحة نحو إسقاط النصوص ذات الطول الصفري وتخطي أي تقسيم لا يفضي إلى قيمة محرفية حقيقية.
لتفعيل هذه الميزة، تُكتب المعادلة متضمنة تخطي المعامل الثالث (المخصص لفاصل الصفوف عبر ترك فاصلة فارغة)، وضبط المعامل الرابع على القيمة المنطقية `TRUE`، كما هو موضح في الصيغة التالية:
=TEXTSPLIT(A2, ” “, , TRUE)
عند تنفيذ هذه المعادلة على نص يتضمن مسافات متتالية متعددة، تقوم خوارزمية الدالة بفحص المقاطع الناتجة تباعًا؛ فإذا رصدت مقطعًا فارغًا ناتجًا عن مسافتين متجاورتين، فإنها تستبعده فورًا من مصفوفة النتائج ولا تنشئ له خلية في ورقة العمل، متيحة للكلمة التالية أن تحتل موقعها المنطقي السليم مباشرة في الخلية المجاورة.
يقودنا هذا إلى المفاضلة المنهجية بين استخدام دالة `TRIM` المدمجة واستخدام المعامل `ignore_empty` الخاص بـ `TEXTSPLIT`؛ في حين يوفر المعامل `ignore_empty` أداءً ممتازًا واختصارًا في عدد الدوال المستخدمة مع معالجة الفراغات البينية والناهية، إلا أنه قد لا يحذف بالضرورة المسافات غير القابلة للكسر (Non-breaking spaces) التي قد تتطلب دمجًا متخصصًا مع دوال الاستبدال. ومع ذلك، يظل تفعيل `ignore_empty` الخيار البرمجي الأكثر أناقة وسرعة في الحوسبة الجداولية المعاصرة للتعامل مع النصوص الإنجليزية والعربية التقليدية.
5. المقارنة المنهجية: التقسيم الأفقي (أعمدة) مقابل التقسيم الرأسي (صفوف)
5.1 التحويل الهيكلي للنصوص إلى سجلات رأسية باستخدام row_delimiter
على الرغم من أن الاستخدام النمطي الشائع لتقسيم النصوص يتجه نحو التوزيع الأفقي عبر الأعمدة (Horizontal Splitting) لتفكيك عناصر مثل الأسماء والعناوين، إلا أن الاحتياجات المنهجية في تنقيب البيانات وإدارتها تقتضي في أحيان كثيرة تحويل النصوص إلى توزيع رأسي متتابع عبر الصفوف (Vertical Splitting). يبرز هذا الاحتياج بوضوح عند معالجة الكلمات المفتاحية (Keywords)، أو سلاسل الإجابات في الأسئلة متعددة الخيارات، أو الأرقام التعريفية المحشورة في سجل مفرد، حيث تتطلب قواعد تطبيع البيانات تحويل المتغيرات العرضية إلى سجلات طولية مستقلة.
تتيح دالة `TEXTSPLIT` إنجاز هذا التحويل الهيكلي بمرونة فائقة من خلال توظيف معاملها الثالث `row_delimiter` وتجاوز معامل الأعمدة الثاني. يتم ذلك بترك موضع المعامل الثاني شاغرًا بوضع فاصلتين متتاليتين، وتمرير المسافة كمعامل للمحدد الرأسي، وفق الصياغة البرمجية التالية:
=TEXTSPLIT(A2, , ” “)
بمجرد إدخال هذه الصيغة، تتمدد مصفوفة النتائج رأسيًا نحو الأسفل انطلاقًا من خلية الصيغة وحتى استيفاء كافة مقاطع النص. يوفر هذا التوزيع الرأسي مزايا تحليلية حاسمة؛ إذ تصبح البيانات مهيأة بصورة مثالية لإنشاء الجداول المحورية (Pivot Tables)، أو استخدامها في التجميع الإحصائي عبر دوال العد التراكمي مثل `COUNTIF`، فضلًا عن تسهيل فحص التكرارات وتوافقها التام مع المعايير القياسية للسجلات الطولية المطلوبة في معظم برمجيات التحليل المتقدمة.
5.2 الجمع المتزامن بين الفواصل الأفقية والرأسية لتشكيل جداول ثنائية الأبعاد
تتجلى القوة الرياضية القصوى لدالة `TEXTSPLIT` في قدرتها الفريدة على تفكيك النصوص المعقدة إلى مصفوفات ثنائية الأبعاد (2D Arrays) تحتوي على صفوف وأعمدة في آن واحد وبمعادلة واحدة فقط. ينشأ هذا السيناريو عندما تحتوي السلسلة النصية المدخلة على مستويين مختلفين من الفواصل البنيوية؛ مثل وجود مسافة تفصل بين القيم داخل السجل الواحد، ووجود فاصلة منقوطة أو فاصلة عادية تفصل بين السجلات المختلفة داخل الخلية ذاتها.
لتحقيق هذا التوزيع المزدوج، يتم تمرير محدد الأعمدة ومحدد الصفوف معًا داخل المعاملين الثاني والثالث للدالة. لنفترض وجود خلية `A2` تحتوي على أزواج من البيانات مثل: “أحمد 25; محمد 30; علي 28″، حيث تفصل المسافة بين الاسم والعمر، بينما تفصل الفاصلة المنقوطة بين الأشخاص. يمكن تجزئة هذه الخلية إلى جدول منتظم عبر الصيغة التالية:
=TEXTSPLIT(A2, ” “, “; “)
ستقوم الدالة بنشر الأسماء في العمود الأول والأعمار في العمود الثاني، مع توزيع كل شخص في صف مستقل نحو الأسفل. وفي حال كانت بعض السجلات تعاني من نقص في عدد العناصر (كأن يحتوي أحد الصفوف على اسم دون عمر)، تتيح الدالة استخدام المعامل السادس `pad_with` لتحديد قيمة تكميلية تعوض النقص (مثل: “غير متوفر”) بدلاً من ظهور خطأ عدم توفر القيمة (`#N/A`)، مما يضمن اتساق المصفوفة وتماسكها الجمالي والرياضي.
5.3 معايير الاختيار بين التوزيعين الأفقي والرأسي وفق أهداف التحليل
تخضع المفاضلة بين خياري التقسيم الأفقي والرأسي لمعايير منهجية وترتيبات بنيوية ترتبط بالأهداف النهائية للبحث وخصائص البرمجيات المستخدمة لمعالجة النتائج. يوضح الجدول التالي مقارنة تحليلية دقيقة بين النمطين لمساعدة المحلل في اتخاذ القرار الأمثل:
- التوزيع الأفقي (عبر الأعمدة):
- الملاءمة الهيكلية: يناسب السجلات التي تعبر فيها كل كلمة مفصولة عن سمة نوعية مختلفة كليًا عن الكلمة المجاورة (مثل: الاسم الأول، اللقب، العمر).
- التوافق البرمجي: يتماشى مع البنية العريضة (Wide Format) المفضلة في نماذج الانحدار الخطي المتعدد والمقارنات الارتباطية الأفقية في برامج مثل SPSS.
- الاعتبارات البصرية: يسهل القراءة الطبيعية للبيانات الفردية على شاشات العرض التقليدية من اليمين إلى اليسار.
- التوزيع الرأسي (عبر الصفوف):
- الملاءمة الهيكلية: يناسب السجلات التي تمثل فيها الكلمات عناصر متجانسة تنتمي لنفس المتغير الكلي (مثل: قائمة بالمهارات، أو أسماء أدوية، أو مفردات دلالية).
- التوافق البرمجي: يتماشى مع البنية الطولية (Long/Tidy Format) التي تتطلبها لغات البرمجة الحديثة (مثل مكتبة Tidyverse في R أو مكتبة Pandas في Python).
- إدارة المفاتيح: يتيح تكرار المعرف الأساسي (Primary Key) لكل صف فرعي عند دمج التقنيات، مما يدعم قواعد البيانات العلائقية المعقدة.
6. البدائل التقليدية: توظيف معالج تحويل النص إلى أعمدة (Text to Columns)
6.1 آلية تشغيل معالج تحويل النصوص المضمن في واجهة إكسيل
يعد معالج تحويل النص إلى أعمدة (Text to Columns Wizard) الأداة التاريخية الأكثر استخدامًا وتجذرًا في بيئة مايكروسوفت إكسيل لتجزئة السلاسل النصية عبر واجهة تفاعلية خالية من المعادلات الحسابية. يمكن الوصول إلى هذه الأداة عبر التوجه إلى شريط الأدوات العلوي، واختيار تبويب “بيانات” (Data)، ومن ثم النقر على أمر “النص إلى أعمدة” (Text to Columns) المندرج تحت مجموعة أدوات البيانات (Data Tools) بعد تضليل عمود السجلات المستهدفة.
يعتمد المعالج على نافذة إرشادية تتألف من ثلاث خطوات متعاقبة؛ في الخطوة الأولى، يُطلب من المستخدم تحديد طبيعة الفصل بين نوعين: محدد بفواصل (Delimited) أو بعرض ثابت (Fixed width)، ويجب اختيار “محدد” للتعامل مع المسافات. في الخطوة الثانية، يتم تحديد الفاصل الفعلي عبر تفعيل خانة الاختيار الخاصة بـ “مسافة” (Space) وإلغاء تفعيل الفواصل الأخرى. ومن الأهمية بمكان في هذه الخطوة تفعيل خيار “معاملة الفواصل المتتالية كفاصل واحد” (Treat consecutive delimiters as one)، وهو الخيار المكافئ وظيفيًا لدالة `TRIM`، حيث يمنع تشتت البيانات وتوليد أعمدة فارغة ناتجة عن المسافات المزدوجة.
في الخطوة الثالثة والأخيرة، يتيح المعالج معاينة حية لشكل البيانات الناتجة، مع إمكانية تحديد نوع البيانات لكل عمود مستحدث (نصي، تاريخي، أو عام)، فضلًا عن تحديد “وجهة الاستخراج” (Destination). يُنصح دائمًا بتغيير وجهة الاستخراج الافتراضية (التي تشير إلى الخلية المصدرية نفسها) إلى خلية مجاورة فارغة (مثل `$B$2`) لضمان عدم الكتابة التدميرية فوق البيانات الأصلية والحفاظ على سجلات المصدر دون تغيير.
6.2 مقارنة تحليلية: المزايا الثابتة للمعالج مقابل ديناميكية الدوال
على الرغم من النجاح الواسع لمعالج تحويل النص إلى أعمدة عبر الإصدارات المختلفة، إلا أن هناك فوارق بنيوية جوهرية بينه وبين الدوال الديناميكية الحديثة مثل `TEXTSPLIT`. تتجلى السمة الأبرز للمعالج في كونه أداة تحويل “ثابتة وغير تفاعلية” (Static Transformation)؛ فالبيانات المقسمة الناتجة عنه تستقر في خلاياها كقيم نصية جامدة، لا تتفاعل إطلاقًا مع أي تعديل أو تصحيح أو إضافة تطرأ على نصوص العمود الأصلي، مما يلزم المستخدم بإعادة تنفيذ خطوات المعالج كاملة عند كل تحديث في البيانات.
في المقابل، تمتاز المعالجة بالدوال بالديناميكية المطلقة (Dynamic Reactivity)؛ إذ ترتبط المخرجات بالمدخلات بروابط برمجية مستمرة؛ فبمجرد تعديل مسافة أو تصحيح حرف في الخلية المصدرية، تنعكس التغييرات فورًا في الأعمدة المقسمة دون أدنى تدخل بشري. ومع ذلك، يحتفظ المعالج الثابت بميزة تنافسية كبرى عند التعامل مع قواعد البيانات الهائلة التي تضم مئات الآلاف من السجلات، حيث إن تحويل النصوص إلى قيم جامدة يوفر موارد المعالجة للذاكرة العشوائية (RAM) ووحدة المعالجة المركزية، والتي قد تستنزفها الدوال الحسابية كثيفة الانسكاب في حال إعادة الحساب التلقائي المستمر.
ميزة أخرى لا يمكن إغفالها لصالح المعالج وهي التوافقية الشاملة مع كافة النسخ التاريخية من برنامج إكسيل منذ مطلع التسعينيات وحتى اللحظة الراهنة، مما يجعله الحل الآمن المتاح أمام المستخدمين الذين يعملون في مؤسسات تفتقر إلى التحديثات السحابية لحزمة Microsoft 365 ولا تستطيع تشغيل دوال المصفوفات الحديثة.
6.3 أفضل الممارسات لتطبيق المعالج في المشاريع البحثية المستقرة
لضمان الاستخدام الآمن والفعال لمعالج تحويل النص إلى أعمدة في الأبحاث الأكاديمية والمسوحات الميدانية، ينبغي للباحثين اتباع بروتوكول صارم من الإجراءات الوقائية. تأتي في مقدمة هذه الإجراءات ضرورة إنشاء نسخة احتياطية مطابقة للعمود المصدر وتجميده أو إخفائه قبل بدء عملية التقسيم؛ فالطبيعة الكتابية للمعالج تنطوي على مخاطرة الاستبدال غير المقصود للبيانات في حال حدوث خطأ في ضبط نطاق الوجهة.
يتعين كذلك فحص أقصى عدد من الكلمات التي يحتوي عليها أي سجل داخل العمود المستهدف لتحديد عدد الأعمدة التي ستشغلها البيانات الجديدة. فإذا كان هناك سجل واحد شاذ يتضمن ست كلمات بينما تتضمن باقي السجلات كلمتين فقط، فإن المعالج سيتمدد لستة أعمدة كاملة، وإذا صادف وجود بيانات قائمة في تلك الأعمدة دون الانتباه لها، فسيتم الكتابة فوقها وإتلافها دون سابق إنذار أو تحذير كافٍ من البرنامج.
أخيرًا، يجب توثيق الخطوات والإعدادات المتبعة في المعالج (مثل تفعيل خيار دمج الفواصل وتحديد أنواع الأعمدة) ضمن مذكرة المنهجية البحثية في ملحق إدارة البيانات؛ لضمان إمكانية تكرار التجربة الاستخراجية والوصول إلى نفس النتائج المتطابقة من قِبل أي باحث خارجي يراجع الدراسة وفق مبادئ الشفافية العلمية وإعادة إنتاجية التحليلات (Reproducibility).
7. الصيغ الكلاسيكية المركبة: تقسيم النص بالمسافة في الإصدارات القديمة
7.1 استخراج الكلمة الأولى باستخدام دمج دالتي LEFT و FIND
في البيئات الحسابية التي تفتقر إلى دالة `TEXTSPLIT` وتفرض الاعتماد على التحديث اللحظي للبيانات بعيدًا عن المعالجات الثابتة، تصبح الصيغ الكلاسيكية المركبة هي الخيار الوحيد القابل للتطبيق. لاستخراج الكلمة الأولى من سلسلة نصية مفصولة بمسافة (كالاسم الأول من الاسم الكامل)، يتم دمج دالة الاقتطاع من اليسار `LEFT` مع دالة البحث المكاني `FIND`.
تقوم خوارزمية هذا الحل على استخدام دالة `FIND` لتحديد الموقع الرقمي الترتيبي لأول مسافة تصادفها الدالة في النص، ومن ثم خصم رقم واحد من هذا الموضع لتحديد نهاية الكلمة الأولى بدقة، لتقوم دالة `LEFT` باقتطاع هذا العدد من الأحرف ابتداءً من أقصى الطرف. تأخذ الصيغة التركيبية الشكل التالي:
=LEFT(A2, FIND(” “, A2) – 1)
إلا أن هذه المعادلة البسيطة تنطوي على ثغرة برمجية خطيرة؛ فإذا صادف أن احتوت الخلية `A2` على كلمة وحيدة دون أي مسافة بعدها، فإن دالة `FIND` ستعجز عن إيجاد المسافة وسترجع خطأ القيمة الشهير (`#VALUE!`)، مما يفسد حسابات العمود بأكمله. لتحصين المعادلة علميًا ضد هذا الخطأ، يُنصح بإضافة دالة استبدال أو دمج تقنية دمج مسافة وهمية في نهاية النص داخل مسار البحث، أو تغليف الصيغة بدالة معالجة الأخطاء `IFERROR` بالشكل التالي:
=IFERROR(LEFT(A2, FIND(” “, A2) – 1), A2)
تضمن هذه الصياغة المحصنة أنه في حال غياب المسافة، فإن الدالة سترجع النص الأصلي بكامله بصفته الكلمة الأولى والوحيدة، متجنبة ظهور الأخطاء البصرية في السجلات البحثية.
7.2 استخراج الكلمات اللاحقة والنهائية بواسطة RIGHT و MID و LEN
تزداد درجة التعقيد الرياضي بصورة حادة عند الرغبة في استخراج الكلمات التالية، وتحديدًا الكلمة الأخيرة أو الكلمات الوسطى من السلسلة النصية. لاستخراج الكلمة الأخيرة (مثل اللقب)، يتم استخدام دالة الاقتطاع من اليمين `RIGHT` بالتضامن مع دالة الطول `LEN` ودالة الاستبدال `SUBSTITUTE` لتحديد موقع المسافة الأخيرة في النص، حيث تفتقر النسخ القديمة لدالة بحث عكسي تبدأ من نهاية النص.
تعتمد التقنية الكلاسيكية العبقرية لاقتطاع الكلمة الأخيرة على تضخيم المسافات داخل النص باستخدام دالة `SUBSTITUTE`، عبر استبدال كل مسافة مفردة بعدد هائل من المسافات يعادل طول النص الكلي المقاس عبر `LEN`، ثم اقتطاع هذا الطول من اليمين عبر `RIGHT`، وأخيرًا تنظيف الناتج من المسافات الزائدة بواسطة `TRIM`. تتجسد هذه المعادلة المعقدة في الصيغة التالية:
=TRIM(RIGHT(SUBSTITUTE(A2, ” “, REPT(” “, LEN(A2))), LEN(A2)))
أما عند الحاجة لاستخراج الكلمة الوسطى (اسم الأب مثلًا)، فإن الأمر يتطلب توظيف دالة `MID` مع تكرار نفس آلية تضخيم المسافات وتحديد نقطة الانطلاق في منتصف المصفوفة المتضخمة. ورغم كفاءة هذه الصيغ الخوارزمية في إنجاز المهمة الرياضية بدقة عبر كافة إصدارات إكسيل بلا استثناء، إلا أنها تمثل عبئًا كبيرًا على كفاءة إعادة الحساب؛ حيث تستهلك عمليات التكرار والاستبدال النصي طاقة معالجة مكثفة تبطئ أداء الملفات الضخمة وتزيد من احتمالية حدوث تعليق في النظام أثناء العمليات الحسابية المتزامنة.
7.3 تقييم العبء الإدراكي والبرمجي للصيغ الكلاسيكية مقارنة بالدوال الحديثة
عند تقييم مسار تطور برمجيات الجداول الإلكترونية، يتضح بجلاء الفارق الهائل في العبء المعرفي والإدراكي (Cognitive Load) المفروض على المستخدم بين العصر الكلاسيكي والعصر الحديث. فالصيغ التركيبية المعقدة المعتمدة على دمج `LEFT` و`MID` و`RIGHT` و`FIND` و`REPT` تتطلب معرفة متقدمة بالحيل الهندسية للتعامل مع السلاسل المحرفية وتفكيرًا رياضيًا مجردًا لتتبع حركة المؤشرات الحرفية (Index Offsets) لتفادي أخطاء الإزاحة بمقدار حرف واحد (Off-by-one errors).
هذا التعقيد الشديد يجعل مراجعة وتدقيق الصيغ من قِبل طرف ثالث مهمة بالغة الصعوبة وتستنزف وقتًا ثمينًا كان ينبغي تخصيصه للتحليل الإحصائي والاستنتاج العلمي. إن أي باحث يرغب في مراجعة كود يحتوي على معادلة مثل `=TRIM(MID(SUBSTITUTE(A2,” “,REPT(” “,100)),100,100))` سيحتاج إلى تفكيك رموزها ذهنيًا لفهم منطقها التشغيلي المتوارث.
وهنا تبرز الدلالة المعمارية لإطلاق دالة `TEXTSPLIT`؛ إذ نقلت العملية من عالم “الحيل الحسابية والالتفافات البرمجية” إلى عالم “التصريح الدلالي المباشر” (Declarative Functionality). فكتابة `=TEXTSPLIT(A2, ” “)` تعبر مباشرة وبشكل صريح عن الغاية المقصودة دون الحاجة لمعرفة طول النص أو مواضع المسافات، مما قلل معدل الأخطاء البشرية وحقق تحسينًا جذريًا في قابلية صيانة وتوريث المشاريع البحثية المشتركة.
8. أتمتة تقسيم النصوص بواسطة أداة استعلامات الطاقة Power Query
8.1 تحميل البيانات إلى بيئة Power Query وإعداد نموذج التحويل
يمثل محرر استعلامات الطاقة “Power Query” المحرك الأحدث والأقوى في بيئة إكسيل المتخصص في إجراء عمليات الاستخراج والتحويل والتحميل المتقدمة (Extract, Transform, Load – ETL). يعد استخدام هذه الأداة الخيار المؤسسي المفضل عند التعامل مع مجموعات البيانات الكبيرة والمتجددة دوريًا؛ حيث تفصل بيئة الاستعلام بالكامل بين البيانات الخام الأصلية وبين خطوات المعالجة، مما يضمن أمان السجلات من التعديل غير المقصود وتجنب التحويلات التدميرية تمامًا.
تبدأ العملية بتحديد أي خلية داخل نطاق البيانات أو الجدول المستهدف، ثم الانتقال إلى تبويب “بيانات” (Data) والنقر على خيار “من جدول/نطاق” (From Sheet/Table/Range). يؤدي هذا الإجراء إلى فتح نافذة محرر Power Query المستقلة تمامًا عن ورقة العمل، حيث يتم تمثيل البيانات في شكل مصفوفة استعلامية يتم فيها قراءة كل عمود وتعيين نوع بياناته تلقائيًا، ويتعين على المحلل هنا التأكد من أن العمود المراد تفكيكه معرّف بنوع بيانات “نص” (Text) ممثلاً برمز `ABC` في رأس العمود.
تتميز هذه البيئة بما يُعرف بـ “خطوات المعالجة المطبقة” (Applied Steps)؛ فكل نقرة زر أو إجراء تحويلي ينفذه المستخدم يسجل تلقائيًا كخطوة برمجية مكتوبة بلغة M المتقدمة في اللوحة الجانبية، مما يوفر سجلاً وثائقيًا كاملاً لجميع العمليات الحسابية والتحويلية التي خضعت لها البيانات، ويتيح الرجوع عن أي خطوة أو تعديلها في أي وقت دون التأثير على استقرار الملف الأصلي.
8.2 تنفيذ إجراء تقسيم العمود حسب المسافة (Split Column by Delimiter)
بمجرد جهوزية البيانات داخل محرر الاستعلام، يتم النقر بزر الفأرة الأيمن على رأس العمود المستهدف تقسيمه، أو الانتقال إلى تبويب “الصفحة الرئيسية” (Home) في المحرر والنقر على أيقونة “تقسيم العمود” (Split Column) ومن ثم اختيار خيار “بواسطة المحدد” (By Delimiter). تفتح هذه الخطوة نافذة حوارية مخصصة للتحكم في معايير وخوارزميات الفصل.
في هذه النافذة، يختار المستخدم “مسافة” (Space) كمحدد افتراضي من القائمة المنسدلة، ويتاح له تحديد النمط التشغيلي للتقسيم بين ثلاثة خيارات رئيسية:
- عند المحدد الموجود في أقصى اليسار: لاقتطاع الكلمة الأولى فقط والاحتفاظ بباقي النص متصلًا في عمود ثانٍ.
- عند المحدد الموجود في أقصى اليمين: لاقتطاع الكلمة الأخيرة فقط وعزلها عن باقي النص.
- عند كل تكرار للمحدد: وهو الخيار القياسي الشامل لتفكيك كافة الكلمات وتوزيعها بالكامل على أعمدة مستقلة.
كما تتيح الخيارات المتقدمة (Advanced Options) داخل نفس النافذة تحديد ما إذا كان المطلوب هو إخراج البيانات إلى أعمدة جديدة (Columns) أو تحويلها هيكليًا لتنسكب في صفوف متتالية (Rows)، وهو ما يعكس مرونة موازية لدالة `TEXTSPLIT`. وبعد تأكيد الخيارات، يولد المحرر تلقائيًا كود بلغة M يستند إلى الدالة `Table.SplitColumn`، ويقوم بتقسيم النص وتحديث واجهة المعاينة فورًا لإظهار الأعمدة المستحدثة بأسمائها التلقائية المرقمة بدقة.
8.3 تحميل النتائج وتحديث خطوط المعالجة تلقائياً عند تغير المصدر
بعد إتمام عملية التقسيم والتحقق من التوزيع السليم للكلمات في المحرر، يتم الانتقال إلى الخطوة النهائية وهي تصدير البيانات إلى بيئة إكسيل الجداولية. يتم ذلك عبر النقر على زر “إغلاق وتحميل” (Close & Load) المتواجد في الزاوية العلوية من شريط الأدوات. يتيح هذا الأمر للمحرر إنشاء ورقة عمل جديدة تمامًا تودع فيها البيانات المعالجة داخل جدول إكسيل رسمي مهيكل وأنيق يحمل كافة المتغيرات المستقلة المفروزة بحرفية تامة.
يكمن السحر الحقيقي لأداة Power Query في إمكانية أتمتة خطوط المعالجة وتحديثها الدوري (Automated Pipeline Refresh)؛ فإذا قام الباحث لاحقًا بإضافة مئات أو آلاف السجلات الجديدة التي تحوي أسماء مدمجة إلى الجدول الأصلي في ورقة العمل الأولى، فإنه لا يحتاج مطلقًا لإعادة إجراءات التقسيم. كل ما عليه فعله هو التوجه إلى الجدول المعالج والضغط بزر الفأرة الأيمن واختيار أمر “تحديث” (Refresh)، أو النقر على اختصار لوحة المفاتيح المخصص.
بمجرد إعطاء أمر التحديث، يعيد محرك Power Query تشغيل كافة الخطوات المسجلة تلقائيًا في أجزاء من الثانية؛ فيقرأ السجلات المضافة حديثًا، وينظف المسافات، ويقسم النصوص، ثم يسقط النتائج المحدثة في الجدول النهائي بسلاسة تامة. تجعل هذه الميزة من Power Query البنية التحتية المثلى للمشاريع البحثية المعقدة والاستبانات المتجددة باستمرار، حيث تجمع بين توفير الجهد وضمان خلو النتائج من الأخطاء البشرية المحتملة.
9. استكشاف الأخطاء الشائعة وحلولها البرمجية أثناء تقسيم النصوص
9.1 تحليل أسباب وحلول خطأ الانسكاب (#SPILL!)
يعد خطأ الانسكاب (`#SPILL! Error`) الظاهرة الأكثر إرباكًا للمستخدمين الذين ينتقلون حديثًا إلى استخدام الدوال المصفوفية الحديثة مثل `TEXTSPLIT`. تكمن العلة الجوهرية لهذا الخطأ في الطبيعة المتطلبة لمحرك الحسابات؛ فالدالة تتوقع مسارًا خاليًا تمامًا من أي معوقات لتفريغ مصفوفة الكلمات المجزأة في الخلايا المجاورة. إذا كان هناك حرف واحد، أو معادلة أخرى، أو حتى مسافة فارغة غير مرئية في إحدى الخلايا التي يفترض أن ينسكب إليها الناتج، سيتوقف المحرك فورًا ويطلق خطأ `#SPILL!` كإجراء حمائي للبيانات الموجودة.
لتشخيص سبب هذا الخطأ وتجاوزه، يتيح إكسيل أداة بصرية مساعدة؛ فعند النقر على الخلية التي تحتوي على الخطأ، يظهر مؤشر تحذيري أصفر إلى جانب إطار منقط يحدد “نطاق الانسكاب المتوقع” (Spill Range). يتعين على الباحث فحص هذا النطاق المحدد؛ فإذا وجد بيانات مرئية، يجب نقلها أو حذفها. وإذا بدت الخلايا فارغة ظاهريًا واستمر الخطأ، فمن المرجح وجود مسافات فارغة غير مرئية أدخلت بالخطأ، ويتم حل ذلك بتحديد نطاق الخلايا المجاورة والضغط على مفتاح الحذف (Delete) لتنظيف الفضاء الجدولي بالكامل.
سبب هيكلي آخر شائع لحدوث هذا الخطأ هو محاولة كتابة دالة `TEXTSPLIT` داخل عمود تابع لـ “جدول إكسيل رسمي مهيكل” (Excel Table)؛ حيث تحظر البنية البرمجية لهذه الجداول تقنية المصفوفات الديناميكية المتسربة داخل صفوفها لتجنب تداخل مسارات البيانات التلقائية. ويتمثل العلاج الجذري هنا إما في تطبيق الدالة في نطاق خلايا عادي خارج حدود الجدول، أو تحويل الجدول نفسه إلى نطاق قياسي لتنشيط قدرات الانسكاب المصفوفي المباشر.
9.2 التعامل مع المحارف غير القابلة للطباعة والمسافات غير القابلة للكسر
من المشكلات المستعصية التي تواجه الباحثين عند استيراد البيانات من مصادر الويب، أو قواعد البيانات المركزية، أو ملفات PDF، هي مشكلة “المسافات غير القابلة للكسر” (Non-breaking Spaces). تحمل هذه المسافة الرمز المحرفي 160 في كود ASCII وتُعرف برمجيًا بـ ` `، وهي تختلف كليًا في بنيتها الثنائية عن المسافة القياسية المعتادة ذات الرمز المحرفي 32 التي نولدها عبر لوحة المفاتيح. يؤدي هذا التمايز التقني إلى عجز دالة `TEXTSPLIT` أو معالج النصوص عن التعرف عليها كفاصل نصي إذا حُددت المسافة العادية (” “) كمعامل تقسيم.
لحل هذه المعضلة وتجاوز الفشل الخوارزمي في التقسيم، يجب تطبيق دالة الاستبدال `SUBSTITUTE` بالتزامن مع دالة استدعاء المحارف `CHAR` لتحويل المسافات الشاذة إلى مسافات قياسية قبل تمريرها لدالة التجزئة. تتجسد هذه المعالجة الذكية في الصيغة المركبة التالية:
=TEXTSPLIT(SUBSTITUTE(A2, CHAR(160), ” “), ” “)
تقوم الدالة الداخلية في هذه الصيغة بالتقاط أي مسافة غير قابلة للكسر تحمل الرمز 160 وتحويلها فورًا إلى مسافة نظامية معتادة (رمز 32)، لتقوم الدالة الخارجية بتقسيم النص بسلاسة. بالإضافة إلى ذلك، قد تتلوث البيانات بمحارف تحكم غير قابلة للطباعة ناتجة عن التحويل الرقمي للأجهزة (المحارف من 0 إلى 31 في جدول ASCII)، وهنا يُفضل دمج دالة `CLEAN` لتطهير السلسلة من أي شوائب إلكترونية تشوش على دقة المعالجة، مما يضمن خروج مخرجات نظيفة تلبي أعلى المعايير المعملية لجودة البيانات الرقمية.
9.3 إدارة تفاوت عدد الكلمات بين السجلات المختلفة وضمان انتظام الهيكل
تنشأ أزمة تنظيمية كبرى في قواعد البيانات عند تباين عدد الكلمات المكونة للسلاسل النصية عبر السجلات المختلفة؛ كأن يحتوي سجل أحد المشاركين على اسم ثنائي، بينما يحتوي سجل آخر على اسم ثلاثي، وسجل ثالث على اسم رباعي أو مركب. يؤدي تطبيق دالة `TEXTSPLIT` التقليدية في هذه الحالة إلى ظاهرة “تشتت الأعمدة”؛ فاللقب العائلي للشخص الأول سيستقر في العمود الثاني، في حين يستقر لقب الشخص الثاني في العمود الثالث، ولقب الثالث في العمود الرابع، مما يخلق عدم تجانس دلالي في الأعمدة الناتجة ويدمر إمكانية المقارنة الإحصائية المباشرة.
لإدارة هذا التباين البنيوي وضمان التوحيد القياسي للبيانات، يتعين على المحلل أولاً تقييم حجم الظاهرة عبر بناء عمود مساعد يحسب عدد الكلمات الموجودة في كل خلية قبل الشروع في التجزئة النهائية. يمكن حساب عدد الكلمات بدقة عبر قياس الفرق في طول السلسلة قبل وبعد إزالة المسافات، وتطبيق المعادلة الكلاسيكية المعروفة:
=LEN(TRIM(A2)) – LEN(SUBSTITUTE(A2, ” “, “”)) + 1
تتيح هذه المعادلة فرز السجلات حسب عدد الكلمات، مما يمكن الباحث من عزل السجلات الشاذة التي تحتوي على كلمات زائدة أو ناقصة والتعامل معها بشكل مخصص. كما تبرز هنا أهمية التوحيد القياسي للمسميات والأسماء المركبة مسبقًا عبر دمج أجزائها قبل تطبيق التقسيم النهائي، بحيث تضمن المعالجة استقرار كل متغير في عموده الدلالي المخصص وتفادي اختلاط الأسماء بالألقاب عبر المصفوفة الجداولية المستخلصة.
10. تطبيقات ودراسات حالة عملية في تفكيك البيانات البحثية والميدانية
10.1 تفكيك الأسماء المركبة للمشاركين في الدراسات المسحية
تعتبر معضلة معالجة الأسماء الشخصية في المجتمعات العربية من أكثر التحديات المعقدة في هندسة البيانات الميدانية؛ نظرًا للانتشار الواسع للأسماء المركبة التي تتضمن مسافات طبيعية في أصل بنائها اللغوي دون أن تعبر عن اسمين منفصلين (مثل: “عبد الله”، “عبد الرحمن”، “نور الدين”، “فاطمة الزهراء”). إذا طُبقت دالة التقسيم بالمسافة على اسم مثل “عبد الله أحمد محمد” بشكل أعمى، فسيتم فصل كلمة “عبد” في عمود، و”الله” في عمود ثانٍ، مما يؤدي إلى تشويه تام لهوية المشارك وضرب اتساق السجلات في الدراسات التتبعية والمسحية.
لحل هذه المعضلة علميًا، يعتمد خبراء معالجة البيانات على “بروتوكول المعالجة المسبقة للكيانات المسماة” (Named-Entity Preprocessing). يقضي هذا البروتوكول باستبدال المسافة الفاصلة بين شقي الاسم المركب بفاصل خاص أو حرف ربط غير مرئي أو دمجها مؤقتًا قبل تشغيل دالة التقسيم. يمكن تحقيق ذلك برمجياً عبر دمج دالة `SUBSTITUTE` للبحث عن البوادئ الشائعة واستبدالها بنصوص متصلة، مثل استبدال “عبد ” بـ “عبد_” أو “عبد”. تتضح هذه الآلية في المعادلة التالية:
=TEXTSPLIT(SUBSTITUTE(A2, “عبد “, “عبد_”), ” “)
بهذا الإجراء الوقائي، تُعامل كتلة “عبد_الله” ككلمة أحادية مسمطة تودع بالكامل وبسلامة لغوية في حقل الاسم الأول المستقل، مع ترك المسافات التالية لتقوم الدالة بتفكيك اسم الأب واللقب في مواقعهما السليمة. إن حماية هذه البنى الاسمية يضمن تطبيق المعايير الأخلاقية والمصداقية المنهجية في دراسات العلوم الاجتماعية والسلوكية، فضلًا عن تيسير ربط البيانات وفرزها أبجديًا وفق الأصول العلمية المتبعة في التوثيق الأكاديمي.
10.2 فصل المتغيرات الرقمية عن الوحدات القياسية الملتصقة بها مسافياً
من المشكلات التقنية المتكررة في جمع البيانات الفسيولوجية والفيزيائية في البحوث التجريبية والمسحية تسجيل القياسات الرقمية مدمجة بوحداتها الحسابية داخل نفس الخلية تفصل بينها مسافة بيضاء؛ كأن يُسجل وزن المشارك بالشكل “75 كجم” أو “75 kg”، أو يسجل الطول “175 سم” أو “175 cm”. يؤدي هذا الدمج النصي إلى تعطيل الخاصية الحسابية للرقم؛ فبرنامج إكسيل يعامل الخلية كقيمة نصية مسمطة يمتنع تطبيق العمليات الرياضية الأساسية عليها مثل حساب المتوسط الحسابي، أو الانحراف المعياري، أو إدراجها في مصفوفات التباين والارتباط.
يوفر تقسيم النص بالمسافة عبر دالة `TEXTSPLIT` حلاً فوريًا وأنيقًا لتحرير المتغير الرقمي من قيده الحرفي. فبتطبيق الصيغة التالية على الخلية `A2`:
=TEXTSPLIT(A2, ” “)
تفرز الدالة القيمة العددية “75” في العمود الأول، وتنقل وحدة القياس “كجم” إلى العمود الثاني. ومع ذلك، فإن القيمة العددية المستخرجة تظل معرفة “كنص” لدى إكسيل نظرًا لخروجها من دالة نصية؛ لذا يجب تحويلها فورًا إلى صيغة رقمية قابلة للحساب الرياضي عبر إحاطة الدالة بمعامل رياضي محايد مثل علامة السالب المزدوجة (Double Unary `–`) أو دالة القيمة `VALUE` بالشكل التالي للاستخراج الرقمي الصرف:
=–INDEX(TEXTSPLIT(A2, ” “), 1)
تضمن هذه الصياغة عزل المقدار الكمي وتحويله المباشر إلى رقم حقيقي يقبله محرك التحليل الإحصائي، مما يوفر مئات الساعات من التنقيح اليدوي الروتيني لاستجابات الاستبيانات ويؤسس لقاعدة بيانات نظيفة وقابلة للنمذجة الرياضية المباشرة فور انتهاء مرحلة الجمع الميداني.
10.3 بروتوكول التحقق والتوثيق الأكاديمي لسلامة البيانات بعد التجزئة
تقتضي معايير الحوكمة والنزاهة الأكاديمية في معالجة البيانات عدم افتراض كمال العمليات الخوارزمية بصورة مطلقة، بل إخضاع كافة السجلات الناتجة بعد عملية التجزئة لبروتوكول تدقيق وتحقق منهجي (Data Verification Protocol). يتمثل الإجراء الرقابي الأول في “اختبار إعادة الدمج والمطابقة” (Reconstruction Test)؛ حيث يهدف هذا الاختبار إلى التأكد من أن إعادة تجميع الكلمات المقسمة يعيد بناء النص الأصلي بالكامل دون فقدان أي محارف أو تدمير للمحتوى.
يمكن تطبيق هذا الاختبار بإنشاء عمود تدقيق مؤقت يُعاد فيه تجميع الخلايا المنسكبة عبر دالة الربط النصي الحديثة `TEXTJOIN`، ومقارنة الناتج بالخلية الأصلية عبر صيغة منطقية شرطية، كالتالي:
=EXACT(A2, TEXTJOIN(” “, TRUE, B2:D2))
إذا كانت نتيجة المعادلة `TRUE`، فهذا يؤكد بالدليل الرياضي القاطع أن عملية التفكيك تمت بنقاء مطلق ودون إسقاط أو تحريف لأي تفصيلة نصية. أما إذا ظهرت القيمة `FALSE`، فإن هذا يوجه المحلل فورًا لوجود شائبة نصية أو مسافة شاذة تسببت في إخفاق العملية في ذلك السجل المحدد، مما يتيح التدخل الفوري لتصحيح الخلل.
يتكامل هذا البروتوكول مع إجراء المعاينة الإحصائية العشوائية على عينات محددة من السجلات، وتوثيق كافة الصيغ وخوارزميات المعالجة المستخدمة في قسم المنهجية ضمن التقارير العلمية أو أوراق العمل المنشورة. إن هذا المستوى العالي من الانضباط التوثيقي يضمن الشفافية والمساءلة العلمية، ويدعم موثوقية النتائج الإحصائية المستخلصة، متيحًا للباحثين الآخرين التحقق المستقل من سلامة إجراءات المعالجة وتكرار التجربة بثقة واطمئنان كاملين.
خاتمة
استعرض هذا المقال الأكاديمي الموسع كافة الأبعاد الهندسية والعملية المرتبطة بتقسيم وتفكيك النصوص استنادًا إلى المسافة في برنامج ميكروسوفت إكسيل، بوصفه إجراءً تحضيريًا محوريًا في إدارة قواعد البيانات والبحوث الميدانية. لقد أحدثت التحديثات الأخيرة، ولا سيما ظهور دالة `TEXTSPLIT` ضمن حزمة Microsoft 365، تحولًا جذريًا في مرونة المعالجة الجداولية؛ حيث أتاحت إمكانيات غير مسبوقة للتحكم في تدفق المصفوفات الديناميكية أفقياً ورأسياً، متفوقة على قيود التعقيد التي فرضتها المعادلات الكلاسيكية المركبة لعقود طويلة.
ومع ذلك، يظل نجاح هذه التقنيات مرهونًا بوعي المحلل بطبيعة البيانات المعالجة؛ فالتعامل الحذر مع المسافات المزدوجة، والمحارف غير القابلة للطباعة، والمسافات غير القابلة للكسر، وتفاوت أطوال السجلات يمثل الفارق الجوهري بين قاعدة بيانات متماسكة وأخرى مشوهة إحصائيًا. وسواء اختار المستخدم الاعتماد على ديناميكية دالة `TEXTSPLIT`، أو استقرار وسرعة معالج النصوص إلى أعمدة، أو الأتمتة المتقدمة لأداة Power Query، فإن الالتزام ببروتوكولات التطهير والتدقيق والمطابقة يظل الضمانة الأساسية للحفاظ على مصداقية التحليلات وسلامة المخرجات العلمية في عصر يعتمد على دقة البيانات كمعيار لا يقبل المساومة.
المراجع
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- Harvey, G. (2021). Excel All-in-One For Dummies. John Wiley & Sons.
- Microsoft Corporation. (2022). TEXTSPLIT function. Microsoft Support. https://support.microsoft.com/en-us/office/textsplit-function-b15e1e49-ac4f-4f24-a612-4f11048148b0
- Microsoft Corporation. (2023). Split text into different columns with functions. Microsoft Support. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-functions-49ec57f4-d0b2-4b8e-acac-8d63e064b40e
- Microsoft Corporation. (2023). Split text into different columns with the Convert Text to Columns Wizard. Microsoft Support. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-the-convert-text-to-columns-wizard-30b14968-ae4f-4ee8-9004-893e4214f825
- Perez, D. (2023). Dynamic Arrays and Formulas in Excel. Apress.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10