
تُعد معالجة النصوص والتحقق من جودة البيانات المدخلة إحدى الركائز الأساسية في بناء النماذج الإحصائية الدقيقة والتحليلات المتقدمة ضمن بيئة نظام التحليل الإحصائي (SAS). يواجه المحللون وعلماء البيانات يومياً تحديات جمّة تتعلق بوجود سجلات غير نمطية، حيث تتداخل الأرقام والرموز والأحرف الأبجدية في حقول نصية يفترض أن تكون موحدة البنية. تبرز هنا الحاجة الملحة إلى أدوات فحص وتدقيق تمتلك كفاءة حسابية عالية وقدرة على تحديد مواضع المحارف بدقة متناهية دون الحاجة إلى كتابة خوارزميات معقدة أو استهلاك موارد النظام بشكل غير مبرر.
تأتي الدالة ANYALPHA كإحدى أهم الأدوات المتخصصة التي توفرها شركة (SAS Institute) لتسهيل مهام تنظيف البيانات وفرز السجلات النصية. ورغم الاسم الذي قد يوحي للوهلة الأولى لدى بعض الباحثين غير المتخصصين في البرمجة بارتباطه بمقاييس إحصائية أو سيكومترية مثل معامل ألفا كرونباخ للاتساق الداخلي (Cronbach’s Alpha) أو مستويات الدلالة الإحصائية، فإن الدالة برمجية بحتة مخصصة لمعالجة السلاسل النصية ومسح محتوياتها لإرجاع الفهرس الرقمي لأول محرف أبجدي تصادفه في النص المدخل.
يهدف هذا الدليل الأكاديمي الشامل إلى تقديم دراسة معمقة وتفصيلية حول بنية الدالة ANYALPHA وسلوكها التشغيلي وخوارزميات البحث المرتبطة بها. سنستعرض عبر هذا المقال صيغتها النحوية الكاملة، وتحليل وسائطها الإجبارية والاختيارية، ودلالة القيم المرجعة، مع تدعيم الشرح بأمثلة تطبيقية واقعية وسيناريوهات برمجية متقدمة تتيح للمبرمجين والمحللين استثمار أقصى إمكانات هذه الأداة لرفع كفاءة وموثوقية خطوط أنابيب معالجة البيانات الضخمة.
1. مقدمة عامة إلى دوال معالجة النصوص والدالة ANYALPHA في SAS
1.1 أهمية معالجة النصوص والسلاسل المحرفية في بيئة SAS
تشكل مرحلة تنظيف وتدقيق البيانات النصية (Data Hygiene and Cleansing) حجر الزاوية في مشاريع التحليل الإحصائي الحديثة. في الواقع العملي، نادراً ما تأتي البيانات في صيغ قياسية نظيفة؛ فالبيانات المستخرجة من استطلاعات الرأي، والأنظمة الإدارية، وسجلات المرضى في التجارب السريرية، أو حتى مخرجات البرمجيات النفسية التجريبية، غالباً ما تعاني من أخطاء في الإدخال، أو تداخل غير مقصود للمحارف، مما يستدعي إجراء عمليات غربلة دقيقة قبل البدء بأي خطوة نمذجة إحصائية تفادياً لنتائج مضللة.
من أبرز هذه التحديات التعامل مع المعرفات المدمجة (Alphanumeric Identifiers) التي تحتوي على خليط غير منتظم من الأرقام والحروف والرموز الخاصة، كأن يحتوي حقل الرقم الوظيفي على بادئات حرفية متباينة الطول أو حقول تحتوي على أرقام هواتف مشوبة بأسماء مدن أو ملاحظات نصية. يتطلب تفكيك هذه السلاسل النصية أدوات فحص وتحقق نمطية مدمجة تمتلك السرعة والموثوقية، وهو ما توفره بيئة SAS من خلال مكتبة غنية من الدوال المتخصصة في الفهرسة والبحث والتقطيع.
تساعد دوال التحقق من الأنماط المدمجة المبرمجين على تقليص الجهد المبذول في كتابة الحلقات التكرارية المعقدة، وتضمن استهلاكاً مثالياً لذاكرة النظام والمعالج، مما ينعكس إيجاباً على زمن تنفيذ البرامج الإحصائية التي تتعامل مع جداول بيانات عملاقة تضم مئات الملايين من القيود، حيث يصبح كل ميكروثانية يتم توفيرها في فحص المحارف عاملاً حاسماً في استقرار المنظومة البرمجية ككل.
1.2 التعريف الوظيفي للدالة ANYALPHA وسياق استخدامها
تُعرّف الدالة ANYALPHA وظيفياً بأنها دالة بحث ومسح نصي متخصصة صُممت لإرجاع الموضع الرقمي (الفهرس) لأول محرف أبجدي (Letter) يتم العثور عليه داخل سلسلة نصية محددة. تتميز الدالة بأنها تبحث عن أي حرف ينتمي إلى الأبجدية، سواء كان حرفاً كبيراً (Uppercase) أو حرفاً صغيراً (Lowercase)، وفقاً لمعايير الترميز واللغة المعتمدة في بيئة النظام، دون الحاجة إلى تحديد الحرف بعينه مسبقاً من قِبل المستخدم.
يختلف هذا المفهوم اختلافاً جوهرياً عن دوال البحث الشاملة الكلاسيكية؛ فبينما تتطلب الدوال التقليدية تقديم نمط نصي محدد أو محرف بعينه للبحث عن موقعه، تقوم ANYALPHA بالتحقق من “الفئة التصنيفية” للمحرف، فتبحث عن أي محرف يقع ضمن تصنيف الحروف الهجائية، مما يجعلها أداة تدقيق نوعية (Type-checking function) تحدد على الفور ما إذا كانت السلسلة تحتوي على نصوص لغوية أم أنها مقتصرة على أرقام ورموز خاصة فقط.
تتجلى الأهمية الإجرائية لهذه الدالة في إعداد مجموعات البيانات وتنظيفها؛ إذ تمكّن محلل البيانات من فرز السجلات غير المتجانسة، كعزل المعرفات التي كُتبت بصيغ خاطئة، أو تحديد نقطة البداية للنصوص الوصفية الملتحمة بالأرقام، مما يمهد الطريق لتقطيع السلاسل وفصل الحقول المتداخلة بصورة منهجية تضمن اتساق الهياكل البيانية المعدة للتحليل.
1.3 موقع الدالة ANYALPHA ضمن عائلة دوال البحث في SAS
تنتمي الدالة ANYALPHA إلى عائلة دوال البحث الحديثة التي قدمتها شركة SAS لتسهيل عمليات تدقيق المحارف، والتي تُعرف اختصاراً بعائلتي دوال ANY* ودوال NOT*. تضم هذه المنظومة البرمجية أدوات متكاملة تعمل بالتوازي؛ حيث تختص الدالة ANYDIGIT بالبحث عن أول موضع رقمي (من 0 إلى 9)، وتتولى الدالة ANYPUNCT العثور على علامات الترقيم، بينما تبحث ANYSPACE عن الفراغات البيضاء بمختلف أنواعها.
تستقبل جميع هذه الدوال مدخلات نصية (سواء كانت متغيرات نصية، أو ثوابت، أو تعبيرات ناتجة عن دوال أخرى) وتنتج مخرجات فهرسة رقمية تمثل الموضع الفعلي للمحرف المطلوب. يتميز هذا التصميم البرمجي بالاتساق الهيكلي؛ إذ تعتمد العائلة بأكملها نفس القواعد الصرفية والنحوية لتمرير الوسائط وطرق استرجاع القيم، مما يسهل على المطور الانتقال بينها وفقاً لطبيعة العنصر النصي المستهدف.
قُدمت الدالة ANYALPHA رسمياً في الإصدار التاسع من نظام SAS الإحصائي (SAS Version 9)، حيث تم طرحها الأولي في النسخة SAS 9.0 عام 2002 ثم اكتمل استقرارها الإنتاجي في SAS 9.1 عام 2004، لتلبي احتياجات المبرمجين الذين كانوا يعتمدون سابقاً على حيل برمجية شاقة باستخدام دوال الترجمة والتطابق القديمة. تتمتع الدالة بتوافق تشغيلي كامل عبر كافة إصدارات SAS الحديثة بما فيها بيئات SAS Viya السحابية، مما يجعلها معياراً قياسياً موثوقاً في معالجة السلاسل النصية.
2. الصيغة التركيبية والنحوية (Syntax) للدالة ANYALPHA
2.1 التركيب الهيكلي العام للأمر البرمجي
تتبع الدالة ANYALPHA صيغة استدعاء قياسية بسيطة ولكنها مرنة للغاية، وتُكتب وفق الهيكل البرمجي الآتي:
ANYALPHA(expression <, start>)
توضح هذه الصيغة النحوية أن الدالة تعتمد على وسيطين أساسيين؛ أحدهما إلزامي لا يمكن تنفيذ الأمر بدونه، والآخر اختياري يوفر إمكانية التحكم المتقدم في مسار البحث وسلوكه. يخضع هذا التركيب للقواعد الإلزامية الصارمة الخاصة بلغة برمجة SAS؛ حيث يجب وضع الوسائط بين قوسين هلاليين، واستخدام الفاصلة العادية للفصل بين التعبير النصي وموضع البدء في حال الرغبة في تحديده.
يُمثل التمييز بين المعامل الإجباري والمعامل الاختياري ركيزة مهمة للمطور؛ فالاستدعاء الأدنى يتطلب فقط تمرير المتغير أو السلسلة النصية المراد فحصها، وفي هذه الحالة تفترض الدالة قيماً افتراضية منطقية تضمن تنفيذ عملية البحث من البداية الأولى للسلسلة. أما عند إدراج المعامل الاختياري، فإن سلوك الدالة يتكيف وفق المتطلبات المحددة للمسار البحثي، مما يتيح تجاوز مقاطع محددة من النص كما سيتم توضيحه بالتفصيل.
2.2 تحليل وسيط التعبير النصي (Expression Argument)
يُعد وسيط التعبير (Expression) هو المعامل الإجباري الأول في الدالة ANYALPHA، وهو يمثل المحتوى النصي المستهدف بالفحص. يقبل هذا الوسيط طيفاً واسعاً من المدخلات؛ حيث يمكن أن يكون متغيراً نصياً معرفاً مسبقاً في خطوة البيانات، أو ثابتاً حرفياً محاطاً بعلامات اقتباس فردية أو مزدوجة (مثل 'ID_908A')، أو حتى تعبيراً معقداً ينتج عن تداخل دوال نصية أخرى مثل دمج سلاسل باستخدام مشغل الربط النصي أو دوال مثل CATX وSTRIP.
تتعامل الدالة باحترافية تامة مع السلاسل النصية ذات الأطوال الثابتة والمتغيرة. ومع ذلك، يجب على المبرمج الانتباه إلى طبيعة المتغيرات النصية في SAS؛ إذ تُخزن المتغيرات محددة الطول عادةً بملء المساحات المتبقية بفراغات بيضاء لاحقة (Trailing Blanks). لا تؤثر هذه الفراغات عادةً على كفاءة عمل ANYALPHA إذا كان الحرف الأبجدي يسبقها، ولكنها تصبح مهمة للغاية عند الرغبة في قياس طول السلسلة أو تطبيق عمليات البحث العكسي.
أما بالنسبة للفراغات البيضاء البادئة (Leading Blanks)، فإن الدالة تعاملها كرموز محرفية مستقلة؛ حيث يتم احتسابها ضمن فهرس الموضع ولكنها لا تُصنف إطلاقاً على أنها أحرف أبجدية. هذا يعني أنه إذا كانت السلسلة النصية تبدأ بثلاث مسافات متبوعة بحرف أبجدي، فإن الدالة ستتجاهل المسافات الثلاث في التصنيف وتعيد الرقم 4 كفهرس لأول حرف، وهو ما يبرز أهمية استخدام دوال التهذيب النصي قبل البحث إذا كان الهدف هو تجاهل المسافات البادئة في قياس الموضع النسبي.
2.3 تحليل وسيط البداية الاختياري (Start Argument)
يُمثل وسيط البداية (Start) المعامل الثاني في الدالة، وهو وسيط اختياري ذو طبيعة رقمية يحدد موضع المحرف الذي تنطلق منه عملية المسح والتفتيش داخل السلسلة النصية. يؤدي هذا المعامل دوراً حيوياً في توجيه محرك البحث الخاص بـ SAS للتركيز على مقاطع محددة من النص وتخطي البوادئ أو الرموز الأولية التي تم تدقيقها مسبقاً، مما يمنح المبرمج تحكماً دقيقاً في ديناميكية الفحص.
في حال إغفال تمرير وسيط البداية، تعتمد الدالة القيمة الافتراضية وهي الرقم 1؛ مما يعني أن عملية البحث ستبدأ بصورة تلقائية وتصاعدية من المحرف الأول في أقصى يسار السلسلة النصية وتتجه نحو اليمين. يُشترط في وسيط البداية أن يكون قيمة عددية صحيحة سواء كانت ثابتة أو متغيراً رقمياً مستقلاً أو ناتج تعبير حسابي.
تخضع قيم وسيط البداية لقواعد منطقية واضحة؛ فالقيم الموجبة تشير إلى موضع الانطلاق في اتجاه البحث القياسي، بينما تشير القيم السالبة إلى البحث في الاتجاه المعاكس. ومع ذلك، يجب مراعاة حدود الطول القصوى للسلسلة النصية المفحوصة، إذ إن تمرير قيم تتجاوز الحدود المنطقية قد يؤدي إلى نتائج قد تفاجئ المبرمج إن لم يكن مدركاً لكيفية معالجة النظام للوسائط الخارجة عن النطاق.
3. آلية عمل الدالة وتفسير القيم الرقمية المُرجعة
3.1 دلالة القيم الإيجابية الناتجة عن الدالة
عند تنفيذ الدالة ANYALPHA على سلسلة نصية تحتوي على محرف أبجدي واحد على الأقل، فإن النتيجة المسترجعة تكون دائماً عدداً صحيحاً موجباً يعبر عن الفهرس الدقيق لذلك الحرف. يرتكز نظام الفهرسة في SAS على مبدأ الترقيم القائم على الأساس واحد (1-based Indexing)، وهو ما يعني أن المحرف الأول في السلسلة النصية يحمل الرقم 1، والمحرف الثاني يحمل الرقم 2، وهكذا دواليك، خلافاً لبعض لغات البرمجة الأخرى (مثل بايثون أو سي) التي تعتمد الترقيم القائم على الصفر.
تتميز الدالة بأنها لا تفرق بين الحروف الكبيرة (Uppercase) والصغيرة (Lowercase)؛ فكلاهما يُصنفان على أنهما محارف أبجدية صالحة تماماً. على سبيل المثال، إذا تم فحص النص '123a' أو النص '123A'، فإن الدالة ستعيد القيمة الرقمية 4 في الحالتين دون أي تمييز، مما يعفي المبرمج تماماً من تطبيق دوال التحويل الحرفي مثل UPCASE قبل إجراء عملية الفحص.
ينبغي التأكيد الأكاديمي الصارم هنا على أن القيمة الرقمية الموجبة تدل حصراً على “موضع” الحرف داخل السلسلة، ولا تعكس بأي حال من الأحوال الحرف نفسه أو قيمته الترتيبية في الأبجدية؛ فالرقم 5 العائد من فحص نص معين يعني ببساطة أن المحرف الخامس هو أول حرف هجائي ظهر أثناء المسح، بغض النظر عما إذا كان هذا الحرف هو A أو Z.
3.2 دلالة القيمة صفر وتفسير حالات الغياب الحرفي
تُعد القيمة الرقمية (0) النتيجة المعيارية التي ترجعها الدالة ANYALPHA عندما تفشل في العثور على أي محرف أبجدي ضمن النطاق المفحوص في السلسلة النصية. تكتسب هذه القيمة أهمية بالغة في البرمجة الإحصائية، حيث تعمل كمؤشر ثنائي قاطع (Boolean Indicator) يثبت خلو النص المدروس تماماً من أي حروف هجائية صريحة، واقتصاره الكلي على الأرقام، أو المسافات، أو الرموز الخاصة وعلامات الترقيم.
تُوظف القيمة صفر بشكل مكثف داخل الجمل الشرطية (IF-THEN Statements) لفلترة البيانات والتحقق من صحتها؛ فعلى سبيل المثال، إذا كان المطلوب التأكد من أن حقل “الرقم القومي” أو “المعرف الضريبي” لا يحتوي على أي أخطاء إدخال حرفية، فإن الشرط البرمجي يتحقق مما إذا كانت نتيجة ANYALPHA(TaxID) = 0. إذا تحقق هذا الشرط، يتأكد النظام من نقاء الحقل من التلوث الحرفي.
من الضروري إدراك أن الصفر في SAS ضمن السياقات المنطقية يُعامل كقيمة غير صحيحة (False)، بينما تُعامل أي قيمة موجبة كقيمة صحيحة (True). يتيح ذلك كتابة شروط برمجية مختصرة وأنيقة؛ حيث يمكن كتابة IF ANYALPHA(string) THEN DO; لاستهداف السجلات التي تحتوي على حروف فقط، دون الحاجة لصياغة مقارنات صريحة مثل > 0، مما يسرع كتابة الأكواد البرمجية ويحافظ على مقروئيتها.
3.3 تأثير إعدادات اللغة ومجموعة المحارف المحلية (Locale)
يعتمد السلوك التشغيلي للدالة ANYALPHA بشكل جذري على إعدادات اللغة ومجموعة المحارف المحلية (Locale) المحددة في جلسة SAS النشطة ومواصفات نظام التشغيل المضيف. تُحدد هذه الإعدادات ما يُعتبر رسمياً “محرفاً أبجدياً”، ففي الإعدادات القياسية للغة الإنجليزية، ينحصر نطاق البحث الصارم في الحروف اللاتينية الأساسية من A إلى Z بنوعيها الصغير والكبير.
أما عند العمل في بيئات تشغيل متعددة اللغات تدعم اللغات الأوروبية، تتوسع مصفوفات الفهرسة لتشمل الأحرف المُميزة بعلامات التشكيل اللغوية (Accented Characters) مثل (é, à, ü, ñ)؛ حيث تتعرف الدالة على هذه الرموز باعتبارها أحرفاً أبجدية كاملة الحقوق وتعيد مواضعها الرقمية بدقة دون أن تصنفها كرموز خاصة، وهو ما يُعد ميزة تنافسية كبرى لبيئة SAS في معالجة البيانات الدولية.
علاوة على ذلك، تُحافظ الدالة على استقرار سلوكي ملحوظ عبر مختلف بيئات التشفير الرقمي سواء كانت قائمة على نظام ASCII الحديث أو بيئات الخوادم المركزية القديمة التي تعتمد تشفير EBCDIC؛ حيث تستعين SAS بجداول ترجمة داخلية موحدة (Translation Tables) تضمن تطابق نتائج الفحص وتفادي الأخطاء الناجمة عن اختلاف الأوزان الرقمية للمحارف بين منصات التشغيل المختلفة.
4. تطبيق عملي: استخراج مواضع الحروف من معرفات الموظفين
4.1 بناء مجموعة البيانات التجريبية (Data Step)
لتوضيح الآليات البرمجية للدالة بصورة تطبيقية ملموسة، سنقوم بإنشاء مجموعة بيانات تجريبية تحاكي سيناريو واقعي لتدقيق السجلات الوظيفية في إحدى المؤسسات الكبرى. تعاني هذه السجلات من تباين ملحوظ في طريقة إدخال أرقام الموظفين التعريفية؛ فبعضها يحتوي على أرقام مسبوقة بأصفار، وبعضها يدمج بادئات حرفية دالة على الأقسام، وبعضها الآخر كُتب بصيغ رقمية بحتة دون أي حروف.
يتم بناء مجموعة البيانات هذه داخل خطوة بيانات (DATA Step) نموذجية باستخدام أمر INPUT لقراءة المتغيرات النصية بكفاءة، مع تفعيل سطر DATALINES لتزويد البرنامج بالنماذج المتنوعة التي تغطي الحالات الممكنة، بما في ذلك السجلات التي تبدأ بأحرف، وتلك التي تتوسطها أحرف، والسجلات الخالية تماماً من الأحرف. يتيح هذا التنوع اختبار قدرة الدالة على التعامل مع مختلف السيناريوهات الهيكلية.
يوضح البرنامج التالي الخطوات البرمجية الدقيقة لإنشاء هذا الجدول التجريبي، وتجهيزه لاستقبال عمليات المعالجة والفحص اللاحقة:
DATA employee_records;

  LENGTH EmpID $10 Description$30;

  INPUT EmpID $ Description $;

DATALINES;

0054A IT_Specialist

B1300 Lead_Auditor

04429 Regional_Clerk

89X02 Plant_Manager

99999 Pure_Numeric

K_900 Logistics_Lead

;

RUN;
4.2 تنفيذ كود المعالجة واستحداث متغير الفهرس
بعد تهيئة مجموعة البيانات الأولية، تأتي خطوة المعالجة المركزية بتطبيق الدالة ANYALPHA لاستكشاف خصائص كل معرف وظيفي. نقوم في هذه الخطوة بإنشاء متغير رقمي جديد يُطلق عليه firstAlphaChar، حيث يتم إسناد ناتج فحص المتغير النصي EmpID مباشرة إلى هذا الحقل المستحدث عبر تعبير برمجي صريح وسلس داخل خطوة بيانات تالية.
يعمل محرك SAS أثناء تنفيذ هذا الكود على قراءة كل سجل على حدة، وتمرير السلسلة المحرفية المخزنة في EmpID إلى الدالة ANYALPHA، والتي تقوم بدورها بمسح المحارف حرفاً تلو الآخر بدءاً من الموضع الأول، حتى تعثر على أول محرف هجائي، فتقوم على الفور بتخزين رقمه في المتغير الجديد، أو تخزين القيمة صفر في حال انتهاء السلسلة دون مصادفة أي حرف.
لعرض النتائج ومراجعتها بدقة، يتم استدعاء الإجراء الطباعي القياسي PROC PRINT، والذي ينتج جدولاً مقارناً يتيح للمحلل معاينة المعرف الأصلي بجانب المتغير الرقمي المستحدث للتأكد من مطابقة السلوك البرمجي للتوقعات النظرية، كما هو موضح في الكود التالي:
DATA processed_records;

  SET employee_records;

  firstAlphaChar = ANYALPHA(EmpID);

RUN;
PROC PRINT DATA=processed_records NOOBS;
TITLE "Employee ID Alpha Search Results";
RUN;
4.3 تحليل معمق للنتائج المستخرجة سطراً بسطر
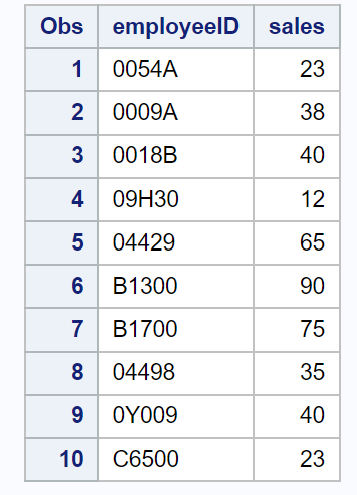
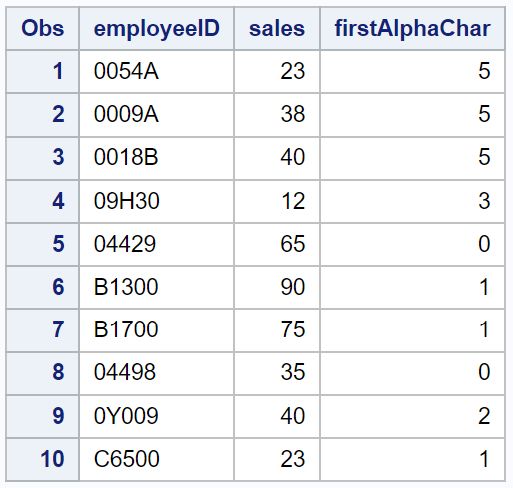
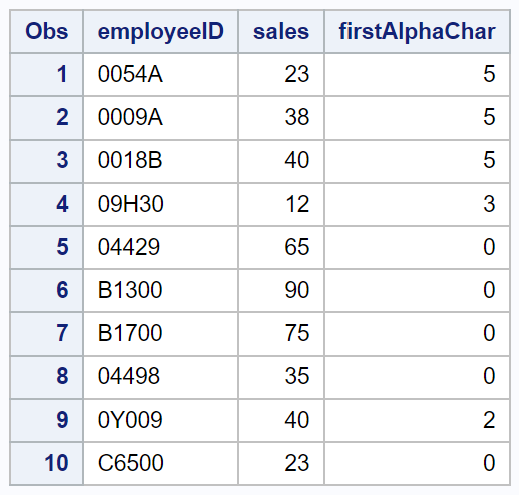
يُظهر فحص جدول المخرجات الناتجة دقة عمل خوارزمية الفهرسة الخاصة بالدالة. في السجل الأول ذي المعرف '0054A'، نجد أن المحارف الأربعة الأولى عبارة عن أرقام، بينما جاء الحرف اللاتيني الكبير في الموضع الخامس؛ لذا كانت النتيجة المسجلة في firstAlphaChar هي تماماً الرقم 5. هذا يؤكد أن الدالة لم تتأثر بتكرار الأصفار أو الأرقام السابقة بل واصلت المسح بدقة متناهية.
أما في السجل الثاني ذي المعرف 'B1300'، فقد بدأ المعرف مباشرة بحرف أبجدي في خانته الأولى؛ لذا أعادت الدالة فوراً القيمة 1، وتوقفت عن استكمال مسح باقي السلسلة، مما يوفر جهداً حوسبياً كبيراً. بالمقابل، يُظهر السجل الثالث '04429' والسجل الخامس '99999' عودة القيمة صفر بدقة متناهية، وهو ما يبرهن على خلو هذه المعرفات من أي عناصر أبجدية، مما يتيح تصنيفها كسجلات رقمية خالصة تخضع لقواعد معالجة مختلفة.
في السجل الرابع '89X02'، تم رصد الحرف في الموضع الثالث فأعادت الدالة القيمة 3، في حين يُظهر السجل الأخير 'K_900' رصد الحرف في الموضع الأول أيضاً بقيمة 1، متجاهلة الرمز الخاص اللاحق وهو الشرطة السفلية. يبرهن هذا الاستعراض السطري على أن الدالة لا تتأثر بتركيبة البيانات المختلطة المحيطة بالحرف، وتقتصر مهمتها الصارمة على توثيق موضع الظهور الأول للأبجدية.
5. الاستخدام المتقدم لوسيط موضع البدء (Start Parameter)
5.1 تخطي الأحرف الأولى والبحث في المقاطع اللاحقة
في كثير من المهام المتقدمة لإعداد البيانات، لا يقتصر الهدف على معرفة أول حرف أبجدي في النص، بل يتعدى ذلك إلى الرغبة في اكتشاف الحروف التالية أو استكشاف الأقسام الداخلية من السلسلة بعد تجاوز مقطع ثابت معروف سلفاً. يتحقق هذا الغرض ببراعة من خلال توظيف وسيط البداية (Start Parameter) لتوجيه الدالة نحو تخطي المواضع الأولى.
إذا كان لدينا على سبيل المثال معرف يبدأ بحرف كودي يمثل المنطقة الجغرافية ونرغب في معرفة ما إذا كان هناك حرف آخر يمثل نوع الفئة في بقية المعرف، فيمكننا تمرير وسيط بداية بقيمة 2؛ حيث تتجاهل الدالة الخانة الأولى كلياً وتبدأ الفحص انطلاقاً من الخانة الثانية وما بعدها. يمنع هذا الأسلوب حدوث التوقف المبكر عند الحرف الأول ويسمح بفحص البنى التركيبية الأكثر تعقيداً.
يمكن أيضاً ربط هذا الوسيط بقيم متغيرة ديناميكياً ناتجة عن دوال أخرى؛ كأن نستخدم ناتج استدعاء سابق للدالة ANYALPHA مضافاً إليه الرقم 1 كوسيط بداية لاستدعاء ثانٍ للدالة نفسها. يتيح هذا التركيب المتسلسل استكشاف الحرف الثاني بكل دقة عبر كود مثل: secondAlpha = ANYALPHA(EmpID, firstAlpha + 1);، وهي تقنية أساسية في هندسة استخراج الخصائص من البيانات غير المنظمة.
5.2 البحث العكسي باستخدام القيم السالبة لوسيط البداية
تُعد إمكانية تمرير قيمة سالبة لوسيط البداية إحدى أقوى الخصائص المتقدمة في الدالة ANYALPHA والتي يغفل عنها كثير من المبرمجين. عندما يتم تزويد الدالة بقيمة سالبة، فإنها تترجم هذه الإشارة تلقائياً كأمر لتغيير اتجاه البحث، بحيث ينطلق المسح من أقصى اليمين متجهاً نحو اليسار (عكس اتجاه القراءة اللاتينية)، انطلاقاً من الموضع المقابل للقيمة المطلقة للرقم السالب الممرر.
تسمح هذه التقنية بتحديد موضع “آخر” حرف أبجدي في السلسلة النصية بسهولة فائقة دون الحاجة إلى عكس النص برمجياً عبر دوال إضافية مثل REVERSE. على سبيل المثال، إذا قمنا بتمرير القيمة -10 داخل نص طوله 10 أحرف، فإن الدالة ستبدأ الفحص من الحرف العاشر وتتحرك تراجعياً نحو المحرف الأول، بحثاً عن أول حرف أبجدي يصادف مسارها المعاكس.
من الأهمية بمكان التأكيد على أن القيمة الرقمية الناتجة عن البحث العكسي تظل دائماً فهرساً موجباً محسوباً من بداية السلسلة الأصلية (من اليسار إلى اليمين). فإذا كان الحرف الأخير في موضع الخانة التاسعة وتم رصده عبر بحث عكسي، فإن الدالة ستعيد الرقم 9 وليس الرقم 2، مما يحفظ اتساق نظم الفهرسة ويمنع حدوث ارتباك في العمليات الحسابية التالية لاقتطاع النصوص.
5.3 بناء حلقات تكرارية (Loops) لجلب كافة مواضع الحروف
عندما تتطلب متطلبات التحليل استخراج مواضع جميع الأحرف الأبجدية الموجودة في النص دون استثناء، يصبح من الضروري دمج الدالة ANYALPHA داخل حلقات تكرارية ديناميكية مثل حلقة DO WHILE. يقوم هذا التصميم البرمجي بمسح النص بصورة متكررة، وتحديث موضع البدء تلقائياً بعد كل خطوة بمقدار (الموضع المكتشف سابقاً + 1) حتى تنتهي السلسلة النصية تماماً.
يتم في كل دورة داخل الحلقة التحقق من أن القيمة المرجعة أكبر من الصفر؛ فإذا تم العثور على حرف، يتم تخزين موقعه داخل مصفوفة رقمية (Array) مخصصة لتجميع المواضع، ثم تستمر الحلقة في الفحص انطلاقاً من الموضع التالي مباشرة. تنتهي الحلقة تلقائياً فور إرجاع الدالة للقيمة صفر، مما يشير إلى عدم وجود أي أحرف متبقية في المقاطع غير المفحوصة من النص.
يوضح النموذج التالي كيفية تطبيق هذا النمط المتقدم لاستخراج فهرس كافة الحروف وتخزينها بصورة منظمة تمهيداً لمعالجتها إحصائياً:
DATA extract_all_indices;

  SET employee_records;

  ARRAY alpha_pos[5] _TEMPORARY_;

  CALL MISSING(OF alpha_pos[*]);

  count = 0;

  pos = ANYALPHA(EmpID, 1);

  DO WHILE(pos > 0 AND count < 5);

    count + 1;

    alpha_pos[count] = pos;

    pos = ANYALPHA(EmpID, pos + 1);

  END;

RUN;
6. التعامل مع الحالات الخاصة والقيم الاستثنائية
6.1 معالجة القيم المفقودة (Missing Values) والسلاسل الفارغة
يواجه المبرمج في بيئات العمل الواقعية مشكلات مرتبطة بوجود قيم مفقودة (Missing Values) أو سلاسل نصية فارغة تماماً ضمن مجموعات البيانات. عند تمرير متغير نصي مفقود (يحتوي فقط على نقطة مفقودة أو مسافات فارغة) إلى الدالة ANYALPHA، فإنها تسلك مساراً آمناً للغاية ومصمماً لتفادي تعطل البرنامج؛ حيث تعيد مباشرة القيمة صفر دون تسجيل أي خطأ فادح يوقف خطوة البيانات.
على الرغم من هذا السلوك الآمن، يُفضل دائماً من منظور هندسة البرمجيات وتصميم الأكواد المتينة إجراء فحص احترازي استباقي للقيم المفقودة باستخدام الدالة MISSING قبل تطبيق أي معالجة فهرسية. يضمن هذا التدقيق عدم إهدار دورات المعالجة في فحص سجلات فارغة، ويسمح بتوجيه السجلات الخالية نحو مسارات معالجة استثنائية أو تدوينها في تقارير تدقيق البيانات.
يوضح المبدأ البرمجي الآمن ضرورة كتابة جمل شرطية مثل IF NOT MISSING(EmpID) THEN pos = ANYALPHA(EmpID); ELSE pos = . ;؛ حيث يُميز هذا الفصل بين الحالة التي تم فيها فحص النص ولم نجد فيه حروفاً (فتأخذ القيمة 0)، والحالة التي يكون فيها الحقل غير مدخل من الأساس في قاعدة البيانات الأصلية (فتأخذ القيمة المفقودة .)، مما يرفع من جودة ودقة التحليل الإحصائي اللاحق.
6.2 التعامل مع الرموز الخاصة والأرقام والمحارف غير المطبوعة
صُممت الدالة ANYALPHA بمرونة تامة لفرز وفصل المدخلات المختلطة التي تعج بالرموز المعقدة؛ فهي تتجاهل تماماً علامات الترقيم بمختلف أشكالها، مثل الفواصل والنقاط والأقواس والرموز الرياضية، وتعاملها كحواجز غير أبجدية تعبرها الخوارزمية حتى تصل إلى أول حرف هجائي حقيقي دون أن تتسبب تلك الرموز في أي خلل أو أخطاء وقت التشغيل (Runtime Errors).
يمتد هذا السلوك المنضبط إلى البيانات القادمة من أنظمة حاسوبية خارجية أو قنوات إدخال غير موثوقة والتي قد تحتوي على محارف تحكم غير مطبوعة (Non-printable Control Characters) مثل علامات الجدولة (Tabs)، ومحارف فواصل الأسطر (Line Feeds / Carriage Returns)، أو إشارات التحكم الثنائية. تصنف الدالة كافة هذه المحارف تلقائياً ضمن فئة غير الأحرف وتواصل البحث بسلاسة.
ومع ذلك، ينصح خبراء SAS في حال الشك بوجود محارف تحكم خبيثة أو نصوص مشوهة باستخدام دالة التطهير COMPRESS مع وسائط تنظيف المحارف غير القابلة للطباعة بالتكامل مع ANYALPHA، لضمان أن مواضع الفهرسة المحسوبة تعكس بدقة الترتيب الظاهري للمحارف التي سيراها المستخدم النهائي في التقارير الإحصائية المطبوعة.
6.3 إدارة قيم وسيط البداية الخارجة عن النطاق المسموح
تتطلب إدارة وسيط البداية (Start Argument) حذراً برمجياً دقيقاً لتفادي السلوكيات غير المتوقعة الناتجة عن تمرير قيم تقع خارج الحدود المنطقية لطول السلسلة النصية المفحوصة. إذا مرر المبرمج قيمة موجبة لوسيط البداية تتجاوز الطول الفعلي للنص (كأن يطلب البحث بدءاً من الموضع 15 في سلسلة طولها الإجمالي 8 أحرف فقط)، فإن الدالة تعيد فوراً القيمة صفر مشيرة إلى عدم العثور على أي حرف، دون أن تُصدر رسائل خطأ توقف التنفيذ.
أما في حال تمرير القيمة صفر كوسيط للبداية (وهو موضع غير معرف في نظام الفهرسة المعتمد على الأساس واحد)، فإن سجل النظام (SAS Log) قد يسجل ملاحظة تحذيرية تفيد بأن وسيط البداية يقع خارج النطاق الصالح، وتُرجع الدالة القيمة صفر. كما أن تمرير قيم سالبة تفوق القيمة المطلقة لطول السلسلة يؤدي إلى نفس الاستجابة الآمنة بعد إطلاق تنبيه في السجل البرمجي.
لضمان متانة الأكواد في بيئات الإنتاج الحرجة، يُوصى بحساب طول السلسلة مسبقاً باستخدام الدالة LENGTH أو LENGTHN وإجراء تدقيق منطقي قبل تمرير وسيط البداية الديناميكي، مما يحافظ على نظافة سجل SAS Log ويمنع تراكم الملاحظات التحذيرية التي قد تصعّب من مهام المراجعة والتدقيق البرمجي.
7. مقارنة الدالة ANYALPHA مع الدوال الشبيهة في SAS
7.1 المقارنة بين ANYALPHA ودالتي FIND وINDEX
يخلط بعض المبرمجين المبتدئين أحياناً بين استخدام الدالة ANYALPHA ودوال البحث النصي التقليدية مثل FIND وINDEX. يكمن الفارق الجوهري والأساسي في الهدف الوظيفي لكل منها؛ فدالتا FIND وINDEX تتطلبان من المستخدم تقديم نمط حرفي محدد وثابت (Substring) للبحث عنه، مثل البحث عن كلمة “SAS” أو الحرف “A” تحديداً داخل الجملة.
في المقابل، تعمل الدالة ANYALPHA على مستوى التجريد الفئوي؛ إذ إنها لا تبحث عن حرف بعينه، بل تبحث عن أي عنصر ينتمي إلى صنف الأبجدية ككل. إذا أردنا معرفة موضع أول حرف في النص أياً كان نوعه باستخدام دالة INDEX، فسنضطر إلى كتابة شفرة شديدة التعقيد تقوم بمسح 52 حرفاً (الحروف اللاتينية بنوعيها الكبير والصغير) ومقارنة النتائج للحصول على أدنى موضع، وهو ما يمثل هدراً تقنياً هائلاً.
لذلك، تتفوق ANYALPHA تفوقاً ساحقاً في سهولة كتابة الكود وكفاءة استهلاك موارد المعالج والذاكرة عند التعامل مع مهام التدقيق العام والتصنيف، بينما يقتصر استخدام FIND على الحالات التي نبحث فيها عن سلاسل فرعية محددة ومعروفة مسبقاً ضمن النصوص المستهدفة بالتحليل.
7.2 الدالة ANYALPHA في مواجهة الدالة NOTALPHA
تُمثل الدالة NOTALPHA الوجه الآخر المتمم للدالة ANYALPHA ضمن منظومة دوال البحث الحديثة في SAS؛ فبينما تبحث الأولى عن أول محرف ينتمي إلى فئة الحروف الأبجدية (إثبات)، تبحث الثانية عن أول محرف لا ينتمي إلى هذه الفئة إطلاقاً (نفي). يشمل ذلك الأرقام، والمسافات البيضاء، وعلامات الترقيم، والرموز الحسابية المتنوعة.
تتكامل هاتان الدالتان بشكل استثنائي في مهام معالجة السلاسل وتجزئتها؛ فعند الحاجة إلى استخراج مقطع أبجدي نقي محشور بين أرقام ورموز، يتم استخدام ANYALPHA لتحديد نقطة انطلاق المقطع الأبجدي، ثم يتم استدعاء NOTALPHA مع تمرير موضع البداية الجديد لتحديد نقطة نهاية ذلك المقطع الأبجدي بدقة متناهية.
يعتمد الاختيار بين الدالتين على صياغة المشكلة التحليلية؛ فإذا كان المطلوب هو إثبات وجود محتوى لغوي داخل حقل رقمي مشوه، فإن ANYALPHA هي الخيار الأمثل. أما إذا كان المطلوب تدقيق حقل نصي خالص (مثل حقل “اسم المريض” أو “اسم العائلة”) للتأكد من عدم احتوائه على أرقام أو رموز شاذة، فإن الدالة NOTALPHA تكون هي الخيار الأكثر مباشرة وفاعلية.
7.3 ANYALPHA مقابل التعبيرات النمطية المتقدمة (PRX Functions)
يوفر نظام SAS محركاً فائق القوة لمعالجة النصوص قائم على لغة بيرل للتعبيرات النمطية (Perl Regular Expressions) عبر عائلة دوال PRX، مثل الدالة الشهيرة PRXMATCH. يستطيع المطور نظرياً استبدال الدالة ANYALPHA باستدعاء التعبير النمطي PRXMATCH('/[a-zA-Z]/', string) لتحقيق نفس النتيجة الوظيفية في تحديد موضع أول حرف.
ورغم القوة اللامحدودة لمحرك PRX في التقاط الأنماط المعقدة، إلا أن استخدام ANYALPHA يوفر مزايا حاسمة من حيث بساطة كتابة الكود وسرعة التنفيذ الفائقة. فالدوال المدمجة كـ ANYALPHA مكتوبة بلغة C منخفضة المستوى ومترجمة بشكل مباشر ضمن نواة نظام SAS الأساسية، مما يجعلها أسرع بكثير في التنفيذ ولا تتطلب تجهيز مسارات ترجمة الأنماط النمطية أو إدارة المؤشرات الخاصة بمحرك بيرل.
لذا، تقتضي القواعد البرمجية الرصينة تفضيل الدالة ANYALPHA للمهام المباشرة التي تركز على فئات المحارف البسيطة، وقصر الانتقال إلى تعقيدات محرك التعبيرات النمطية PRX على السيناريوهات المتقدمة جداً التي تتطلب التحقق من أنماط مركبة مثل مطابقة عناوين البريد الإلكتروني أو أرقام الهواتف الدولية ذات الصيغ المتعددة.
8. التطبيقات العملية لتقسيم السلاسل وتنظيف البيانات
8.1 تقسيم المعرفات المركبة إلى شقين رقمي وأبجدي
يُعد تقسيم المعرفات المركبة إلى حقول مستقلة متجانسة من أكثر العمليات تكراراً في إعداد البيانات الضخمة. في كثير من الأحيان، يتكون رقم الحساب أو كود الصنف المخزني من شق رقمي بادئ يتبعه لاحقة حرفية تصف طبيعة الحساب دون وجود فاصل قياسي بينهما (مثل: '108459WEST' أو '4402A')، مما يعيق العمليات الإحصائية وحساب المجاميع الرياضية.
يمكن التغلب على هذه العقبة من خلال دمج الدالة ANYALPHA مع دالة اقتطاع النصوص الكلاسيكية SUBSTR. تقوم الدالة الأولى بتحديد الفهرس الرقمي الذي يبدأ عنده المقطع الحرفي، لتقوم الدالة الثانية باستغلال هذا الفهرس لتقسيم السلسلة الأصلية بدقة متناهية إلى متغيرين مستقلين؛ أحدهما يمثل الشق الرقمي والآخر يمثل الشق الوصفي.
يوضح البرنامج النموذجي التالي كيفية إنجاز هذه المعالجة البرمجية الصارمة بأعلى درجات الكفاءة والأمان البياني:
DATA split_accounts;

  SET raw_accounts;

  alpha_start = ANYALPHA(AccountCode);

  IF alpha_start > 1 THEN DO;

    NumericPart = SUBSTR(AccountCode, 1, alpha_start - 1);

    AlphaPart   = SUBSTR(AccountCode, alpha_start);

  END;

  ELSE IF alpha_start = 1 THEN DO;

    NumericPart = "";

    AlphaPart   = AccountCode;

  END;

  ELSE DO;

    NumericPart = AccountCode;

    AlphaPart   = "";

  END;

RUN;
8.2 عزل وتصحيح أخطاء إدخال البيانات البشرية
تشكل الأخطاء العرضية الناتجة عن التدخل البشري في إدخال البيانات مصدراً رئيسياً لفساد النماذج التحليلية؛ كأن يقوم موظف الإدخال بكتابة حرف الحرف ‘O’ عوضاً عن الرقم صفر ‘0’ أثناء إدخال أرقام الحسابات البنكية، أو كتابة الحرف ‘l’ عوضاً عن الرقم واحد ‘1’. تؤدي هذه الأخطاء إلى تحويل الحقل بالكامل إلى صيغة نصية تمنع إجراء العمليات الحسابية عليه.
توفر الدالة ANYALPHA آلية آلية مؤتمتة وسريعة لاكتشاف هذه السجلات المعيبة؛ إذ يكفي تطبيق الدالة على الحقل المفترض نقاؤه الرقمي، فإذا كانت النتيجة أكبر من صفر، يتم على الفور تحويل السجل إلى جدول تدقيق استثنائي (Audit Exception Dataset) لإخضاعه للمراجعة البشرية أو تطبيق خوارزميات الاستبدال والتصحيح الآلي.
تساعد هذه المقاربة في إنشاء لوحات متابعة جودة البيانات (Data Quality Dashboards)؛ حيث يتم حساب النسبة المئوية للسجلات الملوثة بالحروف عبر خطوة تلخيصية بسيطة، مما يمنح إدارة حوكمة البيانات في المؤسسة مؤشرات كمية موثوقة حول مستوى دقة العمليات التشغيلية وتحديد مصادر الخلل الميداني لمعالجتها استباقياً.
8.3 إعادة هيكلة العناوين والرموز البريدية المختلطة
تتسم الحقول الجغرافية كالرموز البريدية وعناوين الإقامة بتعقيد تركيبي واسع؛ فبينما تعتمد بعض الدول أنظمة بريدية رقمية بالكامل، تتبنى دول أخرى مثل بريطانيا وكندا أنظمة بريدية مدمجة تمزج بين الحروف والأرقام بصيغ متداخلة. كما أن كتابة عناوين الشوارع في حقل واحد مدمج (مثل: '742 Evergreen Terrace') يتطلب فصل رقم المبنى عن اسم الشارع.
تُعد الدالة ANYALPHA الأداة المثالية لتحديد نقطة التحول من رقم المبنى إلى الاسم الأبجدي للشارع؛ فبمجرد تحديد موضع أول حرف في حقل العنوان المدمج، يستطيع المحلل تقسيم النص إلى رقم العقار واسم الشارع بكل يسر، مما يسهل عمليات الربط المكاني (Geocoding) مع قواعد البيانات الخرائطية الرسمية.
يسهم هذا التوحيد المعياري للمتغيرات الديموغرافية والوصفية في رفع كفاءة خوارزميات التجميع والتصنيف الإحصائي، وتفادي الازدواجية في السجلات الناتجة عن تباين أساليب الكتابة اليدوية للعناوين بين المشاركين في المسوح الإحصائية والدراسات الميدانية الكبرى.
9. أفضل الممارسات البرمجية وتحسين كفاءة الأداء
9.1 تحسين استهلاك الذاكرة وسرعة المعالجة في البيانات الضخمة
عند التعامل مع مجموعات بيانات ضخمة (Big Data) تبلغ أحجامها مئات الجيجابايت وتحتوي على عشرات الملايين من القيود، تصبح الكفاءة الحسابية لكل دالة برمجية مستخدمة عاملاً حاسماً في نجاح العمليات التحليلية واستقرار منظومة الخوادم. تتفوق الدالة ANYALPHA في هذه البيئات بفضل خفتها التشغيلية وقلة استهلاكها لذاكرة التخزين المؤقت مقارنة بالتعبيرات النمطية الثقيلة.
من أهم الاستراتيجيات البرمجية لرفع كفاءة المعالجة استخدام الدالة مباشرة داخل عبارات التصفية WHERE أثناء قراءة البيانات من القرص الصلب بدلاً من قراءتها بالكامل ثم فلترتها في خطوة تالية؛ مثل كتابة: DATA clean; SET raw(WHERE=(ANYALPHA(Code) = 0)); RUN;. تمنع هذه الطريقة تحميل السجلات غير المرغوبة إلى ذاكرة الوصول العشوائي (RAM)، مما يوفر مساحات تخزينية هائلة ويسرع المعالجة بأضعاف مضاعفة.
علاوة على ذلك، ينبغي تجنب استدعاء الدالة بشكل متكرر لفحص نفس الحقل داخل شروط منطقية متعددة في خطوة البيانات ذاتها؛ بل يجب حساب قيمتها مرة واحدة وتخزينها في متغير مؤقت يتم استخدامه في بقية المقارنات الشرطية، مما يقلل عدد العمليات الحسابية المنفذة على مستوى المعالج الدقيق.
9.2 توثيق الكود البرمجي والحفاظ على إمكانية صيانته
يُعد توثيق الأكواد البرمجية جزءاً لا يتجزأ من الممارسات الأكاديمية والمهنية الرصينة، خاصة عند التعامل مع دوال معالجة النصوص التي تعتمد على وسائط رقمية قد تبدو مبهمة لمن يقرأ الكود لاحقاً. يجب على المبرمج إدراج تعليقات برمجية واضحة تشرح الغرض من استدعاء الدالة ANYALPHA، وتوضح أسباب اختيار وسيط بداية محدد بدلاً من القيمة الافتراضية.
تكتسب تسمية المتغيرات الناتجة أهمية قصوى في تسهيل صيانة البرمجيات؛ فبدلاً من استخدام أسماء غامضة مثل X أو P1، يُنصح بشدة باعتماد أسماء وصفية دالة تعكس المضمون الإحصائي والوظيفي للحقل المستحدث، مثل first_letter_pos أو is_alphanumeric_flag، مما يجعل الشيفرة ذاتية التوثيق ويسهل مراجعتها من قِبل فرق التدقيق البرمجي ومحللي البيانات اللاحقين.
في المشروعات المؤسسية الكبرى التي تتكرر فيها عمليات تنظيف المعرفات، يُستحسن تغليف هذه العمليات داخل وحدات ماكرو (SAS Macros) موحدة وقابلة لإعادة الاستخدام؛ مما يضمن تطبيق نفس معايير الفحص والتدقيق في مختلف أقسام المؤسسة ويقلل من تكرار الأكواد ويحد من احتمالات الخطأ البشري أثناء إعادة كتابة الشفرات التحليلية.
9.3 تفادي الأخطاء المنطقية الشائعة أثناء البرمجة
يقع كثير من مطوري SAS في أخطاء منطقية شائعة عند استخدام الدالة ANYALPHA، وأبرز هذه الأخطاء هو الخلط بين “الموضع الفهرسي” المسترجع والحرف نفسه؛ حيث يفترض المبرمج خطأً أن الدالة تعيد الحرف المستكشف، فيقوم بمقارنته مع حروف أخرى كأن يكتب IF ANYALPHA(code) = 'A'، وهو ما يؤدي إلى خطأ فادح في توافق الأنواع، حيث تنتج الدالة قيمة رقمية بحتة لا تقبل المقارنة المباشرة مع نصوص.
من الأخطاء المنطقية المتكررة أيضاً مشكلة الانزياح الفهرسي (Off-by-one Error) عند دمج الدالة مع دالة القص SUBSTR؛ إذ ينسى المطور أحياناً أن الفهرس الناتج يشير إلى الحرف ذاته، فإذا كان المطلوب اقتطاع الجزء الرقمي السابق للحرف، فيجب تحديد طول الجزء الرقمي بمقدار (pos - 1) وليس pos، تفادياً لاقتطاع الحرف الأبجدي مع الأرقام وتشوية النتائج.
أخيراً، يجب الحذر الشديد من مشاكل التحويل التلقائي للأنواع (Implicit Type Conversion) في SAS؛ فإذا تم إسناد ناتج الدالة إلى متغير تم تعريفه مسبقاً كمتغير نصي، سيقوم النظام بمحاولة تحويل الرقم إلى نص تلقائياً مما يسجل ملاحظات تنبيهية في سجل التشغيل ويستهلك وقتاً حوسبياً إضافياً كان من الممكن تفاديه بتعريف المتغيرات المستقبلة كمتغيرات رقمية منذ البداية.
10. تمارين وحلول برمجية شاملة باستخدام الدالة ANYALPHA
10.1 سيناريو فرز قيود وسجلات الموظفين بناءً على صيغة المعرف
يتناول هذا التمرين مسألة مؤسسية واقعية؛ حيث تمتلك إحدى الشركات قاعدة بيانات تضم فئات وظيفية متعددة تختلف هياكل معرفاتها باختلاف نوع العقد؛ فالموظفون المثبتون تبدأ معرفاتهم بأرقام وتنتهي بأحرف، بينما المتعاقدون المؤقتون تبدأ معرفاتهم بحروف، في حين أن السجلات غير المكتملة لا تحتوي على أي حروف إطلاقاً. المطلوب تصنيف هذه السجلات تلقائياً إلى ثلاث فئات مستقلة.
لحل هذه المسألة، نقوم بكتابة برنامج متكامل يستخدم الدالة ANYALPHA لحساب موضع أول حرف، ثم تطبيق جمل شرطية تصنف السجل بناءً على قيمة هذا الموضع: إذا كان الموضع 1 يصنف الموظف كـ “مؤقت”، وإذا كان الموضع أكبر من 1 يصنف كـ “مثبت”، وإذا كان الموضع 0 يصنف كـ “سجل غير صالح”.
يوضح الكود التالي الحل البرمجي المتكامل مع استعراض النتائج في جدول نهائي مصنف:
DATA contract_types;

  LENGTH RawCode $10 Category$15;

  INPUT RawCode $;

  alpha_loc = ANYALPHA(RawCode);

  SELECT (alpha_loc);

    WHEN (0) Category = "Invalid/Numeric";

    WHEN (1) Category = "Contractor";

    OTHERWISE Category = "Permanent";

  END;

DATALINES;

EMP092

90812T

77643

A8812

00129B

;

RUN;
PROC PRINT DATA=contract_types NOOBS;
RUN;
10.2 سيناريو استخراج أول مصفوفة أبجدية من سلسلة نصية معقدة
يركز هذا التمرين على سيناريو أكثر تقدماً يتعلق باستخراج أول كتلة أحرف متصلة (Word/Alphabetic Block) من داخل نص فوضوي يحتوي على أرقام ورموز خاصة محيطة بالكلمة (مثل: '#994_ALPHA_88'). يتطلب الحل البرمجي تحديد بداية المقطع الأبجدي بدقة، وتحديد نقطة نهايته دون استخراج أي رموز لاحقة.
يتحقق هذا الحل عبر التكامل العبقري بين الدالتين ANYALPHA وNOTALPHA؛ حيث نستخدم الدالة الأولى لتحديد نقطة انطلاق الكلمة، ثم نمرر هذا الموضع كمعامل بداية للدالة الثانية للعثور على أول رمز أو رقم يظهر بعد تلك الكلمة، مما يمكننا من حساب الطول الدقيق للكتلة الأبجدية واقتطاعها بنجاح.
توضح الشيفرة التالية تطبيق هذه الخوارزمية واستخراج الكلمة المستهدفة بصورة نقية تماماً:
DATA extract_pure_word;

  LENGTH MixedString $20 ExtractedWord$20;

  INPUT MixedString $;

  start_word = ANYALPHA(MixedString);

  IF start_word > 0 THEN DO;

    end_word = NOTALPHA(MixedString, start_word);

    IF end_word = 0 THEN word_len = LENGTH(MixedString) - start_word + 1;

    ELSE word_len = end_word - start_word;

    ExtractedWord = SUBSTR(MixedString, start_word, word_len);

  END;

  ELSE ExtractedWord = "NONE";

DATALINES;

10294SAS_Pro

$$$METRICS99

99999

DATA_Step_44

;

RUN;
PROC PRINT DATA=extract_pure_word NOOBS;
RUN;
10.3 ملخص شامل وتوصيات للمحللين والمبرمجين في SAS
في ختام هذه المراجعة المعمقة للدالة ANYALPHA، يمكن تلخيص القيمة الوظيفية الكبرى لهذه الأداة في كونها حلقة الوصل المثالية بين معالجة النصوص وتدقيق البيانات في بيئة SAS الإحصائية. تمتاز الدالة بالسرعة الفائقة، والخفة التشغيلية، والدقة المتناهية في تحديد مواضع الحروف اللاتينية بنوعيها الصغير والكبير، مما يجعلها ركيزة لا غنى عنها في صندوق أدوات أي مبرمج أو محلل إحصائي محترف.
نوصي جميع الباحثين والمحللين بالالتزام الصارم بالإرشادات البرمجية المعتمدة؛ ومن أهمها تذكر أن الدالة تعيد موضعاً رقمياً يعتمد على الأساس واحد، وليس الحرف نفسه، وتوظيف وسيط البداية لتنفيذ عمليات البحث المتقدم والعكسي وتجاوز البوادئ، والحرص الدائم على توثيق الأكواد البرمجية والتأكد من توافق إعدادات اللغة (Locale) في المنظومة لتفادي أي انحرافات غير متوقعة في تصنيف المحارف الخاصة.
تفتح هذه الدالة آفاقاً واسعة لإتقان بقية عائلة دوال البحث والتنظيف في SAS، ونحث المطورين على مواصلة استكشاف الدوال الشقيقة مثل ANYDIGIT وANYPUNCT وNOTALPHA والدمج بينها، لبناء خوارزميات تدقيق متقدمة تضمن جودة البيانات ونقائها، مما ينعكس بشكل إيجابي ومباشر على موثوقية القرارات والتحليلات الإحصائية المستخرجة.
المراجع
- Cody, R. (2017). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Press.
- SAS Institute Inc. (2020). SAS(R) 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2023). Character Search Functions in SAS: Modern Approaches to String Manipulation. SAS Global Forum Proceedings. https://support.sas.com