
تمثل إدارة ومعالجة البيانات النصية والسلاسل الحرفية إحدى الركائز الجوهرية في علوم البيانات، والتحليل الإحصائي الحيوي، والأبحاث السلوكية والكمية المعاصرة. وفي بيئات البرمجة المتقدمة مثل نظام التحليل الإحصائي SAS، تتطلب معالجة السجلات الضخمة خوارزميات برمجية تتسم بأعلى درجات الكفاءة الحوسبية والدقة التحليلية. لا يقتصر التعامل مع النصوص على مجرد تخزينها كمسميات أو واصفات هامشية، بل يمتد ليشمل استخراج الأنماط، وتدقيق صحة الإدخال، وتنظيف المفاتيح التعريفية، وتفكيك المقاطع النصية المركبة لتأهيلها للنمذجة الرياضية المعمقة والتحليلات القياسية.
في سياق تطور منظومة لغة SAS، شكل الانتقال إلى الإصدار التاسع (SAS 9) نقلة نوعية فارقة في بنية الدوال النصية المدمجة، حيث طُورت مجموعة من الأدوات المحسنة لتجاوز قيود الدوال التقليدية الموروثة. وتبرز دالة FINDC في صدارة هذه الأدوات، بوصفها إحدى أقوى الدوال وأكثرها مرونة في تقفي مواقع المحارف الفردية داخل النصوص. صُممت هذه الدالة لتمكين الإحصائيين والمحللين من تتبع أي محرف ينتمي إلى قائمة محددة سلفاً، مع إتاحة خيارات متقدمة لتعديل اتجاه الفحص، والتحكم بحساسية حالة الأحرف، وتطبيق قواعد التدقيق العكسي بأسلوب فائق الإحكام والسرعة.
يتناول هذا الدليل الأكاديمي الشامل دراسة متعمقة لكافة جوانب دالة FINDC في نظام SAS؛ بدءاً من أصولها المنهجية وبنيتها النحوية، مروراً بآليات عملها ومعدلاتها المتقدمة، ووصولاً إلى مقارنتها بالدوال المناظرة وتطبيقاتها التطبيقية في تنظيف البيانات الضخمة، وتدقيق مقاييس الاستبانات في العلوم السلوكية، مع استعراض أفضل الممارسات البرمجية لتفادي الأخطاء الشائعة وتحسين الأداء الحوسبي عند التعامل مع مصفوفات البيانات الواسعة.
1. مقدمة عامة حول معالجة النصوص ودالة FINDC في نظام SAS
1.1 مفهوم معالجة السلاسل النصية في بيئة SAS
تشكل البيانات الحرفية (Character Data) في بيئة SAS جزءاً بالغ الأهمية من قواعد البيانات الإحصائية، حيث تمتد استخداماتها من ترميز المتغيرات التصنيفية والمعرفات الفريدة، إلى تخزين الإجابات المفتوحة، وسجلات الرعاية الصحية، والمؤشرات الجغرافية. ومع تزايد حجم البيانات الواردة من مصادر رقمية متعددة وغير متجانسة، تتفاقم التحديات المنهجية المتعلقة بنقاء البيانات؛ إذ تظهر مشكلات شائعة كالمسافات الزائدة، والرموز الخاصة العشوائية، والخلط بين الحروف الكبيرة والصغيرة، والأخطاء الطباعية الناتجة عن التدخل البشري أثناء جمع البيانات الميدانية.
إن إغفال هذه التحديات النصية قبل مرحلة التحليل الإحصائي المتقدم يترتب عليه تشوهات جوهرية في نماذج التنبؤ، وتكرار غير مبرر للفئات الاسمية، وفشل في عمليات دمج الجداول المرتبطة بمفاتيح ربط نصية (Merge Keys). من هنا، تكتسب الدوال النصية المدمجة في SAS دوراً محورياً في خط أنابيب هندسة البيانات (Data Engineering Pipeline). فهي لا تعمل فقط كأدوات لتعديل المظهر الخارجي للسلسلة، بل كمرشحات دقيقة لرفع جودة البيانات، وضمان اتساقها مع الفرضيات الإحصائية المقررة، وتحويل النصوص الخام إلى مصفوفات هيكلية منضبطة تخدم التحليلات الاستكشافية والنهائية بكفاءة بالغة.
1.2 تعريف دالة FINDC ودورها الوظيفي
تُعرّف دالة FINDC إجرائياً داخل بيئة Base SAS بأنها دالة بحث متخصصة في مسح السلاسل النصية للعثور على موقع أول ظهور لأي محرف فردي محدد ضمن قائمة من المحارف المستهدفة. تتميز الدالة بطبيعتها الذرية؛ فهي لا تبحث عن التطابق التام لسلسلة نصية مجتمعة أو كلمة مركبة، بل تفكك قائمة البحث إلى وحدات حرفية مستقلة، وتفحص السلسلة الهدف حرفاً بحرف حتى تصادف أول محرف يطابق أياً من عناصر القائمة المحددة، ثم تعيد فوراً ترتيبه الرقمي ضمن السلسلة النصية.
يمثل هذا التمييز الهيكلي الفارق الجوهري بين دالة FINDC والدوال التي تتعامل مع الكلمات أو السلاسل المتكاملة مثل دالتي FIND وINDEX. ففي حين تتطلب دالة FIND تطابقاً كلياً ومتتابعاً للكلمة الهدف بالترتيب نفسه، تسمح دالة FINDC بإجراء مطابقة متعددة الخيارات في خطوة برمجية واحدة؛ مما يجعلها الخيار الأمثل للبحث عن علامات الترقيم، أو الفواصل، أو أي رمز من مجموعة رموز غير مسموح بها، دون الحاجة إلى كتابة جمل شرطية متداخلة أو استدعاءات متكررة تؤثر سلباً على بساطة الكود ومقروئيته.
1.3 أهمية الدالة في التحليل الاستكشافي والتنظيف المسبق للبيانات
في مراحل الفحص الأولي للبيانات (Exploratory Data Analysis)، تبرز الحاجة الملحة إلى اكتشاف الشوائب النصية بسرعة قبل الشروع في بناء النماذج الإحصائية المعقدة. تتيح دالة FINDC للباحثين ومحللي البيانات الكشف الفوري عن الرموز الخاصة المندسة في حقول المفاتيح التعريفية، مثل علامات التعجب، والشرطات المائلة، أو الرموز الرياضية غير المتوقعة التي غالباً ما تنتج عن أخطاء القراءة الآلية أو المسح الضوئي الضوئي للمستندات (OCR).
تسهم هذه الآلية في تسريع عمليات التدقيق المعياري للمتغيرات النصية؛ إذ يمكن بمسحة واحدة عبر الدالة التحقق من خلو السجلات من أي إدخال معيب. ومن الناحية الحوسبية، يتميز استهداف مواقع الأحرف مباشرة بواسطة FINDC بتوفير زمن المعالجة وتقليل استهلاك موارد المعالج وذاكرة الوصول العشوائي (RAM) مقارنة بالحلول البديلة القائمة على التعبيرات النمطية المعقدة، مما يضمن معالجة ملايين السجلات في أجزاء من الثانية مع الحفاظ على أعلى درجات الدقة الإجرائية.
2. البنية النحوية والصيغة البرمجية لدالة FINDC
2.1 المعاملات الأساسية الإلزامية: السلسلة وقائمة الأحرف
تعتمد دالة FINDC صيغة برمجية منضبطة ترتكز على معاملين إلزاميّين، يتبعهما معاملات اختيارية تمنح الدالة مرونتها الفائقة. وتُكتب الصيغة العامة للدالة وفق النحو التالي: FINDC(string, charlist <, modifiers> <, startpos>). يمثل المعامل الأول (string) المتغير النصي أو التعبير الحرفي الهدف المراد فحصه، في حين يمثل المعامل الثاني (charlist) قائمة المحارف الفردية المستهدفة بالبحث، ويتم تمريرها إما في صورة متغير نصي آخر أو كنص حرفي محاط بعلامات اقتباس فردية أو مزدوجة.
تجدر الإشارة إلى أن ترتيب المعاملات الإلزامية صارم تماماً؛ إذ يجب تقديم السلسلة المبحوث فيها أولاً، تليها قائمة المحارف المبحوث عنها. تقوم الدالة داخلياً بالتعامل مع كل حرف وارد في المعامل الثاني بوصفه كياناً مستقلاً بذاته، بصرف النظر عن ترتيب كتابة تلك المحارف داخل القائمة؛ فالقائمة ‘abc’ تعني منطقياً البحث عن أول ظهور للحرف ‘a’ أو الحرف ‘b’ أو الحرف ‘c’ في السلسلة الأصلية، دون افتراض أي تتابع ترتيبي بينها.
2.2 المعامل الاختياري لتحديد موقع البداية (Startpos)
يوفر المعامل الاختياري startpos للمبرمج القدرة على التحكم الدقيق في نقطة انطلاق الفحص داخل السلسلة النصية المستهدفة. عند إغفال هذا المعامل، تبدأ الدالة افتراضياً بفحص السلسلة من الحرف الأول (الموقع 1). ولكن عند تمرير قيمة عددية صحيحة موجبة، تتجاوز الدالة كافة المحارف السابقة لتلك القيمة وتبدأ التدقيق المباشر انطلاقاً من الفهرس المحدد، مما يسهل عمليات البحث التكراري وتجاوز المقاطع التي تم فحصها مسبقاً.
تكتسب الدالة بعداً تشغيلياً متقدماً عند استخدام قيم عددية سالبة في معامل startpos؛ إذ تؤدي القيمة السالبة إلى تحويل اتجاه مسح السلسلة ليصبح تراجعياً (Right-to-Left)، حيث تبدأ الدالة من القيمة المطلقة للموقع المحدد وتتجه نحو بداية السلسلة من اليمين إلى اليسار. تتيح هذه الميزة استخراج آخر ظهور لمحرف معين في النص دون الحاجة إلى عكس السلسلة بأكملها بواسطة دوال إضافية مثل REVERSE، مما يعزز بساطة الكود وسرعته الحوسبية.
2.3 المعاملات الإضافية: معدلات البحث البرمجية (Modifiers)
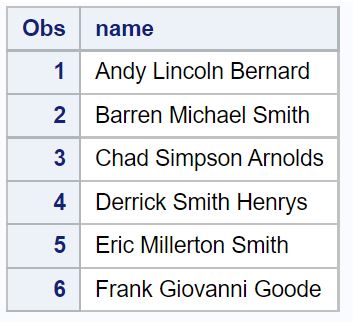
تعد المعدلات البرمجية (Modifiers) المعامل الأكثر مرونة في دالة FINDC، حيث تُمرر في صورة سلسلة نصية محاطة باقتباس تحتوي على رمز أو أكثر من الرموز الحرفية المعتمدة في بيئة SAS لتعديل السلوك القياسي لعملية البحث. ومن المزايا الهيكلية للدالة أن ترتيب المعاملين الاختياريين (المعدلات وموقع البداية) تبادلي؛ إذ يمكن وضع المعدلات كمعامل ثالث وموقع البداية كمعامل رابع، أو العكس، وسيقوم مترجم SAS البرمجي بالتعرف التلقائي على نوع كل معامل وتطبيقه بدقة متناهية.
تكمن قوة هذه المعدلات في قدرتها على دمج قواعد فحص متعددة ومعقدة في سطر برمجي واحد دون كتابة دوال فرعية مساعدة. يمكن للمبرمج الجمع بين معدلات متعددة مثل ‘it’ لتحقيق الجمع بين تجاهل حالة الأحرف واستبعاد المسافات اللاحقة، مما يقلل من حجم الكود المكتوب ويرفع كفاءة معالجة السجلات النصية بصورة دراماتيكية في بيئات الإنتاج والبحث الإحصائي المتقدم.
3. آليات عمل دالة FINDC وتفسير النتائج الرقمية
3.1 دلالة القيمة المرجعة عندما تكون موجبة
تُرجع دالة FINDC دائماً قيمة عددية صحيحة تمثل الفهرس الحسابي لموقع أول محرف مطابق في السلسلة النصية. تعتمد بيئة SAS نظام الترقيم الأحادي (1-based indexing)، مما يعني أن الحرف الأول في السلسلة يحمل الفهرس رقم 1، والحرف الثاني يحمل الفهرس 2، وهكذا دواليك وصولاً إلى نهاية طول السلسلة الفعلي. وبالتالي، فإن القيمة المرجعة تعكس الإحداثي الدقيق للمحرف المستهدف دون إزاحة صفرية كما هو معتاد في لغات برمجة أخرى مثل Python أو C.
تسهم هذه الطبيعة الرقمية الصريحة في تسهيل دمج القيمة المرجعة داخل الجمل الشرطية والمنطقية؛ فحصول المبرمج على أي قيمة عددية موجبة أكبر من الصفر يُعد دليلاً منطقياً قاطعاً (Boolean True) على تحقق شرط وجود واحد على الأقل من المحارف المستهدفة داخل السلسلة. يتيح ذلك توظيف النتيجة مباشرة كمدخل في دوال الاقتطاع النصي مثل SUBSTR لقص النصوص اعتماداً على موقع الرمز المكتشف بدقة حسابية مطلقة.
3.2 تفسير النتيجة عند القيمة صفر (حالة عدم التطابق)
في الحالات التي تفشل فيها دالة FINDC في العثور على أي محرف من المحارف المحددة في قائمة البحث داخل السلسلة النصية المعطاة، فإنها تُرجع القيمة العددية 0 (صفر). ويحمل هذا الصفر دلالة قطعية في منطق لغة SAS على الغياب التام لجميع عناصر البحث الحرفية، وهو ما يُترجم منطقياً إلى شرط زائف (False) في العبارات الشرطية، مما يوجه تدفق التنفيذ البرمجي إلى المسارات البديلة تلقائياً.
من الضروري الانتباه من الناحية المنهجية إلى التمييز الصارم بين القيمة الصفرية الناتجة عن عدم التطابق، وبين القيمة المفقودة الحسابية (Missing Value المرموز لها بنقطة .). فالدالة لا تُنتج قيماً مفقودة عند فشل البحث، بل تُرجع صفراً صريحاً. هذا السلوك البرمجي المنضبط يمنع توليد تنبيهات تحذيرية في سجل التشغيل (SAS Log) حول التعامل مع قيم مفقودة في العمليات الحسابية التالية، مما يضمن تدفقاً سلساً وخالياً من الأخطاء المنطقية في برامج التحليل الضخمة.
3.3 حساسية حالة الأحرف (Case Sensitivity) وتأثيرها
تعمل دالة FINDC في سلوكها الافتراضي بنمط حساس لحالة الأحرف (Case-Sensitive) عند التعامل مع النصوص المكتوبة بالأبجدية اللاتينية. وهذا يعني أن الحرف الصغير ‘a’ يُعد كياناً مغايراً تماماً للحرف الكبير ‘A’، تبعاً لاختلاف قيم الترميز الثنائي في جداول ASCII أو EBCDIC المعتمدة في بيئة النظام؛ وعليه، فإن البحث عن ‘sas’ لن يلتقط الكلمات المكتوبة بصيغة ‘SAS’ أو ‘Sas’ ما لم يتم التعامل مع هذه الجزئية برمجياً.
ينطوي هذا السلوك الافتراضي على مخاطر منهجية جسيمة في تنظيف البيانات الواقعية، حيث يؤدي تباين إدخال المستخدمين للأحرف الكبيرة والصغيرة إلى إخفاق عمليات المطابقة، وفقدان بيانات حيوية أثناء التصنيف. ولمعالجة هذه الفجوة دون إجهاد موارد النظام باستدعاء دوال تحويل الحالات مثل UPCASE أو LOWCASE على ملايين الصفوف، توفر FINDC حلولاً مدمجة فائقة الكفاءة عبر معدلات البحث المخصصة، مما يضمن اتساق النتائج وموثوقيتها الإحصائية التامة.
4. أمثلة تطبيقية أساسية لاستخدام دالة FINDC في SAS
4.1 البحث عن أحرف مفردة داخل سلاسل نصية بسيطة
لتوضيح التطبيق الأساسي لدالة FINDC، يمكن النظر في حالة فحص سجلات الموظفين لتحديد موقع أول مسافة فاصلة في الأسماء الثنائية. يتم بناء خطوة البيانات (Data Step) بتعريف متغير نصي يحتوي على الاسم الكامل، ثم استدعاء الدالة وتخزين النتيجة في متغير رقمي جديد يعكس فهرس المحرف. يُوضح المثال البرمجي التالي آلية التنفيذ المباشرة:
data example1;

    length FullName $30;

    FullName = 'Tariq Al-Hashemi';

    SpacePosition = findc(FullName, ' ');

run;

proc print data=example1 noobs;

run;
عند تشغيل هذا الكود البرمجي عبر إجراء PROC PRINT، تُظهر المخرجات أن المتغير SpacePosition يحمل القيمة العددية 6، وهي الموقع الفعلي للمسافة الفارغة التي تفصل بين الاسمين. يتيح هذا المؤشر العددي البسيط لمحلل البيانات إمكانية إجراء عمليات لاحقة كاستخراج الاسم الأول حصراً باستخدام الدالة substr(FullName, 1, SpacePosition - 1)، مما يبرز التكامل الوظيفي السلس بين دوال معالجة النصوص في SAS.
4.2 البحث عن مجموعة محارف عشوائية ضمن مصفوفة نصوص
يتجلى التفوق الحقيقي لدالة FINDC عند توسيع نطاق البحث ليشمل عدة محارف متفرقة دفعة واحدة لمعرفة أيها يسبق في الظهور الزمني داخل السلسلة. لنفترض رغبتنا في فحص نصوص تقارير سريرية لرصد أسبقية ظهور أي علامة ترقيم محتملة مثل الفاصلة، النقطة، أو علامة التعجب لتحديد نهاية الجملة التشخيصية الأولى:
data example2;

    length DiagnosisText $50;

    DiagnosisText = 'Patient stable; blood pressure normal, pulse steady.';

    FirstPunct = findc(DiagnosisText, ';,.!');

run;

proc print data=example2 noobs;

run;
في هذا التطبيق، تفحص الدالة النص وتكتشف وجود الفاصلة المنقوطة ‘;’ في الموقع 15، والفاصلة العادية ‘,’ في الموقع 38، والنقطة ‘.’ في الموقع 52. واستناداً إلى منطقها التشغيلي، تتوقف الدالة فور العثور على أول محرف مطابق من القائمة المعطاة وتُرجع القيمة 15. يؤكد هذا المثال قدرة الدالة على تقييم مصفوفة من الخيارات المتعددة بالتوازي، وإرجاع الأسبق ظهوراً بدقة متناهية دون الحاجة إلى مقارنات شرطية معقدة ومجهدة للذاكرة.
4.3 تطبيق الدالة على مجموعات بيانات حقيقية متعددة السجلات
عند التعامل مع مجموعات بيانات ميدانية تشمل مئات الآلاف من السجلات، تصبح كفاءة المعالجة الجماعية عبر خطوة البيانات المعيار الحاسم لتقييم الأداء. في المثال الإحصائي التالي، ننشئ جدول بيانات يحاكي أرقام ملفات مرجعية في دراسة وبائية تحتوي على بادئات مشوشة تتطلب كشف أول رقم عددي لتحديد بداية المعرف الحقيقي:
data ClinicalRegistry;

    infile datalines truncover;

    input RecordID $20.;

    datalines;

PAT-A-98214

SUBJ_X_0034

CTR98762

INVALID_ENTRY

;

run;
data ProcessedRegistry;
set ClinicalRegistry;
DigitPos = findc(RecordID, '0123456789');
run;
تُظهر نتائج معالجة هذا الجدول أن السجل الأول يُرجع القيمة 7، والسجل الثاني يُرجع القيمة 8، في حين يُرجع السجل الثالث القيمة 4. أما السجل الرابع الخالي من أي أرقام فيُرجع القيمة 0 تلقائياً. يوفر هذا المتغير الرقمي المستحدث (DigitPos) معياراً تصنيفياً دقيقاً، يمكّن فريق تحليل البيانات من فرز السجلات السليمة وعزل السجلات الشاذة التي تفتقر للمكون الرقمي بمرونة حوسبية مطلقة.
5. استخدام معدلات البحث المتقدمة مع دالة FINDC
5.1 المعدل ‘i’: تجاهل الفروق بين الحالات الكبيرة والصغيرة
يعد المعدل ‘i’ (أو ‘I’) المستمد من مصطلح Case-Insensitive أحد أكثر المعدلات استخداماً في التحليلات النصية. يعمل هذا المعدل على تعطيل الحساسية الافتراضية لحالة الأحرف، مما يجعل عملية البحث تطابق كلاً من الأحرف اللاتينية الكبيرة والصغيرة بالتساوي ودون تمييز، بصرف النظر عن طريقة كتابتها داخل قائمة البحث (charlist) أو داخل السلسلة الأصلية.
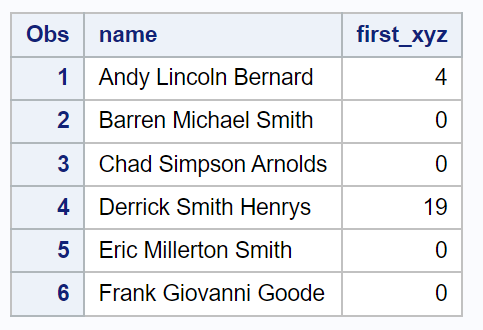
يوفر هذا المعدل وفورات برمجية وحوسبية هائلة؛ إذ يغني المبرمج تماماً عن استدعاء الدوال التحويلية الإضافية مثل upcase() التي تستهلك دورات معالجة إضافية لإنشاء نسخ معدلة من السلاسل في الذاكرة المؤقتة. على سبيل المثال، فإن تنفيذ الكود findc(SubjectCode, 'xyz', 'i') سيحدد موقع أي من الأحرف المذكورة سواء وردت بصيغة ‘x’ أو ‘X’ أو ‘y’ أو ‘Y’ أو ‘z’ أو ‘Z’، مما يضمن شمولية الفحص والحد من أخطاء المطابقة الناتجة عن تباين صيغ الإدخال.
5.2 المعدل ‘v’: تقليب منطق البحث للعثور على المحارف غير المطابقة
يقدم المعدل ‘v’ (أو نظيره الوظيفي ‘k’) نقلة نوعية في منهجيات تدقيق البيانات؛ إذ يقوم بقلب منطق البحث تماماً ليتحول إلى وضع التحقق (Verify Mode). عند تفعيل هذا المعدل، تتوقف الدالة عن البحث عن المحارف الموجودة في القائمة، لتبحث عوضاً عن ذلك عن موقع أول محرف لا ينتمي إلى قائمة المحارف المحددة مصرحاً بوجود قيمة غير معتمدة.
يمثل هذا النمط أداة رقابية مثالية لفحص التزام السجلات بالمعايير التشفيرية المعتمدة؛ فإذا أردنا التحقق من أن حقلاً مخصصاً للأرقام يحتوي على أرقام حصرية فقط، نمرر الأرقام ‘0123456789’ في القائمة مع تفعيل المعدل ‘v’ عبر الكود findc(FieldVal, '0123456789', 'v'). إذا أرجعت الدالة القيمة صفر، فهذا يعني أن جميع محارف السلسلة تتألف من أرقام شرعية، أما إذا أرجعت أي رقم موجب، فإن ذلك يشير مباشرة إلى موقع أول رمز أو حرف متسلل ينتهك القواعد المقررة، ليحل هذا المعدل محل دالة VERIFY التاريخية بكفاءة واقتدار.
5.3 المعدلات ‘t’ و ‘b’: إدارة الفراغات البيضاء البادئة واللاحقة
تشكل الفراغات البيضاء المتأصلة في حقول النصوص ذات الأطوال الثابتة في SAS (Trailing Blanks) مصدراً متكرراً للنتائج الإحصائية المضللة؛ حيث تحسب الدالات أحياناً تلك المسافات اللاحقة كمدخلات نظامية. وهنا يبرز دور المعدل ‘t’ (Trim) الذي يوجه الدالة إلى استبعاد وحذف المسافات الفارغة اللاحقة من نهايات السلاسل المستهدفة وقوائم البحث بصورة ديناميكية أثناء الفحص الفوري، مانعاً احتسابها كمحارف متطابقة بطريق الخطأ.
من ناحية أخرى، يتيح المعدل ‘b’ (Backward) تغيير اتجاه المسح من الاتجاه التقدمي المعتاد ليصبح اتجاهاً تراجعياً من نهاية السلسلة إلى بدايتها. وعند الجمع بين عدة معدلات، مثل استخدام التعبير 'it'، يحصل محلل البيانات على أعلى مستويات الدقة الرقابية؛ حيث يتجاهل النظام حالة الأحرف نهائياً وفي الوقت نفسه يقتطع كافة الفراغات الهامشية اللاحقة، مما يحصن الكود ضد أكثر العيوب البرمجية خفاءً في خطوط تنقية البيانات المعقدة.
بالإضافة إلى ذلك، توفر دالة FINDC فئات المحارف المدمجة (Character Class Modifiers) التي تغني عن كتابة القوائم الطويلة يدوياً؛ مثل استخدام المعدل ‘d’ للبحث عن أي رقم (Digits)، والمعدل ‘a’ لتقفي أي حرف أبجدي (Alphabetic)، والمعدل ‘s’ لاكتشاف المسافات والفراغات (Whitespace)، والمعدل ‘p’ لرصد علامات الترقيم (Punctuation)، والمعدل ‘c’ لمحارف التحكم (Control characters)، والمعدل ‘u’ للحروف الكبيرة (Uppercase)، والمعدل ‘l’ للحروف الصغيرة (Lowercase)، علاوة على المعدل ‘o’ (Optimize) الذي يوجه مترجم SAS لمعالجة وتجهيز قائمة البحث لمرة واحدة فقط بدلاً من إعادة معالجتها عند كل سجل في خطوة البيانات، مما يحقق قفزات ملحوظة في سرعة التنفيذ عند التعامل مع مجموعات البيانات المليونية.
6. المقارنة التحليلية بين FINDC والدوال النصية الشبيهة في SAS
6.1 المقارنة التفصيلية بين FINDC ودالة FIND
على الرغم من التشابه السطحي في التسمية والتقارب في بنية المعاملات، إلا أن هناك تبايناً جوهرياً في المنطق الخوارزمي بين دالة FINDC ودالة FIND القياسية. تختص دالة FIND بالبحث عن تطابق تام لسلسلة نصية فرعية محددة (Sub-string) ككيان متصل وموحد؛ فالبحث عن كلمة ‘cat’ بواسطة دالة FIND يتطلب ظهور الحروف الثلاثة متتابعة بالترتيب الدقيق نفسه داخل السلسلة الهدف لكي تُرجع الدالة موقع الحرف الأول ‘c’.
في المقابل، تتعامل دالة FINDC مع القائمة ‘cat’ بوصفها مصفوفة مكونة من ثلاثة محارف مستقلة تماماً (c أو a أو t) دون أي اعتبار للتتابع أو التركيب النحوي؛ وبالتالي فإنها تُرجع موقع ظهور أي واحد منها يصادف الفحص أولاً في النص. يترتب على هذا التمايز اختلاف مجالات الاستخدام التحليلي؛ حيث تستخدم FIND للبحث عن مفردات كاملة وعبارات محددة، بينما تمثل FINDC الحل الأمثل لاكتشاف المحددات المكانية، والرموز المعزولة، وعلامات الترقيم، والأحرف التالفة.
6.2 المقارنة بين FINDC ودالة INDEXC التقليدية
تاريخياً، اعتمد مبرمجو نظام SAS على دالة INDEXC في الإصدارات القديمة (SAS 6 وSAS 8) لتنفيذ مهام تقفي المحارف الفردية. ورغم أن دالة INDEXC تؤدي الوظيفة المحورية نفسها من حيث البحث عن أول ظهور لأي حرف من مجموعة معطاة، إلا أنها تفتقر بشدة إلى المرونة التشغيلية الحديثة؛ إذ لا تدعم نظام المعدلات البرمجية المتقدمة إطلاقاً، ولا تتيح تحديد موقع البداية للبحث بصورة مباشرة وسلسة.
مع إطلاق الإصدار التاسع من SAS (SAS 9)، طورت شركة SAS Institute Inc. دالة FINDC لتكون البديل المعياري المتطور لدالة INDEXC. تمتاز FINDC بقدرتها على دمج معدلات تجاهل الحالة (‘i’)، والبحث العكسي (‘v’)، ومسح الاتجاه العكسي (‘b’) في تعليمة واحدة، فضلاً عن دعم معامل موقع البدء الإيجابي والسلبي. لذا توصي المراجع البرمجية الأكاديمية والمهنية بتحديث الشفرات القديمة واستبدال INDEXC بدالة FINDC لرفع موثوقية التطبيقات التحليلية وتوافقها مع المعايير البرمجية الحديثة.
6.3 المقارنة مع دوال النمط والتعبيرات النمطية (PRXMATCH)
توفر دوال التعبيرات النمطية المقتبسة من بيئة بيرل (Perl Regular Expressions) وعلى رأسها دالة PRXMATCH إمكانات هائلة لمعالجة النصوص شديدة التعقيد والتنوع في SAS. ورغم ذلك، فإن توظيف محرك التعبيرات النمطية يستلزم بناء نمط صياغي معقد (Regex Pattern)، وإجراء عمليات ترجمة وتجميع داخلية للنمط (Pattern Compilation)، مما يفرض عبئاً حسابياً ملحوظاً على المعالج عند تكرار العملية عبر ملايين الملاحظات الإحصائية.
هنا تبرز دالة FINDC بوصفها البديل فائق السرعة والخفة في الحالات التي تتطلب مجرد البحث عن محارف محددة أو أصناف رمزية معيارية دون الحاجة إلى تشكيل تراكيب نحوية شرطية معقدة. إن بساطة استدعاء FINDC واستهلاكها الضئيل للذاكرة يجعلها الخيار التقني الأفضل هندسياً لمراحل تدقيق البيانات الأولية، مع قصر استخدام PRXMATCH على السيناريوهات المتقدمة جداً التي تتطلب مطابقة أنماط بنيوية ديناميكية كأرقام الهواتف الدولية وعناوين البريد الإلكتروني المركبة.
7. التطبيقات العملية لدالة FINDC في تنظيف وتحضير البيانات
7.1 اكتشاف الرموز الخاصة والمحارف غير المقبولة في المعرفات
تعد جودة المعرفات الفريدة (IDs) في قواعد البيانات السريرية والسلوكية خط الدفاع الأول لضمان سلامة التحليلات اللاحقة. تؤدي الرموز غير المقبولة كعلامات الهاشتاج (#)، والأقواس، وعلامات التنصيص الناتجة عن مشاكل إدخال واجهات المستخدم إلى كسر خوارزميات الربط الآلي بين الجداول. يمكن توظيف دالة FINDC بفاعلية لبناء مرشحات تدقيق فورية تكتشف هذه العيوب وتعزل السجلات المتضررة:
data CleanIDs CorruptIDs;

    set RawDatabase;

    IllegalPos = findc(PatientCode, '!@#$%^&*()+=[]{}|/<>?');

    if IllegalPos > 0 then output CorruptIDs;

    else output CleanIDs;

run;
يقوم هذا الإجراء بتقسيم تدفق البيانات تلقائياً وبسرعة حوسبية فائقة؛ حيث تُوجه السجلات النظيفة إلى خط المعالجة الإحصائية المباشرة، في حين تُحال السجلات المعيبة المتضمنة رموزاً محظورة إلى جدول منفصل يخضع للمراجعة والتدقيق اليدوي من قبل مسؤولي إدارة قواعد البيانات، مما يحفظ موثوقية العينة الكلية ونزاهتها المنهجية.
7.2 تجزئة النصوص واستخراج المقاطع بالاعتماد على الفواصل
تواجه مشاريع إدارة البيانات تحديات مستمرة عند استيراد نصوص مركبة تحتوي على عدة بيانات مدمجة داخل حقل واحد، مثل العناوين الجغرافية أو الأسماء الرباعية، وتزداد المشكلة تعقيداً إذا تباينت الفواصل المستخدمة بين الشرطة (-) والفاصلة (,) والنقطتين (:). تتيح دالة FINDC، بالتكامل مع دالتي LENGTH وSUBSTR، تفكيك هذه السلاسل بمرونة تامة:
data ParsedData;

    length FullString $40 Part1 Part2$20;

    FullString = 'AreaCode-5491:ZoneB';

    DelimPos = findc(FullString, '-:,');

    if DelimPos > 0 then do;

        Part1 = substr(FullString, 1, DelimPos - 1);

        Part2 = substr(FullString, DelimPos + 1);

    end;

run;
في هذا التطبيق، تحدد الدالة أول فاصل مستخدم بصرف النظر عن نوعه، مما يتيح قص المقطع الأول بدقة، واستخلاص المقطع اللاحق وتخزينه في متغيرات هيكلية مستقلة. هذه المرونة تجعل النظام قادراً على استيعاب تباين صيغ الملفات المصدرية الموردة من جهات مختلفة دون الحاجة إلى إعادة صياغتها يدوياً مسبقاً.
7.3 توحيد صياغة البيانات غير المتجانسة قبل دمج الجداول
عند دمج مصفوفات البيانات من خلال إجراء MERGE في SAS، يؤدي أي اختلاف طفيف في بنية محارف مفاتيح الربط، مثل وجود أحرف أبجدية ممتزجة مع أرقام في جدول وغيابها في جدول آخر، إلى فشل الربط التام وفقدان السجلات المقابلة. تلعب دالة FINDC دوراً حاسماً في تهيئة وتوحيد المفاتيح عبر تقصي مواضع الأحرف غير الرقمية وعزلها لضمان تجانس التركيب الهيكلي.
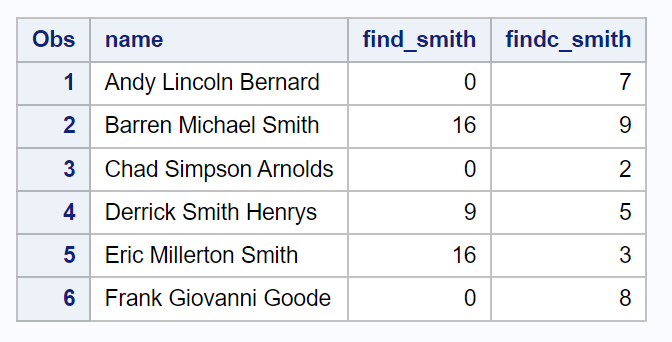
يمكن عبر توظيف المعدل ‘a’ التحقق من خلو مفاتيح الربط المخصصة للأرقام من أي حرف أبجدي متسلل قبل البدء بعملية الترتيب PROC SORT والدمج. يضمن هذا الإجراء الاستباقي تطابق أنواع البيانات وهياكلها عبر الجداول المتقاطعة، متفادياً المشكلات الصامتة الناتجة عن اختلاف أنماط المحارف التي غالباً ما تضلل الباحثين وتهدد اتساق النتائج التحليلية الختامية.
8. توظيف دالة FINDC في سياق الأبحاث والتحليلات المتقدمة
8.1 تدقيق استجابات المسوح والاستبانات
في مجالات العلوم النفسية والاجتماعية والبحوث السلوكية، تعتمد المسوح الميدانية على استبانات تتضمن أسئلة مغلقة ومقننة تتطلب استجابات محددة بدقة (مثل الاختيار من متعدد A, B, C, D أو ترقيمات رقمية محددة). تتسلل أحياناً أثناء الإدخال الإلكتروني السريع أو التدوين الورقي رموز عشوائية كعلامات الاستفهام، أو إشارات الجمع والطرح، أو أحرف غير مخصصة للاختبار تخل بسلامة البنية القياسية للمتغيرات.
يعد استخدام دالة FINDC المدعومة بمعدل التحقق العكسي ‘v’ الاستراتيجية البرمجية المثالية لأتمتة فحص الاستبانات. من خلال حصر الرموز المسموح بها وتطبيق الدالة على حقول الإجابات، يمكن استخراج السجلات التي انتهكت المعايير القياسية فوراً. يقلل هذا التدقيق المؤتمت من التحيز المنهجي، ويزيل البيانات الشاذة، مما يرفع من مؤشرات الاتساق الداخلي وموثوقية معاملات الثبات (Reliability Metrics) كمعامل ألفا كرونباخ للمقاييس قيد الدراسة.
8.2 معالجة بيانات المقاييس النفسية ومقاييس ليكرت المتعددة
تعتمد مقاييس ليكرت (Likert Scales) الثلاثية، الخماسية، والسباعية على تدرجات رتبية رقمية صارمة تعبر عن درجات الموافقة أو الرفض. وفي بيئات جمع البيانات البحثية غير المنضبطة، قد يدخل المبحوث تعليقات نصية مختصرة أو علامات تردد (مثل كتابة ‘3?’ أو ‘4/5’ أو ‘N/A’) داخل الخانات المخصصة للدرجات الرقمية فقط، مما يعطل تحويلها إلى متغيرات كمية صالحة للتحليل العاملي (Factor Analysis).
تتدخل دالة FINDC لرصد أي محرف نصي أو رمزي غريب داخل مصفوفة بنود المقياس النفسي. يتيح ذلك للباحث برمجة معالجات شرطية ذكية تستبدل الإدخالات المشوشة بقيم مفقودة نظامية معتمدة وفق بروتوكولات التعامل مع البيانات المفقودة، أو إعادة تصنيفها وفق قواعد محددة سلفاً، مما يضمن تدفق بيانات نقية تماماً إلى نماذج معادلات البناء الهيكلي (Structural Equation Modeling) دون تشويش إحصائي.
8.3 تأهيل وتجهيز النصوص لتحليلات المحتوى والتحليل النوعي
مع تنامي الدراسات السلوكية المختلطة (Mixed Methods Research)، بات دمج البيانات النوعية المستخلصة من المقابلات المفتوحة مع النماذج الكمية توجهاً بحثياً شائعاً. تتطلب عمليات تحليل المحتوى المعجمي وتعدين النصوص تفكيك الفقرات السردية الطويلة إلى جمل وعبارات دلالية معزولة بناءً على محارف الوقف الطبيعية كالنقط، وعلامات التعجب، والفواصل التفسيرية.
توفر FINDC للباحثين آلية فائقة المرونة لرصد علامات نهاية الجمل والفقرات بدقة حسابية متناهية، متيحة قص النصوص المطولة إلى وحدات تحليل لغوية متجانسة. يمكن بعد ذلك ربط مخرجات هذه الوحدات كمتغيرات تنبؤية في نماذج الانحدار اللوجستي أو الانحدار المتعدد، مما يوثق الصلة المنهجية بين التحليل السلوكي النوعي والقياس النفسي الإحصائي المتطور داخل منظومة SAS الموحدة.
9. أفضل الممارسات البرمجية وتحسين الأداء عند استخدام FINDC
9.1 إدارة السلاسل النصية الفارغة والقيم المفقودة
يعد التعامل مع المتغيرات النصية الفارغة (Blank or Missing Strings) من النقاط الحرجة التي تتطلب انتباهاً خاصاً من مبرمج SAS. عندما تمرر سلسلة نصية فارغة كلياً إلى المعامل الأول في دالة FINDC، فإن الدالة تُرجع تلقائياً القيمة 0، معلنة عدم العثور على أي تطابق، دون أن تتسبب في توقف تنفيذ خطوة البيانات أو توليد رسائل خطأ قاتلة في سجل التشغيل.
ورغم سلامة هذا السلوك تقنياً، إلا أن المخاطر المنطقية قد تنشأ إذا كانت قائمة المحارف المبحوث عنها (charlist) تتضمن مسافة فارغة ‘ ‘ أو إذا استخدم المبرمج معدل التحقق ‘v’ دون توخي الحذر؛ حيث ستعتبر الدالة الفراغ تطابقاً شرعياً أو العكس. ولتفادي هذه الإشكالات، يُنصح دائماً بالتحصين البرمجي عبر استخدام دالة missing() للتحقق المسبق من وجود بيانات صالحة في الحقل قبل تطبيق دوال البحث الحرفي، مما يضمن اتساق المنطق الإحصائي المتبع وتفادي النتائج الخادعة.
9.2 تحسين كفاءة التنفيذ الحوسبي في مجموعات البيانات الضخمة (Big Data)
في بيئات البيانات الضخمة التي تحتوي على مصفوفات تتجاوز عشرات الملايين من الصفوف الإحصائية، تصبح كل دورة معالجة إضافية عاملاً مؤثراً في تكلفة وقت التشغيل واستهلاك موارد الخادم. لتحقيق أقصى كفاءة عند استخدام FINDC، يتعين استغلال المعامل الاختياري startpos لتحديد موقع البحث بدقة وتفادي المسح العشوائي لكامل السلسلة من بدايتها عند توفر مؤشرات مسبقة لموقع البيانات المستهدفة.
علاوة على ذلك، يمثل استدعاء الدالة داخل الحلقات التكرارية المعقدة (DO LOOPS) عبئاً كبيراً ما لم يتم ضبط قواعد الخروج المبكر من الحلقة بمجرد تحقيق الشرط المطلوب. كذلك فإن استخدام المعدل المتقدم ‘o’ (Optimize) يعد من أهم الاستراتيجيات البرمجية الواجب اتباعها؛ حيث يقوم هذا المعدل بتوجيه المترجم إلى معالجة قائمة المحارف وفهرستها لمرة واحدة فقط طوال فترة تشغيل خطوة البيانات، بدلاً من إعادة بنائها مع كل ملاحظة إحصائية مستقلة، مما يحقق اختصاراً ملموساً لزمن التنفيذ واستهلاك المعالج المركزي (CPU).
9.3 تحديد أطوال المتغيرات المخرجة وضبط مساحات التخزين
تنتج دالة FINDC بطبيعتها قيماً عددية يتم تخزينها في متغيرات رقمية جديدة. في لغة SAS، تأخذ المتغيرات الرقمية الجديدة تلقائياً طولاً افتراضياً يبلغ 8 بايت من مساحة التخزين، وهو طول كافٍ لتخزين أكبر الأرقام بدقة النقطة العائمة، ولكنه يمثل هدراً تخزينياً ملحوظاً لمؤشرات مواقع أحرف لا تتجاوز قيمتها الفعلية عادة بضع عشرات أو مئات من البايتات.
لذا يفضل برمجياً في مشاريع المستودعات الإحصائية الكبرى استخدام تعليمة LENGTH استباقياً لضبط أطوال المتغيرات النصية المستخرجة وتخصيص أحجام المتغيرات الرقمية بدقة بما يلائم النطاق المتوقع، مع استخدام تعليمة DROP لاستبعاد المتغيرات الوسيطة المؤقتة الناتجة عن دوال الفحص النصي قبل حفظ مجموعة البيانات النهائية. يسهم هذا الانضباط في تقليص المساحة القرصية المطلوبة، وتسريع عمليات الإدخال والإخراج (I/O)، وتقديم سجل تشغيل SAS Log نظيف وخالٍ من التحذيرات التشغيلية.
10. دليل إرشادي سريع وأخطاء شائعة يجب تجنبها
10.1 جدول مرجعي شامل لمعاملات ومعدلات دالة FINDC
يوضح الجدول التركيبي التالي ملخصاً شاملاً لأهم المعدلات البرمجية المستخدمة مع دالة FINDC في SAS، مبيناً الوظيفة الإجرائية الدقيقة لكل معدل وحالات التطبيق الإحصائي الأكثر ملاءمة له في بيئات التحليل المتقدمة:
| رمز المعدل | التسمية الوظيفية | الآلية الإجرائية للدالة | سياق التطبيق الموصى به |
|---|---|---|---|
| i / I | Ignore Case | تجاهل الفروق بين الأحرف الكبيرة والصغيرة ومطابقتها بالتساوي | تنظيف حقول الأسماء والمسميات ذات صيغ الإدخال العشوائية |
| v / V أو k / K | Verify / Keep Logic | قلب نمط البحث للعثور على أول محرف غير موجود في القائمة | تدقيق الأرقام التعريفية والمقاييس النفسية للتأكد من شرعية الرموز |
| t / T | Trim Blanks | إهمال واستبعاد المسافات البيضاء الفارغة في نهاية السلاسل النصية | معالجة المتغيرات ذات الأطوال الثابتة لمنع اعتبار الفراغ تطابقاً |
| b / B | Backward Search | مسح السلسلة من نهايتها إلى بدايتها تراجعياً (يمين إلى يسار) | استخراج آخر فاصل أو لاحقة محددة في المسارات والعناوين |
| d / D | Digits Class | البحث التلقائي عن أي محرف رقمي (0-9) دون سرده يدوياً | تحديد موضع بداية الأرقام في السجلات المختلطة والمشفرة |
| a / A | Alphabetic Class | البحث التلقائي عن أي محرف أبجدي لاتيني كبير أو صغير | فصل الكلمات عن الأرقام في المفاتيح التعريفية المركبة |
| s / S | Space / Whitespace | البحث التلقائي عن المسافات والفراغات البيضاء ومحارف الجدولة | تجزئة العبارات السردية واستخراج الكلمات في دراسات تحليل المحتوى |
| o / O | Optimize | معالجة وتجميع قائمة البحث لمرة واحدة فقط عبر كافة الملاحظات | تسريع تنفيذ المعالجة الحوسبية في مجموعات البيانات الضخمة والمليونية |
10.2 الأخطاء الشائعة في كتابة واستدعاء دالة FINDC وكيفية معالجتها
يقع العديد من المحللين في خطأ منهجي شائع يتمثل في الخلط التام بين منطق دالة FINDC ومنطق دالة FIND؛ حيث يفترض المبرمج خطأً أن تمرير الكلمة ‘ERROR’ إلى دالة FINDC سيبحث عن ورود الكلمة ككتلة واحدة، بينما تقوم الدالة فعلياً بالتقاط أول ظهور لأي من أحرف تلك الكلمة منفردة (مثل التقاط أول حرف ‘E’ أو ‘R’ في النص)، مما يولد مؤشرات خاطئة في شروط التصفية. ولتصحيح ذلك، يجب قصر استخدام FINDC على حالات البحث الذري عن محارف مستقلة، والاعتماد على FIND عند الرغبة في تقفي عبارات مكتملة.
من الأخطاء المتكررة أيضاً إهمال إضافة المعدل ‘i’ عند فحص متغيرات نصية مستوردة من أنظمة تشغيل متنوعة، مما يؤدي إلى تجاهل حالات التطابق بسبب التباين في كتابة الحروف الكبيرة والصغيرة. يضاف إلى ذلك سوء تفسير القيمة الصفرية المرجعة (0)؛ حيث يعاملها بعض المحللين في الحسابات التراكمية اللاحقة على أنها قيمة صالحة تمثل الموقع الأول بينما هي في الحقيقة مؤشر انعدام التطابق، ولتفادي هذه المعضلة الحسابية، يجب دائماً وضع شروط تحقق مسبقة if Position > 0 then ... لضمان توجيه التدفق التحليلي للمسار السليم دون تشويه الإحصاءات الوصفية.
10.3 خلاصة وتوصيات نهائية لدمج الدالة في مسارات العمل التحليلية
تشكل دالة FINDC في نظام SAS أداة برمجية لا غنى عنها لأي محلل بيانات أو باحث إحصائي يتعامل مع السلاسل النصية المعقدة والبيانات الميدانية غير المنظمة. إن تمكن الباحث من فهم دقائق بنيتها النحوية، وإتقان توظيف معدلاتها المتقدمة يتيح له تشييد خطوط أنابيب لمعالجة البيانات تتسم بالرصانة والسرعة، وتضمن تنقية السجلات وتأهيلها للنمذجة بأعلى درجات الموثوقية العلمية.
لتحقيق أقصى استفادة مستدامة، يوصى بأتمتة استدعاءات FINDC عبر تضمينها داخل حزم الماكرو (SAS Macros)، مما يسمح بتطبيق قواعد التنظيف والتدقيق المعياري بصورة ديناميكية موحدة عبر مشاريع المؤسسة البحثية بأكملها. كما ينبغي الالتزام الكامل بتوثيق الأكواد والتعليق البرمجي التوضيحي داخل الشفرات المصدرية لبيان الأسباب المنهجية الكامنة خلف اختيار كل معدل برمجي، بما يضمن شفافية التحليل الإحصائي وقابليته لإعادة الإنتاج الأكاديمي الصارم (Academic Reproducibility) وفق أرقى المعايير العالمية المعتمدة في علوم البيانات.
خاتمة
في الختام، تجسد دالة FINDC التوازن المثالي بين البساطة التركيبية والقوة الحوسبية الفائقة ضمن ترسانة معالجة النصوص في بيئة SAS. ومن خلال قدرتها المتفوقة على رصد وتدقيق المحارف الفردية، وتجاوز الفراغات الهامشية، وتوفير خيارات البحث العكسي المتطورة، تسهم الدالة بشكل جوهري في رفع كفاءة التحليل الاستكشافي وضمان جودة قواعد البيانات الأكاديمية والمهنية. إن الاستثمار في استيعاب هذه الأداة وتطبيقها الرشيد يمثل خطوة أساسية لكل ممارس إحصائي يسعى إلى تحقيق أعلى مستويات النزاهة والدقة في مخرجاته البحثية والتحليلية.
المراجع
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com