
تُعد معالجة البيانات الخام واستيرادها الركيزة الأساسية التي تقوم عليها كافة التحليلات الإحصائية والنمذجة التنبؤية المتقدمة في بيئات البحوث التجريبية والعلوم السلوكية والاجتماعية. فعندما يواجه الباحث تدفقات هائلة من السجلات الرقمية والوصفية المأخوذة من أدوات القياس الميدانية، أو الاستبيانات الإلكترونية، أو مسجلات القياس النفسي، فإن التحدي الجوهري لا يقتصر على صياغة الفرضيات الإحصائية واختبارها فحسب، بل يمتد إلى كيفية تطويع تلك الملفات المسطحة غير المنظمة وتحويلها إلى مصفوفات بيانية رصينة تخضع لقواعد المعالجة الصارمة داخل البرمجيات الإحصائية المتخصصة. ويبرز نظام التحليل الإحصائي SAS (Statistical Analysis System) كأحد أرسخ وأقوى النظم الحاسوبية في هذا المضمار، حيث صُممت بنيته الأساسية لتوفير سيطرة مطلقة على حركة البيانات من وسائط التخزين الخارجية إلى الذاكرة العاملة.
تتمحور هذه القوة البرمجية الفائقة في بيئة SAS حول خطوة البيانات (DATA Step)، وتحديداً من خلال توظيف عبارة INFILE التي تمثل حجر الزاوية في بناء قنوات الاتصال بالملفات النصية الخارجية. لا تُعد عبارة INFILE مجرد أداة لاستدعاء الملفات، بل هي آلية دقيقة تتحكم في ميكانيكية قراءة السجلات، وتوجيه مؤشرات المسح، وإدارة مخازن الذاكرة المؤقتة. إن الإلمام العميق بأبعاد هذه العبارة يُمكّن المحلل من تجاوز عيوب المعالجة التلقائية السطحية، والتعامل بحرفية مع التحديات المزمنة مثل البيانات المفقودة، والفواصل غير المنتظمة، وتداخل السلاسل النصية المركبة، مما يضمن في نهاية المطاف سلامة المدخلات ودقة الاستدلالات الإحصائية اللاحقة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك البنية المعمارية والوظيفية لعبارة INFILE في نظام SAS، متتبعاً أصولها النظرية والتقنية، ومستعرضاً آليات عملها التفاعلية مع عبارات خطوة البيانات الأخرى، ومحللاً بصورة مفصلة المعاملات المرافقة لها مثل DLM وDSD وMISSOVER وFIRSTOBS. كما يقدم الدليل نموذجاً تطبيقياً متكاملاً يحاكي السيناريوهات الواقعية لمعالجة مجموعات البيانات الميدانية، متبوعاً بأفضل الممارسات المنهجية لتشخيص الأخطاء وضمان موثوقية قواعد البيانات وتكاملها قبل الانخراط في النمذجة الإحصائية المتقدمة.
1. مقدمة إلى عبارة INFILE ودورها في إدارة البيانات الإحصائية في SAS
1.1 مفهوم استيراد البيانات الخارجية في بيئة SAS
يمثل استيراد البيانات الخارجية في نظام SAS جسر العبور الحرج بين الواقع الميداني الخام والنماذج الإحصائية المجردة. تنشأ الحاجة الماسة لقراءة الملفات النصية المسطحة—سواء كانت ملفات ذات امتدادات نصية عامة (.txt) أو ملفات مفصولة بفواصل (.csv) أو علامات جدولة (.tsv)—من طبيعة تدفق البيانات في مراكز البحوث والمختبرات؛ حيث تُنتج أدوات القياس النفسي والفيزيولوجي مخرجات رقمية أولية تفتقر إلى أي بنية علائقية جاهزة. تتطلب المعالجة الإحصائية تحويل هذه الكتل غير المتجانسة من الحروف والأرقام إلى جداول منظمة تتألف من أعمدة تُمثل المتغيرات (Variables) وصفوف تُمثل الملاحظات أو الحالات (Observations).
تتدفق البيانات من الملفات الخارجية إلى جداول بيانات SAS عبر قناة منظمة تبدأ من مستوى نظام التشغيل ومساحات التخزين المادية، مروراً بمخزن الإدخال المؤقت في الذاكرة العشوائية، لتستقر في نهاية المطاف داخل مكتبة العمل المؤقتة (Work Library) أو إحدى المكتبات الدائمة المخصصة للمشروع. يتيح هذا المسار للمحلل القدرة على مراقبة جودة البيانات في لحظة تدفقها الأولى، وفحص سلامة التوزيعات التكرارية والترميزات الرقمية، بدلاً من التعامل مع أخطاء هيكلية مستترة يصعب كشفها لاحقاً.
تتجلى المرونة الاستثنائية التي توفرها خطوة DATA المدعومة بعبارة INFILE مقارنة بالإجراءات الجاهزة في قدرتها على بناء مجموعات البيانات من الصفر وفق خوارزميات يحددها الباحث بدقة متناهية. لا يُجبر المحلل على قبول هيكل افتراضي مفروض من برمجيات أخرى، بل يمتلك الصلاحية الكاملة لتحديد شروط قراءة كل سطر، وتعديل قيم المتغيرات أثناء عملية الإدخال، واستبعاد السجلات الشاذة برمجياً في لحظة القراءة الأولى، مما يعزز الحصانة المنهجية للبيانات المستوردة.
1.2 الفرق بين خطوة DATA المعززة بـ INFILE وأداة PROC IMPORT
يقود فحص المقارنة بين خطوة DATA المعتمدة على INFILE وإجراء الاستيراد التلقائي PROC IMPORT إلى إدراك الفارق بين التحكم البرمجي الصارم والأتمتة المبنية على التخمين. يعتمد إجراء PROC IMPORT على ما يُعرف بمحرك التخمين الإحصائي (Guesser Engine)، وهو آلية تفحص أول عدد معين من الأسطر في الملف المصدر لمحاولة استنتاج أنواع المتغيرات (رقمية أم نصية) وتحديد أطوالها المناسبة. ورغم أن هذا الإجراء يوفر سرعة ملحوظة في معالجة الملفات القياسية المتناسقة، إلا أنه ينطوي على مخاطر منهجية كبرى؛ فإذا كان السجل رقم 100 يحتوي على قيمة نصية بينما كانت السجلات العشرين الأولى أرقاماً متجانسة، فإن PROC IMPORT قد يُسند نوعاً رقمياً للعمود بالكامل، مما يؤدي إلى فقدان القيمة النصية لاحقاً واعتبارها قيمة غير صالحة.
في المقابل، توفر عبارة INFILE في سياق خطوة DATA تحكماً دقيقاً وقطعياً في أنماط المدخلات، حيث يلغي الباحث أي مساحة للتخمين العشوائي. يتم تحديد نوع كل متغير وطوله وتنسيقه المسبق (Informat) بدقة يدويّة صارمة. تمتد هذه السيطرة لتشمل الملفات المعقدة التي تحتوي على سجلات غير نمطية، كأن تختلف بنية السطر الواحد بناءً على رمز معين في بدايته، أو الملفات التي تتطلب دمج عدة أسطر فيزيائية لبناء ملاحظة إحصائية واحدة، وهي مهام يعجز PROC IMPORT بنيوياً عن إنجازها.
وعلاوة على الدقة المنهجية، تتفوق خطوة INFILE بشكل حاسم في معايير الكفاءة الحاسوبية والسرعة الزمنية عند معالجة مجموعات البيانات الضخمة (Big Data). فمن خلال تجاوز مرحلة مسح التخمين التي يفرضها PROC IMPORT، وقراءة الملف في مسار تدفقي واحد مع إمكانية تحسين استهلاك الذاكرة وتحديد حدود الذاكرة المؤقتة، توفر INFILE للمؤسسات البحثية والباحثين وسيلة فائقة الكفاءة لمعالجة ملايين السجلات دون إرهاق موارد الخوادم الحوسبية المركزية.
1.3 البنية التركيبية العامة (Syntax) لعبارة INFILE
تخضع عبارة INFILE لقواعد صياغة دقيقة وصارمة تعكس الفلسفة التصميمية لنظام SAS البرمجي. يتمثل الموضع الصحيح لعبارة INFILE داخل خطوة البيانات الإنشائية بوجودها المباشر بعد عبارة DATA التي تحدد اسم الجدول المراد إنشاؤه، وقبل عبارة INPUT المسؤولة عن قراءة وتفكيك الحقول الفردية. يُعد هذا الترتيب محورياً لأن عبارة INFILE هي التي تفتح القناة الفيزيائية للملف وتحدد شروط التدفق، مما يمهد الطريق لعبارة INPUT لمسح البيانات المودعة في مخزن الإدخال المؤقت وفق التعليمات المعطاة.
تتطلب الصياغة النموذجية للعبارة تحديد المسار البرمجي للملف المصدر بدقة متناهية، محاطاً بعلامات تنصيص متوافقة، متبوعاً بحزمة من الخيارات الموجهة لمترجم SAS. تبدأ الصياغة بالكلمة المحجوزة INFILE، تليها مسار الملف، ثم سلسلة المعاملات الإضافية التي تنظم عملية القراءة، وتنتهي دائماً بالفاصلة المنقوطة الشهيرة (;) التي تمثل نهاية العبارة التنفيذية في لغة SAS. إن أي إخلال في موقع الفاصلة المنقوطة أو ترتيب العبارات يؤدي إلى إجهاض مرحلة الترجمة البرمجية وتوقف التنفيذ فوراً.
تتضمن الخيارات الإضافية المصاحبة للعبارة طيفاً واسعاً من المحددات التشغيلية التي تمنح الباحث مرونة غير محدودة في التعامل مع تنوع هياكل الملفات الخام. تشمل هذه المعاملات خيارات لتحديد نوع الفواصل بين الحقول، وطريقة التعامل مع القيم المفقودة المتتالية، وتجاوز أسطر الترويسة، وتقييد عدد الأسطر المقروءة لأغراض الفحص الأولي، بالإضافة إلى معالجة السجلات المقتطعة أو الممتدة، مما يجعل البنية التركيبية لعبارة INFILE بيئة معمارية متكاملة تتكيف مع كافة سيناريوهات إدارة البيانات المعقدة.
2. التشريح التفصيلي لصيغة عبارة INFILE الأساسية
2.1 تحديد مسار الملف المصدر وقواعد كتابته
يتطلب الربط الناجح للملفات الخارجية فهم القواعد الدقيقة لكتابة المسارات داخل بيئة SAS. يمكن للباحث استخدام المسار المطلق (Absolute Path) الذي يحدد الموقع الفيزيائي الكامل للملف من جذر نظام الملفات وحتى امتداد الملف النهائي، أو اللجوء إلى المسار النسبي (Relative Path) الذي يرتبط بدليل العمل الحالي للجلسة الإحصائية. يُفضل دائماً في البحوث الأكاديمية والتحليلات المؤسسية استخدام المسارات المطلقة لضمان إمكانية إعادة تشغيل الكود البرمجي (Reproducibility) في أوقات لاحقة دون الاعتماد على موقع حفظ البرنامج ذاته.
يخضع التعامل مع علامات التنصيص المفردة (‘) والمزدوجة (“) لقواعد برمجية واضحة في SAS؛ فعلى الرغم من أن كلاهما صالح للإحاطة بالمسار النصي، إلا أن استخدام علامات التنصيص المزدوجة يُعد ضرورياً إذا كان المسار يحتوي على متغيرات ماكرو (Macro Variables) يُراد حلها وتوسيعها أثناء مرحلة الترجمة البرمجية. أما إذا كان المسار ثابتاً ومجرداً من أي رموز برمجية خاصة، فإن علامات التنصيص المفردة تفي بالغرض وتمنع المترجم من محاولة تفسير أي رمز بداخل المسار كرمز ماكرو غير مقصود.
كما يجب مراعاة الفروق التقنية العميقة بين أنظمة التشغيل عند صياغة المسارات. ففي بيئات Windows، تُستخدم الشرطة المائلة العكسية (Backslash: ) للفصل بين المجلدات، بينما تفرض أنظمة Linux وUNIX والأنظمة السحابية المعاصرة استخدام الشرطة المائلة للأمام (Forward Slash: /). يمتلك مترجم SAS في الإصدارات الحديثة مرونة ملحوظة في قبول الشرطة المائلة للأمام حتى على أنظمة Windows، مما يجعل اعتماد الشرطة المائلة للأمام ممارسة موصى بها لكتابة أكواد برمجية عابرة للمنصات وقابلة للتشغيل عبر بيئات الحوسبة السحابية المختلفة دون تعديل.
2.2 التكامل بين عبارة DATA وعبارة INFILE
يرتكز التشغيل البرمجي لخطوة البيانات في SAS على تكامل صارم بين عبارة DATA وعبارة INFILE ينعكس مباشرة على إدارة الذاكرة الحاسوبية. عندما يعلن الباحث عن اسم مجموعة البيانات في عبارة DATA، كأن يكتب اسماً في مكتبة العمل المؤقتة Work، يقوم النظام بتخصيص مساحة جدولية جديدة في الذاكرة لتلقي البيانات الناتجة. فور وصول المترجم إلى عبارة INFILE، يتم فتح مؤشر قراءة لنظام الملفات يربط تلك المساحة الجدولية بالملف الخارجي المستهدف، مما ينشئ قناة تدفق تضمن حركة السجلات بانسيابية وانتظام.
تخضع هذه العملية لدورة حياة ثنائية تتألف من مرحلة الترجمة (Compilation Phase) ومرحلة التنفيذ (Execution Phase). في مرحلة الترجمة، تقوم عبارة INFILE بتجهيز مخزن الإدخال المؤقت (Input Buffer)، وهو نطاق ذاكرة مخصص لاحتواء السطر النصي الخام فور قراءته من القرص الصلب، كما تقوم خطوة DATA بتجهيز متجه بيانات البرنامج (Program Data Vector – PDV)، وهو الوعاء المنطقي الذي يتضمن المتغيرات التي ستُكتب في مصفوفة البيانات النهائية، بالإضافة إلى المتغيرات النظامية التلقائية مثل رقم الملاحظة (_N_) ورمز الخطأ (_ERROR_).
في مرحلة التنفيذ، تتولى عبارة INFILE توجيه قراءة سطر فيزيائي كامل ونسخه إلى مخزن الإدخال المؤقت، لتبدأ حلقة تكرارية مستمرة تقرأ سطراً تلو الآخر حتى استنزاف الملف. يُعد الترتيب الهيكلي للأوامر بالغ الأهمية؛ فأي محاولة لوضع عبارات تحويلية تسبق استدعاء INFILE قد تؤدي إلى خلل في تهيئة متجه بيانات البرنامج، مما يبرز الأهمية المفصلية لفهم ميكانيكية الذاكرة في تحقيق الأداء الإحصائي الأمثل وضمان عدم تداخل قيم الحالات المختلفة داخل المصفوفة الجدولية.
2.3 دور عبارة INPUT المكمل لعبارة INFILE
إذا كانت عبارة INFILE هي الأداة المسؤولة عن فتح الباب واستقبال السجل الخام في مخزن الإدخال المؤقت، فإن عبارة INPUT هي المهندس الذي يقوم بتفكيك هذا السجل وفرز عناصره ونقلها إلى متجه بيانات البرنامج (PDV). لا تمتلك INFILE القدرة بمفردها على فهم المعاني الإحصائية للحقول، بل يقتصر دورها على إدارة الوسط الفيزيائي للتدفق، وهنا يأتي دور INPUT لتحديد المتغيرات الرقمية والنصية؛ حيث تُعرّف المتغيرات النصية بإلحاق علامة الدولار ($) باسم المتغير، بينما تُعامل المتغيرات الخالية من هذه العلامة تلقائياً كمتغيرات رقمية تخضع للعمليات الحسابية المباشرة.
يتحقق التوافق المنهجي عندما يتطابق ترتيب المتغيرات في عبارة INPUT تماماً مع التوزيع الهيكلي للأعمدة في الملف النصي الخام. فإذا احتوى الملف على اسم المبحوث، ثم عمره، ثم درجته على مقياس الاكتئاب، يجب أن تسرد عبارة INPUT هذه المتغيرات بالترتيب ذاته لضمان أن مؤشر القراءة الداخلي يفرغ القيم في مواقعها المنطقية الصحيحة داخل متجه البيانات دون حدوث انزياح أو ترحيل غير مقصود للمعلومات.
يقوم مؤشر القراءة التابع لعبارة INPUT بالتحرك عبر الحقول في مخزن الإدخال المؤقت بناءً على قواعد دقيقة يحددها أسلوب الإدخال المتبع. يتتبع المؤشر المسافات أو الفواصل للانتقال من قيمة إلى أخرى، ويتحقق من مطابقة المحتوى للنوع الإحصائي المصرح به؛ فإذا واجه المؤشر أحرفاً نصية في حقل مخصص لمتغير رقمي، يُصدر النظام تحذيراً فورياً ويُسند قيمة مفقودة لتلك الخلية مع توثيق الخلل في سجل المعالجة (SAS Log)، مما يؤكد الطبيعة التكاملية الرقابية بين أداتي INFILE وINPUT.
3. التحكم في محددات الفواصل باستخدام خيار DLM
3.1 ماهية خيار DLM (Delimiter) وأهميته الإحصائية
يُمثل خيار DLM، وهو اختصار لكلمة Delimiter، المعامل الرئيس المسؤول عن إخطار نظام SAS بنوع الرمز المستخدم للفصل بين القيم المتتالية في السجل النصي الواحد. في غياب هذا الخيار، يعتمد SAS سلوكاً افتراضياً صارماً يفترض أن المسافة الواحدة (Blank Space) هي المحدد الوحيد للفصل بين المتغيرات. ورغم ملاءمة هذا السلوك الافتراضي للملفات المجدولة البسيطة، إلا أنه ينهار فور مواجهة ملفات نصية تستخدم علامات ترقيم خاصة أو فواصل قياسية، مما يستدعي تدخلاً صريحاً من المحلل لضبط إعدادات الفصل.
يكتسب خيار DLM أهمية إحصائية بالغة في الحفاظ على سلامة المتغيرات النصية المتعددة الكلمات؛ ففي بحوث العلوم النفسية والاجتماعية، كثيراً ما تتضمن استجابات المبحوثين نصوصاً مركبة مثل الأسماء المركبة أو أسماء المدن التي تحتوي على مسافات داخلية. فإذا تُرك النظام على إعداده الافتراضي، سيعتبر SAS المسافة الفاصلة بين كلمتي الاسم المركب بداية لمتغير جديد، مما يؤدي إلى ترحيل البيانات وتدمير البنية الهيكلية للمصفوفة. يتيح تعيين محدد مخصص، كالفاصلة المنقوطة أو النقطتين، حماية هذه النصوص من التجزئة الخاطئة.
تتم كتابة خيار DLM مباشرة ضمن عبارة INFILE بإسناد الرمز المرغوب بين علامتي تنصيص مفردتين، مثل صياغة الفاصلة المنقوطة كفاصل مخصص أو استخدام الشارحة العمودية (Pipe: |). يُرشد هذا التحديد البسيط مترجم SAS إلى تجاهل المسافات الفارغة كفواصل للأعمدة، وقصر عملية الانتقال بين حقول متجه بيانات البرنامج على مواجهة الرمز المحدد حصراً، مما يحفظ التجانس الرياضي والوصفي للبيانات المستوردة بدقة وموثوقية عالية.
3.2 التعامل مع الفواصل الخاصة وعلامات الجدولة (Tab Delimiters)
تشيع في قواعد البيانات الإحصائية والأنظمة المخبرية ملفات نصية تعتمد على علامات الجدولة (Tab-delimited files) للفصل بين الحقول، وهي علامات غير مرئية لا يمكن تمثيلها مباشرة بكتابة مسافة عادية بين علامتي تنصيص. للتغلب على هذا التحدي التقني وتفادي الغموض البرمجي، يُتيح نظام SAS استخدام التدوين الست عشري (Hexadecimal Notation) لتعريف المحددات غير المطبوعة بدقة بالغة؛ حيث يُشار إلى علامة الجدولة القياسية برمز ASCII الست عشري الشهير المقابل لها، وتُكتب برمجياً بالصيغة ’09’x في بيئات ترميز ASCII وUTF-8 الشائعة.
وعند الرغبة في استيراد ملفات القيم المفصولة بفواصل عادية (CSV)، يتيح استخدام خيار DLM تحديد الفاصلة المألوفة صراحة، مما يضمن تدفق البيانات بسلاسة دون الحاجة إلى معالجات وسيطة معقدة. إن التعريف الدقيق لهذه الفواصل يمنع أخطاء المحاذاة الشائعة التي تحدث عندما تختلط المسافات الحرة داخل الخلية الواحدة بالفواصل الهيكلية للملف، وهو ما يوفر حماية متقدمة للقياسات الميدانية المسجلة عبر منصات متعددة.
يتطلب التعامل مع علامات الجدولة والرموز الخاصة انتباهاً خاصاً من الباحث للتحقق من عدم وجود مسافات إضافية تسبق علامة الجدولة أو تعقبها داخل الملف الخام؛ إذ قد تؤدي المسافات الزائدة إلى تشويه القيم الرقمية أو اعتبارها جزءاً من السلسلة النصية إذا لم تُضبط خيارات الاقتطاع والتنظيف المرافقة، مما يبرز ضرورة المعاينة الهيكلية للملف عبر محررات النصوص المتقدمة قبل صياغة كود الاستيراد النهائي في SAS.
3.3 قراءة ملفات ذات محددات فواصل مركبة أو غير نمطية
تواجه المشروعات البحثية الكبرى أحياناً ملفات بيانات قديمة أو مجمعة من مصادر برمجية متباينة تعاني من فوضى هيكلية في استخدام الفواصل؛ كأن يُستخدم الفاصل النقطي والفاصلة العادية والمسافة بشكل متبادل داخل الملف ذاته للفصل بين القياسات. يُظهر خيار DLM في SAS تفوقاً لافتاً في معالجة هذه البيانات غير المنظمة، حيث يسمح بسرد أكثر من محدد فاصل في السلسلة النصية ذاتها الملحقة بالخيار، مثل وضع الفاصلة والفاصلة المنقوطة معاً بين علامتي التنصيص دون أي حواجز برمجية إضافية.
عند تحديد محددات متعددة، يُعامل نظام SAS أي رمز يطابق أياً من المحددات المذكورة كإشارة كافية لإنهاء قراءة الحقل الحالي والانتقال إلى الحقل التالي. ورغم هذه القوة البرمجية، يجب الحذر الشديد من سلوك SAS التلقائي عند مواجهة رموز محددة متجاورة دون استخدام خيارات إضافية متقدمة؛ فالوضع الافتراضي لخيار DLM يتجاهل المحددات المتتالية ويعتبرها بمثابة فاصل واحد ممتد، مما يؤدي إلى كارثة إحصائية إذا كانت المحددات المتتالية تُشير في الأصل إلى وجود قيم مفقودة بينها.
تقتضي أفضل الممارسات المنهجية إجراء فحص أولي للملف الخام (Raw Data Profiling) باستخدام برامج التحرير المتخصصة أو استعراض العينات الأولية لرصد أنماط الفواصل المركبة والتأكد من مدى اتساقها عبر كافة السجلات. يضمن هذا الإجراء الاستباقي للباحث اختيار التوليفة الصحيحة من محددات الفواصل والخيارات الداعمة، مما يمنع انزياح البيانات بين الأعمدة الإحصائية ويؤسس لقاعدة بيانات صلبة خالية من التشوهات الهيكلية.
4. معالجة البيانات المفقودة والنصوص المقتبسة عبر خيار DSD
4.1 الوظيفة الأساسية لخيار DSD (Delimiter-Sensitive Data)
يُمثل خيار DSD، وهو اختصار لعبارة Delimiter-Sensitive Data (البيانات الحساسة للمحددات)، قفزة نوعية في هندسة قراءة البيانات النصية داخل نظام SAS. يتجاوز هذا الخيار القيود الكلاسيكية لعبارة INFILE البسيطة، متيحاً معالجة ذكية وحذرة للملفات التي تحتوي على تعقيدات ترقيمية شائعة في الاستبيانات وقواعد البيانات الميدانية. عند تضمين خيار DSD في عبارة INFILE، يقوم النظام تلقائياً بتغيير المحدد الافتراضي للفصل ليصبح الفاصلة (Comma) بدلاً من المسافة الفارغة، مما يجعله الإعداد المثالي لاستيراد ملفات CSV القياسية حتى دون الحاجة لكتابة خيار DLM إضافي.
تتمثل إحدى أهم القدرات الوظيفية لخيار DSD في تفعيل التحليل الذكي للقيم المحاطة بعلامات اقتباس (Quotation Marks). ففي كثير من الأحيان، تُصدّر الاستبيانات الاجتماعية والنفسية النصوص الحرة أو العبارات الوصفية محاطة بعلامات تنصيص لتمييزها. يتولى خيار DSD رصد هذه العلامات والتعامل مع المحتوى المحصور داخلها ككتلة دلالية واحدة متصلة، متجاوزاً أي فواصل قد توجد بداخلها، وموفراً حماية مطلقة لبنية الجمل والعبارات من التمزق والتشظي.
يبرز الفارق الجوهري بين قراءة البيانات مع تفعيل DSD وبدونه في كيفية تفسير محددات الحقول؛ فبدون DSD، يعامل SAS الفاصلة أو المحدد كمجرد قاطع ميكانيكي أصم يتجاهل ما حوله، مما يؤدي إلى قراءة علامات الاقتباس كجزء من القيمة النصية ذاتها أو تجزئة النصوص المقتبسة فور مواجهة أول فاصلة داخلية. أما مع تفعيل DSD، فإن النظام يتحول إلى محلل سياقي متطور يحافظ على تماسك النص ويفهم البنية العميقة للمصفوفة البيانية بدقة فائقة.
4.2 معالجة المحددات المتتالية واحتساب القيم المفقودة
تُعد مشكلة البيانات المفقودة (Missing Data) من أخطر القضايا التي تواجه الباحث المنهجي في العلوم التجريبية والسلوكية؛ حيث يؤدي سوء التعامل مع الحقول الفارغة إلى ترحيل البيانات وتخريب المطابقة بين المتغيرات والمفحوصين. في السلوك الافتراضي لـ SAS بدون خيارات مخصصة، إذا ظهر فاصلان متتاليان (مثل فاصلتين بدون أي رقم بينهما)، فإن النظام يقفز فوق الفاصل الثاني معتبراً إياه مساحة زائدة، ويذهب للبحث عن أول قيمة صالحة في السطر، مما يتسبب في إزاحة كافة المتغيرات اللاحقة بمقدار عمود واحد جهة اليسار وتدمير الملاحظة الإحصائية بأكملها.
يأتي خيار DSD كحل جذري وحاسم لهذا الخلل الهيكلي؛ إذ يُجبر النظام على تفسير ظهور فاصلين متتاليين كدلالة قاطعة على وجود قيمة مفقودة (Missing Value). عند رصد فاصلين لا يفصل بينهما محتوى، يقوم DSD بإيداع قيمة مفقودة فوراً في المتغير المقابل داخل متجه بيانات البرنامج (PDV)، ثم ينقل مؤشر القراءة بهدوء إلى الحقل التالي دون أي قفز أو ترحيل جائر للقيم التالية، مما يضمن الحفاظ التام على محاذاة الأعمدة عبر آلاف السجلات.
تنعكس هذه المعالجة السليمة على التمثيل الإحصائي للقيم المفقودة داخل جدول بيانات SAS الناتج؛ حيث تُسجل الحقول الرقمية المفقودة كنقطة عشرية مفردة (.)، بينما تُسجل المتغيرات النصية المفقودة كمساحة فارغة (Blank). يتيح هذا التمثيل المنضبط للبرمجيات الإحصائية وحزم التحليل المتقدم في SAS استيعاب هذه الفجوات وتطبيق خوارزميات الاستبدال أو الحذف المناسبة وفق شروط التحليل الإحصائي المعتمد من قبل الباحث.
4.3 إدارة النصوص المحاطة بعلامات تنصيص وإزالة الشوائب
تشمل البيانات الميدانية في كثير من الأحيان متغيرات اسمية معقدة تحتوي على فواصل في تركيبتها الأصلية، مثل أسماء المؤسسات، أو العناوين الجغرافية، أو المقاييس السيكومترية المتبوعة بفقرات توضيحية. عند تصدير هذه الحقول من برمجيات جمع البيانات كاستبيانات Qualtrics أو Google Forms، تُحاط السلسلة النصية بعلامات تنصيص مفردة أو مزدوجة لضمان عدم معاملة الفاصلة الداخلية كفاصل للأعمدة. يقدم خيار DSD آلية متكاملة للتعامل مع هذا النمط الشائع دون أي ارتباك برمجي.
عندما يواجه مؤشر القراءة في SAS علامة تنصيص تحت مظلة خيار DSD، فإنه يقوم بتعليق البحث عن محددات الفواصل مؤقتاً، ويواصل قراءة كافة الحروف والرموز والمسافات والفواصل الواقعة داخل علامات التنصيص كقيمة وحيدة تابعة لمتغير واحد. لا ينتهي هذا الاستيعاب إلا بمواجهة علامة تنصيص إغلاقية تعقبها الفاصلة الرسمية للحقل، مما يمنع انقسام المتغير الوصفي إلى متغيرين إحصائيين مستقلين بطريق الخطأ.
وعلاوة على هذه الحماية الاستيعابية، يقوم خيار DSD بمهمة تطهيرية إضافية بالغة الأهمية تتمثل في تجريد السلسلة النصية من علامات التنصيص الخارجية تلقائياً فور كتابتها في متجه بيانات البرنامج. وبذلك يستقر النص النهائي داخل جدول بيانات SAS نقياً من الشوائب والرموز الترقيمية الزائدة التي قد تعيق عمليات الفرز أو المطابقة أو التحليل المعجمي والنصي لاحقاً، مما يوفر على الباحث ساعات طويلة من عمليات التنظيف اليدوي والمعالجة اللاحقة.
5. إدارة السجلات غير المكتملة باستخدام خيار MISSOVER
5.1 مشكلة السلوك الافتراضي لفائض القراءة (FLOWOVER)
تمثل مشكلة السجلات القصيرة أو غير المكتملة تحدياً مزمناً في استيراد البيانات، ويعود ذلك إلى السلوك الافتراضي الصارم الذي يتبناه نظام SAS والمسمى بسلوك فائض القراءة (FLOWOVER). ينطلق هذا السلوك من فرضية فلسفية مفادها أن كل ملاحظة إحصائية يجب أن تستوفي بالضرورة كافة المتغيرات المذكورة في عبارة INPUT. فإذا انتهى السطر الفيزيائي في الملف الخام قبل أن يجد مؤشر القراءة قيماً لجميع المتغيرات المعلنة، فإن سلوك FLOWOVER يُجبر المؤشر على القفز فوراً إلى السطر الفيزيائي التالي لاستكمال المتغيرات الناقصة من بداية السجل الجديد.
تؤدي هذه القفزة التلقائية إلى نتائج كارثية ومدمرة للمصفوفة البيانية؛ حيث يؤدي دمج سطرين فيزيائيين في ملاحظة إحصائية واحدة إلى اختلال تعداد الملاحظات الإجمالي للبحث، وفقدان النصف الأول من بيانات السطر الثاني المقتطع. وما يفاقم خطورة هذا السلوك هو استمرار عملية الانزياح كالدومينو المتساقط عبر باقي أسطر الملف؛ فتصبح قياسات المبحوث الثاني منسوبة زوراً للمبحوث الأول، وتتحول البيانات الديموغرافية للمفحوصين إلى استجابات لمتغيرات نفسية وسلوكية لا علاقة لها بها، دون أن يتوقف البرنامج أو يصدر خطأ قاتلاً ينهي المعالجة.
يكتفي سجل المعالجة في SAS بتسجيل ملاحظة تحذيرية عابرة تُفيد بأن النظام قفز إلى سطر جديد لاستكمال قراءة المتغيرات، وهي ملاحظة قد يتجاهلها الباحث غير المتمرس معتقداً أن العملية تمت بنجاح. لذلك، يُعد رصد اختلال محاذاة البيانات وفهم مخاطر السلوك الافتراضي FLOWOVER أول خطوة في صياغة استراتيجية استيراد رصينة تحمي مصفوفة البيانات من التآكل وفقدان المصداقية الإحصائية.
5.2 آلية عمل خيار MISSOVER في ضبط تدفق الأسطر
يُمثل خيار MISSOVER الدرع الواقي الذي يمنع نظام SAS من القفز العشوائي بين الأسطر الفيزيائية للملف الخام. بمجرد إدراج هذا الخيار الحاسم ضمن عبارة INFILE، تتغير القواعد التنفيذية لمؤشر القراءة بالكامل؛ حيث يُلزم الخيار النظام بالتعامل مع نهاية السطر الفيزيائي الفعلي (End-of-Line) كحد قاطع ونهائي للملاحظة الإحصائية الحالية قيد المعالجة، مانعاً المؤشر منعاً باتاً من التطلع إلى محتويات السطر التالي لاستيفاء المتغيرات الشاغرة.
تتجلى الميكانيكية الدقيقة لـ MISSOVER في أنه عند وصول مؤشر القراءة إلى نهاية السطر مع بقاء متغيرات معلنة في عبارة INPUT لم تجد قيماً تقابلها، يقوم النظام تلقائياً بإسناد قيم مفقودة (Missing Values) لكافة تلك المتغيرات المتبقية في متجه بيانات البرنامج (PDV). وبعد تفريغ هذه القيم المفقودة، تُكتب الملاحظة بأمان في مصفوفة بيانات SAS، ثم ينتقل المؤشر بانتظام إلى بداية السطر الفيزيائي التالي لبدء ملاحظة إحصائية جديدة ومستقلة تماماً.
يضمن هذا الضبط المحكم التطابق الرياضي التام بين عدد أسطر الملف المصدر الفيزيائي وعدد صفوف جدول البيانات النهائي في SAS، وهو شرط أساسي للنزاهة المنهجية في البحوث الكمية. يتيح ذلك للباحث الاطمئنان إلى أن غياب استجابات معينة لدى بعض المفحوصين على الأسئلة الأخيرة من الاستبيان لن يؤدي إلى ابتلاع بيانات المفحوص التالي، بل سيُوثق الغياب كقيم مفقودة نظامية تخضع للتحليل العلمي المعتاد.
5.3 المقارنة التقنية بين خيارات التدفق: MISSOVER و TRUNCOVER و STOPOVER
يوفر نظام SAS ترسانة متكاملة من خيارات التحكم في تدفق الأسطر المقتطعة لتلبية الاحتياجات البحثية المتنوعة، وتبرز الفروق التقنية الدقيقة عند المقارنة بين MISSOVER وTRUNCOVER وSTOPOVER. يكمن الفارق الجوهري بين MISSOVER وTRUNCOVER في كيفية معالجة الحقول ذات الأعمدة الثابتة؛ فإذا كان السطر ينتهي في منتصف حقل رقمي أو نصي معين، فإن خيار MISSOVER يقوم بتفريغ الحقل بالكامل وإسناد قيمة مفقودة له حتى لو وُجدت به بعض الحروف الأولية. في المقابل، يقوم خيار TRUNCOVER بقراءة ما تبقى من الحقل المقتطع وتخزينه كقيمة صالحة حتى حدود السطر الفيزيائي، مما يجعله الخيار الأنسب عالمياً عند قراءة الملفات ذات الأعمدة الثابتة المقتطعة.
أما خيار STOPOVER، فيمثل المقاربة الصارمة للتحقق من جودة البيانات في المشروعات الحساسة للغاية؛ مثل التجارب الإكلينيكية والدوائية التي لا تحتمل وجود أي سطر ناقص أو غير مكتمل التنسيق. بموجب هذا الخيار، إذا واجه النظام سجلاً قصيراً لا يستوفي كافة المتغيرات المحددة في عبارة INPUT، فإنه يعتبر ذلك خطأً جسيماً ويوقف تنفيذ خطوة البيانات فوراً، مع إصدار رسالة خطأ صريحة في سجل المعالجة، مما يمنع تشكل أي قاعدة بيانات تحتوي على تشوهات هيكلية غير مرصودة.
تعتمد المعايير المنهجية لاختيار الأنسب من بين هذه الأدوات على طبيعة بروتوكول جمع البيانات؛ ففي استبيانات الرأي والبحوث السلوكية التي تعتمد القراءة بالقوائم المفصولة بفواصل، يُعد خيار MISSOVER الخيار القياسي الأكثر أماناً وموثوقية. أما في المسوحات الوطنية ذات النماذج الثابتة والأعمدة المحددة سلفاً، فإن خيار TRUNCOVER يضمن حفظ كل بت متاح من المعلومات، بينما يظل STOPOVER الحارس الرقابي الصارم لمطابقة البيانات للمعايير القياسية المطلقة.
6. تحديد نقاط انطلاق القراءة عبر خياري FIRSTOBS و OBS
6.1 تخطي عناوين الأعمدة والبيانات الوصفية عبر FIRSTOBS=2
تحتوي الملفات المجدولة الحديثة بصورة شبه دائمة على سطر ترويسة أولى (Header Row) يحمل أسماء الأعمدة والتصنيفات مثل “ID, Age, Score”. ورغم الفائدة التوثيقية الكبيرة لهذه الترويسة للإنسان، إلا أنها تمثل فخاً برمجياً خطيراً لمترجم SAS إذا تمت محاولة قراءتها كبيانات رصد عادية؛ إذ سيحاول النظام إدخال نصوص الترويسة كقيم رقمية للمتغيرات الرياضية، مما ينتج عنه سيل من التحذيرات حول عدم صلاحية البيانات (Invalid Data Warnings)، وتوليد سطر أولي مشوه مليء بالقيم المفقودة.
يبرز هنا خيار FIRSTOBS كحل منهجي بالغ البساطة والقوة، حيث يحدد رقم السطر الفيزيائي الدقيق الذي يجب أن يبدأ مؤشر القراءة مسح البيانات منه داخل الملف الخام. من خلال صياغة FIRSTOBS=2 في عبارة INFILE، يُصدر الباحث أمراً صارماً لمترجم SAS بتجاوز السطر الأول بالكامل وعدم إرساله إلى مخزن الإدخال المؤقت، وتوجيه الانتباه الفوري إلى السطر الثاني الذي يحتوي على الملاحظة الأولى للمفحوص الفعلي، مما يقضي جذرياً على أخطاء تحويل الأنواع.
يؤثر هذا الخيار إجرائياً على فهرسة السجلات في الذاكرة ومؤقتات الملاحظات الداخلية (_N_)؛ حيث تصبح الملاحظة الإحصائية الأولى في مصفوفة بيانات SAS مستمدة مباشرة من السطر الفيزيائي الثاني في الملف المصدر. يمنح ذلك البيانات المستوردة نظافة هيكلية تامة، ويحول دون تشويه المؤشرات الإحصائية العامة كالمتوسطات والانحرافات المعيارية التي قد تتأثر بوجود سجلات ترويسة فارغة أو مشوهة في مقدمة الجدول.
6.2 اختبار استيراد البيانات وتقييد العينة باستخدام OBS
عند الشروع في التعامل مع قواعد بيانات ضخمة تحتوي على مئات الآلاف أو الملايين من السجلات الميدانية، يُعد تشغيل كود الاستيراد على كامل الملف مخاطرة حاسوبية غير حكيمة؛ فأي خطأ في ترتيب المتغيرات أو تحديد الفواصل سيتطلب إيقاف المعالجة وإعادة فحص الملف بالكامل، مما يستهلك أوقاتاً معالجة طويلة وموارد حوسبية ثمينة. يتيح خيار OBS للباحث ضبط حد أقصى لعدد السجلات التي تتم قراءتها، موفراً وسيلة مثالية لتجربة واختبار كفاءة الكود في بيئة مصغرة.
يتكامل خيار OBS بصورة مذهلة مع خيار FIRSTOBS لتحديد نافذة قراءة مقطعية محددة؛ فعلى سبيل المثال، يتيح ضبط FIRSTOBS=2 مع OBS=11 للمحلل استخلاص عينة تجريبية تتألف من أول 10 ملاحظات فعلية فقط من الملف الكبير. يكفي هذا النطاق المحدود للتحقق التام من صحة محاذاة الأعمدة، وسلامة قراءة المتغيرات النصية والرقمية، ودقة خيارات الفواصل دون إجهاد الذاكرة الحاسوبية أو الانتظار الطويل.
يساهم هذا الأسلوب المنهجي في تحسين زمن دورة تطوير وتدقيق البرمجيات الإحصائية في الفرق البحثية، مما يمكن المحلل من فحص مصفوفة البيانات في نافذة المخرجات وتعديل معلمات خطوة البيانات وتكرار التجربة في ثوانٍ معدودة. وبمجرد التحقق النهائي من سلامة الهيكل البرمجي وخلو سجل المعالجة من أي ملاحظات سلبية، يمكن إزالة خيار OBS أو تعديله ببساطة لمعالجة الملف الكامل بأمان مطلق واحترافية عالية.
6.3 معالجة أسطر الترويسة المتعددة والبيانات الوصفية التمهيدية
تتضمن ملفات البيانات الناتجة عن أجهزة القياس المعملية المتطورة—مثل مسجلات التخطيط الدماغي (EEG)، وأجهزة تتبع حركة العين، أو مخرجات أجهزة التحليل الكيميائي—مقدمات توثيقية معقدة في أسطرها الأولى تشمل تاريخ المعايرة، ورقم الجهاز التسلسلي، وبيانات المشرف على التجربة، وهي معلومات قد تمتد لعشرات الأسطر قبل الوصول إلى جدول القراءات الحقيقي. يتطلب هذا النمط المعقد من البيانات قدرة دقيقة على تجاوز تلك البيانات الوصفية التمهيدية.
تتمثل الاستراتيجية المنهجية المثلى في فتح الملف الخام أولاً باستخدام محرر نصوص بسيط لفحص أرقام الأسطر والتعرف على السطر الدقيق الذي تبدأ منه القراءات الميدانية للمتغيرات. إذا تبين أن الأسطر العشرين الأولى مخصصة لوصف بروتوكول القياس وأن السطر 21 يمثل ترويسة الأعمدة، فإن ضبط الخيار البرمجي المباشر FIRSTOBS=22 سيؤدي إلى قفز النظام فوق كافة الملاحظات الإدارية والترويسة، والشروع المباشر في قراءة بيانات المبحوثين دون أي تداخل رقمي مربك.
يجب التثبت المنهجي أثناء تحديد قيمة FIRSTOBS من عدم اقتطاع ملاحظات المفحوصين الحقيقيين؛ ففي الملفات الكبيرة قد تبدو بعض الأسطر كأنها شروح تمهيدية بينما هي في الواقع رموز استجابة غير معتادة. إن الفحص الدقيق والتوثيق البرمجي لسبب تخطي عدد محدد من الأسطر داخل الكود الإحصائي يعزز من النزاهة العلمية للدراسة ويسهل مراجعة الكود من قبل لجان التحكيم والأقران في المجلات العلمية المرموقة.
7. مثال تطبيقي شامل: استيراد بيانات نصية خطوة بخطوة
7.1 بنية ملف البيانات التجريبي (ملف bball_data.txt)
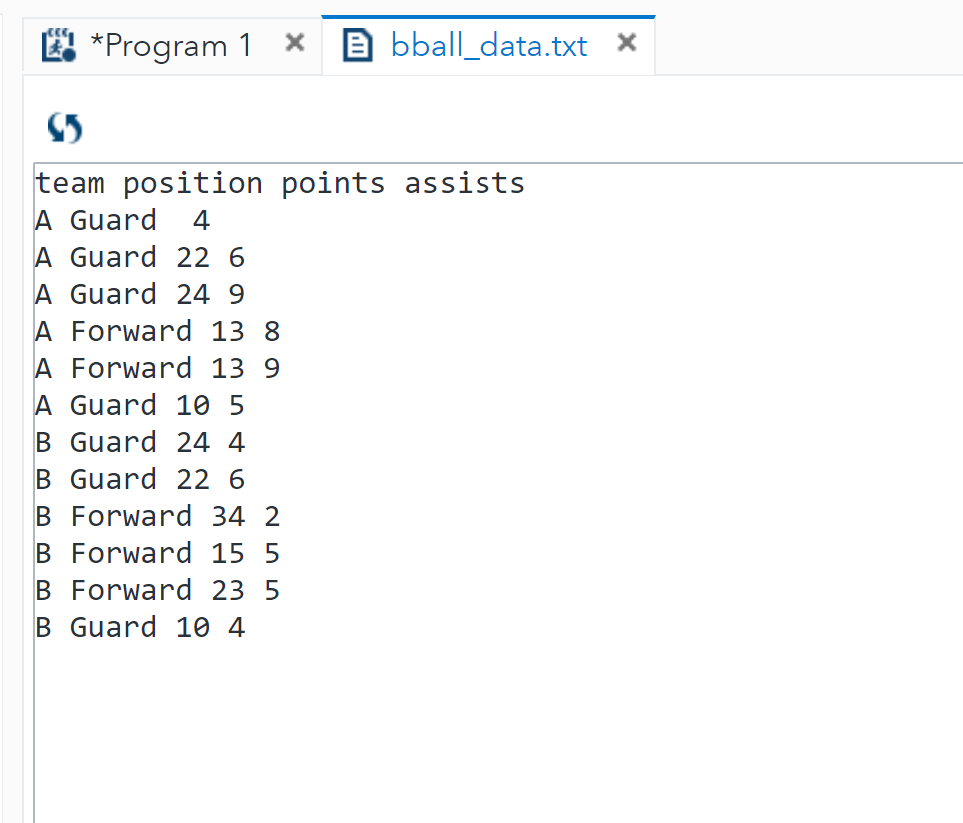
لترسيخ المفاهيم المعمارية والنظرية السابقة في قالب تطبيقي ملموس، سنفترض وجود ملف بيانات رياضي واقعي يحمل اسم bball_data.txt، وهو نموذج كلاسيكي يحاكي القياسات الميدانية للفرق والرياضيين في العلوم الحركية والتحليلات الرياضية. يتكون هذا الملف النصي الخام من مجموعة سجلات مفصولة بمسافات فارغة وفواصل مركبة، مع وجود سطر ترويسة في البداية، بالإضافة إلى تباين في اكتمال السجلات وظهور علامات اقتباس حول أسماء بعض الفرق.
تتوزع حقول الملف لتشمل أربعة متغيرات أساسية هي: اسم الفريق (Team_Name)، ومركز اللعب (Position)، وإجمالي النقاط المسجلة (Points)، وإجمالي التمريرات الحاسمة المساعدة (Assists). يكشف الفحص الهيكلي الأولي للملف أن السطر الأول يحتوي على الترويسة الوصفية للأعمدة، بينما يحتوي السطر الثالث على اسم فريق محاط بعلامات تنصيص لكونه اسماً مركباً من كلمتين بينهما مسافة، ويحتوي السطر الخامس على سجل غير مكتمل يفتقر إلى بيانات التمريرات المساعدة للمفحوص.
يفرض هذا التوصيف الهيكلي المعقد استخدام باقة متكاملة من خيارات INFILE؛ حيث يستوجب وجود سطر الترويسة استبعاداً منهجياً لمنع تشويه المتغيرات الرقمية، ويتطلب السجل غير المكتمل كبح جماح سلوك FLOWOVER التلقائي لضمان عدم ابتلاع السجلات اللاحقة، بينما يستدعي الاسم المركب المحاط بعلامات تنصيص ضبطاً دقيقاً لخيارات الحساسية للفواصل، مما يجعل هذا السيناريو بيئة مثالية لاختبار التكامل البرمجي لعبارة INFILE.
7.2 صياغة الكود البرمجي المتكامل وشرح مكوناته
لبناء قاعدة البيانات الرياضية بنجاح من هذا الملف النصي المعقد، نقوم بصياغة كتلة برمجية محكمة داخل خطوة DATA تجمع كافة الخيارات المتخصصة التي جرى تفكيكها مسبقاً. تبدأ الخطوة بإنشاء مجموعة بيانات جديدة في مكتبة العمل باسم BBALL_STATS، تليها مباشرة عبارة INFILE التي توجه المؤشر إلى المسار الفيزيائي لملف bball_data.txt، مع تفعيل حزمة الخيارات المترابطة: DLM وDSD وMISSOVER وFIRSTOBS.
يتجلى الترابط البرمجي في ضبط FIRSTOBS=2 لتخطي سطر الترويسة الوصفي الأول مباشرة والانطلاق من الملاحظة الحقيقية الأولى. كما يتيح تفعيل خيار DSD للمترجم فهم الفواصل كفواصل أعمدة رسمية، وقراءة اسم الفريق المركب المحاط بعلامات تنصيص كقيمة واحدة نقية مع إزالة علامات التنصيص الخارجية تلقائياً، والتعامل مع الفواصل المتتالية إن وجدت كقيم مفقودة. ويعمل خيار MISSOVER بتناغم موازٍ لضمان أن السجل الخامس غير المكتمل يتم إسناد قيمة مفقودة لمتغير التمريرات المساعدة الخاص به دون القفز إلى سطر المفحوص التالي.
تكتمل الكتلة بعبارة INPUT التي تُحدد خارطة المتغيرات بدقة متناهية؛ حيث يُصرح عن متغير Team_Name متبوعاً بعلامة الدولار ($) لتعريفه كمتغير نصي ممتد، يليه متغير Position النصي الموسوم كذلك بعلامة ($)، ثم المتغيران الرقميان Points وAssists المجردان من أي علامات نصية. تنتهي الكتلة البرمجية بعبارة RUN التنفيذية التي تدفع مترجم SAS إلى بدء دورة الترجمة والتنفيذ المترابطة، وقراءة الأسطر من مخزن الإدخال المؤقت إلى متجه بيانات البرنامج ثم إلى جدول البيانات النهائي بسلاسة تامة.
7.3 عرض النتائج والتحقق من صحتها باستخدام PROC PRINT
لا تنتهي الممارسة المنهجية بمجرد تشغيل خطوة DATA دون ظهور أخطاء حمراء في السجل، بل يتعين على الباحث التحقق العيني والتطبيقي من سلامة مصفوفة البيانات المتكونة داخل بيئة SAS ومقارنتها بالملف المصدر. يُعد إجراء PROC PRINT الأداة القياسية الأسرع والأكثر فاعلية لاستعراض محتويات مجموعة البيانات الجديدة والتأكد من مطابقة بنيتها الهيكلية للتوقعات النظرية.
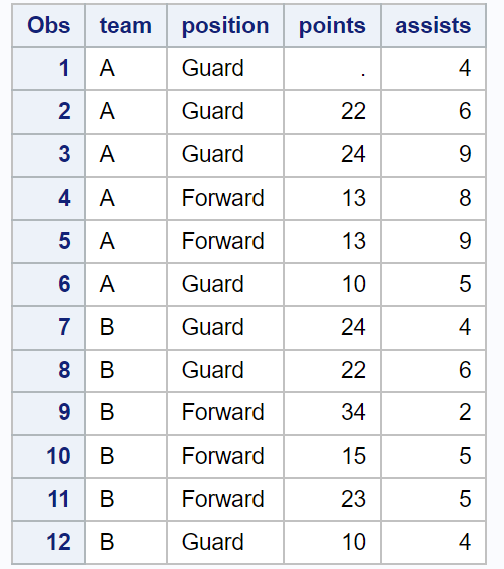
نقوم بتنفيذ إجراء الطباعة باستدعاء الكود المباشر PROC PRINT DATA=BBALL_STATS مع إلحاق خيار RUN؛ حيث يولد النظام نافذة مخرجات بصرية أنيقة تعرض جدول الملاحظات بأعمدته الأربعة كاملة مسبوقة بعمود رقم الملاحظة القياسي Obs. تُظهر معاينة النتائج أن الملاحظة التي احتوت على اسم مركب قد استقرت في خانة Team_Name ككتلة واحدة نظيفة خالية من علامات التنصيص المزعجة، وأن الملاحظة الناقصة قد ظهرت بها خانة Assists ممثلة بنقطة مفردة تدل على قيمة مفقودة نظامية، دون أن يختل توازن الصفوف.
تؤكد مطابقة عدد الملاحظات الناتجة لعدد أسطر الملف الخام (مطروحاً منها سطر الترويسة) أن عملية القراءة حققت هدفها المنهجي بنسبة 100%. كما يضمن فحص سجل المعالجة المصاحب عدم ظهور أي رسائل تفيد بتحويل غير صالح للبيانات أو قفز قسري للأسطر، مما يمنح الباحث الثقة الكاملة في نظافة البيانات وصلاحيتها للانتقال المباشر إلى مراحل الإحصاء الوصفي والتحليل الاستدلالي المتقدم.
8. التوافق بين عبارة INFILE وأساليب قراءة المدخلات (INPUT Styles)
8.1 أسلوب القراءة الحر القائم على القوائم (List Input)
يُمثل أسلوب القراءة بالقوائم (List Input) النمط الأكثر بساطة وتلقائية في قراءة المدخلات في SAS، وتعتمد عبارة INFILE عليه بشكل واسع في الملفات النصية المفصولة بمحددات واضحة. يرتكز هذا الأسلوب على فرضية أن كل قيمة في السجل يفصل بينها وبين القيمة التالية محدد واحد على الأقل، وأن البيانات تتدفق بشكل حر دون التقيد بمواقع أعمدة فيزيائية صارمة على الشاشة. يتطلب نجاح هذا الأسلوب أن تكون البيانات مرتبة بنفس تسلسل المتغيرات المذكورة في كود SAS، مع غياب المسافات الفارغة داخل القيم النصية الفردية إلا إذا كانت محاطة بعلامات اقتباس مدعومة بـ DSD.
في الحالات التي تتضمن فيها المتغيرات النصية مسافات مفردة دون أن تكون محاطة بعلامات اقتباس، يوفر SAS معدل التنسيق البرمجي المرموز له بعلامة العطف (&) ضمن عبارة INPUT؛ حيث يوجه هذا المعدل مؤشر القراءة إلى التوقف عن اعتبار المسافة الواحدة فاصلاً، ومواصلة القراءة حتى مواجهة مسافتين متتاليتين أو المحدد المعتمد، مما يسمح باستيعاب نصوص مركبة قصيرة ضمن نمط القراءة بالقوائم دون تعقيدات إضافية.
ومع ذلك، تبرز حدود تقنية حاسمة لأسلوب القراءة بالقوائم الافتراضي تتمثل في قصر طول المتغير النصي على 8 أحرف (Bytes) فقط كحد افتراضي؛ فإذا كان الاسم يحتوي على 12 حرفاً، فإن النظام يقتطع الأحرف الأربعة الأخيرة تلقائياً. لتجاوز هذا القصور المنهجي، يتعين على الباحث دائماً استباق عبارة INPUT بعبارة LENGTH صريحة تحدد الطول الأقصى المتوقع للمتغيرات النصية، مما يضمن احتفاظ النصوص الكاملة بسلامتها المعجمية دون تشويه أو اقتطاع تعسفي.
8.2 أسلوب القراءة المعتمد على الأعمدة الثابتة (Column Input)
يُعد أسلوب القراءة بالأعمدة الثابتة (Column Input) المعيار الذهبي في التعامل مع المسوحات السكانية الكبرى، وقواعد البيانات الحكومية التاريخية، والملفات المستخرجة من الحواسيب المركزية القديمة (Mainframes)؛ حيث تتسم هذه الملفات بتصميم معماري صارم يحتل فيه كل متغير نطاقاً محدداً وثابتاً من أرقام الأعمدة الفيزيائية لا يتغير من سطر لآخر. في هذا الأسلوب، لا توجد فواصل أو علامات ترقيم بين الحقول، بل تتراص الأرقام والحروف جنباً إلى جنب في مواضع محددة سلفاً.
تتم صياغة القراءة بالأعمدة في عبارة INPUT بتحديد رقم عمود البداية ورقم عمود النهاية مباشرة بعد اسم المتغير، مثل تحديد أن المتغير العمري يقع بين العمودين 10 و12. يلغي هذا الأسلوب الحاجة إلى استخدام خيار DLM في عبارة INFILE؛ إذ يستند مؤشر القراءة إلى الإحداثيات الرقمية المباشرة بدلاً من البحث عن محددات الفواصل، مما يمنحه سرعة استثنائية وحصانة تامة ضد أخطاء الفواصل المفقودة.
تتجلى إحدى أبرز مزايا القراءة بالأعمدة في قدرتها المنهجية الفائقة على تخطي وتجاوز الحقول غير المرغوب فيها بسهولة تامة؛ فإذا كان الملف يحتوي على خمسين متغيراً وكان الباحث مهتماً بثلاثة متغيرات فقط، يكفيه ذكر تلك المتغيرات الثلاثة بإحداثياتها المكانية الصحيحة في عبارة INPUT ليتجاهل النظام تلقائياً كافة الأعمدة الأخرى في مخزن الإدخال المؤقت، مما يوفر جهداً معمارياً كبيراً ويختزل استهلاك الذاكرة بشكل ملحوظ.
8.3 أسلوب القراءة المنسقة (Formatted Input)
يجمع أسلوب القراءة المنسقة (Formatted Input) بين القوة الرياضية والمرونة العالية، وهو الأداة الأساسية للتعامل مع البيانات المعقدة التي تتخذ أشكالاً غير قياسية يصعب على القراءة الحرة أو المكانية البسيطة فك شفراتها. يُستخدم هذا الأسلوب لقراءة التواريخ المكتوبة بتنسيقات مختلفة، والأوقات، والأرقام التي تتضمن فواصل الآلاف أو علامات العملات النقدية، أو القيم ذات الإشارات السالبة والموجبة غير النمطية، من خلال استدعاء ما يُعرف في SAS بمنسقات الإدخال (Informats).
تتضمن منسقات الإدخال الشائعة أدوات متقدمة مثل MMDDYY10. لقراءة التواريخ التقويمية وتحويلها داخلياً إلى القيمة الرياضية المعيارية لـ SAS (عدد الأيام منذ الأول من يناير 1960)، أو منسق COMMA12.2 الذي يتولى قراءة الأرقام المالية التي تحتوي على فواصل عشرية وفواصل آلاف ويجردها من الشوائب محولاً إياها إلى أرقام نقية قابلة للتحليل الإحصائي. تُصاغ هذه المنسقات في عبارة INPUT مقترنة بأسماء المتغيرات إما مباشرة أو عبر استخدام محددات المواضع المنطقية مثل علامات المؤشرات المكانية (@).
يحقق الدمج المتقدم بين القراءة المنسقة وخيارات عبارة INFILE المتخصصة تكاملاً حاسوبياً مبهراً؛ حيث يمكن قراءة ملفات نصية متباينة الأطوال باستخدام خيارات مثل TRUNCOVER لمنع سقوط أطراف التنسيقات المكانية، مما يتيح استيراد التواريخ التاريخية والاستجابات الموزونة بأعلى درجات الدقة الإحصائية الممكنة، دون تشويه للبنية الزمنية أو الرقمية للبيانات الميدانية.
9. الأخطاء الشائعة واستراتيجيات تشخيص مشكلات عبارة INFILE
9.1 قراءة سجل المعالجة (SAS Log) وفك شفرات الأخطاء
يُمثل سجل المعالجة (SAS Log) المرآة العاكسة للصحة البرمجية والتنفيذية لكافة العمليات الإحصائية داخل النظام، وهو الأداة التشخيصية الأولى التي يتعين على المحلل فحصها بعناية فائقة فور انتهاء تشغيل خطوة INFILE. يحتوي هذا السجل على توثيق تاريخي دقيق لمسار التنفيذ يتضمن عدد الأسطر الفيزيائية التي قرأها النظام من الملف الخارجي، وعدد الملاحظات الناتجة التي استقرت في جدول البيانات، بالإضافة إلى رسائل الأخطاء القاتلة المرموز لها باللون الأحمر، ورسائل التحذير الصفراء، والملاحظات الإجرائية الزرقاء.
تُعد رسالة التحذير الخاصة بعدم تطابق البيانات (Invalid Data Warning) من أكثر المشكلات شيوعاً أثناء تشغيل INFILE، وتحدث عندما يواجه مؤشر القراءة قيمة نصية في موضع ينتظر فيه رقماً، أو عندما يحتوي السجل على رموز غريبة غير متوافقة مع التنسيق المعتمد. يقوم SAS في هذه الحالة بطباعة صورة مصغرة من محتويات مخزن الإدخال المؤقت في السجل، مع رسم خط إشارة دلالي يحدد الموضع والعمود الدقيق الذي تسبب في المشكلة، مسنداً قيمة مفقودة لتلك الخلية لضمان استمرار تنفيذ باقي السجلات.
يتطلب التحليل الرصين للسجل الانتباه الدقيق لملاحظات قفز الأسطر غير المقصودة الناجمة عن سلوك FLOWOVER؛ حيث يذكر السجل بوضوح عبارة تفيد بأن SAS انتقل إلى سطر جديد لاستكمال قراءة المتغيرات. إن ظهور مثل هذه الرسالة يُعد مؤشراً حاسماً على وجود خلل في تطابق الأعمدة أو غياب خيار MISSOVER، مما يوجب على الباحث مراجعة هيكل الكود فوراً وتصحيح معلمات القراءة قبل الاعتماد على البيانات الناتجة في أي قرارات بحثية.
9.2 مشكلات تشفير الملفات وفواصل نهايات الأسطر
مع تنوع المنصات الحاسوبية المستخدمة في جمع البيانات وتحليلها، تبرز مشكلات تقنية خفية ترتبط باختلافات ترميز نهايات الأسطر بين أنظمة التشغيل المختلفة. تعتمد بيئة Microsoft Windows على محرفين مدمجين لتمييز نهاية السطر هما محرف الإرجاع ومحرف تغذية السطر (Carriage Return + Line Feed: CRLF)، في حين تقتصر أنظمة UNIX وLinux وmacOS الحديثة على استخدام محرف تغذية السطر الفردي (Line Feed: LF). إذا نُقل ملف تم إنشاؤه على Windows إلى خادم إحصائي يعمل بنظام Linux، فقد يُعامل SAS محرف الإرجاع الزائد كجزء من القيمة الإحصائية الأخيرة، مما يؤدي إلى تشوه المتغيرات.
يبرز هنا دور خيار TERMSTR المتقدم في عبارة INFILE كأداة حاسمة لمعالجة هذه التباينات المنصية؛ حيث يتيح للمحلل تحديد نوع فاصل نهاية السطر المتوقع صراحة، مثل كتابة TERMSTR=CRLF لقراءة الملفات القادمة من بيئات Windows على خوادم Linux بسلاسة تامة، أو العكس، مما يلغي التداخلات غير المرغوبة ويحفظ اتساق السجلات دون الحاجة لتحويل الملفات مسبقاً عبر برمجيات خارجية.
كما تكتسي مسألة تشفير الأحرف (Character Encoding) أهمية مضاعفة عند استيراد بيانات تحتوي على نصوص بغير اللغة الإنجليزية كاللغة العربية. إذا اختلف تشفير الملف المصدر (مثل UTF-8 أو Windows-1256) عن تشفير جلسة عمل SAS، فستظهر النصوص في مصفوفة البيانات في هيئة رموز غير مفهومة (Mojibake). يتم ترويض هذه الإشكالية باستخدام خيار ENCODING ضمن عبارة INFILE، كأن يحدد الباحث ENCODING=’UTF-8’، مما يضمن فك شفرات الحروف العربية بصورة سليمة وصحيحة تحافظ على الدلالات اللفظية والوصفية للمتغيرات السلوكية المقاسة.
9.3 أفضل الممارسات لضمان نزاهة البيانات وجودتها
تقتضي النزاهة العلمية في إدارة البيانات الإحصائية تبني بروتوكول صارم للتحقق والتدقيق المنهجي يعقب كل عملية استيراد باستخدام عبارة INFILE. لا يجوز الاكتفاء بنجاح التنفيذ الظاهري، بل يجب أن يتبع خطوة DATA مباشرة تشغيل إجراء الفحص الهيكلي PROC CONTENTS؛ حيث يوفر هذا الإجراء تقريراً مفصلاً يتضمن أسماء المتغيرات، وأنواعها الإحصائية، وأطوالها التخزينية في الذاكرة، مما يتيح للباحث التأكد من أن المتغيرات التي ينبغي أن تكون كمية متصلة لم تتحول بطريق الخطأ إلى متغيرات نصية، وأن الأطوال كافية لمنع اقتطاع النصوص.
تشمل أفضل الممارسات البرمجية أيضاً إدراج تعليقات توثيقية واضحة ومكثفة داخل الكود البرمجي ذاته باستخدام علامات التعليق المعتمدة في SAS (/* … */)؛ حيث يوثق الباحث تاريخ الاستيراد، ومصدر الملف النصي الخام، والخيارات المستخدمة في INFILE والعلة المنهجية وراء اختيارها (مثل توضيح سبب اختيار MISSOVER بدلاً من TRUNCOVER). يسهل هذا التوثيق الشفاف عمليات المراجعة النظيرة، ويضمن استمرارية المشروع حتى في حال انتقال مهام التحليل بين باحثين متعددين.
وأخيراً، يُعد تأمين نسخ احتياطية للقراءة فقط (Read-Only Backups) من الملفات النصية الأصلية قبل الشروع في استيرادها قاعدة ذهبية لا غنى عنها؛ إذ يجب عزل الملفات الخام في مستودعات آمنة والتأكد من أن برمجيات التحليل لا تقوم بتعديلها أو الكتابة عليها أثناء محاولات الاستيراد المتكررة. يضمن هذا الإجراء العزل التام للمصدر التجريبي، متيحاً للمحلل العودة إلى الأصل الميداني غير المشوه في حال حدوث أي خطأ برمجي غير متوقع أثناء معالجة البيانات.
10. تطبيقات متقدمة وسياقات استخدام INFILE في البحوث الميدانية
10.1 استيراد ملفات متعددة دفعة واحدة باستخدام محارف البدل (Wildcards)
تواجه المشروعات البحثية الميدانية المعاصرة سيناريوهات تتطلب جمع البيانات في ملفات نصية منفصلة لكل مفحوص أو لكل يوم تجريبي على حدة؛ مما ينتج عنه مئات أو آلاف الملفات ذات البنية المتطابقة التي يتعين دمجها في جدول تحليلي موحد. يوفر نظام SAS عبر عبارة INFILE حلاً برمجياً فائق القوة يتمثل في استخدام محارف البدل (Wildcards)، وتحديداً رمز النجمة (*)، داخل مسار الملف في عبارة INFILE، كأن يكتب الباحث مساراً ينتهي بـ /subject_*.txt لقراءة كافة الملفات التي تبدأ بكلمة subject في مجلد معين دفعة واحدة.
يتكامل هذا الأسلوب المتقدم مع خيار FILENAME التابع لعبارة INFILE، والذي يتيح إنشاء متغير نصي جديد داخل مصفوفة البيانات يُسجل تلقائياً المسار الكامل واسم الملف الفيزيائي الذي استُمدت منه كل ملاحظة إحصائية. يمنح هذا المتغير الباحث القدرة على استخلاص معرّف المفحوص (Subject ID) أو تاريخ التجربة مباشرة من اسم الملف ذاته باستخدام دوال معالجة النصوص في SAS، مما يحول البيانات المفككة إلى سلسلة مترابطة من القياسات المتكررة دون الحاجة إلى فتح كل ملف على حدة.
يحقق هذا الاستيراد المجمع وفورات هائلة في الوقت والجهد الحوسبي؛ حيث تُقرأ آلاف الملفات النصية في دورة برمجية واحدة متصلة، وتتراصف الملاحظات في جدول SAS النهائي بتسلسل منطقي منضبط، مما يمهد الطريق لإجراء تحليلات السلاسل الزمنية والنمذجة الخطية متعددة المستويات (Multilevel Modeling) على البيانات الميدانية الضخمة بموثوقية وكفاءة منقطعة النظير.
10.2 تطبيق عبارة INFILE على البيانات الاستبيانية والقياسات النفسية والسلوكية
تحتل عبارة INFILE مكانة خاصة في مختبرات القياس النفسي والسلوكي، حيث تُفرز استبيانات مقاييس ليكرت المتعددة وأدوات القياس السيكومتري ملفات نصية مكثفة تفتقر إلى النظافة البرمجية. تتضمن هذه الملفات عادةً ترميزات عددية محددة تشير إلى استجابات مفقودة لأسئلة حساسة (مثل الرموز 99 أو -9)، أو إجابات لأسئلة مفتوحة محاطة بفواصل وتداخلات ترقيمية عشوائية تتطلب تفكيكاً دقيقاً عبر خياري DSD وMISSOVER لضمان عدم اختلاط درجات المفحوصين عبر أبعاد المقياس المختلفة.
يتيح استخدام INFILE لعلماء النفس المعرفي والباحثين السلوكيين قراءة مصفوفات الاستجابات الخام وتحويل الرموز النصية إلى درجات رقمية متصلة أثناء خطوة الإدخال ذاتها. كما يتيح التحقق الفوري من الاتساق المنطقي للإجابات، كاستبعاد السجلات التي تتضمن درجات تقع خارج النطاق النظري للمقياس (مثل رصد الدرجة 7 في مقياس خماسي) فور قراءتها في مخزن الإدخال المؤقت، مما يرفع من جودة البيانات الواردة إلى مستودع التحليل النفسي.
يؤسس هذا الإعداد الرصين للمصفوفات النفسية للانتقال السلس إلى إجراءات التحليل الإحصائي السيكومتري المتقدمة داخل SAS؛ مثل فحص الاتساق الداخلي ومعاملات الثبات عبر إجراء PROC CORR مع خيار ALPHA، أو إجراء التحليل العاملي الاستكشافي والتوكيدي عبر إجراء PROC FACTOR وPROC CALIS. إن دقة الاستيراد عبر INFILE تضمن سلامة مصفوفات التغاير والارتباط الرياضية، وهي الأساس الذي ترتكز عليه مصداقية النتائج النفسية وجودة تفسيراتها السلوكية.
10.3 التحضير المنهجي للبيانات المستوردة للتحليلات الإحصائية المتقدمة
تمثل مرحلة استيراد البيانات عبر عبارة INFILE الخطوة الأولى في مسار منهجي متكامل لإعداد المتغيرات للنمذجة الإحصائية المتقدمة. فبمجرد قراءة السجلات الخام وإسناد القيم المفقودة بدقة وضبط محاذاة الأعمدة، يمكن للباحث توظيف مرونة خطوة DATA لتنفيذ عمليات تنظيف لاحقة تشمل فحص التوزيعات التكرارية والاعتدالية، واكتشاف القيم الشاذة المتطرفة، وإجراء التحويلات الرياضية اللازمة (كالتحويل اللوغاريتمي أو تحويل الجذر التربيعي) لمعالجة الالتواء والتفرطح في البيانات المستوردة.
يرتبط هذا التحضير الهيكلي المتقن بالربط المباشر مع إجراءات النمذجة الإحصائية الكبرى في SAS، مثل النماذج الخطية العامة عبر PROC GLM، ونماذج الانحدار الخطي المتعدد عبر PROC REG، ونماذج الانحدار اللوجستي المتعدد عبر PROC LOGISTIC. فعندما تُبنى مصفوفة البيانات عبر INFILE بأسس صارمة، تصبح مخرجات هذه النماذج محصنة ضد الانحرافات الناتجة عن أخطاء القراءة الهيكلية، مما يرفع من القوة الإحصائية للاختبارات ويقلل من أخطاء النوع الأول والثاني في اتخاذ القرارات العلمية.
يسهم هذا التكامل البرمجي في بناء مسارات عمل مؤتمتة وقابلة للتكرار الكامل (Reproducible Research Pipelines)؛ حيث يستطيع الباحث كتابة برنامج نصي واحد في SAS يبدأ بقراءة الملفات الخام غير المنظمة عبر عبارة INFILE، ويمر بمراحل التحقق والتطهير، وينتهي بإنتاج الجداول والنماذج الإحصائية النهائية والرسوم البيانية المرافقة. يُعد هذا التسلسل البرمجي المنضبط المعيار الأسمى للأمانة العلمية والدقة المنهجية في البحوث الأكاديمية المعاصرة المنشورة في الدوريات العالمية المصنفة.
خاتمة
تظل عبارة INFILE في بيئة SAS الإحصائية النموذج الأبرز للهندسة البرمجية التي تمنح المحلل سيطرة مطلقة على حركة البيانات من مصادرها الخام إلى مساحات المعالجة الرياضية المتقدمة. ومن خلال التعمق في معمارية مخزن الإدخال المؤقت ومتجه بيانات البرنامج، يتضح جلياً أن إدارة الاستيراد ليست مجرد مهمة تقنية روتينية، بل هي مرحلة منهجية حرجة ترتبط بها دقة التحليلات الإحصائية وسلامة النتائج العلمية برمتها.
أظهر استعراض المعاملات المتقدمة لعبارة INFILE—بدءاً من خيار DLM لضبط الفواصل، وخيار DSD لإدارة النصوص المقتبسة والمحددات المتتالية، وخيار MISSOVER لمنع تشويه السجلات غير المكتملة، وصولاً إلى FIRSTOBS وOBS لإدارة نوافذ القراءة—أن SAS يوفر حلولاً قطعية لكافة التحديات التي قد تطرأ على مجموعات البيانات الميدانية. إن الجمع بين هذه الخيارات بحكمة وخبرة يلغي مساحات التخمين، ويقي المصفوفة البيانية من الانزياحات الكارثية التي تسببها الإجراءات التلقائية غير المنضبطة.
وختاماً، فإن إتقان استخدام عبارة INFILE وفك شفرات سجل المعالجة المصاحب لها يُمثل مهارة جوهرية لا غنى عنها لكل باحث ومحلل يسعى إلى التميز في إدارة البيانات الضخمة والمعقدة. إن الاستثمار المنهجي في بناء أكواد استيراد دقيقة وموثقة وقابلة للتكرار يضع الأساس المتين لقواعد بيانات رصينة، تمهد الطريق لبناء نماذج إحصائية قوية واستخلاص رؤى معرفية تساهم في دفع عجلة التقدم العلمي والبحثي في مختلف مجالات المعرفة الإنسانية.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A user’s guide to SAS 76. SAS Institute Inc.
- Cody, R. (2018). Cody’s data cleaning techniques using SAS (3rd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- Goodnight, J. H. (1979). A tutorial on the SAS DATA step. Technometrics, 21(3), 397–403.
- SAS Institute Inc. (2020). SAS 9.4 language reference: Concepts (6th ed.). SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/base/index.html
- SAS Institute Inc. (2023). Base SAS procedures guide: Statistical procedures. SAS Institute Inc.