
تعد مسألة معالجة البيانات وضبط جودتها الركيزة الجوهرية التي تسبق أي تحليل إحصائي متقدم؛ إذ إن سلامة الاستنتاجات العلمية والقرارات الاستراتيجية ترتبط ارتباطاً وثيقاً بمدى دقة المدخلات ونظافتها. وفي بيئة البرمجة الإحصائية المتقدمة لنظام تحليلات ساس (SAS – Statistical Analysis System)، تبرز أدوات الفحص الاستكشافي للبيانات كعناصر حاسمة لا غنى عنها لأي محلل بيانات أو باحث أكاديمي يسعى إلى استكشاف مكامن الخلل في مجموعات البيانات الضخمة والمعقدة. وتعتبر مشكلة غياب القيم ظاهرة حتمية ترافق الدراسات المسحية، والتجارب المعملية، والبحوث النفسية والاجتماعية على حد سواء.
إن فهم آليات توزيع القيم المفقودة وتقدير حجمها الدقيق يمثل الخطوة الأولى في سبيل تشخيص نمط الفقد وتحديد الإجراء الإحصائي الأنسب للتعامل معه، سواء كان ذلك عبر الحذف المدروس أو استخدام خوارزميات التعويض الإحصائي المتقدمة. وتتصدر دالة NMISS قائمة الأدوات المتخصصة التي يوفرها نظام SAS لإجراء هذا الفحص بدقة متناهية؛ حيث تجمع هذه الأداة بين البساطة النحوية والقوة التحليلية، مما يمكن الباحث من تشخيص مواضع الفقد على المستويين: الأفقي (لكل ملاحظة أو مستجيب) والرأسي (لكل متغير عبر كامل العينة).
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك منهجي معمق لدالة NMISS في برمجية SAS، مبرزاً آليات استخدامها البرمجية داخل خطوة البيانات (DATA Step) وداخل الإجراءات الإحصائية الجاهزة مثل إجراء المتوسطات الإحصائية (PROC MEANS). وسوف نتناول بالشرح والتطبيق العملي كيفية توظيف هذه الدالة لاكتشاف القيم المفقودة، مع المقارنة بينها وبين الدوال المماثلة، ومناقشة التداعيات المنهجية التي تترتب على نتائج الفحص في سياق البحوث السلوكية والاجتماعية.
1. مقدمة عامة حول دالة NMISS وأهميتها في فحص البيانات في SAS
1.1 مفهوم القيم المفقودة وتأثيرها على التحليلات الإحصائية
تشير البيانات المفقودة (Missing Data) في البرمجيات الإحصائية، وعلى رأسها نظام SAS، إلى غياب الملاحظات أو القياسات الرقمية أو النصية لقيم متغير معين لدى مفردة أو أكثر من مفردات العينة محل الدراسة. ويتجلى هذا الغياب نتيجة لعوامل ميدانية ومنهجية متعددة؛ منها امتناع المشاركين عن الإجابة على بعض بنود الاستبيانات، أو حدوث أعطال تقنية في أجهزة الرصد الآلي، أو تسرب بعض أفراد العينة خلال مراحل الدراسات الطولية (Attrition). وفي بيئة SAS، تُمثل القيمة المفقودة الرقمية بنقطة مفردة (.) كرمز قياسي يعبر عن انعدام المعلومة الحسابية لذلك السجل.
يتجاوز تأثير البيانات المفقودة مجرد كونه نقصاً شكلياً في جداول البيانات؛ إذ ينعكس مباشرة على دقة النماذج الإحصائية وكفاءة التقديرات المعلمية. يؤدي الفقد إلى تقليص حجم العينة الفعال (Effective Sample Size)، الأمر الذي يتسبب في انخفاض القوة الإحصائية (Statistical Power) للاختبارات، وزيادة الخطأ المعياري للتقديرات، وتضخيم فترات الثقة. والأخطر من ذلك هو احتمال إدخال تحيزات نسقية (Systematic Biases) في معاملات الارتباط والانحدار إذا لم يكن غياب البيانات عشوائياً تماماً، مما يقود إلى استنتاجات مضللة تقوض مصداقية البحث العلمي برمتها.
من هنا تنبع الضرورة الحتمية لإجراء الفحص الاستكشافي الأولي للمفقودات قبل التورط في تطبيق الإحصاءات الوصفية المعمقة أو النماذج الاستدلالية المتقدمة مثل النمذجة بالمعادلات البنائية (SEM) أو الانحدار الخطي واللوجستي. يتيح هذا التشخيص الاستباقي للباحث تكوين رؤية شاملة حول حجم النقص ومواضعه، مما يمهد الطريق لاتخاذ قرارات منهجية صائبة ومبنية على براهين رقمية واضحة للتعامل مع هذا الفقد وفق المعايير الأكاديمية الرصينة.
1.2 التعريف التقني بدالة NMISS ودورها في SAS
تُعرّف دالة NMISS في نظام SAS بأنها دالة رياضية وإحصائية مدمجة صُممت خصيصاً لحساب وتعداد عدد القيم العددية المفقودة (Number of Missing Values) عبر قائمة محددة من الوسائط الرقمية. وتُعد هذه الدالة من الدوال العددية الأساسية التي ترجع عدداً صحيحاً موجباً يمثل إجمالي الحقول الفارغة أو التي تحتوي على مؤشر الفقد القياسي بين المتغيرات الممررة إليها، مما يجعلها أداة بالغة الفعالية في أتمتة عمليات التحقق من اكتمال السجلات البيانية.
يقتصر نطاق عمل دالة NMISS الحسابي بصورة حصرية على المتغيرات ذات الطبيعة الرقمية (Numeric Variables)، حيث لا تقبل الدالة المتغيرات النصية (Character Variables) بشكل مباشر كمدخلات صالحة للعد الرياضي. وعند محاولة تمرير متغيرات نصية إليها، يُجري محرك SAS محاولة تحويل ضمني تؤدي عادة إلى إصدار تحذيرات برمجية في سجل النظام (SAS Log) أو تسجيل أخطاء تنفيذية تحول دون المعالجة الدقيقة، وهو ما يفرض على المحلل فهماً دقيقاً للبنية التحتية لبياناته قبل استدعاء هذه الدالة.
وتجدر الإشارة إلى وجود فارق تشغيلي جوهري بين استخدام NMISS كدالة حسابية داخل خطوة بناء البيانات (DATA Step) واستخدامها كخيار إحصائي ضمن الإجراءات التحليلية المدمجة مثل إجراء المتوسطات الإحصائية (PROC MEANS) أو إجراء التلخيص (PROC SUMMARY). فبينما تعمل الدالة في خطوة البيانات على المستوى الأفقي لحساب المفقودات لكل صف أو حالة استجابة على حدة، يعمل الخيار الإحصائي ضمن الإجراءات الجاهزة على تجميع الفقد عمودياً عبر المشاهدات ليقدم تقريراً إجمالياً يوضح حجم الفقد في كل متغير على مستوى كامل العينة.
1.3 أهمية الفحص الاستكشافي للبيانات في الدراسات السلوكية والنفسية
تكتسب مسألة كشف المفقودات أهمية مضاعفة في سياق البحوث السلوكية والعلوم النفسية والاجتماعية؛ نظراً لاعتماد هذه التخصصات الواسع على مقاييس التقرير الذاتي (Self-Report Scales) والاستبانات متعددة الأبعاد. ففي مثل هذه البيئات البحثية، يكثر غياب الاستجابات الجزئية؛ سواء بدافع الإحراج من البنود الحساسة، أو الإرهاق المعرفي الناجم عن طول المقاييس، أو عدم وضوح بعض الأسئلة للمبحوثين، مما يهدد اكتمال السجلات الفردية للمشاركين.
يلعب الرصد الدقيق للقيم المفقودة عبر دالة NMISS دوراً محورياً في الحفاظ على الصدق البنائي (Construct Validity) والاتساق الداخلي للمقاييس السيكومترية. فعلى سبيل المثال، يؤدي حساب درجات الأبعاد الفرعية للمقاييس النفسية عبر جمع استجابات الفقرات مع وجود قيم مفقودة مجهولة إلى خفض مصداقية معامل ألفا كرونباخ وتشوه مصفوفات التغاير المستخدمة في التحليل العاملي التوكيدي (CFA)، مما ينتج عنه تمثيل زائف للبناء النفسي المقاس.
وعلاوة على ذلك، تفرض الهيئات الأكاديمية والجمعيات العلمية، وفي مقدمتها جمعية علم النفس الأمريكية (APA – American Psychological Association)، معايير صارمة تلزم الباحثين بالإفصاح الكامل والشفاف عن معدلات الفقد وتوثيق طبيعتها ضمن تقارير البحوث المنشورة. إن استخدام أدوات موثوقة مثل NMISS يضمن الامتثال الكامل لهذه المعايير المنهجية، ويوفر قاعدة بيانات استكشافية تدعم القرارات التحليلية المتعلقة باستبقاء الحالات أو تطبيق نماذج التعويض الرياضي الحديثة.
2. البنية النحوية والصيغ البرمجية لدالة NMISS في بيئة SAS
2.1 الصيغة الأساسية لدالة NMISS ضمن خطوة البيانات (DATA Step)
تأخذ دالة NMISS داخل خطوة البيانات (DATA Step) تركيبة برمجية مرنة ومباشرة تتيح للمحلل إدراج سلسلة من المتغيرات العددية كمدخلات تفصل بينها فواصل، وتأتي الصيغة العامة للدالة على النحو الآتي:
Missing_Count = NMISS(var1, var2, var3, …, varN);
حيث تمثل المدخلات من var1 إلى varN أسماء المتغيرات الرقمية المراد فحصها، بينما يمثل المتغير Missing_Count المتغير الجديد المستحدث الذي يستقبل القيمة التراكمية للفقد العددي داخل السجل الواحد. وتقوم الدالة بفحص كل وسيط من الوسائط بصورة تسلسلية؛ فإذا صادفت قيمة مفقودة أضافت رقماً صحيحاً إلى العداد الداخلي، لتُرجع في النهاية صفراً في حال اكتمال جميع البيانات، أو رقماً مساوياً لعدد المتغيرات المفقودة في تلك الملاحظة.
وتدعم الدالة استخدام قوائم المتغيرات المتسلسلة (Variable Lists) والمصفوفات (Arrays) لتسهيل التعامل مع عشرات أو مئات المتغيرات دون الحاجة إلى كتابتها بصورة فردية ومطولة. ويتحقق ذلك من خلال استخدام المعامل البرمجي OF، كأن يُكتب: NMISS(of Item1-Item50) أو NMISS(of Scale_A -- Scale_Z). تمنح هذه الصياغة المحلل كفاءة برمجية استثنائية تختصر مئات الأسطر، وتضمن فحص الحقول العددية المتتالية بسلاسة متناهية وسرعة معالجة عالية داخل محرك SAS.
2.2 استدعاء خيار NMISS ضمن الإجراءات الإحصائية الجاهزة
إلى جانب توظيفها البرمجي الحسابي داخل خطوة البيانات، تبرز NMISS كإحصاء تلخيصي أساسي يمكن استدعاؤه ضمن خيارات الإجراء الإحصائي الشهير PROC MEANS. وتتخذ الصياغة البرمجية لهذا الاستدعاء الشكل الآتي:
PROC MEANS DATA=dataset_name NMISS; VAR numeric_var1 numeric_var2; RUN;
يعمل هذا الخيار على توجيه الإجراء لإخراج عمود إحصائي مستقل يُظهر عدد الملاحظات المفقودة لكل متغير رقمي محدد في جملة VAR، مما يوفر نظرة فاحصة وشاملة لمستوى الفقد العام في قاعدة البيانات قبل المضي قدماً نحو التحليلات المعقدة.
كما يمكن توظيف الخيار ذاته داخل إجراء التلخيص PROC SUMMARY لإنشاء جداول إحصائية هيكلية مدمجة تُحفظ في مجموعات بيانات جديدة لأغراض المراقبة والمقارنة. ويتمثل الفارق الجوهري بين التطبيقين في أن استخدام NMISS في خطوة البيانات يجري حساباً “أفقياً” (Horizontal Calculation) على مستوى الصف الواحد للمستجيب لرصد سلوك الفقد الفردي، في حين يمثل استخدامها ضمن الإجراءات الإحصائية حساباً “رأسياً” (Vertical Calculation) عبر الأعمدة يهدف إلى تقييم جودة أدوات القياس والمتغيرات ككل عبر كامل عينة الدراسة.
2.3 قواعد التسمية ونوعية البيانات المقبولة
تشترط لغة SAS التزاماً صارماً بنوعية البيانات المقبولة لدى دالة NMISS؛ إذ يجب أن تكون كافة الحقول الممررة حقولاً عددية صريحة. ويفسر محرك النظام القيم المفقودة العددية الاعتيادية بالرمز النقطي (.)، حيث يُعامل هذا الرمز رياضياً كأصغر قيمة عددية سالبة ممكنة داخل بنية النظام الداخلية، مما يسمح لدالة NMISS بالتعرف عليه وتصنيفه فوراً كقيمة مفقودة وزيادة عداد الفقد بمقدار وحدة واحدة.
وفي حال قام المبرمج بتمرير متغير نصي إلى الدالة دون قصد، فإن بيئة SAS تصدر تنبيهاً تشخيصياً في سجل التنفيذ يوضح أن الدالة تتطلب وسائط رقمية، وقد يلجأ النظام أحياناً إلى محاولة إجراء تحويل آلي من نمط نصي إلى نمط عددي (Implicit Character-to-Numeric Conversion). وإذا تعذر هذا التحويل لاحتواء الحقل النصي على أحرف أبجدية أو رموز غير قابلة للتحويل الحسابي، فإن النظام يُسجل رسالة خطأ صريحة، أو يعتبر القيمة غير الصالحة مفقودة، مما قد يربك النتائج ويفسد دقة التعداد.
علاوة على ذلك، تتميز برمجية SAS بقدرتها على التعامل مع القيم المفقودة الخاصة (Special Missing Values)، والتي يُرمز لها بنقطة تتبعها أحرف أبجدية من (.A) إلى (.Z) أو الشرطة السفلية (._). وتُستخدم هذه الترميزات في الدراسات المتقدمة للتمييز النوعي بين أسباب الفقد المتنوعة؛ كأن يرمز (.A) لرفض الإجابة، بينما يرمز (.B) لعدم انطباق السؤال على المشارك. وتتعامل دالة NMISS ببراعة فائقة مع هذه الرموز الخاصة كافة، وتدرجها جميعاً ضمن إجمالي القيم العددية المفقودة دون أي استثناء، مما يضمن شمولية الفحص التشخيصي مهما تنوعت أسباب الفقد.
3. إنشاء مجموعة البيانات التجريبية لمحاكاة التحليل العملي
3.1 كتابة شيفرة DATA Step لبناء بيانات تجريبية متكاملة
لتطبيق المفاهيم النظرية السابقة بطريقة عملية ملموسة، سنقوم بإنشاء مجموعة بيانات تجريبية تحاكي إحصاءات الأداء الرياضي للاعبي كرة السلة عبر خطوة بناء البيانات في SAS تحت اسم my_data. تتضمن هذه المجموعة متغيرات تجمع بين السمات التصنيفية النصية والقياسات الرقمية المتصلة، لتوضيح كيفية تفاعل دوال وإجراءات النظام مع مختلف الهياكل البيانية.
تشتمل مجموعة البيانات على أربعة متغيرات محورية تمثل أبعاداً متباينة للأداء الرياضي: المتغير الأول هو اسم الفريق (team)، وهو متغير تصنيفي نصي؛ والمتغير الثاني يمثل إجمالي النقاط المسجلة (points) كمتغير رقمي؛ والمتغير الثالث يمثل التمريرات الحاسمة (assists) كمتغير رقمي أيضاً؛ في حين يقيس المتغير الرابع المتابعات الدفاعية والهجومية (rebounds) كمتغير رقمي رابع. وتُستخدم جملة INPUT المعيارية لتعريف هذه الأعمدة، مع إلحاق علامة الدولار ($) باسم متغير الفريق لتوجيه محرك SAS لقراءته كمتغير نصي، وترك المتغيرات الأخرى دون علامة لتعريفها كمتغيرات عددية خالصة.
3.2 تضمين البيانات الخام بواسطة سطر datalines
تُدمج الملاحظات الرقمية مباشرة ضمن برنامج SAS باستخدام الكلمة المفتاحية DATALINES (أو CARDS). وقد صُممت هذه البيانات عمداً لتضم تشكيلات متنوعة من السجلات المكتملة والسجلات التي تحتوي على قيم مفقودة في مواضع متباينة، بهدف اختبار قدرة الدوال البرمجية على رصد الفقد وتشخيصه بدقة.
وتُمثل الحالات المفقودة برمجياً بالرمز النقطي القياسي (.) في مواضع متفرقة تحاكي الواقع التجريبي؛ حيث يغيب أحياناً قياس النقاط، وأحياناً قياس التمريرات، أو تجتمع عدة مفقودات في سجل رياضي واحد. وتتجسد الشيفرة البرمجية الكاملة لإنشاء مجموعة البيانات هذه على النحو التالي:
DATA my_data;
INPUT team $ points assists rebounds;
DATALINES;
A 25 8 10
A 18 . 7
A . 5 6
A 30 12 .
B . . 4
B 22 7 9
B 15 4 .
B . 9 8
C 28 6 11
C . . .
;
RUN;
يعكس هذا التوزيع المدروس تعقيدات جمع البيانات الميدانية؛ فالحالة العاشرة في الفريق (C)، على سبيل المثال، تمثل حالة فقد كلي لجميع المؤشرات الرقمية للاعب، بينما تمثل الحالة الأولى في الفريق (A) سجلاً مكتملاً خالياً من أي نقص، مما يوفر بيئة تجريبية ثرية لاختبار دقة الفحص الإحصائي.
3.3 معاينة البيانات المدخلة عبر إجراء PROC PRINT
عقب إتمام بناء مجموعة البيانات وتشغيل خطوة DATA Step بنجاح، تأتي خطوة المعاينة البصرية والتحقق من سلامة قراءة البيانات وهيكليتها التأسيسية. ويُعد إجراء PROC PRINT الأداة المثالية في SAS لفحص السجلات والتأكد من مطابقة الأبعاد والصفوف للمدخلات المحددة.
يتم تنفيذ استعلام الطباعة عبر الشيفرة الآتية:
PROC PRINT DATA=my_data; RUN;
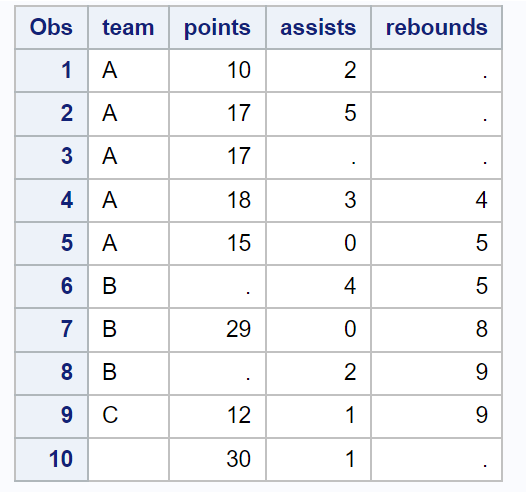
وعند استعراض نافذة المخرجات (Output Window أو Results Viewer)، تظهر البيانات في جدول منظم يعرض عموداً افتراضياً لأرقام الملاحظات (Obs) بجانب الأعمدة الأربعة المعرفة. وتتضح النقاط الدالة على القيم المفقودة داخل خلايا الأعمدة الرقمية بصورة جلية تتيح للباحث التأكد البصري من صحة التموضع الهيكلي للمدخلات ومطابقتها للمتغيرات النصية التابعة لها قبل الشروع في إجراء التحليلات المعقدة وتطبيق دوال الفحص المتقدمة.
4. تطبيق عملي: حساب القيم المفقودة لكل متغير باستخدام PROC MEANS
4.1 كتابة وتشغيل شيفرة PROC MEANS مع الخيار NMISS
يُعد إجراء PROC MEANS الأداة الأكثر شيوعاً في بيئة SAS لاستخراج المعالم الإحصائية الوصفية وتلخيص المتغيرات الرقمية. وعند إضافة الخيار الإحصائي NMISS إلى جملة الإجراء التأسيسية، يتحول الإجراء إلى أداة تدقيق سريعة وشاملة تقيس وتلخص معدلات الفقد الرأسي في البيانات.
لتشغيل هذا الفحص على مجموعة البيانات السابقة my_data، نكتب الشيفرة البرمجية التالية:
PROC MEANS DATA=my_data NMISS;
VAR points assists rebounds;
RUN;
تعمل جملة VAR الاختيارية المرفقة في هذا السياق كأداة تحكم دقيقة تحدد المتغيرات المستهدفة بالتحليل الإحصائي، وتستبعد أية متغيرات أخرى لا يرغب المحلل في إدراجها ضمن التقرير الموجز. يقوم محرك SAS بقراءة السجلات العشرة ومعالجة قيم كل متغير على حدة عبر قنوات التجميع الرأسي، ثم يقوم بتوليد جدول مخرجات إحصائي موحد يُبرز تكرارات الفقد في كل مؤشر رياضي مدرج بدقة تامة.
4.2 قراءة وتفكيك جدول المخرجات الصادر عن SAS
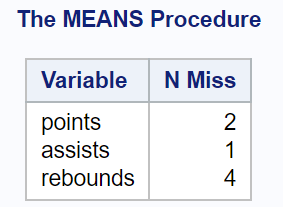
يُظهر تقرير المخرجات الناتج عن تشغيل الكود السابق جدولاً إحصائياً دقيقاً يتضمن المتغيرات الرقمية المفحوصة وأمام كل منها عدد القيم المفقودة الخاصة به تحت عمود معنون باسم N Miss. وعند فحص هذا التقرير في ضوء البيانات التجريبية التي تم إدخالها، نلاحظ ظهور النتائج على النحو الآتي:
- points: يُظهر التقرير وجود 4 قيم مفقودة (حيث غابت النقاط في الملاحظات 3 و 5 و 8 و 10).
- assists: يُظهر التقرير وجود 3 قيم مفقودة (الملاحظات 2 و 5 و 10).
- rebounds: يُظهر التقرير وجود 3 قيم مفقودة (الملاحظات 4 و 7 و 10).
ومن الأهمية بمكان ملاحظة الغياب التلقائي لمتغير الفريق (team) عن جدول المخرجات؛ إذ يتعرف إجراء PROC MEANS تلقائياً على نوعية المتغير ويستبعد المتغيرات النصية من التحليلات الحسابية حتى لو تم ذكرها أو تمرير الجدول بأكمله دون تخصيص جملة VAR. هذا السلوك المعياري يحمي المحلل من الأخطاء البرمجية الناتجة عن تضارب أنواع البيانات، ويؤكد توافق الإحصاء الرصود مع التركيبة الحقيقية لمجموعة البيانات الأصلية.
4.3 تخصيص الإحصاءات الإضافية بجانب خيار NMISS
لا يقتصر استخدام PROC MEANS على حصر المفقودات فحسب؛ بل يُفضل منهجياً الجمع بين خيار NMISS وخيارات إحصائية مكملة لتوفير تقييم وصفي شامل لجودة القياسات وأبعاد العينة. ومن أبرز هذه الخيارات الإحصائية خيار N الذي يحسب عدد المشاهدات الصالحة والمكتملة، بالإضافة إلى خيارات النزعة المركزية والتشتت كالمتوسط الحسابي (MEAN) والانحراف المعياري (STD).
تتم صياغة التقرير الإحصائي الموسع من خلال الشيفرة التالية:
PROC MEANS DATA=my_data N NMISS MEAN STD MIN MAX;
VAR points assists rebounds;
RUN;
ينتج عن هذه الشيفرة جدول تحليلي ثري يمنح الباحث رؤية مزدوجة متكاملة؛ حيث يوضح عمود N حجم الملاحظات الفعلية التي بُني عليها حساب المتوسط والانحراف المعياري، بينما يكشف عمود NMISS الحجم الموازي للبيانات المستبعدة من الحساب. وبجمع قيمتي (N + NMISS) لكل متغير، يستطيع الباحث التحقق من مطابقة المجموع الكلي لحجم العينة الأصلي المكون من 10 ملاحظات، مما يقدم تقريراً وصفياً متكاملاً يعكس دقة البيانات وموثوقية المؤشرات المشتقة منها.
5. استخدام دالة NMISS ضمن خطوة البيانات لحساب الفقد على مستوى الحالات (Rows)
5.1 إنشاء مؤشرات الفردية للبيانات المفقودة لكل ملاحظة
إذا كان إجراء PROC MEANS يمنح الباحث نظرة شمولية عمودية حول الفقد في كل متغير، فإن الحاجة المنهجية تقتضي في أحيان كثيرة فحص سلوك الاستجابة على المستوى الفردي لكل مشارك أو صف (Horizontal Counting). وتتجلى قوة دالة NMISS عند استدعائها داخل خطوة البيانات (DATA Step) لتحقيق هذا الغرض بدقة متناهية عبر إنشاء متغير رقمي جديد يسجل رصيد الفقد التراكمي في كل سجل مفرد.
يتحقق هذا التوظيف العملي بكتابة الشيفرة البرمجية الآتية:
DATA analyzed_data;
SET my_data;
total_miss = NMISS(points, assists, rebounds);
RUN;
تقوم لغة SAS عند تنفيذ هذه الشيفرة بالمرور التسلسلي عبر سجلات جدول my_data صفاً تلو الآخر؛ حيث تحسب الدالة عدد الحقول الفارغة ضمن المتغيرات الثلاثة المحددة لكل لاعب، وتخزن النتيجة في المتغير الجديد total_miss. ففي السطر الأول للاعب من الفريق A ترجع الدالة القيمة (0) لاكتمال بياناته، بينما ترجع القيمة (2) في السطر الخامس للاعب من الفريق B لوجود نقطتين مفقودتين، في حين تُسجل القيمة (3) للاعب العاشر من الفريق C الذي يفتقر لجميع القياسات. وتكتسب هذه التقنية أهمية قصوى في تنقية عينات الدراسات المسحية لتحديد المستجيبين الذين يفتقرون للحد الأدنى من البيانات المقبولة للتحليل.
5.2 تطبيق الشروط المنطقية المعتمدة على دالة NMISS
تمثل النتائج الرقمية المشتقة من دالة NMISS قاعدة ارتكاز صلبة لصياغة الشروط المنطقية واستبعاد الحالات المعيبة عبر جملة IF الشرطية؛ إذ تتيح للباحث وضع حدود عتبية (Thresholds) منهجية تحدد نسبة الفقد المقبولة التي يمكن التسامح معها قبل إقصاء المفردة بالكامل من العينة النهائية.
فعلى سبيل المثال، إذا وضع الباحث معياراً يقضي باستبعاد أي رياضي تنقصه أكثر من قيمة واحدة من أصل المؤشرات الثلاثة المقاسة، يمكنه تنفيذ هذا القرار البرمجي المنهجي بسلاسة تامة عبر الكود التالي:
DATA clean_data;
SET my_data;
IF NMISS(points, assists, rebounds) > 1 THEN DELETE;
RUN;
كما يمكن توظيف الدالة ذاتها لإنشاء مؤشرات وصفية ثنائية (Binary Indicators أو Flags) ترمز لاكتمال السجل الرياضي من عدمه، مما يسهل عمليات الفرز والتحليل اللاحقة، وذلك عبر الصياغة الآتية:
DATA flagged_data;
SET my_data;
miss_count = NMISS(points, assists, rebounds);
IF miss_count = 0 THEN is_complete = 1;
ELSE is_complete = 0;
RUN;
تؤسس هذه المتغيرات الثنائية لأرضية تحليلية منظمة تمكن الباحث من إجراء مقارنات سريعة لاحقة بين الأفراد أصحاب الاستجابات الكاملة وأولئك الذين لديهم بيانات منقوصة لتحديد ما إذا كان الفقد عشوائياً أم يرتبط بسمات ديموغرافية وسلوكية معينة.
5.3 التعامل مع المصفوفات وقوائم المتغيرات الكبيرة (Arrays)
في بيئات البحوث الواقعية المعقدة، مثل استطلاعات الرأي الشاملة والاختبارات النفسية واسعة النطاق، غالباً ما يواجه المحلل بنوكاً من الأسئلة تضم عشرات أو مئات البنود المقاسة (مثل مقاييس الشخصية أو الرضا الوظيفي). وفي هذه الحالات، يصبح إدراج المتغيرات واحداً تلو الآخر داخل دالة NMISS عملاً غير عملي ومصدراً للأخطاء المطبعية.
هنا تتجلى مرونة دالة NMISS الفائقة في استيعاب قوائم المتغيرات الموسعة باستخدام المعامل البرمجي OF، حيث يمكن التعبير عن فحص 50 فقرة استبيان تبدأ من Q1 وتنتهي عند Q50 بسطر واحد موجز:
DATA survey_filtered;
SET survey_raw;
unanswered_items = NMISS(of Q1-Q50);
RUN;
وعند العمل داخل هياكل المصفوفات البرمجية المتقدمة (SAS Arrays)، تتكامل الدالة بسلاسة لتوفير أعلى كفاءة ممكنة؛ حيث يمكن تمرير اسم المصفوفة بأكمله للدالة كأن يقال: total_missing = NMISS(of scale_items{*});. يساهم هذا النمط البرمجي في اختصار مئات الأسطر من الكود، ويعزز من سرعة المعالجة الحاسوبية وخفض استهلاك الذاكرة العشوائية لمحرك SAS عند معالجة قواعد البيانات الضخمة التي تحتوي على ملايين السجلات وعشرات المتغيرات الرقمية المتتالية.
6. المقارنة المنهجية بين دالة NMISS والدوال الإحصائية المقابلة في SAS
6.1 المقارنة المباشرة بين دالة N ودالة NMISS
تمثل دالة N الوجه المكمل والمناظر وظيفياً لدالة NMISS داخل منظومة دوال SAS الإحصائية؛ فبينما تتخصص NMISS في احتساب عدد القيم المفقودة حصراً، تتولى دالة N مهمة حساب وتعداد القيم الرقمية غير المفقودة (Non-missing Values) المتواجدة بالفعل ضمن قائمة المتغيرات الممررة.
وتخضع العلاقة بين هاتين الدالتين لقاعدة تكاملية رياضية صارمة ومطلقة، تتلخص في المعادلة الآتية لأي مجموعة من المتغيرات العددية المفحوصة داخل الملاحظة الواحدة:
N(var1, var2, …, varK) + NMISS(var1, var2, …, varK) = K
حيث يمثل K العدد الإجمالي للمتغيرات المدرجة في الفحص. فإذا قمنا بتطبيق الدالتين معاً على السجل الثاني من بياناتنا السابقة (points=18, assists=., rebounds=7)، فإن دالة N سترجع القيمة (2) نظراً لوجود قياسين مكتملين، بينما ترجع NMISS القيمة (1) لوجود قياس مفقود واحد، ويكون حاصل جمعهما مساوياً للعدد الكلي للمتغيرات وهو (3). وتحدد أهداف الفحص أي الدالتين أنسب للتطبيق؛ فإذا كان التركيز ينصب على التحقق من استيفاء شروط اكتمال العينة يُفضل استخدام N، بينما يُلجأ إلى NMISS كخيار مثالي في سيناريوهات التدقيق واكتشاف الأخطاء وتصفية البيانات المعتلة.
6.2 الفروق بين NMISS ودالة MISSING في SAS
يقع كثير من المبرمجين المبتدئين في خلط منهجي بين دالة NMISS ودالة MISSING في SAS، على الرغم من وجود فوارق هيكلية وجوهرية بينهما تؤثر على طبيعة النتائج البرمجية. تعمل دالة MISSING كدالة فحص منطقي ثنائية القيمة (Logical Boolean Function) تختبر متغيراً واحداً مفرداً، وتُرجع القيمة (1) إذا كان المتغير المعني مفقوداً، أو القيمة (0) إذا كان يحتوي على بيانات حقيقية صالحة.
علاوة على ذلك، تتميز دالة MISSING بدعمها المتكافئ لكل من المتغيرات الرقمية والنصية على حد سواء؛ حيث تختبر وجود الرمز النقطي (.) في الحقول العددية، أو وجود الفراغات البيضاء (‘ ‘) في السلاسل النصية دون أي قيود نوعية، بخلاف دالة NMISS التي تقتصر حصرياً على الأرقام. ويوضح الجدول الآتي أبرز الفروق المنهجية بين الأداتين:
- عدد المدخلات: تقبل دالة NMISS قائمة لا نهائية من المتغيرات في آن واحد، بينما لا تقبل دالة MISSING سوى متغير واحد فقط في كل استدعاء.
- نوع المدخلات: تدعم دالة NMISS المتغيرات الرقمية فقط، في حين تقبل دالة MISSING المتغيرات النصية والرقمية دون تمييز.
- طبيعة المخرجات: ترجع NMISS عدداً تراكمياً يمثل حصيلة الفقد الإجمالي، بينما ترجع MISSING قيمة ثنائية (0 أو 1) تمثل الحالة المنطقية للمتغير المفحوص.
وبناءً على ذلك، يُفضل استخدام التعبير المنطقي IF MISSING(x) THEN ... عند الرغبة في اختبار متغير واحد محدد وبناء تفرع شرطي سريع بناءً عليه، في حين يُعد استخدام IF NMISS(x, y, z) > 0 THEN ... الخيار الأمثل والوحيد لفحص عدة متغيرات رقمية معاً بكفاءة واختصار.
6.3 دوال التعامل مع النصوص المفقودة: دالة CMISS
نظراً للقصور الهيكلي لدالة NMISS المتمثل في عجزها عن معالجة الحقول النصية، وفرت بيئة SAS الحديثة دالة مكملة وشاملة تُعرف باسم CMISS. صُممت دالة CMISS لتكون الأداة العامة لحساب القيم المفقودة بغض النظر عن النوع؛ حيث تقبل خليطاً متجانساً أو غير متجانس من المتغيرات العددية والنصية في القائمة ذاتها، مما يمنحها مرونة برمجية فائقة عند التعامل مع الجداول التي تتضمن بيانات مختلطة الأنماط.
وعند تطبيق المقارنة العملية على مجموعة بيانات تحتوي على متغير الفريق (team النصي) ومتغير النقاط (points العددي)، نجد أن استدعاء NMISS(team, points) سيؤدي إلى فشل أو رسائل تحذيرية في سجل النظام بسبب وجود المتغير النصي team. وفي المقابل، فإن كتابة الصيغة التالية:
total_all_miss = CMISS(team, points, assists, rebounds);
ستعمل بمنتهى الانسيابية، حيث ستقوم الدالة بفحص الحقل team؛ فإن كان فارغاً أضافت واحداً إلى العداد، ثم تفحص الحقول الرقمية الأخرى متبعة القواعد ذاتها، لتُرجع في النهاية إجمالي الفقد الشامل في السجل الواحد بصرف النظر عن تباين مستويات القياس. لذلك، يوصى بالاعتماد على دالة NMISS عند تخصيص التحليل بالمقاييس الرقمية الصرفة لضمان صرامة التحقق النوعي، والتحول نحو CMISS عند إدارة جداول بيانات استطلاعية واسعة تجمع بين المتغيرات الديموغرافية الاسمية والمقاييس السيكومترية الرقمية.
7. التحليلات المتقدمة: تصنيف الفقد وتجميعه باستخدام BY و CLASS
7.1 تحليل الفقد عبر المجموعات الفرعية باستخدام جملة CLASS
لا يقتصر فحص جودة البيانات على التقييم الإجمالي للعينة بأكملها؛ بل يتطلب التحليل الإحصائي الرصين استكشاف كيفية توزيع الفقد بين الفئات والمجموعات المكونة للمجتمع المدروس. وفي هذا السياق، يوفر دمج خيار NMISS مع جملة CLASS داخل إجراء PROC MEANS وسيلة استكشافية متقدمة لتشخيص أنماط الفقد التوزيعية عبر المجموعات الفرعية.
تتم كتابة الشيفرة التحليلية المصنفة على النحو التالي:
PROC MEANS DATA=my_data NMISS;
CLASS team;
VAR points assists rebounds;
RUN;
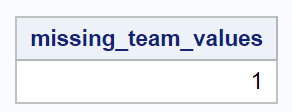
ينتج عن تنفيذ هذه الشيفرة جدول إحصائي تحليلي مجمع يعرض معدلات الفقد لكل مؤشر رياضي مقسماً حسب فئات الفرق (A و B و C). تتيح هذه الرؤية المصنفة للباحثين في التجارب المقارنة، كالتجارب السريرية أو الدراسات التربوية، رصد أي فقد انتقائي أو غير متماثل (Differential Attrition) بين المجموعات التجريبية والمجموعات الضابطة؛ حيث قد يشير ارتفاع معدلات الفقد في فريق أو فئة بعينها إلى وجود خلل منهجي في جمع البيانات بتلك المجموعة يستوجب تدخلاً إحصائياً متخصصاً.
7.2 استخدام جملة BY المسبوقة بإجراء PROC SORT لتنظيم التقرير
تُعد جملة BY خياراً متقدماً وبديلاً لجملة CLASS عند الرغبة في تنظيم مخرجات التقرير في جداول إحصائية مستقلة ومنفصلة بصرياً لكل مستوى من مستويات المتغير التصنيفي. وتفرض لغة SAS قاعدة هيكلية صارمة عند استخدام جملة BY؛ إذ تشترط فرز مجموعة البيانات مسبقاً وتصنيفها ترتيبياً وفقاً لمتغير الفرز باستخدام إجراء PROC SORT قبل تنفيذ إجراء التحليل.
يتحقق هذا الترتيب المنهجي عبر الخطوتين البرمجيتين الآتيتين:
PROC SORT DATA=my_data OUT=sorted_data;
BY team;
RUN;
PROC MEANS DATA=sorted_data NMISS;
BY team;
VAR points assists rebounds;
RUN;
تؤدي هذه الشيفرة إلى توليد ثلاثة تقارير إحصائية منفصلة في نافذة النتائج؛ بحيث يحصل الفريق A على جدوله المستقل، يليه جدول منفصل للفريق B، ثم تقرير مستقل للفريق C. وتعتبر هذه الصيغة البرمجية الخيار المفضل عند إعداد التقارير الفنية والوثائق الأكاديمية الرسمية التي تستلزم أرشفة وتوثيق سلوك كل عينة فرعية في قسم مستقل يسهل الرجوع إليه واستيعابه بمعزل عن بقية الفئات.
7.3 تصدير نتائج فحص المفقودات إلى جداول بيانات جديدة (OUTPUT Statement)
في مسارات المعالجة البرمجية المتكاملة، لا يكتفي المحلل بمعاينة مخرجات فحص الفقد على الشاشة؛ بل تقتضي الحاجة التشغيلية تصدير تلك الإحصاءات الملخصة إلى جداول بيانات جديدة داخل بيئة SAS لإعادة استخدامها في مراحل لاحقة، كإنشاء رسوم بيانية للمفقودات، أو بناء تقارير رقابية آلية لجودة البيانات المتجددة.
ويتم ذلك عبر توظيف جملة OUTPUT داخل إجراء PROC MEANS مع استدعاء إحصاء NMISS وحفظه في أعمدة مسماة بدقة، كما توضح الشيفرة الآتية:
PROC MEANS DATA=my_data NOPRINT;
CLASS team;
VAR points assists rebounds;
OUTPUT OUT=missing_summary
NMISS(points assists rebounds) = miss_pts miss_ast miss_reb;
RUN;
تؤدي إضافة الخيار NOPRINT إلى منع طباعة الجداول في نافذة النتائج لتسريع الأداء وتفادي تكديس المخرجات، بينما تقوم جملة OUTPUT بإنشاء مجموعة بيانات جديدة دائمة أو مؤقتة تحمل اسم missing_summary. ويحتوي هذا الجدول الجديد على أعمدة مخصصة تلخص إجمالي الفقد لكل متغير تحت مسميات واضحة (miss_pts, miss_ast, miss_reb) مقسمة حسب الفرق، مما يتيح دمجها بسلاسة مع قواعد بيانات أخرى أو استخدامها كمدخلات لمؤشرات لوحات القيادة (Dashboards) المعنية برصد جودة البيانات دورياً.
8. الأخطاء البرمجية والتحذيرات الشائعة عند تطبيق NMISS وكيفية حلها
8.1 خطأ إدخال المتغيرات النصية داخل دالة NMISS
يعد التمرير الخاطئ للمتغيرات النصية داخل دالة NMISS من أبرز الهفوات البرمجية الشائعة التي يقع فيها مبرمجو ومحللو SAS. فعند قيام المستخدم بكتابة صياغة غير دقيقة مثل: total_miss = NMISS(team, points);، فإن محرك النظام يستجيب فوراً بتسجيل ملاحظات ورسائل تحذيرية صريحة في سجل النظام (SAS Log) تفيد بأن الدالة تتطلب متغيراً عددياً، كما يلي:
NOTE: Character values have been converted to numeric values at the places given by: ...
NOTE: Invalid numeric data, team='A' , at line ... column ...
توضح هذه الرسائل أن النظام حاول قسراً تحويل الحروف النصية إلى أرقام لتلبية الشروط الحسابية للدالة، ولما عجز عن ذلك سجل أخطاء تحويل واعتبر القيمة مفقودة بصورة زائفة. ولتلافي هذه المعضلة التشخيصية، يتعين على الباحث التحقق المسبق من بنية البيانات وأنواع المتغيرات باستخدام إجراء فحص الخصائص المرجعي PROC CONTENTS:
PROC CONTENTS DATA=my_data; RUN;
وفي حال كانت المتغيرات تمثل قياسات عددية خُزنت سهواً بصيغة نصية أثناء مرحلة الاستيراد الميداني، يجب حينئذ تحويلها برمجياً إلى النمط العددي الصحيح باستخدام دالة INPUT مع التنسيق الملائم قبل تمريرها لدالة NMISS، وفق النمط الآتي:
numeric_var = INPUT(char_var, BEST12.);
8.2 سوء صياغة المتغيرات المتعددة وسقوط كلمة OF الأساسية
يمثل إغفال الكلمة المفتاحية OF عند الرغبة في فحص نطاق من المتغيرات المتسلسلة فخاً برمجياً خطيراً في لغة SAS؛ والسبب في ذلك أن غياب هذه الكلمة لا يوقف تنفيذ البرنامج في كثير من الحالات، ولكنه يؤدي إلى إجراء عمليات حسابية مشوهة تقود إلى نتائج خاطئة تماماً دون أن يدرك المبرمج ذلك.
لتوضيح ذلك، تأمل الفارق الدلالي والتقني الشاسع بين الصياغتين التاليتين:
- الصياغة الخاطئة:
nmiss_wrong = NMISS(var1 - var5); - الصياغة الصحيحة:
nmiss_correct = NMISS(of var1 - var5);
في الصياغة الأولى التي سقطت منها كلمة OF، يفسر محرك SAS علامة الشرطة (-) كمعامل حسابي للطرح (Subtraction Operator)، فيقوم بحساب ناتج طرح قيمة المتغير var5 من قيمة المتغير var1، ثم يمرر ناتج الطرح المفرد هذا كوسيط واحد لدالة NMISS، وبذلك تحسب الدالة ما إذا كان ناتج الطرح مفقوداً أم لا، متجاهلة تماماً المتغيرات الوسيطة (var2 و var3 و var4). أما في الصياغة الثانية، فإن وجود المعامل OF يوجه المحرك لاعتبار الشرطة أداة تسلسلية لتعريف نطاق يشمل جميع المتغيرات الخمسة فيحسب مفقوداتها بدقة تامة. لذلك يجب توخي الحذر الشديد وفحص سجل SAS Log للتأكد من عدم وجود عمليات رياضية غير مقصودة نشأت عن هذا السقوط الشائع.
8.3 تجاهل تأثير القيم المفقودة الخاصة (Special Missing Values)
تسمح بيئة SAS المتقدمة للباحثين بترميز سبعة وعشرين نوعاً مختلفاً من الفقد الرقمي المخصص، تتألف من النقطة متبوعة بأي حرف أبجدي من (.A إلى .Z) بالإضافة إلى رمز الشرطة السفلية (._). وتُستخدم هذه القيم في المسوح الاجتماعية والنفسية الدقيقة للتفريق الميداني بين فئات الفقد المتعددة؛ مثل التمييز بين المشارك الذي رفض الإجابة عمداً (.R)، والمشارك الذي لا تنطبق عليه الفقرة أصلاً (.N)، والسؤال الذي سقط سهواً من أداة القياس (.M).
وعلى الرغم من أن دالة NMISS ترصد هذه القيم الخاصة ببراعة فائقة وتدرجها جميعاً ضمن عداد الفقد الكلي دون أي عائق برمجي، إلا أن الخلل المنهجي ينشأ عندما يغفل الباحث توحيد معايير هذا الترميز أثناء مراحل تنظيف البيانات ومعالجتها. فقد يؤدي غياب خطة واضحة وموثقة للترميز الخاص إلى خلط المفقودات الحقيقية الناتجة عن عدم استجابة المبحوثين مع حالات عدم انطباق البند، مما يضخم بصورة مصطنعة معدلات الفقد الظاهرة في تقارير NMISS ويوجه الباحثين لاتخاذ قرارات حذف غير مبررة إحصائياً تؤثر سلباً على سلامة الاستنتاجات العلمية.
9. التداعيات المنهجية لنتائج NMISS في البحوث النفسية والاجتماعية
9.1 تقييم آليات الفقد بناءً على نتائج الإحصاء الوصفي
تمثل المؤشرات الرقمية الناتجة عن دالة NMISS، سواء على مستوى المتغيرات أو الأفراد، المحطة الأولى والمنطلق الأساسي لتقييم وتصنيف آليات الفقد الثلاث التي أرساها العالم الإحصائي دونالد روبين (Rubin’s Missing Data Taxonomy). وتتمثل هذه الآليات في: الفقد العشوائي تماماً (Missing Completely at Random – MCAR)، والفقد العشوائي (Missing at Random – MAR)، والفقد غير العشوائي (Missing Not at Random – MNAR).
على الرغم من أن دالة NMISS تقدم إحصاءً وصفياً بحتاً ولا تفصل بشكل قطعي بين هذه الآليات بمفردها، إلا أن أنماط التكرار التي تكشفها تشكل مؤشراً أولياً حيوياً لاختبار فرضيات الفقد؛ فإذا كشفت مخرجات NMISS عن تركّز الفقد في فقرات استبيانية معينة تتناول موضوعات محرجة، أو مقاييس دخل مرتفعة الحساسية، أو بنوداً تتسم بصعوبة الإدراك والتعقيد اللغوي، فإن ذلك يعد دليلاً تشخيصياً قوياً يرجح وجود فقد غير عشوائي (MNAR). في مثل هذه الحالات، ترتبط احتمالية غياب الإجابة بقيمة المتغير ذاته، مما ينبه الباحث إلى عدم كفاية المعالجات التقليدية وضرورة اللجوء إلى نماذج النمذجة الإحصائية المتقدمة للبيانات المفقودة لضمان ضبط التحيزات المحتملة.
9.2 القرارات المنهجية التالية لعملية رصد الفقد
تسهم المعايير الكمية المستخرجة عبر دالة NMISS في ترشيد وتوجيه القرارات المنهجية الحاسمة التي يجب على الباحث اتخاذها لمعالجة البيانات المنقوصة؛ وتتمثل أولى هذه الخيارات وأكثرها تقليدية في أسلوب الحذف القائم على الحالات الكاملة (Listwise Deletion)، والذي يتلخص في استبعاد أي مشارك يحمل سجله مفقوداً واحداً فأكثر.
وعلى الرغم من سهولة تطبيق الحذف الكامل برمجياً، إلا أن نتائجه قد تكون كارثية على التحليل الإحصائي؛ إذ تؤدي إلى تقليص هائل في حجم العينة الفعال، مما يتسبب في هبوط حاد في القوة الإحصائية (Statistical Power) للنماذج، وارتفاع أخطاء التقدير. ولا يسوغ اللجوء لهذا الإجراء منهجياً إلا إذا أثبتت فحوص NMISS أن نسبة الفقد الكلية طفيفة جداً (أقل من 5% عادة) وأن آلية الفقد تتبع تماماً نمط الفقد العشوائي الكامل (MCAR).
أما إذا كشفت المؤشرات عن نسب فقد ملحوظة تتجاوز هذه الحدود العتبية، فإن المسار المنهجي السليم يفرض على الباحث تجنب الحذف الآلي، والتحول فوراً نحو استخدام تقنيات التعويض الإحصائي المتطورة، مثل خوارزميات التعويض المتعدد (Multiple Imputation – MI) أو تقدير الاحتمالية العظمى للمعلومات الكاملة (Full Information Maximum Likelihood – FIML). تعمل هذه التقنيات الحديثة على استبقاء العينة الأصلية كاملة والحفاظ على تبايناتها الطبيعية، مما يحد من التحيز ويضمن ثبات المعالم المقدرة.
9.3 توثيق شفافية البيانات المفقودة في التقارير العلمية
تفرض التوجيهات المنهجية المعاصرة لتوثيق البحوث ونشرها في المجلات العلمية المحكمة، لا سيما المعايير الصادرة عن جمعية علم النفس الأمريكية (APA Style Guidelines)، ضرورة الإفصاح الكامل والشفاف عن تفاصيل ومعدلات الفقد كجزء أساسي من قسم المنهجية وإجراءات التحليل في الورقة البحثية.
وتقتضي الأمانة العلمية من الباحثين إدراج جداول إحصائية توضح بوضوح الملاحظات المحسوبة عبر دالة NMISS والنسب المئوية المقابلة لها لكل متغير من المتغيرات المفحوصة. ويجب أن تتضمن التقارير الأكاديمية استعراضاً تحليلياً مفصلاً يربط بين حجم الفقد الظاهر في المخرجات وبين الإجراء التصحيحي المتخذ؛ سواء كان استبعاداً معللاً لحالات محددة أو تعويضاً رياضياً مبنياً على النمذجة الاحتمالية.
إن هذا التوثيق الدقيق والصارم لا يعزز مصداقية النتائج المنشورة فحسب؛ بل يدعم كذلك قابلية تكرار البحث والتحقق من صدق مخرجاته من قِبل باحثين مستقلين (Reproducibility and Replicability)، وهو ما يمثل المعيار الذهبي لجودة النشر والنزاهة العلمية في الأوساط الأكاديمية المعاصرة.
10. أفضل الممارسات البرمجية والتحليلية للتعامل مع البيانات في SAS
10.1 بناء سيناريو برمجي معياري لتنظيف البيانات (Data Cleansing Pipeline)
تقتضي الممارسات الاحترافية في إدارة قواعد البيانات الضخمة دمج خطوات الفحص والتدقيق ضمن مسار برمجي معياري موحد ومؤتمت (Automated Pipeline) يسبق الشروع في أي نمذجة رياضية. ويتحقق ذلك من خلال الربط المنهجي المحكم بين إجراء فحص البنية PROC CONTENTS وإجراء التلخيص الإحصائي PROC MEANS المزود بخيار NMISS، ثم فحص الحالات الفردية عبر خطوة DATA Step.
ويمكن رفع كفاءة هذا المسار المعياري بصورة استثنائية من خلال كتابة برامج ماكرو ذكية (SAS Macros) تتيح أتمتة فحص المفقودات عبر مصفوفات بيانات وجداول متعددة بضغطة زر واحدة، كالتالي:
%MACRO check_missing(dset=, vars=);
PROC MEANS DATA=&dset NMISS N MEAN STD;
VAR &vars;
TITLE “تقرير فحص جودة البيانات والمفقودات لجدول: &dset”;
RUN;
%MEND check_missing;
يوفر هذا السيناريو المؤتمت تقارير تشخيصية دورية تلخص مؤشرات الجودة لجميع قواعد البيانات المستلمة تباعاً، مما يقلص زمن المعالجة اليدوية، ويحد من الأخطاء البشرية، ويضمن خضوع جميع المتغيرات للفحص الأكاديمي الصارم قبل اعتمادها في مراحل النمذجة النهائية.
10.2 الربط بين NMISS وإجراءات التعويض الإحصائي (مثل PROC MI)
تعتبر الإحصاءات التشخيصية المستخرجة عبر دالة NMISS حجر الزاوية الذي يُبنى عليه إعداد وتوجيه نماذج التعويض الإحصائي المتقدمة داخل نظام SAS، وتحديداً عبر إجراء التعويض المتعدد PROC MI. فبناءً على تكرارات الفقد المرصودة، يحدد المحلل بدقة المتغيرات المؤهلة للدخول كمتغيرات مستهدفة بالتعويض أو كمتغيرات تنبؤية مساعدة في نماذج التقدير الاحتمالي.
ويمكن فحص بنية الفقد عبر استدعاء إجراء التعويض الاستكشافي دون إنشاء قيم جديدة بصياغة مثل:
PROC MI DATA=my_data NIMPUTE=0;
VAR points assists rebounds;
RUN;
يقوم هذا الإجراء بتحليل الترابط بين أنماط الفقد المشخصة بواسطة NMISS عبر المتغيرات المختلفة، مما يساعد في اختيار خوارزمية التعويض الأنسب؛ سواء كانت طريقة الانحدار التسلسلي (Monotone Regression)، أو طريقة سلاسل ماركوف ومونت كارلو (MCMC – Markov Chain Monte Carlo). وعقب اكتمال عمليات التعويض، يعيد الباحث استدعاء دالة NMISS على مجموعة البيانات المعوضة الجديدة للتحقق التام من وصول عدد المفقودات إلى الصفر، ثم يقارن المعالم الإحصائية قبل التعويض وبعده لتقييم ثبات واستقرار النماذج السلوكية المستخلصة.
10.3 إرشادات عملية لكتابة شيفرات إحصائية نظيفة وقابلة للصيانة
يتطلب التحليل الإحصائي الأكاديمي المتقن الالتزام بمجموعة من الضوابط البرمجية التي تضمن وضوح الشيفرات وسهولة تدقيقها وصيانتها من قِبل باحثين آخرين؛ ويأتي في مقدمة هذه الضوابط التوثيق والتعليق المنهجي المستمر داخل الكود (Code Commenting)، حيث يجب توضيح الأسباب النظرية والمنهجية التي دعت لاستدعاء دالة NMISS والحدود العتبية التي بُنيت عليها قرارات استبعاد أو تعديل السجلات.
كما يُوصى بالفصل التام بين مرحلة الفحص التشخيصي والتنظيف ومرحلة التحليل الإحصائي وبناء النماذج في برامج نصية مستقلة ومنظمة؛ بحيث تنتهي مرحلة التنظيف بإنتاج قاعدة بيانات نهائية منقحة وموثقة تثبيتاً قاطعاً، تُحفظ في مكتبة SAS دائمة ليتم استدعاؤها في نصوص التحليل دون تداخل بين الإجراءات. وأخيراً، يجب تدريب المحللين على القراءة الدقيقة لمخرجات سجل النظام (SAS Log) عقب كل تشغيل لدالة NMISS، والتأكد التام من خلوه من رسائل التحذير غير المقصودة الناتجة عن التداخل بين الأنماط النصية والرقمية، مما يضمن في نهاية المطاف سلامة البناء المنهجي للبحوث وصحة النتائج المشتقة منها.
خاتمة
استعرض هذا المقال دالة NMISS في برمجية SAS، مسلطاً الضوء على دورها كأداة فحص إحصائي لا غنى عنها في استكشاف وتدقيق جودة البيانات العددية. وقد تناولنا بالتحليل والشرح بنية الدالة وصيغها النحوية المختلفة، وميزنا بدقة بين استخدامها الحسابي الأفقي داخل خطوة البيانات (DATA Step) لفحص سلوك الحالات الفردية، واستخدامها الرأسي التجميعي ضمن إجراء PROC MEANS لتقييم معدلات الفقد العامة على مستوى المتغيرات ككل.
كما أوضحنا الحدود الفاصلة والفروق الجوهرية بين دالة NMISS ومجموعة الدوال الإحصائية والمنطقية المجاورة لها في بيئة SAS، مثل دالتي N و MISSING، والدالة الشاملة CMISS المخصصة للتعامل مع المتغيرات النصية والعددية معاً. وتطرقنا إلى كيفية تجميع وتصنيف نتائج الفقد عبر المجموعات المختلفة، واستعرضنا سبل تجنب الأخطاء البرمجية الشائعة التي تعيق المعالجة السليمة للبيانات.
إن الإدراك العميق لكيفية توظيف دالة NMISS والتعامل مع مخرجاتها ليس مجرد مهارة برمجية تكميلية، بل هو كفاءة منهجية فارقة تمكن الباحث من فهم خصائص بياناته، والالتزام بمعايير النشر العلمي الرصينة، واتخاذ قرارات إحصائية مبنية على براهين رقمية دقيقة تضمن دقة وموثوقية النماذج البحثية النهائية.
المراجع
- Allison, P. D. (2001). Missing Data. SAGE Publications, Inc. https://doi.org/10.4135/9781412985079
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Enders, C. K. (2010). Applied Missing Data Analysis. The Guilford Press.
- Little, R. J. A., & Rubin, D. B. (2019). Statistical Analysis with Missing Data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- SAS Institute Inc. (2023). SAS® 9.4 Functions and CALL Routines: Reference. SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2023). Base SAS® 9.4 Procedures Guide: Statistical Procedures. SAS Institute Inc. https://documentation.sas.com
- Schafer, J. L. (1997). Analysis of Incomplete Multivariate Data. Chapman and Hall/CRC. https://doi.org/10.1201/9781439821862