
تعد لغة نظام التحليل الإحصائي (SAS) إحدى الركائز البرمجية الأكثر رسوخاً واعتمادية في مضمار معالجة البيانات، والتحليل الإحصائي المتقدم، وإدارة قواعد البيانات المؤسسية الضخمة. ومنذ نشأتها الأولى، تميزت هذه البيئة ببنية معمارية فريدة تجمع بين الصرامة الرياضية والمرونة الإجرائية، مما مكن المحللين الإحصائيين والباحثين من إدارة كميات هائلة من السجلات واستخلاص الأنماط الحيوية منها بدقة متناهية. وتتوقف كفاءة أي برنامج مكتوب بلغة SAS بصورة جوهرية على كيفية توجيه تدفق العمليات المنطقية، حيث تمثل المعاملات الشرطية أداة التحكم الأساسية التي تميز بين البيانات المتطابقة والمتباينة، وتحدد مسارات المعالجة والاختزال لكل سجل على حدة.
إن التمكن من أدوات التصفية والمقارنة المنطقية يمثل الفارق الجوهري بين المعالجة السطحية للبيانات والتحليل المؤسسي الرصين؛ إذ تتطلب التطبيقات الواقعية، سواء في التجارب السريرية أو القطاعات المالية أو أبحاث العلوم الاجتماعية، استبعاداً دقيقاً لحالات معينة أو عزلاً لمدخلات متباينة دون التسبب في تشويه البنية الإحصائية للعينة. ويبرز معامل عدم المساواة (Not Equal) بوصفه أحد أهم المعاملات العلاقية التي تحكم هذه التحولات، حيث يقوم بالتحقق من انتفاء التكافؤ بين قيم المتغيرات أو التعبيرات الرياضية. ورغم بساطة المفهوم ظاهرياً، فإن تطبيقه البرمجي في SAS ينطوي على تعقيدات تقنية دقيقة ترتبط بآلية تمثيل القيم في الذاكرة، وسلوك البيانات المفقودة، والاختلافات الجوهرية بين مراحل الترجمة والتنفيذ.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك كافة الجوانب النظرية والتطبيقية المرتبطة باستخدام معامل عدم المساواة داخل نظام SAS. وسيتناول المقال بالتحليل المفصل الصياغات النحوية المعتمدة، والسلوك الميكانيكي للمعامل مع المتغيرات الرقمية والنصية، وتفاعله المعقد مع مصفوفة القيم المفقودة، فضلاً عن المقارنة المعمارية بين أدوات التصفية المتباينة مثل عبارات التصفية الفورية وعبارات التصفية اللاحقة. ومن خلال استعراض الأمثلة التطبيقية المستندة إلى أسس برمجية موثوقة، يوفر هذا العمل مرجعاً متكاملاً للمطورين والباحثين الساعين إلى كتابة شفرات برمجية تتسم بأعلى درجات الكفاءة التشغيلية والدقة التحليلية.
1. مقدمة إلى معاملات المقارنة المنطقية في لغة SAS
1.1 مفهوم العمليات الشرطية وأهميتها في معالجة البيانات
تمثل العمليات الشرطية في نظام SAS العصب المحرك لتدفق البيانات وتوجيه مسارات المعالجة الخوارزمية داخل خطوة البيانات (DATA Step) وخطوات الإجراءات (PROC Steps). وتستند هذه العمليات في جوهرها إلى مبادئ جبر بول (Boolean Algebra)، حيث يتم تقييم كل تعبير منطقي لينتج عنه قيمة ثنائية تعبر عن الصحة أو الخطأ. وفي بيئة SAS، لا يوجد نوع بيانات بولياني (Boolean Data Type) منفصل ومستقل بذاته في البنية التحتية لتخزين البيانات؛ بل يعبر النظام عن القيمة المنطقية “صواب” (True) بالقيمة الرقمية 1، في حين يعبر عن القيمة المنطقية “خطأ” (False) بالقيمة الرقمية 0. كما يعتبر أي رقم غير صفري وغير مفقود معادلاً للقيمة المنطقية صواب، بينما تعامل القيمة المفقودة والصفر الحسابي كقيم دالة على الخطأ عند استخدامها في سياق شرطي.
تكمن أهمية هذه العمليات في قدرتها الفائقة على تصفية وتعديل السجلات الإحصائية عبر سلسلة من الفحوص المنطقية الدقيقة التي تجري لكل ملاحظة (Observation) بشكل تكراري ومنتظم. ويؤدي اتخاذ القرارات الخوارزمية دوراً محورياً في تنقية المجموعات الإحصائية من الشوائب، وتطبيق قواعد الأعمال المعقدة، وبناء التصنيفات المتفرعة. إن دقة هذه المقارنات الشرطية تنعكس مباشرة على موثوقية نتائج التحليل الإحصائي؛ إذ إن خطأً طفيفاً في تقييم شرط مقارنة قد يؤدي إما إلى استبعاد بيانات صالحة وتحريف أحجام العينات، أو إلى إدراج مدخلات غير مرغوب فيها، مما يقوض النزاهة العلمية للاستنتاجات والقرارات المبنية عليها.
1.2 تعريف معامل عدم المساواة (Not Equal) ودوره البرمجي
يُعرف معامل عدم المساواة (Not Equal Operator) رياضياً وبرمجياً بأنه رابط علائقي يُستخدم لاختبار انتفاء التكافؤ بين قيمتين أو تعبيرين مختلفين. ووفقاً للتصنيف المعياري المعتمد في بنية لغة SAS، يصنف هذا المعامل ضمن معاملات المجموعة الخامسة (Group V Comparison Operators)، وهي المعاملات المسؤولة عن دراسة العلاقات بين المتغيرات والثوابت. وتتمثل الوظيفة الأساسية لهذا المعامل في التحقق مما إذا كانت القيمة الواقعة على الجانب الأيمن للتعبير لا تطابق القيمة الواقعة على الجانب الأيسر، وإرجاع القيمة الرقمية 1 إذا تحقق الاختلاف، أو إرجاع 0 إذا تطابقت القيمتان تماماً من الناحية الرياضية أو النصية.
يتجلى الدور البرمجي لمعامل عدم المساواة في قدرته على عزل واستبعاد السجلات المتطابقة لتمكين الباحث من التركيز على التباينات والاختلافات الإحصائية. فعلى سبيل المثال، يحتاج المحلل المالي في كثير من الأحيان إلى استخراج المعاملات التجارية التي لا تتطابق فيها المبالغ المقيدة في الفواتير مع المبالغ المستلمة فعلياً في الحسابات البنكية للكشف عن الأخطاء المحاسبية، كما يحتاج باحث العلوم الطبية الحيوية إلى استبعاد المرضى الذين لم يطرأ أي تغير على قياساتهم الحيوية لدراسة التغيرات الاستثنائية. ومن هنا، يتيح معامل عدم المساواة آلية صلبة وسريعة للتحقق من التباين وتصنيف السجلات بناءً على هذا التمايز التشغيلي.
1.3 نظرة عامة على الصياغات المدعومة لمعامل عدم المساواة في SAS
تتميز لغة SAS بمرونة نحوية استثنائية صُممت لتلائم بيئات الحوسبة المتعددة وتاريخ تطور العتاد والبرمجيات، ولذلك تدعم عدة صياغات متكافئة لمعامل عدم المساواة. الصياغة الأكثر انتشاراً واعتماداً في التوثيق الأكاديمي القياسي هي الصياغة الحرفية المتمثلة في الكلمة المحجوزة NE، وهي اختصار للمصطلح الإنجليزي (Not Equal). وإلى جانب هذه الصياغة الحرفية، يتيح محرك SAS استخدام صياغات رمزية مكافئة وظيفياً بشكل كامل، وأشهرها الرمز المركب من علامة الإقحام تليها علامة التساوي ^=، والذي يمثل البديل الشائع في بيئات العمل المعاصرة نظراً لسرعة كتابته وتوافقه البرمجي.
بالإضافة إلى ذلك، توجد بدائل رمزية إضافية تشمل علامة التلدة المتبوعة بالمساواة ~=، وكذلك رمز النفي المنطقي التقليدي المتبوع بعلامة المساواة ¬=. وقد نشأت هذه التعددية لدعم أنظمة الترميز المتباينة ومجموعات الحروف الخاصة بأنظمة التشغيل المتنوعة؛ حيث يتولى المفسر الداخلي للنظام (SAS Compiler) قراءة هذه الأنماط وتحويلها إلى نفس الشجرة الدلالية في مرحلة التحليل النحوي، مما يضمن أن الناتج الرياضي والمنطقي لا يتأثر إطلاقاً بالاختيار الشكلي للصيغة المستخدمة طالما روعيت شروط البيئة البرمجية المحددة.
2. البنية النحوية والصيغ المعتمدة لمعامل عدم المساواة في SAS
2.1 الصيغة النصية الحرفية (NE) وخصائصها
تعد الصيغة النصية الحرفية NE المعيار الذهبي الموصى به في التوثيق الرسمي الصادر عن معهد SAS، وذلك نظراً لخصائصها التشغيلية والجمالية المتميزة. من الناحية النحوية، يُكتب المعامل ككلمة مفصولة بمسافات تفصل بين المتغير المراد اختباره والقيمة المقارن بها (مثل: Variable NE Value). وتتميز هذه الصيغة بأنها غير حساسة إطلاقاً لحالة الأحرف، حيث يمكن للمبرمج كتابتها بأحرف كبيرة NE، أو بأحرف صغيرة ne، أو بأحرف متباينة Ne، وسيقوم المفسر بالتعرف عليها مباشرة دون أي لبس دلالي أو تشغيلي.
تبرز الأفضلية الهندسية للصياغة الحرفية في تعزيز مقروئية الشفرة البرمجية (Code Readability)، لا سيما في المشاريع المؤسسية التعاونية والبحوث الإحصائية طويلة الأمد التي تخضع لمراجعات وتدقيق متكرر من قِبل فرق متعددة التخصصات. والأهم من ذلك، أن الصيغة الحرفية NE محصنة ضد كافة مشكلات التوافق واختلافات التشفير، إذ تعتمد على الحروف الأبجدية اللاتينية الأساسية الموحدة في كافة منصات الحوسبة من الحواسيب الشخصية وصولاً إلى بيئات الخوادم المركزية المعقدة، مما يمنع حدوث أخطاء غير متوقعة ناجمة عن سوء ترجمة الرموز الخاصة.
2.2 الصيغة الرمزية القياسية (^=) واستخداماتها الشائعة
تمثل الصيغة الرمزية القياسية المكونة من رمز الإقحام متبوعاً بعلامة المساواة ^= المعادل الوظيفي المباشر للصيغة الحرفية NE. ويحظى هذا الرمز بشعبية واسعة بين المطورين ومبرمجي الأنظمة الذين اعتادوا على كتابة الرموز الرياضية والمنطقية السريعة في لغات برمجة أخرى. ويوفر هذا المعامل اختصاراً بصرياً يقلل من حجم العبارات البرمجية، خاصة عند بناء تعبيرات بولية بالغة التعقيد تتضمن سلاسل متداخلة من الشروط العلاقية داخل الجمل الشرطية المركبة.
من الناحية التركيبية، يعامل محرك SAS رمز ^= ككتلة نحوية موحدة، ولا يُسمح بوضع مسافة فاصلة بين رمز الإقحام وعلامة المساواة، حيث يؤدي الفصل بينهما إلى فشل التحليل النحوي وتوليد رسالة خطأ صريحة في سجل النظام. ورغم أن هذا الرمز يمنح الشفرة البرمجية مظهراً مقتضباً، إلا أنه يتطلب انتباهاً خاصاً من المبرمجين لضمان عدم الخلط بينه وبين رموز أخرى، مع ضرورة الالتزام بالقواعد القياسية للتطوير البرمجي المعتمدة داخل المؤسسة، والتي قد تفضل الصياغة الحرفية لتوحيد أسلوب التوثيق الإحصائي في الأوراق المنشورة.
2.3 البدائل الرمزية الإضافية (~= و ¬=) واعتبارات التوافق
يوفر نظام SAS دعماً لبدائل رمزية إضافية استجابة للتنوع التاريخي والتقني لمنصات التشغيل التي رافقت مسيرة تطور النظام منذ إطلاقه الأول في السبعينيات. ومن هذه البدائل استخدام علامة التلدة متبوعة بالمساواة ~=، وهي الصيغة التي تظهر بشكل متكرر في بيئات أنظمة التشغيل القائمة على يونكس ولينكس (UNIX/Linux)، حيث يُستخدم رمز التلدة تقليدياً للتعبير عن النفي المنطقي. كما يدعم النظام استخدام رمز النفي الصريح المتبوع بالمساواة ¬=، وهو خيار واسع الانتشار في بيئات الحواسيب المركزية (IBM Mainframe Systems) التي تعتمد على نظم الترميز EBCDIC بدلاً من ترميز ASCII التقليدي.
ترتبط هذه البدائل بمسألة بالغة الأهمية تتعلق بصفحات التشفير (Character Encodings) والمحارف الخاصة؛ إذ قد يؤدي نقل كود برمجي كُتب في بيئة تعتمد تشفيراً معيناً إلى خادم يعمل بترميز مختلف إلى تحول الرمز ¬ أو ~ إلى محرف غير معروف أو تشويهه البرمجي، الأمر الذي يتسبب في توقف تنفيذ خطوة المعالجة أو إفراز نتائج غير متوقعة تماماً. ولتجاوز هذه المعضلات، استحدث النظام خياراً نظامياً يُعرف باسم SAS CHARCODE لترجمة المحارف المعقدة. ومع ذلك، يجمع الخبراء على أن التوصية القياسية المعيارية لضمان قابلية النقل الكاملة والآمنة للبرامج (Code Portability) بين المنصات السحابية والمركزية تقتضي الاعتماد الحصري على الصيغة الحرفية NE.
3. إعداد بيئة العمل وبناء مجموعة البيانات النموذجية
3.1 إنشاء مجموعة البيانات باستخدام خطوة DATA وعبارة DATALINES
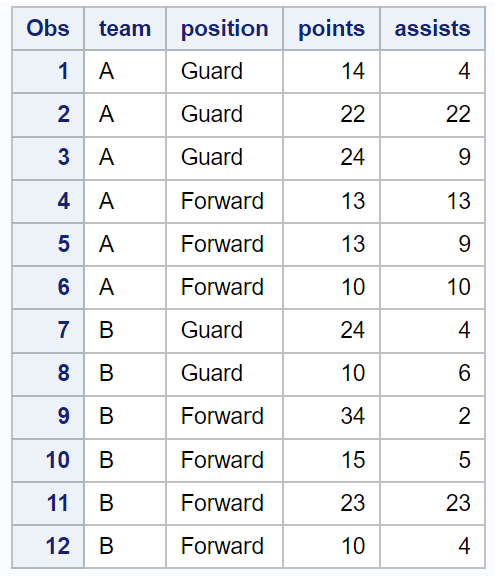
لتطبيق المفاهيم الرياضية والبرمجية لمعامل عدم المساواة بشكل عملي وعلمي، سنقوم ببناء مجموعة بيانات نموذجية مستمدة من عالم الإحصاء الرياضي التطبيقي، وتحديداً إحصائيات الأداء الفردي لنخبة من لاعبي كرة السلة. يتم إنشاء هذا الجدول الإحصائي عبر خطوة البيانات المعيارية DATA Step بالاعتماد على عبارة DATALINES التي تسمح بتضمين البيانات السطرية الخام مباشرة في صلب البرنامج المصدري دون الحاجة إلى الاتصال بمصادر بيانات خارجية معقدة في هذه المرحلة التوضيحية.
يتم في هذه الخطوة تعريف بنية الجدول وتحديد أسماء المتغيرات وأنماطها الفيزيائية عبر عبارة INPUT. ويتضمن نموذجنا أربعة متغيرات محورية تمثل مختلف الجوانب التحليلية: متغير اسم الفريق (team) وهو متغير نصي يشار إليه بالرمز $، ومتغير مركز اللاعب التكتيكي في الملعب (position) وهو متغير نصي أيضاً، يليهما متغيران كميان مستمران هما عدد النقاط المسجلة (points) وعدد التمريرات الحاسمة المنجزة (assists). يوضح الكود التالي كيفية إنشاء هذا الجدول بدقة:
data basket_data;

  input team $ position $ points assists;

  datalines;

Mavs G 22 10

Mavs F 18 18

Mavs F 15 5

Cavs G 24 24

Cavs F 12 8

Cavs C 9 9

Warriors G 30 12

Warriors F 20 20

;

run;
تؤسس هذه البنية المتقنة مصفوفة تجريبية متنوعة تحتوي على حالات تماثل كامل بين الأرقام المسجلة وحالات أخرى تبرز تبايناً واضحاً، مما يوفر بيئة مثالية لاختبار سلوك محرك المقارنات في نظام SAS.
3.2 فحص بنية السجلات باستخدام إجراء PROC PRINT
يمثل التفتيش البصري للبيانات خطوة منهجية إلزامية في التحليل الإحصائي الرصين قبل الشروع في تطبيق أي تحويلات رياضية أو شروط تصفية منطقية. وتتيح أداة PROC PRINT في نظام SAS استعراض محتويات مصفوفة السجلات بطريقة منظمة ومجدولة، والتحقق من أن محرك قراءة المدخلات قد أتم معالجة السلاسل النصية والأرقام وفقاً للمحددات والمواقع المخصصة لها دون أي انزياح في الحقول (Field Misalignment) أو تشويه في القيم المخزنة.
يتم تنفيذ هذا الإجراء عبر كتابة الشفرة البسيطة التالية:
proc print data=basket_data noobs;

run;
عند تنفيذ هذا الأمر، يظهر الجدول النهائي مستعرضاً ثماني ملاحظات متكاملة. ويلاحظ المحلل المدقق على الفور التوزيع الأولي للتطابق والتباين؛ حيث تتساوى قيم النقاط والتمريرات لدى بعض الملاحظات (مثل اللاعب الثاني في فريق Mavs الذي حقق 18 نقطة و18 تمريرة، واللاعب الأول في فريق Cavs الذي حقق 24 نقطة و24 تمريرة، واللاعب الأخير في فريق Warriors الذي حقق 20 نقطة و20 تمريرة)، بينما يظهر التباين الصريح لدى الملاحظات المتبقية. وتؤكد هذه المعاينة المباشرة جاهزية مجموعة البيانات للانتقال إلى المرحلة الإجرائية التالية.
3.3 تحديد أهداف المعالجة والتحليل المقارن
يرتكز الهدف الإجرائي من وراء هذا التمرين العملي على بناء منطق تحليلي قادر على الفصل الدقيق بين فئتين من الأداء الرياضي: فئة توازن المردود التي تتطابق فيها النقاط مع التمريرات الحاسمة، وفئة تباين المردود التي تختلف فيها المحصلتان. ويتطلب هذا الهدف بناء معالجة شرطية تفحص العلاقة الرياضية بين عمود النقاط وعمود التمريرات في كل سجل يمر عبر متجه بيانات البرنامج (Program Data Vector – PDV).
يتضمن المخطط المنطقي توليد متغير تصنيفي تفسيري جديد يُضاف إلى هيكل الجدول الأصلي ليوثق النتيجة المقارنة لكل لاعب بوضوح. وسيتم الاعتماد على هذا المتغير المشتق لاحقاً في إجراء تحليلات إحصائية متقدمة، واستخلاص النسب المئوية للاعبين الذين يظهرون تنوعاً في إحصائياتهم مقارنة بأولئك الذين يلتزمون بنمط عددي متطابق، مما يوضح الربط الوثيق بين العمليات المنطقية البسيطة ومتطلبات التفسير الإحصائي المعقد في بحوث الأداء الرياضي.
4. التطبيق العملي للمعامل الحرفي (NE) في خطوة البيانات
4.1 صياغة الجملة الشرطية IF-THEN-ELSE باستخدام NE
تبدأ المعالجة العملية للمعامل الحرفي NE بإنشاء خطوة بيانات جديدة تشتق بنيتها من الجدول الأساسي عبر استدعاء عبارة SET. ويتيح هذا الأسلوب المعماري الحفاظ على البيانات الخام دون أي تعديل مباشر، وتوجيه المخرجات المعدلة إلى جدول جديد تماماً، وهو مبدأ أساسي من مبادئ الحوسبة الإحصائية لضمان تتبع مسار تدفق البيانات (Data Provenance).
تتم صياغة التعبير المنطقي للمقارنة بين المتغيرين الرقميين points وassists بواسطة الجملة الشرطية التفرعية IF-THEN-ELSE على النحو التالي:
data basket_analysis_ne;

  set basket_data;

  length points_vs_assists $10;

  if points ne assists then points_vs_assists = 'not equal';

  else points_vs_assists = 'equal';

run;
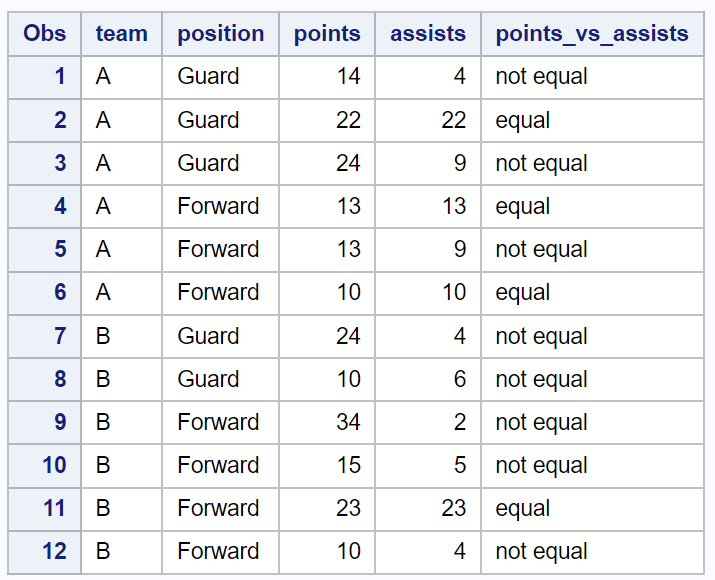
في هذا السياق، يقوم محرك التنفيذ بتقييم التعبير points ne assists لكل ملاحظة؛ فإذا كانت قيمة النقاط لا تساوي قيمة التمريرات، يكون ناتج التعبير البولياني 1 (صواب)، وبالتالي تنفذ العبارة التابعة لـ THEN، أما إذا كانت القيمتان متساويتين تماماً، يؤول التعبير إلى 0 (خطأ)، وينتقل التدفق البرمجي مباشرة إلى الفرع البديل ELSE.
4.2 إنشاء وتخصيص المتغيرات التفسيرية الناتجة
يعد التحكم في سمات المتغيرات النصية المستحدثة في خطوة البيانات من أهم التدابير التقنية التي يجب على مبرمج SAS مراعاتها. ففي الكود السابق، تم إدراج عبارة length points_vs_assists $10; قبل صياغة التعبير الشرطي بصورة مقصودة؛ إذ إن محرك SAS يقوم في غياب هذا التعريف المسبق بتحديد طول المتغير النصي الجديد بالاستناد إلى أول قيمة تُسند إليه في شجرة التنفيذ، وهو ما قد يعرض النصوص اللاحقة لخطر الاقتطاع (Truncation) إذا كانت أطول من أول قيمة مسندة.
خلال دورة المعالجة التكرارية لخطوة البيانات (Data Step Iteration)، يتم إنشاء المتغير التفسيري داخل متجه بيانات البرنامج (PDV)، ثم تسند إليه القيمة النصية ‘not equal’ في حالات التباين، أو القيمة ‘equal’ في حالات التطابق. ويضمن تخصيص مساحة كافية تبلغ 10 بايت استيعاب كلا النصين بمرونة كاملة ودون اقتطاع الحروف الأخيرة، مما يضمن خروج الجدول المشتق بأعلى معايير الدقة والاتساق البرمجي.
4.3 تحليل مخرجات التنفيذ والتحقق الإحصائي
عقب إتمام معالجة خطوة البيانات بنجاح، يتم استدعاء إجراء PROC PRINT لاستعراض السجلات المحسوبة ومقارنة القيم المنطقية المشتقة مع القيم الإحصائية الفعلية الواردة في الجدول، للتأكد التام من خلو المعالجة من أي انحرافات حسابية:
proc print data=basket_analysis_ne noobs;

run;
تكشف مراجعة النتائج سطراً بسطر عن الدقة المطلقة للمعامل الحرفي NE في التمييز الإحصائي؛ إذ يُلاحظ أن اللاعب الأول حصل على التصنيف ‘not equal’ نظراً لتباين النقاط (22) مع التمريرات (10)، في حين أُسند التصنيف ‘equal’ للاعب الثاني بسبب تطابق القيمتين عند الرقم (18). كما يُظهر استعراض سجل النظام (SAS Log) سلامة التنفيذ بصورة قاطعة، حيث يوثق السجل قراءة 8 ملاحظات من الجدول الأصلي وكتابة 8 ملاحظات في الجدول الجديد بنجاح تام ودون تسجيل أي أخطاء أو رسائل تحذيرية تتعلق بتضارب الأنواع أو اقتطاع النصوص.
5. التطبيق العملي للمعامل الرمزي (^=) في لغة SAS
5.1 بناء الشروط المنطقية البديلة بالاعتماد على رمز الإقحام
يقدم المعامل الرمزي ^= مساراً بنائياً بديلاً لصياغة ذات الشرط المنطقي لاختبار انتفاء التكافؤ الحسابي، ولكن بصيغة رمزية مقتضبة. وتخضع كتابة هذا المعامل لنفس القواعد المنطقية الصارمة التي تحكم المعامل الحرفي؛ حيث يتم دمجه ضمن الجملة الشرطية بنفس الكيفية التفرعية:
data basket_analysis_symbol;

  set basket_data;

  length points_vs_assists $10;

  if points ^= assists then points_vs_assists = 'not equal';

  else points_vs_assists = 'equal';

run;
من الناحية النحوية، لا يفرض نظام SAS وضع مسافات بيضاء تفصل المعامل ^= عن المتغيرات المحيطة به، فيمكن كتابة points^=assists دون أن يتعطل المفسر البرمجي. إلا أن أفضل الممارسات المعتمدة في هندسة البرمجيات توصي بالإبقاء على مسافة مفردة تفصل المعامل عن الأطراف المقارنة بهدف تعزيز الوضوح البصري للشفرة ومنع التداخل الشكلي بين الرموز الرياضية المعقدة.
5.2 المقارنة التحليلية للأداء بين الرمزين NE و ^=
تثير المفاضلة بين المعامل الحرفي NE والمعامل الرمزي ^= تساؤلات متكررة بين المطورين حول ما إذا كان أحدهما يتفوق على الآخر في مؤشرات الأداء الحوسبي، مثل سرعة التنفيذ (Execution Speed) أو استهلاك وحدة المعالجة المركزية (CPU Consumption). ومن الناحية المعمارية العميقة لمحرك SAS، لا يوجد أي فارق في الأداء إطلاقاً بين الصياغتين؛ فبمجرد قراءة الشفرة بواسطة المحلل المعجمي للنظام (Lexical Analyzer)، يتم تحويل كلا المعاملين إلى نفس الرمز الداخلي المجرد (Internal Token) الذي يمثل معامل عدم المساواة في المجموعة الخامسة.
وبناءً على ذلك، تنحصر معايير الاختيار بينهما في الأبعاد المتعلقة بجودة الكود البرمجي والسياسات المؤسسية للتطوير؛ فالصيغة الرمزية ^= توفر سرعة طفيفة في الكتابة وتفضيلها بعض الفرق ذات الخلفيات الرياضية الصرفة، بينما تتفوق الصيغة الحرفية NE في خفض الجهد الذهني اللازم لمراجعة البرامج من قِبل المحللين الإحصائيين الجدد، وضمان خلو الأكواد من الأخطاء العرضية الناتجة عن اختلاف توزيع لوحات المفاتيح أو تبديل محارف الترميز بين بيئات العمل المختلفة.
5.3 توثيق النتائج ومراجعة سجل المعالجة (SAS Log)
عند طباعة الجدول الناتج عن خطوة البيانات المعتمدة على المعامل الرمزي عبر الإجراء PROC PRINT، يتبين التطابق التام والمطلق بين مخرجاته ومخرجات الجدول الذي بُني بواسطة المعامل الحرفي؛ حيث صُنفت السجلات بنفس النمط الدقيق، وسجلت الحالات ذات الأرقام المتماثلة الكلمة ‘equal’، في حين نالت السجلات المتباينة الكلمة ‘not equal’.
ويعكس فحص سجل المعالجة (SAS Log) تطابقاً بيانياً كاملاً في إحصائيات المعالجة وموارد النظام المستخدمة. وتؤكد هذه النتيجة الاستنتاج الهندسي الراسخ بأن لغة SAS تعامل كلا التعبيرين بوصفهما وجهين لعملة منطقية واحدة. غير أن الممارسة التوثيقية الرصينة تفرض الإشارة إلى خلو سجل التشغيل من أي رسائل تفيد بإعادة تفسير الرموز، مما يعزز الثقة في استقرار البنية التحتية البرمجية عند التوسع في تحليل مجموعات بيانات ضخمة تتجاوز ملايين السجلات الإحصائية.
6. استخدام معامل عدم المساواة مع المتغيرات النصية (Character Variables)
6.1 حساسية حالة الأحرف وتأثيرها على شرط عدم التماثل
تخضع مقارنة المتغيرات النصية (Character Variables) في لغة SAS لقواعد دقيقة ترتبط بالقيم الثنائية الرقمية للحروف ضمن جدول التشفير المعتمد (سواء كان ASCII أو EBCDIC). ويعتبر نظام SAS حساساً لحالة الأحرف (Case Sensitive) بطبيعته عند إجراء المقارنات النصية؛ مما يعني أن الحرف الكبير ‘A’ لا يساوي الحرف الصغير ‘a’، وذلك لاختلاف موقعهما العددي في جدول الترميز الداخلي. ويترتب على ذلك أن استخدام معامل عدم المساواة لاختبار تطابق كلمتين متماثلتين في الهجاء ومختلفتين في حالة الأحرف سيؤول دائماً إلى القيمة 1 (صواب)، معلناً انتفاء التكافؤ بينهما.
لتجنب هذه المعضلة وتفادي التباين غير المقصود الناتج عن الاختلافات الشكلية في إدخال البيانات، يتعين على المبرمج توحيد حالة النصوص قبل تطبيق شرط عدم المساواة، وذلك بالاعتماد على الدوال التحويلية القياسية مثل دالة UPCASE لتحويل كافة النصوص إلى أحرف كبيرة، أو دالة LOWCASE لتحويلها إلى أحرف صغيرة. فعلى سبيل المثال، تضمن الصياغة الشرطية التالية: if upcase(team) ne 'MAVS' استبعاد جميع الأشكال الإملائية للفريق (سواء كُتبت Mavs أو mavs أو MAVS) دون الوقوع في خطأ الاحتفاظ ببعضها نتيجة اختلاف حالة المحارف.
6.2 معالجة المسافات البيضاء والرموز الخفية في النصوص
تمثل المسافات البيضاء الزائدة، سواء كانت بادئة (Leading Blanks) أو لاحقة (Trailing Blanks)، مصدراً رئيساً لأخطاء التحليل المنطقي عند تقييم عدم المساواة بين المتغيرات النصية في SAS؛ إذ يتعامل النظام مع المسافة الفارغة كمحرف فعلي له وزن عددي محدد في جدول التشفير. فإذا احتوى متغير نصي على كلمة ‘G ‘ متبوعة بمسافة بيضاء إضافية، فإن مقارنته بالثابت النصي ‘G’ باستخدام المعامل NE ستقود إلى الحكم بانتفاء التكافؤ بينهما، وهو استنتاج منطقي من منظور الآلة لكنه خاطئ ومضلل من منظور المعالجة الإحصائية للبيانات.
لضمان الحصانة ضد هذه الشوائب البيانية، يدمج المبرمجون المحترفون معامل عدم المساواة مع دوال تطهير النصوص المتخصصة، وعلى رأسها دالة STRIP التي تقوم بحذف المسافات البادئة واللاحقة معاً، أو دالة TRIM التي تزيل المسافات اللاحقة. إن صياغة الشرط على النحو التالي: if strip(position) ne 'G' توفر حماية حاسمة ضد تباينات التنسيق غير المرئية، وتضمن استبعاد السجلات التي تنتمي بالفعل لمركز الحراسة دون أي تأثر بالمسافات الطفيلية الناتجة عن عمليات تصدير واستيراد البيانات من قواعد البيانات غير المتجانسة.
6.3 المقارنات الترتيبية الأبجدية باستخدام معاملات التباين
تتجاوز إمكانيات معامل عدم المساواة مجرد التحقق من التطابق الحرفي البسيط لتشمل المساهمة في استبعاد الفئات التصنيفية وضبط التسلسل الأبجدي وفقاً لترتيب الفرز المعياري (Collating Sequence) المعتمد في بيئة التشغيل. وعند الرغبة في استبعاد شريحة نصية واسعة، يمكن صياغة شروط عدم المساواة لاستثناء مستويات تصنيفية كاملة من الدراسة الإحصائية، مثل استبعاد مناطق جغرافية معينة أو مراكز وظيفية محددة بأسلوب التصفية المباشرة.
علاوة على ذلك، توفر لغة SAS معدلاً خاصاً يُعرف باسم “معدل النقطتين” (Colon Modifier :)، والذي يمكن إلحاقه بمعامل عدم المساواة (مثل: if position ne: 'G'). وتكمن الأهمية المعمارية لهذا المعدل في تنفيذ مقارنة مبتورة (Truncated Comparison) تقارن النصوص فقط حتى طول السلسلة النصية الأقصر؛ مما يتيح استبعاد كافة المسميات التي تبدأ بحرف أو نمط محدد دون الحاجة إلى كتابة المسمى الكامل أو اللجوء إلى تعبيرات قياسية معقدة (Regular Expressions)، وهو ما يعزز مرونة محرك SAS في معالجة النصوص متعددة المستويات بكفاءة برمجية عالية.
7. التعامل مع القيم المفقودة (Missing Values) ومعامل عدم المساواة
7.1 السلوك الرياضي للقيم المفقودة في نظام SAS
يعد التعامل مع البيانات المفقودة أحد الجوانب الأكثر دقة وتعقيداً في لغة SAS، ويتطلب إدراكاً عميقاً للهيكل الرياضي الداخلي الذي يحكم هذه القيم. ففي المتغيرات الرقمية، يرمز النظام للقيمة المفقودة بنقطة مفردة (.)، غير أن هذه النقطة لا تعني العدم المجرد من الوجهة الرياضية، بل تُعامل داخلياً كأصغر قيمة عددية سالبة ممكنة، تقع في أقصى يسار خط الأعداد الحقيقية تحت سالب ما لا نهاية. ويمتلك نظام SAS تدرجاً هرمياً صارماً للقيم المفقودة الرقمية يخضع للمتراجحة الرياضية التالية:
$$\text{.} < \text{._} < \text{.A} < \text{.B} < dots < \text{.Z} < -\infty < \text{Real Numbers}$$
أما بالنسبة للمتغيرات النصية، فيتم تمثيل القيمة المفقودة بسلسلة فارغة مكونة من مسافات بيضاء (Blanks). وبناءً على هذه التفرقة المعمارية، فإن إخضاع القيمة المفقودة لمعامل عدم المساواة يؤدي إلى نواتج منطقية حتمية: فالقيمة المفقودة لا تساوي إطلاقاً أي رقم حقيقي، وبالمثل فإن القيمة النصية الفارغة لا تساوي أي نص يحتوي على حروف فعلية، وهو سلوك رياضي منتظم لكنه ينطوي على مخاطر جمة إن لم يفطن المبرمج لكيفية تقييم المحرك له.
7.2 الأخطاء الشائعة عند تقييم عدم المساواة مع وجود بيانات غائبة
ينشأ الفخ البرمجي الأكثر شيوعاً في بيئة SAS—والذي يقع فيه الكثير من الباحثين في استطلاعات الرأي والبيانات السلوكية والطبية—عند محاولة استبعاد فئة محددة باستخدام معامل عدم المساواة. فإذا افترضنا وجود متغير يمثل المجموعة التجريبية (group)، وأراد الباحث استبعاد المجموعة المرجعية ذات الرمز 1 فكتب الشرط التالي:
if group ne 1;
فإن النتيجة الكارثية لهذا الشرط تتمثل في أن النظام سيحتفظ بجميع الملاحظات التي تكون فيها قيمة المتغير group مفقودة (.) إلى جانب المجموعات الأخرى (مثل 2 و3)! والسبب في ذلك يعود إلى أن النقطة (.) كقيمة مفقودة تختلف جبرياً وحسابياً عن الرقم 1؛ وبالتالي فإن ناتج التعبير . ne 1 يؤول حتماً إلى القيمة 1 (صواب)، مما يدفع النظام إلى الاحتفاظ بها داخل العينة الصالحة للتحليل.
يترتب على هذا الخطأ المنطقي الشائع تشويه جسيم في مخرجات التحليلات الديموغرافية والسريرية؛ إذ تُحسب حالات عدم الاستجابة أو البيانات الغائبة ضمن العينات الفعلية، مما يفسد نتائج اختبارات الفروق الإحصائية مثل تحليل التباين (ANOVA) ونماذج الانحدار الخطي، ويفرض ضرورة اتباع استراتيجيات وقائية حاسمة عند كتابة شروط الاستبعاد.
7.3 التكامل مع دالة MISSING والتحقق الاحترازي
لتفادي الوقوع في مصيدة البيانات المفقودة عند استخدام معامل عدم المساواة، يجب تطبيق مبدأ “الحراسة المنطقية” (Logical Guarding) عبر فحص وجود البيانات وصلاحيتها قبل تقييم انتفاء التكافؤ. وتعد دالة MISSING() الأداة البرمجية المثلى لتحقيق هذا الغرض، حيث تقوم هذه الدالة بفحص المتغير سواء كان رقمياً أو نصياً، وترجع القيمة 1 إذا كانت القيمة مفقودة و0 إذا كانت القيمة موجودة وحقيقية.
تتم صياغة الشرط الاحترازي السليم عبر دمج دالة MISSING() مع معامل عدم المساواة باستخدام رابط الوصل المنطقي AND، كما يتضح في النموذج التالي:
if group ne 1 and not missing(group);
كما يمكن في بيئات معينة استخدام الصياغة المكافئة: if group ne 1 and group is not null;. تضمن هذه الصياغة المركبة تصفية البيانات على مرحلتين متزامنتين داخل نفس التعبير: المرحلة الأولى تتأكد من أن السجل يحتوي على بيانات فعلية وغير مفقودة، والمرحلة الثانية تتحقق من أن هذه القيمة الفعلية لا تساوي القيمة المستهدفة بالاستبعاد. إن هذا التكامل الاحترازي يمثل معيار الجودة الأساسي المعتمد في كتابة برمجيات SAS الموجهة للقطاعات التنظيمية الحساسة كالأدوية والتمويل.
8. استخدام معامل عدم المساواة في عبارات التصفية WHERE و IF
8.1 الفروق الجوهرية بين عبارة WHERE وعبارة IF التصفوية
تحتوي لغة SAS على آليتين رئيستين لتصفية السجلات الإحصائية هما: عبارة التصفية القبلية WHERE، وعبارة التصفية البعدية المتمثلة في الجملة الشرطية الفرعية IF (المعروفة بـ Subsetting IF). ورغم أن كلتيهما تدعمان معامل عدم المساواة لتصفية البيانات، إلا أن الاختلاف المعماري بينهما عميق وجوهري من حيث توقيت ودورة التنفيذ وموقع المعالجة في الذاكرة.
تعمل عبارة WHERE كمرشح أولي على مستوى وسائط التخزين والإدخال/الإخراج؛ حيث تقوم بتقييم شرط عدم المساواة وتصفية السجلات قبل تحميل الملاحظات إلى متجه بيانات البرنامج (Program Data Vector – PDV). في المقابل، تقوم عبارة IF التصفوية باستدعاء السجل بالكامل وقراءته داخل الـ PDV أولاً، ثم تقوم في مرحلة لاحقة من دورة المعالجة بتقييم شرط عدم المساواة، فإذا تحقق الشرط استمر السجل في مسار المعالجة، وإن لم يتحقق تم إسقاطه من التكرار الحالي. يوضح الجدول المقارن التالي الفروق الجوهرية بين الآليتين:
- نقطة تقييم الشرط: عبارة WHERE تقيم الشرط أثناء قراءة البيانات من القرص وقبل دخول الـ PDV، بينما عبارة IF تقيمه بعد تحميل السجل كاملاً في الـ PDV.
- التعامل مع المتغيرات الجديدة: عبارة WHERE لا تستطيع تصفية المتغيرات التي يتم إنشاؤها داخل خطوة البيانات الحالية لأنها لا تراها، في حين تتعامل عبارة IF بمرونة كاملة مع المتغيرات المستحدثة والمشتقة محلياً.
- استهلاك موارد الإدخال والإخراج (I/O): عبارة WHERE تستهلك موارد أقل بكثير لأنها تمنع تحميل الملاحظات غير المرغوبة إلى الذاكرة، مما يجعلها الخيار الأسرع في معالجة الجداول العملاقة.
8.2 تصفية البيانات في خطوات الإجراءات PROC STEPS باستخدام WHERE
تنفرد عبارة WHERE بميزة تشغيلية استثنائية تتمثل في إمكانية تطبيقها المباشر داخل خطوات الإجراءات التحليلية والإحصائية (PROC Steps) دون الحاجة إلى إنشاء خطوة بيانات وسيطة لتصفية السجلات. وتوفر هذه الخاصية وفراً هائلاً في المساحات التخزينية المخصصة للجداول المؤقتة وسرعة استثنائية في توليد المؤشرات الإحصائية السريعة.
فإذا أردنا حساب المتوسطات الحسابية لنقاط وتمريرات اللاعبين الذين لا ينتمون لفريق معين، يمكن تمرير شرط عدم المساواة مباشرة إلى إجراء التحليل الإحصائي PROC MEANS على النحو التالي:
proc means data=basket_data mean std max min;

  where team ne 'Warriors';

  var points assists;

run;
يقوم محرك التحليل في هذا المثال بقراءة وحساب إحصائيات الفرق المتبقية فقط وتجاهل بيانات الفريق المستبعد تماماً عند جلب السجلات من القرص الصلب. كما يمكن التوسع في استخدام صيغ النفي المتقدمة عبر عبارة WHERE، مثل صيغة استبعاد المجموعات: where team not in ('Warriors', 'Cavs'); والتي تمثل توسيعاً منطقياً شاملاً لمعامل عدم المساواة على مصفوفات القيم المتعددة، وتعمل بكفاءة استثنائية عبر واجهات الاتصال بقواعد البيانات الخارجية المدارة بواسطة محرك SAS/ACCESS.
8.3 تحسين كفاءة استرجاع السجلات وتقليل استهلاك الذاكرة
تتصل كفاءة استخدام معامل عدم المساواة في بيئات البيانات الضخمة (Big Data) بآلية استغلال الفهارس (Indexes) المنشأة على الجداول الإحصائية. وعند استخدام عبارة WHERE المقترنة بمعامل عدم المساواة (مثل where team ne 'Mavs')، يقوم محسن الاستعلامات الداخلي لنظام SAS بفحص ما إذا كان استخدام الفهرس المتاح سيسرع من عملية الاسترجاع أم أن الفحص الشامل للجدول (Full Table Scan) سيكون أكثر كفاءة حوسبية.
ومن الحقائق المعمارية المعروفة في علوم قواعد البيانات أن شروط عدم المساواة والاستبعاد تتسم عموماً بانخفاض درجة الانتقائية (Low Selectivity)؛ إذ إن استبعاد قيمة واحدة غالباً ما يعني الإبقاء على الأغلبية الساحقة من بيانات الجدول. ولذلك، قد يتجاهل محرك SAS الفهارس عمداً ويفضل القراءة المتسلسلة لتقليل عمليات القراءة العشوائية للقرص (Random Disk I/O). وتتجلى أفضل الممارسات البرمجية في تقييد شروط عدم المساواة بشروط إضافية ذات انتقائية عالية، مثل حصر النطاقات الزمنية، لتحقيق أقصى درجات الاستجابة وتقليل الضغط التشغيلي على خوادم المعالجة المركزية.
9. دمج معامل عدم المساواة مع المعاملات المنطقية المركبة (AND, OR, NOT)
9.1 بناء التعبيرات الشرطية المتعددة والمترابطة
تقتضي التحليلات الإحصائية المتقدمة دمج معامل عدم المساواة ضمن شبكات من الشروط البوليانية المتراكبة للوصول إلى شرائح بيانات متناهية الدقة. وتوفر المعاملات المنطقية AND (الوصل الشرطي) وOR (الفصل الشرطي) وNOT (النفي الشامل) الأدوات البنائية اللازمة لتأسيس هذه الروابط المعقدة داخل خطوات البيانات والتصفية.
عند بناء هذه التعبيرات، يجب على المبرمج الإلمام التام بقوانين دي مورغان (De Morgan’s Laws) التي تحكم تحولات النفي والوصل المنطقي في الجبر البولياني. فالنفي الشامل لتعبير يحتوي على رابطة فصلية مثل: not (A = 1 or B = 1) يتحول رياضياً وبشكل مكافئ تماماً إلى رابطة وصلية تستخدم معاملات عدم المساواة: (A ne 1 and B ne 1). إن الفهم الدقيق لهذه التحولات يكفل كتابة شفرات برمجية مبسطة وخالية من التناقضات المنطقية التي قد تؤدي إلى إقصاء سجلات صالحة أو تضمين بيانات خاطئة دون قصد.
9.2 أسبقية تنفيذ المعاملات الرياضية والمنطقية وأهمية الأقواس
تخضع محركات معالجة الشفرات في SAS لجدول تراتبي صارم يحدد أسبقية تنفيذ المعاملات (Operator Precedence) عند تقييم التعبيرات المركبة التي تمتزج فيها العمليات الحسابية والمعاملات العلاقية والروابط المنطقية. ويصنف النظام أولويات التقييم وفق المستويات المعيارية التالية:
- المستوى الأول: المعاملات الحسابية الأحادية والأسس (+، -، **).
- المستوى الثاني: عمليات الضرب والقسمة (*، /).
- المستوى الثالث: عمليات الجمع والطرح الثنائية (+، -).
- المستوى الرابع: معاملات التسلسل والمطابقة النصية (||).
- المستوى الخامس: معاملات المقارنة والعلاقات (بما فيها معامل عدم المساواة NE، ^=، =، <، >).
- المستوى السادس: النفي المنطقي الأحادي (NOT، ^).
- المستوى السابع: معامل الوصل المنطقي (AND، &).
- المستوى الثامن: معامل الفصل المنطقي (OR، |).
توضح هذه التراتبية الهندسية أن معاملات المقارنة (ومنها NE) تسبق المعاملات المنطقية AND وOR في التنفيذ، ولكن المعامل AND يسبق دائماً المعامل OR. ويقود إغفال هذا الترتيب إلى مخاطر برمجية بالغة؛ فالتعبير الشرطي: if team ne 'Mavs' and points > 20 or assists > 10; سيقوم بتقييم شق الوصل أولاً ثم يعطف عليه الشق الثاني، وهو ما قد يخالف تماماً نية الباحث الذي قد يهدف إلى استبعاد الفريق أولاً ثم فحص أحد الشرطين التاليين. وتفرض الممارسة البرمجية الرصينة الاستخدام الصريح للأقواس الدائرية () لفرض تسلسل التنفيذ المطلوب بصرف النظر عن الترتيب التلقائي للمحرك، وضمان الوضوح المطلق للمعنى الدلالي للشفرة.
9.3 دراسة حالات تطبيقية للبيانات متعددة الأبعاد
لتجسيد هذا التكامل المنطقي المركب في سياق تطبيقي عملي، نفترض وجود مسألة إحصائية متعددة الأبعاد تهدف إلى استخراج سجلات اللاعبين الذين تنطبق عليهم ثلاثة معايير دقيقة مجتمعة: ألا ينتموا لفريق Mavs، وألا تتطابق نقاطهم مع تمريراتهم، وأن يكون مجموع ما أحرزوه من نقاط وتمريرات معاً يتجاوز 25 نقطة. تتم صياغة هذا النموذج المتقدم عبر الشفرة التالية:
data high_performing_outliers;

  set basket_data;

  where (team ne 'Mavs') and (points ne assists) and ((points + assists) > 25);

run;
proc print data=high_performing_outliers;
run;
يقوم محرك المعالجة في هذا الكود المركب بتنفيذ عملية الجمع الحسابي داخل القوسين أولاً كأسبقية قصوى، ثم يشرع في تقييم شروط عدم المساواة والمقارنة العلاقية، ثم يربط الحصائل المنطقية عبر معاملات الوصل AND. وتبرز هذه المعالجة الرياضية المتكاملة كيف يمكن لمعامل عدم المساواة، عند دمجه باحترافية مع الروابط المنطقية والأقواس التنظيمية، أن يتحول إلى أداة اكتشاف واستخلاص إحصائي بالغة القوة والدقة في مصفوفات البيانات الكبيرة.
10. أفضل الممارسات واستكشاف الأخطاء الشائعة وإصلاحها
10.1 معايير اختيار الصياغة المثلى وضمان جودة الكود البرمجي
يتطلب الارتقاء بجودة البرمجيات المكتوبة بلغة SAS تبني معايير هندسية موحدة (Coding Standards) تلتزم بها كافة الفرق البحثية والتحليلية داخل المؤسسة. وفيما يخص معامل عدم المساواة، تستقر التوصيات الأكاديمية العالمية على منح الأولوية المطلقة لاستخدام المعامل الحرفي المكتوب بالأحرف الكبيرة NE في كافة البرامج التنفيذية والمشاريع المخصصة للإنتاج طويل الأجل، وذلك لضمان أعلى مستوى من وضوح الشفرة واستبعاد أي احتمالية لتشوه الرموز عند ترحيل الأكواد بين أنظمة التشغيل ومستودعات البرمجيات السحابية.
كما يُوصى بضرورة مرافقة كل شرط استبعادي مركب بتعليقات برمجية شارحة (Comments) توثق الأساس المنطقي والإحصائي للاستبعاد، مع تجنب الاعتماد على الرموز النادرة مثل ¬= التي قد تربك المطورين المراجعين. إن الالتزام بهذه الضوابط المنهجية لا يحمي فقط البنية البرمجية من الأخطاء العرضية، بل يرفع من قيمة الكود كأصل تقني مؤسسي قابل للصيانة والتطوير المستمر عبر الأجيال البرمجية المتلاحقة.
10.2 تشخيص الأخطاء المنطقية وتفسير رسائل سجل النظام (SAS Log)
ينطوي استخدام لغة SAS على خصوصية تاريخية ومعمارية تتطلب انتباهاً تشخيصياً شديداً عند استخدام الرموز المركبة، ويبرز ذلك جلياً في الفارق الخطير بين استخدام الرمز <> في خطوة البيانات (DATA Step) واستخدامه في لغة الاستعلامات البنيوية (PROC SQL) أو عبارة WHERE:
- في خطوة البيانات (DATA Step): لا يعتبر الرمز
<>معامل عدم مساواة إطلاقاً! بل هو معامل حسابي داخلي يرمز إلى دالة القيمة العظمى (MAX Operator)، حيث ينتج عن التعبيرA <> Bالقيمة الكبرى بين المتغيرين، في حين يرمز المعاكس><إلى القيمة الدنيا (MIN Operator). وعند كتابة جملة شرطية مثل:if x <> y then ...داخل خطوة البيانات، فإن مفسر SAS لا يتوقف بل يمرر الكود ويصدر ملاحظة تحذيرية شهيرة في السجل نصها:
NOTE: The "<>" operator is interpreted as "MAX".
مما يقود إلى خطأ منطقي كارثي في مسار المعالجة الشرطية دون أن يتعطل البرنامج! - في عبارة WHERE وإجراء PROC SQL: يلتزم المحرك بمعايير ANSI SQL، ولذلك يُعترف بالرمز
<>رسمياً كمعامل لعدم المساواة (Not Equal). ومن هنا، يجب تجنب هذا الرمز نهائياً في خطوات البيانات منعاً للخلط والوقوع في هذا الفخ التشغيلي الخفي.
كذلك تبرز مشكلة أخطاء المقارنة بين الأرقام العشرية ذات الفاصلة العائمة (Floating-Point Precision Errors)؛ إذ قد يؤدي التمثيل الثنائي للكسور العشرية إلى فروق بالغة الصغر في المراتب المتناهية (مثل 0.000000000000001)، مما يجعل الحاسوب يحكم بانتفاء التكافؤ عبر المعامل NE بين قيمتين يفترض تساويهما نظرياً. ولحل هذه المشكلة الشائعة، يتعين دمج شروط المقارنة مع دالة التقريب الحسابي ROUND() (مثل: if round(x, 0.001) ne round(y, 0.001)) لضمان عدم تأثر التحليل الإحصائي بالفروق الرقمية الدقيقة الناتجة عن قيود المعالجات الحاسوبية.
10.3 إرشادات صيانة وتحسين الأداء للتحليلات الإحصائية الكبيرة
تشكل صيانة وتحديث الأكواد البرمجية القديمة (Legacy Code) ركيزة أساسية لضمان استمرارية وكفاءة الأنظمة الإحصائية المؤسسية. وتتطلب هذه العملية مراجعة شاملة لكافة التعبيرات الشرطية القديمة، واستبدال البدائل الرمزية الغامضة أو المعرضة لمشاكل التشفير بالصيغة المعيارية الموحدة NE، والتأكد من إحاطة التعبيرات المنطقية المركبة بالأقواس المناسبة وتأمينها ضد مصائد البيانات المفقودة.
كما يُنصح بشدة عند التعامل مع مستودعات البيانات العملاقة (Big Data Warehouses) باختبار الشروط التصفوية والاستبعادية الجديدة على عينات مصغرة وممثلة من البيانات أولاً، وتفحص توزيعات المتغيرات الناتجة ومطابقتها للتوقعات النظرية، ومراقبة مؤشرات استهلاك المعالج وأزمنة الإدخال والإخراج عبر خيارات النظام مثل FULLSTIMER. إن هذا النهج الوقائي الممنهج يضمن تحقيق التوازن الأمثل بين دقة التفسير الإحصائي والسرعة القصوى لمعالجة البيانات الضخمة، مما يعزز الموثوقية العامة لكافة مخرجات التحليل الرقمي في بيئة SAS.
خاتمة
يمثل معامل عدم المساواة (Not Equal Operator) في بيئة SAS إحدى الركائز المنطقية الرئيسة التي تستند إليها معالجة وتصفية البيانات الإحصائية بكافة مستوياتها. ومن خلال هذا العرض العلمي المفصل، اتضح أن النجاح في توظيف هذا المعامل يتطلب تجاوز النظرة السطحية له كأداة مقارنة بسيطة، والإحاطة الكاملة بالأبعاد المعمارية الدقيقة التي تتحكم في سلوكه؛ بدءاً من التمييز بين الصياغة الحرفية القياسية NE والبدائل الرمزية المكافئة لها، ومروراً بالانتباه الحذر للاختلافات الجوهرية بين توقيت تنفيذ عبارات WHERE وعبارات IF في دورة معالجة متجه بيانات البرنامج (PDV)، ووصولاً إلى استيعاب السلوك الرياضي الخاص للقيم المفقودة في التدرج الهرمي الحسابي لنظام SAS.
إن الالتزام بالمعايير البرمجية الرصينة، والاعتماد على الصياغة الحرفية NE لضمان قابلية نقل الكود وسلامة قراءته، والدمج الواعي للأقواس الرياضية والدوال الوقائية مثل MISSING() وROUND()، يمثل الضمانة الأساسية لحماية التحليلات الإحصائية والأبحاث العلمية من الانحرافات الخوارزمية والأخطاء الخفية. ويظل الفهم المعمق لمنطق عمل مفسر لغة SAS وأولويات معالجة التعبيرات البوليانية هو السبيل الأمثل لتمكين الباحثين والمطورين من استخلاص الرؤى الدقيقة من مجموعات البيانات الكبيرة بكفاءة استثنائية ونزاهة تحليلية مطلقة.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A user’s guide to SAS 76. SAS Institute Inc.
- SAS Institute Inc. (2013). SAS 9.4 language reference: Concepts (6th ed.). SAS Institute Inc. https://support.sas.com/documentation/cdl/en/lrcon/62955/HTML/default/viewer.htm
- SAS Institute Inc. (2017). Base SAS 9.4 procedures guide: Statistical procedures (5th ed.). SAS Institute Inc.
- Cody, R. (2018). Cody’s data cleaning techniques using SAS (3rd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.