
يحتل تحليل الانحدار الخطي العادي مكانة مركزية في ترسانة المنهجيات الإحصائية المعتمدة عبر شتى فروع العلوم الاجتماعية والسلوكية والطبية والاقتصادية؛ إذ يتيح للباحثين استكشاف طبيعة العلاقات الاقترانية والسببية بين المتغيرات وتحديد أوزانها النسبية بدقة رياضية متناهية. وفي بيئة نظام التحليل الإحصائي (SAS)، يبرز إجراء الانحدار الخطي PROC REG بوصفه إحدى الأدوات البرمجية الأكثر رسوخاً ومرونة لتقدير نماذج المربعات الصغرى العادية (Ordinary Least Squares – OLS)، وتقديم حزمة غير مسبوقة من الاختبارات التشخيصية التي تتناول بنية النموذج، وجودة توفيقه، ومدى استيفائه للافتراضات الإحصائية الكلاسيكية التي تشترطها مبرهنة غاوس-ماركوف لضمان كفاءة التقدير ونقاء النتائج من التحيز.
تستهدف هذه المعالجة العلمية الشاملة تفكيك هذا الإجراء الإحصائي المتقدم خطوة بخطوة، بدءاً من أركانه النظرية ومبرراته الرياضية، مروراً بآليات برمجته وصياغته النحوية داخل بيئة SAS، وصولاً إلى استعراض مثال تطبيقي عملي متكامل يتناول العلاقة بين ساعات الاستذكار ومستويات التحصيل الأكاديمي لدى عينة محددة من الطلاب. ولن تقتصر غايتنا على استعراض أوامر الشيفرة البرمجية فحسب، بل ستمتد لتشمل القراءة النقدية المتأنية للمخرجات المعقدة وجداول التباين ومؤشرات جودة التوفيق، مع استعراض استراتيجيات توسيع النموذج نحو الانحدار المتعدد، وسبل تقييم الفروض التشخيصية المعقدة كالتعدد الخطي وتجانس التباين واعتدالية البواقي باستخدام أحدث إمكانات الإخراج البياني الإحصائي (ODS Graphics).
إن الاستخدام الرشيد لإجراء PROC REG يتطلب من الباحث فهماً إبستمولوجياً ومنهجياً عميقاً يتجاوز مجرد النقر على الأزرار أو تمرير سطور الأوامر الجافة؛ إذ يتوجب الموازنة الدقيقة بين البساطة المنهجية للنموذج وقدرته التفسيرية، مع التنبه الصارم للقيود المفروضة على بنية البيانات وحجم العينة وطرق التعامل مع المشاهدات الشاذة أو المؤثرة. ومن خلال هذا الدليل المرجعي الموسع، نضع بين يدي الباحث الأكاديمي والمحلل المتقدم مرجعاً تفصيلياً يجمع بين الصرامة الرياضية والتطبيق العملي الدقيق وفق أحدث معايير التوثيق والنشر العلمي الدولية.
1. المقدمة والأسس النظرية لإجراء الانحدار الخطي في برنامج SAS (PROC REG)
1.1 مفهوم إجراء PROC REG وأهميته الإحصائية
يُمثّل إجراء PROC REG الركيزة الهيكلية الأولى لتحليل الانحدار الخطي القياسي في بيئة SAS الإحصائية، حيث صُمم خصيصاً للتعامل مع النماذج التي تفترض علاقة خطية مستقيمة بين متغير تابع كمي متصل ومتغير تفسيري أو أكثر. وتتجلى الأهمية الإحصائية لهذا الإجراء في اعتماده الصارم على طريقة المربعات الصغرى العادية (OLS)، والتي تُعد المعيار الذهبي في تقدير معالم الانحدار الخطي نظراً لقدرتها الفريدة على توفير مقدرات غير متحيزة وذات أقل تباين ممكن (BLUE) شريطة تحقق الفروض التأسيسية للمنهجية. ويتيح هذا الإجراء الانتقال بالبحث من مجرد رصد الارتباطات البسيطة إلى بناء نماذج تفسيرية وتنبؤية تمكّن صناع القرار والباحثين من فهم الآليات الديناميكية المعقدة التي تحكم الظواهر المدروسة بدقة بالغة.
وعند مضاهاة إجراء PROC REG بالأساليب التقديرية البارامترية الأخرى داخل برمجية SAS، يلحظ الباحث بوضوح أنه يتميز بتركيزه الحصري والمكثف على الانحدار الخطي المستمر وما يتصل به من اختبارات الفروض التفصيلية وتشخيصات البواقي، على خلاف الإجراءات التي تستهدف تصاميم تحليل التباين البحتة أو تلك المتخصصة في الاستجابات الثنائية أو الفئوية. وتتجلى قوة هذا الإجراء في التطبيقات المعاصرة لمعالجة البيانات القياسية، حيث يسهم بفاعلية في توفير منظومة تشخيصية بالغة الحساسية ترصد أي اختلالات بنيوية في مصفوفة البيانات، بما يضمن سلامة الاستدلال الإحصائي وموثوقية النتائج المستخلصة في البحوث العلمية المنشورة.
1.2 الصياغة الرياضية لنماذج الانحدار الخطي
تقوم الصياغة الرياضية للانحدار الخطي البسيط على علاقة ثنائية مباشرة تربط المتغير التابع، والذي يُرمز له بالرمز Y، بمتغير تفسيري وحيد X، مضافاً إليه حد الخطأ العشوائي غير الملاحظ، وتُكتب المعادلة على النحو الآتي: Y = β₀ + β₁X + ε. وفي هذا السياق، يُشير β₀ إلى معامل التقاطع مع المحور الرأسي، وهو يمثل القيمة المتوقعة للمتغير التابع عندما تنعدم قيمة المتغير المستقل تماماً، في حين يعبر المعامل β₁ عن ميل خط الانحدار، موضحاً مقدار ومسار التغير المتوقع في المتغير التابع لكل زيادة بمقدار وحدة قياسية واحدة في المتغير المستقل. أما حد الخطأ العشوائي ε، فيختزل جميع العوامل العشوائية والتقلبات القياسية التي لم تدخل صراحة في بنية المعادلة التنبؤية.
وعند الانتقال إلى الانحدار الخطي المتعدد، تتسع الصياغة لتأخذ شكلاً مصفوفياً يعبر عن تكامل مجموعة من المتغيرات التفسيرية: Y = Xβ + ε، حيث يمثل Y متجهاً للمشاهدات، بينما تمثل X مصفوفة التصميم الإحصائي التي تضم أعمدة المتغيرات المستقلة إلى جانب عمود الآحاد الخاص بحد التقاطع، ويمثل β متجه المعلمات المراد تقديرها. وترتكز آلية التقدير الحسابية في PROC REG على تقليل المجموع التربيعي للبواقي عبر المعادلة التفاضلية المغلقة للحل العمودي: β̂ = (X’X)⁻¹X’Y، وهو الحل الرياضي الذي يشترط بالضرورة أن تكون المصفوفة (X’X) غير منفردة وذات رتبة كاملة، بما يضمن الحصول على أفضل توفيق خطي يقلل الفروق بين القيم المشاهدة والقيم التنبؤية إلى أدنى حد ممكن.
1.3 متى يتم اختيار PROC REG مقارنة بالإجراءات الأخرى
يثور في الأدبيات الإحصائية نقاش مستمر حول المفاضلة التشغيلية بين إجراء PROC REG وإجراء النموذج الخطي العام PROC GLM؛ وتكمن النقطة المفصلية هنا في أن PROC REG يمتلك تفوقاً كاسحاً في سرعة المعالجة الحاسوبية وحجم الذاكرة المستهلكة، لا سيما عند التعامل مع مجموعات البيانات الكبيرة التي تقتصر متغيراتها التفسيرية على المتغيرات الكمية المستمرة. إضافة إلى ذلك، يوفر PROC REG طيفاً متقدماً وحصرياً من المؤشرات التشخيصية التفاعلية وأساليب الاختيار التلقائي للمتغيرات (Model Selection Methods)، مثل الانحدار التدريجي وحساب مسافة كوك ومؤشرات تضخم التباين، وهي خيارات لا تتوفر بنفس المرونة المباشرة في إجراءات النمذجة العامة الأخرى.
ومع ذلك، يفرض إجراء PROC REG قيداً تقنياً حاسماً يتمثل في عجزه عن إدراج المتغيرات الفئوية (Categorical Variables) مباشرة عبر عبارة تصنيف داخلية كما هو الحال في PROC GLM، مما يُلزم الباحث باللجوء إلى إنشاء متغيرات وهمية (Dummy Variables) مسبقاً داخل خطوة تجهيز البيانات (DATA Step). ولهذا السبب، فإن حالات الاستخدام البحثية الأكاديمية التي تتطلب توظيف PROC REG ترتكز بشكل أساسي على الدراسات التي تسعى إلى التنبؤ الدقيق، أو التي تتطلب التحقق المتعمق من استقرار النماذج وسلامة الفروض التوزيعية للبواقي عبر مؤشرات رياضية متطورة، مثلما هو ملاحظ في أبحاث قياس الأداء والسلوك الإنساني التي تفترض مقاييس متصلة للأداء المعرفي والتحصيلي (Lackmann et al., 2021).
2. البنية النحوية البرمجية الأساسية لإجراء PROC REG
2.1 الهيكل العام للأمر واستدعاء مجموعة البيانات
يرتكز البناء البرمجي لإجراء PROC REG على صياغة جملية تبدأ بالكلمة المفتاحية المخصصة للإجراء وتحديد مصدر البيانات المستهدفة، وتتخذ الصيغة الأساسية الشكل التالي: proc reg data = dataset_name; حيث يحدد المعامل data اسم ملف بيانات SAS المحفوظ مسبقاً في الذاكرة المؤقتة أو الدائمة. ويُعد هذا الإعلان الصريح للبيانات صمام أمان برمجي يمنع النظام من استخدام آخر مجموعة بيانات نشطة بشكل تلقائي، مما يدرأ مخاطر الخلط الإحصائي أو التحليل الخاطئ للعينات. كما تتيح العبارة الافتتاحية للمستخدم تمرير خيارات تشغيلية عامة للتحكم في كيفية إرسال المخرجات أو تحديد مصفوفات الارتباط كمدخلات بديلة، وهو ما يمنح المحلل مرونة استثنائية في إدارة تدفقات البيانات الضخمة.
علاوة على ذلك، يمثل استدعاء خيارات الرسوم البيانية الإحصائية ضمن العبارة الافتتاحية أو عبر أوامر النظام البيئية خطوة محورية لإدارة جودة النتائج البصرية. ويتعين على المبرمج التحقق الدقيق من توافق المتغيرات المستدعاة مع القواعد النحوية لبرمجية SAS، والتأكد من خلو مسمياتها من المسافات أو الرموز الخاصة التي قد تعرقل سير المعالجة. إن الانضباط في بناء العبارة الرئاسية يمهد الطريق لتنفيذ الإجراء بسلاسة ويوفر بيئة تشغيلية آمنة خالية من الأخطاء النحوية التي قد توقف تنفيذ الكود قبل استعراض النتائج.
2.2 بناء عبارة النموذج (MODEL Statement)
تمثل عبارة النموذج MODEL القلب النابض لإجراء PROC REG، إذ من خلالها تتحدد الهيكلية الرياضية للعلاقة المراد تقديرها. وتعتمد الصيغة القياسية لهذه العبارة وضع المتغير التابع المستجيب على يسار علامة التساوي، متبوعاً بقائمة المتغيرات التفسيرية المستقلة المفصولة بمسافات فارغة دون الحاجة إلى استخدام أي فواصل، كما في الصيغة الرياضية: model Dependent_Variable = Predictor1 Predictor2; وتتيح هذه العبارة تضمين خيارات تحليلية وتشخيصية إضافية عبر وضع علامة الشرطة المائلة (/) بعد سرد المتغيرات، حيث يُلحق بها حزم من الكلمات المفتاحية المتخصصة في حساب مصفوفات التباين، أو فحص التعدد الخطي، أو ضبط خوارزميات الاختيار الآلي للمتغيرات.
ومن الخصائص البنيوية الفريدة لإجراء PROC REG داخل SAS قدرته على استيعاب عدة عبارات MODEL داخل استدعاء برمجي واحد للإجراء؛ مما يتيح للباحث اختبار نماذج بديلة متوازية ومقارنة مخرجاتها التفسيرية في خطوة تنفيذية واحدة دون تكرار كتابة الكود من البداية. غير أن صياغة التفاعلات بين المتغيرات أو التحويلات غير الخطية المباشرة كالتطبيع اللوغاريتمي تستوجب حساب تلك المتغيرات المحولة صراحة في خطوة معالجة البيانات السابقة، إذ لا يدعم PROC REG العمليات الحسابية الضمنية داخل عبارة النموذج ذاتها كما تفعل بعض الإجراءات التقديرية الأحدث.
2.3 أوامر التنفيذ والإغلاق والتحكم البرمجي
تخضع بيئة عمل إجراء PROC REG لنمط تشغيلي تفاعلي مستمر (Interactive Mode)، وهي سمة تصميمية حاسمة تقتضي الانتباه المنهجي من المبرمج. فعلى النقيض من معظم إجراءات SAS التقليدية التي تكتفي بعبارة RUN لتنفيذ الأوامر وإنهاء الخطوة، فإن عبارة RUN في PROC REG تقوم بتشغيل الأوامر وحساب التقديرات الإحصائية للنموذج المطلوب، ولكنها تُبقي الإجراء مفتوحاً في الذاكرة بانتظار عبارات نموذج جديدة أو خيارات اختبارات لاحقة. وتتيح هذه الخاصية ميزة نوعية للمحلل لاستكشاف فروض إضافية دون الحاجة إلى إعادة قراءة مصفوفة البيانات الضخمة من القرص الصلب مرة أخرى في كل محاولة تجريبية.
ولضمان الاستقرار التشغيلي وتفريغ الذاكرة المؤقتة لنظام SAS، يتعين دوماً إغلاق جلسة PROC REG باستخدام عبارة QUIT متبوعة بفاصلة منقوطة. إن إغفال عبارة QUIT يُبقي الإجراء معلقاً في الخلفية، مما قد يتسبب في تداخل التحليلات اللاحقة، أو حدوث أخطاء غير مقصودة في سجل المعالجة، أو تعطل تدفق الخطوات البرمجية المجدولة داخل البيئات الحسابية المؤتمتة. ولذلك، فإن المعيار الاحترافي لكتابة الأكواد يستلزم ترسيخ ثنائية (RUN; ثم QUIT;) ككتلة ختامية متماسكة لكل نموذج انحدار يتم بناؤه.
3. إعداد وتجهيز مجموعة البيانات التطبيقية في SAS
3.1 بناء مجموعة بيانات ساعات الدراسة ودرجات الاختبار
لإرساء فهم تطبيقي متكامل لإجراء PROC REG، سنقوم بتأسيس مجموعة بيانات تجريبية تحاكي دراسة تربوية استقصائية تستهدف فحص العلاقة الارتباطية والسببية بين الجهد الأكاديمي المبذول ومستوى التحصيل العلمي النهائي. تنطلق هذه المرحلة عبر إنشاء خطوة DATA Step مخصصة تحمل اسم study_data، حيث يُحدد فيها المتغير التفسيري hours ممثلاً لعدد ساعات المذاكرة الأسبوعية المخصصة للاستعداد للاختبار، والمتغير التابع score الذي يعكس الدرجة المتحصل عليها في الاختبار النهائي والمحسوبة على مقياس مئوي من 0 إلى 100 نقطة لدى عينة قوامها 15 طالباً.
تُعد عملية التسمية والتوصيف الدقيق للمتغيرات خطوة تأسيسية في صياغة النماذج؛ إذ يحرص الباحث على اعتماد أسماء قصيرة ذات دلالة واضحة ومباشرة تتسق مع المعايير المعرفية المتداولة في الأدبيات. ويتيح استخدام العبارة التعريفية INPUT تحديد طبيعة المتغيرين بوصفهما متغيرين كميين رقميين مستمرين، مما يجعلهما مهيئين تماماً لتطبيق افتراضات الانحدار الخطي البسيط دون الحاجة إلى معالجات ترقيمية أو ترميزات وسيطة معقدة قد تشوه المسار التحليلي.
3.2 إدخال مصفوفة البيانات المباشرة (DATALINES)
يتيح نظام SAS إدراج البيانات التجريبية بشكل فوري داخل برنامج التحليل عبر استخدام عبارة DATALINES (أو بديلتها التاريخية CARDS)، مما يسهل توثيق الأكواد ومشاركتها للأغراض الأكاديمية والتعليمية. ويتم تنظيم المشاهدات في أسطر رأسية متتابعة تضم كل سطر منها زوجاً مرتباً من القيم الرقمية (ساعات المذاكرة متبوعة بدرجة الاختبار المقابلة للطالب)، مع مراعاة وضع فواصل المسافات الفاصلة بدقة تامة لتفادي أخطاء المحاذاة التلقائية لقارئ البيانات المدمج في SAS. وتُختتم كتلة إدخال البيانات بوضع فاصلة منقوطة مستقلة في سطر منفرد لإشعار المحرك بانتهاء تدفق السجلات.
فيما يلي الشيفرة البرمجية التأسيسية التي تنشئ مجموعة البيانات التطبيقية بدقة متناهية متضمنة المشاهدات الخمس عشرة:
data study_data;
input hours score;
datalines;
2.5 58
3.0 62
3.5 65
4.0 68
4.5 70
5.0 74
5.5 75
6.0 80
6.5 82
7.0 85
7.5 87
8.0 90
8.5 92
9.0 95
9.5 98
;
run;
تتميز هذه المصفوفة بتدرج مدروس في ساعات الدراسة يمتد من ساعتين ونصف إلى تسع ساعات ونصف، يقابله صعود تدريجي منتظم في درجات الاختبار، مما يشكل بنية بيانات مثالية لتوضيح آليات عمل الانحدار البسيط واستخلاص مخرجاته الإحصائية بوضوح كامل.
3.3 التحقق من صحة المدخلات باستخدام PROC PRINT
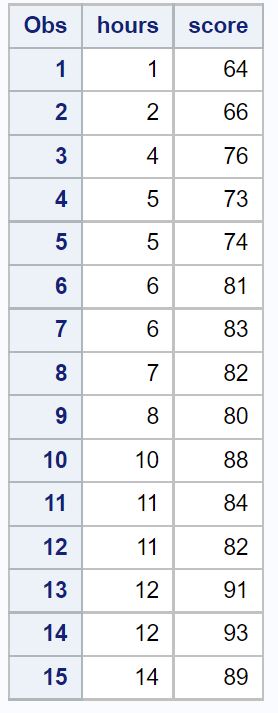
تقتضي الرصانة المنهجية في البحث الإحصائي عدم الشروع في التحليلات الاستدلالية المتقدمة قبل التحقق التام من سلامة بنية البيانات المدخلة وخلوها من الأخطاء المطبعية أو الانحرافات الناتجة عن إزاحة الأعمدة. وتحقيقاً لذلك، يُستدعى إجراء المعاينة الطباعية PROC PRINT لفحص المشاهدات المقروءة ومقارنتها بالقائمة الأصلية. وتتجلى أهمية هذه المراجعة البصرية في تأكيد استيعاب SAS لجميع السجلات الخمسة عشر بصورة صحيحة وبدون تسجيل أي قيم مفقودة (Missing Values) غير مقصودة قد تقلص حجم العينة الفعلي وتؤثر سلباً على القوة الإحصائية للنموذج.
proc print data=study_data noobs;
title “جدول فحص وتدقيق البيانات الأولية لساعات الدراسة والدرجات”;
run;
من خلال فحص الجدول المستخرج، يتأكد الباحث من أن نطاقات القيم تقع ضمن الحدود المنطقية لدرجات الاختبار ومقاييس الوقت، وبذلك تصبح البيانات مهيأة منهجياً وإحصائياً لتغذية إجراء PROC REG، مما يعزز الثقة في النتائج التي ستسفر عنها مرحلة النمذجة الرياضية اللاحقة ويدعم سلامة الاستنتاجات العلمية المشتقة منها.
4. تنفيذ نموذج الانحدار الخطي البسيط خطوة بخطوة
4.1 صياغة الكود البرمجي لانحدار الدرجة على ساعات الدراسة
بعد إتمام تجهيز البيانات والتحقق من سلامتها، ننتقل مباشرة إلى صياغة الشيفرة التنفيذية لنموذج الانحدار الخطي البسيط. وفي هذه المعادلة، نموضع المتغير score بوصفه المتغير التابع الذي نسعى لتفسير تباينه والتنبؤ بقيمه، بينما نضع المتغير hours كمتغير تفسيري وحيد يعبر عن المدخل الزمني للتعلم. ويستند هذا البناء إلى الأساس النظري القائل بأن الوقت المخصص للاستذكار ينعكس طردياً وبشكل بنيوي على درجة الاستيعاب والأداء في الاختبارات المعيارية (Lackmann et al., 2021).
تُكتب الشيفرة البرمجية التنفيذية في محرر أوامر SAS على النحو الآتي:
proc reg data=study_data;
model score = hours;
title “تحليل انحدار الدرجة النهائية على ساعات الدراسة الأسبوعية”;
run;
quit;
يتم إرسال هذا الأمر إلى خادم المعالجة في SAS عبر الضغط على مفتاح التنفيذ، ليبدأ النظام في استدعاء خوارزميات المربعات الصغرى وحساب مصفوفات التباين المشترك، وتوليد النتائج المجدولة والرسوم البيانية المرافقة وإيداعها في بيئة عرض النتائج النشطة.
4.2 مراقبة سجل الأحداث (SAS Log) والتحقق من التنفيذ
يُمثل سجل العمليات (SAS Log) المرجع التشخيصي الأول للمحلل الإحصائي؛ إذ ينبغي فحصه بعناية فائقة فور انتهاء المعالجة الحسابية للتأكد من خلوه تماماً من أي رسائل خطأ حمراء أو تنبيهات تحذيرية صفراء. ويوفر السجل توثيقاً رقمياً يؤكد عدد المشاهدات المقروءة من ملف البيانات، وعدد المشاهدات المستخدمة فعلياً في تقدير النموذج. وتكتسب هذه الخطوة أهمية حاسمة لضمان عدم استبعاد أي طالب من التحليل بسبب مشكلات تنسيقية في البيانات، فضلاً عن التأكد من اكتمال استدعاءات الوحدات الفرعية لتوليد المخرجات الإحصائية بنجاح ودون أي عوائق في الذاكرة.
كما يفيد تدقيق سجل العمليات في التأكد من عدم مواجهة النظام لأي مشكلات جبرية تتعلق بانفراد المصفوفات أو تعذر حساب مقلوب مصفوفة المتغيرات التفسيرية، وهو ما يحدث عند وجود ارتباط خطي تام. وفي حالتنا الراهنة، يوثق السجل استخدام 15 مشاهدة كاملة في حساب الانحدار، بما يثبت سلامة البنية التقنية للكود وجاهزية المخرجات الإحصائية المستخلصة للانتقال إلى مرحلة التفسير والدراسة المتعمقة.
4.3 توليد وعرض جداول المخرجات القياسية
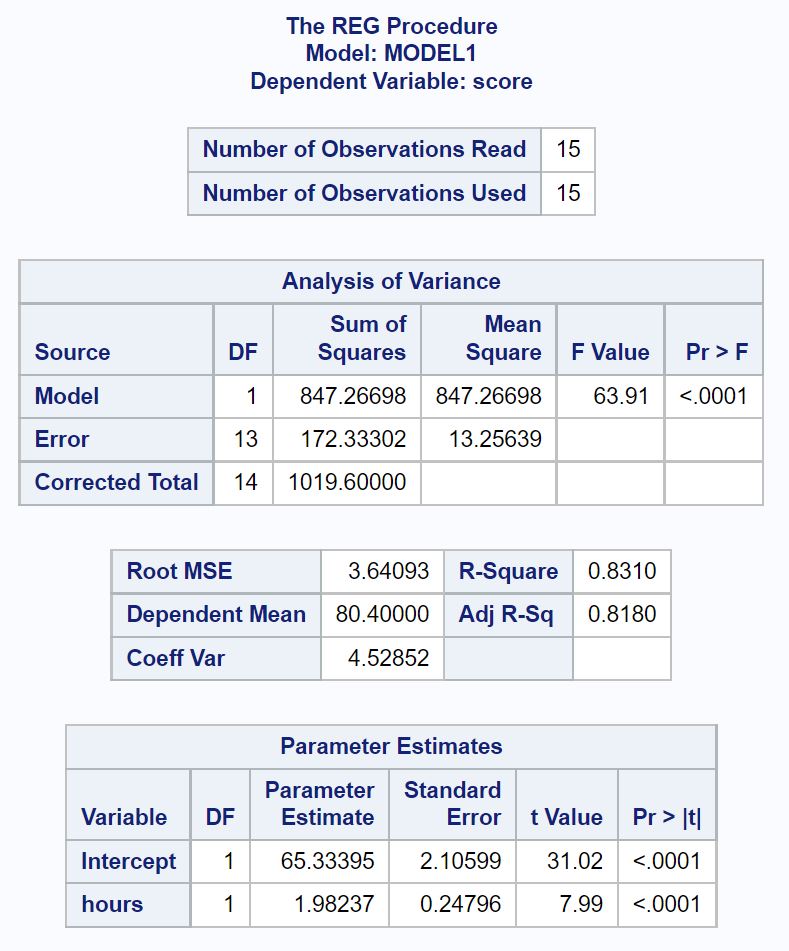
ينتج عن تشغيل الكود السابق ظهور نافذة النتائج المنظمة التي تتضمن ثلاثة جداول إحصائية رئيسية متعارف عليها في الأدبيات القياسية لبرنامج SAS: جدول تحليل التباين (Analysis of Variance)، وجدول ملخص جودة توفيق النموذج (Model Fit Summary)، وجدول تقديرات المعلمات الإحصائية (Parameter Estimates). وتعرض هذه الجداول بتسلسل منهجي يبدأ بتقييم النموذج ككل، مروراً بمقدار التباين المفسر، وصولاً إلى التفاصيل الدقيقة لمعاملات المتغيرات وقيم اختباراتها الجزئية.
تتكامل هذه المخرجات التقريرية لتقدم للمحلل صورة بالغة الشمول والوضوح عن الظاهرة؛ حيث يرتبط كل جدول بالآخر عبر خيوط رياضية وثيقة تربط مجموع المربعات بالدلالة الكلية وبقيم معاملات الانحدار المقدرة وأخطائها المعيارية. ويتعين على الباحث استيعاب التمفصلات البنيوية بين هذه الجداول لقراءتها ككل موحد يفسر العلاقة بين المتغيرات بصورة دقيقة ورصينة، تمهيداً لصياغة التقرير الإحصائي النهائي وفق الضوابط الأكاديمية الصارمة.
5. تفسير المخرجات الإحصائية لنموذج الانحدار البسيط
5.1 تفسير جدول تحليل التباين (ANOVA Table)
يُعد جدول تحليل التباين (ANOVA) المنطلق الجوهري للحكم على الجدوى الإحصائية الكلية لنموذج الانحدار؛ حيث يقوم بتفكيك التباين الإجمالي للمتغير التابع (المجموع الكلي للمربعات – Corrected Total SS) إلى مكونين أساسيين: التباين الذي استطاع النموذج تفسيره (Model Sum of Squares)، والتباين العشوائي غير المفسر المتبقي في الأخطاء والبواقي (Error Sum of Squares). وفي نموذجنا التطبيقي، يبلغ إجمالي مجموع المربعات الكلي 1974.93333 بدرجات حرية قدرها 14 (N – 1)، في حين نجح متغير ساعات المذاكرة في تفسير مجموع مربعات بالغ الضخامة مقداره 1961.47273 بدرجة حرية واحدة، متبقياً تباين خطأ عشوائي ضئيل للغاية قدره 13.46061 مقسماً على 13 درجة حرية متبقية للخطأ.
وبقسمة مجموع مربعات النموذج على درجات حريته، نحصل على متوسط مربعات النموذج (Mean Square = 1961.47273)، كما نحصل على متوسط مربعات الخطأ (MSE = 1.03543) عبر قسمة مجموع مربعات البواقي على درجات حرية الخطأ المقابلة (13.46061 / 13). ويمثل إحصاء F النسبة بين متوسط مربعات النموذج إلى متوسط مربعات الخطأ، لتبلغ قيمته المحسوبة هنا 1894.35. ونظراً لأن القيمة الاحتمالية المصاحبة لاختبار F تظهر في المخرجات كقيمة بالغة الصغر تقل عن 0.0001 (Pr > F < .0001)، فإننا نرفض بصورة قاطعة الفرضية الصفرية التي تدعي انعدام الأثر الخطي لساعات الدراسة، مؤكدين بذلك الدلالة الإحصائية الفائقة للنموذج ككل وقدرته الاستثنائية على التنبؤ بدرجات الطلاب.
5.2 تقييم مؤشرات جودة التوفيق (Goodness of Fit)
يقدم الجدول التلخيصي المصاحب لجداول الانحدار حزمة من المؤشرات الأساسية التي تُعنى بتقييم الكفاءة التوفيقية للنموذج الرياضي، وفي مقدمتها معامل التحديد (R-Square). ويسجل هذا المعامل في نموذجنا قيمة استثنائية تصل إلى 0.9932، مما يعني أن 99.32% من التباين الكلي في درجات الاختبار للطلاب يمكن تفسيره والتنبؤ به مباشرة من خلال التباين في عدد الساعات الأسبوعية المخصصة للمذاكرة، في حين لا يتبقى سوى أقل من 1% من التباين خاضعاً لتأثير الفروق الفردية الأخرى أو الأخطاء العشوائية غير المفسرة. ويُعد هذا المؤشر دليلاً قاطعاً على قوة العلاقة الخطية واستقرارها في العينة المختارة.
أما معامل التحديد المعدل (Adj R-Sq)، والذي يراعي حجم العينة وعدد المتغيرات التفسيرية، فقد بلغ 0.9927، وهو ما يؤكد أن جودة التوفيق المحققة تعكس قوة حقيقية في القدرة التفسيرية للمتغير وليست نتاجاً مصطنعاً لتشبع البيانات. كما يظهر مقياس جذر متوسط مربعات الخطأ (Root MSE) بقيمة تبلغ 1.01756، وهي بمثابة الانحراف المعياري لتقديرات البواقي وتقاس بنفس وحدة قياس المتغير التابع (الدرجات)؛ مما يدل على أن متوسط خطأ التنبؤ بالدرجات لا يتجاوز نقطة واحدة تقريباً. ويعزز ذلك انخفاض معامل التغير (Coeff Var = 1.306%)، مما يؤكد الدقة التنبؤية المرتفعة وموثوقية النموذج في الاستخدامات التربوية والسلوكية القياسية (Phillips et al., 2016).
5.3 تفسير مقادير المعلمات الإحصائية (Parameter Estimates)
يتضمن جدول تقديرات المعلمات الإحصائية التقديرات الرقمية المباشرة لثوابت المعادلة الانحدارية، حيث يظهر معامل التقاطع (Intercept) بقيمة مقدرة تبلغ 43.68485 بخطأ معياري قدره 0.82522. ووفقاً للتفسير الرياضي، تمثل هذه القيمة النقطة التي يقطع عندها خط الانحدار المحور الرأسي، مما يعني أن الطالب الذي لا يقضي أي ساعة في المذاكرة نهائياً (hours = 0) يُتوقع له نظرياً الحصول على درجة تعادل 43.68 نقطة في الاختبار. وقد بلغت قيمة t المحسوبة لهذا المعامل 52.94 بمستوى دلالة فائق (p < .0001)، مما يثبت معنوية حد التقاطع الإحصائية.
وفيما يخص معامل انحدار المتغير التفسيري (hours)، فقد بلغت قيمته التقديرية 5.70909 بخطأ معياري دقيق للغاية لا يتجاوز 0.13117. ويعني هذا المعامل الموجب أنه لكل ساعة مذاكرة إضافية يستثمرها الطالب أسبوعياً، ترتفع درجته المتوقعة في الاختبار النهائي بمقدار 5.71 نقطة في المتوسط، مع بقاء العوامل الأخرى ثابتة. وبقسمة المعامل المقدر على خطئه المعياري، نصل إلى قيمة t المحسوبة والبالغة 43.52، وهي قيمة تقع في أقصى منطقة الرفض وتصاحبها قيمة احتمالية بالغة الصغر (Pr > |t| < .0001)، مما يقود إلى رفض الفرضية الصفرية القائلة بأن ميل الانحدار يساوي صفراً، ويثبت إحصائياً الأثر الطردي المباشر لساعات الاستذكار على التحصيل الأكاديمي.
6. توسيع التحليل إلى الانحدار الخطي المتعدد (Multiple Linear Regression)
6.1 تعديل بناء النموذج لإدراج عدة متغيرات مستقلة
على الرغم من القوة التفسيرية العالية لنموذج الانحدار البسيط، فإن الظواهر الإنسانية والسلوكية نادراً ما تتشكل بتأثير عامل منفرد؛ إذ تتشابك المتغيرات وتتفاعل لتنتج المحصلة النهائية للأداء (Brose et al., 2014). ومن هذا المنطلق، تتجلى ضرورة توسيع التحليل نحو الانحدار الخطي المتعدد عبر إدراج مفسرات إضافية في مصفوفة البيانات، مثل نسبة الحضور الأكاديمي للمحاضرات (attendance) ومعدل ساعات النوم اليومية (sleep)، للوقوف على أثر كل متغير بمفرده مع ضبط وتثبيت تأثير بقية العوامل التفسيرية.
وتتحقق الصياغة البرمجية لهذا التوسع المتقدم داخل إجراء PROC REG عبر تعديل عبارة النموذج لتستوعب المتغيرات الجديدة مفصولة بمسافات كما في الكود التالي:
proc reg data=extended_study_data;
model score = hours attendance sleep;
title “تحليل الانحدار المتعدد للأداء الأكاديمي مع ضبط الحضور وساعات النوم”;
run;
quit;
يترتب على هذا التعديل البنيوي إعادة توزيع درجات الحرية في مصفوفة النموذج، حيث تقتطع المتغيرات الجديدة درجات حرية إضافية من درجات حرية الخطأ العشوائي، مما يفرض اشتراطات رياضية إضافية على حجم العينة وقوة الاختبار لضمان دقة التقدير الإحصائي للمعلمات المتعددة وتفادي تشتت التباين.
6.2 تفسير المعاملات الجزئية والمقارنة بينها
يتطلب تفسير معلمات الانحدار في النموذج المتعدد إدراكاً إحصائياً دقيقاً لمفهوم “المعامل الجزئي” (Partial Slope)؛ إذ لا يعبر المعامل هنا عن الارتباط البسيط المنفرد، بل يمثل التغير المتوقع في المتغير التابع المقترن بزيادة وحدة واحدة في المتغير المستقل المعني، بشرط تثبيت أو عزل التأثير الخطي لكافة المتغيرات المستقلة الأخرى الداخلة في النموذج (Controlling for other variables). ويتيح هذا الضبط التحليلي تجريد العلاقات التفسيرية من أي تأثيرات تضخمية مضللة تنشأ عن المتغيرات المربكة المشتركة.
وللمقارنة العادلة بين المتغيرات التفسيرية ذات وحدات القياس المتباينة (كساعات المذاكرة مقيسة بالوقت والنسبة المئوية للحضور مقيسة بالمعدل المئوي)، يُستحسن إضافة الخيار STDBETA إلى عبارة MODEL داخل إجراء PROC REG لاستخراج معاملات الانحدار المعيارية (Standardized Beta Coefficients). وتعمل هذه المعاملات المعيارية على توحيد مقاييس المتغيرات بحساب التغير بدلالة الانحرافات المعيارية، مما يمكّن الباحث من تحديد المتغير صاحب الوزن النسبي الأقوى والأكثر حسماً في التنبؤ بدرجات الاختبار بترتيب هرمي دقيق وموثوق منهجياً.
6.3 تقييم التغير في القدرة التفسيرية للنموذج الموسع
عند بناء النماذج التفسيرية المعقدة، يُعد تقييم مقدار الزيادة في القدرة التفسيرية خطوة منهجية حاسمة. فمن المعروف رياضياً أن قيمة R-Square ترتفع بصورة حتمية وتلقائية بمجرد إضافة أي متغير جديد إلى عبارة النموذج، حتى وإن كان ذلك المتغير عديم الجدوى النظرية والارتباط الإحصائي. وهنا يبرز دور معامل التحديد المعدل (Adjusted R-Square)، والذي يتضمن عقوبة رياضية تخصم من قيمته إذا لم يعوض المتغير المضاف استهلاكه لدرجات الحرية بتحسين ملموس في مجموع مربعات النموذج؛ مما يجعله المعيار الأدق للمقارنة بين النماذج المتعاقبة.
علاوة على ذلك، يوفر استخدام اختبار F التفاضلي (Incremental F-test) أداة استدلالية قطعية لاختبار ما إذا كان الإسهام التفسيري الإضافي لحزمة المتغيرات الجديدة دالاً إحصائياً أم أنه مجرد تباين تصادفي عشوائي. ويحمي هذا النهج الصارم الباحث من الوقوع في منزلق التوفيق الزائد للبيانات (Overfitting)، والذي يفقد النموذج قدرته على التعميم خارج العينة المدروسة، ويضمن التوازن الأمثل بين المبدأ الفلسفي للبساطة المنهجية (Parsimony) والدقة الرياضية في النمذجة الإحصائية (Cheah & Ho, 2019).
7. فحص واختبار الفروض الإحصائية الكلاسيكية للنموذج
7.1 فحص خطية العلاقة واعتدالية توزيع البواقي
تفترض مبرهنة غاوس-ماركوف الكلاسيكية أن العلاقة الرياضية بين المتغيرات التفسيرية والمتغير التابع هي علاقة خطية في المعلمات، وأن الأخطاء العشوائية للبواقي تتبع توزيعاً طبيعياً معتدلاً بمتوسط حسابي قدره صفر وتباين ثابت. ويؤدي الإخلال بفرضية اعتدالية البواقي إلى بطلان اختبارات الدلالة الإحصائية (t-test وF-test) وعدم دقة فترات الثقة الناتجة، لا سيما في الدراسات التي تعتمد على عينات بيانية صغيرة الحجم (Manolov & Onghena, 2017).
ويتم التحقق المنهجي من اعتدالية توزيع البواقي داخل بيئة SAS عبر دراسة المخططات البيانية للاعتدالية (Normal Quantile-Quantile Plots – Q-Q Plots)، حيث يُستدل على الاعتدالية من خلال اصطفاف نقاط البواقي المحسوبة بصورة متراصة على امتداد الخط القطري المرجعي. كما يُستعان بإجراء PROC UNIVARIATE بالتكامل مع مخرجات الانحدار لحساب المؤشرات الكمية الصارمة كمعاملي الالتواء والتفرطح واختبار شابيرو-ويلك (Shapiro-Wilk) للاعتدالية، مما يعزز الموثوقية التقديرية لبواقي النموذج قبل الشروع في بناء الأحكام العلمية.
7.2 الكشف عن تجانس تباين الأخطاء (Homoscedasticity)
يقتضي فرض تجانس التباين (Homoscedasticity) أن يكون تباين الأخطاء العشوائية ثابتاً عبر جميع مستويات ومجالات القيم التنبؤية للمتغيرات المستقلة. ويُطلق على نقيض هذه الحالة اصطلاح “عدم تجانس التباين” (Heteroscedasticity)، وهي معضلة شائعة في البيانات الميدانية يترتب عليها فقدان مقدرات المربعات الصغرى لخاصية الكفاءة، وتقديم أخطاء معيارية مشوهة تقود في أغلب الأحيان إلى رفض غير مبرر للفرضيات الصفرية الصائبة ووقوع الباحث في الخطأ الإحصائي من النوع الأول.
يتيح إجراء PROC REG الكشف التشخيصي الدقيق عن هذه الظاهرة عبر إضافة الخيار SPEC ضمن عبارة MODEL، والذي يولد اختبار وايت (White’s Test) الصارم لفحص تجانس التباين دون اشتراط مسبق للاعتدالية. ويتكامل هذا الفحص العددي مع التحليل البصري لمخطط البواقي في مواجهة القيم التنبؤية (Residual vs. Predicted Plot)؛ فإذا انتشرت النقاط في نمط عشوائي منتظم يشبه سحابة أفقية متجانسة العرض، تأكد تحقق الفرض الإحصائي، أما إذا اتخذت النقاط هيئة قمعية تتسع أو تضيق مع تزايد القيم التنبؤية، فإن ذلك يشخص اختلال التجانس، مما يستوجب معالجته إما بالتحويلات التثبيطية كاللوغاريتمات أو بتوظيف أسلوب الانحدار الموزون (Weighted Least Squares – WLS).
7.3 تشخيص مشكلة التعدد الخطي (Multicollinearity)
تنشأ معضلة التعدد الخطي (Multicollinearity) في نماذج الانحدار المتعدد عند وجود ارتباطات خطية وثيقة وقوية بين متغيرين مستقلين أو أكثر، مما يحد من قدرة الخوارزمية الرياضية على فصل الأثر المستقل لكل متغير على حدة. وتتمثل العواقب الوخيمة لهذه المعضلة في تضخم مفرط في الأخطاء المعيارية للمعلمات المقدرة، الأمر الذي يجعل قيم t صغيرة وغير دالة إحصائياً بالرغم من الارتفاع الكبير لقيمة R-Square والمعنوية العالية لاختبار F الكلي للنموذج، فضلاً عن احتمال انقلاب إشارات المعاملات لتخالف المنطق النظري الراسخ.
ولتشخيص هذه المشكلة بدقة، يوفر إجراء PROC REG خيارين تشخيصيين جوهريين يُلحقان بعبارة MODEL وهما: VIF (معامل تضخم التباين – Variance Inflation Factor) وTOL (مستوى التسامح – Tolerance). ويشير العرف الإحصائي القياسي إلى أن تجاوز قيمة VIF للحد 10 (أو انخفاض التسامح TOL عن 0.10) يمثل دليلاً قاطعاً على وجود تعدد خطي حرج يتطلب تدخلاً علاجياً حاسماً، إما باستبعاد المتغيرات الزائدة أو دمجها في مؤشرات قياسية مركبة عبر التحليل العاملي، لضمان استقرار مصفوفات التقدير وسلامة الاستدلال الإحصائي.
8. الخيارات المتقدمة والتشخيصات البيانية التلقائية (ODS Graphics)
8.1 تفعيل وإدارة مخرجات نظام الإخراج الإحصائي (ODS Graphics)
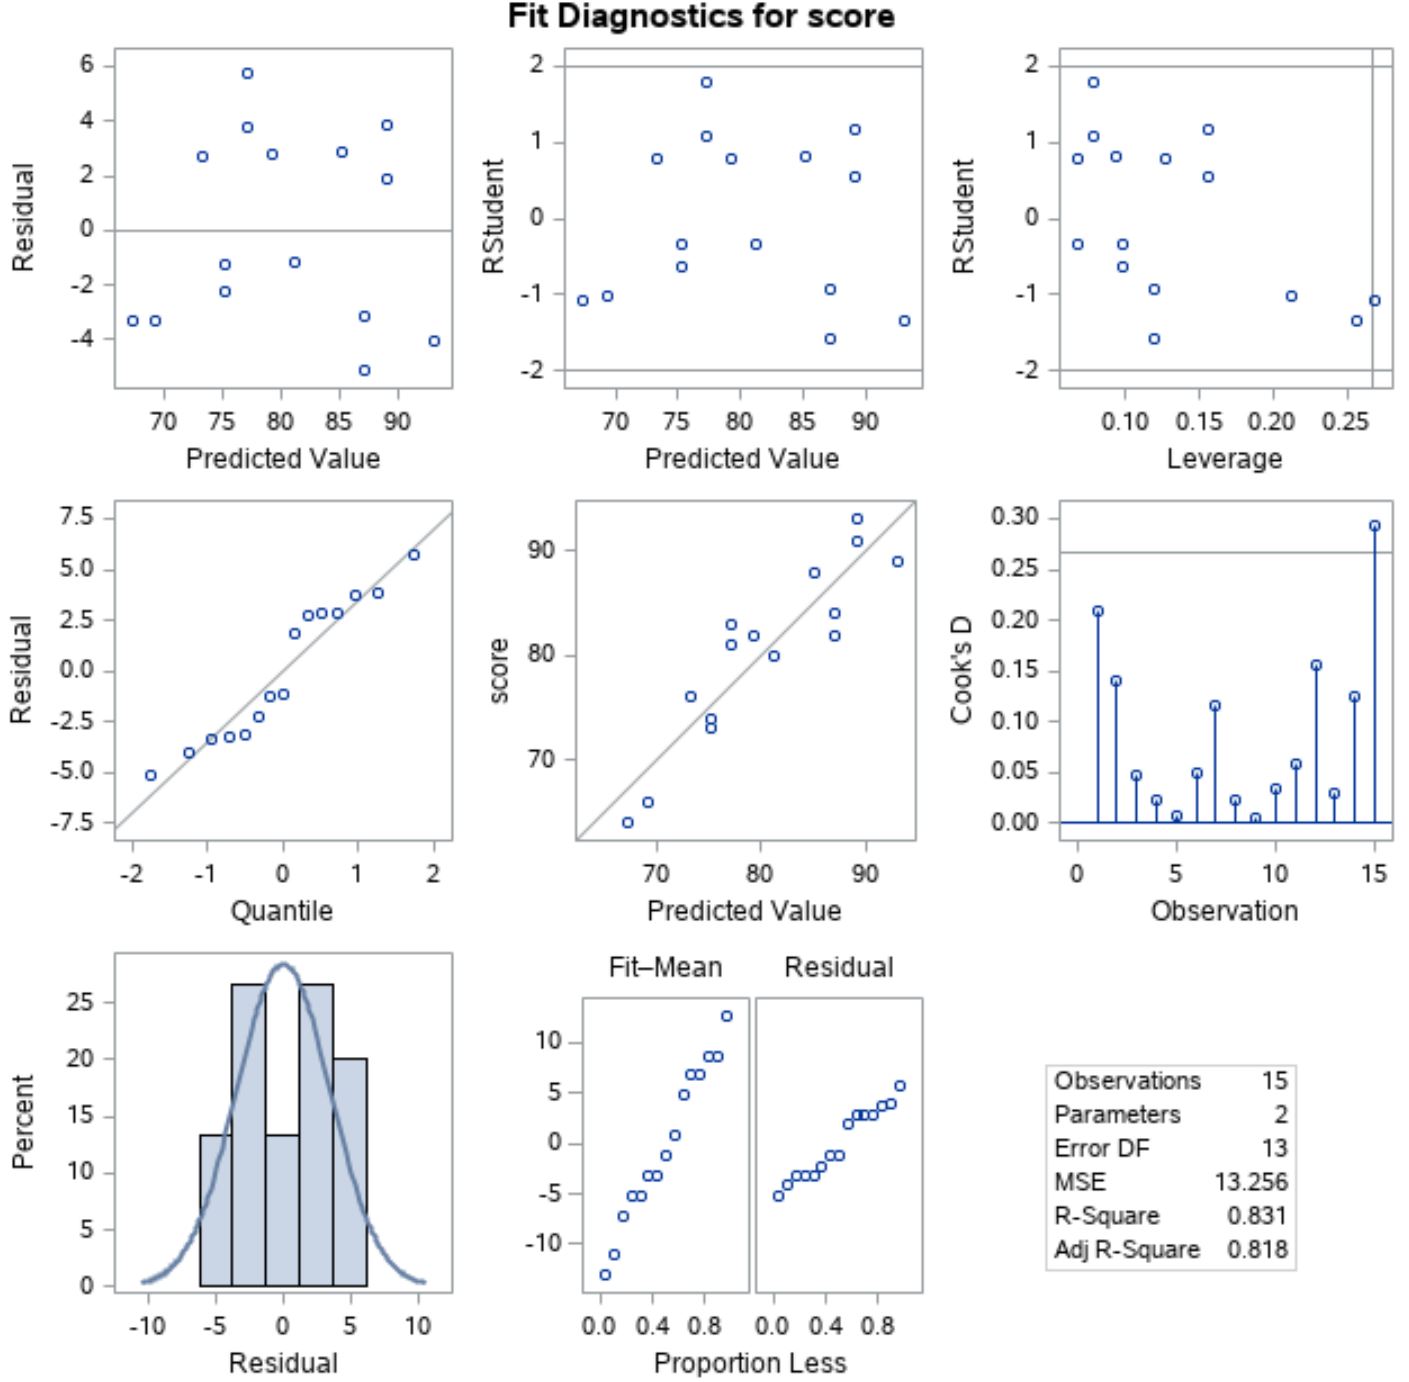
أحدث دمج نظام الإخراج الإحصائي البياني (ODS Graphics) في بيئة SAS نقلة نوعية في قدرات الفحص والتشخيص المصاحب لإجراء PROC REG؛ إذ لم يعد الباحث بحاجة إلى كتابة أكواد برمجية معقدة لإنتاج الرسوم البيانية الاستكشافية. ويتم تفعيل هذه المنظومة البصرية الفائقة بكل يسر عبر تضمين الأمر التشغيلي ods graphics on; قبل استدعاء إجراء الانحدار، مما يحفز محرك النظام لتوليد مصفوفة بصرية متكاملة وشاملة تتضمن لوحة تشخيص التوفيق الانحداري المدمجة (Fit Diagnostics Panel).
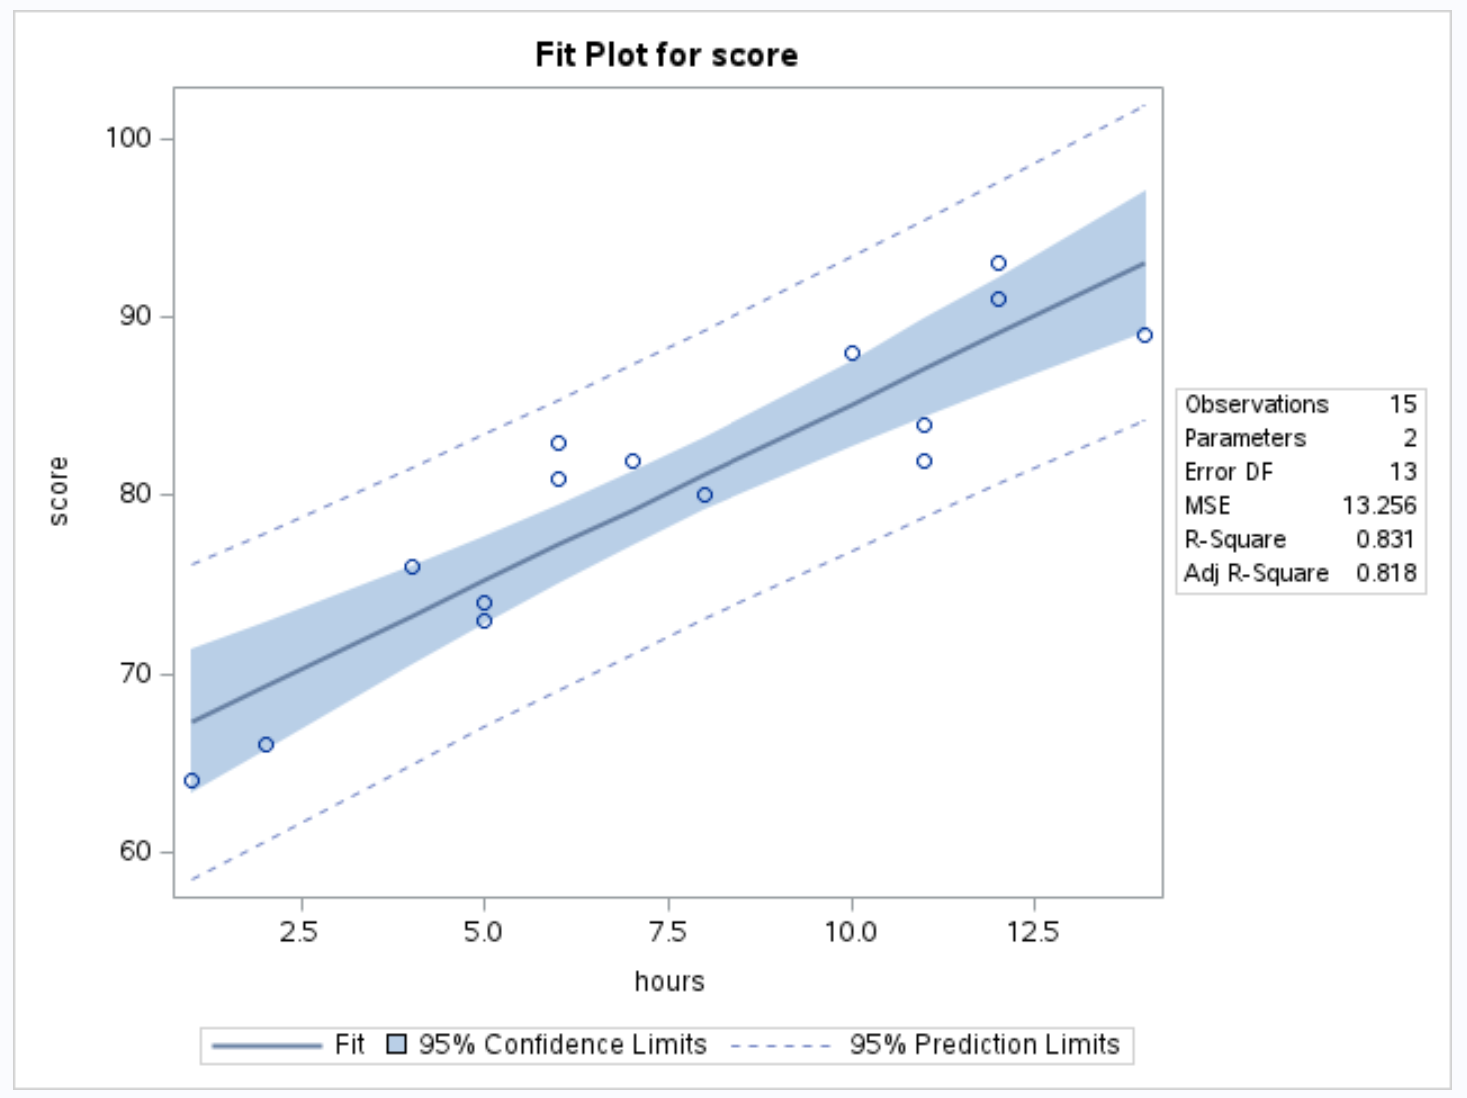
تحتوي هذه اللوحة التشخيصية القياسية على مجموعة متناسقة من الرسوم المصغرة التي تغطي في آن واحد: مخطط البواقي الطلابية، ومخطط مسافات كوك، والتوزيع التكراري للأخطاء مدمجاً به المنحنى الطبيعي، والخط التنبؤي المحاط بحدود الثقة بنسبة 95%. وتتيح هذه الأداة للمحلل تقييماً بصرياً فورياً وشاملاً لمدى توافق النموذج مع البيانات التجريبية؛ مع إمكانية إيقاف تشغيل الرسوم البيانية عبر الأمر ods graphics off; في حال معالجة مصفوفات البيانات المليونية الضخمة لترشيد استهلاك طاقة المعالجة وتسريع الأداء الحاسوبي.
8.2 تشخيص المشاهدات الشاذة والنقاط المؤثرة
قد تتعرض نتائج الانحدار الخطي للتشويه أو الانحياز الشديد بفعل وجود مشاهدة مفردة متطرفة تمتلك وزناً هندسياً غير متناسب في توجيه خط الانحدار، وتُعرف هذه الحالات في القياس الإحصائي بالنقاط المؤثرة (Influential Observations). ويوفر إجراء PROC REG منظومة ثنائية الأبعاد للكشف عن هذه الحالات تجمع بين قياس الشذوذ في فضاء المتغيرات التفسيرية وقياس الشذوذ في فضاء المتغير التابع، مما يتيح التمييز الدقيق بين المشاهدات الشاذة ظاهرياً وتلك التي تؤثر فعلياً على تقدير المعلمات وميل الانحدار.
ولتحقيق ذلك، يتيح الإجراء حساب مقياس الرافعة (Hat Diag / Leverage) لرصد القيم ذات البعد المتطرف في المتغيرات التفسيرية، بالتوازي مع حساب البواقي الطلابية المحذوفة (Studentized Deleted Residuals) لرصد الانحرافات الاستثنائية في المتغير التابع. وتتوج هذه المنظومة بحساب مقياس مسافة كوك (Cook’s Distance – Cook’s D)، والذي يختزل مقدار التغير الشامل الذي يطرأ على كافة معلمات النموذج التنبؤية في حال حذف مشاهدة معينة؛ حيث يُنظر إلى أي قيمة لمسافة كوك تقترب من الواحد الصحيح أو تتجاوزه بوصفها نقطة مؤثرة تأثيراً بالغاً يستوجب الدراسة المنهجية المعمقة والتعليل الأكاديمي الحذر قبل تقرير استبقائها أو استبعادها من التحليل النهائي (Cornelissen et al., 2017).
8.3 تصدير القيم التنبؤية والبواقي عبر عبارة OUTPUT
لا تتوقف غايات التحليل الإحصائي عند مجرد معاينة النتائج على الشاشة، بل تمتد لتتطلب في كثير من الأحيان استثمار التقديرات التنبؤية والبواقي المشتقة في تحليلات إحصائية وبنائية لاحقة. وهنا تبرز عبارة OUTPUT داخل إجراء PROC REG كأداة تصديرية بالغة القوة والمرونة؛ إذ تتيح بناء وتوليد ملف بيانات SAS جديد ومستقل يدمج البيانات الأصلية للمشاهدات مع حزمة المتغيرات الحسابية الجديدة الناتجة عن عملية النمذجة.
تتضح الصيغة البرمجية الاحترافية لعبارة OUTPUT في الكود الآتي:
proc reg data=study_data;
model score = hours;
output out=regression_results
predicted=predicted_score
residual=residual_error
rstudent=studentized_res
cookd=cooks_distance
lcl=lower_pred_individual
ucl=upper_pred_individual;
run;
quit;
يولد هذا الأمر ملفاً إحصائياً ثرياً يحمل اسم regression_results يضم القيم التنبؤية لكل طالب، والبواقي الخام المعبرة عن الفارق بين الدرجة الحقيقية والمتوقعة، ومسافات كوك، بالإضافة إلى حدود فترات الثقة التنبؤية للتنبؤ الفردي والمتوسط بنسبة ثقة 95%؛ مما يمهد الطريق لإجراء فحوصات تكميلية متقدمة وتوثيق مخرجات البحث بدرجة فائقة من الشفافية والدقة القياسية.
9. استراتيجيات اختيار النماذج وبناء المعادلات التنبؤية المثلى
9.1 أساليب الاختيار الآلي للمتغيرات (Selection Methods)
في الدراسات الاستكشافية التي تتضمن مصفوفات واسعة من المتغيرات التفسيرية المرشحة، يواجه الباحث تحدياً حقيقياً في انتقاء الحزمة الأكثر كفاءة وأصالة لتضمينها في النموذج النهائي. ويتيح إجراء PROC REG أتمتة هذه العملية الرياضية عبر تزويد عبارة MODEL بخيار الاختيار التلقائي selection=؛ ومن أبرز هذه الطرق الانحدار التدريجي المزدوج (Stepwise Selection)، والذي يجمع بين فحص الإدخال التدريجي للأمام واستبعاد المتغيرات التي تفقد دلالتها لاحقاً، مع ضبط عتبات الدخول والخروج الصارمة عبر معايير القيمة الاحتمالية SLENTRY وSLSTAY.
كما يدعم الإجراء طريقتي الحذف التراجعي (Backward Elimination)، والتي تنطلق من النموذج الكامل وتستبعد المتغير الأقل إسهاماً خطوة بخطوة، والإدخال الأمامي (Forward Selection) الذي يضيف المفسرات تباعاً. وعلى الرغم من المزايا التشغيلية السريعة لهذه الخوارزميات الآلية، فإن الأدبيات الإحصائية المعاصرة توجه لها انتقادات منهجية ترتبط بتشويش مستويات الدلالة الاسمية والميل نحو تفصيل النموذج على مقاس العينة العشوائية، مما يفرض ضرورة الاسترشاد بالنظريات العلمية الحاكمة للمجال المدروس وعدم الركون الأعمى للأتمتة الإحصائية (Joensen et al., 2022).
9.2 معايير المفاضلة بين النماذج المتنافسة
تتجاوز المقارنة العلمية الرصينة بين النماذج الانحدارية المتنافسة مجرد الاعتماد على معامل التحديد البسيط؛ حيث طور علماء القياس حزمة من المعايير المعلوماتية والترجيحية متعددة الأبعاد لتحقيق المفاضلة الرشيدة. ويأتي في طليعة هذه المعايير معيار أكايكي للمعلومات (Akaike Information Criterion – AIC) ومعيار شوارتز البيزي (Schwarz Bayesian Criterion – SBC / BIC)، حيث يعتمد كلا المعيارين على مفهوم تعظيم دالة الإمكان مع فرض جزاء حسابي صارم يتناسب طردياً مع عدد المعلمات المقدرة؛ ويُعد النموذج الذي يسجل أدنى قيمة رقمية لمعياري AIC وSBC هو النموذج الأفضل توازناً وكفاءة.
إضافة إلى ذلك، يوفر PROC REG إمكانية تقييم معيار موازنة الخطأ لميلوز (Mallows’ C_p Statistic)، والذي يقارن الخطأ التربيعي الكلي للنموذج المصغر بالنموذج الكامل؛ وتتمثل القاعدة الذهبية في البحث عن النماذج التي تقترب فيها قيمة C_p من عدد المعلمات المقدرة في النموذج (p) لتفادي الانحياز والتباين المفرط. ويتكامل ذلك مع تقييم مجموع مربعات أخطاء التنبؤ التبادلي (PRESS Statistic)، حيث يشير انخفاض قيمة PRESS إلى قدرة تنبؤية متفوقة للنموذج عند تطبيقه على مشاهدات جديدة لم تدخل في مرحلة التدريب، مما يعزز الثقة في صلاحيته للتطبيق العملي والتعميم المعرفي.
9.3 التحقق المتقاطع واستقرار النموذج المختار
يُمثل التحقق المتقاطع (Cross-Validation) المعيار الحاسم للتحقق من استقرار المعادلة التنبؤية ومقاومتها للانحياز الداخلي المشترك؛ إذ يهدف إلى التأكد من أن النموذج لا يعكس فقط الخصائص العشوائية الفريدة للعينة الميدانية المختارة بل يمتلك قدرة راسخة على التكرارية والمطابقة في عينات مستقلة مأخوذة من ذات المجتمع الإحصائي. ويتحقق ذلك منهجياً إما بتقسيم البيانات إلى عينة تدريب (Training Set) وعينة اختبار (Testing Set)، أو عبر خوارزميات الاستبعاد المتتالي الفردي التي تحاكيها إحصائية PRESS في مخرجات SAS.
وتقتضي أفضل الممارسات المنهجية مراقبة مقدار التباين التنبؤي بين بيانات البناء وبيانات التحقق؛ فإذا لوحظ هبوط دراماتيكي في قيمة R-Square أو قفزة واسعة في متوسط مربعات الخطأ عند التطبيق على العينة المستقلة، دل ذلك بوضوح على عدم استقرار المعلمات وتضخم التوفيق المصطنع. ولا يجوز اعتماد النموذج النهائي لأغراض التنبؤ في المجالات التربوية والعلوم السلوكية إلا بعد إثبات متانة معاملاته وتجانس أدائه التنبؤي عبر استراتيجيات التحقق المستقل (McCallum & Piper, 1990).
10. الأخطاء الشائعة وأفضل الممارسات الأكاديمية عند استخدام PROC REG
10.1 الأخطاء البرمجية والتشغيلية المتكررة وكيفية معالجتها
يقع العديد من الباحثين ومحللي البيانات المبتدئين في جملة من الأخطاء البرمجية والتشغيلية الشائعة عند التعامل مع إجراء PROC REG. ويأتي في مقدمة هذه الأخطاء محاولة إدراج متغيرات نصية فئوية (Character Variables)، مثل متغير النوع أو المستوى التعليمي، مباشرة داخل عبارة MODEL دون إجراء تحويل وترميز مسبق لها إلى متغيرات وهمية ثنائية التكويد (0 أو 1)؛ وهو ما يؤدي إلى توقف تنفيذ الإجراء فوراً وظهور رسالة خطأ صريحة في سجل المعالجة تشير إلى عدم قبول المتغيرات غير الرقمية.
ومن الأخطاء التشغيلية المؤثرة أيضاً نسيان إنهاء الإجراء بعبارة QUIT، مما يترك بيئة PROC REG مفتوحة تفاعلياً في الذاكرة ويتسبب في تراكم استدعاءات النماذج والتشويش على العمليات البرمجية اللاحقة. يضاف إلى ذلك خطأ الخلط بين مواضع المتغيرات داخل عبارة MODEL بوضع المستقل موضع التابع، وهو ما يقلب المنطق الرياضي للعلاقة التقديرية بالكامل، فضلاً عن إغفال المعالجة المنهجية للقيم المفقودة؛ حيث يعتمد الإجراء الحذف التلقائي لكامل السطر بمجرد فقدان قيمة واحدة في أي متغير داخل النموذج، مما قد يقلص حجم العينة بنسب خطيرة تؤثر على قوة الاختبار دون أن ينتبه المحلل لذلك.
10.2 أفضل الممارسات لتوثيق نتائج PROC REG وفق دليل APA
يتطلب توثيق مخرجات الانحدار الخطي في الأبحاث المنشورة الامتثال الدقيق للإرشادات التحريرية المعتمدة في دليل الجمعية الأمريكية لعلم النفس (APA الإصدار السابع). وتقضي هذه المعايير بتجنب النسخ الحرفي للجداول الإحصائية المعقدة والمكتظة بالأرقام الناتجة عن شاشات SAS، والاستعاضة عنها بجداول قياسية منسقة بعناية تركز حصراً على الإحصاءات الجوهرية للقرار العلمي؛ وتشمل هذه المؤشرات: معاملات الانحدار غير المعيارية (B) متبوعة بأخطائها المعيارية (SE)، والمعاملات المعيارية (β)، وقيم t المحسوبة والدلالة الإحصائية المقابلة (p)، إضافة إلى فترات الثقة بنسبة 95% لكل معلمة.
وفيما يخص الصياغة النصية داخل متن البحث، يجب كتابة التقرير التلخيصي للنموذج ككتلة لغوية متماسكة ودقيقة، تتضمن ذكر قيمة F ودرجات الحرية المصاحبة لها، ومستوى الدلالة، وقيمة معامل التحديد، كأن يُكتب بالصيغة التعبيرية القياسية: “أظهرت نتائج الانحدار الخطي البسيط قدرة تنبؤية دالة إحصائياً لعدد ساعات الدراسة على درجات الاختبار، حيث بلغت قيمة F(1, 13) = 1894.35 بمستوى دلالة p < .001، وبلغ معامل التحديد R² = .993، مما يشير إلى أن ساعات الدراسة تفسر ما نسبته 99.3% من تباين درجات الطلاب”، مع الإشارة الصريحة في نص المنهجية إلى اكتمال التحقق من الفروض الإحصائية للبواقي وخلو النموذج من التعدد الخطي أو المشاهدات الشاذة المؤثرة.
10.3 اعتبارات حجم العينة وقوة الاختبار الإحصائي
ترتبط مصداقية التقديرات المستخلصة عبر إجراء PROC REG ارتباطاً وثيقاً بمدى كفاية حجم العينة المستخدمة مقارنة بعدد المتغيرات التفسيرية المدرجة في النموذج (N:k ratio). وتوصي الأدبيات القياسية الكلاسيكية بضرورة ألا يقل عدد المشاهدات عن 15 إلى 20 مشاهدة لكل متغير مستقل لضمان استقرار مصفوفات التباين والتباين المشترك، وتفادي الوقوع في التقديرات المشوهة للأخطاء المعيارية ومستويات الدلالة الجزئية للمعلمات المقدرة.
وعلى الرغم من أن المثال التطبيقي المعتمد في هذا الدليل قد اقتصر على عينة رمزية قوامها 15 طالباً لأغراض الشرح والتبسيط التوضيحي، إلا أنه يتعين على الباحث الأكاديمي الحذر الشديد عند التعامل مع العينات الصغيرة في البحوث الميدانية الحقيقية؛ حيث يؤدي صغر حجم العينة إلى انخفاض ملحوظ في القوة الإحصائية للاختبار (Statistical Power)، مما يقلل من احتمالية رصد التأثيرات والعلاقات الحقيقية الموجودة في المجتمع الأصلي (الخطأ من النوع الثاني). ويُعد إجراء تحليل القوة الإحصائية القبلية (A priori Power Analysis) لتحديد الحجم الأدنى للعينة، بالتوازي مع الإفصاح المنهجي النزيه عن محددات العينة في تقرير البحث، شرطاً لازماً لضمان موثوقية الاستنتاجات العلمية وإمكانية تكرارها واستدامتها في البيئات التطبيقية المختلفة (Keller & Just, 2009).
خاتمة
يمثل إجراء الانحدار الخطي PROC REG في بيئة SAS أداة تحليلية فائقة القوة تجمع بين البساطة المنهجية للمربعات الصغرى العادية والعمق التشخيصي المتقدم المطلوب في الأبحاث الأكاديمية الرصينة. ومن خلال استعراض الأسس النظرية والصياغة البرمجية الدقيقة وقراءة المخرجات القياسية خطوة بخطوة، يتضح أن الاستثمار الأمثل لهذا الإجراء يقتضي من الباحث إحاطة متكاملة تبدأ من مرحلة فحص المدخلات وتدقيق سجل المعالجة، مروراً باختبار الفروض التأسيسية كالتعدد الخطي وتجانس التباين واعتدالية الأخطاء، وصولاً إلى الترجيح المحكم بين النماذج المتنافسة باستخدام المعايير المعلوماتية المتطورة.
إن التحول من مجرد تشغيل الأكواد إلى ممارسة النمذجة التفسيرية الرشيدة يفرض التزاماً صارماً بأفضل الممارسات الإحصائية وأدلة التوثيق العلمية، مع الموازنة الدائمة بين كفاءة النموذج وقدرته على التعميم الميداني الصادق. ونأمل أن يشكل هذا الدليل المرجعي الموسع أساساً علمياً متيناً يسهم في الارتقاء بجودة التحليلات الإحصائية ويدعم الباحثين في استنطاق بياناتهم واستخلاص الدلالات الكامنة فيها بأعلى درجات الدقة والموثوقية المنهجية.
المراجع
- Brose, A., Schmiedek, F., Koval, P., & Kuppens, P. (2014). Emotional inertia contributes to depressive symptoms beyond perseverative thinking. Cognition & Emotion. https://doi.org/10.1080/02699931.2014.916252
- Cheah, S. L.-Y., & Ho, Y.-P. (2019). Coworking and Sustainable Business Model Innovation in Young Firms. Sustainability. https://doi.org/10.3390/su11102959
- Cornelissen, K. K., McCarty, K., Cornelissen, P. L., & Tovée, M. J. (2017). Body size estimation in women with anorexia nervosa and healthy controls using 3D avatars. Scientific Reports. https://doi.org/10.1038/s41598-017-15339-z
- Joensen, A., Danielsen, S., Andersen, P. K., Groot, J., & Strandberg‐Larsen, K. (2022). The impact of the initial and second national COVID-19 lockdowns on mental health in young people with and without pre-existing depressive symptoms. Journal of Psychiatric Research. https://doi.org/10.1016/j.jpsychires.2022.03.001
- Keller, T. A., & Just, M. A. (2009). Altering Cortical Connectivity: Remediation-Induced Changes in the White Matter of Poor Readers. Neuron. https://doi.org/10.1016/j.neuron.2009.10.018
- Lackmann, S., Léger, P.-M., Charland, P., Aubé, C., & Talbot, J. (2021). The Influence of Video Format on Engagement and Performance in Online Learning. Brain Sciences. https://doi.org/10.3390/brainsci11020128
- Manolov, R., & Onghena, P. (2017). Analyzing data from single-case alternating treatments designs. Psychological Methods. https://doi.org/10.1037/met0000133
- McCallum, M., & Piper, W. E. (1990). A Controlled Study of Effectiveness and Patient Suitability for Short-Term Group Psychotherapy. International Journal of Group Psychotherapy. https://doi.org/10.1080/00207284.1990.11490621
- Phillips, S. P., Auais, M. A., Bélanger, E., Alvarado, B., & Zunzunegui, M. V. (2016). Life-course social and economic circumstances, gender, and resilience in older adults: The longitudinal International Mobility in Aging Study (IMIAS). SSM – Population Health. https://doi.org/10.1016/j.ssmph.2016.09.007