
تُعد معالجة السلاسل النصية وتطهير البيانات الحرفية غير المهيكلة من التحديات المنهجية والحسابية الجوهرية في تحليل البيانات المتقدم، لاسيما في البيئات البحثية والسريرية والمسوح الميدانية التي تعتمد على حزم برمجية متخصصة مثل نظام التحليل الإحصائي SAS (Statistical Analysis System). تاريخياً، واجه المحللون قيوداً تقنية عند استخدام الدوال النصية التقليدية لمطابقة النصوص غير المتجانسة، مما خلق حاجة ماسة لتبني آليات حوسبية قادرة على إدراك الأنماط النصية المعقدة والاستبدال الحتمي المستند إلى قواعد محددة سلفاً. ومن هنا، تمثل التعبيرات النمطية المتوافقة مع لغة بيرل (Perl Compatible Regular Expressions – PCRE) نقلة نوعية في قدرات نظام SAS التحليلية، حيث أتاحت للمحللين إمكانية التعامل مع التباينات الأسلوبية، والأخطاء الطباعية، والرموز المشوشة بكفاءة برمجية استثنائية.
تتبوأ دالة PRXCHANGE مكانة مركزية داخل منظومة دوال التعبيرات النمطية في SAS (المعروفة بمجموعة دوال PRX)، إذ تشكل الأداة الحسابية الرئيسية المخصصة لعمليات البحث والإحلال والاستبدال النصي المنهجي. لا تقتصر وظيفة هذه الدالة على مجرد استبدال حرف بآخر أو كلمة بأخرى، بل تمتد لتشمل إعادة تشكيل السلاسل النصية، واستخلاص المتغيرات الفرعية عبر مجموعات الالتقاط، وتوحيد صياغة السجلات الوصفية والطبية، وإخفاء الهويات المعرفة لضمان حماية خصوصية المشاركين في الأبحاث العلمية. ومع انتقال مجتمع التحليل الإحصائي نحو معالجة مجموعات البيانات الضخمة (Big Data)، أصبح الإلمام بآليات ضبط أداء هذه الدالة، وتفادي هدر الموارد الحسابية أثناء ترجمة الأنماط، معياراً أساسياً لتقييم كفاءة مهندسي ومحللي البيانات الأكاديمية والتطبيقية.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تشريح علمي وتطبيقي شامل لدالة PRXCHANGE في بيئة نظام SAS. سنتناول في هذا المقال الجذور النظرية لتكامل محرك التعبيرات النمطية داخل لغة SAS، ونستعرض بالتفصيل البنية النحوية والمعاملات التشغيلية التي تحكم عمل الدالة. علاوة على ذلك، سنقدم تطبيقات عملية متدرجة تبدأ من الاستبدال النمطي البسيط، مروراً بالتحكم في تكرار المطابقة واستخدام المراجع الخلفية المتقدمة، ووصولاً إلى استراتيجيات تحسين الأداء الحسابي ودمج الدالة مع دالة التجميع المسبق PRXPARSE لمعالجة الملايين من المشاهدات البرمجية دون استنزاف ذاكرة التشغيل، وصولاً إلى استعراض أفضل الممارسات الأخلاقية والمنهجية لتطهير البيانات الحساسة.
1. مقدمة إلى دالة PRXCHANGE ودور التعبيرات النمطية في SAS
1.1 مفهوم التعبيرات النمطية بنظام Perl في بيئة SAS
تعود الجذور المعرفية لنظرية التعبيرات النمطية إلى أعمال عالم الرياضيات الأمريكي ستيفن كول كليني (Stephen Cole Kleene) في خمسينيات القرن العشرين، وتحديداً عبر أبحاثه الرائدة حول المجموعات المنتظمة والأوتوماتا المحدودة المنشورة لدى مؤسسة راند (RAND Corporation) عام 1951 ومؤلفه المنهجي لعام 1956، حيث صاغ الأسس الرياضية المجردة لتوصيف لغات الأنماط الرمزية. ومع بزوغ فجر البرمجة الحديثة وتطور لغات المعالجة النصية، قام لاري وول (Larry Wall) عام 1987 بابتكار لغة بيرل (Perl)، والتي أرست معايير صناعية متقدمة لبناء التعابير النمطية مدعومة بميزات التراجع الخلفي (Backtracking)، والمطابقة الكسولة، والمحددات المعقدة. لاحقاً، وفي عام 1997، قام فيليب هيزل (Philip Hazel) في جامعة كامبريدج بتطوير مكتبة التعبيرات النمطية المتوافقة مع بيرل (PCRE) بلغة C، وهي النواة البرمجية التي تبنتها كبرى المنصات التقنية حول العالم.
في عام 2002، ومع إطلاق الإصدار التاسع من نظام التحليل الإحصائي (SAS Version 9.0)، قامت شركة SAS Institute Inc. بدمج محرك PCRE أصلياً داخل بيئة خطوة البيانات (DATA Step)، مما مثل تحولاً نوعياً في بنية المعالجة النصية للنظام. تميز هذا التكامل بتقديم عائلة متكاملة من الدوال المتخصصة التي تبدأ بالبادئة PRX (وهي اختصار لعبارة Perl Regular Expression)، وتشمل دوال البحث والتحقق مثل PRXMATCH، ودوال الاستخراج والتقطيع مثل PRXPOSN وPRXSUBSTR، ودوال التحليل والتجميع المسبق مثل PRXPARSE، إلى جانب دالة التحويل والإحلال المركزية PRXCHANGE. يمنح هذا التكامل لمحللي البيانات والباحثين الأكاديميين قدرة استثنائية على اختراق الهياكل النصية المعقدة وغير المنضبطة، وتحويل البيانات الحرفية الخام إلى أشكال مقننة تدعم النمذجة الرياضية والإحصائية المتقدمة دون الحاجة إلى اللجوء لأدوات خارجية أو برامج وسيطة.
تتجلى الأهمية الأكاديمية لهذا المحرك داخل بيئة SAS عند التعامل مع الدراسات البيولوجية الطبية، وسجلات الرعاية الصحية، والمسوح الاجتماعية والنفسية واسعة النطاق؛ إذ نادراً ما تأتي البيانات النصية المتجمعة من الممارسات السريرية أو المقابلات المفتوحة في صيغة نقية موحدة. تتيح نواة PCRE داخل SAS فحص السلاسل الحرفية بمستوى دقة خوارزمي متناهٍ، حيث يمكن للتعبير النمطي الواحد مطابقة المئات من التباينات الإملائية والنحوية والمقاطع المبعثرة، وهو ما يقضي على مشكلات فقدان المشاهدات الحسابية الناجمة عن تباين أساليب إدخال البيانات، ويضع لبنة متينة لضمان دقة ونقاء العينات التحليلية قبل إخضاعها للاختبارات الفرضية.
1.2 أهمية دالة PRXCHANGE في معالجة وتطهير السلاسل النصية
تمثل دالة PRXCHANGE إحدى الركائز الحسابية الأكثر ديناميكية في ترسانة تطهير البيانات النصية (Text Cleansing) داخل بيئة SAS، حيث تؤدي دوراً محورياً في أتمتة عمليات الإحلال النصي متعدد الأبعاد. في سياق تنظيف البيانات الوصفية، تواجه المشروعات البحثية صعوبات جمة تتعلق بتوحيد المصطلحات وتصفية الضوضاء النصية الناجمة عن أخطاء لوحة المفاتيح، والمسافات البينية المزدوجة، وعلامات الترقيم المقحمة بصورة غير نظامية. تقدم الدالة في هذا الإطار حلاً حتمياً (Deterministic Algorithmic Solution) يتجاوز الاستبدال الثابت المحدود إلى الاستبدال المشروط بقواعد الصياغة، مما يجعل من الممكن تحويل مدخلات عشوائية متباينة إلى مصطلحات معيارية قابلة للترميز الإحصائي والتحليل الكمي اللاحق.
تكتسب الدالة أهمية استثنائية في معالجة المسوح الاستقصائية والاستبانات المفتوحة التي تسجل ردود المشاركين بلغة طبيعية حرة؛ إذ يتيح الاستبدال النمطي تصحيح الأخطاء الشائعة وحذف الأحرف الخاصة غير القابلة للطباعة (Non-printable characters) التي قد تتسبب في انهيار عمليات استيراد وتصدير قواعد البيانات العلائقية. بدلاً من كتابة العشرات من الشروط المنطقية المعقدة باستخدام عبارات IF-THEN-ELSE المتداخلة، توفر PRXCHANGE صياغة مقتضبة ومركزة تتيح للمبرمج اختزال عشرات الأسطر البرمجية في تعليمة خوارزمية واحدة، مما يقلل بشكل ملموس من احتمالات الخطأ البرمجي البشري، ويسهل توثيق خطوات تنقية البيانات في تقارير المنهجية البحثية.
علاوة على ذلك، تلعب الدالة دوراً حاسماً في إدارة البيانات الإدارية وسجلات المرضى، حيث تتطلب المعايير المؤسسية تطهير النصوص الحرة من المعرفات الفريدة، وتصحيح التنسيقات التاريخية والتشخيصية المتضاربة. إن قدرة الدالة على التعامل مع نصوص متباينة الأطوال ودمج قواعد الاستبدال الجزئي والشامل تجعل منها الأداة المفضلة لمختبرات القياس النفسي والتحليل الاجتماعي المقارن، حيث تصبح كفاءة تحويل المتغيرات الوصفية إلى متغيرات فئوية منظمة عاملاً حاسماً في تعزيز الموثوقية وقابلية إعادة الإنتاج في المشروعات العلمية الكبرى.
1.3 مقارنة معيارية بين PRXCHANGE والدوال النصية التقليدية
عند تقييم القدرات الحسابية لمعالجة النصوص في نظام SAS، تتضح الفروق الجوهرية بين دالة PRXCHANGE والدوال التقليدية الموروثة من الإصدارات الأولى للنظام، مثل دالة TRANWRD ودالة TRANSLATE. تؤدي دالة TRANSLATE دوراً حرفياً ثابتاً يقتصر على استبدال رمز محدد بآخر بناءً على مواقعهما في قائمة المحارف، مما يجعلها عاجزة تماماً عن معالجة الكلمات الكاملة أو التعرف على السياقات التركيبية. ومن جهة أخرى، تقدم دالة TRANWRD إمكانية استبدال سلسلة نصية محددة بسلسلة أخرى، إلا أنها تعاني من قيد صارم يتمثل في اعتمادها المطلق على التطابق الحرفي الثابت (Literal Exact Matching)؛ فهي لا تمتلك أدنى مرونة لمطابقة أشكال الكلمة المتنوعة أو التباينات الرقمية ما لم يتم حصر كافة الاحتمالات يدوياً عبر استدعاءات برمجية متكررة ومتعددة.
تتفوق دالة PRXCHANGE بصورة حاسمة في تعاملها مع الأنماط الديناميكية غير المقيدة بسلسلة نصية محددة. فعلى سبيل المثال، إذا تطلب مشروع بحثي استبدال كافة التنسيقات المحتملة لأرقام الهواتف أو إخفاء أرقام الهويات الوطنية المتضمنة مسافات وفواصل وشرطات عشوائية، فإن استخدام TRANWRD يتطلب بناء حلقات تكرارية معقدة وعشرات الشروط المعلقة، في حين تستطيع دالة PRXCHANGE إنجاز المهمة عبر تعبير نمطي موجز يصف النمط المجرد للأرقام والفواصل. تتيح هذه المرونة التعامل مع الأنماط المتبدلة، وتجاهل حالات الأحرف، والبحث عن الكلمات الجزئية أو المستقلة، وهو ما تفتقر إليه الدوال الكلاسيكية جملة وتفصيلاً.
من زاوية الأداء الحسابي واستهلاك موارد الذاكرة العشوائية (RAM) ووحدة المعالجة المركزية (CPU)، تتميز الدوال الكلاسيكية مثل TRANWRD بخفة وزنها الحسابي نظراً لبساطة خوارزميات البحث الحرفي المدمجة بها، وتعتبر مناسبة لعمليات الاستبدال البسيطة في بيئات الحوسبة المحدودة. في المقابل، تفرض دالة PRXCHANGE عبئاً حسابياً أولياً يرجع إلى الحاجة إلى بناء مصفوفة الانتقال في محرك الأوتوماتا وترجمة التعبير النمطي؛ ومع ذلك، فإن هذا العبء يمكن تحييده كلياً من خلال تقنيات التجميع المسبق للأنماط. وعند قياس الأداء الشامل في معالجة السجلات المعقدة والضخمة التي تتضمن ملايين المشاهدات غير المتجانسة، تتفوق دالة PRXCHANGE بمراحل على الحلول الملتوية التي قد تتشكل من دمج دوال كلاسيكية متعددة، حيث تختصر زمن المعالجة وتقلل من دورات الإدخال والإخراج وتضمن اتساق المخرجات المنهجية.
2. البنية النحوية والمعاملات الأساسية لدالة PRXCHANGE
2.1 المعامل الأول: صياغة التعبير النمطي ونمط الاستبدال
ترتكز البنية النحوية لدالة PRXCHANGE على تمرير معاملات محددة بدقة رياضية لإدارة السلوك الخوارزمي للإحلال النصي. يأتي المعامل الأول في صيغته الأساسية كـ سلسلة نصية مجردة تعبر عن أمر استبدال متوافق مع معايير Perl، وتتخذ هذه الصيغة النمط القياسي التالي: 's/pattern/replacement/flags'. يشير الحرف الافتتاحي s إلى تعليمة الإحلال الحسابي (Substitution)، بينما يمثل المقطع الأول المحصور بين الفواصل النمط المراد البحث عنه (Pattern/Regex)، في حين يمثل المقطع الثاني النص أو النمط البديل (Replacement)، وتُخصص المساحة الأخيرة للأعلام التوجيهية (Flags/Modifiers) التي تعدل السلوك التشغيلي للمطابقة.
تستخدم الخطوط المائلة للأمام (Forward Slashes /) كمحددات افتراضية للفصل بين أركان التعبير النمطي؛ ومع ذلك، تتيح نواة PCRE مرونة برمجية عالية تسمح باستخدام محددات بديلة في حال كان النص المراد البحث عنه أو الاستبدال به يحتوي أصلاً على خطوط مائلة، كأن تكون نصوص مسارات تخزين الملفات أو روابط الويب (URLs). في مثل هذه الحالات، يمكن للمبرمج اعتماد رموز مثل علامة النسبة المئوية %، أو الخط العمودي |، أو علامة التعجب !، كأن تصاغ الدالة بالهيئة 's%pattern%replacement%flags' لتجنب الحاجة إلى تفادي الرموز يدوياً وتحسين وضوح الكود المصدري.
يتطلب هذا المعامل دقة بالغة في إدارة المحارف الخاصة التابعة لمحرك التعبيرات النمطية (Metacharacters)، مثل الأقواس، والنقاط، وعلامات النجمة والجمع. إذا كان الهدف هو البحث عن أحد هذه الرموز كرمز مجرد في النص المصدر وليس كأداة تحكم منطقية، فإنه يتحتم استخدام رمز الشرطة المائلة العكسية (Backslash ) قبل الرمز لتحييد وظيفته الخوارزمية وتوجيه المحرك للتعامل معه كنص حرفي خالص، وهو ما يضمن استقرار الكود وتطابق النتائج مع الفرضيات التحليلية بدقة متناهية.
2.2 المعامل الثاني: التحكم في عدد مرات الاستبدال
يتحكم المعامل الثاني لدالة PRXCHANGE في النطاق التكراري لعملية الاستبدال، وهو عبارة عن قيمة عددية صحيحة تملي على محرك البحث الحسابي عدد المرات التي يُسمح له فيها بتطبيق التعديل على السلسلة النصية المصدرية. يمنح هذا المعامل الباحث قدرة دقيقة على الموازنة بين الاستبدال الانتقائي المحدد والاستبدال الشامل، وفقاً للمتطلبات الإجرائية للمشروع البحثي ونوعية البيانات الخاضعة للمعالجة.
عند تعيين قيمة هذا المعامل إلى العدد الصحيح 1، يُلزم المحرك بالبحث في السلسلة النصية حتى العثور على أول تطابق يتوافق مع التعبير النمطي المدخل؛ وبمجرد إتمام استبدال هذا النمط بالنمط الجديد، يتوقف المحرك فوراً عن إجراء أي تعديلات إضافية ويتجاهل كافة التكرارات اللاحقة لنفس النمط داخل السجل الواحد. يُستخدم هذا النمط المقيد بكثرة عند التعامل مع البيانات المهيكلة التي تتضمن بادئات محددة (Prefixes) يراد تعديلها لمرة واحدة فقط في مقدمة السلسلة دون المساس بصلب النص أو لاحقاته.
في المقابل، يمثل استخدام القيمة السالبة -1 الآلية القياسية لتفعيل الاستبدال الشامل والمستمر (Global Replacement) حتى نهاية السلسلة الحرفية. عند تمرير القيمة -1، يقوم المحرك بمسح السجل بالكامل من البداية إلى النهاية، واستبدال كل تكرار يطابق المعايير المحددة دون استثناء. وفي بعض السيناريوهات الخاصة، يمكن للمبرمج تمرير قيم عددية موجبة أخرى (مثل 2 أو 3) لتقييد الاستبدال بعدد محدد مسبقاً من الحالات، وهو ما يوفر مرونة استثنائية في ضبط وتحويل السجلات المركبة التي تتطلب معالجة جزئية دقيقة دون المساس بالهياكل اللاحقة.
2.3 المعامل الثالث: المتغير المصدر وإدارة مخرجات السلسلة النصية
يمثل المعامل الثالث المتغير المصدر الخاضع للتدقيق، وهو السلسلة الحرفية المستهدفة التي يتم البحث بداخلها وإجراء عمليات الإحلال عليها. يمكن أن يكون هذا المعامل اسماً لمتغير حرفي (Character Variable) معرف مسبقاً في مجموعة البيانات، أو تعبيراً حرفياً ثابتاً يمرر بين علامتي تنصيص. داخل خطوة البيانات (DATA Step)، تقوم دالة PRXCHANGE بقراءة قيمة هذا المتغير لكل مشاهدة على حدة، وتوليد سلسلة نصية معدلة تمثل الناتج النهائي لعملية الاستبدال.
تعتبر إدارة طول المتغير الناتج (Variable Length) إحدى أدق المسائل المنهجية المرتبطة بهذا المعامل؛ إذ تتبع لغة SAS قواعد افتراضية قد تؤدي إلى تحديد طول المتغير الناتج بما لا يتجاوز 200 حرف ما لم يقم المبرمج بتعريف الطول صراحة. فإذا أدت عملية الاستبدال إلى زيادة طول السلسلة النصية الأصلية—كأن يتم استبدال اختصارات قصيرة بعبارات وصفية طويلة—وكان طول المتغير المستهدف غير كافٍ، فإن نظام SAS سيقوم باقتطاع النص بصورة صامتة (Silent Truncation)، مما يترتب عليه فقدان خطير للمعلومات الأكاديمية والسريرية الهامة. لذا، فإن أفضل الممارسات المنهجية تقتضي دائماً استخدام تعليمة LENGTH لتعريف حجم المتغير الجديد بسعة كافية قبل استدعاء دالة PRXCHANGE.
فيما يتعلق بالسلوك الرياضي للدالة عند مواجهة قيم فارغة أو مفقودة (Missing Values)، تتصرف PRXCHANGE بنمط متماسك حسابياً؛ فإذا كانت قيمة المتغير المصدر خالية كلياً، فإن الدالة تُرجع سلسلة فارغة دون أن تتسبب في توليد أخطاء برمجية فادحة تؤدي لتوقف تنفيذ الكود. ومع ذلك، يتم تسجيل ملاحظات في سجل التنفيذ (SAS Log) إذا كانت المعاملات غير متسقة، مما يتطلب من المحلل الانتباه الدائم لحالات المتغيرات المفقودة وتأمين تدفق التحويلات الحسابية بصورة منضبطة.
3. فهم صيغة الاستبدال Perl وأعلام التعديل المصاحبة
3.1 بنية أمر الاستبدال وعناصره التشغيلية
تنبثق بنية أمر الاستبدال في صيغة Perl من مفهوم المعالجة الثلاثية، حيث تتألف من عنصر التشغيل الأساسي، وعنصر التوصيف النمطي، وعنصر الصياغة البديلة. يمثل الحرف s، الذي يستهل التعبير دوماً، اختصاراً وظيفياً للمصطلح الحسابي Substitution. هذا الرمز ليس مجرد علامة شكلية، بل هو تعليمة حاسمة لمحرك PCRE المدمج في SAS تفيد بأن العملية المطلوبة تتجاوز التحقق المنطقي من صحة النمط أو تحديد موقعه، لتشمل إعادة كتابة الذاكرة المخصصة للسلسلة النصية عبر إحلال محتوى جديد مكان الجزء المطابق.
يتم الفصل بين مكونات الأمر التشغيلي بدقة بالغة؛ فالجزء المحصور بين المحدد الأول والمحدد الثاني يمثل “تعبير البحث” الذي يخضع لخوارزمية التحليل النمطي، حيث يقرأ المحرك الرموز المجردة والمحددات الكمية (Quantifiers) لبناء مسار المطابقة. أما الجزء المحصور بين المحدد الثاني والمحدد الثالث فيمثل “سلسلة الإحلال”، وهي النص الحرفي أو التوليفي الذي سيحل محل كل جزء يتم اقتطاعه بنجاح من النص الأصلي. إذا تُرك هذا الجزء خالياً تماماً (كأن يُكتب التعبير s/pattern//)، فإن الدالة تفهم ذلك على أنه أمر بحذف النمط المطابق كلياً من السلسلة المصدرية، وهي تقنية بالغة الأهمية لتطهير النصوص من الرموز الملوثة.
يتيح استخدام علامات الفصل المخصصة (Delimiters) تجنب ما يُعرف برمجياً بظاهرة “الميل المتكدس” (Leaning Toothpick Syndrome)، والتي تحدث عند محاولة معالجة مسارات نظام التشغيل أو عناوين الويب التي تحتوي على وفرة من الخطوط المائلة للأمام. فعلى سبيل المثال، للبحث عن المسار /usr/local/bin واستبداله بـ /opt/bin، يتطلب استخدام الفواصل التقليدية وضع شُرط عكسية لتفادي كل خط مائل، مما يجعل قراءة الكود وتدقيقه أمراً شاقاً. وباستخدام فواصل بديلة، يمكن كتابة التعبير بصيغة أنيقة مثل: 's!/usr/local/bin!/opt/bin!g'، مما يعزز المقروئية ويقلل فرص الخطأ البشري في إعداد الدراسات التحليلية.
3.2 دور علم تجاهل حالة الأحرف (i modifier)
يمثل علم تجاهل حالة الأحرف، والذي يُرمز له بالحرف اللاتيني الصغير i (Case-Insensitivity Modifier)، أحد أهم الأعلام المنهجية في تنظيف البيانات النصية باللغات التي تميز بين الحالات الحرفية كاللغة الإنجليزية. بطبيعته الافتراضية، يعمل محرك التعبيرات النمطية بحساسية صارمة لحالة الأحرف استناداً إلى ترميزات ASCII وUnicode؛ وعليه، فإن الحرف الصغير ‘a’ يمثل كياناً حسابياً منفصلاً تماماً عن الحرف الكبير ‘A’. في البحوث الميدانية، يؤدي هذا التمايز الصارم إلى إخفاقات واسعة في مطابقة المتغيرات إذا تم إدخال النص بصيغ متباينة بواسطة جامعي البيانات أو المشاركين.
عند تذييل أمر الاستبدال بالعلم i (مثل 's/hypertension/HTN/i')، يتم تعديل جدول المطابقة الحسابي داخل المحرك، بحيث يتم توحيد تقييم الأحرف الكبيرة والصغيرة دون تمييز. هذا التعديل يضمن أن نمط البحث سيطابق تلقائياً كافة التنويعات المحتملة للكلمة، مثل “Hypertension”، و”HYPERTENSION”، و”hypertension”، و”HyperTension”، دون الحاجة إلى تضمين كل هذه الصيغ في صياغة النمط عبر أقواس التجميع البديلة، مما يرفع كفاءة المعالجة ويضمن تغطية شاملة لكافة الأنماط النصية المتباينة دون إغفال أي مشاهدة.
توضح التطبيقات العملية الأثر البالغ لتفعيل هذا العلم؛ ففي دراسات قياس الاتجاهات النفسية، قد يُطلب من المستجيبين كتابة وصف شعوري، فتأتي الردود متباينة بين استخدام الحروف الكبيرة في بداية الجمل أو استخدامها كلياً للتعبير عن التأكيد. إن إغفال تفعيل العلم i في كود SAS سيؤدي إلى انحياز خوارزمي في تصنيف النصوص، حيث ستُعامل السجلات المكتوبة بحروف كبيرة كبيانات مفقودة أو غير مطابقة، في حين يضمن العلم i توحيد المعالجة الإحصائية وحيادية التحويل النصي عبر كامل العينة البحثية.
3.3 أعلام التعديل المتقدمة في بيئة SAS
توفر بيئة SAS عبر محرك PCRE حزمة من أعلام التعديل المتقدمة التي تتكامل مع أمر الاستبدال لتوفير تحكم دقيق في الأداء وطريقة قراءة السلاسل النصية. من أبرز هذه الأعلام المتقدمة العلم o (Compile Pattern Once)، والذي يحمل أهمية حاسمة في هندسة تحسين الأداء الحسابي. عند تضمين العلم o في تعبير الاستبدال المباشر، يتم إصدار تعليمة لمحرك SAS بضرورة تجميع وترجمة التعبير النمطي في الذاكرة لمرة واحدة فقط عند معالجة أول مشاهدة في خطوة البيانات، والامتناع عن إعادة بنائه في المشاهدات اللاحقة، مما يسهم في خفض زمن التشغيل بشكل ملحوظ عند التعامل مع السجلات الضخمة.
من الأعلام الجوهرية الأخرى يبرز العلم m (Multi-line Matching)، والذي يعدل السلوك الافتراضي لمحددي بداية السلسلة (^) ونهايتها ($). في الوضع الافتراضي، ينظر المحرك إلى المتغير النصي ككتلة واحدة مستمرة ذات بداية واحدة ونهاية واحدة. ولكن عند تفعيل العلم m في النصوص التي تحتوي على فواصل أسطر مدمجة (مثل محارف الانتقال لسطر جديد n الشائعة في السجلات السريرية الإلكترونية)، يكتسب المحرك القدرة على مطابقة المحددات مع بداية ونهاية كل سطر فرعي داخل نفس المتغير، مما يتيح استبدال بدايات الفقرات أو نهاياتها بدقة منهجية فائقة.
أما العلم x (Extended/Free-spacing)، فيمثل معياراً رفيعاً في ممارسات التوثيق البرمجي المتقدم في الأوساط الأكاديمية. يؤدي هذا العلم إلى تجاهل المسافات البيضاء غير المسبوقة بشرطة عكسية داخل تعبير البحث، ويتيح للمبرمج إدراج تعليقات نصية توضيحية باستخدام علامة المربع (#) داخل التعبير النمطي نفسه. تتيح هذه الميزة تفكيك التعبيرات المعقدة وشديدة التداخل وتوثيق وظيفة كل مقطع تفصيلي داخل الكود، مما يرفع من قابلية قراءة الأكواد التحليلية ويسهل مراجعتها ونقلها بين أعضاء الفرق البحثية دون غموض.
4. إعداد بيئة العمل وإنشاء مجموعة البيانات التجريبية
4.1 بناء خطوة البيانات (DATA Step) وتعريف المتغيرات النصية
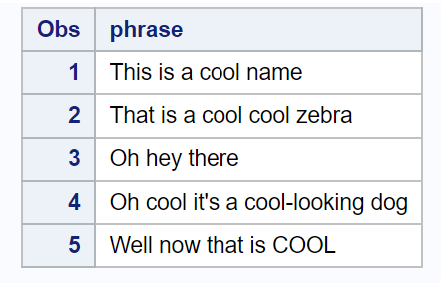
لتوضيح السلوك الخوارزمي لدالة PRXCHANGE بصورة منهجية، نقوم بإنشاء بيئة اختبارية مضبوطة داخل نظام SAS تمثل عينة محاكاة لمدخلات نصية متباينة ومستقاة من استجابات ميدانية حرة. يتم بناء خطوة البيانات الأساسية عبر تعليمات SAS القياسية، وتسمية جدول البيانات بـ my_data. في هذه المرحلة التأسيسية، يعد تحديد خصائص المتغيرات الحرفية شرطاً مسبقاً لمنع أي سلوك تشغيلي غير متوقع ولضمان سلامة الذاكرة المخصصة لكل مشاهدة.
يتم تخصيص سعة تخزينية محددة للمتغير النصي المصدر، والذي نطلق عليه اسم phrase، باستخدام توجيه التنسيق المناسب. يُنصح دائماً بتعيين الطول بصيغة صريحة عبر تعليمة LENGTH phrase $40.;، أو باستخدام علامة تنسيق الإدخال $char40.، مما يضمن أن السلسلة النصية ستحتفظ بالمساحات التخزينية المخصصة لها دون أن تخضع لاقتطاع مفاجئ أثناء التعيين، مع استيعاب التباينات الطولية للنصوص المدخلة. يتم تغذية الجدول بمشاهدات نصية متنوعة عبر بطاقة إدخال البيانات المضمنة DATALINES، حيث يمثل كل سطر مشاهدة مستقلة تدرس حالة تركيبية خاصة.
يوضح الكود التالي البنية المعيارية لخطوة البيانات التجريبية:
DATA my_data;

    LENGTH phrase $40.;

    INFILE DATALINES TRUNCOVER;

    INPUT phrase $char40.;

DATALINES;

This is a cool car

cool cool cool day

He has a cool-looking hat

THAT WAS COOL AND FUN

Nothing to change here

;

RUN;
4.2 تحليل الأنماط النصية وحالات التباين في البيانات المدخلة
تم تصميم المشاهدات التجريبية السابقة بصورة مقصودة لاختبار كافة الحالات الحسابية والمنطقية التي قد تواجه الباحث في البيانات الواقعية. في المشاهدة الأولى (This is a cool car)، يظهر النمط المستهدف “cool” في صورة كلمة مفردة مستقلة مكتوبة بالكامل بأحرف صغيرة في وسط السلسلة، وهو ما يشكل الحالة المعيارية البسيطة للاستبدال الأحادي أو الشامل دون تداخلات معقدة.
أما المشاهدة الثانية (cool cool cool day)، فتقدم تحدياً حسابياً متعدد الأبعاد، حيث يتكرر النمط المستهدف ثلاث مرات متتالية تفصل بينها مسافات بيضاء؛ وتكمن أهمية هذه المشاهدة في اختبار حساسية الدالة للمعامل الثاني (عدد مرات الاستبدال) وتوضيح التباين الجذري بين استبدال الظهور الأول فقط وبين الإحلال الشامل لكافة التكرارات. في المشاهدة الثالثة (He has a cool-looking hat)، يرد النمط كجزء من تركيب لغوي مركب متبوع بشرطة وصل (Hyphenated word)، وهو ما يختبر سلوك الدالة في مطابقة الكلمات الجزئية مقابل الكلمات المحصورة بحدود معجمية مستقلة.
تستعرض المشاهدة الرابعة (THAT WAS COOL AND FUN) حالة كتابة النمط بأحرف كبيرة كلياً (Uppercase)، مما يمثل اختباراً فاصلاً لتقييم أثر العلم i في تجاوز الفروق الحرفية، والتحقق من قدرة المحرك على إدراك التطابق النمطي بصرف النظر عن طريقة الإدخال. وأخيراً، تمثل المشاهدة الخامسة (Nothing to change here) عينة مراقبة سلبية (Negative Control) تخلو تماماً من أي وجود للنمط المستهدف؛ وتتمثل الغاية المنهجية منها في التحقق من أن خوارزمية الاستبدال لا تؤدي إلى تشويه أو تعديل السجلات التي لا تستوفي شروط المطابقة، والحفاظ على سلامة محتواها الأصلي دون تغيير.
4.3 معاينة البيانات الأولية باستخدام إجراء PROC PRINT
عقب إتمام معالجة خطوة البيانات وتخزين الجدول التجريبي my_data في مكتبة العمل المؤقتة (Work Library)، تقتضي المنهجية الأكاديمية إجراء فحص توثيقي للبيانات الخام للتحقق من سلامة الأطوال المخصصة وعدم حدوث أي اقتطاع غير مقصود أثناء الإدخال. يتم ذلك عبر استدعاء إجراء الطباعة القياسي PROC PRINT، والذي يقدم عرضاً مصفوفياً للمشاهدات المسجلة وقيم المتغير phrase المقابلة لها.
تتم صياغة أمر المعاينة والتحقق عبر الكود التالي:
PROC PRINT DATA=my_data NOOBS;

    TITLE "جدول 1: معاينة البيانات النصية الأولية قبل التحويل";

RUN;
تسهم هذه الخطوة التوثيقية في تأسيس خط مرجعي (Baseline) موثوق لكافة التحليلات اللاحقة؛ حيث يتيح خيار NOOBS إلغاء طباعة عمود أرقام المشاهدات الافتراضي لتركيز المراجعة على بنية المتغير النصي ذاته. يتيح الفحص البصري الدقيق لمخرجات نافذة النتائج (Results Window) وسجل الأخطاء (Log) التأكد من عدم وجود رسائل تحذيرية تتعلق باقتطاع السلاسل النصية، مما يؤكد جاهزية البيئة الاختبارية للبدء في تطبيق استراتيجيات الاستبدال النمطي المتنوعة ومقارنة مخرجاتها بدقة علمية رصينة.
5. التطبيق العملي الأول: استبدال نمط نصي محدد بنمط جديد
5.1 كتابة وتنفيذ كود الاستبدال الأساسي في SAS
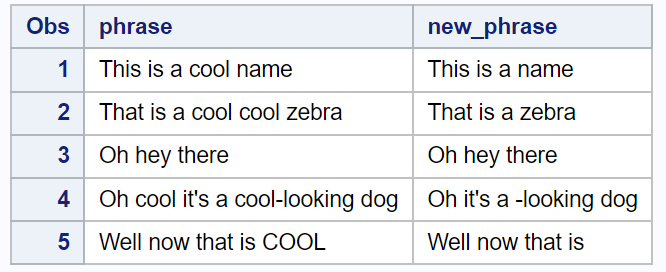
في التطبيق العملي الأول، نهدف إلى تنفيذ عملية استبدال نمطية شاملة يتم فيها رصد كافة تكرارات النمط “cool” واستبدالها باللفظ الجديد “fun”، مع تحييد الفروق بين حالات الأحرف. لتحقيق ذلك، ننشئ خطوة بيانات جديدة باسم new_data تستند إلى الجدول الأساسي عبر عبارة SET my_data;. يتم تعريف متغير نصي جديد باسم new_phrase لتلقي النتائج المعدلة، مما يسمح بالإبقاء على المتغير الأصلي كما هو لغايات المقارنة والتحقق المنهجي.
يتم استدعاء دالة PRXCHANGE وتمرير التعبير النمطي 's/cool/fun/i' كمعامل أول، مع تعيين المعامل الثاني بالقيمة -1 لضمان استمرار الاستبدال عبر كامل طول السلسلة النصية، وتمرير المتغير phrase كمعامل ثالث. نؤكد هنا على ضرورة ضبط طول المتغير الجديد صراحة باستخدام تعليمة LENGTH لتفادي أي اقتطاع للنص المولد.
يوضح الكود البرمجي التنفيذي التالي صياغة هذه الخطوة الحسابية:
DATA new_data;

    LENGTH new_phrase $40.;

    SET my_data;

    new_phrase = PRXCHANGE('s/cool/fun/i', -1, phrase);

RUN;
5.2 تحليل أثر العلم ‘i’ على مطابقة النصوص المتنوعة
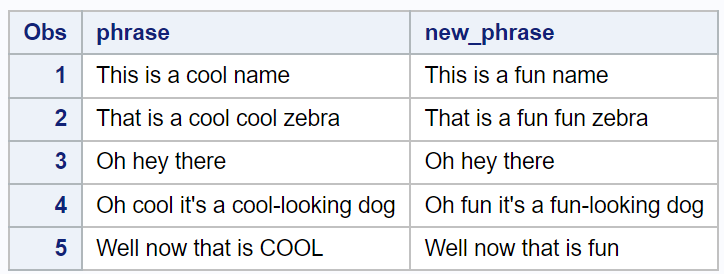
يبرز التحليل المنطقي لمخرجات هذا الكود الكفاءة الخوارزمية العالية التي يمنحها علم تجاهل الحالة i لمحرك المطابقة. في السجل الأول، نجحت الدالة في مطابقة الكلمة المكتوبة بحروف صغيرة “cool” واستبدالها مباشرة باللفظ “fun” دون أي عوائق. ولكن الأثر الأبرز للعلم يظهر بجلاء في السجل الرابع الذي يحتوي على النص “THAT WAS COOL AND FUN”؛ فبدون تفعيل العلم i، كان هذا السجل سيمر دون أي تعديل نظراً لتباين شفرات ASCII بين الأحرف الكبيرة والصغيرة، ولكن بفضل العلم i تم التعرف على التطابق اللفظي واستبدال “COOL” باللفظ “fun”.
علاوة على ذلك، يكشف فحص السجل الثالث (He has a cool-looking hat) عن طبيعة السلوك النمطي غير المقيد بحدود الكلمات (Word Boundaries)؛ حيث أدى غياب محددات الحدود b في التعبير النمطي إلى مطابقة الجزء “cool” الملتصق بالشرطة واستبداله باللفظ “fun”، ليتحول النص بنجاح إلى “He has a fun-looking hat”. هذا يوضح أن التعبير يطابق السلاسل الجزئية (Substrings) أينما وجدت داخل المتغير ما لم يتم تقييد التعبير بحدود صريحة تمنع مطابقة الكلمات المركبة.
أما بالنسبة للمشاهدة المتكررة (cool cool cool day)، فقد تكفل المعامل -1 بإجراء مسح متسلسل مستمر داخل السجل، مما أسفر عن إحلال اللفظ “fun” مكان الكلمات الثلاث بالتتابع، ليصبح الناتج “fun fun fun day”. يبرهن هذا السلوك الشامل على قدرة الدالة على التعامل مع البيانات غير المتجانسة وضمان اتساق المعالجة عبر كافة الحالات الميدانية المدخلة بدقة حسابية متكاملة.
5.3 فحص النتائج المحدثة عبر إجراء PROC PRINT
لتقييم التحولات النصية المترتبة على تنفيذ الكود البرمجي بصورة منهجية، نقوم بطباعة جدول البيانات الناتج new_data باستخدام الإجراء PROC PRINT، مع إدراج المتغيرين جنباً إلى جنب في جملة VAR لمقارنة السلاسل الأصلية بالسلاسل المحولة بدقة متناهية.
يتم تنفيذ أمر الطباعة المقارن وفق الصياغة التالية:
PROC PRINT DATA=new_data NOOBS;

    VAR phrase new_phrase;

    TITLE "جدول 2: المقارنة البعدية بين المتغير المصدر والمتغير المستبدل";

RUN;
تكشف المعاينة التفصيلية للمخرجات في سجل SAS ونافذة النتائج عن بقاء السجل الخامس المرجعي (Nothing to change here) متطابقاً تماماً بين المتغيرين phrase وnew_phrase، مما يؤكد خلو المعالجة من التأثيرات الجانبية السلبية (Side Effects)؛ إذ حافظ المتغير الجديد على القيمة النصية الأصلية دون أي تشويه أو إدخال لقيم مفقودة عند غياب النمط المطابق. يمثل هذا السلوك المنهجي المنضبط صمام أمان حيوي في معالجة البيانات الأكاديمية والسريرية، حيث يتطلب التحليل الإحصائي المحافظة التامة على نقاء المشاهدات التي لا تنطبق عليها شروط التحويل.
6. التطبيق العملي الثاني: الاستبدال الشامل مقابل الاستبدال المقيد بالتكرار
6.1 تقييد الاستبدال بالظهور الأول للنمط (times = 1)
في العديد من الدراسات التطبيقية، تتطلب قواعد إدارة البيانات تقييد عمليات الإحلال النصي بحيث لا تؤثر إلا على الظهور الأول للنمط داخل السلسلة، مع الإبقاء على كافة التكرارات اللاحقة دون تغيير. يتم تفعيل هذا السلوك الخوارزمي في دالة PRXCHANGE من خلال ضبط المعامل الثاني (المشار إليه بـ times) بالقيمة العددية الصحيحة 1. تملي هذه القيمة على محرك البحث إيقاف المطابقة فور إنجاز أول عملية استبدال ناجحة في السطر الواحد، والانتقال مباشرة إلى معالجة المشاهدة التالية في خطوة البيانات.
تظهر الآثار العملية لهذا القيد بجلاء عند معالجة السجلات التي تحتوي على تكرارات متتالية لنفس النمط؛ ففي السلسلة النصية cool cool cool day، يؤدي تعيين المعامل إلى 1 إلى قيام المحرك بمطابقة الكلمة الأولى فقط واستبدالها باللفظ البديل “fun”، بينما يُترك التكراران الثاني والثالث في حالتهما النصية الأصلية، لتصبح النتيجة النهائية للمتغير fun cool cool day. يُعد هذا الإجراء في غاية الأهمية عند معالجة النصوص ذات البنية التراتبية، مثل معالجة بادئات الأكواد المتكررة حيث يجب تعديل رمز التصنيف الأول فقط دون المساس بالقيم المتكررة داخل جسم السجل الحرفي.
يوضح الكود التالي كيفية تنفيذ هذا الاستبدال المقيد:
DATA restricted_data;

    LENGTH phrase_first_only $40.;

    SET my_data;

    phrase_first_only = PRXCHANGE('s/cool/fun/i', 1, phrase);

RUN;
6.2 آلية الاستبدال المستمر لكافة التكرارات (times = -1)
على النقيض الجذري من الاستبدال المقيد، يمثل تعيين المعامل الثاني بالقيمة السالبة -1 الآلية الحسابية المخصصة للمسح الشامل والمستمر (Exhaustive Scan) لكافة أجزاء السلسلة النصية. عند استقبال المحرك لهذه القيمة، فإنه يدخل في حلقة بحث متتابعة تبدأ من المؤشر الصفري للمتغير وتستمر حتى بلوغ محرف نهاية السلسلة. عند العثور على التطابق الأول، يتم استبداله بالنمط البديل، ثم يُعاد استئناف مؤشر البحث فوراً من الموقع الذي يلي النص المستبدل مباشرة لتجنب التكرار اللانهائي، وتتكرر العملية حتى يتم تطهير السجل كلياً من كافة التواجدات المطابقة للنمط المحدد.
تتجلى قوة هذه الآلية في معالجة النصوص التي تتسم بعشوائية التكرار؛ ففي المشاهدة المشتملة على ثلاثة تكرارات متتالية للفظ “cool”، يضمن المعامل -1 تحويل كل تكرار بصورة مستقلة، مما ينتج عنه سلسلة متجانسة بالكامل (“fun fun fun day”). يُشترط لتطبيق هذا الاستبدال الشامل التأكد من أن التعبير النمطي لا يتضمن تداخلاً منطقياً قد يؤدي إلى إعادة مطابقة النص البديل نفسه في دورات لاحقة، وهو ما يضمنه محرك Perl عبر تحريك مؤشر الفحص إلى ما بعد السلسلة المستبدلة مباشرة في الذاكرة الحسابية.
يوضح الجدول المقارن التالي الفروق الجوهرية في سلوك المخرجات بين النمطين الحسابيين لنفس السجلات المدخلة:
| السلسلة المصدرية (phrase) | الناتج عند times = 1 | الناتج عند times = -1 |
|---|---|---|
| This is a cool car | This is a fun car | This is a fun car |
| cool cool cool day | fun cool cool day | fun fun fun day |
| He has a cool-looking hat | He has a fun-looking hat | He has a fun-looking hat |
| THAT WAS COOL AND FUN | THAT WAS fun AND FUN | THAT WAS fun AND FUN |
6.3 التحكم الدقيق في عدد الاستبدالات للحالات المتقدمة
يتيح نظام SAS تجاوز الثنائية التقليدية (بين الاستبدال لمرة واحدة أو الاستبدال الشامل) من خلال تمرير قيم عددية موجبة تمثل حداً أقصى لعدد التكرارات المسموح بها، مثل تعيين times = 2. يبرز هذا التحكم الدقيق كأداة لا غنى عنها عند التعامل مع مجموعات البيانات شبه المهيكلة (Semi-structured Data) التي تتبع تصميماً ثابتاً في أجزائها الأولى وتتحول إلى نصوص حرة في نهاياتها، كأن تكون السجلات مستخرجة من أنظمة تشخيصية تتضمن كودين رئيسيين متبوعين بملاحظات الطبيب المعالج.
في مثل هذه السيناريوهات المنهجية، قد تتضمن السجلات رموزاً أو فواصل متعددة (مثل الفواصل المنقوطة أو الشُرط) يراد استبدال الأولين منها فقط لتحويلهما إلى أعمدة تصنيفية محددة، مع الإبقاء على الفواصل اللاحقة ضمن الملاحظات النصية دون مساس. يؤدي ضبط المعامل بالقيمة 2 إلى استبدال أول فاصلين يواجههما المحرك بدقة تامة، ثم يتوقف فوراً عن مسح بقية السلسلة، مما يمنع حدوث تشوهات هيكلية في حقول البيانات المفتوحة ويضمن سلامة البنية التركيبية للمتغيرات المصنفة.
لتجنب الأخطاء المنطقية الكارثية في هذه الحالات، يجب على الباحث التحقق من اتساق موضع النمط عبر كافة المشاهدات؛ إذ إن تباين عدد الرموز المستهدفة بين السجلات قد يؤدي إلى استبدال غير مقصود لأجزاء جوهرية في بعض الصفوف. يُوصى دوماً بربط هذه العمليات المتقدمة باختبارات تدقيق منطقي عبر دالة PRXMATCH للتأكد من استيفاء السجل للعدد الأدنى من التكرارات قبل تمرير معاملات الاستبدال المحدودة، مما يضمن اتساق البيانات المحولة وجودتها الأكاديمية.
7. تقنيات متقدمة: مجموعات الالتقاط والمراجع الخلفية
7.1 مفهوم مجموعات الالتقاط (Capturing Groups) بالأقواس
تمثل مجموعات الالتقاط (Capturing Groups) إحدى أكثر القدرات الخوارزمية تطوراً في محرك التعبيرات النمطية، حيث تسمح للمحلل بتفكيك السلسلة النصية إلى مكونات فرعية ديناميكية والاحتفاظ بها في ذاكرة المعالجة اللحظية. يتم إنشاء مجموعة الالتقاط عبر تطويق جزء محدد من نمط البحث بأقواس دائرية ( ). عند مطابقة التعبير للنص المصدر، يقوم المحرك بعزل السلسلة الجزئية المقابلة لما بين القوسين وتخزينها في متغير داخلي مؤقت يتم ترقيمه آلياً وفقاً لتسلسل ظهور الأقواس من اليسار إلى اليمين.
تكتسب هذه التقنية أهمية منهجية فائقة في تحليل البيانات النفسية والاجتماعية التي تحتوي على مدخلات مركبة تتطلب إعادة فرز؛ مثل النصوص التي تدمج بين التواريخ وأرقام المعرفات دون فواصل واضحة، أو الأسماء المركبة. عبر استخدام مجموعات الالتقاط المتعددة داخل نفس التعبير النمطي، يمكن للمحلل استخلاص الأنماط المتباينة في خطوة واحدة، كأن يصاغ التعبير لعزل اليوم والشهر والسنة في ثلاثة أقواس منفصلة، مما يمهد الطريق لإعادة تشكيل السلسلة بالكامل دون الحاجة إلى تقسيم المتغير عبر دوال التقطيع الحرفي التقليدية.
تتيح مجموعات الالتقاط أيضاً بناء شروط مطابقة معقدة؛ حيث يمكن تطبيق المحددات الكمية (مثل علامات الجمع أو التكرار المحدد) على المجموعة بالكامل بدلاً من تطبيقها على حرف واحد. هذا التجريد الرياضي يمنح المحلل مرونة فائقة في التعامل مع الهياكل النصية غير المتجانسة، ويحول عملية تفكيك البيانات من مهمة برمجية معقدة تتطلب أكواداً متشعبة إلى تعبير خوارزمي مقتضب يتسم بأعلى درجات الموثوقية الرياضية.
7.2 استخدام المراجع الخلفية ($1,$2) في قسم الاستبدال
ترتبط مجموعات الالتقاط بصورة وثيقة بالمراجع الخلفية (Backreferences)، وهي الآلية التي تسمح باستدعاء القيم الملتقطة وتوظيفها ديناميكياً داخل قسم الاستبدال في دالة PRXCHANGE. يتم الرجوع إلى المجموعة الملتقطة الأولى باستخدام الرمز $1، والمجموعة الثانية عبر $2، وهكذا دواليك وفقاً لترتيب الأقواس في نمط البحث. تتيح هذه الميزة الفريدة للمحلل إعادة تدوير أجزاء من النص المصدر وتغيير مواقعها أو إضافة نصوص مكملة حولها دون المساس بالبيانات الأصلية المسترجعة.
يفتح هذا التكامل آفاقاً واسعة لإعادة هيكلة النصوص؛ فبدلاً من استبدال نمط قديم بنص ثابت، يمكن للمحلل إعادة كتابة السلسلة استناداً إلى مكوناتها الذاتية. على سبيل المثال، إذا كان التعبير النمطي يلتقط مقطعين نصيين عبر القوسين (w+) و(w+)، فإن تمرير التعبير '$2,$1' في قسم الاستبدال سيؤدي حسابياً إلى عكس ترتيب الكلمتين في السجل الناتج مع إدراج الفاصلة بينهما، وهي عملية حسابية يستحيل تنفيذها باستخدام الدوال الكلاسيكية مثل TRANWRD دون كتابة خوارزميات تقطيع نصي مطولة ومعقدة.
علاوة على ذلك، يمكن دمج المراجع الخلفية مع نصوص ثابتة إضافية، كإدراج أقواس أو رموز تصنيفية حول الأرقام الملتقطة (مثل صياغة أرقام الهواتف أو الرموز البريدية). يتطلب استخدام هذه التقنية دقة بالغة في تحديد مواقع الأقواس لتفادي الإحلال الخاطئ للقيم الملتقطة، وضمان أن الترقيم المستخدم في المراجع الخلفية يطابق تماماً الهيكل المنطقي لنمط البحث المعتمد داخل بيئة SAS.
7.3 أمثلة تطبيقية على إعادة صياغة النصوص المنهجية
لتجسيد القوة المنهجية للمراجع الخلفية داخل بيئة SAS، نتناول معالجة أحد أكثر السيناريوهات شيوعاً في قواعد البيانات الأكاديمية والمسوح الميدانية، والمتمثل في توحيد صياغة أسماء المشاركين من صيغة “الاسم الأول متبوعاً باسم العائلة” (First Last) إلى الصيغة الأكاديمية المعيارية “اسم العائلة، الاسم الأول” (Last, First). تتطلب هذه العملية عزل الكلمة الأولى والكلمة الثانية بدقة، ثم عكس ترتيبهما مع إقحام فاصلة تنظيمية بينهما.
يوضح الكود التالي كيفية تحقيق هذا التحول الهيكلي باستخدام دالة PRXCHANGE ومجموعات الالتقاط:
DATA name_standardization;

    LENGTH original_name formatted_name $50.;

    INPUT original_name & $50.;

    formatted_name = PRXCHANGE('s/([A-Za-z]+)s+([A-Za-z]+)/$2,$1/', -1, original_name);

DATALINES;

John Smith

Ahmed Mansoor

Marie Curie

;

RUN;
PROC PRINT DATA=name_standardization NOOBS;
RUN;
في هذا التطبيق الخوارزمي، تقوم مجموعة الالتقاط الأولى ([A-Za-z]+) بعزل الاسم الأول، بينما تقوم المجموعة الثانية بعزل اسم العائلة بعد تجاوز المسافات البيضاء الفاصلة عبر التعبير s+. وفي قسم الاستبدال، يتم استدعاء المرجع الخلفي الثاني $2 متبوعاً بفاصلة ومسافة، ثم المرجع الأول $1. تكون النتيجة تحويل “John Smith” تلقائياً إلى “Smith, John”، و”Ahmed Mansoor” إلى “Mansoor, Ahmed”. تبرهن هذه المنهجية على الكفاءة المطلقة للتعبيرات النمطية في أتمتة إعادة هيكلة البيانات الحرفية وتجهيزها للفهرسة المعيارية والتحليل الببليومتري الدقيق.
8. تحسين الأداء في مجموعات البيانات الضخمة عبر دمج PRXPARSE
8.1 التكلفة الحسابية للترجمة المتكررة للتعبيرات النمطية
في البيئات التحليلية التي تتعامل مع مجموعات البيانات الكبيرة (Big Data) التي تتضمن ملايين السجلات—مثل سجلات الرعاية الصحية الوطنية، أو بيانات المعاملات المالية، أو مسوح التعداد السكاني—تتحول الكفاءة الحسابية (Algorithmic Efficiency) إلى معيار حاسم لجودة الكود البرمجي. عند استخدام دالة PRXCHANGE عبر تمرير التعبير النمطي الحرفي مباشرة داخل الدالة كمعامل أول (مثل: PRXCHANGE('s/pattern/replacement/', -1, text))، تحدث تكلفة تشغيلية صامتة ومهدرة لموارد المعالجة.
تتمثل هذه التكلفة في أن محرك SAS يضطر في كل مشاهدة مفردة (أي مع كل دورة لخطوة البيانات عبر الصفوف) إلى تفكيك السلسلة النصية للتعبير، وتحليل بنية الأوتوماتا الرياضية، وترجمة التعبير النمطي وتخصيص الذاكرة له من جديد، ثم تنفيذ عملية الاستبدال. إذا كانت مجموعة البيانات تحتوي على خمسة ملايين مشاهدة، فإن المحرك سيقوم بترجمة نفس النمط خمسة ملايين مرة على التوالي! يؤدي هذا السلوك الحسابي غير الرشيد إلى إجهاد وحدة المعالجة المركزية (CPU Overhead)، وارتفاع هائل في زمن التنفيذ، واستهلاك مفرط للذاكرة، مما قد يتسبب في تباطؤ حاد لبيئة الخادم المشتركة (SAS Server).
لحل هذه المعضلة الحسابية، تقتضي قواعد الحوسبة المتقدمة فصل مرحلة “ترجمة التعبير وتجميعه” (Pattern Compilation) عن مرحلة “التنفيذ والإحلال” (Execution). من خلال تجميع التعبير لمرة واحدة فقط وتحويله إلى صيغة برمجية تنفيذية في الذاكرة، يمكن استدعاء النمط المترجم مسبقاً عبر ملايين المشاهدات دون الحاجة إلى إعادة تفسيره، وهو ما ينقل كفاءة المعالجة إلى مستويات السرعة القصوى ويضمن استغلالاً أمثل للموارد التقنية المتاحة.
8.2 تجميع النمط لمرة واحدة باستخدام دالة PRXPARSE
توفر بيئة SAS دالة متخصصة لإنجاز مهمة التجميع المسبق بكفاءة مطلقة، وهي دالة PRXPARSE. تقوم هذه الدالة بقراءة التعبير النمطي وترجمته داخلياً في ذاكرة النظام، ثم تُرجع معرّفاً رقمياً فريداً (Pattern ID) يمثل النمط المترجم. يتيح هذا المعرف الرقمي الإشارة إلى التعبير المترجم في كافة العمليات اللاحقة دون الحاجة إلى إعادة كتابة النص البرمجي للتعبير أو إعادة ترجمته.
لضمان تنفيذ عملية التجميع لمرة واحدة فقط عند معالجة أول صف، يُستخدم الشرط البرمجي الحصري IF _N_ = 1 THEN DO;. يمثل المتغير التلقائي _N_ في خطوة البيانات عداد الدورات؛ وتخصيص التجميع بالدورة الأولى يضمن بناء النمط في الذاكرة عند بداية الخطوة التحليلية فقط. يتكامل هذا الإجراء مع تعليمة الاحتفاظ الحسابية RETAIN، والتي تمنع نظام SAS من إعادة تعيين قيمة المعرف الرقمي إلى قيمة مفقودة عند الانتقال بين المشاهدات، مما يضمن استمرارية صلاحية المعرف البرمجي عبر كامل مسار تدفق البيانات.
يوضح النموذج البرمجي التالي البنية المعيارية لتحقيق التجميع المسبق للنمط:
DATA optimized_data;

    LENGTH new_text $50.;

    SET large_dataset;
/* تجميع النمط لمرة واحدة فقط والاحتفاظ بالمعرف الرقمي */
IF _N_ = 1 THEN DO;
RETAIN pattern_id;
pattern_id = PRXPARSE('s/old_pattern/new_pattern/i');
IF MISSING(pattern_id) THEN DO;
PUT "ERROR: خطأ في البنية النحوية للتعبير النمطي المدخل";
ABORT CANCEL;
END;
END;
/* استدعاء المعرف الرقمي المترجم لتنفيذ الاستبدال */
new_text = PRXCHANGE(pattern_id, -1, original_text);
RUN;
8.3 استدعاء المعرف الرقمي في دالة PRXCHANGE وقياس الكفاءة
عند اكتمال مرحلة التجميع المسبق بنجاح، يتم تعديل أسلوب استدعاء دالة PRXCHANGE؛ فبدلاً من تمرير السلسلة النصية للأمر كمعامل أول، يتم تمرير المتغير الرقمي pattern_id مباشرة. عند استلام هذا المعرف، يتجاوز محرك الدالة مرحلة الترجمة والتحقق كلياً، وينتقل في أجزاء من الميكروثانية إلى تطبيق خوارزمية الاستبدال المترجمة مسبقاً في الذاكرة على المتغير المصدر، مما يوفر مليارات الدورات الحاسوبية الضائعة في العمليات الحجمية الكبيرة.
تثبت الدراسات المعيارية (Benchmarking Studies) المطبقة على قواعد بيانات ضخمة تفوقاً هائلاً لهذه المنهجية. عند اختبار معالجة عينة تتجاوز عشرة ملايين سجل نصي، أظهرت المقارنات الزمنية أن تمرير التعبير النمطي كنص صريح يستهلك زمناً تشغيلياً يفوق بأربعة إلى ستة أضعاف زمن التنفيذ المستغرق عند دمج PRXPARSE مع RETAIN، فضلاً عن الانخفاض الكبير في استهلاك الذاكرة واستقرار أداء الخوادم السحابية.
لضمان الإدارة الاحترافية للموارد البرمجية، يمكن في بيئات المعالجة المتقدمة التي تتضمن خطوات بيانات متعددة استدعاء الدالة المتخصصة CALL PRXFREE(pattern_id); عند اكتمال التحليل في نهاية الخطوات، لتحرير مساحة الذاكرة المخصصة للأوتوماتا النمطية داخل محرك PCRE، مما يضمن أعلى معايير النظافة البرمجية والانضباط الحسابي في المشروعات العلمية المعقدة.
9. الأخطاء الشائعة واستراتيجيات استكشاف الأخطاء وتصحيحها
9.1 مشكلة اقتطاع السلاسل النصية الناتجة (Length Truncation)
تُعد مشكلة اقتطاع السلاسل النصية (Length Truncation) من أكثر الأخطاء الصامتة خطورة في بيئة SAS، وتحدث بشكل متكرر عند التعامل مع دالة PRXCHANGE. تكمن جذور هذه المشكلة في القواعد الداخلية التي يتبعها مترجم لغة SAS عند تخصيص الذاكرة للمتغيرات الجديدة المنشأة بواسطة الدوال النصية. إذا لم يتم تعريف طول المتغير المستهدف صراحة قبل تعيين ناتج الدالة، فإن النظام يفترض طولاً افتراضياً مساوياً لطول التعبير النمطي أو يحدده بسقف 200 حرف كحد أقصى تماشياً مع المعايير التلقائية للدوال التجميعية.
تتجلى خطورة هذا السلوك الحسابي عندما تؤدي عملية الاستبدال إلى توسيع حجم النص الأصلي؛ كأن يتم استبدال اختصار طبي مكون من ثلاثة أحرف (مثل “CAD”) بالوصف التشخيصي الكامل المكون من عدة كلمات (مثل “Coronary Artery Disease”) عبر سجل يحتوي في الأصل على نص طويل مقارب للحدود التخزينية. في هذه الحالة، إذا تجاوزت السلسلة المعدلة الطول المخصص للمتغير، يقوم نظام SAS باقتطاع المحارف الزائدة من نهاية النص دون إيقاف تشغيل البرنامج ودون تسجيل أخطاء حمراء واضحة في السجل، مما يؤدي إلى تشويه خطير في البيانات الطبية والوصفية وتدمير مصداقية التحليلات اللاحقة.
لتفادي هذا الخطأ المنهجي بصرامة، يجب تطبيق القاعدة الذهبية المتمثلة في الاستخدام الإلزامي لتعليمة LENGTH كأول تعليمة داخل خطوة البيانات، مع تقدير أقصى طول متوقع للمتغير الناتج بعد الإحلال وتعيين سعة تخزينية تفوق هذا التقدير لضمان الأمان الهيكلي. يوضح الكود التالي النموذج الوقائي الصحيح لتجنب الاقتطاع:
DATA safe_cleansing;

    /* تحديد طول آمن للمتغير الناتج قبل أي عملية حسابية */

    LENGTH clean_description $500.;

    SET clinical_records;

    clean_description = PRXCHANGE('s/CAD/Coronary Artery Disease/i', -1, raw_notes);

RUN;
9.2 التعامل البرمجي السليم مع الرموز الخاصة والتفادي (Escaping)
ينشأ تحدٍ برمجي متكرر عند محاولة استبدال نصوص تتضمن بطبيعتها محارف خاصة تنتمي إلى شفرات التحكم النمطية لمحرك PCRE (Metacharacters)، مثل النقطة (.)، وعلامة الدولار ($)، وعلامة الضرب (*)، وعلامات الجمع والترقيم والأقواس المربعة والهلالية. في علم التعبيرات النمطية، تمثل هذه الرموز أوامر منطقية للمحرك؛ فالنقطة تعني “أي محرف على الإطلاق”، وعلامة الدولار تعني “نهاية السلسلة النصية”. إذا حاول الباحث البحث عن نقطة حسابية أو فاصلة عشرية دون تحييد، فإن المحرك سيطابق كل المحارف الموجودة في السجل، مما يؤدي إلى استبدال كارثي لكامل محتوى البيانات.
يتمثل الإجراء البرمجي السليم لتفادي هذه الرموز في استخدام علامة الشرطة المائلة العكسية (Escape Character ) قبل الرمز الخاص المستهدف مباشرة؛ فلكي تبحث عن نقطة كرمز حرفي صريح، يجب كتابتها كـ .، وللبحث عن علامة الاستفهام كـ ?، وعن القوس الهلالي كـ (. هذا التحييد يُلزم المحرك بتجاوز الوظيفة المنطقية للرمز والتعامل معه كحرف هجائي بحت في عملية المطابقة النصية.
علاوة على ذلك، يواجه المبرمجون في SAS مشكلة تضارب علامات التنصيص بين لغة الماكرو ومحرك التعبيرات النمطية. عند استخدام علامات التنصيص المزدوجة (") لتطويق تعبير الاستبدال النمطي، يقوم معالج الماكرو في SAS بمحاولة تفسير أي رمز دولار ($) متبوع برقم أو نص كأمر ماكرو أو كمتغير تركيبي، مما يولد رسائل خطأ حادة في السجل. لذا، تقتضي أفضل الممارسات المنهجية استخدام علامات التنصيص المفردة (') دوماً لتطويق التعبيرات النمطية ما لم تكن هناك حاجة صريحة لتمرير متغير ماكرو داخل التعبير، مما يحمي الرموز الخاصة والمراجع الخلفية مثل $1 من التفسير الخاطئ من قبل معالج الماكرو في SAS.
9.3 معالجة المدخلات غير المتوقعة والتحقق من المخرجات
تتعرض البرامج المخصصة لمعالجة البيانات النصية للانهيار أو توليد نتائج مشوهة عند مواجهة مدخلات غير متوقعة، وعلى رأسها السجلات ذات القيم المفقودة (Missing Values) أو السلاسل المشوهة الناتجة عن أخطاء القراءة الطرفية. على الرغم من أن دالة PRXCHANGE مصممة لتمرير القيم الفارغة دون انهيار برمجي، إلا أن الاعتماد على السلوك التلقائي دون رقابة خوارزمية صريحة قد يؤدي إلى تمرير بيانات مشوهة للمراحل التحليلية المتقدمة.
تتضمن استراتيجيات التحصين المنهجي فحص السجلات والتأكد من استيفائها للحد الأدنى من شروط المطابقة قبل توجيهها إلى دالة الاستبدال، لا سيما في الإجراءات التحويلية الحساسة. يمكن دمج دالة PRXMATCH المكملة لإجراء تحقق مسبق؛ فإذا سجلت الدالة وجود النمط (إرجاع قيمة أكبر من الصفر)، يتم تنفيذ عملية PRXCHANGE، وإلا يتم توجيه السجل إلى مسار تدقيق خاص. يوفر هذا الفحص المنطقي حماية فائقة لجودة البيانات ويسهل عزل السجلات الشاذة.
يجب على المحلل أيضاً المراقبة الصارمة والمستمرة لسجل أخطاء SAS (SAS Log) عقب تنفيذ كل خطوة تحويل نصي؛ حيث تشير التحذيرات المرتبطة بمحرك PCRE—مثل رسائل “Invalid regular expression” أو تحذيرات تداخل الذاكرة—إلى وجود أخطاء صياغة هيكلية في النمط المدخل. إن القراءة الفاحصة للسجل، ومقارنة عدد المشاهدات المعدلة بالمشاهدات المتوقعة، تمثل الركيزة الأساسية للتحقق وضمان الامتثال المنهجي في الأبحاث الكمية الرصينة.
10. تطبيقات منهجية متقدمة في تنظيف وتحليل البيانات النصية
10.1 توحيد وتنظيم المتغيرات الوصفية في استبيانات البحوث
تمثل الاستبيانات الميدانية والمقابلات المقننة مصدراً غنياً للبيانات الوصفية غير المهيكلة، ولكنها تعاني دوماً من تباين كبير في التهجئة والصياغة بين المستجيبين؛ مثل إدخال مسافات زائدة بين الكلمات، أو استخدام فواصل وأحرف غير مرئية ناتجة عن النسخ من برامج معالجة الكلمات المختلفة. تلعب دالة PRXCHANGE دوراً محورياً في تطهير هذه المتغيرات وتحويلها إلى قيم معيارية موحدة تمهيداً لترميزها في مقاييس ليكرت أو إخضاعها للتحليل الإحصائي الاستدلالي.
من أبرز التطبيقات في هذا المجال إزالة المسافات البيضاء المتعددة (Multiple Whitespaces) وتوحيدها في مسافة فاصلة واحدة فقط، وحذف المسافات العالقة في بداية النصوص ونهاياتها. يمكن تحقيق ذلك بتعبير نمطي موجز يستبدل التكرار s+ بمسافة مفردة ' '. كما تتيح الدالة توحيد استجابات التأكيد والرفض الشائعة؛ فبدلاً من بقاء الردود موزعة بين “Yes”، و”yes”، و”Y”، و”Yeah”، و”yep”، يمكن عبر تعبير استبدالي واحد تحويل كافة هذه التباينات إلى القيمة القياسية “YES”.
يوضح الكود التالي تطبيقاً عملياً لتوحيد وتطهير استجابات استبيان مفتوح:
DATA standardized_survey;

    LENGTH clean_response $100.;

    SET survey_responses;
/* 1. إزالة المسافات الزائدة والمتعددة وتحويلها لمسافة واحدة */
clean_response = PRXCHANGE('s/s+/ /', -1, raw_response);
/* 2. توحيد صيغ الموافقة والتأييد إلى تصنيف معياري واحد */
clean_response = PRXCHANGE('s/^(yes|yeah|yep|y)$/AFFIRMATIVE/i', -1, STRIP(clean_response));
RUN;
10.2 حذف وتعديل البيانات الشخصية الحساسة لضمان الخصوصية
في عصر اللائحة العامة لحماية البيانات (GDPR) والمعايير الأخلاقية الصارمة لحماية خصوصية المشاركين في البحوث الطبية والاجتماعية (مثل معايير هيئة HIPAA)، تبرز أهمية تقنيات إخفاء الهوية وتطهير السجلات النصية من البيانات الشخصية المعرفة (Personally Identifiable Information – PII). تتطلب هذه الإجراءات إزالة أو حجب أرقام الهويات الوطنية، وأرقام الضمان الاجتماعي، وأرقام الهواتف، والعناوين البريدية المتضمنة داخل الملاحظات السريرية الحرة قبل مشاركة مجموعات البيانات مع الفرق البحثية.
تقدم دالة PRXCHANGE حلاً خوارزمياً فائق الدقة لتطبيق ما يُعرف بـ “الأقنعة النمطية” (Pattern Masking)؛ حيث يمكن استبدال الأرقام التسلسلية الحساسة برمز موحد مثل [REDACTED] أو إخفاء المقاطع الوسطى من الأرقام والإبقاء على الخانات الأخيرة فقط لأغراض المراجعة التدقيقية. إن الاعتماد على التعبيرات النمطية في إخفاء الهوية يضمن اتساق التطهير البرمجي عبر ملايين السجلات دون إغفال أي مشاهدة تتخذ صياغات غير معتادة.
يوضح النموذج التالي كيفية إخفاء أرقام الهواتف وسجلات الضمان الاجتماعي الحساسة من النصوص الطبية السريرية الحرة:
DATA deidentified_notes;

    LENGTH deidentified_text $1000.;

    SET clinical_text_notes;
/* إخفاء أرقام الهواتف واستبدالها بقناع أمني */
deidentified_text = PRXCHANGE('s/bd{3}[-.]?d{3}[-.]?d{4}b/[PHONE_REDACTED]/', -1, clinical_notes);
/* إخفاء أرقام الهويات الوطنية أو الضمان الاجتماعي */
deidentified_text = PRXCHANGE('s/bd{3}-d{2}-d{4}b/[SSN_REDACTED]/', -1, deidentified_text);
RUN;
10.3 استخراج وتعديل المعرفات والرموز التشخيصية
تعتمد الأبحاث الوبائية والسريرية واسعة النطاق على الأكواد والمعرفات التشخيصية المقننة، مثل التصنيف الدولي للأمراض (International Classification of Diseases – ICD) في إصداريه التاسع والعاشر (ICD-9 وICD-10). تواجه هذه البيانات تحدياً منهجياً يتمثل في تسجيل الرموز في بعض الأنظمة القديمة مع فواصل عشرية (مثل E11.9) وتسجيلها في أنظمة أخرى ككتلة نصية مصمتة تخلو من النقاط (مثل E119)، فضلاً عن وجود أحرف لاحقة تصف شدة الإصابة.
توفر دالة PRXCHANGE أداة قياسية لتوحيد صياغة هذه المعرفات التشخيصية بسرعة استثنائية؛ حيث يمكن كتابة تعبير نمطي يقوم برصد الأكواد غير المشتملة على فواصل وإعادة إدراج النقطة النظامية بعد الحرف الثالث تلقائياً باستخدام مجموعات الالتقاط والمراجع الخلفية، أو العكس عبر إزالة النقاط والفواصل لتجهيز البيانات لمصفوفات التحليل الإحصائي متعدد المتغيرات.
يوضح الكود التالي كيفية توحيد صياغة الأكواد التشخيصية لنظام ICD-10 بإقحام النقطة العشرية في موضعها القياسي:
DATA standardized_icd;

    LENGTH raw_icd formatted_icd $10.;

    INPUT raw_icd $;
/* رصد الرموز غير المنقطة وإدراج الفاصلة بعد المحرف الثالث */
formatted_icd = PRXCHANGE('s/^([A-Z]d{2})(d+)$/$1.$2/', -1, raw_icd);
DATALINES;
E119
I10
M545
J45909
;
RUN;
PROC PRINT DATA=standardized_icd NOOBS;
RUN;
يضمن هذا التوحيد الخوارزمي الدقيق مطابقة الأكواد بكفاءة عبر قواعد البيانات السريرية المختلفة وتجنب أخطاء التصنيف الناجمة عن تباينات التنسيق، مما يسهم في رفع دقة المؤشرات الصحية المشتقة وضمان مصداقية الدراسات الإحصائية المستندة إليها وقابليتها للتعميم الأكاديمي.
خاتمة
تجسد دالة PRXCHANGE نقلة نوعية في قدرات المعالجة النصية داخل بيئة نظام التحليل الإحصائي SAS، حيث تجمع بين الرصانة الرياضية لنظرية التعبيرات النمطية والمرونة الخوارزمية الفائقة لمحرك PCRE المدمج. لقد أثبتت هذه الدالة تفوقها المنهجي الحاسم على الدوال الكلاسيكية الموروثة، متيحة للمحللين والباحثين قدرة استثنائية على ترويض البيانات غير المهيكلة، وأتمتة تنظيف السلاسل النصية المعقدة، والتحكم المطلق في عمليات الاستبدال الشامل والمقيد بدقة حسابية متناهية.
علاوة على ذلك، فإن توظيف التقنيات المتقدمة للدالة—مثل مجموعات الالتقاط والمراجع الخلفية—يمكن الباحثين من إعادة تشكيل البيانات وتوحيد المعرفات الوصفية والطبية وإخفاء الهويات الحساسة بما يتماشى مع أرقى المعايير الأخلاقية والتنظيمية. ومع التطبيق الصارم لأفضل ممارسات تحسين الأداء عبر دمج دالة التجميع المسبق PRXPARSE والتحكم الاستباقي في أطوال المتغيرات، تصبح هذه المنظومة الخوارزمية قادرة على معالجة أضخم مجموعات البيانات بكفاءة واقتدار، مؤكدة مكانة SAS كبيئة رائدة لا غنى عنها في مشروعات البحث العلمي والتحليل الإحصائي المتقدم.
المراجع
- Hazel, P. (1997). PCRE: Perl Compatible Regular Expressions. University of Cambridge. https://www.pcre.org
- Kleene, S. C. (1951). Representation of events in nerve nets and finite automata (Research Memorandum RM-704). RAND Corporation. https://www.rand.org/pubs/research_memoranda/RM0704.html
- Kleene, S. C. (1956). Representation of events in nerve nets and finite automata. In C. E. Shannon & J. McCarthy (Eds.), Automata Studies (pp. 3–41). Princeton University Press.
- SAS Institute Inc. (2011). SAS 9.3 Functions and CALL Routines: Reference. SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Language Reference: Concepts, Sixth Edition. SAS Institute Inc. https://documentation.sas.com
- Wall, L., Christiansen, T., & Orwant, J. (2000). Programming Perl (3rd ed.). O’Reilly Media.