
تتبوأ المعالجة المتقدمة للبيانات النصية مكانة محورية في مسارات التحليل الإحصائي الحديث، حيث تمثل جودة البيانات المدخلة حجر الزاوية الذي يحدد مدى دقة وموثوقية النماذج التنبؤية والتفسيرية المستخرجة. وفي إطار منظومة البرمجة الإحصائية عبر نظام التحليل الإحصائي (Statistical Analysis System – SAS)، الذي تعود بدايات تطويره التاريخية إلى أواخر ستينيات القرن العشرين على يد أنتوني جيمس بار (Anthony James Barr) وجيمس غودنايت (James Goodnight) ورفاقهما في جامعة ولاية كارولاينا الشمالية وصولاً إلى تأسيس معهد ساس عام 1976، تطورت حزمة واسعة من الدوال الموجهة للتعامل مع البيانات غير المنظمة والتعبيرات المحرفية المعقدة لتلبية متطلبات الباحثين في ميادين العلوم الكمية والقياس النفسي والاجتماعي.
وتبرز دالة TRANSLATE بوصفها واحدة من أقوى الأدوات الموضعية الأساسية وأكثرها كفاءة في خطوة البيانات (DATA Step)، حيث تتخصص في إجراء عمليات الاستبدال الحرفي الفردي والتناظري وفق نسق متوازٍ وخوارزمية مسح عالية السرعة. يتيح الفهم المتعمق للخصائص التشغيلية لهذه الدالة للمبرمجين والمحللين الإحصائيين إجراء تنقيح فوري للبيانات، وتحويل المقاييس الاسمية والترتيبية، وإزالة الرموز الدخيلة، وتوحيد المعرفات النصية بكفاءة حسابية تتفوق في كثير من الأحيان على المعالجات القائمة على التعابير النمطية المعقدة، ما يقلل من العبء المالي والزمني لمرحلة تحضير البيانات.
يتناول هذا الدليل الأكاديمي الشامل كل ما يتعلق بدالة TRANSLATE في نظام SAS، بدءاً من تفكيك بنيتها المفاهيمية والخوارزمية، مروراً بتحليل محدداتها البنائية وتطبيقاتها العملية على مجموعات بيانات قياسية، وصولاً إلى مقارنتها بالبدائل الوظيفية ودراسة استخداماتها المتقدمة في حقول تنقية بيانات القياس السلوكي والنفسي، مع إبراز أفضل الممارسات البرمجية لتجنب الأخطاء المنطقية وضمان استدامة الأكواد في البيئات الحسابية الضخمة.
1. المدخل النظري لدالة TRANSLATE في بيئة برمجة SAS
1.1 المفهوم العام لمعالجة السلاسل النصية في نظام SAS
تشكل السلاسل النصية (Character Strings) جزءاً جوهرياً من هياكل البيانات الخاضعة للتحليل، إلا أنها غالباً ما تتسم بقدر كبير من عدم الانتظام الناتج عن أخطاء الإدخال اليدوي، أو تباين بروتوكولات الترميز، أو استخدام علامات ترقيم وفواصل غير قياسية. في بيئات التحليل الإحصائي الصارمة، لا يمكن إخضاع المتغيرات النصية غير المنقحة للنمذجة الرياضية المباشرة؛ إذ يتطلب التحليل تحويل هذه البيانات إلى صيغ معيارية مستقرة تدعم عمليات التصنيف والمطابقة. وتزداد هذه المشكلة إلحاحاً في الدراسات المسحية واسعة النطاق التي تشمل عينات مجتمعية معقدة، حيث تتباين أساليب تسجيل الإجابات الرمزية، مما يتطلب هندسة برمجية دقيقة لتحويل النصوص الأولية إلى مؤشرات قابلة للقياس.
تنهض الدوال النصية المتخصصة في لغة SAS بمهمة تسريع عمليات تنقيح البيانات وتحويلها عبر توفير مسارات تنفيذ سريعة تتكامل مباشرة مع دورة حياة خطوة البيانات (DATA Step). تتيح هذه الدوال للمحللين اقتطاع النصوص، أو دمجها، أو البحث عن أنماط جزئية داخلها، أو استبدال محتوياتها. وضمن هذا الفضاء التطبيقي، تتميز دالة TRANSLATE بموقع فريد؛ فهي ليست أداة لاستبدال الكلمات أو المقاطع النصية ككتل متجانسة، بل هي أداة موضعية ميكانيكية مصممة لتبديل الحروف الفردية بطريقة محددة بدقة، مما يمنحها سرعة استثنائية وأداءً حاسوبياً مستقراً عند التعامل مع ملايين السجلات.
يعتمد استقرار التحليلات الإحصائية، خاصة في النماذج البارامترية واللابارامترية، على اتساق المدخلات المحرفية وجودتها، وهو ما توفره دالة TRANSLATE من خلال قدرتها على ضبط المحارف دون المساس بسلامة الحقول المجاورة. وتبرز أهميتها في تحويل رموز المتغيرات المستقلة والتابعة بصورة متزامنة وسريعة، مما يجعلها أداة أولية لا غنى عنها في مراحل هندسة الخصائص وإعداد البيانات السريرية والنفسية، حيث يؤدي أي خطأ في حرف منفرد إلى تصنيف غير دقيق للمفحوصين أو تشويه في جداول التكرارات والتقاطعات المرجعية.
1.2 آلية عمل دالة TRANSLATE على المستوى الخوارزمي
تعمل دالة TRANSLATE على المستوى الخوارزمي الداخلي عبر تطبيق تقنية المسح المتسلسل للحروف الفردية داخل السلسلة المصدرية من اليسار إلى اليمين. عند تمرير متغير نصي إلى الدالة، يقوم محرك التنفيذ في SAS بفحص كل بايت أو محرف في السلسلة بشكل مستقل، ومقارنة قيمته المحرفية بمصفوفة الحروف المستهدفة المحددة في معلمات الاستدعاء. تتم هذه المعالجة دون الحاجة إلى إنشاء مصفوفات ديناميكية مؤقتة في الذاكرة العشوائية من قبل المستخدم، بل عبر دوال مبنية داخلياً بلغة C المنخفضة المستوى التي تستفيد من السجلات السريعة للمعالج المركزي.
يعتمد نظام الاستبدال في الدالة على المطابقة الموضعية الأحادية (Positional One-to-One Matching). إذا تطابق المحرف المقروء في السلسلة المصدرية مع المحرف الواقع في الترتيب رقم k ضمن مصفوفة الحروف المراد إزالتها، يُستبدل هذا المحرف مباشرة وبشكل متزامن بالمحرف المقابل الواقع في الترتيب نفسه k ضمن مصفوفة الحروف البديلة. هذا النمط من التعيين المباشر يلغي الحاجة إلى حلقات التكرار (Loops) اليدوية التي يضطر المبرمجون لصياغتها في بيئات برمجية أخرى، ويوفر حماية كاملة من تداخل عمليات الاستبدال المتتالية التي قد تؤدي إلى تشويه البيانات في حال استبدال حرف بحرف آخر ثم إعادة استبدال الحرف الجديد في الدورة نفسها.
تتسم خوارزمية الدالة بحساسية مطلقة لحالة الأحرف اللاتينية (Case-Sensitivity)؛ حيث يعتبر الحرف الصغير (مثل ‘a’) كياناً برمجياً مستقلاً تماماً يختلف في رمزه الثنائي (ASCII أو EBCDIC) عن الحرف الكبير (مثل ‘A’). وبالتالي، فإن تحديد أحد الحرفين في معاملات الدالة لا يؤثر مطلقاً على الآخر ما لم يُنص على ذلك صراحة. وتخضع هذه الآلية لتأثير الترميز النصي المعتمد في جلسة SAS؛ ففي بيئات العمل التي تعتمد ترميز UTF-8 متعدد البايتات، تتولى الدالة معالجة الحدود البايتية لضمان عدم حدوث تشويه للمحارف متعددة البايت، وهو اعتبار جوهري عند معالجة النصوص متعددة اللغات أو الرموز الخاصة في قواعد البيانات الموحدة.
2. البنية التركيبية والصياغة العامة لدالة TRANSLATE
2.1 المحددات الثلاثة الأساسية للدالة (Source, To, From)
تتطلب الصياغة العامة لدالة TRANSLATE تزويدها بثلاثة معاملات رئيسية تحكم مسار التنفيذ والتحويل. وتتخذ الصيغة العامة الشكل البنائي الآتي:
TRANSLATE(source, to, from).
يمثل المعامل الأول، المشار إليه باسم source، المتغير المصدر أو التعبير الحرفي المستهدف الذي يحتوي على النص الأصلي المراد إخضاعه لعملية الفحص والاستبدال. يمكن أن يكون هذا المعامل اسماً لمتغير نصي موجود مسبقاً في مجموعة البيانات، أو قيمة نصية ثابتة محاطة بعلامات اقتباس، أو حتى تعبيراً ناتجاً عن دالة نصية أخرى متداخلة معها، مما يمنح المبرمج مرونة عالية في بناء تدفقات التحويل.
يمثل المعامل الثاني، المشار إليه باسم to، سلسلة الإحلال والتعويض (Replacement Characters). وتتضمن هذه السلسلة مجموعة المحارف التي يرغب المحلل في وضعها في النص النهائي لتحل محل المحارف المستهدفة. لا تشترط الدالة أن تتشكل هذه السلسلة من كلمات ذات معنى لغوي، بل تُعامل كمصفوفة خطية من الرموز الفردية التي سيتم توزيعها موضعياً وفقاً لترتيبها التسلسلي داخل السلسلة النصية، حيث يكون لكل موضع رقمي وزنه الخاص في عملية المطابقة مع المعامل التالي.
أما المعامل الثالث، المشار إليه باسم from، فهو سلسلة الاستبدال أو الإزالة (Target Characters)، ويضم قائمة الحروف والرموز غير المرغوب فيها والموجودة في النص الأصلي، والتي يُراد التخلص منها واستبدالها بحروف السلسلة to. تتقاطع هذه السلسلة مع السلسلة السابقة في تناظر هندسي دقيق؛ حيث يقابل كل حرف في from الحرف الذي يشغل الترتيب المكافئ له في to. تتيح بنية SAS أيضاً تكرار أزواج المعاملات (to-2, from-2, … to-n, from-n) لتنفيذ عمليات تحويل متعددة ومتباينة الأهداف ضمن استدعاء برمجي واحد، مما يرفع من تكامل الشيفرة ويقلل من تعقيدها السطحي.
2.2 القواعد البرمجية لترتيب المعاملات والقيود النوعية
يخضع استدعاء دالة TRANSLATE لقواعد نحوية صارمة داخل لغة SAS، يأتي في مقدمتها الالتزام المطلق بالترتيب المحدد للمعاملات. يقع كثير من المبرمجين المبتدئين في خطأ منطقي ناتج عن الخلط بين موضع سلسلة الإحلال وموضع سلسلة الاستبدال؛ حيث يفرض نظام SAS أن يأتي المعامل to قبل المعامل from. وإن أي عكس لهذا الترتيب سيؤدي إلى تطبيق عملية تحويل عكسية تماماً لما كان يهدف إليه المحلل الإحصائي، مما ينتج عنه تشويه جذري في مصفوفة البيانات المعالجة دون أن يطلق مفسر SAS أي رسالة خطأ صريحة (Syntax Error)، نظراً لأن المعاملات من حيث نوعها البياني تعتبر مقبولة نحوياً.
تتعامل الدالة بدقة مع المتغيرات ذات الطول الثابت والمتغير في خطوة DATA. عند تطبيق الدالة، يرث المتغير الجديد الناتج في الحالة الافتراضية طول المتغير المصدر الأصلي (source)، ما لم يتم تحديد طول مخصص مسبقاً عبر عبارة LENGTH. وفي حال تكرار الحرف نفسه داخل السلسلة المستهدفة from، فإن نظام SAS يتبنى قاعدة الحدوث الأول (First Occurrence Rule)؛ إذ تُعتمد المطابقة المحددة في الظهور الأول للحرف ويهمل النظام أي تعيينات لاحقة للحرف ذاته داخل السلسلة المستهدفة، وهو ما ينبغي للمحلل الانتباه إليه لتفادي التداخل في قواعد التحويل المعقدة.
ويرتبط تمرير المعاملات أيضاً بطبيعة علامات الاقتباس المستخدمة في الكود البرمجي؛ فالمعاملات النصية الثابتة يجب أن تُحاط إما بعلامات اقتباس فردية (”) أو مزدوجة (“”). يفضل استخدام علامات الاقتباس الفردية في الحالات القياسية لعزل المحارف ومنع محرك ماكرو SAS (Macro Processor) من محاولة تفسير أي رمز داخل السلسلة كمتغير ماكرو. أما إذا كانت سلاسل الإحلال أو الاستبدال مشتقة من متغيرات ماكرو ديناميكية يتم توليدها وقت التشغيل، فيتعين استخدام علامات الاقتباس المزدوجة للسماح بعملية التحليل والاستبدال الماكروي المناسبة قبل بدء معالجة خطوة البيانات الفعلية.
3. بناء وتجهيز مجموعة البيانات التوضيحية في SAS
3.1 كتابة شيفرة DATA Step لإنشاء مصفوفة البيانات الأولية
لتوضيح التطبيقات العملية لدالة TRANSLATE بأسلوب منهجي قابل لإعادة الإنتاج، نبدأ بتشييد مجموعة بيانات توضيحية تعكس بنية سجلات رياضية تحتوي على متغيرات نصية ورقمية متباينة الخصائص. تتيح خطوة البيانات (DATA Step) تعريف أسس المتغيرات وتخصيص الذاكرة اللازمة لها عبر محددات التنسيق المناسبة، مما يضمن تدفق البيانات واستيعابها دون حدوث اقتطاع للمحارف النصية أثناء القراءة المباشرة من أسطر الإدخال.
تتضمن الشيفرة البرمجية إنشاء جدول بيانات يحمل اسم original_data، ويتم تعريفه باستخدام عبارة INPUT التي تحدد المتغير النصي الأساسي team والمتغير الحرفي المستهدف بالمعالجة position، بالإضافة إلى متغير عددي هو points يمثل الأداء التهديفي. تُستخدم علامة الدولار ($) للإشارة إلى الطبيعة النصية للمتغيرات، مع تحديد أطوال الحقول لضمان استيعاب الكلمات الكاملة قبل تنفيذ أي عمليات استبدال لاحقة. يوضح الكود التالي كيفية إنشاء هذا الجدول:
data original_data;
input team $ position $ points;
datalines;
Mavs Guard 22
Nets Guard 14
Spurs Forward 20
Warriors Guard 29
Hawks Center 18
Celtics Forward 40
;
run;
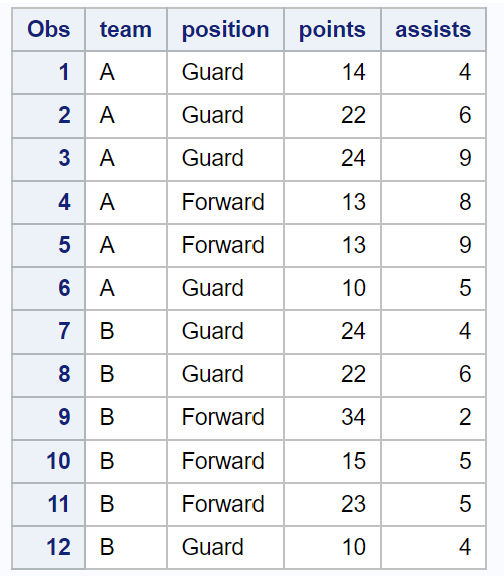
يحتوي هذا الجدول على ستة سجلات تمثل وحدات رصد مختلفة، حيث يشتمل متغير الموضع (position) على ثلاثة أنماط نصية رئيسية هي: الحارس (Guard)، والمهاجم (Forward)، ولاعب الوسط (Center). تحتوي هذه الأنماط على حروف متكررة مثل حرف ‘r’ وحرف ‘a’، مما يجعلها بيئة اختبار نموذجية لتطبيق خوارزميات الاستبدال الحرفي الفردي والمتعدد، ومراقبة سلوك الدالة في حفظ سلامة الكلمات وبنيتها العامة دون المساس بالمتغيرات الرقمية المرتبطة بكل سجل.
3.2 فحص البيانات عبر إجراء PROC PRINT لتوثيق الحالة الأساسية
يمثل استدعاء الإجراء التحليلي PROC PRINT مرحلة أساسية في بروتوكولات جودة البيانات المعتمدة في بيئات التحليل الإحصائي؛ إذ يوفر هذا الإجراء معاينة موثقة للحالة الأولية لمصفوفة البيانات قبل إجراء أي تعديل بنيوي على متغيراتها. يُسهم الفحص البصري الأولي في التحقق من صحة مواقع الأعمدة، وتطابق القيم مع فئات المتغيرات المصممة، وضمان خلو السجلات من أي إزاحة مكانية ناتجة عن أخطاء محاذاة البيانات في عبارة DATALINES.
تتم كتابة شيفرة الاستعراض بتمرير اسم الجدول المولد وتخصيص خيارات العرض المناسبة لتعطيل طباعة أرقام الملاحظات الافتراضية إذا تطلب الأمر، مع إضافة عنوان توثيقي يحدد طبيعة التقرير المعروض:
proc print data=original_data noobs;
title “عرض بيانات خط الأساس الأولية (Baseline Dataset)”;
run;
يُظهر التقرير الناتج عن تنفيذ هذه العملية جدولاً إحصائياً دقيقاً يتضمن الحقول الثلاثة لجميع الوحدات الست المسجلة. يتم التركيز بصورة محددة على عمود position لملاحظة تكرار الحروف المستهدفة: فحرف ‘r’ يظهر مرتين في كلمة “Forward” ومرة واحدة في كل من “Guard” و”Center”. يمثل هذا التوثيق قاعدة المقارنة التي سنعتمد عليها لتقييم مخرجات دوال التحويل في الأقسام اللاحقة، والتأكد من أن التعديلات الحرفية تقع بدقة متناهية ودون إحداث أي تغييرات جانبية في الخلايا الأخرى.
4. التطبيق العملي الأول: استبدال حرف مفرد بحرف بديل
4.1 استبدال الحرف ‘r’ بالحرف ‘z’ في المتغيرات النصية
يركز التطبيق العملي الأول على تفكيك سلوك دالة TRANSLATE عند التعامل مع استبدال حرف مفرد بحرف بديل واحد عبر كامل مساحة المتغير النصي. نفترض في هذا السيناريو متطلباً إحصائياً أو ترميزياً يقضي بتحويل كل حرف لاتيني صغير ‘r’ يظهر في عمود الموضع الرياضي إلى الحرف ‘z’، مع الإبقاء على بقية الحروف المكونة للنص كما هي دون أي مساس بهيكلها الترتيبي أو بطول السلسلة الكلي.
تتضمن الصياغة البرمجية استدعاء الدالة بتحديد المتغير position كمعامل أول، يليه الحرف البديل ‘z’ كمعامل ثانٍ، ثم الحرف المراد إزالته ‘r’ كمعامل ثالث. تُنفذ هذه الخطوة عبر إنشاء خطوة بيانات مستقلة تقرأ من مصفوفة البيانات الأصلية وتنتج مصفوفة جديدة معدلة، كما يتضح من الشيفرة الآتية:
data single_char_replace;
set original_data;
position = translate(position, ‘z’, ‘r’);
run;
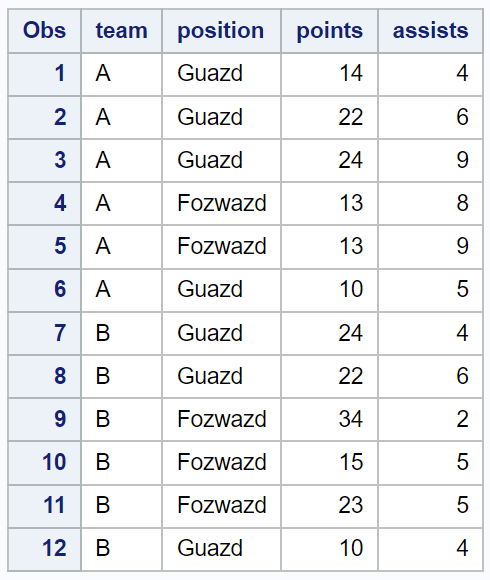
أثناء التنفيذ، تفحص الخوارزمية كل محرف داخل متغير position لكل سجل من السجلات الستة. عند فحص كلمة “Guard”، يمر المؤشر بالحرف ‘G’ ثم ‘u’ ثم ‘a’ دون مطابقة، حتى يصل إلى الحرف الرابع ‘r’، فيستبدله فوراً بالحرف ‘z’ ليتحول النص إلى “Guazd”. أما في كلمة “Forward”، فإن الخوارزمية ترصد ظهورين مستقلين للحرف ‘r’؛ الأول في الموضع الرابع والثاني في الموضع السادس، فتجري استبدالاً مزدوجاً ومتزامناً ليتحول النص الأصلي إلى “Fozwazd”. وأخيراً، تتحول كلمة “Center” إلى “Centez” باستبدال الحرف الأخير فقط.
4.2 توثيق التعديلات باستخدام خطوة DATA جديدة وعرض النتائج
تقتضي الممارسات البرمجية الرصينة في هندسة البيانات تفادي الكتابة المباشرة فوق البيانات الأصلية (Overwriting) أثناء مراحل التجريب والاختبار، والاعتماد بدلاً من ذلك على إنشاء مجموعات بيانات جديدة لتسهيل التدقيق والمراجعة. يسمح هذا النهج بعزل المتغيرات المعدلة ومقارنتها بسجل البيانات التاريخي للتحقق من خلو العملية من أي تشوهات غير مقصودة في الأنماط النصية المجاورة أو في المتغيرات الرقمية التابعة.
تُوثق النتائج المترتبة على تنفيذ عملية الاستبدال الحرفي الفردي عبر استدعاء إجراء PROC PRINT على مجموعة البيانات الجديدة single_char_replace، لطباعة القيم الناتجة والتحقق الإحصائي من شمولية التعديل ودقته:
proc print data=single_char_replace noobs;
title “نتائج استبدال الحرف المفرد ‘r’ بالحرف ‘z'”;
run;
يكشف الفحص المنهجي لمخرجات الطباعة عن نجاح العملية بنسبة دقة مطلقة؛ حيث شمل التحويل جميع حالات ظهور الحرف ‘r’ الصغير بصرف النظر عن موقعه داخل الكلمة (في المنتصف كما في “Guazd”، أو متكرراً كما في “Fozwazd”، أو في النهاية كما في “Centez”). ويؤكد هذا الإجراء ثبات الحروف الأخرى التي لم تشملها قائمة الاستبدال؛ فحرف ‘G’ الكبير في بداية الكلمة ظل محتفظاً بحالته وخصائصه دون تأثر، وكذلك حافظت الحقول الرقمية points وأسماء الفرق team على سلامتها البنائية الكاملة.
5. التطبيق العملي الثاني: استبدال أحرف متعددة بالتوازي
5.1 بناء مصفوفات الإحلال المتناظرة بين سلاسل الحروف
يتجاوز النطاق الوظيفي لدالة TRANSLATE مجرد الاستبدال الفردي البسيط ليمتد إلى المعالجة المتوازية لمجموعات من الحروف المتباينة ضمن تعليمة برمجية واحدة. في كثير من سيناريوهات تنقية البيانات، يحتاج المحلل إلى تعديل عدة حروف ذات دلالات مختلفة لتوحيد نظم الترميز. تفترض هذه الحالة الحاجة إلى استبدال حرفي العلة ‘a’ و’o’ بالحرفين ‘e’ و’u’ على التوالي داخل عمود position، بحيث يحل ‘e’ محل ‘a’، ويحل ‘u’ محل ‘o’ بصورة متزامنة.
لبناء هذه المصفوفة المتناظرة، يتم تجميع الحروف المستهدفة في المعامل الثالث from كسلسلة نصية واحدة هي 'ao'، وتجميع الحروف البديلة في المعامل الثاني to كسلسلة متناظرة تماماً هي 'eu'. تضمن هذه الصياغة الحفاظ على التطابق الموضعي الفردي، حيث يرتبط المحرف الأول في السلسلة الأولى بالمحرف الأول في السلسلة الثانية، ويرتبط المحرف الثاني بالثاني، وهكذا. تُصاغ الشيفرة البرمجية داخل خطوة بيانات جديدة على النحو الآتي:
data multi_char_replace;
set original_data;
position = translate(position, ‘eu’, ‘ao’);
run;
توضح هذه الصياغة المباشرة قوة دالة TRANSLATE في اختزال الشيفرات البرمجية؛ فبدلاً من استدعاء دوال متعددة ومتعاقبة قد تؤدي إلى تكرار قراءة السجلات واستهلاك دورات المعالجة المركزية، تتم معالجة السلسلة في مسار مسح واحد. يعالج النظام كل حرف يصادفه بمقارنته بكامل عناصر مصفوفة from دفعة واحدة، مما يمنع حدوث أي تضارب بين الحروف المستبدلة والحروف الجديدة خلال لحظة التنفيذ الحسابي.
5.2 التحقق من التطابق الموضعي الفردي لكل حرف
تتطلب موثوقية التحليل التحقق من دقة التناظر الفردي لكل حرف تم استبداله داخل الكلمات المركبة في مجموعة البيانات. عند تحليل مخرجات الشيفرة البرمجية السابقة باستخدام إجراء PROC PRINT، يمكن تتبع التحولات الحرفية بدقة متناهية:
proc print data=multi_char_replace noobs;
title “نتائج الاستبدال المتعدد المتوازي للحروف (‘a’->’e’, ‘o’->’u’)”;
run;
تكشف المعاينة التفصيلية للمخرجات عن تحول كلمة “Guard” إلى “Guerd” نتيجة استبدال الحرف ‘a’ بالحرف ‘e’، مع بقاء بقية المحارف دون تغيير. أما في كلمة “Forward”، فقد خضعت السلسلة لعملية استبدال مركبة وشاملة؛ حيث استُبدل الحرف ‘o’ بالحرف ‘u’ في المقطع الأول، واستُبدل الحرف ‘a’ بالحرف ‘e’ في المقطع الثاني، لتتحول الكلمة بأكملها إلى “Furwerd” في خطوة موحدة. وفي المقابل، بقيت كلمة “Center” دون أي تعديل لعدم احتوائها على أي من الحرفين ‘a’ أو ‘o’.
من الأهمية بمكان التأكيد على أن هذا الإجراء ينفذ استبدالاً حرفياً موضعياً (Character-by-Character) ولا يمت بصلة إلى استبدال المقاطع أو الكلمات (Word/Substring Replacement). فالدالة لا تبحث عن المقطع المجمع “ao” لتستبدله بالمقطع “eu”، بل تتعامل مع كل رمز ككيان إحداثي مستقل تماماً، وهو تمييز جوهري يحمي المحلل من الوقوع في سوء فهم شائع لطبيعة المعالجة المحرفية في خطوة بيانات SAS.
6. معالجة التباين في أطوال سلاسل الإحلال والاستبدال
6.1 حالة زيادة طول السلسلة المستهدفة (From) عن سلسلة البدائل (To)
يعد التعامل مع التباين في أطوال سلاسل المعاملات النصية من أبرز الخصائص الخوارزمية لدالة TRANSLATE في لغة SAS. عندما يُدخل المبرمج سلسلة مستهدفة from تفوق في عدد حروفها طول سلسلة البدائل to، يواجه النظام حالة عدم تكافؤ عددي في مصفوفات التناظر. في مثل هذه الظروف، لا يتوقف النظام عن العمل ولا يطلق رسالة خطأ حرجة في سجل التشغيل (SAS Log)، بل يطبق قاعدة سلوكية محددة مسبقاً في تصميمه البرمجي.
تتمثل هذه القاعدة في قيام نظام SAS بإسناد المسافة البيضاء الفارغة (Blank Space: ‘ ‘) كبديل تلقائي وافتراضي لأي محرف يقع في السلسلة from ولا يقابله محرف مناظر في السلسلة to. فإذا كانت السلسلة from تحتوي على أربعة محارف 'abcd' بينما تحتوي السلسلة to على محرفين فقط هما 'xy'، فإن المحرف ‘a’ يُستبدل بـ ‘x’، والمحرف ‘b’ يُستبدل بـ ‘y’، في حين يُستبدل كل من المحرفين ‘c’ و’d’ بمسافة فارغة (‘ ‘). يوضح الكود الآتي تطبيق هذا السلوك:
data asymmetry_from_longer;
set original_data;
/* ‘r’ يستبدل بـ ‘z’، بينما ‘d’ و ‘t’ يستبدلان بمسافة فارغة */
position = translate(position, ‘z’, ‘rdt’);
run;
تعتبر هذه الميزة المعمارية أداة تقنية بالغة القوة عند استغلالها بوعي واحترافية؛ إذ تتيح للمحللين حذف الحروف غير المرغوب فيها من النصوص عبر تعيينها في نهاية سلسلة from دون توفير بدائل لها في to، مما يؤدي إلى تحويلها إلى مسافات فارغة يمكن إزالتها لاحقاً وبسهولة عبر دوال الضغط مثل COMPRESS، وهو ما يختصر خطوات المعالجة في تحضير المتغيرات النصية المعقدة.
6.2 حالة زيادة طول سلسلة البدائل (To) عن السلسلة المستهدفة (From)
في الحالة العكسية، قد يمرر المبرمج سلسلة بدائل to تتجاوز في عدد عناصرها الحرفية طول السلسلة المستهدفة from. على سبيل المثال، قد تحتوي السلسلة to على أربعة حروف 'wxyz' بينما تقتصر السلسلة from على حرفين فقط هما 'ab'. يثير هذا السيناريو تساؤلات حول الكيفية التي يتعامل بها محرك SAS مع تلك المحارف الإضافية التي لا تقابلها أي أهداف استبدال داخل السلسلة المصدرية.
يتبنى نظام SAS في هذا السياق آلية التجاهل الصامت للمحارف الفائضة؛ حيث يربط المحرف الأول بالأول، والمحرف الثاني بالثاني، ويتجاهل بصورة كلية وتلقائية جميع الحروف الإضافية الواقعة في ذيل السلسلة to والتي تتجاوز الطول المحدد للسلسلة from. وبناءً على ذلك، فإن المحارف الزائدة مثل ‘y’ و’z’ في المثال السابق لا تؤثر بأي شكل من الأشكال على مجريات التنفيذ، ولا تسبب أي استبدالات غير متوقعة في النص المصدر. يتضح هذا السلوك في المثال البرمجي التالي:
data asymmetry_to_longer;
set original_data;
/* ‘r’ يستبدل بـ ‘z’، بينما الحروف الزائدة ‘k’ و ‘m’ يتم تجاهلها تماماً */
position = translate(position, ‘zkm’, ‘r’);
run;
على الرغم من أن هذا السلوك لا يترتب عليه توقف البرنامج أو صدور تحذيرات برمجية، إلا أن الممارسات البرمجية الأكاديمية الصارمة تعتبر وجود حروف زائدة في سلسلة البدائل مؤشراً على تدني جودة الشيفرة البرمجية وهدراً في التعليمات المعالجة. يُوصى دائماً بضبط التكافؤ العددي الدقيق بين أطوال سلاسل الإحلال والاستبدال، لضمان وضوح الكود وقابليته للقراءة والمراجعة من قبل باحثين ومحللين آخرين وتجنب أي لبس في الأهداف المنطقية لعمليات التحويل.
7. المقارنة المنهجية بين دالتي TRANSLATE وTRANWRD في SAS
7.1 أوجه الاختلاف في فلسفة المعالجة النصية
تعد المقارنة بين دالتي TRANSLATE وTRANWRD من أهم الموضوعات المنهجية في برمجة SAS؛ نظراً لتشابه وظائفهما الظاهري في استبدال النصوص، مع اختلافهما الجوهري في فلسفة المعالجة وآليات التنفيذ الخوارزمي. تكمن نقطة التباين المركزية في أن دالة TRANSLATE هي دالة موضعية حرفية بحتة (Positional Character-Based Function)، تتعامل مع المحارف كذرات مستقلة وتستبدل كل حرف على حدة وفقاً لتناظره في المصفوفات المدخلة، بغض النظر عن السياق اللغوي أو الكلمات التي تشكلها تلك الحروف داخل السلسلة المصدرية.
في المقابل، صُممت دالة TRANWRD للتعامل مع المقاطع والكلمات ككتل نصية متكاملة (String/Pattern-Based Function). عند استدعاء هذه الدالة، فإنها تبحث عن التطابق التام لكلمة أو مقطع كامل محدد في السلسلة المصدرية لاستبداله بكتلة نصية أخرى قد تختلف عنها كلياً في الطول وعدد الحروف. يوضح الجدول المفاهيمي التالي الفروق الجوهرية بين الدالتين في البيئة التشغيلية:
| وجه المقارنة | دالة TRANSLATE | دالة TRANWRD |
|---|---|---|
| وحدة المعالجة الأساسية | الحروف الفردية المستقلة موضعياً | الكلمات والمقاطع ككتلة نصية موحدة |
| التكافؤ في أطوال المدخلات | استبدال حرف مقابل حرف (طول ثابت) | إمكانية استبدال مقطع قصير بسلسلة طويلة والعكس |
| حجز الذاكرة وطول الناتج | لا يتجاوز طول النص الأصلي في خطوة DATA | قد يقتطع النص إذا لم يُحدد طول كافٍ عبر LENGTH |
| السرعة والكفاءة الحاسوبية | عالية جداً (تنفيذ منخفض المستوى بلغة C) | تتطلب جهداً حاسوبياً أكبر لمسح الأنماط المركبة |
تؤثر هذه الفروق تأثيراً مباشراً على استقرار هياكل البيانات وحجز الذاكرة؛ فاستخدام دالة TRANWRD لاستبدال كلمة قصيرة بأخرى أطول قد يؤدي إلى اقتطاع غير مقصود للنص (Truncation) إذا لم يكن طول المتغير معرفاً مسبقاً بمساحة بايتات كافية لاستيعاب الكلمة الجديدة. أما دالة TRANSLATE، فإنها تحافظ دوماً على البنية الطولية الأصلية للمتغير دون خطر الاقتطاع، مما يجعلها خياراً فائق الأمان والسرعة في المعالجات الحرفية المباشرة.
7.2 معايير اختيار الدالة المثلى وفق طبيعة البيانات
يتوقف الاختيار المنهجي بين TRANSLATE وTRANWRD على طبيعة المشكلة التحليلية المراد حلها والخصائص البنيوية للمتغيرات النصية المستهدفة. يُفضل الاعتماد المطلق على دالة TRANSLATE في الحالات التي تستهدف توحيد الرموز المحرفية البسيطة؛ مثل استبدال الفواصل العادية بفواصل منقوطة، أو تحويل المسافات إلى شرطات سفلية، أو تعديل شفرات إجابات الاستبيانات المكونة من رموز فردية، أو استبدال علامات الترقيم والأقواس برموز قياسية لتهيئة النصوص للمعالجات الإحصائية المتقدمة.
في المقابل، يتعين اللجوء إلى دالة TRANWRD عندما تقتضي الحاجة معالجة ألفاظ كاملة ومصطلحات علمية أو أسماء مركبة؛ كاستبدال الاختصارات الطبية بأسمائها الكاملة (مثل استبدال ‘DM’ بـ ‘Diabetes Mellitus’)، أو تعديل المسميات الجغرافية في السجلات السكانية، أو معالجة التسميات الأكاديمية للمقاييس السلوكية. محاولة استخدام TRANSLATE في مثل هذه الحالات ستؤدي إلى نتائج كارثية؛ حيث ستقوم بتفتيت الكلمة واستبدال حروفها المنفردة بدلاً من استبدال المسمى ككيان لغوي واحد.
ومن منظور الكفاءة الحسابية واستهلاك الموارد في بيئات البيانات الضخمة (Big Data) ومستودعات البيانات الضخمة، تتمتع دالة TRANSLATE بأفضلية تشغيلية ملحوظة مقارنة بـ TRANWRD والتعابير النمطية (Perl Regular Expressions). فخوارزمية المسح الحرفي المباشر تستهلك عدداً أقل بكثير من دورات المعالج المركزي وتتطلب قدراً أدنى من الذاكرة المؤقتة، مما يجعلها الخيار الهندسي الأمثل عندما تكون أهداف التنقية قابلة للإنجاز على مستوى المحارف الفردية.
8. توظيف دالة TRANSLATE في تنقية بيانات القياس النفسي والسلوكي
8.1 توحيد رموز مقاييس ليكرت والاستجابات الاستبيانية
تحظى تنقية وتجهيز البيانات بأهمية بالغة في أبحاث القياس النفسي (Psychometrics) والعلوم السلوكية، حيث تعتمد موثوقية المقاييس وصدقها على نظافة البيانات الأولية المستخرجة من الاستبيانات وأدوات الرصد الميداني. وتعتمد المقاييس السيكومترية المقننة، مثل مقياس شدة الأرق (Morin et al., 2011) وأدوات قياس تلبية الحاجات النفسية الأساسية في بيئة العمل (Van den Broeck et al., 2010)، ومقاييس تقييم ضبط النفس والسمات الشخصية (de Ridder et al., 2011)، على رصد استجابات الأفراد عبر تدريجات رتبية دقيقة تتطلب توحيداً صارماً لرموزها قبل حساب الدرجات الكلية وإجراء التحليلات العاملية ونماذج الانحدار.
في كثير من التطبيقات الميدانية والمقابلات التشخيصية المقننة للأطفال والبالغين، كتلك المستخدمة في المقابلات التشخيصية الموجهة (Shaffer et al., 2000)، قد تُسجل استجابات ليكرت بصيغ حرفية أبجدية غير موحدة (مثل تسجيل الفئات كـ ‘A’ و’B’ و’C’ و’D’ و’E’ لتمثيل درجات الموافقة من “أعارض بشدة” إلى “أوافق بشدة”). ولاستخدام هذه البيانات في النمذجة الرياضية، يجب تحويل هذه الرموز الحرفية إلى قيم عددية مقابلة (1 إلى 5) بدقة متناهية. تبرز دالة TRANSLATE كأداة فائقة الكفاءة لإنجاز هذا التحويل الموضعي المتوازي عبر خطوة بيانات مباشرة:
data survey_clean;
set survey_raw;
/* إعادة ترميز استجابات ليكرت من أحرف أبجدية إلى قيم رقمية مكافئة */
response_num = translate(response_char, ‘12345’, ‘ABCDE’);
run;
تسهم هذه العملية البرمجية السريعة في توحيد استجابات المشاركين وتجهيزها لحساب مقاييس الاتساق الداخلي، مثل معامل ألفا كرونباخ، والتحقق من البنية العاملية للمقاييس السلوكية، مما يضمن خلو المؤشرات النفسية من أي أخطاء ناجمة عن عدم تجانس شفرات الإدخال، ويوفر بيئة قياس كمية تتسم بأعلى درجات الصرامة الإحصائية.
8.2 تنظيف معرفات المفحوصين والسجلات السلوكية من الرموز الشاذة
تواجه الدراسات الوبائية والنفسية واسعة النطاق التي تفحص أثر الصدمات النفسية والاضطرابات العقلية والضغوط الحياتية عبر مسوح عالمية متعددة المراكز، مثل مبادرات مسح الصحة النفسية العالمية (Benjet et al., 2015; Kessler et al., 2010) ودراسات المرونة النفسية في مواجهة الكوارث والأزمات المجتمعية (Bonanno et al., 2007)، تحديات جسيمة تتعلق بسلامة المعرفات الفريدة للمشاركين (Subject IDs). وتظهر تحديات مماثلة في الدراسات التلوية والسجلات السريرية المتقاطعة التي ترصد التظاهرات النفسية والعصبية للأوبئة والأمراض الشديدة (Rogers et al., 2020)، حيث تتجمع السجلات من مصادر ومستشفيات متباينة بتنسيقات متضاربة تحوي محارف خاصة ورموزاً عشوائية.
قد تحتوي المعرفات المستخرجة من أجهزة تسجيل الاستجابة السلوكية الزمنية أو واجهات الاستبيانات الإلكترونية على محارف مشوشة؛ مثل الشرطات المائلة (‘/’ أو ”)، والنقاط، وعلامات الهاشتاغ، أو المسافات العشوائية الناتجة عن تباين لوحات المفاتيح أو بروتوكولات التصدير. يؤدي وجود هذه المحارف الشاذة إلى إفشال عمليات ربط الجداول الطولية (Longitudinal Data Merging) عبر عبارة MERGE في SAS. وتُستخدم دالة TRANSLATE كخط دفاع أول لتطهير هذه المعرفات وتوحيدها عبر استبدال المحارف غير المتوافقة برمز معياري موحد كالشرطة السفلية (‘_’):
data clinical_cleaned;
set clinical_cohort_raw;
/* استبدال الرموز غير المعيارية والفواصل بشرطات سفلية لتوحيد المعرفات */
subject_id_std = translate(subject_id, ‘___’, ‘/-#’);
run;
تضمن هذه المعالجة حماية تكامل قواعد البيانات السلوكية والسريرية الطولية وتفادي فقدان السجلات الفردية أثناء عمليات الربط والدمج المتسلسل. وتتكامل هذه الإجراءات المنهجية مع المعايير النوعية والتصميمية المتبعة في بحوث الرصد السلوكي والتحليل الوصفي (Shaliha et al., 1989)، حيث تشكل نظافة السلاسل الرمزية وسلامة تتبع الحالات ركيزة حاسمة تضمن سلامة الاستدلال العلمي وجودة النتائج النهائية المنشورة في الأدبيات المحكمة.
9. الأخطاء الشائعة واستراتيجيات استكشافها وتصحيحها
9.1 إهمال حساسية الأحرف وتأثيره على اكتمال المعالجة
يعد إغفال الحساسية الصارمة لحالة الأحرف اللاتينية (Case-Sensitivity) في نظام SAS من أكثر الأخطاء المنطقية شيوعاً عند تطبيق دالة TRANSLATE. يميل المبرمجون في كثير من الأحيان إلى افتراض أن الدالة تطبق استبدالاً شمولياً للمحرف بصرف النظر عن صيغته البنائية، فيكتفون بإدراج الحرف بصيغته الصغيرة (Lower-case) داخل سلسلة from. ونتيجة لذلك، تبقى كافة الحالات التي يظهر فيها الحرف بصيغته الكبيرة (Upper-case) في البيانات الأصلية دون معالجة، مما يخلق تشتتاً غير مقصود في الفئات المصنفة ويشوه نتائج الجداول التكرارية.
لتفادي هذا القصور المنهجي وضمان اكتمال المعالجة الاستبدالية، تتضمن أفضل الممارسات البرمجية دمج دوال ضبط الحالة مع دالة TRANSLATE، أو تضمين كافة حالات الحرف داخل السلسلة المستهدفة. يمكن على سبيل المثال استخدام دالة UPCASE أو LOWCASE لتوحيد حالة النص قبل تمريره للدالة، أو توسيع سلاسل الدالة لتشمل الحروف الصغيرة والكبيرة معاً بالتناظر الدقيق:
data case_handling;
set original_data;
/* ضمان استبدال الحرف بكافة حالاته: الكبيرة والصغيرة بالتوازي */
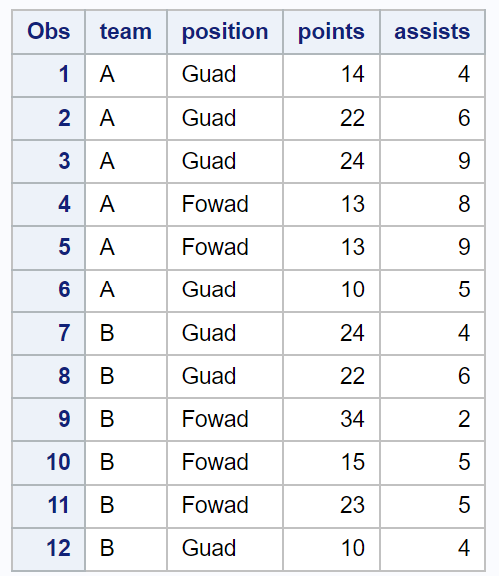
position_fixed = translate(position, ‘zz’, ‘Rr’);
run;
كما ينبغي للمحللين اختبار سلوك الدالة عند التعامل مع المحارف الخاصة المحجوزة في نظام SAS، مثل علامات النسبة المئوية (%) أو علامة الفاصلة المنقوطة (;) أو علامة الدولار ($). عند الرغبة في استبدال هذه الرموز، يجب إحاطتها بعناية داخل علامات اقتباس فردية صلبة لمنع تداخلها مع محركات الترجمة النصية الأخرى ولضمان معاملتها كمحارف نصية بحتة دون أي دلالة وظيفية خاصة.
9.2 الخلط في ترتيب المعاملات وحدوث التحويل العكسي
يمثل الخلط بين موضع سلسلة الإحلال (to) وموضع سلسلة الاستبدال (from) فخاً برمجياً شائعاً يقع فيه العديد من المشتغلين بتحليل البيانات؛ نظراً لأن الترتيب المألوف في اللغة الطبيعية أو في بعض لغات البرمجة الأخرى يميل إلى ذكر “الحرف الأصلي المراد استبداله أولاً ثم الحرف الجديد البديل”. غير أن البنية النحوية لدالة TRANSLATE في SAS تعكس هذا المنطق الطبيعي وتفرض وضع سلسلة الحروف البديلة to كمعامل ثانٍ وسلسلة الحروف الأصلية from كمعامل ثالث.
يترتب على عكس هذين المعاملين حدوث تحويل معاكس وغير مقصود؛ فبدلاً من إزالة الرموز الشاذة ووضع الرموز المعيارية، يقوم البرنامج بإزالة الرموز المعيارية ونشر الرموز الشاذة في مصفوفة البيانات. ولأن هذا الخطأ منطقي بحت (Logical Error) ولا يخالف القواعد الإعرابية لمترجم SAS، فإن النظام لا يسجل أي أخطاء برمجية في نافذة السجل (Log Window)، مما يصعّب اكتشافه ما لم يتبع الباحث استراتيجيات تدقيق إحصائي استباقية.
تتمثل استراتيجية التحقق الفعالة في تشغيل جداول التكرار المتقاطعة عبر إجراء PROC FREQ قبل وبعد عملية الاستبدال، لمراقبة التوزيع التكراري للفئات والتحقق من اختفاء الأنماط القديمة وظهور الأنماط الجديدة كما هو مخطط له. علاوة على ذلك، يُنصح ببناء اختبارات فحص آلي داخل خطوة البيانات باستخدام عبارات شرطية (Assertive IF-THEN Logic) ترسل رسائل تحذيرية مخصصة إلى نافذة السجل عبر تعليمة PUT في حال رصد استمرار وجود المحارف المفترض إزالتها في السجلات الناتجة.
10. الكفاءة الحاسوبية وأفضل الممارسات البرمجية المتقدمة
10.1 تحسين الأداء عند معالجة السجلات الضخمة (Big Data)
في عصر البيانات الضخمة (Big Data) حيث تشتمل مستودعات البيانات السريرية والسلوكية على عشرات ومئات الملايين من السجلات الموزعة، تصبح الكفاءة الحسابية واستهلاك الموارد معياراً حاسماً لجودة الحلول البرمجية. تتمتع دالة TRANSLATE بميزة استثنائية في هذا المضمار؛ لكونها مكتوبة ومحسنة داخلياً بلغة C المنخفضة المستوى، مما يمنحها قدرة فائقة على النفاذ السريع إلى كتل الذاكرة دون الحاجة إلى معالجة وسيطة معقدة للمؤشرات.
لتحقيق أقصى درجات الكفاءة وتقليل استهلاك الذاكرة العشوائية وسرعة النفاذ إلى القرص، يُنصح بتطبيق عمليات الاستبدال مباشرة على المتغير المصدر نفسه وتجنب إنشاء أعمدة وسيطة مؤقتة كلما كان ذلك ممكناً بعد استقرار التحقق المنطقي، لأن إنشاء متغيرات جديدة يزيد من عرض ناقل بيانات البرنامج (Program Data Vector – PDV) ويضاعف من مساحة التخزين المستهلكة في كل سجل. وعند مقارنة الأداء بين دالة TRANSLATE ودوال التعابير النمطية المتقدمة في SAS مثل PRXCHANGE، تظهر الاختبارات المعيارية تفوقاً كاسحاً لدالة TRANSLATE بفارق زمني يتراوح بين 5 إلى 10 أضعاف لصالحها عند تنفيذ الاستبدالات الحرفية البسيطة، نظراً لأن محرك تعابير بيرل يتطلب بناء جداول فحص معقدة تستهلك وقتاً تشغيلياً ثميناً لا مبرر له في مثل هذه العمليات الحرفية المباشرة.
يتيح هذا التباين في الأداء توفير موارد حاسوبية ضخمة عند التعامل مع المعالجات المجمعة المتكررة (Batch Processing) في الخوادم المركزية أو بيئات الحوسبة السحابية مثل SAS Viya، مما يقلل من زمن إنجاز مهام تحضير البيانات المعقدة ويتيح استثمار الوقت والموارد في مراحل النمذجة والتحليل الإحصائي المتقدم.
10.2 إرشادات كتابة الأكواد القابلة للصيانة والتوثيق الأكاديمي
تتطلب الكتابة البرمجية الأكاديمية القابلة للصيانة والتطوير الالتزام بمجموعة من الضوابط المنهجية التي تضمن وضوح الشيفرات وقابليتها لإعادة الإنتاج والمراجعة النظيرة. يأتي في مقدمة هذه الإرشادات التوثيق الدقيق لأهداف الاستبدال ومسوغاته عبر إدراج التعليقات البرمجية (Comments) التوضيحية داخل خطوة البيانات، مع تبيان الأساس المنطقي وراء استبدال كل محرف، لا سيما في المشروعات البحثية طويلة الأمد التي يشارك فيها فرق عمل متعددة التخصصات.
ومن الإجراءات الجوهرية أيضاً التحديد الصارم والمسبق لأطوال المتغيرات النصية باستخدام عبارة LENGTH قبل أول ظهور للمتغير أو استدعاء للدالة في خطوة البيانات. على الرغم من أن دالة TRANSLATE لا تغير في الطول الأصلي للسلسلة، إلا أن تهيئة المتغيرات بأطوال محددة بدقة يحمي من التخصيص العشوائي الافتراضي لمساحات الذاكرة، ويضمن تكامل هياكل الجداول عبر خطوات التحليل المتلاحقة. ويمكن صياغة هذه البنية المتكاملة كما يلي:
data final_production;
length position $12;
set original_data;
/* توثيق: توحيد شفرات المراكز الرياضية وفق الدليل المعياري للترميز */
position = translate(position, ‘Z’, ‘r’);
run;
وفي التطبيقات التحليلية المتقدمة، يُوصى ببناء دوال ماكرو (SAS Macros) معيارية وقابلة لإعادة الاستخدام تحتوي على دالة TRANSLATE لمعالجة متغيرات نصية متعددة عبر مجموعات بيانات متنوعة بأسلوب آلي وموحد، مما يقلل من تكرار الأكواد اليدوية ويحد من احتمالات الخطأ البشري، ويعزز من انضباط مسارات المعالجة الحسابية في المؤسسات الأكاديمية والبحثية الكبرى.
خاتمة واستنتاجات
تمثل دالة TRANSLATE ركيزة معمارية بالغة الأهمية في ترسانة المعالجة النصية داخل لغة برمجة SAS، حيث تجمع بين البساطة البنائية في صياغتها والكفاءة الخوارزمية الفائقة في تنفيذ الاستبدالات الحرفية الموضعية المتوازية. ومن خلال استعراض آليات عملها وقواعدها النحوية وتطبيقاتها المتنوعة في هذا الدليل، يتضح أن الاستيعاب الدقيق لخصائصها التشغيلية يسهم بصورة حاسمة في تسريع وتأمين مراحل تنقية البيانات وتهيئتها للتحليل الإحصائي المتقدم.
إن قدرة الدالة على معالجة السلاسل النصية على مستوى الحروف الفردية، وتجاوبها المنضبط مع حالات تباين أطوال المعاملات، وتميزها عن البدائل المقطعية مثل TRANWRD والتعابير النمطية، يجعلها خياراً مثالياً وموثوقاً لإعادة ترميز المقاييس النفسية وتطهير السجلات السلوكية والسريرية من الشوائب والمحارف الشاذة دون استهلاك مفرط لموارد المعالجة والذاكرة.
ويظل الالتزام بأفضل الممارسات البرمجية—من تحديد مسبق لأطوال المتغيرات، وفهم لحساسية الأحرف اللاتينية، وتوثيق دقيق لخطوات التحويل، وفحص إحصائي مستمر للمخرجات عبر الإجراءات التقاريرية المعتمدة—هو الضمانة الحقيقية لتحقيق أقصى استفادة من هذه الأداة المتخصصة، بما يدعم جودة الاستدلال العلمي ويحافظ على رصانة النتائج التحليلية المستخرجة من قواعد البيانات البحثية المعقدة.
المراجع
- Benjet, C. L., Bromet, E. J., Karam, E. G., Kessler, R. C., McLaughlin, K. A., Ruscio, A. M., et al. (2015). The epidemiology of traumatic event exposure worldwide: results from the World Mental Health Survey Consortium. Psychological Medicine. https://doi.org/10.1017/s0033291715001981
- Bonanno, G. A., Galea, S., Bucciarelli, A., & Vlahov, D. (2007). What predicts psychological resilience after disaster? The role of demographics, resources, and life stress. Journal of Consulting and Clinical Psychology. https://doi.org/10.1037/0022-006x.75.5.671
- de Ridder, D. T. D., Lensvelt‐Mulders, G., Finkenauer, C., Stok, F. M., & Baumeister, R. F. (2011). Taking Stock of Self-Control. Personality and Social Psychology Review. https://doi.org/10.1177/1088868311418749
- Kessler, R. C., Green, J. G., Gruber, M. J., Sampson, N. A., Bromet, E. J., Cuitan, M., et al. (2010). Screening for serious mental illness in the general population with the K6 screening scale: results from the WHO World Mental Health (WMH) survey initiative. International Journal of Methods in Psychiatric Research. https://doi.org/10.1002/mpr.310
- Morin, C. M., Belleville, G., Bélanger, L., & Ivers, H. (2011). The Insomnia Severity Index: Psychometric Indicators to Detect Insomnia Cases and Evaluate Treatment Response. SLEEP. https://doi.org/10.1093/sleep/34.5.601
- Rogers, J. P., Chesney, E., Oliver, D., Pollak, T. A., McGuire, P. K., Fusar‐Poli, P., et al. (2020). Psychiatric and neuropsychiatric presentations associated with severe coronavirus infections: a systematic review and meta-analysis with comparison to the COVID-19 pandemic. The Lancet Psychiatry. https://doi.org/10.1016/s2215-0366(20)30203-0
- Shaffer, D., Fisher, P. W., Lucas, C. P., Dulcan, M. K., & Schwab‐Stone, M. (2000). NIMH Diagnostic Interview Schedule for Children Version IV (NIMH DISC-IV): Description, Differences From Previous Versions, and Reliability of Some Common Diagnoses. Journal of the American Academy of Child & Adolescent Psychiatry. https://doi.org/10.1097/00004583-200001000-00014
- Shaliha, F., Mozaffari, M., Ramezani, F., Hajnasiri, H., & Moafi, F. (1989). Designing qualitative research. Choice Reviews Online. https://doi.org/10.5860/choice.27-1232
- Van den Broeck, A., Vansteenkiste, M., De Witte, H., Soenens, B., & Lens, W. (2010). Capturing autonomy, competence, and relatedness at work: Construction and initial validation of the Work‐related Basic Need Satisfaction scale. Journal of Occupational and Organizational Psychology. https://doi.org/10.1348/096317909×481382