
تُمثّل معالجة السلاسل النصية وضبط جودة البيانات الحرفية ركيزة جوهرية في منظومة التحليل الإحصائي المتقدم، لا سيما في البيئات البحثية والأكاديمية التي تعتمد على حزم برمجية رصينة مثل نظام التحليل الإحصائي SAS (Statistical Analysis System). فعند التعامل مع قواعد البيانات المستخلصة من الدراسات الميدانية، والمسوح السلوكية، والتجارب النفسية، يواجه الباحثون تدفقات ضخمة من المتغيرات النصية غير المتجانسة، والتي تتطلب تطهيراً دقيقاً وإعادة هيكلة بنيوية قبل إخضاعها للنمذجة الرياضية أو الاختبارات الاستدلالية. ومن بين الأدوات البرمجية الأكثر كفاءة التي توفرها خطوة البيانات في هذا النظام، تبرز دالة استبدال الكلمات والأنماط النصية المعروفة باسم دالة TRANWRD كأداة لا غنى عنها لتحقيق التوافق المعياري للنصوص.
تُعد هذه الدالة أداة قطعية برمجية صُممت خصيصاً للبحث عن مقاطع نصية أو كلمات محددة واستبدالها بأنماط أخرى بديلة عبر كامل السلسلة النصية المستهدفة دون المساس بالبنية الكلية للسجل. وعلى خلاف العمليات الإحصائية البحتة التي تنتج تقديرات احتمالية وقيم اختبار كمية، فإن دالة TRANWRD تؤدي وظيفة تشغيلية حاسمة تضمن اتساق المدخلات وسلامة تمثيل البيانات النوعية، مما يحول دون تشتت الفئات وتعدد المسميات للمتغير الواحد. إن الفهم الدقيق للآليات الدقيقة التي تحكم عمل هذه الدالة، بدءاً من طريقة تفسيرها للمسافات الفارغة وحساسيتها لحالة الأحرف، وصولاً إلى إدارتها للمساحات التخزينية في الذاكرة، يُعد شرطاً أساسياً لضمان عدم فقدان البيانات أو اقتطاعها أثناء عمليات التنظيف الآلي.
يسعى هذا الدليل الشامل والمفصل إلى تقديم دراسة معمقة وتطبيقية متكاملة حول كيفية استخدام دالة TRANWRD في بيئة SAS الإحصائية. سيتم استعراض الأسس النظرية والمفاهيمية المنظمة لمعالجة السلاسل النصية، وتفكيك البنية النحوية الرياضية للدالة ووسائطها، تليها تطبيقات معملية مبرمجة خطوة بخطوة تغطي استبدال الكلمات، وحذف المقاطع غير المرغوبة، والتعامل مع الفراغات الزائدة، ومقارنتها بالدوال النصية المقابلة. كما يتطرق الدليل إلى الاستراتيجيات المتقدمة في معالجة البيانات الضخمة وتفادي المزالق التقنية الشائعة، متوجاً ذلك بدراسة حالة واقعية لتنظيف بيانات استبيان نفسي مفتوح، ليكون هذا المرجع بمثابة مرشد إجرائي للباحثين ومحللي البيانات الراغبين في رفع كفاءة وموثوقية معالجاتهم النصية.
1. مقدمة نظرية حول معالجة السلاسل النصية ودالة TRANWRD في نظام SAS
1.1 مفهوم معالجة البيانات النصية في التحليل الإحصائي الأكاديمي
تحتل البيانات النصية والمتغيرات الفئوية الحرفية موقعاً حيوياً في البحوث التجريبية والمسوح الميدانية عبر مختلف التخصصات الاجتماعية، والنفسية، والوبائية. وعلى الرغم من أن جوهر التحليل الإحصائي ينصب في الغالب على النمذجة الرياضية للأرقام والمقاييس الكمية، إلا أن جودة هذه النماذج تعتمد اعتماداً كلياً على دقة وموثوقية المتغيرات التصنيفية الحرفية التي تُبنى عليها المقارنات ومحددات التباين. وتبرز أهمية تنقية وتطهير المتغيرات النصية كخطوة تأسيسية إجبارية تسبق أي اختبار إحصائي، حيث إن وجود أي تباين طفيف في صياغة الكلمات، أو إدراج محارف غير مقصودة، أو تشتت التسميات المعبرة عن نفس الظاهرة، يؤدي حتماً إلى تفتيت المتغير الواحد إلى فئات متعددة وهمية، مما يفسد نتائج التوزيعات التكرارية ويشوه مخرجات الاختبارات الإحصائية مثل اختبار مربع كاي وتحليل التباين متعدد المسارات.
وتواجه البحوث الأكاديمية تحديات منهجية جسيمة ناجمة عن الطبيعة غير المنظمة للمدخلات النصية، والتي تتجلى بوضوح في الأخطاء الإملائية المتكررة، والتفاوت في استخدام المسافات البيضاء الفاصلة، والتباين الصرفي في الصياغات اللغوية المستخدمة من قِبل المفحوصين أو جامعي البيانات الميدانية. هذا التشتت يُنتج ما يُعرف بالضجيج البياني، الذي يحد من القدرة على اكتشاف العلاقات الإحصائية الحقيقية ويضعف القوة الاختبارية للدراسة. ومن هنا تبرز الأدوات البرمجية المتطورة لمعالجة السلاسل النصية المضمنة في نظام SAS، والتي طورها معهد SAS عبر عقود من البناء البرمجي المتين، لتتيح للباحث إمكانية تحويل السلاسل النصية الخام والمضطربة إلى مصفوفات بيانات معيارية منظمة تخضع لمعايير الضبط المنهجي الصارم وبكفاءة حسابية استثنائية.
1.2 التعريف الوظيفي لدالة TRANWRD وآلية عملها الحسابية
تُعرّف دالة TRANWRD داخل مكتبة دوال نظام التحليل الإحصائي SAS بأنها دالة معالجة سلاسل حرفية وظيفية مصممة خصيصاً لأداء عمليات البحث والاستبدال المنهجي للكلمات والأنماط النصية الكاملة داخل متغير حرفي مستهدف. وتعمل الدالة على مسح السلسلة النصية المصدرية بصورة متسلسلة ودقيقة لاكتشاف كافة مواضع الظهور غير المتداخلة لنمط محرفي معين، ومن ثم إحلال نمط نصي بديل محدد محله مباشرة. وتستند هذه الآلية إلى مفهوم مطابقة الأنماط المتكاملة، حيث لا تقتصر المعالجة على الحروف المعزولة بل تمتد لتشمل التراكيب اللفظية، والعبارات الاصطلاحية، والرموز المشفرة متتابعة المحارف.
ويكمن الفارق المفاهيمي الجوهري الذي يميز دالة TRANWRD عن غيرها من دوال التبديل في طبيعة وحدة المعالجة النصية؛ ففي حين تركز الدوال الحرفية التقليدية على استبدال المحارف الفردية بناءً على مواقعها الأبجدية، فإن TRANWRD تتعامل مع المقاطع والكلمات ككتل بنائية موحدة ذات دلالة سياقية متكاملة. وعلاوة على ذلك، تتميز الدالة بقدرتها الحسابية الأصيلة على المعالجة الشاملة لكافة تكرارات النمط المستهدف داخل السجل الواحد في خطوة برمجية واحدة، دون الحاجة إلى كتابة حلقات تكرارية معقدة، ودون أن تقع في فخ التكرار اللانهائي الناتج عن تطابق النمط البديل مع جزء من النمط المستهدف، مما يمنحها موثوقية تنفيذية عالية في البيئات الأكاديمية الحساسة للوقت ودقة المعالجة.
1.3 سياقات الاستخدام في تنظيف بيانات المسوح والبحوث السلوكية
تجد دالة TRANWRD بيئتها التطبيقية الخصبة في ميدان معالجة بيانات العلوم السلوكية والنفسية، حيث تشكل الاستجابات المفتوحة للمشاركين تحدياً كبيراً في التحليل والترميز. فعند تطبيق المقاييس النفسية التي تسمح بكتابة نصوص حرة، مثل وصف الحالات الوجدانية أو التعبير عن مستويات الضغط النفسي، تتعدد المفردات المستخدمة للتعبير عن فئة تشخيصية واحدة؛ كأن يُعبّر المفحوص عن قلقه الشديد بعبارات متفاوتة مثل “توتر حاد”، أو “انفعال حاد”، أو “اضطراب حاد”. ومن خلال التوظيف الذكي لدالة TRANWRD، يستطيع الباحث صياغة قواعد ترميز آلية توحد هذه التوصيفات المتباينة تحت مظلة معيارية واحدة، كاستبدال كافة السوابق واللواحق غير الدقيقة بمصطلحات سريرية متفق عليها تمهيداً لترميزها رقمياً.
كما تمتد استخدامات الدالة في البحوث الاجتماعية والوبائية إلى مهام تصحيح وتوحيد المسميات الجغرافية، والمهنية، والتعليمية التي تتكرر بصور متعددة نتيجة الأخطاء الطباعية أو اختلاف أساليب الاختصار، مثل توحيد صيغ المؤهلات الدراسية كاستبدال اختصارات الدرجات الجامعية بصيغ رسمية موحدة عبر مئات الآلاف من السجلات. كذلك تُستخدم الدالة بفاعلية في مهام إخفاء الهوية وسرية البيانات البحثية، حيث يتم استبدال أسماء المراكز الطبية المشاركة أو الأرقام التعريفية للمرضى بأنماط مشفرة تضمن الامتثال لأخلاقيات البحث العلمي وحماية الخصوصية قبل مشاركة مجموعات البيانات مع فرق التحليل الإحصائي الخارجي.
2. البنية النحوية (Syntax) والوسائط الرياضية لدالة TRANWRD
2.1 تفكيك الصيغة العامة للدالة والمعاملات الثلاثة
تعتمد دالة TRANWRD في بنائها التركيبي على صياغة برمجية محددة وثلاثية المعاملات، تخضع لقواعد لغة SAS الصارمة لضمان سلامة التنفيذ الحسابي أثناء مرحلة تصريف خطوة البيانات. وتأخذ الصيغة العامة للدالة الشكل التالي: TRANWRD(source, target, replacement). يتطلب كل معامل من هذه المعاملات الثلاثة الالتزام بطبيعة بيانية محددة ترتبط بمجال السلاسل الحرفية، حيث يمثل الوسيط الأول، المعروف بالمتغير المصدر (source)، السلسلة النصية الأساسية المراد تفتيشها وفحص محتواها؛ وقد يكون هذا الوسيط متغيراً حرفياً موجوداً مسبقاً في جدول البيانات، أو ثابتاً نصياً موضوعاً بين علامتي تنصيص، أو تعبيراً برمجياً مركباً يُنتج قيمة حرفية.
أما الوسيط الثاني، وهو النمط المستهدف (target)، فيحدد الكلمة، أو العبارة، أو التتابع المحرفي الدقيق الذي تسعى الدالة إلى رصده وتحديده داخل السلسلة المصدرية بهدف إزالته وإحلال البديل محله. ويشترط في هذا النمط أن يُصاغ بدقة متناهية، سواء كان ثابتاً نصياً صريحاً أو متغيراً ديناميكياً يحمل قيمة النمط المطلوب، مع ضرورة الوعي التام بأن مطابقة النمط المستهدف لا تخضع للمرونة الدلالية، بل تتطلب تطابقاً حرفياً كاملاً في ترتيب المحارف، وحالتها، والفراغات المحيطة بها لكي تكتمل عملية الاكتشاف بنجاح.
2.2 الوسيط البديل (Replacement) وإدارة استبدال القيم
يمثل الوسيط الثالث، المعرف بالنمط البديل (replacement)، السلسلة المحرفية التي ستتولى الدالة زراعتها في المواضع النصية التي تم تطهيرها من النمط المستهدف. ويلعب هذا المعامل دوراً حاسماً في إعادة تشكيل البنية النهائية للمتغير، حيث يتيح للباحث مرونة تامة في تحديد طبيعة الإحلال؛ فقد يكون البديل عبارة عن كلمة جديدة موسعة، أو رمزاً تصنيفياً مختصراً، أو مصطلحاً معيارياً، كما يمكن أن يكون تعبيراً حرفياً ديناميكياً مستمداً من متغير آخر في نفس السجل البياني.
ومن الخصائص البنيوية البارزة في آلية عمل دالة TRANWRD أنها لا تشترط أي تكافؤ في الطول أو عدد المحارف بين النمط المستهدف والنمط البديل؛ إذ يمكن للدالة بكل سلاسة استبدال كلمة طويلة تتكون من عشرات المحارف بكلمة قصيرة لا تتجاوز حرفين، أو العكس بالعكس، حيث يمكن إحلال عبارة تفسيرية مطولة محل رمز حرفي مقتضب. وتتولى الخوارزمية الداخلية للدالة إعادة حوسبة مواقع المحارف، وإزاحة النصوص اللاحقة، وإعادة بناء الفضاء النصي للسجل تلقائياً ليتوافق مع الطول الإجمالي الجديد، وهو ما يميزها جذرياً عن عمليات التشفير الموضعي البسيطة.
2.3 قواعد التعامل مع المسافات والفراغات البيضاء داخل الوسائط
تُعد معالجة المسافات والفراغات البيضاء داخل وسائط دالة TRANWRD من أكثر القضايا البرمجية دقة والتي يترتب عليها نتائج حاسمة في صحة استرجاع وتعديل البيانات. فالنظام الحسابي لبيئة SAS يتعامل مع الفراغ المحرفي كقيمة نصية قائمة بذاتها لها وزنها التخزيني ورمزها الثنائي في جدول المحارف، وليست مجرد عدم. وبناءً على ذلك، فإن وجود أي فراغات بادئة أو لاحقة داخل النمط المستهدف (target) أو النمط البديل (replacement) يغير من ماهية النمط بصورة جوهرية، ويحول دون اكتمال المطابقة إذا لم تكن تلك المسافات متطابقة تماماً مع ما هو موجود في السلسلة المصدرية.
وعند تمرير سلاسل نصية ثابتة بين علامتي تنصيص تتضمن مسافات، تحتفظ دالة TRANWRD بتلك المسافات بدقة دون أن تجري لها أي اقتطاع أو تهذيب تلقائي؛ فإذا حُدد النمط المستهدف بصيغة تتضمن مسافة لاحقة، فإن الدالة لن تستبدل الكلمة إلا إذا كانت متبوعة بتلك المسافة تحديداً. كما يجب التمييز الرياضي الصارم بين تمرير فراغ نصي يحتوي على مسافة بيضاء واحدة كنمط بديل، وبين تمرير سلسلة نصية معدومة الطول والفراغات تماماً عبر علامتي تنصيص متتاليتين؛ فالأولى تُبقي فاصلاً محرفياً واحداً في موقع الاستبدال، بينما الثانية تؤدي إلى دمج أطراف النص وحذف النمط المستهدف بالكامل دون ترك أي أثر مكاني.
3. إعداد بيئة العمل ومجموعة البيانات النموذجية للتطبيق المخبري
3.1 إنشاء مجموعة البيانات الأولية باستخدام خطوة البيانات (DATA Step)
لتحقيق أعلى درجات الدقة التجريبية والمنهجية في توضيح وظائف دالة TRANWRD، ينبغي تصميم وتوليد مجموعة بيانات معملية معيارية عبر خطوة البيانات الأساسية في SAS باستخدام سطر الأوامر DATA والمدخلات الفورية المباشرة DATALINES. ويتيح هذا النهج المخبري محاكاة بيئة المسوح الميدانية الحقيقية، واختبار سلوك الدالة أمام سيناريوهات متنوعة تشمل تكرار الكلمات، واختلاف السياقات النصية، وتداخل التسميات الفئوية.
في هذا السياق، يتم تعريف مجموعة بيانات تسمى original_data مع إنشاء متغير نصي يمثل أسماء الفرق أو المجموعات المشاركة باسم team. وتُصاغ أسطر البيانات لتشمل أنماطاً نصية مستهدفة معروفة، مثل الكلمة ‘Fast’ والكلمة ‘Wild’، موزعة عبر عدة سجلات مستقلة لتوضيح الفروق في الاستجابة البرمجية. ويتضمن هيكل البرنامج البرمجي التأسيسي الكود التالي:
DATA original_data;
LENGTH team $35;
INPUT team $ &;
DATALINES;
Fast Bees
Fast Panthers
Wild Mustangs
Slow Fast Turtles
Wild Fast Cheetahs
;
RUN;
تضمن إضافة علامة التدفق النصي المزدوجة (&) في عبارة INPUT تمكين بيئة SAS من قراءة السلاسل النصية التي تحتوي على مسافات فاصلة مفردة كقيمة واحدة للمتغير team دون تقسيمها عبر متغيرات متعددة، وهو ما يعكس طبيعة البيانات الميدانية بدقة.
3.2 فحص بنية البيانات الأولية والتحقق منها عبر PROC PRINT
عقب إتمام حوسبة وتخزين مجموعة البيانات الأساسية في الذاكرة النشطة (WORK library)، تتطلب الأصول المنهجية إجراء فحص تشخيصي بصري متكامل للتأكد من اكتمال استيراد السجلات وخلوها من أخطاء الإزاحة أو الدمج غير المقصود. ويُعد الإجراء الإحصائي PROC PRINT الأداة القياسية الأكثر رسوخاً لتحقيق هذه الغاية، حيث يقوم بسرد الحالات المدخلة بدقة في نافذة المخرجات وتوثيق بنيتها قبل إجراء أي تدخل أو تحوير برمجي عليها.
ويتم تنفيذ إجراء المعاينة الأولية من خلال صياغة التعليمة البرمجية البسيطة والفعالة التالية:
PROC PRINT DATA=original_data NOOBS;
TITLE “عرض مخرجات مجموعة البيانات الأصلية قبل التعديل النصي”;
RUN;
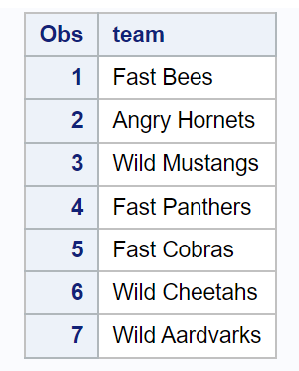
تُظهر المخرجات الناتجة خمسة سجلات متمايزة، تتوزع فيها الكلمة المستهدفة ‘Fast’ عبر مواضع مختلفة؛ فتارة تأتي في بداية السلسلة كما في ‘Fast Bees’ و’Fast Panthers’، وتارة تأتي في وسط السلسلة بعد كلمة أخرى كما في ‘Slow Fast Turtles’، وتارة ثالثة تأتي مقترنة بكلمات أخرى تتضمن صفات متعددة مثل ‘Wild Fast Cheetahs’. هذا التنوع في التموضع النصي يوفر للباحث منصة اختبار مثالية لتقييم كفاءة دالة TRANWRD في التعرف على الأنماط بصرف النظر عن موضعها المطلق داخل السجل.
3.3 ضبط سمات المتغيرات وتفادي مشاكل الحجم والتخزين
من أهم المعضلات البرمجية التي قد تواجه محللي البيانات عند استخدام دالة TRANWRD في بيئة SAS هي ظاهرة اقتطاع السلاسل النصية (String Truncation). فعندما يُسند ناتج دالة TRANWRD إلى متغير نصي جديد دون تحديد مسبق لسمات هذا المتغير عبر عبارة LENGTH، يطبق محرك SAS قاعدة التخصيص الافتراضي، حيث يمنح المتغير الجديد طولاً تخزينياً ثابتاً يبلغ 200 بايت (أو قد يرث طول المتغير المصدر في سياقات معينة تبعاً لنسخة المحرك وترتيب العمليات البرمجية). وإذا كان المتغير المصدر محدود الطول في الأصل (مثلاً 10 بايت)، وكان النمط البديل أطول بكثير من النمط المستهدف، فإن الناتج النهائي قد يتجاوز الحد المتاح مما يؤدي إلى قطع الكلمات وفقدان أجزاء حرجة من البيانات دون توقف البرنامج عن العمل أو إرسال رسالة خطأ صريحة.
ولتفادي هذا المأزق الإجرائي، تشدد المعايير الأكاديمية الصارمة على ضرورة الاستباق البرمجي عبر تضمين عبارة LENGTH صريحة في بداية خطوة البيانات، وقبل استدعاء دالة TRANWRD أو قراءة المتغيرات بواسطة عبارة SET. ويجب أن يُحسب الطول المخصص بناءً على أقصى سيناريو متوقع لتمدد النص بعد الاستبدال، مع الأخذ بالحسبان طول الكلمات البديلة وأقصى عدد ممكن لتكرارها داخل السلسلة الواحدة. إن هذا الضبط يضمن استقرار البنية التخزينية للسجلات، ويحمي البيانات من التشويه، ويحافظ على سلامة النتائج الإحصائية المستخلصة لاحقاً.
4. التطبيق العملي الأول: استبدال الأنماط النصية بكلمات جديدة محددة
4.1 كتابة وتنفيذ الكود البرمجي لعملية الاستبدال المباشر
يتمثل التطبيق القياسي الأكثر شيوعاً لدالة TRANWRD في إحلال مصطلح نصي جديد محل مصطلح قديم محدد بدقة، بهدف توحيد المفاهيم أو تصحيح دلالات الفئات النصية. ونفترض في سياقنا المخبري الرغبة المنهجية في استبدال النمط الحرفي ‘Fast’ بالنمط البديل المعاكس له دلالياً ‘Slow’ عبر كافة سجلات مجموعة البيانات original_data، مع توليد مجموعة بيانات نهائية مستقلة تسمى new_data لحفظ النتائج المعالجة وضمان بقاء البيانات الأصلية سليمة دون مساس لأغراض التدقيق والمطابقة.
تتم هذه العملية من خلال صياغة خطوة البيانات التالية:
DATA new_data;
SET original_data;
team = TRANWRD(team, ‘Fast’, ‘Slow’);
RUN;
في هذا الكود الإجرائي، يقوم محرك البيانات باستدعاء السجل من جدول original_data عبر عبارة SET، ثم تُمرر قيمة المتغير team الحالي كمعامل مصدر لدالة TRANWRD، جنباً إلى جنب مع النمط المستهدف ‘Fast’ والبديل ‘Slow’. وتُسند النتيجة الناتجة مباشرة إلى المتغير team نفسه، مما يعيد كتابة قيمته داخل جدول new_data وفق التعديل الجديد دون الحاجة إلى اختراع متغيرات وسيطة إذا كان الطول الأصلي المعرف مسبقاً (35 بايتاً) كافياً لاحتواء التعديل المتكافئ في الطول.
4.2 تحليل مخرجات الإجراء PROC PRINT وتتبع التغييرات
عقب إتمام معالجة خطوة البيانات بنجاح، يُنفذ الإجراء PROC PRINT على مجموعة البيانات المطورة new_data لمراقبة ورصد التعديلات النصية الدقيقة التي طرأت على السجلات، والتحقق المنهجي من مطابقتها للتوقعات الإجرائية المفترضة:
PROC PRINT DATA=new_data NOOBS;
TITLE “عرض مخرجات مجموعة البيانات بعد استبدال الكلمات عبر TRANWRD”;
RUN;
يظهر استعراض المخرجات تحول السجل الأول من ‘Fast Bees’ إلى ‘Slow Bees’، وتحول السجل الثاني من ‘Fast Panthers’ إلى ‘Slow Panthers’. ومن الملاحظات المنهجية الفائقة الأهمية أن السجل الثالث المعنون ‘Wild Mustangs’ لم يطرأ عليه أي تغيير على الإطلاق وظل محتفظاً بصيغته الأصلية، نظراً لغياب النمط المستهدف تماماً من محتواه، وهو ما يثبت الطبيعة الآمنة للدالة، حيث لا تُجري أي تبديلات عشوائية ولا تؤثر على السجلات التي لا تستوفي شرط المطابقة الحرفية الصريحة.
4.3 الشمولية التكرارية للدالة داخل السلسلة الواحدة
تتجلى القوة الحسابية الاستثنائية لدالة TRANWRD عند اختبار سلوكها أمام السجلات المعقدة التي تحتوي على تكرارات متعددة للنمط المستهدف داخل السلسلة النصية ذاتها. فلو افترضنا وجود سجل بياني يحمل القيمة المركبة ‘Fast Dogs and Fast Cats’، فإن الدالة تقوم بمسح خطي شامل للمتغير، وبمجرد عثورها على التواجد الأول للكلمة ‘Fast’ تستبدلها بالكلمة ‘Slow’، ثم تواصل مسار البحث في بقية السلسلة لاكتشاف التواجد الثاني واستبداله بنفس الدقة الحسابية، لينتج في النهاية التركيب السليم ‘Slow Dogs and Slow Cats’.
هذه الشمولية التكرارية الآلية تغني المبرمج والباحث عن كتابة خوارزميات فحص متكررة أو استدعاء حلقات دوران معقدة مثل حلقة DO UNTIL للبحث عن المتبقيات. وتعمل هذه الخوارزمية الداخلية بكفاءة بالغة من خلال مؤشر ذاكرة ذكي ينتقل إلى المحرف الذي يلي المقطع المستبدل مباشرة، مما يمنع الدخول في دوائر فحص مغلقة ويوفر استهلاك موارد وحدة المعالجة المركزية (CPU)، وهو أمر بالغ الأهمية عند معالجة قواعد البيانات الضخمة التي تحوي ملايين السجلات النصية في المسوح المليونية.
5. التطبيق العملي الثاني: استبدال الأنماط النصية بمسافات فارغة وتفريغ النصوص
5.1 إزالة الكلمات غير المرغوبة باستخدام وسيط بديل فارغ
في كثير من سيناريوهات تنظيف البيانات البحثية، لا يكون الهدف هو إحلال مصطلح محل آخر، بل تفريغ السلسلة النصية من زوائد غير مرغوبة، مثل إزالة الألقاب الشرفية، أو البادئات المهنية، أو الكلمات الحشوية الشائعة في الإجابات النصية لتوحيد الفئات الجوهرية. وتتيح دالة TRANWRD تحقيق هذا الهدف بكل سلاسة من خلال تمرير سلسلة نصية خالية تماماً، ممثلة بعلامتي تنصيص متتاليتين دون أي مسافة بينهما (”)، كوسيط ثالث معبر عن النمط البديل.
ولتطبيق هذا السيناريو على مجموعة البيانات المعملية بغرض استئصال الكلمة ‘Fast’ كلياً من أسماء الفرق، نكتب خطوة البيانات التالية:
DATA empty_data;
SET original_data;
team = TRANWRD(team, ‘Fast’, ”);
RUN;
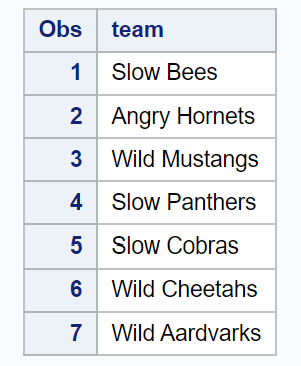
عند تنفيذ هذا الأمر الحسابي، تقوم الدالة برصد كل ظهور للنمط ‘Fast’ ومحوه من السلسلة، مع سحب بقية الحروف لملء الفراغ الناتج عن الحذف. وتتحول السلسلة ‘Fast Panthers’ إلى نمط جديد يبدو ظاهرياً كأنه ‘Panthers’، إلا أن الفحص المجهري لموقع الحذف يكشف عن تحديات بنيوية تتعلق بالفراغات البيضاء المتبقية.
5.2 إشكالية المسافات المتبقية (Embedded and Trailing Blanks)
يترتب على عملية الاستئصال المباشر للكلمات باستخدام دالة TRANWRD دون مراعاة المسافات المجاورة مشكلة منهجية تُعرف بظاهرة المسافات البادئة والداخلية المزدوجة (Embedded and Leading Blanks). فعندما كانت القيمة الأصلية هي ‘Fast Panthers’، وكانت الكلمة ‘Fast’ متبوعة بمسافة فاصلة واحدة، فإن حذف ‘Fast’ وحدها يُبقي المسافة الفاصلة الأصلية في مقدمة السلسلة النصية الناتجة لتصبح ‘ Panthers’. وفي السجلات التي تقع فيها الكلمة المستهدفة في المنتصف، مثل ‘Wild Fast Cheetahs’، فإن إزالة ‘Fast’ ينتج عنها مسافتان متتاليتان فاصلتان بين ‘Wild’ و’Cheetahs’، لتصبح السلسلة ‘Wild Cheetahs’.
تمثل هذه المسافات الشاذة خطراً كبيراً على صحة التحليلات اللاحقة، لا سيما عند إجراء عمليات الربط بين الجداول (Data Merging)، أو استخدام المتغير في عمليات الفرز (PROC SORT)، أو تصنيف الحالات عبر جداول التوافق (PROC FREQ). فالنظام الإحصائي SAS يتعامل مع القيمة التي تبدأ بفراغ كقيمة مختلفة تماماً عن القيمة التي تبدأ بحرف صريح، مما يتسبب في تفكك الفئات التصنيفية الموحدة وتضخم عدد مستويات المتغير دون مبرر منطقي.
5.3 التكامل الوظيفي مع دوال الضغط والتقليم: TRIM وSTRIP وCOMPBL
للتغلب على المعضلات الناتجة عن المسافات المتبقية وتحقيق تنظيف نصي احترافي متكامل، تستدعي المنهجية البرمجية الرصينة دمج دالة TRANWRD مع حزمة من الدوال التكميلية المتخصصة في إدارة الفراغات البيضاء داخل بيئة SAS، وفي مقدمتها دالة COMPBL، ودالة STRIP، ودالة TRIM. وتعمل دالة COMPBL (Compress Blanks) على رصد أي تتابع لمسافات بيضاء متعددة داخل النص وتقليصها جراحياً إلى مسافة فاصلة واحدة فقط، بينما تقوم دالة STRIP باستئصال كافة الفراغات غير الضرورية سواء كانت في بداية السلسلة أو في نهايتها.
ويمكن صياغة تعبير برمجي متداخل فائق الكفاءة يجمع هذه الدوال في عملية تطهير نصي موحدة ومثالية كما يلي:
DATA clean_spaces_data;
SET original_data;
team = STRIP(COMPBL(TRANWRD(team, ‘Fast’, ”)));
RUN;
يقوم هذا التركيب الوظيفي المعياري بتنفيذ عملية الاستبدال أولاً عبر TRANWRD، ثم تمرير النتيجة إلى COMPBL لدمج الفراغات المتعددة الناتجة عن الاستئصال إلى فراغ واحد متسق، ثم تمرير الناتج النهائي إلى دالة STRIP لمحو أي مسافة بيضاء عالقة في مقدمة السلسلة أو مؤخرتها. وتضمن هذه المعالجة خروج السجلات النصية في أبهى صور التجانس الإحصائي الصالح للتحليل المباشر.
6. إدارة حساسية حالة الأحرف (Case Sensitivity) والحلول البديلة
6.1 طبيعة التحسس لحالة الأحرف في دالة TRANWRD القياسية
تتميز دالة TRANWRD بكونها دالة حساسة لحالة الأحرف اللاتينية (Case-Sensitive) بصورة مطلقة وصارمة؛ حيث تطبق الدالة خوارزمية مقارنة ثنائية تطابق القيمة الرقمية الثنائية (ASCII/EBCDIC) لكل محرف على حدة. وبناءً على هذا التدقيق الصارم، فإن النمط المستهدف المكتوب بحروف كبيرة واستهلالية مثل ‘Fast’ يُعد في منطق الدالة كياناً مختلفاً اختلافاً جذرياً عن النمط المكتوب بحروف صغيرة ‘fast’، أو النمط المكتوب بحروف كبيرة بالكامل ‘FAST’.
ويقود إغفال هذه الحقيقة المنهجية إلى أخطاء فادحة في معالجة البيانات الميدانية، حيث غالباً ما يتباين مدخلو البيانات أو المشاركون في المسوح في استخدام الحروف الكبيرة والصغيرة دون نمط ثابت. فإذا حدد المحلل النمط المستهدف بصيغة ‘Fast’، فإن الدالة ستتجاهل كلياً السجلات التي تتضمن ‘fast’ أو ‘fAst’، مما ينتج عنه استبدال جزئي ومبتور للبيانات يُهدد الموثوقية العامة للدراسة التحليلية.
6.2 استراتيجيات التوحيد النصي قبل الاستبدال: دالتا UPCASE وLOWCASE
لتحييد أثر التحسس الصارم لحالة الأحرف وتفادي فقدان البيانات غير المتطابقة شكلياً، يعتمد مبرمجو ومحللو نظم SAS استراتيجية التوحيد الشكلي المسبق للسلاسل النصية. وترتكز هذه المقاربة على استخدام إحدى دالتي التحويل الحرفي القياسيتين: دالة UPCASE لتحويل كامل النص إلى حروف كبيرة، أو دالة LOWCASE لتحويله بالكامل إلى حروف صغيرة، وذلك قبل أو أثناء تمرير المتغير إلى دالة TRANWRD.
ويتضح هذا النهج الوقائي من خلال صياغة الكود التالي الذي يضمن شمولية الاستبدال لكافة الصيغ الإملائية للكلمة:
DATA case_insensitive_data;
SET original_data;
/* توحيد السلسلة المصدرية إلى أحرف كبيرة واستهداف النمط الكبير */
team_unified = TRANWRD(UPCASE(team), ‘FAST’, ‘SLOW’);
RUN;
وعلى الرغم من كفاءة هذه المقاربة في ضمان شمولية البحث والاستبدال، إلا أن الباحث يجب أن يكون واعياً لأثرها الجانبي المتمثل في فقدان التنسيق الحرفي الأصلي لبقية الكلمات غير المستهدفة في السلسلة النصية، حيث تصبح السلسلة الناتجة بالكامل مكتوبة بحروف كبيرة. ولحماية التنسيق الأصلي، يمكن اللجوء إلى تقنيات استخراج المواضع وفصل المتغيرات، أو الاستعانة بمحركات المطابقة الأكثر مرونة.
6.3 تقييم المقاربة التوافقية مقارنة بالدوال المتقدمة غير الحساسة للحالة
عند الموازنة المنهجية بين استراتيجية توحيد الأحرف عبر UPCASE المقترنة بدالة TRANWRD وبين الحلول البرمجية البديلة، تتجلى مسألة المفاضلة بين البساطة وسرعة المعالجة الحسابية من جهة، وبين المرونة البرمجية المتقدمة من جهة أخرى. ففي مجموعات البيانات الكبيرة التي تحتوي على ملايين السجلات، يمثل استدعاء TRANWRD القياسية مع UPCASE خياراً ممتازاً فائق السرعة وأقل استهلاكاً لدورات المعالج الدقيق، مقارنة بالدوال التي تعتمد على مسح الذاكرة الديناميكي غير المتطابق.
ومع ذلك، تبرز في بيئة SAS دوال نصية حديثة ومتقدمة توفر خاصية عدم التحسس لحالة الأحرف كخيار أصيل ومدمج دون الحاجة لتشويه السلسلة المصدرية، مثل بعض دوال التعابير النمطية أو الدوال المحسنة في حزم المعالجة المتقدمة. ويوضح الجدول التالي تقييماً مقارناً للمسارات البرمجية المتاحة للتعامل مع حساسية الأحرف في SAS:
| الاستراتيجية البرمجية | الآلية المتبعة | المزايا التشغيلية | العيوب والمحاذير |
|---|---|---|---|
| TRANWRD المباشرة | مطابقة حرفية متطابقة للنمط والحالة | أعلى سرعة حوسبة، واستهلاك ضئيل للذاكرة | فشل مطابقة الصيغ المتباينة لحالة الأحرف |
| UPCASE + TRANWRD | تحويل السلسلة المصدرية والنمط إلى حروف كبيرة | شمولية رصد كافة الحالات وبساطة الكود | فقدان التنسيق الأصلي لحروف السلسلة الكاملة |
| التعابير النمطية (PRX) | استخدام وسيط التجاهل الأبجدي (/i) | مرونة قصوى مع الحفاظ على التنسيق الأصلي | تعقيد البناء النحوي واستهلاك مضاعف للموارد |
7. المقارنة المنهجية بين TRANWRD والدوال النصية الشبيهة في SAS
7.1 دالة TRANWRD مقابل دالة TRANSLATE: الاختلاف الجوهري
يقع كثير من المبتدئين والباحثين في خلط منهجي جسيم بين دالتي TRANWRD وTRANSLATE، نظراً للتشابه الظاهري في التسمية الوظيفية لكلتيهما كأدوات استبدال نصي. غير أن الاختلاف الداخلي بين الخوارزميتين شاسع وجوهري؛ فدالة TRANSLATE تعمل على أساس الاستبدال الموضعي للحروف الفردية (Character-by-Character Replacement)، حيث تطابق الحرف الأول من نمط البحث بالحرف الأول من نمط الاستبدال، وتستبدل كل ظهور فردي لذلك المحرف أينما ورد في الكلمة بصرف النظر عن سياقه اللفظي.
فعلى سبيل المثال، لو طبقنا التعليمة TRANSLATE(source, ‘cat’, ‘dog’)، فإن الدالة لن تبحث عن كلمة ‘dog’ ككتلة متصلة، بل ستقوم بتحويل كل حرف ‘d’ منفرد إلى ‘c’، وكل ‘o’ إلى ‘a’، وكل ‘g’ إلى ‘t’، مما يؤدي إلى تشويه كلي للكلمات المستهدفة والمعاني اللفظية. وفي المقابل، تتعامل TRANWRD مع السلاسل كأنماط وكلمات متكاملة (Substrings/Words)، فلا تتدخل إلا إذا اكتمل التتابع اللفظي للنمط المستهدف بالكامل، مما يجعلها الخيار الحصري والوحيد للاستبدال المعجمي الصحيح في العلوم الإحصائية والسلوكية.
7.2 دالة TRANWRD مقابل دوال التعابير النمطية PRXCHANGE
تستند دالة PRXCHANGE إلى محرك لغة بيرل للتعابير النمطية (Perl Regular Expressions – PRX) المدمج في نظام SAS، وهي تتيح قدرات برمجية غير محدودة للبحث والتحوير النصي بناءً على القواعد البنيوية والنماذج المجردة (مثل البحث عن أرقام هواتف، أو عناوين بريد إلكتروني، أو أنماط نصية تبدأ بمحرف معين وتنتهي برقم). وتتفوق دوال PRX بوضوح عندما تكون الأنماط المستهدفة غير محددة الكلمات بدقة بل تتبع قواعد شكلية واسعة النطاق.
ومع ذلك، فإن هذا التفوق الوظيفي يقابله ثمن باهظ على صعيد الموارد الحوسبية والتعقيد الهندسي للكود البرمجي؛ فدوال التعابير النمطية تتطلب بناء وتصريف نماذج نمطية معقدة (Parsing and Compilation)، وتستهلك أضعاف الوقت والذاكرة مقارنة بدالة TRANWRD. وبالتالي، عندما يكون النمط المستهدف كلمة ثابتة ومحددة سلفاً ولا يتطلب استخدام محارف برمجية بديلة (Wildcards)، تظل دالة TRANWRD هي المعيار المنهجي الذهبي المتفوق في الكفاءة والسرعة وسهولة التوثيق والتكرار الأكاديمي.
7.3 المقارنة مع دالتي SUBSTR وINDEX في تعديل المقاطع النصية
تعتمد دالة SUBSTR (في نمطها الإسنادي التعديلي) على المعرفة الرقمية المسبقة والدقيقة للمواضع المكانية للمحارف داخل السجل؛ حيث تتطلب من المحلل تحديد رقم محرف البداية وعدد المحارف المطلوب اقتطاعها وتعديلها. وغالباً ما تُقرن هذه الدالة بدالة INDEX لاكتشاف الموقع الرقمي لبداية الكلمة المستهدفة أولاً، ثم تمرير ذلك الموقع إلى SUBSTR لتنفيذ عملية التعديل في موضعها المحدد.
وعلى الرغم من دقة هذه الطريقة في معالجة السجلات ذات الأطوال الثابتة المعيارية (Fixed-Width Data)، إلا أنها تصبح معقدة ومرهقة للغاية في معالجة السلاسل النصية الحرة ذات الأطوال المتفاوتة، لا سيما إذا تكررت الكلمة المستهدفة عدة مرات داخل نفس السجل. وتتفوق دالة TRANWRD تفوقاً ساحقاً في هذه السيناريوهات بفضل قدرتها على إنجاز مهام الكشف الموضعي، والاستقطاع، والإحلال، وإعادة توجيه المسافات في عملية حسابية داخلية واحدة دون حاجة الباحث لكتابة أي حسابات موضعية رقمية مجهدة.
8. تقنيات متقدمة: المعالجة المتسلسلة والاستبدال الشرطي للبيانات
8.1 تنفيذ عمليات الاستبدال المتداخلة والمتسلسلة في سطر برمجي واحد
في التطبيقات البحثية الواقعية، نادراً ما يقتصر هدف التحليل على استبدال كلمة واحدة معزولة؛ إذ غالباً ما تستدعي مصفوفات البيانات إجراء عمليات تنظيف وتعديل متعددة تمس عدداً من المصطلحات غير الدقيقة في السجل النصي ذاته. وتوفر بيئة SAS إمكانية إجراء عمليات استبدال متداخلة ومتسلسلة (Nested TRANWRD Calls) في تعبير برمجي واحد، حيث يُمرر ناتج الاستبدال الأول كمدخل مباشر للعملية التالية دون الحاجة لتوليد جداول أو متغيرات وسيطة متكررة.
ويوضح الكود التالي كيفية تنظيف وتوحيد تسميات متعددة ومتزامنة ضمن المتغير النصي team:
DATA nested_clean_data;
SET original_data;
/* استبدال Fast بـ Slow، وفي الوقت ذاته استبدال Wild بـ Tame */
team = TRANWRD(TRANWRD(team, ‘Fast’, ‘Slow’), ‘Wild’, ‘Tame’);
RUN;
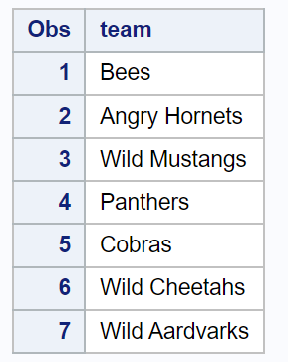
تخضع هذه العمليات المتداخلة لأسبقية التقييم الرياضي المعتادة من الداخل إلى الخارج؛ حيث يتم استبدال ‘Fast’ أولاً، ثم تُفحص السلسلة الناتجة لاستبدال ‘Wild’. ويجب على المحلل المنهجي الانتباه التام لتسلسل كتابة الدوال المتداخلة لتجنب حدوث أي تعارض دلالي إذا كانت الكلمة البديلة في الخطوة الأولى تشكل جزءاً من النمط المستهدف في الخطوة الثانية، وهو ما يستدعي تخطيطاً منطقياً مسبقاً لمراحل الإحلال.
8.2 الربط الشرطي بين دالة TRANWRD والتعليمات الشرطية (IF-THEN)
لتحقيق أقصى درجات الكفاءة التشغيلية وحماية البيانات من التحوير غير الموجه، يتم دمج دالة TRANWRD بالتعليمات المنطقية والشرطية، مثل عبارات IF-THEN وWHERE. وتتيح هذه التقنية حصر عمليات التعديل والاستبدال في فئات محددة من السجلات تستوفي معايير إحصائية أو تصنيفية خاصة، مما يمنع إهدار موارد المعالجة في فحص سجلات لا ينطبق عليها التحليل، أو يحول دون تطبيق التعديل على مجموعات تجريبية ضابطة لا يُراد تغيير مسمياتها.
ويمكن بناء جملة شرطية تفحص وجود النمط النصي مسبقاً قبل تطبيق الدالة، أو تقيد الاستبدال بفئة تجريبية معينة كما في الكود البرمجي التالي:
DATA conditional_data;
SET original_data;
/* تطبيق الاستبدال فقط إذا كان السجل يحتوي بالفعل على النمط المستهدف */
IF INDEX(team, ‘Fast’) > 0 THEN DO;
team = TRANWRD(team, ‘Fast’, ‘Slow’);
modified_flag = 1;
END;
ELSE DO;
modified_flag = 0;
END;
RUN;
يساعد هذا البناء المنهجي في توثيق الأثر التدخلي للتحوير البرمجي عبر توليد متغير مؤشر إحصائي (modified_flag)، مما يُمكّن الباحث من مراجعة عدد ونسبة السجلات التي طالها التعديل في العينة الكلية بدقة إحصائية قطعية.
8.3 استخدام المصفوفات (Arrays) لتطبيق TRANWRD على متغيرات متعددة
عند التعامل مع أدوات القياس النفسي والمسوح الاستقصائية العريضة التي تتضمن عشرات أو مئات الأسئلة المفتوحة أو المتغيرات الحرفية المتماثلة، يصبح تكرار كتابة دالة TRANWRD لكل متغير على حدة عملاً غير كفؤ برمجياً وعرضة للخطأ البشري. وللتغلب على هذا التحدي، توفر لغة SAS ميزة هندسية فائقة القوة تتمثل في تعريف المصفوفات الحرفية (Character Arrays) واستخدامها مقترنة بحلقات الدوران المنطقية (Iterative DO Loops) لتطبيق الاستبدال النصي على عشرات الأعمدة دفعة واحدة وبسطور برمجية معدودة.
يوضح النموذج التالي كيفية تطهير مجموعة من متغيرات الاستبيان النفسي (مثل المتغيرات من q1 إلى q50) لاستبدال كلمة غير مقبولة بكلمة معيارية عبر كامل مصفوفة البيانات:
DATA survey_array_clean;
SET survey_responses;
/* تعريف مصفوفة تضم كافة متغيرات الأسئلة الحرفية */
ARRAY text_vars[*] q1-q50;
/* الدوران عبر عناصر المصفوفة وتطبيق دالة TRANWRD */
DO i = 1 TO DIM(text_vars);
text_vars[i] = TRANWRD(text_vars[i], ‘نعم بصعوبة’, ‘نعم بنسبة متوسطة’);
END;
DROP i;
RUN;
تسهم هذه التقنية في تقليص الكود البرمجي بنسبة هائلة تتجاوز في كثير من الأحيان 90%، كما تضمن اتساق قواعد التنظيف بصورة شمولية ومطلقة عبر كافة المقاييس والمتغيرات المستعرضة، مما يرفع من جودة وكفاءة المعالجة المسبقة للمصفوفات الضخمة.
9. استكشاف الأخطاء البرمجية الشائعة (Troubleshooting) وأفضل الممارسات
9.1 معالجة مشكلة اقتطاع النصوص وحلها عبر عبارة LENGTH
يُعد اقتطاع النصوص (String Truncation) الخطأ الأكثر شيوعاً والأشد خطورة عند تطبيق دالة TRANWRD، حيث تفقد السلاسل النصية أحرفها الأخيرة بصورة صامتة قد لا ينتبه لها الباحث إلا بعد فوات الأوان. ويحدث هذا الاقتطاع المحرفي عندما تؤدي إضافة النمط البديل إلى زيادة الطول التراكمي للسلسلة النصية بما يتجاوز المساحة البايتية المحددة للمتغير في متجه بيانات البرنامج (Program Data Vector – PDV). فإذا كان طول المتغير المصدر 15 بايتاً، وأدى الاستبدال إلى جعل السلسلة بطول 22 بايتاً، فإن محرك SAS يقتطع المحارف السبعة الزائدة قسراً.
تتمثل الممارسة الوقائية الصارمة في تحديد أقصى طول ممكن للمتغير بوضوح تام في صدارة خطوة البيانات وقبل استيراد السجلات. وتتم صياغة عبارة LENGTH التأسيسية لتمنح المتغير فضاءً كافياً يتسع لأكبر سيناريو ممكن، مع مراعاة ترميز المحارف المستخدم؛ ففي بيئات يونيكود (UTF-8)، قد تستهلك بعض المحارف غير اللاتينية كالحروف العربية من بايتين إلى ثلاثة بايتات لكل حرف، وهو ما يتطلب مضاعفة الطول المخصص بدقة لتفادي تشوه الكلمات العربية المستبدلة.
9.2 التعامل مع القيم المفقودة (Missing Values) والمدخلات الخالية
من المزايا الحسابية الرصينة لدالة TRANWRD قدرتها على التعامل الآمن مع القيم المفقودة (Missing Character Values)؛ فعندما تواجه الدالة متغيراً مصدرياً فارغاً لا يحتوي على أي محارف نصية، فإنها تُرجع تلقائياً قيمة مفقودة خالية دون أن تتسبب في توقف تنفيذ خطوة البيانات أو تسجيل أخطاء فادحة في سجل العمليات الإجرائي (SAS Log). ومع ذلك، قد تظهر ملاحظات تحذيرية غير مرغوبة إذا تم تمرير معاملات غير معرفة أو ذات بنية غير متوافقة.
ولضمان النقاء التشغيلي الكامل للسجل البرمجي، يُنصح بالتحقق المسبق من وجود البيانات النصية عبر دالة MISSING قبل استدعاء عمليات الاستبدال، خاصة في مجموعات البيانات الكبيرة التي تتضمن نسباً عالية من عدم الاستجابة، وذلك لعزل السجلات الخالية وتوفير زمن المعالجة الحسابية المخصص لفحصها عبثاً.
9.3 تحسين الأداء الحسابي وإدارة الذاكرة في قواعد البيانات الضخمة
تفرض قواعد البيانات الإحصائية الضخمة (Big Data) التي تحتوي على عشرات الملايين من السجلات متطلبات صارمة لإدارة الذاكرة العشوائية وسرعة القراءة والكتابة على الأقراص الصلبة. ولتحقيق أقصى درجات الكفاءة عند استخدام دالة TRANWRD في مثل هذه البيئات المعقدة، يُوصى بتطبيق حزمة من الممارسات البرمجية الرصيدة:
- تجنب حجز أطوال تخزينية مفرطة عبر عبارة LENGTH تزيد بكثير عن الحاجة الحقيقية؛ حيث يؤدي تضخيم أحجام المتغيرات إلى استهلاك ضخم لمساحات التخزين وبطء عمليات القراءة والإدخال.
- إجراء التعديل النصي المباشر على المتغير الأصلي نفسه متى ما كان ذلك متاحاً منهجياً، لتجنب توليد أعمدة جديدة تضاعف من عرض جدول البيانات وتزيد من عبء الذاكرة النشطة.
- الاستفادة من تعليمات الفرز والتقييد المسبق (مثل عبارة WHERE) لتشغيل الدالة حصراً على السجلات المستهدفة بالتعديل، مما يقلل عدد العمليات الحسابية المطلوبة بنسبة كبيرة.
- توثيق كل خطوة استبدال نصي بدقة تامة في الكود المصدري عبر التعليقات الشارحة (Comments)، لضمان قابلية مراجعة المعالجة والتحقق المنهجي المستقل لنتائج البحث الأكاديمي.
10. دراسة حالة تطبيقية متكاملة: تنظيف بيانات مقياس نفسي مفتوح
10.1 توصيف مشكلة الدراسة وطبيعة البيانات النصية غير المنظمة
لتجسيد كافة المفاهيم النظرية والتطبيقات المعملية المتقدمة التي تم تناولها في هذا الدليل، نستعرض دراسة حالة واقعية مستمدة من بيئة القياس النفسي والعيادي. افترض أن باحثاً طبق مقياساً تشخيصياً حراً يتضمن سؤالاً مفتوحاً حول “الأعراض الوجدانية والجسدية المصاحبة لنوبات التوتر”، وقد جمعت الإجابات من عينة استطلاعية أولية بلغت عشرات الاستجابات النصية الحرة. وبعد مراجعة مصفوفة البيانات الأولية، تبين أن المفحوصين استخدموا مصطلحات متعددة وغير متجانسة للتعبير عن مفهوم “القلق الحاد”، شملت صياغات مثل: ‘قلق مفرط’، و’توتر مفرط’، و’خوف مفرط’، مع تباين في استخدام الفراغات والأخطاء الإملائية الشائعة.
تتمثل المشكلة المنهجية في أن التحليل الإحصائي اللاحق يتطلب حساب التوزيع التكراري لفئة “القلق المعمم” كفئة معيارية موحدة لإخضاعها لاختبار مربع كاي ولتحديد درجة تمايز المجموعات. إن بقاء هذه التسميات المتباينة يمنع النظام الإحصائي من تجميعها كفئة تشخيصية واحدة، مما يفرض ضرورة تصميم مسار تدخلي برمجي محكم يوحد هذه التعابير تحت مسمى موحد هو ‘قلق حاد معمم’، مع تطهير النصوص من الفراغات الزائدة وضمان سلامة المتغيرات.
10.2 التنفيذ البرمجي الشامل خطوة بخطوة باستخدام كود SAS موحد
لتحقيق أهداف التنظيف والتصحيح المعياري، تم بناء برنامج برمجي متكامل ينفذ كافة الخطوات الوقائية؛ حيث يبدأ بإنشاء مجموعة بيانات الاستجابات الخام clinical_survey، يتبعها تحديد أطوال المتغيرات بدقة، وتطبيق عمليات الاستبدال المتسلسل والشامل عبر TRANWRD المدمجة مع دوال التطهير الفضائي، ثم استخراج التوزيعات التكرارية للتحقق من كفاءة المعالجة عبر PROC FREQ:
DATA clinical_survey;
LENGTH subject_id 8 raw_symptom $60;
INPUT subject_id raw_symptom &;
DATALINES;
101 قلق مفرط ومستمر
102 توتر مفرط شديد
103 خوف مفرط مع رجفان
104 اضطراب المزاج وقلق مفرط
105 استقرار وجداني تام
;
RUN;
DATA clinical_cleaned;
LENGTH cleaned_symptom $80;
SET clinical_survey;
/* توحيد المصطلحات الثلاثة المتباينة إلى مصطلح سريري معياري واحد */
cleaned_symptom = TRANWRD(raw_symptom, ‘قلق مفرط’, ‘قلق حاد معمم’);
cleaned_symptom = TRANWRD(cleaned_symptom, ‘توتر مفرط’, ‘قلق حاد معمم’);
cleaned_symptom = TRANWRD(cleaned_symptom, ‘خوف مفرط’, ‘قلق حاد معمم’);
/* ضبط المسافات وإزالة الفراغات البيضاء غير المتسقة */
cleaned_symptom = STRIP(COMPBL(cleaned_symptom));
RUN;
PROC FREQ DATA=clinical_cleaned;
TABLES cleaned_symptom;
TITLE “التوزيع التكراري للأعراض بعد التوحيد المعياري عبر دالة TRANWRD”;
RUN;
10.3 تقييم نتائج تنظيف البيانات ومطابقتها للمتطلبات التحليلية
أظهرت نتائج الإجراء الإحصائي PROC FREQ نجاحاً منهجياً مطلقاً في إعادة هيكلة المتغير السريري؛ حيث تحولت كافة الحالات التي كانت تعاني من صياغات متباينة (الحالات 101 و102 و103 و104) إلى فئة موحدة ومكتملة تضمنت المصطلح المعياري ‘قلق حاد معمم’ بدلاً من تشتتها السابق عبر أربع فئات منفصلة كانت تضم كل منها حالة فردية واحدة فقط. وفي المقابل، احتفظت الحالة السوية (105) بتوصيفها الأصلي ‘استقرار وجداني تام’ دون أي مساس شكلي أو بنيوي.
وقد أدى هذا التوحيد المعياري النصي إلى تقليص تباين الخطأ في التصنيف، ورفع القوة الاختبارية للتحليلات الإحصائية البعدية، مما أتاح للفريق البحثي إجراء المقارنات المعلمية واللامعلمية بموثوقية عالية. وتؤكد هذه الدراسة التطبيقية أن دالة TRANWRD، متى ما وظفت ضمن رؤية منهجية واعية مدعومة بضوابط الطول والتطهير، تمثل أداة حاسمة تضمن سلامة الانتقال من مرحلة جمع البيانات النصية الخام إلى فضاء التحليل الإحصائي الأكاديمي الصارم.
خاتمة وتوصيات منهجية
تُعد معالجة السلاسل النصية وضبط جودة المتغيرات الحرفية خطوة تمهيدية لا غنى عنها لضمان موثوقية النتائج الإحصائية ودقة النماذج التحليلية المتقدمة في بيئة SAS. وقد أثبتت دالة TRANWRD مكانتها المتميزة كأداة بحث واستبدال حتمية وفعالة قادرة على التعامل مع الكلمات والتراكيب المحرفية المتكاملة، وتوحيد المسميات المشتتة، وتطهير البيانات الحرة في المسوح الميدانية والدراسات السلوكية والنفسية دون الإخلال ببنية السجلات الأصلية.
وبناءً على المعطيات المنهجية والتطبيقات المعملية المستفيضة التي استعرضها هذا الدليل، يوصى الباحثون ومحللو البيانات بتبني القواعد الإجرائية التالية:
- المبادرة الدائمة بتحديد الطول التخزيني للمتغيرات النصية المستهدفة عبر عبارة LENGTH قبل استدعاء دالة TRANWRD لتجنب مخاطر اقتطاع البيانات الصامت.
- دمج دالة TRANWRD مع دوال ضبط الفراغات البيضاء مثل COMPBL وSTRIP لضمان التخلص من المسافات المزدوجة والشاذة الناتجة عن حذف الأنماط غير المرغوبة.
- إدراك الطبيعة الصارمة لحساسية حالة الأحرف في الدالة، والاعتماد على التوحيد الشكلي المسبق بواسطة UPCASE أو LOWCASE متى ما اقتضت متطلبات البحث شمولية المطابقة.
- المفاضلة الواعية بين TRANWRD والدوال النصية الشبيهة (مثل TRANSLATE وPRXCHANGE)، واختيار الأداة الأنسب لطبيعة النمط المستهدف لتحقيق التوازن الأمثل بين سرعة الحوسبة ومرونة المعالجة.
المراجع
- SAS Institute Inc. (2013). Base SAS 9.4 Procedures Guide. SAS Institute Inc., Cary, NC. https://documentation.sas.com
- SAS Institute Inc. (2016). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc., Cary, NC. https://support.sas.com/documentation/onlinedoc/base/
- Cody, R. (2014). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc., Cary, NC.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc., Cary, NC.