
تعد معالجة السلاسل النصية وتفكيك البيانات المركبة داخل جداول البيانات الإلكترونية من أهم المهارات التقنية التي يحتاجها محللو البيانات والباحثون في شتى الميادين الأكاديمية والتطبيقية. ففي كثير من الأحيان، تُستورد البيانات من أنظمة تخطيط الموارد، أو قواعد البيانات المركزية، أو السجلات الرقمية وهي مدمجة في حقول غير معيارية؛ كأن تجتمع تفاصيل العناوين الجغرافية، أو أسماء المنتجات وفئاتها، أو التوصيفات المركبة للموظفين والرياضيين داخل خلية واحدة تفصل بين عناصرها فواصل تقليدية. وتنشأ هنا إشكالية تقنية تتمثل في الحاجة إلى استخلاص الجزء الأخير من هذا النص المركب، وتحديداً المحتوى الواقع بعد الفاصلة الأخيرة، وهو ما يتطلب فهماً رياضياً وخوارزمياً دقيقاً لطبيعة بناء الدوال النصية داخل برنامج مايكروسوفت إكسل (Microsoft Excel).
يتناول هذا الدليل الأكاديمي الشامل دراسة تفصيلية ومعمقة للأساليب الحسابية والخوارزمية المعتمدة لاستخراج النصوص الواقعة بعد الفاصلة الأخيرة في برنامج إكسل. سنبدأ بالتعرف على الأسس النظرية والمفاهيمية لإدارة النصوص المدمجة، مروراً بالتشريح الوظيفي الدقيق لدالة TEXTAFTER الحديثة التي تمثل ثورة نوعية في بيئة Microsoft 365 وإصدارات إكسل الحديثة بفضل دعمها لمحرك الصفائف الديناميكية وميزة الفهرسة العكسية. ولن يقتصر الطرح على الدوال الحديثة فحسب، بل سنتوسع في تفكيك الحلول التراكمية الكلاسيكية الصالحة للعمل على كافة الإصدارات القديمة من البرنامج، من خلال توظيف مصفوفة الدوال الرياضية والنصية التقليدية مثل SUBSTITUTE وRIGHT وLEN وFIND، موضحين المعمارية الحسابية التي تحكم كل صيغة.
علاوة على ذلك، يستعرض المقال التقنيات المثلى للتعامل مع الشوائب النصية المصاحبة لعمليات الاقتطاع، كالمسافات الزائدة، والمحددات غير المنتظمة، وإدارة الأخطاء الشائعة لتفادي توقف العمليات الحسابية في النماذج الكبيرة. وسنختتم بتقديم دراسات حالة تطبيقية في مجالات الأعمال المتنوعة، ومقارنة منهجية بين الحلول القائمة على الصيغ وتلك المعتمدة على محرك التحويل المتقدم Power Query، مع تسليط الضوء على أفضل الممارسات المنهجية المتبعة في توثيق وصيانة جداول البيانات المعقدة لضمان استدامتها ودقة مخرجاتها التحليلية.
1. المدخل المنهجي لمعالجة السلاسل النصية في مايكروسوفت إكسل
### 1.1 أهمية استخلاص البيانات الجزئية من النصوص المركبة
تمثل البيانات النصية المركبة داخل الخلايا المفردة في الجداول الممتدة تحدياً كبيراً أمام بناء نماذج تحليلية تتسم بالصلابة والكفاءة؛ حيث تميل الأنظمة البرمجية القديمة ونماذج تصدير السجلات إلى دمج أبعاد بيانات متعددة داخل نسق نصي واحد لتقليل عدد الأعمدة أو لتسهيل القراءة البشرية المجردة. غير أن هذا الدمج يُعد عائقاً جوهرياً عند الرغبة في إخضاع البيانات للتحليل الإحصائي المتقدم أو التصنيف الآلي، إذ تتطلب خوارزميات التجميع وحساب المقاييس الإحصائية تجزئة كل متغير كمي أو نوعي إلى حقل مستقل بذاته. إن استخلاص البيانات الجزئية يُسهم بشكل مباشر في رفع مستوى معيارية البيانات الأولية، مما يقلل من معدلات الخطأ الناتجة عن تكرار النصوص أو تشوهها أثناء المعالجة، ويهيئ بيئة البيانات للدخول في نماذج التنبؤ والنمذجة الرياضية المتقدمة بكفاءة عالية، وهو ما يتسق مع المنهجيات المتبعة في إدارة السجلات المعقدة وتنظيفها (Mundnich et al., 2020).
وتتجلى أهمية هذه المعالجة في التطبيقات الشائعة للتقارير الإدارية والرياضية، حيث نجد على سبيل المثال لا الحصر سجلات تحوي معلومات مفصولة بفواصل مثل “الاسم الكامل، القسم الإداري، الدرجة الوظيفية”، أو في البيانات الرياضية “اسم اللاعب، النادي، التقييم النهائي”. إن الرغبة الدائمة في عزل العنصر الأخير—والذي غالباً ما يمثل المؤشر الحاسم أو النتيجة النهائية للتقييم—تتطلب استراتيجية عزل محكمة. إن تحويل هذه النصوص غير المهيكلة إلى حقول رقمية أو فئوية نقية يمثل الخطوة الأولى في مسار هندسة البيانات، وبدونها تفقد أدوات التلخيص، كالجداول المحورية (Pivot Tables) والرسوم البيانية التفاعلية، قدرتها على تجميع المتغيرات بدقة، مما يؤدي إلى تشويه التحليلات الإدارية واختلال مؤشرات الأداء الرئيسية في بيئات الأعمال المختلفة.
### 1.2 إشكالية تعدد الفواصل وتحديد الموضع المستهدف
يكمن التحدي الحسابي الأساسي في التعامل مع السلاسل النصية المفصولة بمحددات في التكرار غير المنتظم لرمز الفاصلة داخل نفس السلسلة النصية؛ إذ قد يحتوي السجل الأول على فاصلة واحدة تفصل بين مدينتين، بينما يشتمل سجل آخر في نفس العمود على ثلاث أو أربع فواصل نتيجة لتفصيل العنوان ليشمل الشارع، والحي، والمدينة، والرمز البريدي، واسم الدولة. إن هذا التباين في عدد الفواصل يُبطل فاعلية الحلول الساذجة المعتمدة على مواقع المؤشرات الثابتة؛ فمحاولة استخراج النص بناءً على عدّ الأحرف من بداية النص تفشل حتماً عند أدنى تغير في طول الكلمات السابقة. كما أن أدوات البحث والمسح النصي التقليدية في الإصدارات القديمة من إكسل كانت تفتقر إلى خاصية البحث العكسي التلقائي، حيث كانت تبدأ المسح الافتراضي دائماً من أقصى اليسار في النصوص اللاتينية أو من الحرف الأول في اتجاه القراءة المحدد، مما يجعل تحديد “الفاصلة الأخيرة” مسألة رياضية تتطلب حيلة حسابية معقدة.
يتعين على المحلل تحديد الفاصلة الأخيرة بدقة تامة وبصورة ديناميكية، بغض النظر عما إذا كان النص يحتوي على فاصلتين أو عشر فواصل، وبغض النظر عن تفاوت الأطوال الكلية للمقاطع النصية المختلفة. فالنصوص ذات الأطوال الثابتة تندر في قواعد البيانات الواقعية، بينما تمثل النصوص الديناميكية المتغيرة القاعدة العامة. إن هذا التباين البنيوي يستوجب التمييز بين الدوال التي تبحث عن الموضع المطلق للمحدد والدوال التي تستطيع فهم الترتيب النسبي للتكرارات. وتبرز هنا الحاجة إلى منهجيات برمجية قادرة على تجاوز الفواصل الأولى والثانية وما بعدها، وتوجيه اهتمام محرك الحساب فقط نحو المحدد الأخير ليكون نقطة الانطلاق للاقتطاع، مما يضمن خروج النص المستهدف بعيداً عن أية تشوهات ناتجة عن عدم اتساق الإدخال الأولي للبيانات في السجلات الأصلية.
### 1.3 التطور الوظيفي لمعالجات النصوص في الإصدارات الحديثة من إكسل
شهد برنامج مايكروسوفت إكسل—منذ إطلاقه التاريخي على أيدي شركة مايكروسوفت (Microsoft Corporation) في ثمانينيات القرن الماضي وحتى إطلاق التحديثات الأخيرة ضمن بيئة Microsoft 365 وإصدار أوفيس 2024—تطوراً جذرياً في فلسفة التعامل مع النصوص. فعلى مدار عقود، كان المحللون مجبرين على بناء معادلات مصفوفية شديدة التعقيد تتداخل فيها دوال متعددة لاقتطاع النصوص، مما كان يشكل عبئاً ذهنياً كبيراً على المستخدم ويزيد من احتمالية وقوع أخطاء الصيانة والتوثيق، فضلاً عن استهلاك موارد المعالجة عند تطبيقها على مئات الآلاف من الصفوف. وقد استدعى هذا الواقع قيام مهندسي البرمجيات في مايكروسوفت بإعادة هيكلة البنية الرياضية لمعالجة النصوص وإدخال محرك الصفائف الديناميكية (Dynamic Arrays Engine) الذي غيّر جذرياً طريقة تمدد النتائج في أوراق العمل وتدفقها التلقائي.
وفي هذا السياق التطويري، أعلنت شركة مايكروسوفت في مطلع عام 2022 (مع طرحه رسمياً للمستخدمين لاحقاً في أواخر 2022 وبدايات 2023) عن حزمة من الدوال النصية الثورية كان على رأسها دالة TEXTAFTER، مصحوبة بدوال مكملة مثل TEXTBEFORE وTEXTSPLIT. وقد جاءت هذه الدالة خصيصاً لسد الفجوة الوظيفية في اقتطاع النصوص اعتماداً على محددات معينة، متيحة للمستخدمين استبدال المعادلات التراكمية المعقدة بصيغة برمجية واحدة واضحة المعالم. لم يعد المحلل بحاجة إلى حساب طول النص أو إجراء استبدالات رمزية مصطنعة، بل أصبحت دالة TEXTAFTER تتعامل مع السلسلة النصية كوحدة متكاملة يمكن توجيه مسار البحث فيها للأمام أو للخلف مباشرة وبكفاءة حسابية متناهية، مما يمثل تحولاً نوعياً في بنية النمذجة الرياضية داخل الجداول الحسابية الحديثة.
2. التشريح التركيبي لدالة TEXTAFTER ومعايير عملها
### 2.1 المعاملات الإلزامية: النص المحدد والمحدد الفاصل
تعتمد دالة TEXTAFTER في بنائها الوظيفي على معمارية معيارية واضحة تتضمن وسائط إلزامية وأخرى اختيارية تمنح المستخدم تحكماً فائقاً في سلوك الاقتطاع. تُكتب الصيغة الرياضية للدالة وفق البنية العامة التالية:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
حيث يمثل المعامل الأول text مرجع الخلية أو السلسلة النصية الصريحة الخاضعة للتحليل والتفكيك. يعمل هذا المعامل كنقطة الارتكاز لمصدر البيانات الأولي، ويشترط أن يحتوي على قيمة نصية صالحة أو مرجع خلية يتضمن نصاً، وإلا فإن محرك إكسل سيقوم بتحويل القيم الرقمية أو المنطقية ضمنياً إلى صيغة نصية مؤقتة أثناء تنفيذ المعالجة الحسابية.
أما المعامل الثاني الإلزامي فهو delimiter، ويمثل المحدد الرمزي الذي يستند إليه محرك الدالة لاقتطاع النص؛ وفي حالتنا هذه، يتم تعريف الفاصلة كنقطة ارتكاز للقطع. ومن القواعد البرمجية الصارمة في كتابة معادلات إكسل ضرورة إحاطة المحدد الرمزي بعلامتي تنصيص مزدوجتين، أي كتابته بالصيغة “,”، وإلا اعتبر محرك الصيغ الرمز كأنه اسم لنطاق مسمى أو خطأ نحوي، مما يؤدي فوراً إلى ظهور خطأ التسمية الشائع #NAME?. تتيح الدالة أيضاً تمرير مصفوفة من المحددات المتعددة بين قوسي مصفوفة متعرجين إذا تطلب السياق البحث عن أكثر من علامة ترقيم في آن واحد، غير أن تحديد الفاصلة بمفردها يظل المعيار القياسي في عزل المكونات الأخيرة للسجلات المجدولة تقليدياً.
### 2.2 المعامل الحاسم: وسيط رقم التكرار ودور القيمة السالبة
يُعد المعامل الثالث، وهو وسيط رقم التكرار instance_num، المعامل الحاسم والمحور الرياضي الذي يمنح دالة TEXTAFTER ميزتها الفريدة وتفوقها على سائر الدوال التقليدية. ففي حال تُرِك هذا الوسيط فارغاً، فإن الدالة تفترض تلقائياً القيمة الافتراضية (1)، مما يعني اقتطاع النص الواقع بعد أول فاصلة تظهر في السلسلة النصية بدءاً من اليسار. أما إذا تم إدخال قيمة موجبة مثل (2) أو (3)، فإن الدالة تتجاوز التكرار الأول والثاني وتقتطع ما بعد التكرار المحدد تحديداً، وهو ما يظل قاصراً في البيئات ذات البيانات غير المنتظمة التي يتفاوت فيها عدد الفواصل بين خلية وأخرى.
وهنا تبرز الأهمية الرياضية والبرمجية لتمرير القيمة السالبة (-1) لهذا الوسيط. إن إدخال الرقم (-1) يُعد بمثابة أمر تنفيذي لمحرك إكسل لعكس اتجاه البحث كلياً؛ بحيث يتجاهل المسار الطبيعي للقراءة ويبدأ مسح الرموز المحرفية من نهاية النص متجهاً إلى بدايته. وعند تطبيق هذه القيمة السالبة، يقوم المحرك بمطابقة الفاصلة الأولى التي تصادفه في مساره العكسي، والتي هي بالضرورة “الفاصلة الأخيرة” وفق ترتيب النص الأصلي. هذا التوجيه العكسي يعزل تماماً كافة الفواصل السابقة مهما كان عددها أو توزعها في السلسلة النصية، ويضمن استخراج النص الواقع مباشرة بعد تلك الفاصلة الأخيرة وحتى نهاية السلسلة بدقة رياضية مطلقة لا تتأثر بالاختلافات الهيكلية في أطوال البيانات أو عدد حقولها الداخلية.
### 2.3 المعاملات الاختيارية المتقدمة لضبط سلوك الاقتطاع
تشتمل دالة TEXTAFTER كذلك على ثلاثة معاملات اختيارية متقدمة صُممت لضبط سلوك الاقتطاع بدقة والتعامل مع السيناريوهات غير القياسية في قواعد البيانات الضخمة. المعامل الأول منها هو نمط المطابقة match_mode، ويأخذ القيمة (0) افتراضياً ليشير إلى حساسية الصيغة لحالة الأحرف (Case-sensitive)، أو القيمة (1) لجعل البحث غير حساس لحالة الأحرف (Case-insensitive). ومع أن هذا المعامل يُستخدم بكثرة مع المحددات الأبجدية، إلا أن فائدته تظهر عند التعامل مع محددات تتضمن رموزاً متداخلة مع حروف نصية تتطلب ضبطاً دقيقاً لنمط التعرف على المحارف في قواعد البيانات المتعددة اللغات.
أما المعامل الاختياري الثاني فهو مطابقة نهاية النص match_end، ويحدد كيفية تصرف الدالة في حال عدم العثور على المحدد الرمزي داخل النص. يأخذ هذا المعامل القيمة (0) افتراضياً للإشارة إلى عدم اعتبار نهاية النص كمحدد بديل، في حين تتيح القيمة (1) معاملة نهاية السلسلة النصية كمحدد طبيعي، مما يتيح استخراج النص بالكامل في حال غياب المحدد تماماً. وأخيراً، يأتي المعامل فائق الأهمية وهو القيمة البديلة if_not_found؛ حيث يسمح هذا الوسيط للمحلل بتحديد القيمة أو الرسالة التي يجب أن تُرجعها الدالة في حال عدم تطابق الشرط وغياب الفاصلة كلياً عن السلسلة النصية، كأن نطلب إرجاع نص فارغ “” أو إعادة كتابة النص الأصلي كما هو، مما يقي المصنف الحسابي من توقف سلاسل العمليات بسبب أخطاء القيمة المفقودة ويعزز من انسيابية التقارير التحليلية.
3. التطبيق العملي خطوة بخطوة لاستخراج النصوص باستخدام TEXTAFTER
### 3.1 هيكلة جدول البيانات وتجهيز أعمدة الإدخال والمخرجات
يتطلب الشروع في تطبيق دالة TEXTAFTER تخطيطاً أولياً لهيكل جدول البيانات داخل ورقة العمل لضمان انسيابية تدفق المدخلات إلى المخرجات بصورة معيارية. يُنصح دائماً بتحويل النطاق العادي من الخلايا إلى جدول إكسل رسمي (Excel Table) عبر الضغط على اختصار لوحة المفاتيح Ctrl + T؛ حيث تضمن هذه الخطوة ديناميكية التحديث التلقائي لكافة الصيغ عند إضافة سجلات جديدة في المستقبل. يتم تخصيص العمود الأول، وليكن العمود (A)، لاحتواء البيانات الأصلية المركبة، بينما يُخصص عمود مجاور، وليكن العمود (B)، لاستقبال النصوص المستخلصة بعد الفاصلة الأخيرة، مع إطلاق تسميات ترويسية واضحة مثل “البيانات الأصلية” و”التقييم المستخرج”.
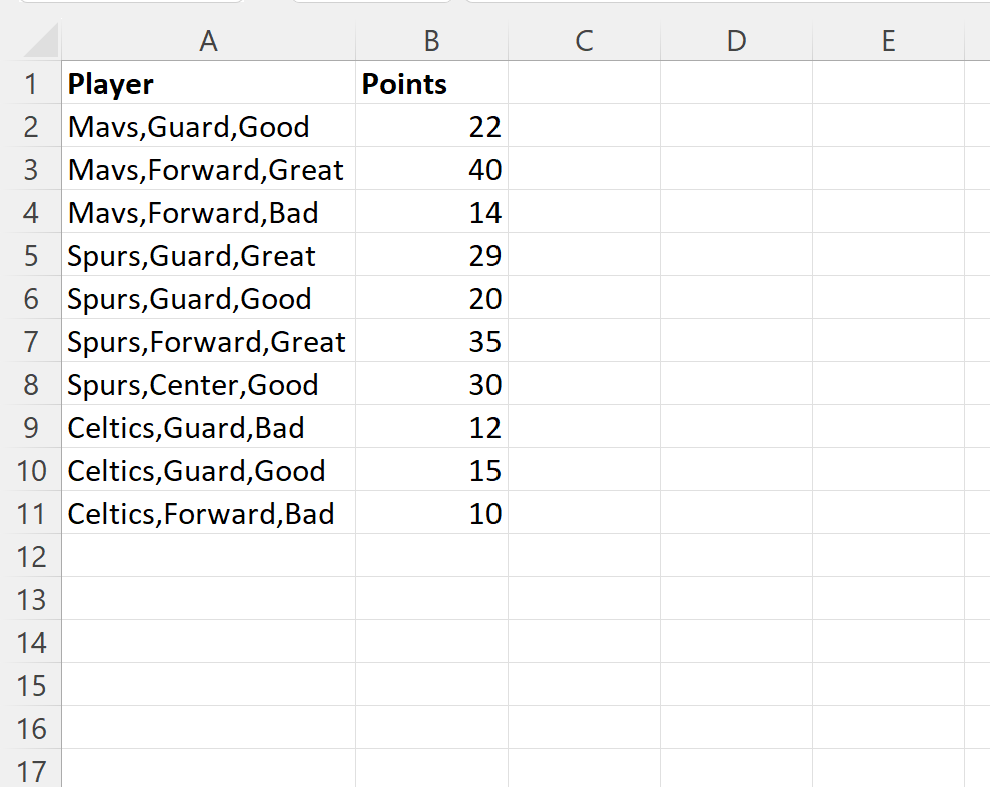
قبل كتابة أية صيغة، يجب إجراء فحص أولي لتنسيق الخلايا في العمودين للتأكد من ضبطهما على التنسيق “نص” (Text) أو “عام” (General)، وتجنب التنسيقات التي قد تتداخل مع المعالجة النصية كالتنسيقات النقدية أو التواريخ المخصصة. ولتوضيح ذلك عبر نموذج قياسي مستمد من سجلات تتبع أداء الرياضيين، نفترض أن لدينا خلايا تحتوي على أوصاف مدمجة بصيغة: “الفريق، المركز، التقييم النهائي”؛ كأن نجد في الخلية A2 النص: “Real Madrid, Midfielder, Excellent”، وفي الخلية A3 النص: “Arsenal, Forward, Winger, Good”. يُلاحظ هنا تباين عدد الفواصل بين السجلين، مما يجعل هذا الجدول بيئة مثالية لاختبار استخراج القيمة الطرفية الأخيرة المتمثلة في التقييم الرياضي.
### 3.2 صياغة الصيغة الرياضية وتفعيلها في الخلية المستهدفة
بمجرد تجهيز جدول البيانات، يتم الانتقال إلى الخلية المستهدفة، ولتكن B2، لكتابة الصيغة الرياضية بالدقة النحوية المطلوبة وفق معايير إكسل. تبدأ الصيغة بعلامة المساواة، تليها كتابة اسم الدالة متبوعاً بقوس الفتح، ثم تمرير مرجع الخلية المحتوية على النص، ثم الفاصلة كنقطة فصل بين وسائط الدالة نفسها، يليها المحدد النصي بين علامتي تنصيص، وأخيراً القيمة السالبة لرقم التكرار:
=TEXTAFTER(A2, “,”, -1)
يجب الانتباه بدقة إلى الفرق بين الفاصلة المستخدمة للفصل بين وسائط الدوال في إكسل (والتي قد تكون فاصلة منقوطة “;” في بعض التوزيعات الإقليمية لنظام التشغيل ويندوز) والفاصلة النصية المحصورة بين علامتي تنصيص والتي تمثل المحدد الفاصل الفعلي داخل السلسلة النصية.
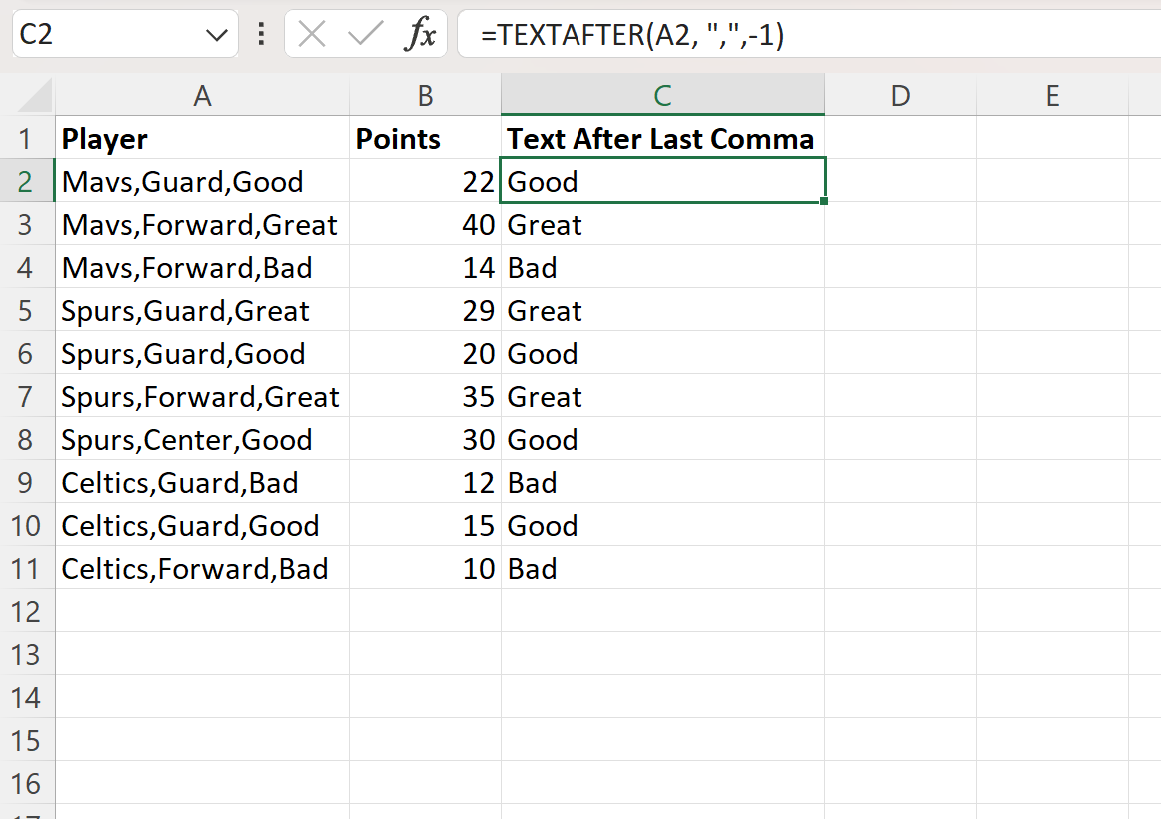
عند الضغط على مفتاح الإدخال Enter، يقوم محرك الحساب الداخلي بمسح النص الموجود في الخلية A2 من نهايته باتجاه بدايته، فيلتقط أول فاصلة تقع مباشرة قبل كلمة “Excellent” ويقتطع ما بعدها حتى نهاية النص. إن التحقق الأكاديمي من مطابقة الناتج يُظهر استخراج الكلمة بدقة بالغة. وبالمثل، عند تطبيق الصيغة على الخلية A3 التي تحتوي على ثلاث فواصل، يتجاوز المحرك الفواصل الأولى والثانية الخاصة بالفريق والمركز، ويلتقط الفاصلة الثالثة ليقتطع فقط التقييم الأخير “Good”. تتيح هذه الدقة عزل القيم والصفات النهائية بصورة متجانسة عبر كامل السجلات دون أدنى تشويش ناتج عن تفاصيل التوصيفات الوسطية.
### 3.3 تعميم المعادلة على نطاقات البيانات الكبيرة وتقنيات السحب التلقائي
بعد التحقق من صحة الصيغة في الخلية الأولى، تأتي مرحلة التعميم على كامل السجلات في مصنف البيانات. في الجداول التقليدية، يمكن للمستخدم استخدام مقبض التعبئة التلقائية (AutoFill Handle) عبر النقر المزدوج على المربع الصغير في الزاوية اليسرى السفلية للخلية المحددة، ليقوم إكسل بنسخ الصيغة وتعديل المراجع النسبية تلقائياً على امتداد آلاف الصفوف في أجزاء من الثانية. أما إذا كانت البيانات مدرجة ضمن جدول إكسل رسمي، فإن إكسل يوظف ميزة “العمود المحسوب” (Calculated Column) لتعبئة الصيغة تلقائياً في كامل العمود بمجرد إدخالها في الصف الأول، مستخدماً المراجع الهيكلية مثل [@البيانات_الأصلية].
وعلاوة على ذلك، في بيئة Microsoft 365 الداعمة لمحرك الصفائف الديناميكية، يمكن تعميم العملية بصيغة واحدة مفردة دون الحاجة لنسخها في كل خلية؛ وذلك بتمرير النطاق العمودي كاملاً كمعامل أول داخل الدالة، كأن نكتب:
=TEXTAFTER(A2:A10000, “,”, -1)
في هذه الحالة، تتفعل ميزة الصفائف المنسكبة (Spill Ranges)، حيث تُرجع الدالة مصفوفة نتائج كاملة تمتد من الخلية B2 وحتى B10000 تلقائياً. تتميز هذه الطريقة بكفاءة فائقة في استهلاك الذاكرة وسرعة إعادة الحساب، حيث يُدار النطاق ككتلة معالجة واحدة داخل المعالج بدلاً من إدارة عشرة آلاف صيغة مستقلة، مما يقلل بشكل ملحوظ من حجم ملف العمل ويزيد من استجابته أثناء التحليلات المكثفة لقواعد البيانات الضخمة (Maki et al., 2004).
4. التحليل المعمق لآلية البحث العكسي باستخدام الوسيط السالب (-1)
### 4.1 الفلسفة البرمجية للمؤشرات السالبة في محركات الجداول الحسابية
تُمثل إضافة المؤشرات السالبة إلى دوال برنامج إكسل الحديثة نقلة نوعية في الفلسفة البرمجية لمحركات الجداول الممتدة؛ حيث استلهم مهندسو إكسل هذا المفهوم من لغات البرمجة المتقدمة مثل لغة بايثون (Python) التي تعتمد نظام الفهرسة السالبة للوصول المباشر إلى العناصر الطرفية في المصفوفات والقوائم دون الحاجة إلى معرفة طولها الكلي مسبقاً. ففي البرمجة الكلاسيكية، كان الوصول إلى العنصر الأخير يتطلب خطوتين خوارزميتين: حساب الطول الكلي للمصفوفة (n)، ثم استدعاء العنصر في الموضع (n-1). غير أن المؤشر السالب (-1) يُلغي هذه الخطوة البينية ويوجه مؤشر الذاكرة مباشرة إلى الطرف الأخير من بنية البيانات.
وعند تطبيق هذه الفلسفة داخل محرك دالة TEXTAFTER، يقوم محرك معالجة النصوص في إكسل بقراءة الخلية بصورة عكسية من اليمين إلى اليسار (من نهاية السلسلة إلى بدايتها). هذا التحول في مسار القراءة يُحسّن من زمن التعقيد الحسابي (Time Complexity) للعملية الخوارزمية؛ حيث يتوقف المحرك فور مصادفة أول فاصلة في المسار العكسي، مما يعني أنه لا يضطر إلى قراءة وفهرسة كامل الحروف والمحددات السابقة في السلسلة النصية. هذا التحسين الخوارزمي الصغير يُحدث فارقاً ملموساً في زمن الاستجابة والأداء العام للنظام عند معالجة ملفات بيانات عملاقة تحوي ملايين السجلات النصية المتشعبة.
### 4.2 المقارنة الرياضية بين المسح الأمامي والمسح الخلفي للنصوص
لتوضيح الفارق الحسابي بين استراتيجيتي المسح الأمامي والمسح الخلفي، دعنا نفترض سجلاً نصياً يحتوي على المسار التالي: “قسم أ، فرع ب، وحدة ج، مكتب د”. إذا استخدم المحلل وسيطاً موجباً ثابتاً، ولنقل البحث عن المحدد رقم (3)، فإن الدالة ستقوم بمسح الحروف: “قسم أ” ثم المحدد (1)، ثم “فرع ب” ثم المحدد (2)، ثم “وحدة ج” ثم المحدد (3)، لتقتطع ما بعده وتُرجع “مكتب د”. تنجح هذه الصيغة الرياضية طالما كان عدد الفواصل ثابتاً في كل الصفوف. ولكن، بمجرد ظهور سجل جديد بصيغة أطول مثل: “إدارة رئيسية، قسم أ، فرع ب، وحدة ج، مكتب د”، فإن المحدد رقم (3) سيقتطع ما بعد “فرع ب”، مما يُرجع ناتجاً خاطئاً تماماً هو “وحدة ج، مكتب د”.
في المقابل، فإن اعتماد المسح الخلفي عبر الوسيط (-1) يضمن استقراراً رياضياً مطلقاً؛ فالخوارزمية في السجل الأول تبدأ من حرف “د” في كلمة “مكتب”، وتتحرك للخلف حتى تصادف أول فاصلة تفصل بين “وحدة ج” و”مكتب د”، فتقتطع “مكتب د”. وفي السجل الثاني الأطول، تبدأ الخوارزمية أيضاً من حرف “د” وتتحرك للخلف فتصادف نفس الفاصلة الأخيرة وتقتطع “مكتب د” أيضاً، متجاهلة تماماً وجود أربع فواصل سابقة بدلاً من ثلاث. إن ثبات القيمة المستخرجة وعدم تأثرها بالتقلبات البنيوية لحقول النص السابقة يجعل من الفهرسة العكسية الحل الرياضي الوحيد القادر على تحقيق الاتساق المعياري في مخرجات التحليل النصي.
### 4.3 التعامل مع النصوص ذات التوزيع العشوائي للفواصل
في بيئات العمل الواقعية وقواعد البيانات المفتوحة، كثيراً ما يواجه محللو البيانات سجلات تتسم بالعشوائية الشديدة في بنيتها التركيبية؛ حيث تجتمع في عمود واحد سجلات لا تحوي سوى فاصلة يتيمة تفصل بين متغيرين، وسجلات أخرى تتكدس فيها ست أو سبع فواصل نتيجة دمج حقول وصفية متعددة أو تعليقات نصية حرة. إن محاولة تطبيق حلول تعتمد على الفهرسة الموجبة في مثل هذه البيئات العشوائية تؤدي إلى انهيار النموذج التحليلي وظهور أخطاء عدم العثور على القيمة #N/A في السجلات القصيرة، أو استخراج أجزاء نصية مشوهة وغير مكتملة في السجلات الطويلة.
إن منهجية التنظيف الموحدة القائمة على استخدام TEXTAFTER مع الوسيط (-1) تستوعب هذه الاختلافات الهيكلية بمرونة بالغة. فالقاعدة المنطقية هنا تعمل كمعيار استقطاب طرفي: “استخرج فقط الجزء الذي يلي الفاصلة الأخيرة أينما كان موقعها في السلسلة”. هذا التجريد المنطقي يعزل المحلل عن القلق بشأن التوزيع التكراري للفواصل داخل كل صف، ويؤسس لتدفق عمل تحويلي موحد يُعامل السجل ذا الفاصلة الواحدة بنفس الدقة الحسابية التي يُعامل بها السجل ذا الفواصل المتعددة، مما يرفع من جودة البيانات المجهزة للاستخدام في بحوث معالجة اللغات الطبيعية أو نماذج التصنيف الإحصائي (Huebner & Willits, 2018).
5. استخراج النصوص في الإصدارات الكلاسيكية لإكسل عبر الدوال التراكمية
### 5.1 استراتيجية الاستبدال الذكي باستخدام دالة SUBSTITUTE
بالرغم من القوة والسهولة التي توفرها دالة TEXTAFTER، إلا أن قيود التوافق المؤسسي في بيئات الأعمال تجعل عدداً كبيراً من المنظمات والباحثين مقيدين بالعمل على إصدارات إكسل الكلاسيكية (مثل إكسل 2019، و2016، و2013 وما قبلها) التي تفتقر كلياً إلى هذه الدوال الحديثة. ولحل إشكالية استخراج النص بعد الفاصلة الأخيرة في هذه البيئات، ابتكر خبراء إكسل استراتيجية رياضية عبقرية تُعرف بـ “الاستبدال الذكي” تعتمد بشكل أساسي على الدالة SUBSTITUTE. تتيح هذه الدالة استبدال نص قديم بنص جديد، مع ميزة فريدة تتمثل في وسيطها الرابع الاختياري [instance_num] الذي يسمح باستبدال تكرار محدد دون سواه.
تقوم الفكرة الرياضية على تحديد الفاصلة الأخيرة بدقة عبر حساب إجمالي عدد الفواصل الموجودة في الخلية، ويتم ذلك عبر حساب الفرق بين الطول الإجمالي للنص وطوله بعد حذف كافة الفواصل، وفق المعادلة الجزئية:
LEN(A2) – LEN(SUBSTITUTE(A2, “,”, “”))
فإذا كان طول النص الأصلي 50 حرفاً وطوله بعد حذف الفواصل 47 حرفاً، فإن ذلك يعني رياضياً وجود 3 فواصل في الخلية. هنا يتم توظيف دالة SUBSTITUTE الخارجية لاستبدال الفاصلة رقم (3) تحديداً—والتي هي الفاصلة الأخيرة حتماً—برمز تحكمي فريد وغير مرئي لا يمكن أن يرد في النصوص العادية، مثل محرف البداية CHAR(1). وبذلك، يتم وسم الفاصلة الأخيرة بعلامة مميزة تمهد الطريق للدوال الأخرى لتحديد موقعها واقتطاع النص الواقع بعدها.
### 5.2 حساب الموضع واقتطاع الجزء الأيمن عبر الدوال RIGHT و LEN و FIND
بمجرد وضع الرمز الفريد في موضع الفاصلة الأخيرة، يتم تفعيل مصفوفة الدوال النصية التقليدية لاستكمال عملية الاقتطاع. تُستخدم دالة FIND للبحث عن موضع ذلك الرمز الفريد CHAR(1) داخل السلسلة النصية، مما يُعطي رقماً يمثل الفهرس العددي الدقيق للفاصلة الأخيرة بدءاً من الحرف الأول. بعد ذلك، يتم طرح هذا الموضع من الطول الإجمالي للخلية المقاس بواسطة دالة LEN، لنحصل بدقة رياضية متناهية على عدد الأحرف الواقعة على يمين ذلك الرمز وحتى نهاية السلسلة النصية. وأخيراً، يتم تمرير هذا العدد الناتج كمعامل لدالة الاقتطاع اليميني RIGHT، مع تغليف الصيغة بأكملها بدالة TRIM لضمان التخلص من أية مسافات زائدة:
=TRIM(RIGHT(A2, LEN(A2) – FIND(CHAR(1), SUBSTITUTE(A2, “,”, CHAR(1), LEN(A2) – LEN(SUBSTITUTE(A2, “,”, “”))))))
وثمة طريقة بديلة أخرى كانت شائعة جداً في الإصدارات القديمة وتُعرف بـ “طريقة الحشو الديناميكي” (Dynamic Padding Method). تعتمد هذه الطريقة على استبدال كل فاصلة بكتلة هائلة من المسافات الفارغة مساوية لطول النص الأصلي باستخدام دالتي SUBSTITUTE وREPT، ثم اقتطاع كتلة نصية كاملة من اليمين مساوية لطول النص الأصلي عبر دالة RIGHT، وأخيراً حذف بحر المسافات الشاسع بواسطة دالة TRIM:
=TRIM(RIGHT(SUBSTITUTE(A2, “,”, REPT(” “, LEN(A2))), LEN(A2)))
تتميز هذه الصيغة البديلة بقصرها النسبي وعدم حاجتها لحساب مواضع الحروف عبر دالة FIND، إلا أنها تعتمد على معالجة كتل ضخمة من الفراغات داخل الذاكرة المؤقتة لمحرك النصوص.
### 5.3 تقييم الكفاءة والتعقيد بين الحل التقليدي والحل الحديث
تُظهر المقارنة التحليلية بين الحلول التقليدية المركبة ودالة TEXTAFTER الحديثة بوناً شاسعاً في مستويات التعقيد البرمجي وسهولة الصيانة؛ فالصيغ التراكمية التقليدية تتطلب استدعاء خمس أو ست دوال متداخلة (TRIM, RIGHT, LEN, FIND, SUBSTITUTE, CHAR)، مما يرفع من معدل الصعوبة الإدراكية على المحللين ويزيد بشكل حاد من احتمالات الخطأ البشري أثناء كتابة الصيغ أو تحريرها. كما أن قراءة هذه الصيغ المعقدة بعد فترة زمنية طويلة أو عند تسليم ملفات العمل لمستخدمين آخرين تمثل عائقاً تشغيلياً كبيراً يتطلب وقتاً إضافياً لتفكيك وفهم المنطق الحسابي الكامن وراء كل استبدال وموقع محرف.
من جانب الأداء الحسابي واستهلاك الذاكرة، تُجري الصيغ التقليدية عمليات مسح وتوليد نصوص فرعية متعددة في الذاكرة لتنفيذ نفس المهمة؛ فاستبدال الفواصل بمسافات تعادل طول النص يضاعف حجم السلسلة النصية المعالجة بمقدار هائل قبل أن تقوم دالة TRIM بتقليصها مجدداً، وهو ما يؤدي إلى بطء ملحوظ في حساب أوراق العمل الضخمة التي تحتوي على مئات الآلاف من الصفوف. يوضح الجدول التالي مقارنة معيارية بين الحلول التقليدية والحديثة:
- دالة TEXTAFTER الحديثة: صياغة مقتضبة للغاية، وقراءة برمجية مباشرة، ومستوى تعقيد منخفض جداً، ودعم كامل للصفائف الديناميكية، ولكنها تتطلب إصدارات Microsoft 365 أو Excel 2024.
- صيغة الاستبدال الدقيق (SUBSTITUTE + FIND): صياغة معقدة ومتعددة الدوال، وتتطلب فهماً خوارزمياً لحساب الفواصل والمحارف الخاصة، وتوافق تام مع كافة الإصدارات التاريخية لإكسل منذ إصداراته الأولى.
- صيغة الحشو الديناميكي (SUBSTITUTE + REPT): صياغة متوسطة الطول، وتستهلك موارد معالجة مؤقتة لإنشاء كتل المسافات الكبيرة، وتوفر توافقية كلية مع كافة إصدارات إكسل دون الحاجة لحساب عدد الفواصل مسبقاً.
6. معالجة المسافات البيضاء والشوائب التنسيقية المصاحبة
### 6.1 إزالة المسافات البادئة واللاحقة عبر دالة TRIM
من الإشكاليات الأكثر شيوعاً التي تعقب استخراج النصوص بعد الفواصل وجود مسافات فارغة بادئة (Leading Spaces) تلتصق بالكلمة المستخرجة؛ ففي قواعد الترقيم المعيارية للكتابة، يعقب كل فاصلة مسافة مسطرة تفصل بينها وبين الكلمة التالية (مثال: “Chicago, Illinois”). عندما نطلب من دالة TEXTAFTER استخراج النص الواقع بعد الفاصلة، فإنها تقتطع كل شيء يقع بعد رمز الفاصلة مباشرة، مما يعني أن الناتج المستخرج من المثال السابق سيكون ” Illinois” (بمسافة بادئة) وليس “Illinois” الصريحة. تكمن خطورة هذه المسافة الخفية في أنها تغير القيمة الثنائية والرمزية للخلية تماماً في نظر محرك الجداول الحسابية.
إن وجود مسافة بيضاء بادئة أو لاحقة يُفسد عمليات المطابقة والبحث المتقدمة؛ فإذا حاول المحلل استخدام دوال البحث مثل VLOOKUP أو XLOOKUP أو MATCH لمطابقة الناتج المستخرج مع جدول آخر للولايات أو التقييمات، فإن عمليات البحث ستفشل حتماً وتُرجع خطأ عدم العثور #N/A، لأن إكسل يعامل السلسلة ذات المسافة كسلسلة مختلفة تماماً عن الكلمة المجردة. ولتلافي هذا الخطأ القاتل في نمذجة البيانات، يجب دوماً تغليف عملية الاقتطاع بدالة التنظيف القياسية TRIM، لتصبح الصيغة الموصى بها أكاديمياً وتطبيقياً كالآتي:
=TRIM(TEXTAFTER(A2, “,”, -1))
تقوم دالة TRIM بفحص النص المستخرج تلقائياً وحذف أية مسافات بادئة أو لاحقة، بالإضافة إلى تقليص المسافات المتعددة بين الكلمات إلى مسافة واحدة، مما يضمن خروج نص نقي تماماً ومؤهل للدخول في عمليات الربط والمطابقة الرياضية.
### 6.2 التعامل مع الفواصل المتبوعة بمسافات اختيارية في المحدد نفسه
تتمثل إحدى الطرق الذكية التي يلجأ إليها بعض المحللين في محاولة تجنب دمج دالة TRIM، في تضمين المسافة الفارغة مباشرة داخل وسيط المحدد الفاصل في الدالة، كأن تتم صياغة المعادلة كالتالي:
=TEXTAFTER(A2, “, “, -1)
حيث يتم وضع فاصلة متبوعة بمسافة واحدة بين علامتي التنصيص. نظرياً، ينجح هذا الحل في استخراج الكلمة التالية دون مسافة بادئة لأنه يعتبر الكتلة المكونة من الفاصلة والمسافة بمثابة محدد واحد متصل يتم اقتطاع كل ما بعده مباشرة.
غير أن الاعتماد الحصري على هذا الحل ينطوي على مخاطرة جسيمة عند التعامل مع بيانات واقعية ناجمة عن إدخال بشري غير منضبط؛ فإذا صادف السجل إدخالاً نسي فيه المستخدم كتابة المسافة بعد الفاصلة (مثل: “Chicago,Illinois”)، فإن الدالة لن تعثر على المحدد المستهدف (فاصلة + مسافة) في نهاية النص، وستتجاوز الفاصلة الأخيرة أو تُرجع خطأ حسابياً. ولذلك، فإن الممارسة الأكثر متانة وموثوقية في هندسة البيانات تتمثل في إبقاء المحدد النصي مقتصراً على الفاصلة المجردة “,”، مع إيكال مهمة ضبط الفراغات وتوحيدها كلياً إلى دالة TRIM المحيطة، حيث يستوعب هذا النهج كلا النمطين من الإدخال اليدوي بكفاءة تامة.
### 6.3 توحيد حالة الأحرف والتنظيف المعياري للنصوص المستخرجة
لا تقتصر الشوائب النصية في قواعد البيانات على المسافات البيضاء فحسب، بل تمتد لتشمل عدم اتساق حالة الأحرف (في النصوص اللاتينية) ووجود محارف تحكم غير قابلة للطباعة ناتجة عن تصدير السجلات من أنظمة قديمة أو عبر بروتوكولات نقل غير متوافقة كلياً. لتحقيق النقاء المعياري للبيانات، يمكن للمحلل دمج دالة تنظيف المحارف CLEAN، والتي تعمل على إزالة المحارف غير القابلة للطباعة ذات التكوين الرمزي من 0 إلى 31 في جدول آسكي (ASCII)، والتي تتسبب في تجميد أو تشويه مظهر النصوص في التقارير الإدارية النهائية.
علاوة على ذلك، يُنصح بتوحيد التنسيق الإملائي للمخرجات النصية المستخرجة باستخدام دوال التحويل القياسية؛ كاستخدام دالة PROPER لتحويل الحرف الأول من كل كلمة إلى حرف كبير، أو دالة UPPER لتحويل الكلمات أو الرموز البرمجية بالكامل إلى أحرف كبيرة، أو دالة LOWER لتوحيد عناوين البريد الإلكتروني. تصبح بنية تدفق العمل الشاملة لتنظيف النص المستخرج كالتالي:
=PROPER(TRIM(CLEAN(TEXTAFTER(A2, “,”, -1))))
يضمن هذا التداخل المتزن بين دوال التطهير النصي إنتاج بيانات غاية في المعيارية، جاهزة للدمج الفوري في لوحات القياس التنفيذية، ومتوافقة تماماً مع معايير تنقية البيانات المعتمدة في الأوساط الأكاديمية ومراكز الأبحاث المتقدمة.
7. إدارة الأخطاء وحالات الشذوذ في البيانات النصية
### 7.1 التعامل مع الخلايا التي تخلو من المحدد الفاصل وخطر الخطأ #N/A
تعتبر حالة “غياب المحدد الفاصل” من أبرز حالات الشذوذ التي تهدد استقرار النماذج الحسابية في إكسل؛ فعند تطبيق دالة TEXTAFTER بصيغتها الأساسية على عمود يحوي آلاف السجلات، قد يصادف المحرك خلايا لا تحتوي إطلاقاً على أي رمز للفاصلة، كأن يكون الحقل مدخلاً بقيمة وحيدة مثل “Unassigned” أو “Unknown” أو حتى قيمة عددية مجردة. في مثل هذه الحالات، يفشل محرك الدالة في مطابقة المحدد، وينتج عن ذلك فوراً توليد خطأ القيمة المفقودة #N/A داخل الخلية.
إن ظهور أخطاء #N/A في جدول البيانات لا يُشوه المظهر العام لورقة العمل فحسب، بل يمتد أثره السلبي ليوقف عمل كافة المعادلات والعمليات الحسابية المتسلسلة المرتبطة بذلك العمود؛ حيث ترفض معظم دوال التلخيص الإحصائي، مثل COUNTA أو XLOOKUP، معالجة النطاقات التي تتخللها أخطاء حسابية، مما يتسبب في تعطل لوحات القياس ومؤشرات الأداء كلياً. ومن هنا، يبرز التنبؤ الرياضي بالحالات الشاذة ووضع تدابير وقائية مسبقة داخل بنية الصيغة كأحد أهم معايير الجودة في تصميم أوراق العمل المهنية الموجهة للتحليل طويل الأمد (Mundnich et al., 2020).
### 7.2 استثمار الوسيط الاختياري [if_not_found] لتوليد مخرجات آمنة
استدرك مهندسو شركة مايكروسوفت إشكالية توقف الحساب عند غياب المحدد، وزودوا دالة TEXTAFTER بوسيط داخلي استثنائي هو المعامل السادس [if_not_found]، والذي يتيح تجاوز الحاجة إلى كتابة دوال خارجية لمعالجة الأخطاء. من خلال هذا المعامل، يستطيع المحلل تحديد النتيجة المباشرة التي يجب على إكسل إظهارها في حال لم يجد أي فاصلة داخل الخلية المستهدفة. وتختلف الاستراتيجية المتبعة بحسب طبيعة النمذجة المطلوبة:
- إرجاع النص الأصلي كاملاً: في كثير من الحالات، يُفضل اعتبار الخلية التي تخلو من الفواصل كبيان نهائي مجرد يجب الحفاظ عليه؛ ويتم ذلك عبر تمرير مرجع الخلية الأصلي داخل الوسيط السادس:
=TRIM(TEXTAFTER(A2, “,”, -1, , , A2)) - إرجاع خلية فارغة: لتجنب تشتيت الانتباه وحصر النتائج فقط في السجلات المركبة التي تم تفكيكها بالفعل:
=TRIM(TEXTAFTER(A2, “,”, -1, , , “”)) - إرجاع رسالة تنبيهية مخصصة: لتسهيل عمليات التدقيق اليدوي وحصر الحقول غير المكتملة لاحقاً:
=TRIM(TEXTAFTER(A2, “,”, -1, , , “محدد مفقود”))
يُحقق استخدام هذا الوسيط المدمج كفاءة تشغيلية فائقة مقارنة بالوسائل الكلاسيكية، إذ يتم احتساب التحقق من الخطأ ضمن دورة معالجة داخلية واحدة للدالة دون الحاجة إلى مضاعفة الجهد الحسابي للمعالج.
### 7.3 التكامل مع دوال الحماية من الأخطاء IFERROR و IFNA
في السيناريوهات التي تُطبق فيها حلول الإصدارات القديمة من إكسل، أو عند الحاجة إلى بناء طبقة حماية إضافية تشمل أخطاء متعددة المصادر كأخطاء تجاوز طول السلسلة المحرفية أو أخطاء تعارض أنواع البيانات، يبرز التكامل مع الدوال الوقائية العامة مثل IFNA وIFERROR كضرورة حتمية. تختص دالة IFNA باعتراض أخطاء #N/A حصراً دون اعتراض الأخطاء الحسابية الأخرى كخطأ القسمة على صفر #DIV/0! أو خطأ التسمية #NAME?، مما يجعلها أداة تدقيق ممتازة تكشف الأخطاء الإملائية في كتابة المعادلات مع معالجة غياب الفواصل بأمان:
=IFNA(TRIM(TEXTAFTER(A2, “,”, -1)), A2)
أما دالة IFERROR، فتتميز بنطاق حماية شامل يعترض كافة أنواع الأخطاء دون تمييز، وهو ما يُعد ملائماً جداً عند بناء الصيغ التراكمية القديمة المركبة من دوال FIND وSUBSTITUTE؛ حيث قد تتسبب أي قيمة نصية شاذة أو فارغة في انهيار دالة FIND وتوليد الخطأ #VALUE!. في مثل هذه البيئات القديمة، تُمثل صياغة المعادلة كالتالي:
=IFERROR(TRIM(RIGHT(A2, LEN(A2) – FIND(CHAR(1), SUBSTITUTE(A2, “,”, CHAR(1), LEN(A2) – LEN(SUBSTITUTE(A2, “,”, “”)))))), A2)
صمام أمان أساسي يضمن تدفق البيانات وسلاسة تحديث المصنف، مع توثيق هذه القواعد الوقائية في دليل التشغيل لضمان سهولة مراجعة المنطق البرمجي عند حدوث أي انحراف في البيانات الواردة.
8. دراسات حالة وتطبيقات عملية في مجالات الأعمال المتنوعة
### 8.1 تفكيك العناوين الجغرافية المعقدة واستخراج اسم الدولة أو الرمز البريدي
تعتبر العناوين الجغرافية في قواعد بيانات التجارة الإلكترونية وإدارة علاقات العملاء (CRM) من أكثر النصوص المدمجة تعقيداً؛ حيث تُكتب العناوين عادة في نسق تسلسلي يضم رقم العقار، واسم الشارع، والحي، والمدينة، والولاية، والدولة، مفصولة بفواصل غير متجانسة كالمثال التالي: “1025 Market St, Suite 400, San Francisco, CA, USA”. يحتاج قسم العمليات وسلاسل الإمداد في كثير من الأحيان إلى عزل اسم الدولة النهائي (“USA”) لحساب الرسوم الجمركية وفرز الشحنات الدولية عن المحلية بصورة آلية وفورية.
تُقدم المعادلة الرياضية القائمة على TEXTAFTER مع الفهرسة العكسية حلاً حاسماً لهذه المسألة؛ فعلى الرغم من أن العنوان السابق يشتمل على أربع فواصل، بينما قد يحتوي عنوان آخر لمقر شركة في سنغافورة على فاصلتين فقط: “Marina Bay, Singapore”، فإن الصيغة الحسابية الموحدة:
=TRIM(TEXTAFTER(A2, “,”, -1))
تتجاوز كافة التفاصيل المتباينة الخاصة برقم الجناح أو الشارع أو المدينة، وتقتطع بدقة متناهية الحقل الأخير ألا وهو اسم الدولة. يُهيئ هذا الاستخلاص البيانات للربط مع جداول أسعار الشحن الدولية وإنشاء تقارير توزيع المبيعات الجغرافية بدقة متناهية ودون الحاجة لتقسيم العناوين يدوياً أو اللجوء إلى خوارزميات الاسترجاع المعقدة.
### 8.2 استخلاص التقييمات النهائية من بيانات الموارد البشرية والرياضة
في إدارات الموارد البشرية والأندية الرياضية التنافسية، غالباً ما تُسجل بيانات الموظفين أو الرياضيين في هيئة قيود وصفية مدمجة لتقييم الأداء الفصلي؛ كأن تجد في حقل الملاحظات: “إدارة العمليات، أخصائي أول، كفاءة ممتازة”، وفي سجل آخر: “التسويق الرقمي، إدارة المحتوى، كاتب إعلانات، أداء استثنائي”. يواجه المحلل هنا متطلباً إدارياً يتمثل في تصنيف جميع الموظفين وفق مستويات أدائهم المعزولة في التقييم النهائي، لتحديد المكافآت التشجيعية وتغذية الجداول المحورية (Pivot Tables) التي تُجري مقارنات نوعية بين الإدارات.
بتطبيق الصيغة الآمنة في عمود التقييم:
=TRIM(TEXTAFTER(A2, “,”, -1, , , “غير مقيم”))
يتم عزل عبارات الأداء المستهدفة مثل “كفاءة ممتازة” و”أداء استثنائي” بصورة فورية، مع تجنب الأخطاء في السجلات التي لم تُستكمل تقييماتها بعد عبر إظهار عبارة “غير مقيم”. تتيح هذه الخطوة لمحللي الموارد البشرية إجراء تلخيص فوري لمستويات الأداء، وبناء رسوم بيانية توضح التوزيع التكراري للدرجات الوظيفية، مما يرفع من جودة وكفاءة صناعة القرار الإداري في المؤسسة.
### 8.3 فرز الامتدادات والمسارات البرمجية في قواعد البيانات التقنية
لا يقتصر المنطق الخوارزمي المكتسب من هذا التطبيق على الفاصلة التقليدية وحدها، بل يمتد بمرونة تامة ليشمل مختلف المحددات الرمزية في قواعد البيانات التقنية؛ كالمحددات المعتمدة في تتبع المسارات البرمجية للمجلدات وعناوين الروابط الشبكية (URLs) أو أسماء الملفات المحفوظة بامتداداتها المختلفة، والتي تستخدم علامات الفاصلة المائلة الأمامية (/) أو الخلفية (). ففي مسار تقني طويل مثل:
“C:Program FilesAnalyticsReportsFinancial_Summary_2024.xlsx”
تنشأ الحاجة إلى استخراج اسم الملف النهائي فقط مع امتداده، وتجاوز كافة أسماء المجلدات المتفرعة السابقة.
هنا، وبمجرد استبدال الفاصلة بالمحدد المائل الخلفي “”:
=TRIM(TEXTAFTER(A2, “”, -1))
ينتقل محرك إكسل إلى نهاية المسار فوراً ويقتطع الاسم النهائي “Financial_Summary_2024.xlsx”. وإذا أراد المحلل التقني استخراج نوع الامتداد البرمجي للملف فقط للتأكد من توافقه البرمجي، فإنه يقوم بتغيير المحدد إلى علامة النقطة “.”:
=TRIM(TEXTAFTER(A2, “.”, -1))
ليحصل مباشرة على الرمز “xlsx”. تُبرهن هذه المرونة على أن الفلسفة الرياضية للفهرسة العكسية تمثل أداة تحليلية شاملة تخدم مهندسي البيانات ومطوري النظم في أتمتة تصنيف الملفات والمسارات الرقمية بدقة وكفاءة متناهية (Yao et al., 2020).
9. الحلول البديلة المتقدمة: باور كويري وأدوات تحويل النصوص
### 9.1 استخراج النصوص عبر أداة تحويل النص إلى أعمدة (Text to Columns)
تُعد أداة “تحويل النص إلى أعمدة” (Text to Columns) واحدة من أقدم وأشهر الأدوات المدمجة في واجهة مستخدم إكسل لمعالجة السلاسل النصية المفصولة بمحددات. يمكن الوصول إليها عبر شريط الأدوات من تبويب “بيانات” (Data). تعتمد هذه الأداة على معالج خطوات يتيح للمستخدم تحديد الفاصلة كمحدد، ليقوم إكسل بتوزيع كافة المقاطع النصية الواقعة بين الفواصل على أعمدة متتالية ومستقلة على يمين الخلية الأصلية بشكل فوري.
ومع سهولة هذه الأداة للاستخدامات العارضة، إلا أنها تعاني من نقطتي ضعف جوهريتين في سياق استخراج النص بعد الفاصلة الأخيرة:
- تفاوت أعمدة المخرجات: إذا كانت النصوص تحتوي على أعداد متفاوتة من الفواصل، فإن الجزء الأخير سينتهي به المطاف متناثراً عبر أعمدة مختلفة (فالسجل ذو الفاصلتين يستقر ناتجه في العمود C، بينما السجل ذو الأربع فواصل يستقر في العمود E)، مما يجعل تجميع النتائج النهائية في عمود موحد مهمة شاقة تتطلب معالجة يدوية إضافية.
- جمود النتائج (Static Nature): تعمل الأداة كإجراء تحويلي لمرة واحدة، مما يعني أن أية بيانات جديدة تُضاف أو تُعدل في العمود الأصلي لن تتحدث تلقائياً، مما يفقد ورقة العمل طابعها الديناميكي ويجعلها غير صالحة للاستخدام في النماذج التشغيلية المستمرة.
### 9.2 توظيف محرر Power Query في التقسيم التلقائي المتقدم
يمثل محرر Power Query الأداة الأكثر احترافية وقوة في بيئة إكسل لهندسة وتحويل البيانات الضخمة بطريقة قابلة للأتمتة وإعادة التكرار دون كتابة معادلات معقدة داخل خلايا العمل. لمعالجة مشكلتنا من خلال Power Query، يقوم المستخدم باستيراد الجدول إلى المحرر، ثم تحديد عمود النصوص، والضغط بالزر الأيمن لاختيار:
Split Column -> By Delimiter
تتيح النافذة المنبثقة خياراً استثنائياً صُمم خصيصاً لهذه الغاية وهو تحديد موضع التقسيم عند:
Right-most delimiter (المحدد الواقع في أقصى اليمين).
عند تفعيل هذا الخيار واختيار الفاصلة، يقوم محرك لغة M البرمجي في Power Query بتوليد خطوة تحويل تقسم العمود إلى جزأين فقط؛ الجزء الأول يحتوي على كافة النصوص السابقة للفاصلة الأخيرة، والجزء الثاني يحتوي حصراً على النص الأخير المستهدف. تتميز هذه الطريقة بأنها تبني تدفق عمل استخلاصي (ETL Pipeline) يُحفظ ضمن خطوات الاستعلام؛ فعند ورود بيانات جديدة في المستقبل، لا يتطلب الأمر سوى الضغط على زر “تحديث” (Refresh) ليعيد المحرك تطبيق منطق استخراج الفاصلة الأخيرة تلقائياً على كافة السجلات الجديدة بكفاءة معالجة استثنائية وبمعزل تام عن استهلاك ذاكرة ورقة العمل المباشرة.
### 9.3 المفاضلة المعيارية لاختيار الأداة الأنسب حسب حجم وطبيعة المشروع
تتوقف المفاضلة التقنية بين استخدام صيغ ورقة العمل المباشرة (مثل TEXTAFTER) واستخدام بيئة التحويل المتقدمة Power Query على عدة معايير تشغيلية ترتبط بحجم البيانات، وسرعة متطلبات التحديث، والجمهور المستهدف للمصنف الحسابي:
- استخدام صيغة TEXTAFTER المباشرة: يُعد الخيار الأمثل في المشاريع الصغيرة والمتوسطة (أقل من مئة ألف سجل) التي تتطلب تفاعلاً لحظياً؛ حيث تظهر النتائج في نفس اللحظة التي يدخل فيها المستخدم البيانات دون حاجة للضغط على زر التحديث. كما أنها تحافظ على خفة المصنف وسهولة مشاركته بين المستخدمين الذين يفضلون التعامل مع الصيغ الواضحة داخل خلايا الإدخال.
- استخدام محرر Power Query: يُعد الخيار الأكاديمي والصناعي الأفضل عند بناء نماذج بيانات ضخمة (تتجاوز مئات الآلاف من الصفوف) أو عند دمج السجلات النصية من مصادر خارجية متعددة كقواعد بيانات SQL أو ملفات نصية مجدولة (CSV). يتميز Power Query بقدرته على ضغط البيانات في الذاكرة وتقليل حجم الملف الإجمالي، وحماية بنية العمل من أخطاء التعديل اليدوي العرضي التي قد تمس صيغ الخلايا في بيئات العمل المشتركة.
10. أفضل الممارسات الأكاديمية لتوثيق وصيانة أوراق عمل إكسل
### 10.1 بناء نماذج قابلة للتوسع والتكيف مع تحديثات البرمجيات
إن التصميم الاحترافي لجداول البيانات يتجاوز مجرد كتابة معادلة تعمل بنجاح في اللحظة الراهنة، ليمتد إلى تأسيس بنية عمل قابلة للتوسع والصيانة المستمرة. وتتمثل القاعدة الذهبية الأولى في هذا المضمار في الاعتماد المطلق على “جداول إكسل الرسمية” (Excel Tables) واستخدام المراجع الهيكلية (Structured References) بدلاً من مراجع الخلايا الجامدة. فعند كتابة المعادلة بالصيغة:
=TRIM(TEXTAFTER([@العنوان_الكامل], “,”, -1))
تصبح الصيغة مفهومة بذاتها لكل من يقرأ المصنف، وتتوسع تلقائياً لتشمل أية مدخلات مستقبلية دون الحاجة لإعادة سحب الصيغة يدوياً.
بالإضافة إلى ذلك، يجب مراعاة التوافقية البرمجية عند مشاركة المصنفات عبر المؤسسات؛ فإذا كان المصنف سيُعرض على مستخدمين يعملون بإصدارات قديمة من البرنامج لا تدعم TEXTAFTER، يجب إما تثبيت القيم المحسوبة مسبقاً (Paste as Values) لحماية النتائج من التحول إلى خطأ #NAME?، أو استخدام صيغة الاستبدال الكلاسيكية المدعومة عالمياً، مع توثيق أسباب هذا الاختيار التقني في ورقة توثيق مخصصة ترفق بالمصنف الحسابي لضمان استمرارية التشغيل.
### 10.2 التدقيق المنهجي لسلامة البيانات المخرجة والتحقق الآلي
تتطلب المعايير الأكاديمية في تدقيق البيانات بناء أعمدة اختبار وتحقق آلي موازية للتأكد من عدم انحراف النتائج المستخرجة عن المتوقع أو خلوها من البيانات. يمكن للمحلل إنشاء عمود مراقبة الجودة (Quality Control Column) يحتوي على صيغ شرطية تتحقق من مطابقة النتائج للمحددات المعيارية؛ كاستخدام دالة ISBLANK للتأكد من عدم وجود مخرجات فارغة غير مبررة، أو قياس طول النص المستخرج عبر LEN للتأكد من أنه لا يتجاوز الحدود المنطقية للمتغيرات الفئوية (مثل ألا يتجاوز التقييم 20 حرفاً).
علاوة على ذلك، يُنصح بتطبيق قواعد “التنسيق الشرطي” (Conditional Formatting) لتمييز الحالات الشاذة بصرياً؛ كأن تُلون الخلايا التي تحتوي على أخطاء حسابية أو التي تُرجع قيماً تماثل النص الأصلي باللون الأحمر الفاتح، مما يُمكّن المدققين من رصد أية تشوهات في نمط البيانات المدخلة ومعالجتها فوراً. إن إجراء هذه المراجعات الدورية المؤتمتة على عينات من السجلات يضمن اتساق النماذج الحسابية ويمنح مخرجات التحليل النهائي موثوقية إحصائية رفيعة المستوى تتوافق مع معايير جودة البيانات المعتمدة في الأبحاث العلمية المتقدمة.
### 10.3 تحسين الأداء الحسابي والتوثيق التوضيحي داخل المصنف
مع تضخم أوراق العمل وزيادة تعقيد الصيغ المتداخلة، يُصبح تحسين الأداء الحسابي واستهلاك المعالج مسألة حيوية لمنع تجمد المصنف الحسابي أثناء التشغيل. يتحقق ذلك بتفادي الدوال المتطايرة (Volatile Functions) غير الضرورية، واستبدال الصيغ التراكمية الطويلة بدوال حديثة ومباشرة مثل TEXTAFTER متى ما كان ذلك متاحاً، فضلاً عن تحويل النتائج القديمة غير الخاضعة للتغيير المستمر إلى قيم ثابتة لتخفيف العبء عن محرك إعادة الحساب التلقائي (Automatic Calculation Engine).
وأخيراً، يُمثل التوثيق البرمجي والتوضيحي حجر الزاوية في بناء المصنفات الاحترافية؛ ويتحقق ذلك بإدراج تعليقات برمجية وملاحظات توضيحية داخل رؤوس الأعمدة الحسابية تشرح دور كل دالة، وتوضح بالتحديد سبب استخدام المؤشر السالب (-1) كأداة للفهرسة العكسية من نهاية السلسلة. كما يُوصى بإنشاء ورقة مخصصة باسم “دليل المصنف” (Data Dictionary) توثق أنواع المتغيرات، والمحددات المستخدمة، وسجل التعديلات البرمجية، مما يُسهل نقل المعرفة المؤسسية بين أعضاء فرق العمل والباحثين، ويضمن بقاء النموذج الحسابي قوياً وشفافاً وقابلاً للصيانة والتطوير لسنوات عديدة قادمة.
خاتمة
استعرض هذا الدليل الشامل الأبعاد النظرية والتطبيقية المعمقة لاستخراج النصوص الواقعة بعد الفاصلة الأخيرة في مايكروسوفت إكسل، كأحد أهم متطلبات تنقية وتأهيل البيانات غير المهيكلة للتحليل الإحصائي وصناعة القرار. وقد أظهر التحليل التفوق الكاسح لدالة TEXTAFTER الحديثة في بيئة Microsoft 365 وإصدار أوفيس 2024، حيث مكّنت الفلسفة الرياضية للفهرسة العكسية عبر الوسيط السالب (-1) المحللين من تجاوز التعقيدات الخوارزمية القديمة واستخراج البيانات بدقة مطلقة، دون تأثر بتفاوت أطوال النصوص أو عدد الفواصل السابقة. كما قدّم المقال تفكيكاً دقيقاً لبنية الحلول التراكمية الكلاسيكية المعتمدة على مصفوفة الدوال التقليدية (SUBSTITUTE وRIGHT وLEN وFIND) لضمان التوافقية الكاملة في الأنظمة القديمة.
وعلاوة على الصياغة الحسابية، تم التأكيد على الأهمية البالغة لتطهير النتائج من الشوائب والمسافات البيضاء بواسطة دالة TRIM، وبناء تدابير وقائية مدمجة لإدارة الحالات الشاذة وغياب المحددات دون تعطيل انسيابية النماذج الحسابية. كما أبرزت دراسات الحالة المتنوعة ومقارنة الحلول المباشرة مع محرك Power Query المتقدم أن اختيار الأداة المثلى يعتمد على حجم البيانات وطبيعة تدفقها التشغيلي. ومن خلال الالتزام بأفضل الممارسات الأكاديمية في توثيق وصيانة أوراق العمل، وبناء نماذج ديناميكية قائمة على الجداول المعيارية وأعمدة التحقق الآلي، يمكن للمؤسسات والباحثين ضمان أعلى درجات النقاء الإحصائي والكفاءة الحسابية في إدارة وتحليل قواعد بياناتهم الممتدة.
المراجع
- Huebner, P. A., & Willits, J. A. (2018). Structured Semantic Knowledge Can Emerge Automatically from Predicting Word Sequences in Child-Directed Speech. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2018.00133
- Maki, W. S., McKinley, L. N., & Thompson, A. G. (2004). Semantic distance norms computed from an electronic dictionary (WordNet). Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195590
- Mundnich, K., Booth, B. M., L’Hommedieu, M., Feng, T., Girault, B., L’Hommedieu, J., et al. (2020). TILES-2018, a longitudinal physiologic and behavioral data set of hospital workers. Scientific Data. https://doi.org/10.1038/s41597-020-00655-3
- Yao, H., Rashidian, S., Dong, X., Duanmu, H., Rosenthal, R. N., & Wang, F. (2020). Detection of Suicidality Among Opioid Users on Reddit: Machine Learning–Based Approach. Journal of Medical Internet Research. https://doi.org/10.2196/15293